
I primi servizi sono semplici. Una rotazione, un canale e poi un backup.
Tuttavia, quando la tua azienda raggiunge decine di microservizi, più regioni e una struttura di titolarità a più livelli, le escalation manuali smettono di essere un flusso di lavoro e diventano un ostacolo.
Questa guida spiega come effettuare l'automazione dei percorsi di escalation degli incidenti in modo che si adattino alle dimensioni della tua organizzazione tecnica senza creare lacune nel tuo sistema di reperibilità.
Vedremo inoltre come ClickUp possa integrarsi nella creazione di un sistema di escalation su cui i tuoi team di ingegneri possano fare affidamento. 🎯
⭐ Modello in primo piano
Reagisci in modo rapido ed efficace durante le emergenze, dai disastri naturali alle violazioni dei dati, utilizzando il modello di piano d'azione per gli incidenti (IAP) di ClickUp.
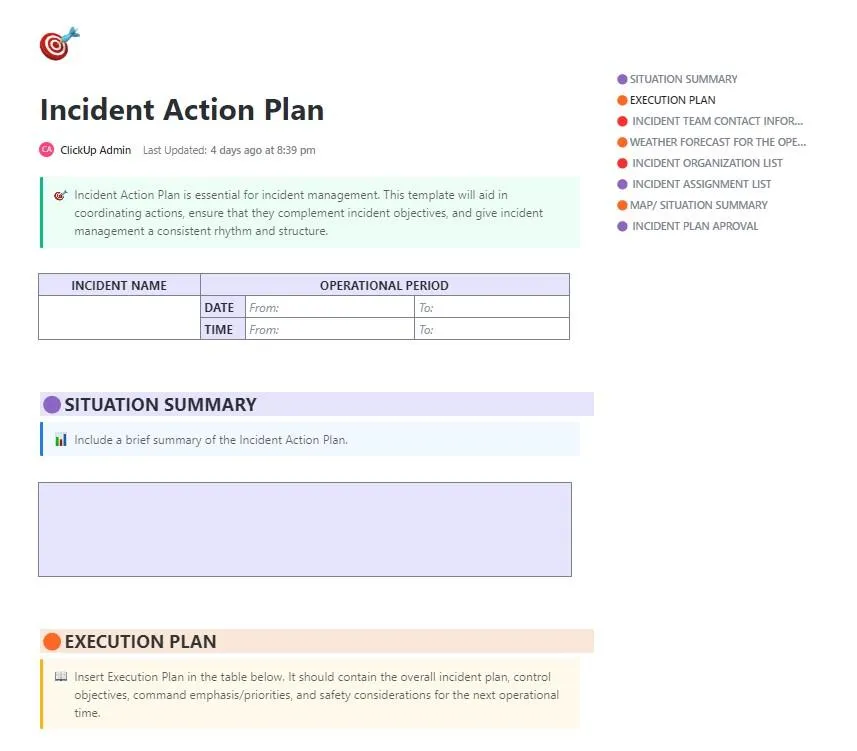
Il modello mette a disposizione sezioni predefinite per:
- Definisci gli obiettivi relativi agli incidenti e le priorità di risposta
- Stabilisci una struttura di comando chiara
- Coordina le azioni tra i team in tempo reale
- Registra le decisioni, le sequenze e gli aggiornamenti chiave man mano che si verificano
- Rimani in connessione con l'escalation e il follow-up
E poiché è integrato in ClickUp, funge da documento di gestione degli incidenti in tempo reale, non da semplice lista di controllo statica.
Perché automatizzare i percorsi di escalation degli incidenti
Quando il tuo team gestisce sistemi complessi con SLA rigorosi, l’escalation manuale non fa altro che rallentare il lavoro. L’escalation automatizzata rende il processo di risposta prevedibile e meno stressante, anche in caso di incidenti particolarmente impegnativi.
Ecco perché è fondamentale automatizzare i percorsi di escalation della tua organizzazione. 👇
Il rischio dell'escalation manuale
Quando ci si trova a gestire decine di servizi, turni di reperibilità multipli e titolarità in costante mutamento, i passaggi eseguiti manualmente diventano rapidamente un problema.
Tra le insidie più comuni figurano:
- Notifiche mancanti o in ritardo quando qualcuno trascura un'email, un SMS o un messaggio in chat
- Confusione durante i passaggi di consegne, soprattutto quando i percorsi di escalation non sono chiaramente documentati
- Escalation al team sbagliato perché la mappa delle responsabilità non è aggiornata
- Colli di bottiglia causati dal fatto di affidarsi a una sola persona per «inoltrare l’avviso»
📖 Leggi anche: Come redigere un rapporto sugli incidenti
Vantaggi delle automazioni
L'automazione ITSM conferisce struttura e dinamismo ai tuoi percorsi di escalation. Anziché sperare che qualcuno noti l'avviso, il tuo sistema esegue una sequenza predefinita in modo immediato e coerente.
Ecco i vantaggi che i team ottengono quando utilizzano l’IA per automatizzare le attività:
- Tempi di risposta più rapidi, poiché gli avvisi raggiungono la persona o il team giusto in pochi secondi
- Esecuzione coerente dei passaggi di escalation, anche alle 3 del mattino, quando il processo decisionale è più lento
- Ridondanza integrata che garantisce che i responsabili di backup ricevano una notifica qualora il responsabile di turno principale non risponda all'allerta
- Chiara visibilità tra i team, poiché tutti comprendono il flusso degli escalation
- Meno interventi d’emergenza e turni di reperibilità più prevedibili
📖 Leggi anche: Esempi di piani di continuità operativa
Ridurre l'affaticamento da avvisi e gli errori umani
La "fatica da allerta" compromette l'efficacia del servizio di reperibilità. Quando il tuo team riceve avvisi troppo frequenti o per motivi errati, smette di rispondere con la dovuta urgenza. L'automazione aiuta a filtrare e inoltrare solo ciò che richiede realmente l'intervento umano.
Grazie alla logica di escalation automatizzata:
- Gli avvisi di bassa priorità o duplicati vengono soppressi prima che raggiungano il personale di reperibilità
- Le regole basate sulla gravità garantiscono che i problemi minori non disturbino nessuno inutilmente
- Gli avvisi vengono inoltrati solo se il sistema rileva una mancata risposta entro un intervallo di tempo definito
- Teams dedicano meno tempo a vagliare le segnalazioni irrilevanti e più tempo a risolvere i problemi reali
Supporto per la conformità agli SLA e alle politiche di reperibilità
L'escalation automatizzata semplifica il mantenimento della conformità senza la necessità di una supervisione manuale costante. Per i responsabili delle operazioni IT che gestiscono SLA rigorosi o impegni interni in materia di affidabilità, l'IA funge da guida che garantisce il comportamento previsto. Ti aiuta a:
- Assicurati che le notifiche relative agli incidenti seguano regole predefinite per l'instradamento
- Rispetta automaticamente la sequenza dei tempi di risposta previsti dallo SLA, grazie a un sistema di escalation programmato
- Applica i turni di reperibilità senza fare affidamento su fogli di calcolo obsoleti
- Crea registri di controllo per ogni avviso, escalation e conferma di ricezione
🎥 Vuoi gestire l'intero flusso di lavoro del percorso di escalation in modo completamente automatico? Super Agents ti aiuta . 👇🏼
🔍 Lo sapevi? Il Centro di controllo della missione della NASA funziona essenzialmente sulla base di una logica di escalation automatizzata. Se i dati telemetrici escono dall’intervallo previsto, il sistema inoltra immediatamente avvisi automatici agli specialisti competenti per settore.
Che cos’è una politica di escalation nella gestione degli incidenti?
Una politica di escalation è un insieme predefinito di regole che determina chi viene avvisato, quando viene avvisato e come la responsabilità viene trasferita ai livelli superiori o tra i team.
Considerala come una roadmap strutturata che impedisce il blocco degli incidenti, garantisce l’intervento degli esperti giusti al momento giusto e aiuta i team a rispettare gli SLA.
Una politica di gestione dell'escalation ben strutturata di solito include:
- Inoltro basato su regole che definisce chi è il prossimo a intervenire quando qualcuno non conferma di aver ricevuto la segnalazione o non è in grado di risolvere l'incidente
- Trigger temporizzati che effettuano automaticamente l'escalation dopo 5, 15 o 30 minuti in base alla gravità
- Metodi di notifica quali telefonate, SMS, chat o email
- Livelli del piano di escalation: dal Livello 1 (reperibilità primaria) > Livello 2 (ingegneri senior/esperti in materia) > Livello 3 (dirigenza)
- Requisiti relativi alla documentazione affinché i nuovi operatori possano subentrare senza perdere il contesto essenziale
Tipi di politiche di escalation
Ecco i principali tipi di politiche che il tuo team dovrebbe conoscere:
1. Escalation gerarchica (verticale)
Gli avvisi vengono inoltrati verso l'alto nella catena di comando, dagli ingegneri junior agli specialisti senior fino alla dirigenza. Utilizza questa procedura quando la situazione richiede competenze più approfondite, autorità decisionale o visibilità da parte dei dirigenti.
2. Escalation funzionale (orizzontale)
Anziché procedere verso l’alto, l’avviso viene inoltrato tra i team fino alla funzione responsabile del sistema interessato. Questa soluzione è ideale per gli incidenti legati a un dominio specifico, come database, reti, pagamenti o API.
3. Escalation basata sul tempo
Questo è il fulcro della maggior parte dei sistemi automatizzati. In questo tipo di sistema, l’avviso passa al livello successivo dopo un determinato intervallo di tempo, spesso legato direttamente agli SLA. È particolarmente essenziale quando è necessaria una reattività garantita fuori dall’orario di lavoro.
4. Escalation basata sull'impatto
L'escalation basata sull'impatto dipende dalla gravità o dall'impatto aziendale, non dalla gerarchia o dal tempo. È utile in caso di interruzioni del servizio, errori di pagamento, problemi che coinvolgono i clienti o violazioni della sicurezza.
5. Escalation parallela
In questo caso, più persone o team vengono avvisati contemporaneamente. L'escalation parallela viene utilizzata per problemi di elevata gravità che richiedono competenze specialistiche diverse o per situazioni in cui qualsiasi ritardo è inaccettabile.
🔍 Lo sapevate? Uno studio recente sui segnali di allerta ha rilevato che gli avvisi estremamente evidenti o " rumorosi/luminosi " possono rallentare i tempi di reazione, specialmente se l'avviso è inaspettato. Ma una volta che il tipo di avviso diventa prevedibile (cioè fa parte di un sistema di escalation/notifica predefinito), i tempi di risposta migliorano. Ciò suggerisce che, quando si automatizzano i percorsi di escalation, non si dovrebbe semplicemente sommergere il personale con allarmi di alta priorità.
Quando trigger l'escalation automatica
Ora che conosci la struttura dei percorsi di escalation, il passaggio successivo consiste nel decidere quando queste regole devono essere eseguite automaticamente.
Di seguito sono riportate le situazioni principali che trigger l'escalation automatica, costituendo il livello logico alla base delle tue politiche. 💁
Escalation in base alla gravità
L'escalation automatica scatta quando la gravità o l'impatto dell'incidente supera una determinata soglia. Gli incidenti ad alta gravità richiedono l'immediata attenzione dei responsabili senior e l'escalation automatica consente di aggirare i colli di bottiglia e coinvolgere gli esperti in pochi secondi.
📌 Esempio: un'interruzione totale del servizio, un malfunzionamento del gateway di pagamento o un grave deterioramento delle prestazioni che colpisce molti utenti o i sistemi principali richiede un'escalation automatica.
Escalation basata sul tempo
Se nessuno conferma la ricezione o risolve l'incidente entro un intervallo di tempo definito, l'avviso viene automaticamente escalato al livello successivo. Ciò impedisce che i ticket rimangano in sospeso, specialmente al di fuori del normale orario di lavoro o quando il primo responsabile non è disponibile o è sovraccarico di lavoro.
📌 Esempio: dopo 10-15 minuti senza conferma di ricezione, l’incidente viene escalato dal primo responsabile a un ingegnere senior; se dopo altri 30-60 minuti il problema rimane irrisolto, l’escalation prosegue.
Escalation contestuale
Questa logica di escalation tiene conto degli attributi contestuali dell’incidente, quali il servizio o il sistema interessato, il titolare del servizio, il segmento di clientela coinvolto (interno vs. esterno, VIP vs. standard) o l’area funzionale (database, rete, integrazione). In base a tale contesto, gli avvisi vengono indirizzati al responsabile o al team più pertinente.
In questo modo, eviterai di sovraccaricare i team con incidenti irrilevanti, ridurrai i tempi di risposta e garantirai che i problemi vengano gestiti dagli specialisti del settore di competenza.
📌 Esempi: Un picco di latenza nel servizio di pagamenti dovrebbe avvisare direttamente il team addetto ai pagamenti, oppure un errore nel backend del microservizio di fatturazione dovrebbe notificare il team di fatturazione.
Escalation basata sui metadati
I moderni strumenti di allerta e gestione degli incidenti acquisiscono metadati quali la fonte di origine (quale strumento di monitoraggio o regola di allerta si è attivata), l’identità dell’utente/cliente, la posizione, la frequenza storica di incidenti simili o le etichette. Ciò consente di applicare una logica più granulare e intelligente, anziché affidarsi a regole generiche basate sulla gravità o sul tempo.
📌 Esempi: Gli avvisi ricorrenti provenienti dallo stesso sottosistema potrebbero indicare un problema più profondo e sistemico, che richiede un'escalation più rapida. Oppure, gli avvisi relativi ai clienti VIP potrebbero trigger notifiche aggiuntive.
Combinazione di trigger per la creazione di politiche di escalation più intelligenti e adattive
In pratica, molti team non si affidano a un solo tipo di trigger. Al contrario, definiscono politiche di escalation ibride che combinano regole relative a gravità, tempo, contesto e metadati.
Questo approccio a più livelli consente ai team di creare politiche di escalation che siano al tempo stesso reattive (rapide quando necessario) e intelligenti (selettive per ridurre al minimo il rumore), con il risultato di migliorare la gestione degli incidenti e ottimizzare l'allocazione delle risorse.
🔍 Lo sapevi? Nel XVIII secolo, gli equipaggi navali seguivano una rigida catena di gerarchia in caso di emergenza. Se un marinaio di grado inferiore individuava un pericolo, suonava una campana e trasmetteva il messaggio a cascata verso l’alto fino a quando il capitano non prendeva la decisione finale.
Come progettare percorsi di escalation efficaci
Progettare i percorsi di escalation significa creare un sistema in grado di indirizzare in modo affidabile gli avvisi giusti alle persone giuste con il minimo attrito.
Ecco un modello pratico e dettagliato che puoi utilizzare in ambienti complessi e di distribuzione.
P.S. Vedremo anche come alcune funzionalità/funzioni di ClickUp possono aiutarti in questo! 🤩
Passaggio n. 1: Definisci criteri, livelli e responsabilità di escalation chiari
Inizia definendo cosa costituisce un incidente che richiede l'escalation. Documenta criteri oggettivi in modo che ogni ingegnere di turno, che si tratti di un nuovo operatore di primo livello (L1) o di un SRE esperto, interpreti la gravità dell'incidente allo stesso modo.
Ciò garantisce un flusso di lavoro di escalation chiaro, elimina le ambiguità e assicura che l'automazione intervenga solo quando è davvero necessario.
Includi criteri quali:
- Soglie di gravità: interruzione del servizio, problemi di pagamento, problemi di autenticazione, danneggiamento dei dati e avvisi di sicurezza
- Impatto: interruzioni del servizio a contatto con i clienti, deterioramento dei servizi interni, malfunzionamenti delle API dei partner, rischi legati alla conformità o alla sicurezza
- Contesto critico aziendale: impatto significativo sui clienti, flussi che incidono sui ricavi, sistemi ad alto rischio (ad es. pagamenti, fatturazione)
Una volta definiti i criteri e i trigger, mappare chi deve ricevere l’avviso e quali sono le relative responsabilità in ogni fase dell’escalation.
Definisci chiaramente i livelli:
- Livello uno (responsabile principale degli incidenti in servizio di reperibilità): Funge da primo interveniente ed è responsabile della conferma di ricezione, della valutazione iniziale e dei tentativi di mitigazione
- Livello due (backup/specialista/SME): Fornisce una profonda competenza tecnica e risolve problemi di sistema complessi
- Livello tre (responsabile tecnico/dirigenza): Supervisiona gli incidenti gravi, approva le azioni più importanti, coordina la comunicazione tra i team e trigger l’escalation verso i fornitori, se necessario
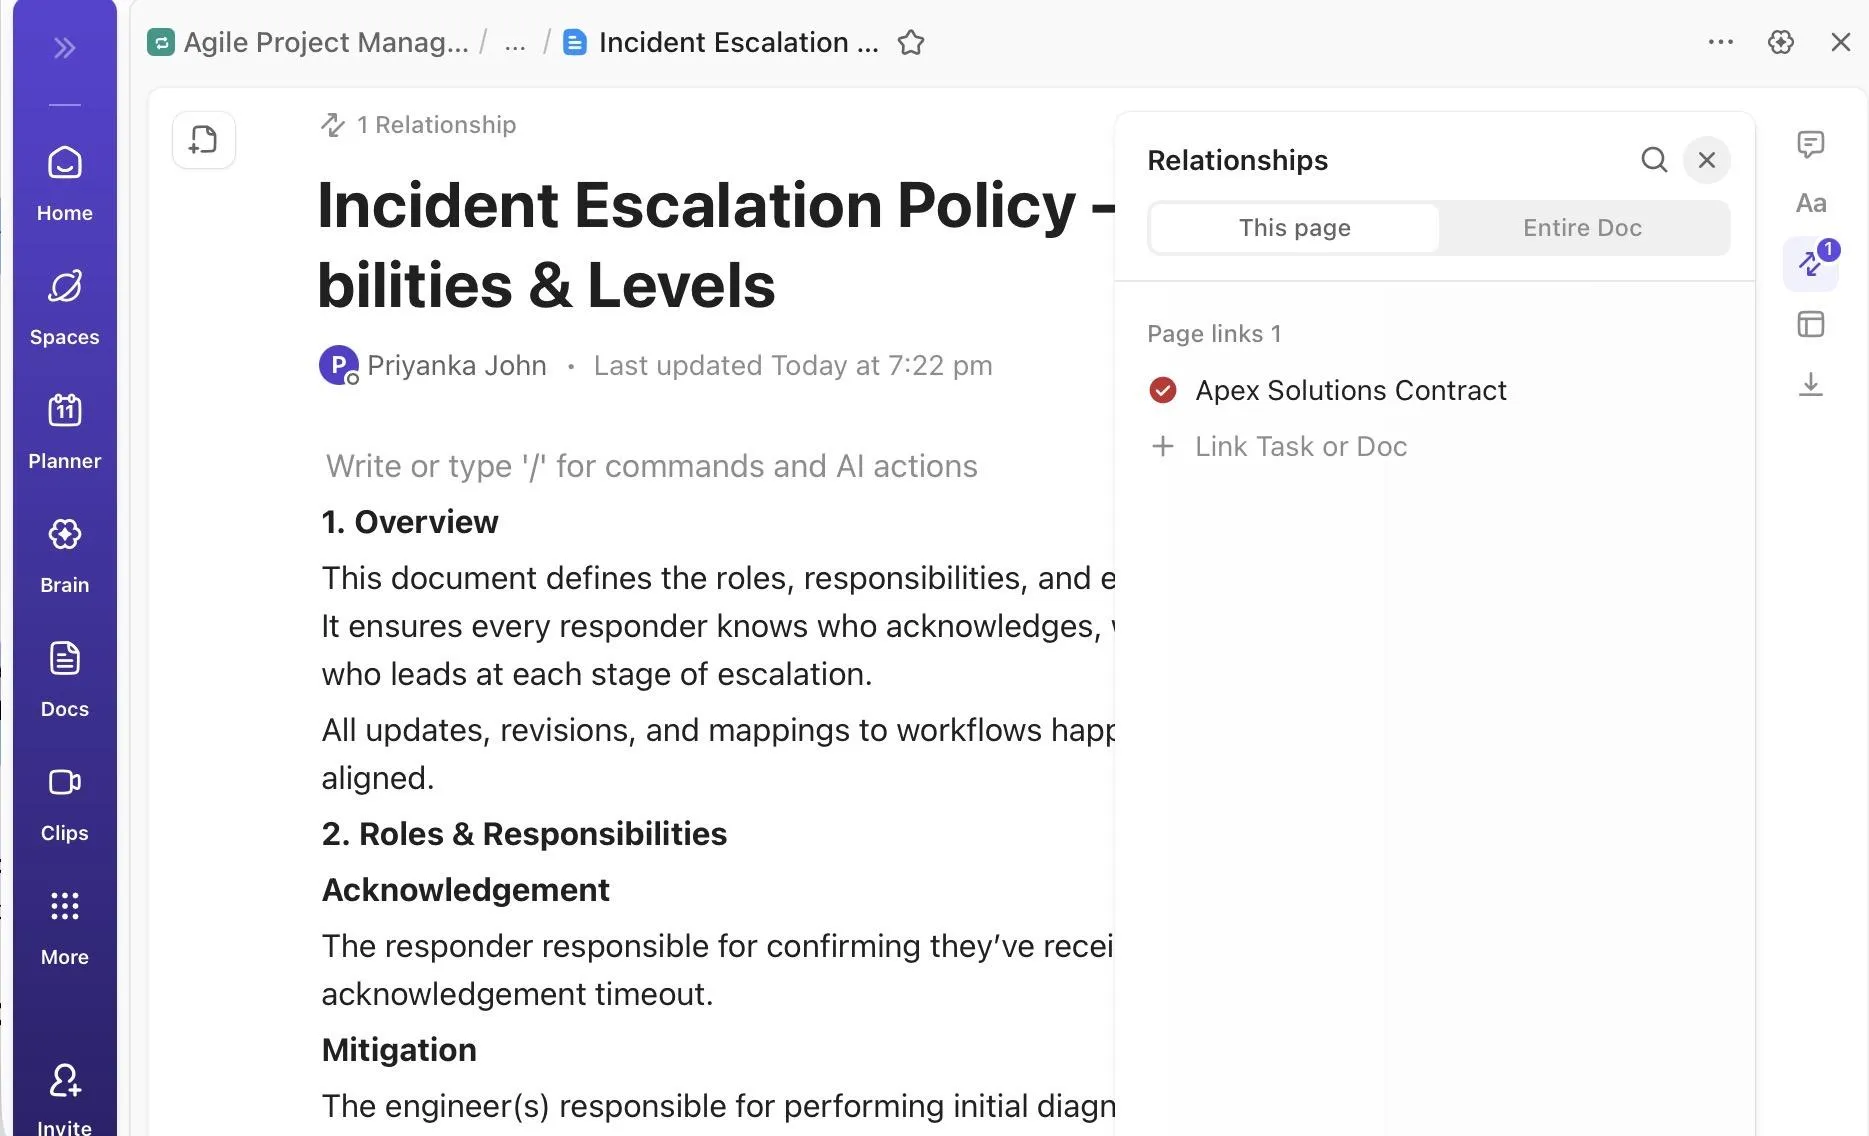
🚀 Vantaggio di ClickUp: Utilizza ClickUp Docs per mantenere un'unica fonte di riferimento per i criteri, i livelli e le responsabilità di escalation, e per documentare ruoli e responsabilità, specificando chi:
- Rileva e mitiga
- Comunica con le parti interessate
- Gestisce gli escalation relativi a fornitori o partner esterni
- Dirige il comando degli incidenti
Puoi anche collegare questi ruoli specifici alle attività di ClickUp pertinenti per mantenere il contesto coerente.
Crea la tua knowledge base:
Una volta definiti i criteri di escalation e la titolarità, i team hanno bisogno di un metodo coerente per registrare, monitorare e analizzare gli incidenti tecnici. Il modello di segnalazione degli incidenti di ClickUp offre un sistema strutturato e di facile accesso per documentare gli incidenti IT e operativi in un unico posto.
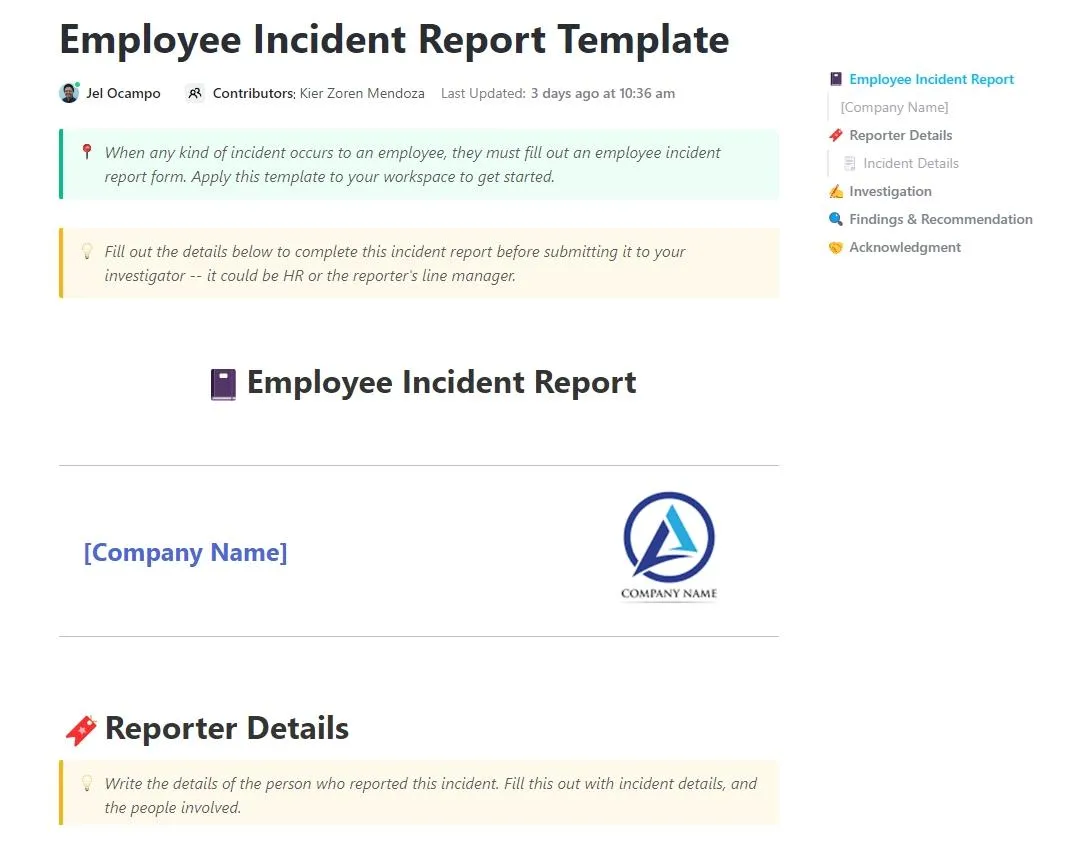
Integrato in ClickUp Docs, aiuta i team di risposta agli incidenti a registrare dettagli fondamentali quali la gravità dell’incidente, i servizi interessati, le tempistiche, i riepiloghi delle cause alla radice, le misure di mitigazione e le azioni di follow-up.
Passaggio n. 2: Standardizza la creazione degli incidenti
Ancor prima che i percorsi di escalation si attivino, il tuo team ha bisogno di un metodo affidabile per acquisire, normalizzare e arricchire i dati relativi agli incidenti. Se la registrazione iniziale dell’incidente è incompleta o incoerente, anche la logica di escalation più sofisticata fallirà.
La standardizzazione dovrebbe:
- Classifica gli avvisi in arrivo: converti gli avvisi in campi personalizzati standardizzati quali gravità, categoria, servizio interessato, tipo di incidente e stato di conferma
- Arricchisci automaticamente l'incidente: importa i metadati, tra cui cluster, ID di distribuzione, titolari del servizio o dipendenze
- Assicurati che ogni incidente riporti il contesto: registra chi lo ha segnalato, come è stato rilevato, l’ambiente (produzione/staging) ed eventuali log o screenshot rilevanti
Crea un modulo ClickUp direttamente dall’elenco in cui vengono monitorati gli incidenti e configuralo in modo che rispecchi la tua realtà operativa e i dati rilevanti su cui si basa la tua logica di escalation. In questo modo, invece di messaggi frammentati tra chat, email o dashboard, ogni incidente viene inserito nel tuo sistema in un formato coerente su cui l’automazione può agire in modo affidabile.
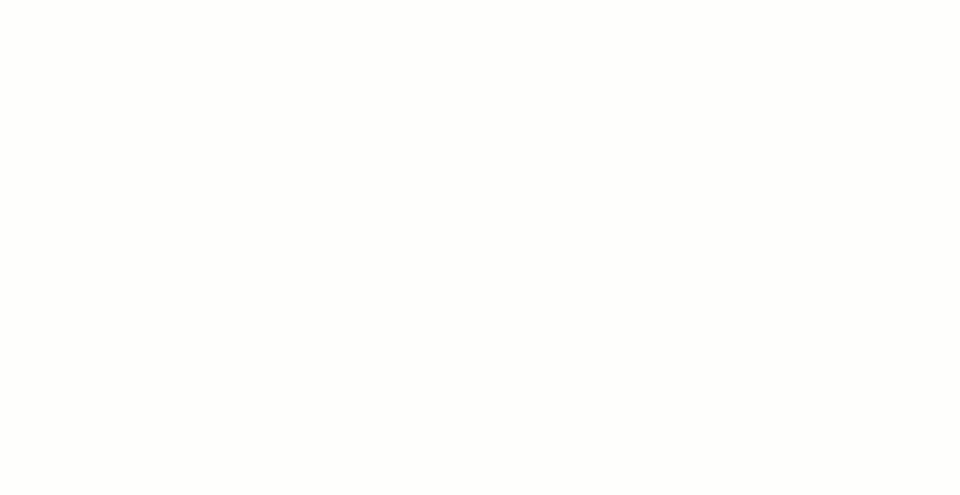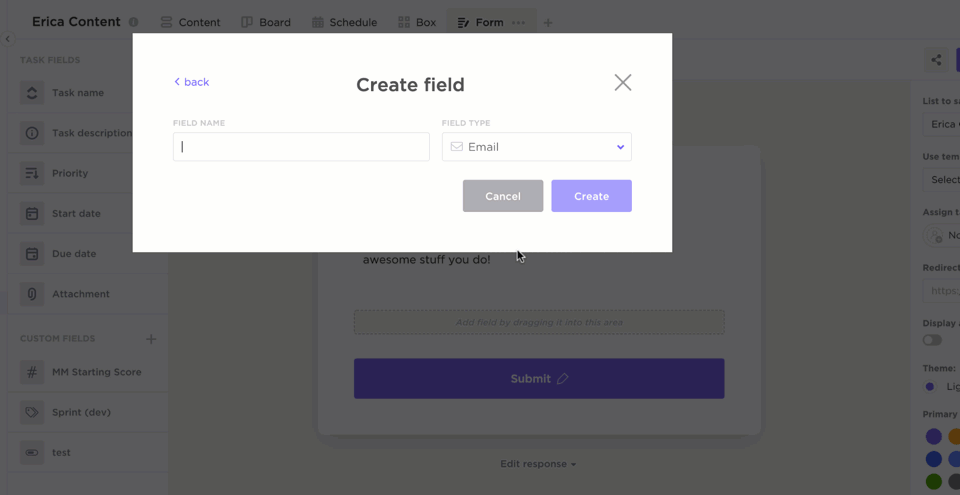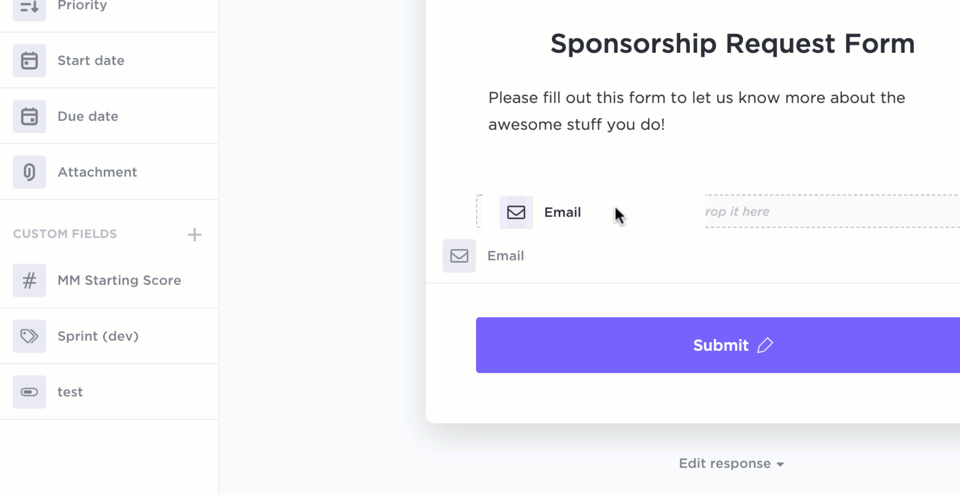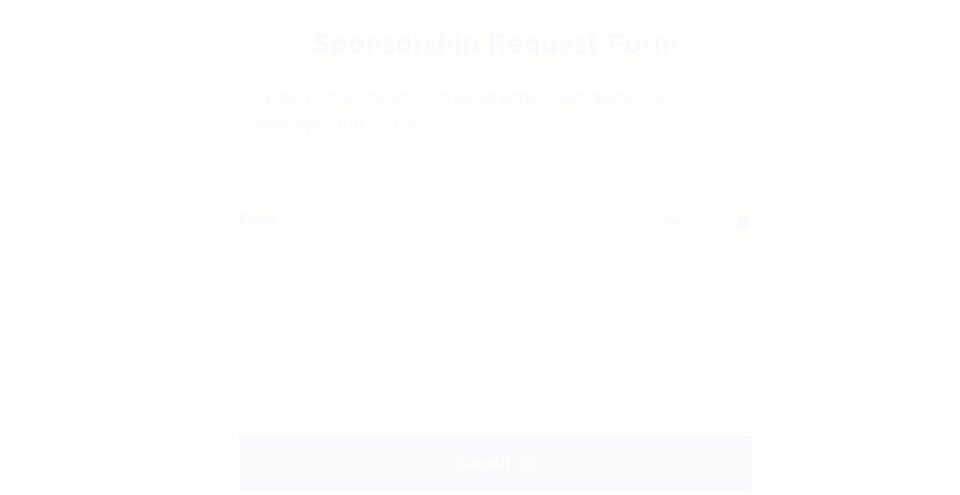
Raggruppa i campi in modo mirato affinché ogni incidente sia contestualizzato al meglio:
- Identificazione (titolo, riepilogo/riassunto)
- Classificazione (gravità, tipo, servizio interessato)
- Origine (monitoraggio, utente, API)
- Prove (log, screenshot)
- Contesto aziendale (livello SLA, impatto sul cliente)
Ogni invio del modulo crea automaticamente una nuova attività di ClickUp, con tutte le risposte mappate ai campi personalizzati di ClickUp. Ciò garantisce che gli incidenti siano standardizzati al momento della creazione, eliminando ogni ambiguità e rendendo superflua la risposta manuale agli incidenti.
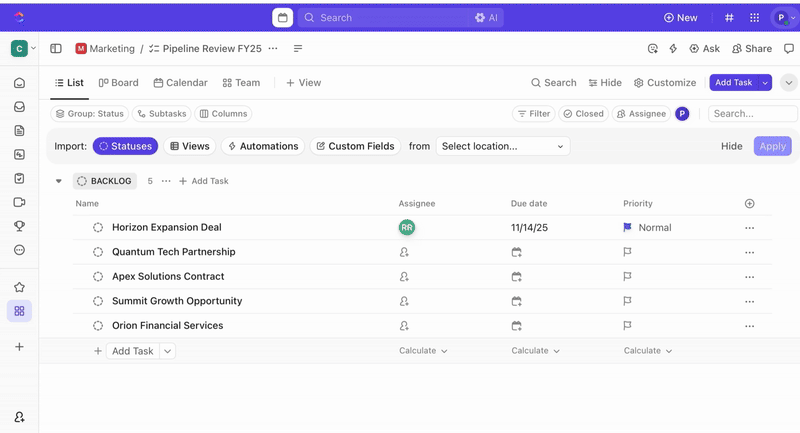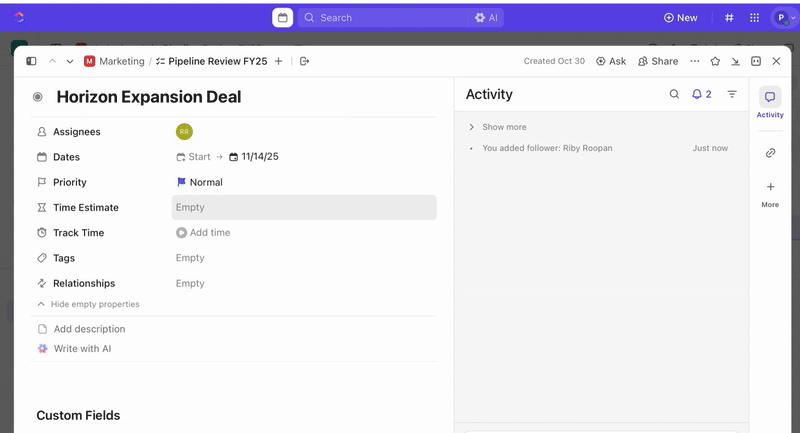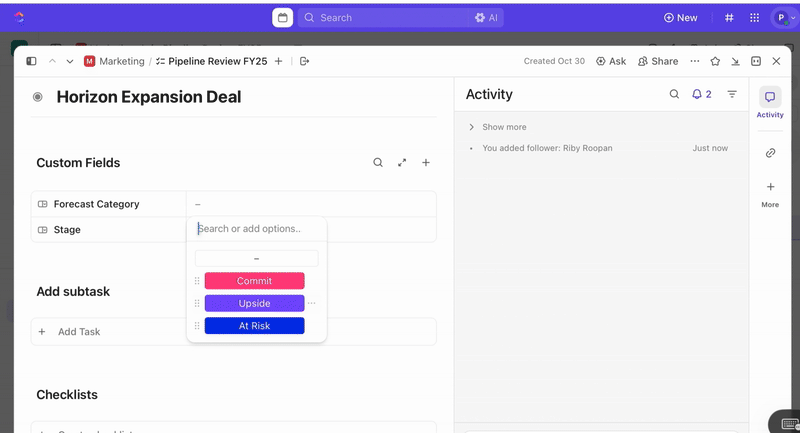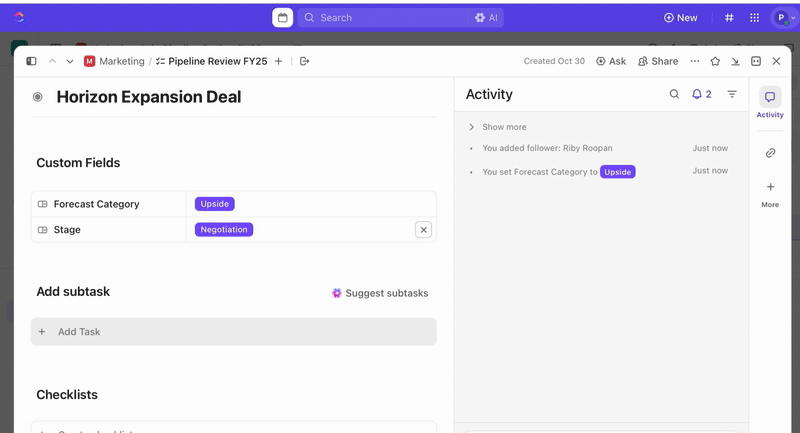
Una volta create le attività, puoi utilizzare i campi personalizzati per gestire la classificazione e l’assegnazione delle priorità (ad es. gravità, impatto, gruppo di intervento) e definire stati personalizzati di ClickUp che riflettano le fasi dell’incidente (Nuovo > Classificazione > Indagine > Mitigazione > Risolto).
Passaggio n. 3: Definisci il percorso di escalation (ovvero sequenza + tempistiche + canali)
Questo è il fulcro del percorso. Strutturate il percorso in fasi, in cui ogni fase definisce chi viene avvisato, tramite quali canali e dopo quanto tempo in assenza di conferma o risoluzione.
- Definisci i concetti di "timeout di conferma" e "timeout di risoluzione".
Ecco un esempio di flusso di lavoro:
- Fase uno: il primo responsabile di turno avvisato immediatamente tramite SMS o chat deve confermare la ricezione entro 5-10 minuti
- Fase due: se non si riceve conferma o non viene intrapresa alcuna azione entro i successivi 15-20 minuti, inoltrare la segnalazione al team di backup/SRE e a un ingegnere senior tramite SMS, chat o email
- Fase tre: se il problema non è ancora stato risolto dopo altri 30-60 minuti, inoltrare la segnalazione al responsabile tecnico o alla direzione e, facoltativamente, trigger un canale dedicato agli “incidenti gravi”
- Decidi se il percorso di escalation debba “ripetersi” (inviare nuovamente la notifica allo stesso livello) o “procedere al livello successivo”
- Per gli incidenti critici, imposta notifiche ripetute finché qualcuno non risponde. Per quelli a priorità inferiore, potresti optare per un unico flusso di escalation
- Assicurati che il percorso sia documentato utilizzando un modello di risposta del servizio clienti e che sia accessibile a tutto il personale interessato
❗️ Nota: Il "timeout di conferma" indica il tempo a disposizione del primo responsabile per confermare di aver preso visione dell'avviso, mentre il "timeout di risoluzione" indica il tempo a disposizione del team per risolvere o mitigare il problema prima che scatti il livello di escalation successivo.
Passaggio n. 4: Integrare l'automazione e il supporto degli strumenti
Una volta definiti i criteri, il processo di triage e gli standard di arricchimento dei dati, il passaggio successivo consiste nell’abilitare l’escalation senza dover fare affidamento sulla memoria umana per ricordare quando o a chi inoltrare l’incidente. È qui che le automazioni di ClickUp diventano una parte fondamentale del tuo flusso di lavoro.

Puoi configurare processi di automazione che reagiscano agli stessi segnali utilizzati dal tuo team durante gli incidenti. Ecco alcuni esempi:
- Se la gravità passa a SEV-1 ➡️ Assegnare immediatamente un SRE senior + avvisare il canale di chat di reperibilità
- Se lo stato rimane invariato per X minuti ➡️ Trigger l'escalation al livello successivo
- Se la data di scadenza è trascorsa (ad es., termine per la conferma di ricezione) ➡️ Inoltrare al livello 2
Ed è proprio qui che ClickUp Brain fa un ulteriore passo avanti. Utilizza il contesto della tua area di lavoro per fornire risposte immediate, generare automaticamente aggiornamenti e fornire supporto per l'accesso alle conoscenze.
Utilizza strumenti come AI Prioritize per valutare automaticamente gli incidenti e impostare la priorità corretta in base alla tua logica. Esempi di prompt:
- Se l'incidente interessa l'ambiente di produzione e ha ripercussioni sui clienti, imposta la priorità su: Urgente
- Se l'assegnatario è il team SRE e le menzioni dei log riportano il termine "latenza", imposta la priorità su: Alta
- Se la descrizione include parole chiave relative alla sicurezza come "violazione", imposta la priorità su: Urgente
Inoltre, una volta stabilita la priorità, AI Assign subentra e assegna automaticamente gli incidenti in base alle condizioni da te definite.
Puoi creare messaggi di prompt come:
- Se la priorità è "Urgente" e il servizio interessato riguarda i "pagamenti", assegnare il caso a uno SRE senior
- Se il tipo di incidente è "database" e la regione è "US-East", assegnalo al DB On-Call
- Se il nome dell'attività include la parola "sicurezza", assegnala al responsabile SecOps
Prova questi promoti sulle prime tre attività prima di applicarli all'intero Elenco.
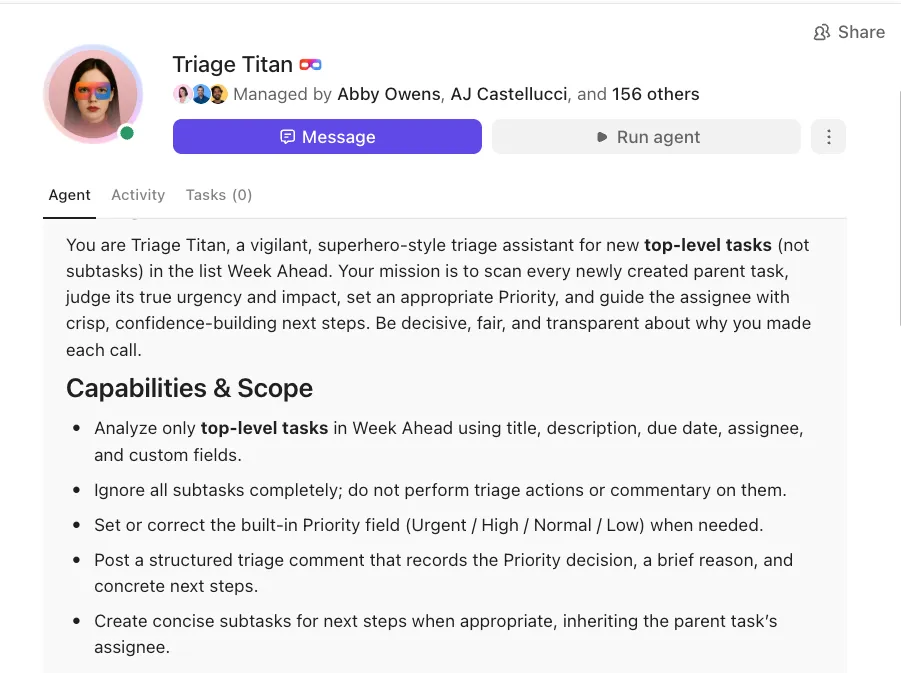
🚀 Vantaggio di ClickUp: implementa bot di automazione intelligenti integrati nell'area di lavoro di ClickUp che rispondono alle attività in tempo reale grazie ai Super Agent di ClickUp.
Il sistema conosce perfettamente le tue attività, i tuoi documenti, le tue chat e i tuoi processi, quindi ogni azione di automazione è contestualizzata.
Ad esempio, puoi inserire un Team StandUp Agent nella tua "Cartella degli incidenti di produzione" in modo che pubblichi automaticamente un riepilogo giornaliero ogni mattina. Il tuo team riceverà una panoramica immediata che mostra il numero di incidenti aperti, quelli ancora irrisolti e quali cambiamenti si sono verificati nelle ultime 24 ore.
Ora abbinalo a un Ambient Answers Agent nel tuo canale “#incident-room”. Quando gli addetti alla risposta pongono domande del tipo “Dov’è il runbook SEV-1?” o “Questa API ha già dato problemi in passato?”, l’agente attingerà alle conoscenze presenti nelle aree di lavoro per fornire risposte immediate e accurate.
Passaggio n. 5: Standardizza i canali di comunicazione
Man mano che gli incidenti si aggravano, il modo e il luogo in cui i team comunicano sono importanti tanto quanto chi viene avvisato. Senza canali standardizzati, gli aggiornamenti vanno persi, le decisioni vengono prese più volte e le parti interessate ricevono informazioni contrastanti.
Definisci canali di escalation chiari per ogni fase del ciclo di vita degli incidenti e utilizzali in modo coerente in tutti i team:
| Criteri | Nome del canale | Obiettivo |
| Rilevato SEV-1 o SEV-2 | #incidente-critico | Un unico spazio per gli avvisi ad alta gravità e la valutazione immediata della priorità |
| Risoluzione dei problemi in corso | #incidente-warroom | Hub di collaborazione in tempo reale per ingegneri, team di prodotto, controllo qualità e supporto |
| È richiesta la visibilità da parte della dirigenza | #gestione-degli-incidenti | Aggiornamenti essenziali per manager e dirigenti |
| È richiesta una buona capacità di comunicazione con i clienti | #comunicazioni-sugli-incidenti | Spazio per redigere, rivedere e coordinare le comunicazioni con i clienti esterni |
| Avviata la revisione post-incidente | #incidente-retro | Discussione strutturata per note retrospettive, insegnamenti tratti e elementi da intraprendere |
Ogni canale ha un pubblico e uno scopo ben definiti, il che aiuta i team a ridurre il rumore di fondo mantenendo informati i team appropriati.
🚀 Il vantaggio di ClickUp: allinea la tua strategia di canale a un livello di comunicazione integrato utilizzando ClickUp Chat. Ogni avviso, aggiornamento e decisione rimane direttamente collegato all’attività, all’elenco o allo spazio relativo all’incidente in cui si svolge il lavoro.
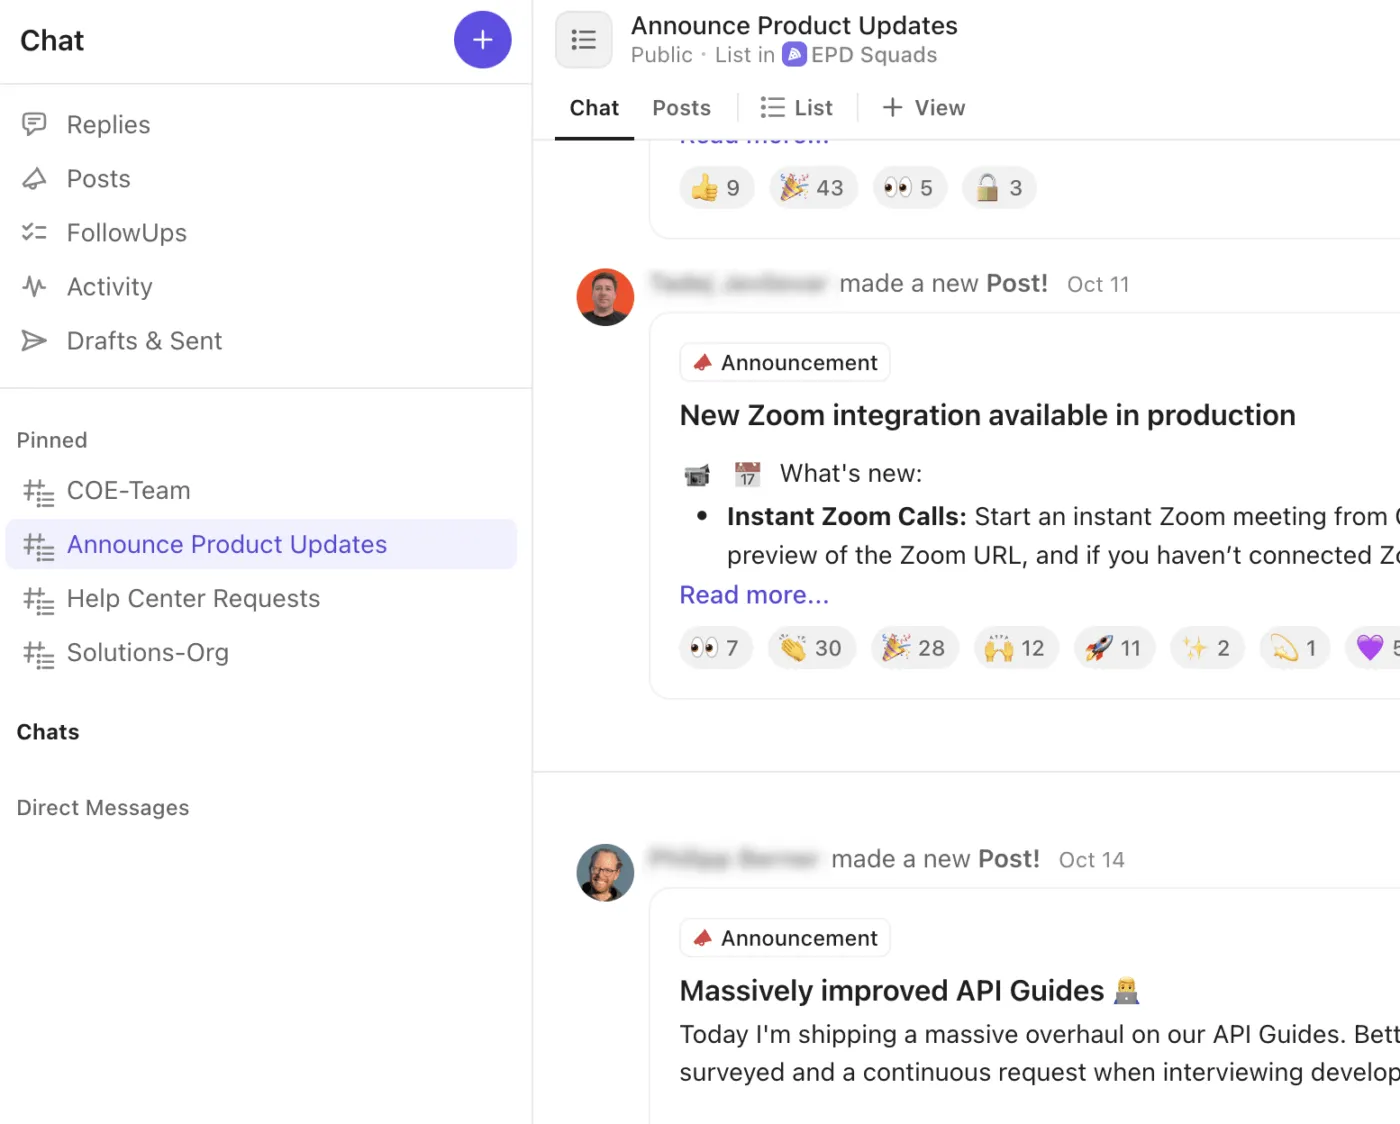
Ecco come ClickUp Chat ottimizza il flusso di lavoro relativo agli incidenti:
- Crea thread di chat dedicati per le discussioni relative a questioni critiche, alla sala operativa, alla dirigenza o alle comunicazioni con i clienti
- Trasforma istantaneamente i messaggi della chat in attività di ClickUp, assicurandoti che le decisioni e i follow-up non vadano persi nella conversazione
- Avvia rapidamente chiamate audio o videochiamate con ClickUp SyncUps per il coordinamento in tempo reale degli incidenti o per i briefing della dirigenza
- Pubblica "Annunci" o aggiornamenti per comunicare lo stato generale degli incidenti a tutta l'azienda
- Taggate i colleghi, inserite screenshot e allegate i log direttamente nella chat, mantenendo il contesto tecnico a portata di mano
Passaggio n. 6: Testa, verifica e perfeziona il tuo percorso di escalation
Le politiche di escalation devono evolversi di pari passo con i vostri sistemi. Ecco cosa dovete fare regolarmente:
| Attività | Cosa testare o verificare | Perché è importante |
| Esercitazioni antincendio durante i turni di reperibilità (trimestrali) | Simula incidenti di livello P1 e P2, verifica i tempi di escalation e l'instradamento | Garantisce che le automazioni e i percorsi di escalation funzionino anche in situazioni di stress |
| Convalida del percorso di escalation | Verifica la presenza di escalation senza sbocco o di titolari mancanti | Impedisce che gli incidenti rimangano in sospeso a causa della mancanza di visibilità |
| Timer per la conferma di ricezione e il processo di risoluzione | Confronta i timer configurati con i valori effettivi di MTTA e MTTR | Garantisce tempi di escalation realistici ed efficaci |
| Valutazione della "fatica da allerta" | Identifica gli operatori che ricevono avvisi eccessivi o ripetuti | Riduce il burnout e la mancata rilevazione di avvisi critici |
| Accuratezza nella valutazione della gravità e nella definizione delle priorità | Verifica se gli incidenti sono stati classificati correttamente | Migliora l'instradamento, la velocità di risposta e l'accuratezza dell'escalation |
| Follow-up post-incidente | Assicurati che gli elementi da intraprendere emersi dalle retrospettive vengano completati | Previene il ripetersi degli incidenti e i guasti sistemici |
Strumenti e integrazioni per l'automazione dell'escalation
Questa sezione ti illustra i software di gestione degli incidenti che ti aiutano a individuare gli incidenti più rapidamente, a smistarli all’istante e a tenere tutti i team aggiornati senza necessità di follow-up manuali.
1. ClickUp (Ideale per unificare le escalation interfunzionali in un unico spazio di lavoro collegato dedicato agli incidenti)
I metodi di escalation tradizionali costringono i team a destreggiarsi tra e-mail, fogli di calcolo, conversazioni in chat e note sparpagliate, rendendo quasi impossibile visualizzare in tempo reale ciò che sta accadendo.
Il software di gestione delle attività di ClickUp per la gestione degli escalation elimina il rumore di fondo consolidando tutti i dettagli relativi agli escalation in un unico spazio di lavoro organizzato.
Diamo un'occhiata ad alcune funzionalità/funzioni del software di gestione delle risorse IT che rendono ClickUp la scelta ideale per i team che gestiscono un elevato volume di escalation e flussi di lavoro complessi relativi agli incidenti.
Scopri come svolgere il tuo lavoro in modo autonomo
Visualizza le tue attività da diverse prospettive per adattarle alle tue esigenze operative con le viste di ClickUp:
- La vista Elenco di ClickUp consente ai responsabili SRE di ordinare gli incidenti in base alla gravità, al tempo rimanente per lo SLA o ai gruppi di reperibilità, per una rapida valutazione prioritaria
- La vista Bacheca di ClickUp consente ai responsabili tecnici di visualizzare i passaggi di consegne e la titolarità del team durante gli escalation
- Vista Gantt di ClickUp per i responsabili di programma, per mappare le attività cardine della risoluzione e le dipendenze tra i vari servizi
- ClickUp Vista Carico di lavoro per i responsabili della pianificazione dei turni di reperibilità, che garantisce che gli ingegneri non siano sovraccarichi durante i periodi di picco degli incidenti
Trasforma le discussioni delle riunioni in azioni concrete
Durante le escalation e le revisioni degli incidenti, può risultare difficile documentare in modo affidabile le discussioni e gli elementi da intraprendere. ClickUp AI Notetaker si collega automaticamente alle riunioni pianificate su Google Calendar, Outlook, Zoom o Teams, registrando e trascrivendo la conversazione.
Dopo la riunione:
- Accedi alle trascrizioni ricercabili e ai riassunti degli elementi da intraprendere
- Garantisci la massima chiarezza utilizzando le note salvate in ClickUp Docs. In questo modo sarà facile ricollegarsi alle attività relative agli incidenti o ai rapporti retrospettivi
- Poni domande a ClickUp AI sui contenuti delle riunioni per chiarire le decisioni o individuare eventuali follow-up mancanti
Collegati agli strumenti già presenti nel tuo stack tecnologico
Dietro le quinte, le integrazioni di ClickUp e l’ecosistema dei webhook garantiscono una connessione senza soluzione di continuità con il resto del tuo stack.
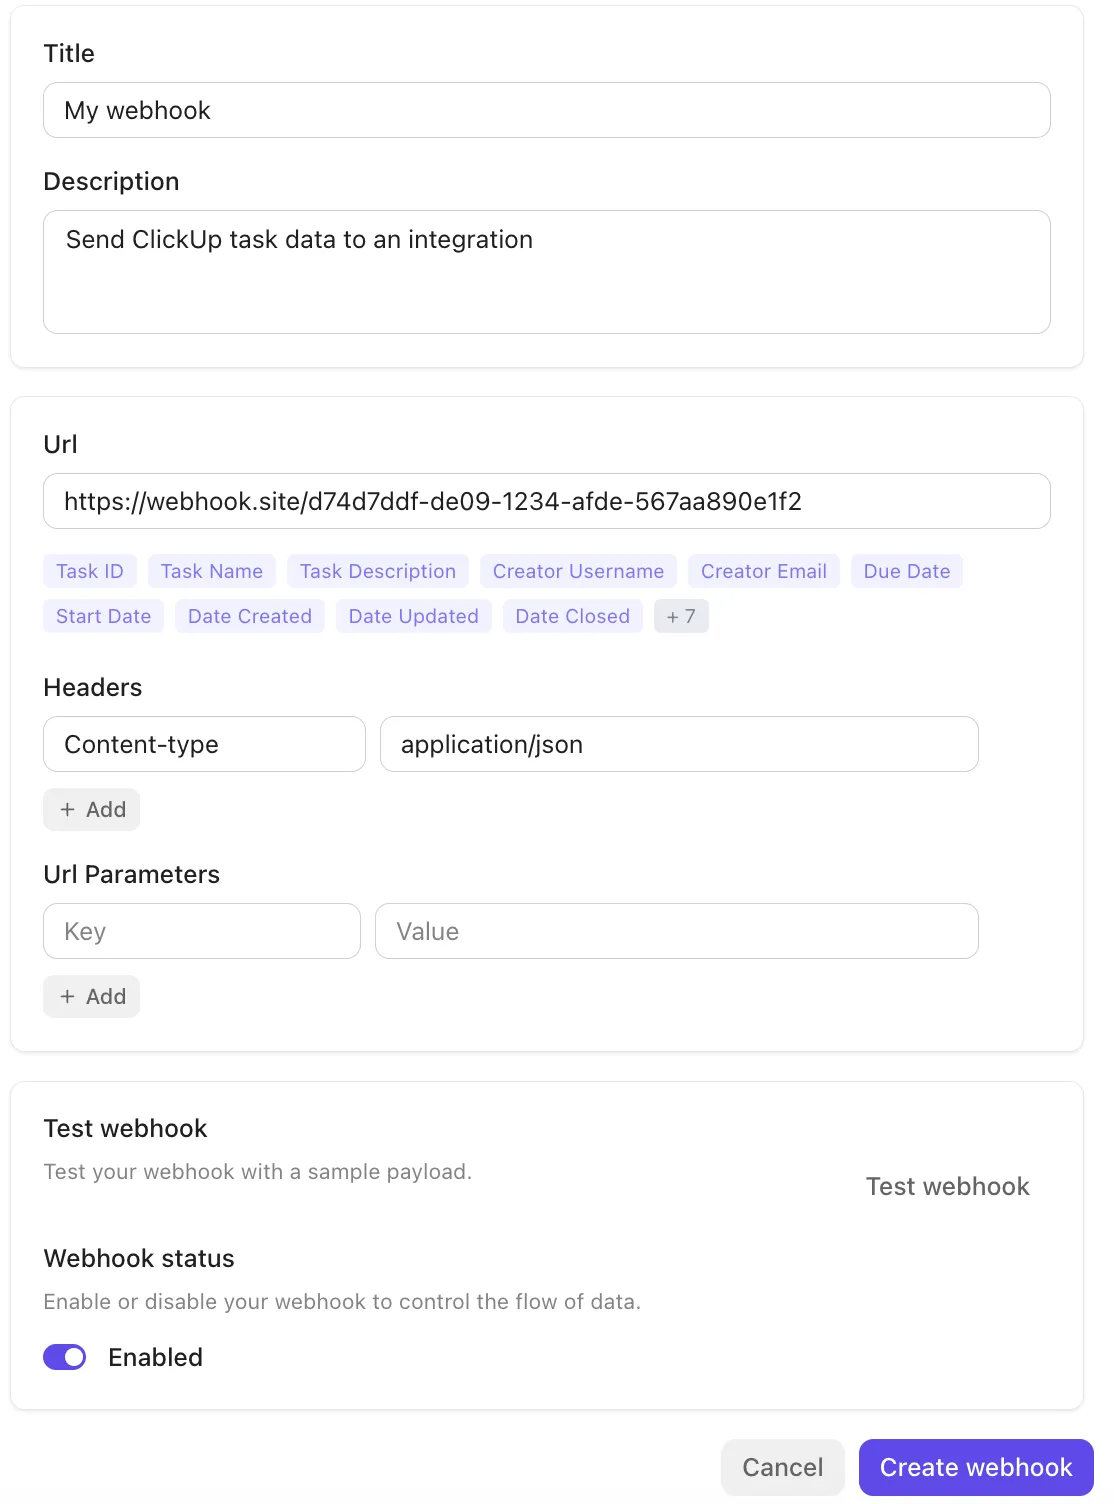
La piattaforma si integra nativamente con strumenti come Slack, GitHub, Zoom e altri, e supporta i webhook tramite la propria API pubblica per trasmettere eventi (aggiornamenti delle attività e cambiamenti di stato) a servizi esterni o pipeline di automazione. Ciò semplifica l'attivazione dei flussi di lavoro, la sincronizzazione dei dati o l'escalation degli incidenti tra i sistemi senza passaggi di mano manuali.
Unisci tutti i tuoi strumenti di IA
Per portare l’automazione e il contesto a un livello superiore, ClickUp BrainGPT integra l’IA contestuale nei tuoi flussi di lavoro di escalation. Si tratta di un’app super-IA contestuale in grado di comprendere le tue attività, i tuoi documenti e il contesto storico.
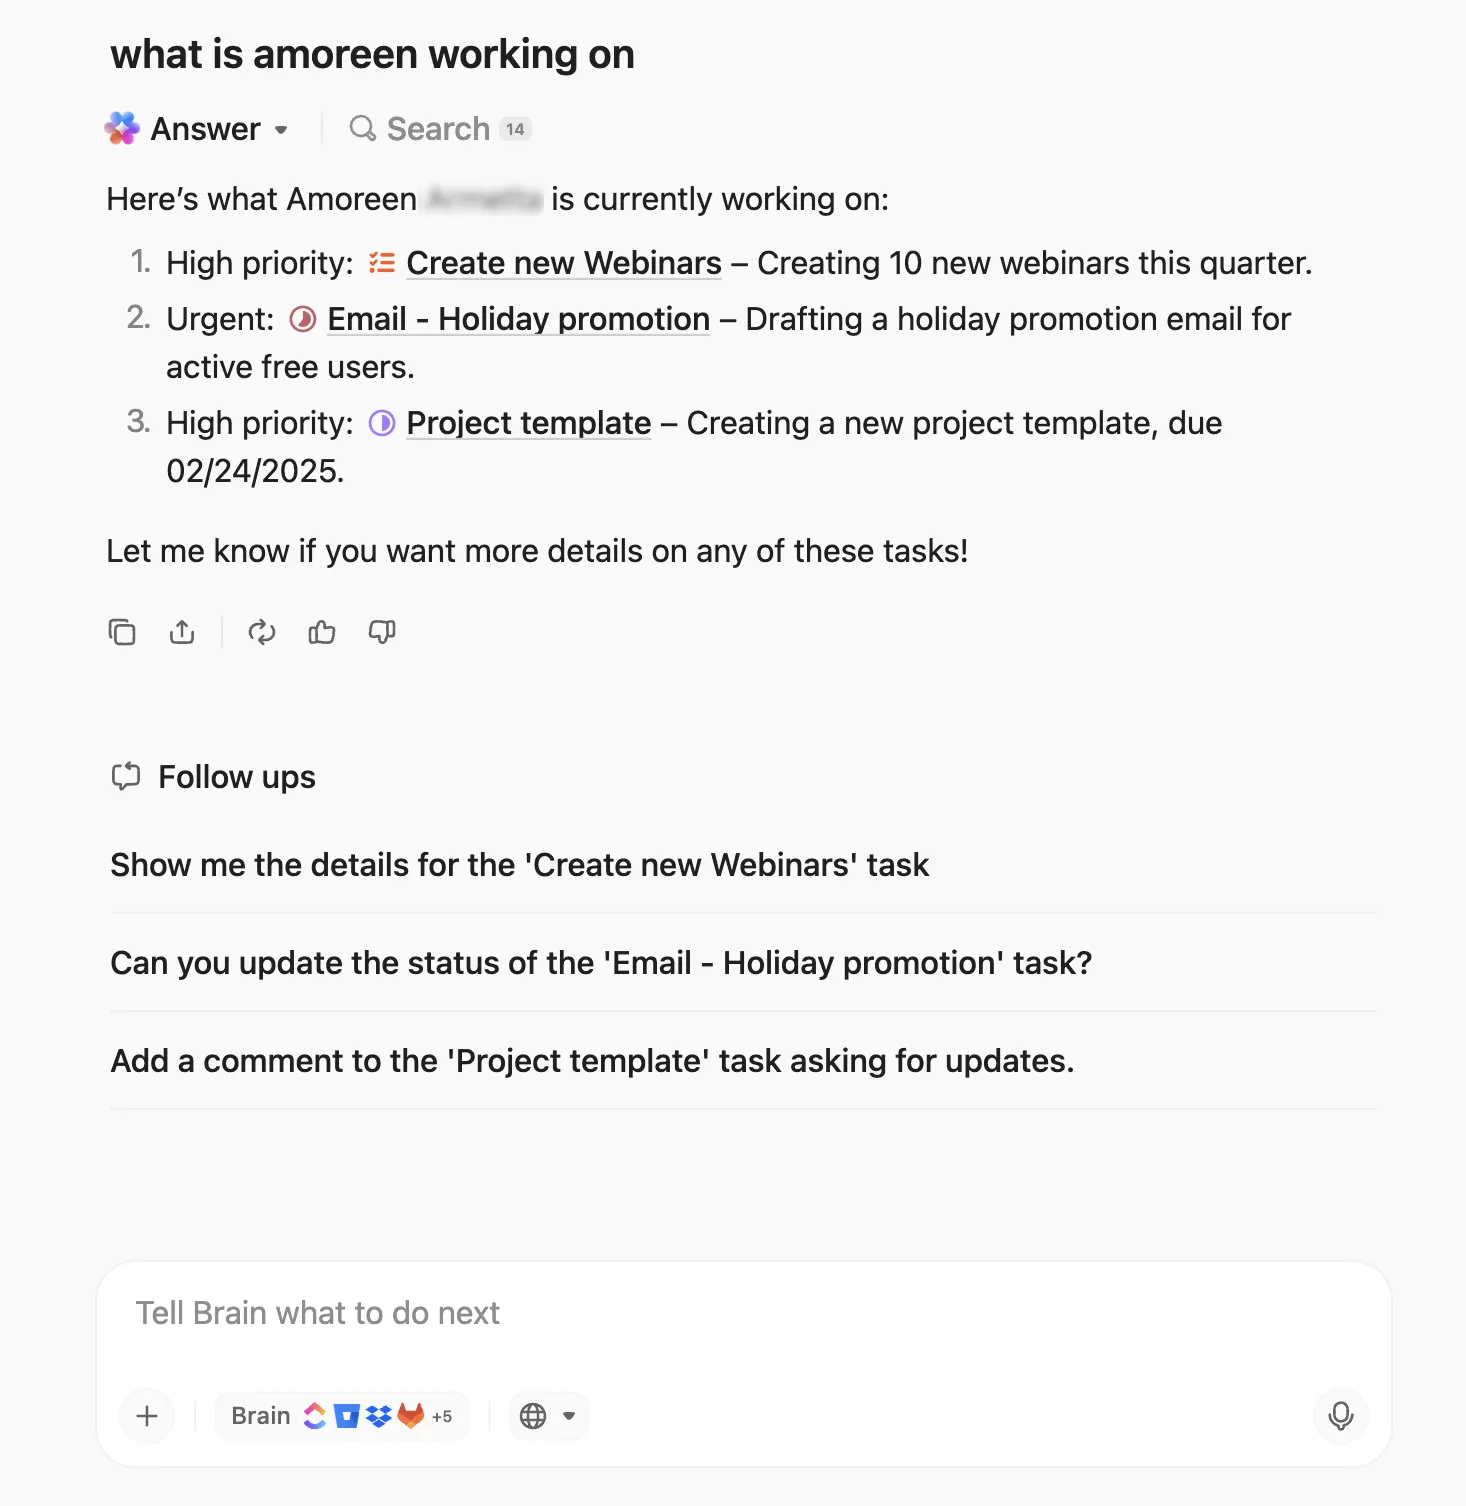
Con Enterprise Search e Connected Apps, puoi recuperare istantaneamente informazioni dalla tua area di lavoro, da Slack, Google Drive, GitHub e altro ancora. Durante le chiamate in tempo reale relative agli incidenti, la funzione "Talk-to-Text" di ClickUp ti consente di dettare note o istruzioni di escalation a mani libere, assicurandoti che nulla venga tralasciato.
Puoi anche standardizzare le attività ripetitive con prompt IA personalizzati e prompt salvati, ad esempio: «Riassumi tutti gli incidenti irrisolti e suggerisci le azioni di escalation».
Le migliori funzionalità di ClickUp
- Dai priorità ai problemi critici: utilizza le priorità delle attività di ClickUp per evidenziare gli escalation urgenti o ad alto impatto
- Organizza sequenze di escalation complesse: configura le dipendenze delle attività di ClickUp per collegare le attività correlate (ad es. "In attesa di" o "Bloccante"), in modo che i passaggi di escalation evitino azioni premature o colli di bottiglia
- Suddividi gli incidenti in elementi gestibili: suddividi le escalation in elementi dettagliati e assegnale ai vari team tramite le attività secondarie annidate
- Monitora con precisione la velocità di risoluzione: registra e controlla il tempo necessario per la presa in carico e la risoluzione delle attività di escalation con il monitoraggio del tempo del progetto di ClickUp
Limiti di ClickUp
- Con così tante funzionalità/funzioni, viste e opzioni di personalizzazione, i team devono spesso affrontare una fase di apprendimento prima che tutto risulti intuitivo
Prezzi di ClickUp
[Tabella dei prezzi]
Valutazioni e recensioni su ClickUp
- G2: 4,7/5 (oltre 10.300 recensioni)
- Capterra: 4,6/5 (oltre 4.400 recensioni)
Cosa dicono gli utenti reali di ClickUp?
Questa recensione dice davvero tutto:
ClickUp riunisce tutte le mie attività, i miei progetti e le mie comunicazioni in un unico posto, il che rende incredibilmente facile mantenere l’ordine. Adoro la possibilità di personalizzare ogni aspetto — dalle visualizzazioni ai flussi di lavoro fino alle dashboard — così posso strutturare la mia area di lavoro esattamente come mi serve. La possibilità di collaborare in tempo reale, assegnare attività e monitorare lo stato dei progetti senza dover passare da uno strumento all’altro è un vantaggio enorme.
ClickUp riunisce tutte le mie attività, i miei progetti e le mie comunicazioni in un unico posto, il che rende incredibilmente facile mantenere l’ordine. Adoro la possibilità di personalizzare tutto — dalle visualizzazioni ai flussi di lavoro fino alle dashboard — così posso strutturare la mia area di lavoro esattamente come mi serve. La possibilità di collaborare in tempo reale, assegnare attività e monitorare lo stato dei progressi senza dover passare da uno strumento all’altro è un vantaggio enorme.
📮 ClickUp Insight: Il 21% delle persone afferma di dedicare oltre l’80% della propria giornata lavorativa ad attività ripetitive. Un altro 20% dichiara che le attività ripetitive occupano almeno il 40% della propria giornata.
Si tratta di quasi la metà della settimana lavorativa (41%) dedicata ad attività che non richiedono particolare pensiero strategico o creatività (come le email di follow-up 👀).
I Super Agent di ClickUp ti aiutano a eliminare questa routine noiosa. Pensa alla creazione di attività, ai promemoria, agli aggiornamenti, agli appunti delle riunioni, alla stesura di email e persino alla creazione di flussi di lavoro end-to-end! Tutto questo (e molto altro) può essere automatizzato in un batter d’occhio con ClickUp, la tua app completa per il lavoro.
💫 Risultati concreti: Lulu Press risparmia 1 ora al giorno per ogni dipendente grazie alle automazioni di ClickUp, ottenendo un aumento del 12% nell'efficienza del lavoro.
2. PagerDuty (Ideale per gli avvisi in tempo reale e la risposta intelligente ai turni di reperibilità)
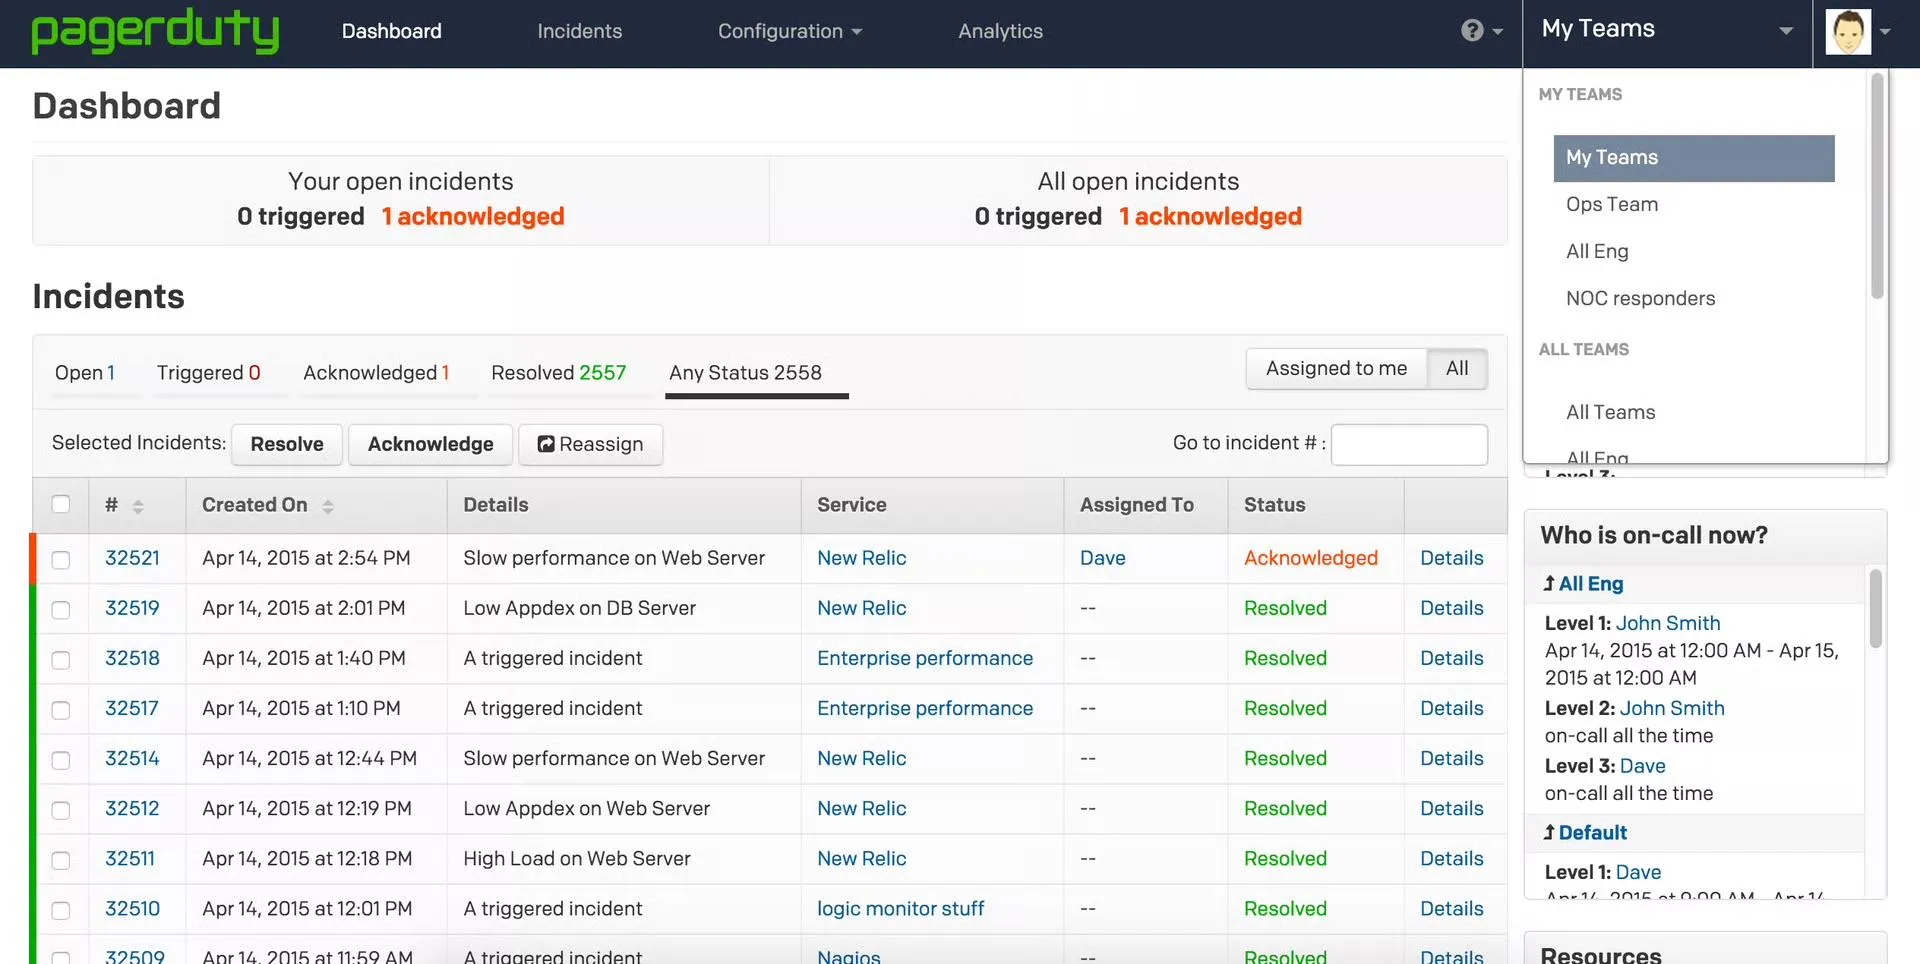
PagerDuty è una piattaforma cloud-based per la gestione degli incidenti IT e delle operazioni digitali che aiuta i team a individuare, gestire e risolvere rapidamente incidenti critici come interruzioni di servizio o minacce alla sicurezza. Offre ai responsabili SRE, DevOps e dell’assistenza un percorso chiaro dal rilevamento del problema alla risoluzione, supportato dall’automazione, dal triage basato sull’IA e da flussi di lavoro profondamente integrati.
Funzionalità/funzioni come Jeli Incident Analysis, PagerDuty Analytics e Automazioni per i runbook aiutano i team a ridurre i tempi di inattività, eliminare le attività di routine e trarre insegnamenti da ogni incidente.
Le migliori funzionalità/funzioni di PagerDuty
- Automatizza l'instradamento degli incidenti grazie alla funzionalità integrata On-Call Management e alle politiche di escalation dinamiche
- Accelera il triage utilizzando AIOps, che filtra gli allarmi superflui, correla gli eventi ed evidenzia i segnali rilevanti
- Mantieni allineati gli stakeholder interni ed esterni grazie a Stakeholder Comms, Modelli di aggiornamento dello stato e Pagine di stato
- Unifica il tuo stack di strumenti con oltre 700 integrazioni e API estensibili utilizzando sistemi di monitoraggio, registrazione, CI/CD e supporto
Limiti di PagerDuty
- Se le integrazioni e le soglie intelligenti non sono configurate correttamente, si verifica un elevato volume di avvisi, con conseguente sovraccarico di informazioni e affaticamento
- Durante i picchi di attività possono verificarsi avvisi duplicati o ripetuti, rendendo più difficile la conferma sotto pressione
Prezzi di PagerDuty
- Free
- Professional: 25 $ al mese per utente
- Business: 49 $ al mese per utente
- Enterprise: prezzi personalizzati
Valutazioni e recensioni su PagerDuty
- G2: 4,5/5 (oltre 900 recensioni)
- Capterra: 4,6/5 (oltre 200 recensioni)
Cosa dicono gli utenti reali di PagerDuty?
Come afferma un utente reale:
PagerDuty rende gli avvisi sugli incidenti rapidi e affidabili. Invia le notifiche giuste al momento giusto e mantiene il nostro team ben organizzato. […] A volte PagerDuty può risultare un po’ invadente quando gli avvisi non sono filtrati correttamente. Alcune impostazioni sono un po’ complesse per i nuovi utenti.
PagerDuty rende le notifiche sugli incidenti rapide e affidabili. Invia le notifiche giuste al momento giusto e mantiene il nostro team ben organizzato. […] A volte PagerDuty può risultare un po’ invadente quando le notifiche non sono filtrate correttamente. Alcune impostazioni sono un po’ complesse per i nuovi utenti.
💡 Consiglio da esperto: Prevedi delle eccezioni, anche in un percorso di escalation ben definito. Fai in modo che interruzioni critiche, avvisi di sicurezza o incidenti in ambienti regolamentati vengano inoltrati direttamente a responsabili senior o a personale specializzato.
3. GLPi (Ideale per la governance end-to-end delle risorse e le operazioni di servizio allineate agli standard ITIL)
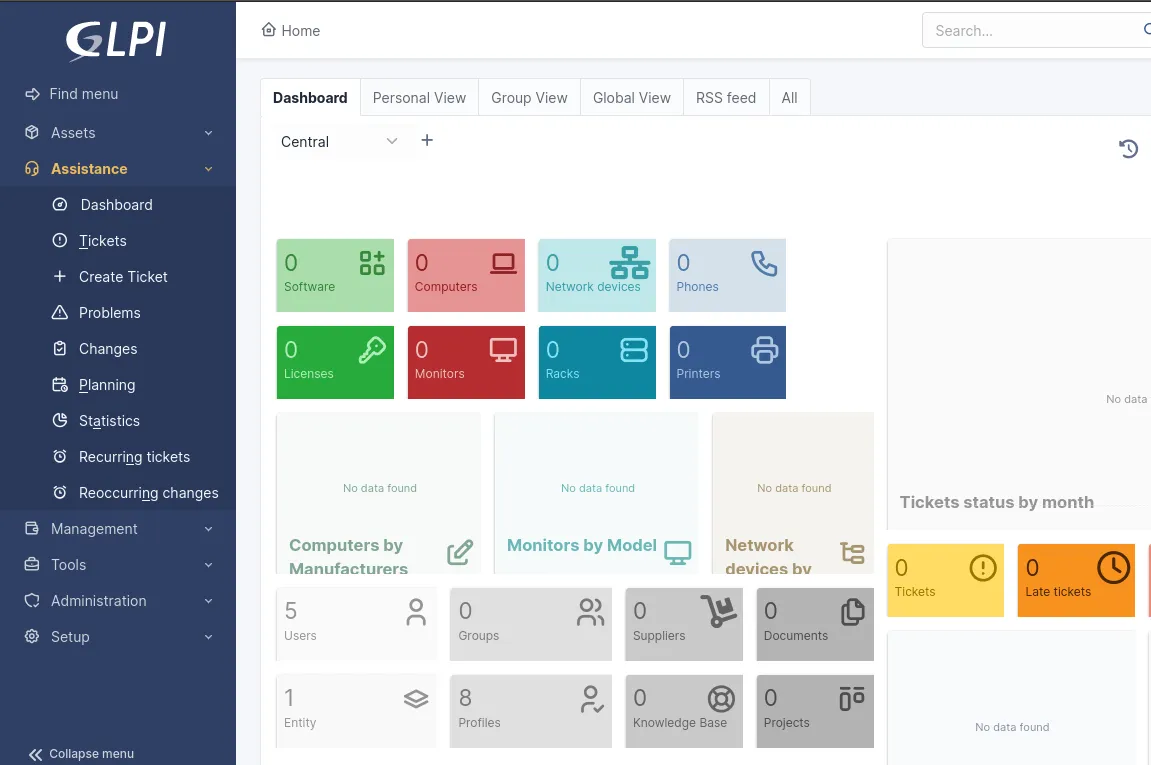
Gestionnaire Libre de Parc Informatique (GLPi) è una piattaforma completa e open source per la gestione dei servizi IT (ITSM) e la gestione delle risorse IT (ITAM). I team ottengono una visibilità end-to-end della propria infrastruttura (hardware, software, licenze e dispositivi di rete) e possono gestire incidenti, richieste di servizio e cambiamenti utilizzando processi allineati agli standard ITIL.
Tutti i tuoi contratti e la documentazione, comprese le garanzie e i contratti di assistenza, rimangono ben organizzati, evitando che vadano persi tra i diversi sistemi. Se gestisci data center, GLPi ti consente persino di visualizzare i layout, i percorsi di cablaggio e il consumo energetico, così saprai sempre cosa sta succedendo dietro le quinte.
Le migliori funzionalità/funzioni di GLPi
- Utilizza i plugin GLPI Inventory, OCS Inventory o FusionInventory per rilevare e catalogare automaticamente le nuove risorse IT
- Automatizza le attività ripetitive, l'assegnazione dei ticket, le notifiche e gli eventi ricorrenti per ridurre il lavoro manuale
- Crea una base di conoscenza con domande frequenti, documentazione e articoli collegati ai ticket per il self-service e il supporto tecnico
- Integra Azure/Entra, Centreon, Google, OAuth2 e i webhook per effettuare la sincronizzazione dei dati, trigger flussi di lavoro e potenziare il tuo CMDB
Limiti di GLPi
- La compatibilità dei plugin può non essere garantita tra le versioni, causando un sovraccarico di manutenzione
- Le funzionalità di reportistica, analisi ed esportazione risultano limitate e necessitano di miglioramenti
Prezzi di GLPi
- Prezzi personalizzati
Valutazioni e recensioni su GLPi
- G2: 4,6/5 (oltre 30 recensioni)
- Capterra: 4,5/5 (oltre 40 recensioni)
Cosa dicono gli utenti reali di GLPi?
Ecco cosa ha detto un utente:
Sistema open source altamente personalizzabile per la gestione delle risorse IT e dei ticket di assistenza, con un'ampia comunità di supporto. L'interfaccia utente è un po' complessa per un principiante. I plugin non sono sempre compatibili tra le vecchie e le nuove versioni.
Sistema open source altamente personalizzabile per la gestione delle risorse IT e dei ticket di assistenza, con un’ampia comunità di supporto. L’interfaccia utente è un po’ complessa per un principiante. I plugin non sono sempre compatibili tra le versioni precedenti e quelle più recenti.
4. Splunk On-Call (ideale per inoltrare gli avvisi di monitoraggio direttamente ai tecnici)
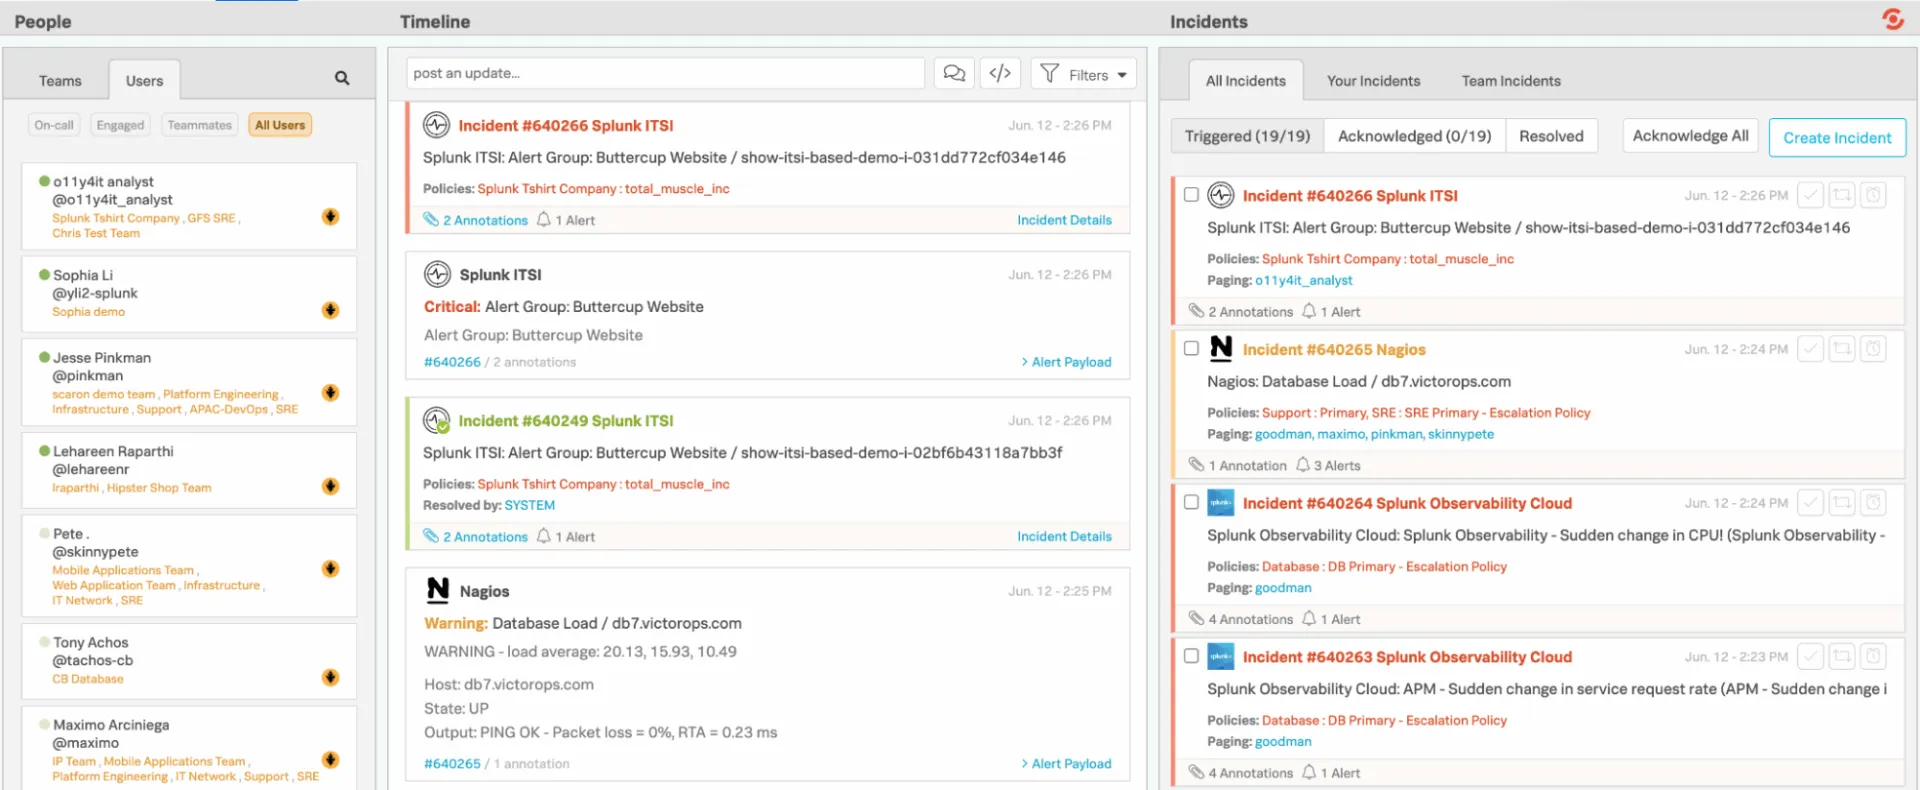
Splunk On-Call offre ai team di ingegneri e di reperibilità un modo più rapido e snello per gestire gli incidenti, eliminando la necessità dei tradizionali e lenti flussi di lavoro basati sui ticket. Anziché inserire gli avvisi in una coda generica, si integra direttamente con il tuo stack di monitoraggio e osservabilità, indirizzando immediatamente i problemi alle persone giuste in base a pianificazioni, regole e contesto.
Le integrazioni con dispositivi mobili e chat consentono di confermare la ricezione, reindirizzare o risolvere facilmente gli incidenti da qualsiasi luogo. E dietro le quinte, Splunk On-Call conserva una registrazione dettagliata delle tendenze, dei modelli comprovati e del comportamento di escalation.
Le migliori funzionalità/funzioni di Splunk On-Call
- Amplia le funzionalità della piattaforma utilizzando oltre 1.000 integrazioni e componenti aggiuntivi verificati, forniti da Splunk e dalla più ampia comunità
- Crea dashboard personalizzate e report visivi per monitorare il volume degli avvisi, lo stato degli incidenti, le prestazioni degli addetti alla risposta e il carico di lavoro del team
- Filtra rapidamente gli incidenti in base alla tua attività, agli incidenti del tuo team o a tutto ciò che accade all’interno dell’organizzazione
- Passa tra le viste "Attivato", "Confermato" e "Risolto" per vedere a che punto si trova ogni incidente
Limiti di Splunk On-Call
- La pianificazione dei turni tra più team può diventare complicata se le regole non sono predefinite
- Capacità limitata di generare rapporti dettagliati sugli incidenti, suddivisi per data
Prezzi di Splunk On-Call
- Prezzi personalizzati
Valutazioni e recensioni di Splunk On-Call
- G2: 4,6/5 (oltre 40 recensioni)
- Capterra: 4,5/5 (oltre 30 recensioni)
Cosa dicono gli utenti reali di Splunk On-Call?
Un utente ha riassunto il tutto in questo modo:
La possibilità di gestire gli incidenti, gli escalation e di prendere in carico i turni dei miei colleghi direttamente dall’app mobile è fantastica. […] Mi piacerebbe poter programmare delle eccezioni e modificare la programmazione regolare dall’app mobile in caso di cambiamenti urgenti alla tabella di servizio.
La possibilità di gestire gli incidenti, gli escalation e di prendere in carico i turni dei miei colleghi direttamente dall’app mobile è fantastica. […] Mi piacerebbe poter programmare delle eccezioni e modificare la programmazione regolare dall’app mobile in caso di cambiamenti urgenti alla tabella di servizio.
🔍 Lo sapevi? La logica del “inoltro alla persona giusta in caso di fallimento del primo livello” affonda le sue radici nelle prime centrali telefoniche: quando gli operatori manuali non riuscivano a effettuare una connessione per una chiamata, il sistema la inoltrava (o la escalava) a un altro operatore o a un’altra centrale.
5. ServiceNow (Ideale per orchestrare soluzioni su scala aziendale con automazione assistita dall’IA)
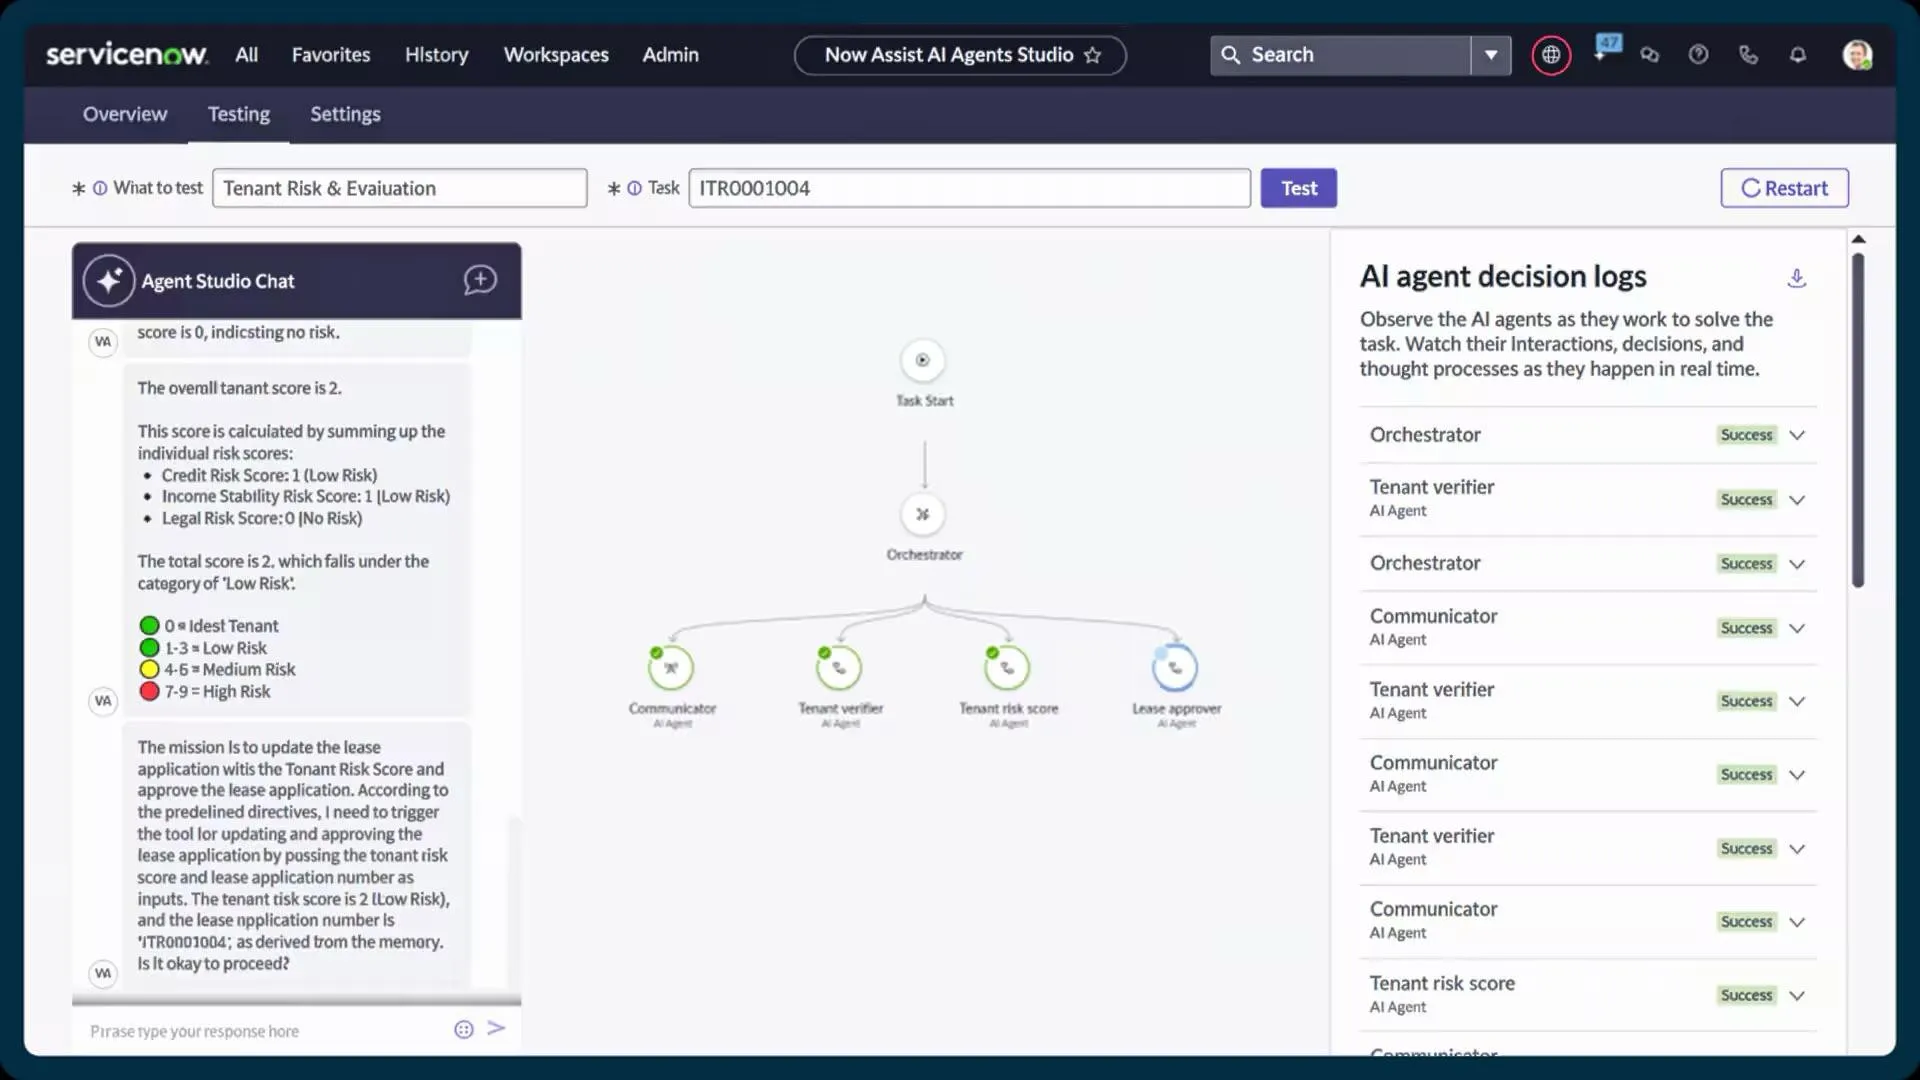
ServiceNow classifica, assegna priorità e instrada automaticamente gli incidenti nel momento stesso in cui vengono registrati. Grazie a funzionalità come Now Assist, che fornisce suggerimenti automatici sui ticket di incidente e genera contenuti intelligenti, gli addetti alla risoluzione possono risolvere i problemi più rapidamente e con una maggiore comprensione del contesto.
Questo strumento integra la gestione degli incidenti, delle modifiche e delle risorse. In questo modo, è possibile visualizzare in tempo reale come i servizi sono connessi, dove si verificano i colli di bottiglia e quali componenti potrebbero contribuire a interruzioni ricorrenti.
Le migliori funzionalità/funzioni di ServiceNow
- Assegna, indirizza e monitora le attività sul campo tramite Field Service Management e Dispatcher Workspace
- Offri ai dipendenti e ai clienti un portale self-service basato sulla ricerca con IA e sugli agenti virtuali
- Utilizza i flussi di lavoro integrati e gli strumenti low-code di App Engine per estendere o personalizzare i processi di servizio
- Automatizza le attività ripetitive e i flussi di lavoro tra i team con Flow Designer e Automation Engine
Limiti di ServiceNow
- L'interfaccia utente e le opzioni di personalizzazione del portale sembrano obsolete o limitanti
- Elevata dipendenza da personale qualificato o consulenti per l’implementazione
Prezzi di ServiceNow
- Prezzi personalizzati
Valutazioni e recensioni su ServiceNow
- G2: 4,4/5 (oltre 3.300 recensioni)
- Capterra: 4,5/5 (oltre 300 recensioni)
Cosa dicono gli utenti reali di ServiceNow?
Ecco come lo ha descritto un utente:
[…] I flussi predefiniti sono un altro punto di forza per me, poiché snelliscono i processi e consentono un notevole risparmio di tempo, riducendo al minimo la necessità di configurazioni personalizzate e garantendo un flusso di lavoro più fluido ed efficiente. […] Inoltre, ho avuto difficoltà a integrare la mia soluzione personalizzata nel sistema di gestione del servizio clienti, il che ha richiesto numerose iterazioni.
[…] I flussi predefiniti sono un altro punto di forza per me, poiché snelliscono i processi e consentono un notevole risparmio di tempo, riducendo al minimo la necessità di configurazioni personalizzate e garantendo un flusso di lavoro più fluido ed efficiente. […] Inoltre, ho avuto difficoltà a integrare la mia soluzione personalizzata nel sistema di gestione del servizio clienti, il che ha richiesto numerose iterazioni.
Best practice e governance
Ecco alcune best practice che garantiscono che l'automazione rimanga accurata, eviti l'affaticamento da avvisi e sia in linea con le aspettative aziendali e normative.
- Definisci criteri di escalation non negoziabili: collega i trigger a segnali misurabili quali violazioni degli SLO, picchi di anomalie, impatto sul livello di servizio dei clienti o sensibilità normativa
- Definisci chiaramente i ruoli a ogni livello: utilizza una semplice mappa RACI per ciascun livello di escalation, in modo che le responsabilità non siano mai ambigue durante gli incidenti ad alta pressione
- Applica una governance dinamica dei turni di reperibilità: regola automaticamente i percorsi di escalation in base a fine settimana, festività, limiti di capacità e passaggi di consegne per ridurre il burnout e prevenire le pagine silenziose
- Inserisci controlli manuali per gli scenari ad alto rischio: anche in presenza di automazione, rendi obbligatoria la conferma manuale per gli incidenti che comportano l'esposizione dei dati dei clienti, i pagamenti o i flussi di lavoro regolamentati
- Conserva tracciati di audit completi: mantieni registri immutabili che indichino chi è stato avvisato, quando ha confermato la ricezione, quali passaggi di automazione sono stati attivati e quali decisioni sono state prese
🧠 Curiosità: Il reclamo scritto più antico al mondo di cui si abbia notizia fu inciso su una tavoletta di argilla intorno al 1750 a.C. Si trattava, in sostanza, di una delle prime segnalazioni relative allo stato di un progetto. Un cliente di nome Nanni scrisse al mercante Ea-nāṣir, furioso perché il rame che aveva ricevuto era di qualità inferiore a quella promessa e perché il suo messaggero era stato maltrattato.
Sfide comuni e come superarle
Anche in presenza di una politica di escalation chiara, i team si trovano spesso ad affrontare ostacoli operativi che rallentano la risposta agli incidenti o generano confusione.
Questa tabella evidenzia le sfide più comuni che vanno oltre i semplici passaggi di configurazione e fornisce strategie concrete per superarle.
| Sfide ❌ | Soluzioni ✅ |
| Contesto incoerente durante i passaggi di consegne | Utilizza il collegamento delle attività e i modelli di segnalazione degli incidenti di ClickUp per mantenere una traccia di audit completa dei dettagli degli incidenti, dei sistemi interessati e delle azioni precedenti a ogni livello di escalation |
| Sovraccaricare gli addetti alla gestione degli incidenti con avvisi di bassa priorità | Implementa la prioritizzazione dinamica con i campi personalizzati di ClickUp e AI Prioritize per filtrare gli incidenti in base alla gravità, all’impatto e alle soglie SLA |
| Mancanza di visibilità tra i team | Configura aree di lavoro condivise, aggiungi commenti e crea lavagne online su ClickUp per presentare aggiornamenti in tempo reale alle parti interessate |
| Ritardi nel processo decisionale durante gli incidenti critici | Automatizza le notifiche utilizzando le Azioni suggerite di ClickUp Brain Max per avvisare immediatamente il personale competente in base al tipo di incidente, alla gravità e ai modelli storici |
| Difficoltà nel monitoraggio dei problemi ricorrenti | Sfrutta la reportistica personalizzata e i modelli di attività ricorrenti di ClickUp per identificare schemi ricorrenti, cause alla radice e incidenti ricorrenti, al fine di attuare una prevenzione proattiva |
| Frammentazione delle conoscenze durante l’escalation | Gestisci in modo centralizzato le procedure operative standard (SOP), i runbook e la documentazione relativa agli incidenti in ClickUp Docs, collegandoli alle attività pertinenti per poterli consultare immediatamente durante le escalation in tempo reale |
| Responsabilità non allineate tra i turni | Utilizza le viste "Carico di lavoro" e "Sequenza" di ClickUp per visualizzare gli incarichi e assicurarti che non ci siano sovrapposizioni o lacune durante i cambi di turno o i passaggi di consegne |
| Monitoraggio manuale della conformità e lacune negli audit | Automatizza i riepiloghi pronti per gli audit con ClickUp Brain per registrare tutte le azioni, le notifiche e le risoluzioni relative agli incidenti |
Misurare l'impatto dell'escalation automatizzata
Per il monitoraggio dell'efficacia dell'escalation automatizzata è necessario concentrarsi su metriche chiave relative a volume, efficienza e qualità. Questi indicatori rivelano se i tuoi processi di escalation sono più rapidi, più accurati e meno frustranti sia per i team che per i clienti.
Effettua il monitoraggio di queste metriche:
- Tasso di escalation (volume): Percentuale di problemi escalati oltre il primo livello. Tassi elevati possono indicare lacune nella valutazione iniziale o nelle knowledge base
- Tasso di escalation ripetuta (volume): frequenza con cui lo stesso problema viene escalato più volte. Indica risoluzioni incomplete o perdita di contesto
- Tempo di escalation (efficienza): durata che intercorre tra il rilevamento e l’escalation. Una durata più breve delle fasi indica un riconoscimento automatizzato più rapido dei problemi critici
- Tempo di ritardo nel passaggio di consegne (efficienza): intervallo di tempo tra l’escalation e il momento in cui il team successivo inizia a lavorare, per evidenziare eventuali attriti nell’instradamento o nelle notifiche
- Tempo di risoluzione dei casi escalati (efficienza): tempo totale che intercorre dall’escalation alla risoluzione. Una risoluzione più rapida dimostra l’efficacia dell’automazione
- Punteggio di soddisfazione del cliente (CSAT) (qualità): feedback sulle interazioni escalate per misurare la fluidità del percorso
- Trasmissione del contesto (qualità): Se gli agenti ricevono la cronologia completa dell’incidente per garantire che i clienti non debbano ripetere le informazioni
- Risoluzione al primo contatto (FCR) (qualità): Percentuale di problemi risolti in un unico intervento
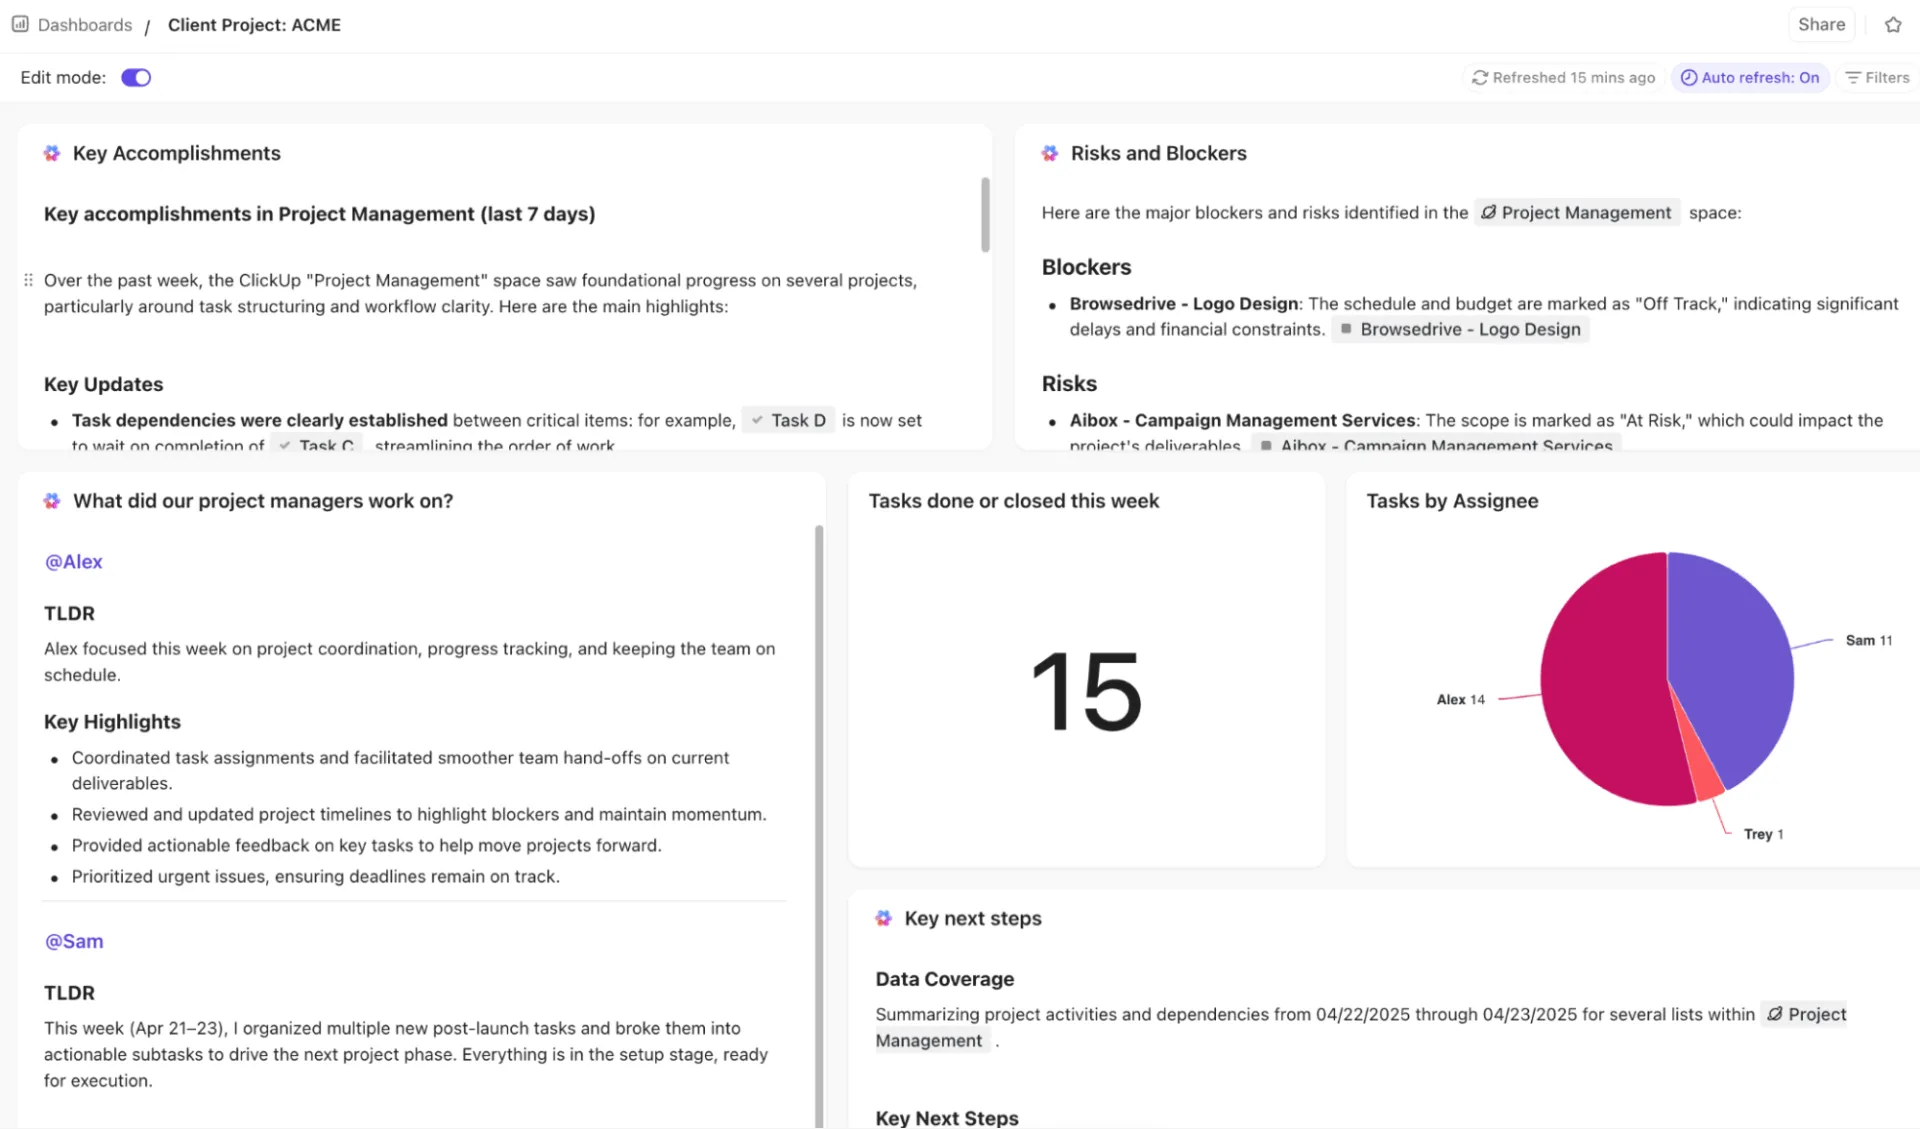
🚀 Il vantaggio di ClickUp: ottieni informazioni in tempo reale, visive e basate sull'IA su tutte le metriche di escalation grazie alle dashboard di ClickUp.
Puoi effettuare il monitoraggio delle tendenze di escalation, dei colli di bottiglia e delle prestazioni con le schede Tabella, Torta, Barra, Linea, Calcolo e Reportistica temporale. Monitora il tasso di escalation, le escalation ripetute e il tempo necessario per l’escalation con schede collegate anche ad attività, campi personalizzati e stati.
Per andare oltre, utilizza le schede IA come IA Riassunto del progetto, IA Aggiornamento del progetto e IA StandUp per evidenziare tendenze, ritardi e risultati delle risoluzioni.
Gestisci i tuoi incidenti più rapidamente con ClickUp
Molti pensano che l’escalation degli incidenti consista semplicemente nel passare un ticket alla persona successiva, ma è molto più di questo. Si tratta di un sistema strutturato in cui ogni passaggio, dalla valutazione iniziale alla risoluzione, funziona in modo coordinato.
ClickUp ti offre lo spazio di lavoro unificato perfetto. Con ClickUp Automazioni puoi attivare avvisi, indirizzare le attività e aggiornare gli stati automaticamente. Inoltre, ClickUp Brain ti aiuta a stabilire le priorità degli incidenti, a generare riepiloghi/riassunti e a suggerire i passaggi successivi.
Gli agenti AI di ClickUp fungono da assistenti intelligenti all'interno del tuo spazio di lavoro, mentre le dashboard di ClickUp offrono una visione in tempo reale delle tue escalation.
Iscriviti oggi stesso gratis a ClickUp!
Domande frequenti (FAQ)
Che cos’è un percorso di escalation degli incidenti?
Un percorso di escalation degli incidenti è una sequenza predefinita di passaggi che determina come i problemi vengano indirizzati al team o alla persona giusta in base alla gravità, all’impatto e alla tempistica. Assicura che gli incidenti vengano gestiti in modo efficiente e che le responsabilità siano chiare. TESTO
Come faccio a decidere quando escalare un incidente automaticamente anziché manualmente?
Utilizza l'automazione per gli incidenti ben definiti e ad alta priorità con criteri chiari (ad es., interruzioni del servizio, violazioni della sicurezza). Riserva l'escalation manuale alle situazioni ambigue o critiche che richiedono il giudizio umano o un contesto aggiuntivo.
Quali strumenti supportano l'escalation automatizzata per una gestione efficace degli incidenti?
Piattaforme come ClickUp, PagerDuty, Jira Service Management e ServiceNow consentono l'instradamento automatico, le notifiche e gli aggiornamenti. Aiutano i team a ridurre i ritardi e a mantenere flussi di lavoro strutturati per la gestione degli incidenti.
Come posso evitare l’affaticamento da avvisi quando utilizzo l’escalation basata sull’automazione?
Imposta soglie chiare per gli avvisi, assegna priorità in base alla gravità e utilizza notifiche intelligenti. Limita le notifiche ripetute agli incidenti critici e sfrutta i dashboard o gli strumenti di IA per riepilogare gli aggiornamenti, anziché inviare ogni minima modifica.
Con quale frequenza dovrei rivedere le mie politiche di escalation?
Rivedi regolarmente le politiche di escalation, almeno una volta al trimestre o dopo incidenti di grave entità. In questo modo ti assicuri che i criteri, le responsabilità e le regole di automazione riflettano i flussi di lavoro attuali, le strutture dei team e le priorità aziendali.