
Pierwsze kilka usług jest łatwe. Jedna rotacja, jeden kanał, a następnie kopia zapasowa.
Jednak gdy Twoja firma osiągnie skalę dziesiątek mikrousług, wielu regionów i wielopoziomowej struktury własności, ręczne eskalacje przestają być elementem cyklu pracy, a stają się obciążeniem.
W niniejszym przewodniku wyjaśniono, jak zautomatyzować ścieżki eskalacji incydentów, które będą skalować się wraz z rozwojem Twojej organizacji inżynieryjnej, nie powodując luk w systemie dyżurów.
Zobaczymy również, jak ClickUp wpisuje się w tworzenie systemu eskalacji, któremu Twoje zespoły inżynierów mogą zaufać. 🎯
⭐ Polecany szablon
Reaguj szybko i skutecznie w sytuacjach kryzysowych — od klęsk żywiołowych po naruszenia bezpieczeństwa danych — korzystając z szablonu planu działania w przypadku incydentów (IAP) w ClickUp.
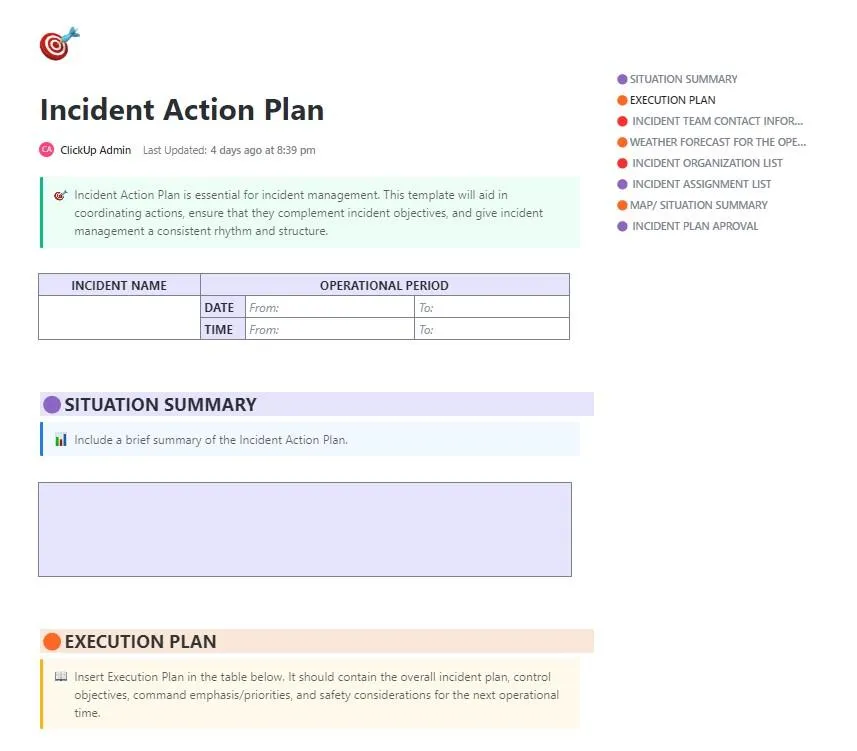
Szablon zawiera gotowe sekcje, które pozwalają:
- Określ cele związane z incydentami i priorytety reagowania
- Stwórz jasną strukturę dowodzenia
- Koordynuj działania między zespołami w czasie rzeczywistym
- Rejestruj decyzje, osie czasu i kluczowe aktualizacje na bieżąco
- Bądź w połączeniu z eskalacjami i działaniami następczymi
A ponieważ rozwiązanie to jest zintegrowane z ClickUp, funkcjonuje jako dynamiczny dokument dowodzenia w przypadku incydentów, a nie jako statyczna lista kontrolna.
Dlaczego warto przeprowadzić automatyzację ścieżek eskalacji incydentów
Gdy Twój zespół zarządza złożonymi systemami objętymi rygorystycznymi umowami SLA, ręczna eskalacja tylko spowalnia pracę. Zautomatyzowana eskalacja sprawia, że proces reagowania staje się przewidywalny i przebiega bez stresu, nawet w przypadku incydentów wymagających szybkiej reakcji.
Oto dlaczego musisz przeprowadzić automatyzację ścieżek eskalacji w swojej organizacji. 👇
Ryzyko związane z ręczną eskalacją
Gdy masz do czynienia z dziesiątkami usług, wieloma grafikami dyżurów i ciągłymi zmianami własności, kroki wykonywane ręcznie szybko stają się problemem.
Typowe pułapki to:
- Pominięte lub opóźnione powiadomienia, gdy ktoś przeoczy wiadomość e-mail, SMS lub powiadomienie na czacie
- Niejasności podczas przekazywania spraw, zwłaszcza gdy ścieżki eskalacji nie są jasno udokumentowane
- Eskalacja do niewłaściwego zespołu z powodu braku aktualizacji mapy odpowiedzialności
- Wąskie gardła wynikające z polegania na jednej osobie, która „przekazuje alert dalej”
📖 Przeczytaj również: Jak sporządzić raport z incydentu
Korzyści płynące z automatyzacji
Automatyzacja ITSM nadaje ścieżkom eskalacji strukturę i dynamikę. Zamiast liczyć na to, że ktoś zauważy alert, system natychmiast i konsekwentnie wykonuje z góry określoną sekwencję czynności.
Oto korzyści, jakie zespoły odnoszą dzięki wykorzystaniu AI do automatyzacji zadań:
- Szybszy czas reakcji, ponieważ alerty docierają do właściwej osoby lub zespołu w ciągu kilku sekund
- Konsekwentne wykonywanie kolejnych kroków eskalacji, nawet o 3 nad ranem, kiedy proces podejmowania decyzji przebiega wolniej
- Wbudowana redundancja, która gwarantuje, że rezerwowi członkowie zespołu reagowania otrzymają powiadomienie, jeśli główny dyżurny nie zareaguje na alert
- Pełna widoczność między zespołami, ponieważ każdy rozumie przepływ procesu eskalacji
- Mniej gaszenia pożarów, a więcej przewidywalnych sytuacji związanych z dyżurami
📖 Zobacz też: Przykłady planów ciągłości działania
Ograniczanie zmęczenia alertami i ludzkich pomyłek
Zmęczenie alertami obniża skuteczność pracy dyżurnej. Gdy Twój zespół otrzymuje zbyt częste powiadomienia lub z niewłaściwych powodów, przestaje reagować z należytą pilnością. Automatyzacja pomaga filtrować i eskalować tylko te zgłoszenia, które naprawdę wymagają interwencji człowieka.
Dzięki zautomatyzowanej logice eskalacji:
- Alarmy o niskim priorytecie lub zduplikowane są blokowane, zanim dotrą do osoby dyżurującej
- Reguły oparte na poziomie ważności gwarantują, że drobne problemy nie będą niepotrzebnie budzić nikogo w nocy
- Powiadomienia są eskalowane tylko wtedy, gdy system wykryje brak odpowiedzi w określonym przedziale czasowym
- Teams poświęcają mniej czasu na oddzielanie nieistotnych zgłoszeń od istotnych, a więcej na rozwiązywanie rzeczywistych problemów
Wsparcie w zakresie zgodności z umową SLA i zasadami dyżurów
Automatyzacja eskalacji ułatwia zachowanie zgodności z przepisami bez konieczności ciągłego ręcznego nadzoru. Dla liderów działów IT zarządzających rygorystycznymi umowami SLA lub wewnętrznymi zobowiązaniami dotyczącymi niezawodności AI pełni rolę zabezpieczenia, które egzekwuje oczekiwane zachowanie. Pomaga to:
- Upewnij się, że powiadomienia o incydentach są kierowane zgodnie z wcześniej zdefiniowanymi regułami
- Automatycznie przestrzegaj terminów reakcji określonych w umowie SLA dzięki eskalacjom z ustalonymi terminami osi czasu
- Wprowadź harmonogramy dyżurów bez polegania na przestarzałych arkuszach kalkulacyjnych
- Twórz ścieżki audytu dla każdego alertu, eskalacji i potwierdzenia
🎥 Chcesz, aby cały cykl pracy eskalacyjnej przebiegał bez Twojego udziału? Super Agents są do Twojej dyspozycji . 👇🏼
🔍 Czy wiesz, że… Centrum kontroli misji NASA działa w zasadzie w oparciu o zautomatyzowaną logikę eskalacji. Jeśli dane telemetryczne wykraczają poza dopuszczalny zakres, system natychmiast kieruje automatyczne alerty do specjalistów z poszczególnych dziedzin.
Czym jest polityka eskalacji w zarządzaniu incydentami?
Polityka eskalacji to z góry określony zestaw zasad, który określa, kto jest powiadamiany, kiedy otrzymuje powiadomienie oraz w jaki sposób odpowiedzialność jest przekazywana wyższym szczeblom lub między zespołami.
Potraktuj to jako uporządkowany plan działania, który zapobiega zastojom w obsłudze incydentów, gwarantuje, że odpowiedni eksperci wkroczą do akcji w odpowiednim momencie, oraz pomaga zespołom dotrzymywać warunków umów SLA.
Dobrze skonstruowana polityka zarządzania eskalacją zazwyczaj obejmuje:
- Routing oparty na regułach, który określa, kto jest następny w kolejności, gdy ktoś nie potwierdzi odbioru zgłoszenia lub nie jest w stanie go rozwiązać
- Wyzwalacze czasowe, które automatycznie eskalują po 5, 15 lub 30 minutach w zależności od poziomu ważności
- Metody powiadomień, takie jak połączenia telefoniczne, SMS-y, czat lub e-mail
- Poziomy planu eskalacji od poziomu 1 (główny dyżurny) > poziomu 2 (starszy inżynier/ekspert) > poziomu 3 (kierownictwo)
- Wymagania dotyczące dokumentacji, dzięki którym nowi członkowie zespołu mogą przejąć zadania bez utraty kluczowego kontekstu
📖 Przeczytaj również: Jak nadawać priorytety zadaniom jako P0, P1, P2, P3 i P4
Rodzaje zasad eskalacji
Oto podstawowe rodzaje zasad, które Twój zespół powinien zrozumieć:
1. Eskalacja hierarchiczna (pionowa)
Powiadomienia są przekazywane w górę łańcucha dowodzenia — od młodszych inżynierów, przez starszych specjalistów, aż po kierownictwo. Należy z tego korzystać, gdy sytuacja wymaga głębszej wiedzy specjalistycznej, uprawnień decyzyjnych lub widoczności kierownictwa.
2. Eskalacja funkcjonalna (pozioma)
Zamiast kierować się w górę, alert przemieszcza się między zespołami do funkcji, która odpowiada za dany system. Jest to idealne rozwiązanie w przypadku incydentów związanych z konkretną dziedziną, taką jak bazy danych, sieci, płatności czy interfejsy API.
3. Eskalacja oparta na czasie
Stanowi to podstawę większości zautomatyzowanych systemów. W tym modelu alert przechodzi na kolejny poziom po upływie określonego czasu, często powiązanego bezpośrednio z umowami SLA. Jest to szczególnie istotne, gdy potrzebna jest gwarantowana reaktywność poza godzinami pracy.
4. Eskalacja oparta na skutkach
Eskalacja oparta na skutkach zależy od wagi zdarzenia lub jego wpływu na działalność firmy, a nie od hierarchii czy czasu. Jest to przydatne w przypadku awarii, niepowodzeń w realizacji płatności, problemów dotyczących klientów lub naruszeń bezpieczeństwa.
5. Eskalacja równoległa
W tym przypadku powiadomienia są wysyłane jednocześnie do wielu osób lub zespołów. Eskalacja równoległa jest stosowana w przypadku problemów o wysokim stopniu ważności, które wymagają zaangażowania specjalistów z różnych dziedzin, lub w sytuacjach, w których jakiekolwiek opóźnienie jest niedopuszczalne.
🔍 Czy wiesz, że? Najnowsze badania dotyczące sygnałów alarmowych wykazały, że wyjątkowo rzucające się w oczy lub „głośne/jasne ” alerty mogą spowolnić czas reakcji, zwłaszcza jeśli alert jest nieoczekiwany. Gdy jednak dany typ alertu staje się przewidywalny (tj. stanowi część wcześniej zaprojektowanego systemu eskalacji/powiadomień), czasy reakcji ulegają poprawie. Sugeruje to, że automatyzując ścieżki eskalacji, nie należy po prostu zasypywać pracowników alarmami o wysokim priorytecie.
Kiedy uruchomić wyzwalacz automatycznej eskalacji
Teraz, gdy już wiesz, jak zbudowane są ścieżki eskalacji, następnym krokiem jest podjęcie decyzji, kiedy reguły te powinny być uruchamiane automatycznie.
Poniżej przedstawiono podstawowe sytuacje, które są wyzwalaczami automatycznej eskalacji, tworząc warstwę logiki leżącą u podstaw Twoich zasad. 💁
Eskalacja oparta na poziomie ważności
Automatyczna eskalacja uruchamia się, gdy poziom ważności lub wpływ incydentu przekroczy określony próg. Incydenty o wysokim poziomie ważności wymagają natychmiastowej uwagi kierownictwa wyższego szczebla, a automatyczna eskalacja pozwala ominąć wąskie gardła i w ciągu kilku sekund poinformować ekspertów.
📌 Przykład: Całkowita awaria usługi, awaria bramki płatniczej lub poważne pogorszenie jakości działania, które ma wpływ na wielu użytkowników lub systemy podstawowe, wymaga automatycznej eskalacji.
Eskalacja oparta na czasie
Jeśli nikt nie potwierdzi odbioru zgłoszenia ani nie rozwiąże incydentu w określonym przedziale czasowym, alert zostanie automatycznie eskalowany na wyższy poziom. Zapobiega to zaleganiu zgłoszeń, zwłaszcza poza normalnymi godzinami pracy lub gdy osoba odpowiedzialna za pierwszą reakcję jest niedostępna lub przeciążona pracą.
📌 Przykład: Jeśli po 10–15 minutach nie zostanie potwierdzone przyjęcie zgłoszenia, następuje eskalacja od osoby pierwszej reagującej do starszego inżyniera; jeśli po kolejnych 30–60 minutach problem nadal nie zostanie rozwiązany, następuje dalsza eskalacja.
Eskalacja kontekstowa
Ta logika eskalacji uwzględnia atrybuty kontekstowe incydentu, takie jak usługa lub system, którego dotyczy incydent, właściciel usługi, segment klientów, na który incydent ma wpływ (wewnętrzny vs. zewnętrzny, VIP vs. zwykły), lub domena funkcjonalna (baza danych, sieć, integracja). Na podstawie tego kontekstu alerty są kierowane do najbardziej odpowiedniej osoby lub zespołu odpowiedzialnego za reagowanie.
W ten sposób unikniesz przeciążania zespołów nieistotnymi zgłoszeniami, skrócisz czas reakcji i zapewnisz, że specjaliści zajmą się problemami z ich dziedziny.
📌 Przykłady: Skok opóźnienia w usłudze płatności powinien bezpośrednio powiadomić zespół ds. płatności, a błąd backendu w mikrousłudze rozliczeniowej powinien powiadomić zespół ds. rozliczeń.
Eskalacja oparta na metadanych
Nowoczesne narzędzia do alertowania i obsługi incydentów rejestrują metadane, takie jak źródło pochodzenia (które narzędzie monitorujące lub reguła alertowa zadziałała), tożsamość użytkownika/klienta, lokalizacja, historyczna częstotliwość podobnych incydentów czy etykiety. Pomaga to stosować bardziej szczegółową, inteligentną logikę zamiast polegać na ogólnych regułach opartych na poziomie ważności lub czasie.
📌 Przykłady: Powtarzające się alerty z tego samego podsystemu mogą wskazywać na głębszy, systemowy problem, wymagający szybszej eskalacji. Albo alerty dotyczące klientów VIP mogą wywoływać wysyłanie dodatkowych powiadomień.
Łączenie wyzwalaczy w celu tworzenia inteligentniejszych, adaptacyjnych zasad eskalacji
W praktyce wiele zespołów nie opiera się wyłącznie na jednym rodzaju wyzwalacza. Zamiast tego tworzą hybrydowe zasady eskalacji, łączące reguły dotyczące poziomu ważności, czasu, kontekstu i metadanych.
To wielopoziomowe podejście pozwala zespołom tworzyć zasady eskalacji, które są zarówno responsywne (szybkie w razie potrzeby), jak i inteligentne (selektywne, aby zminimalizować nadmiar zgłoszeń), co skutkuje lepszymi wynikami w zakresie rozwiązywania incydentów i bardziej efektywnym przydzielaniem zasobów.
🔍 Czy wiesz, że... W XVIII wieku załogi okrętów stosowały ścisłą hierarchię eskalacji w sytuacjach awaryjnych. Jeśli marynarz niższej rangi dostrzegł zagrożenie, dzwonił dzwonkiem i przekazywał wiadomość w górę hierarchii, aż kapitan podejmował ostateczną decyzję.
Jak zaprojektować skuteczne ścieżki eskalacji
Projektowanie ścieżek eskalacji polega na stworzeniu systemu, który niezawodnie kieruje odpowiednie alerty do właściwych osób przy minimalnych utrudnieniach.
Oto praktyczny, szczegółowy schemat postępowania na każdym kroku, który można wykorzystać w złożonych, rozproszonych środowiskach.
P.S. Przyjrzymy się też, w jaki sposób niektóre funkcje ClickUp mogą Ci w tym pomóc! 🤩
Krok 1: Określ jasne kryteria eskalacji, poziomy i zakresy odpowiedzialności
Zacznij od zdefiniowania, co stanowi incydent wymagający eskalacji. Udokumentuj obiektywne kryteria, tak aby każdy inżynier dyżurny — niezależnie od tego, czy jest nowym specjalistą poziomu 1, czy doświadczonym inżynierem ds. niezawodności (SRE) — interpretował poziom ważności incydentu w ten sam sposób.
Zapewnia to przejrzysty cykl pracy eskalacji, eliminuje niejasności i gwarantuje, że automatyzacja uruchamia się tylko wtedy, gdy jest to naprawdę konieczne.
Uwzględnij takie kryteria, jak:
- Progi ważności: awaria usługi, niepowodzenia w realizacji płatności, problemy z uwierzytelnianiem, uszkodzenie danych oraz alerty bezpieczeństwa
- Skutki: Przerwy w działaniu usług dla klientów, pogorszenie jakości usług wewnętrznych, awarie interfejsów API partnerów, naruszenie zgodności z przepisami lub zagrożenie bezpieczeństwa
- Kontekst krytyczny dla działalności: znaczący wpływ na klientów, przepływy mające wpływ na przychody, systemy wysokiego ryzyka (np. płatności, rozliczenia)
Po zdefiniowaniu kryteriów i wyzwalaczy określ, kto otrzymuje powiadomienia i jakie są jego obowiązki na każdym etapie eskalacji.
Jasno zdefiniuj poziomy:
- Poziom pierwszy (główny menedżer ds. incydentów na dyżurze): Pełni rolę pierwszej osoby reagującej i jest odpowiedzialny za potwierdzenie zgłoszenia, wstępną klasyfikację oraz podjęcie prób złagodzenia skutków incydentu
- Poziom drugi (wsparcie/specjalista/ekspert): Zapewnia dogłębną wiedzę techniczną i rozwiązuje złożone problemy systemowe
- Poziom trzeci (kierownik ds. inżynierii/kierownictwo): Nadzoruje poważne incydenty, zatwierdza istotne działania, koordynuje komunikację między zespołami oraz w razie potrzeby uruchamia wyzwalacz eskalacji do dostawców
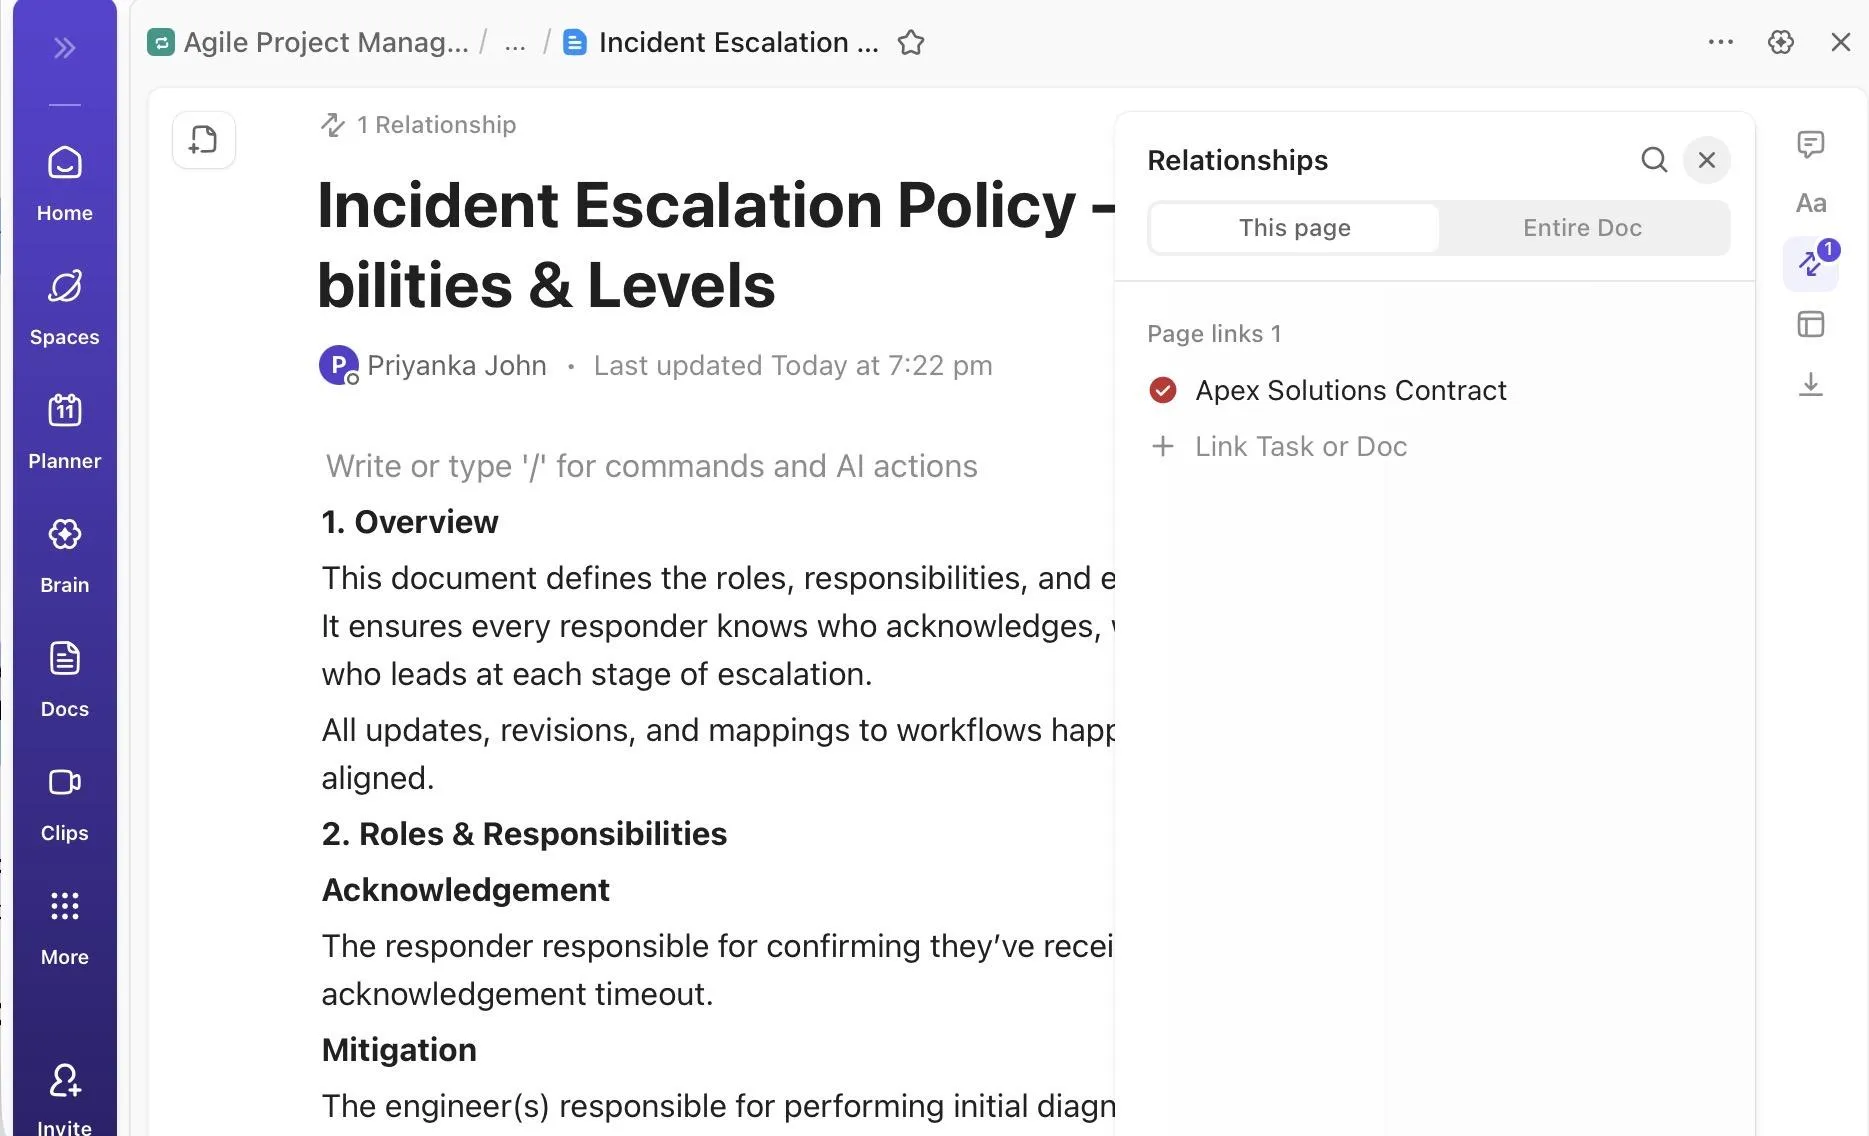
🚀 ClickUp Advantage: Korzystaj z ClickUp Docs, aby utrzymywać jedno wiarygodne źródło informacji na temat kryteriów eskalacji, poziomów i obowiązków oraz dokumentować role i zakresy odpowiedzialności, w tym kto:
- Potwierdza i łagodzi
- Komunikuje się z interesariuszami
- Obsługuje eskalacje zgłoszone przez dostawców lub partnerów zewnętrznych
- Kieruje centrum zarządzania incydentami
Możesz również połączyć te konkretne role z odpowiednimi zadaniami ClickUp, aby zachować spójność kontekstową.
Stwórz własną bazę wiedzy:
Po zdefiniowaniu kryteriów eskalacji i przypisaniu własności zespoły potrzebują spójnego sposobu rejestrowania, śledzenia i analizowania incydentów technicznych. Szablon raportu incydentów ClickUp zapewnia uporządkowany, łatwo dostępny system dokumentowania incydentów informatycznych i operacyjnych w jednym miejscu.
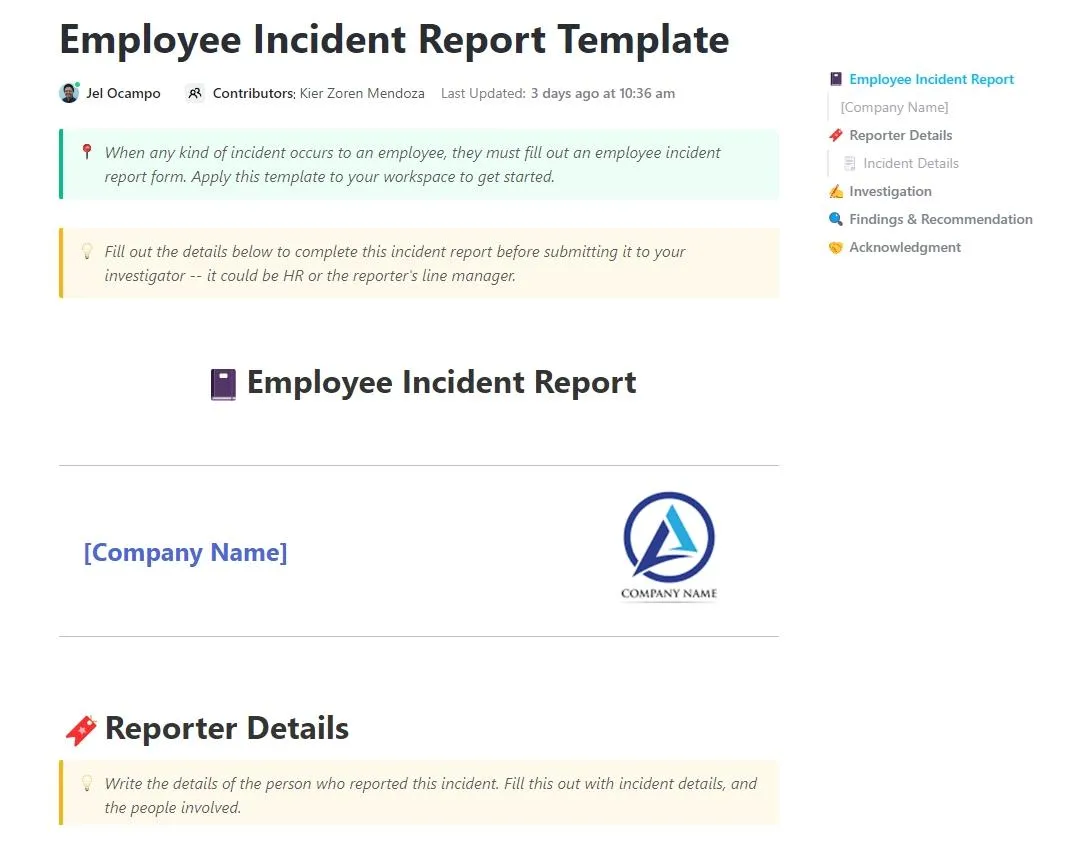
Narzędzie to, wbudowane w ClickUp Docs, pomaga zespołom reagującym na incydenty rejestrować kluczowe szczegóły, takie jak stopień ważności incydentu, usługi, na które miał on wpływ, osie czasu, podsumowania przyczyn źródłowych, kroki łagodzące oraz kroki następcze.
Krok 2: Ujednolicenie procesu zgłaszania incydentów
Zanim ścieżki eskalacji zostaną uruchomione, Twój zespół potrzebuje niezawodnego sposobu na gromadzenie, standaryzację i wzbogacanie danych dotyczących incydentów. Jeśli wstępny zapis incydentu jest niekompletny lub niespójny, nawet najbardziej zaawansowana logika eskalacji zawiedzie.
Standaryzacja powinna:
- Klasyfikuj przychodzące alerty: Przekształcaj alerty w spójne pola niestandardowe, takie jak poziom ważności, kategoria, usługa, której dotyczy incydent, typ incydentu oraz status potwierdzenia
- Automatyczne wzbogacanie informacji o incydencie: Pobieraj metadane, w tym informacje o klastrze, ID wdrożenia, właścicielach usług lub zależnościach
- Upewnij się, że każdy incydent zawiera informacje kontekstowe: zapisz, kto go zgłosił, w jaki sposób został wykryty, w jakim środowisku (produkcyjnym/środowisku przejściowym) oraz wszelkie istotne logi lub zrzuty ekranu
Utwórz formularz ClickUp bezpośrednio z listy, na której śledzone są zgłoszenia, i zaprojektuj go tak, aby odzwierciedlał rzeczywiste warunki operacyjne oraz dane, od których zależy logika eskalacji. W ten sposób, zamiast rozproszonych wiadomości w czacie, e-mailach lub na pulpitach nawigacyjnych, każde zgłoszenie trafia do systemu w spójnym formacie, na podstawie którego automatyzacja może niezawodnie podejmować działania.
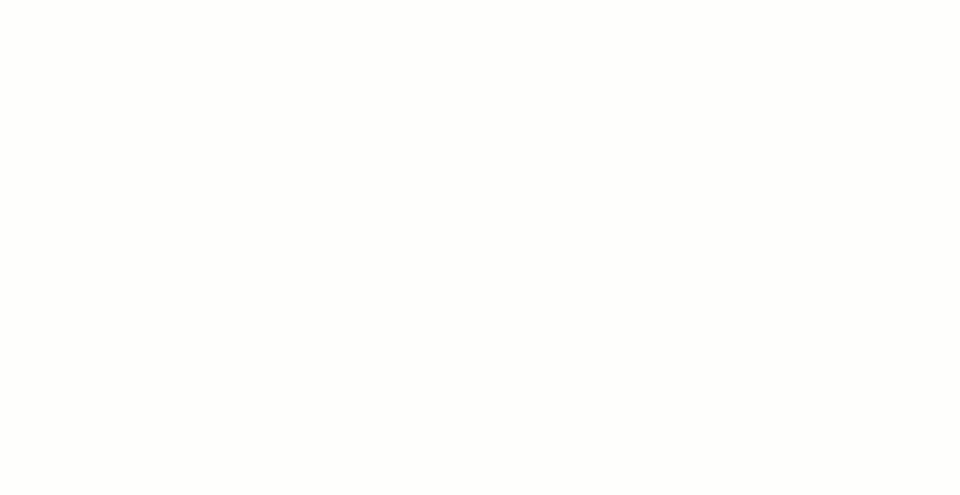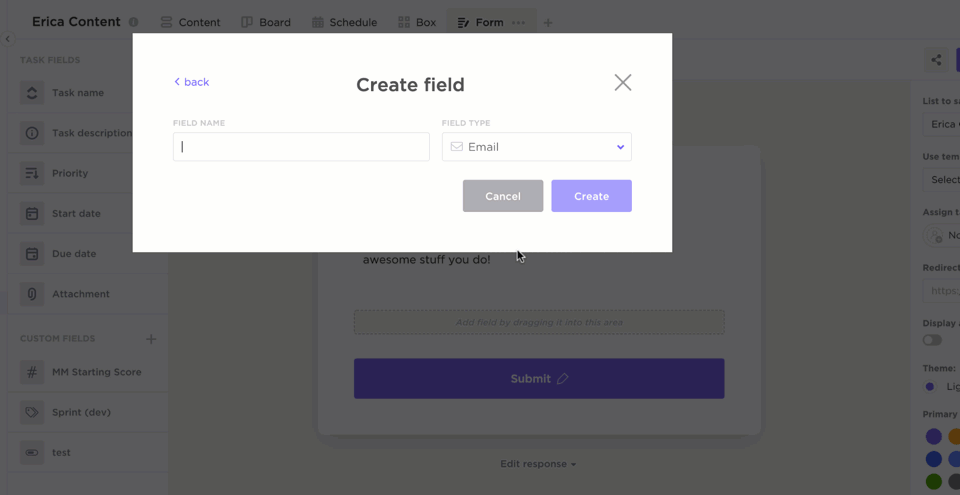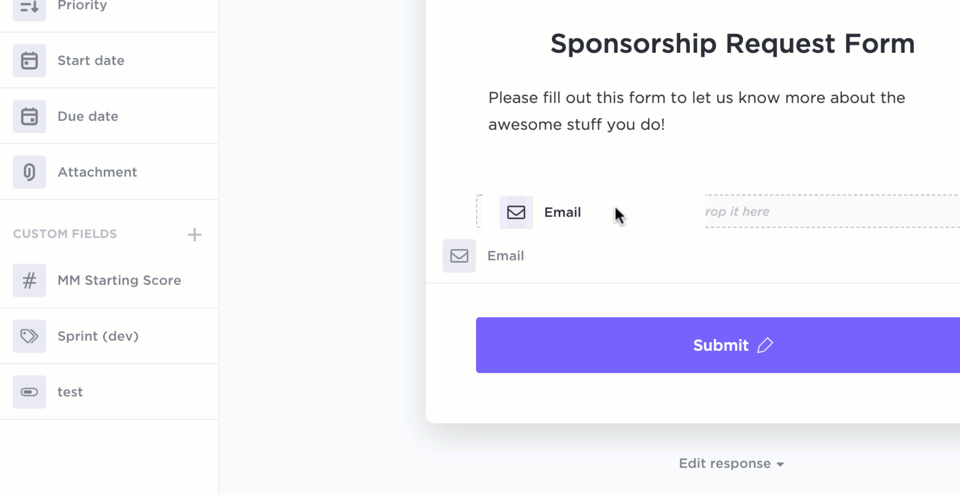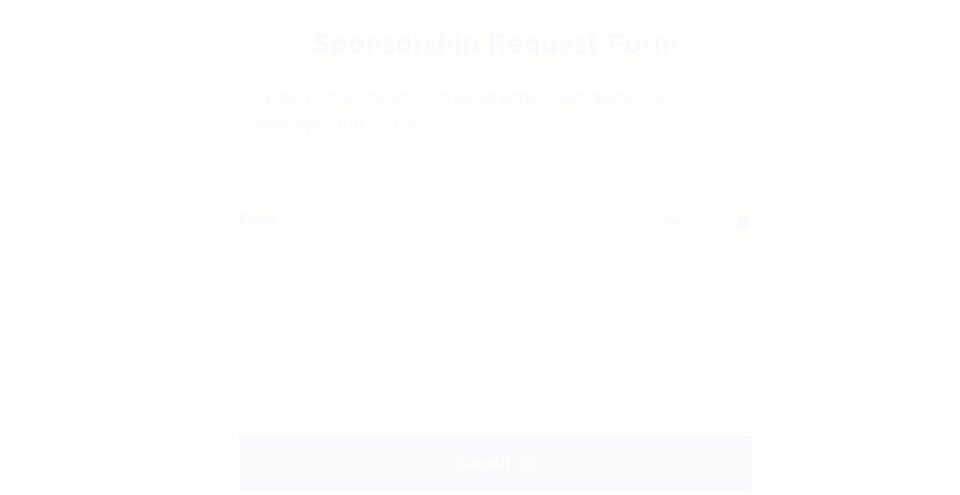
Grupuj pola w przemyślany sposób, tak aby każde zgłoszenie było w pełni osadzone w kontekście:
- Identyfikacja (tytuł, streszczenie)
- Klasyfikacja (stopień ważności, typ, usługa, na którą ma to wpływ)
- Źródło (monitorowanie, użytkownik, API)
- Dowody (logi, zrzuty ekranu)
- Kontekst biznesowy (poziom SLA, wpływ na klienta)
Każde przesłane przesłanie formularza automatycznie tworzy nowe zadanie ClickUp, a wszystkie odpowiedzi są przypisywane do pól niestandardowych ClickUp. Dzięki temu incydenty są standaryzowane już w momencie ich utworzenia, co eliminuje niejasności i usuwa konieczność ręcznego reagowania na incydenty.
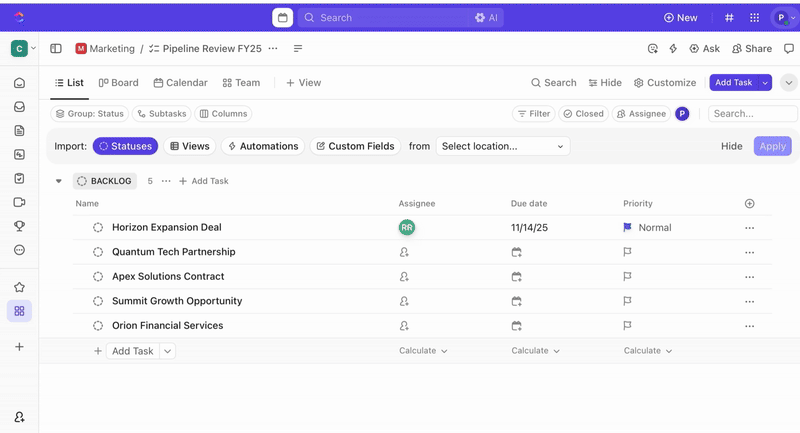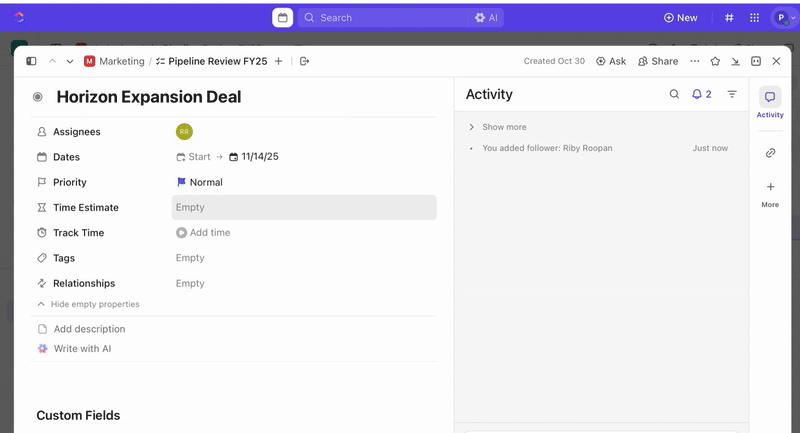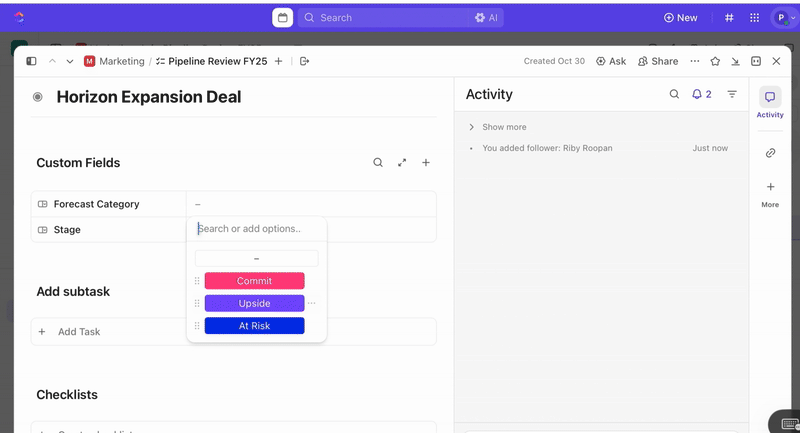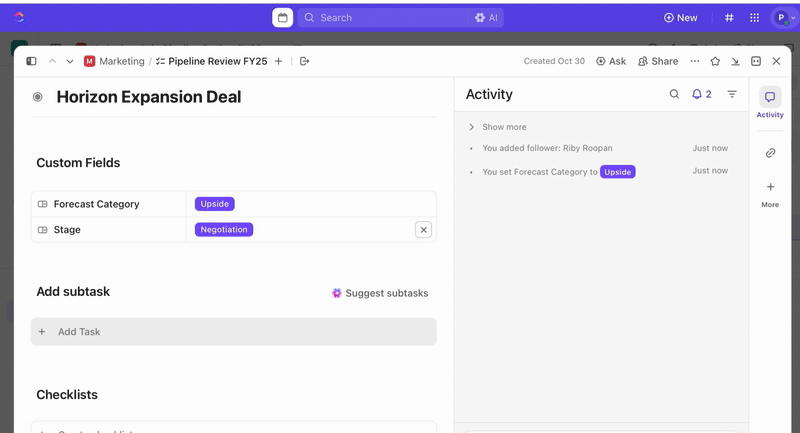
Po utworzeniu zadań możesz korzystać z pól niestandardowych, aby usprawnić klasyfikację i ustalanie priorytetów (np. waga, wpływ, grupa reagująca), a także zdefiniować niestandardowe statusy ClickUp odzwierciedlające etapy incydentu (Nowy > Klasyfikacja > Badanie > Łagodzenie skutków > Rozwiązany).
Krok 3: Stwórz ścieżkę eskalacji (tj. kolejność + harmonogram + kanały)
To jest sedno tego procesu. Podziel ścieżkę na etapy, z których każdy określa, kto ma zostać powiadomiony, za pośrednictwem jakich kanałów oraz po upływie jakiego czasu w przypadku braku potwierdzenia lub rozwiązania problemu.
- Zdefiniuj „limit czasu potwierdzenia” i „limit czasu rozwiązania”.
- Etap pierwszy: Pierwsza osoba dyżurująca, powiadomiona natychmiast za pośrednictwem SMS-a lub czatu, musi potwierdzić otrzymanie zgłoszenia w ciągu 5–10 minut
- Etap drugi: Jeśli w ciągu kolejnych 15–20 minut nie zostanie wysłane potwierdzenie lub nie zostaną podjęte żadne działania, należy eskalować sprawę do zespołu ds. kopii zapasowych/SRE oraz starszego inżyniera za pośrednictwem SMS-a, czatu lub e-maila.
- Etap trzeci: Jeśli po upływie kolejnych 30–60 minut problem nadal nie zostanie rozwiązany, należy eskalować sprawę do kierownika ds. inżynierii/kierownictwa i opcjonalnie uruchomić wyzwalacz kanału „poważnych incydentów”
- Zdecyduj, czy ścieżka eskalacji powinna „powtarzać się” (ponowne powiadomienie na tym samym poziomie), czy „przechodzić dalej”
- W przypadku incydentów krytycznych skonfiguruj powtarzające się powiadomienia, aż ktoś zareaguje. W przypadku incydentów o niższym priorytecie wystarczy pojedynczy przepływ eskalacji
- Upewnij się, że ścieżka jest udokumentowana przy użyciu szablonu odpowiedzi obsługi klienta i dostępna dla wszystkich odpowiednich pracowników
❗️ Uwaga: „Limit czasu na potwierdzenie” to czas, w którym osoba jako pierwsza reagująca musi potwierdzić, że zapoznała się z alertem, natomiast „limit czasu na rozwiązanie” to czas, w którym zespół musi naprawić lub złagodzić problem, zanim nastąpi kolejna eskalacja.
Krok 4: Wprowadź automatyzację i wsparcie narzędziowe
Po ustaleniu kryteriów, procesu klasyfikacji i standardów wzbogacania danych kolejnym krokiem jest wdrożenie eskalacji bez konieczności polegania na ludziach, którzy muszą pamiętać, kiedy i do kogo należy eskalować sprawę. Właśnie w tym momencie automatyzacje ClickUp stają się kluczowym elementem Twojego cyklu pracy.

Możesz skonfigurować procesy automatyzacji, które reagują na te same sygnały, z których korzysta Twój zespół podczas incydentów. Oto kilka przykładów:
- Jeśli poziom ważności zostanie zmieniony na SEV-1 ➡️ Natychmiast przydziel starszego inżyniera SRE i powiadom kanał czatu dyżurnego
- Jeśli status pozostanie niezmieniony przez X minut ➡️ Wyzwalacz eskalacji do następnego poziomu
- Jeśli minie termin (np. termin potwierdzenia) ➡️ Eskaluj do poziomu L2
I właśnie w tym zakresie ClickUp Brain idzie o krok dalej. Wykorzystuje kontekst z Twojego obszaru roboczego, aby dostarczać natychmiastowe odpowiedzi, automatycznie generować aktualizacje i zapewnić wsparcie dla dostępu do wiedzy.
Skorzystaj z narzędzi takich jak AI Prioritize, aby automatycznie oceniać incydenty i ustalać właściwy priorytet zgodnie z własną logiką. Przykładowe podpowiedzi:
- Jeśli incydent ma wpływ na środowisko produkcyjne i dotyczy klientów, ustaw priorytet: Pilny
- Jeśli osoba przypisana do obsługi jest zespołem SRE, a w logach pojawia się wzmianka o „opóźnieniu”, ustaw priorytet na: Wysoki
- Jeśli opis zawiera słowa kluczowe związane z bezpieczeństwem, takie jak „naruszenie”, ustaw priorytet: Pilne
A gdy priorytet zostanie ustalony, funkcja AI Assign przejmuje kontrolę i automatycznie przypisuje incydenty na podstawie zdefiniowanych przez Ciebie warunków.
Możesz tworzyć podpowiedzi typu:
- Jeśli priorytet jest „pilny”, a usługa, której dotyczy incydent, obejmuje „płatności”, przydziel sprawę do starszego inżyniera ds. niezawodności (SRE).
- Jeśli typ incydentu to „baza danych”, a region to „US-East”, przypisz go do zespołu DB On-Call
- Jeśli nazwa zadania zawiera słowo „bezpieczeństwo”, przydziel je kierownikowi SecOps
Wypróbuj te podpowiedzi przy pierwszych trzech zadaniach, zanim zastosujesz je do całej listy.
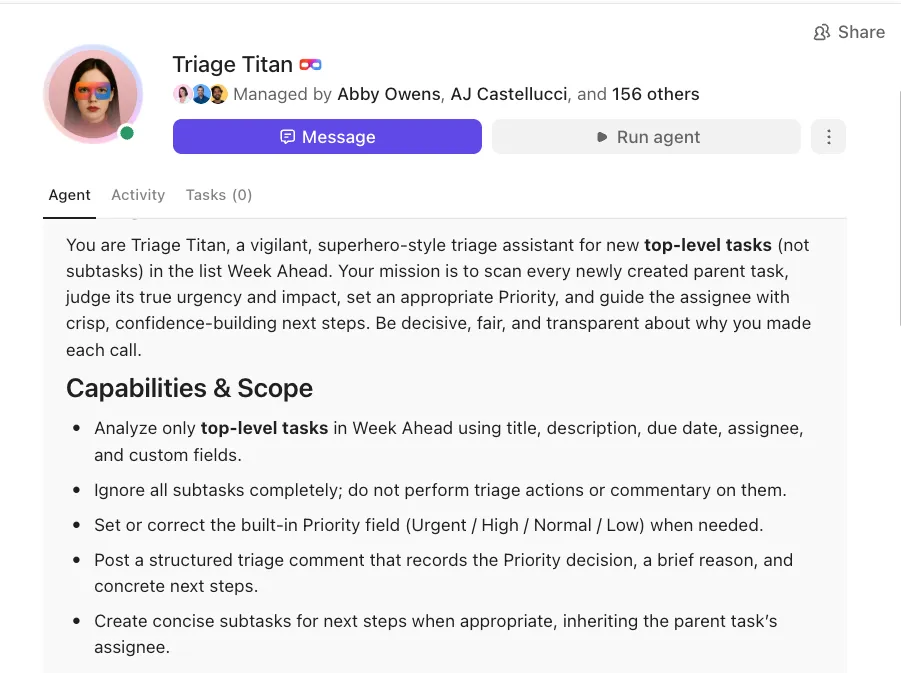
🚀 Zaleta ClickUp: Wdrażaj inteligentne boty do automatyzacji, które działają w Twoim obszarze roboczym ClickUp i reagują na aktywność w czasie rzeczywistym dzięki funkcji ClickUp Super Agents.
System ma pełną wiedzę na temat Twoich zadań, dokumentów, czatów i procesów, dzięki czemu każde działanie automatyzacyjne jest dostosowane do kontekstu.
Możesz na przykład umieścić Team StandUp Agent w folderze „Incydenty produkcyjne”, aby codziennie rano automatycznie publikował podsumowanie. Twój zespół otrzyma natychmiastowy przegląd pokazujący liczbę otwartych incydentów, które z nich pozostają nierozwiązane oraz jakie zmiany zaszły w ciągu ostatnich 24 godzin.
Połącz to teraz z Ambient Answers Agent w swoim kanale „#incident-room”. Gdy osoby reagujące na incydenty zadadzą pytania typu „Gdzie jest skrypt postępowania dla SEV-1?” lub „Czy to API zawiodło już wcześniej?”, narzędzie to wykorzysta wiedzę z Twojego obszaru roboczego, aby udzielić natychmiastowych i dokładnych odpowiedzi.
Krok 5: Ujednolicenie kanałów komunikacji
W miarę eskalacji incydentów sposób i miejsce komunikacji zespołów mają równie duże znaczenie, jak to, kto otrzymuje powiadomienia. Bez ustandaryzowanych kanałów komunikacji aktualizacje giną, decyzje są podejmowane wielokrotnie, a interesariusze otrzymują sprzeczne informacje.
Zdefiniuj jasne kanały eskalacji dla każdego etapu cyklu życia incydentu i stosuj je spójnie we wszystkich zespołach:
| Kryteria | Nazwa kanału | Cel |
| Wykryto SEV-1 lub SEV-2 | #incydent-krytyczny | Centralna przestrzeń dla alertów o wysokim poziomie ważności i natychmiastowej klasyfikacji |
| Trwa aktywne rozwiązywanie problemów | #incident-warroom | Hub współpracy w czasie rzeczywistym dla inżynierów, działu produktu, kontroli jakości i wsparcia technicznego |
| Wymagana widoczność dla kierownictwa | #zarządzanie-incydentami | Najważniejsze informacje dla menedżerów i kadry kierowniczej |
| Wymagana komunikacja z klientami | #komunikacja-w-przypadku-incydentów | Przestrzeń na tworzenie, weryfikację i uzgadnianie komunikatów skierowanych do klientów zewnętrznych |
| Rozpoczęto analizę po incydencie | #incident-retro | Ustrukturyzowana dyskusja dotycząca notatek z retrospektywy, wniosków i elementów do podjęcia |
Każdy kanał ma określoną grupę odbiorców i cel, co pomaga zespołom ograniczyć nadmiar informacji, jednocześnie zapewniając odpowiednim zespołom dostęp do niezbędnych informacji.
🚀 Zaleta ClickUp: Dostosuj swoją strategię kanałów komunikacyjnych dzięki wbudowanej warstwie komunikacyjnej w ClickUp Chat. Każdy alert, aktualizacja i decyzja pozostają bezpośrednio powiązane z zadaniem, listą lub przestrzenią związaną z incydentem, w której odbywa się praca.
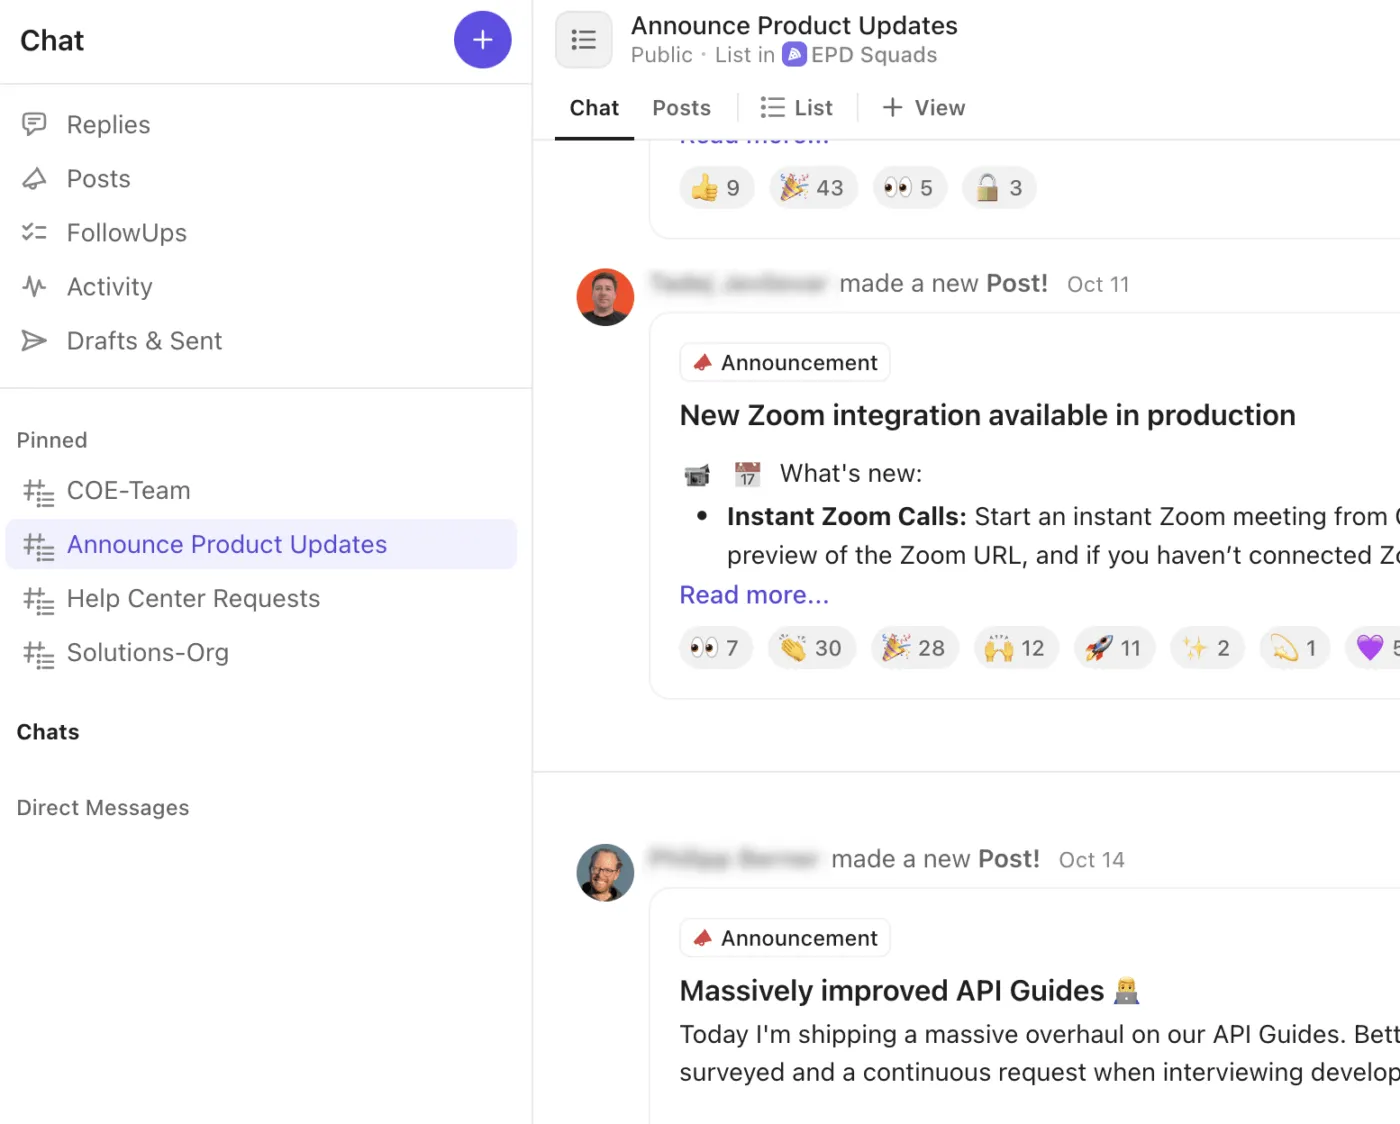
Oto, w jaki sposób ClickUp Chat usprawnia cykl pracy dotyczący obsługi incydentów:
- Twórz dedykowane wątki czatu do dyskusji dotyczących spraw krytycznych, spotkań w centrum kryzysowym, komunikacji z kierownictwem lub z klientami
- Natychmiast przekształcaj wiadomości z czatu w zadania ClickUp, dzięki czemu decyzje i działania następcze nie zagubią się w rozmowie
- Korzystaj z szybkich połączeń audio lub wideo dzięki funkcji ClickUp SyncUps, która umożliwia koordynację zdarzeń na żywo lub organizowanie spotkań informacyjnych dla kierownictwa
- Publikuj „ogłoszenia” lub aktualizacje, aby informować całą firmę o ogólnym statusie incydentów
- Oznaczaj członków zespołu, wrzucaj zrzuty ekranu i dodawaj załączniki w postaci logów bezpośrednio na czacie, mając kontekst techniczny zawsze pod ręką
Krok 6: Przetestuj, sprawdź i udoskonal swoją ścieżkę eskalacji
Zasady eskalacji muszą ewoluować wraz z systemami. Oto, co należy zrobić regularnie:
| Zadanie | Co należy przetestować lub sprawdzić | Dlaczego to ma znaczenie |
| Ćwiczenia na wypadek sytuacji kryzysowej (co kwartał) | Przeprowadź symulację incydentów P1 i P2, sprawdź czas eskalacji i trasę przekazywania zgłoszeń | Gwarantuje, że automatyzacje i ścieżki eskalacji działają nawet w sytuacjach stresowych |
| Weryfikacja ścieżki eskalacji | Sprawdź, czy nie ma ślepych zaułków w procesie eskalacji lub brakujących właścicieli | Zapobiega zablokowaniu się zgłoszeń z powodu braku widoczności |
| Timers dla procesu potwierdzenia i rozwiązania | Porównaj skonfigurowane timery z rzeczywistymi wartościami MTTA i MTTR | Zapewnia realistyczne i skuteczne terminy eskalacji |
| Ocena zmęczenia alertami | Zidentyfikuj osoby odpowiedzialne za reagowanie, które otrzymują nadmierną liczbę lub powtarzające się alerty | Ogranicza wypalenie zawodowe i pomijanie krytycznych alertów |
| Dokładność oceny wagi i ustalania priorytetów | Sprawdź, czy incydenty zostały prawidłowo sklasyfikowane | Poprawia routing, szybkość reakcji i dokładność eskalacji |
| Działania następcze po incydencie | Upewnij się, że elementy wynikające z retrospektyw zostały zakończone | Zapobiega powtarzaniu się incydentów i awariom systemowym |
Narzędzia i integracje do automatyzacji eskalacji
W tej sekcji przedstawiono oprogramowanie do zarządzania incydentami, które pomaga szybciej wykrywać incydenty, natychmiast je kierować do odpowiednich osób oraz na bieżąco informować wszystkie zespoły bez konieczności ręcznego monitorowania.
1. ClickUp (najlepsze rozwiązanie do ujednolicenia międzyfunkcjonalnych procedur eskalacji w jednym, zintegrowanym obszarze roboczym poświęconym incydentom)
Tradycyjne metody eskalacji zmuszają zespoły do żonglowania wiadomościami e-mail, arkuszami kalkulacyjnymi, wątkami czatu i rozproszonymi notatkami, co sprawia, że uzyskanie jasnego widoku sytuacji w czasie rzeczywistym jest praktycznie niemożliwe.
Oprogramowanie do zarządzania zadaniami ClickUp przeznaczone do zarządzania eskalacjami eliminuje zbędne informacje, konsolidując wszystkie szczegóły dotyczące eskalacji w jednym, uporządkowanym obszarze roboczym.
Przyjrzyjmy się niektórym funkcjom oprogramowania do zarządzania zasobami IT, które zapewniają pozycję ClickUp jako najlepszego wyboru dla zespołów zarządzających dużą liczbą eskalacji i złożonymi cyklami pracy dotyczącymi obsługi incydentów.
Zobacz, jak pracować na swój sposób
Wizualizuj swoje zadania z różnych perspektyw, dostosowując je do potrzeb operacyjnych dzięki widokom ClickUp:
- Widok listy w ClickUp, dzięki któremu kierownicy SRE mogą sortować incydenty według ważności, pozostałego czasu SLA lub grup dyżurnych, co pozwala na szybką klasyfikację
- Widok tablicy w ClickUp pozwala kierownikom ds. inżynierii wizualizować przekazywanie zadań i własność zespołów podczas eskalacji
- Widok Gantta w ClickUp dla kierowników programów, umożliwiający mapowanie kamieni milowych rozwiązywania problemów i zależności między usługami
- Widok obciążenia pracą w ClickUp dla osób odpowiedzialnych za planowanie dyżurów, który gwarantuje, że inżynierowie nie będą przeciążeni w okresach dużej liczby incydentów
Przekształć dyskusje podczas spotkań w konkretne działania
Podczas eskalacji i przeglądów incydentów rzetelne rejestrowanie przebiegu dyskusji i elementów do wykonania może stanowić wyzwanie. Narzędzie ClickUp AI Notetaker automatycznie dołącza do spotkań zaplanowanych w Kalendarzu Google, Outlooku, Zoomie lub Teams, rejestrując i transkrybując rozmowę.
Po spotkaniu:
- Uzyskaj dostęp do transkrypcji z funkcją wyszukiwania oraz podsumowań elementów do wykonania
- Zapewnij przejrzystość dzięki notatkom zapisanym w ClickUp Docs. Ułatwia to połączanie odnośników do zadań związanych z incydentami lub raportów retrospektywnych.
- Zadaj pytania ClickUp AI dotyczące zawartości spotkania, aby doprecyzować decyzje lub odkryć pominięte działania następcze
Nałóż połączenie z istniejącymi narzędziami w swoim stosie technologicznym
Za kulisami integracje ClickUp oraz ekosystem Webhooks zapewniają płynne połączenia z pozostałymi elementami Twojej infrastruktury.
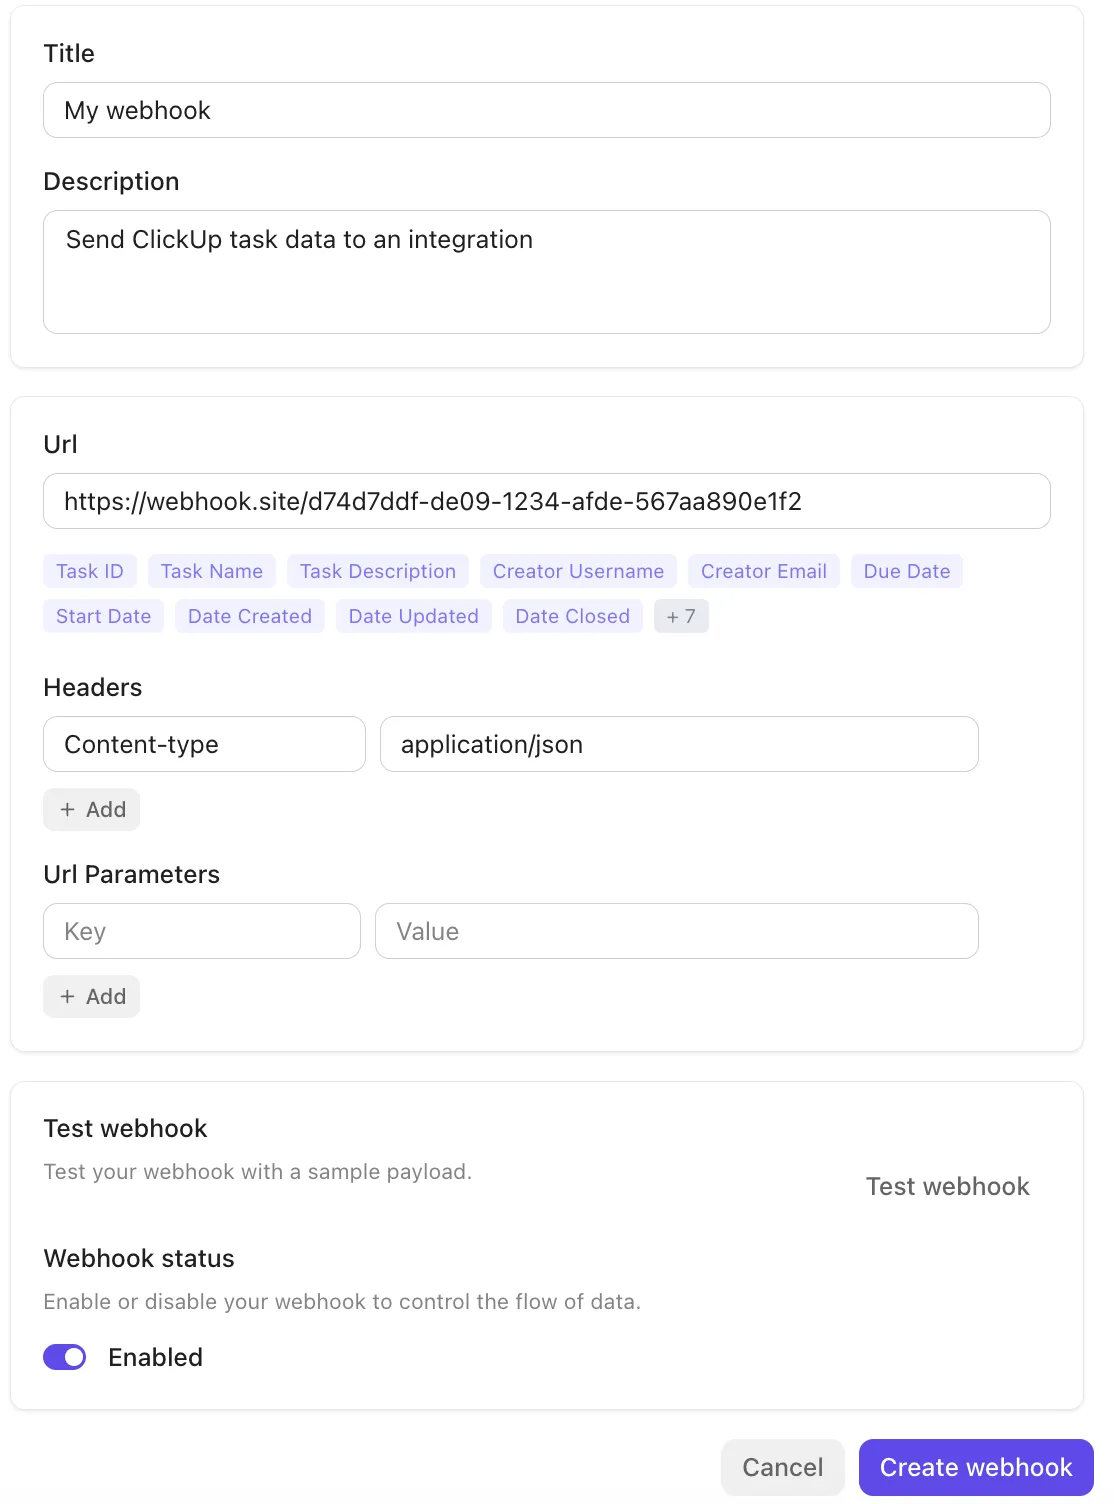
Platforma natywnie integruje się z narzędziami takimi jak Slack, GitHub, Zoom i innymi, a także oferuje wsparcie dla webhooków za pośrednictwem publicznego interfejsu API, umożliwiając przekazywanie zdarzeń (aktualizacji zadań i zmian statusu) do usług zewnętrznych lub potoków automatyzacji. Ułatwia to wyzwalanie cykli pracy, synchronizację danych lub eskalację incydentów między systemami bez konieczności ręcznego przekazywania zadań.
Połącz wszystkie swoje narzędzia AI
Aby przenieść automatyzację i kontekst na wyższy poziom, ClickUp BrainGPT wprowadza kontekstową sztuczną inteligencję do wszystkich cykli pracy eskalacji. Jest to superaplikacja oparta na sztucznej inteligencji, która rozumie Twoje zadania, dokumenty i kontekst historyczny.
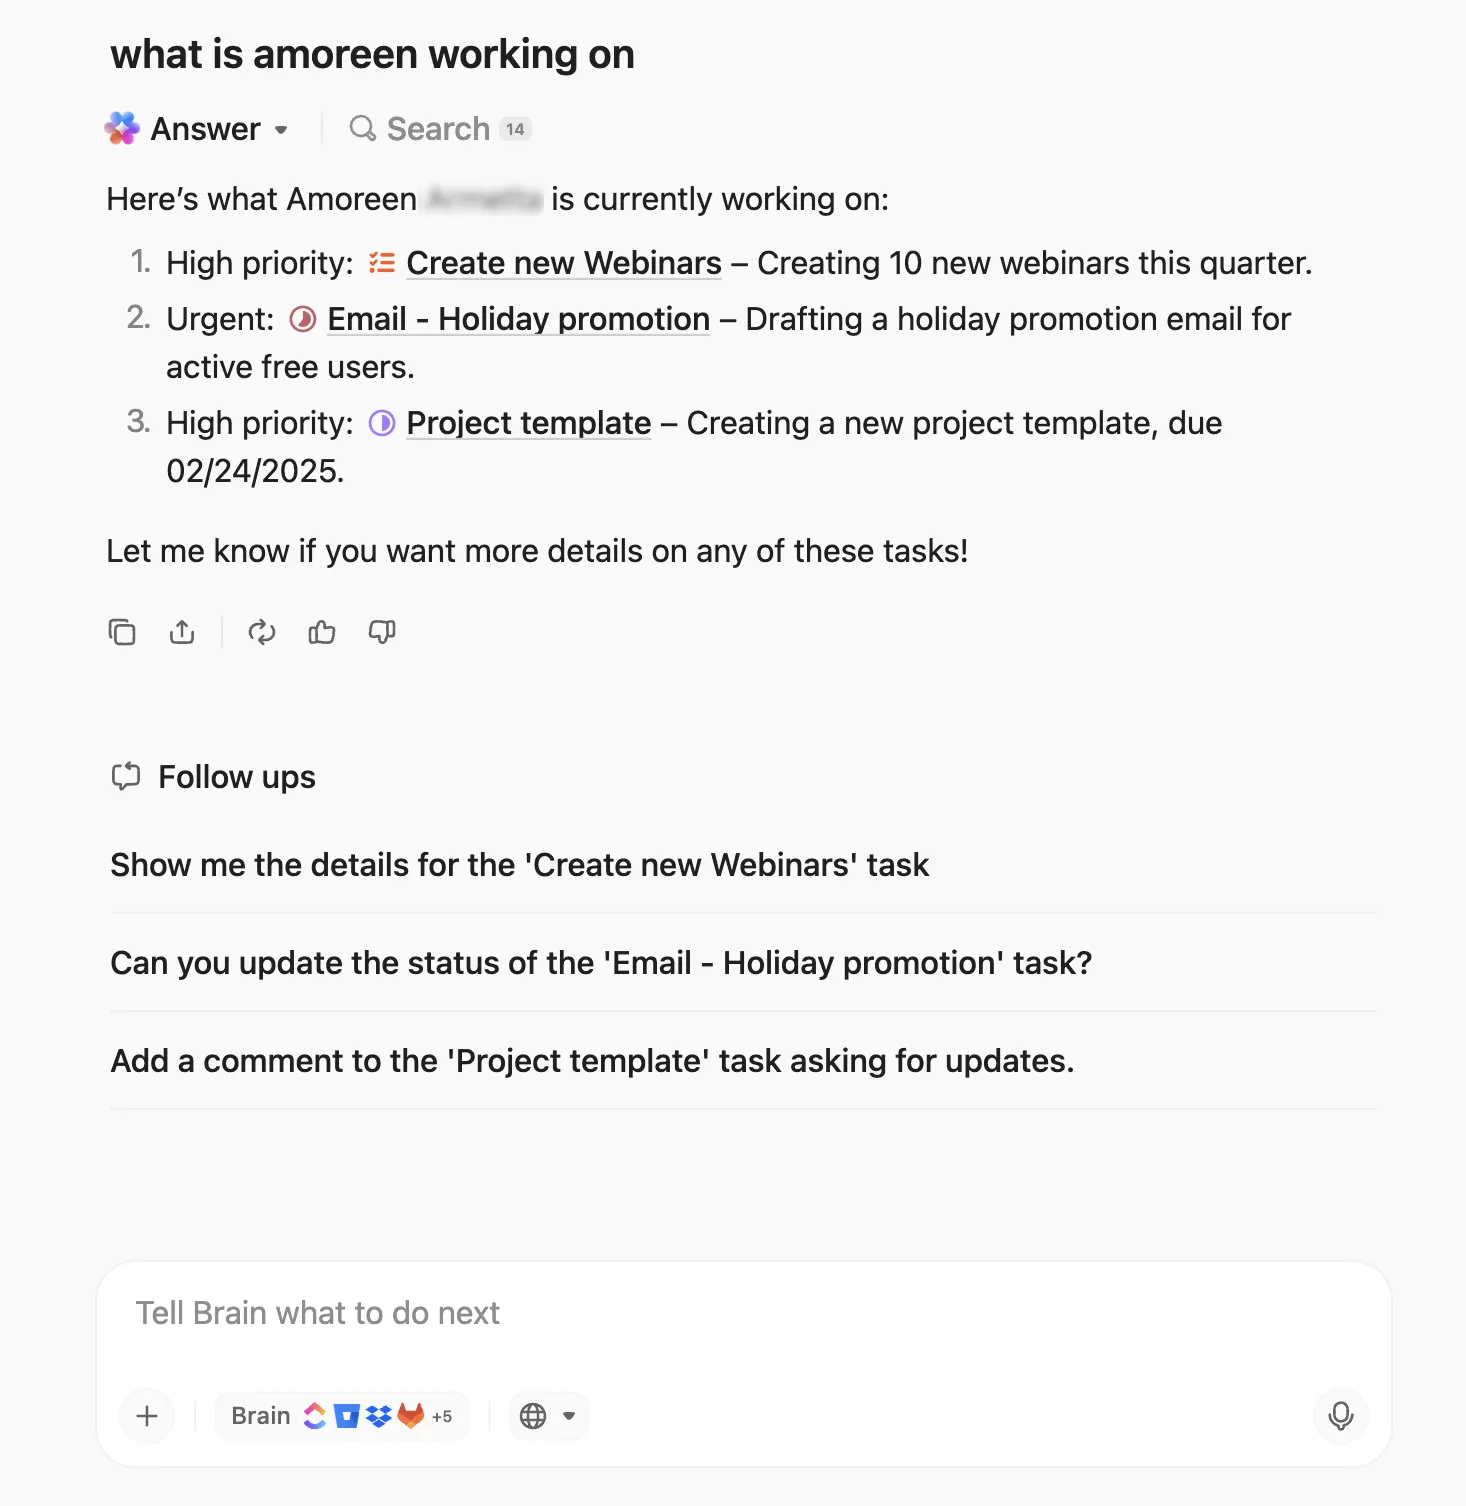
Dzięki Enterprise Search i Connected Apps możesz błyskawicznie pobierać informacje z obszaru roboczego ClickUp, Slacka, Google Drive, GitHub i innych serwisów. Podczas rozmów na żywo dotyczących incydentów funkcja Talk-to-Text w ClickUp pozwala dyktować notatki dotyczące eskalacji lub instrukcje bez użycia rąk, dzięki czemu nic nie zostanie pominięte.
Możesz również ujednolicić powtarzalne zadania za pomocą niestandardowych podpowiedzi AI i zapisanych podpowiedzi, np.: „Podsumuj wszystkie nierozwiązane incydenty i zaproponuj działania eskalacyjne”.
Najlepsze funkcje ClickUp
- Nadaj priorytet krytycznym problemom: Skorzystaj z funkcji priorytetów zadań ClickUp, aby wyróżnić pilne lub mające duże znaczenie eskalacje
- Organizuj złożone sekwencje eskalacji: Skonfiguruj zależności zadań ClickUp, aby połączyć ze sobą powiązane zadania (np. „Oczekuje na” lub „Blokuje”), dzięki czemu kroki eskalacji pozwolą uniknąć przedwczesnych działań lub wąskich gardeł
- Podziel incydenty na konkretne elementy: Podziel procesy eskalacji na szczegółowe elementy i przydziel je poszczególnym zespołom za pomocą zagnieżdżonych podzadań
- Dokładnie śledź szybkość rozwiązywania problemów: Rejestruj i monitoruj, ile czasu zajmuje potwierdzenie i rozwiązanie zadań związanych z eskalacją, korzystając z funkcji śledzenia czasu pracy w projektach w ClickUp.
Limity ClickUp
- Przy tak dużej liczbie funkcji, widoków i opcji dostosowywania zespoły często muszą przejść proces nauki, zanim wszystko stanie się dla nich intuicyjne
Ceny ClickUp
[Tabela cen]
Oceny i recenzje ClickUp
- G2: 4,7/5 (ponad 10 300 recenzji)
- Capterra: 4,6/5 (ponad 4 400 recenzji)
Co mówią o ClickUp prawdziwi użytkownicy?
Ta recenzja naprawdę mówi wszystko:
ClickUp gromadzi wszystkie moje zadania, projekty i komunikację w jednym miejscu, co sprawia, że utrzymanie porządku jest niezwykle łatwe. Bardzo podoba mi się to, jak wszystko da się dostosować — od widoków i cykli pracy po pulpity — dzięki czemu mogę zorganizować swój obszar roboczy dokładnie tak, jak mi odpowiada. Ogromną zaletą jest możliwość współpracy w czasie rzeczywistym, przydzielania zadań i śledzenia postępów bez konieczności przełączania się między narzędziami.
ClickUp gromadzi wszystkie moje zadania, projekty i komunikację w jednym miejscu, co sprawia, że utrzymanie porządku jest niezwykle łatwe. Bardzo podoba mi się to, jak wszystko da się dostosować — od widoków i cykli pracy po pulpity nawigacyjne — dzięki czemu mogę zorganizować swoją przestrzeń roboczą dokładnie tak, jak mi odpowiada. Ogromną zaletą jest możliwość współpracy w czasie rzeczywistym, przydzielania zadań i śledzenia postępów bez konieczności przełączania się między narzędziami.
📮 ClickUp Insight: 21% osób twierdzi, że ponad 80% swojego dnia pracy poświęca na powtarzalne zadania. Kolejne 20% twierdzi, że powtarzalne zadania zajmują im co najmniej 40% dnia.
To prawie połowa tygodnia pracy (41%) poświęcona na zadania, które nie wymagają zbytniego myślenia strategicznego ani kreatywności (takie jak e-maile z przypomnieniem 👀).
Superagenci ClickUp pomagają wyeliminować tę żmudną pracę. Pomyśl o tworzeniu zadań, przypomnieniach, aktualizacjach, notatkach ze spotkań, redagowaniu e-maili, a nawet tworzeniu kompleksowych cykli pracy! Wszystko to (i wiele więcej) można zautomatyzować w mgnieniu oka dzięki ClickUp – aplikacji, która zaspokaja wszystkie Twoje potrzeby związane z pracą.
💫 Rzeczywiste wyniki: Firma Lulu Press oszczędza 1 godzinę dziennie na każdego pracownika dzięki automatyzacjom ClickUp — co przekłada się na 12-procentowy wzrost wydajności pracy.
2. PagerDuty (najlepsze rozwiązanie do powiadamiania w czasie rzeczywistym i inteligentnego reagowania na wezwania)
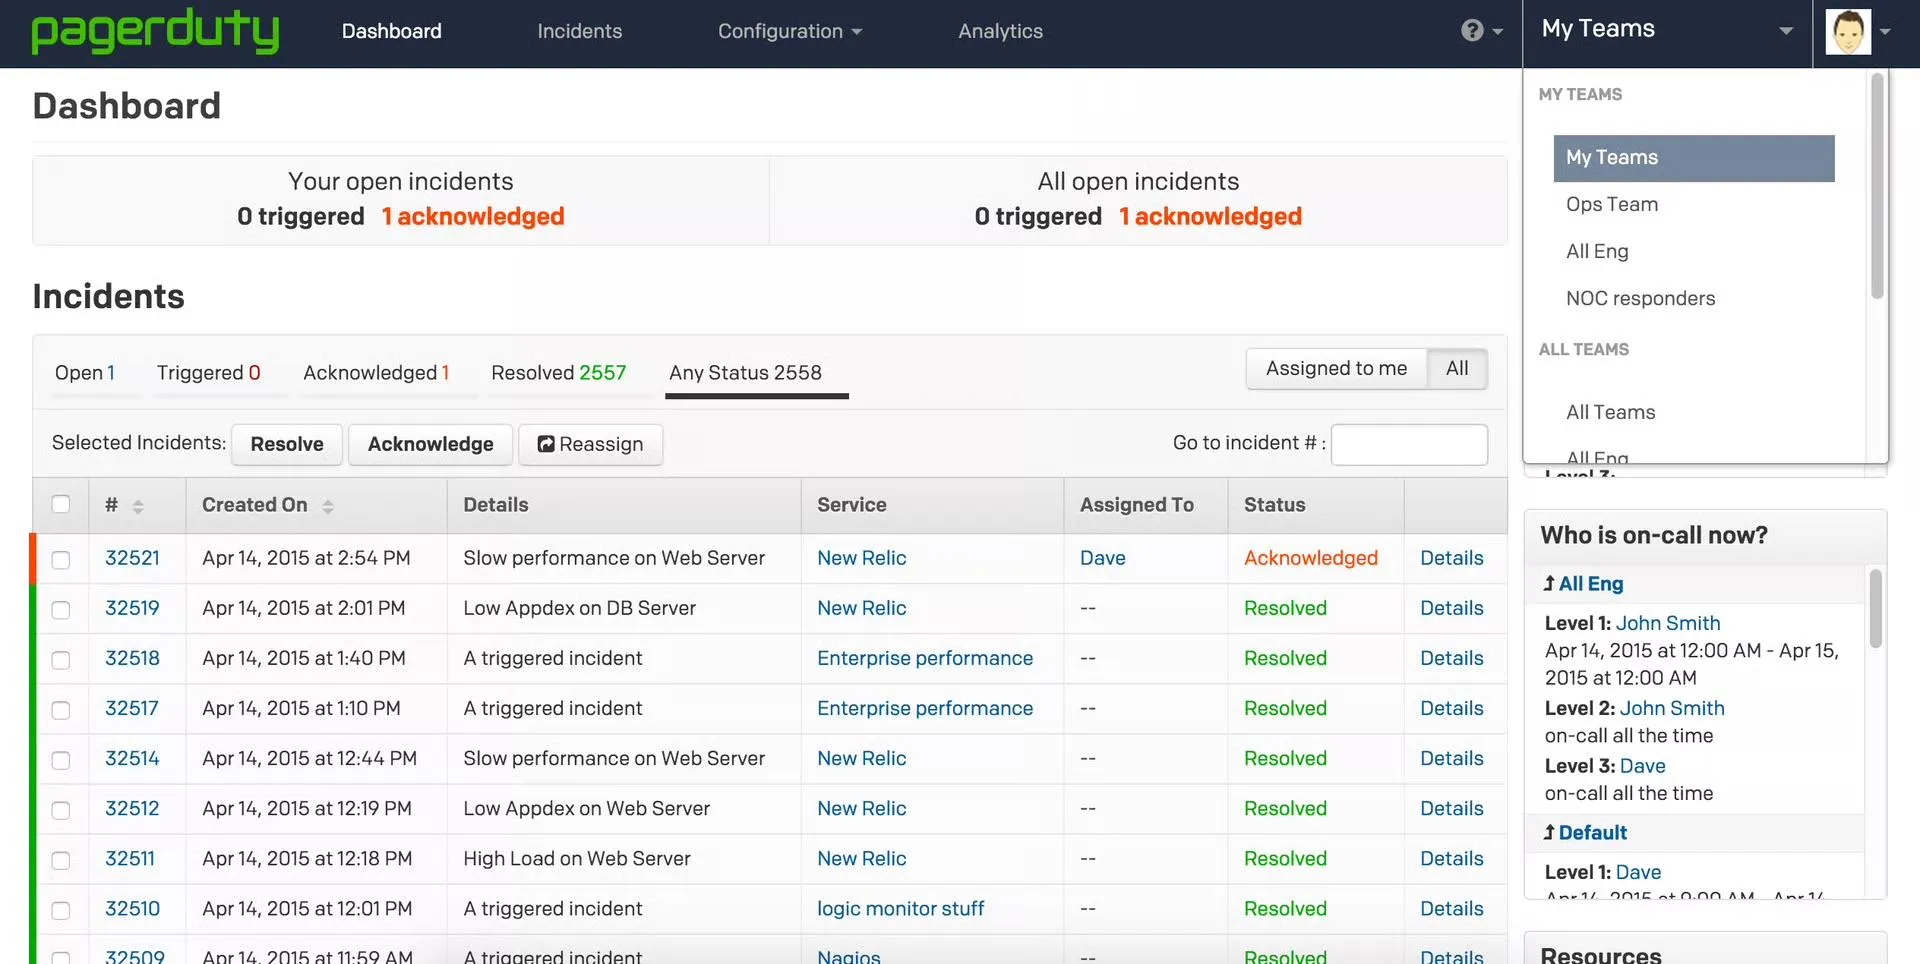
PagerDuty to oparta na chmurze platforma do zarządzania incydentami IT i operacjami cyfrowymi, która pomaga zespołom szybko wykrywać, reagować na i rozwiązywać krytyczne incydenty, takie jak awarie czy zagrożenia bezpieczeństwa. Zapewnia ona liderom zespołów SRE, DevOps i wsparcia technicznego jasną ścieżkę od sygnału do rozwiązania, wspieraną przez automatyzację, klasyfikację opartą na AI oraz głęboko zintegrowane cykle pracy.
Funkcje takie jak Jeli Incident Analysis, PagerDuty Analytics oraz Runbook Automatyzacja pomagają zespołom skrócić przestoje, wyeliminować rutynowe zadania i wyciągać wnioski z każdego incydentu.
Najlepsze funkcje PagerDuty
- Zautomatyzuj kierowanie zgłoszeń dzięki wbudowanemu modułowi zarządzania dyżurami oraz dynamicznym zasadom eskalacji
- Przyspiesz proces klasyfikacji zdarzeń dzięki AIOps, które filtruje zbędne alerty, koreluje zdarzenia i wyróżnia istotne sygnały
- Zapewnij spójność działań wewnętrznych i zewnętrznych interesariuszy dzięki komunikacji z interesariuszami, szablonom aktualizacji statusu oraz stronom statusu
- Ujednolicaj swój zestaw narzędzi dzięki ponad 700 integracjom i rozszerzalnym interfejsom API, wykorzystując systemy monitorowania, rejestrowania, CI/CD oraz wsparcia technicznego
Limity PagerDuty
- Duża liczba alertów w przypadku braku odpowiedniego dostrojenia integracji i inteligentnych progów, co prowadzi do nadmiaru informacji i zmęczenia
- W okresach wzmożonego ruchu mogą pojawiać się zduplikowane lub powtarzające się alerty, co utrudnia ich potwierdzanie w warunkach presji
Ceny PagerDuty
- Free
- Wersja Professional: 25 USD miesięcznie za użytkownika
- Business: 49 USD miesięcznie za użytkownika
- Enterprise: niestandardowe ceny
Oceny i recenzje serwisu PagerDuty
- G2: 4,5/5 (ponad 900 recenzji)
- Capterra: 4,6/5 (ponad 200 recenzji)
Co mówią o PagerDuty prawdziwi użytkownicy?
Jak powiedział jeden z użytkowników:
PagerDuty sprawia, że powiadomienia o incydentach są szybkie i niezawodne. Wysyła odpowiednie powiadomienia we właściwym czasie i pomaga naszemu zespołowi zachować porządek. […] PagerDuty może czasami wydawać się zbyt „hałaśliwy”, gdy powiadomienia nie są odpowiednio filtrowane. Niektóre ustawienia są nieco skomplikowane dla nowych użytkowników.
PagerDuty sprawia, że powiadomienia o incydentach są szybkie i niezawodne. Wysyła odpowiednie powiadomienia we właściwym czasie i pomaga naszemu zespołowi zachować porządek. […] PagerDuty może czasami wydawać się zbyt „hałaśliwy”, gdy powiadomienia nie są odpowiednio filtrowane. Niektóre ustawienia są nieco skomplikowane dla nowych użytkowników.
💡 Wskazówka dla profesjonalistów: Zdefiniuj wyjątki, nawet w przypadku jasno określonej ścieżki eskalacji. Niech krytyczne awarie, alerty bezpieczeństwa lub incydenty w środowiskach podlegających regulacjom trafiały bezpośrednio do osób z wyższego szczebla lub wyspecjalizowanych specjalistów ds. reagowania.
3. GLPi (Najlepsze rozwiązanie do kompleksowego zarządzania zasobami i operacji serwisowych zgodnych z ITIL)
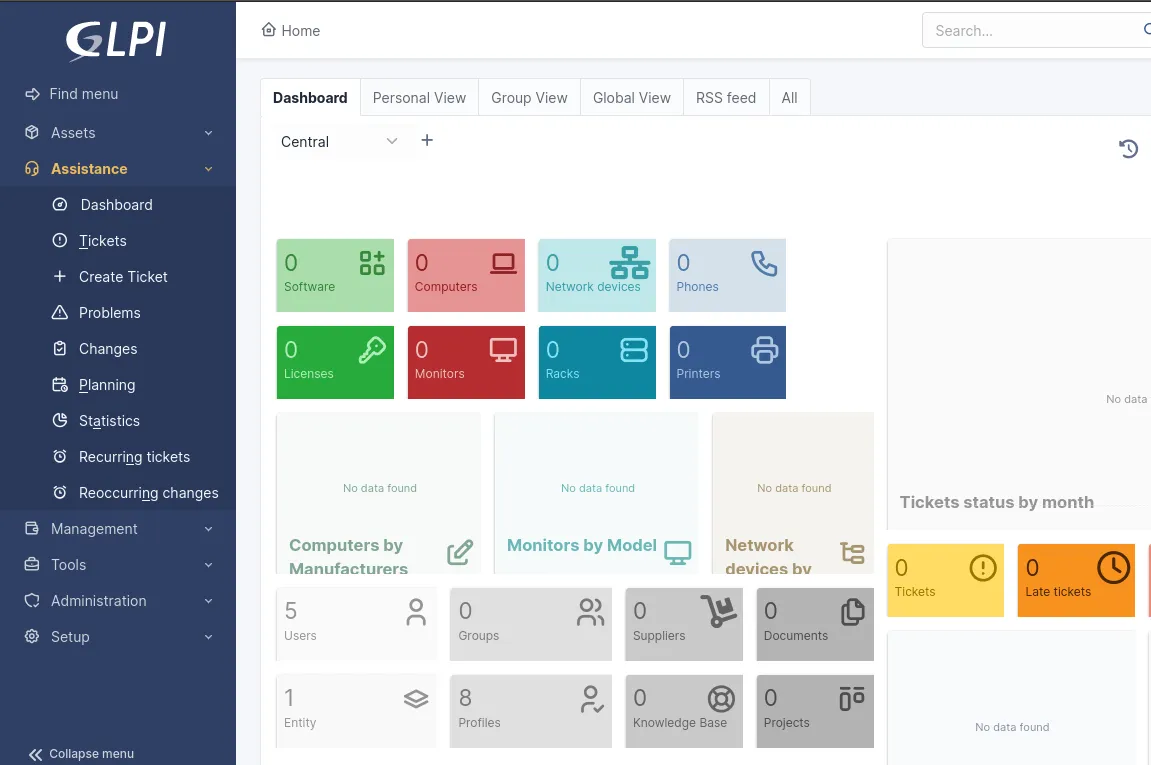
Gestionnaire Libre de Parc Informatique (GLPi) to kompleksowa platforma typu open source do zarządzania usługami IT (ITSM) i zasobami IT (ITAM). Teams zyskują kompleksową widoczność w swojej infrastrukturze (sprzęt, oprogramowanie, licencje i urządzenia sieciowe) oraz mogą zarządzać incydentami, zgłoszeniami serwisowymi i zmianami przy użyciu procesów zgodnych z ITIL.
Wszystkie umowy i dokumenty, w tym gwarancje i umowy serwisowe, są uporządkowane, co zapobiega ich zagubieniu w różnych systemach. Jeśli zarządzasz centrami danych, GLPi pozwala nawet na wizualizację układów, przebiegu okablowania i zużycia energii, dzięki czemu zawsze wiesz, co dzieje się „za kulisami”.
Najlepsze funkcje GLPi
- Skorzystaj z wtyczek GLPI Inventory, OCS Inventory lub FusionInventory, aby automatycznie wykrywać i katalogować nowe zasoby IT
- Zautomatyzuj powtarzające się zadania, przydzielanie zgłoszeń, powiadomienia i cykliczne zdarzenia, aby ograniczyć nakład pracy ręcznej
- Stwórz bazę wiedzy zawierającą często zadawane pytania, dokumentację i artykuły połączone ze zgłoszeniami, która posłuży zarówno do samoobsługi, jak i wsparcia technicznego
- Połącz się z usługami Azure/Entra, Centreon, Google, OAuth2 i webhookami, aby synchronizować dane, uruchamiać cykle pracy i ulepszać bazę danych CMDB
Limity GLPi
- Zgodność wtyczek może ulec pogorszeniu między wersjami, powodując dodatkowe obciążenie związane z konserwacją
- Funkcje raportowania, analizy i eksportu wydają się mieć limit i wymagają ulepszeń
Ceny GLPi
- Niestandardowa wycena
Oceny i recenzje GLPi
- G2: 4,6/5 (ponad 30 recenzji)
- Capterra: 4,5/5 (ponad 40 recenzji)
Co mówią o GLPi prawdziwi użytkownicy?
Oto, co powiedział jeden z użytkowników:
Bardzo elastyczny system zarządzania zasobami IT i zgłoszeniami serwisowymi typu open source, wspierany przez dużą społeczność. Interfejs użytkownika jest nieco skomplikowany dla początkujących. Wtyczki nie zawsze są w stanie uzyskać wsparcie przy przejściu ze starszych wersji na nowsze.
Bardzo elastyczny system zarządzania zasobami IT i zgłoszeniami serwisowymi typu open source, wspierany przez dużą społeczność użytkowników. Interfejs użytkownika może wydawać się nieco skomplikowany dla początkujących. Wtyczki nie zawsze są objęte wsparciem przy przejściu ze starszych wersji na nowsze.
4. Splunk On-Call (najlepsze rozwiązanie do kierowania alertów monitorujących bezpośrednio do inżynierów)
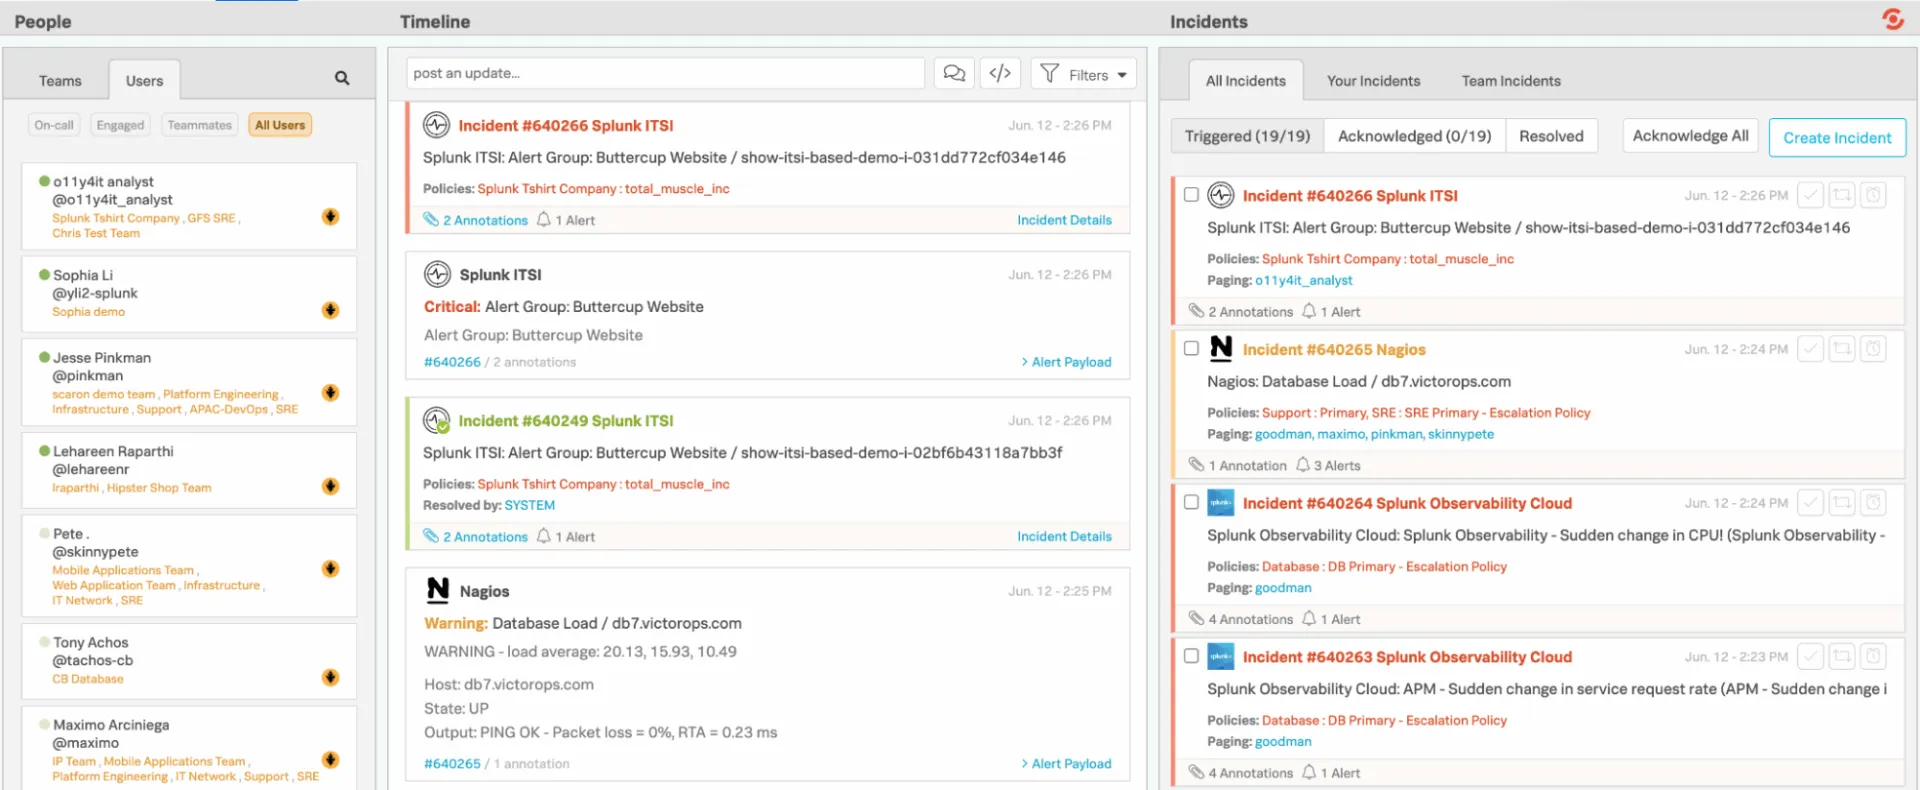
Splunk On-Call zapewnia zespołom inżynierów i dyżurnym szybszy i bardziej przejrzysty sposób zarządzania incydentami, eliminując konieczność stosowania powolnych, tradycyjnych cykli pracy zgłaszania problemów. Zamiast kierować alerty do ogólnej kolejki, rozwiązanie to integruje się bezpośrednio ze stosem narzędzi do monitorowania i obserwowalności, natychmiast kierując problemy do odpowiednich osób w oparciu o harmonogramy, reguły i kontekst.
Dzięki integracji z aplikacjami mobilnymi i komunikatorami czatu możesz z łatwością potwierdzać, przekierowywać lub rozwiązywać incydenty z dowolnego miejsca. A w tle Splunk On-Call prowadzi szczegółowy rejestr trendów, sprawdzonych wzorców i zachowań związanych z eskalacją.
Najważniejsze funkcje Splunk On-Call
- Rozszerz możliwości platformy, korzystając z ponad 1000 sprawdzonych integracji i dodatków od firmy Splunk oraz szerszej społeczności
- Twórz niestandardowe pulpity nawigacyjne i raporty wizualne, aby monitorować liczbę alertów, stan incydentów, wydajność osób reagujących oraz obciążenie pracą zespołu
- Szybko filtruj incydenty według własnej aktywności, incydentów zespołu lub Wszystkiego, co dzieje się w całej organizacji
- Przełączaj się między widokami Wyzwalane, Potwierdzone i Rozwiązane, aby sprawdzić, na jakim etapie znajduje się każde zgłoszenie
Limity usługi Splunk On-Call
- Planowanie zmian w wielu zespołach może stać się skomplikowane, jeśli zasady nie zostaną wcześniej zdefiniowane
- Ograniczona możliwość generowania szczegółowych raportów dotyczących incydentów w podziale na daty
Ceny usługi Splunk On-Call
- Niestandardowa wycena
Oceny i recenzje Splunk On-Call
- G2: 4,6/5 (ponad 40 recenzji)
- Capterra: 4,5/5 (ponad 30 recenzji)
Co mówią o Splunk On-Call prawdziwi użytkownicy?
Jeden z użytkowników podsumował to w następujący sposób:
Możliwość obsługi incydentów, eskalacji oraz przejmowania dyżurów od członków zespołu za pomocą aplikacji mobilnej jest niesamowita. […] Chciałbym mieć możliwość planowania nadpisywania harmonogramów oraz zmiany standardowego harmonogramu za pomocą aplikacji mobilnej w przypadku pilnych zmian w harmonogramie.
Możliwość obsługi incydentów, eskalacji oraz przejmowania dyżurów od członków zespołu za pomocą aplikacji mobilnej jest niesamowita. […] Chciałbym mieć możliwość planowania nadpisywania harmonogramów oraz zmiany standardowego harmonogramu za pomocą aplikacji mobilnej w przypadku pilnych zmian w harmonogramie.
🔍 Czy wiesz, że… Logika „przekierowania do właściwej osoby w przypadku niepowodzenia na pierwszym poziomie” ma swoje korzenie we wczesnych centralach telefonicznych: gdy operatorzy nie byli w stanie przeprowadzić połączenia, system przekierowywał (lub eskalował) ją do innego operatora lub centrali.
5. ServiceNow (najlepsze rozwiązanie do koordynacji działań na skalę Enterprise z wykorzystaniem automatyzacji wspomaganej AI)
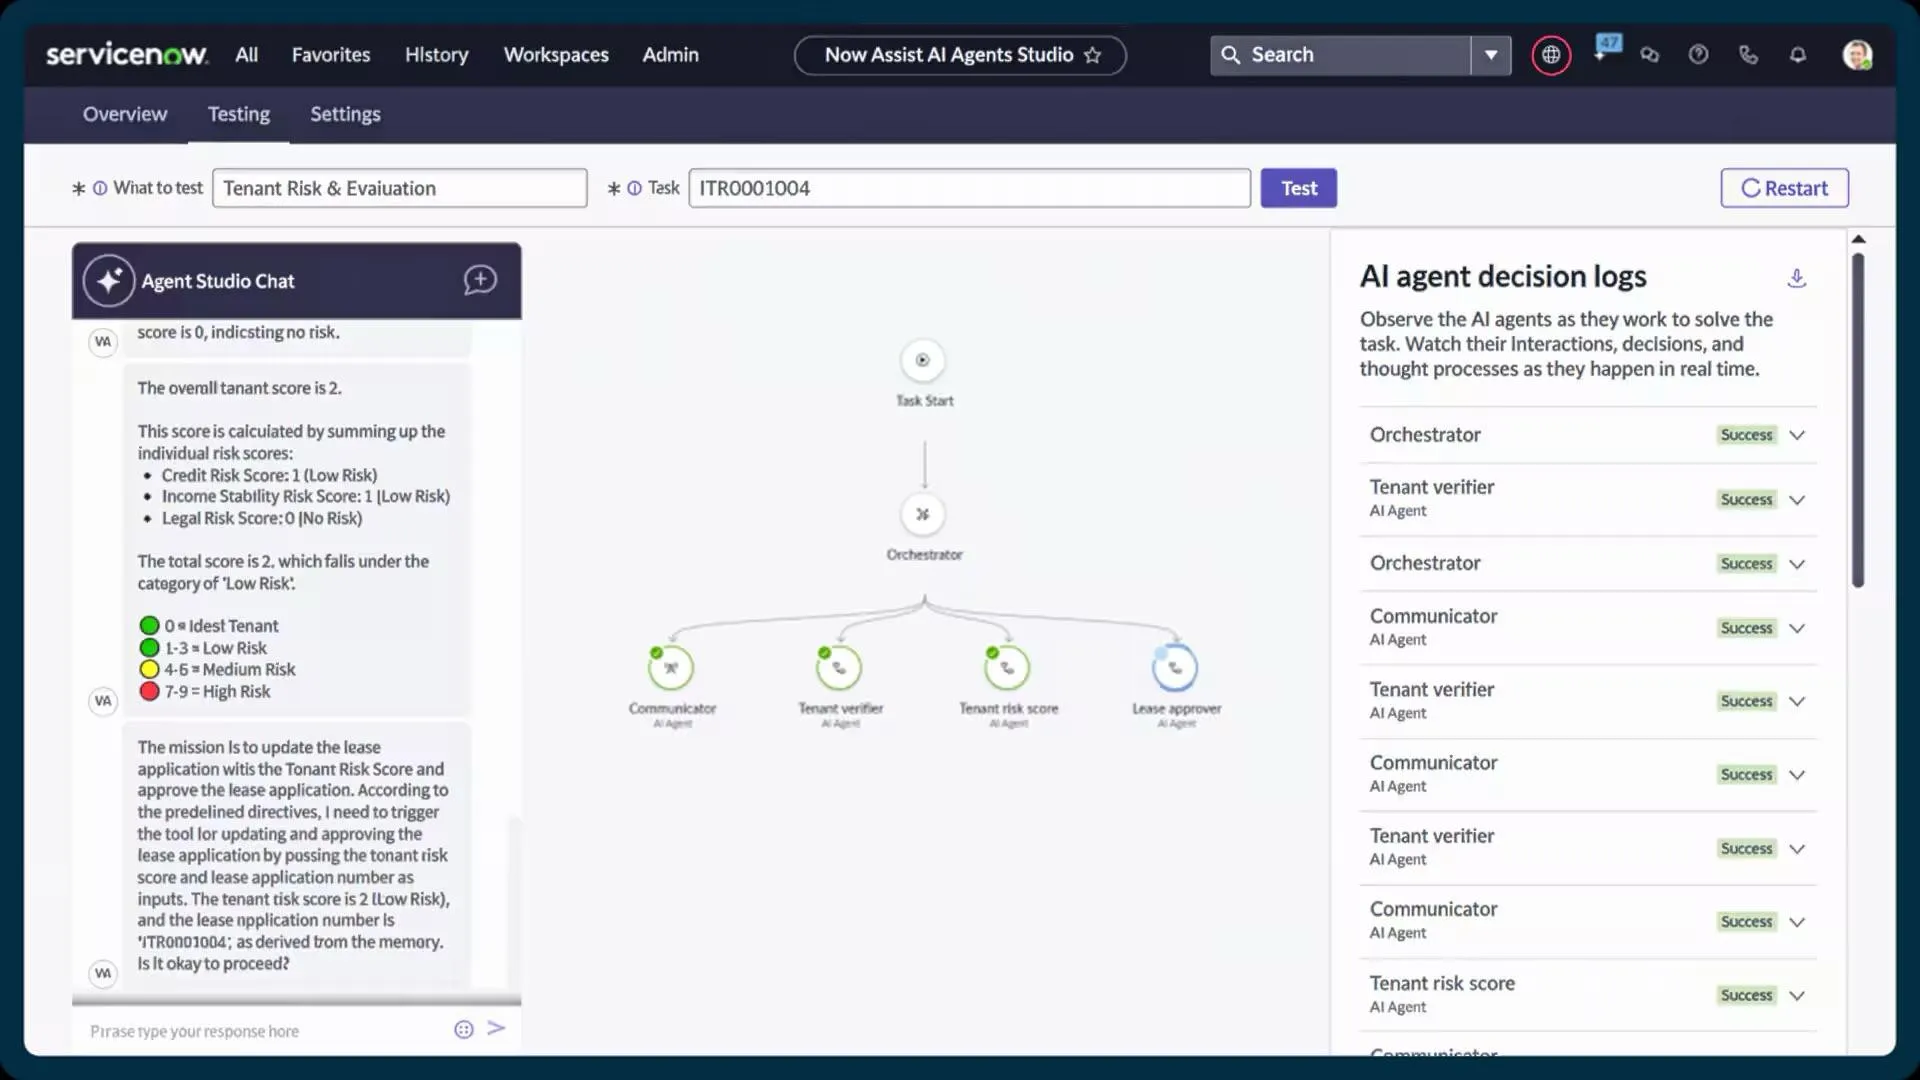
ServiceNow automatycznie klasyfikuje, nadaje priorytety i kieruje zgłoszenia w momencie ich zarejestrowania. Dzięki funkcjom takim jak Now Assist, umożliwiającym automatyczne generowanie rekomendacji dotyczących zgłoszeń oraz inteligentne tworzenie zawartości, osoby odpowiedzialne za reagowanie mogą rozwiązywać problemy szybciej i z większym zrozumieniem kontekstu.
Rozwiązanie to łączy zarządzanie incydentami, zmianami i zasobami. Dzięki temu zyskujesz w czasie rzeczywistym widok na to, jak usługi są ze sobą połączone, gdzie pojawiają się wąskie gardła oraz które komponenty mogą przyczyniać się do powtarzających się zakłóceń.
Najlepsze funkcje ServiceNow
- Przydzielaj, kieruj i monitoruj zadania terenowe za pomocą modułów Field Service Management i Dispatcher Workspace
- Zapewnij pracownikom i klientom większą swobodę działania dzięki portalowi samoobsługowemu opartemu na wyszukiwaniu opartym na AI i wirtualnych agentach
- Wykorzystaj wbudowane cykle pracy i narzędzia typu „low-code” w App Engine, aby rozszerzać lub dostosowywać procesy obsługi niestandardowe
- Zautomatyzuj powtarzalne zadania i cykle pracy w różnych zespołach dzięki Flow Designer i Automation Engine
Limity platformy ServiceNow
- Interfejs użytkownika i opcje dostosowywania wyglądu portalu wydają się przestarzałe lub ograniczające
- Duża zależność od wykwalifikowanego personelu lub konsultantów przy wdrażaniu
Ceny ServiceNow
- Niestandardowa wycena
Oceny i recenzje ServiceNow
- G2: 4,4/5 (ponad 3 300 recenzji)
- Capterra: 4,5/5 (ponad 300 recenzji)
Co mówią o ServiceNow prawdziwi użytkownicy?
Oto, jak ujął to jeden z użytkowników:
[…] Gotowe przepływy są dla mnie kolejną zaletą, ponieważ usprawniają procesy i pozwalają zaoszczędzić sporo czasu, minimalizując potrzebę wprowadzania niestandardowych konfiguracji oraz zapewniając płynniejszy i bardziej wydajny cykl pracy. […] Ponadto miałem trudności z dostosowaniem mojego niestandardowego rozwiązania do systemu zarządzania obsługą klienta, co wymagało wielu iteracji.
[…] Gotowe przepływy są dla mnie kolejną zaletą, ponieważ usprawniają procesy i pozwalają zaoszczędzić sporo czasu, minimalizując potrzebę wprowadzania niestandardowych konfiguracji oraz umożliwiając płynniejszy i bardziej wydajny cykl pracy. […] Ponadto miałem trudności z dostosowaniem mojego niestandardowego rozwiązania do systemu zarządzania obsługą klienta, co wymagało wielu iteracji.
Najlepsze praktyki i zarządzanie
Oto kilka najlepszych praktyk, które gwarantują, że automatyzacja będzie przebiegać bezbłędnie, pozwoli uniknąć zmęczenia alertami oraz będzie zgodna z oczekiwaniami biznesowymi i regulacyjnymi.
- Określ niepodlegające negocjacjom kryteria eskalacji: Powiąż wyzwalacze z mierzalnymi sygnałami, takimi jak naruszenia SLO, skoki anomalii, wpływ na poziom obsługi klienta lub wrażliwość regulacyjna
- Zapewnij jasność ról na każdym poziomie: Wykorzystaj prostą mapę RACI dla każdego poziomu eskalacji, aby w sytuacjach kryzysowych, gdy presja jest duża, obowiązki nigdy nie były niejasne.
- Wprowadź dynamiczne zarządzanie dyżurami: automatycznie dostosowuj ścieżki eskalacji w weekendy, święta, w przypadku limitów obciążenia oraz podczas przekazywania obowiązków, aby zmniejszyć wypalenie zawodowe i zapobiegać cichym powiadomieniom
- Wprowadź punkty kontroli wykonywane przez ludzi w scenariuszach wysokiego ryzyka: Nawet przy automatyzacji wymagaj ręcznego potwierdzenia incydentów związanych z ujawnieniem danych klientów, płatnościami lub cyklami pracy podlegającymi regulacjom prawnym.
- Prowadź pełne ścieżki audytu: Przechowuj niezmienne dzienniki zawierające informacje o tym, kto został powiadomiony, kiedy potwierdził otrzymanie powiadomienia, jakie automatyczne kroki zostały uruchomione oraz jakie decyzje zostały podjęte
🧠 Ciekawostka: Najstarsza znana na świecie pisemna skarga została wyryta na glinianej tabliczce około 1750 r. p.n.e. Była to w zasadzie wczesna forma eskalacji statusu projektu. Klient o imieniu Nanni napisał do kupca Ea-nāṣira, wściekły, że otrzymana miedź była gorszej jakości niż obiecano, a jego posłaniec został źle potraktowany.
Typowe wyzwania i sposoby ich pokonywania
Nawet przy jasno określonej polityce eskalacji zespoły często napotykają przeszkody operacyjne, które spowalniają reakcję na incydenty lub powodują zamieszanie.
W poniższej tabeli przedstawiono typowe wyzwania wykraczające poza podstawowe kroki ustawień oraz praktyczne strategie pozwalające je pokonać.
| Wyzwania ❌ | Rozwiązania ✅ |
| Niespójny kontekst podczas przekazywania spraw | Skorzystaj z funkcji łączenia zadań oraz szablonów zgłoszeń incydentów w ClickUp, aby zachować pełną ścieżkę audytu zawierającą szczegóły incydentów, systemy, na które miały one wpływ, oraz wcześniejsze działania na każdym poziomie eskalacji |
| Przeładowywanie osób reagujących alertami o niskim priorytecie | Wprowadź dynamiczne ustalanie priorytetów dzięki polom niestandardowym ClickUp i funkcji AI Prioritize, aby filtrować zgłoszenia na podstawie ważności, wpływu i progów SLA |
| Brak widoczności między zespołami | Skonfiguruj wspólne obszary robocze ClickUp, dodawaj komentarze i twórz wizualne tablice ClickUp, aby przedstawiać interesariuszom aktualizacje w czasie rzeczywistym |
| Opóźnienia w podejmowaniu decyzji podczas krytycznych incydentów | Zautomatyzuj powiadomienia, korzystając z funkcji Sugerowane działania w ClickUp Brain Max, aby natychmiast powiadomić odpowiednich pracowników w oparciu o rodzaj incydentu, jego priorytet oraz wzorce historyczne. |
| Trudności w śledzeniu powtarzających się problemów | Wykorzystaj niestandardowe narzędzia raportowania i szablony powtarzających się zadań w ClickUp, aby identyfikować wzorce, przyczyny źródłowe i powtarzające się incydenty, co pozwoli na proaktywne zapobieganie. |
| Rozproszona wiedza podczas eskalacji | Przechowuj scentralizowane standardowe procedury operacyjne (SOP), podręczniki postępowania i dokumentację incydentów w ClickUp Docs, łącząc je z odpowiednimi zadaniami, aby mieć do nich natychmiastowy dostęp podczas eskalacji na żywo |
| Niespójny podział obowiązków między zmianami | Skorzystaj z widoków „Obciążenie pracą” i „Oś czasu” w ClickUp, aby wizualizować przydzielone zadania i zapewnić, że podczas zmian lub przekazywania obowiązków nie dojdzie do nakładania się zadań ani luk w pracy. |
| Ręczne śledzenie zgodności i luki audytowe | Zautomatyzuj tworzenie podsumowań gotowych do audytu za pomocą ClickUp Brain, aby rejestrować wszystkie działania związane z incydentami, powiadomienia i rozwiązania |
Pomiar wpływu zautomatyzowanej eskalacji
Śledzenie skuteczności automatycznej eskalacji wymaga skupienia się na kluczowych wskaźnikach dotyczących liczby zgłoszeń, wydajności i jakości. Wskaźniki te pokazują, czy procesy eskalacji są szybsze, dokładniejsze i mniej frustrujące zarówno dla zespołów, jak i dla klientów.
Śledź następujące wskaźniki:
- Wskaźnik eskalacji (liczba problemów): Odsetek problemów eskalowanych poza pierwszy poziom. Wysokie wskaźniki mogą wskazywać na luki w początkowej klasyfikacji problemów lub w bazach wiedzy
- Wskaźnik powtarzających się eskalacji (liczba): Częstotliwość wielokrotnego eskalowania tego samego problemu. Wskazuje na niepełne rozwiązania lub utratę kontekstu
- Czas do eskalacji (wydajność): Czas trwania od wykrycia do eskalacji. Krótszy czas trwania poszczególnych etapów oznacza szybsze automatyczne rozpoznawanie krytycznych problemów
- Czas opóźnienia w przekazaniu sprawy (wydajność): Różnica między momentem eskalacji a momentem, w którym kolejny zespół rozpoczyna pracę, pozwalająca zidentyfikować utrudnienia związane z kierowaniem zgłoszeń lub powiadomieniami
- Czas rozwiązania eskalowanych zgłoszeń (wydajność): Całkowity czas od eskalacji do rozwiązania. Szybsze rozwiązanie świadczy o skuteczności automatyzacji.
- Wskaźnik satysfakcji klienta (CSAT) (jakość): Opinie dotyczące eskalowanych interakcji służące do oceny płynności przebiegu ścieżki
- Przekazywanie kontekstu (jakość): Czy agenci otrzymują pełną historię zgłoszenia, aby klienci nie musieli powtarzać informacji
- Rozwiązanie problemu przy pierwszym kontakcie (FCR) (jakość): Odsetek problemów rozwiązanych podczas jednej interakcji
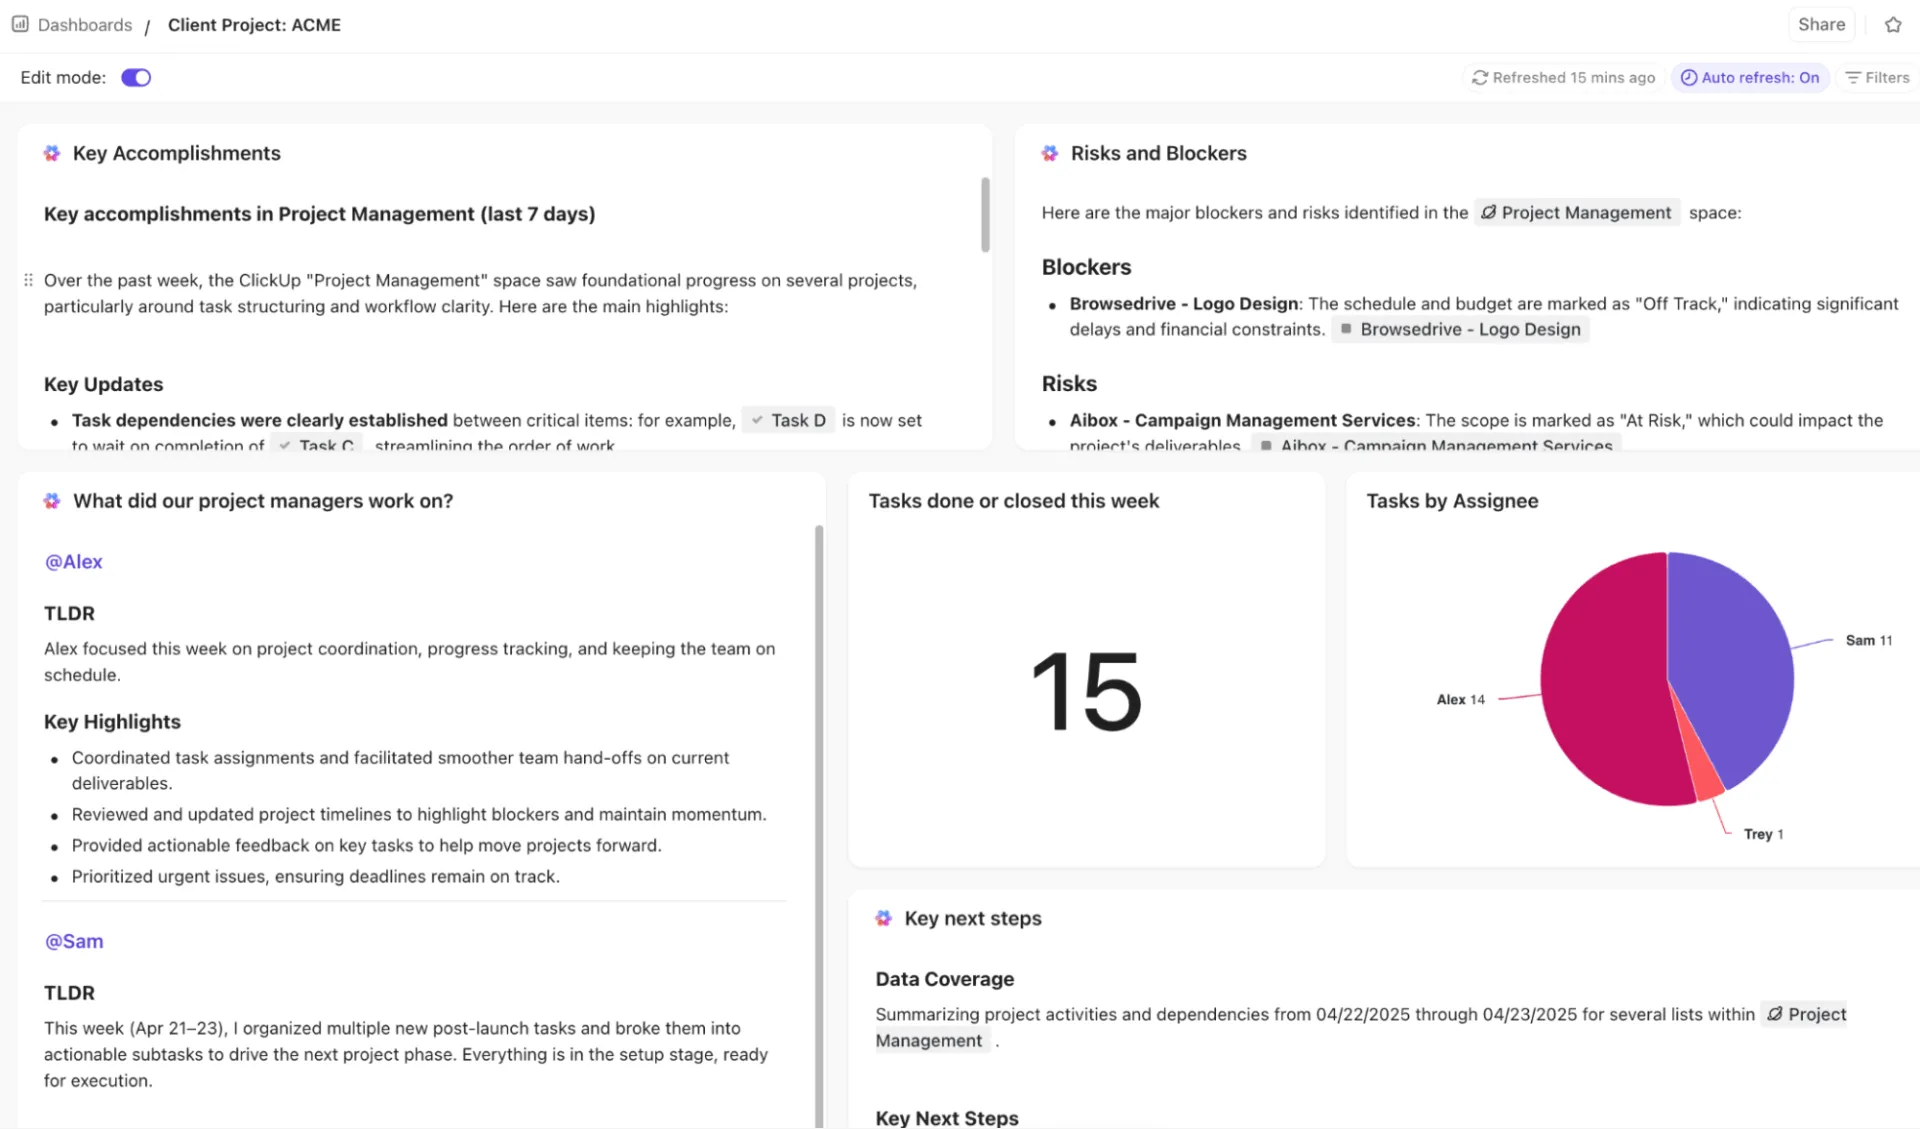
🚀 Zaleta ClickUp: Uzyskaj wizualne, oparte na AI analizy wszystkich wskaźników eskalacji w czasie rzeczywistym dzięki pulpitom nawigacyjnym ClickUp.
Możesz śledzić trendy w eskalacjach, wąskie gardła i wydajność za pomocą kart tabelarycznych, kołowych, słupkowych, liniowych, obliczeniowych oraz kart raportowania czasowego. Monitoruj wskaźnik eskalacji, powtarzające się eskalacje oraz czas do eskalacji za pomocą kart połączonych z zadaniami, polami niestandardowymi i statusami.
Aby pójść o krok dalej, skorzystaj z kart AI, takich jak AI Executive Summary, AI Project Update i AI StandUp, aby podkreślić trendy, opóźnienia i wyniki działań naprawczych.
Szybsze zarządzanie incydentami dzięki ClickUp
Wiele osób uważa, że eskalacja incydentów polega jedynie na przekazaniu zgłoszenia kolejnej osobie, ale to znacznie więcej. Jest to ustrukturyzowany system, w którym każdy krok — od wstępnej oceny po rozwiązanie — przebiega w sposób zharmonizowany.
ClickUp zapewnia idealną, zintegrowaną przestrzeń roboczą. Dzięki funkcji ClickUp automatyzacji możesz automatycznie uruchamiać alerty, kierować zadania i aktualizować statusy. Natomiast ClickUp Brain pomaga ustalać priorytety incydentów, generować podsumowania i sugerować kolejne kroki.
Agenci ClickUp AI działają jak inteligentni asystenci w Twoim obszarze roboczym, a pulpity nawigacyjne ClickUp zapewniają widok eskalacji w czasie rzeczywistym.
Zarejestruj się w ClickUp już dziś za darmo!
Najczęściej zadawane pytania (FAQ)
Czym jest ścieżka eskalacji incydentów?
Ścieżka eskalacji incydentów to z góry określona sekwencja kroków, która określa, w jaki sposób problemy są kierowane do odpowiedniego zespołu lub osoby w zależności od ich ważności, wpływu i czasu wystąpienia. Zapewnia to skuteczne rozwiązywanie incydentów oraz jasny podział odpowiedzialności. TEKST
Jak zdecydować, kiedy eskalować incydent automatycznie, a kiedy ręcznie?
Wykorzystaj automatyzację w przypadku jasno zdefiniowanych incydentów o wysokim priorytecie, spełniających wyraźne kryteria (np. przerwy w działaniu usług, naruszenia bezpieczeństwa). Ręczną eskalację zarezerwuj dla niejednoznacznych lub krytycznych sytuacji, które wymagają ludzkiej oceny lub dodatkowego kontekstu.
Jakie narzędzia zapewniają wsparcie dla automatycznej eskalacji, umożliwiając skuteczne zarządzanie incydentami?
Platformy takie jak ClickUp, PagerDuty, Jira Service Management i ServiceNow umożliwiają automatyczną automatyzację kierowania zgłoszeń, powiadomień i aktualizacji. Pomagają zespołom ograniczyć opóźnienia i utrzymać uporządkowane cykle pracy obsługi incydentów.
Jak uniknąć zmęczenia alertami podczas korzystania z automatycznej eskalacji?
Ustal jasne progi dla alertów, ustalaj priorytety według ważności i korzystaj z inteligentnych powiadomień. Limit powtarzające się powiadomienia do incydentów krytycznych i wykorzystuj pulpity nawigacyjne lub narzędzia AI do podsumowywania aktualizacji zamiast wysyłania informacji o każdej drobnej zmianie.
Jak często należy weryfikować zasady eskalacji?
Regularnie weryfikuj zasady eskalacji — co najmniej raz na kwartał lub po poważnych incydentach. Dzięki temu kryteria, zakresy odpowiedzialności i reguły automatyzacji będą odzwierciedlać aktualne cykle pracy, strukturę zespołów i priorytety biznesowe.