
Die ersten paar Dienste sind einfach. Eine Rotation, ein Kanal und dann ein Backup.
Sobald Ihr Unternehmen jedoch Dutzende von Microservices, mehrere Regionen und eine mehrschichtige Eigentümerschaft umfasst, sind manuelle Eskalationen kein Workflow mehr, sondern werden zu einer Belastung.
In diesem Leitfaden wird erläutert, wie Sie Eskalationspfade für Incidents so automatisieren können, dass sie mit Ihrer Entwicklungsorganisation mitwachsen, ohne dass dabei Lücken in Ihrem Bereitschaftssystem entstehen.
Außerdem werden wir sehen, wie sich ClickUp in die Erstellung eines Eskalationssystems einfügt, auf das sich Ihre Entwicklerteams verlassen können. 🎯
⭐ Empfohlene Vorlage
Reagieren Sie in Notfällen – von Naturkatastrophen bis hin zu Datenschutzverletzungen – schnell und effektiv mit der ClickUp-Vorlage für den Incident-Plan (IAP).
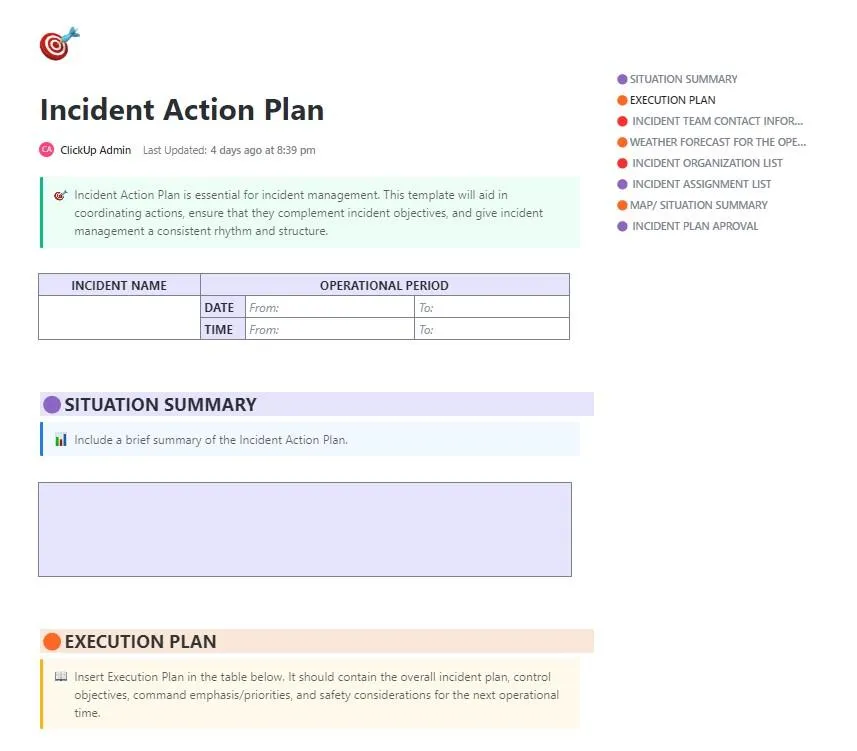
Die Vorlage enthält vordefinierte Abschnitte für folgende Zwecke:
- Legen Sie Ziele für Incidents und Prioritäten bei der Reaktion fest
- Schaffen Sie eine klare Führungsstruktur
- Koordinieren Sie Maßnahmen teamübergreifend in Echtzeit
- Erfassen Sie Entscheidungen, Zeitleisten und wichtige Aktualisierungen in Echtzeit
- Halten Sie sich über Eskalationen auf dem Laufenden und verfolgen Sie diese weiter
Und da es direkt in ClickUp integriert ist, fungiert es als dynamisches Dokument zur Vorfallsteuerung und nicht als statische Checkliste.
Warum sollten Eskalationspfade für Incidents automatisiert werden?
Wenn Ihr Team für komplexe Systeme mit strengen SLAs verantwortlich ist, verlangsamt eine manuelle Eskalation den Prozess nur. Eine automatisierte Eskalation macht Ihren Reaktionsprozess vorhersehbar und stressfrei – selbst bei Incidents unter hohem Druck.
Hier erfahren Sie, warum Sie die Eskalationspfade in Ihrem Unternehmen automatisieren sollten. 👇
Das Risiko der manuellen Eskalation
Sobald Sie es mit Dutzenden von Diensten, mehreren Bereitschaftsdiensten und ständig wechselnder Eigentümerschaft zu tun haben, werden manuell ausgeführte Schritte schnell zum Problem.
Zu den häufigsten Fallstricken gehören:
- Verpasste oder verspätete Benachrichtigungen, wenn jemand eine E-Mail, eine SMS oder einen Chat-Ping übersieht
- Verwirrung bei der Übergabe, insbesondere wenn Eskalationspfade nicht klar dokumentiert sind
- Eskalation an das falsche Team, weil die Karte der Eigentümerschaft nicht aktualisiert wurde
- Engpässe, die dadurch entstehen, dass man sich auf eine einzige Person verlässt, um „die Warnmeldung weiterzuleiten“
📖 Lesen Sie auch: So verfassen Sie einen Incident-Bericht
Vorteile der Automatisierung
Die ITSM-Automatisierung verleiht Ihren Eskalationspfaden Struktur und Dynamik. Anstatt darauf zu hoffen, dass jemand die Warnmeldung sieht, führt Ihr System sofort und konsistent eine vordefinierte Abfolge von Schritten aus.
Folgende Vorteile ergeben sich für Teams, wenn sie Aufgaben mithilfe von KI für die Automatisierung nutzen:
- Schnellere Reaktionszeiten, da Warnmeldungen innerhalb von Sekunden die richtige Person oder das richtige Team erreichen
- Konsequente Umsetzung der Eskalationsschritte, selbst um 3 Uhr morgens, wenn die Entscheidungsfindung langsamer verläuft
- Integrierte Redundanz, die sicherstellt, dass Backup-Kräfte benachrichtigt werden, falls der primäre Bereitschaftsdienst die Benachrichtigung verpasst
- Klare Sichtbarkeit über alle Teams hinweg, da jeder versteht, wie Eskalationen ablaufen
- Weniger „Feuerwehreinsätze“ und besser planbare Bereitschaftsdienste
📖 Lesen Sie auch: Beispiele für Geschäftskontinuitätspläne
Verringerung von Alarmmüdigkeit und menschlichen Fehlern
Alarmüberflutung beeinträchtigt die Effektivität des Bereitschaftsdienstes. Wenn Ihr Team zu oft oder aus den falschen Gründen benachrichtigt wird, reagiert es nicht mehr mit der nötigen Dringlichkeit. Durch Automatisierung lassen sich Benachrichtigungen filtern, sodass nur noch diejenigen eskaliert werden, die wirklich menschliche Aufmerksamkeit erfordern.
Mit automatisierter Eskalationslogik:
- Alarme mit geringer Priorität oder doppelte Alarme werden unterdrückt, bevor sie den Bereitschaftsdienst erreichen
- Schweregradbasierte Regeln stellen sicher, dass kleinere Probleme niemanden unnötig aus dem Schlaf reißen.
- Warnmeldungen werden nur dann eskaliert, wenn das System innerhalb eines festgelegten Zeitraums keine Reaktion feststellt.
- Teams verbringen weniger Zeit damit, unwichtige Meldungen auszusortieren, und mehr Zeit damit, echte Probleme zu lösen.
Unterstützung bei der Einhaltung von SLAs und Bereitschaftsrichtlinien
Durch Automatisierung der Eskalation lässt sich die Einhaltung von Vorschriften leichter gewährleisten, ohne dass eine ständige manuelle Überwachung erforderlich ist. Für IT-Leiter, die strenge SLAs oder interne Zuverlässigkeitsverpflichtungen verwalten, dient KI als Leitplanke, die das erwartete Verhalten sicherstellt. Sie hilft Ihnen dabei:
- Stellen Sie sicher, dass Benachrichtigungen zu Incidents vordefinierten Regeln für die Weiterleitung folgen
- Halten Sie SLA-Reaktionszeitleisten automatisch ein – mit zeitgesteuerten Eskalationen
- Setzen Sie Bereitschaftspläne durch, ohne sich auf veraltete Tabellenkalkulationen verlassen zu müssen
- Erstellen Sie Prüfpfade für jede Warnmeldung, Eskalation und Bestätigung
🎥 Möchten Sie Ihren gesamten Eskalations-Workflow vollautomatisch abwickeln? Super Agents sind für Sie da . 👇🏼
🔍 Wussten Sie schon? Die Missionskontrolle der NASA basiert im Wesentlichen auf einer automatisierten Eskalationslogik. Wenn Telemetriedaten außerhalb des zulässigen Bereichs liegen, leitet das System sofort automatisierte Warnmeldungen an die jeweiligen Spezialisten weiter.
Was ist eine Eskalationsrichtlinie im Incident-Management?
Eine Eskalationsrichtlinie ist ein vordefinierter Regelkatalog, der festlegt, wer benachrichtigt wird, wann die Benachrichtigung erfolgt und wie die Verantwortung nach oben oder zwischen Teams weitergegeben wird.
Stellen Sie sich dies als einen strukturierten Fahrplan vor, der verhindert, dass Incidents ins Stocken geraten, sicherstellt, dass die richtigen Experten zum richtigen Zeitpunkt eingreifen, und den Teams hilft, SLAs einzuhalten.
Eine gut strukturierte Richtlinie zum Eskalationsmanagement umfasst in der Regel:
- Regelbasiertes Routing, das festlegt, wer als Nächstes an der Reihe ist, wenn jemand den Incident nicht bestätigt oder nicht beheben kann
- Zeitgesteuerte Auslöser, die je nach Schweregrad nach 5, 15 oder 30 Minuten automatisch eine Eskalation auslösen
- Benachrichtigungsmethoden wie Telefonanrufe, SMS, Chatten oder E-Mail
- Pläne zur Eskalation: Stufe 1 (primärer Bereitschaftsdienst) > Stufe 2 (erfahrene Ingenieure/Fachexperten) > Stufe 3 (Führungskräfte)
- Anforderungen an die Dokumentation, damit neue Einsatzkräfte die Arbeit übernehmen können, ohne wichtige Zusammenhänge aus den Augen zu verlieren
📖 Lesen Sie auch: So priorisieren Sie Aufgaben als P0, P1, P2, P3 und P4
Arten von Eskalationsrichtlinien
Hier sind die wichtigsten Arten von Richtlinien, die Ihr Team kennen sollte:
1. Hierarchische Eskalation (vertikal)
Warnmeldungen werden in der Befehlskette nach oben weitergeleitet – von Nachwuchskräften über erfahrene Spezialisten bis hin zur Führungsebene. Nutzen Sie diese Vorgehensweise, wenn die Situation tieferes Fachwissen, Entscheidungsbefugnis oder Sichtbarkeit der Geschäftsleitung erfordert.
2. Funktionale Eskalation (horizontal)
Anstatt nach oben weitergeleitet zu werden, wird die Warnmeldung quer durch die Teams an diejenige Funktion weitergeleitet, die für das betroffene System zuständig ist. Dies ist ideal für Incidents, die mit einem bestimmten Bereich zusammenhängen, wie beispielsweise Datenbanken, Netzwerke, Zahlungen oder APIs.
3. Zeitbasierte Eskalation
Dies ist das Rückgrat der meisten automatisierten Systeme. Bei diesem Modell wird die Warnmeldung nach Ablauf einer bestimmten Zeitspanne an die nächste Ebene weitergeleitet, wobei diese Zeitspanne häufig direkt an SLAs gekoppelt ist. Dies ist besonders wichtig, wenn Sie auch außerhalb der Geschäftszeiten eine garantierte Reaktionsfähigkeit benötigen.
4. Auswirkungsbasierte Eskalation
Eine auswirkungsbasierte Eskalation richtet sich nach dem Schweregrad oder den geschäftlichen Auswirkungen, nicht nach der Hierarchie oder der Zeit. Sie eignet sich für Ausfälle, Zahlungsfehler, kundenbezogene Probleme oder Sicherheitsverletzungen.
5. Parallele Eskalation
Hier werden mehrere Personen oder Teams gleichzeitig benachrichtigt. Die parallele Eskalation wird bei Problemen mit hohem Schweregrad eingesetzt, die das Fachwissen mehrerer Bereiche erfordern, oder in Situationen, in denen jegliche Verzögerung inakzeptabel ist.
🔍 Wussten Sie schon? Eine aktuelle Studie zu Alarmsignalen hat ergeben, dass extrem auffällige oder „laute/helle “ Alarme die Reaktionszeiten verlangsamen können, insbesondere wenn der Alarm unerwartet auftritt. Sobald der Alarmtyp jedoch erwartet wird (d. h. Teil eines vorab festgelegten Eskalations-/Benachrichtigungssystems ist), verbessern sich die Reaktionszeiten. Dies legt nahe, dass Sie bei der Automatisierung von Eskalationspfaden die Mitarbeiter nicht einfach mit Alarmen hoher Priorität überfluten sollten.
Wann sollte der Auslöser für eine automatische Eskalation ausgelöst werden?
Nachdem Sie nun wissen, wie Eskalationspfade aufgebaut sind, besteht der nächste Schritt darin, zu entscheiden, wann diese Regeln automatisch ausgeführt werden sollen.
Im Folgenden finden Sie die wichtigsten Situationen, die die Auslöser für eine automatische Eskalation sind und die Logik hinter Ihren Richtlinien bilden. 💁
Schweregradbasierte Eskalation
Die automatische Eskalation wird ausgelöst, sobald der Schweregrad oder die Auswirkungen des Incidents einen bestimmten Schwellenwert überschreiten. Incidents mit hohem Schweregrad erfordern sofortige Aufmerksamkeit durch Führungskräfte, und durch die automatische Eskalation werden Engpässe umgangen und Experten innerhalb von Sekunden informiert.
📌 Beispiel: Ein vollständiger Dienstausfall, ein Ausfall des Systems für Zahlungen oder eine erhebliche Leistungsminderung, von der viele Benutzer oder Kernsysteme betroffen sind, erfordert eine automatische Eskalation.
Zeitbasierte Eskalation
Wenn niemand den Incident innerhalb eines festgelegten Zeitfensters bestätigt oder behebt, wird die Warnmeldung automatisch an die nächste Ebene eskaliert. Dadurch wird verhindert, dass Tickets liegen bleiben, insbesondere außerhalb der normalen Arbeitszeiten oder wenn der Erstbearbeiter nicht erreichbar oder überlastet ist.
📌 Beispiel: Nach 10–15 Minuten ohne Bestätigung erfolgt eine Eskalation vom Erstbearbeiter an einen leitenden Techniker; nach weiteren 30–60 Minuten ohne Lösung wird das Problem weiter eskaliert.
Kontextbezogene Eskalation
Diese Eskalationslogik berücksichtigt die kontextbezogenen Merkmale des Incidents, wie beispielsweise den betroffenen Dienst oder das betroffene System, den Eigentümer des Dienstes, das betroffene Kundensegment (intern vs. extern, VIP vs. regulär) oder den Funktionsbereich (Datenbank, Netzwerk, Integration). Auf Grundlage dieses Kontexts werden Warnmeldungen an den am besten geeigneten Ansprechpartner oder das am besten geeignete Team weitergeleitet.
So vermeiden Sie eine Überlastung der Teams durch irrelevante Incidents, verkürzen die Reaktionszeit und stellen sicher, dass Probleme von Spezialisten aus dem jeweiligen Fachgebiet bearbeitet werden.
📌 Beispiele: Ein plötzlicher Anstieg der Latenz im Dienst für Zahlungen sollte direkt das Team für Zahlungen benachrichtigen, oder ein Backend-Fehler im Abrechnungs-Mikroservice sollte das Team für Abrechnungen benachrichtigen.
Metadatenbasierte Eskalation
Moderne Alarmierungs- und Incident-Management-Tools erfassen Metadaten wie die Ursprungsquelle (welches Überwachungstool oder welche Alarmregel ausgelöst wurde), die Identität des Benutzers/Kunden, den Standort, die historische Häufigkeit ähnlicher Incidents oder Beschreibungen. Dies hilft Ihnen dabei, eine detailliertere, intelligentere Logik anzuwenden, anstatt sich auf pauschale Schweregrade oder zeitbasierte Regeln zu verlassen.
📌 Beispiele: Wiederkehrende Warnmeldungen aus demselben Teilsystem können auf ein tiefer liegendes, systemisches Problem hindeuten, das eine schnellere Eskalation erfordert. Oder Warnmeldungen für VIP-Kunden können zusätzliche Benachrichtigungen als Auslöser auslösen.
Kombination von Auslösern zur Erstellung intelligenterer, anpassungsfähiger Eskalationsrichtlinien
In der Praxis verlassen sich viele Teams nicht nur auf eine einzige Art von Auslöser. Stattdessen entwickeln sie hybride Eskalationsrichtlinien, die Regeln zu Schweregrad, Zeit, Kontext und Metadaten kombinieren.
Dieser mehrstufige Ansatz ermöglicht es Teams, Eskalationsrichtlinien zu erstellen, die sowohl reaktionsschnell (bei Bedarf schnell) als auch intelligent (durch Auswahl von Meldungen, um unnötige Meldungen zu minimieren) sind, was zu besseren Ergebnissen bei Incidents und einer effizienteren Ressourcenzuweisung führt.
🔍 Wussten Sie schon? Im 18. Jahrhundert hielten sich Schiffsbesatzungen in Notfällen an eine strenge Eskalationskette. Wenn ein rangniedrigerer Matrose eine Gefahr entdeckte, läutete er eine Glocke und gab die Nachricht die Hierarchie hinauf weiter, bis der Kapitän die endgültige Entscheidung traf.
So gestalten Sie effektive Eskalationspfade
Bei der Gestaltung von Eskalationspfaden geht es darum, ein System aufzubauen, das die richtigen Warnmeldungen zuverlässig und reibungslos an die richtigen Personen weiterleitet.
Hier finden Sie ein praktisches Konzept für jeden Schritt, das Sie in komplexen, verteilten Umgebungen anwenden können.
P. S. Wir werden auch untersuchen, wie bestimmte ClickUp-Features dir dabei helfen können! 🤩
Schritt 1: Definieren Sie klare Eskalationskriterien, Eskalationsstufen und Zuständigkeiten
Definieren Sie zunächst, was einen Incident ausmacht, der eine Eskalation erfordert. Dokumentieren Sie objektive Kriterien, damit jeder Techniker im Bereitschaftsdienst – egal ob ein neuer L1-Mitarbeiter oder ein erfahrener SRE – den Schweregrad eines Incidents auf die gleiche Weise einschätzt.
Dies sorgt für einen klaren Eskalations-Workflow, beseitigt Unklarheiten und stellt sicher, dass die Automatisierung nur dann greift, wenn es wirklich darauf ankommt.
Berücksichtigen Sie dabei Kriterien wie:
- Schweregradschwellenwerte: Dienstausfall, Probleme mit der Zahlung, Probleme mit der Authentifizierung, Datenbeschädigung und Warnungen zur Sicherheit
- Auswirkungen: Ausfälle mit Auswirkungen auf Kunden, interne Serviceeinbußen, API-Ausfälle bei Partnern, Compliance- oder Sicherheitsrisiken
- Geschäftskritischer Kontext: Erhebliche Auswirkungen auf Kunden, umsatzrelevante Flows, risikoreiche Systeme (z. B. Zahlungen, Rechnungsstellung)
Sobald Kriterien und Auslöser definiert sind, legen Sie fest, wer benachrichtigt wird und welche Aufgaben die jeweiligen Personen an jedem Eskalationspunkt haben.
Stufen klar definieren:
- Stufe 1 (primärer Bereitschaftsmanager für Incidents): Fungiert als Ersthelfer und ist für die Bestätigung, die erste Triage und Maßnahmen zur Schadensbegrenzung verantwortlich
- Stufe 2 (Backup/Spezialist/Fachexperte): Verfügt über fundiertes technisches Fachwissen und löst komplexe Systemprobleme
- Stufe 3 (Technikleiter/Führungskraft): Beaufsichtigt schwerwiegende Incidents, genehmigt wichtige Maßnahmen, koordiniert die teamübergreifende Kommunikation und ist der Auslöser für eine Eskalation beim Anbieter, wenn nötig.
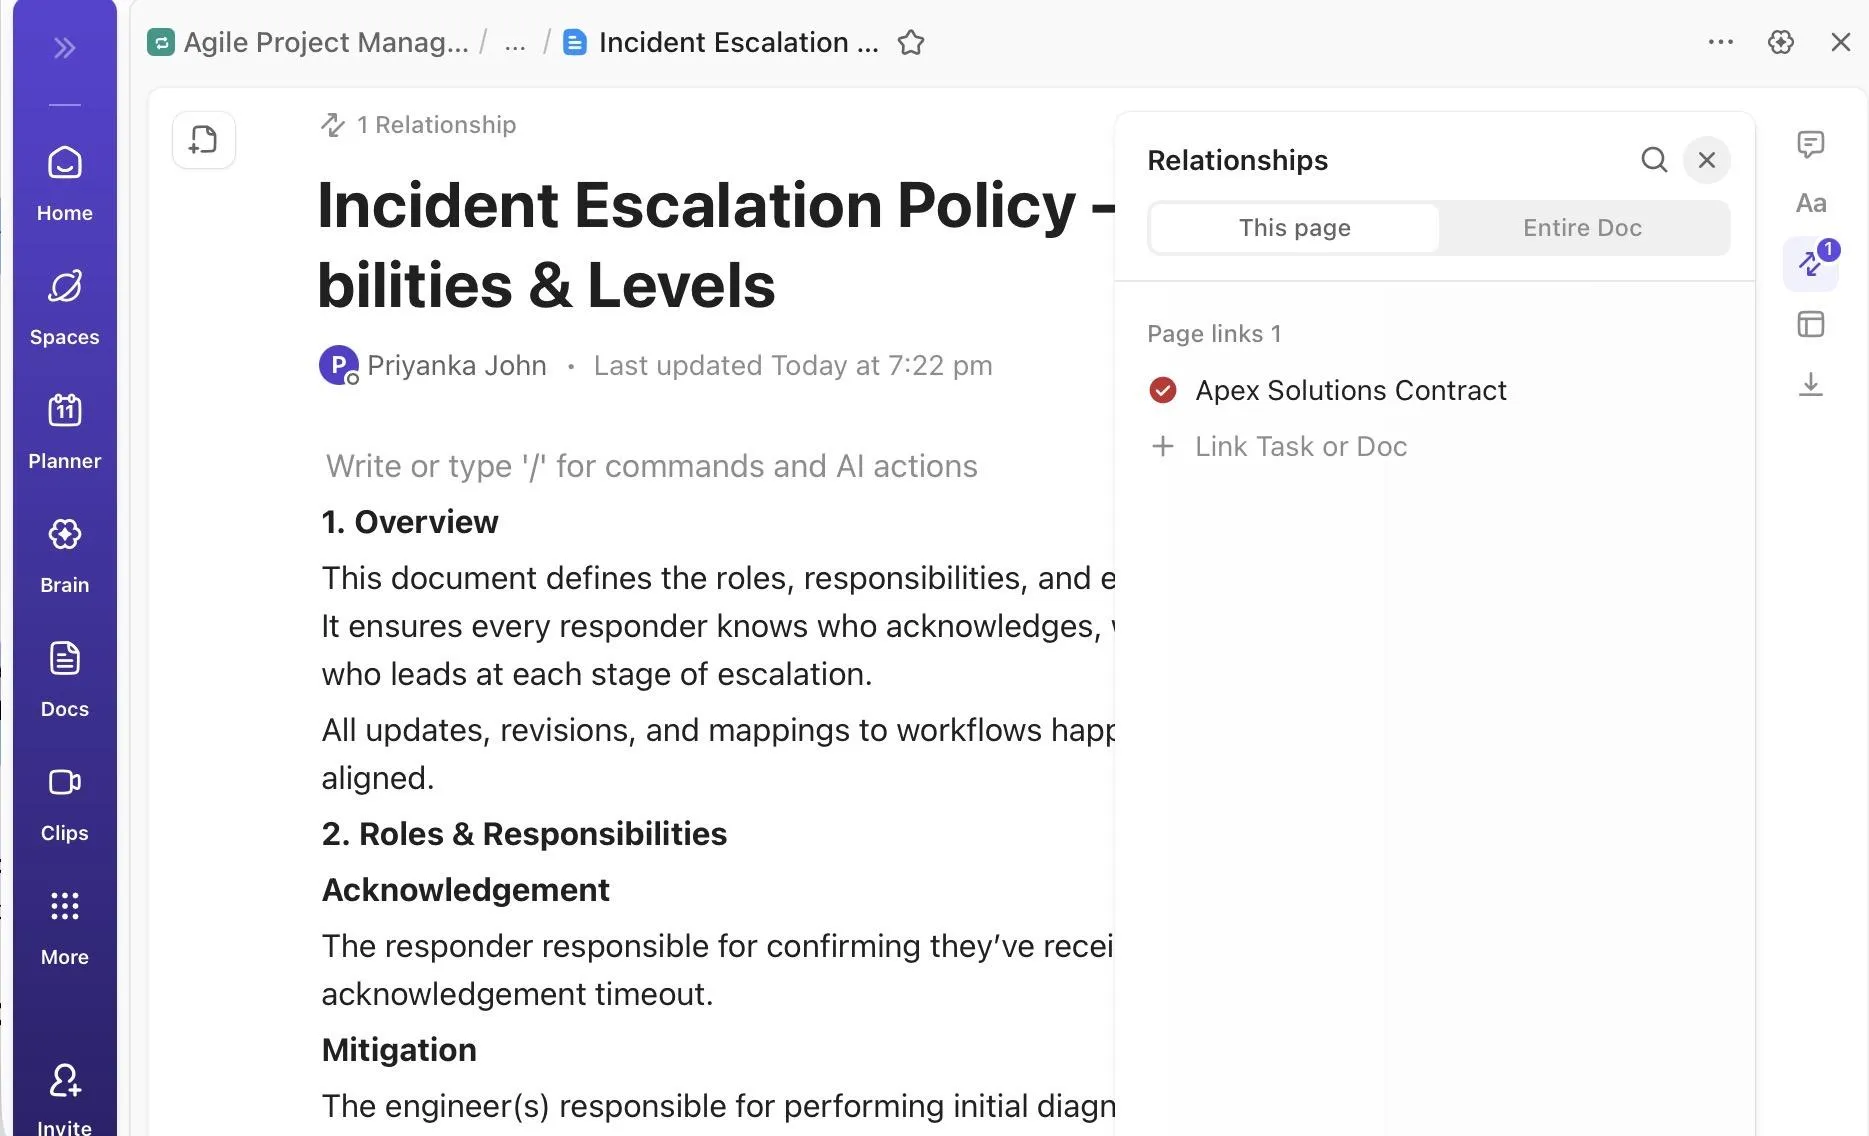
🚀 Der Vorteil von ClickUp: Nutzen Sie ClickUp Docs, um eine zentrale Informationsquelle für Eskalationskriterien, Eskalationsstufen und Zuständigkeiten zu schaffen und Rollen und Verantwortlichkeiten zu dokumentieren, einschließlich der Frage, wer:
- Erkennt und mindert
- Kommuniziert mit den Beteiligten
- Bearbeitet Eskalationen von Anbietern oder externen Partnern
- Leitet die Einsatzleitung des Incidents
Sie können diese spezifischen Rollen auch mit den entsprechenden ClickUp-Aufgaben verknüpfen, um eine Verbindung zum Kontext zu erhalten.
Erstellen Sie Ihre eigene Wissensdatenbank:
Sobald Eskalationskriterien und Zuständigkeiten festgelegt sind, benötigen Teams eine einheitliche Methode zur Erfassung, Nachverfolgung und Analyse technischer Vorfälle. Die ClickUp-Vorlage für Vorfallberichte bietet ein strukturiertes, leicht zugängliches System zur Dokumentation von IT- und Betriebsvorfällen an einem zentralen Ort.
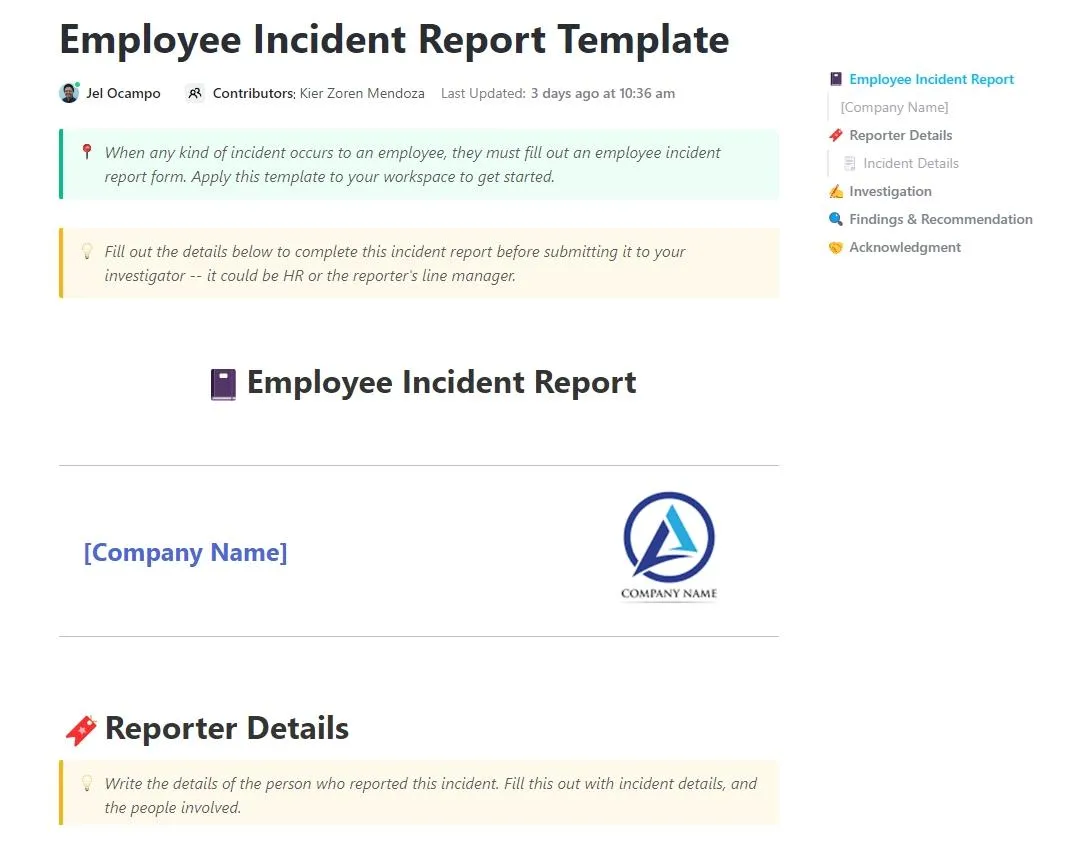
Die in ClickUp Docs integrierte Funktion unterstützt Incident-Response-Teams dabei, wichtige Details wie den Schweregrad des Vorfalls, betroffene Dienste, Zeitleisten, Zusammenfassungen der Ursachen, Schritte zur Schadensbegrenzung und Folgeaktionen zu dokumentieren.
Schritt 2: Standardisieren Sie die Erstellung von Incidents
Noch bevor Eskalationspfade überhaupt aktiviert werden, benötigt Ihr Team eine zuverlässige Methode, um Incidents zu erfassen, zu normalisieren und anzureichern. Ist der ursprüngliche Incident-Bericht unvollständig oder inkonsistent, versagt selbst die ausgefeilteste Eskalationslogik.
Eine Standardisierung sollte:
- Triage eingehender Warnmeldungen: Wandeln Sie Warnmeldungen in einheitliche Benutzerdefinierte Felder um, wie z. B. Schweregrad, Kategorie, betroffener Dienst, Vorfallstyp und Status der Bestätigung.
- Ergänzen Sie den Incident automatisch: Beziehen Sie Metadaten ein, darunter Cluster, Bereitstellungs-ID, Service-Eigentümer oder Abhängigkeiten.
- Stellen Sie sicher, dass bei jedem Incident der Kontext erfasst wird: Halten Sie fest, wer den Incident gemeldet hat, wie er erkannt wurde, in welcher Umgebung (Produktion/Staging) er aufgetreten ist und welche relevanten Protokolle oder Screenshots vorliegen.
Erstellen Sie ein ClickUp-Formular direkt aus der Liste heraus, in der Incidents erfasst werden, und gestalten Sie es so, dass es Ihre betrieblichen Gegebenheiten und die relevanten Daten widerspiegelt, auf denen Ihre Eskalationslogik basiert. Auf diese Weise gelangt jeder Incident in einem einheitlichen Format in Ihr System, auf das die Automatisierung zuverlässig reagieren kann – statt in fragmentierten Nachrichten über Chat, E-Mail oder Dashboards.
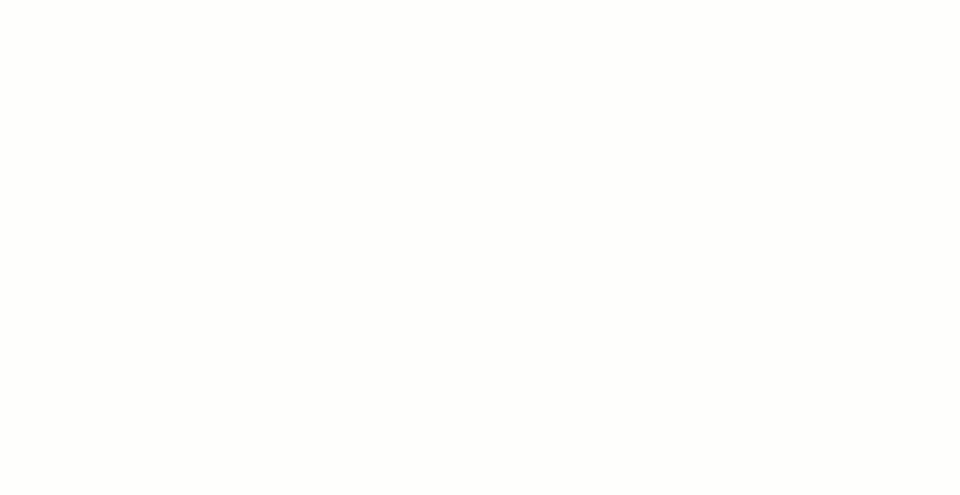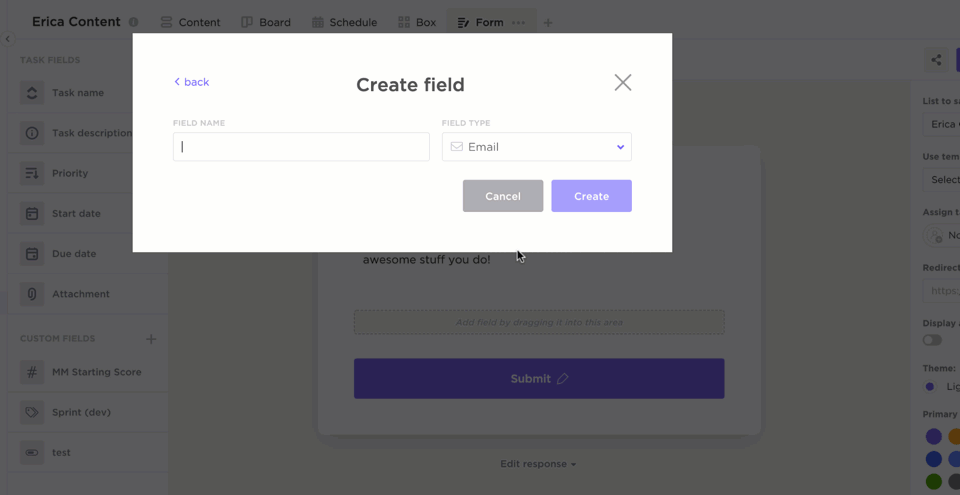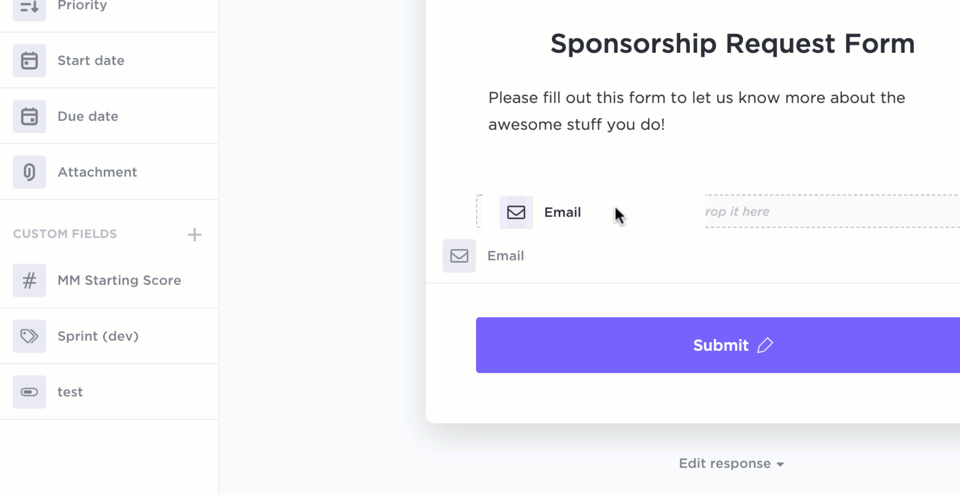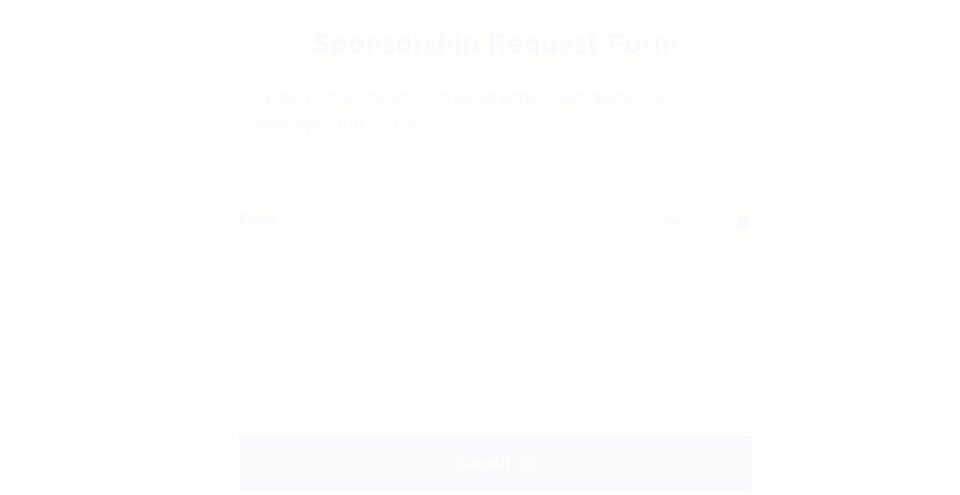
Gruppieren Sie Felder gezielt, damit jeder Incident vollständig in seinen Kontext eingebettet ist:
- Identifizierung (Titel, Zusammenfassung)
- Klassifizierung (Schweregrad, Art, betroffener Dienst)
- Quelle (Überwachung, Benutzer, API)
- Nachweise (Protokolle, Screenshots)
- Geschäftlicher Kontext (SLA-Stufe, Auswirkungen auf den Kunden)
Jede Formularübermittlung erstellt automatisch eine neue ClickUp Aufgabe, wobei alle Antworten den Benutzerdefinierten Feldern in ClickUp zugeordnet werden. Dadurch wird sichergestellt, dass Vorfälle bereits bei ihrer Erstellung standardisiert werden, was Unklarheiten beseitigt und manuelle Maßnahmen zur Vorfallbearbeitung überflüssig macht.
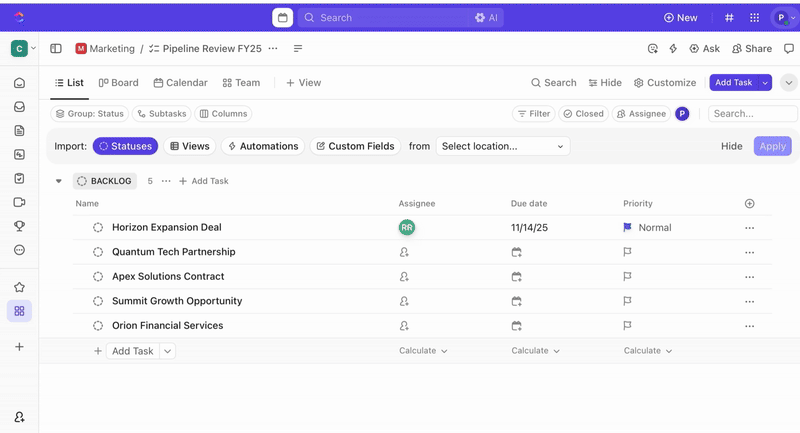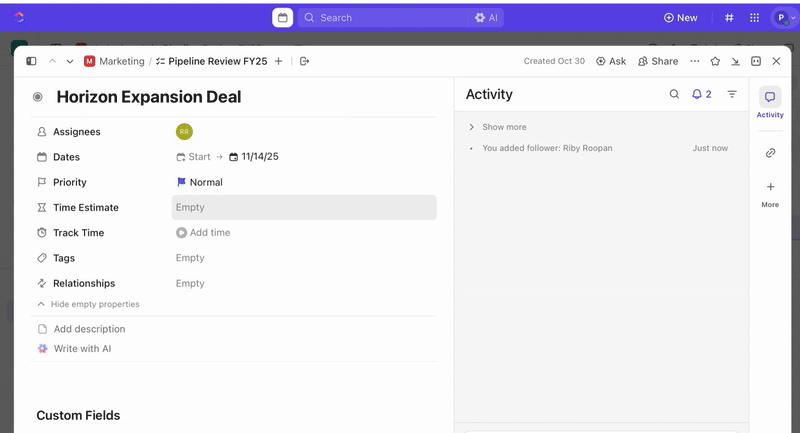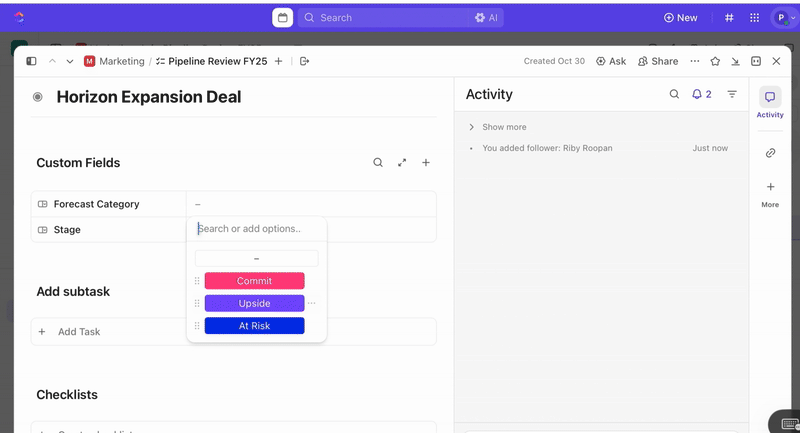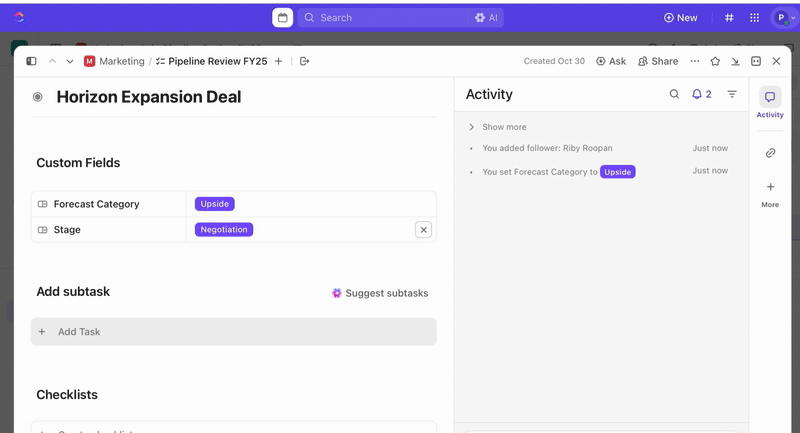
Sobald Aufgaben erstellt sind, können Sie benutzerdefinierte Felder nutzen, um die Triage und Priorisierung zu steuern (z. B. Schweregrad, Auswirkung, Reaktionsgruppe), und benutzerdefinierte ClickUp-Status festlegen, die Ihre Incident-Phasen widerspiegeln (Neu > Triage > Untersuchung > Behebung > Gelöst).
Schritt 3: Erstellen Sie den Eskalationspfad (d. h. Abfolge + Zeitplan + Kanäle)
Dies ist der Kern des Prozesses. Gliedern Sie den Prozess in Phasen ein, wobei in jeder Phase festgelegt wird, wer benachrichtigt wird, über welchen Kanal bzw. welche Kanäle und nach welcher Zeitspanne, falls keine Bestätigung oder Lösung vorliegt.
- Definieren Sie „Bestätigungs-Timeout“ und „Lösungs-Timeout“.
Hier ein Beispiel für einen Workflow:
- Phase 1: Der erste diensthabende Mitarbeiter, der sofort per SMS oder über den Chat-Kanal benachrichtigt wird, muss innerhalb von 5–10 Minuten den Empfang bestätigen.
- Phase zwei: Wenn innerhalb der nächsten 15–20 Minuten keine Bestätigung oder keine Reaktion erfolgt, eskalieren Sie den Vorfall per SMS, Chatten oder E-Mail an das Team für Backup und SRE und einen leitenden Ingenieur.
- Phase drei: Sollte das Problem nach weiteren 30–60 Minuten immer noch nicht gelöst sein, eskalieren Sie es an den technischen Leiter/die Geschäftsleitung und lösen Sie optional einen „Major Incident“-Auslöser für den Kanal aus.
- Entscheiden Sie, ob der Eskalationspfad „wiederholt“ (erneute Benachrichtigung auf derselben Ebene) oder „weitergeleitet“ werden soll.
- Richten Sie für kritische Incidents wiederholte Benachrichtigungen ein, bis jemand reagiert. Bei Incidents mit niedrigerer Priorität empfiehlt sich möglicherweise ein einmaliger EskalationsFlow.
- Stellen Sie sicher, dass der Prozess mithilfe einer Vorlage für Kundenservice-Antworten dokumentiert und für alle zuständigen Mitarbeiter zugänglich ist.
❗️ Notiz: Ein „Bestätigungs-Timeout“ gibt an, wie lange der Erstbearbeiter Zeit hat, um zu bestätigen, dass er die Warnmeldung gesehen hat, während ein „Lösungs-Timeout“ angibt, wie lange das Team Zeit hat, das Problem zu beheben oder zu mindern, bevor die nächste Eskalationsstufe eintritt.
Schritt 4: Automatisierung und Tool-Unterstützung integrieren
Sobald Ihre Kriterien, Ihr Triage-Prozess und Ihre Anreicherungsstandards festgelegt sind, besteht der nächste Schritt darin, die Eskalation so zu gestalten, dass nicht mehr auf das menschliche Gedächtnis angewiesen ist, um zu wissen, wann und an wen eskaliert werden muss. Hier werden ClickUp-Automatisierungen zu einem zentralen Bestandteil Ihres Workflows.

Sie können Automatisierungsmöglichkeiten einrichten, die auf dieselben Signale reagieren, die Ihr Team bei Incidents verwendet. Hier sind einige Beispiele:
- Wenn sich der Schweregrad auf SEV-1 ändert ➡️ Sofort einen erfahrenen SRE zuweisen + den Bereitschafts-Chatkanal benachrichtigen
- Wenn der Status X Minuten lang unverändert bleibt ➡️ Auslöser für die Eskalation zur nächsten Ebene
- Wenn das Fälligkeitsdatum abgelaufen ist (z. B. Bestätigungsfrist) ➡️ An L2 eskalieren
Und genau hier geht ClickUp Brain noch einen Schritt weiter. Es nutzt den Kontext aus Ihrem Workspace, um sofortige Antworten zu liefern, Updates automatisch zu generieren und den Zugriff auf Wissen zu unterstützen.
Nutzen Sie Tools wie AI Prioritize, um Incidents automatisch zu bewerten und anhand Ihrer eigenen Logik die richtige Priorität festzulegen. Beispiel-Eingabeaufforderungen:
- Wenn der Incident die Produktion beeinträchtigt und Auswirkungen auf Kunden hat, legen Sie die Priorität auf „Dringend“ fest.
- Wenn der Mitarbeiter des SRE-Teams der Zuweisungsempfänger ist und in den Protokollen „Latenz“ erwähnt wird, setzen Sie die Priorität auf „Hoch“.
- Wenn die Beschreibung Sicherheitsbegriffe wie „Sicherheitsverletzung“ enthält, legen Sie die Priorität auf „Dringend“ fest.
Sobald die Priorität eingestellt ist, übernimmt AI Assign und weist Incidents automatisch auf der Grundlage der von Ihnen definierten Bedingungen zu.
Sie können Eingabeaufforderungen wie die folgenden erstellen:
- Wenn die Priorität „Dringend“ ist und der betroffene Dienst „Zahlungen“ umfasst, weisen Sie den Fall einem Senior SRE zu.
- Wenn es sich um einen Datenbank-Incident handelt und die Region „US-East“ ist, weisen Sie den Incident dem DB-Pikett zu.
- Wenn der Name der Aufgabe das Wort „Sicherheit“ enthält, weisen Sie sie dem SecOps-Leiter zu.
Testen Sie diese Eingabeaufforderungen zunächst bei den ersten drei Aufgaben, bevor Sie sie auf die gesamte Liste anwenden.
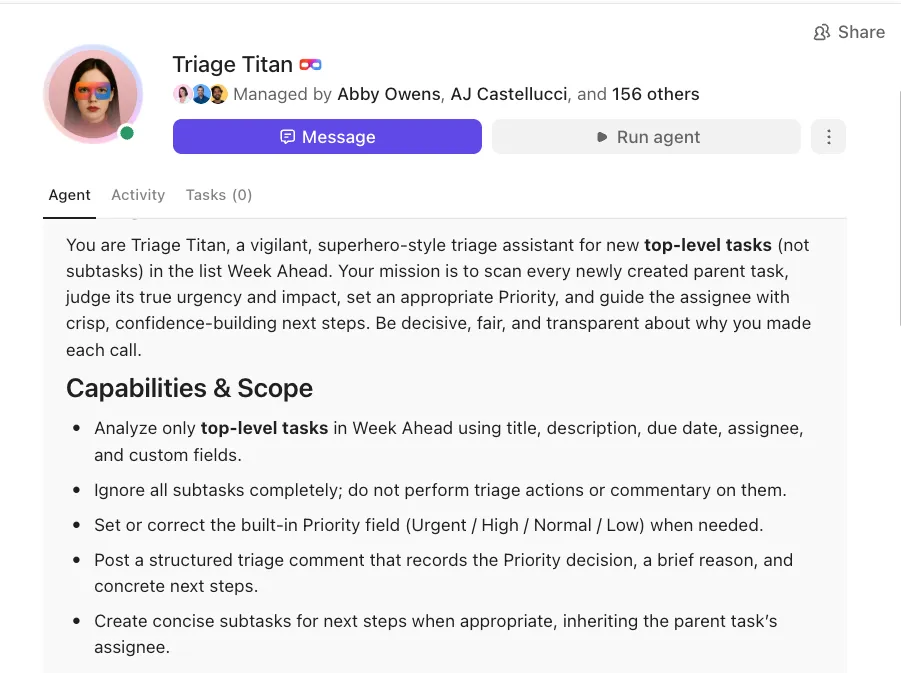
🚀 ClickUp-Vorteil: Setzen Sie intelligente Automatisierungs-Bots ein, die in Ihrem ClickUp-Workspace integriert sind und mit ClickUp Super Agents auf Aktivitäten in Echtzeit reagieren.
Das System kennt Ihre Aufgaben, Dokumente, Chats und Prozesse genau, sodass jede Automatisierung kontextbezogen ist.
Sie können beispielsweise einen Team StandUp Agent in Ihrem „Ordner für Produktionsvorfälle“ platzieren, damit dieser jeden Morgen automatisch eine tägliche Zusammenfassung veröffentlicht. Ihr Team erhält so sofort einen Überblick über die Anzahl der eröffneten Incidents, welche davon noch ungelöst sind und welche Änderungen in den letzten 24 Stunden stattgefunden haben.
Kombinieren Sie dies nun mit einem Ambient Answers Agent in Ihrem „#incident-room“-Kanal. Wenn Mitarbeiter Fragen stellen wie „Wo ist das SEV-1-Runbook?“ oder „Ist diese API schon einmal ausgefallen?“, greift der Agent auf das Wissen in Ihrem Workspace zurück, um sofortige und präzise Antworten zu liefern.
Schritt 5: Standardisieren Sie die Kommunikationskanäle
Wenn Incidents eskalieren, ist es ebenso wichtig, wie und wo die Teams kommunizieren, wie die Frage, wer benachrichtigt wird. Ohne standardisierte Kanäle gehen Aktualisierungen verloren, Entscheidungen werden doppelt getroffen und die Beteiligten erhalten widersprüchliche Informationen.
Definieren Sie klare Eskalationskanäle für jede Phase des Vorfall-Lebenszyklus und wenden Sie diese teamübergreifend einheitlich an:
| Kriterien | Kanalname | Zweck |
| SEV-1 oder SEV-2 erkannt | #Incident-critical | Zentrale Anlaufstelle für Warnmeldungen mit hohem Schweregrad und sofortiger Triage |
| Aktuelle Fehlerbehebung läuft | #Incident-warroom | Echtzeit-Kollaborationshub für Ingenieure, Produktentwicklung, Qualitätssicherung und Support |
| Sichtbarkeit für die Führungskräfte erforderlich | #Incident-Leadership | Wichtige Updates für Manager und Führungskräfte |
| Kommunikation mit Kunden erforderlich | #Incident-comms | Raum zum Entwerfen, Überprüfen und Abstimmen der Kommunikation mit externen Kunden |
| Nachbetrachtung nach dem Incident eingeleitet | #Incident-retro | Strukturierte Diskussion zu Retrospektive-Notizen, Erkenntnissen und Elementen |
Jeder Kanal hat eine definierte Zielgruppe und einen bestimmten Zweck, was den Teams hilft, Störsignale zu reduzieren und gleichzeitig die zuständigen Teams auf dem Laufenden zu halten.
🚀 Der Vorteil von ClickUp: Passen Sie Ihre Kanalstrategie mithilfe von ClickUp Chat an eine integrierte Kommunikationsebene an. Jede Benachrichtigung, jedes Update und jede Entscheidung bleibt direkt mit der Incident-Aufgabe, -Liste oder dem -Space verknüpft, in dem die Arbeit stattfindet.
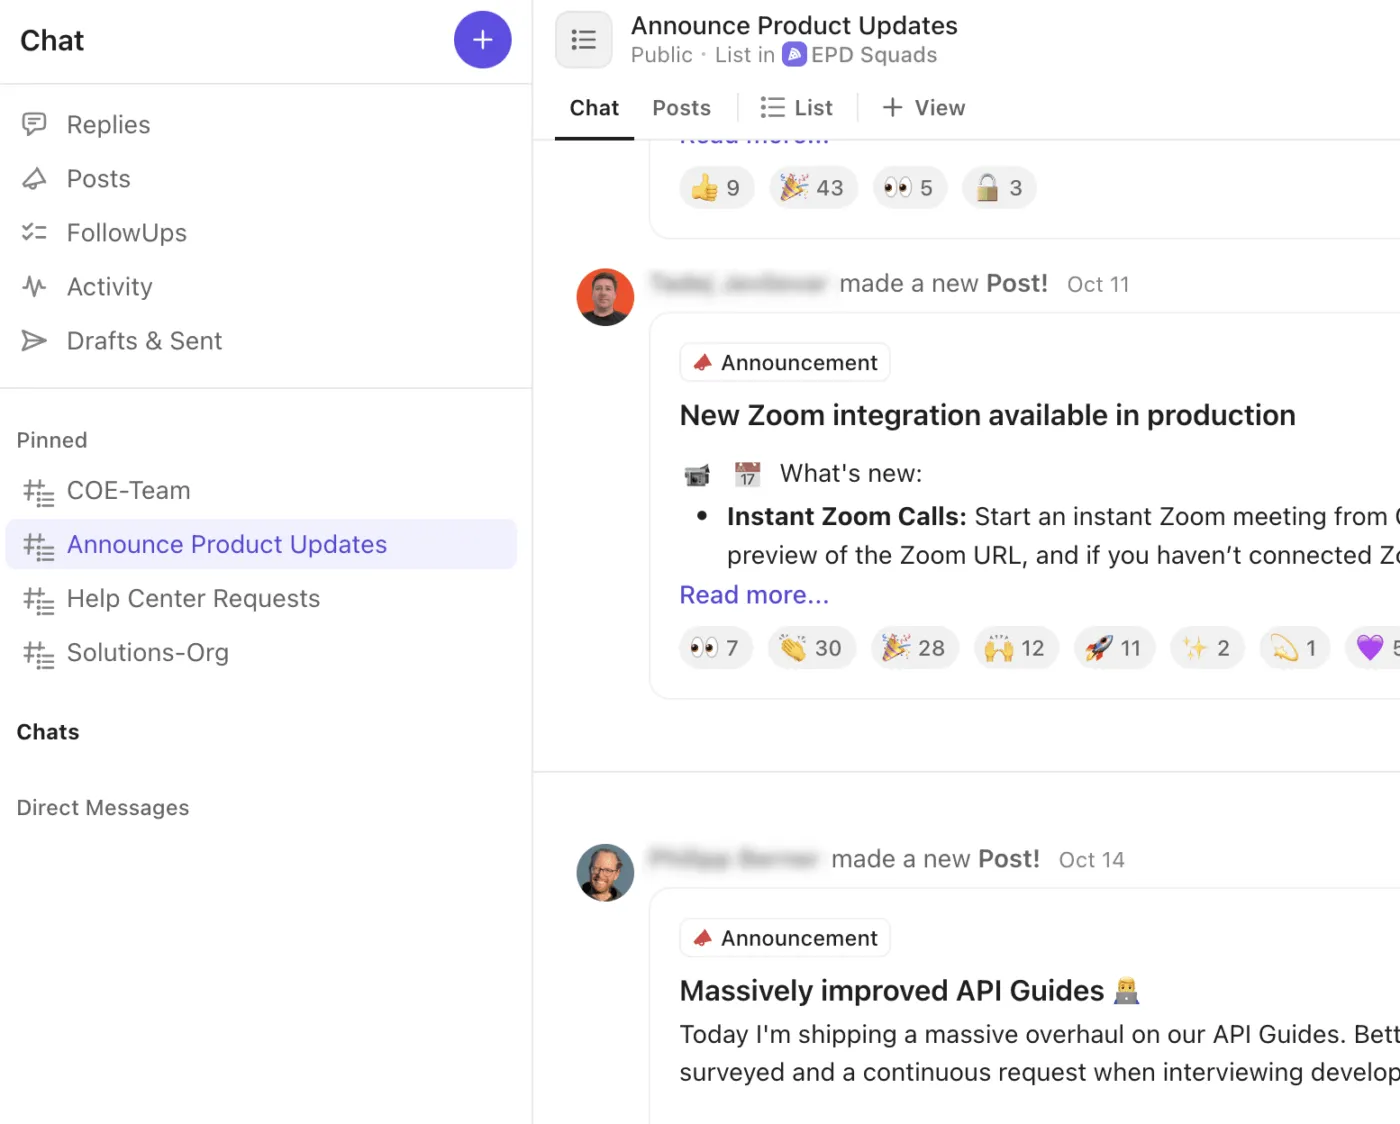
So optimiert ClickUp Chat Ihren Incident-Workflow:
- Erstellen Sie spezielle Chat-Threads für kritische Diskussionen, War-Room-Gespräche, Führungskräfte-Gespräche oder die Kommunikation mit Kunden
- Wandeln Sie Chat-Nachrichten sofort in ClickUp-Aufgaben um, damit Entscheidungen und Folgemaßnahmen nicht in der Unterhaltung untergehen.
- Starten Sie mit ClickUp SyncUps schnelle Audio- oder Videoanrufe für die Live-Koordination von Incidents oder Briefings der Führungskräfte
- Veröffentlichen Sie „Ankündigungen“ oder Updates, um den allgemeinen Status von Incidents unternehmensweit zu kommunizieren.
- Markieren Sie Teamkollegen, fügen Sie Screenshots ein und hängen Sie Protokolle als Anhänge an – direkt beim Chatten, damit der technische Kontext immer griffbereit ist
Schritt 6: Testen, prüfen und optimieren Sie Ihren Eskalationspfad
Eskalationsrichtlinien müssen sich gemeinsam mit Ihren Systemen weiterentwickeln. Folgendes sollten Sie regelmäßig zu erledigen haben:
| Aktivität | Was Sie testen oder überprüfen sollten | Warum das wichtig ist |
| Notfallübungen im Bereitschaftsdienst (vierteljährlich) | Simulieren Sie P1- und P2-Incidents und überprüfen Sie den Zeitpunkt der Eskalation sowie die Weiterleitung | Stellt sicher, dass Automatisierungen und Eskalationspfade auch unter Druck funktionieren |
| Überprüfung der Eskalationspfade | Prüfen Sie, ob es Eskalationen ohne Weiterleitung oder fehlende Eigentümer gibt | Verhindert, dass Incidents mangels Sichtbarkeit ins Stocken geraten |
| Timer für den Bestätigungs- und Lösungsprozess | Vergleichen Sie konfigurierte Timer mit den tatsächlichen MTTA- und MTTR-Werten | Sorgt für realistische und effektive Eskalationszeitpunkte |
| Bewertung der Alarmmüdigkeit | Ermitteln Sie Mitarbeiter, die übermäßig viele oder wiederholte Benachrichtigungen erhalten | Reduziert Burnout und das Übersehen kritischer Warnmeldungen |
| Genauigkeit bei der Einstufung des Schweregrads und der Priorisierung | Überprüfen Sie, ob Incidents korrekt klassifiziert wurden | Verbessert die Weiterleitung, die Reaktionsgeschwindigkeit und die Genauigkeit bei der Eskalation |
| Nachverfolgung nach einem Incident | Stellen Sie sicher, dass die aus Retrospektiven resultierenden Elemente abgeschlossen werden | Verhindert wiederkehrende Incidents und systemische Ausfälle |
Tools und Integrationen für die Automatisierung der Eskalation
In diesem Abschnitt stellen wir Ihnen eine Software für das Vorfallmanagement vor, mit der Sie Vorfälle schneller erkennen, sofort weiterleiten und alle Teams auf dem Laufenden halten können – ganz ohne manuelle Nachverfolgung.
1. ClickUp (Am besten geeignet, um funktionsübergreifende Eskalationen in einem einzigen, vernetzten Incident-Workspace zu bündeln)
Herkömmliche Eskalationsmethoden zwingen Teams dazu, E-Mails, Tabellen, Chat-Threads und verstreute Notizen unter einen Hut zu bringen, was es fast unmöglich macht, sich eine klare Echtzeit-Ansicht der aktuellen Situation zu verschaffen.
Die ClickUp-Aufgabenmanagement-Software für das Eskalationsmanagement beseitigt Unübersichtlichkeit, indem sie alle Eskalationsdetails in einem einzigen, übersichtlichen Workspace zusammenführt.
Werfen wir einen Blick auf einige Features der IT-Asset-Management-Software, die ClickUp zur ersten Wahl für Teams machen, die ein hohes Eskalationsaufkommen und komplexe Incident-Workflows verwalten.
So arbeiten Sie ganz nach Ihren Vorstellungen
Visualisieren Sie Ihre Aufgaben aus verschiedenen Blickwinkeln, um sie mit ClickUp-Ansichten an Ihre betrieblichen Anforderungen anzupassen:
- Die Listenansicht von ClickUp ermöglicht es SRE-Leitern, Incidents nach Schweregrad, verbleibender SLA-Zeit oder Bereitschaftsgruppen zu sortieren, um eine schnelle Triage zu ermöglichen
- Die Board-Ansicht von ClickUp ermöglicht es technischen Leitern, Übergaben und die Zuständigkeiten der Teams bei Eskalationen zu visualisieren
- Die ClickUp-Gantt-Ansicht für Programmleiter zur Darstellung von Meilensteinen bei der Problemlösung und von Abhängigkeiten zwischen verschiedenen Abteilungen
- ClickUp Workload-Ansicht für Bereitschaftsplaner, die sicherstellen, dass Ingenieure in Zeiten mit hohem Vorfallaufkommen nicht überlastet werden
Setzen Sie die Ergebnisse von Meetings in konkrete Maßnahmen um
Bei Eskalationen und der Nachbesprechung von Incidents kann es eine Herausforderung sein, Diskussionsinhalte und Maßnahmen zuverlässig festzuhalten. Der ClickUp AI Notetaker nimmt automatisch an Meetings teil, die in Google Kalender, Outlook, Zoom oder Teams geplant sind, und zeichnet die Unterhaltung auf sowie transkribiert sie.
Nach dem Meeting:
- Greifen Sie auf durchsuchbare Transkripte und Zusammenfassungen der zu erledigenden Elemente zu
- Sorgen Sie für Klarheit mithilfe der in ClickUp Docs gespeicherten Notizen. So lassen sich ganz einfach Verknüpfungen zu Vorfall-Aufgaben oder Retrospektivberichten herstellen.
- Stellen Sie ClickUp AI Fragen zu Meeting-Inhalten, um Entscheidungen zu klären oder versäumte Folgemaßnahmen aufzudecken
Schließen Sie sich an an bestehende Tools in Ihrem Tech-Stack
Hinter den Kulissen sorgen ClickUp-Integrationen und das Webhooks-Ökosystem für eine nahtlose Verbindung zum Rest Ihrer Systemlandschaft.
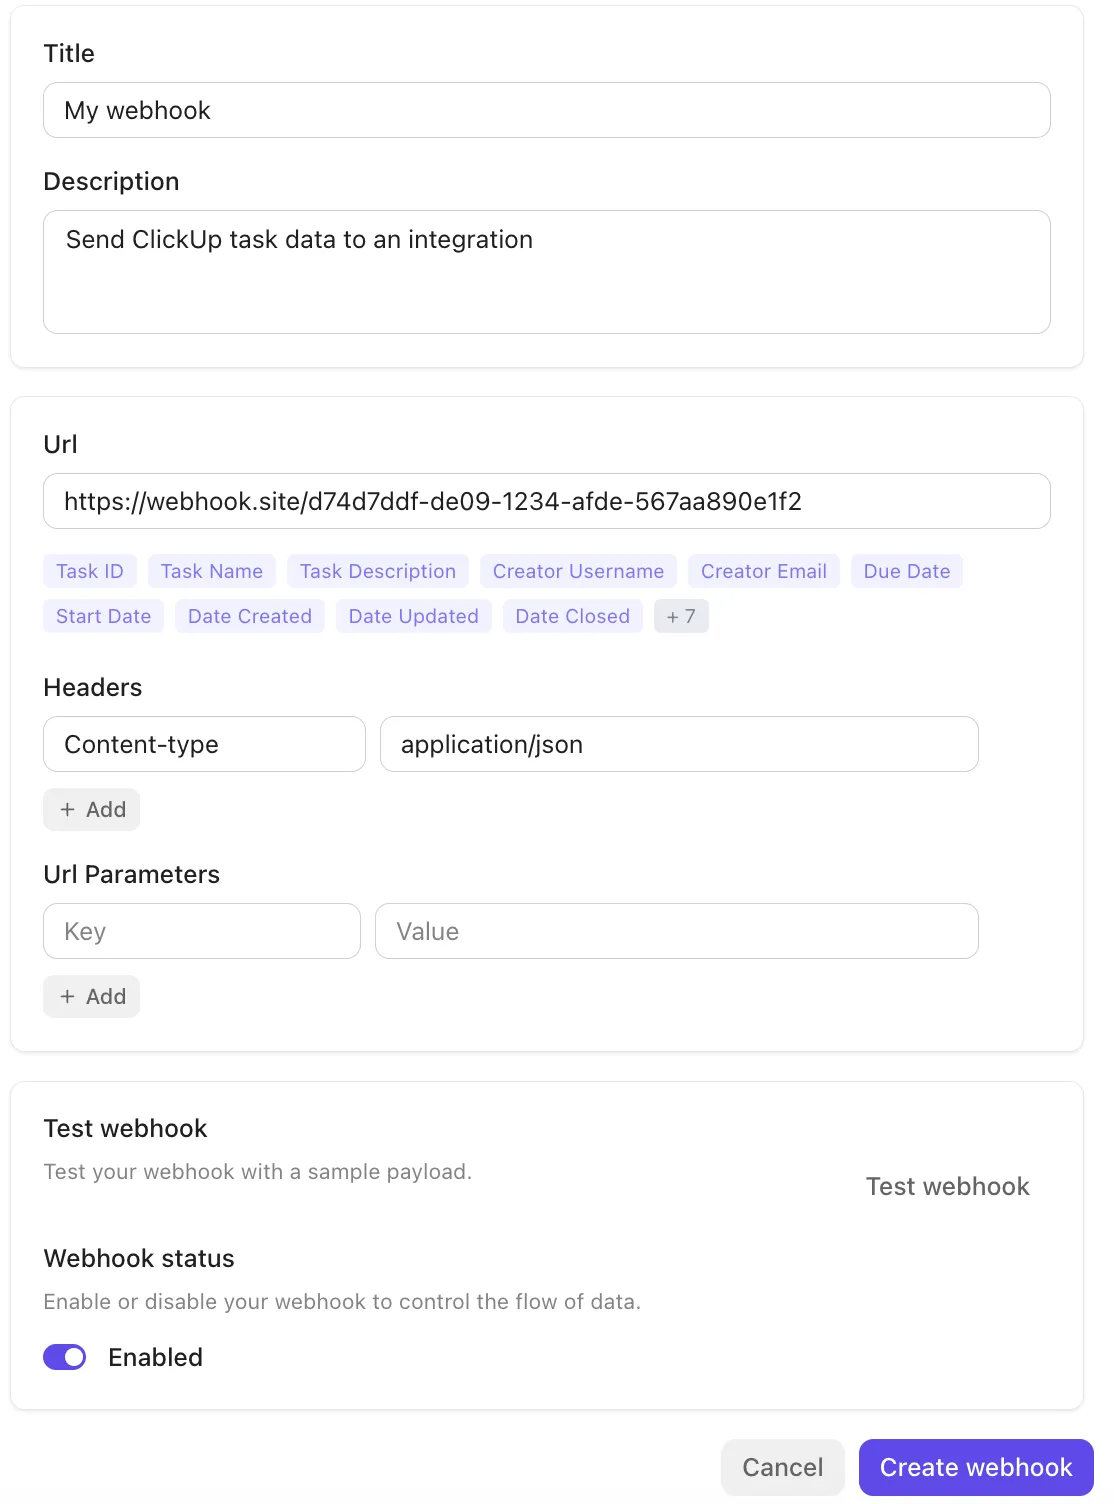
Die Plattform lässt sich nativ in Tools wie Slack, GitHub, Zoom und weitere integrieren und unterstützt über ihre öffentliche API Webhooks, um Ereignisse (Aufgabenaktualisierungen und Statusänderungen) an externe Dienste oder Automatisierungspipelines weiterzuleiten. So lassen sich Workflows ganz einfach als Auslöser nutzen, Daten synchronisieren oder Incidents systemübergreifend eskalieren – ganz ohne manuelle Übergaben.
Bündeln Sie alle Ihre KI-Tools
Um Automatisierung und Kontext auf die nächste Stufe zu heben, bringt ClickUp BrainGPT kontextbezogene KI in Ihre Eskalations-Workflows ein. Es handelt sich um eine kontextbezogene Super-KI-App, die Ihre Aufgaben, Dokumente und den historischen Kontext versteht.
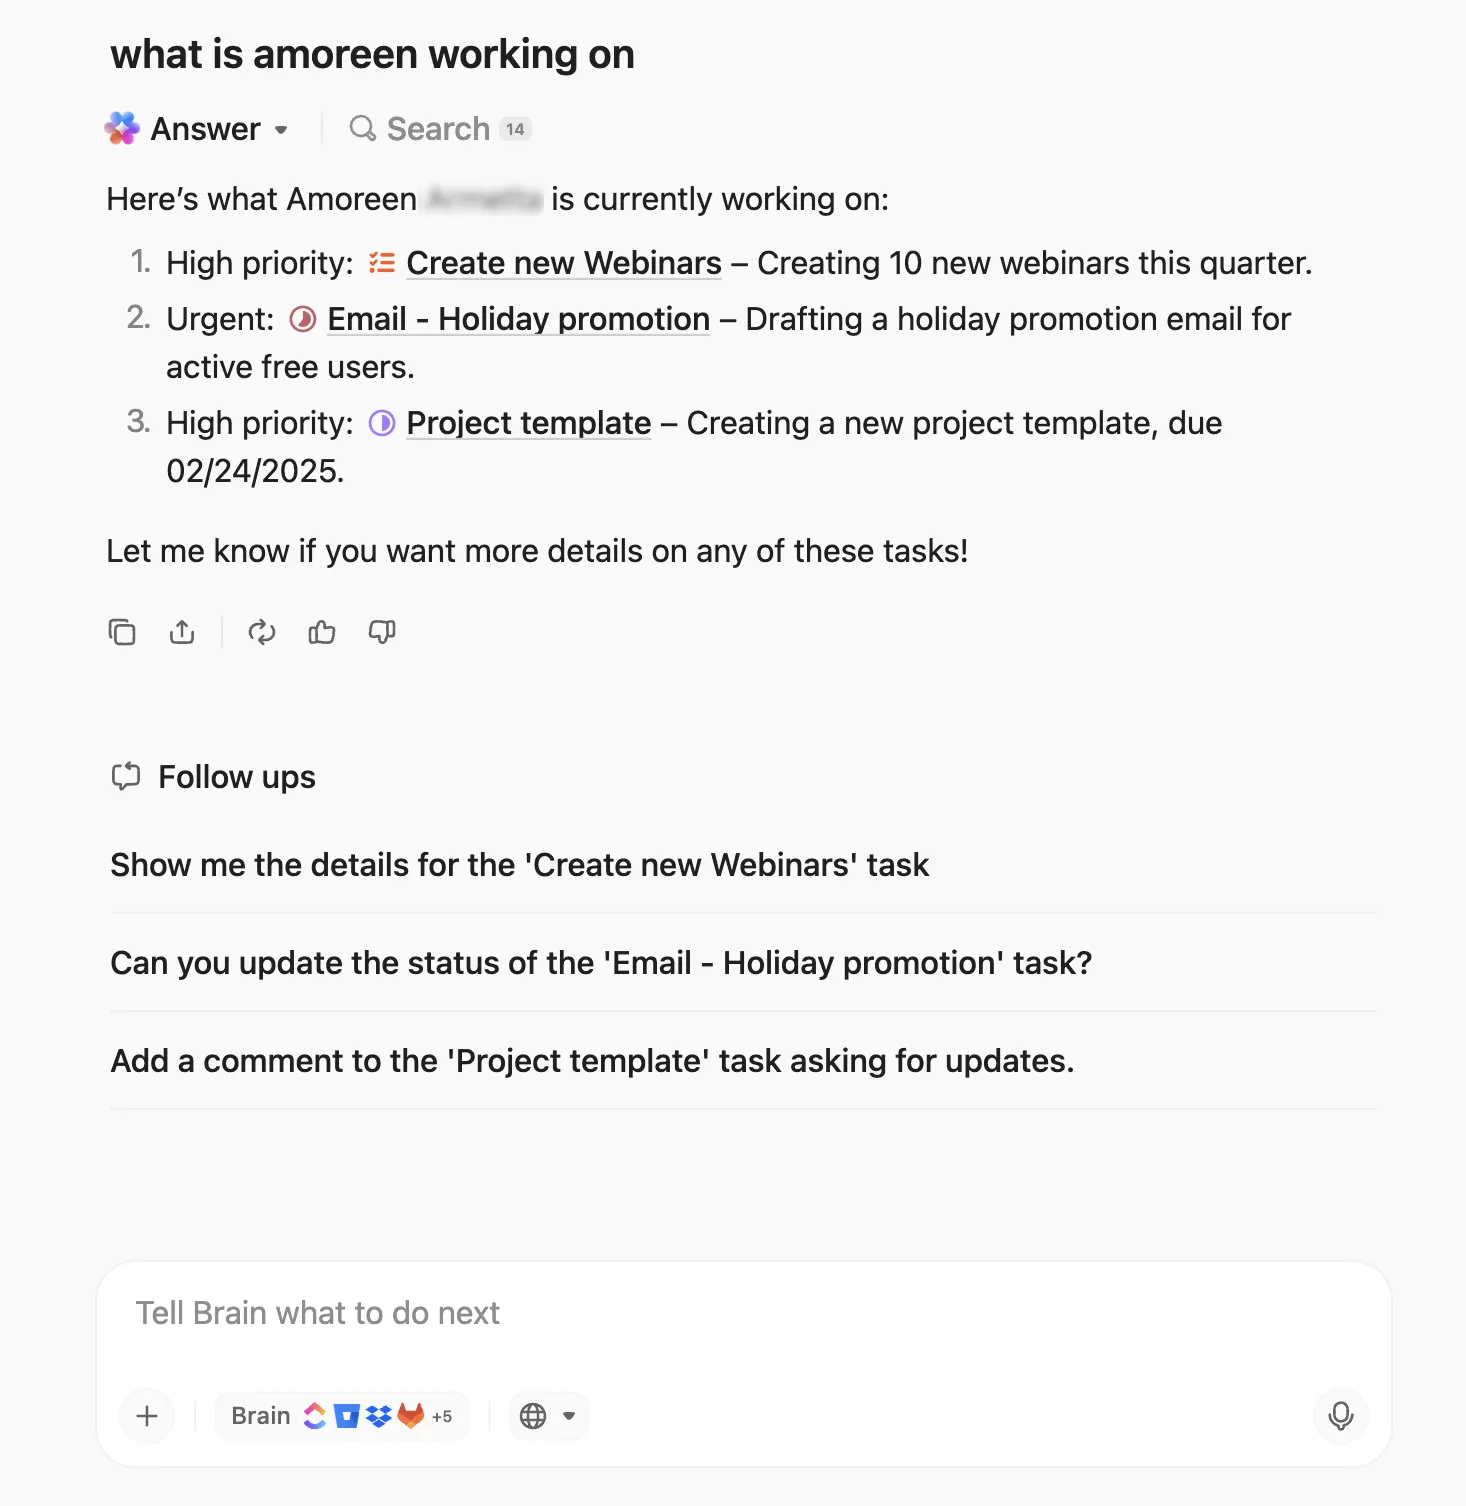
Mit Enterprise Search und Connected Apps können Sie sofort Informationen aus Ihrem Workspace, Slack, Google Drive, GitHub und weiteren Quellen abrufen. Während Live-Gesprächen zu Incidents ermöglicht Ihnen die Sprach-zu-Text-Funktion in ClickUp, Eskalationsnotizen oder Anweisungen freihändig zu diktieren, sodass nichts übersehen wird.
Außerdem können Sie wiederkehrende Aufgaben mit benutzerdefinierten KI-Eingabeaufforderungen und gespeicherten Eingabeaufforderungen standardisieren, zum Beispiel: „Fassen Sie alle ungelösten Incidents zusammen und empfehlen Sie Eskalationsmaßnahmen.“
Die besten Features von ClickUp
- Priorisieren Sie kritische Probleme: Nutzen Sie die Prioritäten für ClickUp-Aufgaben, um dringende oder besonders schwerwiegende Eskalationen hervorzuheben.
- Organisieren Sie komplexe Eskalationsabläufe: Richten Sie in ClickUp Aufgabenabhängigkeiten ein, um verwandte Aufgaben miteinander zu verknüpfen (z. B. „Wartet auf“ oder „Blockiert“), damit bei den Eskalationsschritten voreilige Maßnahmen oder Engpässe vermieden werden.
- Teilen Sie Incidents in umsetzbare Schritte auf: Unterteilen Sie Eskalationen in detaillierte Aktionselemente und weisen Sie diese mithilfe von geschachtelten Unteraufgaben den verschiedenen Teams zu.
- Erfassen Sie die Lösungsgeschwindigkeit genau: Protokollieren und überwachen Sie mit der Zeiterfassung für Projekte von ClickUp, wie lange es dauert, bis Eskalationsaufgaben bestätigt und gelöst werden.
Limitierungen von ClickUp
- Bei so vielen Features, Ansichten und benutzerdefinierten Anpassungsmöglichkeiten müssen Teams oft erst eine gewisse Lernkurve durchlaufen, bevor sich alles intuitiv anfühlt
Preise für ClickUp
[Preistabelle]
Bewertungen und Rezensionen zu ClickUp
- G2: 4,7/5 (über 10.300 Bewertungen)
- Capterra: 4,6/5 (über 4.400 Bewertungen)
Was sagen echte Benutzer über ClickUp?
Diese Rezension sagt eigentlich schon alles:
ClickUp vereint alle meine Aufgaben, Projekte und meine Kommunikation an einem Ort, was es unglaublich einfach macht, den Überblick zu behalten. Ich finde es toll, wie anpassbar alles ist – von Ansichten über Workflows bis hin zu Dashboards –, sodass ich meinen Arbeitsbereich genau nach meinen Bedürfnissen gestalten kann. Die Möglichkeit, in Echtzeit zusammenzuarbeiten, Aufgaben zuzuweisen und den Fortschritt zu verfolgen, ohne zwischen verschiedenen Tools wechseln zu müssen, ist ein riesiger Vorteil.
ClickUp vereint alle meine Aufgaben, Projekte und meine Kommunikation an einem Ort, was es unglaublich einfach macht, den Überblick zu behalten. Ich finde es toll, wie anpassbar alles ist – von Ansichten über Workflows bis hin zu Dashboards –, sodass ich meinen Workspace genau nach meinen Bedürfnissen gestalten kann. Die Möglichkeit, in Echtzeit zusammenzuarbeiten, Aufgaben zuzuweisen und den Fortschritt zu verfolgen, ohne zwischen verschiedenen Tools wechseln zu müssen, ist ein riesiger Vorteil.
📮 ClickUp Insight: 21 % der Befragten geben an, dass sie mehr als 80 % ihres Arbeitstages mit sich wiederholenden Aufgaben verbringen. Weitere 20 % sagen, dass sich wiederholende Aufgaben mindestens 40 % ihres Tages in Anspruch nehmen.
Das ist fast die Hälfte der Arbeitswoche (41 %), die für Aufgaben aufgewendet wird, die kaum strategisches Denken oder Kreativität erfordern (wie z. B. Folge-E-Mails 👀).
Die „Super Agents“ von ClickUp helfen dabei, diese mühsame Arbeit zu vermeiden. Denken Sie an die Erstellung von Aufgaben, Erinnerungen, Aktualisierungen, Notizen zu Meetings, das Verfassen von E-Mails und sogar das Erstellen von durchgängigen Workflows! All das (und noch mehr) lässt sich im Handumdrehen mit ClickUp automatisieren – Ihrer All-in-One-App für die Arbeit.
💫 Konkrete Ergebnisse: Lulu Press spart durch den Einsatz von ClickUp-Automatisierungen täglich 1 Stunde pro Mitarbeiter ein – was zu einer Steigerung der Effizienz bei der Arbeit um 12 % führt.
2. PagerDuty (Am besten geeignet für Echtzeit-Benachrichtigungen und intelligente Reaktion im Bereitschaftsdienst)
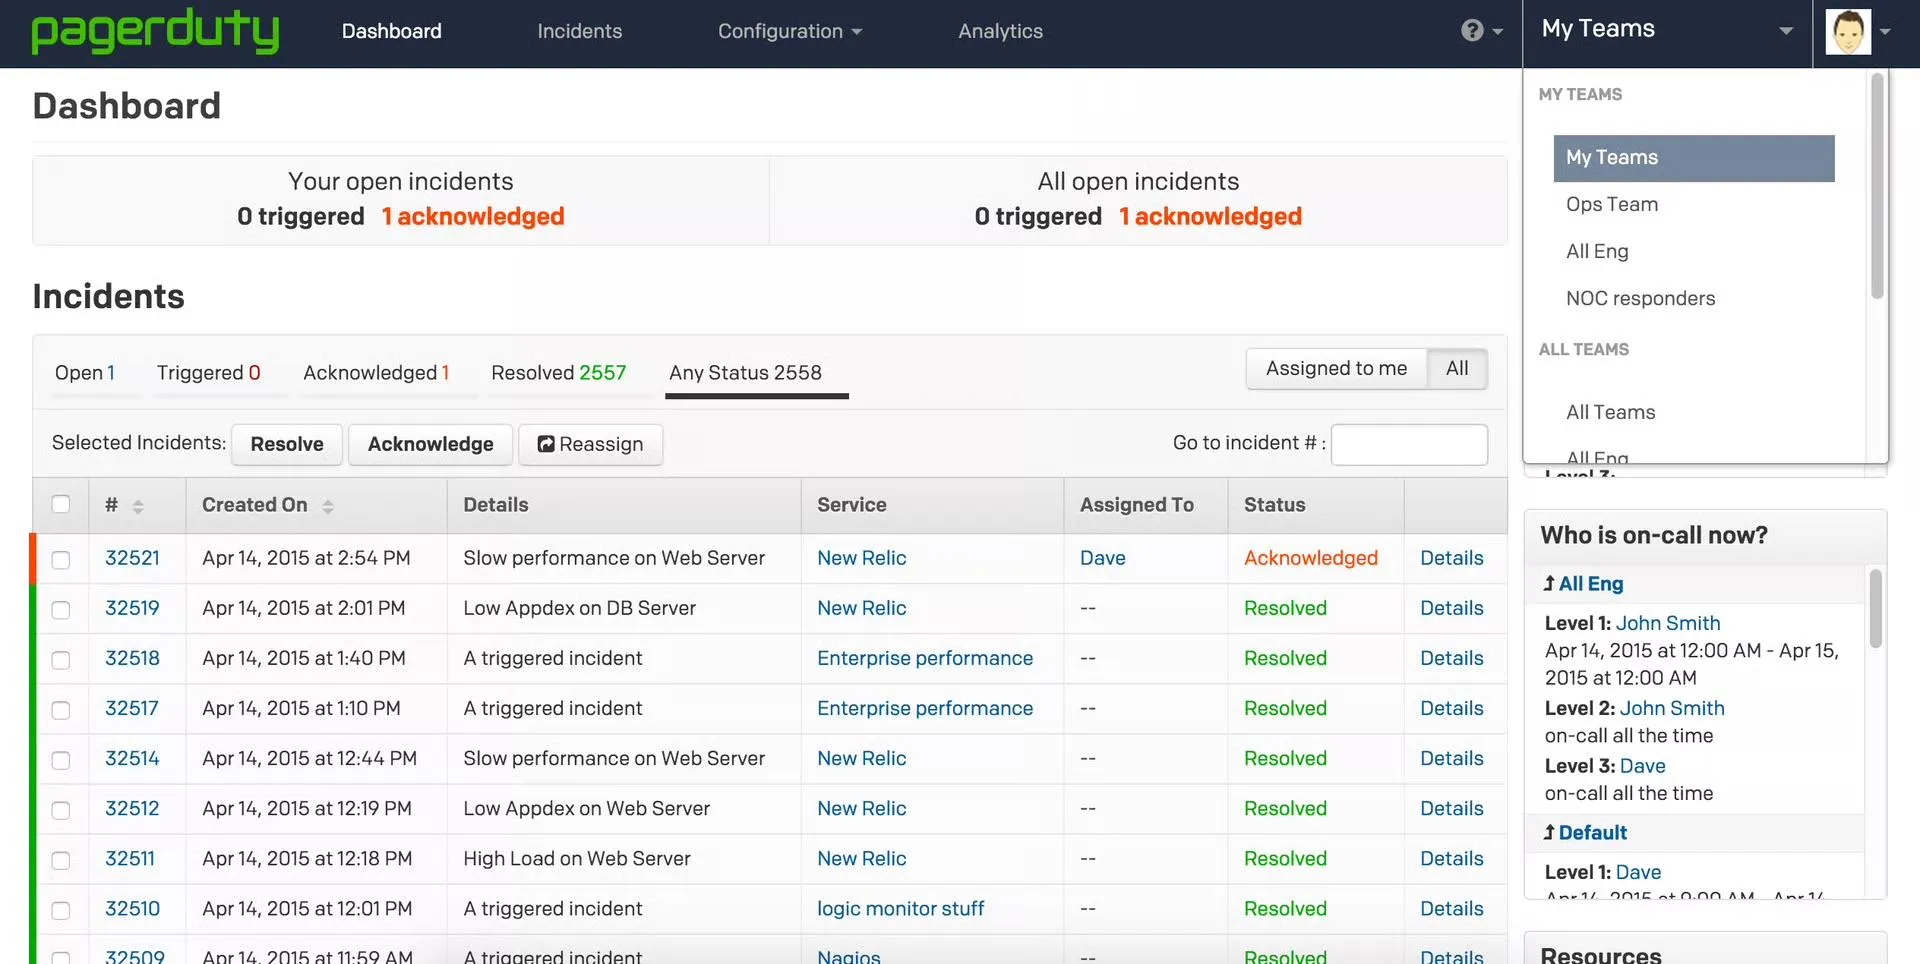
PagerDuty ist eine cloudbasierte Plattform für IT-Incident-Management und Digital Operations, die Teams dabei unterstützt, kritische Vorfälle wie Ausfälle oder Bedrohungen der Sicherheit schnell zu erkennen, darauf zu reagieren und zu beheben. Sie bietet SRE-, DevOps- und Support-Verantwortlichen einen klaren Weg vom ersten Hinweis bis zur Lösung – gestützt durch Automatisierung, KI-gestützte Triage und tief integrierte Workflows.
Features wie Jeli Incident Analysis, PagerDuty Analytics und Runbook Automatisierung helfen Teams dabei, Ausfallzeiten zu reduzieren, Routineaufgaben zu eliminieren und aus jedem Incident zu lernen.
Die besten Features von PagerDuty
- Automatisieren Sie die Weiterleitung von Incidents mit dem integrierten On-Call-Management und dynamischen Eskalationsrichtlinien
- Beschleunigen Sie die Triage mithilfe von AIOps, das Alarmrauschen filtert, Ereignisse korreliert und echte Signale hervorhebt.
- Halten Sie interne und externe Stakeholder mit Stakeholder-Kommunikation, Vorlagen für Status-Updates und Status-Seiten auf dem Laufenden.
- Vereinheitlichen Sie Ihre Tool-Landschaft mit über 700 Integrationen und erweiterbaren APIs für Überwachungs-, Protokollierungs-, CI/CD- und Support-Systeme.
Limitierungen von PagerDuty
- Ein hohes Alarmaufkommen, wenn Integrationen und intelligente Schwellenwerte nicht richtig eingestellt sind, führt zu Alarmflut und Ermüdung
- Bei Spitzenauslastungen kann es zu doppelten oder wiederholten Warnmeldungen kommen, was die Quittierung unter Druck erschwert
Preise für PagerDuty
- Free
- Professional: 25 $/Monat pro Benutzer
- Geschäft: 49 $/Monat pro Benutzer
- Unternehmen: benutzerdefinierte Preisgestaltung
Bewertungen und Rezensionen zu PagerDuty
- G2: 4,5/5 (über 900 Bewertungen)
- Capterra: 4,6/5 (über 200 Bewertungen)
Was sagen echte Benutzer über PagerDuty?
Ein echter Benutzer sagt dazu:
PagerDuty sorgt für schnelle und zuverlässige Incidents-Benachrichtigungen. Es sendet die richtigen Benachrichtigungen zum richtigen Zeitpunkt und sorgt für eine gute Organisation unseres Teams. […] PagerDuty kann manchmal etwas überladen wirken, wenn die Benachrichtigungen nicht gut gefiltert werden. Einige Einstellungen sind für neue Benutzer etwas komplex.
PagerDuty sorgt für schnelle und zuverlässige Incidents-Benachrichtigungen. Es sendet die richtigen Benachrichtigungen zum richtigen Zeitpunkt und sorgt für eine gute Organisation unseres Teams. […] PagerDuty kann manchmal etwas überladen wirken, wenn die Benachrichtigungen nicht gut gefiltert werden. Einige Einstellungen sind für neue Benutzer etwas komplex.
💡 Profi-Tipp: Legen Sie Ausnahmen fest, selbst bei einem klar definierten Eskalationspfad. Sorgen Sie dafür, dass kritische Ausfälle, Warnungen zur Sicherheit oder Incidents in regulierten Umgebungen direkt an leitende oder spezialisierte Mitarbeiter weitergeleitet werden.
3. GLPi (Am besten geeignet für durchgängige Asset-Governance und ITIL-konformen Servicebetrieb)
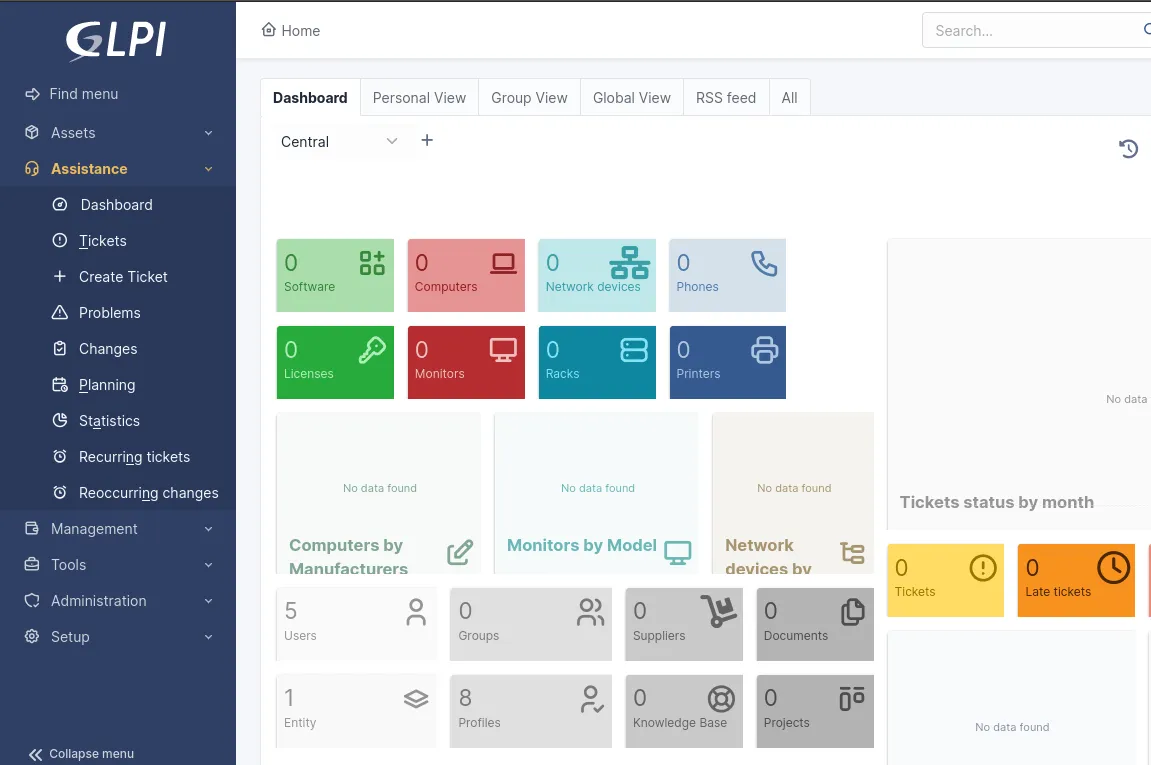
Gestionnaire Libre de Parc Informatique (GLPi) ist eine umfassende Open-Source-Plattform für IT-Service-Management (ITSM) und IT-Asset-Management (ITAM). Teams erhalten eine durchgängige Sichtbarkeit über ihre Infrastruktur (Hardware, Software, Lizenzen und Netzwerkgeräte) und können Incidents, Serviceanfragen und Änderungen mithilfe von ITIL-konformen Prozessen verwalten.
Alle Ihre Verträge und Unterlagen, einschließlich Garantien und Servicevereinbarungen, bleiben übersichtlich organisiert, sodass sie nicht in verschiedenen Systemen verloren gehen können. Wenn Sie Rechenzentren verwalten, können Sie mit GLPi sogar Layouts, Verkabelungswege und den Energieverbrauch visualisieren, sodass Sie stets wissen, was hinter den Kulissen vor sich geht.
Die besten Features von GLPi
- Verwenden Sie die Plugins GLPI Inventory, OCS Inventory oder FusionInventory, um neue IT-Assets automatisch zu erkennen und zu katalogisieren.
- Automatisieren Sie wiederholende Aufgaben, die Zuweisung von Tickets, Benachrichtigungen und wiederkehrende Ereignisse, um den manuellen Aufwand zu reduzieren.
- Erstellen Sie eine Wissensdatenbank mit FAQs, Dokumentationen und Artikeln, die mit Tickets verknüpft sind, um Self-Service und technischen Support zu ermöglichen.
- Stellen Sie eine Verbindung zu Azure/Entra, Centreon, Google, OAuth2 und Webhooks her, um eine Synchronisierung der Daten durchzuführen, Workflows als Auslöser zu verwenden und Ihre CMDB zu optimieren.
Limitierungen von GLPi
- Die Kompatibilität von Plugins kann zwischen verschiedenen Versionen beeinträchtigt sein, was zu zusätzlichem Wartungsaufwand führt.
- Die Funktionen für Berichterstellung, Analyse und Export wirken eingeschränkt und sind verbesserungswürdig.
GLPi-Preise
- Benutzerdefinierte Preisgestaltung
Bewertungen und Rezensionen zu GLPi
- G2: 4,6/5 (über 30 Bewertungen)
- Capterra: 4,5/5 (über 40 Bewertungen)
Was sagen echte Benutzer über GLPi?
Hier ist das Feedback eines Benutzers:
Sehr anpassbares Open-Source-System für das IT-Asset-Management und die Bearbeitung von Support-Tickets mit einer großen, aktiven Community. Die Benutzeroberfläche ist für Anfänger etwas kompliziert. Plugins werden nicht immer von älteren auf neuere Versionen übertragen.
Sehr anpassbares Open-Source-System für das IT-Asset-Management und die Bearbeitung von Support-Tickets mit einer großen, aktiven Community. Die Benutzeroberfläche ist für Anfänger etwas kompliziert. Plugins werden nicht immer von älteren auf neuere Versionen übertragen.
4. Splunk On-Call (Ideal für die direkte Weiterleitung von Überwachungswarnungen an Techniker)
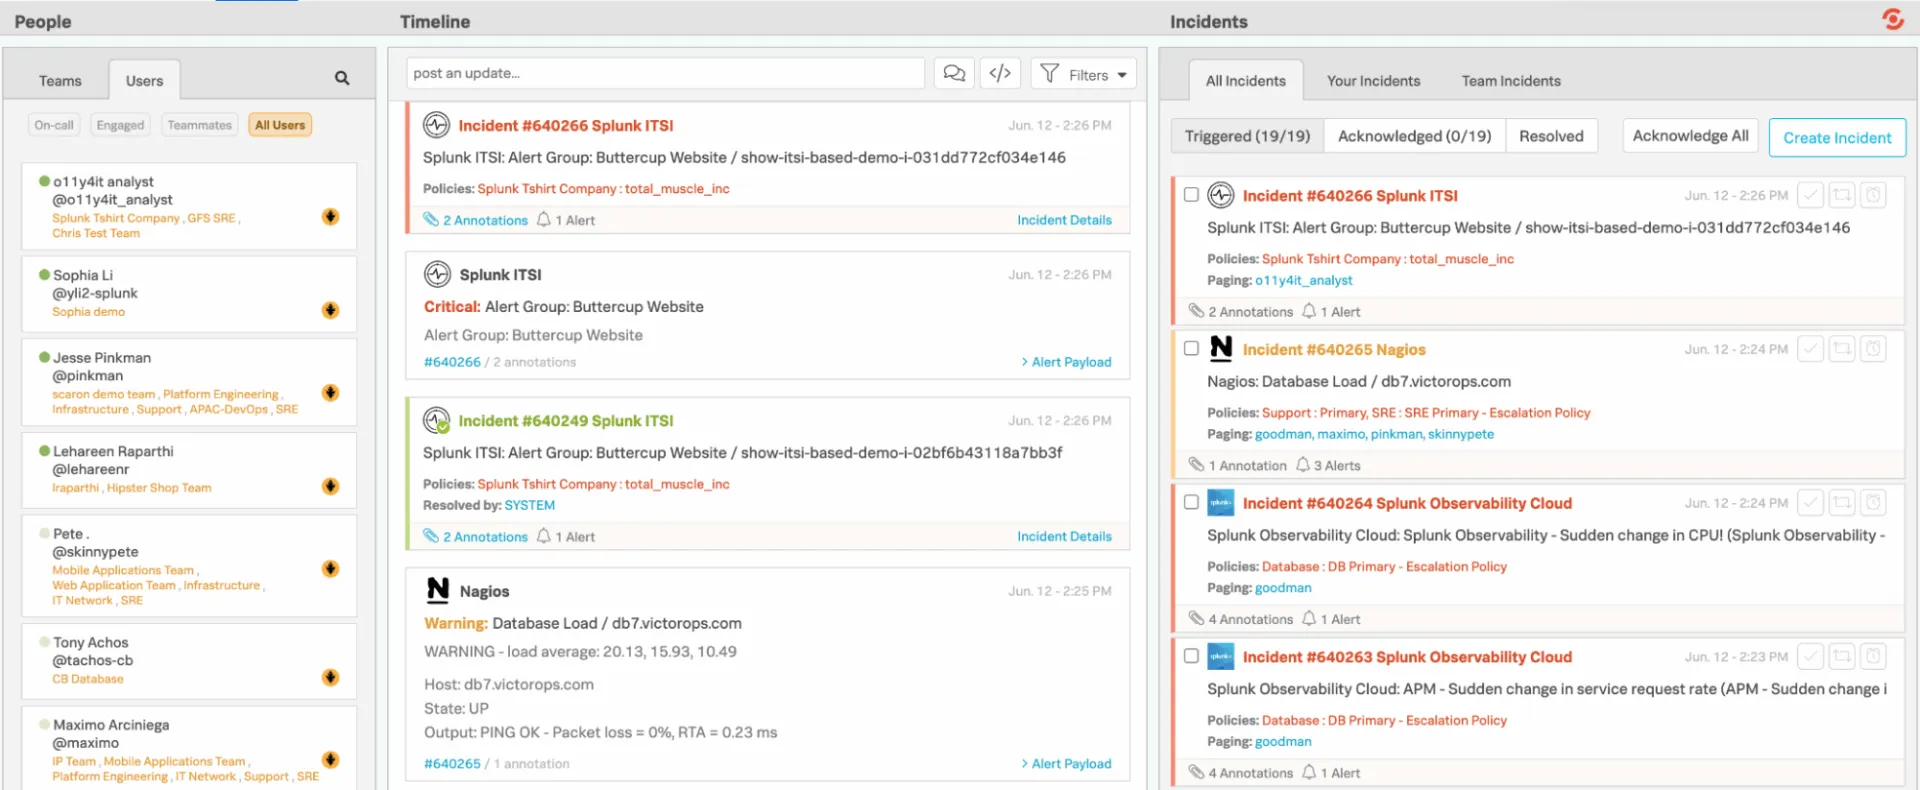
Splunk On-Call bietet Entwicklungs- und Bereitschaftsteams eine schnellere und übersichtlichere Möglichkeit, Incidents zu verwalten, und macht langsame, herkömmliche Ticket-Workflows überflüssig. Anstatt Warnmeldungen in eine allgemeine Warteschlange zu leiten, lässt sich die Lösung direkt in Ihren Überwachungs- und Observability-Stack integrieren und leitet Probleme auf der Grundlage von Zeitplänen, Regeln und Kontext sofort an die richtigen Ansprechpartner weiter.
Dank der Mobil- und Chat-Integrationen lassen sich Incidents ganz einfach von überall aus bestätigen, weiterleiten oder lösen. Und hinter den Kulissen protokolliert Splunk On-Call detailliert Trends, bewährte Muster und das Eskalationsverhalten.
Die besten Features von Splunk On-Call
- Erweitern Sie die Funktionen der Plattform mit über 1.000 geprüften Integrationen und Add-Ons von Splunk und der breiteren Community.
- Erstellen Sie benutzerdefinierte Dashboards und visuelle Berichte, um das Alarmvolumen, den Status von Incidents, die Leistung der Einsatzkräfte und die Workload des Teams zu überwachen.
- Filtern Sie Incidents schnell nach Ihren eigenen Aktivitäten, den Incidents Ihres Teams oder Alles, was im gesamten Unternehmen passiert.
- Wechseln Sie zwischen den Ansichten „Auslöser“, „Bestätigt“ und „Gelöst“, um den aktuellen Status jedes Incidents zu sehen.
Limitierungen von Splunk On-Call
- Die Planung von Schichten über mehrere Teams hinweg kann kompliziert werden, wenn keine Regeln vordefiniert sind
- Eingeschränkte Möglichkeiten zur Erstellung detaillierter, datumsbezogener Incidents
Preise für Splunk On-Call
- Benutzerdefinierte Preisgestaltung
Bewertungen und Rezensionen zu Splunk On-Call
- G2: 4,6/5 (über 40 Bewertungen)
- Capterra: 4,5/5 (über 30 Bewertungen)
Was sagen echte Benutzer über Splunk On-Call?
Ein Benutzer fasste es so zusammen:
Die Möglichkeit, Incidents und Eskalationen zu bearbeiten und meinen Teamkollegen über die App Dienstschichten zu übernehmen, ist großartig. […] Ich würde mir wünschen, dass ich über die App Ausnahmeregelungen planen und bei dringenden Änderungen am Dienstplan die reguläre Planung anpassen kann.
Die Möglichkeit, Incidents und Eskalationen zu bearbeiten und meinen Teamkollegen über die App Dienstschichten zu übernehmen, ist großartig. […] Ich würde mir wünschen, dass ich über die App Ausnahmeregelungen planen und bei dringenden Änderungen am Dienstplan die reguläre Planung anpassen kann.
🔍 Wussten Sie schon? Die Logik, einen Vorfall „an die richtige Person weiterzuleiten, wenn die erste Instanz versagt“, hat ihre Wurzeln in den frühen Telefonzentralen: Wenn manuelle Vermittler keine Verbindung zum Anruf herstellen konnten, leitete das System ihn an einen anderen Vermittler oder eine andere Vermittlungsstelle weiter (bzw. eskalierte ihn).
5. ServiceNow (Am besten geeignet für die Koordination unternehmensweiter Prozesse mit KI-gestützter Automatisierung)
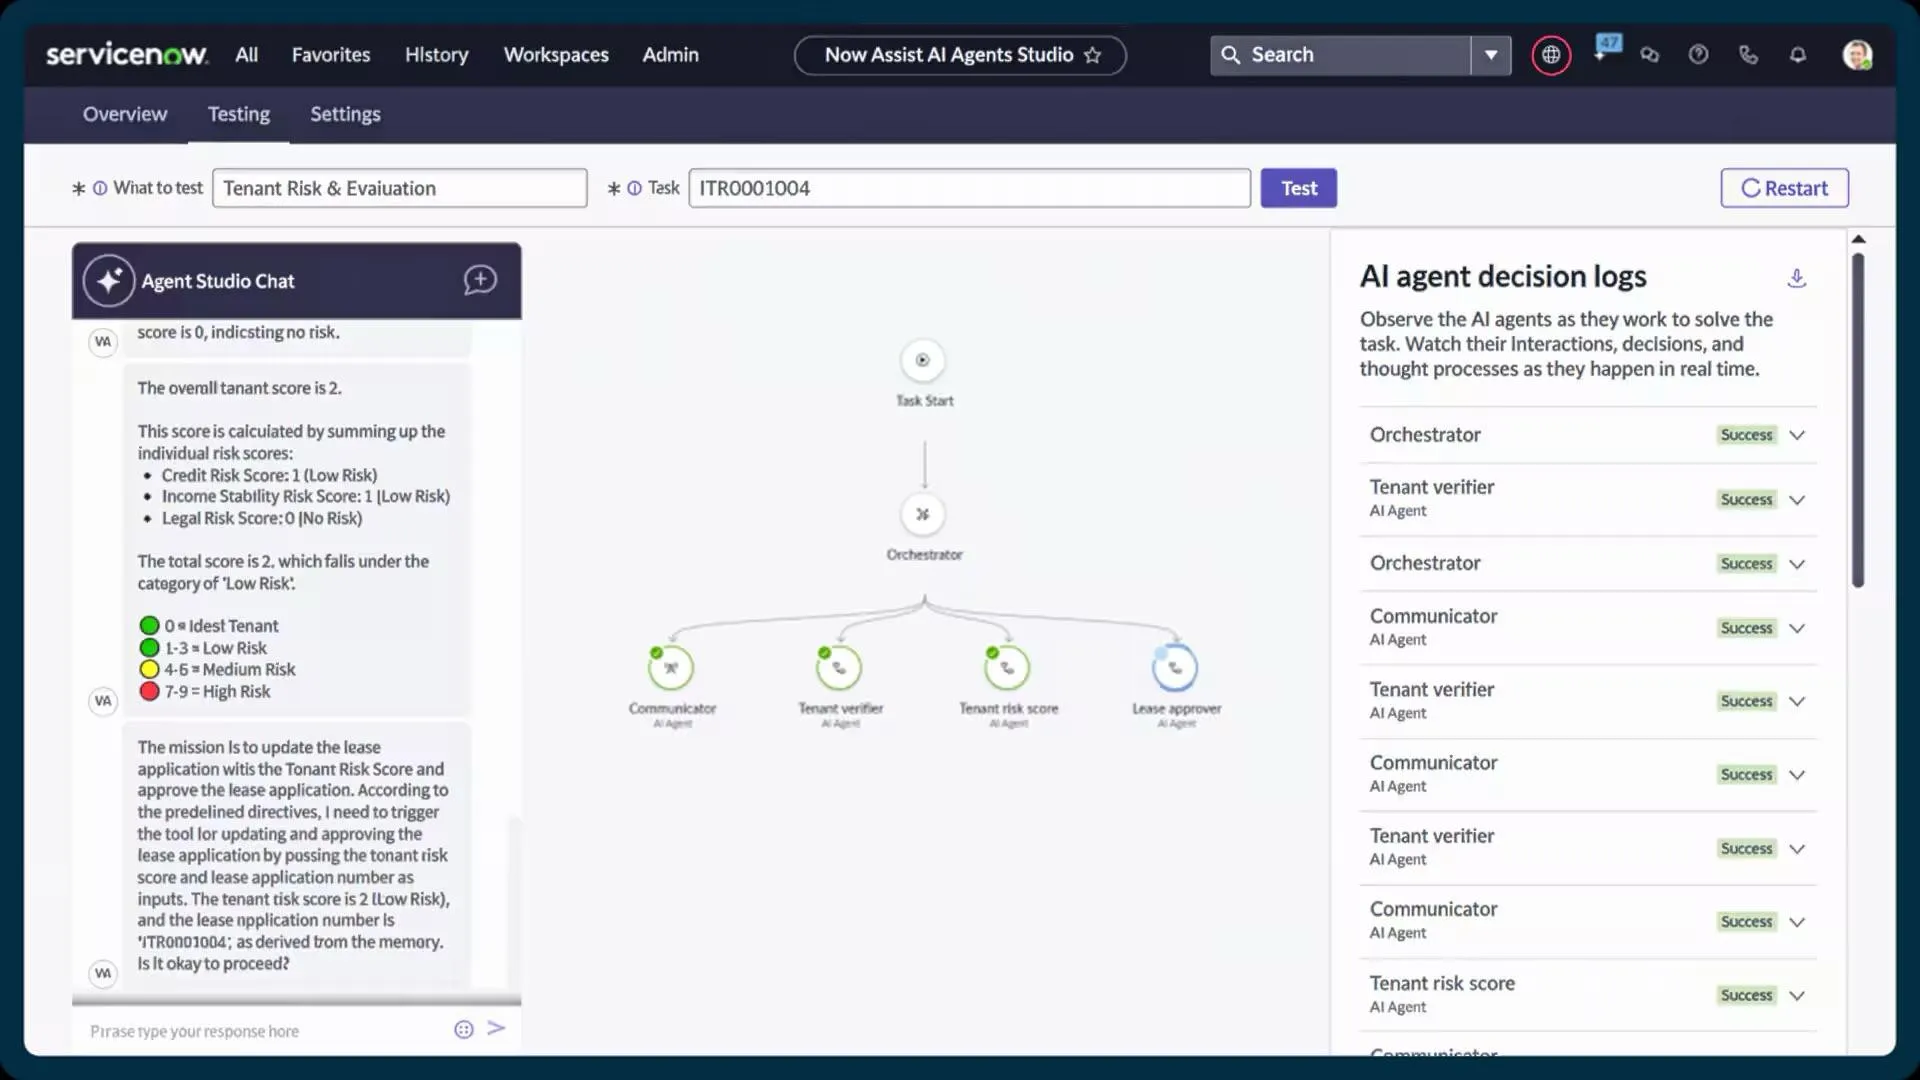
ServiceNow klassifiziert, priorisiert und leitet Vorfälle automatisch weiter, sobald sie erfasst werden. Mit Funktionen wie Now Assist für automatisierte Empfehlungen zu Incident-Tickets und die Erstellung intelligenter Inhalte können die Bearbeiter Probleme schneller und mit mehr Kontext lösen.
Es vereint das Incident-, Änderungs- und Anlagenmanagement. Auf diese Weise erhalten Sie eine Echtzeit-Ansicht darüber, wie Dienste miteinander verbunden sind, wo Engpässe auftreten und welche Komponenten möglicherweise zu wiederkehrenden Störungen beitragen.
Die besten Features von ServiceNow
- Weisen Sie Außendienstaufgaben über Field Service Management und Dispatcher Workspace zu, leiten Sie sie weiter und überwachen Sie sie.
- Stärken Sie Mitarbeiter und Kunden mit einem Self-Service-Portal, das auf KI Search und virtuellen Agenten basiert.
- Nutzen Sie integrierte Workflows und Low-Code-Tools in App Engine, um Serviceprozesse zu erweitern oder benutzerdefiniert anzupassen.
- Automatisieren Sie wiederholende Aufgaben und Workflows teamübergreifend mit Flow Designer und Automation Engine
Limitierungen von ServiceNow
- Die Optionen für die Benutzeroberfläche und das Portal-Branding wirken veraltet oder einschränkend
- Hohe Abhängigkeit von qualifiziertem Personal oder Beratern bei der Umsetzung
Preise für ServiceNow
- Benutzerdefinierte Preisgestaltung
ServiceNow-Bewertungen und Rezensionen
- G2: 4,4/5 (über 3.300 Bewertungen)
- Capterra: 4,5/5 (über 300 Bewertungen)
Was sagen echte Benutzer über ServiceNow?
Ein Benutzer hat es so formuliert:
[…] Die vorgefertigten Flows sind für mich ein weiteres Highlight, da sie Prozesse optimieren und viel Zeit sparen, den Bedarf an benutzerdefinierten Konfigurationen minimieren und einen reibungsloseren, effizienteren Workflow ermöglichen. […] Außerdem hatte ich Schwierigkeiten, meine benutzerdefinierte Lösung in das Kundenservice-Management-System zu integrieren, was zahlreiche Iterationen erforderte.
[…] Die vorgefertigten Flows sind für mich ein weiteres Highlight, da sie Prozesse optimieren und viel Zeit sparen, den Bedarf an benutzerdefinierten Konfigurationen minimieren und einen reibungsloseren, effizienteren Workflow ermöglichen. […] Außerdem hatte ich Schwierigkeiten, meine benutzerdefinierte Lösung in das Kundenservice-Managementsystem zu integrieren, was zahlreiche Iterationen erforderte.
Best Practices und Governance
Hier finden Sie einige Best Practices, die sicherstellen, dass die Automatisierung präzise bleibt, eine Alarmüberflutung verhindert und den geschäftlichen sowie regulatorischen Erwartungen entspricht.
- Definieren Sie unverhandelbare Eskalationskriterien: Verknüpfen Sie Auslöser mit messbaren Signalen wie SLO-Verstößen, Anomaliespitzen, Auswirkungen auf Kundengruppen oder regulatorischer Relevanz.
- Sorgen Sie auf jeder Ebene für klare Rollenverteilung: Verwenden Sie für jede Eskalationsstufe eine einfache RACI-Karte, damit die Zuständigkeiten bei Incidents unter hohem Druck niemals unklar sind.
- Dynamische Regelung des Bereitschaftsdienstes durchsetzen: Passen Sie Eskalationspfade automatisch an Wochenenden, Feiertagen, Limiten der Kapazität und Schichtwechseln an, um Burnout zu reduzieren und stille Seiten-Benachrichtigungen zu vermeiden.
- Fügen Sie manuelle Kontrollpunkte für Szenarien mit hohem Risiko ein: Verlangen Sie auch bei Automatisierung eine manuelle Bestätigung für Incidents, bei denen Kundendaten offengelegt werden, Zahlungen betroffen sind oder regulierte Workflows eine Rolle spielen.
- Führen Sie lückenlose Prüfpfade: Erstellen Sie unveränderliche Protokolle darüber, wer benachrichtigt wurde, wann die Benachrichtigung bestätigt wurde, welche automatisierten Schritte ausgelöst wurden und welche Entscheidungen getroffen wurden.
🧠 Wissenswertes: Die älteste bekannte schriftliche Beschwerde der Welt wurde um 1750 v. Chr. auf eine Tontafel geritzt. Im Grunde handelte es sich dabei um eine frühe Form der Eskalation des Projekt-Status. Ein Kunde namens Nanni schrieb an den Kaufmann Ea-nāṣir und war wütend darüber, dass das gelieferte Kupfer von minderer Qualität war als versprochen und dass sein Bote schlecht behandelt worden war.
Häufige Herausforderungen und wie man sie bewältigt
Selbst mit einer klaren Eskalationsrichtlinie sehen sich Teams oft mit operativen Hürden konfrontiert, die die Reaktion auf Incidents verlangsamen oder Verwirrung stiften.
Diese Tabelle zeigt häufige Herausforderungen auf, die über die grundlegenden Setup-Schritte hinausgehen, und bietet umsetzbare Strategien zu deren Bewältigung.
| Herausforderungen ❌ | Lösungen ✅ |
| Uneinheitliche Kontextinformationen bei der Übergabe | Nutzen Sie die Verknüpfungen zwischen Aufgaben und Vorlagen für Vorfallberichte von ClickUp, um auf jeder Eskalationsstufe einen lückenlosen Prüfpfad mit Vorfalldetails, betroffenen Systemen und zuvor ergriffenen Maßnahmen zu führen. |
| Überlastung der Einsatzkräfte durch Warnmeldungen mit niedriger Priorität | Implementieren Sie eine dynamische Priorisierung mit ClickUp-Benutzerdefinierten Feldern und KI Prioritize, um Incidents anhand von Schweregrad, Auswirkungen und SLA-Schwellenwerten zu filtern. |
| Mangelnde teamübergreifende Sichtbarkeit | Richten Sie gemeinsame Workspaces ein, fügen Sie Kommentare hinzu und erstellen Sie visuelle ClickUp-Whiteboards, um den Beteiligten Echtzeit-Updates zu präsentieren. |
| Verzögerte Entscheidungsfindung bei kritischen Incidents | Automatisieren Sie Benachrichtigungen mithilfe der Vorgeschlagenen Aktionen von ClickUp Brain Max, um je nach Typ des Incidents, Schweregrad und historischen Mustern sofort die richtigen Mitarbeiter zu benachrichtigen. |
| Schwierigkeiten bei der Nachverfolgung wiederkehrender Probleme | Nutzen Sie die benutzerdefinierten Funktionen für die Berichterstellung und Vorlagen für wiederholende Aufgaben von ClickUp, um Muster, Ursachen und wiederholende Incidents zu identifizieren und so proaktiv vorbeugen zu können. |
| Zersplittertes Wissen bei der Eskalation | Verwalten Sie zentralisierte SOPs, Runbooks und Incidents in ClickUp Docs und verknüpfen Sie diese mit den entsprechenden Aufgaben, um bei laufenden Eskalationen sofort darauf zugreifen zu können. |
| Unklare Zuständigkeiten zwischen den Schichten | Nutzen Sie die Workload-Ansicht und die Zeitleiste von ClickUp, um Aufgaben zu visualisieren und sicherzustellen, dass es bei Schichtwechseln oder Übergaben zu keinen Überschneidungen oder Lücken kommt. |
| Manuelle Nachverfolgung der Compliance und Lücken bei Audits | Automatisieren Sie auditfähige Zusammenfassungen mit ClickUp Brain, um alle Maßnahmen, Benachrichtigungen und Lösungen im Zusammenhang mit Incidents zu protokollieren. |
Messung der Auswirkungen automatisierter Eskalationen
Um die Effektivität automatisierter Eskalationen zu verfolgen, müssen Sie sich auf wichtige Metriken in den Bereichen Volumen, Effizienz und Qualität konzentrieren. Diese Indikatoren zeigen, ob Ihre Eskalationsprozesse schneller und präziser ablaufen und sowohl für die Teams als auch für die Kunden weniger frustrierend sind.
Verfolgen Sie folgende Metriken:
- Eskalationsrate (Volumen): Prozentsatz der Probleme, die über die erste Ebene hinaus eskaliert wurden. Hohe Raten können auf Lücken bei der ersten Triage oder in den Wissensdatenbanken hindeuten.
- Wiederholungsrate bei Eskalationen (Volumen): Häufigkeit, mit der dasselbe Problem mehrfach eskaliert wird. Dies deutet auf unvollständige Lösungen oder fehlenden Kontext hin.
- Zeit bis zur Eskalation (Effizienz): Dauer von der Erkennung bis zur Eskalation. Kürzere Phasen-Dauern deuten auf eine schnellere Automatisierung der Erkennung kritischer Probleme hin.
- Verzögerungszeit bei der Übergabe (Effizienz): Zeitabstand zwischen der Eskalation und dem Beginn der Arbeit durch das nächste Team, um Reibungsverluste bei der Weiterleitung oder Benachrichtigung aufzuzeigen
- Lösungszeit für eskalierte Fälle (Effizienz): Gesamtzeit von der Eskalation bis zur Lösung. Eine schnellere Lösung zeigt die Wirksamkeit der Automatisierung.
- Kundenzufriedenheitswert (CSAT) (Qualität): Feedback zu eskalierten Interaktionen, um den reibungslosen Ablauf des Eskalationspfads zu messen
- Kontextweitergabe (Qualität): Ob die Mitarbeiter den vollständigen Incident-Verlauf erhalten, um sicherzustellen, dass Kunden Informationen nicht wiederholen müssen
- First-Contact-Resolution (FCR) (Qualität): Prozentsatz der Probleme, die in einem einzigen Kontakt gelöst wurden
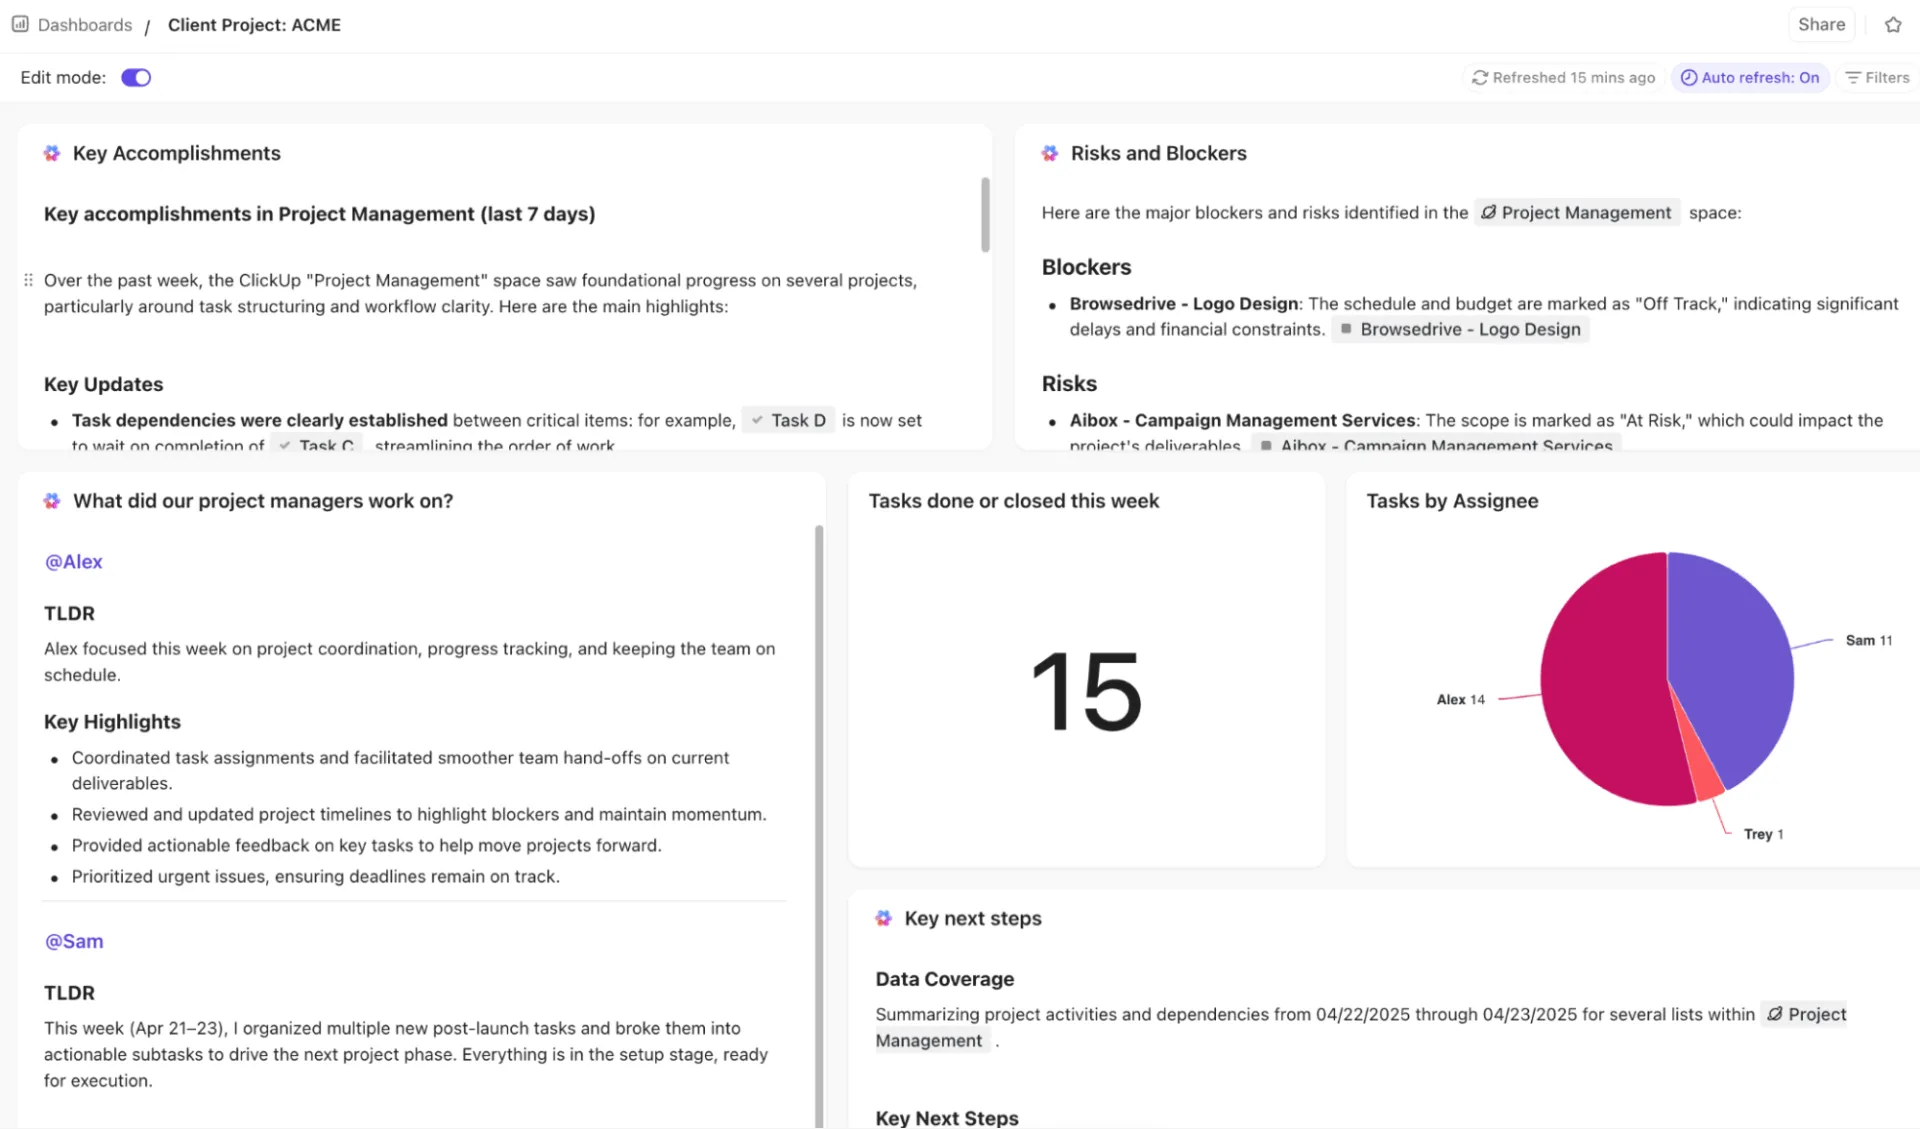
🚀 ClickUp-Vorteil: Mit ClickUp-Dashboards erhalten Sie visuelle, KI-gestützte Einblicke in Echtzeit zu allen Eskalationsmetriken.
Mit Tabellen-, Kreisdiagramm-, Balkendiagramm-, Liniendiagramm-, Berechnungs- und Zeit-Berichtskarten können Sie Eskalationstrends, Engpässe und die Leistung nachverfolgen. Überwachen Sie die Eskalationsrate, wiederholte Eskalationen und die Zeit bis zur Eskalation mithilfe von Karten, die mit Aufgaben, benutzerdefinierten Feldern und Status verknüpft sind.
Um noch einen Schritt weiter zu gehen, nutzen Sie KI-Karten wie KI-Zusammenfassung, KI-Projekt-Update und KI-StandUp, um Trends, Verzögerungen und Lösungsergebnisse hervorzuheben.
Verwalten Sie Ihre Incidents schneller mit ClickUp
Viele glauben, bei der Eskalation von Incidents gehe es lediglich darum, ein Ticket an die nächste Person weiterzuleiten, doch es steckt viel mehr dahinter. Es handelt sich um ein strukturiertes System, in dem jeder Schritt – von der Triage bis zur Lösung – harmonisch ineinandergreift.
ClickUp bietet Ihnen den perfekten einheitlichen Arbeitsbereich. Mit ClickUp Automatisierungen können Sie automatisch Benachrichtigungen auslösen, Aufgaben weiterleiten und Status aktualisieren. Und ClickUp Brain hilft Ihnen dabei, Vorfälle zu priorisieren, Zusammenfassungen zu erstellen und nächste Schritte vorzuschlagen.
ClickUp AI-Agenten fungieren als intelligente Assistenten in Ihrem Workspace, während ClickUp-Dashboards eine Echtzeit-Ansicht Ihrer Eskalationen bieten.
Melden Sie sich noch heute kostenlos bei ClickUp an!
Häufig gestellte Fragen (FAQ)
Was ist ein Eskalationspfad für Incidents?
Ein Eskalationspfad für Vorfälle ist eine vordefinierte Abfolge von Schritten, die festlegt, wie Probleme je nach Schweregrad, Auswirkung und Zeitpunkt an das richtige Team oder die richtige Person weitergeleitet werden. Er stellt sicher, dass Vorfälle effizient bearbeitet werden und die Verantwortlichkeiten klar sind. TEXT
Wie entscheide ich, wann ein Incident automatisch und wann manuell eskaliert werden soll?
Setzen Sie Automatisierung für klar definierte Incidents mit hoher Priorität und eindeutigen Kriterien ein (z. B. Dienstausfälle, Verletzungen der Sicherheit). Behalten Sie die manuelle Eskalation für unklare oder kritische Situationen vor, die menschliches Urteilsvermögen oder zusätzliche Kontextinformationen erfordern.
Welche Tools unterstützen die Automatisierung der Eskalation für ein effektives Vorfallmanagement?
Plattformen wie ClickUp, PagerDuty, Jira Service Management und ServiceNow ermöglichen automatisierte Weiterleitung, Benachrichtigungen und Aktualisierungen. Sie helfen Teams dabei, Verzögerungen zu reduzieren und strukturierte Incident-Workflows aufrechtzuerhalten.
Wie kann ich bei der Verwendung von Automatisierungen für Eskalationen eine Alarmmüdigkeit vermeiden?
Legen Sie klare Schwellenwerte für Warnmeldungen fest, priorisieren Sie diese nach Schweregrad und nutzen Sie intelligente Benachrichtigungen. Beschränken Sie wiederholte Benachrichtigungen auf kritische Incidents und nutzen Sie Dashboards oder KI-Tools, um Aktualisierungen zusammenzufassen, anstatt jede noch so kleine Änderung zu melden.
Wie oft sollte ich meine Eskalationsrichtlinien überprüfen?
Überprüfen Sie die Eskalationsrichtlinien regelmäßig, mindestens vierteljährlich oder nach schwerwiegenden Incidents. So stellen Sie sicher, dass Kriterien, Zuständigkeiten und Regeln der Automatisierung den aktuellen Workflows, Teamstrukturen und Prioritäten des Geschäfts entsprechen.