U brengt de nieuwste software-update uit en de rapportages stromen binnen.
Plotseling is er één statistiek die alles bepaalt, van CSAT/NPS tot vertragingen in de roadmap: de tijd die nodig is om bugs op te lossen.
Leidinggevenden zien het als een maatstaf voor het nakomen van beloften: kunnen we op tijd opleveren, leren en de omzet veiligstellen? Praktijkmensen ondervinden de dagelijkse problemen in de praktijk: dubbele tickets, onduidelijke eigendommen, onnodige escalaties en context die verspreid is over Slack, spreadsheets en afzonderlijke tools.
De versnippering verlengt de cyclusen, verhult de onderliggende oorzaken en maakt van prioritering een kwestie van giswerk.
Het resultaat? Trager leerproces, niet-nagekomen toewijzingen en een achterstand die elke Sprint stilletjes onder druk zet.
Deze gids is uw complete handleiding voor het meten, vergelijken en verkorten van de tijd die nodig is om bugs op te lossen, en laat concreet zien hoe AI de werkstroom verandert in vergelijking met traditionele, handmatige processen.
Wat is de tijd die nodig is om bugs op te lossen?
De tijd die nodig is om een bug op te lossen is de tijd die verstrijkt vanaf het moment dat de bug wordt gemeld totdat deze volledig is opgelost.
In de praktijk begint de klok te lopen wanneer een probleem wordt gemeld of gedetecteerd (door gebruikers, QA of monitoring) en stopt deze wanneer de oplossing is geïmplementeerd en samengevoegd, klaar voor verificatie of release – afhankelijk van hoe uw team ‘Klaar’ definieert.
Voorbeeld: een P1-crash die op Monday om 10.00 uur is gemeld, waarbij de oplossing op dinsdag om 15.00 uur is samengevoegd, heeft een oplostijd van ~29 uur.
Dit is niet hetzelfde als de detectietijd van bugs. De detectietijd meet hoe snel u een defect herkent nadat het zich heeft voorgedaan (alarmen gaan af, QA-testtools ontdekken het, klanten voeren rapportage uit over het defect).
De oplostijd geeft aan hoe snel u van signalering naar oplossing gaat: triage, reproduceren, diagnosticeren, implementeren, controleren, testen en voorbereiden voor release. Beschouw detectie als ‘we weten dat het niet werkt’ en oplossing als ‘het is gerepareerd en klaar’.
Teams hanteren soms iets andere afbakeningen; kies er één en houd je daar consequent aan, zodat je trends een betrouwbaar beeld geven:
- Gemeld → Opgelost: Eindigt wanneer de code-fix is samengevoegd en klaar is voor kwaliteitscontrole. Geschikt voor de doorvoer van engineeringprojecten
- Gemeld → Gesloten: Inclusief QA-validatie en release. Het meest geschikt voor SLA's die van invloed zijn op klanten
- Gedetecteerd → Opgelost: Begint wanneer monitoring/QA het probleem detecteert, nog voordat er een ticket bestaat. Handig voor teams die veel in productie werken
🧠 Leuk weetje: Een eigenaardige maar hilarische bug in Final Fantasy XIV werd geprezen omdat hij zo specifiek was dat lezers hem de titel „Meest specifieke bugfix in een MMO 2025” gaven. ” De bug deed zich voor wanneer spelers in een bepaalde zone tijdens een gebeurtenis de prijs van items vaststelden op precies tussen de 44.442 gil en 49.087 gil, wat leidde tot verbroken verbindingen als gevolg van wat mogelijk een glitch door een integer overflow was.
Waarom dit belangrijk is
De oplostijd is een hefboom voor het releasetempo. Lange of onvoorspelbare oplostijden dwingen tot het inperken van de scope, hotfixes en het bevriezen van releases; ze zorgen voor planningsachterstanden omdat de 'long tail' (uitbijters) Sprints meer ontsporen dan het gemiddelde doet vermoeden.
Dit hangt ook rechtstreeks samen met de klanttevredenheid. Klanten accepteren problemen als deze snel worden erkend en op voorspelbare wijze worden opgelost. Trage oplossingen – of erger nog, wisselende oplossingen – leiden tot escalaties, hebben een negatieve invloed op de CSAT/NPS en brengen verlengingen in gevaar.
Kortom: als u de tijd die nodig is om bugs op te lossen nauwkeurig meet en deze systematisch verkort, zullen uw roadmaps en relaties verbeteren.
Hoe meet u de tijd die nodig is om bugs op te lossen?
Bepaal eerst waar uw tijdregistratie begint en eindigt.
De meeste teams kiezen voor ‘Gemeld → Opgelost’ (de oplossing is samengevoegd en klaar voor verificatie) of ‘Gemeld → Gesloten’ (QA heeft de wijziging gevalideerd en deze is vrijgegeven of op een andere manier afgesloten).
Kies één definitie en gebruik deze consequent, zodat uw trends betekenisvol zijn.
Nu hebt u enkele meetbare statistieken nodig. Laten we deze eens op een rijtje zetten:
Belangrijke statistieken voor het bijhouden van bugs om in de gaten te houden:
| 📊 Metriek | 📌 Wat het betekent | 💡 Hoe dit helpt | 🧮 Formule (indien van toepassing) |
|---|---|---|---|
| Aantal bugs 🐞 | Totaal nummer van gemelde bugs | Geeft een weergave van de systeemstatus. Is het nummer hoog? Tijd om dit te onderzoeken. | Totaal aantal bugs = alle bugs die in het systeem zijn geregistreerd {Open + Gesloten} |
| Openstaande bugs 🚧 | Bugs die nog niet zijn verholpen | Geeft de huidige werklast weer. Helpt bij het stellen van prioriteiten. | Openstaande bugs = Totaal aantal bugs - Gesloten bugs |
| Gesloten bugs ✅ | Opgeloste en geverifieerde bugs | Houdt de voortgang en het verrichte werk bij. | Gesloten bugs = Aantal bugs met de status "Gesloten" of "Opgelost" |
| Ernst van bugs 🔥 | Ernstgraad van de bug (bijv. kritiek, ernstig, licht) | Helpt bij het triageren op basis van impact. | Geregistreerd als categorisch veld, geen formule. Gebruik filters/groepering. |
| Prioriteit van bugs 📅 | Hoe urgent is het om een bug te verhelpen? | Dit helpt bij de planning van Sprints en releases. | Ook een categorisch veld, dat doorgaans wordt gerangschikt (bijv. P0, P1, P2). |
| Oplostijd ⏱️ | Tijd tussen bugmelding en oplossing | Meet de reactiesnelheid. | Oplostijd = Datum van geslotenheid - Datum van rapportage |
| Heropeningspercentage 🔄 | Percentage bugs dat na afsluiting opnieuw is geopend | Geeft de kwaliteit van de oplossing of problemen weer. | Heropeningspercentage (%) = {Heropende bugs ÷ Totaal aantal gesloten bugs} × 100 |
| Buglekkage 🕳️ | Bugs die in de productie zijn geslopen | Geeft de effectiviteit van QA /softwaretesten aan. | Lekpercentage (%) = {Productbugs ÷ Totaal aantal bugs} × 100 |
| Defectdichtheid 🧮 | Bugs per eenheid van de code-grootte | Brengt risicovolle codegebieden in kaart. | Foutdichtheid = Aantal bugs ÷ KLOC {Kilo Lines of Code} |
| Toegewezen versus niet-toegewezen bugs 👥 | Verdeling van bugs naar eigendom | Zorgt ervoor dat er niets door de mazen van het net glipt. | Gebruik een filter: Niet toegewezen = Bugs waarbij "Toegewezen aan" leeg is |
| Leeftijd van openstaande bugs 🧓 | Hoe lang blijft een bug onopgelost? | Signaleert risico's op stagnatie en achterstanden. | Leeftijd van de bug = huidige datum - datum van melding |
| Dubbele bugs 🧬 | Aantal dubbele meldingen | Brengt fouten in intake-processen aan het licht. | Duplicaatpercentage = Aantal duplicaten ÷ Totaal aantal bugs × 100 |
| MTTD (Mean Time to Detect) 🔎 | Gemiddelde tijd die nodig is om bugs of incidenten op te sporen | Meet de efficiëntie van monitoring en bewustwording. | MTTD = Σ(Tijd van detectie - Tijd van ontstaan) ÷ Nummer van bugs |
| MTTR (Mean Time to Resolve) 🔧 | Gemiddelde tijd die nodig is om een bug volledig te verhelpen na detectie | Houdt de reactiesnelheid van de engineeringafdeling en de reparatietijd bij. | MTTR = Σ(Tijd van oplossing - Tijd van detectie) ÷ Nummer opgeloste bugs |
| MTTA (Mean Time to Acknowledge) 📬 | De tijd tussen het moment van detectie en het moment waarop iemand begint met het werk aan de bug | Geeft inzicht in de reactiesnelheid van het team en de respons op waarschuwingen. | MTTA = Σ(Tijd van bevestiging - Tijd van detectie) ÷ Nummer van bugs |
| MTBF (Mean Time Between Failures) 🔁 | De tijd tussen het oplossen van een storing en het optreden van de volgende | Geeft de stabiliteit in de loop van de tijd aan. | MTBF = Totale uptime ÷ Aantal storingen |
⚡️ Sjabloonarchief: 15 gratis sjablonen en formulieren voor bugrapporten voor het bijhouden van bugs
Factoren die van invloed zijn op de tijd die nodig is om bugs op te lossen
De oplostijd wordt vaak gelijkgesteld aan „hoe snel ontwikkelaars codeen“.
Maar dat is slechts één onderdeel van het proces.
De tijd die nodig is om bugs op te lossen, is het resultaat van de kwaliteit bij de intake, de efficiëntie van de doorstroom in uw systeem en het risico op afhankelijkheden. Wanneer een van deze factoren hapert, neemt de cyclustijd toe, neemt de voorspelbaarheid af en klinken de klachten steeds luider.
De kwaliteit van de intake bepaalt de toon
Meldingen die binnenkomen zonder duidelijke stappen om het probleem te reproduceren, details over de omgeving, logbestanden of versie-/build-informatie leiden tot extra heen-en-weer-communicatie. Dubbele meldingen via meerdere kanalen (support, QA, monitoring, Slack) zorgen voor ruis en versnipperen de eigendom.
Hoe eerder u de juiste context vastlegt – en dubbele gegevens verwijdert – hoe minder overdrachten en verduidelijkende vragen u later nodig zult hebben.
Prioritering en toewijzing bepalen wie de bug behandelt en wanneer
Ernstlabels die niet in kaart brengen wat de impact is voor klanten of het bedrijf (of die in de loop van de tijd verschuiven) leiden tot onrust in de wachtrij: de meest opvallende tickets springen voor, terwijl defecten met grote impact blijven liggen.
Duidelijke routeringsregels per component/eigenaar en één enkele ‘waarheidsqueue’ zorgen ervoor dat P0/P1-werk niet onder ‘recent en rumoerig’ begraven raakt.
Eigendom en overdrachten zijn stille moordenaars
Als het onduidelijk is of een bug onder de verantwoordelijkheid van het mobiele team, het backend-authenticatieteam of het platformteam valt, wordt de bug doorgestuurd. Bij elke doorverwijzing wordt de context opnieuw ingesteld.
Tijdzones maken dit nog complexer: een bug die laat op de dag wordt gemeld zonder dat er een eigenaar is aangewezen, kan 12–24 uur verloren gaan voordat iemand zelfs maar begint met het reproduceren ervan. Duidelijke afspraken over ‘wie waarvoor eigenaar is’, met een dienstdoende of wekelijkse DRI, voorkomen dat dit gebeurt.
Reproduceerbaarheid is afhankelijk van observeerbaarheid
Schrale logbestanden, ontbrekende correlatie-ID’s of een gebrek aan crash-traces maken van diagnose giswerk. Bugs die alleen optreden bij specifieke vlaggen, tenants of vormen van gegevens zijn moeilijk te reproduceren in de ontwikkelomgeving.
Als engineers geen veilige toegang hebben tot gezuiverde, productie-achtige gegevens, moeten ze instrumenteren, opnieuw implementeren en wachten – dagen in plaats van uren.
Consistentie in omgeving en gegevens zorgt ervoor dat u betrouwbare resultaten krijgt
"Het werkt op mijn machine" betekent meestal "de productiedata is anders". Hoe meer je dev/staging-omgeving afwijkt van de productieomgeving (configuratie, services, versies van third-party-software), hoe meer tijd je kwijt bent aan het najagen van schimmen. Veilige datasnapshots, seed-scripts en pariteitscontroles verkleinen die kloof.
Lopende werkzaamheden en focus bepalen de daadwerkelijke doorvoer
Overbelaste teams krijgen te veel bugs tegelijk op hun bord, versnipperen hun aandacht en schakelen voortdurend heen en weer tussen taken en vergaderingen. Het wisselen van context kost onzichtbare uren.
Een zichtbare WIP-limiet en de neiging om eerst af te maken wat je bent begonnen voordat je nieuw werk aanneemt, zullen je mediaan sneller omlaag brengen dan welke individuele heldenprestatie dan ook.
Code review, CI en de snelheid van kwaliteitscontrole zijn klassieke knelpunten
Trage bouwtijden, onbetrouwbare tests en onduidelijke SLA’s voor beoordelingen vertragen anders zo snelle oplossingen. Een patch van 10 minuten kan twee dagen in beslag nemen door het wachten op een beoordelaar of het inpassen in een urenlange pijplijn.
Evenzo kunnen QA-wachtrijen waarin tests in batches worden uitgevoerd of die afhankelijk zijn van handmatige rooktests, hele dagen toevoegen aan het traject „Gemeld → Gesloten“, zelfs als het traject „Gemeld → Opgelost“ snel verloopt.
Afhankelijkheden zorgen voor langere wachtrijen
Teamoverschrijdende wijzigingen (schema's, platformmigraties, SDK-updates), bugs bij leveranciers of beoordelingen in de app-store (mobiel) zorgen voor wachttijden. Zonder expliciete tracking van 'Geblokkeerd/Gepauzeerd' zorgen die wachttijden er onzichtbaar voor dat uw gemiddelden omhoogschieten en dat de echte knelpunten verborgen blijven.
Het releasemodel en de rollback-strategie zijn van belang
Als u in grote release-treinen met handmatige poorten uitbrengt, blijven zelfs opgeloste bugs liggen totdat de volgende trein vertrekt. Functie-flags, canary-releases en hotfix-lanes verkorten de wachttijd – vooral voor P0/P1-incidenten – doordat u de implementatie van fixes kunt loskoppelen van volledige cycli van releasing.
Architectuur en technische schuld bepalen uw limiet
Strakke koppeling, het ontbreken van testgrenzen en verouderde modules maken eenvoudige aanpassingen riskant. Teams compenseren dit met extra tests en langere reviews, waardoor de cyclus langer duurt. Omgekeerd stelt modulaire code met goede contracttests je in staat om snel te handelen zonder aangrenzende systemen te verstoren.
Communicatie en statusbeheer beïnvloeden de voorspelbaarheid
Vage updates (“we kijken ernaar”) leiden tot extra werk wanneer belanghebbenden om een verwachte opleverdatum vragen, de supportafdeling tickets heropent of het productteam de kwestie escaleert. Duidelijke statuswijzigingen, aantekeningen over het reproduceren van het probleem en de onderliggende oorzaak, en een gepubliceerde verwachte opleverdatum verminderen het verloop en zorgen ervoor dat uw engineeringteam gefocust blijft.
📮ClickUp Insight: De gemiddelde professional besteedt meer dan 30 minuten per dag aan het zoeken naar werkgerelateerde informatie – dat is meer dan 120 uur per jaar die verloren gaat aan het doorzoeken van e-mails, Slack-threads en verspreide bestanden.
Een intelligente AI-assistent die in uw werkruimte is geïntegreerd, kan daar verandering in brengen. Maak kennis met ClickUp Brain. Het biedt direct inzicht en antwoorden door binnen enkele seconden de juiste documenten, gesprekken en taakdetails naar voren te halen – zodat u kunt stoppen met zoeken en aan de slag kunt gaan.
💫 Concrete resultaten: Teams zoals QubicaAMF hebben met ClickUp wekelijks meer dan 5 uur teruggewonnen – dat is meer dan 250 uur per jaar per persoon – door verouderde kennisbeheerprocessen te elimineren. Stel je eens voor wat jouw team zou kunnen bereiken met een extra week productiviteit per kwartaal!
Belangrijke signalen die erop wijzen dat uw Lead Time zal oplopen
❗️Toenemende ‘Time to Acknowledge’ en veel tickets die al meer dan 12 uur geen eigenaar hebben
❗️Toenemende segmenten van "Time in Review/CI" en frequente testinstabiliteit
❗️Hoog percentage duplicaten bij de intake en inconsistente ernstlabels tussen teams
❗️Er staan verschillende bugs in de status „Geblokkeerd“ zonder dat er een externe afhankelijkheid is opgegeven
❗️Het percentage heropende tickets stijgt langzaam (oplossingen zijn niet reproduceerbaar of de definities van ‘Klaar’ zijn vaag)
Verschillende organisaties ervaren deze factoren op verschillende manieren. Leidinggevenden ervaren ze als gemiste leercyclusen en vertraging ten opzichte van omzetkansen; uitvoerende medewerkers ervaren ze als ruis bij de triage en onduidelijke eigendomsverhoudingen.
Door de intake, de werkstroom en de afhankelijkheden te optimaliseren, kunt u de hele curve – zowel de mediaan als de P90 – naar beneden brengen.
Wil je meer informatie over het schrijven van betere bugrapporten? Begin hier. 👇🏼
📖 Lees meer: De softwaretesten-cyclus (STLC): Overzicht en fasen
Branchebenchmarks voor de tijd die nodig is om bugs op te lossen
Benchmarks voor het oplossen van bugs variëren afhankelijk van de risicotolerantie, het releasemodel en de snelheid waarmee u wijzigingen kunt doorvoeren.
Hier kunt u medianen (P50) gebruiken om inzicht te krijgen in uw typische werkstroom en P90 om toezeggingen en SLA's in te stellen – op basis van ernst en bron (klant, QA, monitoring).
Laten we eens bekijken wat dat precies inhoudt:
| 🔑 Term | 📝 Beschrijving | 💡 Waarom dit belangrijk is |
|---|---|---|
| P50 (mediaan) | De gemiddelde waarde: 50% van de bugoplossingen verloopt sneller dan dit, en 50% verloopt langzamer | 👉 Geeft uw gebruikelijke of meest voorkomende oplostijd weer. Handig om inzicht te krijgen in de normale prestaties |
| P90 (90e percentiel) | 90% van de bugs wordt binnen deze tijd opgelost. Slechts 10% duurt langer | 👉 Dit vertegenwoordigt een worst-case (maar nog steeds realistische) grens. Handig voor de instelling van externe beloften |
| SLA's (Service Level Agreements) | Toezeggingen die u doet – intern of aan klanten – over hoe snel problemen zullen worden opgelost | 👉 Voorbeeld: “In 90% van de gevallen lossen we P1-bugs binnen 48 uur op.” Dit helpt bij het opbouwen van vertrouwen en verantwoordelijkheid |
| Per ernst en bron | Segmenteer uw statistieken op basis van twee belangrijke dimensies: • Ernst (bijv. P0, P1, P2) • Bron (bijv. klant, QA, monitoring) | 👉 Maakt nauwkeurigere bijhouding en prioritering mogelijk, zodat kritieke bugs sneller worden aangepakt |
Hieronder vindt u bereiken op basis van sectoren waarop ervaren teams zich vaak richten; beschouw deze als uitgangspunten en pas ze vervolgens aan uw specifieke situatie aan.
SaaS
Het systeem is altijd beschikbaar en CI/CD-vriendelijk, waardoor hotfixes veel voorkomen. Voor kritieke problemen (P0/P1) wordt vaak gestreefd naar een mediaan van minder dan één werkdag, met een P90 binnen 24–48 uur. Niet-kritieke problemen (P2+) worden doorgaans binnen 3–7 dagen opgelost (mediaan), met een P90 binnen 10–14 dagen. Teams met robuuste feature flags en geautomatiseerde tests zitten meestal aan de snellere kant.
E-commerceplatforms
Omdat conversie- en winkelwagenwerkstroomen cruciaal zijn voor de omzet, liggen de verwachtingen hoger. P0/P1-problemen worden doorgaans binnen enkele uren verholpen (door een rollback, markering of configuratie) en nog dezelfde dag volledig opgelost; P90 aan het einde van de dag of binnen <12 uur is gebruikelijk in het hoogseizoen. P2+-problemen worden vaak binnen 2–5 dagen opgelost, met P90 binnen 10 dagen.
Enterprise software
Strengere validatie en langere aanpassingsperiodes voor klanten vertragen het tempo. Voor P0/P1 targeten teams een tijdelijke oplossing binnen 4–24 uur en een definitieve oplossing binnen 1–3 werkdagen; P90 binnen 5 werkdagen. P2+-items worden vaak gebundeld in releasetrains, met medianen van 2–4 weken, afhankelijk van de uitrolschema’s van klanten.
Gaming en mobiele apps
Backends van live-services gedragen zich als SaaS (flags en rollbacks binnen enkele minuten tot uren; P90 nog dezelfde dag). Clientupdates worden beperkt door beoordelingen door de store: voor P0/P1 worden vaak onmiddellijk server-side maatregelen genomen en wordt binnen 1–3 dagen een clientpatch uitgebracht; P90 binnen een week bij versnelde beoordeling. P2+-oplossingen worden doorgaans ingepland in de volgende Sprint of contentdrop.
Bankwezen/Fintech
Risico- en compliance-controlepunten zorgen voor een patroon van ‘snel verhelpen, zorgvuldig aanpassen’. P0/P1-problemen worden snel verholpen (waarschuwingen, rollbacks, verkeersomleidingen binnen enkele minuten tot uren) en volledig opgelost binnen 1–3 dagen; P90 binnen een week, rekening houdend met wijzigingsbeheer. P2+ duurt vaak 2–6 weken om beoordelingen van veiligheid, audit en CAB door te lopen.
Als uw nummers buiten dit bereik vallen, kijk dan naar de kwaliteit van de intake, de eigendom/eigendom, de doorloopsnelheid van code-review en kwaliteitscontrole, en de goedkeuring van afhankelijkheden, voordat u ervan uitgaat dat de ‘ontwikkelingssnelheid’ het kernprobleem is.
🌼 Wist je dat: Volgens een Stack Overflow-enquête uit 2024 gebruikten ontwikkelaars AI steeds vaker als hun trouwe hulpje tijdens het programmeerproces. Maar liefst 82% gebruikte AI om daadwerkelijk code te schrijven – dat is nog eens een creatieve medewerker! Wanneer ze vastliepen of op zoek waren naar oplossingen, vertrouwde 67,5% op AI om antwoorden te vinden, en meer dan de helft (56,7%) maakte er gebruik van om fouten op te sporen en hulp te krijgen.
Voor sommigen bleken AI-tools ook handig bij het documenteren van projecten (40,1%) en zelfs bij het genereren van synthetische gegevens of content (34,8%). Benieuwd naar een nieuwe codebase? Bijna een derde (30,9%) gebruikt AI om snel op de hoogte te raken. Het testen van code is voor velen nog steeds een handmatig karwei, maar 27,2% heeft ook hier AI omarmd. Op andere gebieden, zoals codereview, projectplanning en voorspellende analyses, is de acceptatie van AI lager, maar het is duidelijk dat AI zich gestaag in elke fase van de softwareontwikkeling nestelt.
📖 Lees meer: Hoe u AI kunt inzetten voor kwaliteitsborging
Hoe de tijd die nodig is om bugs op te lossen te verkorten
Snelheid bij het oplossen van bugs komt neer op het wegnemen van wrijving bij elke overdracht, van intake tot release.
De grootste winst wordt behaald door de eerste 30 minuten slimmer in te richten (duidelijke registratie, juiste eigenaar, juiste prioriteit) en vervolgens de daaropvolgende stappen (reproduceren, beoordelen, verifiëren) te verkorten.
Hier zijn negen strategieën die als één systeem samenwerken. AI versnelt elke stap en de werkstroom is overzichtelijk op één plek ondergebracht, zodat leidinggevenden voorspelbaarheid krijgen en medewerkers een soepele werkstroom ervaren.
1. Centraliseer de registratie en leg de context vast bij de bron
De tijd die nodig is om bugs op te lossen neemt toe wanneer u de context moet reconstrueren aan de hand van Slack-threads, supporttickets en spreadsheets. Leid alle meldingen – van support, QA en monitoring – naar één enkele wachtrij met een gestructureerd sjabloon dat gegevens verzamelt over het onderdeel, de ernst, de omgeving, de app-versie/build, de stappen om het probleem te reproduceren, het verschil tussen verwacht en werkelijk, en bijlagen (logs/HAR/schermafbeeldingen).
AI kan lange rapporten automatisch samenvatten, stappen om het probleem te reproduceren en omgevingsdetails uit bijlagen halen, en mogelijke duplicaten markeren, zodat de triage begint met een samenhangend, verrijkt dossier.
Belangrijke statistieken: MTTA (bevestiging binnen minuten, niet binnen uren), percentage duplicaten, tijd die nodig is voor ‘Informatie nodig’.
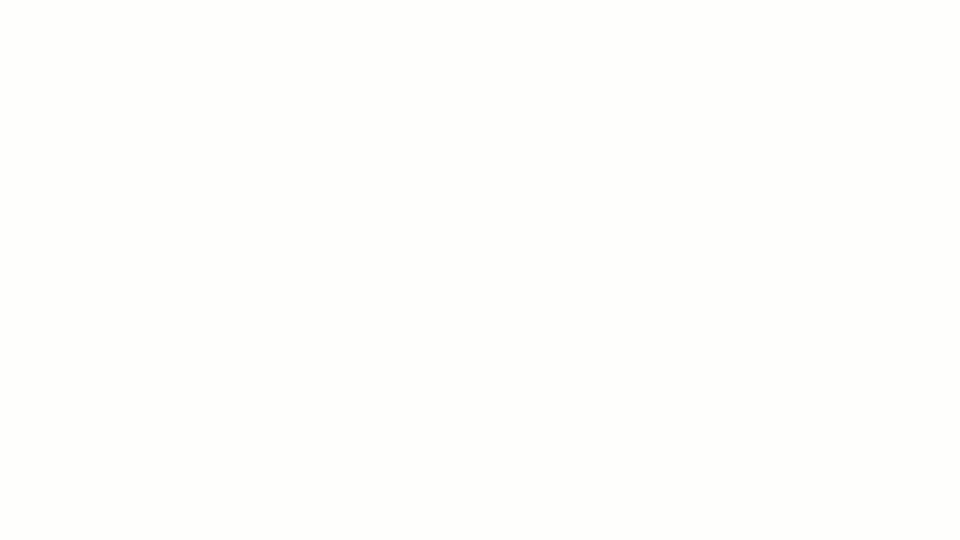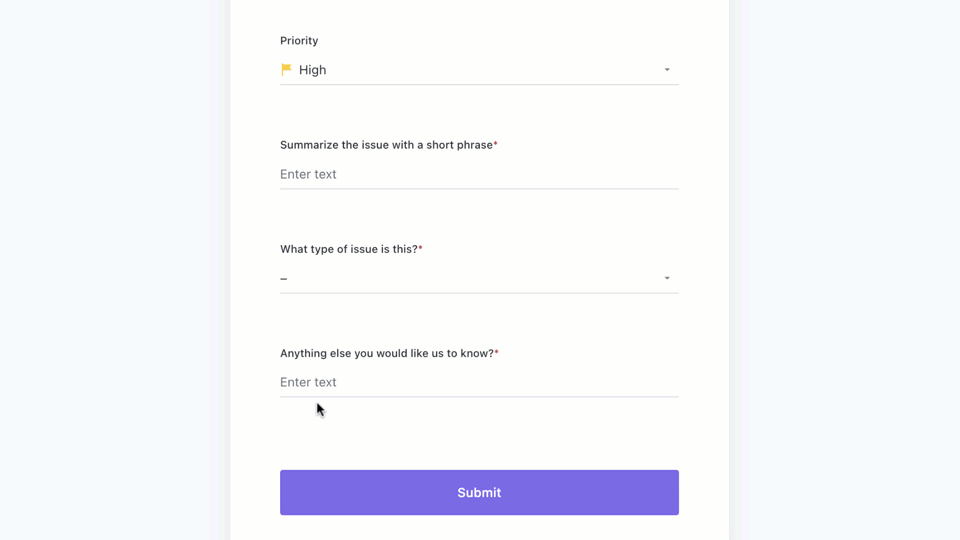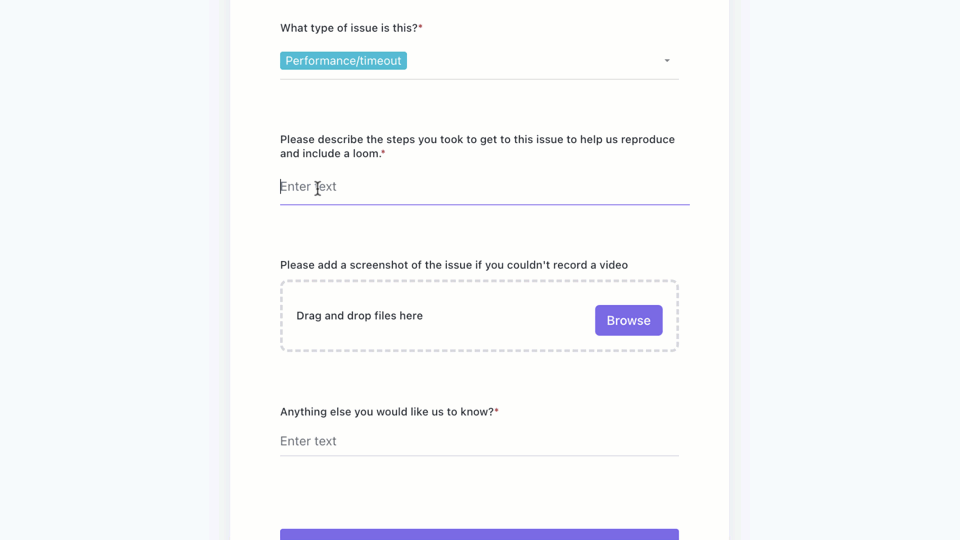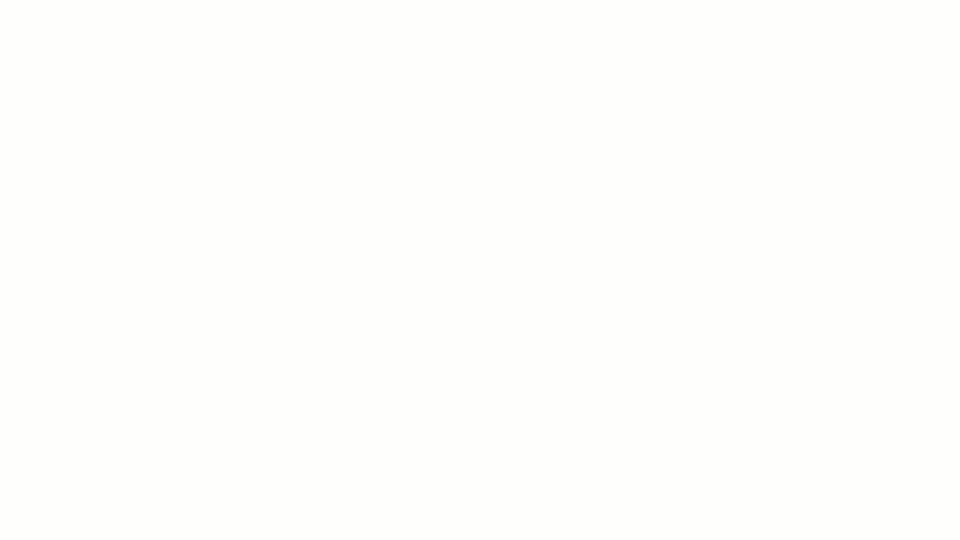
2. AI-ondersteunde triage en routering om de MTTA drastisch te verkorten
De snelste oplossingen zijn de oplossingen die direct op het juiste bureau terechtkomen.
Gebruik eenvoudige regels in combinatie met AI om de ernst te classificeren, mogelijke eigenaars per component/codegebied te identificeren en automatisch toe te wijzen met een SLA-tijdklok. Stel duidelijke swimlanes in voor P0/P1 versus al het andere en maak het onomstotelijk duidelijk wie waarvoor eigenaar is.
De automatisering kan op basis van velden prioriteit toekennen, tickets per component naar een team doorsturen, een SLA-timer starten en een dienstdoende engineer op de hoogte brengen; AI kan op basis van eerdere patronen een ernstniveau en eigenaar voorstellen. Wanneer triage een proces van 2–5 minuten wordt in plaats van een discussie van 30 minuten, daalt uw MTTA en volgt uw MTTR.
Belangrijke statistieken: MTTA, kwaliteit van de eerste reactie (wordt in de eerste reactie om de juiste informatie gevraagd?), aantal overdrachten per bug.
Zo ziet dat er in de praktijk uit:
3. Stel prioriteiten op basis van de impact op het bedrijf met duidelijke SLA-niveaus
"De luidste stem wint" maakt wachtrijen onvoorspelbaar en ondermijnt het vertrouwen bij leidinggevenden die CSAT/NPS en contractverlengingen in de gaten houden.
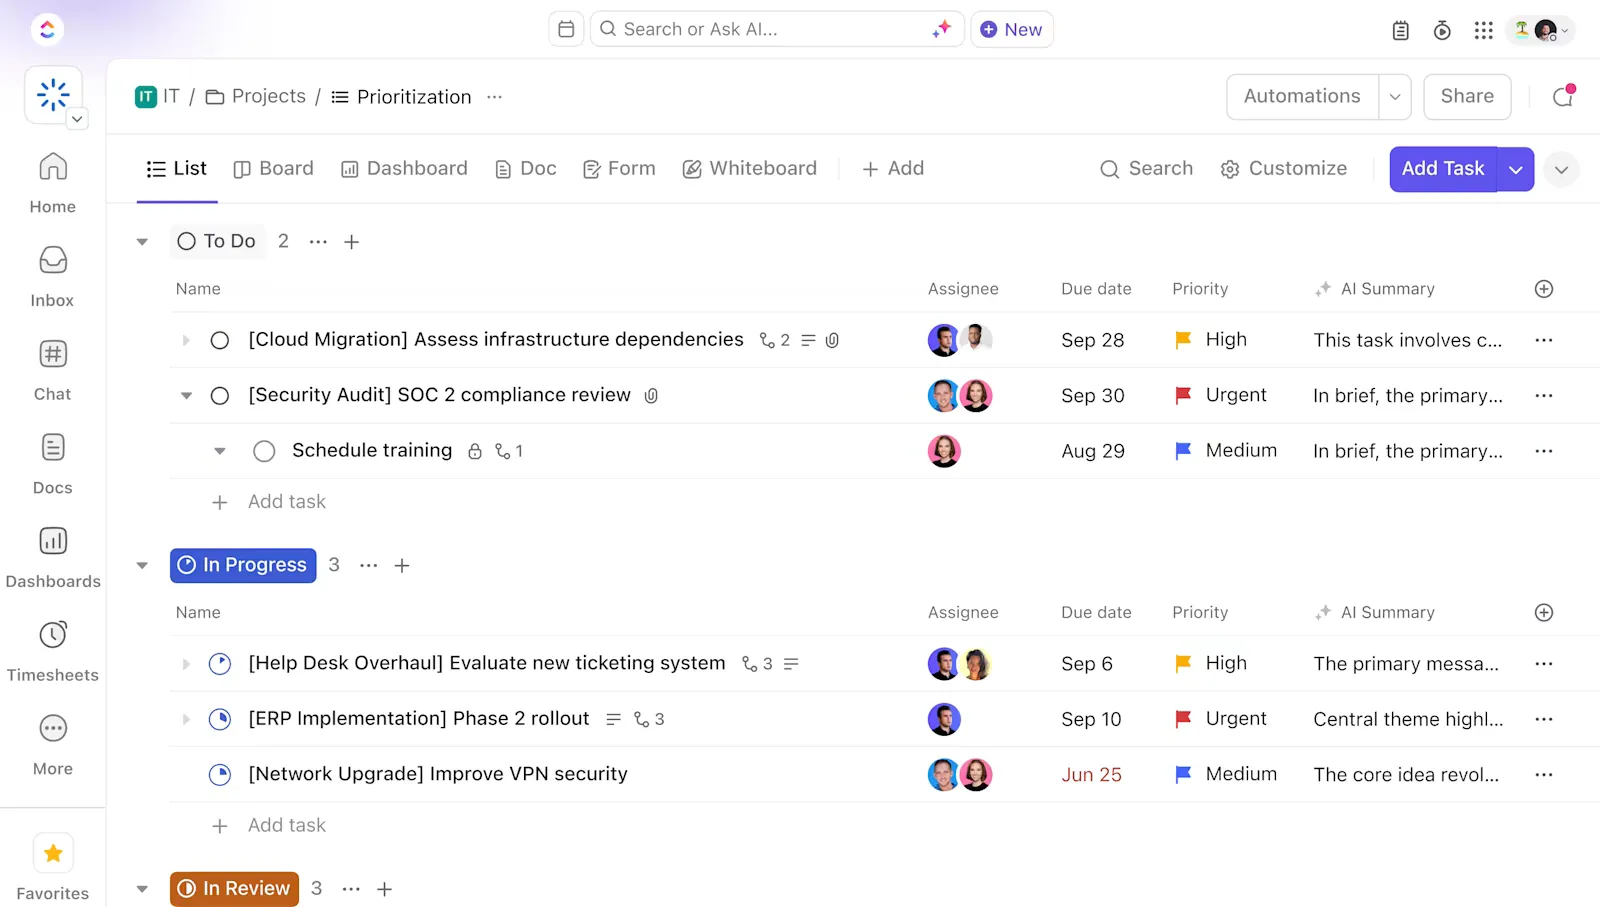
Vervang dat door een score die een combinatie is van ernst, frequentie, de getroffen ARR, de kriticiteit van de functie en de nabijheid van verlengingen/lanceringen – en onderbouw deze met SLA-niveaus (bijv. P0: binnen 1–2 uur verhelpen, binnen een dag oplossen; P1: dezelfde dag; P2: binnen een Sprint).
Zorg voor een zichtbare P0/P1-spoor met WIP-limieten, zodat niets in de wacht blijft staan.
Belangrijke statistieken: P50/P90-oplossingspercentage per niveau, percentage SLA-overtredingen, correlatie met CSAT/NPS.
💡Pro-tip: Met de velden ‘Taakprioriteiten’, ‘Aangepaste velden’ en ‘Afhankelijkheden’ in ClickUp kunt u een impactscore berekenen en bugs koppelen aan accounts, feedback of roadmap-items; bovendien helpen de ‘Doelen’ in ClickUp u om de naleving van SLA’s te koppelen aan doelstellingen op bedrijfsniveau, wat rechtstreeks inspeelt op de zorgen van het management over afstemming.
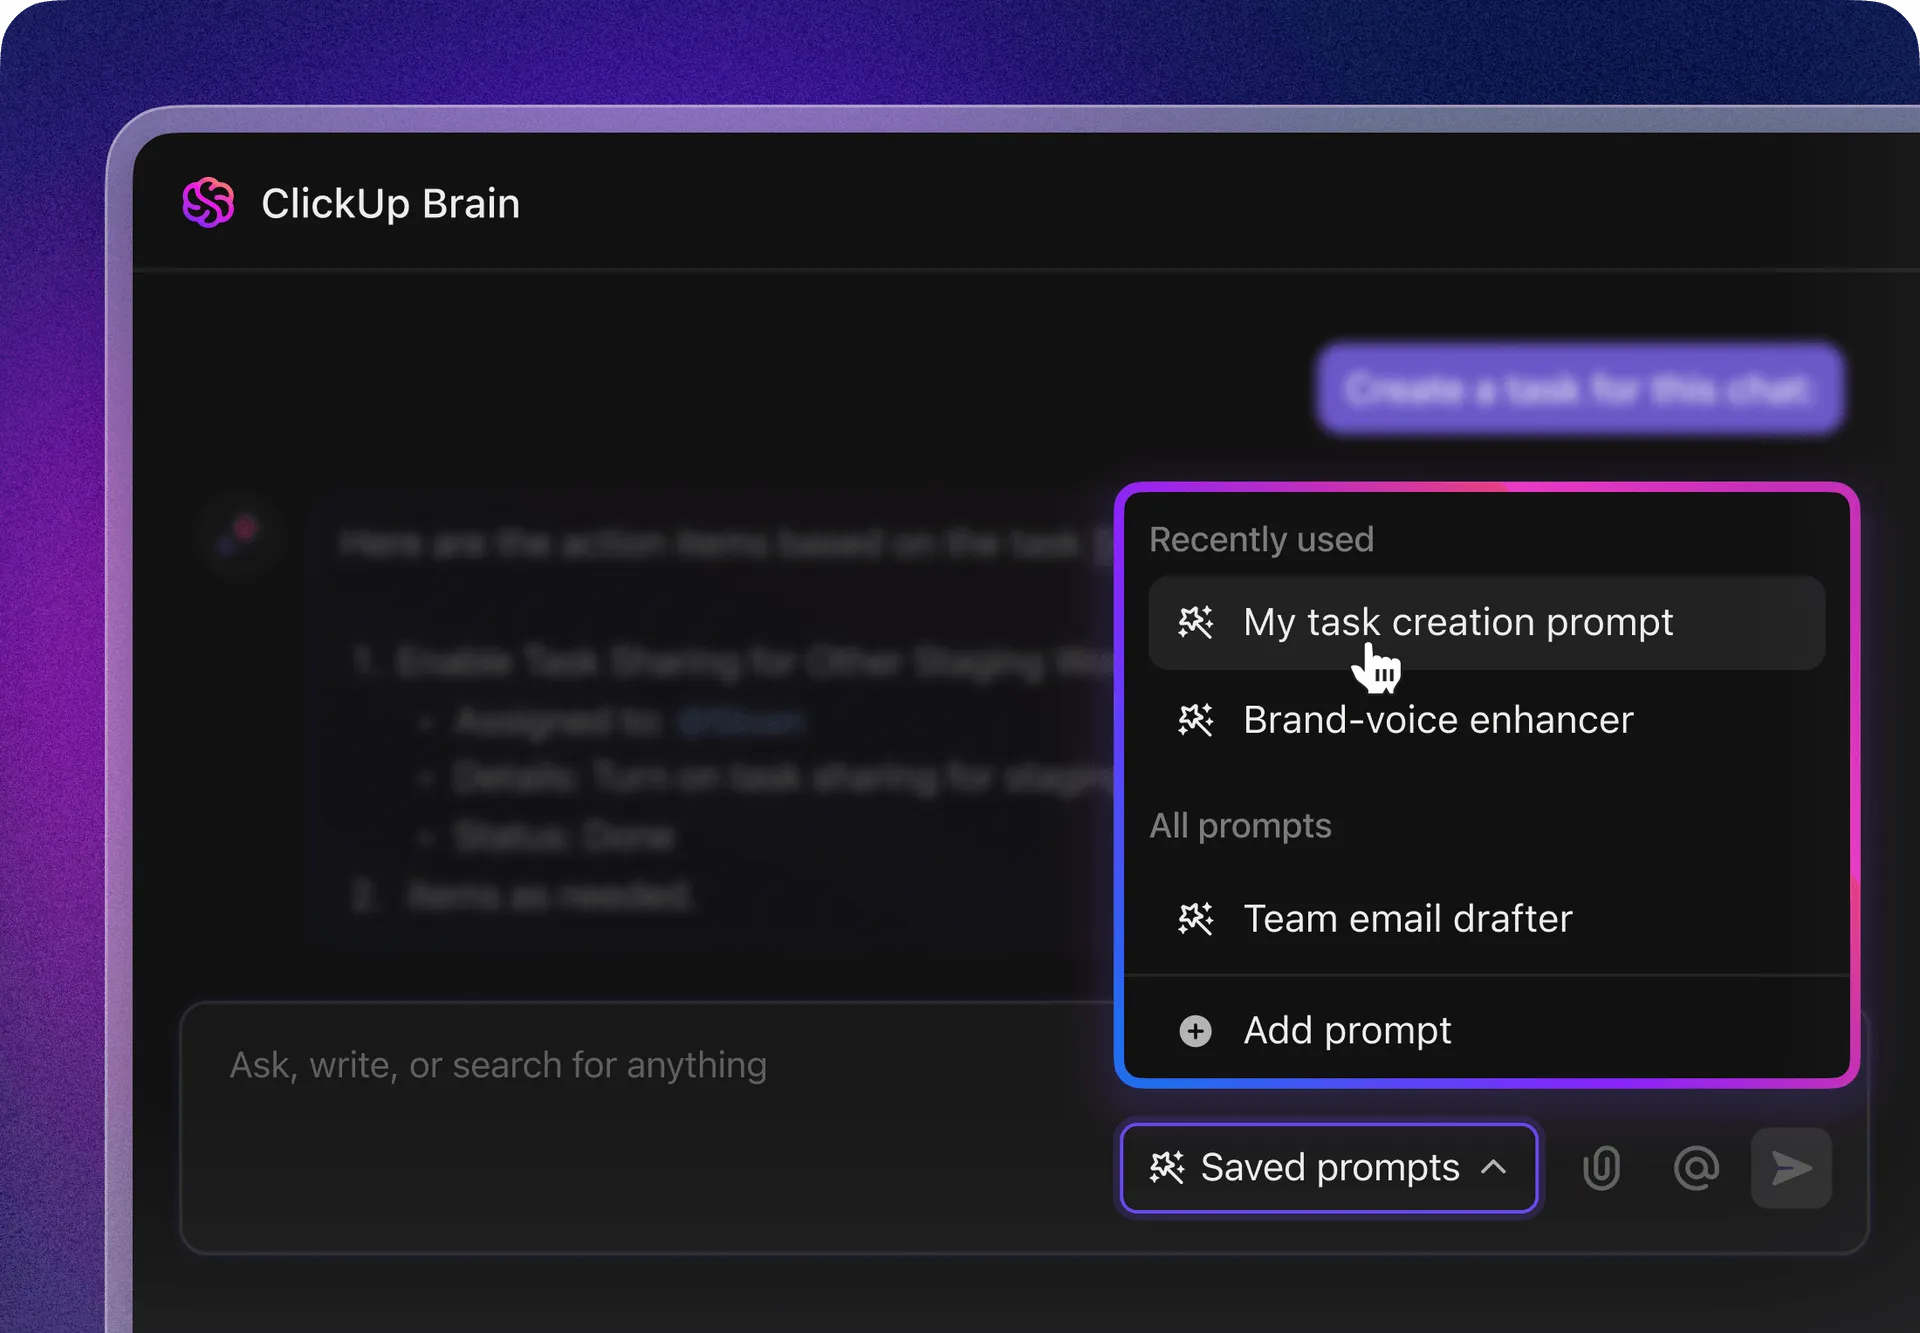
4. Maak van het reproduceren en diagnosticeren een activiteit die in één keer kan worden uitgevoerd
Elke extra vraag als „kunt u de logbestanden sturen?“ verlengt de oplostijd.
Standaardiseer wat ‘goed’ inhoudt: verplichte velden voor build/commit, omgeving, stappen om de fout te reproduceren, verwacht versus werkelijk, plus bijlagen voor logbestanden, crashdumps en HAR-bestanden. Implementeer client/server-telemetrie zodat crash-ID’s en verzoek-ID’s aan traces kunnen worden gekoppeld.
Gebruik Sentry (of een vergelijkbaar systeem) voor stacktraces en koppel dat probleem direct aan de bug. AI kan logs en traces analyseren om een waarschijnlijk foutdomein voor te stellen en een minimale reproductie te genereren, waardoor een uur lang zoeken met het blote oog wordt teruggebracht tot een paar minuten gericht werk.
Sla runbooks op voor veelvoorkomende soorten bugs, zodat engineers niet steeds helemaal opnieuw hoeven te beginnen.
Belangrijke statistieken: Tijd besteed aan ‘Wachten op informatie’, percentage dat bij de eerste poging kan worden gereproduceerd, heropeningspercentage in verband met ontbrekende reproductie.
📖 Meer informatie: Hoe u AI kunt gebruiken bij softwareontwikkeling (toepassingen en tools)
5. Verkort de code-review- en testcyclus
Grote PR's lopen vast. Streef naar gerichte patches, trunk-based ontwikkeling en feature flags, zodat fixes veilig kunnen worden uitgerold. Wijs reviewers vooraf toe op basis van code-eigendom om stilstand te voorkomen, en gebruik checklists (tests bijgewerkt, telemetrie toegevoegd, flag achter een kill switch) zodat kwaliteit van meet af aan is ingebouwd.
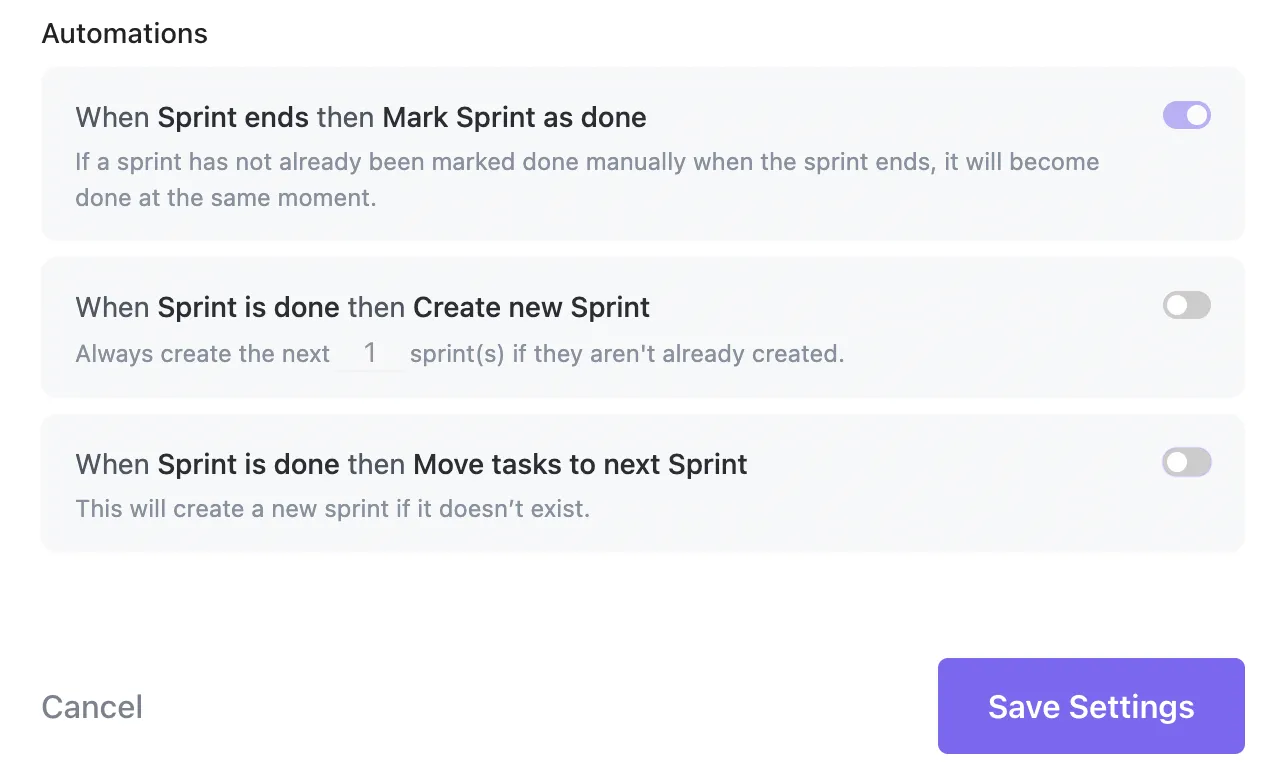
Automatisering moet de bug bij het openen van een pull-request naar de status ‘In Review’ verplaatsen en bij het samenvoegen naar ‘Resolved’; AI kan unit-tests voorstellen of risicovolle diffs markeren om de focus van de review te sturen.
Belangrijke statistieken: Tijd in de status ‘In Review’, het percentage mislukte wijzigingen bij PR's voor bugfixes en de P90-beoordelingsvertraging.
U kunt GitHub/GitLab-integraties in ClickUp gebruiken om de status van de oplossing te synchroniseren; automatiseringen kunnen de 'definitie van 'Klaar'' afdwingen.
6. Voer verificatie parallel uit en zorg ervoor dat de QA-omgeving daadwerkelijk gelijkwaardig is
Verificatie mag niet pas dagen later beginnen of plaatsvinden in een omgeving die geen van uw klanten gebruikt.
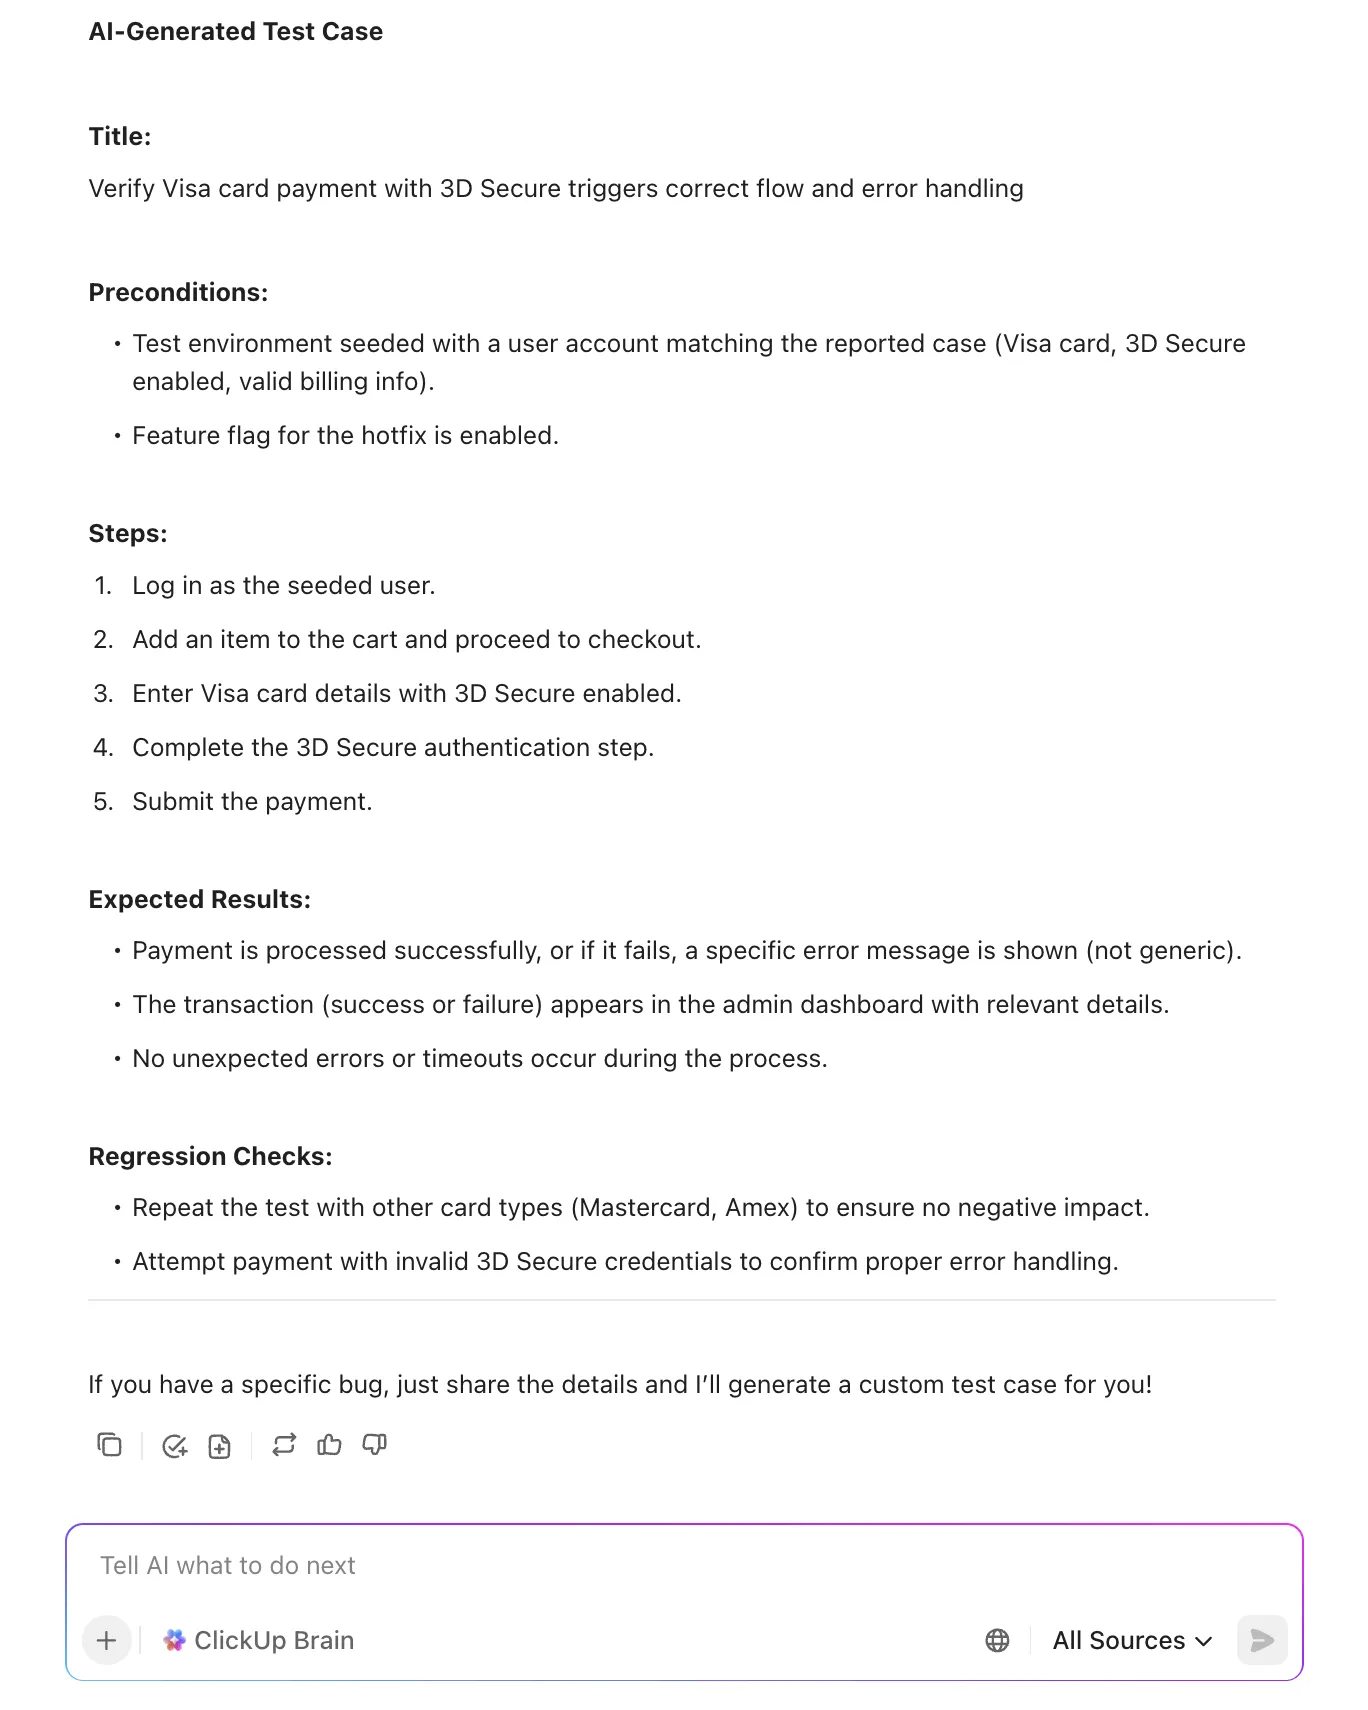
Zorg ervoor dat ‘klaar voor QA’ strak wordt gehandhaafd: op vlaggen gebaseerde hotfixes die zijn gevalideerd in productieachtige omgevingen met seed-data die overeenkomen met gemelde gevallen.
Zet waar mogelijk tijdelijke omgevingen op vanuit de bug-vertakking, zodat QA onmiddellijk kan valideren; AI kan vervolgens testcases genereren op basis van de bugbeschrijving en eerdere regressies.
Belangrijke statistieken: Tijd in „QA/verificatie”, percentage terugverwijzingen van QA naar ontwikkeling, mediaantijd tot afsluiting na samenvoeging.
📖 Lees meer: Hoe schrijf je effectieve testcases?
7. Communiceer de status duidelijk om de coördinatie-last te verminderen
Een goede update voorkomt drie statusupdates en één escalatie.
Behandel updates als een product: kort, specifiek en afgestemd op de doelgroep (support, leidinggevenden, klanten). Stel een frequentie vast voor P0/P1 (bijv. elk uur totdat het probleem is verholpen, daarna om de vier uur) en zorg voor één enkele bron van waarheid.
AI kan op basis van de taakgeschiedenis klantveilige updates en interne samenvattingen opstellen, inclusief de actuele status per ernstgraad en per team. Voor leidinggevenden zoals uw Productdirecteur kunt u bugs koppelen aan initiatieven, zodat zij kunnen zien of kritieke kwaliteitsproblemen de opleveringsbeloften in gevaar brengen.
Belangrijke statistieken: Tijd tussen statusupdates voor P0/P1, klanttevredenheid (CSAT) van belanghebbenden met betrekking tot de communicatie.
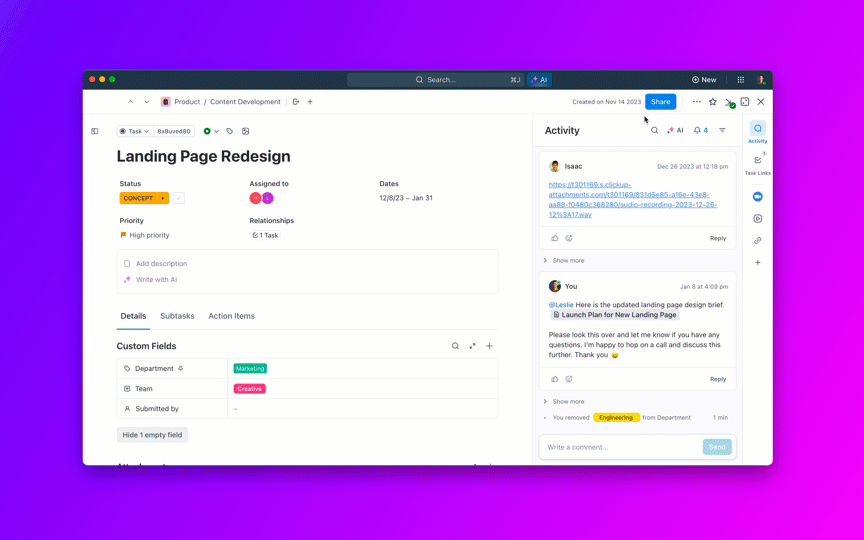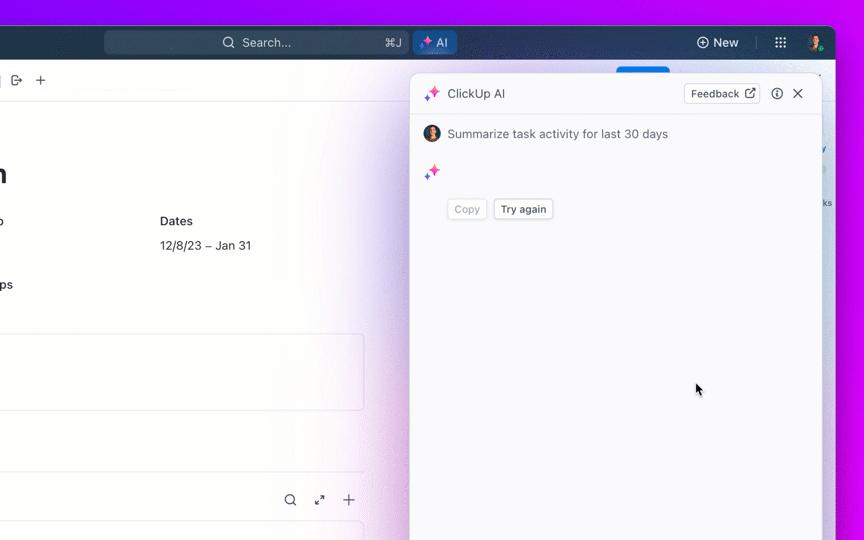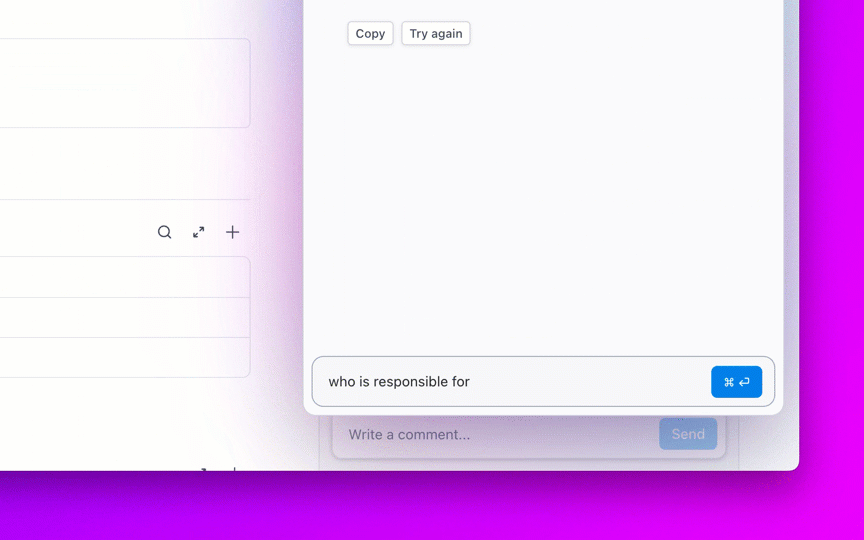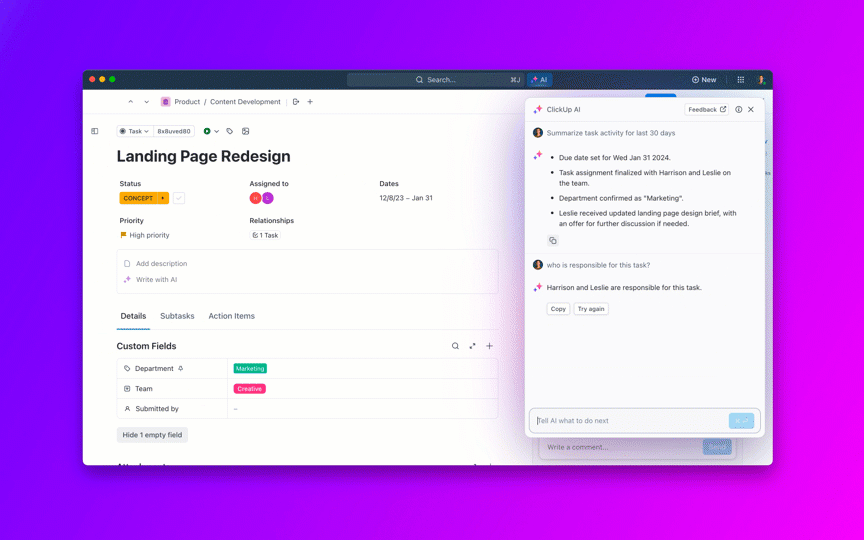
8. Beheers de veroudering van de backlog en voorkom dat tickets ‘voor altijd open’ blijven staan
Een groeiende, verouderde backlog legt stilletjes een druk op elke Sprint.
Stel verouderingsbeleidsregels in (bijv. P2 > 30 dagen is een trigger voor een herziening, P3 > 90 dagen vereist een motivering) en plan wekelijks een ‘verouderingstriage’ in om duplicaten samen te voegen, verouderde rapporten te sluiten en bugs met lage prioriteit om te zetten in productbacklog-items.
Gebruik AI om de backlog per thema te groeperen (bijv. ‘vervaldatum authenticatietoken’, ‘onbetrouwbaarheid bij het uploaden van afbeeldingen’), zodat u thematische ‘fix-weken’ kunt inplannen en een categorie defecten in één keer kunt oplossen.
Belangrijke statistieken: Aantal openstaande problemen per tijdsperiode, percentage problemen dat is gesloten als dubbel of achterhaald, thematische burn-down-snelheid.
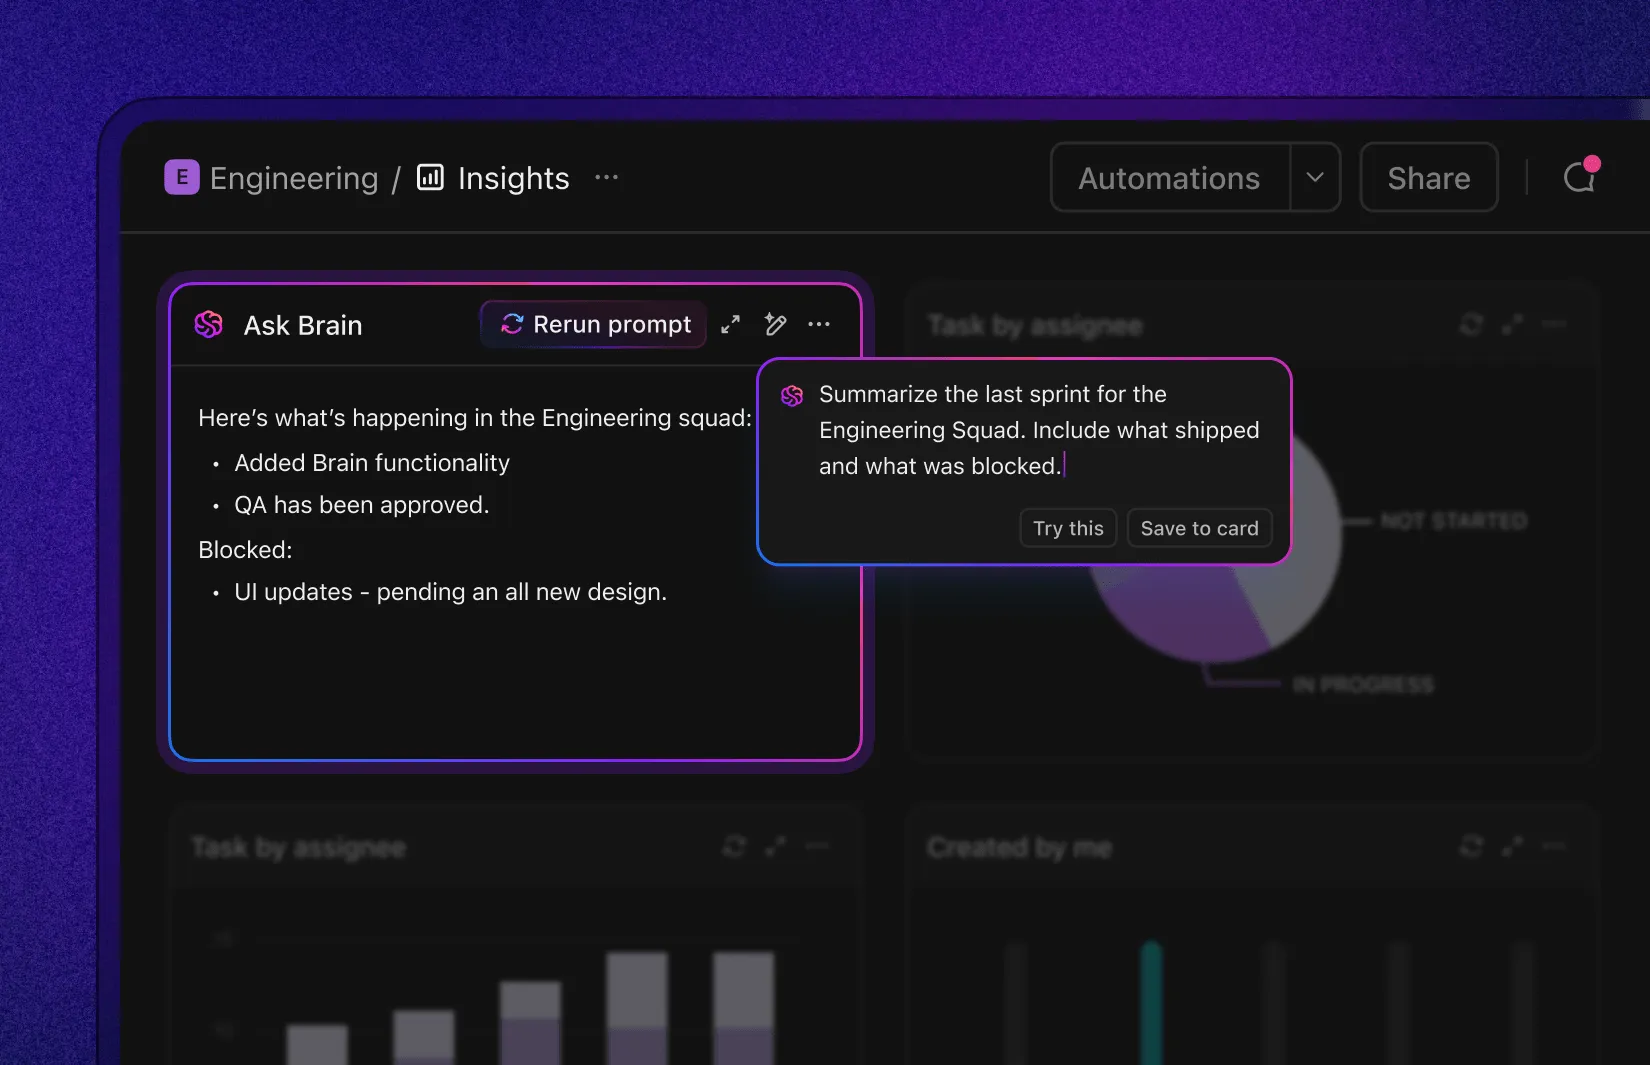
9. Sluit de cirkel met het achterhalen van de hoofdoorzaak en preventie
Als dezelfde categorie defecten steeds weer terugkomt, verhullen uw verbeteringen in de MTTR een groter probleem.
Voer snelle, objectieve oorzaakanalyses uit voor P0/P1- en veelvoorkomende P2-issues; tag de onderliggende oorzaken (tekortkomingen in specificaties, tests of tooling, onbetrouwbare integratie), koppel ze aan de betrokken componenten en incidenten, en houd de vervolgtaaken bij (waarschuwingen, tests, lint-regels) totdat ze zijn voltooid.
AI kan RCA-samenvattingen opstellen en preventieve tests of lint-regels voorstellen op basis van de wijzigingsgeschiedenis. En zo ga je van brandbestrijding naar minder branden.
Belangrijke statistieken: heropeningspercentage, regressiepercentage, tijd tussen herhalingen en percentage RCA's met voltooide preventieve maatregelen.
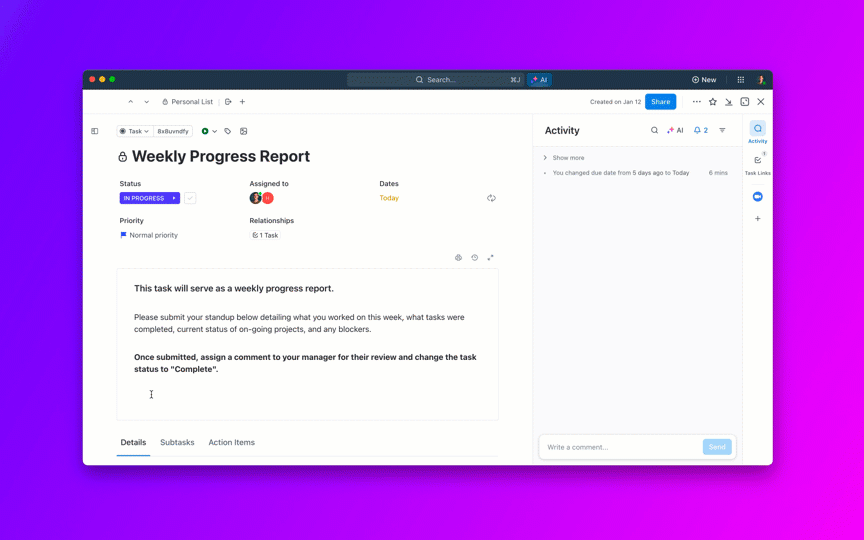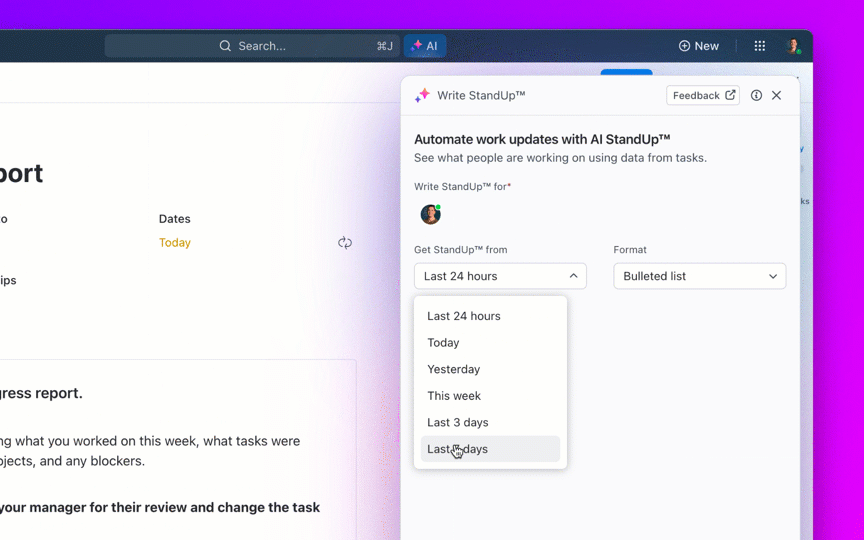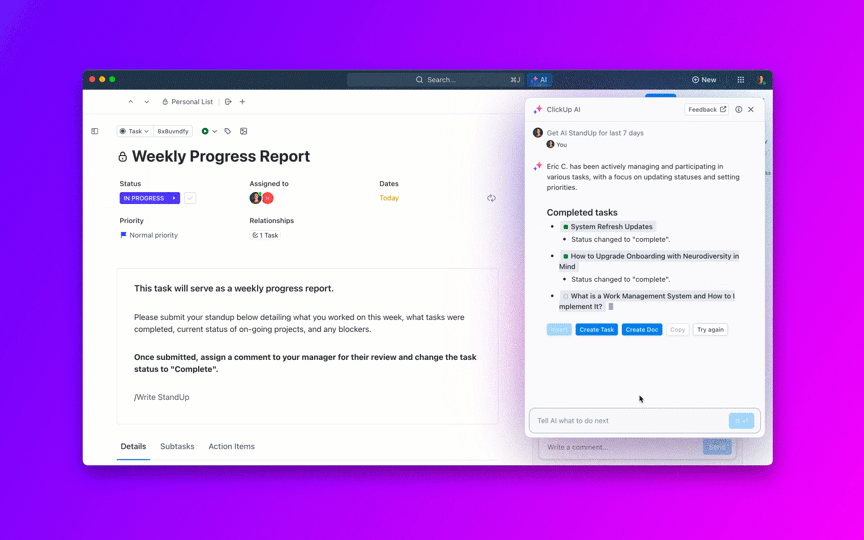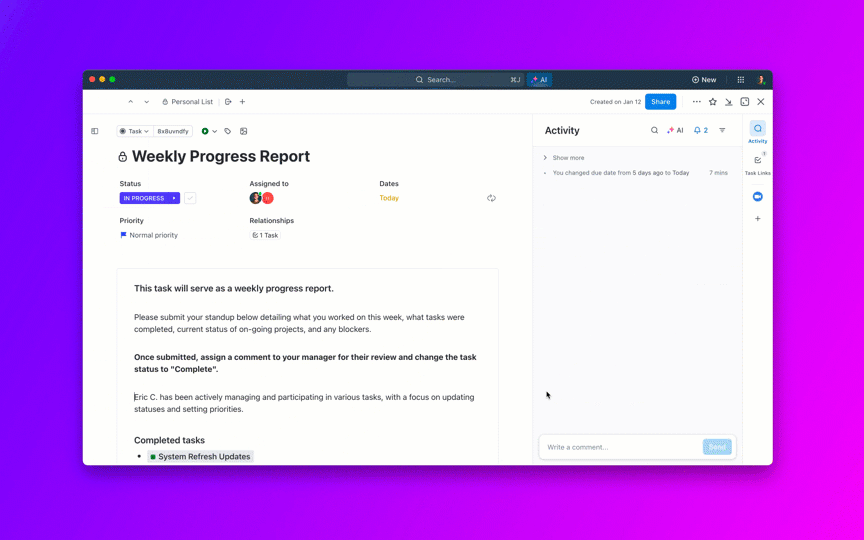
Samen zorgen deze veranderingen voor een verkorting van het volledige traject: snellere bevestiging, duidelijkere triage, slimmere prioritering, minder vertragingen bij beoordeling en kwaliteitscontrole, en duidelijkere communicatie. Leidinggevenden krijgen voorspelbaarheid gekoppeld aan CSAT/NPS en omzet; medewerkers krijgen een rustigere wachtrij met minder contextwisselingen.
📖 Lees meer: Hoe voer je een analyse van de onderliggende oorzaak uit?
AI-tools die helpen de tijd die nodig is om bugs op te lossen te verkorten
AI kan de oplostijd op elke stap verkorten: registratie, triage, toewijzing, oplossing en verificatie.
De echte voordelen ontstaan echter pas wanneer tools de context begrijpen en het werk in gang houden zonder dat er voortdurend ingegrepen hoeft te worden.
Zoek naar systemen die rapporten automatisch aanvullen (stappen om de bug te reproduceren, omgeving, duplicaten), prioriteren op basis van impact, doorsturen naar de juiste eigenaar, duidelijke updates opstellen en naadloos integreren met je code, CI en observability.
De beste tools ondersteunen ook agent-achtige werkstroomen: bots die SLA’s in de gaten houden, beoordelaars een herinnering sturen, vastgelopen items escaleren en de resultaten voor belanghebbenden samenvatten. Hier is onze selectie van AI-tools voor een betere bugoplossing:
1. ClickUp (Het meest geschikt voor contextuele AI, automatiseringen en agentgebaseerde werkstroomen)
Als u op zoek bent naar een gestroomlijnde, intelligente werkstroom voor het oplossen van bugs, dan biedt ClickUp, de alles-in-één-app voor werk, AI, automatiseringen en agentgebaseerde workflowondersteuning op één plek.
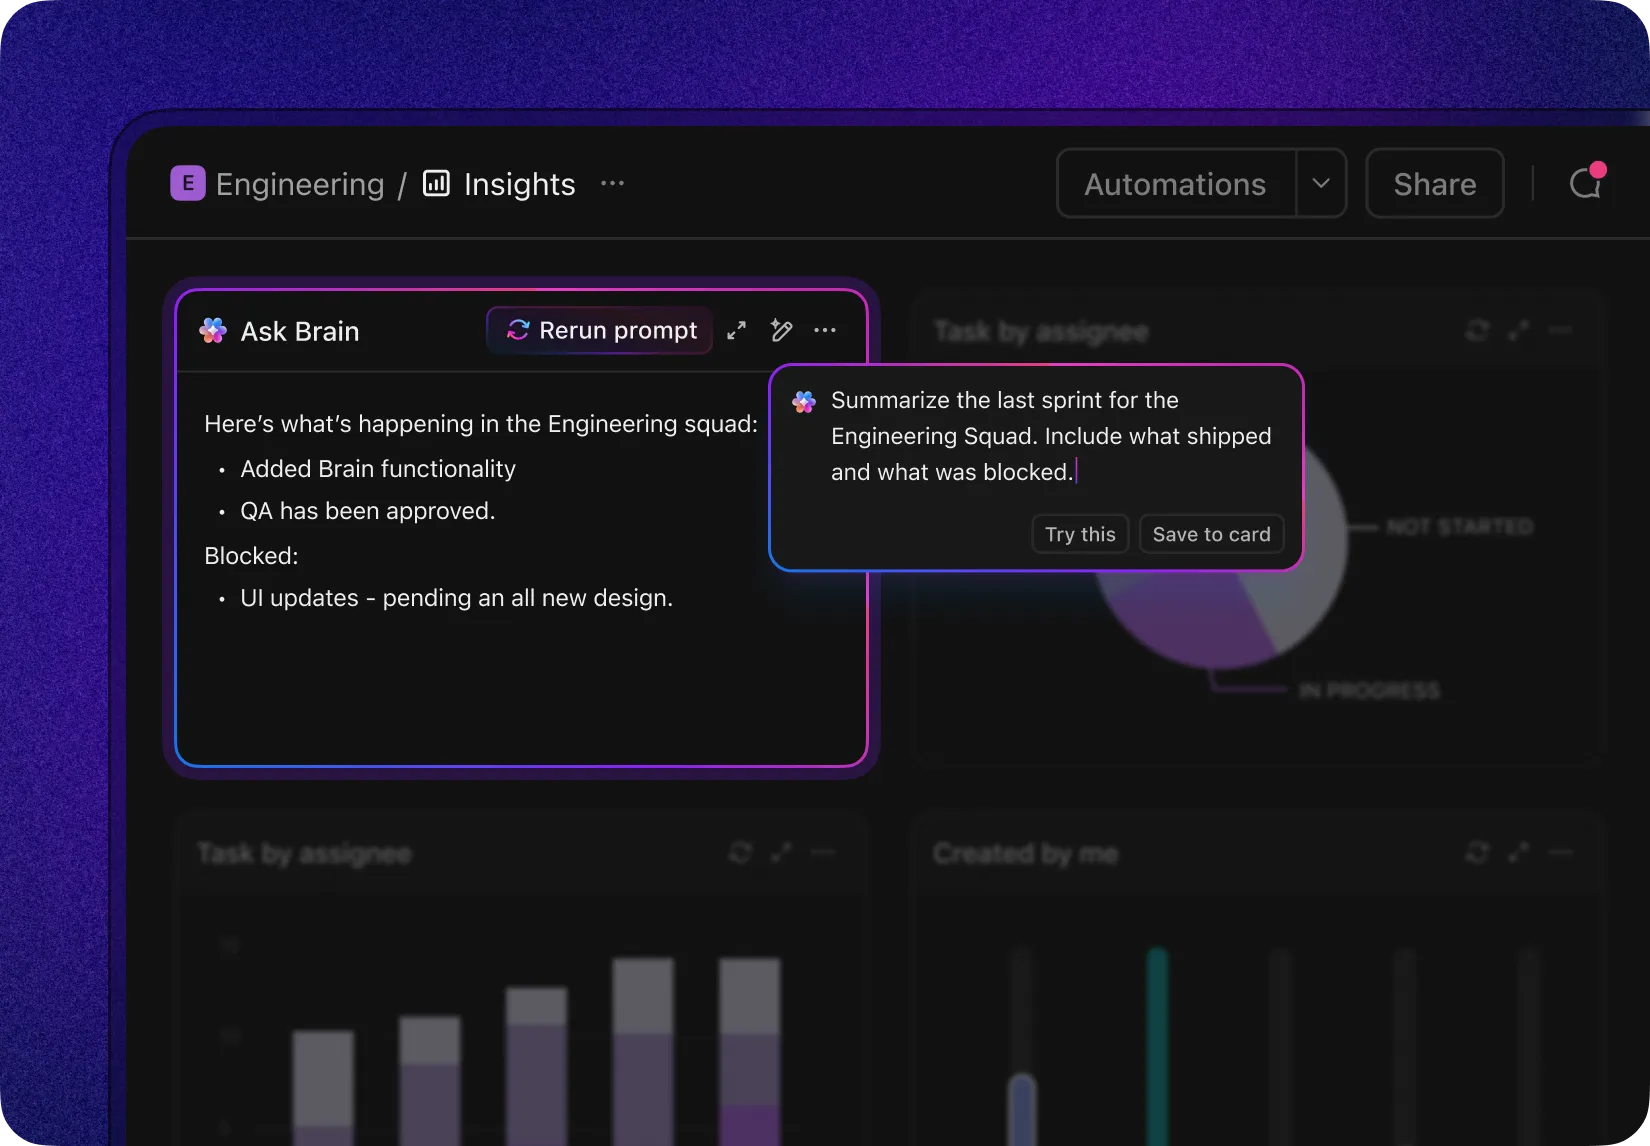
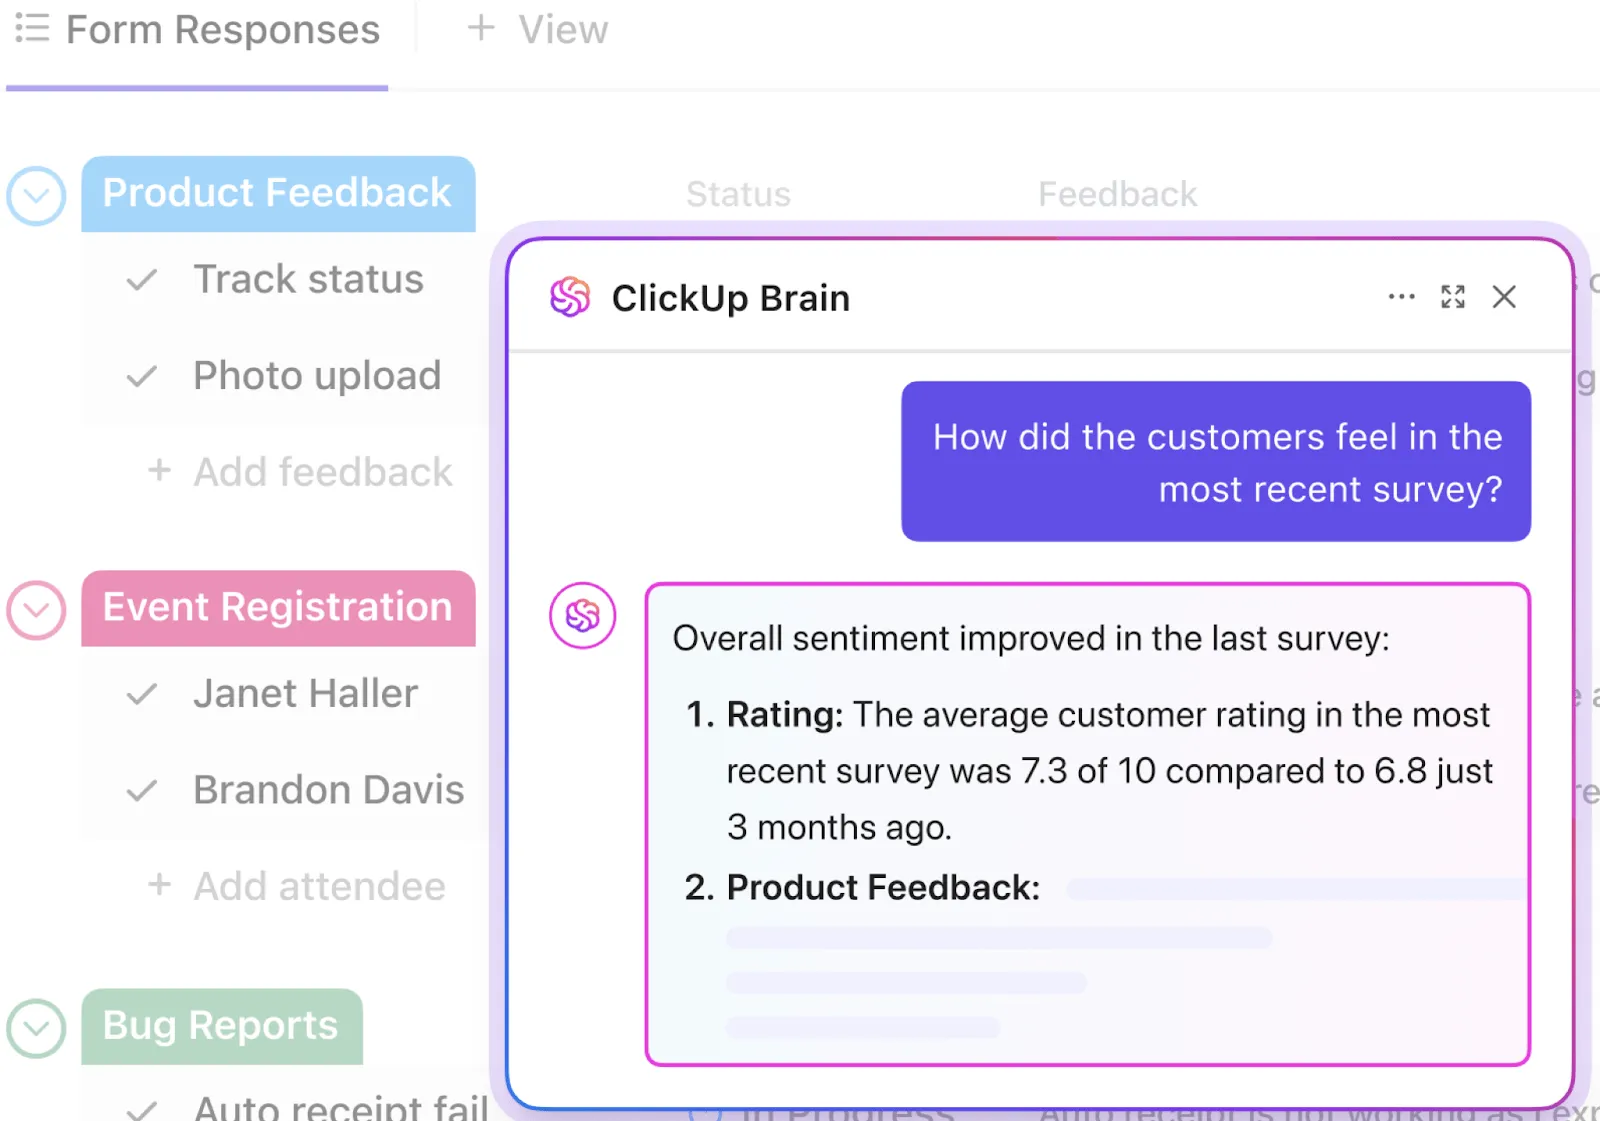
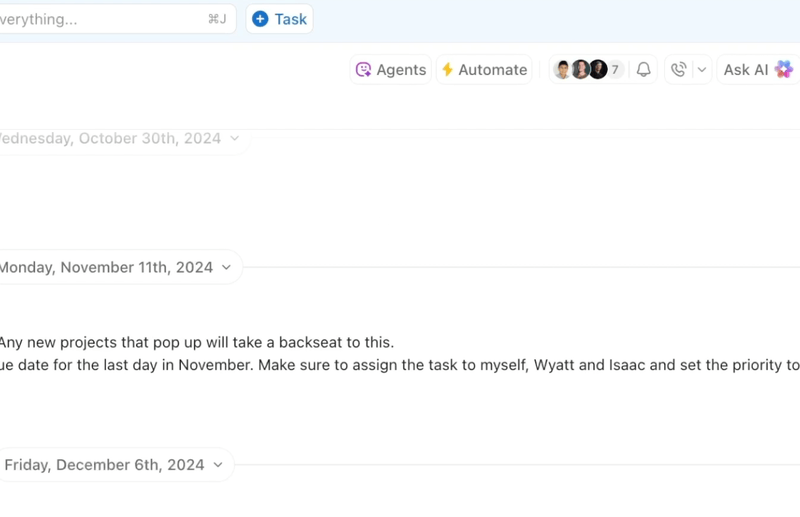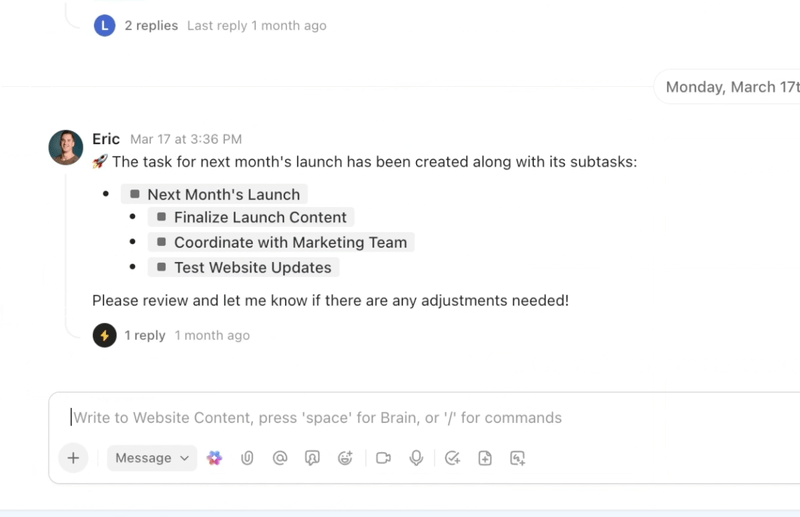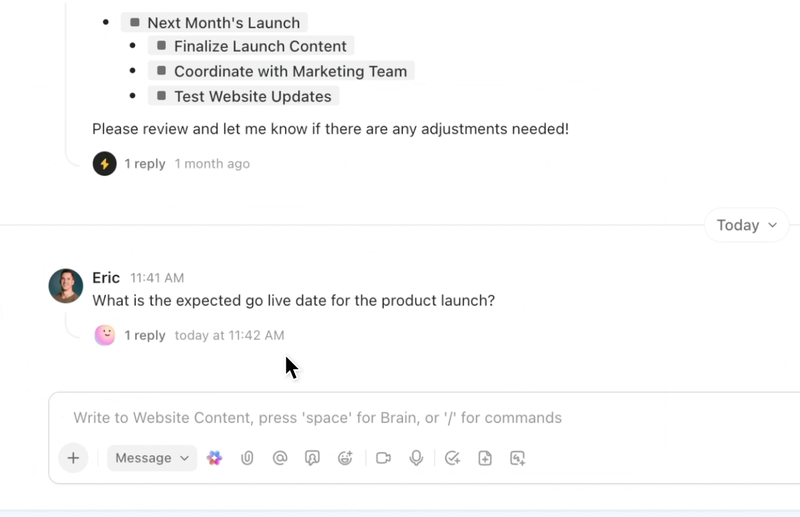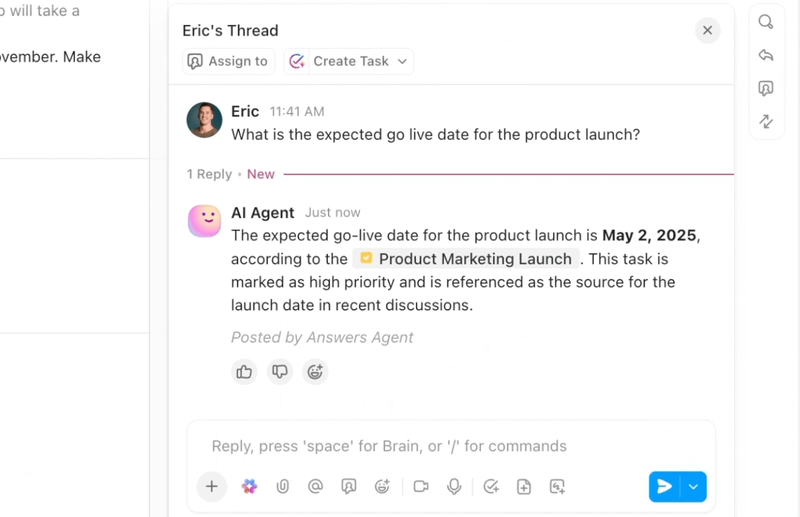
ClickUp Brain brengt direct de juiste context naar voren: het vat lange bugthreads samen, haalt stappen om de bug te reproduceren en omgevingsdetails uit bijlagen, markeert mogelijke duplicaten en stelt vervolgacties voor. In plaats van zich door Slack, tickets en logbestanden te moeten worstelen, krijgen teams een overzichtelijk, verrijkt overzicht waarop ze direct kunnen handelen.
De automatiseringen en Autopilot-agents in ClickUp zorgen ervoor dat het werk doorloopt zonder dat er voortdurend handmatig ingegrepen hoeft te worden. Bugs worden automatisch doorgestuurd naar het juiste team, er worden eigenaren toegewezen, SLA's en deadlines worden ingesteld, de status wordt bijgewerkt naarmate de voortgang vordert en belanghebbenden ontvangen tijdige notificaties.
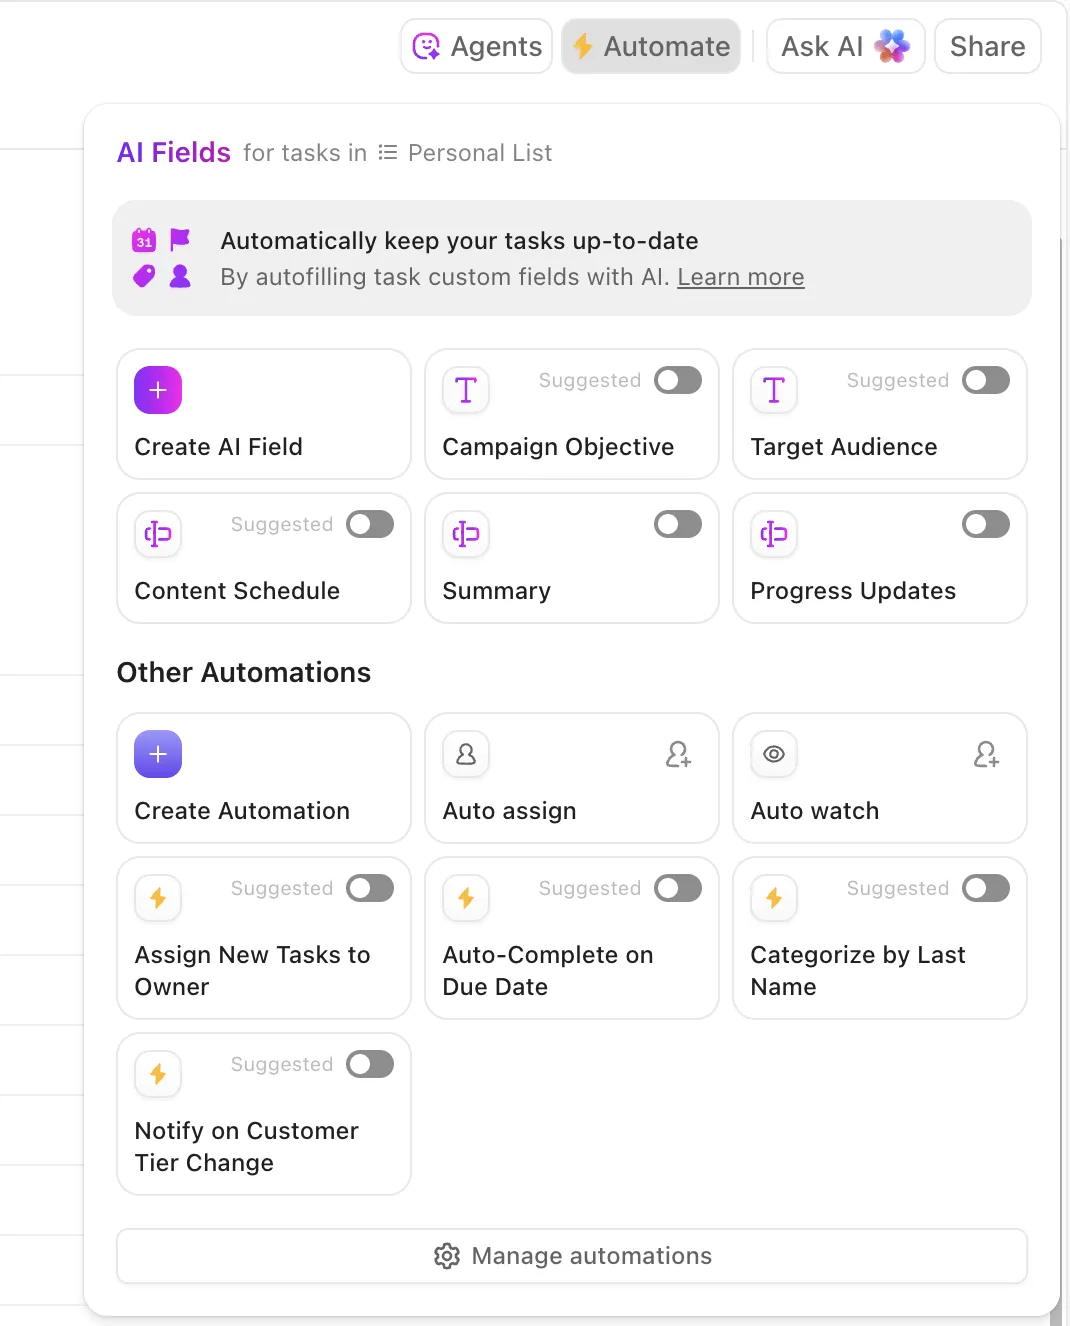
Deze agents kunnen zelfs problemen triageren en categoriseren, vergelijkbare meldingen groeperen, historische oplossingen raadplegen om mogelijke oplossingen voor te stellen en urgente items escaleren – zodat de MTTA en MTTR dalen, zelfs bij pieken in het aantal meldingen.
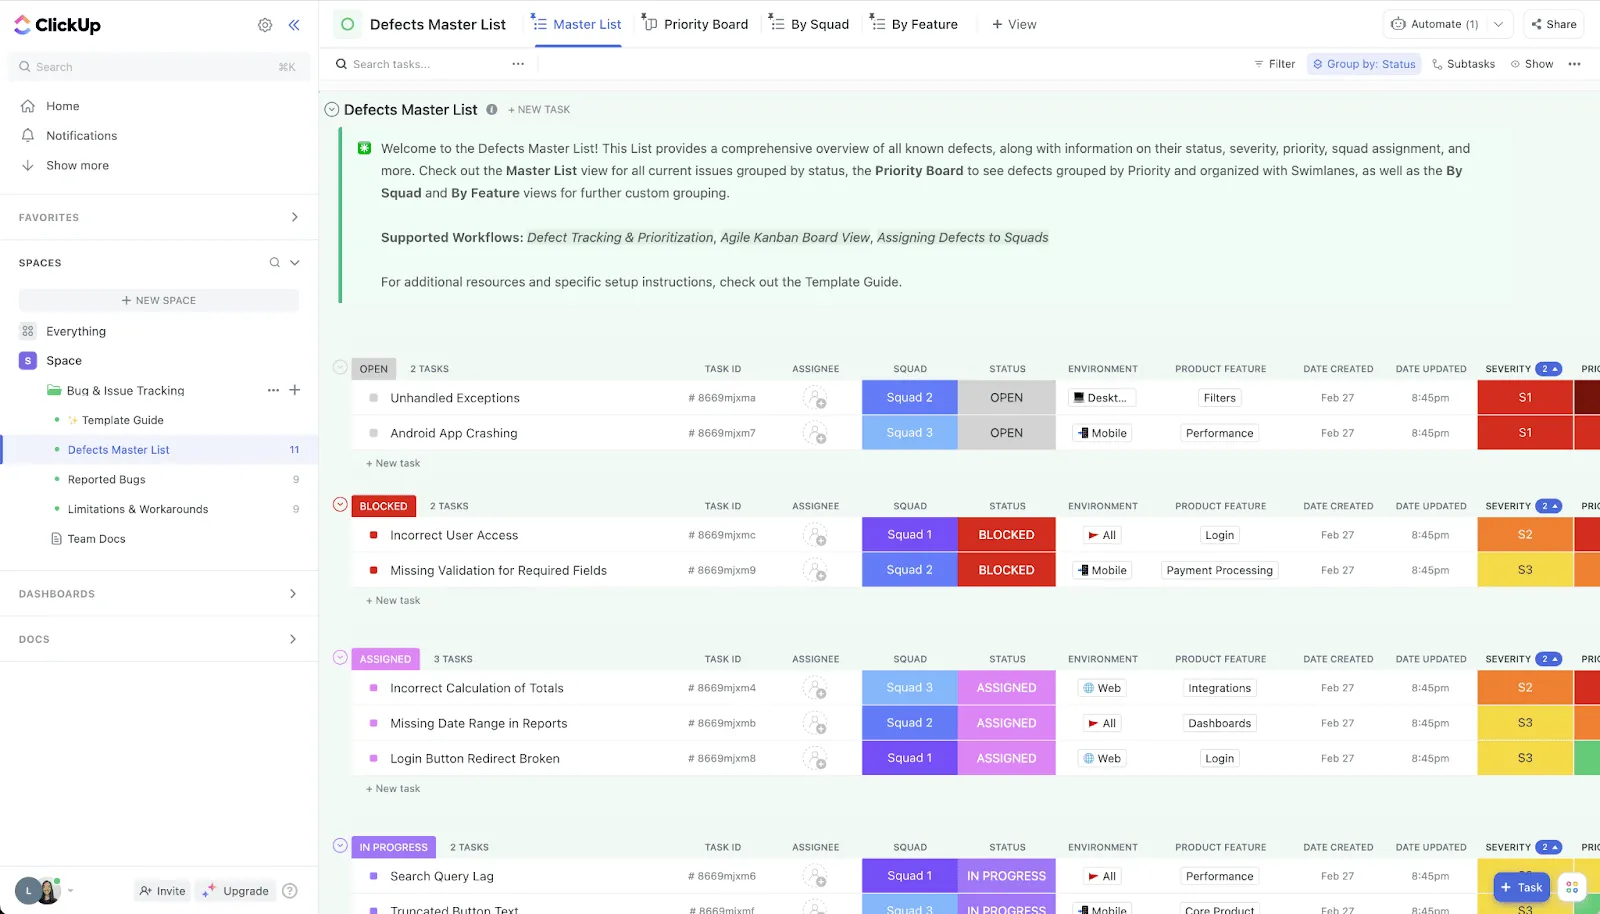
🛠️ Op zoek naar een kant-en-klare toolkit? De ClickUp-sjabloon voor het bijhouden van bugs en problemen is een krachtige oplossing van ClickUp for Software, ontworpen om support-, engineering- en productteams te helpen softwarebugs en -problemen moeiteloos onder controle te houden. Met aanpasbare weergaven zoals Lijst, Bord, Werklast, Formulier en Tijdlijn kunnen teams hun proces voor het bijhouden van bugs visualiseren en beheren op de manier die het beste bij hen past.
Dankzij de 20 aangepaste statussen en 7 aangepaste velden van de sjabloon kunt u een werkstroom op maat creëren, zodat elk probleem wordt bijgehouden vanaf de ontdekking tot en met de oplossing. Ingebouwde automatiseringen nemen repetitieve taken uit handen, waardoor u kostbare tijd bespaart en handmatig werk wordt verminderd.
💟 Bonus: Brain MAX is je AI-aangedreven desktopassistent, ontworpen om het oplossen van bugs te versnellen met slimme, praktische functies.
Wanneer u een bug tegenkomt, gebruikt u gewoon de spraak-naar-tekstfunctie van Brain MAX om het probleem te dicteren: uw gesproken aantekeningen worden direct getranscribeerd en kunnen als bijlage aan een nieuw of bestaand bugticket worden toegevoegd. De Enterprise Search-functie doorzoekt al uw gekoppelde tools – zoals ClickUp, GitHub, Google Drive en Slack – om gerelateerde bugrapporten, foutenlogboeken, codefragmenten en documentatie te vinden, zodat u over alle benodigde context beschikt zonder van app te hoeven wisselen.
Moet u een oplossing coördineren? Met Brain MAX kunt u de bug aan de juiste ontwikkelaar toewijzen, automatische herinneringen instellen voor updates over de status en de voortgang bijhouden – allemaal vanaf uw desktop!
2. Sentry (het meest geschikt voor het vastleggen van fouten)
Sentry verkort de MTTD en de tijd die nodig is om een probleem te reproduceren door fouten, traces en gebruikerssessies op één plek vast te leggen. AI-gestuurde groepering van problemen vermindert ruis; ‘Suspect Commit’ en regels over eigendom identificeren de waarschijnlijke eigenaar van de code, zodat de toewijzing direct plaatsvindt. Met Session Replay krijgen engineers het exacte pad van de gebruiker en de console-/netwerkdetails om het probleem te reproduceren, zonder eindeloos heen en weer te hoeven gaan.
De functies van Sentry AI kunnen de context van een probleem samenvatten en, in sommige stackconfiguraties, Autofix-patches voorstellen die verwijzen naar de betreffende code. Het praktische resultaat: minder dubbele tickets, snellere toewijzing en een kortere weg van melding naar werkende patch.
3. GitHub Copilot (het meest geschikt om code sneller te beoordelen)
Copilot versnelt de reparatiecyclus binnen de editor. Het legt stacktraces uit, stelt gerichte patches voor, schrijft unit-tests om de oplossing vast te leggen en genereert scripts om de fout te reproduceren.
Copilot Chat kan je door foutieve code leiden, veiligere refactoren voorstellen en opmerkingen of PR-beschrijvingen genereren die de codereview versnellen. In combinatie met verplichte reviews en CI bespaart dit uren in het traject ‘diagnose → implementatie → testen’, vooral bij bugs met een duidelijk omschreven scope en die eenvoudig te reproduceren zijn.
4. Snyk van DeepCode AI (het meest geschikt voor het herkennen van patronen)
De AI-aangedreven statische analyse van DeepCode spoort fouten en onveilige patronen op terwijl je codeert en in pull-requests. Het wijst op problematische werkstroomen, legt uit waarom ze voorkomen en stelt veilige oplossingen voor die aansluiten bij de stijl van je codebase.
Door regressies vóór het samenvoegen op te sporen en ontwikkelaars te begeleiden naar veiligere patronen, verminder je het aantal nieuwe bugs en versnel je het verhelpen van lastige logische fouten die tijdens de review moeilijk te ontdekken zijn. Dankzij IDE- en PR-integraties gebeurt dit dicht bij de plek waar het werk plaatsvindt.
5. Datadog’s Watchdog en AIOps (het meest geschikt voor logboekanalyse)
Watchdog van Datadog maakt gebruik van ML om afwijkingen in logs, metrics, traces en real user monitoring aan het licht te brengen. Het legt verbanden tussen pieken en deploy-markers, infrastructuurwijzigingen en topologie om mogelijke oorzaken te suggereren.
Voor defecten die gevolgen hebben voor klanten betekent dit dat ze binnen enkele minuten worden gedetecteerd, automatisch worden gegroepeerd om het aantal onnodige meldingen te verminderen, en dat er concrete aanwijzingen worden gegeven over waar u moet zoeken. De triagetijd neemt af omdat u begint met „deze implementatie had invloed op deze services en de foutpercentages stegen op dit eindpunt”, in plaats van met een schone lei.
⚡️ Sjabloonarchief: Gratis sjablonen voor het bijhouden van problemen en logboeken in Excel en ClickUp
6. New Relic AI (het meest geschikt voor het identificeren en samenvatten van trends)
De Errors Inbox van New Relic groepeert vergelijkbare fouten per service en versie, terwijl de AI-assistent de impact samenvat, mogelijke oorzaken aangeeft en koppelingen biedt naar de betreffende traces en transacties.
Dankzij implementatiecorrelaties en informatie over entiteitswijzigingen wordt meteen duidelijk wanneer een recente release de oorzaak is. Voor gedistribueerde systemen bespaart die context uren aan overleg tussen teams en zorgt ervoor dat de bug bij de juiste eigenaar terechtkomt met een reeds gevormde, solide hypothese.
7. Rollbar (het meest geschikt voor geautomatiseerde werkstroomen)
Rollbar is gespecialiseerd in realtime foutmonitoring met intelligente fingerprinting om duplicaten te groeperen en trends bij te houden bij gebeurtenissen met fouten. De AI-gestuurde samenvattingen en aanwijzingen voor de onderliggende oorzaak helpen teams inzicht te krijgen in de omvang (getroffen gebruikers, betrokken versies), terwijl telemetrie en stacktraces snelle aanwijzingen geven voor het reproduceren van fouten.
Van de werkstroom van Rollbar kunnen taken automatisch worden aangemaakt, de ernst worden getagd en deze worden doorgestuurd naar de eigenaars, waardoor rommelige foutstromen worden omgezet in geprioriteerde wachtrijen met bijbehorende context.
8. PagerDuty AIOps en runbook-automatisering (het beste op het gebied van low-touch-diagnostiek)
PagerDuty maakt gebruik van gebeurteniscorrelatie en op machine learning gebaseerde ruisonderdrukking om alarmstormen terug te brengen tot concrete incidenten.
Dynamische routering zorgt ervoor dat het probleem onmiddellijk bij de juiste dienstdoende medewerker terechtkomt, terwijl automatisering via runbooks diagnostische stappen of noodmaatregelen kan in gang zetten (services opnieuw opstarten, een implementatie terugdraaien, een functie in- of uitschakelen) voordat er menselijke tussenkomst nodig is. Voor de tijd die nodig is om bugs op te lossen betekent dit een kortere MTTA, snellere noodmaatregelen voor P0-bugs en minder urenverlies door alarmmoeheid.
De rode draad is automatisering in combinatie met AI bij elke stap. U detecteert fouten eerder, leidt ze slimmer door, komt sneller bij de code en communiceert de status zonder ontwikkelaars te vertragen – wat alles bij elkaar leidt tot een aanzienlijke verkorting van de tijd die nodig is om bugs op te lossen.
📖 Lees meer: Hoe u AI kunt gebruiken in DevOps
Praktijkvoorbeelden van het gebruik van AI bij het oplossen van bugs
AI is dus officieel uit het laboratorium gekomen. Het verkort de tijd die nodig is om bugs op te lossen in de praktijk.
Laten we eens kijken hoe dat werkt!
| Domein / Organisatie | Hoe AI werd ingezet | Impact / Voordelen |
|---|---|---|
| Ubisoft | Ontwikkelde Commit Assistant, een AI-tool die is getraind op basis van tien jaar aan interne code en die bugs al in de codeerfase voorspelt en voorkomt. | Het doel is om tijd en kosten drastisch te verminderen – tot wel 70% van de uitgaven voor game-ontwikkeling wordt traditioneel besteed aan het verhelpen van bugs. |
| Razer (Wyvrn-platform) | We hebben de AI-aangedreven QA Copilot (geïntegreerd met Unreal en Unity) gelanceerd om bugdetectie te automatiseren en QA-rapporten te genereren. | Verbetert de detectie van bugs met tot wel 25% en halveert de QA-tijd. |
| Google / DeepMind & Project Zero | Introductie van Big Sleep, een AI-tool die zelfstandig kwetsbaarheden op het gebied van veiligheid detecteert in open-source software zoals FFmpeg en ImageMagick. | Er zijn 20 bugs geïdentificeerd, die allemaal door menselijke experts zijn geverifieerd en op de lijst staan om te worden verholpen. |
| Onderzoekers van UC Berkeley | Met behulp van een benchmark genaamd CyberGym analyseerden AI-modellen 188 open-sourceprojecten , waarbij 17 kwetsbaarheden werden ontdekt – waaronder 15 onbekende ‘zero-day’-bugs – en proof-of-concept-exploits werden gegenereerd. | Toont de steeds grotere bekwaamheid van AI op het gebied van het opsporen van kwetsbaarheden en de automatische redactie van misbruik. |
| Spur (startup van Yale) | Een AI-agent ontwikkeld die testcasebeschrijvingen in gewone taal vertaalt naar geautomatiseerde testroutines voor websites — in feite een zichzelf schrijvende QA-werkstroom. | Maakt autonoom testen mogelijk met minimale menselijke tussenkomst |
| Android-bugrapporten automatisch reproduceren | Gebruik van NLP en reinforcement learning om de tekst van bugrapporten te interpreteren en stappen te genereren om Android-bugs te reproduceren. | Er werd een precisie van 67%, een recall van 77% behaald en 74% van de bugrapporten werd gereproduceerd, waarmee traditionele methoden werden overtroffen. |
Veelgemaakte fouten bij het meten van de tijd die nodig is om bugs op te lossen
Als uw metingen niet kloppen, zal uw verbeterplan dat ook niet zijn.
De meeste ‘slechte nummers’ in werkstroommaten voor het oplossen van bugs zijn het gevolg van vage definities, inconsistente workflows en oppervlakkige analyses.
Begin dus eerst bij de basis – wat telt als start/stop, hoe u omgaat met wachttijden en heropening – en bekijk vervolgens de gegevens vanuit het perspectief van uw klanten. Dat omvat:
❌ Onduidelijke afbakeningen: Het door elkaar gebruiken van ‘Gemeld→Opgelost’ en ‘Gemeld→Gesloten’ in hetzelfde dashboard (of het wisselen van maand tot maand) maakt trends onduidelijk. Kies één afbakening, documenteer deze en zorg ervoor dat alle teams zich hieraan houden. Als u beide nodig hebt, publiceer ze dan als afzonderlijke statistieken met duidelijke labels.
❌ Een benadering die uitsluitend op gemiddelden is gebaseerd: Als u alleen op het gemiddelde vertrouwt, wordt de realiteit van wachtrijen met enkele langdurige uitschieters verborgen. Gebruik de mediaan (P50) voor uw ‘typische’ tijd, P90 voor voorspelbaarheid/SLA’s, en behoud het gemiddelde voor capaciteitsplanning. Kijk altijd naar de verdeling, niet alleen naar één enkel nummer.
❌ Geen segmentatie: Door alle bugs op één hoop te gooien, worden P0-incidenten vermengd met cosmetische P3-bugs. Segmenteer op ernst, bron (klant vs. QA vs. monitoring), component/team en “nieuw vs. regressie”. Uw P0/P1 P90 is wat stakeholders ervaren; uw P2+ mediaan is waar de engineeringafdeling haar planning op baseert.
❌ 'Gepauzeerde' tijd negeren: Wacht u op logbestanden van klanten, een externe leverancier of een releasetermijn? Als u 'Geblokkeerd/Gepauzeerd' niet als een volwaardige status bijhoudt, wordt uw oplostijd een argument. Rapporteer zowel de kalendertijd als de actieve tijd, zodat knelpunten zichtbaar worden en discussies worden voorkomen.
❌ Hiaten in de tijdnormalisatie: Het combineren van tijdzones of het halverwege schakelen tussen kantooruren en kalenderuren vertekent de vergelijkingen. Normaliseer tijdstempels naar één tijdzone (of UTC) en bepaal eenmalig of SLA’s worden gemeten in kantooruren of kalenderuren; pas dit consequent toe.
❌ Onvolledige registratie en duplicaten: Ontbrekende informatie over de omgeving of build en dubbele tickets zorgen voor langere doorlooptijden en onduidelijkheid over de eigendom. Standaardiseer verplichte velden bij de registratie, vul deze automatisch aan (logs, versie, apparaat) en verwijder duplicaten zonder de doorlooptijd te resetten – sluit duplicaten af als gekoppelde, niet als ‘nieuwe’ problemen.
❌ Inconsistente statusmodellen: Aangepaste statussen (“QA Ready-ish”, “Pending Review 2”) verbergen de tijd die een ticket in een bepaalde status doorbrengt en maken statusovergangen onbetrouwbaar. Definieer een standaardwerkstroom (Nieuw → Gesorteerd → In uitvoering → In beoordeling → Opgelost → Gesloten) en controleer op statussen die afwijken van deze werkstroom.
❌ Geen inzicht in de tijd per status: Eén enkel nummer voor de ‘totale tijd’ zegt niets over waar het werk vastloopt. Leg vast en analyseer de tijd die wordt besteed aan de statussen ‘Triaged’, ‘In Review’, ‘Blocked’ en ‘QA’. Als de P90 voor codereview veel hoger ligt dan die voor implementatie, gaat het bij je oplossing niet om ‘sneller coderen’, maar om het vrijmaken van reviewcapaciteit.
🧠 Leuk weetje: De nieuwste AI Cyber Challenge van DARPA liet een baanbrekende sprong voorwaarts zien op het gebied van cyberbeveiligingsautomatisering. Tijdens de wedstrijd werden AI-systemen getoond die zijn ontworpen om kwetsbaarheden in software autonoom te detecteren, te exploiteren en te patchen – zonder menselijke tussenkomst. Het winnende team, „Team Atlanta“, ontdekte maar liefst 77% van de geïnjecteerde bugs en wist 61% daarvan met succes te verhelpen, waarmee het de kracht van AI aantoonde om fouten niet alleen op te sporen, maar ook actief te verhelpen.
❌ Blindheid bij heropeningen: Door heropeningen als nieuwe bugs te behandelen, wordt de klok gereset en wordt de MTTR verfraaid. Houd het percentage heropeningen en de „tijd tot stabiele afsluiting“ bij (van de eerste melding tot de definitieve afsluiting over alle cycli heen). Een stijgend aantal heropeningen duidt meestal op een zwakke reproduceerbaarheid, hiaten in de tests of een vage definitie van „Klaar“.
❌ Geen MTTA: Teams zijn geobsedeerd door MTTR en negeren MTTA (bevestigings-/eigendomstijd). Een hoge MTTA is een vroege waarschuwing voor een langdurige oplossing. Meet deze, stel SLA's vast op basis van ernst en voer automatisering uit voor routering/escalatie om de MTTA laag te houden.
❌ AI/automatisering zonder waarborgen: Als u AI de ernst laat instellen of duplicaten laat afsluiten zonder controle, kunnen randgevallen verkeerd worden geclassificeerd en kunnen statistieken ongemerkt worden vertekend. Gebruik AI voor suggesties, vereis menselijke bevestiging bij P0/P1 en controleer de prestaties van het model maandelijks, zodat uw gegevens betrouwbaar blijven.
Zorg dat deze schakels strakker aansluiten, en uw grafieken over de oplostijd zullen eindelijk de werkelijkheid weerspiegelen. Van daaruit stapelen de verbeteringen zich op: een betere intake verkort de MTTA, overzichtelijkere statussen leggen de echte knelpunten bloot en gesegmenteerde P90's geven leidinggevenden beloften die u kunt nakomen.
⚡️ Sjabloonarchief: 10 sjablonen voor testcases voor het testen van software
Best practices voor een betere bugoplossing
Samenvattend zijn dit de belangrijkste punten om in gedachten te houden!
| 🧩 Best practice | 💡 Wat dit betekent | 🚀 Waarom dit belangrijk is |
| Gebruik een robuust bugtrackingsysteem | Houd alle gemelde bugs bij met behulp van een gecentraliseerd bugtrackingsysteem. | Zorgt ervoor dat geen enkele bug uit het oog wordt verloren en biedt zichtbaarheid op de status van bugs voor alle teams. |
| Schrijf gedetailleerde bugrapporten | Voeg visuele context, besturingssysteeminformatie, stappen om de fout te reproduceren en de ernst toe. | Helpt ontwikkelaars om bugs sneller op te lossen doordat alle essentiële informatie direct beschikbaar is. |
| Bugs categoriseren en prioriteren | Gebruik een prioriteitsmatrix om bugs te sorteren op urgentie en impact. | Zorgt ervoor dat het team zich eerst richt op kritieke bugs en urgente problemen. |
| Maak gebruik van geautomatiseerd testen | Voer automatisch tests uit in uw CI/CD-pijplijn. | Ondersteunt vroegtijdige detectie en voorkomt regressies. |
| Stel duidelijke richtlijnen voor rapportage op | Bied sjablonen en trainingen aan voor de rapportage van bugs. | Dit leidt tot nauwkeurige informatie en soepelere communicatie. |
| Houd belangrijke statistieken bij | Meet de oplostijd, de verstreken tijd en de responstijd. | Maakt het mogelijk om prestaties bij te houden en te verbeteren aan de hand van historische gegevens. |
| Kies voor een proactieve aanpak | Wacht niet tot gebruikers klagen – test proactief. | Verhoogt de klanttevredenheid en vermindert de werkdruk bij de helpdesk. |
| Maak gebruik van slimme tools en ML | Gebruik machine learning om bugs te voorspellen en oplossingen voor te stellen. | Verbetert de efficiëntie bij het opsporen van de onderliggende oorzaken en het verhelpen van bugs. |
| Afstemmen op SLA's | Bespreek de overeengekomen service level agreements voor het oplossen van bugs tijdens een vergadering. | Dit schept vertrouwen en zorgt ervoor dat er tijdig aan de verwachtingen van de client wordt voldaan. |
| Voortdurend evalueren en verbeteren | Analyseer heropende bugs, verzamel feedback en pas processen aan. | Bevordert de voortdurende verbetering van uw ontwikkelingsproces en bugbeheer. |
Bugoplossing eenvoudig gemaakt met contextuele AI
De snelste teams voor bugoplossing vertrouwen niet op heldendaden. Ze ontwerpen een systeem: duidelijke definities van begin en einde, een gestructureerde intake, prioritering op basis van impact op het bedrijf, heldere eigendommen en strakke feedbackloops tussen support, QA, engineering en release.
ClickUp kan fungeren als dat AI-aangedreven commandocentrum voor uw bugoplossingssysteem. Centraliseer alle meldingen in één wachtrij, standaardiseer de context met gestructureerde velden en laat de ClickUp AI triageren, samenvatten en prioriteren, terwijl automatiseringen SLA's handhaven, escaleren wanneer deadlines worden overschreden en belanghebbenden op één lijn houden. Koppel bugs aan klanten, code en releases, zodat leidinggevenden de impact zien en medewerkers in hun werkstroom blijven.
Als je klaar bent om de tijd die nodig is om bugs op te lossen te verkorten en je roadmap voorspelbaarder te maken, meld je dan aan bij ClickUp en begin met het meten van de verbetering in dagen – niet in kwartalen.
Veelgestelde vragen
Wat is een goede tijd voor het oplossen van bugs?
Er is niet één ‘goed’ nummer – het hangt af van de ernst, het releasemodel en de risicotolerantie. Gebruik medianen (P50) voor ‘typische’ prestaties en P90 voor toezeggingen/SLA’s, en segmenteer op basis van ernst en bron.
Wat is het verschil tussen het oplossen en het afsluiten van bugs?
Van 'opgelost' is sprake wanneer de oplossing is geïmplementeerd (bijv. code samengevoegd, configuratie toegepast) en het team het defect als verholpen beschouwt. Van 'gesloten' is sprake wanneer het probleem is geverifieerd en formeel is afgehandeld (bijv. door QA gevalideerd in de target-omgeving, vrijgegeven of gemarkeerd als 'wordt niet verholpen'/'duplicaat' met onderbouwing). Veel teams meten beide: 'Gemeld → Opgelost' geeft de snelheid van de engineering weer; 'Gemeld → Gesloten' geeft de end-to-end werkstroom weer. Gebruik consistente definities, zodat dashboards de fasen niet door elkaar halen.
Wat is het verschil tussen de tijd die nodig is om een bug op te lossen en de tijd die nodig is om een bug te detecteren?
Detectietijd (MTTD) is de tijd die nodig is om een defect te ontdekken nadat het is opgetreden of is uitgebracht – via monitoring, kwaliteitscontrole of gebruikers. Oplostijd is de tijd die nodig is vanaf de detectie/melding tot het moment dat de oplossing is geïmplementeerd (en, indien gewenst, gevalideerd/vrijgegeven). Samen bepalen ze het impactvenster voor de klant: snel detecteren, snel bevestigen, snel oplossen en veilig vrijgeven. U kunt ook de MTTA (tijd tot bevestiging/toewijzing) bijhouden om vertragingen bij de triage op te sporen, die vaak wijzen op een langere oplostijd.
Hoe helpt AI bij het oplossen van bugs?
AI verkort de cycli die doorgaans veel tijd in beslag nemen: intake, triage, diagnose, oplossing en verificatie.
- Intake en triage: Maakt automatisch een samenvatting van lange rapporten, haalt stappen voor het reproduceren van de fout en de omgeving eruit, markeert duplicaten en stelt een ernst- en prioriteitsniveau voor, zodat engineers met een heldere context aan de slag kunnen (bijv. ClickUp AI, Sentry AI).
- Routering en SLA's: Voorspelt de waarschijnlijke component/eigenaar, stelt timers in en escaleert wanneer MTTA of beoordelingswachttijden uitlopen — waardoor de inactieve 'tijd in status' wordt verminderd (ClickUp-automatiseringen en agentachtige werkstroomen).
- Diagnose: Groepeert vergelijkbare fouten, brengt pieken in verband met recente commits/releases en wijst op mogelijke hoofdoorzaken aan de hand van stacktraces en code-context (Sentry AI en vergelijkbare oplossingen).
- Implementatie: Stelt codewijzigingen en tests voor op basis van patronen uit uw opslagplaats, waardoor de ‘schrijven/corrigeren’-cyclus wordt versneld (GitHub Copilot; Snyk Code AI van DeepCode).
- Verificatie en communicatie: schrijft testcases op basis van stappen om fouten te reproduceren, stelt release-opmerkingen en updates voor belanghebbenden op en vat de status samen voor leidinggevenden en klanten (ClickUp AI). Door deze tools samen te gebruiken – ClickUp als commandocentrum met Sentry/Copilot/DeepCode in de stack – kunnen teams de MTTA- en P90-tijden verkorten zonder te hoeven vertrouwen op heldendaden.