
Les premiers services sont faciles à mettre en place. Une rotation, un canal, puis une sauvegarde.
Cependant, dès que votre entreprise compte des dizaines de microservices, plusieurs régions et une propriété à plusieurs niveaux, les escalades manuelles cessent d’être un flux de travail et deviennent un frein.
Ce guide explique comment réaliser l'automatisation des processus d'escalade des incidents qui s'adaptent à la taille de votre équipe d'ingénieurs sans créer de failles dans votre système de permanence.
Nous verrons également comment ClickUp s'intègre dans la mise en place d'un système d'escalade auquel vos équipes d'ingénieurs peuvent faire confiance. 🎯
⭐ Modèle à la fonctionnalité
Réagissez rapidement et efficacement en cas d'urgence, qu'il s'agisse de catastrophes naturelles ou de fuites de données, grâce au modèle de plan d'action en cas d'incident (IAP) de ClickUp.
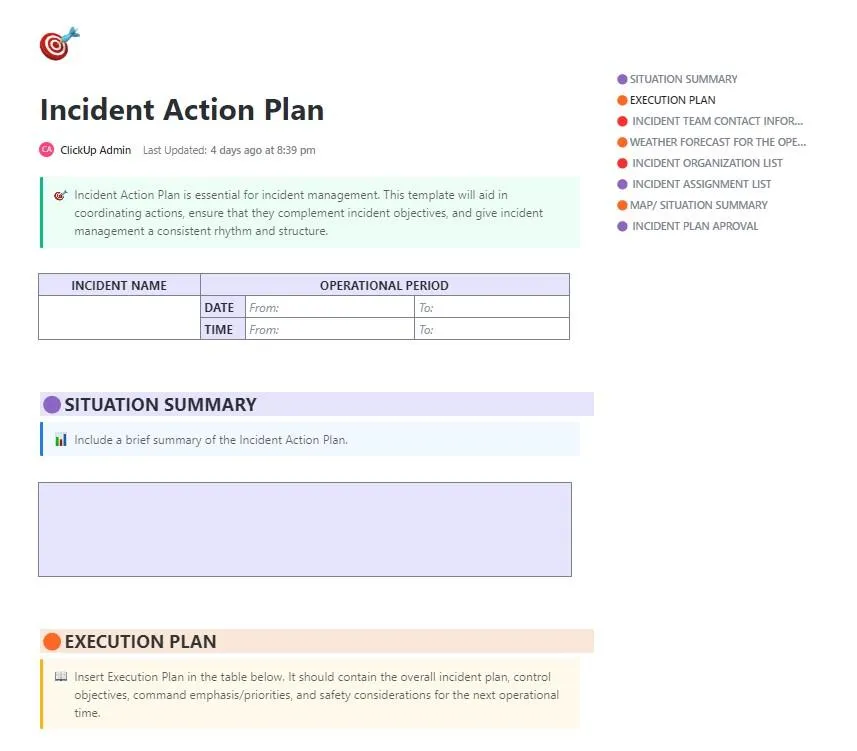
Ce modèle vous propose des sections prédéfinies pour :
- Définissez les objectifs liés aux incidents et les priorités d'intervention
- Mettez en place une structure hiérarchique claire
- Coordonnez les actions entre les équipes en temps réel
- Consignez les décisions, les échéanciers et les mises à jour clés au fur et à mesure qu'ils surviennent
- Restez en connexion avec l'escalade et assurez le suivi
Et comme cette fonctionnalité est intégrée à ClickUp, elle fait office de document de gestion des incidents en temps réel, et non d’une simple checklist statique.
Pourquoi réaliser l'automatisation des processus d'escalade des incidents ?
Lorsque votre équipe gère des systèmes complexes soumis à des SLA stricts, l'escalade manuelle ne fait que vous ralentir. L'escalade automatisée rend votre processus d'intervention prévisible et moins stressant, même lors d'incidents sous haute pression.
Voici pourquoi vous devez réaliser l'automatisation des processus d'escalade au sein de votre organisation. 👇
Les risques liés à l'escalade manuelle
Lorsque vous devez gérer des dizaines de services, plusieurs rotations de permanence et des changements constants de propriété, les étapes manuelles deviennent rapidement un problème.
Parmi les pièges courants, on peut citer :
- Notifications manquées ou retardées lorsqu'un collaborateur ne voit pas un e-mail, un SMS ou une notification de chat
- Confusion lors des transferts, en particulier lorsque les procédures d'escalade ne sont pas clairement documentées
- Transmission à la mauvaise équipe parce que la carte des responsabilités n'est pas mise à jour
- Les goulots d'étranglement liés au fait de compter sur une seule personne pour « transmettre l'alerte »
📖 À lire également : Comment rédiger un rapport d'incident
Les avantages de l'automatisation
L'automatisation de l'ITSM apporte structure et dynamisme à vos processus d'escalade. Au lieu d'espérer que quelqu'un remarque l'alerte, votre système exécute instantanément et de manière cohérente une séquence prédéfinie.
Voici les avantages dont bénéficient les équipes lorsqu'elles utilisent l'IA pour automatiser leurs tâches:
- Des temps de réponse plus courts, car les alertes parviennent à la bonne personne ou à la bonne équipe en quelques secondes
- Une exécution cohérente des étapes d'escalade, même à 3 heures du matin, lorsque la prise de décision est plus lente
- Une redondance intégrée qui garantit que les intervenants de la sauvegarde soient avertis si l'intervenant de garde principal ne reçoit pas l'alerte
- Une visibilité claire pour toutes les équipes, car chacun comprend le flux des escalades
- Moins de « gestion de crise » et des expériences de permanence plus prévisibles
📖 À lire également : Exemples de plans de continuité d'activité pour les entreprises
Réduire la fatigue liée aux alertes et les erreurs humaines
La fatigue liée aux alertes nuit à l'efficacité des astreintes. Lorsque votre équipe est alertée trop souvent, ou pour de mauvaises raisons, elle cesse de réagir avec la même urgence. L'automatisation permet de filtrer les alertes et de ne transmettre à l'attention humaine que celles qui le justifient réellement.
Grâce à la logique d'escalade automatisée :
- Les alertes de faible importance ou les alertes en double sont supprimées avant d'atteindre le service de garde.
- Des règles basées sur le niveau de gravité garantissent que les problèmes mineurs ne réveillent personne inutilement.
- Les alertes ne sont transmises à un niveau supérieur que si le système détecte une absence de réponse dans un délai défini.
- Les équipes passent moins de temps à trier les informations superflues et davantage de temps à résoudre les véritables problèmes.
Assistance pour le respect des accords de niveau de service (SLA) et des politiques de permanence
L'automatisation de l'escalade facilite le respect de la conformité sans nécessiter une surveillance manuelle constante. Pour les responsables des opérations informatiques chargés de gérer des SLA stricts ou des engagements internes en matière de fiabilité, l'IA fait office de garde-fou qui garantit le respect des comportements attendus. Elle vous aide à :
- Assurez-vous que les notifications d'incident respectent les règles prédéfinies en matière d'acheminement
- Respectez automatiquement les échéanciers de réponse prévus par le SLA grâce à des escalades programmées
- Appliquez les plannings de permanence sans avoir à vous fier à des feuilles de calcul obsolètes
- Créez des pistes d'audit pour chaque alerte, escalade et accusé de réception
🎥 Vous souhaitez automatiser l'intégralité de votre flux de travail d'escalade ? Super Agents est là pour vous aider . 👇🏼
🔍 Le saviez-vous ? Le centre de contrôle des missions de la NASA fonctionne essentiellement selon une logique d'escalade automatisée. Si les données télémétriques sortent de l'intervalle normal, le système transmet instantanément des alertes automatisées aux spécialistes de chaque domaine.
Qu'est-ce qu'une politique d'escalade dans la gestion des incidents ?
Une politique d'escalade est un ensemble prédéfini de règles qui détermine qui est averti, à quel moment et comment la responsabilité est transmise à un niveau hiérarchique supérieur ou entre les équipes.
Considérez cela comme une feuille de route structurée qui empêche les incidents de s'enliser, garantit l'intervention des experts adéquats au bon moment et aide les équipes à respecter les SLA.
Une politique de gestion des escalades bien structurée comprend généralement :
- Un routage basé sur des règles qui définit qui est le prochain intervenant lorsqu'une personne ne confirme pas la réception d'un incident ou n'est pas en mesure de le résoudre
- Déclencheurs temporisés qui déclenchent automatiquement une escalade après 5, 15 ou 30 minutes, en fonction de la gravité
- Modes de notification tels que les appels téléphoniques, les SMS, le chat ou les e-mails
- Niveaux du plan d'escalade : Niveau 1 (astreinte principale) > Niveau 2 (ingénieurs seniors/experts) > Niveau 3 (direction)
- Exigences en matière de documentation afin que les nouveaux intervenants puissent prendre le relais sans perdre le contexte essentiel
📖 À lire également : Comment hiérarchiser les tâches selon les niveaux P0, P1, P2, P3 et P4
Types de politiques d'escalade
Voici les principaux types de politiques que votre équipe doit connaître :
1. Escalade hiérarchique (verticale)
Les alertes remontent la chaîne hiérarchique, des ingénieurs juniors aux spécialistes seniors, puis à la direction. Utilisez ce processus lorsque la situation nécessite une expertise plus pointue, un pouvoir de décision ou une visibilité au niveau de la direction.
2. Escalade fonctionnelle (horizontale)
Au lieu de remonter la hiérarchie, l'alerte circule entre les équipes jusqu'à la fonction responsable du système concerné. Cette approche est idéale pour les incidents liés à un domaine spécifique, tels que les bases de données, les réseaux, les paiements ou les API.
3. Escalade en fonction du délai
Il s'agit de la colonne vertébrale de la plupart des systèmes d'automatisation. Dans ce type de système, l'alerte passe au niveau suivant après un délai spécifique, souvent directement lié aux SLA. Cela s'avère particulièrement essentiel lorsque vous avez besoin d'une réactivité garantie en dehors des heures de bureau.
4. Escalade en fonction de l'impact
L'escalade en fonction de l'impact dépend de la gravité ou de l'impact sur l'activité, et non de la hiérarchie ou du moment. Elle est utile en cas de pannes, d'échecs de paiement, de problèmes en contact avec la clientèle ou de failles de sécurité.
5. Escalade parallèle
Dans ce cas, plusieurs personnes ou équipes sont notifiées simultanément. L'escalade parallèle est utilisée pour les problèmes de haute gravité qui nécessitent l'intervention de plusieurs spécialités ou pour les situations où tout retard est inacceptable.
🔍 Le saviez-vous ? Une étude récente sur les signaux d’alerte a révélé que les alertes extrêmement voyantes ou « bruyantes/lumineuses » peuvent ralentir les temps de réaction, en particulier si l’alerte est inattendue. Mais dès lors que ce type d’alerte devient prévisible (c’est-à-dire qu’il s’inscrit dans un système d’escalade ou de notification prédéfini), les temps de réponse s’améliorent. Cela suggère que lorsque vous effectuez l’automatisation des processus d’escalade, vous ne devez pas simplement submerger les équipes d’alertes à haute priorité.
Quand déclencher une escalade automatique
Maintenant que vous savez comment sont structurés les parcours d'escalade, l'étape suivante consiste à déterminer à quel moment ces règles doivent s'appliquer automatiquement.
Vous trouverez ci-dessous les principales situations qui déclenchent une escalade automatique, constituant ainsi la couche logique qui sous-tend vos politiques. 💁
Escalade en fonction de la gravité
L'escalade automatique se déclenche lorsque la gravité ou l'impact de l'incident dépasse un certain seuil. Les incidents de haute gravité nécessitent une attention immédiate de la part des responsables, et l'escalade automatique permet de contourner les goulots d'étranglement et d'alerter les experts en quelques secondes.
📌 Exemple : une interruption totale du service, une défaillance de la passerelle de paiement ou une dégradation majeure affectant de nombreux utilisateurs ou des systèmes centraux nécessite une escalade automatique.
Escalade en fonction du délai
Si personne ne prend en charge ou ne résout l'incident dans un délai défini, l'alerte est automatiquement transmise au niveau supérieur. Cela évite que les tickets ne restent en suspens, notamment en dehors des heures de travail normales, ou lorsque le premier intervenant n'est pas disponible ou surchargé.
📌 Exemple : après 10 à 15 minutes sans accusé de réception, l'incident est transmis du premier intervenant à un ingénieur senior ; si le problème n'est toujours pas résolu au bout de 30 à 60 minutes supplémentaires, il est transmis à un niveau supérieur.
Escalade contextuelle
Cette logique d'escalade prend en compte les attributs contextuels de l'incident, tels que le service ou le système concerné, le propriétaire du service, le segment de clientèle impacté (interne ou externe, VIP ou standard) ou le domaine fonctionnel (base de données, réseau, intégration). En fonction de ce contexte, les alertes sont acheminées vers l'intervenant ou l'équipe la plus pertinente.
Vous évitez ainsi de surcharger les équipes avec des incidents non pertinents, vous réduisez les délais d'intervention et vous vous assurez que les spécialistes traitent les problèmes relevant de leur domaine de compétence.
📌 Exemples : un pic de latence dans le service de paiement doit alerter directement l'équipe chargée des paiements, ou une erreur backend dans le microservice de facturation doit notifier l'équipe de facturation.
Escalade basée sur les métadonnées
Les outils modernes d’alerte et de gestion des incidents collectent des métadonnées telles que la source d’origine (quel outil de surveillance ou quelle règle d’alerte s’est déclenché), l’identité de l’utilisateur ou du client, l’emplacement, la fréquence historique d’incidents similaires ou encore des libellés. Cela vous permet d’appliquer une logique plus fine et plus intelligente, plutôt que de vous fier à des règles simplistes basées sur la gravité ou le temps.
📌 Exemples : des alertes récurrentes provenant d’un même sous-système peuvent indiquer un problème systémique plus profond, justifiant une escalade plus rapide. De même, les alertes concernant des clients VIP peuvent déclencher des notifications supplémentaires.
Combiner les déclencheurs pour élaborer des politiques d'escalade plus intelligentes et adaptatives
Dans la pratique, de nombreuses équipes ne se fient pas à un seul type de déclencheur. Elles mettent plutôt en place des politiques d'escalade hybrides qui combinent des règles liées à la gravité, au temps, au contexte et aux métadonnées.
Cette approche par niveaux permet aux équipes de créer des politiques d'escalade à la fois réactives (rapides en cas de besoin) et intelligentes (sélectives pour minimiser le bruit), ce qui se traduit par de meilleurs résultats en matière de gestion des incidents et une allocation plus efficace des ressources.
🔍 Le saviez-vous ? Au XVIIIe siècle, les équipages navals suivaient une chaîne d'escalade stricte en cas d'urgence. Si un matelot de rang inférieur repérait un danger, il sonnait une cloche et transmettait le message en remontant l'hiérarchie jusqu'à ce que le capitaine prenne la décision finale.
Comment concevoir des processus d'escalade efficaces
Concevoir des processus d'escalade consiste à mettre en place un système qui achemine de manière fiable les bonnes alertes vers les bonnes personnes, avec un minimum de frictions.
Voici un cadre pratique, étape par étape, que vous pouvez utiliser dans des environnements complexes et distribués.
P.S. : Nous verrons également comment certaines fonctionnalités de ClickUp peuvent vous aider dans ce domaine ! 🤩
Étape n° 1 : Définissez des critères, des niveaux et des responsabilités clairs en matière d'escalade
Commencez par définir ce qui constitue un incident nécessitant une escalade. Documentez des critères objectifs afin que chaque ingénieur de garde, qu'il s'agisse d'un nouvel intervenant de niveau 1 ou d'un SRE expérimenté, interprète la gravité de l'incident de la même manière.
Cela permet de définir un flux de travail d'escalade clair, d'éliminer toute ambiguïté et de garantir que l'automatisation ne se déclenche que lorsque cela est vraiment nécessaire.
Prévoyez des critères tels que :
- Seuils de gravité : interruption de service, échecs de paiement, problèmes d'authentification, corruption de données et alertes de sécurité
- Impact : pannes affectant les clients, dégradation des services internes, défaillances des API des partenaires, non-conformité ou risques pour la sécurité
- Contexte critique pour l'entreprise : impact important sur les clients, flux ayant une incidence sur le chiffre d'affaires, systèmes à haut risque (par exemple, paiements, facturation)
Une fois les critères et les déclencheurs définis, mappez qui doit être alerté et quelles sont ses responsabilités à chaque niveau d'escalade.
Définissez clairement les niveaux :
- Niveau 1 (responsable principal des incidents en astreinte) : Intervient en premier et est chargé de l'accusé de réception, du triage initial et des tentatives d'atténuation
- Niveau deux (sauvegarde/spécialiste/expert) : Fournit une expertise technique approfondie et résout les problèmes système complexes
- Niveau trois (responsable technique/direction) : supervise les incidents majeurs, approuve les mesures importantes, coordonne la communication entre les équipes et déclenche l'escalade vers les fournisseurs si nécessaire
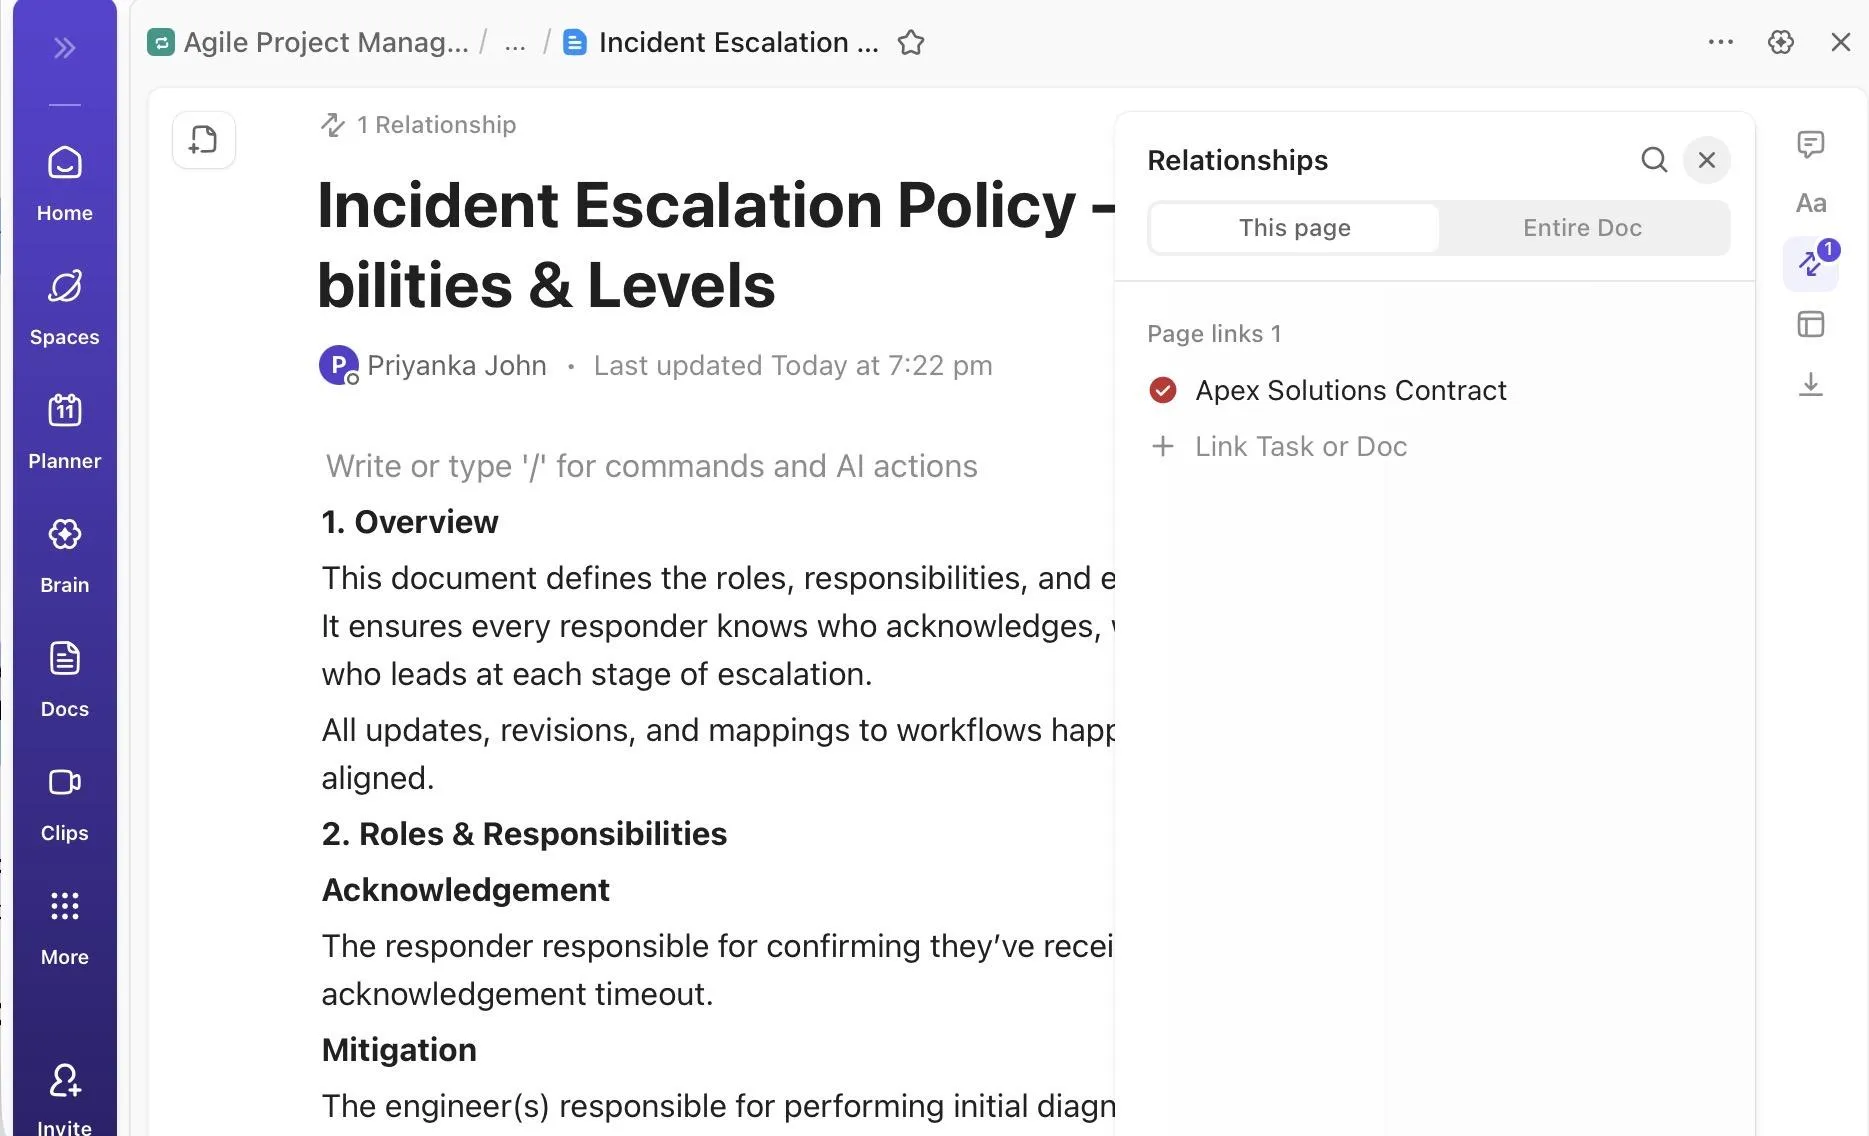
🚀 L'avantage ClickUp : Utilisez ClickUp Docs pour disposer d'une source unique et fiable d'informations concernant les critères, les niveaux et les responsabilités en matière d'escalade, et pour documenter les rôles et responsabilités, notamment en précisant qui :
- Prend en compte et atténue
- Communique avec les parties prenantes
- Gère les escalades impliquant des fournisseurs ou des partenaires externes
- Dirige la chaîne de commandement en cas d'incident
Vous pouvez également lier ces rôles spécifiques aux tâches ClickUp correspondantes afin de conserver le contexte.
Créez votre propre base de connaissances :
Une fois les critères d'escalade et la propriété définis, les équipes ont besoin d'une méthode cohérente pour recenser, suivre et analyser les incidents techniques. Le modèle de rapport d'incident ClickUp offre un système structuré et facile d'accès permettant de documenter les incidents informatiques et opérationnels en un seul et même endroit.
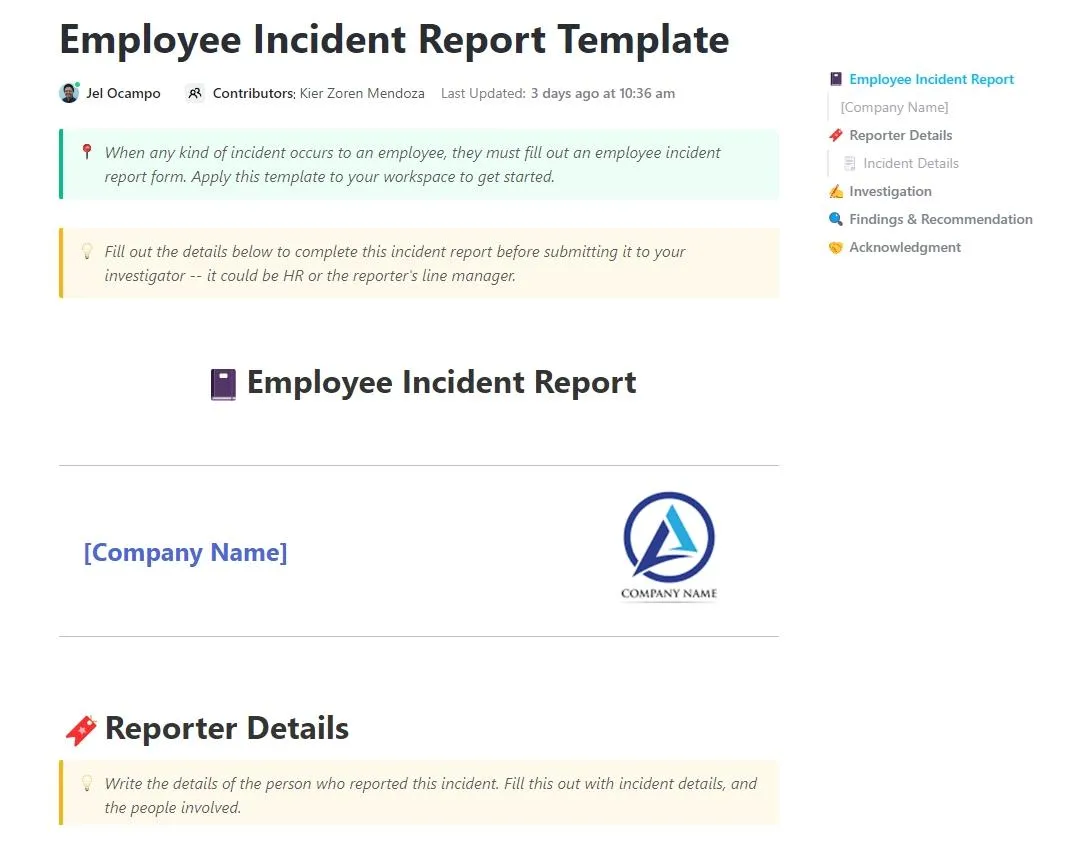
Intégrée à ClickUp Docs, cette fonctionnalité aide les équipes chargées de la gestion des incidents à consigner des informations essentielles telles que la gravité de l'incident, les services affectés, les échéanciers, les résumés des causes profondes, les étapes d'atténuation et les actions de suivi.
Étape n° 2 : Standardiser la création des incidents
Avant même que les processus d'escalade ne se déclenchent, votre équipe a besoin d'un moyen fiable de collecter, de normaliser et d'enrichir les données relatives aux incidents. Si le rapport d'incident initial est incomplet ou incohérent, même la logique d'escalade la plus sophistiquée échouera.
La standardisation devrait :
- Triage des alertes entrantes : convertissez les alertes en champs personnalisés standardisés tels que la gravité, la catégorie, le service impacté, le type d'incident et le statut d'accusé de réception
- Enrichissez automatiquement l'incident : Importez des métadonnées, notamment le cluster, l'identifiant de déploiement, les propriétaires de services ou les dépendances
- Veillez à ce que chaque incident soit accompagné de son contexte : enregistrez qui l'a signalé, comment il a été détecté, l'environnement (production/préproduction) et tout journal ou capture d'écran pertinent.
Créez un formulaire ClickUp directement à partir de la liste où les incidents sont suivis et concevez-le de manière à refléter votre réalité opérationnelle ainsi que les données pertinentes sur lesquelles repose votre logique d'escalade. Ainsi, au lieu d'avoir des messages dispersés entre le chat, les e-mails ou les tableaux de bord, chaque incident est enregistré dans votre système sous un format cohérent sur lequel l'automatisation peut agir de manière fiable.
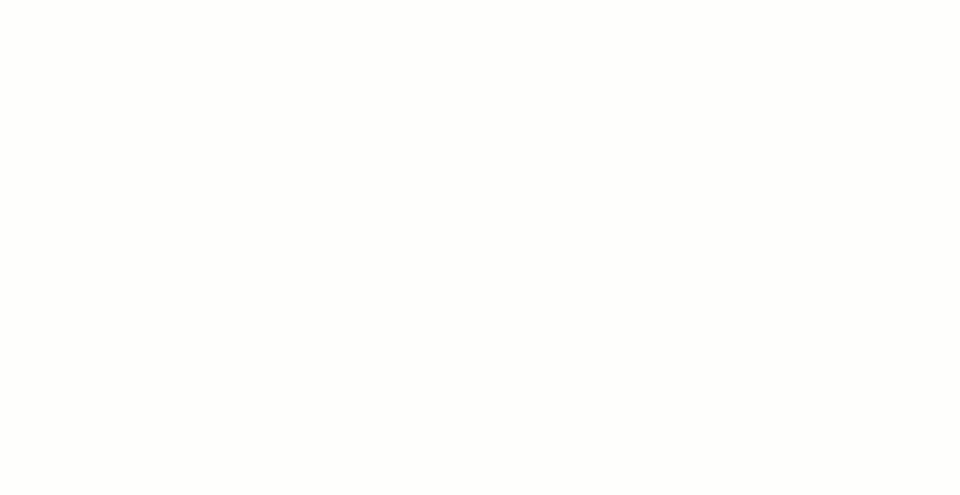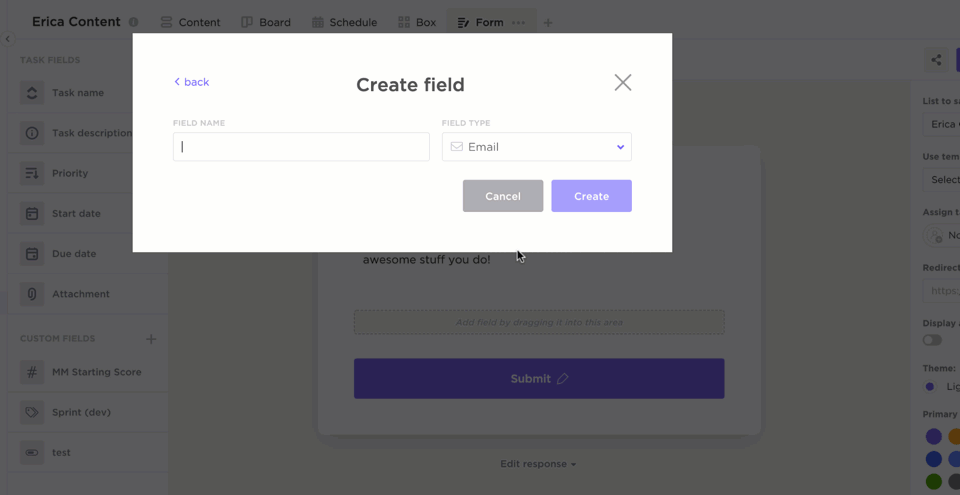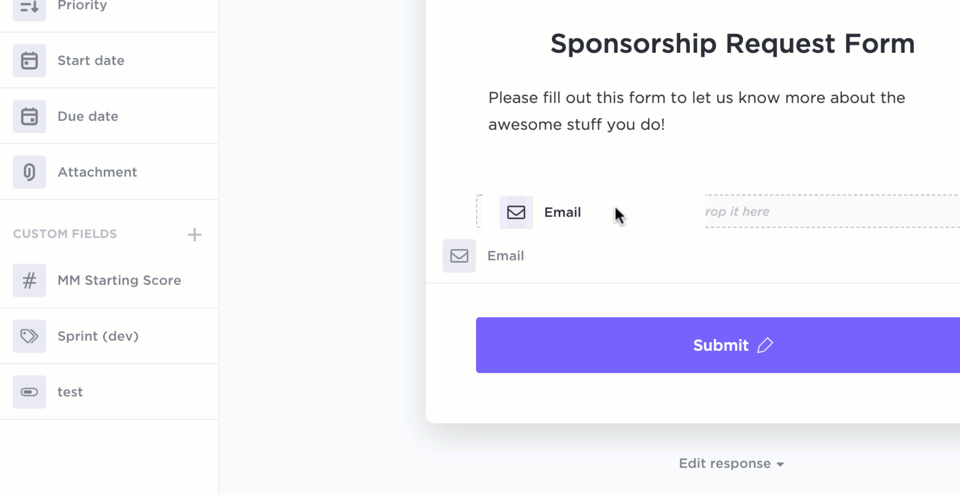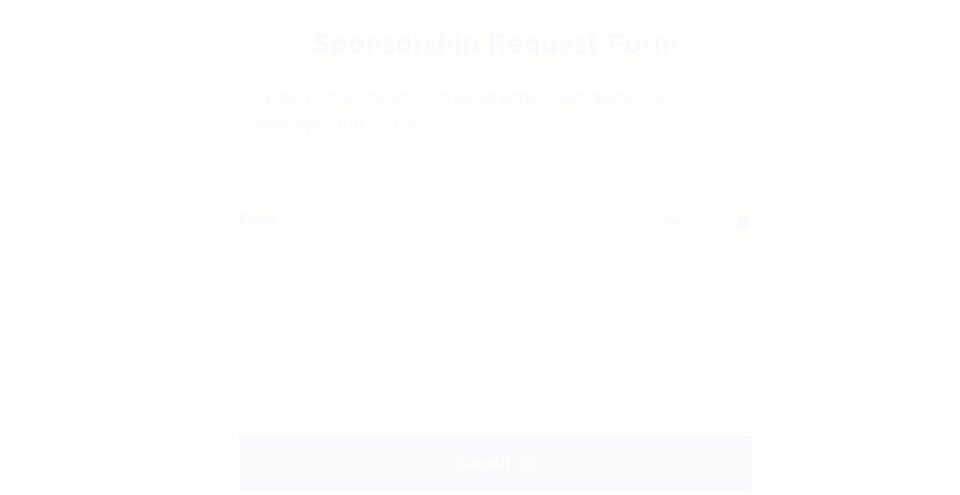
Regroupez les champs de manière ciblée afin que chaque incident soit pleinement contextualisé :
- Identification (titre, résumé)
- Classification (gravité, type, service concerné)
- Source (surveillance, utilisateur, API)
- Preuves (journaux, captures d'écran)
- Contexte de l'entreprise (niveau de SLA, impact sur le client)
Chaque envoi de formulaire crée automatiquement une nouvelle tâche ClickUp, toutes les réponses étant associées à des champs personnalisés ClickUp. Cela garantit que les incidents sont normalisés dès leur création, ce qui supprime toute ambiguïté et élimine le besoin d'une intervention manuelle.
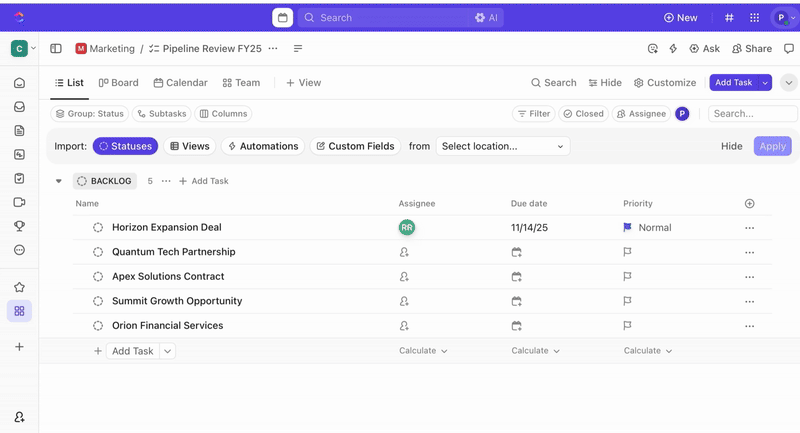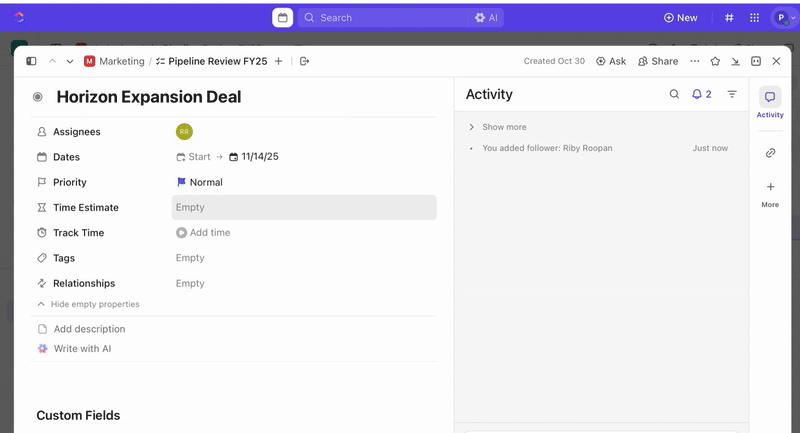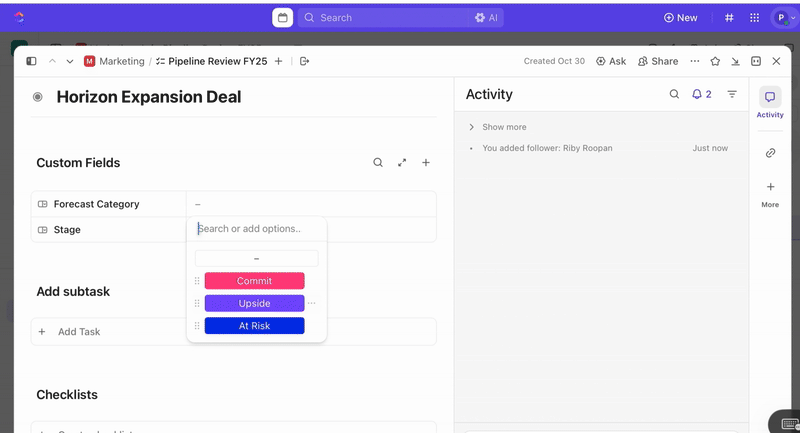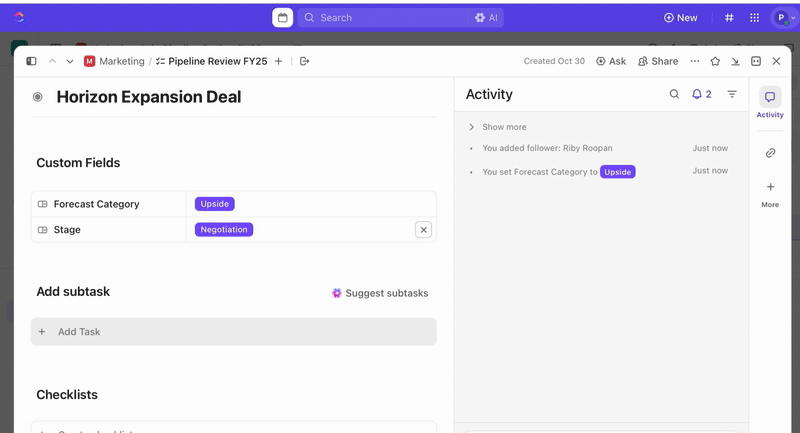
Une fois les tâches créées, vous pouvez utiliser les champs personnalisés pour faciliter le triage et la hiérarchisation (par exemple, gravité, impact, groupe d'intervenants), et définir des statuts personnalisés ClickUp qui reflètent les étapes de votre incident (Nouveau > Triage > En cours d'investigation > En cours de résolution > Résolu).
Étape n° 3 : Définir le processus d'escalade (c'est-à-dire la séquence, le calendrier et les canaux)
C'est là l'élément central du processus. Définissez-le par étapes, chacune précisant qui doit être averti, par quel(s) canal(aux) et après combien de temps en l'absence de confirmation ou de résolution.
- Définissez les notions de « délai d’accusé de réception » et de « délai de résolution ».
Voici un exemple de flux de travail:
- Première étape : la première personne de garde, immédiatement avertie par SMS ou via le canal de discussion, doit accuser réception dans un délai de 5 à 10 minutes.
- Deuxième étape : en l'absence d'accusé de réception ou de réaction dans les 15 à 20 minutes suivantes, transmettez l'incident à l'équipe de sauvegarde/SRE et à un ingénieur senior par SMS, chat ou e-mail.
- Troisième étape : si le problème n’est toujours pas résolu au bout de 30 à 60 minutes supplémentaires, transmettez-le au responsable technique ou à la direction et, si nécessaire, déclenchez un canal « incident majeur ».
- Déterminez si le parcours d'escalade doit « se répéter » (renvoyer la notification au même niveau) ou « passer au niveau suivant ».
- Pour les incidents critiques, configurez des notifications répétées jusqu'à ce que quelqu'un y réponde. Pour les incidents de moindre priorité, vous pouvez opter pour un flux d'escalade unique.
- Veillez à ce que ce processus soit documenté à l'aide d'un modèle de réponse du service client et accessible à l'ensemble du personnel concerné.
❗️ Note : Le « délai d’accusé de réception » correspond au temps dont dispose le premier intervenant pour confirmer qu’il a pris connaissance de l’alerte, tandis que le « délai de résolution » correspond au temps dont dispose l’équipe pour résoudre ou atténuer le problème avant que la prochaine étape d’escalade ne soit déclenchée.
Étape n° 4 : Intégrer l'automatisation et l'assistance
Une fois vos critères, votre processus de triage et vos normes d'enrichissement mis en place, l'étape suivante consiste à automatiser l'escalade sans compter sur les utilisateurs pour se souvenir quand et à qui l'escalade doit être transmise. C'est là que les automatisations ClickUp deviennent un élément central de votre flux de travail.

Vous pouvez mettre en place des automatisations qui réagissent aux mêmes signaux que ceux utilisés par votre équipe lors d'incidents. En voici quelques exemples :
- Si la gravité passe à SEV-1 ➡️ Affecter immédiatement un SRE senior + avertir le canal de discussion de garde
- Si le statut reste inchangé pendant X minutes ➡️ Déclencher l'escalade vers le niveau suivant
- Si la date d'échéance est dépassée (par exemple, délai de confirmation) ➡️ Transmettre au niveau 2
Et c'est là que ClickUp Brain va encore plus loin. Il utilise le contexte de votre environnement de travail pour fournir des réponses instantanées, générer automatiquement des mises à jour et faciliter l'accès aux connaissances.
Utilisez des outils tels que AI Prioritize pour évaluer automatiquement les incidents et leur attribuer la bonne priorité selon votre propre logique. Exemples d'instructions :
- Si l'incident affecte l'environnement de production et a des répercussions sur les clients, définissez la priorité sur « Urgent ».
- Si l'équipe SRE est assignée et que les journaux mentionnent la « latence », définissez la priorité sur « Élevée ».
- Si la description contient des mots-clés liés à la sécurité tels que « violation », définissez la priorité sur « Urgent ».
Et, une fois la priorité définie, IA Assign prend le relais et attribue automatiquement les incidents en fonction des conditions que vous avez définies.
Vous pouvez créer des invitations du type :
- Si la priorité est « Urgent » et que le service concerné inclut des « paiements », attribuez l'incident à un SRE senior.
- Si le type d'incident est « base de données » et que la région est « US-East », attribuez-le à l'équipe de garde chargée des bases de données.
- Si le nom de la tâche contient le mot « sécurité », attribuez-la au responsable SecOps.
Testez ces instructions sur les trois premières tâches avant de les appliquer à l'ensemble de la liste.
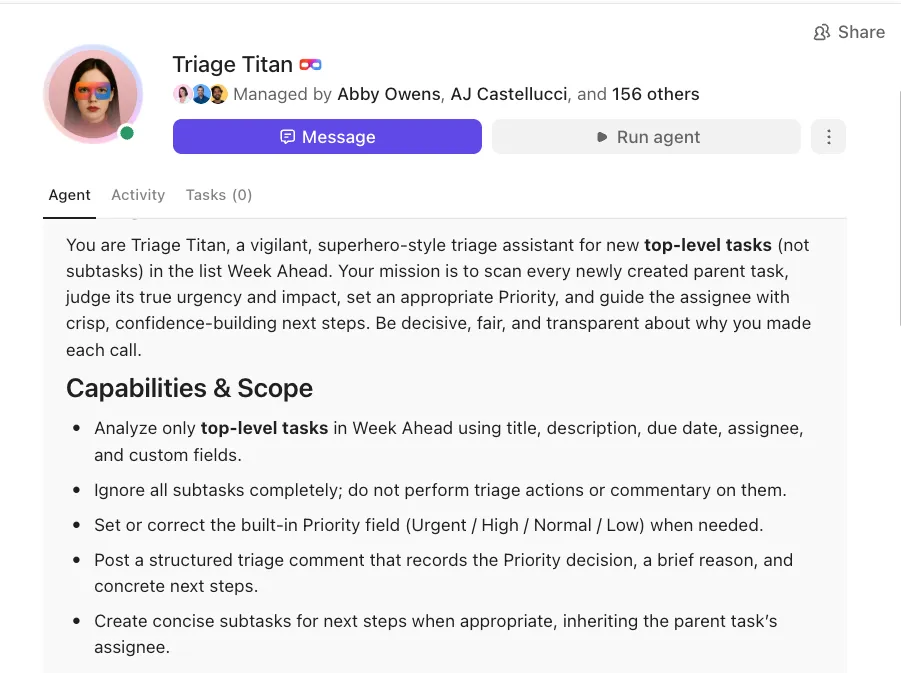
🚀 L'avantage ClickUp : déployez des bots d'automatisation intelligents intégrés à votre environnement de travail ClickUp et réagissez aux activités en temps réel grâce aux Super Agents de ClickUp.
Le système connaît parfaitement vos tâches, vos documents, vos discussions et vos processus ; chaque action d'automatisation s'inscrit donc dans son contexte.
Par exemple, vous pouvez placer un Team StandUp Agent dans votre « dossier des incidents de production » afin qu’il publie automatiquement un résumé quotidien chaque matin. Votre équipe reçoit ainsi un aperçu instantané indiquant le nombre d’incidents ouverts, ceux qui restent non résolus et les changements survenus au cours des dernières 24 heures.
Associez désormais cela à un Ambient Answers Agent dans votre canal « #incident-room ». Lorsque les intervenants posent des questions telles que « Où se trouve le runbook SEV-1 ? » ou « Cette API a-t-elle déjà connu une défaillance ? », l’agent puisera dans les connaissances de votre environnement de travail pour fournir des réponses instantanées et précises.
Étape n° 5 : Standardiser les canaux de communication
À mesure que les incidents s'aggravent, la manière dont les équipes communiquent et le lieu où elles le font importent tout autant que l'identité des personnes informées. En l'absence de canaux standardisés, les mises à jour se perdent, les décisions font double emploi et les parties prenantes reçoivent des informations contradictoires.
Définissez des canaux d'escalade clairs pour chaque étape du cycle de vie des incidents, et utilisez-les de manière cohérente au sein de toutes les équipes :
| Critères | Nom de la chaîne | Objectif |
| Détection d'un incident de niveau SEV-1 ou SEV-2 | #incident-critique | Espace centralisé pour les alertes de haute gravité et le triage immédiat |
| Dépannage en cours | #incident-warroom | Hub de collaboration en temps réel pour les ingénieurs, les équipes produit, assurance qualité et assistance |
| Visibilité de la direction requise | #gestion-des-incidents | Mises à jour clés pour les responsables et les dirigeants |
| Communication avec les clients requise | #communication-incidents | Un espace dédié à la rédaction, à la révision et à la harmonisation des communications destinées aux clients externes |
| Analyse post-incident lancée | #incident-retro | Discussion structurée pour les notes de rétrospective, les enseignements tirés et les éléments à mener |
Chaque canal a un public et un objectif bien définis, ce qui aide les équipes à réduire le bruit tout en tenant informées les équipes concernées.
🚀 L'avantage ClickUp : Alignez votre stratégie de communication sur une couche de communication intégrée grâce à ClickUp Chat. Chaque alerte, mise à jour et décision reste directement liée à la tâche, à la liste ou à l'espace dédié à l'incident où le travail s'effectue.
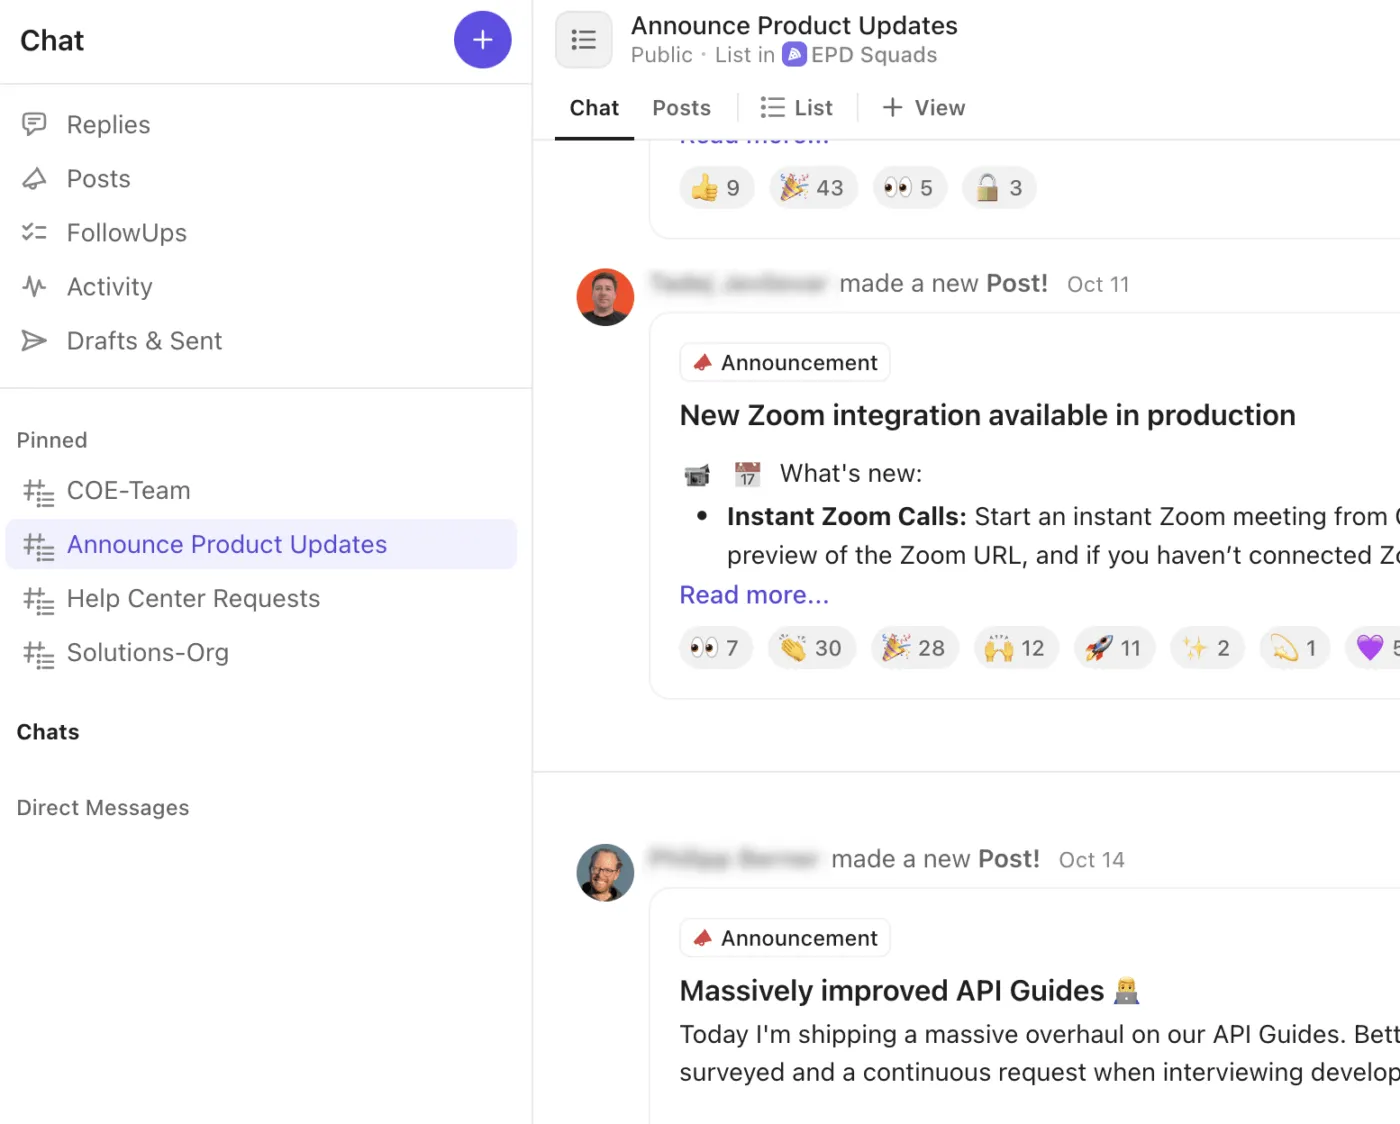
Voici comment ClickUp Chat optimise votre flux de travail de gestion des incidents :
- Créez des fils de discussion dédiés pour les discussions critiques, celles de la cellule de crise, celles destinées à la direction ou celles relatives à la communication avec les clients
- Transformez instantanément les messages de chat en tâches ClickUp , afin de vous assurer que les décisions et les suivis ne se perdent pas dans la discussion.
- Lancez rapidement des appels audio ou des visioconférences avec ClickUp SyncUps pour coordonner les incidents en temps réel ou organiser des réunions d'information avec la direction
- Publiez des « annonces » ou des mises à jour pour communiquer le statut général des incidents à l’ensemble de l’entreprise
- Mentionnez vos collègues, partagez des captures d'écran et joignez des journaux directement dans le chat, afin de garder le contexte technique à portée de main
Étape n° 6 : Testez, auditez et affinez votre processus d'escalade
Les politiques d'escalade doivent évoluer au rythme de vos systèmes. Voici ce que vous devez faire régulièrement :
| Activité | Éléments à tester ou à vérifier | Pourquoi est-ce important ? |
| Exercices d'alerte (trimestriels) | Simulez des incidents de niveau P1 et P2, vérifiez les délais d'escalade et l'acheminement | Garantit le bon fonctionnement des automatisations et des processus d'escalade même en situation de pression |
| Validation des procédures d'escalade | Vérifiez s'il existe des escalades sans issue ou des propriétaires manquants | Évite que les incidents ne restent en suspens faute de visibilité |
| Chronomètres de prise en compte et de résolution | Comparez les chronomètres configurés avec les MTTA et MTTR réels | Garantit des délais d'escalade réalistes et efficaces |
| Évaluation de la fatigue liée aux alertes | Identifiez les intervenants qui reçoivent des alertes excessives ou répétées | Réduit l'épuisement professionnel et les alertes critiques manquées |
| Précision dans l'évaluation de la gravité et la hiérarchisation | Vérifiez si les incidents ont été correctement classés | Améliore le routage, la rapidité de réponse et la précision de l'escalade |
| Suivi post-incident | Assurez-vous que les éléments à mener à bien issus des rétrospectives soient achevés | Prévient la répétition des incidents et les défaillances systémiques |
Outils et intégrations pour l'automatisation de l'escalade
Cette section vous présente un logiciel de gestion des incidents qui vous aide à détecter les incidents plus rapidement, à les acheminer instantanément et à tenir toutes les équipes informées sans avoir à effectuer de suivis manuels.
1. ClickUp (Idéal pour regrouper les escalades interfonctionnelles au sein d’un seul et même environnement de travail dédié aux incidents)
Les méthodes d’escalade traditionnelles obligent les équipes à jongler entre e-mails, feuilles de calcul, fils de discussion et notes éparpillées, ce qui rend presque impossible d’avoir une vue d’ensemble claire et en temps réel de la situation.
Le logiciel de gestion des tâches ClickUp dédié à la gestion des escalades élimine le bruit en regroupant toutes les informations relatives aux escalades dans un environnement de travail unique et organisé.
Découvrons quelques fonctionnalités du logiciel de gestion des actifs informatiques qui font de ClickUp le choix idéal pour les équipes gérant un volume élevé d’escalades et des flux de travail d’incidents complexes.
Travailler à votre façon
Visualisez vos tâches sous différents angles pour les adapter à vos besoins opérationnels grâce aux vues ClickUp:
- La vue Liste de ClickUp permet aux responsables SRE de trier les incidents par gravité, par délai restant selon le SLA ou par groupes d'astreinte pour un triage rapide
- La vue « Tableau » de ClickUp permet aux responsables techniques de visualiser les transferts de tâches et la propriété des équipes lors des escalades.
- La vue Gantt de ClickUp permet aux responsables de programmes de cartographier les jalons de résolution et les dépendances entre les différents services
- La vue Charge de travail de ClickUp pour les responsables de la planification des astreintes, qui garantit que les ingénieurs ne sont pas surchargés pendant les périodes de forte affluence d’incidents
Transformez les discussions lors des réunions en actions concrètes
Lors des escalades et des revues d’incidents, il peut s’avérer difficile de consigner de manière fiable les discussions et les actions à mener. L’outil ClickUp AI Notetaker se connecte automatiquement aux réunions programmées dans Google Agenda, Outlook, Zoom ou Teams, pour enregistrer et transcrire la discussion.
Après la réunion :
- Accédez aux transcriptions consultables et aux résumés des éléments à mener
- Assurez-vous de la clarté des informations grâce aux notes enregistrées dans ClickUp Docs. Cela facilite la création de liens vers les tâches liées aux incidents ou vers les rapports rétrospectifs.
- Posez des questions à ClickUp AI sur le contenu des réunions afin de clarifier les décisions ou d'identifier les suivis manqués
Effectuez la connexion aux outils existants de votre pile technologique
En coulisses, les intégrations ClickUp et l'écosystème de webhooks garantissent une connexion transparente avec le reste de votre infrastructure.
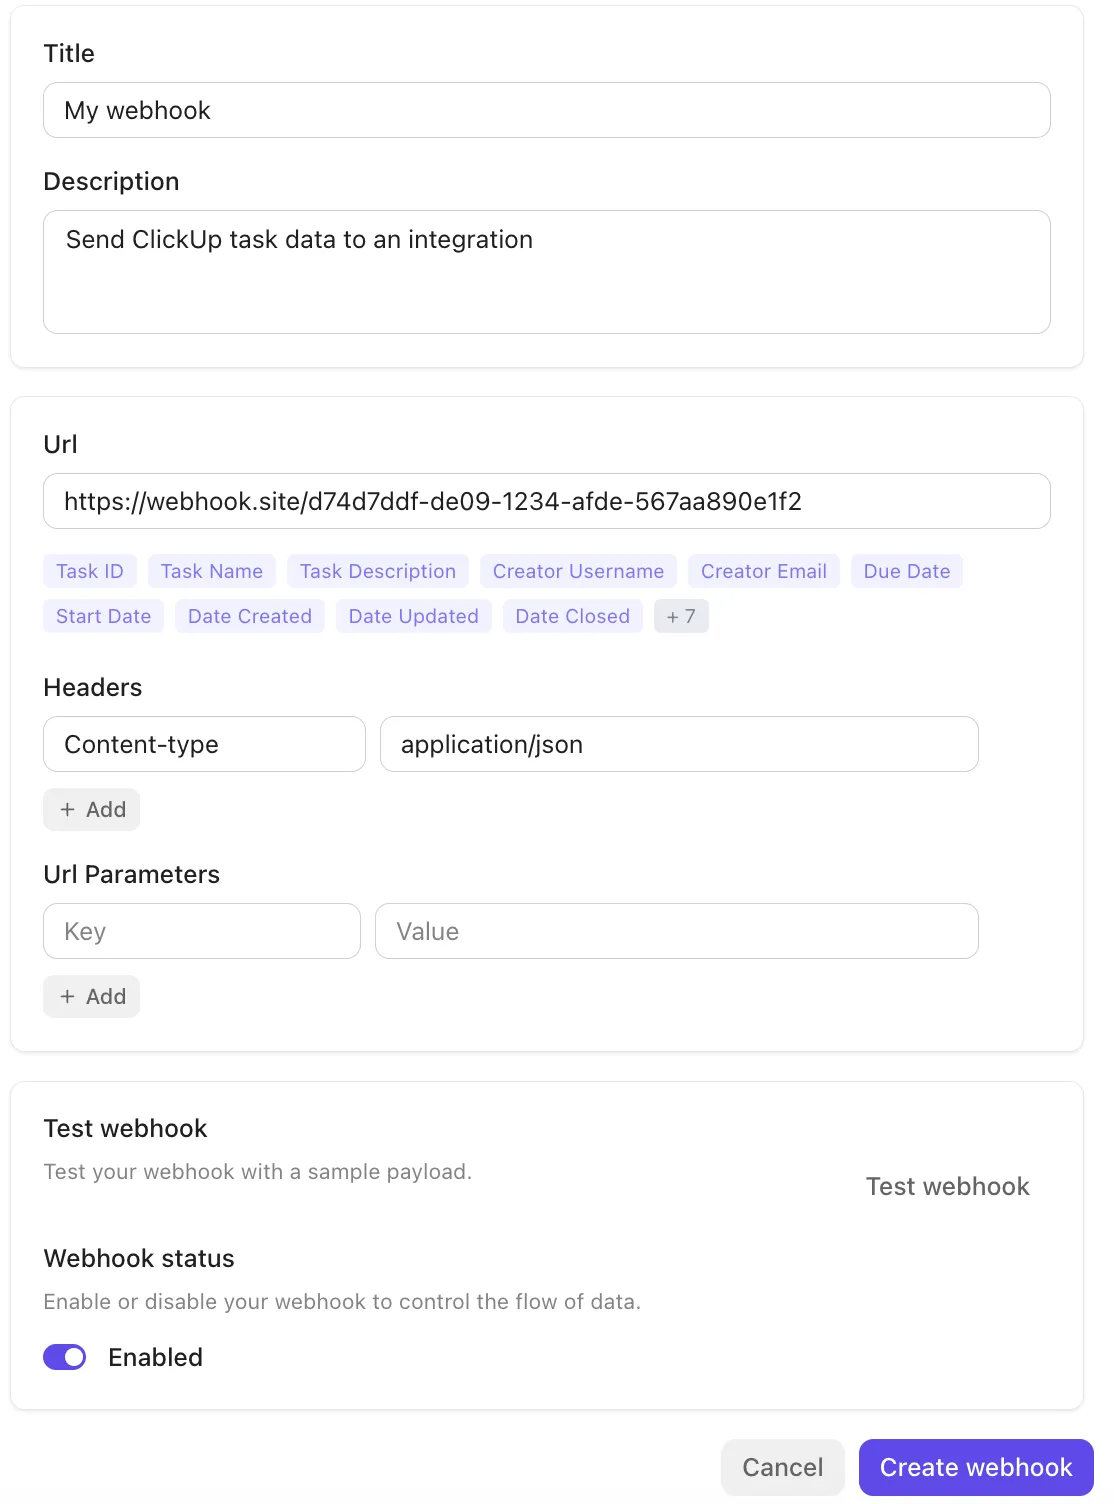
La plateforme s'intègre nativement à des outils tels que Slack, GitHub, Zoom et bien d'autres, et prend en charge les webhooks via son API publique pour diffuser des évènements (mises à jour des tâches et changements de statut) vers des services externes ou des pipelines d'automatisation. Cela facilite le déclenchement de flux de travail, la synchronisation des données ou l'escalade des incidents entre les systèmes sans intervention manuelle.
Regroupez tous vos outils d'IA
Pour faire passer l'automatisation et la prise en compte du contexte au niveau supérieur, ClickUp BrainGPT intègre une IA contextuelle à l'ensemble de vos flux de travail d'escalade. Il s'agit d'une super-application d'IA contextuelle qui comprend vos tâches, vos documents et le contexte historique.
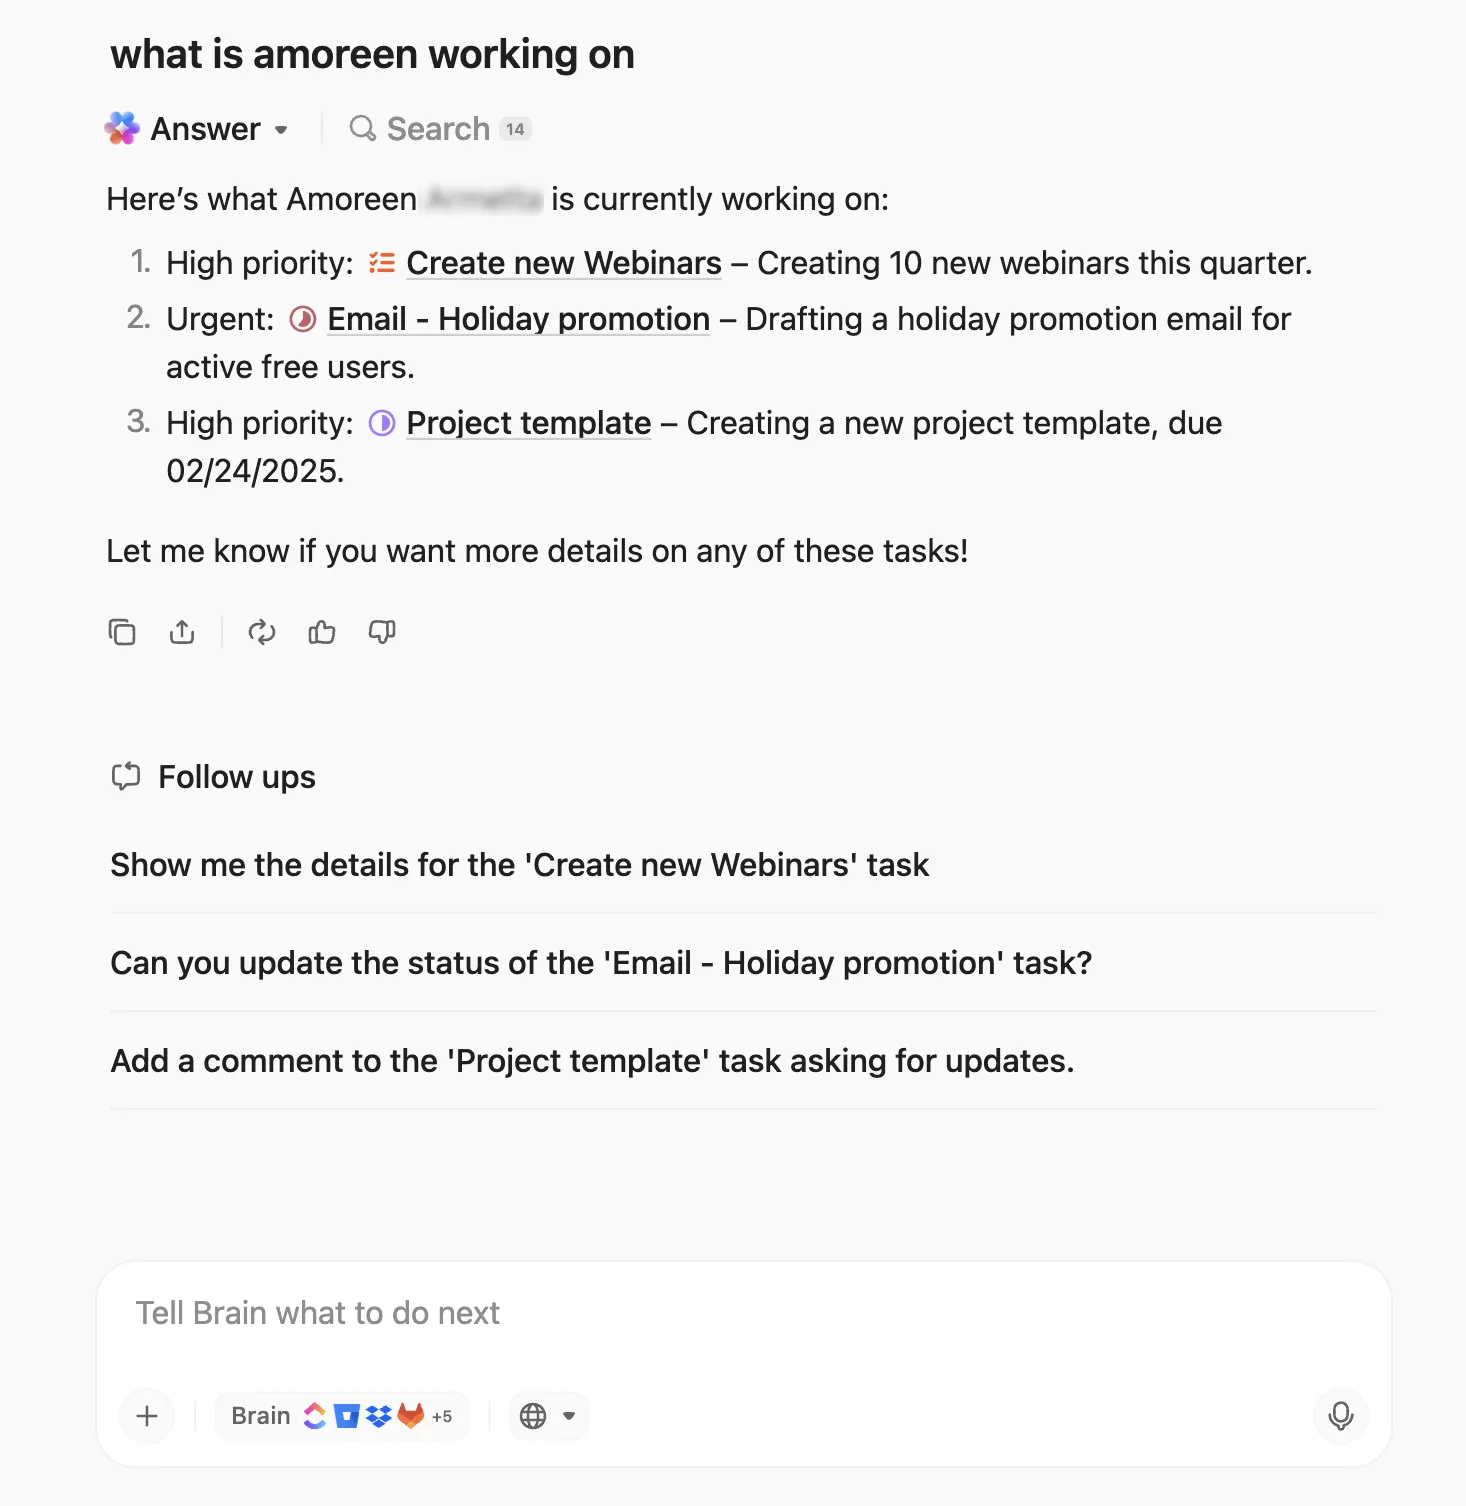
Grâce à Enterprise Search et Connected Apps, vous pouvez extraire instantanément des informations de votre environnement de travail, de Slack, de Google Drive, de GitHub et bien plus encore. Lors des appels en direct liés à un incident, la fonctionnalité « Talk-to-Text » de ClickUp vous permet de dicter des notes ou des instructions d’escalade sans utiliser vos mains, ce qui garantit qu’aucun détail ne sera oublié.
Vous pouvez également standardiser les tâches récurrentes grâce aux invites IA personnalisées et aux invites enregistrées, par exemple : « Résumez tous les incidents non résolus et recommandez des mesures d’escalade. »
Les meilleures fonctionnalités de ClickUp
- Donnez la priorité aux problèmes critiques : utilisez les priorités des tâches ClickUp pour mettre en évidence les escalades urgentes ou à fort impact
- Organisez des séquences d'escalade complexes : configurez les dépendances de tâches ClickUp pour relier les tâches associées (par exemple, « En attente de » ou « Bloquant ») afin que les étapes d'escalade évitent les actions prématurées ou les goulots d'étranglement
- Décomposez les incidents en éléments concrets : décomposez les escalades en éléments détaillés et répartissez-les entre les équipes à l'aide de sous-tâches imbriquées.
- Suivez avec précision la rapidité de résolution : enregistrez et surveillez le temps nécessaire à la prise en charge et à la résolution des tâches d'escalade grâce à la fonctionnalité de suivi du temps pour les projets de ClickUp.
Limites de ClickUp
- Avec autant de fonctionnalités, de vues et d'options de personnalisation, les équipes doivent souvent passer par une phase d'apprentissage avant que tout ne devienne intuitif.
Tarifs de ClickUp
[Tableau des tarifs]
Évaluations et avis sur ClickUp
- G2 : 4,7/5 (plus de 10 300 avis)
- Capterra : 4,6/5 (plus de 4 400 avis)
Que disent les utilisateurs de ClickUp dans la vie de tous les jours ?
Cet avis résume parfaitement la situation :
ClickUp regroupe toutes mes tâches, tous mes projets et toutes mes communications en un seul endroit, ce qui me permet de m'organiser très facilement. J'apprécie particulièrement le niveau de personnalisation de toutes les fonctionnalités — des vues aux flux de travail en passant par les tableaux de bord —, ce qui me permet de structurer mon environnement de travail exactement comme je le souhaite. La possibilité de collaborer en temps réel, d'attribuer des tâches et de suivre la progression sans avoir à changer d'outil est un énorme avantage.
ClickUp regroupe toutes mes tâches, tous mes projets et toutes mes communications en un seul endroit, ce qui me permet de m'organiser très facilement. J'apprécie particulièrement le niveau de personnalisation de toutes les fonctionnalités — des vues aux flux de travail en passant par les tableaux de bord —, ce qui me permet de structurer mon environnement de travail exactement comme je le souhaite. La possibilité de collaborer en temps réel, d'attribuer des tâches et de suivre les progrès sans avoir à changer d'outil est un énorme avantage.
📮 ClickUp Insight : 21 % des personnes interrogées déclarent consacrer plus de 80 % de leur journée de travail à des tâches répétitives. Et 20 % supplémentaires affirment que les tâches répétitives occupent au moins 40 % de leur journée.
C'est près de la moitié de la semaine de travail (41 %) qui est consacrée à des tâches ne nécessitant guère de réflexion stratégique ni de créativité (comme les e-mails de suivi 👀).
Les « Super Agents » de ClickUp vous aident à éliminer ces tâches fastidieuses. Pensez à la création de tâches, aux rappels, aux mises à jour, aux notes de réunion, à la rédaction d'e-mails et même à la création de flux de travail de bout en bout ! Tout cela (et bien plus encore) peut être automatisé en un clin d'œil avec ClickUp, votre application tout-en-un pour le travail.
💫 Résultats concrets : Lulu Press gagne 1 heure par jour et par employé grâce aux automatisations ClickUp, ce qui se traduit par une augmentation de 12 % de l'efficacité au travail.
2. PagerDuty (Idéal pour les alertes en temps réel et les interventions intelligentes en permanence)
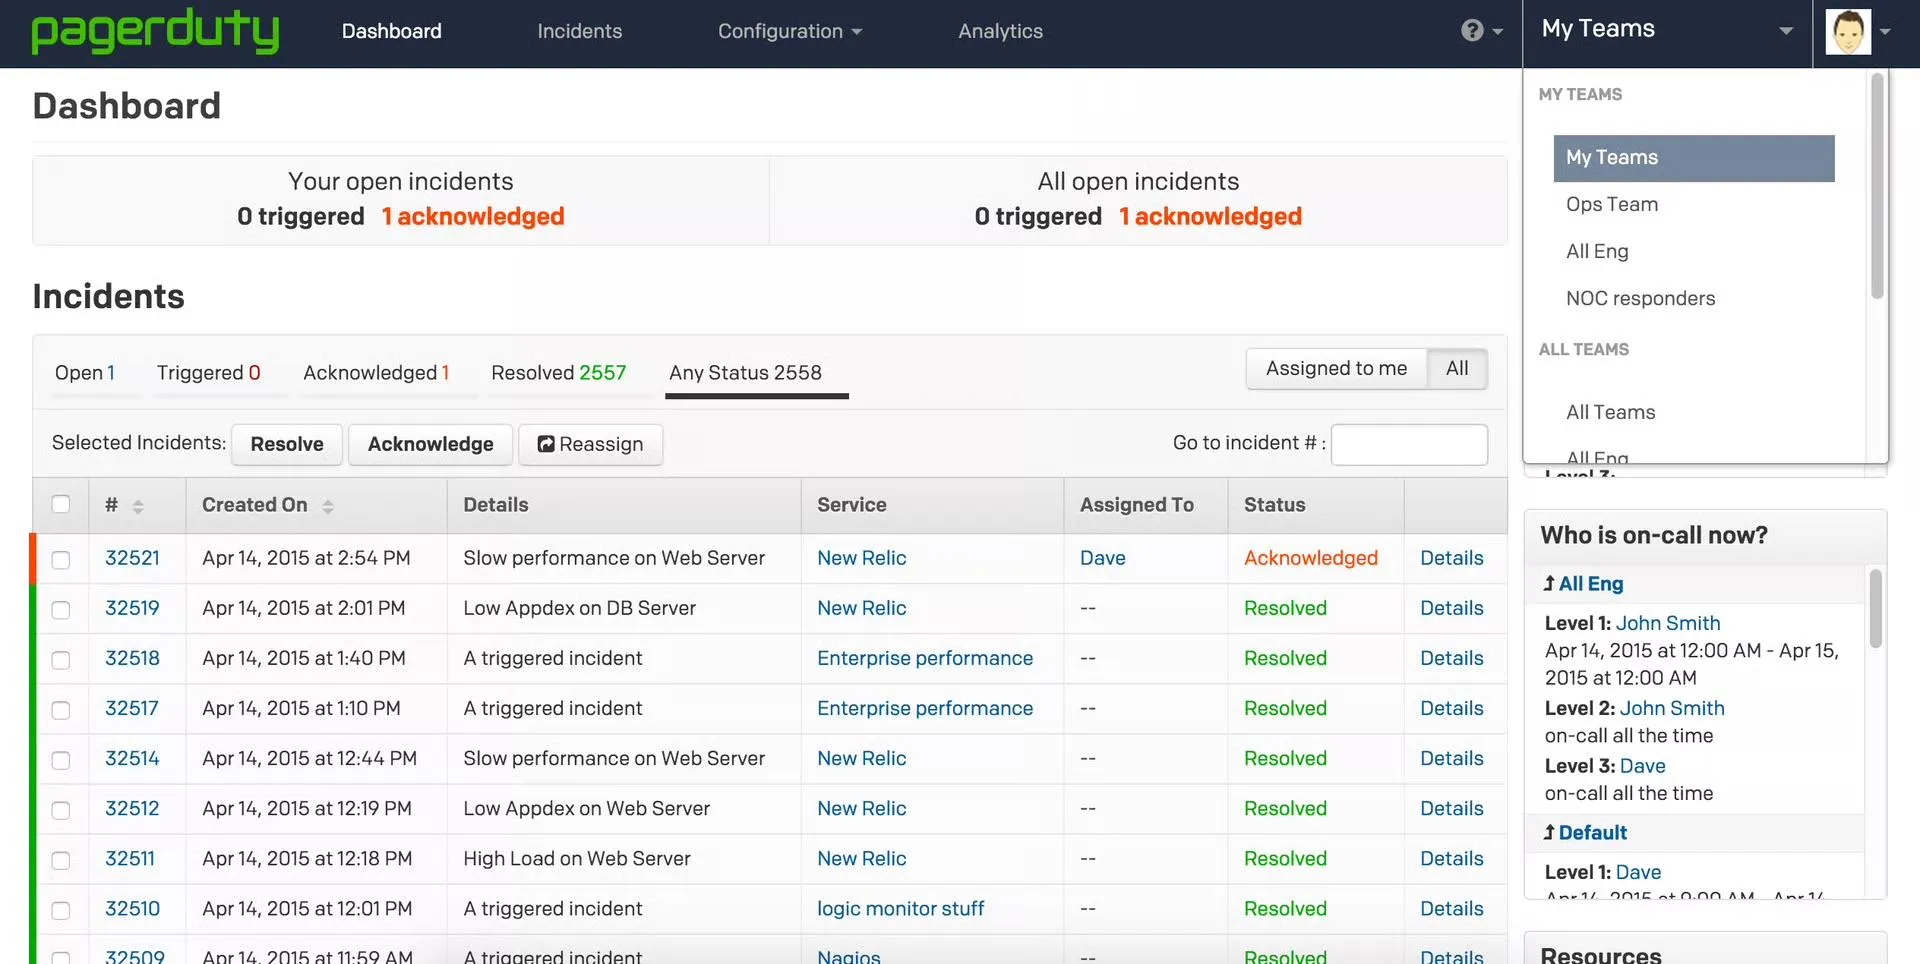
PagerDuty est une plateforme cloud de gestion des incidents informatiques et d’opérations numériques qui aide les équipes à détecter, traiter et résoudre rapidement les incidents critiques tels que les pannes ou les menaces de sécurité. Elle offre aux responsables SRE, DevOps et d’assistance une feuille de route claire, de la détection à la résolution, grâce à l’automatisation, au triage basé sur l’IA et à des flux de travail profondément intégrés.
Des fonctionnalités telles que Jeli Incident Analysis, PagerDuty Analytics et Runbook Automatisation aident les équipes à réduire les temps d'arrêt, à éliminer les tâches routinières et à tirer des enseignements de chaque incident.
Les meilleures fonctionnalités de PagerDuty
- Automatisez l'acheminement des incidents grâce à la fonctionnalité intégrée Gestion des astreintes et aux politiques d'escalade dynamiques
- Accélérez le triage grâce à l'AIOps, qui filtre le bruit des alertes, établit des corrélations entre les évènements et met en évidence les signaux pertinents
- Assurez la coordination entre les parties prenantes internes et externes grâce aux communications avec les parties prenantes, aux modèles de mise à jour de statut et aux pages de statut.
- Unifiez votre pile d'outils grâce à plus de 700 intégrations et des API extensibles, en utilisant des systèmes de surveillance, de journalisation, de CI/CD et d'assistance.
Limites de PagerDuty
- Un volume d'alertes élevé si les intégrations et les seuils intelligents ne sont pas correctement configurés, ce qui entraîne un excès d'alertes et de la fatigue
- Des alertes en double ou répétées peuvent survenir lors de pics d'activité, ce qui rend leur prise en compte plus difficile en situation de pression.
Tarifs de PagerDuty
- Free
- Formule Professionnelle : 25 $/mois par utilisateur
- Formule Business : 49 $ par mois et par utilisateur
- Enterprise : tarification personnalisée
Évaluations et avis sur PagerDuty
- G2 : 4,5/5 (plus de 900 avis)
- Capterra : 4,6/5 (plus de 200 avis)
Que disent les utilisateurs de PagerDuty dans la pratique ?
Selon les mots d'un véritable utilisateur:
PagerDuty rend les alertes d’incident rapides et fiables. Il envoie les bonnes notifications au bon moment et permet à notre équipe de rester organisée. […] PagerDuty peut parfois sembler trop envahissant lorsque les alertes ne sont pas bien filtrées. Certains paramètres sont un peu complexes pour les nouveaux utilisateurs.
PagerDuty rend les alertes d'incident rapides et fiables. Il envoie les bonnes notifications au bon moment et permet à notre équipe de rester organisée. […] PagerDuty peut parfois sembler trop envahissant lorsque les alertes ne sont pas bien filtrées. Certains paramètres sont un peu complexes pour les nouveaux utilisateurs.
💡 Conseil de pro : Prévoyez des exceptions, même dans un processus d’escalade bien défini. Faites en sorte que les pannes critiques, les alertes de sécurité ou les incidents survenant dans des environnements réglementés soient directement transmis à des intervenants de haut niveau ou spécialisés.
3. GLPi (Idéal pour la gouvernance des actifs de bout en bout et les opérations de services conformes à l'ITIL)
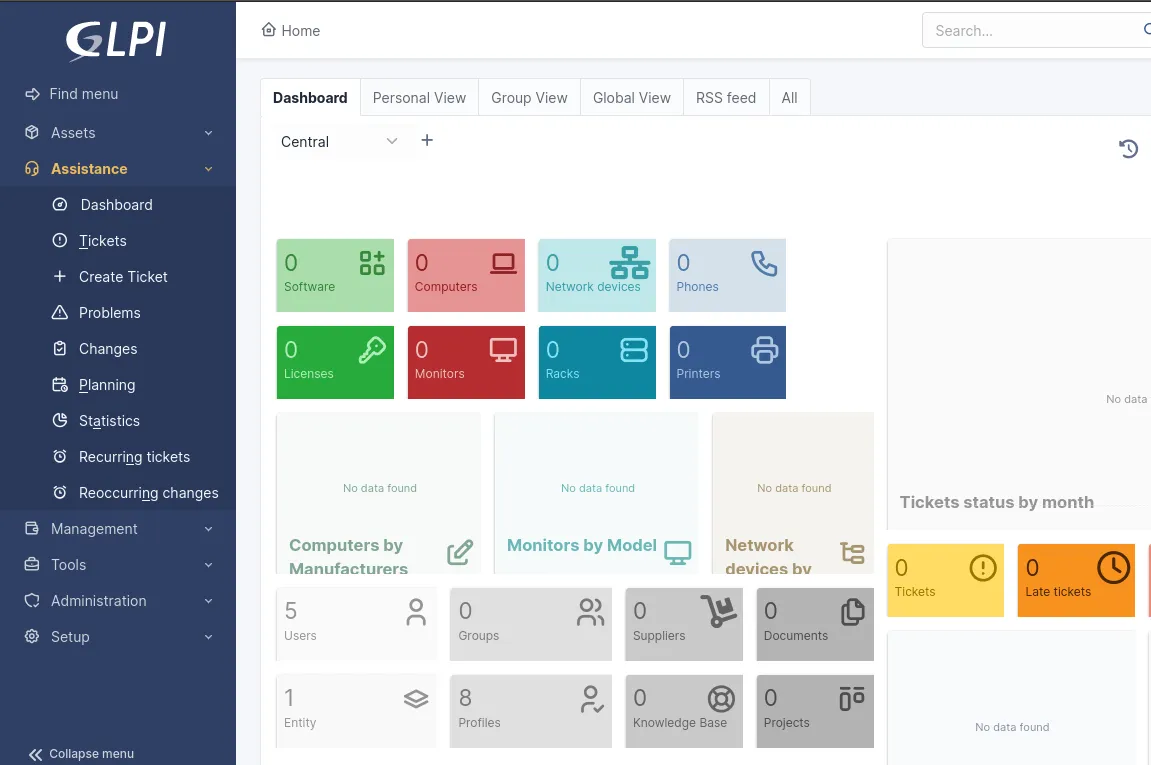
Gestionnaire Libre de Parc Informatique (GLPi) est une plateforme open source complète de gestion des services informatiques (ITSM) et de gestion des actifs informatiques (ITAM). Les équipes bénéficient d'une visibilité de bout en bout sur leur infrastructure (matériel, logiciels, licences et équipements réseau) et peuvent gérer les incidents, les demandes de service et les changements à l'aide de processus conformes à la méthodologie ITIL.
Tous vos contrats et documents, y compris les garanties et les contrats de service, sont parfaitement organisés, ce qui évite qu’ils ne se perdent entre différents systèmes. Si vous gérez des centres de données, GLPi vous permet même de visualiser les dispositions, les chemins de câblage et la consommation d’énergie afin que vous sachiez toujours ce qui se passe en coulisses.
Les meilleures fonctionnalités de GLPi
- Utilisez les plugins GLPI Inventory, OCS Inventory ou FusionInventory pour détecter et répertorier automatiquement les nouveaux actifs informatiques.
- Automatisez les tâches répétitives, l'attribution des tickets, les notifications et les évènements récurrents afin de réduire le travail manuel
- Créez une base de connaissances regroupant les FAQ, la documentation et les articles liés aux tickets, afin de faciliter le libre-service et l'assistance technique.
- Connectez-vous à Azure/Entra, Centreon, Google, OAuth2 et aux webhooks pour synchroniser les données, déclencher des flux de travail et améliorer votre CMDB
Limites de GLPi
- La compatibilité des plugins peut être rompue d'une version à l'autre, ce qui entraîne des coûts de maintenance supplémentaires.
- Les fonctionnalités de rapports, d'analyse et d'exportation semblent limitées et doivent être améliorées
Tarifs GLPi
- Tarification personnalisée
Évaluations et avis sur GLPi
- G2 : 4,6/5 (plus de 30 avis)
- Capterra : 4,5/5 (plus de 40 avis)
Que disent les utilisateurs de GLPi dans la pratique ?
Voici ce qu'en dit un utilisateur:
Système open source de gestion des actifs informatiques et de tickets d'assistance hautement personnalisable, bénéficiant d'une vaste communauté d'assistance. L'interface utilisateur est un peu complexe pour un débutant. La compatibilité des plugins n'est pas toujours assurée entre les anciennes et les nouvelles versions.
Système open source de gestion des actifs informatiques et de tickets d'assistance hautement personnalisable, bénéficiant d'une vaste communauté de soutien. L'interface utilisateur est un peu complexe pour un débutant. La compatibilité des plugins n'est pas toujours assurée entre les anciennes et les nouvelles versions.
4. Splunk On-Call (idéal pour acheminer directement les alertes de surveillance vers les ingénieurs)
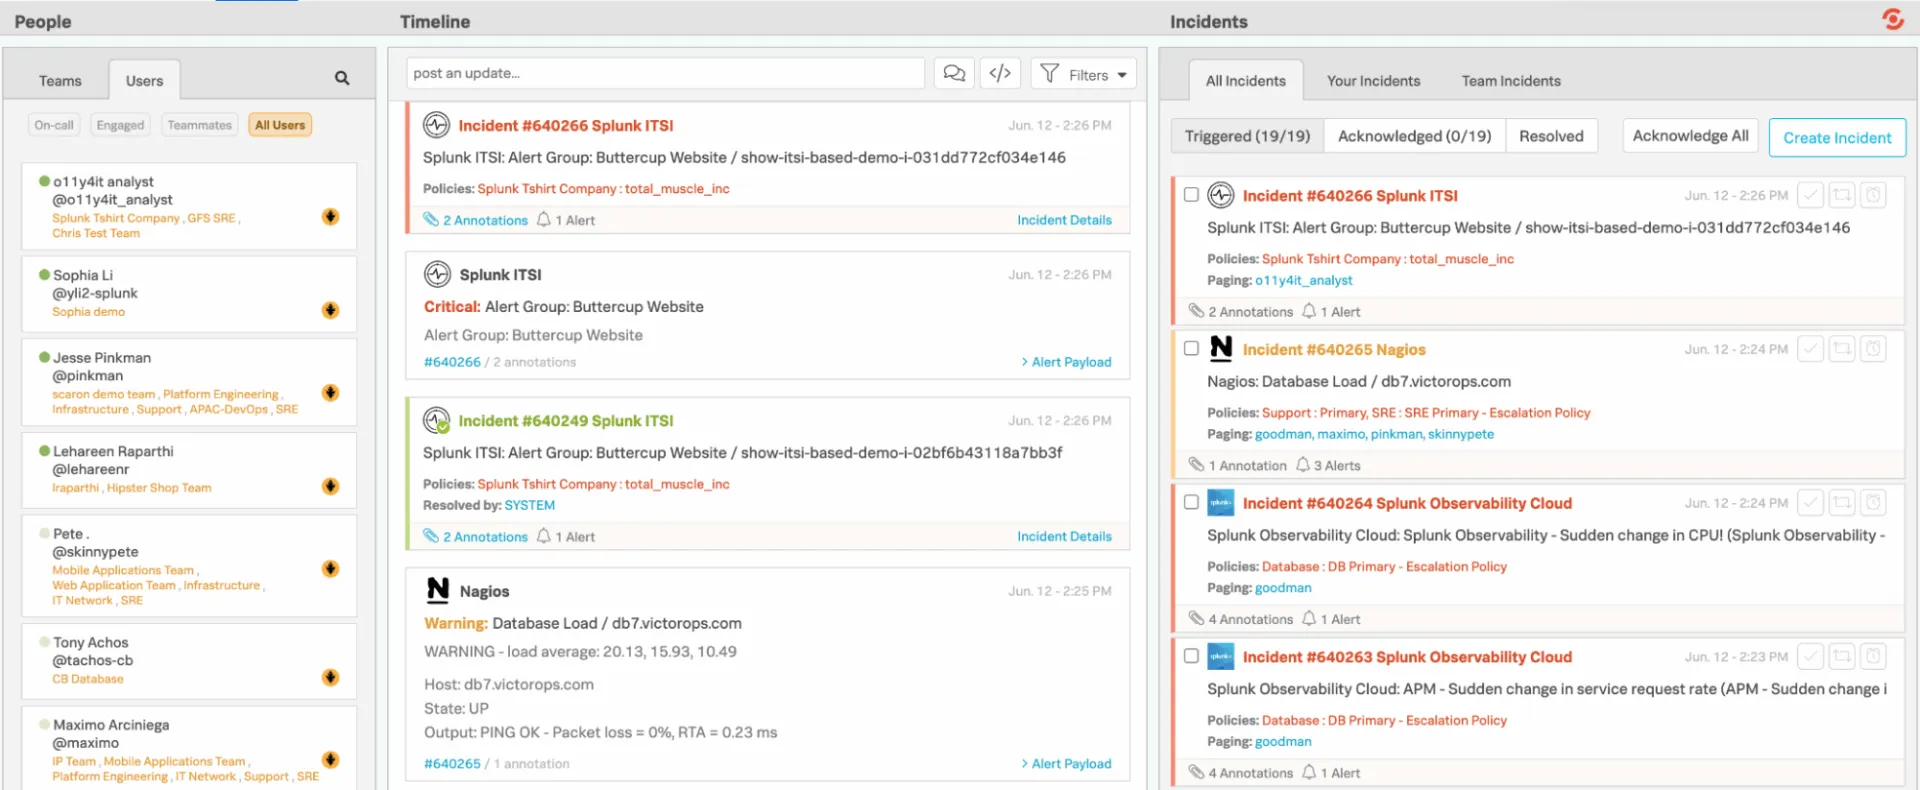
Splunk On-Call offre aux équipes d'ingénierie et d'astreinte un moyen plus rapide et plus clair de gérer les incidents, en éliminant le recours aux flux de travail de tickets traditionnels, souvent lents. Au lieu d'envoyer les alertes dans une file d'attente générique, il s'intègre directement à votre pile de surveillance et d'observabilité, en acheminant immédiatement les problèmes vers les bonnes personnes en fonction des plannings, des règles et du contexte.
Les intégrations mobiles et de chat permettent d’accuser réception, de réacheminer ou de résoudre facilement les incidents, où que vous soyez. Et en arrière-plan, Splunk On-Call conserve un historique détaillé des tendances, des schémas récurrents et des comportements d’escalade.
Les meilleures fonctionnalités de Splunk On-Call
- Élargissez les capacités de la plateforme grâce à plus de 1 000 intégrations et modules complémentaires validés, proposés par Splunk et l'ensemble de la communauté.
- Créez des tableaux de bord et des rapports visuels personnalisés pour surveiller le volume des alertes, l'état des incidents, les performances des intervenants et la charge de travail de l'équipe
- Filtrez rapidement les incidents en fonction de votre propre activité, des incidents de votre équipe ou de tout ce qui se passe au sein de l'organisation
- Passez des vues « Déclenché », « Pris en compte » et « Résolu » pour connaître l'état d'avancement de chaque incident
Limitations de Splunk On-Call
- La planification des plannings entre plusieurs équipes peut s'avérer compliquée si les règles ne sont pas prédéfinies
- Capacité limitée à générer des rapports d'incidents détaillés, classés par date
Tarifs de Splunk On-Call
- Tarification personnalisée
Évaluations et avis sur Splunk On-Call
- G2 : 4,6/5 (plus de 40 avis)
- Capterra : 4,5/5 (plus de 30 avis)
Que disent les utilisateurs de Splunk On-Call dans la pratique ?
Un utilisateur a résumé la situation ainsi :
La possibilité de gérer les incidents, les escalades et de prendre le relais de mes collègues depuis l’application mobile est géniale. […] J’aimerais pouvoir programmer des dérogations et modifier les plannings habituels depuis l’application mobile en cas de changements d’horaires urgents.
La possibilité de gérer les incidents, les escalades et de prendre le relais de mes collègues depuis l’application mobile est géniale. […] J’aimerais pouvoir programmer des dérogations et modifier les plannings habituels depuis l’application mobile en cas de changements d’horaires urgents.
🔍 Le saviez-vous ? Le principe consistant à « acheminer l’appel vers la bonne personne en cas d’échec au premier niveau » trouve ses origines dans les premiers centraux téléphoniques : lorsque les opérateurs manuels ne parvenaient pas à établir une connexion, le système acheminait (ou escaladait) l’appel vers un autre opérateur ou un autre central.
5. ServiceNow (Idéal pour orchestrer des opérations à l'échelle de l'entreprise grâce à l'automatisation assistée par l'IA)
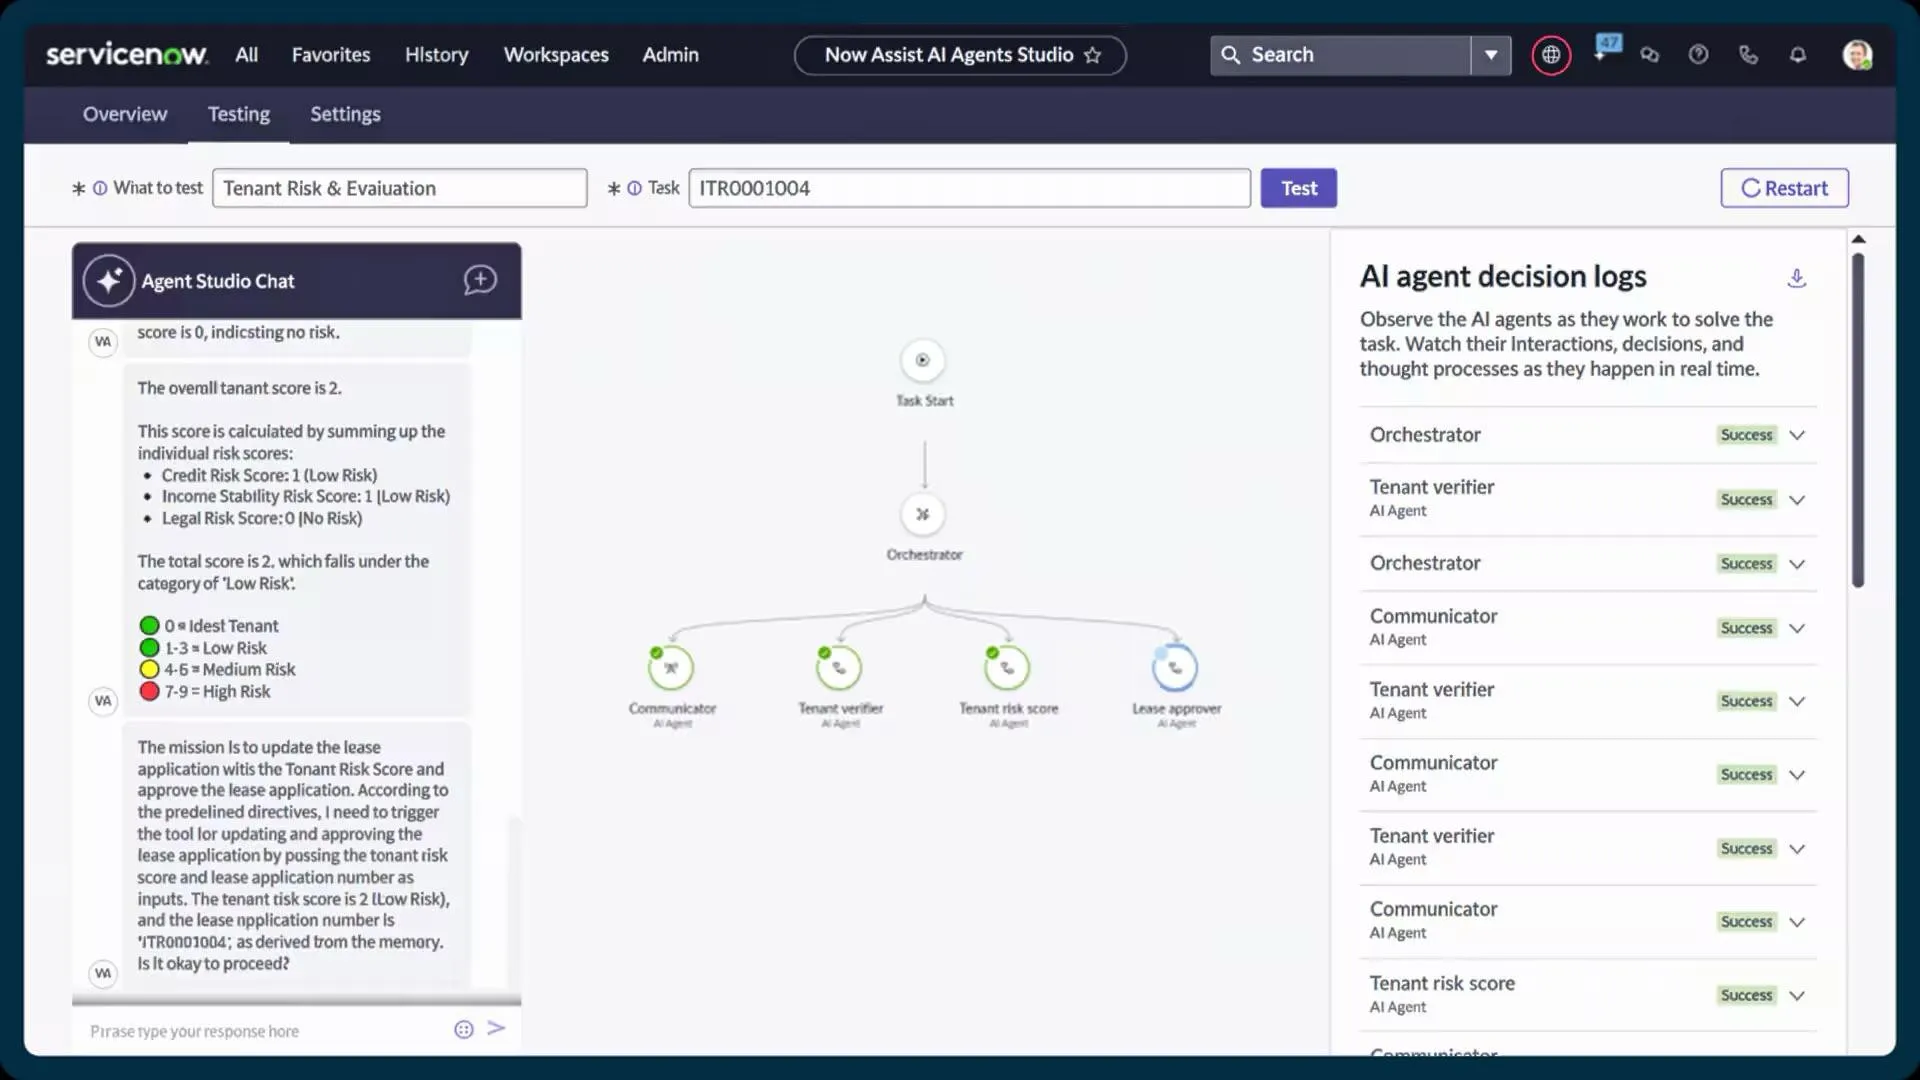
ServiceNow classe, hiérarchise et achemine automatiquement les incidents dès leur enregistrement. Grâce à des fonctionnalités telles que Now Assist, qui propose des recommandations automatisées pour les tickets d’incident et génère du contenu intelligent, les intervenants peuvent résoudre les problèmes plus rapidement et en disposant de davantage de contexte.
Cette solution regroupe la gestion des incidents, des changements et des actifs. Vous bénéficiez ainsi d’une vue en temps réel sur les connexions entre les services, les goulots d’étranglement et les composants susceptibles de contribuer à des perturbations récurrentes.
Les meilleures fonctionnalités de ServiceNow
- Attribuez, acheminez et suivez les tâches sur le terrain grâce à Field Service Management et Dispatcher Workspace
- Donnez plus d’autonomie à vos collaborateurs et à vos clients grâce à un portail en libre-service optimisé par la recherche IA et des agents virtuels
- Utilisez les flux de travail intégrés et les outils « low-code » d'App Engine pour étendre ou personnaliser les processus de service.
- Automatisez les tâches répétitives et les flux de travail entre les équipes grâce à Flow Designer et Automation Engine
Limites de ServiceNow
- L'interface utilisateur et les options de personnalisation du portail semblent obsolètes ou restrictives
- Forte dépendance vis-à-vis d'un personnel qualifié ou de consultants pour la mise en œuvre
Tarifs de ServiceNow
- Tarification personnalisée
Évaluations et avis sur ServiceNow
- G2 : 4,4/5 (plus de 3 300 avis)
- Capterra : 4,5/5 (plus de 300 avis)
Que disent les utilisateurs de ServiceNow dans la pratique ?
Voici comment un utilisateur l'a formulé :
[…] Les flux prédéfinis constituent pour moi un autre atout majeur, car ils rationalisent les processus et permettent un gain de temps considérable, en réduisant au minimum le recours à des configurations personnalisées et en garantissant un flux de travail plus fluide et plus efficace. […] De plus, j’ai eu des difficultés à intégrer ma solution personnalisée au système de gestion du service client, ce qui a nécessité de nombreuses itérations.
[…] Les flux prédéfinis constituent pour moi un autre atout majeur, car ils rationalisent les processus et permettent un gain de temps considérable, en réduisant au minimum le recours à des configurations personnalisées et en garantissant un flux de travail plus fluide et plus efficace. […] De plus, j’ai eu des difficultés à intégrer ma solution personnalisée au système de gestion du service client, ce qui a nécessité de nombreuses itérations.
Bonnes pratiques et gouvernance
Voici quelques bonnes pratiques qui garantissent la précision de l'automatisation, évitent la fatigue liée aux alertes et répondent aux attentes de l'entreprise et aux exigences réglementaires.
- Définissez des critères d’escalade non négociables : associez les déclencheurs à des signaux mesurables tels que les violations des SLO, les pics d’anomalies, l’impact sur les niveaux de service client ou la sensibilité réglementaire
- Définissez clairement les rôles à chaque niveau : utilisez une matrice RACI simple pour chaque niveau d'escalade afin que les responsabilités ne soient jamais ambiguës lors d'incidents sous haute pression.
- Mettez en place une gouvernance dynamique des astreintes : adaptez automatiquement les processus d’escalade en fonction des week-ends, des jours fériés, des limites de capacité et des relais afin de réduire l’épuisement professionnel et d’éviter les alertes silencieuses.
- Prévoyez des contrôles manuels pour les scénarios à haut risque : même en cas d’automatisation, imposez une validation manuelle pour les incidents impliquant la divulgation de données clients, des paiements ou des flux de travail réglementés.
- Conservez des pistes d'audit complètes : conservez des journaux immuables indiquant qui a été alerté, quand la personne a accusé réception, quelles étapes d'automatisation ont été déclenchées et quelles décisions ont été prises
🧠 Anecdote : La plus ancienne plainte écrite connue au monde a été gravée sur une tablette d'argile vers 1750 avant J.-C. Il s'agissait en fait d'une des premières escalades concernant le statut d'un projet. Un client nommé Nanni a écrit au marchand Ea-nāṣir, furieux que le cuivre qu'il avait reçu soit de moins bonne qualité que promis et que son messager ait été maltraité.
Défis courants et comment les surmonter
Même avec une politique d'escalade claire, les équipes sont souvent confrontées à des obstacles opérationnels qui ralentissent la réponse aux incidents ou sont source de confusion.
Ce tableau met en évidence les défis courants qui vont au-delà des étapes d’installation de base et propose des stratégies concrètes pour les surmonter.
| Défis ❌ | Solutions ✅ |
| Manque de cohérence dans le contexte lors des transferts | Utilisez les fonctionnalités de liaison des tâches et les modèles de rapport d’incident de ClickUp pour conserver une piste d’audit complète des détails de l’incident, des systèmes affectés et des actions précédentes à chaque niveau d’escalade. |
| Surcharger les intervenants avec des alertes de faible priorité | Mettez en place une hiérarchisation dynamique grâce aux champs personnalisés de ClickUp et à AI Prioritize afin de filtrer les incidents en fonction de leur gravité, de leur impact et des seuils définis dans le SLA. |
| Manque de visibilité entre les équipes | Configurez des environnements de travail partagés, ajoutez des commentaires et créez des tableaux blancs visuels ClickUp pour présenter des mises à jour en temps réel aux parties prenantes |
| Retards dans la prise de décision lors d'incidents critiques | Automatisez les notifications à l'aide des actions suggérées de ClickUp Brain Max pour alerter instantanément les personnes concernées en fonction du type d'incident, de sa gravité et des tendances historiques. |
| Difficulté au suivi des problèmes récurrents | Tirez parti des rapports personnalisés et des modèles de tâches récurrentes de ClickUp pour identifier les tendances, les causes profondes et les incidents récurrents afin de mettre en place une prévention proactive. |
| Fragmentation des connaissances lors de l'escalade | Effectuez la maintenance des procédures opératoires normalisées (SOP), des guides d'intervention et de la documentation relative aux incidents dans ClickUp Docs, en les liant aux tâches concernées pour pouvoir les consulter instantanément lors des escalades en temps réel. |
| Manque de coordination des responsabilités entre les équipes de service | Utilisez les vues « Charge de travail » et « Échéancier » de ClickUp pour visualiser les affectations et vous assurer qu’il n’y a ni chevauchements ni lacunes lors des changements d’équipe ou des passations de service. |
| Suivi manuel de la conformité et lacunes en matière d'audit | Automatisez la création de résumés prêtes pour les audits grâce à ClickUp Brain afin de consigner toutes les actions, notifications et résolutions liées aux incidents. |
Mesurer l'impact de l'escalade automatisée
Pour suivre l'efficacité de l'escalade automatisée, il faut se concentrer sur des indicateurs clés portant sur le volume, l'efficacité et la qualité. Ces indicateurs permettent de déterminer si vos processus d'escalade sont plus rapides, plus précis et moins source de frustration, tant pour les équipes que pour les clients.
Suivez ces indicateurs :
- Taux d'escalade (volume) : pourcentage des problèmes escaladés au-delà du premier niveau. Des taux élevés peuvent indiquer des lacunes dans le triage initial ou dans les bases de connaissances.
- Taux de remontée répétée (volume) : Fréquence à laquelle un même problème est remonté à plusieurs reprises. Indique des résolutions incomplètes ou une perte de contexte.
- Délai d'escalade (efficacité) : durée entre la détection et l'escalade. Des durées d'étapes plus courtes indiquent une automatisation de la reconnaissance des problèmes critiques plus rapide.
- Délai de transfert (efficacité) : écart entre le moment de l'escalade et celui où l'équipe suivante commence à effectuer du travail, afin de mettre en évidence les frictions au niveau de l'acheminement ou de la notification
- Délai de résolution des cas escaladés (efficacité) : durée totale entre l'escalade et la résolution. Une résolution plus rapide témoigne de l'efficacité de l'automatisation.
- Score de satisfaction client (CSAT) (qualité) : retours d'expérience sur les interactions ayant fait l'objet d'une escalade, permettant d'évaluer la fluidité du parcours
- Transmission du contexte (qualité) : Les agents reçoivent-ils l'historique complet de l'incident afin de s'assurer que les clients n'ont pas à répéter les informations ?
- Résolution dès le premier contact (FCR) (qualité) : pourcentage de problèmes résolus en un seul échange
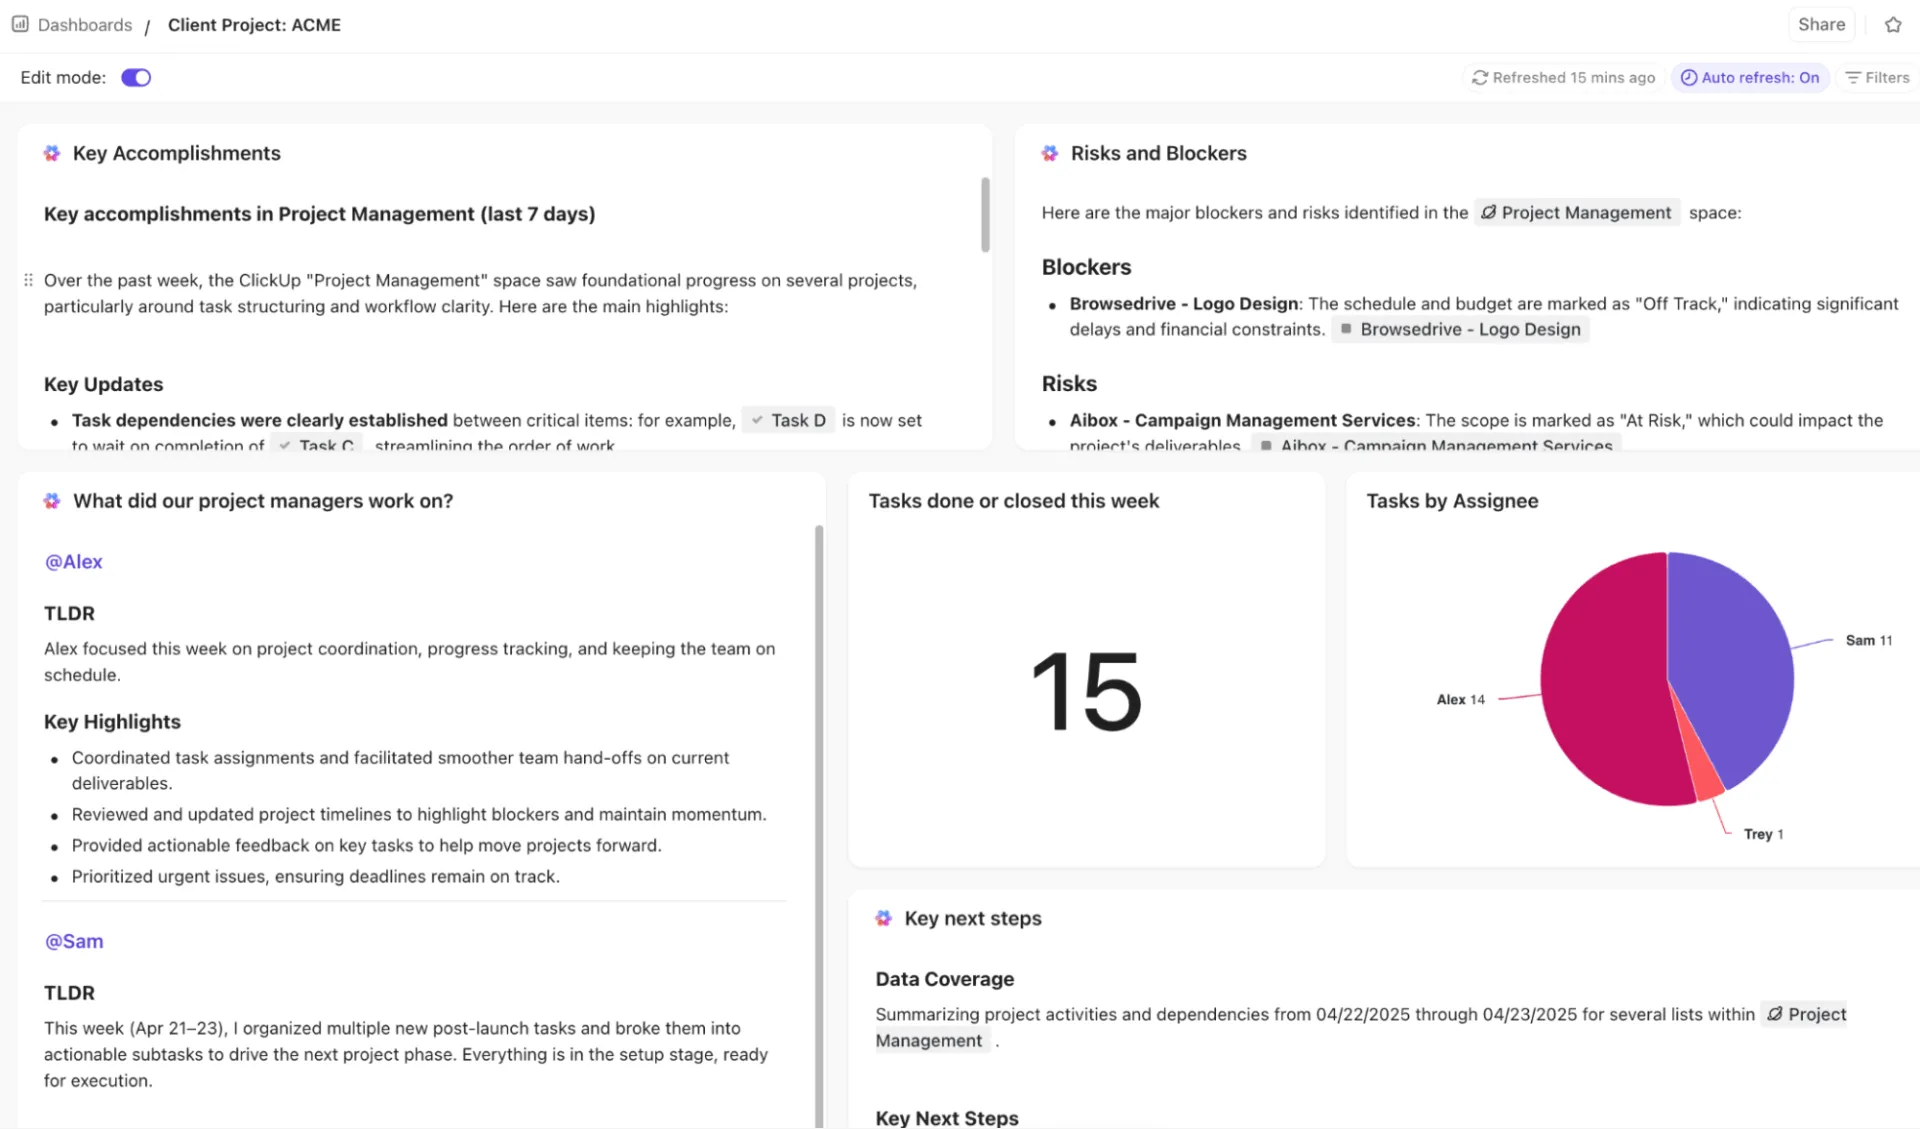
🚀 L'avantage ClickUp : bénéficiez d'informations en temps réel, visuelles et basées sur l'IA pour tous les indicateurs d'escalade grâce aux tableaux de bord ClickUp.
Vous pouvez suivre les tendances d'escalade, les goulots d'étranglement et les performances à l'aide des cartes Tableau, Circulaire, Barre, Ligne, Calcul et Chronologique. Surveillez le taux d'escalade, les escalades récurrentes et le délai d'escalade grâce à des cartes liées aux tâches, aux champs personnalisés et aux statuts.
Pour aller plus loin, utilisez des cartes IA telles que AI Résumé, AI Compte rendu du projet et StandUp par l'IA afin de mettre en évidence les tendances, les retards et les résultats des résolutions.
Gérez vos incidents plus rapidement avec ClickUp
Beaucoup pensent que l'escalade des incidents se résume à transmettre un ticket à la personne suivante, mais c'est bien plus que cela. Il s'agit d'un système structuré dans lequel chaque étape, du triage à la résolution, s'enchaîne de manière harmonieuse.
ClickUp vous offre l'espace de travail unifié idéal. Grâce aux automatisations ClickUp, vous pouvez déclencher des alertes, acheminer des tâches et mettre à jour les statuts automatiquement. Et ClickUp Brain vous aide à hiérarchiser les incidents, à générer des résumés et à suggérer les prochaines étapes.
Les agents ClickUp AI agissent comme des assistants intelligents au sein de votre environnement de travail, tandis que les tableaux de bord ClickUp offrent une vue en temps réel de vos escalades.
Inscrivez-vous gratuitement à ClickUp dès aujourd'hui !
Foire aux questions (FAQ)
Qu'est-ce qu'un parcours d'escalade des incidents ?
Un parcours d'escalade des incidents est une séquence prédéfinie d'étapes qui détermine comment les problèmes sont acheminés vers l'équipe ou la personne appropriée en fonction de leur gravité, de leur impact et du moment où ils surviennent. Il garantit que les incidents sont traités efficacement et que les responsabilités sont clairement définies. TEXTE
Comment déterminer s'il vaut mieux escalader un incident automatiquement ou manuellement ?
Utilisez l'automatisation pour les incidents bien définis et à haute priorité, répondant à des critères clairs (par exemple, les interruptions de service ou les failles de sécurité). Réservez l'escalade manuelle aux situations ambiguës ou critiques qui nécessitent un jugement humain ou des informations contextuelles supplémentaires.
Quels outils fournissent l'assistance pour l'escalade automatisée pour une gestion efficace des incidents ?
Des plateformes telles que ClickUp, PagerDuty, Jira Service Management et ServiceNow permettent l'acheminement, les notifications et les mises à jour automatisés. Elles aident les équipes à réduire les retards et à maintenir des flux de travail d'incidents structurés.
Comment éviter la fatigue liée aux alertes lorsque l'on utilise l'escalade par automatisation ?
Définissez des seuils clairs pour les alertes, hiérarchisez-les en fonction de leur gravité et utilisez des notifications intelligentes. Limitez les notifications répétées aux incidents critiques et tirez parti des tableaux de bord ou des Outils d'IA pour résumer les mises à jour plutôt que d'envoyer chaque modification mineure.
À quelle fréquence dois-je revoir mes politiques d'escalade ?
Réexaminez régulièrement les politiques d'escalade, au moins une fois par trimestre ou après chaque incident majeur. Cela permet de s'assurer que les critères, les responsabilités et les règles d'automatisation reflètent les flux de travail actuels, les structures des équipes et les priorités de l'entreprise.