
Os primeiros serviços são fáceis. Uma rotação, um canal e, em seguida, um backup.
No entanto, quando sua empresa chega a dezenas de microsserviços, várias regiões e uma estrutura de responsabilidade em camadas, as escalações manuais deixam de ser um fluxo de trabalho e passam a ser um risco.
Este guia explica como automatizar os fluxos de escalonamento de incidentes que se adaptam ao tamanho da sua equipe de engenharia sem causar falhas no seu sistema de plantão.
E também veremos como o ClickUp se encaixa na criação de um sistema de escalonamento no qual suas equipes de engenharia possam confiar. 🎯
⭐ Modelo em destaque
Reaja de forma rápida e eficaz em situações de emergência, desde desastres naturais até violações de dados, usando o modelo de Plano de Ação para Incidentes (IAP) do ClickUp.
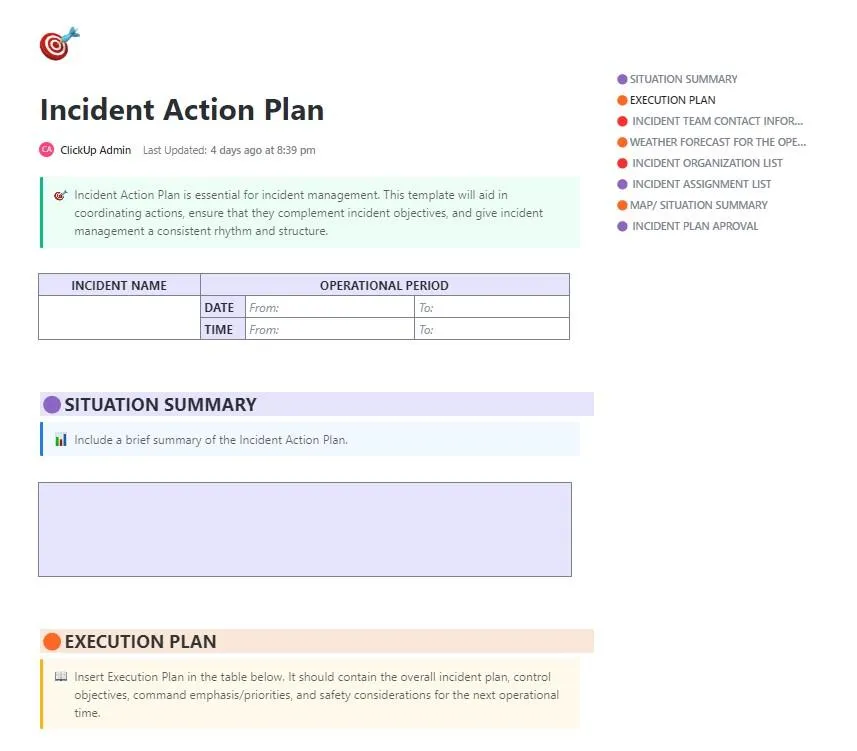
O modelo oferece seções predefinidas para:
- Defina os objetivos dos incidentes e as prioridades de resposta
- Estabeleça uma estrutura de comando clara
- Coordene ações entre equipes em tempo real
- Registre decisões, cronogramas e atualizações importantes à medida que elas ocorrem
- Mantenha-se atualizado sobre a escalação e o acompanhamento
E, como está integrado ao ClickUp, ele funciona como um documento dinâmico de comando de incidentes, e não como uma lista de verificação estática.
Por que automatizar os fluxos de escalonamento de incidentes
Quando sua equipe é responsável por sistemas complexos com SLAs rigorosos, a escalação manual só atrasa o processo. A escalação automatizada torna seu processo de resposta previsível e menos estressante, mesmo durante incidentes de alta pressão.
Veja por que você deve automatizar os fluxos de escalonamento da sua organização. 👇
O risco da escalonamento manual
Quando você lida com dezenas de serviços, várias escalas de plantão e responsabilidades em constante mudança, as etapas realizadas manualmente rapidamente se tornam um problema.
As armadilhas mais comuns incluem:
- Notificações perdidas ou atrasadas quando alguém não percebe um e-mail, SMS ou mensagem de chat
- Confusão durante as transferências, especialmente quando os fluxos de escalonamento não estão claramente documentados
- Escalar para a equipe errada porque o mapa de responsabilidades não está atualizado
- Gargalos causados pela dependência de uma única pessoa para “encaminhar o alerta”
📖 Leia também: Como redigir um relatório de incidente
Benefícios da automação
A automação do ITSM dá estrutura e dinamismo aos seus fluxos de escalonamento. Em vez de ficar esperando que alguém veja o alerta, seu sistema executa uma sequência predefinida de forma instantânea e consistente.
Veja o que as equipes ganham ao usar IA para automatizar tarefas:
- Tempos de resposta mais rápidos, pois os alertas chegam à pessoa ou equipe certa em questão de segundos
- Execução consistente das etapas de escalonamento, mesmo às 3 da manhã, quando a tomada de decisões é mais lenta
- Redundância integrada que garante que os responsáveis de backup sejam notificados caso o responsável de plantão principal não receba o alerta
- Visibilidade clara entre as equipes, pois todos entendem como ocorre o fluxo de escalonamentos
- Menos trabalho de emergência e experiências de plantão mais previsíveis
📖 Leia também: Exemplos de planos de continuidade de negócios
Reduzindo a fadiga de alertas e os erros humanos
A fadiga de alertas prejudica a eficácia dos plantões. Quando sua equipe é notificada com muita frequência, ou por motivos equivocados, ela deixa de responder com urgência. A automação ajuda a filtrar e escalar apenas o que realmente requer atenção humana.
Com a lógica de escalonamento automatizada:
- Alertas de baixa prioridade ou duplicados são suprimidos antes de chegarem ao plantonista
- Regras baseadas na gravidade garantem que problemas menores não acordem ninguém desnecessariamente
- Os alertas são escalados somente se o sistema detectar a ausência de resposta dentro de um prazo definido
- As equipes gastam menos tempo filtrando ruídos e mais tempo resolvendo problemas reais
Garantindo a conformidade com o SLA e com a política de plantão
A escalonamento automatizado facilita a manutenção da conformidade sem a necessidade de supervisão manual constante. Para líderes de operações de TI que gerenciam SLAs rigorosos ou compromissos internos de confiabilidade, a IA atua como uma barreira de proteção que garante o comportamento esperado. Ela ajuda você a:
- Garanta que as notificações de incidentes sigam regras predefinidas para o encaminhamento
- Mantenha os prazos de resposta do SLA automaticamente, com escalações programadas
- Faça valer os escalas de plantão sem depender de planilhas desatualizadas
- Crie registros de auditoria para cada alerta, escalonamento e confirmação
🎥 Quer executar todo o fluxo de trabalho do caminho de escalonamento sem precisar intervir? O Super Agents te ajuda . 👇🏼
🔍 Você sabia? O Controle de Missão da NASA funciona essencialmente com base em uma lógica de escalonamento automatizada. Se a telemetria sair do intervalo normal, o sistema encaminha instantaneamente alertas automatizados aos especialistas de cada área.
O que é uma política de escalonamento no gerenciamento de incidentes?
Uma política de escalonamento é um conjunto predefinido de regras que determina quem é notificado, quando é notificado e como a responsabilidade é repassada para os níveis superiores ou entre equipes.
Pense nisso como um roteiro estruturado que evita que os incidentes fiquem parados, garante que os especialistas certos entrem em ação no momento certo e ajuda as equipes a cumprir os SLAs.
Uma política de gerenciamento de escalonamento bem estruturada geralmente inclui:
- Roteamento baseado em regras que define quem é o próximo responsável quando alguém não confirma o recebimento ou não consegue resolver o incidente
- Gatilhos temporizados que escalam automaticamente após 5, 15 ou 30 minutos, com base na gravidade
- Métodos de notificação, como ligações telefônicas, SMS, chat ou e-mail
- Níveis do plano de escalonamento: Nível 1 (plantão principal) > Nível 2 (engenheiros sênior/especialistas) > Nível 3 (liderança)
- Expectativas em relação à documentação para que novos atendentes possam assumir o trabalho sem perder o contexto essencial
📖 Leia também: Como priorizar tarefas como P0, P1, P2, P3 e P4
Tipos de políticas de escalonamento
Aqui estão os principais tipos de políticas que sua equipe deve conhecer:
1. Escalonamento hierárquico (vertical)
Os alertas sobem pela cadeia de comando, passando dos engenheiros juniores aos especialistas seniores e, por fim, à liderança. Utilize esse procedimento quando a situação exigir conhecimento mais aprofundado, autoridade para tomar decisões ou visibilidade da diretoria.
2. Escalonamento funcional (horizontal)
Em vez de seguir para os níveis superiores, o alerta percorre entre as equipes até a função responsável pelo sistema afetado. Isso é ideal para incidentes relacionados a um domínio específico, como bancos de dados, redes, pagamentos ou APIs.
3. Escalonamento baseado no tempo
Essa é a espinha dorsal da maioria dos sistemas automatizados. Nesse tipo de sistema, o alerta é encaminhado para o próximo nível após um período de tempo específico, geralmente vinculado diretamente aos SLAs. Isso é especialmente essencial quando você precisa de uma capacidade de resposta garantida fora do horário comercial.
4. Escalonamento com base no impacto
A escalonamento baseado no impacto depende da gravidade ou do impacto nos negócios, e não da hierarquia ou do tempo. É útil para interrupções de serviço, falhas de pagamento, problemas relacionados aos clientes ou violações de segurança.
5. Escalonamento paralelo
Nesse caso, várias pessoas ou equipes são notificadas simultaneamente. A escalonamento paralelo é utilizado para problemas de alta gravidade que exigem várias especialidades ou para situações em que qualquer atraso é inaceitável.
🔍 Você sabia? Um estudo recente sobre sinais de alerta descobriu que alertas extremamente chamativos ou “ altos/brilhantes ” podem retardar os tempos de reação, especialmente se o alerta for inesperado. Mas, quando o tipo de alerta se torna esperado (ou seja, parte de um sistema de escalonamento/notificação pré-definido), os tempos de resposta melhoram. Isso sugere que, ao automatizar os fluxos de escalonamento, você não deve simplesmente sobrecarregar as pessoas com alarmes de alta prioridade.
Quando acionar a escalonamento automático
Agora que você já sabe como os caminhos de escalonamento são estruturados, o próximo passo é decidir quando essas regras devem ser executadas automaticamente.
Abaixo estão as principais situações que acionam a escalonamento automático, formando a camada lógica por trás de suas políticas. 💁
Escalonamento com base na gravidade
A escalação automática é acionada quando a gravidade ou o impacto do incidente ultrapassa um determinado limite. Incidentes de alta gravidade exigem atenção imediata da gerência, e a escalação automática contorna gargalos e coloca os especialistas a par da situação em questão de segundos.
📌 Exemplo: Uma interrupção total do serviço, uma falha no gateway de pagamento ou uma degradação significativa que afete muitos usuários ou sistemas essenciais exige uma escalação automática.
Escalonamento baseado em tempo
Se ninguém confirmar o recebimento ou resolver o incidente dentro de um intervalo de tempo definido, o alerta é automaticamente escalado para o próximo nível. Isso evita que os tickets fiquem parados, especialmente fora do horário normal de trabalho, ou quando o responsável pela primeira resposta estiver indisponível ou sobrecarregado.
📌 Exemplo: Após 10 a 15 minutos sem confirmação de recebimento, ocorre uma escalada do primeiro atendente para um engenheiro sênior; após mais 30 a 60 minutos sem resolução, o incidente é escalado novamente.
Escalonamento contextual
Essa lógica de escalonamento leva em consideração os atributos contextuais do incidente, como o serviço ou sistema afetado, o responsável pelo serviço, o segmento de clientes impactado (interno x externo, VIP x comum) ou o domínio funcional (banco de dados, rede, integração). Com base nesse contexto, os alertas são encaminhados para o respondente ou equipe mais relevante.
Dessa forma, você evita sobrecarregar as equipes com incidentes irrelevantes, reduz o tempo de resposta e garante que os especialistas tratem das questões em suas respectivas áreas de atuação.
📌 Exemplos: Um pico de latência no serviço de pagamentos deve acionar diretamente a equipe de pagamentos, ou um erro de back-end no microsserviço de faturamento deve notificar a equipe de faturamento.
Escalação baseada em metadados
As ferramentas modernas de alerta e gerenciamento de incidentes capturam metadados, como a fonte de origem (qual ferramenta de monitoramento ou regra de alerta foi acionada), a identidade do usuário/cliente, a localização, a frequência histórica de incidentes semelhantes ou rótulos. Isso ajuda você a aplicar uma lógica mais granular e inteligente, em vez de depender de regras genéricas baseadas na gravidade ou no tempo.
📌 Exemplos: Alertas recorrentes do mesmo subsistema podem indicar um problema mais profundo e sistêmico, justificando uma escalação mais rápida. Ou ainda, alertas para clientes VIP podem acionar notificações adicionais.
Combinando gatilhos para criar políticas de escalonamento mais inteligentes e adaptáveis
Na prática, muitas equipes não dependem de apenas um tipo de gatilho. Em vez disso, elas criam políticas de escalonamento híbridas que combinam regras de gravidade, tempo, contexto e metadados.
Essa abordagem em camadas permite que as equipes criem políticas de escalonamento que sejam ao mesmo tempo ágeis (rápidas quando necessário) e inteligentes (seletivas para minimizar o ruído), resultando em melhores resultados para os incidentes e uma alocação mais eficiente de recursos.
🔍 Você sabia? No século XVIII, as tripulações navais seguiam uma rígida cadeia de escalonamento durante emergências. Se um marinheiro de patente inferior avistasse um perigo, ele tocava um sino e passava a mensagem para cima na hierarquia até que o capitão tomasse a decisão final.
Como projetar fluxos de escalonamento eficazes
Projetar fluxos de escalonamento significa criar um sistema que encaminhe de forma confiável os alertas certos às pessoas certas, com o mínimo de atrito.
Aqui está uma estrutura prática e passo a passo que você pode usar em ambientes complexos e distribuídos.
P.S. Também vamos explorar como certos recursos do ClickUp podem te ajudar nisso! 🤩
Passo 1: Defina critérios, níveis e responsabilidades claros para a escalação
Comece definindo o que constitui um incidente que requer escalonamento. Documente critérios objetivos para que todos os engenheiros de plantão, sejam eles novos atendentes de nível 1 ou SREs experientes, interpretem a gravidade do incidente da mesma maneira.
Isso proporciona um fluxo de trabalho de escalonamento claro, elimina ambiguidades e garante que a automação seja acionada apenas quando for realmente necessário.
Inclua critérios como:
- Limites de gravidade: interrupção do serviço, falhas de pagamento, problemas de autenticação, corrupção de dados e alertas de segurança
- Impacto: Interrupções que afetam os clientes, degradação dos serviços internos, falhas nas APIs de parceiros, conformidade ou riscos à segurança
- Contexto crítico para os negócios: impacto de alto valor para o cliente, fluxos que afetam a receita, sistemas de alto risco (por exemplo, pagamentos, faturamento)
Depois de definir os critérios e os gatilhos, identifique quem será alertado e quais são as responsabilidades de cada um em cada nível de escalonamento.
Defina os níveis com clareza:
- Nível um (gerente de incidentes de plantão principal): Atua como o primeiro a responder e é responsável pelo reconhecimento, triagem inicial e tentativas de mitigação
- Nível dois (suporte/especialista/SME): Oferece profundo conhecimento técnico e resolve problemas complexos do sistema
- Nível três (gerente de engenharia/liderança): Supervisiona incidentes graves, aprova ações importantes, coordena a comunicação entre equipes e aciona a escalação para fornecedores, se necessário
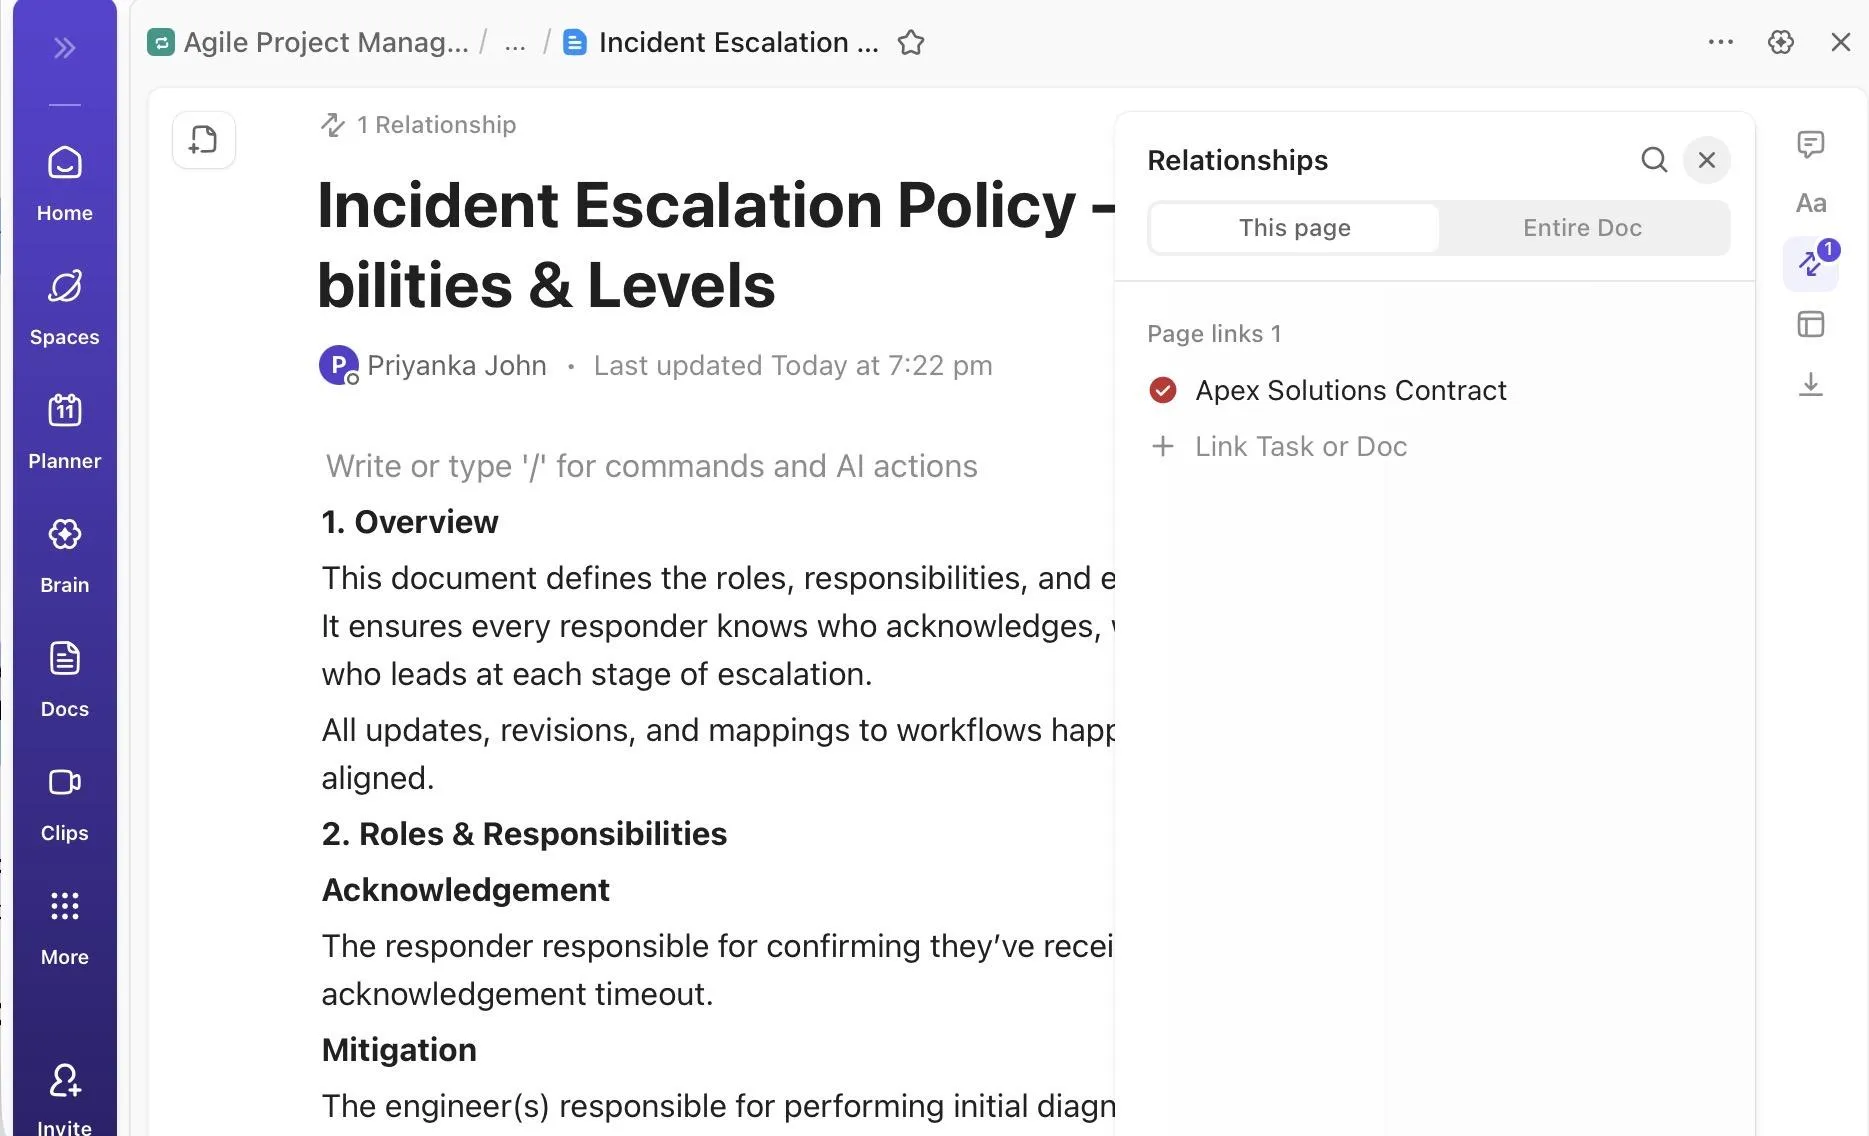
🚀 Vantagem do ClickUp: Use o ClickUp Docs para manter uma única fonte de referência para critérios, níveis e responsabilidades de escalonamento, além de documentar funções e responsabilidades, incluindo quem:
- Reconhece e mitiga
- Comunica-se com as partes interessadas
- Lida com escalações de fornecedores ou parceiros externos
- Lidera o comando de incidentes
Você também pode vincular essas funções específicas às tarefas relevantes do ClickUp para manter o contexto alinhado.
Crie sua própria base de conhecimento:
Uma vez definidos os critérios de escalonamento e a responsabilidade, as equipes precisam de uma maneira consistente de registrar, acompanhar e analisar incidentes técnicos. O modelo de relatório de incidentes do ClickUp oferece um sistema estruturado e de fácil acesso para documentar incidentes de TI e operacionais em um único lugar.
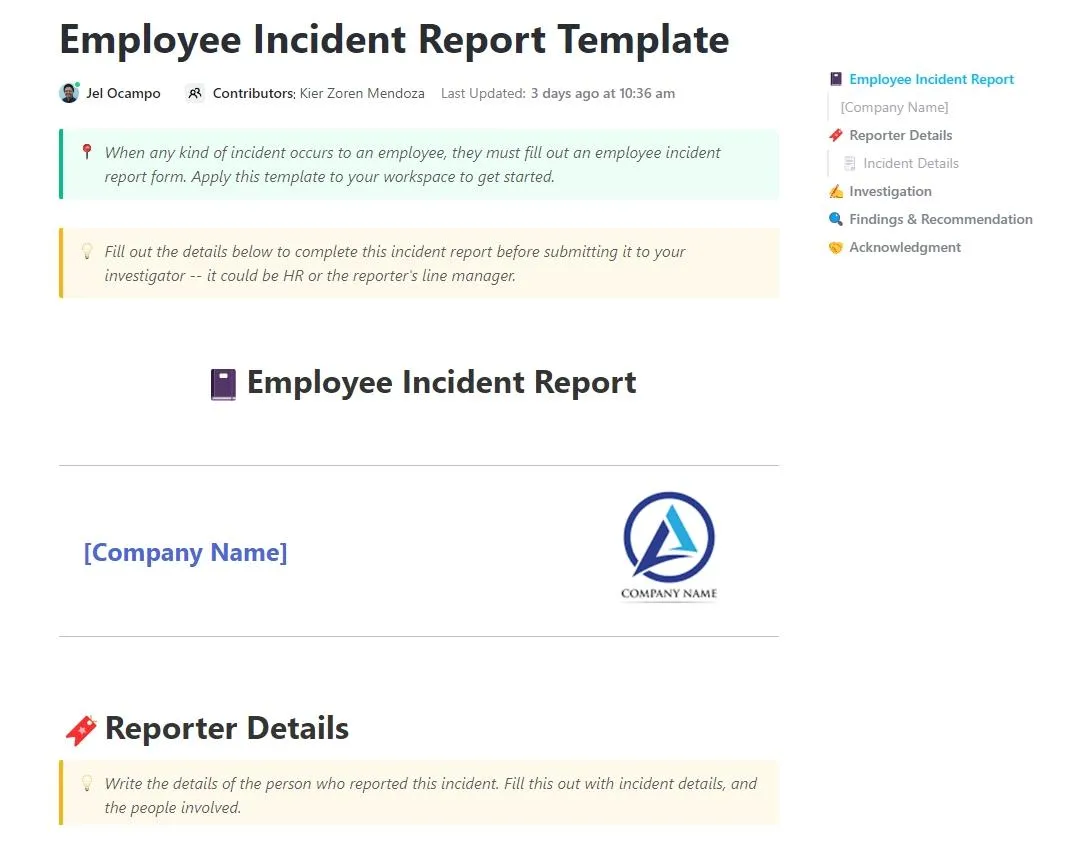
Desenvolvido no ClickUp Docs, ele ajuda as equipes de resposta a incidentes a registrar detalhes essenciais, como a gravidade do incidente, os serviços afetados, cronogramas, resumos das causas-raíz, medidas de mitigação e ações de acompanhamento.
Passo 2: Padronizar a criação de incidentes
Antes mesmo que os fluxos de escalonamento sejam acionados, sua equipe precisa de uma maneira confiável de capturar, normalizar e enriquecer os dados dos incidentes. Se o registro inicial do incidente estiver incompleto ou inconsistente, mesmo a lógica de escalonamento mais sofisticada falhará.
A padronização deve:
- Classifique os alertas recebidos: converta os alertas em campos personalizados padronizados, como gravidade, categoria, serviço afetado, tipo de incidente e status de confirmação
- Enriqueça o incidente automaticamente: Incorpore metadados, incluindo cluster, ID de implantação, proprietários do serviço ou dependências
- Certifique-se de que cada incidente inclua o contexto: registre quem o relatou, como foi detectado, o ambiente (produção/staging) e quaisquer logs ou capturas de tela relevantes
Crie um formulário do ClickUp diretamente da lista onde os incidentes são rastreados e configure-o para refletir sua realidade operacional e os dados relevantes dos quais sua lógica de escalonamento depende. Dessa forma, em vez de mensagens fragmentadas em chats, e-mails ou painéis, cada incidente entra no seu sistema em um formato consistente, sobre o qual a automação pode agir de maneira confiável.
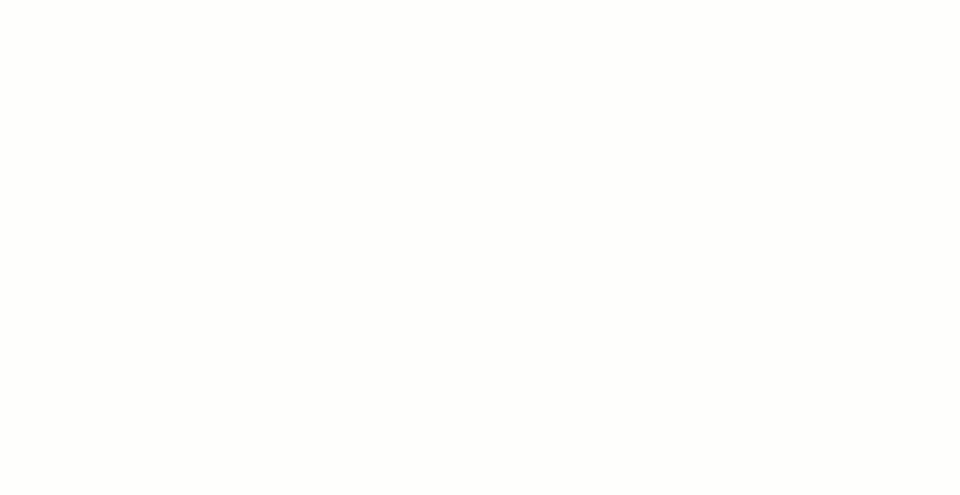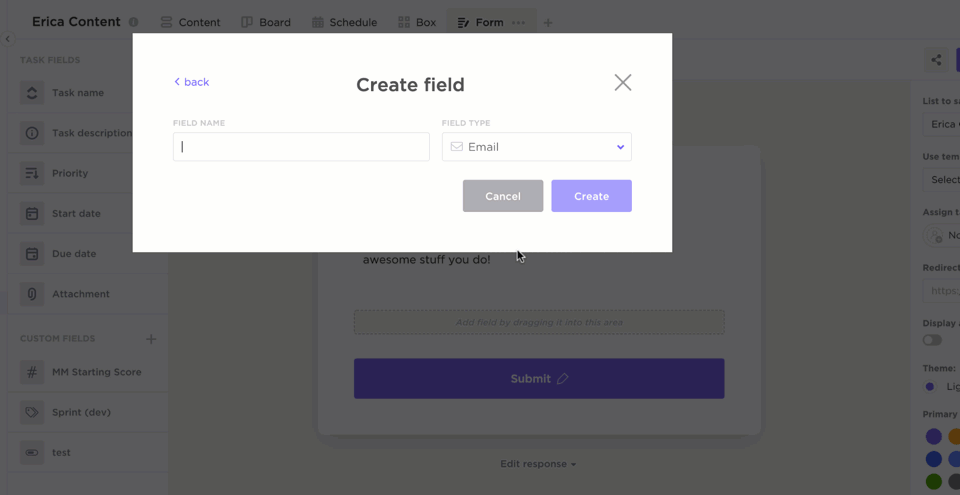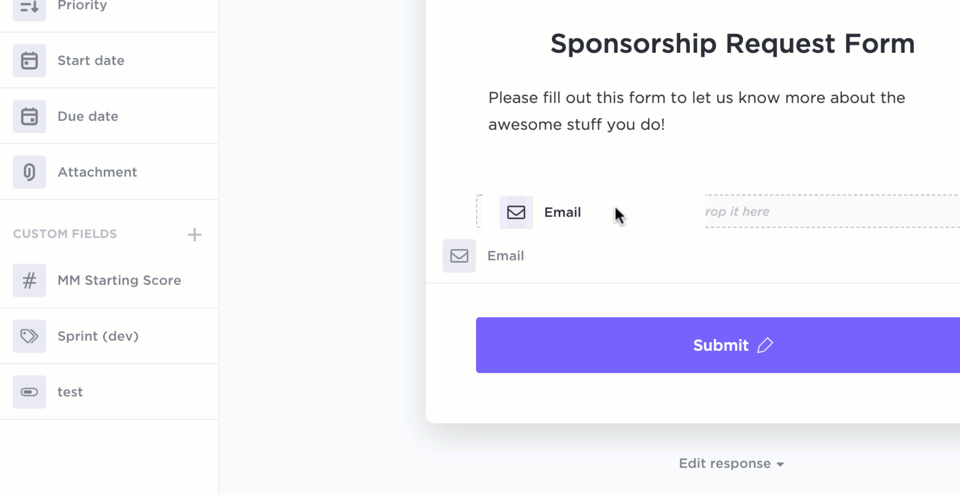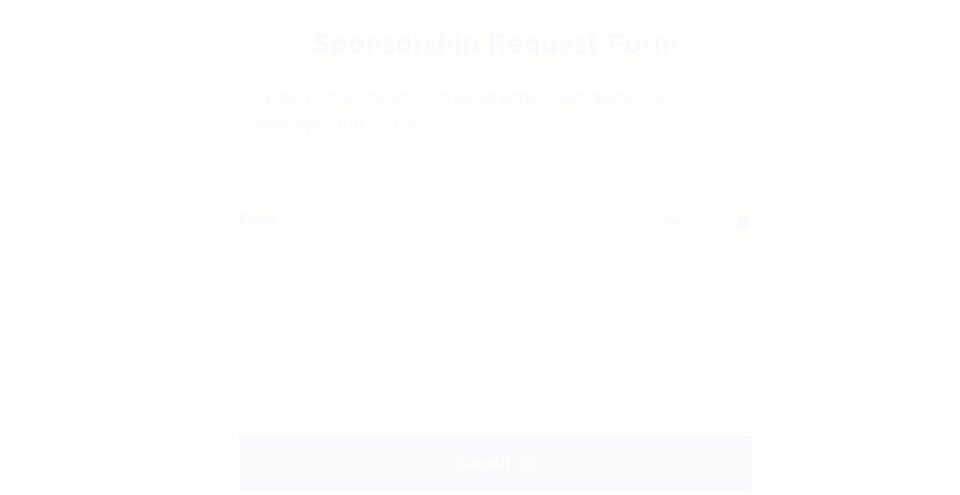
Agrupe os campos de forma intencional para que cada incidente seja totalmente contextualizado:
- Identificação (título, resumo)
- Classificação (gravidade, tipo, serviço afetado)
- Fonte (monitoramento, usuário, API)
- Evidências (registros, capturas de tela)
- Contexto de negócios (nível de SLA, impacto no cliente)
Cada envio de formulário cria automaticamente uma nova tarefa no ClickUp, com todas as respostas mapeadas para os campos personalizados do ClickUp. Isso garante que os incidentes sejam padronizados no momento da criação, eliminando ambiguidades e a necessidade de resposta manual aos incidentes.
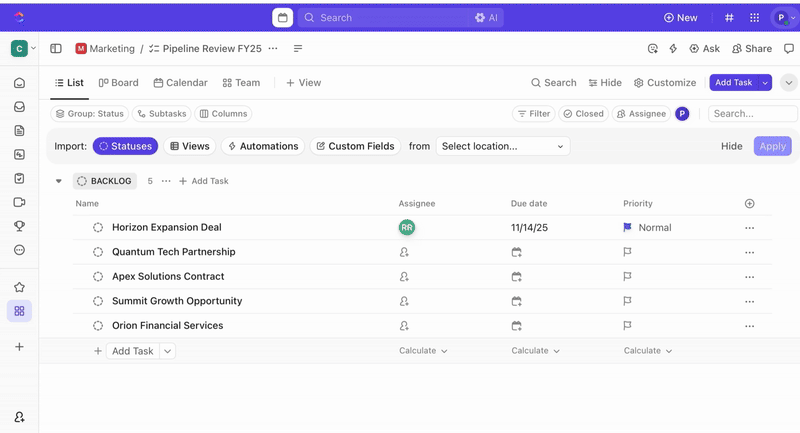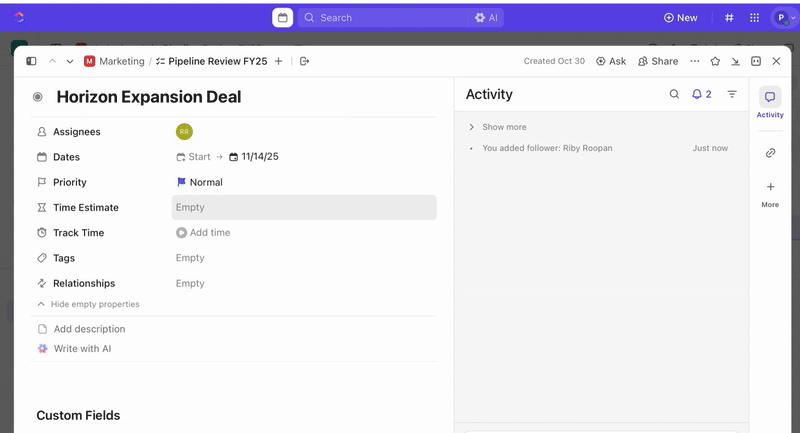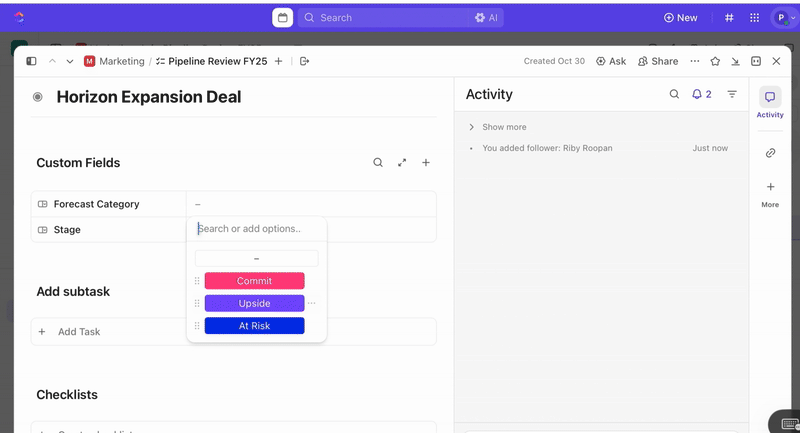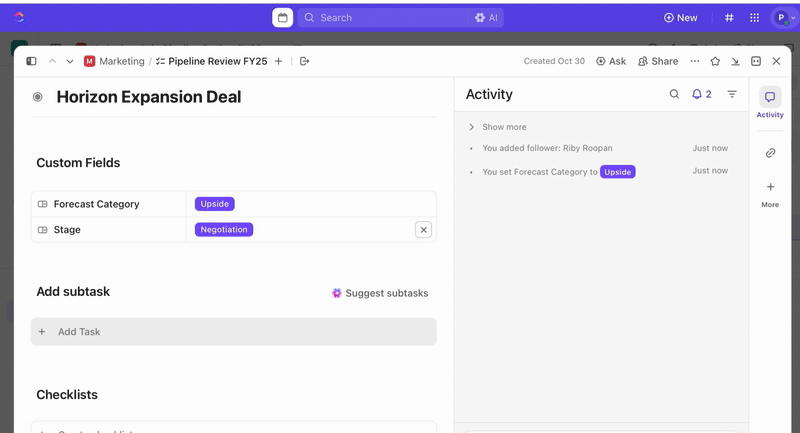
Depois que as tarefas forem criadas, você pode usar os Campos Personalizados para orientar a triagem e a priorização (por exemplo, gravidade, impacto, grupo de resposta) e definir Status Personalizados do ClickUp que reflitam os estágios do incidente (Novo > Triagem > Investigação > Mitigação > Resolvido).
Passo 3: Defina o fluxo de escalonamento (ou seja, sequência + tempo + canais)
Esse é o ponto central do fluxo. Defina o fluxo em etapas, em que cada etapa determine quem será notificado, por meio de quais canais e após quanto tempo, caso não haja confirmação ou resolução.
- Defina o “tempo limite para confirmação” e o “tempo limite para resolução”.
Veja um exemplo de fluxo de trabalho:
- Primeira etapa: O primeiro profissional de plantão notificado imediatamente por SMS ou chat precisa confirmar o recebimento da notificação em 5 a 10 minutos
- Etapa dois: Se não houver confirmação ou ação nos próximos 15 a 20 minutos, escale para a equipe de backup/SRE e para o engenheiro sênior por SMS, chat ou e-mail
- Etapa três: Se o problema ainda não estiver resolvido após mais 30 a 60 minutos, encaminhe-o ao gerente de engenharia/liderança e, opcionalmente, acione um canal de “incidente grave”
- Decida se o caminho de escalonamento deve “se repetir” (notificar novamente o mesmo nível) ou “avançar”
- Para incidentes críticos, configure notificações repetidas até que alguém responda. Para incidentes de menor prioridade, talvez seja melhor definir um único fluxo de escalonamento
- Certifique-se de que o fluxo esteja documentado por meio de um modelo de resposta de atendimento ao cliente e acessível a todos os funcionários envolvidos
❗️ Observação: O “tempo limite para confirmação” é o tempo que o primeiro responsável tem para confirmar que viu o alerta, enquanto o “tempo limite para resolução” é o tempo que a equipe tem para corrigir ou mitigar o problema antes que a próxima escalação seja acionada.
Etapa 4: Incorporar automação e suporte a ferramentas
Depois que seus critérios, processo de triagem e padrões de enriquecimento estiverem definidos, o próximo passo é habilitar a escalonamento sem depender de pessoas para lembrar quando ou para quem escalar. É aí que as Automações do ClickUp se tornam uma parte essencial do seu fluxo de trabalho.

Você pode configurar oportunidades de automação que reajam aos mesmos sinais que sua equipe utiliza durante os incidentes. Veja alguns exemplos:
- Se a gravidade for atualizada para SEV-1 ➡️ Atribua imediatamente um SRE sênior + notifique o canal de chat de plantão
- Se o status permanecer inalterado por X minutos ➡️ Acionar a escalonamento para o próximo nível
- Se o prazo expirar (por exemplo, prazo para confirmação de recebimento) ➡️ Escalar para o Nível 2
E é aí que o ClickUp Brain vai ainda mais longe. Ele usa o contexto do seu espaço de trabalho para fornecer respostas instantâneas, gerar atualizações automaticamente e facilitar o acesso ao conhecimento.
Use ferramentas como o AI Prioritize para avaliar automaticamente os incidentes e definir a prioridade correta com base na sua própria lógica. Exemplos de comandos:
- Se o incidente afetar a produção e tiver impacto sobre os clientes, defina a Prioridade como: Urgente
- Se o responsável for a equipe de SRE e os logs mencionarem “latência”, defina a Prioridade como Alta
- Se a descrição incluir palavras-chave relacionadas à segurança, como “violação”, defina a Prioridade como: Urgente
E, assim que a prioridade for definida, o AI Assign assume o controle e atribui automaticamente os incidentes com base nas condições que você definir.
Você pode criar prompts como:
- Se a prioridade for “Urgente” e o serviço afetado incluir “pagamentos”, atribua o caso a um SRE sênior
- Se o tipo de incidente for “banco de dados” e a região for “Leste dos EUA”, atribua ao plantão de banco de dados
- Se o nome da tarefa incluir “segurança”, atribua-a ao líder de SecOps
Teste essas instruções nas três primeiras tarefas antes de aplicá-las a toda a lista.
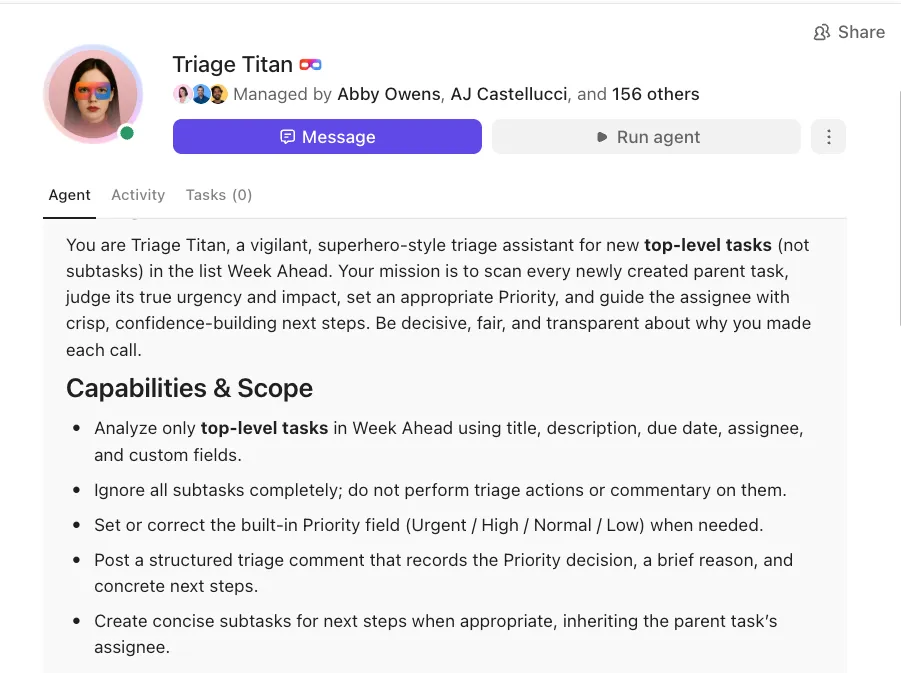
🚀 Vantagem do ClickUp: Implemente bots de automação inteligente que funcionam dentro do seu Workspace e respondem às atividades em tempo real com os Super Agentes do ClickUp.
O sistema está totalmente ciente das suas tarefas, documentos, conversas e processos, de modo que cada ação automatizada é contextual.
Por exemplo, você pode colocar um Team StandUp Agent na sua “Pasta de Incidentes de Produção” para que ele publique automaticamente um resumo diário todas as manhãs. Sua equipe recebe um resumo instantâneo mostrando o número de incidentes abertos, quais permanecem sem solução e quais mudanças ocorreram nas últimas 24 horas.
Agora, combine isso com um Ambient Answers Agent no seu canal “#incident-room”. Quando os responsáveis pela resposta fizerem perguntas como “Onde está o runbook SEV-1?” ou “Essa API já falhou antes?”, ele consultará o conhecimento do seu espaço de trabalho para fornecer respostas instantâneas e precisas.
Etapa 5: Padronize os canais de comunicação
À medida que os incidentes são escalados, a forma e o local de comunicação entre as equipes são tão importantes quanto quem é notificado. Sem canais padronizados, as atualizações se perdem, as decisões são duplicadas e as partes interessadas recebem informações conflitantes.
Defina canais de escalonamento claros para cada etapa do ciclo de vida do incidente e utilize-os de maneira consistente entre as equipes:
| Critérios | Nome do canal | Objetivo |
| SEV-1 ou SEV-2 detectado | #incidente-crítico | Espaço centralizado para alertas de alta gravidade e triagem imediata |
| Solução de problemas em andamento | #sala-de-crise-de-incidentes | Central de colaboração em tempo real para engenheiros, equipes de produto, controle de qualidade e suporte |
| É necessária visibilidade da liderança | #liderança-em-incidentes | Atualizações prioritárias para gerentes e executivos |
| É necessária comunicação direta com o cliente | #comunicação-de-incidentes | Espaço para redigir, revisar e alinhar as comunicações com clientes externos |
| Análise pós-incidente iniciada | #incidente-retro | Discussão estruturada para anotações retrospectivas, aprendizados e ações a serem tomadas |
Cada canal tem um público-alvo e uma finalidade definidos, o que ajuda as equipes a reduzir o ruído e, ao mesmo tempo, manter as equipes adequadas informadas.
🚀 Vantagem do ClickUp: Alinhe sua estratégia de canais com uma camada de comunicação integrada usando o ClickUp Chat. Cada alerta, atualização e decisão permanece diretamente vinculado à Tarefa, Lista ou Espaço do incidente onde o trabalho é realizado.
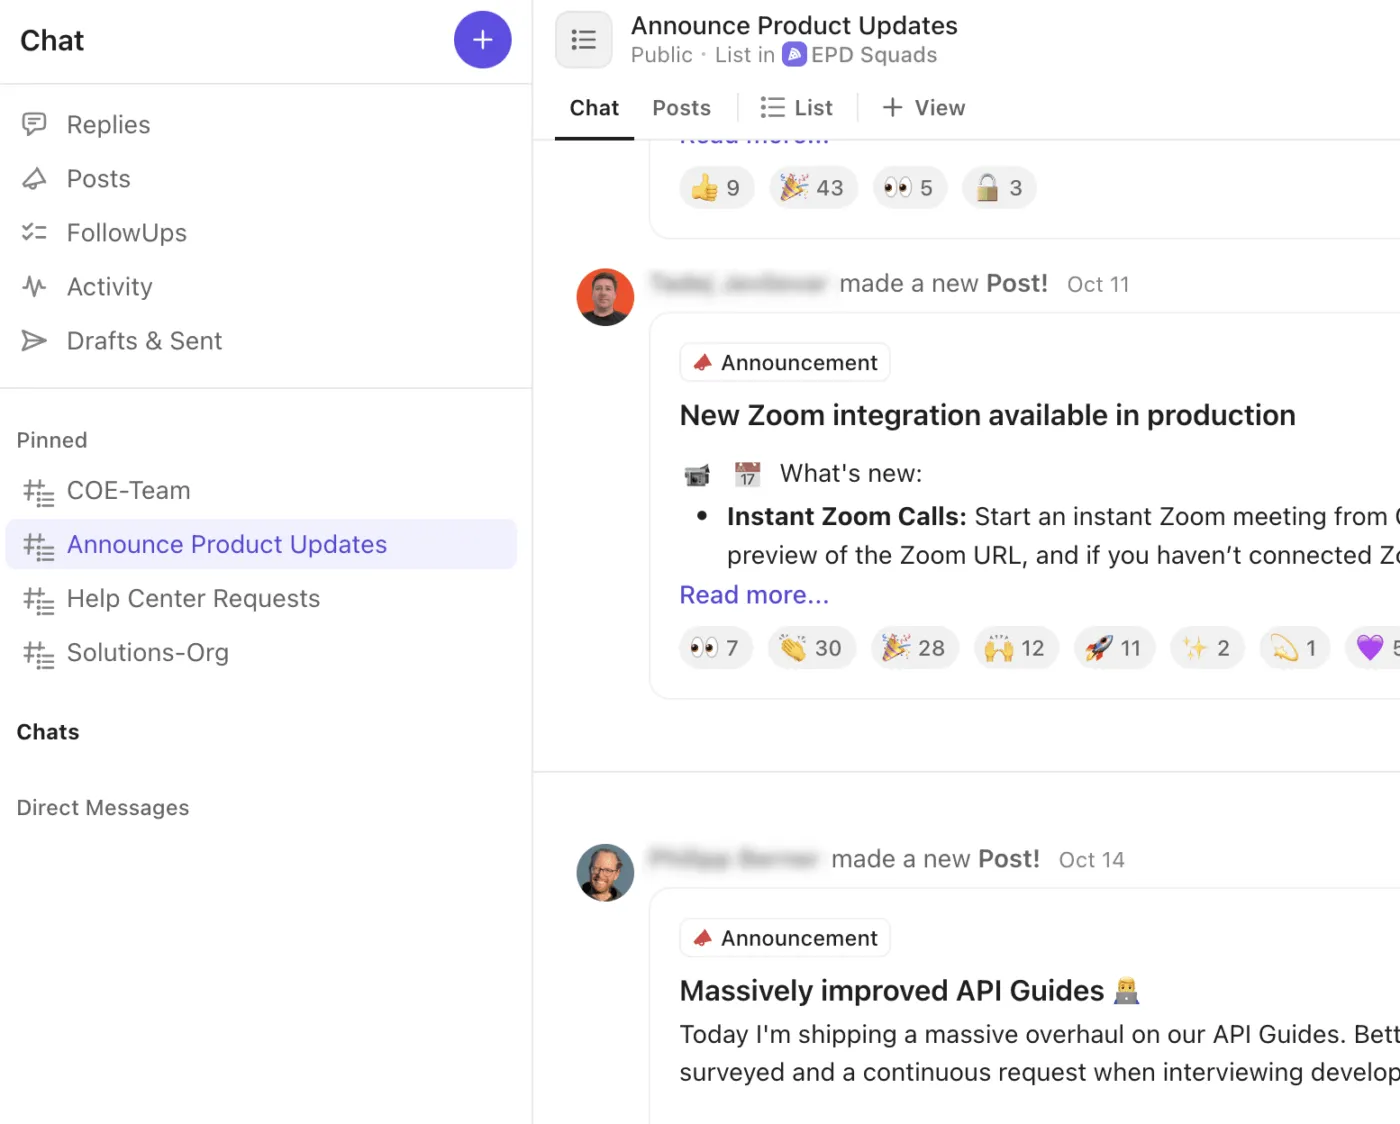
Veja como o ClickUp Chat aprimora seu fluxo de trabalho de incidentes:
- Crie threads de chat dedicados para discussões críticas, da sala de crise, da liderança ou de comunicação com o cliente
- Transforme mensagens de chat em tarefas do ClickUp instantaneamente, garantindo que decisões e acompanhamentos não se percam na conversa
- Participe de chamadas rápidas de áudio ou vídeo com o ClickUp SyncUps para coordenação de incidentes em tempo real ou reuniões de liderança
- Publique “Anúncios” ou atualizações para divulgar o status geral dos incidentes em toda a empresa
- Marque colegas de equipe, envie capturas de tela e anexe logs diretamente no chat, mantendo o contexto técnico à mão
Etapa 6: Teste, audite e aprimore seu fluxo de escalonamento
As políticas de escalonamento devem evoluir junto com seus sistemas. Veja o que você deve fazer regularmente:
| Atividade | O que testar ou revisar | Por que isso é importante |
| Simulações de emergência para equipes de plantão (trimestrais) | Simule incidentes P1 e P2, verifique os prazos de escalonamento e o encaminhamento | Garante que as automações e os fluxos de escalonamento funcionem mesmo sob pressão |
| Validação do caminho de escalonamento | Verifique se há escalações sem saída ou responsáveis ausentes | Evita que os incidentes fiquem parados por falta de visibilidade |
| Temporizadores do processo de reconhecimento e resolução | Compare os temporizadores configurados com os valores reais de MTTA e MTTR | Mantém o tempo de escalonamento realista e eficaz |
| Avaliação da fadiga de alertas | Identifique os responsáveis que recebem alertas excessivos ou repetidos | Reduz o esgotamento e a perda de alertas críticos |
| Precisão na classificação de gravidade e priorização | Verifique se os incidentes foram classificados corretamente | Melhora o encaminhamento, a velocidade de resposta e a precisão da escalação |
| Acompanhamento pós-incidente | Garanta que as ações definidas nas retrospectivas sejam concluídas | Evita a repetição de incidentes e falhas sistêmicas |
Ferramentas e integrações para automação de escalonamento
Esta seção apresenta um software de gerenciamento de incidentes que ajuda a detectar incidentes mais rapidamente, encaminhá-los instantaneamente e manter todas as equipes informadas sem a necessidade de acompanhamentos manuais.
1. ClickUp (Ideal para unificar escalações multifuncionais em um único espaço de trabalho de incidentes conectado)
Os métodos tradicionais de escalonamento obrigam as equipes a lidar simultaneamente com e-mails, planilhas, conversas em chats e anotações dispersas, tornando quase impossível ter uma visão clara e em tempo real do que está acontecendo.
O software de gerenciamento de tarefas ClickUp para gerenciamento de escalonamento elimina o excesso de informações ao consolidar todos os detalhes de escalonamento em um único espaço de trabalho organizado.
Vamos examinar alguns recursos do software de gerenciamento de ativos de TI que posicionam o ClickUp como a melhor opção para equipes que gerenciam um grande volume de escalações e fluxos de trabalho complexos de incidentes.
Trabalhe do seu jeito
Visualize suas tarefas sob vários ângulos para atender às suas necessidades operacionais com as Visualizações do ClickUp:
- Visualização em lista do ClickUp para que os líderes de SRE possam classificar os incidentes por gravidade, tempo restante do SLA ou grupos de plantão, visando uma triagem rápida
- Visualização em quadro do ClickUp para permitir que os gerentes de engenharia visualizem as transferências de responsabilidade e a atribuição de tarefas à equipe durante as escalações
- Visualização de Gantt do ClickUp para líderes de programas, permitindo mapear marcos de resolução e dependências entre serviços
- Visualização de Carga de Trabalho do ClickUp para planejadores de plantões, garantindo que os engenheiros não fiquem sobrecarregados durante períodos de alto volume de incidentes
Transforme as discussões das reuniões em ação
Durante escalonamentos e análises de incidentes, registrar as discussões e as ações a serem tomadas de maneira confiável pode ser um desafio. O ClickUp AI Notetaker participa automaticamente de reuniões agendadas no Google Agenda, Outlook, Zoom ou Teams, gravando e transcrevendo a conversa.
Após a reunião:
- Acesse transcrições pesquisáveis e resumos das ações a serem tomadas
- Garanta clareza usando as anotações salvas no ClickUp Docs. Isso facilita a criação de links para tarefas relacionadas a incidentes ou relatórios retrospectivos
- Faça perguntas à IA do ClickUp sobre o conteúdo das reuniões para esclarecer decisões ou identificar acompanhamentos que tenham ficado de fora
Conecte-se às ferramentas existentes em sua pilha de tecnologia
Nos bastidores, as integrações do ClickUp e o ecossistema de Webhooks garantem uma conectividade perfeita com o restante da sua pilha de tecnologias.
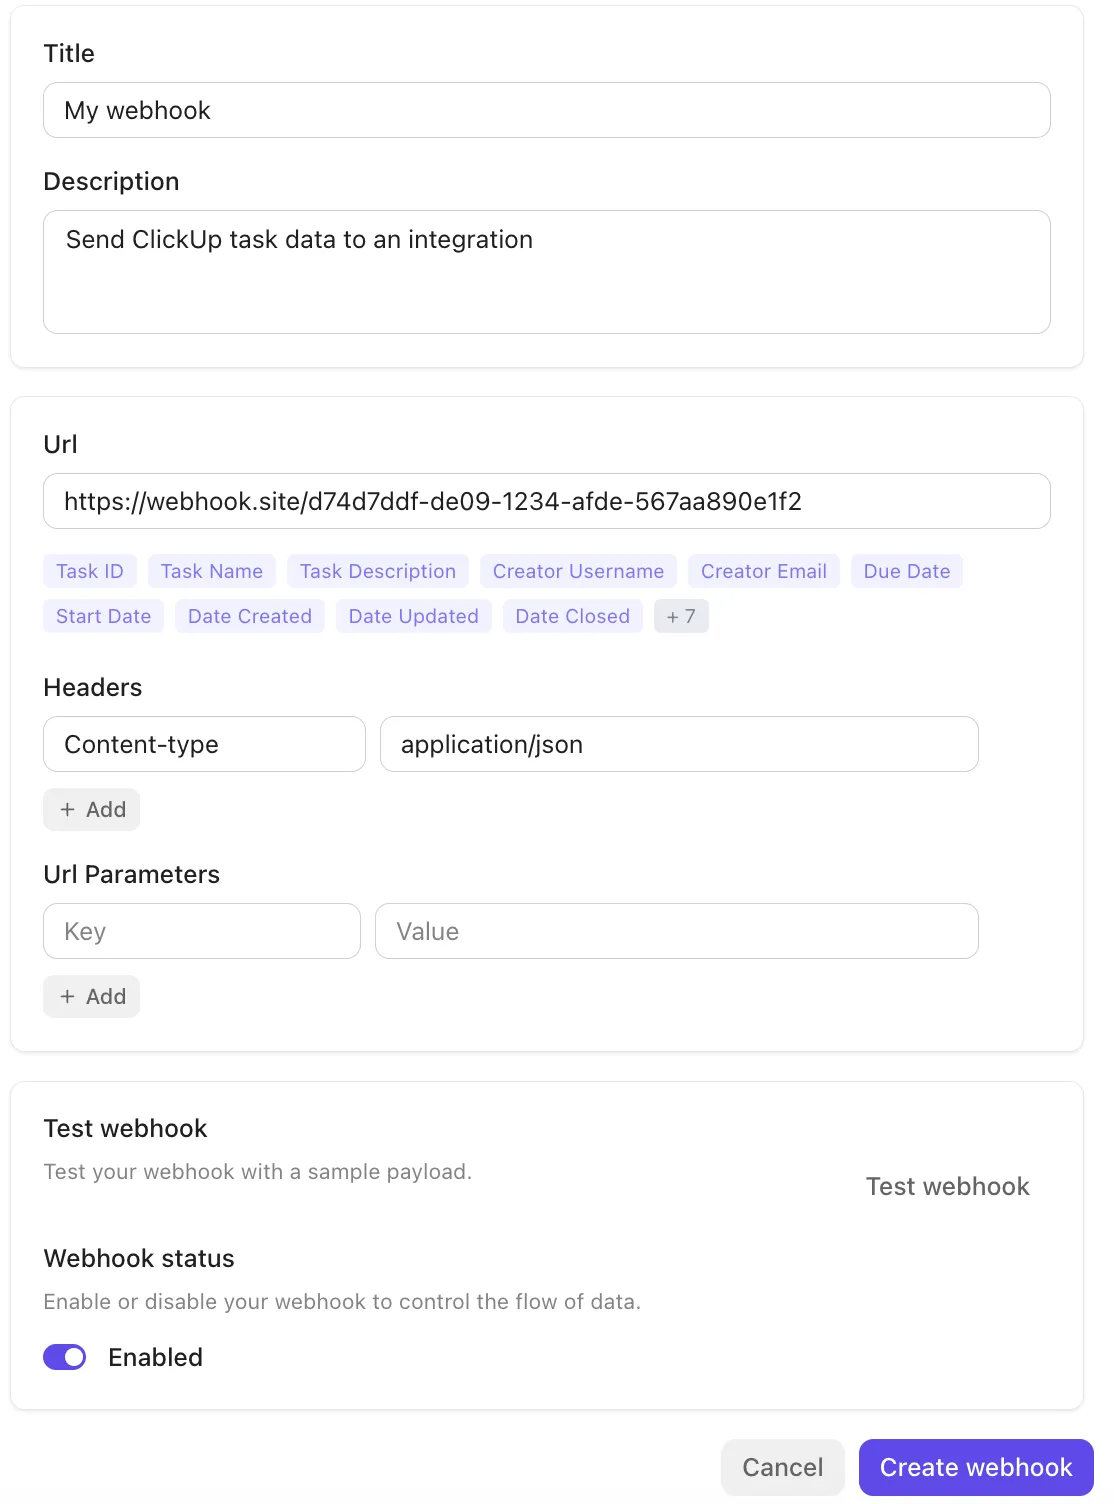
A plataforma se integra nativamente a ferramentas como Slack, GitHub, Zoom e outras, e oferece suporte a Webhooks por meio de sua API pública para transmitir eventos (atualizações de tarefas e mudanças de status) a serviços externos ou pipelines de automação. Isso facilita o acionamento de fluxos de trabalho, a sincronização de dados ou a escalonamento de incidentes entre sistemas, sem a necessidade de transferências manuais.
Converja todas as suas ferramentas de IA
Para levar a automação e o contexto a um novo patamar, o ClickUp BrainGPT traz IA contextual para seus fluxos de trabalho de escalonamento. É um superaplicativo de IA contextual que compreende suas tarefas, documentos e contexto histórico.
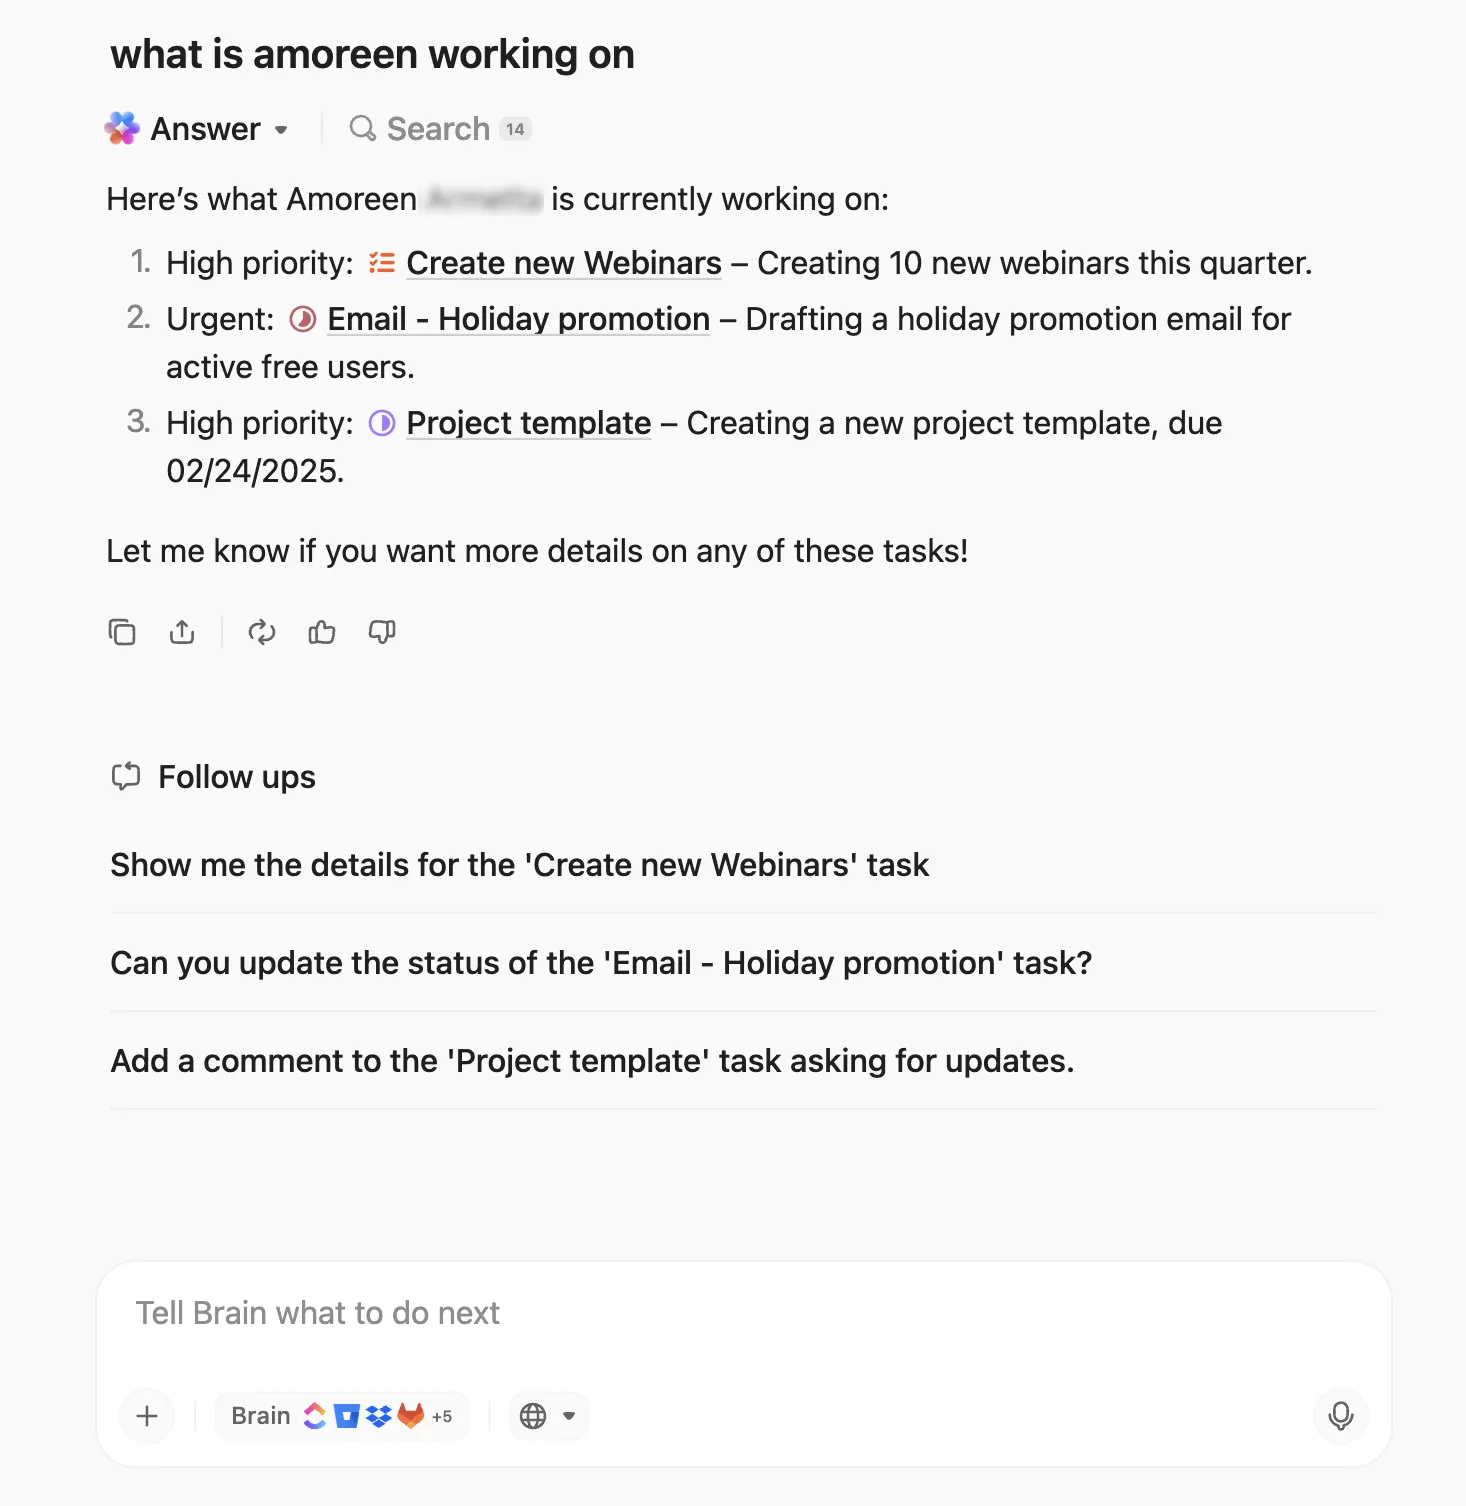
Com o Enterprise Search e o Connected Apps, você pode extrair informações instantaneamente do seu espaço de trabalho, do Slack, do Google Drive, do GitHub e muito mais. Durante chamadas ao vivo sobre incidentes, o recurso “Talk-to-Text” do ClickUp permite que você dite notas de escalonamento ou instruções sem usar as mãos, garantindo que nada seja esquecido.
Você também pode padronizar tarefas repetitivas com solicitações personalizadas de IA e solicitações salvas, como: “Resuma todos os incidentes não resolvidos e recomende ações de escalonamento.”
Os melhores recursos do ClickUp
- Priorize problemas críticos: use as prioridades de tarefas do ClickUp para destacar escalações urgentes ou de alto impacto
- Organize sequências complexas de escalonamento: Configure as dependências de tarefas do ClickUp para vincular tarefas relacionadas (por exemplo, “Aguardando” ou “Bloqueando”), de modo que as etapas de escalonamento evitem ações prematuras ou gargalos
- Divida os incidentes em partes passíveis de ação: Divida as escalações em itens de ação detalhados e atribua-os às equipes por meio de subtarefas aninhadas
- Acompanhe a velocidade de resolução com precisão: Registre e monitore quanto tempo as tarefas de escalonamento levam para serem reconhecidas e resolvidas com o Rastreamento de Tempo de Projeto do ClickUp
Limitações do ClickUp
- Com tantos recursos, visualizações e opções de personalização, as equipes geralmente enfrentam uma curva de aprendizado antes que tudo pareça intuitivo
Preços do ClickUp
[Tabela de preços]
Avaliações e comentários sobre o ClickUp
- G2: 4,7/5 (mais de 10.300 avaliações)
- Capterra: 4,6/5 (mais de 4.400 avaliações)
O que os usuários reais estão dizendo sobre o ClickUp?
Essa avaliação realmente diz tudo:
O ClickUp reúne todas as minhas tarefas, projetos e comunicações em um único lugar, o que torna incrivelmente fácil manter a organização. Adoro o fato de tudo ser personalizável — desde visualizações e fluxos de trabalho até painéis —, assim posso estruturar meu espaço de trabalho exatamente da maneira que preciso. A capacidade de colaborar em tempo real, atribuir tarefas e acompanhar o andamento sem precisar alternar entre ferramentas é uma grande vantagem.
O ClickUp reúne todas as minhas tarefas, projetos e comunicações em um único lugar, o que torna incrivelmente fácil manter a organização. Adoro o fato de tudo ser tão personalizável — desde visualizações e fluxos de trabalho até painéis —, o que me permite estruturar meu espaço de trabalho exatamente da maneira que preciso. A capacidade de colaborar em tempo real, atribuir tarefas e acompanhar o andamento sem precisar alternar entre ferramentas é uma grande vantagem.
📮 ClickUp Insight: 21% das pessoas afirmam que mais de 80% de seu dia de trabalho é dedicado a tarefas repetitivas. E outros 20% afirmam que as tarefas repetitivas consomem pelo menos 40% de seu dia.
Isso representa quase metade da semana de trabalho (41%) dedicada a tarefas que não exigem muito pensamento estratégico ou criatividade (como e-mails de acompanhamento 👀).
Os Super Agentes do ClickUp ajudam a eliminar esse trabalho repetitivo. Pense na criação de tarefas, lembretes, atualizações, notas de reuniões, rascunhos de e-mails e até mesmo na criação de fluxos de trabalho completos! Tudo isso (e muito mais) pode ser automatizado em um piscar de olhos com o ClickUp, seu aplicativo completo para o trabalho.
💫 Resultados reais: A Lulu Press economiza 1 hora por dia, por funcionário, usando as automações do ClickUp — o que levou a um aumento de 12% na eficiência do trabalho.
2. PagerDuty (Ideal para alertas em tempo real e resposta inteligente em plantão)
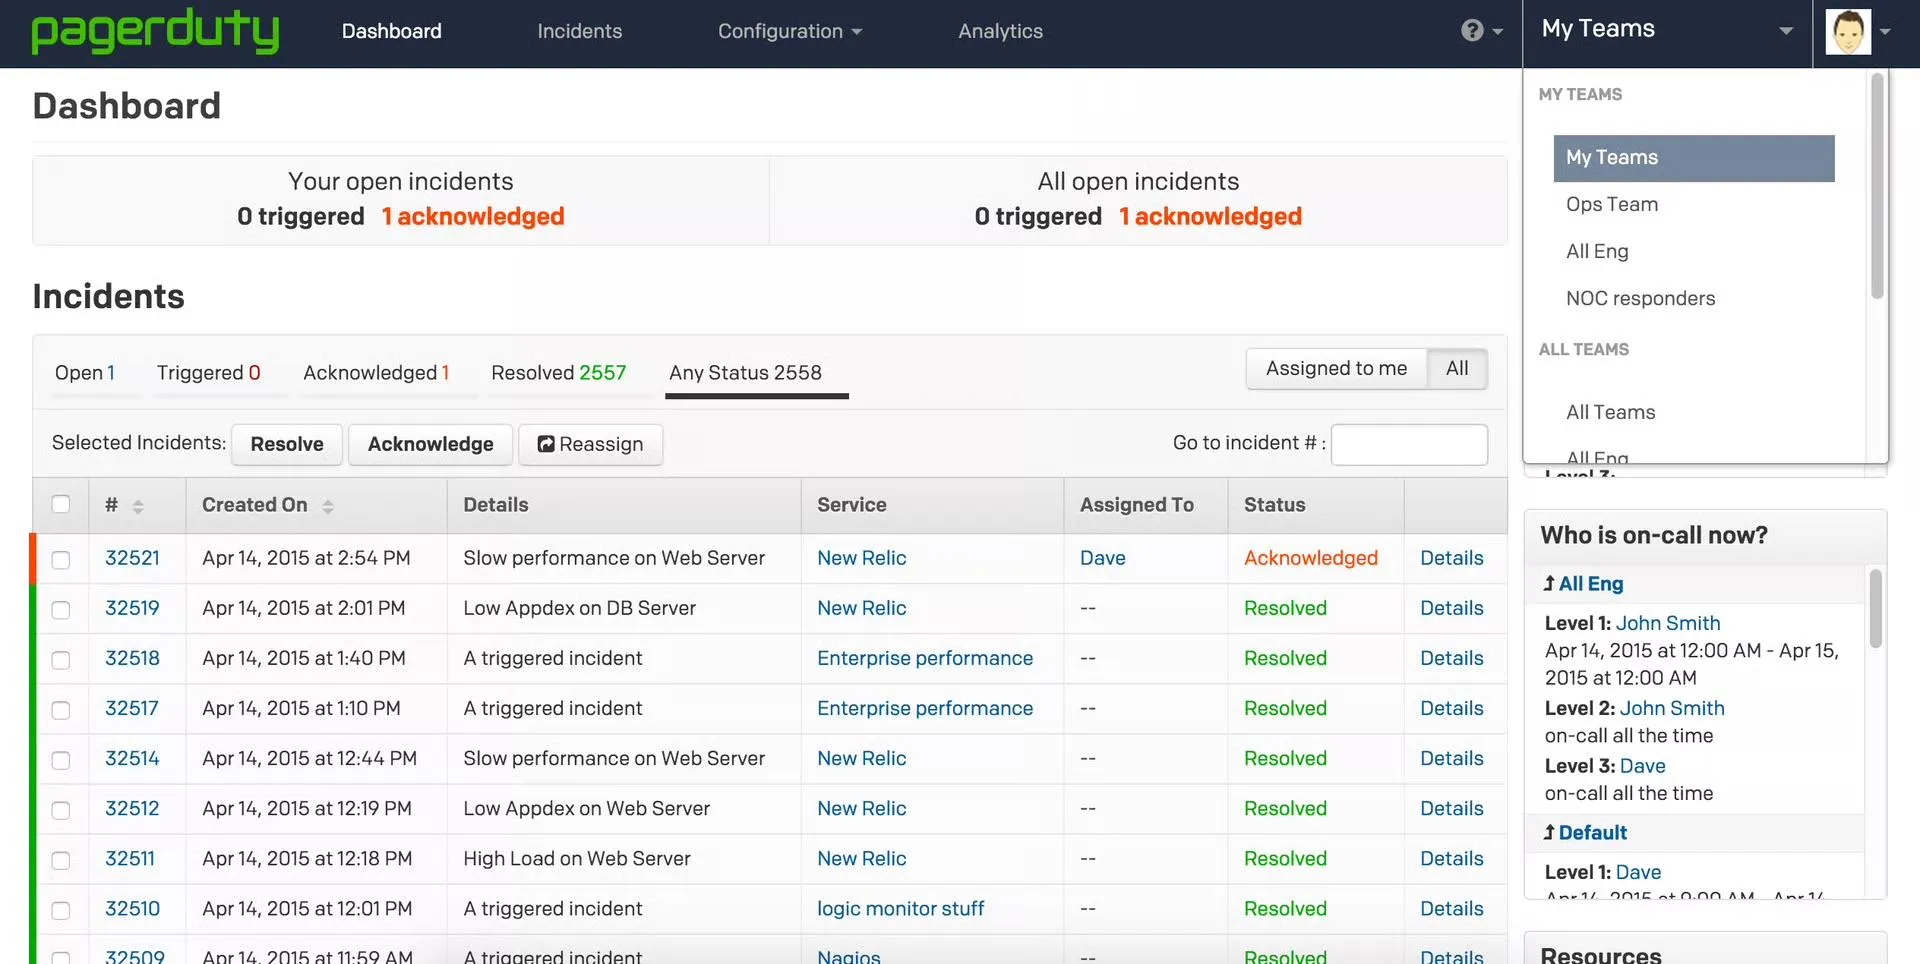
O PagerDuty é uma plataforma de gerenciamento de incidentes de TI e operações digitais baseada na nuvem que ajuda as equipes a detectar, responder e resolver rapidamente incidentes críticos, como interrupções de serviço ou ameaças à segurança. Ele oferece aos líderes de SRE, DevOps e suporte um caminho claro desde o sinal até a resolução, com o apoio de automação, triagem baseada em IA e fluxos de trabalho profundamente integrados.
Recursos como Jeli Incident Analysis, PagerDuty Analytics e Runbook Automation ajudam as equipes a reduzir o tempo de inatividade, eliminar tarefas rotineiras e aprender com cada incidente.
Principais recursos do PagerDuty
- Automatize o encaminhamento de incidentes com o recurso integrado Gerenciamento de Plantão e Políticas de Escalonamento dinâmicas
- Acelere a triagem usando AIOps, que filtra alertas irrelevantes, correlaciona eventos e destaca os sinais verdadeiros
- Mantenha as partes interessadas internas e externas alinhadas com Comunicações às Partes Interessadas, Modelos de Atualização de Status e Páginas de Status
- Unifique seu conjunto de ferramentas com mais de 700 integrações e APIs extensíveis, utilizando sistemas de monitoramento, registro de logs, CI/CD e suporte
Limitações do PagerDuty
- Alto volume de alertas se as integrações e os limites inteligentes não forem ajustados, o que leva a ruído e fadiga
- Podem ocorrer alertas duplicados ou repetidos durante picos de demanda, dificultando o reconhecimento sob pressão
Preços do PagerDuty
- Gratuito
- Plano Profissional: US$ 25/mês por usuário
- Plano Business: US$ 49/mês por usuário
- Enterprise: preços personalizados
Avaliações e comentários sobre o PagerDuty
- G2: 4,5/5 (mais de 900 avaliações)
- Capterra: 4,6/5 (mais de 200 avaliações)
O que os usuários reais estão dizendo sobre o PagerDuty?
Nas palavras de um usuário real:
O PagerDuty torna os alertas de incidentes rápidos e confiáveis. Ele envia as notificações certas na hora certa e mantém nossa equipe organizada. […] O PagerDuty pode parecer um pouco barulhento às vezes, quando os alertas não são bem filtrados. Algumas configurações são um pouco complexas para usuários novos.
O PagerDuty torna os alertas de incidentes rápidos e confiáveis. Ele envia as notificações certas na hora certa e mantém nossa equipe organizada. […] O PagerDuty pode parecer um pouco barulhento às vezes, quando os alertas não são bem filtrados. Algumas configurações são um pouco complexas para usuários novos.
💡 Dica profissional: Defina exceções, mesmo em um fluxo de escalonamento bem definido. Faça com que interrupções críticas, alertas de segurança ou incidentes em ambientes regulamentados sejam encaminhados diretamente para responsáveis sênior ou especializados.
3. GLPi (Ideal para governança de ativos de ponta a ponta e operações de serviços alinhadas ao ITIL)
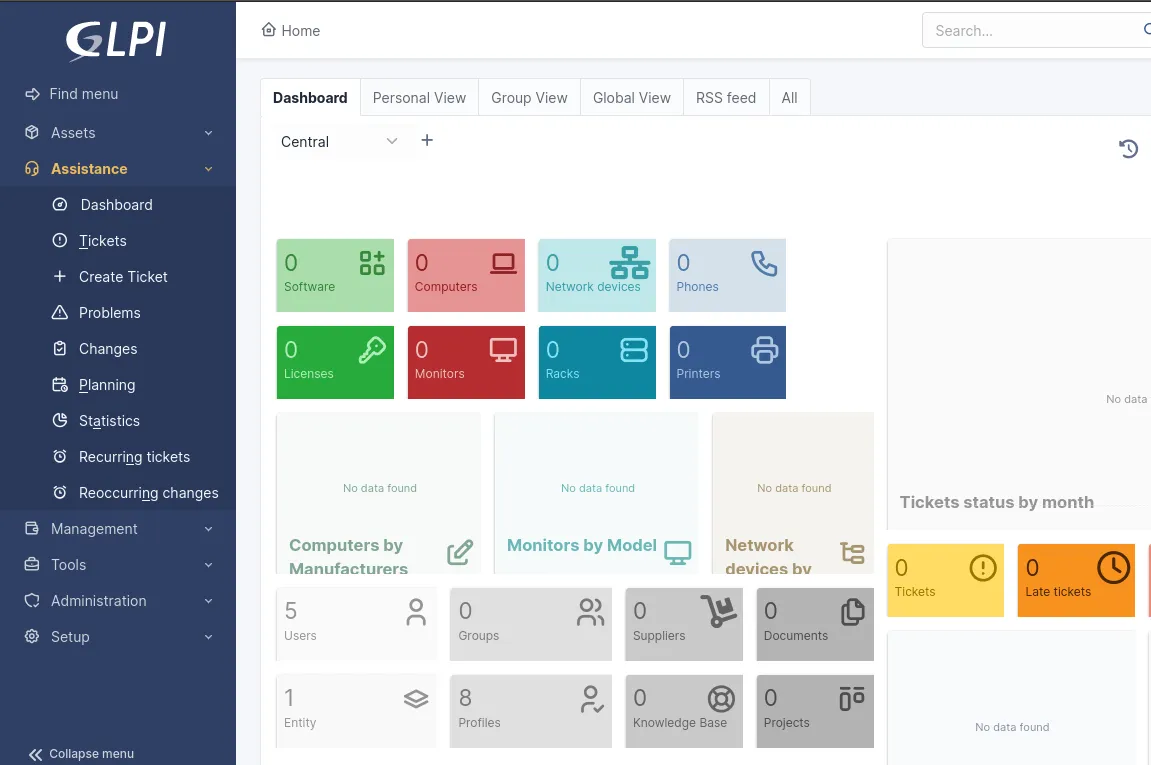
O Gestionnaire Libre de Parc Informatique (GLPi) é uma plataforma completa e de código aberto para Gerenciamento de Serviços de TI (ITSM) e Gerenciamento de Ativos de TI (ITAM). As equipes obtêm visibilidade completa de sua infraestrutura (hardware, software, licenças e dispositivos de rede) e podem gerenciar incidentes, solicitações de serviço e mudanças utilizando processos alinhados ao ITIL.
Todos os seus contratos e documentação, incluindo garantias e contratos de serviço, ficam bem organizados, evitando que se percam entre diferentes sistemas. Se você gerencia data centers, o GLPi permite até mesmo visualizar layouts, trajetórias de cabeamento e consumo de energia, para que você sempre saiba o que está acontecendo nos bastidores.
Principais recursos do GLPi
- Use os plug-ins GLPI Inventory, OCS Inventory ou FusionInventory para detectar e catalogar automaticamente novos ativos de TI
- Automatize tarefas repetitivas, atribuições de tickets, notificações e eventos recorrentes para reduzir o trabalho manual
- Crie uma base de conhecimento com perguntas frequentes, documentação e artigos vinculados aos tickets para atendimento autônomo e suporte técnico
- Conecte-se ao Azure/Entra, Centreon, Google, OAuth2 e webhooks para sincronizar dados, acionar fluxos de trabalho e aprimorar seu CMDB
Limitações do GLPi
- A compatibilidade dos plug-ins pode ser prejudicada entre versões, causando sobrecarga de manutenção
- Os recursos de relatórios, análises e exportação parecem limitados e precisam de melhorias
Preços do GLPi
- Preços personalizados
Avaliações e comentários sobre o GLPi
- G2: 4,6/5 (mais de 30 avaliações)
- Capterra: 4,5/5 (mais de 40 avaliações)
O que os usuários reais estão dizendo sobre o GLPi?
Veja o que um usuário disse:
Sistema de código aberto altamente personalizável para gerenciamento de ativos de TI e tickets de suporte, com uma grande comunidade de apoio. A interface do usuário é um pouco complicada para um iniciante. Nem sempre os plug-ins são compatíveis entre versões antigas e novas.
Sistema de código aberto altamente personalizável para gerenciamento de ativos de TI e tickets de suporte, com uma grande comunidade de apoio. A interface do usuário é um pouco complicada para um iniciante. Nem sempre os plug-ins são compatíveis entre versões antigas e novas.
4. Splunk On-Call (Ideal para encaminhar alertas de monitoramento diretamente aos engenheiros)
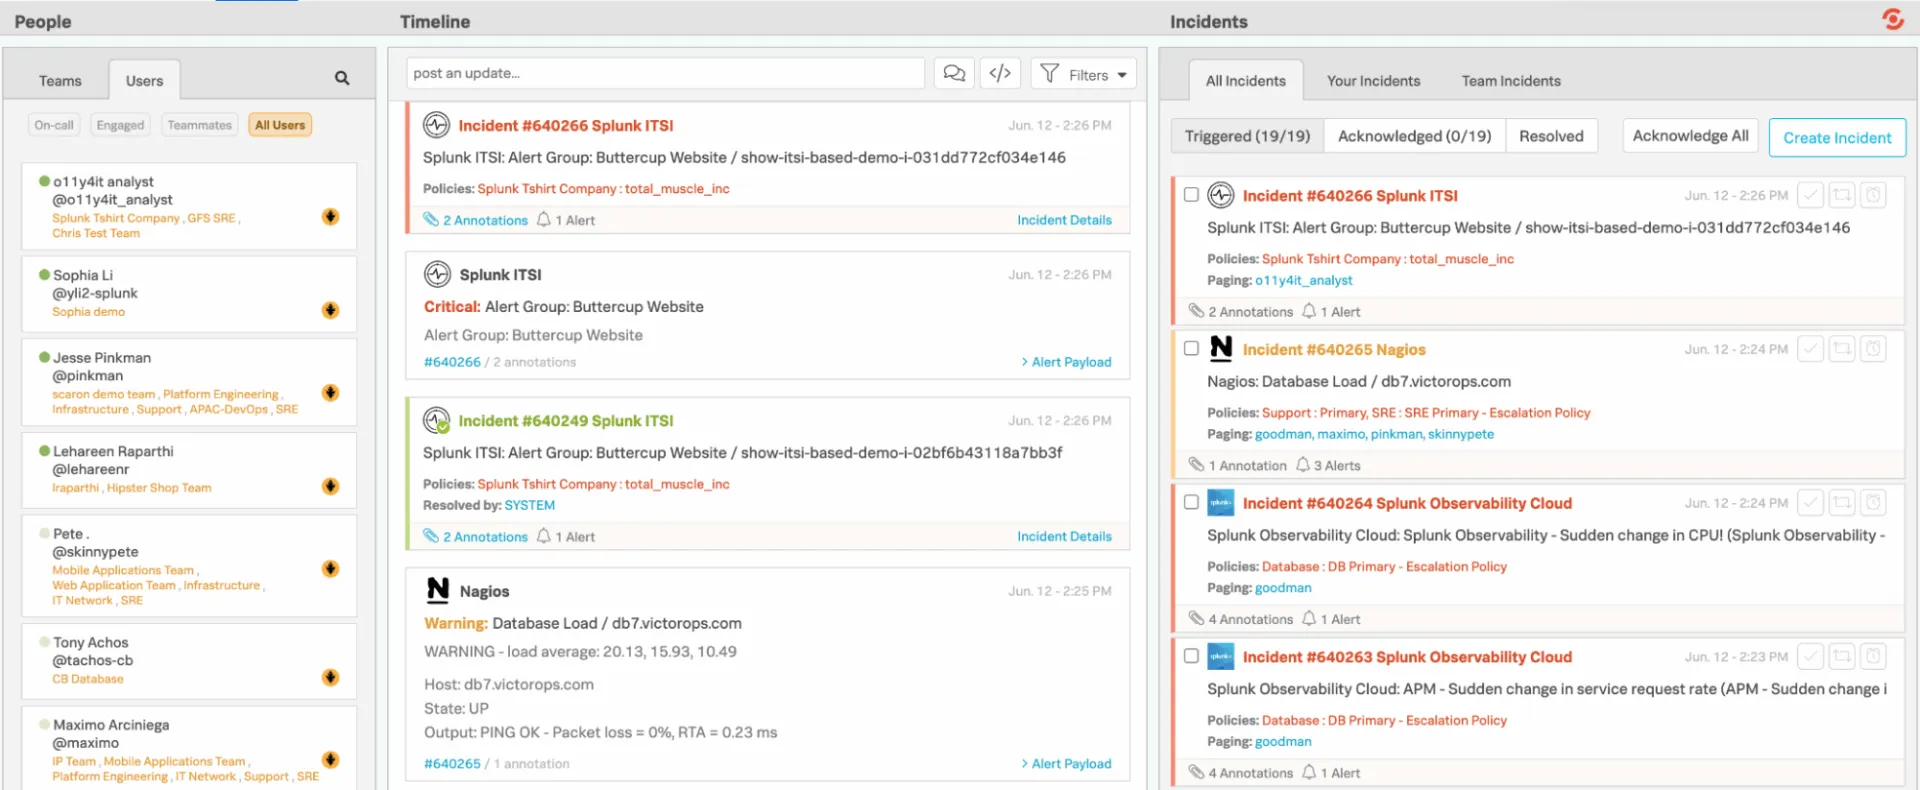
O Splunk On-Call oferece às equipes de engenharia e de plantão uma maneira mais rápida e organizada de gerenciar incidentes, eliminando a necessidade de fluxos de trabalho tradicionais e lentos de emissão de tickets. Em vez de enviar alertas para uma fila genérica, ele se integra diretamente à sua pilha de monitoramento e observabilidade, encaminhando imediatamente os problemas às pessoas certas com base em horários, regras e contexto.
As integrações com dispositivos móveis e chat facilitam o reconhecimento, o redirecionamento ou a resolução de incidentes de qualquer lugar. E, nos bastidores, o Splunk On-Call mantém um registro detalhado de tendências, padrões comprovados e comportamento de escalonamento.
Principais recursos do Splunk On-Call
- Expanda os recursos da plataforma usando mais de 1.000 integrações e complementos verificados da Splunk e da comunidade em geral
- Crie painéis personalizados e relatórios visuais para monitorar o volume de alertas, o status dos incidentes, o desempenho dos responsáveis pela resposta e a carga de trabalho da equipe
- Filtre rapidamente os incidentes de acordo com suas próprias atividades, os incidentes da equipe ou tudo o que está ocorrendo em toda a organização
- Alterne entre as visualizações “Acionado”, “Confirmado” e “Resolvido” para ver em que estágio cada incidente se encontra
Limitações do Splunk On-Call
- O agendamento de turnos entre várias equipes pode se tornar complicado se as regras não forem predefinidas
- Capacidade limitada de gerar relatórios detalhados de incidentes por data
Preços do Splunk On-Call
- Preços personalizados
Avaliações e comentários sobre o Splunk On-Call
- G2: 4,6/5 (mais de 40 avaliações)
- Capterra: 4,5/5 (mais de 30 avaliações)
O que os usuários reais estão dizendo sobre o Splunk On-Call?
Um usuário resumiu assim:
A capacidade de lidar com incidentes, escalações e assumir as tarefas dos meus colegas de equipe pelo aplicativo móvel é incrível. […] Gostaria de poder programar substituições e alterar a programação regular pelo aplicativo móvel para mudanças de horário de emergência.
A capacidade de lidar com incidentes, escalações e assumir as tarefas dos meus colegas de equipe pelo aplicativo móvel é incrível. […] Gostaria de poder programar substituições e alterar a programação regular pelo aplicativo móvel para mudanças de horário de emergência.
🔍 Você sabia? A lógica de “encaminhar para a pessoa certa caso o primeiro nível falhe” tem origem nas primeiras centrais telefônicas: quando os operadores manuais não conseguiam conectar uma chamada, o sistema a encaminhava (ou escalava) para outro operador ou central.
5. ServiceNow (Ideal para orquestrar operações em escala empresarial com automação assistida por IA)
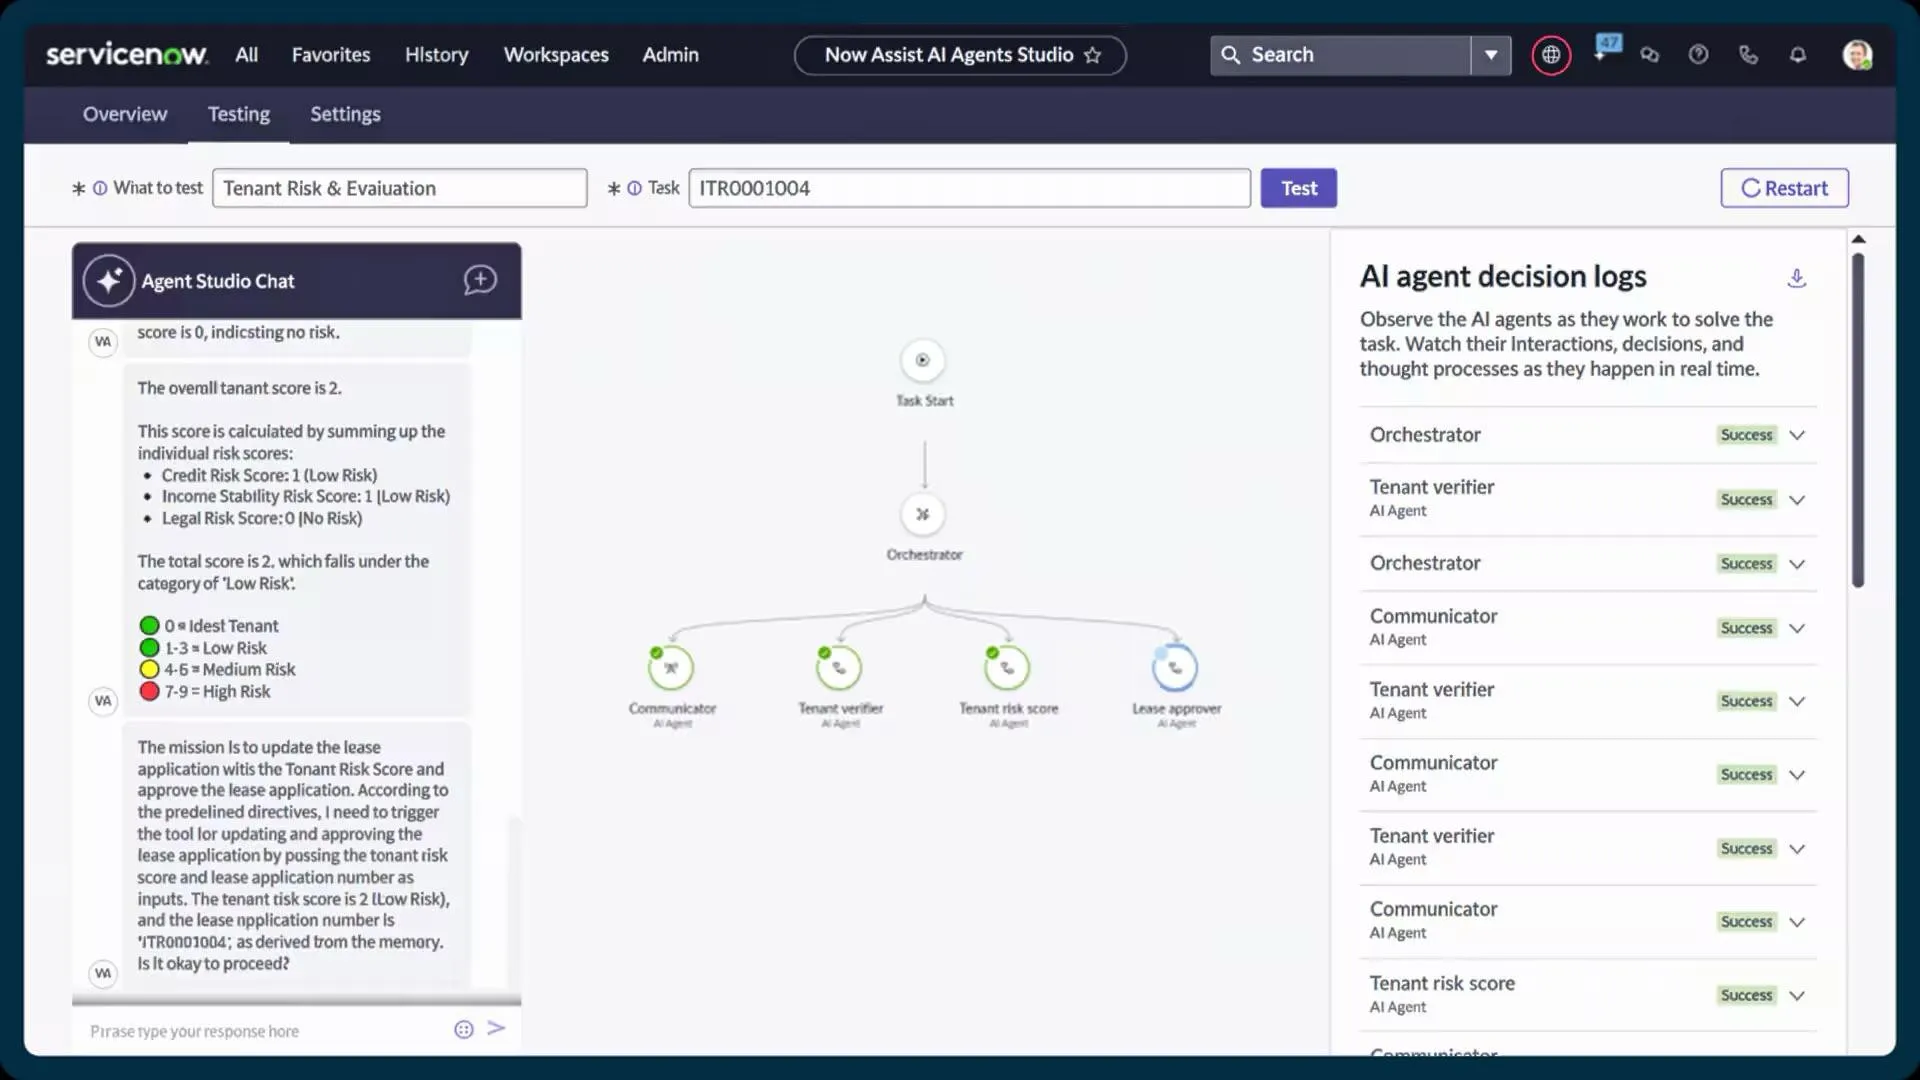
O ServiceNow classifica, prioriza e encaminha automaticamente os incidentes no momento em que são registrados. Com recursos como o Now Assist para recomendações automatizadas de tickets de incidente e geração inteligente de conteúdo, os responsáveis pela resposta podem resolver os problemas mais rapidamente e com mais contexto.
Ele integra o gerenciamento de incidentes, mudanças e ativos. Dessa forma, você obtém uma visão em tempo real de como os serviços estão conectados, onde surgem gargalos e quais componentes podem estar contribuindo para interrupções recorrentes.
Os melhores recursos do ServiceNow
- Atribua, encaminhe e monitore tarefas de campo por meio do Field Service Management e do Dispatcher Workspace
- Capacite funcionários e clientes com um portal de autoatendimento equipado com Pesquisa por IA e agentes virtuais
- Use fluxos de trabalho integrados e ferramentas de baixo código no App Engine para ampliar ou personalizar os processos de serviço
- Automatize tarefas e fluxos de trabalho repetitivos entre equipes com o Flow Designer e o Automation Engine
Limitações do ServiceNow
- As opções de personalização da interface do usuário e do portal parecem ultrapassadas ou restritivas
- Alta dependência de pessoal qualificado ou consultores para a implementação
Preços do ServiceNow
- Preços personalizados
Avaliações e comentários sobre o ServiceNow
- G2: 4,4/5 (mais de 3.300 avaliações)
- Capterra: 4,5/5 (mais de 300 avaliações)
O que os usuários reais estão dizendo sobre o ServiceNow?
Veja o que um usuário disse a respeito:
[…] Os fluxos pré-definidos são outro destaque para mim, pois simplificam os processos e economizam muito tempo, minimizando a necessidade de configurações personalizadas e permitindo um fluxo de trabalho mais suave e eficiente. […] Além disso, tive dificuldades para integrar minha solução personalizada ao sistema de Gestão de Atendimento ao Cliente, o que exigiu várias iterações.
[…] Os fluxos pré-definidos são outro destaque para mim, pois simplificam os processos e economizam muito tempo, minimizando a necessidade de configurações personalizadas e permitindo um fluxo de trabalho mais suave e eficiente. […] Além disso, tive dificuldades para integrar minha solução personalizada ao sistema de Gestão de Atendimento ao Cliente, o que exigiu várias iterações.
Melhores práticas e governança
Aqui estão algumas práticas recomendadas que garantem que a automação permaneça precisa, evite a sobrecarga de alertas e esteja alinhada às expectativas comerciais e regulatórias.
- Defina critérios de escalonamento inegociáveis: Vincule os gatilhos a sinais mensuráveis, como violações de SLO, picos de anomalias, impacto no nível de atendimento ao cliente ou questões regulatórias sensíveis
- Estabeleça clareza nas funções em cada nível: utilize um mapa RACI simples para cada nível de escalonamento, de modo que as responsabilidades nunca sejam ambíguas durante incidentes de alta pressão
- Implemente uma gestão dinâmica dos plantões: ajuste automaticamente os caminhos de escalonamento em função de fins de semana, feriados, limites de capacidade e transferências de plantão para reduzir o esgotamento e evitar chamadas silenciosas
- Insira etapas de verificação humana para cenários de alto risco: Mesmo com a automação, exija a confirmação manual para incidentes envolvendo exposição de dados de clientes, pagamentos ou fluxos de trabalho regulamentados
- Mantenha registros de auditoria completos: Mantenha registros imutáveis de quem foi notificado, quando confirmou o recebimento, quais etapas automatizadas foram acionadas e quais decisões foram tomadas
🧠 Curiosidade: A reclamação escrita mais antiga conhecida do mundo foi gravada em uma tabuinha de argila por volta de 1750 a.C. Tratava-se, basicamente, de uma das primeiras escalações de status de projeto. Um cliente chamado Nanni escreveu ao comerciante Ea-nāṣir, furioso porque o cobre que recebeu era de qualidade inferior à prometida e porque seu mensageiro havia sido maltratado.
Desafios comuns e como superá-los
Mesmo com uma política de escalonamento clara, as equipes frequentemente enfrentam obstáculos operacionais que retardam a resposta a incidentes ou geram confusão.
Esta tabela destaca desafios comuns que vão além das etapas básicas de configuração e oferece estratégias práticas para superá-los.
| Desafios ❌ | Soluções ✅ |
| Contexto inconsistente durante as transferências | Use o recurso de vinculação de tarefas e os modelos de relatório de incidentes do ClickUp para manter um registro completo de auditoria com detalhes dos incidentes, sistemas afetados e ações anteriores em cada nível de escalonamento |
| Sobrecarregar os responsáveis pelo atendimento com alertas de baixa prioridade | Implemente a priorização dinâmica com os Campos Personalizados do ClickUp e o AI Prioritize para filtrar incidentes com base na gravidade, no impacto e nos limites do SLA |
| Falta de visibilidade entre equipes | Configure espaços de trabalho compartilhados, adicione comentários e crie quadros brancos visuais no ClickUp para apresentar atualizações em tempo real às partes interessadas |
| Atrasos na tomada de decisões durante incidentes críticos | Automatize notificações usando as Ações Sugeridas do ClickUp Brain Max para alertar instantaneamente o pessoal certo com base no tipo de incidente, na gravidade e nos padrões históricos |
| Dificuldade em acompanhar problemas recorrentes | Aproveite os relatórios personalizados e os modelos de tarefas recorrentes do ClickUp para identificar padrões, causas-raiz e incidentes recorrentes, visando uma prevenção proativa |
| Conhecimento fragmentado durante a escalada | Mantenha SOPs, manuais operacionais e documentação de incidentes centralizados no ClickUp Docs, vinculando-os às tarefas relevantes para consulta imediata durante escalações em tempo real |
| Responsabilidades desalinhadas entre os turnos | Use as visualizações “Carga de Trabalho” e “Linha do Tempo” do ClickUp para visualizar as atribuições e garantir que não haja sobreposições ou lacunas durante as trocas de turno ou transferências de tarefas |
| Acompanhamento manual da conformidade e lacunas nas auditorias | Automatize resumos prontos para auditoria com o ClickUp Brain para registrar todas as ações, notificações e resoluções relacionadas a incidentes |
Avaliando o impacto da escalação automatizada
Para acompanhar a eficácia da escalação automatizada, é preciso se concentrar em métricas-chave relacionadas a volume, eficiência e qualidade. Esses indicadores revelam se seus processos de escalação estão mais rápidos, mais precisos e menos frustrantes tanto para as equipes quanto para os clientes.
Acompanhe estas métricas:
- Taxa de escalonamento (volume): Porcentagem de problemas escalonados para além do primeiro nível. Taxas elevadas podem indicar falhas na triagem inicial ou nas bases de conhecimento
- Taxa de escalonamento repetido (volume): frequência com que o mesmo problema é escalonado várias vezes. Indica resoluções incompletas ou perda de contexto
- Tempo até a escalada (eficiência): tempo decorrido entre a detecção e a escalada. Duras mais curtas nas etapas indicam um reconhecimento automatizado mais rápido de problemas críticos
- Tempo de atraso na transferência (eficiência): Intervalo entre a escalada e o momento em que a próxima equipe começa a trabalhar, para identificar atritos no encaminhamento ou na notificação
- Tempo de resolução para casos escalados (eficiência): Tempo total desde a escalação até a resolução. Uma resolução mais rápida demonstra a eficácia da automação
- Índice de satisfação do cliente (CSAT) (qualidade): Feedback sobre interações escaladas para avaliar a fluidez do fluxo
- Transmissão do contexto (qualidade): Se os atendentes recebem o histórico completo do incidente para garantir que os clientes não precisem repetir as informações
- Resolução no primeiro contato (FCR) (qualidade): Porcentagem de problemas resolvidos em uma única interação
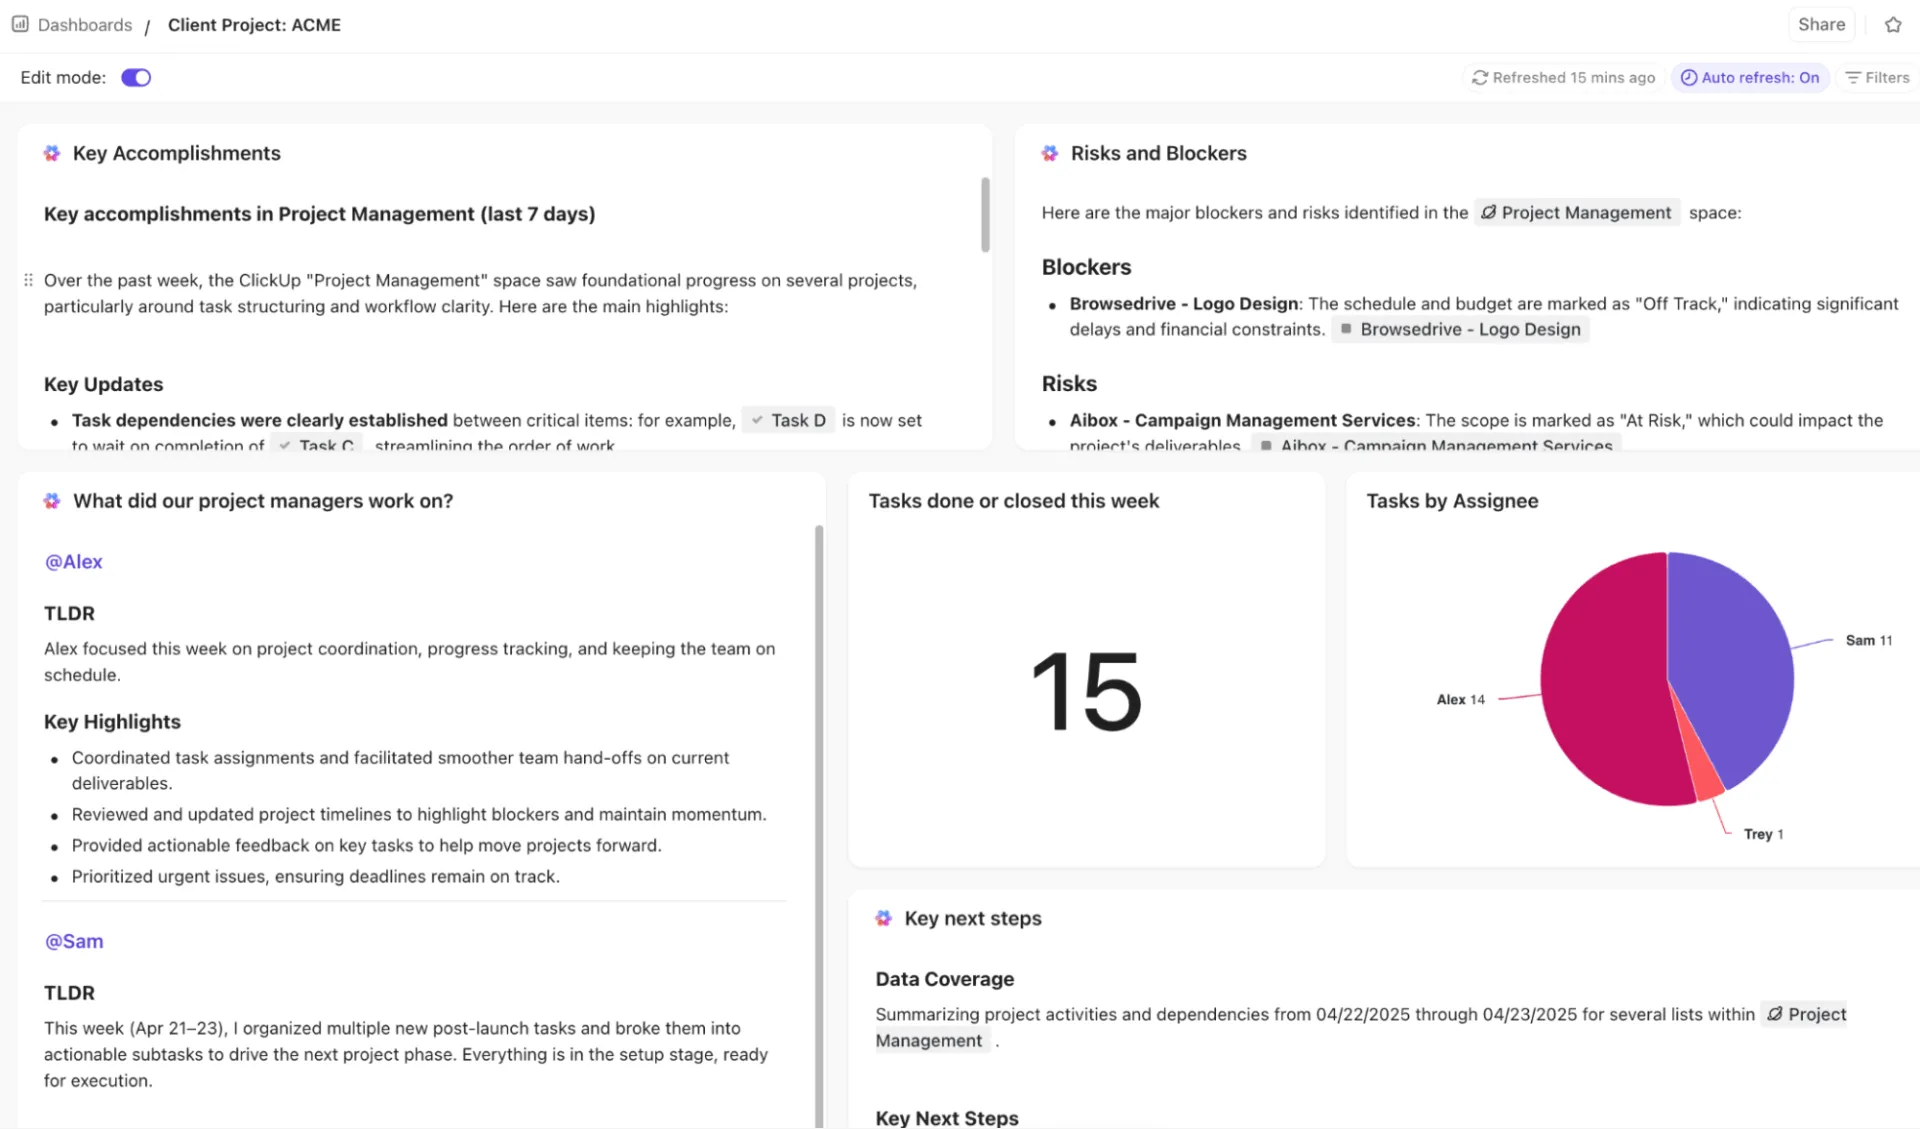
🚀 Vantagem do ClickUp: Obtenha insights em tempo real, visuais e baseados em IA sobre todas as métricas de escalonamento com os painéis do ClickUp.
Você pode acompanhar tendências de escalonamento, gargalos e desempenho com cartões de tabela, cartões de pizza, cartões de barra, cartões de linha, cartões de cálculo e cartões de relatório de tempo. Monitore a taxa de escalonamento, escalonamentos repetidos e o tempo até o escalonamento com cartões vinculados a tarefas, campos personalizados e status.
Para ir além, use cartões de IA como Resumo Executivo de IA, Atualização do Projeto de IA e Reunião Diária de IA para destacar tendências, atrasos e resultados das resoluções.
Gerencie seus incidentes mais rapidamente com o ClickUp
Muitos acham que a escalação de incidentes se resume a repassar um ticket para a próxima pessoa, mas é muito mais do que isso. Trata-se de um sistema estruturado em que cada etapa, desde a triagem até a resolução, funciona em harmonia.
O ClickUp oferece o espaço de trabalho unificado perfeito. Com as Automações do ClickUp, você pode acionar alertas, encaminhar tarefas e atualizar status automaticamente. E o ClickUp Brain ajuda a priorizar incidentes, gerar resumos e sugerir os próximos passos.
Os Agentes de IA do ClickUp atuam como assistentes inteligentes dentro do seu espaço de trabalho, enquanto os painéis do ClickUp oferecem uma visão em tempo real das suas escalações.
Cadastre-se gratuitamente no ClickUp hoje mesmo!
Perguntas frequentes (FAQ)
O que é um fluxo de escalonamento de incidentes?
Um fluxo de escalonamento de incidentes é uma sequência predefinida de etapas que determina como os problemas são encaminhados para a equipe ou pessoa certa, com base na gravidade, no impacto e no momento. Isso garante que os incidentes sejam tratados com eficiência e que a responsabilidade seja clara. TEXTO
Como decidir quando escalar um incidente automaticamente ou manualmente?
Utilize a automação para incidentes bem definidos e de alta prioridade, com critérios claros (por exemplo, interrupções de serviço, violações de segurança). Reserve a escalonamento manual para situações ambíguas ou críticas que exijam julgamento humano ou contexto adicional.
Quais ferramentas oferecem suporte à escalação automatizada para um gerenciamento eficaz de incidentes?
Plataformas como ClickUp, PagerDuty, Jira Service Management e ServiceNow permitem o encaminhamento, as notificações e as atualizações automatizadas. Elas ajudam as equipes a reduzir atrasos e a manter fluxos de trabalho estruturados para incidentes.
Como posso evitar a fadiga de alertas ao usar a escalação automatizada?
Defina limites claros para alertas, priorize por gravidade e utilize notificações inteligentes. Limite as notificações repetidas a incidentes críticos e aproveite painéis ou ferramentas de IA para resumir as atualizações, em vez de enviar cada pequena alteração.
Com que frequência devo revisar minhas políticas de escalonamento?
Revise regularmente as políticas de escalonamento, pelo menos trimestralmente ou após incidentes graves. Isso garante que os critérios, as responsabilidades e as regras de automação reflitam os fluxos de trabalho atuais, as estruturas das equipes e as prioridades da empresa.