Wprowadzasz najnowszą aktualizację oprogramowania i natychmiast zaczynają napływać raporty.
Nagle jeden wskaźnik zaczyna decydować o wszystkim – od wskaźników CSAT/NPS po opóźnienia w realizacji planu działania: czas usuwania błędów.
Kierownictwo postrzega to jako wskaźnik dotrzymywania obietnic — czy jesteśmy w stanie dostarczać produkty, uczyć się i chronić przychody zgodnie z harmonogramem? Praktycy odczuwają trudności na pierwszej linii frontu — zduplikowane zgłoszenia, niejasna własność, chaotyczne eskalacje oraz informacje rozproszone po Slacku, arkuszach kalkulacyjnych i oddzielnych narzędziach.
Ta fragmentacja wydłuża cykle, utrudnia zidentyfikowanie przyczyn źródłowych i sprawia, że ustalanie priorytetów staje się zgadywanką.
Wynik? Wolniejsze przyswajanie wiedzy, niedotrzymane zobowiązania i zaległości, które po cichu obciążają każdy sprint.
Ten przewodnik stanowi kompleksowy podręcznik dotyczący pomiaru, porównywania wyników i skracania czasu rozwiązywania błędów, a także konkretnie pokazuje, w jaki sposób AI zmienia cykl pracy w porównaniu z tradycyjnymi, ręcznymi procesami.
Czym jest czas usuwania błędów?
Czas naprawy błędu to czas potrzebny do usunięcia błędu, mierzony od momentu raportowania błędu do jego całkowitego usunięcia.
W praktyce odliczanie czasu rozpoczyna się w momencie zgłoszenia lub wykrycia problemu (przez użytkowników, dział kontroli jakości lub system monitorowania), a kończy się, gdy poprawka zostanie wdrożona i scalona, gotowa do weryfikacji lub wydania — w zależności od tego, jak Twój zespół definiuje pojęcie „zrobione”.
Przykład: awaria o priorytecie P1 zgłoszona w Monday o godz. 10:00, której poprawka została wdrożona we wtorek o godz. 15:00, miała czas rozwiązania wynoszący około 29 godzin.
Nie jest to to samo, co czas wykrywania błędów. Czas wykrywania mierzy, jak szybko rozpoznajesz usterkę po jej wystąpieniu (uruchomienie alarmów, wykrycie przez narzędzia do testowania jakości, raportowanie przez klientów).
Czas rozwiązania błędu mierzy, jak szybko przechodzisz od wykrycia do naprawy — klasyfikacji, odtworzenia, diagnozy, wdrożenia, przeglądu, testowania i przygotowania do wydania. Pomyśl o wykryciu jako o „wiemy, że coś nie działa”, a o rozwiązaniu jako o „zostało naprawione i jest gotowe”.
Teams stosują nieco różne kryteria; wybierz jedno i stosuj je konsekwentnie, aby Twoje trendy odzwierciedlały rzeczywistą sytuację:
- Zgłoszone → Rozwiązane: Proces kończy się, gdy poprawka kodu zostanie wkompilowana i będzie gotowa do kontroli jakości. Przydatne do pomiaru wydajności inżynierów
- Zgłoszone → Zamknięte: Obejmuje weryfikację przez dział kontroli jakości (QA) i wydanie. Najlepsze rozwiązanie w przypadku umów SLA mających wpływ na klientów
- Wykryto → Rozwiązano: Proces rozpoczyna się w momencie wykrycia problemu przez system monitorowania lub dział kontroli jakości, jeszcze przed utworzeniem zgłoszenia. Przydatne dla zespołów intensywnie korzystających ze środowiska produkcyjnego
🧠 Ciekawostka: Dziwaczny, ale przezabawny błąd w grze Final Fantasy XIV zyskał uznanie za to, że był tak specyficzny, że czytelnicy nazwali go „Najbardziej specyficzną poprawką błędu w grze MMO 2025”. ”. Pojawiał się on, gdy gracze wyceniali elementy na kwotę dokładnie między 44 442 gil a 49 087 gil w określonej strefie wydarzenia — powodując rozłączenia z powodu błędu, który mógł wynikać z przepełnienia liczby całkowitej.
Dlaczego to ma znaczenie
Czas rozwiązania jest czynnikiem wpływającym na częstotliwość wydawania nowych wersji. Długie lub nieprzewidywalne czasy wymuszają ograniczenia zakresu, wprowadzanie poprawek i wstrzymywanie wydawania nowych wersji; powodują one powstanie długu planistycznego, ponieważ długi ogon (wartości odstające) zakłóca przebieg sprintów w większym stopniu, niż sugeruje to średnia.
Ma to również bezpośredni wpływ na zadowolenie klientów. Klienci są w stanie zaakceptować problemy, o ile są one szybko rozpoznane i rozwiązywane w przewidywalny sposób. Powolne naprawy — lub, co gorsza, naprawy o zmiennej jakości — prowadzą do eskalacji problemów, obniżają wskaźniki CSAT/NPS i zagrażają przedłużeniu umów.
Krótko mówiąc, jeśli będziesz precyzyjnie mierzyć czas usuwania błędów i systematycznie go skracać, poprawi się realizacja Twoich planów oraz powiązania z klientami.
Jak mierzyć czas usuwania błędów?
Najpierw określ, kiedy zaczyna i kończy się pomiar czasu.
Większość zespołów wybiera opcję „Zgłoszone → Rozwiązane” (poprawka została wtopiona i jest gotowa do weryfikacji) lub „Zgłoszone → Zamknięte” (dział kontroli jakości zweryfikował zmianę, a ta została wprowadzona lub w inny sposób zamknięta).
Wybierz jedną definicję i stosuj ją konsekwentnie, aby Twoje trendy miały sens.
Teraz potrzebujesz kilku mierzalnych wskaźników. Przyjrzyjmy się im:
Kluczowe wskaźniki śledzenia błędów, na które należy zwrócić uwagę:
| 📊 Wskaźnik | 📌 Co to oznacza | 💡 Jak to pomaga | 🧮 Formuła (jeśli dotyczy) |
|---|---|---|---|
| Liczba błędów 🐞 | Łączna liczba zgłoszonych błędów w procesie raportowania | Zapewnia ogólny widok na stan systemu. Wysoka liczba? Czas to zbadać. | Łączna liczba błędów = wszystkie błędy zarejestrowane w systemie {otwarte + zamknięte} |
| Otwarte zgłoszenia 🚧 | Błędy, które nie zostały jeszcze naprawione | Pokazuje aktualne obciążenie pracą. Pomaga w ustalaniu priorytetów. | Liczba otwartych zgłoszeń = Łączna liczba zgłoszeń – Liczba zamkniętych zgłoszeń |
| Zamknięte błędy ✅ | Błędy, które zostały usunięte i zweryfikowane | Śledzi postępy i zrobioną pracę. | Zamknięte błędy = liczba błędów o statusie „Zamknięte” lub „Rozwiązane” |
| Waga błędu 🔥 | Stopień krytyczności błędu (np. krytyczny, poważny, drobny) | Pomaga w klasyfikacji zgłoszeń na podstawie ich wpływu. | Śledzone jako pole kategoryczne, bez formuły. Użyj filtrów/grupowania. |
| Priorytet błędów 📅 | Jak pilne jest usunięcie błędu | Pomaga w planowaniu sprintów i wydań. | Jest to również pole kategoryczne, zazwyczaj z podziałem na poziomy priorytetu (np. P0, P1, P2). |
| Czas rozwiązania ⏱️ | Czas od zgłoszenia błędu do jego usunięcia | Mierzy szybkość reakcji. | Czas rozwiązania = data zamknięta – data zgłoszenia |
| Wskaźnik ponownego otwarcia 🔄 | Odsetek błędów ponownie otwartych po zamknięciu | Odzwierciedla jakość poprawek lub problemy związane z regresją. | Wskaźnik ponownego otwarcia (%) = {Ponownie otwarte błędy ÷ Łączna liczba zamkniętych błędów} × 100 |
| Ucieczka błędów 🕳️ | Błędy, które przedostały się do środowiska produkcyjnego | Wskazuje na skuteczność kontroli jakości i testowania oprogramowania. | Wskaźnik wycieków (%) = {Błędy w środowisku produkcyjnym ÷ Łączna liczba błędów} × 100 |
| Gęstość defektów 🧮 | Liczba błędów na jednostkę wielkości kodu | Wskazuje obszary kodu podatne na ryzyko. | Gęstość defektów = liczba błędów ÷ KLOC {kilokilometrów kodu} |
| Błędy przypisane a nieprzypisane 👥 | Dystrybucja błędów według własności | Gwarantuje, że nic nie zostanie pominięte. | Użyj filtru: Nieprzypisane = Błędy, w których pole „Przypisane do” ma wartość null |
| Wiek otwartych błędów 🧓 | Jak długo błąd pozostaje nierozwiązany | Wykrywa ryzyko stagnacji i zaległości. | Wiek błędu = data bieżąca – data zgłoszenia |
| Powtarzające się błędy 🧬 | Liczba zduplikowanych zgłoszeń | Wskazuje błędy w procesach przyjmowania zgłoszeń. | Wskaźnik duplikatów = liczba duplikatów ÷ łączna liczba błędów × 100 |
| MTTD (średni czas wykrycia) 🔎 | Średni czas potrzebny do wykrycia błędów lub incydentów | Mierzy efektywność monitorowania i świadomości. | MTTD = Σ(czas wykrycia – czas pojawienia się) ÷ liczba błędów |
| MTTR (średni czas rozwiązania problemu) 🔧 | Średni czas potrzebny do całkowitego usunięcia błędu po jego wykryciu | Śledzi szybkość reakcji inżynierów oraz czas naprawy. | MTTR = Σ(czas usunięcia – czas wykrycia) ÷ liczba usuniętych błędów |
| MTTA (średni czas potwierdzenia zgłoszenia) 📬 | Czas od wykrycia błędu do momentu, gdy ktoś rozpocznie pracę nad jego usunięciem | Pokazuje szybkość reakcji zespołu i skuteczność reagowania na alerty. | MTTA = Σ(czas potwierdzenia – czas wykrycia) ÷ liczba błędów |
| MTBF (średni czas między awariami) 🔁 | Czas między rozwiązaniem jednej awarii a wystąpieniem kolejnej | Wskazuje na stabilność w czasie. | MTBF = całkowity czas sprawności ÷ liczba awarii |
⚡️ Archiwum szablonów: 15 darmowych szablonów i formularzy zgłoszeń błędów do śledzenia błędów
Czynniki wpływające na czas usuwania błędów
Czas rozwiązywania problemów często utożsamia się z „tym, jak szybko inżynierowie piszą kod”.
To jednak tylko jedna z części tego procesu.
Czas rozwiązywania błędów to suma jakości przy zgłoszeniu, wydajności przepływu przez system oraz ryzyka związanego z zależnościami. Gdy którykolwiek z tych elementów zawodzi, czas cyklu się wydłuża, przewidywalność spada, a liczba eskalacji rośnie.
Jakość przyjmowania zgłoszeń ustawia ton
Zgłoszenia, które napływają bez jasnych kroków odtworzenia problemu, szczegółów dotyczących środowiska, logów lub informacji o wersji/kompilacji, powodują niepotrzebną wymianę wiadomości. Zduplikowane zgłoszenia z wielu kanałów (wsparcie techniczne, kontrola jakości, monitorowanie, Slack) powodują nadmiar informacji i rozmywają własność sprawy.
Im wcześniej zgromadzisz odpowiednie informacje kontekstowe — i wyeliminujesz powtórzenia — tym mniej będzie później potrzebnych przekazywania spraw i pytań wyjaśniających.
Priorytetyzacja i kierowanie zgłoszeń decydują o tym, kto zajmuje się danym błędem i kiedy
Etykiety ważności, które nie odzwierciedlają wpływu na klienta lub działalność (lub które z czasem ulegają zmianie), powodują chaos w kolejce zgłoszeń: zgłoszenia o największym natężeniu przeskakują do przodu, podczas gdy usterki o dużym wpływie pozostają bez uwagi.
Przejrzyste reguły przydzielania zadań według komponentu/właściciela oraz jedna, wiarygodna kolejka sprawiają, że zadania o priorytecie P0/P1 nie giną w natłoku „najnowszych i mniej istotnych spraw”.
Własność i przekazywanie zadań to ciche zabójcy
Jeśli nie jest jasne, czy błąd należy do zespołu ds. urządzeń mobilnych, autoryzacji backendowej czy platformy, zostaje on odesłany. Każde odesłanie resetuje kontekst.
Sytuację pogarszają strefy czasowe: błąd zgłoszony późnym popołudniem bez wyznaczonego właściciela może stracić 12–24 godziny, zanim ktokolwiek w ogóle rozpocznie odtwarzanie błędu. Precyzyjne określenie „kto jest odpowiedzialny za co”, wraz z dyżurem lub cotygodniowym wyznaczonym osobą odpowiedzialną (DRI), eliminuje to opóźnienie.
Odtwarzalność zależy od obserwowalności
Niedostateczne logi, brak ID-ów korelacji lub brak śladów awarii sprawiają, że diagnozowanie staje się zgadywanką. Błędy, które pojawiają się wyłącznie przy określonych flagach, dzierżawcach lub formatach danych, są trudne do odtworzenia w środowisku deweloperskim.
Jeśli inżynierowie nie mają bezpiecznego dostępu do oczyszczonych danych przypominających te z środowiska produkcyjnego, muszą przeprowadzać pomiary, ponownie wdrażać rozwiązania i czekać — dni zamiast godzin.
Spójność środowiska i danych zapewnia rzetelność
Stwierdzenie „na moim komputerze działa” zazwyczaj oznacza, że „dane produkcyjne są inne”. Im bardziej środowisko deweloperskie/testowe różni się od produkcyjnego (konfiguracja, usługi, wersje oprogramowania innych firm), tym więcej czasu spędzisz na poszukiwaniu nieistniejących problemów. Bezpieczne migawki danych, skrypty inicjalizacyjne i kontrole zgodności zmniejszają tę rozbieżność.
Praca w toku (WIP) i skupienie decydują o rzeczywistej przepustowości
Przeciążone zespoły zajmują się zbyt wieloma błędami naraz, rozpraszają swoją uwagę i miotają się między zadaniami a spotkaniami. Zmiana kontekstu powoduje straty czasu, których nie da się zmierzyć.
Widoczny limit prac WIP oraz dążenie do zakończenia rozpoczętych zadań przed podjęciem nowych sprawi, że mediana czasu rozwiązania spadnie szybciej niż w przypadku jakiegokolwiek pojedynczego heroicznego wysiłku.
Przegląd kodu, ciągła integracja (CI) oraz tempo kontroli jakości (QA) to klasyczne wąskie gardła
Długie czasy kompilacji, zawodne testy i niejasne umowy SLA dotyczące przeglądów opóźniają naprawy, które w innym przypadku byłyby szybkie. 10-minutowa poprawka może spędzić dwa dni na oczekiwaniu na recenzenta lub na wpasowaniu się w trwający wiele godzin proces.
Podobnie kolejki kontroli jakości, w których testy są przeprowadzane partiami lub opierają się na ręcznych testach wstępnych, mogą wydłużyć czas przejścia od etapu „Zgłoszone → Zamknięte” o całe dni, nawet jeśli przejście od etapu „Zgłoszone → Rozwiązane” przebiega szybko.
Zależności powodują wydłużanie się kolejek
Zmiany obejmujące różne zespoły (schematy, migracje platform, aktualizacje SDK), błędy dostawców lub procesy weryfikacji w sklepach z aplikacjami (urządzenia mobilne) powodują powstawanie stanów oczekiwania. Bez wyraźnego śledzenia statusów „Zablokowane/Wstrzymane” te okresy oczekiwania w niewidoczny sposób zawyżają średnie i ukrywają, gdzie faktycznie znajduje się prawdziwe wąskie gardło.
Znaczenie modelu wydawania aktualizacji i strategii przywracania poprzedniej wersji
Jeśli wdrażasz aktualizacje w dużych seriach z ręcznymi punktami kontrolnymi, nawet usunięte błędy pozostają nierozwiązane do momentu rozpoczęcia kolejnej serii. Flagi funkcji, wersje testowe typu „canary” oraz ścieżki poprawek skracają czas oczekiwania — zwłaszcza w przypadku incydentów o priorytecie P0/P1 — umożliwiając oddzielenie wdrażania poprawek od pełnych cykli wydawniczych.
Architektura i dług techniczny ograniczają Twoje możliwości
Ścisłe powiązania, brak punktów testowych oraz nieprzejrzyste moduły z starszą wersją sprawiają, że proste poprawki stają się ryzykowne. Teams rekompensują to dodatkowymi testami i dłuższymi przeglądami, co wydłuża cykle. Z drugiej strony, modułowy kod z dobrymi testami kontraktowymi pozwala działać szybko bez zakłócania pracy sąsiednich systemów.
Komunikacja i porządek w zarządzaniu statusami wpływają na przewidywalność
Niejasne aktualizacje („sprawdzamy to”) powodują konieczność ponownej pracy, gdy interesariusze pytają o przewidywany czas zakończenia, dział wsparcia ponownie otwiera zgłoszenia lub kierownictwo produktu eskaluje sprawę. Jasne zmiany statusu, notatki dotyczące odtworzenia błędu i przyczyny źródłowej oraz podany przewidywany czas zakończenia zmniejszają rotację i pozwalają zespołowi inżynierów skupić się na pracy.
📮ClickUp Insight: Przeciętny pracownik spędza ponad 30 minut dziennie na poszukiwaniu informacji związanych z pracą — to ponad 120 godzin rocznie straconych na przeglądanie e-maili, wątków na Slacku i rozproszonych plików.
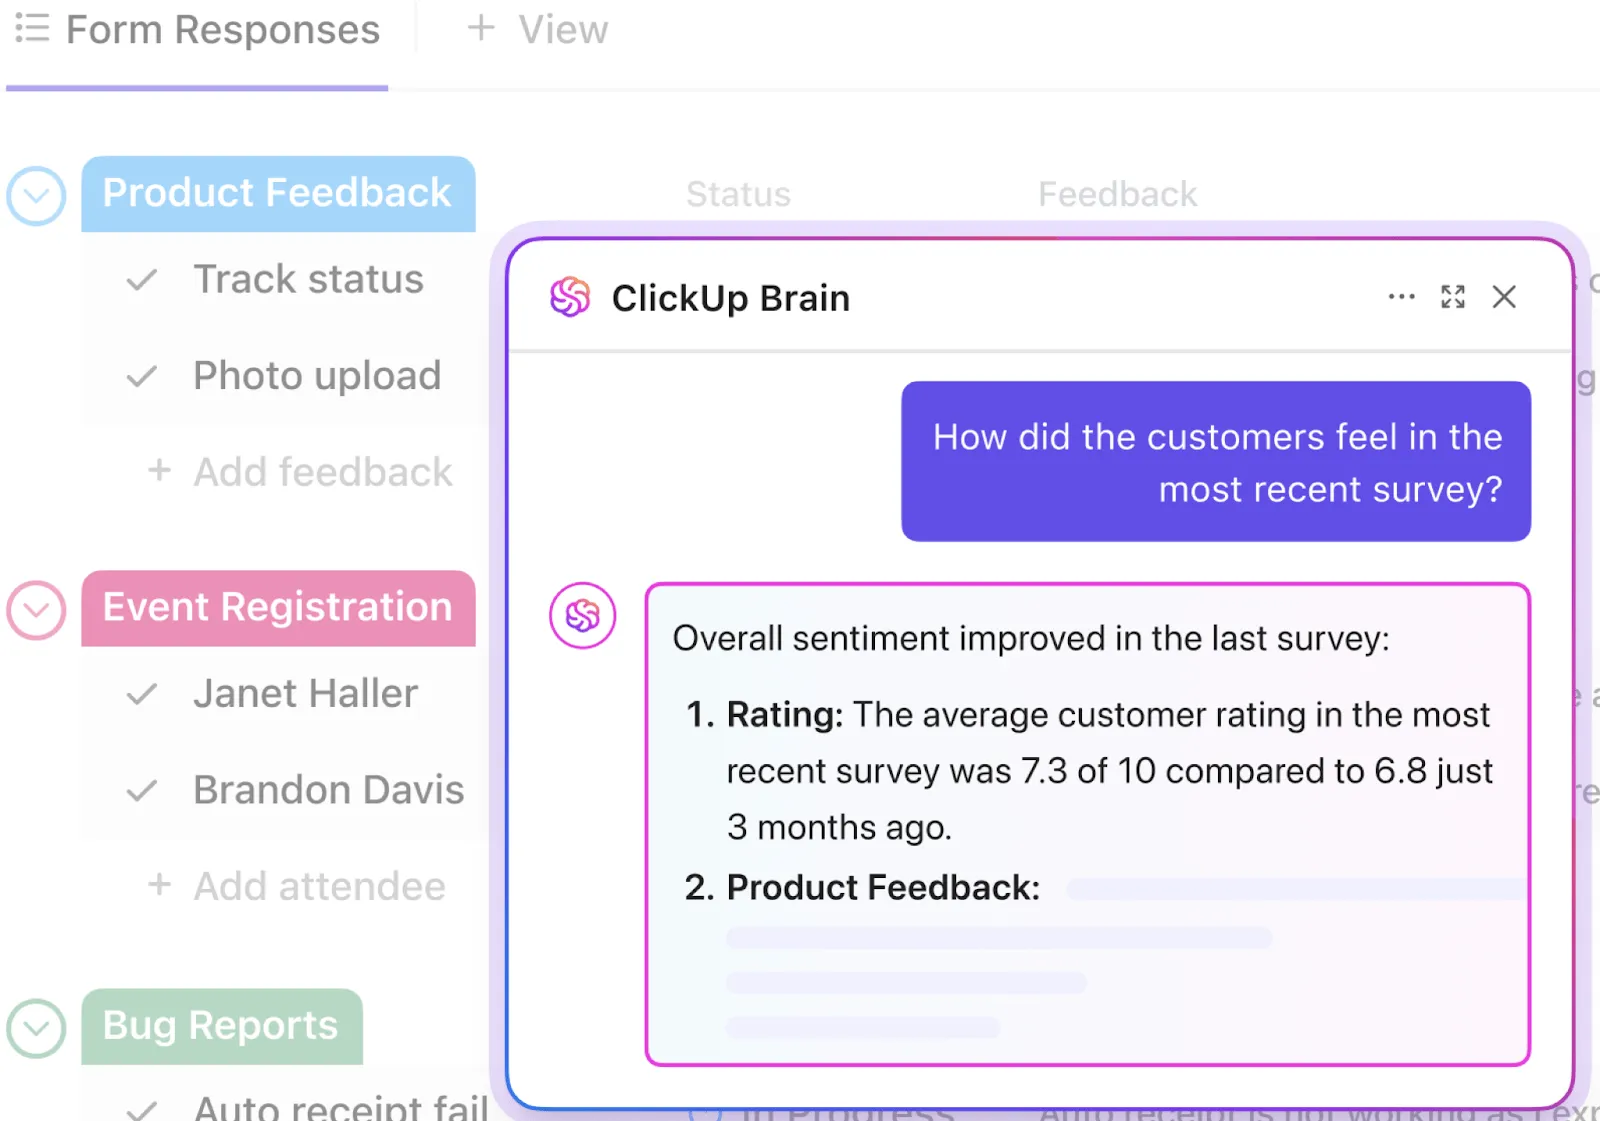
Inteligentny asystent oparty na AI, wbudowany w Twój obszar roboczy, może to zmienić. Poznaj ClickUp Brain. Dostarcza on natychmiastowe spostrzeżenia i odpowiedzi, wyświetlając w ciągu kilku sekund odpowiednie dokumenty, rozmowy i szczegóły zadań — dzięki czemu możesz przestać szukać i zacząć pracować.
💫 Prawdziwe wyniki: Teams takie jak QubicaAMF odzyskały ponad 5 godzin tygodniowo dzięki ClickUp — to ponad 250 godzin rocznie na osobę — eliminując przestarzałe procesy zarządzania wiedzą. Wyobraź sobie, co Twój zespół mógłby osiągnąć, mając dodatkowy tydzień wydajności w każdym kwartale!
Wskazówki zapowiadające wydłużenie czasu realizacji
❗️Wzrastający czas „Time to Acknowledge” oraz duża liczba zgłoszeń bez właściciela przez ponad 12 godzin
❗️Rosnące przedziały czasu „Time in Review/CI” oraz częste nieprawidłowości w testach
❗️Wysoki odsetek duplikatów podczas rejestracji zgłoszeń oraz niespójne etykiety poziomu ważności w poszczególnych zespołach
❗️Kilka błędów pozostaje w statusie „Zablokowane” bez wskazania konkretnej zależności zewnętrznej
❗️Wskaźnik ponownego zgłaszania problemów powoli rośnie (poprawki nie są powtarzalne lub definicje „zrobione” są niejasne)
Różne organizacje postrzegają te czynniki w różny sposób. Kadra kierownicza odbiera je jako utracone cykle szkoleniowe i opóźnienia w osiąganiu przychodów; pracownicy operacyjni postrzegają je jako nadmierny hałas związany z klasyfikacją zgłoszeń oraz niejasną własność.
Optymalizacja przyjmowania zgłoszeń, przepływu i zależności pozwala obniżyć całą krzywą – zarówno medianę, jak i P90.
Chcesz dowiedzieć się więcej o tym, jak pisać lepsze zgłoszenia błędów? Zacznij tutaj. 👇🏼
📖 Czytaj więcej: Cykl życia testowania oprogramowania (STLC): przegląd i etapy
Branżowe wskaźniki porównawcze dotyczące czasu usuwania błędów
Wyniki porównawcze dotyczące rozwiązywania błędów zmieniają się w zależności od tolerancji ryzyka, modelu wydawania aktualizacji oraz tego, jak szybko można wprowadzać zmiany.
W tym miejscu możesz wykorzystać mediany (P50) do zrozumienia typowego przepływu procesu oraz P90 do ustawienia obietnic i umów SLA — w podziale na poziom ważności i źródło (klient, kontrola jakości, monitorowanie).
Przyjrzyjmy się, co to oznacza:
| 🔑 Termin | 📝 Opis | 💡 Dlaczego to ma znaczenie |
|---|---|---|
| P50 (mediana) | Wartość średnia — 50% napraw błędów odbywa się szybciej niż ten czas, a 50% — wolniej | 👉 Odzwierciedla typowy lub najczęściej występujący czas rozwiązywania problemów. Pomaga zrozumieć normalną wydajność |
| P90 (90. percentyl) | 90% błędów jest usuwanych w tym czasie. Tylko 10% zajmuje więcej czasu | 👉 Odzwierciedla najgorszy (ale wciąż realistyczny) scenariusz. Przydatne do ustawienia zewnętrznych terminów realizacji |
| Umowy o gwarantowanym poziomie usług (SLA) | Zobowiązania, które podejmujesz — wewnętrznie lub wobec klientów — dotyczące szybkości rozwiązywania problemów | 👉 Przykład: „W 90% przypadków usuwamy błędy o priorytecie P1 w ciągu 48 godzin”. Pomaga to budować zaufanie i poczucie odpowiedzialności. |
| Według poziomu ważności i źródła | Segmentuj wskaźniki według dwóch kluczowych wymiarów: • Waga (np. P0, P1, P2) • Źródło (np. klient, kontrola jakości, monitorowanie) | 👉 Umożliwia dokładniejsze śledzenie i ustalanie priorytetów, dzięki czemu krytyczne błędy są szybciej rozpatrywane |
Poniżej przedstawiono orientacyjne zakresy oparte na branżach, na których często stawiają cel dojrzałe zespoły; potraktuj je jako punkty wyjścia, a następnie dostosuj do swojego kontekstu.
SaaS
System działa w trybie ciągłym i jest dostosowany do CI/CD, więc poprawki są częstym zjawiskiem. W przypadku problemów krytycznych (P0/P1) często dąży się do mediany poniżej jednego dnia roboczego, a P90 mieści się w przedziale 24–48 godzin. Problemy niekrytyczne (P2+) zazwyczaj mają medianę wynoszącą 3–7 dni, a P90 mieści się w przedziale 10–14 dni. Zespoły dysponujące solidnymi flagami funkcji i zautomatyzowanymi testami osiągają zazwyczaj szybsze wyniki.
Platformy e-commerce
Ponieważ przepływy konwersji i koszyka mają kluczowe znaczenie dla przychodów, poprzeczka jest ustawiona wyżej. Problemy o priorytecie P0/P1 są zazwyczaj łagodzone w ciągu kilku godzin (przez wycofanie zmian, oznaczenie lub konfigurację) i całkowicie rozwiązywane tego samego dnia; w szczytowych okresach P90 jest zwykle rozwiązywane do końca dnia lub w ciągu mniej niż 12 godzin. Problemy o priorytecie P2+ często rozwiązuje się w ciągu 2–5 dni, a P90 w ciągu 10 dni.
Oprogramowanie dla Enterprise
Bardziej rygorystyczna walidacja i okna zmian dla klientów spowalniają tempo pracy. W przypadku błędów P0/P1 zespoły mają za cel wprowadzenie rozwiązania tymczasowego w ciągu 4–24 godzin, a poprawki w ciągu 1–3 dni roboczych; dla P90 — w ciągu 5 dni roboczych. Elementy P2+ są często grupowane w cykle wydawnicze, a mediana czasu ich rozwiązania wynosi 2–4 tygodnie w zależności od harmonogramów wdrażania u klientów.
Gry i aplikacje mobilne
Backendy usług działających na żywo zachowują się jak SaaS (wprowadzanie zmian i przywracanie poprzednich wersji trwa od kilku minut do kilku godzin; P90 — tego samego dnia). Aktualizacje po stronie klienta są ograniczone przez proces weryfikacji sklepu: w przypadku P0/P1 często natychmiast stosuje się środki po stronie serwera, a poprawkę dla klienta udostępnia się w ciągu 1–3 dni; P90 — w ciągu tygodnia po przyspieszonej weryfikacji. Poprawki P2+ są zazwyczaj planowane na następny sprint lub aktualizację zawartości.
Bankowość/Fintech
Kontrole ryzyka i zgodności wymuszają model działania oparty na zasadzie „szybkiego ograniczania ryzyka, ostrożnego wprowadzania zmian”. Błędy o priorytecie P0/P1 są szybko ograniczane (flagi, cofanie zmian, przekierowanie ruchu w ciągu kilku minut do kilku godzin) i całkowicie naprawiane w ciągu 1–3 dni; błędy o priorytecie P90 — w ciągu tygodnia, z uwzględnieniem kontroli zmian. Błędy o priorytecie P2+ często wymagają 2–6 tygodni na przejście przeglądów bezpieczeństwa, audytów i zatwierdzeń przez komitet CAB.
Jeśli Twoje wyniki wykraczają poza te zakresy, zanim uznasz, że głównym problemem jest „tempo prac inżynieryjnych”, przyjrzyj się jakości przyjmowanych zgłoszeń, własności spraw, wydajności przeglądu kodu i kontroli jakości oraz zatwierdzaniu zależności.
🌼 Czy wiesz, że: Według ankiety przeprowadzonej przez Stack Overflow w 2024 r. programiści coraz częściej korzystali z AI jako niezawodnego pomocnika podczas pracy nad kodem. Aż 82% z nich wykorzystywało AI do faktycznego pisania kodu — to dopiero kreatywny współpracownik! Gdy napotykali trudności lub szukali rozwiązań, 67,5% polegało na AI w poszukiwaniu odpowiedzi, a ponad połowa (56,7%) korzystała z niej do debugowania i uzyskiwania pomocy.
Dla niektórych narzędzia AI okazały się również przydatne do dokumentowania projektów (40,1%), a nawet do generowania danych syntetycznych lub zawartości (34,8%). Ciekawi Cię nowy kod źródłowy? Prawie jedna trzecia (30,9%) korzysta ze sztucznej inteligencji, aby szybko się w nim zorientować. Testowanie kodu nadal jest dla wielu żmudnym, ręcznym zajęciem, ale 27,2% wykorzystuje sztuczną inteligencję również w tym obszarze. W innych obszarach, takich jak przegląd kodu, planowanie projektów i analityka predykcyjna, wdrażanie AI jest mniejsze, ale jasne jest, że AI stopniowo wplata się w każdy etap tworzenia oprogramowania.
📖 Czytaj więcej: Jak wykorzystać AI w zapewnianiu jakości
Jak skrócić czas usuwania błędów
Szybkość usuwania błędów sprowadza się do eliminowania przeszkód na każdym etapie procesu — od zgłoszenia do wydania.
Największe korzyści płyną z bardziej efektywnego wykorzystania pierwszych 30 minut (precyzyjne zgłoszenie, właściwy właściciel, właściwy priorytet), a następnie skrócenia kolejnych etapów (odtworzenie, przegląd, weryfikacja).
Oto dziewięć strategii, które współdziałają jako spójny system. AI przyspiesza każdy krok, a cykl pracy jest przejrzyście zorganizowany w jednym miejscu, dzięki czemu kadra kierownicza zyskuje przewidywalność, a specjaliści – przepływ działania.
1. Scentralizuj proces przyjmowania zgłoszeń i rejestruj kontekst u źródła
Czas rozwiązywania błędów wydłuża się, gdy musisz odtwarzać kontekst na podstawie wątków ze Slacka, zgłoszeń do wsparcia technicznego i arkuszy kalkulacyjnych. Skieruj wszystkie zgłoszenia — z działu wsparcia technicznego, kontroli jakości i monitoringu — do jednej kolejki za pomocą ustrukturyzowanego szablonu, który gromadzi informacje o komponencie, poziomie ważności, środowisku, wersji/kompilacji aplikacji, krokach pozwalających odtworzyć błąd, porównaniu oczekiwanych z rzeczywistymi wynikami oraz załącznikach (logi/HAR/zrzuty ekranu).
Sztuczna inteligencja może automatycznie podsumowywać długie raporty, wyodrębniać kroki pozwalające odtworzyć błąd oraz szczegóły środowiska z załączników, a także oznaczać potencjalne duplikaty, dzięki czemu klasyfikacja rozpoczyna się od spójnego, wzbogaconego zapisu.
Wskaźniki, na które warto zwrócić uwagę: MTTA (potwierdzenie w ciągu minut, a nie godzin), wskaźnik duplikatów, czas oczekiwania na „informacje dodatkowe”.
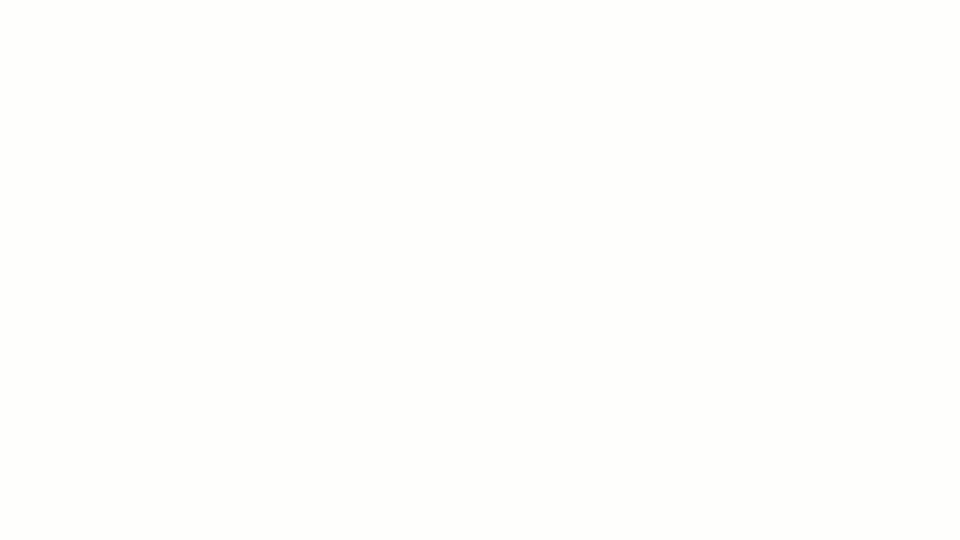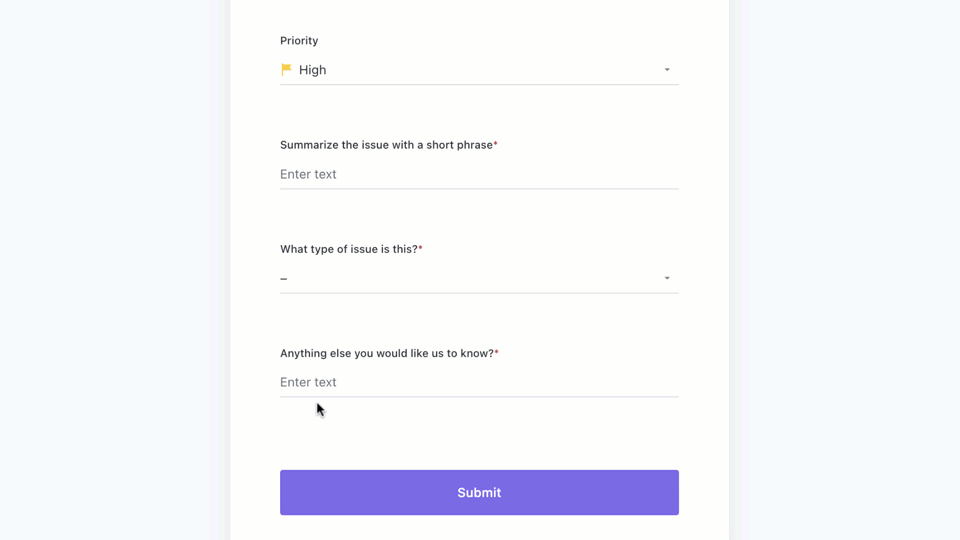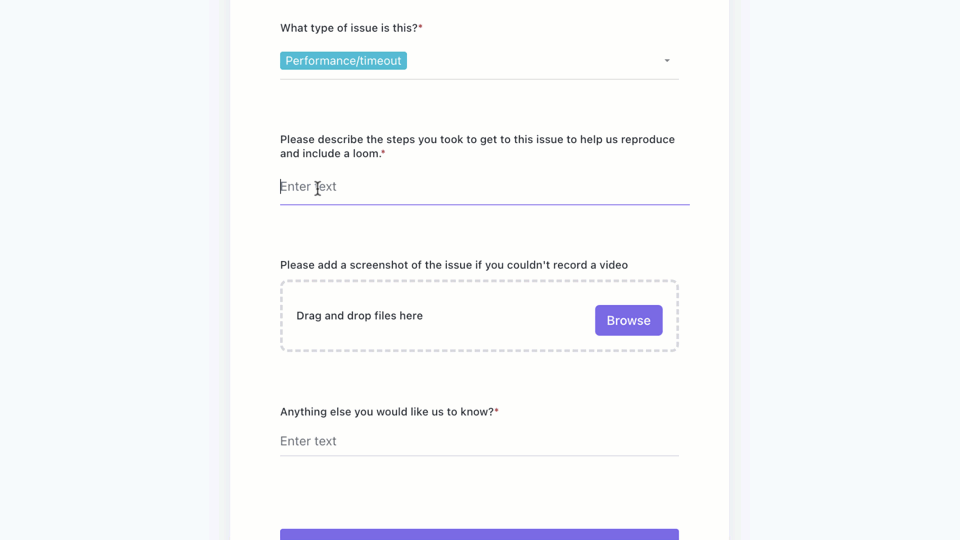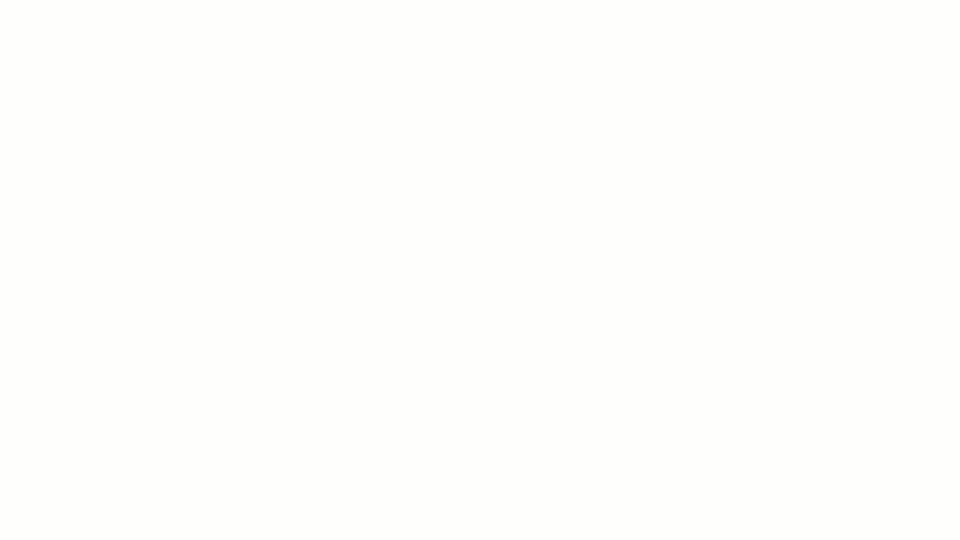
2. Klasyfikacja i kierowanie zgłoszeń wspomagane przez AI w celu radykalnego skrócenia czasu MTTA
Najszybsze naprawy to te, które natychmiast trafiają na właściwe biurko.
Wykorzystaj proste reguły w połączeniu z AI, aby klasyfikować poziom ważności, identyfikować potencjalnych właścicieli według komponentów lub obszarów kodu oraz automatycznie przypisywać zadania z uwzględnieniem terminów określonych w umowie SLA. Ustal jasne ścieżki postępowania dla zgłoszeń P0/P1 w odróżnieniu od Wszystkiego i spraw, by kwestia „kto jest za to odpowiedzialny” była jednoznaczna.
Automatyzacje mogą ustalać priorytet na podstawie danych z pól, kierować zgłoszenia do odpowiedniego zespołu w zależności od komponentu, uruchamiać timer czasu SLA oraz powiadamiać inżyniera dyżurnego; AI może proponować poziom ważności i właściciela na podstawie wcześniejszych wzorców. Gdy klasyfikacja zgłoszeń zajmuje 2–5 minut zamiast 30-minutowej dyskusji, skraca się czas MTTA, a wraz z nim MTTR.
Wskaźniki, na które warto zwrócić uwagę: MTTA, jakość pierwszej odpowiedzi (czy w pierwszym komentarzu poproszono o właściwe informacje?), liczba przekazów na jeden błąd.
Oto, jak to wygląda w praktyce:
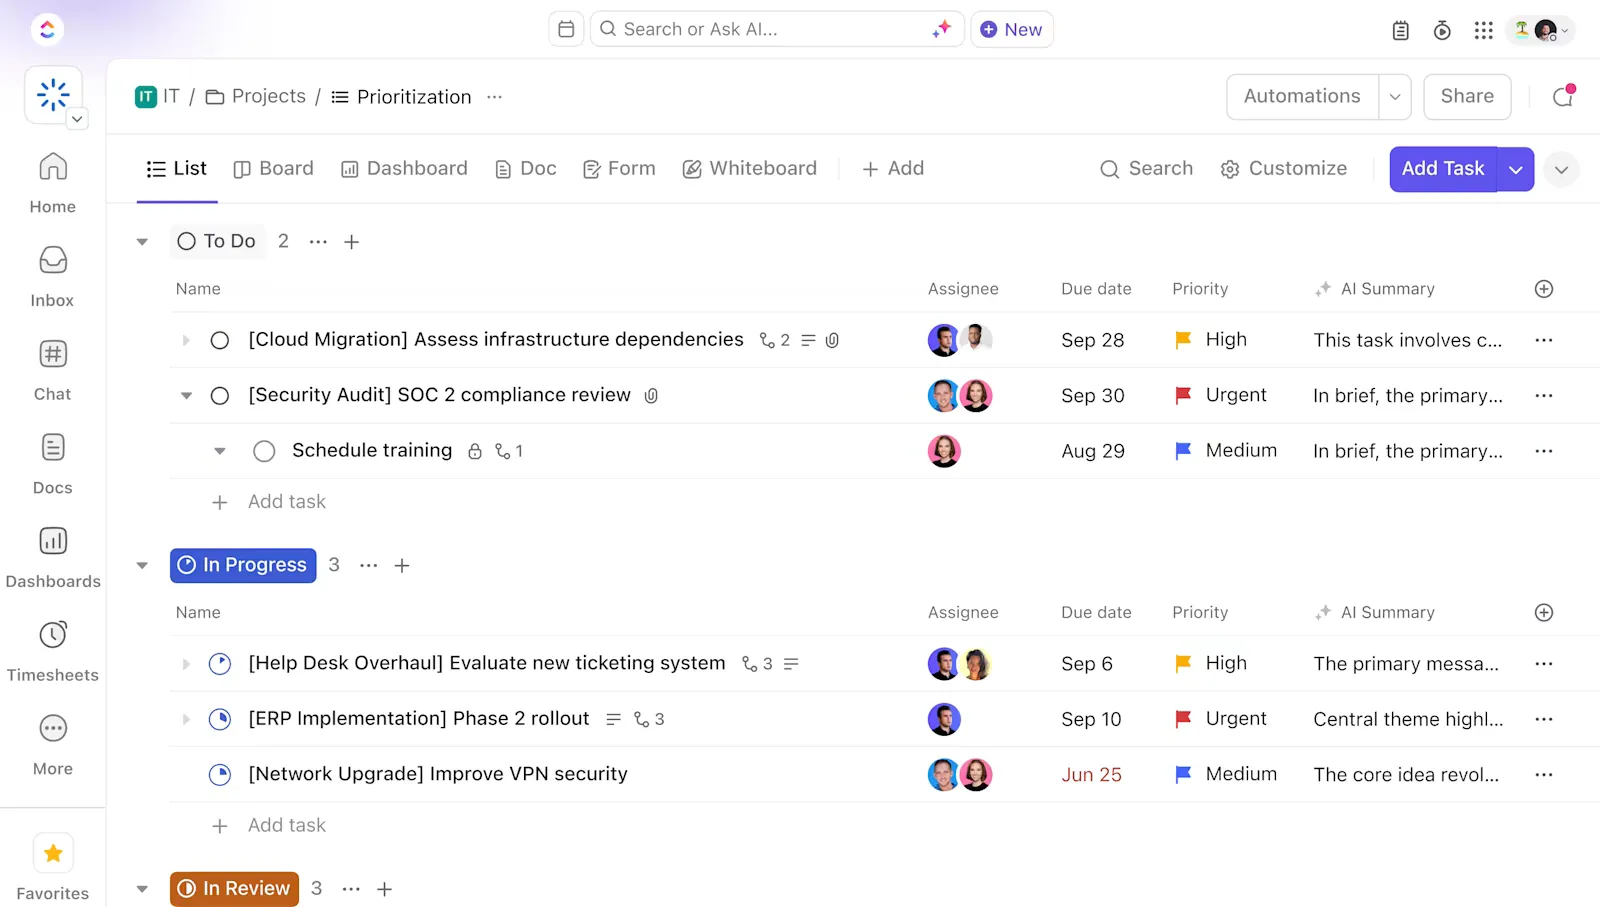
3. Ustalaj priorytety na podstawie wpływu na działalność firmy, korzystając z jasno określonych poziomów SLA
Zasada „wygrywa ten, kto najgłośniej krzyczy” sprawia, że kolejki stają się nieprzewidywalne i podważa zaufanie kadry kierowniczej, która śledzi wskaźniki CSAT/NPS oraz odnowienia umów.
Zastąp to punktacją uwzględniającą powagę, częstotliwość, wpływ na ARR, krytyczność funkcji oraz bliskość terminów odnowień/wprowadzeń na rynek — i poprzyj ją poziomami SLA (np. P0: złagodzenie skutków w ciągu 1–2 godzin, usunięcie w ciągu jednego dnia; P1: tego samego dnia; P2: w ramach sprintu).
Utrzymuj widoczny tor P0/P1 z limitami WIP, aby żadne zadanie nie zostało zaniedbane.
Wskaźniki, na które warto zwrócić uwagę: wskaźniki P50/P90 dla poszczególnych poziomów, wskaźnik naruszeń SLA, korelacja z CSAT/NPS.
💡Wskazówka dla profesjonalistów: Funkcje priorytetów zadań, pól niestandardowych i zależności w ClickUp pozwalają obliczyć wskaźnik wpływu oraz połączyć błędy z kontami, opiniami lub elementami w planie działania; ponadto cele w ClickUp pomagają powiązać przestrzeganie umów SLA z celami na poziomie firmy, co bezpośrednio odpowiada na obawy kadry kierowniczej dotyczące spójności działań.
4. Spraw, aby odtworzenie i diagnoza błędu odbywały się w jednym etapie
Każda dodatkowa pętla pytań typu „czy możesz przesłać logi?” wydłuża czas rozwiązywania problemów.
Ujednolicaj standardy „prawidłowości”: pola obowiązkowe dotyczące kompilacji/commitu, środowiska, kroków odtworzenia błędu, wyników oczekiwanych i rzeczywistych, a także załączniki zawierające logi, zrzuty pamięci po awarii i pliki HAR. Wprowadź telemetrię klient-serwer, aby identyfikatory awarii i identyfikatory żądań można było powiązać ze śladami.
Wprowadź narzędzie Sentry (lub podobne) do śledzenia stosu i połącz ten problem bezpośrednio z błędem. AI może analizować logi i ślady, aby zaproponować prawdopodobną domenę usterki i wygenerować minimalny przykład odtwarzający błąd, zamieniając godzinę ręcznego przeglądania na kilka minut ukierunkowanej pracy.
Przechowuj instrukcje postępowania dla typowych kategorii błędów, aby inżynierowie nie musieli zaczynać od zera.
Wskaźniki, na które warto zwrócić uwagę: czas spędzony na „oczekiwaniu na informacje”, odsetek przypadków odtworzonych przy pierwszej próbie oraz wskaźnik ponownego otwarcia zgłoszeń związany z brakiem możliwości odtworzenia błędu.
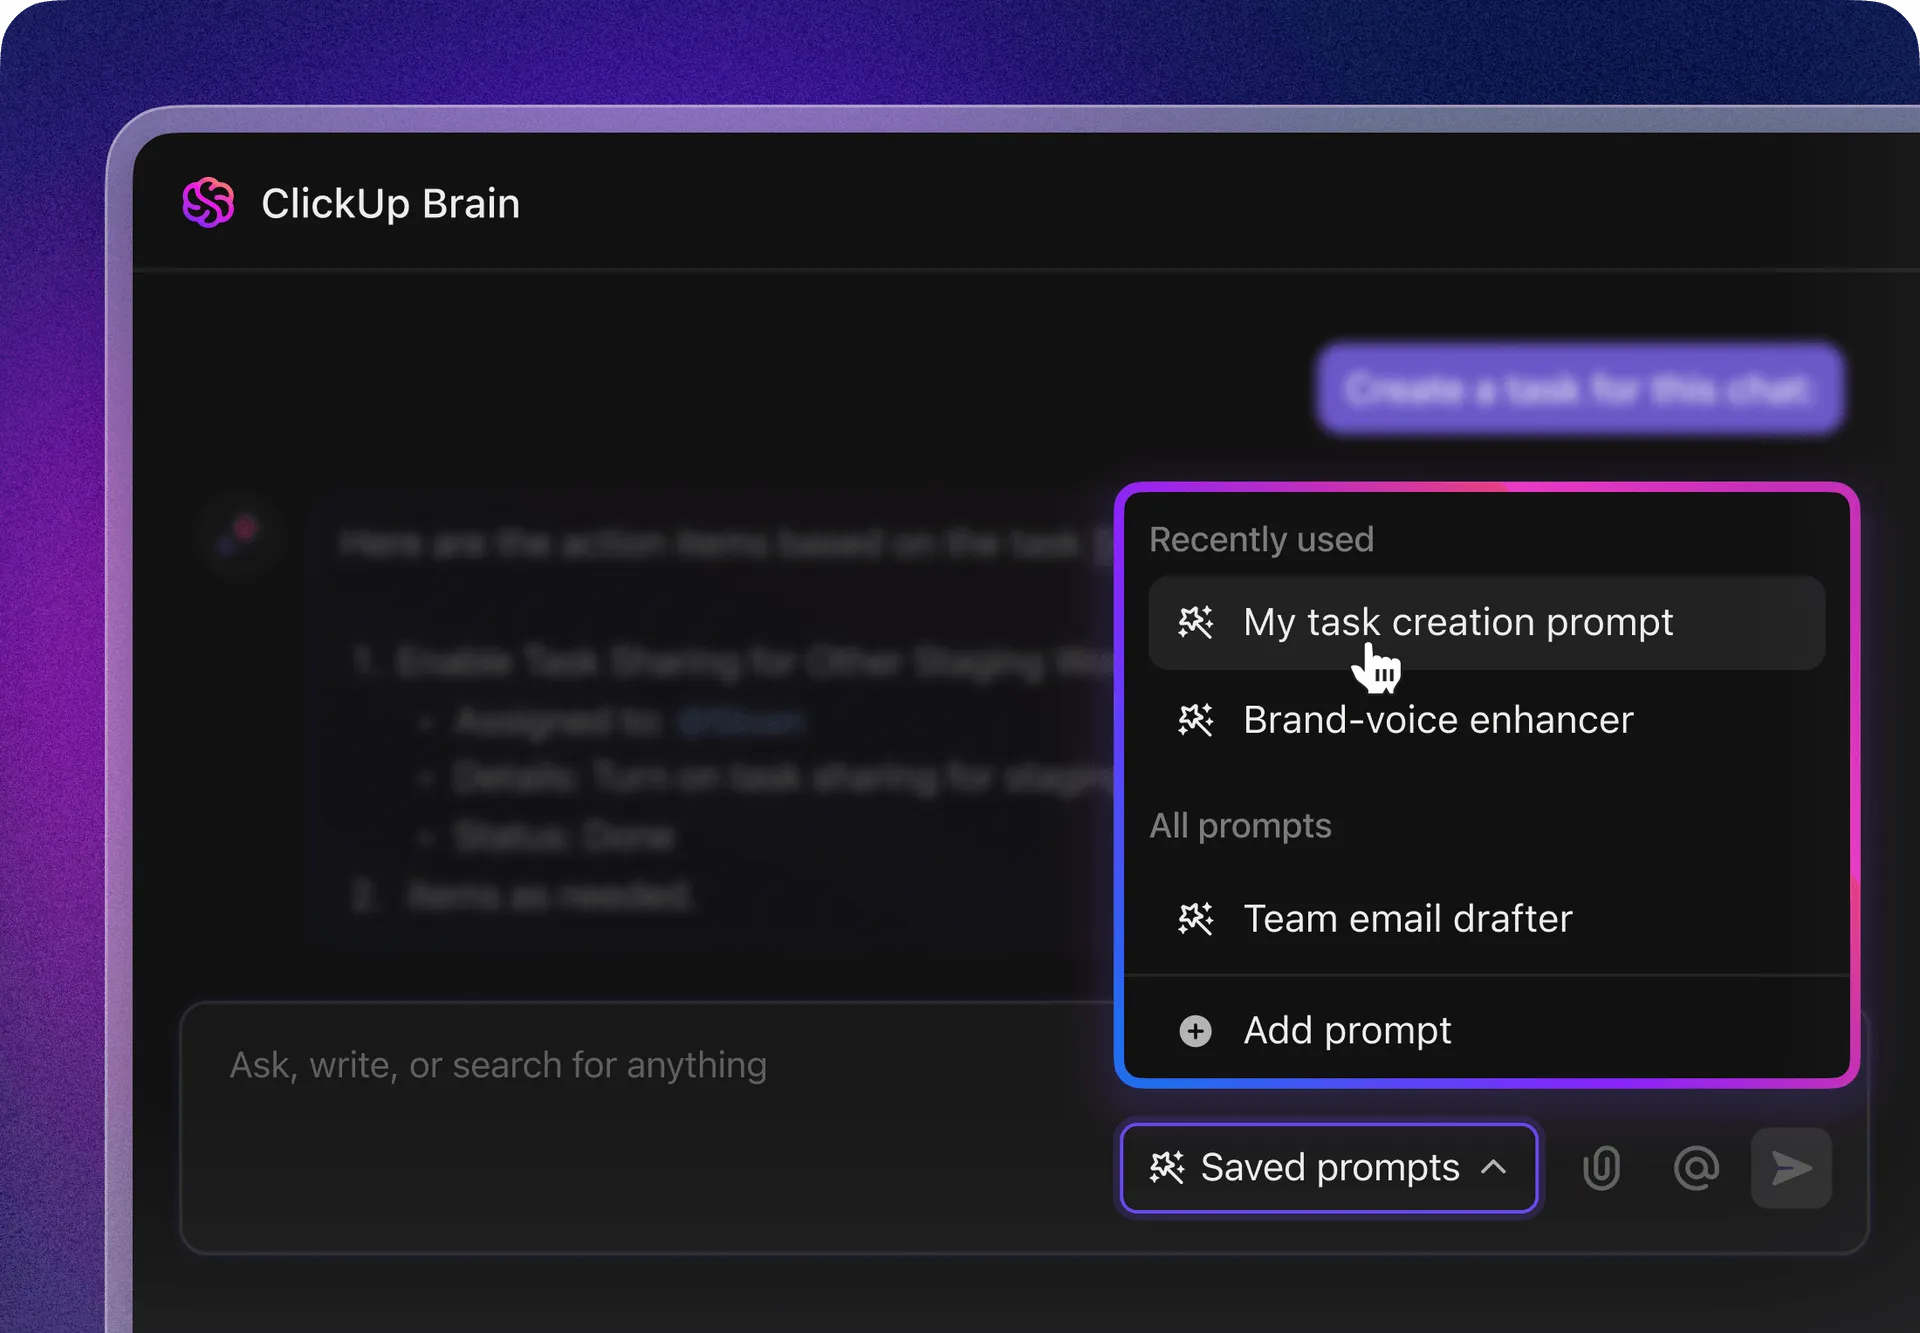
📖 Dowiedz się więcej: Jak wykorzystać AI w tworzeniu oprogramowania (przykłady zastosowań i narzędzia)
5. Skróć cykl przeglądu kodu i testowania
Duże zgłoszenia PR utknęły w martwym punkcie. Postaw na precyzyjne poprawki, programowanie oparte na gałęzi głównej oraz flagi funkcji, aby poprawki mogły być bezpiecznie wdrażane. Przydziel recenzentów z wyprzedzeniem na podstawie własności kodu, aby uniknąć przestojów, i korzystaj z list kontrolnych (zaktualizowane testy, dodana telemetria, flaga za wyłącznikiem awaryjnym), aby zapewnić wysoką jakość.
Automatyzacja powinna przenosić błąd do statusu „W trakcie przeglądu” po otwarciu pull requestu oraz do statusu „Rozwiązany” po scaleniu; AI może sugerować testy jednostkowe lub wskazywać ryzykowne różnice w kodzie, aby ukierunkować proces przeglądu.
Wskaźniki, na które warto zwrócić uwagę: czas spędzony w statusie „W trakcie przeglądu”, wskaźnik niepowodzeń zmian w pull requestach dotyczących poprawek błędów oraz opóźnienie przeglądu P90.
Możesz korzystać z integracji GitHub/GitLab w ClickUp, aby zsynchronizować statusy rozwiązywania błędów; automatyzacje mogą egzekwować „definicję zrobionego”.
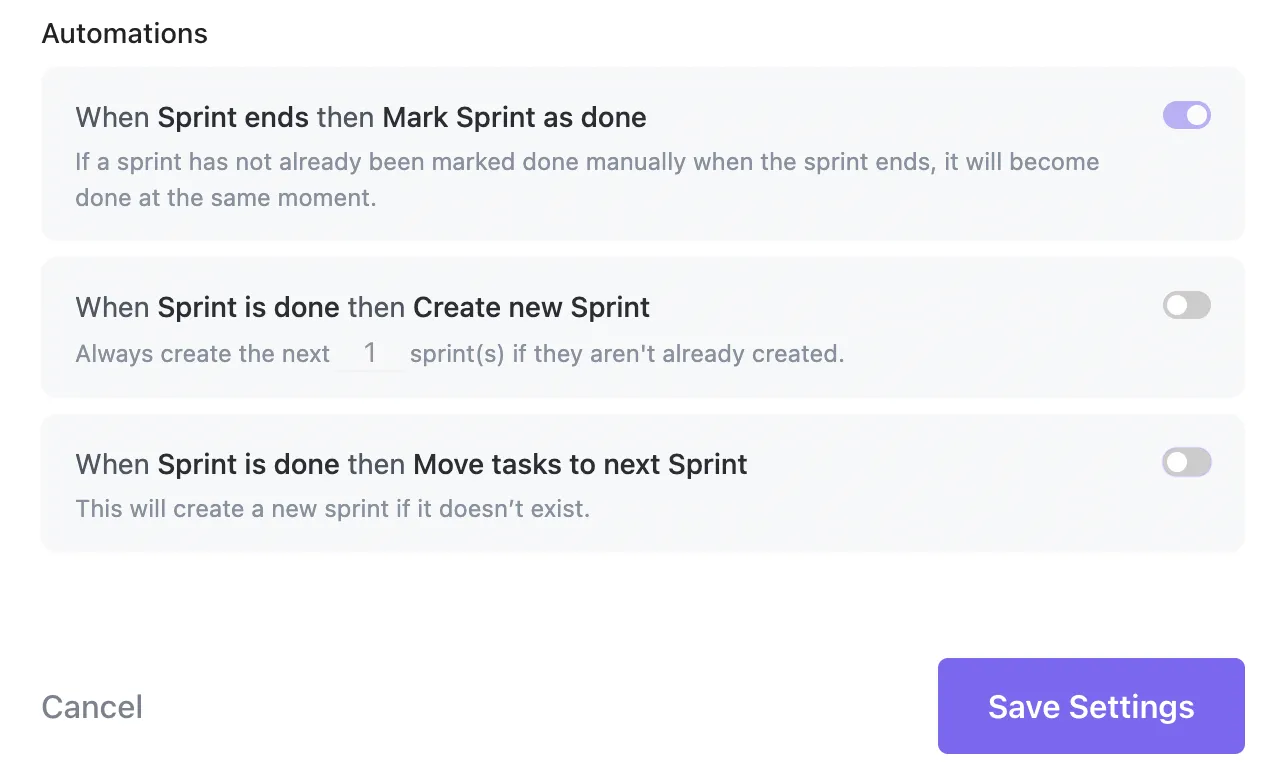
📖 Czytaj więcej: Jak wykorzystać AI do automatyzacji zadań
6. Zrównałaj procesy weryfikacji i zapewnij rzeczywistą spójność środowiska kontroli jakości
Weryfikacja nie powinna rozpoczynać się dopiero po kilku dniach ani w środowisku, z którego nie korzysta żaden z Twoich klientów.
Dbaj o wysoki poziom gotowości do kontroli jakości: poprawki oparte na flagach, weryfikowane w środowiskach zbliżonych do produkcyjnych przy użyciu danych testowych odpowiadających zgłoszonym przypadkom.
Tam, gdzie to możliwe, konfiguruj tymczasowe środowiska na podstawie branchu błędów, aby zespół kontroli jakości mógł natychmiast przeprowadzić weryfikację; AI może następnie wygenerować przypadki testowe na podstawie opisu błędu i wcześniejszych regresji.
Wskaźniki, na które warto zwrócić uwagę: czas spędzony na etapie „kontroli jakości/weryfikacji”, wskaźnik odsyłania z kontroli jakości z powrotem do działu programistów, mediana czasu potrzebnego do zamknięcia zgłoszenia po scaleniu.
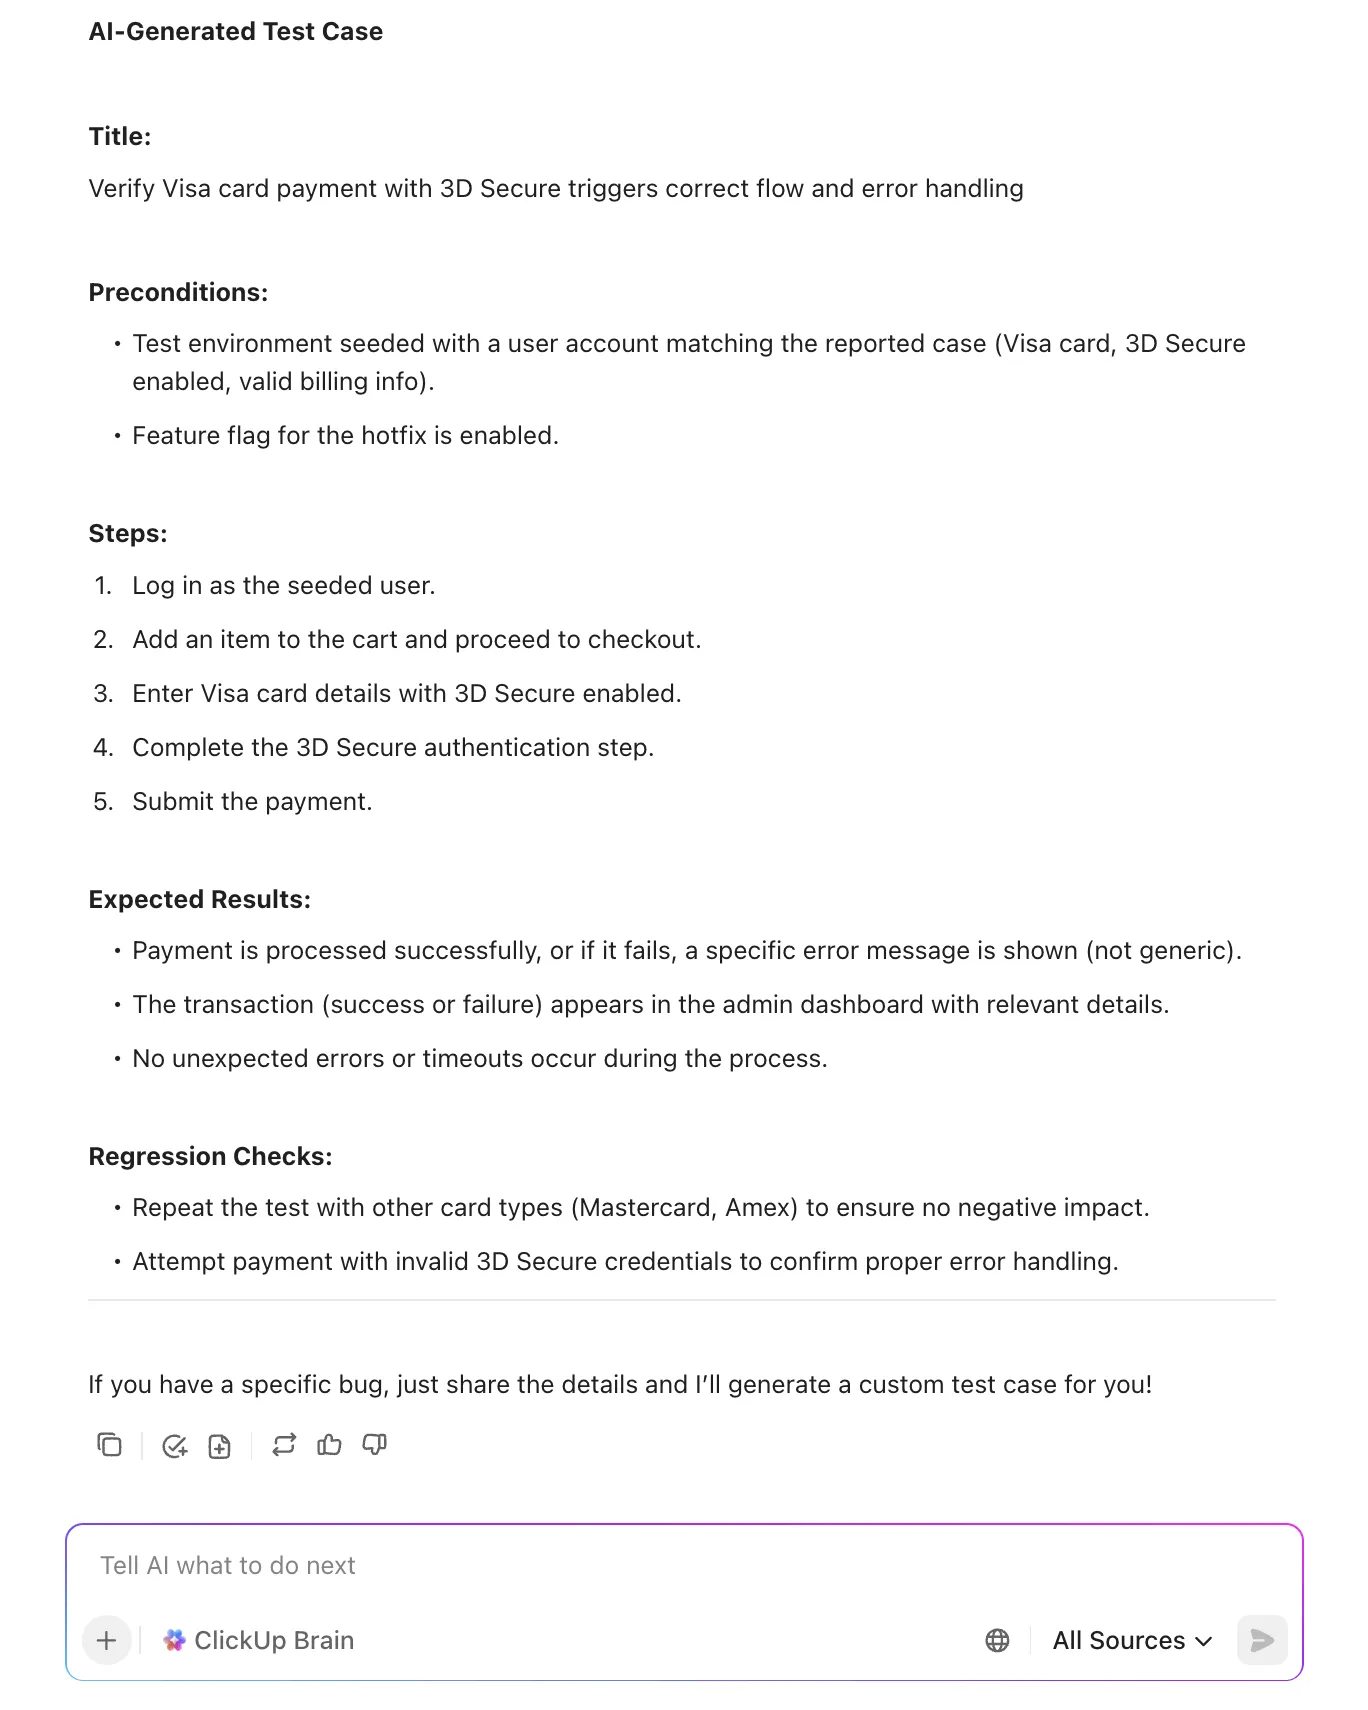
📖 Czytaj więcej: Jak tworzyć skuteczne przypadki testowe
7. Przekazuj informacje o statusie w zwięzły sposób, aby zmniejszyć obciążenie związane z koordynacją
Jedna dobra aktualizacja pozwala uniknąć trzech zapytań o status i jednej eskalacji.
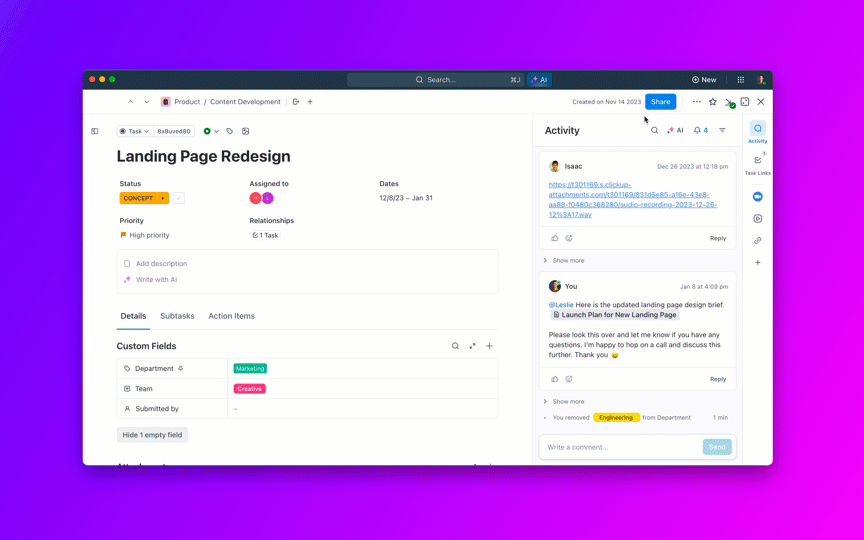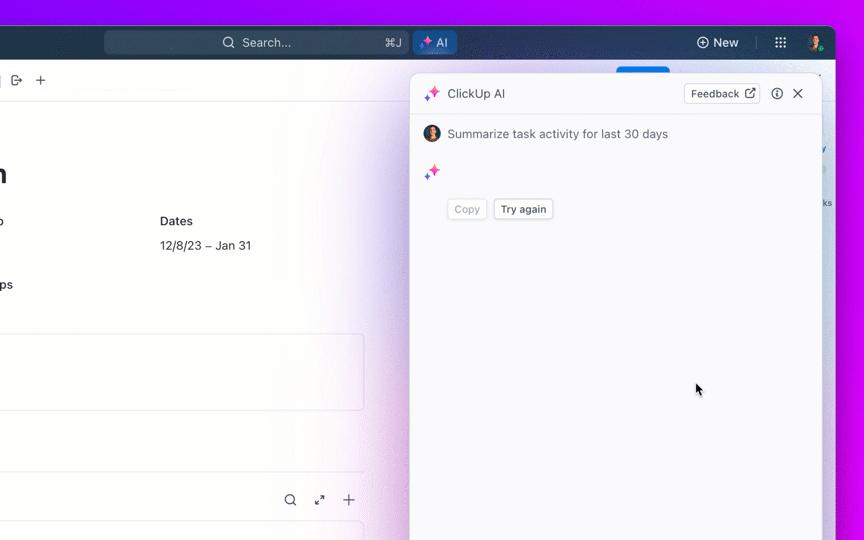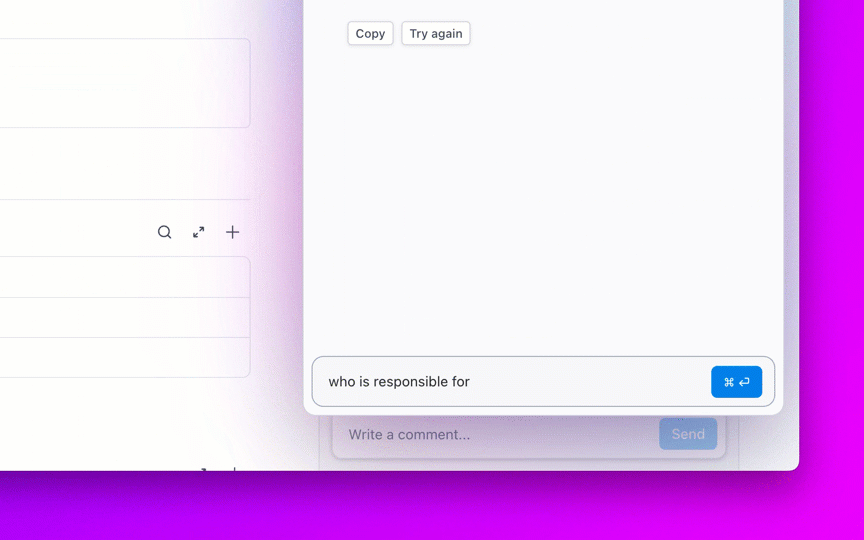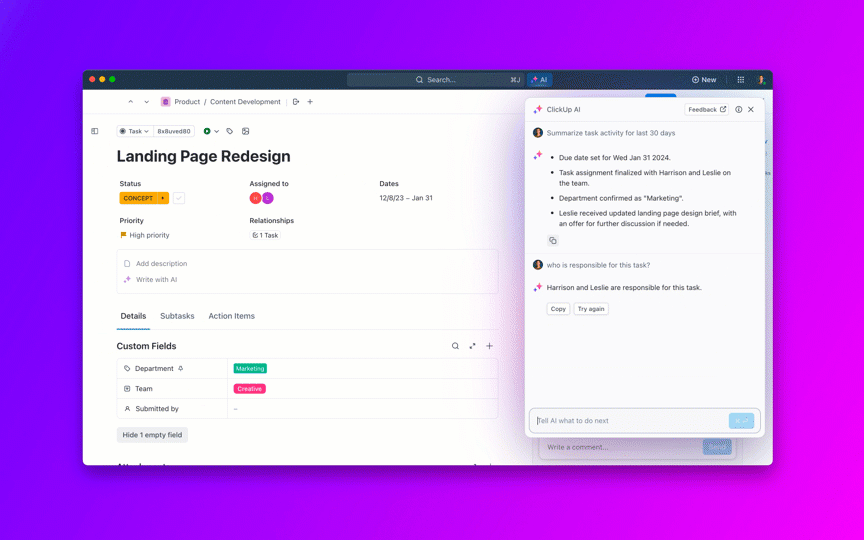
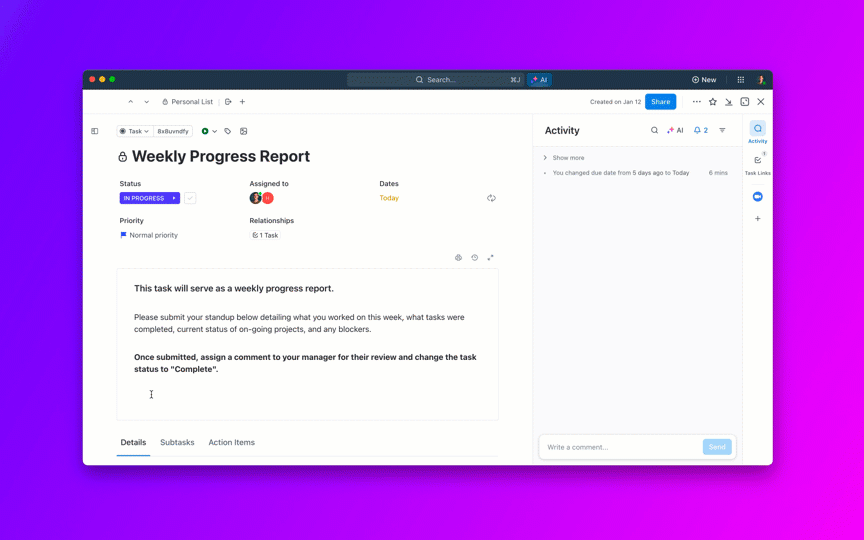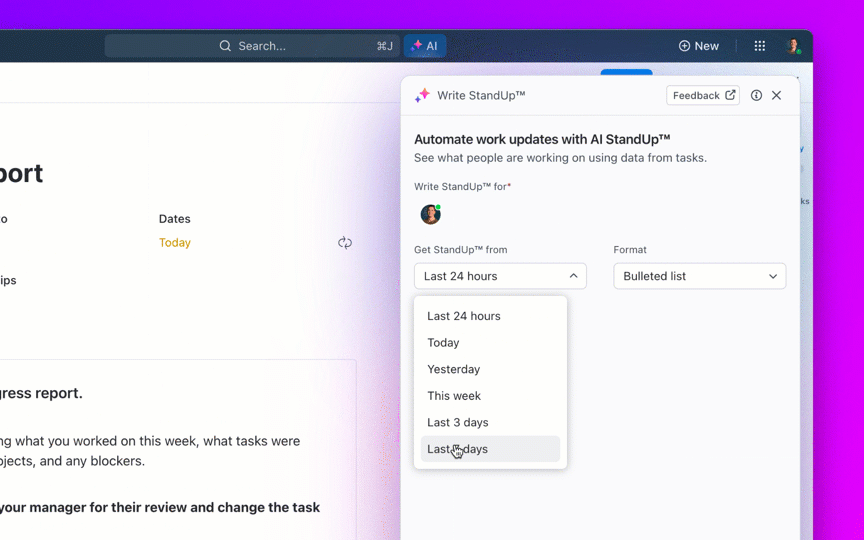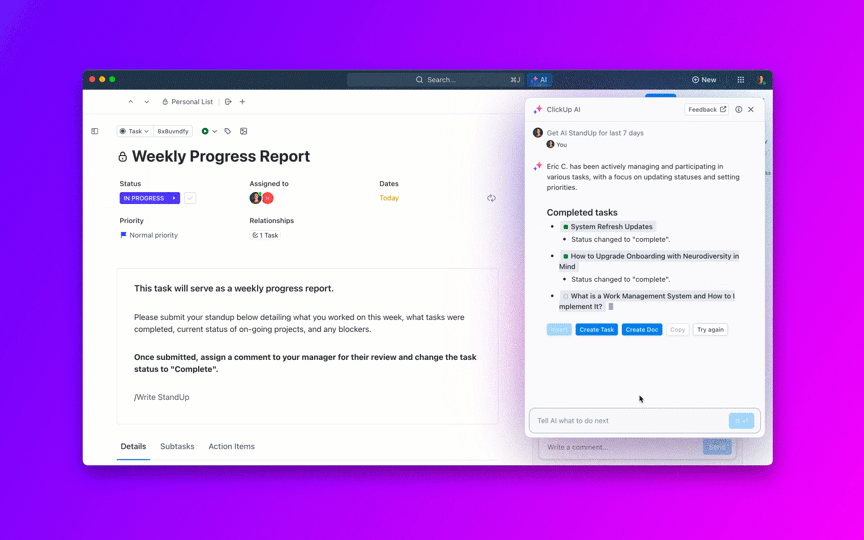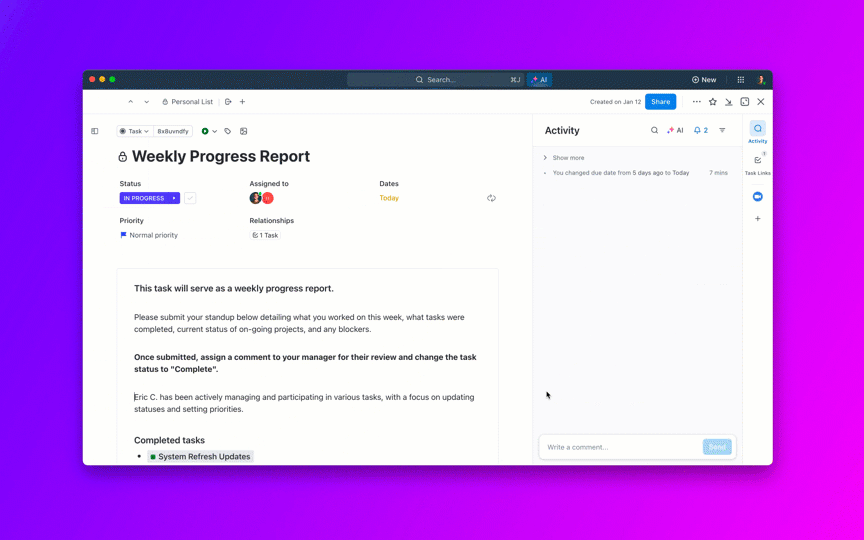
Traktuj aktualizacje jak produkt: niech będą krótkie, konkretne i dostosowane do odbiorców (dział wsparcia, kadra kierownicza, klienci). Ustal częstotliwość aktualizacji dla błędów P0/P1 (np. co godzinę do momentu usunięcia, a następnie co cztery godziny) i dbaj o to, by informacje pochodziły z jednego wiarygodnego źródła.
Sztuczna inteligencja może tworzyć bezpieczne dla klientów aktualizacje i wewnętrzne podsumowania na podstawie historii zadań, w tym aktualnego statusu według poziomu ważności i zespołu. W przypadku kadry kierowniczej, takiej jak dyrektor ds. produktu, należy przyporządkować błędy do poszczególnych inicjatyw, aby mogli oni sprawdzić, czy krytyczne problemy związane z jakością zagrażają dotrzymaniu obietnic dotyczących terminów dostaw.
Wskaźniki, na które warto zwrócić uwagę: czas między aktualizacjami statusu zgłoszeń P0/P1 oraz wskaźnik zadowolenia interesariuszy (CSAT) z komunikacji.
8. Kontroluj wiek zadań w backlogu i zapobiegaj powstawaniu zadań „wiecznie otwartych”
Rosnąca lista zaległych zadań, która pozostaje niezmieniona, po cichu obciąża każdy sprint.
Ustal zasady dotyczące przedawnienia (np. P2 > 30 dni jest wyzwalaczem przeglądu, P3 > 90 dni wymaga uzasadnienia) i zaplanuj cotygodniową „selekcję przedawnionych zgłoszeń”, aby scalić duplikaty, zamknąć nieaktualne zgłoszenia i przekształcić błędy o niskiej wartości w elementy backlogu produktu.
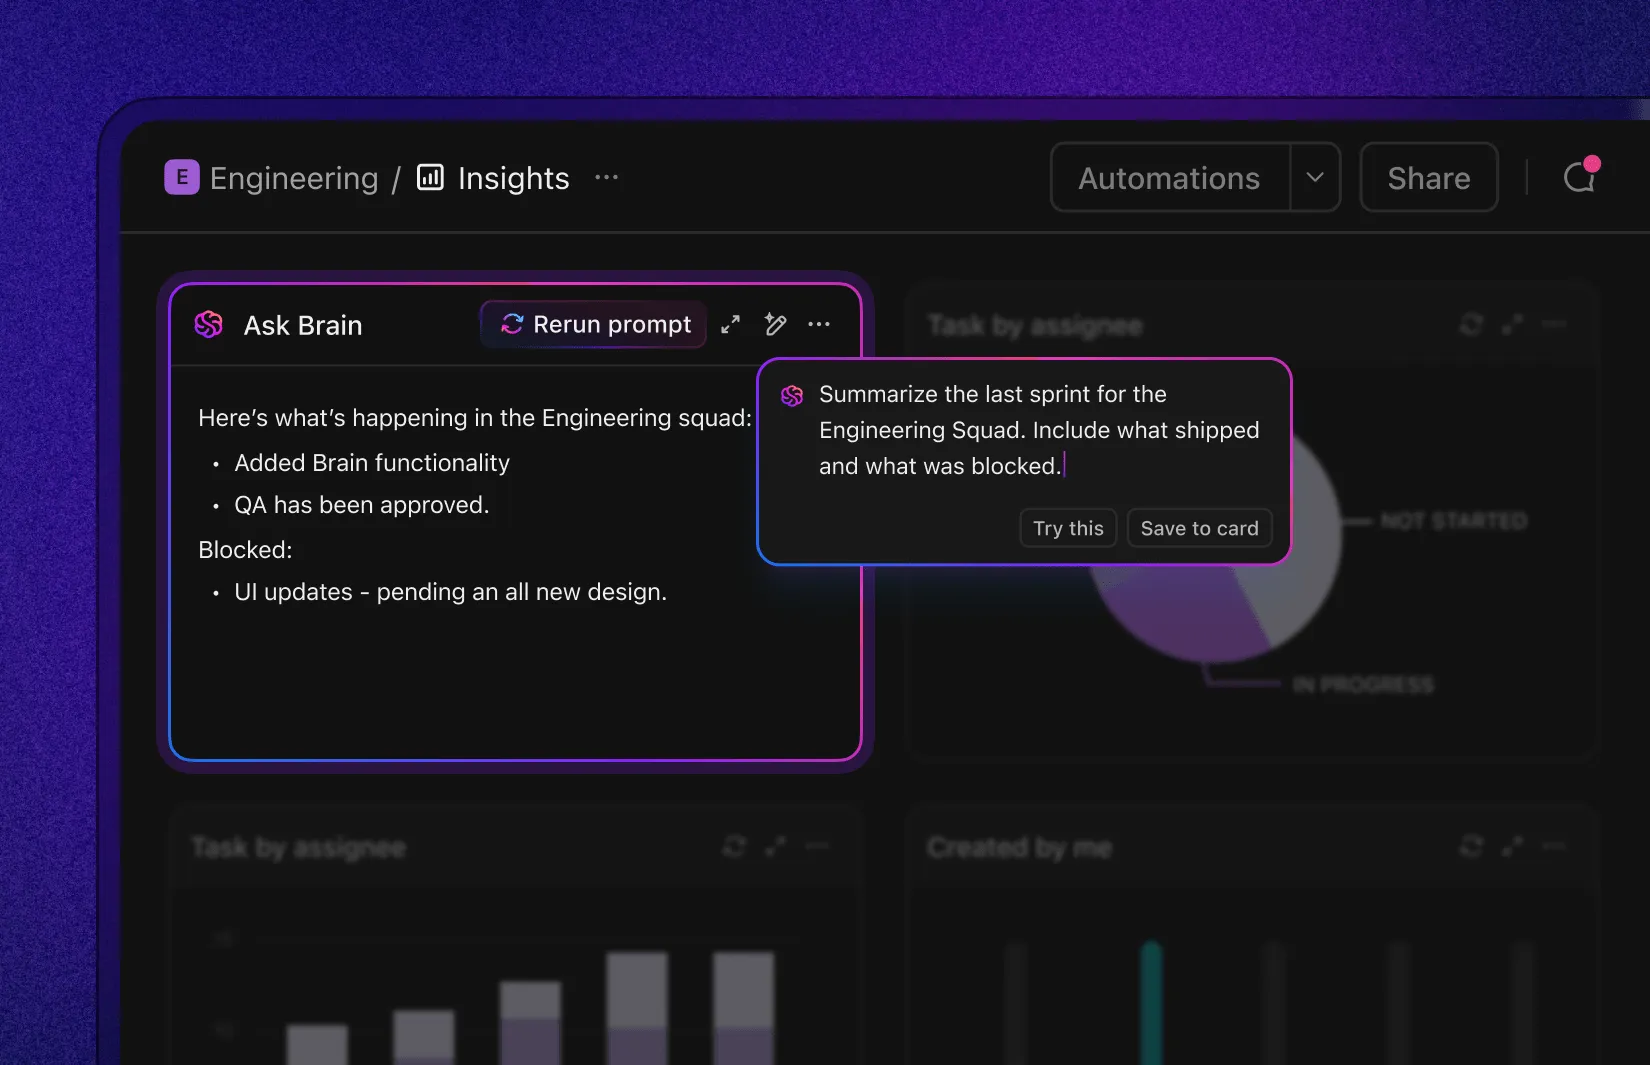
Wykorzystaj AI do pogrupowania zaległości według tematów (np. „wygasanie tokenu uwierzytelniającego”, „niestabilność przesyłania obrazów”), aby móc zaplanować tematyczne tygodnie napraw i wyeliminować całą klasę błędów za jednym razem.
Wskaźniki, na które warto zwrócić uwagę: liczba zaległych problemów w podziale na przedziały czasowe, odsetek problemów zamkniętych jako duplikaty lub nieaktualne, prędkość redukcji zaległości w podziale na tematy.
9. Zamknij cykl, identyfikując przyczyny źródłowe i wprowadzając środki zapobiegawcze
Jeśli ta sama kategoria usterek ciągle się powtarza, poprawa wskaźnika MTTR maskuje poważniejszy problem.
Przeprowadzaj szybką, bezosobową analizę przyczyn źródłowych błędów P0/P1 oraz często występujących błędów P2; oznaczaj przyczyny źródłowe (luki w specyfikacjach, luki w testach, luki w narzędziach, niestabilność integracji), łącz je z komponentami i incydentami, których dotyczą, oraz śledź zadania następcze (mechanizmy zabezpieczające, testy, reguły lintowania) aż do ich zakończenia.
AI może sporządzać podsumowania analizy przyczyn źródłowych (RCA) oraz proponować testy zapobiegawcze lub reguły lintowania na podstawie historii zmian. W ten sposób przechodzisz od gaszenia pożarów do ograniczania ich liczby.
Wskaźniki, na które należy zwrócić uwagę: wskaźnik ponownego zgłoszenia, wskaźnik regresji, czas między cyklicznymi wystąpieniami oraz odsetek analiz przyczyn źródłowych (RCA) z zakończonymi działaniami zapobiegawczymi.
Wszystkie te zmiany razem skracają cały proces: szybsze potwierdzenie odbioru zgłoszenia, bardziej przejrzysta klasyfikacja, inteligentniejsze ustalanie priorytetów, mniej opóźnień podczas weryfikacji i kontroli jakości oraz jaśniejsza komunikacja. Kadra kierownicza zyskuje przewidywalność powiązaną z wskaźnikami CSAT/NPS oraz przychodami; specjaliści zyskują spokojniejszą kolejkę zgłoszeń i rzadsze przełączanie się między zadaniami.
📖 Czytaj więcej: Jak przeprowadzić analizę przyczyn źródłowych
Narzędzia AI, które pomagają skrócić czas usuwania błędów
AI może skrócić czas rozwiązywania problemów na każdym kroku — przyjmowania zgłoszenia, klasyfikacji, kierowania zgłoszenia, naprawy i weryfikacji.
Jednak prawdziwe korzyści pojawiają się wtedy, gdy narzędzia rozumieją kontekst i zapewniają ciągłość pracy bez konieczności ręcznego nadzorowania.
Poszukaj systemów, które automatycznie wzbogacają raporty (kroki odtworzenia błędu, środowisko, duplikaty), ustalają priorytety na podstawie wpływu, kierują zgłoszenia do właściwego właściciela, generują przejrzyste aktualizacje oraz ściśle integrują się z kodem, ciągłym wdrażaniem (CI) i obserwowalnością.
Najlepsze z nich zapewniają wsparcie dla procesów pracy podobnych do tych stosowanych przez agentów: boty, które monitorują umowy SLA, przypominają recenzentom o zadaniach, eskalują zablokowane elementy i podsumowują wyniki dla interesariuszy. Oto nasze zestawienie narzędzi AI, które usprawniają rozwiązywanie błędów:
1. ClickUp (najlepsze rozwiązanie pod względem kontekstowej sztucznej inteligencji, automatyzacji i cykli pracy opartych na agentach)
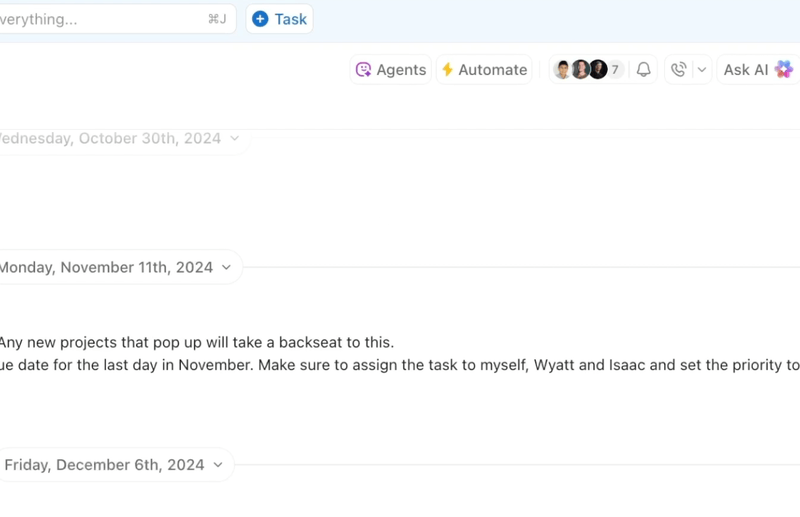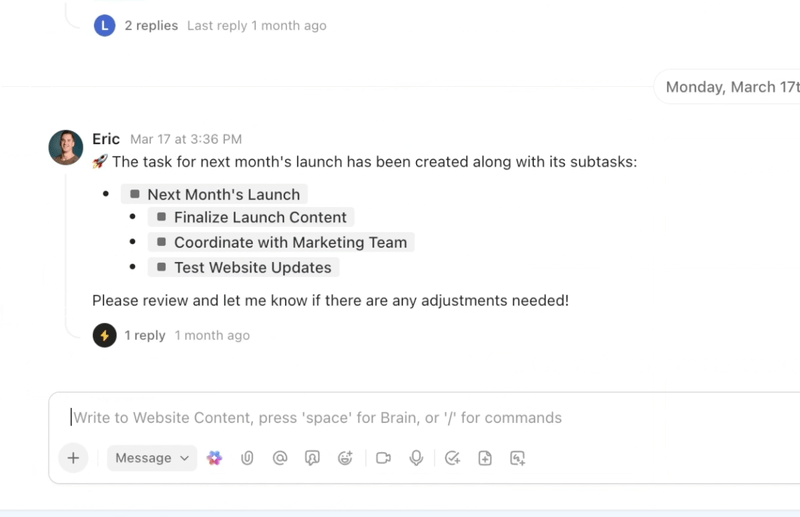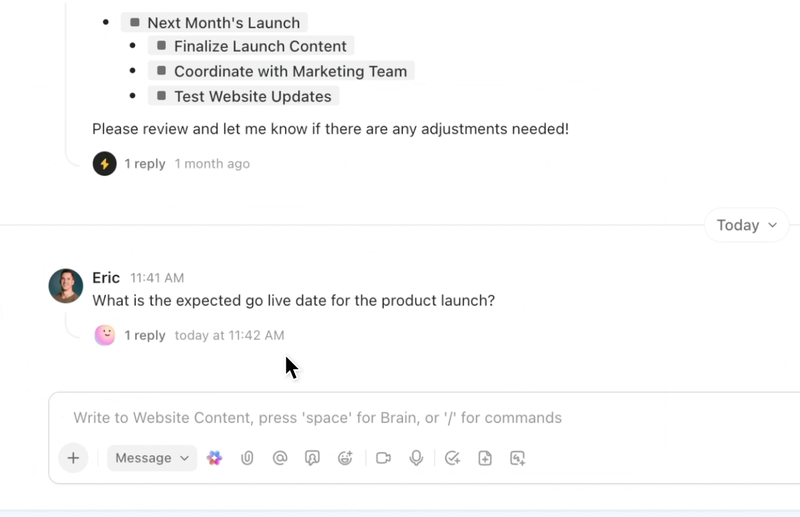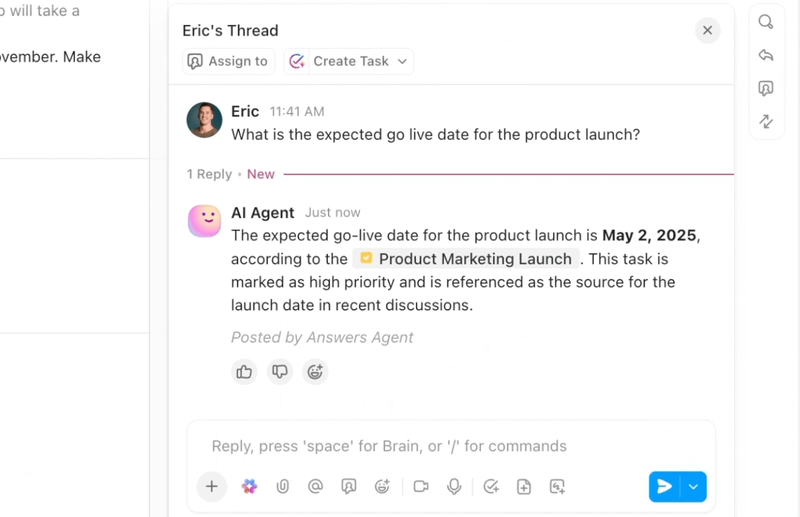
Jeśli zależy Ci na usprawnionym, inteligentnym cyklu rozwiązywania błędów, ClickUp – uniwersalna aplikacja do pracy – łączy w jednym miejscu sztuczną inteligencję, automatyzację oraz asystenckie wsparcie w zarządzaniu cyklem pracy.
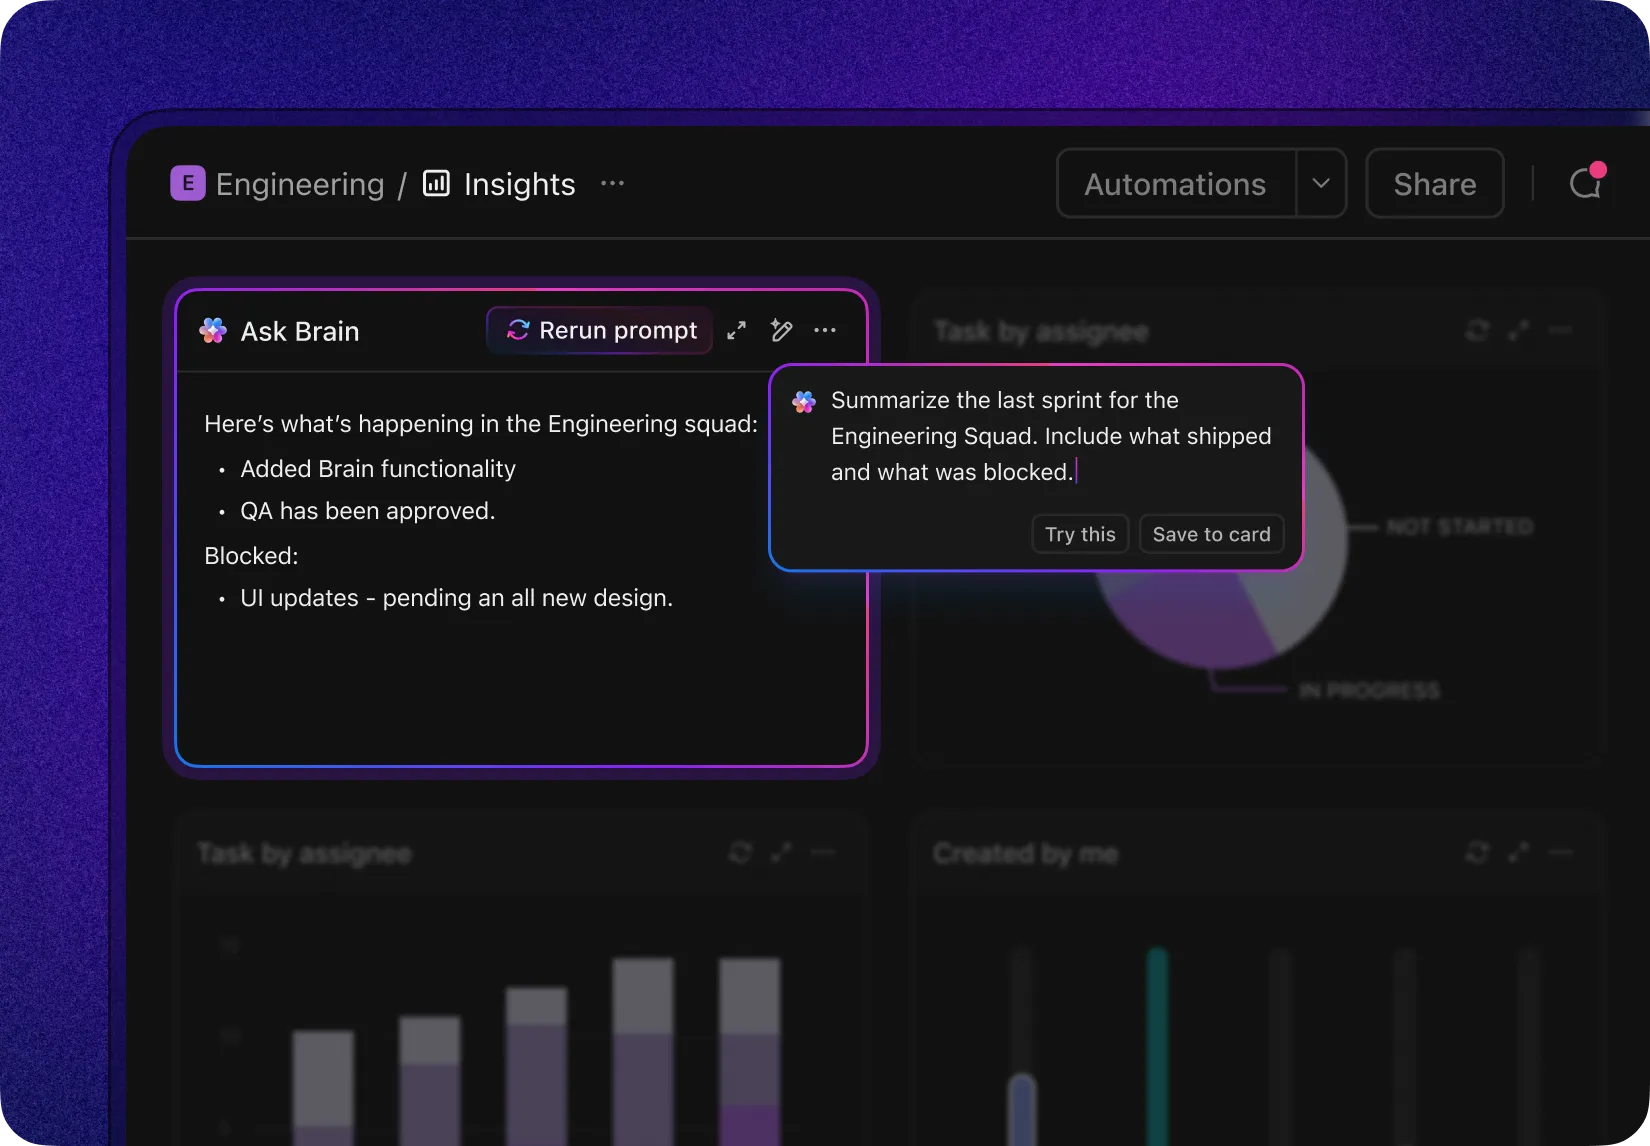
ClickUp Brain natychmiast wyświetla odpowiedni kontekst — podsumowuje długie wątki dotyczące błędów, wyodrębnia kroki pozwalające odtworzyć błąd oraz szczegóły środowiska z załączników, sygnalizuje prawdopodobne duplikaty i sugeruje kolejne działania. Zamiast przedzierać się przez Slacka, zgłoszenia i logi, zespoły otrzymują przejrzysty, wzbogacony zapis, na podstawie którego mogą natychmiast podjąć działania.
Automatyzacje i agenci Autopilot w ClickUp zapewniają ciągłość pracy bez konieczności stałego nadzoru. Błędy są automatycznie kierowane do odpowiedniego zespołu, wyznaczani są właściciele, ustalane są umowy SLA i terminy realizacji, statusy są aktualizowane w miarę postępu prac, a interesariusze otrzymują powiadomienia na czas.
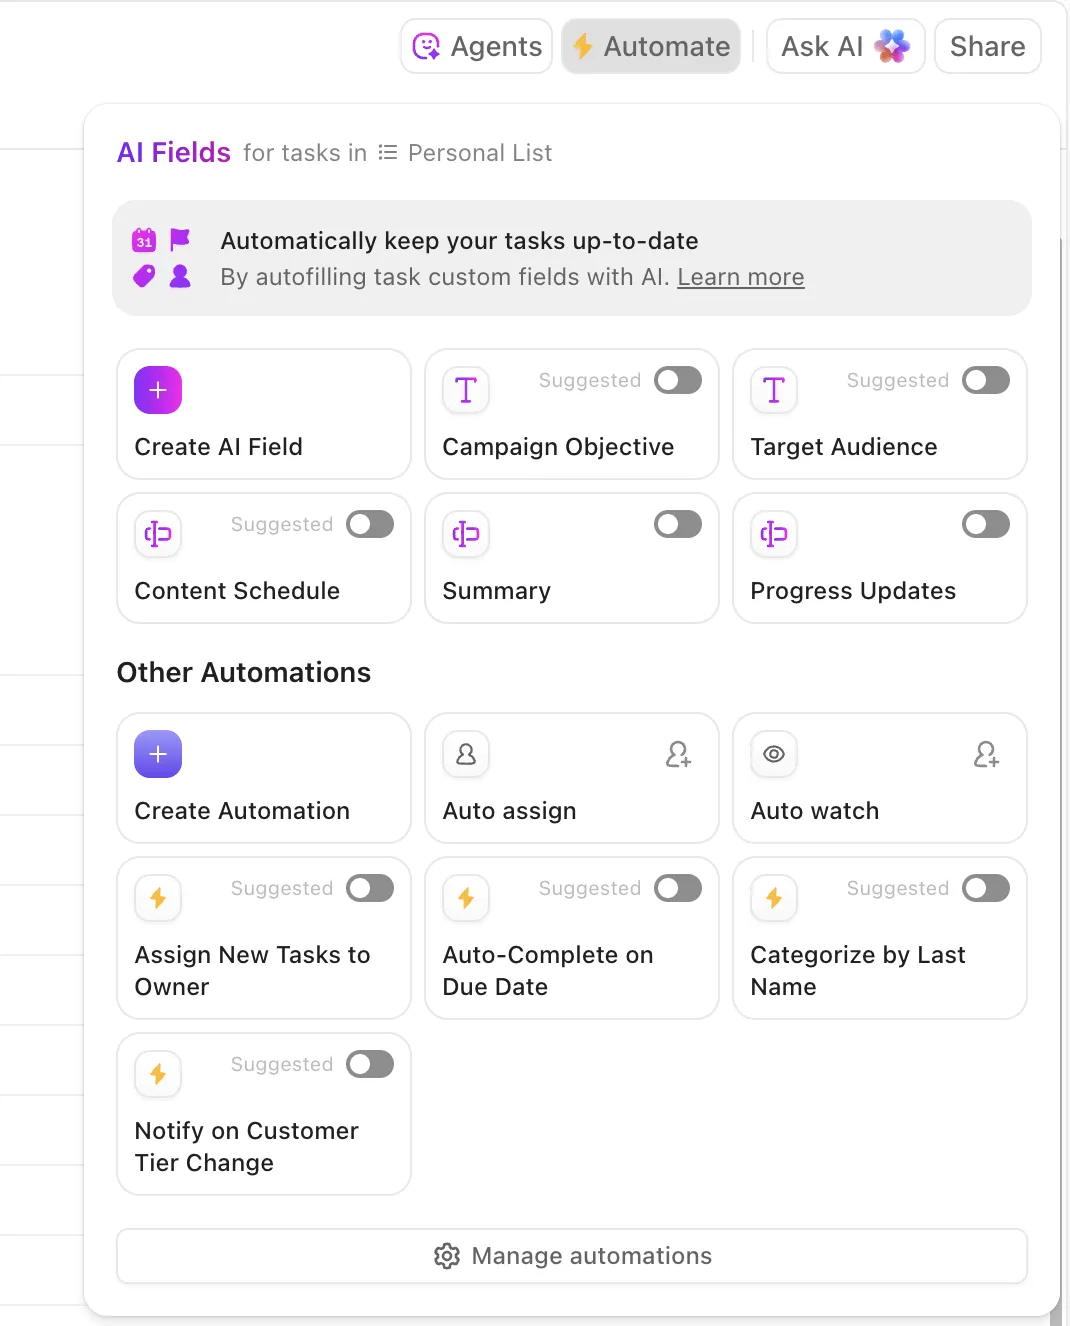
Agenci ci potrafią nawet dokonywać selekcji i kategoryzować problemy, grupować podobne problemy, odwoływać się do historii napraw w celu zaproponowania prawdopodobnych rozwiązań oraz eskalować pilne elementy — dzięki czemu wskaźniki MTTA i MTTR spadają nawet w przypadku gwałtownego wzrostu liczby problemów.
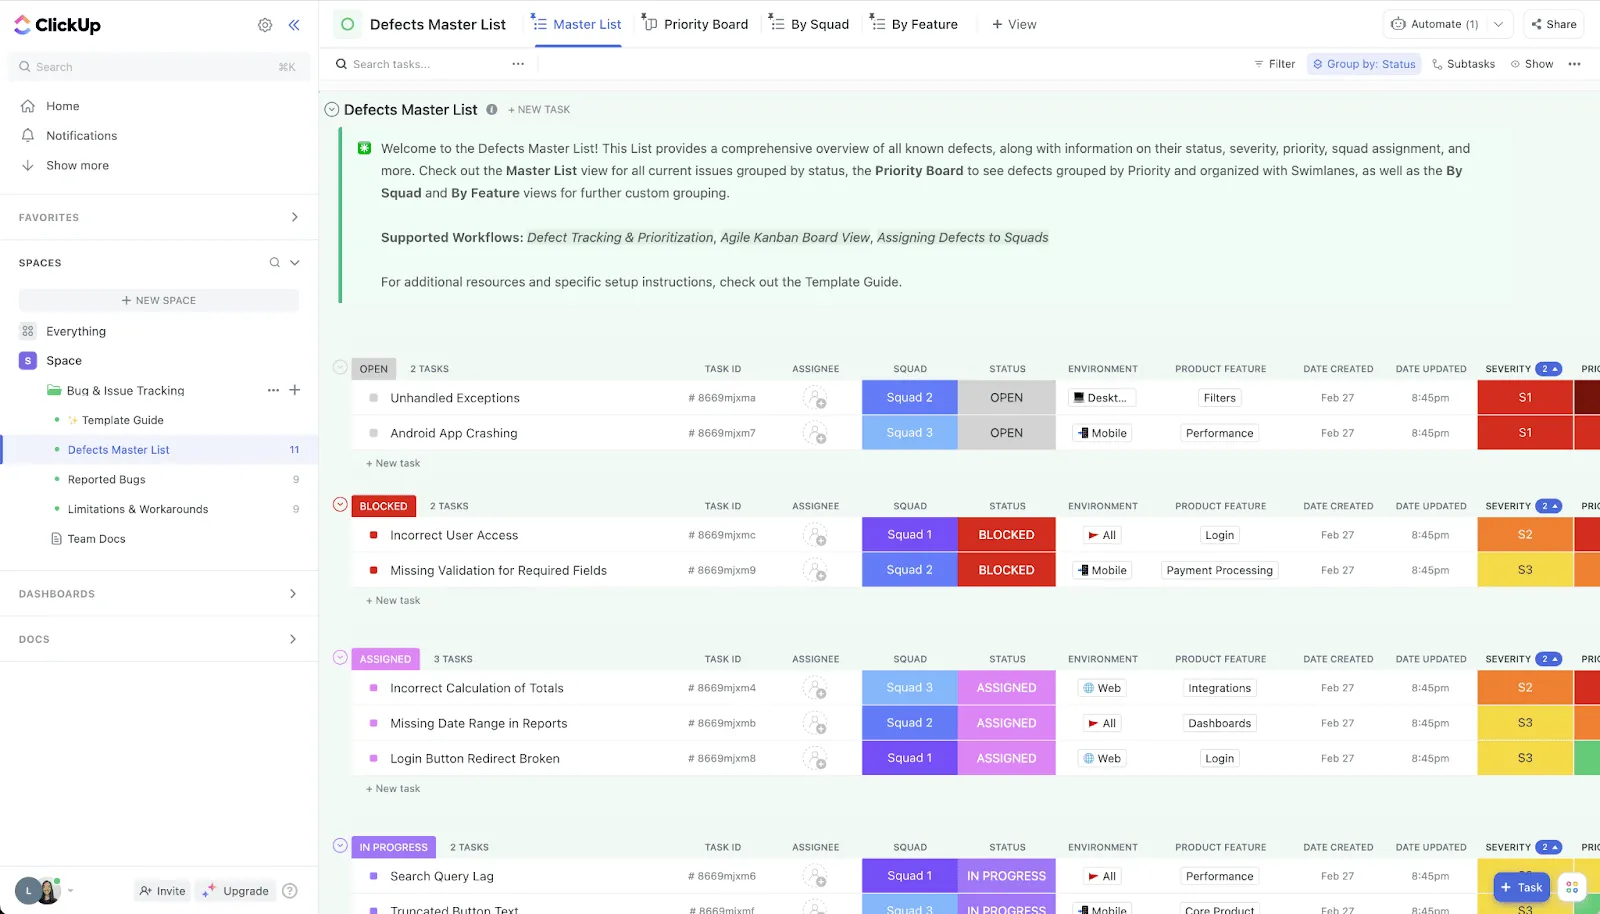
🛠️ Potrzebujesz gotowego zestawu narzędzi? Szablon ClickUp do śledzenia błędów i problemów to potężne rozwiązanie od ClickUp dla branży oprogramowania, zaprojektowane , aby pomóc zespołom wsparcia technicznego, inżynierów i produktowym z łatwością radzić sobie z błędami i problemami w oprogramowaniu. Dzięki konfigurowalnym widokom, takim jak Lista, Tablica, Obciążenie pracą, Formularz i Oś czasu, zespoły mogą wizualizować i zarządzać procesem śledzenia błędów w sposób, który najbardziej im odpowiada.
20 niestandardowych statusów i 7 niestandardowych pól dostępnych w szablonie pozwalają na dostosowanie cyklu pracy do indywidualnych potrzeb, zapewniając śledzenie każdego problemu od momentu wykrycia do rozwiązania. Wbudowane automatyzacje przejmują powtarzalne zadania, oszczędzając cenny czas i ograniczając wysiłek ręczny.
💟 Bonus: Brain MAX to oparty na AI pomocnik na pulpicie, zaprojektowany w celu przyspieszenia usuwania błędów dzięki inteligentnym i praktycznym funkcjom.
Gdy napotkasz błąd, po prostu skorzystaj z funkcji zamiany mowy na tekst w Brain MAX, aby podyktować opis problemu — Twoje notatki głosowe zostaną natychmiast przepisane i można je wykorzystać jako załączniki do nowego lub istniejącego zgłoszenia błędu. Funkcja Enterprise Search przeszukuje wszystkie połączone narzędzia — takie jak ClickUp, GitHub, Google Drive i Slack — w celu wyświetlenia powiązanych zgłoszeń błędów, dzienników błędów, fragmentów kodu i dokumentacji, dzięki czemu masz dostęp do całego potrzebnego kontekstu bez konieczności przełączania się między aplikacjami.
Chcesz koordynować proces naprawy? Brain MAX pozwala przypisać błąd odpowiedniemu programiście, ustawić automatyczne przypomnienia o aktualizacjach statusu oraz śledzić postępy — a wszystko to z poziomu pulpitu!
2. Sentry (najlepsze rozwiązanie do rejestrowania błędów)
Sentry skraca czas wykrycia problemu (MTTD) oraz czas odtworzenia błędu, gromadząc błędy, ślady i sesje użytkowników w jednym miejscu. Grupowanie problemów oparte na AI ogranicza nadmiar informacji; funkcje „Suspect Commit” oraz reguły przypisania własności identyfikują prawdopodobnego właściciela kodu, dzięki czemu kierowanie zgłoszeń odbywa się natychmiastowo. Funkcja odtwarzania sesji (Session Replay) zapewnia inżynierom dokładną ścieżkę użytkownika oraz szczegóły dotyczące konsoli i sieci, umożliwiając odtworzenie błędu bez niekończącej się wymiany wiadomości.
Funkcje Sentry AI potrafią podsumować kontekst problemu, a w niektórych środowiskach proponują poprawki Autofix, które odwołują się do błędnego kodu. Praktyczne korzyści: mniej zduplikowanych problemów, szybsze przydzielanie zadań oraz krótsza droga od problemu do działającej poprawki.
3. GitHub Copilot (najlepsze rozwiązanie do szybszego przeglądania kodu)
Copilot przyspiesza cykl napraw w redaktorze. Wyjaśnia ślady stosu, sugeruje poprawki kierowane na cele, tworzy testy jednostkowe w celu zweryfikowania poprawki oraz generuje szkielety skryptów odtwarzających błąd.
Copilot Chat może przeanalizować kod powodujący błędy, zaproponować bezpieczniejsze refaktoryzacje oraz generować komentarze lub opisy pull requestów, które przyspieszają proces przeglądu kodu. W połączeniu z obowiązkowymi przeglądami i ciągłą integracją (CI) skraca to o wiele godzin proces „diagnoza → wdrożenie → testowanie”, zwłaszcza w przypadku dobrze zdefiniowanych błędów z jasnym sposobem odtworzenia.
4. Snyk by DeepCode AI (najlepsze rozwiązanie do wykrywania wzorców)
Analiza statyczna DeepCode oparta na AI wykrywa defekty i niebezpieczne wzorce podczas pisania kodu oraz w pull requestach. Wskazuje problematyczne przepływy, wyjaśnia przyczyny ich występowania i proponuje bezpieczne poprawki dostosowane do idiomów Twojego kodu.
Wykrywając regresje przed scaleniem i kierując programistów ku bezpieczniejszym wzorcom, zmniejszasz częstotliwość pojawiania się nowych błędów oraz przyspieszasz usuwanie skomplikowanych błędów logicznych, które trudno wykryć podczas przeglądu. Integracja z IDE i PR pozwala realizować te działania bezpośrednio w miejscu, gdzie odbywa się praca.
5. Watchdog i AIOps firmy Datadog (najlepsze rozwiązanie do analizy logów)
Narzędzie Watchdog firmy Datadog wykorzystuje uczenie maszynowe do wykrywania anomalii w logach, metrykach, śladach i monitorowaniu rzeczywistych użytkowników. Koreluje ono skoki wartości z markerami wdrożeń, zmianami w infrastrukturze i topologią, aby sugerować prawdopodobne przyczyny źródłowe.
W przypadku usterek mających wpływ na klientów oznacza to wykrywanie w ciągu kilku minut, automatyczne grupowanie w celu ograniczenia nadmiaru alertów oraz konkretne wskazówki dotyczące obszarów, które należy sprawdzić. Czas klasyfikacji skraca się, ponieważ zaczynasz od stwierdzenia „to wdrożenie miało wpływ na te usługi, a wskaźniki błędów wzrosły na tym punkcie końcowym”, zamiast zaczynać od zera.
⚡️ Archiwum szablonów: Bezpłatne szablony do śledzenia problemów i rejestrów w programach Excel i ClickUp
6. New Relic AI (najlepsze rozwiązanie do identyfikowania i podsumowywania trendów)
Funkcja „Errors Inbox” firmy New Relic grupuje podobne błędy w różnych usługach i wersjach, a jej asystent oparty na AI podsumowuje skutki, wskazuje prawdopodobne przyczyny i udostępnia połączone linki do powiązanych śladów/transakcji.
Korelacje związane z wdrożeniami oraz analiza zmian w encjach pozwalają jednoznacznie ustalić, czy winę ponosi najnowsza wersja oprogramowania. W przypadku systemów rozproszonych takie informacje pozwalają zaoszczędzić wiele godzin na wymianie informacji między zespołami i skierować zgłoszenie błędu do właściwego właściciela, który dysponuje już solidną hipotezą.
7. Rollbar (najlepsze rozwiązanie do cykli pracy automatyzowanych)
Rollbar specjalizuje się w monitorowaniu błędów w czasie rzeczywistym z wykorzystaniem inteligentnego identyfikowania wzorców w celu grupowania duplikatów i śledzenia trendów występowania. Generowane przez AI podsumowania i wskazówki dotyczące przyczyn źródłowych pomagają zespołom zrozumieć zakres problemu (dotknięci użytkownicy, wersje, na które ma to wpływ), a dane telemetryczne i ślady stosu zapewniają szybkie wskazówki dotyczące odtworzenia błędu.
Reguły cyklu pracy Rollbar umożliwiają automatyczne tworzenie zadań, oznaczanie poziomu ważności oraz kierowanie zgłoszeń do właścicieli, przekształcając chaotyczne strumienie błędów w uporządkowane kolejki z dołączonym kontekstem.
8. PagerDuty AIOps i automatyzacja procedur operacyjnych (najlepsze rozwiązania w zakresie diagnostyki wymagającej minimalnej interwencji)
PagerDuty wykorzystuje korelację zdarzeń i redukcję szumu opartą na uczeniu maszynowym, aby przekształcić lawinę alertów w konkretne incydenty, które można rozwiązać.
Dynamiczne kierowanie zgłoszeń natychmiast przekazuje problem do właściwej osoby dyżurującej, a automatyzacja oparta na runbookach może uruchomić diagnostykę lub działania łagodzące (ponowne uruchomienie usług, cofnięcie wdrożenia, przełączenie flagi funkcji) jeszcze przed interwencją człowieka. W przypadku czasu rozwiązywania błędów oznacza to krótszy wskaźnik MTTA, szybsze działania łagodzące w przypadku błędów P0 oraz mniej godzin straconych z powodu zmęczenia alertami.
Czerp z automatyzacji i AI na każdym kroku. Wykrywasz błędy wcześniej, kierujesz zgłoszenia w bardziej przemyślany sposób, szybciej docierasz do kodu i informujesz o statusie bez spowalniania pracy inżynierów — wszystko to składa się na znaczące skrócenie czasu rozwiązywania błędów.
📖 Czytaj więcej: Jak wykorzystać AI w DevOps
Praktyczne przykłady wykorzystania AI do usuwania błędów
/AI oficjalnie wyszła już z laboratorium. W praktyce skraca czas rozwiązywania błędów.
Zobaczmy, jak to zrobić!
| Dziedzina / Organizacja | Jak wykorzystano AI | Wpływ / Korzyści |
|---|---|---|
| Ubisoft | Opracowano Commit Assistant – narzędzie oparte na AI, wyszkolone na danych z dziesięciu lat wewnętrznego kodu, które przewiduje i zapobiega błędom już na etapie kodowania. | Celem jest radykalne skrócenie czasu i obniżenie kosztów — tradycyjnie nawet 70% wydatków związanych z tworzeniem gier przeznacza się na naprawę błędów. |
| Razer (platforma Wyvrn) | Wprowadzono oparty na AI QA Copilot (zintegrowany z Unreal i Unity) w celu automatyzacji wykrywania błędów i generowania raportów kontroli jakości. | Zwiększa wykrywalność błędów nawet o 25% i skraca czas kontroli jakości o połowę. |
| Google / DeepMind i Project Zero | Wprowadzono Big Sleep – narzędzie oparte na AI, które samodzielnie wykrywa luki w zabezpieczeniach oprogramowania open source, takiego jak FFmpeg i ImageMagick. | Zidentyfikowano 20 błędów, wszystkie zweryfikowane przez ekspertów i przeznaczone do naprawy. |
| Naukowcy z Uniwersytetu Kalifornijskiego w Berkeley | Wykorzystując test porównawczy o nazwie CyberGym, modele AI przeanalizowały 188 projektów open source, wykrywając 17 luk w zabezpieczeniach — w tym 15 nieznanych błędów typu „zero-day” — oraz generując exploity potwierdzające możliwość wykorzystania tych luk. | Pokazuje rosnące możliwości AI w zakresie wykrywania luk w zabezpieczeniach i automatycznego zabezpieczania przed atakami. |
| Spur (start-up z Yale) | Opracowano agenta opartego na AI, który przekształca opisy przypadków testowych napisane prostym językiem w procedury automatyzacji testowania stron internetowych — w praktyce jest to samopiszący się cykl pracy kontroli jakości. | Umożliwia autonomiczne testowanie przy minimalnym udziale człowieka |
| Automatyczne odtwarzanie zgłoszeń błędów w systemie Android | Wykorzystano technologię NLP oraz uczenie wzmacniające do interpretacji treści zgłoszeń błędów i generowania kroków pozwalających odtworzyć błędy w systemie Android. | Osiągnięto 67% precyzji, 77% wskaźnika odzysku oraz odtworzono 74% zgłoszeń błędów, co przewyższa wyniki tradycyjnych metod. |
Typowe błędy w mierzeniu czasu rozwiązywania błędów
Jeśli pomiary są niedokładne, niedokładny będzie również plan usprawnień.
Większość „złych wyników” w cyklach pracy nad rozwiązywaniem błędów wynika z niejasnych definicji, niespójnych procesów i powierzchownej analizy.
Zacznij więc od podstaw — od tego, co uznaje się za rozpoczęcie/zakończenie, jak radzić sobie z okresami oczekiwania i ponownym otwieraniem zgłoszeń — a następnie interpretuj dane tak, jak postrzegają je Twoi klienci. Obejmuje to:
❌ Niejasne granice: Mieszanie wskaźników „Zgłoszone→Rozwiązane” i „Zgłoszone→Zamknięte” na tym samym pulpicie nawigacyjnym (lub zmienianie ich z miesiąca na miesiąc) sprawia, że trendy tracą znaczenie. Wybierz jedną granicę, udokumentuj ją i egzekwuj we wszystkich zespołach. Jeśli potrzebujesz obu, opublikuj je jako oddzielne wskaźniki z jasnymi etykietami.
❌ Podejście oparte wyłącznie na średnich: Opieranie się na średniej maskuje rzeczywistą sytuację w kolejkach, w których występuje kilka długotrwałych wartości odstających. Używaj mediany (P50) jako „typowego” czasu, P90 do celów przewidywalności/umów SLA, a średnią zachowaj do planowania obciążenia. Zawsze analizuj dystrybucję danych, a nie tylko pojedynczą liczbę.
❌ Brak segmentacji: Łączenie wszystkich błędów w jedną grupę powoduje, że incydenty P0 mieszają się z błędami kosmetycznymi P3. Należy segmentować według poziomu ważności, źródła (klient vs. kontrola jakości vs. monitorowanie), komponentu/zespołu oraz „nowe vs. regresja”. Wskaźnik P90 dla P0/P1 odzwierciedla odczucia interesariuszy; mediana dla P2+ stanowi podstawę planowania prac inżynieryjnych.
❌ Ignorowanie czasu „wstrzymania”: Czekasz na logi od klienta, na odpowiedź zewnętrznego dostawcy czy na termin wydania? Jeśli nie śledzisz statusu „Zablokowane/Wstrzymane” jako statusu pierwszorzędnego, czas rozwiązania staje się argumentem. Podawaj zarówno czas kalendarzowy, jak i czas aktywny, aby wąskie gardła miały widoczność, a dyskusje ustały.
❌ Luki w normalizacji czasu: Mieszanie stref czasowych lub przełączanie się w trakcie procesu między godzinami roboczymi a kalendarzowymi zniekształca porównania. Znormalizuj znaczniki czasu do jednej strefy (lub czasu UTC) i zdecyduj raz na zawsze, czy wskaźniki SLA są mierzone w godzinach roboczych, czy kalendarzowych; stosuj to spójnie.
❌ Nieprawidłowe zgłoszenia i duplikaty: Brakujące informacje o środowisku lub kompilacji oraz zduplikowane zgłoszenia wydłużają czas rozpatrywania i powodują niejasności co do własności. Ujednolicaj wymagane pola podczas rejestracji zgłoszeń, automatycznie uzupełniaj dane (logi, wersja, urządzenie) i usuwaj duplikaty bez resetowania licznika czasu — zamykaj duplikaty jako połączone, a nie jako „nowe” problemy.
❌ Niespójne modele statusów: Indywidualnie zdefiniowane statusy („Prawie gotowe do kontroli jakości”, „Oczekuje na przegląd 2”) ukrywają czas przebywania w danym statusie i sprawiają, że przejścia między stanami są niewiarygodne. Zdefiniuj standardowy cykl pracy (Nowe → Poddane selekcji → W trakcie postępu → W trakcie przeglądu → Rozwiązane → Zamknięte) i sprawdź, czy nie występują stany odbiegające od tej ścieżki.
❌ Nie zwracaj uwagi na czas spędzony w poszczególnych statusach: Pojedyncza wartość „czasu całkowitego” nie wskaże, gdzie praca utknęła. Rejestruj i analizuj czas spędzony w statusach „Klasyfikacja”, „W trakcie przeglądu”, „Zablokowane” i „Kontrola jakości”. Jeśli 90. percentyl czasu poświęconego na przegląd kodu znacznie przewyższa czas wdrożenia, rozwiązaniem nie jest „szybsze kodowanie”, ale odblokowanie obciążenia procesu przeglądu.
🧠 Ciekawostka: Najnowszy konkurs DARPA „AI Cyber Challenge” pokazał przełomowy skok w automatyzacji cyberbezpieczeństwa. W konkursie wzięły udział systemy oparte na AI, zaprojektowane do samodzielnego wykrywania, wykorzystywania i łatania luk w oprogramowaniu — bez udziału człowieka. Zwycięska drużyna, „Team Atlanta”, wykryła imponujące 77% wprowadzonych błędów i osiągnęła powodzenie w załataniu 61% z nich, demonstrując potęgę AI nie tylko w wykrywaniu luk, ale także w ich aktywnym naprawianiu.
❌ „Ślepota” związana z ponownym zgłaszaniem: Traktowanie ponownych zgłoszeń jako nowych błędów resetuje licznik czasu i zawyża wskaźnik MTTR. Śledź wskaźnik ponownych zgłoszeń oraz „czas do stabilnego zamknięcia” (od pierwszego zgłoszenia do ostatecznego zamknięcia we wszystkich cyklach). Rosnąca liczba ponownych zgłoszeń zazwyczaj wskazuje na słabą reprodukcję, luki w testach lub niejasną definicję „zakończenia”.
❌ Brak MTTA: Teams skupiają się wyłącznie na MTTR, ignorując MTTA (czas potwierdzenia/własności). Wysoki wskaźnik MTTA jest wczesnym ostrzeżeniem wskazującym na długi czas rozwiązywania problemów. Należy go mierzyć, ustalać umowy SLA w zależności od poziomu ważności oraz zautomatyzować kierowanie zgłoszeń i eskalację, aby utrzymać ten wskaźnik na niskim poziomie.
❌ AI/automatyzacja bez zabezpieczeń: Pozwolenie AI na ustalanie poziomu ważności lub zamykanie duplikatów bez weryfikacji może prowadzić do błędnej klasyfikacji przypadków granicznych i niepostrzeżonego zniekształcenia wskaźników. Wykorzystuj AI do generowania sugestii, wymagaj potwierdzenia przez człowieka w przypadku błędów P0/P1 oraz przeprowadzaj comiesięczne audyty wydajności modelu, aby Twoje dane pozostały wiarygodne.
Usprawnij te procesy, a wykresy czasu rozwiązywania problemów w końcu będą odzwierciedlać rzeczywistość. Stąd wynikają kolejne korzyści: lepsza rejestracja zgłoszeń skraca MTTA, przejrzystość stanów ujawnia prawdziwe wąskie gardła, a segmentowane wartości P90 dają liderom obietnice, które można spełnić.
⚡️ Archiwum szablonów: 10 szablonów przypadków testowych do testowania oprogramowania
Najlepsze praktyki dotyczące skuteczniejszego rozwiązywania błędów
Podsumowując, oto najważniejsze wskazówki, o których należy pamiętać!
| 🧩 Najlepsze praktyki | 💡 Co to oznacza | 🚀 Dlaczego to ma znaczenie |
| Korzystaj z niezawodnego systemu śledzenia błędów | Śledź wszystkie zgłoszone błędy za pomocą scentralizowanego systemu śledzenia błędów. | Gwarantuje, że żaden błąd nie zostanie pominięty, oraz zapewnia widoczność statusu błędów we wszystkich zespołach. |
| Twórz szczegółowe zgłoszenia błędów | Uwzględnij kontekst wizualny, informacje o systemie operacyjnym, kroki pozwalające odtworzyć błąd oraz poziom jego ważności. | Pomaga programistom szybciej usuwać błędy, zapewniając im wszystkie niezbędne informacje od samego początku. |
| Klasyfikuj i ustalaj priorytety błędów | Skorzystaj z matrycy priorytetów, aby posortować błędy według pilności i wpływu. | Pozwala zespołowi skupić się w pierwszej kolejności na krytycznych błędach i pilnych problemach. |
| Wykorzystaj automatyzację testowania | Uruchamiaj testy automatycznie w swoim potoku CI/CD. | Oferuje wsparcie wczesnego wykrywania i zapobiega regresjom. |
| Określ jasne wytyczne dotyczące raportowania | Zapewnij szablony i szkolenia dotyczące raportowania błędów. | Zapewnia to dokładne informacje i sprawniejszą komunikację. |
| Śledź kluczowe wskaźniki | Mierz czas rozwiązania, czas, który upłynął, oraz czas reakcji. | Umożliwia śledzenie wydajności i jej poprawę na podstawie danych historycznych. |
| Stosuj podejście proaktywne | Nie czekaj, aż użytkownicy zaczną zgłaszać skargi — przeprowadzaj testy z wyprzedzeniem. | Zwiększa to zadowolenie klientów i zmniejsza obciążenie działu wsparcia technicznego. |
| Wykorzystaj inteligentne narzędzia i uczenie maszynowe | Wykorzystaj uczenie maszynowe do przewidywania błędów i sugerowania rozwiązań. | Zwiększa efektywność w identyfikowaniu przyczyn źródłowych i naprawianiu błędów. |
| Dostosuj się do umów SLA | Organizuj spotkania dotyczące ustalonych umów o gwarantowanym poziomie usług (SLA) w zakresie rozwiązywania problemów. | Buduje zaufanie i terminowo spełnia oczekiwania klientów. |
| Ciągła weryfikacja i doskonalenie | Analizuj ponownie otwarte zgłoszenia, zbieraj opinie i dostosowuj procesy. | Wspiera ciągłe usprawnianie procesu programowania i zarządzania błędami. |
Proste rozwiązywanie błędów dzięki kontekstowej AI
Najszybsze zespoły zajmujące się usuwaniem błędów nie polegają na heroicznych wyczynach. Tworzą one system oparty na: jasnych definicjach rozpoczęcia i zakończenia, przejrzystym procesie przyjmowania zgłoszeń, ustalaniu priorytetów na podstawie wpływu na działalność firmy, precyzyjnym przypisaniu własności oraz ścisłej współpracy między działami wsparcia, kontroli jakości, inżynierii i wydawania aktualizacji.
ClickUp może stać się centrum dowodzenia opartym na sztucznej inteligencji dla Twojego systemu rozwiązywania błędów. Skoncentruj wszystkie zgłoszenia w jednej kolejce, ujednolicaj kontekst dzięki ustrukturyzowanym polom i pozwól ClickUp AI na klasyfikację, podsumowanie oraz ustalanie priorytetów, podczas gdy automatyzacje zapewniają przestrzeganie umów SLA, eskalują problemy w przypadku przekroczenia terminów i zapewniają spójność działań wszystkich interesariuszy. Powiąż błędy z klientami, kodem i wydaniami, aby kadra kierownicza widziała ich wpływ, a specjaliści mogli płynnie kontynuować przepływ pracy.
Jeśli chcesz skrócić czas rozwiązywania błędów i uczynić swój plan działania bardziej przewidywalnym, zarejestruj się w ClickUp i zacznij mierzyć poprawę w ciągu kilku dni — a nie kwartałów.
Najczęściej zadawane pytania
Jaki jest optymalny czas usuwania błędów?
Nie ma jednej „dobrej” wartości — zależy to od poziomu ważności, modelu wydawania aktualizacji i tolerancji ryzyka. Wykorzystaj mediany (P50) do oceny „typowej” wydajności, a P90 do oceny zobowiązań/umów SLA, oraz dokonaj podziału według poziomu ważności i źródła.
Jaka jest różnica między usunięciem błędu a zamknięciem zgłoszenia błędu?
Rozwiązanie ma miejsce, gdy wprowadzono poprawkę (np. scalono kod, zastosowano konfigurację) i zespół uznaje, że problem został usunięty. Zamknięcie ma miejsce, gdy problem został zweryfikowany i formalnie zakończony (np. zatwierdzony przez dział kontroli jakości w środowisku celu, wydany lub oznaczony jako „nie będzie naprawiany”/„duplikat” wraz z uzasadnieniem). Wiele zespołów mierzy oba wskaźniki: „Zgłoszone → Rozwiązane” odzwierciedla szybkość pracy inżynierów; „Zgłoszone → Zamknięte” odzwierciedla przepływ jakości od początku do końca. Należy stosować spójne definicje, aby pulpity nawigacyjne nie mieszały etapów.
Jaka jest różnica między czasem usuwania błędów a czasem ich wykrywania?
Czas wykrycia (MTTD) to czas potrzebny na wykrycie defektu po jego wystąpieniu lub wprowadzeniu do produkcji — poprzez monitorowanie, kontrolę jakości lub zgłoszenia użytkowników. Czas rozwiązania to czas potrzebny od wykrycia/zgłoszenia do wdrożenia poprawki (a także, jeśli wolisz, jej walidacji/wydania). Razem definiują one okno wpływu na klienta: szybkie wykrywanie, szybkie potwierdzenie, szybkie rozwiązanie i bezpieczne wydanie. Można również prowadzić śledzenie MTTA (czas potwierdzenia/przypisania), aby wykrywać opóźnienia w klasyfikacji, które często zapowiadają dłuższy czas rozwiązania.
W jaki sposób AI pomaga w usuwaniu błędów?
AI skraca etapy, które zazwyczaj powodują opóźnienia: rejestrację, klasyfikację, diagnozę, naprawę i weryfikację.
- Przyjmowanie zgłoszeń i klasyfikacja: automatycznie podsumowuje długie raporty, wyodrębnia kroki odtworzenia błędu i informacje o środowisku, oznaczają duplikaty oraz sugerują poziom ważności i priorytet, dzięki czemu inżynierowie zaczynają pracę od przejrzystego kontekstu (np. ClickUp AI, Sentry AI).
- Kierowanie zgłoszeń i umowy SLA: Przewiduje prawdopodobny komponent/właściciela, ustawia timery czasu i eskaluje, gdy MTTA lub czas oczekiwania na weryfikację ulegną wydłużeniu — zmniejszając bezczynny „czas w statusie” (automatyzacje ClickUp i cykle pracy przypominające pracę agentów).
- Diagnoza: Grupuje podobne błędy, koreluje skoki aktywności z ostatnimi commitami/wydaniami oraz wskazuje prawdopodobne przyczyny źródłowe za pomocą śladów stosu i kontekstu kodu (Sentry AI i podobne narzędzia).
- Wdrożenie: Sugeruje zmiany w kodzie i testy na podstawie wzorców z Twojego repozytorium, przyspieszając cykl „pisania/naprawiania” (GitHub Copilot; Snyk Code AI firmy DeepCode).
- Weryfikacja i komunikacja: tworzy przypadki testowe na podstawie kroków odtwarzania błędu, sporządza notatki do wydania i aktualizacje dla interesariuszy oraz podsumowuje status dla kadry kierowniczej i klientów (ClickUp AI). Dzięki połączeniu tych narzędzi — ClickUp jako centrum dowodzenia wraz z Sentry/Copilot/DeepCode w stosie technologicznym — zespoły skracają czasy MTTA/P90 bez konieczności polegania na heroicznych wysiłkach pojedynczych osób.