Rilasci l’ultimo aggiornamento software e la reportistica inizia ad arrivare a valanga.
Improvvisamente, un'unica metrica determina tutto, dal CSAT/NPS ai ritardi nella roadmap: il tempo di risoluzione dei bug.
I dirigenti la considerano una metrica che misura il rispetto degli impegni: riusciamo a rilasciare i prodotti, imparare e proteggere i ricavi nei tempi previsti? Chi lavora sul campo ne subisce le conseguenze: ticket duplicati, titolarità poco chiara, escalation confuse e informazioni sparse su Slack, fogli di calcolo e strumenti separati.
Tale frammentazione allunga i cicli, nasconde le cause alla radice e trasforma la definizione delle priorità in un'operazione di approssimazione.
Il risultato? Un apprendimento più lento, impegni non rispettati e un backlog che grava silenziosamente su ogni sprint.
Questa guida è il tuo manuale completo per misurare, confrontare e ridurre i tempi di risoluzione dei bug, illustrando in modo concreto come l’IA modifichi il flusso di lavoro rispetto ai processi tradizionali e manuali.
Che cos’è il tempo di risoluzione dei bug?
Il tempo di risoluzione dei bug è il tempo necessario per correggere un bug, misurato dal momento in cui il bug viene segnalato fino alla sua completa risoluzione.
In pratica, il conteggio del tempo inizia quando viene segnalato o rilevato un problema (da parte degli utenti, del team di controllo qualità o tramite il monitoraggio) e termina quando la correzione viene implementata e unita, pronta per la verifica o il rilascio, a seconda di come il vostro team definisce il concetto di “terminato”.
Esempio: un crash di priorità P1 segnalato alle 10:00 di Monday, con una correzione unita alle 15:00 di martedì, ha un tempo di risoluzione di circa 29 ore.
Non è la stessa cosa del tempo di rilevamento dei bug. Il tempo di rilevamento misura la rapidità con cui si riconosce un difetto dopo che si è verificato (attivazione di allarmi, individuazione da parte degli strumenti di test QA, reportistica da parte dei clienti).
Il tempo di risoluzione misura la rapidità con cui si passa dalla segnalazione alla correzione: triage, riproduzione, diagnosi, implementazione, revisione, test e preparazione al rilascio. Pensa al rilevamento come a “sappiamo che c’è un problema” e alla risoluzione come a “è stato risolto ed è tutto pronto”.
Teams utilizzano criteri leggermente diversi; scegline uno e mantieni la coerenza, in modo che le tue tendenze siano reali:
- Segnalato → Risolto: Il processo termina quando la correzione del codice viene unita ed è pronta per il controllo qualità. Utile per la produttività del reparto di ingegneria
- Segnalato → Chiuso: include la convalida da parte del controllo qualità e il rilascio. Ideale per gli SLA che hanno un impatto sui clienti
- Rilevato → Risolto: Il processo inizia quando il monitoraggio o il controllo qualità rileva il problema, anche prima che venga creato un ticket. Utile per i team con un carico di lavoro elevato in produzione
🧠 Curiosità: Un bug bizzarro ma esilarante in Final Fantasy XIV ha ricevuto elogi per essere così specifico che i lettori l’hanno soprannominato la “Correzione di bug più specifica in un MMO del 2025”. ” Si manifestava quando i giocatori fissavano il prezzo degli elementi esattamente tra 44.442 e 49.087 gil in una particolare zona di evento, causando disconnessioni dovute a quello che potrebbe essere un glitch da overflow di interi.
Perché è importante
Il tempo di risoluzione è una leva che influenza la cadenza delle release. Tempi lunghi o imprevedibili costringono a riduzioni dell’ambito, hotfix e blocchi delle release; generano un debito di pianificazione perché la coda lunga (i valori anomali) compromette gli sprint più di quanto suggerisca la media.
Questo aspetto è anche direttamente collegato alla soddisfazione dei clienti. I clienti tollerano i problemi quando questi vengono riconosciuti rapidamente e risolti in modo prevedibile. Le risoluzioni lente — o, peggio ancora, quelle incostanti — causano escalation, intaccano il CSAT/NPS e mettono a rischio i rinnovi.
In breve, se misurate accuratamente i tempi di risoluzione dei bug e li riducete in modo sistematico, i vostri piani di sviluppo e le vostre relazioni miglioreranno.
📖 Per saperne di più: Come stabilire le priorità dei bug per una risoluzione efficiente dei problemi
Come misurare i tempi di risoluzione dei bug?
Per prima cosa, stabilisci da dove parte e dove finisce il tuo conteggio.
La maggior parte dei team sceglie tra "Segnalato → Risolto" (la correzione è stata unita ed è pronta per la verifica) e "Segnalato → Chiuso" (il controllo qualità ha convalidato la modifica, che è stata rilasciata o comunque chiusa).
Scegli una definizione e utilizzala in modo coerente, in modo che le tue tendenze siano significative.
Ora ti servono alcune metriche osservabili. Vediamo quali sono:
Metriche chiave da tenere d'occhio nel monitoraggio dei bug:
| 📊 Metrica | 📌 Cosa significa | 💡 In che modo è utile | 🧮 Formula (se applicabile) |
|---|---|---|---|
| Numero di bug 🐞 | Numero totale di bug segnalati | Fornisce una panoramica generale dello stato di salute del sistema. Il numero è elevato? È ora di indagare. | Totale bug = Tutti i bug registrati nel sistema {Aperti + Chiusi} |
| Bugs aperti 🚧 | Bug non ancora risolti | Mostra il carico di lavoro attuale. Aiuta a stabilire le priorità. | Bug aperti = Totale bug - Bug chiusi |
| Bug chiusi ✅ | Bug risolti e verificati | Tiene traccia dello stato e del lavoro terminato. | Bug chiusi = Numero di bug con stato "Chiuso" o "Risolto" |
| Gravità dei bug 🔥 | Gravità del bug (ad es., critico, grave, minore) | Aiuta a classificare i bug in base all’impatto. | Monitorato come campo categoriale, senza formule. Utilizza filtri/raggruppamenti. |
| Priorità dei bug 📅 | Quanto è urgente risolvere un bug | Aiuta nella pianificazione degli sprint e delle versioni. | Si tratta inoltre di un campo categoriale, solitamente classificato (ad es., P0, P1, P2). |
| Tempo di risoluzione ⏱️ | Tempo che intercorre tra la segnalazione di un bug e la sua correzione | Misura la reattività. | Tempo di risoluzione = Data chiusa - Data di reportistica |
| Tasso di riapertura 🔄 | Percentuale di bug riaperti dopo essere stati chiusi | Riflette la qualità delle correzioni o i problemi di regressione. | Tasso di riapertura (%) = {Bug riaperti ÷ Totale bug chiusi} × 100 |
| Fughe di bug 🕳️ | Bug che sono sfuggiti al controllo e sono finiti in produzione | Indica l'efficacia del controllo qualità (QA) e dei test del software. | Tasso di dispersione (%) = {Bug di produzione ÷ Totale bug} × 100 |
| Densità dei difetti 🧮 | Bug per unità di dimensione del codice | Evidenzia le aree di codice soggette a rischio. | Densità dei difetti = Numero di bug ÷ KLOC {Kilo Lines of Code} |
| Bug assegnati vs bug non assegnati 👥 | Distribuzione dei bug in base alla titolarità | Assicura che nulla sfugga all’attenzione. | Utilizza un filtro: Non assegnati = Bug in cui il campo "Assegnato a" è nullo |
| Anzianità dei bug aperti 🧓 | Per quanto tempo un bug rimane irrisolto | Individua i rischi di stagnazione e di accumulo di lavoro arretrato. | Anzianità del bug = Data odierna - Data di segnalazione |
| Bugs duplicati 🧬 | Numero di segnalazioni duplicate | Evidenzia gli errori nei processi di acquisizione. | Tasso di duplicati = Duplicati ÷ Totale bug × 100 |
| MTTD (tempo medio di rilevamento) 🔎 | Tempo medio necessario per individuare bug o incidenti | Misura l'efficienza del monitoraggio e della consapevolezza. | MTTD = Σ(Tempo di rilevamento - Tempo di introduzione) ÷ Numero di bug |
| MTTR (tempo medio di risoluzione) 🔧 | Tempo medio necessario per risolvere completamente un bug dopo il suo rilevamento | Monitora la reattività del team di ingegneri e i tempi di risoluzione dei bug. | MTTR = Σ(Tempo di risoluzione - Tempo di rilevamento) ÷ Numero di bug risolti |
| MTTA (tempo medio di risposta) 📬 | Tempo che intercorre tra il rilevamento del bug e il momento in cui qualcuno inizia a lavorarci | Mostra la reattività del team e la prontezza nel rispondere agli avvisi. | MTTA = Σ(Tempo di conferma - Tempo di rilevamento) ÷ Numero di bug |
| MTBF (tempo medio tra i guasti) 🔁 | Tempo che intercorre tra la risoluzione di un guasto e il verificarsi di quello successivo | Indica la stabilità nel tempo. | MTBF = Tempo di funzionamento totale ÷ Numero di guasti |
⚡️ Archivio modelli: 15 modelli e moduli gratis per la segnalazione dei bug e il monitoraggio dei bug
Fattori che influenzano i tempi di risoluzione dei bug
Il tempo di risoluzione viene spesso equiparato alla “velocità con cui gli ingegneri scrivono il codice”.
Ma questa è solo una parte del processo.
Il tempo di risoluzione dei bug è dato dalla somma della qualità in fase di acquisizione, dell’efficienza del flusso all’interno del sistema e del rischio di dipendenza. Quando uno di questi elementi viene meno, la durata ciclo si allunga, la prevedibilità diminuisce e le segnalazioni di problemi aumentano.
La qualità dell’acquisizione dei ticket dà il tono
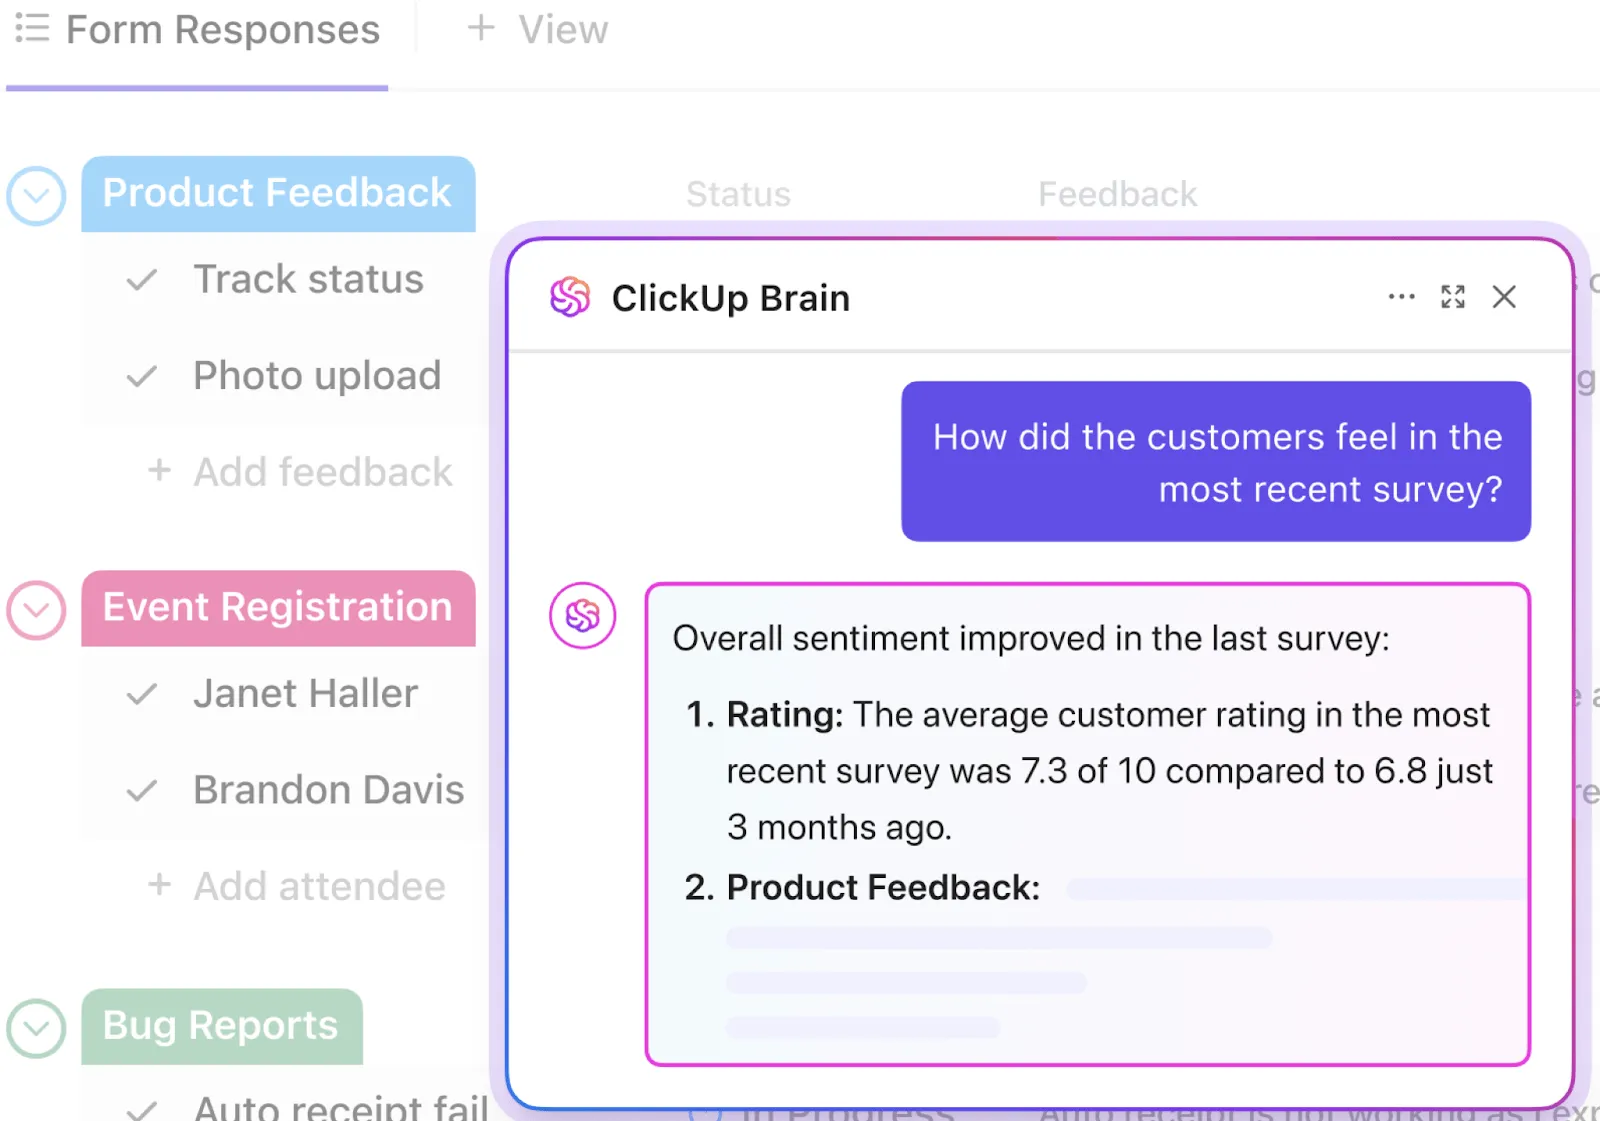
Le segnalazioni che arrivano senza chiari passaggi di riproduzione, dettagli sull’ambiente, log o informazioni su versione e build costringono a ulteriori scambi di comunicazioni. Le segnalazioni duplicate provenienti da più canali (assistenza, controllo qualità, monitoraggio, Slack) aumentano il rumore e frammentano la titolarità.
Prima si acquisisce il contesto corretto — ed si eliminano i dati duplicati — meno passaggi di consegne e richieste di chiarimenti saranno necessari in seguito.
La definizione delle priorità e l’instradamento determinano chi si occupa del bug e quando
Le etichette di gravità che non rispecchiano l’impatto sul cliente o sull’azienda (o che cambiano nel tempo) causano un’instabilità nella coda: i ticket più urgenti saltano la fila, mentre i difetti ad alto impatto rimangono in sospeso.
Regole di smistamento chiare per componente/titolare e un'unica coda di riferimento impediscono che il lavoro P0/P1 venga sepolto sotto quello “recente e rumoroso”.
La titolarità e i passaggi di consegne sono killer silenziosi
Se non è chiaro se un bug sia di competenza del team mobile, di quello dell’autenticazione backend o di quello della piattaforma, viene rinviato. Ogni rinvio azzera il contesto.
I fusi orari aggravano la situazione: un bug segnalato in tarda giornata senza un titolare designato può richiedere dalle 12 alle 24 ore prima che qualcuno inizi anche solo a riprodurlo. Definizioni chiare su “chi è il titolare di cosa”, con un DRI di turno o settimanale, eliminano questa perdita di tempo.
La riproducibilità dipende dall’osservabilità
Log incompleti, ID di correlazione mancanti o l’assenza di tracce di crash trasformano la diagnosi in un lavoro di congetture. I bug che si verificano solo con determinati flag, tenant o forme di dati sono difficili da riprodurre in ambiente di sviluppo.
Se gli ingegneri non riescono ad accedere in modo sicuro a dati puliti simili a quelli di produzione, finiscono per dover eseguire operazioni di strumentazione, reimplementazione e attesa — per giorni anziché per ore.
La parità di ambiente e dati garantisce la correttezza dei risultati
«Funziona sul mio computer» di solito significa «i dati di produzione sono diversi». Più i tuoi ambienti di sviluppo e staging si discostano da quelli di produzione (configurazione, servizi, versioni di componenti di terze parti), più tempo passerai a rincorrere fantasmi. Snapshot dei dati protetti, script di inizializzazione e controlli di parità riducono tale divario.
Il lavoro in corso (WIP) e la concentrazione determinano la produttività effettiva
I team sovraccarichi devono gestire troppi bug contemporaneamente, frammentano la loro attenzione e passano freneticamente da un'attività all'altra e da una riunione all'altra. Il cambio di contesto aggiunge ore di lavoro invisibili.
Un limite visibile al lavoro in corso (WIP) e la tendenza a portare a termine ciò che è stato iniziato prima di accettare nuovi incarichi ridurranno la mediana più rapidamente di qualsiasi singolo lavoro richiesto.
La revisione del codice, l’integrazione continua (CI) e la velocità del controllo qualità (QA) sono i classici colli di bottiglia
Tempi di compilazione lenti, test inaffidabili e SLA di revisione poco chiari rallentano correzioni che altrimenti sarebbero rapide. Una patch che richiederebbe 10 minuti può impiegare due giorni in attesa di un revisore o per inserirsi in una pipeline che richiede ore.
Allo stesso modo, le code di controllo qualità che eseguono test in batch o si basano su test di verifica manuali possono aggiungere intere giornate al percorso “Segnalato → Chiuso”, anche quando il percorso “Segnalato → Risolto” è veloce.
Le dipendenze allungano le code
Le modifiche che coinvolgono più team (schemi, migrazioni di piattaforma, aggiornamenti SDK), i bug dei fornitori o le revisioni degli app store (dispositivi mobili) generano tempi di attesa. Senza un monitoraggio esplicito degli stati “Bloccato/In pausa”, tali attese gonfiano invisibilmente le medie e nascondono dove si trova il vero collo di bottiglia.
Il modello di rilascio e la strategia di rollback sono fondamentali
Se effettui il rilascio in "release train" di grandi dimensioni con gate manuali, anche i bug risolti rimangono in sospeso fino alla partenza del train successivo. Gli interruttori di funzionalità, i rilasci canary e le hotfix lane accorciano i tempi di risoluzione — specialmente per gli incidenti P0/P1 — consentendoti di separare la distribuzione delle correzioni dai cicli di rilascio completi.
L’architettura e il debito tecnico determinano il tuo limite massimo
L'accoppiamento stretto, la mancanza di punti di test e i moduli legacy poco trasparenti rendono rischiose anche le correzioni più semplici. I team compensano con test aggiuntivi e revisioni più lunghe, il che allunga i cicli. Al contrario, un codice modulare con test di contratto efficaci consente di agire rapidamente senza compromettere i sistemi adiacenti.
La comunicazione e la gestione accurata dello stato influenzano la prevedibilità
Aggiornamenti vaghi (“stiamo esaminando la questione”) generano lavoro aggiuntivo quando gli stakeholder chiedono informazioni sui tempi di risoluzione previsti (ETA), il supporto riapre i ticket o il reparto prodotto interviene a livello superiore. Transizioni di stato chiare, note sulla riproducibilità e sulla causa principale, nonché un’indicazione chiara dei tempi di risoluzione previsti (ETA) riducono il tasso di abbandono e consentono al tuo team di ingegneri di rimanere concentrato sul proprio lavoro.
📮ClickUp Insight: In media, un professionista impiega più di 30 minuti al giorno alla ricerca di informazioni relative al lavoro: si tratta di oltre 120 ore all’anno perse a setacciare email, thread di Slack e file sparsi qua e là.
Un assistente intelligente basato sull’IA integrato nella tua area di lavoro può cambiare questa situazione. Scopri ClickUp Brain. Fornisce approfondimenti e risposte immediate, mettendo in evidenza i documenti, le conversazioni e i dettagli delle attività giusti in pochi secondi, così potrai smettere di cercare e iniziare a lavorare.
💫 Risultati concreti: Teams come QubicaAMF hanno recuperato più di 5 ore alla settimana grazie a ClickUp — ovvero oltre 250 ore all’anno a persona — eliminando i processi obsoleti di gestione delle conoscenze. Immagina cosa potrebbe realizzare il tuo team con una settimana in più di produttività ogni trimestre!
Indicatori anticipatori di un possibile allungamento del lead time di risoluzione
❗️Aumento del “tempo di conferma” e numerosi ticket senza un titolare per più di 12 ore
❗️Aumento delle fasce temporali relative al “Tempo di revisione/CI” e frequenti instabilità nei test
❗️Elevato tasso di duplicati nella registrazione dei bug e etichette di gravità incoerenti tra i vari team
❗️Diversi bug si trovano nello stato «Bloccato» senza una dipendenza esterna specificata
❗️Il tasso di riapertura sta aumentando (le correzioni non sono riproducibili o le definizioni di “terminato” sono vaghe)
Queste dinamiche vengono percepite in modo diverso a seconda delle organizzazioni. I dirigenti le interpretano come cicli di apprendimento persi e ritardi rispetto alle opportunità di fatturato; gli operatori le percepiscono come confusione nel triage e mancanza di chiarezza sulla titolarità.
Ottimizzando l’acquisizione, il flusso e le dipendenze è possibile abbassare l’intera curva, sia la mediana che il P90.
Vuoi ricevere ulteriori informazioni su come redigere segnalazioni di bug più efficaci? Inizia da qui. 👇🏼
📖 Per saperne di più: Il ciclo di vita del testing del software (STLC): panoramica e fasi
Parametri di riferimento del settore per i tempi di risoluzione dei bug
I parametri di riferimento per la risoluzione dei bug variano in base alla tolleranza al rischio, al modello di rilascio e alla rapidità con cui è possibile implementare le modifiche.
È qui che puoi utilizzare le mediane (P50) per comprendere il tuo flusso tipico e il P90 per definire impegni e SLA, in base alla gravità e alla fonte (cliente, controllo qualità, monitoraggio).
Analizziamo nel dettaglio cosa significa:
| 🔑 Termine | 📝 Descrizione | 💡 Perché è importante |
|---|---|---|
| P50 (mediana) | Il valore medio: il 50% delle correzioni dei bug è più veloce di questo, mentre il 50% è più lento | 👉 Riflette il tuo tempo di risoluzione tipico o più comune. Utile per comprendere le prestazioni normali |
| P90 (90° percentile) | Il 90% dei bug viene risolto entro questo lasso di tempo. Solo il 10% richiede più tempo | 👉 Rappresenta un limite nel caso peggiore (ma comunque realistico). Utile per definire promesse esterne |
| SLA (Accordi sul livello di servizio) | Gli impegni che assumi — internamente o nei confronti dei clienti — riguardo alla rapidità con cui verranno risolti i problemi | 👉 Esempio: «Risolviamo i bug P1 entro 48 ore nel 90% dei casi». Questo contribuisce a rafforzare la fiducia e la responsabilità. |
| Per gravità e origine | Segmenta le tue metriche in base a due dimensioni chiave: • Gravità (ad es. P0, P1, P2) • Origine (ad es. Cliente, QA, Monitoraggio) | 👉 Consente un monitoraggio e una definizione delle priorità più accurati, in modo che i bug critici ricevano attenzione più rapidamente |
Di seguito sono riportati gli intervalli indicativi basati sui settori a cui i team più esperti spesso si rivolgono; considerali come valori di partenza, poi adattali al tuo contesto.
SaaS
Il sistema è sempre attivo e compatibile con CI/CD, quindi le correzioni urgenti (hotfix) sono all’ordine del giorno. Per i problemi critici (P0/P1) si punta spesso a una mediana inferiore a un giorno lavorativo, con un P90 compreso tra 24 e 48 ore. I problemi non critici (P2+) hanno solitamente una mediana di 3–7 giorni, con un P90 compreso tra 10 e 14 giorni. I team che dispongono di interruttori di funzionalità affidabili e test automatizzati tendono a ottenere tempi di risoluzione più rapidi.
Piattaforme di e-commerce
Poiché i flussi di conversione e del carrello sono fondamentali per il fatturato, gli standard sono più elevati. I problemi P0/P1 vengono in genere mitigati nel giro di poche ore (rollback, segnalazione o configurazione) e risolti completamente entro lo stesso giorno; il P90 entro la fine della giornata o in meno di 12 ore è comune nei periodi di picco. I problemi P2+ spesso si risolvono in 2–5 giorni, con il P90 entro 10 giorni.
Software aziendale
Processi di convalida più complessi e finestre di modifica dei clienti rallentano il ritmo. Per i bug P0/P1, i team puntano a una soluzione provvisoria entro 4–24 ore e a una correzione entro 1–3 giorni lavorativi; per il P90 entro 5 giorni lavorativi. Gli elementi P2+ vengono spesso raggruppati in release train, con tempi mediani di 2–4 settimane a seconda delle tempistiche di implementazione dei clienti.
Giochi e app mobili
I backend dei servizi live si comportano come un SaaS (flag e rollback in pochi minuti o ore; P90 entro lo stesso giorno). Gli aggiornamenti client sono vincolati dalle revisioni dello store: i livelli P0/P1 spesso utilizzano immediatamente le leve lato server e distribuiscono una patch client in 1–3 giorni; il P90 entro una settimana con revisione accelerata. Le correzioni di livello P2+ vengono solitamente programmate per lo sprint successivo o il prossimo rilascio di contenuti.
Settore bancario/Fintech
I controlli di rischio e conformità determinano un modello di “mitigazione rapida, modifica attenta”. I bug P0/P1 vengono mitigati rapidamente (segnalazioni, rollback, deviazioni del traffico in pochi minuti o ore) e risolti completamente in 1–3 giorni; i bug P90 entro una settimana, tenendo conto del controllo delle modifiche. I bug P2+ richiedono spesso da 2 a 6 settimane per superare le revisioni di sicurezza, di audit e del CAB.
Se i tuoi numeri esulano da questi intervalli, esamina la qualità dell'accettazione, l'instradamento/la titolarità, la revisione del codice e la produttività del controllo qualità, nonché le approvazioni delle dipendenze, prima di dare per scontato che la "velocità di sviluppo" sia il problema principale.
🌼 Lo sapevate che: Secondo un sondaggio di Stack Overflow del 2024, gli sviluppatori ricorrevano sempre più spesso all’IA come fidato alleato nel loro percorso di programmazione. Un incredibile 82% ha utilizzato l’IA per scrivere effettivamente il codice: un vero e proprio collaboratore creativo! Quando si trovavano in difficoltà o alla ricerca di soluzioni, il 67,5% si è affidato all’IA per cercare risposte e oltre la metà (56,7%) l’ha utilizzata per il debug e per ottenere assistenza.
Per alcuni, gli strumenti di IA si sono rivelati utili anche per documentare i progetti (40,1%) e persino per generare dati o contenuti sintetici (34,8%). Sei curioso di scoprire un nuovo codice sorgente? Quasi un terzo (30,9%) utilizza l’IA per mettersi al passo. Il test del codice è ancora un lavoro manuale e faticoso per molti, ma il 27,2% ha adottato l’IA anche in questo ambito. Altri settori come la revisione del codice, la pianificazione dei progetti e l’analisi predittiva registrano un’adozione dell’IA più limitata, ma è chiaro che l’IA si sta progressivamente integrando in ogni fase dello sviluppo del software.
📖 Per saperne di più: Come utilizzare l’IA per il controllo qualità
Come ridurre i tempi di risoluzione dei bug
La rapidità nella risoluzione dei bug dipende dall’eliminazione degli attriti in ogni fase del processo, dall’acquisizione al rilascio.
I vantaggi maggiori derivano dall'ottimizzazione dei primi 30 minuti (registrazione accurata, titolare giusto, definizione della priorità corretta) e dalla successiva compressione dei cicli successivi (riproduzione, revisione, verifica).
Ecco nove strategie che funzionano insieme come un unico sistema. L’IA accelera ogni passaggio e il flusso di lavoro è organizzato in modo chiaro in un unico posto, garantendo così prevedibilità ai dirigenti e fluidità agli operatori.
1. Centralizza la raccolta dei bug e acquisisci il contesto alla fonte
I tempi di risoluzione dei bug si allungano quando devi ricostruire il contesto attingendo da thread di Slack, ticket di supporto e fogli di calcolo. Canalizza ogni segnalazione — assistenza, controllo qualità, monitoraggio — in un'unica coda grazie a un modello strutturato che raccoglie informazioni su componente, gravità, ambiente, versione/build dell'app, passaggi per riprodurre il problema, valori attesi rispetto a quelli effettivi e allegati (log/HAR/schermate).
L'IA è in grado di riassumere automaticamente rapporti lunghi, estrarre i passaggi necessari per riprodurre il bug e i dettagli dell'ambiente dagli allegati, nonché segnalare i possibili duplicati, in modo che la classificazione parta da una documentazione coerente e arricchita.
Metriche da monitorare: MTTA (risposta entro pochi minuti, non ore), tasso di duplicati, tempo trascorso in stato “Needs informazioni”.
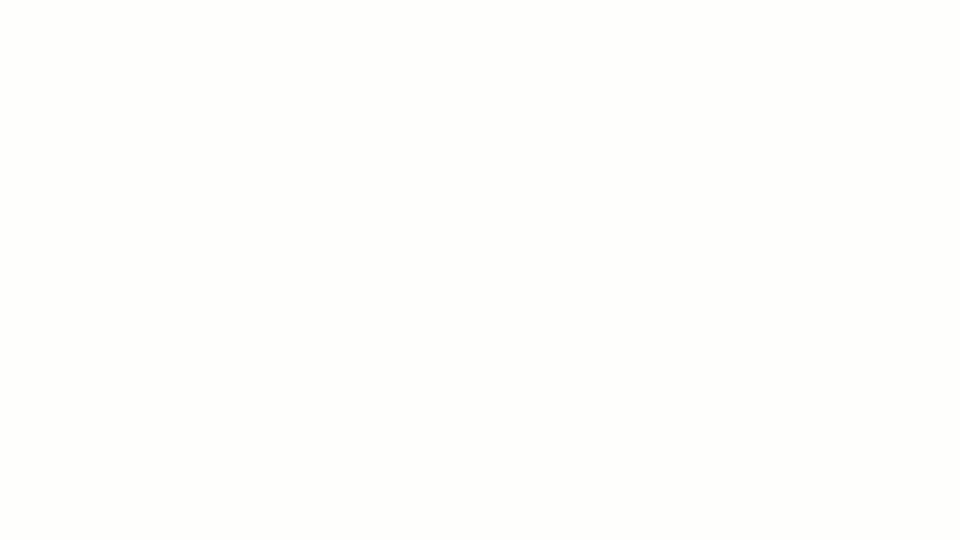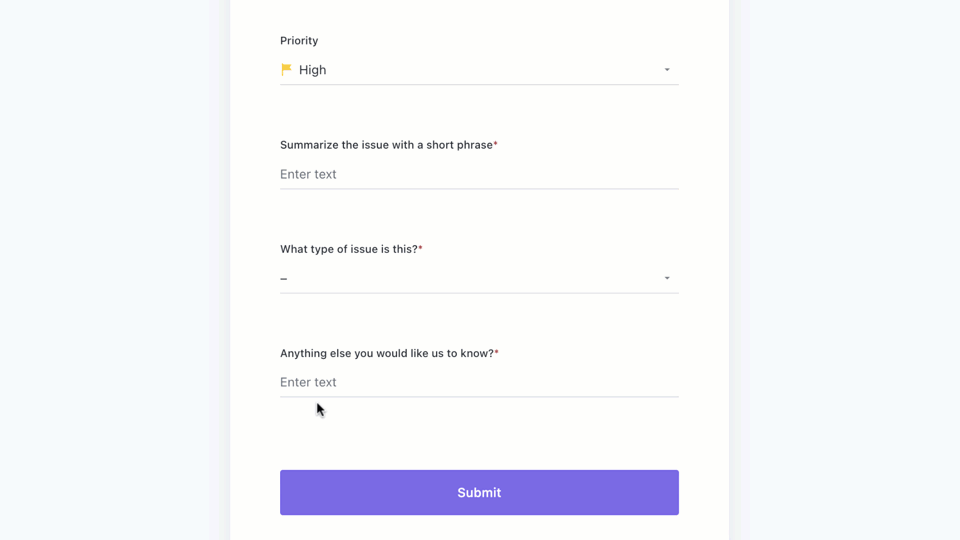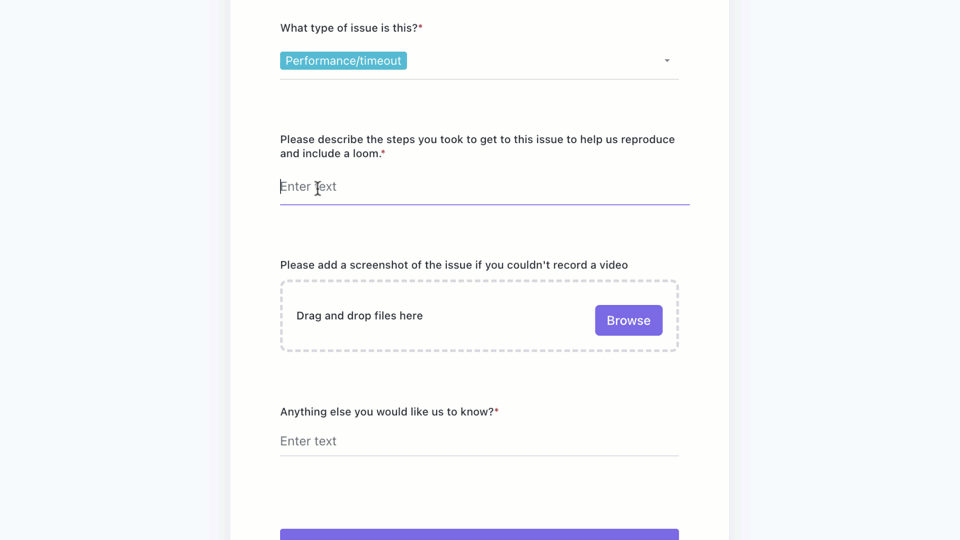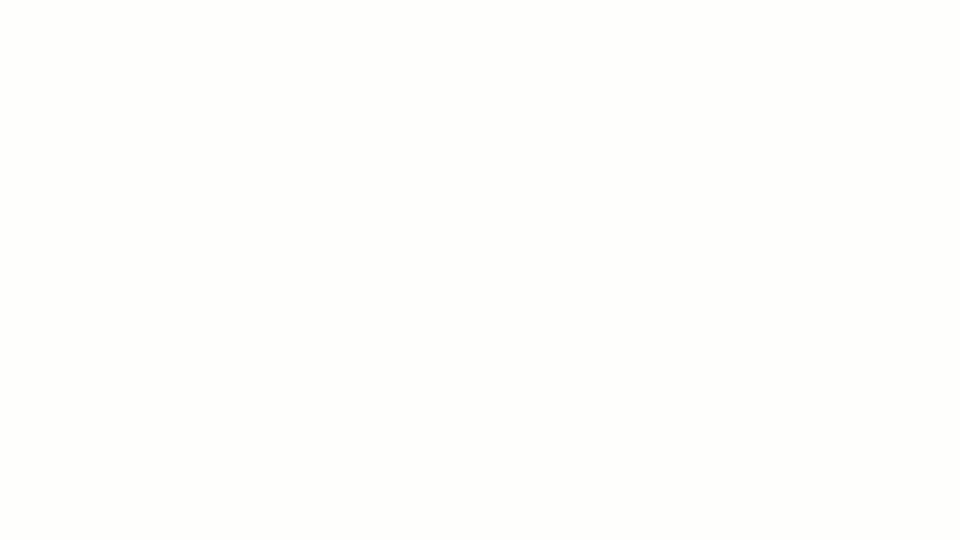
📖 Per saperne di più: La potenza dei moduli di ClickUp: ottimizzare il lavoro dei team di sviluppo software
2. Triage e instradamento assistiti dall'IA per ridurre drasticamente l'MTTA
Le soluzioni più rapide sono quelle che arrivano immediatamente sulla scrivania giusta.
Utilizza regole semplici e l’IA per classificare la gravità, identificare i titolari probabili in base al componente o all’area di codice e assegnare automaticamente i bug con un timer SLA. Definisci corsie chiare per i bug P0/P1 rispetto a tutto e rendi inequivocabile la titolarità di ciascun bug.
Le automazioni possono impostare la priorità in base ai campi, indirizzare i casi a un team in base al componente, avviare un timer SLA e avvisare un tecnico di turno; l’IA può proporre il livello di gravità e il titolare sulla base dei modelli passati. Quando il triage diventa un’operazione di 2–5 minuti invece che una discussione di 30 minuti, il tuo MTTA diminuisce e di conseguenza anche il tuo MTTR.
Metriche da monitorare: MTTA, qualità della prima risposta (il primo commento richiede le informazioni giuste?), numero di passaggi di responsabilità per bug.
Ecco come funziona nella pratica:
3. Assegnare le priorità in base all’impatto aziendale con livelli SLA ben definiti
Il principio secondo cui “chi urla più forte vince” rende le code imprevedibili e mina la fiducia dei dirigenti che monitorano i dati CSAT/NPS e i rinnovi.
Sostituisci questo approccio con un punteggio che tenga conto della gravità, della frequenza, dell’ARR interessato, della criticità della funzionalità/funzione e della vicinanza a rinnovi/lanci, e supportalo con livelli di SLA (ad es., P0: mitigare in 1–2 ore, risolvere entro un giorno; P1: entro lo stesso giorno; P2: entro un sprint).
Mantieni una corsia P0/P1 con una buona visibilità e limiti per il lavoro in corso (WIP), in modo che nessuna attività rimanga in sospeso.
Metriche da monitorare: risoluzione P50/P90 per livello, tasso di violazione degli SLA, correlazione con CSAT/NPS.
💡Suggerimento da esperto: le priorità delle attività, i campi personalizzati e i campi delle dipendenze di ClickUp ti consentono di calcolare un punteggio di impatto e di collegare i bug ad account, feedback o elementi della roadmap; inoltre, gli Obiettivi in ClickUp ti aiutano a collegare il rispetto degli SLA agli obiettivi a livello aziendale, rispondendo direttamente alle preoccupazioni dei dirigenti in merito all’allineamento.
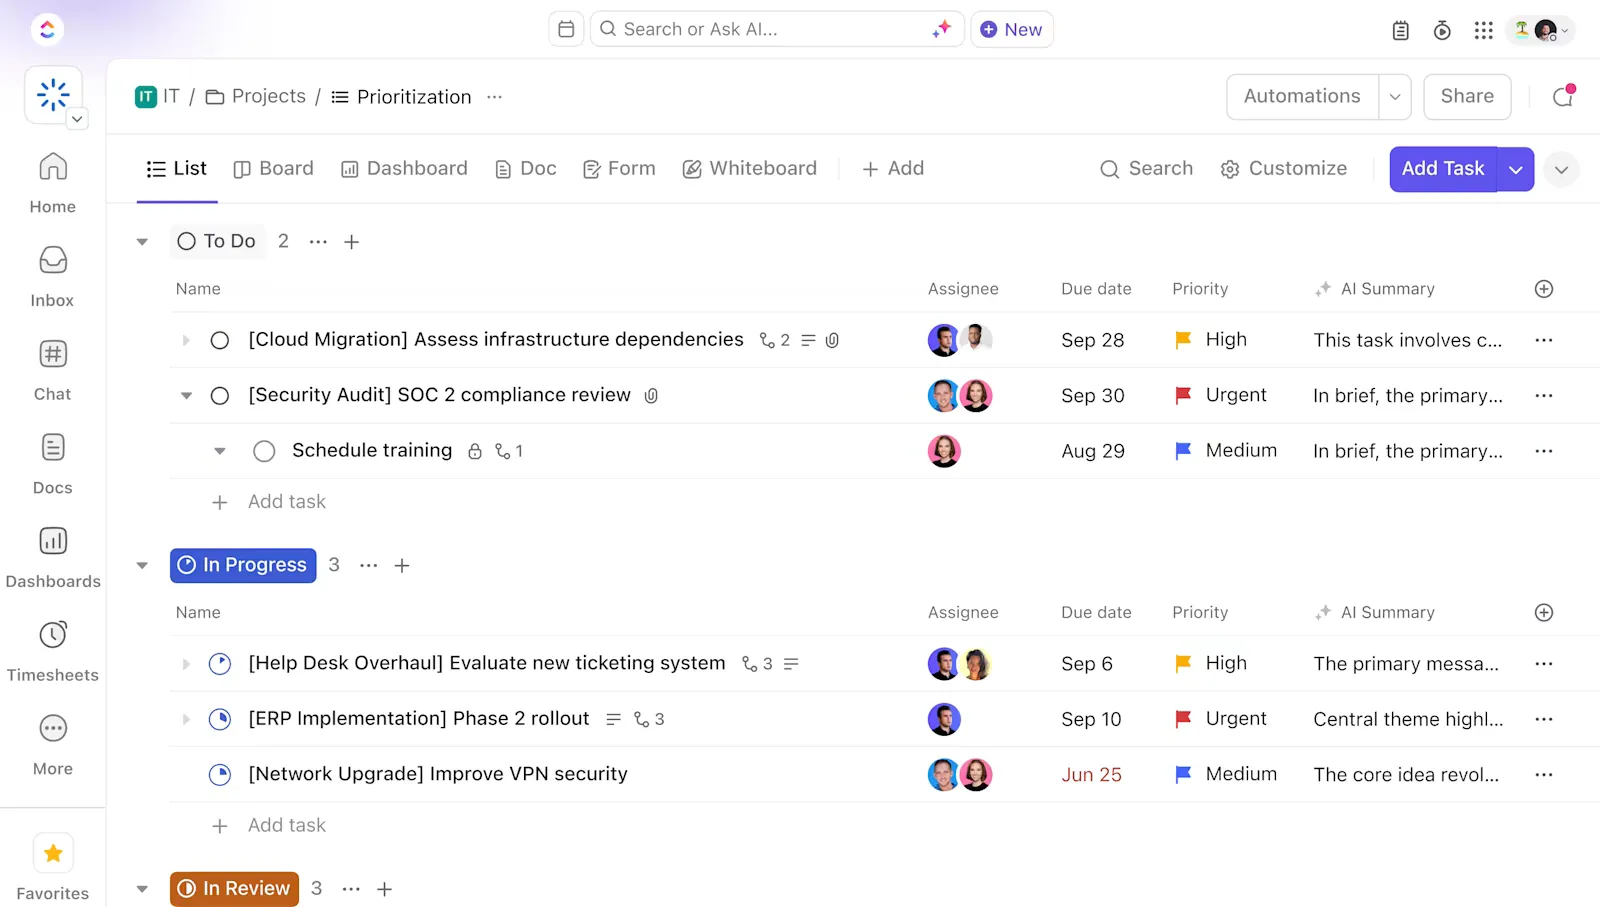
4. Trasforma la riproduzione e la diagnosi in un'attività che richiede un unico passaggio
Ogni ulteriore richiesta del tipo «puoi inviarmi i log?» allunga i tempi di risoluzione.
Standardizza i criteri di qualità: campi obbligatori per build/commit, ambiente, passaggi di riproduzione, valori attesi rispetto a quelli effettivi, oltre ad allegati per log, dump di crash e file HAR. Implementa la telemetria client/server in modo che gli ID dei crash e delle richieste siano collegabili alle tracce.
Integra Sentry (o una soluzione simile) per ottenere le tracce dello stack e collega direttamente quel problema al bug. L’IA è in grado di analizzare i log e le tracce per suggerire un possibile dominio di errore e generare un caso di riproduzione minimale, trasformando un’ora di analisi visiva in pochi minuti di lavoro mirato.
Archivia i runbook relativi alle categorie più comuni di bug, in modo che i tecnici non debbano partire da zero.
Metriche da monitorare: tempo trascorso in “Attesa di informazioni”, percentuale di riproducibilità al primo tentativo, tasso di riapertura legato alla mancata riproducibilità.
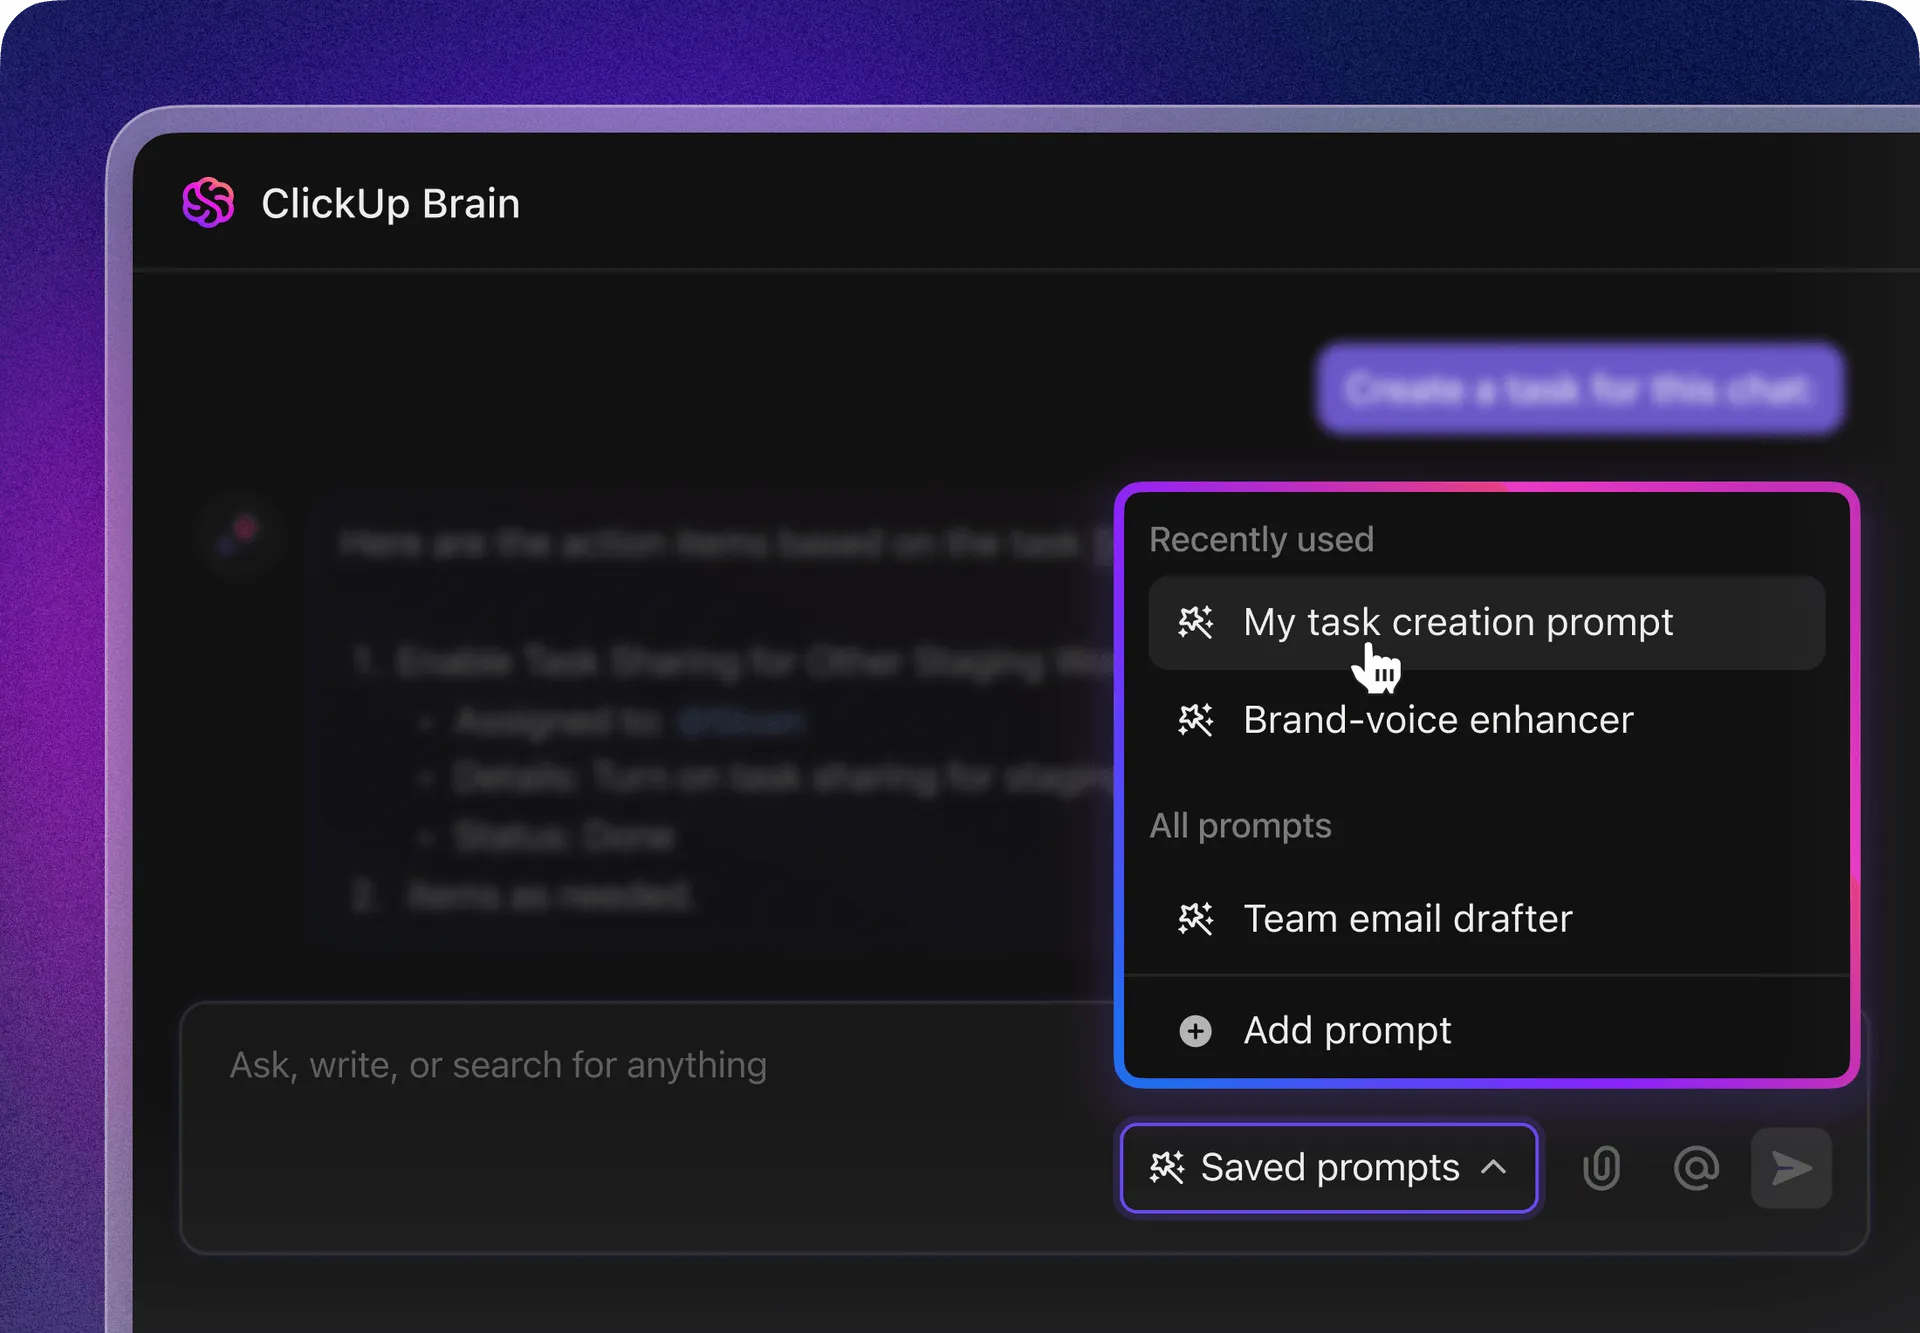
📖 Ulteriori informazioni: Come utilizzare l’IA nello sviluppo software (casi d’uso e strumenti)
5. Accorciare il ciclo di revisione del codice e di test
I PR di grandi dimensioni tendono a rimanere in sospeso. Punta a patch mirate, allo sviluppo basato sul trunk e agli interruttori di funzionalità, in modo che le correzioni possano essere distribuite in sicurezza. Assegna in anticipo i revisori in base alla titolarità del codice per evitare tempi di inattività e utilizza liste di controllo (test aggiornati, telemetria aggiunta, flag protetto da un kill switch) per garantire che la qualità sia integrata fin dall’inizio.
L'automazione dovrebbe spostare il bug nello stato "In revisione" all'apertura della pull request e nello stato "Risolto" al momento di unire i file; l'IA può suggerire test unitari o evidenziare le differenze rischiose su cui concentrare la revisione.
Metriche da monitorare: tempo trascorso nello stato “In revisione”, tasso di fallimento delle modifiche per le PR di correzione dei bug e latenza di revisione P90.
Puoi utilizzare le integrazioni GitHub/Gitlab in ClickUp per mantenere sincronizzato lo stato di risoluzione; le automazioni possono far rispettare la “definizione di completamento”.
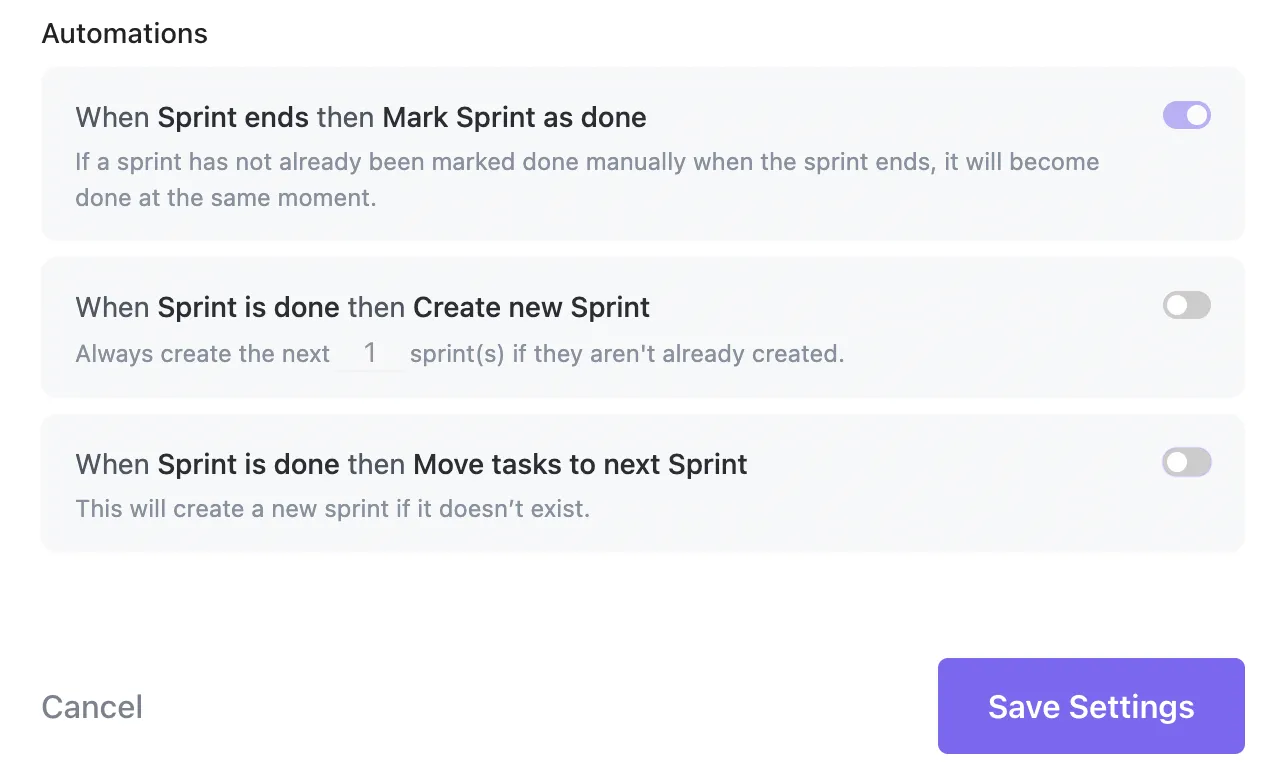
📖 Per saperne di più: Come utilizzare l’IA per automatizzare le attività
6. Parallelizza la verifica e rendi reale la parità dell’ambiente QA
La verifica non dovrebbe iniziare giorni dopo o in un ambiente che nessuno dei tuoi clienti utilizza.
Mantieni rigorosamente lo stato “pronto per il controllo qualità”: hotfix basati su segnalazioni e convalidati in ambienti simili a quelli di produzione con dati di test che corrispondono ai casi segnalati.
Ove possibile, configura ambienti temporanei a partire dal ramo del bug in modo che il team di controllo qualità possa effettuare immediatamente la convalida; l'IA potrà quindi generare casi di test sulla base della descrizione del bug e delle regressioni passate.
Metriche da monitorare: Tempo trascorso in “QA/Verifica”, tasso di rimbalzo dal QA allo sviluppo, tempo mediano di chiusura dopo che si uniscono le due versioni.
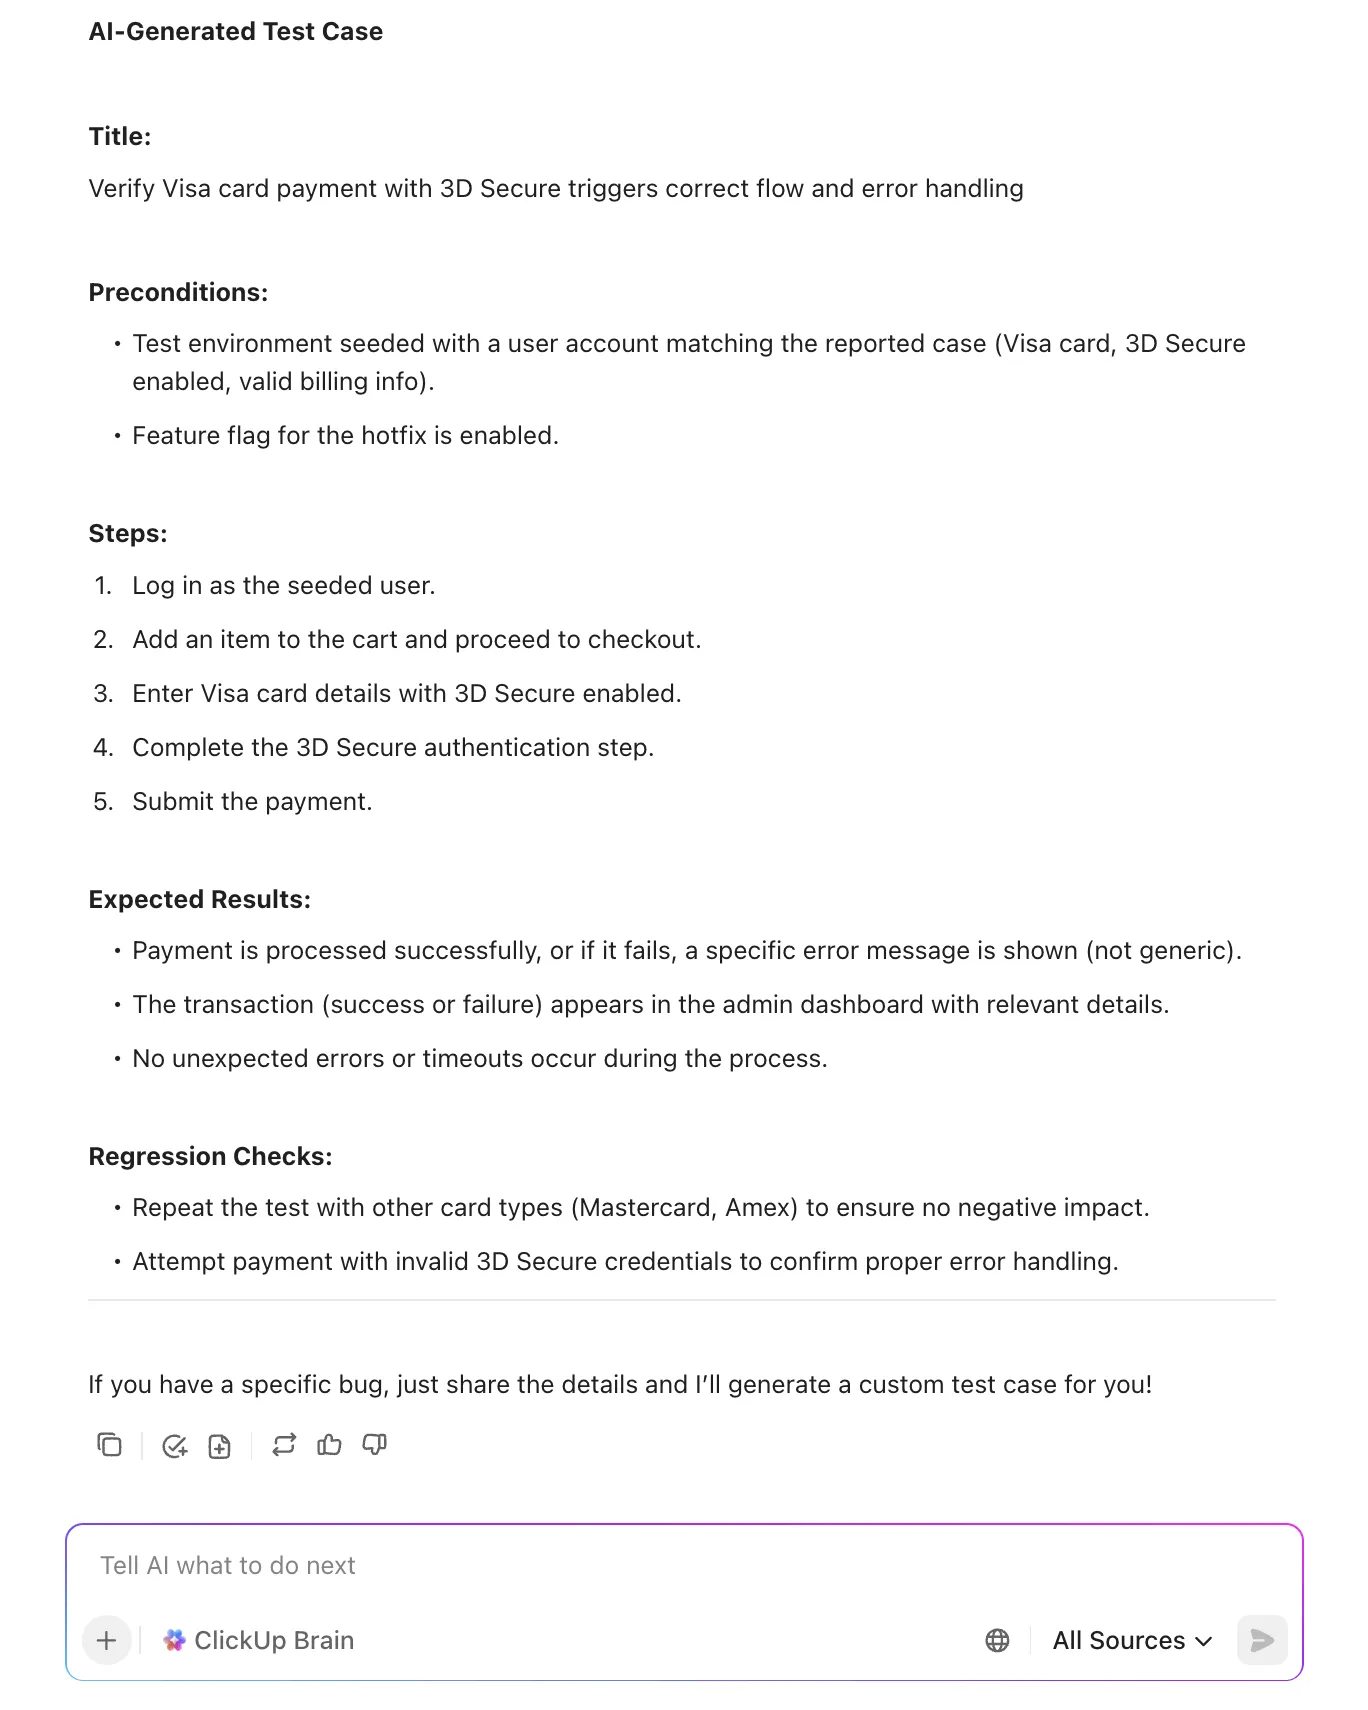
📖 Per saperne di più: Come scrivere casi di test efficaci
7. Comunicare lo stato in modo chiaro per ridurre gli oneri di coordinamento
Un aggiornamento ben fatto evita tre richieste di aggiornamento sullo stato e un'escalation.
Trattate gli aggiornamenti come un prodotto: brevi, specifici e mirati al pubblico di destinazione (assistenza, dirigenti, clienti). Stabilite una cadenza per i bug P0/P1 (ad esempio, ogni ora fino alla risoluzione, poi ogni quattro ore) e mantenete un'unica fonte di verità.
L’IA può redigere aggiornamenti sicuri per i clienti e riepiloghi interni sulla base della cronologia delle attività, includendo lo stato in tempo reale per gravità e per team. Per i dirigenti, come il tuo direttore di prodotto, raggruppa i bug in base alle iniziative, in modo che possano verificare se eventuali problemi critici relativi alla qualità potrebbero compromettere le promesse di consegna.
Metriche da monitorare: tempo che intercorre tra gli aggiornamenti dello stato su P0/P1, indice di soddisfazione dei clienti (CSAT) delle parti interessate riguardo alle comunicazioni.
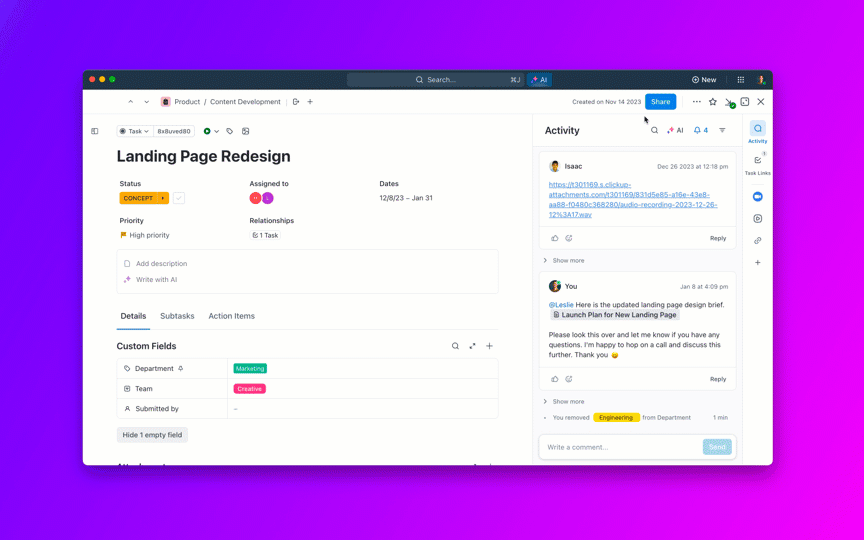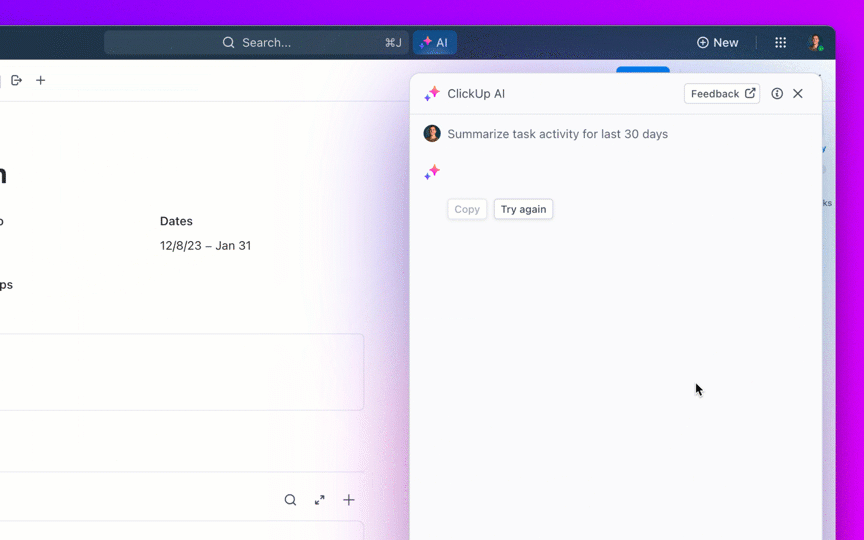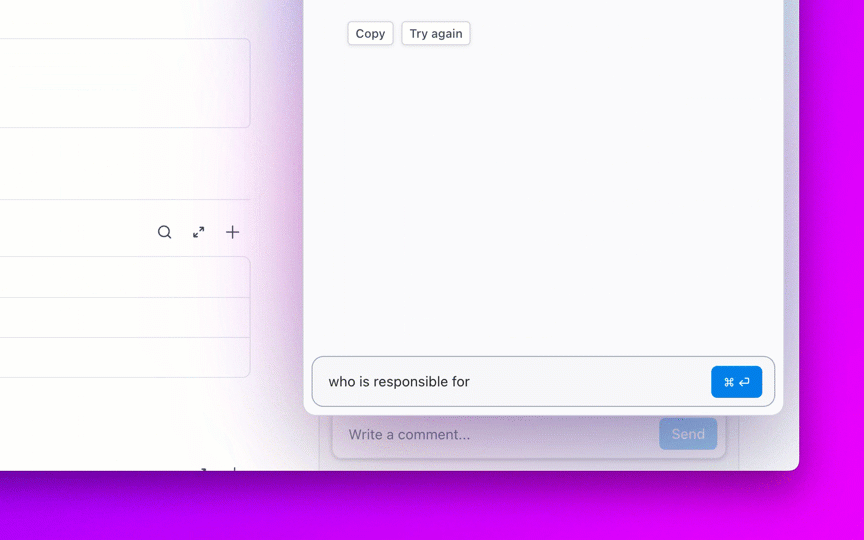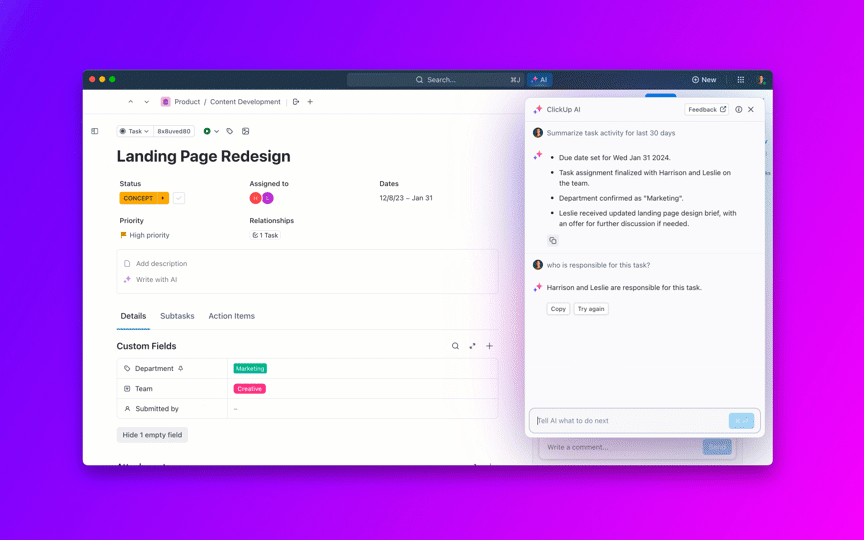
8. Controlla l’anzianità del backlog e previeni i ticket “permanentemente aperti”
Un backlog in continua crescita e ormai obsoleto grava silenziosamente su ogni sprint.
Imposta criteri di scadenza (ad es., P2 > 30 giorni attiva la revisione, P3 > 90 giorni richiede una giustificazione) e programma un “triage delle scadenze” settimanale per unire i duplicati, chiudere i report obsoleti e convertire i bug di basso valore in elementi del backlog di prodotto.
Utilizza l’IA per raggruppare il backlog per tema (ad es., «scadenza del token di autenticazione», «instabilità nel caricamento delle immagini») in modo da poter programmare settimane dedicate alla correzione di problemi specifici ed eliminare una categoria di difetti in un colpo solo.
Metriche da monitorare: numero di ticket in arretrato per fascia temporale, percentuale di problemi chiusi perché duplicati o obsoleti, velocità di riduzione per area tematica.
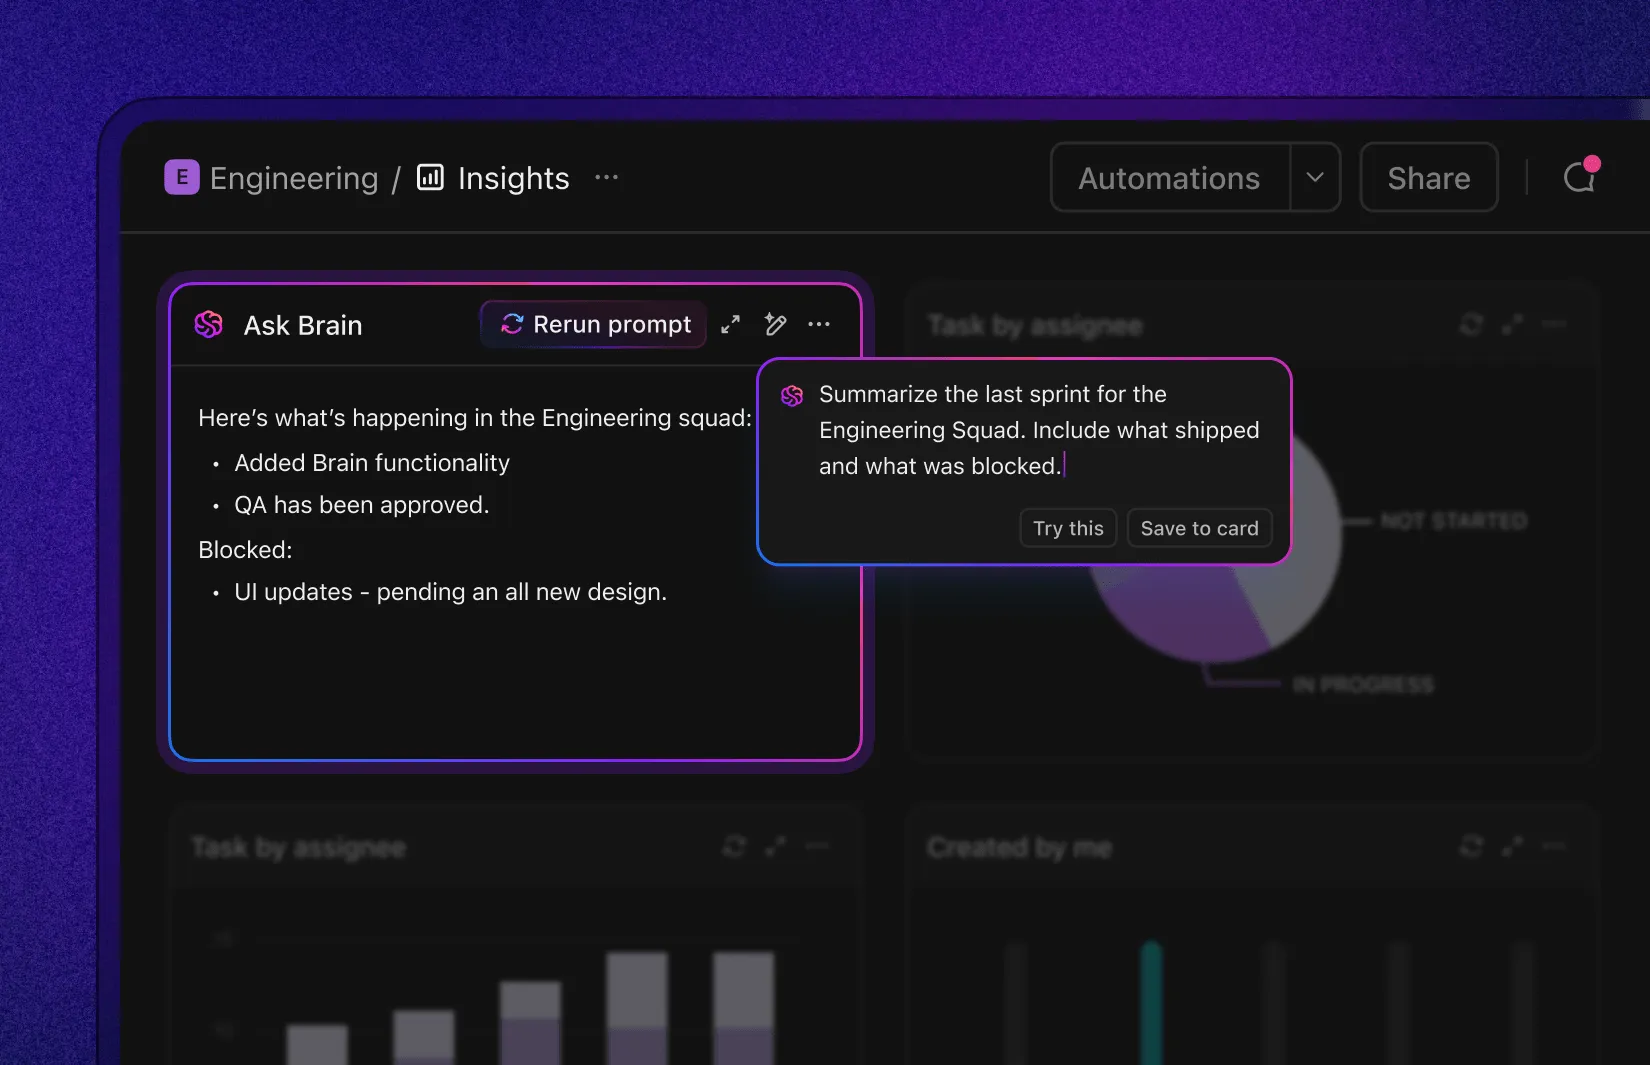
9. Chiudere il ciclo con l'individuazione della causa principale e la prevenzione
Se la stessa categoria di difetti continua a ripresentarsi, i miglioramenti ottenuti nell’MTTR nascondono un problema più grave.
Esegui analisi rapide e imparziali delle cause alla radice per i bug P0/P1 e P2 ad alta frequenza; assegna tag alle cause alla radice (lacune nelle specifiche, nei test o negli strumenti, instabilità dell’integrazione), collegale ai componenti e agli incidenti interessati e monitora le attività di follow-up (misure di protezione, test, regole di lint) fino al loro completamento.
L’IA può redigere riassunti delle analisi delle cause alla radice (RCA) e proporre test preventivi o regole di lint sulla base della cronologia delle modifiche. Ed è così che si passa dal dover spegnere gli incendi al ridurne il numero.
Metriche da monitorare: tasso di riapertura, tasso di regressione, intervallo tra le ricorrenze e percentuale di analisi delle cause (RCA) con azioni preventive completate.
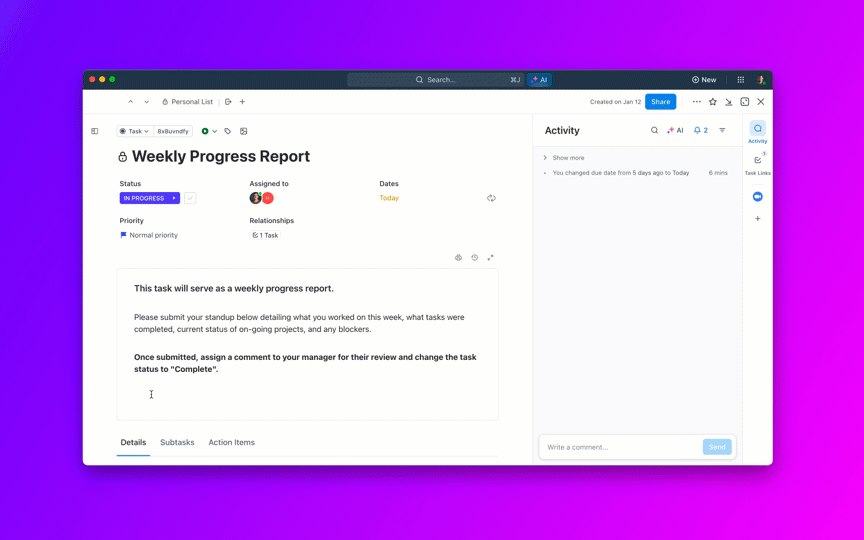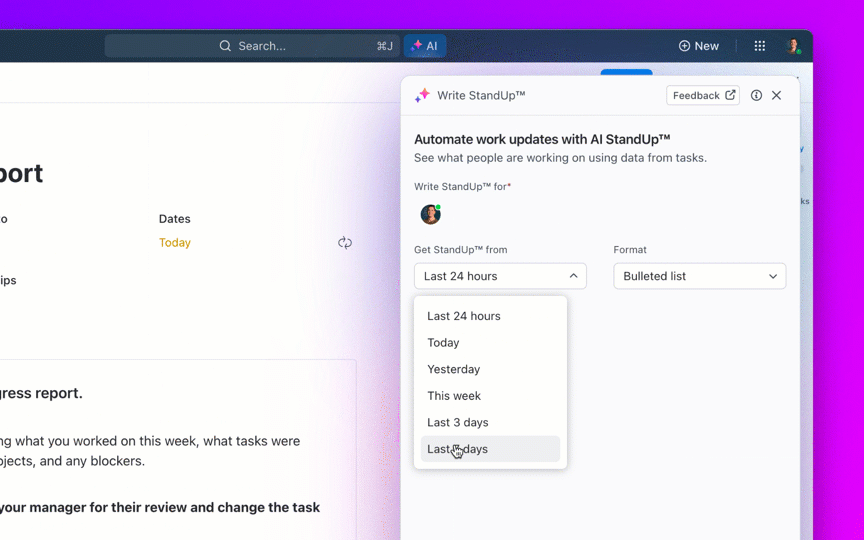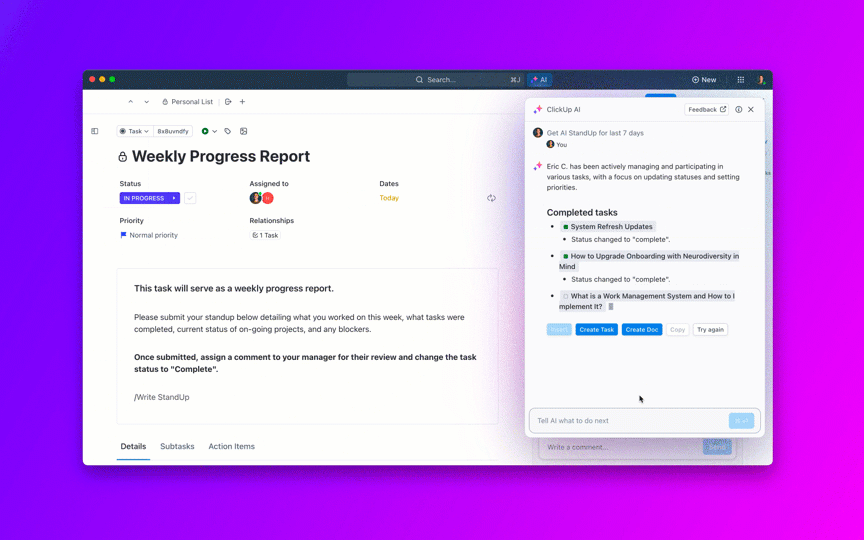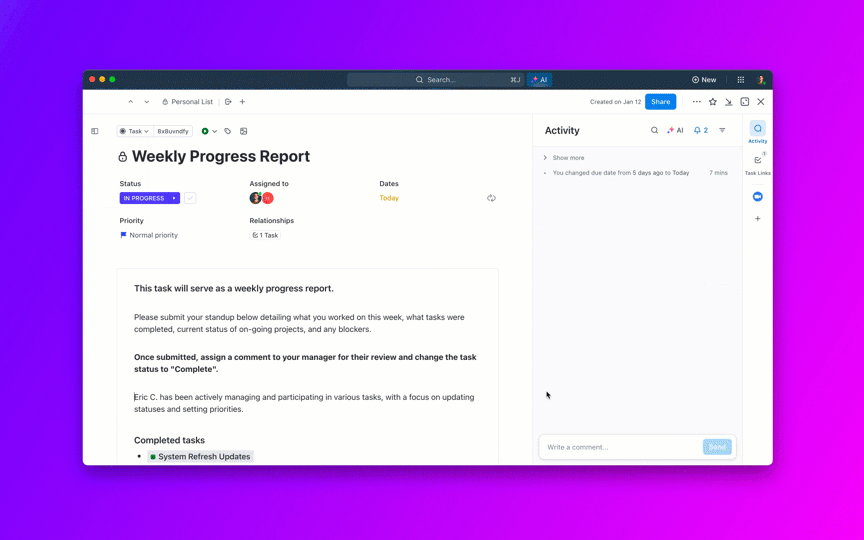
Nel loro insieme, questi cambiamenti snelliscono l’intero percorso: conferma di ricezione più rapida, triage più preciso, definizione delle priorità più intelligente, minori ritardi nelle fasi di revisione e controllo qualità e una comunicazione più chiara. I dirigenti ottengono una maggiore prevedibilità in termini di CSAT/NPS e fatturato; gli operatori hanno a disposizione una coda più gestibile con meno cambi di contesto.
📖 Per saperne di più: Come eseguire un'analisi delle cause alla radice
Strumenti di IA che aiutano a ridurre i tempi di risoluzione dei bug
L'IA può ridurre i tempi di risoluzione in ogni passaggio: ricezione, triage, instradamento, correzione e verifica.
Tuttavia, i veri vantaggi si ottengono quando gli strumenti comprendono il contesto e mantengono il lavoro senza bisogno di un intervento manuale.
Cerca sistemi in grado di arricchire automaticamente i report (passaggi per la riproduzione, ambiente, duplicati), stabilire le priorità in base all’impatto, indirizzare i bug al titolare corretto, redigere aggiornamenti chiari e integrarsi perfettamente con il tuo codice, la CI e l’osservabilità.
I migliori di questi strumenti offrono anche supporto per flussi di lavoro simili a quelli degli agenti: bot che monitorano gli SLA, sollecitano i revisori, inoltrano gli elementi in stallo e riepilogano i risultati per le parti interessate. Ecco la nostra selezione di strumenti di IA per una migliore risoluzione dei bug:
1. ClickUp (Ideale per l'IA contestuale, le automazioni e i flussi di lavoro basati sugli agenti)
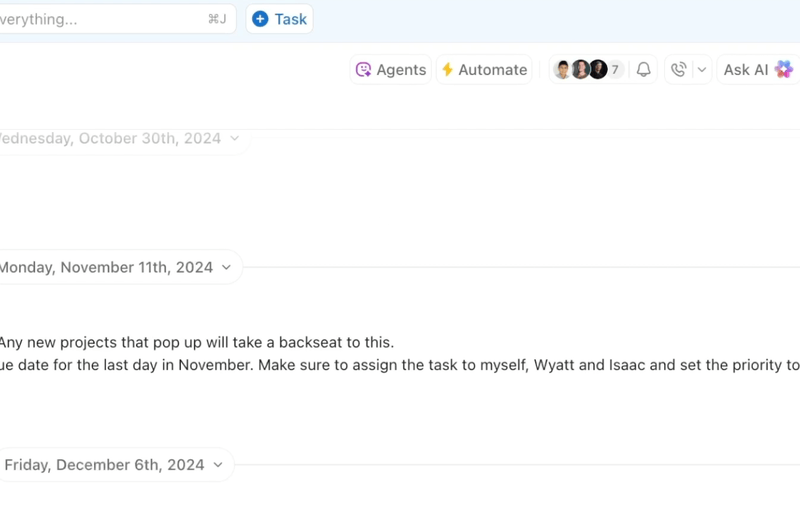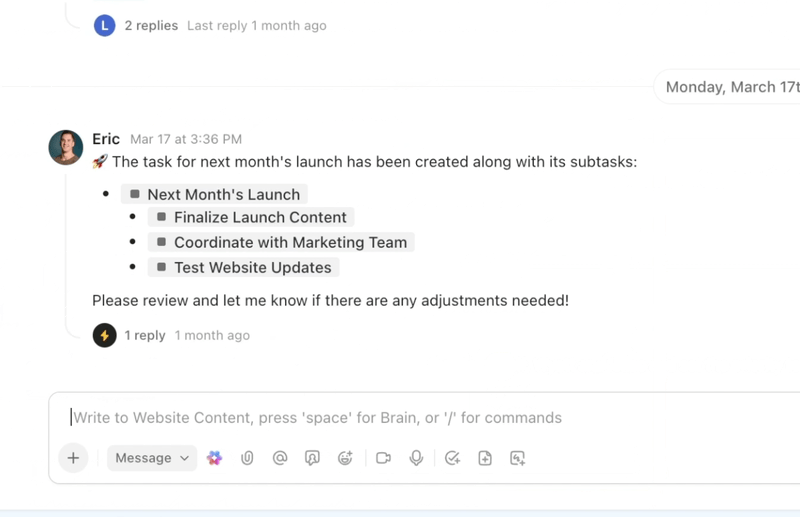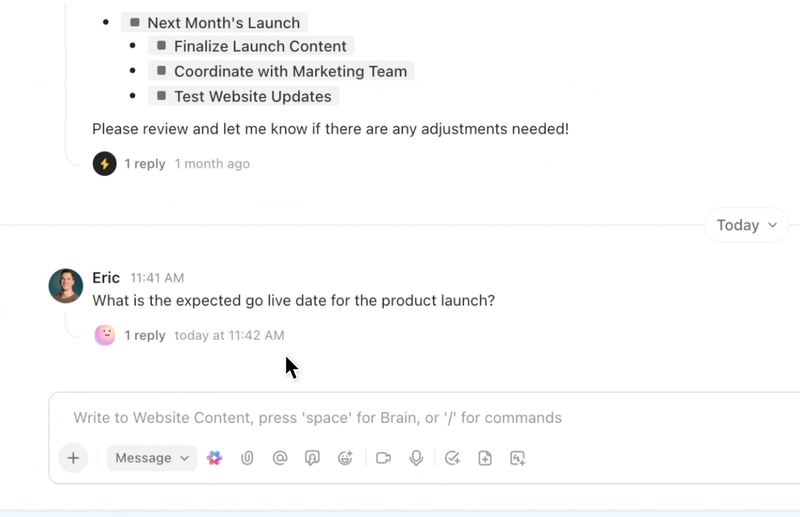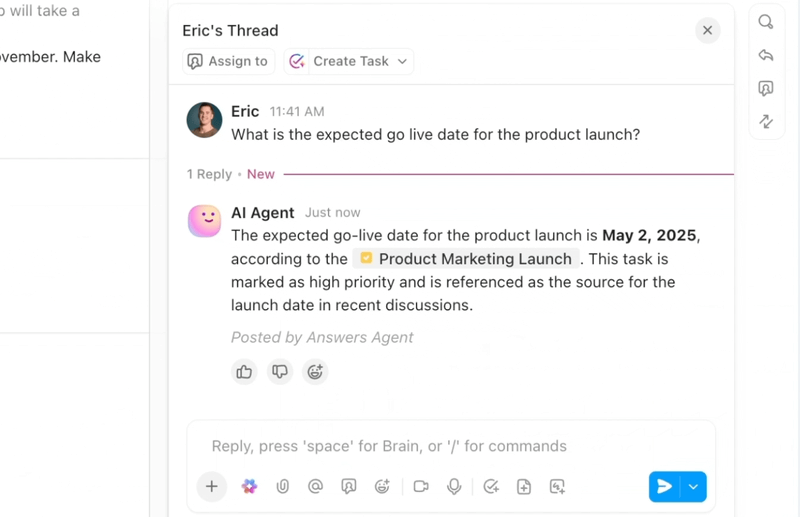
Se desideri un flusso di lavoro snello e intelligente per la risoluzione dei bug, ClickUp, l’app completa per il lavoro, riunisce in un unico posto IA, automazioni e assistenza automatizzata per i flussi di lavoro.
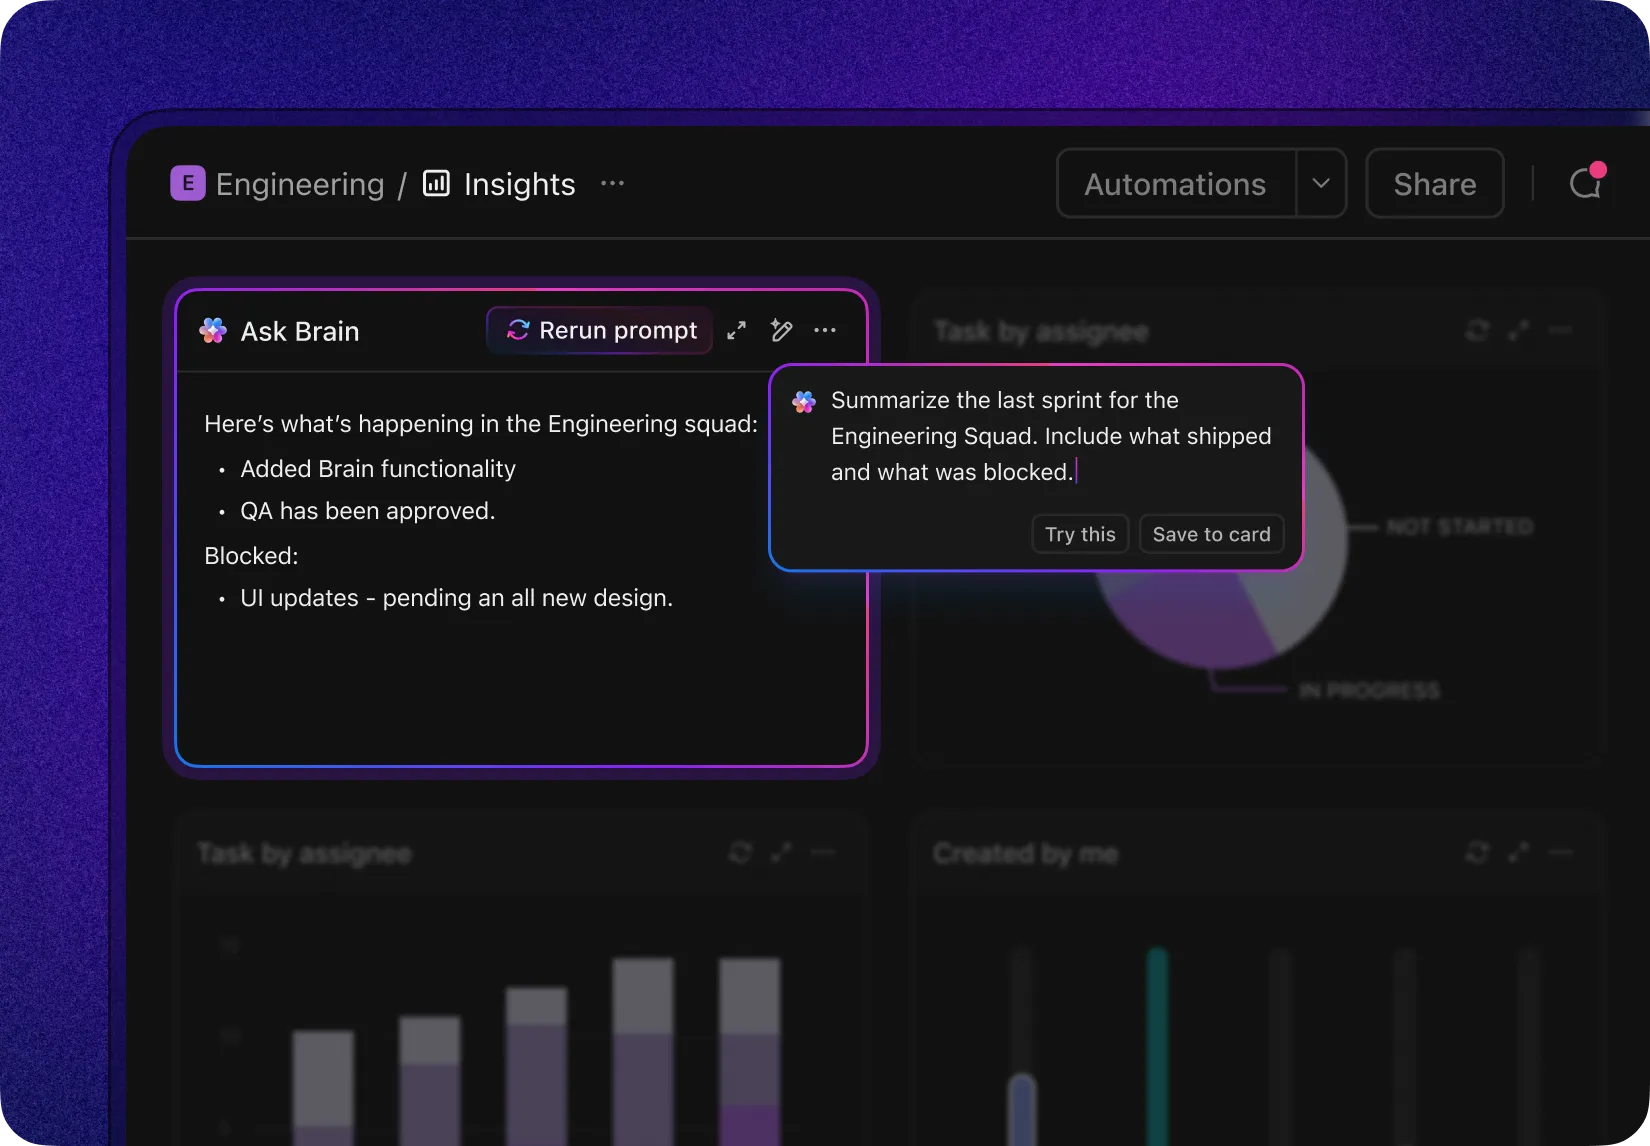
ClickUp Brain mette immediatamente in evidenza il contesto giusto: riepiloga le lunghe discussioni sui bug, estrae dagli allegati i passaggi per riprodurre il problema e i dettagli sull’ambiente, segnala i possibili duplicati e suggerisce le azioni successive. Invece di dover setacciare Slack, i ticket e i log, i team ottengono una cronologia chiara e arricchita su cui possono agire immediatamente.
Le automazioni e gli agenti Autopilot di ClickUp mantengono il flusso di lavoro senza bisogno di un intervento costante. I bug vengono indirizzati automaticamente al team giusto, vengono assegnati i titolari, vengono impostati gli SLA e le date di scadenza, gli stati si aggiornano man mano che il lavoro procede e le parti interessate ricevono notifiche tempestive.
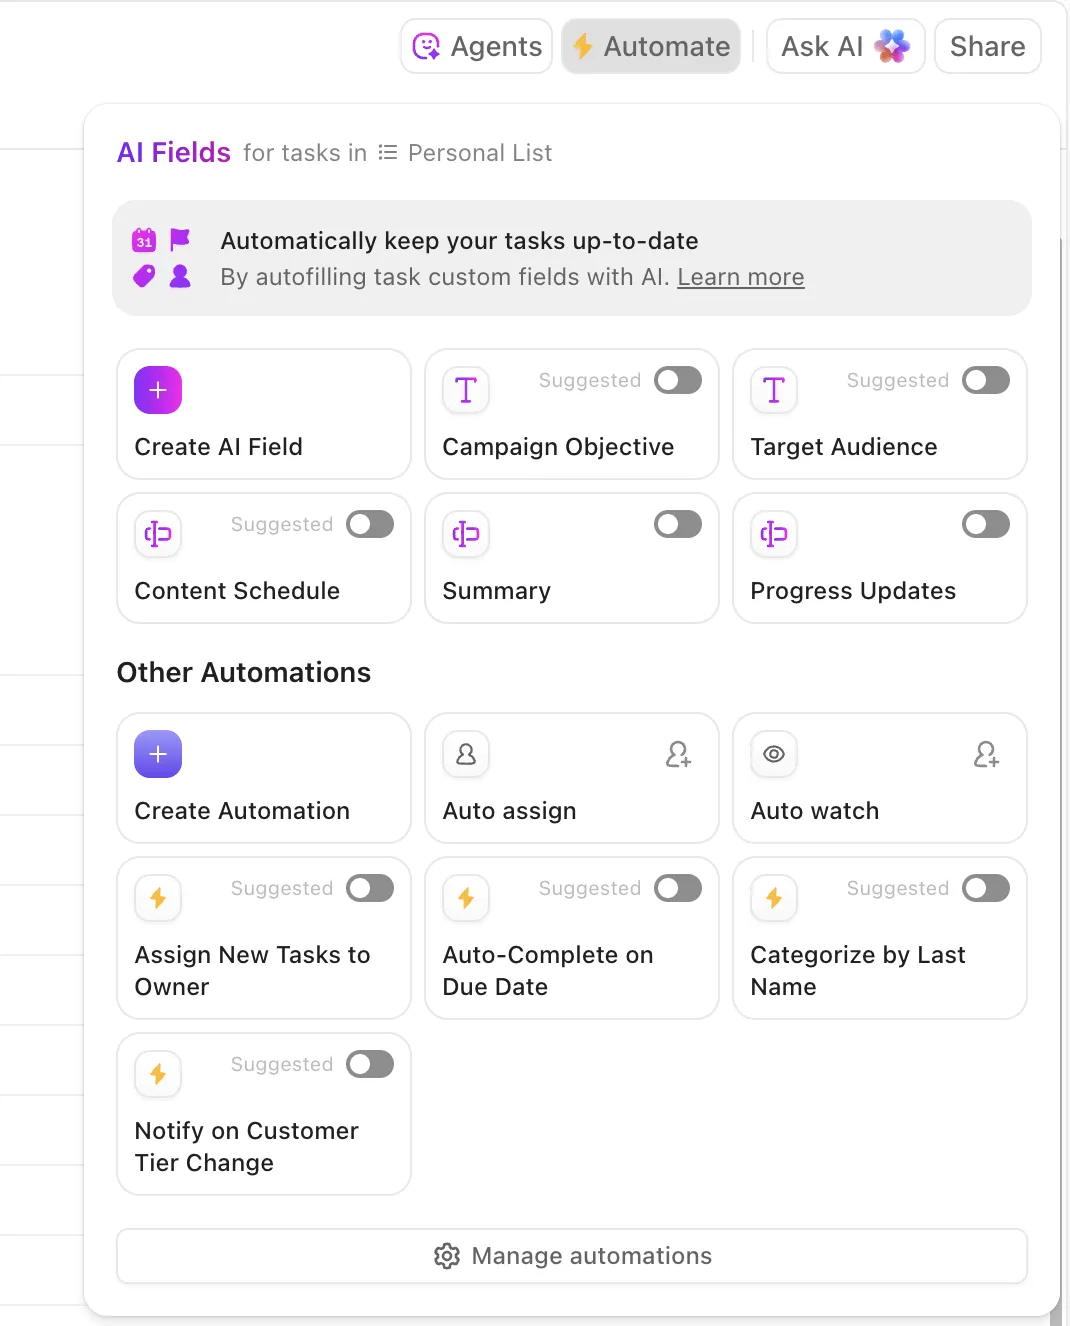
Questi agenti sono persino in grado di effettuare il triage e classificare i problemi, raggruppare segnalazioni simili, fare riferimento alle soluzioni storiche per suggerire possibili percorsi da seguire ed escalare gli elementi urgenti: in questo modo, MTTA e MTTR diminuiscono anche in caso di picchi di volume.
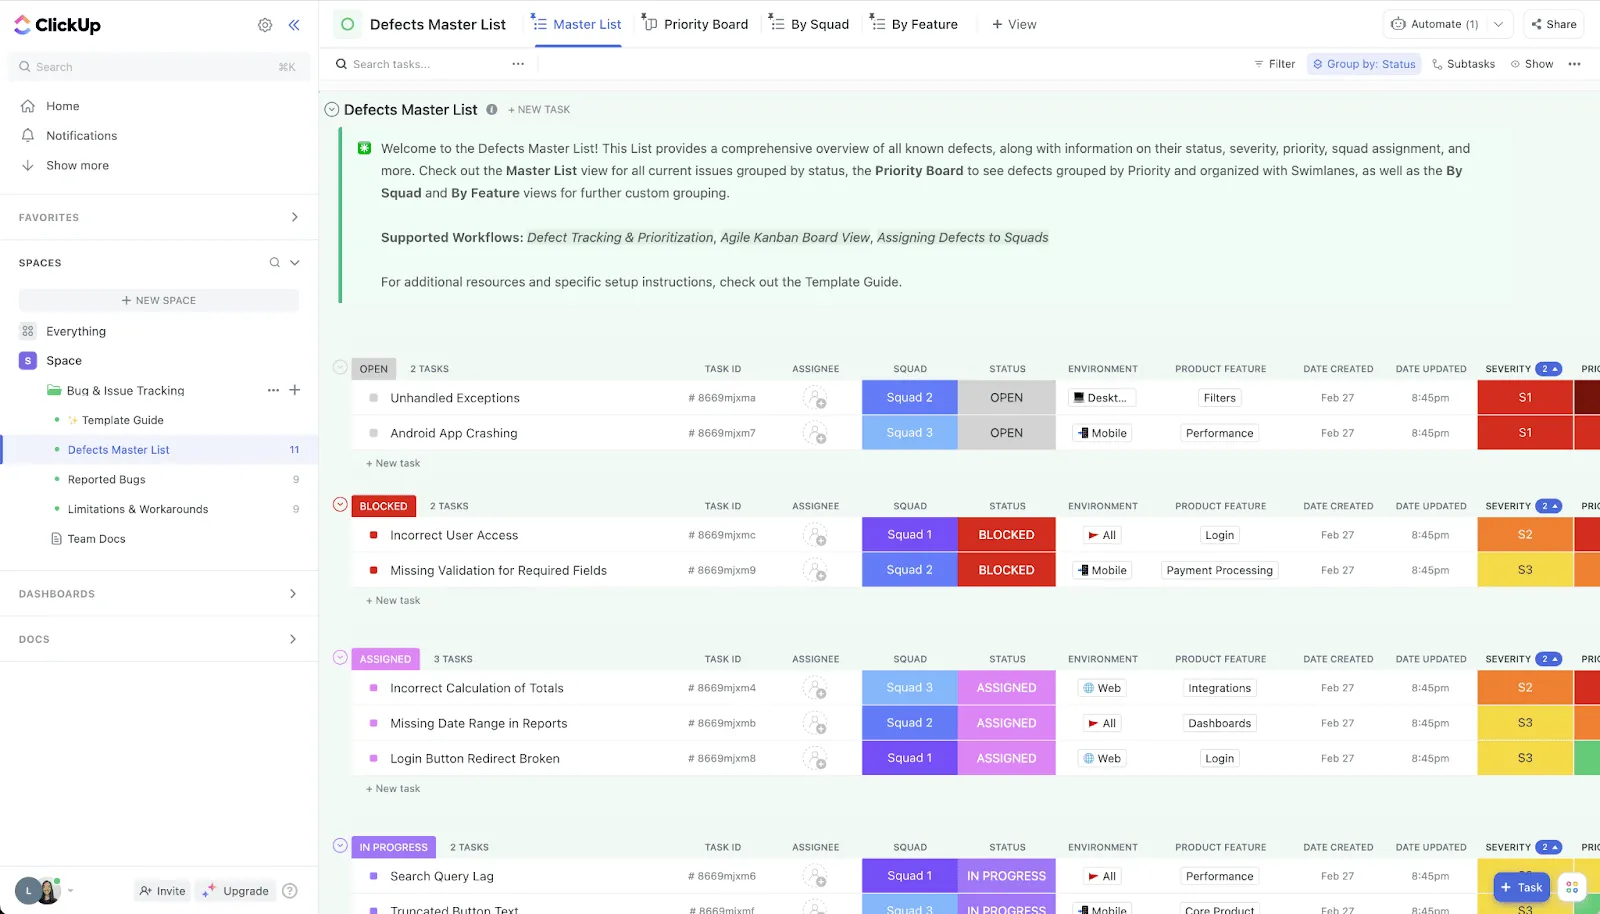
🛠️ Cerchi un kit di strumenti pronto all’uso? Il modello ClickUp per il monitoraggio di bug e problemi è una potente soluzione di ClickUp for Software, progettata per aiutare i team di assistenza, ingegneria e prodotto a tenere sotto controllo con facilità i bug e i problemi del software. Grazie a visualizzazioni personalizzabili come Elenco, Bacheca, Carico di lavoro, Modulo e Sequenza, i team possono visualizzare e gestire il proprio processo di monitoraggio dei bug nel modo che più si adatta alle loro esigenze.
I 20 stati personalizzati e i 7 campi personalizzati del modello consentono di creare un flusso di lavoro su misura, garantendo che ogni problema venga monitorato dall’individuazione alla risoluzione. Le automazioni integrate si occupano delle attività ripetitive, liberando tempo prezioso e riducendo lo sforzo richiesto.
💟 Bonus: Brain MAX è il tuo assistente desktop basato sull’IA, progettato per accelerare la risoluzione dei bug grazie a funzionalità/funzioni intelligenti e pratiche.
Quando riscontri un bug, ti basta utilizzare la funzione di riconoscimento vocale di Brain MAX per dettare il problema: le tue note vocali vengono trascritte all’istante e possono essere allegate a un ticket di bug nuovo o esistente. La sua funzione Enterprise Search analizza tutti i tuoi strumenti collegati — come ClickUp, GitHub, Google Drive e Slack — per individuare segnalazioni di bug correlate, log di errore, frammenti di codice e documentazione, in modo da fornirti tutto il contesto necessario senza dover passare da un’app all’altra.
Hai bisogno di coordinare una correzione? Brain MAX ti consente di assegnare il bug allo sviluppatore giusto, impostare promemoria automatici per gli aggiornamenti di stato e effettuare il monitoraggio dei progressi, il tutto direttamente dal tuo desktop!
2. Sentry (Ideale per rilevare gli errori)
Sentry riduce l’MTTD e i tempi di riproduzione degli errori raccogliendo errori, tracce e sessioni utente in un unico posto. Il raggruppamento dei problemi basato sull’IA riduce il rumore; le funzioni “Suspect Commit” e le regole di titolarità identificano il probabile titolare del codice, garantendo un instradamento immediato. La funzione Session Replay fornisce agli ingegneri il percorso esatto dell’utente e i dettagli relativi alla console e alla rete necessari per riprodurre l’errore, evitando interminabili scambi di informazioni.
Le funzionalità/funzioni di Sentry IA sono in grado di riassumere il contesto dei problemi e, in alcuni stack, di proporre patch Autofix che fanno riferimento al codice difettoso. L’impatto pratico: meno ticket duplicati, assegnazione più rapida e un percorso più breve dalla segnalazione alla patch funzionante.
3. GitHub Copilot (Ideale per revisionare il codice più velocemente)
Copilot accelera il ciclo di correzione all’interno dell’editor. Spiega le tracce dello stack, suggerisce patch mirate, scrive test unitari per garantire la correzione e crea script di riproduzione.
Copilot Chat è in grado di analizzare il codice difettoso, proporre rifattorizzazioni più sicure e generare commenti o descrizioni delle pull request che velocizzano la revisione del codice. In combinazione con le revisioni obbligatorie e la CI, riduce di ore il processo “diagnosi → implementazione → test”, specialmente per i bug ben definiti e con una chiara procedura di riproduzione.
4. Snyk by DeepCode IA (Ideale per individuare modelli ricorrenti)
L’analisi statica basata sull’IA di DeepCode individua difetti e modelli non sicuri mentre scrivi il codice e nelle pull request. Evidenzia i flussi problematici, spiega perché si verificano e propone correzioni sicure che si adattano agli idiomi del tuo codice.
Individuando le regressioni prima di unire le branche e guidando gli sviluppatori verso modelli più sicuri, riduci il tasso di insorgenza di nuovi bug e acceleri la correzione di errori logici complessi, difficili da individuare durante la revisione. Le integrazioni con IDE e PR mantengono tutto questo vicino al luogo in cui si svolge il lavoro.
5. Watchdog e AIOps di Datadog (Ideali per l’analisi dei log)
Watchdog di Datadog utilizza l’apprendimento automatico per individuare le anomalie nei log, nelle metriche, nelle tracce e nel monitoraggio degli utenti reali. Correlando i picchi con gli indicatori di distribuzione, le modifiche all’infrastruttura e la topologia, suggerisce le probabili cause alla radice.
Per i difetti che incidono sui clienti, ciò si traduce in minuti per l’individuazione, raggruppamento automatico per ridurre il rumore degli avvisi e indicazioni concrete su dove cercare. Il tempo di triage si riduce perché si parte da informazioni del tipo “questa distribuzione ha interessato questi servizi e i tassi di errore sono aumentati su questo endpoint”, anziché da zero.
⚡️ Archivio modelli: Modelli gratis per il monitoraggio dei problemi e dei log in Excel e ClickUp
6. New Relic IA (Ideale per identificare e riassumere le tendenze)
La finestra In arrivo degli errori di New Relic raggruppa gli errori simili tra servizi e versioni, mentre il suo assistente basato sull’IA riepiloga l’impatto, evidenzia le cause probabili e fornisce collegamenti alle tracce/transazioni coinvolte.
Le correlazioni tra le distribuzioni e le informazioni sulle modifiche alle entità rendono evidente quando la causa è da attribuire a una versione recente. Per i sistemi distribuiti, questo contesto riduce di ore le comunicazioni tra i team e indirizza il bug al titolare giusto con un'ipotesi già ben definita.
7. Rollbar (Ideale per i flussi di lavoro automatizzati)
Rollbar è specializzata nel monitoraggio degli errori in tempo reale con l’utilizzo di un sistema di identificazione intelligente per raggruppare i duplicati e effettuare il monitoraggio delle tendenze di occorrenza. I suoi riepiloghi/riassunti basati sull’IA e i suggerimenti sulle cause alla radice aiutano i team a comprendere la portata del problema (utenti coinvolti, versioni interessate), mentre la telemetria e le tracce dello stack forniscono indizi rapidi per la riproduzione del problema.
Le regole di flusso di lavoro di Rollbar possono creare automaticamente attività, assegnare livelli di gravità e inoltrarle ai titolari, trasformando flussi di errori disordinati in code ordinate per priorità con informazioni contestuali allegate.
8. PagerDuty AIOps e automazione dei runbook (Il meglio della diagnostica a intervento minimo)
PagerDuty utilizza la correlazione degli eventi e la riduzione del rumore basata sull'apprendimento automatico per trasformare le ondate di avvisi in incidenti gestibili.
L'instradamento dinamico indirizza immediatamente il problema al tecnico di turno corretto, mentre l'automazione dei runbook può avviare procedure diagnostiche o misure di mitigazione (riavvio dei servizi, rollback di una distribuzione, attivazione/disattivazione di un interruttore di funzionalità) prima che intervenga un operatore umano. Per quanto riguarda i tempi di risoluzione dei bug, ciò si traduce in un MTTA più breve, mitigazioni più rapide per i bug di priorità P0 e un minor numero di ore perse a causa dell'affaticamento da avvisi.
Il filo conduttore è l’automazione unita all’IA in ogni passaggio. È possibile individuare i bug prima, indirizzarli in modo più intelligente, arrivare al codice più rapidamente e comunicare lo stato senza rallentare il lavoro degli ingegneri: tutti questi fattori contribuiscono a una significativa riduzione dei tempi di risoluzione dei bug.
📖 Per saperne di più: Come utilizzare l’IA nel DevOps
Esempi concreti di utilizzo dell’IA per la risoluzione dei bug
L’IA è quindi ufficialmente uscita dai laboratori. Sta riducendo i tempi di risoluzione dei bug in contesti reali.
Vediamo come!
| Settore / Organizzazione | Come è stata utilizzata l’IA | Impatto / Vantaggi |
|---|---|---|
| Ubisoft | Abbiamo sviluppato Commit Assistant, uno strumento basato sull’IA addestrato su un decennio di codice interno, in grado di prevedere e prevenire i bug già in fase di programmazione. | L'obiettivo è ridurre drasticamente tempi e costi: tradizionalmente, fino al 70% delle spese di sviluppo dei giochi viene destinato alla correzione dei bug. |
| Razer (piattaforma Wyvrn) | Abbiamo lanciato QA Copilot, basato sull’IA (integrato con Unreal e Unity), per automatizzare il rilevamento dei bug e generare report di controllo qualità. | Aumenta il rilevamento dei bug fino al 25% e dimezza i tempi di controllo qualità. |
| Google / DeepMind e Project Zero | È stato presentato Big Sleep, uno strumento basato sull’IA che rileva in modo autonomo le vulnerabilità di sicurezza nel software open source come FFmpeg e ImageMagick. | Sono stati individuati 20 bug, tutti verificati da esperti umani e in attesa di correzione. |
| Ricercatori dell’Università della California, Berkeley | Utilizzando un benchmark denominato CyberGym, i modelli di IA hanno analizzato 188 progetti open source, individuando 17 vulnerabilità — tra cui 15 bug “zero-day” sconosciuti — e generando exploit di prova. | Dimostra le capacità in continua evoluzione dell’IA nel rilevamento delle vulnerabilità e nella protezione automatizzata dagli exploit. |
| Spur (startup di Yale) | Abbiamo sviluppato un agente basato sull’IA che traduce le descrizioni dei casi di test in linguaggio semplice in routine automatizzate di test dei siti web — in pratica, un flusso di lavoro di controllo qualità che si auto-genera. | Consente di eseguire test in modo autonomo con un intervento umano minimo |
| Riproduzione automatica dei rapporti sui bug di Android | Ho utilizzato l'elaborazione del linguaggio naturale (NLP) e l'apprendimento per rinforzo per interpretare il linguaggio utilizzato nelle segnalazioni di bug e generare i passaggi necessari per riprodurre i bug su Android. | Abbiamo raggiunto una precisione del 67%, un recall del 77% e riprodotto il 74% delle segnalazioni di bug, superando i risultati dei metodi tradizionali. |
Errori comuni nella misurazione dei tempi di risoluzione dei bug
Se la tua misurazione non è accurata, lo sarà anche il tuo piano di miglioramento.
La maggior parte dei «numeri negativi» nei flussi di lavoro di risoluzione dei bug deriva da definizioni vaghe, flussi di lavoro incoerenti e analisi superficiali.
Inizia quindi dalle basi: cosa si intende per "avvio/arresto", come gestire le attese e le riaperture, per poi interpretare i dati dal punto di vista dei tuoi clienti. Ciò include:
❌ Confini poco chiari: mescolare "Segnalati → Risolti" e "Segnalati → Chiusi" nella stessa dashboard (o alternarli di mese in mese) rende le tendenze prive di significato. Scegli un unico criterio, documentalo e applicalo in tutti i team. Se hai bisogno di entrambi, pubblicali come metriche separate con etichette chiare.
❌ Approccio basato esclusivamente sulle medie: affidarsi alla media nasconde la realtà delle code caratterizzate da pochi valori anomali di lunga durata. Utilizza la mediana (P50) per il tempo “tipico”, il P90 per la prevedibilità e gli SLA, e conserva la media per la pianificazione della capacità. Considera sempre la distribuzione, non solo un singolo numero.
❌ Assenza di segmentazione: raggruppare tutti i bug insieme significa mescolare gli incidenti P0 con i P3 di natura estetica. Segmenta per gravità, origine (cliente vs. QA vs. monitoraggio), componente/team e “nuovo vs. regressione”. Il tuo P0/P1 P90 riflette ciò che percepiscono gli stakeholder; la tua mediana P2+ è ciò su cui si basa il piano del team di ingegneri.
❌ Ignorare i tempi di “pausa”: Siete in attesa dei log dei clienti, di un fornitore esterno o di una finestra di rilascio? Se non monitorate lo stato “Bloccato/In pausa” come uno stato a tutti gli effetti, il tempo di risoluzione diventa argomento di discussione. Riportate sia il tempo di calendario che il tempo attivo, in modo che i colli di bottiglia siano visibili e le discussioni cessino.
❌ Discrepanze nella normalizzazione temporale: mescolare fusi orari diversi o passare dalle ore lavorative alle ore di calendario a metà processo compromette i confronti. Normalizza i timestamp su un unico fuso orario (o UTC) e stabilisci una volta per tutte se gli SLA devono essere misurati in ore lavorative o in ore di calendario; applica questa scelta in modo coerente.
❌ Acquisizione imprecisa e duplicati: le informazioni mancanti sull’ambiente o sulla build e i ticket duplicati allungano i tempi di risoluzione e creano confusione sulla titolarità. Standardizza i campi obbligatori in fase di acquisizione, arricchisci automaticamente i dati (log, versione, dispositivo) ed elimina i duplicati senza azzerare il timer: chiudi i duplicati come problemi collegati, non come “nuovi” problemi.
❌ Modelli di stato incoerenti: gli stati personalizzati (“QA quasi pronto”, “In attesa di revisione 2”) nascondono il tempo trascorso in quello stato e rendono inaffidabili le transizioni tra gli stati. Definisci un flusso di lavoro canonico (Nuovo → Selezionato → In corso → In revisione → Risolto → Chiuso) e verifica la presenza di stati fuori percorso.
❌ Non tenere conto del tempo trascorso in ogni stato: un unico numero relativo al “tempo totale” non è in grado di indicare dove si verificano i colli di bottiglia. Raccogli e analizza il tempo trascorso negli stati “Triage”, “In revisione”, “Bloccato” e “QA”. Se il tempo dedicato alla revisione del codice (P90) supera di gran lunga quello dedicato all’implementazione, la soluzione non sta nel “scrivere codice più velocemente”, ma nel sbloccare la capacità di revisione.
🧠 Curiosità: L’ultima AI Cyber Challenge della DARPA ha messo in luce un balzo in avanti rivoluzionario nell’automazione della sicurezza informatica. La competizione ha visto protagonisti sistemi di IA progettati per rilevare, sfruttare e correggere autonomamente le vulnerabilità nel software, senza alcun intervento umano. Il team vincitore, “Team Atlanta”, ha individuato in modo impressionante il 77% dei bug inseriti e ne ha corretti con esito positivo il 61%, dimostrando la potenza dell’IA non solo nell’individuare i difetti, ma anche nel risolverli attivamente.
❌ Cecità da riapertura: trattare le riaperture come nuovi bug azzerano il conteggio e abbelliscono l’MTTR. Monitora il tasso di riapertura e il “tempo necessario per la chiusura stabile” (dal primo rapporto alla chiusura definitiva in tutti i cicli). L’aumento delle riaperture di solito indica una riproducibilità insufficiente, lacune nei test o una definizione poco chiara di “terminato”.
❌ Nessun MTTA: I team si concentrano eccessivamente sull'MTTR e ignorano l'MTTA (tempo di riconoscimento/titolarità). Un MTTA elevato è un avviso precoce di una risoluzione lunga. Misuratelo, impostate gli SLA in base alla gravità e implementate l'automazione per l'instradamento e l'escalation per mantenerlo basso.
❌ IA/automazione senza controlli di sicurezza: Lasciare che l’IA stabilisca la gravità o chiuda i duplicati senza revisione può portare a una classificazione errata dei casi limite e a una distorsione silenziosa delle metriche. Utilizza l’IA per i suggerimenti, richiedi la conferma umana per i livelli P0/P1 e verifica mensilmente le prestazioni del modello, in modo che i tuoi dati rimangano affidabili.
Rafforzando questi punti deboli, i tuoi grafici sui tempi di risoluzione rifletteranno finalmente la realtà. Da lì, i miglioramenti si moltiplicheranno: una migliore gestione delle richieste riduce l’MTTA, stati più chiari rivelano i veri colli di bottiglia e i P90 segmentati offrono ai dirigenti promesse che potrai mantenere.
⚡️ Archivio modelli: 10 modelli di casi di test per il collaudo del software
Migliori pratiche per una risoluzione più efficace dei bug
Per riassumere, ecco i punti fondamentali da tenere a mente!
| 🧩 Best practice | 💡 Cosa significa | 🚀 Perché è importante |
| Utilizza un sistema affidabile di monitoraggio dei bug | Tieni traccia di tutti i bug segnalati utilizzando un sistema centralizzato di monitoraggio dei bug. | Garantisce che nessun bug venga trascurato e offre visibilità sullo stato dei bug a tutti i team. |
| Scrivi segnalazioni dettagliate dei bug | Includi il contesto visivo, le informazioni sul sistema operativo, i passaggi per riprodurre il problema e il livello di gravità. | Aiuta gli sviluppatori a correggere i bug più rapidamente, fornendo loro in anticipo tutte le informazioni essenziali. |
| Classificare e assegnare priorità ai bug | Utilizza una matrice delle priorità per classificare i bug in base all'urgenza e all'impatto. | Consente al team di concentrarsi innanzitutto sui bug critici e sui problemi urgenti. |
| Sfrutta i test automatizzati | Esegui i test automaticamente nella tua pipeline CI/CD. | Offre supporto per il rilevamento precoce e previene le regressioni. |
| Definisci linee guida chiare per la reportistica | Fornisci modelli e formazione sulla reportistica per segnalare i bug. | Ciò garantisce informazioni accurate e una comunicazione più fluida. |
| Monitora le metriche chiave | Misura i tempi di risoluzione, il tempo trascorso e i tempi di risposta. | Consente il monitoraggio e il miglioramento delle prestazioni utilizzando i dati storici. |
| Adotta un approccio proattivo | Non aspettare che gli utenti si lamentino: esegui i test in modo proattivo. | Aumenta la soddisfazione dei clienti e riduce il carico di lavoro dell’assistenza. |
| Sfrutta strumenti intelligenti e l'apprendimento automatico | Utilizza l'apprendimento automatico per prevedere i bug e suggerire soluzioni. | Migliora l'efficienza nell'identificazione delle cause alla radice e nella correzione dei bug. |
| Rispetta gli SLA | Organizza riunioni per rispettare gli accordi sul livello di servizio concordati per la risoluzione dei problemi. | Crea fiducia e soddisfa le aspettative dei clienti in modo tempestivo. |
| Rivedi e migliora continuamente | Analizza i bug riaperti, raccogli feedback e ottimizza i processi. | Favorisce il miglioramento continuo del processo di sviluppo e della gestione dei bug. |
Risoluzione dei bug semplificata grazie all’IA contestuale
I team più veloci nella risoluzione dei bug non fanno affidamento su imprese eroiche. Progettano un sistema: definizioni chiare di inizio e fine, acquisizione ordinata dei casi, prioritizzazione in base all’impatto sul business, titolarità precisa delle responsabilità e cicli di feedback serrati tra supporto, controllo qualità, ingegneria e rilascio.
ClickUp può fungere da Centro di comando basato sull’intelligenza artificiale per il tuo sistema di risoluzione dei bug. Centralizza ogni segnalazione in un’unica coda, standardizza il contesto con campi strutturati e lascia che l’IA di ClickUp si occupi della classificazione, della sintesi e della definizione delle priorità, mentre le automazioni garantiscono il rispetto degli SLA, segnalano gli scostamenti rispetto alle scadenze e mantengono allineati gli stakeholder. Collega i bug a clienti, codice e versioni, in modo che i dirigenti possano valutare l’impatto e i tecnici possano continuare a lavorare nel flusso.
Se sei pronto a ridurre i tempi di risoluzione dei bug e a rendere la tua roadmap più prevedibile, registrati su ClickUp e inizia a misurare i miglioramenti in pochi giorni, non in trimestri.
Domande frequenti
Qual è un buon tempo di risoluzione dei bug?
Non esiste un unico numero “ottimale”: dipende dalla gravità, dal modello di rilascio e dalla tolleranza al rischio. Utilizza le mediane (P50) per le prestazioni “tipiche” e il P90 per gli impegni/gli SLA, e segmenta i dati in base alla gravità e alla fonte.
Qual è la differenza tra risoluzione di un bug e chiusura di un bug?
Si parla di risoluzione quando la correzione viene implementata (ad es. codice unito, configurazione applicata) e il team considera il difetto risolto. Si parla di chiusura quando il problema viene verificato e formalmente chiuso (ad es. convalidato dal controllo qualità nell’ambiente di destinazione, rilasciato o contrassegnato come “non risolvibile” o “duplicato” con relativa motivazione). Molti team misurano entrambi gli aspetti: “Segnalato→Risolto” riflette la velocità di sviluppo; “Segnalato→Chiuso” riflette il flusso di qualità end-to-end. Utilizzate definizioni coerenti in modo che i dashboard non mescolino le fasi.
Qual è la differenza tra il tempo di risoluzione dei bug e il tempo di rilevamento dei bug?
Il tempo di rilevamento (MTTD) indica il tempo necessario per individuare un difetto dopo che si è verificato o è stato distribuito, tramite monitoraggio, controllo qualità o segnalazione da parte degli utenti. Il tempo di risoluzione indica il tempo necessario per passare dal rilevamento/segnalazione all’implementazione della correzione (e, se si preferisce, alla sua convalida/rilascio). Insieme, questi due tempi definiscono la finestra di impatto sul cliente: rilevare rapidamente, riconoscere rapidamente, risolvere rapidamente e rilasciare in sicurezza. È inoltre possibile effettuare il monitoraggio dell’MTTA (tempo di riconoscimento/assegnazione) per individuare i ritardi nel triage che spesso preannunciano tempi di risoluzione più lunghi.
In che modo l’IA aiuta nella risoluzione dei bug?
L’IA accelera le fasi che solitamente rallentano il processo: acquisizione, triage, diagnosi, correzione e verifica.
- Acquisizione e triage: riepiloga automaticamente i rapporti lunghi, estrae i passaggi per la riproduzione del bug e l’ambiente, segnala i duplicati e suggerisce il livello di gravità e la priorità, in modo che i tecnici possano partire da un contesto chiaro (ad es., ClickUp AI, Sentry IA).
- Inoltro e SLA: prevede il componente/titolare più probabile, imposta i timer e segnala l’escalation quando il MTTA o i tempi di revisione subiscono ritardi, riducendo il “tempo in stato” di inattività (automazioni ClickUp e flussi di lavoro simili a quelli degli agenti).
- Diagnosi: raggruppa errori simili, correla i picchi di attività ai commit o alle versioni recenti e individua le probabili cause alla radice grazie alle tracce dello stack e al contesto del codice (Sentry IA e simili).
- Implementazione: suggerisce modifiche al codice e test basati sui modelli presenti nel tuo repository, accelerando il ciclo "scrittura/correzione" (GitHub Copilot; Snyk Code IA di DeepCode).
- Verifica e comunicazione: redige casi di test a partire dai passaggi di riproduzione, prepara bozze delle note di rilascio e degli aggiornamenti per le parti interessate e riepiloga lo stato per i dirigenti e i clienti (ClickUp AI). Utilizzando questi strumenti insieme — ClickUp come Centro di comando con Sentry/Copilot/DeepCode nello stack — i team riducono i tempi MTTA/P90 senza dover ricorrere a soluzioni estreme.