
De eerste paar services zijn eenvoudig. Eén rotatie, een kanaal en vervolgens een back-up.
Zodra uw bedrijf echter tientallen microservices, meerdere regio's en gelaagde eigendommen omvat, zijn handmatige escalaties niet langer een werkstroom, maar worden ze een risico.
In deze handleiding wordt uitgelegd hoe u escalatiepaden voor incidenten kunt automatiseren die meegroeien met uw engineeringorganisatie, zonder dat er hiaten in uw oproepsysteem ontstaan.
En we zullen ook bekijken hoe ClickUp past in het opzetten van een escalatiesysteem waarop je engineeringteams kunnen vertrouwen. 🎯
⭐ Aanbevolen sjabloon
Reageer snel en effectief tijdens noodsituaties, van natuurrampen tot datalekken, met behulp van de ClickUp-sjabloon voor incidentactieplannen (IAP).
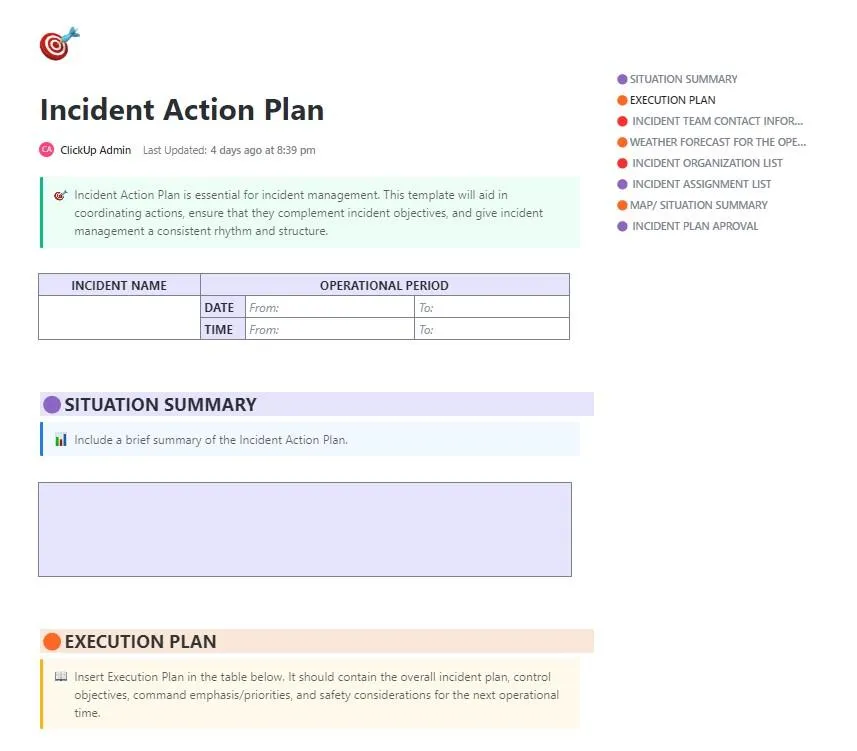
De sjabloon biedt u vooraf gedefinieerde secties om:
- Definieer doelstellingen voor incidenten en prioriteiten voor de respons
- Zorg voor een duidelijke commandostructuur
- Coördineer acties tussen teams in realtime
- Leg beslissingen, tijdlijnen en belangrijke updates vast op het moment dat ze plaatsvinden
- Blijf in verbinding met escalaties en zorg voor opvolging
En omdat het in ClickUp is geïntegreerd, fungeert het als een live incidentcommandodocument, niet als een statische checklist.
Waarom escalatieprocedures voor incidenten automatiseren?
Wanneer uw team verantwoordelijk is voor complexe systemen met strakke SLA's, remt handmatige escalatie u alleen maar af. Geautomatiseerde escalatie maakt uw reactieproces voorspelbaar en stressvrij, zelfs tijdens incidenten waarbij de druk hoog is.
Dit is waarom u de escalatieprocedures binnen uw organisatie moet automatiseren. 👇
Het risico van handmatige escalatie
Zodra u te maken krijgt met tientallen services, meerdere wachtroosters en voortdurend wisselend eigendom, worden handmatige stappen al snel een probleem.
Veelvoorkomende valkuilen zijn onder meer:
- Gemiste of vertraagde notificaties wanneer iemand een e-mail, sms of notificatie tijdens het chatten over het hoofd ziet
- Verwarring bij de overdracht, vooral wanneer escalatieprocedures niet duidelijk zijn gedocumenteerd
- Escaleren naar het verkeerde team omdat de kaart van de eigenaar niet is bijgewerkt
- Knelpunten die ontstaan doordat men afhankelijk is van één persoon om ‘de melding door te sturen’
📖 Lees ook: Hoe schrijf je een incidentrapport?
Voordelen van automatisering
ITSM-automatisering geeft uw escalatieprocessen structuur en vaart. In plaats van te hopen dat iemand de melding opmerkt, voert uw systeem onmiddellijk en consistent een vooraf gedefinieerde reeks stappen uit.
Dit zijn de voordelen voor teams wanneer ze AI gebruiken voor automatisering van taken:
- Snellere reactietijden omdat waarschuwingen binnen enkele seconden bij de juiste persoon of het juiste team terechtkomen
- Consistente uitvoering van escalatiestappen, zelfs om 3 uur ’s nachts, wanneer de besluitvorming trager verloopt
- Ingebouwde redundantie die ervoor zorgt dat back-uphulpverleners worden gewaarschuwd als de primaire dienstdoende medewerker de melding mist
- Duidelijke zichtbaarheid voor alle teams, omdat iedereen begrijpt hoe de werkstroom van escalaties verloopt
- Minder brandjes blussen en meer voorspelbare ervaringen tijdens de wachtdienst
📖 Lees ook: Voorbeelden van bedrijfscontinuïteitsplannen
Vermindering van alarmmoeheid en menselijke fouten
Alarmmoeheid ondermijnt de effectiviteit van de wachtdienst. Wanneer uw team te vaak of om de verkeerde redenen wordt gewaarschuwd, reageert het niet meer met de nodige urgentie. Automatisering helpt bij het filteren en escaleren van alleen die zaken die daadwerkelijk menselijke aandacht vereisen.
Met automatiserde escalatielogica:
- Waarschuwingen met een laag signaal of dubbele waarschuwingen worden onderdrukt voordat ze bij de dienstdoende medewerker terechtkomen
- Regels op basis van ernst zorgen ervoor dat kleine problemen niemand onnodig uit zijn slaap halen
- Waarschuwingen worden alleen geëscaleerd als het systeem binnen een bepaald tijdsbestek geen reactie detecteert
- Teams besteden minder tijd aan het filteren van onbelangrijke meldingen en meer tijd aan het oplossen van echte problemen
Ondersteuning van naleving van SLA's en het oproepbeleid
Dankzij automatisering van escalatie is het eenvoudiger om aan de voorschriften te voldoen zonder dat er voortdurend handmatig toezicht nodig is. Voor leidinggevenden in de IT-operaties die te maken hebben met strikte SLA's of interne betrouwbaarheidsverplichtingen, fungeert AI als een vangrail die het verwachte gedrag afdwingt. Het helpt u om:
- Zorg ervoor dat notificaties over incidenten volgens vooraf gedefinieerde regels worden doorgestuurd
- Houd de SLA-reactietijdlijnen automatisch aan met getimede escalaties
- Handhaaf wachtroosters zonder gebruik te maken van verouderde spreadsheets
- Maak audittrajecten aan voor elke waarschuwing, escalatie en bevestiging
🎥 Wilt u uw volledige escalatiewerkstroom volledig automatisch laten verlopen? Super Agents helpen u daarbij. 👇🏼
🔍 Wist u dat? De Mission Control van NASA werkt in feite op basis van automatiseringslogica voor escalatie. Als telemetrie buiten het bereik valt, stuurt het systeem onmiddellijk geautomatiseerde waarschuwingen door naar specialisten per domein.
Wat is een escalatiebeleid in incidentbeheer?
Een escalatiebeleid is een vooraf gedefinieerde reeks regels die bepaalt wie er wordt geïnformeerd, wanneer dat gebeurt en hoe de verantwoordelijkheid naar een hoger niveau of tussen teams wordt doorgegeven.
Zie het als een gestructureerd stappenplan dat voorkomt dat incidenten vastlopen, ervoor zorgt dat de juiste experts op het juiste moment ingrijpen en teams helpt om aan SLA's te voldoen.
Een goed gestructureerd beleid voor escalatiebeheer omvat doorgaans:
- Op regels gebaseerde routering die bepaalt wie de volgende is als iemand het incident niet bevestigt of niet kan oplossen
- Tijdgestuurde triggers die automatisch escaleren na 5, 15 of 30 minuten, afhankelijk van de ernst
- Notificatiemethoden zoals telefoontjes, sms, chatten of e-mail
- Niveaus van het escalatieplan: van niveau 1 (primaire oproepdienst) > niveau 2 (senior engineers/SME's) > niveau 3 (leidinggevenden)
- Verwachtingen ten aanzien van de documentatie, zodat nieuwe hulpverleners het kunnen overnemen zonder cruciale context te verliezen
📖 Lees ook: Hoe u taken prioriteert als P0, P1, P2, P3 en P4
Soorten escalatiebeleid
Dit zijn de belangrijkste soorten beleidsregels die uw team moet begrijpen:
1. Hiërarchische escalatie (verticaal)
Waarschuwingen worden omhoog doorgegeven in de hiërarchie, van junior engineers naar senior specialisten en vervolgens naar het management. Gebruik dit wanneer de situatie diepgaandere expertise, beslissingsbevoegdheid of zichtbaarheid bij het management vereist.
2. Functionele escalatie (horizontaal)
In plaats van naar boven te gaan, wordt de melding tussen teams doorgegeven naar de functie die verantwoordelijk is voor het betreffende systeem. Dit is ideaal voor incidenten die verband houden met een specifiek domein, zoals databases, netwerken, betalingen of API's.
3. Escalatie op basis van tijd
Dit vormt de ruggengraat van de meeste geautomatiseerde systemen. Bij dit type wordt de melding na een bepaalde tijd doorgegeven naar het volgende niveau, vaak direct gekoppeld aan SLA's. Dit is vooral essentieel wanneer u buiten kantooruren gegarandeerde responsiviteit nodig hebt.
4. Op impact gebaseerde escalatie
Impactgebaseerde escalatie is afhankelijk van de ernst of de impact op het bedrijf, niet van hiërarchie of tijd. Dit is nuttig bij storingen, mislukte betalingen, klantgerelateerde problemen of inbreuken op het gebied van veiligheid.
5. Parallelle escalatie
Hierbij worden meerdere personen of teams tegelijkertijd op de hoogte gebracht. Parallelle escalatie wordt gebruikt voor problemen met een hoge ernstgraad waarvoor meerdere specialismen nodig zijn, of voor situaties waarin elke vertraging onaanvaardbaar is.
🔍 Wist u dat? Uit een recent onderzoek naar waarschuwingssignalen is gebleken dat extreem opvallende of ‘luide/felle ’ waarschuwingen de reactietijd kunnen vertragen, vooral als de waarschuwing onverwacht is. Maar zodra het type waarschuwing voorspelbaar wordt (d.w.z. onderdeel van een vooraf ontworpen escalatie-/notificatiesysteem), verbeteren de reactietijden. Dit suggereert dat je bij de automatisering van escalatiepaden mensen niet zomaar moet overspoelen met alarmen met hoge prioriteit.
Wanneer moet automatische escalatie worden triggered?
Nu u weet hoe escalatiepaden zijn opgebouwd, is de volgende stap om te bepalen wanneer deze regels automatisch moeten worden uitgevoerd.
Hieronder staan de belangrijkste situaties die automatische escalatie triggeren en die de logische basis vormen voor uw beleid. 💁
Escalatie op basis van ernst
Automatische escalatie treedt in werking wanneer de ernst of impact van het incident een bepaalde drempel overschrijdt. Incidenten met een hoge ernstgraad vereisen onmiddellijke aandacht van het management, en door automatische escalatie worden knelpunten omzeild en worden experts binnen enkele seconden op de hoogte gebracht.
📌 Exemplaar: Een volledige dienstonderbreking, een storing in de betalingsgateway of een ernstige verslechtering van de dienstverlening die veel gebruikers of kernsystemen treft, vereist een automatische escalatie.
Op tijd gebaseerde escalatie
Als niemand het incident binnen een bepaald tijdsbestek bevestigt of oplost, wordt de melding automatisch geëscaleerd naar het volgende niveau. Dit voorkomt dat tickets blijven liggen, met name buiten de normale werktijden of wanneer de eerste hulpverlener niet beschikbaar of overbelast is.
📌 Exemplaar: Als er na 10-15 minuten nog geen bevestiging is ontvangen, wordt het incident geëscaleerd van de eerste responder naar een senior engineer; als het na nog eens 30-60 minuten nog steeds niet is opgelost, wordt het verder geëscaleerd.
Contextuele escalatie
Deze escalatielogica houdt rekening met de contextuele kenmerken van het incident, zoals de getroffen dienst of het getroffen systeem, de eigenaar van de dienst, het getroffen klantsegment (intern versus extern, VIP versus regulier) of het functionele domein (database, netwerk, integratie). Op basis van die context worden waarschuwingen doorgestuurd naar de meest relevante hulpverlener of het meest relevante team.
Zo voorkomt u dat teams worden overbelast met irrelevante incidenten, verkort u de reactietijd en zorgt u ervoor dat specialisten problemen binnen hun vakgebied afhandelen.
📌 Voorbeelden: Een piek in de vertraging bij de betalingsdienst moet direct het betalingsteam waarschuwen, of een backend-fout in de factureringsmicroservice moet het factureringsteam op de hoogte brengen.
Op metagegevens gebaseerde escalatie
Moderne waarschuwings- en incidenttools leggen metadata vast, zoals de bron (welke monitoringtool of waarschuwingsregel is geactiveerd), de identiteit van de gebruiker of klant, de locatie, de historische frequentie van soortgelijke incidenten of labels. Dit helpt u om meer gedetailleerde, intelligente logica toe te passen in plaats van te vertrouwen op algemene regels op basis van ernst of tijd.
📌 Voorbeelden: Terugkerende waarschuwingen uit hetzelfde subsysteem kunnen wijzen op een dieperliggend, systemisch probleem, waardoor snellere escalatie gerechtvaardigd is. Of waarschuwingen voor VIP-klanten kunnen triggers zijn voor extra notificaties.
Triggers combineren voor het opstellen van slimmere, adaptieve escalatiebeleidsregels
In de praktijk vertrouwen veel teams niet op slechts één type trigger. In plaats daarvan stellen ze hybride escalatiebeleidsregels op waarin regels op basis van ernst, tijd, context en metadata worden gecombineerd.
Dankzij deze gelaagde aanpak kunnen teams escalatiebeleid opstellen dat zowel responsief (snel wanneer dat nodig is) als slim (met selectie om ruis te minimaliseren) is, wat leidt tot betere resultaten bij incidenten en een efficiëntere toewijzing van middelen.
🔍 Wist u dat? In de 18e eeuw hanteerden scheepsbemanningen tijdens noodsituaties een strikte escalatieketen. Als een matroos van lagere rang gevaar signaleerde, luidde hij een bel en gaf hij het bericht door naar boven totdat de kapitein de uiteindelijke beslissing nam.
Hoe u effectieve escalatieprocedures ontwerpt
Bij het ontwerpen van escalatiepaden gaat het om het opzetten van een systeem dat de juiste waarschuwingen op betrouwbare wijze en met zo min mogelijk wrijving naar de juiste personen stuurt.
Hier volgt een praktisch, stapsgewijs raamwerk dat u kunt gebruiken in complexe, gedistribueerde omgevingen.
P.S. We zullen ook bekijken hoe bepaalde ClickUp-functies je hierbij kunnen helpen! 🤩
Stap 1: Stel duidelijke escalatiecriteria, escalatieniveaus en verantwoordelijkheden vast
Begin met het definiëren van wat een incident is dat escalatie vereist. Leg objectieve criteria vast, zodat elke technicus die dienst heeft – of het nu een nieuwe L1-responsmedewerker is of een ervaren SRE – de ernst van een incident op dezelfde manier interpreteert.
Dit zorgt voor een duidelijke escalatiewerkstroom, neemt onduidelijkheden weg en zorgt ervoor dat de automatisering alleen in werking treedt wanneer dat echt nodig is.
Neem criteria op zoals:
- Ernstdrempels: uitval van de dienst, betalingsfouten, problemen met de verificatie, gegevenscorruptie en problemen met de veiligheid
- Gevolgen: Storingen die klanten raken, verslechtering van interne dienstverlening, storingen in API's van partners, nalevingsproblemen of veiligheidsrisico's
- Bedrijfskritische context: grote waarde voor klanten, werkstroom die van invloed is op de omzet, risicovolle systemen (bijv. betalingen, facturering)
Zodra de criteria en triggers zijn gedefinieerd, breng dan in kaart wie er wordt gewaarschuwd en wat hun verantwoordelijkheden zijn bij elk escalatiepunt.
Definieer niveaus duidelijk:
- Niveau één (primaire incidentmanager op afroep): Fungeert als eerste hulpverlener en is verantwoordelijk voor de bevestiging, de eerste triage en pogingen tot afzwakking
- Niveau twee (back-up/specialist/SME): Biedt diepgaande technische expertise en lost complexe systeemproblemen op
- Niveau drie (engineeringmanager/leidinggevende): Houdt toezicht op grote incidenten, keurt belangrijke maatregelen goed, coördineert de communicatie tussen teams en triggert indien nodig escalatie naar leveranciers
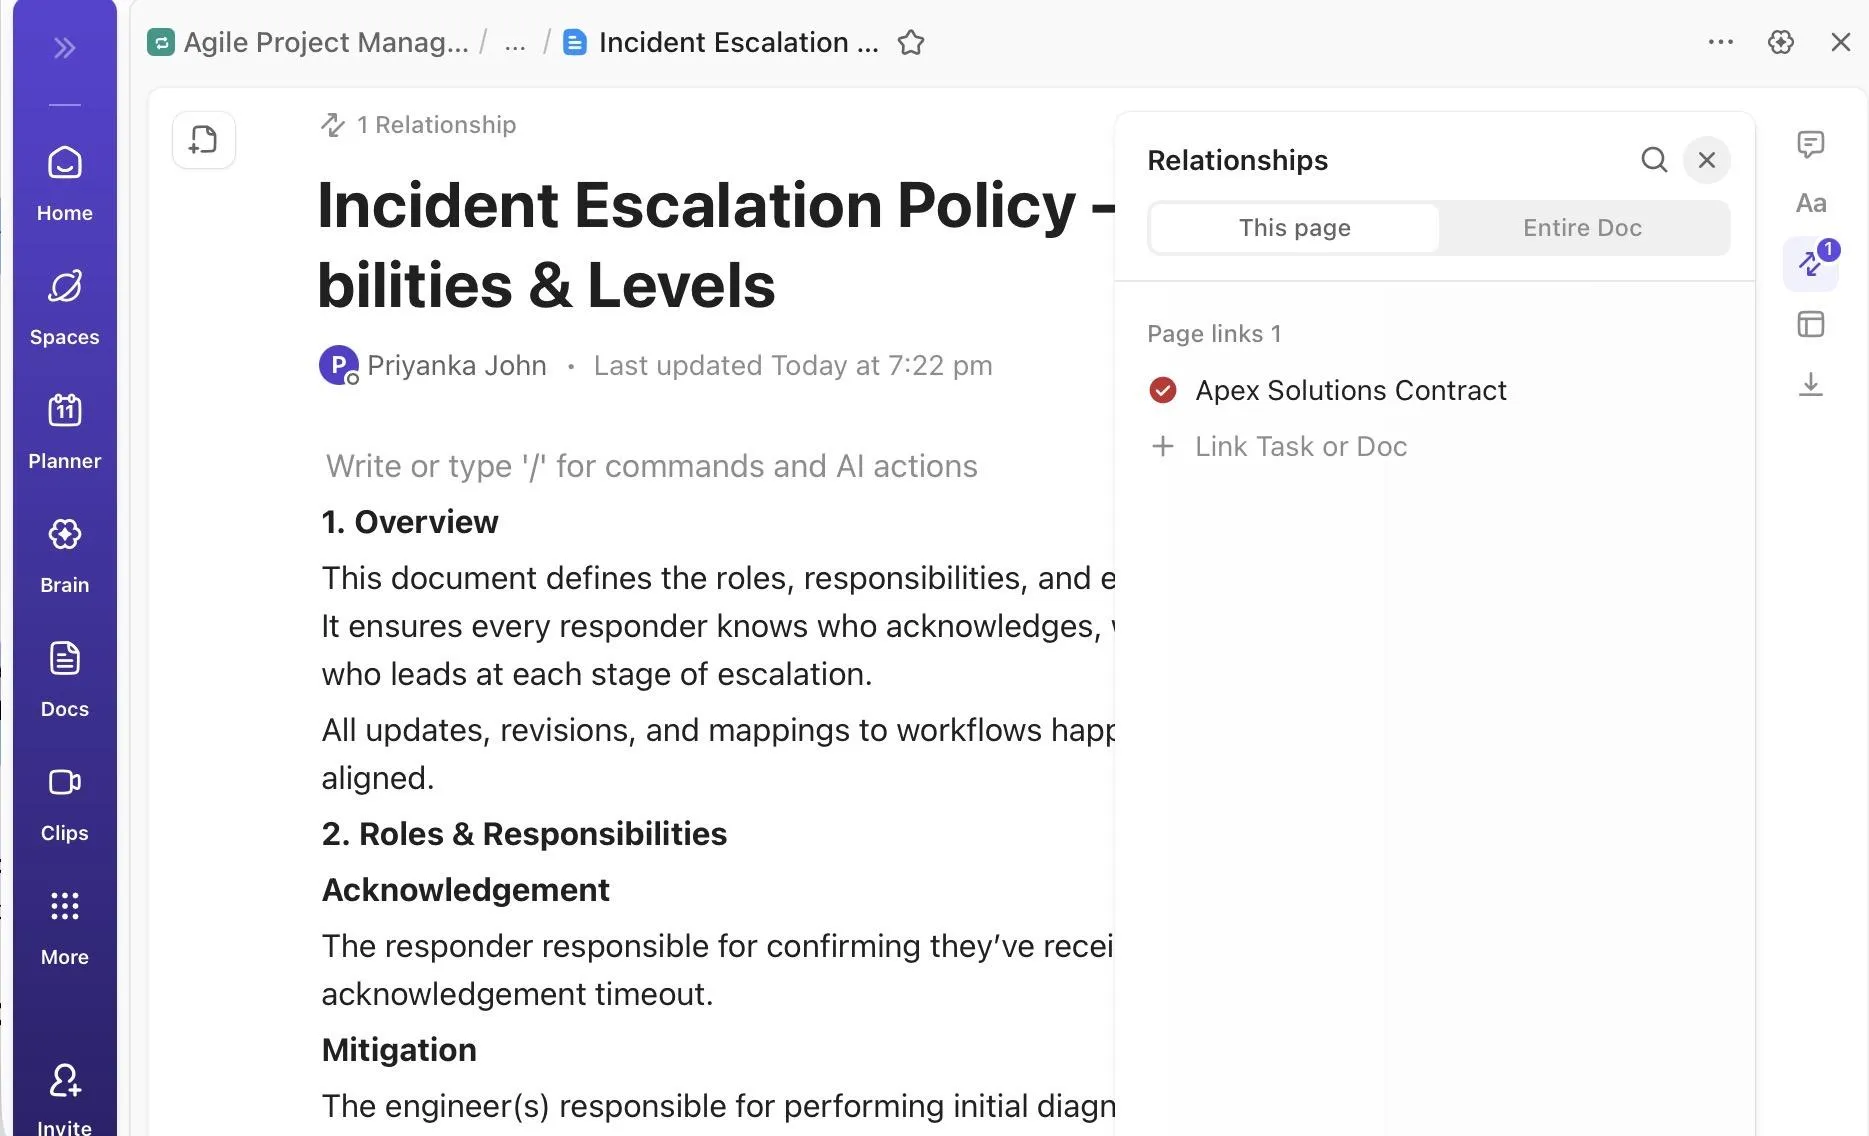
🚀 Het voordeel van ClickUp: Gebruik ClickUp Docs om één centrale bron van informatie te onderhouden voor escalatiecriteria, -niveaus en -verantwoordelijkheden, en documenteer rollen en verantwoordelijkheden, waaronder wie:
- Erkent en beperkt
- Communiceert met belanghebbenden
- Verwerkt escalaties van leveranciers of externe partners
- Geeft leiding aan het incidentcommando
Je kunt deze specifieke rollen ook koppelen aan de relevante ClickUp-taken om de context te behouden.
Bouw uw eigen kennisbank op:
Zodra de escalatiecriteria en eigendom zijn vastgesteld, hebben teams een consistente manier nodig om technische incidenten vast te leggen, bij te houden en te analyseren. De ClickUp-sjabloon voor incidentrapporten biedt een gestructureerd, gemakkelijk toegankelijk systeem om IT- en operationele incidenten op één plek te documenteren.
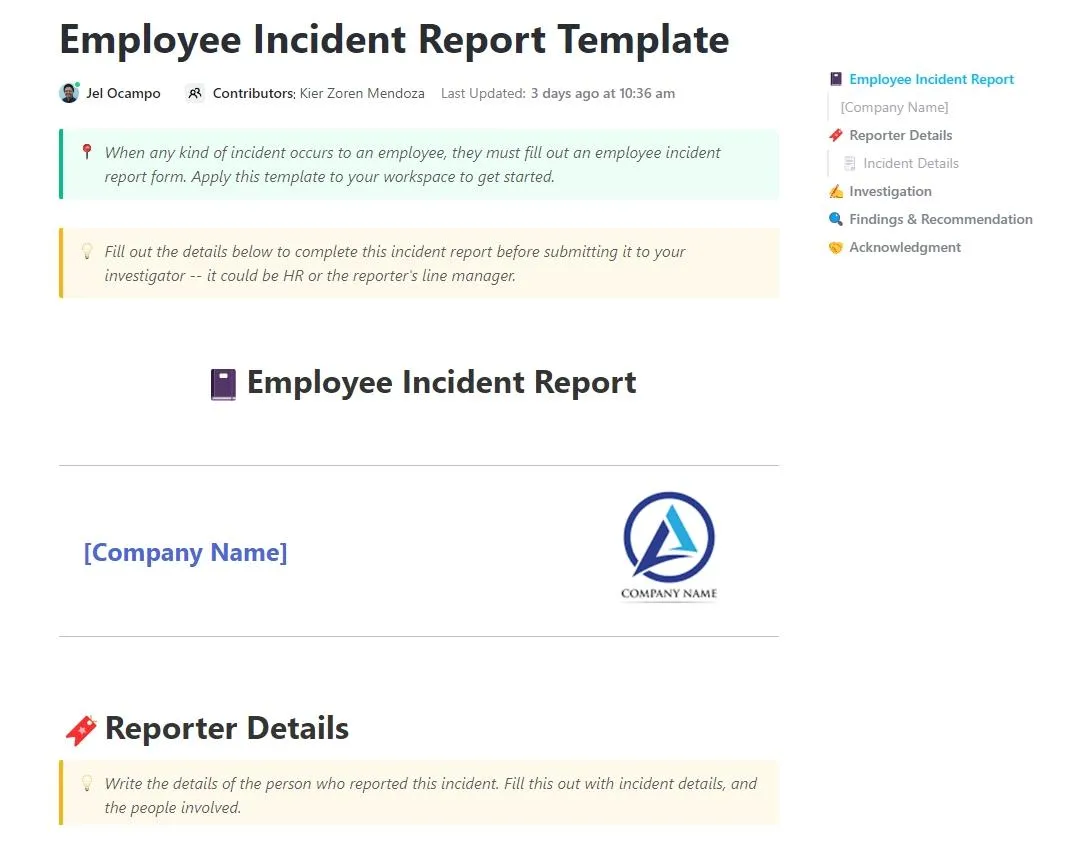
Deze functie is geïntegreerd in ClickUp Docs en helpt incidentresponsteams bij het vastleggen van cruciale details, zoals de ernst van het incident, de getroffen diensten, tijdlijnen, samenvattingen van de onderliggende oorzaken, maatregelen ter beperking van de schade en vervolgacties.
Stap 2: Standaardiseer het aanmaken van incidenten
Nog voordat escalatieprocessen in werking treden, heeft uw team een betrouwbare manier nodig om incidentgegevens vast te leggen, te standaardiseren en aan te vullen. Als het eerste incidentrapport onvolledig of inconsistent is, zal zelfs de meest geavanceerde escalatielogica falen.
Standaardisatie moet:
- Inkomende meldingen triageren: Zet meldingen om in consistente aangepaste velden, zoals ernst, categorie, getroffen dienst, incidenttype en status van bevestiging
- Vul de incidentgegevens automatisch aan: Importeer metagegevens, waaronder cluster, implementatie-ID, service-eigenaars of afhankelijkheden
- Zorg ervoor dat bij elk incident de context wordt vastgelegd: Noteer wie het heeft gemeld, hoe het is gedetecteerd, de omgeving (productie/staging) en eventuele relevante logbestanden of schermafbeeldingen
Maak rechtstreeks vanuit de lijst waarin incidenten worden bijgehouden een ClickUp-formulier aan en ontwerp dit zo dat het aansluit bij uw dagelijkse praktijk en de relevante gegevens waarop uw escalatielogica is gebaseerd. Op deze manier komt elk incident in een consistent format in uw systeem terecht, waarop automatisering betrouwbaar kan reageren, in plaats van versnipperde berichten via chat, e-mail of dashboards.
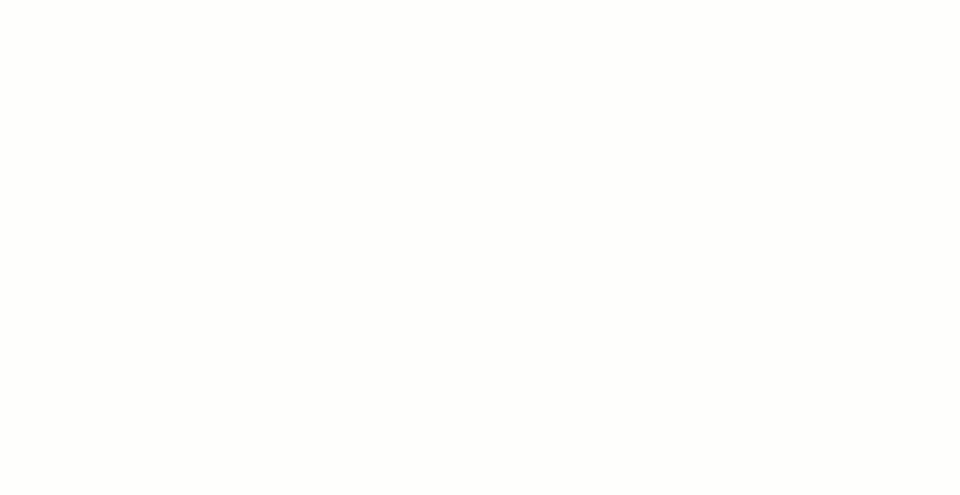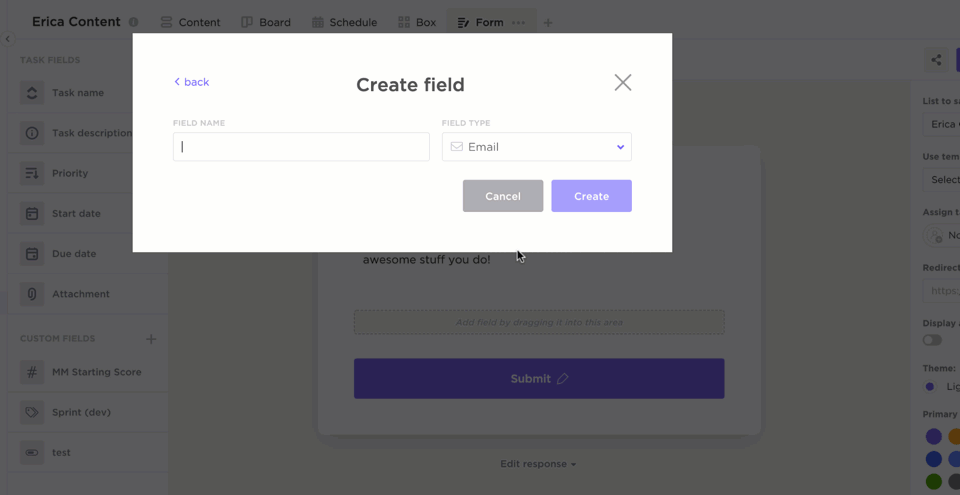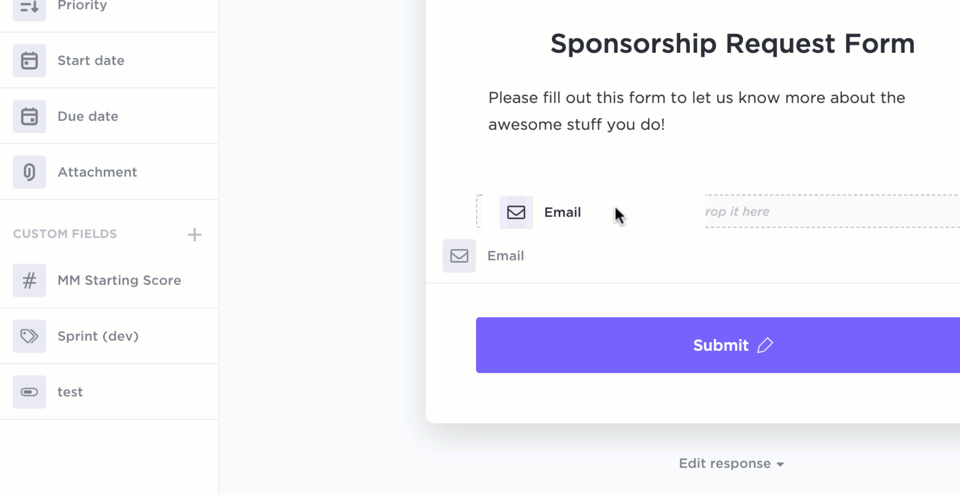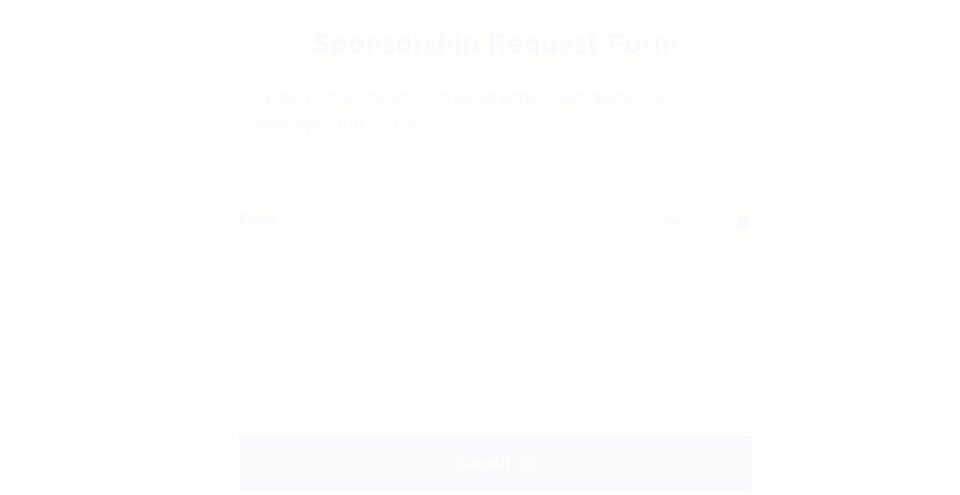
Groepeer velden doelbewust, zodat elk incident volledig in zijn context wordt geplaatst:
- Identificatie (titel, samenvatting)
- Classificatie (ernst, type, getroffen dienst)
- Bron (monitoring, gebruiker, API)
- Bewijsmateriaal (logbestanden, schermafbeeldingen)
- Zakelijke context (SLA-niveau, impact op de klant)
Elke ingediende formulieraanvraag creëert automatisch een nieuwe ClickUp-taak, waarbij alle antwoorden worden ingekoppeld aan aangepaste velden in ClickUp. Dit zorgt ervoor dat incidenten bij het aanmaken worden gestandaardiseerd, waardoor onduidelijkheden worden weggenomen en handmatige incidentafhandeling overbodig wordt.
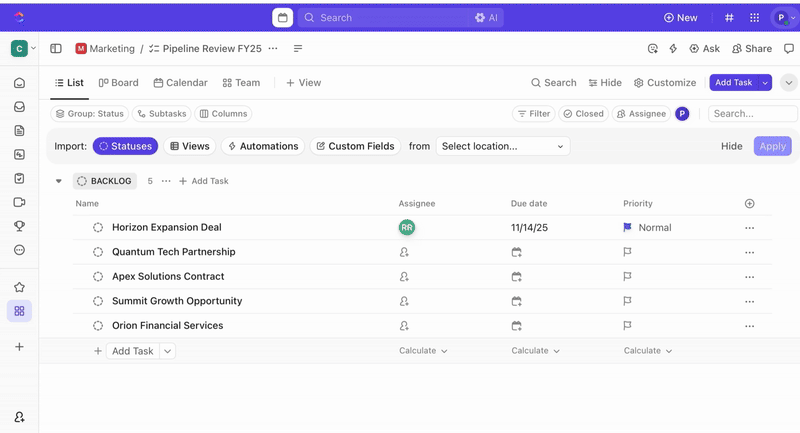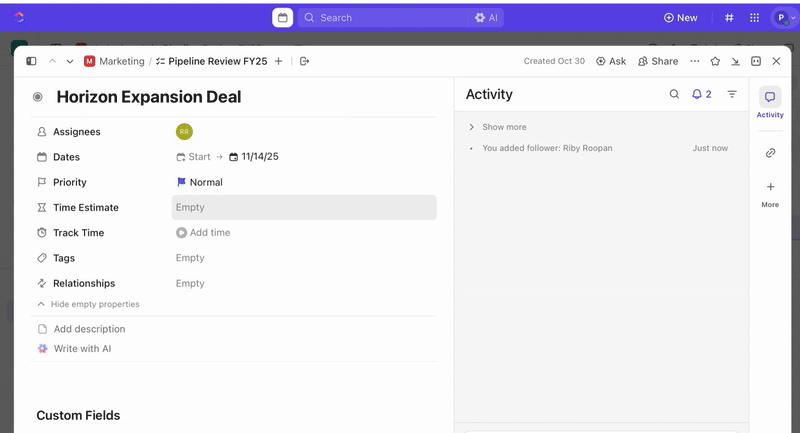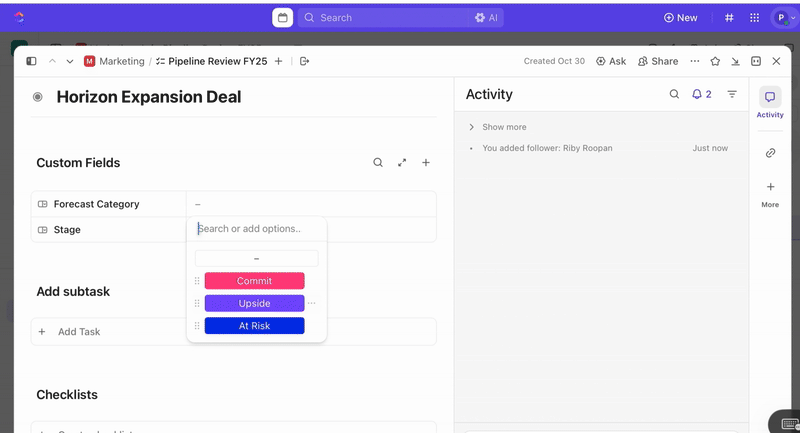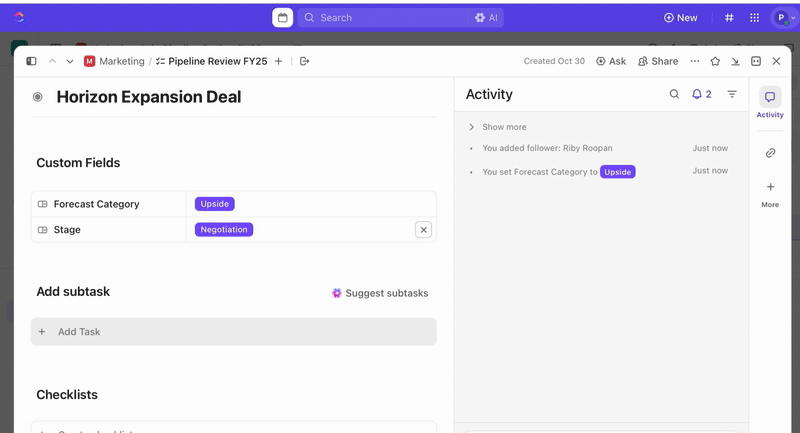
Zodra taken zijn aangemaakt, kunt u aangepaste velden gebruiken om de triage en prioritering te sturen (bijv. ernst, impact, responsgroep) en aangepaste statussen in ClickUp definiëren die de fasen van uw incidenten weerspiegelen (Nieuw > Triage > Onderzoek > Beperking > Opgelost).
Stap 3: Stel het escalatieproces op (d.w.z. volgorde + timing + kanalen)
Dit is de kern van het traject. Stel het traject in fasen op, waarbij in elke fase wordt bepaald wie er wordt geïnformeerd, via welk(e) kana(a)l(en) en na hoeveel tijd als er geen bevestiging of oplossing is.
- Definieer ‘time-out voor bevestiging’ en ‘time-out voor oplossing’.
Hier volgt een voorbeeld van een werkstroom:
- Fase één: De eerste dienstdoende medewerker die onmiddellijk via sms of door te chatten wordt gewaarschuwd, moet binnen 5-10 minuten reageren
- Fase twee: Als er binnen de komende 15-20 minuten geen bevestiging of actie volgt, escaleer dan naar het back-up-/SRE-team en de senior engineer via sms, chat of e-mail
- Fase drie: Als het probleem na nog eens 30-60 minuten nog steeds niet is opgelost, escaleer het dan naar de engineeringmanager/leiding en trigger eventueel een ‘groot incident’-kanaal
- Bepaal of het escalatiepad moet ‘herhalen’ (opnieuw melden op hetzelfde niveau) of ‘verdergaan’
- Stel voor kritieke incidenten herhaalde notificaties in totdat iemand reageert. Voor incidenten met een lagere prioriteit kunt u volstaan met één werkstroom voor escalatie
- Zorg ervoor dat het traject wordt gedocumenteerd met behulp van een sjabloon voor de klantenservice en toegankelijk is voor alle betrokken medewerkers
❗️ Aantekening: Een ‘bevestigingstime-out’ is de tijd die de eerste responder heeft om te bevestigen dat hij de melding heeft gezien, terwijl een ‘oplossingstime-out’ de tijd is die het team heeft om het probleem op te lossen of te beperken voordat de volgende escalatie in werking treedt.
Stap 4: Integreer automatisering en ondersteuning door tools
Zodra je criteria, triageproces en verrijkingsnormen zijn vastgesteld, is de volgende stap het mogelijk maken van escalatie zonder dat mensen hoeven te onthouden wanneer en naar wie ze moeten escaleren. Dit is waar ClickUp-automatiseringen een essentieel onderdeel van je werkstroom worden.

U kunt automatiseringen instellen die reageren op dezelfde signalen die uw team tijdens incidenten gebruikt. Hier volgen enkele voorbeelden:
- Als de ernst wordt bijgesteld naar SEV-1 ➡️ Wijs onmiddellijk een senior SRE toe + breng het chatkanaal voor de dienstdoende medewerker op de hoogte
- Als de status gedurende X minuten ongewijzigd blijft ➡️ Trigger escalatie naar het volgende niveau
- Als de deadline is verstreken (bijv. de deadline voor bevestiging) ➡️ Escaleren naar L2
En hier gaat ClickUp Brain nog een stap verder. Het maakt gebruik van de context uit je werkruimte om direct antwoorden te geven, automatisch updates te genereren en toegang tot kennis te ondersteunen.
Gebruik tools zoals AI Prioritize om incidenten automatisch te beoordelen en de juiste prioriteit in te stellen op basis van uw eigen logica. Voorbeelden van prompts:
- Als het incident de productie beïnvloedt en gevolgen heeft voor klanten, stel dan de prioriteit in op: Dringend
- Als de toegewezen persoon het SRE-team is en er in de logboeken een melding is van ‘latentie’, stel dan de prioriteit in op: Hoog
- Als de beschrijving trefwoorden van de veiligheid bevat zoals ‘inbreuk’, stel dan de prioriteit in op: Dringend
En zodra de prioriteit is ingesteld, neemt AI Assign het over en wijst het incidenten automatisch toe op basis van de door u gedefinieerde voorwaarden.
U kunt prompts maken zoals:
- Als de prioriteit ‘Dringend’ is en de getroffen dienst betrekking heeft op ‘betalingen’, wijs het dan toe aan een Senior SRE
- Als het incidenttype 'database' is en de regio 'US-East', wijs het dan toe aan DB On-Call
- Als de taaknaam het woord ‘veiligheid’ bevat, wijs deze dan toe aan de SecOps Lead
Test deze aanwijzingen eerst bij de eerste drie Taaken voordat u ze op de hele lijst toepast.
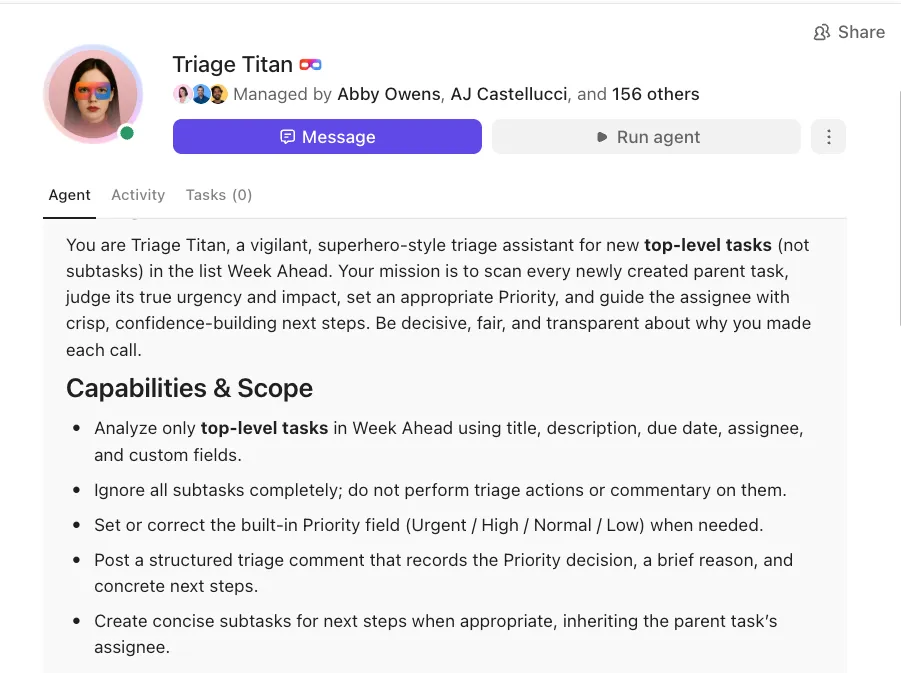
🚀 Het voordeel van ClickUp: Implementeer intelligente bots voor automatisering die in je ClickUp-werkruimte zijn geïntegreerd en met ClickUp Super Agents reageren op realtime activiteiten.
Het systeem is volledig op de hoogte van uw taken, documenten, chats en processen, zodat elke geautomatiseerde actie in de juiste context plaatsvindt.
U kunt bijvoorbeeld een Team StandUp Agent in uw ‘Productie-incidentenmap’ plaatsen, zodat deze elke ochtend automatisch een dagelijks overzicht publiceert. Uw team ontvangt direct een momentopname met het aantal geopende incidenten, welke nog onopgelost zijn en welke veranderingen er in de afgelopen 24 uur hebben plaatsgevonden.
Combineer dat nu met een Ambient Answers Agent in je ‘#incident-room-kanaal’. Wanneer hulpverleners vragen stellen als ‘Waar is het SEV-1-runbook?’ of ‘Heeft deze API eerder gefaald?’, put de agent uit de kennis in je werkruimte om direct nauwkeurige antwoorden te geven.
Stap 5: Standaardiseer communicatiekanalen
Naarmate incidenten escaleren, is het net zo belangrijk hoe en waar teams communiceren als wie er op de hoogte wordt gesteld. Zonder gestandaardiseerde communicatiekanalen raken updates zoek, worden beslissingen dubbel genomen en krijgen belanghebbenden tegenstrijdige informatie.
Definieer duidelijke escalatiekanalen voor elke fase van de incidentcyclus en pas deze consistent toe binnen alle teams:
| Criteria | Kanaalnaam | Doel |
| SEV-1 of SEV-2 gedetecteerd | #incident-kritiek | Centrale ruimte voor waarschuwingen met hoge ernstgraad en onmiddellijke triage |
| Er wordt momenteel aan probleemoplossing gewerkt | #incident-warroom | Realtime hub voor samenwerking voor engineers, productontwikkeling, kwaliteitscontrole en ondersteuning |
| Zichtbaarheid vanuit het management vereist | #incident-leiderschap | Belangrijke updates voor managers en leidinggevenden |
| Communicatie met klanten vereist | #incident-comms | Ruimte om externe klantcommunicatie op te stellen, te controleren en af te stemmen |
| Evaluatie na het incident gestart | #incident-retro | Gestructureerde bespreking van retrospectieve aantekeningen, geleerde lessen en actiemedelijnen |
Elk kanaal heeft een specifieke doelgroep en een duidelijk doel, waardoor teams ruis kunnen verminderen en tegelijkertijd de juiste teams op de hoogte kunnen houden.
🚀 Het voordeel van ClickUp: Stem je kanaalstrategie af op een ingebouwde communicatielaag met behulp van ClickUp Chat. Elke melding, update en beslissing blijft direct gekoppeld aan de incident-Taak, -lijst of -ruimte waar het werk plaatsvindt.
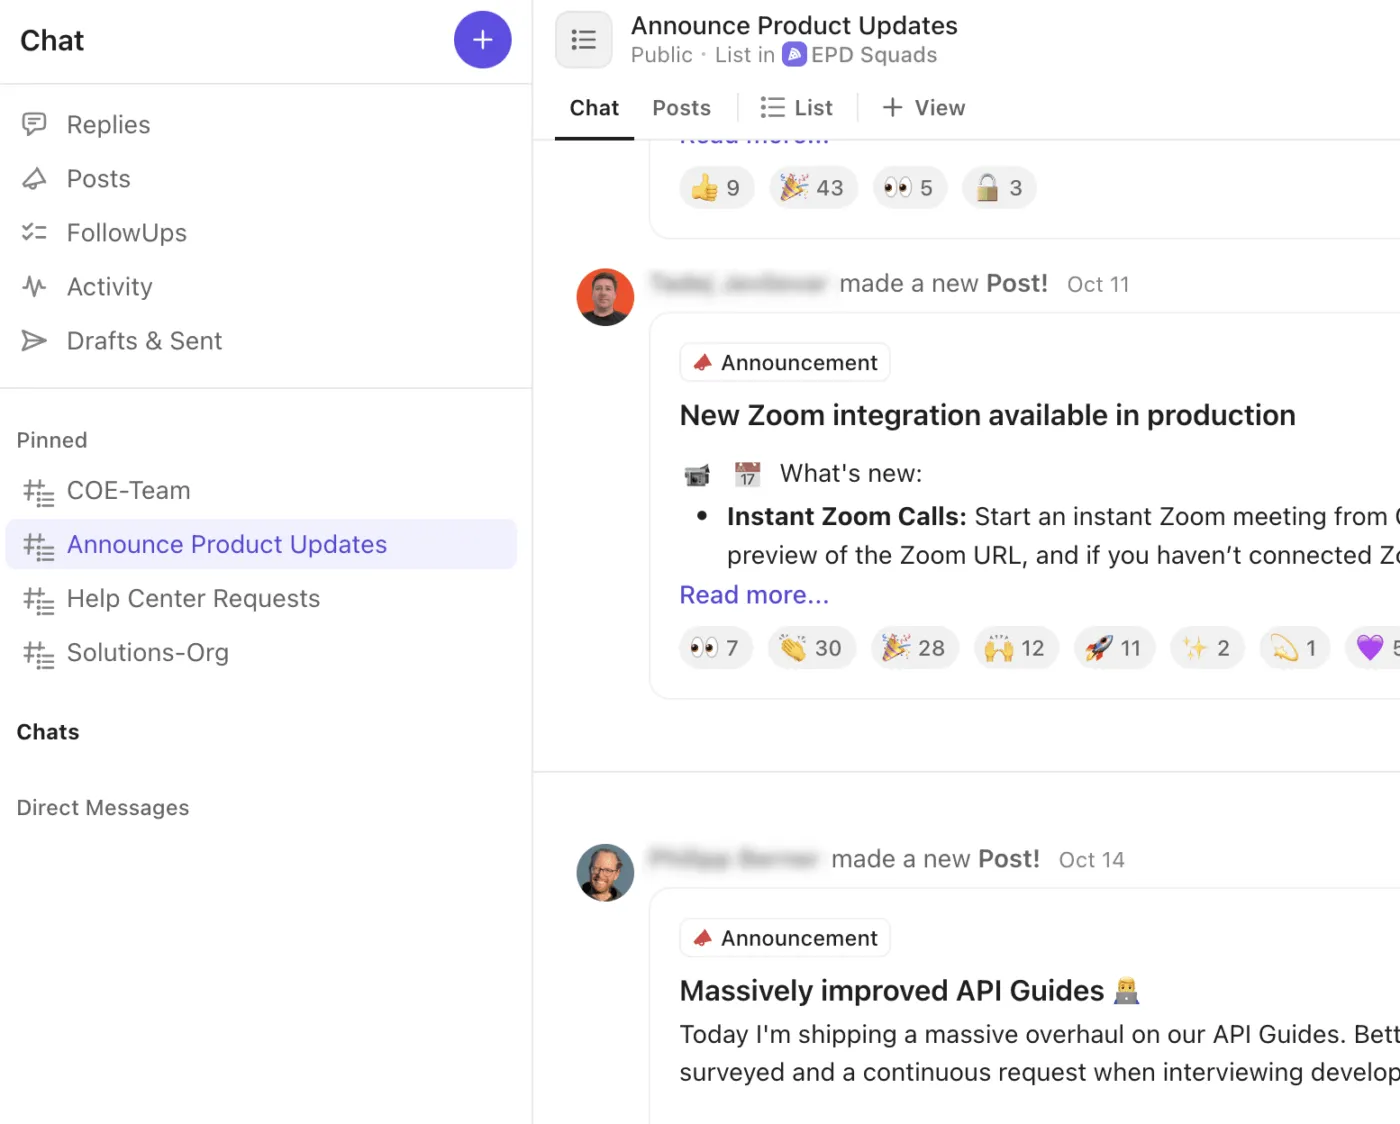
Zo verbetert ClickUp Chat uw incidentwerkstroom:
- Maak speciale chatthreads aan voor besprekingen over kritieke zaken, in de war room, met het management of met klanten
- Zet chatberichten direct om in ClickUp-taken, zodat beslissingen en vervolgacties niet verloren gaan in het gesprek
- Voer snel audio- of video-gesprekken met ClickUp SyncUps voor live coördinatie van incidenten of briefings voor het management
- Plaats ‘Aankondigingen’ of updates om de algemene status van incidenten binnen het hele bedrijf bekend te maken
- Tag teamgenoten, plaats schermafbeeldingen en voeg logbestanden toe als bijlagen rechtstreeks tijdens het chatten, zodat de technische context altijd binnen handbereik blijft
Stap 6: Test, controleer en verfijn uw escalatieprocedure
Escalatiebeleid moet mee evolueren met uw systemen. Dit is wat u regelmatig nog moet doen:
| Activiteit | Wat u moet testen of controleren | Waarom dit belangrijk is |
| Brandweeroefeningen tijdens de wachtdienst (elk kwartaal) | Simuleer P1- en P2-incidenten, controleer de timing en routing van de escalatie | Zorgt ervoor dat automatiseringen en escalatieprocedures ook onder druk goed functioneren |
| Validatie van escalatietrajecten | Controleer op escalaties die nergens toe leiden of ontbrekende eigenaars | Voorkomt dat incidenten vastlopen door een gebrek aan zichtbaarheid |
| Timers voor bevestiging en afhandeling | Vergelijk geconfigureerde timers met de werkelijke MTTA en MTTR | Zorgt ervoor dat de timing van escalaties realistisch en effectief blijft |
| Beoordeling van alarmmoeheid | Identificeer hulpverleners die buitensporig veel of herhaaldelijke waarschuwingen ontvangen | Vermindert burn-out en het missen van kritieke waarschuwingen |
| Nauwkeurigheid bij het bepalen van ernst en prioriteit | Controleer of incidenten correct zijn geclassificeerd | Verbetert de routering, reactiesnelheid en nauwkeurigheid van escalaties |
| Opvolging na een incident | Zorg ervoor dat actiepunten uit retrospectieven worden voltooid | Voorkomt herhaling van incidenten en systeemstoringen |
Tools en integraties voor automatisering van escalaties
In dit gedeelte maakt u kennis met incidentbeheersoftware waarmee u incidenten sneller kunt opsporen, direct kunt doorsturen en elk team op de hoogte kunt houden zonder handmatige follow-ups.
1. ClickUp (het meest geschikt voor het samenbrengen van functieoverschrijdende escalaties in één geïntegreerde incidentwerkruimte)
Bij traditionele escalatiemethoden moeten teams jongleren met e-mails, spreadsheets, chatthreads en verspreide aantekeningen, waardoor het bijna onmogelijk is om een duidelijk, realtime beeld te krijgen van wat er gaande is.
De ClickUp-taakbeheersoftware voor escalatiebeheer elimineert ruis door alle escalatiegegevens samen te brengen in één overzichtelijke werkruimte.
Laten we eens kijken naar enkele functies van IT-assetmanagementsoftware die ClickUp de positie geven van de beste keuze voor teams die grote hoeveelheden escalaties en complexe werkstroomprocessen beheren.
Zie hoe u op uw eigen manier kunt werken aan het werk
Bekijk uw taken vanuit verschillende invalshoeken om ze af te stemmen op uw operationele behoeften met ClickUp-weergaven:
- ClickUp-lijstweergave, zodat SRE-leiders incidenten kunnen sorteren op ernst, resterende SLA-tijd of oproepgroepen voor een snelle triage
- ClickUp Board Weergave, waarmee engineeringmanagers de overdracht en de eigendom van teams tijdens escalaties kunnen visualiseren
- ClickUp Gantt-weergave voor programmaleiders om mijlpalen voor het oplossen van problemen en afhankelijkheden tussen diensten in kaart te brengen
- ClickUp werklastweergave voor coördinatoren van de oproepdienst, die ervoor zorgen dat engineers niet overbelast raken tijdens periodes met een hoog aantal incidenten
Zet besprekingen tijdens vergaderingen om in actie
Tijdens escalaties en incidentbesprekingen kan het een uitdaging zijn om discussies en actiepunten betrouwbaar vast te leggen. De ClickUp AI Notetaker neemt automatisch deel aan vergaderingen die zijn gepland in Google Agenda, Outlook, Zoom of Teams, en neemt het gesprek op en transcribeert het.
Na de vergadering:
- Bekijk doorzoekbare transcripties en samenvattingen van actiepunten
- Zorg voor duidelijkheid met behulp van de aantekeningen die zijn opgeslagen in ClickUp Docs. Zo kun je eenvoudig koppelen aan incidenttaken of retrospectieve rapporten
- Stel vragen aan ClickUp AI over de content van vergaderingen om beslissingen te verduidelijken of gemiste vervolgacties aan het licht te brengen
Maak verbinding met bestaande tools in uw tech stack
Achter de schermen zorgen ClickUp-integraties en het Webhooks-ecosysteem voor een naadloze verbinding met de rest van je stack.
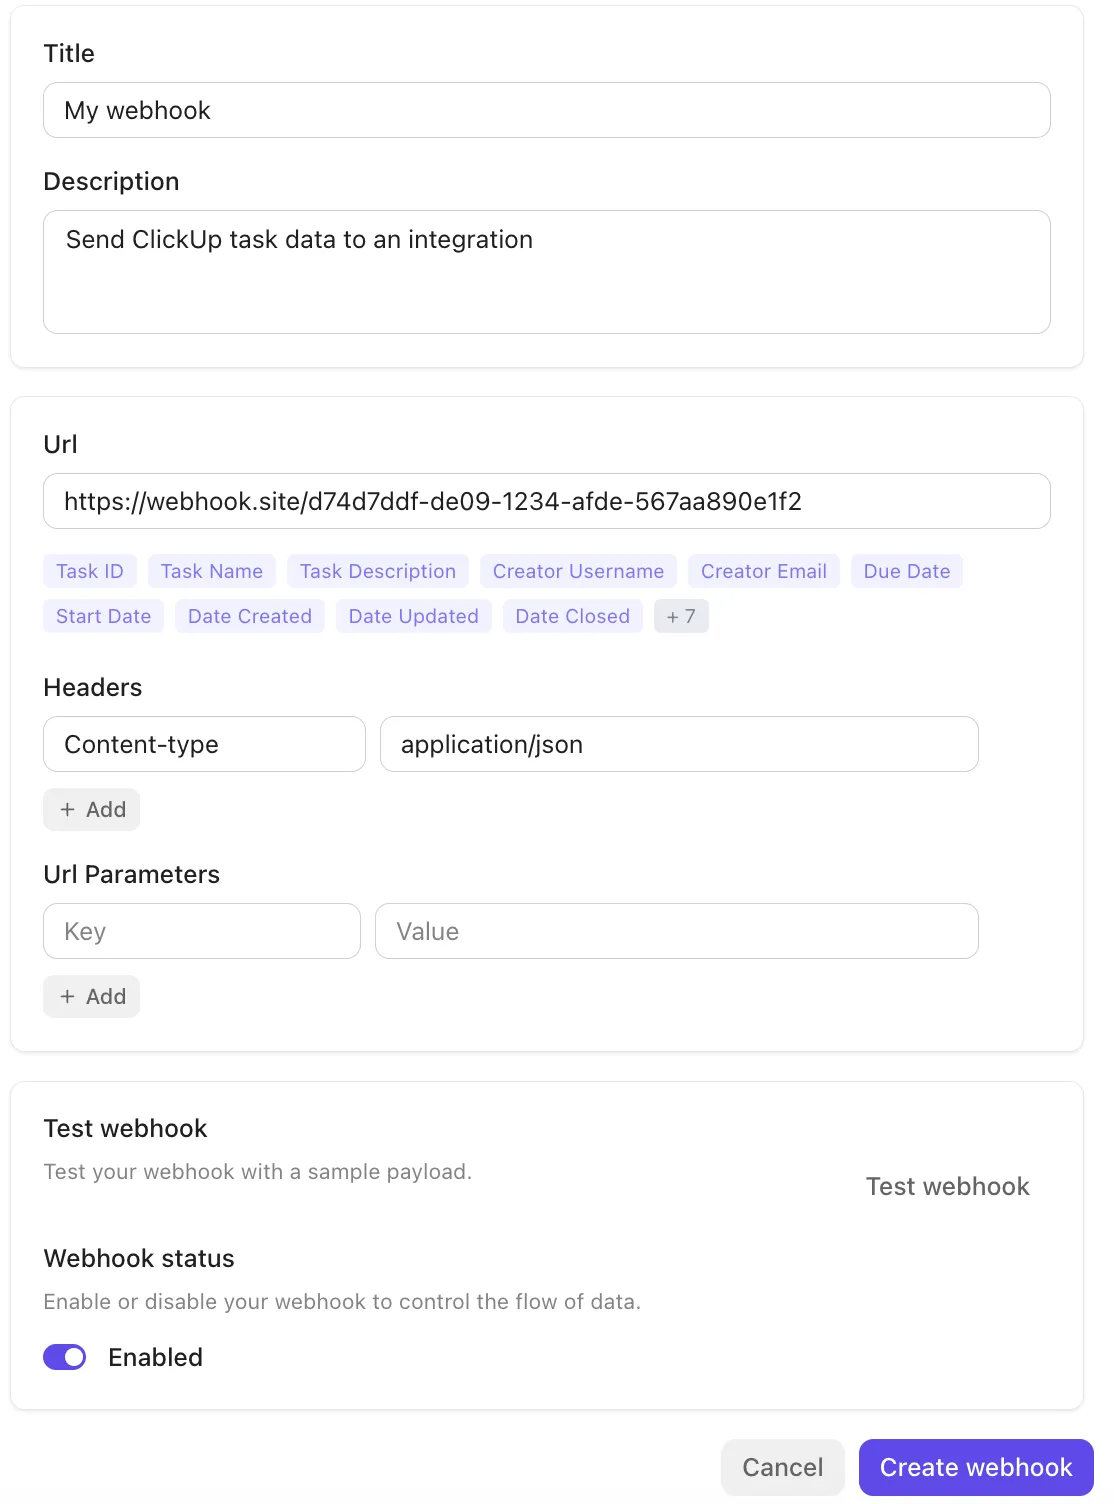
Het platform integreert native met tools zoals Slack, GitHub, Zoom en meer, en ondersteunt Webhooks via de openbare API om gebeurtenissen (taakupdates en statuswijzigingen) door te sturen naar externe diensten of pijplijnen voor automatisering. Dit maakt het eenvoudig om werkstroomtriggers te activeren, gegevens te synchroniseren of incidenten tussen systemen te escaleren zonder handmatige overdrachten.
Breng al uw AI-tools samen
Om automatisering en context naar een hoger niveau te tillen, integreert ClickUp BrainGPT contextuele AI in al je escalatiewerkstroomen. Het is een contextuele super-AI-app die je taken, documenten en historische context begrijpt.
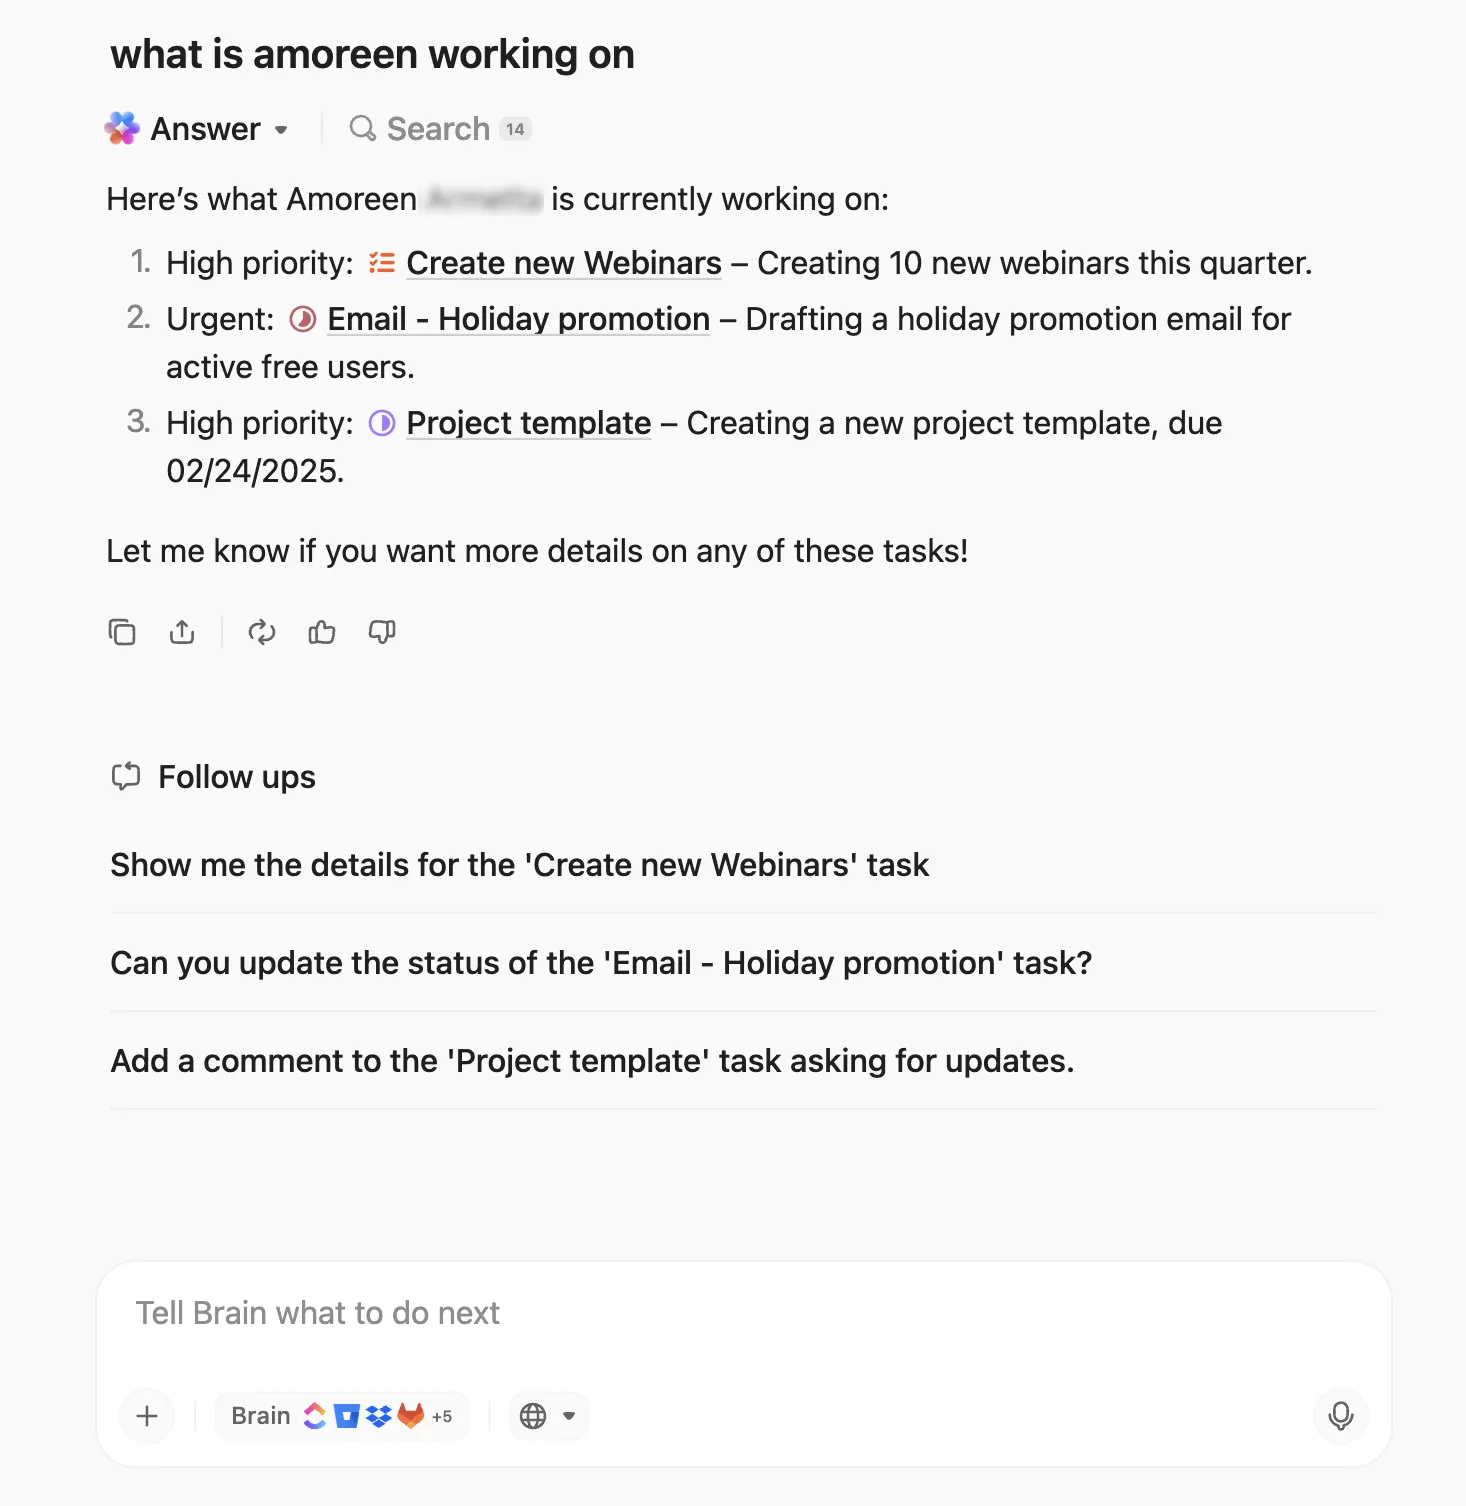
Met Enterprise Search en Connected Apps kun je direct informatie ophalen uit je werkruimte, Slack, Google Drive, GitHub en meer. Tijdens live incidentgesprekken kun je met Talk-to-Text in ClickUp handsfree escalatienotities of instructies dicteren, zodat er niets over het hoofd wordt gezien.
U kunt herhaalbare taken ook standaardiseren met aangepaste AI-prompts en opgeslagen prompts, zoals: ‘Geef een overzicht van alle onopgeloste incidenten en doe aanbevelingen voor escalatiemaatregelen.’
De beste functies van ClickUp
- Geef prioriteit aan kritieke problemen: Gebruik ClickUp-taakprioriteiten om urgente of zeer ingrijpende escalaties te markeren
- Organiseer complexe escalatiereeksen: Stel ClickUp-taakafhankelijkheden in om gerelateerde taken aan elkaar te koppelen (bijv. ‘In afwachting van’ of ‘Blokkerend’), zodat er tijdens de escalatiestappen geen voortijdige acties worden ondernomen en er geen knelpunten ontstaan
- Verdeel incidenten in uitvoerbare stappen: Verdeel escalaties in gedetailleerde actiepunten en wijs deze toe aan verschillende teams met geneste subtaaken
- Houd de afhandelingssnelheid nauwkeurig bij: Registreer en monitor hoe lang het duurt voordat escalatietaken worden bevestigd en opgelost met de functies voor tijdsregistratie van ClickUp
Limieten van ClickUp
- Met zoveel functies, weergaven en aanpassingsmogelijkheden moeten teams vaak eerst een leercurve doorlopen voordat alles intuïtief aanvoelt
Prijzen van ClickUp
[Prijstabel]
Beoordelingen en recensies van ClickUp
- G2: 4,7/5 (meer dan 10.300 beoordelingen)
- Capterra: 4,6/5 (meer dan 4.400 beoordelingen)
Wat zeggen echte gebruikers over ClickUp?
Deze recensie zegt eigenlijk alles:
ClickUp brengt al mijn taken, projecten en communicatie op één plek samen, waardoor het ongelooflijk eenvoudig is om georganiseerd te blijven. Ik vind het geweldig hoe aanpasbaar alles is – van weergaven en werkstroom tot dashboards – zodat ik mijn werkruimte precies zo kan inrichten als ik wil. De mogelijkheid om in realtime samen te werken, taken toe te wijzen en de voortgang bij te houden zonder van tool te wisselen, is een enorm voordeel.
ClickUp brengt al mijn taken, projecten en communicatie op één plek samen, waardoor het ongelooflijk eenvoudig is om georganiseerd te blijven. Ik vind het geweldig hoe aanpasbaar alles is – van weergaven en werkstroom tot dashboards – zodat ik mijn werkruimte precies zo kan inrichten als ik wil. De mogelijkheid om in realtime samen te werken, taken toe te wijzen en de voortgang bij te houden zonder van tool te wisselen, is een enorm voordeel.
📮 ClickUp Insight: 21% van de mensen zegt dat meer dan 80% van hun werkdag wordt besteed aan repetitieve taken. En nog eens 20% zegt dat repetitieve taken minstens 40% van hun dag in beslag nemen.
Dat is bijna de helft van de werkweek (41%) die wordt besteed aan taken die niet veel strategisch denken of creativiteit vereisen (zoals follow-up-e-mails 👀).
De Super Agents van ClickUp helpen je deze sleur te elimineren. Denk aan het aanmaken van taken, herinneringen, updates, aantekeningen over vergaderingen, het opstellen van e-mails en zelfs het creëren van end-to-end-werkstroomen! Dat alles (en nog veel meer) kun je in een handomdraai automatiseren met ClickUp, jouw alles-in-één-app voor werk.
💫 Concrete resultaten: Lulu Press bespaart 1 uur per dag per medewerker dankzij ClickUp-automatiseringen, wat heeft geleid tot een toename van de werkefficiëntie met 12%.
2. PagerDuty (het beste voor realtime waarschuwingen en intelligente respons bij oproepen)
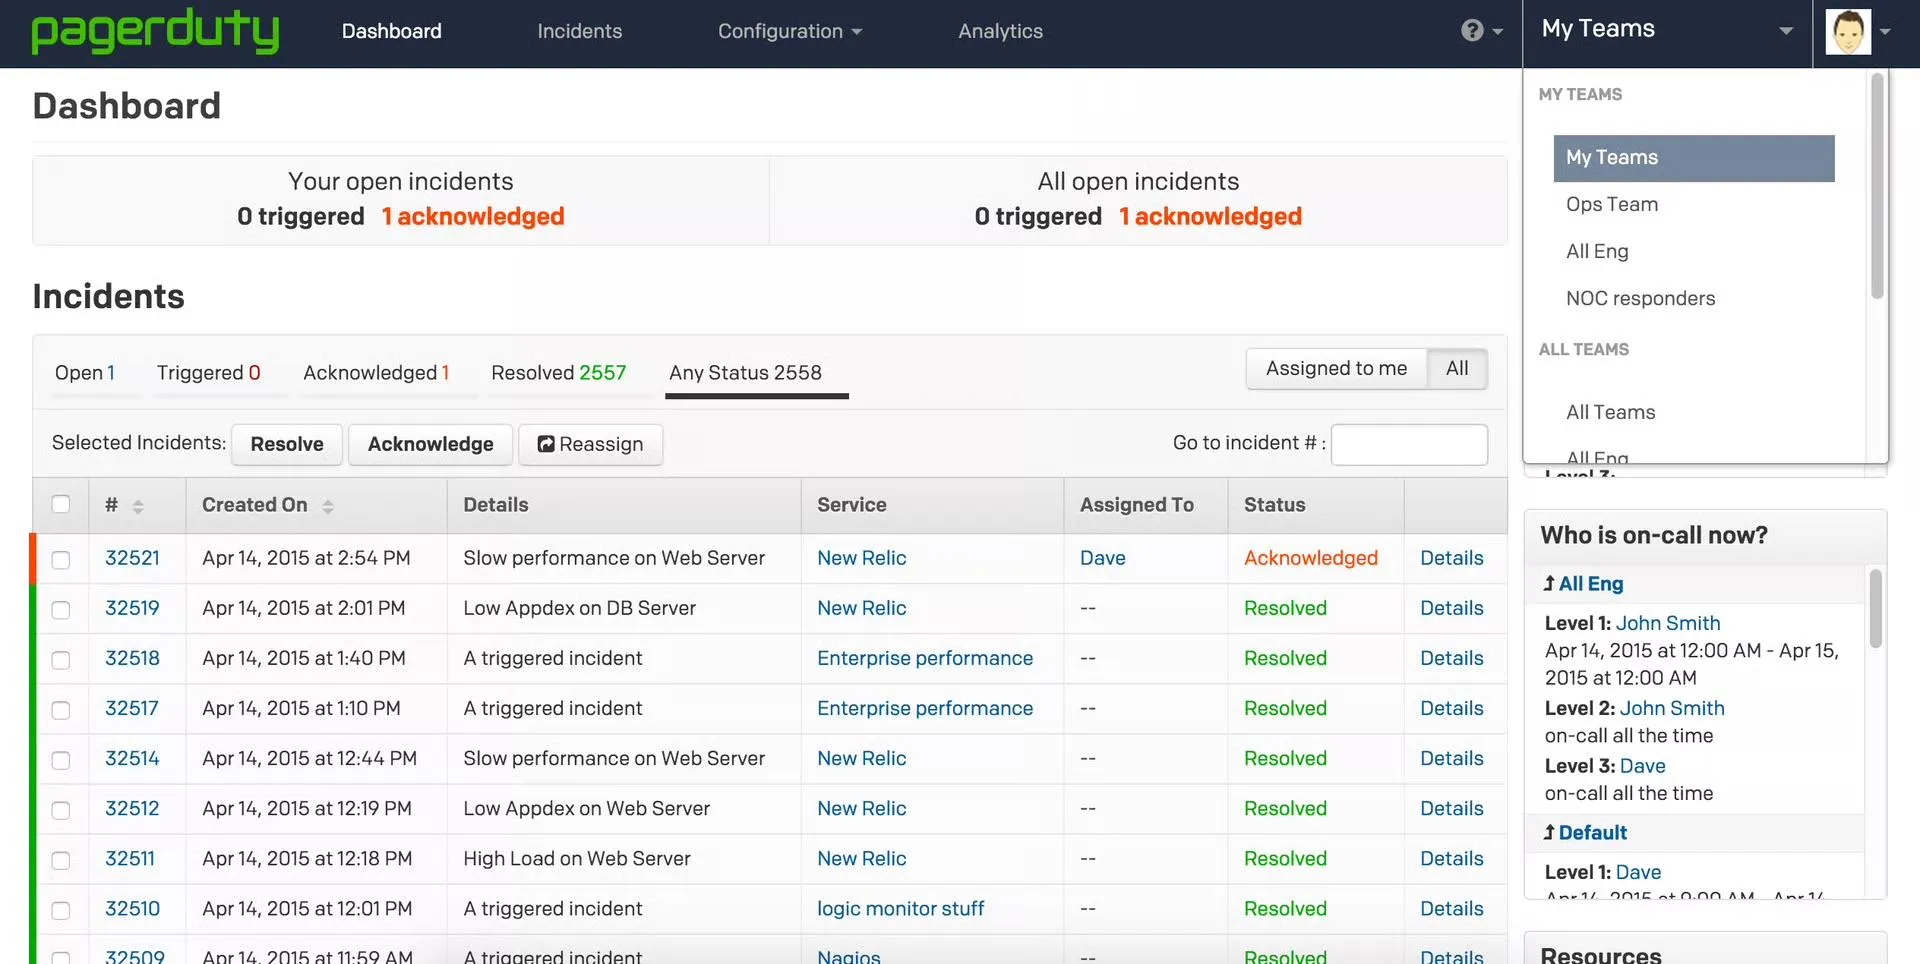
PagerDuty is een cloudgebaseerd platform voor IT-incidentbeheer en digitale operaties dat teams helpt bij het snel detecteren van, reageren op en oplossen van kritieke incidenten, zoals storingen of risico's op gebied van veiligheid. Het biedt SRE-, DevOps- en supportmanagers een duidelijk traject van signaal tot oplossing, ondersteund door automatisering, AI-gestuurde triage en diep geïntegreerde werkstroom.
Functies zoals Jeli Incident Analysis, PagerDuty Analytics en Runbook automatisering helpen teams om downtime te verminderen, routinetaken te elimineren en te leren van elk incident.
De beste functies van PagerDuty
- Automatiseer de routering van incidenten met ingebouwd On-Call Management en dynamische escalatiebeleidsregels
- Versnel de triage met behulp van AIOps, dat onnodige waarschuwingen filtert, gebeurtenissen met elkaar in verband brengt en echte signalen benadrukt
- Zorg ervoor dat interne en externe belanghebbenden op de hoogte blijven met Stakeholder Comms, sjablonen voor statusupdates en statuspagina's
- Breng uw toolstack samen met meer dan 700 integraties en uitbreidbare API's voor monitoring, logboekregistratie, CI/CD en ondersteuningssystemen
Limieten van PagerDuty
- Een hoog aantal waarschuwingen als integraties en slimme drempels niet goed zijn afgestemd, wat leidt tot ruis en vermoeidheid
- Tijdens pieken kunnen dubbele of herhaalde waarschuwingen optreden, waardoor het onder druk moeilijker wordt om deze te bevestigen
Prijzen van PagerDuty
- Free
- Professional: $25 per maand per gebruiker
- Business: $49 per maand per gebruiker
- Enterprise: aangepaste prijs
Beoordelingen en recensies van PagerDuty
- G2: 4,5/5 (meer dan 900 beoordelingen)
- Capterra: 4,6/5 (meer dan 200 beoordelingen)
Wat zeggen echte gebruikers over PagerDuty?
In de woorden van een echte gebruiker:
PagerDuty zorgt voor snelle en betrouwbare incidentnotificaties. Het verstuurt de juiste notificaties op het juiste moment en houdt ons team georganiseerd. […] PagerDuty kan soms wat overweldigend aanvoelen als notificaties niet goed worden gefilterd. Sommige instellingen zijn wat complex voor nieuwe gebruikers.
PagerDuty zorgt voor snelle en betrouwbare incidentnotificaties. Het verstuurt de juiste notificaties op het juiste moment en houdt ons team georganiseerd. […] PagerDuty kan soms wat overweldigend aanvoelen als notificaties niet goed worden gefilterd. Sommige instellingen zijn wat complex voor nieuwe gebruikers.
💡 Pro-tip: Bouw uitzonderingen in, zelfs in een duidelijk escalatiepad. Zorg ervoor dat kritieke storingen, waarschuwingen over veiligheid of incidenten in gereguleerde omgevingen direct worden doorgestuurd naar senior of gespecialiseerde hulpverleners.
3. GLPi (Het meest geschikt voor end-to-end assetbeheer en ITIL-conforme serviceactiviteiten)
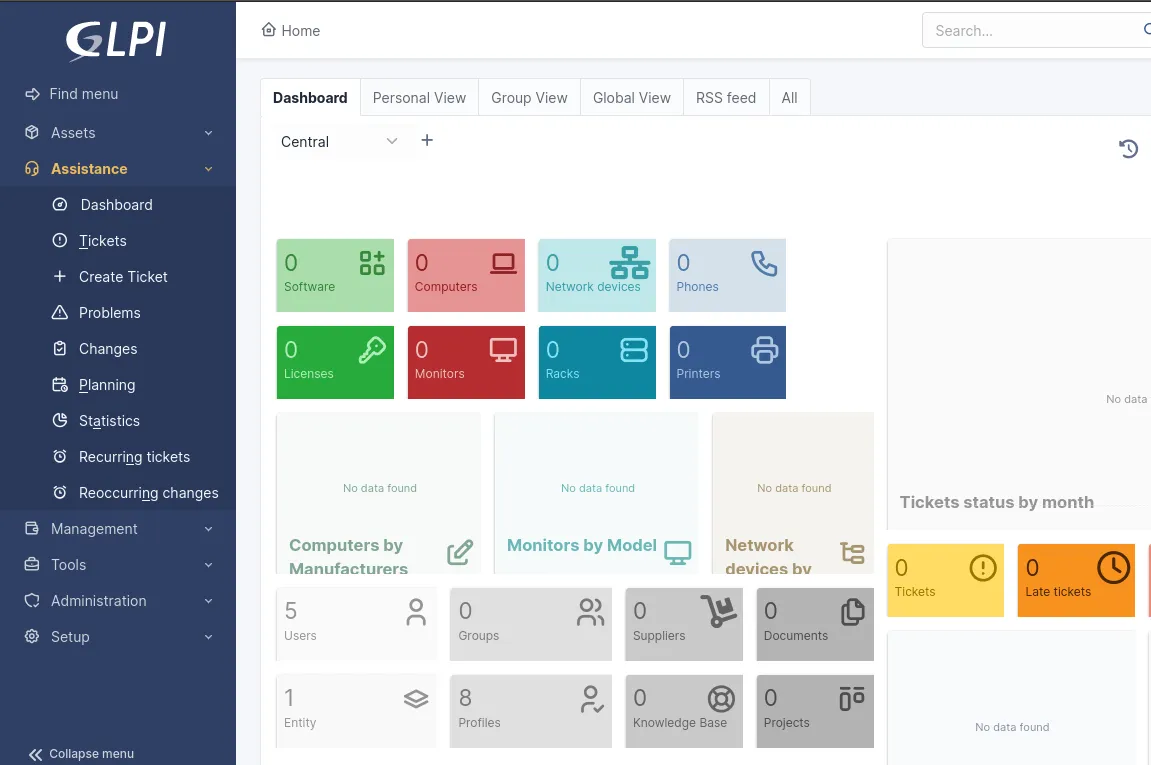
Gestionnaire Libre de Parc Informatique (GLPi) is een volledig, open-source platform voor IT-servicemanagement (ITSM) en IT-activabeheer (ITAM). Teams krijgen end-to-end zichtbaarheid in hun infrastructuur (hardware, software, licenties en netwerkapparatuur) en kunnen incidenten, serviceverzoeken en wijzigingen beheren met behulp van ITIL-conforme processen.
Al uw contracten en documentatie, inclusief garanties en serviceovereenkomsten, blijven overzichtelijk geordend, waardoor ze niet verloren raken in verschillende systemen. Als u datacenters beheert, kunt u met GLPi zelfs layouts, bekabelingsroutes en energieverbruik visualiseren, zodat u altijd weet wat er achter de schermen gebeurt.
De beste functies van GLPi
- Gebruik de plug-ins GLPI Inventory, OCS Inventory of FusionInventory om nieuwe IT-middelen automatisch te detecteren en te catalogiseren
- Automatiseer repetitieve taken, de toewijzing van tickets, notificaties en terugkerende gebeurtenissen om handmatig werk te verminderen
- Bouw een kennisbank op met veelgestelde vragen, documentatie en artikelen die aan tickets zijn gekoppeld, voor zelfhulp en ondersteuning door technici
- Maak verbinding met Azure/Entra, Centreon, Google, OAuth2 en webhooks om gegevens te synchroniseren, werkstroom te triggeren en uw CMDB te verbeteren
Limieten van GLPi
- De compatibiliteit van plug-ins kan tussen versies verloren gaan, wat extra onderhoudskosten met zich meebrengt
- De rapportage-, analyse- en exportmogelijkheden komen beperkt over en moeten worden verbeterd
Prijzen van GLPi
- Aangepaste prijzen
Beoordelingen en recensies van GLPi
- G2: 4,6/5 (meer dan 30 beoordelingen)
- Capterra: 4,5/5 (meer dan 40 beoordelingen)
Wat zeggen echte gebruikers over GLPi?
Dit is wat een gebruiker te zeggen had:
Zeer aanpasbaar open-source systeem voor IT-middelenbeheer en supporttickets met een grote ondersteunende community. De gebruikersinterface is voor een beginner wat ingewikkeld. Plug-ins worden niet altijd ondersteund bij de overgang van oude naar nieuwe versies.
Zeer aanpasbaar open-source systeem voor IT-middelenbeheer en supporttickets met een grote ondersteunende community. De gebruikersinterface is voor een gebruiker wat ingewikkeld. Plug-ins worden niet altijd ondersteund bij de overgang van oude naar nieuwe versies.
4. Splunk On-Call (het meest geschikt om monitoringwaarschuwingen rechtstreeks naar technici door te sturen)
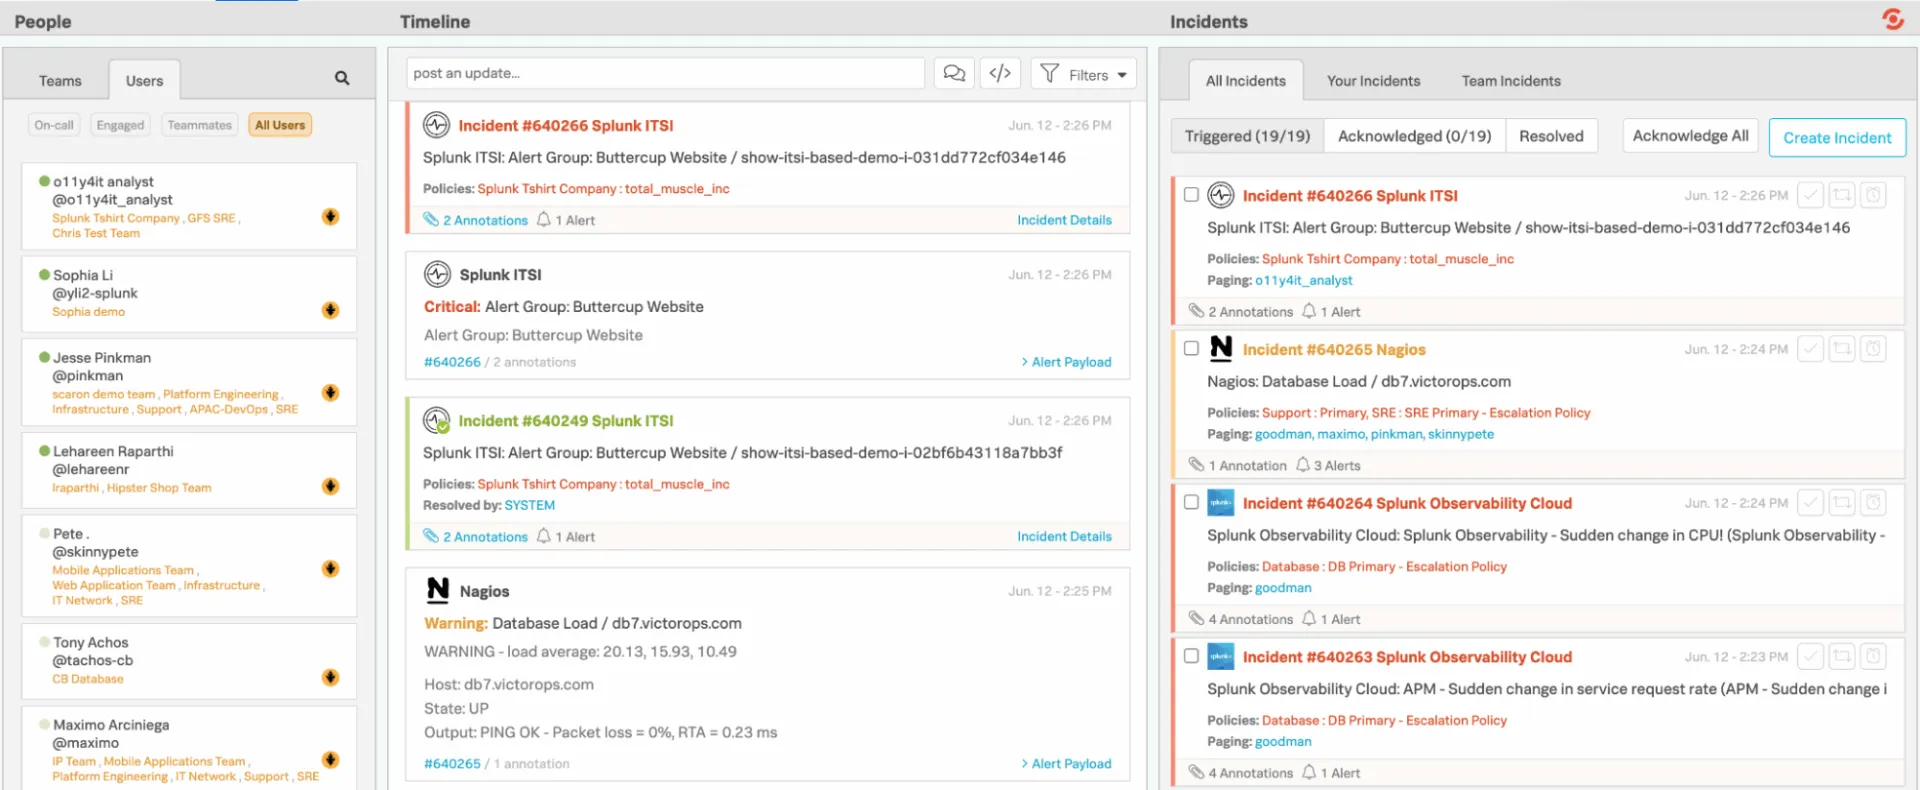
Splunk On-Call biedt engineering- en on-call-teams een snellere, overzichtelijkere manier om incidenten te beheren, waardoor trage, traditionele werkstroomen overbodig worden. In plaats van waarschuwingen naar een algemene wachtrij te sturen, integreert het rechtstreeks met uw monitoring- en observability-stack, waardoor problemen onmiddellijk naar de juiste personen worden doorgestuurd op basis van roosters, regels en context.
Dankzij de mobiele en chat-integraties kunt u incidenten eenvoudig overal vandaan bevestigen, doorsturen of oplossen. En achter de schermen houdt Splunk On-Call een gedetailleerd overzicht bij van trends, beproefde patronen en escalatiegedrag.
De beste functies van Splunk On-Call
- Breid de mogelijkheden van het platform uit met meer dan 1.000 geteste integraties en add-ons van Splunk en de bredere community
- Maak aangepaste dashboards en visuele rapporten om het aantal waarschuwingen, de status van incidenten, de prestaties van de hulpverleners en de werklast van het team te monitoren
- Filter incidenten snel op basis van uw eigen activiteiten, de incidenten van uw team of alle incidenten binnen de organisatie
- Schakel tussen de weergaven Getriggerd, Bevestigd en Opgelost om te zien in welke fase elk incident zich bevindt
Limieten van Splunk On-Call
- Het inroosteren van diensten voor meerdere teams kan ingewikkeld worden als er geen vooraf gedefinieerde regels zijn
- Limiet voor het genereren van gedetailleerde incidentrapporten per datum
Prijzen voor Splunk On-Call
- Aangepaste prijzen
Beoordelingen en recensies van Splunk On-Call
- G2: 4,6/5 (meer dan 40 beoordelingen)
- Capterra: 4,5/5 (meer dan 30 beoordelingen)
Wat zeggen echte gebruikers over Splunk On-Call?
Een gebruiker vatte het als volgt samen:
De mogelijkheid om via de mobiele app incidenten en escalaties af te handelen en diensten van mijn teamgenoten over te nemen is geweldig. […] Ik zou graag via de mobiele app uitzonderingen kunnen inplannen en de reguliere roostering kunnen aanpassen voor noodwijzigingen in het rooster.
De mogelijkheid om via de mobiele app incidenten en escalaties af te handelen en diensten van mijn teamgenoten over te nemen is geweldig. […] Ik zou graag via de mobiele app uitzonderingen kunnen inplannen en de reguliere roosters kunnen aanpassen voor noodwijzigingen in de planning.
🔍 Wist u dat? De logica van ‘doorverbinden naar de juiste persoon als het eerste niveau faalt’ vindt zijn oorsprong in de vroege telefooncentrales: wanneer handmatige telefonisten geen verbinding konden maken met een gesprek, leidde het systeem het gesprek door (of escaleerde het) naar een andere telefonist of centrale.
5. ServiceNow (het meest geschikt voor het coördineren van activiteiten op niveau van de onderneming met AI-ondersteunde automatisering)
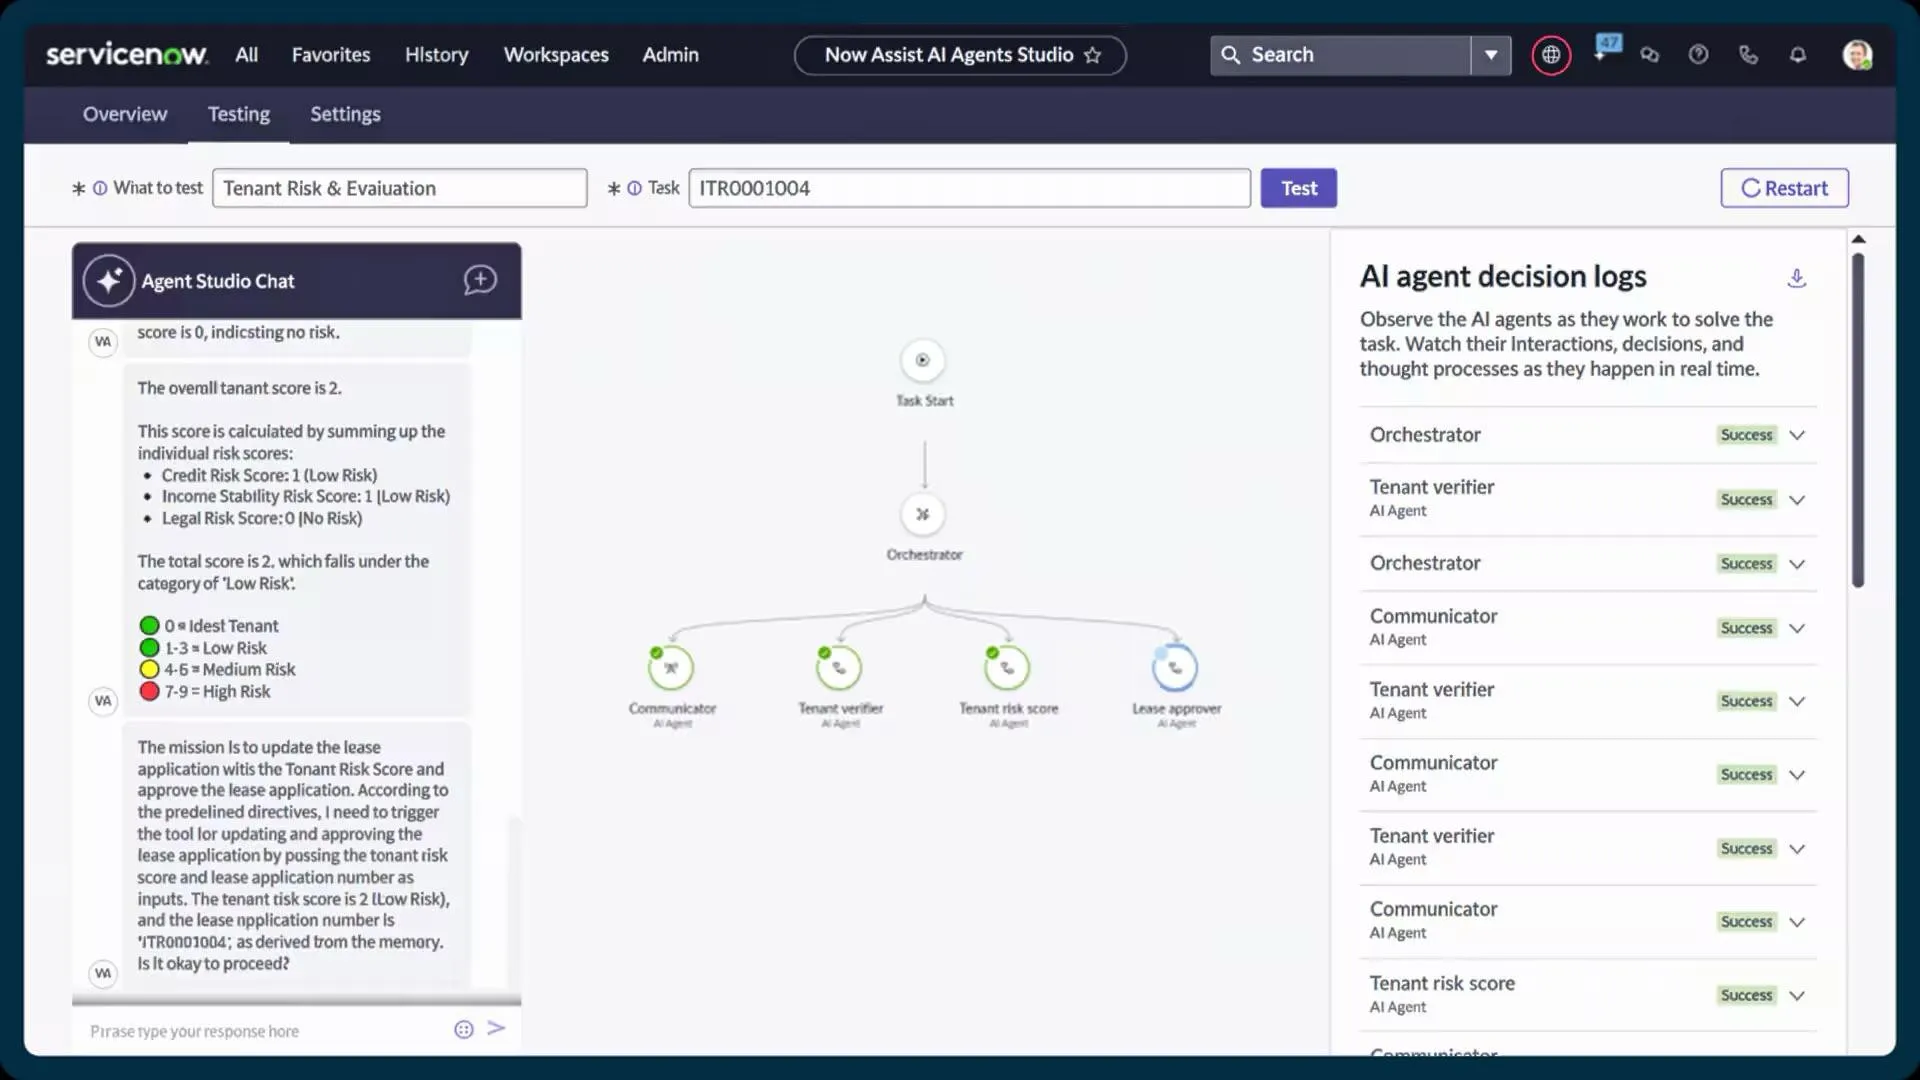
ServiceNow classificeert, prioriteert en routeert incidenten automatisch zodra ze worden geregistreerd. Met functies zoals Now Assist voor geautomatiseerde aanbevelingen voor incidenttickets en het genereren van slimme content kunnen hulpverleners problemen sneller en met meer context oplossen.
Het brengt incident-, wijzigings- en assetbeheer samen. Zo krijgt u een realtime weergave van hoe services met elkaar zijn verbonden, waar knelpunten ontstaan en welke componenten mogelijk bijdragen aan terugkerende storingen.
De beste functies van ServiceNow
- Wijs genomen in het veld, stuur ze door en houd ze in de gaten via Field Service Management en Dispatcher-werkruimte
- Geef medewerkers en klanten meer mogelijkheden met een selfserviceportaal op basis van AI Search en virtuele assistenten
- Gebruik de ingebouwde werkstroomen en low-code-tools in App Engine om serviceprocessen uit te breiden of aan te passen
- Automatiseer repetitieve taken en werkstroomen binnen verschillende teams met Flow Designer en Automation Engine
Limieten van ServiceNow
- De gebruikersinterface en de brandingopties van het portaal komen verouderd of beperkend over
- Grote afhankelijkheid van bekwaam personeel of consultants voor de implementatie
Prijzen van ServiceNow
- Aangepaste prijzen
Beoordelingen en recensies van ServiceNow
- G2: 4,4/5 (meer dan 3.300 beoordelingen)
- Capterra: 4,5/5 (meer dan 300 beoordelingen)
Wat zeggen echte gebruikers over ServiceNow?
Een gebruiker verwoordde het als volgt:
[…] De kant-en-klare werkstroomen zijn voor mij een ander hoogtepunt, omdat ze processen stroomlijnen en veel tijd besparen, waardoor de noodzaak voor aangepaste configuraties tot een minimum wordt beperkt en een soepelere, efficiëntere werkstroom mogelijk wordt. […] Bovendien had ik moeite om mijn aangepaste oplossing in het Customer Service Management-systeem te integreren, wat behoorlijk wat aanpassingen vergde.
[…] De kant-en-klare werkstroomen zijn voor mij een ander hoogtepunt, omdat ze processen stroomlijnen en veel tijd besparen, waardoor de noodzaak voor aangepaste configuraties tot een minimum wordt beperkt en een soepelere, efficiëntere werkstroom mogelijk wordt. […] Bovendien had ik moeite om mijn aangepaste oplossing in het Customer Service Management-systeem te integreren, wat behoorlijk wat aanpassingen vergde.
Best practices en governance
Hier volgen enkele best practices die ervoor zorgen dat automatisering nauwkeurig blijft, ‘alert fatigue’ voorkomt en aansluit bij de verwachtingen van het bedrijf en de regelgeving.
- Stel niet-onderhandelbare escalatiecriteria vast: Koppel triggers aan meetbare signalen zoals SLO-overtredingen, pieken in afwijkingen, impact op klantniveaus of gevoeligheid ten opzichte van regelgeving
- Zorg voor duidelijke rolverdeling op elk niveau: Gebruik een eenvoudige RACI-matrix voor elk escalatieniveau, zodat verantwoordelijkheden nooit onduidelijk zijn tijdens incidenten waarbij de druk hoog is
- Zorg voor dynamisch beheer van de wachtdienst: Pas escalatiepaden automatisch aan in het weekend, op feestdagen, bij limieten voor capaciteit en bij overdrachten om burn-out te verminderen en stille pagina's te voorkomen
- Voeg handmatige controlepunten in voor scenario's met een hoog risico: Zelfs bij automatisering moet handmatige bevestiging verplicht worden gesteld voor incidenten waarbij klantgegevens worden blootgesteld, betalingen betrokken zijn of gereguleerde werkstroom in het geding is.
- Zorg voor volledige audittrajecten: Houd onveranderlijke logboeken bij van wie er werd opgeroepen, wanneer ze dit bevestigden, welke geautomatiseerde stappen werden geactiveerd en welke beslissingen er werden genomen
🧠 Leuk weetje: De oudst bekende schriftelijke klacht ter wereld werd rond 1750 v.Chr. op een kleitablet gegraveerd. Het was in feite een vroege vorm van escalatie van de projectstatus. Een klant genaamd Nanni schreef aan de handelaar Ea-nāṣir, woedend omdat het koper dat hij had ontvangen van mindere kwaliteit was dan beloofd en omdat zijn boodschapper slecht was behandeld.
Veelvoorkomende uitdagingen en hoe u deze kunt overwinnen
Zelfs met een duidelijk escalatiebeleid worden teams vaak geconfronteerd met operationele hindernissen die de respons op incidenten vertragen of voor verwarring zorgen.
Deze tabel belicht veelvoorkomende uitdagingen die verder gaan dan de basisstappen van de installatie en biedt praktische strategieën om deze te overwinnen.
| Uitdagingen ❌ | Oplossingen ✅ |
| Inconsistente context bij overdrachten | Gebruik de functies voor het koppelen van taken en de sjablonen voor incidentrapporten van ClickUp om op elk escalatieniveau een volledig controlespoor bij te houden van incidentdetails, getroffen systemen en eerdere acties |
| Overbelasting van hulpverleners met meldingen met lage prioriteit | Implementeer dynamische prioritering met aangepaste velden van ClickUp en AI Prioritize om incidenten te filteren op basis van ernst, impact en SLA-drempels |
| Gebrek aan zichtbaarheid tussen teams | Richt gedeelde werkruimten in, voeg opmerkingen toe en maak visuele ClickUp-Whiteboards om realtime updates aan belanghebbenden te presenteren |
| Vertraagde besluitvorming tijdens kritieke incidenten | Automatiseer notificaties met behulp van de Voorgestelde acties van ClickUp Brain Max om direct de juiste medewerkers te waarschuwen op basis van het type incident, de ernst en historische patronen |
| Moeilijkheden bij het bijhouden van terugkerende problemen | Maak gebruik van de aangepaste rapportages en sjablonen voor terugkerende taken van ClickUp om patronen, onderliggende oorzaken en terugkerende incidenten te identificeren, zodat u deze proactief kunt voorkomen |
| Versnipperde kennis tijdens escalatie | Beheer gecentraliseerde SOP's, runbooks en incidentdocumentatie in ClickUp Docs en koppel deze aan relevante taken, zodat u er tijdens live-escalaties direct naar kunt verwijzen |
| Ongecoördineerde verantwoordelijkheden tussen de verschillende diensten | Gebruik de weergaven ‘Werklast’ en ‘Tijdlijn’ van ClickUp om taken te visualiseren en ervoor te zorgen dat er geen overlappingen of hiaten ontstaan tijdens dienstwisselingen of overdrachten |
| Handmatig bijhouden van nalevingscontrole en hiaten in audits | Automatiseer auditklare overzichten met ClickUp Brain om alle incidentacties, notificaties en oplossingen vast te leggen |
Het meten van de impact van geautomatiseerde escalatie
Om de effectiviteit van geautomatiseerde escalatie bij te houden, moet u zich richten op belangrijke statistieken op het gebied van volume, efficiëntie en kwaliteit. Deze indicatoren laten zien of uw escalatieprocessen sneller en nauwkeuriger verlopen en minder frustrerend zijn voor zowel teams als klanten.
Houd de volgende statistieken bij:
- Escalatiepercentage (volume): Percentage van de problemen dat verder wordt geëscaleerd dan het eerste niveau. Hoge percentages kunnen wijzen op tekortkomingen in de eerste triage of in de kennisbanken
- Herhaalde escalatiefrequentie (volume): De frequentie waarmee hetzelfde probleem meerdere keren wordt geëscaleerd. Dit duidt op onvolledige oplossingen of verloren context.
- Tijd tot escalatie (efficiëntie): De duur van de fase tussen het detecteren en het escaleren van een incident. Kortere duurtijden van de fases duiden op een snellere automatische herkenning van kritieke problemen
- Vertragingstijd bij de overdracht (efficiëntie): De tijd tussen de escalatie en het moment waarop het volgende team begint met het uitvoeren van werk, om knelpunten in de doorsturing of notificaties aan het licht te brengen
- Oplostijd voor geëscaleerde cases (efficiëntie): Totale tijd vanaf de escalatie tot de oplossing. Een snellere oplossing toont de effectiviteit van automatisering aan
- Klanttevredenheidsscore (CSAT) (kwaliteit): Feedback over geëscaleerde interacties om te meten hoe soepel het traject verloopt
- Contextdoorgave (kwaliteit): Krijgen medewerkers de volledige incidentgeschiedenis te zien, zodat klanten informatie niet hoeven te herhalen?
- First Contact Resolution (FCR) (kwaliteit): Percentage problemen dat in één contactmoment is opgelost
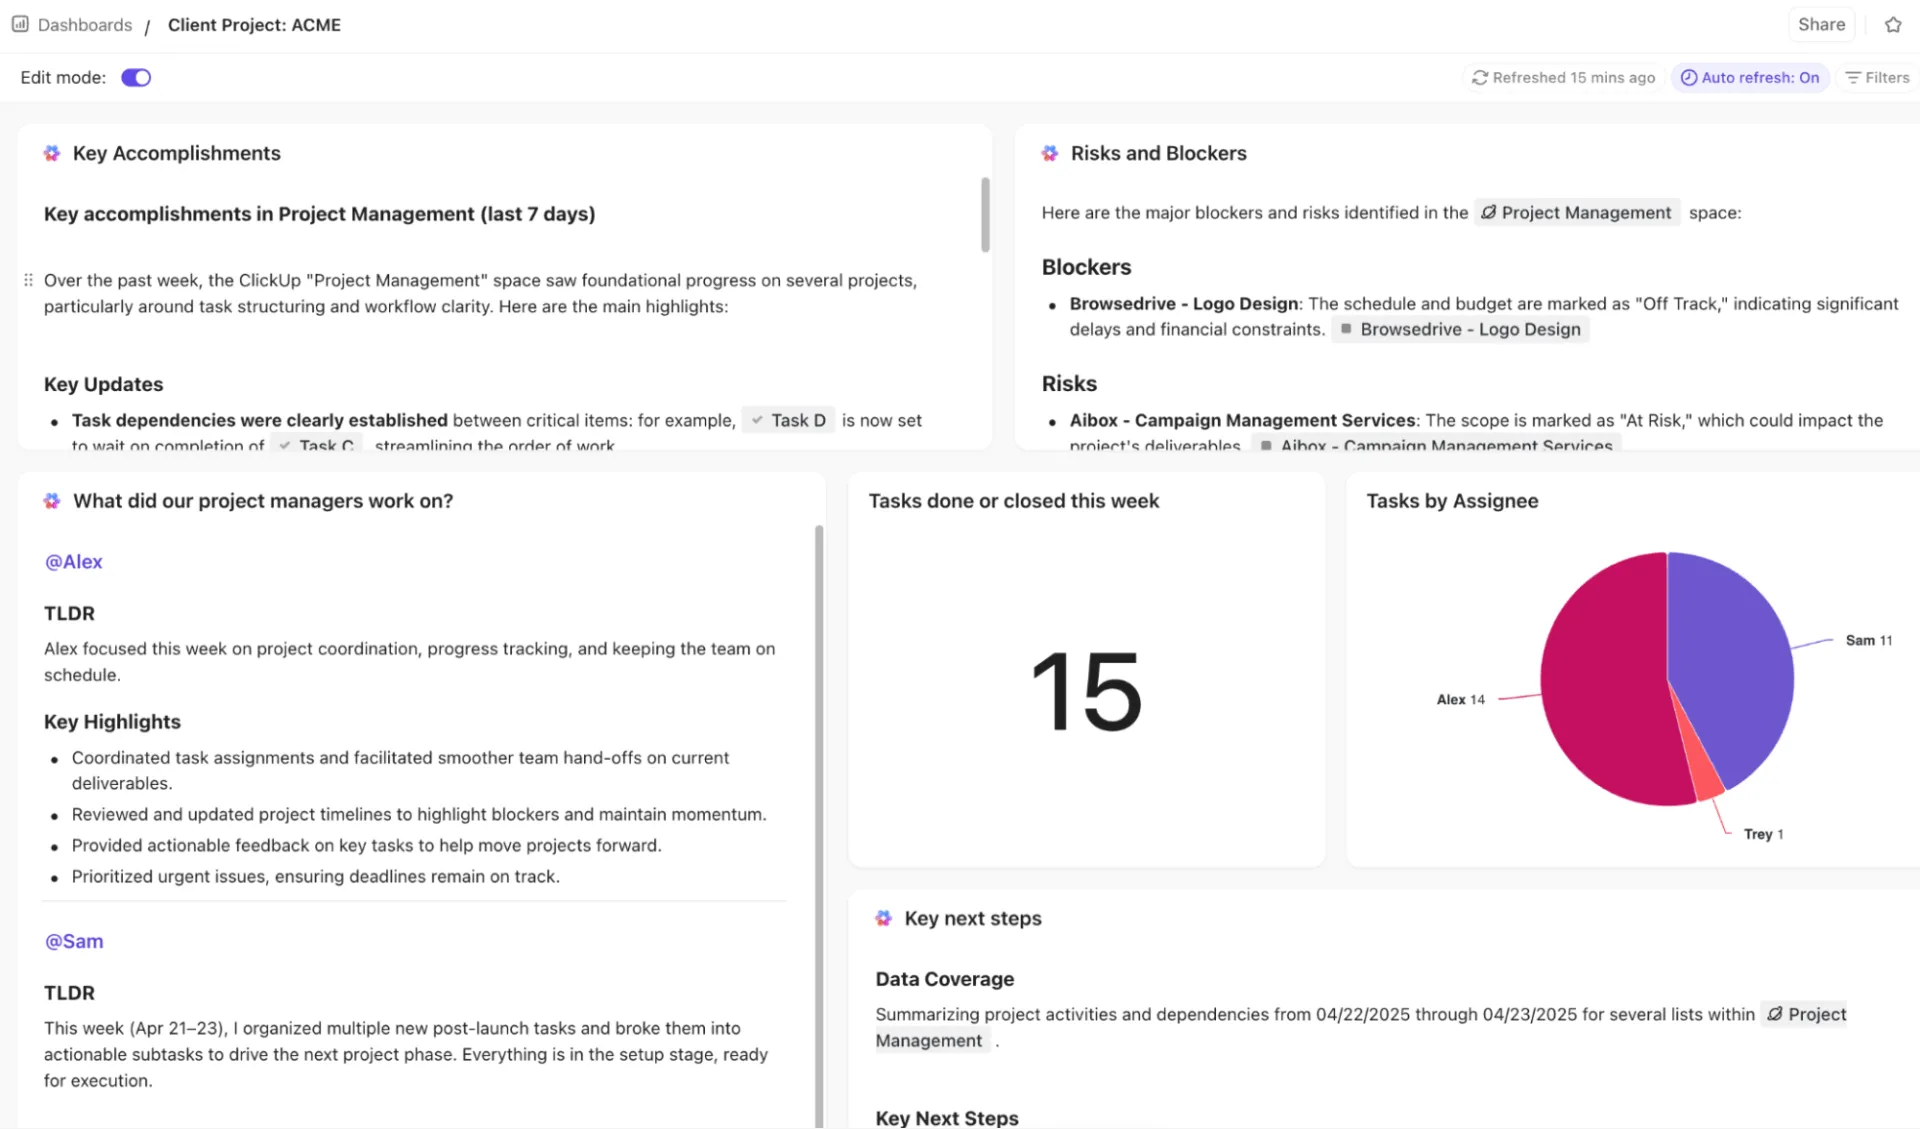
🚀 Het voordeel van ClickUp: Krijg met ClickUp Dashboards realtime, visuele en door AI aangestuurde inzichten in alle escalatiestatistieken.
U kunt escalatietrends, knelpunten en prestaties bijhouden met Tabel-, Cirkeldiagram-, Balkdiagram-, Lijndiagram-, Berekening- en Tijdrapportagekaarten. Houd het escalatiepercentage, herhaalde escalaties en de tijd tot escalatie in de gaten met kaarten die ook aan taken, aangepaste velden en statussen zijn gekoppeld.
Om nog een stap verder te gaan, kunt u AI-kaarten zoals AI Executive Summary, AI Project Update en AI StandUp gebruiken om trends, vertragingen en oplossingen onder de aandacht te brengen.
Beheer je incidenten sneller met ClickUp
Velen denken dat het escaleren van incidenten alleen maar neerkomt op het doorgeven van een ticket aan de volgende persoon, maar het is veel meer dan dat. Het is een gestructureerd systeem waarin elke stap, van triage tot oplossing, naadloos op elkaar aansluit.
ClickUp biedt je de perfecte geïntegreerde werkruimte. Met ClickUp automatiseringen kun je automatisch waarschuwingen triggeren, taken doorsturen en statussen bijwerken. En ClickUp Brain helpt bij het prioriteren van incidenten, het genereren van samenvattingen en het voorstellen van vervolgstappen.
ClickUp AI-agenten fungeren als intelligente assistenten binnen uw werkruimte, terwijl ClickUp-dashboards een live weergave van uw escalaties bieden.
Meld u vandaag nog gratis aan bij ClickUp!
Veelgestelde vragen (FAQ)
Wat is een escalatieprocedure voor incidenten?
Een escalatiepad voor incidenten is een vooraf gedefinieerde reeks stappen die bepaalt hoe problemen worden doorgestuurd naar het juiste team of de juiste persoon op basis van ernst, impact en timing. Het zorgt ervoor dat incidenten efficiënt worden aangepakt en dat de verantwoordelijkheid duidelijk is. TEKST
Hoe bepaal ik wanneer ik een incident automatisch moet escaleren en wanneer handmatig?
Gebruik automatisering voor duidelijk omschreven incidenten met hoge prioriteit en duidelijke criteria (bijv. serviceonderbrekingen, inbreuken op de veiligheid). Bewaar handmatige escalatie voor onduidelijke of kritieke situaties die menselijk oordeel of aanvullende context vereisen.
Welke tools ondersteunen automatisering van escalatie voor effectief incidentbeheer?
Platforms zoals ClickUp, PagerDuty, Jira Service Management en ServiceNow maken geautomatiseerde routering, notificaties en updates mogelijk. Ze helpen teams vertragingen te verminderen en gestructureerde incidentwerkstroomen te handhaven.
Hoe kan ik ‘alert fatigue’ voorkomen bij het gebruik van geautomatiseerde escalatie?
Stel duidelijke limieten in voor notificaties, prioriteer op basis van ernst en maak gebruik van intelligente notificaties. Beperk herhaalde notificaties tot kritieke incidenten en gebruik dashboards of AI-tools om updates samen te vatten in plaats van elke kleine wijziging te versturen.
Hoe vaak moet ik mijn escalatiebeleid herzien?
Evalueer het escalatiebeleid regelmatig, minimaal elk kwartaal of na ernstige incidenten. Zo zorgt u ervoor dat de criteria, verantwoordelijkheden en regels voor automatisering aansluiten bij de huidige werkstroom, teamstructuren en prioriteiten.