Você lança a atualização de software mais recente e os relatórios começam a chegar em grande quantidade.
De repente, uma única métrica passa a reger tudo, desde o CSAT/NPS até atrasos no roteiro: o tempo de resolução de bugs.
Os executivos veem isso como uma métrica de cumprimento de promessas — será que conseguimos lançar produtos, aprender e proteger a receita dentro do prazo? Os profissionais sentem o peso do dia a dia — tickets duplicados, responsabilidades pouco claras, escalações confusas e informações dispersas entre o Slack, planilhas e ferramentas separadas.
Essa fragmentação prolonga os ciclos, oculta as causas-raiz e transforma a priorização em adivinhação.
O resultado? Aprendizado mais lento, compromissos não cumpridos e um backlog que, discretamente, sobrecarrega cada sprint.
Este guia é o seu manual completo para medir, comparar e reduzir o tempo de resolução de bugs, além de mostrar, de forma concreta, como a IA transforma o fluxo de trabalho em comparação com os processos manuais tradicionais.
O que é o tempo de resolução de bugs?
O tempo de resolução de bugs é o tempo necessário para corrigir um bug, medido desde o momento em que o bug é relatado até que seja totalmente resolvido.
Na prática, o cronômetro começa a correr quando um problema é relatado ou detectado (por usuários, pela equipe de controle de qualidade ou pelo monitoramento) e para quando a correção é implementada e incorporada, pronta para verificação ou lançamento — dependendo de como sua equipe define “concluído”.
Exemplo: uma falha de prioridade P1 relatada às 10h da manhã de segunda-feira, com uma correção incorporada às 15h da terça-feira, tem um tempo de resolução de aproximadamente 29 horas.
Isso não é o mesmo que o tempo de detecção de bugs. O tempo de detecção mede a rapidez com que você reconhece um defeito após sua ocorrência (acionamento de alarmes, identificação por ferramentas de teste de controle de qualidade, relatos de clientes).
O tempo de resolução mede a rapidez com que você passa da detecção à correção — triagem, reprodução, diagnóstico, implementação, revisão, teste e preparação para lançamento. Pense na detecção como “sabemos que está com defeito” e na resolução como “está consertado e pronto”.
As equipes utilizam limites ligeiramente diferentes; escolha um e seja consistente para que suas tendências sejam reais:
- Relatado → Resolvido: Finaliza quando a correção do código é incorporada e está pronta para o controle de qualidade. Ideal para a produtividade da engenharia
- Relatado → Fechado: Inclui validação de controle de qualidade e lançamento. Ideal para SLAs que afetam os clientes
- Detectado → Resolvido: Começa quando o monitoramento/controle de qualidade detecta o problema, mesmo antes da criação de um ticket. Útil para equipes com grande volume de produção
🧠 Curiosidade: Um bug peculiar, mas hilário, no Final Fantasy XIV recebeu elogios por ser tão específico que os leitores o apelidaram de “A correção de bug mais específica em um MMO de 2025”. ” Ele ocorria quando os jogadores definiam preços de itens entre exatamente 44.442 gil e 49.087 gil em uma zona de evento específica — causando desconexões devido ao que poderia ser uma falha de estouro de inteiro.
Por que isso é importante
O tempo de resolução é um fator determinante para a cadência de lançamentos. Tempos longos ou imprevisíveis forçam cortes no escopo, correções de emergência e congelamentos de lançamentos; eles geram dívida de planejamento, pois os casos atípicos (outliers) prejudicam os sprints mais do que a média sugere.
Isso também está diretamente ligado à satisfação do cliente. Os clientes toleram problemas quando estes são reconhecidos rapidamente e resolvidos de forma previsível. Correções demoradas — ou, pior ainda, correções inconsistentes — geram escalações, prejudicam o CSAT/NPS e colocam as renovações em risco.
Resumindo: se você medir o tempo de resolução de bugs de forma clara e sistemática e reduzi-lo, seus planos de ação e seus relacionamentos melhorarão.
Como medir o tempo de resolução de bugs?
Primeiro, decida onde o seu tempo começa e termina.
A maioria das equipes opta por “Relatado → Resolvido” (a correção foi incorporada e está pronta para verificação) ou “Relatado → Encerrado” (o controle de qualidade validou e a alteração foi lançada ou encerrada por outro motivo).
Escolha uma definição e use-a de forma consistente para que suas tendências sejam significativas.
Agora você precisa de algumas métricas observáveis. Vamos delineá-las:
Principais métricas de acompanhamento de bugs a serem observadas:
| 📊 Métrica | 📌 O que isso significa | 💡 Como isso ajuda | 🧮 Fórmula (se aplicável) |
|---|---|---|---|
| Número de bugs 🐞 | Número total de bugs relatados | Oferece uma visão geral da integridade do sistema. Número alto? É hora de investigar. | Total de bugs = Todos os bugs registrados no sistema {Abertos + Fechados} |
| Bugs em aberto 🚧 | Bugs que ainda não foram corrigidos | Mostra a carga de trabalho atual. Ajuda na definição de prioridades. | Bugs em aberto = Total de bugs – Bugs fechados |
| Bugs fechados ✅ | Bugs resolvidos e verificados | Acompanha o progresso e o trabalho realizado. | Bugs fechados = Número de bugs com o status “Fechado” ou “Resolvido” |
| Gravidade do bug 🔥 | Gravidade do bug (por exemplo, crítico, grave, leve) | Auxilia na triagem com base no impacto. | Rastreado como campo categórico, sem fórmula. Use filtros/agrupamento. |
| Prioridade dos bugs 📅 | Qual é o grau de urgência para a correção de um bug? | Auxilia no planejamento de sprints e lançamentos. | Também é um campo categórico, normalmente classificado (por exemplo, P0, P1, P2). |
| Tempo de resolução ⏱️ | Tempo decorrido entre o relato do bug e a correção | Mede a capacidade de resposta. | Tempo de resolução = Data de encerramento – Data de notificação |
| Taxa de reabertura 🔄 | Porcentagem de bugs reabertos após terem sido fechados | Reflete a qualidade das correções ou problemas de regressão. | Taxa de reabertura (%) = {Bugs reabertos ÷ Total de bugs fechados} × 100 |
| Vazamento de bugs 🕳️ | Bugs que passaram despercebidos na produção | Indica a eficácia do controle de qualidade (QA) e dos testes de software. | Taxa de fuga (%) = {Erros em produção ÷ Total de erros} × 100 |
| Densidade de defeitos 🧮 | Bugs por unidade de tamanho de código | Destaca áreas de código propensas a riscos. | Densidade de defeitos = Número de bugs ÷ KLOC {mil linhas de código} |
| Bugs atribuídos x não atribuídos 👥 | Distribuição de bugs por responsável | Garante que nada passe despercebido. | Use um filtro: Não atribuídos = Bugs em que “Atribuído a” é nulo |
| Tempo de existência dos bugs pendentes 🧓 | Por quanto tempo um bug permanece sem solução | Identifica riscos de estagnação e acúmulo de tarefas pendentes. | Tempo de existência do bug = Data atual - Data em que foi relatado |
| Bugs duplicados 🧬 | Número de relatórios duplicados | Destaca erros nos processos de recebimento. | Taxa de duplicatas = Duplicatas ÷ Total de bugs × 100 |
| MTTD (Tempo Médio de Detecção) 🔎 | Tempo médio necessário para detectar bugs ou incidentes | Avalia a eficiência do monitoramento e da detecção de problemas. | MTTD = Σ(Tempo de detecção - Tempo de introdução) ÷ Número de bugs |
| MTTR (Tempo Médio de Resolução) 🔧 | Tempo médio para corrigir totalmente um bug após a detecção | Monitora a capacidade de resposta da equipe de engenharia e o tempo de correção. | MTTR = Σ(Tempo de resolução - Tempo de detecção) ÷ Número de bugs resolvidos |
| MTTA (Tempo Médio de Reconhecimento) 📬 | Tempo decorrido desde a detecção até o momento em que alguém começa a trabalhar no bug | Mostra a capacidade de reação da equipe e a agilidade na resposta a alertas. | MTTA = Σ(Tempo de confirmação - Tempo de detecção) ÷ Número de bugs |
| MTBF (Tempo Médio Entre Falhas) 🔁 | Tempo entre a resolução de uma falha e a ocorrência da próxima | Indica estabilidade ao longo do tempo. | MTBF = Tempo total de atividade ÷ Número de falhas |
⚡️ Arquivo de modelos: 15 modelos e formulários gratuitos de relatório de bugs para rastreamento de bugs
Fatores que afetam o tempo de resolução de bugs
O tempo de resolução costuma ser equiparado à “rapidez com que os engenheiros programam”.
Mas isso é apenas uma parte do processo.
O tempo de resolução de bugs é a soma da qualidade no momento do registro, da eficiência do fluxo pelo seu sistema e do risco de dependências. Quando qualquer um desses fatores falha, o tempo de ciclo aumenta, a previsibilidade diminui e as reclamações se intensificam.
A qualidade do recebimento define o tom
Relatórios que chegam sem etapas claras de reprodução, detalhes do ambiente, logs ou informações de versão/compilação geram trocas desnecessárias de mensagens. Relatórios duplicados provenientes de vários canais (suporte, controle de qualidade, monitoramento, Slack) aumentam o ruído e fragmentam a responsabilidade.
Quanto mais cedo você identificar o contexto correto — e eliminar duplicatas —, menos transferências de responsabilidade e solicitações de esclarecimento serão necessárias posteriormente.
A priorização e o encaminhamento determinam quem lida com o bug e quando
Rótulos de gravidade que não correspondem ao impacto no cliente ou nos negócios (ou que se alteram com o tempo) causam agitação na fila: os tickets mais urgentes pulam a fila, enquanto defeitos de alto impacto ficam parados.
Regras claras de encaminhamento por componente/responsável e uma única fila de referência evitam que as tarefas P0/P1 fiquem enterradas sob as “recente e ruidosas”.
A responsabilidade e as transferências de tarefas são inimigos silenciosos
Se não ficar claro se um bug pertence à equipe de dispositivos móveis, de autenticação de back-end ou à equipe de plataforma, ele fica sem destino. Cada vez que isso acontece, o contexto é reiniciado.
Os fusos horários agravam essa situação: um bug relatado no final do dia, sem um responsável designado, pode levar de 12 a 24 horas até que alguém comece a reproduzi-lo. Definições claras de “quem é responsável por quê”, com um responsável de plantão ou um DRI semanal, eliminam esse atraso.
A reprodutibilidade depende da observabilidade
Logs incompletos, IDs de correlação ausentes ou a falta de rastreamentos de falhas transformam o diagnóstico em adivinhação. Bugs que só aparecem com determinados sinalizadores, locatários ou formatos de dados são difíceis de reproduzir no ambiente de desenvolvimento.
Se os engenheiros não conseguirem acessar com segurança dados sanitizados semelhantes aos de produção, eles acabam tendo que instrumentar, reimplantar e esperar — dias, em vez de horas.
A paridade de ambiente e dados garante a integridade dos dados
“Funciona na minha máquina” geralmente significa “os dados de produção são diferentes”. Quanto mais seu ambiente de desenvolvimento/teste divergir da produção (configuração, serviços, versões de terceiros), mais tempo você vai perder atrás de fantasmas. Snapshots de dados seguros, scripts de inicialização e verificações de paridade reduzem essa lacuna.
O trabalho em andamento (WIP) e o foco impulsionam a produtividade real
Equipes sobrecarregadas lidam com muitos bugs ao mesmo tempo, dispersam sua atenção e ficam pulando entre tarefas e reuniões. A alternância de contexto acrescenta horas invisíveis.
Um limite visível de trabalho em andamento (WIP) e a prioridade de concluir o que foi iniciado antes de assumir novas tarefas reduzirão sua mediana mais rapidamente do que qualquer esforço individual de um único colaborador.
A revisão de código, a integração contínua (CI) e a velocidade do controle de qualidade (QA) são gargalos clássicos
Tempos de compilação lentos, testes instáveis e SLAs de revisão pouco claros atrasam correções que, de outra forma, seriam rápidas. Um patch de 10 minutos pode levar dois dias esperando por um revisor ou sendo encaixado em um pipeline que leva horas.
Da mesma forma, filas de controle de qualidade que agrupam testes ou dependem de testes preliminares manuais podem adicionar dias inteiros ao processo “Relatado → Fechado”, mesmo quando o processo “Relatado → Resolvido” é rápido.
As dependências aumentam as filas
Alterações que envolvem várias equipes (esquema, migrações de plataforma, atualizações de SDK), bugs de fornecedores ou análises da loja de aplicativos (dispositivos móveis) geram períodos de espera. Sem um acompanhamento explícito do status “Bloqueado/Pausado”, essas esperas inflacionam invisivelmente suas médias e ocultam onde está o verdadeiro gargalo.
O modelo de lançamento e a estratégia de reversão são importantes
Se você faz lançamentos em grandes blocos com etapas manuais, mesmo os bugs resolvidos ficam parados até a próxima série de lançamentos. Flags de recurso, lançamentos canary e canais de hotfix encurtam o tempo de espera — especialmente para incidentes P0/P1 —, permitindo que você separe a implantação de correções dos ciclos completos de lançamento.
A arquitetura e a dívida técnica definem seu limite máximo
O acoplamento estreito, a falta de pontos de teste e módulos legados opacos tornam as correções simples arriscadas. As equipes compensam isso com testes adicionais e revisões mais demoradas, o que prolonga os ciclos. Por outro lado, um código modular com bons testes de contrato permite que você avance rapidamente sem afetar sistemas adjacentes.
A comunicação e a organização do status influenciam a previsibilidade
Atualizações vagas (“estamos analisando”) geram trabalho extra quando as partes interessadas solicitam estimativas de conclusão, o suporte reabre tickets ou a equipe de produto escala o problema. Transições de status claras, notas sobre a reprodução e a causa raiz, além de uma estimativa de conclusão divulgada, reduzem a rotatividade e protegem o foco da sua equipe de engenharia.
📮ClickUp Insight: O profissional médio gasta mais de 30 minutos por dia procurando informações relacionadas ao trabalho — isso significa mais de 120 horas por ano perdidas vasculhando e-mails, conversas no Slack e arquivos espalhados.
Um assistente inteligente de IA integrado ao seu espaço de trabalho pode mudar isso. Conheça o ClickUp Brain. Ele oferece insights e respostas instantâneas, exibindo os documentos, conversas e detalhes de tarefas certos em segundos — para que você possa parar de procurar e começar a trabalhar.
💫 Resultados reais: Equipes como a QubicaAMF recuperaram mais de 5 horas por semana usando o ClickUp — o que equivale a mais de 250 horas por ano por pessoa — ao eliminar processos ultrapassados de gestão do conhecimento. Imagine o que sua equipe poderia criar com uma semana extra de produtividade a cada trimestre!
Indicadores importantes de que seu tempo de resolução pode aumentar
❗️Aumento do “tempo de confirmação” e grande número de tickets sem responsável por mais de 12 horas
❗️Aumento dos intervalos de “Tempo em revisão/CI” e instabilidade frequente nos testes
❗️Alta taxa de duplicatas no registro de bugs e classificações de gravidade inconsistentes entre as equipes
❗️Vários bugs estão na categoria “Bloqueados” sem uma dependência externa especificada
❗️A taxa de reabertura está aumentando (as correções não são reproduzíveis ou as definições de “concluído” são vagas)
Diferentes organizações percebem esses fatores de maneiras distintas. Os executivos os veem como ciclos de aprendizado perdidos e atrasos em relação a oportunidades de receita; os operadores os percebem como ruído na triagem e falta de clareza quanto à responsabilidade.
O ajuste da entrada, do fluxo e das dependências é o que permite reduzir toda a curva — mediana e P90.
Quer saber mais sobre como escrever relatórios de bugs melhores? Comece por aqui. 👇🏼
Referências do setor para o tempo de resolução de bugs
Os parâmetros de referência para a resolução de bugs variam de acordo com a tolerância ao risco, o modelo de lançamento e a rapidez com que você consegue implementar as alterações.
É aqui que você pode usar as medianas (P50) para entender seu fluxo típico e a P90 para definir compromissos e SLAs — por gravidade e origem (cliente, controle de qualidade, monitoramento).
Vamos explicar o que isso significa:
| 🔑 Termo | 📝 Descrição | 💡 Por que isso é importante |
|---|---|---|
| P50 (mediana) | O valor médio — 50% das correções de bugs são mais rápidas do que isso e 50% são mais lentas | 👉 Reflete seu tempo de resolução típico ou mais comum. É útil para entender o desempenho normal |
| P90 (90º percentil) | 90% dos bugs são corrigidos dentro desse prazo. Apenas 10% levam mais tempo | 👉 Representa um limite para o pior cenário possível (mas ainda assim realista). Útil para definir prazos externos |
| SLAs (Acordos de Nível de Serviço) | Compromissos que você assume — internamente ou com os clientes — sobre a rapidez com que os problemas serão resolvidos | 👉 Exemplo: “Resolvemos os bugs P1 em até 48 horas em 90% das vezes.” Isso ajuda a construir confiança e responsabilidade |
| Por gravidade e origem | Segmente suas métricas por duas dimensões principais: • Gravidade (por exemplo, P0, P1, P2) • Origem (por exemplo, Cliente, Controle de Qualidade, Monitoramento) | 👉 Permite um acompanhamento e uma priorização mais precisos, para que os bugs críticos recebam atenção mais rapidamente |
Abaixo estão intervalos orientativos baseados nos setores que equipes experientes costumam ter como alvo; considere-os como pontos de partida e, em seguida, ajuste-os ao seu contexto.
SaaS
Sempre ativo e compatível com CI/CD, por isso as correções urgentes são comuns. Problemas críticos (P0/P1) geralmente têm como meta uma mediana inferior a um dia útil, com P90 entre 24 e 48 horas. Problemas não críticos (P2+) costumam ter uma mediana de 3 a 7 dias, com P90 entre 10 e 14 dias. Equipes com feature flags robustos e testes automatizados tendem a ter tempos de resolução mais rápidos.
Plataformas de comércio eletrônico
Como os fluxos de conversão e de carrinho são essenciais para a receita, o padrão de exigência é mais alto. Problemas P0/P1 são normalmente mitigados em poucas horas (reversão, sinalização ou configuração) e totalmente resolvidos no mesmo dia; o P90 até o final do dia ou em menos de 12 horas é comum em épocas de pico. Problemas P2+ costumam ser resolvidos em 2 a 5 dias, com o P90 em até 10 dias.
Software corporativo
Validações mais complexas e janelas de alteração dos clientes diminuem o ritmo. Para P0/P1, as equipes têm como meta uma solução alternativa em 4 a 24 horas e uma correção em 1 a 3 dias úteis; para P90, em 5 dias úteis. Itens P2+ são frequentemente agrupados em ciclos de lançamento, com medianas de 2 a 4 semanas, dependendo dos cronogramas de implementação dos clientes.
Jogos e aplicativos móveis
Os back-ends de serviços em tempo real funcionam como SaaS (sinalizações e reversões em minutos a horas; P90 no mesmo dia). As atualizações do cliente são limitadas pelas revisões da loja: P0/P1 geralmente utilizam recursos do lado do servidor imediatamente e lançam um patch para o cliente em 1 a 3 dias; P90 em até uma semana, com revisão acelerada. As correções P2+ são normalmente agendadas para o próximo sprint ou lançamento de conteúdo.
Setor bancário/Fintech
Os controles de risco e conformidade impulsionam um padrão de “mitigação rápida, mudança cuidadosa”. Os bugs P0/P1 são mitigados rapidamente (sinalizações, reversões, redirecionamento de tráfego em questão de minutos a horas) e totalmente corrigidos em 1 a 3 dias; os P90, em até uma semana, levando em conta o controle de mudanças. Os bugs P2+ geralmente levam de 2 a 6 semanas para passar pelas revisões de segurança, auditoria e do Comitê de Avaliação de Mudanças (CAB).
Se seus números estiverem fora desses intervalos, analise a qualidade do registro de problemas, o encaminhamento/atribuição de responsabilidade, a revisão de código e a produtividade do controle de qualidade, além das aprovações de dependências, antes de presumir que a “velocidade da engenharia” seja o principal problema.
🌼 Você sabia? De acordo com uma pesquisa do Stack Overflow de 2024, os desenvolvedores passaram a usar cada vez mais a IA como sua fiel aliada ao longo da jornada de programação. Impressionantes 82% usavam a IA para realmente escrever código — isso sim é um colaborador criativo! Quando ficavam em dúvida ou buscavam soluções, 67,5% contavam com a IA para procurar respostas, e mais da metade (56,7%) recorria a ela para depurar e obter ajuda.
Para alguns, as ferramentas de IA também se mostraram úteis para documentar projetos (40,1%) e até mesmo para gerar dados ou conteúdo sintético (34,8%). Curioso sobre uma nova base de código? Quase um terço (30,9%) usa IA para se atualizar rapidamente. Testar código ainda é uma tarefa manual árdua para muitos, mas 27,2% já adotaram a IA nessa área também. Outras áreas, como revisão de código, planejamento de projetos e análise preditiva, apresentam menor adoção de IA, mas está claro que a IA está se integrando de forma constante a todas as etapas do desenvolvimento de software.
📖 Leia mais: Como usar a IA para garantia de qualidade
Como reduzir o tempo de resolução de bugs
A rapidez na resolução de bugs depende da eliminação de atritos em cada etapa do processo, desde o recebimento até o lançamento.
Os maiores ganhos vêm de tornar os primeiros 30 minutos mais eficientes (recebimento organizado, responsável correto, prioridade adequada) e, em seguida, comprimir os ciclos que se seguem (reprodução, revisão, verificação).
Aqui estão nove estratégias que funcionam juntas como um sistema. A IA acelera cada etapa, e o fluxo de trabalho fica organizado em um único lugar, de modo que os executivos tenham previsibilidade e os profissionais tenham fluidez.
1. Centralize o recebimento de relatórios e capture o contexto na fonte
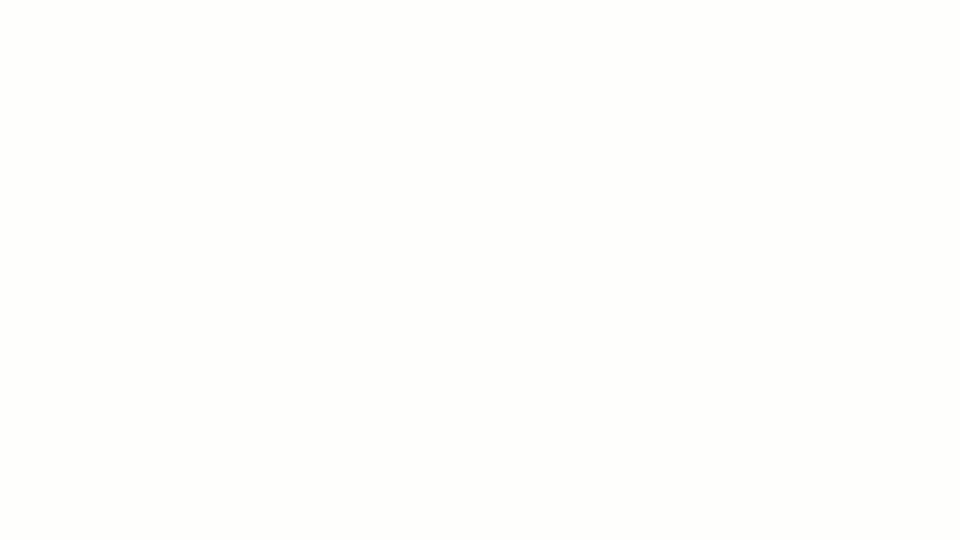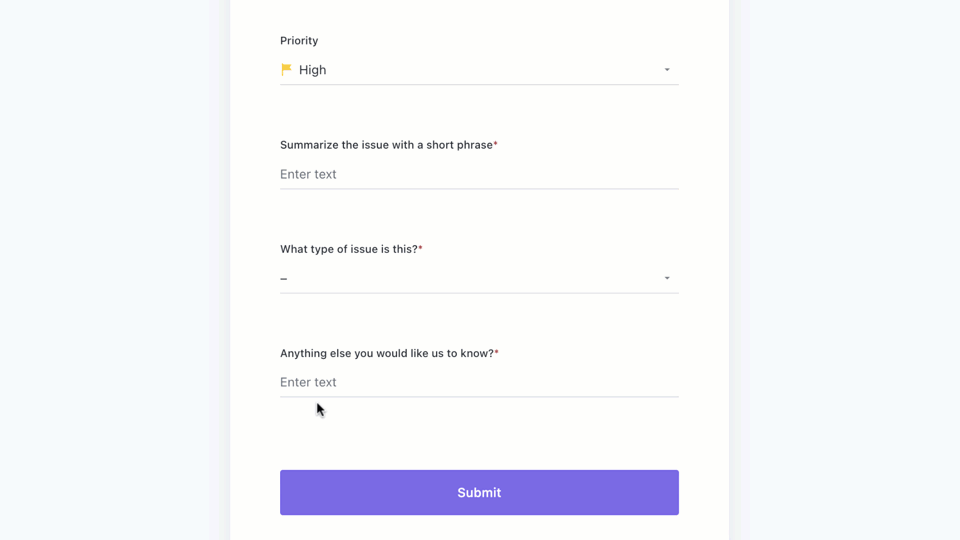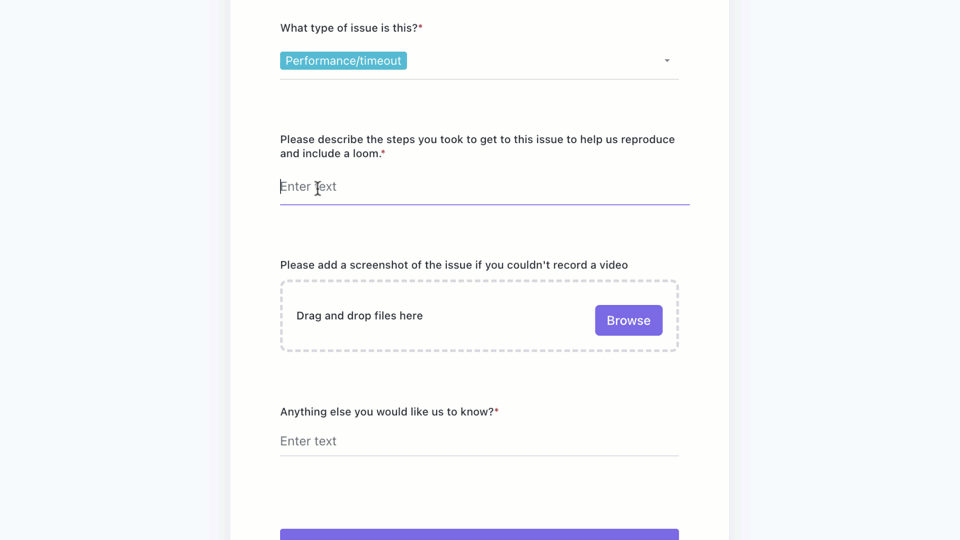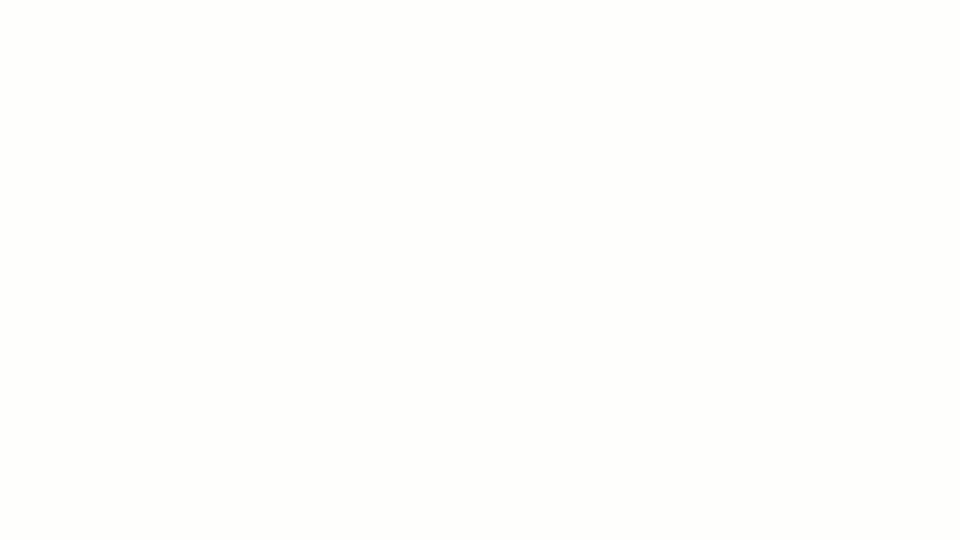
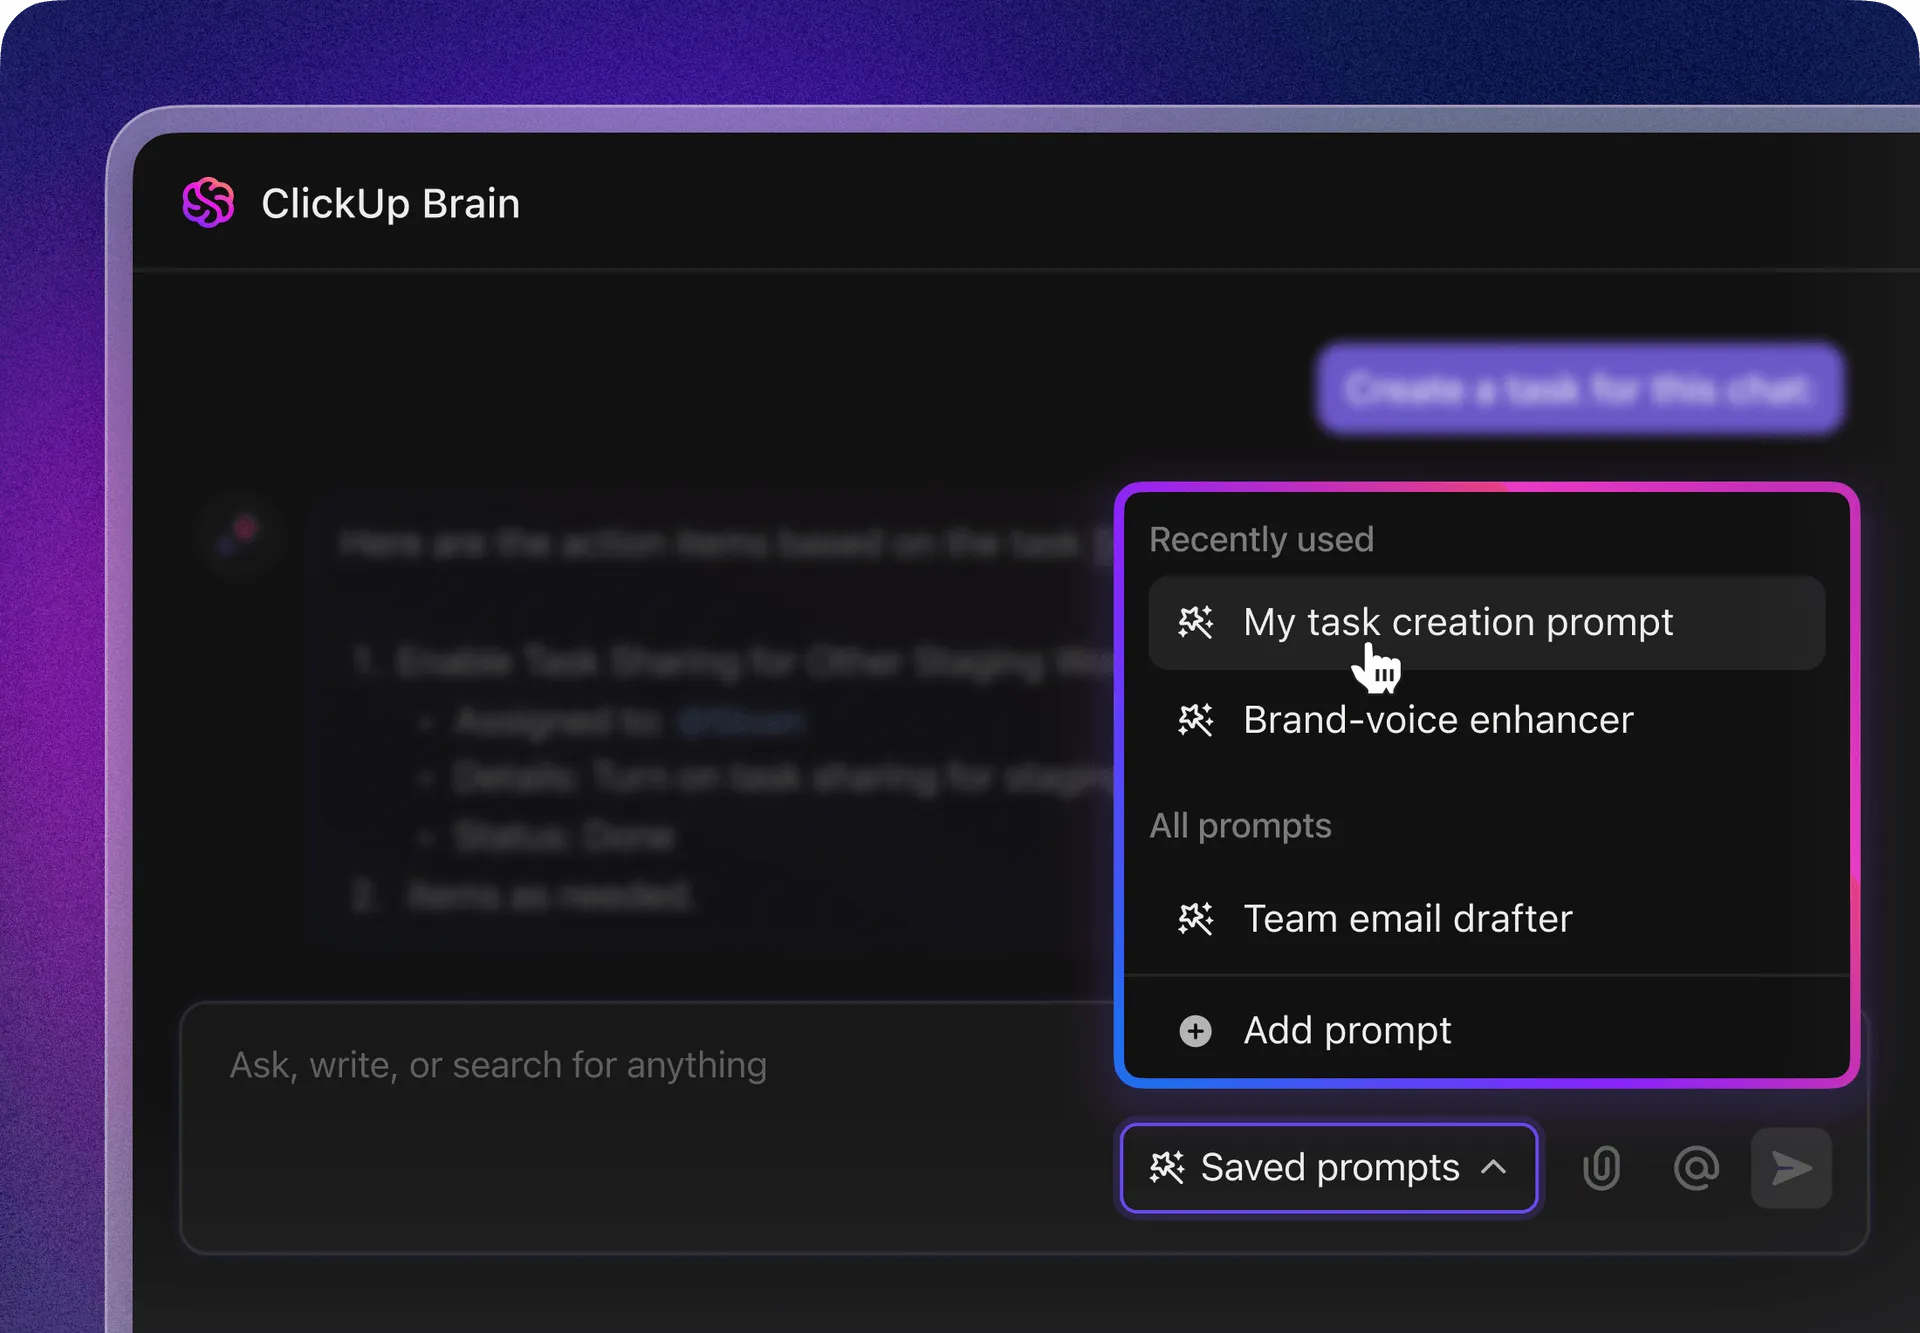
O tempo de resolução de bugs aumenta quando você precisa reconstruir o contexto a partir de conversas no Slack, tickets de suporte e planilhas. Canalize todos os relatórios — de suporte, controle de qualidade e monitoramento — para uma única fila com um modelo estruturado que coleta informações sobre componente, gravidade, ambiente, versão/compilação do aplicativo, etapas para reproduzir o problema, resultados esperados versus reais e anexos (logs/HAR/capturas de tela).
A IA pode resumir automaticamente relatórios longos, extrair etapas de reprodução e detalhes do ambiente a partir de anexos e sinalizar possíveis duplicatas, para que a triagem comece com um registro coerente e enriquecido.
Métricas a serem observadas: MTTA (confirmação em minutos, não em horas), taxa de duplicatas e tempo de “Precisa de informações”.
2. Triagem e encaminhamento assistidos por IA para reduzir drasticamente o MTTA
As correções mais rápidas são aquelas que chegam imediatamente à pessoa certa.
Use regras simples combinadas com IA para classificar a gravidade, identificar os prováveis responsáveis por componente/área de código e atribuir automaticamente com um cronômetro de SLA. Defina faixas de responsabilidade claras para P0/P1 em comparação com todas as outras categorias e deixe bem claro “quem é o responsável por isso”.
As automações podem definir prioridades com base em campos, encaminhar por componente para uma equipe, iniciar um cronômetro de SLA e notificar um engenheiro de plantão; a IA pode sugerir o nível de gravidade e o responsável com base em padrões anteriores. Quando a triagem passa a ser um processo de 2 a 5 minutos, em vez de um debate de 30 minutos, seu MTTA diminui e seu MTTR segue o mesmo caminho.
Métricas a serem observadas: MTTA, qualidade da primeira resposta (o primeiro comentário solicita as informações corretas?), número de transferências por bug.
Veja como isso funciona na prática:
3. Priorize de acordo com o impacto nos negócios, utilizando níveis explícitos de SLA
A lógica de que “quem fala mais alto vence” torna as filas imprevisíveis e corrói a confiança dos executivos que acompanham os índices de satisfação do cliente (CSAT/NPS) e as renovações.
Substitua isso por uma pontuação que combine gravidade, frequência, ARR afetado, criticidade do recurso e proximidade de renovações/lançamentos — e respalde-a com níveis de SLA (por exemplo, P0: mitigar em 1 a 2 horas, resolver em um dia; P1: no mesmo dia; P2: dentro de um sprint).
Mantenha uma fila P0/P1 visível com limites de trabalho em andamento (WIP) para que nada fique sem atenção.
Métricas a serem monitoradas: resolução P50/P90 por nível, taxa de violação do SLA, correlação com CSAT/NPS.
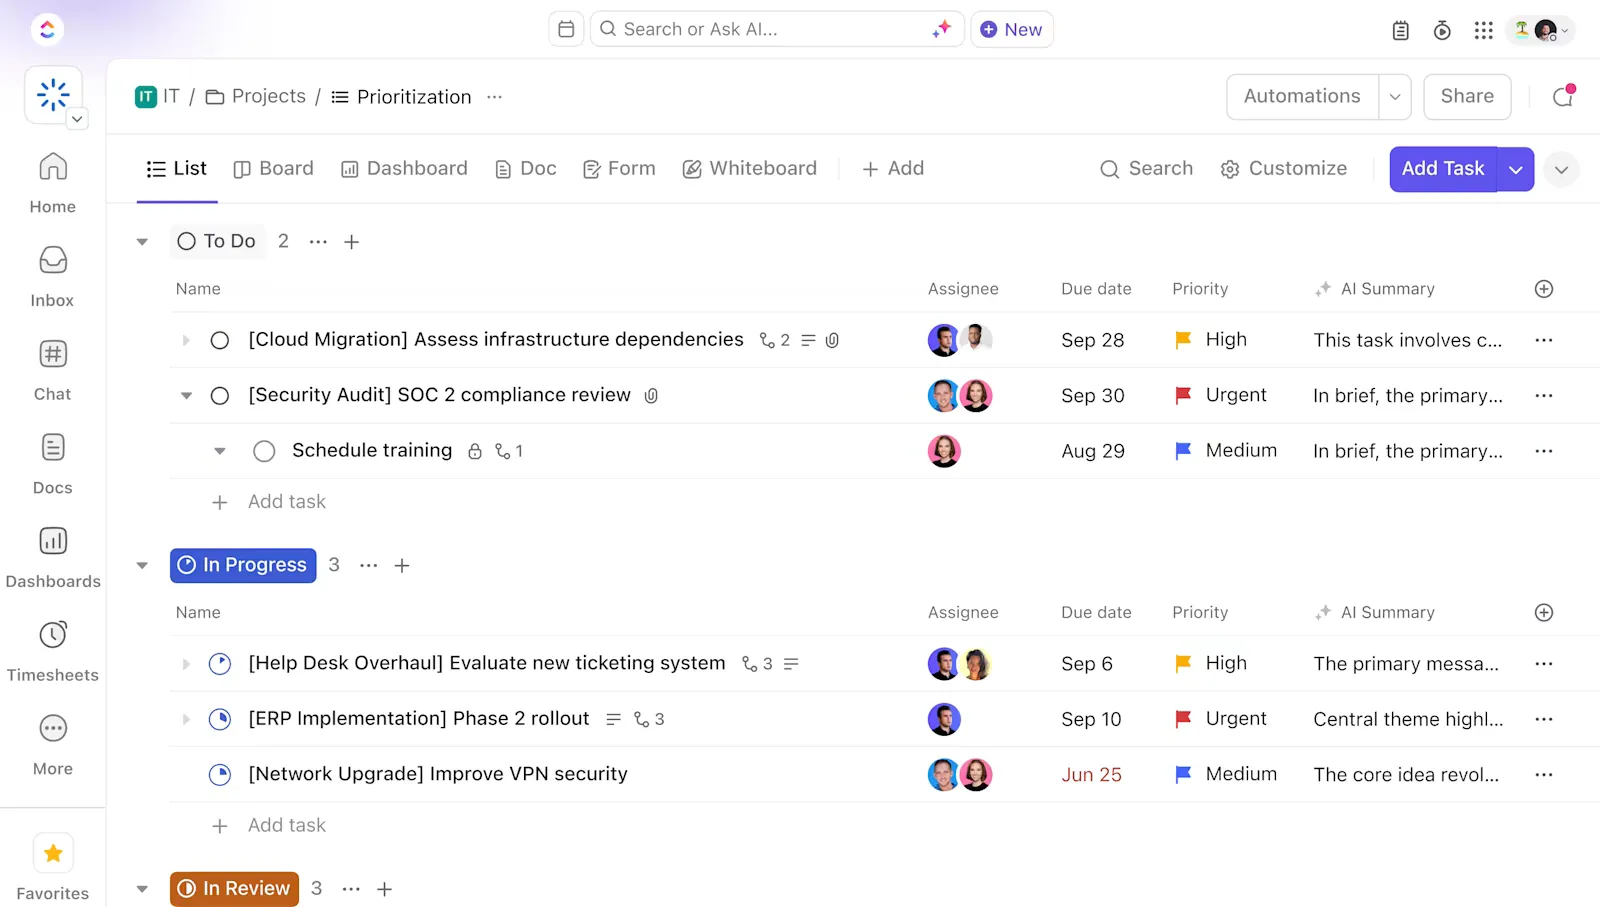
💡Dica profissional: os campos “Prioridades de tarefas”, “Campos personalizados” e “Dependências” do ClickUp permitem que você calcule uma pontuação de impacto e vincule bugs a contas, feedbacks ou itens do roadmap; além disso, as “Metas” no ClickUp ajudam a vincular o cumprimento do SLA aos objetivos da empresa, o que responde diretamente às preocupações da diretoria sobre o alinhamento.
4. Transforme a reprodução e o diagnóstico em uma atividade realizada em uma única etapa
Cada etapa extra com a pergunta “você pode enviar os logs?” aumenta o tempo de resolução.
Padronize o que é considerado “bom”: campos obrigatórios para build/commit, ambiente, etapas de reprodução, resultados esperados versus reais, além de anexos para logs, dumps de falha e arquivos HAR. Implemente telemetria cliente/servidor para que os IDs de falha e os IDs de solicitação possam ser vinculados aos rastreamentos.
Incorpore o Sentry (ou similar) para rastreamentos de pilha e vincule essa ocorrência diretamente ao bug. A IA pode analisar logs e rastreamentos para sugerir um domínio de falha provável e gerar um exemplo mínimo de reprodução, transformando uma hora de análise visual em poucos minutos de trabalho focado.
Armazene manuais de procedimentos para categorias comuns de bugs, para que os engenheiros não precisem começar do zero.
Métricas a serem observadas: Tempo gasto em “Aguardando informações”, porcentagem de reprodução na primeira tentativa, taxa de reabertura relacionada à falta de reprodução.
5. Reduza o ciclo de revisão de código e testes
PRs grandes ficam paralisados. Busque patches precisos, desenvolvimento baseado no trunk e sinalizadores de recurso para que as correções possam ser implementadas com segurança. Designe revisores antecipadamente com base na responsabilidade pelo código para evitar tempo ocioso e use listas de verificação (testes atualizados, telemetria adicionada, sinalizador protegido por um kill switch) para garantir que a qualidade seja incorporada.
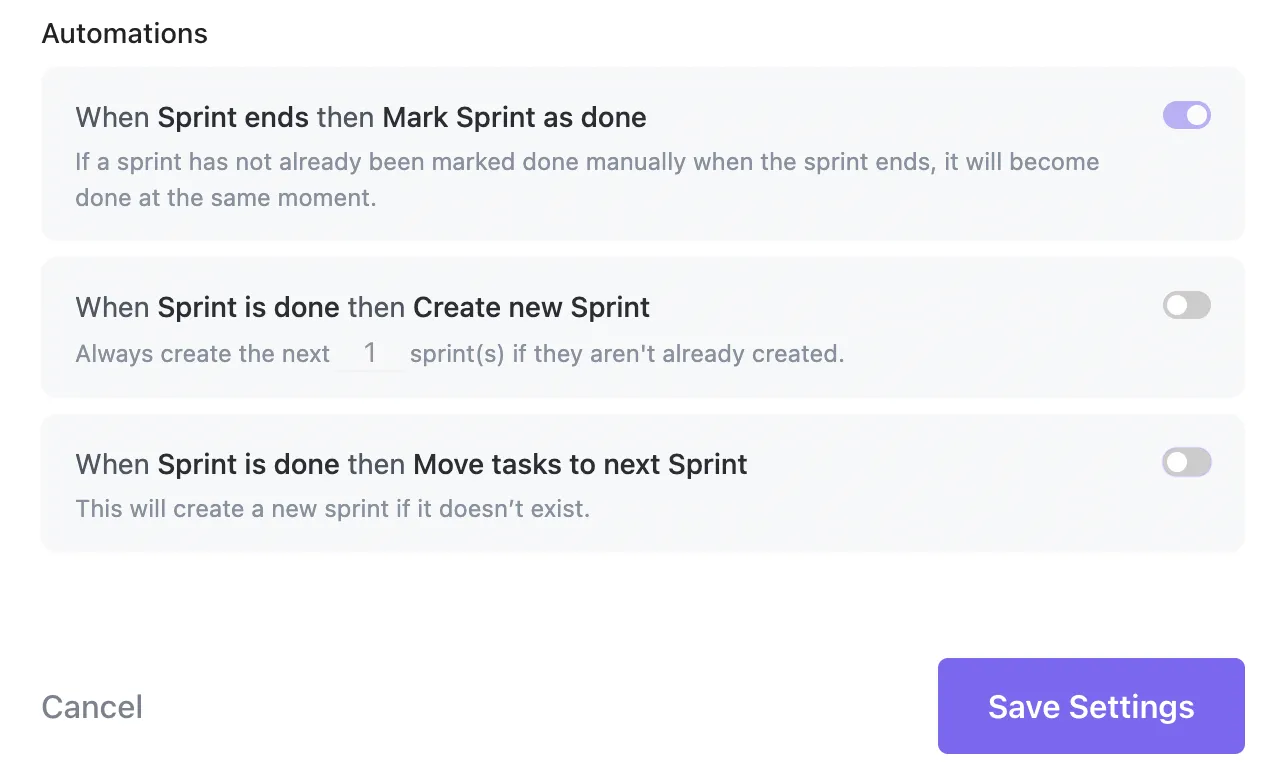
A automação deve mover o bug para o status “Em revisão” ao abrir o pull request e para “Resolvido” ao fazer a fusão; a IA pode sugerir testes unitários ou destacar diferenças de risco para direcionar a revisão.
Métricas a serem observadas: Tempo na etapa “Em revisão”, taxa de falha nas alterações para PRs de correção de bugs e latência de revisão P90.
Você pode usar integrações com o GitHub/GitLab no ClickUp para manter o status de resolução sincronizado; as automações podem garantir o cumprimento da “definição de concluído”.
📖 Leia mais: Como usar a IA para automatizar tarefas
6. Paralelize a verificação e torne a paridade do ambiente de controle de qualidade uma realidade
A verificação não deve começar dias depois ou em um ambiente que nenhum de seus clientes utiliza.
Mantenha o processo “pronto para o controle de qualidade” rigoroso: hotfixes baseados em sinalizadores, validados em ambientes semelhantes aos de produção com dados de teste que correspondem aos casos relatados.
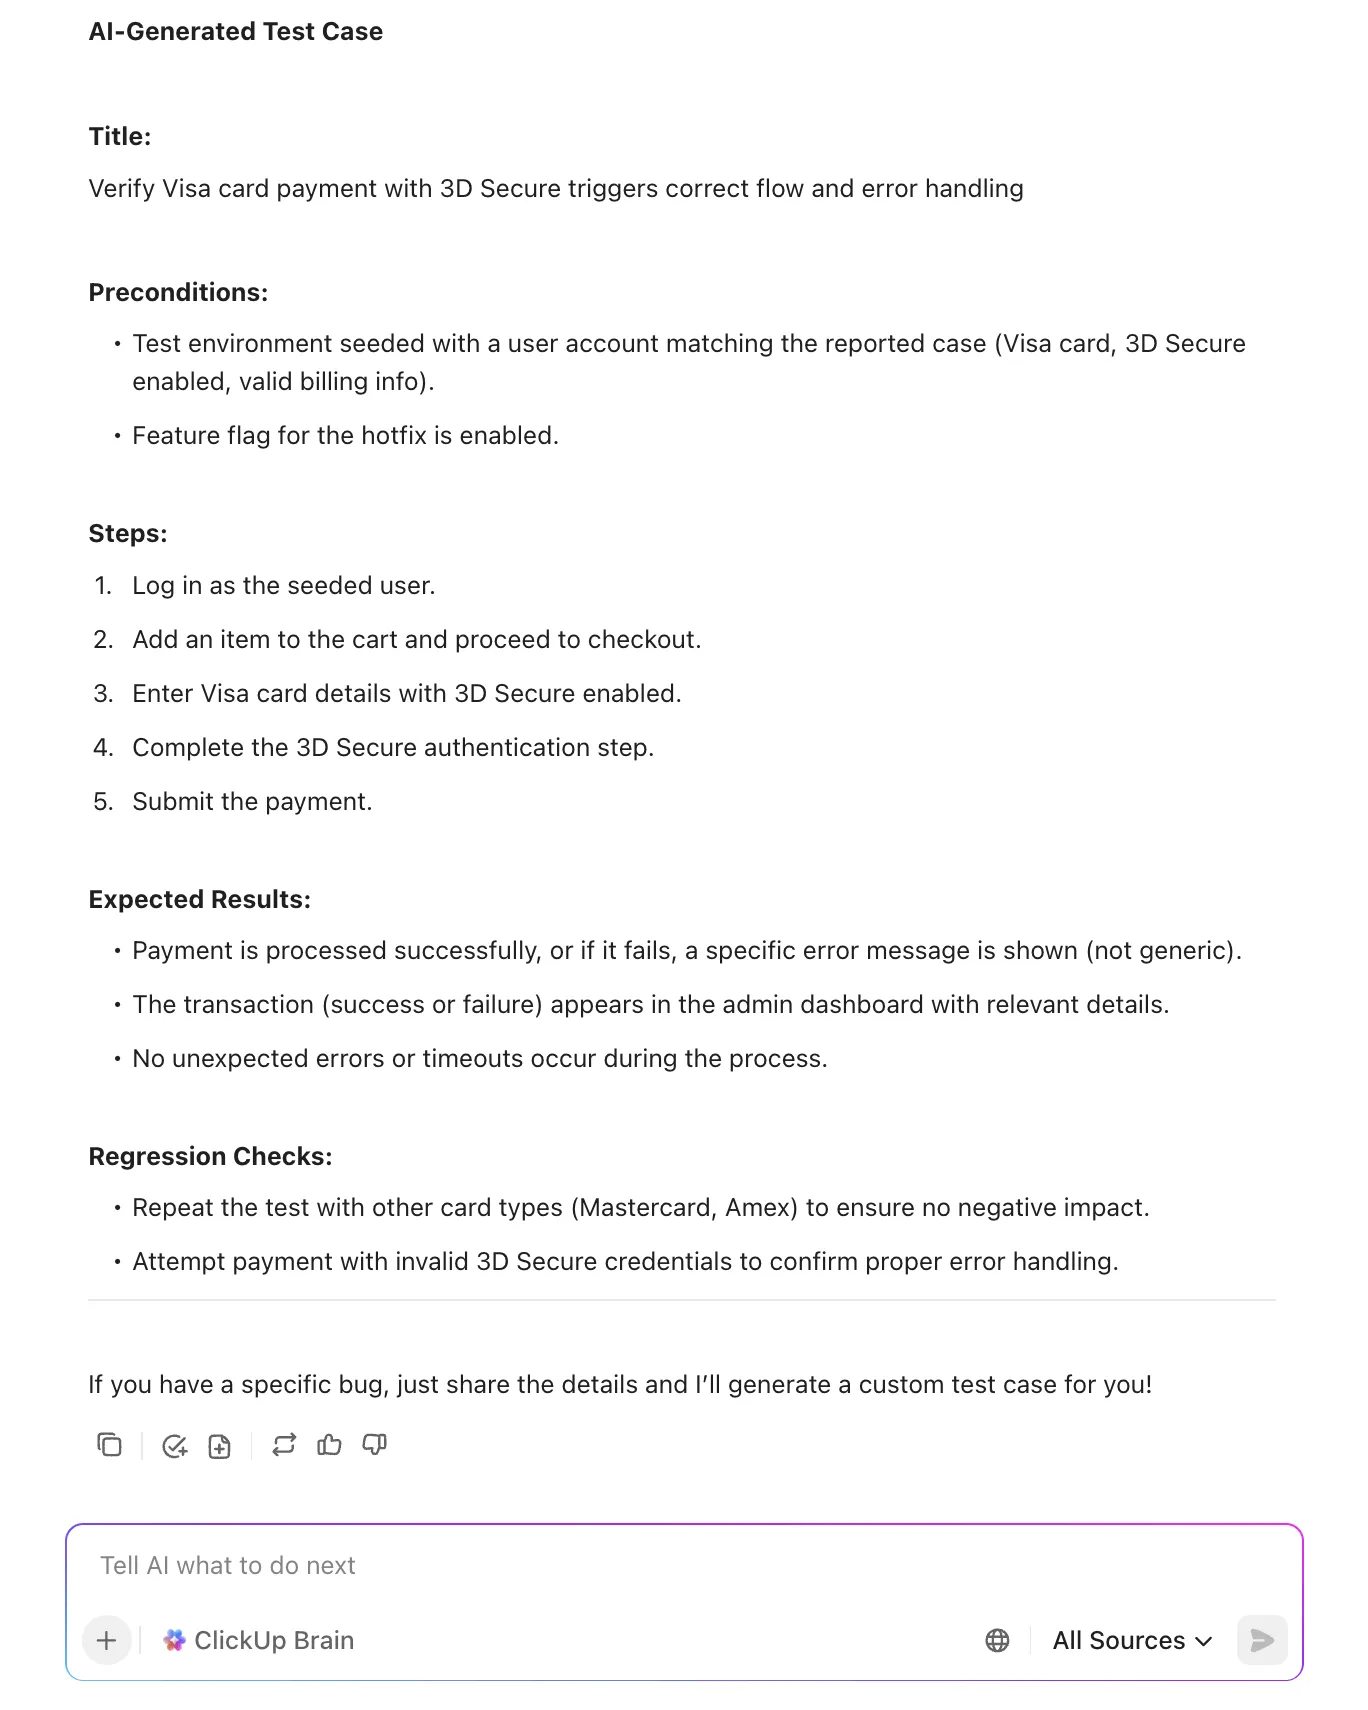
Sempre que possível, configure ambientes temporários a partir do branch de bugs para que a equipe de controle de qualidade possa validar imediatamente; a IA pode então gerar casos de teste a partir da descrição do bug e de regressões anteriores.
Métricas a serem observadas: Tempo na etapa “QA/Verificação”, taxa de rejeição do QA de volta para o desenvolvimento, tempo mediano para fechamento após a integração.
📖 Leia mais: Como escrever casos de teste eficazes
7. Comunique o status de forma concisa para reduzir a carga de coordenação
Uma boa atualização evita três solicitações de status e uma escalação.
Trate as atualizações como um produto: curtas, específicas e voltadas para o público-alvo (suporte, executivos, clientes). Estabeleça uma frequência para P0/P1 (por exemplo, a cada hora até a resolução, depois a cada quatro horas) e mantenha uma única fonte de informação confiável.
A IA pode elaborar atualizações seguras para os clientes e resumos internos a partir do histórico de tarefas, incluindo o status em tempo real por gravidade e equipe. Para executivos como o seu diretor de produto, agrupe os bugs em iniciativas para que eles possam verificar se problemas críticos de qualidade ameaçam as promessas de entrega.
Métricas a serem monitoradas: Tempo entre atualizações de status em P0/P1, índice de satisfação (CSAT) das partes interessadas em relação à comunicação.
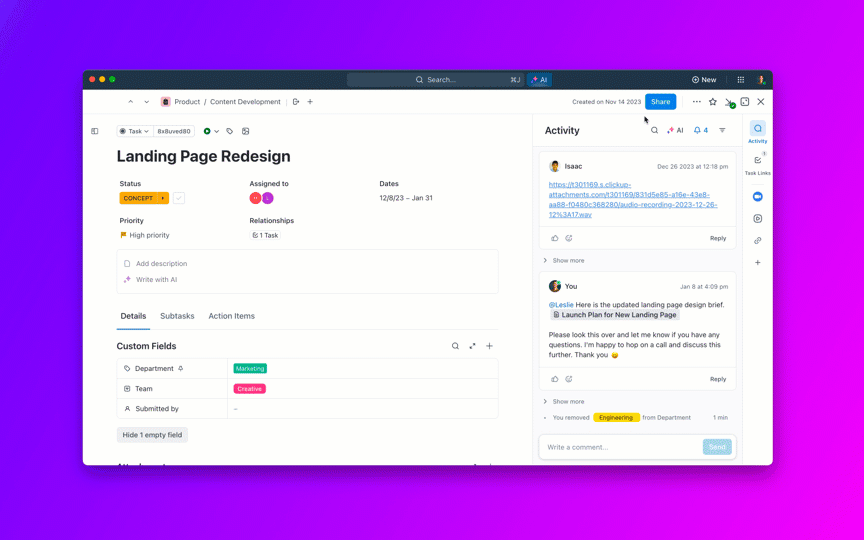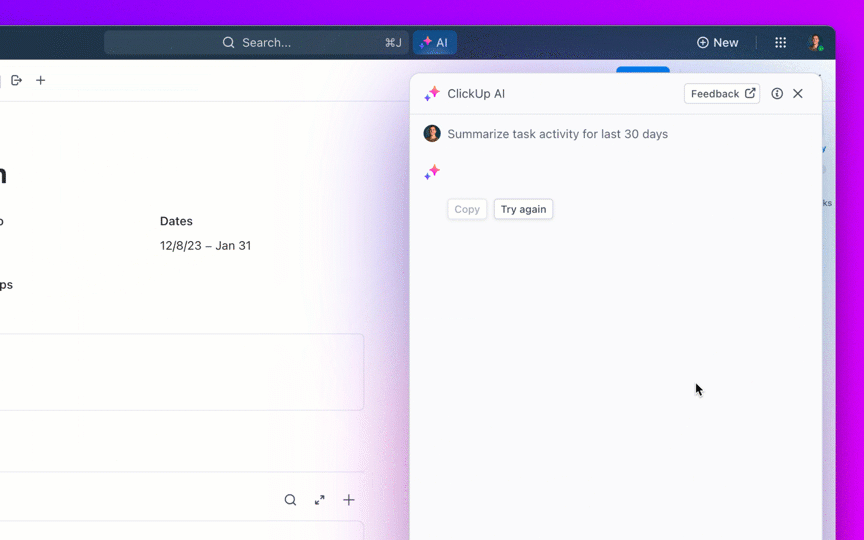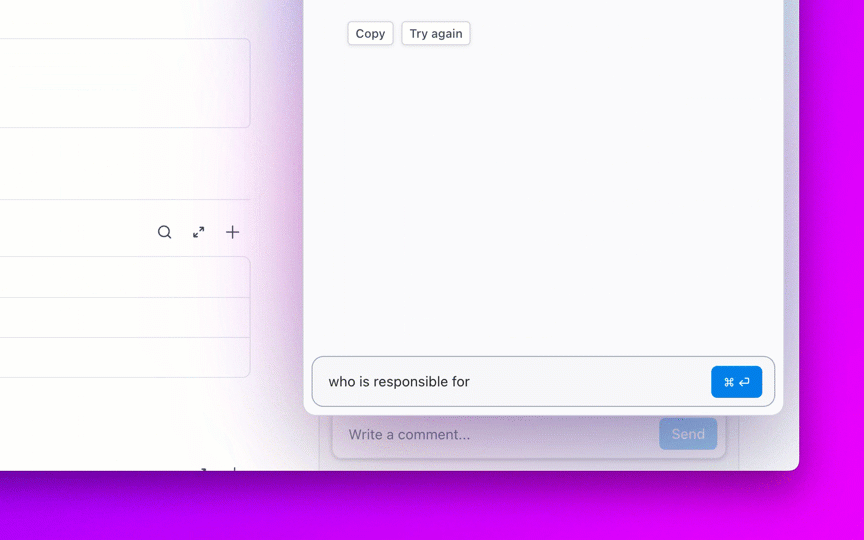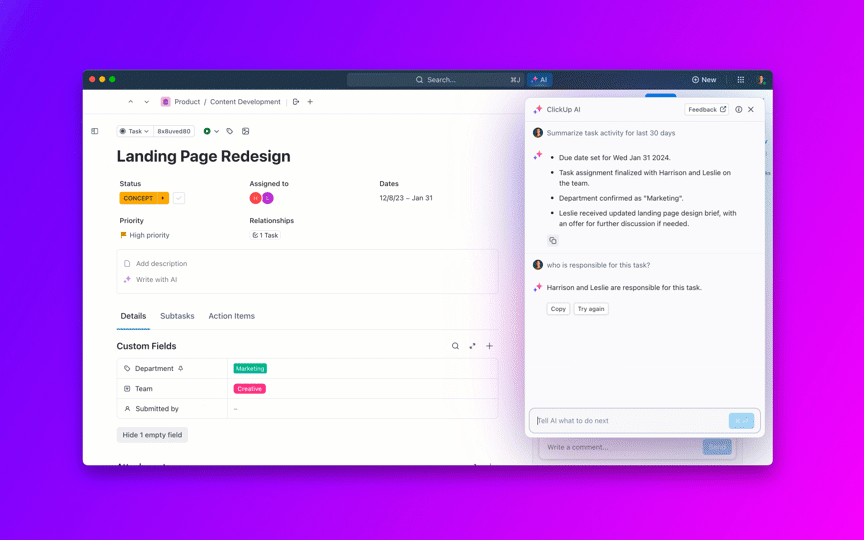
8. Controle o tempo de acumulação de tarefas pendentes e evite que elas fiquem “abertas para sempre”
Um backlog crescente e estagnado sobrecarrega silenciosamente cada sprint.
Defina políticas de tempo de espera (por exemplo, P2 > 30 dias aciona revisão, P3 > 90 dias exige justificativa) e programe uma “triagem de tempo de espera” semanal para mesclar duplicatas, encerrar relatórios obsoletos e converter bugs de baixo valor em itens do backlog do produto.
Use IA para agrupar o backlog por tema (por exemplo, “expiração do token de autenticação”, “instabilidade no upload de imagens”) para que você possa programar semanas temáticas de correção e eliminar uma classe de defeitos de uma só vez.
Métricas a serem observadas: Número de itens em atraso por faixa de tempo, % de problemas encerrados por serem duplicados/obsoletos, velocidade de redução temática.
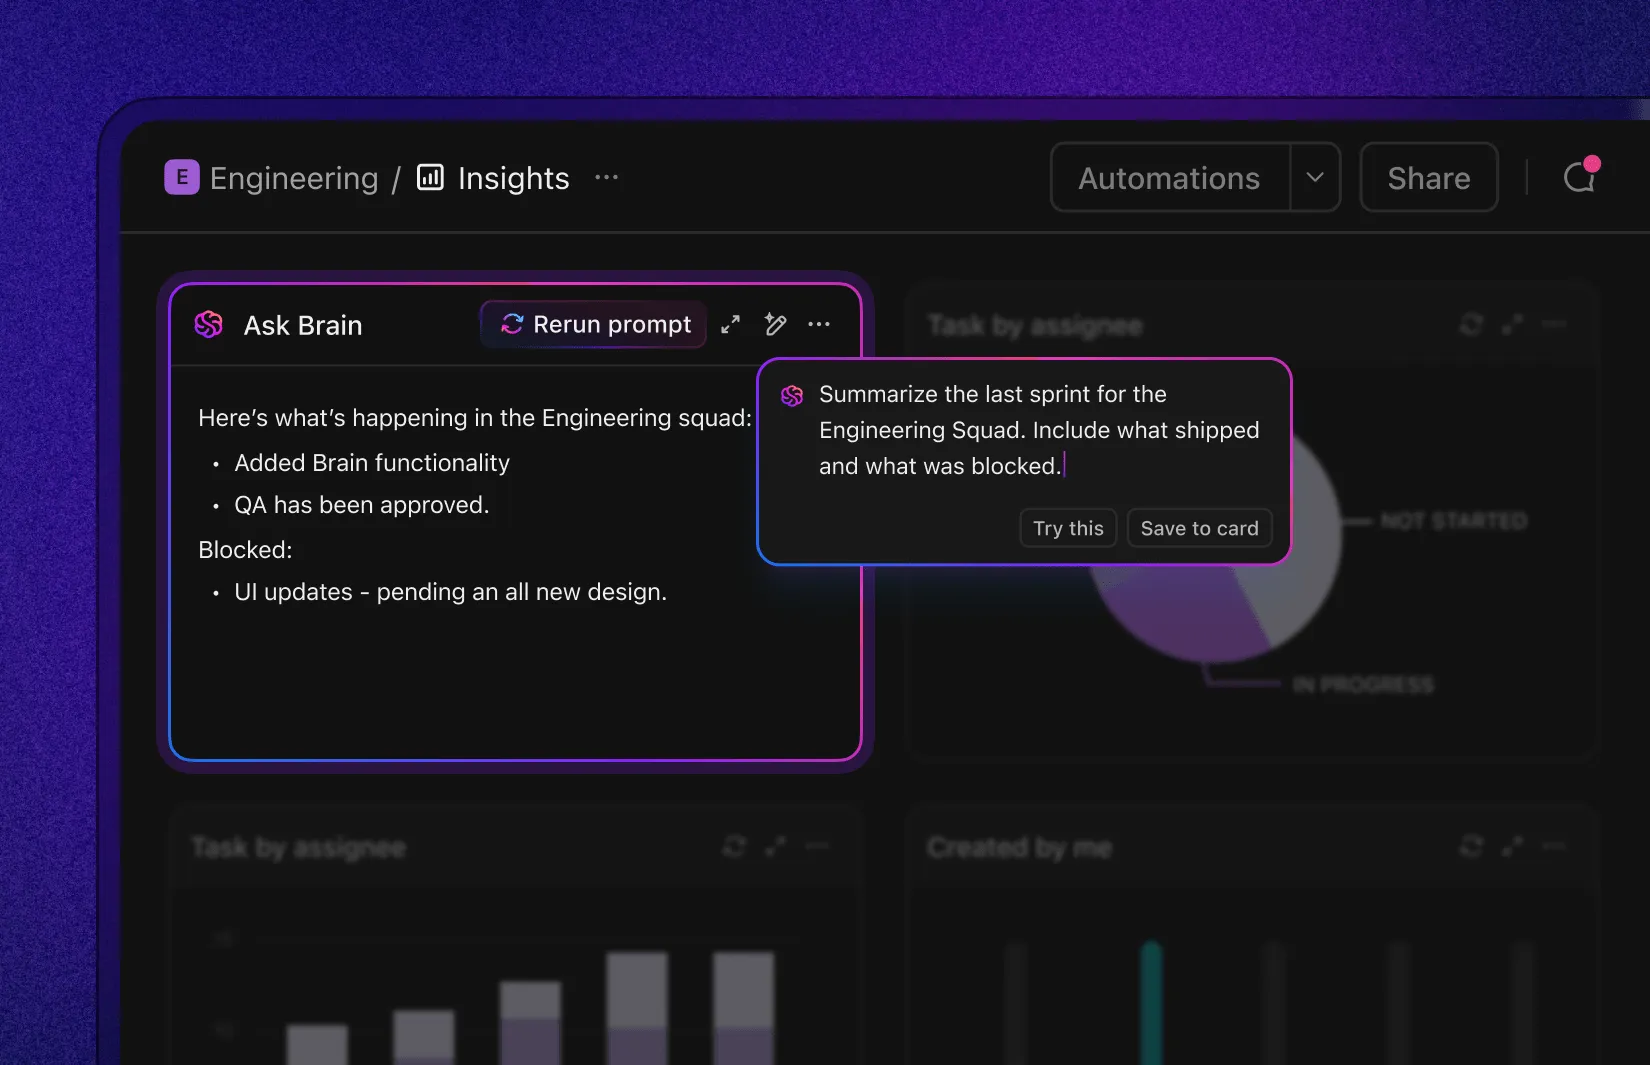
9. Feche o ciclo com a identificação da causa raiz e medidas de prevenção
Se o mesmo tipo de defeito continuar reaparecendo, suas melhorias no MTTR estão mascarando um problema maior.
Realize análises rápidas e isentas de culpa das causas-raíz em P0/P1 e P2s de alta frequência; identifique as causas-raíz (lacunas em especificações, testes e ferramentas, instabilidade na integração), vincule-as aos componentes e incidentes afetados e acompanhe as tarefas de acompanhamento (proteções, testes, regras de lint) até a conclusão.
A IA pode elaborar resumos de análise de causa raiz (RCA) e propor testes preventivos ou regras de lint com base no histórico de alterações. E é assim que você passa de um modo de agir reativo para um cenário com menos problemas.
Métricas a serem observadas: taxa de reabertura, taxa de regressão, tempo entre recorrências e porcentagem de análises de causa raiz (RCA) com ações preventivas concluídas.
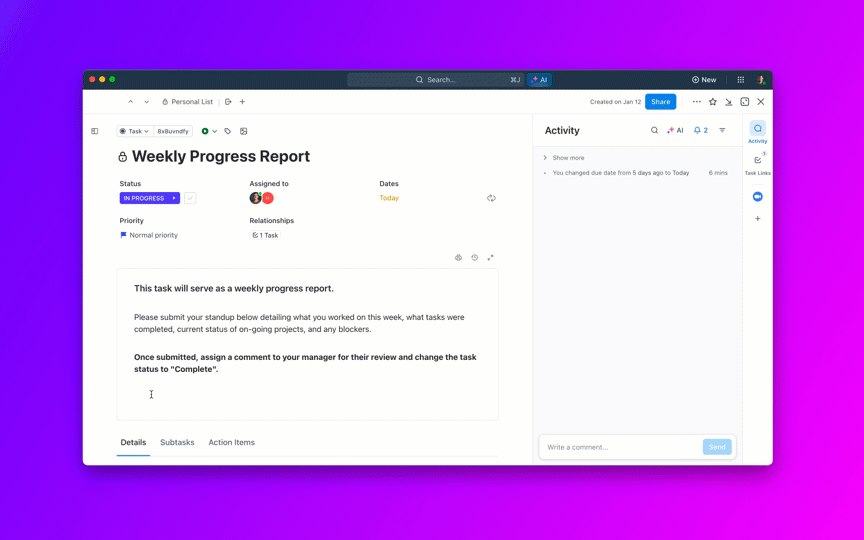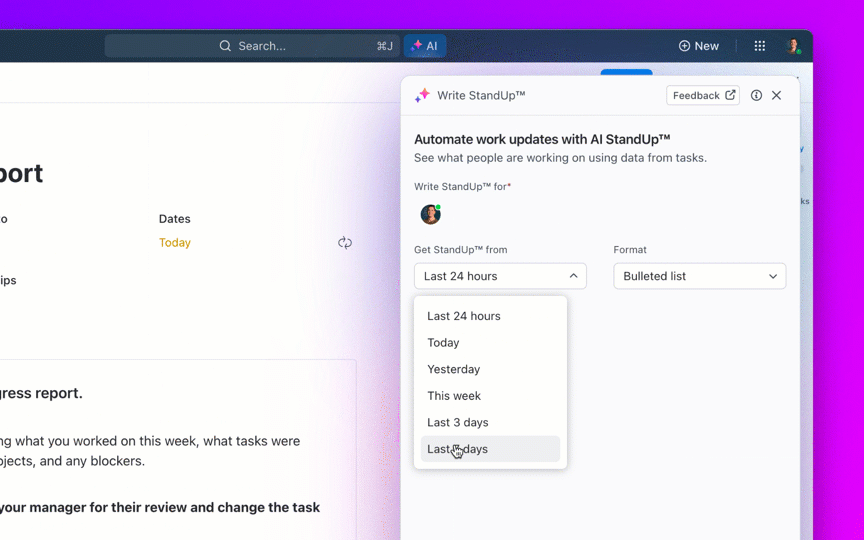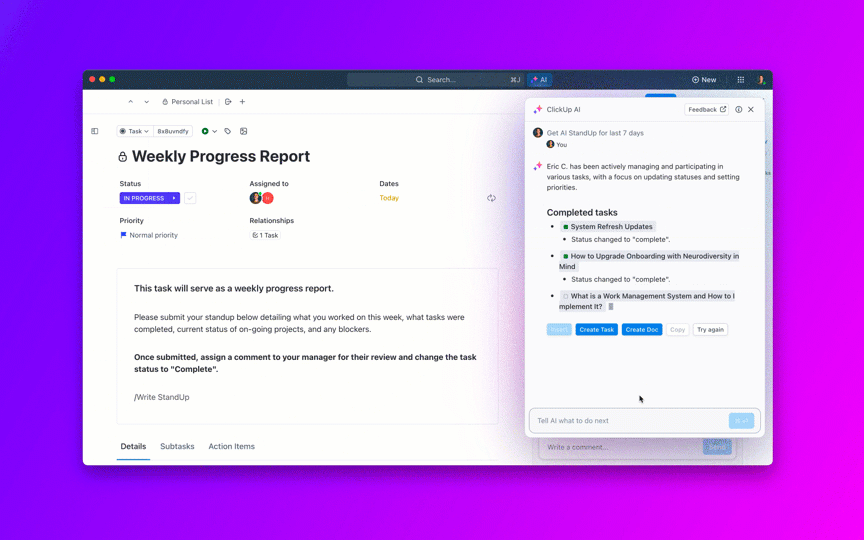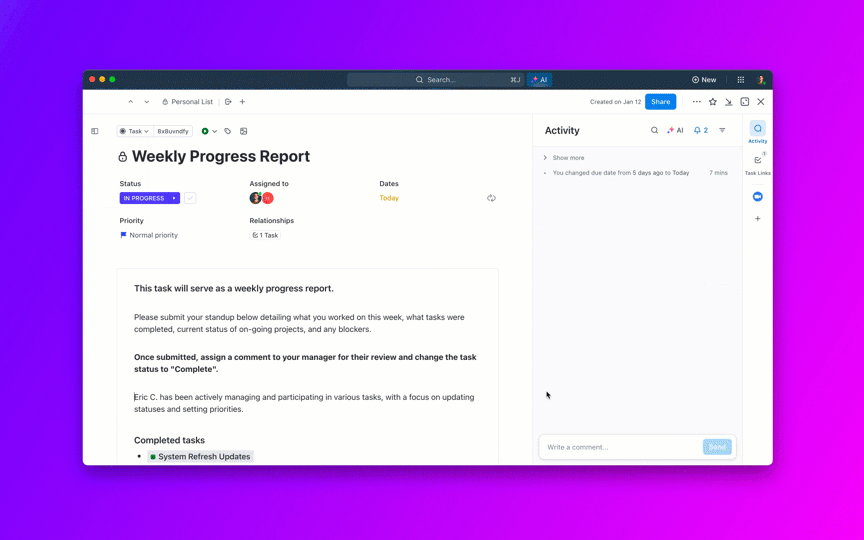
Juntas, essas mudanças agilizam todo o processo: confirmação mais rápida, triagem mais precisa, priorização mais inteligente, menos atrasos na revisão e no controle de qualidade e comunicação mais clara. Os executivos obtêm previsibilidade vinculada ao CSAT/NPS e à receita; os profissionais contam com uma fila mais tranquila, com menos alternância de tarefas.
📖 Leia mais: Como realizar uma análise da causa raiz
Ferramentas de IA que ajudam a reduzir o tempo de resolução de bugs
A IA pode reduzir o tempo de resolução em todas as etapas — recebimento, triagem, encaminhamento, correção e verificação.
No entanto, os ganhos reais surgem quando as ferramentas compreendem o contexto e mantêm o trabalho em andamento sem a necessidade de intervenção manual.
Procure sistemas que enriquecem os relatórios automaticamente (etapas de reprodução, ambiente, duplicatas), priorizem por impacto, encaminhem para o responsável correto, elaborem atualizações claras e se integrem perfeitamente ao seu código, CI e observabilidade.
As melhores opções também oferecem suporte a fluxos de trabalho semelhantes aos de agentes: bots que monitoram SLAs, enviam lembretes aos revisores, escalam itens paralisados e resumem os resultados para as partes interessadas. Aqui está nossa seleção de ferramentas de IA para uma melhor resolução de bugs:
1. ClickUp (Ideal para IA contextual, automações e fluxos de trabalho orientados ao agente)
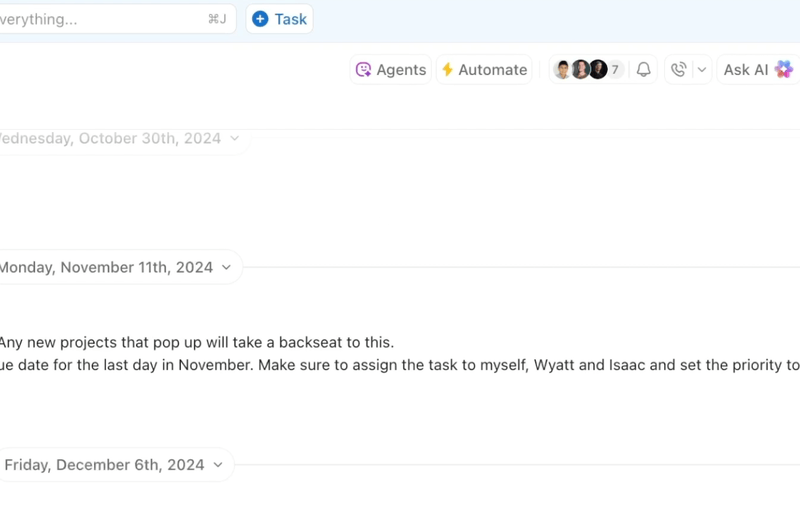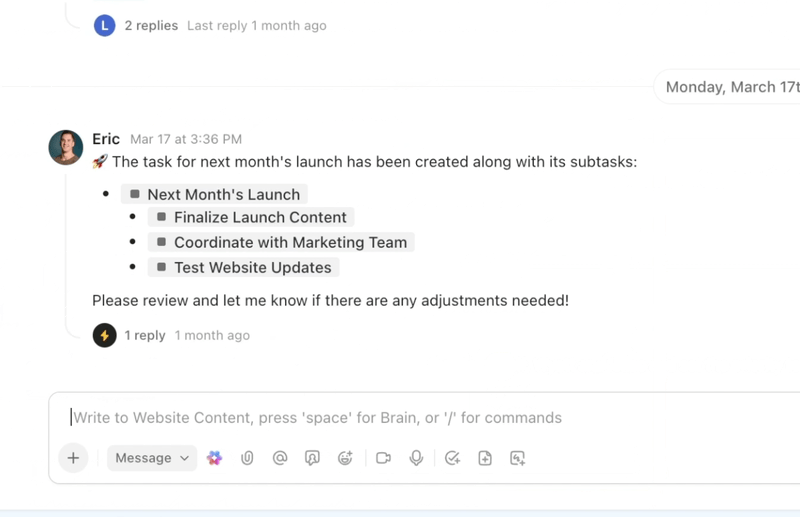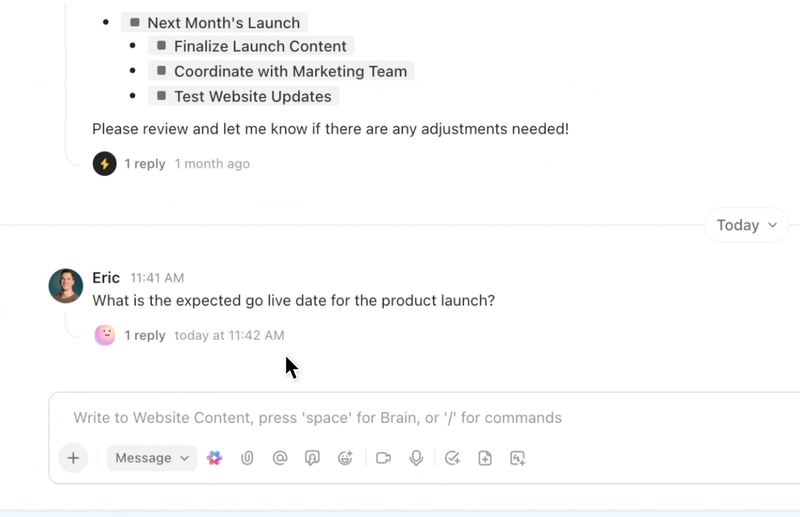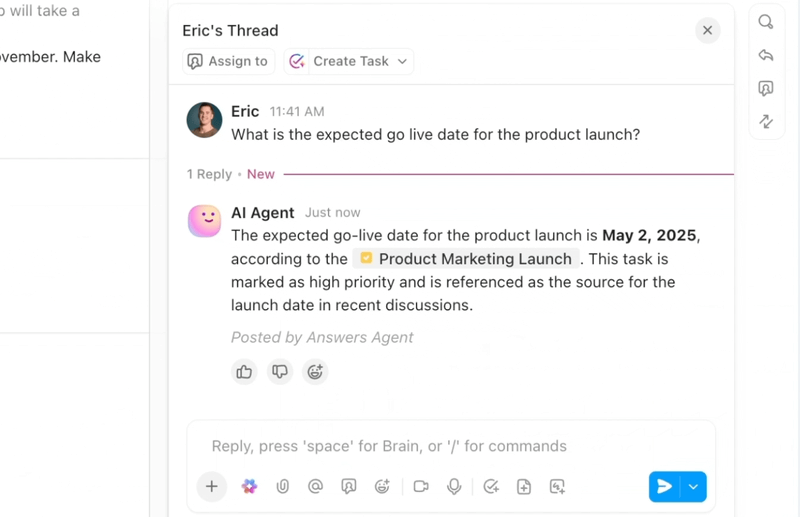
Se você deseja um fluxo de trabalho simplificado e inteligente para a resolução de bugs, o ClickUp, o aplicativo multifuncional para o trabalho, reúne IA, automações e assistência de fluxo de trabalho baseada em agentes em um único lugar.
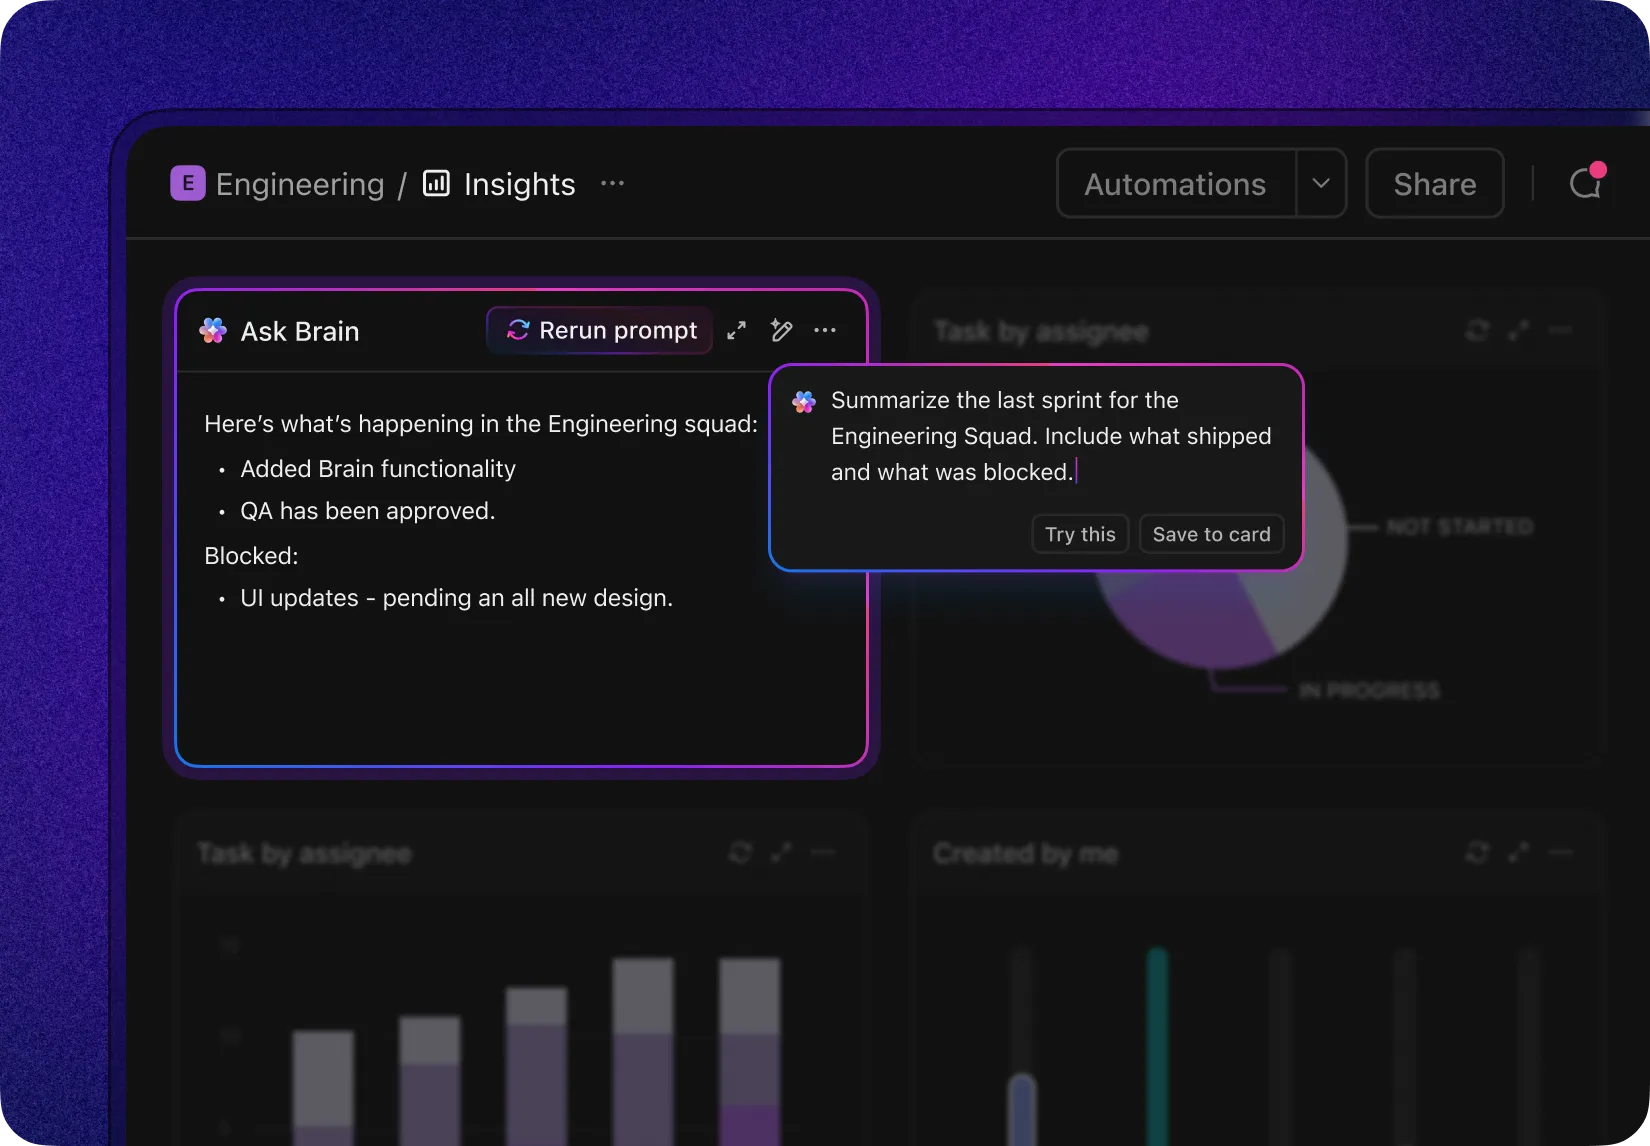
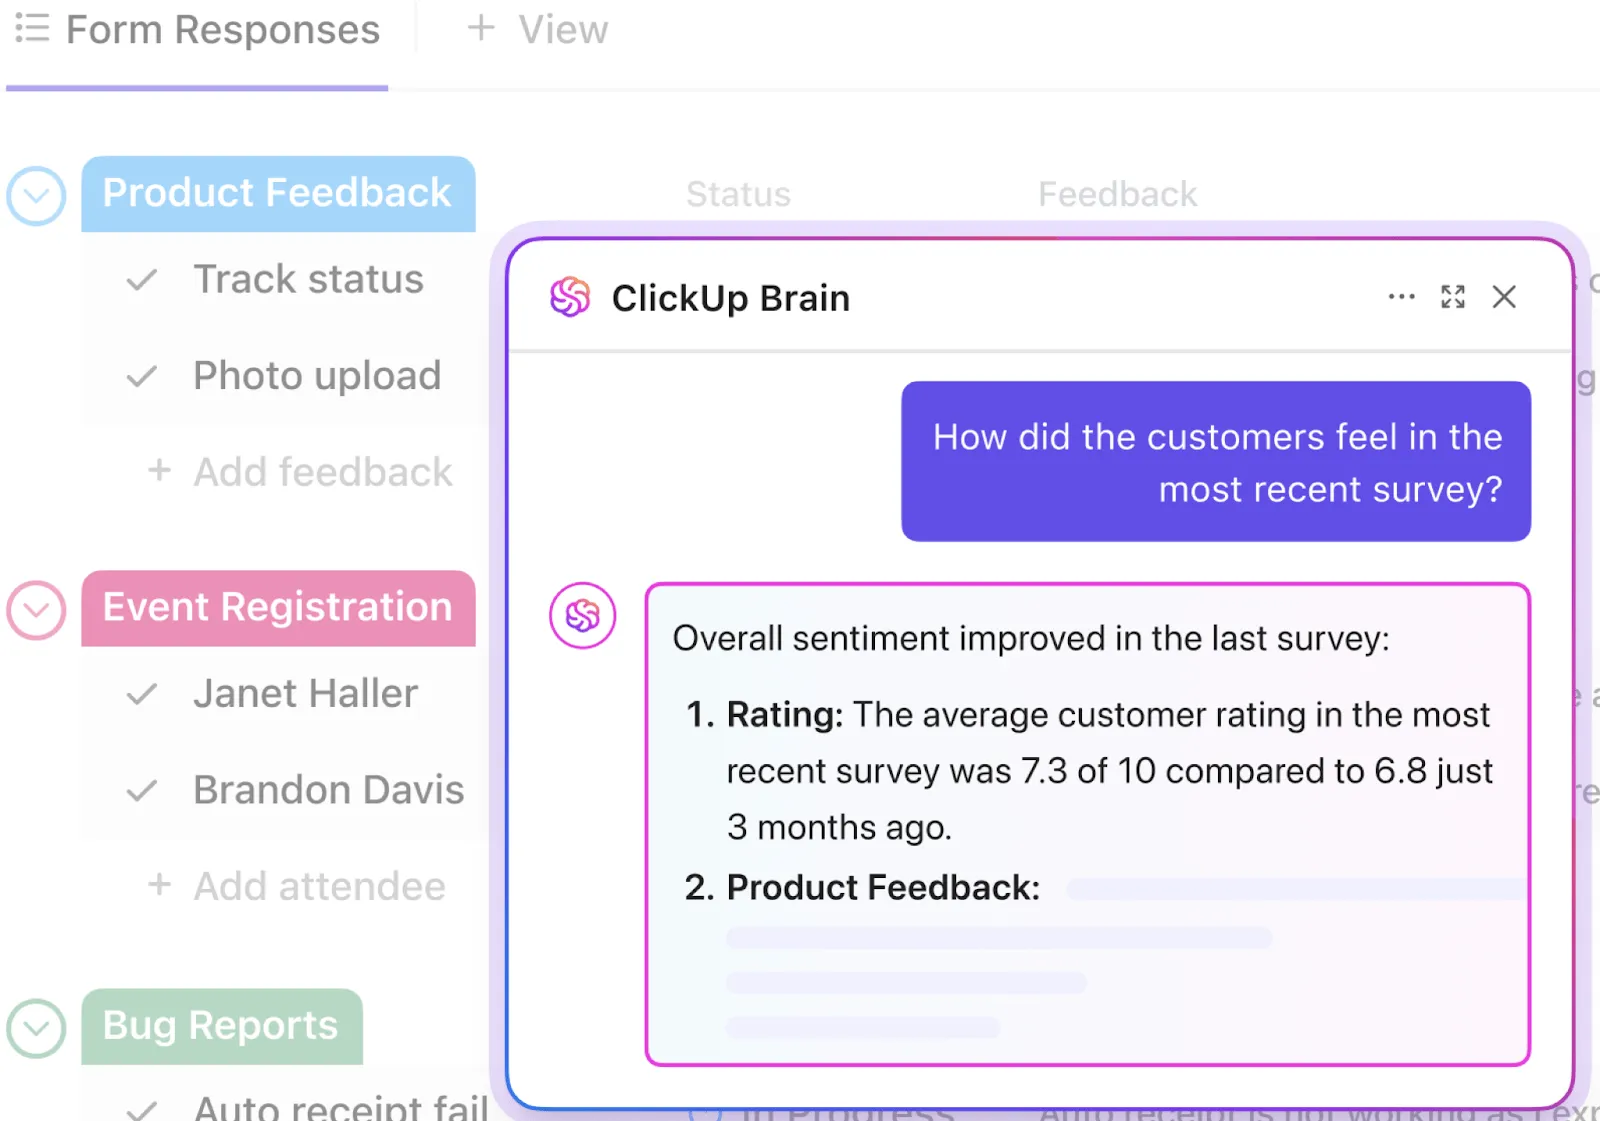
O ClickUp Brain apresenta o contexto certo instantaneamente — resumindo longas discussões sobre bugs, extraindo etapas para reprodução e detalhes do ambiente a partir de anexos, sinalizando possíveis duplicatas e sugerindo as próximas ações. Em vez de ter que vasculhar o Slack, os tickets e os registros, as equipes obtêm um registro claro e enriquecido, com base no qual podem agir imediatamente.
As automações e os agentes do Autopilot no ClickUp mantêm o trabalho em andamento sem a necessidade de acompanhamento constante. Os bugs são encaminhados automaticamente para a equipe certa, os responsáveis são designados, os SLAs e os prazos são definidos, os status são atualizados à medida que o trabalho avança e as partes interessadas recebem notificações em tempo hábil.
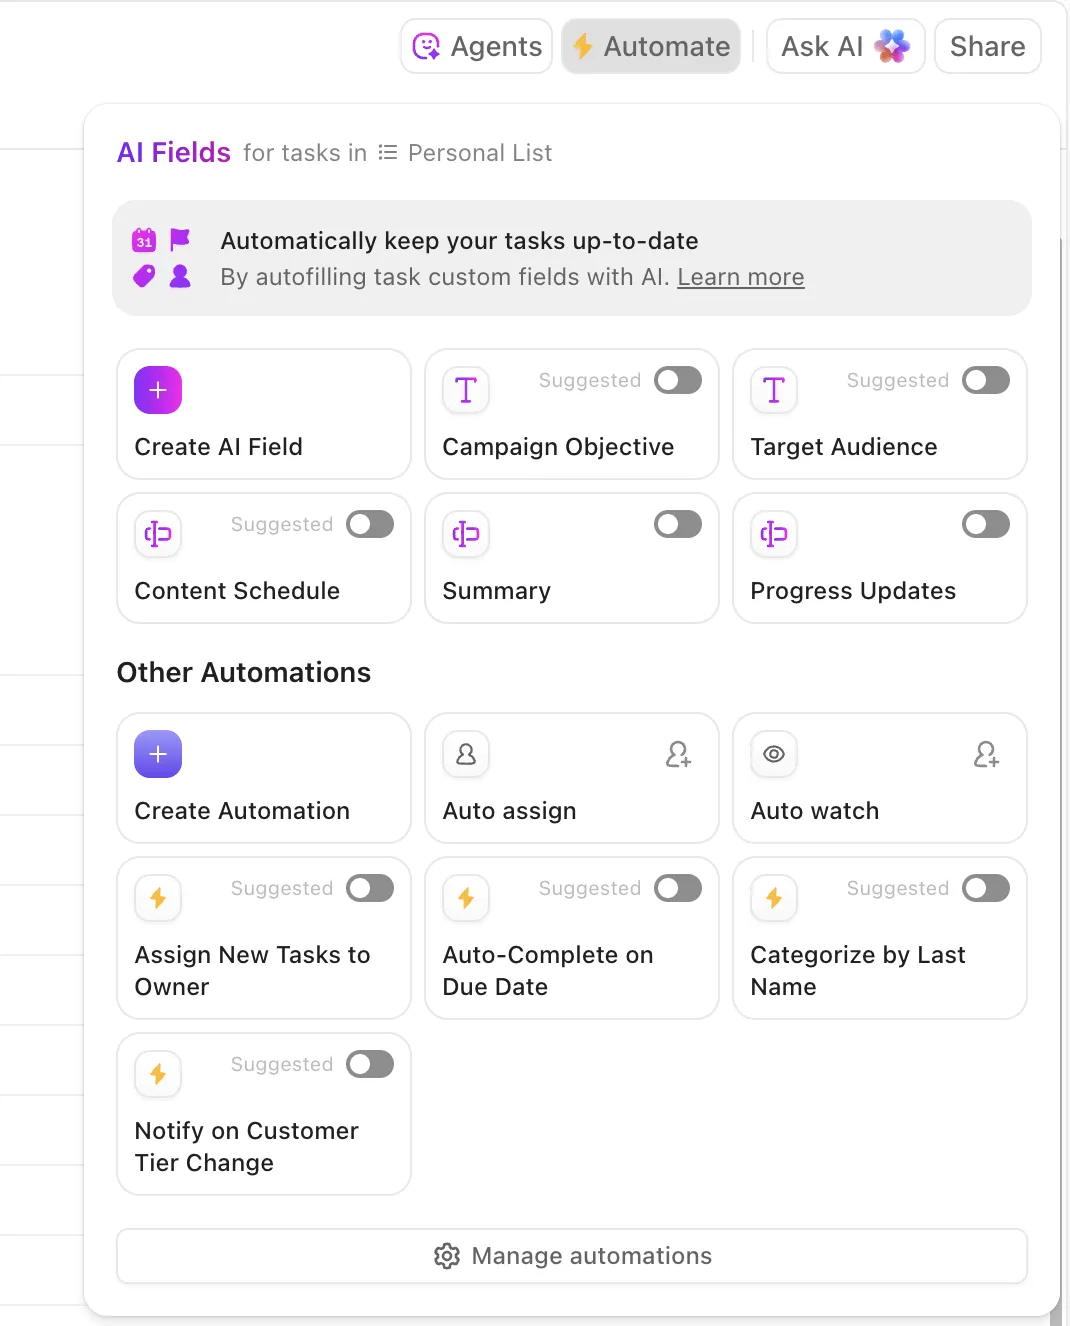
Esses agentes podem até mesmo classificar e categorizar problemas, agrupar relatórios semelhantes, consultar soluções anteriores para sugerir possíveis caminhos a seguir e escalar itens urgentes — de modo que o MTTA e o MTTR diminuam mesmo quando o volume aumenta repentinamente.
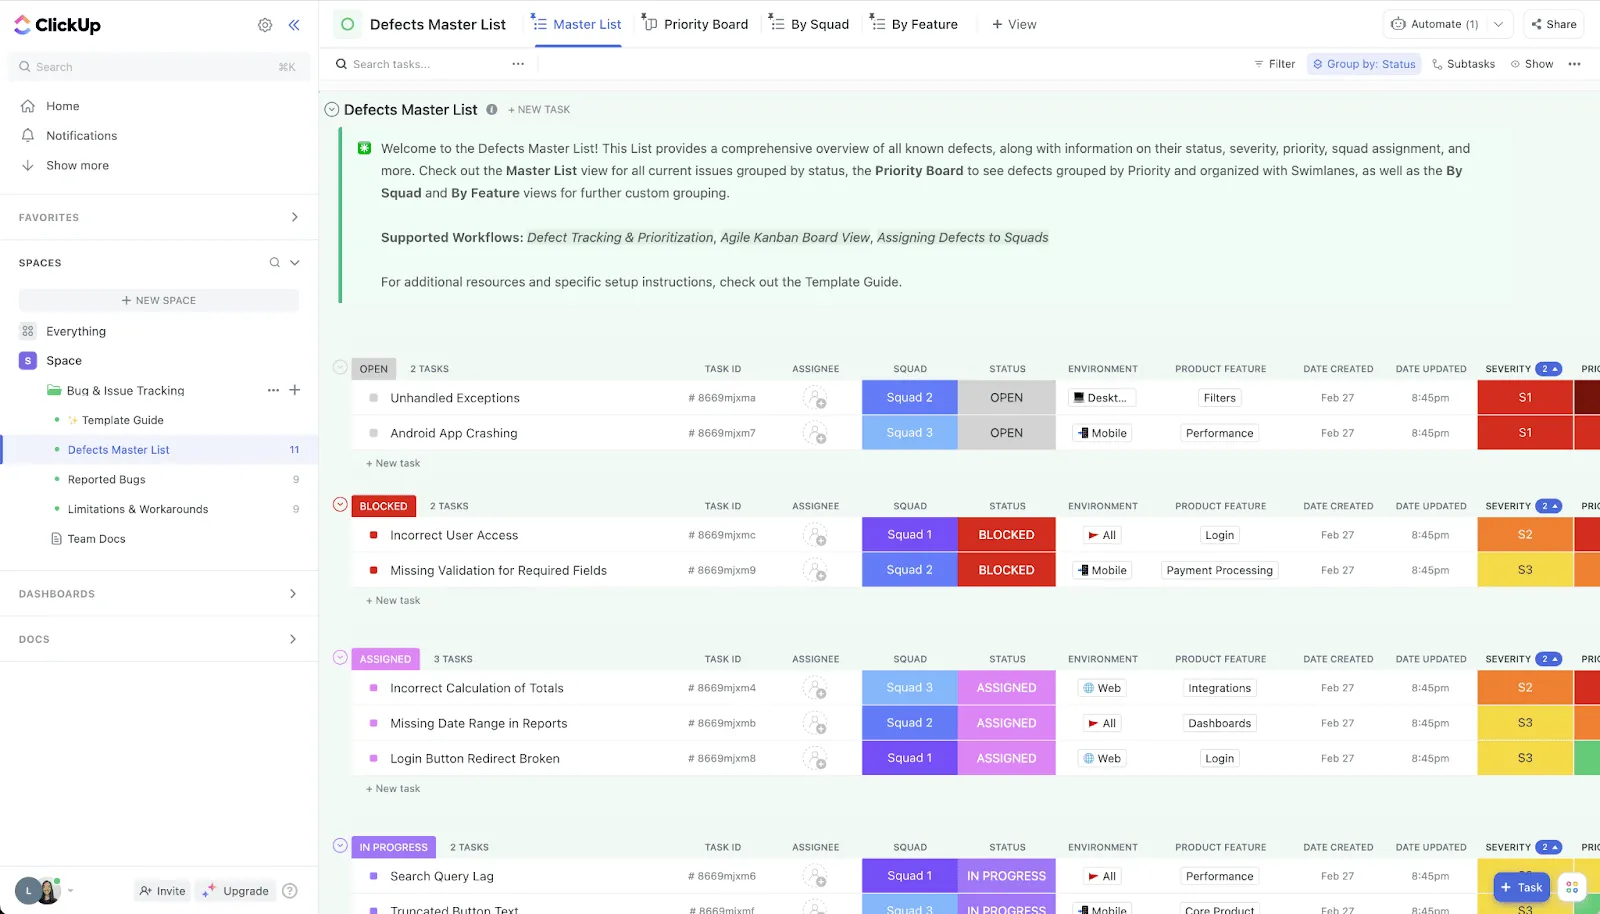
🛠️ Quer um kit de ferramentas pronto para uso? O modelo de rastreamento de bugs e problemas do ClickUp é uma solução poderosa da ClickUp para software, projetada para ajudar as equipes de suporte, engenharia e produto a manterem-se a par dos bugs e problemas de software com facilidade. Com visualizações personalizáveis, como Lista, Quadro, Carga de Trabalho, Formulário e Linha do Tempo, as equipes podem visualizar e gerenciar seu processo de rastreamento de bugs da maneira que melhor lhes convier.
Os 20 status personalizados e os 7 campos personalizados do modelo permitem um fluxo de trabalho sob medida, garantindo que cada problema seja acompanhado desde a detecção até a resolução. As automações integradas cuidam das tarefas repetitivas, liberando tempo valioso e reduzindo o trabalho manual.
💟 Bônus: O Brain MAX é seu assistente de desktop com inteligência artificial, projetado para acelerar a resolução de bugs com recursos inteligentes e práticos.
Quando você encontrar um bug, basta usar o recurso de conversão de voz em texto do Brain MAX para ditar o problema — suas anotações faladas são transcritas instantaneamente e podem ser anexadas a um ticket de bug novo ou já existente. Sua Pesquisa Empresarial vasculha todas as suas ferramentas conectadas — como ClickUp, GitHub, Google Drive e Slack — para identificar relatórios de bugs, logs de erros, trechos de código e documentação relacionados, para que você tenha todo o contexto necessário sem precisar alternar entre aplicativos.
Precisa coordenar uma correção? O Brain MAX permite que você atribua o bug ao desenvolvedor certo, defina lembretes automáticos para atualizações de status e acompanhe o andamento — tudo a partir do seu computador!
2. Sentry (Ideal para capturar erros)
O Sentry reduz o MTTD e o tempo de reprodução ao capturar erros, rastreamentos e sessões de usuários em um único local. O agrupamento de problemas baseado em IA reduz o ruído; o recurso “Suspect Commit” e as regras de responsabilidade identificam o provável responsável pelo código, permitindo um encaminhamento instantâneo. O Session Replay fornece aos engenheiros o caminho exato do usuário e os detalhes do console/rede para reproduzir o problema sem idas e vindas intermináveis.
Os recursos de IA do Sentry podem resumir o contexto dos problemas e, em algumas pilhas de tecnologia, propor patches de correção automática que fazem referência ao código problemático. O impacto prático: menos tickets duplicados, atribuição mais rápida e um caminho mais curto entre o relato e o patch funcional.
3. GitHub Copilot (Ideal para revisar código mais rapidamente)
O Copilot acelera o ciclo de correção dentro do editor. Ele explica os rastreamentos de pilha, sugere patches direcionados, escreve testes unitários para garantir a correção e cria esboços de scripts de reprodução.
O Copilot Chat pode analisar código com falhas, propor refatorações mais seguras e gerar comentários ou descrições de PRs que agilizam a revisão de código. Combinado com revisões obrigatórias e CI, ele reduz em horas o processo “diagnosticar → implementar → testar”, especialmente para bugs bem delimitados e com reprodução clara.
4. Snyk da DeepCode AI (Ideal para identificar padrões)
A análise estática impulsionada por IA do DeepCode identifica defeitos e padrões inseguros enquanto você codifica e nas PRs. Ela destaca fluxos problemáticos, explica por que eles ocorrem e propõe correções seguras que se adaptam às convenções da sua base de código.
Ao detectar regressões antes da fusão e orientar os desenvolvedores para padrões mais seguros, você reduz a taxa de surgimento de novos bugs e agiliza a correção de erros lógicos complexos que são difíceis de identificar durante a revisão. As integrações com IDEs e PRs mantêm esse processo próximo ao local onde o trabalho é realizado.
5. Watchdog e AIOps da Datadog (ideais para análise de logs)
O Watchdog da Datadog usa aprendizado de máquina (ML) para identificar anomalias em logs, métricas, rastreamentos e monitoramento de usuários reais. Ele correlaciona picos com marcadores de implantação, alterações na infraestrutura e topologia para sugerir possíveis causas-raiz.
Para defeitos que afetam os clientes, isso significa detecção em questão de minutos, agrupamento automático para reduzir o excesso de alertas e pistas concretas sobre onde procurar. O tempo de triagem diminui porque você começa com “essa implantação afetou esses serviços e as taxas de erro aumentaram neste terminal”, em vez de partir do zero.
⚡️ Arquivo de modelos: Modelos gratuitos para rastreamento de problemas e registros no Excel e no ClickUp
6. New Relic AI (Ideal para identificar e resumir tendências)
A Caixa de Entrada de Erros da New Relic agrupa erros semelhantes entre serviços e versões, enquanto seu assistente de IA resume o impacto, destaca as causas prováveis e fornece links para os rastreamentos/transações envolvidas.
As correlações de implantação e a inteligência de alterações de entidades tornam evidente quando uma versão recente é a responsável pelo problema. Para sistemas distribuídos, esse contexto elimina horas de troca de mensagens entre equipes e encaminha o bug ao responsável certo, com uma hipótese sólida já formulada.
7. Rollbar (Ideal para fluxos de trabalho automatizados)
A Rollbar é especializada em monitoramento de erros em tempo real com identificação inteligente para agrupar duplicatas e acompanhar tendências de ocorrência. Seus resumos baseados em IA e dicas sobre a causa raiz ajudam as equipes a entender o escopo (usuários afetados, versões impactadas), enquanto a telemetria e os rastreamentos de pilha fornecem pistas rápidas para a reprodução do erro.
As regras de fluxo de trabalho do Rollbar podem criar tarefas automaticamente, classificar a gravidade e encaminhar aos responsáveis, transformando fluxos de erros desorganizados em filas priorizadas com contexto associado.
8. PagerDuty AIOps e automação de runbooks (O melhor em diagnósticos de baixa intervenção)
O PagerDuty utiliza correlação de eventos e redução de ruído baseada em aprendizado de máquina para transformar tempestades de alertas em incidentes passíveis de ação.
O roteamento dinâmico encaminha o problema instantaneamente para o profissional de plantão correto, enquanto a automação do runbook pode iniciar diagnósticos ou medidas de mitigação (reiniciar serviços, reverter uma implantação, ativar ou desativar um sinalizador de recurso) antes que um profissional intervenha. Em termos de tempo de resolução de bugs, isso significa um MTTA mais curto, mitigações mais rápidas para bugs P0 e menos horas perdidas devido à fadiga de alertas.
O fio condutor é a automação aliada à IA em cada etapa. Você detecta mais cedo, encaminha de forma mais inteligente, chega ao código mais rapidamente e comunica o status sem atrasar os engenheiros — tudo isso resulta em uma redução significativa no tempo de resolução de bugs.
📖 Leia mais: Como usar a IA em DevOps
Exemplos práticos do uso da IA na resolução de bugs
Então, a IA saiu oficialmente do laboratório. Ela está reduzindo o tempo de resolução de bugs na prática.
Vamos ver como!
| Domínio / Organização | Como a IA foi utilizada | Impacto / Benefício |
|---|---|---|
| Ubisoft | Desenvolvemos o Commit Assistant, uma ferramenta de IA treinada com uma década de código interno, que prevê e evita bugs já na fase de programação. | O objetivo é reduzir drasticamente o tempo e os custos — tradicionalmente, até 70% das despesas com desenvolvimento de jogos são destinadas à correção de bugs. |
| Razer (Plataforma Wyvrn) | Lançamos o QA Copilot, impulsionado por IA (integrado ao Unreal e ao Unity), para automatizar a detecção de bugs e gerar relatórios de controle de qualidade. | Aumenta a detecção de bugs em até 25% e reduz pela metade o tempo de controle de qualidade. |
| Google / DeepMind e Project Zero | Lançamos o Big Sleep, uma ferramenta de IA que detecta de forma autônoma vulnerabilidades de segurança em softwares de código aberto, como o FFmpeg e o ImageMagick. | Foram identificados 20 bugs, todos verificados por especialistas humanos e programados para correção. |
| Pesquisadores da UC Berkeley | Utilizando um benchmark chamado CyberGym, modelos de IA analisaram 188 projetos de código aberto, identificando 17 vulnerabilidades — incluindo 15 bugs “zero-day” desconhecidos — e gerando exploits de prova de conceito. | Demonstra a capacidade cada vez maior da IA na detecção de vulnerabilidades e na proteção automatizada contra explorações. |
| Spur (startup da Yale) | Desenvolvi um agente de IA que transforma descrições de casos de teste em linguagem simples em rotinas automatizadas de testes de sites — na prática, um fluxo de trabalho de controle de qualidade que se cria sozinho. | Permite testes autônomos com intervenção humana mínima |
| Reprodução automática de relatórios de bugs do Android | Utilizei PLN (Processamento de Linguagem Natural) e aprendizado por reforço para interpretar a linguagem dos relatórios de bugs e gerar passos para reproduzir bugs no Android. | Alcançou 67% de precisão, 77% de recall e reproduziu 74% dos relatórios de bugs, superando os métodos tradicionais. |
Erros comuns na medição do tempo de resolução de bugs
Se sua medição estiver incorreta, seu plano de melhoria também estará.
A maioria dos “números ruins” nos fluxos de trabalho de resolução de bugs decorre de definições vagas, fluxos de trabalho inconsistentes e análises superficiais.
Portanto, comece pelo básico — o que é considerado início/encerramento, como lidar com esperas e reaberturas — e, em seguida, analise os dados da mesma forma que seus clientes os percebem. Isso inclui:
❌ Limites imprecisos: Misturar “Relatado → Resolvido” e “Relatado → Fechado” no mesmo painel (ou alternar entre eles de mês a mês) torna as tendências sem sentido. Escolha um limite, documente-o e faça com que seja seguido por todas as equipes. Se precisar dos dois, publique-os como métricas separadas com rótulos claros.
❌ Abordagem baseada apenas em médias: Confiar na média oculta a realidade das filas com alguns casos atípicos de longa duração. Use a mediana (P50) para o seu tempo “típico”, o P90 para previsibilidade/SLAs e mantenha a média para o planejamento de capacidade. Sempre analise a distribuição, não apenas um único número.
❌ Sem segmentação: Agrupar todos os bugs mistura incidentes P0 com P3s meramente cosméticos. Segmente por gravidade, origem (cliente x QA x monitoramento), componente/equipe e “novo x regressão”. Seu P0/P1 P90 é o que as partes interessadas percebem; sua mediana P2+ é o que a engenharia usa como base para seus planos.
❌ Ignorando o tempo “em pausa”: Está aguardando logs do cliente, um fornecedor externo ou uma janela de lançamento? Se você não monitorar o status “Bloqueado/Em pausa” como um status de primeira linha, seu tempo de resolução se tornará motivo de controvérsia. Relate tanto o tempo no calendário quanto o tempo ativo para que os gargalos fiquem visíveis e as discussões cessem.
❌ Falhas na normalização de tempo: Misturar fusos horários ou alternar entre horário comercial e horário civil no meio do processo prejudica as comparações. Normalize os carimbos de data/hora para um único fuso horário (ou UTC) e decida uma vez se os SLAs serão medidos em horas comerciais ou civis; aplique essa decisão de maneira consistente.
❌ Registros incompletos e duplicatas: A falta de informações sobre ambiente/compilação e os tickets duplicados aumentam o tempo de resolução e confundem a atribuição de responsabilidade. Padronize os campos obrigatórios no momento do registro, preencha automaticamente (logs, versão, dispositivo) e elimine duplicatas sem reiniciar o tempo de resolução — feche as duplicatas como problemas vinculados, não como “novos” problemas.
❌ Modelos de status inconsistentes: Status personalizados (“Quase pronto para QA”, “Aguardando revisão 2”) ocultam o tempo de permanência no status e tornam as transições entre estados pouco confiáveis. Defina um fluxo de trabalho padrão (Novo → Triado → Em andamento → Em revisão → Resolvido → Encerrado) e verifique se há estados fora do caminho normal.
❌ Ignorar o tempo em cada status: Um único número de “tempo total” não é suficiente para identificar onde o trabalho fica parado. Registre e analise o tempo gasto nos status “Triagem”, “Em revisão”, “Bloqueado” e “QA”. Se o tempo de revisão de código (P90) for muito maior do que o de implementação, a solução não é “programar mais rápido”, e sim liberar a capacidade de revisão.
🧠 Curiosidade: O mais recente AI Cyber Challenge da DARPA apresentou um avanço revolucionário na automação da segurança cibernética. A competição contou com sistemas de IA projetados para detectar, explorar e corrigir vulnerabilidades em softwares de forma autônoma — sem intervenção humana. A equipe vencedora, a “Team Atlanta”, identificou de forma impressionante 77% dos bugs injetados e corrigiu com sucesso 61% deles, demonstrando o poder da IA não apenas para encontrar falhas, mas também para corrigi-las ativamente.
❌ Cegueira em relação às reaberturas: Tratar reaberturas como novos bugs reinicia o cronômetro e distorce o MTTR. Acompanhe a taxa de reabertura e o “tempo até o fechamento estável” (desde o primeiro relato até o fechamento final em todos os ciclos). O aumento das reaberturas geralmente indica reprodução deficiente, lacunas nos testes ou uma definição vaga do que constitui “concluído”.
❌ Sem MTTA: As equipes se concentram excessivamente no MTTR e ignoram o MTTA (tempo de reconhecimento/atribuição de responsabilidade). Um MTTA elevado é um sinal precoce de que a resolução será demorada. Meça-o, defina SLAs por gravidade e automatize o encaminhamento/escalonamento para mantê-lo baixo.
❌ IA/automação sem controles de segurança: Permitir que a IA defina a gravidade ou feche duplicatas sem revisão pode classificar erroneamente casos extremos e distorcer as métricas de forma imperceptível. Use a IA para sugestões, exija confirmação humana para P0/P1 e audite o desempenho do modelo mensalmente para que seus dados permaneçam confiáveis.
Aperfeiçoe esses pontos, e seus gráficos de tempo de resolução finalmente refletirão a realidade. A partir daí, as melhorias se acumulam: um melhor processamento inicial reduz o MTTA, estados mais claros revelam os verdadeiros gargalos e os P90s segmentados oferecem aos líderes promessas que você pode cumprir.
⚡️ Arquivo de modelos: 10 modelos de casos de teste para testes de software
Melhores práticas para uma melhor resolução de bugs
Resumindo, aqui estão as dicas essenciais que você deve ter em mente!
| 🧩 Melhores práticas | 💡 O que isso significa | 🚀 Por que isso é importante |
| Utilize um sistema robusto de rastreamento de bugs | Acompanhe todos os bugs relatados usando um sistema centralizado de rastreamento de bugs. | Garante que nenhum bug seja esquecido e permite a visibilidade do status dos bugs entre as equipes. |
| Elabore relatórios detalhados de bugs | Inclua contexto visual, informações sobre o sistema operacional, etapas para reproduzir o problema e nível de gravidade. | Ajuda os desenvolvedores a corrigir bugs mais rapidamente, com todas as informações essenciais disponíveis desde o início. |
| Categorize e priorize bugs | Use uma matriz de prioridades para classificar os bugs por urgência e impacto. | Foca a equipe primeiro nos bugs críticos e nas questões urgentes. |
| Aproveite os testes automatizados | Execute testes automaticamente em seu pipeline de CI/CD. | Facilita a detecção precoce e evita regressões. |
| Defina diretrizes claras para a geração de relatórios | Forneça modelos e treinamento sobre como relatar bugs. | Isso resulta em informações precisas e uma comunicação mais fluida. |
| Acompanhe as principais métricas | Meça o tempo de resolução, o tempo decorrido e o tempo de resposta. | Permite o acompanhamento e a melhoria do desempenho por meio de dados históricos. |
| Adote uma abordagem proativa | Não espere que os usuários reclamem — faça testes de forma proativa. | Aumenta a satisfação do cliente e reduz a carga de trabalho do suporte. |
| Aproveite ferramentas inteligentes e aprendizado de máquina | Use o aprendizado de máquina para prever bugs e sugerir correções. | Aumenta a eficiência na identificação das causas-raiz e na correção de bugs. |
| Alinhar-se aos SLAs | Cumpra os acordos de nível de serviço (SLA) estabelecidos para a resolução. | Isso gera confiança e atende às expectativas dos clientes em tempo hábil. |
| Revise e aprimore continuamente | Analise bugs reabertos, colete feedback e ajuste os processos. | Promove o aprimoramento contínuo do seu processo de desenvolvimento e do gerenciamento de bugs. |
Resolução de bugs simplificada com IA contextual
As equipes mais rápidas na resolução de bugs não dependem de feitos heróicos. Elas projetam um sistema: definições claras de início e término, recebimento organizado, priorização com base no impacto nos negócios, responsabilidades bem definidas e ciclos de feedback ágeis entre os setores de suporte, controle de qualidade, engenharia e lançamento.
O ClickUp pode ser esse centro de comando com inteligência artificial para o seu sistema de resolução de bugs. Centralize todos os relatórios em uma única fila, padronize o contexto com campos estruturados e deixe que a IA do ClickUp faça a triagem, resuma e priorize, enquanto as automações garantem o cumprimento dos SLAs, escalam quando os prazos são ultrapassados e mantêm as partes interessadas alinhadas. Vincule os bugs a clientes, códigos e versões para que os executivos vejam o impacto e os profissionais continuem trabalhando sem interrupções.
Se você está pronto para reduzir o tempo de resolução de bugs e tornar seu roteiro mais previsível, cadastre-se no ClickUp e comece a medir o aumento em dias — e não em trimestres.
Perguntas frequentes
Qual é um bom tempo de resolução de bugs?
Não existe um único número “ideal” — isso depende da gravidade, do modelo de lançamento e da tolerância ao risco. Use medianas (P50) para o desempenho “típico” e P90 para compromissos/SLAs, e segmente por gravidade e origem.
Qual é a diferença entre resolução de bugs e encerramento de bugs?
A resolução ocorre quando a correção é implementada (por exemplo, código mesclado, configuração aplicada) e a equipe considera o defeito resolvido. O encerramento ocorre quando a questão é verificada e formalmente concluída (por exemplo, validada pela equipe de controle de qualidade no ambiente de destino, lançada ou marcada como “não será corrigida”/“duplicada” com justificativa). Muitas equipes medem ambos: “Relatado → Resolvido” reflete a velocidade da engenharia; “Relatado → Encerrado” reflete o fluxo de qualidade de ponta a ponta. Use definições consistentes para que os painéis não misturem os estágios.
Qual é a diferença entre o tempo de resolução de bugs e o tempo de detecção de bugs?
O tempo de detecção (MTTD) é o tempo que leva para descobrir um defeito após sua ocorrência ou lançamento — por meio de monitoramento, controle de qualidade ou usuários. O tempo de resolução é o tempo que leva desde a detecção/notificação até a implementação da correção (e, se preferir, sua validação/lançamento). Juntos, eles definem a janela de impacto ao cliente: detectar rapidamente, reconhecer rapidamente, resolver rapidamente e lançar com segurança. Você também pode acompanhar o MTTA (tempo para reconhecer/atribuir) para identificar atrasos na triagem que, muitas vezes, indicam uma resolução mais demorada.
Como a IA ajuda na resolução de bugs?
A IA agiliza as etapas que normalmente demoram: recebimento, triagem, diagnóstico, correção e verificação.
- Recebimento e triagem: resume automaticamente relatórios longos, extrai etapas de reprodução e ambiente, sinaliza duplicatas e sugere gravidade e prioridade para que os engenheiros comecem com um contexto claro (por exemplo, ClickUp AI, Sentry AI).
- Roteamento e SLAs: Prevê o provável responsável pelo componente, define prazos e escala quando o MTTA ou as esperas de revisão ultrapassam o limite — reduzindo o “tempo ocioso no status” (Automações do ClickUp e fluxos de trabalho semelhantes aos de agentes).
- Diagnóstico: Agrupa erros semelhantes, correlaciona picos com commits/lançamentos recentes e aponta possíveis causas-raiz por meio de rastreamentos de pilha e contexto de código (Sentry AI e similares).
- Implementação: Sugere alterações no código e testes com base em padrões do seu repositório, acelerando o ciclo de “escrever/corrigir” (GitHub Copilot; Snyk Code AI da DeepCode).
- Verificação e comunicação: cria casos de teste a partir de etapas de reprodução, redige notas de lançamento e atualizações para as partes interessadas e resume o status para executivos e clientes (IA do ClickUp). Quando usados em conjunto — o ClickUp como centro de comando, com Sentry/Copilot/DeepCode na pilha de ferramentas —, as equipes reduzem os tempos de MTTA/P90 sem depender de esforços heróicos.