
Awarie informatyczne mogą wystąpić bez ostrzeżenia.
Od awarii serwerów po cyberataki — bez solidnego planu przywracania sprawności Twoja firma może stanąć w obliczu wielogodzinnych przestojów, utraty danych i poważnych strat finansowych, przy czym 54% poważnych awarii kosztuje ponad 100 000 USD.
W tym wpisie na blogu przedstawiono krok po kroku proces tworzenia kompleksowego planu odzyskiwania danych po awarii IT, który chroni systemy, określa jasne cele odzyskiwania oraz gwarantuje, że zespół dokładnie wie, co robić w razie awarii.
Czym jest plan odzyskiwania danych po awarii IT?
Gdyby Twoje serwery uległy awarii w tej chwili, czy Twój zespół wiedziałby dokładnie, co należy zrobić? 🛠️
Plan odzyskiwania danych po awarii (DR) to udokumentowana strategia przywracania systemów informatycznych i danych po wszelkich zakłóceniach — od klęsk żywiołowych po cyberataki. Jest to w zasadzie instrukcja postępowania, która pozwala przywrócić działanie technologii, gdy coś pójdzie nie tak.
💡 Odzyskiwanie po awarii a ciągłość działania
Odzyskiwanie po awarii (DR) koncentruje się konkretnie na przywróceniu infrastruktury IT i danych. Ciągłość działania (BC) ma szerszy zakres i ma na celu utrzymanie funkcjonowania całej firmy w trakcie kryzysu i po jego zakończeniu, nawet w przypadku awarii systemów IT. Potraktuj DR jako kluczowy element swojej ogólnej strategii BC.
💡 Odzyskiwanie po awarii a ciągłość działania
Odzyskiwanie po awarii (DR) koncentruje się konkretnie na przywróceniu infrastruktury IT i danych. Ciągłość działania (BC) ma szerszy zakres i ma na celu utrzymanie funkcjonowania całej firmy w trakcie kryzysu i po jego zakończeniu, nawet w przypadku awarii systemów IT. Potraktuj DR jako kluczowy element ogólnej strategii BC.
Twój plan odzyskiwania danych po awarii ma ogromne znaczenie, ponieważ przestoje kosztują więcej niż tylko pieniądze. Każda minuta, w której Twoje systemy są wyłączone, może podkopać zaufanie klientów, zakłócić działalność operacyjną, a nawet skutkować karami za nieprzestrzeganie przepisów. Kompleksowy plan odzyskiwania danych po awarii to Twoja mapa drogowa do zapewnienia odporności.
Dobry plan obejmuje:
- Procedury tworzenia kopii zapasowych danych: Jak i gdzie przechowujesz kopie kluczowych informacji, aby móc je przywrócić
- Kroki przywracania systemu: Dokładna sekwencja kroków pozwalająca przywrócić działanie usług we właściwej kolejności
- Obowiązki zespołu: Kto co robi podczas incydentu, aby uniknąć nieporozumień
- Protokoły komunikacyjne: W jaki sposób będziesz informować interesariuszy, od swojego zespołu po klientów
- Cele odzyskiwania: konkretne cele dotyczące tego, jak szybko systemy muszą zostać przywrócone oraz jaka utrata danych jest dopuszczalna
Typowe scenariusze awarii informatycznych i ich skutki
Katastrofy to nie tylko scenariusze z Hollywood — zdarzają się one w firmach każdego dnia. Zrozumienie, przed czym się chronisz, pomaga zbudować znacznie silniejszą ochronę.
Klęski żywiołowe i uszkodzenia fizyczne
Zjawiska takie jak powodzie, pożary, trzęsienia ziemi i poważne przerwy w dostawie prądu mogą w ciągu kilku minut zniszczyć całe centra danych. Na przykład, gdy poważna powódź dotknęła centrum danych w Nashville, niektóre firmy straciły dane z kilku tygodni i musiały zmagać się z wielomiesięcznym procesem przywracania danych. Najlepszą ochroną przed takimi wydarzeniami jest redundancja geograficzna, czyli rozłożenie infrastruktury na wiele fizycznych lokalizacji, dzięki czemu pojedyncze wydarzenie nie spowoduje całkowitej awarii systemu.
Cyberataki i naruszenia bezpieczeństwa danych
Oprogramowanie ransomware, ataki typu Distributed Denial-of-Service (DDoS) oraz naruszenia bezpieczeństwa danych różnią się od katastrof fizycznych. Często są trudniejsze do wykrycia, mogą rozprzestrzeniać się w sposób niezauważalny w połączonych systemach, a ponadto często są celem systemów kopii zapasowych, co sprawia, że przywrócenie sprawności staje się szczególnie trudne. Częstotliwość i stopień zaawansowania tych cyberataków stale rosną we wszystkich branżach, a oprogramowanie ransomware stanowi obecnie 44% wszystkich potwierdzonych naruszeń bezpieczeństwa, co czyni je jednym z największych zagrożeń.
📖 Czytaj więcej: 10 sposobów na zmniejszenie ryzyka związanego z cyberbezpieczeństwem w zarządzaniu projektami
Awarie sprzętu i utrata danych
Czasami nawet najlepiej przetestowane i sprawdzone systemy tworzenia kopii zapasowych po prostu ulegają awarii. Awarie serwerów, usterki pamięci masowej i nieprawidłowe działanie sprzętu sieciowego mogą wystąpić bez ostrzeżenia. Nawet jeśli dysponujesz systemami redundantnymi (rezerwowymi), mogą one ulec awarii w tym samym czasie, jeśli udostępniają one wspólne komponenty lub źródła zasilania, tworząc w ten sposób pojedynczy punkt awarii.
👀 Czy wiesz, że: W październiku 2025 r. AWS doświadczył poważnej awarii, gdy błąd w wewnętrznym systemie zarządzania DNS dla usługi Amazon DynamoDB spowodował nieprawidłowe rozpoznawanie nazw domen w regionie centrum danych US-EAST-1. Ta „niewielka” usterka techniczna była wyzwalaczem kaskadowej awarii w dziesiątkach usług AWS i spowodowała wyłączenie setek popularnych aplikacji i platform na całym świecie — od komunikatorów i serwisów społecznościowych po banki, serwisy z grami i wiele innych. Dla wielu osób awaria ta sprawiła, że znaczna część Internetu chwilowo „zniknęła”, co uwydatniło, jak krucha jest nasza infrastruktura cyfrowa, gdy tak wiele zależy od garstki dostawców usług w chmurze.
Błędy oprogramowania i przerwy w świadczeniu usług
Uszkodzona baza danych, nieudana aktualizacja oprogramowania lub zwykły błąd konfiguracji mogą spowodować awarię całych platform. Możesz zauważyć, że jedna nieprawidłowo skonfigurowana linijka kodu może wywołać efekt domina w połączonych systemach, powodując rozległą awarię o szerokim zasięgu. Prawidłowe zarządzanie zmianami i dedykowane środowiska testowe to Twoi najlepsi sprzymierzeńcy w minimalizowaniu tych zagrożeń.
Błędy ludzkie i nieprawidłowe konfiguracje
Przypadkowe usunięcia, nieprawidłowe konfiguracje i nieautoryzowane zmiany pozostają jedną z najczęstszych przyczyn awarii systemów informatycznych. Jedna błędna komenda lub usunięty plik może być wyzwalaczem wielogodzinnych przestojów i pogorszenia jakości usług. Chociaż szkolenia i mechanizmy kontroli dostępu są pomocne, nie są w stanie całkowicie wyeliminować błędów ludzkich.
📮ClickUp Insight: 92% pracowników stosuje niespójne metody śledzenia elementów do wykonania, co ma dla nich następujące wyniki: pominięcie decyzji i opóźnienia w realizacji.
Niezależnie od tego, czy wysyłasz notatki z przypomnieniem, czy korzystasz z arkuszy kalkulacyjnych, proces ten jest często chaotyczny i nieefektywny. Dzięki funkcjom zarządzania zadaniami w ClickUp nigdy nie musisz się tym martwić. Twórz zadania z czatu, komentarzy do zadań ClickUp, dokumentów i e-maili za pomocą jednego kliknięcia!
Kluczowe elementy planu odzyskiwania danych po awarii IT
Solidny plan odzyskiwania po awarii to zakończony zestaw procedur umożliwiający przywrócenie działania systemu. Każdy z tych elementów uzupełnia pozostałe, tworząc kompleksową ochronę dla Twojej firmy.
Ocena ryzyka i ustalanie priorytetów
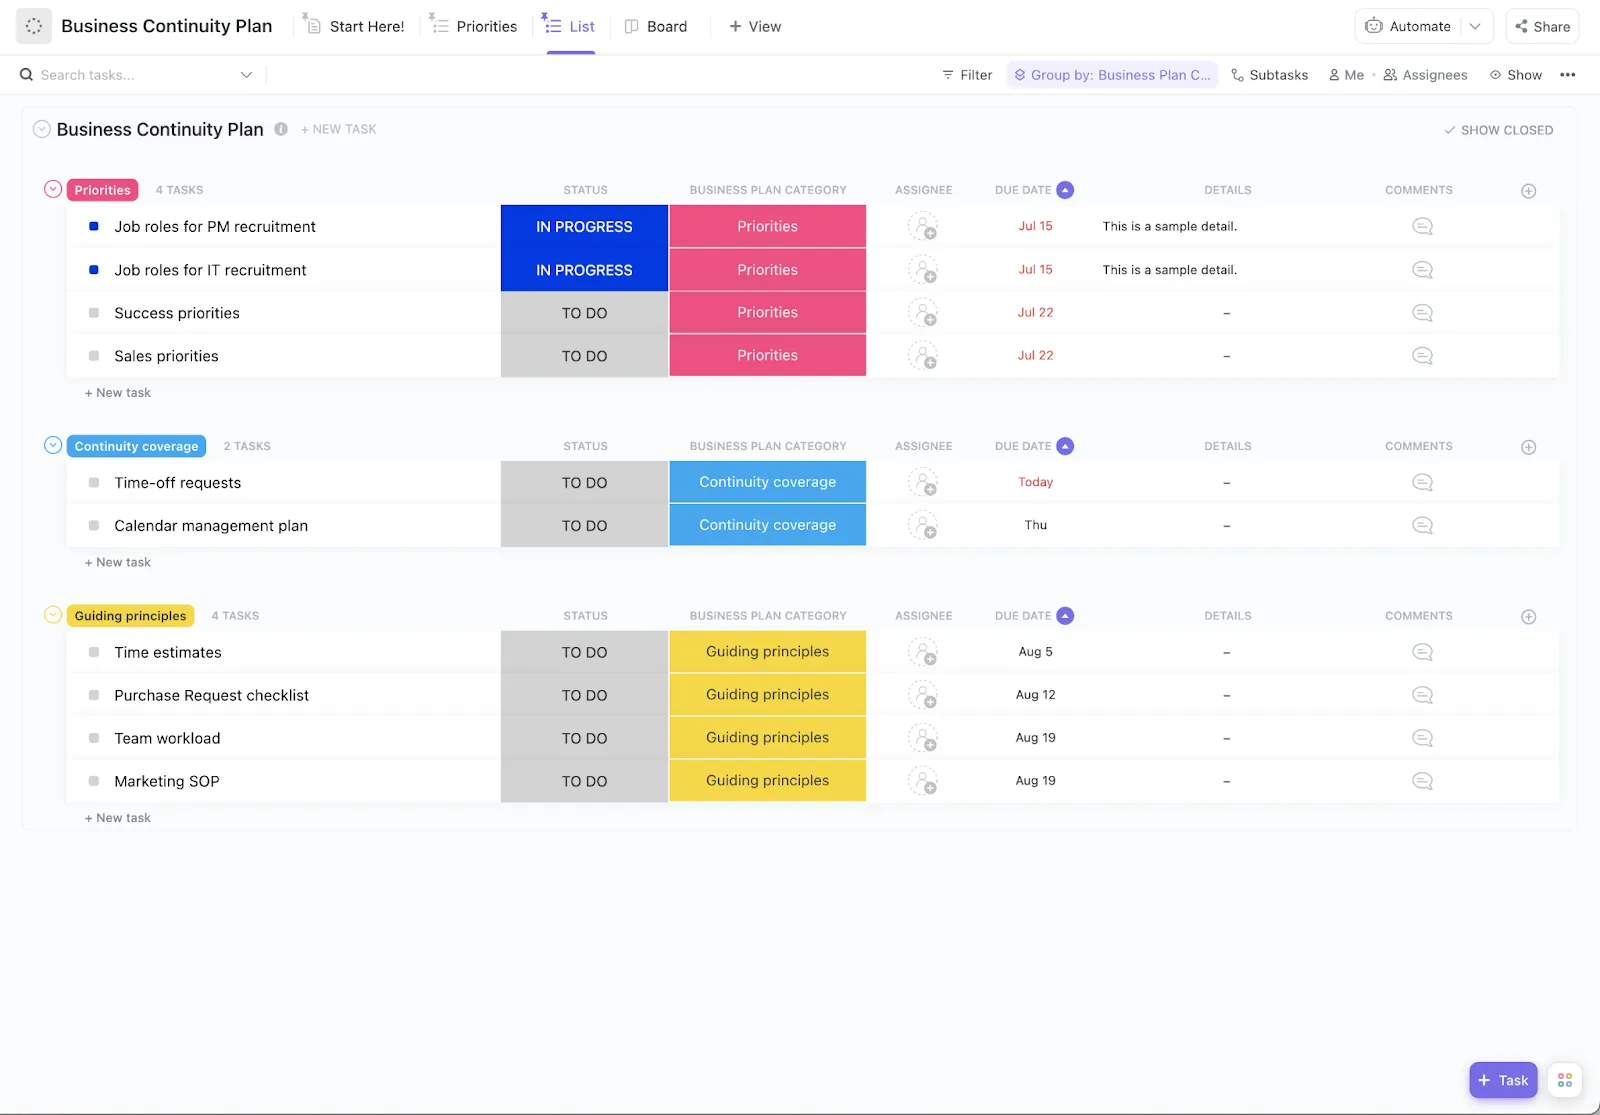
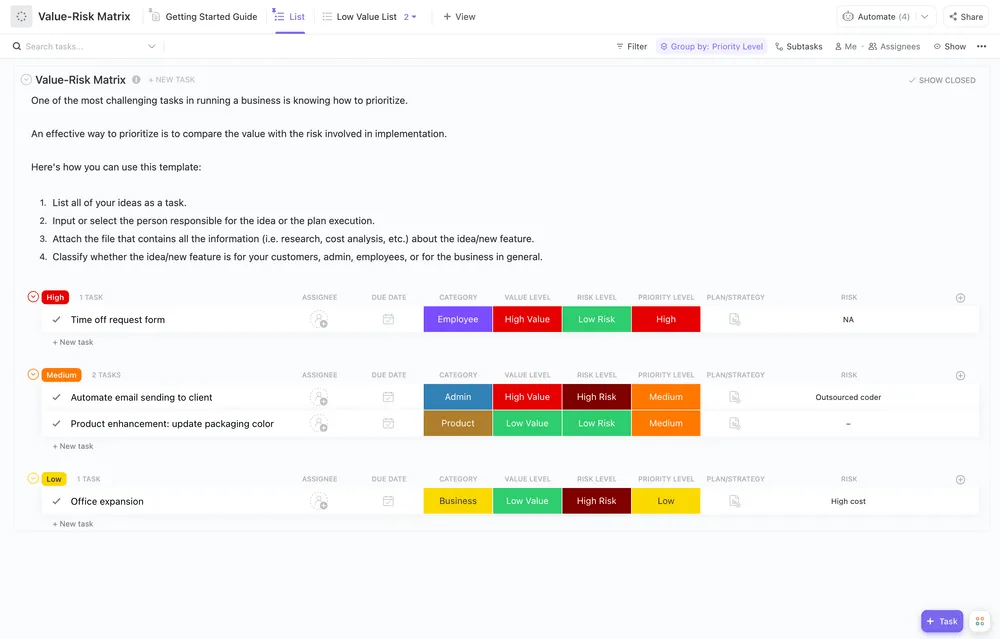
Najpierw musisz wiedzieć, z czym masz do czynienia. Ocena ryzyka to proces identyfikacji słabych punktów oraz oceny prawdopodobieństwa wystąpienia i skutków każdego potencjalnego zagrożenia. Możesz to przedstawić w postaci matrycy ryzyka, aby sprawdzić, które zagrożenia są najpoważniejsze.
Ocena powinna obejmować:
- Systemy krytyczne: Co bezwzględnie musi działać, aby Twoja firma mogła funkcjonować
- Wrażliwość danych: Jakie informacje wymagają najwyższego poziomu ochrony (np. dane klientów)
- Zależności: Jakie inne systemy lub procesy przestają działać w przypadku awarii poszczególnych systemów
📖 Czytaj więcej: Jak wdrożyć zarządzanie infrastrukturą IT
Analiza wpływu na działalność i stopień krytyczności
Następnie oszacuj rzeczywisty koszt przestoju. Analiza wpływu na działalność (BIA) pomoże Ci określić finansowe i operacyjne skutki awarii dla każdego systemu. Pozwoli to na klasyfikację systemów według poziomów krytyczności, co umożliwi ustalenie priorytetów wysiłków związanych z przywróceniem sprawności.
| Krytyczne | Mniej niż godzina | Przetwarzanie płatności, bazy danych klientów |
| Wysoki | Od jednej do czterech godzin | E-mail, narzędzia komunikacji wewnętrznej |
| Medium | Od 4 do 24 godzin | Środowiska programistyczne, narzędzia do raportowania |
| Niski | Ponad 24 godziny | Systemy archiwizacji, serwery testowe nieprzeznaczone do produkcji |
Cele RTO i RPO
Te dwa skróty stanowią sedno Twojej strategii przywracania sprawności.
- Cel czasu przywrócenia (RTO): Jest to maksymalny czas, na jaki możesz sobie pozwolić, gdy system jest niedostępny. Odpowiada on na pytanie: „Jak szybko musimy przywrócić działanie systemu?”.
- Cel punktu odzyskiwania (RPO): Jest to maksymalna ilość danych, na utratę której możesz sobie pozwolić, mierzona w czasie. Odpowiada on na pytanie: „Ile danych możemy stracić bez poniesienia poważnych szkód?”.
Na przykład Twój wewnętrzny system e-maila może mieć RTO wynoszący cztery godziny, ale baza danych e-commerce przeznaczona dla klientów może mieć RPO wynoszący zaledwie 15 minut, co oznacza, że nie możesz stracić więcej niż 15 minut danych związanych z transakcjami.
Plan tworzenia kopii zapasowych i odzyskiwania danych
Twój plan tworzenia kopii zapasowych to Twoja najważniejsza siatka bezpieczeństwa. Powszechnie stosowaną najlepszą praktyką jest zasada 3-2-1: należy przechowywać co najmniej trzy kopie ważnych danych, zapisywać je na dwóch różnych nośnikach oraz przechowywać jedną z tych kopii poza siedzibą firmy.
Będziesz również mógł wybierać spośród różnych typów kopii zapasowych:
- Pełne kopie zapasowe: kompletna kopia wszystkich danych, zrobione zazwyczaj co tydzień lub co miesiąc
- Kopie zapasowe przyrostowe: Kopie zapasowe obejmują wyłącznie zmiany wprowadzone od czasu ostatniej kopii zapasowej dowolnego typu
- Kopie zapasowe różnicowe: Tworzą kopię zapasową wszystkich zmian wprowadzonych od czasu ostatniej pełnej kopii zapasowej
Co najważniejsze, należy regularnie testować proces przywracania kopii zapasowych. Niesprawdzona kopia zapasowa to tylko nadzieja, a nie plan.
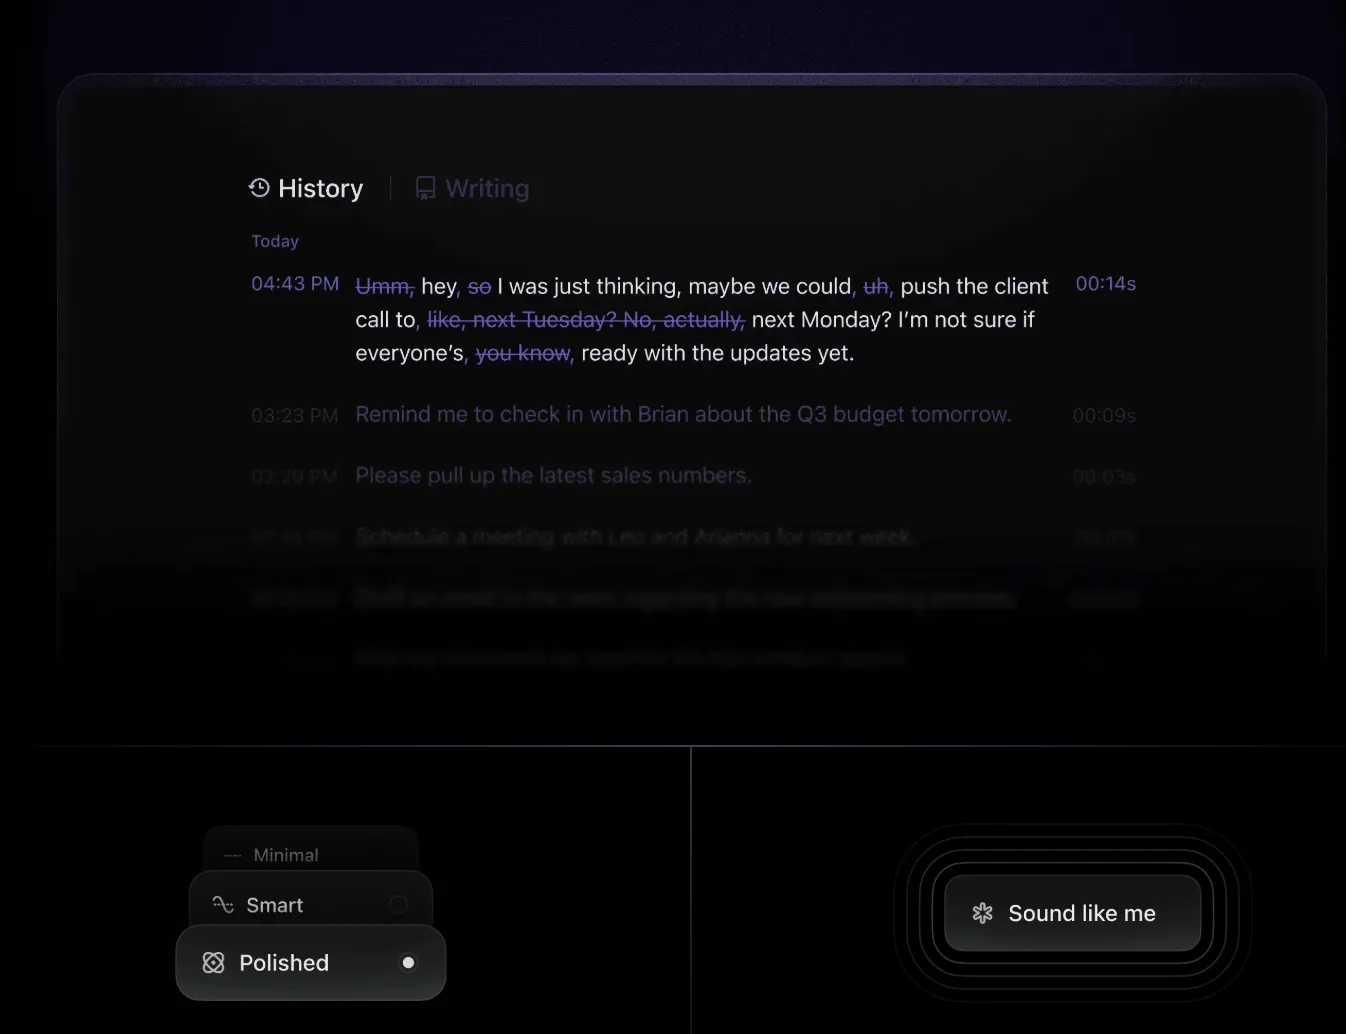
💟 Bonus: Rejestruj kluczowe szczegóły podczas zdarzeń o wysokim poziomie stresu, korzystając z funkcji zamiany mowy na tekst w ClickUp Brain MAX, dzięki czemu nigdy nie przegapisz ważnych informacji, nawet gdy pisanie na klawiaturze jest niemożliwe. Po prostu wypowiedz swoje spostrzeżenia, a AI zajmie się dokumentacją.
Plan komunikacji i aktualizacje dla interesariuszy
W przypadku wystąpienia awarii wszystko zależy od jasnego planu komunikacji. Plan musi określać łańcuchy powiadomień, częstotliwość przekazywania aktualnych informacji oraz kanały, z których będziesz korzystać w przypadku każdego rodzaju incydentu.
Różne grupy potrzebują różnych informacji:
- Zespoły wewnętrzne: Potrzebujecie szczegółowych informacji technicznych i konkretnych elementów do wykonania
- Klienci: Chcą znać status usługi i dowiedzieć się, kiedy można spodziewać się rozwiązania problemu
- Dostawcy: Może zaistnieć potrzeba skorzystania z ich pomocy w zakresie wsparcia technicznego lub eskalacji problemów
- Organy regulacyjne: W zależności od branży mogą wymagać złożenia formalnych powiadomień.
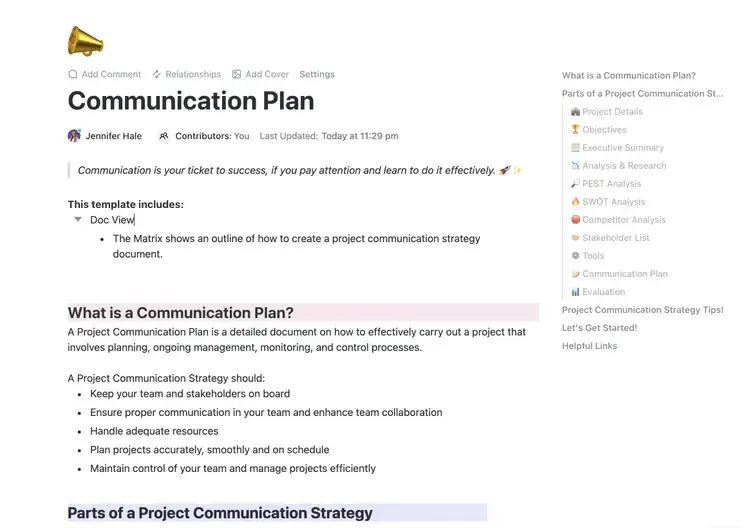
Narzędzia takie jak ten gotowy do użycia szablon planu komunikacji od ClickUp mogą pomóc Ci działać szybciej, korzystając ze sprawdzonego protokołu w sytuacji kryzysowej.
Program testów i szkoleń
Plan, którego nigdy nie testujesz, to plan, który zawiedzie. Regularne testy pozwalają wykryć luki i słabe punkty, zanim dojdzie do prawdziwej awarii.
Zaplanuj różne rodzaje testów w ciągu roku:
- Ćwiczenia symulacyjne: Twój zespół przechodzi przez scenariusz awarii na papierze, aby sprawdzić logikę planu
- Częściowe przełączenie awaryjne: Testujesz przywracanie określonych, niekrytycznych komponentów lub usług
- Pełne testy odzyskiwania po awarii: Przeprowadzasz zakończone przełączenie awaryjne na systemy zapasowe (test ostateczny)
Po każdym teście należy zaktualizować dokumentację i niezwłocznie przeszkolić nowych członków zespołu w zakresie procedur.
📖 Czytaj więcej: Jak opracować skuteczne zasady i procedury IT
Kroki prowadzące do stworzenia planu odzyskiwania danych po awarii IT
Opracowanie planu odzyskiwania danych po awarii nie musi być przytłaczającym zadaniem.
Oto jak możesz to zrobić krok po kroku. 🙌
Krok 1: Stwórz spis zasobów
Nie da się chronić tego, o czym się nie wie. Zacznij od stworzenia listy zasobów, zawierającej wszystkie elementy sprzętu, oprogramowania, repozytoria danych oraz zależności systemowe w Twoim środowisku. Pamiętaj, aby uwzględnić dane kontaktowe dostawców, klucze licencyjne oraz szczegóły konfiguracji, które będą przydatne podczas przywracania systemu.
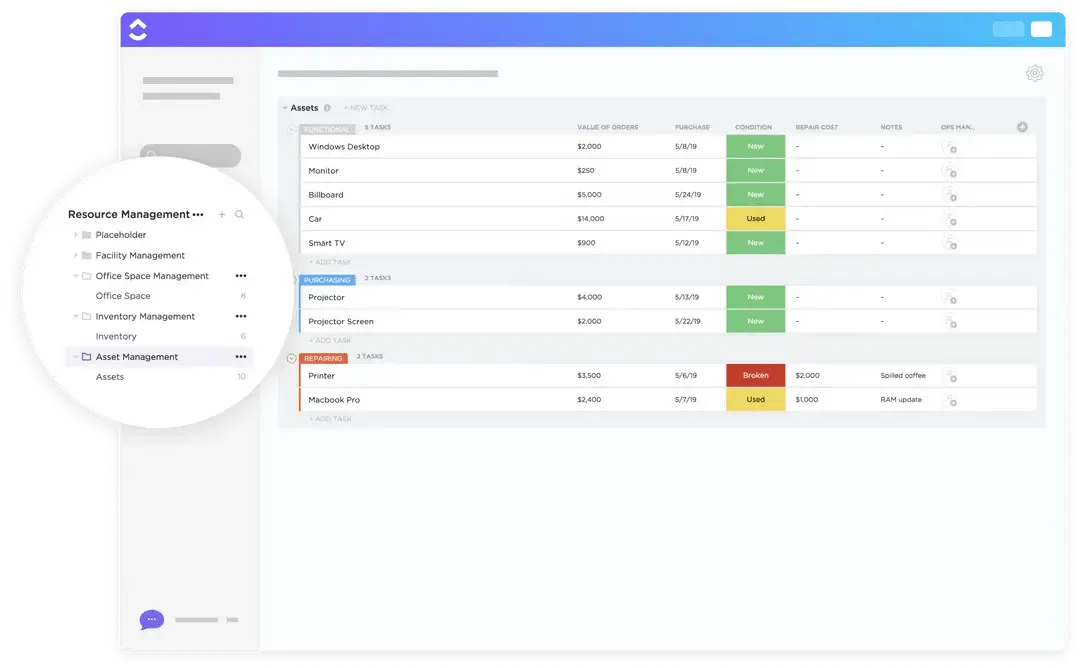
Szablon ClickUp ITAM łączy w sobie zarządzanie incydentami, zarządzanie problemami, zarządzanie zmianami, proste rozwiązania do zarządzania zasobami oraz zarządzanie wiedzą. Nasz szablon ITSM „Znane błędy” ułatwia śledzenie znanych błędów w systemach. Zapoznaj się ze wszystkimi naszymi szablonami IT, gdy tylko zmienią się Twoje potrzeby.
Dostosuj swoje cykle pracy w dowolny sposób na każdym etapie zarządzania aktywami IT (ITAM) — od wdrożenia i konfiguracji po konserwację i wycofanie z eksploatacji.
Krok 2: Klasyfikacja usług krytycznych
Teraz określ, które z tych zasobów mają kluczowe znaczenie dla działalności, a które są jedynie dodatkowe. Stwórz mapy zależności usług, które pokazują, w jaki sposób Twoje systemy są ze sobą połączone i jak się od siebie wzajemnie zależą. Zwróć szczególną uwagę na wszelkie usługi skierowane do klientów, które mają bezpośredni wpływ na przychody lub komfort użytkowania.
🎥 Obejrzyj ten praktyczny przewodnik, który pokazuje, jak stworzyć uporządkowany, ogólny plan przy użyciu zaawansowanych funkcji ClickUp — od wyznaczania celów po przydzielanie zadań i śledzenie postępów.
Krok 3: Ocena ryzyka i zagrożeń
Oceń ryzyko i zagrożenia, analizując prawdopodobieństwo wystąpienia oraz skutki każdego rodzaju zagrożenia w Twojej konkretnej sytuacji. Weź pod uwagę ryzyko związane z położeniem geograficznym (czy znajdujesz się w strefie trzęsień ziemi lub na terenach zalewowych?) oraz wszelkie zagrożenia specyficzne dla branży (takie jak zmiany regulacyjne lub ukierunkowane cyberataki). Udokumentuj wszystko w rejestrze ryzyka, aby móc śledzić zmiany w czasie.

Szablon tablicy do oceny ryzyka w ClickUp nadaje procesowi oceny ryzyka wymiar wizualny. Pomaga w ocenie i kategoryzacji ryzyka, inspirując zespół do udostępniania spostrzeżeń i współpracy w angażującym i wizualnym formacie.
Ten szablon umożliwia:
- Oceń kategorie ryzyka i potencjalne skutki
- Przeanalizuj dane, aby zidentyfikować potencjalne obszary budzące obawy
- Określ środki zapobiegawcze mające na celu zmniejszenie narażenia na ryzyko
Dzięki funkcjom umożliwiającym rysowanie, pisanie i dodawanie notatek samoprzylepnych ten szablon tablicy do zarządzania ryzykiem idealnie nadaje się do oceny ryzyka związanego z projektem.
Krok 4: Ustawienie celów RTO i RPO
Współpracuj bezpośrednio z interesariuszami biznesowymi, aby określić, jaki czas przestoju i jaki poziom utraty danych uznają oni za akceptowalne dla każdego z wcześniej zidentyfikowanych poziomów usług. Konieczne będzie znalezienie równowagi między kosztami szybszego przywrócenia sprawności a wpływem na działalność firmy — nie wszystko wymaga natychmiastowego przywrócenia bez utraty danych. Uzyskaj zgodę kierownictwa na te cele.
Krok 5: Zdefiniuj ścieżki tworzenia kopii zapasowych i przełączania awaryjnego
Po ustaleniu celów możesz teraz zaprojektować rozwiązania techniczne. Opracuj strategie tworzenia kopii zapasowych dostosowane do wskaźnika RPO każdego systemu i planuj szczegółowe procedury przełączania awaryjnego, w tym alternatywne lokalizacje przetwarzania danych oraz metody dostępu awaryjnego. Dołącz schematy sieciowe i instrukcje krok po kroku, aby zapewnić bezbłędną realizację.
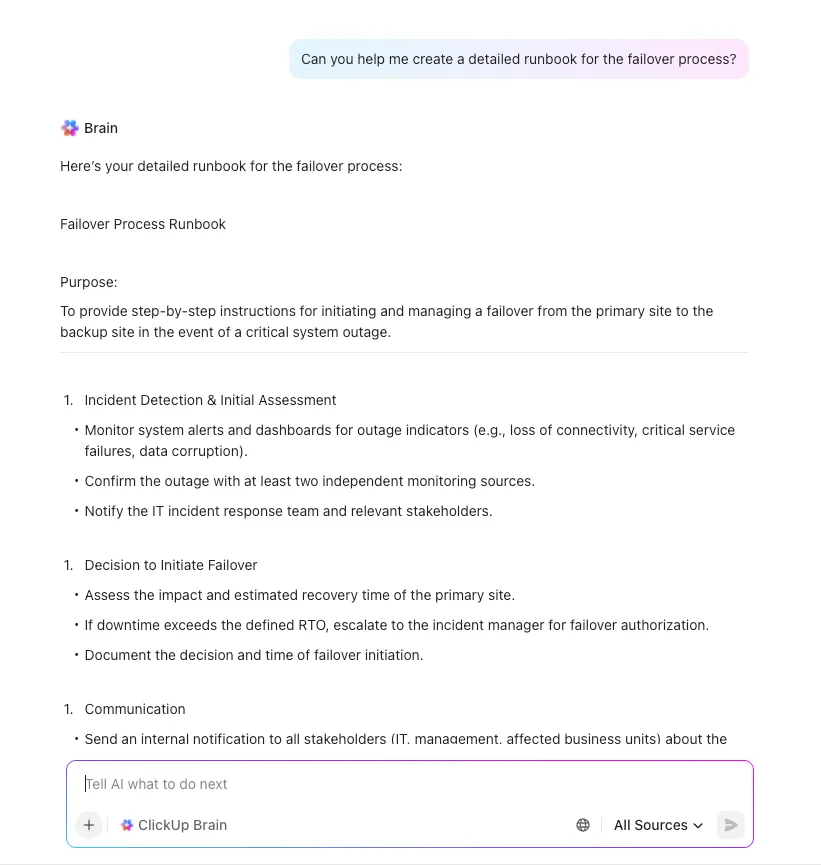
Krok 6: Przypisz role i procedury eskalacji
Określ strukturę zespołu ds. odzyskiwania danych po awarii, przypisując jasne obowiązki i uprawnienia decyzyjne. Stwórz kompleksowe listy kontaktowe z personelem podstawowym i rezerwowym dla każdej roli. Matryca RACI (odpowiedzialny, rozliczalny, konsultowany, informowany) to doskonałe narzędzie pozwalające wyeliminować niejasności podczas zdarzeń o wysokim poziomie stresu.
Krok 7: Udokumentuj i przekaż plan
Sformalizuj plan i przekaż go innym, przedstawiając jasne, szczegółowe procedury, które każdy członek zespołu będzie w stanie wykonać nawet w sytuacji stresowej. Bardzo ważne jest, aby dokumentacja ta była przechowywana w łatwo dostępnej lokalizacji, oddzielonej od głównej infrastruktury. Upewnij się, że każdy członek zespołu dokładnie wie, gdzie znaleźć plan w sytuacji kryzysowej.

Usprawnij planowanie projektów dzięki szablonowi planowania RACI w ClickUp. Ten szablon dokumentu to prawdziwy przełom — zawiera przejrzystą tabelę, która pozwala zdefiniować role i obowiązki członków zespołu w odniesieniu do zadań projektowych. Wykorzystaj model RACI (odpowiedzialny, rozliczalny, konsultowany i informowany), aby zapewnić wszystkim wspólne zrozumienie, gwarantując rozliczalność i zgodność z celami organizacji.
Krok 8: Testowanie, weryfikacja i ulepszanie
Na koniec zaplanuj kwartalne testy, aby zweryfikować swoje procedury i zidentyfikować ewentualne luki. Dokumentuj wszystkie wnioski wyciągnięte z każdego testu oraz wszelkie rzeczywiste incydenty i wykorzystaj je do aktualizacji planu. Stwórz systematyczny system śledzenia usprawnień, aby zapewnić rozwiązanie wszystkich wykrytych problemów.
🌼 Czy wiesz, że: W 2017 roku firma GitLab doświadczyła poważnej awarii bazy danych. Podczas przywracania danych odkryto, że kilka metod tworzenia kopii zapasowych od wielu dni nie działało, nie generując żadnych komunikatów o błędach. Incydent ten dał całej branży technologicznej ważną lekcję: weryfikacja kopii zapasowych jest sprawą bezwzględnie konieczną. Niesprawdzona kopia zapasowa w rzeczywistości nie jest kopią zapasową.
🌼 Czy wiesz, że: W 2017 roku firma GitLab doświadczyła poważnej awarii bazy danych. Podczas przywracania danych odkryto, że kilka metod tworzenia kopii zapasowych od wielu dni nie działało, nie generując żadnych komunikatów o błędach. Incydent ten dał całej branży technologicznej ważną lekcję: weryfikacja kopii zapasowych jest sprawą bezwzględnie konieczną. Niesprawdzona kopia zapasowa w rzeczywistości nie jest kopią zapasową.
Strategie i rozwiązania w zakresie odzyskiwania danych po awarii
Nie każda organizacja potrzebuje takiego samego podejścia do odzyskiwania po awarii. Przyjrzyjmy się dostępnym opcjom w oparciu o Twój budżet, potrzeby w zakresie odzyskiwania danych oraz dostępne zasoby.
Podejście do tworzenia kopii zapasowych i przywracania danych
Jest to najprostsza i najbardziej opłacalna metoda. Polega ona na regularnym tworzeniu kopii zapasowych w lokalizacji poza siedzibą firmy (np. w chmurze lub w dodatkowym centrum danych), a następnie ręcznym przywracaniu ich w razie potrzeby. Takie podejście najlepiej sprawdza się w przypadku systemów o mniejszym znaczeniu, które mogą tolerować dłuższy czas przywrócenia działalności (RTO), ponieważ przywrócenie danych może trwać godziny, a nawet dni.
Wysoka dostępność i nadmiarowość
Strategia ta ma na celu wyeliminowanie pojedynczych punktów awarii poprzez wykorzystanie wielu aktywnych systemów. Techniki takie jak równoważenie obciążenia, klastrowanie serwerów i pamięć masowa RAID gwarantują, że w przypadku awarii jednego komponentu inny natychmiast przejmuje jego funkcje. Chociaż wdrożenie i utrzymanie tego rozwiązania wiąże się z wyższymi kosztami, podejście to pozwala zminimalizować przestoje do zaledwie kilku sekund lub minut, co czyni je idealnym rozwiązaniem dla usług o krytycznym znaczeniu.
Opcje replikacji i przełączania awaryjnego
Replikacja polega na kopiowaniu danych niemal w czasie rzeczywistym do lokalizacji zapasowej, co zapewnia minimalną utratę danych w przypadku awarii.
- Replikacja synchroniczna: zapisuje dane jednocześnie zarówno w lokalizacji głównej, jak i zapasowej, gwarantując zerową utratę danych. Wymaga jednak dużej przepustowości i może spowolnić działanie systemu głównego.
- Replikacja asynchroniczna: Dane są najpierw zapisywane w lokalizacji głównej, a następnie kopiowane do lokalizacji zapasowej z niewielkim opóźnieniem. Jest to rozwiązanie tańsze i ma mniejszy wpływ na wydajność, ale wiąże się z niewielkim ryzykiem utraty danych.
Odzyskiwanie danych po awarii w chmurze i usługa DRaaS
Usługa odzyskiwania danych po awarii (DRaaS) stała się popularnym rozwiązaniem dla wielu firm. Oferuje ona rozliczenie zgodnie z rzeczywistym zużyciem, natychmiastową dystrybucję geograficzną oraz automatyzację koordynacji odzyskiwania danych bez konieczności budowania i utrzymywania własnych fizycznych lokalizacji awaryjnych. Chmurowe rozwiązanie DR eliminuje ogromne nakłady kapitałowe związane z budową zapasowego centrum danych, zapewniając jednocześnie szybsze skalowanie i większą elastyczność niż tradycyjne podejścia oparte na lokalizacjach typu „hot”, „warm” lub „cold”.
Jak ClickUp usprawnia planowanie odzyskiwania danych po awarii IT
Zarządzanie planem odtwarzania po awarii w rozproszonych arkuszach kalkulacyjnych, dokumentach i łańcuchach wiadomości e-mail stwarza dodatkowe ryzyko wystąpienia awarii.
Tego rodzaju rozproszenie pracy, czyli fragmentacja zadań rozłożona na wiele niepowiązanych ze sobą narzędzi, które nie komunikują się między sobą, oraz rozproszenie kontekstu, kiedy zespoły tracą godziny na poszukiwanie informacji rozrzuconych po różnych aplikacjach i platformach, prowadzi do zamieszania, nieaktualnych informacji i opóźnień w reakcji w sytuacjach, w których liczy się każda sekunda.
Dzięki ClickUp Converged AI Obszarowi Roboczemu — jednej, bezpiecznej platformie, na której wszystkie aplikacje służbowe, dane i cykle pracy współistnieją z kontekstową sztuczną inteligencją pełniącą rolę warstwy analitycznej — łączącej zarządzanie projektami, dokumentację i komunikację zespołową. Przestań żonglować wieloma platformami i przenieś planowanie odzyskiwania po awarii, testowanie oraz reagowanie na incydenty do jednego, ujednoliconego systemu.
Scentralizowana dokumentacja dotycząca odzyskiwania po awarii dzięki ClickUp Docs i wbudowanej pomocy opartej na AI
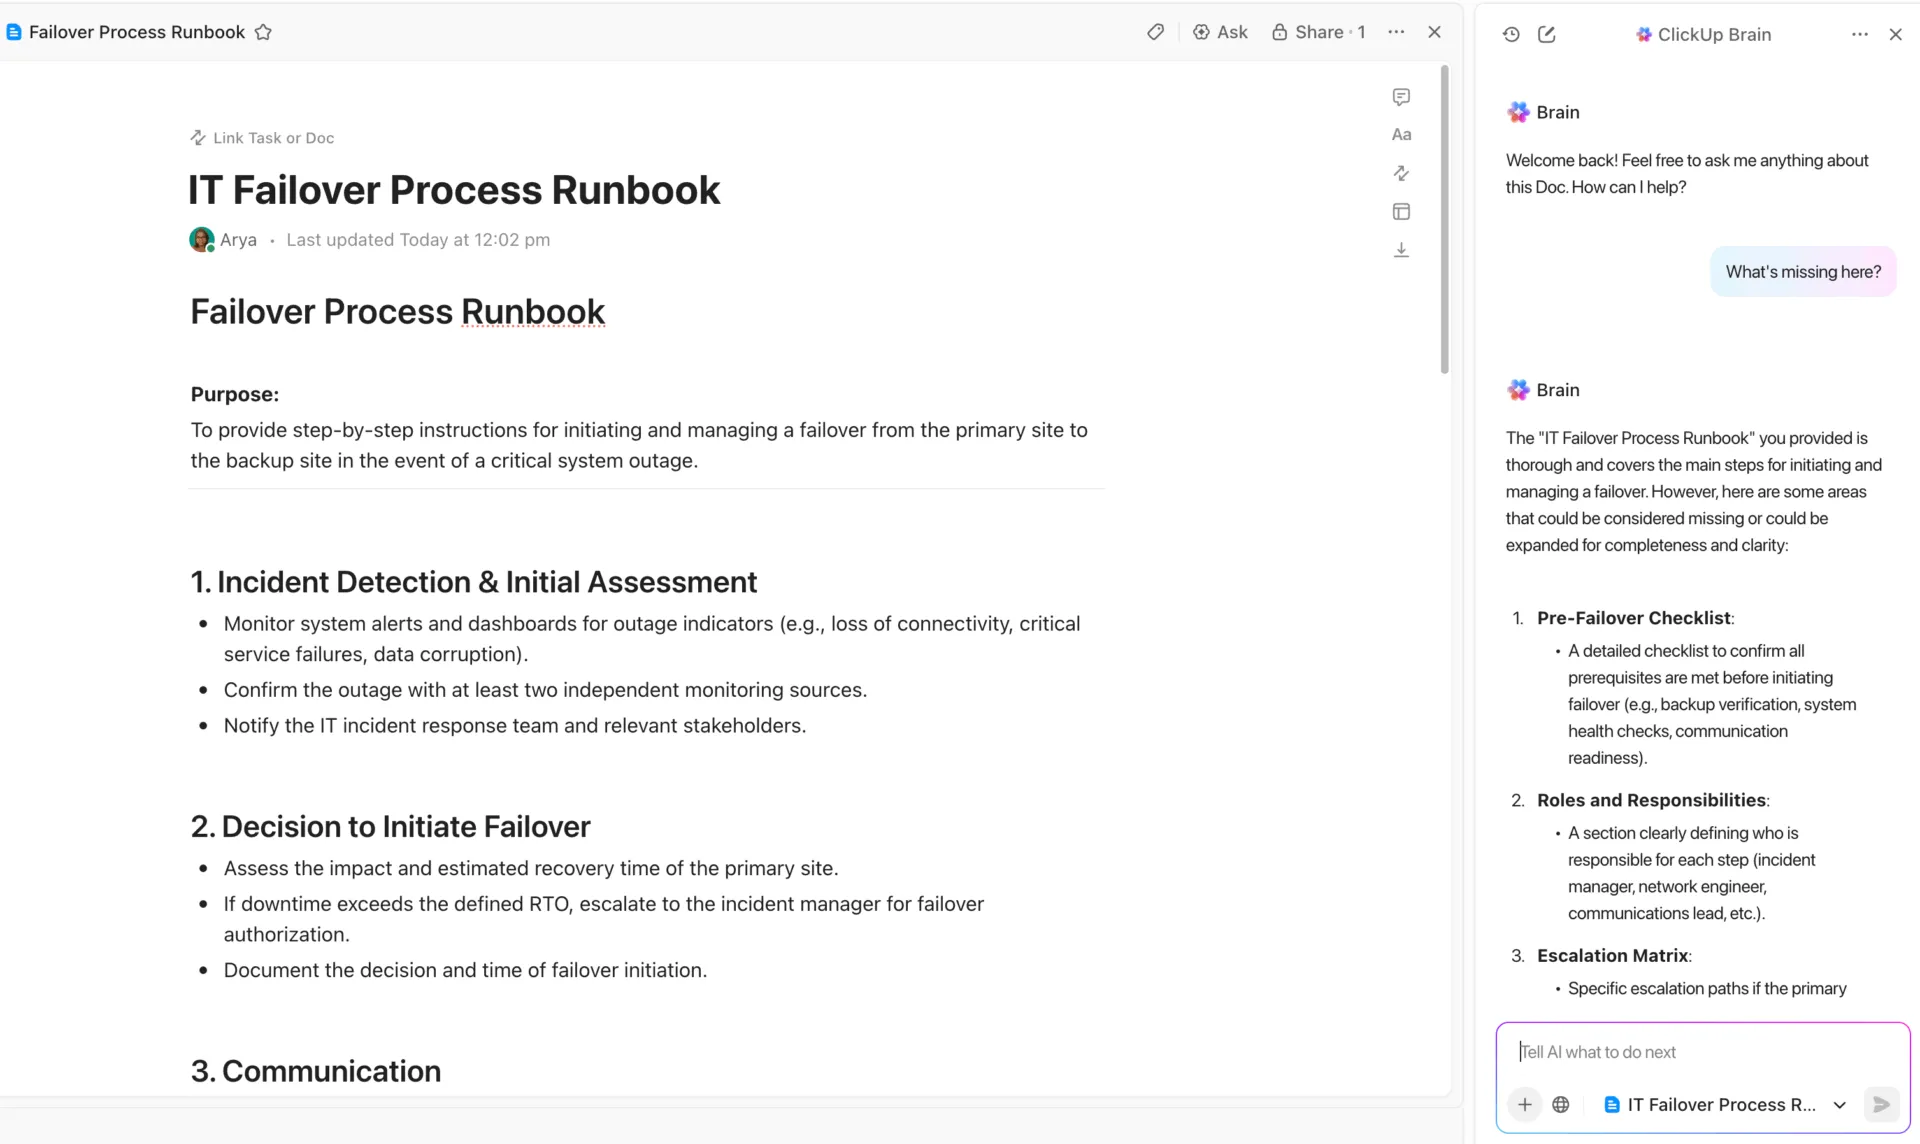
Dzięki ClickUp Docs zapewnij swojemu zespołowi stały dostęp do jednego wiarygodnego źródła informacji w dokumentach.
Opracuj cały plan przywracania sprawności po awarii w przestrzeni współpracy, gdzie każdy może wnosić swój wkład w czasie rzeczywistym podczas incydentu. Powiąż dokumenty bezpośrednio z zadaniami i projektami związanymi z incydentem, aby zapewnić płynną nawigację, oraz osadzaj diagramy lub instrukcje operacyjne, aby mieć kluczowe informacje dokładnie tam, gdzie ich potrzebujesz.
Co najważniejsze, możesz zabezpieczyć swoje dokumenty przed przypadkowymi zmianami oraz korzystać ze szczegółowych uprawnień ClickUp, aby kontrolować, kto może przeglądać lub modyfikować poufne procedury przywracania danych. Każda zmiana jest rejestrowana w historii dokumentu, co zapewnia kompletną ścieżkę audytu.
Tworzenie planów oparte na AI dzięki ClickUp Brain
Przyspiesz planowanie odzyskiwania danych po awarii i wyeliminuj krytyczne luki dzięki ClickUp Brain — kontekstowemu asystentowi opartemu na sztucznej inteligencji, który rozumie całą Twoją przestrzeń roboczą. W przeciwieństwie do ogólnych narzędzi opartych na sztucznej inteligencji, ClickUp Brain wykorzystuje rzeczywiste zadania, dokumenty i cykle pracy Twojej organizacji, aby zapewnić precyzyjne i praktyczne wsparcie dla inicjatyw związanych z odzyskiwaniem danych po awarii.
Wystarczy wpisać w ClickUp Brain polecenie typu: „Utwórz listę kontrolną odzyskiwania danych po awarii dla naszej platformy e-commerce”, a natychmiast otrzymasz kompleksowy, dostosowany do Twoich potrzeb szablon, który jest zgodny z Twoimi systemami, procesami i wymogami zgodności. Pomoże Ci to w:
- Świadomość kontekstowa: ClickUp Brain ma dostęp do struktury, zawartości i uprawnień Twojego obszaru roboczego. Może odwoływać się do zadań, dokumentów, komentarzy, a nawet połączonych aplikacji, dostarczając odpowiedzi i działania dostosowane do Twojej rzeczywistej pracy — a nie tylko ogólne sugestie.
- Rozwiązywanie problemów i wskazówki: Natychmiast rozwiązuj problemy, uzyskaj instrukcje krok po kroku lub zapytaj o najlepsze praktyki dotyczące dowolnej funkcji ClickUp. Brain przeprowadzi Cię przez złożone procesy, zautomatyzuje powtarzalne zadania i pomoże rozwiązać przeszkody.
- Automatyzacja i przyspieszenie cyklu pracy: Korzystaj z gotowych lub niestandardowych agentów AI, aby zautomatyzować wieloetapowe cykle pracy, klasyfikować zgłoszenia lub zarządzać powtarzającymi się zadaniami — oszczędzając w ten sposób wiele godzin tygodniowo
- Wyszukiwanie dogłębne: Znajdź informacje ukryte w dowolnym miejscu w Twoim obszarze roboczym, w tym zadania, dokumenty i zintegrowane narzędzia, nawet jeśli są one sprzed lat lub trudno je zlokalizować za pomocą standardowej wyszukiwarki.
- Podsumowania i aktualizacje w czasie rzeczywistym: Natychmiast generuj aktualizacje dotyczące projektów, podsumowania spotkań lub raporty z postępów, korzystając z danych z obszaru roboczego na żywo
- Uproszczenie dokumentacji technicznej: Przekształć skomplikowane dokumenty techniczne w jasne, praktyczne procedury lub listy kontrolne, z których Twój zespół będzie mógł korzystać nawet w sytuacjach stresowych
- Wielomodelowa inteligencja: Wybieraj spośród wiodących modeli AI (OpenAI GPT-4.1, GPT-5, Claude, Gemini i inne), aby uzyskać najlepsze wyniki w każdym zadaniu — bez konieczności wykupywania oddzielnych subskrypcji
- Bezpieczeństwo i uwzględnienie uprawnień: Brain uzyskuje dostęp wyłącznie do informacji, do których masz już uprawnienia, zachowując rygorystyczne standardy prywatności i zgodności z przepisami
- Interfejs konwersacyjny: Używaj @brain w komentarzach lub czacie, aby uzyskać informacje kontekstowe, tworzyć szkice odpowiedzi lub być wyzwalaczem automatyzacji bez przerywania cyklu pracy.
- Niestandardowe podpowiedzi i zapisane cykle pracy: zapisuj i ponownie wykorzystuj podpowiedzi w przypadku powtarzających się zadań, zapewniając spójność i oszczędzając czas całego zespołu
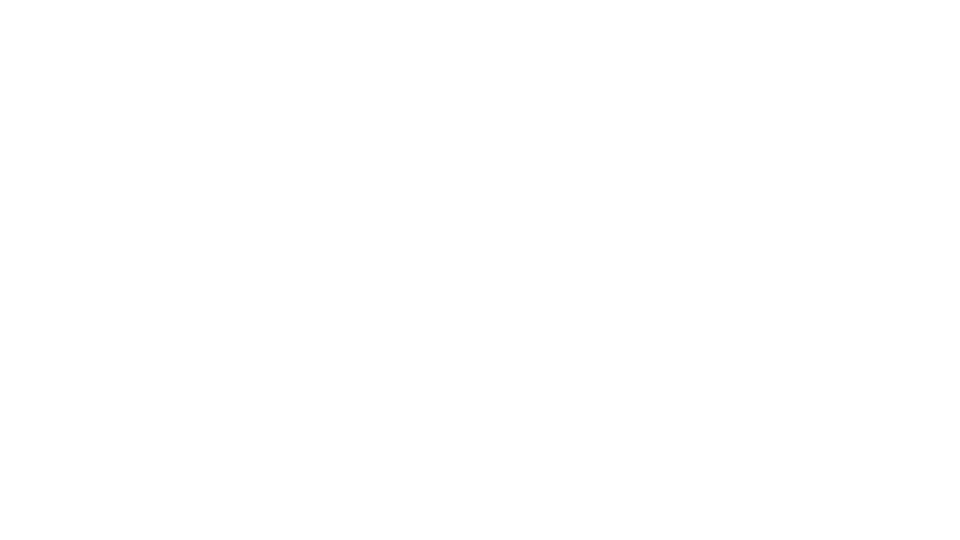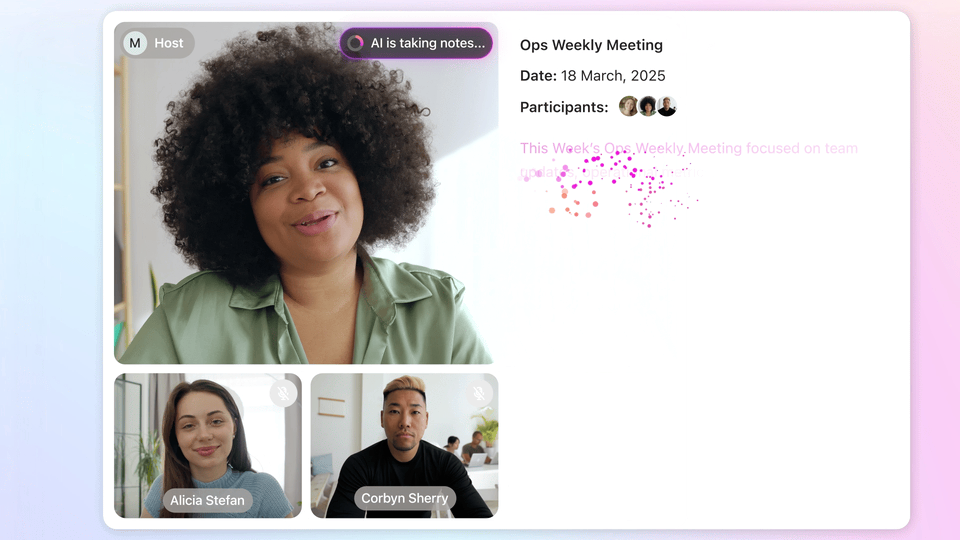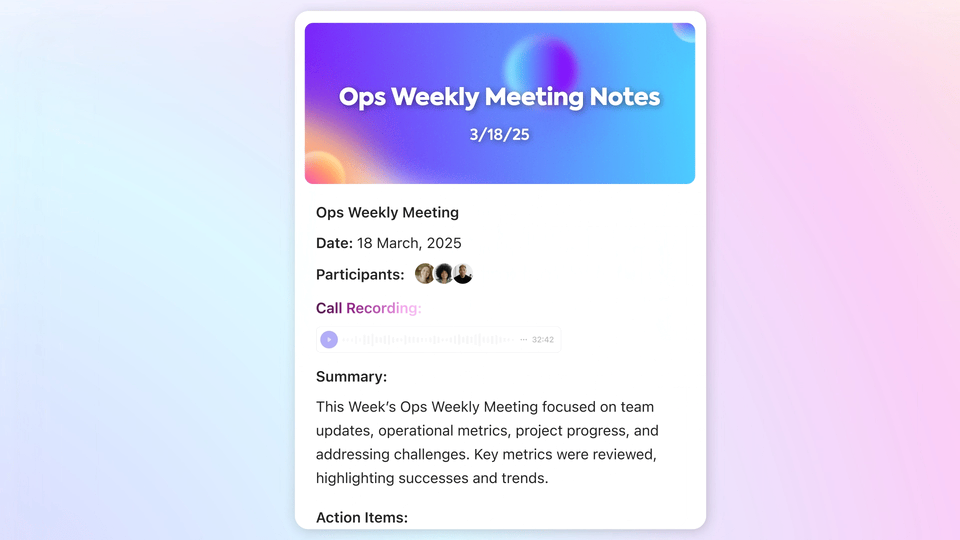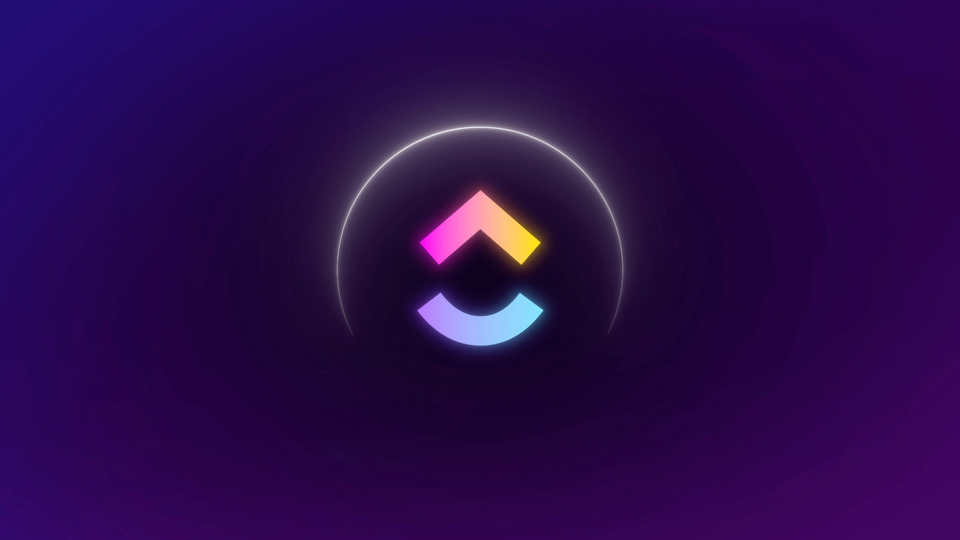
💡Wskazówka dla profesjonalistów: Nigdy nie przegap żadnej lekcji płynącej ze spotkań poświęconych analizie incydentów – rejestruj każdy szczegół za pomocą narzędzia ClickUp AI Notetaker. Narzędzie to może dołączać do Twoich wirtualnych spotkań, transkrybować całą dyskusję i automatycznie generować listę elementów wynikających z wyciągniętych wniosków. W ten sposób tworzona jest historia incydentów z możliwością wyszukiwania, dzięki czemu możesz szybko odwołać się do przeszłych wydarzeń i sposobów ich rozwiązania.
Zautomatyzowane cykle pracy odzyskiwania danych dzięki automatyzacjom ClickUp
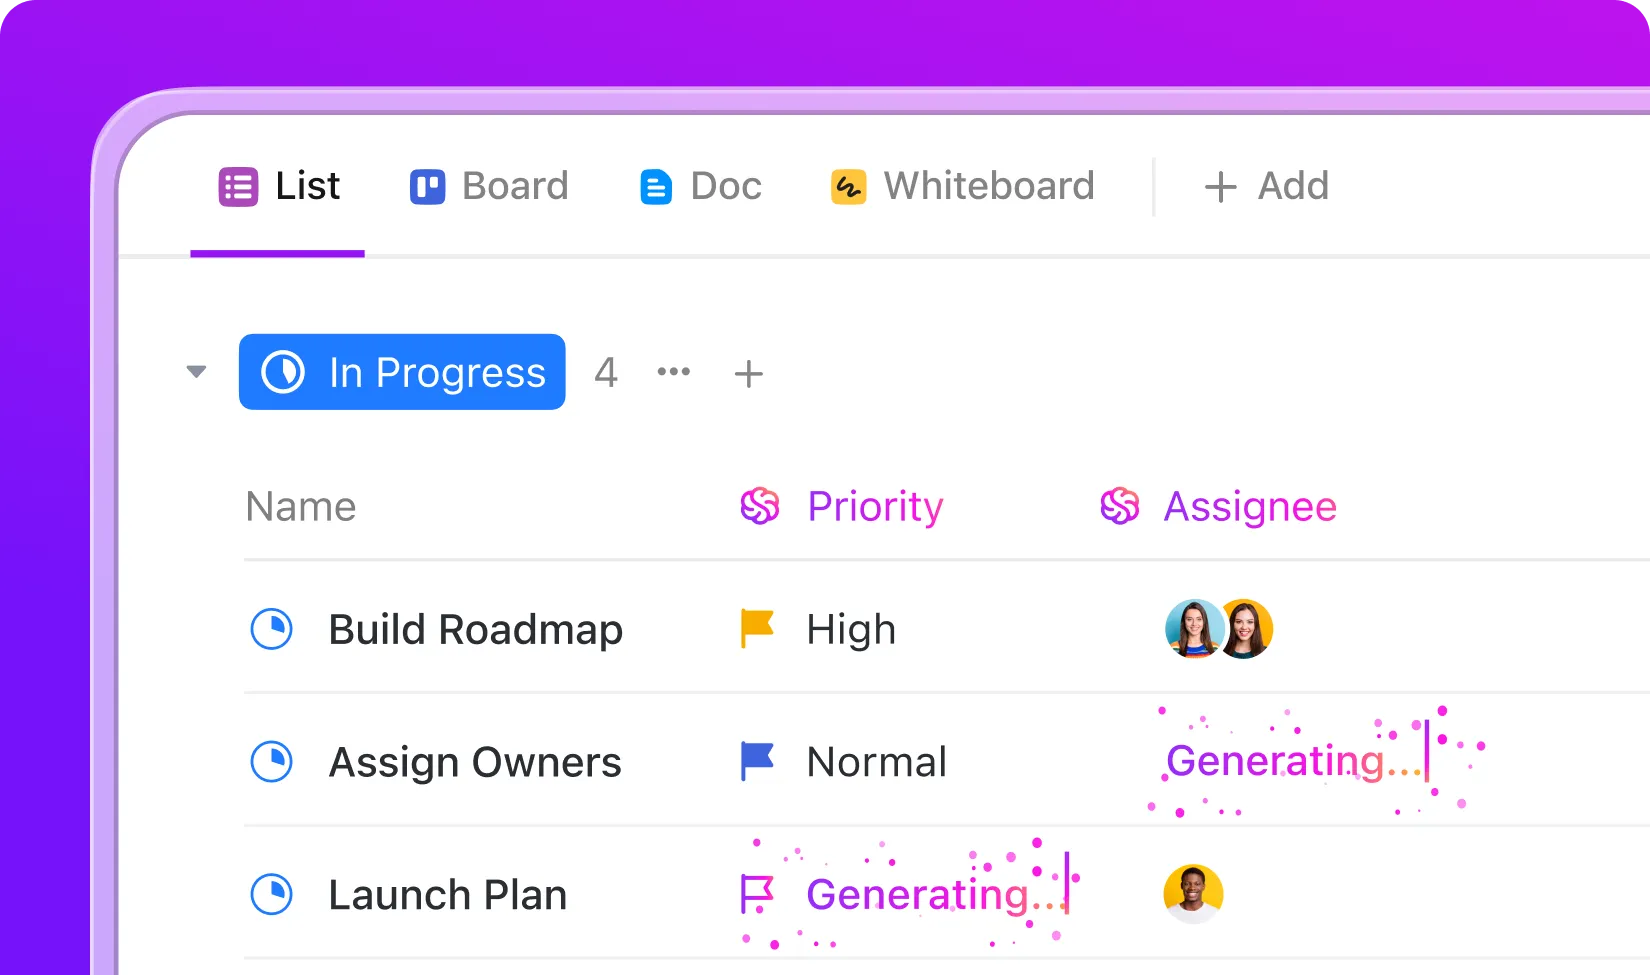
Wyobraź sobie, że Twój zespół stoi w obliczu nagłej awarii — liczy się każda sekunda i nie możesz sobie pozwolić na pominięcie ani jednego kroku. Dzięki agentom AI i automatyzacjom ClickUp nie musisz działać w pośpiechu ani polegać na pamięci. Gdy tylko zgłoszony zostanie incydent, sztuczna inteligencja ClickUp natychmiast wkracza do akcji, kierując działaniami Twojego zespołu i zajmując się rutynowymi zadaniami, dzięki czemu możesz skupić się na rozwiązaniu problemu.
Oto jak to wygląda w praktyce:
- Gdy ktoś oznaczy zadanie jako „Zgłoszono incydent”, ClickUp Agent automatycznie tworzy listę kontrolną kroków reagowania, przypisuje je odpowiednim osobom i uruchamia timer, aby śledzić, ile czasu zajmuje przywrócenie sprawności.
- Jeśli incydent zostanie oznaczony jako „krytyczny”, agent może natychmiast wysłać e-mail z alertem do kierownictwa i utworzyć specjalny pokój czatu — tzw. „centrum dowodzenia” — dzięki czemu wszyscy będą mogli komunikować się w jednym miejscu.
- AI może wyświetlać raporty z poprzednich incydentów oraz odpowiednią dokumentację, dzięki czemu Twój zespół ma wszystko, czego potrzebuje, na wyciągnięcie ręki
Zobacz cykl pracy tutaj:
Dzięki agentom ClickUp AI zyskujesz niezawodnego cyfrowego współpracownika, który pomaga Twojemu zespołowi zachować spokój, porządek i skuteczność — nawet w sytuacjach pod presją.
Śledzenie w czasie rzeczywistym dzięki pulpitom nawigacyjnym ClickUp
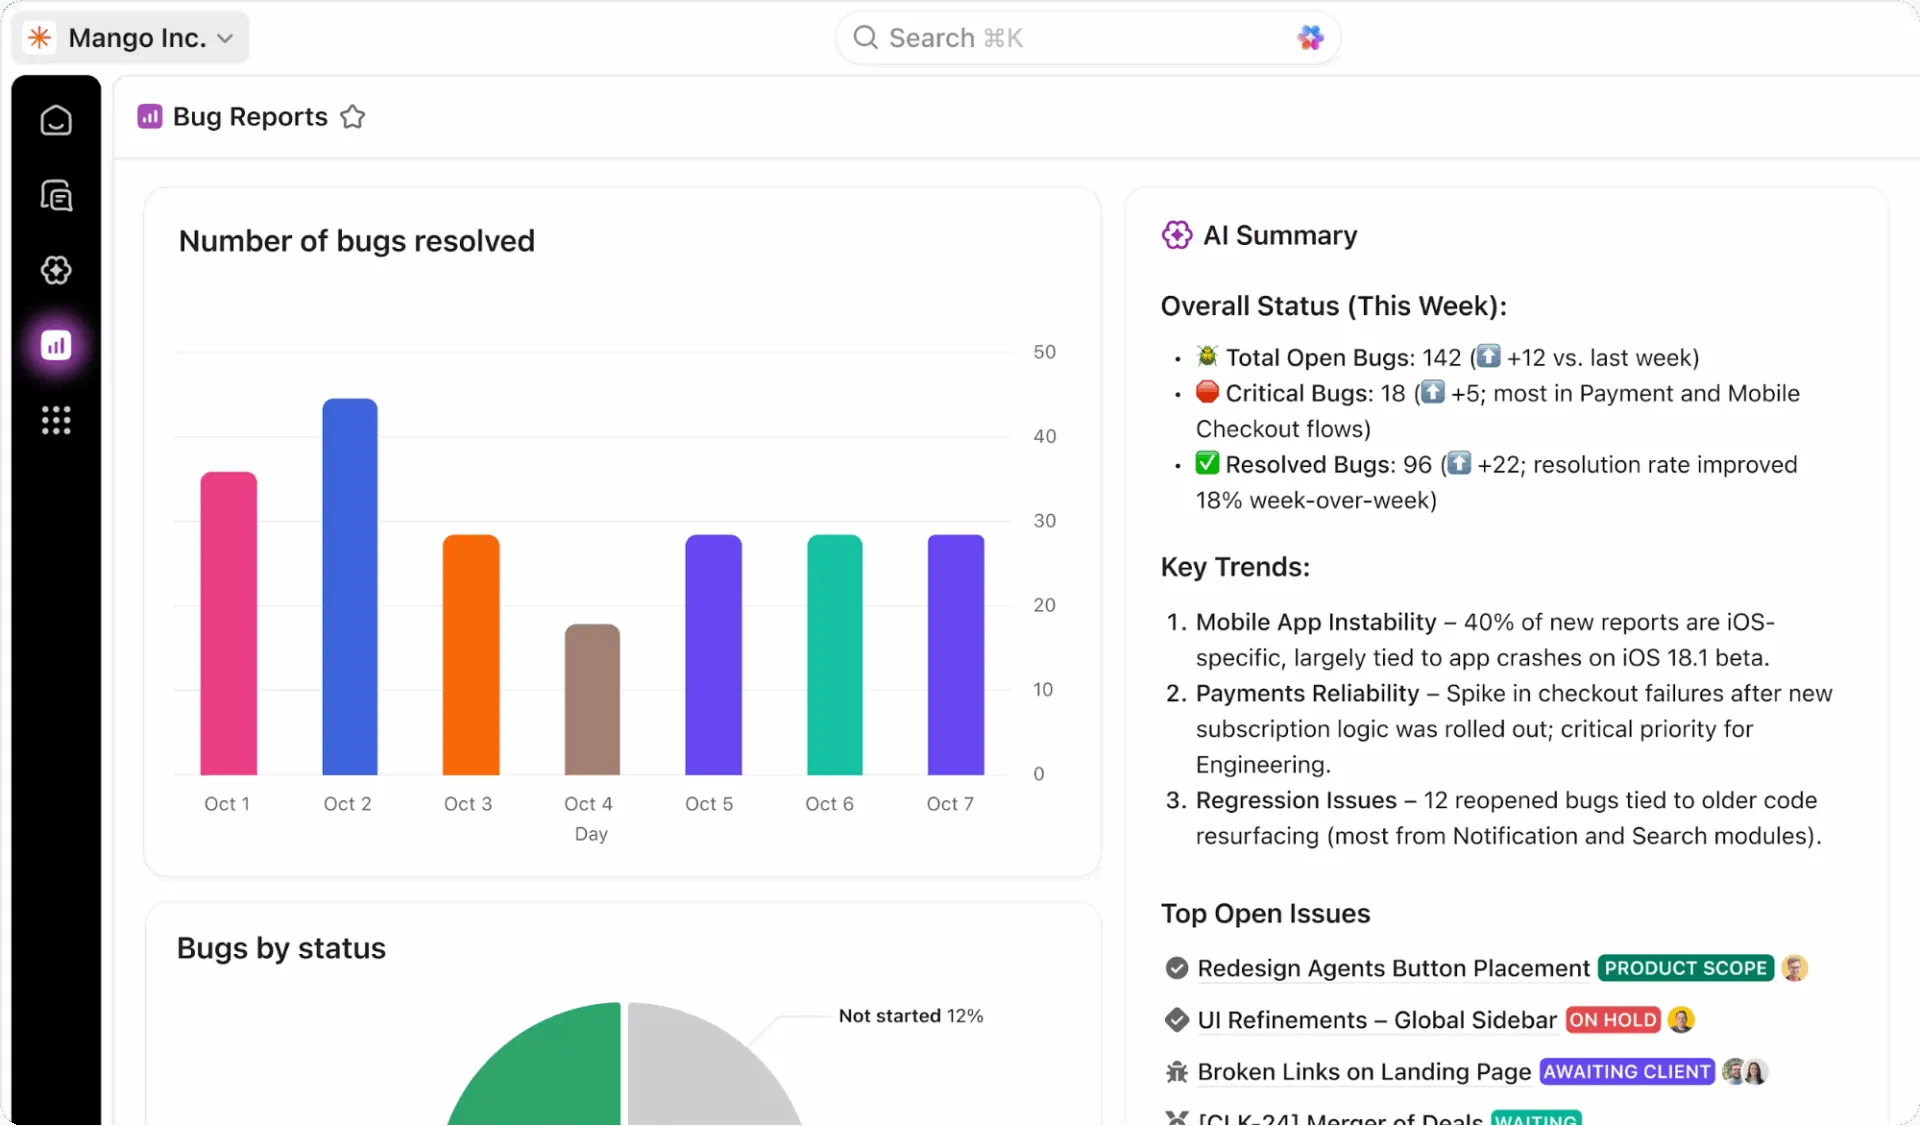
Zyskaj pełny wgląd w stan swojego programu odzyskiwania po awarii, śledząc wszystko w czasie rzeczywistym dzięki pulpitom nawigacyjnym ClickUp. Możesz tworzyć widżety do monitorowania wyników RTO i RPO podczas testów, śledzić wskaźniki ukończenia testów oraz przeglądać trendy dotyczące incydentów w czasie.
Dodaj pola niestandardowe ClickUp do swoich zadań, aby śledzić krytyczność systemu, status przywracania i wyniki testów, a następnie zgromadź wszystkie te dane w jednym widoku ogólnym. Te pulpity nawigacyjne zapewniają gotowe do przedstawienia kierownictwu raporty, które są zawsze aktualne dzięki danym w czasie rzeczywistym pochodzącym z testów i działań zespołu związanych z reagowaniem na incydenty.
📖 Czytaj więcej: Jak stworzyć listę kontrolną do oceny ryzyka
Opracuj swój plan odzyskiwania danych już dziś
Każdy dzień działalności bez planu odtworzenia po awarii to ryzyko, na które nie możesz sobie pozwolić. Katastrofy są nieuniknione — niezależnie od tego, czy wynikają z sił natury, awarii technicznych czy błędów ludzkich — ale to właśnie Twoje przygotowanie decyduje o tym, czy staną się one drobnymi niedogodnościami, czy poważnymi katastrofami.
Kompleksowy plan odzyskiwania danych po awarii wymaga zrozumienia ryzyka, udokumentowania jasnych procedur oraz ich regularnego testowania. Odpowiednie narzędzia ułatwiają zarządzanie tym procesem, eliminując chaos związany z rozproszonymi dokumentami i ręcznymi procesami.
Nawet podstawowe plany awaryjne są lepsze niż brak jakiegokolwiek planu w razie wystąpienia awarii. Regularne testy i aktualizacje sprawią, że Twój plan odzyskiwania danych po awarii przestanie być tylko zakurzonym dokumentem, a stanie się funkcjonującym systemem, który naprawdę chroni Twoją firmę.
Zrób pierwszy krok i już dziś zacznij tworzyć swój plan odzyskiwania danych po awarii (DR) z ClickUp. Zacznij korzystać z ClickUp za darmo i zgromadź wszystkie swoje plany odzyskiwania danych po awarii, dokumentację oraz procedury reagowania na incydenty na jednej, ujednoliconej platformie. ✨
Najczęściej zadawane pytania
Jak często zespoły powinny aktualizować szablon planu odzyskiwania danych po awarii IT?
Plan odzyskiwania danych po awarii należy weryfikować co najmniej cztery razy w roku i aktualizować go natychmiast po wprowadzeniu istotnych zmian w infrastrukturze lub wystąpieniu rzeczywistych incydentów. Większość organizacji przeprowadza raz w roku gruntowną, dogłębną weryfikację planu, aby uwzględnić wszystkie zdobyte doświadczenia i dostosować się do nowych technologii.
Które zespoły są odpowiedzialne za dokumentację i testowanie procedur odzyskiwania danych po awarii?
Za planowanie i testowanie odzyskiwania po awarii zazwyczaj odpowiadają zespoły IT, zespoły ds. bezpieczeństwa oraz osoby odpowiedzialne za planowanie ciągłości działania. Potrzebują one jednak kluczowych informacji od kierownictwa działów operacyjnych i jednostek biznesowych, aby zapewnić zgodność planu z rzeczywistymi potrzebami i priorytetami biznesowymi.
Jak śledzimy wskaźniki RTO i RPO podczas testów odzyskiwania danych po awarii?
Podczas każdego testu używaj stoperów i wyraźnych oznaczeń czasowych, aby zmierzyć rzeczywisty czas przywrócenia w porównaniu z określonymi celami. Bardzo ważne jest, aby w raportach z testów dokumentować wszelkie rozbieżności między wynikami docelowymi a rzeczywistymi, co pozwoli ukierunkować przyszłe działania usprawniające.
Jakie narzędzia pomagają w dokumentowaniu i automatyzacji planu przywracania sprawności po awarii?
Platformy do zarządzania projektami, takie jak ClickUp, idealnie nadają się do centralizacji dokumentacji, automatyzacji cykli pracy oraz śledzenia wskaźników dla całego programu odzyskiwania po awarii. Można je następnie połączyć ze specjalistycznymi narzędziami do odzyskiwania po awarii, które zajmują się technicznymi aspektami replikacji danych i przełączania awaryjnego systemów.