Vous publiez la dernière mise à jour logicielle, et les rapports affluent.
Tout à coup, un seul indicateur régit tout, de la satisfaction client (CSAT) et du NPS aux retards dans la feuille de route : le temps de résolution des bugs.
Pour les dirigeants, il s’agit d’un indicateur permettant de vérifier que les engagements sont tenus : sommes-nous capables de livrer, d’apprendre et de protéger notre chiffre d’affaires dans les délais prévus ? Sur le terrain, les praticiens sont confrontés à des difficultés concrètes : tickets en double, propriété floue, escalades superflues et informations dispersées entre Slack, des feuilles de calcul et divers outils.
Cette fragmentation allonge les cycles, masque les causes profondes et transforme la hiérarchisation des priorités en une véritable loterie.
Le résultat ? Un apprentissage ralenti, des validations non effectuées et un backlog qui pèse discrètement sur chaque sprint.
Ce guide est votre référentiel complet pour mesurer, comparer et réduire le temps de résolution des bugs. Il vous montre concrètement comment l'IA transforme le flux de travail par rapport aux processus manuels traditionnels.
Qu'est-ce que le délai de résolution des bugs ?
Le délai de résolution d'un bug correspond au temps nécessaire pour corriger un bug, mesuré depuis le moment où le bug est signalé jusqu'à sa résolution complète.
Concrètement, le chronomètre démarre lorsqu’un problème est signalé ou détecté (par les utilisateurs, l’assurance qualité ou la surveillance) et s’arrête lorsque le correctif est implémenté et fusionné, prêt à être soumis à la vérification ou mis en production — selon la manière dont votre équipe définit la notion de « terminé ».
Exemple : un plantage de priorité 1 signalé Monday à 10 h, dont le correctif a été fusionné mardi à 15 h, présente un délai de résolution d'environ 29 heures.
Ce n’est pas la même chose que le temps de détection des bogues. Le temps de détection mesure la rapidité avec laquelle vous identifiez un défaut après son apparition (déclenchement d’alarmes, détection par les outils de test d’assurance qualité, rapports des clients).
Le délai de résolution mesure la rapidité avec laquelle vous passez de la prise de connaissance du problème à sa résolution : triage, reproduction, diagnostic, mise en œuvre, vérification, test et préparation à la mise en production. Considérez la détection comme le moment où « on sait que ça ne fonctionne pas », et la résolution comme le moment où « c’est réparé et prêt ».
Les équipes utilisent des critères légèrement différents ; choisissez-en un et restez cohérent afin que vos tendances soient fiables :
- Signalé → Résolu : Le processus prend fin lorsque la correction du code est fusionnée et prête pour le contrôle qualité. Idéal pour le rendement de l'ingénierie
- Signalé → Fermé : Comprend la validation par l'assurance qualité et la mise en production. Idéal pour les SLA ayant un impact sur les clients
- Détecté → Résolu : Le processus démarre dès que la surveillance ou l'assurance qualité détecte le problème, avant même qu'un ticket ne soit créé. Utile pour les équipes travaillant en production intensive.
🧠 Anecdote : Un bug farfelu mais hilarant dans Final Fantasy XIV a été salué pour son caractère si spécifique que les lecteurs l’ont surnommé « la correction de bug la plus spécifique dans un MMO de 2025 ». » Il se manifestait lorsque les joueurs fixaient le prix d’éléments entre exactement 44 442 gils et 49 087 gils dans une zone d’évènement particulière, provoquant des déconnexions dues à ce qui pourrait être un bug de dépassement de capacité des nombres entiers.
Pourquoi est-ce important ?
Le délai de résolution est un levier de la cadence de publication. Des délais longs ou imprévisibles imposent des réductions de périmètre, des correctifs d'urgence et des gels de publication ; ils génèrent une dette de planification, car la « longue traîne » (les valeurs aberrantes) perturbe davantage les sprints que ne le laisse supposer la moyenne.
Cela est également directement lié à la satisfaction client. Les clients acceptent les problèmes lorsqu’ils sont rapidement pris en compte et résolus de manière prévisible. Des corrections lentes — ou pire encore, irrégulières — entraînent des escalades, nuisent au CSAT et au NPS, et mettent en péril les renouvellements.
En résumé, si vous mesurez précisément le temps de résolution des bugs et que vous le réduisez de manière systématique, vos feuilles de route et vos relations s'en trouveront améliorées.
📖 En savoir plus : Comment hiérarchiser les bugs pour une résolution efficace des problèmes
Comment mesurer le temps de résolution des bugs ?
Commencez par déterminer à quel moment le chronomètre démarre et s'arrête.
La plupart des équipes choisissent soit « Signalé → Résolu » (la correction est fusionnée et prête à être soumise à la vérification), soit « Signalé → Fermé » (le service d'assurance qualité a validé la modification et celle-ci est déployée ou clôturée d'une autre manière).
Choisissez une définition et utilisez-la de manière cohérente afin que vos tendances soient pertinentes.
Vous avez désormais besoin d’indicateurs observables. Passons-les en revue :
Indicateurs clés à surveiller en matière de suivi des bugs :
| 📊 Indicateur | 📌 Ce que cela signifie | 💡 En quoi cela vous aide-t-il ? | 🧮 Formule (le cas échéant) |
|---|---|---|---|
| Nombre de bugs 🐞 | Nombre total de bugs signalés | Affiche une vue d'ensemble de la santé du système. Un nombre élevé ? Il est temps d'enquêter. | Nombre total de bogues = Tous les bogues enregistrés dans le système {ouverts + fermés} |
| Bugs ouverts 🚧 | Bugs qui n'ont pas encore été corrigés | Affiche la charge de travail actuelle. Facilite la hiérarchisation des priorités. | Bugs ouverts = Nombre total de bugs - Bugs fermés |
| Bugs fermés ✅ | Bugs résolus et vérifiés | Suivi de l'avancement et du travail terminé. | Bug fermés = Nombre de bugs dont le statut est « Fermé » ou « Résolu » |
| Gravité des bugs 🔥 | Gravité du bug (par exemple : critique, majeure, mineure) | Facilite le triage en fonction de l'impact. | Suivi en tant que champ catégoriel, sans formule. Utilisez des filtres/regroupements. |
| Priorité des bugs 📅 | Urgence de la correction d'un bug | Facilite la planification des sprints et des mises en production. | Il s'agit également d'un champ catégoriel, généralement classé par niveau de priorité (par exemple, P0, P1, P2). |
| Délai de résolution ⏱️ | Délai entre le signalement d'un bug et sa correction | Mesure la réactivité. | Temps de résolution = date fermée - date de rapports |
| Taux de réouverture 🔄 | Pourcentage de bugs rouverts après avoir été fermés | Reflète la qualité des corrections ou les problèmes de régression. | Taux de réouverture (%) = {Bugs rouverts ÷ Nombre total de bugs fermés} × 100 |
| Fuites de bugs 🕳️ | Les bugs qui se sont glissés dans l'environnement de production | Indique l'efficacité de l'assurance qualité et des tests logiciels. | Taux de fuite (%) = {Bugs en production ÷ Nombre total de bugs} × 100 |
| Densité des défauts 🧮 | Nombre de bogues par unité de taille de code | Mets en évidence les zones de code présentant un risque élevé. | Densité des défauts = Nombre de bugs ÷ KLOC {kilo-lignes de code} |
| Bug attribués vs bug non attribués 👥 | Distribution des bugs par propriété | Assurez-vous qu'aucun bug ne passe entre les mailles du filet. | Utilisez un filtre : Non attribués = Bogues dont le champ « Attribué à » est vide |
| Ancienneté des bugs ouverts 🧓 | Combien de temps un bug reste-t-il non résolu ? | Identifie les risques de stagnation et d'accumulation des tâches en attente. | Ancienneté du bug = date du jour - date de signalement |
| Bugs en double 🧬 | Nombre de rapports en double | Mets en évidence les erreurs dans les processus de prise en charge. | Taux de doublons = Nombre de doublons ÷ Nombre total de bugs × 100 |
| MTTD (temps moyen de détection) 🔎 | Temps moyen nécessaire pour détecter les bugs ou les incidents | Mesure l’efficacité de la surveillance et de la sensibilisation. | MTTD = Σ(Heure de détection - Heure d'apparition) ÷ Nombre de bugs |
| MTTR (temps moyen de résolution) 🔧 | Délai moyen nécessaire pour corriger entièrement un bug après sa détection | Permet de suivre la réactivité des équipes d'ingénierie et le temps de correction. | MTTR = Σ(Temps de résolution - Temps de détection) ÷ Nombre de bugs résolus |
| MTTA (temps moyen de prise en compte) 📬 | Délai entre la détection du bug et le moment où quelqu'un commence à y travailler | Montre la réactivité de l'équipe et la rapidité de réponse aux alertes. | MTTA = Σ(Heure de prise en compte - Heure de détection) ÷ Nombre de bugs |
| MTBF (temps moyen entre deux pannes) 🔁 | Délai entre la résolution d'une défaillance et l'apparition de la suivante | Indique la stabilité au fil du temps. | MTBF = Temps de disponibilité total ÷ Nombre de pannes |
⚡️ Archives de modèles : 15 modèles et formulaires gratuits de rapports de bogues pour le suivi des bogues
Facteurs influençant le délai de résolution des bugs
Le délai de résolution est souvent assimilé à « la rapidité avec laquelle les ingénieurs codent ».
Mais ce n'est qu'une partie du processus.
Le délai de résolution des bugs résulte de la qualité de la prise en charge initiale, de l'efficacité du flux au sein de votre système et du risque lié aux dépendances. Lorsque l'un de ces éléments fait défaut, la durée du cycle s'allonge, la prévisibilité diminue et les réclamations se multiplient.
La qualité de la prise en charge donne le ton
Les rapports qui parviennent sans étapes de reproduction claires, sans détails sur l'environnement, sans journaux ni informations sur la version ou la build entraînent des allers-retours supplémentaires. Les rapports en double provenant de plusieurs canaux (assistance, assurance qualité, surveillance, Slack) génèrent du bruit et fragmentent la propriété.
Plus vous identifiez tôt le contexte approprié — et éliminez les doublons —, moins vous aurez besoin de transferts de dossiers et de demandes de précisions par la suite.
La hiérarchisation et l'acheminement déterminent qui traite le bug et à quel moment
Les libellés de gravité qui ne correspondent pas à l’impact sur les clients ou l’activité (ou qui évoluent avec le temps) entraînent une perturbation des files d’attente : les tickets les plus bruyants passent devant les autres, tandis que les défauts à fort impact restent en attente.
Des règles de routage claires par composant/propriétaire et une file d’attente unique et fiable empêchent le travail P0/P1 d’être noyé sous les « travaux récent et bruyants ».
La propriété et les transferts de tâches sont des « tueurs silencieux »
Si l’on ne sait pas clairement si un bug relève de l’équipe mobile, de l’authentification backend ou de l’équipe de la plateforme, il est renvoyé d’une équipe à l’autre. Chaque renvoi réinitialise le contexte.
Les fuseaux horaires aggravent encore la situation : un bug signalé en fin de journée sans propriétaire désigné peut passer 12 à 24 heures avant que quiconque ne commence même à le reproduire. Des définitions précises de « qui est propriétaire de quoi », avec un propriétaire désigné (DRI) de garde ou hebdomadaire, permettent d'éliminer ce décalage.
La reproductibilité dépend de l'observabilité
Des journaux incomplets, des identifiants de corrélation manquants ou l’absence de traces de plantage transforment le diagnostic en une simple conjecture. Les bugs qui n’apparaissent qu’avec des indicateurs, des locataires ou des formes de données spécifiques sont difficiles à reproduire en environnement de développement.
Si les ingénieurs ne peuvent pas accéder en toute sécurité à des données anonymisées similaires à celles de production, ils finissent par devoir mettre en place des outils de surveillance, redéployer les applications et attendre — des jours au lieu de quelques heures.
La parité des environnements et des données vous garantit l'intégrité
« Ça marche sur ma machine » signifie généralement « les données de production sont différentes ». Plus vos environnements de développement et de préproduction s’écartent de la production (configuration, services, versions des logiciels tiers), plus vous passerez de temps à courir après des fantômes. Les instantanés de données sécurisés, les scripts d’initialisation et les contrôles de parité permettent de réduire cet écart.
Les travaux en cours (WIP) et la concentration déterminent le débit réel
Les équipes surchargées traitent trop de bugs à la fois, dispersent leur attention et passent sans cesse d’une tâche à l’autre et d’une réunion à l’autre. Ces changements de contexte ajoutent des heures de travail invisibles.
Une limite visible du travail en cours (WIP) et une tendance à terminer ce qui a été commencé avant d'entamer une nouvelle tâche feront baisser votre médiane plus rapidement que n'importe quel effort héroïque isolé.
La révision du code, l’intégration continue (CI) et la rapidité des contrôles qualité (QA) constituent des goulots d’étranglement classiques
Des temps de compilation trop longs, des tests instables et des SLA de révision flous ralentissent des corrections qui, autrement, seraient rapides. Un correctif de 10 minutes peut passer deux jours à attendre un réviseur ou à s'insérer dans un pipeline pouvant durer plusieurs heures.
De même, les files d’attente d’assurance qualité qui regroupent les tests par lots ou s’appuient sur des tests de validation manuels peuvent ajouter des journées entières au délai « Signalé → Fermé », même lorsque le délai « Signalé → Résolu » est rapide.
Les dépendances allongent les files d'attente
Les changements impliquant plusieurs équipes (schémas, migrations de plateformes, mises à jour des SDK), les bugs des fournisseurs ou les examens par les boutiques d’applications (mobile) génèrent des temps d’attente. Sans suivi explicite des statuts « Bloqué/En pause », ces temps d’attente gonflent de manière invisible vos moyennes et masquent l’emplacement réel du goulot d’étranglement.
Le modèle de déploiement et la stratégie de retour en arrière ont leur importance
Si vous effectuez des livraisons par « release trains » volumineux avec des points de contrôle manuels, même les bugs résolus restent en attente jusqu’au départ du train suivant. Les Feature Flags, les déploiements « canary » et les voies de correctifs (hotfix lanes) raccourcissent le délai de résolution — en particulier pour les incidents P0/P1 — en vous permettant de dissocier le déploiement des correctifs des cycles de livraison complets.
L'architecture et la dette technique constituent vos limites
Le couplage étroit, l’absence de points de test et l’opacité des modules hérités rendent les corrections simples risquées. Les équipes compensent cela par des tests supplémentaires et des revues plus longues, ce qui allonge les cycles. À l’inverse, un code modulaire accompagné de tests de contrat efficaces vous permet d’avancer rapidement sans perturber les systèmes adjacents.
La communication et la bonne gestion des statuts influencent la prévisibilité
Les mises à jour vagues (« nous examinons le problème ») entraînent un surcroît de travail lorsque les parties prenantes demandent des délais d'exécution, que l'assistance rouvre des tickets ou que le produit est remonté à un niveau supérieur. Des transitions de statut claires, des notes sur la reproduction et la cause première, ainsi qu'un délai d'exécution affiché réduisent le taux de désabonnement et permettent à votre équipe d'ingénieurs de rester concentrée sur ses tâches.
📮ClickUp Insight : Un professionnel passe en moyenne plus de 30 minutes par jour à rechercher des informations liées à son travail, soit plus de 120 heures par an perdues à fouiller dans ses e-mails, ses fils de discussion Slack et ses fichiers éparpillés.
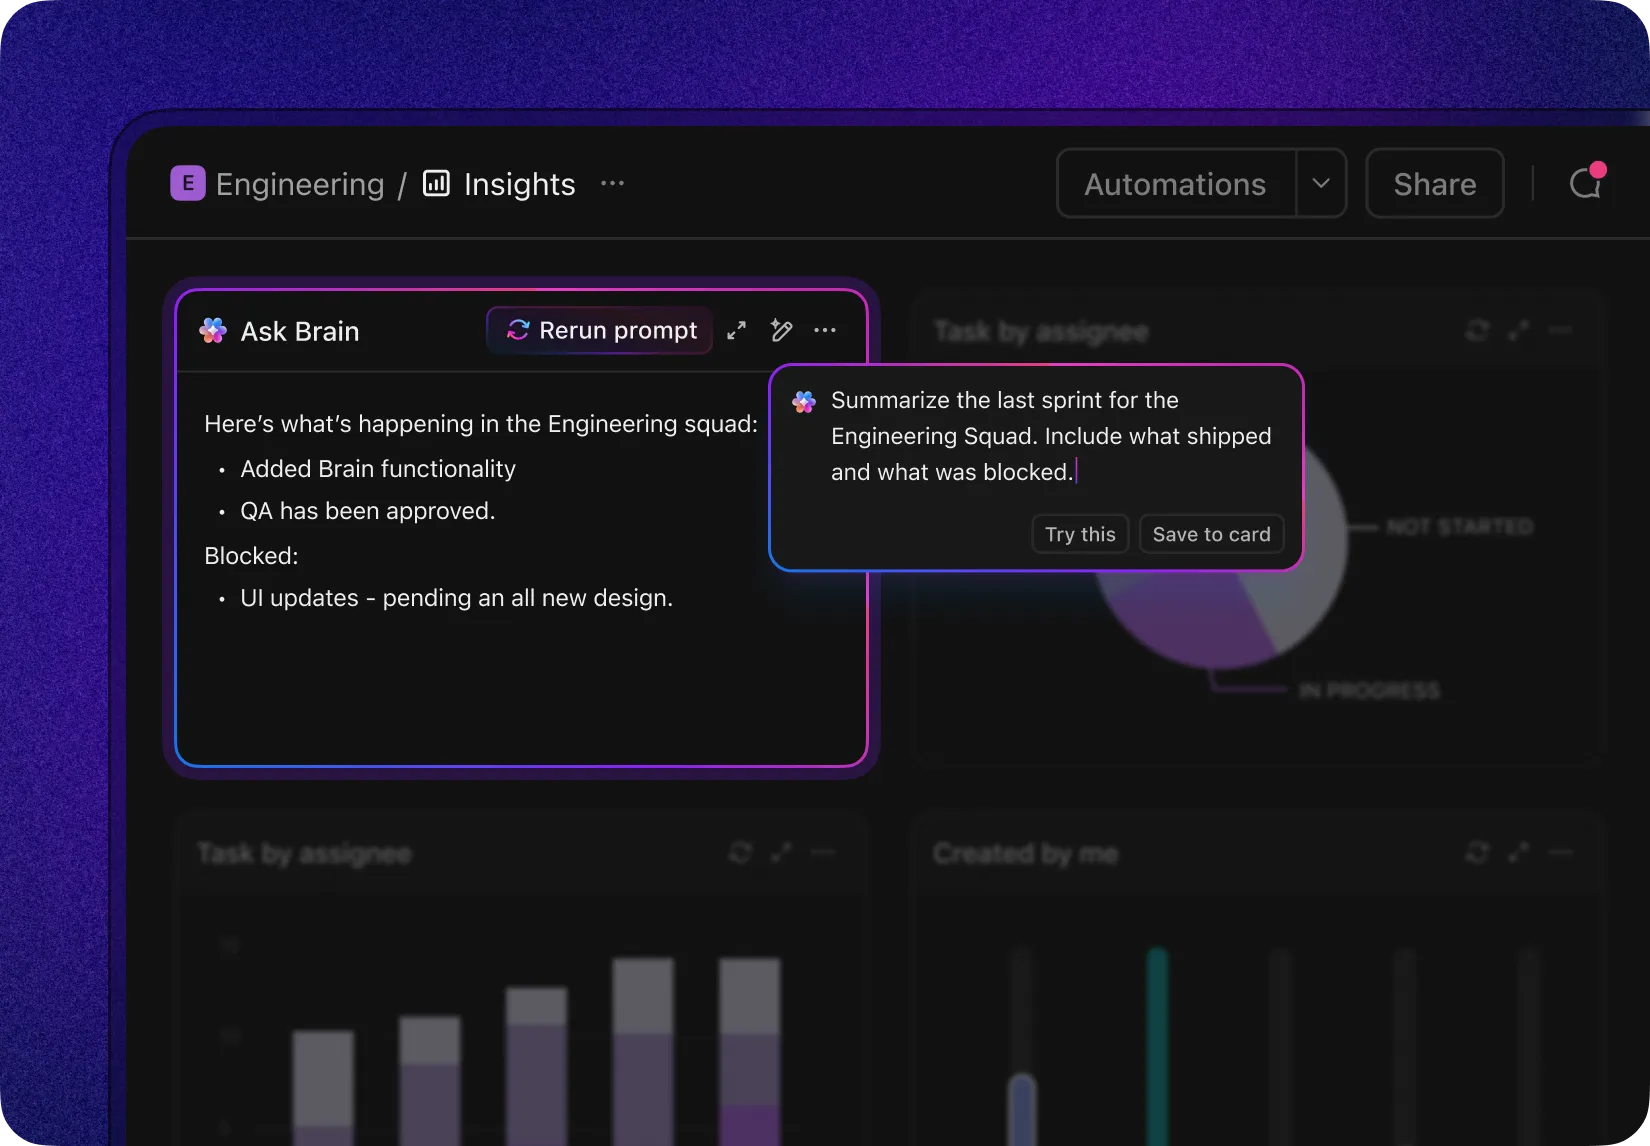
Un assistant IA intelligent intégré à votre environnement de travail peut changer la donne. Découvrez ClickUp Brain. Il fournit des informations et des réponses instantanées en mettant en avant les bons documents, discussions et détails de tâches en quelques secondes, pour que vous puissiez arrêter de chercher et vous mettre au travail.
💫 Résultats concrets : Des équipes comme celle de QubicaAMF ont regagné plus de 5 heures par semaine grâce à ClickUp — soit plus de 250 heures par an et par personne — en éliminant les processus obsolètes de gestion des connaissances. Imaginez ce que votre équipe pourrait accomplir avec une semaine de productivité supplémentaire chaque trimestre !
Indicateurs avancés annonçant un allongement de votre délai de production
❗️Allongement du « délai de prise en compte » et nombreux tickets sans propriétaire pendant plus de 12 heures
❗️Augmentation des tranches de « temps de révision/CI » et instabilité fréquente des tests
❗️Taux élevé de doublons lors de la saisie et incohérence des libellés de gravité entre les équipes
❗️Plusieurs bugs se trouvent dans l’état « Bloqué » sans dépendance externe identifiée
❗️Le taux de réouverture augmente progressivement (les corrections ne sont pas reproductibles ou les critères de « terminé » sont flous)
Ces facteurs sont perçus différemment selon les organisations. Les dirigeants les considèrent comme des cycles d’apprentissage manqués et des retards par rapport aux opportunités de chiffre d’affaires ; les opérateurs les perçoivent comme du bruit dans le triage et un manque de clarté quant à la propriété.
C'est en optimisant la réception des tickets, le flux et les dépendances que vous parviendrez à faire baisser l'ensemble de la courbe, tant la médiane que le P90.
Vous souhaitez en savoir plus sur la rédaction de rapports de bogues plus efficaces? Commencez par ici. 👇🏼
📖 En savoir plus : Le cycle de vie des tests logiciels (STLC) : aperçu et phases
Références du secteur concernant le délai de résolution des bugs
Les références en matière de résolution des bugs varient en fonction de la tolérance au risque, du modèle de déploiement et de la rapidité avec laquelle vous pouvez mettre en production les modifications.
C'est ici que vous pouvez utiliser les médianes (P50) pour comprendre votre flux type et la P90 pour définir des engagements et des SLA, en fonction de la gravité et de la source (client, assurance qualité, surveillance).
Voyons en détail ce que cela signifie :
| 🔑 Terme | 📝 Description | 💡 Pourquoi est-ce important ? |
|---|---|---|
| P50 (médiane) | La valeur médiane : 50 % des corrections de bugs sont plus rapides que cela, et 50 % sont plus lentes. | 👉 Reflète votre temps de résolution habituel ou le plus courant. Utile pour comprendre les performances normales |
| P90 (90e centile) | 90 % des bugs sont corrigés dans ce délai. Seuls 10 % prennent plus de temps. | 👉 Représente une limite correspondant au pire scénario (mais qui reste réaliste). Utile pour définir des paramètres d'engagement vis-à-vis de l'extérieur. |
| SLA (accords de niveau de service) | Les engagements que vous prenez — en interne ou auprès de vos clients — concernant la rapidité avec laquelle les problèmes seront traités | 👉 Exemple : « Nous résolvons les bugs P1 dans les 48 heures, dans 90 % des cas. » Cela contribue à instaurer la confiance et à renforcer la responsabilité. |
| Par gravité et par source | Segmentez vos indicateurs selon deux dimensions clés : • Gravité (par ex. P0, P1, P2) • Source (par ex. client, assurance qualité, surveillance) | 👉 Permet un suivi et une hiérarchisation plus précis, afin que les bugs critiques soient traités plus rapidement |
Vous trouverez ci-dessous des intervalles indicatifs basés sur les secteurs d’activité que les équipes expérimentées ciblent souvent ; considérez-les comme des intervalles de départ, puis adaptez-les à votre contexte.
SaaS
Le système étant toujours actif et compatible avec les pratiques CI/CD, les correctifs sont fréquents. Pour les problèmes critiques (P0/P1), l’objectif est souvent d’atteindre une médiane inférieure à une journée ouvrée, avec un P90 compris entre 24 et 48 heures. Les problèmes non critiques (P2+) ont généralement une médiane de 3 à 7 jours, avec un P90 compris entre 10 et 14 jours. Les équipes disposant de Feature Flags robustes et de tests automatisés ont tendance à se situer dans la fourchette la plus rapide.
Plateformes de commerce électronique
Les flux de conversion et de panier étant essentiels au chiffre d’affaires, les exigences sont plus élevées. Les problèmes de priorité P0/P1 sont généralement atténués en quelques heures (restauration, signalement ou configuration) et entièrement résolus le jour même ; il est courant que le P90 soit résolu avant la fin de la journée ou en moins de 12 heures en période de forte activité. Les problèmes de priorité P2+ sont souvent résolus en 2 à 5 jours, avec un P90 inférieur à 10 jours.
Logiciels d'entreprise
Des validations plus poussées et des fenêtres de changement plus longues pour les clients ralentissent le rythme. Pour les bogues P0/P1, les équipes visent une solution de contournement dans un délai de 4 à 24 heures et une correction dans un délai de 1 à 3 jours ouvrés ; pour le P90, dans un délai de 5 jours ouvrés. Les éléments P2+ sont souvent regroupés dans des trains de déploiement, avec des durées médianes de 2 à 4 semaines selon les calendriers de déploiement des clients.
Jeux vidéo et applications mobiles
Les backends des services en ligne fonctionnent comme des solutions SaaS (activation de drapeaux et retours en arrière en quelques minutes à quelques heures ; P90 le jour même). Les mises à jour côté client sont soumises aux procédures de validation : les incidents P0/P1 font souvent appel immédiatement à des leviers côté serveur et un correctif client est déployé sous 1 à 3 jours ; P90 sous une semaine avec une validation accélérée. Les corrections P2+ sont généralement programmées pour le sprint suivant ou la prochaine mise à jour de contenu.
Banque/Fintech
Les contrôles de risque et de conformité favorisent une approche « atténuer rapidement, modifier avec prudence ». Les bogues P0/P1 sont atténués rapidement (signalements, retours en arrière, redirection du trafic en quelques minutes à quelques heures) et entièrement corrigés en 1 à 3 jours ; les bogues P90 le sont en une semaine, en tenant compte du contrôle des modifications. Les bogues P2+ nécessitent souvent 2 à 6 semaines pour passer les examens de sécurité, d’audit et du comité d’autorisation des changements (CAB).
Si vos nombres se situent en dehors de ces intervalles, examinez la qualité de la saisie des tickets, l'acheminement et la propriété des tickets, le débit des revues de code et des contrôles qualité, ainsi que les validations des dépendances avant de conclure que la « vitesse d'ingénierie » est le problème principal.
🌼 Le saviez-vous ? Selon un sondage Stack Overflow réalisé en 2024, les développeurs recouraient de plus en plus à l’IA comme fidèle alliée tout au long de leur parcours de développement. Pas moins de 82 % d’entre eux utilisaient l’IA pour écrire du code — on peut dire que c’est un collaborateur créatif ! Lorsqu’ils étaient bloqués ou à la recherche de solutions, 67,5 % comptaient sur l’IA pour trouver des réponses, et plus de la moitié (56,7 %) s’appuyaient sur elle pour déboguer et obtenir de l’aide.
Pour certains, les outils d’IA se sont également révélés utiles pour documenter des projets (40,1 %) et même générer des données ou du contenu synthétiques (34,8 %). Vous souhaitez en savoir plus sur une nouvelle base de code ? Près d’un tiers (30,9 %) utilise l’IA pour se mettre rapidement à niveau. Le test de code reste une tâche manuelle fastidieuse pour beaucoup, mais 27,2 % ont également adopté l’IA dans ce domaine. D’autres domaines, tels que la révision de code, la planification de projet et l’analyse prédictive, affichent un taux d’adoption de l’IA plus faible, mais il est clair que l’IA s’intègre progressivement à chaque étape du développement logiciel.
📖 En savoir plus : Comment utiliser l'IA pour l'assurance qualité
Comment réduire le temps de résolution des bugs
La rapidité de résolution des bugs repose sur l'élimination des frictions à chaque étape du processus, de la réception à la mise en production.
Les gains les plus importants proviennent d’une gestion plus intelligente des 30 premières minutes (saisie claire, propriétaire adéquat, priorité appropriée), puis d’une réduction des boucles qui suivent (reproduction, examen, vérification).
Voici neuf stratégies qui fonctionnent ensemble comme un système cohérent. L'IA accélère chaque étape, et le flux de travail est centralisé en un seul endroit, ce qui garantit une prévisibilité aux dirigeants et une fluidité aux praticiens.
1. Centralisez la saisie des tickets et recueillez le contexte à la source
Le temps de résolution des bugs s'allonge lorsque vous devez reconstituer le contexte à partir de fils de discussion Slack, de tickets d'assistance et de feuilles de calcul. Canalisez tous les rapports (assistance, assurance qualité, surveillance) vers une file d'attente unique grâce à un modèle structuré qui recueille les informations suivantes : composant, gravité, environnement, version/build de l'application, étapes de reproduction, résultats attendus vs réels, et pièces jointes (journaux/HAR/captures d'écran).
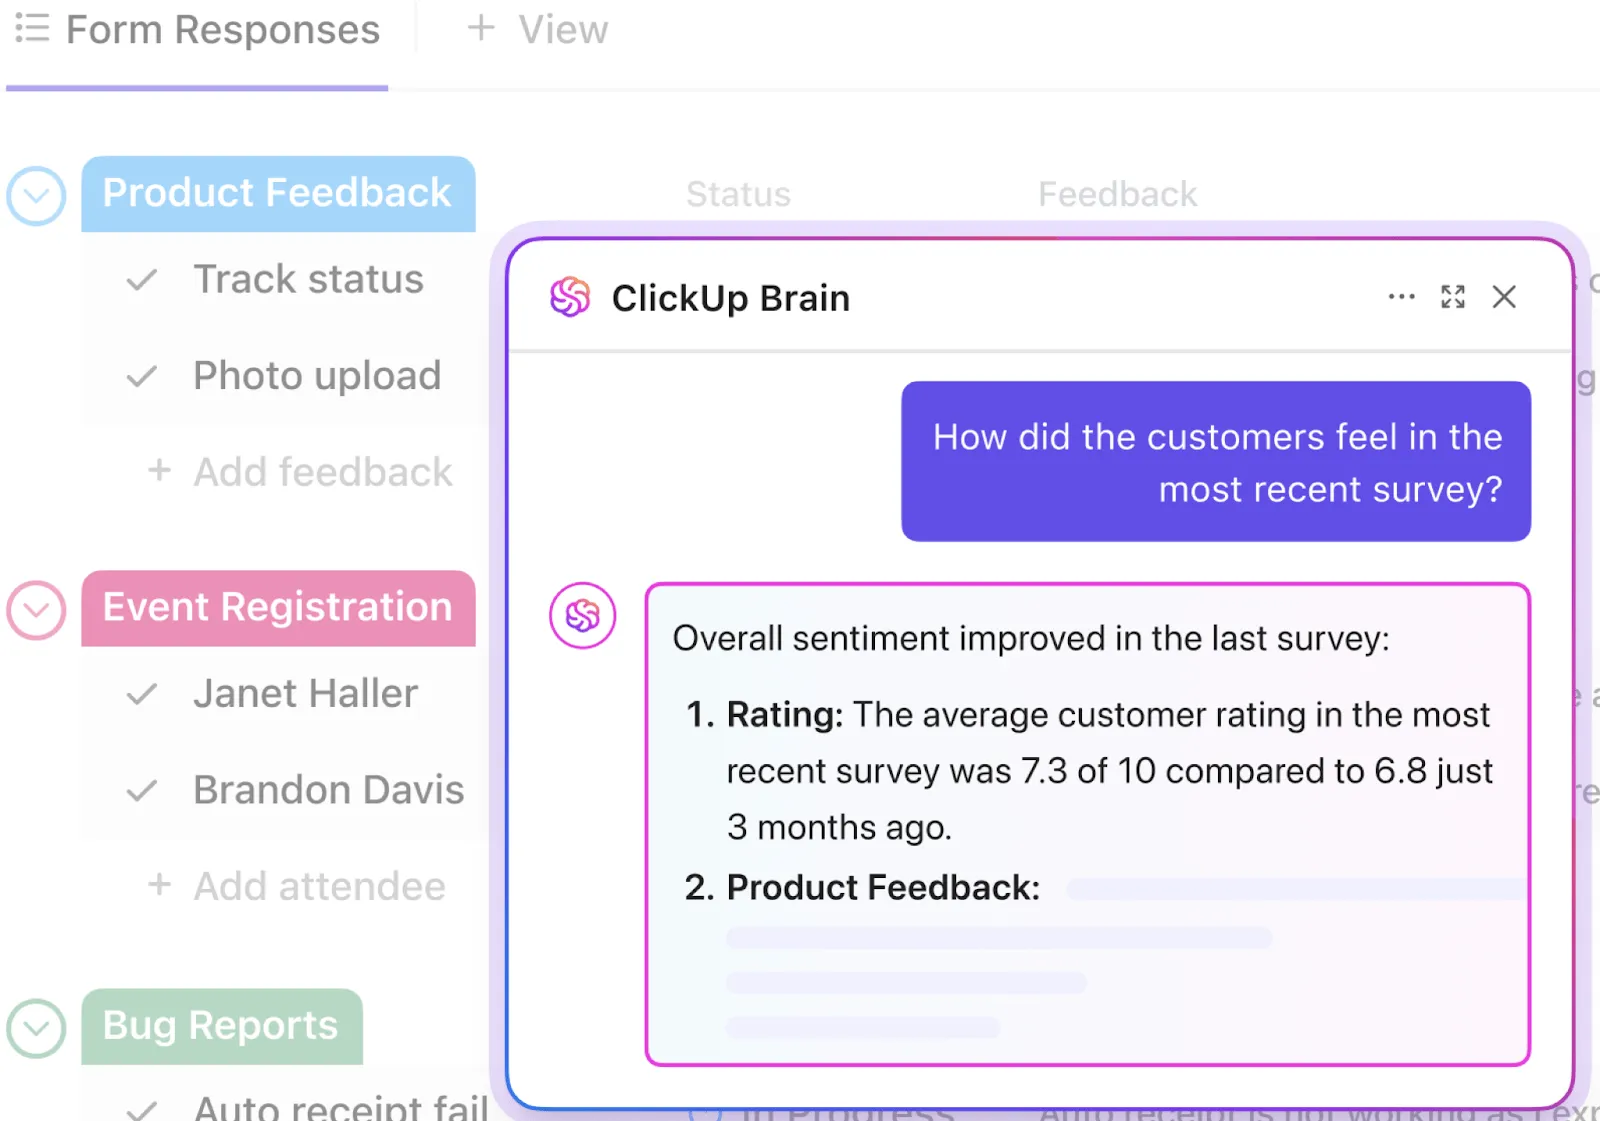
L'IA peut résumer automatiquement les longs rapports, extraire les étapes de reproduction et les détails de l'environnement à partir des pièces jointes, et signaler les doublons potentiels afin que le triage puisse démarrer à partir d'un dossier cohérent et enrichi.
Indicateurs à surveiller : MTTA (réponse en quelques minutes, et non en quelques heures), taux de doublons, délai « Information requise ».
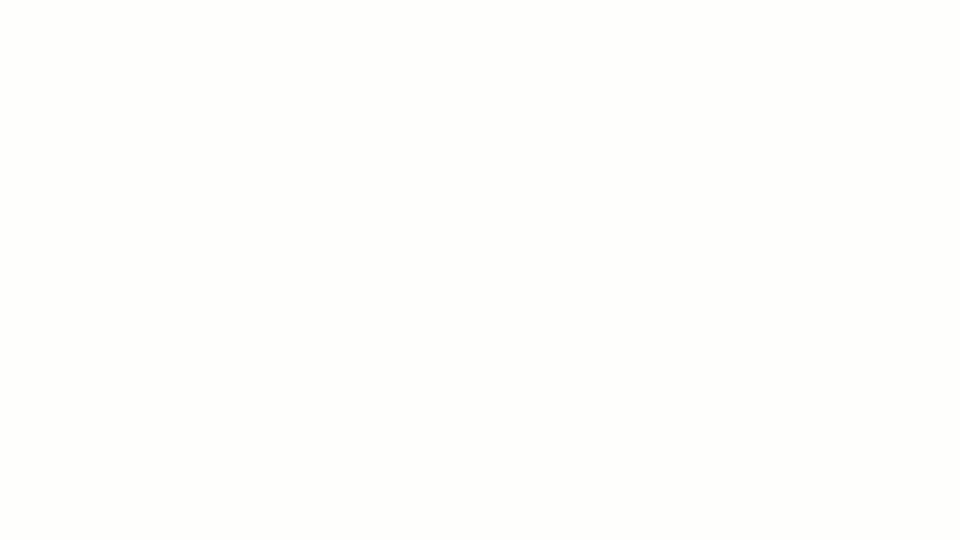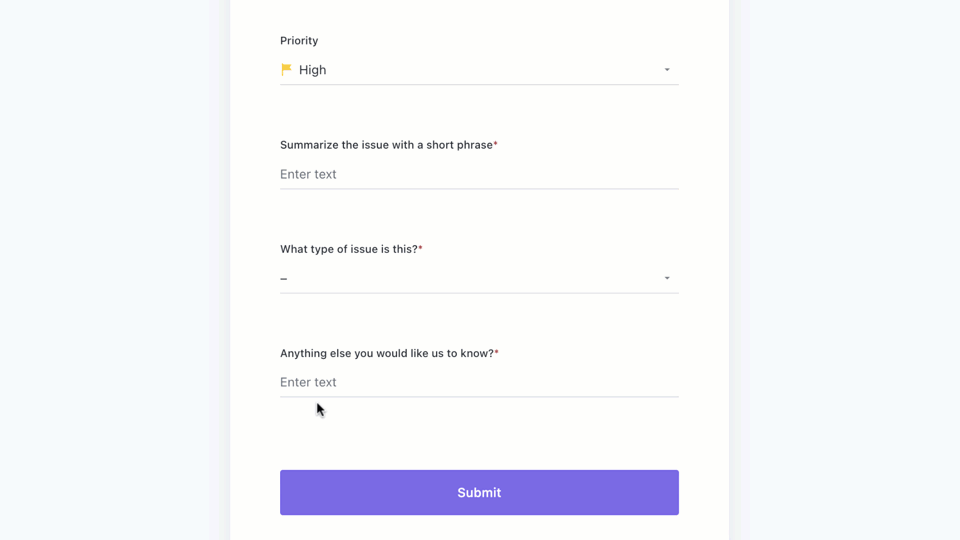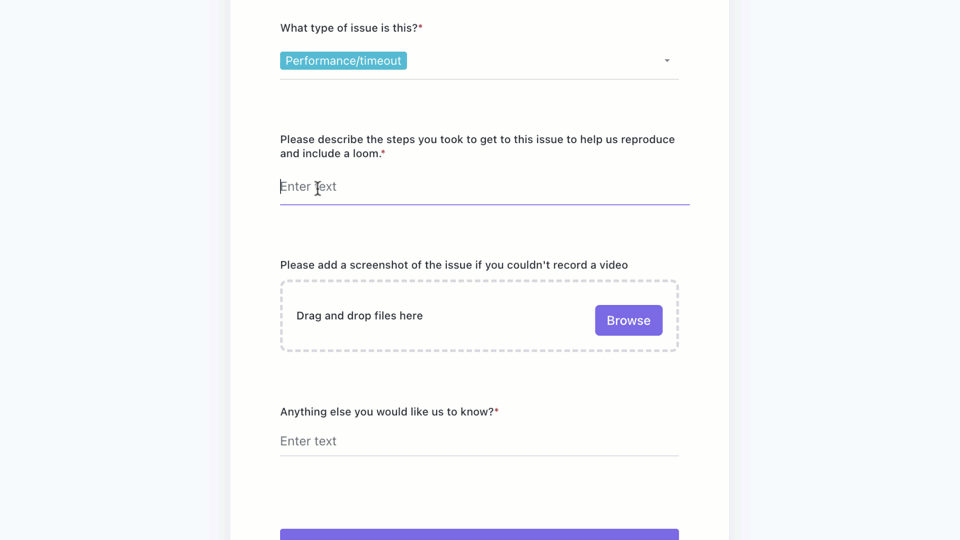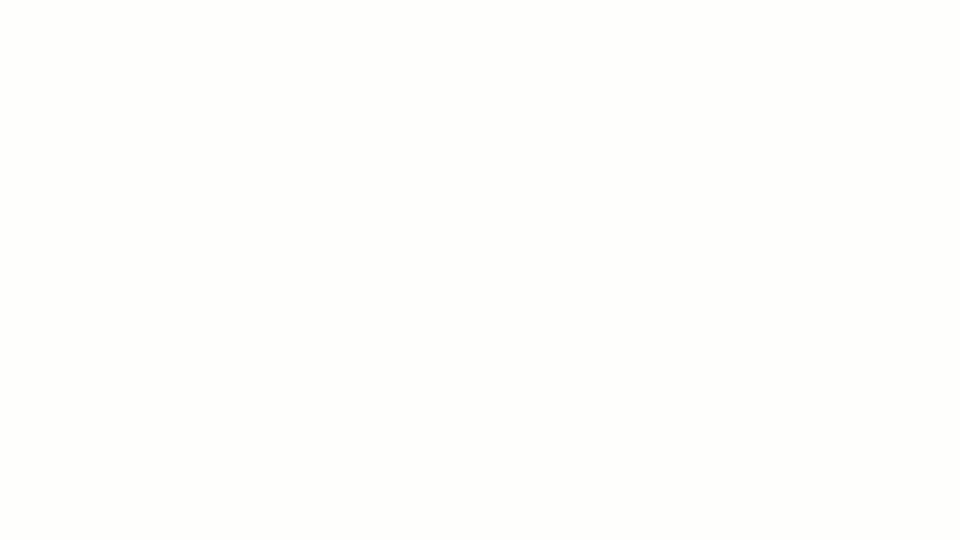
📖 En savoir plus : La puissance des formulaires ClickUp : rationaliser le travail des équipes logicielles
2. Triage et acheminement assistés par l'IA pour réduire considérablement le MTTA
Les corrections les plus rapides sont celles qui parviennent immédiatement au bon interlocuteur.
Utilisez des règles simples associées à l’IA pour classer les bogues par niveau de gravité, identifier les propriétaires potentiels par composant ou zone de code, et attribuer automatiquement les bogues avec un compte à rebours SLA. Définissez clairement les couloirs de traitement pour les bogues P0/P1 par rapport à tout le reste, et établissez sans ambiguïté qui est le propriétaire de quoi.
Les automatisations permettent de définir la priorité à partir des champs, d’acheminer les tickets vers une équipe en fonction du composant concerné, de déclencher un chronomètre SLA et d’alerter un ingénieur de garde ; l’IA peut proposer un niveau de gravité et désigner un propriétaire en fonction des tendances passées. Lorsque le triage se résume à une étape de 2 à 5 minutes au lieu d’un débat de 30 minutes, votre MTTA diminue et votre MTTR suit la même tendance.
Indicateurs à surveiller : MTTA, qualité de la première réponse (le premier commentaire demande-t-il les bonnes informations ?), nombre de transferts par bug.
Voici à quoi cela ressemble en pratique :
3. Établissez des priorités en fonction de l’impact sur l’activité grâce à des niveaux de SLA clairement définis
Le principe selon lequel « c’est la voix la plus forte qui l’emporte » rend les files d’attente imprévisibles et sape la confiance des dirigeants, qui surveillent de près les indices CSAT/NPS et les renouvellements.
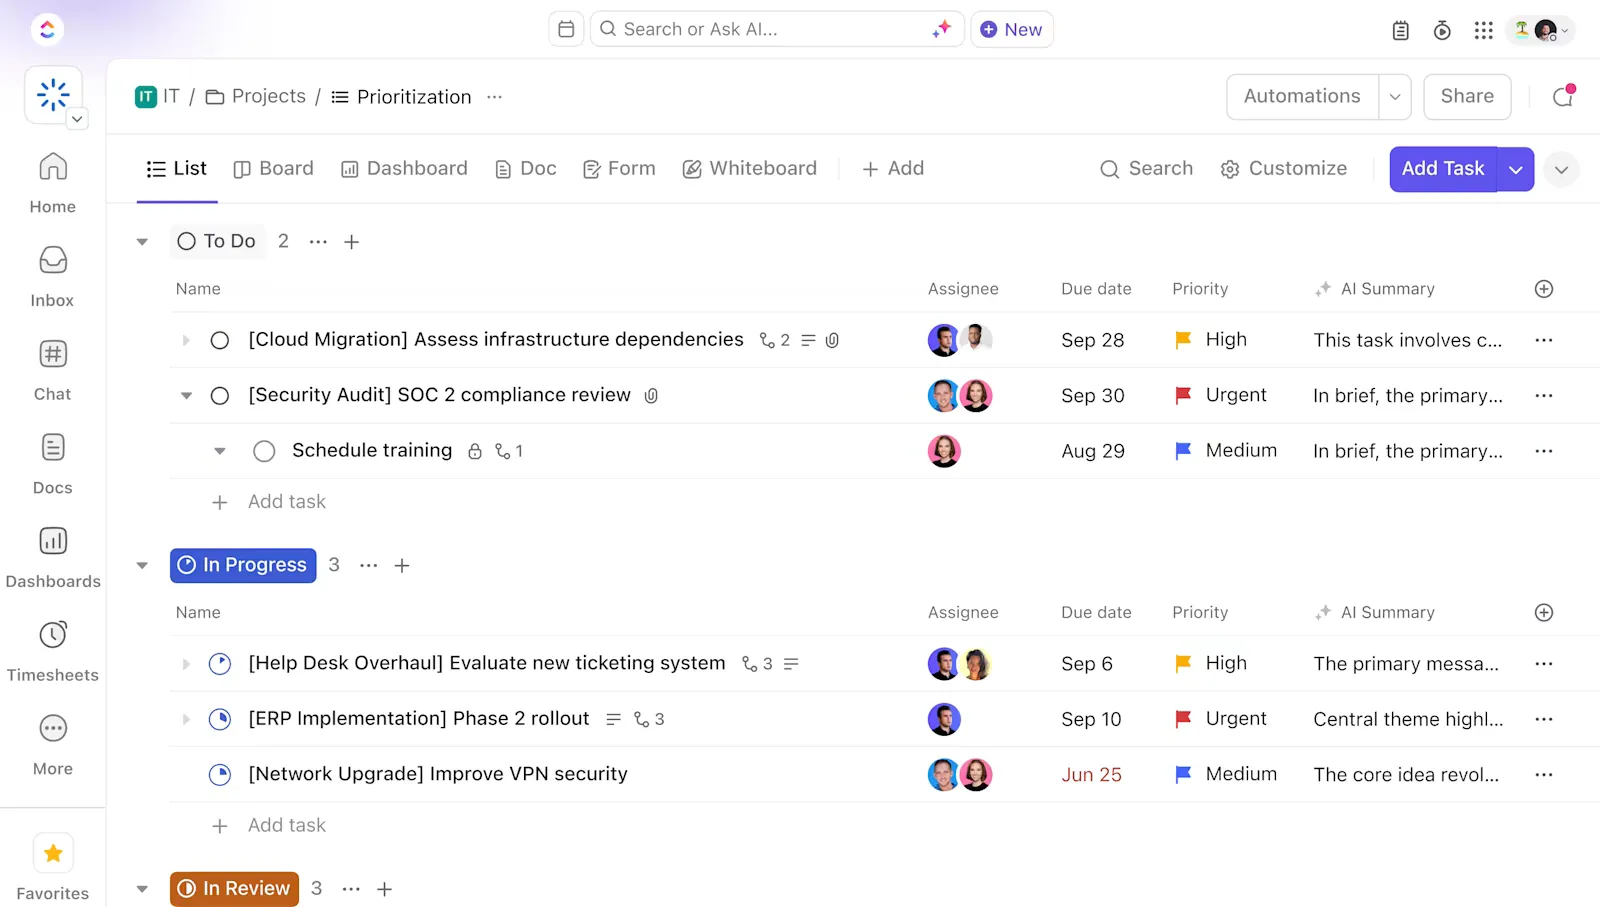
Remplacez cela par un score qui combine la gravité, la fréquence, l’ARR affecté, la criticité de la fonctionnalité et la proximité des renouvellements/lancements, et étayez-le par des niveaux de SLA (par exemple, P0 : atténuation en 1 à 2 heures, résolution dans la journée ; P1 : le jour même ; P2 : au cours d’un sprint).
Maintenez une file d'attente P0/P1 avec des limites de travail en cours (WIP) afin qu'aucune tâche ne soit négligée.
Indicateurs à surveiller : résolution P50/P90 par niveau, taux de non-respect des SLA, corrélation avec le CSAT/NPS.
💡Conseil de pro : les champs « Priorités des tâches », « Champs personnalisés » et « Dépendances » de ClickUp vous permettent de calculer un score d’impact et de lier les bugs à des comptes, des retours d’expérience ou des éléments de la feuille de route ; de plus, les « Objectifs » de ClickUp vous aident à associer le respect des SLA aux objectifs de l’entreprise, ce qui répond directement aux préoccupations de la direction en matière d’alignement.
4. Faites de la reproduction et du diagnostic une activité en une seule étape
Chaque demande supplémentaire du type « Pouvez-vous m'envoyer les journaux ? » allonge le délai de résolution.
Standardisez ce que l’on entend par « correct » : champs obligatoires pour la compilation/la validation, l’environnement, les étapes de reproduction, les résultats attendus par rapport aux résultats réels, ainsi que les pièces jointes pour les journaux, les vidages mémoire et les fichiers HAR. Mettez en place une télémétrie client/serveur afin que les identifiants de plantage et de requête puissent être associés aux traces.
Intégrez Sentry (ou un outil similaire) pour obtenir les traces de pile et liez directement ce problème au bug. L’IA peut analyser les journaux et les traces pour proposer un domaine de défaillance probable et générer un scénario de reproduction minimal, transformant ainsi une heure d’examen minutieux en quelques minutes de travail ciblé.
Enregistrez des guides d'intervention pour les catégories courantes de bugs afin que les ingénieurs n'aient pas à repartir de zéro.
Indicateurs à surveiller : temps passé en « attente d'informations », pourcentage de bugs reproduits dès le premier essai, taux de réouverture lié à l'absence de reproduction.
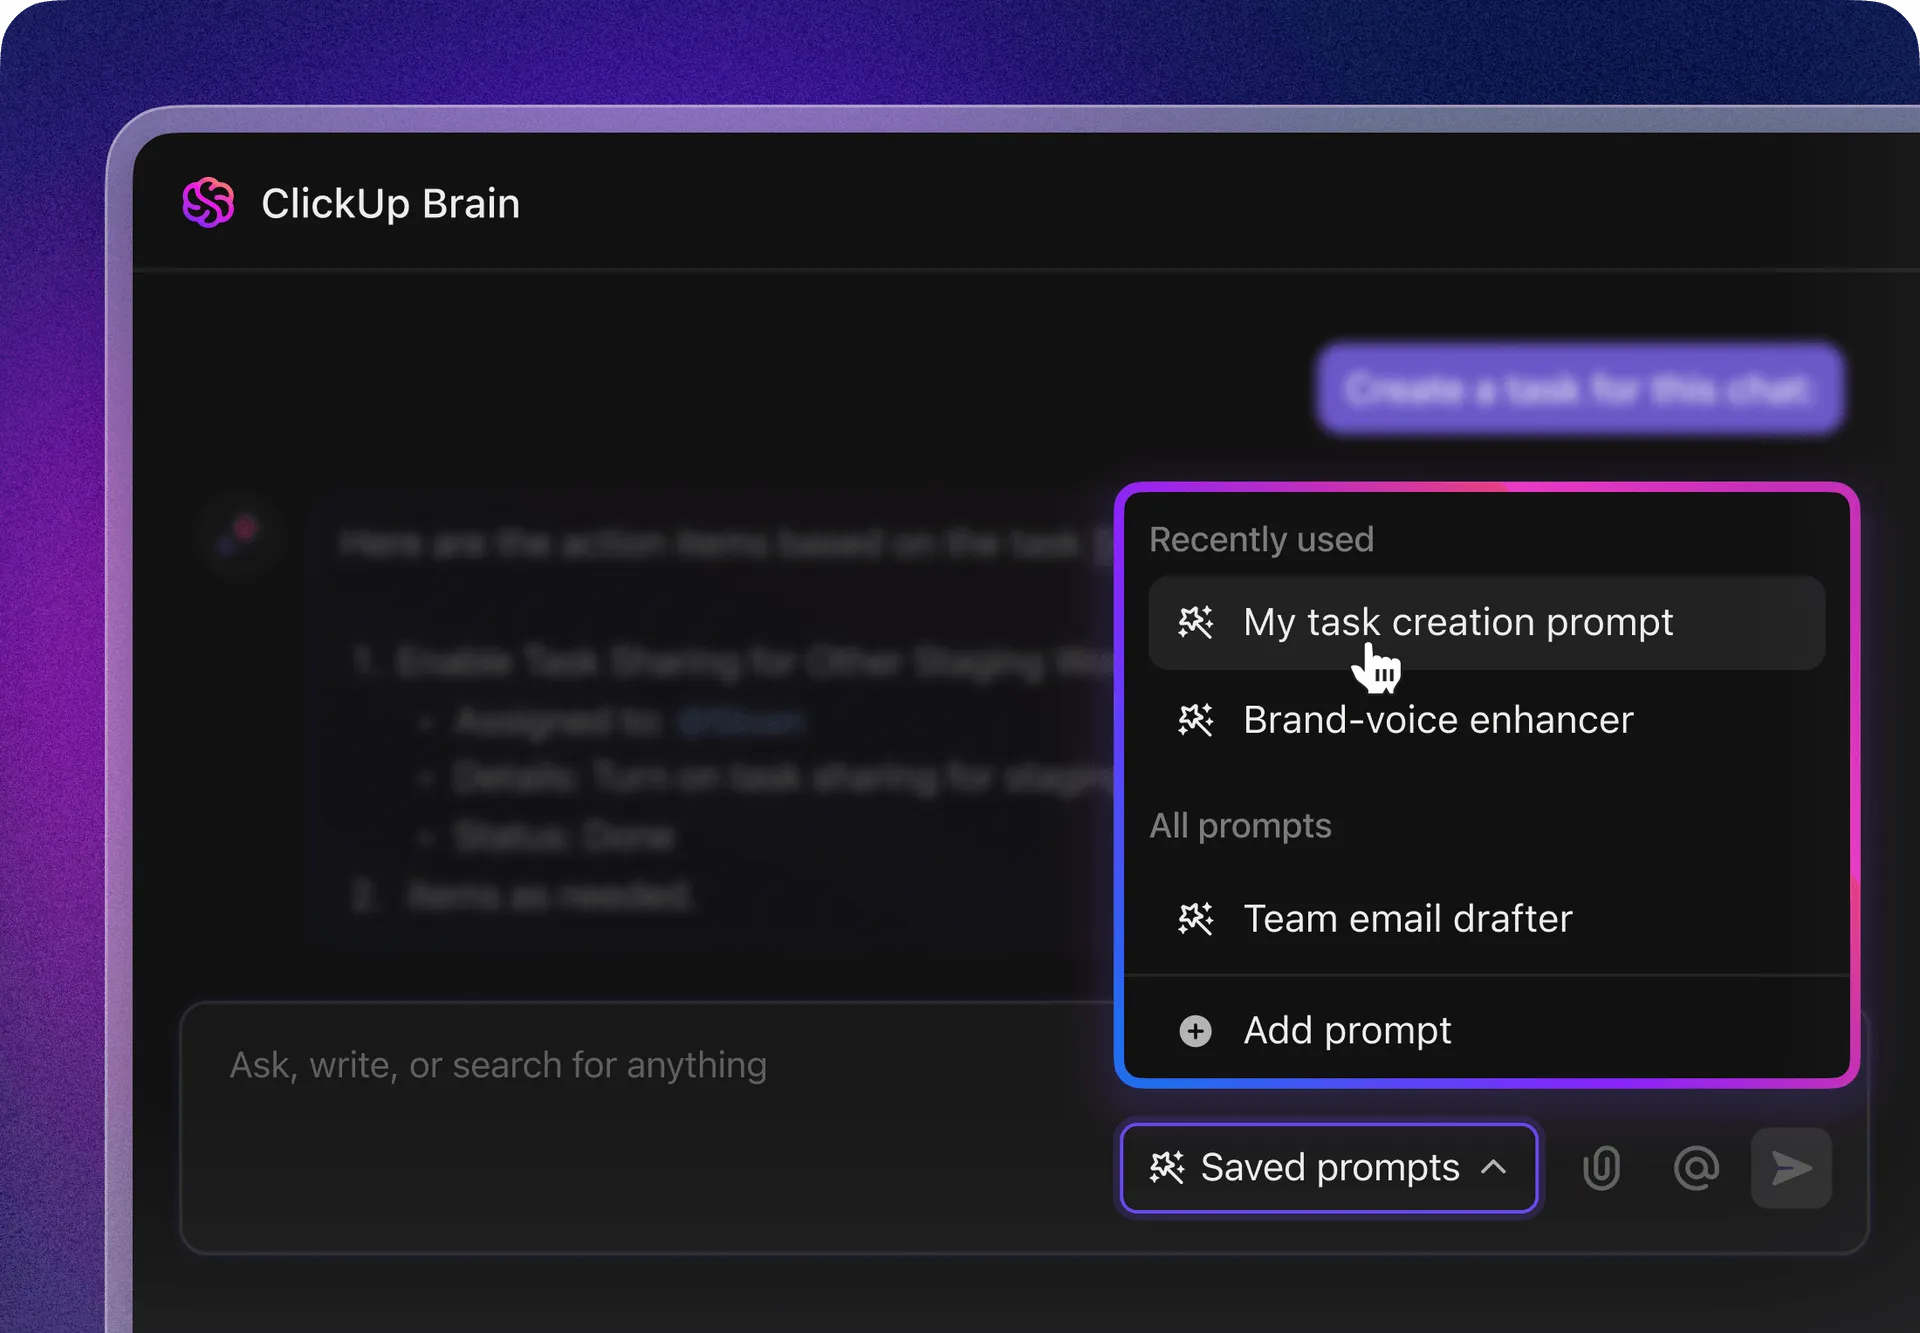
📖 En savoir plus : Comment utiliser l'IA dans le développement logiciel (cas d'utilisation et outils)
5. Raccourcissez le cycle de révision du code et de test
Les grandes demandes de modification (PR) prennent du retard. Privilégiez les correctifs ciblés, le développement basé sur le tronc et les Feature Flags afin que les corrections puissent être déployées en toute sécurité. Attribuez à l'avance les relecteurs en fonction de la propriété du code pour éviter les temps morts, et utilisez des checklists (tests mis à jour, télémétrie ajoutée, indicateur protégé par un « kill switch ») afin d'intégrer la qualité dès le départ.
L'automatisation doit faire passer le bug à l'état « En révision » lors de l'ouverture de la pull request et à l'état « Résolu » lors du fait de fusionner ; l'IA peut suggérer des tests unitaires ou mettre en évidence les différences risquées afin de cibler la révision.
Indicateurs à surveiller : temps passé en « En révision », taux d’échec des modifications pour les PR de correction de bogues et latence de révision P90.
Vous pouvez utiliser les intégrations GitHub/GitLab dans ClickUp pour synchroniser le statut de résolution de vos tickets ; les automatisations permettent de faire respecter la « définition de « terminé » ».
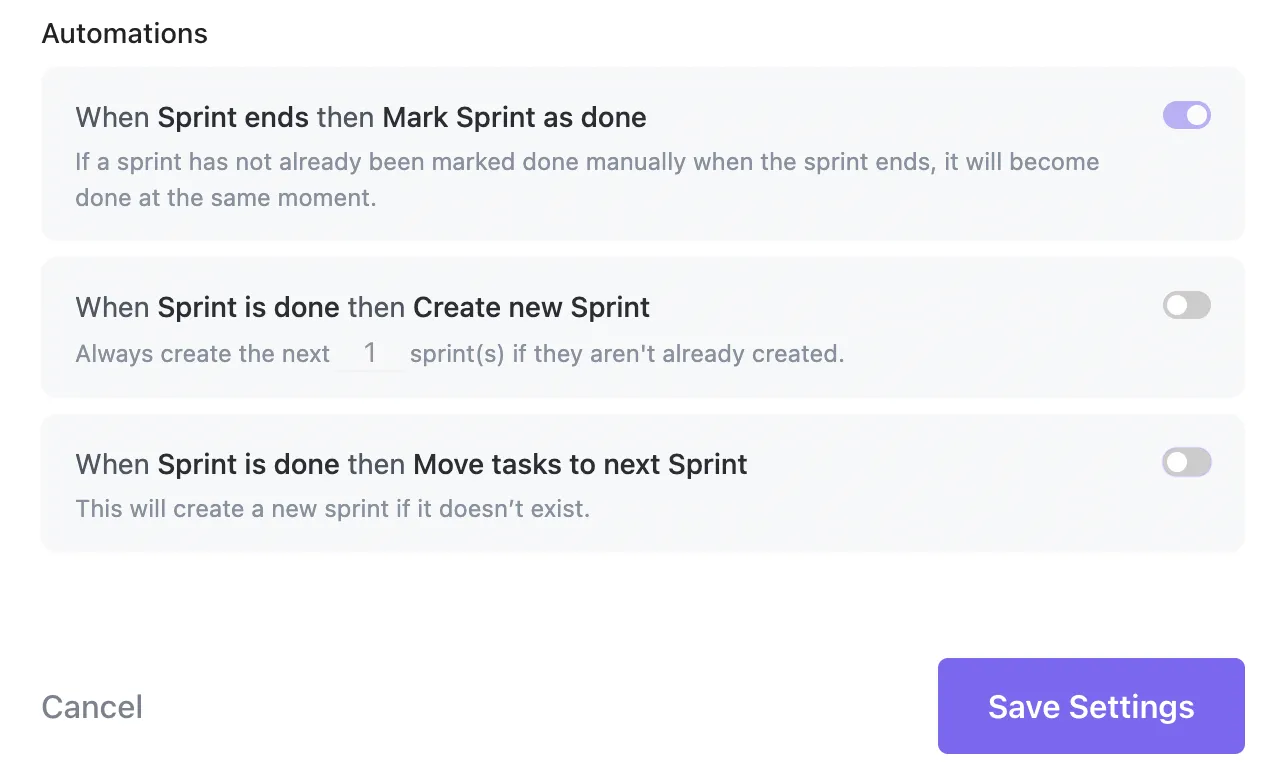
📖 En savoir plus : Comment utiliser l'IA pour réaliser l'automatisation de tâches
6. Parallélisez la vérification et concrétisez la parité de l'environnement d'assurance qualité
La vérification ne devrait pas commencer plusieurs jours plus tard ni dans un environnement que vos clients n'utilisent pas.
Assurez-vous que les éléments « prêts pour l'assurance qualité » soient rigoureusement contrôlés : des correctifs basés sur des indicateurs, validés dans des environnements de type production avec des données de test correspondant aux cas signalés.
Dans la mesure du possible, configurez des environnements éphémères à partir de la branche dédiée aux bogues afin que l'équipe d'assurance qualité puisse les valider immédiatement ; l'IA peut ensuite générer des cas de test à partir de la description du bogue et des régressions antérieures.
Indicateurs à surveiller : temps passé en « QA/vérification », taux de renvoi du QA vers le développement, délai médian de clôture après la fusion.
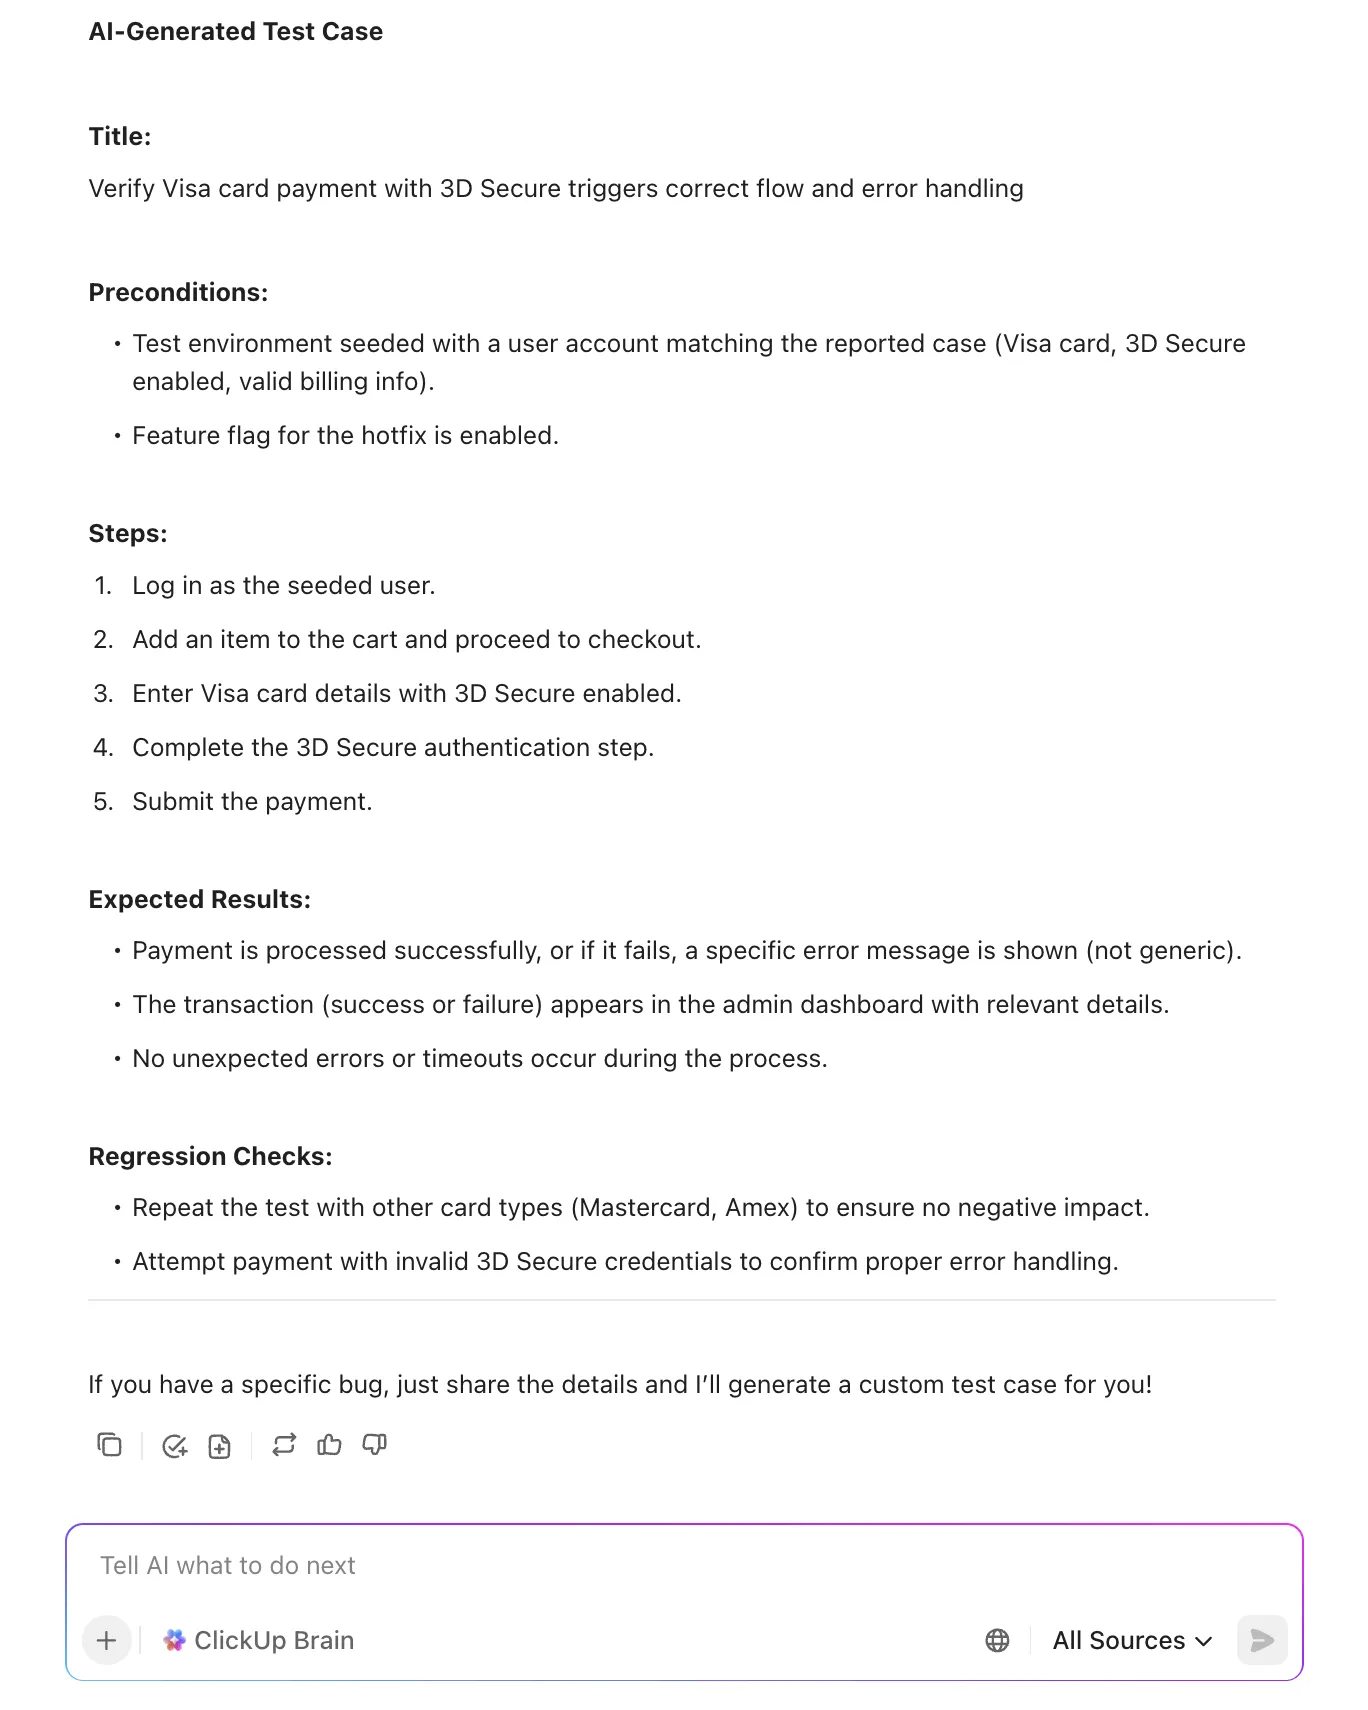
📖 En savoir plus : Comment rédiger des cas de test efficaces
7. Communiquez clairement le statut pour réduire les efforts de coordination
Une bonne mise à jour permet d'éviter trois statuts et une escalade.
Considérez les mises à jour comme un produit : courtes, précises et adaptées au public visé (assistance, dirigeants, clients). Définissez une fréquence pour les incidents P0/P1 (par exemple, toutes les heures jusqu'à leur résolution, puis toutes les quatre heures), et veillez à disposer d'une source unique d'informations fiables.
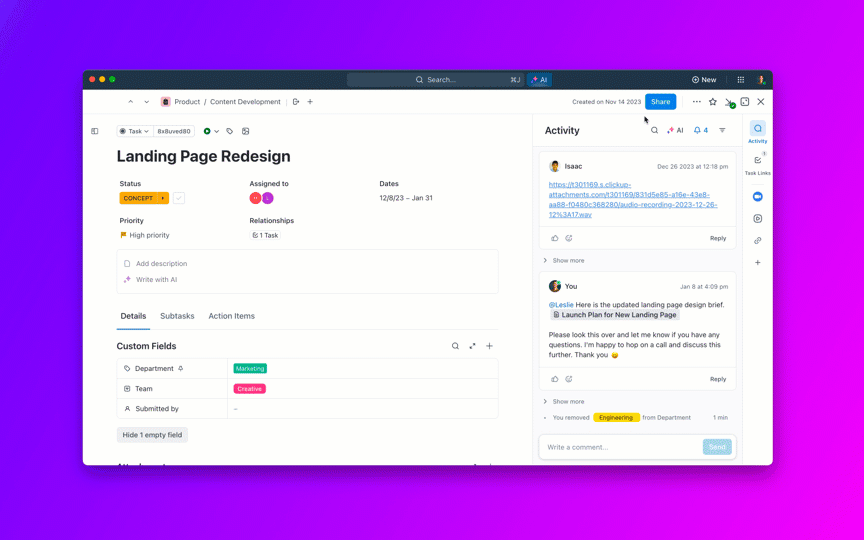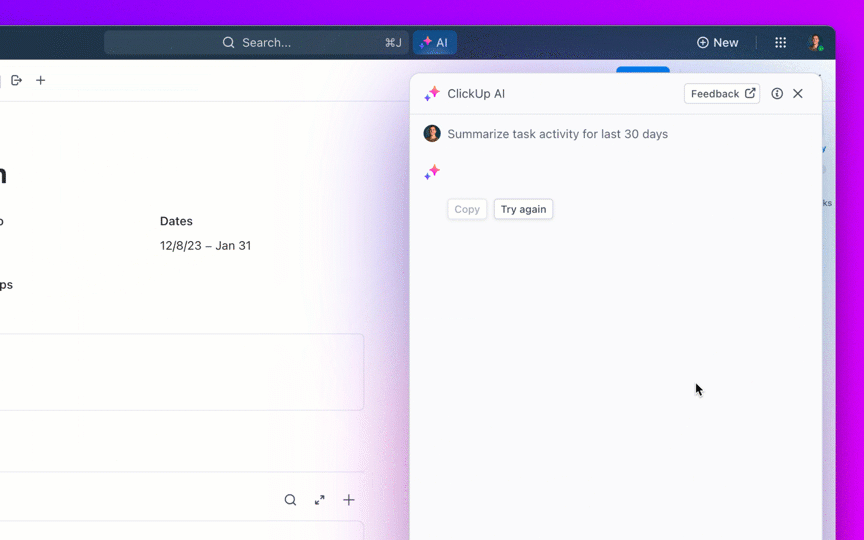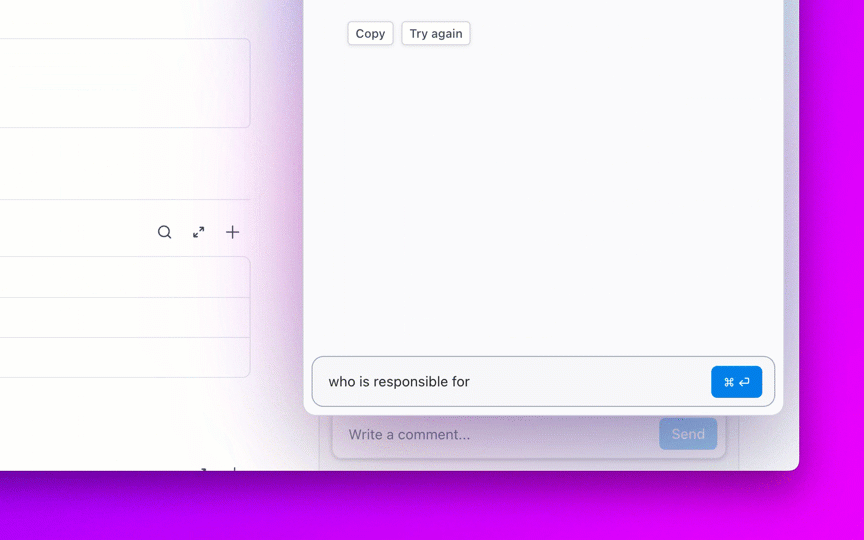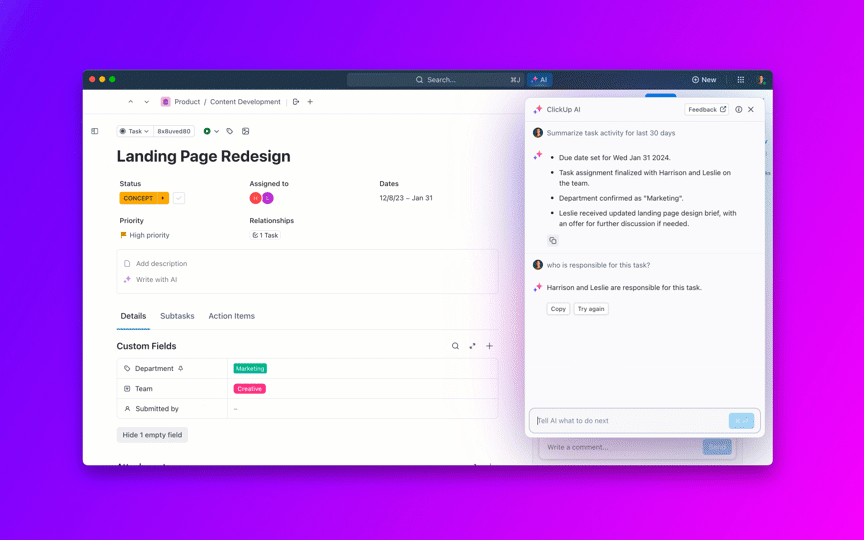
L'IA peut rédiger des mises à jour sans risque pour les clients et des résumés internes à partir de l'historique des tâches, y compris le statut en temps réel par niveau de gravité et par équipe. Pour les dirigeants tels que votre directeur produit, regroupez les bugs par initiative afin qu'ils puissent déterminer si des problèmes de qualité critiques menacent le respect des engagements de livraison.
Indicateurs à surveiller : délai entre les mises à jour de statut sur les tickets P0/P1, taux de satisfaction des parties prenantes (CSAT) concernant la communication.
8. Maîtrisez l'ancienneté du backlog et évitez les tickets « ouverts indéfiniment »
Un backlog qui ne cesse de s'accumuler et de stagner pèse discrètement sur chaque sprint.
Définissez des règles de gestion des bugs anciens (par exemple : un bug de niveau P2 ouvert depuis plus de 30 jours déclenche un examen, un bug de niveau P3 ouvert depuis plus de 90 jours nécessite une justification) et programmez un « triage hebdomadaire des bugs anciens » pour fusionner les doublons, clôturer les rapports obsolètes et convertir les bugs de faible importance en éléments du backlog produit.
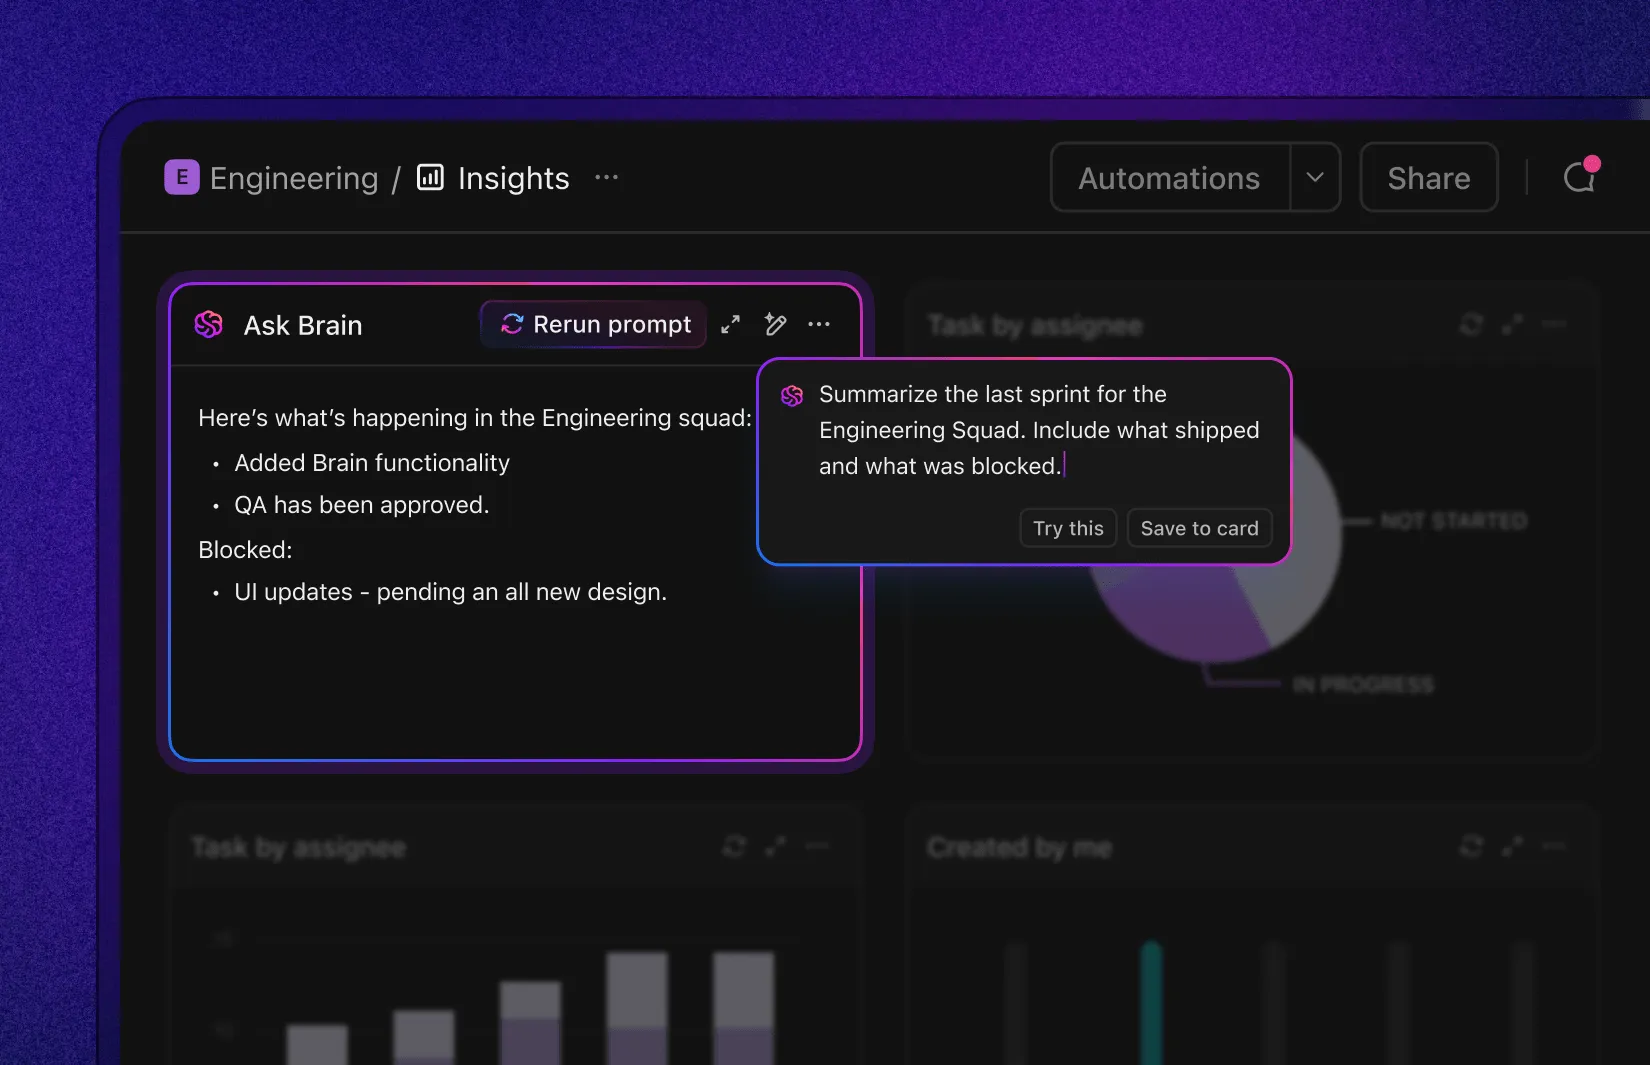
Utilisez l’IA pour regrouper le backlog par thème (par exemple, « expiration des jetons d’authentification », « instabilité du téléchargement d’images ») afin de pouvoir planifier des semaines de correction thématiques et éliminer d’un seul coup toute une catégorie de défauts.
Indicateurs à surveiller : nombre de problèmes en attente par tranche d’ancienneté, pourcentage de problèmes fermés pour cause de doublon ou d’obsolescence, vélocité thématique de réduction du backlog.
9. Boucler la boucle en identifiant la cause première et en mettant en place des mesures préventives
Si le même type de défaut revient sans cesse, vos progrès en matière de MTTR masquent un problème plus grave.
Effectuez rapidement une analyse des causes profondes, sans attribuer de responsabilité, sur les bogues P0/P1 et les bogues P2 à haute fréquence ; identifiez les causes profondes (lacunes dans les spécifications, les tests ou les outils, instabilité de l'intégration), établissez des liens vers les composants et incidents concernés, et suivez les tâches de suivi (contrôles, tests, règles de lint) jusqu'à leur achèvement.
L'IA peut rédiger des résumés d'analyse des causes profondes (RCA) et proposer des tests préventifs ou des règles de linting en fonction de l'historique des modifications. C'est ainsi que vous passez d'une gestion réactive à une approche préventive.
Indicateurs à surveiller : taux de réouverture, taux de régression, délai entre deux réoccurrences et pourcentage d'analyses des causes profondes (RCA) achevées avec des mesures préventives mises en œuvre.
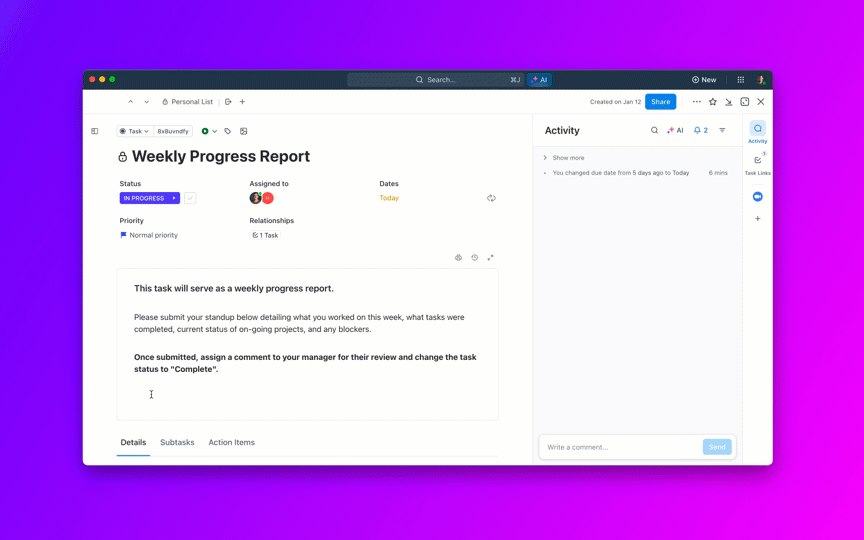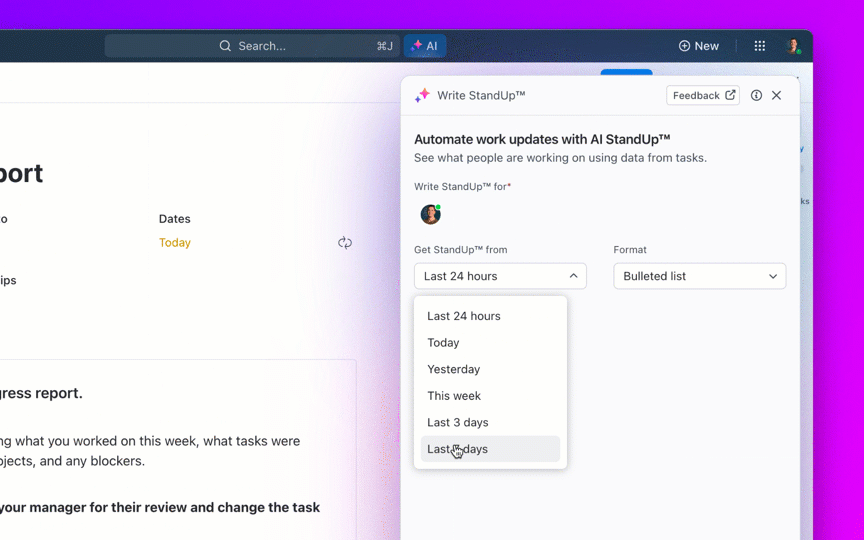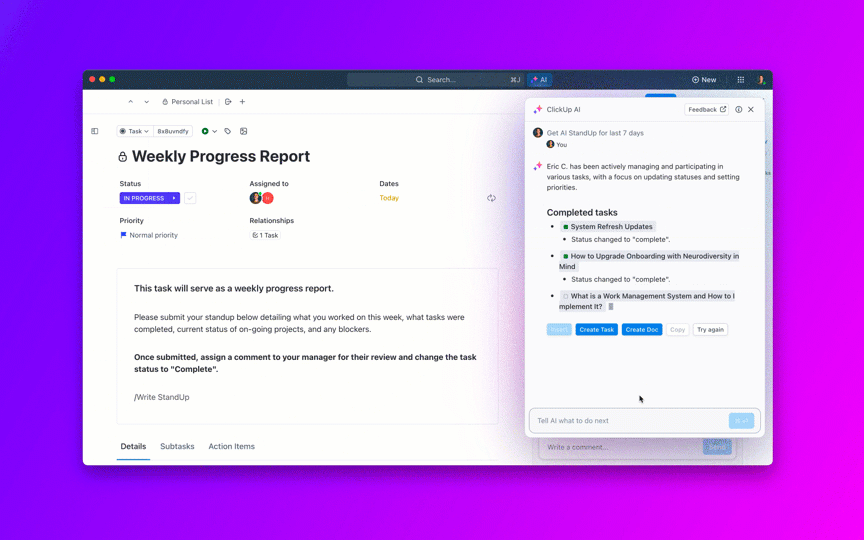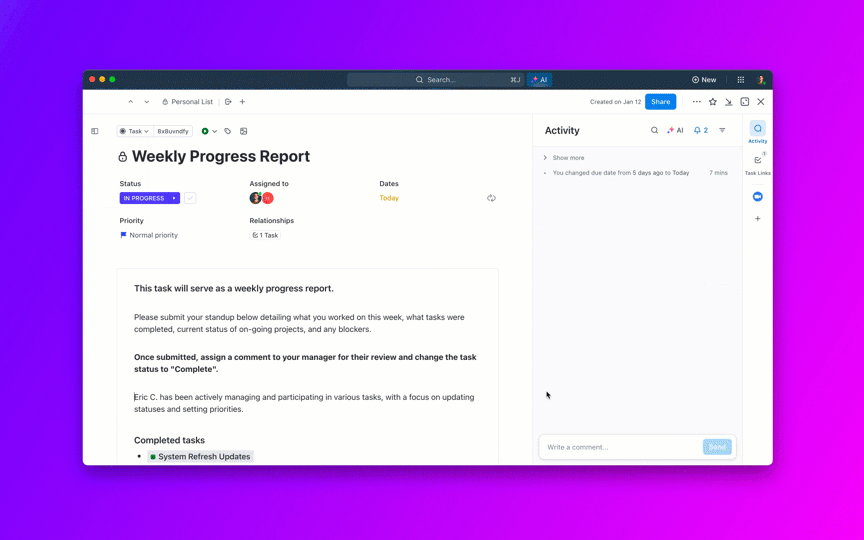
Ensemble, ces changements raccourcissent le parcours de bout en bout : confirmation plus rapide, triage plus précis, hiérarchisation plus intelligente, moins de blocages lors des revues et des contrôles qualité, et une communication plus claire. Les dirigeants bénéficient d’une prévisibilité liée à la satisfaction client (CSAT) et au NPS, ainsi qu’au chiffre d’affaires ; les équipes opérationnelles disposent d’une file d’attente plus fluide, avec moins de changements de contexte.
📖 En savoir plus : Comment réaliser une analyse des causes profondes
Des outils d'IA qui contribuent à réduire le temps de résolution des bugs
L'IA permet de réduire le temps de résolution à chaque étape : enregistrement, triage, acheminement, correction et vérification.
Cependant, les véritables gains apparaissent lorsque les outils comprennent le contexte et permettent de faire avancer le travail sans intervention manuelle.
Recherchez des systèmes qui enrichissent automatiquement les rapports (étapes de reproduction, environnement, doublons), hiérarchisent les bogues en fonction de leur impact, les acheminent vers le propriétaire approprié, rédigent des mises à jour claires et s'intègrent étroitement à votre code, à votre intégration continue (CI) et à votre observabilité.
Les meilleurs d’entre eux prennent également en charge des flux de travail de type « agent » : des bots qui surveillent les SLA, relancent les réviseurs, transmettent les éléments bloqués aux niveaux supérieurs et résument les résultats pour les parties prenantes. Voici notre sélection d’outils d’IA pour une meilleure résolution des bugs :
1. ClickUp (Idéal pour l'IA contextuelle, les automatisations et les flux de travail orientés agents)
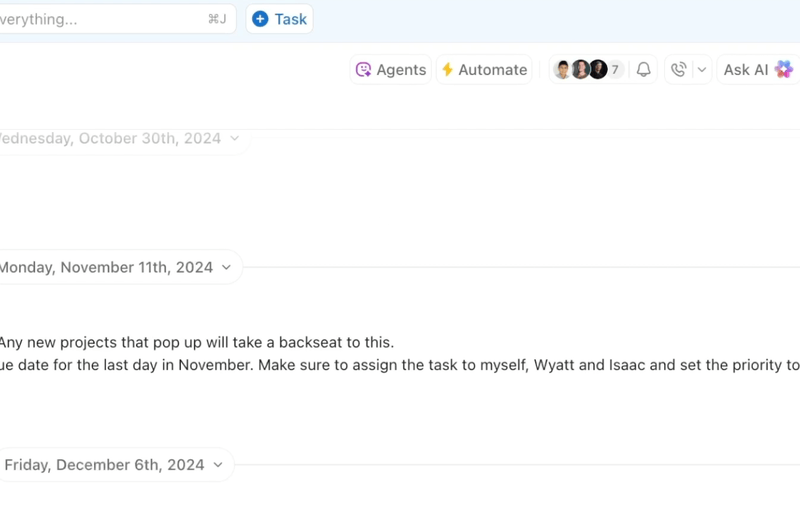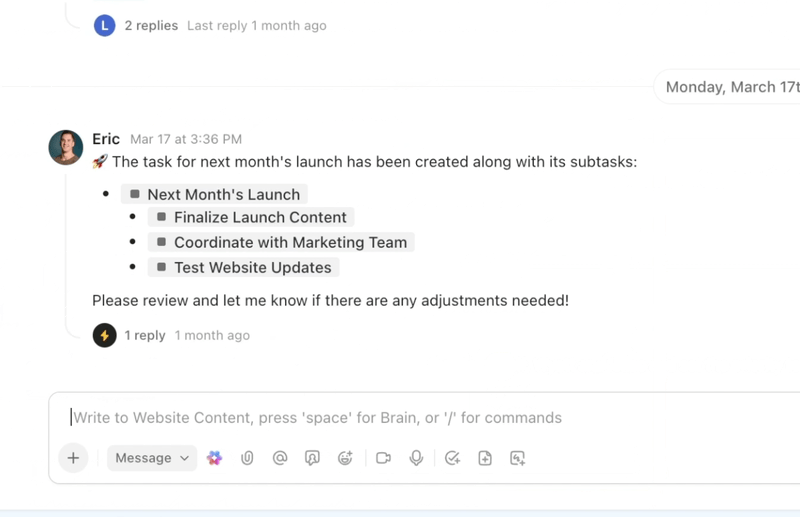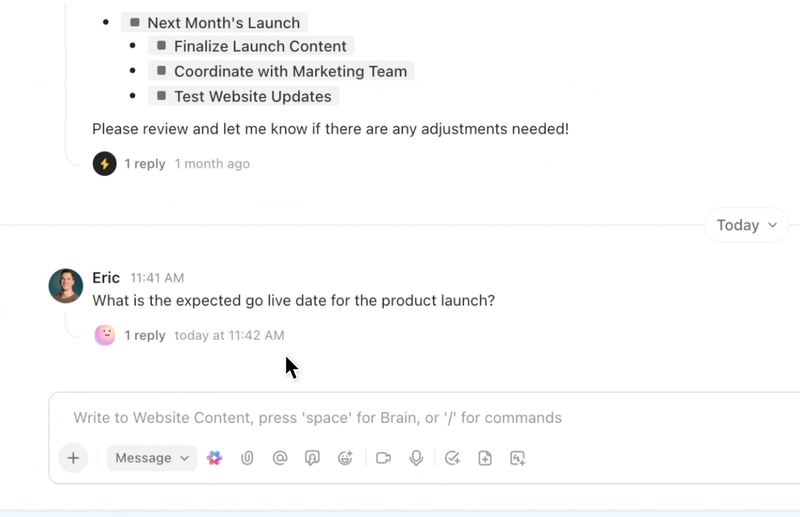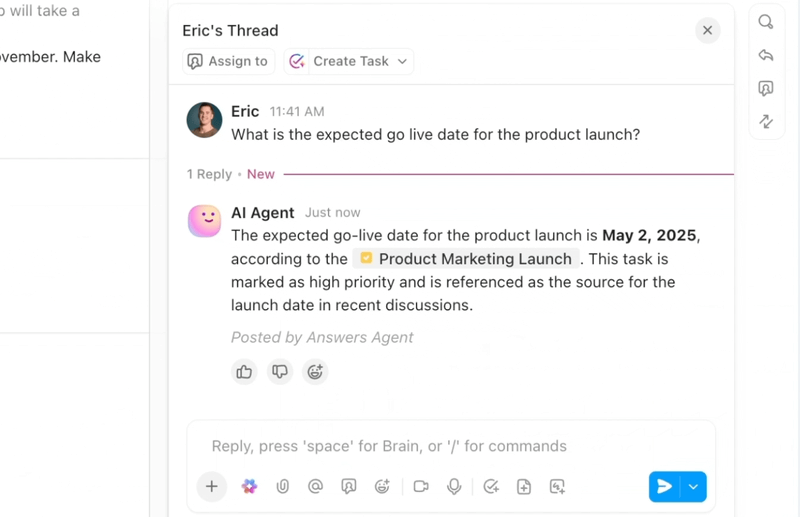
Si vous recherchez un flux de travail rationalisé et intelligent pour la résolution des bugs, ClickUp, l'application tout-en-un pour le travail, rassemble en un seul endroit l'IA, les automatisations et l'assistance au flux de travail par agents.
ClickUp Brain met instantanément en avant le contexte pertinent : il résume les longs fils de discussion sur les bugs, extrait des pièces jointes les étapes permettant de reproduire le problème et les détails de l'environnement, signale les doublons potentiels et suggère les actions à entreprendre. Au lieu de passer au crible Slack, les tickets et les journaux, les équipes disposent d'un historique clair et enrichi sur lequel elles peuvent s'appuyer immédiatement.
Les automatisations et les agents Autopilot de ClickUp assurent la continuité du travail sans intervention manuelle constante. Les bugs sont automatiquement acheminés vers l'équipe compétente, des propriétaires sont désignés, les SLA et les dates d'échéance sont définis, les statuts sont mis à jour au fur et à mesure de l'avancement des tâches, et les parties prenantes reçoivent des notifications en temps réel.
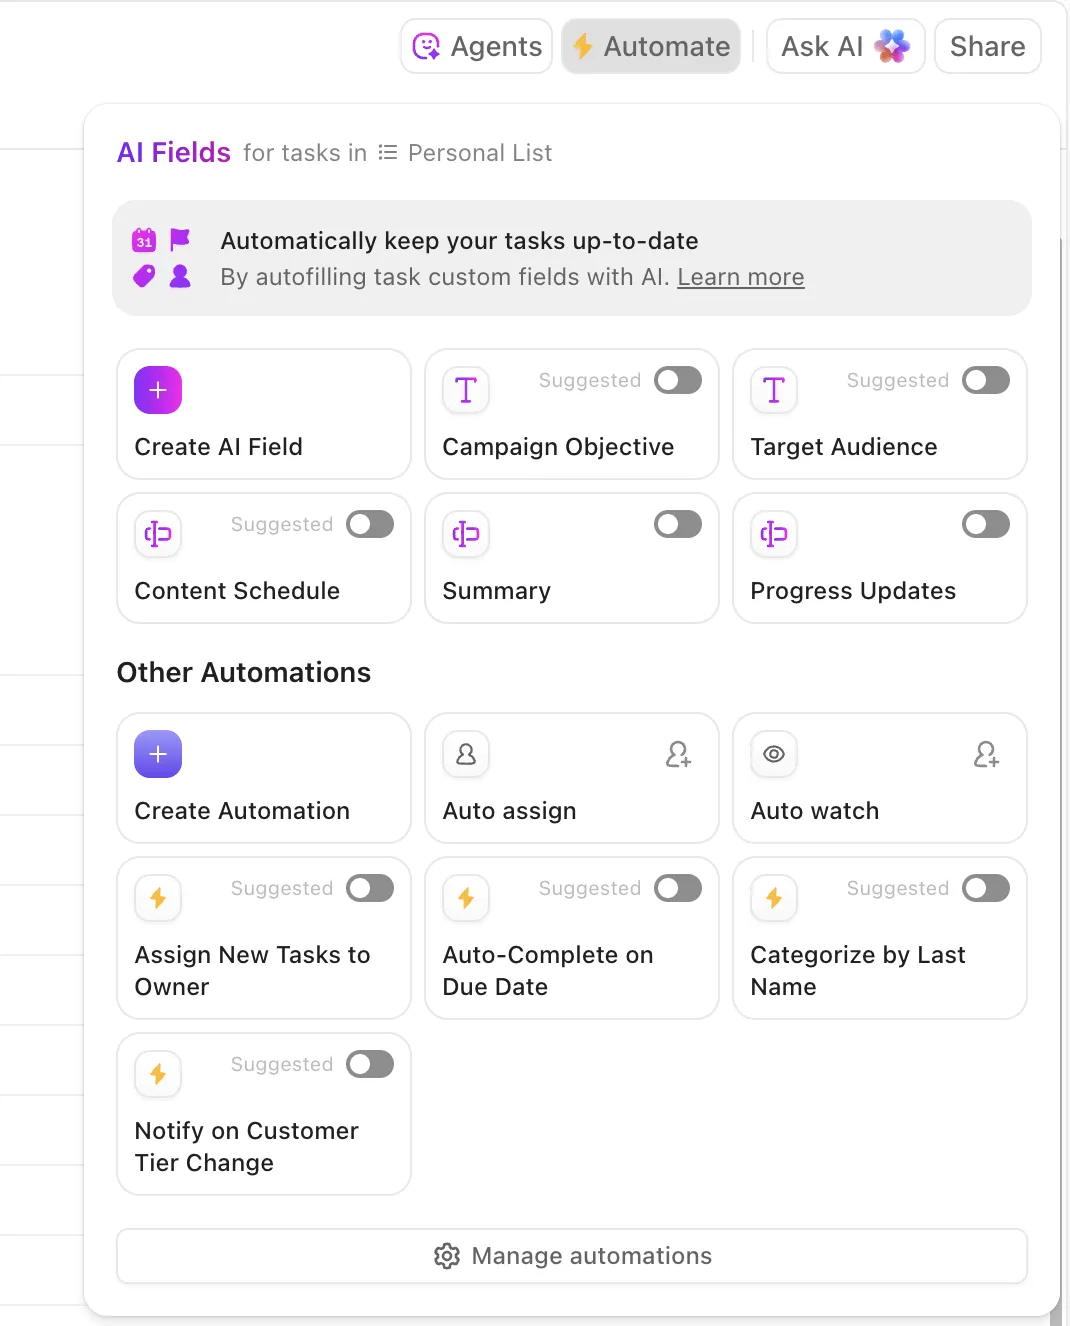
Ces agents sont même capables de trier et de classer les problèmes, de regrouper les rapports similaires, de se référer à l'historique des corrections pour proposer des pistes de résolution, et de remonter les éléments urgents — ce qui permet de réduire le MTTA et le MTTR même en cas de pics de volume.
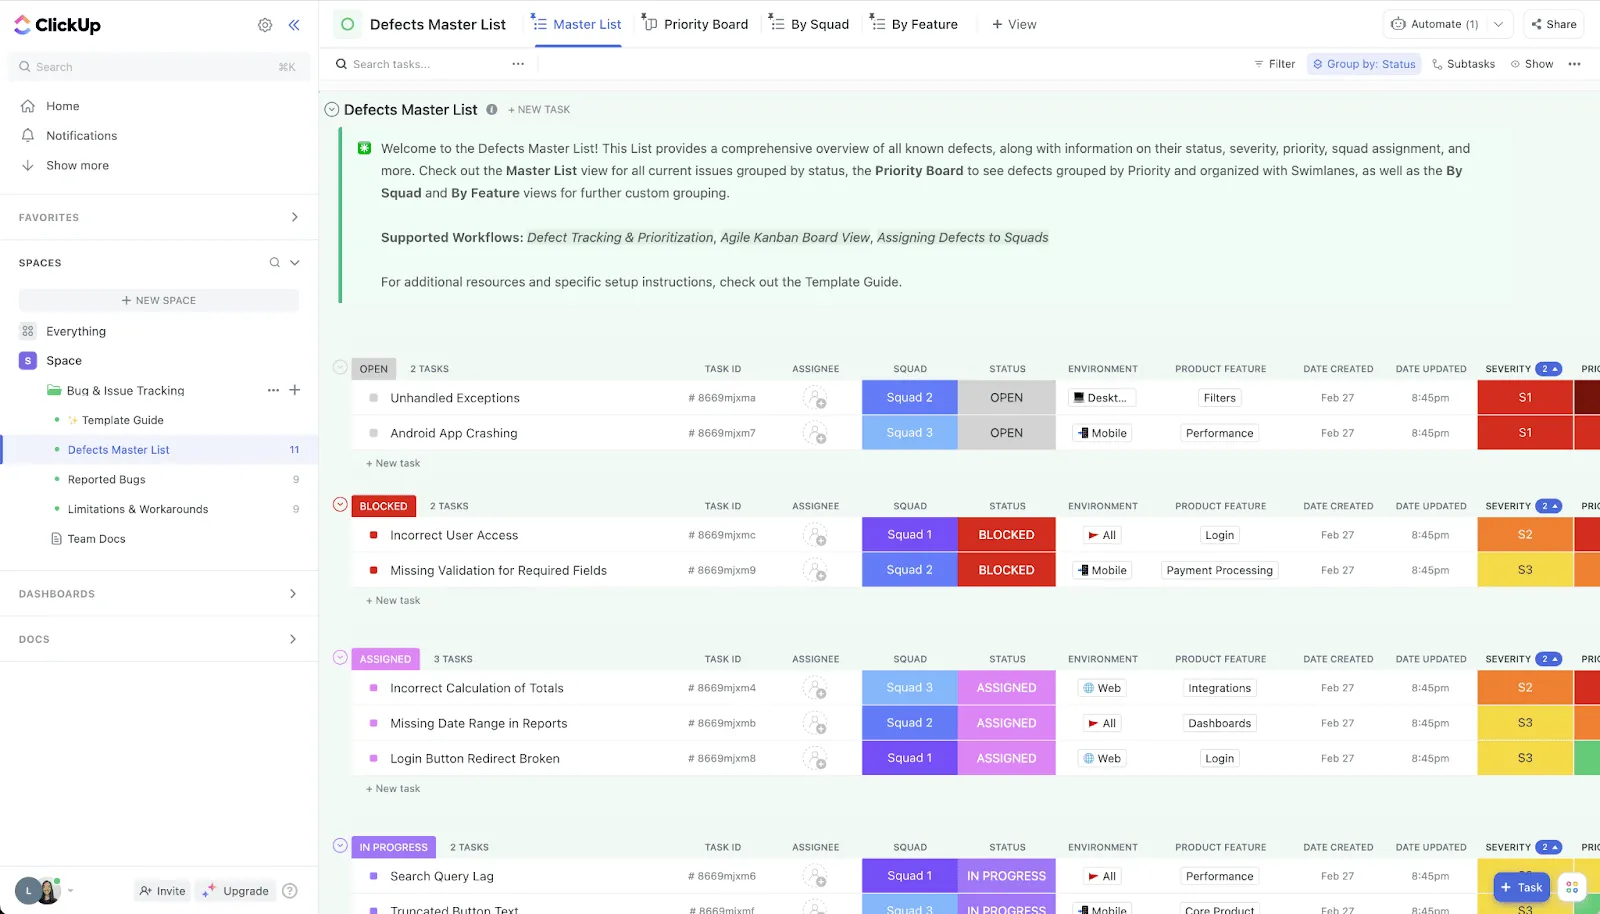
🛠️ Vous recherchez une boîte à outils prête à l'emploi ? Le modèle ClickUp de suivi des bugs et des problèmes est une solution puissante proposée par ClickUp for Software, conçue pour aider les équipes d'assistance, d'ingénierie et de produit à gérer facilement les bugs et les problèmes logiciels. Grâce à des vues personnalisables telles que Liste, Tableau, Charge de travail, Formulaire et Échéancier, les équipes peuvent visualiser et gérer leur processus de suivi des bugs de la manière qui leur convient le mieux.
Les 20 statuts personnalisés et les 7 champs personnalisés du modèle permettent de créer un flux de travail sur mesure, garantissant ainsi le suivi de chaque problème, de sa détection à sa résolution. Les automatisations intégrées prennent en charge les tâches répétitives, ce qui vous fait gagner un temps précieux et réduit l’effort manuel.
💟 Bonus : Brain MAX est votre assistant de bureau alimenté par l'IA, conçu pour accélérer la résolution des bugs grâce à des fonctionnalités intelligentes et pratiques.
Lorsque vous rencontrez un bug, il vous suffit d’utiliser la fonctionnalité de reconnaissance vocale de Brain MAX pour dicter le problème : vos notes vocales sont instantanément transcrites et peuvent être jointes à un ticket de bug nouveau ou existant. Sa fonction de recherche d’entreprise explore tous vos outils connectés — tels que ClickUp, GitHub, Google Drive et Slack — pour faire remonter les rapports de bug, les journaux d’erreurs, les extraits de code et la documentation associés, afin que vous disposiez de tout le contexte nécessaire sans avoir à changer d’application.
Vous avez besoin de coordonner la correction d'un bug ? Brain MAX vous permet d'attribuer le bug au développeur approprié, de définir des rappels d'automatisation pour les mises à jour de statut et de suivre l'avancement, le tout depuis votre bureau !
2. Sentry (Idéal pour la détection des erreurs)
Sentry réduit le MTTD et le temps de reproduction en centralisant les erreurs, les traces et les sessions utilisateur en un seul endroit. Le regroupement des problèmes basé sur l’IA réduit le bruit ; les règles « Suspect Commit » et de propriété identifient le propriétaire probable du code, ce qui permet un acheminement instantané. La fonctionnalité « Session Replay » fournit aux ingénieurs le parcours exact de l’utilisateur ainsi que les détails de la console et du réseau nécessaires à la reproduction, sans allers-retours interminables.
Les fonctionnalités de Sentry IA permettent de résumer le contexte d’un problème et, dans certaines piles technologiques, de proposer des correctifs « Autofix » qui font référence au code à l’origine du problème. Concrètement, cela se traduit par moins de tickets en double, une attribution plus rapide et un chemin plus court entre le signalement et le correctif opérationnel.
3. GitHub Copilot (idéal pour réviser le code plus rapidement)
Copilot accélère le cycle de correction directement dans l'éditeur. Il explique les traces de pile, suggère des correctifs ciblés, rédige des tests unitaires pour valider la correction et génère des scripts de reproduction.
Copilot Chat peut analyser le code défaillant, proposer des refactorisations plus sûres et générer des commentaires ou des descriptions de pull requests qui accélèrent la révision du code. Associé à des révisions obligatoires et à l’intégration continue (CI), il permet de gagner plusieurs heures sur le cycle « diagnostic → implémentation → test », en particulier pour les bugs bien ciblés et dont la reproduction est claire.
4. Snyk by DeepCode IA (idéal pour détecter des schémas récurrents)
L'analyse statique alimentée par l'IA de DeepCode détecte les défauts et les schémas non sécurisés au fur et à mesure que vous codez et dans les PR. Elle met en évidence les flux problématiques, explique pourquoi ils se produisent et propose des corrections sécurisées adaptées aux conventions de votre base de code.
En détectant les régressions avant la fusion et en orientant les développeurs vers des pratiques plus sûres, vous réduisez le taux d’apparition de nouveaux bugs et accélérez la correction des erreurs logiques complexes, difficiles à repérer lors des revues de code. Les intégrations avec les IDE et les pull requests permettent de garder ce processus au plus près du lieu de travail.
5. Watchdog et AIOps de Datadog (idéal pour l'analyse des logs)
La fonctionnalité Watchdog de Datadog utilise l'apprentissage automatique pour détecter les anomalies dans les logs, les indicateurs, les traces et la surveillance des utilisateurs réels. Elle établit des corrélations entre les pics d'activité et les marqueurs de déploiement, les changements d'infrastructure et la topologie afin de suggérer les causes profondes possibles.
Pour les défauts ayant un impact sur les clients, cela se traduit par une détection en quelques minutes, un regroupement automatique permettant de réduire le bruit des alertes et des pistes concrètes sur les éléments à examiner. Le temps de triage diminue, car vous partez d’une base d’informations telle que « ce déploiement a affecté ces services et les taux d’erreur ont augmenté sur ce terminal », plutôt que de partir de zéro.
⚡️ Archives de modèles : Modèles gratuits de suivi des problèmes et de journaux d'événements dans Excel et ClickUp
6. New Relic IA (Idéal pour identifier et résumer les tendances)
La boîte de réception des erreurs de New Relic regroupe les erreurs similaires selon les services et les versions, tandis que son assistant IA résume l’impact, met en évidence les causes probables et fournit des liens vers les traces/transactions concernées.
Les corrélations de déploiement et l’analyse des modifications d’entités permettent d’identifier clairement quand une version récente est en cause. Pour les systèmes distribués, ce contexte évite des heures d’échanges entre équipes et permet d’attribuer le bug au bon propriétaire, avec une hypothèse solide déjà formée.
7. Rollbar (Idéal pour les flux de travail automatisés)
Rollbar est spécialisé dans la surveillance des erreurs en temps réel grâce à une technologie intelligente d'empreinte numérique permettant de regrouper les doublons et de suivre les tendances d'occurrence. Ses résumés basés sur l'IA et ses indications sur les causes profondes aident les équipes à comprendre l'ampleur du problème (utilisateurs concernés, versions impactées), tandis que la télémétrie et les traces de pile fournissent rapidement des indices pour reproduire le problème.
Les règles de flux de travail de Rollbar permettent de créer automatiquement des tâches, d'attribuer une étiquette de niveau de gravité et de les acheminer vers les propriétaires, transformant ainsi les flux d'erreurs bruyants en files d'attente hiérarchisées et accompagnées de contexte.
8. PagerDuty AIOps et automatisation des runbooks (Le meilleur des diagnostics à faible intervention)
PagerDuty utilise la corrélation d'évènements et la réduction du bruit basée sur l'apprentissage automatique pour transformer les tempêtes d'alertes en incidents exploitables.
Le routage dynamique achemine instantanément le problème vers la bonne personne d'astreinte, tandis que l'automatisation des runbooks permet de lancer des diagnostics ou des mesures d'atténuation (redémarrage de services, annulation d'un déploiement, activation/désactivation de Feature Flags) avant même qu'un intervenant humain n'intervienne. En termes de temps de résolution des bugs, cela se traduit par un MTTA plus court, des mesures d'atténuation plus rapides pour les bogues de priorité P0 et moins d'heures perdues à cause de la fatigue liée aux alertes.
Le fil conducteur : l’automatisation associée à l’IA à chaque étape. Vous détectez les bugs plus tôt, les acheminer de manière plus intelligente, identifiez le code concerné plus rapidement et communiquez leur statut sans ralentir le travail des ingénieurs — autant d’éléments qui, combinés, se traduisent par une réduction significative du temps de résolution des bugs.
📖 En savoir plus : Comment utiliser l'IA dans le DevOps
Exemples concrets d'utilisation de l'IA pour la résolution des bugs
L’IA est donc officiellement sortie des laboratoires. Elle réduit désormais le temps de résolution des bugs en conditions réelles.
Voyons comment faire !
| Domaine / Organisation | Comment l'IA a été utilisée | Impact / Avantages |
|---|---|---|
| Ubisoft | Nous avons développé « Commit Assistant », un outil d’IA entraîné sur une décennie de code interne, qui prédit et prévient les bugs dès l’étape de codage. | L'objectif est de réduire considérablement le temps et les coûts : jusqu'à 70 % des dépenses liées au développement de jeux vidéo sont traditionnellement consacrées à la correction des bugs. |
| Razer (plateforme Wyvrn) | Lancement de QA Copilot, un outil basé sur l'IA (intégré à Unreal et Unity), pour automatiser la détection des bugs et générer des rapports d'assurance qualité. | Améliore la détection des bugs jusqu’à 25 % et réduit de moitié le temps consacré à l’assurance qualité. |
| Google / DeepMind & Project Zero | Lancement de Big Sleep, un outil d'IA qui détecte de manière autonome les failles de sécurité dans les logiciels open source tels que FFmpeg et ImageMagick. | 20 bugs ont été identifiés, tous vérifiés par des experts humains et devant faire l'objet d'un correctif. |
| Chercheurs de l'université de Berkeley | À l’aide d’un benchmark appelé CyberGym, des modèles d’IA ont analysé 188 projets open source, mettant au jour 17 vulnérabilités — dont 15 bugs « zero-day » inconnus — et générant des exploits de preuve de concept. | Démontre les capacités sans cesse croissantes de l'IA en matière de détection des vulnérabilités et de révision automatisée des exploits. |
| Spur (start-up de Yale) | Développement d'un agent IA capable de traduire des descriptions de cas de test en langage naturel en routines d'automatisation de tests de sites web — ce qui revient en fait à un flux de travail d'assurance qualité qui s'écrit tout seul. | Permet de réaliser des tests de manière autonome avec une intervention humaine minimale |
| Reproduction automatique des rapports de bogues Android | J'ai utilisé le traitement du langage naturel (NLP) et l'apprentissage par renforcement pour analyser le langage des rapports de bogues et générer des étapes permettant de reproduire les bogues Android. | Nous avons atteint une précision de 67 %, un rappel de 77 % et reproduit 74 % des rapports de bogues, surpassant ainsi les méthodes traditionnelles. |
Erreurs courantes dans la mesure du temps de résolution des bugs
Si vos mesures sont erronées, votre plan d'amélioration le sera également.
La plupart des « mauvais nombres » dans les flux de travail de résolution des bugs proviennent de définitions vagues, de workflows incohérents et d’analyses superficielles.
Commencez donc par les bases : ce qui est considéré comme un « démarrage » ou un « arrêt », comment vous gérez les temps d’attente et les réouvertures, puis interprétez les données à travers le prisme de l’expérience de vos clients. Cela inclut :
❌ Délimitations floues : mélanger les indicateurs « Signalé → Résolu » et « Signalé → Clôturé » dans un même tableau de bord (ou alterner d’un mois à l’autre) rend les tendances ininterprétables. Choisissez une seule délimitation, documentez-la et appliquez-la à toutes les équipes. Si vous avez besoin des deux, publiez-les comme des indicateurs distincts avec des libellés clairs.
❌ Approche basée uniquement sur les moyennes : se fier à la moyenne masque la réalité des files d’attente comportant quelques valeurs aberrantes qui prennent beaucoup de temps à traiter. Utilisez la médiane (P50) pour votre temps « typique », le P90 pour la prévisibilité et les SLA, et conservez la moyenne pour la planification de la capacité. Tenez toujours compte de la distribution, et pas seulement du nombre.
❌ Absence de segmentation : le regroupement de tous les bugs mélange les incidents P0 et les bugs P3 d’ordre esthétique. Segmentez-les par gravité, source (client, assurance qualité ou surveillance), composant/équipe et « nouveau vs régression ». Votre P90 pour les P0/P1 correspond à ce que ressentent les parties prenantes ; votre médiane pour les P2+ est celle sur laquelle s’appuie l’ingénierie pour planifier son travail.
❌ Ignorer les temps « en pause » : Vous attendez les journaux du client, un prestataire externe ou une fenêtre de déploiement ? Si vous ne suivez pas les statuts « Bloqué » ou « En pause » comme des statuts à part entière, votre délai de résolution deviendra un argument de discorde. Indiquez à la fois le temps calendaire et le temps actif afin de rendre les goulots d’étranglement visibles et de mettre fin aux débats.
❌ Écarts de normalisation temporelle : le mélange des fuseaux horaires ou le passage des heures ouvrées aux heures calendaires en cours de route fausse les comparaisons. Normalisez les horodatages selon un seul fuseau horaire (ou l'UTC) et décidez une fois pour toutes si les SLA sont mesurés en heures ouvrées ou en heures calendaires ; appliquez ce choix de manière cohérente.
❌ Saisie incomplète et doublons : les informations manquantes sur l’environnement ou la version, ainsi que les tickets en double, allongent les délais de résolution et créent une confusion quant à la propriété. Standardisez les champs obligatoires lors de la saisie, enrichissez automatiquement les données (journaux, version, appareil) et dédupliquez sans réinitialiser le délai de résolution : clôturez les doublons en les liant, et non en les traitant comme de « nouveaux » problèmes.
❌ Modèles de statut incohérents : les statuts personnalisés (« Prêt pour le QA, plus ou moins », « En attente de révision 2 ») masquent la durée de séjour dans chaque statut et rendent les transitions entre les états peu fiables. Définissez un flux de travail canonique (Nouveau → Trié → En cours → En révision → Résolu → Fermé) et effectuez un audit pour détecter les états hors parcours.
❌ Ne pas tenir compte du temps passé par statut : un simple nombre représentant le « temps total » ne vous permet pas de savoir où le travail stagne. Saisissez et analysez le temps passé dans les statuts « Trié », « En révision », « Bloqué » et « QA ». Si le temps consacré à la révision du code (P90) dépasse largement celui de la mise en œuvre, la solution ne consiste pas à « coder plus vite », mais à libérer de la capacité de révision.
🧠 Anecdote : Le dernier « AI Cyber Challenge » de la DARPA a mis en évidence une avancée révolutionnaire en matière d’automatisation de la cybersécurité. Le concours mettait en scène des systèmes d’IA conçus pour détecter, exploiter et corriger de manière autonome les vulnérabilités logicielles, sans aucune intervention humaine. L’équipe gagnante, « Team Atlanta », a réussi à détecter 77 % des bugs injectés et à corriger 61 % d’entre eux, démontrant ainsi la capacité de l’IA non seulement à repérer les failles, mais aussi à les corriger activement.
❌ Le « aveuglement » lié aux réouvertures : Considérer les réouvertures comme de nouveaux bugs remet le compteur à zéro et embellit le MTTR. Suivez le taux de réouverture et le « délai jusqu’à la clôture stable » (du premier signalement à la clôture définitive, tous cycles confondus). Une augmentation des réouvertures indique généralement une reproduction insuffisante, des lacunes dans les tests ou une définition floue de ce qui est « terminé ».
❌ Absence de MTTA : les équipes se focalisent sur le MTTR et négligent le MTTA (temps de prise en charge/de propriété). Un MTTA élevé est un avertissement concernant une résolution longue. Mesurez-le, définissez des SLA en fonction de la gravité et effectuez l'automatisation de l'acheminement/de la remontée pour le maintenir à un niveau bas.
❌ IA/automatisation sans garde-fous : laisser l’IA définir la gravité d’un bug ou clôturer les doublons sans vérification peut entraîner une classification erronée des cas limites et fausser les indicateurs à l’insu de tous. Utilisez l’IA pour obtenir des suggestions, exigez une confirmation humaine pour les bugs P0/P1 et auditez mensuellement les performances du modèle afin de garantir la fiabilité de vos données.
Renforcez ces maillons, et vos diagrammes de temps de résolution refléteront enfin la réalité. À partir de là, les améliorations s’enchaînent : une meilleure prise en charge réduit le MTTA, des états plus clairs révèlent les véritables goulots d’étranglement, et les P90 segmentés permettent aux dirigeants de faire des promesses que vous pouvez tenir.
⚡️ Archives de modèles : 10 modèles de cas de test pour les tests logiciels
Bonnes pratiques pour une meilleure résolution des bugs
En résumé, voici les points essentiels à retenir !
| 🧩 Bonnes pratiques | 💡 Ce que cela signifie | 🚀 Pourquoi est-ce important ? |
| Utilisez un système de suivi des bugs performant | Suivez tous les bugs signalés à l'aide d'un système centralisé de suivi des bugs. | Garantit qu'aucun bug ne passe inaperçu et offre une visibilité sur le statut des bugs à l'ensemble des équipes. |
| Rédigez des rapports de bug détaillés | Ajoutez des informations contextuelles visuelles, des informations sur le système d'exploitation, les étapes permettant de reproduire le problème et son niveau de gravité. | Aide les développeurs à corriger les bugs plus rapidement en leur fournissant d'emblée toutes les informations essentielles. |
| Classer et hiérarchiser les bugs | Utilisez une matrice de priorités pour classer les bugs en fonction de leur urgence et de leur impact. | Cela permet à l'équipe de se concentrer en priorité sur les bugs critiques et les problèmes urgents. |
| Tirez parti des tests automatisés | Exécutez automatiquement des tests dans votre pipeline CI/CD. | Offre d'assistance pour une détection précoce et la prévention des régressions. |
| Définissez des directives claires en matière de rapports | Mettez à disposition des modèles et proposez des formations sur la manière de réaliser les rapports concernant les bugs. | Cela permet d’obtenir des informations précises et de fluidifier la communication. |
| Suivez les indicateurs clés | Mesurez le temps de résolution, le temps écoulé et le temps de réponse. | Permet de suivre et d'améliorer les performances à l'aide des données historiques. |
| Adoptez une approche proactive | N’attendez pas que les utilisateurs se plaignent : effectuez des tests de manière proactive. | Améliorez la satisfaction client et allégez la charge de travail du service d'assistance. |
| Tirez parti des outils intelligents et du machine learning | Utilisez l'apprentissage automatique pour anticiper les bugs et proposer des solutions. | Améliore l'efficacité dans l'identification des causes profondes et la correction des bugs. |
| Respectez les accords de niveau de service (SLA) | Réalisez les réunions pour répondre aux accords de niveau de service convenus en matière de résolution. | Cela permet de renforcer la confiance et de répondre aux attentes des clients dans les meilleurs délais. |
| Évaluez et améliorez en continu | Analysez les bugs réouverts, recueillez les retours d'expérience et affinez vos processus. | Favorise l'amélioration continue de votre processus de développement et de la gestion des bugs. |
La résolution des bugs simplifiée grâce à l'IA contextuelle
Les équipes les plus rapides en matière de résolution des bugs ne comptent pas sur des exploits individuels. Elles conçoivent un système : des définitions claires du début et de la fin des tâches, une prise en charge rigoureuse des tickets, une hiérarchisation en fonction de l’impact sur l’activité, une propriété claire des responsabilités et des boucles de retour d’information serrées entre le support, l’assurance qualité, l’ingénierie et la mise en production.
ClickUp peut devenir le centre de commande alimenté par l’IA de votre système de résolution des bogues. Centralisez tous les rapports dans une seule file d’attente, uniformisez le contexte grâce à des champs structurés, et laissez l’IA de ClickUp se charger du triage, de la résumation et de la hiérarchisation, tandis que les automatisations garantissent le respect des SLA, déclenchent des alertes en cas de dépassement des délais et assurent la coordination entre les parties prenantes. Associez les bogues aux clients, au code et aux versions afin que les dirigeants puissent en mesurer l’impact et que les équipes opérationnelles puissent rester concentrées sur leur travail.
Si vous êtes prêt à réduire le temps de résolution des bugs et à rendre votre feuille de route plus prévisible, inscrivez-vous sur ClickUp et commencez à mesurer les progrès en quelques jours, et non plus en quelques trimestres.
Foire aux questions
Quel est un bon délai de résolution des bugs ?
Il n’existe pas de nombre « idéal » : tout dépend de la gravité, du modèle de déploiement et de la tolérance au risque. Utilisez les médianes (P50) pour les performances « typiques » et le P90 pour les engagements/SLA, puis segmentez les données par gravité et par source.
Quelle est la différence entre la résolution d'un bug et sa clôture ?
On parle de « résolution » lorsque la correction est mise en œuvre (par exemple, code fusionné, configuration appliquée) et que l’équipe considère que le défaut a été corrigé. On parle de « clôture » lorsque le problème a été vérifié et officiellement fermé (par exemple, validation par l’assurance qualité dans l’environnement cible, mise en production ou marquage « ne sera pas corrigé » / « doublon » avec justification). De nombreuses équipes mesurent ces deux indicateurs : « Signalé → Résolu » reflète la rapidité de l’ingénierie ; « Signalé → Clôturé » reflète le flux de qualité de bout en bout. Utilisez des définitions cohérentes afin que les tableaux de bord ne mélangent pas les étapes.
Quelle est la différence entre le délai de résolution d'un bug et le délai de détection d'un bug ?
Le temps de détection (MTTD) correspond au délai nécessaire pour détecter un défaut après son apparition ou sa mise en production, que ce soit via la surveillance, l’assurance qualité ou les utilisateurs. Le temps de résolution correspond au délai entre la détection/le signalement et la mise en œuvre de la correction (et, si vous le souhaitez, sa validation/sa mise en production). Ensemble, ces deux éléments définissent la fenêtre d’impact client : détecter rapidement, prendre acte rapidement, résoudre rapidement et mettre en production en toute sécurité. Vous pouvez également suivre le MTTA (temps de prise en compte/d’attribution) pour repérer les retards de triage qui laissent souvent présager une résolution plus longue.
Comment l'IA facilite-t-elle la résolution des bugs ?
L'IA raccourcit les étapes qui prennent généralement du temps : enregistrement, triage, diagnostic, correction et vérification.
- Réception et triage : résume automatiquement les longs rapports, extrait les étapes de reproduction et l'environnement, signale les doublons et suggère un niveau de gravité et une priorité afin que les ingénieurs puissent partir d'un contexte clair (par exemple, ClickUp AI, Sentry AI).
- Acheminement et SLA : prédit le composant ou le propriétaire probable, définit des chronomètres et déclenche une escalade lorsque le MTTA ou les délais d’examen sont dépassés, réduisant ainsi le « temps d’inactivité dans un statut » (automatisations ClickUp et flux de travail de type agent).
- Diagnostic : regroupe les erreurs similaires, établit des corrélations entre les pics d'activité et les validations ou versions récents, et identifie les causes profondes probables à l'aide de traces de pile et du contexte du code (Sentry IA et autres outils similaires).
- Mise en œuvre : suggère des modifications de code et des tests en fonction des modèles présents dans votre référentiel, ce qui accélère la boucle « écriture/correction » (GitHub Copilot ; Snyk Code IA par DeepCode).
- Vérification et communication : rédige des cas de test à partir des étapes de reproduction, rédige des notes de mise à jour et des communications destinées aux parties prenantes, et résume le statut pour les dirigeants et les clients (ClickUp AI). En combinant ces outils — ClickUp comme centre de commande avec Sentry/Copilot/DeepCode dans la pile technologique —, les équipes réduisent les délais MTTA et P90 sans avoir à compter sur des exploits individuels.