Sie veröffentlichen das neueste Software-Update, und schon strömen die Berichte herein.
Plötzlich bestimmt eine einzige Metrik Alles – von CSAT/NPS bis hin zu Verzögerungen bei der Roadmap: die Fehlerbehebungszeit.
Führungskräfte betrachten dies als Metrik für die Einhaltung von Versprechen – können wir termingerecht ausliefern, lernen und den Umsatz sichern? Die Praktiker spüren die Probleme an vorderster Front – doppelte Tickets, unklare Eigentümerschaften, unübersichtliche Eskalationen und Informationen, die über Slack, Tabellenkalkulationen und separate Tools verstreut sind.
Diese Fragmentierung verlängert die Zyklen, verschleiert die eigentlichen Ursachen und macht die Priorisierung zu einem Ratespiel.
Das Ergebnis? Langsameres Lernen, verpasste Zusagen und ein Rückstand, der jeden Sprint unbemerkt belastet.
Dieser Leitfaden ist Ihr umfassendes Handbuch zur Messung, zum Benchmarking und zur Verkürzung der Fehlerbehebungszeit und zeigt konkret, wie KI den Workflow im Vergleich zu herkömmlichen, manuellen Prozessen verändert.
Was ist die Fehlerbehebungszeit?
Die Fehlerbehebungszeit ist die Zeitspanne, die zur Behebung eines Fehlers benötigt wird, gemessen vom Zeitpunkt der Fehlermeldung bis zur vollständigen Behebung.
In der Praxis beginnt die Zeitmessung, sobald ein Problem gemeldet oder erkannt wird (durch Benutzer, die Qualitätssicherung oder die Überwachung), und endet, wenn die Korrektur implementiert und in den Code zusammengeführt wurde und zur Überprüfung oder Veröffentlichung bereit ist – je nachdem, wie Ihr Team den Begriff „erledigt“ definiert.
Beispiel: Ein P1-Absturz, der am Monday um 10:00 Uhr gemeldet wurde und dessen Behebung am Dienstag um 15:00 Uhr in den Code zusammengeführt wurde, hat eine Bearbeitungszeit von ca. 29 Stunden.
Dies ist nicht dasselbe wie die Fehlererkennungszeit. Die Erkennungszeit misst, wie schnell Sie einen Fehler erkennen, nachdem er aufgetreten ist (Alarme werden ausgelöst, QA-Tools finden ihn, Kunden erstellen Berichte darüber).
Die Behebungszeit misst, wie schnell Sie vom Erkennen des Problems bis zur Behebung gelangen – Triage, Reproduktion, Diagnose, Implementierung, Überprüfung, Test und Vorbereitung für die Freigabe. Stellen Sie sich die Erkennung als „Wir wissen, dass es nicht funktioniert“ und die Behebung als „Es ist behoben und bereit“ vor.
Teams verwenden leicht unterschiedliche Abgrenzungen; wählen Sie eine aus und wenden Sie diese konsequent an, damit Ihre Trends aussagekräftig sind:
- Gemeldet → Behoben: Der Vorgang ist abgeschlossen, wenn der Code-Fix zusammengeführt und bereit für die Qualitätssicherung ist. Gut für den Durchsatz in der Entwicklung
- Gemeldet → Geschlossen: Beinhaltet QA-Validierung und Freigabe. Ideal für SLAs mit Auswirkungen auf Kunden
- Erkannt → Behoben: Beginnt, sobald die Überwachung/QA das Problem erkennt, noch bevor ein Ticket erstellt wurde. Nützlich für Teams mit hohem Produktionsaufkommen
🧠 Wissenswertes: Ein skurriler und zugleich urkomischer Fehler in Final Fantasy XIV erhielt Lob dafür, dass er so spezifisch war, dass Leser ihn als den „spezifischsten Bugfix in einem MMO 2025“ bezeichneten. “ Er trat auf, wenn Spieler in einer bestimmten Zone während eines Ereignisses Elemente zu einem Preis zwischen genau 44.442 Gil und 49.087 Gil anboten – was zu Verbindungsabbrüchen führte, die möglicherweise auf einen Integer-Überlauf-Fehler zurückzuführen waren.
Warum das wichtig ist
Die Bearbeitungszeit ist ein entscheidender Faktor für den Release-Rhythmus. Lange oder unvorhersehbare Bearbeitungszeiten erzwingen Umfangskürzungen, Hotfixes und Release-Stopps; sie verursachen Planungsschulden, da die „Long Tail“-Effekte (Ausreißer) Sprints stärker aus der Bahn werfen, als der Durchschnitt vermuten lässt.
Dies steht zudem in direktem Zusammenhang mit der Kundenzufriedenheit. Kunden nehmen Probleme in Kauf, wenn diese schnell anerkannt und vorhersehbar behoben werden. Langsame – oder schlimmer noch, uneinheitliche – Fehlerbehebungen führen zu Eskalationen, beeinträchtigen CSAT und NPS und gefährden Vertragsverlängerungen.
Kurz gesagt: Wenn Sie die Fehlerbehebungszeit präzise messen und systematisch verkürzen, werden sich Ihre Roadmaps und Ihre Beziehungen verbessern.
Wie lässt sich die Fehlerbehebungszeit messen?
Legen Sie zunächst fest, wo Ihre Zeitmessung beginnt und endet.
Die meisten Teams wählen entweder „Gemeldet → Behoben“ (die Korrektur wurde zusammengeführt und ist zur Überprüfung bereit) oder „Gemeldet → Geschlossen“ (die Qualitätssicherung hat die Änderung validiert und sie wurde freigegeben oder anderweitig geschlossen).
Wählen Sie eine Definition aus und verwenden Sie diese konsequent, damit Ihre Trends aussagekräftig sind.
Nun benötigen Sie einige messbare Metriken. Lassen Sie uns diese kurz skizzieren:
Wichtige Metriken zur Fehlernachverfolgung, auf die Sie achten sollten:
| 📊 Kennzahl | 📌 Wofür das steht | 💡 So hilft es Ihnen | 🧮 Formel (falls zutreffend) |
|---|---|---|---|
| Fehleranzahl 🐞 | Gesamtzahl der gemeldeten Fehler | Bietet eine Ansicht des Systemzustands. Hoher Wert? Zeit, der Sache auf den Grund zu gehen. | Gesamtzahl der Fehler = Alle im System protokollierten Fehler {offen + geschlossen} |
| Offene Fehler 🚧 | Noch nicht behobene Fehler | Zeigt die aktuelle Workload an. Hilft bei der Priorisierung. | Offene Fehler = Gesamtzahl der Fehler – geschlossene Fehler |
| Geschlossene Fehler ✅ | Behobene und verifizierte Fehler | Verfolgt den Fortschritt und die geleistete Arbeit. | Geschlossene Fehler = Anzahl der Fehler mit dem Status „Geschlossen“ oder „Behoben“ |
| Schweregrad von Fehlern 🔥 | Schweregrad des Fehlers (z. B. kritisch, schwerwiegend, geringfügig) | Unterstützt die Triage anhand der Auswirkungen. | Wird als kategorisches Feld nachverfolgt, keine Formel. Verwenden Sie Filter/Gruppierungen. |
| Fehler-Priorität 📅 | Wie dringend muss ein Fehler behoben werden? | Unterstützt Sie bei der Planung von Sprints und Releases. | Zudem ein kategorisches Feld, das in der Regel nach Prioritätsstufen geordnet ist (z. B. P0, P1, P2). |
| Bearbeitungszeit ⏱️ | Zeit vom Fehlerbericht bis zur Behebung | Misst die Reaktionsfähigkeit. | Bearbeitungsdauer = Datum der Schließung – Datum der Berichterstellung |
| Wiedereröffnungsrate 🔄 | Prozentualer Anteil der Fehler, die nach ihrer Schließung erneut geöffnet wurden | Spiegelt die Qualität der Fehlerbehebung oder Regressionsprobleme wider. | Wiedereröffnungsrate (%) = {Wiedereröffnete Fehler ÷ Gesamtzahl der geschlossenen Fehler} × 100 |
| Bug-Leakage 🕳️ | Fehler, die in die Produktion gelangt sind | Gibt Aufschluss über die Effektivität der Qualitätssicherung und des Softwaretests. | Leckagerate (%) = {Fehler in der Produktion ÷ Gesamtzahl der Fehler} × 100 |
| Fehlerdichte 🧮 | Fehler pro Code-Größe | Hebt risikobehaftete Code-Bereiche hervor. | Fehlerdichte = Anzahl der Fehler ÷ KLOC {Kilo Lines of Code} |
| Zugewiesene vs. nicht zugewiesene Fehler 👥 | Verteilung der Fehler nach Eigentümerschaft | So stellen Sie sicher, dass nichts übersehen wird. | Verwenden Sie einen Filter: Nicht zugewiesen = Fehler, bei denen „Zugewiesen an“ null ist |
| Alter offener Fehler 🧓 | Wie lange ein Fehler ungelöst bleibt | Erkennt Stagnation und Risiken durch Rückstände. | Fehleralter = Aktuelles Datum – Datum der Meldung |
| Doppelte Fehler 🧬 | Anzahl der doppelten Meldungen | Zeigt Fehler in den Erfassungsprozessen auf. | Duplikatsrate = Duplikate ÷ Gesamtzahl der Fehler × 100 |
| MTTD (Mean Time to Detect) 🔎 | Durchschnittliche Zeit bis zur Erkennung von Fehlern oder Incidents | Misst die Effizienz der Überwachung und des Problembewusstseins. | MTTD = Σ(Zeitpunkt der Erkennung – Zeitpunkt des Auftretens) ÷ Anzahl der Fehler |
| MTTR (Mean Time to Resolve) 🔧 | Durchschnittliche Zeit bis zur vollständigen Behebung eines Fehlers nach dessen Erkennung | Erfasst die Reaktionsgeschwindigkeit des Entwicklungsteams und die Zeit bis zur Fehlerbehebung. | MTTR = Σ(Zeit bis zur Behebung – Zeit bis zur Erkennung) ÷ Anzahl der behobenen Fehler |
| MTTA (Mean Time to Acknowledge) 📬 | Zeit von der Erkennung bis zum Beginn der Arbeit an dem Fehler | Zeigt die Reaktionsfähigkeit des Teams und die Reaktionsgeschwindigkeit auf Warnmeldungen. | MTTA = Σ(Zeitpunkt der Bestätigung – Zeitpunkt der Erkennung) ÷ Anzahl der Fehler |
| MTBF (Mean Time Between Failures) 🔁 | Zeit zwischen der Behebung eines Fehlers und dem Auftreten des nächsten Fehlers | Zeigt die Stabilität im Zeitverlauf an. | MTBF = Gesamtverfügbarkeitszeit ÷ Anzahl der Ausfälle |
⚡️ Vorlagenarchiv: 15 kostenlose Vorlagen und Formulare für Fehlerberichte zur Nachverfolgung von Fehlern
Faktoren, die die Fehlerbehebungszeit beeinflussen
Die Behebungszeit wird oft mit der „Geschwindigkeit, mit der Entwickler Code schreiben“ gleichgesetzt.
Doch das ist nur ein Teil des Prozesses.
Die Fehlerbehebungszeit setzt sich zusammen aus der Qualität bei der Erfassung, der Effizienz des Flows durch Ihr System und dem Risiko von Abhängigkeiten. Wenn einer dieser Faktoren ins Stocken gerät, verlängert sich die Zykluszeit, die Vorhersehbarkeit sinkt und die Beschwerden nehmen zu.
Die Qualität der Erfassung gibt den Ton an
Meldungen, die ohne klare Schritte zur Reproduktion, ohne Angaben zur Umgebung, ohne Protokolle oder ohne Info zu Version und Build eingehen, führen zu unnötigem Hin und Her. Doppelte Meldungen aus verschiedenen Kanälen (Support, Qualitätssicherung, Überwachung, Slack) sorgen für Unübersichtlichkeit und eine Zersplitterung der Eigentümerschaft.
Je früher Sie die richtigen Kontextinformationen erfassen – und Duplikate entfernen –, desto weniger Übergaben und Klärungsanfragen sind später erforderlich.
Priorisierung und Weiterleitung bestimmen, wer sich wann mit dem Fehler befasst
Schweregrad-Beschreibungen, die nicht den Auswirkungen auf Kunden oder das Geschäft entsprechen (oder sich im Laufe der Zeit verschieben), führen zu Unruhe in der Warteschlange: Die lautesten Tickets drängeln sich vor, während Fehler mit hohen Auswirkungen unberücksichtigt bleiben.
Klare Weiterleitungsregeln nach Komponente/Eigentümer und eine einzige „Wahrheitswarteschlange“ verhindern, dass P0-/P1-Arbeiten unter „aktuellen und lauten“ Arbeiten begraben werden.
Eigentümerschaft und Übergaben sind stille Killer
Wenn unklar ist, ob ein Fehler in den Zuständigkeitsbereich des Mobile-Teams, des Backend-Auth-Teams oder des Plattformteams fällt, wird er hin- und hergeschoben. Bei jedem Hin- und Herschieben wird der Kontext zurückgesetzt.
Zeitzonen verschärfen dieses Problem noch: Ein Fehler, der spät am Tag gemeldet wird und für den kein Eigentümer benannt ist, kann 12–24 Stunden verlieren, bevor überhaupt mit der Reproduktion begonnen wird. Klare Definitionen darüber, „wer für was zuständig ist“, mit einem Bereitschaftsdienst oder einem wöchentlichen DRI, beseitigen diese Verzögerung.
Die Reproduzierbarkeit ist von der Beobachtbarkeit abhängig
Lückenhafte Protokolle, fehlende Korrelations-IDs oder das Fehlen von Absturz-Traces machen die Diagnose zu reiner Spekulation. Fehler, die nur bei bestimmten Flags, Mandanten oder Formen auftreten, lassen sich in der Entwicklung nur schwer reproduzieren.
Wenn Entwickler keinen sicheren Zugriff auf bereinigte, produktionsähnliche Daten haben, müssen sie Instrumente einrichten, neu bereitstellen und warten – und das tagelang statt nur stundenlang.
Umgebungs- und Datenparität sorgen für Transparenz
„Auf meinem Rechner funktioniert es“ bedeutet in der Regel: „Die Produktionsdaten sind anders.“ Je stärker sich Ihre Entwicklungs- und Staging-Umgebung von der Produktion unterscheiden (Konfiguration, Dienste, Versionen von Drittanbietern), desto länger werden Sie damit beschäftigt sein, Phantomfehlern hinterherzujagen. Sichere Daten-Snapshots, Seed-Skripte und Paritätsprüfungen verringern diese Diskrepanz.
Work-in-Progress (IB) und Fokussierung bestimmen den tatsächlichen Durchsatz
Überlastete Teams bearbeiten zu viele Fehler gleichzeitig, zerstreuen ihre Aufmerksamkeit und hetzen zwischen Aufgaben und Meetings hin und her. Der Kontextwechsel kostet unsichtbare Arbeitsstunden.
Ein sichtbares IB-Limit und die Priorität, Begonnenes abzuschließen, bevor neue Arbeiten angenommen werden, senken Ihren Medianwert schneller als jeder einzelne Aufwand.
Code-Review, CI und die Geschwindigkeit der Qualitätssicherung sind klassische Engpässe
Lange Build-Zeiten, unzuverlässige Tests und unklare SLAs für die Überprüfung verzögern ansonsten schnelle Fehlerbehebungen. Ein 10-minütiger Patch kann zwei Tage lang auf einen Prüfer warten oder in eine stundenlange Pipeline eingereiht werden.
Ebenso können QA-Warteschlangen, in denen Tests gebündelt werden oder manuelle Smoke-Tests durchgeführt werden, den Prozess „Gemeldet → Geschlossen“ um ganze Tage verlängern – selbst wenn der Prozess „Gemeldet → Behoben“ schnell abläuft.
Abhängigkeiten verlängern die Warteschlangen
Teamübergreifende Änderungen (Schema, Plattformmigrationen, SDK-Updates), Fehler bei Anbietern oder App-Store-Prüfungen (Mobilgeräte) führen zu Wartezeiten. Ohne explizite Nachverfolgung von „Blockiert/Pausiert“ blähen diese Wartezeiten Ihre Durchschnittswerte unsichtbar auf und verschleiern, wo der eigentliche Engpass liegt.
Das Release-Modell und die Rollback-Strategie spielen eine wichtige Rolle
Wenn Sie in großen Release-Zügen mit manuellen Gates veröffentlichen, bleiben selbst behobene Fehler so lange liegen, bis der nächste Zug abfährt. Feature Flags, Canary-Releases und Hotfix-Lanes verkürzen den Nachlauf – insbesondere bei P0/P1-Incidents –, indem sie es Ihnen ermöglichen, die Bereitstellung von Korrekturen von den vollständigen Zyklen zu entkoppeln.
Architektur und technische Schulden setzen Ihnen Grenzen
Enge Kopplungen, fehlende Testgrenzen und undurchsichtige Legacy-Module machen einfache Korrekturen riskant. Teams gleichen dies durch zusätzliche Tests und längere Reviews aus, was die Zyklen verlängert. Umgekehrt ermöglicht modularer Code mit guten Kontrakt-Tests ein schnelles Vorankommen, ohne benachbarte Systeme zu beeinträchtigen.
Kommunikation und Statusverwaltung beeinflussen die Vorhersehbarkeit
Vage Statusmeldungen („Wir prüfen das gerade“) führen zu Nacharbeit, wenn Stakeholder nach voraussichtlichen Fertigstellungsterminen fragen, der Support Tickets erneut öffnet oder das Produktteam die Angelegenheit eskaliert. Klare Statusübergänge, Notizen zur Reproduktion und zur Ursache sowie ein veröffentlichter voraussichtlicher Fertigstellungstermin reduzieren die Fluktuation und schützen die Konzentration Ihres Entwicklerteams.
📮ClickUp Insight: Im Durchschnitt verbringt ein Berufstätiger täglich mehr als 30 Minuten mit der Suche nach arbeitsbezogenen Informationen – das sind über 120 Stunden pro Jahr, die durch das Durchforsten von E-Mails, Slack-Threads und verstreuten Dateien verloren gehen.
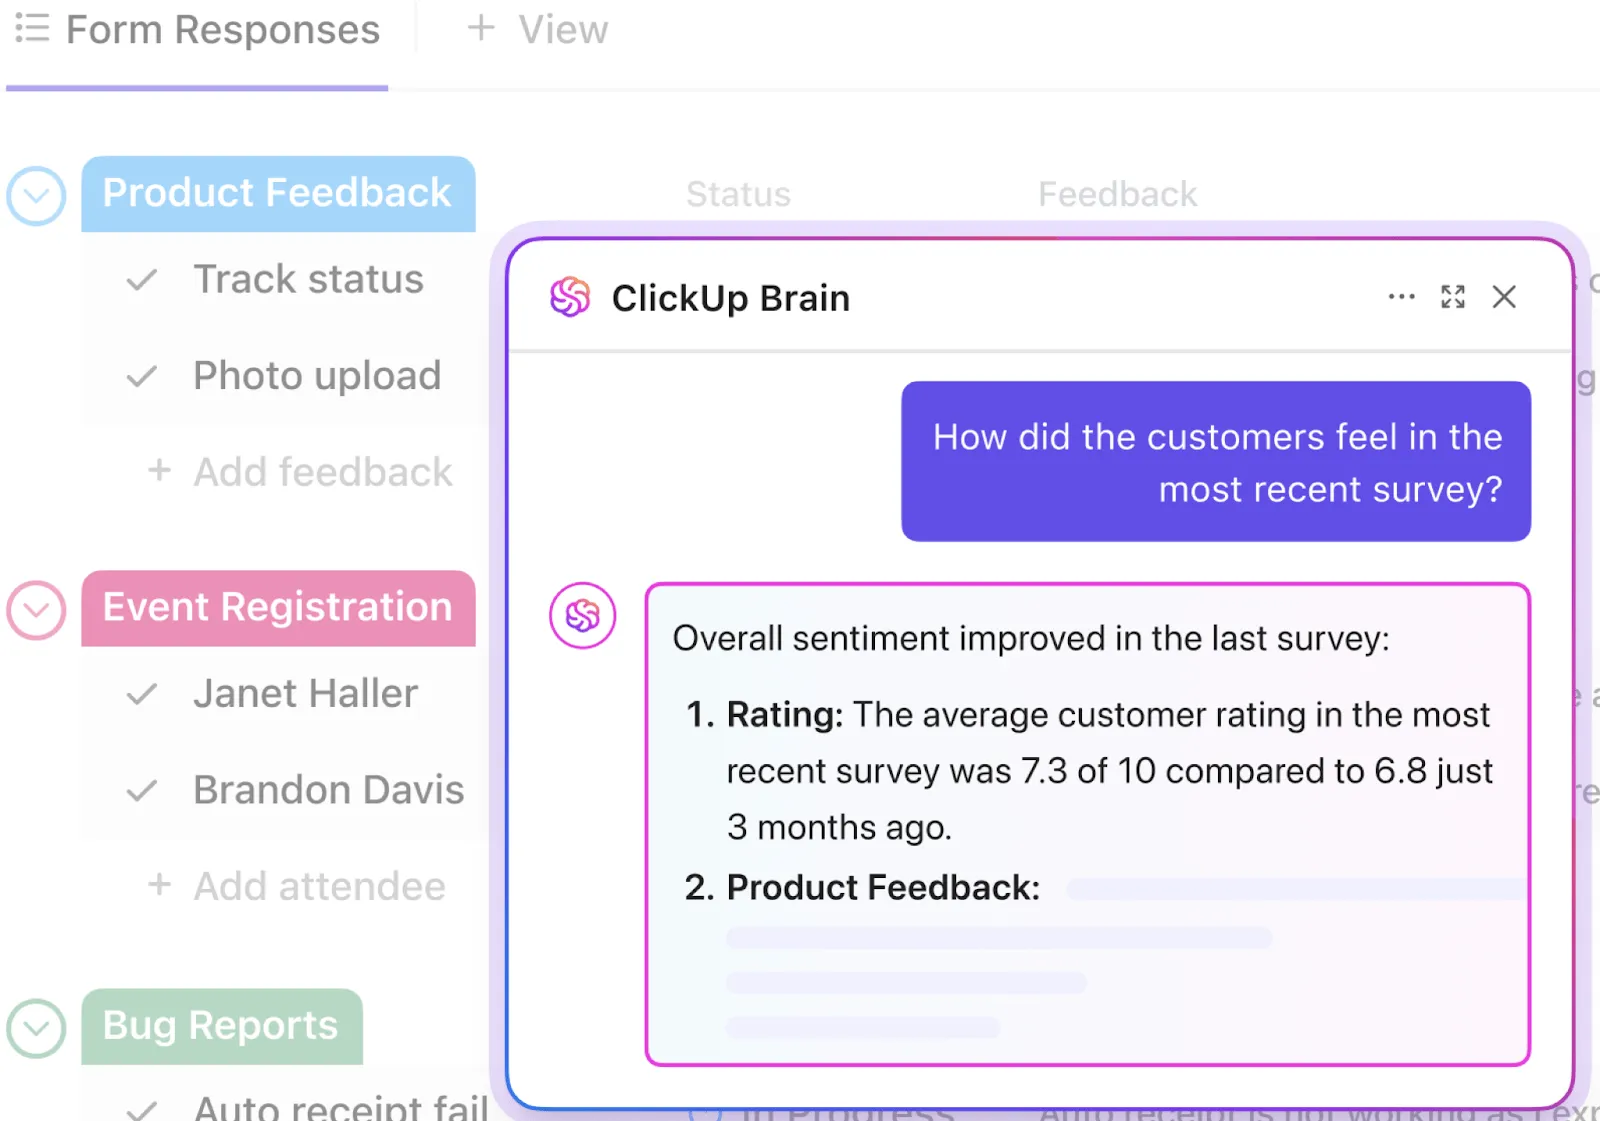
Ein intelligenter KI-Assistent, der in Ihren Arbeitsbereich integriert ist, kann das ändern. Lernen Sie ClickUp Brain kennen. Es liefert sofortige Einblicke und Antworten, indem es innerhalb von Sekunden die richtigen Dokumente, Unterhaltungen und Aufgabendetails anzeigt – so können Sie aufhören zu suchen und mit der Arbeit beginnen.
💫 Konkrete Ergebnisse: Teams wie QubicaAMF haben durch den Einsatz von ClickUp wöchentlich mehr als 5 Stunden eingespart – das sind über 250 Stunden pro Person und Jahr –, indem sie veraltete Wissensmanagementprozesse abgeschafft haben. Stellen Sie sich vor, was Ihr Team mit einer zusätzlichen Woche Produktivität pro Quartal alles erreichen könnte!
Frühwarnzeichen dafür, dass sich Ihre Vorlaufzeit verlängern wird
❗️Steigende „Time to Acknowledge“ und viele Tickets, die seit mehr als 12 Stunden keinen Eigentümer haben
❗️Zunehmende „Time in Review/CI“-Intervalle und häufige Testinstabilität
❗️Hohe Duplikatrate bei der Erfassung und uneinheitliche Beschreibungen der Schweregrade zwischen den Teams
❗️Mehrere Fehler, die im Status „Blockiert“ verbleiben, ohne dass eine externe Abhängigkeit angegeben ist
❗️Die Wiedereröffnungsrate steigt langsam an (Fehlerbehebungen sind nicht reproduzierbar oder die Definitionen für „erledigt“ sind unklar)
Verschiedene Unternehmen empfinden diese Faktoren unterschiedlich. Führungskräfte erleben sie als verpasste Zyklen des Lernens und Verzögerungen bei Umsatzchancen; Mitarbeiter empfinden sie als Störfaktoren bei der Fehlerzuordnung und unklare Eigentümerschaft.
Durch die Optimierung von Erfassung, Flow und Abhängigkeiten können Sie die gesamte Kurve – sowohl den Median als auch den P90-Wert – nach unten senken.
Möchten Sie weitere Informationen darüber erhalten, wie Sie bessere Fehlerberichte verfassen können? Beginnen Sie hier. 👇🏼
📖 Weiterlesen: Der Software-Testzyklus (STLC): Übersicht und Phasen
Branchen-Benchmarks für die Fehlerbehebungszeit
Die Benchmarks für die Fehlerbehebung hängen von der Risikotoleranz, dem Release-Modell und der Geschwindigkeit ab, mit der Sie Änderungen bereitstellen können.
Hier können Sie Mediane (P50) nutzen, um Ihren typischen Flow zu verstehen, und P90, um Zusagen und SLAs einzustellen – nach Schweregrad und Quelle (Kunde, Qualitätssicherung, Überwachung).
Schauen wir uns einmal genauer an, was das bedeutet:
| 🔑 Begriff | 📝 Beschreibung | 💡 Warum das wichtig ist |
|---|---|---|
| P50 (Median) | Der Mittelwert – 50 % der Fehlerbehebungen sind schneller als dieser Wert, 50 % sind langsamer | 👉 Spiegelt Ihre typische oder häufigste Bearbeitungszeit wider. Gut geeignet, um die normale Leistung zu verstehen |
| P90 (90. Perzentil) | 90 % der Fehler werden innerhalb dieser Zeit behoben. Nur 10 % benötigen mehr Zeit. | 👉 Stellt eine Worst-Case-Grenze dar (die aber dennoch realistisch ist). Nützlich für die Einstellung externer Zusagen |
| SLAs (Service Level Agreements) | Verpflichtungen, die Sie – intern oder gegenüber Kunden – hinsichtlich der Geschwindigkeit eingehen, mit der Probleme behoben werden | 👉 Beispiel: „Wir beheben P1-Fehler in 90 % der Fälle innerhalb von 48 Stunden.“ Das stärkt das Vertrauen und fördert die Verantwortlichkeit. |
| Nach Schweregrad und Quelle | Segmentieren Sie Ihre Metriken nach zwei Schlüsseldimensionen: • Schweregrad (z. B. P0, P1, P2) • Quelle (z. B. Kunde, Qualitätssicherung, Überwachung) | 👉 Ermöglicht eine genauere Nachverfolgung und Priorisierung, sodass kritische Fehler schneller Beachtung finden |
Im Folgenden finden Sie Bereiche, die auf Branchen basieren, auf die erfahrene Teams häufig als Einzelziele setzen; betrachten Sie diese als Ausgangswerte und passen Sie sie dann an Ihren Kontext an.
SaaS
Da das System ständig verfügbar und CI/CD-freundlich ist, sind Hotfixes an der Tagesordnung. Bei kritischen Problemen (P0/P1) wird häufig ein Medianwert von weniger als einem Arbeitstag angestrebt, wobei der P90-Wert innerhalb von 24–48 Stunden liegt. Nicht-kritische Probleme (P2+) werden in der Regel innerhalb von 3–7 Tagen (Median) behoben, wobei der P90-Wert bei 10–14 Tagen liegt. Teams mit robusten Feature Flags und automatisierten Tests tendieren zu schnelleren Lösungszeiten.
E-Commerce-Plattformen
Da Konversions- und Warenkorb-Flows für den Umsatz entscheidend sind, liegen die Anforderungen hier höher. P0/P1-Probleme werden in der Regel innerhalb weniger Stunden behoben (Rollback, Markierung oder Konfiguration) und noch am selben Tag vollständig gelöst; P90 bis zum Ende des Tages oder innerhalb von <12 Stunden ist in der Hochsaison üblich. P2+-Probleme werden oft innerhalb von 2–5 Tagen gelöst, wobei P90 innerhalb von 10 Tagen liegt.
Enterprise-Software
Umfangreichere Validierungen und längere Zeitfenster für Kundenänderungen verlangsamen den Arbeitsrhythmus. Bei P0/P1 streben die Teams eine Übergangslösung innerhalb von 4–24 Stunden und eine Behebung innerhalb von 1–3 Werktagen an; P90 innerhalb von 5 Werktagen. P2+-Elemente werden häufig in Release-Züge gebündelt, wobei die Medianwerte je nach den Rollout-Zeitplänen der Kunden bei 2–4 Wochen liegen.
Gaming- und mobile Apps
Live-Service-Backends verhalten sich wie SaaS (Flags und Rollbacks innerhalb von Minuten bis Stunden; P90 noch am selben Tag). Client-Updates unterliegen den Einschränkungen der Store-Prüfung: Bei P0/P1 werden oft sofort serverseitige Maßnahmen ergriffen und ein Client-Patch innerhalb von 1–3 Tagen bereitgestellt; P90 innerhalb einer Woche bei beschleunigter Prüfung. P2+-Korrekturen werden in der Regel für den nächsten Sprint oder Inhalt eingeplant.
Bankwesen/Fintech
Risiko- und Compliance-Kontrollen fördern ein Muster nach dem Motto „Schnell beheben, sorgfältig ändern“. P0/P1-Fehler werden schnell behoben (Flaggen, Rollbacks, Umleitung des Datenverkehrs innerhalb von Minuten bis Stunden) und innerhalb von 1–3 Tagen vollständig behoben; P90-Fehler innerhalb einer Woche, unter Berücksichtigung der Änderungskontrolle. Bei P2+-Fehler dauert es oft 2–6 Wochen, bis sie Prüfungen der Sicherheit, des Audits und des CAB bestehen.
Wenn Ihre Zahlen außerhalb dieser Bereiche liegen, sollten Sie die Qualität der Erfassung, die Eigentümerschaft, den Durchsatz bei Code-Reviews und der Qualitätssicherung sowie die Genehmigungen von Abhängigkeiten überprüfen, bevor Sie davon ausgehen, dass die „Entwicklungsgeschwindigkeit“ das Kernproblem ist.
🌼 Wussten Sie schon: Laut einer Stack-Overflow-Umfrage aus dem Jahr 2024 nutzten Entwickler KI zunehmend als zuverlässigen Begleiter bei der Programmierung. Satte 82 % nutzten KI sogar zum Schreiben von Code – das nenne ich mal einen kreativen Mitstreiter! Wenn sie nicht weiterkamen oder nach Lösungen suchten, verließen sich 67,5 % auf KI, um nach Antworten zu suchen, und mehr als die Hälfte (56,7 %) nutzte sie zum Debuggen und um Hilfe zu erhalten.
Für einige erwiesen sich KI-Tools auch als nützlich für die Dokumentation von Projekten (40,1 %) und sogar für die Erstellung synthetischer Daten oder Inhalte (34,8 %). Neugierig auf eine neue Codebasis? Fast ein Drittel (30,9 %) nutzt KI, um sich schnell einzuarbeiten. Das Testen von Code ist für viele nach wie vor eine mühsame manuelle Arbeit, doch 27,2 % setzen auch hier bereits auf KI. In anderen Bereichen wie Code-Review, Projektplanung und prädiktiver Analytik ist die KI-Nutzung zwar noch geringer, doch es ist offensichtlich, dass sich KI stetig in jede Phase der Softwareentwicklung einfügt.
📖 Weiterlesen: Wie man KI für die Qualitätssicherung einsetzt
So verkürzen Sie die Zeit bis zur Fehlerbehebung
Eine schnelle Fehlerbehebung hängt davon ab, dass Reibungsverluste bei jedem Übergang – von der Erfassung bis zur Veröffentlichung – beseitigt werden.
Die größten Vorteile ergeben sich daraus, die ersten 30 Minuten effizienter zu gestalten (saubere Erfassung, richtiger Eigentümer, richtige Priorität) und anschließend die folgenden Zyklen (Reproduktion, Überprüfung, Verifizierung) zu verkürzen.
Hier sind neun Strategien, die als System zusammenwirken. KI beschleunigt jeden Schritt, und der Workflow ist übersichtlich an einem Ort zusammengefasst, sodass Führungskräfte von Vorhersehbarkeit profitieren und die Mitarbeiter einen reibungslosen Flow genießen.
1. Zentralisieren Sie die Erfassung und erfassen Sie den Kontext direkt an der Quelle
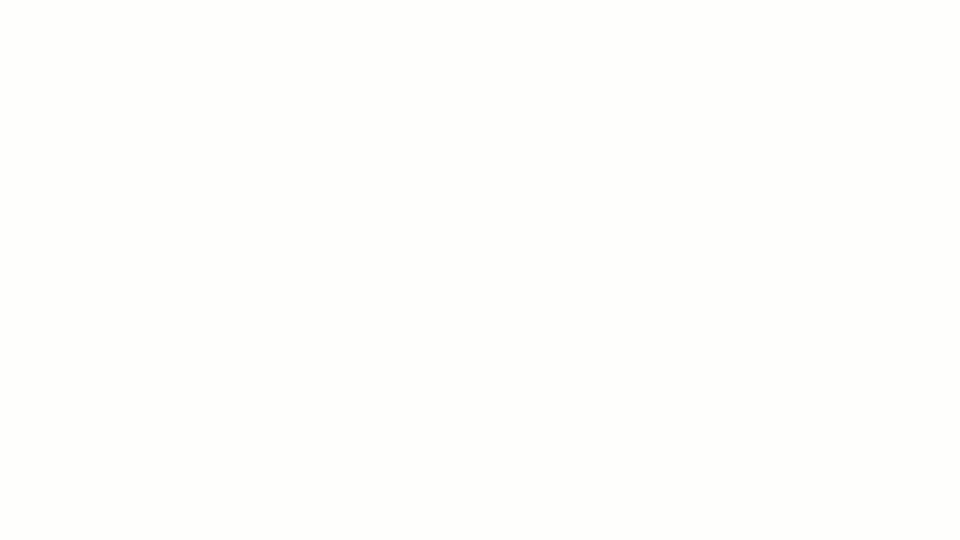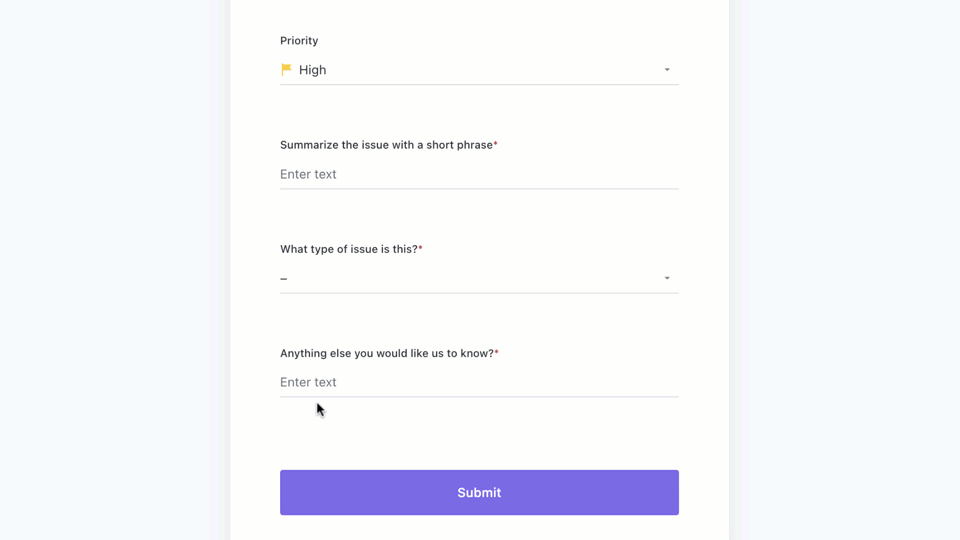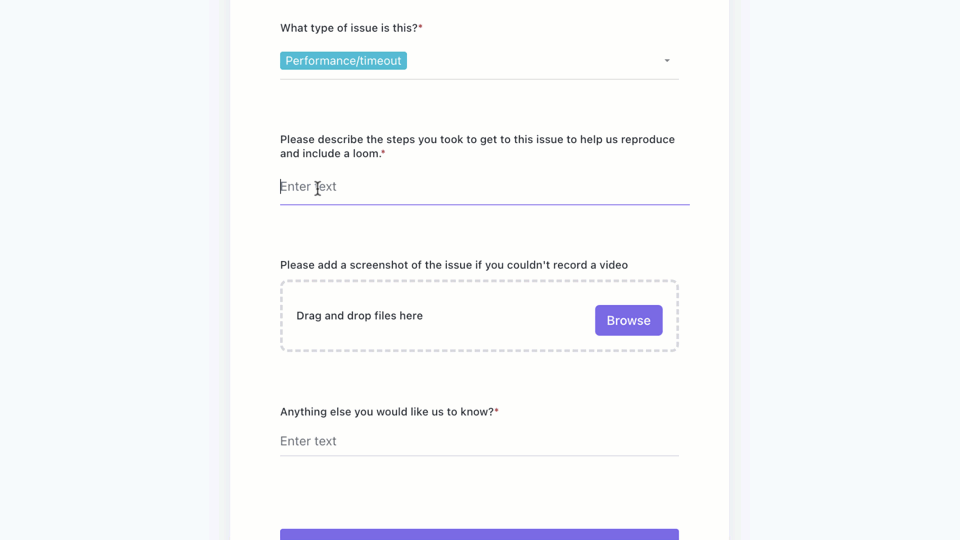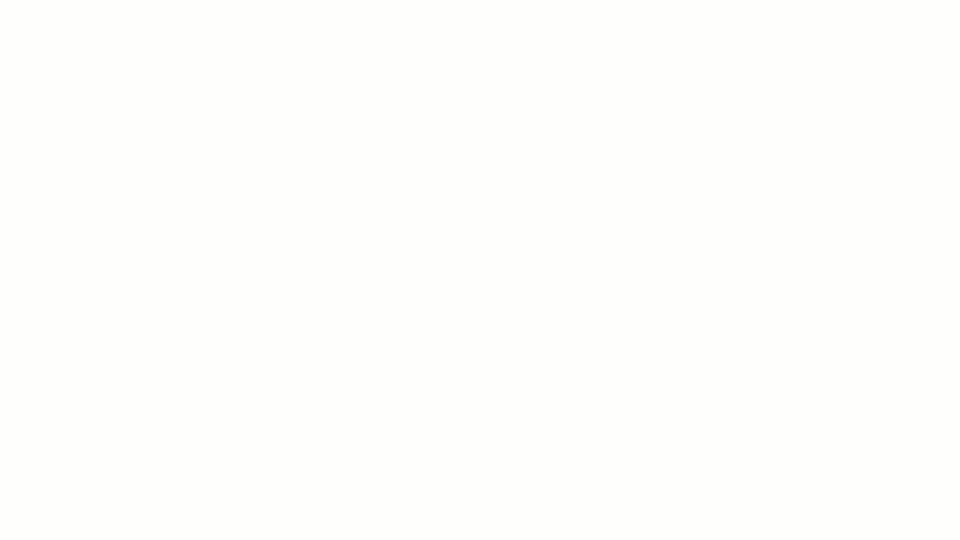
Die Fehlerbehebungszeit verlängert sich, wenn Sie den Kontext aus Slack-Threads, Support-Tickets und Tabellenkalkulationen rekonstruieren müssen. Leiten Sie alle Meldungen – aus Support, Qualitätssicherung und Überwachung – in eine einzige Warteschlange mit einer strukturierten Vorlage, die Angaben zu Komponente, Schweregrad, Umgebung, App-Version/Build, Schritten zur Reproduktion, Soll- und Ist-Zustand sowie Anhängen (Protokolle/HAR/Screenshots) erfasst.
KI kann lange Berichte automatisch zusammenfassen, Schritte zur Reproduktion sowie Umgebungsdetails aus Anhängen extrahieren und mögliche Duplikate kennzeichnen, sodass die Triage auf der Grundlage eines schlüssigen, angereicherten Datensatzes beginnen kann.
Wichtige Metriken: MTTA (Bestätigung innerhalb von Minuten, nicht Stunden), Duplikatsrate, Bearbeitungszeit für „Info erforderlich“.
2. KI-gestützte Triage und Weiterleitung zur drastischen Verkürzung der MTTA
Die schnellsten Lösungen sind diejenigen, die sofort auf dem richtigen Schreibtisch landen.
Nutzen Sie einfache Regeln in Kombination mit KI, um den Schweregrad einzustufen, mögliche Eigentümer nach Komponente bzw. Code-Bereich zu identifizieren und Aufgaben automatisch mit einer SLA-Uhr zuzuweisen. Legen Sie klare Swimlanes zwischen P0/P1 und allen anderen Fällen fest und sorgen Sie dafür, dass immer eindeutig ist, wer dafür zuständig ist.
Automatisierungen können anhand von Feldwerten Prioritäten festlegen, Tickets je nach Komponente an ein Team weiterleiten, einen SLA-Timer starten und einen Techniker im Bereitschaftsdienst benachrichtigen; die KI kann auf der Grundlage früherer Muster den Schweregrad und den Eigentümer vorschlagen. Wenn die Triage nur noch 2 bis 5 Minuten dauert statt einer 30-minütigen Diskussion, sinkt Ihre MTTA und Ihre MTTR folgt diesem Trend.
Wichtige Metriken: MTTA, Qualität der ersten Reaktion (werden im ersten Kommentar die richtigen Infos angefordert?), Anzahl der Übergaben pro Fehler.
So sieht das in der Praxis aus:
3. Priorisieren Sie nach geschäftlichen Auswirkungen mit klar definierten SLA-Stufen
„Wer am lautesten schreit, gewinnt“ macht Warteschlangen unvorhersehbar und untergräbt das Vertrauen der Führungskräfte, die CSAT/NPS und Vertragsverlängerungen im Blick haben.
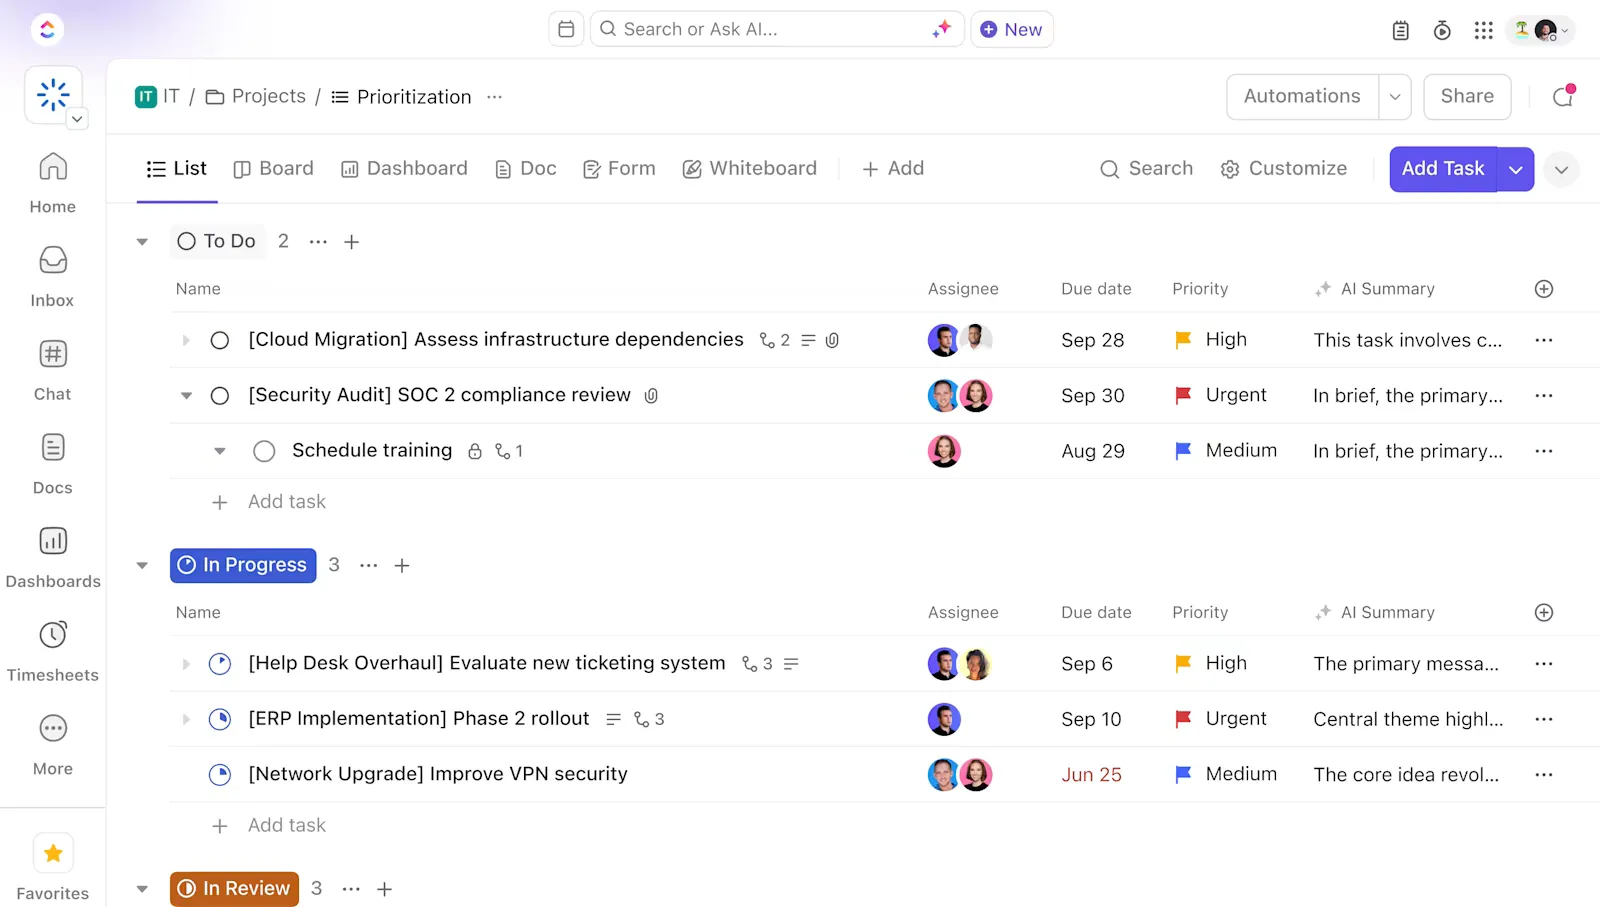
Ersetzen Sie dies durch eine Bewertung, die Schweregrad, Häufigkeit, betroffene ARR, Kritikalität des Features und Nähe zu Verlängerungen/Einführungen berücksichtigt – und untermauern Sie diese mit SLA-Stufen (z. B. P0: Behebung innerhalb von 1–2 Stunden, Lösung innerhalb eines Tages; P1: noch am selben Tag; P2: innerhalb eines Sprints).
Sorgen Sie mit IB-Limits für eine hohe Sichtbarkeit der P0/P1-Spur, damit nichts ins Stocken gerät.
Wichtige Metriken: P50/P90-Behebungsrate nach Schweregrad, SLA-Verletzungsrate, Korrelation mit CSAT/NPS.
💡Profi-Tipp: Mit den Feldern „Prioritäten für Aufgaben“, „Benutzerdefinierte Felder“ und „Abhängigkeiten“ in ClickUp können Sie einen Auswirkungswert berechnen und Fehler mit Konten, Feedback oder Roadmap-Elementen verknüpfen. Außerdem helfen Ihnen die „Ziele“ in ClickUp dabei, die Einhaltung von SLAs mit den Zielen auf Unternehmensebene zu verknüpfen, was direkt auf die Bedenken der Führungskräfte hinsichtlich der Ausrichtung eingeht.
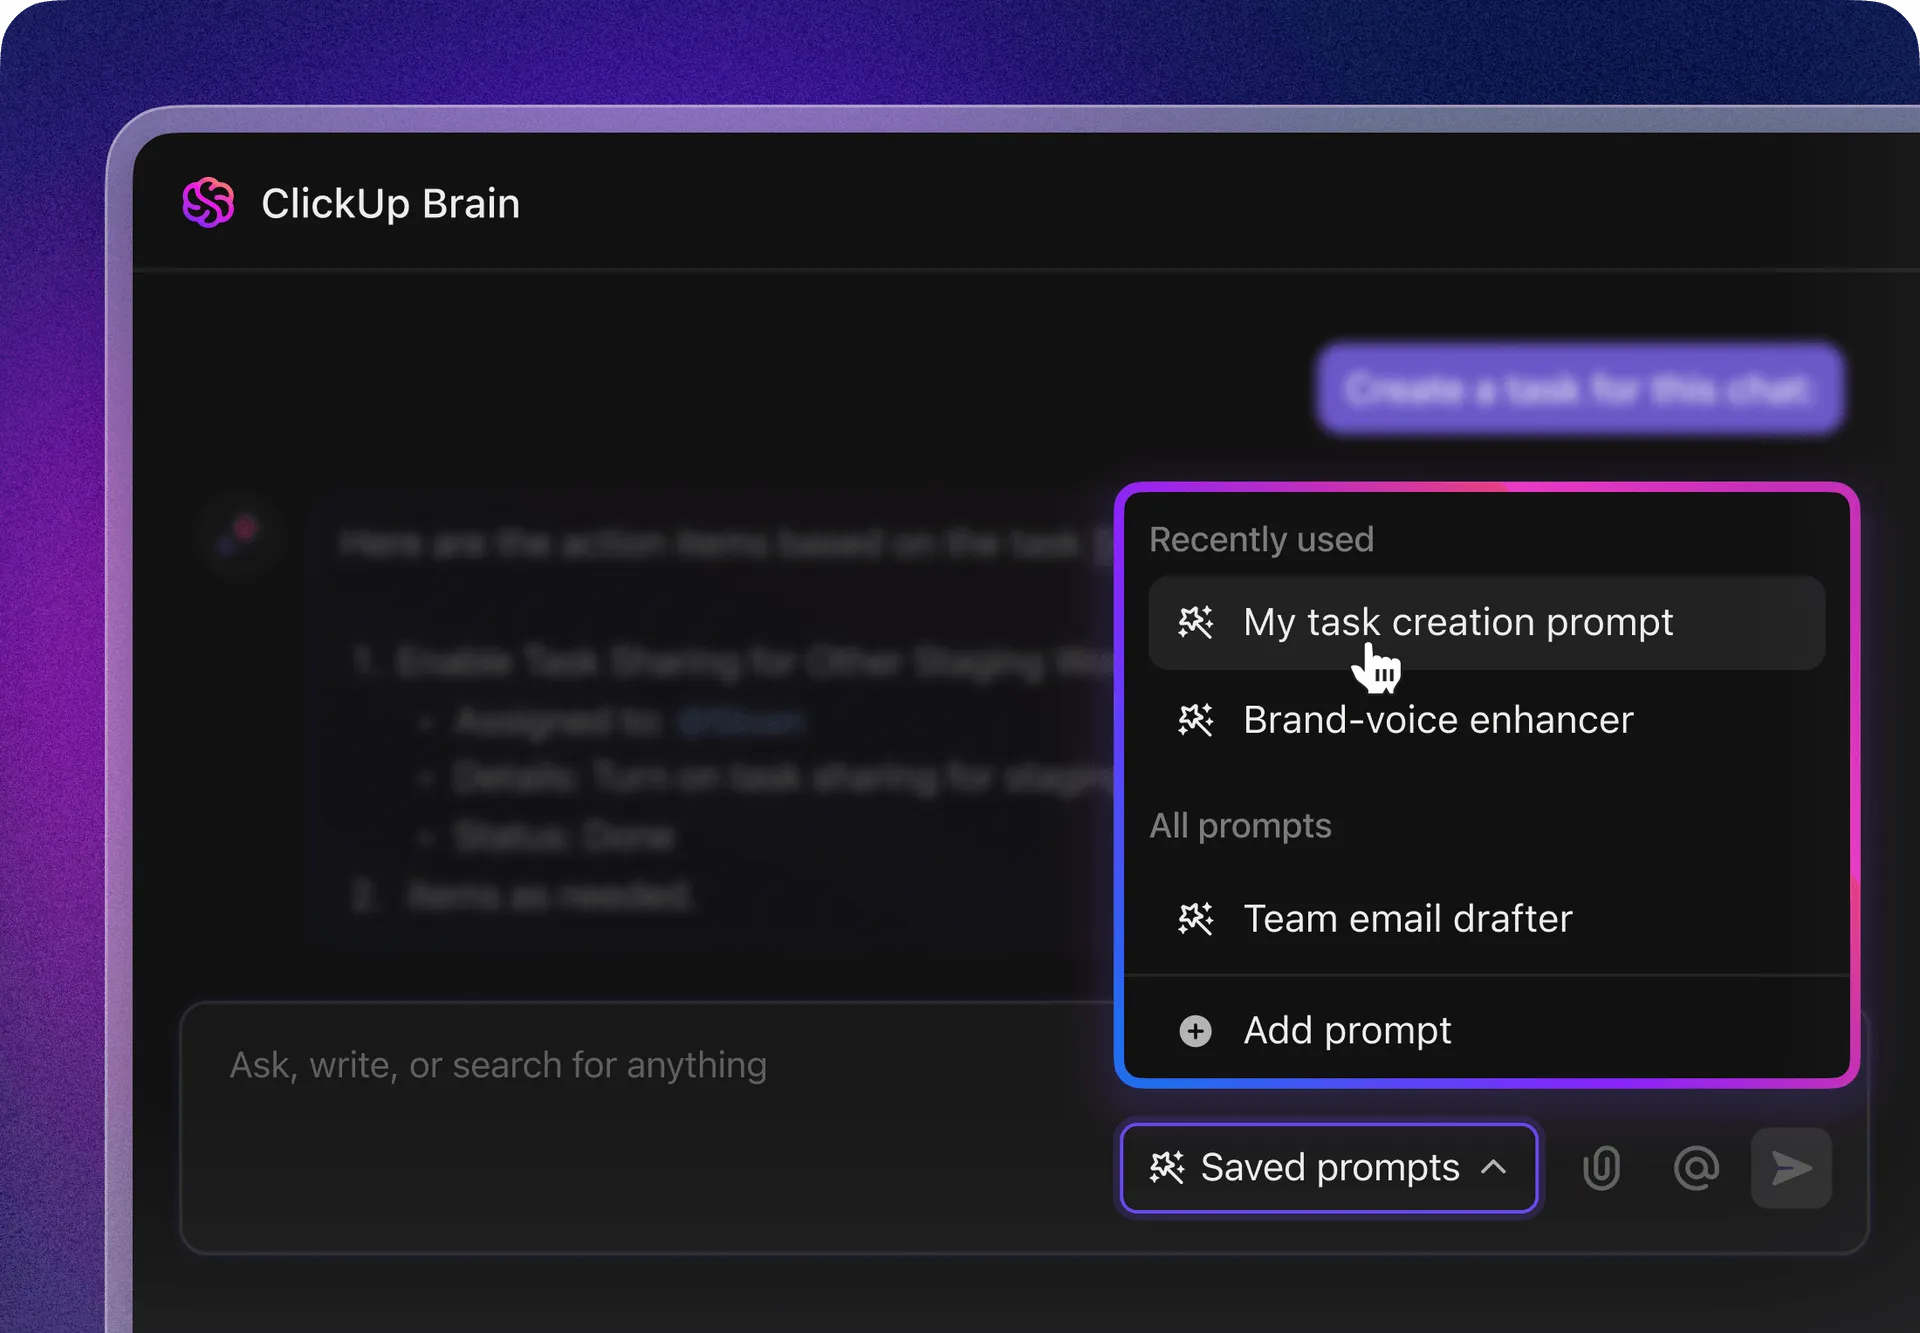
4. Machen Sie die Reproduktion und Diagnose zu einem einmaligen Vorgang
Jeder zusätzliche Schritt mit der Frage „Können Sie mir die Protokolle schicken?“ verlängert die Bearbeitungszeit.
Standardisieren Sie, was als „gut“ gilt: Pflichtfelder für Build/Commit, Umgebung, Reproduktionsschritte, Soll- und Ist-Werte sowie Anhänge für Protokolle, Crash-Dumps und HAR-Dateien. Implementieren Sie Client- und Server-Telemetrie, damit Crash-IDs und Request-IDs mit Traces verknüpft werden können.
Nutzen Sie Sentry (oder ein ähnliches Tool) für Stack-Traces und verknüpfen Sie das Problem direkt mit dem Fehler. KI kann Protokolle und Traces auswerten, um einen wahrscheinlichen Fehlerbereich vorzuschlagen und einen minimalen Reproduktionsfall zu generieren – so wird aus einer Stunde Suchen mit dem bloßen Auge eine gezielte Arbeit von nur wenigen Minuten.
Speichern Sie Runbooks für häufige Fehlerarten, damit Entwickler nicht jedes Mal bei Null anfangen müssen.
Wichtige Metriken: Zeitaufwand für „Warten auf Info“, Prozentsatz der beim ersten Durchlauf reproduzierten Fehler, Wiedereröffnungsrate aufgrund fehlender Reproduktion.
📖 Weitere Informationen: Wie man KI in der Softwareentwicklung einsetzt (Anwendungsfälle & Tools)
5. Verkürzen Sie den Code-Review- und Testzyklus
Große PRs verzögern den Prozess. Setzen Sie auf gezielte Patches, trunk-basierte Entwicklung und Feature Flags, damit Korrekturen sicher bereitgestellt werden können. Weisen Sie Prüfer bereits im Vorfeld entsprechend der Code-Eigentümerschaft zu, um Leerlaufzeiten zu vermeiden, und nutzen Sie Checklisten (Tests aktualisiert, Telemetrie hinzugefügt, Flag hinter einem Kill-Switch), damit die Qualität von vornherein gewährleistet ist.
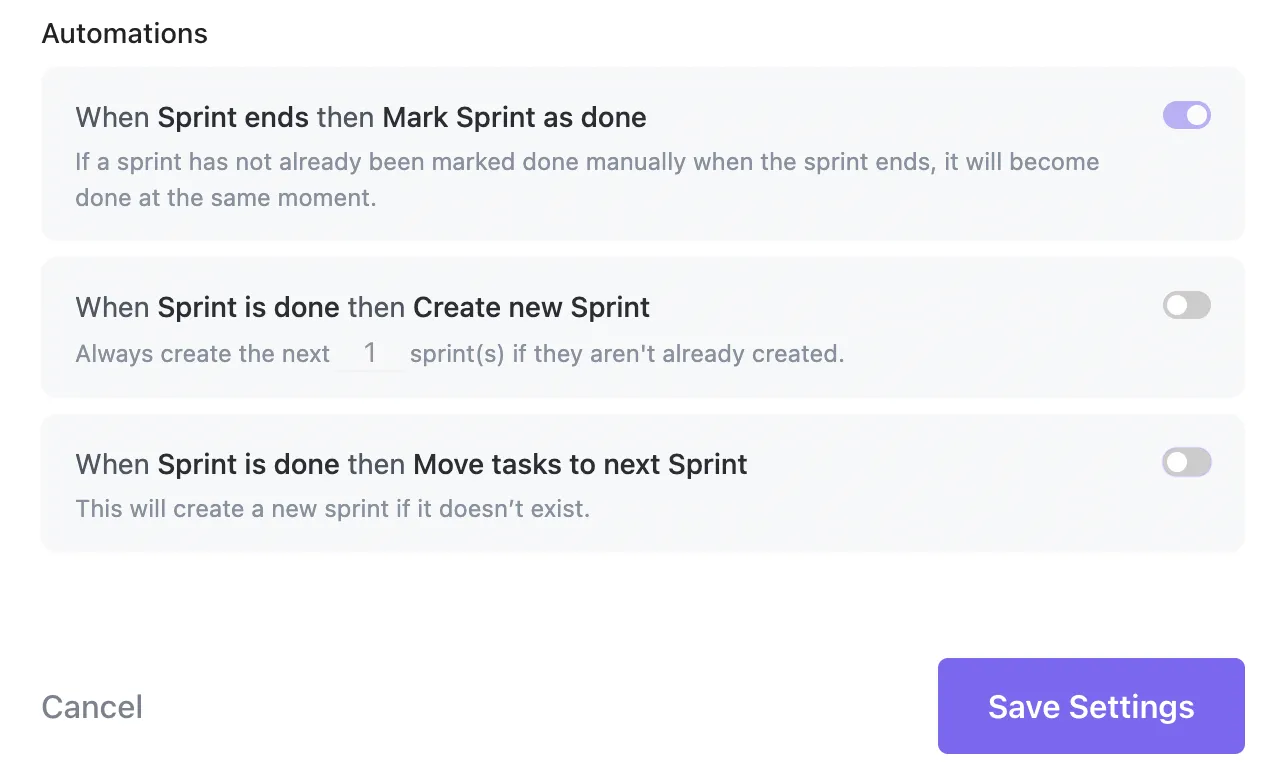
Die Automatisierung sollte den Fehler bei Eröffnung des Pull-Requests in den Status „In Review“ und beim Zusammenführen in den Status „Resolved“ versetzen; KI kann Unit-Tests vorschlagen oder riskante Diffs hervorheben, um den Fokus der Überprüfung zu lenken.
Wichtige Metriken: Verweildauer im Status „In Review“, Fehlerquote bei Pull-Requests zur Fehlerbehebung und P90-Überprüfungsverzögerung.
Sie können GitHub-/Gitlab-Integrationen in ClickUp nutzen, um den Status der Bearbeitung synchron zu halten; Automatisierungen können die „Definition of Done“ durchsetzen.
📖 Weiterlesen: So nutzen Sie KI zur Automatisierung von Aufgaben
6. Parallelisieren Sie die Überprüfung und sorgen Sie für echte Parität in der QA-Umgebung
Die Überprüfung sollte nicht erst Tage später oder in einer Umgebung beginnen, die keiner Ihrer Kunden nutzt.
Sorgen Sie für eine strenge Einhaltung des Status „bereit für die Qualitätssicherung“: Flag-gesteuerte Hotfixes, die in produktionsähnlichen Umgebungen mit Seed-Daten validiert werden, die den gemeldeten Fällen entsprechen.
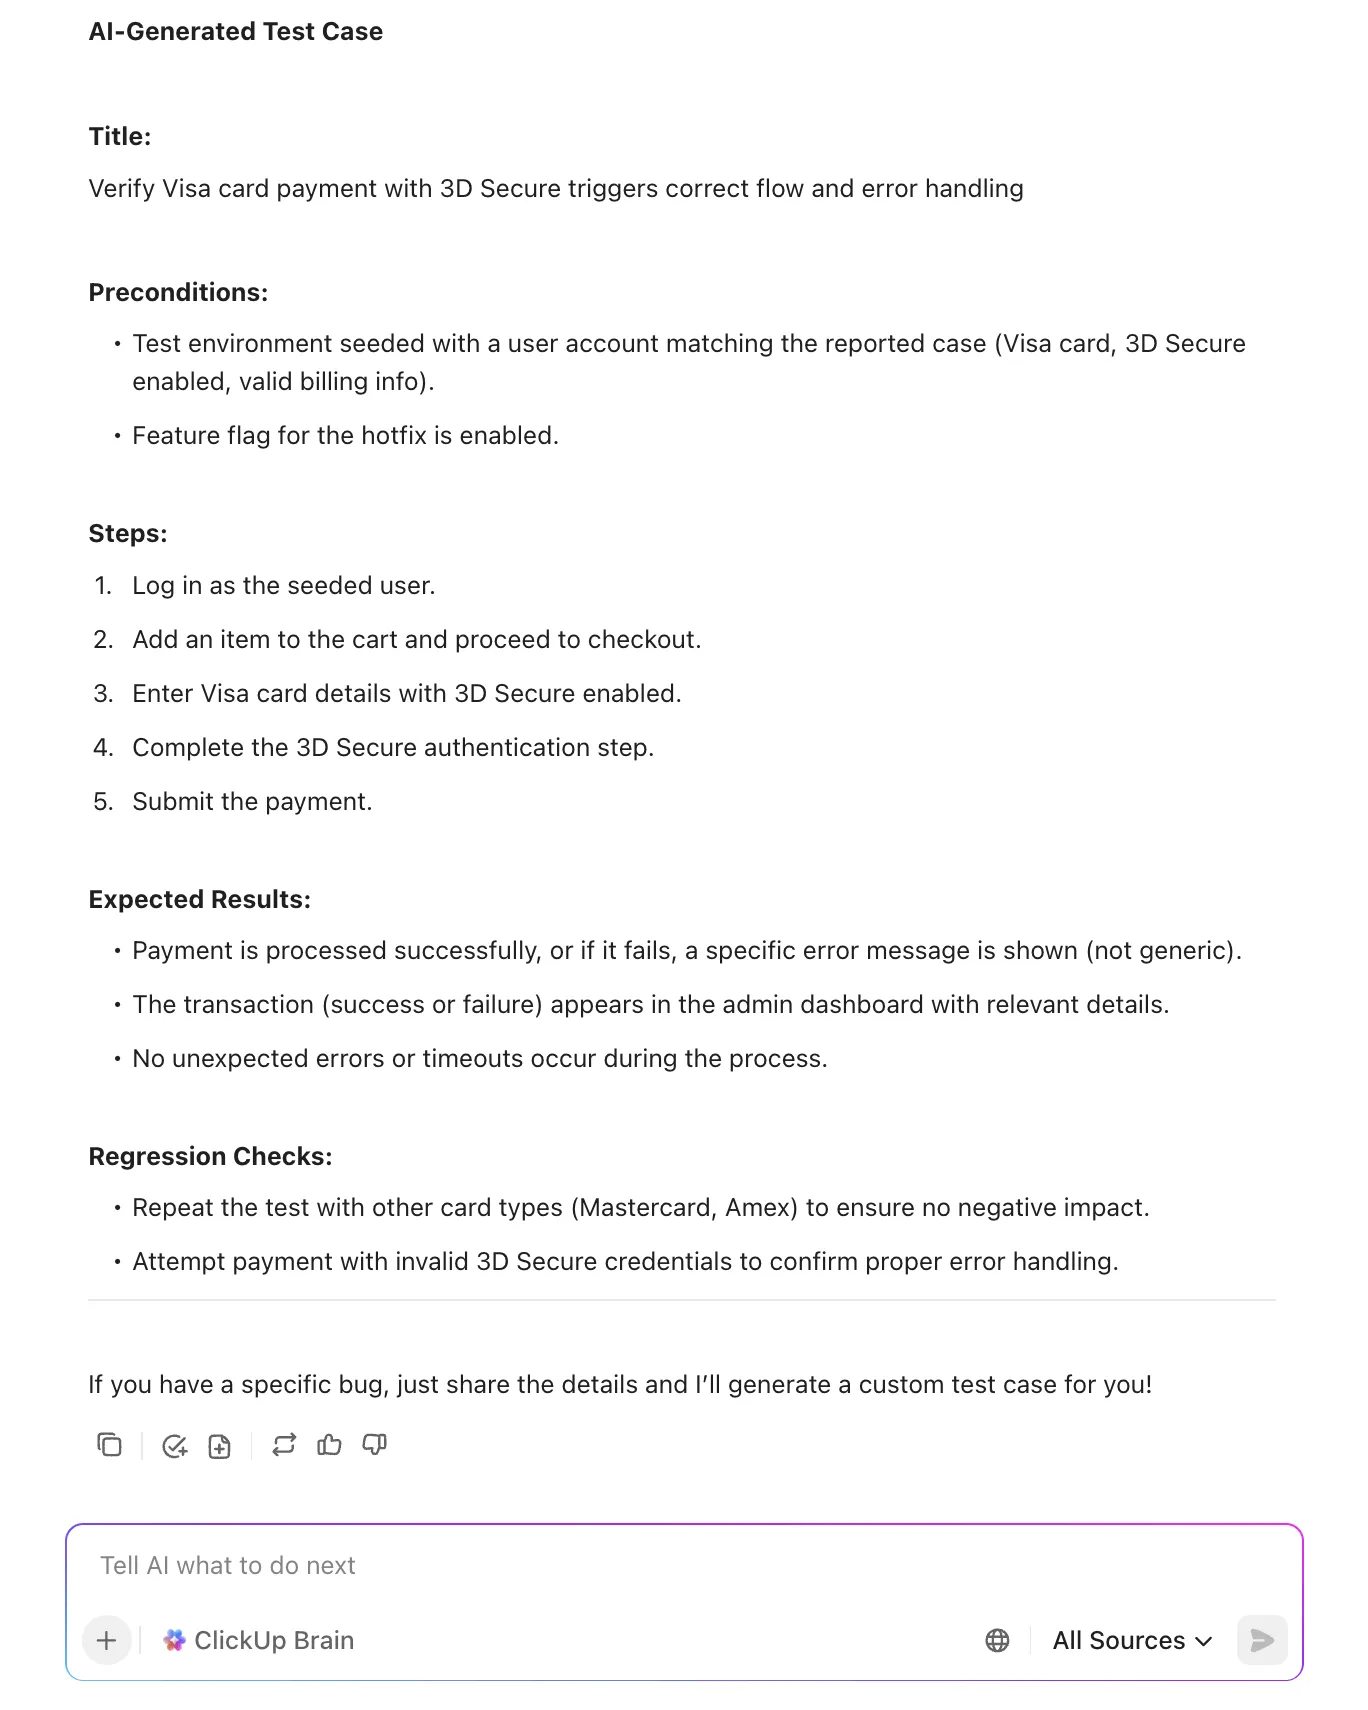
Richten Sie, wo immer möglich, temporäre Umgebungen aus dem Fehlerbereich ein, damit die Qualitätssicherung sofort validieren kann; die KI kann dann anhand der Fehlerbeschreibung und früherer Regressionen Testfälle generieren.
Wichtige Metriken: Verweildauer in der „QA/Überprüfung“, Rücklaufquote von der QA an die Entwicklung, Medianwert der Zeit bis zum Abschluss nach dem Zusammenführen.
📖 Weiterlesen: So verfassen Sie effektive Testfälle
7. Kommunizieren Sie den Status prägnant, um den Koordinationsaufwand zu senken
Ein gutes Update verhindert drei Statusabfragen und eine Eskalation.
Behandeln Sie Updates wie ein Produkt: kurz, konkret und zielgruppengerecht (Support, Führungskräfte, Kunden). Legen Sie einen Rhythmus für P0/P1 fest (z. B. stündlich bis zur Behebung, danach alle vier Stunden) und sorgen Sie für eine einzige verlässliche Informationsquelle.
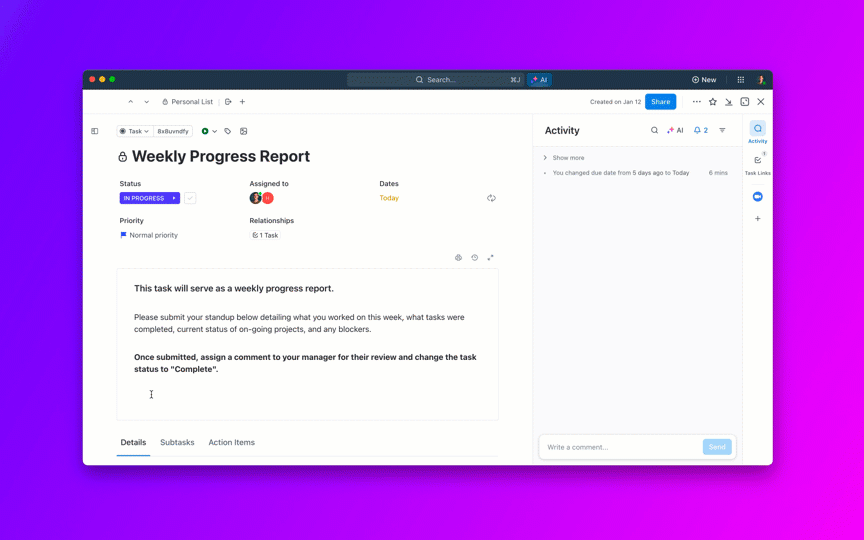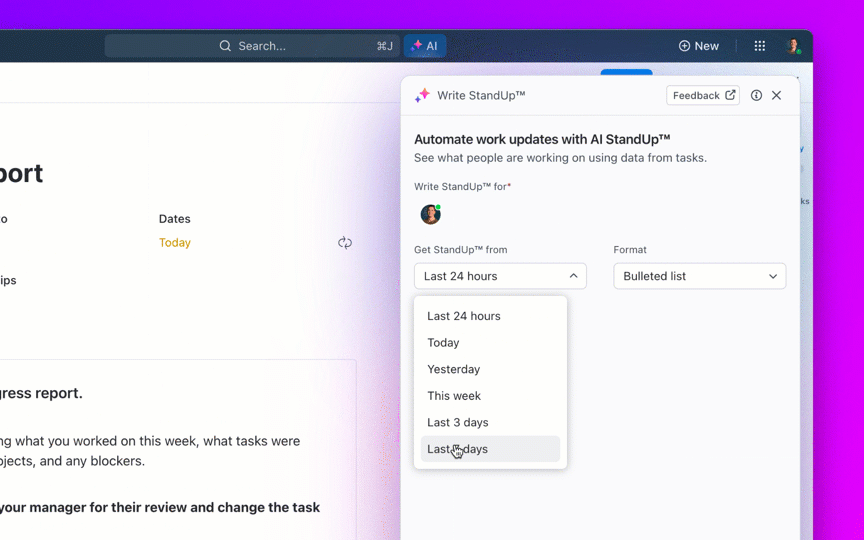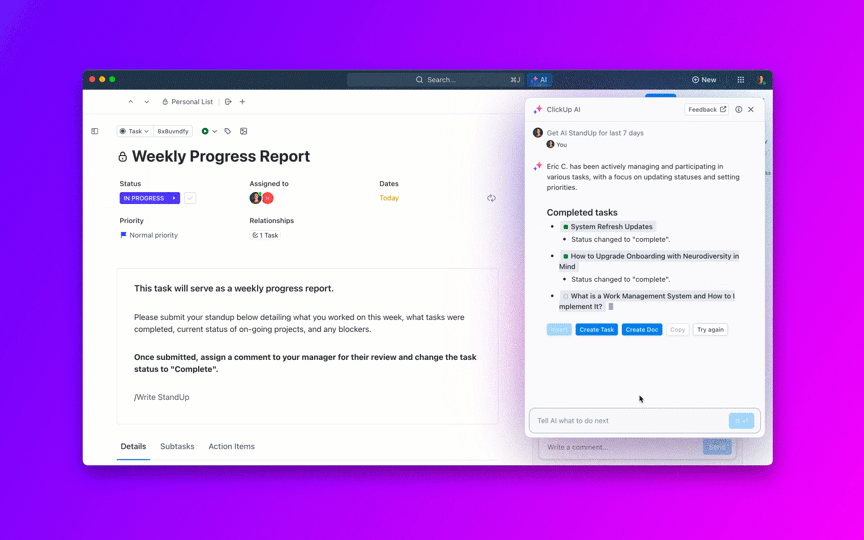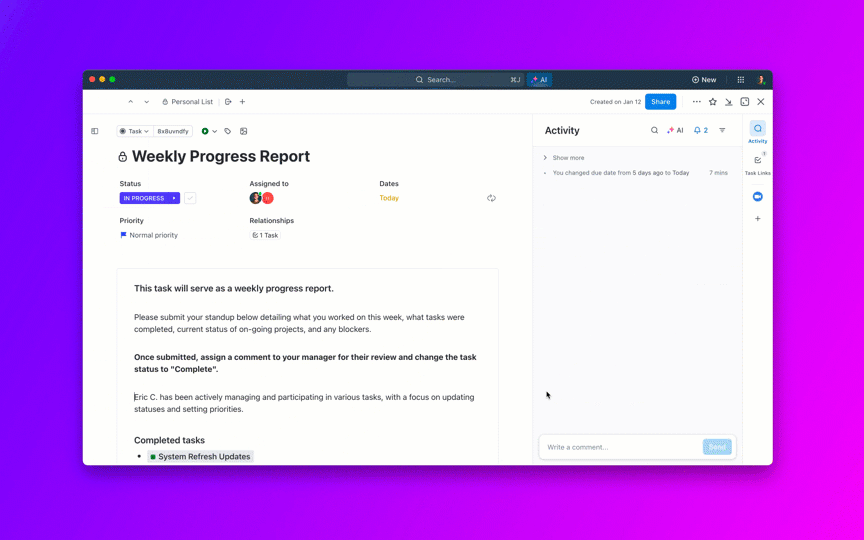
KI kann anhand des Aufgabenverlaufs – einschließlich des aktuellen Status nach Schweregrad und Team – kundenverträgliche Updates und interne Zusammenfassungen erstellen. Für Führungskräfte wie Ihren Produktleiter lassen sich Fehler Initiativen zuordnen, damit diese erkennen können, ob kritische Qualitätsprobleme die Einhaltung von Lieferversprechen gefährden.
Wichtige Metriken: Zeit zwischen Statusaktualisierungen bei P0/P1, CSAT der Stakeholder hinsichtlich der Kommunikation.
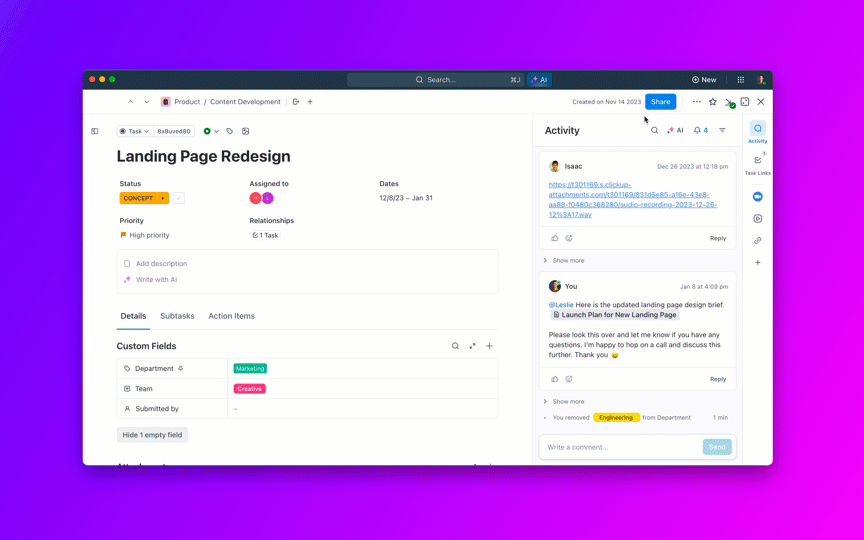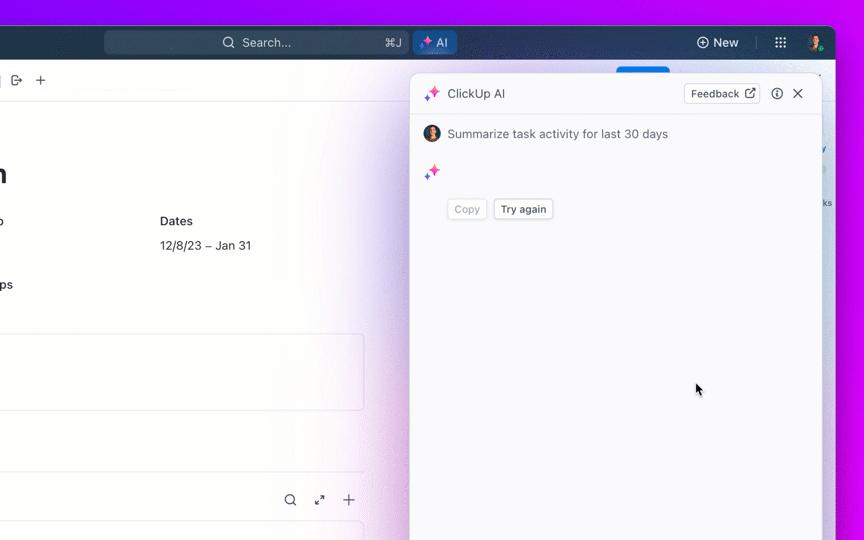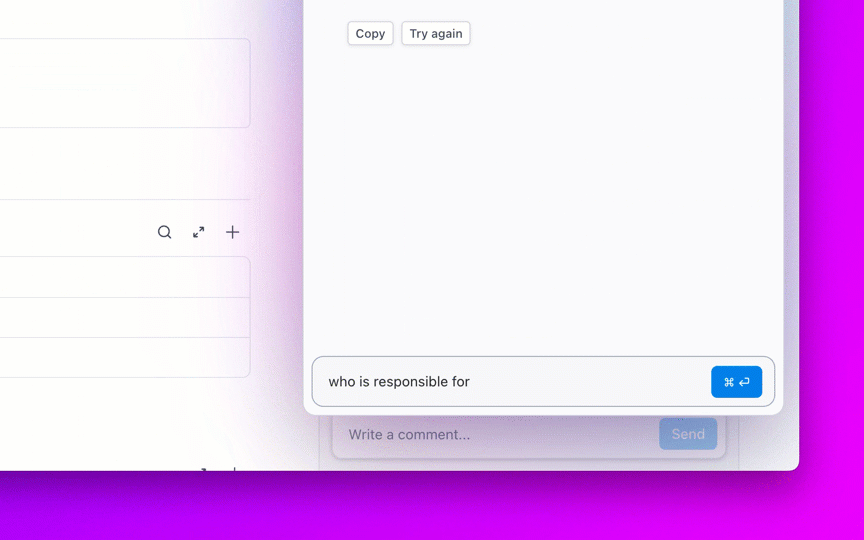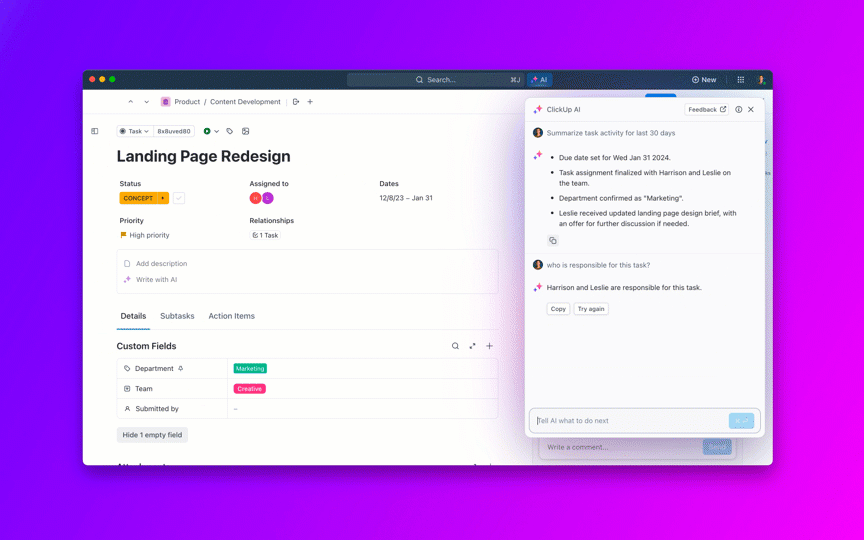
8. Behalten Sie den Alterungsprozess des Backlogs im Blick und verhindern Sie „ewig offene“ Fälle
Ein wachsender, unverarbeiteter Rückstand belastet jeden Sprint still und leise.
Legen Sie Alterungsrichtlinien fest (z. B. ist für P2 ein Auslöser von 30 Tagen gegeben, für P3 ist ein Auslöser von 90 Tagen erforderlich, um eine Begründung vorzulegen) und planen Sie eine wöchentliche „Alterungs-Triage“, um Duplikate zusammenzuführen, veraltete Meldungen zu schließen und Fehler mit geringem Wert in Produkt-Backlog-Elemente umzuwandeln.
Nutzen Sie KI, um das Backlog nach Themen zu gruppieren (z. B. „Ablauf des Tokens für die Authentifizierung“, „Unzuverlässigkeit beim Hochladen von Bildern“), damit Sie thematische „Fix-Wochen“ planen und eine ganze Klasse von Fehlern auf einmal beseitigen können.
Zu beobachtende Metriken: Anzahl der Backlog-Einträge nach Altersklassen, prozentualer Anteil der als Duplikate/veraltet geschlossenen Probleme, thematische Burn-Down-Geschwindigkeit.
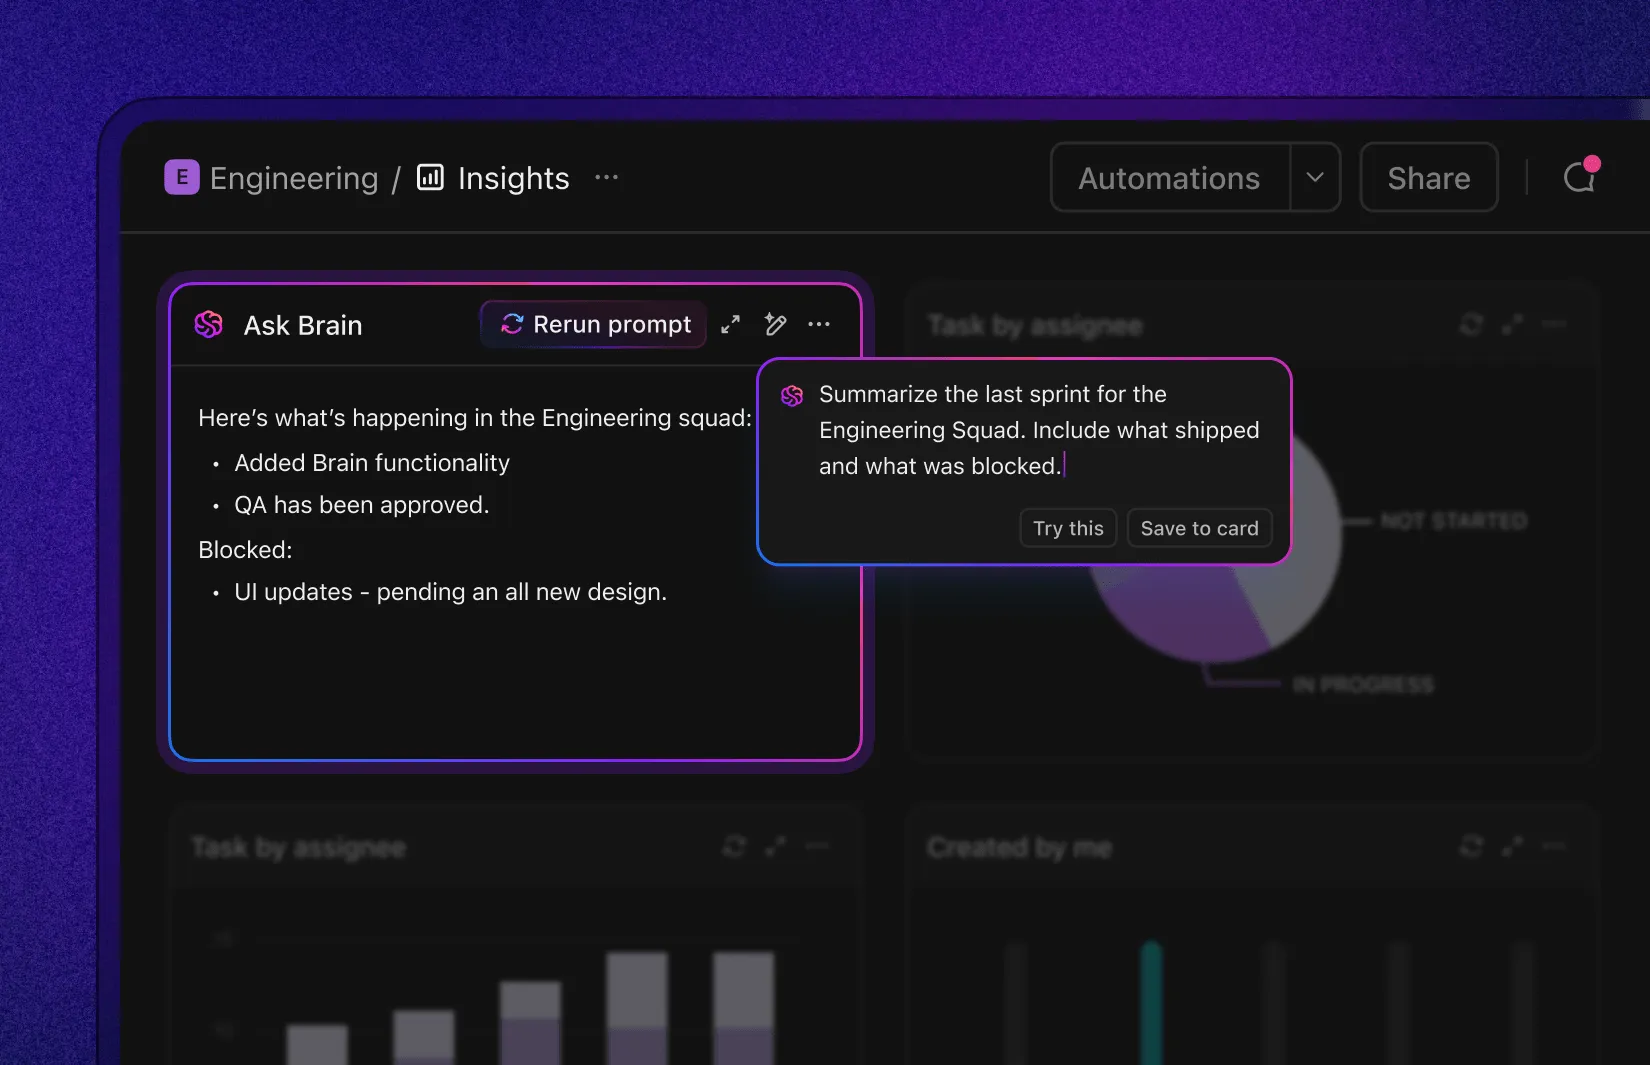
9. Schließen Sie den Kreislauf mit Ursachenanalyse und Prävention
Wenn immer wieder dieselbe Art von Fehlern auftritt, verdecken Ihre Verbesserungen bei der MTTR ein größeres Problem.
Erledigen Sie schnelle, vorurteilsfreie Ursachenanalysen für P0/P1-Fehler und häufig auftretende P2-Fehler; kennzeichnen Sie die Ursachen (Lücken in Spezifikationen, Tests oder Tools, Instabilitäten bei der Integration), verknüpfen Sie sie mit betroffenen Komponenten und Incidents und verfolgen Sie Folgemaßnahmen (Warnmeldungen, Tests, Lint-Regeln) bis zum Abschließen der Aufgaben.
/AI kann RCA-Zusammenfassungen erstellen und auf der Grundlage des Änderungsverlaufs präventive Tests oder Lint-Regeln vorschlagen. Und so schaffen Sie den Übergang vom „Feuerlöschen“ zu weniger „Bränden“.
Zu beobachtende Metriken: Wiedereröffnungsrate, Regressionsrate, Zeit zwischen Wiederholungen und Prozentsatz der Ursachenanalysen (RCAs) mit fertiggestellten Präventionsmaßnahmen.
Zusammengenommen verkürzen diese Änderungen den gesamten Prozess: schnellere Bestätigung, klarere Triage, intelligentere Priorisierung, weniger Verzögerungen bei der Überprüfung und Qualitätssicherung sowie eine klarere Kommunikation. Führungskräfte profitieren von einer besseren Vorhersagbarkeit in Bezug auf CSAT/NPS und Umsatz; die Mitarbeiter profitieren von einer übersichtlicheren Arbeitsliste mit weniger Kontextwechseln.
📖 Weiterlesen: So führen Sie eine Ursachenanalyse durch
KI-Tools, die dabei helfen, die Zeit bis zur Fehlerbehebung zu verkürzen
KI kann die Bearbeitungszeit in jedem Schritt verkürzen – bei der Erfassung, Triage, Weiterleitung, Behebung und Überprüfung.
Die wirklichen Vorteile ergeben sich jedoch erst, wenn tools den Kontext verstehen und die Arbeit ohne ständige Betreuung vorantreiben.
Suchen Sie nach Systemen, die Berichte automatisch ergänzen (Schritte zur Reproduktion, Umgebung, Duplikate), nach Auswirkung priorisieren, an den richtigen Eigentümer weiterleiten, klare Statusmeldungen erstellen und sich nahtlos in Ihren Code, Ihre CI und Ihre Observability integrieren.
Die besten Lösungen unterstützen zudem agentenähnliche Workflows: Bots, die SLAs überwachen, Prüfer anstupsen, festgefahrene Elemente eskalieren und Ergebnisse für die Beteiligten zusammenfassen. Hier ist unsere Auswahl an KI-Tools für eine bessere Fehlerbehebung:
1. ClickUp (Am besten geeignet für kontextbezogene KI, Automatisierungen und agentenbasierte Workflows)
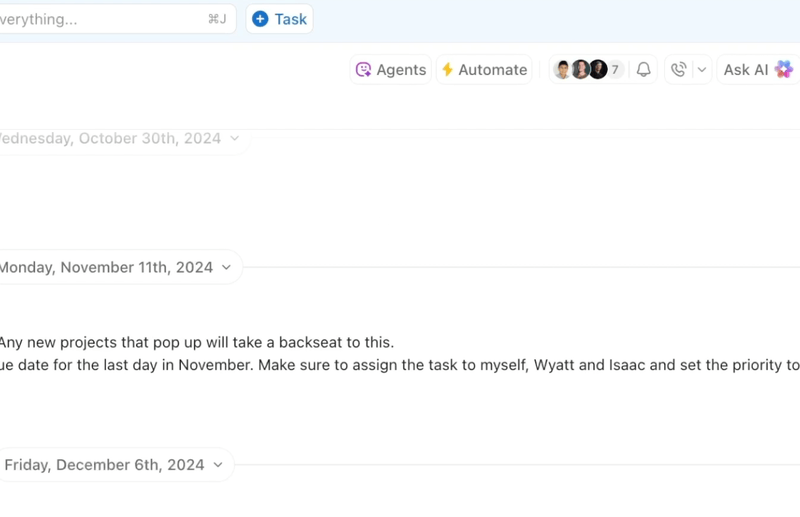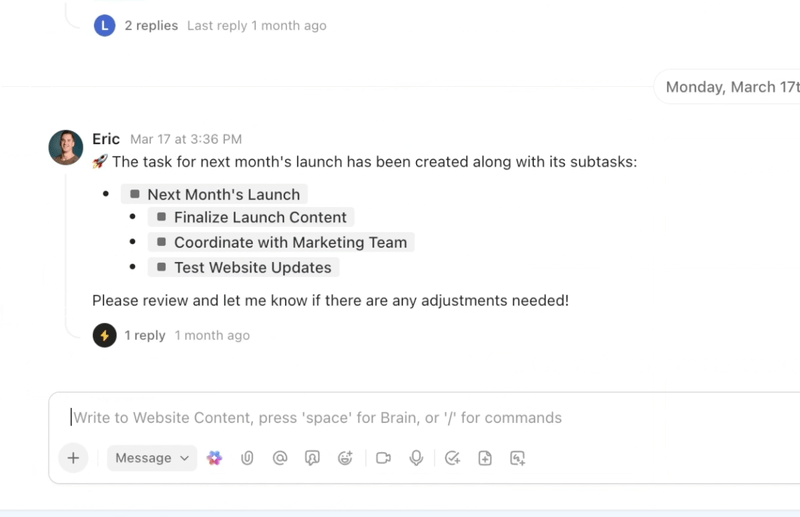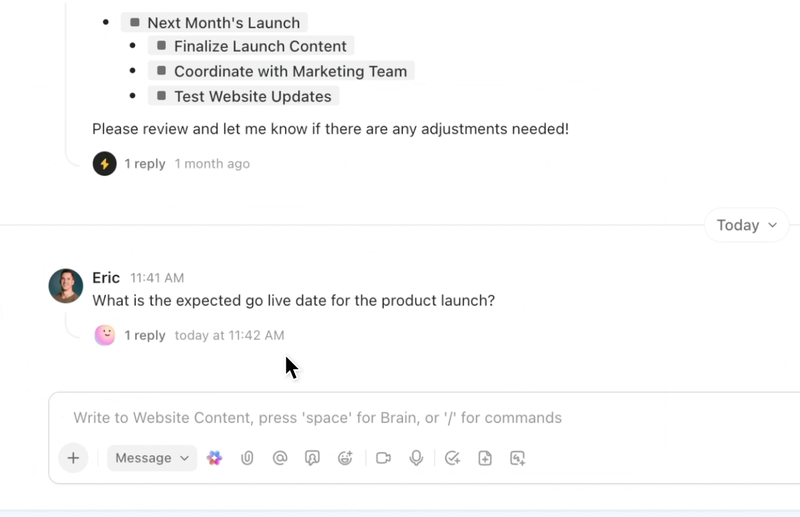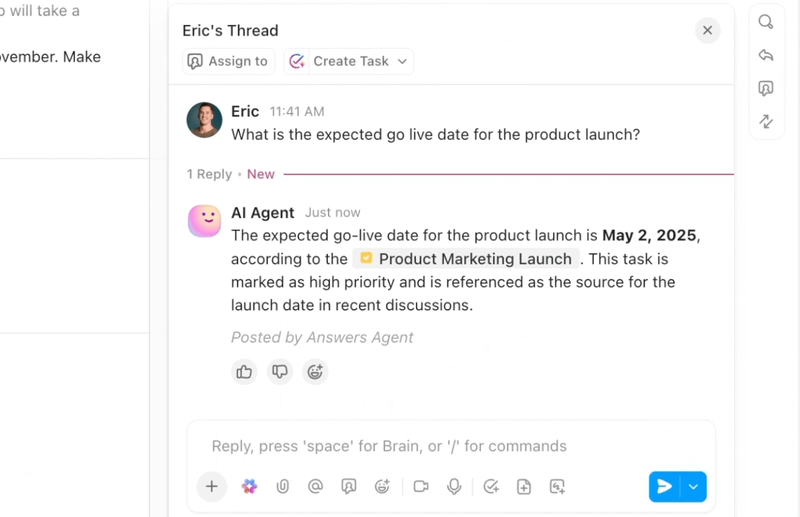
Wenn Sie einen optimierten, intelligenten Workflow zur Fehlerbehebung wünschen, vereint ClickUp – die Allround-App für die Arbeit – KI, Automatisierungen und agentengestützte Workflow-Unterstützung an einem Ort.
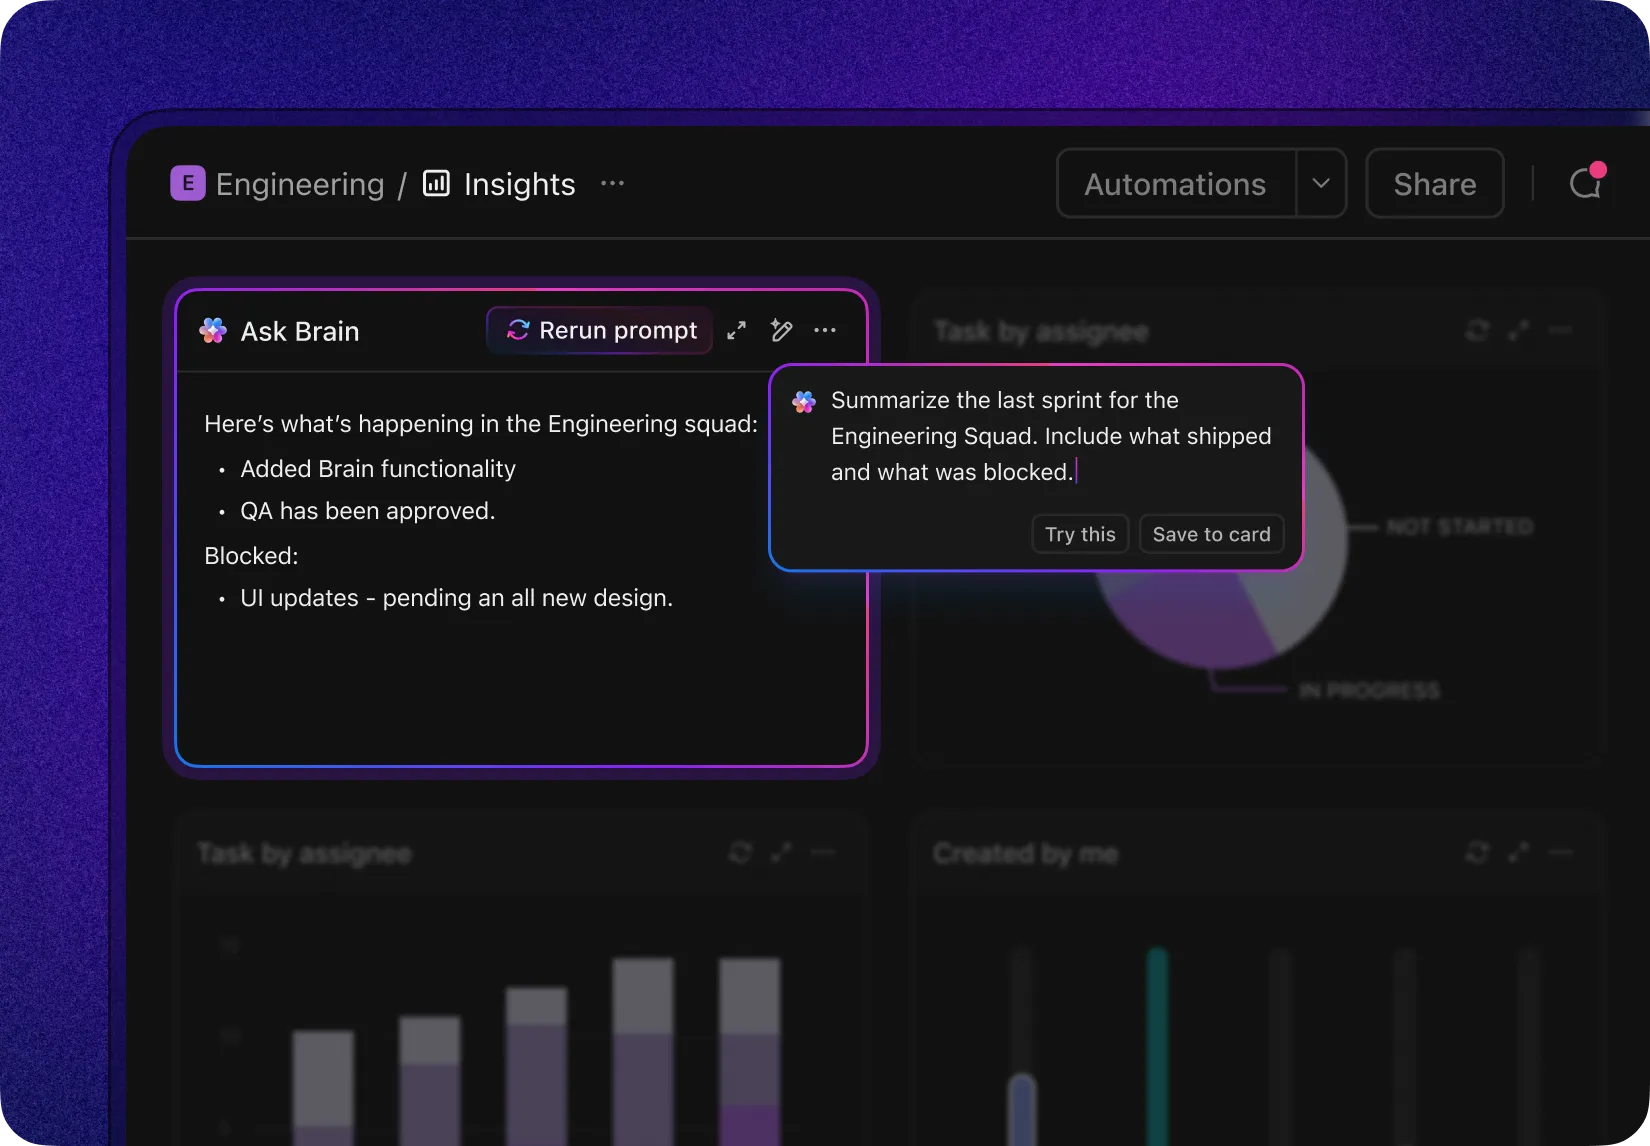
ClickUp Brain liefert sofort den richtigen Kontext – es fasst lange Fehler-Threads zusammen, extrahiert Schritte zur Reproduktion und Umgebungsdetails aus Anhängen, kennzeichnet mögliche Duplikate und schlägt nächste Maßnahmen vor. Anstatt sich durch Slack, Tickets und Protokolle zu wühlen, erhalten Teams eine übersichtliche, angereicherte Aufzeichnung, auf deren Grundlage sie sofort handeln können.
Automatisierungen und Autopilot-Agenten in ClickUp sorgen dafür, dass die Arbeit ohne ständige manuelle Eingriffe voranschreitet. Fehler werden automatisch an das richtige Team weitergeleitet, Eigentümer werden zugewiesen, SLAs und Fälligkeitsdaten festgelegt, der Status wird im Laufe der Arbeit aktualisiert und die Beteiligten erhalten zeitnahe Benachrichtigungen.
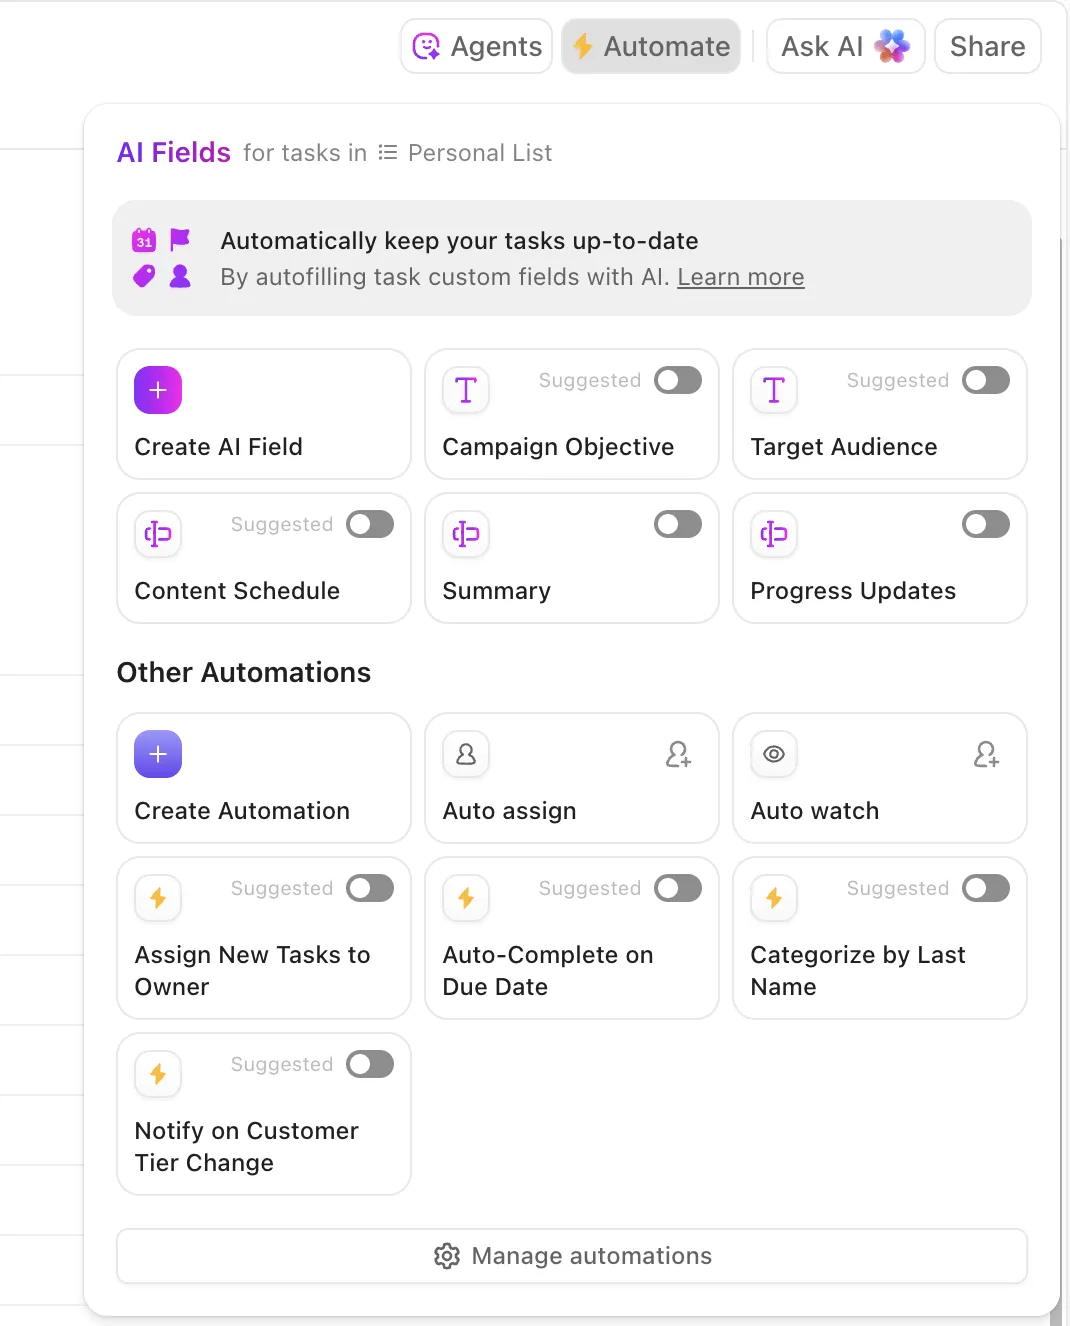
Diese Agenten können Probleme sogar triagieren und kategorisieren, ähnliche Meldungen gruppieren, auf frühere Lösungen zurückgreifen, um mögliche Lösungswege vorzuschlagen, und dringende Elemente eskalieren – sodass MTTA und MTTR auch bei Spitzenauslastungen sinken.
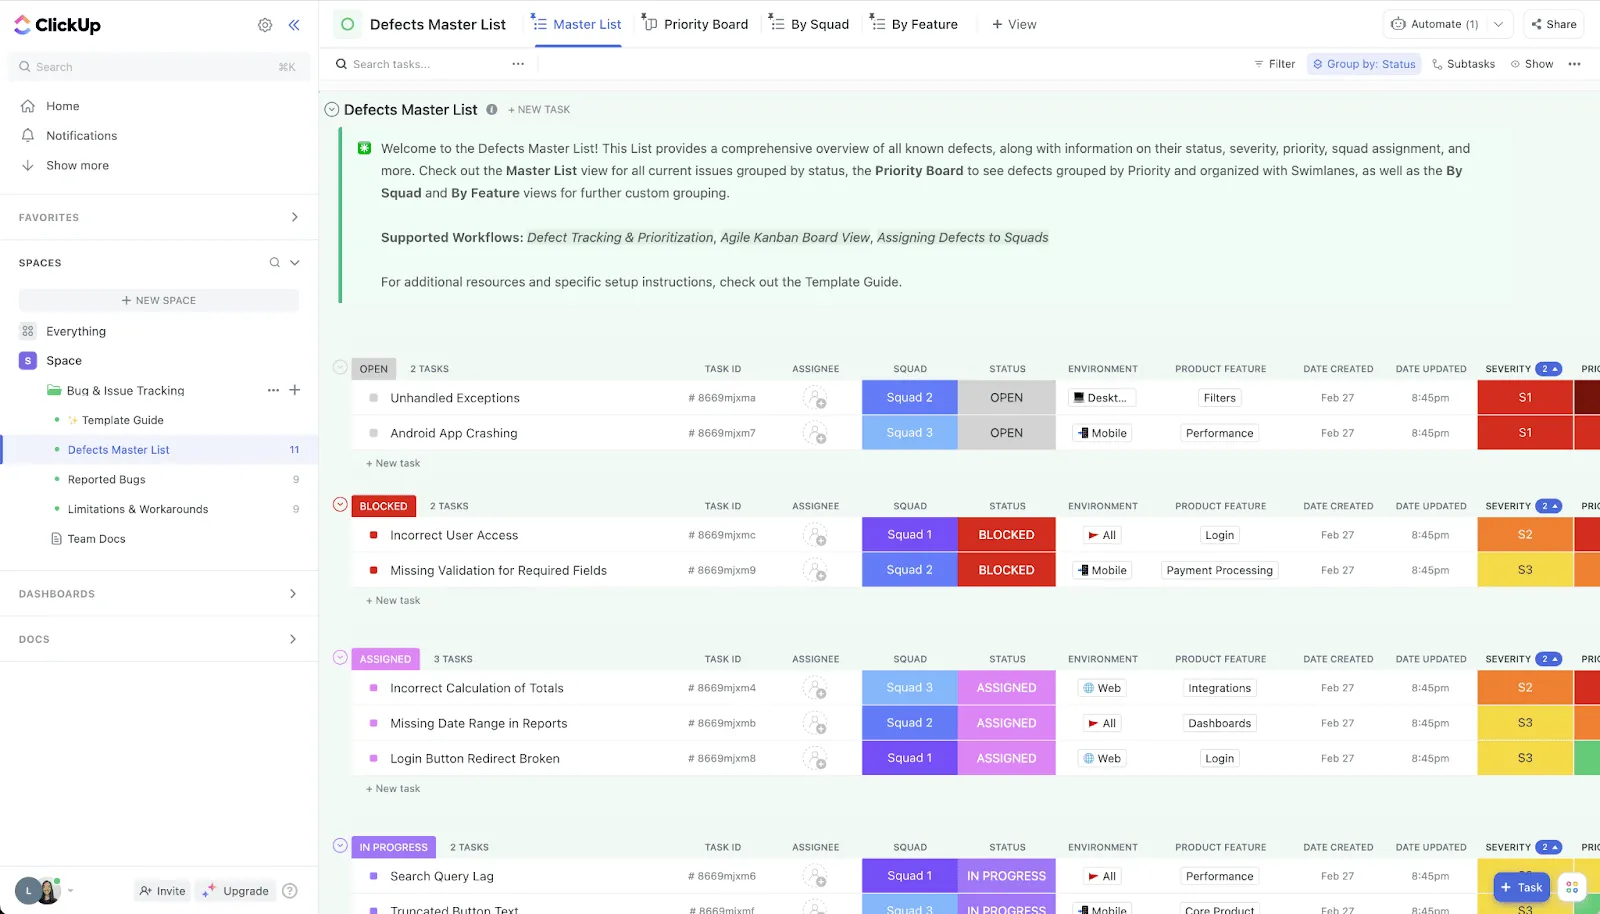
🛠️ Möchten Sie ein sofort einsatzbereites Toolkit? Die ClickUp-Vorlage zur Fehler- und Problemverfolgung ist eine leistungsstarke Lösung von ClickUp für Software, die entwickelt wurde, um Support-, Entwicklungs- und Produktteams dabei zu helfen, Softwarefehler und -probleme mühelos im Griff zu behalten. Mit anpassbaren Ansichten wie „Liste“, „Board“, „Workload“, „Formular“ und „Zeitleiste“ können Teams ihren Fehlerverfolgungsprozess so visualisieren und verwalten, wie es für sie am besten passt.
Die 20 benutzerdefinierten Status und 7 benutzerdefinierten Felder der Vorlage ermöglichen einen maßgeschneiderten Workflow und stellen sicher, dass jedes Problem von der Erkennung bis zur Behebung nachverfolgt wird. Integrierte Automatisierungen übernehmen sich wiederholende Aufgaben, wodurch wertvolle Zeit gespart und der manuelle Aufwand reduziert wird.
💟 Bonus: Brain MAX ist Ihr KI-gestützter Desktop-Begleiter, der mit intelligenten, praktischen Features die Fehlerbehebung beschleunigt.
Wenn Sie auf einen Fehler stoßen, nutzen Sie einfach die Sprach-zu-Text-Funktion von Brain MAX, um das Problem zu diktieren – Ihre gesprochenen Notizen werden sofort transkribiert und können an ein neues oder bestehendes Fehler-Ticket angehängt werden. Die Enterprise-Suche durchforstet alle Ihre verbundenen Tools – wie ClickUp, GitHub, Google Drive und Slack –, um relevante Fehlerberichte, Fehlerprotokolle, Code-Schnipsel und Dokumentation anzuzeigen, sodass Sie den gesamten benötigten Kontext haben, ohne zwischen Apps wechseln zu müssen.
Müssen Sie die Behebung eines Fehlers koordinieren? Mit Brain MAX können Sie den Fehler dem richtigen Entwickler zuweisen, automatische Erinnerungen für Updates zum Status einrichten und die Nachverfolgung des Fortschritts durchführen – alles direkt von Ihrem Desktop aus!
2. Sentry (Am besten geeignet zur Erfassung von Fehlern)
Sentry verkürzt die MTTD und die Reproduktionszeit, indem es Fehler, Traces und Benutzersitzungen an einem Ort erfasst. KI-gestützte Problemgruppierung reduziert Störsignale; „Suspect Commit“ und Regeln der Eigentümerschaft identifizieren den wahrscheinlichen Code-Eigentümer, sodass die Weiterleitung sofort erfolgt. Mit „Session Replay“ erhalten Entwickler den genauen Benutzerpfad sowie Konsolen- und Netzwerkdetails, um das Problem ohne endloses Hin und Her zu reproduzieren.
Die Sentry-KI-Features können den Kontext eines Problems zusammenfassen und in einigen Stacks „Autofix“-Patches vorschlagen, die auf den fehlerhaften Code verweisen. Die praktischen Vorteile: weniger doppelte Tickets, schnellere Zuweisung und ein kürzerer Weg vom Bericht zum funktionierenden Patch.
3. GitHub Copilot (Am besten geeignet für eine schnellere Code-Überprüfung)
Copilot beschleunigt den Fehlerbehebungszyklus direkt im Editor. Es erklärt Stack-Traces, schlägt Patches mit Einzelzielen vor, schreibt Unit-Tests, um die Korrektur zu sichern, und erstellt Skripte zur Reproduktion des Fehlers.
Copilot Chat kann fehlerhaften Code durchgehen, sicherere Refactorings vorschlagen und Kommentare oder PR-Beschreibungen erstellen, die die Code-Review beschleunigen. In Kombination mit obligatorischen Reviews und CI verkürzt es den Prozess „Diagnose → Umsetzung → Test“ um mehrere Stunden, insbesondere bei klar abgegrenzten Fehlern mit eindeutiger Reproduktion.
4. Snyk von DeepCode KI (am besten geeignet zum Erkennen von Mustern)
Die KI-gestützte statische Analyse von DeepCode erkennt Fehler und unsichere Muster bereits während des Programmierens und in Pull-Requests. Sie hebt problematische Flows hervor, erklärt deren Ursachen und schlägt sichere Korrekturen vor, die zu den Konventionen Ihrer Codebasis passen.
Indem Sie Regressionen bereits vor dem Zusammenführen erkennen und Entwickler zu sichereren Programmiermustern anleiten, senken Sie die Rate neuer Fehler und beschleunigen die Behebung kniffliger Logikfehler, die bei der Überprüfung schwer zu erkennen sind. Durch die Integration in die IDE und in Pull-Requests bleibt dieser Prozess nah am eigentlichen Arbeitsgeschehen.
5. Datadog Watchdog und AIOps (am besten geeignet für die Log-Analyse)
Der Watchdog von Datadog nutzt maschinelles Lernen, um Anomalien in Protokollen, Metriken, Traces und der Real-User-Überwachung aufzudecken. Er korreliert Spitzenwerte mit Deployment-Markern, Änderungen an der Infrastruktur und der Topologie, um mögliche Ursachen aufzuzeigen.
Bei Fehlern, die sich auf Kunden auswirken, bedeutet das: Erkennung innerhalb von Minuten, automatische Gruppierung zur Reduzierung von Fehlalarmen und konkrete Hinweise darauf, wo Sie suchen müssen. Die Triage-Zeit verkürzt sich, da Sie nicht bei Null anfangen, sondern mit der Erkenntnis: „Diese Bereitstellung betraf diese Dienste, und die Fehlerraten sind an diesem Endpunkt gestiegen.“
⚡️ Vorlagenarchiv: Kostenlose Vorlagen für die Nachverfolgung von Problemen und Protokolle in Excel und ClickUp
6. New Relic KI (Am besten geeignet zum Erkennen und Zusammenfassen von Trends)
Der „Errors Inbox“ von New Relic gruppiert ähnliche Fehler über Dienste und Versionen hinweg, während der KI-Assistent die Auswirkungen zusammenfasst, wahrscheinliche Ursachen hervorhebt und Verknüpfungen zu den betroffenen Traces/Transaktionen herstellt.
Dank Korrelationen bei der Bereitstellung und Informationen zu Entitätsänderungen lässt sich leicht erkennen, wann ein aktuelles Release die Ursache ist. Bei verteilten Systemen erspart dieser Kontext stundenlange teamübergreifende Rückfragen und leitet den Fehler mit einer bereits fundierten Hypothese an den richtigen Verantwortlichen weiter.
7. Rollbar (Am besten geeignet für automatisierte Workflows)
Rollbar ist auf die Echtzeit-Fehlerüberwachung spezialisiert und nutzt intelligentes Fingerprinting, um Duplikate zu gruppieren und das Vorkommen von Fehlern zu verfolgen. Die KI-gestützten Zusammenfassungen und Hinweise auf die Grundursache helfen Teams dabei, den Umfang (betroffene Benutzer, betroffene Versionen) zu erfassen, während Telemetriedaten und Stack-Traces schnelle Anhaltspunkte für die Reproduktion liefern.
Die Workflow-Regeln von Rollbar können automatisch Aufgaben erstellen, den Schweregrad kennzeichnen und an die Eigentümer weiterleiten, wodurch unübersichtliche Fehlerströme in priorisierte Warteschlangen mit zugehörigem Kontext umgewandelt werden.
8. PagerDuty AIOps und Runbook-Automatisierung (Das Beste aus der „Low-Touch“-Diagnostik)
PagerDuty nutzt Ereigniskorrelation und ML-basierte Rauschunterdrückung, um Alarmfluten auf wenige, umsetzbare Incidents zu reduzieren.
Durch dynamisches Routing wird das Problem sofort an den richtigen Bereitschaftsmitarbeiter weitergeleitet, während die Runbook-Automatisierung Diagnosen oder Abhilfemaßnahmen (Neustart von Diensten, Rollback einer Bereitstellung, Umschalten von Feature Flags) einleiten kann, bevor ein Mitarbeiter eingreifen muss. Für die Fehlerbehebungszeit bedeutet dies eine kürzere MTTA, schnellere Abhilfemaßnahmen bei P0-Fehlern und weniger Zeitverlust durch Alarmmüdigkeit.
Der rote Faden dabei ist Automatisierung plus KI in jedem Schritt. Sie erkennen Fehler früher, leiten sie intelligenter weiter, gelangen schneller zum Code und kommunizieren den Status, ohne die Entwickler zu behindern – all dies führt zu einer deutlichen Verkürzung der Fehlerbehebungszeit.
📖 Weiterlesen: Wie man KI in DevOps einsetzt
Praxisbeispiele für den Einsatz von KI bei der Fehlerbehebung
/AI hat also offiziell den Sprung aus dem Labor geschafft. Sie verkürzt die Fehlerbehebungszeit in der Praxis.
Schauen wir uns an, wie das geht!
| Bereich / Organisation | Wie KI eingesetzt wurde | Auswirkungen / Nutzen |
|---|---|---|
| Ubisoft | Entwicklung von „Commit Assistant“, einem KI-Tool, das auf der Grundlage von internem Code aus einem Jahrzehnt trainiert wurde und Fehler bereits in der Programmierphase vorhersagt und verhindert. | Ziel ist es, Zeit und Kosten drastisch zu senken – traditionell entfallen bis zu 70 % der Kosten für die Spieleentwicklung auf die Behebung von Fehlern. |
| Razer (Wyvrn-Plattform) | Einführung des KI-gestützten „QA Copilot“ (integriert in Unreal und Unity) zur Automatisierung der Fehlererkennung und zur Berichterstellung für QA. | Steigert die Fehlererkennung um bis zu 25 % und halbiert den Zeitaufwand für die Qualitätssicherung. |
| Google / DeepMind & Project Zero | Einführung von „Big Sleep“, einem KI-Tool, das Sicherheitslücken in Open-Source-Software wie FFmpeg und ImageMagick autonom erkennt. | Es wurden 20 Fehler identifiziert, die alle von menschlichen Experten überprüft wurden und deren Behebung geplant ist. |
| Forscher der UC Berkeley | Mithilfe eines Benchmarks namens CyberGym analysierten KI-Modelle 188 Open-Source-Projekte, deckten 17 Schwachstellen auf – darunter 15 unbekannte „Zero-Day“-Fehler – und generierten Proof-of-Concept-Exploits. | Veranschaulicht die sich ständig weiterentwickelnden Fähigkeiten der KI bei der Erkennung von Schwachstellen und der automatisierten Prüfung von Exploits. |
| Spur (Yale-Startup) | Entwicklung eines KI-Agenten, der Testfallbeschreibungen in einfacher Sprache in automatisierte Website-Testroutinen übersetzt – im Grunde ein sich selbst schreibender QA-Workflow. | Ermöglicht autonomes Testen mit minimalem menschlichem Aufwand |
| Automatische Reproduktion von Android-Fehlerberichten | Einsatz von NLP und bestärkendem Lernen zur Interpretation der Sprache in Fehlerberichten und zur Generierung von Schritten zur Reproduktion von Android-Fehlern. | Es wurden eine Präzision von 67 %, ein Recall von 77 % und eine Reproduktionsrate von 74 % bei Fehlerberichten erreicht, womit herkömmliche Methoden übertroffen wurden. |
Häufige Fehler bei der Messung der Fehlerbehebungszeit
Wenn Ihre Messung nicht stimmt, wird auch Ihr Plan zur Verbesserung daneben liegen.
Die meisten „schlechten Zahlen“ in Workflows zur Fehlerbehebung sind auf vage Definitionen, inkonsistente Abläufe und oberflächliche Analysen zurückzuführen.
Beginnen Sie also zunächst mit den Grundlagen – was als Start/Stopp gilt, wie Sie mit Wartezeiten und der Wiederaufnahme von Fällen umgehen – und analysieren Sie dann die Daten so, wie Ihre Kunden sie erleben. Dazu gehören:
❌ Unklare Abgrenzungen: Die Vermischung von „Gemeldet → Behoben“ und „Gemeldet → Geschlossen“ im selben Dashboard (oder der Wechsel von einer Abgrenzung zur anderen von Monat zu Monat) macht Trends aussagekräftig. Wählen Sie eine Abgrenzung, dokumentieren Sie diese und setzen Sie sie teamübergreifend durch. Wenn Sie beide benötigen, veröffentlichen Sie sie als separate Metriken mit eindeutigen Beschreibungen.
❌ Ansatz, der sich ausschließlich auf Durchschnittswerte stützt: Wenn man sich auf den Mittelwert verlässt, wird die Realität von Warteschlangen mit einigen wenigen lang andauernden Ausreißern verschleiert. Verwenden Sie den Median (P50) für Ihre „typische“ Zeit, P90 für Vorhersagbarkeit/SLAs und behalten Sie den Mittelwert für die Planung der Kapazität bei. Betrachten Sie immer die Verteilung, nicht nur eine einzelne Zahl.
❌ Keine Segmentierung: Wenn alle Incidents in einen Topf geworfen werden, werden P0-Incidents mit kosmetischen P3-Incidents vermischt. Segmentieren Sie nach Schweregrad, Quelle (Kunde vs. QA vs. Überwachung), Komponente/Team und „neu vs. Regression“. Ihr P0/P1-P90 spiegelt wider, was die Stakeholder empfinden; Ihr P2+-Median ist die Grundlage für den Plan der Entwickler.
❌ „Pausierte“ Zeit ignorieren: Warten Sie auf Kundenprotokolle, einen externen Anbieter oder ein Release-Fenster? Wenn Sie „Blockiert/Pausiert“ nicht als eigenständigen Status erfassen, wird Ihre Bearbeitungszeit zum Argument. Geben Sie sowohl die Kalenderzeit als auch die aktive Zeit an, damit Engpässe sichtbar werden und Diskussionen ein Ende finden.
❌ Lücken bei der Zeitnormalisierung: Das Mischen von Zeitzonen oder der Wechsel zwischen Geschäfts- und Kalenderzeiten während des Prozesses verfälscht Vergleiche. Normalisieren Sie Zeitstempel auf eine Zeitzone (oder UTC) und legen Sie einmalig fest, ob SLAs in Geschäfts- oder Kalenderzeiten gemessen werden; wenden Sie diese Regelung konsequent an.
❌ Unvollständige Erfassung und Duplikate: Fehlende Info zu Umgebung und Build sowie doppelte Tickets verlängern die Bearbeitungszeiten und führen zu Unklarheiten bei der Eigentümerschaft. Standardisieren Sie Pflichtfelder bei der Erfassung, ergänzen Sie die Daten automatisch (Protokolle, Version, Gerät) und entfernen Sie Duplikate, ohne die Bearbeitungszeit zurückzusetzen – schließen Sie Duplikate als verknüpfte, nicht als „neue“ Probleme.
❌ Inkonsistente Statusmodelle: Maßgeschneiderte Statusbezeichnungen („QA-bereit (sozusagen)“, „Zur Überprüfung ausstehend 2“) verschleiern die Verweildauer in einem Status und machen Statusübergänge unzuverlässig. Definieren Sie einen kanonischen Workflow (Neu → Triage → In Bearbeitung → In Überprüfung → Behoben → Geschlossen) und prüfen Sie auf Status, die vom Workflow abweichen.
❌ Blind gegenüber der Verweildauer in den Statusphasen: Eine einzige Nummer für die „Gesamtzeit“ sagt nichts darüber aus, wo die Arbeit ins Stocken gerät. Erfassen und überprüfen Sie die Zeit, die in den Statusphasen „Triage“, „In Überprüfung“, „Blockiert“ und „QA“ verbracht wird. Wenn die P90-Zeit für die Codeüberprüfung die für die Implementierung bei weitem übersteigt, geht es bei Ihrer Lösung nicht darum, „schneller zu programmieren“ – sondern darum, Kapazitäten für die Überprüfung freizusetzen.
🧠 Interessante Tatsache: Die jüngste „AI Cyber Challenge“ der DARPA zeigte einen bahnbrechenden Fortschritt in der Automatisierung der Cybersicherheit. Im Rahmen des Wettbewerbs traten KI-Systeme gegeneinander an, die darauf ausgelegt waren, Schwachstellen in Software autonom zu erkennen, auszunutzen und zu beheben – ganz ohne menschliches Eingreifen. Das Gewinnerteam „Team Atlanta“ deckte eindrucksvoll 77 % der eingeschleusten Fehler auf und behob 61 % davon erfolgreich, womit es die Leistungsfähigkeit der KI unter Beweis stellte, Schwachstellen nicht nur zu finden, sondern auch aktiv zu beheben.
❌ „Reopen-Blindheit“: Wenn Sie erneut gemeldete Fehler als neue Fehler behandeln, wird die Zeitmessung zurückgesetzt und die MTTR künstlich verbessert. Verfolgen Sie die Reopen-Rate und die „Zeit bis zum stabilen Abschluss“ (vom ersten Bericht bis zum endgültigen Abschluss über alle Zyklen hinweg). Steigende Reopen-Raten deuten in der Regel auf eine unzureichende Reproduzierbarkeit, Testlücken oder eine vage Definition von „Erledigt“ hin.
❌ Keine MTTA: Teams konzentrieren sich zu sehr auf die MTTR und ignorieren die MTTA (Zeit bis zur Bestätigung/Zuweisung). Eine hohe MTTA ist ein Zeichen der Achtung für eine lange Behebungszeit. Messen Sie sie, legen Sie SLAs nach Schweregrad fest und führen Sie die Automatisierung der Weiterleitung/Eskalation durch, um sie niedrig zu halten.
❌ KI/Automatisierung ohne Sicherheitsvorkehrungen: Wenn Sie der KI erlauben, den Schweregrad festzulegen oder Duplikate ohne Überprüfung zu schließen, kann dies zu Fehlklassifizierungen von Grenzfällen führen und die Metriken unbemerkt verfälschen. Nutzen Sie KI für Vorschläge, verlangen Sie eine menschliche Bestätigung bei P0/P1 und überprüfen Sie die Modellleistung monatlich, damit Ihre Daten zuverlässig bleiben.
Optimieren Sie diese Bereiche, und Ihre Diagramme zur Fehlerbehebungszeit werden endlich die Realität widerspiegeln. Von da an summieren sich die Verbesserungen: Eine bessere Erfassung verkürzt die MTTA, übersichtlichere Zustände decken echte Engpässe auf, und segmentierte P90-Werte liefern Führungskräften Versprechen, die Sie einhalten können.
⚡️ Vorlagenarchiv: 10 Testfallvorlagen für das Softwaretesten
Best Practices für eine bessere Fehlerbehebung
Zusammenfassend sind hier die wichtigsten Punkte, die Sie beachten sollten!
| 🧩 Best Practices | 💡 Was das bedeutet | 🚀 Warum das wichtig ist |
| Nutzen Sie ein robustes System für die Nachverfolgung von Fehlern | Verfolgen Sie alle gemeldeten Fehler mithilfe eines zentralen Systems für die Nachverfolgung von Fehlern. | Stellt sicher, dass kein Fehler übersehen wird, und ermöglicht teamübergreifende Sichtbarkeit über den Status von Fehlern. |
| Erstellen Sie detaillierte Fehlerberichte | Fügen Sie visuellen Kontext, Betriebssystem-Info, Schritte zur Reproduktion und den Schweregrad hinzu. | Hilft Entwicklern, Fehler schneller zu beheben, da alle wichtigen Informationen von vornherein vorliegen. |
| Fehler kategorisieren und priorisieren | Verwenden Sie eine Matrix der Prioritäten, um Fehler nach Dringlichkeit und Auswirkung zu sortieren. | Das Team konzentriert sich dabei zunächst auf kritische Fehler und dringende Probleme. |
| Nutzen Sie automatisierte Tests | Führen Sie Tests automatisch in Ihrer CI/CD-Pipeline durch. | Unterstützt die frühzeitige Erkennung und verhindert Regressionen. |
| Definieren Sie klare Richtlinien für die Berichterstellung | Stellen Sie Vorlagen und Schulungen zur Berichterstellung für die Fehlermeldung bereit. | Dies führt zu präzisen Informationen und einer reibungsloseren Kommunikation. |
| Verfolgen Sie wichtige Metriken | Messen Sie die Bearbeitungszeit, die verstrichene Zeit und die Reaktionszeit. | Ermöglicht die Nachverfolgung der Leistung und ihre Verbesserung anhand von Verlaufsdaten. |
| Verfolgen Sie einen proaktiven Ansatz | Warten Sie nicht, bis Benutzer sich beschweren – testen Sie proaktiv. | Steigert die Kundenzufriedenheit und entlastet den Support. |
| Nutzen Sie intelligente Tools und maschinelles Lernen | Nutzen Sie maschinelles Lernen, um Fehler vorherzusagen und Lösungen vorzuschlagen. | Verbessert die Effizienz bei der Ermittlung der Ursachen und der Behebung von Fehlern. |
| Anpassung an SLAs | Halten Sie die vereinbarten Service Level Agreements (SLAs) für die Fehlerbehebung ein. | Das schafft Vertrauen und erfüllt die Erwartungen der Clients zeitnah. |
| Kontinuierlich überprüfen und verbessern | Analysieren Sie erneut geöffnete Fehler, sammeln Sie Feedback und optimieren Sie Prozesse. | Fördert die kontinuierliche Verbesserung Ihres Entwicklungsprozesses und Ihres Fehlermanagements. |
Einfache Fehlerbehebung dank kontextbezogener KI
Die Teams, die Fehler am schnellsten beheben, verlassen sich nicht auf Einzelaktionen. Sie entwickeln ein System: klare Definitionen für Beginn und Ende, eine saubere Erfassung, Priorisierung nach geschäftlichen Auswirkungen, klare Zuständigkeiten und enge Feedbackschleifen zwischen Support, Qualitätssicherung, Entwicklung und Release.
ClickUp kann als KI-gestützte Command-Center für Ihr Fehlerbehebungssystem dienen. Zentralisieren Sie alle Meldungen in einer Warteschlange, standardisieren Sie den Kontext mithilfe strukturierter Felder und lassen Sie die ClickUp AI Fehler triagieren, zusammenfassen und priorisieren, während Automatisierungen SLAs durchsetzen, bei Zeitüberschreitungen eskalieren und alle Beteiligten auf dem Laufenden halten. Verknüpfen Sie Fehler mit Kunden, Code und Releases, damit Führungskräfte die Auswirkungen erkennen und die Mitarbeiter im Flow bleiben.
Wenn Sie bereit sind, die Zeit bis zur Fehlerbehebung zu verkürzen und Ihre Roadmap vorhersehbarer zu gestalten, melden Sie sich bei ClickUp an und messen Sie die Verbesserungen schon nach wenigen Tagen – statt erst nach Quartalen.
Häufig gestellte Fragen
Was ist eine gute Fehlerbehebungszeit?
Es gibt keine einheitliche „gute“ Nummer – sie hängt vom Schweregrad, vom Release-Modell und von der Risikotoleranz ab. Verwenden Sie Medianwerte (P50) für die „typische“ Leistung und P90 für Zusagen/SLAs und segmentieren Sie nach Schweregrad und Ursache.
Was ist der Unterschied zwischen der Fehlerbehebung und dem Schließen eines Fehlers?
Eine „Behebung“ liegt vor, wenn die Korrektur umgesetzt wurde (z. B. Code zusammengeführt, Konfiguration angewendet) und das Team den Fehler als behoben betrachtet. Ein „Abschluss“ liegt vor, wenn das Problem verifiziert und formell geschlossen wurde (z. B. durch die Qualitätssicherung in der Zielumgebung validiert, freigegeben oder mit Begründung als „wird nicht behoben“/„Duplikat“ markiert). Viele Teams messen beides: „Gemeldet → Behoben“ spiegelt die Entwicklungsgeschwindigkeit wider; „Gemeldet → Geschlossen“ spiegelt den End-to-End-Qualitätsflow wider. Verwenden Sie einheitliche Definitionen, damit in Dashboards die Phasen nicht vermischt werden.
Was ist der Unterschied zwischen der Fehlerbehebungszeit und der Fehlererkennungszeit?
Die Erkennungszeit (MTTD) gibt an, wie lange es dauert, bis ein Fehler nach seinem Auftreten oder seiner Auslieferung entdeckt wird – sei es durch Überwachung, Qualitätssicherung oder durch Benutzer. Die Behebungszeit gibt an, wie lange es vom Erkennen/Melden bis zur Implementierung der Korrektur (und, falls gewünscht, bis zur Validierung/Freigabe) dauert. Zusammen definieren sie das Zeitfenster der Kundenauswirkungen: schnell erkennen, schnell bestätigen, schnell beheben und sicher freigeben. Sie können auch die MTTA (Zeit bis zur Bestätigung/Zuweisung) verfolgen, um Verzögerungen bei der Triage zu erkennen, die oft auf eine längere Behebungszeit hindeuten.
Wie hilft KI bei der Fehlerbehebung?
/AI verkürzt die Zyklen, die normalerweise Zeit kosten: Erfassung, Triage, Diagnose, Behebung und Überprüfung.
- Erfassung und Triage: Fasst lange Berichte automatisch zusammen, extrahiert Schritte zur Reproduktion und die Umgebung, kennzeichnet Duplikate und schlägt Schweregrad und Priorität vor, damit Entwickler mit einem übersichtlichen Kontext beginnen können (z. B. ClickUp AI, Sentry AI).
- Weiterleitung und SLAs: Prognostiziert die wahrscheinliche Komponente/den zuständigen Eigentümer, legt Timer fest und eskaliert, wenn MTTA- oder Überprüfungszeiten überschritten werden – wodurch Leerlaufzeiten im Status reduziert werden (ClickUp-Automatisierungen und agentenähnliche Workflows).
- Diagnose: Gruppiert ähnliche Fehler, setzt Spitzenwerte mit aktuellen Commits/Releases in Zusammenhang und zeigt anhand von Stack-Traces und Code-Kontext auf wahrscheinliche Ursachen hin (Sentry KI und ähnliche Lösungen).
- Implementierung: Schlägt Codeänderungen und Tests vor, die auf Mustern aus Ihrem Repo basieren, und beschleunigt so den „Write/Fix“-Zyklus (GitHub Copilot; Snyk Code KI von DeepCode).
- Überprüfung und Kommunikation: Erstellt Testfälle anhand von Reproduktionsschritten, verfasst Entwürfe für Release-Notes und Updates für Stakeholder und fasst den Status für Führungskräfte und Kunden zusammen (ClickUp AI). Durch den kombinierten Einsatz – ClickUp als Command-Center zusammen mit Sentry/Copilot/DeepCode im Stack – verkürzen Teams die MTTA- und P90-Zeiten, ohne auf Einzelkämpfer angewiesen zu sein.