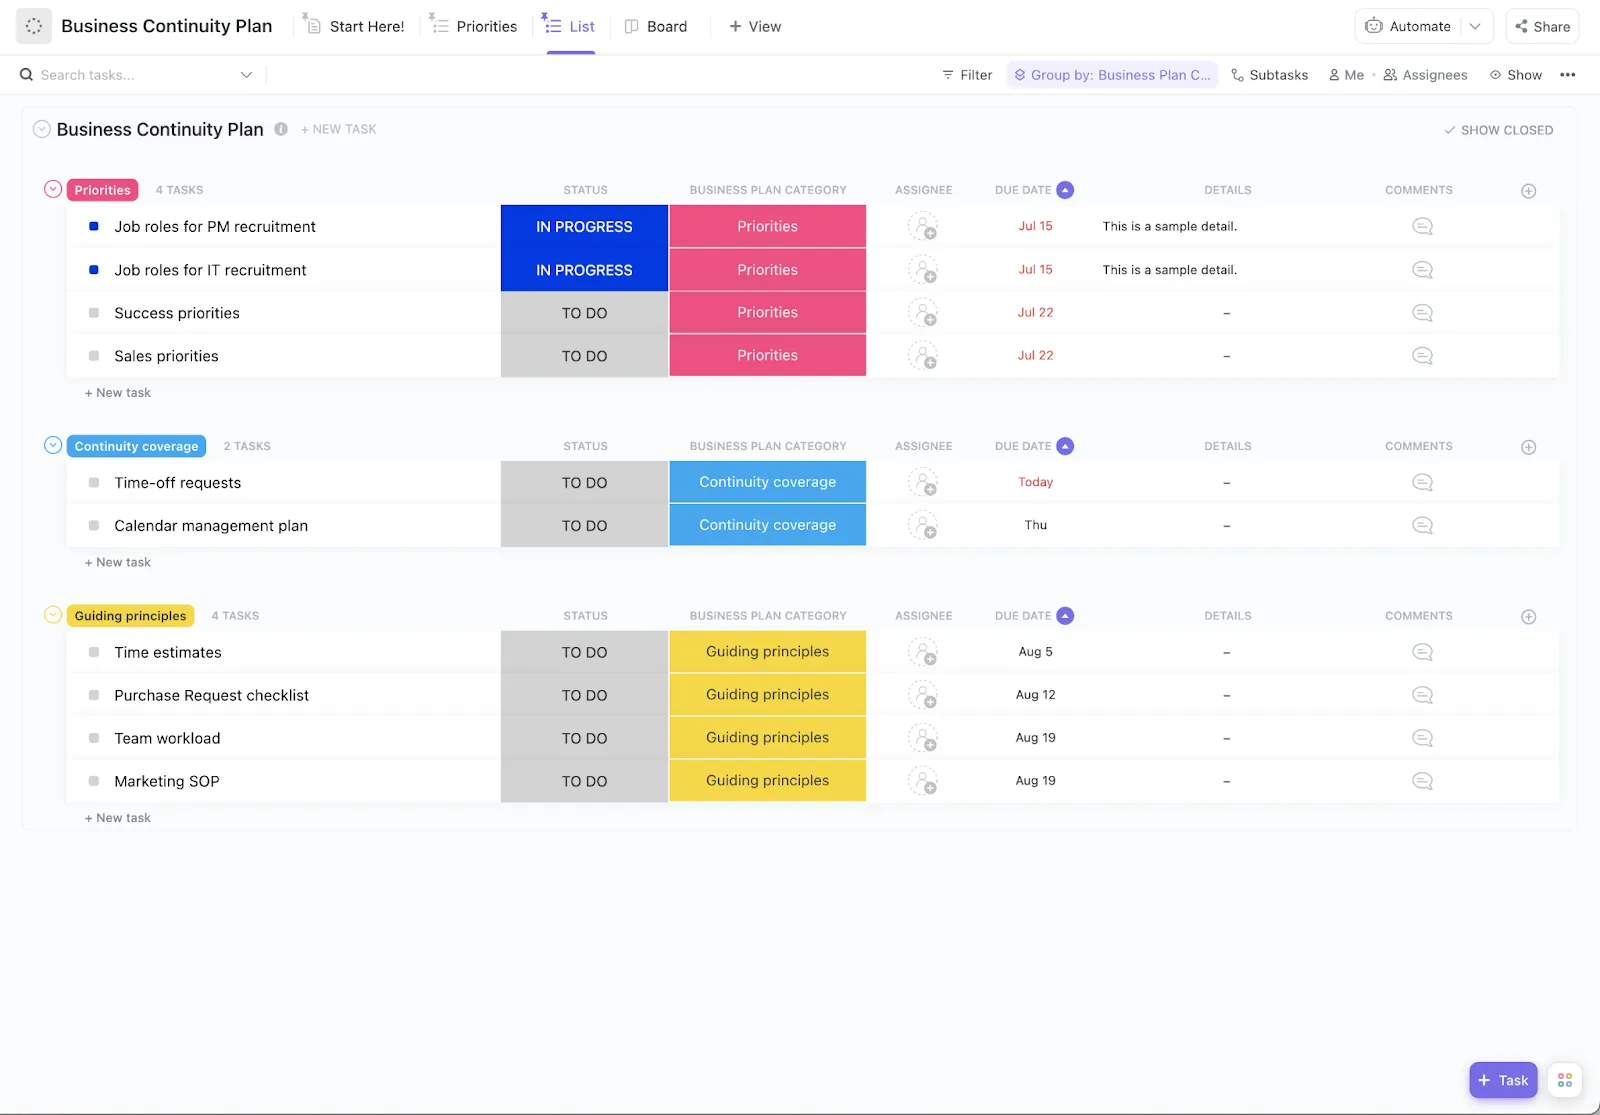

I disastri informatici possono verificarsi senza avviso.
Dai guasti ai server agli attacchi informatici: senza un solido piano di ripristino, la tua azienda potrebbe andare incontro a ore di inattività, perdita di dati e gravi danni finanziari, considerando che il 54% delle interruzioni gravi comporta costi superiori a 100.000 dollari USA.
Questo blog ti guida nella creazione di un piano completo di ripristino di emergenza IT che protegga i tuoi sistemi, definisca chiari obiettivi di ripristino e garantisca che il tuo team sappia esattamente cosa fare quando si verificano problemi.
Che cos’è un piano di ripristino di emergenza IT?
Se i tuoi server si bloccassero proprio ora, il tuo team saprebbe esattamente cosa fare? 🛠️
Un piano di disaster recovery (DR) IT è la strategia documentata per ripristinare i sistemi e i dati IT a seguito di qualsiasi interruzione, dai disastri naturali agli attacchi informatici. Si tratta, in sostanza, della procedura da seguire per riportare la tecnologia in funzione quando si verificano problemi.
💡 DR vs. continuità operativa aziendale
Il Disaster Recovery (DR) si concentra specificamente sul ripristino dell’infrastruttura IT e dei dati. La continuità operativa (BC) ha un ambito più ampio e mira a mantenere operativa l’intera azienda durante e dopo una crisi, anche in caso di interruzione dei servizi IT. Considera il DR come una componente fondamentale della tua strategia complessiva di continuità operativa.
💡 DR vs. continuità operativa
Il Disaster Recovery (DR) si concentra specificamente sul ripristino dell’infrastruttura IT e dei dati. La continuità operativa (BC) ha un ambito più ampio e mira a mantenere operativa l’intera azienda durante e dopo una crisi, anche in caso di interruzione dei servizi IT. Considera il DR come una componente fondamentale della tua strategia complessiva di continuità operativa.
Il tuo piano di ripristino di emergenza è fondamentale perché i tempi di inattività comportano costi che vanno ben oltre quelli economici. Ogni minuto in cui i tuoi sistemi sono offline può minare la fiducia dei clienti, interrompere le operazioni e persino comportare sanzioni per non conformità. Un piano di ripristino di emergenza completo è la tua guida verso la resilienza.
Un piano efficace deve includere:
- Procedura di backup dei dati: come e dove archiviare le copie delle informazioni critiche in modo da poterle ripristinare
- Passaggi di ripristino del sistema: la sequenza esatta per riportare i servizi online nel giusto ordine
- Responsabilità del team: chi fa cosa durante un incidente per evitare confusione
- Protocolli di comunicazione: come aggiornerai le parti interessate, dal tuo team ai tuoi clienti
- Obiettivi di ripristino: i tuoi obiettivi specifici relativi alla rapidità con cui i sistemi devono tornare operativi e alla quantità di perdita di dati ritenuta accettabile
Scenari comuni di disastri informatici e relative conseguenze
I disastri non sono solo scenari da film hollywoodiani: capitano alle aziende ogni giorno. Capire da cosa ti stai proteggendo ti aiuta a costruire una difesa molto più solida.
Catastrofi naturali e danni fisici
Eventi come inondazioni, incendi, terremoti e gravi interruzioni di corrente possono distruggere interi data center in pochi minuti. Quando, ad esempio, una grave inondazione ha colpito un data center di Nashville, alcune aziende hanno perso settimane di dati e hanno dovuto affrontare mesi di ripristino. La migliore protezione contro questo rischio è la ridondanza geografica, ovvero la distribuzione dell’infrastruttura su più posizioni fisiche, in modo che un singolo evento non possa mettere fuori uso l’intero sistema.
Attacchi informatici e compromissione dei dati
Il ransomware, gli attacchi Distributed Denial-of-Service (DDoS) e le violazioni dei dati sono diversi dai disastri fisici. Spesso sono più difficili da rilevare, possono diffondersi silenziosamente attraverso i sistemi collegati e, frequentemente, prendono di mira anche i sistemi di backup, rendendo il ripristino particolarmente impegnativo. La frequenza e la sofisticazione di questi attacchi informatici continuano ad aumentare in tutti i settori; il ransomware è ormai presente nel 44% di tutte le violazioni confermate, rendendolo una delle principali minacce.
📖 Per saperne di più: 10 modi per ridurre i rischi legati alla sicurezza informatica nel project management
Guasti hardware e perdita di dati
A volte, anche i sistemi di backup più collaudati e affidabili possono semplicemente smettere di funzionare. Arresti anomali dei server, guasti allo spazio di archiviazione e malfunzionamenti delle apparecchiature di rete possono verificarsi senza alcun avviso. Anche se si dispone di sistemi ridondanti (di backup), questi possono comunque guastarsi contemporaneamente se vi è condivisione di componenti o fonti di alimentazione comuni, creando un unico punto di guasto.
👀 Lo sapevate che: Nel mese di ottobre 2025, AWS ha subito un grave disservizio quando un bug nel proprio sistema interno di gestione DNS per Amazon DynamoDB ha causato il malfunzionamento della risoluzione dei nomi di dominio nella regione del data center US-EAST-1. Questo “piccolo” difetto tecnico ha triggerato un guasto a cascata su decine di servizi AWS e ha messo fuori uso centinaia di app e piattaforme popolari a livello globale — dalle app di messaggistica e social alle banche, ai siti di giochi e altro ancora. Per molte persone, l’interruzione ha fatto “scomparire” temporaneamente gran parte di Internet, mettendo in evidenza quanto sia fragile la nostra infrastruttura digitale quando così tanto dipende da una manciata di provider di servizi cloud.
Errori software e interruzioni del servizio
Un database danneggiato, un aggiornamento software non riuscito o un semplice errore di configurazione possono mettere fuori uso intere piattaforme. Potresti notare che una sola riga di codice configurata in modo errato può propagarsi a cascata attraverso i sistemi collegati, causando un’interruzione diffusa con un raggio d’azione molto ampio. Una corretta gestione delle modifiche e ambienti di test dedicati sono i tuoi migliori alleati per ridurre al minimo questi rischi.
Errori umani e configurazioni errate
Cancellazioni accidentali, configurazioni errate e modifiche non autorizzate rimangono tra le cause più comuni di interruzioni dei servizi IT. Un singolo comando errato o un file cancellato possono trigger ore di inattività e un deterioramento della qualità del servizio. Sebbene la formazione e i controlli di accesso siano utili, non possono eliminare completamente gli errori umani.
📮ClickUp Insight: Il 92% dei lavoratori utilizza metodi non uniformi per il monitoraggio degli elementi da intraprendere, il che ha come risultato decisioni mancate e ritardi nell’esecuzione.
Che si tratti di inviare note di follow-up o di utilizzare fogli di calcolo, il processo è spesso frammentato e inefficiente. Con le funzionalità di gestione delle attività di ClickUp, non dovrai più preoccuparti di questo. Crea attività dalla chat, dai commenti alle attività di ClickUp, dai documenti e dalle email con un solo clic!
Componenti chiave di un piano di ripristino di emergenza IT
Un solido piano di DR è la tua guida completa per tornare online. Ciascuna di queste componenti si integra con le altre per garantire una protezione completa alla tua azienda.
Valutazione dei rischi e definizione delle priorità
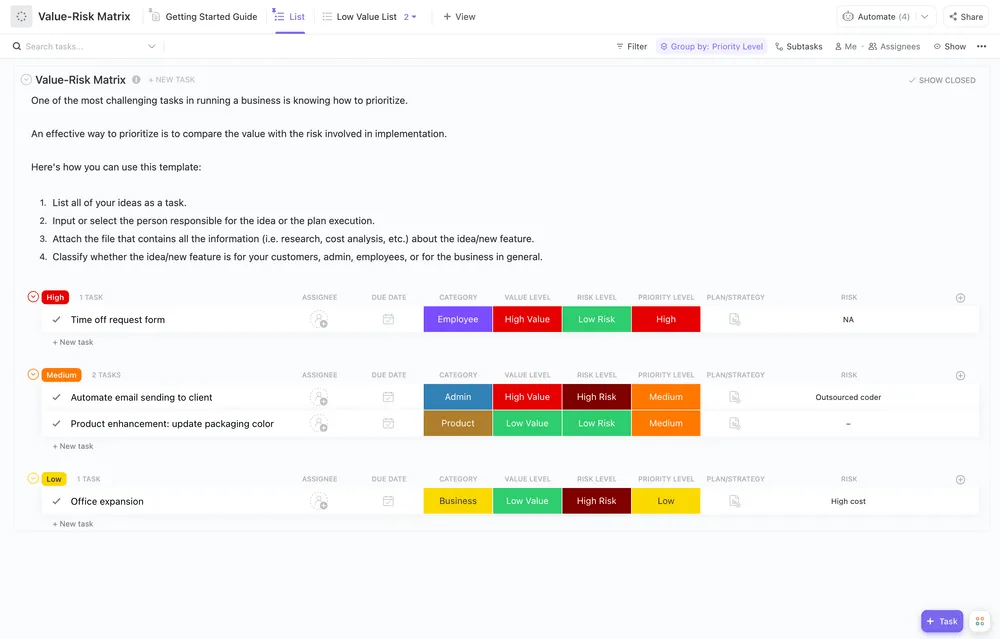
Innanzitutto, devi sapere con cosa hai a che fare. Una valutazione dei rischi è il processo che consente di identificare le tue vulnerabilità e di valutare la probabilità e l’impatto di ciascuna potenziale minaccia. Puoi organizzare questi dati in una matrice dei rischi per individuare quali minacce sono più gravi.
La tua valutazione dovrebbe includere:
- Sistemi critici: ciò che deve assolutamente rimanere in funzione affinché la tua azienda possa operare
- Sensibilità dei dati: quali informazioni richiedono il massimo livello di protezione (come i dati dei clienti)
- Dipendenze: quali altri sistemi o processi smettono di funzionare quando un sistema va in errore
📖 Per saperne di più: Come implementare la gestione dell’infrastruttura IT
Analisi dell’impatto aziendale e criticità
Successivamente, calcola il costo effettivo dei tempi di inattività. Un’analisi dell’impatto aziendale (BIA) ti aiuta a determinare l’impatto finanziario e operativo di un’interruzione per ciascun sistema. Ciò ti consente di classificare i tuoi sistemi in livelli di criticità per stabilire le priorità nel lavoro richiesto per il ripristino.
| Fondamentale | Meno di un'ora | Elaborazione dei pagamenti, database dei clienti |
| Elevato | Da una a quattro ore | Email, strumenti di comunicazione interna |
| Medio | Da 4 a 24 ore | Ambienti di sviluppo, strumenti di reportistica |
| Basso | Oltre 24 ore | Sistemi di archiviazione, server di test non di produzione |
Obiettivi RTO e RPO
Queste due sigle sono il fulcro della tua strategia di ripristino.
- Obiettivo di tempo di ripristino (RTO): Si tratta del tempo massimo che ci si può permettere che un sistema rimanga inattivo. Risponde alla domanda: “Entro quanto tempo dobbiamo ripristinare il funzionamento del sistema?”
- Obiettivo di punto di ripristino (RPO): Si tratta della quantità massima di dati che ci si può permettere di perdere, misurata in termini di tempo. Risponde alla domanda: “Quanti dati possiamo perdere senza subire danni gravi?”
Ad esempio, il sistema di email interno potrebbe avere un RTO di quattro ore, mentre il database dell’e-commerce rivolto ai clienti potrebbe avere un RPO di soli 15 minuti, il che significa che non è possibile perdere più di 15 minuti di dati relativi alle transazioni.
Piano di backup e ripristino dei dati
Il piano di backup è la tua rete di sicurezza definitiva. Una best practice diffusa è la regola del 3-2-1: conserva almeno tre copie dei tuoi dati importanti, archiviale su due diversi tipi di supporto e mantieni una di queste copie fuori sede.
Potrai inoltre scegliere tra diversi tipi di backup:
- Backup completi: una copia completa di tutti i dati, solitamente terminato con cadenza settimanale o mensile
- Backup incrementali: eseguono il backup solo delle modifiche apportate dall’ultimo backup, indipendentemente dal tipo di backup effettuato
- Backup differenziali: eseguono il backup di tutte le modifiche apportate dall’ultimo backup completo
Ma soprattutto, è fondamentale testare regolarmente il processo di ripristino dei backup. Un backup non testato è solo una speranza, non un piano.
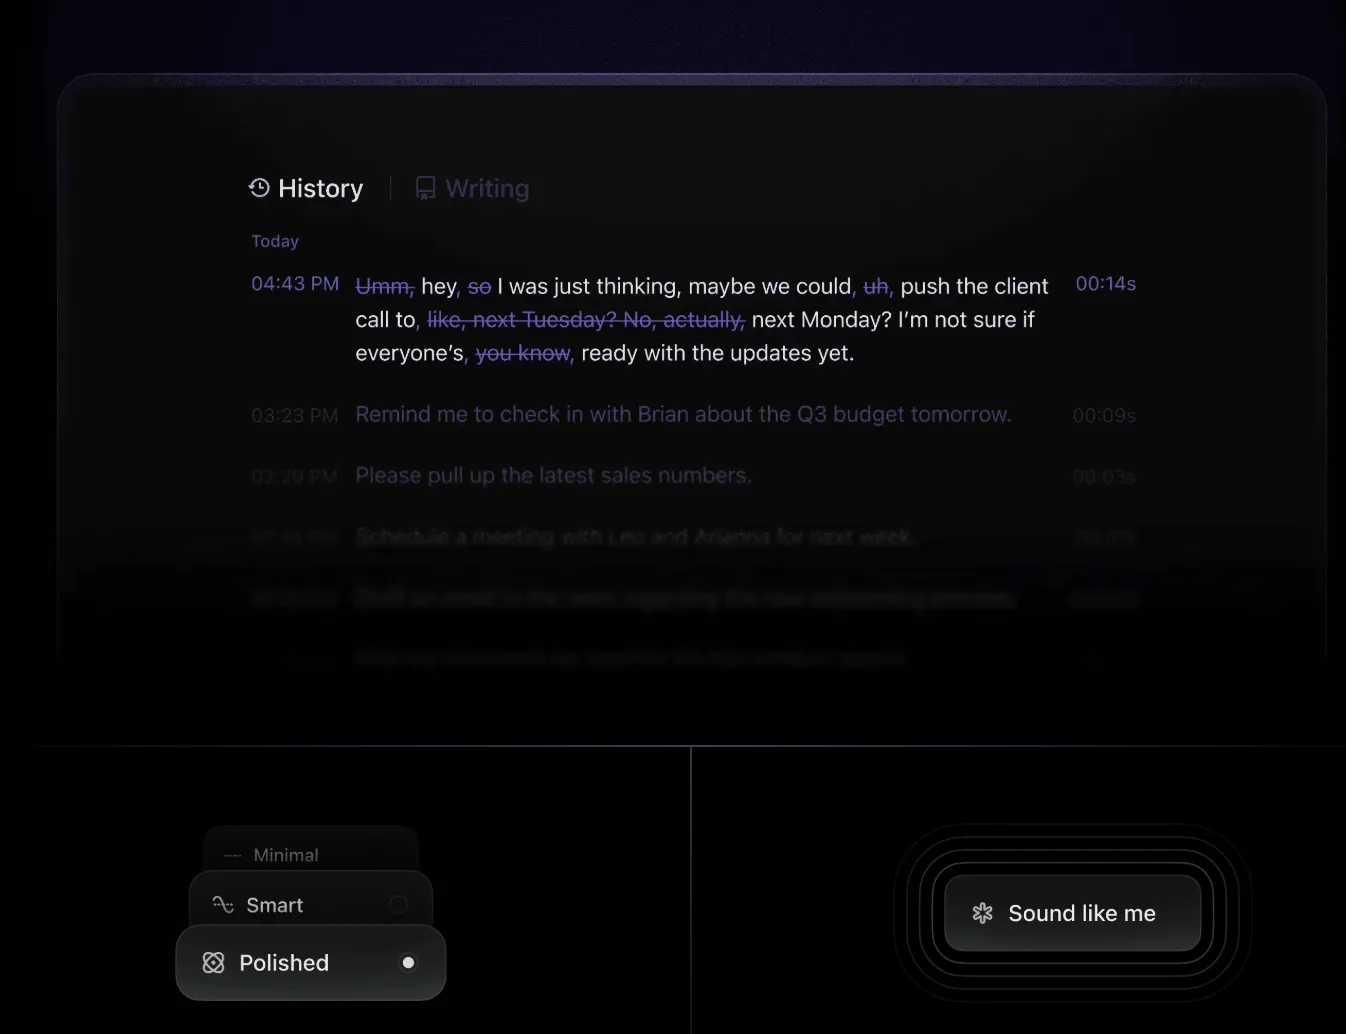
💟 Bonus: Cattura i dettagli critici durante gli incidenti ad alto stress utilizzando la funzione di trascrizione vocale di ClickUp Brain MAX, così non perderai mai informazioni importanti anche quando digitare non è pratico. Basta pronunciare le tue osservazioni e lasciare che l’IA si occupi della documentazione.
Piano di comunicazione e aggiornamenti per le parti interessate
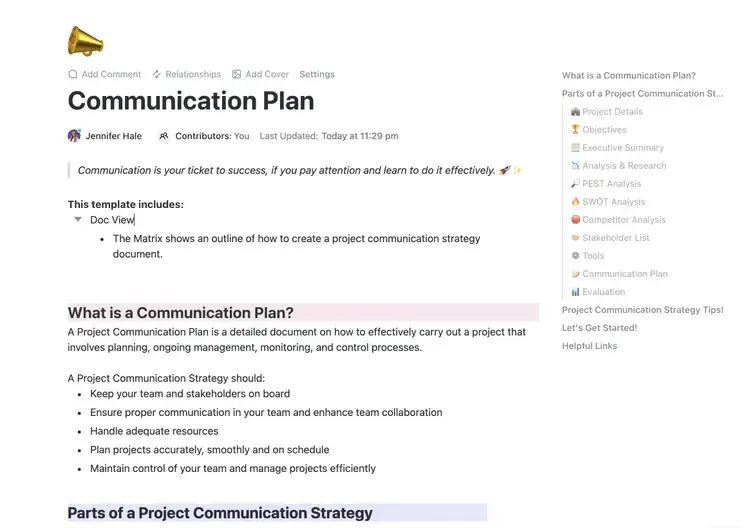
Quando si verifica un disastro, un piano di comunicazione chiaro è fondamentale. Il tuo piano deve definire le catene di notifica, la frequenza con cui fornirai aggiornamenti e i canali che utilizzerai per ogni tipo di incidente.
Gruppi diversi necessitano di informazioni diverse:
- Team interni: avete bisogno di dettagli tecnici e di elementi specifici da intraprendere
- Clienti: È necessario conoscere lo stato del servizio e sapere quando si prevede che il problema venga risolto
- Fornitori: potrebbe essere necessario coinvolgerli per supporto o escalation
- Organismi di regolamentazione: potrebbero richiedere notifiche formali a seconda del settore di attività
Strumenti come questo modello di piano di comunicazione pronto all’uso di ClickUp possono aiutarti ad agire più rapidamente grazie a un protocollo consolidato durante una crisi.
Programma di test e formazione
Un piano che non viene mai testato è un piano destinato a fallire. Test regolari consentono di individuare lacune e punti deboli prima che si verifichi un vero e proprio disastro.
Pianifica diversi tipi di test nel corso dell’anno:
- Esercitazioni teoriche: il tuo team simula uno scenario di emergenza sulla carta per verificare la logica del piano
- Failover parziali: si verifica il ripristino di componenti o servizi specifici e non critici
- Test completi di DR: si esegue un failover completo verso i sistemi di backup (il test definitivo)
Dopo ogni test, aggiorna la documentazione e forma immediatamente i nuovi membri del team sulle procedure.
📖 Per saperne di più: Come sviluppare politiche e procedure IT efficaci
Passaggi per la creazione di un piano di ripristino di emergenza IT
La creazione del tuo piano di DR non deve necessariamente essere un compito arduo.
Ecco come puoi affrontare la questione un passaggio alla volta. 🙌
Passaggio 1: Creare l’inventario delle risorse
Non è possibile proteggere ciò di cui non si conosce l’esistenza. Inizia creando un elenco delle risorse che elenchi ogni componente hardware, software, repository dati e dipendenza di sistema presente nel tuo ambiente. Assicurati di includere i contatti dei fornitori, le chiavi di licenza e i dettagli di configurazione, in modo da poterli consultare rapidamente durante un intervento di ripristino.
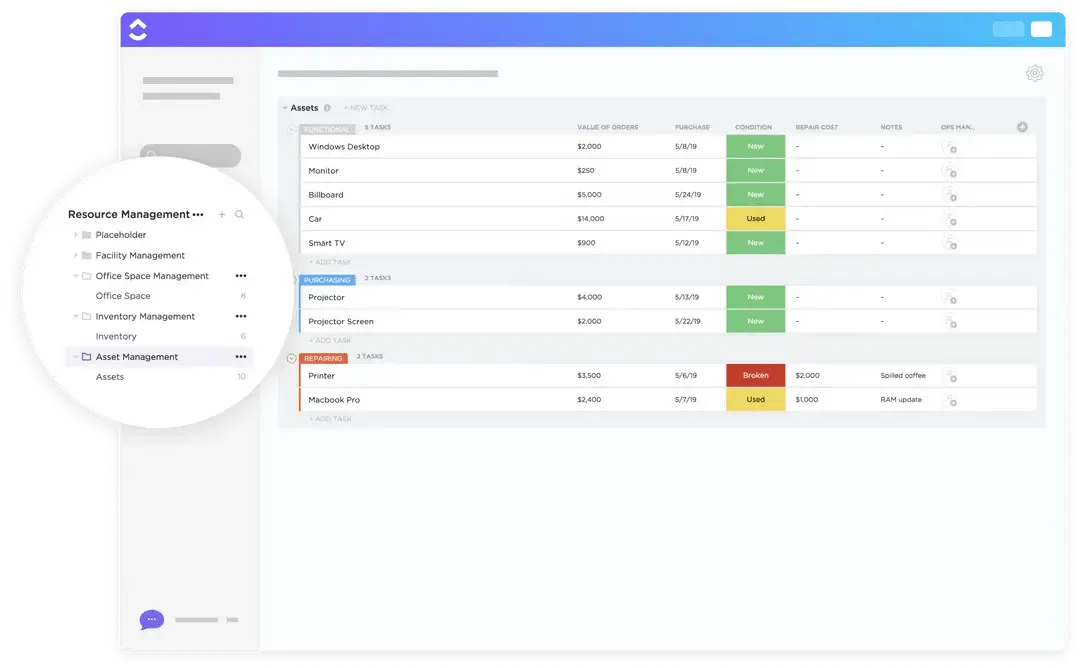
Il modello ITAM di ClickUp riunisce la gestione degli incidenti, la gestione dei problemi, la gestione delle modifiche, semplici soluzioni per la gestione delle risorse e la gestione delle conoscenze. Il nostro modello ITSM per gli errori noti semplifica il monitoraggio degli errori noti nei tuoi sistemi. Esplora tutti i nostri modelli IT non appena cambiano le tue esigenze.
Personalizza i tuoi flussi di lavoro come preferisci per ogni fase dell’ITAM, dall’implementazione e configurazione alla manutenzione e alla dismissione.
Passaggio 2: Classificare i servizi critici
Ora, identifica quali di queste risorse sono fondamentali per la missione aziendale e quali sono semplicemente accessorie. Crea mappe delle dipendenze dei servizi che mostrino come i tuoi sistemi si collegano e dipendono l’uno dall’altro. Presta particolare attenzione a tutti i servizi rivolti ai clienti che hanno un impatto diretto sui ricavi o sull’esperienza utente.
🎥 Guarda questa guida pratica che illustra come creare un piano strutturato e di alto livello utilizzando le potenti funzionalità/funzionalità di ClickUp: dalla definizione degli obiettivi all’assegnazione delle attività e al monitoraggio dei progressi.
Passaggio 3: Valutare rischi e minacce
Valuta i rischi e le minacce analizzando la probabilità e l’impatto di ciascun tipo di minaccia nella tua situazione specifica. Prendi in considerazione i rischi geografici (ti trovi in una zona sismica o in una pianura alluvionale?) e le eventuali minacce specifiche del settore (come modifiche normative o attacchi informatici mirati). Documenta tutto in un registro dei rischi in modo da poterlo effettuare nel tempo.

Il modello di lavagna online per la valutazione dei rischi di ClickUp aggiunge una dimensione visiva al tuo processo di valutazione dei rischi. Ti aiuta a valutare e classificare i rischi, stimolando il tuo team a promuovere la condivisione di intuizioni e a collaborare in un formato coinvolgente e visivo.
Questo modello ti consente di:
- Valutare le categorie di rischio e i potenziali impatti
- Analizza i dati per individuare potenziali aree di preoccupazione
- Individua le misure preventive per ridurre l’esposizione al rischio
Grazie alle funzionalità che consentono di disegnare, scrivere e aggiungere post-it, questo modello di lavagna per la gestione dei rischi è perfetto per valutare i rischi del tuo progetto.
Passaggio 4: Definire i traguardi RTO e RPO
Collabora direttamente con i responsabili aziendali per definire quali tempi di inattività e quali livelli di perdita di dati ritengono accettabili per ciascun livello di servizio identificato in precedenza. Dovrai trovare un equilibrio tra il costo di un ripristino più rapido e l’impatto sul business: non tutto richiede un ripristino immediato e senza alcuna perdita di dati. Ottieni l’approvazione dei dirigenti su questi traguardi.
Passaggio 5: Definire i percorsi di backup e di failover
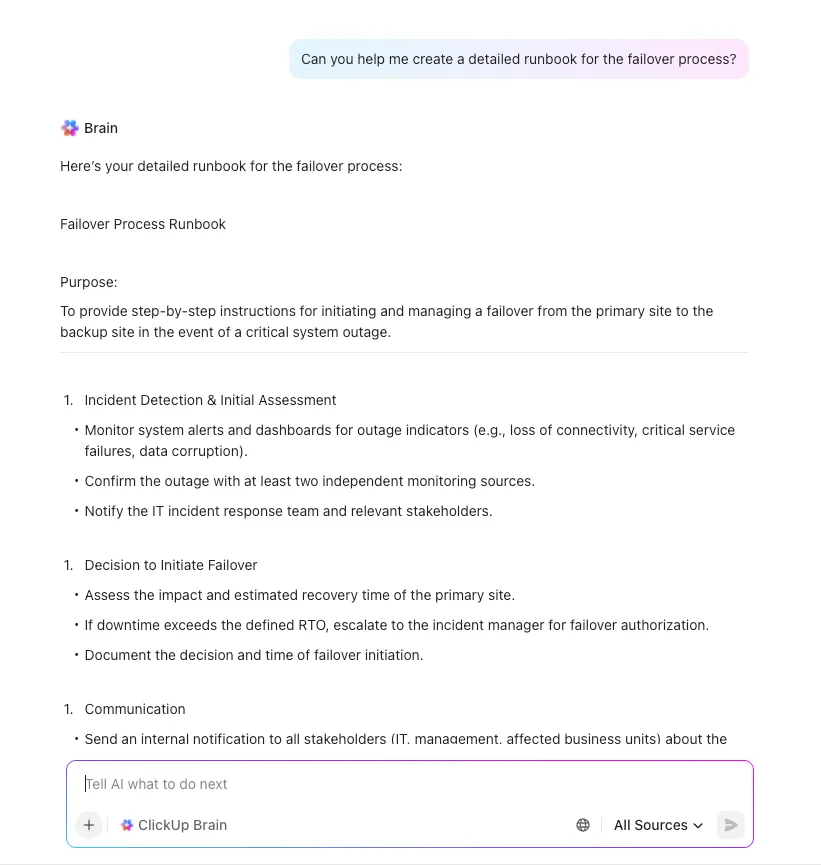
Una volta definiti i traguardi, è possibile progettare le soluzioni tecniche. Crea strategie di backup su misura per l’RPO di ciascun sistema e pianifica piani dettagliati di failover, inclusi siti di elaborazione alternativi e metodi di accesso di emergenza. Includi schemi di rete e guide operative passo dopo passo per garantire un’esecuzione infallibile.
Passaggio 6: Assegnazione dei ruoli e delle procedure di escalation
Definisci la struttura del tuo team di DR con responsabilità chiare e poteri decisionali ben definiti. Crea elenchi di contatti completi con il personale principale e di backup per ogni ruolo. Una matrice RACI (Responsabile, Rispondente, Consultato, Informato) è uno strumento eccellente per eliminare la confusione durante un incidente ad alto stress.
Passaggio 7: Documentare e comunicare il piano
Documenta e comunica il piano con procedure chiare e dettagliate che chiunque nel tuo team possa seguire, anche in situazioni di stress. È fondamentale conservare questa documentazione in un luogo facilmente accessibile e separato dall’infrastruttura principale. Assicurati che ogni membro del team sappia esattamente dove trovare il piano durante una crisi.

Semplifica la pianificazione dei tuoi progetti con il modello di pianificazione RACI di ClickUp. Questo modello di documento rappresenta una vera e propria rivoluzione, poiché offre un grafico chiaro per definire i ruoli e le responsabilità del team in relazione alle attività del progetto. Adotta il modello RACI (Responsabile, Rispondente, Consultato e Informato) per allineare tutti gli attori, garantendo la responsabilità e l’allineamento con gli obiettivi organizzativi.
Passaggio 8: Testare, rivedere e migliorare
Infine, pianifica test trimestrali per verificare le tue procedure e individuare eventuali lacune. Documenta tutte le lezioni apprese da ciascun test e da eventuali incidenti reali, e utilizzale per aggiornare il tuo piano. Crea un sistema sistematico di monitoraggio dei miglioramenti per garantire che eventuali problemi individuati vengano risolti.
🌼 Lo sapevi? Nel 2017, Gitlab ha subito un grave guasto al database. Durante il ripristino, l’azienda ha scoperto che diversi metodi di backup non funzionavano correttamente da giorni senza che nessuno se ne accorgesse. Questo incidente ha insegnato all’intero settore tecnologico una lezione fondamentale: la verifica dei backup è imprescindibile. Un backup non testato non è affatto un vero backup.
🌼 Lo sapevi? Nel 2017, Gitlab ha subito un grave guasto al database. Durante il ripristino, l’azienda ha scoperto che diversi metodi di backup non funzionavano correttamente da giorni senza che nessuno se ne accorgesse. Questo incidente ha insegnato all’intero settore tecnologico una lezione fondamentale: la verifica dei backup è imprescindibile. Un backup non testato non è affatto un vero backup.
Strategie e soluzioni di ripristino di emergenza
Non tutte le organizzazioni necessitano dello stesso approccio al DR. Esploriamo insieme le opzioni disponibili in base al vostro budget, alle vostre esigenze di ripristino e alle risorse a vostra disposizione.
Approccio al backup e al ripristino
Questo è il metodo più semplice ed economico. Prevede l’esecuzione di backup regolari in una posizione esterna (come il cloud o un data center secondario) e il successivo ripristino manuale quando necessario. Questo approccio è ideale per i sistemi non critici in grado di tollerare un RTO più lungo, poiché il ripristino può richiedere ore o addirittura giorni.
Alta disponibilità e ridondanza
Questa strategia mira a eliminare i singoli punti di guasto utilizzando più sistemi attivi. Tecniche quali il bilanciamento del carico, il clustering dei server e lo spazio di archiviazione RAID garantiscono che, in caso di guasto di un componente, un altro subentri immediatamente. Sebbene più costoso da implementare e mantenere, questo approccio è in grado di ridurre al minimo i tempi di inattività a pochi secondi o minuti, rendendolo ideale per i servizi critici.
Opzioni di replica e failover
La replica consiste nel copiare i dati quasi in tempo reale su un sito secondario, garantendo così una perdita minima di dati in caso di disastro.
- Replica sincrona: scrive i dati contemporaneamente sia sul sito primario che su quello secondario, garantendo zero perdite di dati. Tuttavia, richiede un'elevata larghezza di banda e può rallentare il sistema primario
- Replica asincrona: scrive i dati prima sul sito primario e poi li copia sul sito secondario con un leggero ritardo. È meno costosa e ha un impatto minore sulle prestazioni, ma comporta un piccolo rischio di perdita dei dati
Disaster recovery basato sul cloud e DRaaS
Il Disaster Recovery as a Service (DRaaS) è diventato una scelta diffusa per molte aziende. Offre un modello di pagamento pay-as-you-go, una distribuzione geografica immediata e un’automazione dell’orchestrazione del ripristino, senza la necessità di costruire e gestire siti di DR fisici propri. Il DR nel cloud elimina l’enorme spesa in conto capitale legata a un data center di backup, fornendo al contempo una scalabilità più rapida e una maggiore flessibilità rispetto ai tradizionali approcci basati su siti “hot”, “warm” o “cold”.
Come ClickUp semplifica la pianificazione del piano di ripristino di emergenza IT
La gestione di un piano di DR attraverso fogli di calcolo, documenti e catene di email sparsi crea di per sé un rischio di disastro.
Questo tipo di dispersione del lavoro, la frammentazione delle attività su più strumenti scollegati tra loro che non comunicano tra loro, e la dispersione del contesto, quando i team perdono ore alla ricerca di informazioni sparse tra app e piattaforme, portano a confusione, informazioni obsolete e tempi di risposta lenti proprio quando ogni secondo è fondamentale.
Con ClickUp Converged AI Workspace — un'unica piattaforma sicura in cui tutte le tue app di lavoro, i dati e i flussi di lavoro convivono con l'IA contestuale come livello di intelligenza — che combina project management, documentazione e comunicazione di squadra. Smetti di destreggiarti tra più piattaforme e riunisci la pianificazione del DR, i test e la risposta agli incidenti in un unico sistema unificato.
Documentazione centralizzata sul DR con ClickUp Docs e assistenza IA integrata
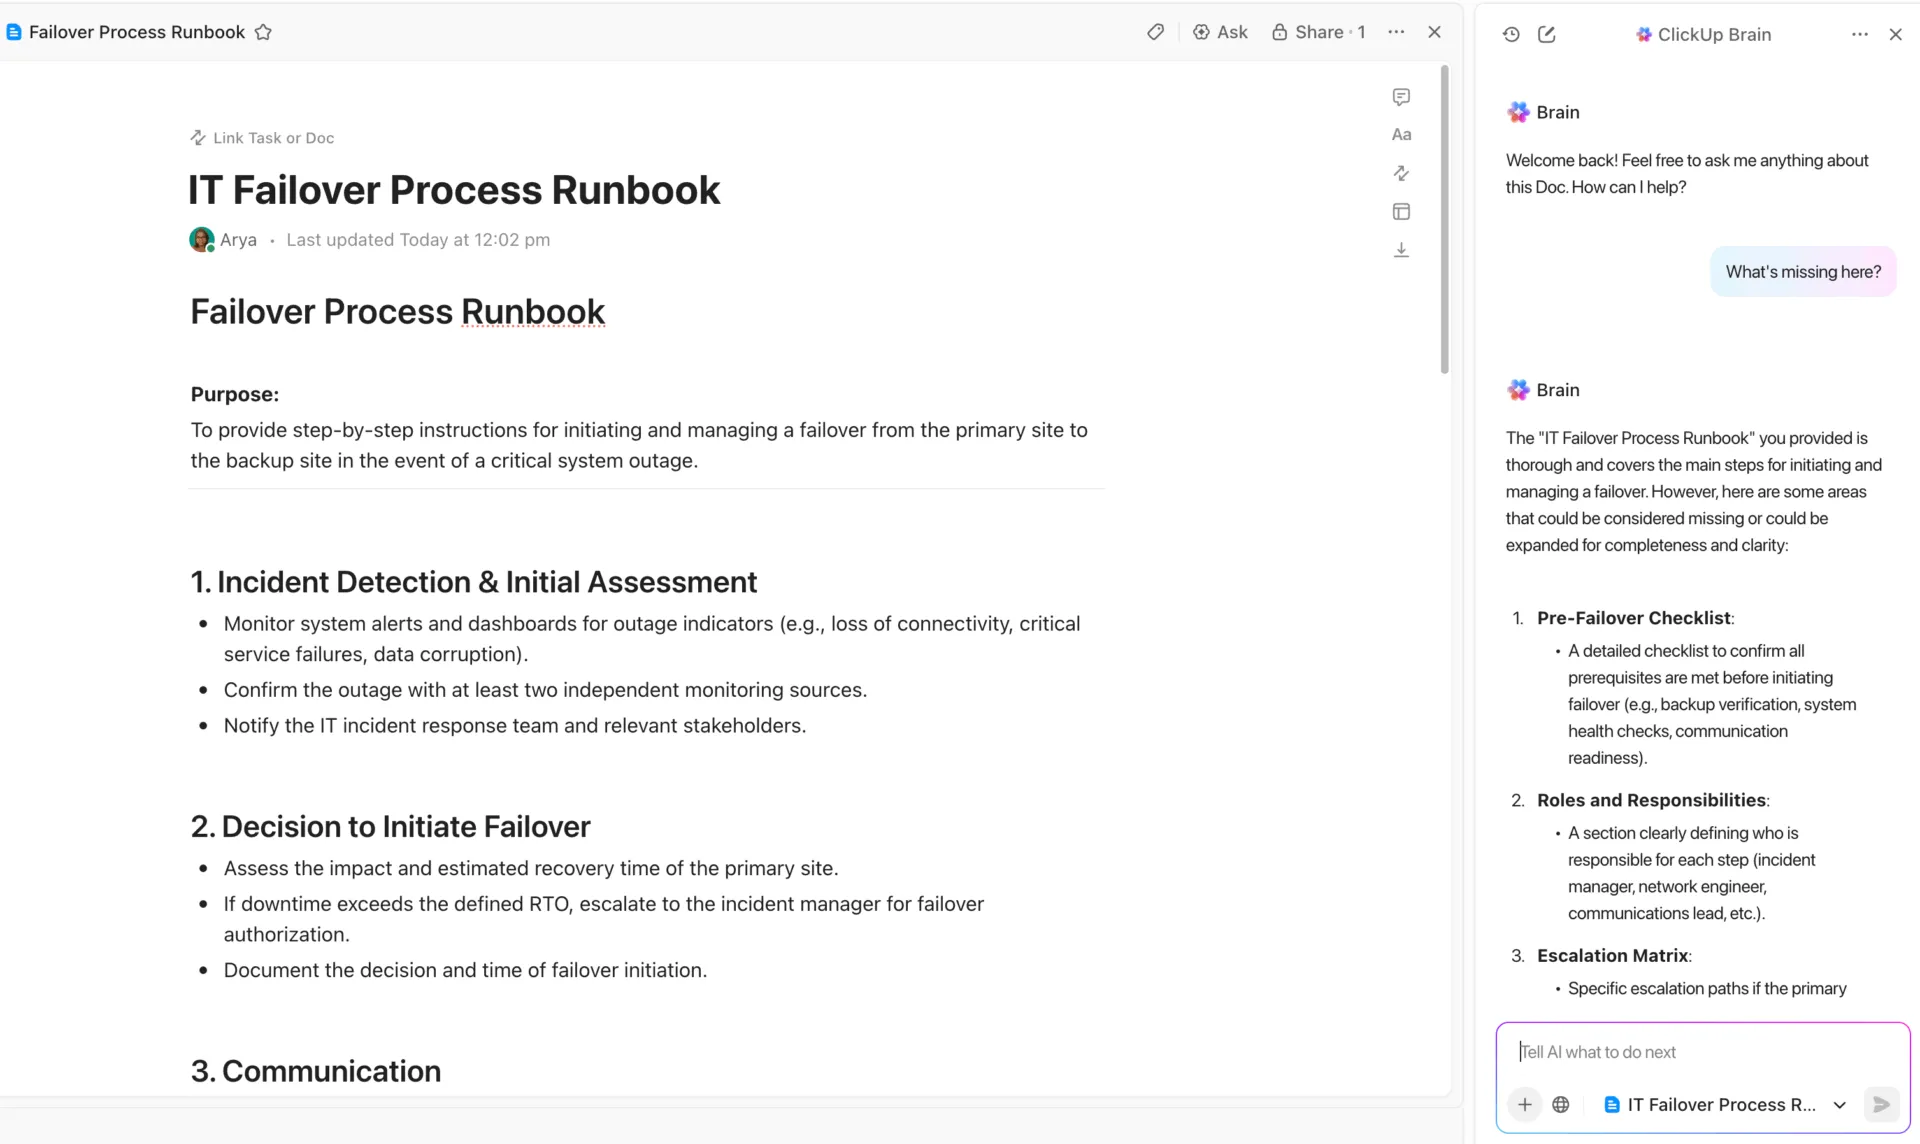
Assicurati che il tuo team disponga sempre di un'unica fonte di informazioni affidabili grazie a ClickUp Docs.
Crea il tuo piano completo di ripristino di emergenza in uno spazio collaborativo in cui tutti possano contribuire in tempo reale durante un incidente. Collega i documenti direttamente alle attività e ai progetti relativi all’incidente per una navigazione fluida e incorpora diagrammi o guide operative per avere le informazioni critiche proprio dove ti servono.
Ma soprattutto, puoi proteggere i tuoi documenti per impedire modifiche accidentali e utilizzare le autorizzazioni granulari di ClickUp per controllare chi può visualizzare o modificare le procedure di ripristino sensibili. Ogni modifica viene tracciata nella cronologia del documento, garantendoti una traccia di audit completa.
Creazione di piani basata sull’IA con ClickUp Brain
Accelera la pianificazione del ripristino di emergenza ed elimina le lacune critiche con ClickUp Brain, il tuo assistente IA contestuale che comprende l’intero spazio di lavoro. A differenza degli strumenti di IA generici, ClickUp Brain sfrutta le attività, i documenti e i flussi di lavoro reali della tua organizzazione per fornire un supporto preciso e concreto alle iniziative di DR.
Basta inviare a ClickUp Brain una richiesta del tipo: “Crea una lista di controllo di ripristino di emergenza per la nostra piattaforma di e-commerce” e riceverai immediatamente un modello completo e personalizzato, in linea con i tuoi sistemi, i tuoi processi e le tue esigenze di conformità. Può aiutarti a:
- Consapevolezza contestuale: ClickUp Brain ha accesso alla struttura, ai contenuti e alle autorizzazioni del tuo spazio di lavoro. Può fare riferimento a attività, documenti, commenti e persino alle app collegate, fornendo risposte e azioni su misura per il tuo lavoro effettivo, non solo suggerimenti generici
- Risoluzione dei problemi e guida: risolvi immediatamente i problemi, ottieni istruzioni dettagliate o richiedi le best practice su qualsiasi funzionalità/funzione di ClickUp. Brain può guidarti attraverso processi complessi, automatizzare attività ripetitive e aiutarti a risolvere gli ostacoli
- Automazioni e accelerazione dei flussi di lavoro: utilizza agenti IA predefiniti o personalizzati per automatizzare flussi di lavoro in più fasi, smistare le richieste o gestire le attività ricorrenti, risparmiando ore ogni settimana
- Ricerca approfondita: trova le informazioni nascoste ovunque nella tua area di lavoro, inclusi documenti, attività e strumenti integrati, anche se risalgono a diversi anni fa o sono difficili da individuare con la ricerca standard
- Riepiloghi e aggiornamenti in tempo reale: genera istantaneamente aggiornamenti sui progetti, riassunti delle riunioni o rapporti sullo stato di avanzamento, attingendo dai dati in tempo reale dell’area di lavoro
- Semplificazione della documentazione tecnica: Trasforma documenti tecnici complessi in procedure o liste di controllo chiare e pratiche che il tuo team possa seguire, anche in situazioni di stress
- Intelligenza multimodale: scegli tra i principali modelli di IA (OpenAI GPT-4.1, GPT-5, Claude, Gemini e altri) per ottenere i migliori risultati in qualsiasi attività, senza bisogno di sottoscrizioni separate
- Sicuro e basato sulle autorizzazioni: Brain accede solo alle informazioni per le quali disponi già delle autorizzazioni necessarie, garantendo il rispetto di rigorosi standard di privacy e conformità
- Interfaccia conversazionale: usa @brain nei commenti o mentre chatti per ottenere approfondimenti contestuali, redigere bozze di risposta o trigger automazioni senza interrompere il tuo flusso di lavoro
- Prompt personalizzati e flussi di lavoro salvati: salva e riutilizza i prompt per le esigenze ricorrenti, garantendo coerenza e risparmiando tempo a tutto il tuo team
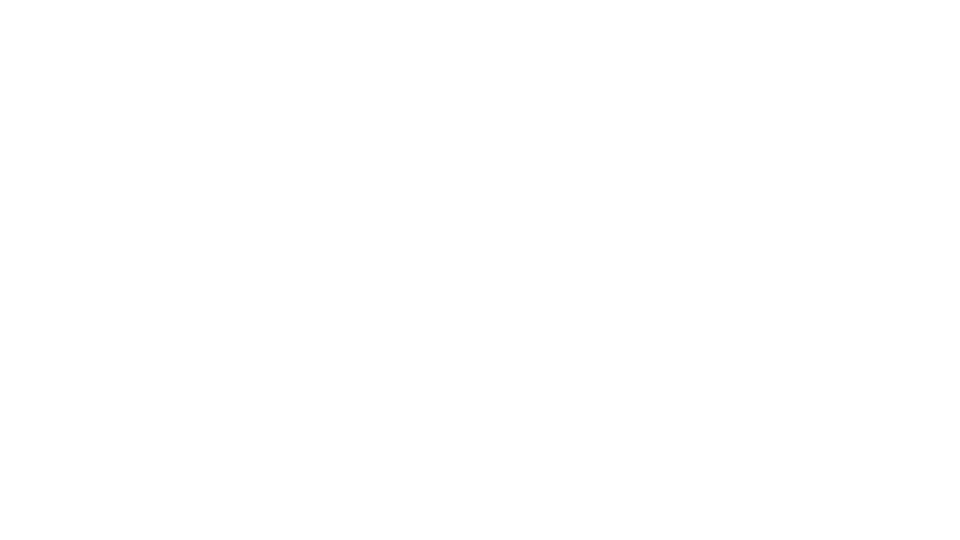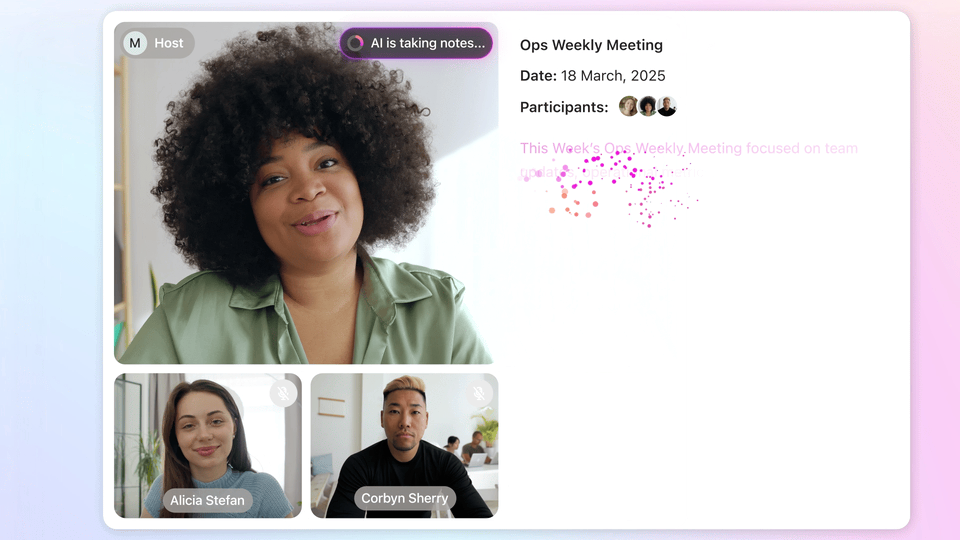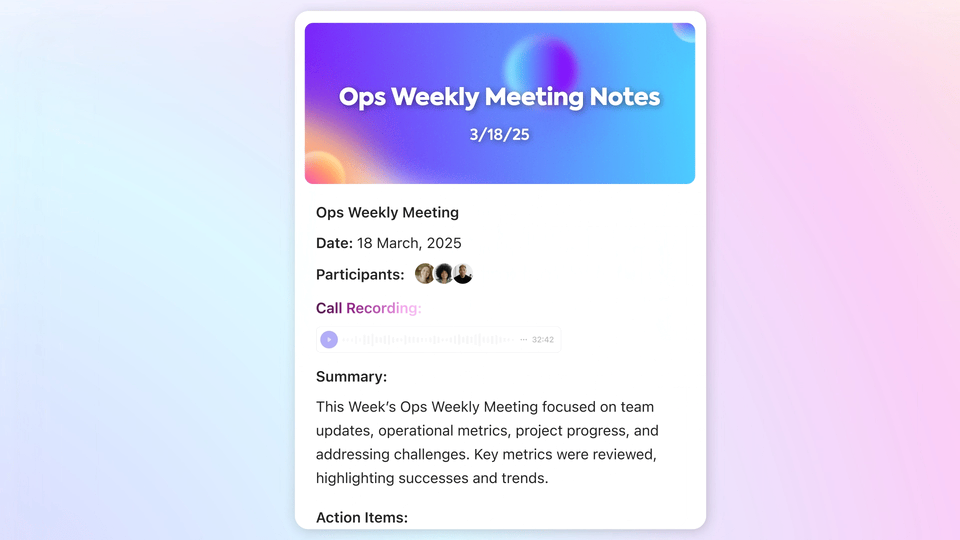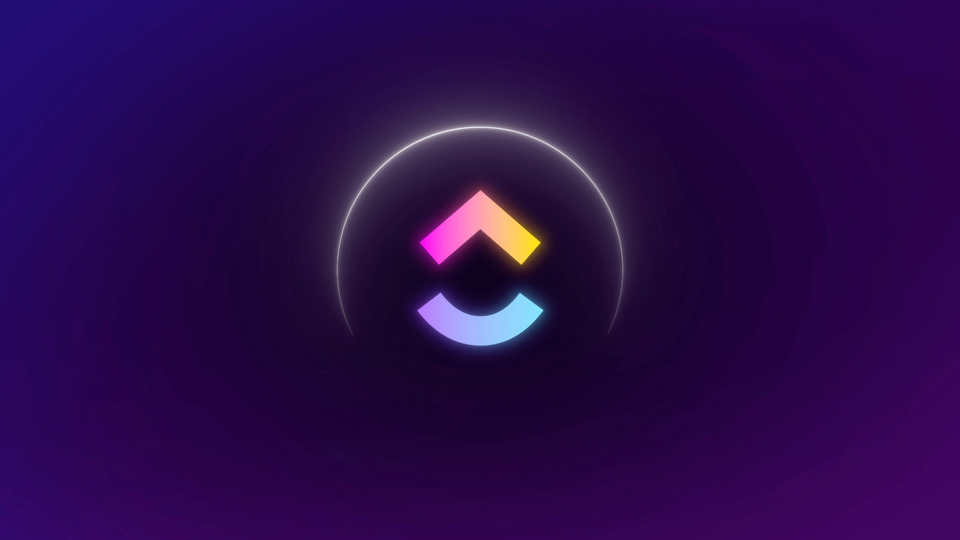
💡Consiglio da esperto: non perderti mai nulla delle riunioni di analisi degli incidenti, registrando ogni dettaglio con ClickUp AI Notetaker. Questo strumento può partecipare alle tue riunioni virtuali, trascrivere l’intera discussione e generare automaticamente un elenco di azioni da intraprendere sulla base degli insegnamenti tratti. In questo modo si crea una cronologia degli incidenti consultabile, che ti permette di fare rapidamente riferimento agli eventi passati e alle relative soluzioni.
Flussi di lavoro automatizzati per il DR con ClickUp Automazioni
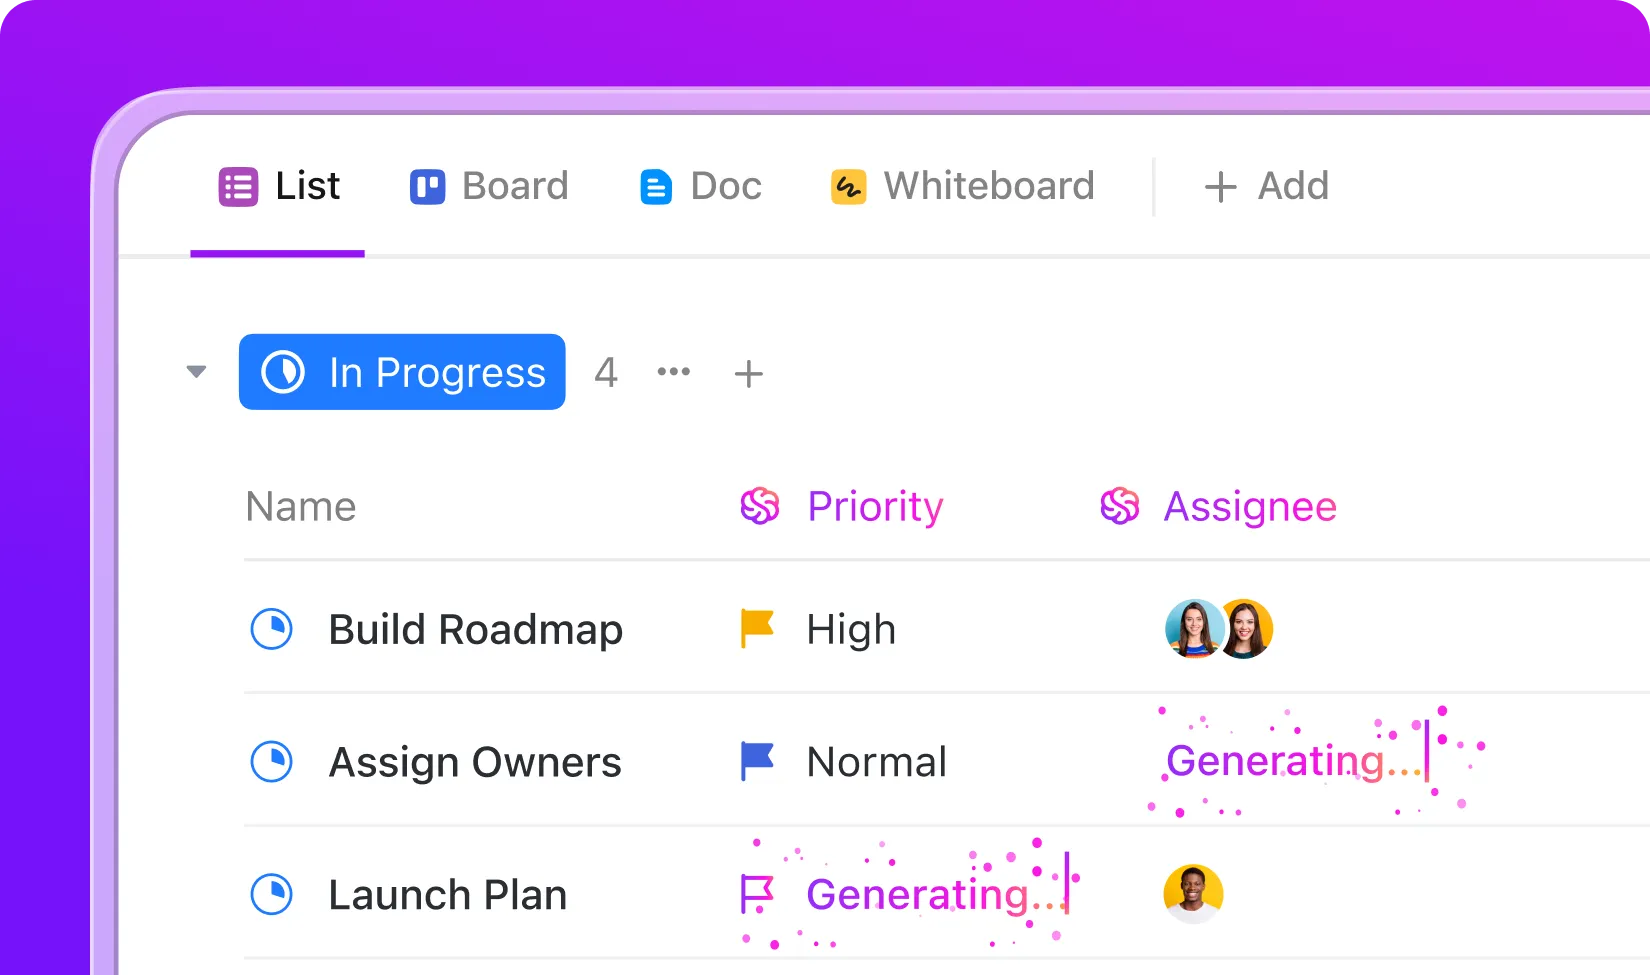
Immagina che il tuo team si trovi ad affrontare un'interruzione improvvisa: ogni secondo è prezioso e non puoi permetterti di tralasciare nemmeno un passaggio. Con gli agenti IA e le automazioni di ClickUp, non dovrai più agire alla cieca né affidarti alla memoria. Non appena viene segnalato un incidente, l'IA di ClickUp entra in azione, guidando il tuo team e occupandosi delle attività ripetitive, così potrai concentrarti sulla risoluzione del problema.
Ecco come funziona in uno scenario reale:
- Quando qualcuno contrassegna un'attività come “Incidente dichiarato”, ClickUp Agent crea automaticamente una lista di controllo dei passaggi da intraprendere, li assegna alle persone giuste e avvia un timer per effettuare il monitoraggio del tempo necessario al ripristino
- Se l’incidente viene contrassegnato come “Critico”, un agente può inviare immediatamente un’email di allerta al tuo team dirigenziale e creare una chat room dedicata — la tua “war room” — in modo che tutti possano comunicare in un unico luogo
- L’IA è in grado di recuperare i rapporti sugli incidenti passati e la documentazione pertinente, in modo che il tuo team abbia tutto ciò di cui ha bisogno a portata di mano
Scopri il flusso di lavoro qui:
Con gli agenti ClickUp AI, avrai a disposizione un compagno di squadra digitale affidabile che aiuterà il tuo team a mantenere la calma, l’organizzazione e l’efficienza, anche nei momenti di maggiore pressione.
Monitoraggio in tempo reale con i dashboard di ClickUp
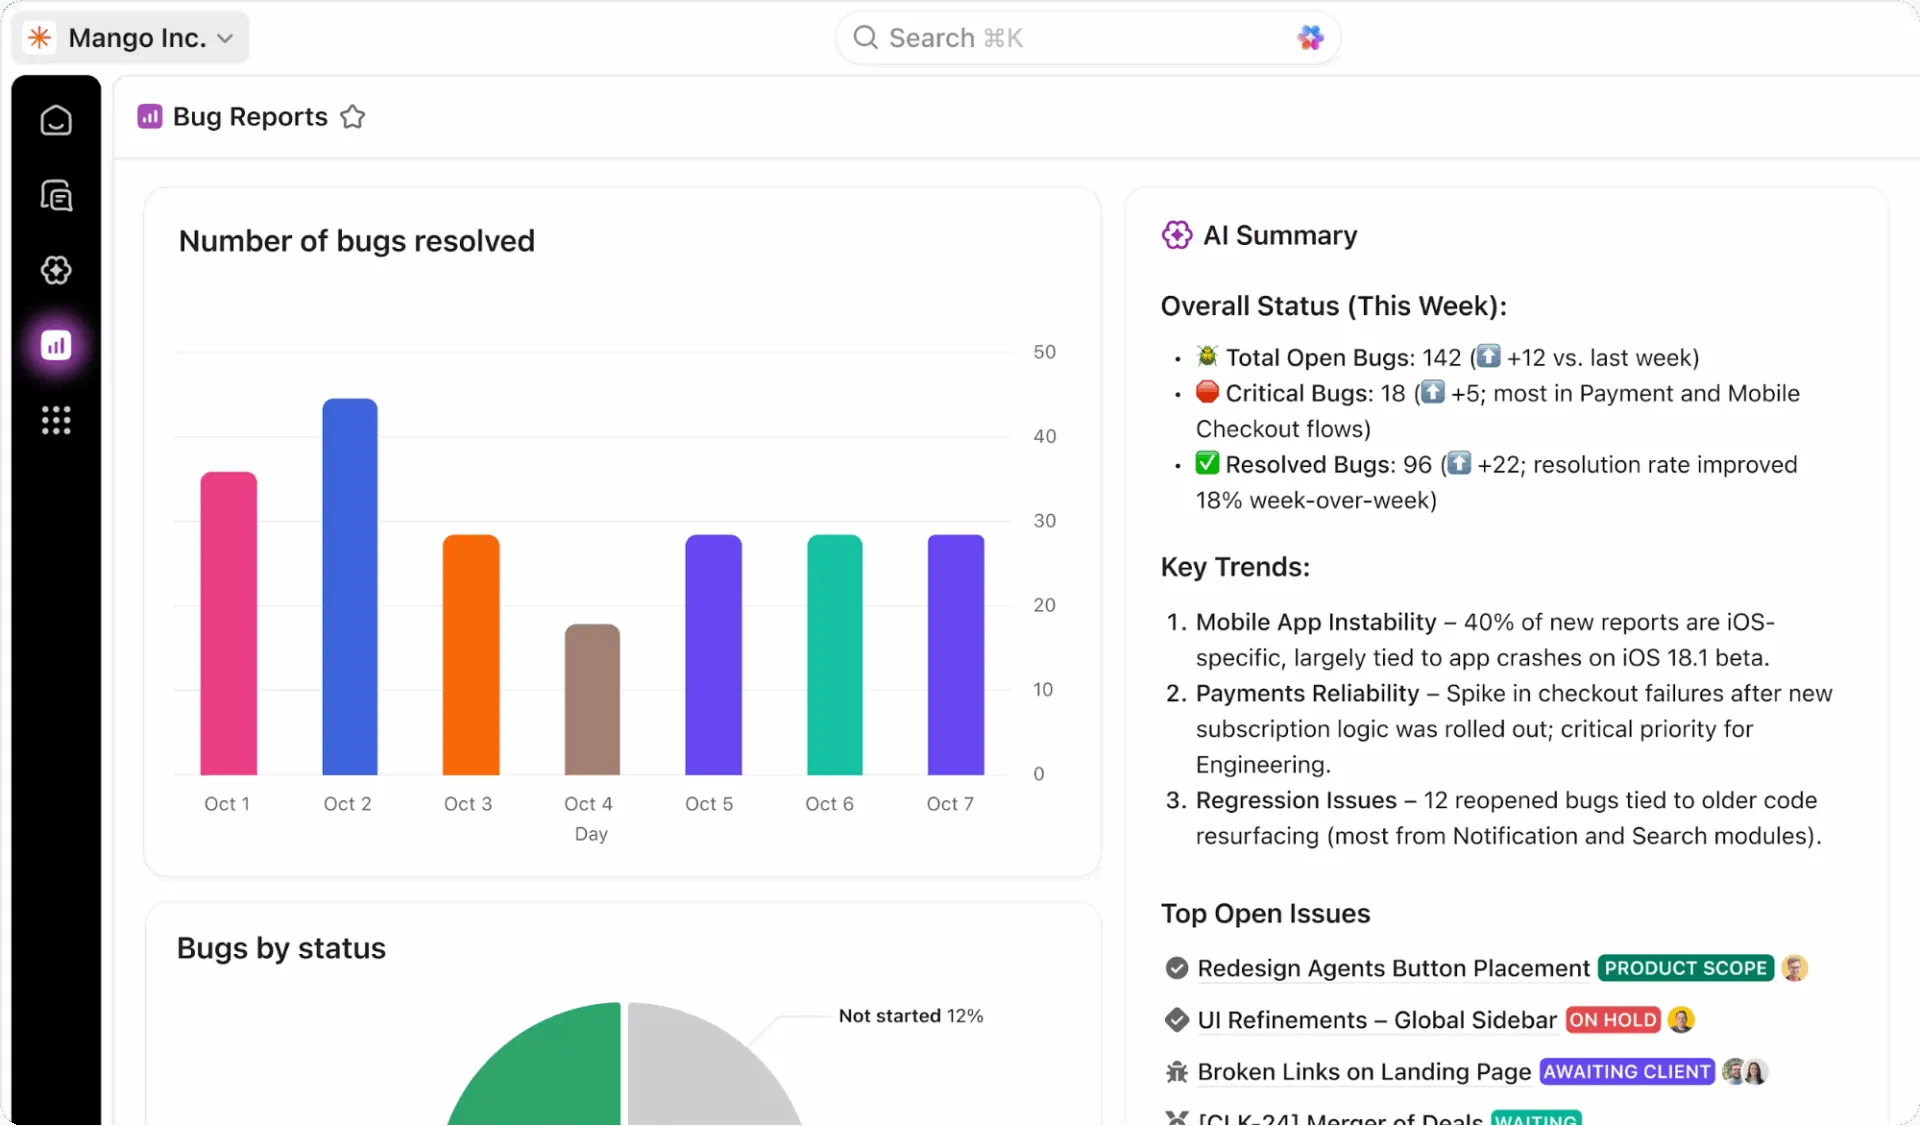
Ottieni una visibilità completa sullo stato del tuo programma di DR monitorando tutto in tempo reale con i dashboard di ClickUp. Puoi creare widget per monitorare le prestazioni di RTO e RPO durante i test, tenere traccia dei tassi di completamento dei test e visualizzare l’andamento degli incidenti nel tempo.
Aggiungi i campi personalizzati di ClickUp alle tue attività per monitorare la criticità del sistema, lo stato di ripristino e i risultati dei test, quindi raggruppa tutti questi dati in una vista dettagliata. Queste dashboard ti offrono report pronti per i dirigenti, sempre aggiornati con dati in tempo reale provenienti dalle attività di test e di risposta agli incidenti del tuo team.
📖 Per saperne di più: Come creare una lista di controllo per la valutazione dei rischi
Crea oggi stesso il tuo piano di DR
Ogni giorno in cui operi senza un piano di DR è una scommessa che non puoi permetterti di perdere. I disastri sono inevitabili — che siano causati da eventi naturali, guasti tecnologici o errori umani — ma è la tua preparazione a determinare se si trasformeranno in piccoli inconvenienti o in gravi catastrofi.
Un piano di DR completo richiede la comprensione dei rischi, la documentazione di procedure chiare e il loro collaudo regolare. Gli strumenti giusti rendono questo processo gestibile, eliminando il caos causato da documenti sparsi e processi manuali.
Anche i piani di emergenza più semplici sono meglio di niente quando si verifica un disastro. Test e aggiornamenti regolari trasformeranno il tuo piano di DR da un documento impolverato a un sistema dinamico in grado di proteggere davvero la tua azienda.
Fai il primo passaggio e inizia oggi stesso a creare il tuo piano di DR con ClickUp. Inizia gratis con ClickUp e riunisci tutta la pianificazione del disaster recovery, la documentazione e la risposta agli incidenti in un’unica piattaforma unificata. ✨
Domande frequenti
Con quale frequenza i team dovrebbero aggiornare un modello di piano di ripristino di emergenza IT?
È opportuno rivedere il piano di DR almeno quattro volte all’anno e aggiornarlo immediatamente dopo eventuali modifiche significative all’infrastruttura o incidenti reali. La maggior parte delle organizzazioni effettua una revisione approfondita una volta all’anno per integrare tutte le lezioni apprese e adattarsi alle nuove tecnologie.
Quali team sono responsabili della documentazione e dei test relativi al ripristino di emergenza?
I team IT, i team di sicurezza e i responsabili della continuità operativa sono solitamente a capo del lavoro richiesto per la pianificazione e i test del DR. Tuttavia, hanno bisogno del contributo fondamentale dei responsabili delle operazioni e delle unità aziendali per garantire che il piano sia in linea con le esigenze e le priorità aziendali reali.
Come viene effettuato il monitoraggio di RTO e RPO durante i test di ripristino di emergenza?
Utilizza cronometri e timestamp chiari per misurare i tempi di ripristino effettivi rispetto ai traguardi definiti durante ogni test. È fondamentale documentare eventuali discrepanze tra i traguardi e le prestazioni effettive nei rapporti di test, al fine di orientare i miglioramenti futuri.
Quali strumenti aiutano a documentare e automatizzare un piano di ripristino di emergenza?
Le piattaforme di project management come ClickUp sono ideali per centralizzare la documentazione, automatizzare i flussi di lavoro e effettuare il monitoraggio delle metriche dell’intero programma di DR. È quindi possibile abbinarle a strumenti specializzati per il DR che gestiscono gli aspetti tecnici della replica dei dati e del failover di sistema.