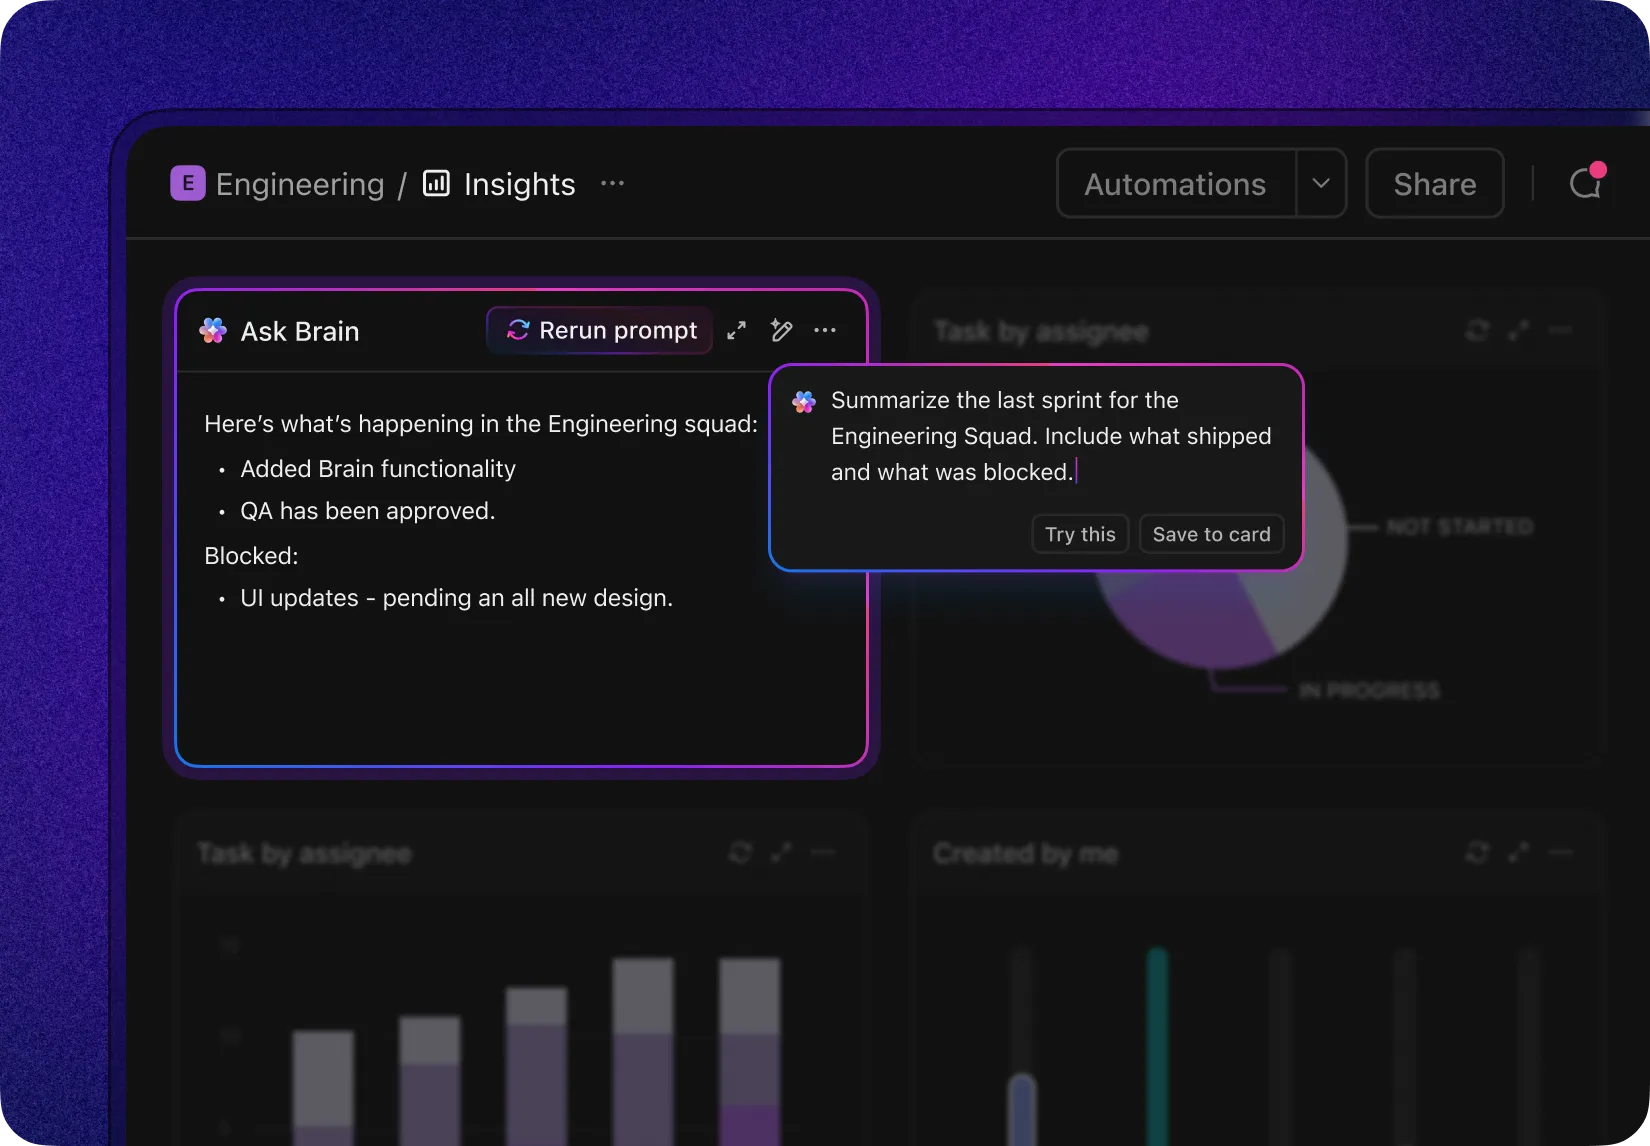
تقوم بإصدار آخر تحديث للبرنامج، فتبدأ التقارير في التدفق.
فجأة، أصبح هناك مؤشر واحد يحكم كل شيء بدءًا من مؤشر رضا العملاء (CSAT) ومؤشر التوصية الصافية (NPS) وصولًا إلى التأخير في تنفيذ خطة العمل: وقت حل الأخطاء.
يرى المسؤولون التنفيذيون في ذلك مقياسًا لوفاء الوعود — هل يمكننا إطلاق المنتجات، والتعلم، وحماية الإيرادات وفقًا للجدول الزمني المحدد؟ أما الممارسون فيعانون من الصعوبات على أرض الواقع — مثل تكرار التذاكر، وعدم وضوح المسؤولية، والتصعيدات المزعجة، وتشتت السياق بين Slack وجداول البيانات والأدوات المنفصلة.
تؤدي هذه التجزئة إلى إطالة دورات العمل، وإخفاء الأسباب الجذرية، وتحويل تحديد الأولويات إلى مجرد تخمينات.
والنتيجة؟ بطء في التعلم، والتخلف عن الوفاء بالالتزامات، وتراكم المهام التي تثقل كاهل كل سبرينت بشكل خفي.
يُعد هذا الدليل دليلك الشامل لقياس وقت حل الأخطاء ومقارنته وتقليصه، كما يوضح بشكل ملموس كيف يغير الذكاء الاصطناعي سير العمل مقارنةً بالعمليات التقليدية اليدوية.
ما هو وقت حل الأخطاء؟
وقت حل الأخطاء هو المدة الزمنية التي يستغرقها إصلاح خطأ ما، ويتم قياسها من لحظة الإبلاغ عن الخطأ حتى يتم حله بالكامل.
في الممارسة العملية، يبدأ العد التنازلي عند الإبلاغ عن مشكلة ما أو اكتشافها (سواء من قبل المستخدمين أو فريق ضمان الجودة أو نظام المراقبة)، ويتوقف عند تنفيذ الإصلاح ودمجه، ليصبح جاهزًا للتحقق أو الإصدار — اعتمادًا على الطريقة التي يحدد بها فريقك معنى «الانتهاء».
مثال: عطل من فئة P1 تم الإبلاغ عنه في الساعة 10:00 صباحًا يوم الاثنين، وتم دمج الإصلاح في الساعة 3:00 مساءً يوم الثلاثاء، ويبلغ وقت حل المشكلة حوالي 29 ساعة.
وهذا يختلف عن «وقت اكتشاف الأخطاء». فوقت الاكتشاف يقيس مدى سرعة اكتشافك للخلل بعد حدوثه (عند انطلاق الإنذارات، أو اكتشافه بواسطة أدوات اختبار ضمان الجودة ، أو الإبلاغ عنه من قبل العملاء).
يقيس وقت الحل مدى سرعة انتقالك من مرحلة اكتشاف المشكلة إلى مرحلة معالجتها — التقييم، وإعادة إنتاج المشكلة، والتشخيص، والتنفيذ، والمراجعة، والاختبار، والتحضير للإصدار. فكر في الكشف على أنه «نعلم أن المشكلة موجودة»، وفي الحل على أنه «تم إصلاح المشكلة وأصبحت جاهزة».
تستخدم الفرق حدودًا تختلف قليلاً؛ اختر حدًا واحدًا والتزم به حتى تكون اتجاهاتك حقيقية:
- تم الإبلاغ → تم الحل: ينتهي عندما يتم دمج إصلاح الكود ويصبح جاهزًا لفحص الجودة. مفيد لزيادة إنتاجية قسم الهندسة
- تم الإبلاغ عنها → تم إغلاقها: يشمل ذلك التحقق من الجودة والإصدار. الأنسب لاتفاقيات مستوى الخدمة (SLA) التي تؤثر على العملاء
- تم الكشف عنها → تم حلها: تبدأ العملية عندما تكتشف المراقبة/ضمان الجودة المشكلة، حتى قبل إنشاء تذكرة الدعم. مفيدة للفرق التي تعمل بكثافة في بيئة الإنتاج
🧠 حقيقة مسلية: حظي خطأ غريب ومضحك في لع بة Final Fantasy XIV بالإشادة لكونه محددًا للغاية، لدرجة أن القراء أطلقوا عليه لقب «أكثر إصلاح للأخطاء تحديدًا في لعبة MMO لعام 2025». " كان هذا الخطأ يظهر عندما يحدد اللاعبون أسعار العناصر بما يتراوح بالضبط بين 44,442 جيل و49,087 جيل في منطقة حدث معينة — مما يتسبب في انقطاع الاتصال بسبب ما قد يكون خللاً في تجاوز سعة الأعداد الصحيحة.
أهمية ذلك
يُعد وقت الحل عاملاً مؤثرًا في وتيرة الإصدارات. فالأوقات الطويلة أو غير المتوقعة تفرض تقليص نطاق العمل، وإصدار تصحيحات عاجلة، وتجميد الإصدارات؛ كما أنها تخلق عجزًا في التخطيط لأن الحالات الشاذة (القيم المتطرفة) تعرقل سير العمل في السبرينتات أكثر مما يوحي به المتوسط.
كما أن هذا الأمر مرتبط ارتباطًا مباشرًا برضا العملاء. فالعملاء يتسامحون مع المشكلات عندما يتم الاعتراف بها بسرعة وحلها بطريقة يمكن التنبؤ بها. أما الإصلاحات البطيئة — أو الأسوأ من ذلك، الإصلاحات المتفاوتة — فتؤدي إلى تصعيد المشكلات، وتضر بمؤشرات رضا العملاء (CSAT) وصافي التوصية (NPS)، وتعرض عمليات التجديد للخطر.
باختصار، إذا قمت بقياس وقت حل الأخطاء بشكل دقيق وعملت على تقليصه بشكل منهجي، فستتحسن خططك الاستراتيجية وعلاقاتك.
📖 اقرأ المزيد: كيفية تحديد أولويات الأخطاء لحل المشكلات بكفاءة
كيف يمكن قياس وقت حل الأخطاء؟
أولاً، حدد متى يبدأ الوقت ومتى ينتهي.
تختار معظم الفرق إما «تم الإبلاغ → تم حل المشكلة» (تم دمج الإصلاح وأصبح جاهزًا للتحقق) أو «تم الإبلاغ → تم إغلاقها» (قامت وحدة ضمان الجودة بالتحقق من صحة التغيير وتم إصداره أو إغلاقه لسبب آخر).
اختر تعريفًا واحدًا واستخدمه بشكل متسق حتى تكون اتجاهاتك ذات مغزى.
الآن أنت بحاجة إلى بعض المقاييس القابلة للرصد. دعنا نلخصها:
المقاييس الرئيسية لتتبع الأخطاء التي يجب الانتباه إليها:
| 📊 المؤشر | 📌 ما الذي يرمز إليه | 💡 كيف يساعد ذلك | 🧮 الصيغة (إن وجدت) |
|---|---|---|---|
| عدد الأخطاء 🐞 | العدد الإجمالي للأخطاء المبلغ عنها | يقدم نظرة شاملة على حالة النظام. الرقم مرتفع؟ حان وقت التحقيق. | إجمالي الأخطاء = جميع الأخطاء المسجلة في النظام {المفتوحة + المغلقة} |
| الأخطاء المفتوحة 🚧 | الأخطاء التي لم يتم إصلاحها بعد | يعرض حجم العمل الحالي. ويساعد في تحديد الأولويات. | الأخطاء المفتوحة = إجمالي الأخطاء - الأخطاء المغلقة |
| الأخطاء المغلقة ✅ | الأخطاء التي تم حلها والتحقق منها | يتتبع التقدم المحرز والعمل المنجز. | الأخطاء المغلقة = عدد الأخطاء التي تحمل الحالة "مغلقة" أو "تم حلها" |
| خطورة الأخطاء 🔥 | درجة خطورة الخطأ (على سبيل المثال: خطير، كبير، بسيط) | يساعد في التصنيف حسب التأثير. | يتم تتبعه كـ حقل تصنيفي، بدون صيغة. استخدم عوامل التصفية/التجميع. |
| أولوية الأخطاء 📅 | مدى إلحاحية إصلاح الخلل | يساعد في تخطيط السبرينت والإصدارات. | كما يُعد حقلًا تصنيفيًا، وعادةً ما يتم تصنيفه (على سبيل المثال، P0، P1، P2). |
| الوقت اللازم للحل ⏱️ | المدة المستغرقة من الإبلاغ عن الخطأ حتى إصلاحه | يقيس سرعة الاستجابة. | وقت الحل = تاريخ الإغلاق - تاريخ الإبلاغ |
| معدل إعادة الفتح 🔄 | النسبة المئوية للأخطاء التي أعيد فتحها بعد إغلاقها | يعكس جودة الإصلاح أو مشكلات التراجع. | معدل إعادة الفتح (%) = {الأخطاء التي أعيد فتحها ÷ إجمالي الأخطاء المغلقة} × 100 |
| تسرب الأخطاء 🕳️ | الأخطاء التي تسللت إلى بيئة الإنتاج | يشير إلى فعالية ضمان الجودة/اختبار البرمجيات. | معدل التسرب (%) = {الأخطاء في بيئة الإنتاج ÷ إجمالي الأخطاء} × 100 |
| كثافة الأخطاء 🧮 | عدد الأخطاء لكل وحدة حجم من الكود | يُبرز مناطق الكود المعرضة للمخاطر. | كثافة الأخطاء = عدد الأخطاء ÷ KLOC {كيلو خط من التعليمات البرمجية} |
| الأخطاء المخصصة مقابل الأخطاء غير المخصصة 👥 | توزيع الأخطاء حسب الجهة المسؤولة | يضمن عدم إغفال أي شيء. | استخدم مرشحًا: غير مخصص = الأخطاء التي يكون فيها حقل «مخصص لـ» فارغًا |
| عمر الأخطاء المفتوحة 🧓 | كم من الوقت يظل الخطأ دون حل | يكتشف مخاطر الركود وتراكم المهام المتأخرة. | عمر الخطأ = التاريخ الحالي - تاريخ الإبلاغ |
| الأخطاء المكررة 🧬 | عدد البلاغات المكررة | يُبرز الأخطاء في عمليات الاستلام. | معدل التكرار = عدد الحالات المكررة ÷ إجمالي الأخطاء × 100 |
| MTTD (متوسط الوقت اللازم للكشف) 🔎 | متوسط الوقت المستغرق في اكتشاف الأخطاء أو الحوادث | يقيس كفاءة المراقبة والتوعية. | MTTD = Σ(وقت الكشف - وقت الظهور) ÷ عدد الأخطاء |
| MTTR (متوسط الوقت اللازم للحل) 🔧 | متوسط الوقت اللازم لإصلاح الخلل بالكامل بعد اكتشافه | يتتبع سرعة استجابة فريق الهندسة ووقت الإصلاح. | MTTR = Σ(وقت الحل - وقت الاكتشاف) ÷ عدد الأخطاء التي تم حلها |
| MTTA (متوسط الوقت المستغرق في الإقرار) 📬 | الوقت المستغرق من لحظة اكتشاف الخلل حتى بدء العمل على إصلاحه | يُظهر مدى سرعة استجابة الفريق وتفاعله مع التنبيهات. | MTTA = Σ(وقت الإقرار - وقت الاكتشاف) ÷ عدد الأخطاء |
| MTBF (متوسط الوقت بين الأعطال) 🔁 | الفترة الزمنية بين حل عطل ما وظهور العطل التالي | يشير إلى الاستقرار بمرور الوقت. | MTBF = إجمالي وقت التشغيل ÷ عدد حالات الفشل |
⚡️ أرشيف القوالب: 15 نموذجًا ونموذجًا مجانيًا لتقارير الأخطاء لتتبع الأخطاء
العوامل التي تؤثر على وقت حل الأخطاء
غالبًا ما يُعتبر وقت حل المشكلات مرادفًا لـ«مدى سرعة المهندسين في كتابة الأكواد».
لكن هذا ليس سوى جزء واحد من العملية.
يُعد وقت حل الأخطاء مجموعًا من جودة الاستلام، وكفاءة التدفق عبر نظامك، ومخاطر التبعية. وعندما يتعثر أي عنصر من هذه العناصر، يطول وقت الدورة، وتنخفض القدرة على التنبؤ، وتزداد الشكاوى.
جودة الاستقبال هي التي تحدد مسار العمل
التقارير التي تصل دون خطوات واضحة لإعادة إنتاج المشكلة، أو تفاصيل البيئة، أو السجلات، أو معلومات الإصدار/البناء، تتسبب في تبادل إضافي للمراسلات. كما أن التقارير المكررة الواردة من قنوات متعددة (الدعم، ضمان الجودة، المراقبة، Slack) تزيد من التشويش وتؤدي إلى تشتت المسؤولية.
فكلما أسرعت في تحديد السياق الصحيح — وإزالة التكرارات — قلّت الحاجة إلى عمليات التسليم والتواصل التوضيحي لاحقًا.
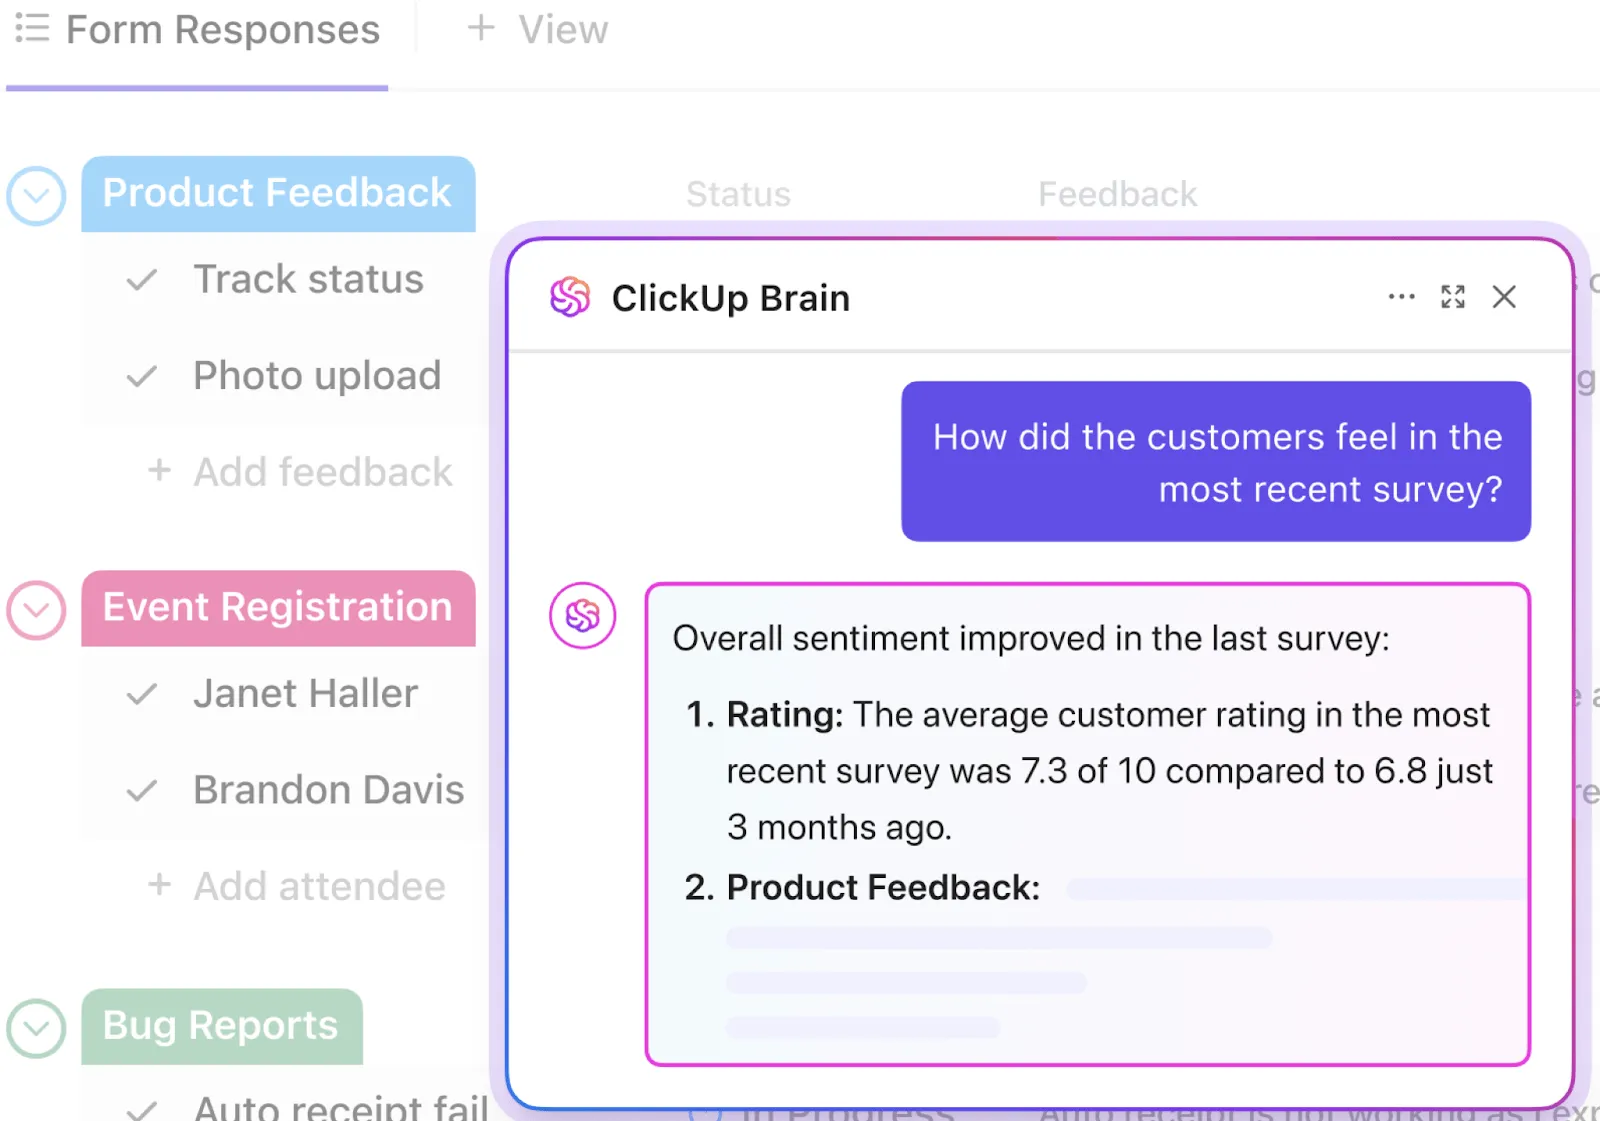
تحدد عملية تحديد الأولويات وتوجيه المهام من سيتولى معالجة الخلل ومتى
تؤدي تصنيفات الخطورة التي لا تتوافق مع التأثير على العملاء أو الأعمال (أو التي تتغير بمرور الوقت) إلى اضطراب في قائمة الانتظار: حيث تتقدم التذاكر الأكثر إلحاحًا في الطابور بينما تظل الأخطاء ذات التأثير الكبير معطلة.
قواعد توجيه واضحة حسب المكون/المسؤول، وقائمة انتظار موحدة تضمن عدم إغراق مهام P0/P1 تحت عبء المهام «الحديثة والمزعجة».
المسؤولية وتسليم المهام هما «القاتلان الصامتان»
إذا لم يكن واضحًا ما إذا كان الخطأ يخص فريق تطبيقات الجوال أو فريق المصادقة الخلفية أو فريق المنصة، فإنه يتم إرجاعه. ويؤدي كل إرجاع إلى إعادة تعيين السياق.
وتزيد المناطق الزمنية من تعقيد الأمر: فالخطأ الذي يتم الإبلاغ عنه في وقت متأخر من اليوم دون تحديد مسؤول عنه قد يضيع ما بين 12 إلى 24 ساعة قبل أن يبدأ أي شخص حتى في محاكاة المشكلة. وتؤدي التعريفات الدقيقة لـ«من المسؤول عن ماذا»، مع وجود مسؤول مباشر (DRI) تحت الطلب أو أسبوعي، إلى إزالة هذا التأخير.
تعتمد قابلية التكرار على قابلية المراقبة
تؤدي السجلات المتفرقة أو معرّفات الارتباط المفقودة أو عدم وجود تتبعات الأعطال إلى تحويل عملية التشخيص إلى مجرد تخمينات. كما يصعب إعادة إنتاج الأخطاء التي تظهر فقط مع علامات أو مستأجرين أو أشكال بيانات محددة في مرحلة التطوير.
إذا لم يتمكن المهندسون من الوصول بأمان إلى بيانات مشابهة لبيانات الإنتاج بعد تنقيتها، فسينتهي بهم الأمر إلى إجراء عمليات القياس وإعادة النشر والانتظار — لأيام بدلاً من ساعات.
تضمن لك التوافق بين البيئة والبيانات النزاهة
عادةً ما تعني عبارة «يعمل على جهازي» أن «بيانات الإنتاج مختلفة». فكلما زاد الاختلاف بين بيئة التطوير/الاختبار وبيئة الإنتاج (في التكوين، والخدمات، وإصدارات الجهات الخارجية)، زاد الوقت الذي تقضيه في مطاردة مشكلات وهمية. وتساعد اللقطات الآمنة للبيانات، ونصوص التهيئة الأولية، وعمليات التحقق من التوافق على تقليص هذه الفجوة.
تساهم الأعمال قيد التنفيذ (WIP) والتركيز في زيادة الإنتاجية الفعلية
تتعامل الفرق المثقلة بالأعباء مع عدد كبير جدًا من الأخطاء في آن واحد، مما يؤدي إلى تشتيت انتباهها وتأرجحها بين المهام والاجتماعات. ويؤدي التبديل بين المهام إلى إضافة ساعات عمل غير مرئية.
إن تحديد حد واضح للأعمال قيد التنفيذ (WIP) والتركيز على إنهاء ما بدأته قبل البدء في عمل جديد سيؤديان إلى خفض متوسط الوقت بشكل أسرع من أي جهد فردي استثنائي.
تعد مراجعة الكود والتكامل المستمر (CI) وسرعة ضمان الجودة (QA) من العقبات التقليدية
فإن بطء أوقات البناء، والاختبارات غير الموثوقة، واتفاقيات مستوى الخدمة (SLA) غير الواضحة للمراجعة تؤدي إلى تعطيل الإصلاحات التي من المفترض أن تكون سريعة. فقد يستغرق تصحيح يستغرق 10 دقائق يومين في انتظار المراجع أو إدراجه في مسار عمل يستغرق ساعات طويلة.
وبالمثل، يمكن لقوائم انتظار ضمان الجودة التي تعتمد على الاختبارات المجمعة أو الاختبارات الأولية اليدوية أن تضيف أيامًا كاملة إلى مسار «تم الإبلاغ → تم الإغلاق»، حتى عندما يكون مسار «تم الإبلاغ → تم الحل» سريعًا.
التبعيات تزيد من طول قوائم الانتظار
تؤدي التغييرات المشتركة بين الفرق (المخططات، وعمليات ترحيل المنصات، وتحديثات SDK)، أو الأخطاء من جانب الموردين، أو عمليات المراجعة في متاجر التطبيقات (على الأجهزة المحمولة) إلى ظهور حالات انتظار. وبدون تتبع صريح لحالات «المحظور/المعلق»، تؤدي حالات الانتظار هذه إلى تضخيم متوسطاتك بشكل خفي وإخفاء المكان الحقيقي للمعوقات.
أهمية نموذج الإصدار واستراتيجية التراجع
إذا كنت تقوم بالإصدار عبر «قطارات إصدار» كبيرة الحجم تتضمن بوابات يدوية، فستظل حتى الأخطاء التي تم حلها معلقة حتى انطلاق «القطار» التالي. تعمل علامات الميزات والإصدارات التجريبية (canary releases) ومسارات الإصلاحات العاجلة (hotfix lanes) على تقصير مدة الانتظار — خاصةً بالنسبة لحوادث P0/P1 — من خلال السماح لك بفصل نشر الإصلاحات عن دورات الإصدار الكاملة.
الهندسة المعمارية والديون التقنية تحدد الحد الأقصى لإمكانياتك
إن الترابط الوثيق بين المكونات، وغياب نقاط الفصل بين الاختبارات، والوحدات القديمة غير الشفافة تجعل الإصلاحات البسيطة محفوفة بالمخاطر. وتقوم الفرق بالتعويض عن ذلك بإجراء اختبارات إضافية ومراجعات أطول، مما يؤدي إلى إطالة دورات التطوير. وعلى العكس من ذلك، فإن الكود المكون من وحدات مع اختبارات تعاقدية جيدة يتيح لك التحرك بسرعة دون الإضرار بالأنظمة المجاورة.
يؤثر التواصل وحسن إدارة الحالة على قابلية التنبؤ
تؤدي التحديثات الغامضة (مثل «نحن نبحث في الأمر») إلى إعادة العمل عندما يطلب أصحاب المصلحة معرفة موعد الانتهاء المتوقع، أو يعيد فريق الدعم فتح التذاكر، أو يتم تصعيد المشكلة إلى مستوى أعلى في المنتج. إن التحولات الواضحة في الحالة، والملاحظات حول كيفية تكرار المشكلة وأسبابها الجذرية، ونشر موعد الانتهاء المتوقع، كل ذلك يقلل من معدل ترك العملاء ويحافظ على تركيز فريق الهندسة لديك.
📮نصائح من ClickUp: يقضي الموظف العادي أكثر من 30 دقيقة يوميًا في البحث عن المعلومات المتعلقة بالعمل — أي ما يزيد عن 120 ساعة سنويًا تضيع في البحث في رسائل البريد الإلكتروني ومحادثات Slack والملفات المتناثرة.
يمكن لمساعد ذكي يعمل بالذكاء الاصطناعي ومدمج في مساحة عملك أن يغير هذا الوضع. تعرف على ClickUp Brain. فهو يقدم رؤى وإجابات فورية من خلال عرض المستندات والمحادثات وتفاصيل المهام الصحيحة في ثوانٍ معدودة — حتى تتمكن من التوقف عن البحث والبدء في العمل.
💫 نتائج حقيقية: استعادت فرق مثل QubicaAMF أكثر من 5 ساعات أسبوعيًا باستخدام ClickUp — أي ما يزيد عن 250 ساعة سنويًا لكل شخص — من خلال التخلص من عمليات إدارة المعرفة القديمة. تخيل ما يمكن لفريقك تحقيقه بفضل أسبوع إضافي من الإنتاجية كل ربع سنة!
المؤشرات الرئيسية التي تشير إلى أن وقت حل المشكلات سيتأخر
❗️ارتفاع «وقت الإقرار» وتراكم عدد كبير من التذاكر التي تظل دون مالك لأكثر من 12 ساعة
❗️تزايد فترات «الوقت المستغرق في المراجعة/التكامل المستمر» وتكرار حالات فشل الاختبارات
❗️ارتفاع معدل التكرار في عملية استلام البلاغات وعدم اتساق تصنيفات خطورة الأخطاء بين الفرق
❗️توجد عدة أخطاء في حالة «محجوبة» دون وجود تبعيات خارجية محددة
❗️ارتفاع تدريجي في معدل إعادة فتح التذاكر (إصلاحات غير قابلة للتكرار أو تعريفات "الإنجاز" غير واضحة)
تختلف طريقة إدراك هذه العوامل من مؤسسة إلى أخرى. فالمديرون التنفيذيون يرونها على أنها دورات تعليمية ضائعة وتأخر في تحقيق فرص الإيرادات؛ بينما يرى المشغلون أنها تشكل ضوضاء في عملية التصنيف وعدم وضوح في تحديد المسؤولية.
إن ضبط عملية استلام البلاغات وتدفقها والتبعيات هو السبيل إلى خفض المنحنى بأكمله — الوسيط وP90—.
هل تريد معرفة المزيد عن كيفية كتابة تقارير أخطاء أفضل؟ ابدأ من هنا. 👇🏼
📖 اقرأ المزيد: دورة حياة اختبار البرمجيات (STLC): نظرة عامة ومراحل
معايير الصناعة لوقت حل الأخطاء
تتغير معايير أداء حل الأخطاء وفقًا لمستوى تحمل المخاطر ونموذج الإصدار ومدى سرعة نشر التغييرات.
هنا يمكنك استخدام القيم الوسيطة (P50) لفهم التدفق النموذجي لديك، وP90 لتحديد الالتزامات واتفاقيات مستوى الخدمة (SLA) — حسب درجة الخطورة والمصدر (العميل، ضمان الجودة، المراقبة).
دعونا نحلل ما يعنيه ذلك:
| 🔑 المصطلح | 📝 الوصف | 💡 لماذا هذا مهم |
|---|---|---|
| P50 (القيمة الوسيطة) | القيمة المتوسطة — 50% من عمليات إصلاح الأخطاء تتم في وقت أسرع من هذا، و50% تتم في وقت أطول | 👉 يعكس وقت الحل المعتاد أو الأكثر شيوعًا لديك. مفيد لفهم الأداء الطبيعي |
| P90 (الشريحة التسعين) | يتم إصلاح 90% من الأخطاء خلال هذه المدة. ولا يستغرق إصلاح سوى 10% منها وقتًا أطول | 👉 يمثل الحد الأقصى (ولكنه لا يزال واقعيًا). مفيد لتحديد التوقعات الخارجية |
| اتفاقيات مستوى الخدمة (SLA) | الالتزامات التي تتعهد بها — سواء داخليًا أو تجاه العملاء — بشأن السرعة التي سيتم بها معالجة المشكلات | 👉 مثال: «نقوم بحل الأخطاء من فئة P1 في غضون 48 ساعة، في 90% من الحالات». يساعد ذلك في بناء الثقة والمساءلة |
| حسب درجة الخطورة والمصدر | قم بتقسيم المقاييس الخاصة بك وفقًا لبعدين رئيسيين: • الخطورة (على سبيل المثال، P0، P1، P2) • المصدر (على سبيل المثال، العميل، ضمان الجودة، المراقبة) | 👉 يتيح تتبعًا وتحديدًا للأولويات بشكل أكثر دقة، بحيث تحظى الأخطاء الحرجة بالاهتمام بشكل أسرع |
فيما يلي نطاقات توجيهية تستند إلى القطاعات التي تستهدفها الفرق المتمرسة غالبًا؛ تعامل معها على أنها نطاقات أولية، ثم قم بتعديلها وفقًا لسياقك.
SaaS
نظام يعمل بشكل مستمر ومتوافق مع ممارسات التكامل المستمر/التسليم المستمر (CI/CD)، لذا فإن الإصلاحات العاجلة شائعة. غالبًا ما يُستهدف حل المشكلات الحرجة (P0/P1) في متوسط أقل من يوم عمل واحد، مع P90 في غضون 24–48 ساعة. أما المشكلات غير الحرجة (P2+)، فيتم حلها عادةً في متوسط 3–7 أيام، مع P90 في غضون 10–14 يومًا. تميل الفرق التي تستخدم علامات الميزات القوية والاختبارات الآلية إلى تحقيق أوقات أسرع.
منصات التجارة الإلكترونية
نظرًا لأن تدفقات التحويل وعربات التسوق ذات أهمية حاسمة للإيرادات، فإن المعايير المطلوبة أعلى. عادةً ما يتم التخفيف من حدة المشكلات من فئة P0/P1 في غضون ساعات (عن طريق التراجع عن التغييرات، أو وضع علامة، أو التهيئة) وحلها بالكامل في نفس اليوم؛ أما المشكلات من فئة P90، فمن الشائع حلها بحلول نهاية اليوم أو في غضون أقل من 12 ساعة خلال مواسم الذروة. وغالبًا ما تُحل المشكلات من فئة P2+ في غضون 2–5 أيام، مع حل المشكلات من فئة P90 في غضون 10 أيام.
برامج المؤسسات
تؤدي عمليات التحقق الأكثر صرامة وفترات تغيير العملاء إلى إبطاء وتيرة العمل. بالنسبة إلى الأخطاء من فئة P0/P1، تستهدف الفرق إيجاد حل مؤقت في غضون 4 إلى 24 ساعة وإصلاحها في غضون 1 إلى 3 أيام عمل؛ أما بالنسبة إلى P90، فيتم إصلاحها في غضون 5 أيام عمل. غالبًا ما يتم تجميع العناصر من فئة P2+ في مجموعات ضمن دورات الإصدار، بمتوسط مدته 2 إلى 4 أسابيع حسب جداول طرح المنتجات للعملاء.
ألعاب وتطبيقات الهاتف المحمول
تعمل الخلفية التقنية للخدمات الحية بشكل مشابه لخدمات SaaS (يتم تطبيق الإشارات والتراجع عن التغييرات في غضون دقائق إلى ساعات؛ P90 في نفس اليوم). تخضع تحديثات العميل لمراجعات المتجر: غالبًا ما تستخدم فئات P0/P1 أدوات التحكم من جانب الخادم على الفور وتصدر تصحيحًا للعميل في غضون 1–3 أيام؛ P90 في غضون أسبوع مع مراجعة معجلة. عادةً ما يتم جدولة إصلاحات P2+ في السباق التالي أو الإصدار التالي للمحتوى.
القطاع المصرفي/التكنولوجيا المالية
تعمل بوابات المخاطر والامتثال على تعزيز نمط «التخفيف السريع، والتغيير الحذر». يتم التخفيف من الأخطاء من الفئتين P0 وP1 بسرعة (من خلال الإشارات، وعمليات التراجع، وتحويل حركة المرور في غضون دقائق إلى ساعات) ويتم إصلاحها بالكامل في غضون 1–3 أيام؛ أما الأخطاء من الفئة P90 فيتم إصلاحها في غضون أسبوع، مع مراعاة ضوابط التغيير. وغالبًا ما تستغرق الأخطاء من الفئة P2+ ما بين 2–6 أسابيع لاجتياز مراجعات الأمان والتدقيق ومجلس تقييم التغيير (CAB).
إذا كانت أرقامك خارج هذه النطاقات، فراجع جودة الاستلام، والتوجيه/المسؤولية، ومعدل إنجاز مراجعة الكود وضمان الجودة، والموافقات على التبعيات قبل أن تفترض أن «سرعة الهندسة» هي المشكلة الأساسية.
🌼 هل تعلم: وفقًا لاستطلاع أجرته Stack Overflow عام 2024، زاد استخدام المطورين للذكاء الاصطناعي كمساعد موثوق بهم خلال رحلة البرمجة. استخدم 82% منهم الذكاء الاصطناعي لكتابة الكود فعليًّا — يا له من شريك مبدع! وعندما يواجهون عقبات أو يبحثون عن حلول، اعتمد 67.5% على الذكاء الاصطناعي للبحث عن إجابات، واعتمد أكثر من النصف (56.7%) عليه لتصحيح الأخطاء والحصول على المساعدة.
بالنسبة للبعض، أثبتت أدوات الذكاء الاصطناعي فائدتها أيضًا في توثيق المشاريع (40.1%) وحتى في إنشاء بيانات أو محتوى اصطناعي (34.8%). هل تشعر بالفضول تجاه قاعدة برمجية جديدة؟ يستخدم ما يقرب من الثلث (30.9%) الذكاء الاصطناعي للاطلاع عليها بسرعة. لا يزال اختبار الكود عملاً يدويًا شاقًا بالنسبة للكثيرين، لكن 27.2% قد تبنوا الذكاء الاصطناعي في هذا المجال أيضًا. تشهد مجالات أخرى مثل مراجعة الكود وتخطيط المشاريع والتحليلات التنبؤية معدلات اعتماد أقل للذكاء الاصطناعي، لكن من الواضح أن الذكاء الاصطناعي يندمج بثبات في كل مرحلة من مراحل تطوير البرمجيات.
📖 اقرأ المزيد: كيفية استخدام الذكاء الاصطناعي لضمان الجودة
كيفية تقليل وقت حل الأخطاء
تتوقف سرعة حل الأخطاء على إزالة العقبات في كل مرحلة من مراحل التسليم، بدءًا من الاستلام وحتى الإصدار.
تتحقق أكبر المكاسب من خلال الاستفادة من أول 30 دقيقة بشكل أكثر ذكاءً (تسجيل دقيق، تحديد المسؤول المناسب، تحديد الأولوية الصحيحة)، ثم تقليص الحلقات التالية (إعادة إنتاج المشكلة، المراجعة، التحقق).
فيما يلي تسع استراتيجيات تعمل معًا كنظام متكامل. يعمل الذكاء الاصطناعي على تسريع كل خطوة، ويتم تنظيم سير العمل بشكل منظم في مكان واحد، مما يمنح المديرين التنفيذيين القدرة على التنبؤ ويمنح العاملين في الميدان سلاسة في العمل.
1. مركزية عملية استلام البلاغات وتسجيل السياق من المصدر
يستغرق حل الأخطاء وقتًا أطول عندما تقوم بإعادة بناء السياق من سلاسل المحادثات في Slack وتذاكر الدعم وجداول البيانات. قم بتوجيه كل تقرير — سواء كان متعلقًا بالدعم أو ضمان الجودة أو المراقبة — إلى قائمة انتظار واحدة باستخدام نموذج منظم يجمع معلومات عن المكون ودرجة الخطورة والبيئة وإصدار/بنية التطبيق والخطوات اللازمة لإعادة إنتاج الخطأ والنتائج المتوقعة مقابل الفعلية والمرفقات (السجلات/ملفات HAR/لقطات الشاشة).
يمكن للذكاء الاصطناعي تلخيص التقارير الطويلة تلقائيًا، واستخراج خطوات إعادة إنتاج الأخطاء وتفاصيل البيئة من المرفقات، وتمييز الحالات المكررة المحتملة، بحيث يبدأ التصنيف بناءً على سجل متماسك وغني بالمعلومات.
المقاييس التي يجب مراقبتها: MTTA (الاستجابة في غضون دقائق، وليس ساعات)، ومعدل التكرار، ووقت حالة «يحتاج إلى معلومات».
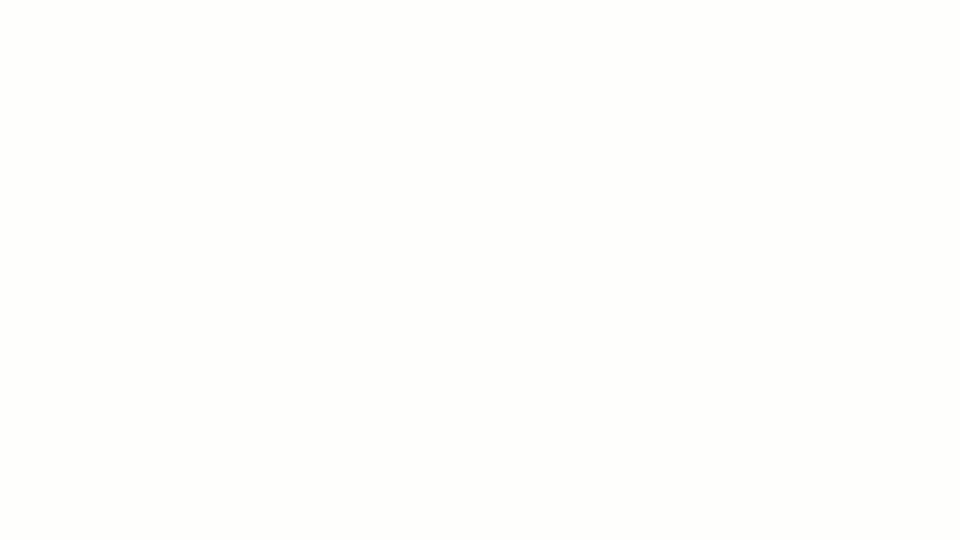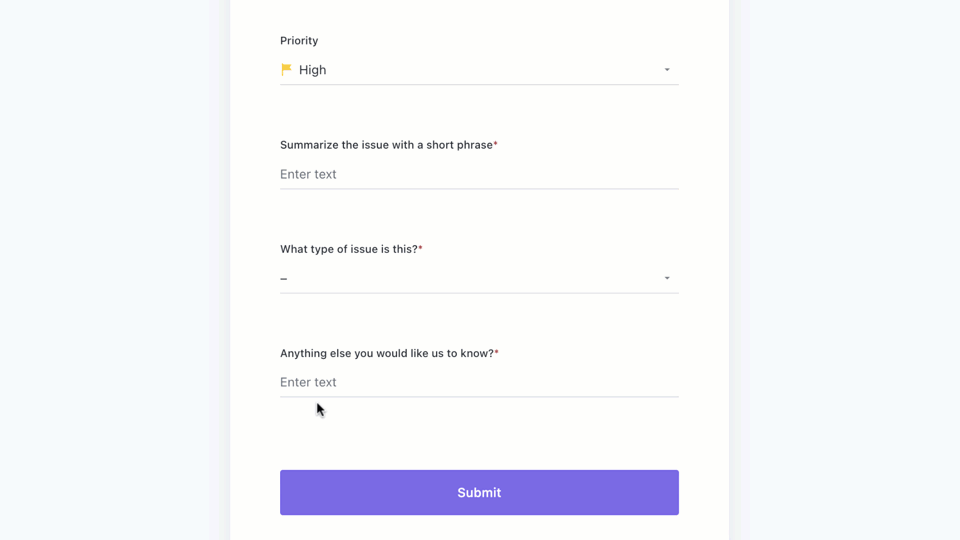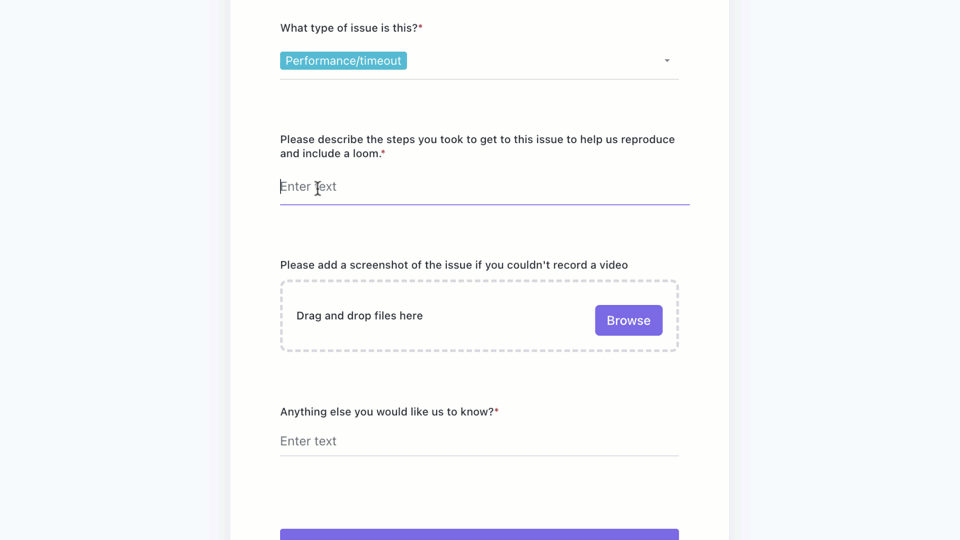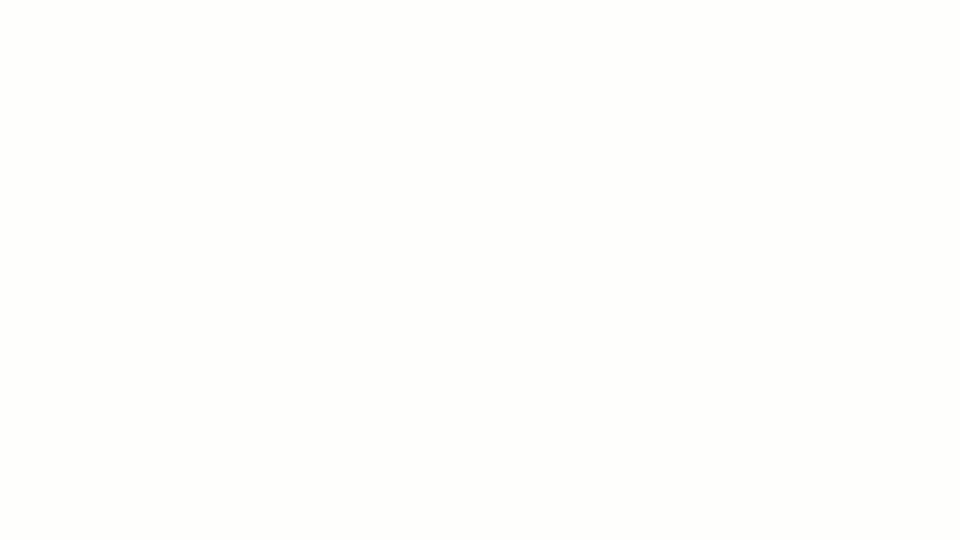
📖 اقرأ المزيد: قوة نماذج ClickUp: تبسيط العمل لفرق البرمجيات
2. التصنيف والتوجيه بمساعدة الذكاء الاصطناعي لتقليص متوسط وقت حل المشكلة (MTTA)
أسرع الحلول هي تلك التي تصل إلى المكتب المناسب على الفور.
استخدم قواعد بسيطة مع الذكاء الاصطناعي لتصنيف درجة الخطورة، وتحديد المسؤولين المحتملين حسب المكون أو منطقة الكود، والتخصيص التلقائي باستخدام مؤشر زمني لاتفاقية مستوى الخدمة (SLA). حدد مسارات عمل واضحة لفئات P0/P1 مقارنة بجميع الفئات الأخرى، واجعل مسألة «من المسؤول عن هذا» خالية من أي لبس.
يمكن للأتمتة تحديد الأولوية بناءً على الحقول، وتوجيه الأخطاء حسب المكون إلى فريق معين، وتشغيل مؤقت اتفاقية مستوى الخدمة (SLA)، وإخطار مهندس مناوب؛ كما يمكن للذكاء الاصطناعي اقتراح درجة الخطورة والمسؤول بناءً على الأنماط السابقة. عندما يصبح التصنيف عملية تستغرق من دقيقتين إلى خمس دقائق بدلاً من نقاش يستمر 30 دقيقة، ينخفض متوسط وقت الوصول إلى المشكلة (MTTA)، ويتبعه انخفاض متوسط وقت الإصلاح (MTTR).
المقاييس التي يجب مراقبةها: متوسط وقت حل المشكلة (MTTA)، وجودة الاستجابة الأولى (هل يطلب التعليق الأول المعلومات الصحيحة؟)، وعدد عمليات التحويل لكل خطأ.
وإليك كيف يبدو ذلك في الواقع:
3. حدد الأولويات حسب التأثير على الأعمال من خلال مستويات واضحة لاتفاقية مستوى الخدمة (SLA)
مبدأ «الصوت الأعلى هو الذي يفوز» يجعل قوائم الانتظار غير متوقعة ويقوض الثقة لدى المديرين التنفيذيين الذين يراقبون مؤشرات رضا العملاء (CSAT) ومؤشر التوصية الصافي (NPS) وعمليات التجديد.
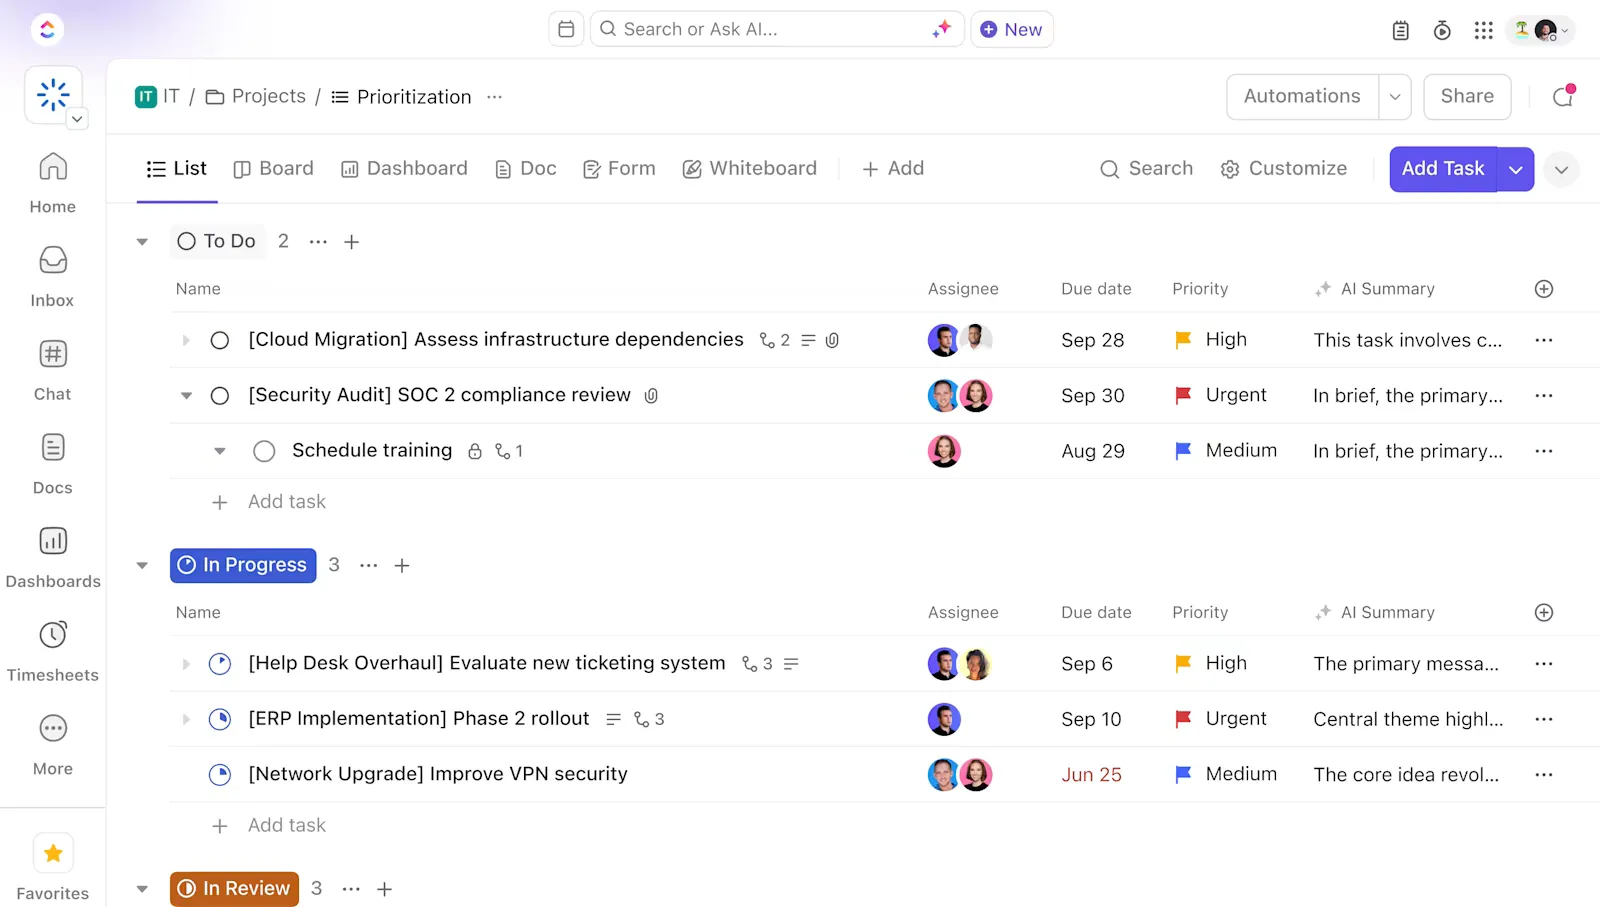
استبدل ذلك بنظام نقاط يجمع بين درجة الخطورة، والتكرار، والإيرادات السنوية المتجددة (ARR) المتأثرة، وأهمية الميزة، وقرب الموعد من عمليات التجديد/الإطلاق — وادعمه بمستويات اتفاقية مستوى الخدمة (SLA) (على سبيل المثال، P0: التخفيف في غضون 1–2 ساعة، والحل في غضون يوم واحد؛ P1: في نفس اليوم؛ P2: خلال سبرينت واحد).
حافظ على مسار P0/P1 واضح مع حدود العمل قيد التنفيذ (WIP) حتى لا يتأخر أي عمل.
المقاييس التي يجب مراقبتها: معدل حل المشكلات P50/P90 حسب المستوى، ومعدل مخالفة اتفاقية مستوى الخدمة (SLA)، والارتباط مع مؤشر رضا العملاء (CSAT) ومؤشر التوصية الصافي (NPS).
💡نصيحة للمحترفين: تتيح لك حقول «أولويات المهام» و«الحقول المخصصة» و«التبعيات» في ClickUp حساب درجة التأثير وربط الأخطاء بالحسابات أو التعليقات أو عناصر خارطة الطريق؛ بالإضافة إلى ذلك، تساعدك «الأهداف» في ClickUp على ربط الالتزام باتفاقية مستوى الخدمة (SLA) بالأهداف على مستوى الشركة، وهو ما يعالج بشكل مباشر مخاوف الإدارة التنفيذية بشأن التوافق.
4. اجعل عملية إعادة إنتاج الأخطاء وتشخيصها تتم في خطوة واحدة
فكل مرة إضافية يُطرح فيها السؤال «هل يمكنك إرسال السجلات؟» تؤدي إلى إطالة وقت حل المشكلة.
قم بتوحيد معايير "الأداء الجيد": الحقول الإلزامية للإنشاء/التسجيل، والبيئة، وخطوات إعادة إنتاج المشكلة، والنتائج المتوقعة مقابل الفعلية، بالإضافة إلى المرفقات الخاصة بالسجلات وملفات تفريغ الأعطال وملفات HAR. قم بتجهيز نظام القياس عن بُعد بين العميل والخادم بحيث يمكن ربط معرّفات الأعطال ومعرّفات الطلبات بمسارات التتبع.
استخدم Sentry (أو ما شابهه) لتتبع مسار المكدس واربط تلك المشكلة مباشرةً بالخطأ. يمكن للذكاء الاصطناعي قراءة السجلات ومسارات التتبع لاقتراح مجال الخطأ المحتمل وإنشاء نموذج إعادة إنتاج بسيط، مما يحول ساعة من المراجعة اليدوية إلى بضع دقائق من العمل المركّز.
قم بتخزين أدلة الإجراءات الخاصة بفئات الأخطاء الشائعة حتى لا يضطر المهندسون إلى البدء من الصفر.
المقاييس التي يجب مراقبتها: الوقت المستغرق في «انتظار المعلومات»، والنسبة المئوية لحالات الأخطاء التي تم إعادة إنتاجها في المرة الأولى، ومعدل إعادة فتح التذاكر المرتبط بعدم التمكن من إعادة إنتاج الخطأ.
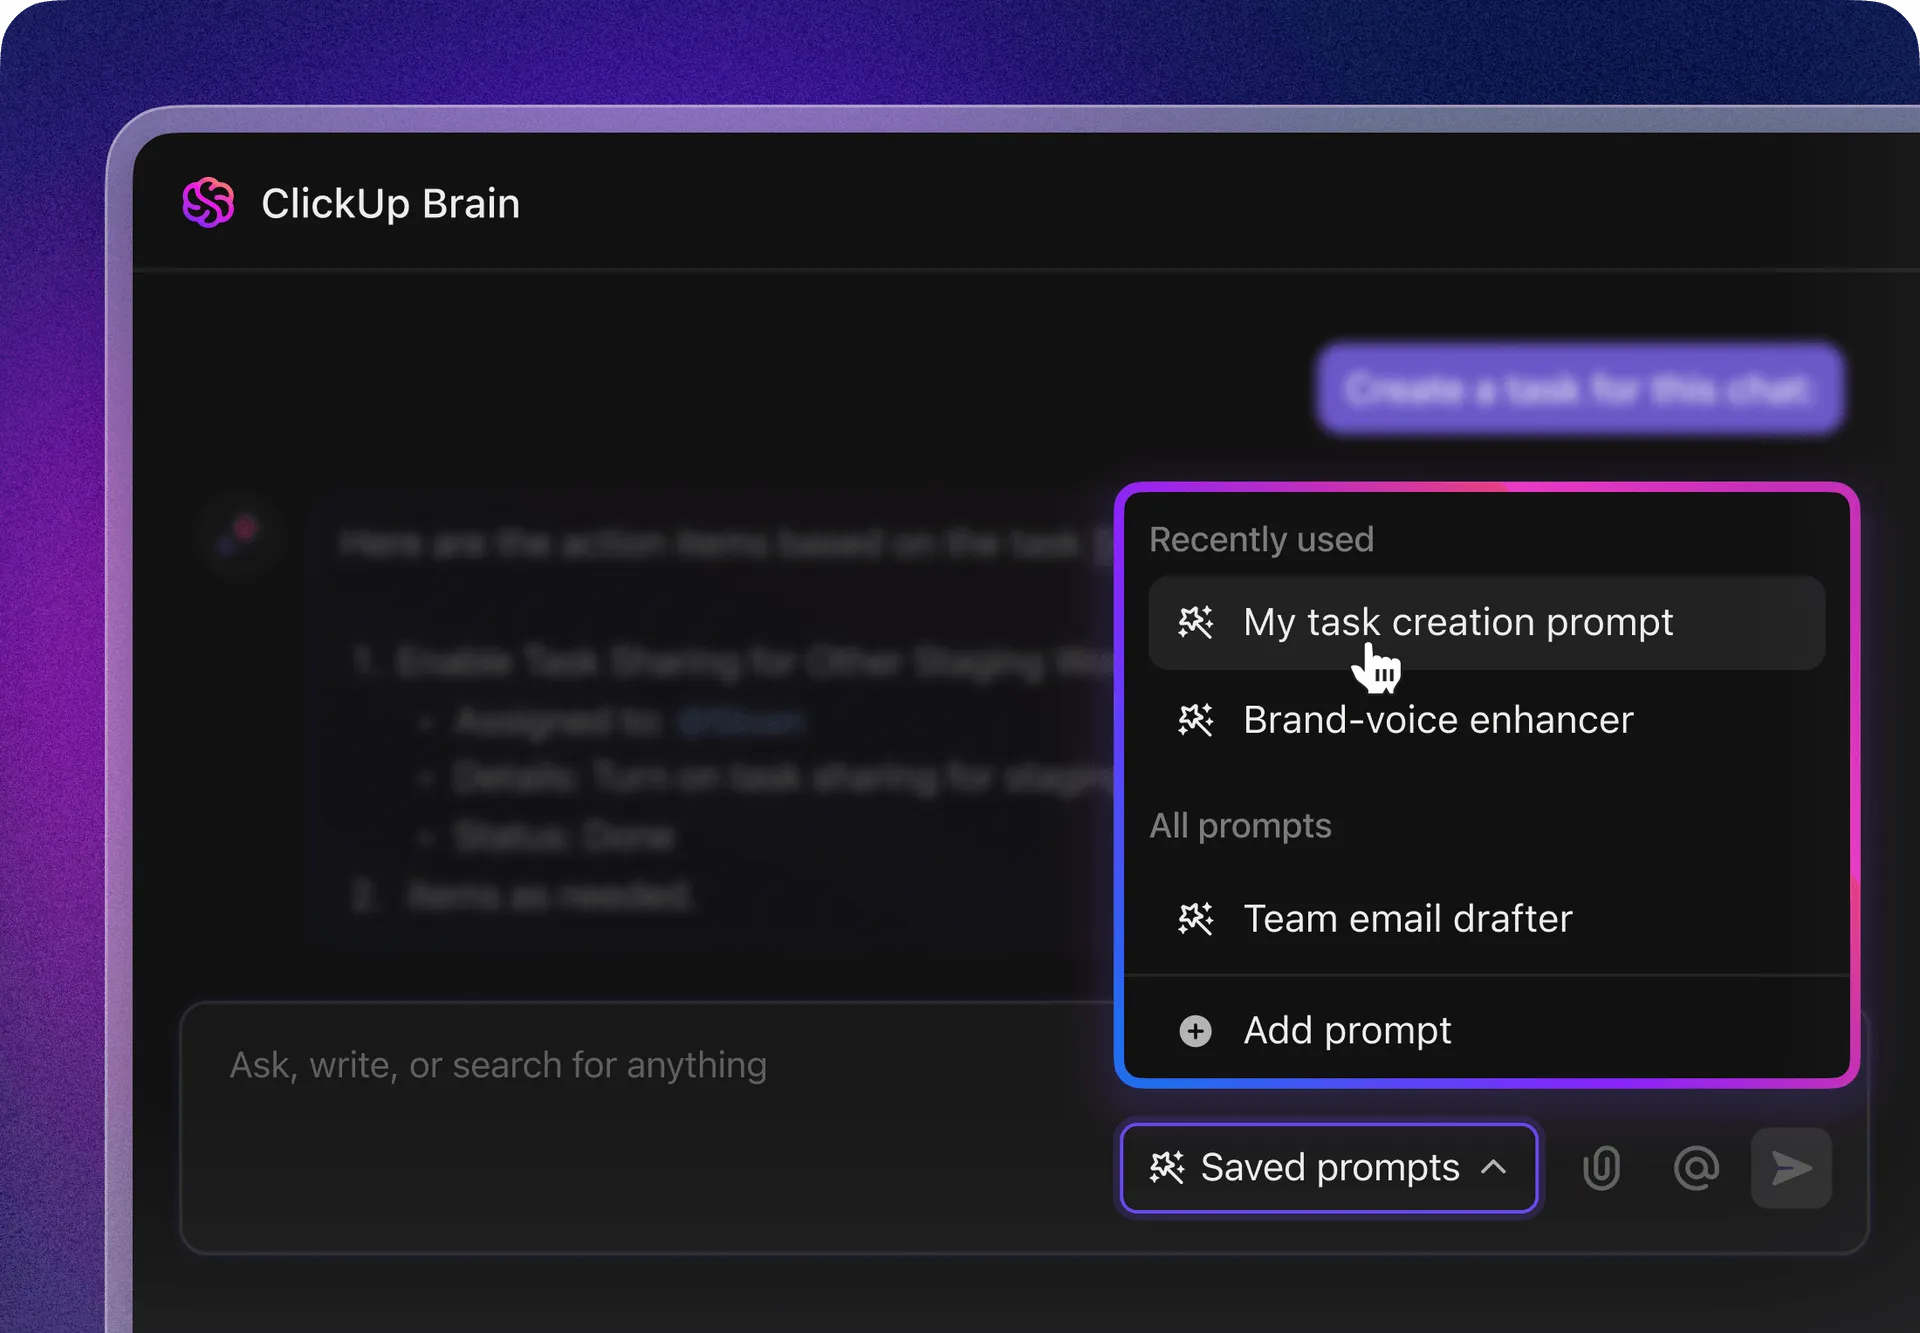
5. تقصير دورة مراجعة الكود والاختبار
تتعطل طلبات السحب الكبيرة. استهدف إجراء تصحيحات دقيقة، والتطوير القائم على الترنك، وعلامات الميزات حتى يمكن نشر الإصلاحات بأمان. قم بتعيين المراجعين مسبقًا حسب ملكية الكود لتجنب وقت التعطل، واستخدم قوائم المراجعة (الاختبارات المحدثة، وإضافة القياس عن بُعد، ووضع علامة خلف مفتاح الإيقاف) حتى تكون الجودة مضمونة.
يجب أن تنقل الأتمتة الخطأ إلى الحالة «قيد المراجعة» عند فتح طلب السحب (PR)، وإلى الحالة «تم حلها» عند الدمج؛ ويمكن للذكاء الاصطناعي اقتراح اختبارات الوحدة أو إبراز الاختلافات المحفوفة بالمخاطر لتركيز المراجعة عليها.
المقاييس التي يجب مراقبتها: الوقت المستغرق في مرحلة «قيد المراجعة»، ومعدل فشل التغييرات في طلبات سحب (PR) الخاصة بإصلاح الأخطاء، وزمن الاستجابة للمراجعة في P90.
يمكنك استخدام تكاملات GitHub/GitLab في ClickUp للحفاظ على مزامنة حالة حل المشكلات؛ ويمكن للأتمتة فرض «تعريف الإنجاز».
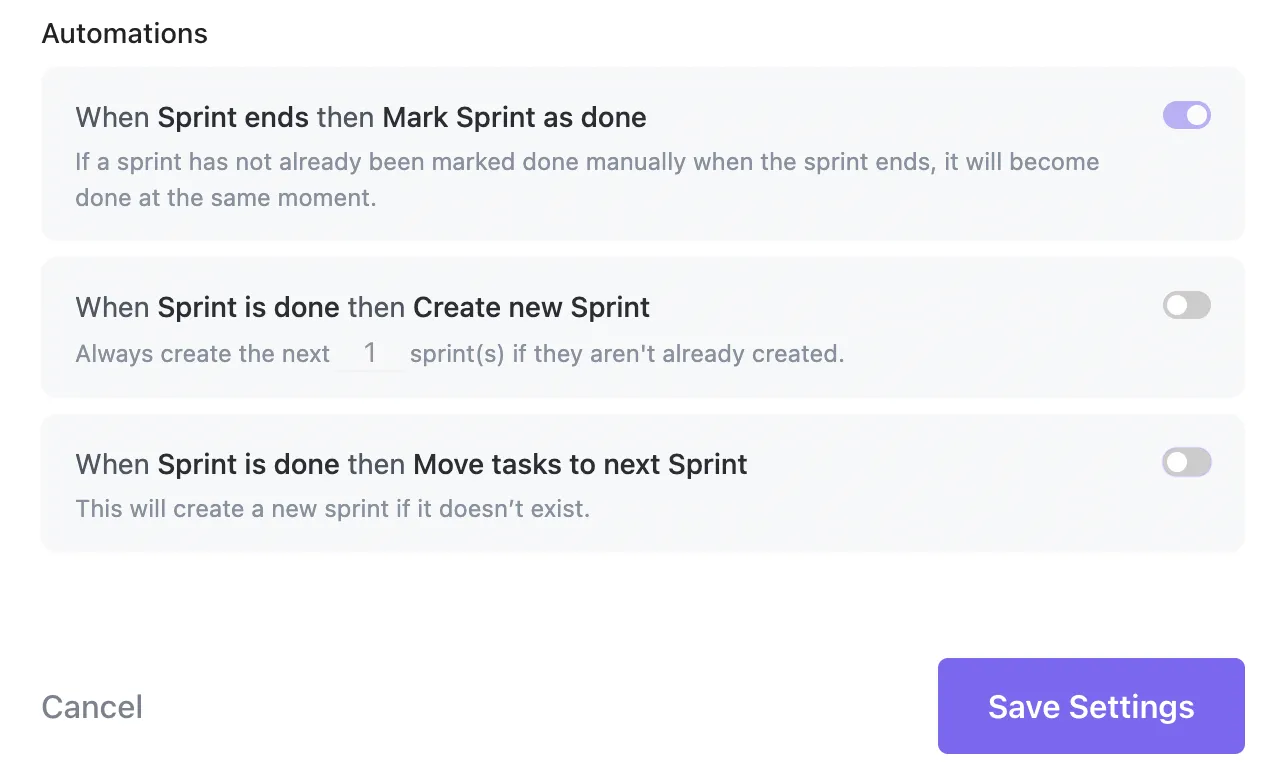
📖 اقرأ المزيد: كيفية استخدام الذكاء الاصطناعي لأتمتة المهام
6. قم بتوازي عمليات التحقق وجعل التكافؤ في بيئة ضمان الجودة حقيقة واقعة
لا ينبغي أن يبدأ التحقق بعد أيام أو في بيئة لا يستخدمها أي من عملائك.
حافظ على دقة معيار «جاهز لفحص الجودة»: تصحيحات سريعة تعتمد على العلامات يتم التحقق من صحتها في بيئات تشبه بيئة الإنتاج باستخدام بيانات أولية تتطابق مع الحالات المبلغ عنها.
وحيثما أمكن، قم بإعداد بيئات مؤقتة من فرع الأخطاء حتى يتمكن فريق ضمان الجودة من التحقق منها على الفور؛ ومن ثم يمكن للذكاء الاصطناعي إنشاء حالات اختبار استنادًا إلى وصف الخطأ وحالات التراجع السابقة.
المقاييس التي يجب مراقبتها: الوقت المستغرق في مرحلة «ضمان الجودة/التحقق»، ومعدل العودة من مرحلة ضمان الجودة إلى مرحلة التطوير، والوقت المتوسط اللازم لإغلاق المشكلة بعد الدمج.
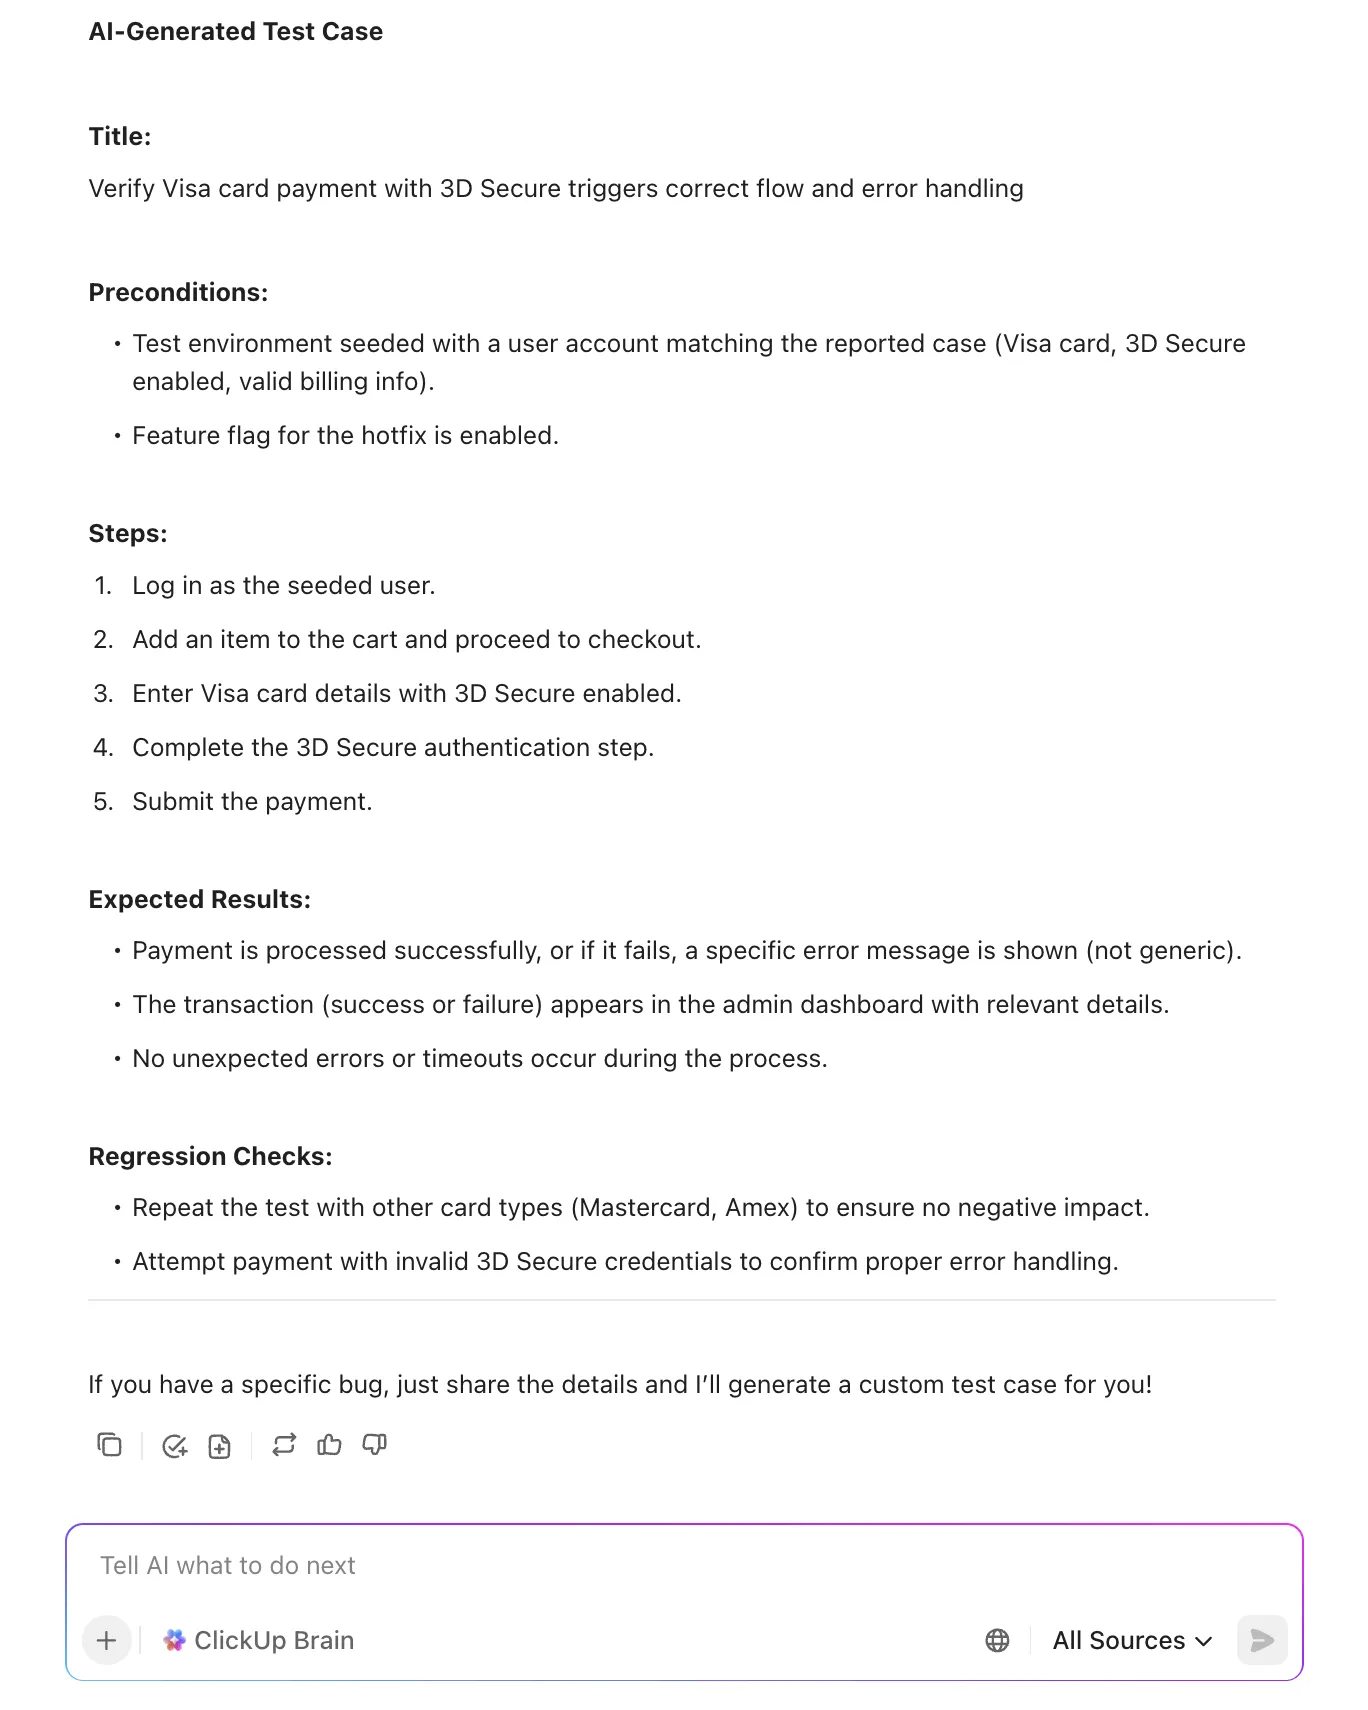
📖 اقرأ المزيد: كيفية كتابة حالات اختبار فعالة
7. توضيح الحالة بوضوح لتقليل عبء التنسيق
التحديث الجيد يمنع إرسال ثلاث إشعارات متابعة للحالة وتصعيدًا واحدًا.
تعامل مع التحديثات كأنها منتج: موجزة، ومحددة، ومراعية لجمهور المستهدف (فريق الدعم، المديرين التنفيذيين، العملاء). حدد وتيرة لإصدارات P0/P1 (على سبيل المثال، كل ساعة حتى يتم التخفيف من الأثر، ثم كل أربع ساعات)، وحافظ على مصدر واحد موثوق للمعلومات.
يمكن للذكاء الاصطناعي صياغة تحديثات آمنة للعملاء وملخصات داخلية استنادًا إلى سجل المهام، بما في ذلك الحالة الحالية حسب درجة الخطورة والفريق المسؤول. بالنسبة للمسؤولين التنفيذيين مثل مدير المنتج لديك، قم بتجميع الأخطاء ضمن المبادرات حتى يتمكنوا من معرفة ما إذا كانت المشكلات الحرجة المتعلقة بالجودة تهدد الوفاء بوعود التسليم.
المقاييس التي يجب مراقبتها: الفترة الزمنية بين تحديثات الحالة لـ P0/P1، ومؤشر رضا العملاء (CSAT) لدى أصحاب المصلحة بشأن الاتصالات.
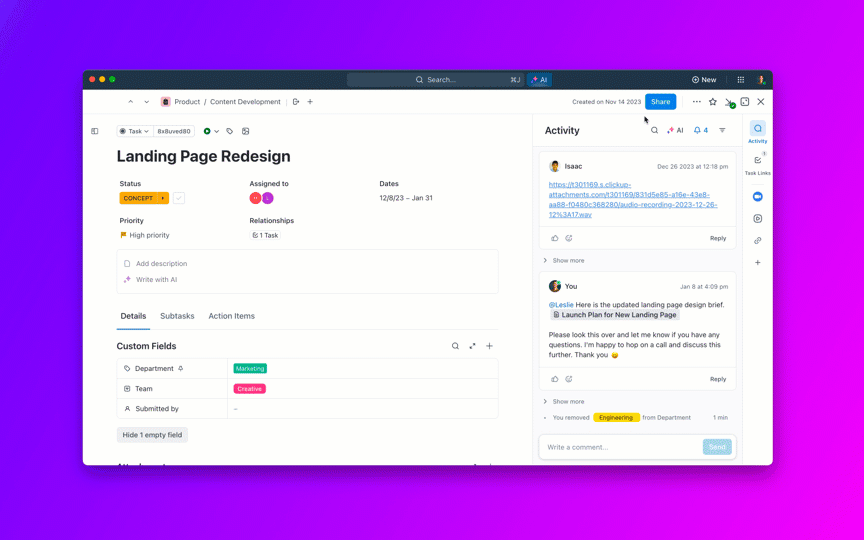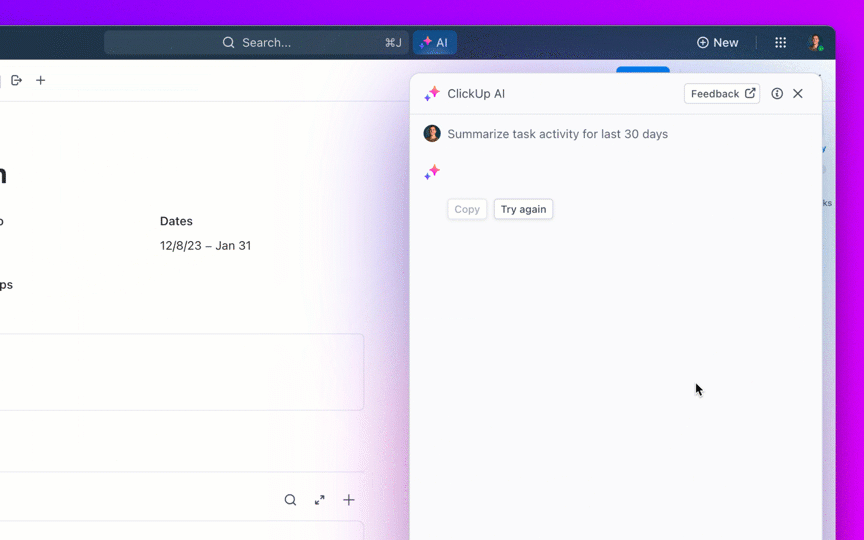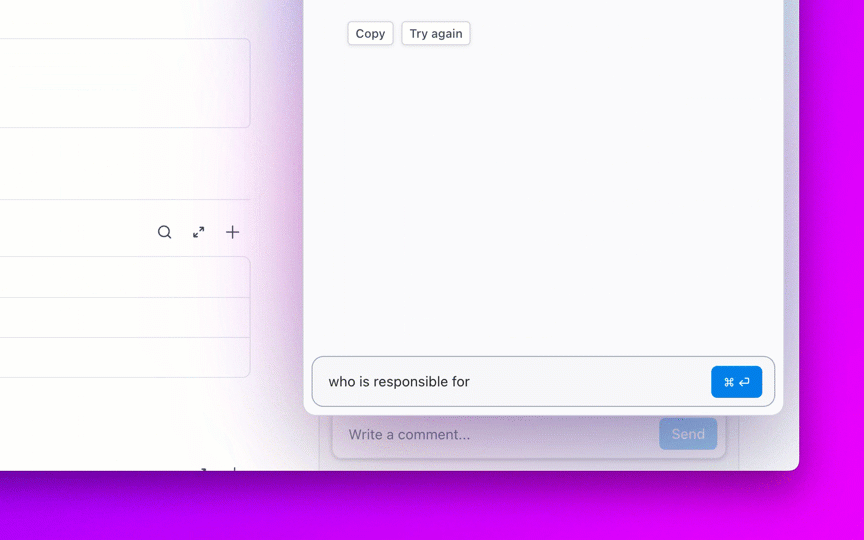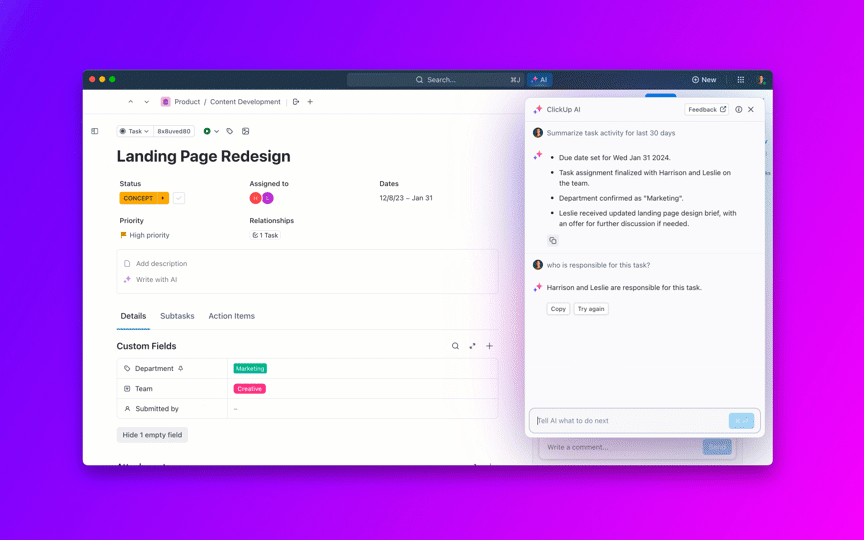
8. التحكم في تقادم المهام المتراكمة ومنع بقاءها "مفتوحة إلى الأبد"
إن تراكم المهام المتأخرة المتزايدة يثقل كاهل كل سبرينت بشكل خفي.
ضع سياسات تتعلق بمدة بقاء الأخطاء (على سبيل المثال، P2 > 30 يومًا تستدعي المراجعة، وP3 > 90 يومًا تتطلب تبريرًا) وقم بجدولة «فحص مدة بقاء الأخطاء» أسبوعيًا لدمج التكرارات، وإغلاق التقارير التي عفا عليها الزمن، وتحويل الأخطاء ذات القيمة المنخفضة إلى عناصر في قائمة المهام المتأخرة للمنتج.
استخدم الذكاء الاصطناعي لتجميع المهام المتراكمة حسب الموضوع (على سبيل المثال، «انتهاء صلاحية رمز المصادقة»، «تقلب تحميل الصور») حتى تتمكن من جدولة أسابيع إصلاح مخصصة لكل موضوع والتخلص من فئة معينة من العيوب دفعة واحدة.
المقاييس التي يجب مراقبتها: عدد المهام المتراكمة حسب الفئة العمرية، والنسبة المئوية للمشكلات التي تم إغلاقها باعتبارها مكررة أو عفا عليها الزمن، وسرعة إنجاز المهام حسب الموضوع.
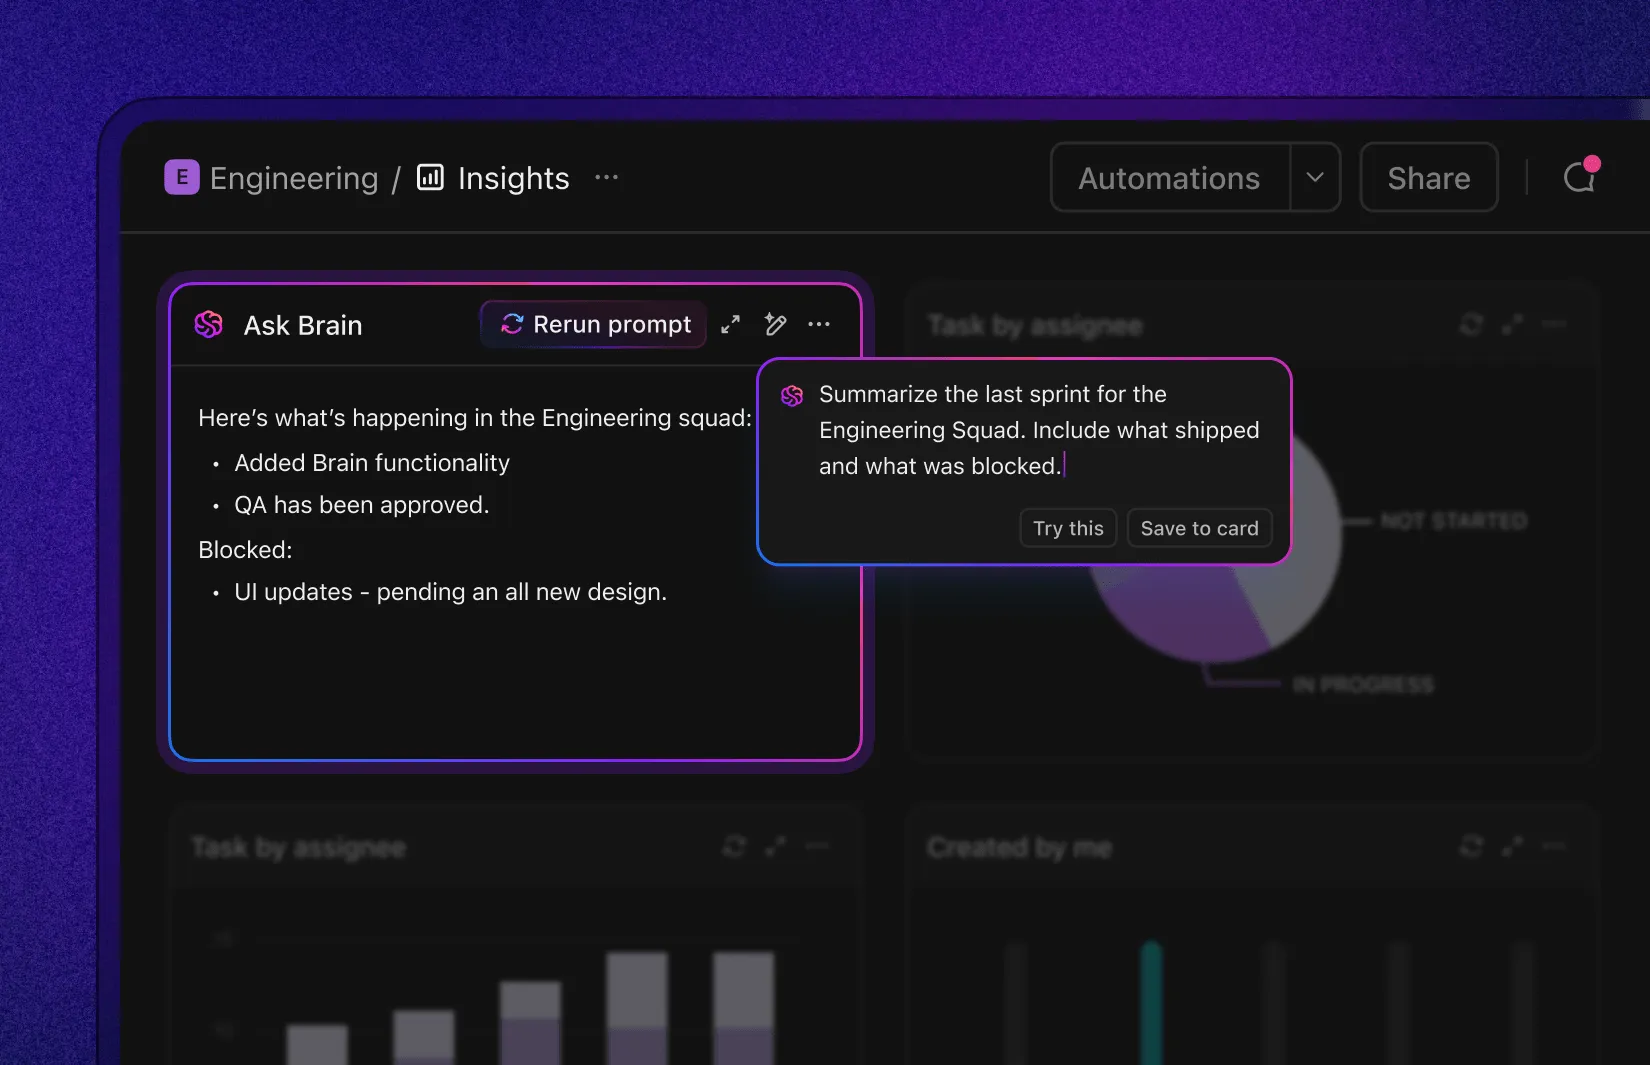
9. إكمال الدورة من خلال تحديد السبب الجذري والوقاية
إذا كانت نفس فئة العيوب تتكرر باستمرار، فإن التحسينات التي تحققها في متوسط وقت حل المشكلة (MTTR) تخفي مشكلة أكبر.
قم بتحليل سريع ودقيق للأسباب الجذرية للأخطاء من فئة P0/P1 والأخطاء المتكررة من فئة P2؛ وقم بتمييز الأسباب الجذرية (ثغرات المواصفات، وثغرات الاختبار، وثغرات الأدوات، ومشاكل التكامل)، وربطها بالمكونات والحوادث المتأثرة، وتتبع مهام المتابعة (إجراءات الوقاية، والاختبارات، وقواعد lint) حتى اكتمالها.
يمكن للذكاء الاصطناعي صياغة ملخصات تحليل أسباب الأعطال (RCA) واقتراح اختبارات وقائية أو قواعد "لينت" استنادًا إلى سجل التغييرات. وهكذا تنتقل من مرحلة إطفاء الحرائق إلى الحد من حدوثها.
المقاييس التي يجب مراقبتها: معدل إعادة فتح الحوادث، ومعدل التراجع، والفترة الزمنية بين تكرار الأخطاء، ونسبة تحليلات أسباب الجذور (RCA) التي تم اتخاذ إجراءات وقائية كاملة بشأنها.
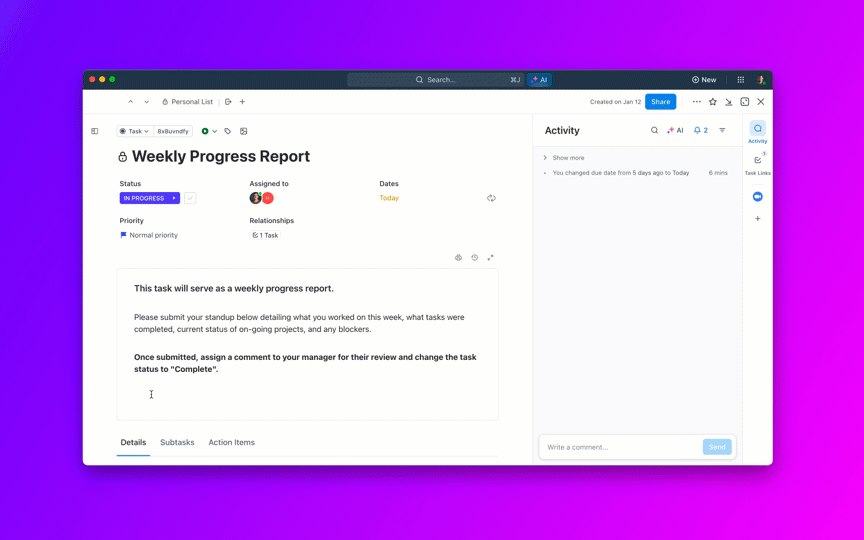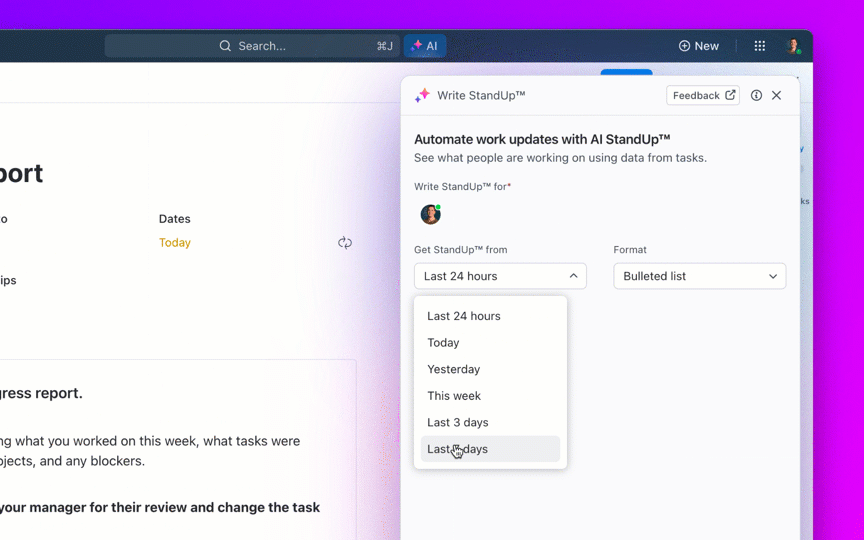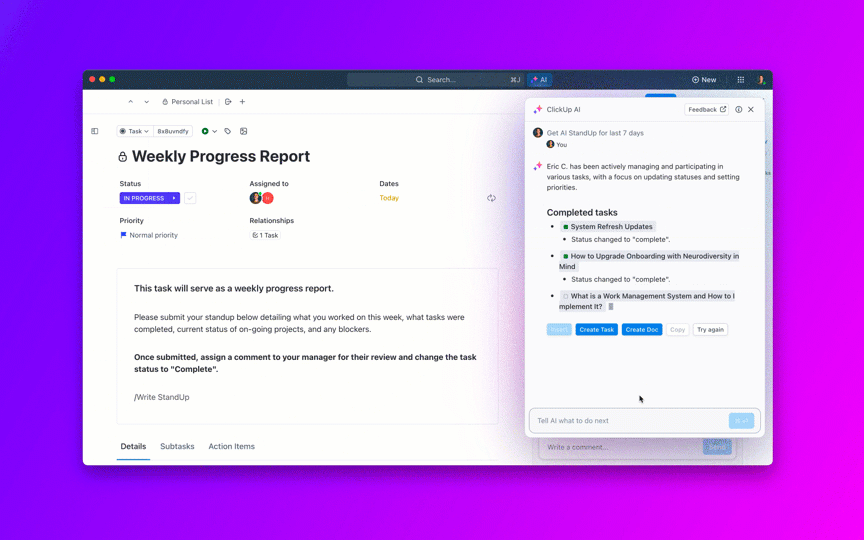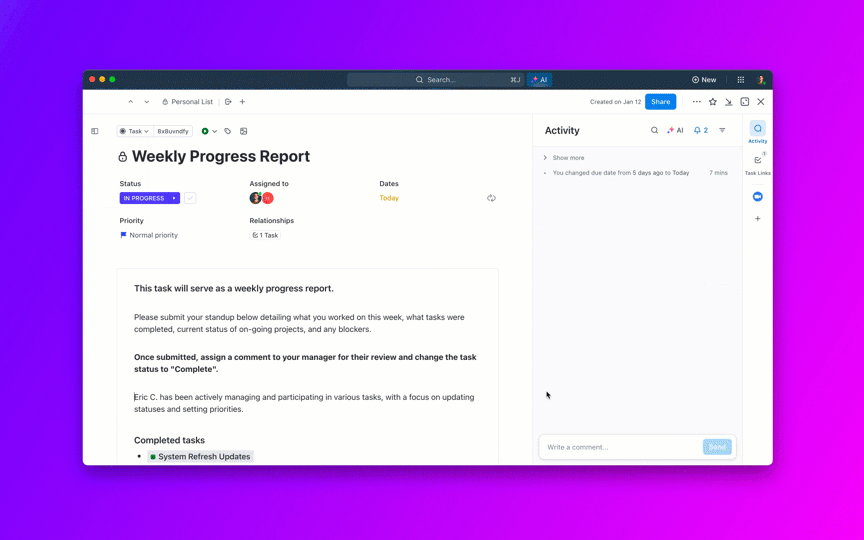
تؤدي هذه التغييرات مجتمعةً إلى تقليص المسار الكامل: استجابة أسرع، وتصنيف أكثر دقة، وتحديد أولويات أكثر ذكاءً، وتقليل حالات التوقف في مراحل المراجعة وضمان الجودة، وتواصل أكثر وضوحًا. يحصل المسؤولون التنفيذيون على قابلية التنبؤ المرتبطة بمؤشرات رضا العملاء (CSAT) ومؤشر التوصية الصافي (NPS) والإيرادات؛ بينما يحصل الممارسون على قائمة انتظار أكثر هدوءًا مع تقليل الحاجة إلى التبديل بين المهام.
📖 اقرأ المزيد: كيفية إجراء تحليل الأسباب الجذرية
أدوات الذكاء الاصطناعي التي تساعد في تقليل وقت حل الأخطاء
يمكن للذكاء الاصطناعي تقليل وقت حل المشكلات في كل خطوة — من الاستلام، إلى التصنيف، إلى التوجيه، إلى الإصلاح، وصولاً إلى التحقق.
ومع ذلك، فإن المكاسب الحقيقية تتحقق عندما تفهم الأدوات السياق وتواصل سير العمل دون الحاجة إلى التدخل اليدوي.
ابحث عن الأنظمة التي تعمل على إثراء التقارير تلقائيًا (خطوات إعادة إنتاج الخطأ، والبيئة، والحالات المكررة)، وتحدد الأولويات حسب التأثير، وتوجه المشكلات إلى المسؤول المناسب، وتُعد تحديثات واضحة، وتتكامل بشكل وثيق مع الكود الخاص بك، و«التكامل المستمر» (CI)، وقدرات الرصد.
كما تدعم أفضل هذه الأدوات سير عمل يشبه عمل وكلاء الدعم الفني: روبوتات تراقب اتفاقيات مستوى الخدمة (SLA)، وتُذكّر المراجعين، وترفع مستوى المشكلات التي تعاني من تعطل، وتلخص النتائج لأصحاب المصلحة. إليك مجموعة أدوات الذكاء الاصطناعي التي نوصي بها لتحسين حل الأخطاء:
1. ClickUp (الأفضل من حيث الذكاء الاصطناعي السياقي، والأتمتة، وسير العمل التفاعلي)
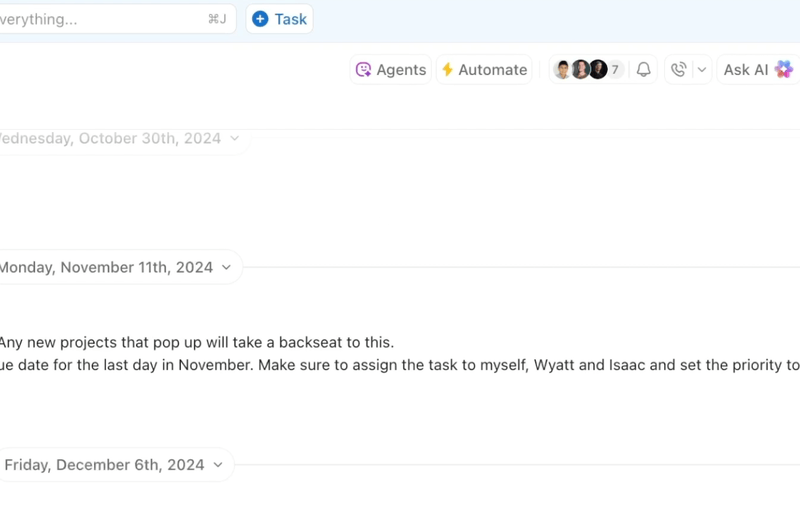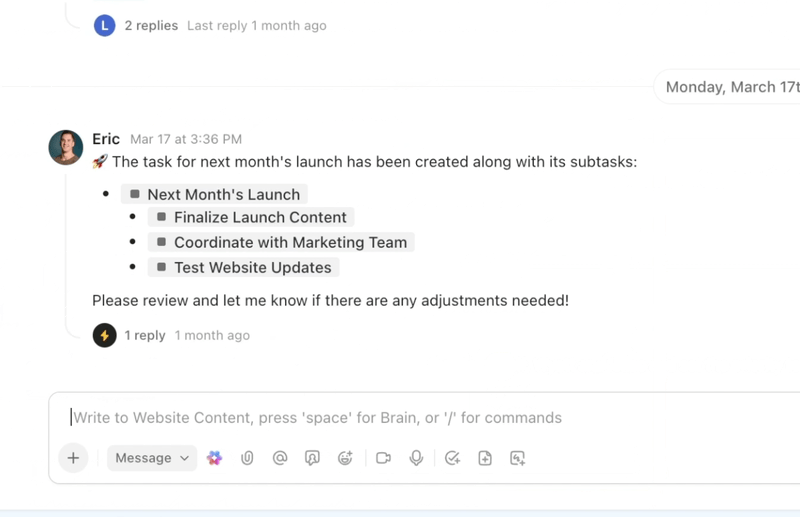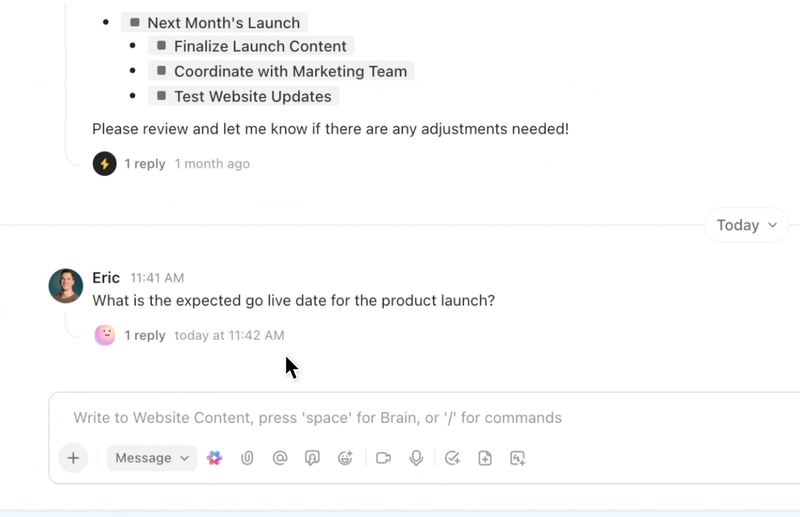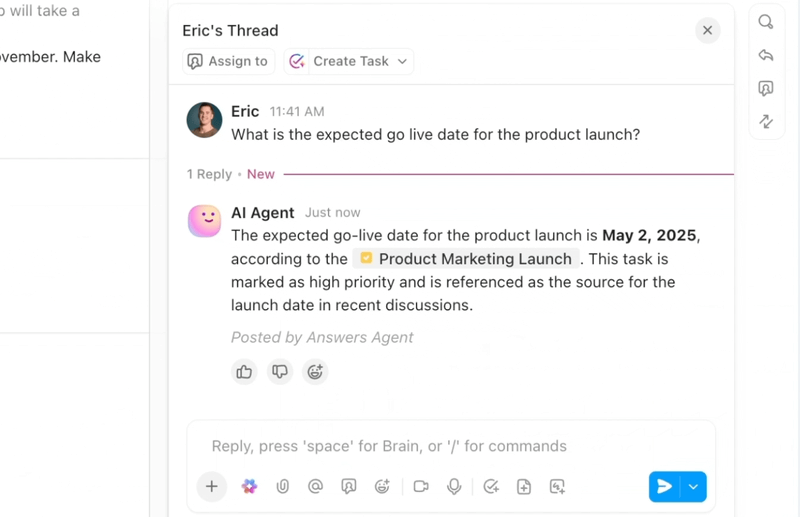
إذا كنت ترغب في سير عمل مبسط وذكي لحل الأخطاء، فإن ClickUp، التطبيق الشامل للعمل، يجمع بين الذكاء الاصطناعي والأتمتة والمساعدة التفاعلية في سير العمل في مكان واحد.
يقدم ClickUp Brain السياق المناسب على الفور — حيث يلخص سلاسل المحادثات الطويلة المتعلقة بالأخطاء، ويستخرج خطوات إعادة إنتاج الخطأ وتفاصيل البيئة من المرفقات، ويُشير إلى الحالات المكررة المحتملة، ويقترح الإجراءات التالية. وبدلاً من البحث في Slack والتذاكر والسجلات، تحصل الفرق على سجل واضح وغني بالمعلومات يمكنها العمل بناءً عليه على الفور.
تعمل الأتمتة ووكلاء «Autopilot» في ClickUp على استمرار سير العمل دون الحاجة إلى تدخل يدوي مستمر. يتم توجيه الأخطاء تلقائيًا إلى الفريق المناسب، وتعيين المسؤولين عنها، وتحديد اتفاقيات مستوى الخدمة (SLA) ومواعيد الاستحقاق، وتحديث الحالات مع تقدم العمل، وتلقي الأطراف المعنية إشعارات في الوقت المناسب.
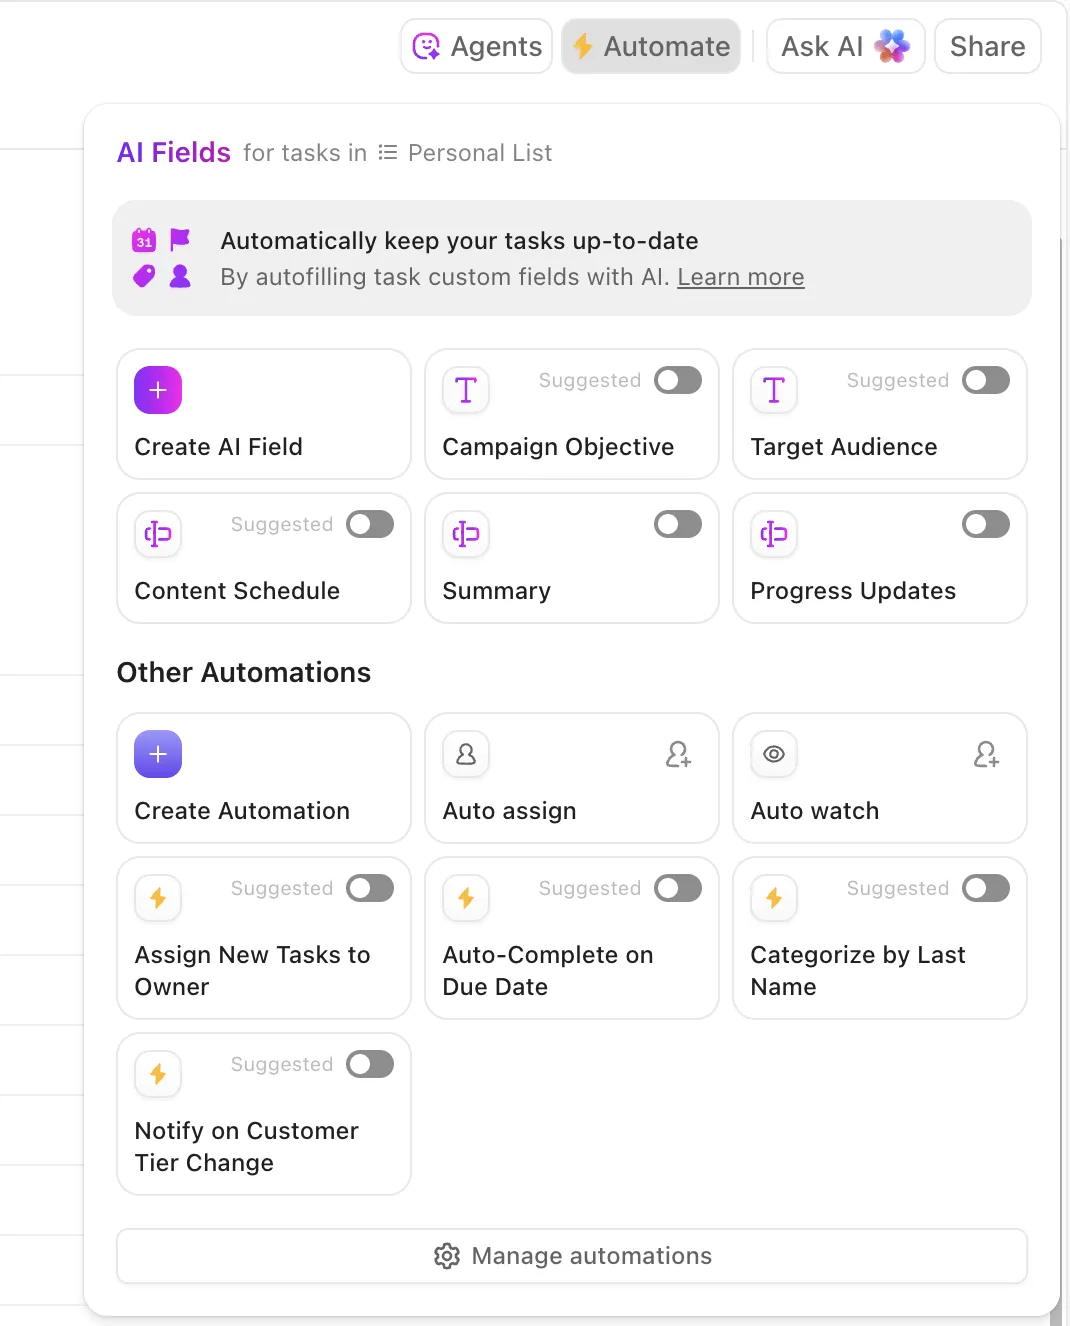
يمكن لهؤلاء الموظفين حتى تصنيف المشكلات وتجميع التقارير المتشابهة، والرجوع إلى الإصلاحات السابقة لاقتراح الحلول المحتملة، وتصعيد المشكلات العاجلة — وبالتالي ينخفض متوسط وقت الاستجابة (MTTA) ومتوسط وقت الإصلاح (MTTR) حتى عند ارتفاع حجم المشكلات.
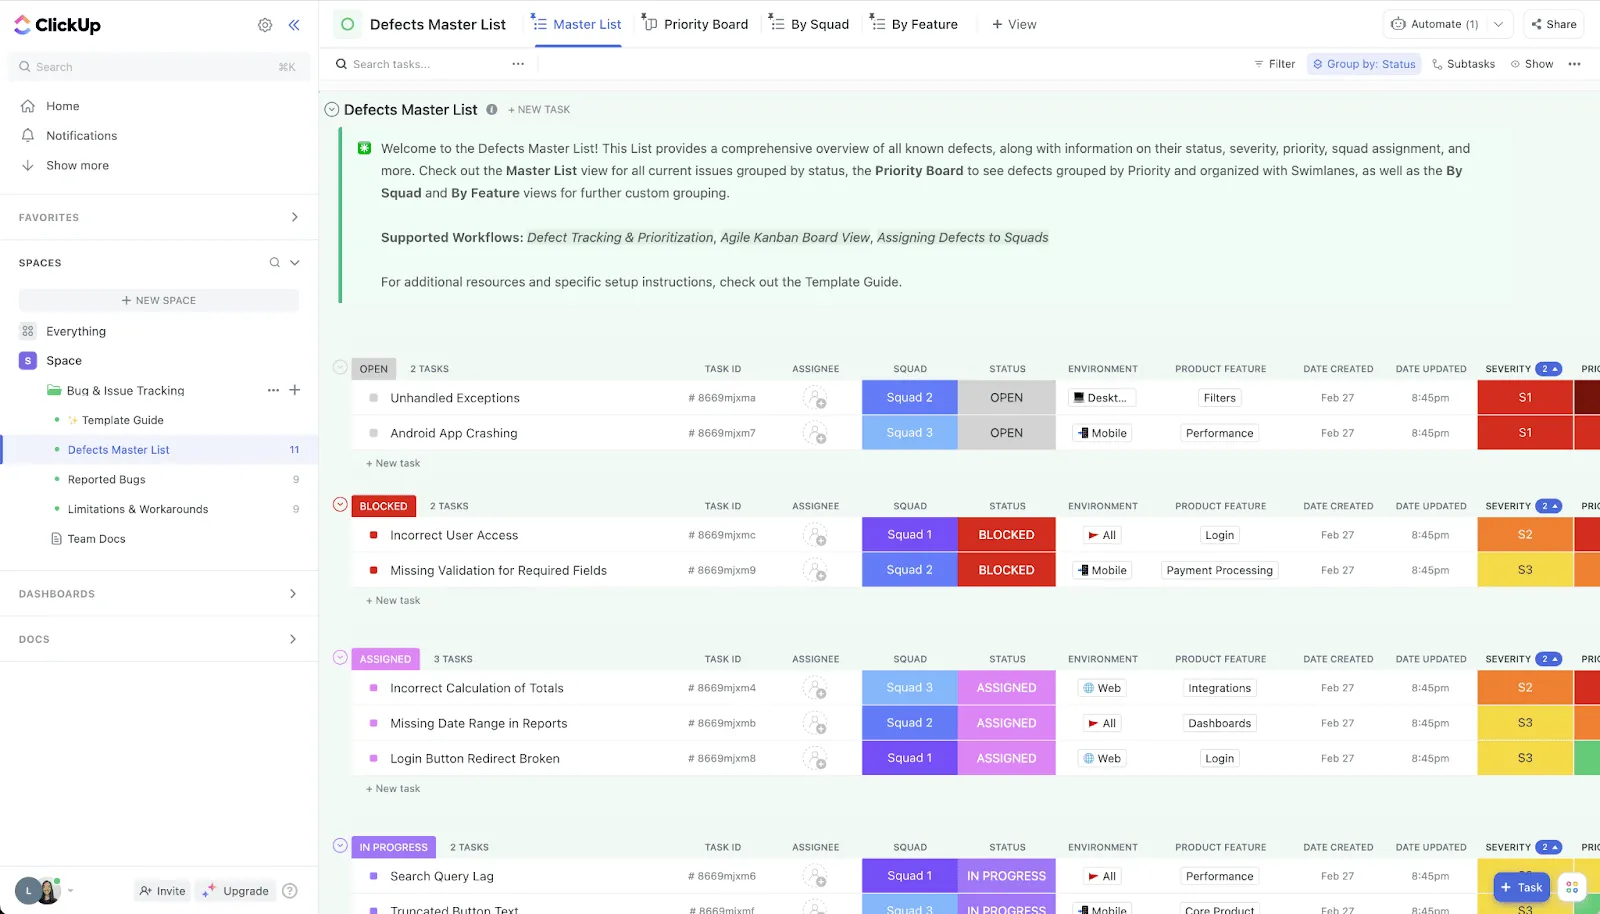
🛠️ هل تريد مجموعة أدوات جاهزة للاستخدام؟ يُعد نموذج ClickUp لتتبع الأخطاء والمشكلات حلاً قويًّا من ClickUp for Software مصممًا لمساعدة فرق الدعم والهندسة والمنتجات على متابعة أخطاء البرامج ومشكلاتها بسهولة. وبفضل طرق العرض القابلة للتخصيص مثل «القائمة» و«اللوحة» و«عبء العمل» و«النموذج» و«الخط الزمني»، يمكن للفرق تصور عملية تتبع الأخطاء وإدارتها بالطريقة التي تناسبها بشكل أفضل.
تتيح الحالات المخصصة العشرين والحقول المخصصة السبعة في القالب إنشاء سير عمل مخصص، مما يضمن تتبع كل مشكلة بدءًا من اكتشافها وحتى حلها. تتولى الأتمتة المدمجة المهام المتكررة، مما يوفر وقتًا ثمينًا ويقلل من الجهد اليدوي.
💟 مكافأة: Brain MAX هو رفيقك على سطح المكتب المدعوم بالذكاء الاصطناعي، والمصمم لتسريع حل الأخطاء بفضل ميزاته الذكية والعملية.
عندما تصادف خطأً برمجيًا، ما عليك سوى استخدام ميزة تحويل الكلام إلى نص في Brain MAX لتسجيل المشكلة صوتيًا — حيث يتم تحويل ملاحظاتك الصوتية إلى نص على الفور ويمكن إرفاقها بتذكرة خطأ جديدة أو موجودة بالفعل. وتقوم ميزة «البحث المؤسسي» (Enterprise Search) بالبحث في جميع أدواتك المتصلة — مثل ClickUp وGitHub وGoogle Drive وSlack — لإظهار تقارير الأخطاء وسجلات الأخطاء ومقتطفات الكود والوثائق ذات الصلة، بحيث تحصل على كل السياق الذي تحتاجه دون الحاجة إلى التبديل بين التطبيقات.
هل تحتاج إلى تنسيق عملية الإصلاح؟ يتيح لك Brain MAX تخصيص الأخطاء للمطور المناسب، وضبط تذكيرات آلية لتحديثات الحالة، وتتبع التقدم المحرز — كل ذلك من جهاز الكمبيوتر المكتبي الخاص بك!
2. Sentry (الأفضل في رصد الأخطاء)
يقلل Sentry من متوسط وقت الكشف عن الأخطاء (MTTD) ووقت إعادة إنتاجها من خلال تجميع الأخطاء والتتبع وجلسات المستخدمين في مكان واحد. تعمل ميزة تجميع المشكلات المدعومة بالذكاء الاصطناعي على تقليل التشويش؛ كما تحدد ميزة «Suspect Commit» وقواعد الملكية مالك الكود المحتمل، مما يتيح التوجيه الفوري. توفر ميزة «Session Replay» للمهندسين المسار الدقيق للمستخدم وتفاصيل وحدة التحكم/الشبكة لإعادة إنتاج المشكلة دون الحاجة إلى تبادل الرسائل بشكل لا نهائي.
تستطيع ميزات Sentry AI تلخيص سياق المشكلة، وفي بعض المجموعات البرمجية، اقتراح تصحيحات «Autofix» تشير إلى الكود المسبب للمشكلة. التأثير العملي: عدد أقل من التذاكر المكررة، وتوزيع أسرع للمهام، ومسار أقصر من الإبلاغ إلى التصحيح الفعال.
3. GitHub Copilot (الأفضل لمراجعة الكود بشكل أسرع)
يعمل Copilot على تسريع دورة الإصلاح داخل المحرر. فهو يشرح مسارات المكدس، ويقترح تصحيحات محددة الهدف، ويكتب اختبارات الوحدة لتثبيت الإصلاح، ويقوم بإنشاء هياكل أساسية لبرامج نصية لإعادة إنتاج الأخطاء.
يمكن لـ Copilot Chat تحليل الكود الذي يعاني من الأخطاء، واقتراح إعادة هيكلة أكثر أمانًا، وإنشاء تعليقات أو أوصاف لطلبات السحب (PR) التي تسرع عملية مراجعة الكود. وبالاقتران مع المراجعات الإلزامية والتكامل المستمر (CI)، فإنه يقلل ساعات العمل في مراحل «التشخيص → التنفيذ → الاختبار»، خاصةً بالنسبة للأخطاء المحددة النطاق والتي يمكن إعادة إنتاجها بوضوح.
4. Snyk من DeepCode AI (الأفضل في اكتشاف الأنماط)
يكتشف التحليل الثابت المدعوم بالذكاء الاصطناعي من DeepCode العيوب والأنماط غير الآمنة أثناء كتابة الكود وفي طلبات السحب (PRs). كما يسلط الضوء على التدفقات التي تنطوي على مشاكل، ويشرح أسباب حدوثها، ويقترح إصلاحات آمنة تتناسب مع أسلوب كتابة الكود الخاص بك.
من خلال اكتشاف حالات التراجع قبل الدمج وتوجيه المطورين نحو أنماط أكثر أمانًا، يمكنك تقليل معدل ظهور الأخطاء الجديدة وتسريع عملية إصلاح الأخطاء المنطقية المعقدة التي يصعب اكتشافها أثناء المراجعة. وتعمل تكاملات بيئة تطوير التطبيقات (IDE) وطلبات السحب (PR) على إبقاء هذه العملية قريبة من مكان العمل الفعلي.
5. Watchdog و AIOps من Datadog (الأفضل لتحليل السجلات)
يستخدم Watchdog من Datadog التعلم الآلي للكشف عن الحالات الشاذة عبر السجلات والمقاييس والتتبع ومراقبة المستخدمين الفعليين. كما يربط الارتفاعات المفاجئة بعلامات النشر والتغييرات في البنية التحتية والطوبولوجيا لاقتراح الأسباب الجذرية المحتملة.
بالنسبة للأخطاء التي تؤثر على العملاء، يعني ذلك اكتشافها في غضون دقائق، والتجميع التلقائي لتقليل التنبيهات غير الضرورية، وتوجيهات محددة حول المكان الذي يجب البحث فيه. ينخفض وقت الفرز لأنك تبدأ بعبارة «أثر هذا النشر على هذه الخدمات وارتفعت معدلات الأخطاء في هذه النقطة الطرفية» بدلاً من البدء من الصفر.
⚡️ أرشيف القوالب: قوالب مجانية لتتبع المشكلات والسجلات في Excel وClickUp
6. New Relic AI (الأفضل لتحديد الاتجاهات وتلخيصها)
يقوم صندوق الوارد الخاص بالأخطاء (Errors Inbox) من New Relic بتجميع الأخطاء المتشابهة عبر الخدمات والإصدارات، بينما يقوم مساعد الذكاء الاصطناعي الخاص بها بتلخيص التأثير، وإبراز الأسباب المحتملة، وتوفير روابط إلى التتبع/المعاملات ذات الصلة.
تُبيّن الارتباطات بين عمليات النشر والمعلومات الاستخبارية المتعلقة بتغييرات الكيانات بوضوح متى يكون الإصدار الأخير هو السبب. وبالنسبة للأنظمة الموزعة، فإن هذا السياق يوفر ساعات من الاتصالات المتبادلة بين الفرق، ويحيل الأخطاء إلى المسؤول المناسب مع وجود فرضية راسخة مسبقًا.
7. Rollbar (الأفضل لسير العمل الآلي)
تتخصص Rollbar في مراقبة الأخطاء في الوقت الفعلي باستخدام تقنية البصمة الذكية لتجميع الحالات المكررة وتتبع اتجاهات حدوثها. وتساعد الملخصات المدعومة بالذكاء الاصطناعي وتلميحات الأسباب الجذرية الفرق على فهم نطاق المشكلة (المستخدمون المتأثرون، والإصدارات المتأثرة)، بينما توفر القياسات عن بُعد وتتبع المكدس أدلة سريعة لإعادة إنتاج المشكلة.
تتيح قواعد سير العمل في Rollbar إنشاء المهام تلقائيًا، وتصنيف درجة خطورتها، وتوجيهها إلى المسؤولين، مما يحول تدفقات الأخطاء المزعجة إلى قوائم انتظار مرتبة حسب الأولوية ومرفقة بالسياق.
8. PagerDuty AIOps وأتمتة دفاتر التشغيل (أفضل ما في التشخيصات التي تتطلب تدخلاً محدوداً)
يستخدم PagerDuty ارتباط الأحداث وتقنية تقليل الضوضاء القائمة على التعلم الآلي لتجميع موجات التنبيهات وتحويلها إلى حوادث قابلة للتنفيذ.
تعمل التوجيه الديناميكي على توجيه المشكلة إلى الشخص المناوب المناسب على الفور، في حين يمكن لأتمتة دفاتر التشغيل أن تبدأ عمليات التشخيص أو الإجراءات التخفيفية (إعادة تشغيل الخدمات، التراجع عن عملية النشر، تبديل علامة الميزة) قبل تدخل الإنسان. بالنسبة لوقت حل الأخطاء، يعني ذلك تقليل متوسط وقت حل المشكلة (MTTA)، وإجراءات تخفيفية أسرع للأخطاء من الفئة P0، وتقليل الساعات المهدرة بسبب إرهاق التنبيهات.
ويتمثل المبدأ الأساسي في الأتمتة والذكاء الاصطناعي في كل خطوة. فأنت تكتشف الأخطاء في وقت أبكر، وتوجهها بطريقة أكثر ذكاءً، وتصل إلى الكود بشكل أسرع، وتبلغ عن الحالة دون إعاقة عمل المهندسين — وكل ذلك يسهم في تقليل وقت حل الأخطاء بشكل ملحوظ.
📖 اقرأ المزيد: كيفية استخدام الذكاء الاصطناعي في DevOps
أمثلة واقعية على استخدام الذكاء الاصطناعي لحل الأخطاء
إذن، لقد خرج الذكاء الاصطناعي رسمياً من المختبر. وهو يعمل على تقليل وقت حل الأخطاء في بيئات التشغيل الفعلية.
لنرى كيف!
| المجال / المؤسسة | كيف تم استخدام الذكاء الاصطناعي | التأثير / الفائدة |
|---|---|---|
| Ubisoft | تم تطوير «Commit Assistant»، وهي أداة تعتمد على الذكاء الاصطناعي تم تدريبها على كود داخلي يمتد على مدى عقد من الزمن، وتقوم بالتنبؤ بالأخطاء ومنعها في مرحلة البرمجة. | يهدف هذا إلى تقليل الوقت والتكلفة بشكل كبير — حيث يُنفق عادةً ما يصل إلى 70% من نفقات تطوير الألعاب على إصلاح الأخطاء. |
| Razer (منصة Wyvrn) | تم إطلاق أداة QA Copilot المدعومة بالذكاء الاصطناعي (المتكاملة مع Unreal وUnity) لأتمتة عملية اكتشاف الأخطاء وإنشاء تقارير ضمان الجودة. | يعزز اكتشاف الأخطاء بنسبة تصل إلى 25% ويقلل وقت ضمان الجودة إلى النصف. |
| Google / DeepMind و Project Zero | تم طرح «Big Sleep»، وهي أداة تعتمد على الذكاء الاصطناعي وتقوم بشكل مستقل باكتشاف الثغرات الأمنية في البرامج مفتوحة المصدر مثل FFmpeg وImageMagick. | تم تحديد 20 خطأً، تم التحقق من صحتها جميعًا بواسطة خبراء بشريين ومن المقرر إصلاحها. |
| باحثو جامعة كاليفورنيا في بيركلي | باستخدام معيار مقارنة يُسمى CyberGym، قامت نماذج الذكاء الاصطناعي بتحليل 188 مشروعًا مفتوح المصدر، وكشفت عن 17 ثغرة أمنية — بما في ذلك 15 خطأً مجهولًا من نوع «يوم الصفر» — وأنتجت استغلالات لإثبات صحة المفهوم. | يُظهر هذا التطور المتزايد لقدرات الذكاء الاصطناعي في اكتشاف الثغرات الأمنية والحماية الآلية من الاستغلال. |
| Spur (شركة ناشئة تابعة لجامعة ييل) | تم تطوير وكيل يعمل بالذكاء الاصطناعي يقوم بترجمة أوصاف حالات الاختبار المكتوبة بلغة بسيطة إلى إجراءات اختبار آلية للمواقع الإلكترونية — وهو ما يُعد فعليًّا سير عمل لضمان الجودة يتم كتابته تلقائيًّا. | يتيح إجراء الاختبارات بشكل مستقل مع الحد الأدنى من التدخل البشري |
| إعادة إنتاج تقارير الأخطاء في نظام أندرويد تلقائيًا | استخدمت معالجة اللغة الطبيعية (NLP) والتعلم المعزز لتفسير لغة تقارير الأخطاء ووضع خطوات لإعادة إنتاج أخطاء نظام أندرويد. | تم تحقيق دقة بنسبة 67%، ومعدل استرجاع بنسبة 77%، وإعادة إنتاج 74% من تقارير الأخطاء، متفوقًا بذلك على الطرق التقليدية. |
الأخطاء الشائعة في قياس وقت حل الأخطاء البرمجية
إذا كانت قياساتك غير دقيقة، فستكون خطة التحسين الخاصة بك غير دقيقة أيضًا.
تنشأ معظم «الأرقام السيئة» في سير عمل حل الأخطاء عن التعريفات الغامضة، وسير العمل غير المتسق، والتحليل السطحي.
لذا ابدأ بالأساسيات أولاً — ما الذي يُعتبر بدءًا/توقفًا، وكيف تتعامل مع فترات الانتظار وإعادة فتح التذاكر — ثم اقرأ البيانات بالطريقة التي يراها عملاؤك. ويشمل ذلك:
❌ الحدود غير الواضحة: إن خلط فئتي «تم الإبلاغ عنها→تم حلها» و«تم الإبلاغ عنها→تم إغلاقها» في نفس لوحة المعلومات (أو التبديل بينهما من شهر لآخر) يجعل الاتجاهات غير ذات معنى. اختر حدًا واحدًا، وقم بتوثيقه، وطبقُه على جميع الفرق. إذا كنت بحاجة إلى كليهما، فقم بنشرهما كمقاييس منفصلة مع تسميات واضحة.
❌ نهج الاعتماد على المتوسطات فقط: الاعتماد على المتوسط يخفي حقيقة قوائم الانتظار التي تحتوي على عدد قليل من الحالات الشاذة التي تستغرق وقتًا طويلاً. استخدم الوسيط (P50) لتحديد الوقت «النموذجي»، وP90 للتنبؤ/اتفاقيات مستوى الخدمة (SLA)، واحتفظ بالمتوسط لتخطيط السعة. انظر دائمًا إلى التوزيع، وليس إلى رقم واحد فقط.
❌ عدم وجود تصنيف: تجميع جميع الأخطاء معًا يؤدي إلى خلط الحوادث من الفئة P0 مع الأخطاء التجميلية من الفئة P3. قم بالتصنيف حسب الخطورة، والمصدر (العميل مقابل ضمان الجودة مقابل المراقبة)، والمكون/الفريق، و«الجديد مقابل التراجع». إن مؤشر P90 الخاص بفئتي P0 وP1 هو ما يشعر به أصحاب المصلحة؛ أما الوسيط الخاص بفئة P2+ فهو ما تستند إليه خطط قسم الهندسة.
❌ تجاهل وقت «التوقف المؤقت»: هل تنتظر سجلات العملاء أو موردًا خارجيًا أو فترة إصدار؟ إذا لم تقم بتتبع حالة «محجوب/متوقف مؤقتًا» كحالة ذات أولوية، فسيصبح وقت الحل موضوعًا للنقاش. قم بالإبلاغ عن كل من الوقت التقويمي والوقت الفعلي حتى تظهر نقاط الاختناق وتتوقف النقاشات.
❌ ثغرات تطبيع الوقت: يؤدي خلط المناطق الزمنية أو التبديل بين ساعات العمل والساعات التقويمية في منتصف العملية إلى إفساد المقارنات. قم بتطبيع الطوابع الزمنية وفقًا لمنطقة زمنية واحدة (أو التوقيت العالمي المنسق (UTC))، وحدد مرة واحدة ما إذا كانت اتفاقيات مستوى الخدمة (SLA) تُقاس بساعات العمل أم بالساعات التقويمية؛ وقم بتطبيق ذلك بشكل متسق.
❌ التسجيل غير الدقيق والتكرارات: تؤدي المعلومات الناقصة عن البيئة أو الإصدار والتذاكر المكررة إلى إطالة مدة المعالجة وإرباك تحديد المسؤولية. قم بتوحيد الحقول الإلزامية عند التسجيل، وإثراء البيانات تلقائيًا (السجلات، والإصدار، والجهاز)، وإزالة التكرارات دون إعادة ضبط مدة المعالجة — وأغلق التكرارات كقضايا مرتبطة، وليس كقضايا «جديدة».
❌ نماذج الحالة غير المتسقة: تخفي الحالات المخصصة («جاهز تقريبًا لفحص الجودة»، «في انتظار المراجعة 2») المدة التي يستغرقها البقاء في كل حالة، وتجعل انتقالات الحالة غير موثوقة. حدد سير عمل قياسيًا (جديد → تم تصنيفه → قيد التنفيذ → قيد المراجعة → تم حله → مغلق) وقم بمراجعة الحالات التي تخرج عن المسار المحدد.
❌ التجاهل لـ«الوقت في كل حالة»: لا يمكن لرقم «الوقت الإجمالي» وحده أن يخبرك أين يتعثر العمل. قم بتسجيل ومراجعة الوقت المستغرق في حالات «التصنيف» و«قيد المراجعة» و«محجوب» و«ضمان الجودة». إذا كان وقت مراجعة الكود (P90) يفوق وقت التنفيذ بكثير، فإن الحل ليس «البرمجة بشكل أسرع» — بل هو إزالة العوائق التي تعرقل سعة المراجعة.
🧠 حقيقة مثيرة للاهتمام: أظهر أحدث تحدي للذكاء الاصطناعي في مجال الأمن السيبراني الذي نظمته وكالة DARPA قفزة رائدة في أتمتة الأمن السيبراني. تضمنت المسابقة أنظمة ذكاء اصطناعي مصممة للكشف عن الثغرات الأمنية في البرامج واستغلالها وإصلاحها بشكل مستقل — دون تدخل بشري. وقد نجح الفريق الفائز، «فريق أتلانتا»، في الكشف عن 77% من الأخطاء المُدخلة وإصلاح 61% منها بنجاح، مما أظهر قدرة الذكاء الاصطناعي ليس فقط على اكتشاف العيوب، بل وإصلاحها بشكل فعال.
❌ التغاضي عن حالات إعادة الفتح: إن التعامل مع حالات إعادة الفتح كأخطاء جديدة يعيد ضبط المؤشر الزمني ويُظهر متوسط وقت الإصلاح (MTTR) بشكل أفضل مما هو عليه في الواقع. قم بتتبع معدل إعادة الفتح و«الوقت اللازم للإغلاق المستقر» (من أول تقرير حتى الإغلاق النهائي عبر جميع الدورات). وعادةً ما يشير ارتفاع حالات إعادة الفتح إلى ضعف في إعادة إنتاج الخطأ، أو ثغرات في الاختبار، أو تعريف غامض لمعيار «الإنجاز».
❌ عدم وجود MTTA: تركز الفرق بشكل مفرط على MTTR وتتجاهل MTTA (وقت الإقرار/تحديد المسؤولية). ارتفاع MTTA هو مؤشر مبكر على طول مدة الحل. قم بقياسه، وحدد اتفاقيات مستوى الخدمة (SLA) حسب درجة الخطورة، وأتمتة عملية التوجيه/التصعيد للحفاظ على انخفاضه.
❌ الذكاء الاصطناعي/الأتمتة دون ضوابط: إن السماح للذكاء الاصطناعي بتحديد درجة الخطورة أو إغلاق الحالات المكررة دون مراجعة قد يؤدي إلى تصنيف الحالات الاستثنائية بشكل خاطئ وتشويه المقاييس دون أن يلاحظ أحد. استخدم الذكاء الاصطناعي لتقديم الاقتراحات، واشترط التأكيد البشري على الحالات P0/P1، وقم بمراجعة أداء النموذج شهريًا لضمان موثوقية بياناتك.
عند تحسين هذه الجوانب، ستعكس مخططات زمن الحلول أخيرًا الواقع الفعلي. ومن هناك، تتراكم التحسينات: حيث يؤدي تحسين عملية استلام البلاغات إلى تقليص متوسط وقت حل المشكلة (MTTA)، وتكشف الحالات الأكثر وضوحًا عن الاختناقات الحقيقية، وتمنح قيم P90 المقسمة حسب الشرائح القادة وعودًا يمكنك الوفاء بها.
⚡️ أرشيف القوالب: 10 قوالب لحالات الاختبار الخاصة باختبار البرمجيات
أفضل الممارسات لتحسين عملية حل الأخطاء
باختصار، إليك النقاط الأساسية التي يجب وضعها في الاعتبار!
| 🧩 أفضل الممارسات | 💡 ماذا يعني ذلك | 🚀 لماذا هذا مهم |
| استخدم نظامًا قويًا لتتبع الأخطاء | تتبع جميع الأخطاء المبلغ عنها باستخدام نظام مركزي لتتبع الأخطاء. | يضمن عدم إغفال أي خطأ ويتيح رؤية حالة الأخطاء عبر الفرق المختلفة. |
| اكتب تقارير مفصلة عن الأخطاء | قم بتضمين السياق المرئي ومعلومات نظام التشغيل والخطوات اللازمة لتكرار المشكلة ودرجة خطورتها. | يساعد المطورين على إصلاح الأخطاء بشكل أسرع من خلال توفير جميع المعلومات الأساسية مسبقًا. |
| تصنيف الأخطاء وتحديد أولوياتها | استخدم مصفوفة الأولويات لفرز الأخطاء حسب مدى إلحاحها وتأثيرها. | يركز الفريق على الأخطاء الحرجة والمشكلات العاجلة أولاً. |
| استفد من الاختبارات الآلية | قم بتشغيل الاختبارات تلقائيًا في مسار التكامل المستمر/التسليم المستمر (CI/CD). | يدعم الكشف المبكر ويمنع حدوث حالات التراجع. |
| حدد إرشادات واضحة لإعداد التقارير | قم بتوفير قوالب وتدريب حول كيفية الإبلاغ عن الأخطاء. | مما يؤدي إلى معلومات دقيقة وتواصل أكثر سلاسة. |
| تتبع المقاييس الرئيسية | قم بقياس وقت حل المشكلات والوقت المنقضي ووقت الاستجابة. | يتيح تتبع الأداء وتحسينه باستخدام البيانات التاريخية. |
| اتبع نهجًا استباقيًا | لا تنتظر حتى يشتكي المستخدمون — قم بإجراء الاختبارات بشكل استباقي. | يعزز رضا العملاء ويقلل من عبء الدعم. |
| استفد من الأدوات الذكية والتعلم الآلي | استخدم التعلم الآلي للتنبؤ بالأخطاء واقتراح الحلول. | يحسّن الكفاءة في تحديد الأسباب الجذرية وإصلاح الأخطاء. |
| التوافق مع اتفاقيات مستوى الخدمة (SLA) | التزم باتفاقيات مستوى الخدمة المتفق عليها فيما يتعلق بحل المشكلات. | يعزز الثقة ويلبي توقعات العملاء في الوقت المناسب. |
| المراجعة والتحسين المستمر | قم بتحليل الأخطاء التي أعيد فتحها، وجمع الملاحظات، وتعديل العمليات. | يعزز التحسين المستمر لعملية التطوير وإدارة الأخطاء. |
حل الأخطاء أصبح أسهل بفضل الذكاء الاصطناعي السياقي
لا تعتمد أسرع فرق حل الأخطاء على الأعمال البطولية. بل تقوم بتصميم نظام يتضمن: تعريفات واضحة لبدء العمل وإنهائه، وعملية استقبال منظمة، وترتيب الأولويات بناءً على التأثير على الأعمال، وتحديد المسؤولية بوضوح، ودورات تغذية مرتدة محكمة بين أقسام الدعم وضمان الجودة والهندسة وإصدار المنتجات.
يمكن أن يكون ClickUp بمثابة مركز القيادة المدعوم بالذكاء الاصطناعي لنظام حل الأخطاء لديك. قم بتجميع كل البلاغات في قائمة انتظار واحدة، وقم بتوحيد السياق باستخدام الحقول المنظمة، ودع الذكاء الاصطناعي في ClickUp يقوم بالتصنيف والتلخيص وتحديد الأولويات، بينما تعمل الأتمتة على فرض اتفاقيات مستوى الخدمة (SLA)، والتصعيد عند تجاوز المواعيد المحددة، والحفاظ على تنسيق جهود الأطراف المعنية. اربط الأخطاء بالعملاء والكود والإصدارات حتى يرى المسؤولون التنفيذيون التأثير ويبقى العاملون في مجال التنفيذ على مسار العمل.
إذا كنت مستعدًا لتقليل الوقت المستغرق في حل الأخطاء وجعل خطة العمل الخاصة بك أكثر قابلية للتنبؤ، فقم بالتسجيل في ClickUp وابدأ في قياس التحسن في غضون أيام — وليس أرباع سنوية.
الأسئلة الشائعة
ما هو الوقت المناسب لحل الأخطاء؟
لا يوجد رقم «جيد» واحد — فالأمر يعتمد على درجة الخطورة ونموذج الإصدار ومستوى تحمل المخاطر. استخدم القيم الوسيطة (P50) للأداء «النموذجي» وP90 للالتزامات/اتفاقيات مستوى الخدمة (SLA)، وقم بالتقسيم حسب درجة الخطورة والمصدر.
ما الفرق بين حل الأخطاء وإغلاق الأخطاء؟
يُعتبر "الحل" هو تنفيذ الإصلاح (على سبيل المثال، دمج الكود أو تطبيق التكوين) واعتبار الفريق أن الخلل قد تم معالجته. أما "الإغلاق" فهو التحقق من المشكلة وإنهائها رسميًا (على سبيل المثال، التحقق من صحة الجودة في البيئة المستهدفة، أو الإصدار، أو وضع علامة "لن يتم إصلاحها" أو "مكررة" مع توضيح الأسباب). تقيس العديد من الفرق كلا الأمرين: "تم الإبلاغ عنها → تم حلها" تعكس سرعة الهندسة؛ و"تم الإبلاغ عنها → تم إغلاقها" تعكس تدفق الجودة من البداية إلى النهاية. استخدم تعريفات متسقة حتى لا تخلط لوحات المعلومات بين المراحل.
ما الفرق بين وقت حل الأخطاء ووقت اكتشاف الأخطاء؟
وقت الكشف (MTTD) هو المدة التي يستغرقها اكتشاف الخلل بعد حدوثه أو طرحه — سواء عبر المراقبة أو ضمان الجودة أو المستخدمين. أما وقت الحل فهو المدة التي يستغرقها الانتقال من مرحلة الكشف/الإبلاغ إلى تنفيذ الإصلاح (و، إذا أردت، التحقق من صلاحيته/إصداره). ويحددان معًا نطاق التأثير على العميل: الكشف السريع، والاعتراف السريع، والحل السريع، والإصدار الآمن. يمكنك أيضًا تتبع MTTA (الوقت اللازم للاعتراف/التخصيص) لاكتشاف تأخيرات التصنيف التي غالبًا ما تنذر بفترة حل أطول.
كيف يساعد الذكاء الاصطناعي في حل الأخطاء؟
يعمل الذكاء الاصطناعي على تقليص المراحل التي عادةً ما تستغرق وقتًا طويلاً: الاستلام، والتصنيف، والتشخيص، والإصلاح، والتحقق.
- استلام البلاغات والتصنيف: يقوم تلقائيًا بتلخيص التقارير الطويلة، واستخراج خطوات إعادة إنتاج الخطأ وبيئته، وتمييز الحالات المكررة، واقتراح درجة الخطورة والأولوية حتى يبدأ المهندسون العمل في سياق واضح (على سبيل المثال، ClickUp AI، Sentry AI).
- التوجيه واتفاقيات مستوى الخدمة (SLA): يتنبأ بالمكون أو المسؤول المحتمل، ويضبط المؤقتات، ويقوم بالتصعيد عند تجاوز متوسط وقت حل المشكلة (MTTA) أو تأخر المراجعة — مما يقلل من «الوقت الضائع في الحالة» (أتمتة ClickUp وسير العمل الشبيهة بعمل الوكلاء).
- التشخيص: تجميع الأخطاء المتشابهة، وربط الارتفاعات المفاجئة في الأخطاء بعمليات التسجيل/الإصدارات الأخيرة، وتحديد الأسباب الجذرية المحتملة باستخدام تتبع المكدس وسياق الكود (Sentry AI وما شابهه).
- التنفيذ: يقترح تغييرات في الكود واختبارات استنادًا إلى الأنماط الموجودة في مستودعك، مما يسرع دورة «الكتابة/الإصلاح» (GitHub Copilot؛ Snyk Code AI من DeepCode).
- التحقق والاتصالات: يكتب حالات الاختبار استنادًا إلى خطوات إعادة إنتاج الأخطاء، ويُعد مسودات ملاحظات الإصدار وتحديثات أصحاب المصلحة، ويلخص الحالة للمديرين التنفيذيين والعملاء (ClickUp AI). وعند استخدام هذه الأدوات معًا — حيث يعمل ClickUp كمركز قيادة مع Sentry/Copilot/DeepCode ضمن المجموعة — تتمكن الفرق من تقليل أوقات MTTA/P90 دون الاعتماد على الجهود الفردية الاستثنائية.