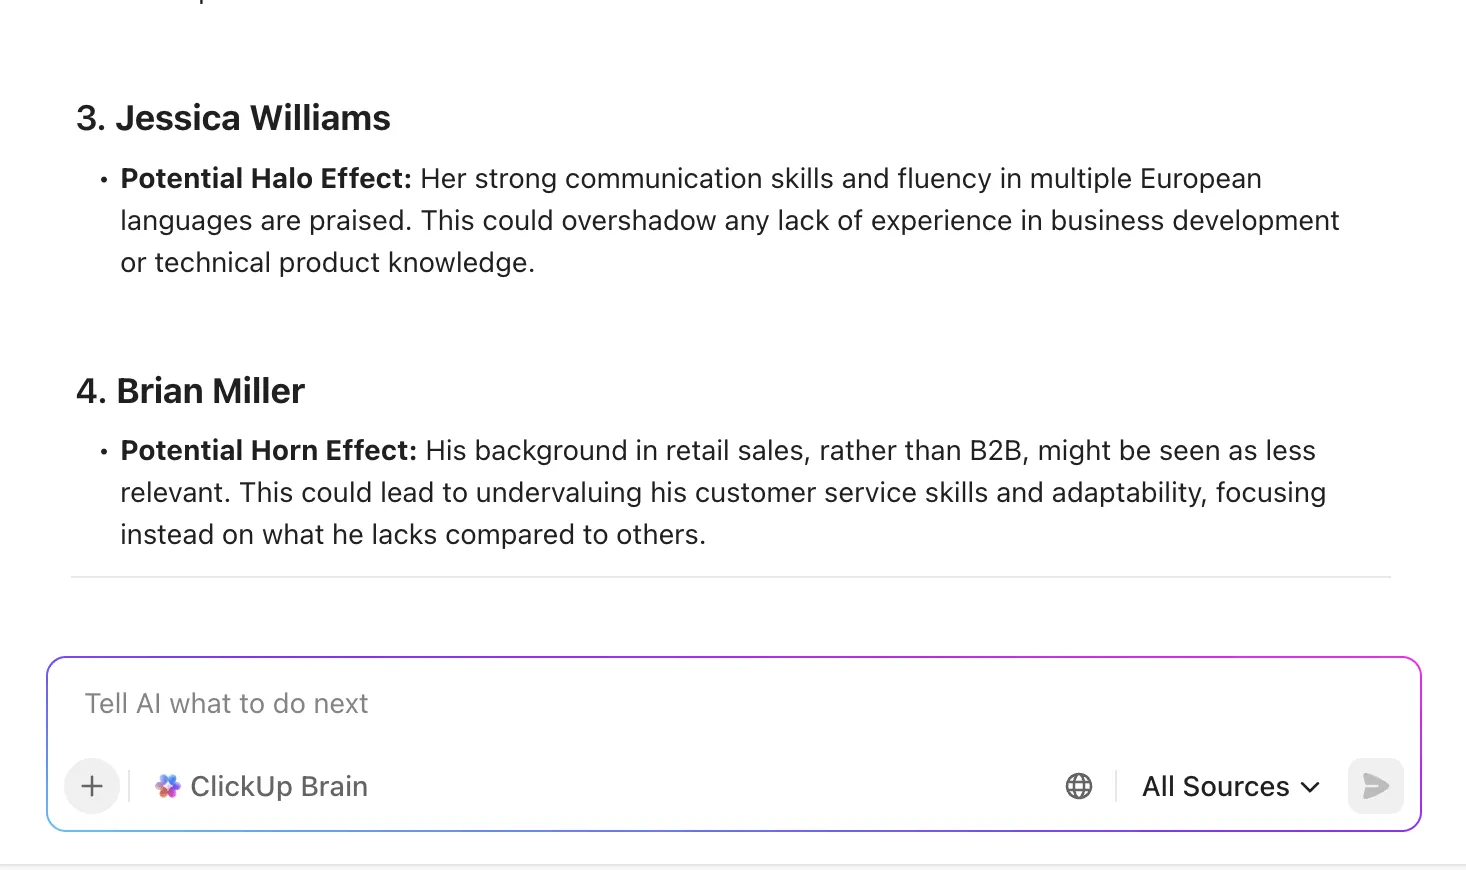

Voreingenommenheit bei KI mag wie ein technisches Problem erscheinen. Doch ihre Auswirkungen zeigen sich in der realen Welt und können oft verheerend sein.
Wenn ein KI-System auch nur geringfügig in die falsche Richtung tendiert, kann dies zu ungerechten Ergebnissen führen.
Und im Laufe der Zeit können diese kleinen Probleme zu frustrierten Kunden, Reputationsproblemen oder sogar zu Compliance-Fragen führen, die Sie nicht kommen sahen.
Die meisten Teams haben nicht die Absicht, voreingenommene KI zu entwickeln. Es passiert einfach, weil die Daten unübersichtlich sind, die reale Welt ungleichmäßig ist und die von uns verwendeten tools nicht immer so denken, wie wir es erwarten. Die gute Nachricht ist: Man muss kein Datenwissenschaftler sein, um zu verstehen, was hier vor sich geht.
In diesem Blogbeitrag erklären wir Ihnen, was KI-Voreingenommenheit eigentlich ist, warum sie auftritt und wie sie sich in alltäglichen Business-Tools äußern kann.
Was ist eine Verzerrung durch KI?
Von einer Verzerrung durch KI spricht man, wenn ein System der künstlichen Intelligenz systematische, unfaire Ergebnisse liefert, die bestimmte Personengruppen konsequent begünstigen oder benachteiligen. Dabei handelt es sich nicht nur um zufällige Fehler, sondern um vorhersehbare Muster, die fest in den Entscheidungsprozess der KI eingebettet sind. Die Ursache? KI lernt aus Daten, die bestehende menschliche Vorurteile, andere unbewusste Verzerrungen und gesellschaftliche Ungleichheiten widerspiegeln.
Stellen Sie sich das einmal so vor: Wenn Sie einen Algorithmus für die Personalauswahl mit Unternehmensdaten aus zehn Jahren trainieren, in denen 90 % der Führungskräfte Männer waren, könnte die KI fälschlicherweise lernen, dass das männliche Geschlecht eine Schlüsselqualifikation für die Rolle des Führungskräftenteams ist. Die KI handelt dabei nicht böswillig; sie identifiziert lediglich die Muster, die ihr vorgelegt wurden, und wiederholt diese.
Das macht Vorurteile in der KI so heikel:
- Es ist systematisch, nicht zufällig: Die Ungerechtigkeit ist kein einmaliger Fehler, sondern ein wiederkehrendes Muster in den Ergebnissen der KI.
- Oft ist es unsichtbar: Voreingenommene Ergebnisse können sich hinter der komplexen Mathematik eines scheinbar neutralen Algorithmus verbergen, wodurch sie schwer zu erkennen sind.
- Es hat seine Wurzeln in Daten und Design: Verzerrungen gelangen durch die Entscheidungen, die wir Menschen beim Aufbau und Training von KI treffen, in das System.
⭐ Empfohlene Vorlage
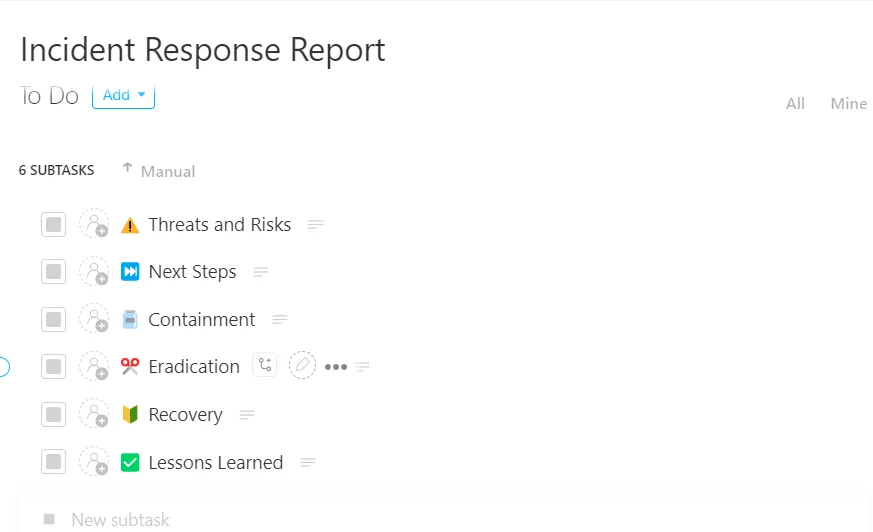
Die Vorlage für Incident-Response-Berichte von ClickUp bietet eine vorgefertigte Struktur zur Dokumentation, Nachverfolgung und Lösung von Vorfällen von Anfang bis Ende. Erfassen Sie alle relevanten Details zu Vorfällen, verwalten Sie klar kategorisierte Status und halten Sie wichtige Attribute wie Schweregrad, betroffene Gruppen und Abhilfemaßnahmen fest. Die Vorlage unterstützt Benutzerdefinierte Felder für Angaben wie „Genehmigt von“, „Notizen zum Vorfall“ und „Begleitdokumente“, die dazu beitragen, Verantwortlichkeiten und Belege während des gesamten Überprüfungsprozesses transparent zu machen.
Warum es wichtig ist, Verzerrungen in der KI zu minimieren
Wenn Ihre KI-Systeme ungerecht sind, riskieren Sie, das Leben realer Menschen zu beeinträchtigen.
Dies wiederum setzt Ihr Unternehmen ernsthaften geschäftlichen Herausforderungen aus und kann sogar das Vertrauen zerstören, das Sie sich bei Ihren Kunden mühsam aufgebaut haben.
Eine voreingenommene KI, die jemandem einen Kredit verweigert, dessen Bewerbung ablehnt oder eine falsche Empfehlung ausspricht, hat schwerwiegende Konsequenzen in der Praxis.
Neue Branchenstandards und Rahmenwerke ermutigen Unternehmen mittlerweile dazu, Verzerrungen in ihren /AI-Systemen aktiv zu identifizieren und zu beheben. Die Risiken bedrohen Ihr Unternehmen von allen Seiten:
- Regulatorisches Risiko: Die Nichteinhaltung neuer KI-Standards kann zu erheblichen geschäftlichen Herausforderungen führen.
- Reputationsschaden: Sobald die Öffentlichkeit erfährt, dass Ihre KI voreingenommen ist, ist es unglaublich schwierig, ihr Vertrauen zurückzugewinnen.
- Operative Ineffizienz: Voreingenommene Modelle liefern unzuverlässige Ergebnisse oder AI-Halluzinationen, die zu schlechten Entscheidungen führen und kostspielige Korrekturen erfordern.
- Ethische Verantwortung: Ihr Unternehmen sollte sicherstellen, dass die von Ihnen eingesetzte Technologie alle Benutzer fair behandelt.
Wenn Sie Voreingenommenheit richtig mindern, entwickeln Sie KI-Systeme, auf die sich Menschen tatsächlich verlassen können. Faire KI eröffnet neue Märkte, verbessert die Qualität Ihrer Entscheidungen und zeigt allen, dass Sie sich für eine ethische Geschäftspraxis einsetzen.
📮 ClickUp Insight: 22 % unserer Befragten sind nach wie vor skeptisch, wenn es um den Einsatz von KI am Arbeitsplatz geht. Von diesen 22 % macht sich die Hälfte Sorgen um den Datenschutz, während die andere Hälfte einfach nicht sicher ist, ob sie den Aussagen der KI vertrauen kann.
ClickUp geht beide Probleme direkt an – mit robusten Maßnahmen zur Sicherheit und durch die Erstellung detaillierter Verknüpfungen zu Aufgaben und Quellen bei jeder Antwort.
Das bedeutet, dass selbst die vorsichtigsten Teams von der Steigerung der Produktivität profitieren können, ohne sich Sorgen darüber machen zu müssen, ob ihre Daten geschützt sind oder ob sie zuverlässige Ergebnisse erhalten.
Arten und Ursachen von Verzerrungen in der KI
Voreingenommenheit kann sich aus verschiedenen Richtungen in Ihre KI-Systeme einschleichen.
Vom Beginn der Datenerfassung bis lange nach der Einführung des Systems bleibt dieser Aspekt relativ konstant. Doch wenn Sie wissen, worauf Sie achten müssen, können Sie Ihren Aufwand gezielt einsetzen und das endlose „Whack-a-Mole“-Spiel mit ungerechten Ergebnissen beenden.
Stichprobenverzerrung
Eine Stichprobenverzerrung tritt auf, wenn die Daten, die Sie zum Trainieren Ihrer KI verwenden, die reale Welt, in der die KI eingesetzt wird, nicht genau widerspiegeln.
Als Beispiel können wir ein Spracherkennungssystem nennen, das hauptsächlich mit Daten von Sprechern des amerikanischen Englisch trainiert wurde. Es wird naturgemäß Schwierigkeiten haben, Menschen mit schottischem oder indischem Akzent zu verstehen – ähnlich wie LLMs bei der Lebenslaufprüfung in 85,1 % der Fälle Namen bevorzugen, die mit Weißen assoziiert werden. Diese Unterrepräsentation führt zu massiven blinden Flecken, wodurch Ihr Modell nicht in der Lage ist, ganze Personengruppen zu bedienen.
Algorithmische Verzerrungen
Algorithmische Verzerrungen treten auf, wenn das Design des Modells oder der mathematische Prozess unfaire Muster verstärkt, selbst wenn die Daten neutral erscheinen.
Die Postleitzahl einer Person sollte nicht darüber entscheiden, ob sie einen Kredit erhält. Wenn jedoch die Postleitzahlen in Ihren Trainingsdaten stark mit der ethnischen Zugehörigkeit korrelieren, könnte der Algorithmus lernen, den Wohnort als Indikator für Diskriminierung zu nutzen.
Dieses Problem verschärft sich durch Rückkopplungsschleifen noch weiter: Wenn eine voreingenommene Vorhersage (wie beispielsweise die Ablehnung eines Kredits) als neue Daten in das System zurückgeführt wird, verstärkt sich die Voreingenommenheit mit der Zeit nur noch weiter.
Voreingenommenheit bei menschlichen Entscheidungen
Jede Entscheidung, die eine Person beim Aufbau eines KI-Systems trifft, kann zu Verzerrungen führen.
Dazu gehört die Entscheidung, welche Daten erfasst werden sollen, wie sie beschrieben werden sollen und wie „Erfolg“ für das Modell definiert wird. So könnte ein Team beispielsweise unbewusst Daten bevorzugen, die seine bestehenden Überzeugungen unterstützen (Bestätigungsverzerrung), oder der ersten Information, die es sieht, zu viel Gewicht beimessen (Verankerungsverzerrung).
Selbst Teams mit den besten Absichten können versehentlich ihre eigenen Annahmen und ihre Weltanschauung in ein KI-System einfließen lassen.
Beispiele für KI-Verzerrungen in der Praxis
Echte Unternehmen mussten erhebliche Konsequenzen hinnehmen, als ihre KI-Systeme Verzerrungen aufwiesen, was sie Millionen an Schadensersatz kostete und zum Verlust des Kundenvertrauens führte. Hier sind einige dokumentierte Beispiele:
1. Voreingenommene Rekrutierungstools
Einer der am häufigsten zitierten Fälle betraf ein großes Technologieunternehmen, das ein internes KI-Rekrutierungssystem einstellte, nachdem es gelernt hatte, männliche Bewerber gegenüber Frauen zu bevorzugen. Das System war anhand von Lebensläufen aus einem Zeitraum von zehn Jahren trainiert worden, in denen die meisten erfolgreichen Bewerber Männer waren. Daher begann es, Lebensläufe mit Begriffen wie „Frauen-“ abzustufen und stufte sogar Absolventinnen von Frauenhochschulen herab.
Dies zeigt, wie sich Verzerrungen in den Verlaufsdaten – wenn vergangene Muster bestehende Ungleichheiten widerspiegeln – in die Automatisierung einschleichen können, sofern diese nicht sorgfältig geprüft wird. Da sich die automatisierte Personalauswahl mit KI jedoch immer weiter verbreitet, nimmt das Ausmaß des Problems noch weiter zu.
🌼 Wussten Sie schon: Aktuelle Daten zeigen, dass 37 % der Unternehmen Gen-AI-Tools mittlerweile „aktiv integrieren“ oder „erproben“, was im Bereich der Personalbeschaffung eingesetzt werden – ein Anstieg gegenüber 27 % vor einem Jahr.
2. Gesichtserkennung, die die Hälfte der Population übersieht
Eine von Joy Buolamwini geleitete und in der Studie Gender Shades dokumentierte Untersuchung ergab, dass kommerzielle Gesichtserkennungssysteme Fehlerquoten von bis zu 34,7 % bei dunkelhäutigen Frauen aufwiesen, verglichen mit weniger als 1 % bei hellhäutigen Männern.
Auch dies ist ein Zeichen für unausgewogene Trainingsdatensätze. Verzerrungen in biometrischen tools haben sogar noch weitreichendere Auswirkungen.
Auch Polizei und Behörden hatten Probleme mit voreingenommener Gesichtserkennung. Untersuchungen der Washington Post ergaben , dass einige dieser Systeme Personen aus marginalisierten Gruppen mit deutlich höherer Wahrscheinlichkeit falsch identifizierten. In mehreren konkreten Fällen führte dies zu unrechtmäßigen Festnahmen, öffentlicher Kritik und großen Bedenken hinsichtlich der Auswirkungen dieser tools auf die Rechte der Menschen.
3. Algorithmen im Gesundheitswesen, die der Versorgung zu geringe Priorität einräumen
Auch KI-Systeme im Gesundheitswesen, die vorhersagen sollen, welche Patienten zusätzliche Betreuung benötigen, haben Verzerrungen gezeigt.
In einem gut dokumentierten Fall kam es bei einem weit verbreiteten Prädiktionsalgorithmus im Gesundheitswesen zu einem schwerwiegenden Fehler. Er sollte eigentlich dabei helfen, zu entscheiden, welche Patienten zusätzliche Betreuung erhalten sollten, führte jedoch dazu, dass schwarze Patienten systematisch eine niedrigere Priorität erhielten, selbst wenn sie genauso krank oder sogar kränker waren als weiße Patienten.
Dies geschah, weil das Modell die Gesundheitsausgaben als Indikator für den medizinischen Bedarf verwendete. Da schwarze Patienten aufgrund des ungleichen Zugangs zur Gesundheitsversorgung in der Vergangenheit geringere Gesundheitsausgaben hatten, stufte der Algorithmus sie als weniger bedürftig ein. Als Ergebnis wurden Versorgungsressourcen von denjenigen abgezogen, die sie tatsächlich am dringendsten benötigten. Forscher fanden heraus, dass bereits die Korrektur dieses Indikators den Zugang zu fairen Versorgungsprogrammen erheblich verbessern könnte.
Gerade diese Probleme haben Bürgerrechtsgruppen dazu veranlasst, auf „Equity-First“-Standards für KI im Gesundheitswesen zu drängen. Im Dezember 2025 veröffentlichte die NAACP einen detaillierten Leitfaden, in dem Krankenhäuser, Technologieunternehmen und politische Entscheidungsträger aufgefordert wurden, Voreingenommenheitsprüfungen, transparente Designpraktiken, inklusive Rahmenbedingungen und KI-Governance-Tools einzuführen, um eine Verschärfung rassistischer Ungleichheiten im Gesundheitswesen zu verhindern.
4. Kreditalgorithmen mit ungleichen Ergebnissen
KI und Automatisierung der Entscheidungsfindung bestimmen nicht nur, was Sie in den sozialen Medien sehen, sondern beeinflussen auch, wer Zugang zu Geld erhält und zu welchen Bedingungen.
Eines der meistdiskutierten Beispiele aus der Praxis stammt von der Apple Card , einer von Goldman Sachs herausgegebenen digitalen Kreditkarte.
Im Jahr 2019 berichteten Kunden in den sozialen Medien, dass der Algorithmus zur Festlegung des Kreditlimits einigen Männern deutlich höhere Limits zuwies als ihren Ehefrauen oder Partnerinnen. Dies geschah selbst dann, wenn die Paare ähnliche finanzielle Profile angaben. Ein Softwareentwickler berichtete, er habe ein 20-mal höheres Limit als seine Frau erhalten, und sogar Apple-Mitbegründer Steve Wozniak bestätigte eine ähnliche Erfahrung im Zusammenhang mit seiner Ehefrau.
Diese Muster lösten einen öffentlichen Aufschrei aus und führten zu einer behördlichen Untersuchung durch das New York State Department of Financial Services, in der geprüft wurde, ob der Algorithmus Frauen diskriminierte – was deutlich machte, wie automatisierte Finanztools zu ungleichen Ergebnissen führen können.
5. Automatisierte Untertitel und Spracherkennung, die bestimmte Stimmen ausschließen
Spracherkennungs- und automatische Untertitelungssysteme verstehen oft nicht alle gleichermaßen. Mehrere Studien haben gezeigt, dass diese Tools bei manchen Sprechern besser funktionieren als bei anderen, abhängig von Faktoren wie Akzent, Dialekt, ethnischer Zugehörigkeit und der Frage, ob Englisch die Muttersprache des Sprechers ist.
Dies liegt daran, dass kommerzielle Systeme in der Regel anhand von Datensätzen trainiert werden, die von bestimmten Sprachmustern dominiert werden – häufig westliches Standard-Englisch –, wodurch andere Stimmen unterrepräsentiert bleiben.
So testeten Forscher der Stanford University beispielsweise fünf führende Sprach-zu-Text-Systeme (von Amazon, Google, Microsoft, IBM und Apple) und stellten fest, dass diese bei der Transkription von Reden schwarzer Sprecher fast doppelt so viele Fehler machten wie bei weißen Sprechern . Das Problem trat sogar dann auf, wenn die Probanden unter denselben Bedingungen dieselben Wörter sagten.
Wenn Untertitel für bestimmte Sprecher ungenau sind, kann dies zu einer schlechten Benutzererfahrung und zu Barrierefreiheit für Menschen führen, die auf Untertitel angewiesen sind. Schlimmer noch: Es kann zu verzerrten Ergebnissen in Systemen beitragen, die Spracherkennung in den Bereichen Personalbeschaffung, Bildung oder Gesundheitswesen einsetzen.
Jedes dieser Beispiele veranschaulicht eine andere Art und Weise, wie Verzerrungen durch verzerrte Trainingsdaten, schlecht gewählte Proxies oder nicht repräsentative Tests in automatisierte Systeme eingebettet werden können. In jedem Fall ist das Ergebnis nicht nur technischer Natur – es beeinflusst Chancen, untergräbt das Vertrauen und bergt echte geschäftliche und ethische Risiken.
📖 Weiterlesen: Risiken vs. Probleme – Was ist der Unterschied?
Zusammenfassung: Wie sich Verzerrungen in der KI äußern und wem sie schaden
| Wo Verzerrungen auftraten | Wer war betroffen? | Auswirkungen in der Praxis |
|---|---|---|
| Rekrutierungsalgorithmen (ausgemustertes KI-Einstellungstool) | Frauen | Lebensläufe wurden aufgrund geschlechtsspezifischer Schlüsselwörter herabgestuft, was den Zugang zu Vorstellungsgesprächen und Stellenangeboten einschränkte. |
| Gesichtserkennungssysteme (Gender Shades + Fälle von unrechtmäßigen Festnahmen) | Dunkelhäutige Frauen; marginalisierte ethnische Gruppen | Weitaus höhere Fehlerquoten bei der Identifizierung führten zu unrechtmäßigen Festnahmen, Rufschädigung und Bedenken hinsichtlich der Bürgerrechte. |
| Algorithmen zur Risikovorhersage im Gesundheitswesen (Studie der University of Chicago) | Schwarze Patienten | Patienten erhielten weniger zusätzliche Versorgung, da die Gesundheitsausgaben als fehlerhafter Indikator für den medizinischen Bedarf herangezogen wurden, was gesundheitliche Ungleichheiten verschärfte. |
| Algorithmen zur Limitierung des Kreditlimits (Untersuchung zur Apple Card) | Frauen | Männer erhielten deutlich höhere Limite als gleich qualifizierte Partnerinnen, was sich auf den Zugang zu Finanzmitteln und die Kreditwürdigkeit auswirkte. |
| Spracherkennung und automatische Untertitel (ASR-Studie der Stanford University) | Redner mit ungewöhnlichen Akzenten; schwarze Redner | Fast doppelt so hohe Fehlerquoten führten zu Barrieren bei der Barrierefreiheit, Missverständnissen und verzerrten Ergebnissen bei tools, die in den Bereichen Personalbeschaffung, Bildung und im täglichen digitalen Zugang zum Einsatz kommen. |
Strategien zur Verringerung von Verzerrungen, die funktionieren
Es gibt kein Patentrezept, um Verzerrungen durch KI zu beseitigen.
Eine wirksame Verringerung von Verzerrungen erfordert einen mehrschichtigen Schutz, den Sie über den gesamten KI-Lebenszyklus hinweg anwenden. Durch die Kombination dieser bewährten Strategien können Sie das Risiko unfairer Ergebnisse drastisch reduzieren.
Sammeln Sie vielfältige Trainingsdaten
Repräsentative Daten sind die unverzichtbare Grundlage für faire KI.
Ihr Modell kann nicht lernen, Gruppen von Menschen zu bedienen, die es während des Trainings noch nie gesehen hat. Beginnen Sie damit, Ihre bestehenden Datensätze zu überprüfen, um etwaige demografische Lücken aufzudecken. Investieren Sie dann bewusst einen gewissen Aufwand in die Beschaffung neuer Daten aus diesen unterrepräsentierten Populationen.
Wenn Daten aus der Praxis schwer zu finden sind, können Sie Techniken wie Datenaugmentierung (Erstellung modifizierter Kopien bestehender Daten) oder die Generierung synthetischer Daten nutzen, um die Lücken zu schließen.
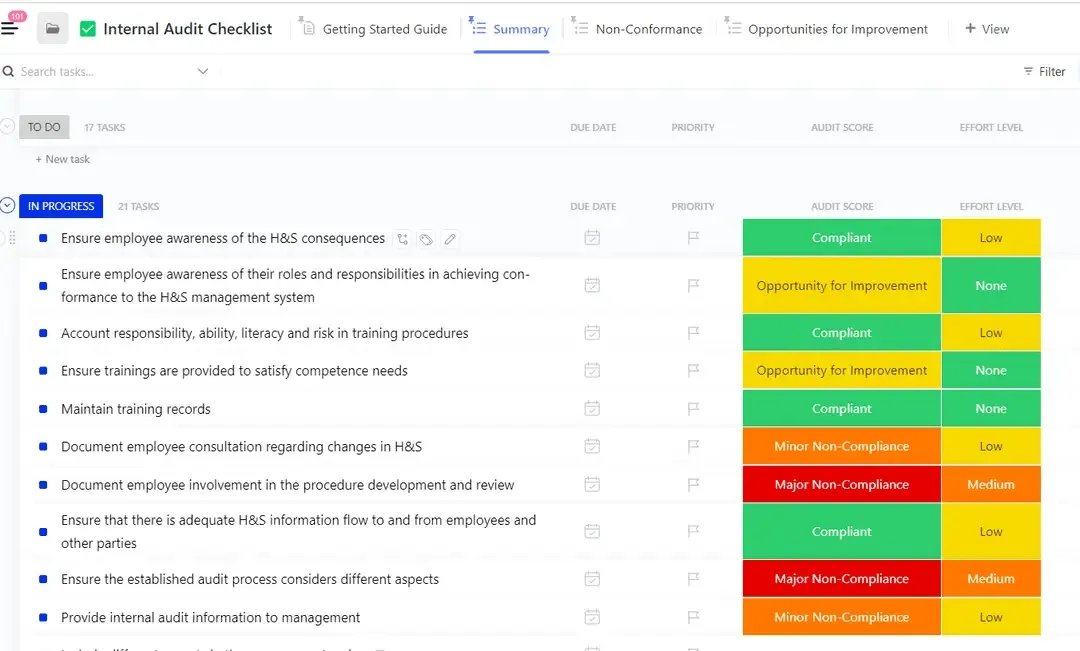
🚧 Toolkit: Nutzen Sie die Vorlage für eine interne Audit-Checkliste von ClickUp, um Ihren Audit-Prozess zu planen.
Modelle auf Verzerrungen testen
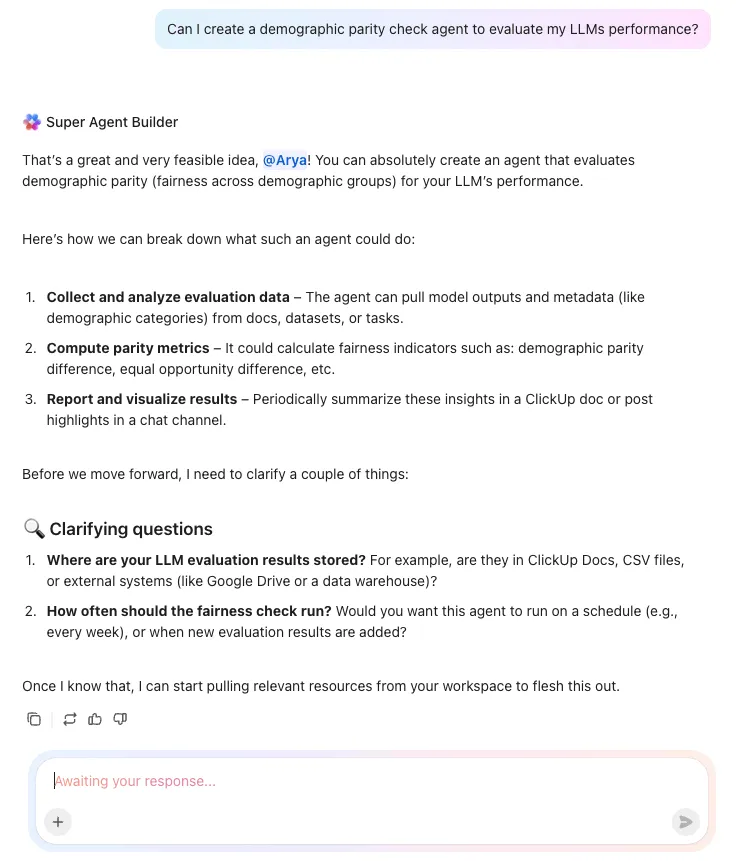
Sie müssen systematisch auf Verzerrungen prüfen, um diese zu erkennen, bevor sie echten Schaden anrichten. Verwenden Sie Fairness-Metriken, um zu messen, wie Ihr Modell bei verschiedenen Gruppen abschneidet.
Beispielsweise prüft die demografische Parität, ob das Modell in allen Gruppen mit gleicher Häufigkeit ein positives Ergebnis (wie beispielsweise eine Kreditbewilligung) liefert, während die Gleichheit der Wahrscheinlichkeiten prüft, ob die Fehlerquoten gleich sind.
Analysieren Sie die Leistung Ihres Modells nach allen möglichen demografischen Merkmalen – ethnische Zugehörigkeit, Geschlecht, Alter, geografische Lage –, um festzustellen, wo die Genauigkeit nachlässt oder Ungerechtigkeiten auftreten.
Den Menschen im System behalten
Automatisierte Systeme können subtile, kontextspezifische Ungerechtigkeiten übersehen, die ein Mensch sofort erkennen würde. Ein „Human-in-the-Loop“-Ansatz ist entscheidend für Entscheidungen mit hohen Risiken, bei denen eine KI zwar eine Empfehlung aussprechen kann, die endgültige Entscheidung jedoch von einem Menschen getroffen wird.
Dies ist besonders wichtig in Bereichen wie der Personalauswahl, der Kreditvergabe und der medizinischen Diagnostik. Damit dies funktioniert, müssen Ihre menschlichen Prüfer darin geschult sein, Verzerrungen zu erkennen, und die Befugnis haben, die Vorschläge der KI zu überstimmen.
Wenden Sie Techniken zur algorithmischen Fairness an
Sie können auch technische Methoden einsetzen, um direkt einzugreifen und Verzerrungen zu reduzieren. Diese Techniken lassen sich in drei Hauptkategorien einteilen:
- Vorverarbeitung: Dabei werden die Trainingsdaten bevor sie dem Modell zugeführt werden, angepasst – häufig durch Neugewichtung oder Resampling der Daten, um eine ausgewogenere Darstellung verschiedener Gruppen zu erzielen.
- In-Processing: Hier fügen Sie Fairness-Beschränkungen direkt in den Trainingsprozess des Modells ein und bringen ihm so bei, gleichzeitig sowohl Genauigkeit als auch Fairness zu optimieren.
- Nachbearbeitung: Dies bedeutet, die endgültigen Vorhersagen des Modells nach ihrer Erstellung anzupassen, um sicherzustellen, dass die Ergebnisse für alle Gruppen gerecht sind.
Diese Techniken sind oft mit Kompromissen verbunden, bei denen eine leichte Verringerung der Gesamtgenauigkeit erforderlich sein kann, um einen erheblichen Gewinn an Fairness zu erzielen.
💟 Bonus: BrainGPT ist Ihr KI-gestützter Desktop-Begleiter, der das Testen von KI-Voreingenommenheit auf die nächste Stufe hebt, indem er Ihnen Zugriff auf mehrere führende Modelle – darunter GPT-5, Claude, Gemini und weitere – an einem Ort bietet.
Das bedeutet, dass Sie dieselben Eingabeaufforderungen oder Szenarien problemlos in verschiedenen Modellen ausführen, deren Schlussfolgerungsfähigkeiten vergleichen und erkennen können, wo die Antworten voneinander abweichen oder Verzerrungen aufweisen. Mit dieser KI-Super-App können Sie außerdem die Sprach-zu-Text-Funktion nutzen, um Testfälle einzurichten, Ihre Erkenntnisse zu dokumentieren und die Ergebnisse für eine Gegenüberstellung zu organisieren.
Dank fortschrittlicher Schlussfolgerungsmechanismen und kontextbezogener Tools können Sie Probleme beheben, Muster erkennen und nachvollziehen, wie jedes Modell mit sensiblen Themen umgeht. Durch die Zentralisierung Ihres Workflows und die Ermöglichung transparenter Tests mit mehreren Modellen versetzt Brain MAX Sie in die Lage, Verzerrungen in der KI mit Sicherheit und Präzision zu prüfen, zu vergleichen und zu beheben.
Steigern Sie Transparenz und Erklärbarkeit
Wenn Sie nicht wissen, wie Ihr Modell Entscheidungen trifft, können Sie es nicht korrigieren, wenn es Fehler macht. Techniken der erklärbaren KI (XAI) helfen Ihnen dabei, einen Blick in die „Black Box“ zu werfen und zu erkennen, welche Daten-Features die Vorhersagen beeinflussen.
Sie können außerdem Modellkarten erstellen, die wie Beschreibungen der Nährwerte für Ihre KI sind und deren Verwendungszweck, Leistungsdaten sowie bekannte Limite dokumentieren.
📮ClickUp Insight: 13 % unserer Umfrageteilnehmer möchten KI nutzen, um schwierige Entscheidungen zu treffen und komplexe Probleme zu lösen. Allerdings geben nur 28 % an, KI regelmäßig bei der Arbeit einzusetzen. Ein möglicher Grund: Bedenken hinsichtlich der Sicherheit!
Benutzer möchten möglicherweise keine sensiblen Entscheidungsdaten an eine externe KI freigeben.
ClickUp löst dieses Problem, indem es KI-gestützte Problemlösungen direkt in Ihren sicheren ClickUp-Workspace integriert. Von SOC 2 bis hin zu ISO-Standards – ClickUp erfüllt die höchsten Standards der Datensicherheit und hilft Ihnen dabei, generative KI-Technologie sicher in Ihrem gesamten Workspace einzusetzen.
Richtlinien zur KI-Governance und Rechenschaftspflicht
Ein starkes KI-Governance-Programm schafft klare Zuständigkeiten und einheitliche Standards, an die sich alle Teammitglieder halten können.
Ihr Unternehmen benötigt klare Governance-Strukturen, um sicherzustellen, dass stets jemand für die ethische Entwicklung und den Einsatz von KI verantwortlich ist.
Hier sind die wesentlichen Elemente eines effektiven KI-Governance-Programms:
| Governance-Aspekt | Was das bedeutet | Schritte für Ihr Unternehmen |
|---|---|---|
| Klare Eigentümerschaft | Speziell dafür zuständige Personen oder Teams sind für KI-Ethik, Überwachung und Compliance verantwortlich. | • Ernennen Sie einen Verantwortlichen für KI-Ethik oder richten Sie einen funktionsübergreifenden Ausschuss ein. • Legen Sie Zuständigkeiten für Daten, Modellqualität, Compliance und Risiken fest. • Beziehen Sie Vertreter aus den Bereichen Recht, Technik, Produktentwicklung und DEI in die Aufsicht ein. |
| Dokumentierte Richtlinien | Schriftliche Richtlinien, die festlegen, wie Daten über den gesamten KI-Lebenszyklus hinweg erhoben, genutzt und überwacht werden | • Erstellen Sie interne Richtlinien für die Datenquellen, die Datenkennzeichnung, den Datenschutz und die Aufbewahrung von Daten • Dokumentieren Sie Standards für die Modellentwicklung, -validierung und -bereitstellung • Verpflichten Sie die Teams, vor der Auslieferung eines KI-Systems eine Checkliste zu befolgen |
| Prüfpfade | Eine transparente Dokumentation von Entscheidungen, Versionen von Modellen, Datensätzen und Änderungen | • Implementieren Sie eine Versionskontrolle für Datensätze und Modelle • Protokollieren Sie wichtige Entscheidungen, Modellparameter und Überprüfungsergebnisse • Speichern Sie Prüfpfade in einem zentralen, leicht zugänglichen Repository |
| Regelmäßige Überprüfungen | Laufende Bewertungen von KI-Systemen zur Überprüfung auf Verzerrungen, Abweichungen und Compliance-Lücken | • Planen Sie vierteljährliche oder halbjährliche Verzerrungsbewertungen mithilfe einer fundierten LLM-Evaluierung ein. • Trainieren Sie Modelle neu oder kalibrieren Sie sie neu, wenn die Leistung nachlässt oder sich das Verhalten ändert. • Überprüfen Sie Modelle nach größeren Datenaktualisierungen oder Produktänderungen. |
| Plan zur Reaktion auf Incidents | Ein klares Protokoll zur Identifizierung, Berichterstellung und Korrektur von Verzerrungen oder Schäden durch KI | • Richten Sie einen internen EskalationsWorkflow für Verzerrungen ein. • Legen Sie fest, wie Probleme untersucht werden und wer Korrekturen genehmigt. • Legen Sie Kommunikationsschritte für Benutzer, Kunden oder Aufsichtsbehörden fest, falls erforderlich. |
💡Profi-Tipp: Rahmenwerke wie das NIST-Rahmenwerk für KI-Risikomanagement und das EU-KI-Gesetz, das Geldstrafen von bis zu 7 % des Jahresumsatzes vorsieht, können hervorragende Vorlagen für den Aufbau Ihres eigenen Governance-Programms bieten.
So setzen Sie Maßnahmen zur Verringerung von Verzerrungen mit ClickUp um
Der konvergierte KI-Workspace von ClickUp vereint alle Komponenten Ihres KI-Governance-Programms in einem übersichtlichen Workspace.
Ihre Teams können Aufgaben verwalten, Richtlinien speichern, Prüfungsergebnisse überprüfen, Risiken besprechen und Incidents nachverfolgen, ohne zwischen verschiedenen Tools hin- und herwechseln zu müssen oder den Kontext aus den Augen zu verlieren. Jeder Modelldatensatz, jedes Entscheidungsprotokoll und jeder Plan für Abhilfemaßnahmen bleiben miteinander verknüpft, sodass Sie stets wissen, wer was getan hat und warum.
Und da die KI von ClickUp die Abläufe in Ihrem Workspace versteht, kann sie frühere Bewertungen aufgreifen, umfangreiche Berichte zusammenfassen und Ihrem Team helfen, bei sich weiterentwickelnden Standards auf dem Laufenden zu bleiben. Das Ergebnis ist ein Governance-System, das einfacher zu befolgen, leichter zu prüfen und weitaus zuverlässiger ist, je mehr Ihre KI-Aktivitäten zunehmen.
Lassen Sie uns das als Workflow aufschlüsseln!
Schritt 1: Richten Sie Ihren KI-Governance-Workspace ein
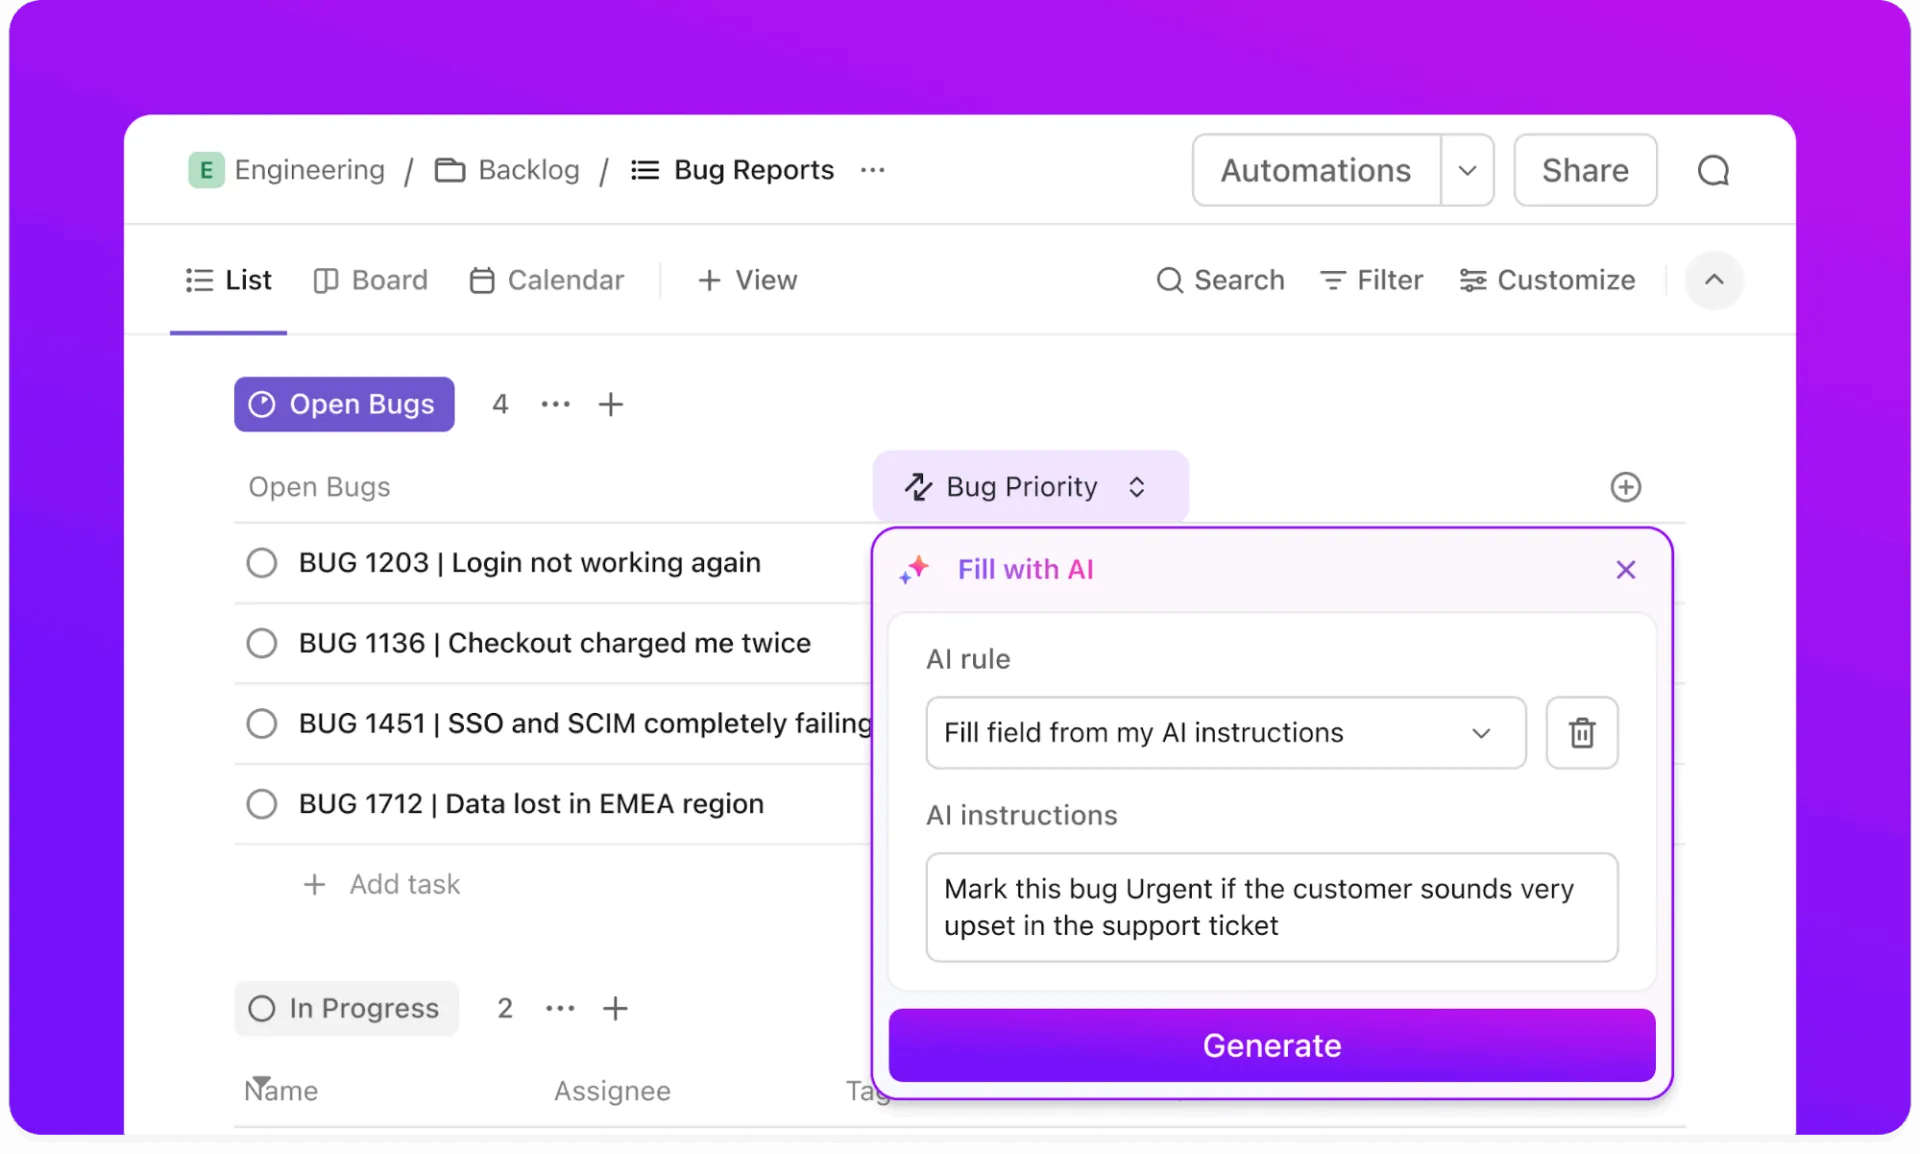
Richten Sie zunächst in ClickUp einen eigenen Bereich für alle Governance-bezogenen Aufgaben ein. Fügen Sie Listen für Ihr Modellinventar, Verzerrungsbewertungen, Vorfallberichte, Richtliniendokumente und geplante Überprüfungen hinzu, damit alle Elemente des Programms in einer kontrollierten Umgebung zusammengefasst sind.
Konfigurieren Sie benutzerdefinierte Felder oder KI-Felder, um Fairness-Metriken, Verzerrungswerte, Modellversionen, Überprüfungsstatus und Risikostufen zu erfassen. Nutzen Sie rollenbasierte Berechtigungen, um sicherzustellen, dass nur autorisierte Prüfer, Entwickler und Compliance-Verantwortliche Zugriff auf sensible KI-Arbeiten haben. Damit schaffen Sie eine strukturelle Grundlage, die punktuelle Tools von Mitbewerbern und generische Projektplattformen nicht bieten können.
Schritt 2: Erstellen Sie Ihr Governance-Rahmenwerk
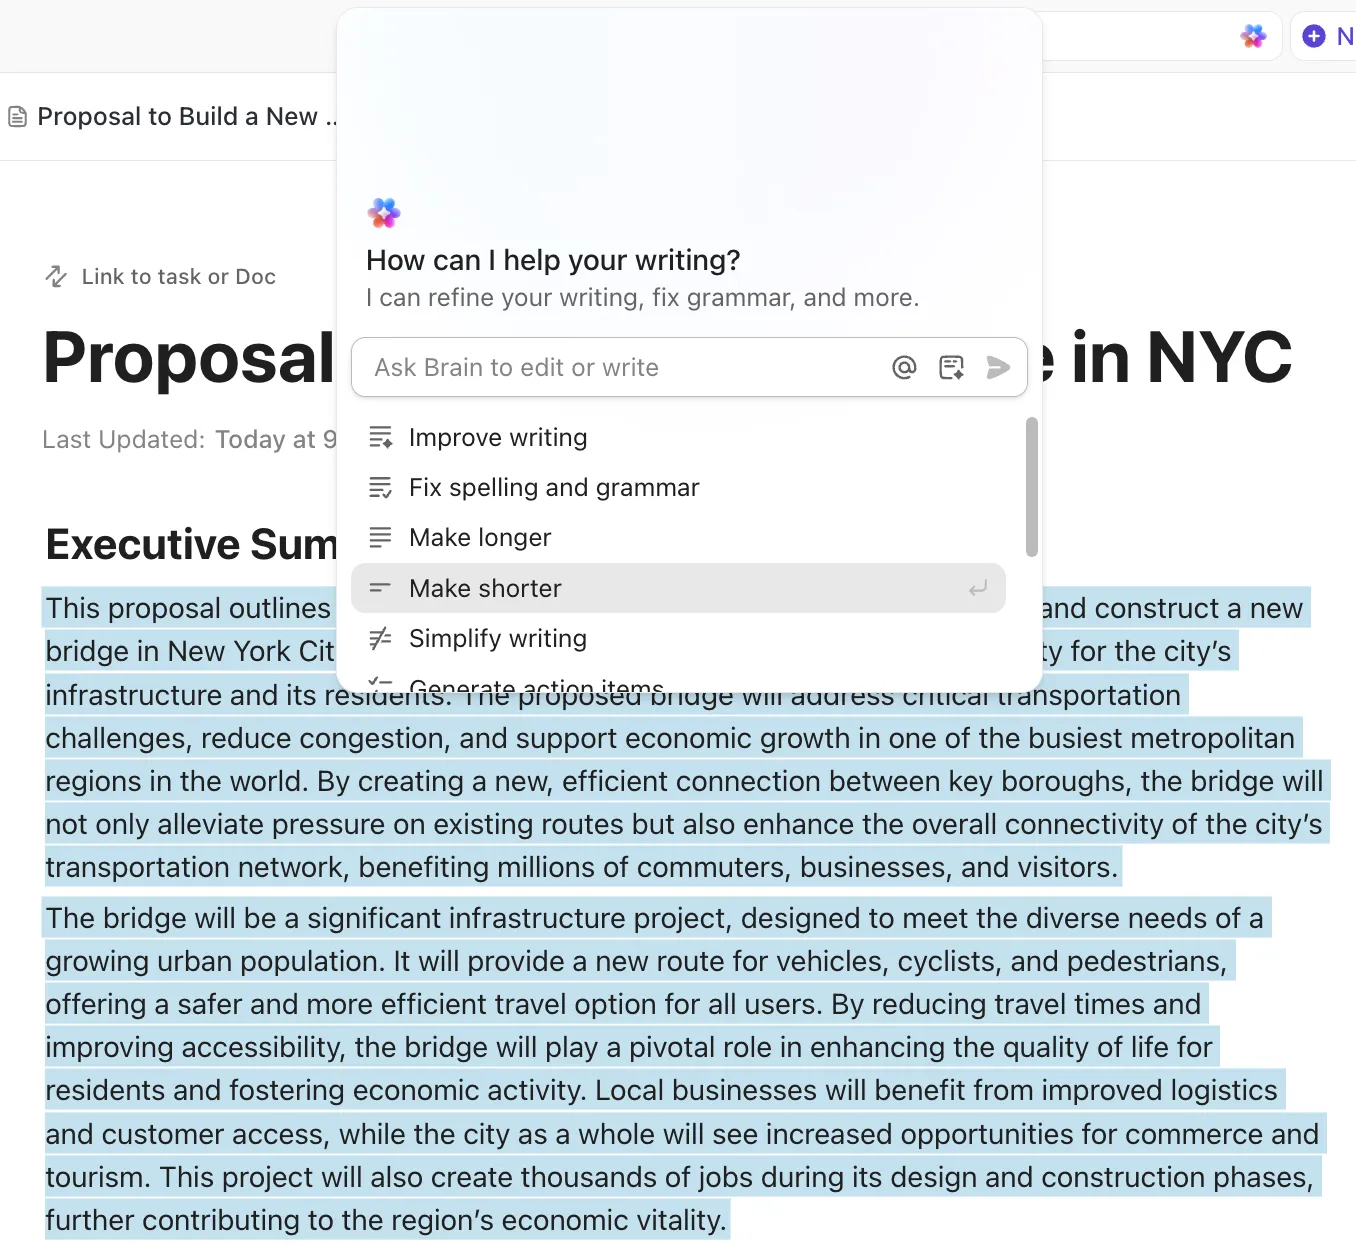
Erstellen Sie anschließend ein ClickUp-Dokument, das als Ihr dynamisches Governance-Handbuch dient. Darin legen Sie Ihre Verfahren zur Bewertung von Verzerrungen, Fairness-Schwellenwerte, Richtlinien zur Modelldokumentation, „Human-in-the-Loop“-Schritte und Eskalationsprotokolle fest.
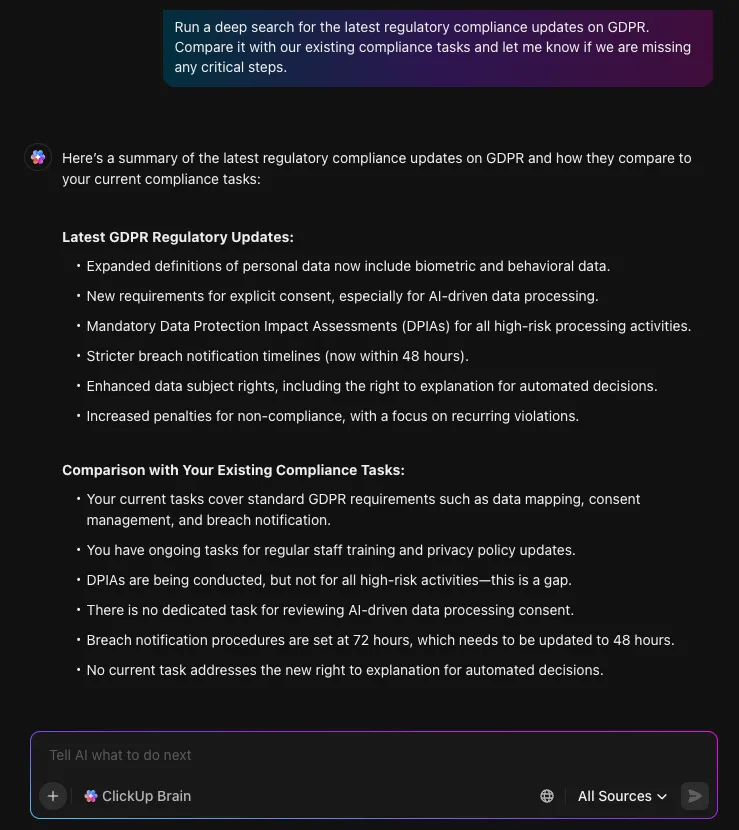
Da Dokumente mit Aufgaben und Modelldatensätzen verbunden bleiben, können Ihre Teams zusammenarbeiten, ohne den Versionsverlauf zu verlieren oder Dateien über verschiedene Tools zu verstreuen. Darüber hinaus kann ClickUp Brain dabei helfen, externe Vorschriften zusammenzufassen, neue Richtlinienformulierungen zu entwerfen oder frühere Prüfungsergebnisse aufzudecken, wodurch die Erstellung von Richtlinien konsistenter und nachvollziehbarer wird.
Da das System das Internet durchsuchen, zwischen verschiedenen KI-Modellen wechseln und Informationen zu klaren Leitlinien zusammenfassen kann, bleibt Ihr Team über neue Standards und Branchenveränderungen auf dem Laufenden, ohne den Workspace verlassen zu müssen. Alles, was Sie benötigen – Aktualisierungen von Richtlinien, Einblicke in regulatorische Rahmenbedingungen und frühere Entscheidungen – ist an einem Ort zusammengefasst, wodurch Ihr Governance-System stabiler und wesentlich einfacher zu verwalten ist.
Schritt 3: Registrieren Sie jedes Modell
Jedes Modell sollte in der Liste „Modellverzeichnis“ eine eigene Aufgabe haben, damit Eigentümerschaft und Verantwortlichkeiten stets klar sind.
Verfolgen Sie jeden Vorfall von Voreingenommenheit ganz einfach als umsetzbares Element, indem Sie ClickUp-Aufgaben und ClickUp-Benutzerdefinierte Felder nutzen, um Ihre Workflows zur Bewertung von Voreingenommenheit zu strukturieren und jedes wichtige Detail zu erfassen.
Auf diese Weise können Sie die Art der Verzerrung, den Schweregrad, den Status der Behebung, das zuständige Teammitglied und das nächste Überprüfungsdatum nachverfolgen und so sicherstellen, dass für jedes Problem eine klare Eigentümerschaft und eine Frist festgelegt sind.
Fügen Sie Datensätze, Auswertungszusammenfassungen und Herkunftsnotizen bei, damit alles an einem Ort gesammelt ist. Automatisierungen können die Prüfer dann benachrichtigen, sobald ein Modell in die Phase Staging oder Produktionsumgebung überführt wird.
Schritt 4: Führen Sie planmäßige und ereignisgesteuerte Verzerrungsprüfungen durch
Voreingenommenheitsprüfungen sollten sowohl regelmäßig als auch als Reaktion auf bestimmte Auslöser stattfinden.
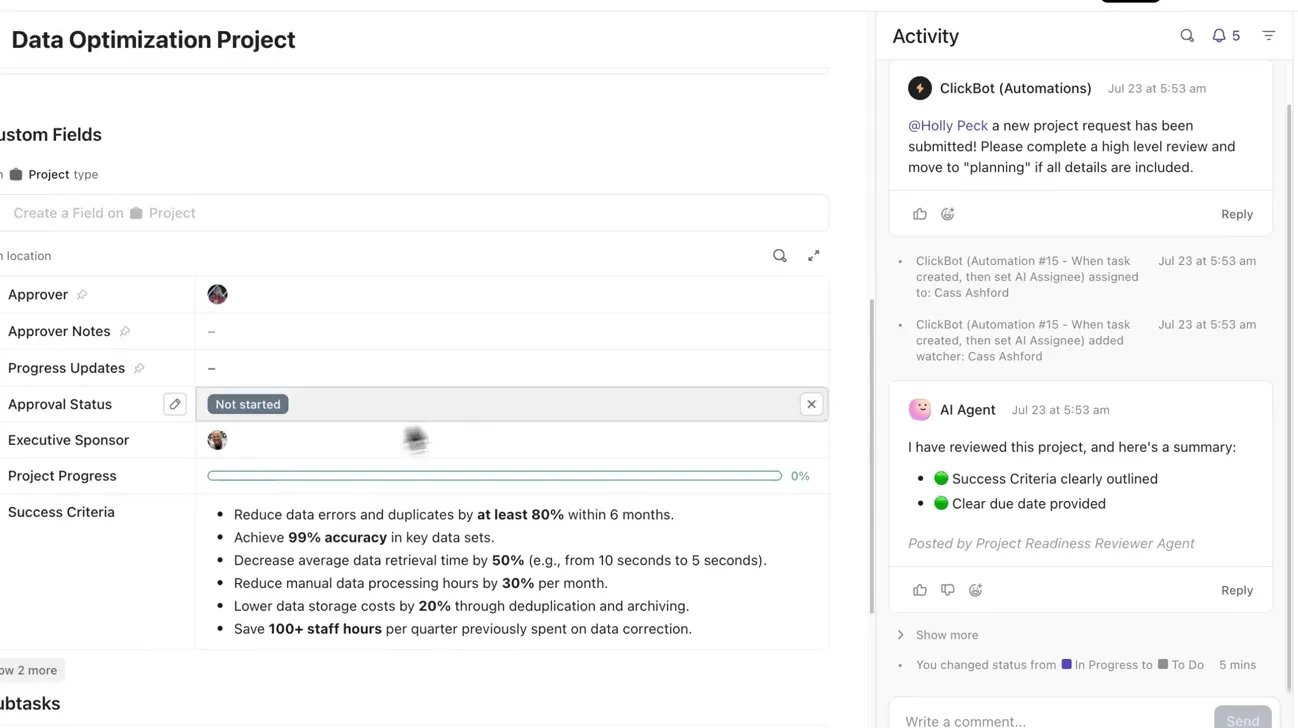
Richten Sie über ClickUp-Automatisierungen einfache Regeln ein, die automatisch Überprüfungsaufgaben als Auslöser auslösen, sobald ein Modell einen neuen Meilenstein der Bereitstellung erreicht oder eine geplante Prüfung fällig ist. Sie werden nie wieder eine vierteljährliche Bias-Bewertung verpassen, da die Automatisierungen die richtigen Prüfer zuweisen, die korrekten Fristen festlegen und sogar Erinnerungen versenden können, wenn sich Fälligkeitsdaten nähern.

Bei ereignisbasierten Audits erleichtern ClickUp-Formulare das Erfassen von Berichten über Voreingenommenheitsvorfälle oder menschlichem Feedback, während Prüfer mithilfe von benutzerdefinierten Feldern Fairnesslücken, Testergebnisse und Empfehlungen protokollieren können. Jede Formularübermittlung wird als Aufgabe an Ihr Team weitergeleitet, wodurch ein wiederholbarer Audit-Prozess entsteht.
Schritt 5: Incidents von Verzerrungen untersuchen und beheben
Wenn ein Voreingenommenheitsproblem identifiziert wird, erstellen Sie eine Incident-Aufgabe, in der der Schweregrad, die betroffenen Gruppen, die Version des Modells und die erforderlichen Abhilfemaßnahmen erfasst werden. KI-Agenten können hochriskante Befunde an Compliance-Verantwortliche eskalieren und die richtigen Prüfer und Ingenieure zuweisen.
Jede Abhilfemaßnahme, jedes Ergebnis des Tests und jeder Validierungsschritt bleibt mit dem Incident-Bericht verknüpft. ClickUp Brain kann Zusammenfassungen für die Führungskräfte erstellen oder bei der Erstellung von Abhilfemaßnahmen für Ihre Governance-Dokumentation helfen, sodass alles transparent und nachvollziehbar bleibt.
Schritt 6: Überwachen Sie den Zustand Ihres KI-Governance-Programms
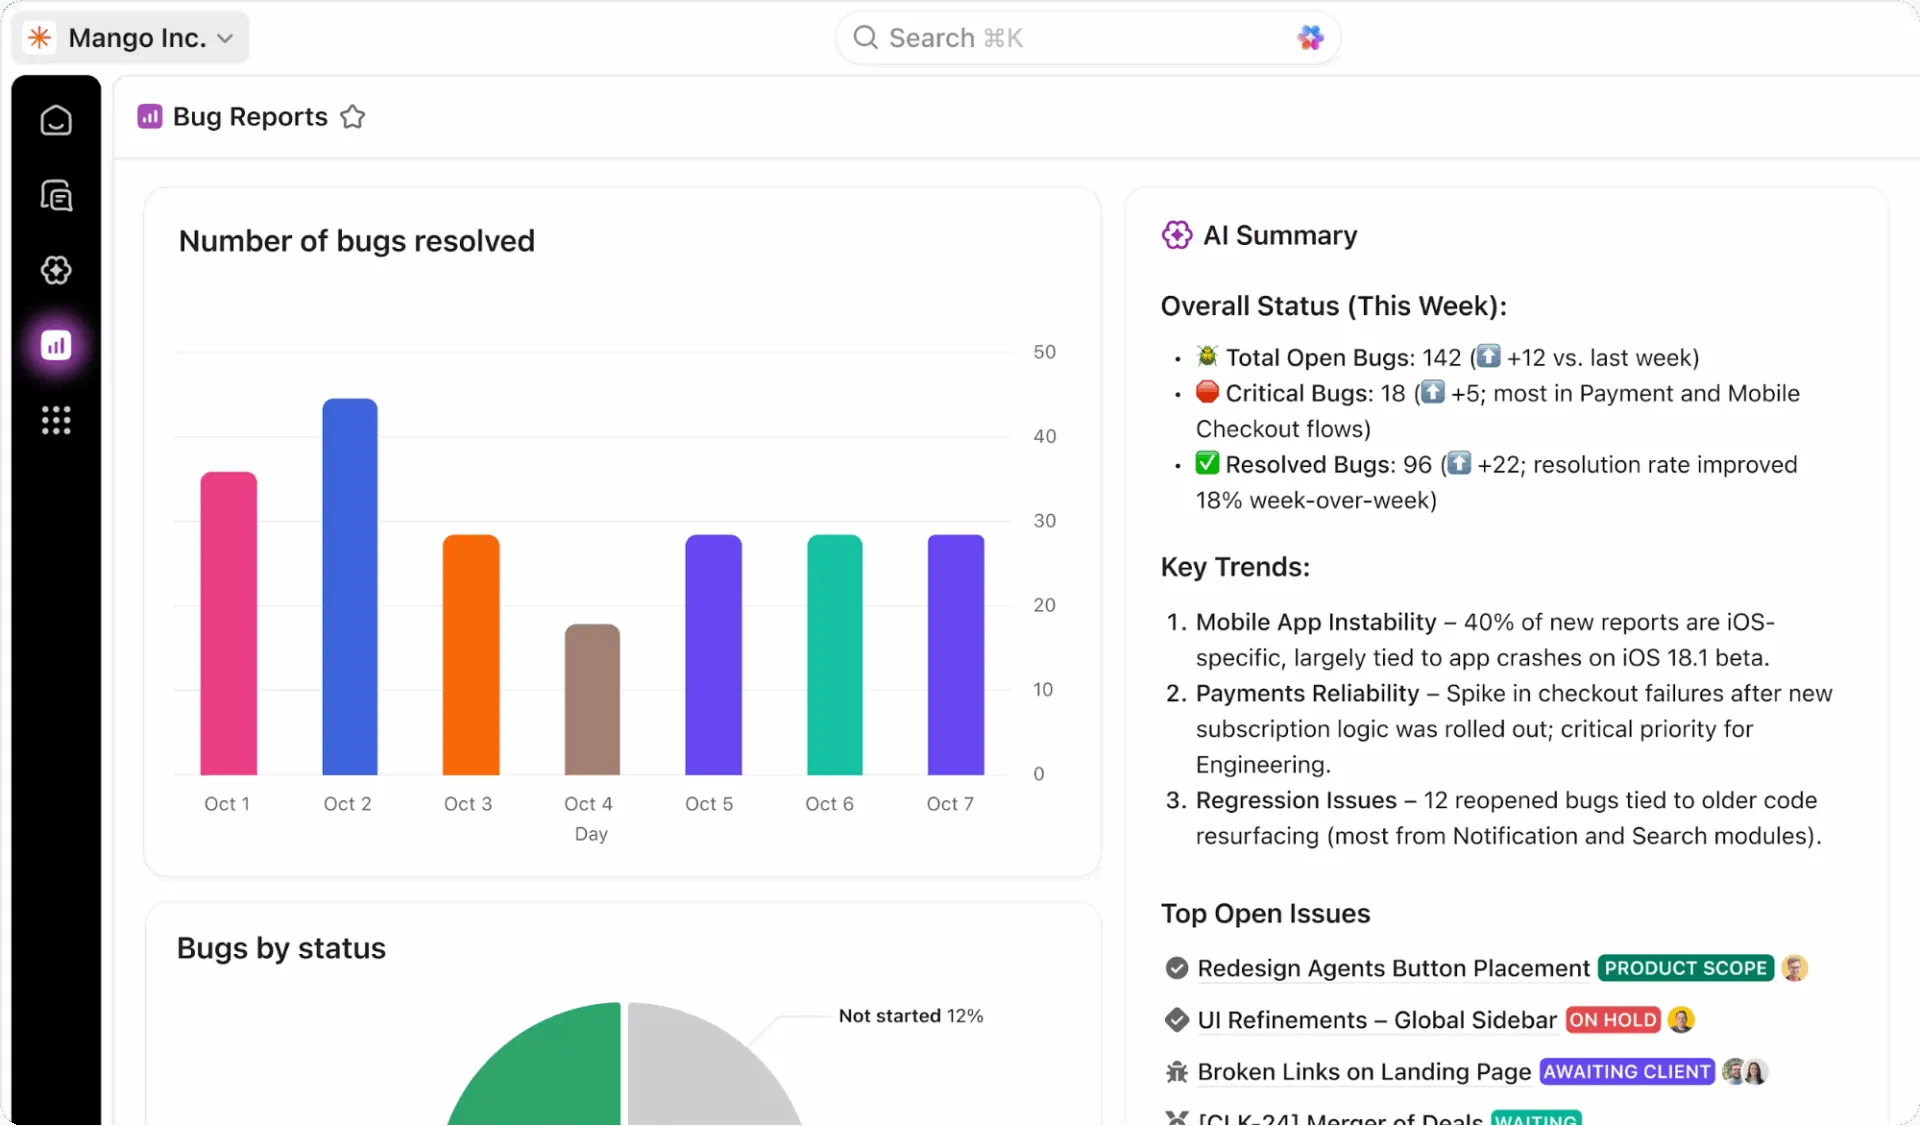
Erstellen Sie schließlich Dashboards, die Führungskräften eine Echtzeit-Ansicht über Ihr Programm zur Verringerung von Verzerrungen bieten.
Fügen Sie Übersichten hinzu, die offene Incidents, die Zeit bis zur Lösung, die Abschlussquoten von Audits, Fairness-Metriken und den Compliance-Status für alle aktiven Modelle anzeigen. Die No- Code-Dashboards in ClickUp können Daten automatisch abrufen und Aufgaben im Laufe der Arbeit aktualisieren, wobei KI-Zusammenfassungen in Ihre Dashboard-Ansicht integriert sind.
📖 Weiterlesen: So meistern Sie häufige KI-Herausforderungen
Verzerrungsprüfungen nach der Bereitstellung
Ihre Arbeit ist noch nicht erledigt, wenn das KI-Modell in Betrieb genommen wird.
Tatsächlich beginnt hier erst die eigentliche Bewährungsprobe. Modelle können im Laufe der Zeit „abdriften“ und neue Verzerrungen entwickeln, wenn sich die realen Daten, mit denen sie gefüttert werden, verändern. Nur durch kontinuierliche Überwachung lassen sich diese aufkommenden Verzerrungen erkennen, bevor sie weitreichenden Schaden anrichten.
Ihre kontinuierliche Überwachung sollte Folgendes umfassen:
| Praxis | Was dies gewährleistet |
|---|---|
| Nachverfolgung der Leistung nach Gruppen | Misst kontinuierlich die Genauigkeit und Fairness von Modellen über verschiedene demografische Segmente hinweg, damit Ungleichheiten frühzeitig erkannt werden |
| Erkennung von Datenverschiebungen | Überwacht Änderungen an den Eingabedaten, die im Laufe der Zeit neue Verzerrungen verursachen oder die Modellleistung beeinträchtigen könnten |
| Feedbackschleifen der Benutzer | Bietet Benutzern klare Möglichkeiten für die Berichterstellung über voreingenommene oder fehlerhafte Ergebnisse, und verbessert so die Kontrolle in der Praxis. |
| Geplante Audits | Gewährleistet vierteljährliche oder halbjährliche eingehende Analysen des Modellverhaltens, der Fairness-Metriken und der Compliance-Anforderungen |
| Reaktion auf Incidents | Definiert einen strukturierten Prozess zur Untersuchung, Korrektur und Dokumentation aller gemeldeten Ereignisse von Verzerrungen |
💟 Bonus: Insbesondere generative KI-Systeme erfordern besondere Wachsamkeit, da ihre Ergebnisse weitaus weniger vorhersehbar sind als bei herkömmlichen Modellen des maschinellen Lernens. Eine hervorragende Methode hierfür ist das Red-Teaming, bei dem ein spezielles Team aktiv versucht, voreingenommene oder schädliche Reaktionen des Modells zu provozieren, um dessen Schwachstellen aufzudecken.
Das „Projekt Lighthouse“ von Airbnb ist beispielsweise ein hervorragendes Beispiel aus der Branche, in der ein Unternehmen eine systematische Überwachung von Verzerrungen nach der Implementierung durchführt.
Es handelt sich um eine Forschungsinitiative, die untersucht, wie sich die wahrgenommene ethnische Zugehörigkeit auf Buchungsergebnisse auswirken kann, und die dem Unternehmen dabei hilft, Diskriminierung auf der Plattform zu erkennen und zu reduzieren. Dabei kommen datenschutzkonforme Methoden zum Einsatz, es wird mit Bürgerrechtsgruppen zusammengearbeitet und die Ergebnisse werden in Produkt- und Richtlinienänderungen umgesetzt, sodass mehr Gäste die Plattform nutzen können, ohne auf unsichtbare Hürden zu stoßen.
Voreingenommenheit bei KI mit ClickUp mindern
Der Aufbau einer fairen und rechenschaftspflichtigen KI ist eine organisatorische Verpflichtung.
Wenn Ihre Richtlinien, Mitarbeiter, Prozesse und Tools harmonisch zusammenwirken, schaffen Sie ein Governance-System, das sich an neue Risiken anpassen, schnell auf Incidents reagieren und das Vertrauen der Menschen gewinnen kann, die sich auf Ihre Produkte verlassen.
Durch strukturierte Überprüfungen, klare Dokumentation und einen wiederholbaren Workflow zum Umgang mit Verzerrungen bleiben Teams aufeinander abgestimmt und übernehmen Verantwortung, anstatt erst im Krisenmodus zu reagieren.
Indem Sie alles in ClickUp zentralisieren – von Modellprotokollen über Audit-Ergebnisse bis hin zu Incidents –, schaffen Sie eine einheitliche operative Ebene, auf der Entscheidungen transparent sind, Verantwortlichkeiten klar definiert sind und Verbesserungsmaßnahmen nicht untergehen.
Eine starke Governance bremst die Innovation nicht, sondern stabilisiert sie. Sind Sie bereit, die Verringerung von Verzerrungen in Ihre KI-Workflows zu integrieren? Starten Sie kostenlos mit ClickUp und beginnen Sie noch heute mit dem Aufbau Ihres KI-Governance-Programms.
Häufig gestellte Fragen
Was ist der erste Schritt zur Minderung von Verzerrungen durch KI?
Ein guter erster Schritt ist die Durchführung eines Bias-Audits Ihrer bestehenden KI-Systeme. Diese Bestandsaufnahme zeigt Ihnen, wo derzeit Ungerechtigkeiten bestehen, und hilft Ihnen dabei, Prioritäten für den Aufwand zur Minderung dieser Verzerrungen zu setzen.
Wie messen Teams Verzerrungen und Fairness in der KI?
Teams verwenden spezifische Fairness-Metriken wie demografische Parität, ausgeglichene Chancen und das Disparate-Impact-Verhältnis, um Verzerrungen zu quantifizieren. Die richtige Metrik hängt von Ihrem konkreten Anwendungsfall und der Art der Fairness ab, die in diesem Kontext am wichtigsten ist.
Wann sollten Teams eine Überprüfung durch Menschen („Human-in-the-Loop“) einführen?
Bei Entscheidungen mit hohen Risiken, die das Leben oder die Chancen einer Person erheblich beeinflussen – beispielsweise bei der Personalauswahl, der Kreditvergabe oder im Gesundheitswesen –, sollten Sie stets einen Schritt zur Überprüfung durch Menschen einbauen. Es ist zudem ratsam, dies bereits in der frühen Phase der Einführung eines neuen Modells zu tun, wenn dessen Verhalten noch unvorhersehbar ist.
Inwiefern unterscheidet sich die Erkennung von Verzerrungen bei generativer KI?
Da generative KI einen nahezu unendlichen Bereich an unvorhersehbaren Antworten erzeugen kann, reicht es nicht aus, lediglich die Genauigkeit zu überprüfen. Sie müssen aktive Testverfahren wie Red-Teaming und groß angelegte Ausgabestichproben einsetzen, um herauszufinden, ob das Modell unter verschiedenen Bedingungen voreingenommene Inhalte erzeugt.