
IT-rampen kunnen zonder waarschuwing toeslaan.
Van servercrashes tot cyberaanvallen – zonder een gedegen herstelplan kan uw bedrijf te maken krijgen met urenlange uitval, gegevensverlies en ernstige financiële schade. 54% van de ernstige storingen kost namelijk meer dan 100.000 dollar.
In deze blog wordt stap voor stap uitgelegd hoe u een uitgebreid IT-rampherstelplan opstelt dat uw systemen beschermt, duidelijke hersteldoelstellingen vastlegt en ervoor zorgt dat uw team precies weet wat het moet doen als er iets misgaat.
Wat is een IT-rampherstelplan?
Als uw servers nu zouden crashen, zou uw team dan precies weten wat er nog te doen is? 🛠️
Een IT-rampherstelplan (DR-plan) is uw gedocumenteerde strategie voor het herstellen van IT-systemen en gegevens na een storing – van natuurrampen tot cyberaanvallen. Het is in feite uw draaiboek om de technologie weer online te krijgen wanneer er iets misgaat.
💡 DR versus bedrijfscontinuïteit
Disaster recovery (DR) richt zich specifiek op het herstellen van uw IT-infrastructuur en gegevens. Bedrijfscontinuïteit (BC) is breder van opzet en heeft tot doel uw hele bedrijf operationeel te houden tijdens en na een crisis, zelfs als de IT uitvalt. Beschouw DR als een sleutelelement van uw algehele BC-strategie.
💡 DR versus bedrijfscontinuïteit
Disaster recovery (DR) richt zich specifiek op het herstellen van uw IT-infrastructuur en gegevens. Bedrijfscontinuïteit (BC) is breder van opzet en heeft tot doel uw hele bedrijf operationeel te houden tijdens en na een crisis, zelfs als de IT uitvalt. Beschouw DR als een sleutelelement van uw algehele BC-strategie.
Uw noodherstelplan is van groot belang, want downtime kost meer dan alleen geld. Elke minuut dat uw systemen offline zijn, kan het vertrouwen van klanten ondermijnen, de bedrijfsvoering verstoren en zelfs leiden tot boetes wegens niet-naleving. Een uitgebreid noodherstelplan is uw routekaart naar veerkracht.
Een goed plan omvat:
- Procedures voor back-ups van gegevens: hoe en waar u kopieën van kritieke informatie opslaat, zodat u deze kunt herstellen
- Stappen voor systeemherstel: De exacte volgorde om diensten in de juiste volgorde weer online te brengen
- Verantwoordelijkheden van het team: Wie doet wat tijdens een incident om verwarring te voorkomen?
- Communicatieprotocollen: Hoe u belanghebbenden op de hoogte houdt, van uw team tot uw klanten
- Hersteldoelstellingen: Uw specifieke doelstellingen met betrekking tot hoe snel systemen weer operationeel moeten zijn en hoeveel gegevensverlies aanvaardbaar is
Veelvoorkomende IT-rampscenario’s en de gevolgen daarvan
Rampen zijn niet alleen scenario's uit Hollywood; ze overkomen bedrijven elke dag. Als u begrijpt waartegen u zich beschermt, kunt u een veel sterkere verdediging opbouwen.
Natuurrampen en materiële schade
Gebeurtenissen zoals overstromingen, branden, aardbevingen en grootschalige stroomuitval kunnen binnen enkele minuten complete datacenters vernietigen. Bijvoorbeeld toen een grootschalige overstroming een datacenter in Nashville trof, verloren sommige bedrijven weken aan gegevens en stonden ze maandenlang herstelwerk te wachten. De beste bescherming hiertegen is geografische redundantie, wat inhoudt dat u uw infrastructuur over meerdere fysieke locaties verspreidt, zodat één gebeurtenis niet alles plat kan leggen.
Cyberaanvallen en gegevenslekken
Ransomware, Distributed Denial-of-Service (DDoS)-aanvallen en datalekken verschillen van fysieke rampen. Ze zijn vaak moeilijker te detecteren, kunnen zich onopgemerkt verspreiden via verbindingen met andere systemen en richten zich vaak ook op uw back-up-systemen, waardoor herstel bijzonder uitdagend is. De frequentie en complexiteit van deze cyberaanvallen blijven in alle sectoren toenemen. Ransomware speelt inmiddels een rol bij 44% van alle bevestigde datalekken, waardoor het een van de grootste bedreigingen is geworden.
Hardwarefouten en gegevensverlies
Soms gaan zelfs de meest geteste en betrouwbare back-upsystemen gewoon kapot. Servercrashes, storingen aan de opslagruimte en defecten aan netwerkapparatuur kunnen zonder waarschuwing optreden. Zelfs als u over redundante (back-up)systemen beschikt, kunnen deze toch tegelijkertijd uitvallen als ze gemeenschappelijke componenten of stroombronnen delen, waardoor er één enkel storingspunt ontstaat.
👀 Wist u dat: In oktober 2025 kreeg AWS te maken met een grote storing toen een bug in het interne DNS-beheersysteem voor Amazon DynamoDB ervoor zorgde dat de domeinnaamresolutie in de datacenterregio US-EAST-1 uitviel. Dit ‘kleine’ technische defect triggerde een kettingreactie van storingen bij tientallen AWS-services en legde wereldwijd honderden populaire apps en platforms plat — van berichten- en sociale apps tot banken, gamesites en meer. Voor veel mensen zorgde de storing ervoor dat een groot deel van het internet tijdelijk ‘verdween’, wat duidelijk maakte hoe kwetsbaar onze digitale infrastructuur is wanneer zoveel afhankelijk is van een handvol cloudproviders.
Softwarefouten en dienstonderbrekingen
Een beschadigde database, een mislukte software-update of een simpele configuratiefout kan hele platforms platleggen. U zult wellicht merken dat één verkeerd geconfigureerde regel code een kettingreactie kan veroorzaken in systemen met verbinding, wat leidt tot een grootschalige storing met een enorme impact. Goed wijzigingsbeheer en speciale testomgevingen zijn uw beste bondgenoten bij het minimaliseren van deze risico's.
Menselijke fouten en verkeerde configuraties
Onbedoeld verwijderen, onjuiste configuraties en ongeautoriseerde wijzigingen blijven een van de meest voorkomende oorzaken van IT-storingen. Eén verkeerd commando of een verwijderd bestand kan al urenlange downtime en een verslechtering van de dienstverlening triggeren. Hoewel training en toegangscontroles helpen, kunnen ze menselijke fouten niet volledig uitsluiten.
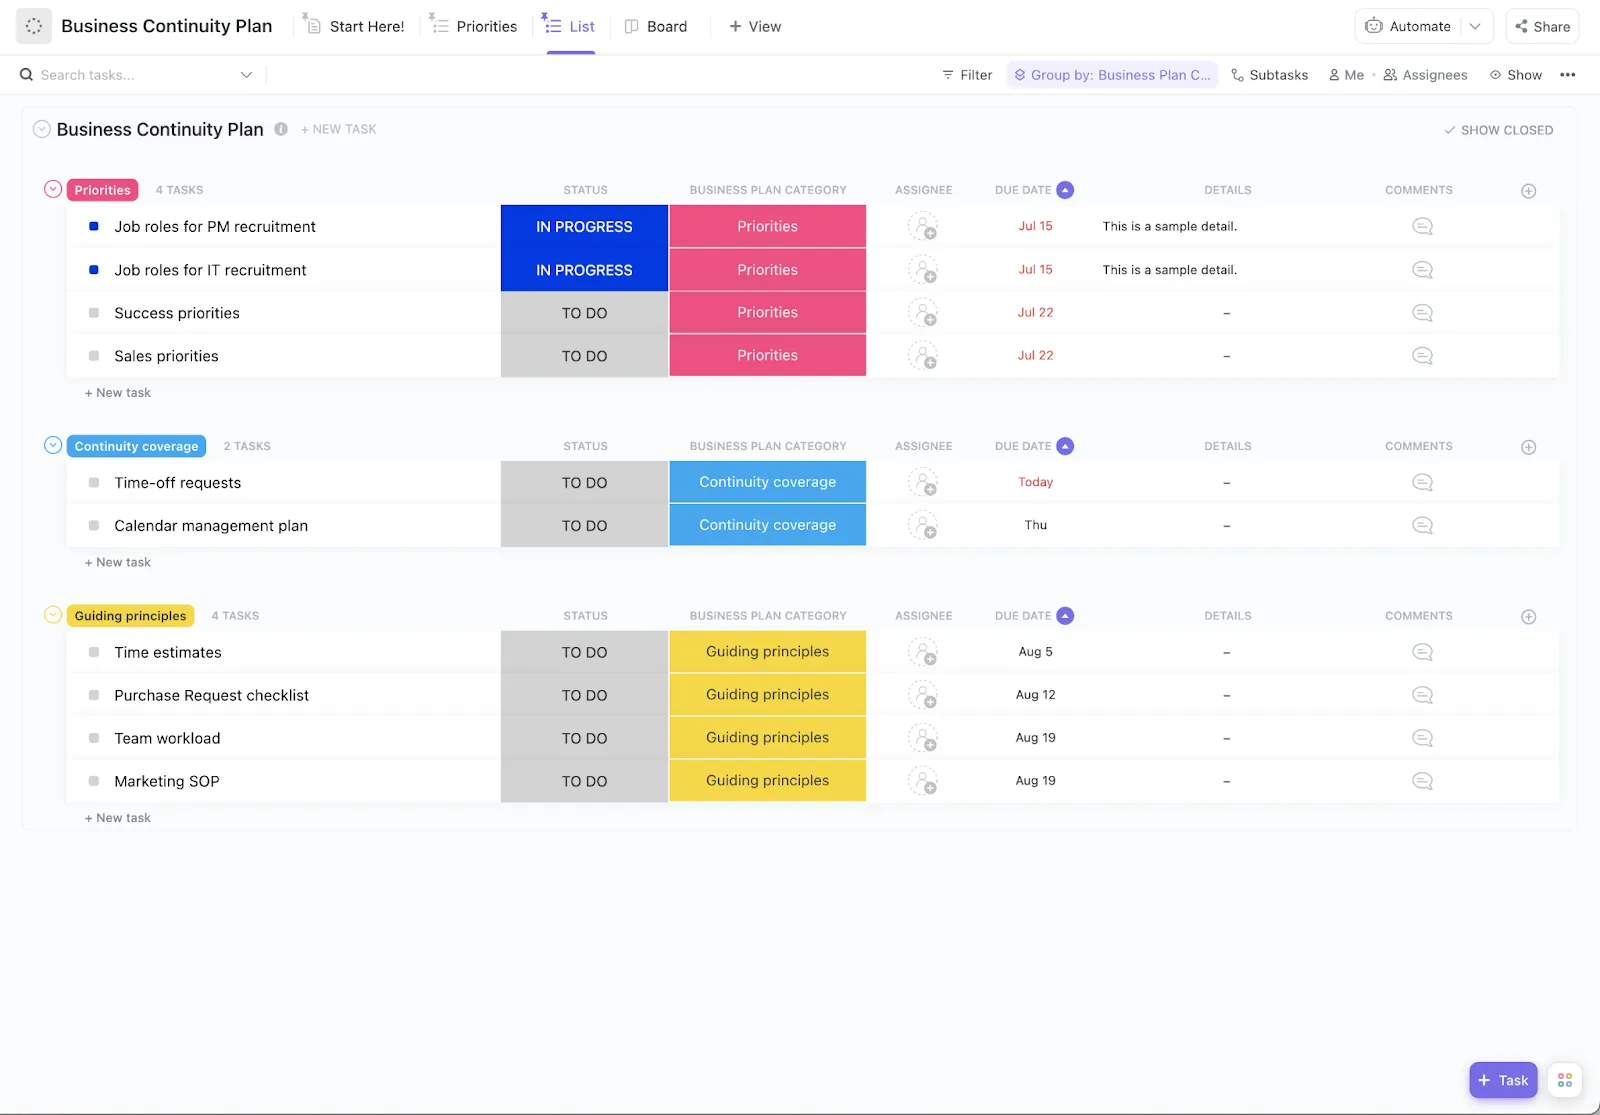
📮ClickUp Insight: 92% van de werknemers gebruikt inconsistente methoden om actiepunten bij te houden, wat als resultaat heeft dat er gemiste beslissingen worden genomen en dat de uitvoering vertraagd wordt.
Of je nu follow-upaantekeningen verstuurt of spreadsheets gebruikt, het proces verloopt vaak versnipperd en inefficiënt. Met de takenbeheerfuncties van ClickUp hoef je je hier nooit meer zorgen over te maken. Maak met één klik taken aan vanuit chats, ClickUp-taakcommentaren, documenten en e-mails!
Belangrijkste onderdelen van een IT-rampherstelplan
Een degelijk DR-plan is uw complete draaiboek om weer online te komen. Elk van deze onderdelen bouwt voort op de andere om zo een uitgebreide bescherming voor uw bedrijf te creëren.
Risicobeoordeling en prioritering
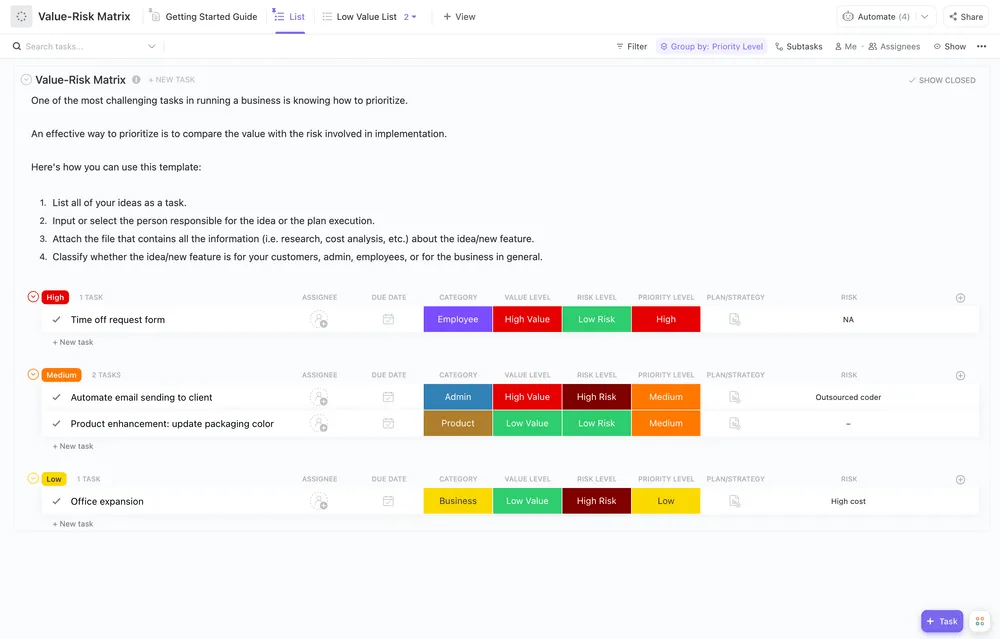
Allereerst moet u weten waar u mee te maken heeft. Een risicobeoordeling is het proces waarbij u uw kwetsbaarheden in kaart brengt en de waarschijnlijkheid en impact van elke potentiële bedreiging evalueert. U kunt dit in een risicomatrix weergeven om te zien welke bedreigingen het ernstigst zijn.
Uw beoordeling moet het volgende omvatten:
- Kritieke systemen: wat absoluut moet blijven draaien om uw Business draaiende te houden
- Gevoeligheid van gegevens: Welke informatie vereist het hoogste beschermingsniveau (zoals klantgegevens)?
- Afhankelijkheden: Welke andere systemen of processen vallen uit wanneer een bepaald systeem uitvalt?
📖 Lees meer: Hoe implementeer je IT-infrastructuurbeheer?
Analyse van de zakelijke impact en kriticiteit
Bepaal vervolgens de werkelijke kosten van downtime. Een Business Impact Analysis (BIA) helpt u de financiële en operationele gevolgen van een storing voor elk systeem in kaart te brengen. Zo kunt u uw systemen indelen in kriticiteitsniveaus om prioriteiten te stellen bij uw herstelinspanningen.
| Kritiek | Minder dan een uur | Betalingsverwerking, klantendatabases |
| Hoog | Eén tot vier uur | E-mail, interne communicatiemiddelen |
| Medium | Vier tot 24 uur | Ontwikkelomgevingen, tools voor rapportage |
| Laag | 24+ uur | Archiefsystemen, testservers buiten de productieomgeving |
RTO- en RPO-doelstellingen
Deze twee afkortingen vormen de kern van uw herstelstrategie.
- Recovery Time Objective (RTO): Dit is de maximale tijd die u zich kunt veroorloven dat een systeem buiten werking is. Het geeft antwoord op de vraag: “Hoe snel moet dit weer online zijn?”
- Recovery Point Objective (RPO): Dit is de maximale hoeveelheid gegevens die u zich kunt veroorloven te verliezen, uitgedrukt in tijd. Het geeft antwoord op de vraag: “Hoeveel gegevens kunnen we verliezen zonder ernstige schade?”
Uw interne e-mailsysteem kan bijvoorbeeld een RTO van vier uur hebben, maar uw klantgerichte e-commercedatabase kan een RPO van slechts 15 minuten hebben, wat betekent dat u niet meer dan 15 minuten aan transactiegegevens mag verliezen.
Plan voor gegevensback-up en -herstel
Uw back-upplan is uw ultieme vangnet. Een veelgebruikte best practice is de 3-2-1-regel: zorg voor ten minste drie kopieën van uw belangrijke gegevens, sla deze op twee verschillende soorten media op en bewaar één van die kopieën buiten uw bedrijfslocatie.
U kunt ook kiezen uit verschillende soorten back-ups:
- Volledige back-ups: een volledige kopie van alle gegevens, meestal wekelijks of maandelijks uitgevoerd
- Incrementele back-ups: Hierbij worden alleen de wijzigingen geback-upt die zijn aangebracht sinds de laatste back-up, ongeacht het type.
- Differentiële back-ups: Hiermee wordt een back-up gemaakt van alle wijzigingen die zijn aangebracht sinds de laatste volledige back-up
Het belangrijkste is dat u uw back-upherstelproces regelmatig test. Een niet-geteste back-up is slechts een hoop, geen plan.
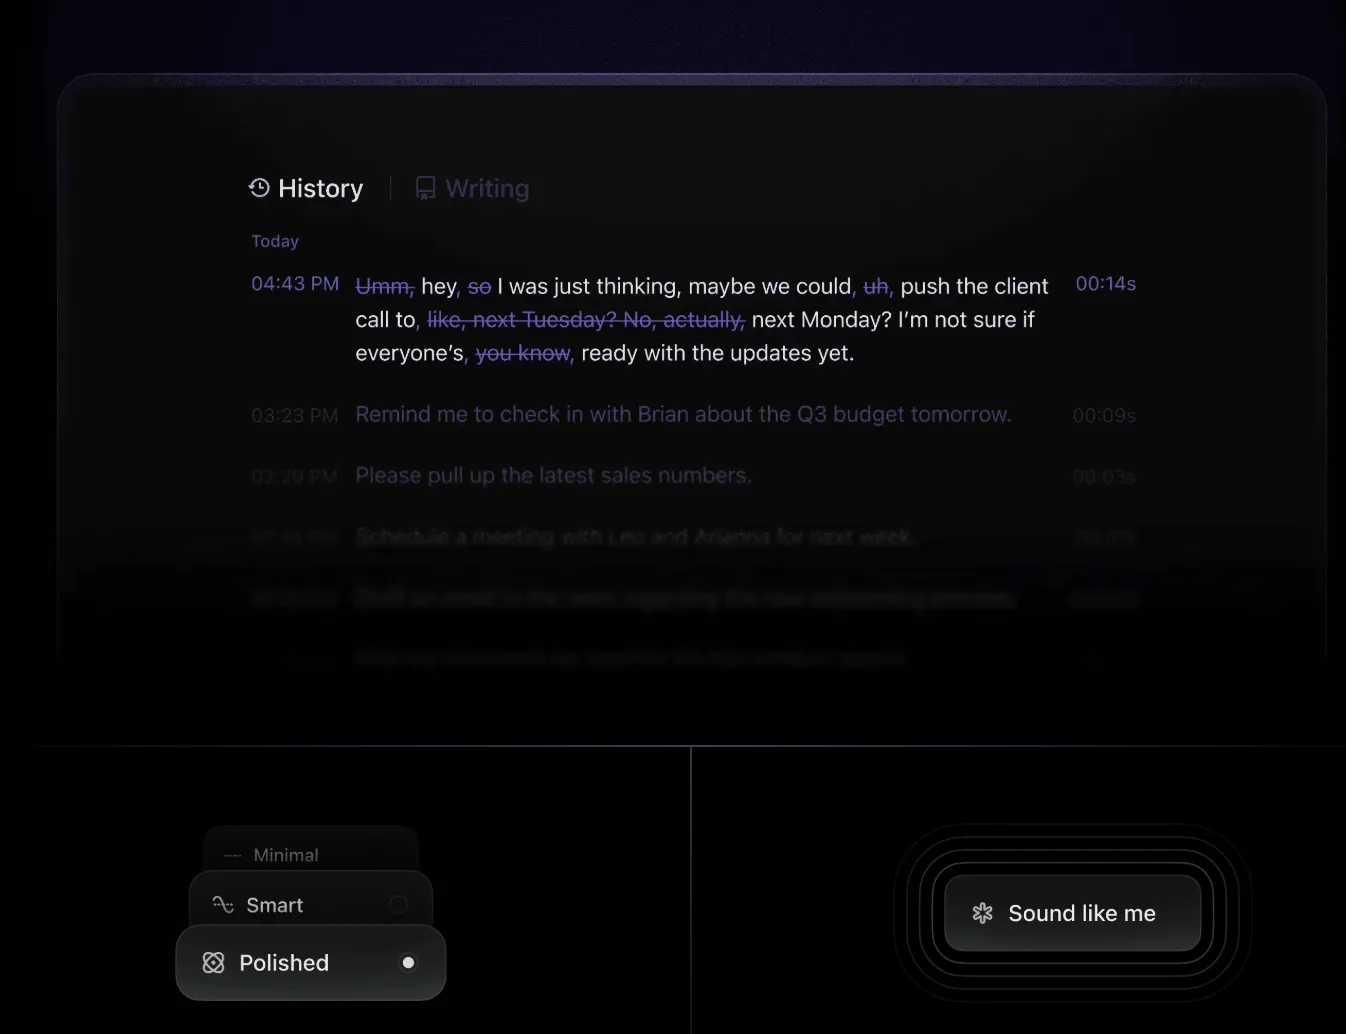
💟 Bonus: Leg cruciale details vast tijdens stressvolle incidenten met de spraak-naar-tekstfunctie van ClickUp Brain MAX, zodat je nooit belangrijke informatie mist, zelfs als typen niet haalbaar is. Spreek gewoon je observaties in en laat de AI de documentatie verzorgen.
Communicatieplan en updates voor belanghebbenden
Wanneer zich een ramp voordoet, is een duidelijk communicatieplan van cruciaal belang. In uw plan moeten de notificatieketens worden vastgelegd, evenals de frequentie waarmee u updates verstrekt en welke kanalen u voor elk type incident gaat gebruiken.
Verschillende groepen hebben verschillende informatie nodig:
- Interne teams: Hebben technische details en specifieke actiepunten nodig
- Klanten: U wilt weten wat de status van de service is en wanneer het probleem naar verwachting zal zijn opgelost
- Leveranciers: Mogelijk moet er een beroep op hen worden gedaan om hen te ondersteunen of om escalaties te behandelen
- Toezichthoudende instanties: kunnen, afhankelijk van uw branche, formele notificaties vereisen
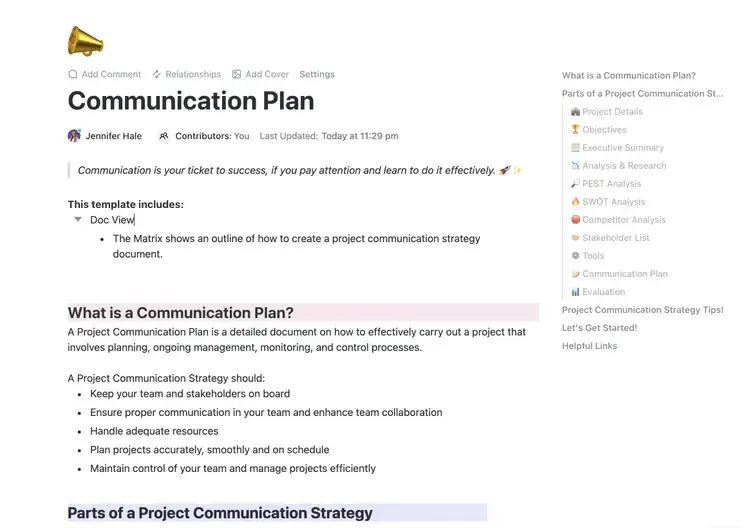
Hulpmiddelen zoals dit kant-en-klare sjabloon voor een communicatieplan van ClickUp kunnen u helpen om tijdens een crisis sneller te handelen dankzij een vast protocol.
Test- en trainingsprogramma
Een plan dat u nooit test, is een plan dat zal mislukken. Door regelmatig te testen worden hiaten en zwakke punten aan het licht gebracht voordat zich een echte ramp voordoet.
Plan het hele jaar door verschillende soorten tests in:
- Tabletop-oefeningen: Uw team doorloopt op papier een rampscenario om de logica van het plan te toetsen
- Gedeeltelijke failovers: u test het herstel van specifieke, niet-kritieke componenten of diensten
- Volledige DR-tests: U voert een volledige failover naar uw back-upsystemen uit (de ultieme test)
Werk na elke test uw documentatie bij en train nieuwe leden van het team onmiddellijk in de procedures.
📖 Lees meer: Hoe u effectief IT-beleid en -procedures ontwikkelt
Stappen voor het opstellen van een IT-rampherstelplan
Het opstellen van uw DR-plan hoeft geen overweldigende klus te zijn.
Zo kunt u dit stap voor stap aanpakken. 🙌
Stap 1: Stel de inventaris van bedrijfsmiddelen op
U kunt niet beschermen wat u niet weet dat u hebt. Begin met het opstellen van een inventaris van bedrijfsmiddelen waarin de lijst met alle hardware, software, opslagplaatsen en systeemafhankelijkheden in uw omgeving wordt vermeld. Zorg ervoor dat u contactgegevens van leveranciers, licentiesleutels en configuratiegegevens opneemt, zodat u deze tijdens een herstel snel kunt raadplegen.
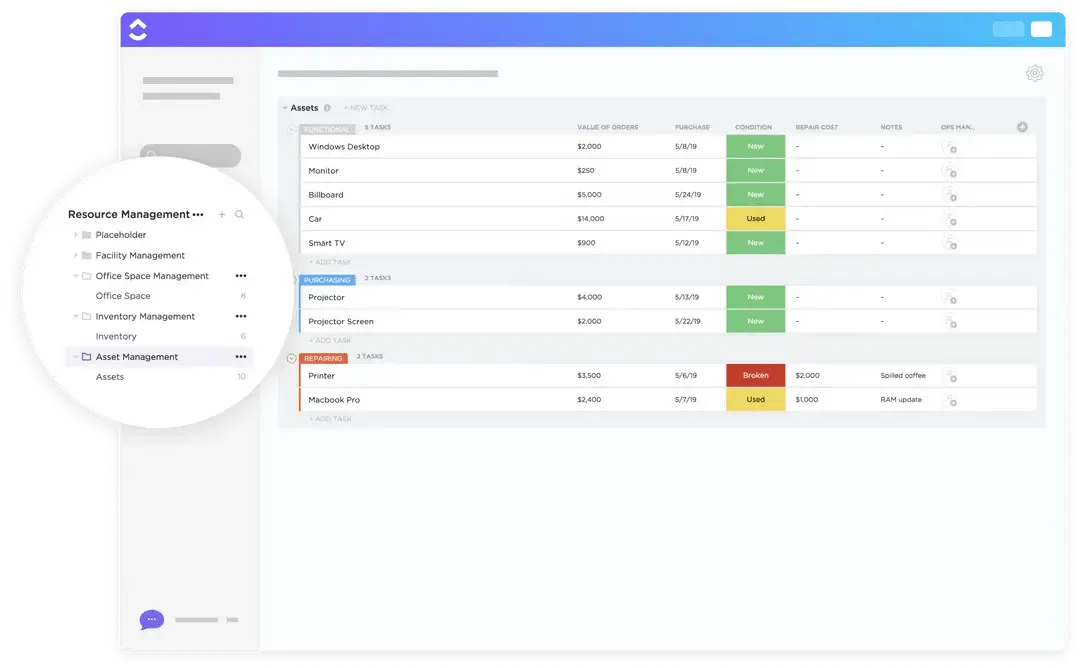
De ClickUp ITAM-sjabloon combineert incidentbeheer, probleembeheer, wijzigingsbeheer, eenvoudige oplossingen voor assetbeheer en kennisbeheer. Onze ITSM-sjabloon voor bekende fouten vereenvoudigt het bijhouden van bekende fouten in uw systemen. Bekijk al onze IT-sjablonen zodra uw doel verandert.
Maak uw werkstroom aan in de stijl die u wilt voor elke ITAM-fase, van implementatie en configuratie tot onderhoud en buitengebruikstelling.
Stap 2: Classificeer kritieke diensten
Bepaal nu welke van die bedrijfsmiddelen bedrijfskritisch zijn en welke slechts een extraatje. Breng de afhankelijkheden in kaart die laten zien hoe uw systemen met elkaar verbonden zijn en op elkaar vertrouwen. Besteed speciale aandacht aan klantgerichte diensten die een directe invloed hebben op de omzet of de gebruikerservaring.
🎥 Bekijk deze praktische uitleg waarin wordt gedemonstreerd hoe u met behulp van de krachtige functies van ClickUp een gestructureerd, overkoepelend plan opstelt – van het stellen van doelen tot het toewijzen van taken en het bijhouden van de voortgang.
Stap 3: Beoordeel risico's en bedreigingen
Beoordeel risico's en bedreigingen door de waarschijnlijkheid en impact van elk type bedreiging voor uw specifieke situatie te evalueren. Houd rekening met uw geografische risico's (bevindt u zich in een aardbevingsgebied of een overstromingsgebied?) en eventuele branchespecifieke bedreigingen (zoals wijzigingen in de regelgeving of gerichte cyberaanvallen). Leg alles vast in een risicoregister, zodat u de ontwikkeling ervan in de loop van de tijd kunt bijhouden.

De ClickUp-sjabloon voor risicobeoordeling op het Whiteboard voegt een visuele dimensie toe aan uw risicobeoordelingsproces. Het helpt bij het beoordelen en categoriseren van risico’s en stimuleert uw team om inzichten te delen en samen te werken in een boeiende en visuele vorm.
Met dit sjabloon kunt u:
- Evalueer risicocategorieën en mogelijke gevolgen
- Analyseer gegevens om mogelijke probleemgebieden te identificeren
- Bepaal preventieve maatregelen om de blootstelling aan risico's te verminderen
Met functies waarmee u kunt tekenen, schrijven en plakbriefjes toevoegen, is dit whiteboard-sjabloon voor risicobeheer perfect voor het evalueren van de risico's van uw project.
Stap 4: Stel RTO- en RPO-doelstellingen vast
Werk rechtstreeks samen met uw zakelijke belanghebbenden om vast te stellen wat zij als aanvaardbare downtime en aanvaardbaar gegevensverlies beschouwen voor elk serviceniveau dat u eerder hebt geïdentificeerd. U moet een afweging maken tussen de kosten van sneller herstel en de impact op het bedrijf – niet alles vereist onmiddellijk herstel zonder gegevensverlies. Zorg dat het management deze targets goedkeurt.
Stap 5: Bepaal back-up- en failover-paden
Nu uw doelstellingen vastliggen, kunt u uw technische oplossingen ontwerpen. Stel back-upstrategieën op die zijn afgestemd op de RPO van elk systeem en plan gedetailleerde failover-procedures, inclusief alternatieve verwerkingslocaties en noodtoegangsmethoden. Voeg netwerkdiagrammen en stapsgewijze runbooks toe om de uitvoering waterdicht te maken.
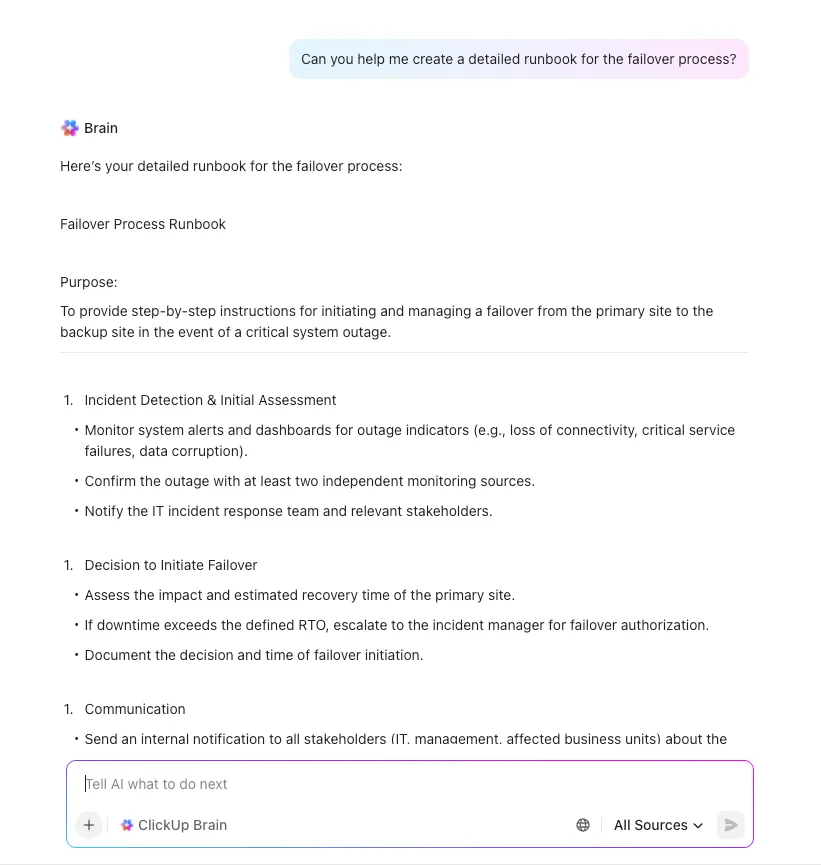
Stap 6: Rollen toewijzen en escalatie regelen
Bepaal de structuur van uw DR-team met duidelijke verantwoordelijkheden en beslissingsbevoegdheden. Stel uitgebreide contactlijsten op met primaire en back-uppersoneel voor elke rol. Een RACI-matrix (Responsible, Accountable, Consulted, Informed) is een uitstekend hulpmiddel om verwarring tijdens een incident met hoge stress te voorkomen.
Stap 7: Documenteer en communiceer het plan
Leg het plan vast en communiceer het met duidelijke, stapsgewijze procedures die iedereen in uw team kan volgen, zelfs onder druk. Het is van cruciaal belang om deze documentatie op te slaan op een goed toegankelijke locatie die losstaat van uw primaire infrastructuur. Zorg ervoor dat elk teamlid precies weet waar het plan te vinden is tijdens een crisis.

Stroomlijn uw projectplanning met de RACI-planningssjabloon van ClickUp. Deze Doc-sjabloon is een echte gamechanger en biedt een duidelijk overzicht om teamrollen en verantwoordelijkheden met betrekking tot projecttaken te definiëren. Maak gebruik van het RACI-raamwerk (Responsible, Accountable, Consulted en Informed) om iedereen op één lijn te brengen, waardoor verantwoordelijkheid en afstemming op de organisatiedoelstellingen worden gewaarborgd.
Stap 8: Testen, evalueren en verbeteren
Plan ten slotte elk kwartaal tests om uw procedures te valideren en eventuele hiaten op te sporen. Leg alle lessen die u uit elke test en uit daadwerkelijke incidenten hebt geleerd vast, en gebruik deze om uw plan bij te werken. Zet een systematisch systeem op om verbeteringen bij te houden, zodat u zeker weet dat alle geconstateerde problemen worden opgelost.
🌼 Wist je dat: In 2017 kreeg GitLab te maken met een grote database-uitval. Tijdens het herstel ontdekten ze dat verschillende van hun back-upmethoden al dagenlang stilletjes faalden. Dit incident heeft de hele tech-industrie een cruciale les geleerd: het valideren van back-ups is absoluut noodzakelijk. Een niet-geteste back-up is eigenlijk helemaal geen back-up.
🌼 Wist je dat: In 2017 kreeg GitLab te maken met een grote database-uitval. Tijdens het herstel ontdekten ze dat verschillende van hun back-upmethoden al dagenlang stilletjes faalden. Dit incident heeft de hele tech-industrie een cruciale les geleerd: het valideren van back-ups is absoluut noodzakelijk. Een niet-geteste back-up is eigenlijk helemaal geen back-up.
Strategieën en oplossingen voor noodherstel
Niet elke organisatie heeft dezelfde DR-aanpak nodig. Laten we uw opties bekijken op basis van uw budget, herstelbehoeften en beschikbare middelen.
Aanpak voor back-up en herstel
Dit is de eenvoudigste en meest kosteneffectieve methode. Hierbij worden regelmatig back-ups gemaakt naar een externe locatie (zoals de cloud of een secundair datacenter) en vervolgens handmatig hersteld wanneer dat nodig is. Deze aanpak is het meest geschikt voor niet-kritieke systemen die een langere RTO kunnen verdragen, aangezien het herstel uren of zelfs dagen kan duren.
Hoge beschikbaarheid en redundantie
Deze strategie is erop gericht om single points of failure te elimineren door gebruik te maken van meerdere actieve systemen. Technieken zoals load balancing, serverclustering en RAID-opslagruimte zorgen ervoor dat als één component uitvalt, een andere onmiddellijk het werk overneemt. Hoewel deze aanpak duurder is om op te zetten en te onderhouden, kan hij de downtime tot slechts enkele seconden of minuten beperken, waardoor hij ideaal is voor kritieke diensten.
Opties voor replicatie en failover
Bij replicatie worden gegevens vrijwel in realtime naar een secundaire locatie gekopieerd, waardoor het gegevensverlies tijdens een ramp tot een minimum wordt beperkt.
- Synchrone replicatie: schrijft gegevens tegelijkertijd naar zowel de primaire als de secundaire locatie, waardoor er gegarandeerd geen gegevensverlies optreedt. Hiervoor is echter een hoge bandbreedte nodig en het kan uw primaire systeem vertragen
- Asynchrone replicatie: Hierbij worden gegevens eerst naar de primaire locatie geschreven en vervolgens met een kleine vertraging naar de secundaire locatie gekopieerd. Deze methode is goedkoper en heeft minder invloed op de prestaties, maar u neemt wel een klein risico op gegevensverlies.
Cloudgebaseerde noodhersteloplossingen en DRaaS
Disaster Recovery as a Service (DRaaS) is voor veel bedrijven een populaire keuze geworden. Het biedt een pay-as-you-go-prijsmodel, onmiddellijke geografische verdeling en automatisering van het herstel, zonder dat u uw eigen fysieke DR-locaties hoeft op te zetten en te onderhouden. Cloud-DR elimineert de enorme kapitaaluitgaven voor een back-updatacenter en biedt tegelijkertijd snellere schaalbaarheid en meer flexibiliteit dan traditionele ‘hot’, ‘warm’ of ‘cold site’-benaderingen.
Hoe ClickUp de planning van IT-rampherstel stroomlijnt
Het beheren van een DR-plan via verspreide spreadsheets, documenten en e-mailconversaties brengt op zichzelf al een rampenrisico met zich mee.
Dit soort ‘work sprawl’ – de versnippering van het werk over meerdere, onderling niet-gekoppelde tools die niet met elkaar communiceren – en ‘context sprawl’, waarbij teams uren verspillen aan het zoeken naar informatie die verspreid is over apps en platforms, leidt tot verwarring, verouderde informatie en trage reactietijden op momenten dat elke seconde telt.
Met ClickUp Converged AI-werkruimte — één enkel, veilig platform waarop al uw werkapps, gegevens en werkstroomen samenkomen, met contextuele AI als intelligentielaag — dat projectmanagement, documentatie en teamcommunicatie combineert. U hoeft niet langer te jongleren met meerdere platforms en kunt uw DR-planning, testen en incidentrespons samenbrengen in één geïntegreerd systeem.
Gecentraliseerde DR-documentatie met ClickUp Docs en ingebouwde AI-ondersteuning
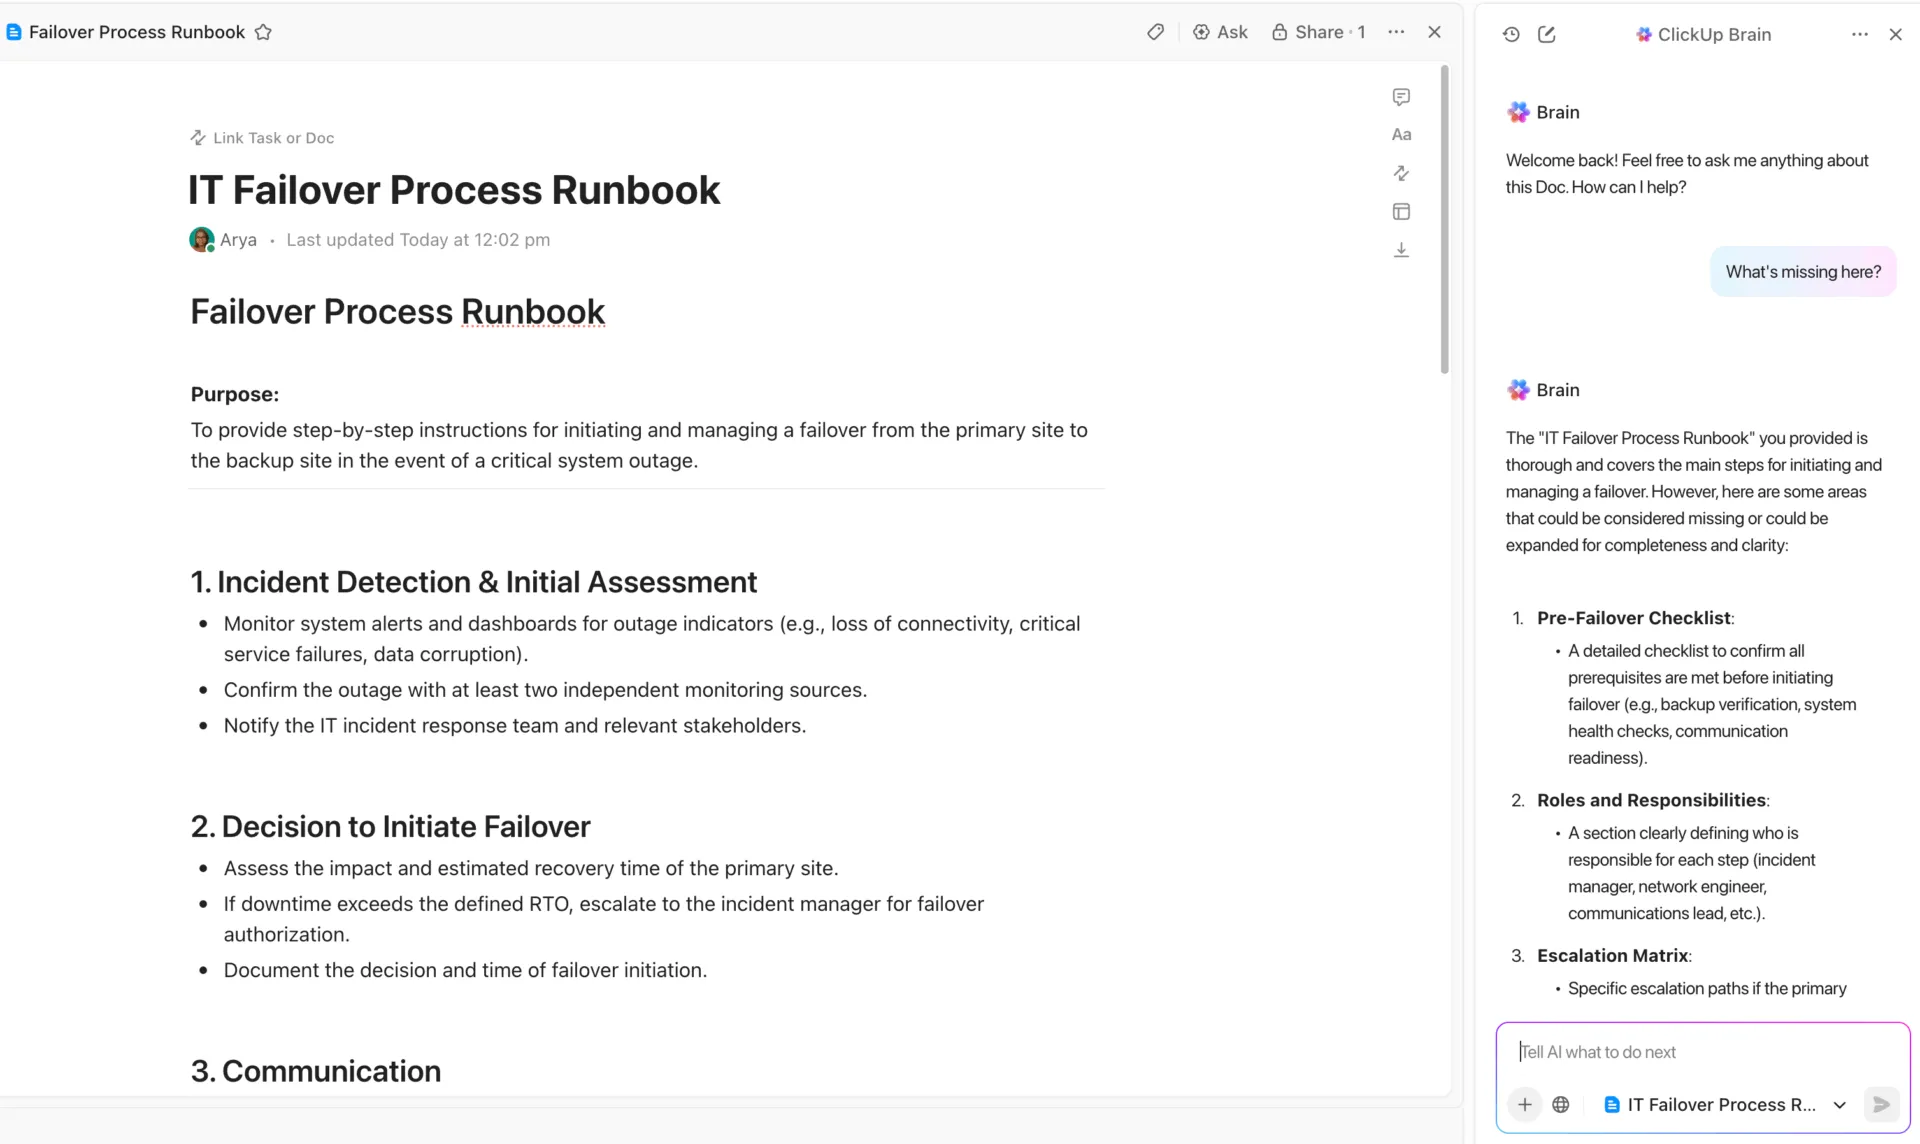
Zorg ervoor dat je team altijd beschikt over één enkele bron van waarheid met ClickUp Docs.
Stel uw volledige noodherstelplan op in een samenwerkingsruimte waar iedereen tijdens een incident in realtime kan bijdragen. Koppel documenten rechtstreeks aan incidenttaken en projecten voor naadloze navigatie, en sluit diagrammen of runbooks in zodat cruciale informatie precies daar beschikbaar is waar u die nodig hebt.
Het beste van alles is dat u uw documenten kunt beveiligen om onbedoelde bewerkingen te voorkomen en dat u met de gedetailleerde ClickUp-toestemmingen kunt bepalen wie gevoelige herstelprocedures mag bekijken of wijzigen. Elke bewerking wordt bijgehouden in de geschiedenis van het document, waardoor u beschikt over een volledig controlespoor.
AI-gestuurd planaanmaken met ClickUp Brain
Versnel de planning van disaster recovery en elimineer kritieke hiaten met ClickUp Brain — uw contextuele AI-assistent die uw volledige werkruimte begrijpt. In tegenstelling tot generieke AI-tools maakt ClickUp Brain gebruik van de daadwerkelijke taken, documenten en werkstroom van uw organisatie om nauwkeurige, bruikbare ondersteuning te bieden voor DR-initiatieven.
Geef ClickUp Brain gewoon een opdracht zoals: “Maak een checklist voor noodherstel voor ons e-commerceplatform”, en ontvang direct een uitgebreide, op maat gemaakte sjabloon die aansluit bij uw systemen, processen en compliance-eisen. Dit kan u helpen bij:
- Contextueel inzicht: ClickUp Brain heeft toegang tot de structuur, content en toestemming van je werkruimte. Het kan verwijzen naar taken, documenten, opmerkingen en zelfs gekoppelde apps, en biedt zo antwoorden en acties die zijn afgestemd op je daadwerkelijke werk – niet alleen algemene suggesties.
- Probleemoplossing en begeleiding: Los problemen direct op, krijg stapsgewijze instructies of vraag om best practices voor elke ClickUp-functie. Brain kan je door complexe processen leiden, repetitieve taken automatiseren en helpen bij het oplossen van knelpunten
- Automatisering en versnelling van werkstroomen: Gebruik kant-en-klare of aangepaste AI-agents om meerstapswerkstroomen te automatiseren, verzoeken te triageren of terugkerende taken te beheren – en zo elke week uren te besparen
- Diepgaand zoeken: Vind informatie die ergens in uw werkruimte verborgen zit, inclusief taken, documenten en geïntegreerde tools, zelfs als deze jaren oud is of moeilijk te vinden is op de locatie van de standaardzoekfunctie
- Realtime overzichten en updates: Genereer direct projectupdates, verslagen van vergaderingen of rapporten over de voortgang op basis van live gegevens uit de werkruimte
- Vereenvoudiging van technische documentatie: Zet complexe technische documenten om in duidelijke, praktische procedures of checklists die uw team kan volgen, zelfs onder druk
- Multi-model intelligence: Kies uit toonaangevende AI-modellen (OpenAI GPT-4.1, GPT-5, Claude, Gemini en meer) voor de beste resultaten bij elke taak – er zijn geen aparte abonnementen nodig
- Veilig en met inachtneming van toegangsrechten: Brain heeft alleen toegang tot informatie waarvoor u al toestemming hebt, waardoor strenge privacy- en nalevingsnormen worden gehandhaafd
- Gesprek-interface: Gebruik @brain in reacties of tijdens het chatten om contextuele inzichten te krijgen, antwoorden op te stellen of automatiseringen te triggeren zonder je werkstroom te onderbreken
- Aangepaste prompts en opgeslagen werkstroomen: Sla prompts op voor terugkerende taken en gebruik ze opnieuw, zodat je team consistent te werk gaat en tijd bespaart
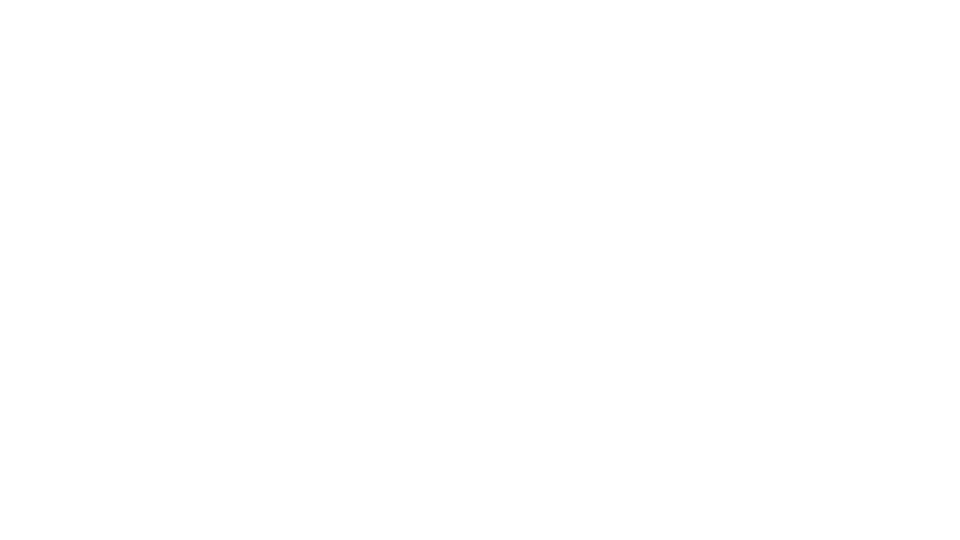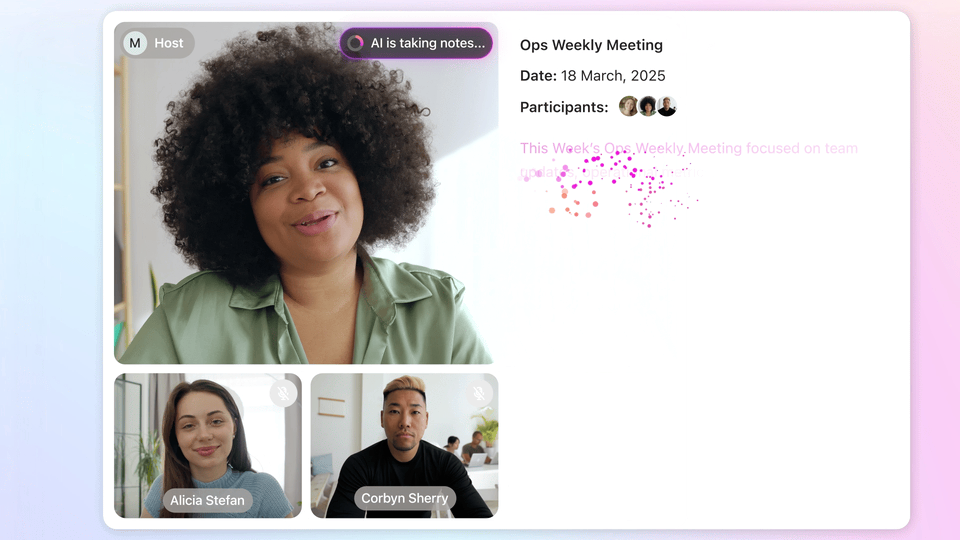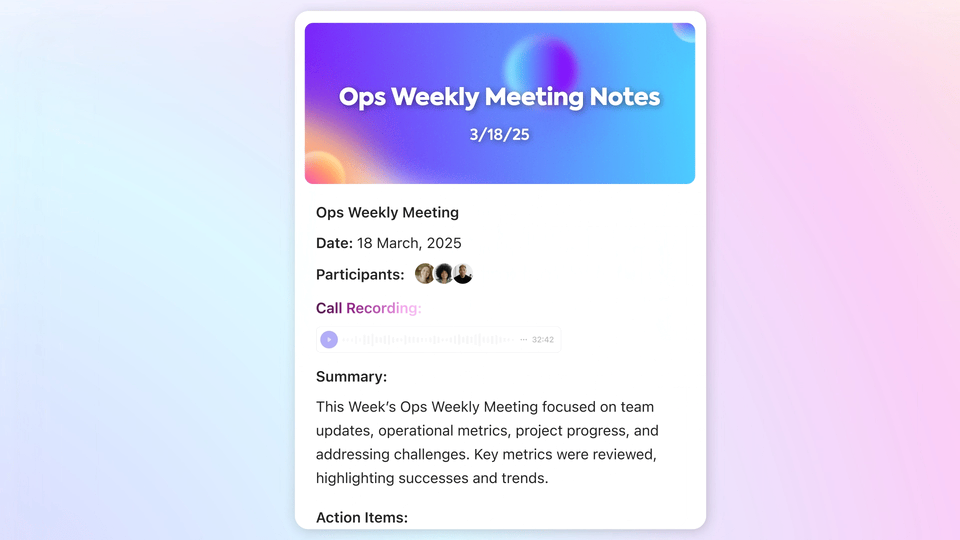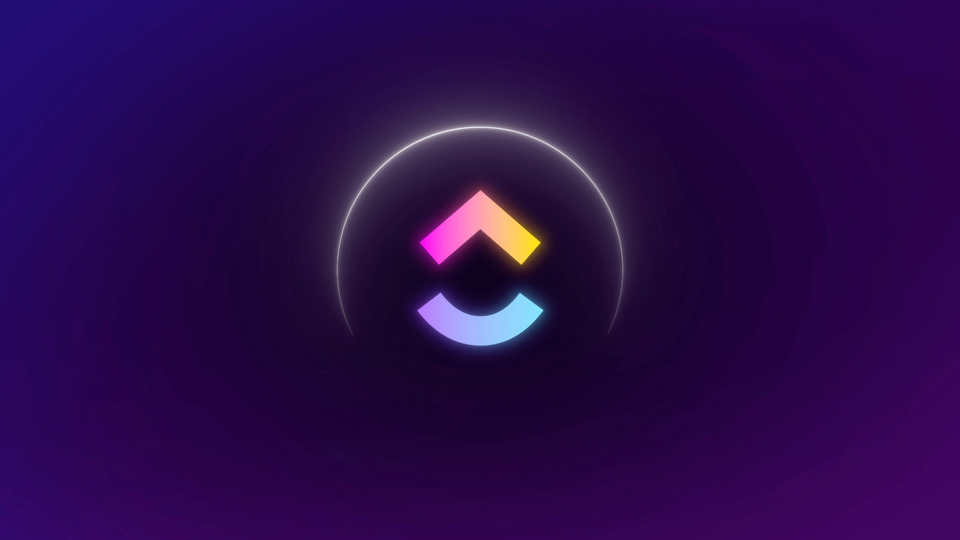
💡Pro-tip: Mis nooit meer een les uit uw incidentevaluatievergaderingen door elk detail vast te leggen met ClickUp AI Notetaker. Deze tool kan deelnemen aan uw virtuele vergaderingen, de volledige discussie uitschrijven en automatisch een lijst met actiepunten genereren op basis van de geleerde lessen. Zo ontstaat een doorzoekbare incidentgeschiedenis, zodat u snel eerdere gebeurtenissen en hun oplossingen kunt raadplegen.
Geautomatiseerde DR-werkstroomen met ClickUp-automatiseringen
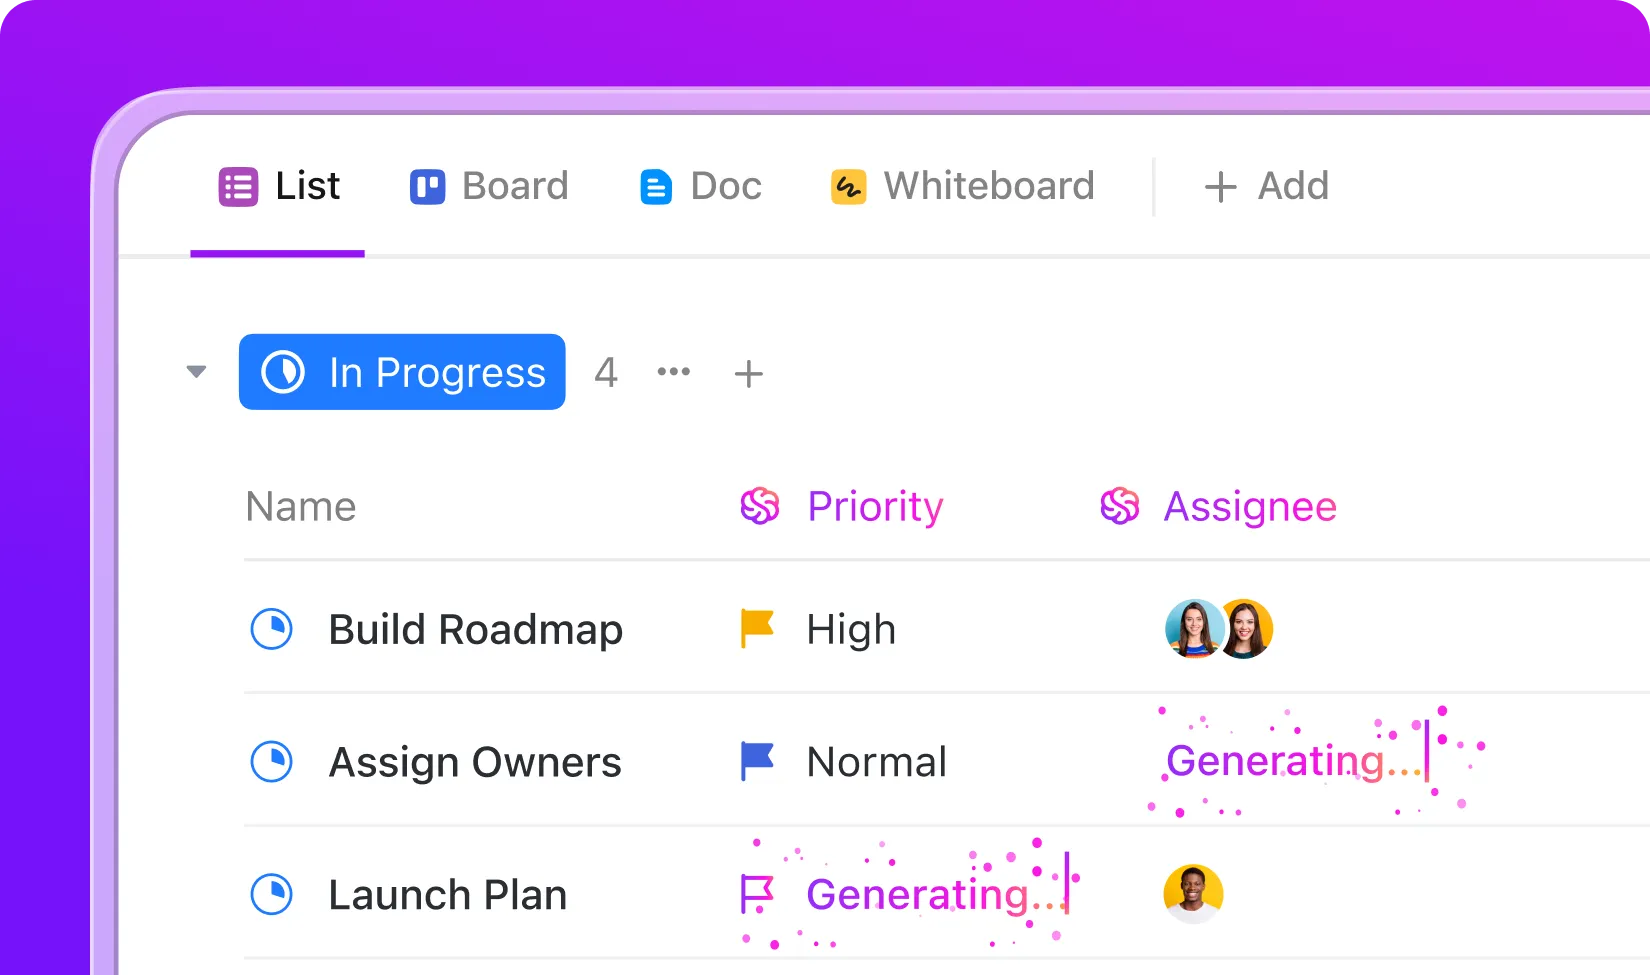
Stel je voor dat je team te maken krijgt met een plotselinge storing: elke seconde telt en je kunt het je niet veroorloven ook maar één stap over het hoofd te zien. Met ClickUp AI-agenten en automatiseringen hoef je niet in paniek te raken of op je geheugen te vertrouwen. Zodra een incident wordt gemeld, komt de ClickUp AI in actie, begeleidt je team en neemt het routinewerk uit handen, zodat jij je kunt concentreren op het oplossen van het probleem.
Zo werkt het in een praktijkvoorbeeld:
- Wanneer iemand een taak markeert als ‘Incident gemeld’, maakt ClickUp Agent automatisch een checklist met responsstappen aan, wijst deze toe aan de juiste personen en start een timer om bij te houden hoe lang het herstel duurt.
- Als het incident als ‘Kritiek’ wordt gemarkeerd, kan een agent onmiddellijk een e-mail sturen naar uw managementteam en een speciale chatroom opzetten – uw ‘war room’ – zodat iedereen op één plek kan communiceren
- De AI kan eerdere incidentrapporten en relevante documentatie opvragen, zodat uw team alles wat het nodig heeft binnen handbereik heeft
Bekijk hier de werkstroom:
Met ClickUp AI Agents krijg je een betrouwbare digitale teamgenoot die je team helpt kalm, georganiseerd en effectief te blijven – zelfs onder druk.
Realtime bijhouden met ClickUp-dashboards
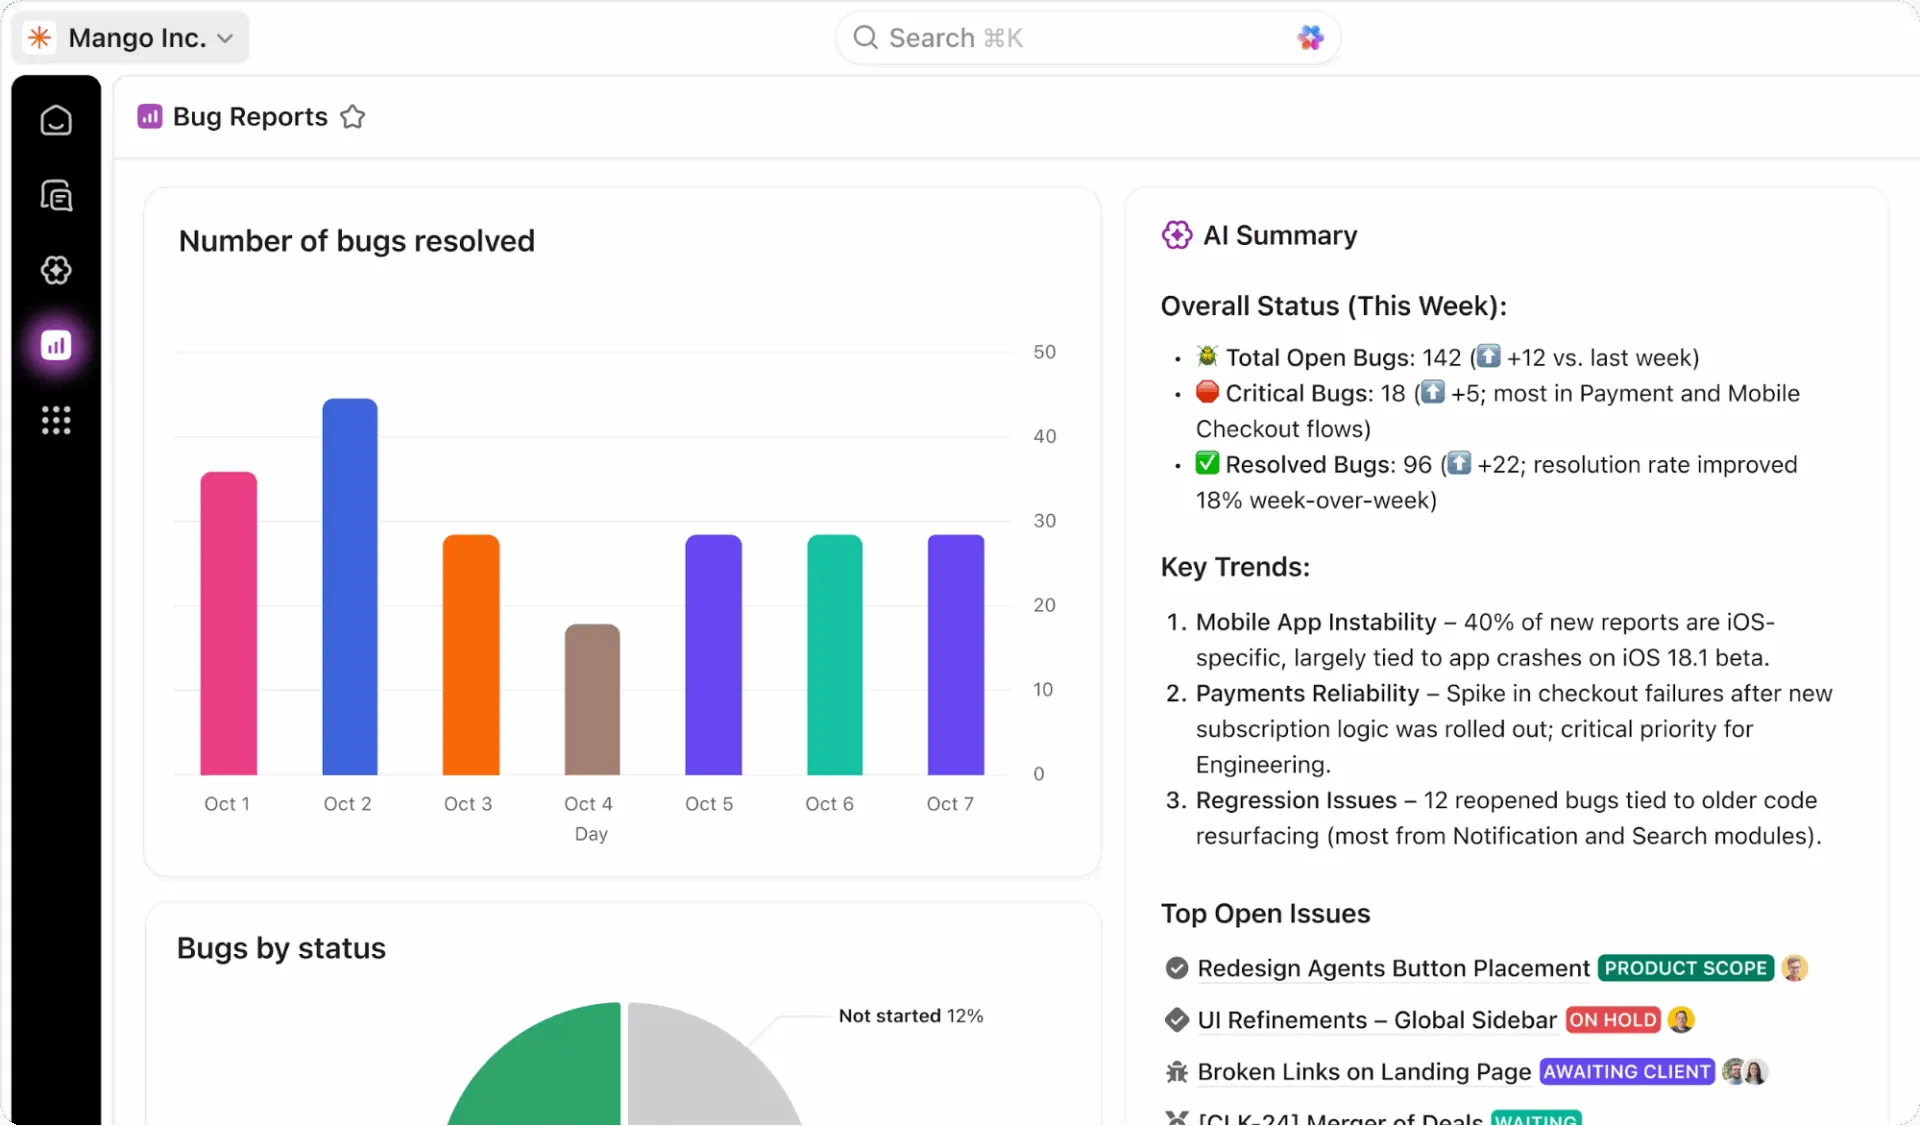
Krijg volledige zichtbaarheid in de status van uw DR-programma door alles in realtime bij te houden met ClickUp-dashboards. U kunt widgets maken om uw RTO- en RPO-prestaties tijdens tests te monitoren, de voltooiingspercentages van tests bij te houden en trends in incidenten in de loop van de tijd te bekijken.
Voeg aangepaste ClickUp-velden toe aan je taken om de kriticiteit van het systeem, de herstelstatus en testresultaten bij te houden, en breng vervolgens al die gegevens samen in één weergave op hoog niveau. Deze dashboards bieden je rapporten die direct aan het management kunnen worden gepresenteerd en die altijd up-to-date zijn met realtime gegevens uit de test- en incidentresponsactiviteiten van je team.
📖 Lees meer: Hoe stelt u een checklist voor risicobeoordeling op?
Stel vandaag nog uw DR-plan op
Elke dag dat u zonder DR-plan werkt, is een gok die u zich niet kunt veroorloven te verliezen. Rampen zijn onvermijdelijk – of ze nu het gevolg zijn van natuurrampen, technologische storingen of menselijke fouten – maar uw voorbereiding bepaalt of ze uitmonden in kleine ongemakken of grote rampen.
Een uitgebreid DR-plan vereist inzicht in uw risico's, het vastleggen van duidelijke procedures en het regelmatig testen daarvan. De juiste tools maken dit proces beheersbaar door een einde te maken aan de chaos van verspreide documenten en handmatige processen.
Zelfs eenvoudige noodplannen zijn beter dan helemaal niets wanneer zich een ramp voordoet. Door regelmatig te testen en bij te werken verandert uw DR-plan van een stoffig document in een levend systeem dat uw bedrijf daadwerkelijk beschermt.
Zet de eerste stap en begin vandaag nog met het opstellen van je DR-plan met ClickUp. Ga gratis aan de slag met ClickUp en breng al je planning, documentatie en incidentrespons op het gebied van disaster recovery samen op één uniform platform. ✨
Veelgestelde vragen
Hoe vaak moeten teams een sjabloon voor een IT-rampherstelplan bijwerken?
U dient uw DR-plan minstens vier keer per jaar te herzien en het onmiddellijk bij te werken na elke ingrijpende wijziging in de infrastructuur of na daadwerkelijke incidenten. De meeste organisaties voeren jaarlijks een grondige herziening uit om alle geleerde lessen te verwerken en zich aan te passen aan nieuwe technologieën.
Welke teams zijn verantwoordelijk voor de documentatie en het testen van disaster recovery?
IT-teams, teams voor veiligheid en planners voor bedrijfscontinuïteit nemen doorgaans het voortouw bij het plannen en testen van het noodherstelplan. Ze hebben echter essentiële input nodig van leidinggevenden van de operationele afdelingen en bedrijfsonderdelen om ervoor te zorgen dat het plan aansluit bij de daadwerkelijke bedrijfsbehoeften en -prioriteiten.
Hoe houden we RTO en RPO bij tijdens disaster recovery-tests?
Gebruik stopwatches en duidelijke tijdstempels om tijdens elke test de werkelijke hersteltijden te vergelijken met de door u gedefinieerde targets. Het is van cruciaal belang om eventuele verschillen tussen uw targets en de werkelijke prestaties in uw testrapporten vast te leggen, zodat u hierop kunt voortbouwen voor toekomstige verbeteringen.
Welke tools helpen bij het documenteren en bij de automatisering van een noodherstelplan?
Projectmanagementplatforms zoals ClickUp zijn ideaal voor het centraliseren van documentatie, de automatisering van werkstroomprocessen en het bijhouden van statistieken voor uw volledige DR-programma. U kunt deze vervolgens combineren met gespecialiseerde DR-tools die de technische aspecten van gegevensreplicatie en systeemfailover afhandelen.