
最初の数つのサービスは簡単です。1回のローテーション、1つのチャネル、そしてバックアップです。
しかし、社内のマイクロサービスが数十に及び、複数のリージョンにまたがり、所有権が複雑化すると、手動によるエスカレーションはもはやワークフローとは言えず、むしろ負担となってしまいます。
このガイドでは、オンコール体制に抜け穴を生じさせることなく、エンジニアリング組織の規模に合わせて拡張可能なインシデントのエスカレーションプロセスを自動化する方法を解説します。
また、エンジニアリングチームが信頼できるエスカレーションシステムの構築において、ClickUpがどのように活用できるかについてもご紹介します。🎯
⭐ 注目のテンプレート
ClickUpのインシデント対応プラン(IAP)テンプレートを活用して、自然災害からデータ漏洩に至るまで、緊急事態に迅速かつ効果的に対応しましょう。
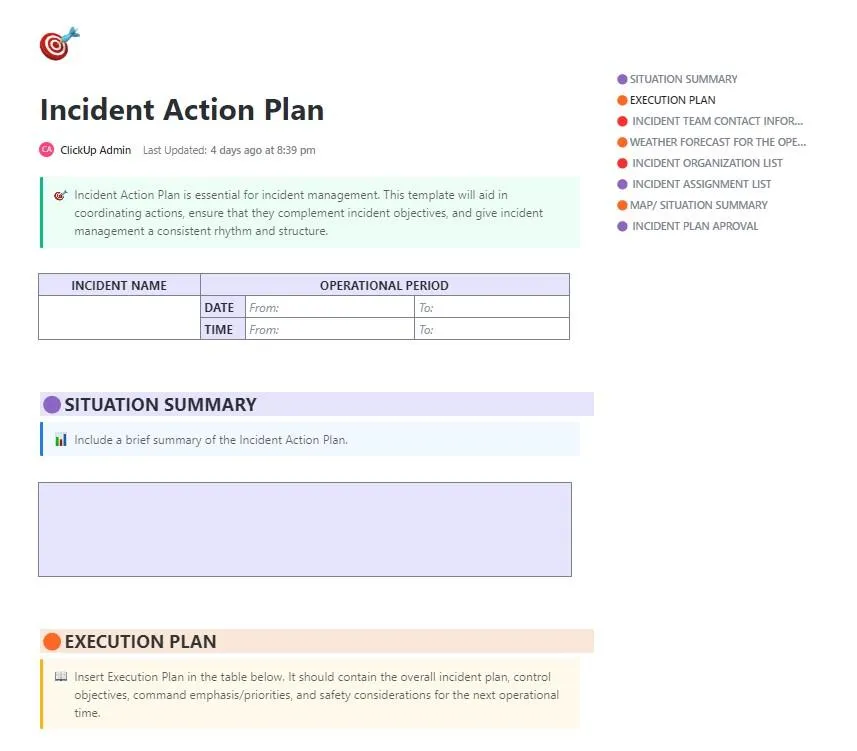
このテンプレートには、以下の目的のためにあらかじめ定義されたセクションが用意されています:
- インシデントの目標と対応の優先度を定義する
- 明確な指揮系統を確立する
- チーム間の連携をリアルタイムで調整する
- 決定事項、タイムライン、重要な更新情報を、発生したその場で記録しましょう
- エスカレーションの進捗を把握し、フォローアップを継続しましょう
また、ClickUp内に組み込まれているため、単なる静的なチェックリストではなく、リアルタイムのインシデント対応マニュアルとして機能します。
インシデントのエスカレーションプロセスを自動化する理由
厳しいSLAが課された複雑なシステムをチームが管理している場合、手動によるエスカレーションは対応を遅らせるだけです。エスカレーションを自動化することで、プレッシャーの高いインシデント発生時であっても、対応プロセスを予測可能かつストレスの少ないものにすることができます。
組織のエスカレーションプロセスを自動化する必要がある理由はこちらです。👇
手動によるエスカレーションのリスク
数十ものサービス、複数の当直ローテーション、そして絶えず変化する所有権を扱うようになると、手作業によるステップはすぐに問題となります。
よくある落とし穴には、次のようなものがあります:
- 通知の見落としや遅延:電子メール、SMS、チャットでの通知を見逃してしまった場合
- 引き継ぎ時の混乱、特にエスカレーション手順が明確に文書化されていない場合
- 担当範囲マップが更新されていないために、誤ったチームへエスカレーションしてしまう
- 「アラートを次の段階へ引き継ぐ」作業を 1人に依存することによるボトルネック
📖 関連記事:インシデントレポートの書き方
自動化のメリット
ITSMの自動化により、エスカレーションプロセスに体系性と推進力が生まれます。誰かがアラートに気づくのを待つのではなく、システムが事前に定義された一連の処理を即座かつ一貫して実行します。
AIを活用してタスクを自動化することで、チームには次のようなメリットがあります:
- 対応時間の短縮:アラートが数秒以内に適切な担当者やチームに届くため
- 一貫した実行――意思決定が鈍りがちな午前3時であっても、エスカレーションのステップを確実に実行する
- 組み込みの冗長性により、一次当直者がアラートを見逃した場合でも、バックアップ担当者に確実に通知されます。
- チーム全体での明確な可視性:エスカレーションのフローを全員が理解しているため
- 緊急対応の負担を軽減し、より予測可能な当直業務を実現
📖 関連記事:事業継続プラン(BCP)の例
アラート疲労と人的ミスの軽減
アラート疲労はオンコール体制の有効性を損ないます。チームが頻繁に、あるいは不適切な理由で通知を受けると、緊急性を持って対応しなくなります。自動化により、本当に人の対応が必要な案件のみをフィルタリングしてエスカレーションすることができます。
自動化されたエスカレーションロジックにより:
- 重要度の低いアラートや重複アラートは、当直担当者に届く前に抑制されます。
- 重大度に基づくルールを設定することで、軽微な問題によって不必要に誰かを起こすことを防ぎます
- アラートは、システムが定義された時間枠内に応答がないことを検出した場合にのみエスカレーションされます
- チームは、重要でない案件の選別にかかる時間を減らし、真の問題の解決により多くの時間を割けるようになります。
SLAおよびオンコールポリシーの順守をサポート
エスカレーションを自動化することで、手動による絶え間ない監視なしでも、コンプライアンスを容易に維持できます。厳格なSLAや社内の信頼性に関する約束を管理するIT運用責任者にとって、AIは期待される行動を強制する「ガードレール」としての役割を果たします。これにより、以下のことが可能になります:
- インシデント通知が、ルーティングに関するあらかじめ定義されたルールに従うようにします。
- 時間指定のエスカレーション機能を活用し、SLAの対応タイムラインを自動的に遵守しましょう
- 時代遅れのスプレッドシートに頼ることなく、当直スケジュールを確実に運用しましょう
- すべてのアラート、エスカレーション、および確認応答について、監査証跡を作成します
🎥 エスカレーションプロセスのワークフロー全体を完全に自動化したいですか?Super Agentsがサポートします 。👇🏼
🔍 ご存知でしたか?NASAのミッションコントロールは、基本的に自動化されたエスカレーションロジックに基づいて運用されています。テレメトリの値が範囲を外れると、システムは即座に、分野ごとの専門家に自動アラートを送信します。
インシデント管理におけるエスカレーションポリシーとは?
エスカレーションポリシーとは、誰に、いつ通知を行うか、また責任を上位者や他チームにどのように引き継ぐかを定める、あらかじめ定義された一連のルールです。
これは、インシデントの停滞を防ぎ、適切なタイミングで適切な専門家が対応に乗り出し、チームがSLAを達成できるよう支援する、体系化されたロードマップと考えてください。
適切に構築されたエスカレーション管理ポリシーには、通常、以下の要素が含まれます:
- ルールベースのルーティングにより、担当者がインシデントの受領確認を行わなかった場合や解決できない場合に、次に誰が対応すべきかを定義します。
- 時間指定トリガー:深刻度に応じて、5分、15分、または30分後に自動的にエスカレーションを行います
- 通知方法:電話、SMS、チャット、電子メールなど
- エスカレーションプランの階層:レベル1(一次当直)>レベル2(シニアエンジニア/SME)>レベル3(経営陣)
- ドキュメント作成の指針:新規対応者が重要な背景情報を失うことなく業務を引き継げるようにするため
エスカレーションポリシーの種類
チームが理解しておくべきポリシーの主な種類は以下の通りです:
1. 階層型エスカレーション(垂直型)
アラートは、ジュニアエンジニアからシニアスペシャリスト、そして経営陣へと、指揮系統に沿って「上」へとエスカレーションされます。状況に応じて、より高度な専門知識、意思決定権限、あるいは経営陣による可視性が必要な場合に、この機能を活用してください。
2. 機能別エスカレーション(水平方向)
アラートは上層へ伝達されるのではなく、チームを横断して、影響を受けたシステムを管理する機能へと送られます。これは、データベース、ネットワーク、支払い、APIなど、特定のドメインに関連するインシデントに最適です。
3. 時間ベースのエスカレーション
これは、ほとんどの自動化システムの根幹をなす仕組みです。この方式では、アラートは特定の時間経過後に次のエスカレーション段階へ移行します。多くの場合、この時間枠はSLAに直接連動しています。営業時間外でも確実な対応が求められる場合、この仕組みは特に不可欠です。
4. 影響度に基づくエスカレーション
影響度に基づくエスカレーションは、階層や時間ではなく、深刻度やビジネスへの影響度に基づいて行われます。これは、サービス停止、支払いエラー、顧客に直接影響する問題、またはセキュリティ侵害などの対応に有効です。
5. 並行エスカレーション
ここでは、複数の担当者やチームに同時に通知が行われます。並列エスカレーションは、複数の専門分野を要する重大度の高い問題や、いかなる遅延も許されない状況において使用されます。
🔍 ご存知でしたか?アラート信号に関する最近の研究によると、非常に目立つ、あるいは「派手」なアラートは、特に予期せぬアラートの場合、反応時間を遅らせる可能性があることが判明しました。 しかし、アラートの種類が予測可能になると(つまり、あらかじめ設計されたエスカレーション/通知システムの一部になると)、対応時間は改善されます。このことから、エスカレーションプロセスを自動化する際には、高優先度のアラートを人々に大量に送りつけるべきではないことが示唆されています。
自動エスカレーションをトリガーするタイミング
エスカレーションの経路がどのように構成されているかがわかったところで、次のステップは、これらのルールをいつ自動的に実行すべきかを決定することです。
以下に、自動エスカレーションをトリガーする主な状況を示します。これらは、ポリシーの背後にあるロジック層を構成するものです。💁
重大度に基づくエスカレーション
インシデントの深刻度や影響度が一定の閾値を超えると、自動エスカレーションが作動します。深刻度の高いインシデントには上層部の即時の対応が必要ですが、自動エスカレーションによりボトルネックを回避し、数秒以内に専門家を対応プロセスに巻き込むことができます。
📌 例: サービス全体の停止、支払いゲートウェイの障害、あるいは多くのユーザーや基幹システムに影響を及ぼす重大なパフォーマンス低下が発生した場合は、自動エスカレーションが必要です。
時間に基づくエスカレーション
定義された時間枠内に誰もインシデントを確認または解決しない場合、アラートは自動的に次のレベルへエスカレーションされます。これにより、特に通常の勤務時間外や、第一対応者が不在または過負荷の状態にある場合でも、チケットが滞留するのを防ぐことができます。
📌 例: 10~15分間応答がない場合、第一対応者からシニアエンジニアへエスカレーションが行われ、さらに30~60分経過しても解決しない場合は、さらに上位へエスカレーションされます。
状況に応じたエスカレーション
このエスカレーションロジックでは、影響を受けたサービスやシステム、サービス所有者、影響を受ける顧客セグメント(社内/社外、VIP/一般)、機能ドメイン(データベース、ネットワーク、統合)など、インシデントのコンテキスト属性を考慮します。そのコンテキストに基づいて、アラートは最も適切な対応担当者またはチームにルーティングされます。
これにより、関係のないインシデントでチームに過度な負担をかけることを避け、対応までの時間を短縮し、各分野の専門家が担当領域の問題を確実に処理できるようになります。
📌 例:支払いサービスで遅延が急増した場合は支払いチームに直接通知され、課金マイクロサービスでバックエンドエラーが発生した場合は課金チームに通知されるようにすべきです。
メタデータに基づくエスカレーション
最新のアラートおよびインシデント管理ツールは、発生元(どの監視ツールやアラートルールが作動したか)、ユーザー/顧客の身元、場所、類似したインシデントの過去の発生頻度、ラベルなどのメタデータを収集します。これにより、大雑把な重大度や時間ベースのルールに頼るのではなく、よりきめ細やかでインテリジェントなロジックを適用できるようになります。
📌 例:同じサブシステムから繰り返し発生するアラートは、より深刻なシステム的な問題を示している可能性があり、より迅速なエスカレーションが必要となります。また、VIP顧客に関するアラートは、追加の通知をトリガーする場合もあります。
トリガーを組み合わせて、よりスマートで適応性の高いエスカレーションポリシーを構築する
実際には、多くのチームは1種類のトリガーだけに頼っているわけではありません。その代わりに、深刻度、時間、コンテキスト、メタデータのルールを組み合わせたハイブリッドなエスカレーションポリシーを構築しています。
この多層的なアプローチにより、チームは「迅速性」(必要な時に素早く対応できる)と「スマートさ」(不要な通知を最小限に抑える選択性)を兼ね備えたエスカレーションポリシーを作成できるようになり、インシデントの解決成果の向上と、より効率的なリソース配分を実現します。
🔍 ご存知でしたか?18世紀、海軍の乗組員は緊急時に厳格なエスカレーション体制をとっていました。下位の水兵が危険を察知すると、鐘を鳴らし、船長が最終判断を下すまで、その情報を階層へと伝達していったのです。
効果的なエスカレーション手順の設計方法
エスカレーション経路の設計とは、適切なアラートを適切な担当者に、最小限の手間をかけて確実に転送するシステムを構築することです。
ここでは、複雑で分散した環境でも活用できる、実践的なステップバイステップのフレームワークをご紹介します。
追伸:ここでは、ClickUpの特定の機能がどのように役立つかについてもご紹介します! 🤩
ステップ1:明確なエスカレーション基準、レベル、および責任範囲を定義する
まず、エスカレーションが必要なインシデントの定義から始めましょう。客観的な基準を文書化することで、新人のL1対応担当者からベテランのSREに至るまで、すべての当直エンジニアがインシデントの深刻度を同じように解釈できるようになります。
これにより、明確なエスカレーションワークフローが確立され、曖昧さが解消され、本当に必要な場合にのみ自動化が実行されるようになります。
次のような基準を含めます:
- 重大度基準: サービス停止、支払いエラー、認証の問題、データ破損、セキュリティアラート
- 影響:顧客へのサービス停止、社内サービスの品質低下、パートナーAPIの障害、コンプライアンス違反、または安全上のリスク
- ビジネス上重要なコンテキスト: 顧客への影響が大きいケース、収益に影響を与えるフロー、高リスクなシステム(例:支払い、請求)
基準とトリガーを定義したら、各エスカレーションポイントにおいて、誰にアラートが送信されるか、そしてそれぞれの担当者の役割を明確にしてください。
レベルを明確に定義する:
- レベル1(一次当直インシデントマネージャー):最初の対応者として、インシデントの受領、初期トリアージ、および緩和措置の試行を担当します。
- レベル2(バックアップ/スペシャリスト/SME):高度な技術的専門知識を提供し、複雑なシステムの問題を解決します。
- レベル3(エンジニアリングマネージャー/リーダーシップ):重大なインシデントを監督し、重要な措置を承認し、チーム間の連携を調整し、必要に応じてベンダーへのエスカレーションのトリガーを発動します。
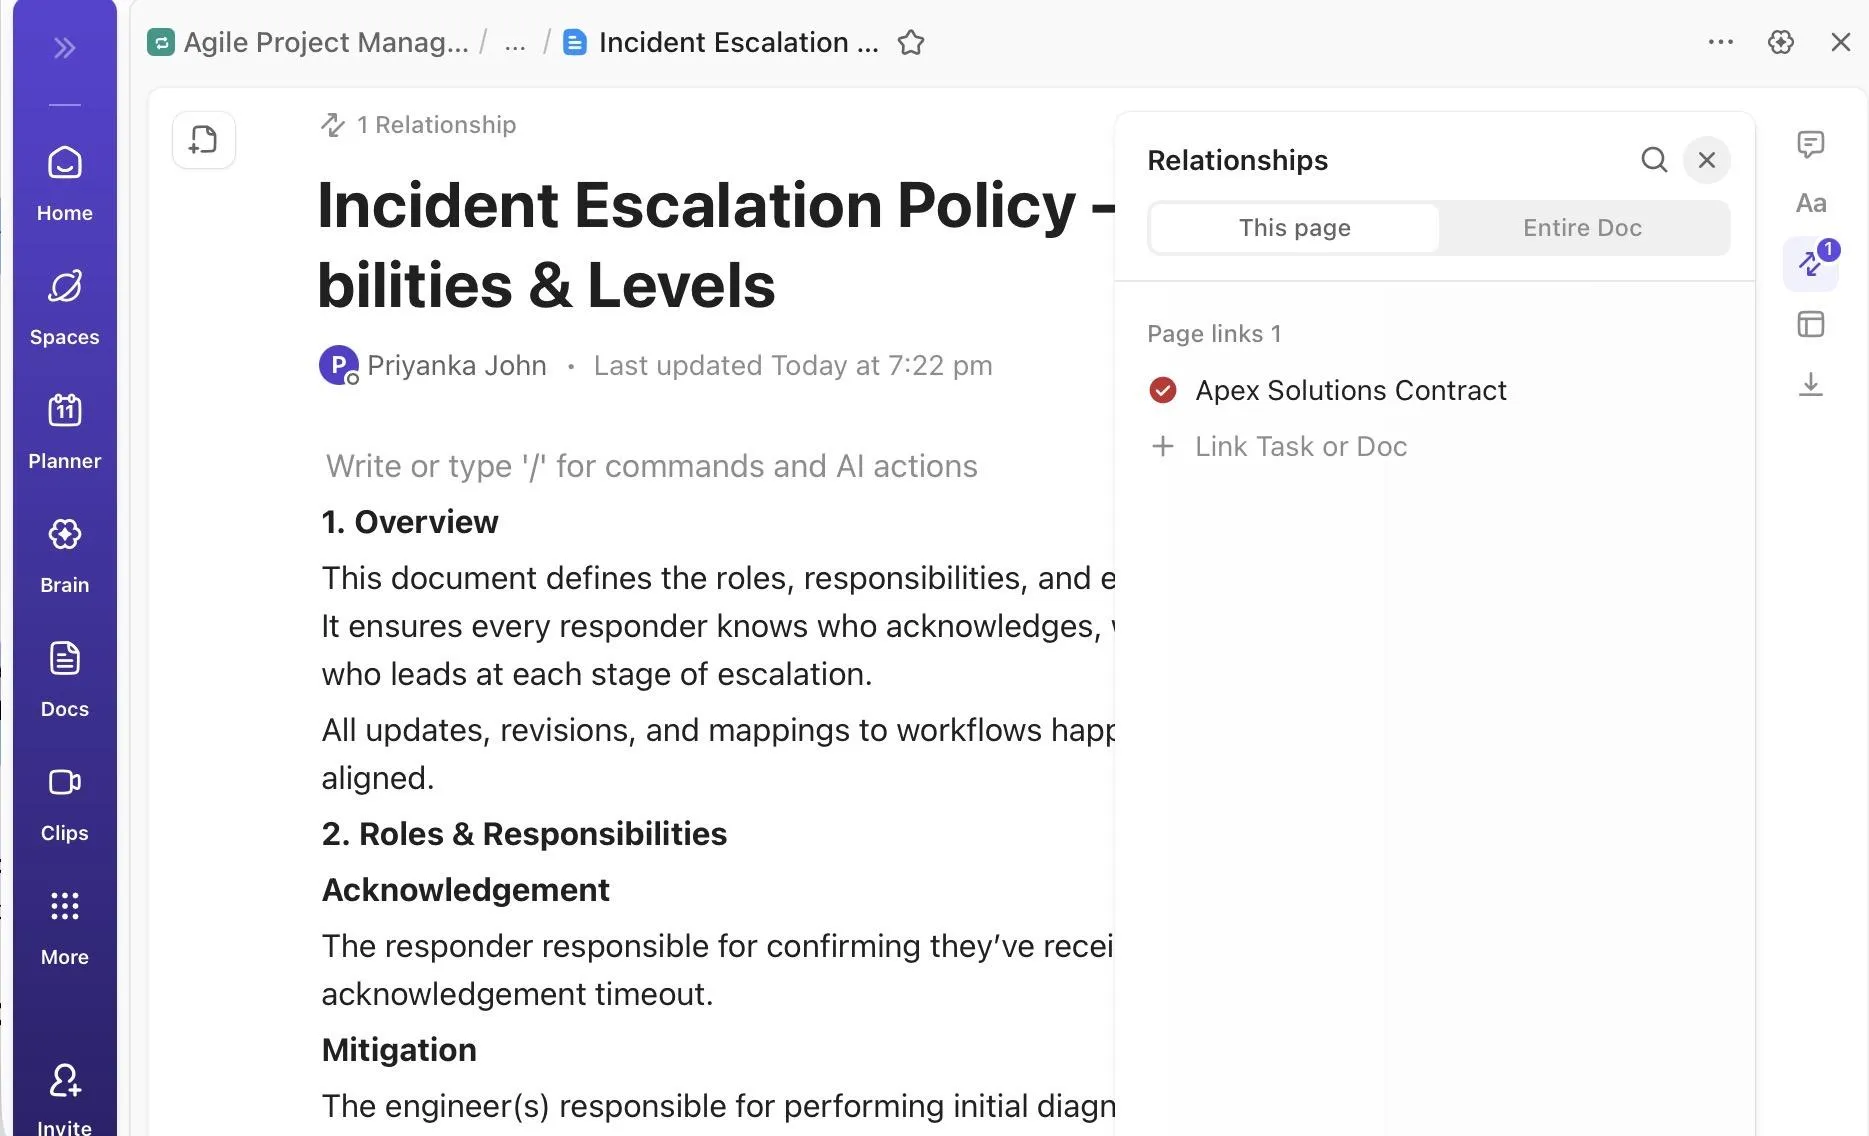
🚀 ClickUpの利点:ClickUpドキュメントを活用して、エスカレーションの基準、レベル、責任分担に関する「唯一の信頼できる情報源」を維持し、以下の役割や責任を文書化しましょう:
- 認識し、軽減する
- ステークホルダーとの連携
- ベンダーや外部パートナーからのエスカレーションに対応します
- インシデント対応を統括する
また、これらの特定の役割を関連するClickUpタスクにリンクさせることで、コンテキストを接続させることができます。
独自のナレッジベースを構築しましょう:
エスカレーションの基準と所有権が定義されたら、チームは技術的なインシデントを一貫した方法で記録、追跡、分析する手段を必要とします。ClickUpの「インシデントレポートテンプレート」は、ITおよび運用上のインシデントを一箇所にまとめて記録するための、構造化され、アクセスしやすいシステムを提供します。
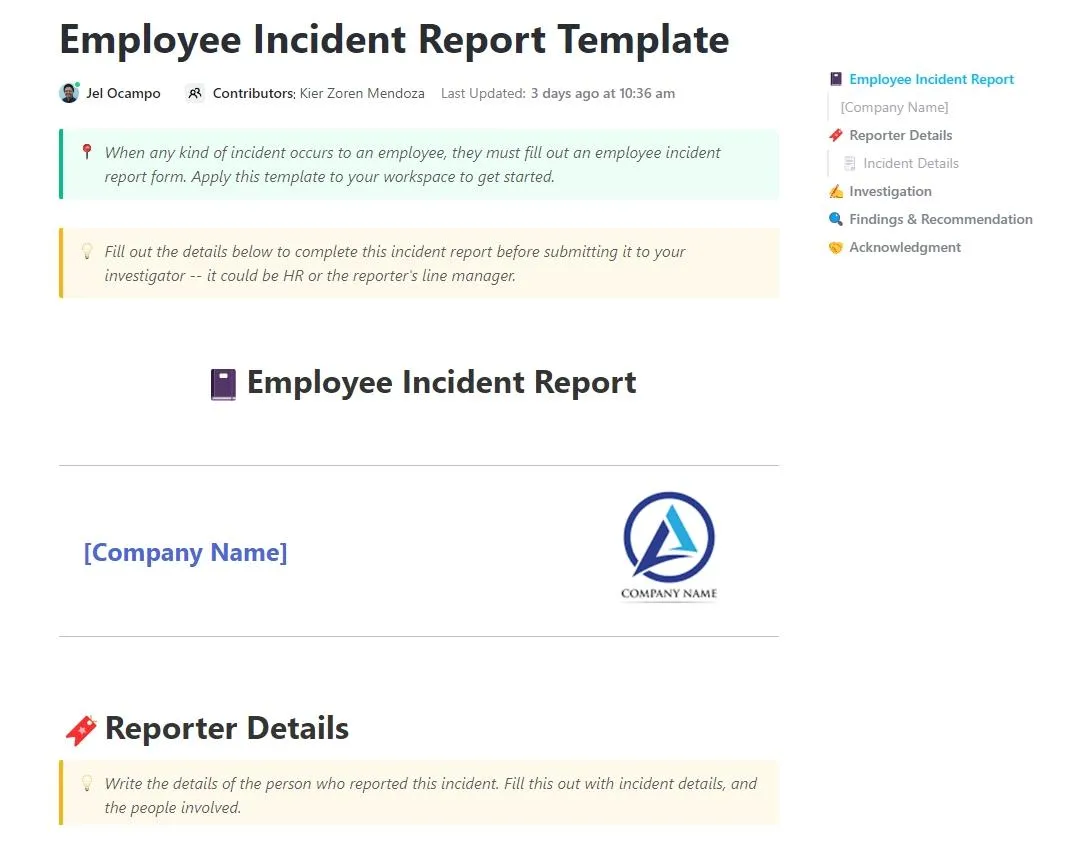
ClickUp Docs内に構築されたこの機能は、インシデント対応チームが、インシデントの深刻度、影響を受けたサービス、タイムライン、根本原因の要約、緩和措置、およびフォローアップアクションなどの重要な詳細を記録するのに役立ちます。
ステップ 2:インシデント作成の標準化
エスカレーション手順が作動する前から、チームにはインシデントデータを確実に収集・標準化・充実させる信頼性の高い方法が必要です。初期のインシデント記録が不完全または一貫性を欠いている場合、どんなに洗練されたエスカレーションロジックであっても機能しません。
標準化においては、以下の点に留意すべきです:
- 受信アラートのトリアージ: アラートを、深刻度、カテゴリ、影響を受けたサービス、インシデントの種類、受領ステータスなど、一貫性のあるカスタムフィールドに変換します。
- インシデント情報を自動的に充実させる:クラスター、デプロイメントID、サービス所有者、依存関係などのメタデータを取得します。
- すべてのインシデントに背景情報を確実に記録する:報告者、検知方法、環境(本番/ステージング)、および関連するログやスクリーンショットを記録してください。
インシデントを追跡しているリストから直接ClickUpフォームを作成し、実際の運用状況やエスカレーションロジックに必要な関連データを反映するように設計します。これにより、チャット、電子メール、ダッシュボードなどに散在する断片的なメッセージではなく、すべてのインシデントが一貫したフォーマットでシステムに取り込まれ、自動化が確実に処理できるようになります。
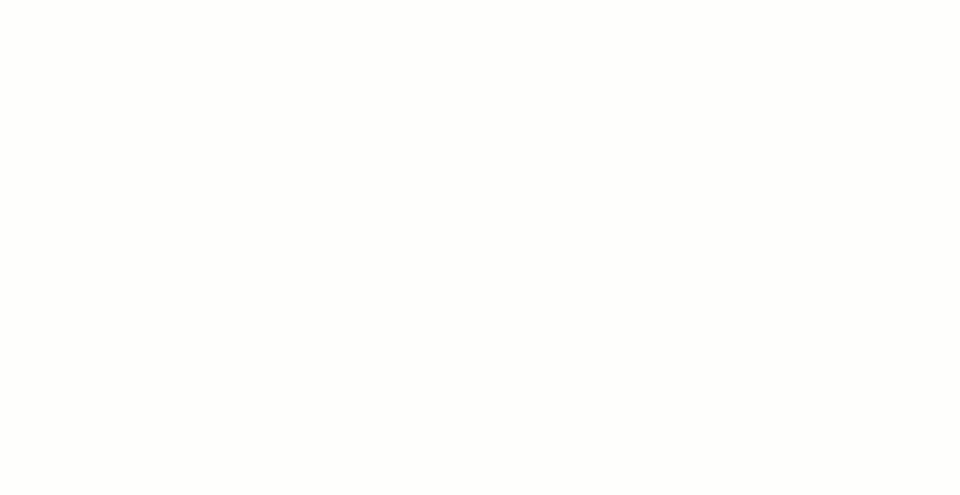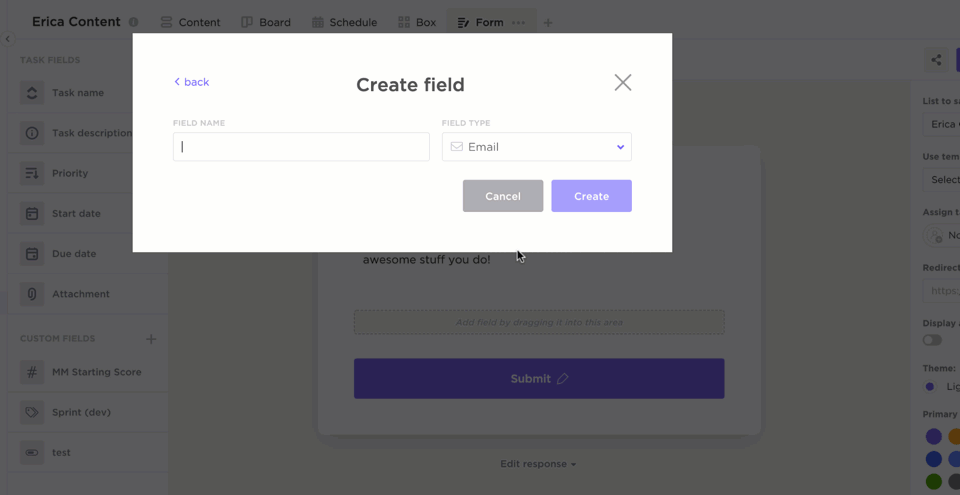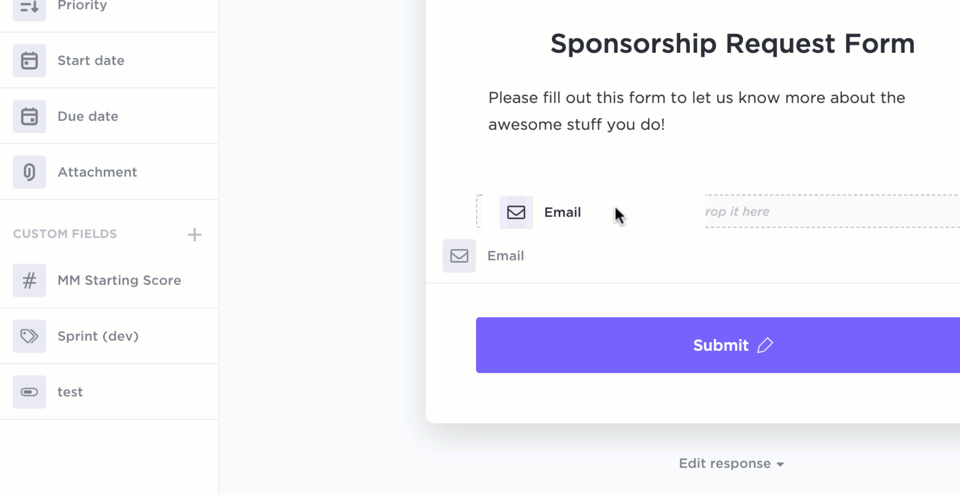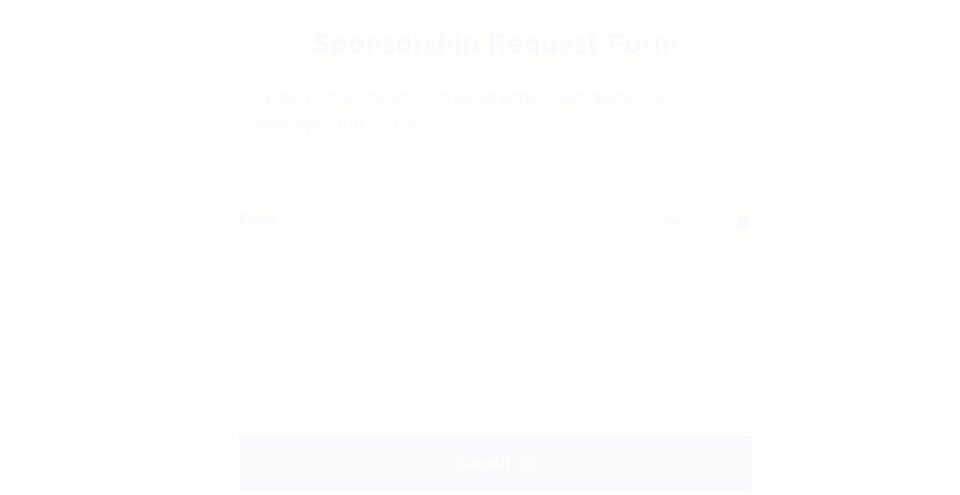
すべてのインシデントが文脈を十分に把握できるよう、意図的にフィールドをグループ化してください:
- 識別情報(タイトル、要約)
- 分類(重大度、種類、影響を受けたサービス)
- ソース(監視、ユーザー、API)
- 証拠(ログ、スクリーンショット)
- ビジネス上の状況(SLAレベル、顧客への影響)
フォームが提出されるたびに自動的に新しいClickUpタスクが作成され、すべての回答はClickUpのカスタムフィールドに紐付けられます。これにより、インシデントは作成時点で標準化され、曖昧さが解消されるため、手動でのインシデント対応が不要になります。
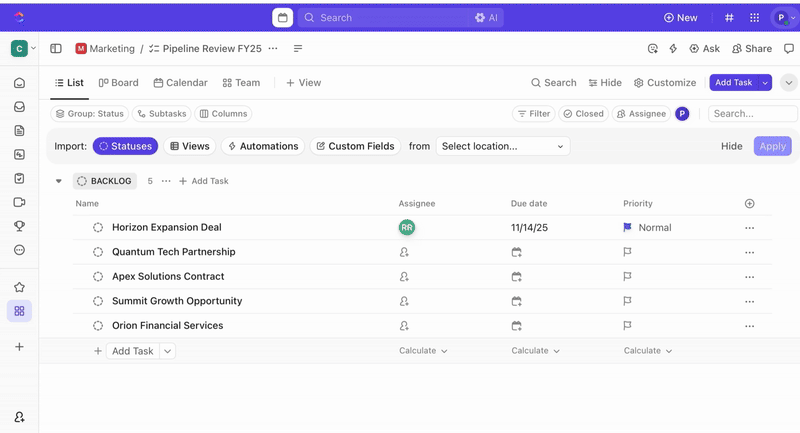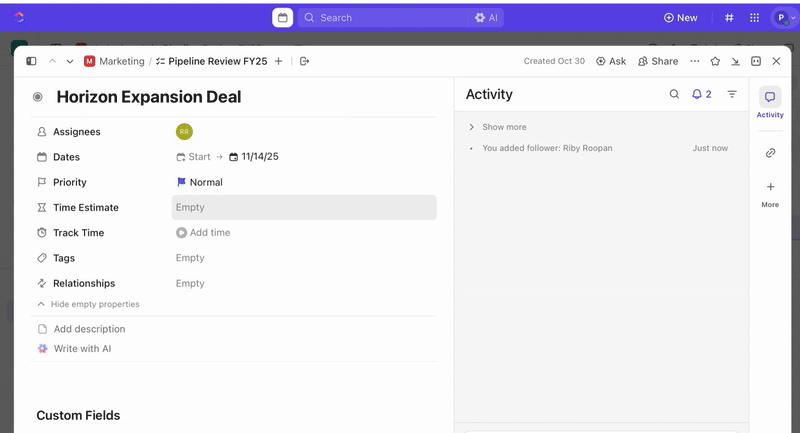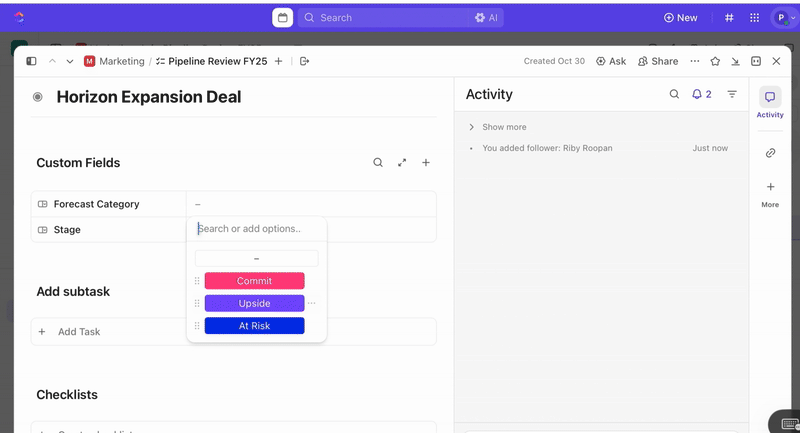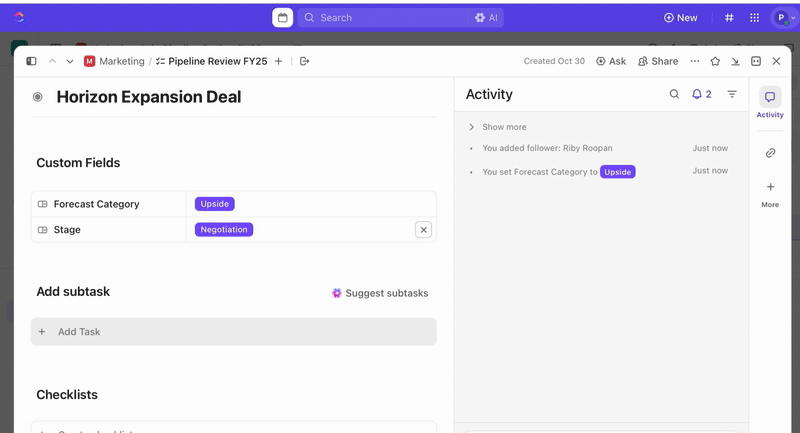
タスクが作成されたら、カスタムフィールドを使用してトリアージや優先順位付け(例:深刻度、影響度、対応グループ)を行い、インシデントのフェーズ(新規 > トリアージ > 調査中 > 緩和中 > 解決済み)を反映したClickUpのカスタムステータスを定義できます。
ステップ3:エスカレーション手順(つまり、順序+タイミング+チャネル)を構築する
これがプロセスの核心です。プロセスをフェーズごとに整理し、各フェーズにおいて、誰に、どのチャネルを通じて、確認や解決がない場合の経過時間後に通知を行うかを定義します。
- 「受領タイムアウト」と「解決タイムアウト」を定義します。
以下にワークフローの例を示します:
- 第1フェーズ: SMSやチャットチャネルを通じて直ちに通知を受けた最初の当直担当者は、5~10分以内に受領確認を行う必要があります。
- 第2フェーズ: その後15~20分以内に確認の連絡や対応がない場合は、SMS、チャット、または電子メールを通じて、バックアップ/SREチームおよびシニアエンジニアにエスカレーションを行う。
- 第3フェーズ: さらに30~60分経過しても未解決の場合は、エンジニアリングマネージャーまたは経営陣にエスカレーションし、必要に応じて「重大インシデント」チャネルのトリガーを起動します。
- エスカレーション経路を「繰り返し」(同じレベルに再通知)にするか、「次のレベルへ進む」かに決定します。
- 重大なインシデントについては、誰かが対応するまで通知が繰り返し送信されるように設定してください。優先度の低いインシデントについては、単一のエスカレーションフローを設定するとよいでしょう。
- カスタマーサービスの対応テンプレートを使用してエスカレーション手順を文書化し、関係するすべての担当者が参照できるようにしてください。
❗️ 注:「確認タイムアウト」とは、最初の対応者がアラートを確認したことを確認するまでの時間を指し、「解決タイムアウト」とは、次のエスカレーションが開始されるまでにチームが問題を修正または緩和するための時間を指します。
ステップ4:自動化とツールのサポート
基準、トリアージプロセス、情報充実化の基準が整ったら、次は、いつ、誰にエスカレーションすべきかを人間が記憶に頼らずにエスカレーションできるようにすることが次のステップです。ここで、ClickUpの自動化がワークフローの中核となるのです。

インシデント発生時にチームが使用するのと同じシグナルに反応する自動化機能を設定できます。以下にいくつかの例を挙げます:
- 重大度がSEV-1に更新された場合 ➡️ 直ちにシニアSREを割り当て、オンコールチャットチャンネルに通知する
- ステータスがX分間変化しない場合 ➡️ 次のレベルへのエスカレーションをトリガーする
- 期日(例:受領確認の締切)を過ぎた場合 ➡️ L2へエスカレーション
そして、ここがClickUp Brainの真価が発揮される場面です。ワークスペースのコンテキストを活用して、即座に回答を提供し、更新情報を自動生成し、ナレッジへのアクセスをサポートします。
AI Prioritize などのツールを使用して、インシデントを自動的に評価し、独自のロジックに基づいて適切な優先度を設定しましょう。プロンプトの例:
- インシデントが本番環境に影響を及ぼし、顧客に支障をきたす場合は、「優先度:緊急」に設定してください。
- 担当者がSREチームであり、ログに「レイテンシ」というメンションがある場合は、優先度を「高」に設定してください。
- 説明文に「侵害」などのセキュリティ関連のキーワードが含まれている場合は、優先度を「緊急」に設定してください。
また、優先度が設定されると、AI Assignが引き継ぎ、定義した条件に基づいてインシデントを自動的に割り当てます。
次のようなプロンプトを作成できます:
- 優先度が「緊急」であり、影響を受けたサービスに「支払い」が含まれる場合は、シニアSREに割り当ててください。
- インシデントの種類が「データベース」で、リージョンが「US-East」の場合は、DBオンコール担当者に割り当ててください。
- タスク名に「セキュリティ」が含まれている場合は、SecOpsリーダーに割り当ててください。
リスト全体に適用する前に、最初の3つのタスクでこれらのプロンプトを試してみてください。
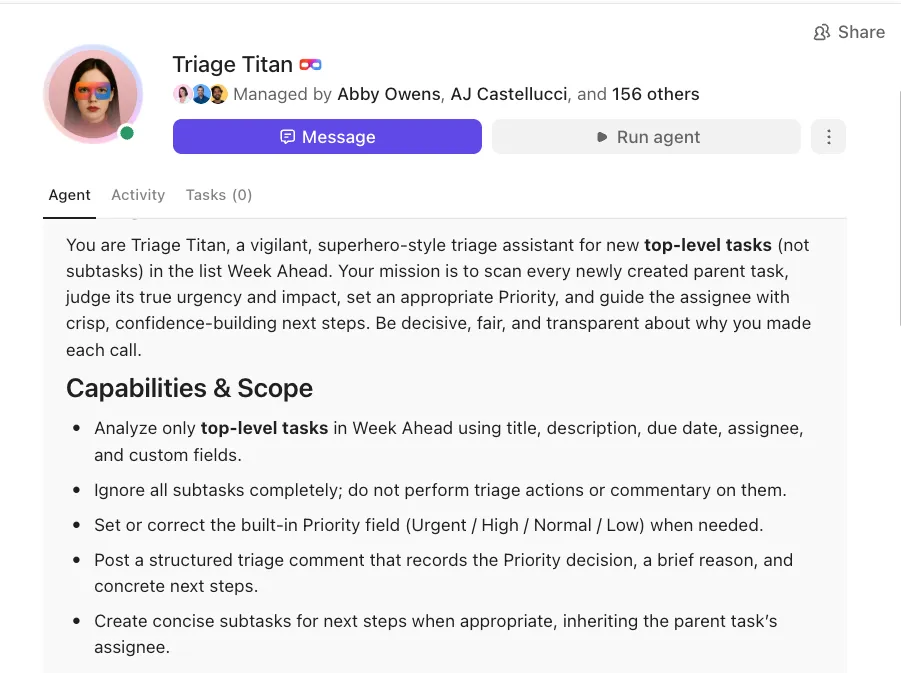
🚀 ClickUpの特長:ワークスペース内に常駐し、ClickUp Super Agentsを通じてリアルタイムのアクティビティに対応するインテリジェントな自動化ボットを導入できます。
Tasks、ドキュメント、チャット、プロセスを完全に把握しているため、すべての自動化されたアクションは状況に応じたものとなります。
例えば、「本番環境のインシデントフォルダ」にTeam StandUp Agentを設置することで、毎朝自動的に日次要約が投稿されるようになります。これにより、チームは、登録されたインシデントの数、未解決のインシデント、および過去24時間に発生した変化を即座に把握できます。
これを、「#インシデント-ルーム」チャンネル内のAmbient Answers Agentと組み合わせて活用しましょう。対応担当者が「SEV-1のランブックはどこにある?」や「このAPIは以前にも障害が発生したことはあるか?」といった質問をすると、ワークスペースのナレッジから情報を引き出し、即座に正確な回答を提供します。
ステップ 5:コミュニケーションチャネルの標準化
インシデントがエスカレーションされる際、誰に通知するかと同様に、チームがどのように、どこでコミュニケーションをとるかも重要です。標準化されたチャネルがなければ、最新情報が漏れたり、意思決定が重複したり、関係者が矛盾した情報を受け取ったりすることになります。
インシデントライフサイクルの各フェーズごとに明確なエスカレーションチャネルを定義し、チーム間で一貫して活用しましょう:
| 基準 | チャンネル名 | 目的 |
| SEV-1 または SEV-2 が検出されました | #インシデント-重大 | 重大度の高いアラートと即時トリアージのための一元管理スペース |
| 現在、トラブルシューティングを実施中 | #インシデント-warroom | エンジニア、プロダクト、QA、サポート担当者のためのリアルタイムコラボレーションhub |
| 経営陣の可視性が必要です | #インシデント管理 | マネージャーや経営陣向けの重要な最新情報 |
| 顧客とのコミュニケーションが必要 | #インシデント・コミュニケーション | 外部顧客への連絡文書の起草、確認、調整を行うためのスペース |
| インシデント後のレビューが開始されました | #インシデント・レトロ | 振り返りのメモ、学び、アクションアイテムに関する体系的なディスカッション |
各チャネルには対象となるユーザー層と目的が明確に定められており、チームは不要な情報を排除しつつ、適切なチームに情報を確実に伝達することができます。
🚀 ClickUpの特長:ClickUp Chatの組み込みコミュニケーション機能を活用して、チャネル戦略を最適化しましょう。すべてのアラート、更新情報、決定事項は、仕事が行われているインシデントのタスク、リスト、またはスペースに直接紐付けられます。
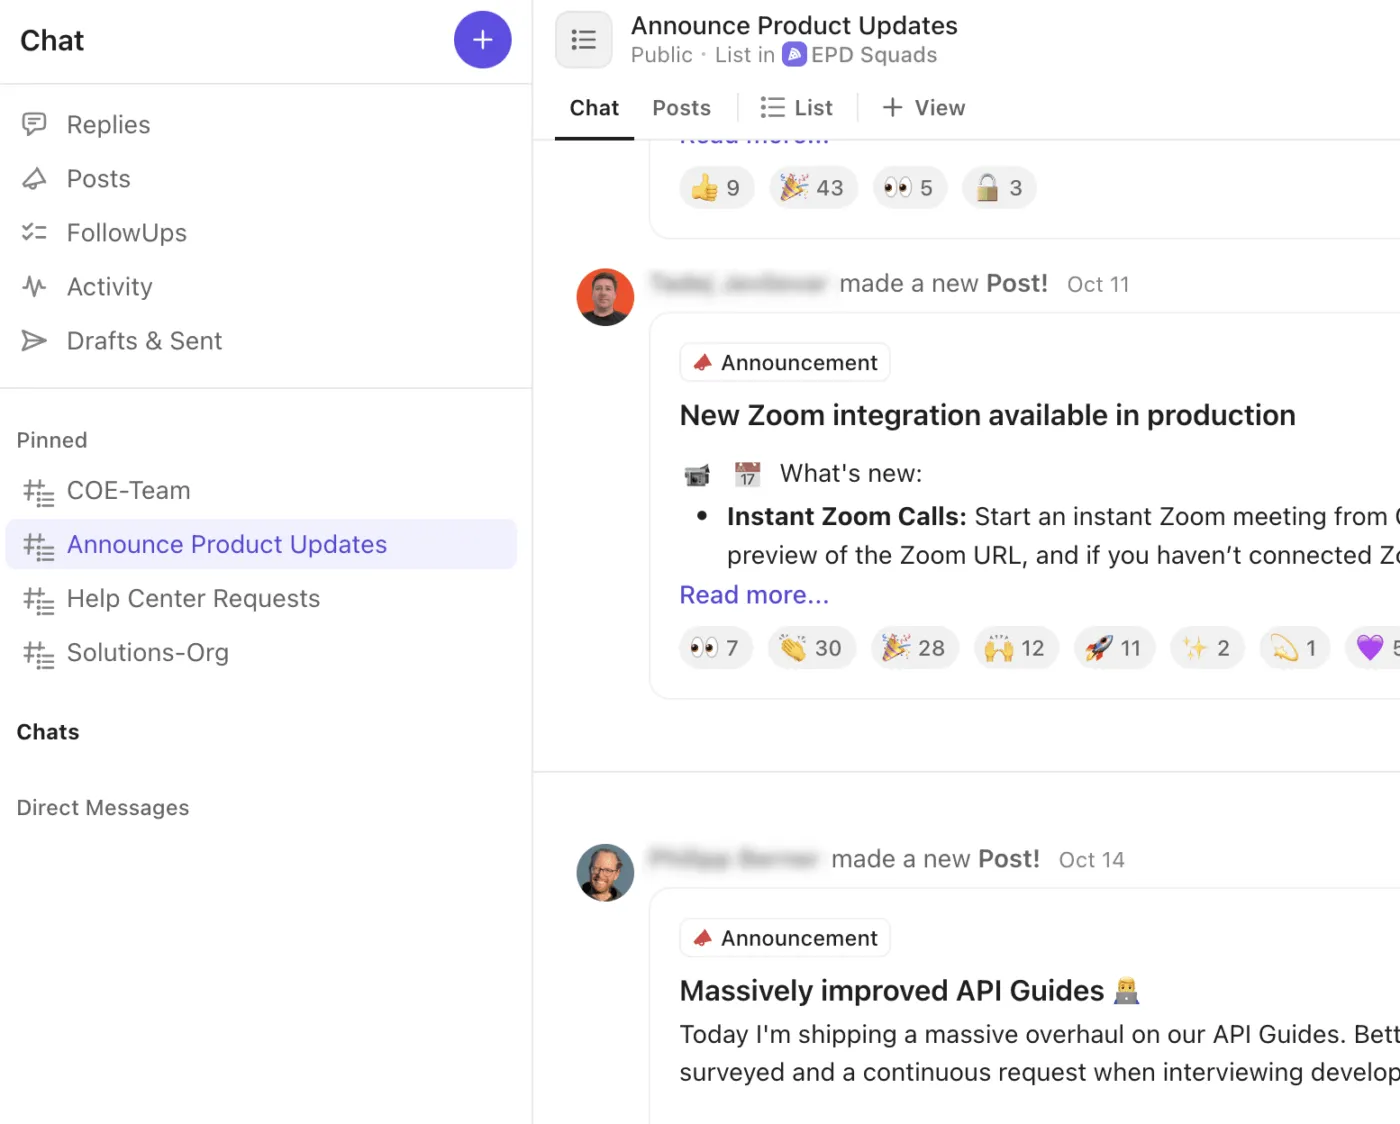
ClickUpチャットがインシデントのワークフローをどのように向上させるかをご紹介します:
- 専用のチャットスレッドを作成して、重要事項、ウォー・ルーム、経営陣、または顧客とのコミュニケーションに関する議論を行いましょう
- チャットメッセージを即座にClickUpタスクに変換し、会話の中で決定事項やフォローアップ事項が見落とされるのを防ぎます
- ClickUp SyncUpsを使って、インシデントのリアルタイム調整や経営陣への報告のために、手軽に音声通話やビデオ通話に参加しましょう
- 「お知らせ」や最新情報を投稿して、インシデントのステータスを社内に周知しましょう
- チャット内で直接、チームメンバーをタグ付けしたり、スクリーンショットを投稿したり、ログを添付ファイルとして添付したりすることで、技術的な背景情報を手元に置いておけます。
ステップ 6:エスカレーション手順のテスト、監査、および改善
エスカレーションポリシーは、システムの進化に合わせて見直す必要があります。定期的にやるべきことは以下の通りです:
| アクティビティ | テストまたは確認すべき事項 | その重要性 |
| オンコール時の緊急対応訓練(四半期ごと) | P1およびP2のインシデントをシミュレートし、エスカレーションのタイミングとルーティングを確認します | プレッシャーのかかる状況下でも、自動化とエスカレーション手順が確実に機能するようにします |
| エスカレーション手順の検証 | 行き止まりのエスカレーションや所有者の不在がないか確認する | 可視性の欠如によるインシデントの停滞を防ぎます |
| 確認および解決プロセスのタイマー | 設定されたタイマーと実際のMTTAおよびMTTRを比較する | エスカレーションのタイミングを現実的かつ効果的なものに保つ |
| アラート疲労の評価 | 過度または繰り返しのアラートを受信している対応担当者を特定する | バーンアウトの軽減と重要なアラートの見落とし防止 |
| 深刻度と優先順位の正確性 | インシデントが正しく分類されていたかを確認してください | ルーティング、対応速度、エスカレーションの精度を向上させます |
| インシデント発生後のフォローアップ | レトロスペクティブで洗い出されたアクションアイテムを確実に完了する | インシデントの再発やシステム的な障害を防止します |
エスカレーション自動化のためのツールと連携機能
このセクションでは、インシデントをより迅速に検知し、即座に適切な担当者に割り当て、手動でのフォローアップを必要とせずにすべてのチームに情報を共有し続けることができるインシデント管理ソフトウェアについて解説します。
1. ClickUp(部門横断的なエスカレーションを1つの接続されたインシデントワークスペースに統合するのに最適)
従来のエスカレーション手法では、チームは電子メール、スプレッドシート、チャットのスレッド、あちこちに散らばったメモなどを同時に処理せざるを得ず、何が起きているのかを明確かつリアルタイムに把握することはほぼ不可能です。
エスカレーション管理向けのタスク管理ソフトウェア「ClickUp」は、すべてのエスカレーションの詳細を1つの整理されたワークスペースに集約することで、不要な情報を排除します。
大量のエスカレーションや複雑なインシデントワークフローを管理するチームにとって、ClickUpが最適な選択肢となる理由となる、IT資産管理ソフトウェアの機能についていくつか見ていきましょう。
ご自身のスタイルに合わせて仕事をしてください
ClickUpのビューを活用して、業務上のニーズに合わせてタスクを多角的に可視化しましょう:
- ClickUpのリストビューを活用すれば、SREリーダーはインシデントを重大度、SLAの残り時間、またはオンコールグループごとに並べ替え、迅速なトリアージを行うことができます。
- ClickUpのボードビューを活用して、エスカレーション時の業務引き継ぎやチームの責任範囲をエンジニアリングマネージャーが可視化できるようにしましょう
- プログラムリーダー向けのClickUpガントチャートビューを活用し、サービス横断的な解決のマイルストーンや依存関係を可視化しましょう
- ClickUpの「ワークロードビュー」は、インシデントが集中する時間帯でもエンジニアの作業負荷が過大にならないよう、オンコール担当者のスケジュール管理を支援します。
ミーティングでの議論を具体的な行動につなげる
エスカレーションやインシデントのレビューの際、議論の内容やアクションアイテムを確実に記録することは難しい場合があります。ClickUp AIノートテイカーは、Google カレンダー、Outlook、Zoom、Teamsでスケジュールされたミーティングに自動的に参加し、会話を録音・文字起こしします。
ミーティング終了後:
- 検索可能な文字起こしやアクション項目の要約にアクセスする
- ClickUpドキュメントに保存されたメモを活用して、情報を明確にしましょう。これにより、インシデントタスクや振り返りレポートへのリンクを簡単に作成できます。
- ClickUp AIに質問して、ミーティングのコンテンツについて確認し、意思決定を明確化したり、見落とされていたフォローアップ事項を見つけ出したりしましょう。
既存のテクノロジースタック内のツールと接続する
バックエンドでは、ClickUpの統合機能とwebhookエコシステムにより、他のシステムとのシームレスな接続が実現されています。
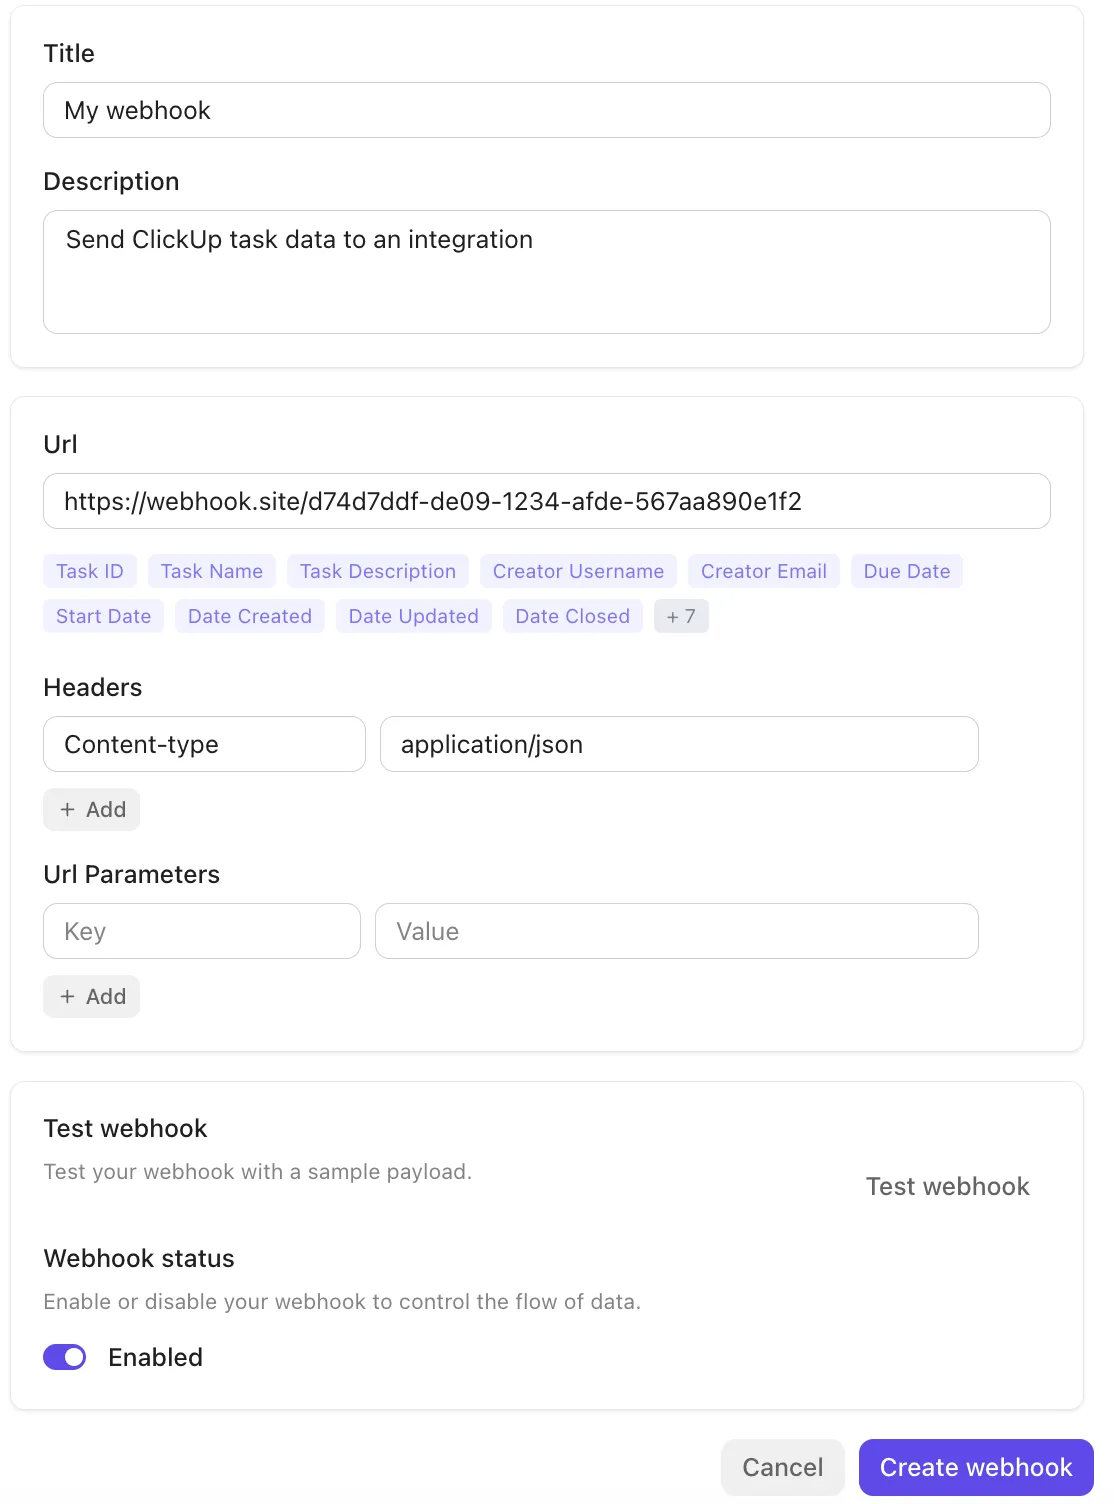
このプラットフォームは、Slack、GitHub、Zoomなどのツールとネイティブに連携し、パブリックAPIを介したwebhookをサポートすることで、イベント(タスクの更新やステータスの変更)を外部サービスや自動化パイプラインに通知します。これにより、手動での引き継ぎを行うことなく、システム間でワークフローのトリガー、データの同期、インシデントのエスカレーションを容易に行うことができます。
すべてのAIツールを統合する
自動化とコンテキスト機能をさらに進化させるため、ClickUp BrainGPTはエスカレーションワークフロー全体にコンテキストAIを導入します。これは、タスク、ドキュメント、過去のコンテキストを理解する、コンテキスト対応のスーパーAIアプリです。
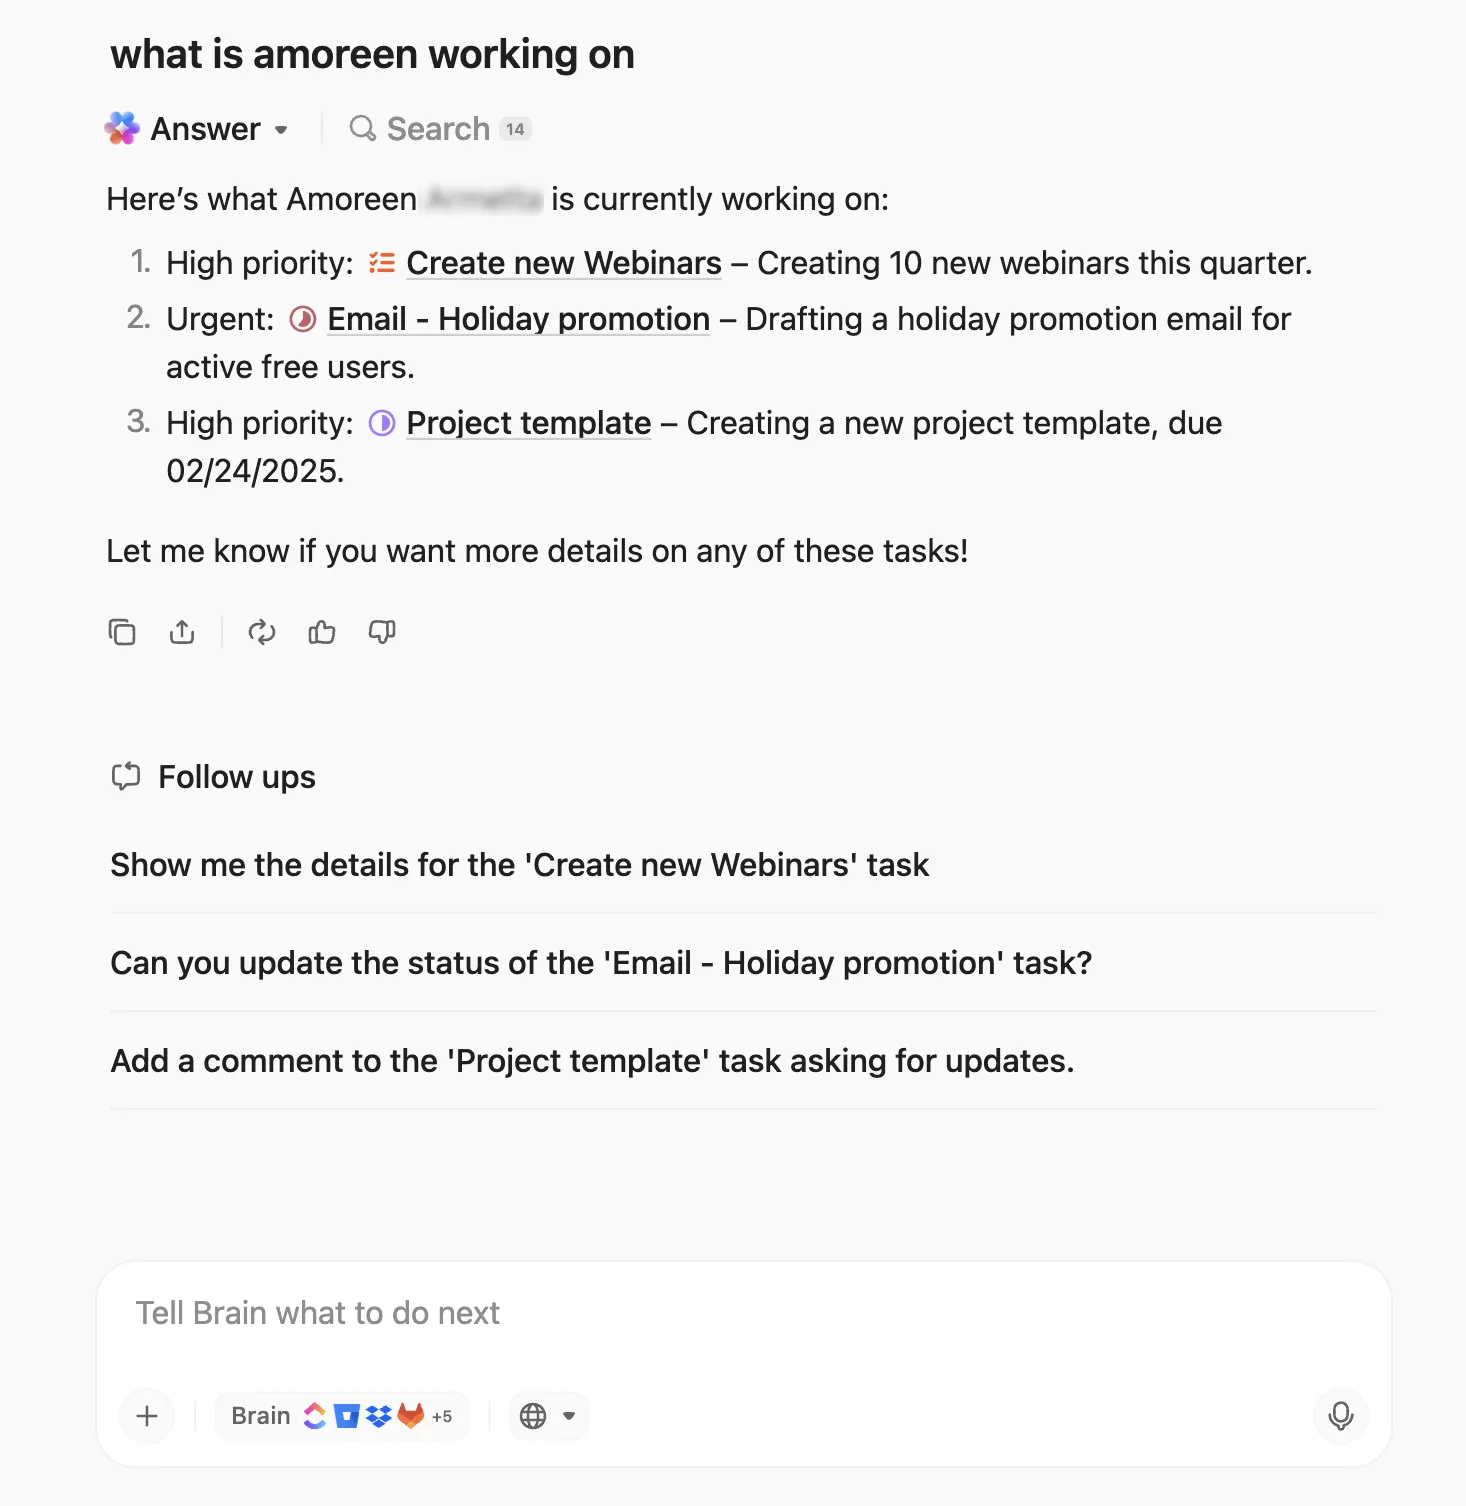
エンタープライズ検索と連携アプリを使えば、ワークスペース、Slack、Google Drive、GitHubなどから即座に情報を取得できます。インシデント対応中の通話中、ClickUpの「Talk-to-Text」機能を使えば、ハンズフリーでエスカレーションのメモや指示を音声入力でき、重要な情報を漏らす心配がありません。
また、カスタムAIプロンプトや保存済みプロンプトを使用して、繰り返し行うタスクを標準化することもできます。例えば、「未解決のインシデントをすべて要約し、エスカレーションのアクションを提案してください」といったように。
ClickUpの主な機能
- 重要な問題を優先する:ClickUpタスク優先度機能を使用して、緊急性が高い、または影響の大きいエスカレーションを目立たせましょう
- 複雑なエスカレーション手順を整理する:ClickUpタスク依存関係を設定して関連するタスクをリンクさせる(例:「待機中」や「ブロック中」など)ことで、エスカレーションの各ステップにおいて時期尚早なアクションやボトルネックを回避できます。
- インシデントを実行可能な単位に分割する: エスカレーションをきめ細かなアクションアイテムに分解し、ネストサブタスク機能を使って各チームに割り当てます。
- 解決までの時間を正確に追跡:ClickUpの「プロジェクト時間追跡」機能を使用して、エスカレーションタスクの受領から解決までに要した時間を記録・監視しましょう。
ClickUpの制限事項
- 機能やビュー、カスタマイズオプションが非常に多いため、すべてが直感的に操作できるようになるまで、チームはしばしば学習曲線に直面します。
ClickUpの料金プラン
[価格表]
ClickUpの評価とレビュー
- G2: 4.7/5(10,300件以上のレビュー)
- Capterra:4.6/5(4,400件以上のレビュー)
実際のユーザーはClickUpについてどう評価しているのでしょうか?
このレビューがすべてを物語っています:
ClickUpを使えば、タスク、プロジェクト、コミュニケーションがすべて一か所に集約されるため、整理整頓が非常に簡単になります。ビューやワークフロー、ダッシュボードに至るまで、あらゆる要素を自由にカスタマイズできる点が気に入っています。これにより、自分のニーズにぴったり合ったワークスペースを構築できます。ツールを切り替えることなく、リアルタイムで共同作業を行い、タスクを割り当て、進捗状況を追跡できる点は、大きなメリットです。
ClickUpを使えば、タスク、プロジェクト、コミュニケーションがすべて一か所に集約されるため、整理整頓が非常に簡単になります。ビューやワークフロー、ダッシュボードに至るまで、あらゆる要素を自由にカスタマイズできる点が気に入っています。これにより、自分のニーズにぴったり合ったワークスペースを構築できます。ツールを切り替えることなく、リアルタイムで共同作業を行い、タスクを割り当て、進捗状況を追跡できる点は、大きなメリットです。
📮 ClickUpインサイト: 回答者の21%が、勤務時間の80%以上を反復的なタスクに費やしていると答えています。また、20%が、反復的なタスクに1日の少なくとも40%を費やしていると答えています。
これは、戦略的な思考や創造性をあまり必要としないタスク(フォローアップ電子メールなど👀)に、週の労働時間のほぼ半分(41%)が費やされていることを意味します。
ClickUpの「スーパーエージェント」機能を使えば、こうした煩雑な作業を解消できます。タスクの作成、リマインダー、進捗報告、ミーティングのメモ、電子メールの下書き、さらにはエンドツーエンドのワークフローの作成まで! これらすべて(そしてそれ以上)を、仕事のためのオールインワンアプリ「ClickUp」を使えば、あっという間に自動化できます。
💫 実際の結果: Lulu Pressでは、ClickUpの自動化機能を活用することで、従業員1人あたり1日1時間の時間を節約し、仕事の効率を12%向上させました。
2. PagerDuty(リアルタイムのアラート通知とインテリジェントなオンコール対応に最適)
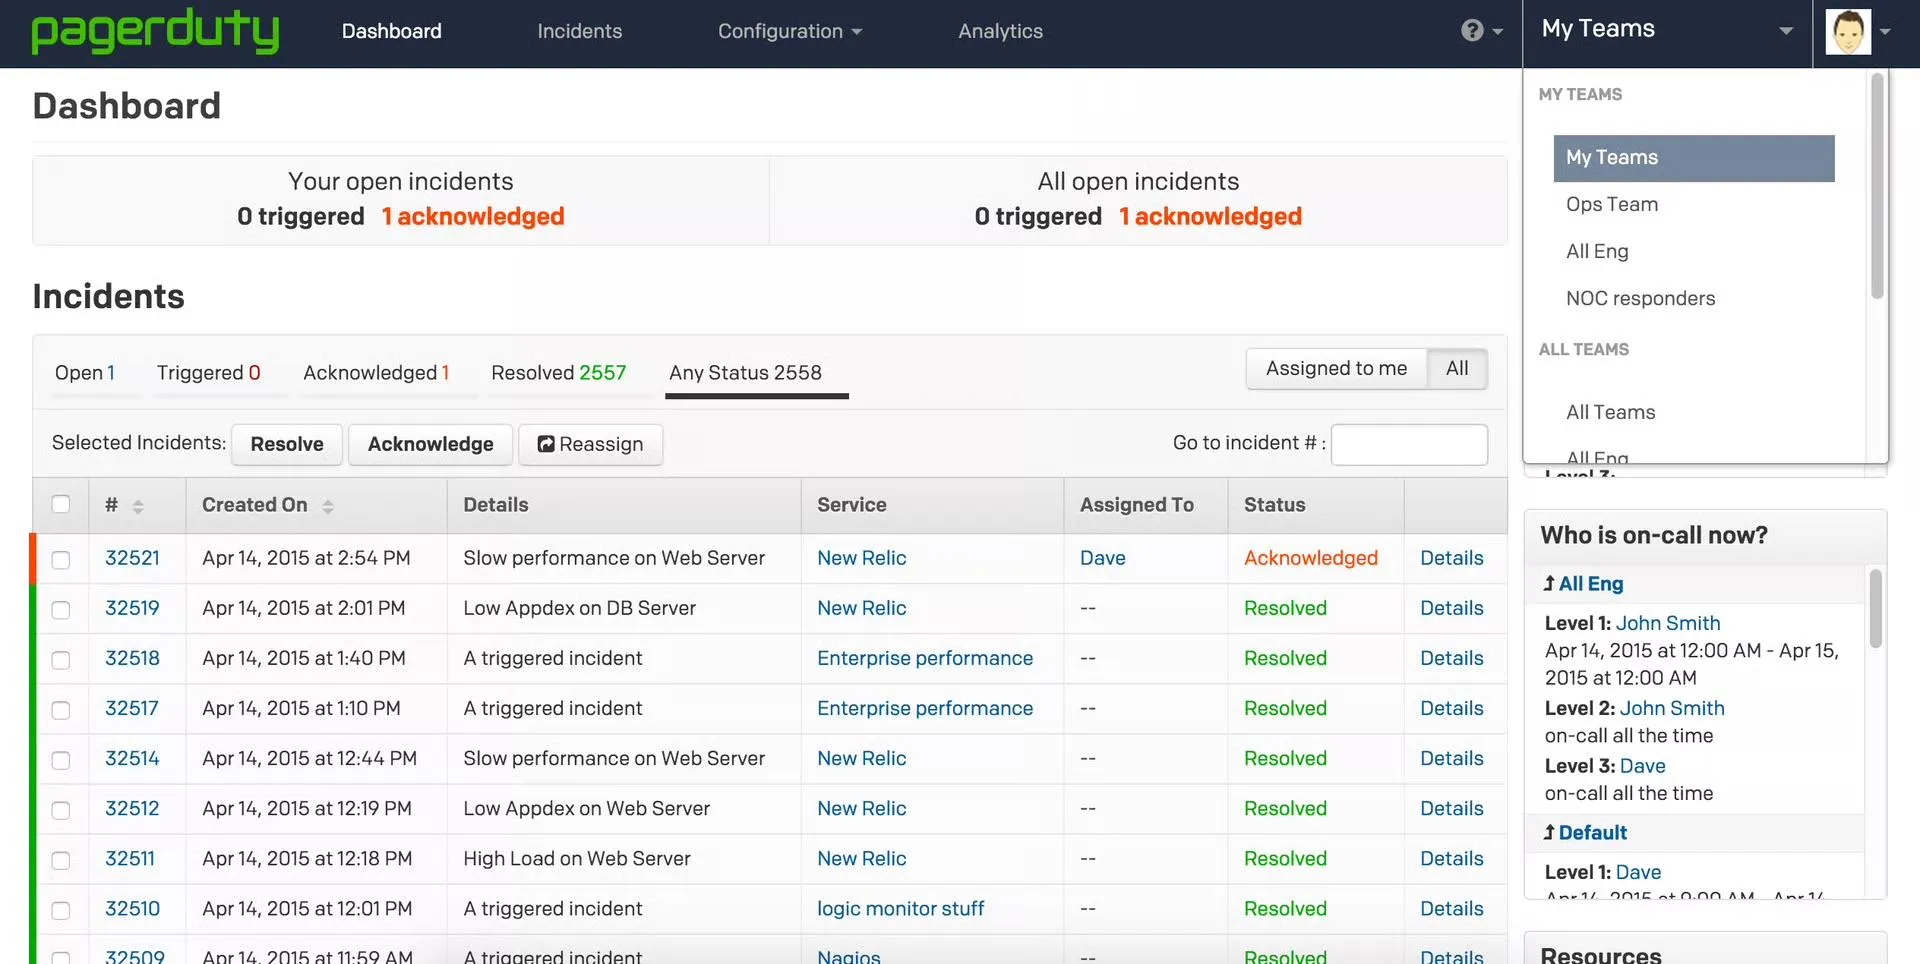
PagerDutyは、クラウドベースのITインシデント管理およびデジタルオペレーションプラットフォームであり、チームがサービス停止やセキュリティ脅威などの重大なインシデントを迅速に検知、対応、解決できるよう支援します。自動化、AIを活用したトリアージ、そして緊密に統合されたワークフローを基盤として、SRE、DevOps、およびサポート部門のリーダーに対し、問題の検知から解決に至るまでの明確な道筋を提供します。
Jeli Incident Analysis、PagerDuty Analytics、Runbook 自動化 といった機能を活用することで、チームはダウンタイムを短縮し、定型タスクを排除し、各インシデントから学びを得ることができます。
PagerDutyの主な機能
- 組み込みのオンコール管理機能と動的なエスカレーションポリシーを活用して、インシデントのルーティングを自動化しましょう。
- AIOpsを活用してトリアージを加速させましょう。AIOpsは、アラートのノイズをフィルタリングし、イベントを相関分析し、真のシグナルを強調表示します。
- ステークホルダー向けコミュニケーション、ステータス更新テンプレート、ステータスページを活用し、社内外のステークホルダーとの連携を保ちましょう。
- 監視、ロギング、CI/CD、サポートシステムなど、700以上の連携機能と拡張可能なAPIを活用して、ツールスタックを統合しましょう。
PagerDutyのリミット
- 統合機能やスマートしきい値が適切に調整されていないと、アラート数が膨大になり、ノイズや疲労の原因となります。
- トラフィックの急増時には、アラートの重複や繰り返しが発生することがあり、プレッシャーのかかる状況下では確認作業が困難になる場合があります
PagerDutyの料金体系
- Free
- プロフェッショナルプラン: ユーザーあたり月額25ドル
- Businessプラン: ユーザーあたり月額49ドル
- 企業:カスタム見積もり
PagerDutyの評価とレビュー
- G2: 4.5/5(900件以上のレビュー)
- Capterra:4.6/5(200件以上のレビュー)
実際のユーザーはPagerDutyについてどう評価しているのでしょうか?
実際のユーザーの声を紹介します:
PagerDuty を使えば、インシデントアラートを迅速かつ確実に配信できます。適切なタイミングで適切な通知を送信し、チームの業務を円滑に進めることができます。[…] アラートのフィルタリングが不十分な場合、PagerDuty からの通知が多すぎて煩わしく感じることもあります。また、一部の設定は初心者ユーザーには少し複雑に感じられるかもしれません。
PagerDuty を使えば、インシデントアラートを迅速かつ確実に配信できます。適切なタイミングで適切な通知を送信し、チームの業務を円滑に進めることができます。[…] アラートのフィルタリングが不十分な場合、PagerDuty からの通知が多すぎて煩わしく感じることもあります。また、一部の設定は初心者には少し複雑に感じられるかもしれません。
💡 プロのヒント: 明確なエスカレーション手順であっても、例外ルートを設定しましょう。重大なサービス停止、セキュリティアラート、または規制対象環境でのインシデントについては、上級担当者や専門の対応担当者に直接エスカレーションされるように設定してください。
3. GLPi(エンドツーエンドの資産ガバナンスとITIL準拠のサービス運用に最適)
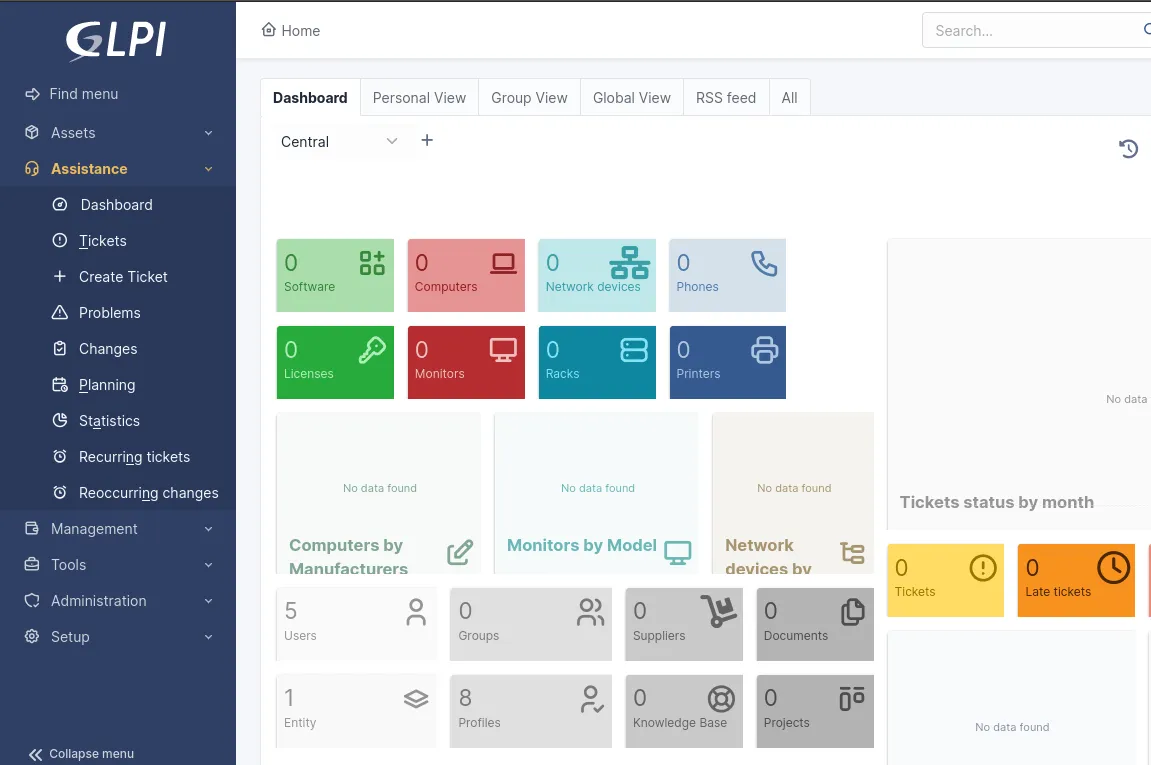
Gestionnaire Libre de Parc Informatique (GLPi) は、本格的なオープンソースのITサービスマネジメント(ITSM)およびIT資産管理(ITAM)プラットフォームです。チームはインフラストラクチャ(ハードウェア、ソフトウェア、ライセンス、ネットワーク機器)の可視性をエンドツーエンドで確保でき、ITILに準拠したプロセスを使用してインシデント、サービスリクエスト、変更を管理することができます。
保証書やサービス契約書を含むすべての契約書や文書が整理整頓され、異なるシステム間で紛失するのを防ぎます。データセンターを管理している場合、GLPi を使えばレイアウト、配線経路、エネルギー使用量を可視化できるため、舞台裏で何が起きているかを常に把握できます。
GLPiの主な機能
- GLPI Inventory、OCS Inventory、またはFusionInventoryのプラグインを使用して、新しいIT資産を自動的に検出してカタログ化しましょう。
- 反復的なタスク、チケットの割り当て、通知、定期的なイベントを自動化し、手作業を削減しましょう
- FAQ、ドキュメント、およびチケットにリンクされている記事のためのナレッジベースを構築し、セルフサービスおよび技術者によるサポートを実現しましょう。
- Azure/Entra、Centreon、Google、OAuth2、webhookと接続して、データの同期、ワークフローのトリガー、CMDBの機能強化を実現しましょう。
GLPiの制限事項
- バージョン間でプラグインの互換性が失われると、メンテナンスの負担が増大する可能性があります。
- レポート作成、分析、およびエクスポート機能にはリミットがあり、改善の余地があります
GLPiの価格
- カスタム価格設定
GLPiの評価とレビュー
- G2: 4. 6/5(30件以上のレビュー)
- Capterra: 4.5/5(40件以上のレビュー)
実際のユーザーはGLPiについてどう評価しているのでしょうか?
あるユーザーからの感想をご紹介します:
カスタマイズ性に非常に優れたオープンソースのIT資産管理・サポートチケットシステムで、大規模なサポートコミュニティがあります。ただし、ユーザーインターフェースは初心者には少々複雑です。また、古いバージョンから新しいバージョンへのプラグインの互換性が必ずしも保証されているわけではありません。
カスタマイズ性に非常に優れたオープンソースのIT資産管理・サポートチケットシステムで、大規模なサポートコミュニティがあります。ただし、ユーザーインターフェースは初心者には少々複雑です。また、古いバージョンから新しいバージョンへのプラグインの互換性が必ずしも保証されているわけではありません。
4. Splunk On-Call(監視アラートをエンジニアに直接ルーティングするのに最適)
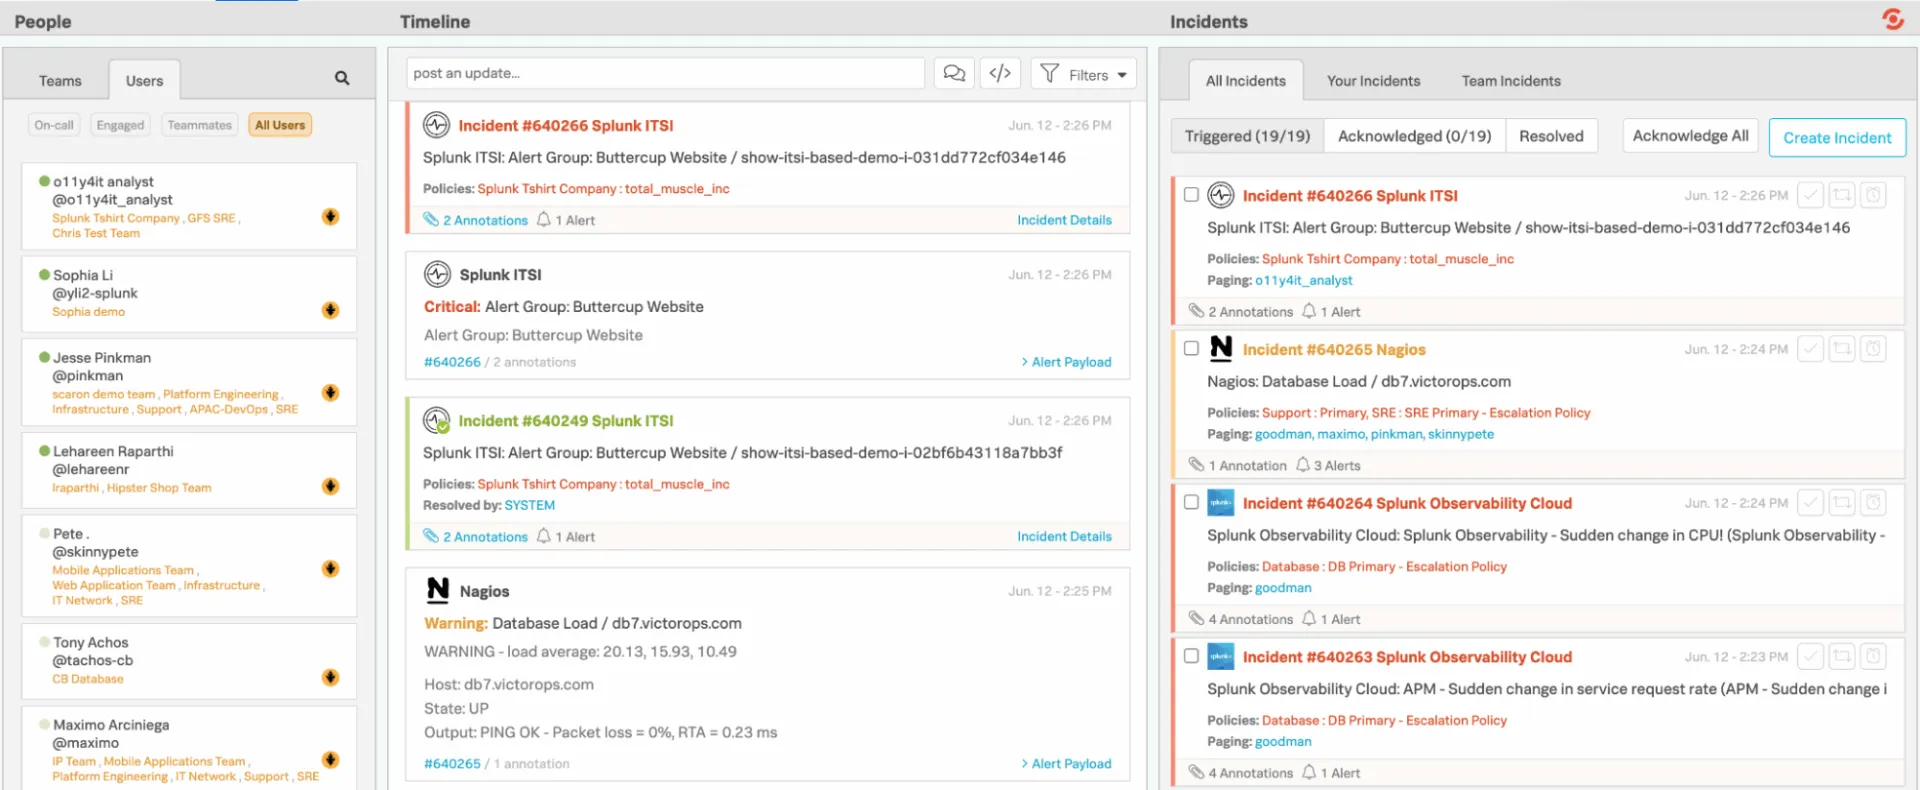
Splunk On-Call は、エンジニアリングチームやオンコールチームに、インシデントを管理するためのより迅速かつ効率的な方法を提供し、遅延しがちな従来のチケット発行ワークフローを不要にします。アラートを一般的なキューに送り込むのではなく、監視および可観測性スタックと直接連携し、スケジュール、ルール、およびコンテキストに基づいて、問題を即座に適切な担当者にルーティングします。
モバイルおよびチャットとの連携により、どこからでもインシデントの受領、再割り当て、解決を簡単に行うことができます。また、Splunk On-Callはバックグラウンドで、傾向、実証済みのパターン、エスカレーションの挙動に関する詳細な記録を保持しています。
Splunk On-Call の主な機能
- Splunkおよび幅広いコミュニティから提供される、1,000件以上の厳選された統合機能やアドオンを活用して、プラットフォームの機能を拡張しましょう。
- カスタムダッシュボードや視覚的なレポートを作成し、アラートの件数、インシデントの状態、対応担当者のパフォーマンス、チームの作業負荷を監視しましょう。
- 自身の活動、チームのインシデント、あるいは組織全体で発生しているすべてのインシデントを、素早く絞り込むことができます。
- 「トリガー済み」、「受領済み」、「解決済み」の各ビューを切り替えて、各インシデントの現在の状況を確認できます。
Splunk On-Call のリミット
- ルールをあらかじめ定義しておかないと、複数のチームにわたるシフトのスケジュール作成は複雑になりがちです
- 日付ごとの詳細なインシデントレポートを作成する機能が限定的である
Splunk On-Call の料金体系
- カスタム価格設定
Splunk On-Call の評価とレビュー
- G2: 4. 6/5 (40件以上のレビュー)
- Capterra:4.5/5(30件以上のレビュー)
Splunk On-Callについて、実際のユーザーからはどのような声が寄せられているのでしょうか?
あるユーザーは次のように要約しています:
モバイルアプリからインシデントやエスカレーションへの対応、チームメイトの当番を引き継ぐことができる機能は素晴らしいです。[…] 緊急時のスケジュール変更に備え、モバイルアプリからオーバーライドのスケジュール設定や通常のスケジュール変更を行えるようになると嬉しいです。
モバイルアプリからインシデントやエスカレーションへの対応、チームメイトの当番を引き継ぐことができる機能は素晴らしいです。[…] 緊急時のスケジュール変更に備え、モバイルアプリからオーバーライドのスケジュール設定や通常のスケジュール変更を行えるようになると嬉しいです。
🔍 ご存知でしたか?「一次対応が失敗した場合、適切な担当者に転送する」というロジックは、初期の電話交換局にその起源があります。手動のオペレーターが通話を接続できなかった場合、システムはその通話を別のオペレーターや交換局に転送(エスカレーション)していたのです。
5. ServiceNow(AIを活用した自動化による企業規模のオーケストレーションに最適)
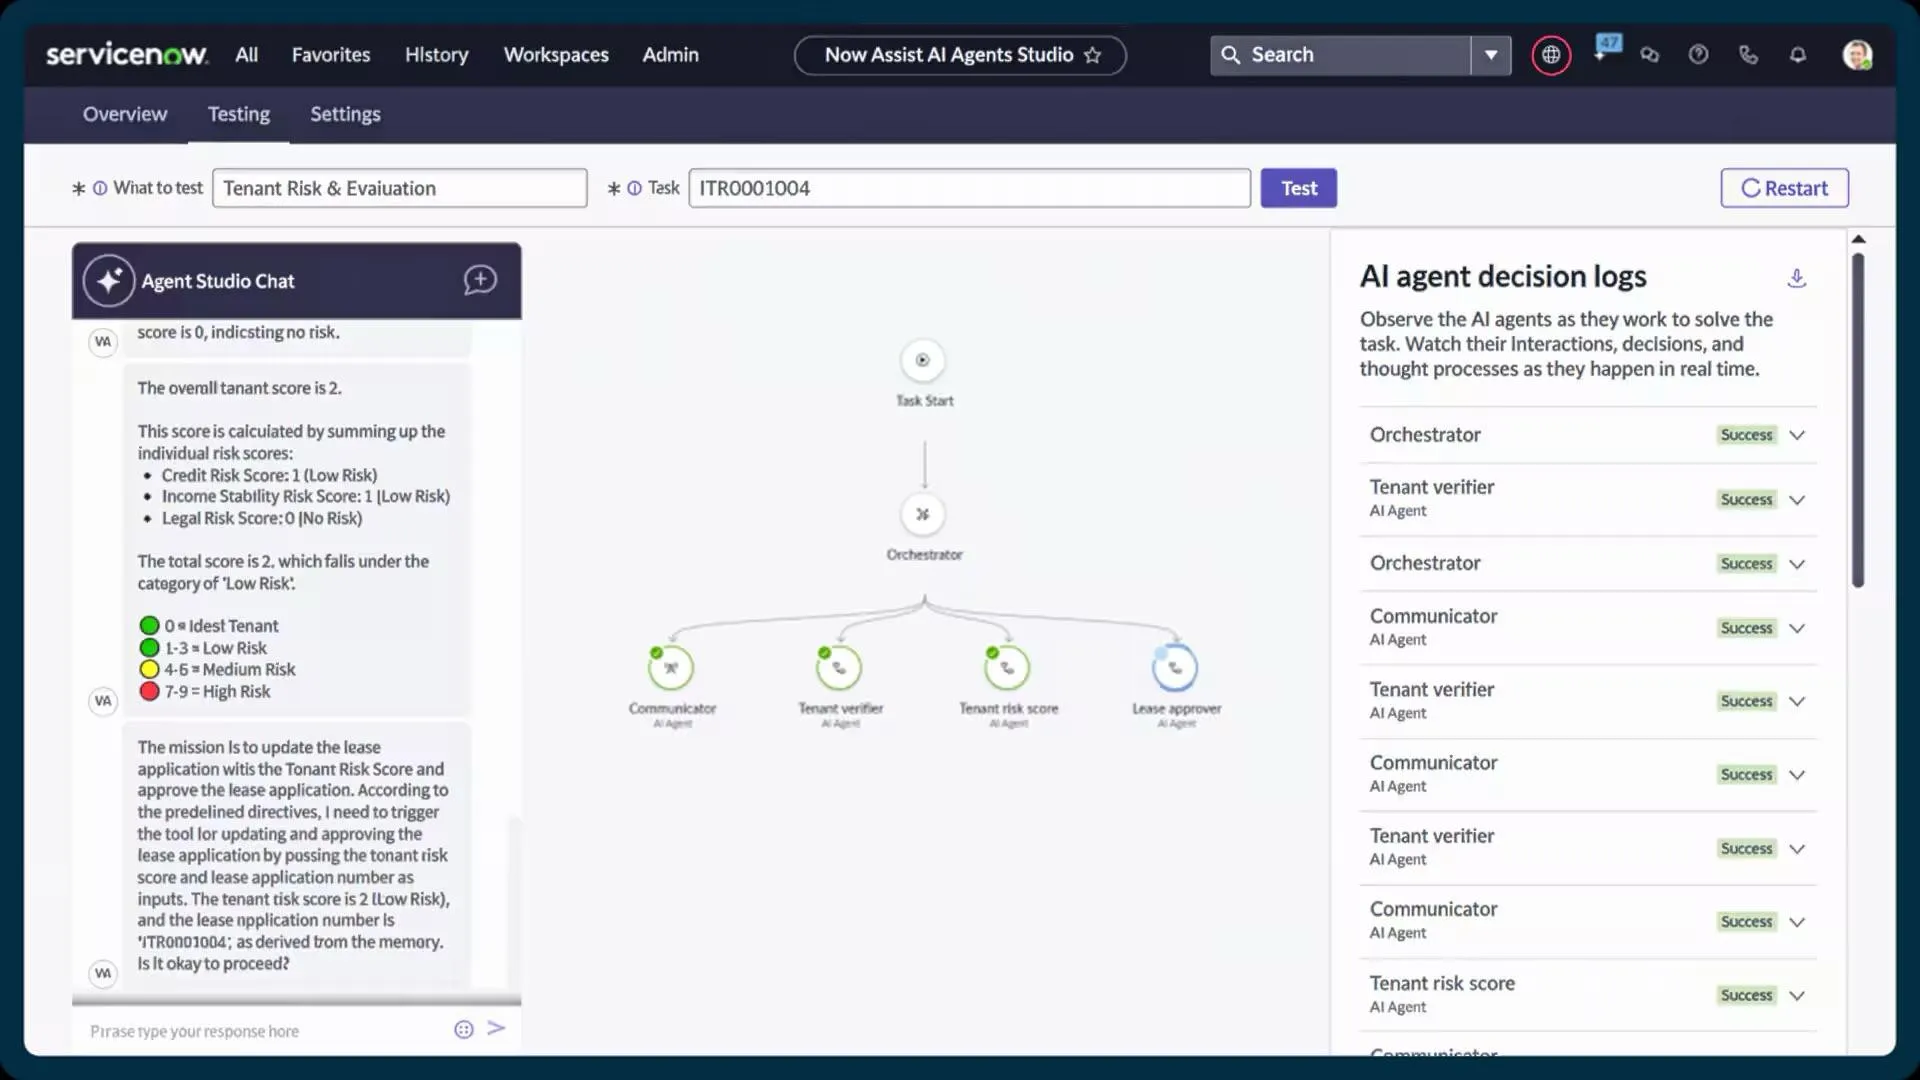
ServiceNowは、インシデントが登録された瞬間に、自動的に分類、優先順位付け、ルーティングを行います。インシデントチケットの自動化による提案やスマートコンテンツ生成を行うNow Assistなどの機能により、対応担当者はより迅速に、かつより詳細なコンテキストを把握した上で問題を解決できます。
インシデント管理、変更管理、資産管理を統合します。これにより、サービスがどのように接続されているか、どこにボトルネックが生じているか、そしてどのコンポーネントが繰り返し発生する障害の一因となっている可能性があるかを、リアルタイムで把握できます。
ServiceNowの主な機能
- フィールドサービス管理およびディスパッチャーワークスペースを通じて、フィールドタスクの割り当て、ルーティング、および監視を行います。
- AI検索とバーチャルエージェントを搭載したセルフサービスポータルを活用し、従業員と顧客の利便性を向上させましょう
- App Engineに組み込まれたワークフローやローコードツールを活用して、サービスプロセスを拡張またはカスタムしましょう。
- Flow DesignerとAutomation Engineを活用して、チームを横断する反復的なタスクやワークフローを自動化しましょう。
ServiceNowのリミット
- UIやポータルのブランディングオプションは、時代遅れに感じられたり、制限が厳しすぎたりします。
- 導入にあたっては、熟練した担当者やコンサルタントとの依存関係が強い
ServiceNowの価格
- カスタム価格設定
ServiceNowの評価とレビュー
- G2: 4. 4/5 (3,300件以上のレビュー)
- Capterra:4.5/5(300件以上のレビュー)
ServiceNowについて、実際のユーザーからはどのような声が寄せられているのでしょうか?
あるユーザーは次のように述べています:
[…] あらかじめ用意されたフローも私にとって大きな魅力です。プロセスを合理化し、大幅な時間の節約につながるため、カスタム設定の必要性を最小限に抑え、よりスムーズで効率的なワークフローを実現できるからです。[…] また、カスタマーサービス管理システムに独自のソリューションを組み込むのに苦労し、かなりの回数にわたる修正が必要でした。
[…] あらかじめ用意されたフローも私にとって大きな魅力です。プロセスを合理化し、大幅な時間の節約につながるため、カスタム設定の必要性を最小限に抑え、よりスムーズで効率的なワークフローを実現できます。[…] また、カスタマーサービス管理システムに独自のソリューションを組み込むのに苦労し、かなりの回数にわたる修正が必要でした。
ベストプラクティスとガバナンス
ここでは、自動化の精度を維持し、アラート疲労を防ぎ、ビジネスおよび規制上の要件を満たすためのベストプラクティスをいくつかご紹介します。
- 絶対条件となるエスカレーション基準を定義する:トリガーを、SLO違反、異常値の急増、顧客階層への影響、規制上の重要度といった測定可能な指標に紐づける
- 各階層で役割を明確にする: 各エスカレーションレベルごとにシンプルなRACIマップを活用し、プレッシャーの高いインシデント発生時でも責任の所在が曖昧にならないようにします。
- 動的な当直体制の運用を徹底する: 週末、祝日、キャパシティのリミット、引き継ぎのタイミングに応じてエスカレーション経路を自動調整し、バーンアウトを軽減し、無応答の緊急連絡を防ぐ
- 高リスクなシナリオには人的チェックポイントを設ける:自動化が行われていても、顧客データの漏洩、支払い、または規制対象のワークフローに関わるインシデントについては、手動による確認を義務付ける
- 完全な監査証跡を維持する:誰にページングが送信されたか、いつ応答があったか、どのような自動化ステップが実行されたか、どのような決定がなされたかについて、改ざん不可能なログを記録します。
🧠 豆知識: 現存する最古の苦情文は、紀元前1750年頃に粘土板に刻まれたものです。これは、いわば初期のプロジェクトステータスに関するエスカレーションでした。ナンニという名の顧客が、商人エア・ナシール宛てに手紙を書き、受け取った銅が約束された品質より劣っていたことや、自分の使者が不当な扱いを受けたことに激怒していました。
よくある課題とその克服方法
明確なエスカレーション方針が定められていても、チームはインシデント対応を遅らせたり混乱を招いたりする運用上の課題にしばしば直面します。
このテーブルでは、基本的なセットアップステップを超えた一般的な課題を挙げ、それらを克服するための実践的な戦略を紹介しています。
| 課題 ❌ | ソリューション ✅ |
| 引き継ぎ時の状況情報の不整合 | ClickUpのタスク連携機能とインシデント報告テンプレートを活用し、各エスカレーションレベルにおけるインシデントの詳細、影響を受けたシステム、およびこれまでの対応措置に関する完全な監査証跡を維持しましょう。 |
| 優先度の低いアラートで対応担当者に過度な負担をかけること | ClickUpのカスタムフィールドとAI Prioritizeを活用して動的な優先順位付けを実装し、深刻度、影響度、SLAの閾値に基づいてインシデントをフィルタリングしましょう。 |
| チーム間の可視性の欠如 | 共有ワークスペースを設定し、コメントを追加し、視覚的なClickUpホワイトボードを作成して、関係者にリアルタイムの最新情報を提示しましょう。 |
| 重大なインシデント発生時の意思決定の遅れ | ClickUp Brain Maxの「推奨アクション」機能を使用して通知を自動化し、インシデントの種類、深刻度、過去の傾向に基づいて、適切な担当者に即座にアラートを送信しましょう。 |
| 繰り返し発生する問題の追跡が困難 | ClickUpのカスタムレポート作成機能や定期的なタスクテンプレートを活用して、パターンや根本原因、繰り返し発生するインシデントを特定し、先手を打った予防策を講じましょう。 |
| エスカレーション時の知識の断片化 | ClickUp DocsでSOP、ランブック、インシデントドキュメントを一元管理し、関連するタスクにリンクさせることで、実際のエスカレーション時に即座に参照できるようにします。 |
| シフト間の責任分担の不一致 | ClickUpの「ワークロードビュー」と「タイムラインビュー」を活用して、割り当て状況を可視化し、シフト交代や引き継ぎの際に業務の重複や抜けがないようにします。 |
| 手動によるコンプライアンス追跡と監査上の不備 | ClickUp Brain を使用して、監査対応可能な要約を自動化し、すべてのインシデントに関するアクション、通知、および解決策を記録しましょう。 |
自動化によるエスカレーションの影響を測定する
自動化されたエスカレーションの効果を追跡するには、処理量、効率、品質にわたる主要なメトリクスに注目する必要があります。これらのメトリクスにより、エスカレーションプロセスがより迅速かつ正確になり、チームと顧客の両方にとってストレスが軽減されているかどうかが明らかになります。
以下のメトリクスを追跡しましょう:
- エスカレーション率(件数): 第一レベルを超えてエスカレーションされた問題の割合。この割合が高い場合は、初期トリアージやナレッジベースに不備がある可能性があります。
- エスカレーションの繰り返し率(件数): 同一の問題が複数回エスカレーションされる頻度。解決が不完全であることや、文脈が失われていることを示唆しています。
- エスカレーションまでの期間(効率): 検知からエスカレーションまでの期間。各フェーズの期間が短いほど、重大な問題の自動化による認識が迅速に行われていることを示します。
- 引き継ぎ遅延時間(効率): エスカレーションから次のチームが仕事を開始するまでの時間差。ルーティングや通知における摩擦を明らかにする指標です。
- エスカレーションされたケースの解決時間(効率): エスカレーションから解決までの合計時間。解決が早ければ早いほど、自動化の有効性が示されます。
- 顧客満足度(CSAT)スコア(品質): エスカレーションされた対応に関するフィードバックに基づき、エスカレーションプロセスの円滑さを測定します。
- コンテキストの引き継ぎ(品質): 顧客が情報を繰り返し説明する必要がないよう、エージェントがインシデントの全履歴を受け取れるかどうか
- 初回対応解決率(FCR)(品質): 1回の対応で解決された問題の割合
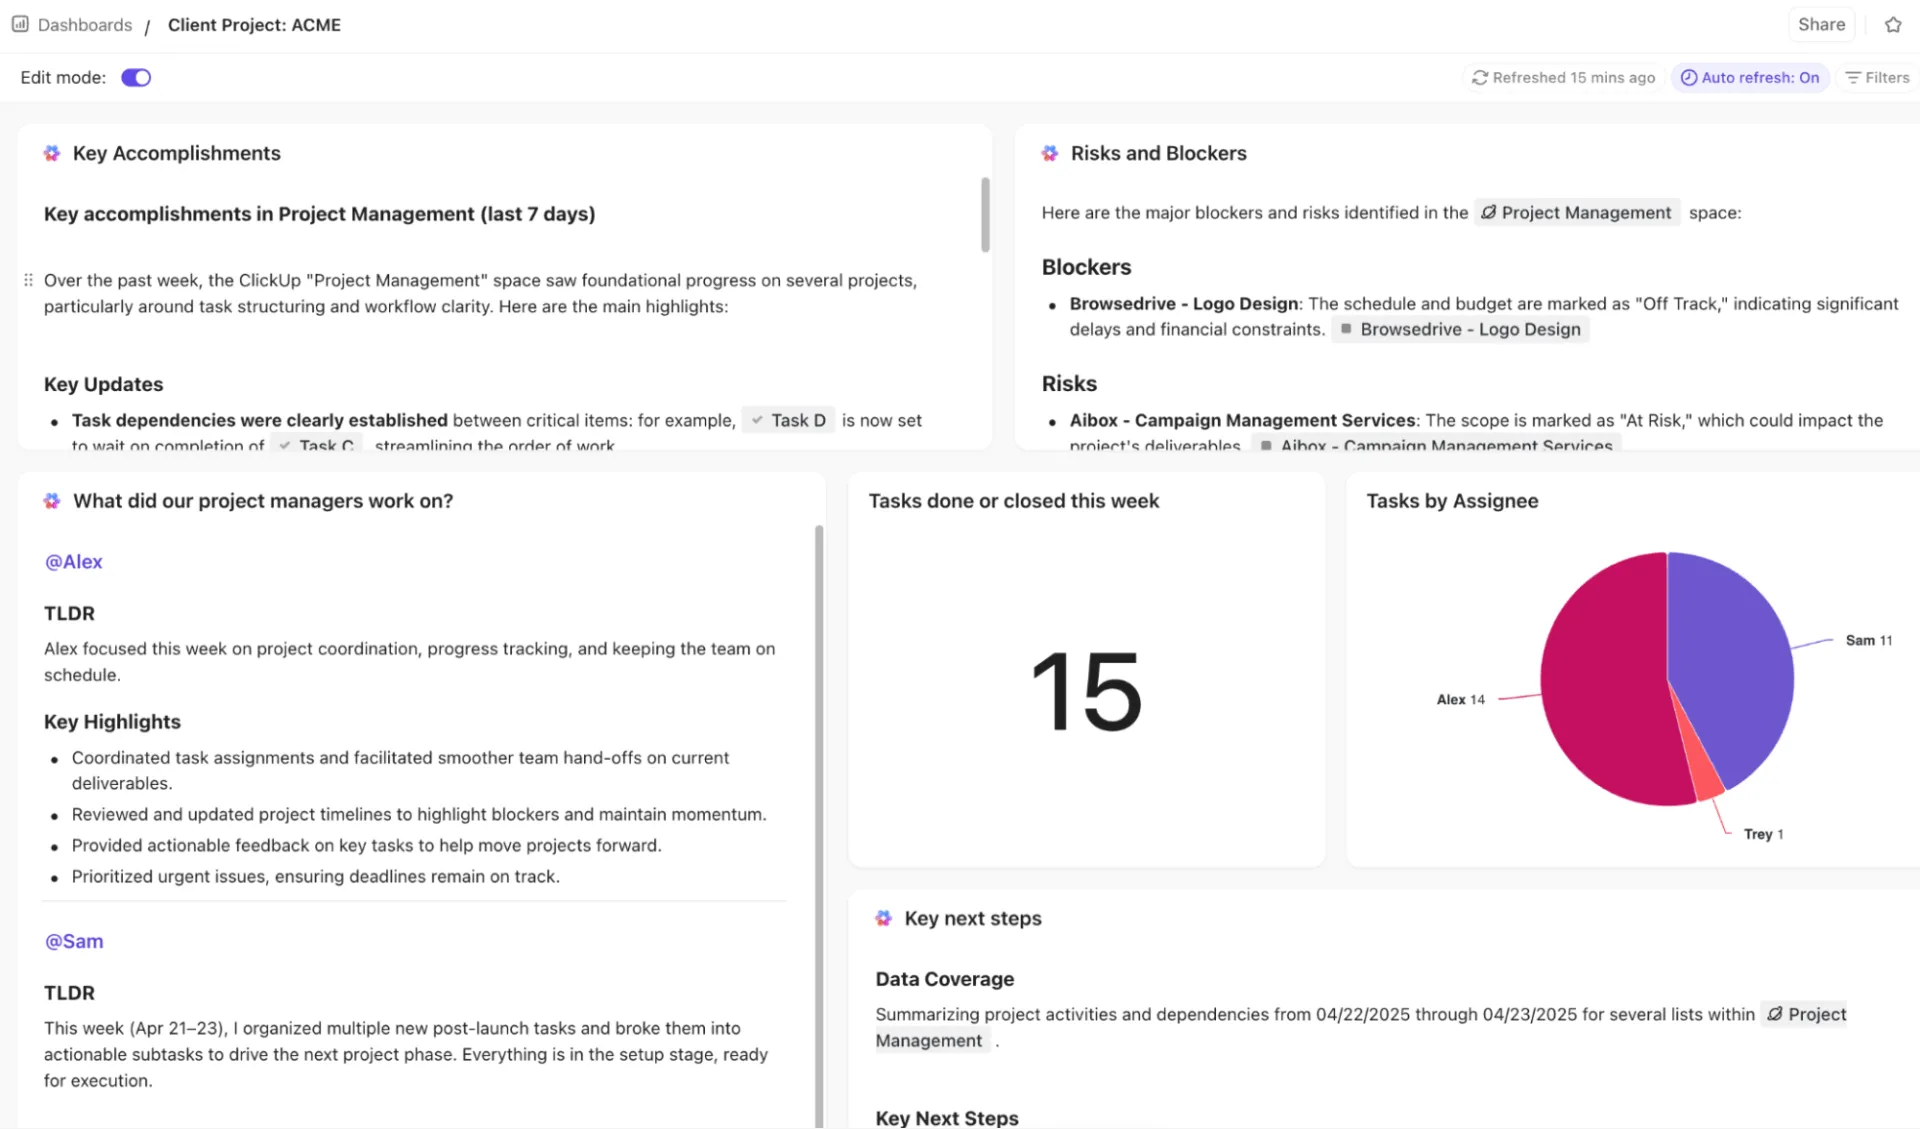
🚀 ClickUpの特長:ClickUpダッシュボードを活用すれば、すべてのエスカレーションメトリクスについて、リアルタイムで視覚的かつAIを活用したインサイトを得ることができます。
テーブル、円グラフ、棒グラフ、折れ線グラフ、計算、時間追跡の各カードを使用して、エスカレーションの傾向、ボトルネック、パフォーマンスを追跡できます。また、タスク、カスタムフィールド、ステータスにリンクされているカードを活用して、エスカレーション率、繰り返しエスカレーション、エスカレーションまでの所要時間を監視することも可能です。
さらに一歩進めるには、AI 要約、AI プロジェクト更新、AI StandUp などのAI カードを活用して、傾向、遅延、解決結果などを明確に示しましょう。
ClickUpでインシデント管理を迅速化
多くの人は、インシデントのエスカレーションとは単にチケットを次の担当者に引き継ぐことだと考えていますが、実際にはそれ以上のものです。これは、トリアージから解決に至るまでのすべてのステップが調和して機能する、体系化されたシステムなのです。
ClickUpは、理想的な統合ワークスペースを提供します。「ClickUp Automations」を使えば、アラートのトリガー、タスクの割り当て、ステータスの更新を自動的に行うことができます。また、「ClickUp Brain」は、インシデントの優先順位付け、要約の作成、次の対応策の提案を支援します。
ClickUp AIエージェントはワークスペース内でインテリジェントなアシスタントとして機能し、ClickUpダッシュボードではエスカレーションの状況をリアルタイムで確認できます。
よくある質問(FAQ)
インシデントのエスカレーション手順とは何ですか?
インシデントのエスカレーション手順とは、深刻度、影響度、発生タイミングに基づいて、問題を適切なチームや担当者に振り分けるための、あらかじめ定義された一連のステップのことです。これにより、インシデントが効率的に対処され、責任の所在が明確になります。TEXT
インシデントを自動でエスカレーションすべきか、手動で行うべきかを、どのように判断すればよいでしょうか?
明確な基準が定められた、優先度の高いインシデント(例:サービス停止、セキュリティ侵害など)には自動化を活用しましょう。人間の判断や追加の背景情報が必要な、曖昧な状況や重大な状況については、手動によるエスカレーションを留保してください。
効果的なインシデント管理のために、自動化によるエスカレーションをサポートするツールにはどのようなものがありますか?
ClickUp、PagerDuty、Jira Service Management、ServiceNowなどのプラットフォームでは、自動ルーティング、通知、更新が可能です。これらは、チームが遅延を削減し、体系的なインシデントワークフローを維持するのに役立ちます。
自動エスカレーションを利用する際、アラート疲労をどのように回避すればよいでしょうか?
アラートの明確な閾値を設定し、深刻度に応じて優先順位をつけ、インテリジェントな通知を活用しましょう。通知の繰り返しは重大なインシデントに限定し、些細な変更を逐一通知するのではなく、ダッシュボードやAIツールを活用して最新情報を要約して共有しましょう。
エスカレーションポリシーはどのくらいの頻度で見直すべきでしょうか?
エスカレーションポリシーは、少なくとも四半期ごとに、あるいは重大なインシデントが発生した後に定期的に見直してください。これにより、基準、責任範囲、および自動化ルールが、現在のワークフロー、チーム体制、ビジネスの優先度を確実に反映するようになります。