
La maggior parte dei team considera la generazione di SQL come un trucco di magia. Basta digitare una domanda per ottenere una query.
Ma la realtà è questa: Snowflake Cortex Analyst funziona solo nella misura in cui è efficace il modello semantico che si crea in precedenza, e tale configurazione non è affatto banale. Imparando a utilizzare Snowflake Cortex per la generazione di SQL, i team che si occupano di dati possono ora trasformare il linguaggio naturale in query complesse ed eseguibili in pochi secondi.
Questa guida ti accompagna attraverso il processo di implementazione vero e proprio, dalla definizione del tuo modello semantico YAML all'esecuzione di query sul tuo data warehouse utilizzando il linguaggio naturale, in modo che tu possa comprendere sia le potenzialità che i prerequisiti prima di iniziare.
Esamineremo inoltre i limiti di Snowflake Cortex e come ClickUp possa fornire supporto ai flussi di lavoro più ampi che ruotano attorno alla generazione di SQL.
Che cos'è Snowflake Cortex Analyst?
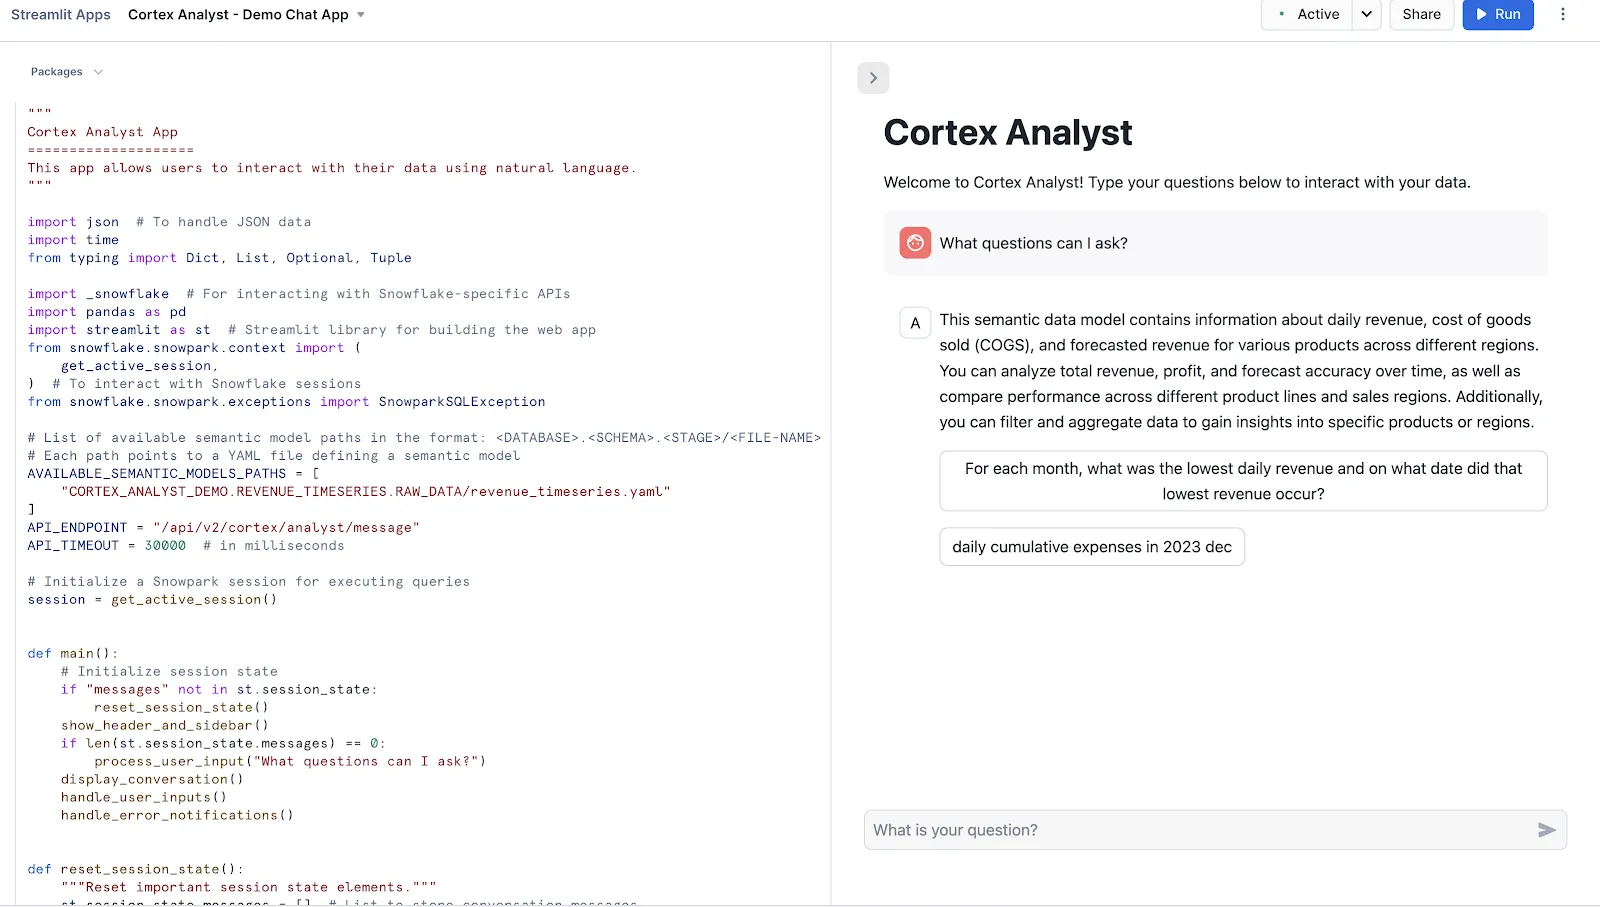
Snowflake Cortex Analyst è un servizio completamente gestito che consente di creare applicazioni conversazionali basate sui propri dati analitici.
Utilizza un agente specializzato di conversione da testo a SQL per trasformare le domande in linguaggio naturale in query accurate ed eseguibili. Questo servizio colma il divario tra strutture di dati complesse e utenti aziendali che necessitano di risposte senza dover scrivere codice.
Le funzionalità principali includono:
- Fornisce un'interfaccia altamente precisa per interagire con i dati strutturati
- Utilizzo di modelli semantici per comprendere la logica aziendale e la terminologia specifiche della tua attività
- Offre un'API REST per una facile integrazione in applicazioni personalizzate o strumenti di BI
- Garantire la privacy dei dati elaborando le richieste all’interno dei confini di sicurezza di Snowflake
📮 ClickUp Insight: L'88% degli intervistati nel nostro sondaggio utilizza l'IA per le proprie attività personali, ma oltre il 50% esita a utilizzarla sul lavoro. Quali sono i tre ostacoli principali? Mancanza di integrazione fluida, lacune di conoscenza o preoccupazioni relative alla sicurezza.
Ma cosa succederebbe se l’IA fosse integrata nel tuo spazio di lavoro e fosse già sicura? ClickUp Brain, l’assistente IA integrato di ClickUp, trasforma questa visione in realtà. Comprende i prompt in linguaggio semplice, risolvendo tutte e tre le preoccupazioni relative all’adozione dell’IA e collegando al contempo la tua chat, le attività, i documenti e le conoscenze all’interno dello spazio di lavoro.
Trova risposte e approfondimenti con un solo clic!
Prerequisiti per la generazione di SQL con Snowflake Cortex
Affrontare Snowflake Cortex senza la giusta configurazione porta a frustrazione. Potresti ottenere risultati imprecisi, perdere tempo nella risoluzione dei problemi e concludere erroneamente che lo strumento non funzioni, quando il vero problema è una base di partenza inadeguata.
Per evitare ciò, è necessario predisporre innanzitutto tre elementi fondamentali.
1. Configura il database e le tabelle
L'intelligenza della tua IA dipende dai dati a cui può accedere. Se lo schema del tuo database è un labirinto di nomi di colonne criptici come cust_dat_v2_final, sia i tuoi analisti che l'IA avranno difficoltà a comprenderlo.
Questa confusione porta l’IA a generare join errati o a estrarre dati dalle colonne sbagliate, e il tuo team spreca ore solo cercando di decifrare lo schema prima ancora di poter scrivere una query.
Inizia assicurandoti che il tuo software di data warehouse contenga le tabelle che desideri che Cortex Analyst query. Quando possibile, utilizza nomi di colonne chiari e descrittivi. Ad esempio, una colonna denominata customer_lifetime_value è molto più intuitiva sia per gli utenti che per l’IA rispetto a clv_01.
Per procedere con la configurazione, il tuo ruolo Snowflake dovrà disporre delle seguenti autorizzazioni:
- UTILIZZO: Sul database e sullo schema contenenti le tue tabelle
- SELECT: Sulle tabelle che desideri che Cortex Analyst query
- FASE DI CREAZIONE: Nello schema, necessario per caricare il file del modello semantico
📖 Leggi anche: Come utilizzare Snowflake Cortex per la Business Intelligence aziendale
2. Crea il tuo file di modello semantico
L'ostacolo principale di qualsiasi strumento di conversione da testo a SQL è che l'intelligenza artificiale non parla il linguaggio specifico della tua azienda. Non sa di per sé che "ARR" sta per "Annual Recurring Revenue" (ricavi ricorrenti annuali) o che la tabella dei clienti si unisce alla tabella degli ordini tramite il campo customer_id.
Senza questo contesto, l'IA potrebbe generare codice SQL tecnicamente valido ma logicamente errato, fornendo risposte che sembrano corrette ma sono pericolosamente fuorvianti.
La soluzione è il modello semantico. Si tratta di un file YAML che funge da “livello di traduzione” personalizzato, insegnando a Cortex Analyst il vocabolario e la logica specifici della tua azienda. La creazione e la manutenzione di questo file richiedono un lavoro collaborativo tra i data engineer, che utilizzano strumenti ETL per conoscere lo schema, e gli analisti aziendali, che conoscono la terminologia.
Il file del modello semantico dovrebbe contenere questi componenti chiave:
| Componente | Scopo |
| Tabella | Elenco delle tabelle con una descrizione in linguaggio semplice del loro scopo |
| Colonne | Definisce il tipo semantico di ciascuna colonna (ad esempio, categoria o metrica) e può includere valori di esempio |
| Relazioni | Specifica come le tabelle effettuano la connessione tramite join, eliminando ogni margine di incertezza per l’IA |
| Queries verificate | Fornisce coppie di domande e SQL di esempio che fungono da guide efficaci per il modello di linguaggio grande (LLM) |
3. Configurare Cortex Search Service (facoltativo)
A volte, le risposte di cui hai bisogno sono nascoste in testi non strutturati, come descrizioni di prodotti, ticket di assistenza o trascrizioni di chiamate. Le query SQL standard non riescono a estrarre informazioni da questi dati, il che significa che spesso ti sfugge il “perché” che sta dietro al “cosa”.
Se lo desideri, puoi aggiungere qui Snowflake Cortex Search Service. Si tratta di un livello di ricerca come servizio (search-as-a-service) che ti consente di eseguire query sia sulle tue tabelle strutturate che sui tuoi dati di testo non strutturati, utilizzando contemporaneamente agenti IA per l’analisi dei dati.
È consigliabile configurare Cortex Search se i tuoi analisti devono porre domande che richiedono l'estrazione del contesto dal testo prima di generare il codice SQL. Ad esempio, potresti prima cercare tutte le recensioni dei prodotti contenenti la frase "problema di batteria" e poi generare una query SQL per aggregare i dati di vendita relativi esclusivamente a quei prodotti.
Per la generazione di codice SQL puro su tabelle strutturate, questo servizio non è necessario.
🧠 Curiosità: All'inizio degli anni '70, i ricercatori IBM Donald Chamberlin e Raymond Boyce crearono lo "Structured English Query Language". Dovettero cambiare il nome in SQL perché "SEQUEL" era già un marchio registrato da un'azienda aeronautica britannica.
Guida passo passo alla generazione di SQL con Cortex Analyst
Hai terminato il lavoro preparatorio, ma ora ti ritrovi davanti a uno schermo vuoto, senza sapere bene quale sia il flusso di lavoro effettivo. Come si fa a trasformare una domanda che hai in mente in una query SQL eseguibile? Quando la gestione del flusso di lavoro non è chiara, spesso i nuovi strumenti rimangono inutilizzati e l’investimento nella configurazione va sprecato.
Il processo pratico è piacevolmente semplice. Ecco una panoramica più dettagliata!
Passaggio n. 1: prepara i tuoi dati in Snowflake
Prima di tutto, i tuoi dati strutturati devono essere presenti all’interno di Snowflake. Ogni applicazione Cortex Analyst è indirizzata a una singola tabella o a una vista composta da una o più tabelle. Assicurati che le tue tabelle siano state create e popolate.
Se stai caricando dati da file flat:
- Carica i tuoi file di dati (ad es. CSV) su una fase di Snowflake
- Utilizza il comando COPY INTO per caricare i dati dalla fase nelle tue tabelle
- Verifica che l'esito del caricamento dei dati sia positivo prima di proseguire
📖 Leggi anche: Come utilizzare Snowflake Cortex per l'analisi dell'azienda
Passaggio n. 2: Creare un modello semantico (o una vista semantica)
Questo è il passaggio più importante della configurazione. La potenza di Cortex Analyst deriva dalla combinazione di modelli linguistici di grandi dimensioni (LLM) con modelli semantici, ovvero un file YAML che affianca lo schema del database e codifica il contesto aziendale.
Le viste semantiche sono ora il metodo consigliato da Snowflake per Cortex Analyst. Esse memorizzano metriche aziendali, relazioni e definizioni direttamente all’interno di Snowflake. I file di modello semantico YAML legacy funzionano ancora, ma Snowflake orienta le nuove implementazioni verso le viste semantiche.
Il tuo modello semantico o la tua vista dovrebbero includere:
- Descrizioni delle tabelle e delle colonne: spiegazioni in linguaggio semplice del significato di ciascun campo
- Metriche aziendali: definizioni per campi calcolati quali fatturato, tasso di abbandono o tasso di conversione
- Filtri e sinonimi: termini alternativi che gli utenti potrebbero utilizzare (ad es., "annullato" mappato a un valore di stato specifico)
- Query verificate: il Verified Query Repository di Snowflake archivia coppie approvate di domande e istruzioni SQL. Quando la domanda di un utente è simile a una di queste voci, Cortex Analyst può farvi riferimento durante la generazione delle istruzioni SQL
🤝 Promemoria: Snowflake consiglia di utilizzare non più di 10 tabelle e non più di 50 colonne sottoposte a selezione per ottenere prestazioni ottimali nel flusso di lavoro di Snowsight.
Passaggio n. 3: carica il modello semantico su una fase di Snowflake
Se utilizzi un modello semantico basato su YAML, è necessario che sia configurato in modo che Cortex Analyst possa farvi riferimento in fase di esecuzione.
- Carica il tuo file .yaml in una fase interna di Snowflake (ad es., RAW_DATA)
- Verifica che il file compaia nella fase tramite l'interfaccia utente di Snowsight o il comando LIST @stage_name
- Prendi nota del percorso della fase; lo utilizzerai nelle tue chiamate API o nella configurazione dell'app
Se utilizzi una vista semantica, questo passaggio viene gestito in modo nativo all'interno di Snowflake e non è necessario alcun caricamento separato.
🔍 Lo sapevi? Il valore NULL in SQL non significa zero né vuoto. Rappresenta dati sconosciuti o mancanti, il che porta a comportamenti controintuitivi come confronti che non restituiscono né vero né falso.
Passaggio n. 4: invia una domanda in linguaggio naturale tramite l'API REST
Ora ha inizio la generazione effettiva del codice SQL. L'API REST genera una query SQL per una determinata domanda utilizzando un modello semantico o una vista semantica forniti nella richiesta.
Struttura la tua richiesta API con:
- messaggi; una matrice contenente la domanda dell'utente con ruolo: “user”
- Un riferimento al tuo modello semantico o alla tua vista semantica
- Il tuo modello preferito (oppure lascia l'impostazione su "Auto" affinché Cortex effettui la selezione del modello migliore)
È possibile intrattenere conversazioni a più scambi, in cui è possibile porre domande di approfondimento che si basano sulle query precedenti.
Passaggio n. 5: Analizza la risposta dell'API
Ogni messaggio in una risposta può contenere più blocchi di contenuto di tipi diversi. I tre valori attualmente supportati per il campo "type" sono: testo, suggerimenti e SQL.
Ecco il significato di ciascun tipo:
- SQL: Cortex ha generato con esito positivo una query; ecco cosa dovrai eseguire
- testo: Una spiegazione o una risposta in linguaggio naturale che accompagna il codice SQL
- suggerimenti: Il tipo di contenuto "suggerimenti" viene incluso nella risposta solo se la domanda dell'utente era ambigua e Cortex Analyst non è riuscito a restituire un'istruzione SQL per quella query. Utilizzali per chiarire o affinare la domanda
🔍 Lo sapevi? L'ordine in cui scrivi il codice SQL non è l'ordine in cui viene eseguito. Anche se scrivi prima SELECT, i database elaborano in realtà FROM e WHERE prima della selezione delle colonne. Questo crea confusione sia tra i principianti che tra gli utenti esperti.
Passaggio n. 6: Esegui il codice SQL generato in Snowflake
Una volta ottenuto il blocco SQL dalla risposta, eseguilo sul tuo magazzino virtuale Snowflake. La query SQL generata viene eseguita nel tuo magazzino virtuale Snowflake per generare il risultato finale. I dati rimangono all'interno dei confini di governance di Snowflake.
Aspetti fondamentali da conoscere al momento dell'esecuzione:
- Cortex Analyst si integra pienamente con le politiche di controllo degli accessi basato sui ruoli (RBAC) di Snowflake, garantendo che le query SQL generate ed eseguite rispettino tutti i controlli di accesso stabiliti
- Se un utente non dispone dei diritti di accesso a una tabella, la query fallirà in fase di esecuzione, proprio come accadrebbe con un codice SQL scritto manualmente
- In questa fase si applicano i costi di elaborazione del data warehouse, distinti dai costi di utilizzo di Cortex Analyst.
Passaggio n. 7: Perfeziona e ripeti il processo
Non è sempre garantito ottenere una query perfetta al primo tentativo. Ecco come migliorare i risultati nel tempo:
- Aggiungi query verificate al tuo modello semantico per le domande che ricorrono più volte
- Arricchisci il tuo modello semantico con descrizioni, sinonimi e filtri più accurati quando Cortex interpreta erroneamente un termine
- Utilizza le conversazioni a più turni per approfondire, ad esempio: «Ora filtra i risultati per regione»; le conversazioni a più turni consentono di porre domande di approfondimento che si basano sulle query precedenti
- Monitora l'utilizzo tramite CORTEX_ANALYST_USAGE_HISTORY e la cronologia delle query di Snowflake per individuare modelli ricorrenti nelle query fallite o imprecise
🧠 Curiosità: Una sola condizione JOIN mancante può causare enormi problemi. Dimenticare una condizione JOIN può generare un prodotto cartesiano, moltiplicando drasticamente il numero di righe e, talvolta, causando il crash dei sistemi.
Best practice per garantire la precisione della conversione da testo a SQL in Snowflake
La qualità del tuo modello semantico determina direttamente l'accuratezza delle query che genera. Ecco le best practice che consentono di migliorare l'accuratezza. 🛠️
- Aggiungi query verificate al tuo modello semantico: questa è l’azione più efficace che puoi intraprendere. Includi numerose coppie di domande e query SQL di esempio che riflettano il modo in cui il tuo team pone realmente le domande
- Utilizza nomi descrittivi per colonne e tabelle: il modello funziona meglio quando i nomi delle colonne e delle tabelle sono intuitivi. Se non puoi modificare lo schema, aggiungi descrizioni chiare nel tuo file YAML per eventuali nomi di colonne poco chiari
- Includi valori di esempio: l'aggiunta di dati di esempio per le colonne categoriali (come lo stato o la regione) aiuta il modello a comprendere le opzioni di filtro valide disponibili
- Esegui test con casi limite: durante lo sviluppo, poni intenzionalmente domande ambigue o complesse per individuare i punti in cui il tuo modello semantico necessita di maggiore contesto o chiarimenti
- Migliora il tuo modello semantico: considera il tuo modello semantico come un documento in continua evoluzione. Dovrebbe essere aggiornato costantemente attraverso un processo iterativo basato sull'analisi delle query che hanno esito positivo e di quelle che falliscono
ClickUp: un'alternativa più semplice a Snowflake Cortex
Snowflake Cortex è particolarmente indicato quando i team desiderano generare codice SQL ed eseguire query su dati strutturati. I team definiscono gli schemi, mappano le relazioni e scrivono le query per estrarre informazioni utili. Questa configurazione è ideale per ambienti con grandi volumi di dati, specialmente quando la responsabilità della reportistica ricade sugli analisti.
Molti team, tuttavia, non hanno bisogno di un livello SQL completo per rispondere alle domande operative quotidiane. I product manager, i responsabili di programma e i team operativi spesso desiderano risposte rapide legate al lavoro in corso.
ClickUp offre un percorso più accessibile. I team pongono domande in linguaggio semplice, esaminano dashboard in tempo reale e agiscono sulla base delle informazioni ottenute senza dover scrivere codice SQL né creare modelli semantici.
Genera e perfeziona le istruzioni SQL più rapidamente
Snowflake Cortex si concentra sulla generazione di query SQL a partire da set di dati strutturati all'interno di un ambiente di data warehouse. Questa soluzione funziona bene quando i dati sono già presenti in Snowflake e gli schemi sono stati mappati.
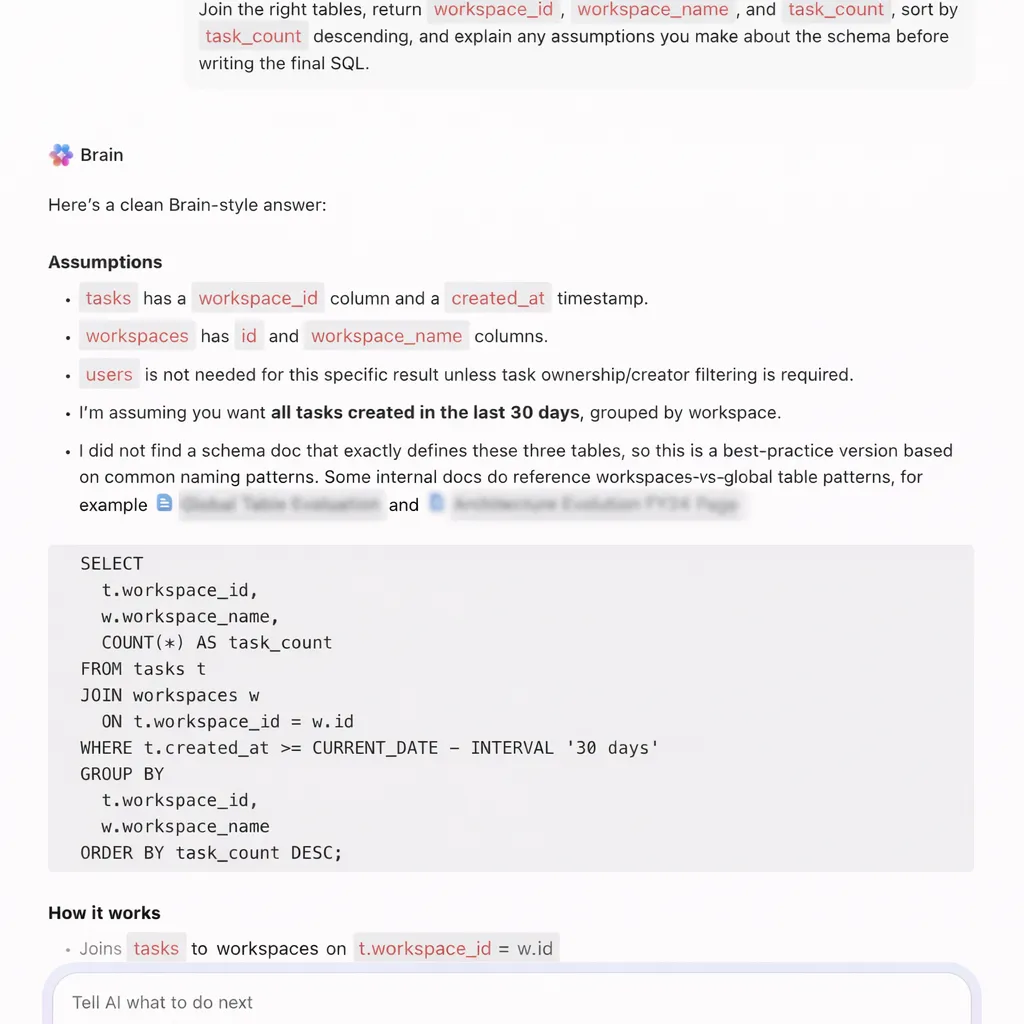
ClickUp Brain supporta la generazione di SQL in modo più flessibile e incentrato sull'esecuzione. I team generano, perfezionano e archiviano le query SQL direttamente all'interno del proprio spazio di lavoro, dove già avvengono analisi, discussioni e decisioni.
Supponiamo che un analista di prodotto stia lavorando a un'analisi sulla fidelizzazione all'interno di ClickUp. Anziché passare a un altro strumento per scrivere le query, chiede a ClickUp Brain:
📌 Prova questo prompt: Scrivi una query SQL per calcolare la ritenzione su sette giorni degli utenti raggruppati per coorte di registrazione.
ClickUp Brain genera una query strutturata che include il raggruppamento per coorte, i filtri di data e la logica di ritenzione. L'analista incolla la query in Snowflake o in un altro data warehouse ed esegue immediatamente l'operazione.
Ti aiuta a:
- Scrivi join su più tabelle, come utenti, ordini ed eventi
- Converti domande sui prodotti formulate in inglese semplice in logica SQL pronta per l'esecuzione
- Esegui il debug delle query non funzionanti e analizza i problemi, come join errati o condizioni mancanti
- Riscrivi le query per migliorare le prestazioni o la leggibilità
Ad esempio, durante la revisione di un esperimento di crescita, un responsabile marketing chiede: «Scrivi una query SQL per confrontare i tassi di conversione tra due pagine di landing negli ultimi 14 giorni».
ClickUp Brain genera la query utilizzando l'aggregazione condizionale e i filtri di data. Il team la esegue in Snowflake e convalida i risultati dell'esperimento.
📌 Prova questo prompt: Correggi questa query SQL in cui il join duplica le righe e spiega il problema.
ClickUp Brain identifica il problema relativo al join, corregge la query e spiega come si siano verificati i record duplicati a causa di condizioni di join errate.
Sostituisci la reportistica basata su SQL
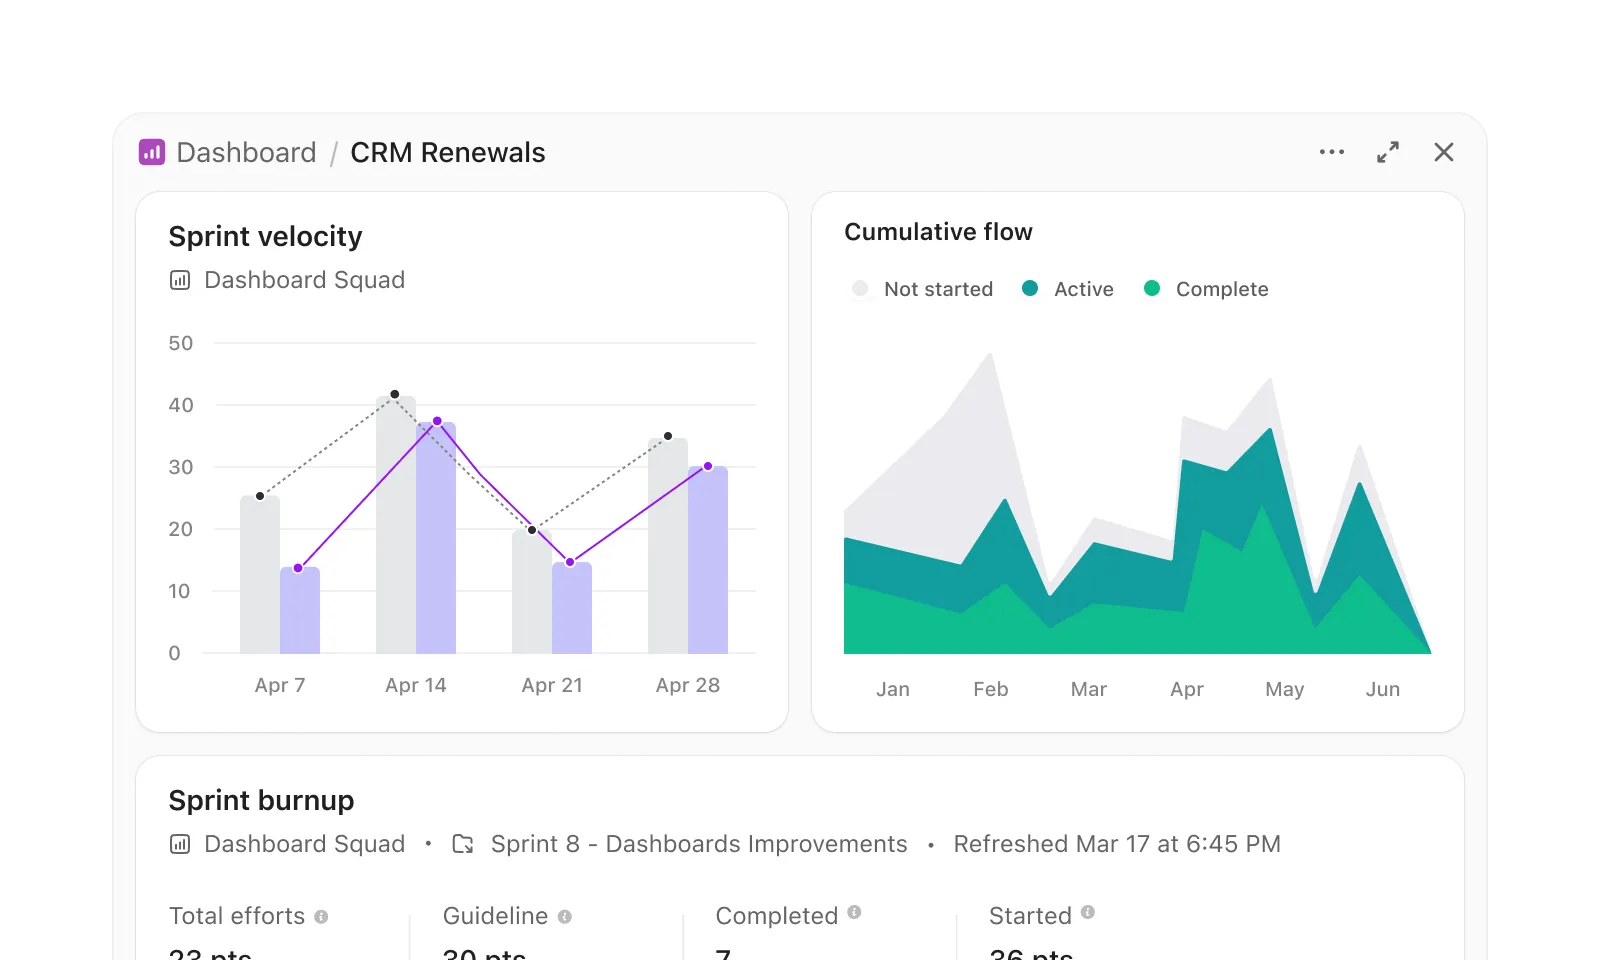
I flussi di lavoro di Snowflake Cortex spesso comportano la generazione di codice SQL, l'esecuzione di query e la visualizzazione dei risultati in un livello separato. Le dashboard di ClickUp eliminano questo processo in più passaggi e presentano le informazioni direttamente dal lavoro in tempo reale.
Un team di gestione del programma che effettua il monitoraggio dello stato di preparazione al rilascio può creare una dashboard senza dover scrivere query. Ad esempio, una dashboard dedicata al rilascio potrebbe includere:
- Una scheda dell'elenco delle attività filtrata per mostrare le attività scadute in tutti i team di prodotto
- Una scheda del carico di lavoro che mostra la distribuzione delle attività tra i tecnici
- Un grafico a barre che mette a confronto le attività completate con quelle in sospeso per ogni sprint
- Una scheda di calcolo che effettua il monitoraggio del tempo medio di completamento
Supponiamo che un responsabile di programma esamini questa dashboard prima di una riunione di rilascio. Noterà immediatamente che i servizi di backend presentano tassi di ritardo più elevati. Aprirà la scheda dell'elenco delle attività e esaminerà le attività specifiche che causano il rischio.
Un utente reale di ClickUp condivide:
ClickUp ci permette di scambiarci RAPIDAMENTE i progetti, di verificare FACILMENTE lo stato dei progetti e offre alla nostra responsabile una panoramica del nostro carico di lavoro in qualsiasi momento senza che debba interromperci. Utilizzando ClickUp abbiamo sicuramente risparmiato un giorno alla settimana, se non di più. Il numero di email si è ridotto NOTEVOLMENTE.
ClickUp ci permette di scambiarci RAPIDAMENTE i progetti, di verificare FACILMENTE lo stato dei progetti e offre alla nostra responsabile una panoramica del nostro carico di lavoro in qualsiasi momento, senza che debba interromperci. Utilizzando ClickUp abbiamo sicuramente risparmiato un giorno alla settimana, se non di più. Il numero di email si è ridotto NOTEVOLMENTE.
Agisci sulla base delle informazioni ottenute senza ricorrere a pipeline
Snowflake Cortex si concentra sulla generazione di approfondimenti dai dati. I team devono comunque interpretare i risultati e trigger le azioni separatamente.
Gli ClickUp AI Super Agents colmano questa lacuna e trasformano le intuizioni in azioni concrete. Operano come colleghi basati sull’intelligenza artificiale che monitorano continuamente i dati dell’area di lavoro e agiscono in base alle condizioni.
Supponiamo che un responsabile di programma coordini diverse iniziative di prodotto. Un Super Agent può:
- Monitora le attività in tutti i progetti e individua quando quelle in ritardo superano una soglia prestabilita
- Identifica modelli ricorrenti, come ritardi ripetuti nella stessa fase del flusso di lavoro
- Crea un'attività che riassuma i progetti interessati e assegnala al responsabile del programma
- Avvisa i titolari dei team quando le attività critiche rimangono irrisolte oltre le scadenze previste
Ad esempio, durante un ciclo di rilascio, un Super Agent rileva che più di 10 attività ad alta priorità non hanno rispettato le scadenze in due team. Crea quindi un'attività di ClickUp intitolata "Rischio di rilascio: scadenze non rispettate", allega tutti gli allegati pertinenti e la assegna al responsabile del programma per una revisione immediata.
I team possono anche interagire direttamente con il Super Agent: «Analizza tutti i progetti attivi ed evidenzia i rischi di consegna per questo sprint».
Il Super Agent esamina le scadenze, le dipendenze e lo stato delle attività, quindi pubblica un riepilogo strutturato all'interno dell'area di lavoro.
Ecco come impostare il tuo Super Agent in ClickUp:
Centralizza i tuoi flussi di lavoro relativi ai dati con ClickUp
Gli strumenti di conversione da testo a SQL come Snowflake Cortex rendono i dati più accessibili. Allo stesso tempo, ottenere risultati affidabili richiede comunque un certo lavoro richiesto.
I team hanno bisogno di schemi ben definiti, modelli semantici solidi e iterazioni continue per garantire l'accuratezza dei risultati. Anche dopo aver generato la query corretta, il lavoro non si ferma qui. Qualcuno deve comunque interpretare i risultati, effettuare la condivisione delle informazioni e trasformarle in decisioni.
ClickUp propone un approccio diverso. Anziché separare l’analisi dall’esecuzione, ClickUp le integra entrambe. I team generano codice SQL, documentano le intuizioni, collaborano sui risultati e agiscono di conseguenza all’interno dello stesso spazio di lavoro.
ClickUp Brain aiuta a scrivere e perfezionare le query, mentre le dashboard e gli agenti AI aiutano i team a effettuare il monitoraggio dei risultati e a portare avanti il lavoro senza dover passare da uno strumento all'altro.
Snowflake Cortex ti aiuta a ottenere risposte. ClickUp ti aiuta a metterle in pratica. Iscriviti a ClickUp oggi stesso!
Domande frequenti
Che cos’è Snowflake Cortex Analyst e in cosa si differenzia da Cortex IA?
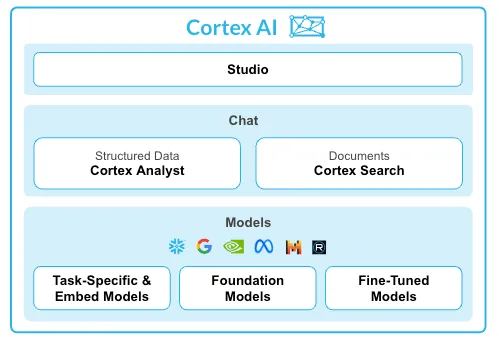
Snowflake Cortex Analyst è un servizio specializzato all'interno della più ampia suite Snowflake Cortex IA. Cortex Analyst è incentrato specificamente sulla generazione di SQL a partire da testo tramite modelli semantici, mentre Cortex IA include un intervallo più ampio di funzioni LLM, inferenza di modelli di machine learning e funzionalità di ricerca.
Snowflake Cortex Analyst funziona con origini dati esterne come le tabelle Iceberg?
Sì, Cortex Analyst è in grado di eseguire query sulle tabelle Apache Iceberg gestite tramite Snowflake. A condizione che le tabelle siano accessibili all’interno del proprio ambiente Snowflake e correttamente definite nel proprio modello semantico, è possibile generare query su di esse.
Quanto è accurata la generazione da testo a SQL di Snowflake per le query complesse?
L'accuratezza delle query complesse dipende quasi interamente dalla qualità del modello semantico. Un modello con relazioni tra le tabelle ben definite, numerose query verificate e metadati descrittivi produrrà risultati significativamente più accurati per i join su più tabelle e le aggregazioni complesse.
Quanto costa Snowflake Cortex per le funzionalità di generazione di SQL?
I prezzi di Snowflake Cortex Analyst seguono il modello basato sul consumo di Snowflake, il che significa che il costo viene addebitato in base ai crediti di calcolo utilizzati durante il processo di generazione delle query. Per conoscere le tariffe più aggiornate, ti consigliamo di consultare sempre la documentazione ufficiale sui prezzi di Snowflake.