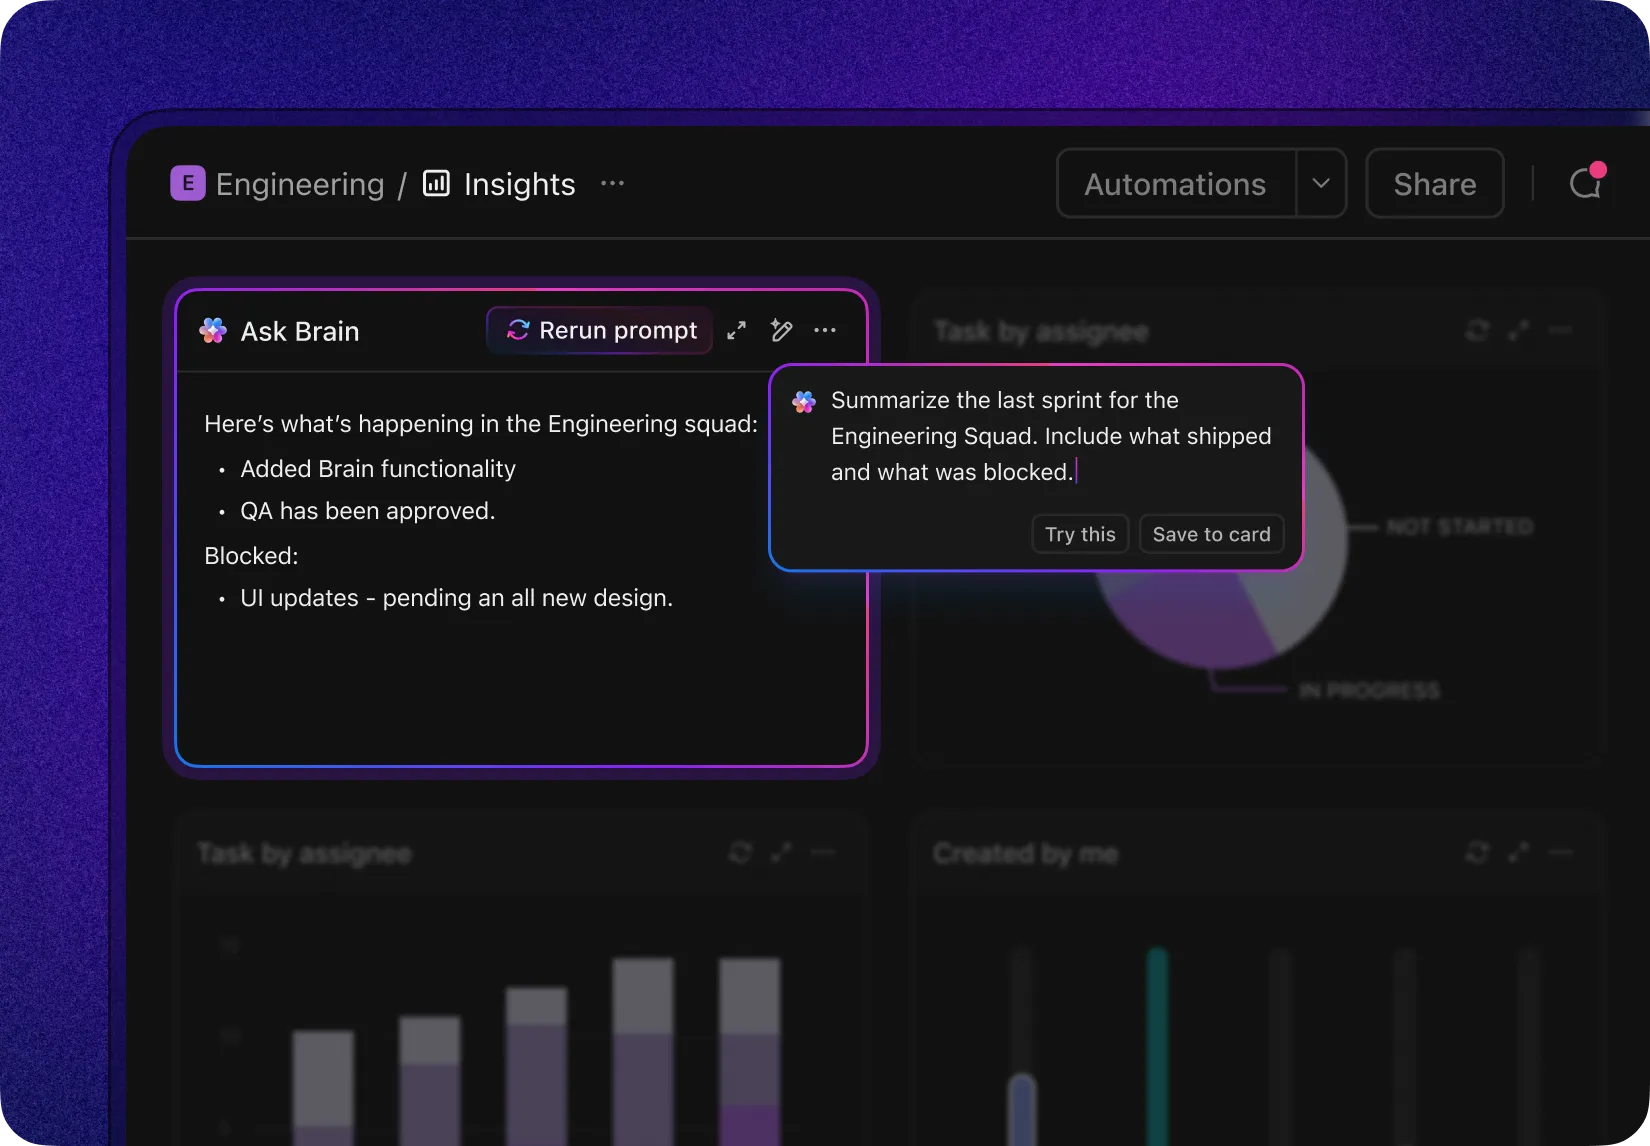
Lanzas la última actualización de software y empiezan a llover los informes.
De repente, una métrica lo rige todo, desde el CSAT y el NPS hasta los retrasos en la hoja de ruta: el tiempo de resolución de errores.
Los directivos lo ven como una métrica que mide el cumplimiento de las promesas: ¿podemos lanzar productos, aprender y proteger los ingresos según lo previsto? Los profesionales sufren las dificultades en el día a día: tickets duplicados, propiedad poco clara, escalaciones confusas y contexto disperso entre Slack, hojas de cálculo y herramientas independientes.
Esa fragmentación alarga los ciclos, oculta las causas fundamentales y convierte la priorización en una cuestión de conjeturas.
¿El resultado? Un aprendizaje más lento, compromisos incumplidos y una lista de tareas pendientes que, sin que nos demos cuenta, lastra cada sprint.
Esta guía es tu manual completo para medir, comparar y reducir el tiempo de resolución de errores, y muestra, de forma concreta, cómo la IA transforma el flujo de trabajo en comparación con los procesos manuales tradicionales.
¿Qué es el tiempo de resolución de errores?
El tiempo de resolución de una incidencia es el tiempo que se tarda en corregirla, medido desde el momento en que se notifica hasta que queda totalmente resuelta.
En la práctica, el reloj empieza a correr cuando se notifica o se detecta un problema (ya sea por parte de los usuarios, del equipo de control de calidad o mediante la supervisión) y se detiene cuando la corrección se ha implementado y combinado, lista para su verificación o lanzamiento, dependiendo de cómo defina su equipo el concepto de «terminado».
Ejemplo: un fallo de prioridad P1 notificado a las 10:00 h del lunes, cuya corrección se combinó a las 15:00 h del martes, tiene un tiempo de resolución de unas 29 horas.
No es lo mismo que el tiempo de detección de errores. El tiempo de detección mide la rapidez con la que se identifica un error después de que se produzca (activación de alarmas, detección mediante herramientas de control de calidad o elaboración de informes por parte de los clientes).
El tiempo de resolución mide la rapidez con la que se pasa de la detección al arreglo: clasificación, reproducción, diagnóstico, implementación, revisión, pruebas y preparación para el lanzamiento. Piensa en la detección como «sabemos que no funciona» y en la resolución como «ya está arreglado y listo».
Los equipos utilizan límites ligeramente diferentes; elige uno y sé coherente para que tus tendencias sean reales:
- Notificado → Resuelto: Finaliza cuando se combina la corrección del código y está lista para el control de calidad. Ideal para medir el rendimiento de ingeniería.
- Notificado → Cerrada: Incluye la validación de control de calidad y el lanzamiento. Ideal para SLA que afectan a los clientes.
- Detectado → Resuelto: Comienza cuando el sistema de monitorización o control de calidad detecta el problema, incluso antes de que exista un ticket. Útil para equipos con un alto volumen de producción.
🧠 Dato curioso: Un error peculiar pero divertidísimo en Final Fantasy XIV recibió elogios por ser tan específico que los lectores lo bautizaron como la «corrección de error más específica en un MMO de 2025». ». Se manifestaba cuando los jugadores fijaban el precio de los elementos entre exactamente 44 442 gil y 49 087 gil en una zona de evento concreta, lo que provocaba desconexiones debido a lo que podría ser un fallo de desbordamiento de enteros.
Por qué es importante
El tiempo de resolución es un factor clave en el ritmo de lanzamiento. Los tiempos prolongados o impredecibles obligan a recortar el alcance, aplicar parches de emergencia y congelar lanzamientos; además, generan deuda de planificación, ya que los casos atípicos (los valores atípicos) descarrilan los sprints más de lo que sugiere la media.
Además, esto está directamente relacionado con la satisfacción del cliente. Los clientes toleran los problemas cuando se reconocen rápidamente y se resuelven de forma predecible. Las soluciones lentas —o, peor aún, las soluciones variables— provocan escaladas, merman el CSAT y el NPS, y ponen en riesgo las renovaciones.
En resumen, si mides el tiempo de resolución de incidencias de forma clara y sistemática y lo reduces, mejorarán tus planes de trabajo y tus relaciones.
📖 Más información: Cómo priorizar las incidencias para resolverlas de forma eficaz
¿Cómo medir el tiempo de resolución de incidencias?
En primer lugar, decide cuándo empieza y cuándo termina el recuento del tiempo.
La mayoría de los equipos eligen entre «Notificado → Resuelto» (la corrección se ha combinado y está lista para su verificación) o «Notificado → Cerrada» (el departamento de control de calidad lo ha validado y el cambio se ha publicado o se ha cerrado por otros motivos).
Elige una definición y utilízala de forma coherente para que tus tendencias sean significativas.
Ahora necesitas algunas métricas observables. Veámoslas:
Métricas clave de seguimiento de errores a tener en cuenta:
| 📊 Métrica | 📌 Qué significa | 💡 Cómo te ayuda | 🧮 Fórmula (si procede) |
|---|---|---|---|
| Número de errores 🐞 | Número total de incidencias notificadas | Ofrece una vista general del estado del sistema. ¿El número es elevado? Es hora de investigar. | Total de incidencias = Todas las incidencias registradas en el sistema {Abiertas + Cerradas} |
| Incidencias pendientes 🚧 | Incidencias que aún no se han solucionado | Muestra la carga de trabajo actual. Ayuda a establecer prioridades. | Incidencias abiertas = Incidencias totales - Incidencias cerradas |
| Incidencias cerradas ✅ | Incidencias resueltas y verificadas | Realiza un seguimiento del progreso y del trabajo terminado. | Errores cerrados = Número de incidencias con el estado «Cerrado» o «Resuelto» |
| Gravedad de las incidencias 🔥 | Gravedad del error (p. ej., crítico, grave, leve) | Ayuda a clasificar los errores en función de su impacto. | Se registra como campo categórico, sin fórmula. Utiliza filtros o agrupaciones. |
| Prioridad de los errores 📅 | La urgencia con la que hay que solucionar un error | Ayuda en la planificación de sprints y lanzamientos. | También es un campo categórico, normalmente clasificado (p. ej., P0, P1, P2). |
| Tiempo de resolución ⏱️ | Tiempo transcurrido desde la notificación del error hasta su corrección | Mide la capacidad de respuesta. | Tiempo de resolución = Fecha cerrada - Fecha de notificación |
| Tasa de reapertura 🔄 | Porcentaje de incidencias reabiertas tras haber sido cerradas | Refleja la calidad de las correcciones o los problemas de regresión. | Tasa de reapertura (%) = {Incidencias reabiertas ÷ Total de incidencias cerradas} × 100 |
| Fuga de errores 🕳️ | Errores que se han colado en la fase de producción | Indica la eficacia del control de calidad y de las pruebas de software. | Índice de fuga (%) = {Errores en producción ÷ Total de incidencias} × 100 |
| Densidad de defectos 🧮 | Errores por unidad de tamaño de código | Destaca las áreas de código propensas a riesgos. | Densidad de defectos = Número de errores ÷ KLOC {kilo líneas de código} |
| Errores asignados frente a errores sin asignar 👥 | Distribución de las incidencias por propiedad | Garantiza que nada se pase por alto. | Utiliza un filtro: Sin asignar = Incidencias en las que el campo «Asignado a» está en blanco |
| Antigüedad de las incidencias abiertas 🧓 | Cuánto tiempo permanece sin resolver un error | Detecta el estancamiento y los riesgos de acumulación de trabajo pendiente. | Antigüedad del error = Fecha actual - Fecha de notificación |
| Incidencias duplicadas 🧬 | Número de informes duplicados | Destaca los errores en los procesos de registro. | Índice de duplicados = Duplicados ÷ Total de incidencias × 100 |
| MTTD (tiempo medio de detección) 🔎 | Tiempo medio que se tarda en detectar errores o incidencias | Mide la eficiencia de la supervisión y la detección. | MTTD = Σ(Tiempo de detección - Tiempo de aparición) ÷ Número de incidencias |
| MTTR (tiempo medio de resolución) 🔧 | Tiempo medio necesario para solucionar completamente una incidencia tras su detección | Realiza un seguimiento de la capacidad de respuesta del equipo de ingeniería y del tiempo de corrección. | MTTR = Σ(Tiempo de resolución - Tiempo de detección) ÷ Número de incidencias resueltas |
| MTTA (tiempo medio de respuesta) 📬 | Tiempo transcurrido desde la detección hasta que alguien empieza a trabajar en el error | Muestra la capacidad de reacción del equipo y la rapidez de respuesta ante las alertas. | MTTA = Σ(tiempo de confirmación - tiempo de detección) ÷ número de incidencias |
| MTBF (tiempo medio entre fallos) 🔁 | Tiempo transcurrido entre la resolución de un fallo y la aparición del siguiente | Indica la estabilidad a lo largo del tiempo. | MTBF = Tiempo total de actividad ÷ Número de fallos |
⚡️ Archivo de plantillas: 15 plantillas y formularios gratuitos para informes de errores y seguimiento de errores
Factores que influyen en el tiempo de resolución de incidencias
El tiempo de resolución suele equipararse a «la rapidez con la que escriben el código los ingenieros».
Pero eso es solo una parte del proceso.
El tiempo de resolución de incidencias es la suma de la calidad en la recepción, la eficiencia del flujo a través de su sistema y el riesgo de dependencia. Cuando alguno de estos aspectos falla, la duración del ciclo se alarga, la previsibilidad disminuye y las quejas se intensifican.
La calidad de la recepción marca la pauta
Los informes que llegan sin pasos de reproducción claros, detalles del entorno, registros o información sobre la versión o compilación obligan a un intercambio de mensajes adicional. Los informes duplicados procedentes de múltiples canales (soporte técnico, control de calidad, monitorización, Slack) generan ruido y fragmentan la propiedad.
Cuanto antes recopiles el contexto adecuado —y elimines los datos duplicados—, menos traspasos y consultas de aclaración necesitarás más adelante.
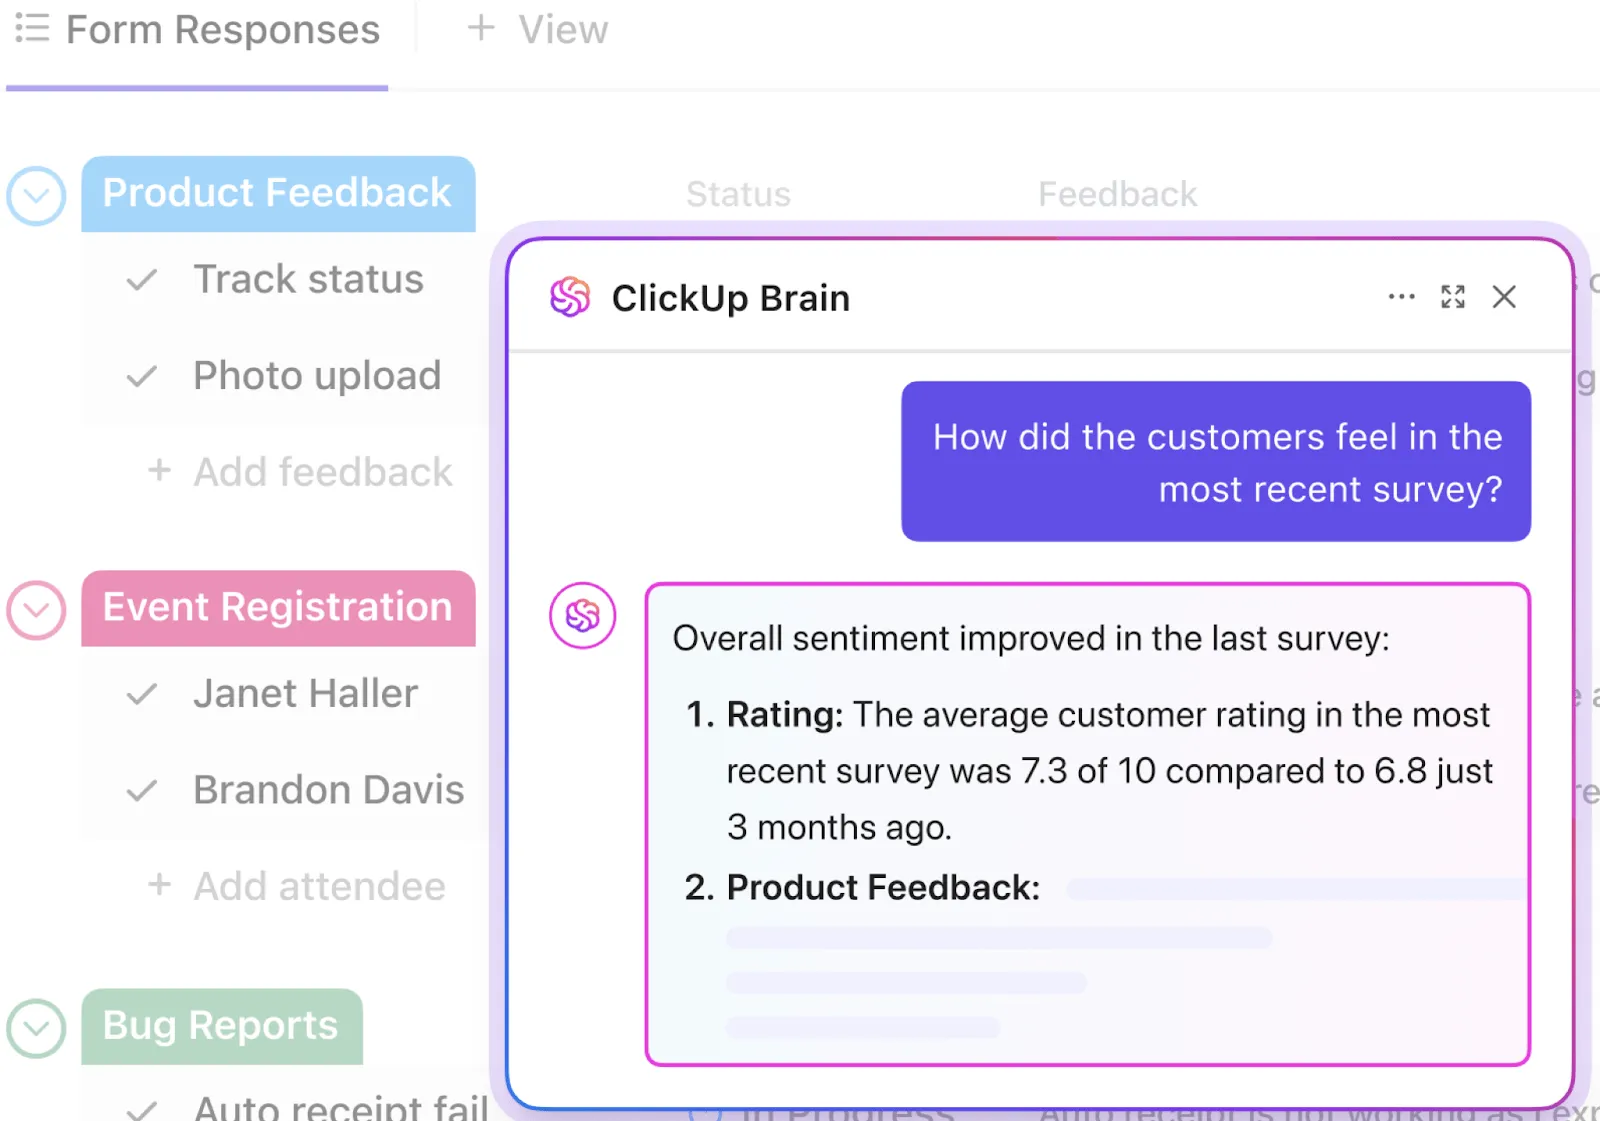
La priorización y el enrutamiento determinan quién se ocupa de la incidencia y cuándo.
Los rótulos de gravedad que no se correlacionan con el impacto en el cliente o en la empresa (o que varían con el tiempo) provocan una rotación en la cola: los tickets más urgentes se saltan la cola, mientras que los defectos de alto impacto quedan en espera.
Unas reglas de enrutamiento claras por componente o propietario, junto con una única cola de referencia, evitan que el trabajo de prioridad P0 y P1 quede sepultado bajo las «recientes y ruidosas».
La propiedad y los traspasos de tareas son enemigos silenciosos
Si no queda claro si un error corresponde al equipo de móviles, al de autenticación del backend o al de la plataforma, el caso rebota. Cada rebote reinicia el contexto.
Las zonas horarias agravan esta situación: una incidencia notificada a última hora del día sin un propietario asignado puede tardar entre 12 y 24 horas en que alguien empiece siquiera a reproducirla. Unas definiciones claras de «quién es el propietario de qué», con un responsable de guardia o un DRI semanal, eliminan ese retraso.
La reproducibilidad depende de la observabilidad
Los registros incompletos, la falta de ID de correlación o la ausencia de trazas de fallos convierten el diagnóstico en una cuestión de conjeturas. Las incidencias que solo aparecen con determinados indicadores, clientes o formatos de datos son difíciles de reproducir en el entorno de desarrollo.
Si los ingenieros no pueden acceder de forma segura a datos depurados similares a los de producción, acaban teniendo que realizar mediciones, volver a implementar y esperar —días en lugar de horas—.
La paridad de entornos y datos garantiza la transparencia
«Funciona en mi máquina» suele significar «los datos de producción son diferentes». Cuanto más se alejen tus entornos de desarrollo y staging de la producción (configuración, servicios, versiones de terceros), más tiempo pasarás persiguiendo fantasmas. Las instantáneas de datos seguras, los scripts de inicialización y las comprobaciones de paridad reducen esa brecha.
El trabajo en curso (WIP) y la concentración impulsan el rendimiento real
Los equipos sobrecargados asumen demasiadas incidencias a la vez, dispersan su atención y se ven obligados a alternar constantemente entre tareas y reuniones. El cambio de contexto añade horas invisibles.
Un límite visible del WIP y la tendencia a terminar lo que se ha empezado antes de aceptar nuevas tareas reducirán tu mediana más rápido que cualquier esfuerzo individual de un «héroe».
La revisión del código, la integración continua (CI) y la rapidez del control de calidad (QA) son los típicos cuellos de botella
Los tiempos de compilación lentos, las pruebas poco fiables y los acuerdos de nivel de servicio (SLA) de revisión poco claros retrasan soluciones que, de otro modo, serían rápidas. Un parche de 10 minutos puede tardar dos días en ser revisado o en incorporarse a un proceso que dura varias horas.
Del mismo modo, las colas de control de calidad que agrupan las pruebas por lotes o se basan en pruebas de fumigación manuales pueden añadir días enteros al proceso «Notificado → Cerrada», incluso cuando el proceso «Notificado → Resuelto» es rápido.
Las dependencias alargan las colas
Los cambios que afectan a varios equipos (esquemas, migraciones de plataformas, actualizaciones de SDK), las incidencias de los proveedores o las revisiones de las tiendas de aplicaciones (móviles) generan tiempos de espera. Sin un seguimiento explícito de los estados «Bloqueado/En pausa», esas esperas inflan de forma invisible tus medias y ocultan dónde se encuentra el verdadero cuello de botella.
El modelo de lanzamiento y la estrategia de reversión son importantes
Si realizas lanzamientos en grandes «trenes de lanzamiento» con controles manuales, incluso los errores ya resueltos permanecen pendientes hasta que sale el siguiente tren. Los conmutadores de función, los lanzamientos «canario» y las vías de correcciones urgentes acortan la cola —especialmente para incidencias P0/P1— al permitirte desacoplar la implementación de las correcciones de los ciclos completos de lanzamiento.
La arquitectura y la deuda técnica marcan tu límite máximo
El acoplamiento estrecho, la falta de puntos de prueba y los módulos heredados opacos hacen que las correcciones sencillas resulten arriesgadas. Los equipos lo compensan con pruebas adicionales y revisiones más largas, lo que alarga los ciclos. Por el contrario, un código modular con buenas pruebas de contrato te permite avanzar rápidamente sin afectar a los sistemas adyacentes.
La comunicación y la gestión adecuada del estado de las incidencias influyen en la previsibilidad
Las actualizaciones imprecisas («lo estamos investigando») generan trabajo adicional cuando las partes interesadas solicitan fechas estimadas de finalización, el equipo de soporte reabre tickets o el equipo de producto eleva el problema. Unas transiciones de estado claras, notas sobre la reproducción del error y su causa raíz, y una fecha estimada de finalización publicada reducen la rotación y protegen la concentración de tu equipo de ingeniería.
📮Dato de ClickUp: El profesional medio dedica más de 30 minutos al día a buscar información relacionada con el trabajo; eso supone más de 120 horas al año perdidas rebuscando entre correos electrónicos, hilos de Slack y archivos dispersos.
Un asistente inteligente basado en IA integrado en tu entorno de trabajo puede cambiar eso. Te presentamos ClickUp Brain. Ofrece información y respuestas al instante al mostrar los documentos, las conversaciones y los detalles de las tareas adecuados en cuestión de segundos, para que puedas dejar de buscar y empezar a trabajar.
💫 Resultados reales: Equipos como QubicaAMF recuperaron más de 5 horas a la semana gracias a ClickUp —lo que supone más de 250 horas al año por persona— al eliminar procesos obsoletos de gestión del conocimiento. ¡Imagina lo que tu equipo podría crear con una semana extra de productividad cada trimestre!
Indicadores adelantados de que tu plazo de entrega se va a alargar
❗️Aumento del «tiempo de confirmación» y gran cantidad de tickets sin propietario durante más de 12 horas
❗️Aumento de los intervalos de «Tiempo en revisión/CI» y inestabilidad frecuente en las pruebas
❗️Alta tasa de duplicados en la recepción de incidencias y rótulos de gravedad inconsistentes entre los distintos equipos
❗️Varias incidencias se encuentran en el estado «Bloqueado» sin una dependencia externa especificada
❗️La tasa de reapertura va en aumento (las correcciones no son reproducibles o las definiciones de «terminado» son imprecisas)
Las distintas organizaciones perciben estos factores de manera diferente. Los ejecutivos los viven como ciclos de aprendizaje perdidos y retrasos en los momentos clave para la generación de ingresos; los operadores los perciben como ruido en la clasificación de incidencias y una falta de claridad en la propiedad.
Ajustar la recepción, el flujo y las dependencias es la forma de reducir toda la curva, tanto la mediana como el P90.
¿Quieres obtener más información sobre cómo redactar mejores informes de errores? Empieza aquí. 👇🏼
📖 Más información: El ciclo de vida de las pruebas de software (STLC): panorámica y fases
Valores de referencia del sector para el tiempo de resolución de errores
Los valores de referencia para la resolución de errores varían en función de la tolerancia al riesgo, el modelo de lanzamiento y la rapidez con la que se pueden implementar los cambios.
Aquí es donde puede utilizar las medianas (P50) para comprender su flujo habitual y la P90 para establecer compromisos y acuerdos de nivel de servicio (SLA), según la gravedad y el origen (cliente, control de calidad, supervisión).
Analicemos qué significa esto:
| 🔑 Término | 📝 Descripción | 💡 Por qué es importante |
|---|---|---|
| P50 (mediana) | El valor medio: el 50 % de las correcciones de errores son más rápidas que esto, y el 50 % son más lentas. | 👉 Refleja tu tiempo de resolución habitual o más común. Útil para comprender el rendimiento normal. |
| P90 (percentil 90) | El 90 % de las incidencias se resuelven en este plazo. Solo el 10 % tarda más. | 👉 Representa un límite en el peor de los casos (aunque sigue siendo realista). Útil para establecer compromisos externos. |
| SLA (acuerdos de nivel de servicio) | Las confirmaciones que haces —ya sea a nivel interno o con los clientes— sobre la rapidez con la que se abordarán los problemas | 👉 Ejemplo: «Resolvemos las incidencias de prioridad P1 en un plazo de 48 horas en el 90 % de los casos». Esto ayuda a generar confianza y a fomentar la responsabilidad. |
| Por gravedad y origen | Segmente sus métricas según dos dimensiones clave: • Gravedad (p. ej., P0, P1, P2) • Origen (p. ej., cliente, control de calidad, supervisión) | 👉 Permite un seguimiento y una priorización más precisos, de modo que las incidencias críticas reciban atención más rápidamente |
A continuación se muestran unos intervalos orientativos basados en los sectores a los que suelen tener como objetivo los equipos con más experiencia; considéralos como puntos de partida y, a continuación, adáptalos a tu contexto.
SaaS
El sistema está siempre activo y es compatible con CI/CD, por lo que las correcciones urgentes son habituales. Para los problemas críticos (P0/P1), el objetivo suele ser una mediana inferior a un día laborable, con un P90 de entre 24 y 48 horas. Los problemas no críticos (P2+) suelen tener una mediana de entre 3 y 7 días, con un P90 de entre 10 y 14 días. Los equipos que cuentan con conmutadores de función robustos y pruebas automatizadas tienden a situarse en el extremo más rápido.
Plataformas de comercio electrónico
Dado que los flujos de conversión y del carrito son fundamentales para los ingresos, el listón está más alto. Los problemas de prioridad P0/P1 suelen mitigarse en cuestión de horas (reversión, marcado o configuración) y resueltarse por completo el mismo día; es habitual que el P90 se resuelva al final del día o en menos de 12 horas en temporada alta. Los problemas de prioridad P2+ suelen resolverse en un plazo de 2 a 5 días, con un P90 en un plazo de 10 días.
Software empresarial
Las validaciones más exhaustivas y los plazos de cambio de los clientes ralentizan el ritmo. Para los errores P0/P1, los equipos se fijan como objetivo una solución provisional en un plazo de 4 a 24 horas y una corrección en 1 a 3 días laborables; para el P90, en un plazo de 5 días laborables. Los elementos P2+ suelen agruparse en trenes de lanzamiento, con medianas de 2 a 4 semanas, dependiendo de los calendarios de implementación de los clientes.
Videojuegos y aplicaciones móviles
Los backends de los servicios en vivo funcionan como el SaaS (activación y reversión de cambios en minutos u horas; P90 el mismo día). Las actualizaciones del cliente están sujetas a revisiones de la tienda: las incidencias P0/P1 suelen utilizar medidas del lado del servidor de forma inmediata y se lanza un parche para el cliente en un plazo de 1 a 3 días; P90 en el plazo de una semana con revisión acelerada. Las correcciones de P2+ suelen programarse para el siguiente sprint o lanzamiento de contenido.
Banca/Tecnología financiera
Los controles de riesgo y cumplimiento impulsan un patrón de «mitigar rápidamente, cambiar con cautela». Los errores P0/P1 se mitigan rápidamente (alertas, reversiones, desviaciones del tráfico en cuestión de minutos u horas) y se corrigen por completo en un plazo de 1 a 3 días; los P90, en el plazo de una semana, teniendo en cuenta el control de cambios. Los errores P2+ suelen tardar entre 2 y 6 semanas en superar las revisiones de seguridad, auditoría y del Comité Asesor de Cambios (CAB).
Si tus números se sitúan fuera de estos intervalos, analiza la calidad de la recepción de incidencias, el enrutamiento y la propiedad, el rendimiento de la revisión del código y del control de calidad, así como las aprobaciones de dependencias, antes de dar por sentado que la «velocidad de ingeniería» es el problema principal.
🌼 ¿Sabías que...? Según una encuesta de Stack Overflow de 2024, los desarrolladores utilizaban cada vez más la IA como su fiel aliada a lo largo del proceso de programación. Un impresionante 82 % utilizaba la IA para escribir código: ¡eso sí que es un colaborador creativo! Cuando se quedaban atascados o buscaban soluciones, el 67,5 % recurría a la IA para buscar respuestas, y más de la mitad (56,7 %) se apoyaba en ella para depurar y obtener ayuda.
Para algunos, las herramientas de IA también resultaron útiles para documentar proyectos (40,1 %) e incluso para generar datos o contenidos sintéticos (34,8 %). ¿Tienes curiosidad por conocer una nueva base de código? Casi un tercio (30,9 %) utiliza la IA para ponerse al día. Probar el código sigue siendo una tarea manual tediosa para muchos, pero el 27,2 % también ha adoptado la IA en este ámbito. En otras áreas, como la revisión de código, la planificación de proyectos y el análisis predictivo, la adopción de la IA es menor, pero está claro que la IA se está integrando de forma constante en todas las fases del desarrollo de software.
📖 Más información: Cómo utilizar la IA para el control de calidad
Cómo reducir el tiempo de resolución de incidencias
La rapidez en la resolución de errores se reduce a eliminar los obstáculos en cada fase del proceso, desde la recepción hasta el lanzamiento.
Los mayores beneficios se obtienen al gestionar de forma más inteligente los primeros 30 minutos (registro claro, propietario adecuado, prioridad correcta) y, a continuación, acortar los ciclos posteriores (reproducción, revisión y verificación).
Aquí tienes nueve estrategias que funcionan conjuntamente como un sistema. La IA acelera cada paso y el flujo de trabajo se gestiona de forma ordenada en un único lugar, de modo que los directivos obtienen previsibilidad y los profesionales, flujo.
1. Centraliza la recepción de incidencias y recoge el contexto en el origen
El tiempo de resolución de errores se alarga cuando hay que reconstruir el contexto a partir de hilos de Slack, tickets de soporte y hojas de cálculo. Canaliza todos los informes —de soporte, control de calidad y monitorización— hacia una única cola mediante una plantilla estructurada que recopila información sobre el componente, la gravedad, el entorno, la versión o compilación de la aplicación, los pasos para reproducir el error, los resultados esperados frente a los reales y los adjuntos (registros, HAR y capturas de pantalla).
La IA puede resumir automáticamente informes extensos, extraer los pasos para reproducir el error y los detalles del entorno a partir de los adjuntos, y señalar posibles duplicados, de modo que la clasificación comience con un registro coherente y enriquecido.
Métricas a tener en cuenta: MTTA (respuesta en cuestión de minutos, no de horas), tasa de duplicados y tiempo de «Necesita información».
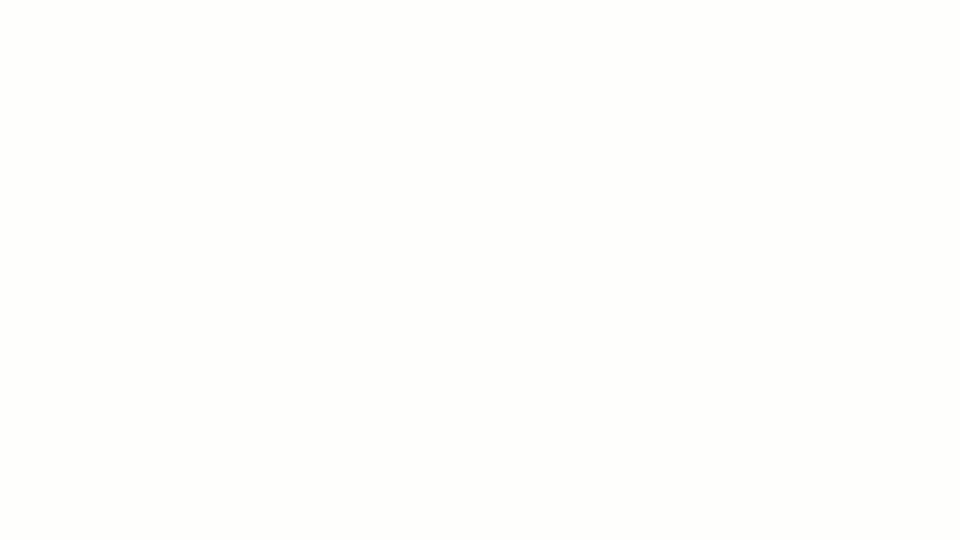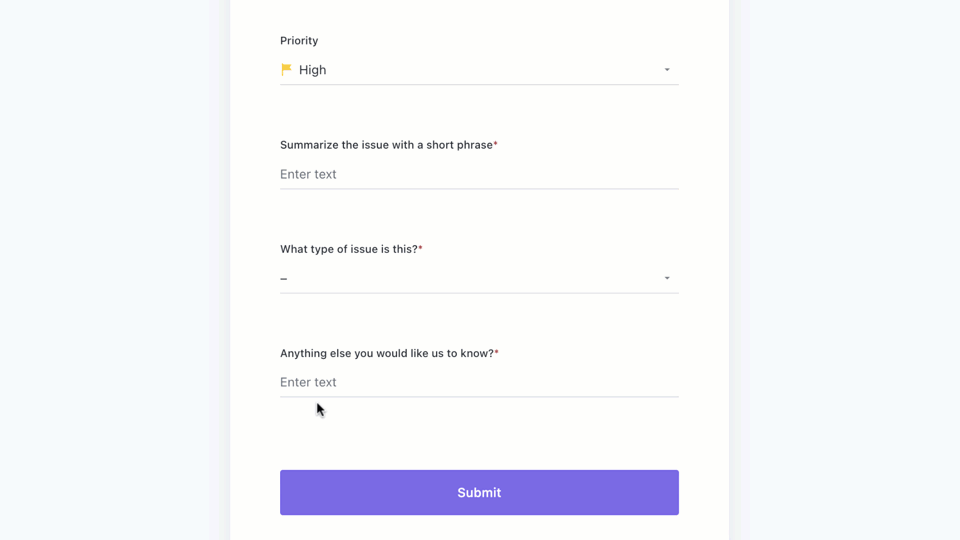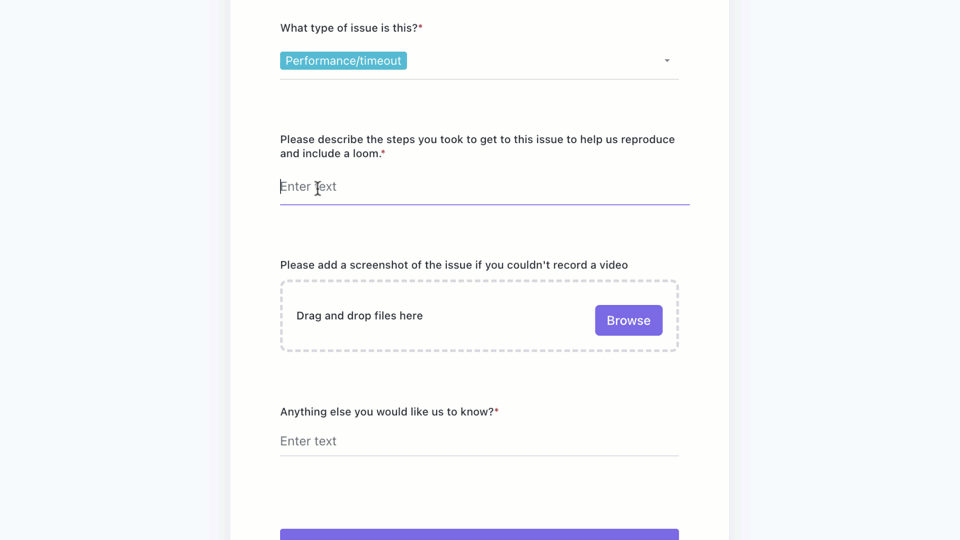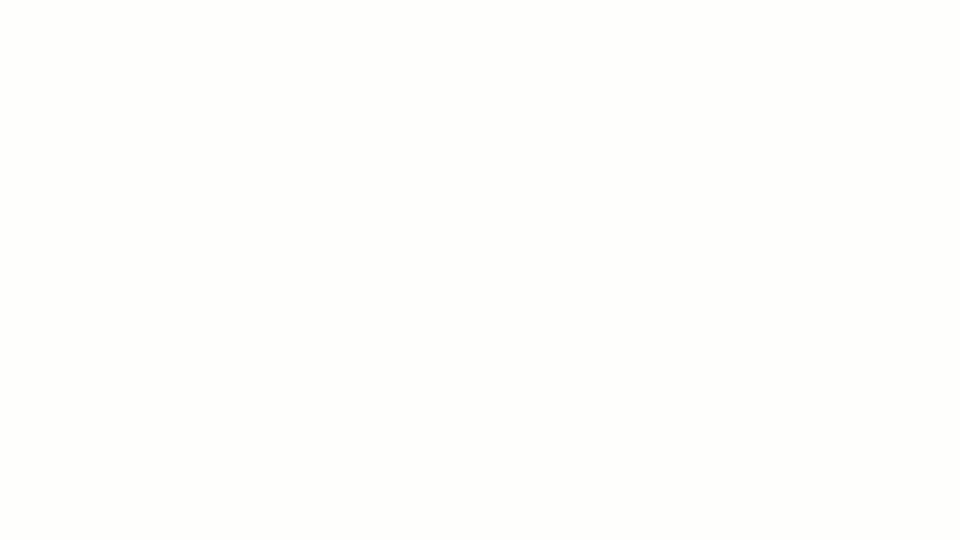
📖 Más información: El poder de los formularios de ClickUp: optimización del trabajo para los equipos de software
2. Clasificación y distribución asistidas por IA para reducir drásticamente el MTTA
Las soluciones más rápidas son aquellas que llegan inmediatamente al escritorio adecuado.
Utiliza reglas sencillas junto con la IA para clasificar la gravedad, identificar a los propietarios probables por componente o área de código y asignar automáticamente con un contador de SLA. Establece carriles claros para P0/P1 frente a todo el resto y deja claro quién es el propietario de cada caso.
Las automatizaciones pueden establecer la prioridad a partir de los campos, derivar el caso a un equipo según el componente, iniciar un cronómetro de SLA y notificar a un ingeniero de guardia; la IA puede proponer el nivel de gravedad y el propietario basándose en patrones anteriores. Cuando la clasificación se convierte en un proceso de 2 a 5 minutos en lugar de un debate de 30 minutos, tu MTTA se reduce y tu MTTR hace lo propio.
Métricas a tener en cuenta: MTTA, calidad de la primera respuesta (¿se solicita la información correcta en el primer comentario?), número de traspasos por incidencia.
Así es como funciona en la práctica:
3. Establece prioridades en función del impacto en la empresa con niveles de SLA bien definidos
La máxima de «la voz más fuerte es la que se impone» hace que las colas sean impredecibles y socava la confianza de los directivos, que están pendientes de los índices CSAT y NPS, así como de las renovaciones.
Sustitúyelo por una puntuación que combine la gravedad, la frecuencia, los ingresos anuales recurrentes (ARR) afectados, la importancia de las funciones y la proximidad a las renovaciones o lanzamientos, y respáldala con niveles de SLA (por ejemplo, P0: mitigar en 1-2 horas, resolver en un día; P1: el mismo día; P2: dentro de un sprint).
Mantén una cola con visibilidad de incidencias P0/P1 con límites de WIP para que nada se quede sin atención.
Métricas a tener en cuenta: resolución P50/P90 por nivel, tasa de incumplimiento del SLA, correlación con el CSAT y el NPS.
💡Consejo profesional: Las prioridades de tareas, los Campos personalizados y los campos de dependencias de ClickUp te permiten calcular una puntuación de impacto y enlazar las incidencias con cuentas, comentarios o elementos de la hoja de ruta; además, las Metas de ClickUp te ayudan a enlazar el cumplimiento del SLA con los objetivos a nivel de empresa, lo que responde directamente a las preocupaciones de la dirección sobre la alineación.
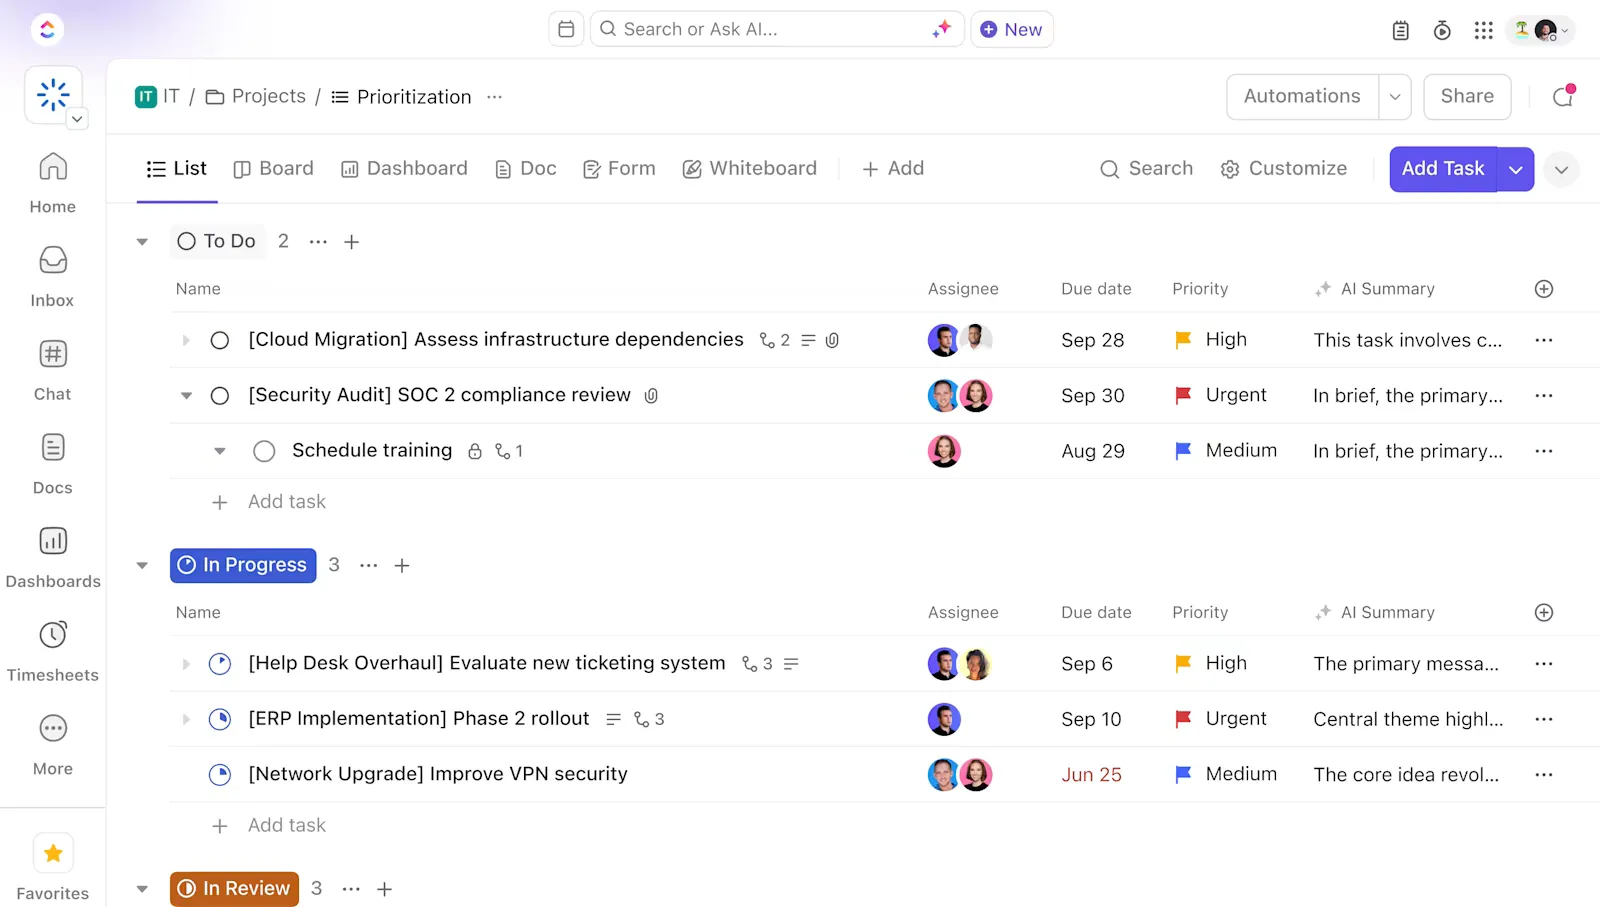
4. Haz que la reproducción y el diagnóstico se realicen en una sola etapa
Cada paso adicional del tipo «¿puedes enviar los registros?» alarga el tiempo de resolución.
Estandarice lo que se considera «correcto»: campos obligatorios para la compilación/confirmación, el entorno, los pasos de reproducción, los resultados esperados frente a los reales, además de archivos adjuntos con registros, volcados de memoria y archivos HAR. Implemente la telemetría de cliente/servidor para que los ID de fallo y los ID de solicitud se puedan vincular a los rastros.
Incorpora Sentry (o una herramienta similar) para obtener trazas de pila y enlaza ese problema directamente con el error. La IA puede leer registros y trazas para proponer un posible dominio de fallo y generar una reproducción mínima, lo que convierte una hora de análisis visual en unos pocos minutos de trabajo específico.
Almacena guías de resolución para tipos habituales de incidencias, de modo que los ingenieros no tengan que empezar desde cero.
Métricas a tener en cuenta: tiempo dedicado a «esperar información», porcentaje de errores reproducidos en la primera revisión y tasa de reapertura relacionada con la falta de reproducción.
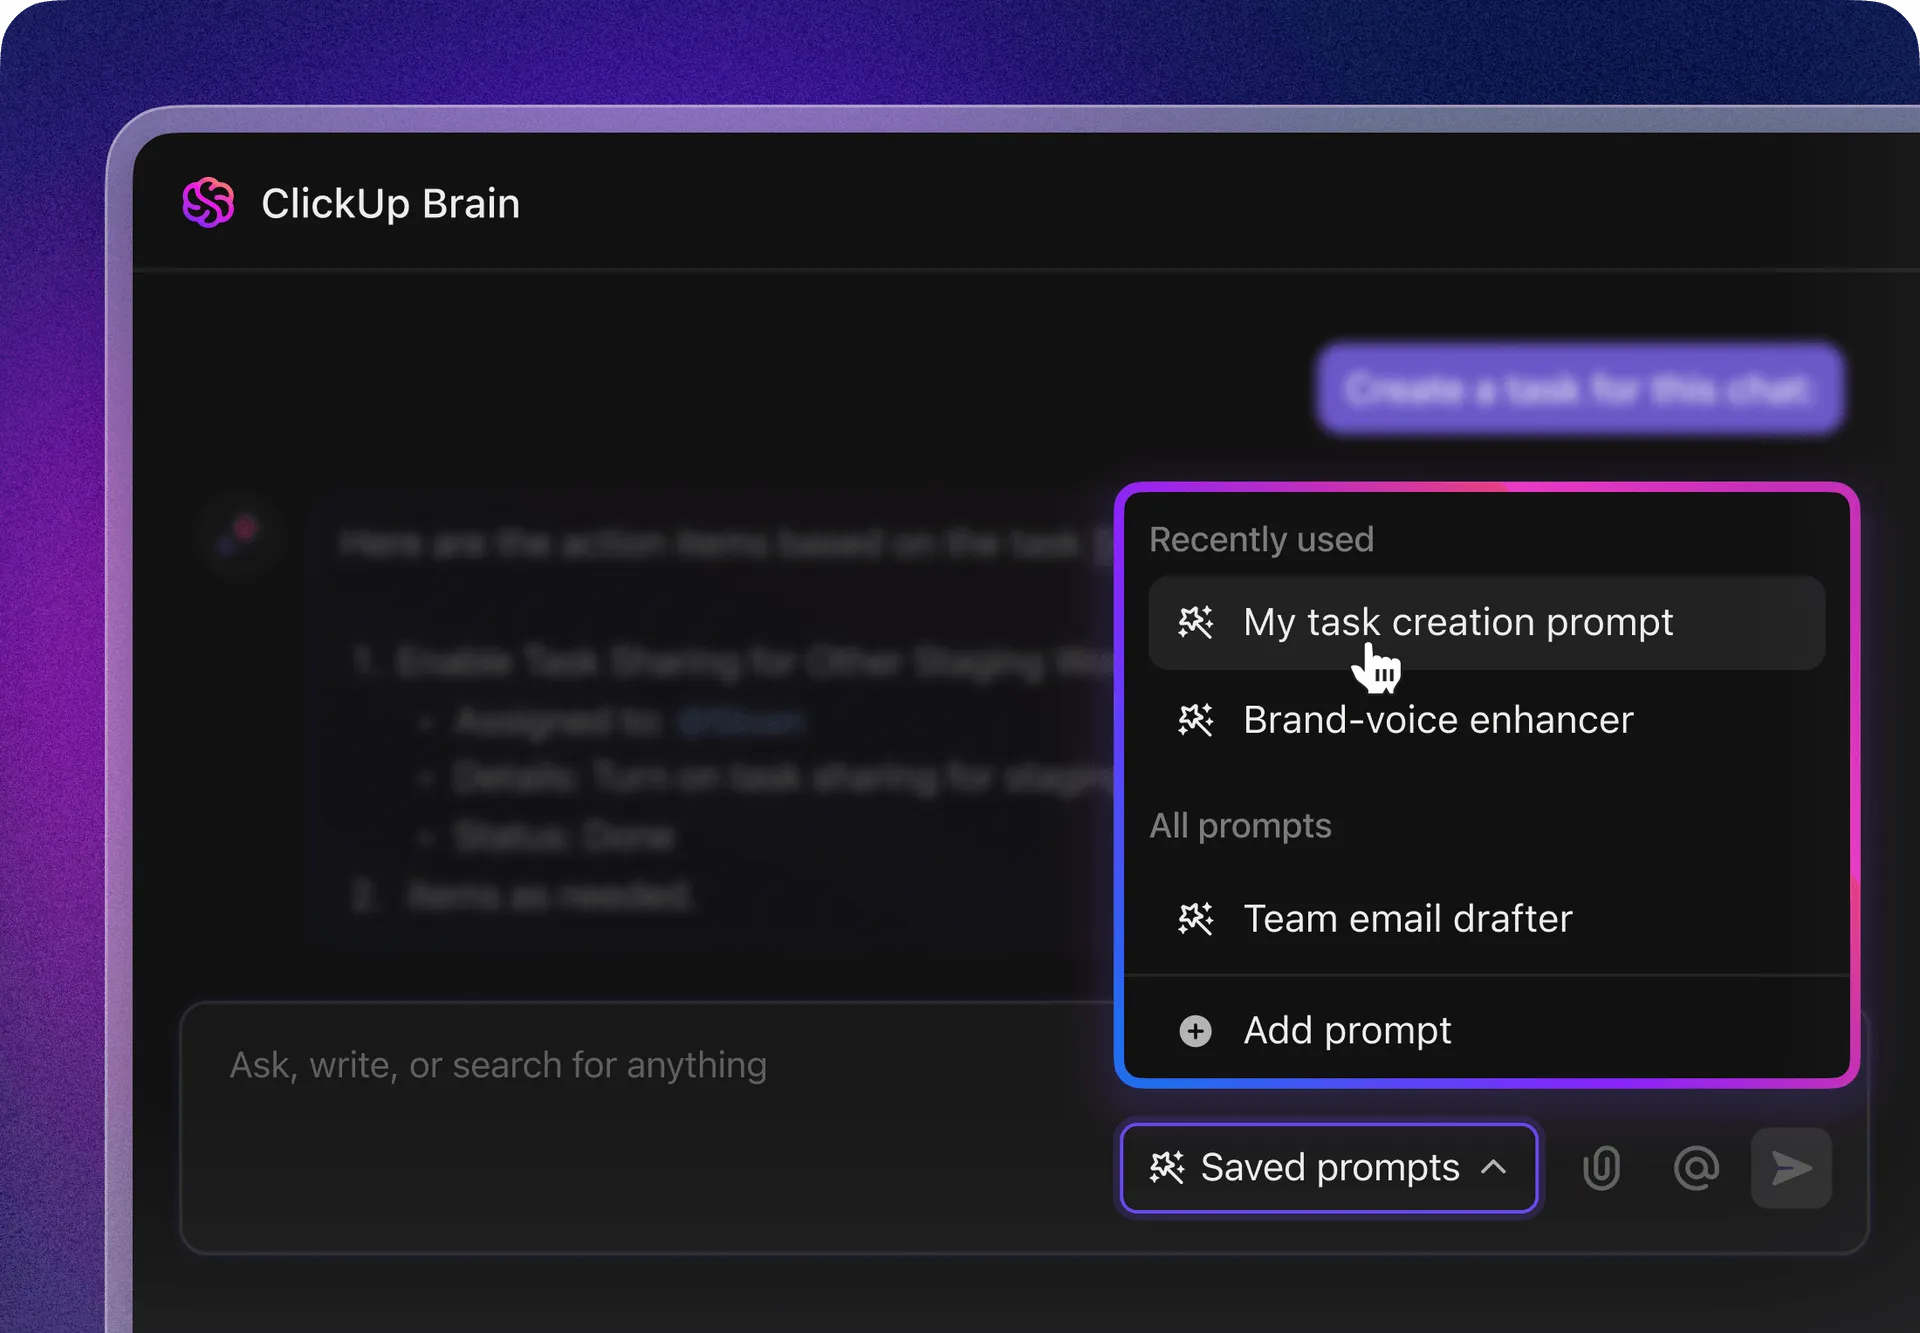
5. Acorta el ciclo de revisión del código y de pruebas
Las solicitudes de incorporación de cambios (PR) de gran envergadura se estancan. Apuesta por parches precisos, desarrollo basado en el tronco y conmutadores de función para que las correcciones se puedan implementar de forma segura. Asigna previamente a los revisores según la propiedad del código para evitar tiempos de inactividad, y utiliza listas de control (pruebas actualizadas, telemetría añadida, conmutador protegido por un interruptor de emergencia) para garantizar la calidad desde el principio.
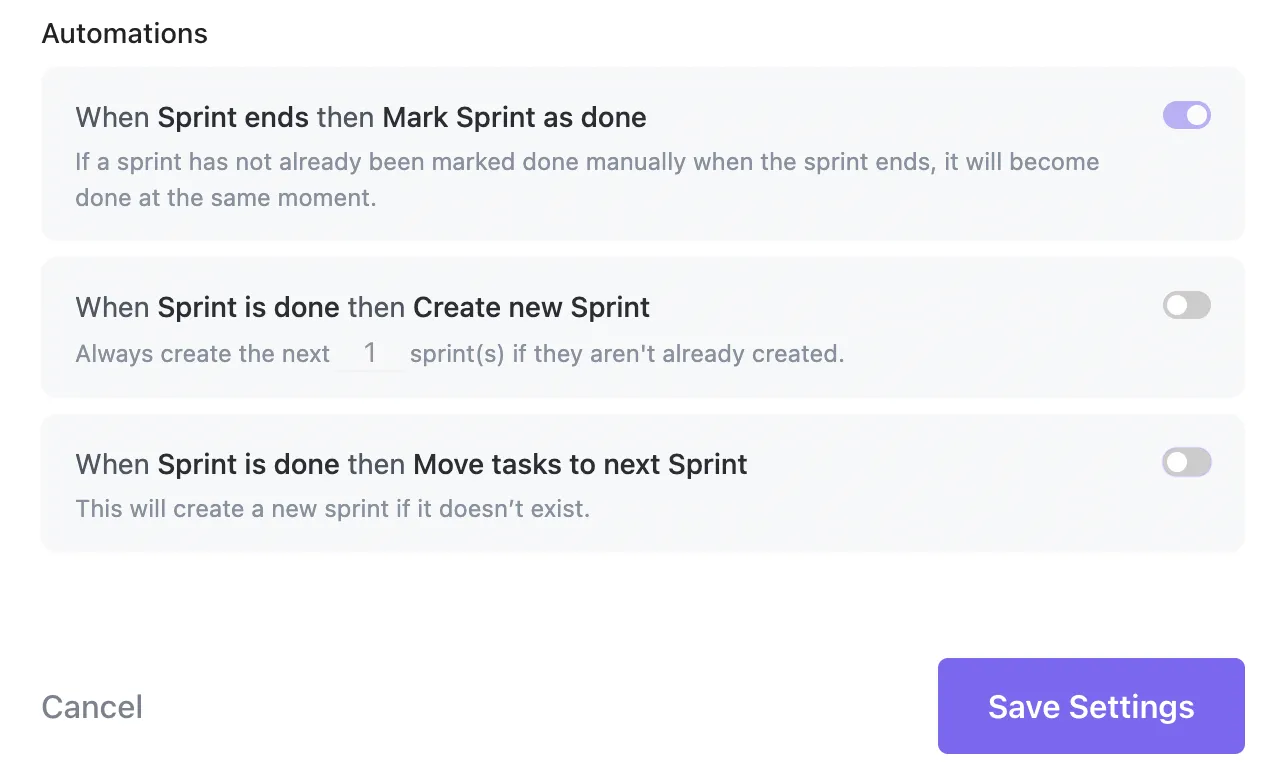
La automatización debería cambiar el estado del error a «En revisión» al abrir la solicitud de incorporación de cambios y a «Resuelto» al combinarla; la IA puede sugerir pruebas unitarias o resaltar diferencias de riesgo para centrar la revisión.
Métricas a tener en cuenta: tiempo en «En revisión», tasa de fallos en los cambios de las solicitudes de incorporación de cambios (PR) para la corrección de errores y latencia de revisión P90.
Puedes utilizar las integraciones de GitHub/GitLab en ClickUp para mantener sincronizado el estado de resolución; las automatizaciones pueden hacer cumplir la «definición de «terminado»».
📖 Más información: Cómo utilizar la IA para automatizar tareas
6. Paraleliza la verificación y haz realidad la paridad del entorno de control de calidad
La verificación no debería comenzar días después ni en un entorno que ninguno de tus clientes utilice.
Mantén un estricto control de la «preparación para el control de calidad»: parches de corrección basados en indicadores y validados en entornos similares a los de producción con datos de referencia que coinciden con los casos notificados.
Siempre que sea posible, configura entornos efímeros a partir de la rama de incidencias para que el equipo de control de calidad pueda validarlos de inmediato; a continuación, la IA puede generar casos de prueba a partir de la descripción del error y de regresiones anteriores.
Métricas a tener en cuenta: Tiempo en «Control de calidad/Verificación», tasa de rebote del control de calidad de vuelta al equipo de desarrollo, tiempo medio hasta el cierre tras combinar las ramas.
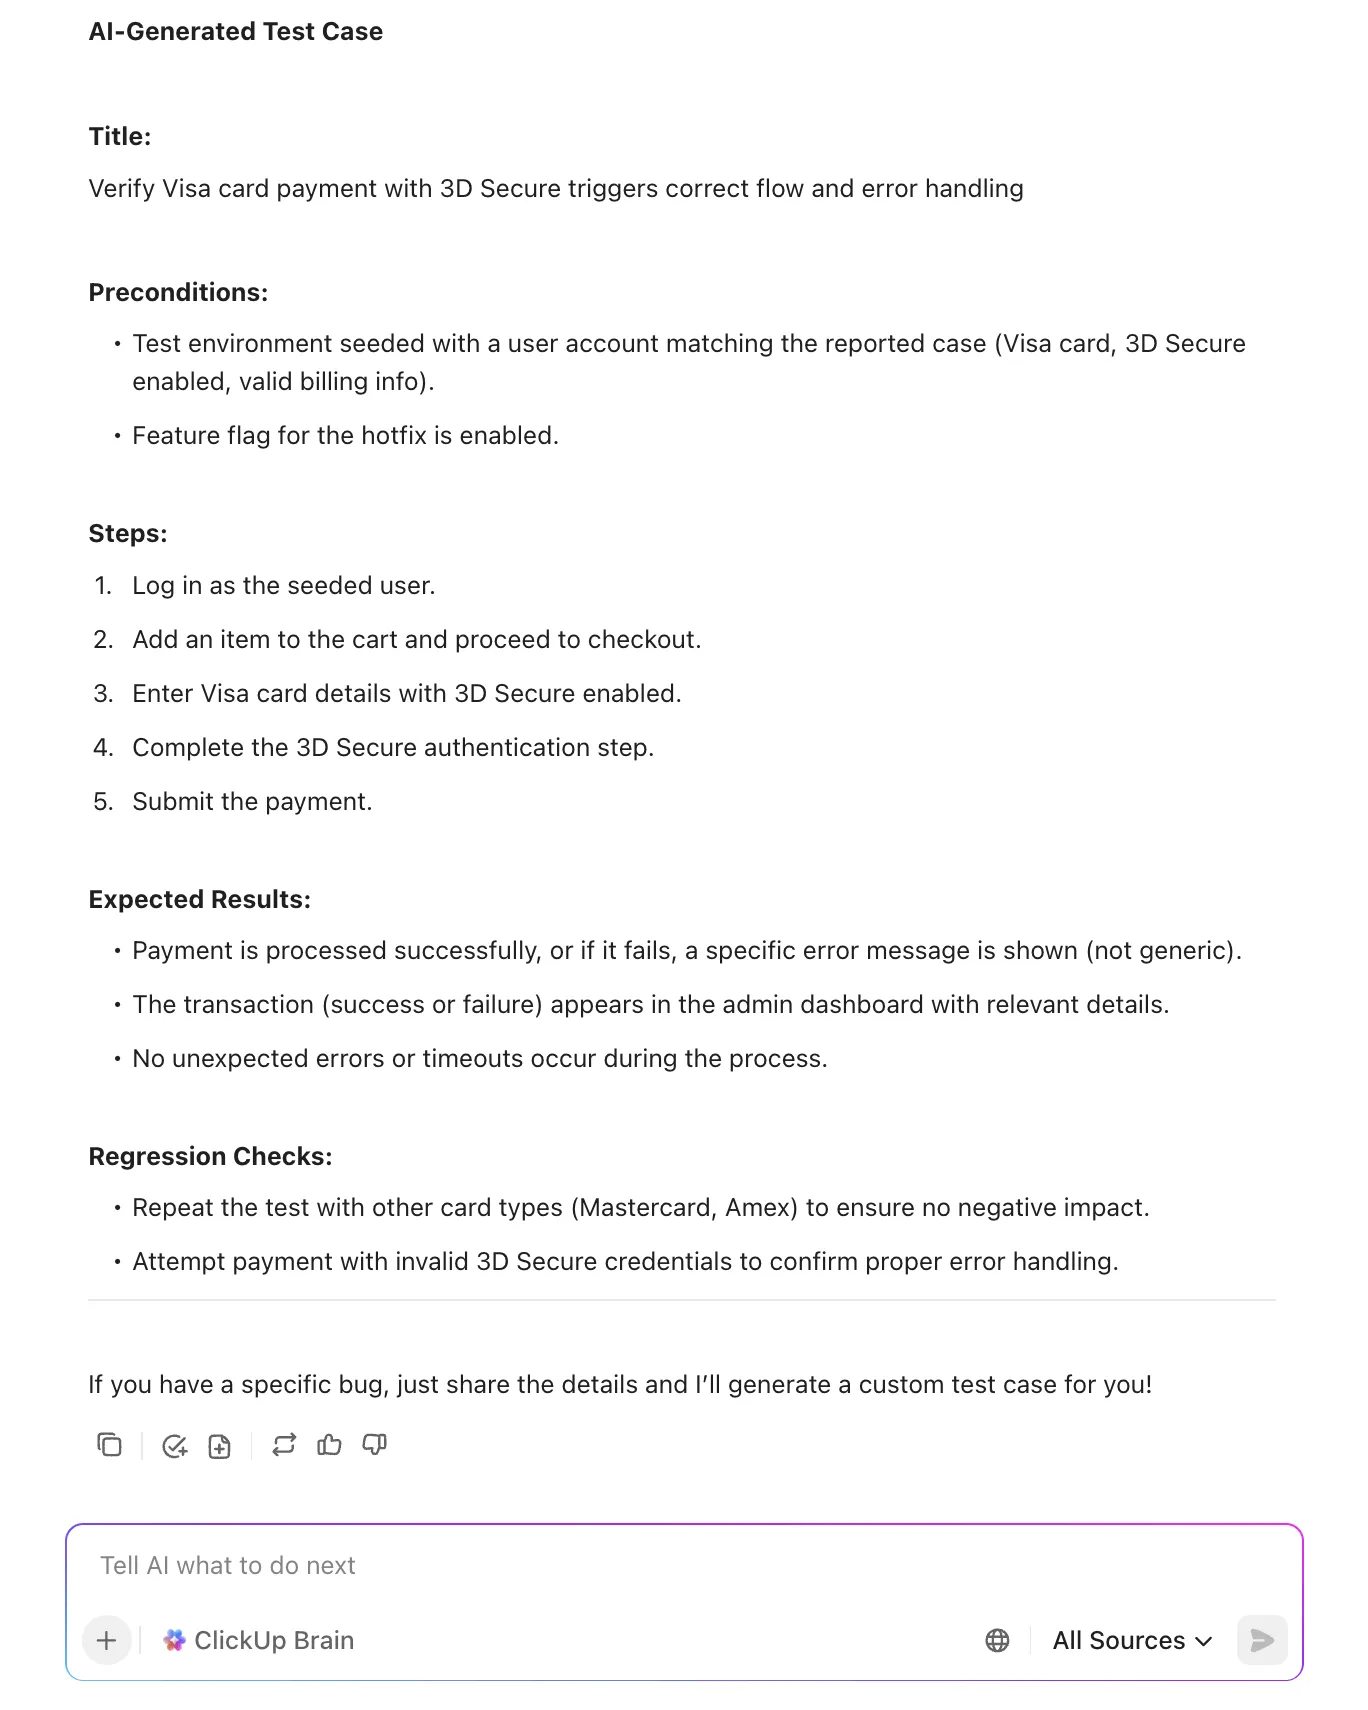
📖 Más información: Cómo redactar casos de prueba eficaces
7. Comunica el estado de forma concisa para reducir la carga de coordinación
Una buena actualización evita tres mensajes de estado y una escalación.
Trata las actualizaciones como si fueran un producto: breves, específicas y adaptadas al público destinatario (soporte técnico, directivos, clientes). Establece una periodicidad para los errores P0/P1 (por ejemplo, cada hora hasta que se solucionen, y después cada cuatro horas) y mantén una única fuente de información fiable.
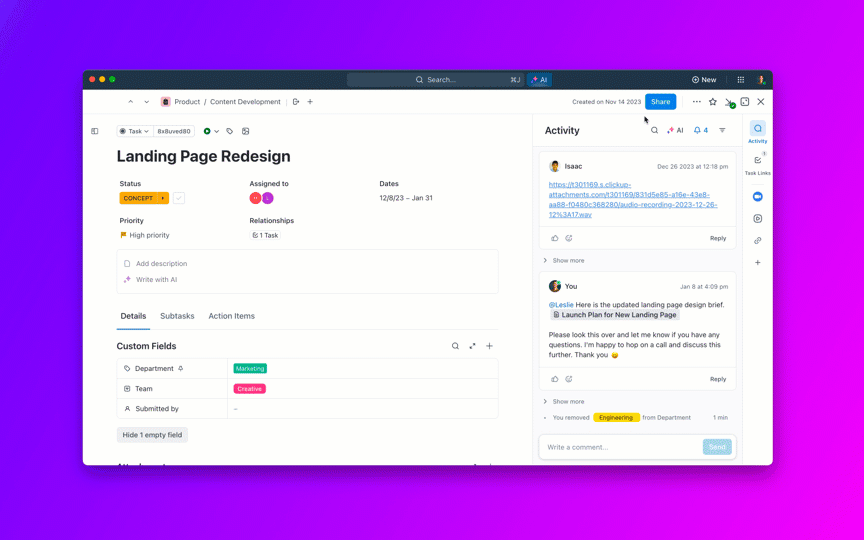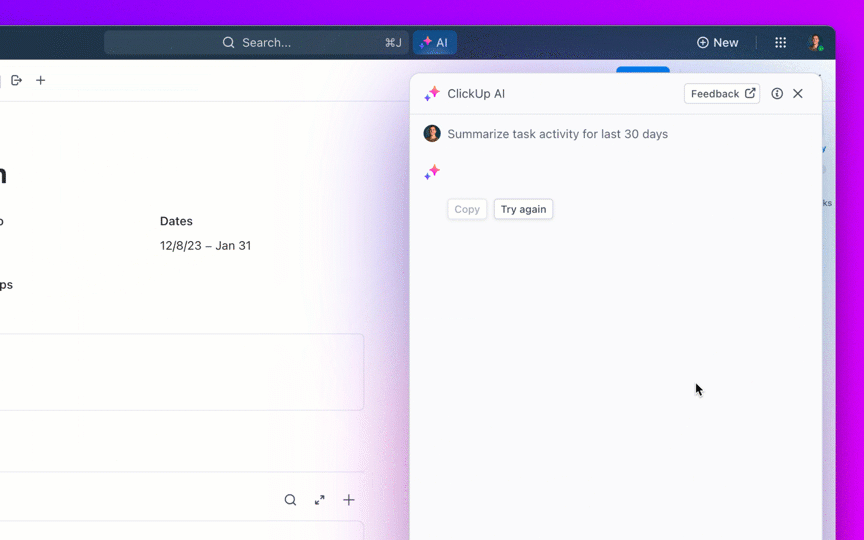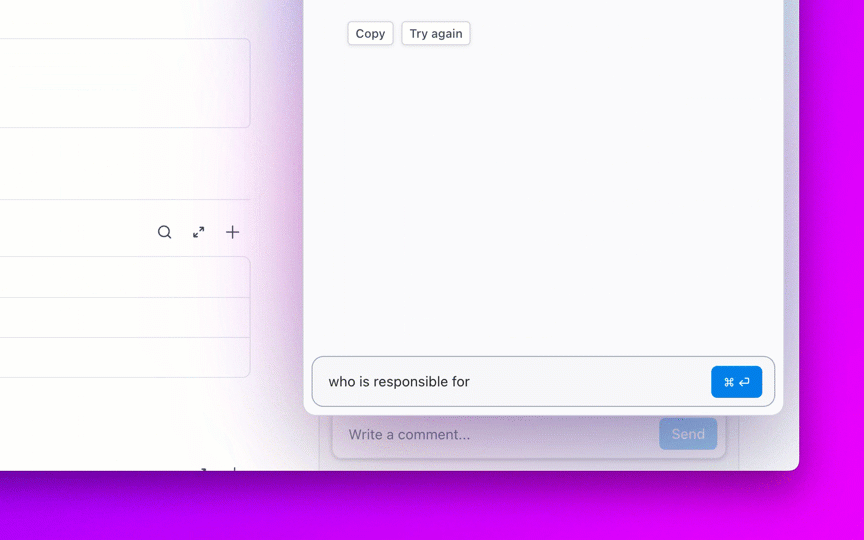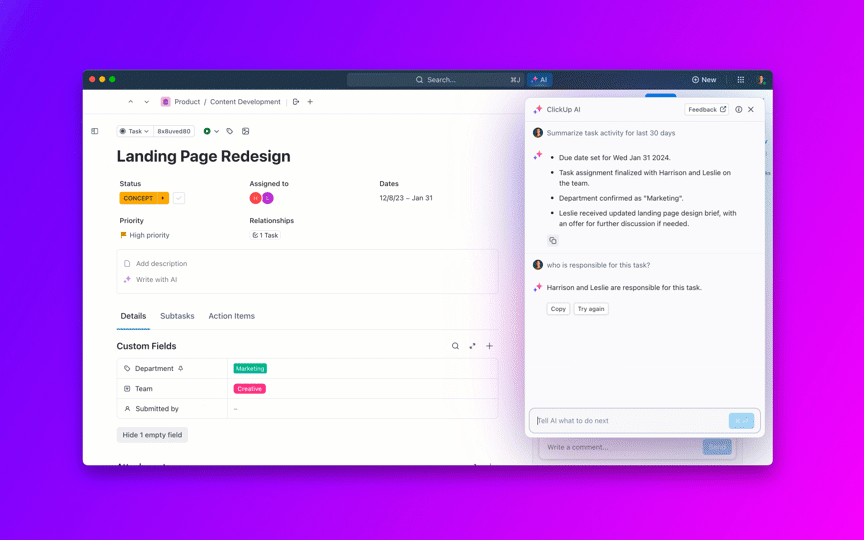
La IA puede elaborar borradores de actualizaciones seguras para los clientes y resúmenes internos a partir del historial de tareas, incluyendo el estado en tiempo real por gravedad y por equipo. Para los ejecutivos, como tu director de producto, agrupa las incidencias por iniciativas para que puedan ver si los problemas críticos de calidad ponen en peligro los plazos de entrega prometidos.
Métricas a tener en cuenta: tiempo transcurrido entre actualizaciones de estado en P0/P1, índice de satisfacción del cliente (CSAT) de las partes interesadas en cuanto a la comunicación.
8. Controla la antigüedad de las tareas pendientes y evita que permanezcan «abiertas indefinidamente»
Una lista de tareas pendientes cada vez mayor y estancada supone una carga silenciosa para cada sprint.
Establece políticas de antigüedad (por ejemplo, P2 > 30 días es un desencadenante para una revisión, P3 > 90 días requiere justificación) y programa un «clasificado por antigüedad» semanal para combinar duplicados, cerrar informes obsoletos y convertir las incidencias de bajo valor en elementos del backlog del producto.
Utiliza la IA para agrupar la lista de tareas pendientes por temas (por ejemplo, «caducidad del token de autenticación» o «instabilidad en la subida de imágenes») para que puedas programar semanas temáticas de correcciones y eliminar una clase de defectos de una sola vez.
Métricas a tener en cuenta: Número de problemas pendientes por intervalo de antigüedad, porcentaje de problemas cerrados por ser duplicados u obsoletos, velocidad de reducción temática.
9. Cierra el ciclo identificando la causa raíz y tomando medidas preventivas
Si sigue reapareciendo el mismo tipo de defecto, las mejoras en el MTTR están ocultando un problema mayor.
Realiza análisis rápidos y sin culpas de las causas raíz en los errores P0/P1 y en los P2 de alta frecuencia; etiqueta las causas raíz (deficiencias en las especificaciones, en las pruebas o en las herramientas, inestabilidad en la integración), vincúlalas a los componentes e incidencias afectadas y realiza el seguimiento de las tareas de seguimiento (medidas de protección, pruebas, reglas de lint) hasta completarlas.
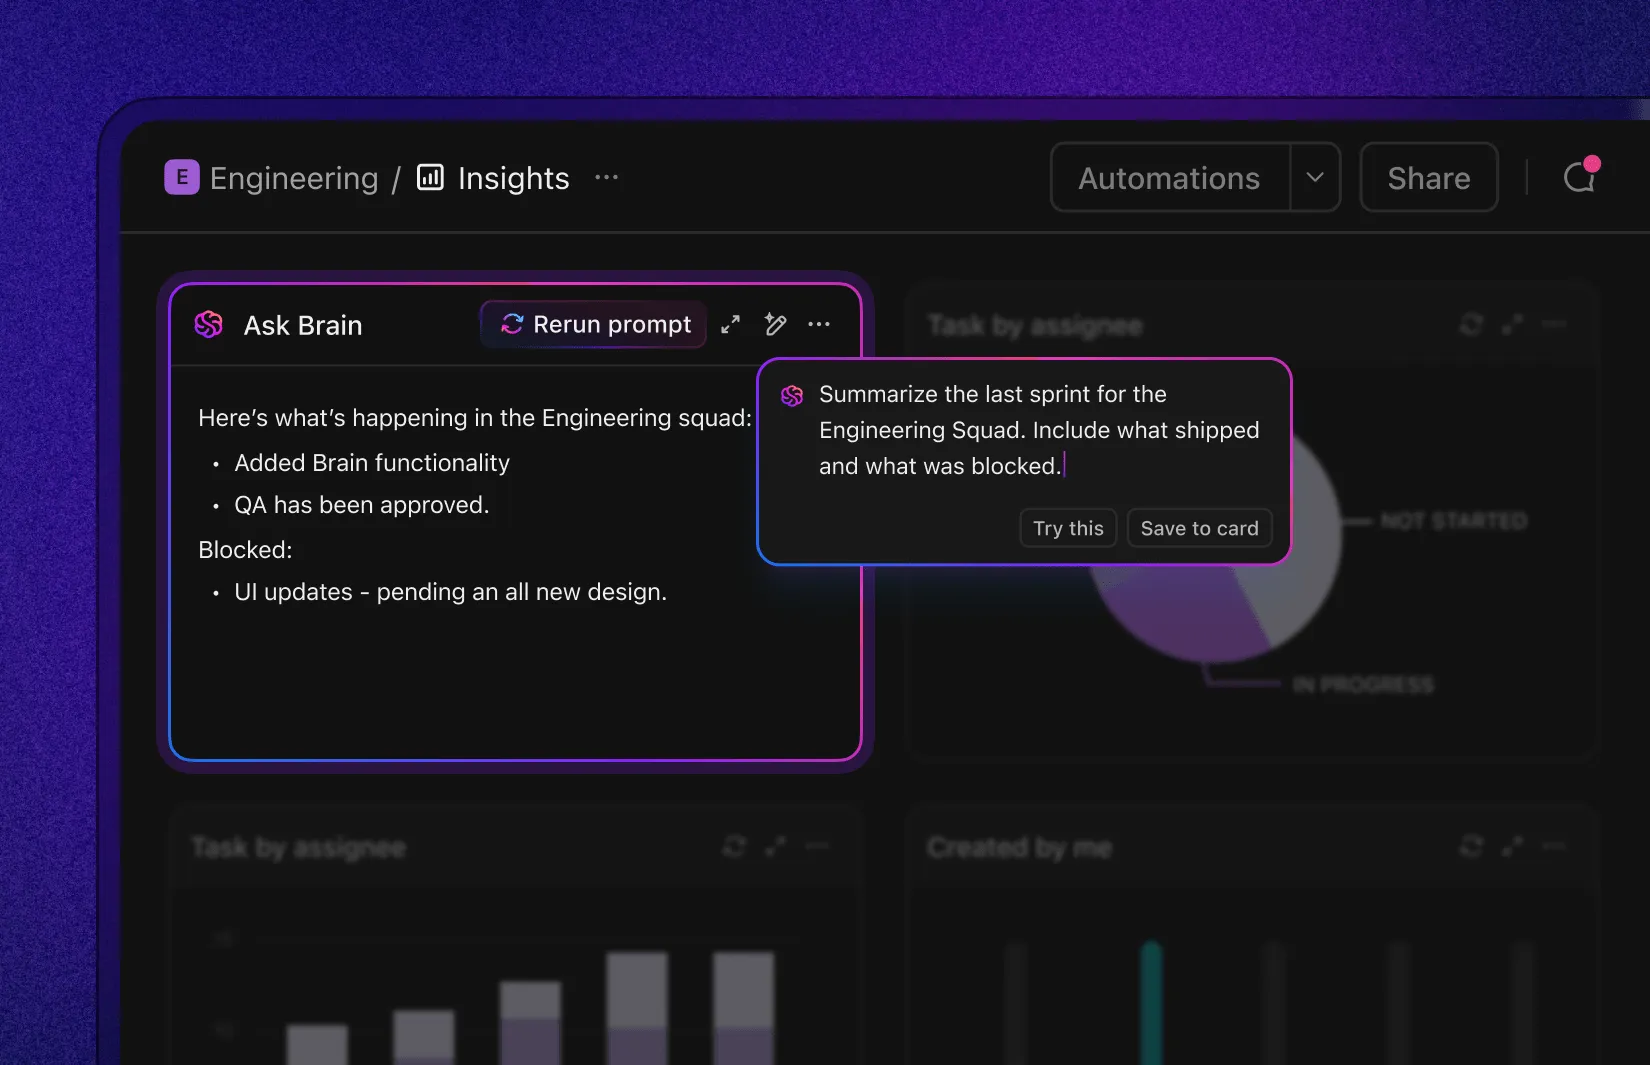
/IA puede redactar resúmenes de análisis de causas raíz (RCA) y proponer pruebas preventivas o reglas de lint basadas en el historial de cambios. Y así es como se pasa de apagar incendios a que haya menos incendios.
Métricas a tener en cuenta: tasa de reapertura, tasa de regresión, tiempo entre repeticiones y porcentaje de análisis de causas raíz (RCA) con medidas preventivas completadas.
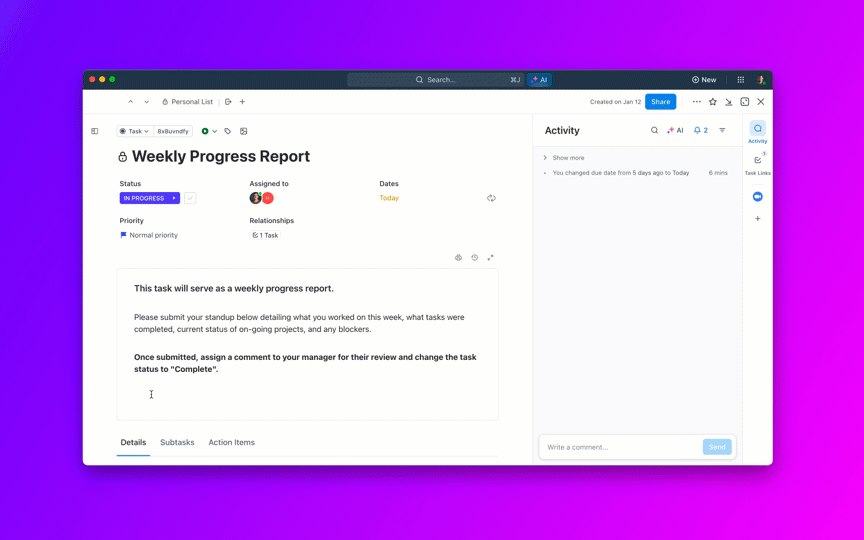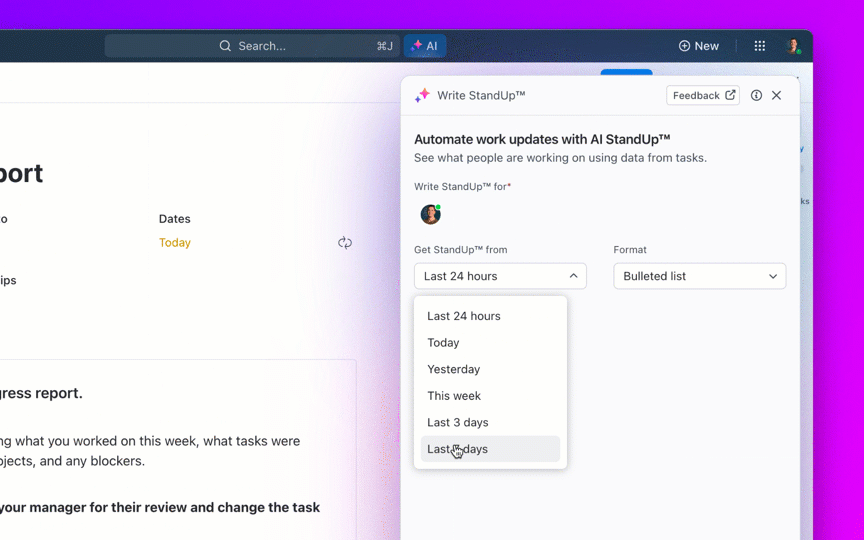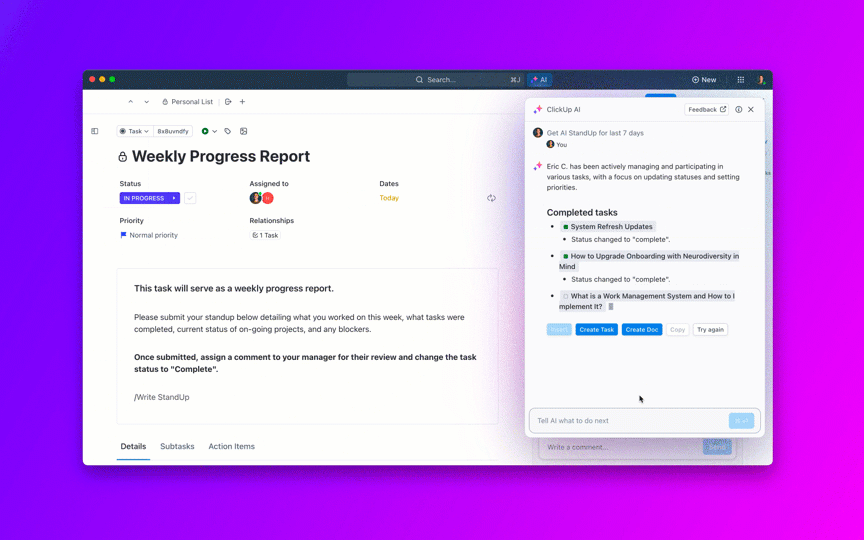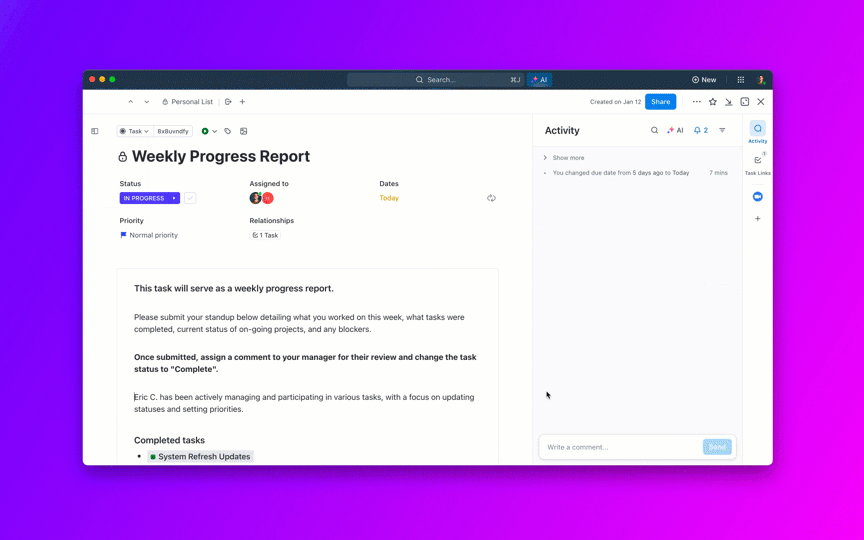
En conjunto, estos cambios agilizan el proceso de principio a fin: confirmación más rápida, clasificación más clara, priorización más inteligente, menos retrasos en la revisión y el control de calidad, y una comunicación más clara. Los directivos obtienen previsibilidad vinculada a la satisfacción del cliente (CSAT), al NPS y a los ingresos; los profesionales, una cola más tranquila con menos cambios de contexto.
📖 Más información: Cómo realizar un análisis de la causa raíz
Herramientas de IA que ayudan a reducir el tiempo de resolución de incidencias
La IA puede reducir el tiempo de resolución en cada paso: recepción, clasificación, asignación, corrección y verificación.
Sin embargo, los verdaderos beneficios se obtienen cuando las herramientas comprenden el contexto y mantienen el trabajo en marcha sin necesidad de intervención manual.
Busca sistemas que enriquezcan los informes automáticamente (pasos para reproducir el error, entorno, duplicados), prioricen según el impacto, deriven el caso al propietario adecuado, redacten actualizaciones claras y se integren perfectamente con tu código, la integración continua (CI) y la observabilidad.
Las mejores de todas también admiten flujos de trabajo similares a los de los agentes: bots que supervisan los SLA, avisan a los revisores, escalan los elementos atascados y resumen los resultados para las partes interesadas. Aquí tienes nuestra selección de herramientas de IA para una mejor resolución de incidencias:
1. ClickUp (ideal para IA contextual, automatizaciones y flujos de trabajo basados en agentes)
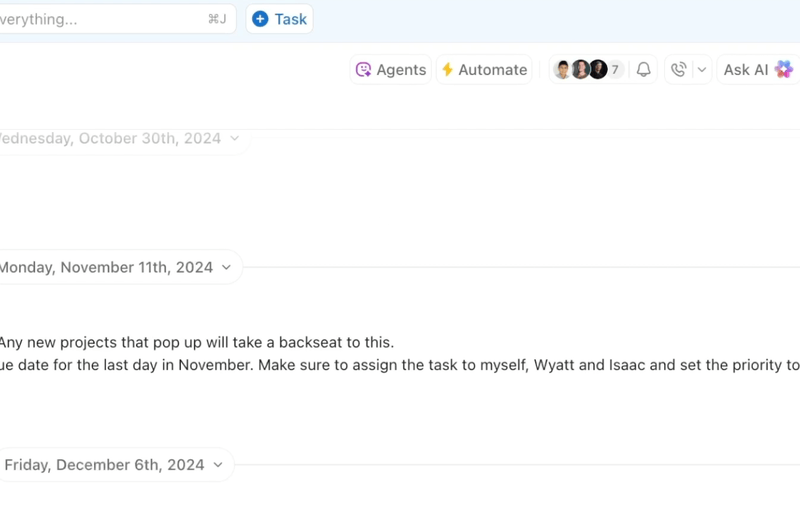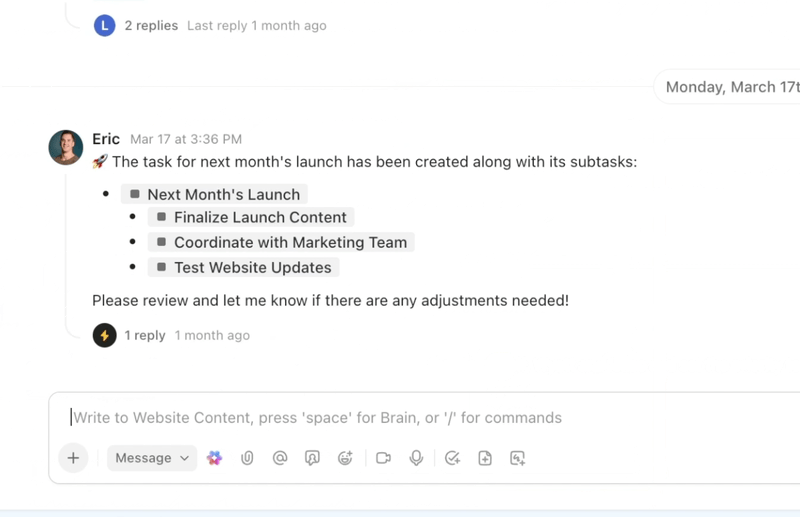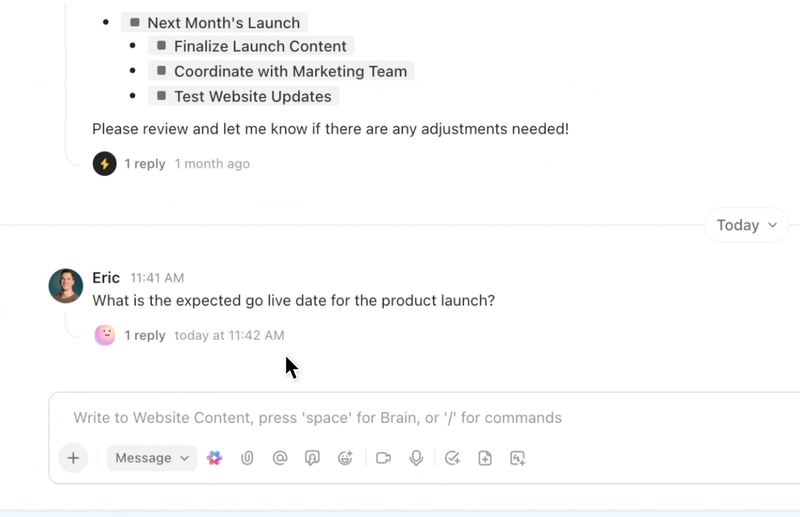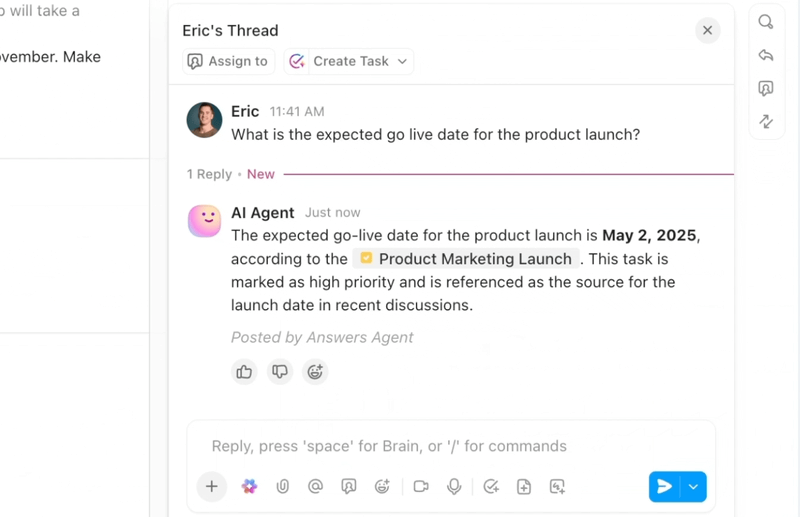
Si quieres un flujo de trabajo optimizado e inteligente para la resolución de incidencias, ClickUp, la aplicación «todo en uno» para el trabajo, reúne en un solo lugar la IA, las automatizaciones y la asistencia en los flujos de trabajo.
ClickUp Brain muestra al instante el contexto adecuado: resume los largos hilos sobre errores, extrae los pasos para reproducirlos y los detalles del entorno de los adjuntos, señala posibles duplicados y sugiere las próximas acciones. En lugar de tener que rebuscar entre Slack, tickets y registros, los equipos obtienen un historial claro y completo sobre el que pueden actuar de inmediato.
Las automatizaciones y los agentes de Autopilot de ClickUp mantienen el trabajo en marcha sin necesidad de una supervisión constante. Las incidencias se derivan automáticamente al equipo adecuado, se asignan propietarios, se establecen los acuerdos de nivel de servicio (SLA) y las fechas límite, los estados se actualizan a medida que avanza el trabajo y las partes interesadas reciben notificaciones puntuales.
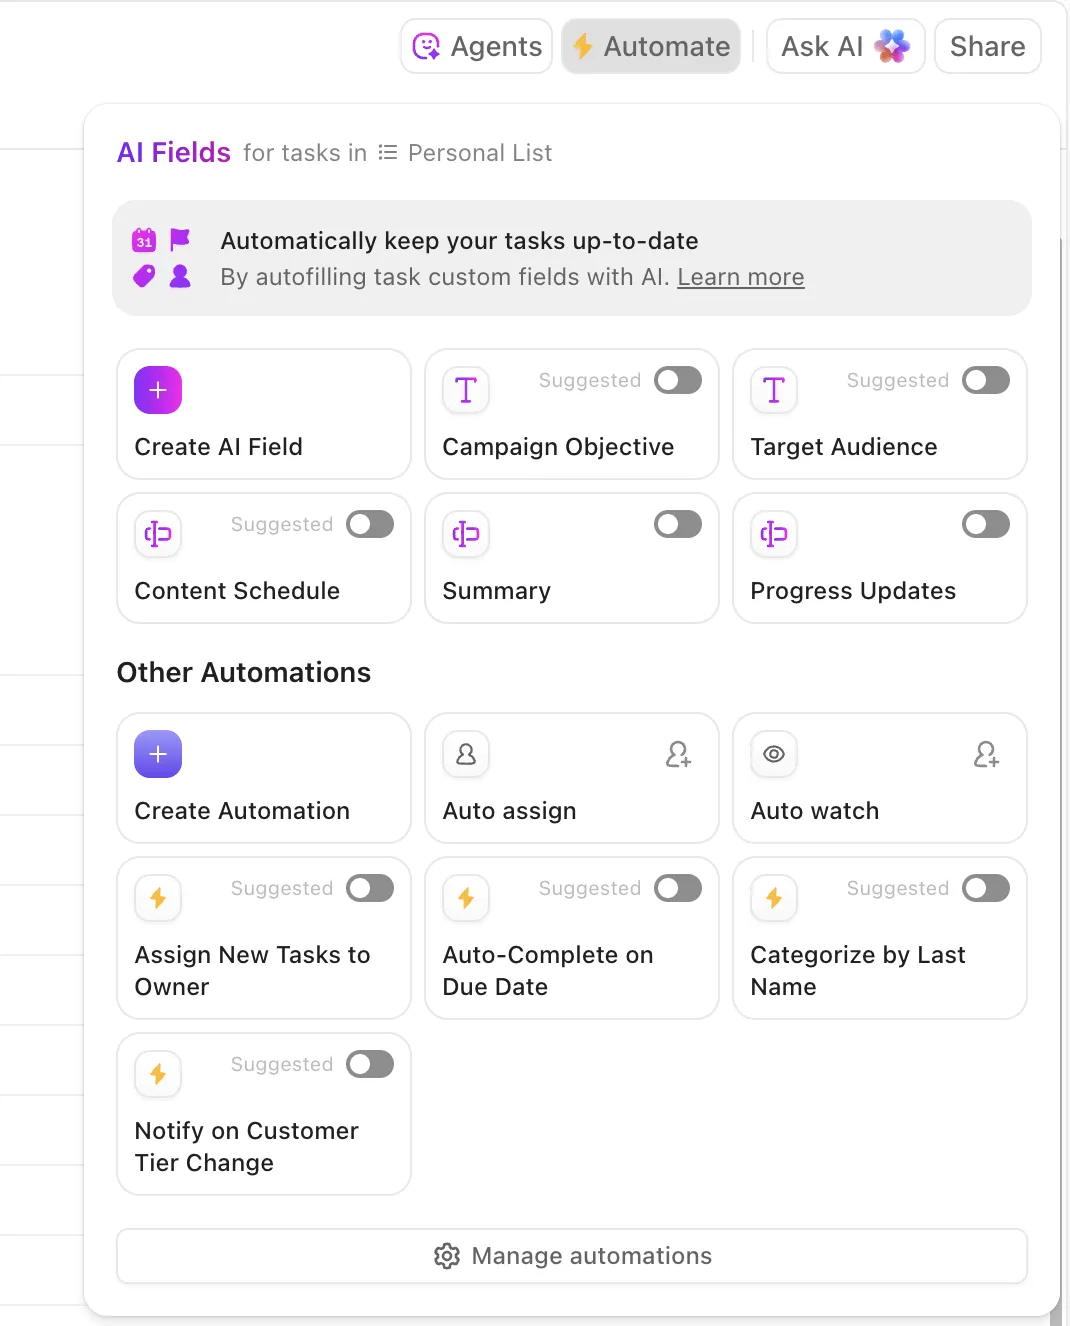
Estos agentes pueden incluso clasificar y categorizar los problemas, agrupar informes similares, consultar soluciones anteriores para sugerir posibles soluciones y escalar los elementos urgentes, de modo que el MTTA y el MTTR se reducen incluso cuando el volumen de problemas se dispara.
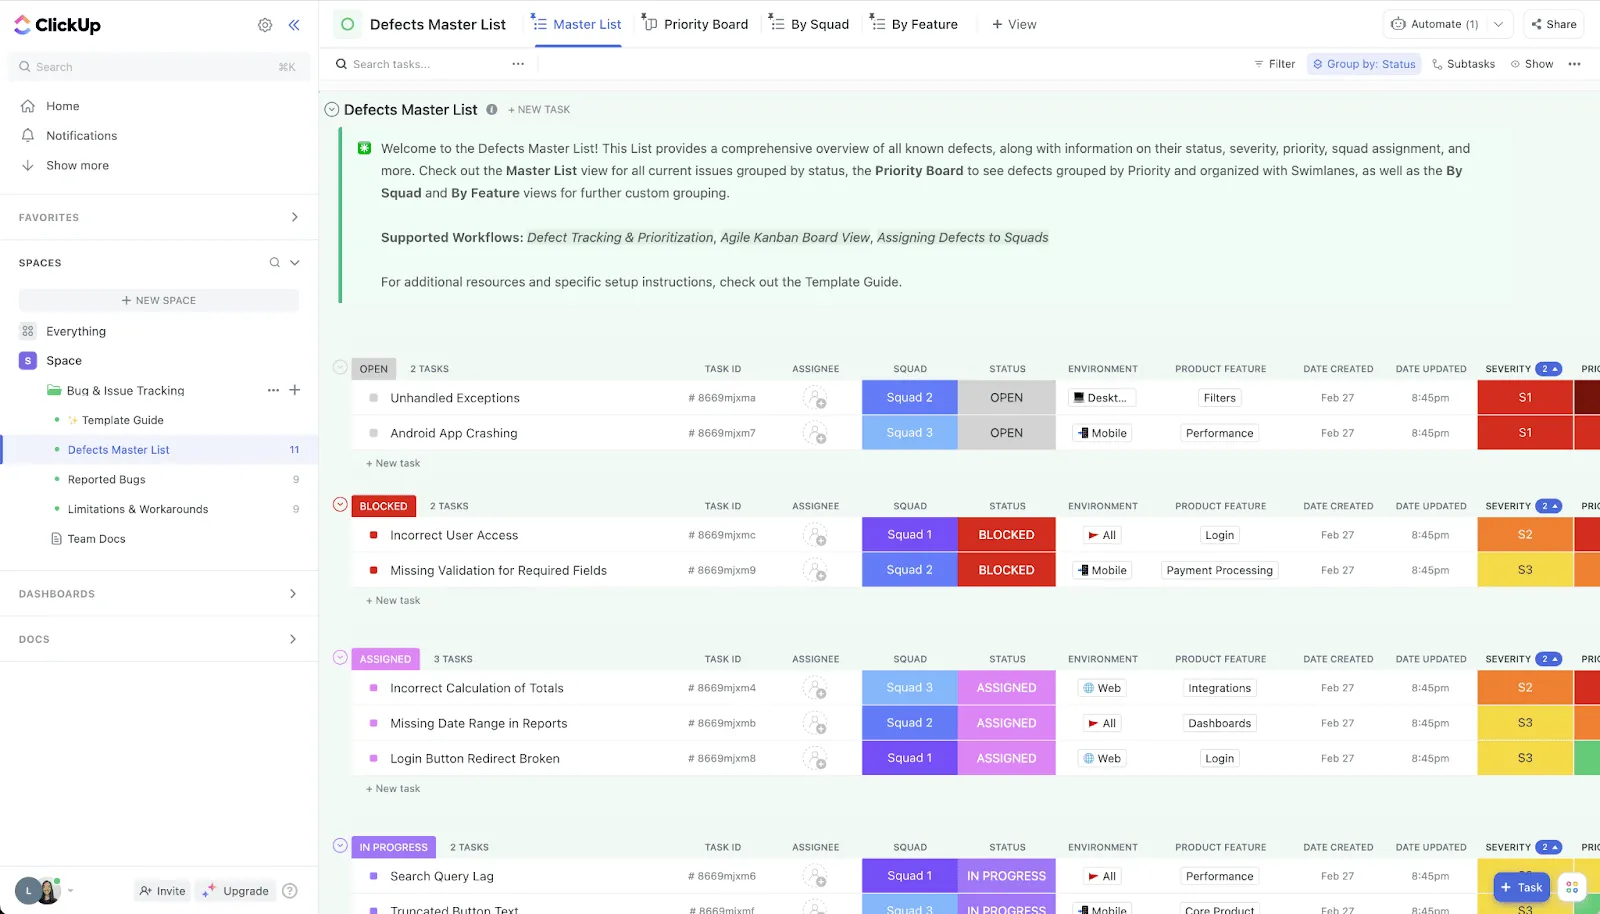
🛠️ ¿Quieres un conjunto de herramientas listo para usar? La plantilla de seguimiento de errores y incidencias de ClickUp es una potente solución de ClickUp para software, diseñada para ayudar a los equipos de Soporte, Ingeniería y Producto a controlar fácilmente los errores y los problemas de software. Con vistas personalizables como Lista, Tablero, Carga de trabajo, Formulario y Cronograma, los equipos pueden visualizar y gestionar su proceso de seguimiento de errores de la forma que mejor les convenga.
Los 20 estados personalizados y los 7 campos personalizados de la plantilla permiten crear un flujo de trabajo a medida, lo que garantiza el seguimiento de cada problema desde su detección hasta su resolución. Las automatizaciones integradas se encargan de las tareas repetitivas, lo que permite ahorrar un tiempo valioso y reducir el esfuerzo manual.
💟 Extra: Brain MAX es tu compañero de escritorio impulsado por IA, diseñado para acelerar la resolución de errores con funciones inteligentes y prácticas.
Cuando detectes un error, solo tienes que utilizar la función de voz a texto de Brain MAX para dictar el problema: tus notas de voz se transcriben al instante y se pueden adjuntar a un ticket de error nuevo o ya existente. Su función de búsqueda empresarial analiza todas tus herramientas conectadas —como ClickUp, GitHub, Google Drive y Slack— para mostrar informes de errores relacionados, registros de errores, fragmentos de código y documentación, de modo que dispongas de todo el contexto que necesitas sin tener que cambiar de aplicación.
¿Necesitas coordinar una corrección? Brain MAX te permite asignar el error al desarrollador adecuado, configurar recordatorios automáticos para las actualizaciones de estado y realizar el seguimiento del progreso, ¡todo ello desde tu escritorio!
2. Sentry (ideal para detectar errores)
Sentry reduce el MTTD y el tiempo de reproducción al recopilar errores, trazas y sesiones de usuario en un único lugar. La agrupación de problemas basada en IA reduce el ruido; las funciones «Suspect Commit» y las reglas de propiedad identifican al probable propietario del código, por lo que el enrutamiento es instantáneo. La función «Session Replay» proporciona a los ingenieros la ruta exacta del usuario y los detalles de la consola y la red para reproducir el error sin interminables idas y venidas.
Las funciones de Sentry IA pueden resumir el contexto de los problemas y, en algunas pilas tecnológicas, proponer parches de corrección automática que hacen referencia al código problemático. El impacto práctico: menos incidencias duplicadas, una asignación más rápida y un proceso más ágil desde la notificación hasta el parche operativo.
3. GitHub Copilot (ideal para revisar el código más rápidamente)
Copilot acelera el ciclo de corrección dentro del editor. Explica los rastros de pila, sugiere parches con objetivos específicos, escribe pruebas unitarias para garantizar la corrección y genera scripts de reproducción.
Copilot Chat puede analizar el código defectuoso, proponer refactorizaciones más seguras y generar comentarios o descripciones de PR que agilizan la revisión del código. En combinación con las revisiones obligatorias y la integración continua (CI), reduce en horas el proceso de «diagnóstico → implementación → prueba», especialmente en el caso de incidencias bien delimitadas y con una reproducción clara.
4. Snyk de DeepCode IA (ideal para detectar patrones)
El análisis estático basado en IA de DeepCode detecta defectos y patrones inseguros mientras programas y en las solicitudes de incorporación de cambios (PR). Resalta los flujos problemáticos, explica por qué se producen y propone soluciones seguras que se adaptan a los convenios de tu código.
Al detectar regresiones antes de combinar y orientar a los desarrolladores hacia patrones más seguros, se reduce la tasa de aparición de nuevos errores y se agiliza la corrección de errores lógicos complejos que son difíciles de detectar durante la revisión. Las integraciones con el IDE y las solicitudes de incorporación de cambios (PR) permiten que todo esto se realice cerca de donde se lleva a cabo el trabajo.
5. Watchdog y AIOps de Datadog (ideales para el análisis de registros)
Watchdog, de Datadog, utiliza el aprendizaje automático para detectar anomalías en registros, métricas, trazas y la monitorización de usuarios reales. Correlaciona los picos con marcadores de implementación, cambios en la infraestructura y la topología para sugerir posibles causas raíz.
En el caso de los defectos que afectan a los clientes, esto se traduce en una detección en cuestión de minutos, una agrupación automática para reducir el ruido de las alertas y pistas concretas sobre dónde buscar. El tiempo de clasificación se reduce porque se parte de la base de que «esta implementación afectó a estos servicios y las tasas de error aumentaron en este punto final», en lugar de partir de cero.
⚡️ Archivo de plantillas: Plantillas gratuitas para el seguimiento de problemas y registros en Excel y ClickUp
6. New Relic IA (Ideal para identificar y resumir tendencias)
La bandeja de entrada de errores de New Relic agrupa errores similares en distintos servicios y versiones, mientras que su asistente de IA resume el impacto, destaca las causas probables y proporciona enlaces a los rastros o transacciones implicados.
Las correlaciones de implementación y la información sobre cambios en las entidades permiten identificar claramente cuándo la culpa es de una versión reciente. En el caso de los sistemas distribuidos, ese contexto ahorra horas de comunicaciones entre equipos y permite asignar el error al propietario adecuado con una hipótesis sólida ya formulada.
7. Rollbar (la mejor opción para flujos de trabajo automatizados)
Rollbar se especializa en la monitorización de errores en tiempo real mediante huellas digitales inteligentes para agrupar duplicados y realizar un seguimiento de las tendencias de repetición. Sus resúmenes basados en IA y sus indicaciones sobre la causa raíz ayudan a los equipos a comprender el alcance (usuarios afectados, versiones implicadas), mientras que la telemetría y los rastros de pila proporcionan pistas rápidas para reproducir el error.
Las reglas de flujo de trabajo de Rollbar pueden crear tareas automáticamente, etiquetar el nivel de gravedad y asignarlas a los propietarios, convirtiendo los flujos de errores desordenados en colas priorizadas con contexto adjunto.
8. PagerDuty AIOps y automatización de runbooks (Lo mejor del diagnóstico de intervención mínima)
PagerDuty utiliza la correlación de eventos y la reducción de ruido basada en el aprendizaje automático para convertir las avalanchas de alertas en incidencias sobre las que se puede actuar.
El enrutamiento dinámico deriva el problema al técnico de guardia adecuado al instante, mientras que la automatización de los manuales de procedimientos puede poner en marcha diagnósticos o medidas de mitigación (reiniciar servicios, revertir una implementación, activar o desactivar un conmutador de función) antes de que intervenga un técnico. En cuanto al tiempo de resolución de errores, esto se traduce en un MTTA más corto, mitigaciones más rápidas para los errores de nivel P0 y menos horas perdidas por fatiga de alertas.
El hilo conductor es la automatización, combinada con la IA en cada paso. Detectas los errores antes, los canalizas de forma más inteligente, llegas antes al código y comunicas el estado sin ralentizar el trabajo de los ingenieros; todo ello se traduce en una reducción significativa del tiempo de resolución de incidencias.
📖 Más información: Cómo utilizar la IA en DevOps
Ejemplos reales del uso de la IA para la resolución de incidencias
Así pues, la IA ha salido oficialmente del laboratorio. Está reduciendo el tiempo de resolución de incidencias en entornos reales.
¡Veamos cómo!
| Ámbito / Organización | Cómo se utilizó la IA | Repercusión / Beneficios |
|---|---|---|
| Ubisoft | Desarrolló «Commit Assistant», una herramienta de IA entrenada con una década de código interno, que predice y previene los errores ya en la fase de programación. | El objetivo es reducir drásticamente el tiempo y los costes: tradicionalmente, hasta el 70 % de los gastos de desarrollo de videojuegos se destinan a la corrección de errores. |
| Razer (plataforma Wyvrn) | Hemos lanzado QA Copilot, una herramienta basada en IA (integrada con Unreal y Unity) para automatizar la detección de incidencias y generar informes de control de calidad. | Aumenta la detección de incidencias hasta en un 25 % y reduce a la mitad el tiempo dedicado al control de calidad. |
| Google / DeepMind y Project Zero | Se ha presentado Big Sleep, una herramienta de IA que detecta de forma autónoma vulnerabilidades de seguridad en software de código abierto como FFmpeg e ImageMagick. | Se han identificado 20 incidencias, todas ellas verificadas por expertos humanos y programadas para su corrección. |
| Investigadores de la Universidad de California en Berkeley | Mediante una prueba de rendimiento denominada CyberGym, los modelos de IA analizaron 188 proyectos de código abierto, detectaron 17 vulnerabilidades —entre ellas, 15 incidencias desconocidas de «día cero»— y generaron exploits de prueba de concepto. | Demuestra la capacidad cada vez mayor de la IA en la detección de vulnerabilidades y la revisión automatizada contra exploits. |
| Spur (startup de Yale) | Se ha desarrollado un agente de IA que traduce descripciones de casos de prueba en lenguaje sencillo en rutinas de automatización de pruebas de sitios web; en la práctica, se trata de un flujo de trabajo de control de calidad que se genera automáticamente. | Permite realizar pruebas autónomas con una intervención humana mínima |
| Reproducción automática de informes de errores de Android | Utilicé el procesamiento del lenguaje natural (NLP) y el aprendizaje por refuerzo para interpretar el lenguaje de los informes de incidencias y generar los pasos necesarios para reproducir las incidencias de Android. | Se ha alcanzado una precisión del 67 %, un recuerdo del 77 % y se ha reproducido el 74 % de los informes de errores, superando a los métodos tradicionales. |
Errores habituales a la hora de medir el tiempo de resolución de incidencias
Si tus mediciones no son precisas, tu plan de mejora tampoco lo será.
La mayoría de los «números negativos» en los flujos de trabajo de resolución de incidencias se deben a definiciones imprecisas, flujos de trabajo incoherentes y análisis superficiales.
Empieza por lo básico: qué se considera inicio o cierre, cómo gestionar las esperas y las reapertura de incidencias; a continuación, interpreta los datos tal y como los perciben tus clientes. Esto incluye:
❌ Límites imprecisos: Mezclar «Notificados→Resueltos» y «Notificados→Cerrados» en el mismo panel (o alternar entre ambos de un mes a otro) hace que las tendencias pierdan sentido. Elige un límite, documéntalo y haz que se aplique en todos los equipos. Si necesitas ambos, publícalos como métricas independientes con rótulos claros.
❌ Enfoque basado únicamente en medias: basarse en la media oculta la realidad de las colas con unos pocos valores atípicos de larga duración. Utiliza la mediana (P50) para tu tiempo «típico», el P90 para la previsibilidad y los SLA, y reserva la media para la planificación de la capacidad. Fíjate siempre en la distribución, no solo en un número.
❌ Sin segmentación: agrupar todas las incidencias mezcla incidencias de gravedad P0 con incidencias de gravedad P3 de carácter superficial. Segmenta por gravedad, origen (cliente frente a control de calidad frente a monitorización), componente/equipo y «nuevo frente a regresión». Tu P90 de P0/P1 es lo que perciben las partes interesadas; tu mediana de P2+ es en lo que se basa la planificación de ingeniería.
❌ Ignorar el tiempo «en pausa»: ¿A la espera de los registros del cliente, de un proveedor externo o de una ventana de lanzamiento? Si no registras el estado «Bloqueado/En pausa» como un estado de primer orden, el tiempo de resolución se convierte en un argumento de discusión. Informa tanto del tiempo calendario como del tiempo activo para que los cuellos de botella sean visibles y se pongan fin a las discusiones.
❌ Discrepancias en la normalización del tiempo: La combinación de zonas horarias o el cambio entre horas laborables y horas naturales a mitad del proceso distorsiona las comparaciones. Normaliza las marcas de tiempo a una sola zona horaria (o UTC) y decide de una vez si los SLA se miden en horas laborables o en horas naturales; aplícalo de forma coherente.
❌ Registro defectuoso y duplicados: La falta de información sobre el entorno o la compilación, así como los tickets duplicados, alargan los tiempos de resolución y crean confusión sobre la propiedad. Estandariza los campos obligatorios en el registro, completa la información automáticamente (registros, versión, dispositivo) y elimina los duplicados sin reiniciar el contador: cierra los duplicados como problemas enlazados, no como problemas «nuevos».
❌ Modelos de estado incoherentes: Los estados personalizados («Listo para control de calidad, más o menos», «Pendiente de revisión 2») ocultan el tiempo que se permanece en cada estado y hacen que las transiciones entre estados sean poco fiables. Define un flujo de trabajo canónico (Nuevo → Clasificado → En curso → En revisión → Resuelto → Cerrada) y comprueba si hay estados que se desvían de la ruta.
❌ No tener en cuenta el tiempo en cada estado: Un único número de «tiempo total» no te permite saber dónde se estanca el trabajo. Registra y analiza el tiempo dedicado a los estados «Clasificado», «En revisión», «Bloqueado» y «Control de calidad». Si el P90 de la revisión de código supera con creces al de la implementación, la solución no es «programar más rápido», sino liberar la capacidad de revisión.
🧠 Dato curioso: El último «AI Cyber Challenge» de la DARPA supuso un avance revolucionario en la automatización de la ciberseguridad. La competición contó con sistemas de IA diseñados para detectar, explotar y corregir de forma autónoma las vulnerabilidades del software, sin intervención humana. El equipo ganador, «Team Atlanta», logró detectar de forma impresionante el 77 % de las incidencias introducidas y corrigió con éxito el 61 % de ellas, lo que demostró el poder de la IA no solo para encontrar fallos, sino también para solucionarlos de forma activa.
❌ Ceguera ante las reapertura: Tratar las reapertura como si fueran nuevos errores reinicia el contador y mejora artificialmente el MTTR. Realiza un seguimiento de la tasa de reapertura y del «tiempo hasta el cierre estable» (desde el primer informe hasta el cierre definitivo en todos los ciclos). El aumento de las reapertura suele indicar una reproducción deficiente, lagunas en las pruebas o una definición poco clara de «terminado».
❌ Sin MTTA: Los equipos se obsesionan con el MTTR e ignoran el MTTA (tiempo de reconocimiento/asignación de responsabilidad). Un MTTA elevado es una advertencia temprana de que la resolución llevará mucho tiempo. Mídelo, establece acuerdos de nivel de servicio (SLA) según la gravedad y realiza la automatización del enrutamiento y la escalación para mantenerlo bajo.
❌ IA/automatización sin controles de seguridad: Dejar que la IA establezca la gravedad o cierre duplicados sin revisión previa puede llevar a clasificar erróneamente casos extremos y sesgar silenciosamente las métricas. Utiliza la IA para obtener sugerencias, exige confirmación humana en los casos P0/P1 y audita el rendimiento del modelo mensualmente para que tus datos sigan siendo fiables.
Si ajustas estos aspectos, tus gráficos de tiempos de resolución reflejarán por fin la realidad. A partir de ahí, las mejoras se multiplican: una mejor gestión de la entrada de incidencias reduce el MTTA, unos estados más claros revelan los verdaderos cuellos de botella y los P90 segmentados ofrecen a los responsables promesas que puedes cumplir.
⚡️ Archivo de plantillas: 10 plantillas de casos de prueba para pruebas de software
Buenas prácticas para una mejor resolución de errores
En resumen, ¡aquí tienes los puntos clave que debes tener en cuenta!
| 🧩 Buenas prácticas | 💡 Qué significa esto | 🚀 Por qué es importante |
| Utiliza un sistema de seguimiento de incidencias robusto | Realiza un seguimiento de todas las incidencias notificadas mediante un sistema centralizado de seguimiento de incidencias. | Garantiza que no se pase por alto ningún error y permite la visibilidad del estado de los errores en todos los equipos. |
| Redacta informes detallados de incidencias | Incluye contexto visual, información del sistema operativo, pasos para reproducir el error y nivel de gravedad. | Ayuda a los desarrolladores a corregir las incidencias más rápidamente al disponer de toda la información esencial desde el principio. |
| Clasificar y priorizar las incidencias | Utiliza una matriz de prioridades para clasificar las incidencias según su urgencia e impacto. | Permite que el equipo se centre primero en las incidencias críticas y los problemas urgentes. |
| Aprovecha las pruebas automatizadas | Ejecuta pruebas automáticamente en tu canalización de CI/CD. | Proporciona soporte para la detección temprana y evita las regresiones. |
| Establece unas directrices claras para la elaboración de informes | Proporcione plantillas y formación sobre la elaboración de informes sobre incidencias. | Esto se traduce en una información más precisa y una comunicación más fluida. |
| Realiza el seguimiento de las métricas clave | Mide el tiempo de resolución, el tiempo transcurrido y el tiempo de respuesta. | Permite realizar un seguimiento y mejorar el rendimiento utilizando datos históricos. |
| Adopta un enfoque proactivo | No esperes a que los usuarios se quejen: realiza pruebas de forma proactiva. | Aumenta la satisfacción del cliente y reduce la carga de trabajo del servicio de asistencia. |
| Aprovecha las herramientas inteligentes y el aprendizaje automático | Utiliza el aprendizaje automático para predecir incidencias y sugerir soluciones. | Mejora la eficiencia a la hora de identificar las causas raíz y corregir las incidencias. |
| Cumple con los SLA | Realice reuniones para cumplir con los acuerdos de nivel de servicio establecidos para la resolución de incidencias. | Genera confianza y satisface las expectativas de los clientes de forma oportuna. |
| Revisa y mejora continuamente | Analiza las incidencias reabiertas, recopila comentarios y ajusta los procesos. | Fomenta la mejora continua de su proceso de desarrollo y la gestión de incidencias. |
Resolución de incidencias simplificada gracias a la IA contextual
Los equipos más rápidos en la resolución de incidencias no se basan en hazañas heroicas. Diseñan un sistema: definiciones claras de inicio y fin, un proceso de recepción ordenado, priorización en función del impacto en la empresa, propiedad bien definida y ciclos de retroalimentación estrechos entre los equipos de soporte, control de calidad, ingeniería y lanzamiento.
ClickUp puede ser ese centro de comandos impulsado por IA para tu sistema de resolución de errores. Centraliza todos los informes en una única cola, estandariza el contexto con campos estructurados y deja que la ClickUp AI clasifique, resuma y priorice, mientras que las automatizaciones garantizan el cumplimiento de los SLA, escalan los casos cuando se superan los plazos y mantienen a las partes interesadas alineadas. Vincula las incidencias a los clientes, al código y a las versiones para que los ejecutivos vean el impacto y los profesionales sigan en el flujo.
Si estás listo para reducir el tiempo de resolución de incidencias y hacer que tu hoja de ruta sea más predecible, regístrate en ClickUp y empieza a medir la mejora en cuestión de días, no de trimestres.
Preguntas frecuentes
¿Cuál es un buen tiempo de resolución de errores?
No existe un número «ideal» único: depende de la gravedad, el modelo de lanzamiento y la tolerancia al riesgo. Utiliza las medianas (P50) para el rendimiento «típico» y el P90 para los compromisos o SLA, y segmenta por gravedad y origen.
¿Cuál es la diferencia entre la resolución de un error y el cierre de un error?
La resolución se produce cuando se implementa la corrección (por ejemplo, se combina el código o se aplica la configuración) y el equipo considera que el defecto se ha solucionado. El cierre tiene lugar cuando el problema se verifica y se da por finalizado formalmente (por ejemplo, cuando el control de calidad lo valida en el entorno de destino, se lanza a producción o se marca como «no se corregirá» o «duplicado» con una justificación). Muchos equipos miden ambos: «Notificado → Resuelto» refleja la rapidez de la ingeniería; «Notificado → Cerrada» refleja el flujo de calidad de principio a fin. Utiliza definiciones coherentes para que los paneles no mezclen las fases.
¿Cuál es la diferencia entre el tiempo de resolución de una incidencia y el tiempo de detección de una incidencia?
El tiempo de detección (MTTD) es el tiempo que se tarda en descubrir un defecto después de que se produzca o se lance, ya sea a través de la supervisión, el control de calidad o los usuarios. El tiempo de resolución es el tiempo que transcurre desde la detección o notificación hasta que se implementa la corrección (y, si lo prefieres, se valida o se lanza). Juntos, definen la ventana de impacto en el cliente: detectar rápido, reconocer rápido, resolver rápido y lanzar de forma segura. También puedes realizar el seguimiento del MTTA (tiempo de reconocimiento/asignación) para detectar retrasos en la clasificación que, a menudo, auguran una resolución más prolongada.
¿Cómo ayuda la IA en la resolución de errores?
/IA
- Recepción y clasificación: Resumir automáticamente los informes largos, extrae los pasos para reproducir el error y el entorno, señala los duplicados y sugiere el nivel de gravedad y la prioridad para que los ingenieros empiecen con un contexto claro (p. ej., ClickUp AI, Sentry AI).
- Enrutamiento y SLA: predice cuál es el componente o propietario probable, establece cronómetros y escala el problema cuando se superan los plazos de MTTA o de revisión, reduciendo así el «tiempo en estado» de inactividad (automatizaciones de ClickUp y flujos de trabajo similares a los de un agente).
- Diagnóstico: Agrupa errores similares, correlaciona los picos con las últimas confirmaciones o versiones y señala las posibles causas raíz mediante trazas de pila y contexto del código (Sentry IA y similares).
- Implementación: Sugiere cambios en el código y pruebas basadas en patrones de tu repositorio, lo que acelera el ciclo de «escribir/corregir» (GitHub Copilot; Snyk Code IA de DeepCode).
- Verificación y comunicaciones: redacta casos de prueba a partir de los pasos de reproducción, elabora borradores de notas de lanzamiento y actualizaciones para las partes interesadas, y resume el estado para los directivos y los clientes (ClickUp AI). Al utilizarlos conjuntamente —ClickUp como centro de comandos junto con Sentry, Copilot y DeepCode en la pila tecnológica—, los equipos reducen los tiempos de MTTA y P90 sin tener que recurrir a soluciones heroicas.