
De första tjänsterna är enkla. En rotation, en kanal och sedan en säkerhetskopia.
Men när ditt företag väl har dussintals mikrotjänster, flera regioner och ett skiktat ägarskap upphör manuella eskaleringar att vara en del av arbetsflödet och blir istället en belastning.
Den här guiden förklarar hur du automatiserar eskaleringsvägar för incidenter som kan skalas upp i takt med din teknikorganisation utan att det uppstår luckor i ditt joursystem.
Vi ska också se hur ClickUp kan användas för att skapa ett eskaleringssystem som dina teknikteam kan lita på. 🎯
⭐ Utvald mall
Reagera snabbt och effektivt vid nödsituationer, från naturkatastrofer till dataintrång, med hjälp av ClickUps mall för incidenthandlingsplan (IAP).
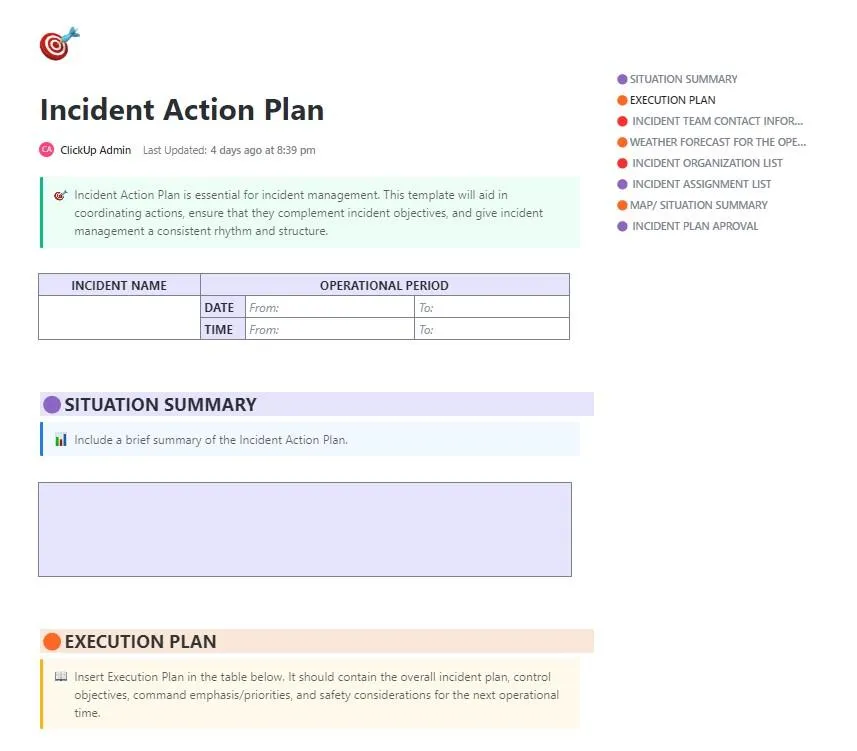
Mallen innehåller fördefinierade avsnitt för att:
- Definiera mål för incidenter och prioriteringar för hanteringen
- Skapa en tydlig befälsstruktur
- Samordna åtgärder mellan team i realtid
- Dokumentera beslut, tidslinjer och viktiga uppdateringar i realtid
- Håll dig uppdaterad om eskaleringar och följ upp dem
Och eftersom det finns inbyggt i ClickUp fungerar det som ett dokument för incidenthantering i realtid, inte som en statisk checklista.
Varför automatisera eskaleringsprocesser för incidenter
När ditt team ansvarar för komplexa system med strikta SLA:er blir manuell eskalering bara ett hinder. Automatiserad eskalering gör din hanteringsprocess förutsägbar och mindre stressande, även vid incidenter med hög press.
Här är anledningen till att du måste automatisera din organisations eskaleringsprocesser. 👇
Risken med manuell eskalering
När du har att göra med dussintals tjänster, flera jourscheman och ständigt skiftande ansvar blir manuella steg snabbt ett problem.
Vanliga fallgropar är bland annat:
- Uteblivna eller försenade aviseringar när någon missar ett e-postmeddelande, SMS eller chattmeddelande
- Förvirring vid överlämningar, särskilt när eskaleringsprocesserna inte är tydligt dokumenterade
- Eskalering till fel team eftersom ansvarsfördelningen inte är uppdaterad
- Flaskhalsar som uppstår när man förlitar sig på en enda person för att ”vidarebefordra larmet”
📖 Läs även: Hur man skriver en incidentrapport
Fördelar med automatisering
ITSM-automatisering ger dina eskaleringsflöden struktur och drivkraft. Istället för att hoppas att någon ser larmet utför ditt system en fördefinierad sekvens omedelbart och konsekvent.
Här är vad teamen vinner på att använda AI för att automatisera uppgifter:
- Snabbare svarstider eftersom varningar når rätt person eller team inom några sekunder
- Konsekvent genomförande av eskaleringsstegen, även klockan 3 på natten, när beslutsfattandet går långsammare
- Inbyggd redundans som säkerställer att reservpersonal får ett meddelande om den primära jourhavande personalen missar larmet
- Tydlig överblick över alla team eftersom alla förstår hur eskaleringarna fungerar
- Mindre brandbekämpning och mer förutsägbara jourupplevelser
📖 Läs även: Exempel på kontinuitetsplaner
Minska larmtrötthet och mänskliga misstag
Varningsutmattning förstör effektiviteten hos jourpersonalen. När ditt team blir kontaktat för ofta, eller av fel anledningar, slutar de att reagera med samma brådska. Automatisering hjälper till att filtrera bort och eskalera endast det som verkligen kräver mänsklig uppmärksamhet.
Med automatiserad eskaleringslogik:
- Varningar med låg prioritet eller dubbletter undertrycks innan de når jourpersonalen
- Regler baserade på allvarlighetsgrad säkerställer att mindre problem inte väcker någon i onödan
- Varningar eskaleras endast om systemet upptäcker utebliven respons inom en definierad tidsram
- Teamen lägger mindre tid på att sortera bort oväsentlig information och mer tid på att lösa verkliga problem
Stöd för efterlevnad av SLA och jourpolicy
Automatiserad eskalering gör det enklare att uppfylla kraven utan ständig manuell övervakning. För IT-chefer som hanterar strikta SLA:er eller interna tillförlitlighetsåtaganden fungerar AI som en säkerhetsbarriär som säkerställer att förväntat beteende följs. Det hjälper dig att:
- Se till att incidentmeddelanden följer fördefinierade regler för vidarebefordran
- Upprätthåll SLA-svarstider automatiskt med tidsstyrda eskaleringar
- Se till att jourlistorna följs utan att förlita dig på föråldrade kalkylblad
- Skapa revisionsspår för varje larm, eskalering och bekräftelse
🎥 Vill du köra hela arbetsflödet för eskaleringsvägarna helt automatiskt? Super Agents hjälper dig. 👇🏼
🔍 Visste du att? NASA:s kontrollcenter fungerar i huvudsak enligt en automatiserad eskaleringslogik. Om telemetrin hamnar utanför normalintervallet skickar systemet omedelbart automatiska varningar till specialister inom respektive område.
Vad är en eskaleringspolicy inom incidenthantering?
En eskaleringspolicy är en fördefinierad uppsättning regler som avgör vem som ska underrättas, när de ska underrättas och hur ansvaret överförs uppåt eller mellan team.
Se det som en strukturerad vägkarta som förhindrar att incidenter fastnar, säkerställer att rätt experter kopplas in vid rätt tidpunkt och hjälper teamen att uppfylla SLA:erna.
En välstrukturerad policy för eskaleringshantering innehåller vanligtvis följande:
- Regelbaserad vidarebefordran som definierar vem som står på tur när någon inte bekräftar eller inte kan lösa incidenten
- Tidsstyrda utlösare som automatiskt eskalerar efter 5, 15 eller 30 minuter beroende på allvarlighetsgrad
- Meddelandemetoder såsom telefonsamtal, SMS, chatt eller e-post
- Nivåer i eskaleringsplanen från nivå 1 (primär jour) > nivå 2 (senioringenjörer/SME:er) > nivå 3 (ledningen)
- Förväntningar på dokumentationen så att nya insatspersoner kan ta över utan att förlora viktig kontext
Olika typer av eskaleringspolicyer
Här är de viktigaste typerna av riktlinjer som ditt team bör känna till:
1. Hierarkisk eskalering (vertikal)
Varningar skickas uppåt i befälskedjan, från junioringenjörer till seniora specialister och vidare till ledningen. Använd detta när situationen kräver djupare expertis, beslutsbefogenhet eller insyn från ledningen.
2. Funktionell eskalering (horisontell)
I stället för att gå uppåt skickas larmet tvärs över teamen till den funktion som ansvarar för det drabbade systemet. Detta är idealiskt för incidenter som är kopplade till en specifik domän, såsom databaser, nätverk, betalningar eller API:er.
3. Tidsbaserad eskalering
Detta är ryggraden i de flesta automatiserade system. I denna typ går larmet vidare till nästa nivå efter en viss tidsperiod, ofta direkt kopplad till SLA:er. Det är särskilt viktigt när du behöver garanterad respons utanför kontorstid.
4. Konsekvensbaserad eskalering
Effektbaserad eskalering baseras på allvarlighetsgraden eller påverkan på verksamheten, inte på hierarki eller tid. Det är användbart vid driftstopp, betalningsfel, kundrelaterade problem eller säkerhetsöverträdelser.
5. Parallell eskalering
Här meddelas flera personer eller team samtidigt. Parallell eskalering används för problem med hög allvarlighetsgrad som kräver flera specialister eller i situationer där varje fördröjning är oacceptabel.
🔍 Visste du att? En ny studie om varningssignaler visade att extremt iögonfallande eller ”högljudda/ljusa ” varningar kan fördröja reaktionstiderna, särskilt om varningen är oväntad. Men när larmtypen blir förväntad (dvs. en del av ett förutbestämt eskalerings-/meddelandesystem) förbättras svarstiderna. Detta tyder på att när du automatiserar eskaleringsflöden bör du inte bara översvämma personalen med larm med hög prioritet.
När ska automatisk eskalering utlösas?
Nu när du vet hur eskaleringsvägarna är uppbyggda är nästa steg att bestämma när dessa regler ska köras automatiskt.
Nedan följer de viktigaste situationerna som utlöser automatisk eskalering och som utgör det logiska underlaget för dina policyer. 💁
Eskalering baserad på allvarlighetsgrad
Automatisk eskalering aktiveras när incidentens allvarlighetsgrad eller påverkan överskrider en viss tröskel. Incidenter med hög allvarlighetsgrad kräver omedelbar uppmärksamhet från ledningen, och automatisk eskalering kringgår flaskhalsar och kopplar in experter inom några sekunder.
📌 Exempel: Ett fullständigt driftavbrott, ett fel i betalningsgatewayen eller en allvarlig försämring som påverkar många användare eller kärnsystem kräver automatisk eskalering.
Tidsbaserad eskalering
Om ingen bekräftar eller löser incidenten inom ett fastställt tidsfönster eskaleras larmet automatiskt till nästa nivå. Detta förhindrar att ärenden fastnar, särskilt utanför normal arbetstid eller när den som först ska hantera ärendet är upptagen eller överbelastad.
📌 Exempel: Om ingen bekräftelse har skett inom 10–15 minuter eskaleras ärendet från den första ansvarige till en senioringenjör; om problemet fortfarande inte är löst efter ytterligare 30–60 minuter eskaleras det ytterligare.
Kontextuell eskalering
Denna eskaleringslogik tar hänsyn till incidentens kontextuella attribut, såsom den drabbade tjänsten eller det drabbade systemet, tjänsteägaren, det berörda kundsegmentet (internt kontra externt, VIP kontra vanligt) eller den funktionella domänen (databas, nätverk, integration). Baserat på den kontexten dirigeras larm till den mest relevanta ansvarige eller det mest relevanta teamet.
På så sätt undviker du att överbelasta teamen med irrelevanta incidenter, minskar svarstiden och säkerställer att specialister hanterar problem inom sina respektive områden.
📌 Exempel: En plötslig ökning av latensen i betalningstjänsten bör direkt avlösa en avisering till betalningsteamet, eller ett backend-fel i faktureringsmikrotjänsten bör medföra en avisering till faktureringsteamet.
Metadatabaserad eskalering
Moderna verktyg för larm och incidenthantering samlar in metadata såsom ursprungskälla (vilket övervakningsverktyg eller vilken larmregel som utlöstes), användar-/kundidentitet, plats, historisk frekvens av liknande incidenter eller etiketter. Detta hjälper dig att tillämpa mer detaljerad och intelligent logik istället för att förlita dig på grova allvarlighetsgrader eller tidsbaserade regler.
📌 Exempel: Återkommande varningar från samma delsystem kan tyda på ett djupare, systemrelaterat problem, vilket motiverar en snabbare eskalering. Eller så kan varningar för VIP-kunder utlösa ytterligare aviseringar.
Kombinera utlösare för att skapa smartare, anpassningsbara eskaleringspolicyer
I praktiken förlitar sig många team inte på en enda typ av utlösare. Istället skapar de hybrideskaleringspolicyer som kombinerar regler för allvarlighetsgrad, tid, sammanhang och metadata.
Denna skiktade strategi gör det möjligt för teamen att skapa eskaleringsriktlinjer som är både responsiva (snabba när det behövs) och smarta (selektiva för att minimera störningar), vilket leder till bättre hantering av incidenter och en mer effektiv resursfördelning.
🔍 Visste du att? På 1700-talet använde sjöbesättningar en strikt eskaleringskedja vid nödsituationer. Om en matros med lägre rang upptäckte fara ringde de i en klocka och vidarebefordrade meddelandet uppåt i hierarkin tills kaptenen fattade det slutgiltiga beslutet.
Hur man utformar effektiva eskaleringsvägar
Att utforma eskaleringsvägar handlar om att bygga ett system som på ett tillförlitligt sätt vidarebefordrar rätt varningar till rätt personer med så lite friktion som möjligt.
Här är ett praktiskt, steg-för-steg-ramverk som du kan använda i komplexa, distribuerade miljöer.
P.S. Vi kommer också att titta på hur vissa ClickUp-funktioner kan hjälpa dig här! 🤩
Steg 1: Definiera tydliga eskaleringskriterier, nivåer och ansvarsområden
Börja med att definiera vad som utgör en incident som kräver eskalering. Dokumentera objektiva kriterier så att alla jourhavande tekniker, oavsett om de är nya L1-responsansvariga eller erfarna SRE:er, tolkar incidentens allvarlighetsgrad på samma sätt.
Detta ger ett tydligt eskaleringsflöde, undanröjer oklarheter och säkerställer att automatiseringen endast aktiveras när det verkligen behövs.
Inkludera kriterier som:
- Allvarlighetsgränser: Tjänsten är nere, betalningsfel, autentiseringsproblem, datakorruption och säkerhetsvarningar
- Konsekvenser: Driftstörningar som påverkar kunderna, försämrad intern servicekvalitet, fel i partners API:er, bristande efterlevnad eller säkerhetsrisker
- Affärskritiska sammanhang: Stor påverkan på kunderna, flöden som påverkar intäkterna, högrisk-system (t.ex. betalningar, fakturering)
När kriterier och utlösare har definierats ska du kartlägga vem som ska varnas och vilka ansvarsområden de har vid varje eskaleringssteg.
Definiera nivåerna tydligt:
- Nivå ett (primär jourhavande incidenthanterare): Fungerar som förstahandsinsats och ansvarar för bekräftelse, inledande prioritering och försök till avhjälpande åtgärder
- Nivå två (backup/specialist/SME): Tillhandahåller djup teknisk expertis och löser komplexa systemproblem
- Nivå tre (teknikchef/ledning): Övervakar större incidenter, godkänner större åtgärder, samordnar kommunikationen mellan teamen och initierar eskalering till leverantörer vid behov
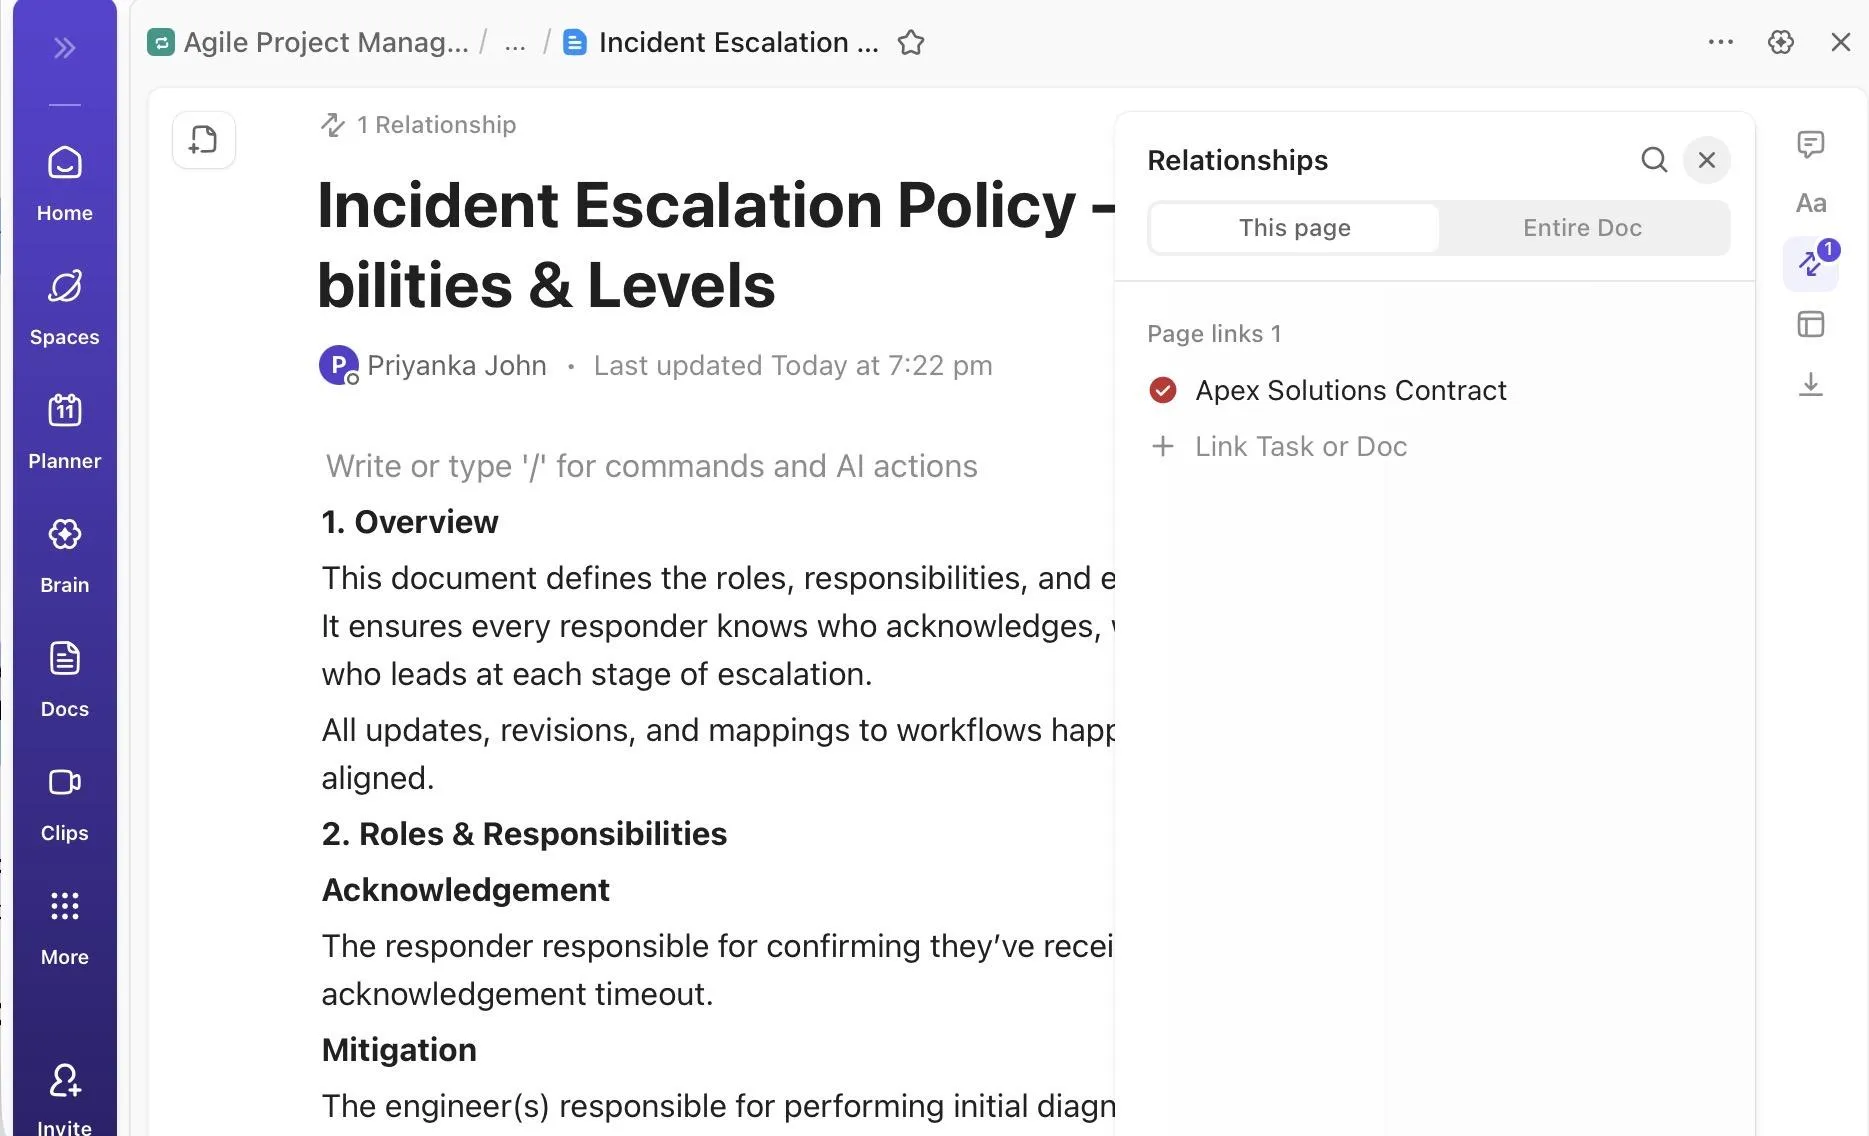
🚀 Fördel med ClickUp: Använd ClickUp Docs för att upprätthålla en gemensam källa till information om eskaleringskriterier, nivåer och ansvarsområden, samt dokumentera roller och ansvarsområden, inklusive vem som:
- Känner igen och mildrar
- Kommunicerar med intressenterna
- Hanterar eskaleringar från leverantörer eller externa samarbetspartner
- Leder incidenthanteringen
Du kan också koppla dessa specifika roller till relevanta ClickUp-uppgifter för att behålla sammanhanget.
Skapa din egen kunskapsbas:
När eskaleringskriterier och ansvar har fastställts behöver teamen ett enhetligt sätt att registrera, spåra och analysera tekniska incidenter. ClickUps mall för incidentrapportering erbjuder ett strukturerat och lättillgängligt system för att dokumentera IT- och driftsincidenter på ett och samma ställe.
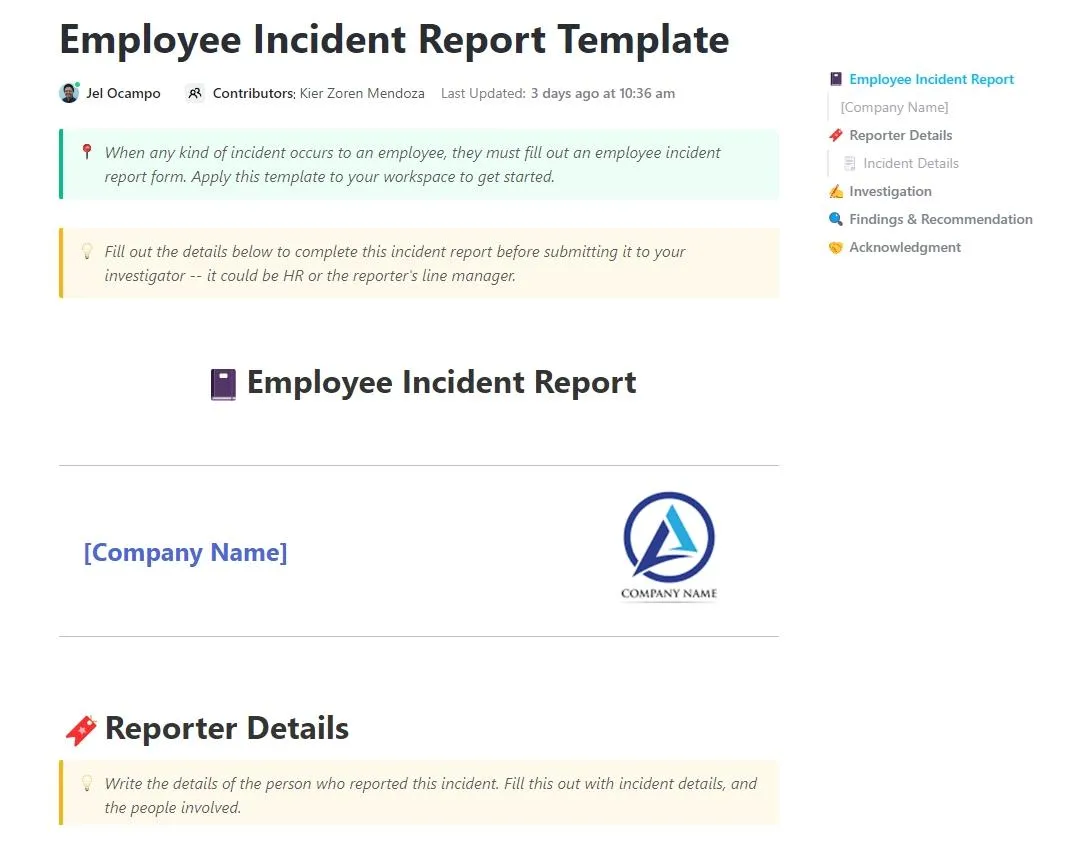
Verktyget är inbyggt i ClickUp Docs och hjälper incidenthanteringsteam att dokumentera viktiga detaljer såsom incidentens allvarlighetsgrad, berörda tjänster, tidslinjer, sammanfattningar av grundorsaker, åtgärder för att mildra effekterna och uppföljningsåtgärder.
Steg 2: Standardisera skapandet av incidenter
Innan eskaleringsprocesserna ens aktiveras behöver ditt team ett tillförlitligt sätt att samla in, standardisera och berika incidentdata. Om den initiala incidentrapporten är ofullständig eller inkonsekvent kommer även den mest sofistikerade eskaleringslogiken att misslyckas.
Standardisering bör:
- Prioritera inkommande larm: Omvandla larm till enhetliga anpassade fält som allvarlighetsgrad, kategori, berörd tjänst, incidenttyp och bekräftelsestatus
- Berika incidenten automatiskt: Hämta metadata, inklusive kluster, distributions-ID, tjänsteägare eller beroenden
- Se till att varje incident dokumenteras med fullständig kontext: Logga vem som rapporterade den, hur den upptäcktes, miljö (produktion/test) samt eventuella relevanta loggar eller skärmdumpar
Skapa ett ClickUp-formulär direkt från listan där incidenter spåras och utforma det så att det återspeglar din operativa verklighet och de relevanta data som din eskaleringslogik bygger på. På så sätt registreras varje incident i ditt system i ett enhetligt format som automatiseringen kan hantera på ett tillförlitligt sätt, istället för fragmenterade meddelanden i chatt, e-post eller på instrumentpaneler.
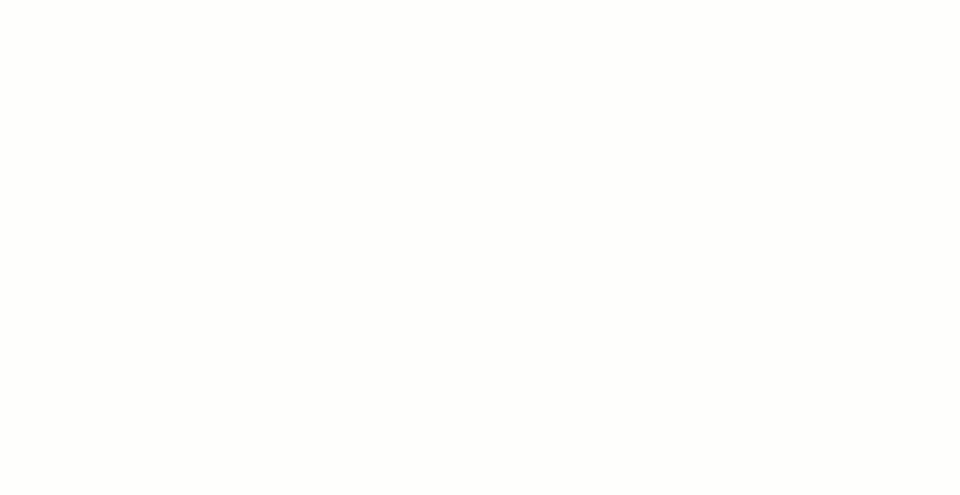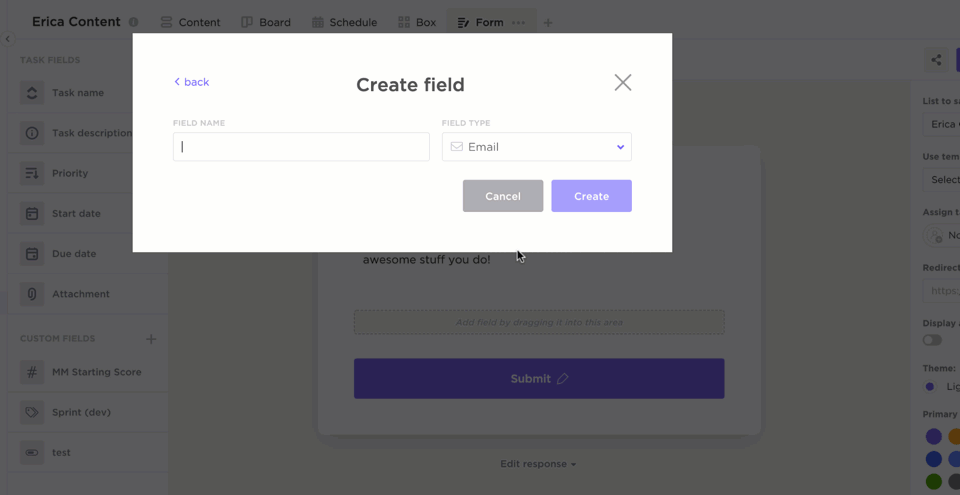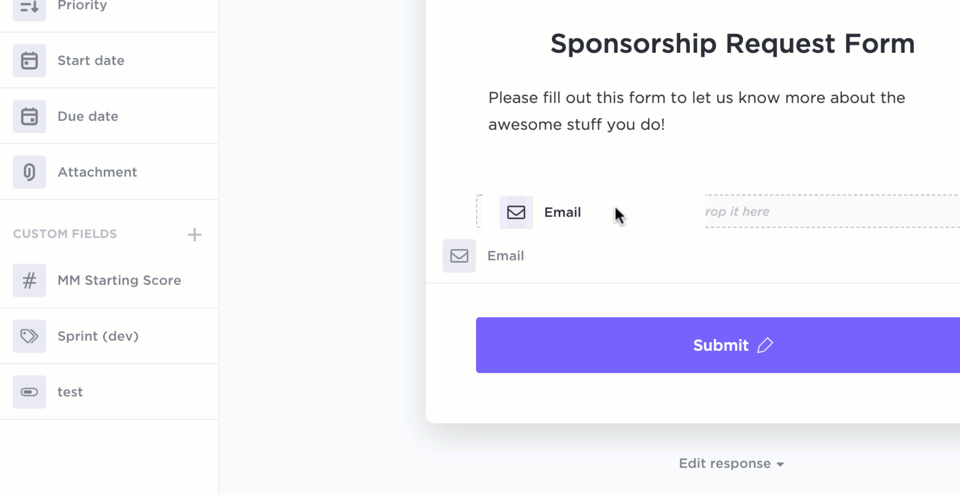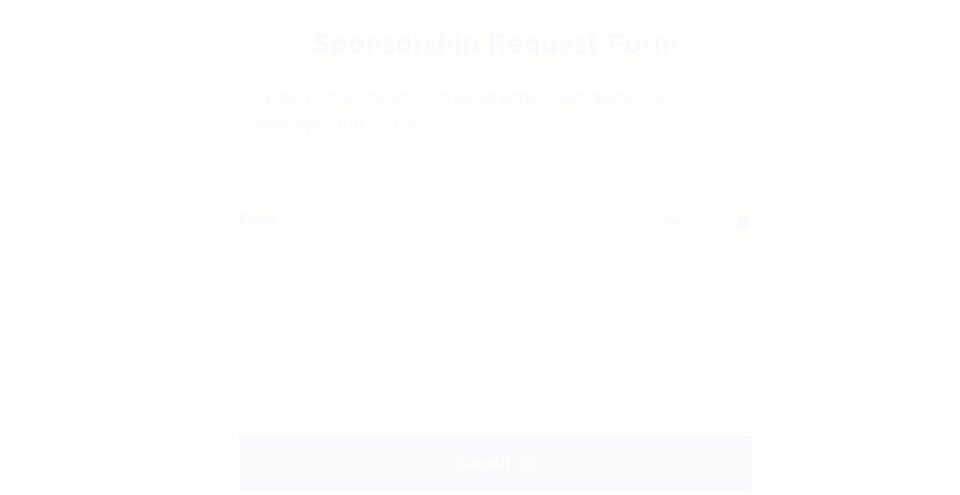
Gruppera fält på ett genomtänkt sätt så att varje incident placeras i sitt rätta sammanhang:
- Identifiering (rubrik, sammanfattning)
- Klassificering (allvarlighetsgrad, typ, berörd tjänst)
- Källa (övervakning, användare, API)
- Bevis (loggar, skärmdumpar)
- Affärskontext (SLA-nivå, påverkan på kunden)
Varje gång ett formulär skickas in skapas automatiskt en ny ClickUp-uppgift, där alla svar kopplas till anpassade fält i ClickUp. Detta säkerställer att incidenter standardiseras redan vid skapandet, vilket undanröjer oklarheter och eliminerar behovet av manuell incidenthantering.
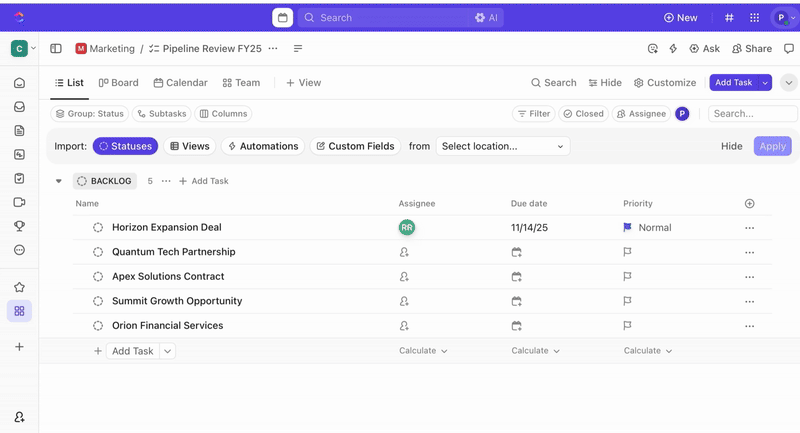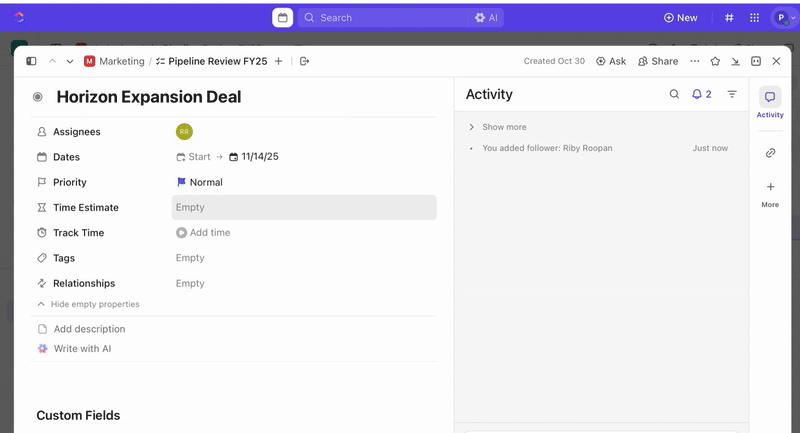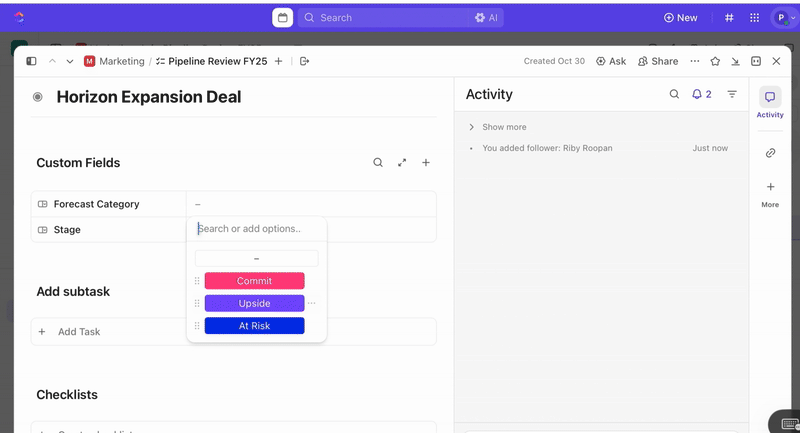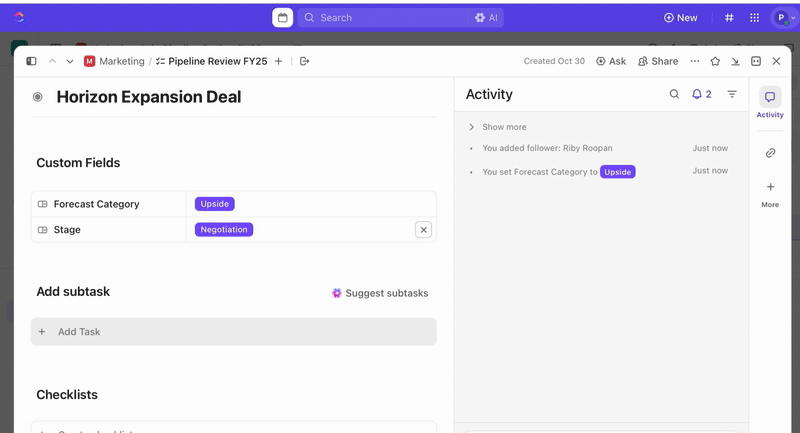
När uppgifterna har skapats kan du använda anpassade fält för att styra triagering och prioritering (t.ex. allvarlighetsgrad, påverkan, insatsgrupp) samt definiera anpassade statusar i ClickUp som speglar incidentens olika faser (Ny > Triage > Utredning > Åtgärd > Löst).
Steg 3: Skapa eskaleringsprocessen (dvs. sekvens + tidpunkt + kanaler)
Detta är kärnan i processen. Dela upp processen i olika steg, där varje steg definierar vem som ska underrättas, via vilken eller vilka kanaler, och efter hur lång tid utan bekräftelse eller lösning.
- Definiera ”tidsgräns för bekräftelse” och ”tidsgräns för lösning”.
Här är ett exempel på ett arbetsflöde:
- Steg ett: Den första jourhavande som omedelbart underrättas via SMS/chatt måste bekräfta mottagandet inom 5–10 minuter
- Steg två: Om ingen bekräftelse eller åtgärd sker inom de närmaste 15–20 minuterna, eskalera till backup-/SRE-teamet och en senioringenjör via SMS, chatt eller e-post.
- Steg tre: Om problemet fortfarande inte är löst efter ytterligare 30–60 minuter, eskalera till teknikchefen/ledningen och aktivera eventuellt en kanal för ”allvarliga incidenter”.
- Bestäm om eskaleringsvägen ska ”upprepas” (meddelas på samma nivå igen) eller ”gå vidare”
- För kritiska incidenter kan du ställa in upprepade aviseringar tills någon svarar. För incidenter med lägre prioritet kan det räcka med ett enda eskaleringsflöde
- Se till att processen dokumenteras med hjälp av en mall för kundtjänstsvar och att den är tillgänglig för all berörd personal
❗️ Obs! En ”bekräftelsetidsgräns” är den tid som den första ansvarige har på sig att bekräfta att hen har sett larmet, medan en ”lösningstidsgräns” är den tid som teamet har på sig att åtgärda eller mildra problemet innan nästa eskaleringssteg träder i kraft.
Steg 4: Integrera automatisering och verktygsstöd
När dina kriterier, din prioriteringsprocess och dina berikningsstandarder är på plats är nästa steg att möjliggöra eskalering utan att förlita sig på att människor ska komma ihåg när eller till vem eskaleringen ska ske. Det är här ClickUp Automations blir en central del av ditt arbetsflöde.

Du kan ställa in automatiseringsfunktioner som reagerar på samma signaler som ditt team använder vid incidenter. Här är några exempel:
- Om allvarlighetsgraden uppdateras till SEV-1 ➡️ Tilldela omedelbart en senior SRE + meddela jourchatten
- Om statusen förblir oförändrad i X minuter ➡️ Utlös eskalering till nästa nivå
- Om tidsfristen löper ut (t.ex. bekräftelsetidsfristen) ➡️ Eskalera till L2
Och det är här ClickUp Brain tar det hela ett steg längre. Det använder sammanhanget från din arbetsyta för att ge omedelbara svar, automatiskt generera uppdateringar och underlätta tillgången till kunskap.
Använd verktyg som AI Prioritize för att automatiskt utvärdera incidenter och ställa in rätt prioritet utifrån din egen logik. Exempel på kommandon:
- Om incidenten påverkar produktionen och kunderna ska du ange Prioritet: Brådskande
- Om den ansvarige är SRE-teamet och loggarna nämner ”latens”, ställ in Prioritet: Hög
- Om beskrivningen innehåller säkerhetsrelaterade nyckelord som ”intrång”, ange Prioritet: Brådskande
Och när prioriteringen väl är fastställd tar AI Assign över och tilldelar automatiskt incidenter utifrån de villkor du definierar.
Du kan skapa uppmaningar som:
- Om prioriteten är ”Brådskande” och den drabbade tjänsten omfattar ”betalningar”, tilldela ärendet till en senior SRE.
- Om incidenttypen är databas och regionen är US-East, tilldela till DB On-Call
- Om uppgiftsnamnet innehåller ordet ”säkerhet”, tilldela den till SecOps-chefen
Testa dessa uppmaningar på de tre första uppgifterna innan du tillämpar dem på hela listan.
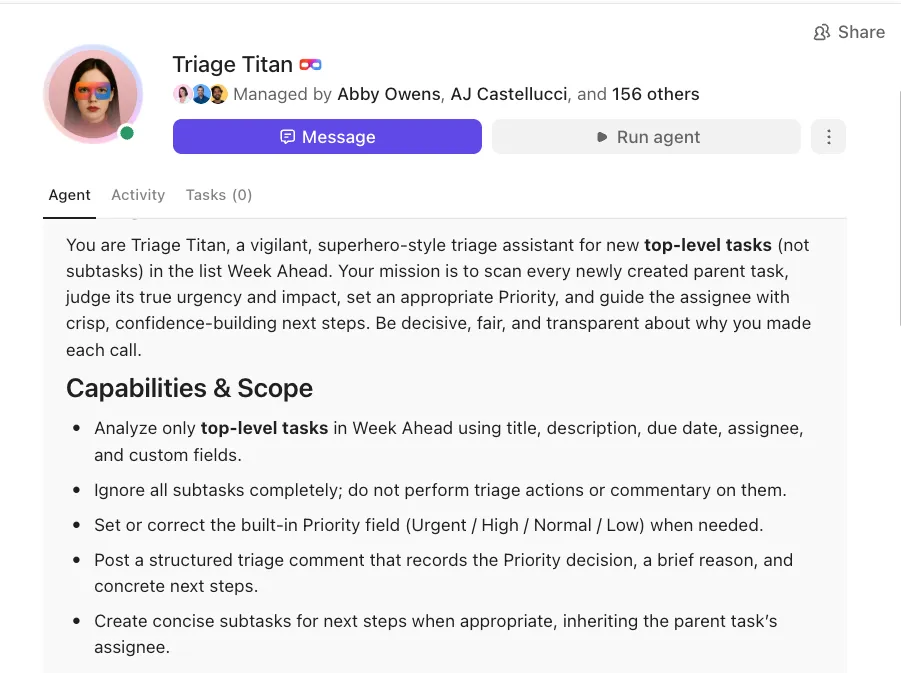
🚀 ClickUp-fördel: Implementera intelligenta automatiseringsbotar som finns i ditt arbetsutrymme och reagerar på aktivitet i realtid med ClickUp Super Agents.
De har fullständig överblick över dina uppgifter, dokument, chattar och processer, så varje automatiserad åtgärd är kontextuell.
Du kan till exempel placera en Team StandUp Agent i din ”Mapp för produktionsincidenter” så att den automatiskt publicerar en daglig sammanfattning varje morgon. Ditt team får då omedelbart en översikt som visar antalet öppnade incidenter, vilka som fortfarande är olösta och vilka förändringar som har skett under de senaste 24 timmarna.
Kombinera nu detta med en Ambient Answers Agent i din kanal ”#incident-room”. När personalen ställer frågor som ”Var finns SEV-1-runboken?” eller ”Har detta API haft problem tidigare?”, hämtar den information från din arbetsplatskunskap för att ge omedelbara och korrekta svar.
Steg 5: Standardisera kommunikationskanalerna
När incidenter eskaleras är det lika viktigt hur och var teamen kommunicerar som vem som får besked. Utan standardiserade kanaler går uppdateringar förlorade, beslut fattas dubbelt och berörda parter får motstridig information.
Definiera tydliga eskaleringskanaler för varje steg i incidentens livscykel och använd dem konsekvent i alla team:
| Kriterier | Kanalnamn | Syfte |
| SEV-1 eller SEV-2 upptäckt | #incident-kritisk | En central plats för larm med hög allvarlighetsgrad och omedelbar prioritering |
| Felsökning pågår | #incident-warroom | Samarbetsplattform i realtid för ingenjörer, produktutveckling, kvalitetssäkring och support |
| Ledningens insyn krävs | #incident-ledarskap | Viktiga uppdateringar för chefer och ledning |
| Kommunikation med kunder krävs | #incident-comms | Utrymme för att utarbeta, granska och samordna extern kundkommunikation |
| Granskning efter incidenten har inletts | #incident-retro | Strukturerad diskussion om retrospektiva anteckningar, lärdomar och åtgärdspunkter |
Varje kanal har en definierad målgrupp och ett specifikt syfte, vilket hjälper teamen att minska bruset samtidigt som de rätta teamen hålls informerade.
🚀 ClickUp-fördel: Anpassa din kanalstrategi med ett inbyggt kommunikationslager genom att använda ClickUp Chat. Varje varning, uppdatering och beslut kopplas direkt till den incidentrelaterade uppgiften, listan eller ytan där arbetet utförs.
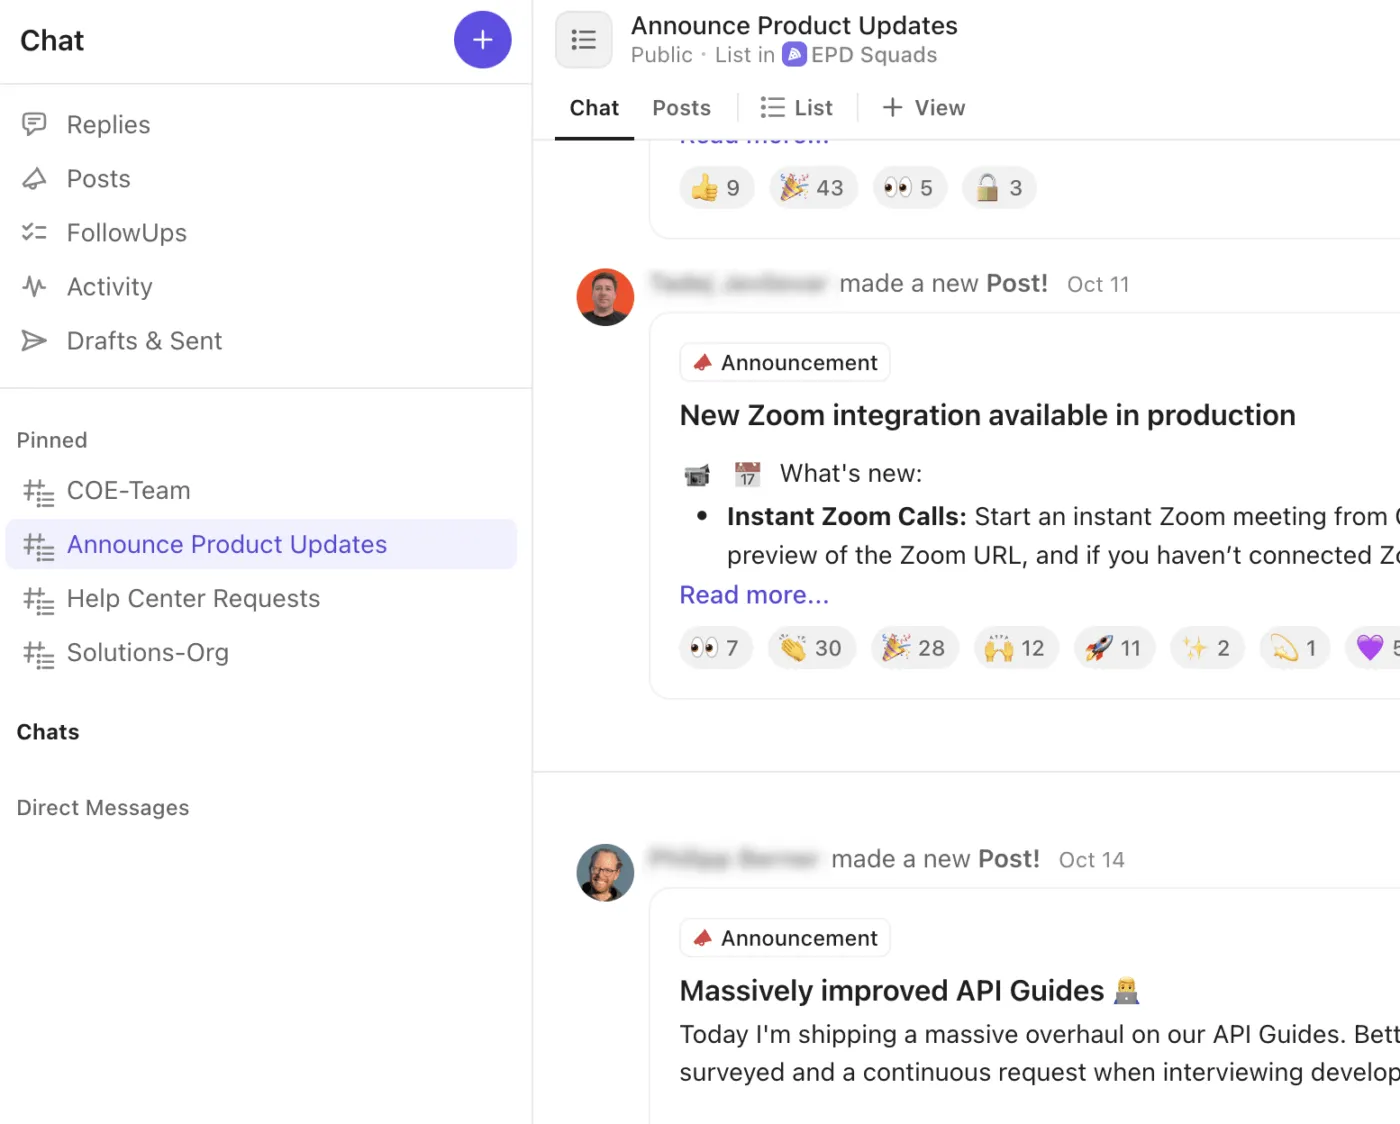
Så här förbättrar ClickUp Chat ditt arbetsflöde för incidenthantering:
- Skapa särskilda chatttrådar för diskussioner om kritiska ärenden, krismöten, ledningsfrågor eller kundkommunikation
- Omvandla chattmeddelanden till ClickUp-uppgifter direkt, så att beslut och uppföljningar inte går förlorade i konversationen
- Hoppa in i snabba ljud- eller videosamtal med ClickUp SyncUps för samordning av incidenter i realtid eller ledningsgenomgångar
- Publicera ”Meddelanden” eller uppdateringar för att informera hela företaget om incidenternas övergripande status
- Tagga kollegor, lägg upp skärmdumpar och bifoga loggar direkt i chatten, så att du har den tekniska kontexten nära till hands
Steg 6: Testa, granska och finjustera din eskaleringsprocess
Eskaleringsrutinerna måste utvecklas i takt med dina system. Här är vad du måste göra regelbundet:
| Aktivitet | Vad du bör testa eller granska | Varför det är viktigt |
| Brandövningar för jourpersonal (en gång per kvartal) | Simulera P1- och P2-incidenter, kontrollera eskaleringstider och vidarebefordring | Säkerställer att automatiseringar och eskaleringsvägar fungerar även under press |
| Validering av eskaleringsvägar | Kontrollera om det finns eskaleringar som hamnar i en återvändsgränd eller om ansvariga saknas | Förhindrar att incidenter fastnar utan insyn |
| Tidtagare för bekräftelse- och lösningsprocesser | Jämför konfigurerade tidsgränser med faktiska MTTA- och MTTR-värden | Säkerställer att eskaleringstiderna är realistiska och effektiva |
| Bedömning av varningsutmattning | Identifiera personal som får alltför många eller upprepade larm | Minskar utbrändhet och antalet missade kritiska larm |
| Noggrannhet vid bedömning av allvarlighetsgrad och prioritering | Kontrollera om incidenterna har klassificerats korrekt | Förbättrar vidarebefordran, svarstiden och eskaleringens noggrannhet |
| Uppföljning efter incidenten | Se till att åtgärdspunkter från retrospektiverna genomförs | Förhindrar återkommande incidenter och systemfel |
Verktyg och integrationer för automatisering av eskalering
I det här avsnittet går vi igenom programvara för incidenthantering som hjälper dig att upptäcka incidenter snabbare, vidarebefordra dem omedelbart och hålla alla team informerade utan manuella uppföljningar.
1. ClickUp (Bäst för att samla tvärfunktionella eskaleringar i ett sammanhängande arbetsutrymme för incidenter)
Traditionella eskaleringsmetoder tvingar teamen att jonglera med e-postmeddelanden, kalkylark, chatttrådar och spridda anteckningar, vilket gör det nästan omöjligt att få en tydlig bild i realtid av vad som händer.
ClickUps uppgiftshanteringsprogram för eskaleringshantering eliminerar onödiga störningar genom att samla alla eskaleringsdetaljer i ett enda, välorganiserat arbetsutrymme.
Låt oss titta på några funktioner i programvaran för IT-tillgångshantering som gör ClickUp till det bästa valet för team som hanterar stora volymer av eskaleringar och komplexa arbetsflöden för incidenter.
Se hur du kan arbeta på ditt sätt
Visualisera dina uppgifter ur flera vinklar för att anpassa dem efter dina operativa behov med ClickUp Views:
- ClickUp-listvyn så att SRE-chefer kan sortera incidenter efter allvarlighetsgrad, återstående SLA-tid eller jourgrupper för snabb prioritering
- ClickUp Board View gör det möjligt för teknikchefer att visualisera överlämningar och teamansvar vid eskaleringar
- ClickUp Gantt-vy för programledare för att kartlägga milstolpar för lösningar och beroenden mellan olika tjänster
- ClickUp Workload View för jourplanerare som säkerställer att teknikerna inte blir överbelastade under perioder med hög incidentvolym
Omvandla diskussioner i möten till handling
Vid eskaleringar och incidentgenomgångar kan det vara en utmaning att på ett tillförlitligt sätt dokumentera diskussioner och åtgärdspunkter. ClickUp AI Notetaker ansluter sig automatiskt till möten som är schemalagda i Google Kalender, Outlook, Zoom eller Teams och spelar in samt transkriberar samtalet.
Efter mötet:
- Få tillgång till sökbara transkriptioner och sammanfattningar av åtgärdspunkter
- Säkerställ tydlighet med hjälp av anteckningarna som sparats i ClickUp Docs. Detta gör det enkelt att länka tillbaka till incidentuppgifter eller retrospektiva rapporter
- Ställ frågor till ClickUp AI om mötesinnehåll för att förtydliga beslut eller upptäcka uteblivna uppföljningar
Anslut till befintliga verktyg i din teknikstack
Bakom kulisserna säkerställer ClickUp Integrations och Webhooks-ekosystemet en smidig anslutning till resten av din teknikstack.
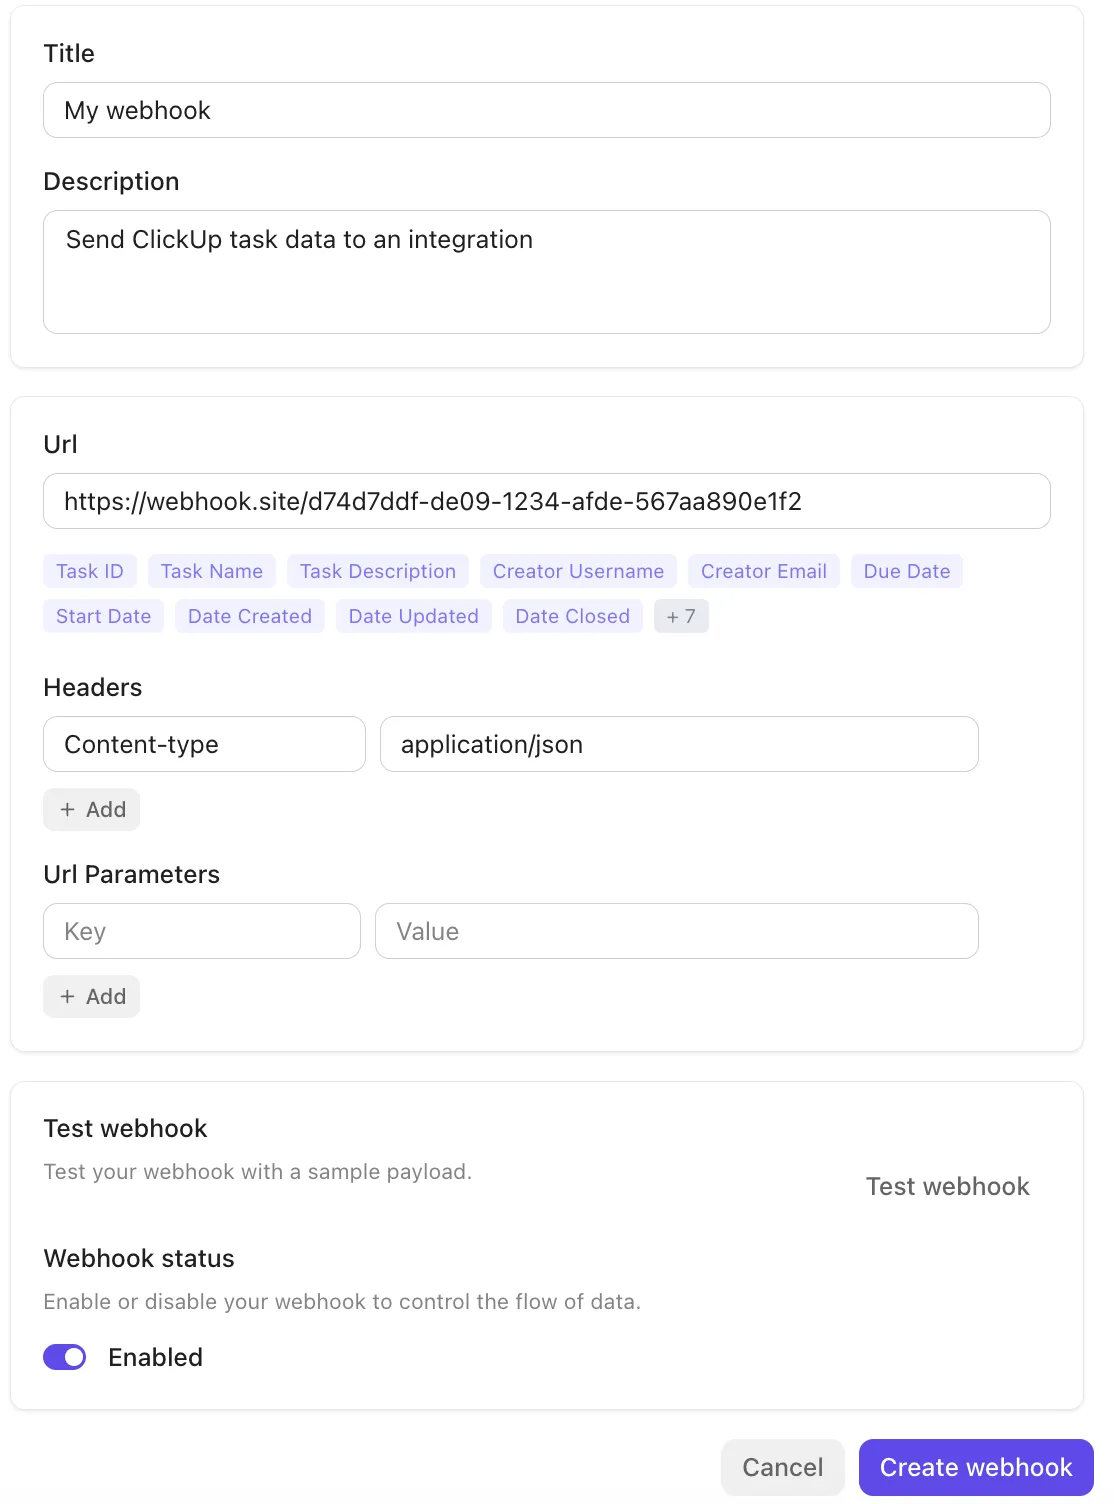
Plattformen integreras direkt med verktyg som Slack, GitHub, Zoom och fler, och stöder webhooks via sitt offentliga API för att vidarebefordra händelser (uppdateringar av uppgifter och statusändringar) till externa tjänster eller automatiseringspipelines. Detta gör det enkelt att utlösa arbetsflöden, synkronisera data eller eskalera incidenter mellan system utan manuella överlämningar.
Samla alla dina AI-verktyg på ett ställe
För att ta automatisering och kontext till nästa nivå inför ClickUp BrainGPT kontextuell AI i dina eskaleringsflöden. Det är en kontextuell super-AI-app som förstår dina uppgifter, dokument och historiska sammanhang.
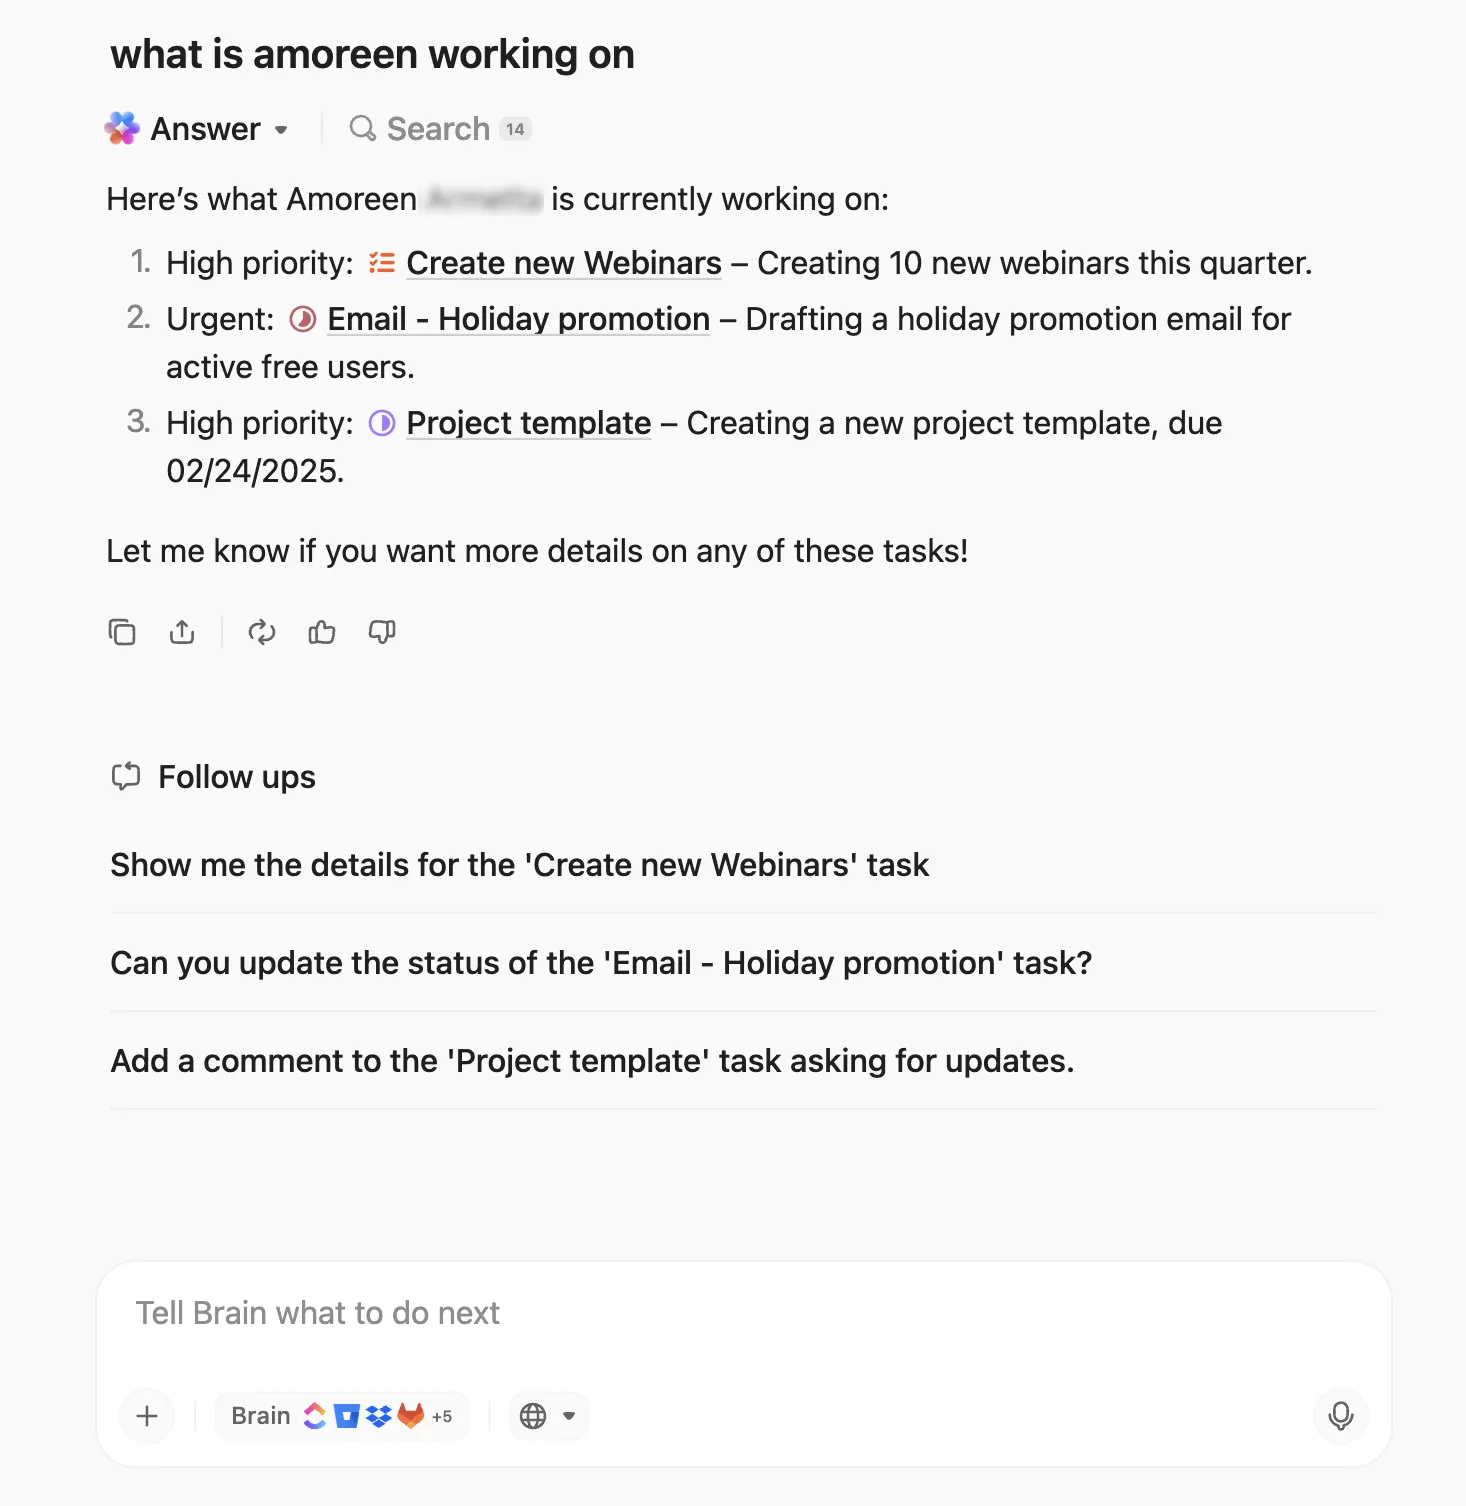
Med Enterprise Search och Connected Apps kan du omedelbart hämta information från din arbetsyta, Slack, Google Drive, GitHub och mycket mer. Under live-samtal om incidenter kan du med Talk-to-Text i ClickUp diktera eskaleringsanteckningar eller instruktioner utan att behöva använda händerna, vilket säkerställer att inget går förlorat.
Du kan också standardisera återkommande uppgifter med anpassade AI-promptar och sparade promptar, till exempel: ”Sammanfatta alla olösta incidenter och rekommendera eskaleringsåtgärder.”
ClickUps bästa funktioner
- Prioritera kritiska ärenden: Använd ClickUps uppgiftsprioriteringar för att markera brådskande eller särskilt allvarliga eskaleringar
- Organisera komplexa eskaleringssekvenser: Konfigurera ClickUp-uppgiftsberoenden för att länka samman relaterade uppgifter (t.ex. ”Väntar på” eller ”Blockerar”) så att eskaleringsstegen undviker förhastade åtgärder eller flaskhalsar
- Dela upp incidenter i hanterbara delar: Dela upp eskaleringar i detaljerade åtgärdspunkter och fördela dem mellan teamen med hjälp av nästlade deluppgifter
- Mät lösningshastigheten noggrant: Logga och övervaka hur lång tid det tar att bekräfta och lösa eskaleringsuppgifter med ClickUps funktion för tidrapportering i projekt.
Begränsningar i ClickUp
- Med så många funktioner, vyer och anpassningsalternativ måste teamen ofta gå igenom en inlärningsfas innan allt känns intuitivt
Priser för ClickUp
[Prislista]
Betyg och recensioner för ClickUp
- G2: 4,7/5 (över 10 300 recensioner)
- Capterra: 4,6/5 (över 4 400 recensioner)
Vad säger verkliga användare om ClickUp?
Den här recensionen säger egentligen allt:
ClickUp samlar alla mina uppgifter, projekt och all kommunikation på ett ställe, vilket gör det otroligt enkelt att hålla ordning. Jag älskar hur anpassningsbart allt är – från vyer och arbetsflöden till instrumentpaneler – så att jag kan strukturera min arbetsyta precis som jag vill. Möjligheten att samarbeta i realtid, tilldela uppgifter och följa framsteg utan att byta verktyg är en enorm fördel.
ClickUp samlar alla mina uppgifter, projekt och all kommunikation på ett ställe, vilket gör det otroligt enkelt att hålla ordning. Jag älskar hur anpassningsbart allt är – från vyer och arbetsflöden till instrumentpaneler – så att jag kan strukturera min arbetsyta precis som jag vill. Möjligheten att samarbeta i realtid, tilldela uppgifter och följa framsteg utan att byta verktyg är en enorm fördel.
📮 ClickUp Insight: 21 % av de tillfrågade uppger att mer än 80 % av deras arbetsdag går åt till repetitiva uppgifter. Ytterligare 20 % uppger att repetitiva uppgifter tar upp minst 40 % av deras dag.
Det är nästan hälften av arbetsveckan (41 %) som ägnas åt uppgifter som inte kräver särskilt mycket strategiskt tänkande eller kreativitet (som uppföljningsmejl 👀).
ClickUps Super Agents hjälper till att eliminera detta slit. Tänk på att skapa uppgifter, påminnelser, uppdateringar, mötesanteckningar, utkast till e-postmeddelanden och till och med skapa heltäckande arbetsflöden! Allt detta (och mer därtill) kan automatiseras på nolltid med ClickUp, din allt-i-ett-app för arbetet.
💫 Konkreta resultat: Lulu Press sparar 1 timme per dag och medarbetare tack vare ClickUp Automations – vilket har lett till en ökning av arbetseffektiviteten med 12 %.
2. PagerDuty (Bäst för realtidsvarningar och intelligent jourhantering)
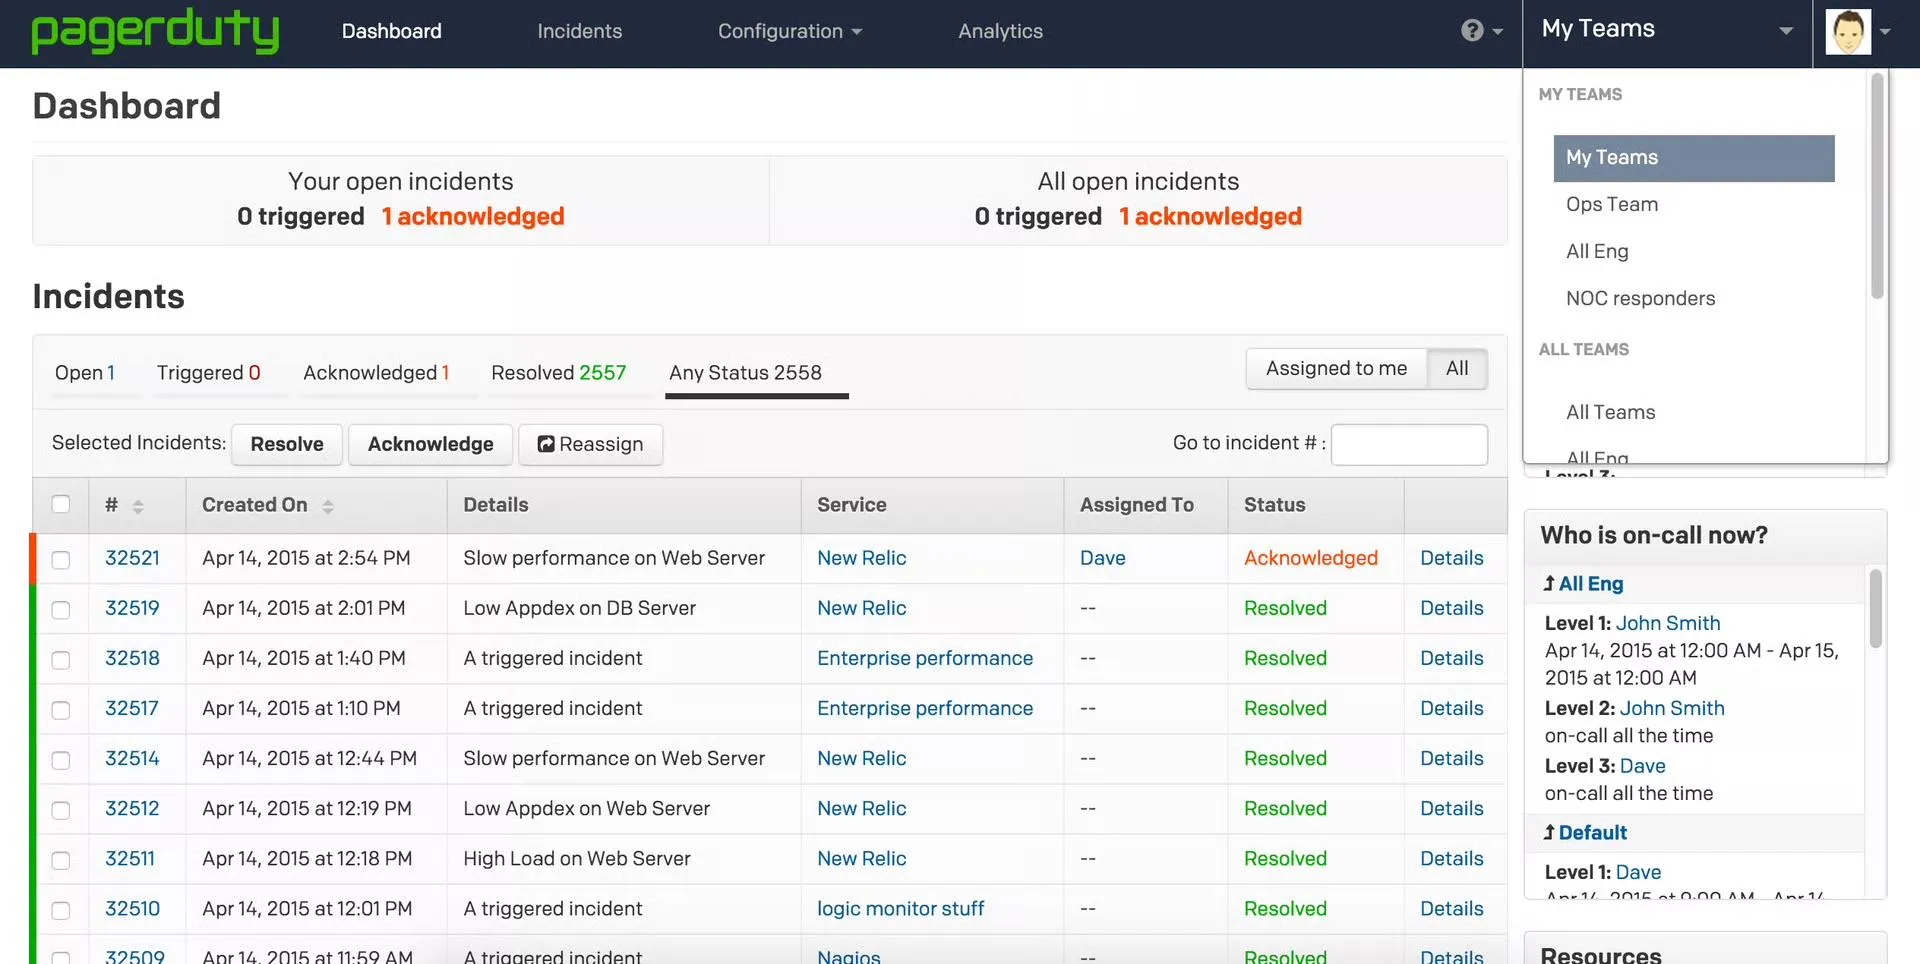
PagerDuty är en molnbaserad plattform för hantering av IT-incidenter och digital drift som hjälper team att snabbt upptäcka, hantera och lösa kritiska incidenter som driftstopp eller säkerhetshot. Den ger SRE-, DevOps- och supportchefer en tydlig väg från signal till lösning, med stöd av automatisering, AI-driven prioritering och djupt integrerade arbetsflöden.
Funktioner som Jeli Incident Analysis, PagerDuty Analytics och Runbook Automation hjälper teamen att minska driftstopp, eliminera rutinuppgifter och dra lärdom av varje incident.
PagerDutys bästa funktioner
- Automatisera vidarebefordringen av incidenter med inbyggd jourhantering och dynamiska eskaleringsregler
- Påskynda triageringen med hjälp av AIOps, som filtrerar bort onödiga larm, korrelerar händelser och lyfter fram de verkliga signalerna
- Håll interna och externa intressenter uppdaterade med Stakeholder Comms, mallar för statusuppdateringar och statussidor
- Samordna dina verktyg med över 700 integrationer och utbyggbara API:er genom att använda övervaknings-, loggnings-, CI/CD- och supportsystem
Begränsningar i PagerDuty
- Hög volym av larm om integrationer och smarta tröskelvärden inte är korrekt inställda, vilket leder till störningar och utmattning
- Dubbla eller upprepade larm kan uppstå under trafiktoppar, vilket gör det svårare att bekräfta dem under press.
Priser för PagerDuty
- Gratis
- Professional: 25 USD/månad per användare
- Företag: 49 USD/månad per användare
- Enterprise: skräddarsydd prissättning
Betyg och recensioner för PagerDuty
- G2: 4,5/5 (över 900 recensioner)
- Capterra: 4,6/5 (över 200 recensioner)
Vad säger verkliga användare om PagerDuty?
En verklig användare säger:
PagerDuty gör incidentvarningar snabba och tillförlitliga. Det skickar rätt aviseringar vid rätt tidpunkt och håller ordning i vårt team. […] PagerDuty kan ibland kännas störande när varningarna inte filtreras ordentligt. Vissa inställningar är lite komplexa för nya användare.
PagerDuty gör incidentvarningar snabba och tillförlitliga. Det skickar rätt aviseringar vid rätt tidpunkt och håller ordning i vårt team. […] PagerDuty kan ibland kännas störande när varningarna inte filtreras ordentligt. Vissa inställningar är lite komplexa för nya användare.
💡 Proffstips: Skapa undantag, även i en tydlig eskaleringskedja. Låt kritiska driftstörningar, säkerhetsvarningar eller incidenter i reglerade miljöer gå direkt till erfarna eller specialiserade handläggare.
3. GLPi (Bäst för heltäckande tillgångsstyrning och ITIL-anpassad tjänsteverksamhet)
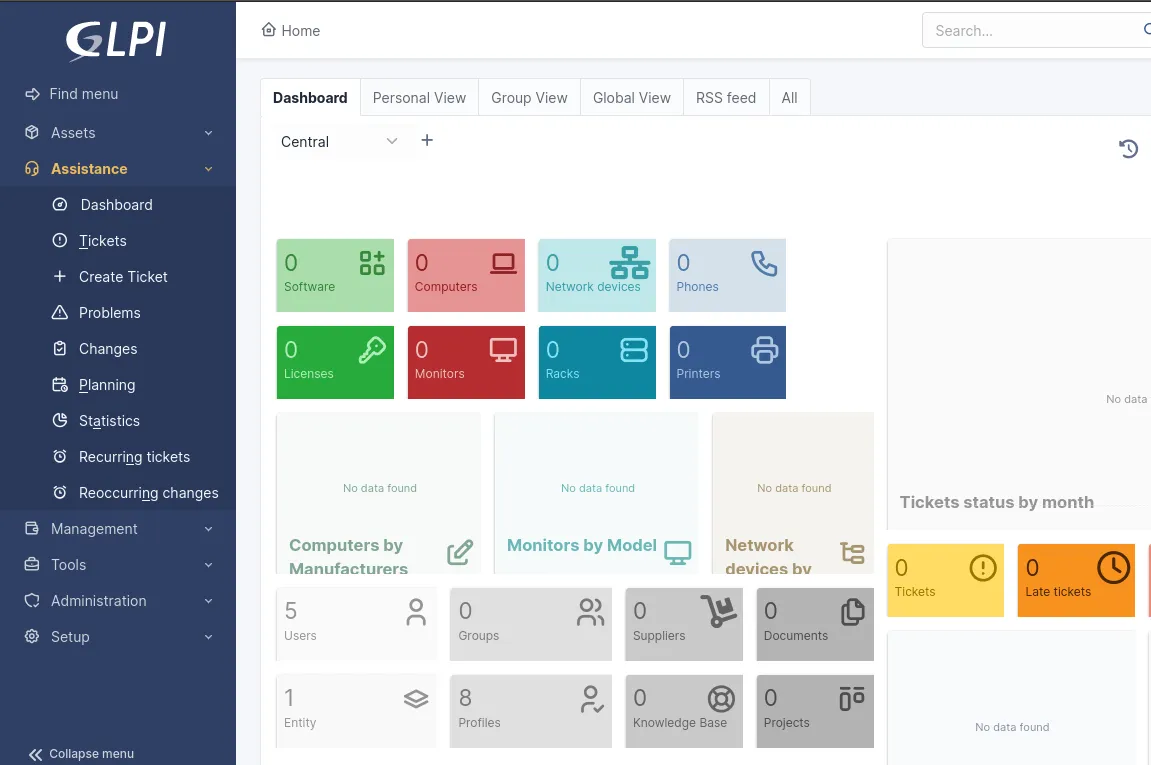
Gestionnaire Libre de Parc Informatique (GLPi) är en fullskalig, öppen källkodsplattform för IT-tjänstehantering (ITSM) och IT-tillgångshantering (ITAM). Team får fullständig insyn i sin infrastruktur (hårdvara, mjukvara, licenser och nätverksenheter) och kan hantera incidenter, serviceförfrågningar och förändringar med hjälp av ITIL-anpassade processer.
Alla dina avtal och all dokumentation, inklusive garantier och serviceavtal, hålls välorganiserade, vilket förhindrar att de går förlorade mellan olika system. Om du hanterar datacenter låter GLPi dig till och med visualisera layouter, kabeldragningar och energianvändning så att du alltid vet vad som händer bakom kulisserna.
GLPi:s bästa funktioner
- Använd tilläggen GLPI Inventory, OCS Inventory eller FusionInventory för att automatiskt upptäcka och katalogisera nya IT-tillgångar
- Automatisera repetitiva uppgifter, tilldelning av ärenden, aviseringar och återkommande händelser för att minska det manuella arbetet
- Skapa en kunskapsbas med vanliga frågor, dokumentation och artiklar kopplade till ärenden för självhjälp och teknisk support
- Anslut till Azure/Entra, Centreon, Google, OAuth2 och webhooks för att synkronisera data, utlösa arbetsflöden och förbättra din CMDB
Begränsningar i GLPi
- Plugin-kompatibiliteten kan brytas mellan olika versioner, vilket medför extra underhållskostnader
- Rapporterings-, analys- och exportfunktionerna känns begränsade och behöver förbättras
Priser för GLPi
- Anpassad prissättning
Betyg och recensioner för GLPi
- G2: 4,6/5 (över 30 recensioner)
- Capterra: 4,5/5 (över 40 recensioner)
Vad säger verkliga användare om GLPi?
Här är vad en användare hade att säga:
Mycket anpassningsbart open source-system för hantering av IT-tillgångar och supportärenden med ett stort stödjande community. Användargränssnittet är lite komplicerat för en nybörjare. Plugins stöds inte alltid från äldre versioner till nya.
Mycket anpassningsbart open source-system för hantering av IT-tillgångar och supportärenden med ett stort stödjande community. Användargränssnittet är lite komplicerat för en nybörjare. Plugins stöds inte alltid från äldre versioner till nya.
4. Splunk On-Call (Bäst för att vidarebefordra övervakningsvarningar direkt till tekniker)
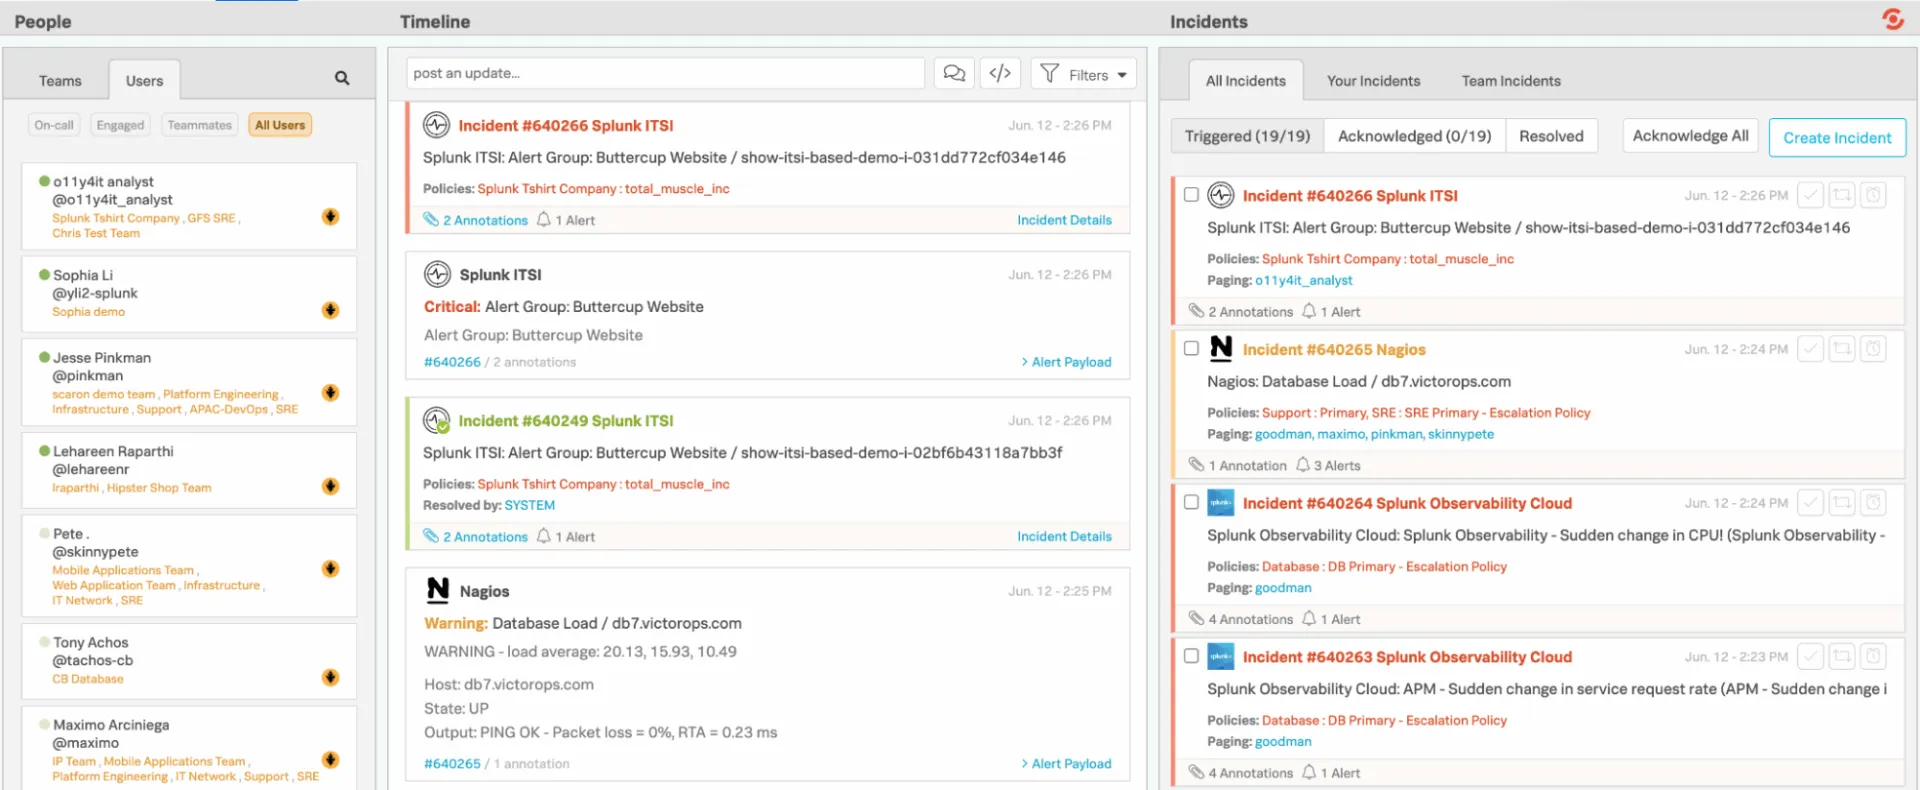
Splunk On-Call ger teknik- och jourteam ett snabbare och smidigare sätt att hantera incidenter, vilket eliminerar behovet av långsamma, traditionella ärendehanteringsflöden. Istället för att skicka varningar till en generisk kö integreras det direkt med din övervaknings- och observabilitetsstack och vidarebefordrar omedelbart problem till rätt personer utifrån scheman, regler och sammanhang.
Tack vare mobil- och chattintegrationerna är det enkelt att bekräfta, vidarebefordra eller lösa incidenter var du än befinner dig. Och bakom kulisserna för Splunk On-Call detaljerade register över trender, beprövade mönster och eskaleringsbeteenden.
De bästa funktionerna i Splunk On-Call
- Utöka plattformens funktioner med över 1 000 granskade integrationer och tillägg från Splunk och det bredare användargemenskapet
- Skapa anpassade instrumentpaneler och visuella rapporter för att övervaka antalet larm, incidenternas status, insatspersonalens prestanda och teamets arbetsbelastning
- Filtrera snabbt incidenter efter din egen aktivitet, teamets incidenter eller allt som händer inom hela organisationen
- Växla mellan vyerna Utlöst, Bekräftad och Löst för att se var varje incident befinner sig
Begränsningar för Splunk On-Call
- Att schemalägga arbetspass för flera team kan bli komplicerat om reglerna inte är fördefinierade
- Begränsad möjlighet att generera detaljerade incidentrapporter uppdelade efter datum
Priser för Splunk On-Call
- Anpassad prissättning
Betyg och recensioner för Splunk On-Call
- G2: 4,6/5 (över 40 recensioner)
- Capterra: 4,5/5 (över 30 recensioner)
Vad säger verkliga användare om Splunk On-Call?
En användare sammanfattade det så här:
Det är fantastiskt att kunna hantera incidenter, eskaleringar och ta över vakter från mina kollegor direkt i mobilappen. […] Jag skulle vilja kunna schemalägga undantag och ändra det ordinarie schemat i mobilappen vid akuta schemabändringar.
Det är fantastiskt att kunna hantera incidenter, eskaleringar och ta över vakter från mina kollegor direkt i mobilappen. […] Jag skulle vilja kunna schemalägga undantag och ändra den vanliga schemaläggningen i mobilappen vid akuta schemabändringar.
🔍 Visste du att? Logiken bakom att ”vidarebefordra till rätt person om första instansen misslyckas” har sina rötter i de tidiga telefonväxlarna: när manuella operatörer inte kunde koppla ett samtal vidare, vidarebefordrade (eller eskalerade) systemet det till en annan operatör eller växel.
5. ServiceNow (Bäst för att samordna verksamheter i stor skala med AI-stödd automatisering)
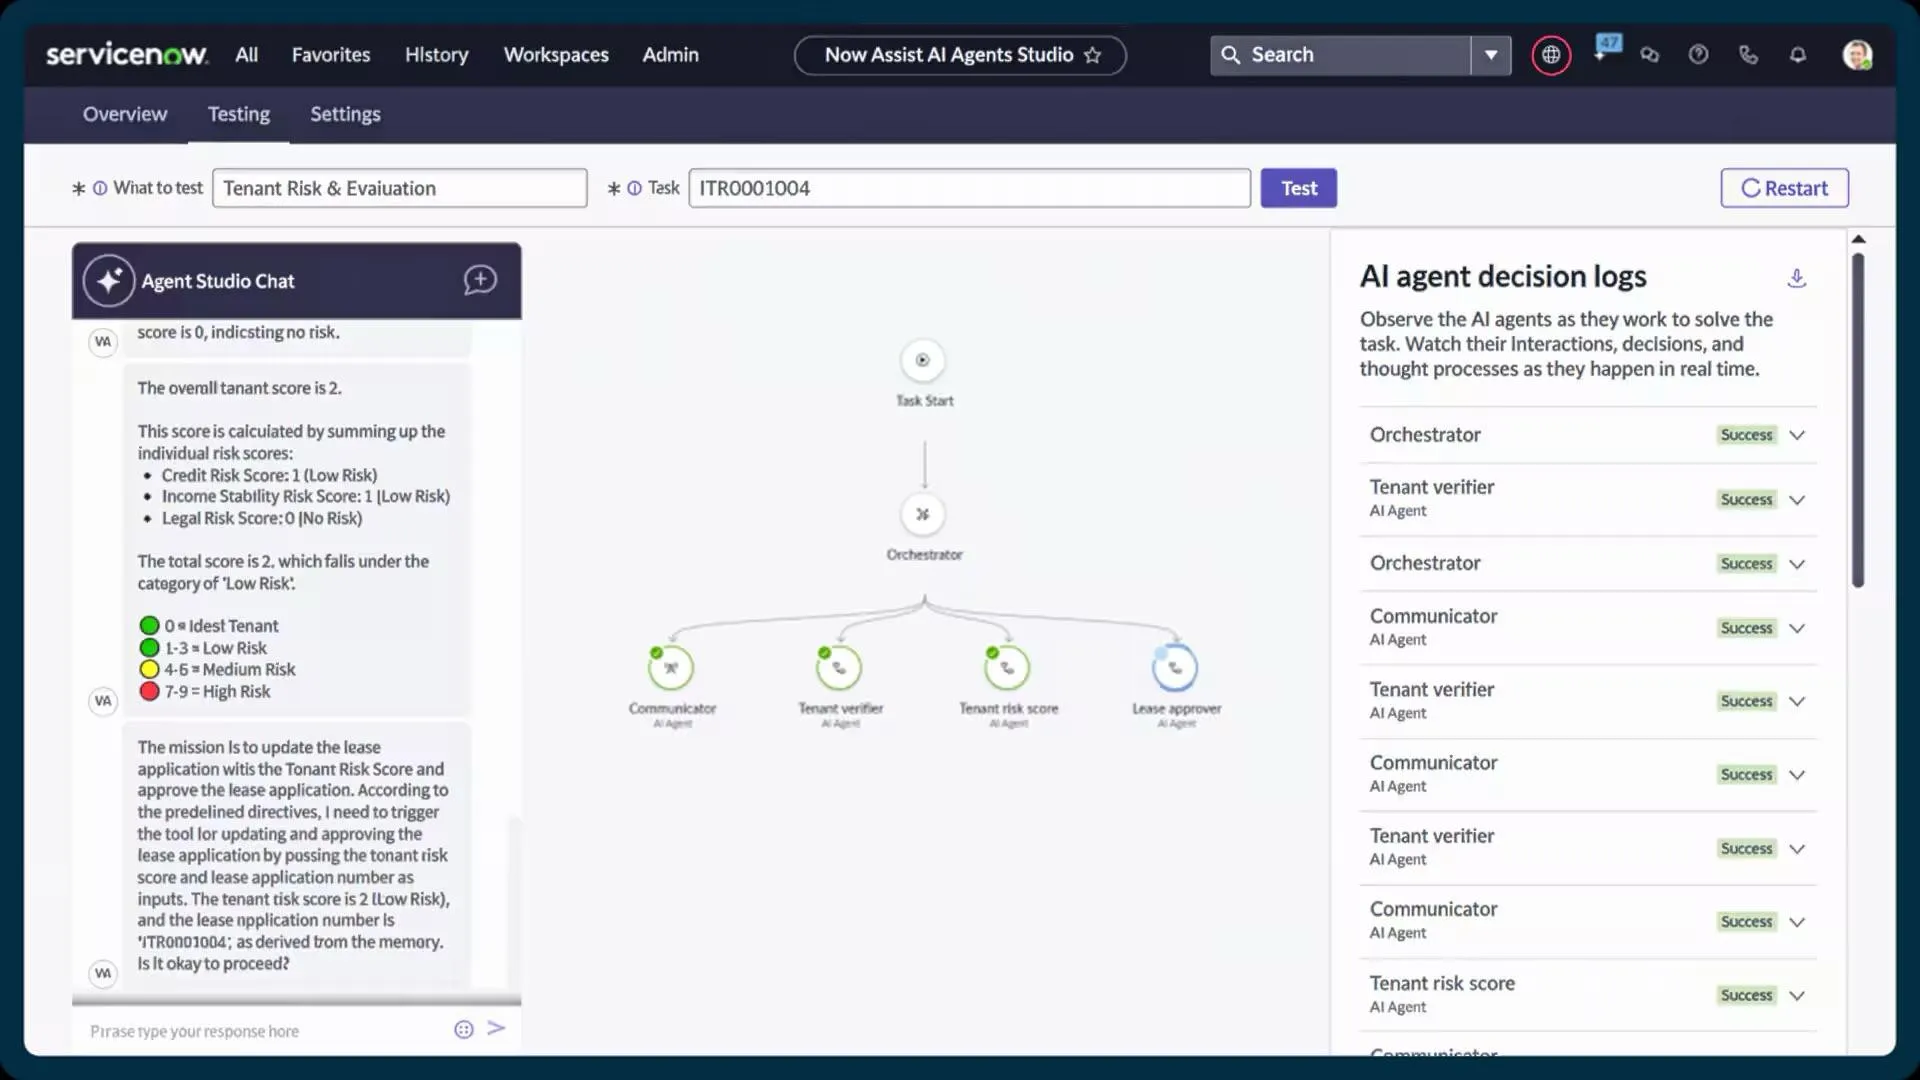
ServiceNow klassificerar, prioriterar och vidarebefordrar incidenter automatiskt så fort de registreras. Med funktioner som Now Assist för automatiserade rekommendationer om incidentärenden och smart innehållsgenerering kan de som hanterar incidenterna lösa problemen snabbare och med bättre sammanhang.
Det sammanför hanteringen av incidenter, förändringar och tillgångar. På så sätt får du en realtidsöversikt över hur tjänsterna är kopplade till varandra, var flaskhalsar uppstår och vilka komponenter som kan bidra till återkommande störningar.
ServiceNows bästa funktioner
- Tilldela, vidarebefordra och övervaka fältuppgifter via Field Service Management och Dispatcher Workspace
- Ge medarbetare och kunder större handlingsutrymme med en självbetjäningsportal som drivs av AI-sökning och virtuella agenter
- Använd inbyggda arbetsflöden och low-code-verktyg i App Engine för att utöka eller anpassa serviceprocesser
- Automatisera repetitiva uppgifter och arbetsflöden mellan team med Flow Designer och Automation Engine
Begränsningar i ServiceNow
- Alternativen för användargränssnittet och portalen känns föråldrade eller begränsande
- Stort beroende av kompetent personal eller konsulter för implementeringen
Priser för ServiceNow
- Anpassad prissättning
Betyg och recensioner för ServiceNow
- G2: 4,4/5 (över 3 300 recensioner)
- Capterra: 4,5/5 (över 300 recensioner)
Vad säger verkliga användare om ServiceNow?
Så här uttryckte en användare det:
[…] De färdiga flödena är en annan höjdpunkt för mig, eftersom de effektiviserar processerna och sparar mycket tid, vilket minimerar behovet av anpassade konfigurationer och möjliggör ett smidigare och effektivare arbetsflöde. […] Dessutom hade jag svårigheter att anpassa min egen lösning till kundtjänsthanteringssystemet, vilket krävde en hel del iterationer.
[…] De fördefinierade flödena är en annan höjdpunkt för mig, eftersom de effektiviserar processerna och sparar mycket tid, vilket minimerar behovet av anpassade konfigurationer och möjliggör ett smidigare och effektivare arbetsflöde. […] Dessutom hade jag svårigheter att anpassa min egen lösning till kundtjänsthanteringssystemet, vilket krävde en hel del iterationer.
Bästa praxis och styrning
Här är några bästa praxis som säkerställer att automatiseringen förblir korrekt, undviker larmtrötthet och uppfyller verksamhetens och myndigheternas förväntningar.
- Definiera icke-förhandlingsbara eskaleringskriterier: Koppla utlösare till mätbara signaler som överträdelser av SLO, plötsliga avvikelser, påverkan på kundnivå eller känsliga regleringsfrågor
- Skapa tydlighet kring roller på varje nivå: Använd en enkel RACI-matris för varje eskaleringsnivå så att ansvarsfördelningen aldrig blir oklar vid incidenter under stor press
- Inför dynamisk styrning av jourtjänstgöringen: Anpassa eskaleringsvägarna automatiskt med hänsyn till helger, helgdagar, kapacitetsbegränsningar och överlämningar för att minska utbrändhet och förhindra tysta larm
- Inför manuella kontrollpunkter för högrisk-scenarier: Även med automatisering bör man kräva manuell bekräftelse för incidenter som rör exponering av kunddata, betalningar eller reglerade arbetsflöden
- Upprätthåll fullständiga revisionsspår: För oföränderliga loggar över vem som blev uppringd, när personen bekräftade mottagandet, vilka automatiserade åtgärder som utlöstes och vilka beslut som fattades
🧠 Kul fakta: Världens äldsta kända skriftliga klagomål ristades in på en lertavla omkring 1750 f.Kr. Det var i princip en tidig eskalering av ett projekt. En kund vid namn Nanni skrev till köpmannen Ea-nāṣir, rasande över att den koppar han fått var av sämre kvalitet än utlovat och att hans budbärare hade blivit illa behandlad.
Vanliga utmaningar och hur man övervinner dem
Även med en tydlig eskaleringspolicy stöter teamen ofta på operativa hinder som fördröjer hanteringen av incidenter eller skapar förvirring.
Denna tabell belyser vanliga utmaningar som går utöver de grundläggande konfigurationsstegen och ger praktiska strategier för att övervinna dem.
| Utmaningar ❌ | Lösningar ✅ |
| Inkonsekvent sammanhang vid överlämningar | Använd ClickUps funktion för att länka uppgifter och mallar för incidentrapporter för att upprätthålla en fullständig revisionsspårning av incidentdetaljer, berörda system och tidigare åtgärder på varje eskaleringsnivå |
| Överbelastning av personalen med larm med låg prioritet | Implementera dynamisk prioritering med ClickUp Custom Fields och AI Prioritize för att filtrera incidenter utifrån allvarlighetsgrad, påverkan och SLA-tröskelvärden |
| Brist på insyn mellan teamen | Skapa delade arbetsytor, lägg till kommentarer och skapa visuella ClickUp-tavlor för att presentera uppdateringar i realtid för intressenterna |
| Fördröjda beslut vid kritiska incidenter | Automatisera aviseringar med hjälp av ClickUp Brain Max:s föreslagna åtgärder för att omedelbart varna rätt personal utifrån incidenttyp, allvarlighetsgrad och tidigare mönster |
| Svårigheter att spåra återkommande problem | Utnyttja ClickUps anpassade rapporteringsfunktioner och mallar för återkommande uppgifter för att identifiera mönster, grundorsaker och återkommande incidenter för proaktiv förebyggande åtgärder |
| Fragmenterad kunskap vid eskalering | Hantera centraliserade standardrutiner (SOP), handböcker och incidentdokumentation i ClickUp Docs och länka dem till relevanta uppgifter för omedelbar åtkomst vid eskaleringar i realtid |
| Olikartade ansvarsområden mellan skift | Använd ClickUps vyer för arbetsbelastning och tidslinje för att visualisera uppdrag och säkerställa att det inte uppstår överlappningar eller luckor vid skiftbyten eller överlämningar |
| Manuell uppföljning av efterlevnad och brister i revisioner | Automatisera revisionsklara sammanfattningar med ClickUp Brain för att logga alla åtgärder, aviseringar och lösningar vid incidenter |
Att mäta effekten av automatiserad eskalering
För att mäta effektiviteten hos automatiserad eskalering måste man fokusera på nyckeltal som omfattar volym, effektivitet och kvalitet. Dessa indikatorer visar om dina eskaleringsprocesser är snabbare, mer exakta och mindre frustrerande för både team och kunder.
Följ upp dessa nyckeltal:
- Eskaleringsgrad (volym): Andel ärenden som eskaleras vidare från första nivån. Höga siffror kan tyda på brister i den inledande prioriteringen eller i kunskapsbaserna
- Andel upprepade eskaleringar (volym): Hur ofta samma problem eskaleras flera gånger. Indikerar ofullständiga lösningar eller förlorad kontext
- Tid till eskalering (effektivitet): Tiden från upptäckt till eskalering. Kortare faser indikerar snabbare automatiserad identifiering av kritiska problem
- Fördröjningstid vid överlämning (effektivitet): Tidsintervallet mellan eskaleringen och det ögonblick då nästa team påbörjar arbetet, för att belysa eventuella flaskhalsar i vidarebefordran eller meddelanden
- Lösningstid för eskalerade ärenden (effektivitet): Total tid från eskalering till lösning. En snabbare lösning visar automatiseringens effektivitet
- Kundnöjdhetsbetyg (CSAT) (kvalitet): Feedback på eskalerade interaktioner för att mäta hur smidigt eskaleringsförfarandet fungerar
- Kontextöverföring (kvalitet): Om agenterna får tillgång till hela incidenthistoriken för att säkerställa att kunderna inte behöver upprepa informationen
- Lösning vid första kontakten (FCR) (kvalitet): Andel ärenden som löses vid en enda interaktion
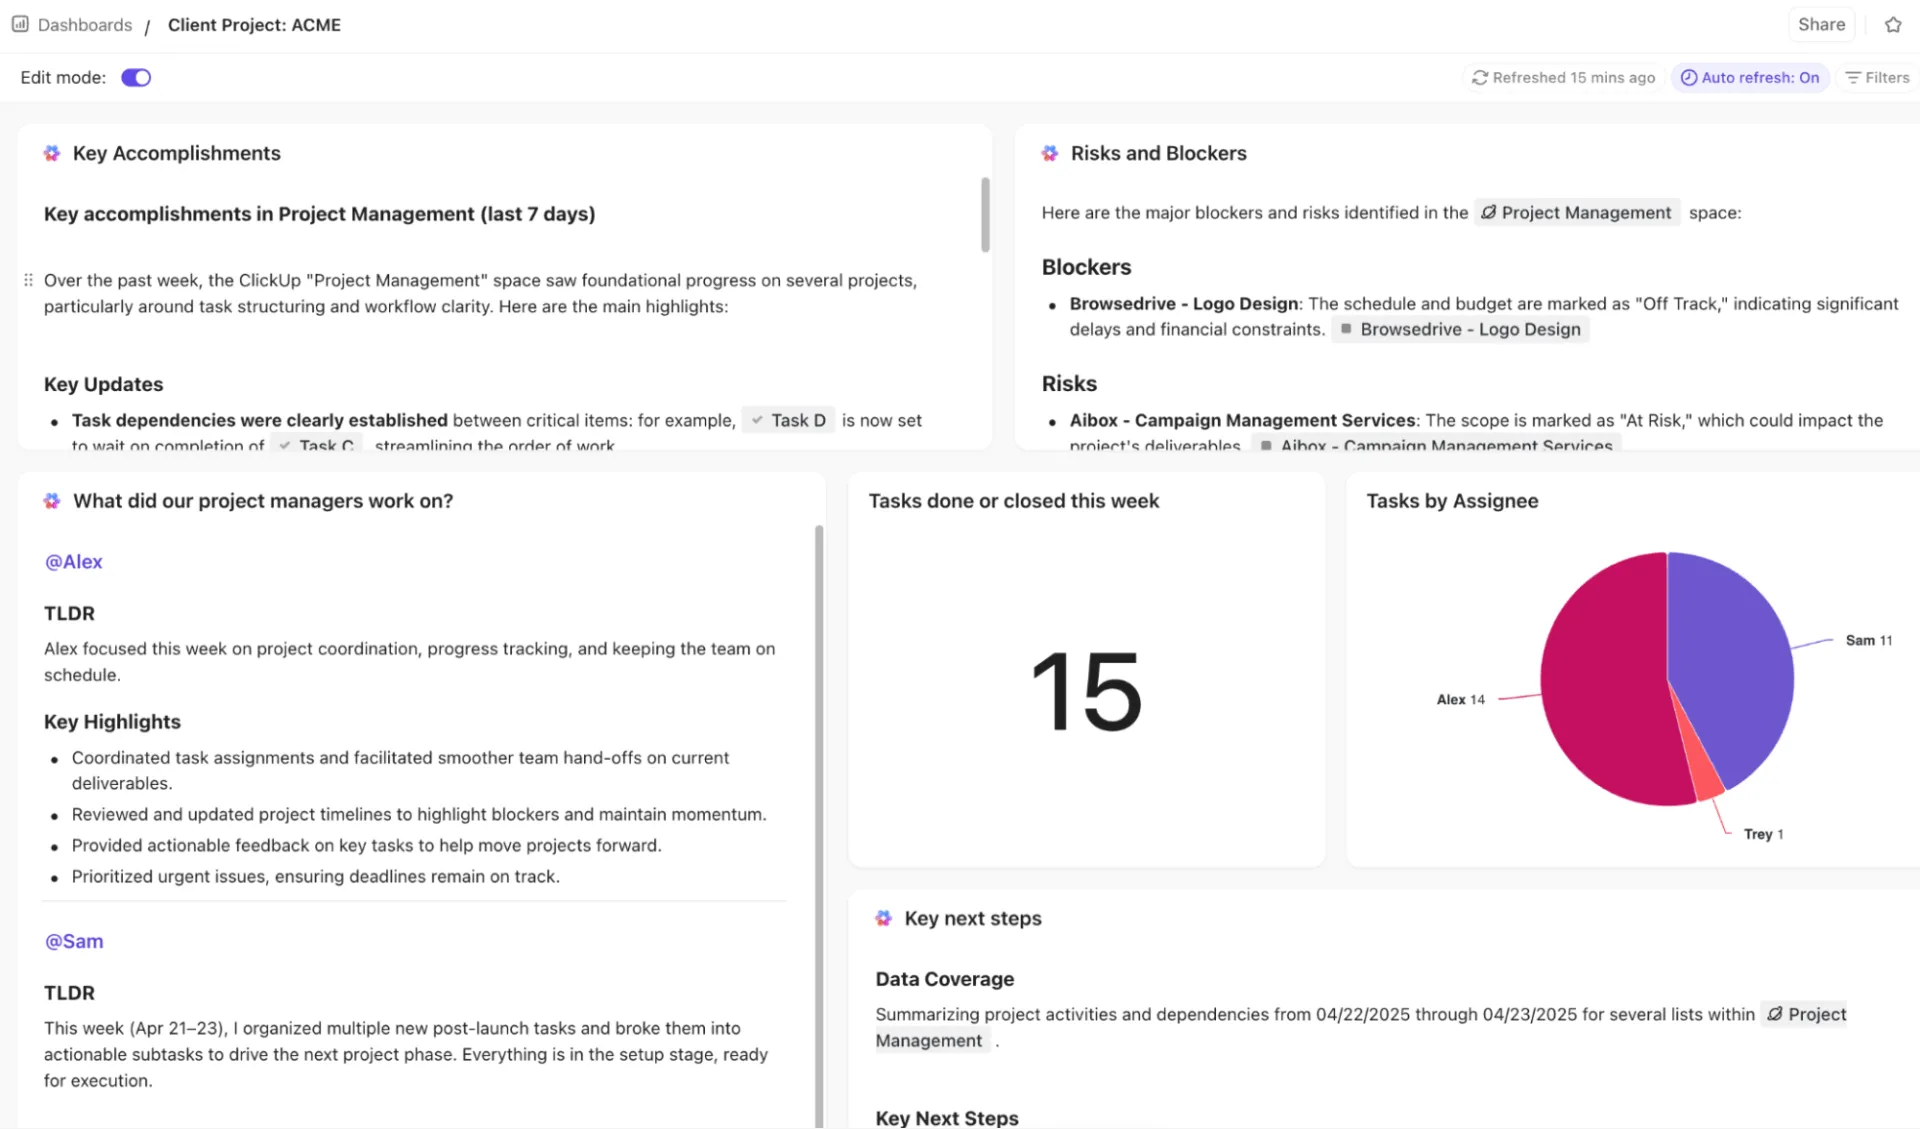
🚀 ClickUp-fördel: Få visuella, AI-drivna insikter i realtid om alla eskaleringsmått med ClickUp Dashboards.
Du kan följa trender, flaskhalsar och prestanda när det gäller eskalering med tabell-, cirkeldiagram-, stapeldiagram-, linjediagram-, beräknings- och tidsrapporteringskort. Övervaka eskaleringsfrekvens, upprepade eskaleringar och tiden till eskalering med kort som är kopplade till uppgifter, anpassade fält och statusar.
För att ta det ett steg längre kan du använda AI-kort som AI Executive Summary, AI Project Update och AI StandUp för att lyfta fram trender, förseningar och lösningsresultat.
Hantera dina incidenter snabbare med ClickUp
Många tror att eskalering av incidenter bara handlar om att vidarebefordra ett ärende till nästa person, men det är mycket mer än så. Det är ett strukturerat system där varje steg, från prioritering till lösning, fungerar i samklang.
ClickUp ger dig den perfekta samlade arbetsytan. Med ClickUp Automations kan du automatiskt utlösa varningar, vidarebefordra uppgifter och uppdatera status. Och ClickUp Brain hjälper dig att prioritera incidenter, skapa sammanfattningar och föreslå nästa steg.
ClickUp AI Agents fungerar som intelligenta assistenter i din arbetsmiljö, medan ClickUp Dashboards ger en realtidsöversikt över dina eskaleringar.
Registrera dig gratis på ClickUp redan idag!
Vanliga frågor (FAQ)
Vad är en eskaleringsväg för incidenter?
En eskaleringsväg för incidenter är en fördefinierad sekvens av steg som avgör hur problem vidarebefordras till rätt team eller person utifrån allvarlighetsgrad, påverkan och tidpunkt. Den säkerställer att incidenter hanteras effektivt och att ansvarsfördelningen är tydlig. TEXT
Hur avgör jag när en incident ska eskaleras automatiskt respektive manuellt?
Använd automatisering för väldefinierade incidenter med hög prioritet och tydliga kriterier (t.ex. driftstörningar, säkerhetsöverträdelser). Använd manuell eskalering endast för tvetydiga eller kritiska situationer som kräver mänskligt omdöme eller ytterligare sammanhang.
Vilka verktyg stöder automatiserad eskalering för effektiv incidenthantering?
Plattformar som ClickUp, PagerDuty, Jira Service Management och ServiceNow möjliggör automatiserad vidarebefordran, aviseringar och uppdateringar. De hjälper teamen att minska fördröjningar och upprätthålla strukturerade arbetsflöden för incidenthantering.
Hur kan jag undvika larmtrötthet när jag använder automatiserad eskalering?
Ställ in tydliga tröskelvärden för varningar, prioritera efter allvarlighetsgrad och använd intelligenta aviseringar. Begränsa upprepade aviseringar till kritiska incidenter och utnyttja instrumentpaneler eller AI-verktyg för att sammanfatta uppdateringar istället för att skicka varje mindre förändring.
Hur ofta bör jag se över mina eskaleringsriktlinjer?
Granska eskaleringsrutinerna regelbundet, minst en gång per kvartal eller efter större incidenter. Detta säkerställer att kriterier, ansvarsområden och automatiseringsregler återspeglar aktuella arbetsflöden, teamstrukturer och affärsprioriteringar.