
Vroeger had je voor het voorspellen van je business-resultaten een data science-team nodig, maandenlange modelontwikkeling en een beetje geluk.
Maar nu 78% van de organisaties volgens McKinsey AI in ten minste één bedrijfsfunctie gebruikt, is die tijd teruggelopen van maanden tot vrijwel onmiddellijke inzichten.
Door die verandering is de druk om voorspellende modellen snel op te leveren nog nooit zo groot geweest.
IBM Watsonx bundelt het proces van het bouwen en implementeren van voorspellende modellen in één uniforme, browsergebaseerde werkstroom die uw ontwikkelteam binnen enkele minuten kan uitvoeren. Maar snelheid alleen is niet genoeg. Als de voorspellingen die deze modellen genereren geen verbinding vinden met de bedrijfsworkflows waarop ze invloed uitoefenen, hebben ze geen daadwerkelijke impact.
Deze handleiding behandelt elke fase, van het uploaden van je eerste dataset en het trainen van het model tot het implementeren ervan als een live API en, het allerbelangrijkste, de verbinding tussen de gegenereerde inzichten en werkstroomprocessen van leidinggevenden in tools zoals ClickUp. 🔨
U leert zowel hoe u het model in Watsonx bouwt als hoe u de resultaten ervan in de praktijk brengt, zodat voorspellingen leiden tot actie binnen uw team.
U leert zowel hoe u het model in Watsonx bouwt als hoe u de resultaten ervan in de praktijk brengt, zodat voorspellingen leiden tot actie binnen uw team.
Wat is IBM Watsonx en hoe ondersteunt het voorspellende analyses?
Het implementeren van AI-modellen voor uw business kan betekenen dat u uw modellen op de ene plek traint, uw gegevens op een andere plek beheert en governance of compliance in weer een andere tool afhandelt.
IBM Watsonx is het AI- en dataplatform voor ondernemingen van IBM, ontworpen om de technische kant van deze versnippering op te lossen. Het is in feite een suite van AI-producten voor het bouwen, trainen en uitvoeren van AI binnen een onderneming, zonder dat het allemaal versnipperd of experimenteel aanvoelt.
Het platform biedt een oplossing voor gefragmenteerde werkstroomen door één enkele projectwerkruimte te bieden. U kunt gegevens uploaden, experimenten uitvoeren en monitoringconfiguraties instellen zonder de omgeving te verlaten.
De Watsonx-suite bestaat uit drie hoofdcomponenten:
- Watsonx.ai: Bouw en train voorspellende modellen met behulp van AutoAI of aangepaste notebooks
- Watsonx. data: Maak verbinding met gegevens uit meerdere databronnen en bereid deze voor in een lakehouse-architectuur
- Watsonx. governance: Bijhoud de prestaties van modellen en handhaaf regels voor eerlijkheid
Specifiek voor voorspellende analyses is watsonx.ai de belangrijkste interface die u zult gebruiken. Deze omvat AutoAI, een ‘no-code’ experimentbouwer die automatisch algoritmen selecteert en kandidaatmodellen rangschikt.
De rest van deze handleiding richt zich op de AutoAI-werkstroom binnen watsonx.ai. Dit is de snelste manier om een werkend voorspellend model van de grond te krijgen.
Stapsgewijze handleiding voor het bouwen van een voorspellend model in Watsonx
In deze handleiding gaan we ervan uit dat u al een IBM Cloud-account hebt en een Watsonx-project hebt aangemaakt. De hele werkstroom kan rechtstreeks in uw browser worden voltooid, zonder dat u een lokale installatie hoeft uit te voeren. Dit is hoe u te werk gaat:
Stap 1: Bereid je gegevens voor en upload ze
Begin met het ordenen van uw gegevens in een tabelformat, zoals een CSV-bestand. Dit bestand moet een duidelijk gedefinieerde target-kolom bevatten die aangeeft wat u precies wilt voorspellen. Daarnaast zijn er functiekolommen nodig: dit zijn de invoergegevens waaruit het model leert.
Om je gegevens te uploaden, ga je naar je Watsonx-project en open je het tabblad Assets. Van daaruit kun je rechtstreeks een CSV-bestand uploaden of verbinding maken met een databron via watsonx.data.
Let op een aantal veelvoorkomende gegevensproblemen voordat u begint:
- Ontbrekende waarden: Verwijder grote hiaten in cruciale kolommen voordat u de gegevens uploadt, om een hoge nauwkeurigheid te garanderen
- Type doelkolom: Zorg ervoor dat classificatiedoelen categorisch zijn en regressiedoelen numeriek
Stap 2: Train een voorspellend model met AutoAI
Hier begint het trainen van het model. Klik in uw projectwerkruimte op ‘Nieuw AutoAI-experiment maken’.
Selecteer de geüploade dataset en kies de target-kolom. Vervolgens kunt u het experimenttype en eventuele optionele instellingen configureren, zoals de verdeling van uw gegevens tussen training en testen.
Voer het experiment uit om AutoAI automatisch een pijplijn-ranglijst te laten genereren. Deze ranglijst rangschikt kandidaatmodellen op basis van de door u gekozen maatstaf, zoals nauwkeurigheid of F1-score.
Elke rij op het klassement vertegenwoordigt een unieke combinatie van machine learning-algoritmen en feature engineering. De pijplijn met de hoogste rangschikking is doorgaans degene die AutoAI aanbeveelt voor uw specifieke dataset.
Ga er niet zomaar vanuit dat de best gerangschikte pijplijn automatisch de juiste keuze is. Het loont de moeite om de twee of drie beste pijplijnen met elkaar te vergelijken in plaats van klakkeloos de eerste te kiezen. U kunt op elk van deze pijplijnen klikken om te bekijken welke functies het belangrijkst zijn of hoe het model fouten maakt aan de hand van verwarringstabellen.
Stap 3: Implementeer uw voorspellend model
Zodra u een succesvolle pijplijn hebt gekozen, slaat u deze op als een model in uw project. Vervolgens moet u dit opgeslagen model promoveren naar een implementatieruimte. Een implementatieruimte is een afzonderlijke omgeving die speciaal is ontworpen voor productiewerklasten.
U kunt kiezen tussen online en batch-implementatie. Bij een online implementatie beschikt u over een realtime REST-API voor voorspellingen op aanvraag. Bij een batch-implementatie worden grote datasets volgens een vast schema geëvalueerd.
Gebruik het ingebouwde tabblad ‘Testen’ om een voorbeeld van een invoerpayload te verzenden. Zo kunt u de voorspellingsuitvoer verifiëren voordat u deze integreert met downstream-systemen. De implementatie genereert een API-eindpunt en een scoring-URL die externe applicaties kunnen aanroepen.
Stap 4: De prestaties van het model monitoren en evalueren
Een model dat is getraind op historische gegevens kan na verloop van tijd aan kwaliteit inboeten naarmate patronen in de praktijk veranderen. Deze verslechtering wordt ‘drift’ genoemd en kan de kwaliteit van het model in de loop van de tijd onopgemerkt verminderen.
Om continu bij te houden hoe uw model in de praktijk presteert en om problemen op te sporen voordat ze ernstig worden, schakelt u monitoring in via de Watson OpenScale-component. Koppel vervolgens uw implementatie aan de monitoringtool en configureer uw kwaliteitsdrempels voor nauwkeurigheid en precisie.
Als uw voorspelling gevoelige kenmerken omvat, zorg er dan voor dat u fairness-monitors configureert om ervoor te zorgen dat de resultaten onbevooroordeeld blijven.
Het systeem kan per voorspelling uitleg genereren die precies laat zien welke functies tot een specifiek resultaat hebben geleid. Vervolgens kunt u een maandelijkse instelling instellen om deze monitoringdashboards te bekijken en het model opnieuw te trainen als de kwaliteit achteruitgaat.
Voordat we dit hoofdstuk afsluiten, is het belangrijk om te beseffen dat bij elke stap in dit proces verschillende mensen betrokken zijn. Zonder een systeem om de uitvoering bij te houden, kan het proces al snel vertragen en uit de hand lopen.
- Een data-analist is verantwoordelijk voor het opschonen en valideren van de dataset voordat deze wordt geüpload
- Een machine learning-engineer voert het AutoAI-experiment uit en vergelijkt de beste pijplijnen
- Dezelfde engineer (of een ML-ops-specialist) zorgt voor de implementatie van het model en de installatie van de API
- Een datawetenschapper of AI-verantwoordelijke houdt de prestaties in de gaten, bekijkt drift-rapporten en beslist wanneer hertraining nodig is
Zonder een gestructureerde manier om dit te beheren, kun je al snel terechtkomen in een situatie waarin je vertrouwt op verspreide aantekeningen, Slack-berichten, e-mails of je geheugen, en dat is waar vertragingen en gemiste stappen ontstaan. Taakbeheer wordt daardoor van cruciaal belang.
In plaats van deze stappen afzonderlijk te laten plaatsvinden, biedt ClickUp-taak een systeem waarin:
- Elke stap wordt een traceerbare taak
- Elke taak wordt aan de juiste persoon toegewezen
- De voortgang is zichtbaar in de gehele werkstroom
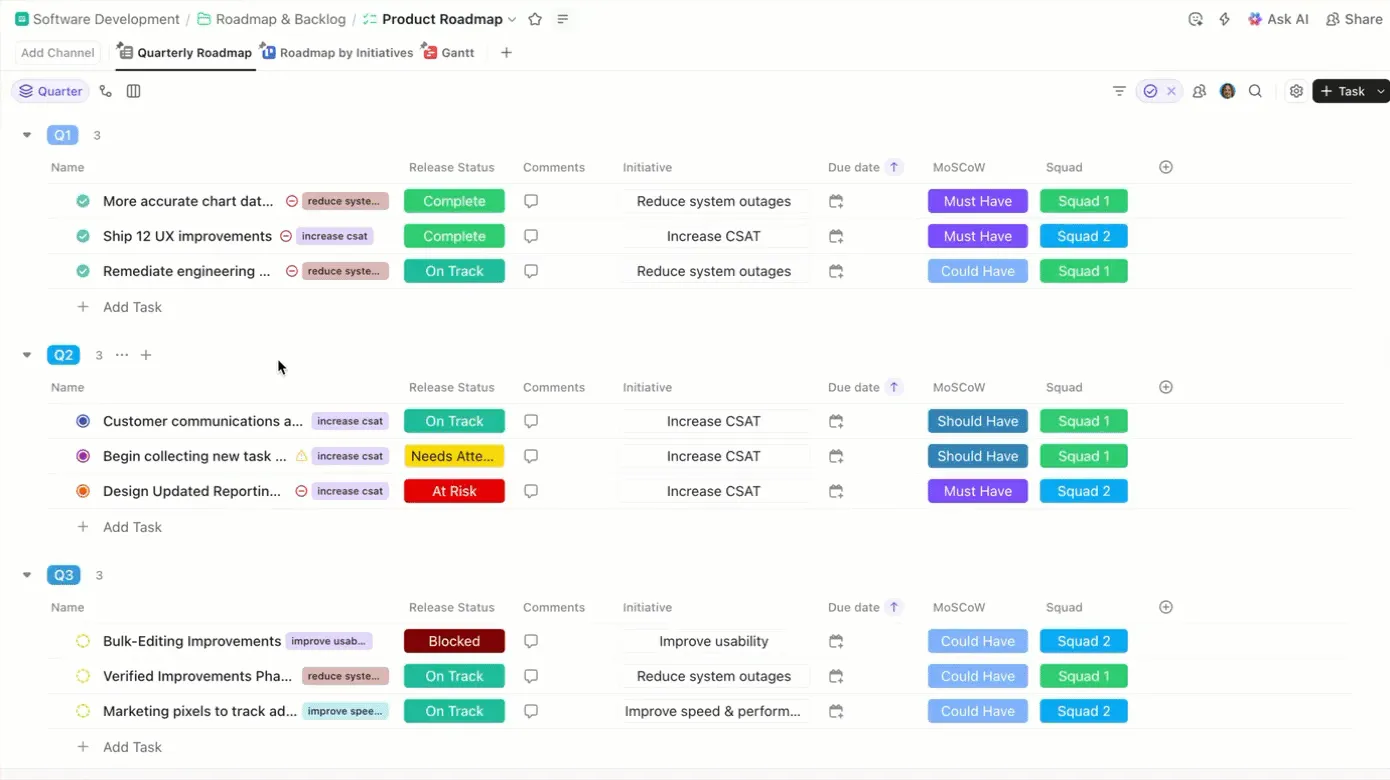
Maar daar blijft het niet bij. Elke taak wordt bovendien ondersteund door de context en gestructureerde gegevens die de uitvoering ervan mogelijk maken.
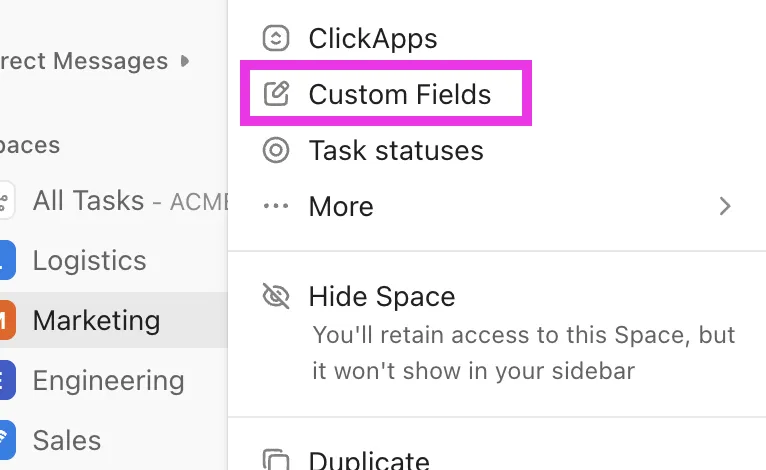
- Aangepaste velden kunnen gestructureerde gegevens vastleggen, zoals de modelversie, de databron van de dataset, evaluatiestatistieken, het implementatietype of de frequentie van hertraining
- ClickUp Docs biedt de mogelijkheid om ondersteunende documentatie op te slaan, zoals richtlijnen voor gegevensvoorbereiding, aannames van modellen, aantekeningen bij experimenten of implementatie-instructies
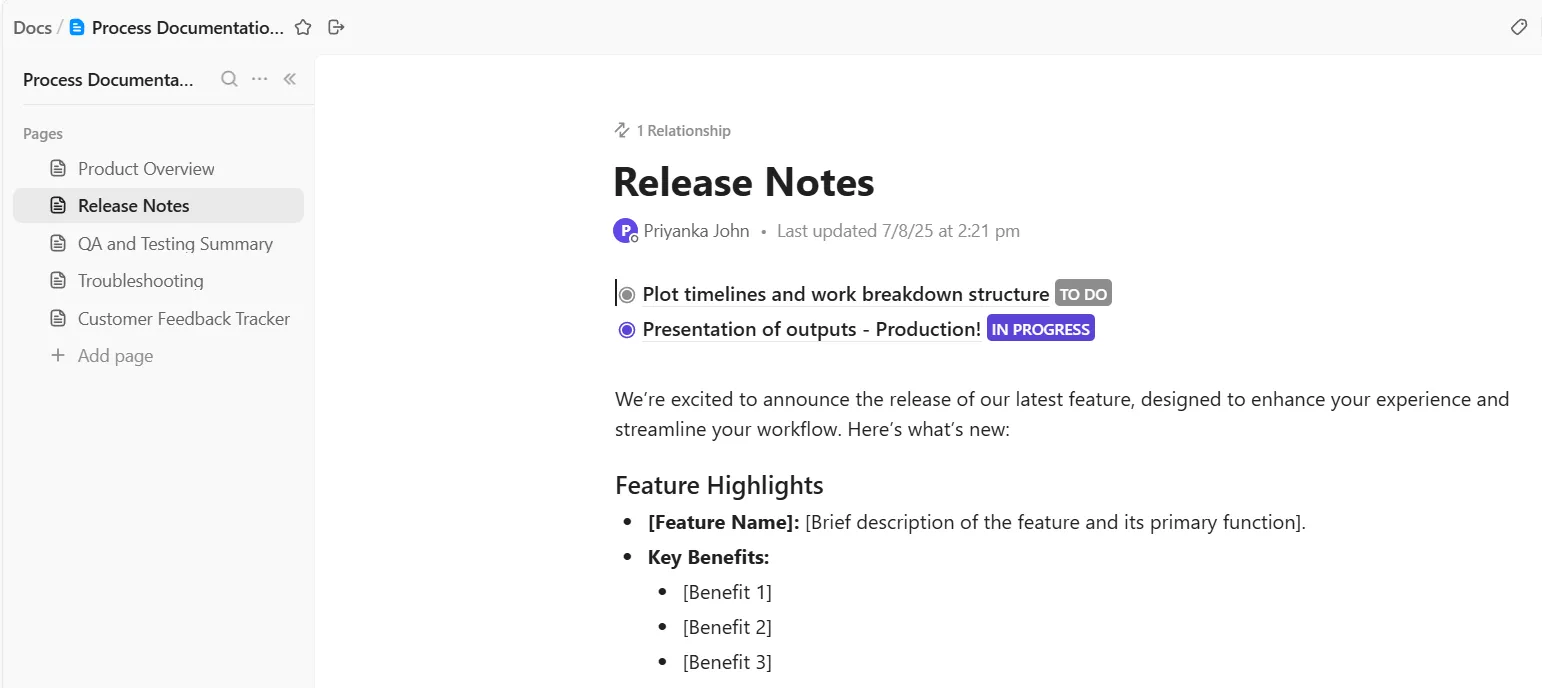
In plaats van vage taken worden het zo volledig in context geplaatste werkeenheden: duidelijk, toegewezen en klaar om te worden uitgevoerd.
Maar het blijft niet alleen bij het bijhouden van taken; deze taken zijn geen eenmalige handelingen. Het zijn doorlopende werkstroomen die voortdurend een zekere mate van repetitieve handmatige handelingen vereisen.
Bijvoorbeeld:
- Als de nauwkeurigheid van het model onder uw drempelwaarde daalt, moet er iemand worden aangewezen om het model opnieuw te trainen
- Als OpenScale afwijkingen signaleert, moet die waarschuwing worden omgezet in een Taak met een duidelijke eigenaar
- Als een implementatie tijdens het testen mislukt, moet dit worden geregistreerd, toegewezen en snel worden opgelost
ClickUp Automatisering gaat nog een stap verder door handmatige overdrachten tussen deze werkstroomen te elimineren door automatische acties te triggeren op basis van vooraf gedefinieerde voorwaarden.
Als er een nieuwe dataset wordt geüpload, wordt er automatisch een validatietaak aangemaakt en toegewezen aan de data-analist. Zodra deze als ‘Klaar’ is gemarkeerd, wordt er automatisch een modeltrainingstaak toegewezen aan de machine learning-engineer. Wanneer de training is voltooid, wordt er een implementatietaak triggerd voor de ML-ops-specialist.
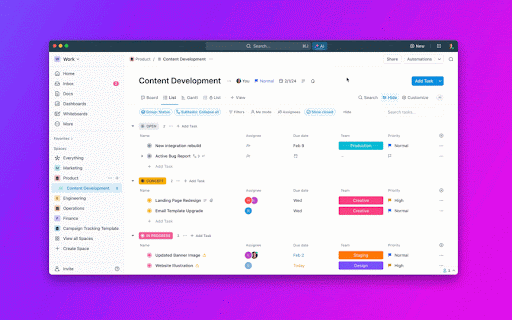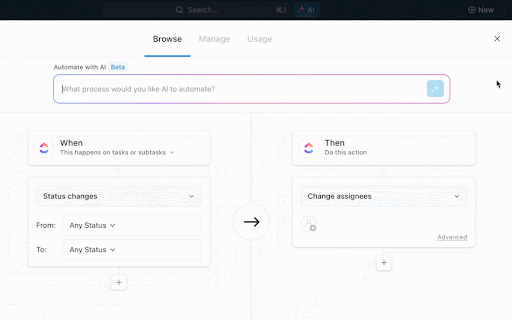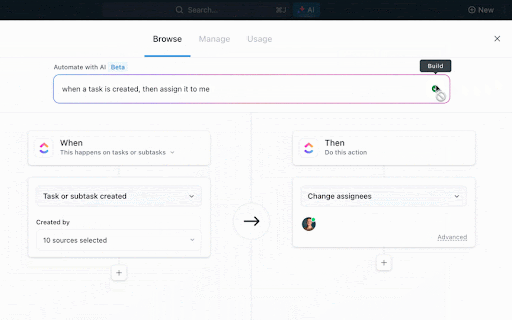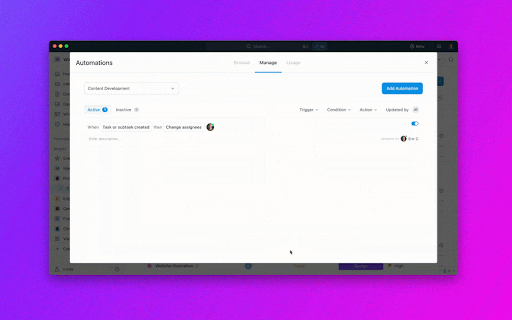
Op deze manier vloeit elke stap naadloos over in de volgende, zonder dat er handmatig hoeft te worden overgedragen. Taaken worden automatisch aangemaakt, toegewezen en verrijkt met context, zodat de hele werkstroom zonder onderbrekingen doorloopt.
Toepassingsvoorbeelden van voorspellende analyses voor teams
Dit zijn de meest voorkomende manieren waarop teams voorspellende analyses gebruiken:
- Vraagprognoses : Voorspelt de vraag naar uw producten voor het komende kwartaal, zodat uw operationele team tijdig voorraad kan aanleggen en tekorten kan voorkomen
- Voorspelling van klantverloop : Beoordeel uw bestaande klanten op basis van de kans dat ze weggaan en leid accounts met een hoog risico door naar retentiewerkstroomen
- Risicoscores voor projecten : Markeert projecten die op basis van historische patronen, zoals wijzigingen in de scope, waarschijnlijk de deadline niet zullen halen
- Prognoses voor de verkooppijplijn : Voorspelt welke deals waarschijnlijk zullen worden gesloten en biedt uw verkoopteams een betrouwbare prognose
- Voorspelling van IT-incidenten : Identificeert infrastructuurcomponenten die waarschijnlijk zullen uitvallen op basis van logpatronen
Daarbij is het belangrijk om op te merken dat de waarde van deze voorspellingen pas echt tot zijn recht komt wanneer de output rechtstreeks wordt ingevoerd in de tools waarmee uw team de beslissingen neemt waarop deze voorspellingen van invloed zijn.
🎯 Onze tip: Breng die inzichten onder in een geconvergeerde AI-werkruimte zoals ClickUp.
Met ClickUp beheer je niet alleen de werkstroom voor het trainen van modellen. Je voert ook je dagelijkse werkzaamheden op dezelfde plek uit, zodat die voorspellingen direct kunnen triggeren voor concrete acties binnen de verschillende teams.
- Voor marketing kan een voorspelling van segmenten met een hoge aankoopintentie automatisch campagnetaaken genereren
- Voor verkoop kunnen de resultaten van leadscoring worden omgezet in geprioriteerde outreach-taken
- Voor operationele activiteiten kunnen risicovoorspellingen (zoals klantverloop of storingen) triggers zijn voor vervolgacties of ingrepen
Elk team kan zijn eigen werkstroom structureren binnen ClickUp-taak, net zoals uw ML-team dat doet voor het trainen en implementeren. Het is hetzelfde systeem, alleen met verschillende toepassingen.
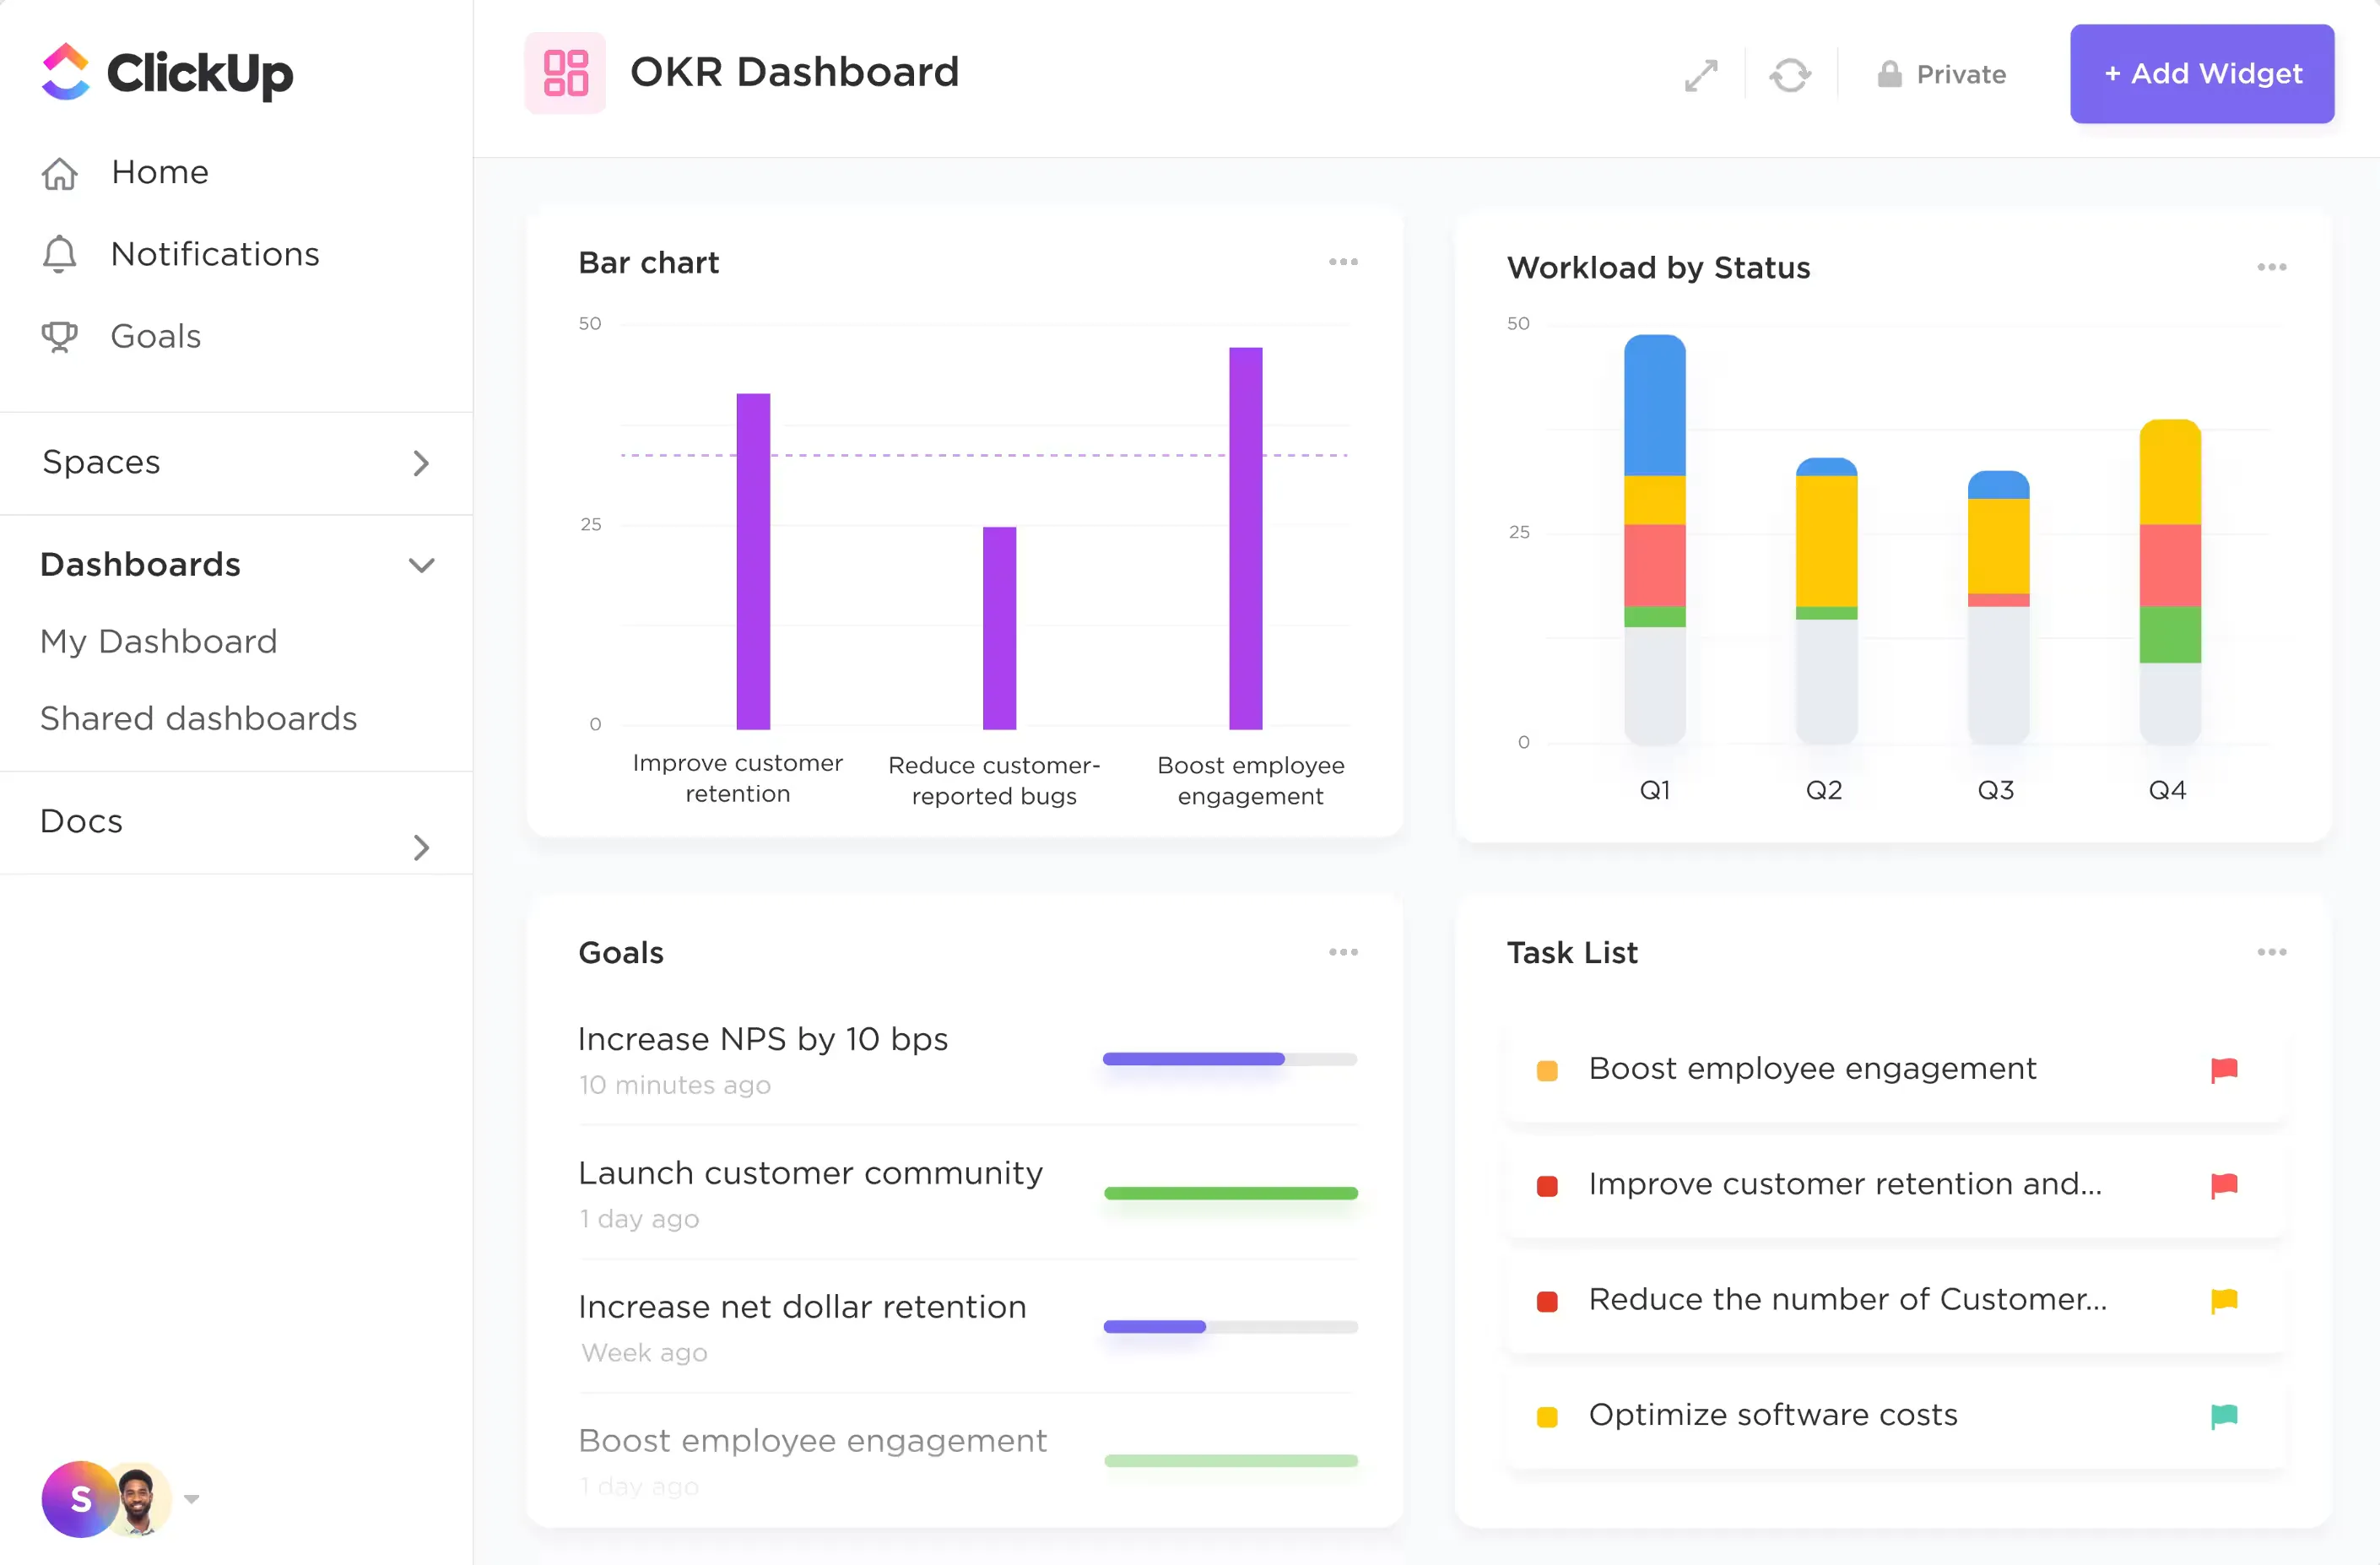
En het blijft niet bij de uitvoering. Met ClickUp Dashboards kunt u:
- Visualiseer voorspellende inzichten (bijv. segmenten met een hoog risico versus segmenten met een laag risico)
- Blijf bijhouden hoe de taken die op basis van de inzichten zijn aangemaakt, voortgaan binnen verschillende teams
- Monitor de werklast binnen alle teams
- Ontdek hoe voorspellingen daadwerkelijk worden omgezet in resultaten
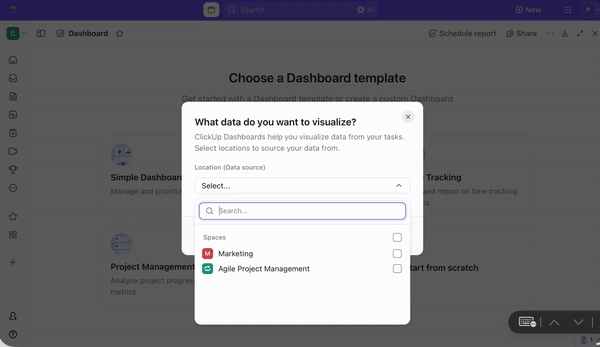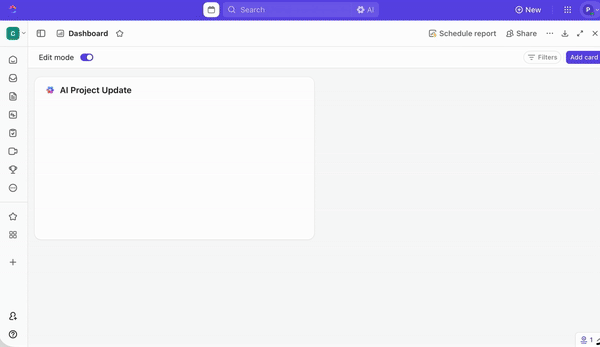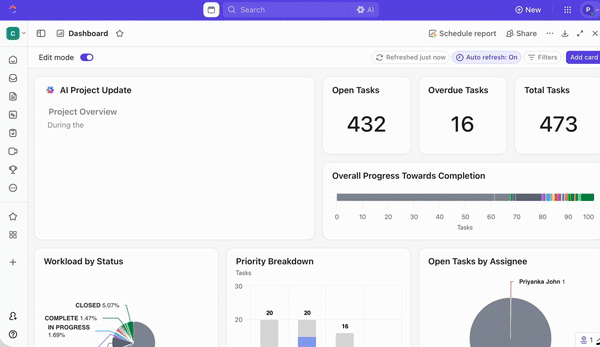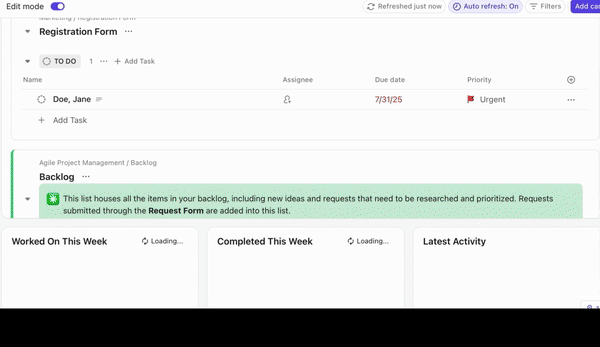
Het enige wat u hoeft te doen, is de gewenste widget kiezen, of het nu gaat om staafdiagrammen, cirkeldiagrammen, lijngrafieken of voortgangsmeter. Op deze manier zit uw model niet in de ene tool en de uitvoering niet in een andere; alles blijft op één plek met elkaar verbonden.
Uw inzichten vormen niet alleen de basis voor beslissingen; ze triggeren deze, worden toegewezen, worden bijgehouden en worden daadwerkelijk uitgevoerd.
💡 Tip van een expert: Je kunt ClickUp Brain gebruiken als je ingebouwde AI-assistent in je hele werkruimte.
Het is geen aparte tool; het is de intelligentielaag binnen je ClickUp-werkruimte, wat betekent dat het al context heeft voor je taken, gegevens en werkstroom.
In plaats van alleen maar taken bij te houden, heb je dus een AI-assistent die met je meedenkt, je helpt te begrijpen wat er gebeurt en je in staat stelt sneller door te gaan met wat nog te doen is.
U kunt bijvoorbeeld een melding van Brain vermelden in een opmerking bij een Taak, net zoals u dat bij een teamgenoot zou doen, en vragen:
- ‘Vat het laatste drift-rapport samen en benadruk wat aandacht vereist.’
- ‘Wat is er de afgelopen 30 dagen veranderd in de prestaties van ons model?’
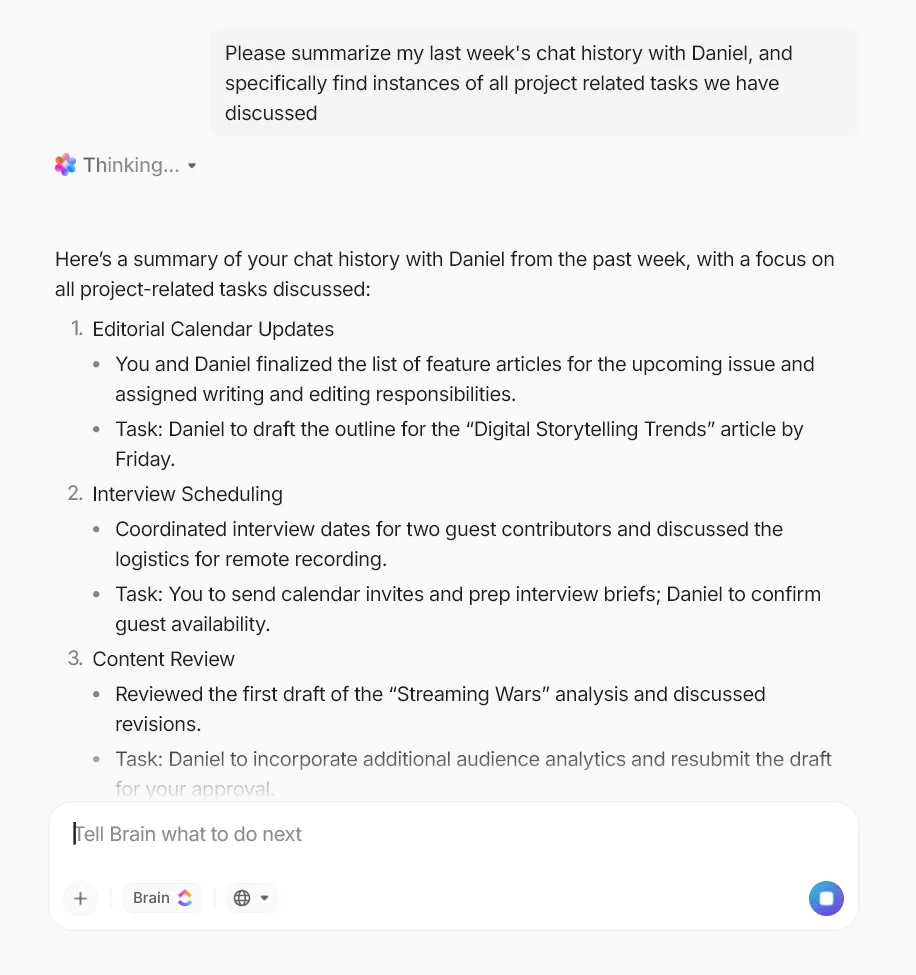
Het haalt gegevens uit uw werkruimte en geeft u direct een duidelijk antwoord. Het kan ook werk voor u genereren. U kunt het vragen om:
- Schrijf een korte update voor belanghebbenden waarin je uitlegt waarom een model opnieuw is geïmplementeerd
- Stel een hertrainingsplan op op basis van recente prestatiedalingen
- Maak een checklist voor het valideren van een nieuwe dataset vóór het trainen
Omdat ClickUp een 'Converged Workspace' biedt, hoeft uw team niet te jongleren met afzonderlijke tools voor communicatie en uitvoering.
Al je gesprekken kunnen rechtstreeks in ClickUp Chat plaatsvinden, of het nu gaat om het bespreken van een afname in de nauwkeurigheid van een model, het beoordelen van een gemarkeerde driftwaarschuwing of het bepalen van de volgende stappen na een mislukte implementatie.
Maar wat nog belangrijker is: die gesprekken blijven niet zomaar liggen.
Gebruik ‘Opmerkingen toewijzen’ om ervoor te zorgen dat discussies tot actie leiden. Tijdens elk gesprek kunt u een bericht aan een specifiek teamlid toewijzen, waardoor het direct een duidelijk actiepunt wordt.
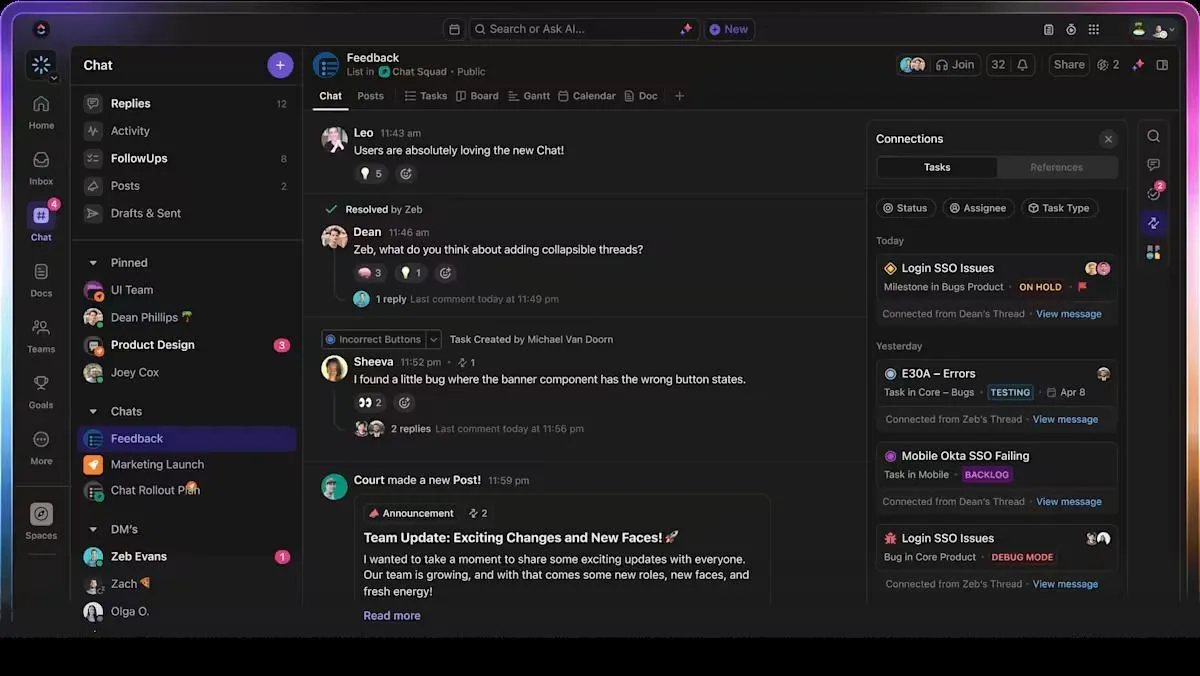
In plaats van dat gesprekken in de vergetelheid raken of eindigen met ‘dat zouden we moeten doen’, worden het taken die daadwerkelijk worden uitgevoerd en van begin tot eind worden bijgehouden, allemaal binnen ClickUp Chat.
🎥 Bekijk dit overzicht van praktijkvoorbeelden van AI-toepassingen om een beter inzicht te krijgen in het bredere landschap van AI-toepassingen in de Business. Hierin wordt gedemonstreerd hoe organisaties kunstmatige intelligentie toepassen in verschillende functies en sectoren. ✨
Beperkingen bij het gebruik van IBM Watsonx voor voorspellende analyses
Elke tool heeft voor- en nadelen, en Watsonx vormt daarop geen uitzondering. Het is inderdaad krachtig, maar houd rekening met deze limieten voordat u voor het platform kiest:
- Leercurve: Het configureren van implementatieruimten en governance-monitoren vereist nog steeds een goed begrip van cloudplatformconcepten, dus dit is wellicht niet de juiste keuze als uw team nog niet veel ervaring heeft met cloudtools of -infrastructuur
- Handmatig gegevensbeheer : Het platform automatiseert het moeilijkste deel van het opschonen en structureren van ruwe gegevens niet, wat betekent dat uw team nog steeds een groot deel van de gegevensvoorbereiding handmatig moet uitvoeren voordat u betrouwbare resultaten kunt krijgen
- Computekosten: Het trainen van experimenten en het hosten van live-implementaties op IBM Watsonx wordt in rekening gebracht op basis van gebruik. Bij groeiende werklasten kunnen cloudresources dus snel worden verbruikt naarmate u opschaalt, wat hogere kosten met zich meebrengt
- Integratie in de werkstroom: Om op voorspellingen te kunnen reageren, moet u verbinding maken met externe tools voor projectmanagement
- Complexiteit van het beheer : Het configureren van fairness- en driftmonitors omvat meerdere stappen die voor kleinere teams als een zware last kunnen aanvoelen
Deze limieten laten juist zien waar aanvullende tools moeten worden ingezet. Dit geldt met name voor de actiekant van de voorspellingspijplijn.
📮 ClickUp Insight: 88% van de respondenten in onze enquête gebruikt AI voor persoonlijke taken, maar meer dan 50% ziet er tegenop om het op het werk te gebruiken. De drie belangrijkste belemmeringen? Gebrek aan naadloze integratie, kennislacunes of bezorgdheid over de veiligheid.
Maar wat als AI al in je werkruimte is ingebouwd en bovendien veilig is? ClickUp Brain, de ingebouwde AI-assistent van ClickUp, maakt dit mogelijk. Het begrijpt vragen in gewone taal, lost alle drie de zorgen rond AI-implementatie op en creëert tegelijkertijd een verbinding tussen je chat, taken, documenten en kennis binnen de hele werkruimte. Vind antwoorden en inzichten met één enkele klik!
Alternatieve AI-tools voor voorspellende analyses
Watsonx is niet de enige optie op de markt voor voorspellende modellen. Afhankelijk van uw technische kennis kunnen andere platforms wellicht beter bij uw stack passen. In de onderstaande tabel ziet u in één oogopslag een vergelijking tussen deze platforms.
| Tool | Meest geschikt voor | Belangrijkste onderscheidende factor |
| IBM Watsonx | Ondernemingsteams die behoefte hebben aan gecontroleerde, controleerbare AI | AutoAI + ingebouwde governance en driftmonitoring |
| Google Vertex AI | Teams die al in Google Cloud zitten | Nauwe integratie met BigQuery en GCP-services |
| Azure Machine Learning | Organisaties binnen het Microsoft-ecosysteem | Ingebouwde verbinding met Power BI en Azure DevOps |
| Amazon SageMaker | AWS-native teams met ML-engineeringmiddelen | Uitgebreide algoritmebibliotheek en flexibele notebookomgeving |
| DataRobot | Bedrijfsanalisten die op zoek zijn naar volledig geautomatiseerde ML | End-to-end-automatisering met sterke standaardinstellingen voor verklaarbaarheid |
| ClickUp Brain | Teams die behoefte hebben aan AI-gestuurde inzichten die rechtstreeks in hun werkstroomen zijn geïntegreerd | Contextbewuste AI die werkt in verschillende taken, documenten en dashboards zonder van tool te hoeven wisselen |
📮 ClickUp Insight: Het wisselen van context tast stilletjes de productiviteit van je team aan. Uit ons onderzoek blijkt dat 42% van de onderbrekingen op het werk voortkomt uit het schakelen tussen platforms, het beheren van e-mails en het heen en weer springen tussen vergaderingen. Wat als je deze kostbare onderbrekingen zou kunnen elimineren?
ClickUp brengt je werkstroom (en chat) samen op één gestroomlijnd platform. Start en beheer je taken vanuit chat, documenten, Whiteboards en meer – terwijl AI-aangedreven functies ervoor zorgen dat de context samenhangend, doorzoekbaar en beheersbaar blijft!
Niet alleen voorspellen, maar ook uitvoeren met ClickUp
Het gebruik van IBM Watsonx voor voorspellende analyses volgt een duidelijk traject, van gegevensvoorbereiding tot driftmonitoring, maar dat is nog maar het makkelijke deel. Het echte werk begint pas wanneer u ervoor zorgt dat die voorspellingen daadwerkelijk invloed hebben op de manier waarop uw team werkt.
Voorspellingen die in dashboards staan die niemand bekijkt, zijn gewoon verspilde rekenkracht, en de teams die er echt waarde uit halen, maken een directe verbinding tussen de output van hun modellen en hun uitvoeringswerkstroom via automatiserende waarschuwingen en opnieuw geprioriteerde taken.
Als je op zoek bent naar één werkruimte waar AI-inzichten, projectuitvoering en teamcommunicatie al naadloos samenkomen, ga dan vandaag nog gratis aan de slag met ClickUp. ✨
Veelgestelde vragen
Waarvoor wordt IBM Watsonx gebruikt?
Het is een platform voor de onderneming voor data en AI voor het bouwen, trainen en implementeren van machine learning-modellen. Teams gebruiken het om hun data lakehouses te beheren en AI-governance te monitoren vanuit één enkele cloudomgeving.
Hoe werkt AutoAI in Watsonx?
AutoAI is een no-code-tool die uw tabelgegevens automatisch analyseert om de beste machine learning-algoritmen te selecteren. De tool genereert functies en rangschikt kandidaatmodellen op een ranglijst, zodat u de meest nauwkeurige optie kunt implementeren.
Wat zijn de limieten van IBM Watsonx?
Het platform vereist een gedegen kennis van cloudconcepten om implementatieruimten en governance-monitoren te configureren. Ook automatiseert het niet het handmatige proces van het opschonen en structureren van uw ruwe gegevens vóór het uploaden.