
I progetti di addestramento dell’IA raramente falliscono a livello di modello. Le difficoltà sorgono quando gli esperimenti, la documentazione e gli aggiornamenti per le parti interessate sono sparsi su troppi strumenti diversi.
Questa guida ti accompagna passo passo nell'addestramento dei modelli con Databricks DBRX — un modello di linguaggio di grandi dimensioni (LLM) che offre un'efficienza di calcolo fino al doppio rispetto ad altri modelli leader — mantenendo al contempo organizzato il lavoro correlato in ClickUp.
Dalla configurazione e messa a punto alla documentazione e agli aggiornamenti tra i team, scoprirai come un unico spazio di lavoro convergente contribuisca a eliminare la dispersione del contesto e permetta al tuo team di concentrarsi sullo sviluppo, anziché sulla ricerca. 🛠
Che cos’è DBRX?
DBRX è un potente modello linguistico di grandi dimensioni (LLM) open source progettato specificamente per l'addestramento e l'inferenza dei modelli di IA delle aziende. Poiché è open source sotto la Databricks Open Model License, il tuo team ha pieno accesso ai pesi e all'architettura del modello, consentendoti di esaminarlo, modificarlo e implementarlo secondo le tue esigenze.
È disponibile in due varianti: DBRX Base per il pre-addestramento approfondito e DBRX Instruct per attività pronte all’uso che prevedono l’esecuzione di istruzioni.
Architettura di DBRX e progettazione "mixture-of-experts"
DBRX risolve le attività utilizzando un'architettura Mixture-of-Experts (MoE). A differenza dei tradizionali modelli linguistici di grandi dimensioni che utilizzano tutti i loro miliardi di parametri per ogni singolo calcolo, DBRX attiva solo una frazione dei suoi parametri totali (gli esperti più rilevanti) per ogni attività specifica.
Immaginalo come un team di esperti specializzati: invece che far lavorare tutti su ogni problema, il sistema indirizza in modo intelligente ogni attività verso i parametri più qualificati e corrispondenti.
Questo non solo riduce i tempi di risposta, ma garantisce anche prestazioni e risultati di altissimo livello, riducendo al contempo in modo significativo i costi di calcolo.
Ecco una rapida panoramica delle sue specifiche principali:
- Numero totale di parametri: 132 miliardi tra tutti gli esperti
- Parametri attivi: 36 miliardi per ogni passaggio in avanti
- Numero di esperti: 16 in totale (routing MoE Top-4), di cui 4 attivi per ogni token
- Finestra di contesto: 32.000 token
Specifiche relative ai dati di addestramento e ai token di DBRX
Le prestazioni di un modello LLM dipendono interamente dalla qualità dei dati su cui è stato addestrato. DBRX è stato pre-addestrato su un enorme set di dati da 12 trilioni di token, accuratamente curato dal team di Databricks utilizzando i propri strumenti avanzati di elaborazione dei dati. È proprio per questo che ha ottenuto ottimi risultati nei benchmark di settore.
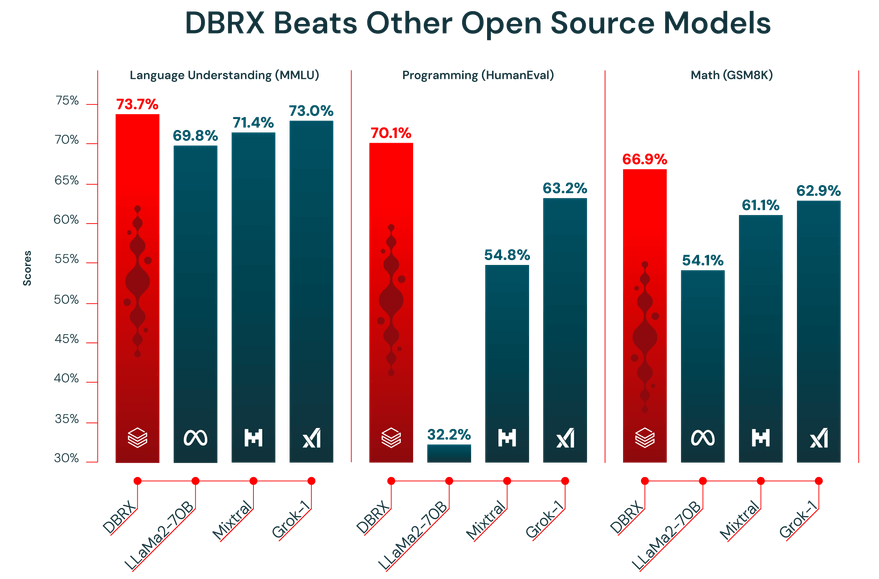
Inoltre, DBRX dispone di una finestra di contesto da 32.000 token. Si tratta della quantità di testo che il modello può prendere in considerazione contemporaneamente. Una finestra di contesto ampia è estremamente utile per attività complesse come riepilogare lunghi rapporti, analizzare documenti legali voluminosi o sviluppare sistemi avanzati di generazione potenziata dal recupero (RAG), poiché consente al modello di mantenere il contesto senza troncare o dimenticare informazioni.
🎥 Guarda questo video per scoprire come un coordinamento ottimizzato dei progetti possa trasformare il tuo flusso di lavoro di addestramento dell’IA ed eliminare le difficoltà legate al passaggio da uno strumento all’altro non integrati tra loro. 👇🏽
Come accedere e configurare DBRX
DBRX offre due modalità di accesso principali, entrambe in grado di garantire pieno accesso ai pesi dei modelli a condizioni commerciali favorevoli. È possibile utilizzare Hugging Face per la massima flessibilità oppure accedervi direttamente tramite Databricks per un'esperienza più integrata.
Accedi a DBRX tramite Hugging Face
Per i team che danno importanza alla flessibilità e hanno già familiarità con l’ecosistema di Hugging Face, accedere a DBRX tramite l’hub è la soluzione ideale. Consente infatti di integrare il modello nei flussi di lavoro esistenti basati su Transformer.
Ecco come iniziare:
- Crea un account Hugging Face o accedi al tuo account esistente
- Accedi alla scheda del modello DBRX nell’hub e accetta i termini della licenza
- Installa la libreria transformers insieme alle dipendenze necessarie, come accelerate
- Utilizza la classe `AutoModelForCausalLM` nel tuo script Python per caricare il modello DBRX
- Configura la tua pipeline di inferenza, tenendo presente che DBRX richiede una notevole quantità di memoria GPU (VRAM) per funzionare in modo efficace
📖 Per saperne di più: Come configurare la temperatura dell’LLM
Accedi a DBRX tramite Databricks
Se il tuo team utilizza già Databricks per il data engineering o il machine learning, accedere a DBRX tramite la piattaforma è il modo più semplice. Elimina le difficoltà di configurazione e ti offre tutti gli strumenti necessari per le MLOps proprio dove stai già lavorando.
Segui questi passaggi all’interno della tua area di lavoro Databricks per iniziare:
- Vai alla sezione Model Garden o Mosaic IA
- Scegli tra DBRX Base e DBRX Instruct, a seconda delle tue esigenze
- Configura un endpoint di servizio per l’accesso tramite API oppure imposta un ambiente notebook per l’utilizzo interattivo
- Inizia a testare l’inferenza con prompt di esempio per assicurarti che tutto funzioni correttamente prima di ampliare l’addestramento o la distribuzione del tuo modello di IA
Questo approccio ti offre un accesso senza soluzione di continuità a strumenti come MLflow per il monitoraggio degli esperimenti e Unity Catalog per la governance dei modelli.
📮 ClickUp Insight: In media, un professionista impiega più di 30 minuti al giorno alla ricerca di informazioni relative al lavoro: si tratta di oltre 120 ore all’anno perse a setacciare email, thread di Slack e file sparsi qua e là.
Un assistente IA intelligente integrato nella tua area di lavoro può cambiare le cose. Scopri ClickUp Brain.
Fornisce approfondimenti e risposte immediate, mettendo in evidenza i documenti, le conversazioni e i dettagli delle attività giusti in pochi secondi, così puoi smettere di cercare e iniziare a lavorare.
Come ottimizzare DBRX e addestrare modelli di IA personalizzati
Un modello preconfezionato, per quanto potente, non potrà mai cogliere le sfumature specifiche della tua attività aziendale. Poiché DBRX è open source, puoi ottimizzarlo per creare un modello personalizzato che "parli" la lingua della tua azienda o svolga un'attività specifica che desideri affidargli.
Ecco tre modi comuni da fare:
1. Ottimizza DBRX con i set di dati di Hugging Face
Per i team alle prime armi o che lavorano su attività comuni, i set di dati pubblici di Hugging Face Hub rappresentano una risorsa eccellente. Sono già formattati e facili da caricare, il che significa che non dovrai passare ore a preparare i tuoi dati.
Il processo è piuttosto semplice:
- Trova nell’hub un set di dati adatto alla tua attività (ad es. seguire istruzioni, riepilogare/riassumere)
- Caricalo utilizzando la libreria dei set di dati
- Assicurati che i dati siano formattati in coppie istruzione-risposta
- Configura il tuo script di addestramento con iperparametri come il tasso di apprendimento e la dimensione del batch
- Avvia il processo di addestramento, assicurandoti di salvare periodicamente i checkpoint
- Valuta il modello ottimizzato su un set di validazione tenuto da parte per misurare il miglioramento
2. Ottimizza DBRX con set di dati locali
Di solito si ottengono i risultati migliori effettuando una messa a punto con i propri dati proprietari. Ciò consente di insegnare al modello la terminologia, lo stile e le conoscenze di settore specifiche della propria azienda. Tieni presente, però, che questo approccio è efficace solo se i dati sono puliti, ben preparati e in quantità sufficiente.
Segui questi passaggi per preparare i tuoi dati interni:
- Raccolta dei dati: raccogli esempi di alta qualità dai tuoi wiki interni, dai documenti e dai database
- Conversione del formato: Struttura i tuoi dati in un formato coerente di tipo "istruzione-risposta", solitamente sotto forma di righe JSON
- Filtraggio per qualità: Rimuovi eventuali esempi di bassa qualità, duplicati o irrilevanti
- Divisione per la validazione: Metti da parte una piccola porzione dei tuoi dati (in genere il 10-15%) per valutare le prestazioni del modello
- Verifica della privacy: Rimuovi o maschera qualsiasi informazione di identificazione personale (PII) o dato sensibile
3. Ottimizza DBRX con StreamingDataset
Se il tuo set di dati risulta troppo grande per essere contenuto nella memoria del tuo computer, non preoccuparti: puoi utilizzare la libreria Streaming Dataset di Databricks. Ti consente di trasmettere i dati in streaming direttamente dall’archiviazione cloud mentre il modello è in fase di addestramento, anziché caricarli tutti in memoria in una sola volta.
Ecco come puoi fare:
- Preparazione dei dati: pulisci e struttura i tuoi dati di addestramento, quindi salvali in un formato compatibile con lo streaming, come JSONL o CSV, in un spazio di archiviazione cloud
- Conversione del formato in streaming: Converti il tuo set di dati in un formato compatibile con lo streaming, come Mosaic Data Shard (MDS), in modo che possa essere letto in modo efficiente durante l'addestramento
- Configurazione del caricatore di addestramento: configura il caricatore di addestramento in modo che punti al set di dati remoto e definisci uno spazio di archiviazione locale per l'archiviazione temporanea dei dati
- Inizializzazione del modello: avvia il processo di ottimizzazione di DBRX utilizzando un framework di addestramento che offra supporto per StreamingDataset, come LLM Foundry
- Addestramento basato sullo streaming: esegui il processo di addestramento mentre i dati vengono trasmessi in batch durante l'addestramento, anziché caricarli interamente in memoria
- Checkpoint e ripristino: riprendi l'addestramento senza interruzioni se un'esecuzione viene interrotta, senza duplicare o saltare i dati
- Valutazione e implementazione: Verifica le prestazioni del modello ottimizzato e implementalo utilizzando la tua configurazione preferita per il serving o l’inferenza
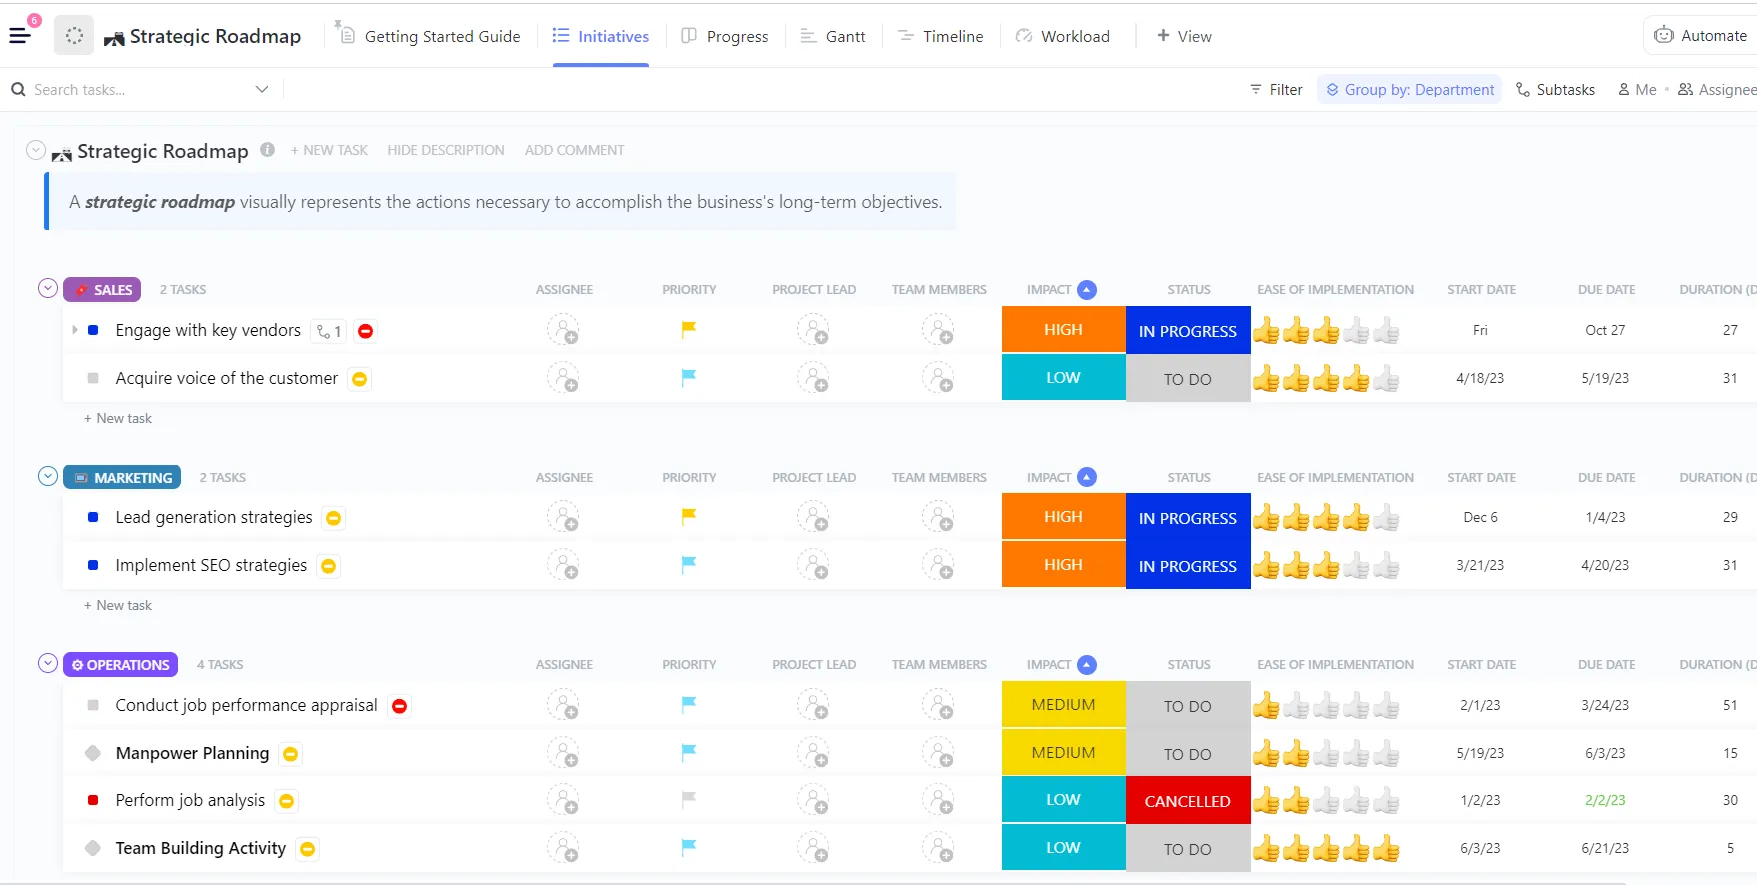
💡Consiglio da esperto: invece di creare un piano di addestramento DBRX da zero, parti dal modello di roadmap per progetti di IA e machine learning di ClickUp e adattalo alle esigenze del tuo team. Offre una struttura chiara per pianificare i set di dati, le fasi di addestramento, la valutazione e l’implementazione, così potrai concentrarti sull’organizzazione del tuo lavoro anziché sulla strutturazione del flusso di lavoro.
Casi d'uso di DBRX per l'addestramento dei modelli di IA
Una cosa è disporre di un modello potente, ma un’altra è sapere esattamente in quali ambiti dà il meglio di sé.
Quando non si ha un quadro chiaro dei punti di forza di un modello, è facile sprecare tempo e risorse cercando di farlo funzionare in contesti in cui semplicemente non è adatto. Ciò porta a risultati deludenti e a frustrazione.
L’architettura esclusiva e i dati di addestramento di DBRX lo rendono particolarmente adatto a diversi casi d’uso aziendali chiave. Conoscere questi punti di forza ti aiuta ad allineare il modello ai tuoi obiettivi aziendali e a massimizzare il ritorno sull’investimento.
Generazione di testo e creazione di contenuti
DBRX Instruct è ottimizzato per seguire le istruzioni e generare testi di alta qualità. Ciò lo rende uno strumento potente per automatizzare un'ampia gamma di attività relative ai contenuti. La sua ampia finestra di contesto rappresenta un vantaggio significativo, consentendogli di gestire documenti lunghi senza perdere il filo del discorso.
Puoi utilizzarlo per:
- Documentazione tecnica: crea e perfeziona manuali di prodotto, guide alle API e guide per gli utenti
- Contenuti di marketing: bozze di post per il blog, newsletter via email e aggiornamenti sui social media
- Generazione di report: riepiloga i risultati di analisi di dati complessi e crea riassunti esecutivi concise
- Traduzione e localizzazione: Adatta i contenuti esistenti a nuovi mercati e a un nuovo pubblico
Generazione di codice e attività di debug
Una parte significativa dei dati di addestramento di DBRX comprendeva codice, rendendolo un valido supporto LLM per gli sviluppatori. Può contribuire ad accelerare i cicli di sviluppo automatizzando le attività di codifica ripetitive e fornendo assistenza nella risoluzione di problemi complessi.
Ecco alcuni modi in cui il tuo team di ingegneri può sfruttarlo:
- Completamento del codice: genera automaticamente i corpi delle funzioni dai commenti o dalle stringhe di documentazione
- Rilevamento dei bug: analizza frammenti di codice per identificare potenziali errori o difetti logici
- Spiegazione del codice: Tradurre algoritmi complessi o codice legacy in un linguaggio semplice e comprensibile
- Generazione di test: crea test unitari basati sulla firma di una funzione e sul comportamento previsto
RAG e applicazioni a contesto esteso
La Retrieval-Augmented Generation (RAG) è una tecnica potente che basa le risposte di un modello sui dati privati della tua azienda. Tuttavia, i sistemi RAG spesso incontrano difficoltà con modelli che hanno finestre di contesto ridotte, costringendo a una suddivisione aggressiva dei dati che può comportare la perdita di contesto importante. La finestra di contesto da 32K di DBRX lo rende una base eccellente per applicazioni RAG robuste.
Questo ti permette di creare potenti strumenti interni, come ad esempio:
- Ricerca aziendale: crea un chatbot che risponda alle domande dei dipendenti utilizzando la tua knowledge base interna
- Supporto clienti: crea un agente in grado di generare risposte di supporto basate sulla documentazione del tuo prodotto
- Assistenza alla ricerca: Sviluppa uno strumento in grado di sintetizzare le informazioni contenute in centinaia di pagine di articoli di ricerca
- Verifica della conformità: verifica automaticamente i testi di marketing rispetto alle linee guida interne del marchio o ai documenti normativi
Come integrare l’addestramento con DBRX nel flusso di lavoro del tuo team
Un progetto di addestramento di modelli di IA di esito positivo non si limita al codice e alla potenza di calcolo. Si tratta di uno sforzo collaborativo che coinvolge ingegneri di ML, data scientist, product manager e parti interessate.
Quando questa collaborazione è frammentata tra notebook Jupyter, canali Slack e strumenti di project management separati, si crea il context sprawl, una situazione in cui le informazioni critiche del progetto sono disperse tra troppi strumenti.
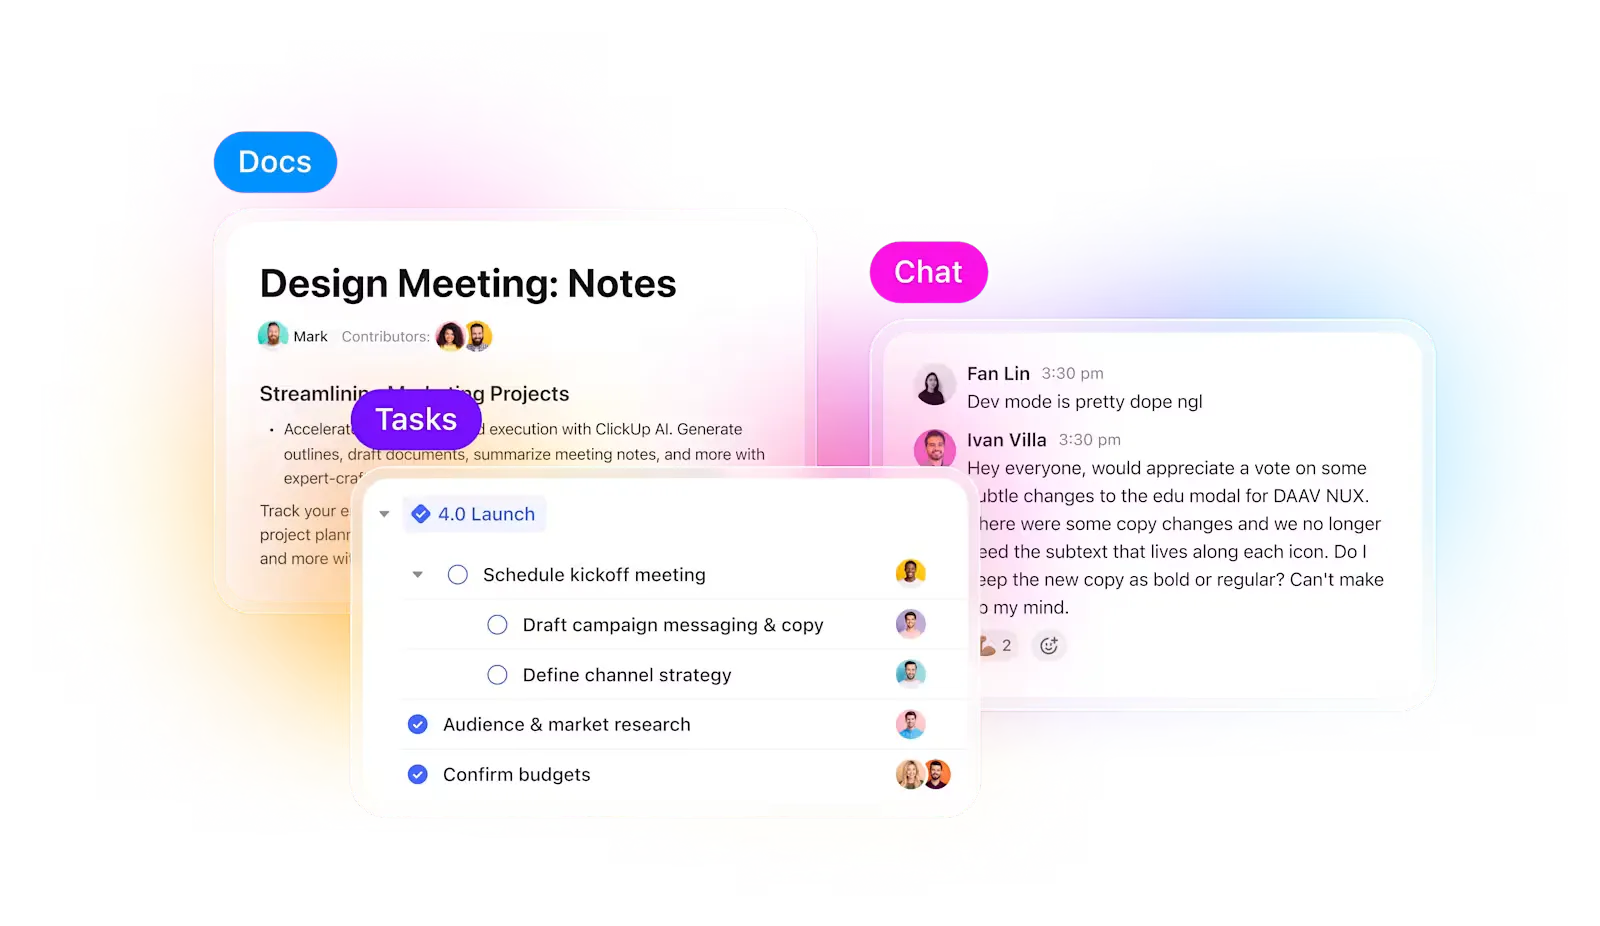
ClickUp risolve questo problema. Invece di destreggiarti tra più strumenti, avrai a disposizione un unico spazio di lavoro convergente per l’IA in cui la project management, la documentazione e la comunicazione convivono, in modo che i tuoi esperimenti rimangano collegati tra loro dalla pianificazione all’esecuzione fino alla valutazione.
Non perdere mai di vista gli esperimenti e lo stato dei progressi compiuti
Quando si eseguono più esperimenti, la parte più difficile non è addestrare il modello, ma il monitoraggio di ciò che è cambiato durante il processo. Quale versione del set di dati è stata utilizzata, quale tasso di apprendimento ha dato i risultati migliori o quale esecuzione è stata distribuita?
ClickUp semplifica notevolmente questo processo. Puoi monitorare ogni sessione di addestramento separatamente nelle attività di ClickUp e, all’interno delle attività, puoi utilizzare i campi personalizzati per registrare:
- Versione del set di dati
- Iperparametri
- Variante del modello (DBRX Base vs DBRX Instruct)
- Stato dell'addestramento (In coda, In esecuzione, In fase di valutazione, Distribuito)
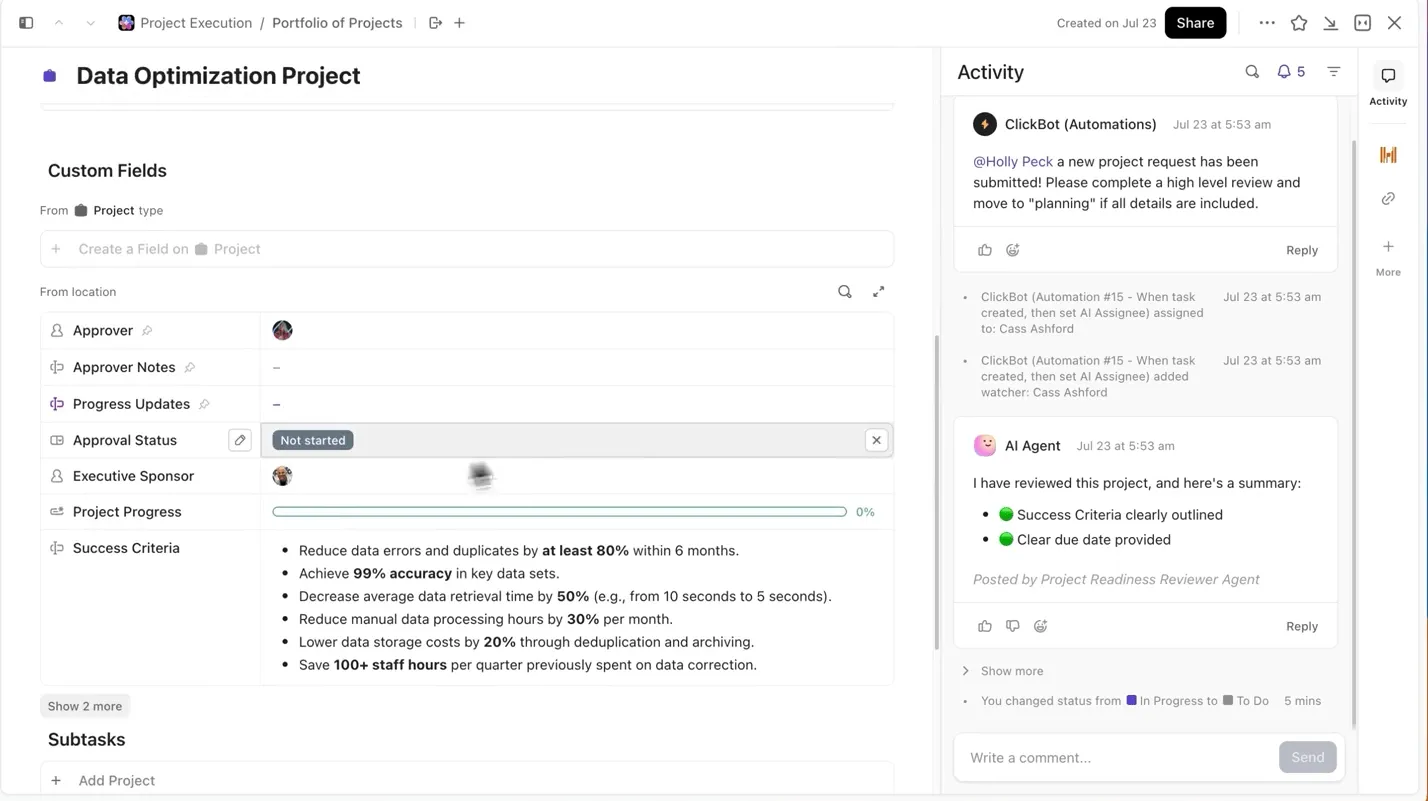
In questo modo, ogni esperimento documentato è ricercabile, facile da confrontare con gli altri e riproducibile.
Mantieni la documentazione dei modelli integrata con il lavoro
Non dovrai più passare continuamente dai notebook Jupyter ai file README o ai thread su Slack per comprendere il contesto di un'attività relativa a un esperimento.
Con ClickUp Docs, puoi mantenere l'architettura del modello, gli script di preparazione dei dati o le metriche di valutazione organizzati e accessibili, documentandoli in un documento ricercabile che è collegato alle attività dell'esperimento da cui provengono.
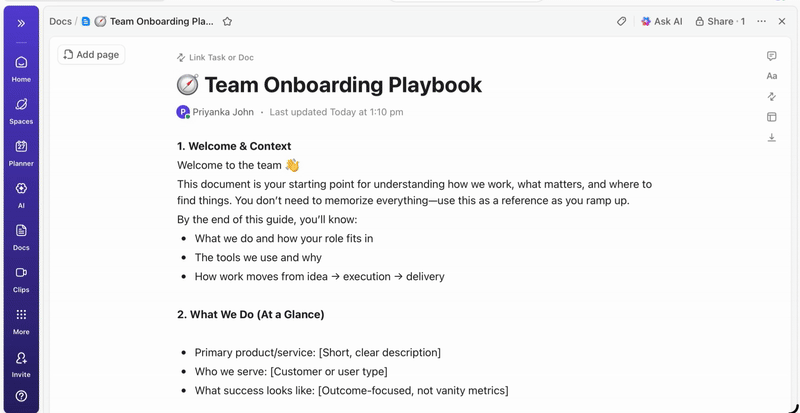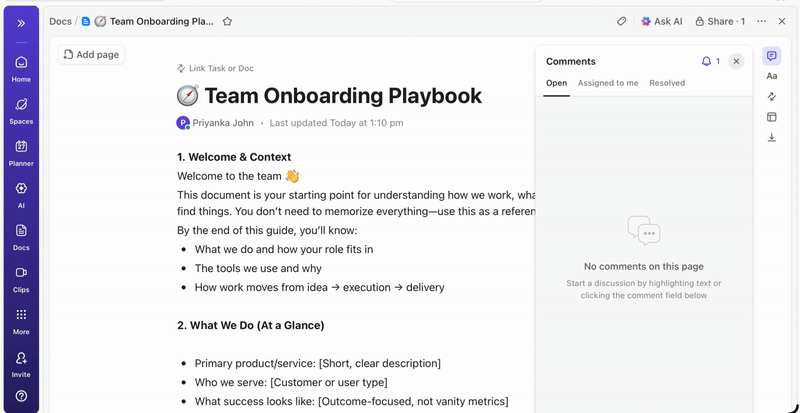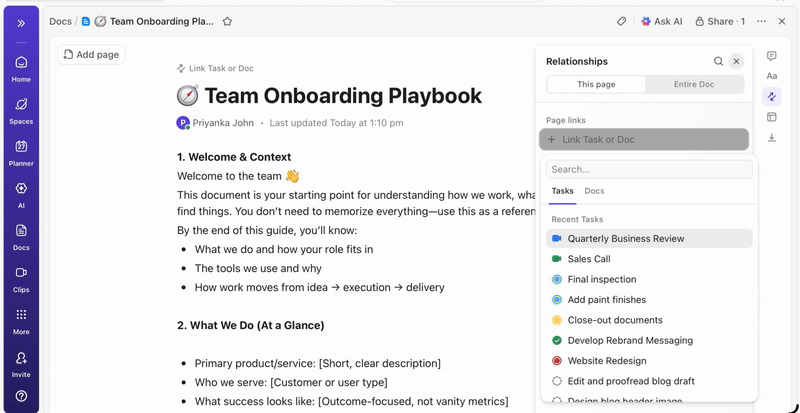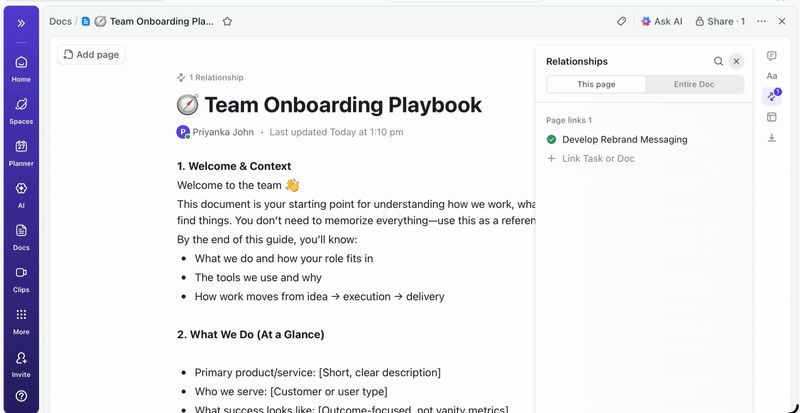
💡Consiglio da esperto: mantieni un brief di progetto aggiornato in ClickUp Docs che descriva in dettaglio ogni decisione, dall’architettura alla distribuzione, in modo che i nuovi membri del team possano sempre mettersi al passo con i dettagli del progetto senza dover cercare tra le vecchie discussioni
Offri agli stakeholder visibilità in tempo reale
I dashboard di ClickUp mostrano in tempo reale lo stato di avanzamento degli esperimenti e il carico di lavoro del team. I
Invece di compilare manualmente gli aggiornamenti o inviare email, i dashboard si aggiornano automaticamente in base ai dati presenti nelle tue attività. In questo modo, le parti interessate possono controllare in qualsiasi momento lo stato delle attività senza mai doverti interrompere con domande del tipo “A che punto siamo?”.
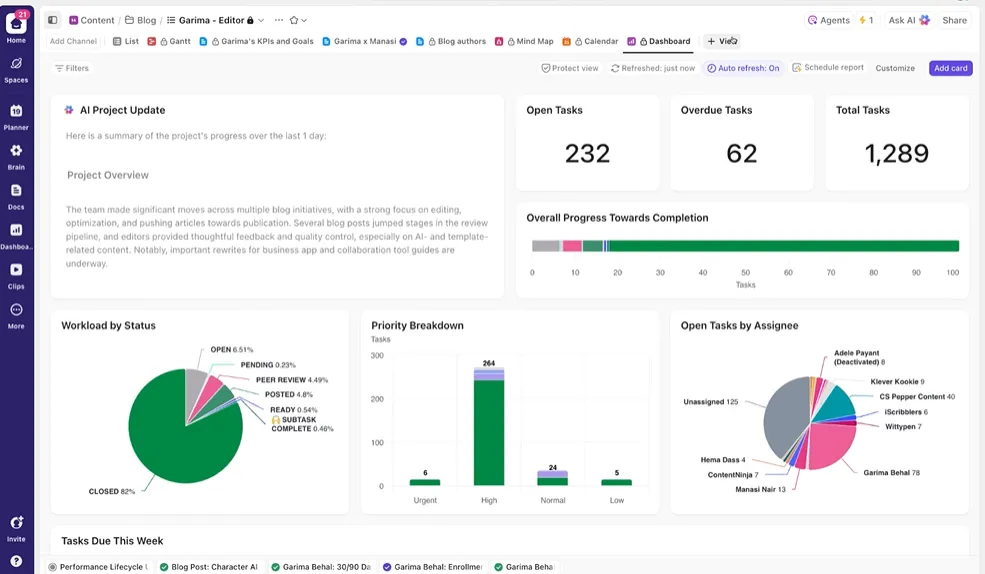
In questo modo, potrai concentrarti sull’esecuzione degli esperimenti anziché doverne costantemente effettuare la reportistica manuale.
Trasforma l’IA nel tuo assistente intelligente per i progetti
Non è necessario setacciare manualmente settimane di dati di addestramento per ottenere un riepilogo/riassunto degli esperimenti condotti finora. Basta effettuare una menzione di @Brain in qualsiasi commento a un'attività e ClickUp Brain ti fornirà l'aiuto di cui hai bisogno, con il contesto completo dei tuoi progetti passati e in corso.
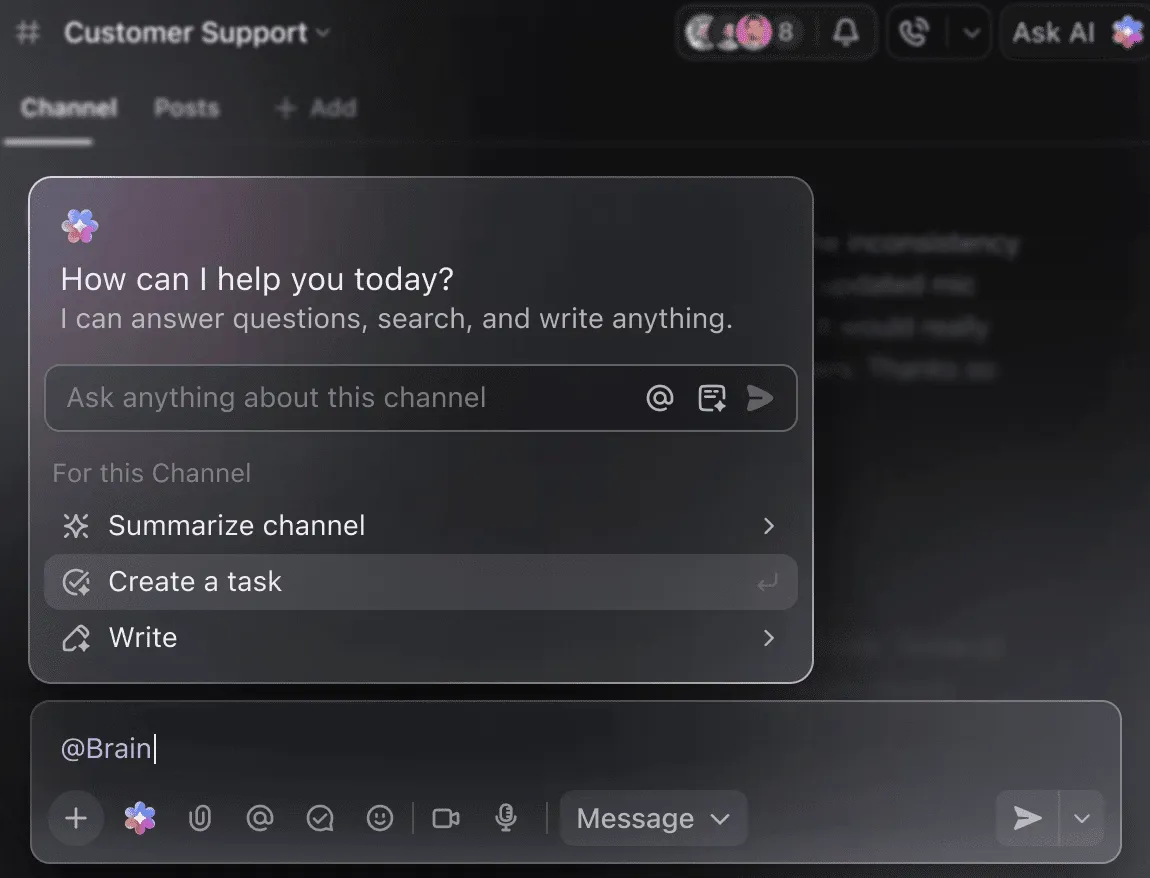
Puoi chiedere a Brain di «riepilogare gli esperimenti della scorsa settimana in 5 punti chiave» o di «redigere un documento con gli ultimi risultati relativi agli iperparametri» e ottenere immediatamente un risultato ben strutturato.
🧠 Il vantaggio di ClickUp: i Super Agenti di ClickUp vanno ben oltre: non si limitano a rispondere alle tue domande, ma possono automatizzare interi flussi di lavoro in base a trigger da te definiti. Con i Super Agenti, puoi creare automaticamente una nuova attività di addestramento DBRX ogni volta che viene caricato un set di dati, avvisare il tuo team e collegare i documenti pertinenti quando l’addestramento termina o raggiunge un checkpoint, oltre a generare un riepilogo settimanale dei progressi e inviarlo alle parti interessate senza che tu debba fare nulla.
Errori comuni da evitare
Avviare un progetto di addestramento con DBRX è entusiasmante, ma alcune insidie comuni possono compromettere i tuoi progressi. Evitare questi errori ti farà risparmiare tempo, denaro e molta frustrazione.
- Sottovalutare i requisiti hardware: DBRX è potente, ma occupa anche molto spazio. Cercare di eseguirlo su hardware inadeguato porterà a errori di memoria insufficiente e al fallimento dei processi di addestramento. Tieni presente che DBRX (132B) richiede almeno 264 GB di VRAM per l’inferenza a 16 bit, oppure circa 70-80 GB quando si utilizza la quantizzazione a 4 bit
- Trascurare i controlli sulla qualità dei dati: se i dati in ingresso sono scadenti, anche quelli in uscita lo saranno. La messa a punto su un set di dati disordinato e di bassa qualità insegnerà al modello solo a produrre risultati disordinati e di bassa qualità.
- Ignorando i limiti di lunghezza del contesto: sebbene la finestra di contesto da 32K di DBRX sia generosa, non è infinita. Fornire al modello input che superano questo limite avrà come risultato un troncamento silenzioso e prestazioni scadenti
- Quando è opportuno utilizzare Base anziché Instruct: DBRX Base è un modello grezzo e preaddestrato, destinato a un ulteriore addestramento su larga scala. Per la maggior parte delle attività che richiedono di seguire istruzioni, è consigliabile iniziare con DBRX Instruct, che è già stato ottimizzato per tale scopo
- Separare il lavoro di addestramento dal coordinamento del progetto: quando il monitoraggio degli esperimenti avviene in uno strumento e il piano del progetto in un altro, si creano silos informativi. Utilizza una piattaforma integrata come ClickUp per garantire la sincronizzazione tra il lavoro tecnico e il coordinamento del progetto
- Trascurare la valutazione prima della distribuzione: un modello che funziona bene sui dati di addestramento potrebbe fallire clamorosamente nel mondo reale. Convalida sempre il tuo modello ottimizzato su un set di test tenuto da parte prima di distribuirlo in produzione
- La complessità della messa a punto spesso viene sottovalutata: poiché DBRX è un modello Mixture-of-Experts, gli script standard di messa a punto potrebbero richiedere librerie specializzate come Megatron-LM o PyTorch FSDP per gestire la suddivisione dei parametri su più GPU
DBRX rispetto ad altre piattaforme di addestramento dell’IA
La scelta di una piattaforma di addestramento dell’IA comporta un compromesso fondamentale: controllo contro praticità. I modelli proprietari, accessibili solo tramite API, sono facili da usare ma ti vincolano all’ecosistema di un fornitore.
I modelli a pesi aperti come DBRX offrono un controllo completo, ma richiedono maggiori competenze tecniche e un'infrastruttura più articolata. Questa scelta può farti sentire bloccato, insicuro su quale percorso supporti effettivamente i tuoi obiettivi a lungo termine: una sfida che molti team devono affrontare durante l'adozione dell'IA.
Questa tabella illustra le principali differenze per aiutarti a prendere una decisione informata.
| Pesi | Apri (personalizzato) | Proprietario | Apri (personalizzato) | Proprietario |
| Messa a punto | Pieno controllo | Basato su API | Pieno controllo | Basato su API |
| Self-hosting | Sì | No | Sì | No |
| Licenza | DB Open Model | Termini di OpenAI | Comunità Llama | Terminologia di Anthropic |
| Contesto | 32K | Da 128.000 a 1 milione | 128K | Da 200.000 a 1 milione |
DBRX è la scelta giusta quando hai bisogno di un controllo totale sul modello, devi ricorrere all’hosting autonomo per motivi di sicurezza o conformità, oppure desideri la flessibilità offerta da una licenza commerciale permissiva. Se non disponi di un’infrastruttura GPU dedicata, o se per te la velocità di immissione sul mercato è più importante di una personalizzazione approfondita, le alternative basate su API potrebbero essere più adatte alle tue esigenze.
Inizia ad addestrare in modo più intelligente con ClickUp
DBRX offre una base pronta per l’uso nell’azienda per la creazione di applicazioni di IA personalizzate, con la trasparenza e il controllo che i modelli proprietari non garantiscono. La sua efficiente architettura MoE mantiene bassi i costi di inferenza, mentre il suo design aperto semplifica la messa a punto. Ma una tecnologia solida è solo metà dell’equazione.
Il vero esito positivo deriva dall’allineamento del lavoro tecnico con il flusso di lavoro collaborativo del team. L’addestramento dei modelli di IA è un lavoro di squadra, ed è fondamentale garantire la sincronizzazione degli esperimenti, della documentazione e della comunicazione con le parti interessate. Quando si riunisce tutto in un unico spazio di lavoro convergente e si riduce la dispersione del contesto, è possibile fornire modelli migliori in tempi più rapidi.
Inizia gratis con ClickUp per coordinare i tuoi progetti di addestramento dell'IA in un unico spazio di lavoro. ✨
Domande frequenti
Come posso monitorare lo stato di avanzamento dell'addestramento in DBRX?
È possibile monitorare l’addestramento utilizzando strumenti di ML standard come TensorBoard, Weights & Biases o MLflow. Se si esegue l’addestramento all’interno dell’ecosistema Databricks, MLflow è integrato in modo nativo per un monitoraggio senza soluzione di continuità degli esperimenti.
È possibile integrare DBRX con le pipeline di CI/CD e di distribuzione?
Sì, DBRX può essere integrato nelle pipeline MLOps standard. Containerizzando il modello, è possibile distribuirlo utilizzando piattaforme di orchestrazione come Kubeflow o flussi di lavoro CI/CD personalizzati.
Qual è la differenza tra DBRX Base e DBRX Instruct?
DBRX Base è il modello preaddestrato di base destinato ai team che desiderano eseguire un preaddestramento continuo specifico per un determinato dominio o una messa a punto approfondita dell’architettura. DBRX Instruct è una versione ottimizzata per seguire le istruzioni, il che lo rende un punto di partenza migliore per la maggior parte dello sviluppo di applicazioni.
Come si posiziona DBRX rispetto a GPT-4 nei progetti di IA per l'azienda?
La differenza principale sta nel controllo. DBRX ti offre pieno accesso ai pesi del modello per una personalizzazione approfondita e l’hosting autonomo, mentre GPT-4 è un servizio disponibile esclusivamente tramite API.
È possibile utilizzare DBRX gratis?
I pesi del modello DBRX sono disponibili gratis ai sensi della licenza Databricks Open Model License. Tuttavia, i costi relativi all’infrastruttura di calcolo necessaria per l’esecuzione o la messa a punto del modello sono a carico dell’utente.