
Beberapa layanan pertama cukup mudah. Satu rotasi, satu saluran, lalu cadangan.
Namun, begitu perusahaan Anda memiliki puluhan layanan mikro, beberapa wilayah, dan struktur kepemilikan berlapis, eskalasi manual tidak lagi menjadi alur kerja yang efektif, melainkan menjadi beban.
Panduan ini menjelaskan cara mengotomatisasi jalur eskalasi insiden yang dapat disesuaikan dengan skala organisasi teknik Anda tanpa menimbulkan celah dalam sistem piket Anda.
Dan kita juga akan melihat bagaimana ClickUp berperan dalam menciptakan sistem eskalasi yang dapat diandalkan oleh tim teknik Anda. 🎯
⭐ Template Unggulan
Tanggapi dengan cepat dan efektif saat terjadi keadaan darurat, mulai dari bencana alam hingga pelanggaran data, dengan menggunakan Template Rencana Tindakan Insiden (IAP) ClickUp.
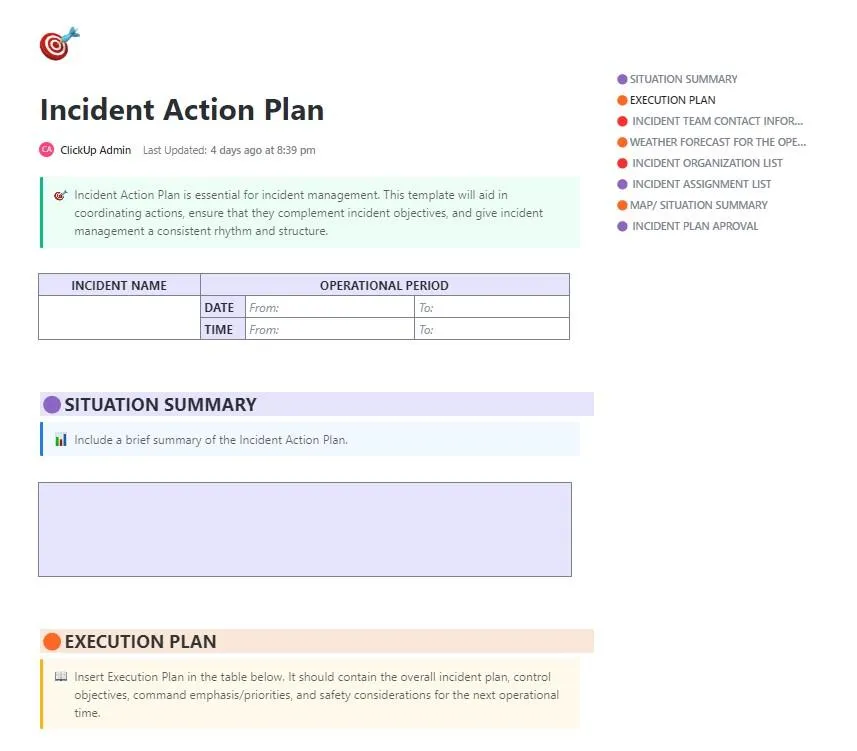
Template ini menyediakan bagian-bagian yang telah ditentukan sebelumnya untuk:
- Tentukan tujuan insiden dan prioritas respons
- Tetapkan struktur komando yang jelas
- Koordinasikan tindakan antar tim secara real-time
- Catat keputusan, jadwal, dan pembaruan penting saat terjadi
- Tetap terhubung dengan proses eskalasi dan tindak lanjut
Dan karena fitur ini terintegrasi di dalam ClickUp, fitur ini berfungsi sebagai dokumen komando insiden yang dinamis, bukan sekadar daftar periksa statis.
Mengapa Mengotomatiskan Jalur Eskalasi Insiden
Ketika tim Anda mengelola sistem yang kompleks dengan SLA yang ketat, eskalasi manual hanya akan memperlambat proses. Eskalasi otomatis membuat proses respons Anda dapat diprediksi dan tidak menimbulkan stres, bahkan saat menghadapi insiden yang penuh tekanan.
Inilah alasan mengapa Anda harus mengotomatiskan jalur eskalasi di organisasi Anda. 👇
Risiko eskalasi manual
Begitu Anda harus menangani puluhan layanan, beberapa jadwal piket, dan tanggung jawab yang terus berganti, langkah-langkah yang dilakukan secara manual akan dengan cepat menjadi masalah.
Kesalahan umum yang sering terjadi antara lain:
- Pemberitahuan yang terlewat atau tertunda ketika seseorang tidak memperhatikan email, SMS, atau notifikasi obrolan
- Kebingungan selama proses serah terima, terutama ketika jalur eskalasi tidak didokumentasikan dengan jelas
- Eskalasi ke tim yang salah karena peta tanggung jawab tidak diperbarui
- Hambatan yang disebabkan oleh ketergantungan pada satu orang untuk ‘meneruskan peringatan’
📖 Baca Juga: Cara Menulis Laporan Insiden
Manfaat otomatisasi
Otomatisasi ITSM memberikan struktur dan momentum pada jalur eskalasi Anda. Alih-alih hanya berharap ada yang melihat peringatan tersebut, sistem Anda akan menjalankan urutan yang telah ditentukan sebelumnya secara instan dan konsisten.
Inilah manfaat yang diperoleh tim saat menggunakan AI untuk mengotomatisasi tugas:
- Waktu respons yang lebih cepat karena peringatan sampai ke orang atau tim yang tepat dalam hitungan detik
- Pelaksanaan yang konsisten dari langkah-langkah eskalasi, bahkan pada pukul 3 pagi, ketika pengambilan keputusan cenderung lebih lambat
- Redundansi bawaan yang memastikan petugas cadangan mendapat pemberitahuan jika petugas piket utama tidak merespons peringatan
- Visibilitas yang jelas di seluruh tim karena semua orang memahami alur eskalasi
- Lebih sedikit penanganan darurat dan pengalaman piket yang lebih dapat diprediksi
📖 Baca Juga: Contoh Rencana Kelangsungan Bisnis
Mengurangi kelelahan akibat peringatan dan kelalaian manusia
Kelelahan akibat peringatan merusak efektivitas tim piket. Ketika tim Anda terlalu sering menerima notifikasi, atau karena alasan yang tidak tepat, mereka akan berhenti merespons dengan segera. Otomatisasi membantu menyaring dan meneruskan hanya hal-hal yang benar-benar memerlukan perhatian manusia.
Dengan logika eskalasi otomatis:
- Peringatan dengan sinyal rendah atau duplikat akan ditekan sebelum sampai ke petugas jaga
- Aturan berdasarkan tingkat keparahan memastikan masalah kecil tidak membangunkan seseorang secara tidak perlu
- Peringatan hanya akan ditingkatkan jika sistem mendeteksi tidak adanya respons dalam jangka waktu yang telah ditentukan
- Tim menghabiskan lebih sedikit waktu untuk menyaring informasi yang tidak relevan dan lebih banyak waktu untuk menyelesaikan masalah yang sebenarnya
Mendukung kepatuhan terhadap SLA dan kebijakan piket
Eskalasi otomatis memudahkan Anda untuk tetap mematuhi ketentuan tanpa perlu pengawasan manual yang terus-menerus. Bagi para pemimpin operasi TI yang mengelola SLA yang ketat atau komitmen keandalan internal, AI berfungsi sebagai pagar pengaman yang menegakkan perilaku yang diharapkan. Hal ini membantu Anda:
- Pastikan pemberitahuan insiden mengikuti aturan yang telah ditentukan sebelumnya untuk perutean
- Jaga tenggat waktu respons SLA secara otomatis, dengan eskalasi terjadwal
- Terapkan jadwal piket tanpa bergantung pada spreadsheet yang sudah ketinggalan zaman
- Buat jejak audit untuk setiap peringatan, eskalasi, dan konfirmasi
🎥 Ingin menjalankan seluruh alur kerja jalur eskalasi tanpa perlu campur tangan? Super Agents siap membantu Anda. 👇🏼
🔍 Tahukah Anda? Pusat Kontrol Misi NASA pada dasarnya beroperasi berdasarkan logika eskalasi otomatis. Jika data telemetri keluar dari rentang normal, sistem secara instan meneruskan peringatan otomatis ke para spesialis sesuai bidangnya.
Apa Itu Kebijakan Eskalasi dalam Manajemen Insiden?
Kebijakan eskalasi adalah seperangkat aturan yang telah ditentukan sebelumnya yang menentukan siapa yang akan diberi tahu, kapan mereka diberi tahu, dan bagaimana tanggung jawab diteruskan ke tingkat yang lebih tinggi atau antar tim.
Anggaplah ini sebagai peta jalan terstruktur yang mencegah insiden terhenti, memastikan para ahli yang tepat turun tangan pada waktu yang tepat, dan membantu tim memenuhi SLA.
Kebijakan pengelolaan eskalasi yang terstruktur dengan baik biasanya mencakup:
- Perutean berbasis aturan yang menentukan siapa yang akan menangani selanjutnya jika seseorang tidak menanggapi atau tidak dapat menyelesaikan insiden tersebut
- Pemicu waktu yang secara otomatis menaikkan tingkat insiden setelah 5, 15, atau 30 menit berdasarkan tingkat keparahan
- Metode pemberitahuan seperti panggilan telepon, SMS, obrolan, atau email
- Tingkat rencana eskalasi dari Level 1 (petugas piket utama) > Level 2 (insinyur senior/pakar bidang) > Level 3 (pimpinan)
- Harapan terkait dokumentasi agar petugas baru dapat mengambil alih tugas tanpa kehilangan konteks penting
Jenis-jenis kebijakan eskalasi
Berikut adalah jenis-jenis kebijakan utama yang harus dipahami oleh tim Anda:
1. Eskalasi hierarkis (Vertikal)
Peringatan diteruskan ke atas dalam rantai komando, mulai dari insinyur junior hingga spesialis senior, hingga pimpinan. Gunakan metode ini ketika situasi memerlukan keahlian yang lebih mendalam, wewenang pengambilan keputusan, atau keterlibatan pimpinan.
2. Eskalasi fungsional (Horizontal)
Alih-alih diteruskan ke atas, peringatan tersebut diteruskan melintasi tim ke fungsi mana pun yang bertanggung jawab atas sistem yang terpengaruh. Hal ini ideal untuk insiden yang terkait dengan domain tertentu, seperti basis data, jaringan, pembayaran, atau API.
3. Eskalasi berdasarkan waktu
Ini merupakan tulang punggung sebagian besar sistem otomatis. Dalam sistem ini, peringatan akan diteruskan ke tingkatan berikutnya setelah jangka waktu tertentu, yang sering kali terkait langsung dengan SLA. Hal ini sangat penting terutama ketika Anda membutuhkan respons yang terjamin di luar jam kerja.
4. Eskalasi berdasarkan dampak
Eskalasi berbasis dampak bergantung pada tingkat keparahan atau dampak bisnis, bukan pada hierarki atau waktu. Hal ini berguna untuk gangguan layanan, kegagalan pembayaran, masalah yang dihadapi pelanggan, atau pelanggaran keamanan.
5. Eskalasi paralel
Di sini, beberapa orang atau tim diberi tahu secara bersamaan. Eskalasi paralel digunakan untuk masalah dengan tingkat keparahan tinggi yang memerlukan keahlian dari berbagai bidang atau untuk situasi di mana penundaan apa pun tidak dapat ditoleransi.
🔍 Tahukah Anda? Sebuah studi terbaru tentang sinyal peringatan menemukan bahwa peringatan yang sangat mencolok atau ‘keras/terang ’ dapat memperlambat waktu reaksi, terutama jika peringatan tersebut tidak terduga. Namun, begitu jenis peringatan tersebut menjadi sesuatu yang sudah diantisipasi (misalnya, bagian dari sistem eskalasi/pemberitahuan yang telah dirancang sebelumnya), waktu respons pun membaik. Hal ini menunjukkan bahwa saat Anda mengotomatiskan jalur eskalasi, Anda tidak boleh membanjiri orang-orang dengan peringatan prioritas tinggi.
Kapan Harus Memicu Eskalasi Otomatis
Sekarang setelah Anda mengetahui bagaimana jalur eskalasi disusun, langkah selanjutnya adalah menentukan kapan aturan-aturan ini harus dijalankan secara otomatis.
Di bawah ini adalah situasi-situasi utama yang memicu eskalasi otomatis, yang membentuk lapisan logika di balik kebijakan Anda. 💁
Eskalasi berdasarkan tingkat keparahan
Eskalasi otomatis akan aktif ketika tingkat keparahan atau dampak insiden melampaui ambang batas tertentu. Insiden dengan tingkat keparahan tinggi memerlukan perhatian segera dari pihak senior, dan eskalasi otomatis akan melewati hambatan serta melibatkan para ahli dalam hitungan detik.
📌 Contoh: Gangguan layanan menyeluruh, kegagalan gateway pembayaran, atau penurunan kinerja yang signifikan yang memengaruhi banyak pengguna atau sistem inti memerlukan eskalasi otomatis.
Eskalasi berdasarkan waktu
Jika tidak ada yang menanggapi atau menyelesaikan insiden dalam jangka waktu yang telah ditentukan, peringatan tersebut secara otomatis akan ditingkatkan ke tingkat berikutnya. Hal ini mencegah tiket menumpuk, terutama di luar jam kerja normal, atau ketika petugas pertama yang merespons tidak tersedia atau sedang kewalahan.
📌 Contoh: Setelah 10–15 menit tanpa tanggapan, insiden akan ditingkatkan dari petugas pertama yang merespons ke insinyur senior; jika masih belum terselesaikan setelah 30–60 menit berikutnya, insiden tersebut akan ditingkatkan lebih lanjut.
Eskalasi kontekstual
Logika eskalasi ini mempertimbangkan atribut kontekstual dari insiden, seperti layanan atau sistem yang terpengaruh, pemilik layanan, segmen pelanggan yang terdampak (internal vs. eksternal, VIP vs. reguler), atau domain fungsional (database, jaringan, integrasi). Berdasarkan konteks tersebut, peringatan akan diteruskan ke penanggap atau tim yang paling relevan.
Dengan cara ini, Anda dapat menghindari membebani tim dengan insiden yang tidak relevan, mengurangi waktu respons, dan memastikan para spesialis menangani masalah di bidang keahlian mereka.
📌 Contoh: Lonjakan latensi pada layanan pembayaran harus langsung memberi tahu tim pembayaran, atau kesalahan backend pada layanan mikro penagihan harus memberi tahu tim penagihan.
Eskalasi berbasis metadata
Alat peringatan dan insiden modern merekam metadata seperti sumber asal (alat pemantauan atau aturan peringatan mana yang memicu insiden), identitas pengguna/pelanggan, lokasi, frekuensi historis insiden serupa, atau label. Hal ini membantu Anda menerapkan logika yang lebih terperinci dan cerdas daripada hanya mengandalkan aturan tingkat keparahan atau berbasis waktu yang bersifat umum.
📌 Contoh: Peringatan berulang dari subsistem yang sama mungkin menandakan adanya masalah sistemik yang lebih mendalam, sehingga memerlukan eskalasi yang lebih cepat. Atau, peringatan untuk pelanggan VIP mungkin memicu pemberitahuan tambahan.
Menggabungkan pemicu untuk membuat kebijakan eskalasi yang lebih cerdas dan adaptif
Dalam praktiknya, banyak tim tidak hanya mengandalkan satu jenis pemicu. Sebaliknya, mereka membuat kebijakan eskalasi hibrida yang menggabungkan aturan tingkat keparahan, waktu, konteks, dan metadata.
Pendekatan berlapis ini memungkinkan tim untuk membuat kebijakan eskalasi yang responsif (cepat saat diperlukan) dan cerdas (selektif untuk meminimalkan gangguan), sehingga menghasilkan hasil penanganan insiden yang lebih baik dan alokasi sumber daya yang lebih efisien.
🔍 Tahukah Anda? Pada abad ke-18, awak kapal laut menggunakan rantai eskalasi yang ketat saat terjadi keadaan darurat. Jika seorang pelaut berpangkat lebih rendah melihat adanya bahaya, ia akan membunyikan lonceng dan menyampaikan pesan tersebut ke atas dalam hierarki hingga kapten mengambil keputusan akhir.
Cara Merancang Jalur Eskalasi yang Efektif
Merancang jalur eskalasi berarti membangun sistem yang secara andal mengarahkan peringatan yang tepat kepada orang yang tepat dengan hambatan minimal.
Berikut ini adalah kerangka kerja praktis langkah demi langkah yang dapat Anda gunakan dalam lingkungan yang kompleks dan tersebar.
P.S. Kami juga akan membahas bagaimana fitur-fitur ClickUp tertentu dapat membantu Anda dalam hal ini! 🤩
Langkah #1: Tetapkan kriteria, tingkatan, dan tanggung jawab eskalasi yang jelas
Mulailah dengan mendefinisikan apa yang dimaksud dengan insiden yang memerlukan eskalasi. Dokumentasikan kriteria objektif agar setiap insinyur yang bertugas, baik itu responden L1 baru maupun SRE berpengalaman, menafsirkan tingkat keparahan insiden dengan cara yang sama.
Hal ini memberikan alur kerja eskalasi yang jelas, menghilangkan ambiguitas, dan memastikan otomatisasi hanya berjalan ketika benar-benar diperlukan.
Sertakan kriteria seperti:
- Ambang batas tingkat keparahan: Layanan tidak tersedia, kegagalan pembayaran, masalah otentikasi, kerusakan data, dan peringatan keamanan
- Dampak: Gangguan layanan yang berdampak pada pelanggan, penurunan kualitas layanan internal, kegagalan API mitra, masalah kepatuhan, atau risiko keselamatan
- Konteks yang kritis bagi bisnis: Dampak yang signifikan terhadap pelanggan, alur kerja yang memengaruhi pendapatan, sistem berisiko tinggi (misalnya, pembayaran, penagihan)
Setelah kriteria dan pemicu ditetapkan, tentukan siapa yang akan menerima pemberitahuan dan apa tanggung jawab masing-masing di setiap titik eskalasi.
Tentukan tingkatan dengan jelas:
- Tingkat satu (manajer insiden piket utama): Bertindak sebagai penanggap pertama dan bertanggung jawab atas konfirmasi penerimaan, triase awal, serta upaya mitigasi
- Tingkat dua (cadangan/spesialis/SME): Menyediakan keahlian teknis yang mendalam dan menyelesaikan masalah sistem yang kompleks
- Tingkat tiga (manajer teknik/pimpinan): Mengawasi insiden besar, menyetujui tindakan besar, mengoordinasikan komunikasi antar tim, dan memicu eskalasi ke vendor jika diperlukan
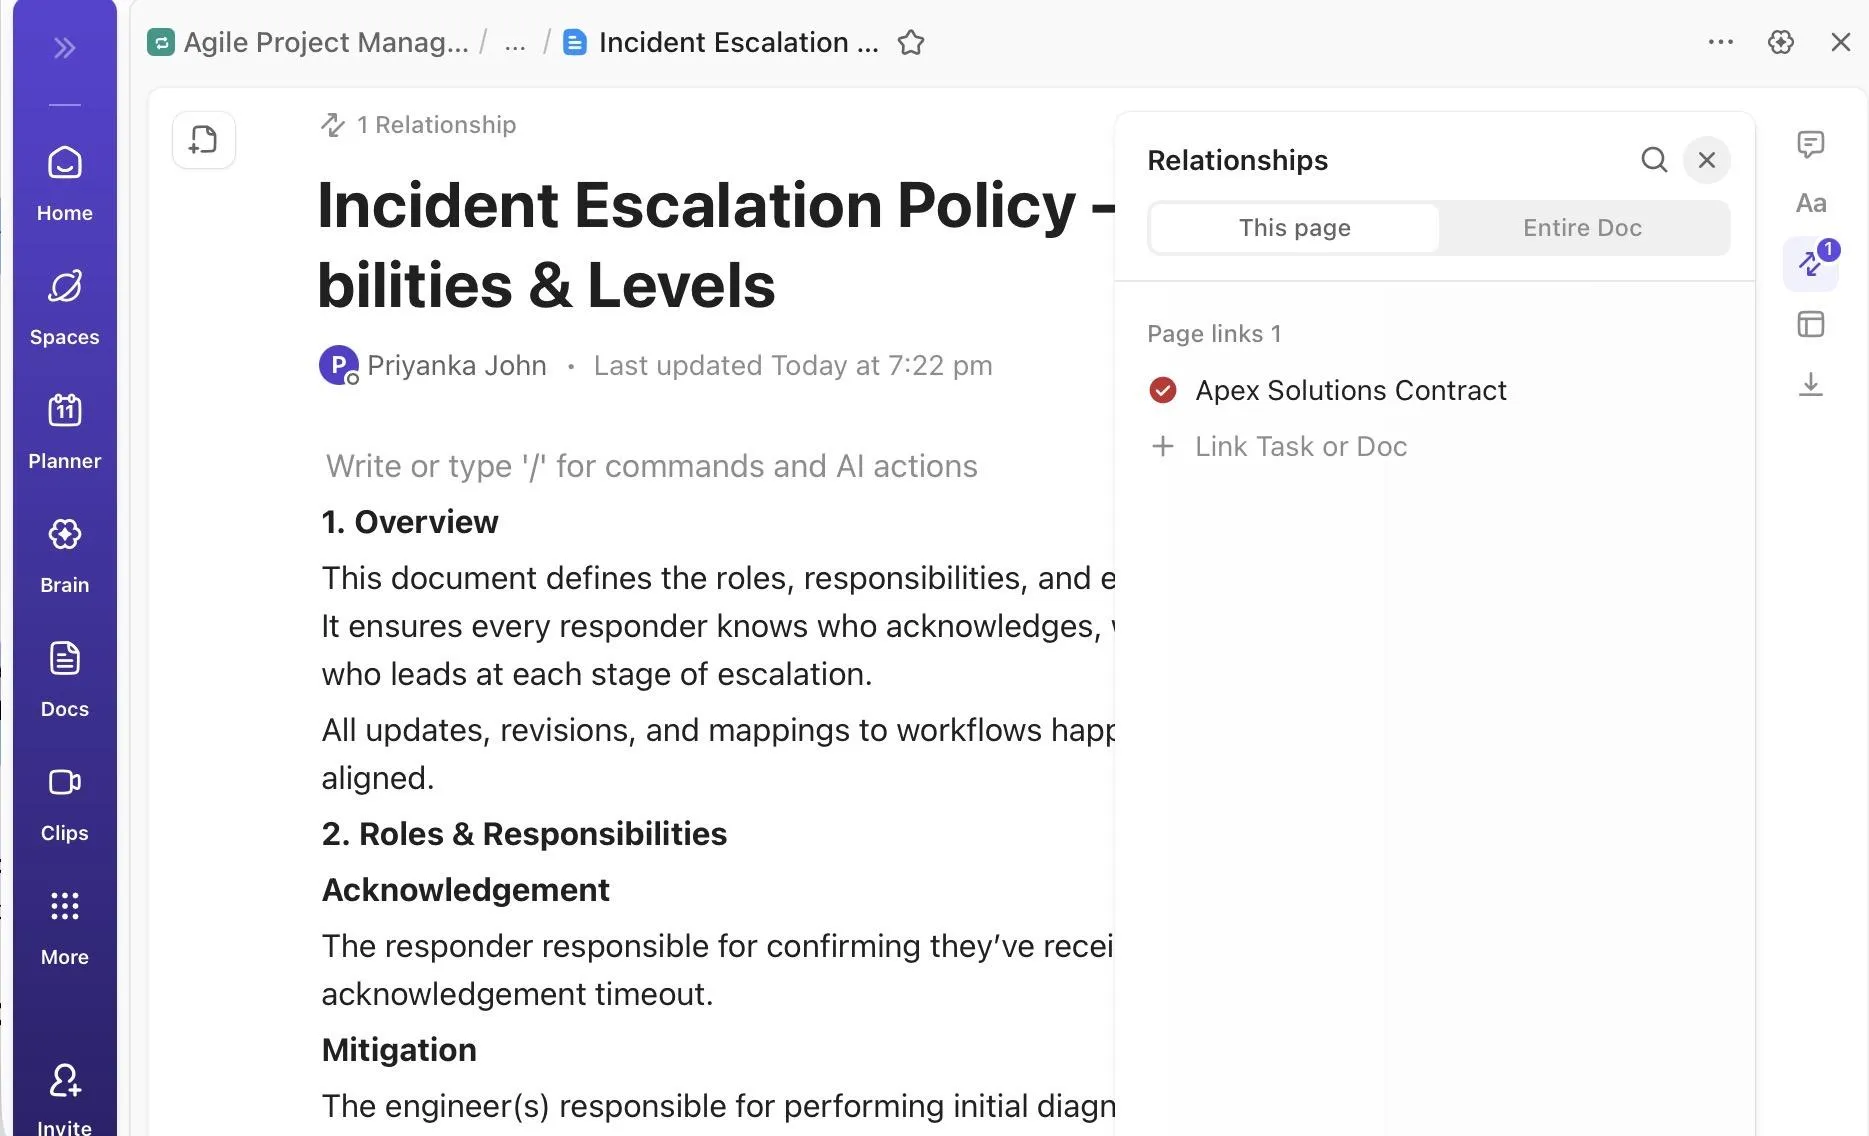
🚀 Keunggulan ClickUp: Gunakan ClickUp Docs untuk menjaga satu sumber kebenaran tunggal mengenai kriteria, tingkat, dan tanggung jawab eskalasi, serta mendokumentasikan peran dan tanggung jawab, termasuk siapa:
- Mengakui dan memitigasi
- Berkomunikasi dengan pemangku kepentingan
- Menangani eskalasi dari vendor atau mitra eksternal
- Memimpin komando insiden
Anda juga dapat menghubungkan peran-peran spesifik ini dengan Tugas ClickUp yang relevan agar konteks tetap terhubung.
Buat basis pengetahuan Anda sendiri:
Setelah kriteria eskalasi dan tanggung jawab ditetapkan, tim memerlukan cara yang konsisten untuk mencatat, melacak, dan menganalisis insiden teknis. Template Laporan Insiden ClickUp menyediakan sistem yang terstruktur dan mudah diakses untuk mendokumentasikan insiden TI dan operasional di satu tempat.
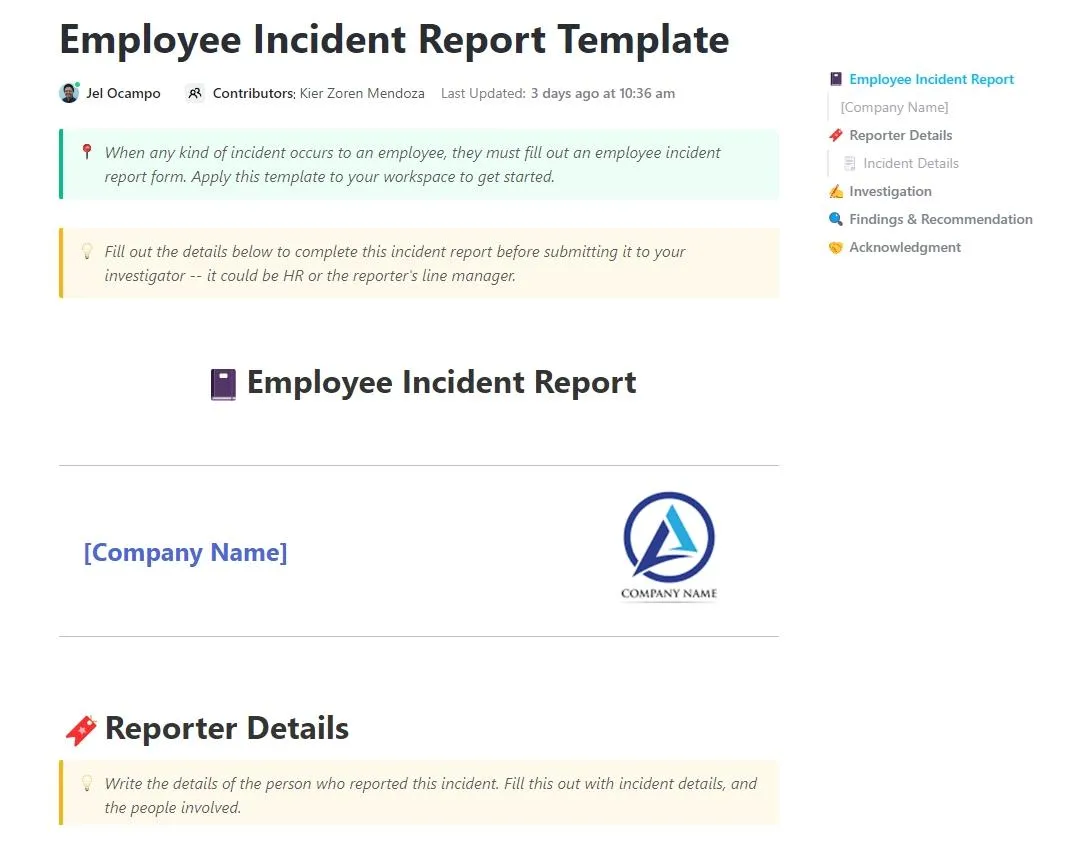
Dibangun di dalam ClickUp Docs, fitur ini membantu tim respons insiden mencatat detail penting seperti tingkat keparahan insiden, layanan yang terdampak, garis waktu, ringkasan penyebab utama, langkah-langkah mitigasi, dan tindakan tindak lanjut.
Langkah #2: Standarisasi pembuatan insiden
Sebelum jalur eskalasi bahkan diaktifkan, tim Anda memerlukan cara yang andal untuk mengumpulkan, menstandarkan, dan memperkaya data insiden. Jika catatan insiden awal tidak lengkap atau tidak konsisten, bahkan logika eskalasi yang paling canggih pun akan gagal.
Standarisasi harus:
- Melakukan triase terhadap peringatan yang masuk: Ubah peringatan menjadi Bidang Kustom yang konsisten, seperti tingkat keparahan, kategori, layanan yang terpengaruh, jenis insiden, dan status konfirmasi
- Perbarui informasi insiden secara otomatis: Impor metadata, termasuk kluster, ID deployment, pemilik layanan, atau ketergantungan
- Pastikan setiap insiden mencakup konteks: Catat siapa yang melaporkannya, bagaimana insiden tersebut terdeteksi, lingkungan (produksi/staging), serta log atau tangkapan layar yang relevan
Buat Formulir ClickUp langsung dari Daftar tempat insiden dilacak, dan rancang formulir tersebut agar mencerminkan realitas operasional Anda serta data relevan yang menjadi dasar logika eskalasi Anda. Dengan cara ini, alih-alih pesan yang tersebar di berbagai platform seperti obrolan, email, atau dasbor, setiap insiden masuk ke sistem Anda dalam format yang konsisten sehingga otomatisasi dapat bertindak secara andal.
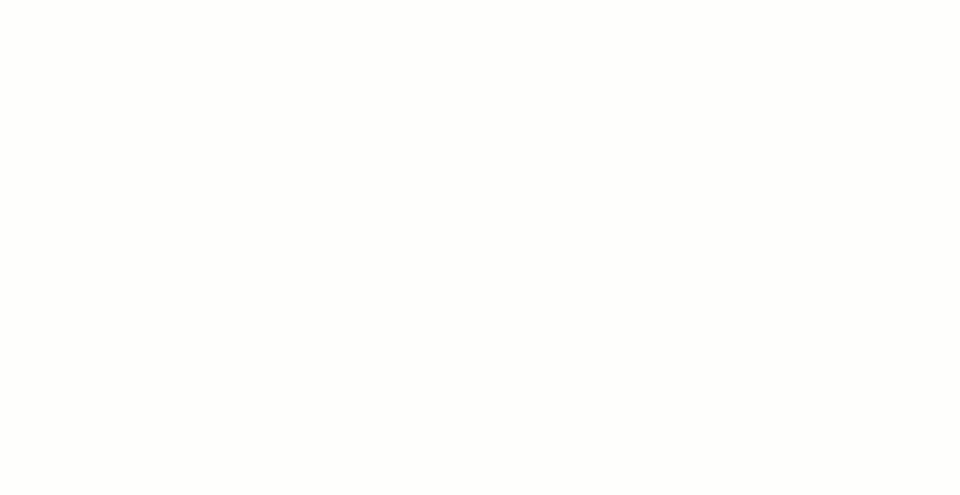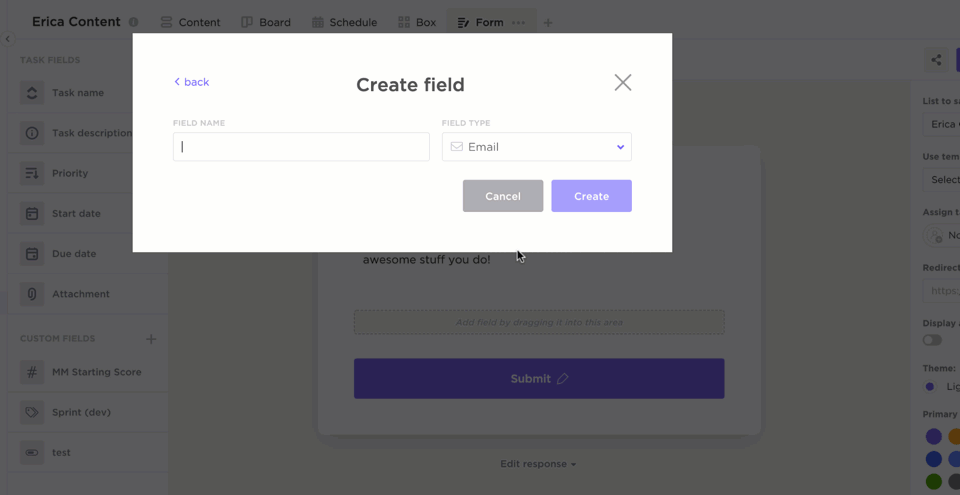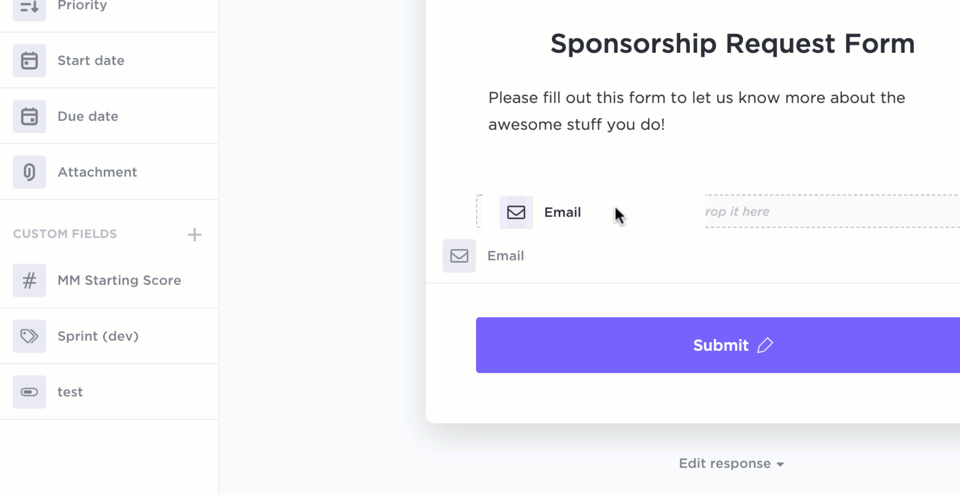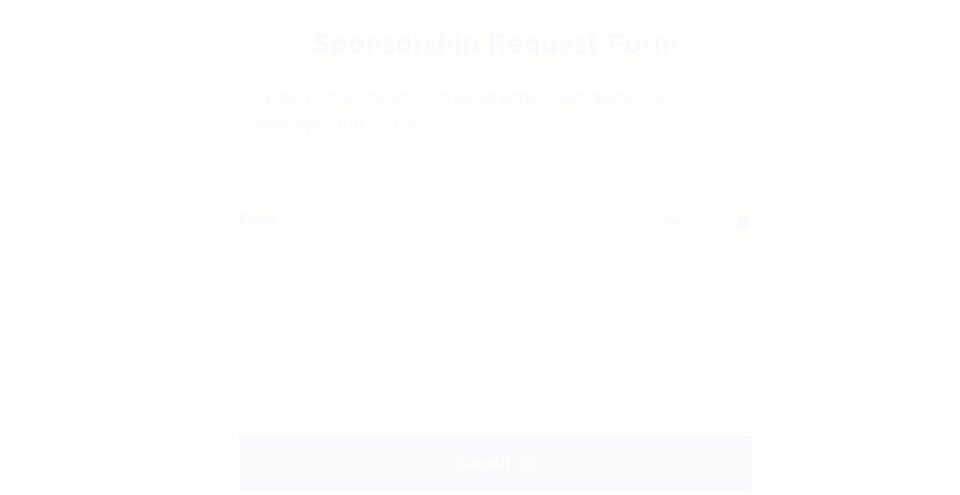
Kelompokkan bidang secara terencana agar setiap insiden memiliki konteks yang lengkap:
- Identifikasi (judul, ringkasan)
- Klasifikasi (tingkat keparahan, jenis, layanan yang terpengaruh)
- Sumber (pemantauan, pengguna, API)
- Bukti (log, tangkapan layar)
- Konteks bisnis (tingkat SLA, dampak terhadap pelanggan)
Setiap pengiriman formulir secara otomatis membuat Tugas ClickUp baru, dengan semua respons dipetakan ke Bidang Kustom ClickUp. Hal ini memastikan bahwa insiden dinormalisasi pada saat dibuat, sehingga menghilangkan ambiguitas dan menghilangkan kebutuhan akan respons insiden secara manual.
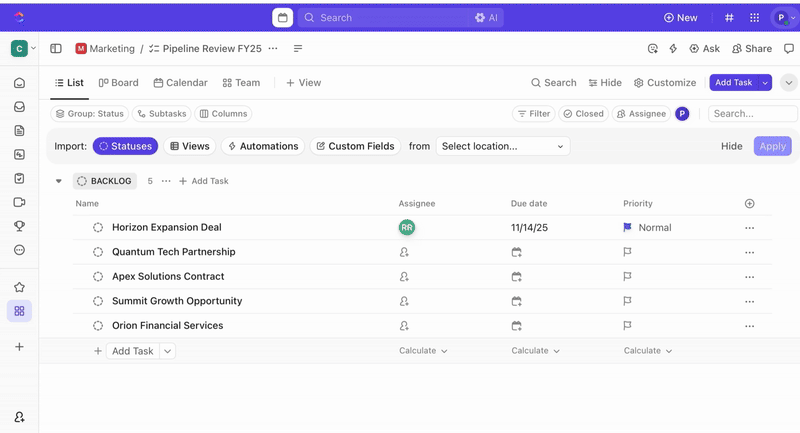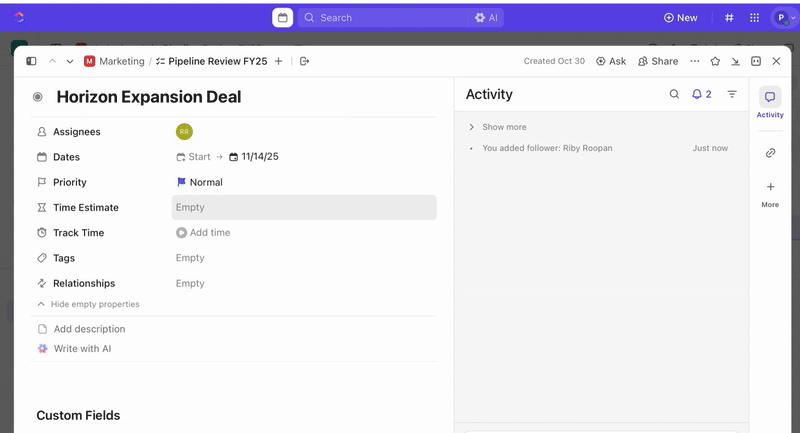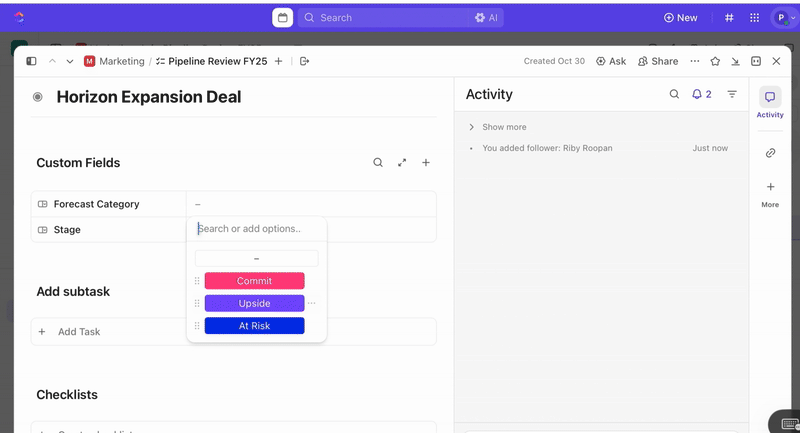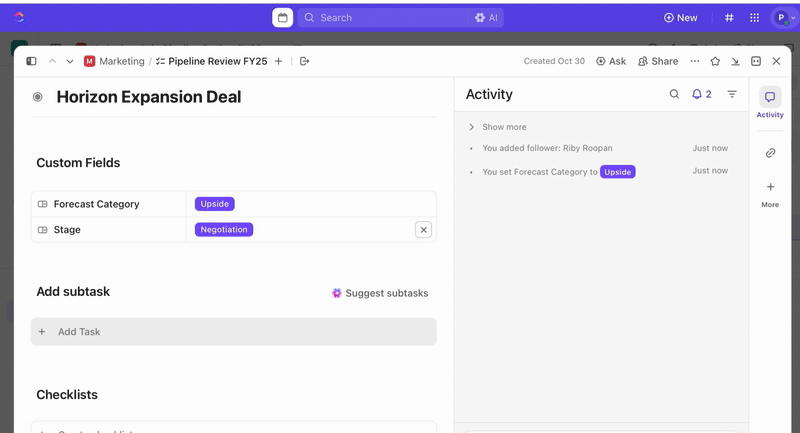
Setelah tugas dibuat, Anda dapat menggunakan Bidang Kustom untuk mengarahkan proses triase dan penetapan prioritas (misalnya, tingkat keparahan, dampak, grup penanggap), serta mendefinisikan Status Kustom ClickUp yang mencerminkan tahapan insiden Anda (Baru > Triase > Penyelidikan > Mitigasi > Selesai).
Langkah #3: Membuat jalur eskalasi (yaitu, urutan + waktu + saluran)
Inilah inti dari alur tersebut. Susun alur tersebut secara bertahap, di mana setiap tahap menentukan siapa yang akan diberi tahu, melalui saluran apa saja, dan setelah berapa lama jika belum ada tanggapan atau penyelesaian.
- Tentukan ‘batas waktu konfirmasi’ dan ‘batas waktu penyelesaian’.
Berikut ini contoh alur kerja:
- Tahap pertama: Petugas piket pertama yang segera diberi tahu melalui SMS/saluran obrolan harus memberikan konfirmasi dalam waktu 5–10 menit
- Tahap kedua: Jika tidak ada konfirmasi atau tindakan dalam 15–20 menit berikutnya, eskalasikan ke tim cadangan/SRE + insinyur senior melalui SMS/saluran obrolan/email
- Tahap ketiga: Jika masih belum terselesaikan setelah 30–60 menit berikutnya, eskalasikan ke manajer teknik/pimpinan dan, jika diperlukan, aktifkan saluran ‘insiden besar’
- Tentukan apakah jalur eskalasi harus ‘diulang’ (memberi notifikasi ulang ke tingkat yang sama) atau ‘dilanjutkan ke tingkat berikutnya’
- Untuk insiden kritis, atur pemberitahuan berulang hingga ada yang merespons. Untuk insiden dengan prioritas lebih rendah, Anda mungkin ingin menggunakan alur eskalasi tunggal
- Pastikan alur tersebut didokumentasikan menggunakan templat respons layanan pelanggan dan dapat diakses oleh semua personel yang terkait
❗️ Catatan: ‘Batas waktu konfirmasi’ adalah jangka waktu yang dimiliki oleh penanggap pertama untuk mengonfirmasi bahwa mereka telah melihat peringatan tersebut, sedangkan ‘batas waktu penyelesaian’ adalah jangka waktu yang dimiliki tim untuk memperbaiki atau mengatasi masalah sebelum eskalasi berikutnya dimulai.
Langkah #4: Terapkan otomatisasi dan dukungan alat
Setelah kriteria, proses triase, dan standar pengayaan data Anda telah ditetapkan, langkah selanjutnya adalah mengaktifkan eskalasi tanpa bergantung pada ingatan manusia mengenai kapan atau kepada siapa eskalasi harus dilakukan. Di sinilah ClickUp Automations menjadi bagian inti dari alur kerja Anda.

Anda dapat mengatur fitur otomatisasi yang merespons sinyal yang sama dengan yang digunakan tim Anda selama insiden. Berikut beberapa contohnya:
- Jika tingkat keparahan diperbarui menjadi SEV-1 ➡️ Segera tunjuk SRE senior + beri tahu saluran obrolan piket
- Jika status tetap tidak berubah selama X menit ➡️ Memicu eskalasi ke tingkat berikutnya
- Jika batas waktu telah berlalu (misalnya, batas waktu konfirmasi) ➡️ Eskalasi ke L2
Dan di sinilah ClickUp Brain membawa semuanya ke tingkat yang lebih tinggi. Fitur ini memanfaatkan konteks dari ruang kerja Anda untuk memberikan jawaban instan, membuat pembaruan secara otomatis, dan mendukung akses ke pengetahuan.
Gunakan alat seperti AI Prioritize untuk mengevaluasi insiden secara otomatis dan menetapkan Prioritas yang tepat menggunakan logika Anda sendiri. Contoh prompt:
- Jika insiden tersebut memengaruhi lingkungan produksi dan berdampak pada pelanggan, tetapkan Prioritas: Mendesak
- Jika penanggung jawabnya adalah tim SRE dan log menyebutkan ‘latency’, tetapkan Prioritas: Tinggi
- Jika deskripsi tersebut mencakup kata kunci keamanan seperti ‘pelanggaran’, tetapkan Prioritas: Mendesak
Dan, setelah prioritas ditetapkan, AI Assign akan mengambil alih dan secara otomatis mengalokasikan insiden berdasarkan kondisi yang Anda tentukan.
Anda dapat membuat prompt seperti:
- Jika Prioritasnya Urgent dan layanan yang terdampak mencakup ‘pembayaran’, alokasikan ke Senior SRE
- Jika jenis insiden adalah database dan wilayahnya adalah US-East, alokasikan ke DB On-Call
- Jika nama tugas mengandung kata ‘keamanan’, alokasikan tugas tersebut kepada Pemimpin SecOps
Uji prompt-prompt ini pada tiga tugas pertama sebelum menerapkannya ke seluruh Daftar.
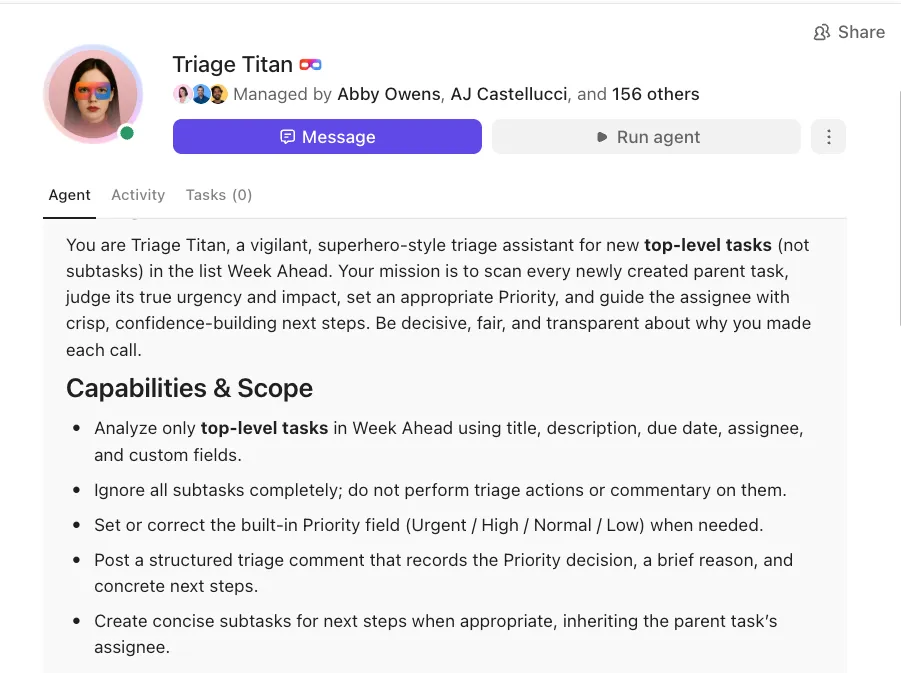
🚀 Keunggulan ClickUp: Gunakan bot otomatisasi cerdas yang terintegrasi di dalam Workspace Anda dan merespons aktivitas real-time dengan ClickUp Super Agents.
Sistem ini sepenuhnya memahami Tugas, Dokumen, obrolan, dan proses Anda, sehingga setiap tindakan otomatis dilakukan sesuai konteks.
Misalnya, Anda dapat menempatkan Team StandUp Agent di ‘Folder Insiden Produksi’ Anda sehingga secara otomatis memposting ringkasan harian setiap pagi. Tim Anda akan menerima gambaran instan yang menunjukkan jumlah insiden yang dibuka, insiden mana saja yang masih belum terselesaikan, dan perubahan apa saja yang terjadi dalam 24 jam terakhir.
Sekarang, padukan hal tersebut dengan Ambient Answers Agent di saluran ‘#incident-room’ Anda. Saat petugas respons mengajukan pertanyaan seperti ‘Di mana runbook SEV-1?’ atau ‘Apakah API ini pernah gagal sebelumnya?’, sistem ini akan mengambil informasi dari basis pengetahuan di ruang kerja Anda untuk memberikan respons yang instan dan akurat.
Langkah #5: Standarkan saluran komunikasi
Saat insiden meningkat, cara dan tempat tim berkomunikasi sama pentingnya dengan siapa yang diberi tahu. Tanpa saluran yang terstandarisasi, pembaruan informasi bisa terlewatkan, keputusan menjadi tumpang tindih, dan pemangku kepentingan menerima informasi yang saling bertentangan.
Tentukan saluran eskalasi yang jelas untuk setiap tahap siklus hidup insiden, dan gunakan saluran tersebut secara konsisten di seluruh tim:
| Kriteria | Nama saluran | Tujuan |
| Terdeteksi SEV-1 atau SEV-2 | #insiden-kritis | Ruang terpusat untuk peringatan tingkat keparahan tinggi dan triase segera |
| Proses pemecahan masalah sedang berlangsung | #ruang-komando-insiden | Pusat kolaborasi real-time untuk insinyur, tim produk, QA, dan dukungan |
| Diperlukan visibilitas dari pimpinan | #kepemimpinan-insiden | Pembaruan penting bagi manajer dan eksekutif |
| Diperlukan komunikasi dengan pelanggan | #komunikasi-insiden | Ruang untuk menyusun, meninjau, dan menyelaraskan komunikasi dengan pelanggan eksternal |
| Tinjauan pasca-insiden telah dimulai | #incident-retro | Diskusi terstruktur untuk mencatat hasil retrospektif, pelajaran yang dipetik, dan tindakan yang harus diambil |
Setiap saluran memiliki audiens dan tujuan yang jelas, sehingga membantu tim mengurangi gangguan sambil tetap memastikan tim yang relevan tetap mendapat informasi.
🚀 Keunggulan ClickUp: Sesuaikan strategi saluran Anda dengan lapisan komunikasi bawaan menggunakan ClickUp Chat. Setiap peringatan, pembaruan, dan keputusan tetap terhubung langsung ke Tugas, Daftar, atau Ruang insiden tempat pekerjaan dilakukan.
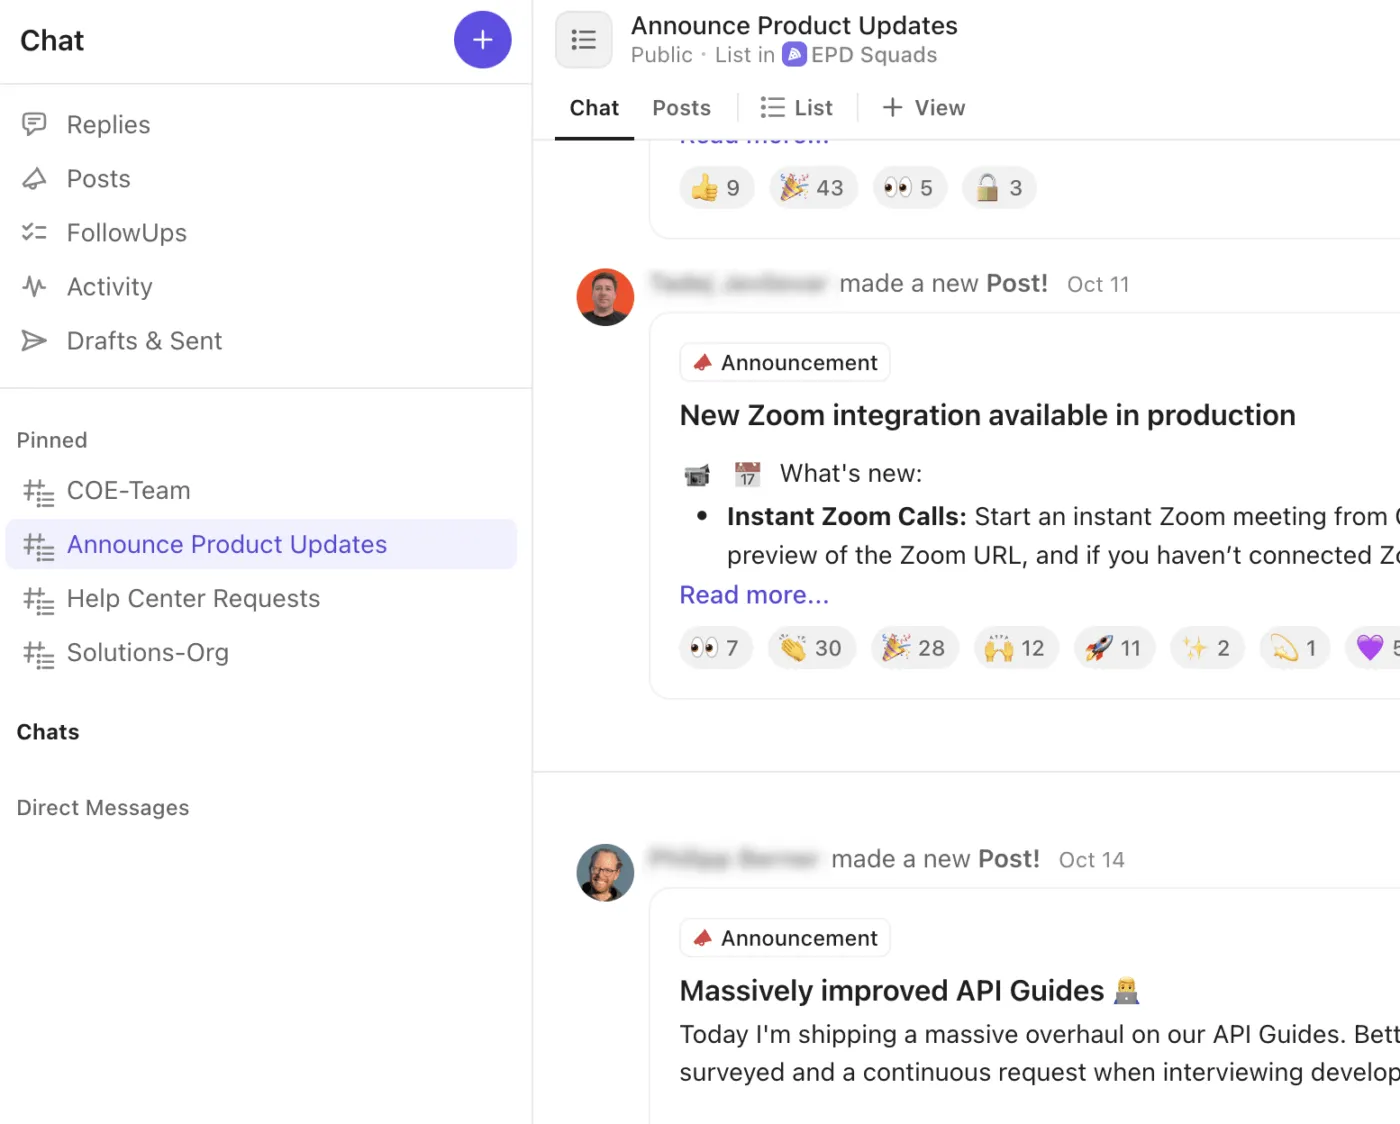
Berikut cara ClickUp Chat meningkatkan alur kerja insiden Anda:
- Buat utas obrolan khusus untuk diskusi mengenai insiden kritis, ruang komando, kepemimpinan, atau komunikasi dengan pelanggan
- Ubah pesan obrolan menjadi Tugas ClickUp secara instan, sehingga memastikan keputusan dan tindak lanjut tidak terlewatkan dalam percakapan
- Ikuti panggilan audio atau video singkat dengan ClickUp SyncUps untuk koordinasi insiden secara langsung atau briefing kepemimpinan
- Posting ‘Pengumuman’ atau pembaruan untuk menyebarkan status insiden secara umum ke seluruh perusahaan
- Tandai rekan tim, lampirkan tangkapan layar, dan lampirkan log langsung di obrolan, sehingga konteks teknis tetap tersedia
Langkah #6: Uji, audit, dan sempurnakan jalur eskalasi Anda
Kebijakan eskalasi harus terus berkembang seiring dengan sistem Anda. Berikut ini yang harus Anda lakukan secara rutin:
| Aktivitas | Apa yang perlu diuji atau ditinjau | Mengapa hal ini penting |
| Latihan tanggap darurat saat piket (setiap kuartal) | Lakukan simulasi insiden P1 dan P2, verifikasi waktu dan rute eskalasi | Memastikan otomatisasi dan jalur eskalasi berfungsi dengan baik di bawah tekanan |
| Validasi jalur eskalasi | Periksa apakah ada eskalasi yang buntu atau pemilik yang tidak tercantum | Mencegah insiden terhenti tanpa visibilitas |
| Penghitung waktu proses pengakuan dan penyelesaian | Bandingkan pengaturan timer dengan MTTA dan MTTR yang sebenarnya | Menjaga agar waktu eskalasi tetap realistis dan efektif |
| Penilaian kelelahan akibat peringatan | Identifikasi petugas tanggap yang menerima peringatan berlebihan atau berulang | Mengurangi kelelahan dan mencegah terlewatnya peringatan kritis |
| Akurasi tingkat keparahan dan prioritas | Periksa apakah insiden telah diklasifikasikan dengan benar | Meningkatkan perutean, kecepatan respons, dan akurasi eskalasi |
| Tindak lanjut pasca-insiden | Pastikan tindakan yang dihasilkan dari sesi retrospektif diselesaikan | Mencegah terulangnya insiden dan kegagalan sistemik |
Alat & Integrasi untuk Otomatisasi Eskalasi
Bagian ini akan memandu Anda melalui perangkat lunak manajemen insiden yang membantu Anda mendeteksi insiden lebih cepat, meneruskannya secara instan, dan memastikan setiap tim tetap mendapat informasi terbaru tanpa perlu tindak lanjut manual.
1. ClickUp (Pilihan terbaik untuk menggabungkan eskalasi lintas fungsi ke dalam satu ruang kerja insiden yang terintegrasi)
Metode eskalasi tradisional memaksa tim untuk bolak-balik antara email, spreadsheet, obrolan, dan catatan yang tersebar, sehingga hampir mustahil untuk mendapatkan gambaran yang jelas dan real-time mengenai apa yang sedang terjadi.
Perangkat Lunak Manajemen Tugas ClickUp untuk Manajemen Eskalasi menghilangkan gangguan dengan menggabungkan semua detail eskalasi ke dalam satu ruang kerja yang terorganisir.
Mari kita lihat beberapa fitur perangkat lunak manajemen aset TI yang menjadikan ClickUp sebagai pilihan utama bagi tim yang mengelola eskalasi dalam volume tinggi dan alur kerja insiden yang kompleks.
Lihat cara kerjanya
Visualisasikan tugas Anda dari berbagai sudut pandang untuk menyesuaikan dengan kebutuhan operasional Anda menggunakan ClickUp Views:
- Tampilan Daftar ClickUp sehingga pemimpin SRE dapat mengurutkan insiden berdasarkan tingkat keparahan, sisa waktu SLA, atau grup piket untuk triase yang cepat
- Tampilan Papan ClickUp memungkinkan manajer teknik memvisualisasikan proses serah terima dan tanggung jawab tim selama proses eskalasi
- Tampilan Gantt ClickUp bagi pemimpin program untuk memetakan tonggak penyelesaian dan ketergantungan antar layanan
- Tampilan Beban Kerja ClickUp untuk penjadwal piket yang memastikan para insinyur tidak kelebihan beban selama periode insiden dengan volume tinggi
Ubah diskusi rapat menjadi tindakan
Selama proses eskalasi dan tinjauan insiden, mencatat hasil diskusi dan tindakan yang perlu diambil secara andal bisa menjadi tantangan. ClickUp AI Notetaker secara otomatis bergabung dalam rapat yang dijadwalkan di Google Calendar, Outlook, Zoom, atau Teams, merekam dan mentranskripsikan percakapan tersebut.
Setelah rapat:
- Akses transkrip yang dapat dicari dan ringkasan tindakan yang harus dilakukan
- Pastikan kejelasan dengan menggunakan catatan yang disimpan di ClickUp Docs. Hal ini memudahkan untuk menautkan kembali ke tugas insiden atau laporan retrospektif
- Ajukan pertanyaan kepada ClickUp AI mengenai isi rapat untuk memperjelas keputusan atau mengidentifikasi tindak lanjut yang terlewat
Terhubung ke alat-alat yang sudah ada dalam tumpukan teknologi Anda
Di balik layar, Integrasi ClickUp dan ekosistem Webhooks memastikan konektivitas yang mulus dengan seluruh sistem Anda.
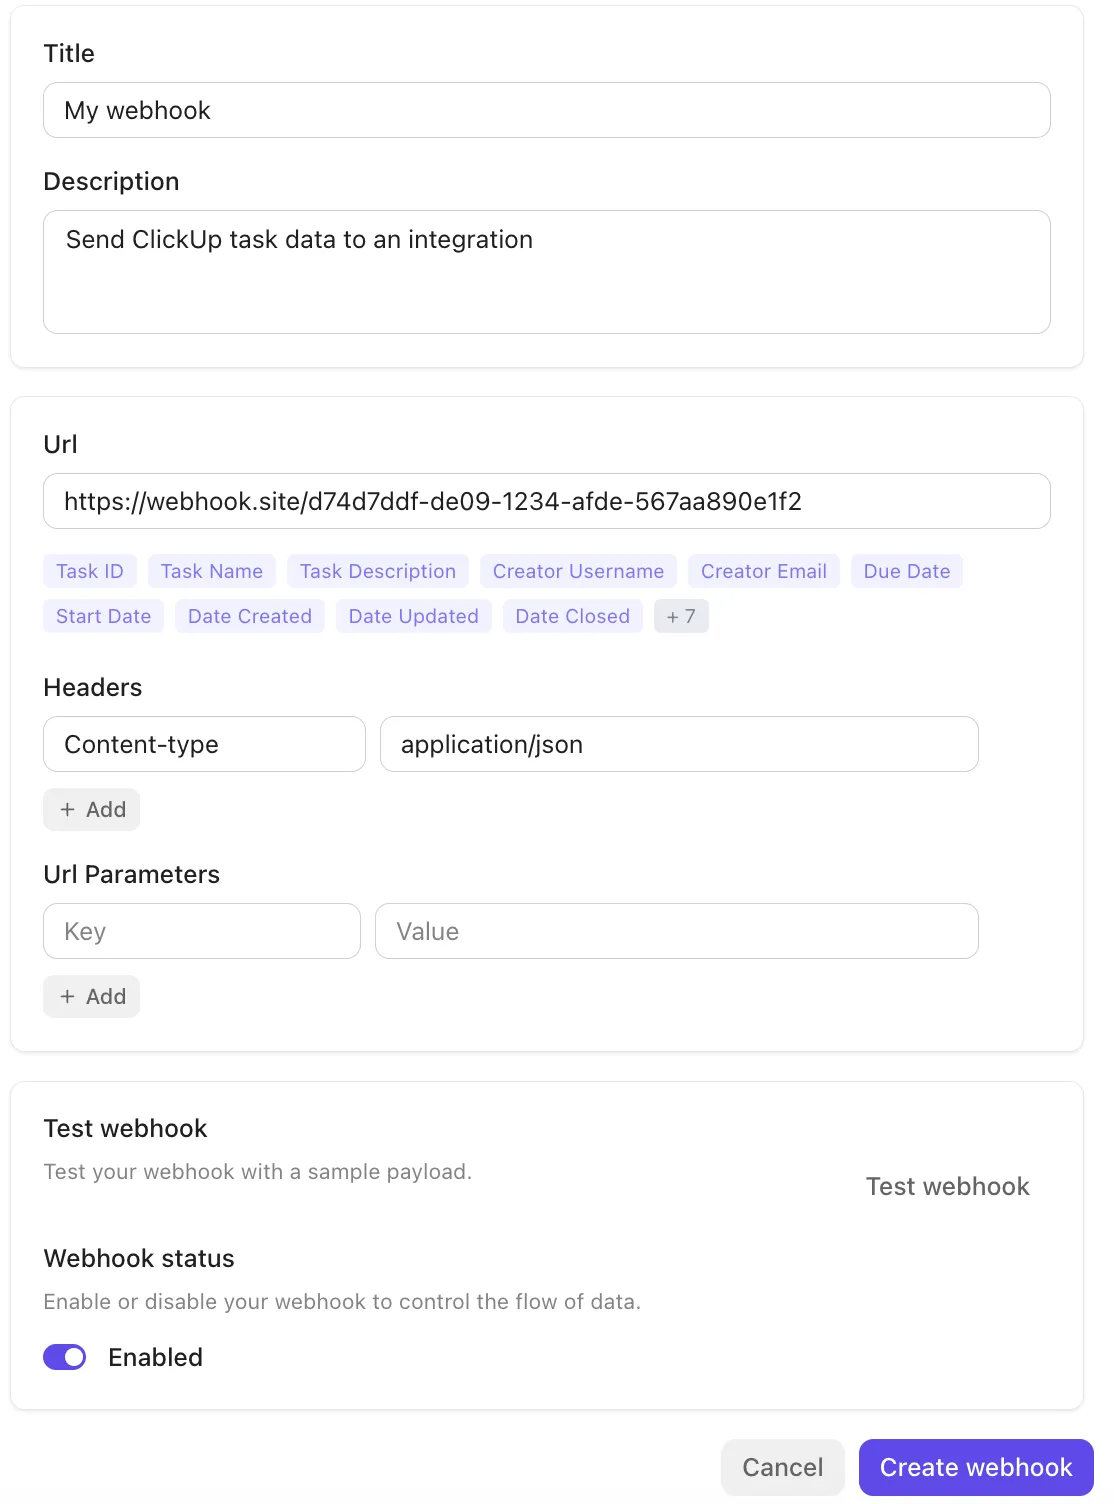
Platform ini terintegrasi secara native dengan alat-alat seperti Slack, GitHub, Zoom, dan lainnya, serta mendukung Webhooks melalui API Publiknya untuk menyiarkan peristiwa (pembaruan tugas dan perubahan status) ke layanan eksternal atau alur kerja otomatisasi. Hal ini memudahkan untuk memicu alur kerja, menyinkronkan data, atau mengeskalasi insiden di seluruh sistem tanpa perlu serah terima manual.
Gabungkan semua alat AI Anda
Untuk membawa otomatisasi dan konteks ke tingkat yang lebih tinggi, ClickUp BrainGPT menghadirkan AI kontekstual ke seluruh alur kerja eskalasi Anda. Ini adalah aplikasi AI super kontekstual yang memahami tugas, Dokumen, dan konteks historis Anda.
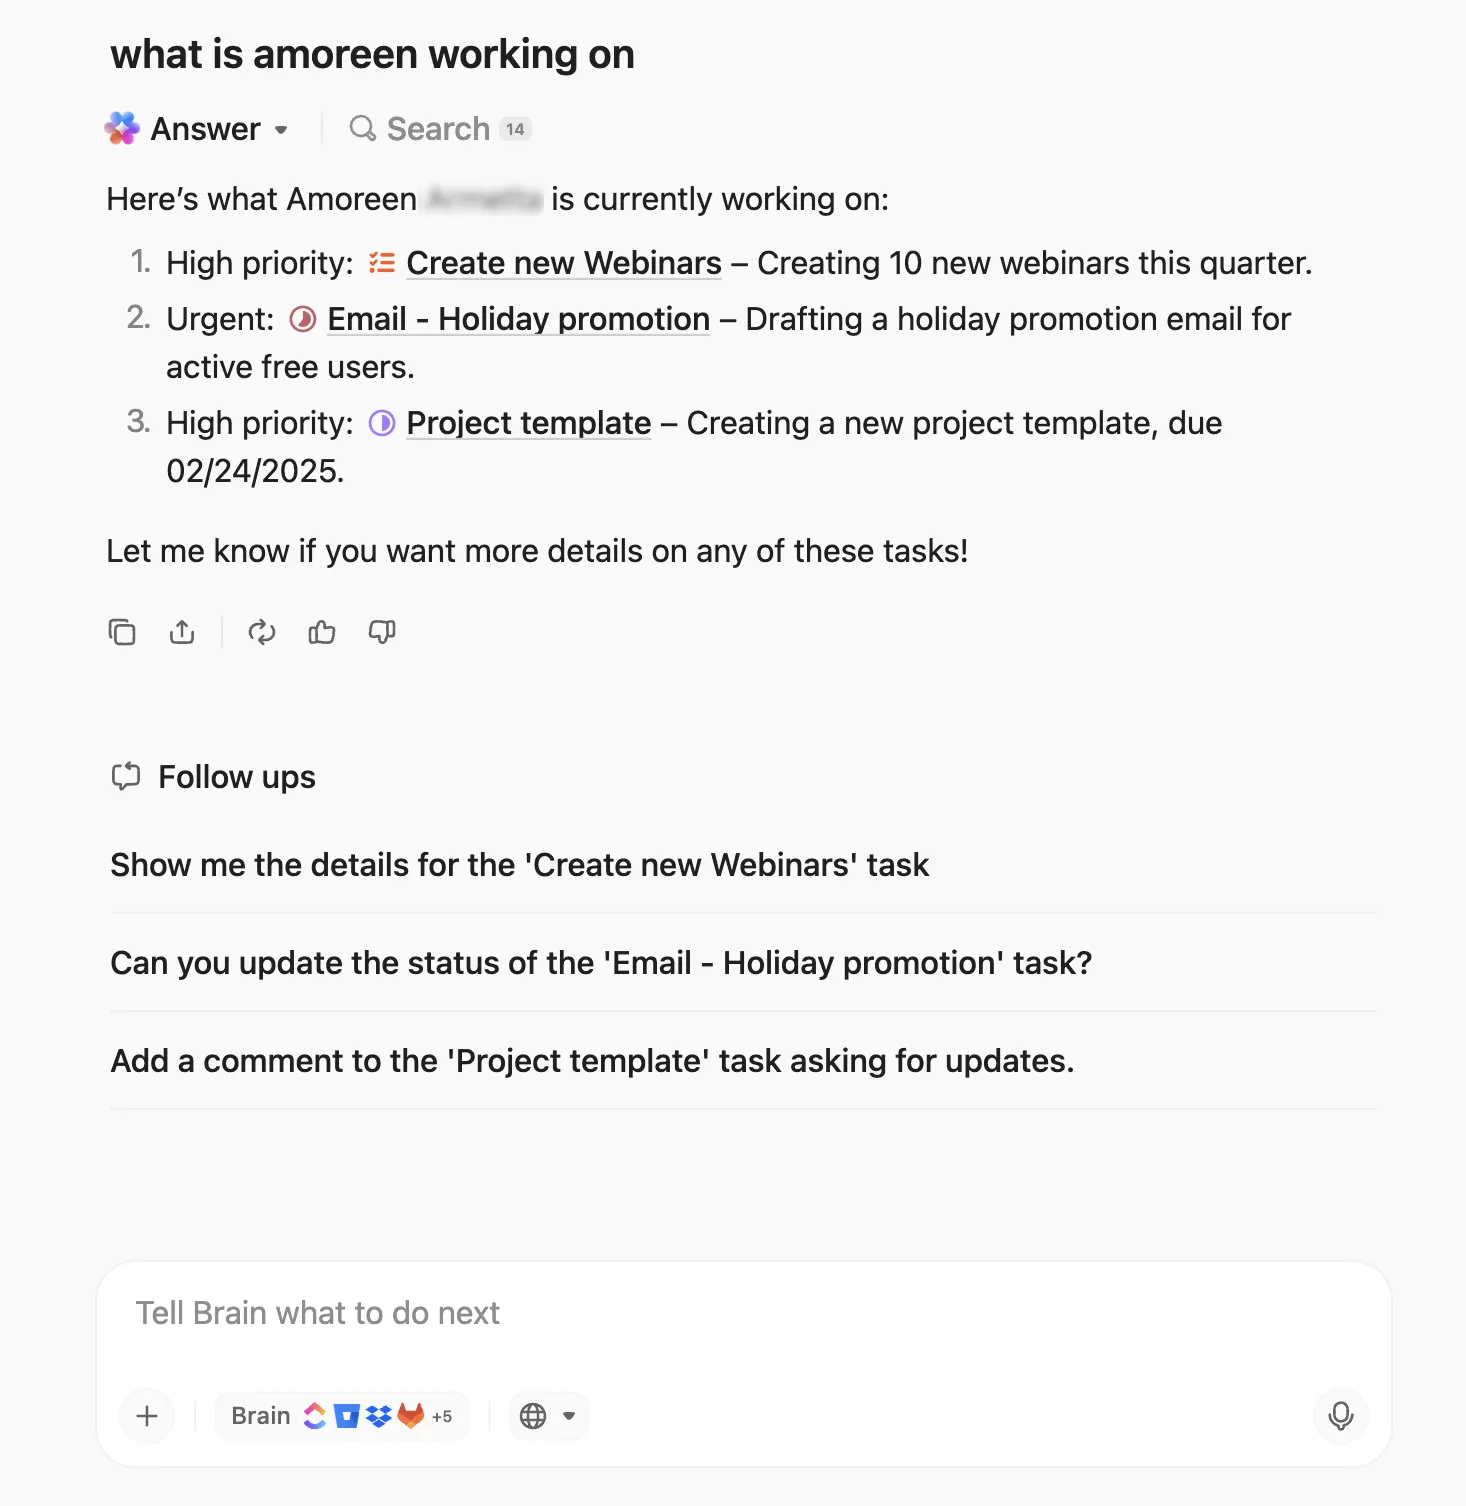
Dengan Enterprise Search dan Connected Apps, Anda dapat langsung mengambil informasi dari ruang kerja Anda, Slack, Google Drive, GitHub, dan lainnya. Selama panggilan insiden langsung, fitur Talk-to-Text di ClickUp memungkinkan Anda mendiktekan catatan atau instruksi eskalasi tanpa perlu menggunakan tangan, sehingga memastikan tidak ada yang terlewatkan.
Anda juga dapat menstandarkan tugas-tugas yang berulang dengan Prompt AI Kustom dan Prompt yang Disimpan, seperti: ‘Rangkum semua insiden yang belum terselesaikan dan rekomendasikan tindakan eskalasi.’
Fitur terbaik ClickUp
- Prioritaskan masalah kritis: Gunakan Prioritas Tugas ClickUp untuk menandai eskalasi yang mendesak atau berdampak besar
- Atur urutan eskalasi yang kompleks: Atur Ketergantungan Tugas ClickUp untuk menghubungkan tugas-tugas terkait (misalnya, ‘Menunggu’ atau ‘Menghalangi’) sehingga langkah-langkah eskalasi dapat menghindari tindakan yang prematur atau kemacetan
- Pecah insiden menjadi bagian-bagian yang dapat ditindaklanjuti: Pecah proses eskalasi menjadi langkah-langkah tindakan yang terperinci dan bagikan tugas-tugas tersebut ke berbagai tim menggunakan Subtugas Bersarang
- Lacak kecepatan penyelesaian secara akurat: Catat dan pantau berapa lama waktu yang dibutuhkan untuk menanggapi dan menyelesaikan tugas eskalasi dengan fitur Pelacakan Waktu Proyek ClickUp
Batasan ClickUp
- Dengan begitu banyak fitur, tampilan, dan opsi penyesuaian, tim sering kali harus melalui proses adaptasi sebelum semuanya terasa intuitif
Harga ClickUp
[Tabel harga]
Peringkat dan ulasan ClickUp
- G2: 4,7/5 (lebih dari 10.300 ulasan)
- Capterra: 4,6/5 (lebih dari 4.400 ulasan)
Apa yang dikatakan pengguna nyata tentang ClickUp?
Ulasan ini benar-benar menjelaskan semuanya:
ClickUp menyatukan semua tugas, proyek, dan komunikasi saya di satu tempat, sehingga sangat mudah untuk tetap terorganisir. Saya sangat menyukai betapa fleksibelnya semua fitur ini—mulai dari tampilan, alur kerja, hingga dasbor—sehingga saya dapat mengatur ruang kerja saya persis seperti yang saya butuhkan. Kemampuan untuk berkolaborasi secara real-time, menugaskan tugas, dan melacak kemajuan tanpa perlu berpindah-pindah alat merupakan keunggulan yang sangat besar.
ClickUp menyatukan semua tugas, proyek, dan komunikasi saya di satu tempat, sehingga sangat mudah untuk tetap terorganisir. Saya sangat menyukai betapa fleksibelnya semua fitur ini—mulai dari tampilan, alur kerja, hingga dasbor—sehingga saya bisa mengatur ruang kerja saya persis seperti yang saya butuhkan. Kemampuan untuk berkolaborasi secara real-time, menugaskan pekerjaan, dan memantau kemajuan tanpa perlu berpindah-pindah aplikasi merupakan keunggulan yang sangat besar.
📮 Wawasan ClickUp: 21% orang mengatakan bahwa lebih dari 80% waktu kerja mereka dihabiskan untuk tugas-tugas berulang. Dan 20% lainnya mengatakan bahwa tugas-tugas berulang menghabiskan setidaknya 40% waktu mereka setiap hari.
Itu berarti hampir setengah dari waktu kerja dalam seminggu (41%) dihabiskan untuk tugas-tugas yang tidak memerlukan banyak pemikiran strategis atau kreativitas (seperti email tindak lanjut 👀).
Super Agents dari ClickUp membantu menghilangkan pekerjaan rutin ini. Mulai dari pembuatan tugas, pengingat, pembaruan, catatan rapat, penyusunan email, hingga pembuatan alur kerja end-to-end! Semua itu (dan masih banyak lagi) dapat diotomatisasi dalam sekejap dengan ClickUp, aplikasi serba guna untuk pekerjaan Anda.
💫 Hasil Nyata: Lulu Press menghemat 1 jam per hari per karyawan dengan menggunakan ClickUp Automations—yang menghasilkan peningkatan efisiensi kerja sebesar 12%.
2. PagerDuty (Pilihan terbaik untuk pemberitahuan real-time dan respons piket yang cerdas)
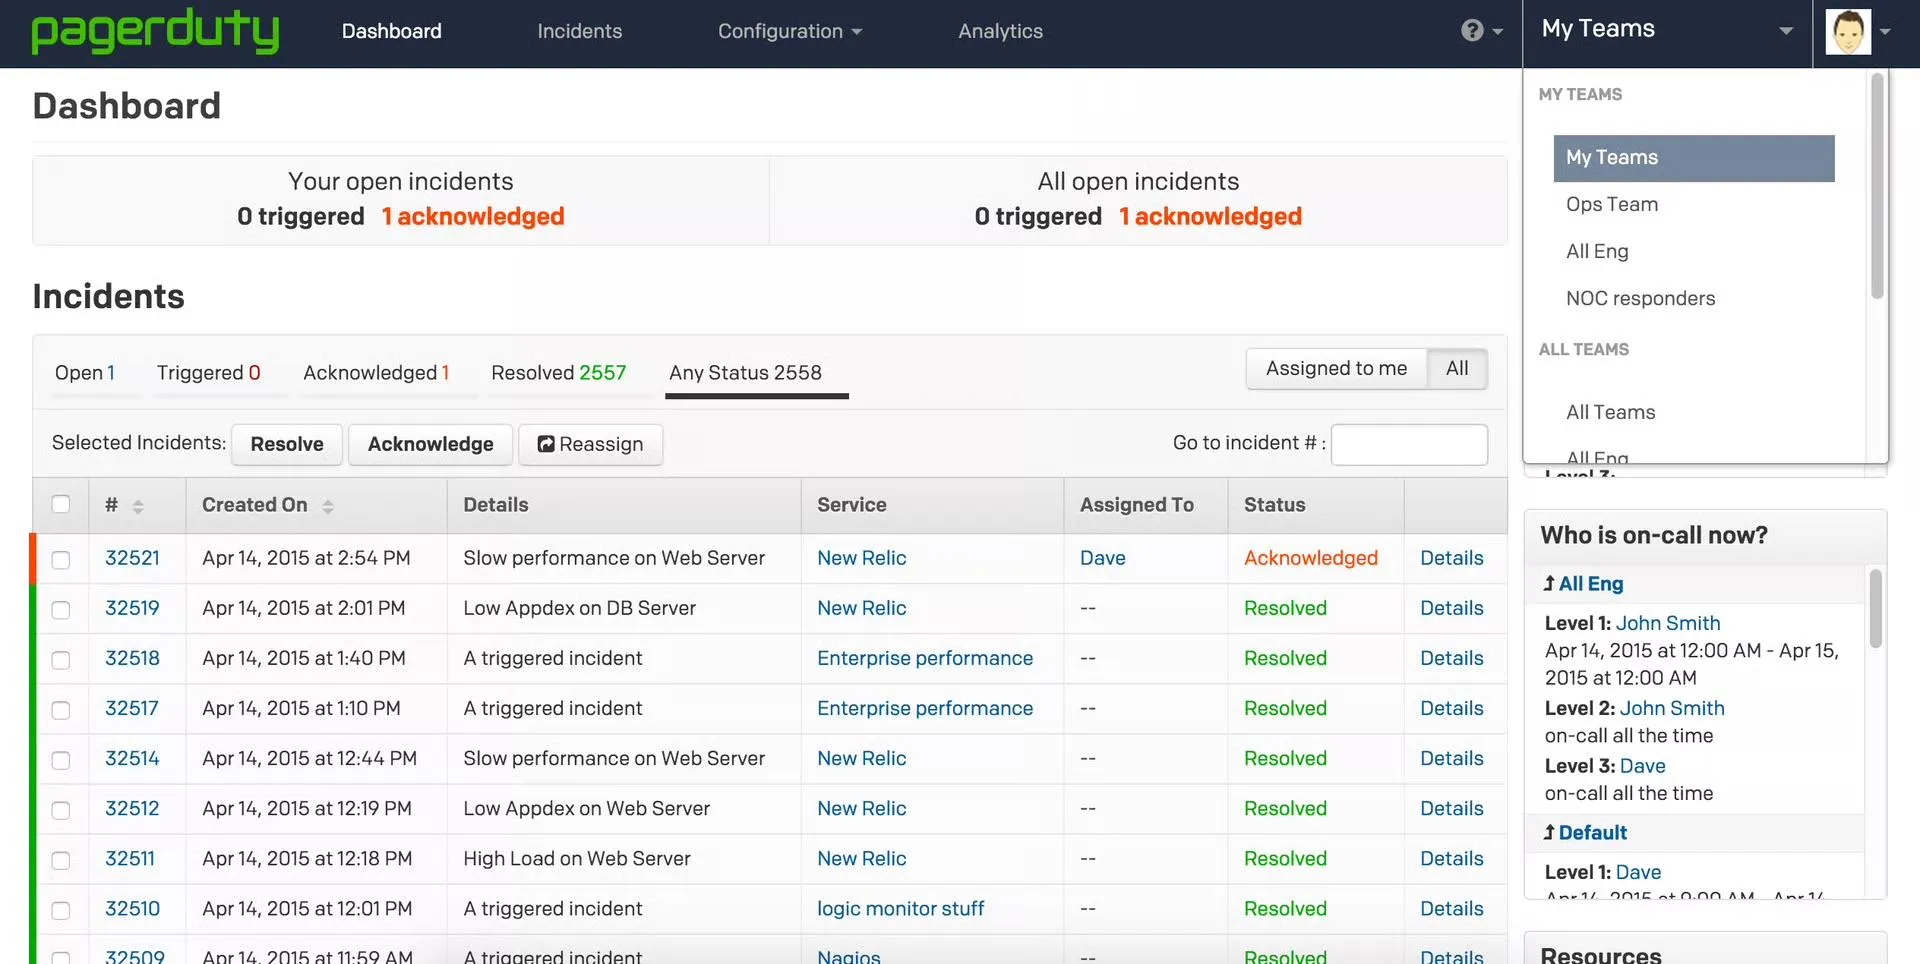
PagerDuty adalah platform manajemen insiden TI dan operasi digital berbasis cloud yang membantu tim mendeteksi, merespons, dan menyelesaikan insiden kritis seperti gangguan layanan atau ancaman keamanan dengan cepat. Platform ini memberikan jalur yang jelas bagi para pemimpin SRE, DevOps, dan dukungan teknis, mulai dari deteksi hingga penyelesaian, yang didukung oleh otomatisasi, triase berbasis AI, dan alur kerja yang terintegrasi secara mendalam.
Fitur-fitur seperti Jeli Incident Analysis, PagerDuty Analytics, dan Runbook Automation membantu tim mengurangi waktu henti, menghilangkan tugas rutin, dan belajar dari setiap insiden.
Fitur terbaik PagerDuty
- Otomatiskan perutean insiden dengan fitur Manajemen Piket bawaan dan Kebijakan Eskalasi dinamis
- Percepat proses triase menggunakan AIOps, yang menyaring peringatan yang tidak relevan, mengkorelasikan peristiwa, dan menyoroti sinyal yang sebenarnya
- Pastikan pemangku kepentingan internal dan eksternal tetap selaras dengan Komunikasi Pemangku Kepentingan, Templat Pembaruan Status, dan Halaman Status
- Satukan rangkaian alat Anda dengan lebih dari 700 integrasi dan API yang dapat diperluas menggunakan sistem pemantauan, pencatatan, CI/CD, dan dukungan
Batasan PagerDuty
- Volume peringatan yang tinggi jika integrasi dan ambang batas cerdas tidak disesuaikan dengan baik, yang dapat menyebabkan kebisingan dan kelelahan
- Peringatan ganda atau berulang mungkin terjadi selama lonjakan, sehingga membuat proses pengakuan menjadi lebih sulit di bawah tekanan
Harga PagerDuty
- Gratis
- Profesional: $25/bulan per pengguna
- Bisnis: $49 per bulan per pengguna
- Enterprise: harga khusus
Peringkat dan ulasan PagerDuty
- G2: 4,5/5 (lebih dari 900 ulasan)
- Capterra: 4,6/5 (lebih dari 200 ulasan)
Apa yang dikatakan pengguna nyata tentang PagerDuty?
Menurut seorang pengguna nyata:
PagerDuty membuat peringatan insiden menjadi cepat dan andal. Aplikasi ini mengirimkan notifikasi yang tepat pada waktu yang tepat dan menjaga tim kami tetap terorganisir. […] PagerDuty terkadang terasa terlalu ramai ketika peringatan tidak difilter dengan baik. Beberapa pengaturan agak rumit bagi pengguna baru.
PagerDuty membuat peringatan insiden menjadi cepat dan andal. Aplikasi ini mengirimkan notifikasi yang tepat pada waktu yang tepat dan menjaga tim kami tetap terorganisir. […] PagerDuty terkadang terasa terlalu ramai ketika peringatan tidak difilter dengan baik. Beberapa pengaturan agak rumit bagi pengguna baru.
💡 Tips Pro: Buat pengecualian, bahkan dalam jalur eskalasi yang jelas. Biarkan gangguan kritis, peringatan keamanan, atau insiden di lingkungan yang diatur langsung diteruskan ke penanggap senior atau yang berspesialisasi.
3. GLPi (Pilihan terbaik untuk tata kelola aset end-to-end dan operasi layanan yang selaras dengan ITIL)
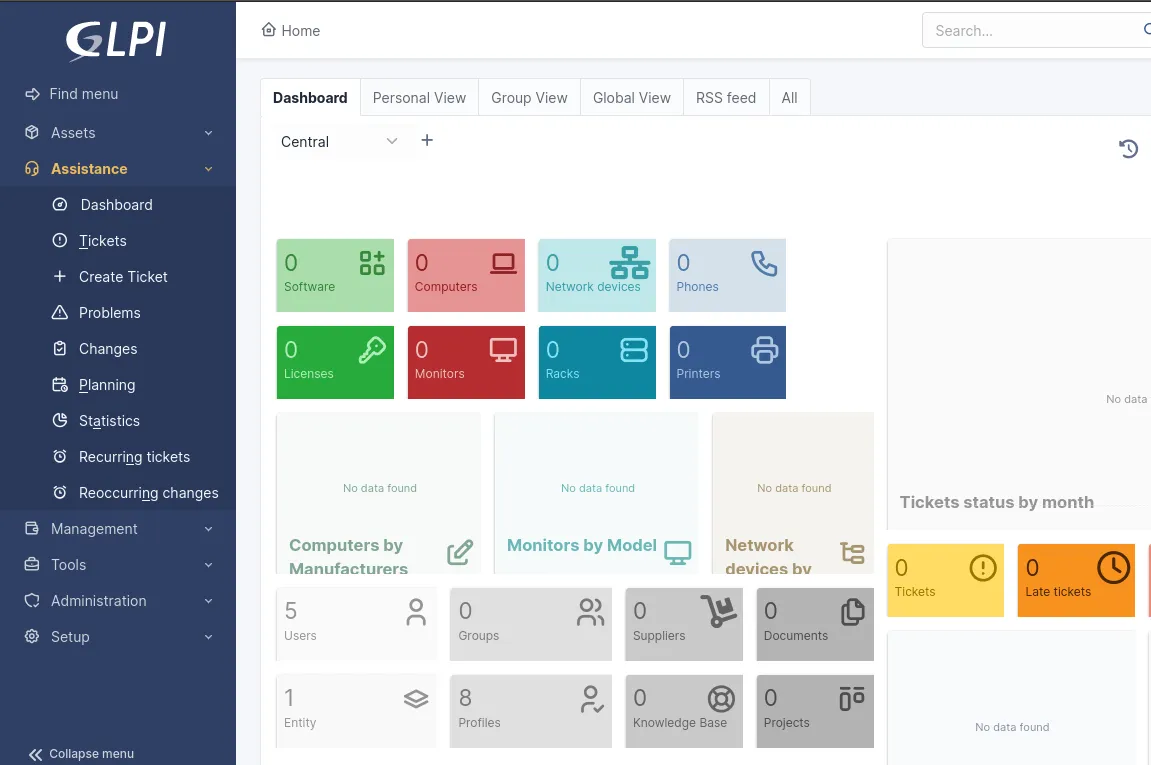
Gestionnaire Libre de Parc Informatique (GLPi) adalah platform Manajemen Layanan TI (ITSM) dan Manajemen Aset TI (ITAM) berskala penuh dan berbasis sumber terbuka. Tim mendapatkan visibilitas menyeluruh atas infrastruktur mereka (perangkat keras, perangkat lunak, lisensi, dan perangkat jaringan) serta dapat mengelola insiden, permintaan layanan, dan perubahan menggunakan proses yang selaras dengan ITIL.
Semua kontrak dan dokumentasi Anda, termasuk garansi dan perjanjian layanan, tetap terorganisir dengan rapi, sehingga tidak tersebar di berbagai sistem. Jika Anda mengelola pusat data, GLPi bahkan memungkinkan Anda memvisualisasikan tata letak, jalur kabel, dan penggunaan energi sehingga Anda selalu mengetahui apa yang terjadi di balik layar.
Fitur terbaik GLPi
- Gunakan plugin GLPI Inventory, OCS Inventory, atau FusionInventory untuk mendeteksi dan mendata aset TI baru secara otomatis
- Otomatiskan tugas-tugas berulang, penugasan tiket, pemberitahuan, dan acara berulang untuk mengurangi pekerjaan manual
- Buat basis pengetahuan untuk pertanyaan umum (FAQ), dokumentasi, dan artikel yang tertaut ke tiket guna mendukung layanan mandiri dan dukungan teknisi
- Terhubung dengan Azure/Entra, Centreon, Google, OAuth2, dan webhooks untuk menyinkronkan data, memicu alur kerja, dan meningkatkan CMDB Anda
Batasan GLPi
- Kompatibilitas plugin dapat terganggu antar versi, sehingga menimbulkan beban pemeliharaan
- Fitur pelaporan, analitik, dan ekspor terasa terbatas dan perlu ditingkatkan
Harga GLPi
- Penetapan harga khusus
Peringkat dan ulasan GLPi
- G2: 4,6/5 (lebih dari 30 ulasan)
- Capterra: 4,5/5 (lebih dari 40 ulasan)
Apa yang dikatakan pengguna nyata tentang GLPi?
Berikut ini adalah testimoni dari salah satu pengguna:
Sistem manajemen aset TI dan tiket dukungan open-source yang sangat dapat disesuaikan dengan komunitas pendukung yang besar. Antarmuka pengguna agak rumit bagi pemula. Plugin tidak selalu didukung saat beralih dari versi lama ke versi baru.
Sistem manajemen aset TI dan tiket dukungan open-source yang sangat dapat disesuaikan dengan komunitas pendukung yang besar. Antarmuka pengguna agak rumit bagi pemula. Plugin tidak selalu didukung saat beralih dari versi lama ke versi baru.
4. Splunk On-Call (Pilihan terbaik untuk meneruskan peringatan pemantauan langsung ke para insinyur)
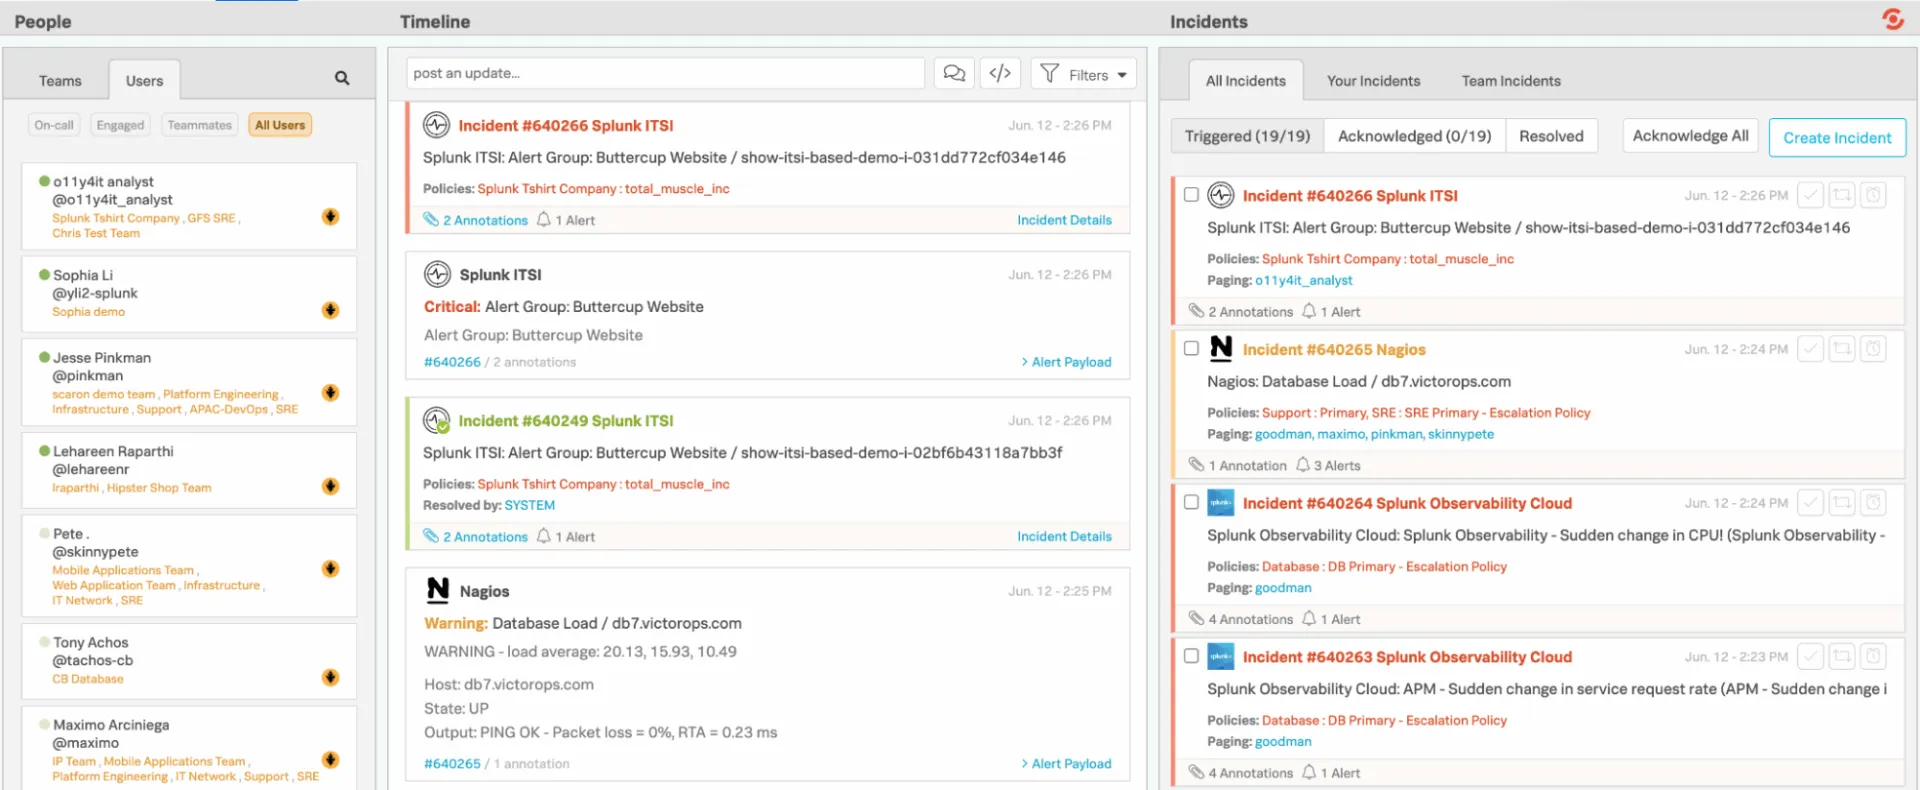
Splunk On-Call memberikan tim teknik dan tim piket cara yang lebih cepat dan lebih efisien untuk mengelola insiden, sehingga menghilangkan kebutuhan akan alur kerja tiket tradisional yang lambat. Alih-alih mengirimkan peringatan ke antrian umum, Splunk On-Call terintegrasi langsung dengan sistem pemantauan dan observabilitas Anda, serta segera meneruskan masalah ke orang yang tepat berdasarkan jadwal, aturan, dan konteks.
Integrasi seluler dan obrolan memudahkan Anda untuk menandai sebagai diterima, mengalihkan, atau menyelesaikan insiden dari mana saja. Dan di balik layar, Splunk On-Call menyimpan catatan terperinci mengenai tren, pola yang telah terbukti, dan perilaku eskalasi.
Fitur terbaik Splunk On-Call
- Perluas kemampuan platform ini dengan memanfaatkan lebih dari 1.000 integrasi dan add-on yang telah diverifikasi dari Splunk dan komunitas yang lebih luas
- Buat dasbor dan laporan visual khusus untuk memantau volume peringatan, status insiden, kinerja penanggap, dan beban kerja tim
- Saring insiden dengan cepat berdasarkan aktivitas Anda sendiri, insiden tim Anda, atau semua insiden yang terjadi di seluruh organisasi
- Beralih di antara Tampilan Dipicu, Tampilan Dikonfirmasi, dan Tampilan Terselesaikan untuk melihat status masing-masing insiden
Batasan Splunk On-Call
- Penjadwalan shift di berbagai tim bisa menjadi rumit jika aturan tidak ditentukan sebelumnya
- Kemampuan yang terbatas dalam menghasilkan laporan insiden yang terperinci berdasarkan tanggal
Harga Splunk On-Call
- Penetapan harga khusus
Peringkat dan ulasan Splunk On-Call
- G2: 4,6/5 (lebih dari 40 ulasan)
- Capterra: 4,5/5 (lebih dari 30 ulasan)
Apa yang dikatakan pengguna nyata tentang Splunk On-Call?
Seorang pengguna merangkumnya seperti ini:
Kemampuan untuk menangani insiden, eskalasi, dan mengambil alih tugas rekan tim saya melalui aplikasi seluler sungguh luar biasa. […] Saya ingin dapat menjadwalkan pengecualian dan mengubah jadwal rutin melalui aplikasi seluler untuk perubahan jadwal darurat.
Kemampuan untuk menangani insiden, eskalasi, dan mengambil alih tugas rekan tim saya melalui aplikasi seluler sungguh luar biasa. […] Saya ingin dapat menjadwalkan pengecualian dan mengubah jadwal rutin melalui aplikasi seluler untuk perubahan jadwal darurat.
🔍 Tahukah Anda? Logika ‘mengalihkan ke orang yang tepat jika tingkat pertama gagal’ berakar pada sistem sentral telepon pada masa awal: ketika operator manual tidak dapat menghubungkan panggilan, sistem akan mengalihkan (atau mengeskalasi) panggilan tersebut ke operator lain atau sentral telepon lain.
5. ServiceNow (Pilihan terbaik untuk mengelola operasi skala perusahaan dengan otomatisasi yang didukung AI)
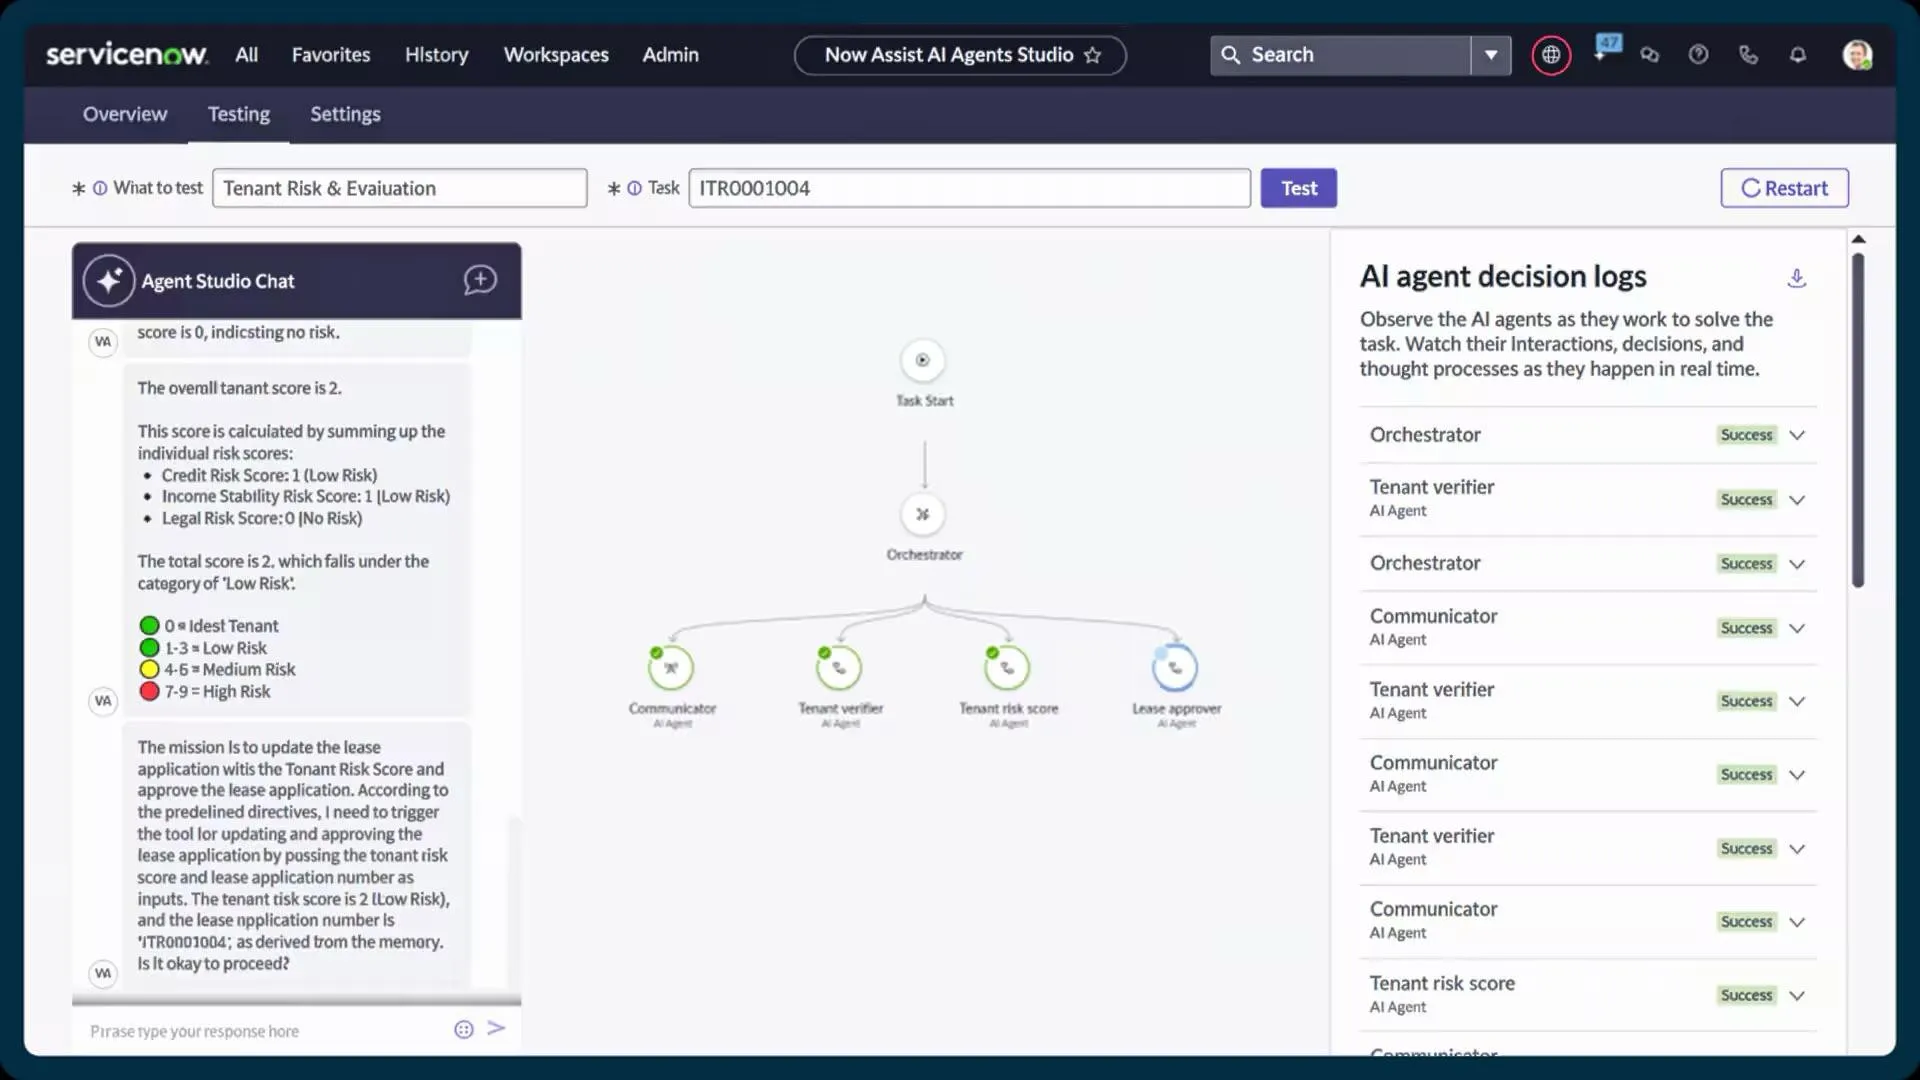
ServiceNow secara otomatis mengklasifikasikan, memprioritaskan, dan meneruskan insiden begitu insiden tersebut tercatat. Dengan fitur seperti Now Assist untuk rekomendasi tiket insiden otomatis dan pembuatan konten cerdas, petugas penanggulangan dapat menyelesaikan masalah lebih cepat dan dengan pemahaman konteks yang lebih baik.
Sistem ini mengintegrasikan manajemen insiden, perubahan, dan aset. Dengan demikian, Anda mendapatkan gambaran real-time mengenai bagaimana layanan saling terhubung, di mana titik kemacetan muncul, dan komponen mana yang mungkin berkontribusi terhadap gangguan yang berulang.
Fitur terbaik ServiceNow
- Tugaskan, alihkan, dan pantau tugas lapangan melalui Field Service Management dan Dispatcher Workspace
- Berikan karyawan dan pelanggan akses ke portal layanan mandiri yang didukung oleh AI Search dan agen virtual
- Gunakan alur kerja bawaan dan alat low-code di App Engine untuk memperluas atau menyesuaikan proses layanan
- Otomatiskan tugas dan alur kerja yang berulang di seluruh tim dengan Flow Designer dan Automation Engine
Batasan ServiceNow
- Opsi antarmuka pengguna (UI) dan penyesuaian merek pada portal terasa ketinggalan zaman atau membatasi
- Tergantung secara berlebihan pada tenaga ahli atau konsultan untuk implementasi
Harga ServiceNow
- Penetapan harga khusus
Peringkat dan ulasan ServiceNow
- G2: 4,4/5 (lebih dari 3.300 ulasan)
- Capterra: 4,5/5 (lebih dari 300 ulasan)
Apa yang dikatakan pengguna nyata tentang ServiceNow?
Berikut adalah pendapat salah satu pengguna:
[…] Alur kerja yang sudah disiapkan sebelumnya merupakan fitur unggulan lainnya bagi saya, karena alur tersebut mempermudah proses dan menghemat waktu secara signifikan, meminimalkan kebutuhan akan konfigurasi khusus, serta memungkinkan alur kerja yang lebih lancar dan efisien. […] Selain itu, saya mengalami kesulitan dalam mengintegrasikan solusi khusus saya ke dalam sistem Manajemen Layanan Pelanggan, yang membutuhkan banyak iterasi.
[…] Alur kerja yang sudah disiapkan sebelumnya merupakan fitur unggulan lainnya bagi saya, karena alur tersebut mempermudah proses dan menghemat waktu secara signifikan, meminimalkan kebutuhan akan konfigurasi khusus, serta memungkinkan alur kerja yang lebih lancar dan efisien. […] Selain itu, saya mengalami kesulitan dalam mengintegrasikan solusi khusus saya ke dalam sistem Manajemen Layanan Pelanggan, yang membutuhkan banyak iterasi.
Praktik Terbaik dan Tata Kelola
Berikut adalah beberapa praktik terbaik yang memastikan otomatisasi tetap akurat, menghindari kelelahan akibat peringatan, dan selaras dengan harapan bisnis serta regulasi.
- Tentukan kriteria eskalasi yang tidak dapat dinegosiasikan: Hubungkan pemicu dengan sinyal yang dapat diukur, seperti pelanggaran SLO, lonjakan anomali, dampak pada tingkatan pelanggan, atau sensitivitas regulasi
- Tentukan kejelasan peran di setiap tingkatan: Gunakan peta RACI sederhana untuk setiap tingkat eskalasi agar tanggung jawab tidak pernah ambigu selama insiden yang penuh tekanan
- Terapkan tata kelola piket dinamis: Sesuaikan jalur eskalasi secara otomatis sesuai dengan akhir pekan, hari libur, batas kapasitas, dan serah terima tugas untuk mengurangi kelelahan dan mencegah panggilan darurat yang tidak terbalas
- Sertakan titik pemeriksaan manual untuk skenario berisiko tinggi: Meskipun telah diotomatisasi, wajibkan konfirmasi manual untuk insiden yang melibatkan paparan data pelanggan, pembayaran, atau alur kerja yang diatur oleh peraturan.
- Jaga jejak audit yang lengkap: Simpan catatan yang tidak dapat diubah mengenai siapa yang dihubungi, kapan mereka menanggapi, langkah-langkah otomatis apa yang dijalankan, dan keputusan apa yang diambil
🧠 Fakta Menarik: Keluhan tertulis tertua yang diketahui di dunia diukir pada sebuah tablet tanah liat sekitar tahun 1750 SM. Pada dasarnya, itu adalah bentuk awal dari eskalasi status proyek. Seorang pelanggan bernama Nanni menulis surat kepada pedagang Ea-nāṣir, marah karena tembaga yang diterimanya berkualitas lebih rendah dari yang dijanjikan dan utusannya diperlakukan dengan buruk.
Tantangan Umum dan Cara Mengatasinya
Bahkan dengan kebijakan eskalasi yang jelas, tim sering kali menghadapi kendala operasional yang memperlambat respons insiden atau menimbulkan kebingungan.
Tabel ini menyoroti tantangan umum yang melampaui langkah-langkah pengaturan dasar dan memberikan strategi praktis untuk mengatasinya.
| Tantangan ❌ | Solusi ✅ |
| Konteks yang tidak konsisten selama serah terima tugas | Gunakan fitur penghubungan tugas dan templat laporan insiden ClickUp untuk menjaga jejak audit lengkap mengenai detail insiden, sistem yang terdampak, dan tindakan sebelumnya di setiap tingkat eskalasi |
| Membebani petugas tanggap darurat dengan peringatan prioritas rendah | Terapkan prioritas dinamis dengan ClickUp Custom Fields dan AI Prioritize untuk menyaring insiden berdasarkan tingkat keparahan, dampak, dan ambang batas SLA |
| Kurangnya visibilitas antar tim | Siapkan Workspaces bersama, tambahkan komentar, dan buat papan tulis visual ClickUp untuk menampilkan pembaruan real-time kepada pemangku kepentingan |
| Penundaan pengambilan keputusan selama insiden kritis | Otomatiskan pemberitahuan menggunakan fitur Suggested Actions dari ClickUp Brain Max untuk segera memberi tahu personel yang tepat berdasarkan jenis insiden, tingkat keparahan, dan pola historis |
| Kesulitan melacak masalah yang berulang | Manfaatkan fitur pelaporan kustom dan templat tugas berulang ClickUp untuk mengidentifikasi pola, akar masalah, dan insiden berulang guna pencegahan proaktif |
| Pengetahuan yang terfragmentasi selama proses eskalasi | Kelola SOP, runbook, dan dokumentasi insiden secara terpusat di ClickUp Docs, serta tautkan ke Tugas yang relevan agar dapat langsung dirujuk saat terjadi eskalasi. |
| Tanggung jawab yang tidak selaras antar shift | Gunakan tampilan Workload dan Timeline di ClickUp untuk memvisualisasikan penugasan dan memastikan tidak ada tumpang tindih atau celah selama pergantian shift atau serah terima tugas |
| Pelacakan kepatuhan secara manual dan celah audit | Otomatiskan ringkasan yang siap diaudit dengan ClickUp Brain untuk mencatat semua tindakan insiden, pemberitahuan, dan penyelesaiannya |
Mengukur Dampak Eskalasi Otomatis
Untuk memantau efektivitas eskalasi otomatis, Anda perlu berfokus pada metrik kunci terkait volume, efisiensi, dan kualitas. Indikator-indikator ini menunjukkan apakah proses eskalasi Anda lebih cepat, lebih akurat, dan tidak membuat frustrasi baik bagi tim maupun pelanggan.
Pantau metrik-metrik berikut ini:
- Tingkat eskalasi (volume): Persentase masalah yang dieskalasi melampaui tingkat pertama. Tingkat yang tinggi mungkin menandakan adanya celah dalam proses triase awal atau basis pengetahuan
- Tingkat eskalasi berulang (volume): Frekuensi suatu masalah yang sama dieeskalasi berulang kali. Hal ini menandakan penyelesaian yang tidak tuntas atau hilangnya konteks
- Waktu hingga eskalasi (efisiensi): Durasi dari deteksi hingga eskalasi. Durasi tahap yang lebih singkat menandakan pengenalan otomatis yang lebih cepat terhadap masalah kritis
- Waktu penundaan serah terima (efisiensi): Selisih waktu antara eskalasi dan saat tim berikutnya mulai bekerja untuk mengidentifikasi hambatan dalam proses perutean atau pemberitahuan
- Waktu penyelesaian untuk kasus yang ditingkatkan (efisiensi): Total waktu dari eskalasi hingga penyelesaian. Penyelesaian yang lebih cepat menunjukkan keefektifan otomatisasi
- Skor kepuasan pelanggan (CSAT) (kualitas): Umpan balik mengenai interaksi yang ditingkatkan untuk mengukur kelancaran alur tersebut
- Penerusan konteks (kualitas): Apakah agen menerima riwayat insiden secara lengkap untuk memastikan pelanggan tidak perlu mengulang informasi
- Resolusi pada kontak pertama (FCR) (kualitas): Persentase masalah yang diselesaikan dalam satu interaksi
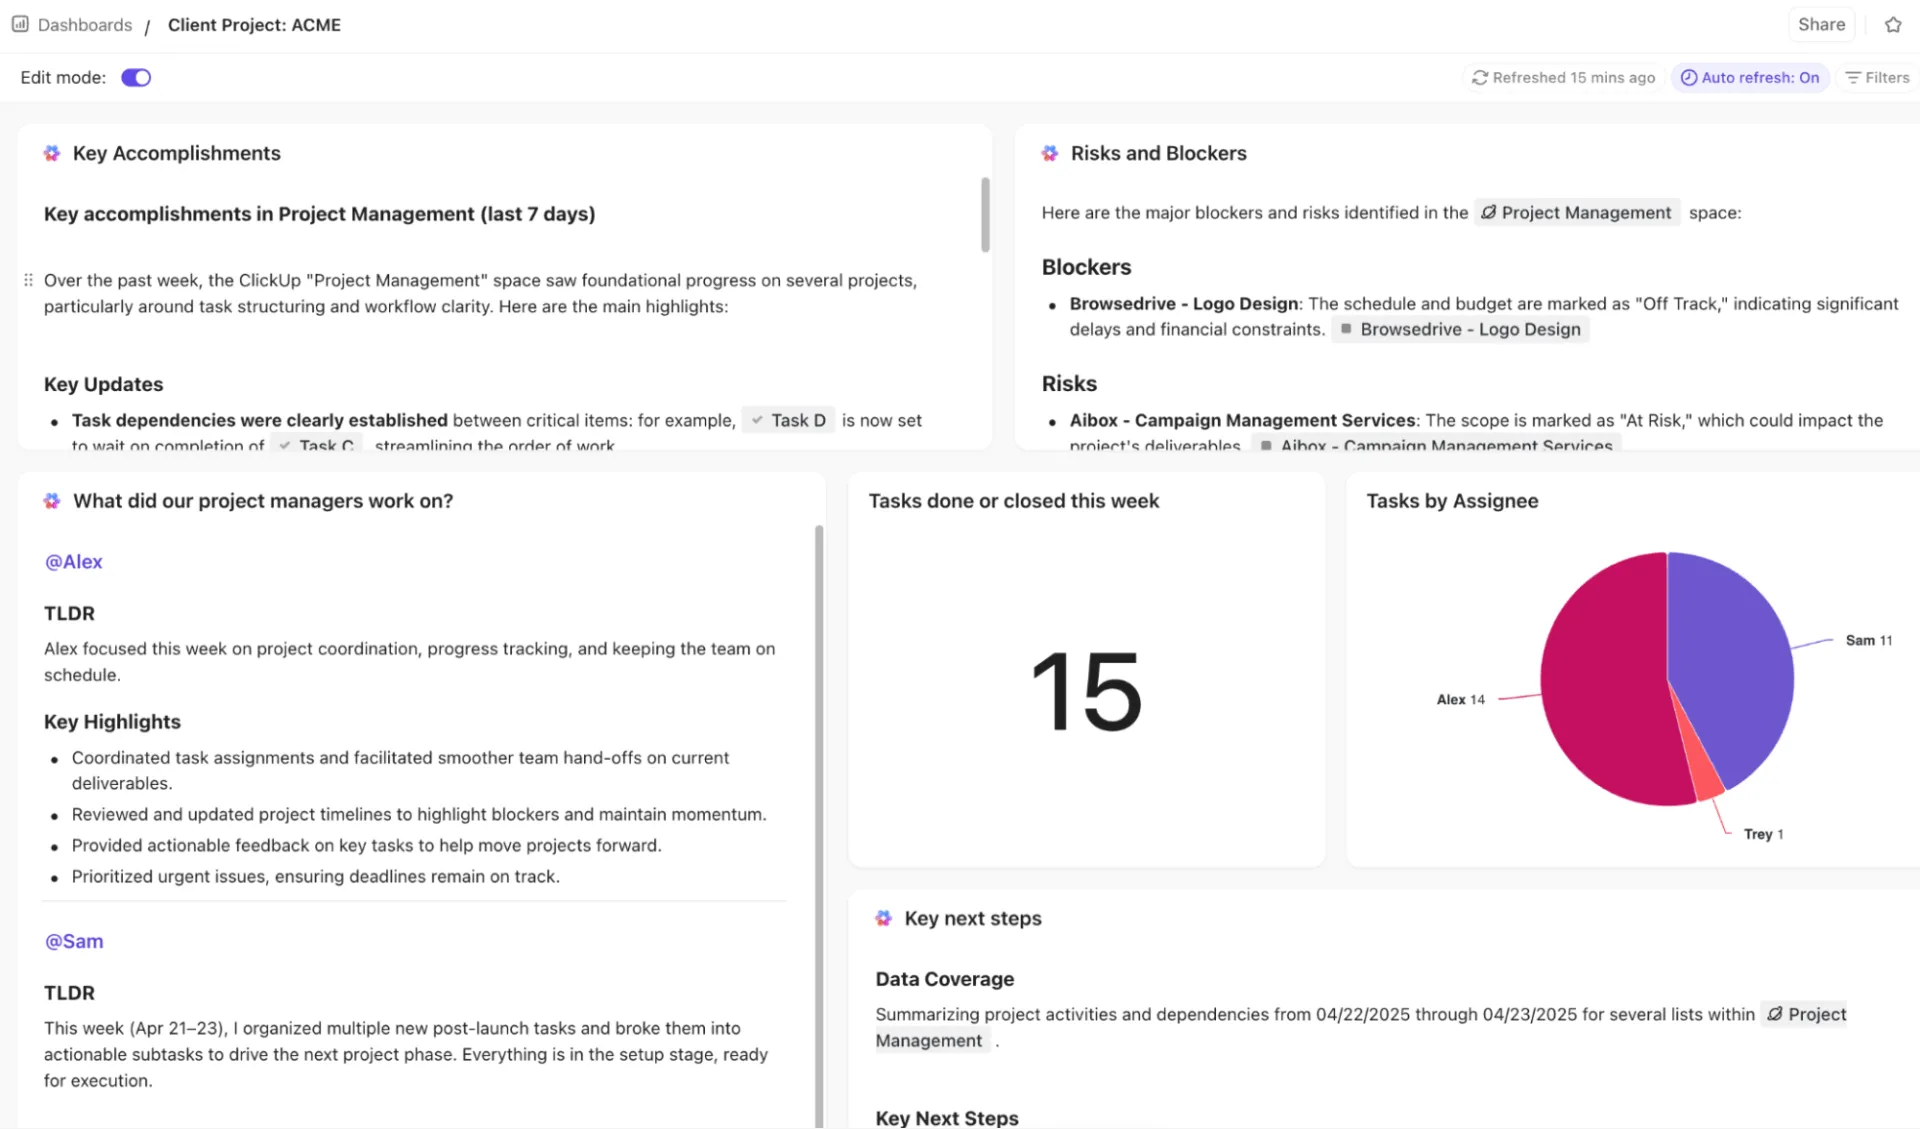
🚀 Keunggulan ClickUp: Dapatkan wawasan real-time, visual, dan didukung AI untuk semua metrik eskalasi melalui Dasbor ClickUp.
Anda dapat melacak tren eskalasi, hambatan, dan kinerja menggunakan Tabel, Diagram Lingkaran, Diagram Batang, Diagram Garis, Perhitungan, dan Kartu Laporan Waktu. Pantau tingkat eskalasi, eskalasi berulang, dan waktu hingga eskalasi dengan kartu yang terhubung ke tugas, bidang kustom, dan status.
Untuk melangkah lebih jauh, gunakan Kartu AI seperti AI Executive Summary, AI Project Update, dan AI StandUp untuk menyoroti tren, penundaan, dan hasil penyelesaian.
Kelola Insiden Anda Lebih Cepat dengan ClickUp
Banyak yang menganggap eskalasi insiden hanyalah soal meneruskan tiket ke orang berikutnya, tetapi sebenarnya jauh lebih dari itu. Ini adalah sistem terstruktur di mana setiap langkah, mulai dari triase hingga penyelesaian, berjalan secara terpadu.
ClickUp menyediakan ruang kerja terpadu yang sempurna. Dengan ClickUp Automations, Anda dapat memicu peringatan, mengalihkan tugas, dan memperbarui status secara otomatis. Selain itu, ClickUp Brain membantu memprioritaskan insiden, membuat ringkasan, dan menyarankan langkah selanjutnya.
Agen AI ClickUp berfungsi sebagai asisten cerdas di dalam ruang kerja Anda, sementara Dasbor ClickUp menampilkan tampilan langsung dari proses eskalasi Anda.
Daftar ke ClickUp secara gratis hari ini!
Pertanyaan yang Sering Diajukan (FAQ)
Apa itu jalur eskalasi insiden?
Rute eskalasi insiden adalah urutan langkah yang telah ditentukan sebelumnya yang menentukan bagaimana masalah dialihkan ke tim atau individu yang tepat berdasarkan tingkat keparahan, dampak, dan waktu. Hal ini memastikan insiden ditangani secara efisien dan pertanggungjawaban jelas. TEXT
Bagaimana cara menentukan kapan harus mengeskalasi insiden secara otomatis atau manual?
Gunakan otomatisasi untuk insiden yang terdefinisi dengan baik dan berprioritas tinggi dengan kriteria yang jelas (misalnya, gangguan layanan, pelanggaran keamanan). Simpan eskalasi manual untuk situasi yang ambigu atau kritis yang memerlukan penilaian manusia atau konteks tambahan.
Alat apa saja yang mendukung eskalasi otomatis untuk manajemen insiden yang efektif?
Platform seperti ClickUp, PagerDuty, Jira Service Management, dan ServiceNow memungkinkan perutean, pemberitahuan, dan pembaruan otomatis. Platform-platform ini membantu tim mengurangi penundaan dan menjaga alur kerja insiden yang terstruktur.
Bagaimana cara menghindari kelelahan akibat peringatan saat menggunakan eskalasi otomatis?
Tetapkan ambang batas yang jelas untuk peringatan, prioritaskan berdasarkan tingkat keparahan, dan gunakan notifikasi cerdas. Batasi notifikasi berulang hanya untuk insiden kritis, serta manfaatkan dasbor atau alat AI untuk merangkum pembaruan daripada mengirimkan setiap perubahan kecil.
Seberapa sering saya harus meninjau kebijakan eskalasi saya?
Tinjau kebijakan eskalasi secara berkala, setidaknya setiap tiga bulan atau setelah insiden besar. Hal ini memastikan bahwa kriteria, tanggung jawab, dan aturan otomatisasi mencerminkan alur kerja terkini, struktur tim, dan prioritas bisnis.