
Większość zespołów traktuje generowanie kodu SQL jak sztuczkę magiczną. Wpisujesz pytanie i otrzymujesz zapytanie.
Jednak rzeczywistość wygląda następująco: Snowflake Cortex Analyst działa tylko tak dobrze, jak model semantyczny, który najpierw zbudujesz, a ustawienia nie są proste. Po opanowaniu korzystania z Snowflake Cortex do generowania zapytań SQL zespoły ds. danych mogą teraz w ciągu kilku sekund przekształcać język naturalny w złożone, wykonalne zapytania.
Niniejszy przewodnik przeprowadzi Cię przez rzeczywisty proces wdrażania, od zdefiniowania modelu semantycznego w formacie YAML po wysyłanie zapytań do hurtowni danych przy użyciu języka naturalnego, dzięki czemu przed rozpoczęciem pracy zrozumiesz zarówno możliwości tego narzędzia, jak i wymagania wstępne.
Przyjrzymy się również, w jakich obszarach Snowflake Cortex ma pewne ograniczenia oraz w jaki sposób ClickUp może zapewnić wsparcie dla szerszych cykli pracy związanych z generowaniem zapytań SQL.
Czym jest Snowflake Cortex Analyst?
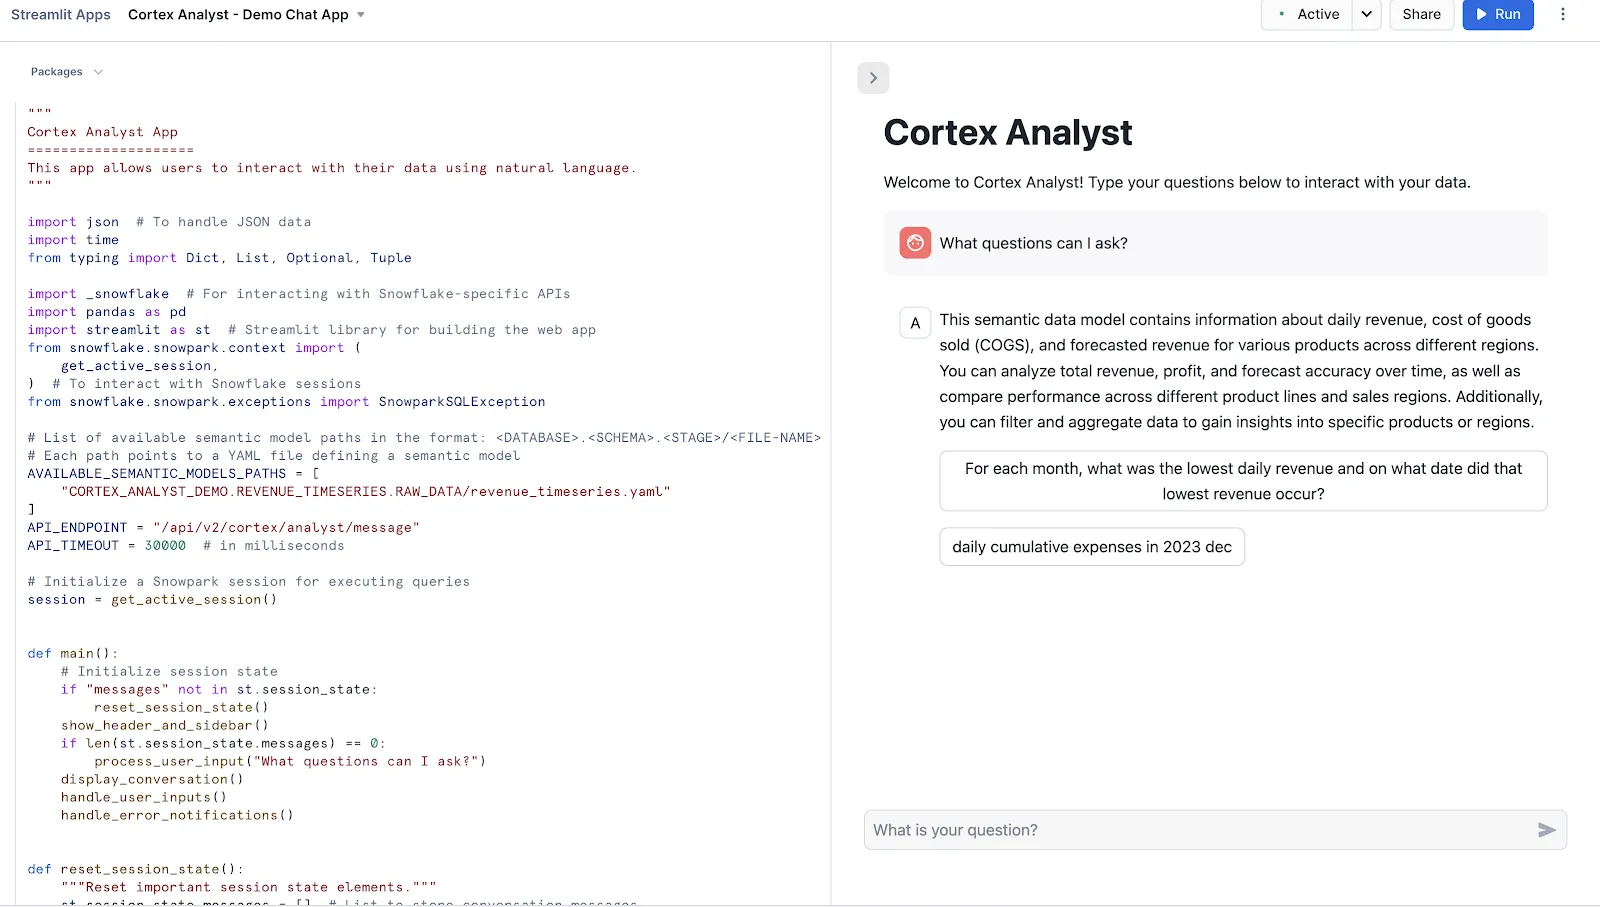
Snowflake Cortex Analyst to w pełni zarządzana usługa, która umożliwia tworzenie aplikacji konwersacyjnych opartych na danych analitycznych.
Wykorzystuje on specjalistyczny agent tekst-do-SQL, który przekształca pytania sformułowane w języku naturalnym w dokładne, wykonalne zapytania. Usługa ta wypełnia lukę między złożonymi strukturami danych a użytkownikami biznesowymi, którzy potrzebują odpowiedzi bez konieczności pisania kodu.
Najważniejsze funkcje obejmują:
- Zapewnienie wysoce precyzyjnego interfejsu do interakcji z danymi ustrukturyzowanymi
- Wykorzystanie modeli semantycznych do zrozumienia specyficznej logiki biznesowej i terminologii
- Oferuje interfejs API REST, który ułatwia integrację z niestandardowymi aplikacjami lub narzędziami BI
- Zapewnienie prywatności danych poprzez przetwarzanie żądań w ramach zabezpieczeń platformy Snowflake
📮 ClickUp Insight: 88% respondentów naszej ankiety korzysta ze sztucznej inteligencji do zadań osobistych, jednak ponad 50% unika jej stosowania w pracy. Jakie są trzy główne przeszkody? Brak płynnej integracji, luki w wiedzy oraz obawy dotyczące bezpieczeństwa.
A co, jeśli sztuczna inteligencja jest wbudowana w Twoje środowisko pracy i już teraz jest bezpieczna? ClickUp Brain, wbudowany asystent AI firmy ClickUp, sprawia, że staje się to rzeczywistością. Rozumie podpowiedzi sformułowane prostym językiem, rozwiązując wszystkie trzy obawy związane z wdrażaniem sztucznej inteligencji, jednocześnie zapewniając połączenie między czatem, zadaniami, dokumentami i wiedzą w całym obszarze roboczym.
Znajdź odpowiedzi i spostrzeżenia jednym kliknięciem!
Wymagania wstępne dotyczące generowania kodu SQL za pomocą Snowflake Cortex
Rozpoczęcie pracy z Snowflake Cortex bez odpowiednich ustawień prowadzi do frustracji. Możesz uzyskać niedokładne wyniki, tracić czas na rozwiązywanie problemów i błędnie uznać, że narzędzie nie działa, podczas gdy prawdziwym problemem jest słaba podstawa.
Aby tego uniknąć, musisz najpierw zadbać o trzy podstawowe elementy.
1. Skonfiguruj bazę danych i tabele
Twoja AI jest tak inteligentna, jak dane, do których ma dostęp. Jeśli schemat Twojej bazy danych to labirynt tajemniczych nazw kolumn, takich jak cust_dat_v2_final, zarówno analitycy, jak i AI będą mieli trudności z jego zrozumieniem.
To niejasności powodują, że AI generuje nieprawidłowe połączenia lub pobiera dane z niewłaściwych kolumn, a Twój zespół traci wiele godzin na próby rozszyfrowania schematu, zanim w ogóle będzie mógł napisać zapytanie.
Na początek upewnij się, że oprogramowanie hurtowni danych zawiera tabele, które mają być przedmiotem zapytań generowanych przez Cortex Analyst. W miarę możliwości używaj jasnych, opisowych nazw kolumn. Na przykład kolumna o nazwie customer_lifetime_value jest znacznie bardziej intuicyjna zarówno dla ludzi, jak i dla AI niż clv_01.
Aby kontynuować ustawienia, Twoja rola w Snowflake będzie wymagała następujących uprawnień:
- ZASTOSOWANIE: W bazie danych i schemacie zawierającym Twoje tabele
- SELECT: W tabelach, które mają być przedmiotem zapytań generowanych przez Cortex Analyst
- SCENA TWORZENIA: W schemacie, który jest wymagany do przesłania pliku modelu semantycznego
📖 Przeczytaj również: Jak korzystać z Snowflake Cortex w analizie biznesowej
2. Utwórz plik modelu semantycznego
Największą przeszkodą w przypadku każdego narzędzia do konwersji tekstu na SQL jest to, że AI nie posługuje się specyficznym językiem Twojej firmy. Nie wie z natury, że „ARR” oznacza „Annual Recurring Revenue” (roczny przychód cykliczny) ani że tabela klientów jest połączona z tabelą zamówień na podstawie pola customer_id.
Bez tego kontekstu AI może wygenerować kod SQL, który jest poprawny pod względem technicznym, ale błędny pod względem logicznym, dostarczając odpowiedzi, które wydają się poprawne, ale są niebezpiecznie mylące.
Rozwiązaniem jest model semantyczny. Jest to plik YAML, który pełni rolę niestandardowej „warstwy tłumaczeniowej”, ucząc Cortex Analyst specyficznego słownictwa i logiki Twojej firmy. Tworzenie i utrzymywanie tego pliku wymaga wspólnego wysiłku między inżynierami danych, którzy korzystają z narzędzi ETL w celu poznania schematu, a analitykami biznesowymi, którzy znają terminologię.
Plik modelu semantycznego powinien zawierać następujące kluczowe elementy:
| Komponent | Cel |
| Tabela | Zawiera listę wszystkich tabel wraz z opisem ich przeznaczenia w języku potocznym |
| Kolumny | Określa typ semantyczny każdej kolumny (np. kategorię lub metrykę) i może zawierać próbki wartości |
| relacje | Określa, w jaki sposób tabele łączą się za pomocą połączeń (joinów), eliminując wszelkie domysły ze strony AI |
| Zweryfikowane zapytania | Zawiera przykładowe pary pytań i zapytań SQL, które stanowią cenne wskazówki dla modelu LLM. |
3. Skonfiguruj usługę Cortex Search (opcjonalnie)
Czasami potrzebne odpowiedzi są ukryte w tekstach nieustrukturyzowanych, takich jak opisy produktów, zgłoszenia do wsparcia technicznego czy transkrypcje rozmów telefonicznych. Standardowe zapytania SQL nie mają dostępu do tych danych, co oznacza, że często umyka Ci „dlaczego” kryjące się za „czym”.
Opcjonalnie możesz tutaj dodać usługę Snowflake Cortex Search Service. Jest to warstwa typu „search-as-a-service”, która umożliwia jednoczesne wysyłanie zapytań zarówno do tabel strukturalnych, jak i do nieustrukturyzowanych danych tekstowych przy użyciu agentów AI do analizy danych.
Należy skonfigurować funkcję Cortex Search, jeśli analitycy muszą zadawać pytania wymagające wyodrębnienia kontekstu z tekstu przed wygenerowaniem kodu SQL. Na przykład można najpierw wyszukać wszystkie recenzje produktów zawierające frazę „problem z baterią”, a następnie wygenerować zapytanie SQL w celu agregacji danych dotyczących sprzedaży wyłącznie tych produktów.
W przypadku generowania czystego kodu SQL dla tabelek strukturalnych usługa ta nie jest konieczna.
🧠 Ciekawostka: Na początku lat 70. badacze z IBM, Donald Chamberlin i Raymond Boyce, stworzyli „Structured English Query Language”. Musieli jednak zmienić nazwę na SQL, ponieważ nazwa „SEQUEL” była już zastrzeżonym znakiem towarowym brytyjskiej firmy lotniczej.
Przewodnik krok po kroku dotyczący generowania kodu SQL za pomocą Cortex Analyst
Przygotowania masz już zrobione, ale teraz stoisz przed pustym ekranem, nie mając pewności co do rzeczywistego cyklu pracy. Jak przekształcić pytanie, które masz w głowie, w działające zapytanie SQL? Gdy sposób pracy nie jest jasny, nowe narzędzia często pozostają niewykorzystane, a inwestycja w ich ustawienia idzie na marne.
Ten praktyczny proces jest zaskakująco prosty. Przyjrzyjmy się temu bliżej!
Krok 1: Przygotuj dane w Snowflake
Przede wszystkim Twoje dane ustrukturyzowane muszą znajdować się w Snowflake. Każda aplikacja Cortex Analyst jest skierowana albo na pojedynczą tabelę, albo na widok złożony z jednej lub więcej tabel. Upewnij się, że tabele zostały utworzone i zapełnione danymi.
Jeśli ładujesz dane z plików płaskich:
- Prześlij swoje pliki danych (np. pliki CSV) do Snowflake Stage
- Użyj komendy COPY INTO, aby załadować dane ze stage'u do swoich tabel
- Przed przejściem dalej sprawdź, czy załadowanie danych przebiegło z powodzeniem
Krok 2: Stwórz model semantyczny (lub widok semantyczny)
Jest to najważniejszy krok ustawień. Siła narzędzia Cortex Analyst wynika z połączenia dużych modeli językowych (LLM) z modelami semantycznymi — plikiem YAML, który znajduje się obok schematu bazy danych i koduje kontekst biznesowy.
Widoki semantyczne są obecnie metodą zalecaną przez Snowflake dla narzędzia Cortex Analyst. Przechowują one wskaźniki biznesowe, związki i definicje bezpośrednio w Snowflake. Starsza wersja plików modeli semantycznych w formacie YAML nadal działa, ale Snowflake kieruje nowe wdrożenia w stronę widoków semantycznych.
Twój model semantyczny lub widok powinien zawierać:
- Opisy tabel i kolumn: Wyjaśnienia w języku potocznym dotyczące znaczenia poszczególnych pól
- Wskaźniki biznesowe: Definicje pól obliczeniowych, takich jak przychody, wskaźnik rezygnacji lub współczynnik konwersji
- Filtry i synonimy: alternatywne terminy, których mogą używać użytkownicy (np. „anulowane” przypisane do konkretnej wartości statusu)
- Zweryfikowane zapytania: Repozytorium zweryfikowanych zapytań Snowflake przechowuje zatwierdzone pary pytań i kodu SQL. Gdy pytanie użytkownika przypomina jeden z tych wpisów, Cortex Analyst może odwołać się do niego podczas generowania kodu SQL.
🤝 Przyjazne przypomnienie: Snowflake zaleca używanie nie więcej niż 10 tabel i nie więcej niż 50 wybranych kolumn, aby zapewnić optymalną wydajność w ramach cyklu pracy Snowsight.
Krok 3: Prześlij model semantyczny do etapu Snowflake
Jeśli korzystasz z modelu semantycznego opartego na YAML, należy go przygotować, aby Cortex Analyst mógł odwoływać się do niego w czasie wykonywania.
- Prześlij plik .yaml do wewnętrznej sceny Snowflake (np. RAW_DATA)
- Sprawdź, czy plik pojawił się w etapie, korzystając z interfejsu użytkownika Snowsight lub komendy LIST @stage_name
- Zapamiętaj ścieżkę etapu; będziesz się do niej odwoływać w wywołaniach API lub konfiguracji aplikacji.
Jeśli korzystasz z widoku semantycznego, ten krok jest obsługiwany natywnie w Snowflake i nie jest wymagane oddzielne przesyłanie danych.
🔍 Czy wiesz, że? Wartość NULL w języku SQL nie oznacza zera ani pustego pola. Oznacza ona nieznane lub brakujące dane, co prowadzi do nieintuicyjnych zachowań, takich jak porównania, które nie zwracają ani wartości true, ani false.
Krok 4: Wyślij pytanie sformułowane w języku naturalnym za pośrednictwem interfejsu API REST
Teraz rozpoczyna się właściwe generowanie kodu SQL. Interfejs API REST generuje zapytanie SQL dla danego pytania, wykorzystując model semantyczny lub widok semantyczny podany w żądaniu.
Zbuduj żądanie API, korzystając z:
- wiadomości; szyk zawierający pytanie użytkownika z rolą: „user”
- Odwołanie do modelu semantycznego lub widoku semantycznego
- Twój preferowany model (lub pozostaw opcję „auto”, aby Cortex wybrał najlepszy)
Możesz prowadzić wieloetapowe rozmowy, w których możesz zadawać pytania uzupełniające, nawiązujące do poprzednich zapytań.
Krok 5: Przetwarzanie odpowiedzi API
Każda wiadomość w odpowiedzi może zawierać wiele bloków zawartości różnych typów. Trzy wartości, które obecnie są w stanie zapewnić wsparcie dla pola typu, to: tekst, sugestie i SQL.
Oto, co oznacza każdy z tych typów:
- SQL: Cortex osiągnął powodzenie w generowaniu zapytania; oto kod, który należy wykonać
- tekst: Wyjaśnienie lub odpowiedź w języku naturalnym towarzysząca zapytaniu SQL
- sugestie: Zawartość sugestii jest uwzględniana w odpowiedzi tylko wtedy, gdy pytanie użytkownika było niejednoznaczne, a Cortex Analyst nie był w stanie zwrócić instrukcji SQL dla tego zapytania. Wykorzystaj je, aby doprecyzować lub udoskonalić pytanie
🔍 Czy wiesz, że... Kolejność, w jakiej piszesz kod SQL, nie jest zgodna z kolejnością jego wykonywania. Nawet jeśli najpierw wpiszesz SELECT, bazy danych w rzeczywistości przetwarzają najpierw klauzule FROM i WHERE, a dopiero potem wybierają kolumny. To dezorientuje zarówno początkujących, jak i doświadczonych użytkowników.
Krok 6: Wykonaj wygenerowany kod SQL w Snowflake
Po uzyskaniu bloku kodu SQL z odpowiedzi uruchom go w swojej wirtualnej hurtowni danych Snowflake. Wygenerowane zapytanie SQL jest wykonywane w wirtualnej hurtowni danych Snowflake w celu uzyskania ostatecznego wyniku. Dane pozostają w granicach zasad zarządzania Snowflake.
Najważniejsze informacje dotyczące etapu wykonywania:
- Cortex Analyst jest w pełni zintegrowany z zasadami kontroli dostępu opartej na rolach (RBAC) platformy Snowflake, co gwarantuje, że generowane i wykonywane zapytania SQL są zgodne ze wszystkimi ustalonymi zasadami kontroli dostępu.
- Jeśli użytkownik nie ma dostępu do tabeli, wykonanie zapytania zakończy się niepowodzeniem, tak samo jak w przypadku ręcznie napisanego kodu SQL.
- Na tym etapie obowiązują opłaty za obliczenia w hurtowni danych, niezależne od opłat za korzystanie z usługi Cortex Analyst.
Krok 7: Dopracuj i powtarzaj
Nie zawsze można mieć pewność, że za pierwszym razem uda się stworzyć idealne zapytanie. Oto jak z czasem poprawiać wyniki:
- Dodaj zweryfikowane zapytania do swojego modelu semantycznego w przypadku pytań, które pojawiają się wielokrotnie
- Wzbogać swój model semantyczny o lepsze opisy, synonimy i filtry, gdy Cortex błędnie zinterpretuje dane pojęcie
- Wykorzystaj rozmowę wieloetapową do zadawania pytań uzupełniających, na przykład: „Teraz przefiltruj to według regionu” — rozmowy wieloetapowe umożliwiają zadawanie pytań uzupełniających, które opierają się na poprzednich zapytaniach
- Monitoruj wykorzystanie za pomocą CORTEX_ANALYST_USAGE_HISTORY oraz historii zapytań Snowflake, aby wykrywać wzorce w nieudanych lub niedokładnych zapytaniach
🧠 Ciekawostka: Jeden brakujący warunek JOIN może spowodować ogromne problemy. Pominięcie warunku połączenia może doprowadzić do powstania iloczynu kartezjańskiego, co powoduje gwałtowny wzrost liczby wierszy, a czasami nawet awarię systemu.
Najlepsze praktyki dotyczące dokładności funkcji Snowflake Text-to-SQL
Jakość modelu semantycznego bezpośrednio wpływa na dokładność generowanych zapytań. Oto najlepsze praktyki pozwalające zwiększyć dokładność. 🛠️
- Dodaj zweryfikowane zapytania do swojego modelu semantycznego: To najważniejsza rzecz, jaką możesz zrobić. Uwzględnij wiele przykładowych par „pytanie–SQL”, które odzwierciedlają sposób, w jaki Twój zespół faktycznie zadaje pytania.
- Używaj opisowych nazw kolumn i tabel: Model działa lepiej, gdy nazwy kolumn i tabel są zrozumiałe same w sobie. Jeśli nie możesz zmienić schematu, dodaj jasne opisy w pliku YAML dla wszelkich niejasnych nazw kolumn.
- Dodaj próbki wartości: Dodanie próbkowych danych dla kolumn kategorycznych (takich jak status lub region) pomaga modelowi zrozumieć dostępne prawidłowe opcje filtrowania
- Przeprowadź testy z wykorzystaniem skrajnych przypadków: Podczas tworzenia aplikacji celowo zadawaj niejednoznaczne lub podchwytliwe pytania, aby zidentyfikować, w których miejscach model semantyczny wymaga dodatkowego kontekstu lub wyjaśnienia.
- Udoskonalaj swój model semantyczny: Traktuj swój model semantyczny jak dokument podlegający ciągłym zmianom. Powinien on być na bieżąco aktualizowany w ramach procesu iteracyjnego opartego na tym, które zapytania kończą się sukcesem, a które nie
ClickUp: prostsza alternatywa dla Snowflake Cortex
Snowflake Cortex sprawdza się doskonale, gdy zespoły chcą generować kod SQL i wykonywać zapytania na danych ustrukturyzowanych. Zespoły definiują schematy, mapują związki i piszą zapytania w celu uzyskania wniosków. Takie ustawienia mają sens w środowiskach z dużą ilością danych, zwłaszcza gdy za raportowanie odpowiadają analitycy.
Wiele zespołów nie potrzebuje jednak pełnej warstwy SQL, aby uzyskać odpowiedzi na codzienne pytania operacyjne. Menedżerowie produktu, kierownicy programów i zespoły operacyjne często potrzebują szybkich odpowiedzi związanych z bieżącą pracą.
ClickUp oferuje łatwiejszą w obsłudze ścieżkę. Teams zadają pytania prostym językiem, przeglądają pulpity nawigacyjne w czasie rzeczywistym i podejmują działania na podstawie uzyskanych wniosków bez konieczności pisania kodu SQL czy tworzenia modeli semantycznych.
Szybsze generowanie i udoskonalanie kodu SQL
Snowflake Cortex skupia się na generowaniu zapytań SQL na podstawie ustrukturyzowanych zbiorów danych w środowisku hurtowni danych. Rozwiązanie to sprawdza się dobrze, gdy dane są już przechowywane w Snowflake i masz opracowane schematy.
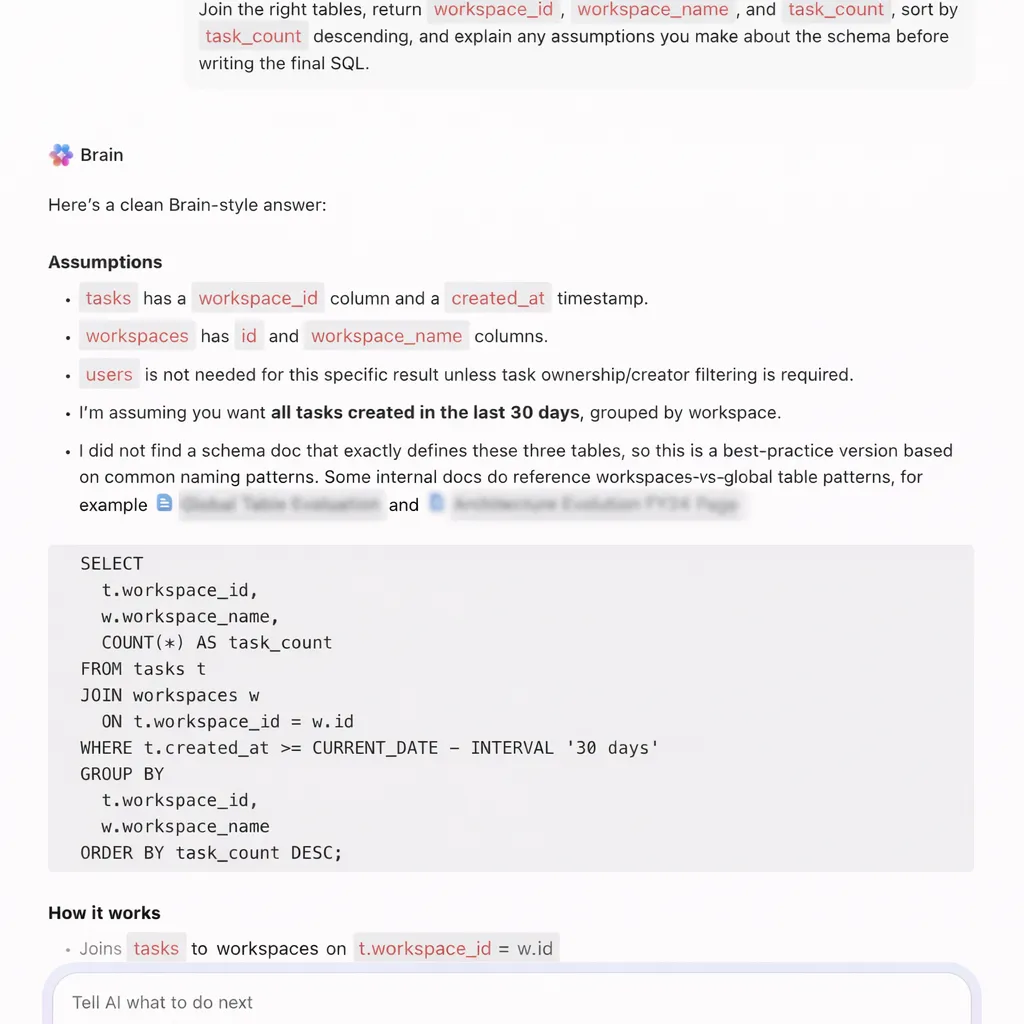
ClickUp Brain zapewnia wsparcie dla generowania zapytań SQL w bardziej elastyczny sposób, skupiając się na ich wykonywaniu. Zespoły generują, udoskonalają i przechowują zapytania SQL bezpośrednio w swoim obszarze roboczym, gdzie już odbywają się analizy, dyskusje i podejmowane są decyzje.
Załóżmy, że analityk produktu pracuje nad analizą retencji w ClickUp. Zamiast przełączać się między narzędziami w celu napisania zapytań, zwraca się do ClickUp Brain z następującym pytaniem:
📌 Wypróbuj następującą podpowiedź: Napisz zapytanie SQL obliczające siedmiodniowy wskaźnik retencji dla użytkowników pogrupowanych według kohorty rejestracji.
ClickUp Brain generuje ustrukturyzowane zapytanie, które obejmuje grupowanie kohortowe, filtry dat oraz logikę retencji. Analityk wkleja zapytanie do Snowflake lub innej hurtowni danych i natychmiast je uruchamia.
Pomaga to:
- Twórz połączenia między wieloma tabelami, takimi jak użytkownicy, zamówienia i zdarzenia
- Przekształcaj proste pytania dotyczące produktów sformułowane w języku angielskim w logikę SQL gotową do wykonania
- Debuguj nieprawidłowe zapytania i wyjaśnij problemy, takie jak nieprawidłowe połączenia lub brakujące warunki
- Przepisuj zapytania, aby poprawić wydajność lub czytelność
Na przykład podczas przeglądu eksperymentu dotyczącego wzrostu marketer zadaje pytanie: „Napisz zapytanie SQL, aby porównać współczynniki konwersji między dwiema stronami docelowymi w ciągu ostatnich 14 dni”.
ClickUp Brain generuje zapytanie przy użyciu agregacji warunkowej i filtrów daty. Zespół uruchamia je w Snowflake i weryfikuje wyniki eksperymentu.
📌 Wypróbuj następującą podpowiedź: Popraw to zapytanie SQL, w którym połączenie powoduje powielanie wierszy, i wyjaśnij, na czym polega problem.
ClickUp Brain identyfikuje problem z połączeniem, koryguje zapytanie i wyjaśnia, w jaki sposób powstały zduplikowane wiersze w wyniku nieprawidłowych warunków połączenia.
Zastąp raportowanie oparte na języku SQL
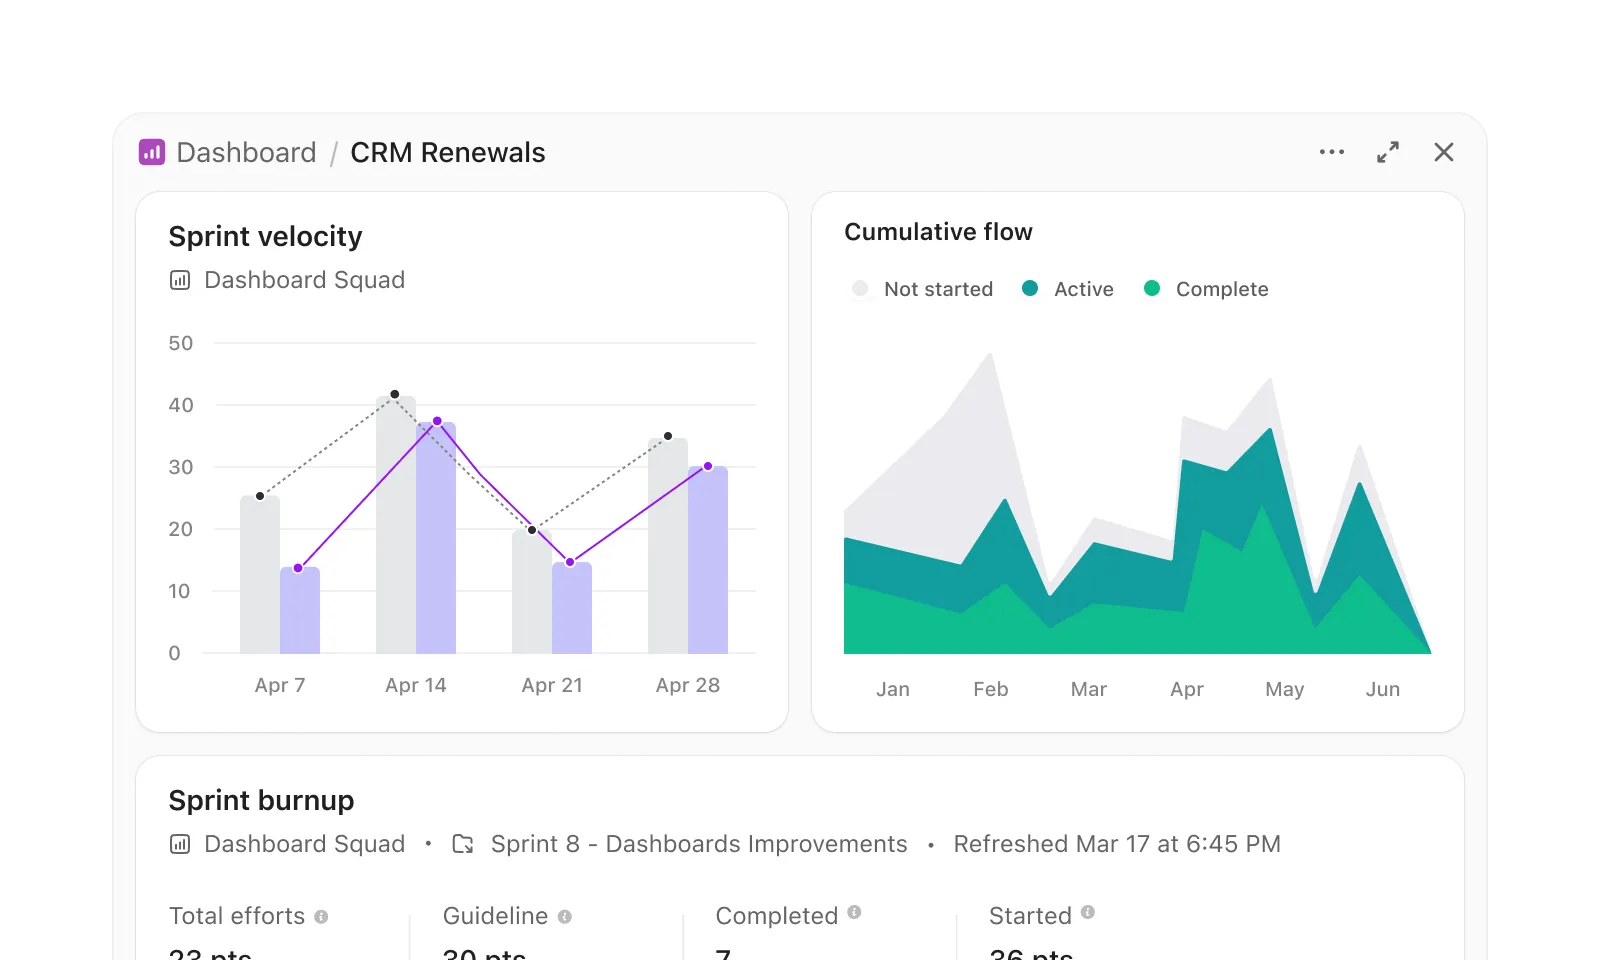
Cykl pracy w Snowflake Cortex często obejmuje generowanie kodu SQL, uruchamianie zapytań i wizualizację wyników w oddzielnej warstwie. Pulpity nawigacyjne ClickUp eliminują ten wieloetapowy proces i przedstawiają wnioski bezpośrednio na podstawie bieżącej pracy.
Zespół zarządzający programem, odpowiedzialny za śledzenie gotowości do wydania, może stworzyć pulpit nawigacyjny bez konieczności pisania zapytań. Na przykład pulpit nawigacyjny dotyczący wydania może zawierać:
- Karta listy zadań przefiltrowana tak, aby wyświetlać zadania przeterminowane we wszystkich zespołach produktowych
- Karta obciążenia przedstawiająca dystrybucję zadań wśród inżynierów
- Wykres słupkowy porównujący zadania zakończone z zadaniami oczekującymi w poszczególnych sprintach
- Karta obliczeniowa wykonująca śledzenie średniego czasu realizacji
Załóżmy, że kierownik projektu przegląda ten pulpit przed spotkaniem dotyczącym wydania. Od razu zauważa, że usługi zaplecza wykazują wyższe wskaźniki opóźnień. Otwiera kartę listy zadań i sprawdza, które konkretne zadania stanowią źródło ryzyka.
Prawdziwy użytkownik ClickUp udostępnia:
ClickUp pozwala nam SZYBKO przekazywać sobie projekty, ŁATWO sprawdzać ich status, a naszej przełożonej zapewnia wgląd w nasze obciążenie pracą w dowolnym momencie, bez konieczności przerywania nam pracy. Dzięki ClickUp z pewnością oszczędzamy co najmniej jeden dzień w tygodniu, jeśli nie więcej. Liczba e-maili ZNACZNIE się zmniejszyła.
ClickUp pozwala nam SZYBKO przekazywać sobie projekty, ŁATWO sprawdzać ich status, a naszej przełożonej zapewnia wgląd w nasze obciążenie pracą w dowolnym momencie, bez konieczności przerywania nam pracy. Dzięki ClickUp zyskaliśmy co najmniej jeden dzień w tygodniu, jeśli nie więcej. Liczba e-maili ZNACZNIE się zmniejszyła.
Wykorzystuj wnioski bez konieczności tworzenia potoków danych
Snowflake Cortex koncentruje się na generowaniu wniosków na podstawie danych. Teams nadal muszą samodzielnie interpretować wyniki i być wyzwalaczami odpowiednich działań.
Superagenci ClickUp AI wypełniają tę lukę i przekształcają spostrzeżenia w konkretne działania. Działają oni jako wirtualni współpracownicy oparci na sztucznej inteligencji, którzy nieustannie monitorują dane w obszarach roboczych i podejmują działania w oparciu o określone warunki.
Załóżmy, że kierownik programu nadzoruje wiele inicjatyw produktowych. Super Agent może:
- Monitoruj zadania w ramach różnych projektów i wykrywaj, kiedy zaległe zadania przekraczają zdefiniowany próg
- Zidentyfikuj wzorce, takie jak powtarzające się opóźnienia na tym samym etapie cyklu pracy
- Utwórz zadanie podsumowujące projekty, na które ma to wpływ, i przypisz je kierownikowi programu
- Powiadamiaj właścicieli zespołów, gdy krytyczne zadania pozostają nierozwiązane po upływie terminów
Na przykład podczas cyklu wydawniczego Super Agent wykrywa, że w dwóch zespołach nie dotrzymano terminów wykonania ponad 10 zadań o wysokim priorytecie. Tworzy on zadanie ClickUp zatytułowane „Ryzyko związane z wydaniem: niedotrzymane terminy”, dołączając do niego wszystkie istotne zadania jako załączniki i przypisując je kierownikowi programu do natychmiastowego przeglądu.
Zespoły mogą również bezpośrednio komunikować się z Super Agentem: „Przeanalizuj wszystkie aktywne projekty i wskaż ryzyka związane z realizacją w tym sprincie”.
Super Agent sprawdza terminy, zależności i status zadań, a następnie publikuje uporządkowane podsumowanie w obszarze roboczym.
Oto jak skonfigurować własnego Super Agenta w ClickUp:
Scentralizuj cykle pracy związane z danymi dzięki ClickUp
Narzędzia typu „text-to-SQL”, takie jak Snowflake Cortex, zwiększają dostępność danych. Jednocześnie uzyskanie wiarygodnych wyników nadal wymaga pewnego wysiłku.
Zespoły potrzebują przejrzystych schematów, solidnych modeli semantycznych oraz ciągłej iteracji, aby zapewnić dokładność wyników. Nawet po wygenerowaniu właściwego zapytania praca nie kończy się na tym. Ktoś nadal musi zinterpretować wyniki, udostępnić spostrzeżenia i przełożyć je na decyzje.
ClickUp oferuje inne podejście. Zamiast oddzielać analizę od wykonania, ClickUp łączy oba te elementy. Zespoły generują zapytania SQL, dokumentują wnioski, współpracują nad wynikami i podejmują działania w tym samym obszarze roboczym.
ClickUp Brain pomaga w pisaniu i udoskonalaniu zapytań, a pulpity nawigacyjne i agenci AI pomagają zespołom śledzić wyniki i realizować zadania bez konieczności przełączania się między narzędziami.
Snowflake Cortex pomaga uzyskać odpowiedzi. ClickUp pomaga je wykorzystać. Zarejestruj się w ClickUp już dziś!
Najczęściej zadawane pytania
Czym jest Snowflake Cortex Analyst i czym różni się od Cortex AI?
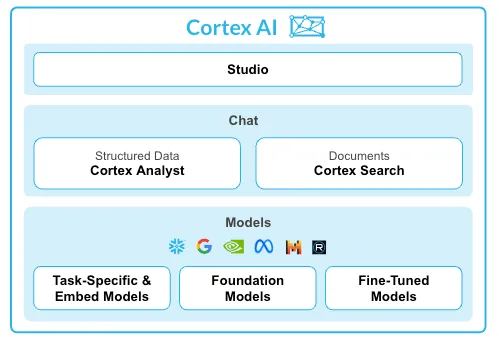
Snowflake Cortex Analyst to wyspecjalizowana usługa w ramach szerszego pakietu Snowflake Cortex AI. Cortex Analyst koncentruje się konkretnie na generowaniu zapytań SQL na podstawie tekstu z wykorzystaniem modeli semantycznych, podczas gdy Cortex AI obejmuje szerszy zakres funkcji LLM, wnioskowania opartego na modelach uczenia maszynowego oraz funkcji wyszukiwania.
Czy Snowflake Cortex Analyst współpracuje z zewnętrznymi źródłami danych, takimi jak tabele Iceberg?
Tak, Cortex Analyst może wysyłać zapytania do tabel Apache Iceberg zarządzanych za pośrednictwem Snowflake. O ile tabele te są dostępne w Twoim środowisku Snowflake i prawidłowo zdefiniowane w modelu semantycznym, możesz generować zapytania dotyczące tych tabel.
Jak dokładne jest generowanie zapytań SQL na podstawie tekstu przez Snowflake w przypadku złożonych zapytań?
Dokładność w przypadku złożonych zapytań zależy niemal wyłącznie od jakości modelu semantycznego. Model z dobrze zdefiniowanymi związkami między tabelami, licznymi zweryfikowanymi zapytaniami i opisowymi metadanymi zapewni znacznie dokładniejsze wyniki w przypadku połączeń wielotablicowych i złożonych agregacji.
Ile kosztują funkcje generowania kodu SQL w Snowflake Cortex?
Ceny usługi Snowflake Cortex Analyst są zgodne z modelem rozliczeniowym Snowflake opartym na zużyciu, co oznacza, że opłaty są naliczane na podstawie kredytów obliczeniowych wykorzystanych podczas procesu generowania zapytań. Aby zapoznać się z aktualnymi stawkami, należy zawsze odwoływać się do oficjalnej dokumentacji cenowej Snowflake.