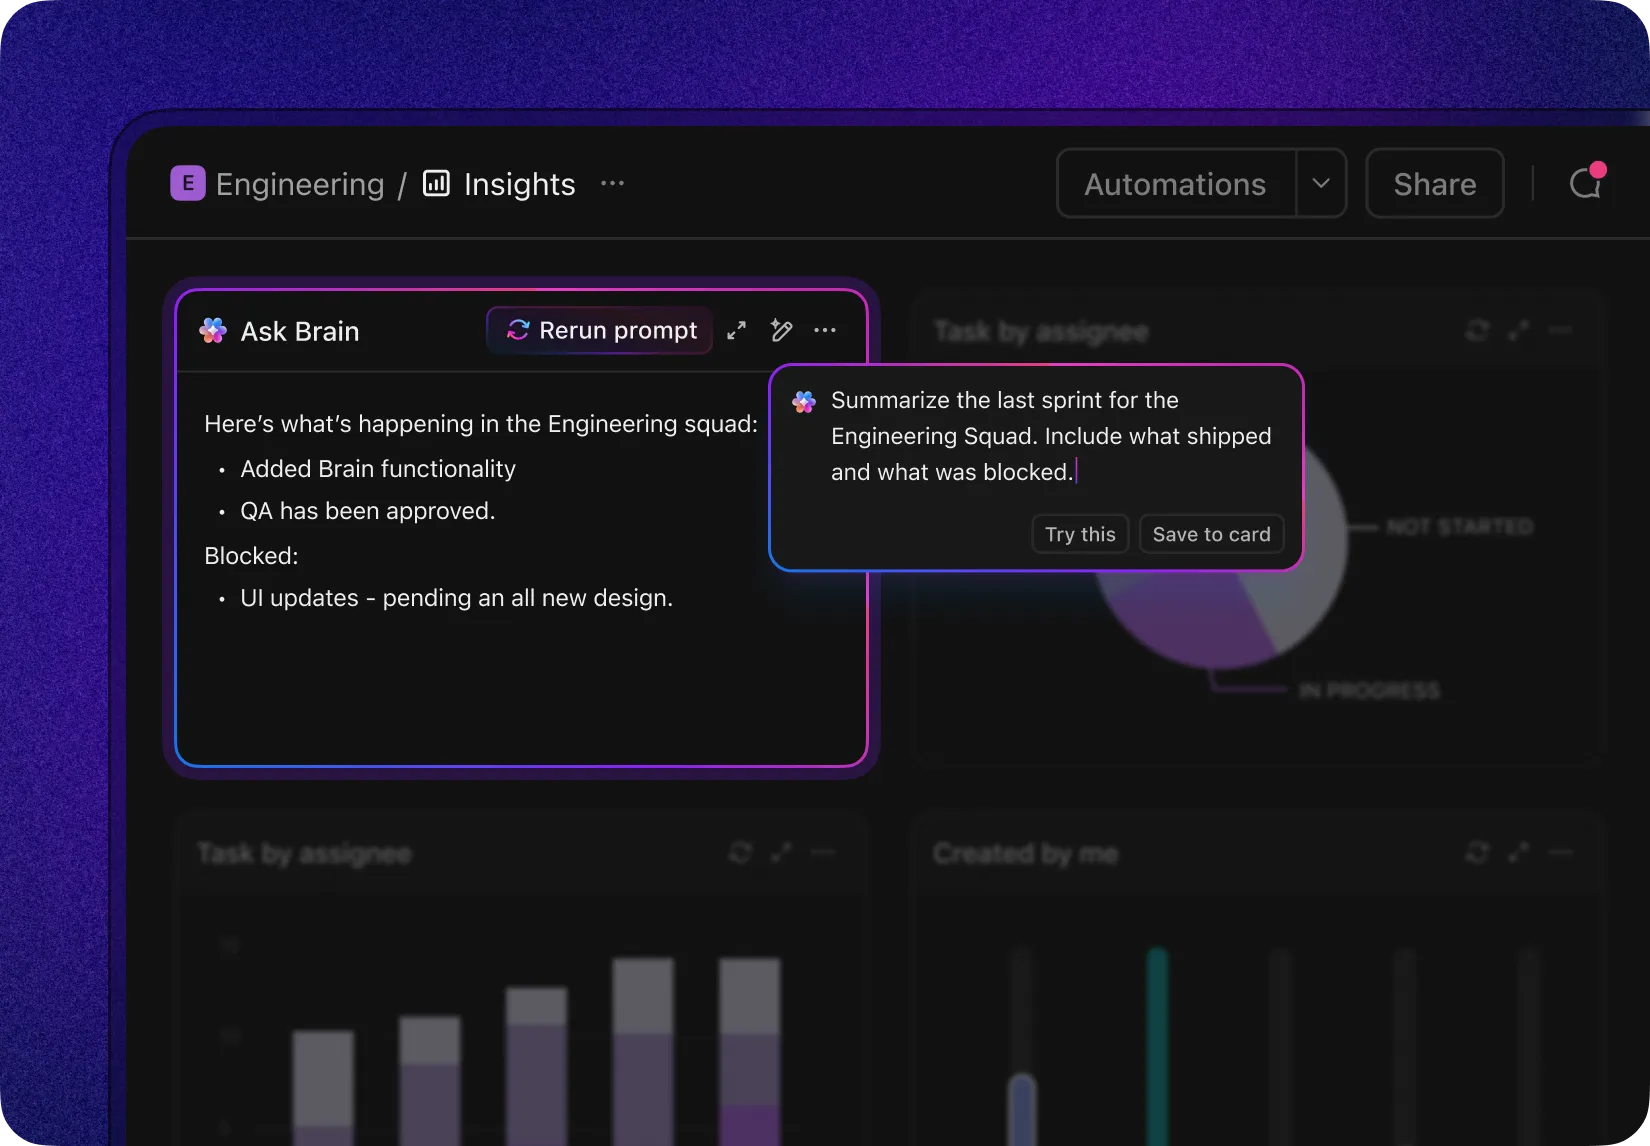
最新のソフトウェアアップデートをリリースすると、レポート作成が次々と始まります。
突然、CSATやNPSからロードマップの遅延に至るまで、すべてを左右するメトリクスが1つだけになりました。それは、バグ解決時間です。
経営陣はこれを「約束を果たすためのメトリクス」と捉えています。予定通りにリリースし、学び、収益を守ることができるでしょうか?一方、現場の実務担当者は、重複したチケット、所有権が不明確なこと、不要なエスカレーション、そしてSlackやスプレッドシート、個別のツールに散在するコンテキストといった課題に日々直面しています。
こうした分断は、サイクルを長引かせ、根本原因を覆い隠し、優先順位の決定を当て推量にしてしまいます。
その結果はどうなるでしょうか? 学習の遅れ、コミットメントの未達成、そしてスプリントごとにひそかに負担となるバックログの蓄積です。
このガイドは、バグ解決時間の測定、ベンチマーク、短縮を実現するための包括的な実践マニュアルであり、従来の手作業によるプロセスと比較して、AIがワークフローを具体的にどのように変革するかを示しています。
バグ解決時間とは?
バグ解決時間とは、バグがレポート作成されてから完全に解決されるまでの時間を指します。
実際には、問題の報告や検出(ユーザー、QA、またはモニタリングを通じて)が行われた時点で計測が開始され、修正が実装・マージされ、検証またはリリース可能な状態になった時点で計測が終了します。ただし、これはチームが「完了」をどのように定義するかによって異なります。
例:Mondayの午前10時に報告されたP1クラスのクラッシュについて、火曜日の午後3時に修正がマージされた場合、解決までの時間は約29時間となります。
これはバグの検出時間とは異なります。検出時間とは、不具合が発生した後(アラームが作動した、QAテストツールが検出した、顧客からレポート作成があったなど)、それをどれだけ迅速に認識できるかを測定するものです。
解決時間は、不具合の認識から修正までのプロセス(トリアージ、再現、診断、実装、レビュー、テスト、リリース準備)をどれだけ迅速に進められるかを測る指標です。検出を「不具合があることが分かった」状態、解決を「修正が完了し、準備が整った」状態と捉えてください。
Teamsによって境界の設定が若干異なる場合があります。傾向を正確に把握できるよう、いずれか1つを選択し、一貫して適用してください:
- 報告済み → 解決済み:コードの修正がマージされ、QAの準備が整った時点で終了します。エンジニアリングのスループット向上に有効です。
- 報告→閉じた:QAによる検証およびリリースを含みます。顧客に影響を与えるSLAに最適です。
- 検出 → 解決:チケットが作成される前の段階、モニタリングやQAが問題を検出した時点でプロセスが開始されます。本番環境を多用するチームに有効です。
🧠 豆知識:『ファイナルファンタジーXIV』 に発生した、風変わりでいて笑えるバグは、その特異性から称賛を浴び 、読者からは「2025年MMOにおける最も特異なバグ修正」と称されました。 このバグは、特定のイベントゾーンでプレイヤーがアイテムの価格を正確に44,442ギルから49,087ギルの間に設定した際に発生し、整数オーバーフローの不具合と思われる原因で接続が切断されるというものでした。
その重要性
解決時間はリリース頻度の重要な要素です。解決時間が長かったり予測不可能だったりすると、スコープの縮小、ホットフィックス、リリースの凍結を余儀なくされます。また、平均値が示す以上に「ロングテール」(外れ値)がスプリントを狂わせるため、プランニング・デットが生じます。
これは顧客満足度にも直結しています。顧客は、問題が迅速に認識され、予測可能な形で解決される限り、その問題を受け入れるものです。修正が遅い場合、あるいはさらに悪いことに、対応にばらつきがある場合は、クレームの増加を招き、CSATやNPSを低下させ、契約更新を危うくすることになります。
要するに、バグ解決時間を正確に測定し、体系的に短縮できれば、ロードマップや関係性も改善されるでしょう。
📖 詳細はこちら:効率的な問題解決に向けたバグの優先順位付け方法
バグ解決時間の測定方法とは?
まず、計測の開始点と終了点を決定しましょう。
ほとんどのチームは、「報告済み → 解決済み」(修正がマージされ、検証の準備が整った状態)または「報告済み → 閉じた」(QAによる検証が完了し、変更がリリースされたか、その他の理由で閉じた状態)のいずれかを選択します。
傾向分析に意味を持たせるため、定義を1つ選定し、一貫して使用してください。
次に、観測可能なメトリクスが必要です。それらを整理してみましょう:
注目すべき主要なバグ追跡メトリクス:
| 📊 メトリクス | 📌 その意味 | 💡 そのメリット | 🧮 式(該当する場合) |
|---|---|---|---|
| バグ件数 🐞 | 報告されたバグの総数 | システムの健全性を俯瞰的に把握できます。数値が高い場合は、調査が必要です。 | バグ総数 = システムに記録されたすべてのバグ {未解決 + 閉じた} |
| 未解決のバグ 🚧 | まだ修正されていないバグ | 現在の作業負荷を表示します。優先順位付けに役立ちます。 | 未解決のバグ数 = バグ総数 - 閉じたバグ数 |
| 閉じたバグ ✅ | 解決および検証済みのバグ | 進捗状況と完了した作業を追跡します。 | 閉じたバグ = ステータスが「閉じた」または「解決済み」のバグの数 |
| バグの重大度 🔥 | バグの重大度(例:クリティカル、メジャー、マイナー) | 影響度に基づいたトリアージを支援します。 | カテゴリ型フィールドとして追跡されており、式は使用できません。フィルターやグループ化機能をご利用ください。 |
| バグの優先度 📅 | バグの修正の緊急度 | スプリントおよびリリース計画の策定に役立ちます。 | また、カテゴリ型フィールドでもあり、通常はランク付けされます(例:P0、P1、P2)。 |
| 解決にかかる時間 ⏱️ | バグ報告から修正までの所要時間 | 対応の迅速さを測定します。 | 解決までの時間 = 閉じた日 - 報告日 |
| 再オープン率 🔄 | 閉じた後に再オープンしたバグの割合 | 修正の品質や回帰問題を反映しています。 | 再オープン率(%) = {再オープンしたバグ ÷ 閉じたバグの総数} × 100 |
| バグの漏れ 🕳️ | 本番環境に混入してしまったバグ | QA/ソフトウェアテストの有効性を示します。 | リーク率(%) = {本番環境のバグ ÷ バグ総数} × 100 |
| 欠陥密度 🧮 | コードのサイズ単位あたりのバグ数 | リスクの高いコード領域を特定します。 | 欠陥密度 = バグ数 ÷ KLOC {キロライン・オブ・コード} |
| 割り当て済みバグと未割り当てバグ 👥 | バグの所有権別内訳 | 見落としを完全に防ぎます。 | フィルターを使用する:「割り当て先」がNULLの未割り当てバグ |
| 未解決バグの経過日数 🧓 | バグが未解決のまま放置される期間 | 停滞やバックログのリスクを早期に発見します。 | バグの経過日数 = 今日の日付 - 報告日 |
| 重複バグ 🧬 | 重複レポートの数 | 受付プロセスにおけるエラーを特定します。 | 重複率 = 重複件数 ÷ バグ総数 × 100 |
| MTTD(平均検出時間) 🔎 | バグやインシデントの検出にかかる平均時間 | 監視と状況把握の効率を測定します。 | MTTD = Σ(検出時刻 - 発生時刻) ÷ バグ数 |
| MTTR(平均解決時間) 🔧 | バグの検出から完全な修正に至るまでの平均所要時間 | エンジニアリング部門の対応速度と修正時間を追跡します。 | MTTR = Σ(解決までの時間 - 検出までの時間) ÷ 解決されたバグの数 |
| MTTA(平均受領時間) 📬 | バグの検出から、誰かがそのバグの対応を開始するまでの時間 | チームの対応力とアラートへの対応速度を示します。 | MTTA = Σ(受領時刻 - 検出時刻)÷ バグ件数 |
| MTBF(平均故障間隔) 🔁 | ある障害が解決されてから、次の障害が発生するまでの時間 | 長期にわたる安定性を示しています。 | MTBF = 総稼働時間 ÷ 障害発生回数 |
⚡️ テンプレートアーカイブ:バグ追跡に役立つ15の無料バグ報告テンプレート&フォーム
バグ解決時間に影響を与える要因
解決時間は、しばしば「エンジニアがコードを書く速さ」と同義と見なされます。
しかし、それはプロセスのほんの一部に過ぎません。
バグ解決時間は、受付時の品質、システムを通じたフロー効率、および依存関係によるリスクの合計によって決まります。これらいずれかが不十分になると、サイクルタイムが長くなり、予測可能性が低下し、エスカレーションの声が大きくなります。
受付の質が全体の基調を決定づける
再現手順、環境の詳細、ログ、バージョンやビルド情報が明確に記載されていないレポートが届くと、余計なやり取りが発生してしまいます。サポート、QA、モニタリング、Slackなど、複数のチャネルから重複したレポートが寄せられると、ノイズが増え、所有権が曖昧になってしまいます。
適切なコンテキストを早い段階で把握し、重複を排除しておけば、後になっての引き継ぎや確認のための連絡が少なくて済みます。
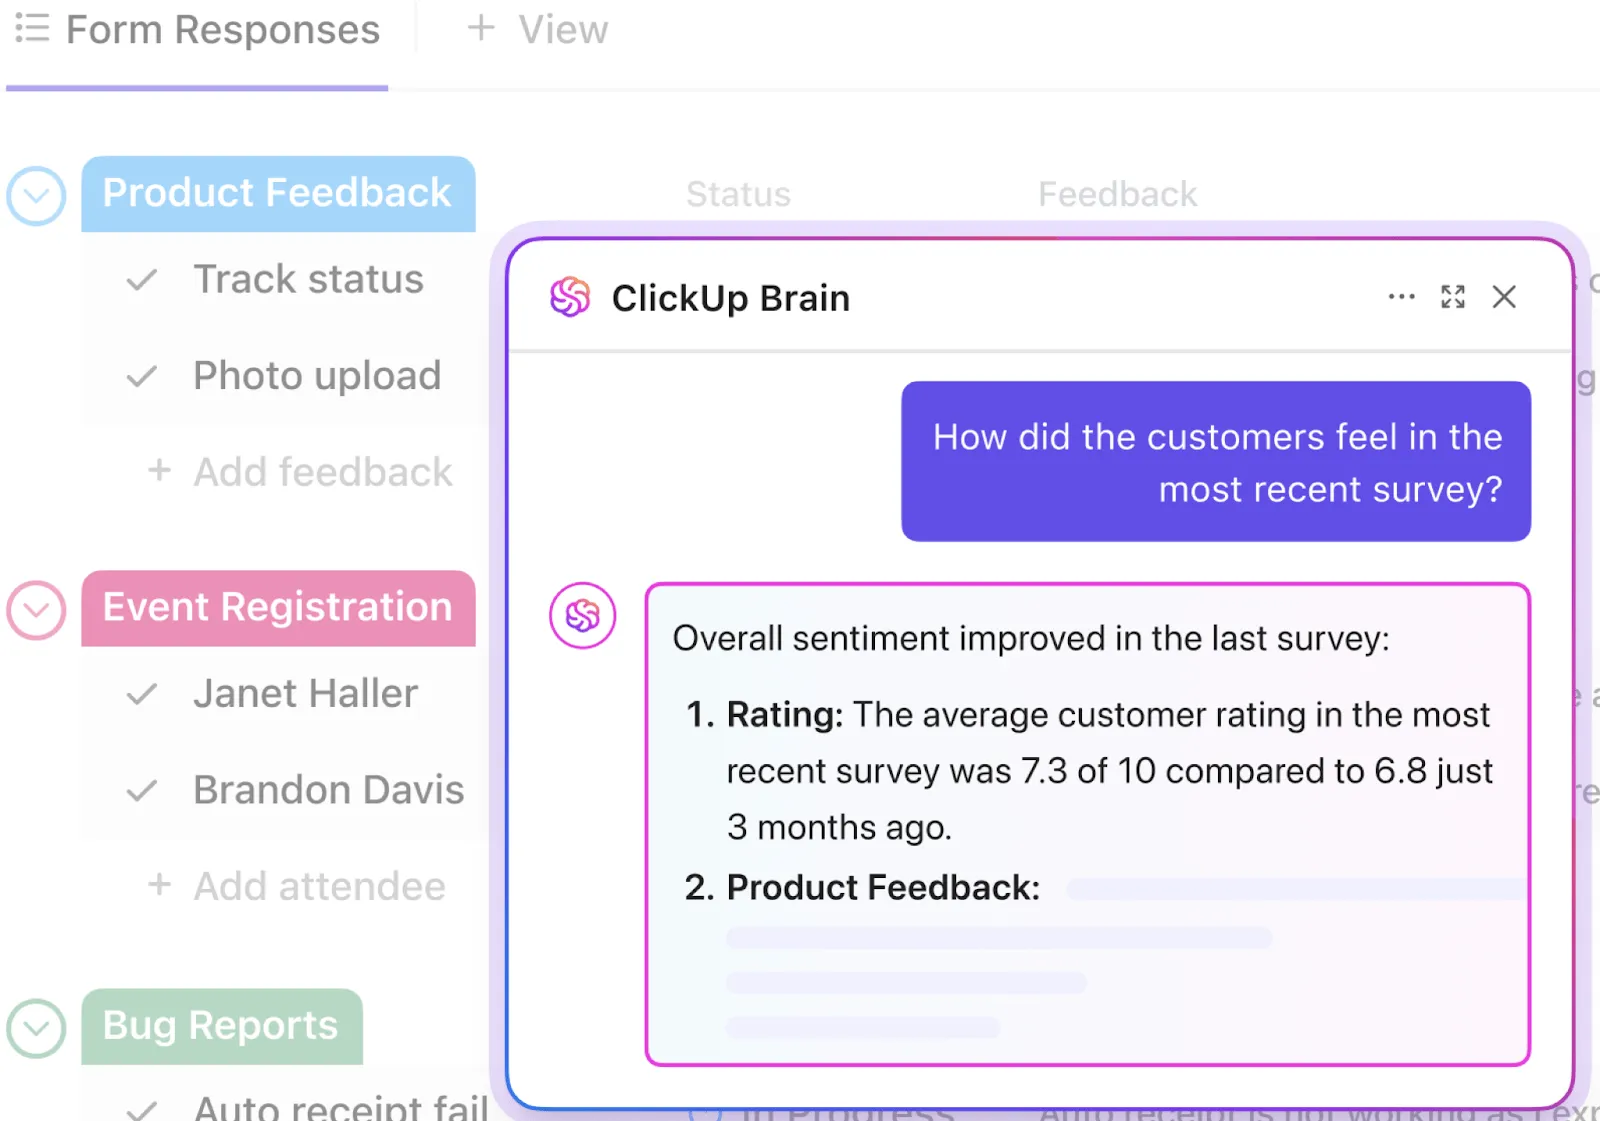
優先順位付けとルーティングによって、誰がいつそのバグに対処するかが決まります
顧客やビジネスへの影響と一致しない(あるいは時間の経過とともにずれていく)重大度ラベルは、キューの混乱を招きます。つまり、最も声高なチケットが優先的に処理される一方で、影響の大きい不具合は放置されてしまうのです。
コンポーネントや所有者ごとに明確なルーティングルールを設定し、単一の「真実のキュー」を維持することで、P0/P1の仕事が「最新かつノイズの多い」タスクに埋もれてしまうのを防ぎます。
所有権と引き継ぎは、知らぬ間に業務を蝕む要因となります
バグがモバイルチーム、バックエンド認証チーム、あるいはプラットフォームチームのいずれに属するかが不明確な場合、そのバグは各チーム間を行き来することになります。行き来するたびに、そのバグに関するコンテキストがリセットされてしまいます。
さらに、タイムゾーンの違いもこの問題を複雑にしています。所有者が指定されていない状態で一日の終わり近くに報告されたバグの場合、誰かが再現作業を開始するまでに12~24時間も無駄になってしまうことがあります。「誰が何を所有するか」を明確に定義し、オンコール体制や週単位のDRI(直接責任者)を定めることで、こうした遅れを解消できます。
再現性は可観測性に依存関係があります
ログが不十分だったり、相関IDが欠けていたり、クラッシュトレースが不足していると、診断は当て推量になってしまいます。特定のフラグ、テナント、またはデータの形でのみ発生するバグは、開発環境で再現するのが困難です。
エンジニアが安全に処理済みの本番環境に近いデータにアクセスできない場合、計測や再デプロイ、そして待機に追われ、作業に数時間ではなく数日かかってしまうことになります。
環境とデータの整合性が、正確性を確保します
「自分のマシンでは動く」というのは、たいてい「本番環境のデータが違う」ということです。開発環境やステージング環境が本番環境から乖離すればするほど(設定、サービス、サードパーティ製ライブラリのバージョンなど)、原因不明の不具合の追跡に費やす時間が長くなります。データのスナップショット、シードスクリプト、パリティチェックを活用することで、その乖離を縮小できます。
作業中 (WIP) と注力度こそが、実際のスループットを左右します
過負荷状態のチームは一度に多くのバグを抱え込み、注意力が分散し、タスクとミーティングの間を右往左往してしまいます。コンテキストスイッチングによって、目に見えない時間が浪費されています。
可視化された作業中 (WIP) リミットと、新しい仕事を引き受ける前に手掛けている仕事を完了させるという姿勢は、どんな個人の英雄的な努力よりも早く、中央値を引き下げる効果があります。
コードレビュー、CI、QAの処理速度は、典型的なボトルネックです
ビルド時間の遅延、不安定なテスト、不明確なレビューSLAは、本来なら迅速に修正できる問題を停滞させてしまいます。10分で作成できるパッチでも、レビュー担当者の確認を待つ間に2日間を費やしたり、数時間に及ぶパイプラインに組み込まれるのを待たされたりすることがあります。
同様に、テストをバッチ処理したり、手動によるスモークテストに依存したりするQAキューでは、「報告→解決」までの時間が短くても、「報告→閉じた」までのプロセスに丸1日以上が追加される可能性があります。
依存関係がキューを膨れ上がらせる
チームをまたぐ変更(スキーマ、プラットフォームの移行、SDKの更新)、ベンダーによるバグ、またはアプリストアの審査(モバイル)は、待機状態を引き起こします。明示的な「ブロック中/一時停止中」の追跡を行わないと、こうした待機時間が平均値を目に見えない形で押し上げ、真のボトルネックがどこにあるかを隠してしまいます。
リリースモデルとロールバック戦略が重要
手動によるゲートが設定された大規模なリリーストレインでデプロイを行っている場合、解決済みのバグであっても、次のトレインが開始されるまで放置されたままになります。Feature Flags、カナリアリリース、ホットフィックスレーンを活用することで、修正のデプロイをフルリリースサイクルから切り離すことができ、特にP0/P1インシデントにおいて、処理の遅れを短縮できます。
アーキテクチャと技術的負債が成長の限界を決定づける
密結合、テストの境界線の欠如、不透明なレガシーモジュールがあると、単純な修正でさえリスクを伴います。チームは、追加のテストやレビュー時間の延長でこれを補おうとしますが、その結果、開発サイクルが長引いてしまいます。逆に、適切な契約テストを備えたモジュール化されたコードであれば、隣接するシステムに影響を与えることなく、迅速に開発を進めることができます。
コミュニケーションとステータスの管理は、予測可能性に影響を与えます
「調査中」といった曖昧な更新情報は、ステークホルダーが完了予定時期(ETA)を問い合わせたり、サポートがチケットを再オープンしたり、製品チームがエスカレーションを行ったりする際に、手戻りを生じさせます。明確なステータス遷移、再現手順や根本原因に関するメモ、そして公開されたETAを設定することで、手戻りを減らし、エンジニアリングチームの集中力を維持できます。
📮ClickUpインサイト: 平均的なビジネスパーソンは、1日30分以上を仕事関連の情報の検索に費やしています。これは、電子メールやSlackのスレッド、散在するファイルを探し回ることに、年間120時間以上を浪費していることに相当します。
ワークスペースに組み込まれたインテリジェントなAIアシスタントが、その状況を一変させます。それが「ClickUp Brain」です。適切なドキュメント、会話、タスクの詳細を数秒で抽出することで、即座に洞察と回答を提供します。これにより、検索に時間を費やすことなく、すぐに作業に取り掛かることができます。
💫 実際の結果:QubicaAMFのようなチームは、ClickUpを活用して時代遅れのナレッジマネジメントプロセスを排除することで、週に5時間以上(1人あたり年間250時間以上)の時間を確保しました。四半期ごとに1週間分の生産性が向上すれば、あなたのチームがどれほどの成果を生み出せるか、想像してみてください!
リードタイムが延びることを示す先行指標
❗️「受付までの時間」が長引いており、12時間以上所有者が割り当てられていないチケットが多数存在しています
❗️「レビュー/CI 処理時間」の区間が長くなっていることや、テストの不安定さが頻繁に発生していること
❗️チケット登録時の重複率が高く、チーム間で深刻度ラベルの付け方に一貫性がない
❗️外部依存関係が特定されていないため、「ブロック中」の状態のまま放置されているバグがいくつかあります
❗️再オープン率が徐々に上昇している(修正内容が再現できない、または「完了」の定義が曖昧であるため)
組織によって、これらの要因に対する認識は異なります。経営陣は、学習サイクルの機会損失や収益機会の逸失として捉え、現場担当者は、トリアージにおけるノイズや所有権が不明確であることとして感じています。
受付、フロー、依存関係を最適化することで、中央値やP90といった全体的な曲線を押し下げることができます。
より良いバグレポートの書き方について詳細はこちらをご覧ください。👇🏼
📖 詳細はこちら:ソフトウェアテストサイクル(STLC):概要と各フェーズ
バグ解決時間の業界ベンチマーク
バグ解決のベンチマークは、リスク許容度、リリースモデル、および変更をどれだけ迅速にリリースできるかによって異なります。
ここでは、中央値(P50)を活用して一般的なフローを把握し、P90を用いて、重大度や発生源(顧客、QA、モニタリング)ごとに目標値やSLAを設定することができます。
その意味を詳しく見ていきましょう:
| 🔑 用語 | 📝 概要 | 💡 なぜ重要なのか |
|---|---|---|
| P50(中央値) | 中間値――バグ修正の50%はこの時間より早く、50%はこの時間より遅くなります | 👉 これは、一般的な、あるいは最も多い解決時間を反映したものです。通常のパフォーマンスを把握するのに役立ちます。 |
| P90(90パーセンタイル) | バグの90%はこの期間内に修正されます。10%のみがそれ以上の時間を要します。 | 👉 最悪のケース(とはいえ現実的な範囲内)の境界値を表します。外部への約束事項を設定する際に役立ちます |
| SLA(サービスレベル契約) | 問題への対応速度について、社内で、あるいは顧客に対して行う約束 | 👉 例:「P1レベルのバグは、90%のケースで48時間以内に解決しています。」これにより、信頼関係の構築と責任の明確化につながります。 |
| 深刻度および発生源別 | 2つの主要な軸でメトリクスをセグメント化します:• 重大度(例:P0、P1、P2)• 発生元(例:顧客、QA、モニタリング) | 👉 より正確な追跡と優先順位付けが可能になり、重大なバグに迅速に対応できるようになります |
以下は、成熟したチームがしばしばターゲットとする業界に基づいた目安の範囲です。これらはあくまで出発点として捉え、自社の状況に合わせて調整してください。
SaaS
常時稼働環境かつCI/CDに対応しているため、ホットフィックスが頻繁に行われます。重大な問題(P0/P1)については、中央値が1営業日未満、P90が24~48時間以内となることを目標としています。非重大な問題(P2+)については、中央値が3~7日、P90が10~14日以内となるのが一般的です。堅牢なFeature Flagsと自動テストを導入しているチームほど、解決時間が短縮される傾向にあります。
Eコマースプラットフォーム
コンバージョンやカートフローは収益に直結するため、求められる基準はより高くなります。P0/P1の問題は通常、数時間以内に(ロールバック、フラグ設定、または設定変更により)影響を軽減し、同日中に完全に解決されます。ピークシーズンにおいては、P90の問題もその日の終わりまで、あるいは12時間以内に解決されるのが一般的です。P2+の問題は多くの場合、2~5日で解決され、P90の問題も10日以内に解決されます。
企業向けソフトウェア
検証の厳格化や顧客側の変更対応期間の長期化により、対応ペースは鈍化します。P0/P1については、チームは4~24時間以内の回避策の提供と1~3営業日以内の修正を目標としています。P90については5営業日以内を目標としています。P2以上のアイテムは、多くの場合、リリーストレインにまとめられ、顧客の展開スケジュールに応じて、中央値は2~4週間となります。
ゲームおよびモバイルアプリ
ライブサービスのバックエンドはSaaSのように動作します(フラグ設定やロールバックは数分から数時間、P90は当日中)。クライアントの更新はストアの審査によって制約を受けます:P0/P1では多くの場合、サーバーサイドの対策が即座に適用され、クライアントパッチは1~3日以内にリリースされます。P90は審査を優先処理することで1週間以内にリリースされます。P2以上の修正は、通常、次のスプリントまたはコンテンツリリースに組み込まれます。
銀行・フィンテック
リスクおよびコンプライアンスのゲートにより、「迅速な緩和、慎重な変更」というパターンが促進されます。P0/P1は迅速に緩和され(フラグ設定、ロールバック、数分から数時間以内のトラフィック切り替え)、1~3日で完全に修正されます。P90は、変更管理を考慮して1週間以内に修正されます。P2+は、セキュリティ、監査、CAB(変更承認委員会)の審査を通過するために、多くの場合2~6週間を要します。
数値がこれらの範囲外にある場合は、「エンジニアリングのスピード」が根本的な問題であると決めつける前に、案件の受付品質、所有権の決定、コードレビューとQAの処理能力、および依存関係の承認状況を確認してください。
🌼 ご存知でしたか:2024年のStack Overflowのアンケートによると、開発者はコーディングの全工程において、AIを頼もしい相棒としてますます活用するようになっていました。 なんと82%が実際にコードを書く際にAIを利用しており、まさに創造的なパートナーと言えるでしょう!行き詰まったり解決策を探ったりする際、67.5%が答えを探すためにAIに頼り、半数以上(56.7%)がデバッグやサポートを得るためにAIを活用していました。
また、AIツールはプロジェクトの文書化(40.1%)や、合成データやコンテンツの生成(34.8%)にも役立つことが判明しました。 新しいコードベースに興味がありますか? 3分の1近く(30.9%)が、AIを活用して素早く理解を深めています。コードのテストは依然として多くの開発者にとって手作業による骨の折れる作業ですが、27.2%がこの分野でもAIを導入しています。コードレビュー、プロジェクト計画、予測分析などの他の分野ではAIの導入率は低いものの、AIがソフトウェア開発のあらゆるフェーズに着実に浸透しつつあることは明らかです。
📖 詳細はこちら:品質保証におけるAIの活用方法
バグ解決時間を短縮する方法
バグ解決のスピードは、受付からリリースに至るまでの各引き継ぎ段階における摩擦を取り除くことにかかっています。
最大の効果は、最初の30分間をより効率的に活用すること(正確な情報収集、適切な所有者への割り当て、適切な優先度付け)から得られ、その後、続く一連のプロセス(再現、確認、検証)を短縮することでさらに高まります。
ここでは、システムとして連携する9つの戦略をご紹介します。AIが各ステップを加速させ、ワークフローは1か所に整理されて管理されるため、経営陣は予測可能性を得られ、実務担当者はスムーズなフローを実現できます。
1. 受付を一元化し、発生源でコンテキスト情報を収集する
Slackのスレッド、サポートチケット、スプレッドシートからコンテキストを再構築していると、バグの解決時間が長引いてしまいます。サポート、QA、モニタリングなど、あらゆるレポートを、コンポーネント、深刻度、環境、アプリのバージョン/ビルド、再現ステップ、期待値と実測値、添付ファイル(ログ/HAR/スクリーンショット)を収集する構造化されたテンプレートを用いて、単一のキューに集約しましょう。
AIは、長文のレポートを自動で要約し、添付ファイルから再現ステップや環境の詳細を抽出し、重複の可能性が高い案件にフラグを立てることで、一貫性があり詳細な情報を盛り込んだ記録に基づいてトリアージを開始できるようにします。
注目すべきメトリクス: MTTA(数時間ではなく数分以内の受付確認)、重複率、「情報要確認」の所要時間。
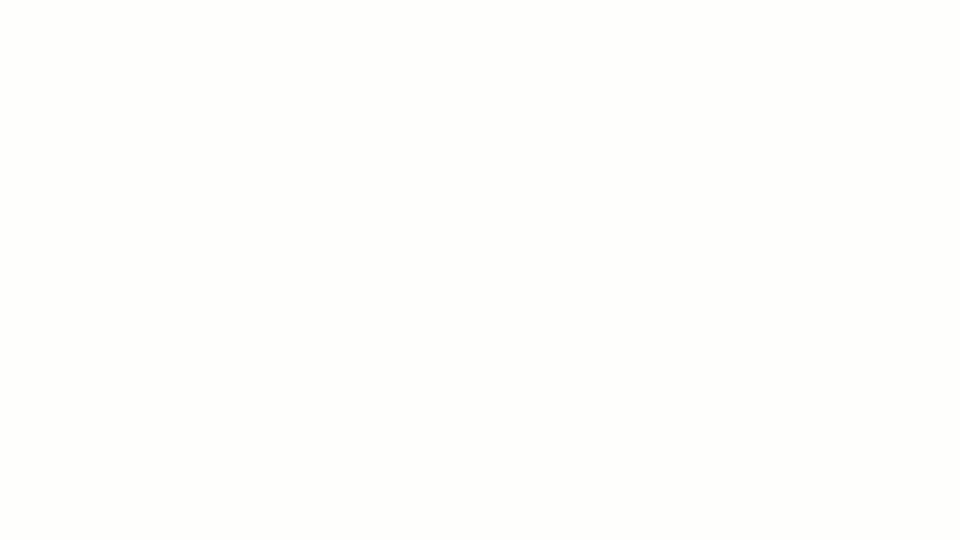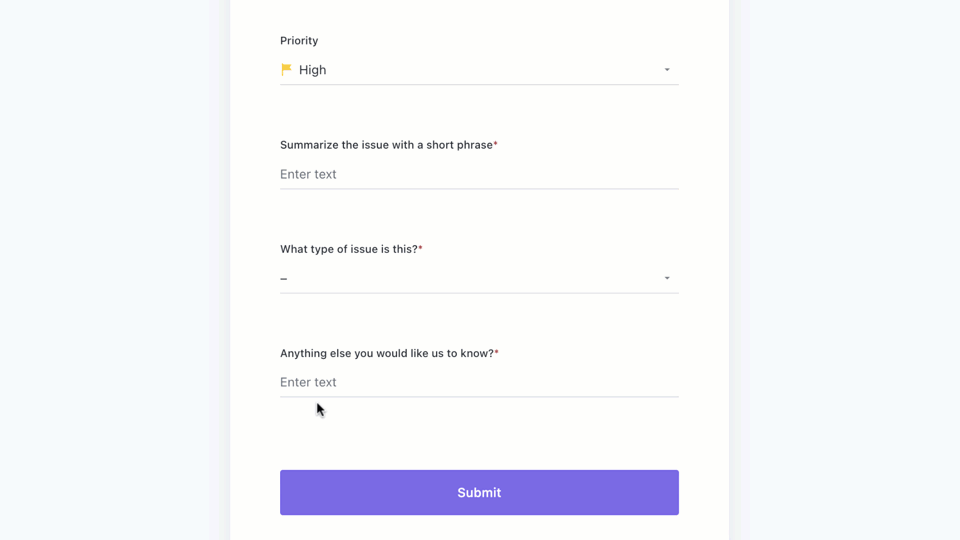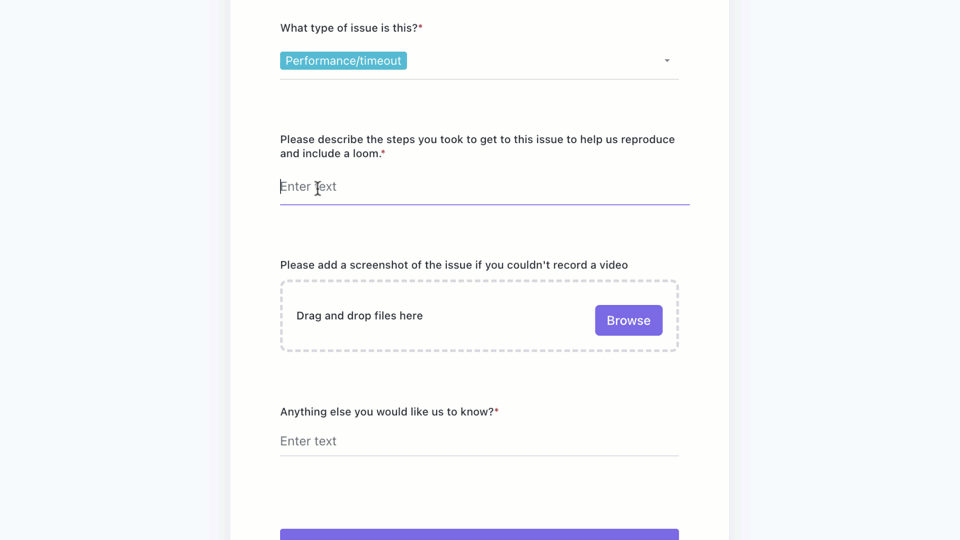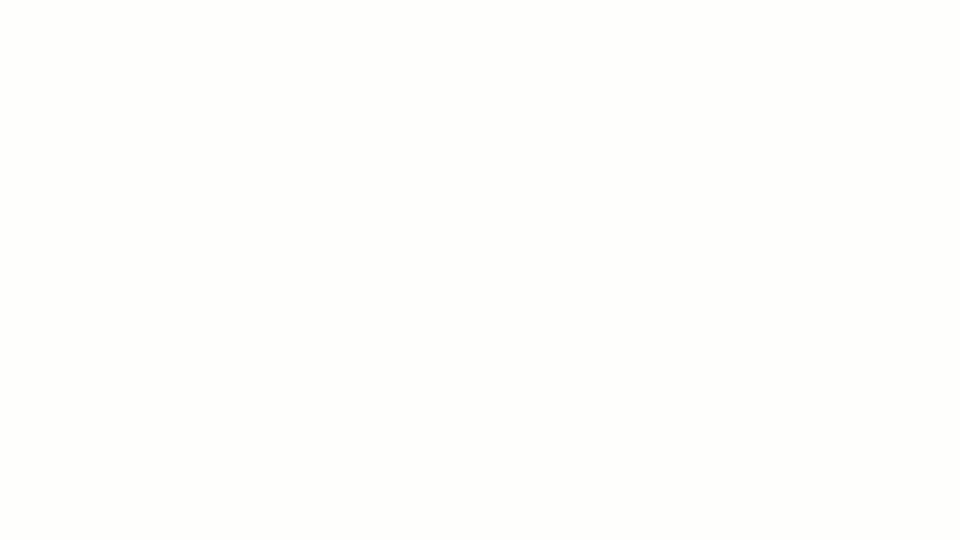
📖 詳細はこちら:ClickUpフォームの威力:ソフトウェアチームの仕事を効率化
2. AIを活用したトリアージとルーティングによるMTTAの大幅短縮
最も迅速な修正とは、適切な担当者の元に即座に届くものです。
シンプルなルールとAIを活用して深刻度を分類し、コンポーネントやコード領域ごとに所有者の候補を特定し、SLAタイムリミットに基づいて自動割り当てを行います。P0/P1とすべての案件を明確に区分し、「誰が所有者か」を曖昧さなく明確にします。
自動化機能により、フィールド情報に基づいて優先度を設定したり、コンポーネントごとに担当チームへ振り分けたり、SLAタイマーを開始したり、当直のエンジニアに通知したりできます。また、AIは過去のパターンに基づいて深刻度や所有者を提案します。トリアージが30分間の議論ではなく、2~5分で完了するようになれば、MTTAが短縮され、それに伴ってMTTRも短縮されます。
注目すべきメトリクス: MTTA、初回対応の質(最初のコメントで適切な情報を求めているか?)、バグごとの引き継ぎ回数。
実際の運用例は以下の通りです:
3. 明確なSLA階層に基づき、ビジネスへの影響度に応じて優先順位を決定する
「声が大きい方が勝つ」という状況は、キューの状況を予測不能にし、CSATやNPS、契約更新率を注視している経営陣との信頼関係を損なうことになります。
その代わりに、深刻度、発生頻度、影響を受けるARR、機能の重要度、更新やリリースまでの期間などを総合的に評価したスコアを採用し、SLAの階層(例:P0:1~2時間以内に影響を軽減、1日以内に解決;P1:当日中;P2:スプリント内)に基づいて対応を決定します。
作業中 (WIP) リミットを設けてP0/P1のレーンを可視化し、どのタスクも滞らないようにしましょう。
注視すべきメトリクス: ティア別のP50/P90解決率、SLA違反率、CSAT/NPSとの相関関係。
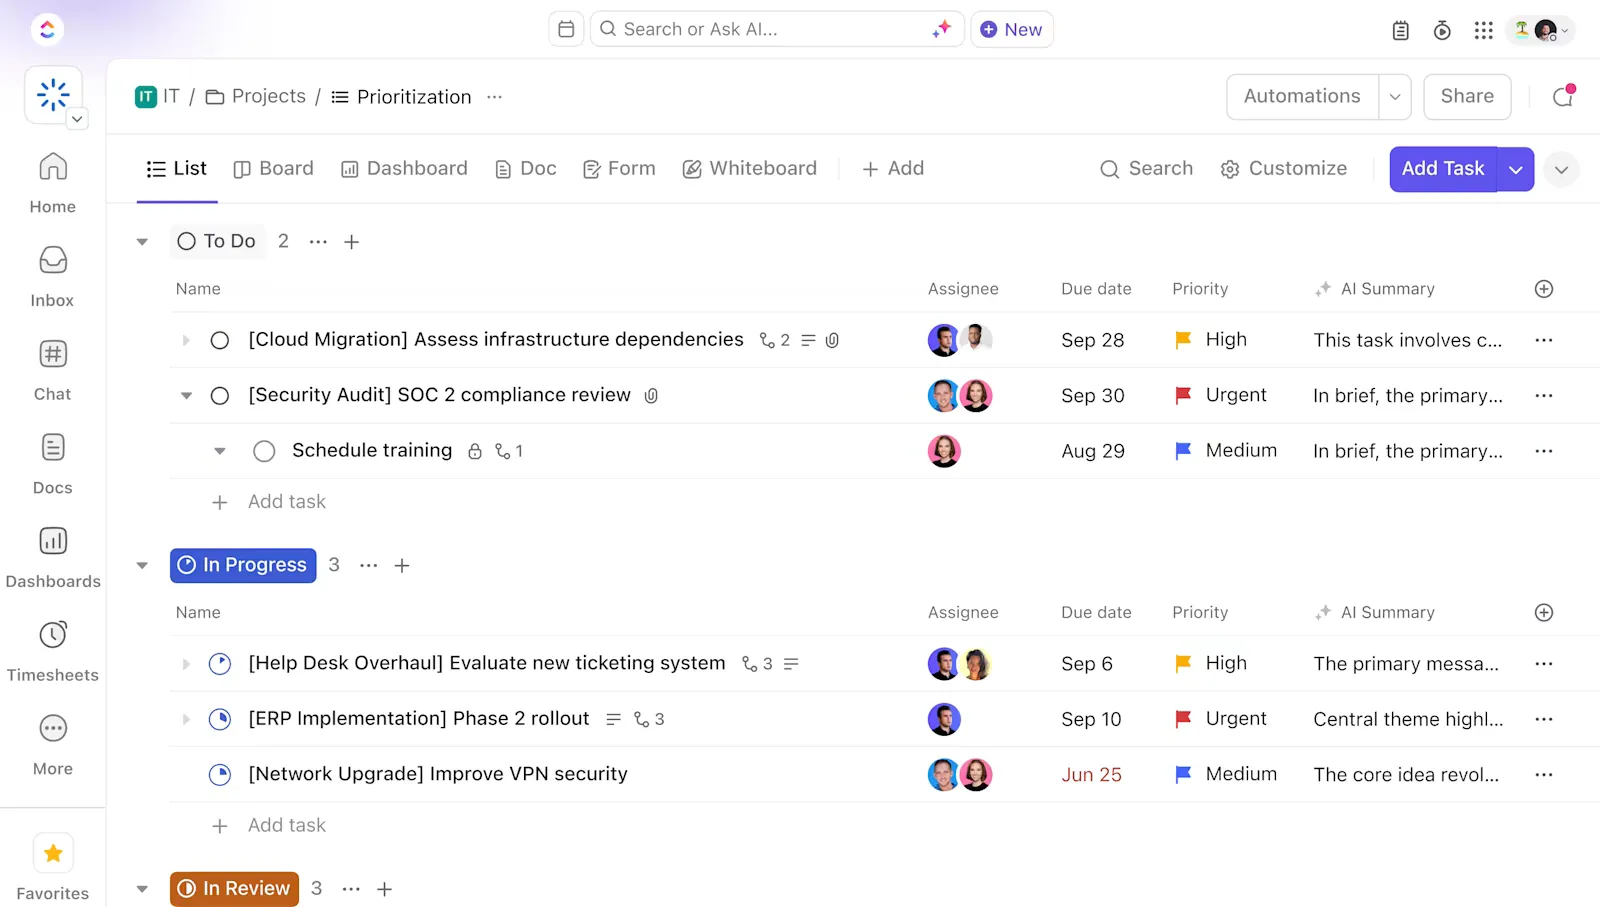
💡プロのヒント:ClickUpの「タスクの優先度」、「カスタムフィールド」、「依存関係 」フィールドを使用すれば 、影響度スコアを算出したり、バグをアカウント、フィードバック、ロードマップアイテムに関連付けたりできます。さらに、 ClickUpの「目標」機能を活用すれば、SLAの遵守状況を企業レベルの目標と結びつけることができ、組織の整合性に関する経営陣の懸念に直接応えることができます。
4. 再現と診断を1回の作業で完了させる
「ログを送っていただけますか?」というやり取りが1回増えるたびに、解決時間が延びてしまいます。
「適切な状態」を標準化しましょう。ビルド/コミット時の必須フィールド、環境、再現ステップ、期待値と実測値の比較に加え、ログ、クラッシュダンプ、HARファイルの添付ファイルも定めます。クライアント/サーバーのテレメトリを実装し、クラッシュIDやリクエストIDをトレースと関連付けられるようにします。
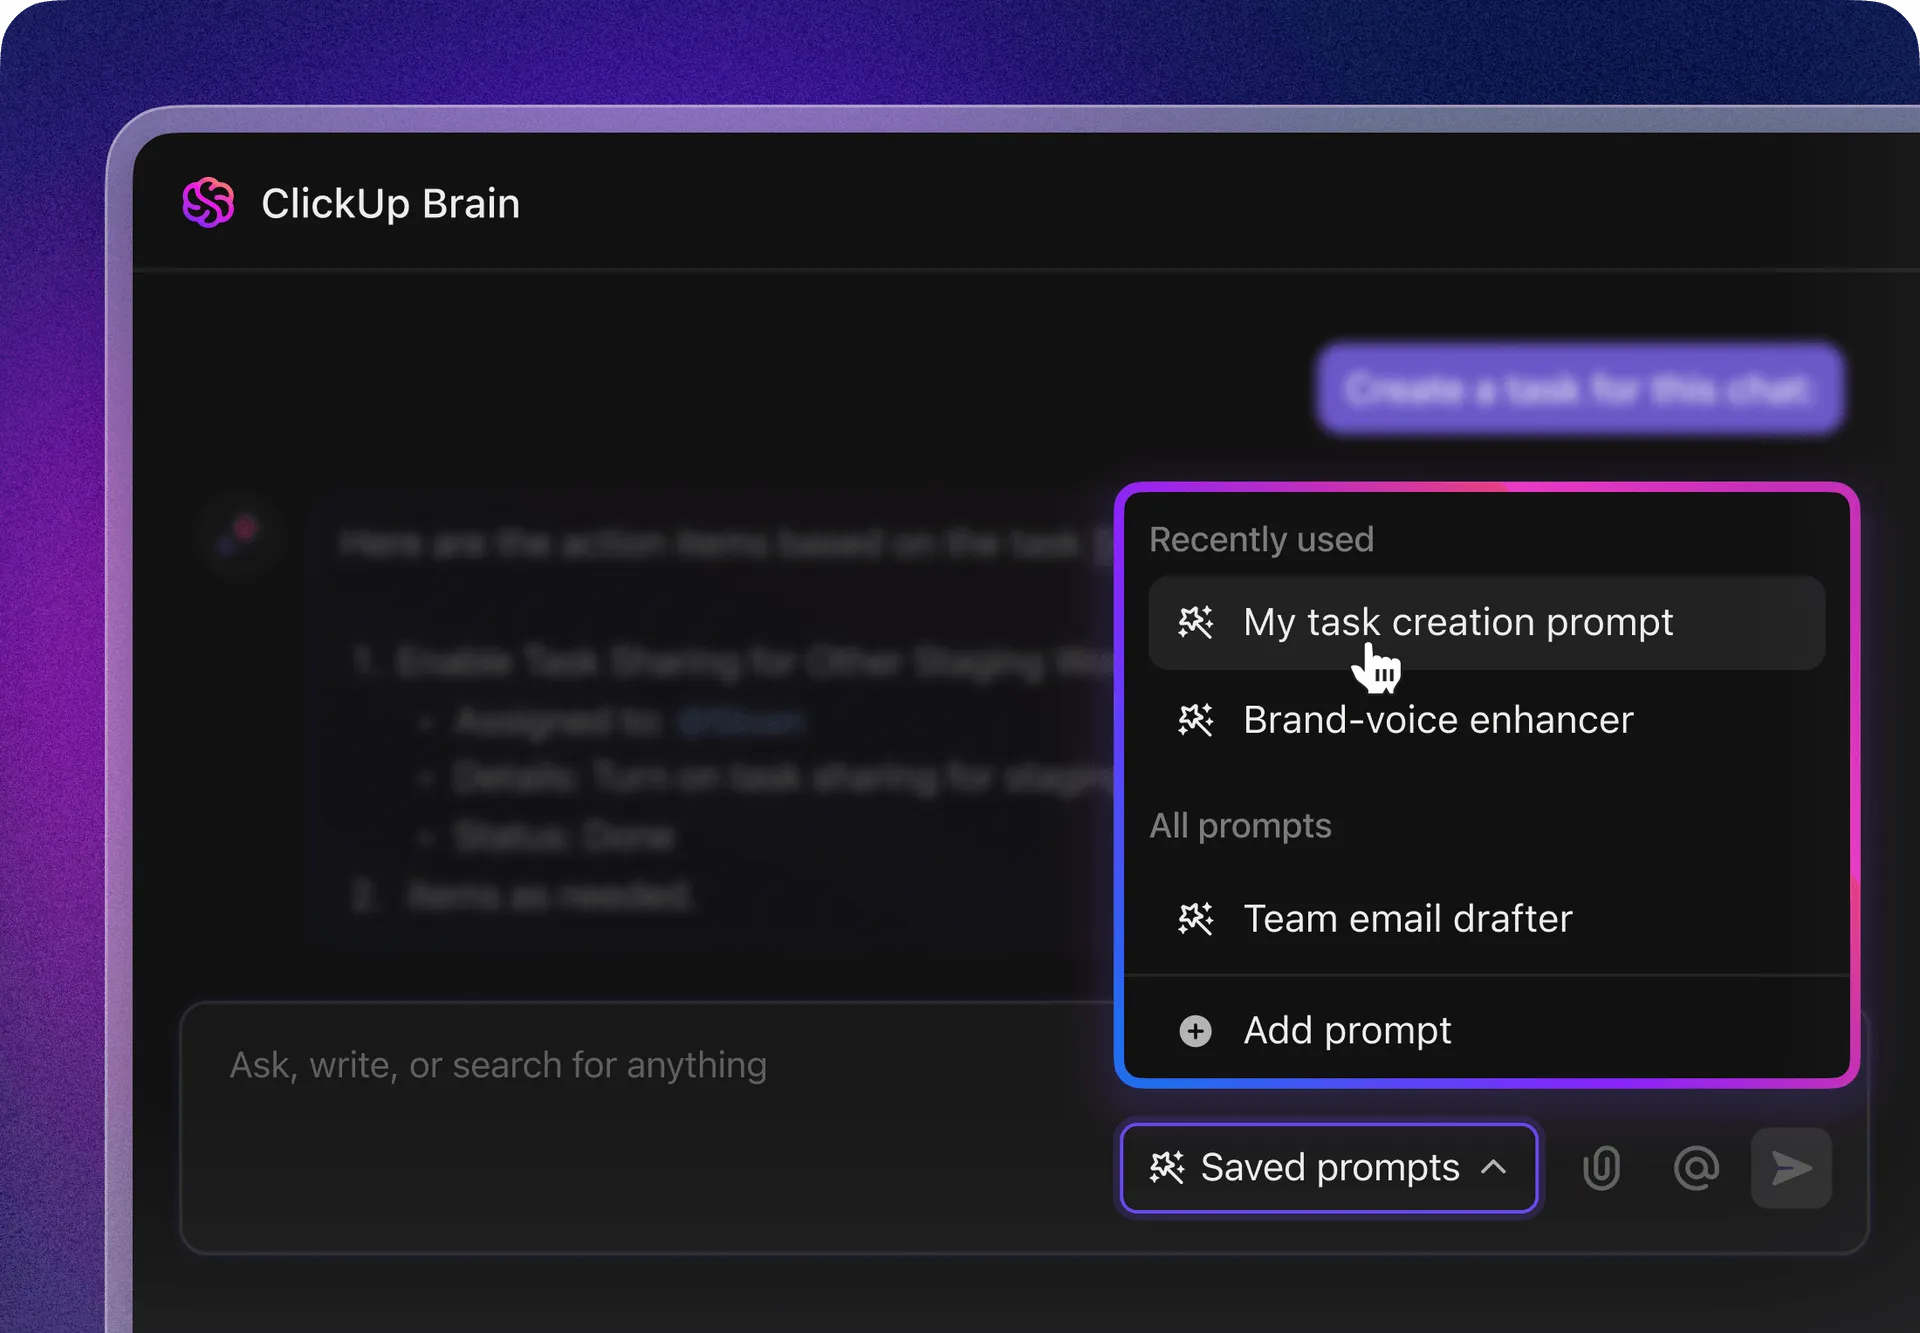
スタックトレースを取得するためにSentry(または類似のツール)を導入し、その情報を問題に直接リンクさせます。AIがログやトレースを分析して、原因となりそうな障害領域を特定し、再現に必要な最小限の手順を生成することで、1時間かけて目視で確認していた仕事を、数分の集中仕事に短縮できます。
一般的な種類のバグに対するランブックを保存しておけば、エンジニアが一から作業を始める必要がなくなります。
注視すべきメトリクス: 「情報待ち」に要した時間、初回再現率、再現情報の不足に起因する再オープン率。
📖 詳細はこちら:ソフトウェア開発におけるAIの活用方法(ユースケースとツール)
5. コードレビューとテストのループを短縮する
大規模なプルリクエストは停滞しがちです。修正を安全にリリースできるよう、ピンポイントなパッチ、トランクベース開発、Feature Flagsの活用を目指しましょう。コードの所有権ごとに事前にレビュアーを割り当てて待ち時間をなくし、チェックリスト(テストの更新、テレメトリの追加、キルスイッチによるフラグのロック)を活用して、品質を確実に組み込みましょう。
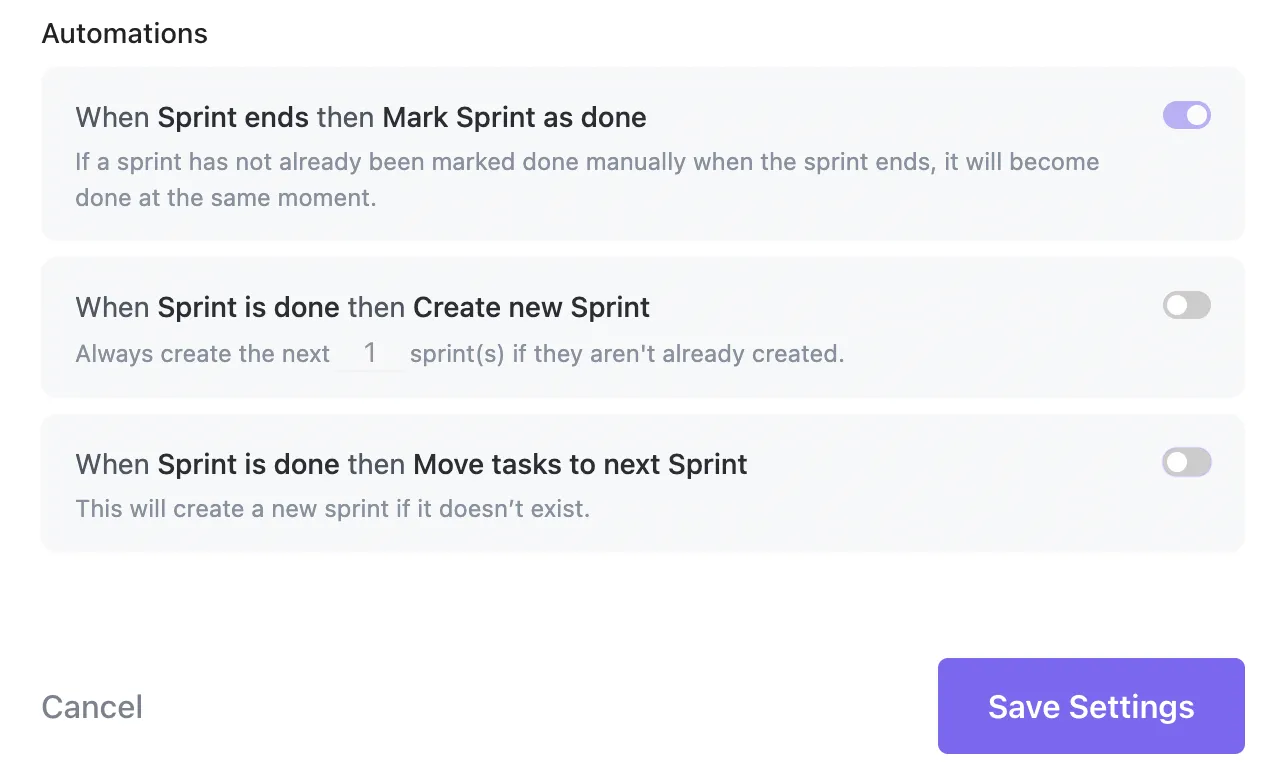
自動化により、PRがオープンされた時点でバグを「レビュー中」に、マージされた時点で「解決済み」に移行させます。また、AIがユニットテストを提案したり、リスクの高い差分を強調表示したりすることで、レビューの重点を絞り込むことができます。
注目すべきメトリクス:「レビュー中」の状態にある時間、バグ修正プルリクエストの変更失敗率、およびP90レビュー遅延時間。
ClickUpのGitHub/GitLab連携機能を使用すれば、バグの解決ステータスを常に同期させることができます。また、自動化機能を活用することで、「完了の定義」を確実に遵守させることができます。
📖 詳細はこちら:AIを活用してタスクを自動化する方法
6. 検証を並行化し、QA環境のパリティを実現する
検証は、数日後になってから、あるいは顧客が誰も使用していない環境で行われるべきではありません。
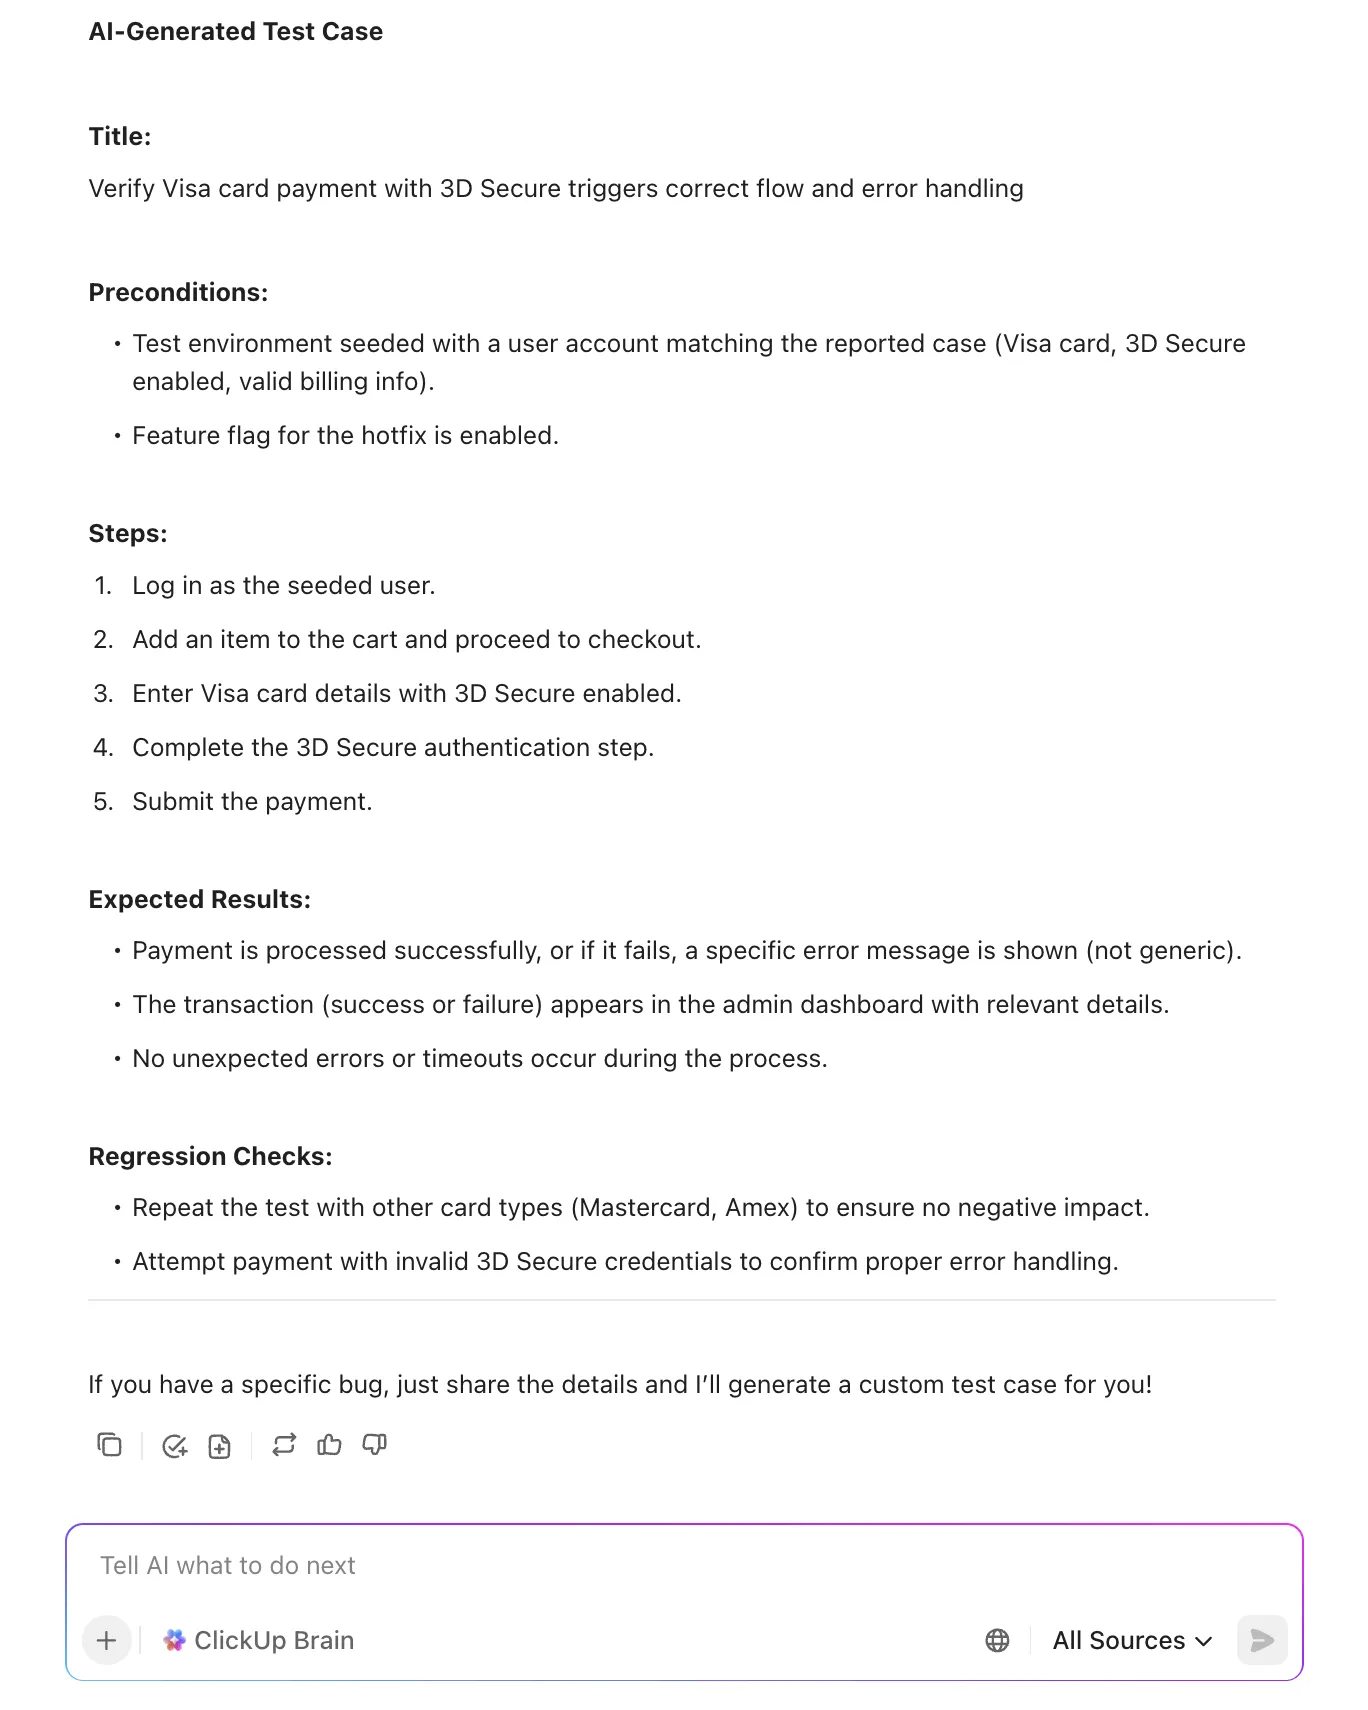
「QA準備完了」の状態を厳格に維持:報告されたケースと一致するシードデータを使用し、本番環境に近い環境で検証されたフラグ駆動型のホットフィックス。
可能な場合は、バグブランチから一時的な環境をセットアップし、QAが即座に検証できるようにします。そうすることで、AIがバグの説明や過去の回帰不具合に基づいてテストケースを生成できるようになります。
注視すべきメトリクス:「QA/検証」段階での所要時間、QAから開発チームへの差し戻し率、マージ後のクローズまでの時間の中央値。
📖 詳細はこちら:効果的なテストケースの書き方
7. ステータスを的確に伝達し、調整にかかる負担を軽減する
適切な更新を行うことで、ステータス確認の問い合わせを3回、エスカレーションを1回防ぐことができます。
アップデートを製品のように扱います。つまり、簡潔かつ具体的で、対象者(サポート、経営陣、顧客)を意識した内容にします。P0/P1の報告頻度(例:問題が解消されるまでは1時間ごと、その後は4時間ごと)を確立し、唯一の信頼できる情報源を維持します。
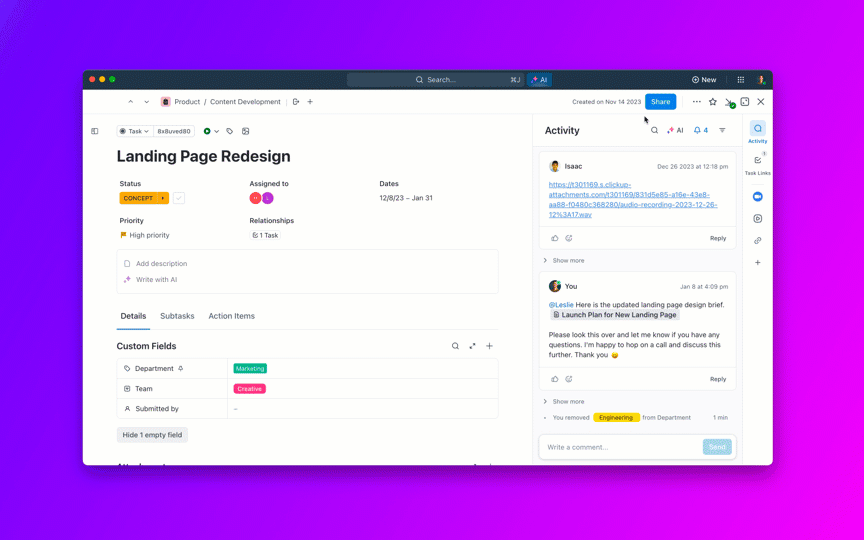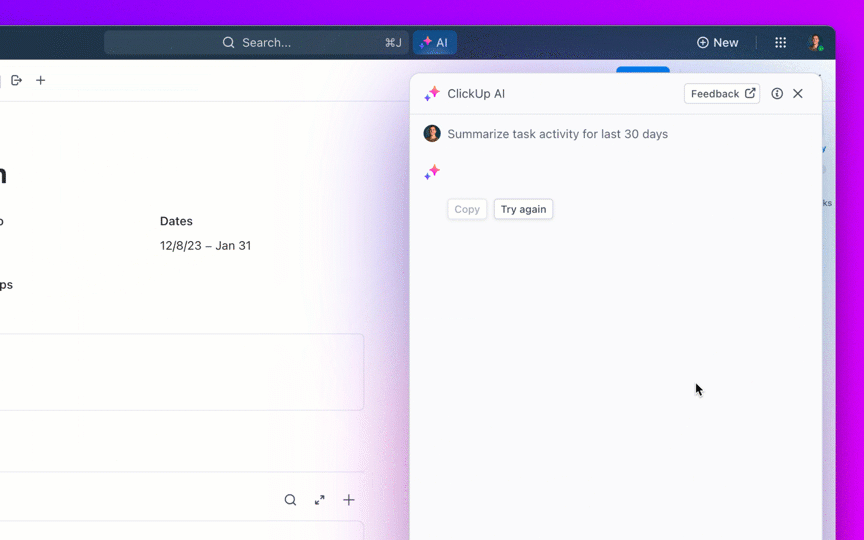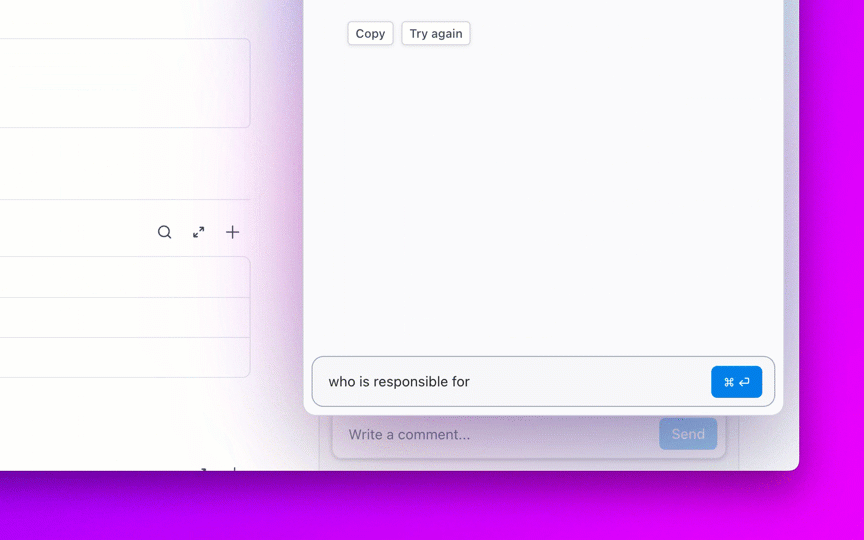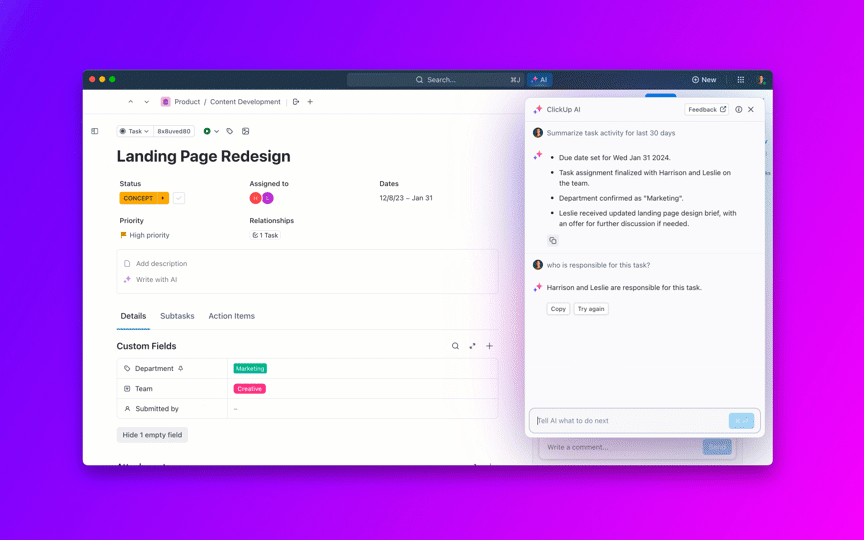
AIは、深刻度や担当チームごとのリアルタイムステータスを含むタスク履歴から、顧客に安全な更新内容や社内向け要約を自動生成できます。プロダクトディレクターなどの経営陣に対しては、バグをイニシアチブ単位で集計し、重要な品質課題が納期の約束を脅かしていないかを確認できるようにします。
注視すべきメトリクス: P0/P1ステータスの更新間隔、コミュニケーションに関するステークホルダーのCSAT。
8. バックログの滞留を管理し、「永遠に未解決」の状態を防ぐ
増え続ける未処理のバックログは、各スプリントに知らず知らずのうちに負担をかけています。
経過期間ポリシー(例:P2が30日を超えるとレビューがトリガーされる、P3が90日を超えると理由の提示が必要になるなど)を設定し、毎週「経過期間トリアージ」を実施して、重複をマージし、不要になったレポートをクローズし、重要度の低いバグをプロダクトバックログアイテムに変換しましょう。
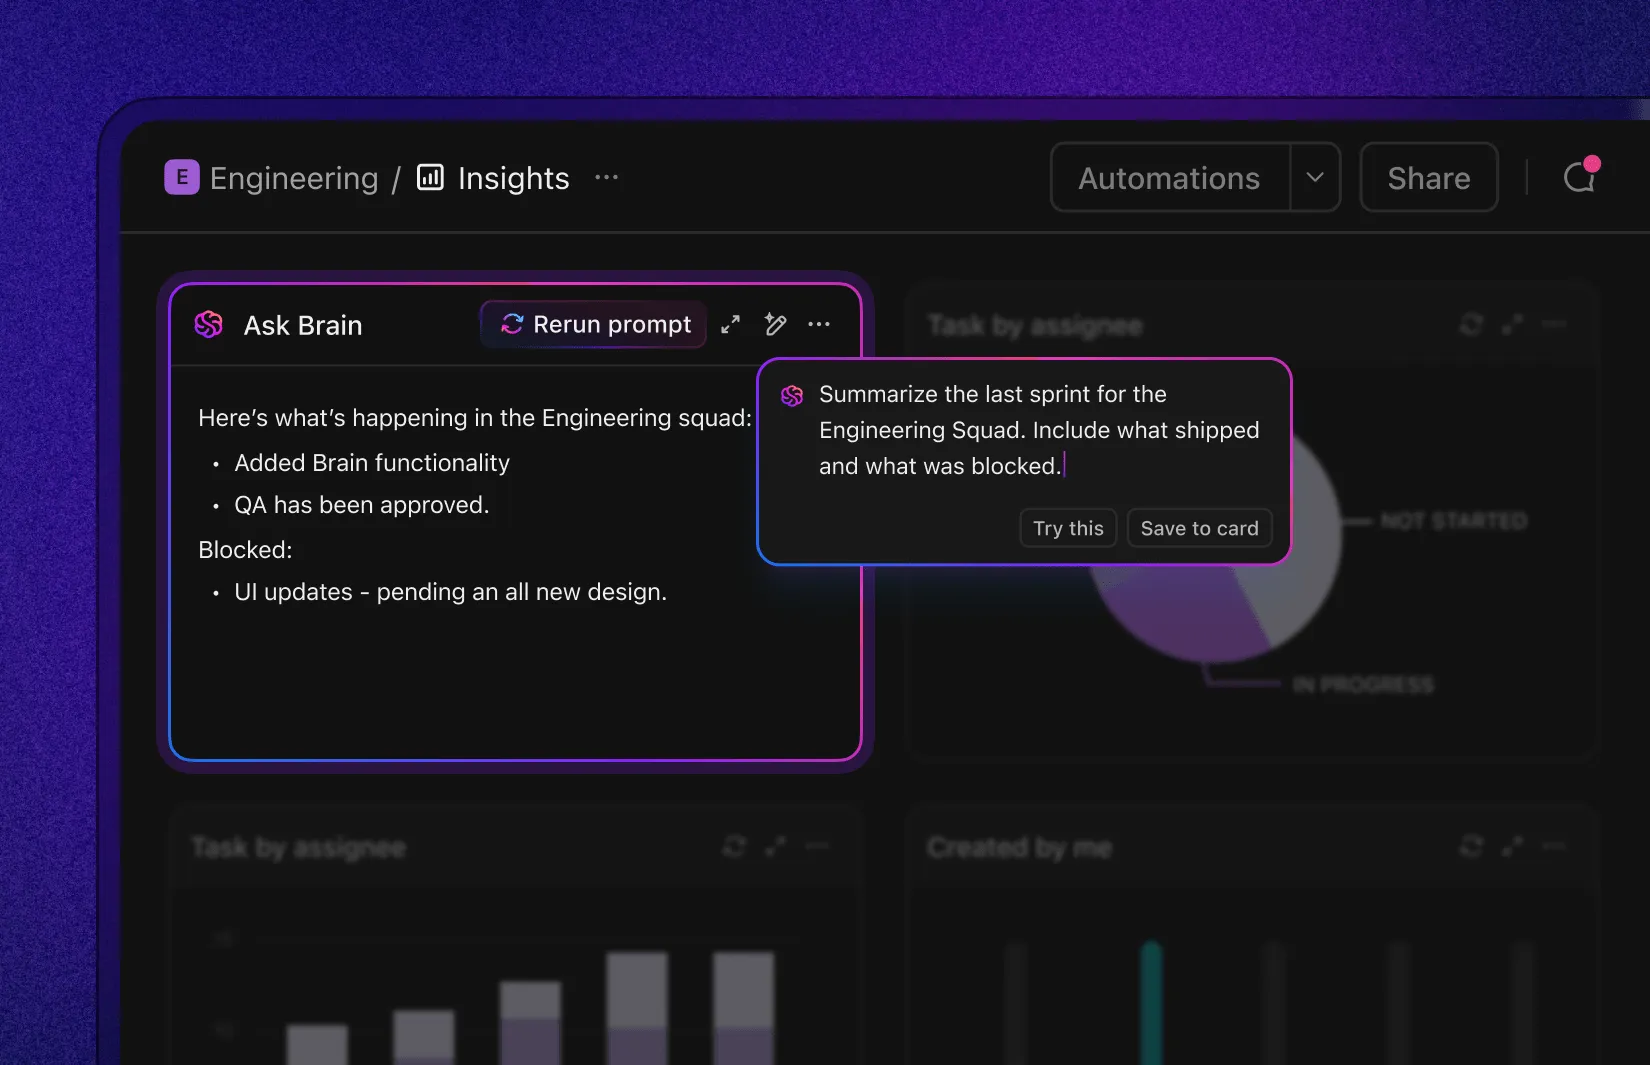
AIを活用してバックログをテーマ別(例:「認証トークンの有効期限切れ」、「画像アップロードの不安定さ」など)にグループ分けし、テーマ別の修正週間を設定して、ある種の不具合をまとめて解消しましょう。
注目すべきメトリクス:期間別バックログ件数、重複・廃止として閉じた問題の割合、テーマ別のバーンダウン速度。
9. 根本原因の特定と再発防止で改善サイクルを閉じた
同じ種類の不具合が繰り返し発生している場合、MTTRの改善は、より大きな問題を覆い隠していることになります。
P0/P1および発生頻度の高いP2バグについて、迅速かつ責任追及のない根本原因分析を行い、根本原因(仕様上の不備、テストの不備、ツールの不備、統合時の不安定性)にタグを付け、影響を受けるコンポーネントやインシデントとリンクし、フォローアップタスク(ガード、テスト、リンティングルール)が完了するまで追跡します。
AIは、変更履歴に基づいてRCA(根本原因分析)の要約を作成し、予防的なテストやLintルールを提案することができます。こうして、「火消し」から「トラブルの発生を未然に防ぐ」体制へと移行できるのです。
注視すべきメトリクス: 再オープン率、回帰率、再発間隔、および予防措置が完了した根本原因分析(RCA)の割合。
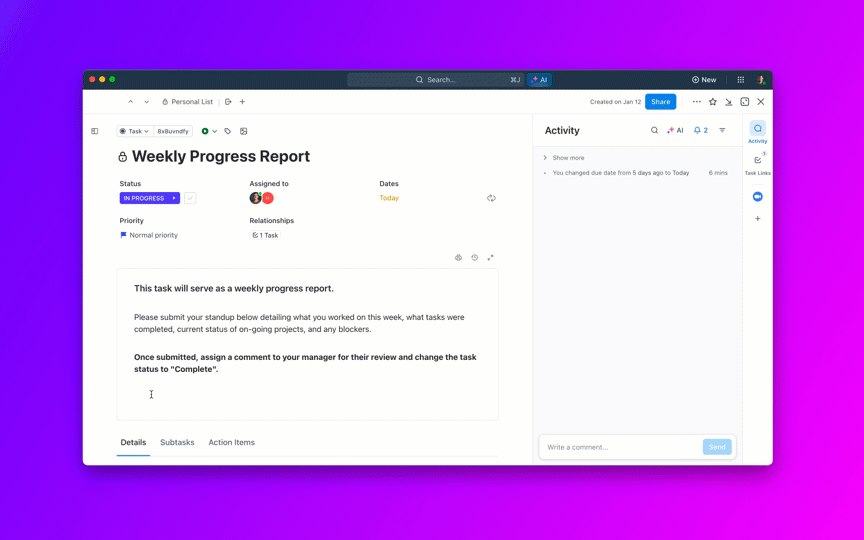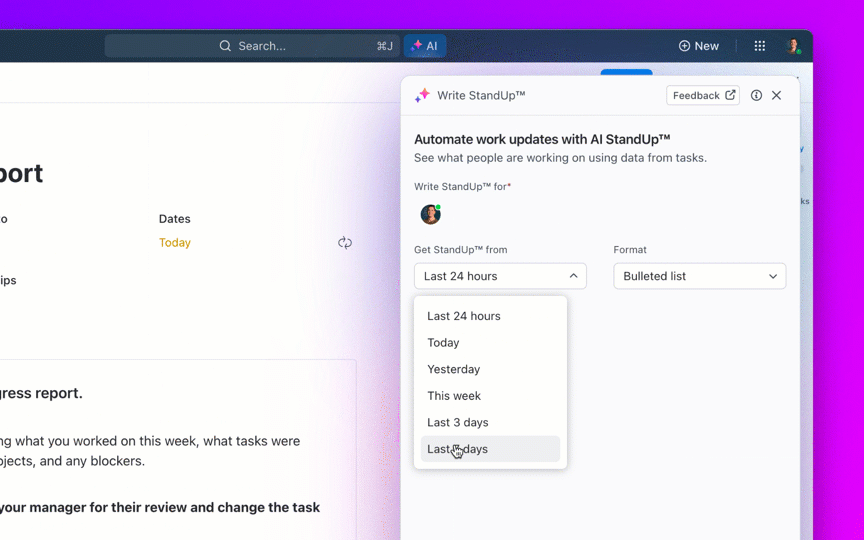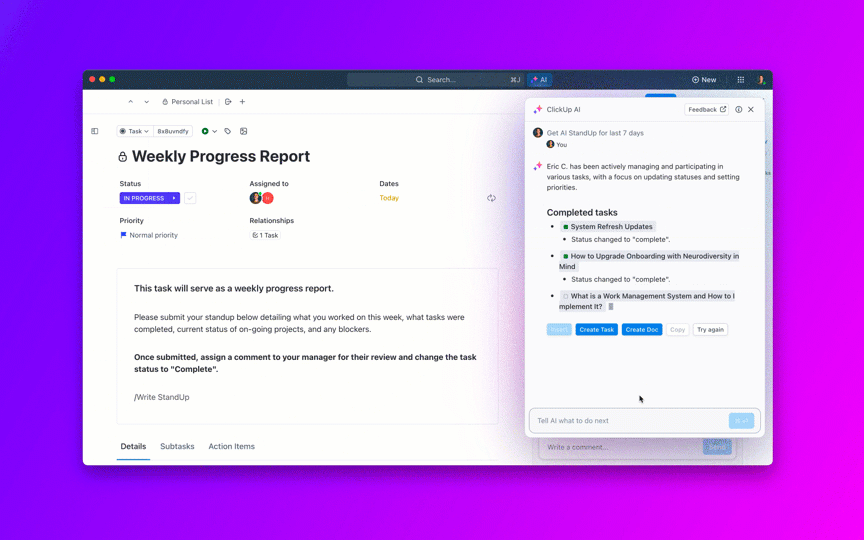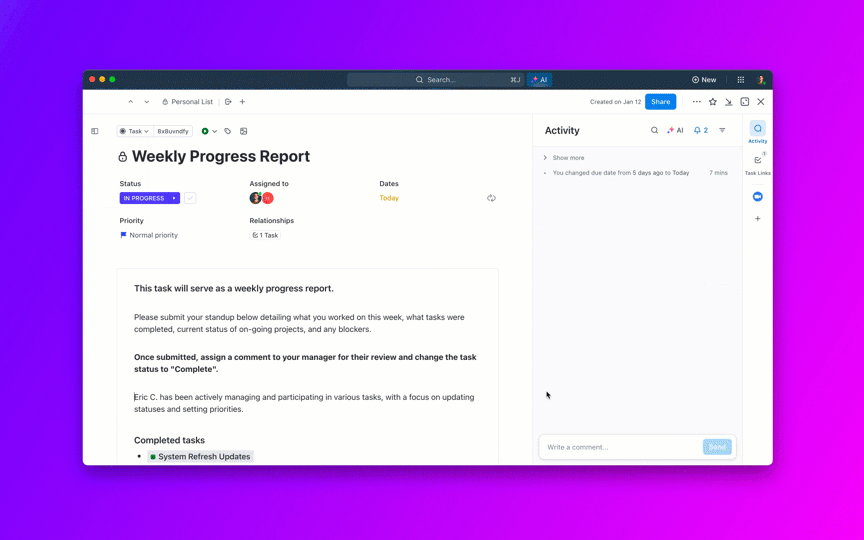
これらの変更を総合することで、エンドツーエンドのプロセスが効率化されます。具体的には、受領確認の迅速化、より的確なトリアージ、スマートな優先順位付け、レビューやQAにおける停滞の減少、そして明確なコミュニケーションが実現します。経営陣はCSAT/NPSや収益に連動した予測可能性を得られ、実務担当者はコンテキスト切り替えが減り、より落ち着いた作業環境を確保できます。
📖 詳細はこちら:根本原因分析の実施方法
バグ解決時間の短縮に役立つAIツール
AIを活用すれば、受付、トリアージ、割り当て、修正、検証の各ステップにおいて、解決時間を短縮できます。
しかし、真のメリットが得られるのは、ツールが状況を理解し、手取り足取りのサポートなしに仕事を円滑に進められるようになったときです。
レポートを自動的に充実させ(再現ステップ、環境、重複情報の追加)、影響度に基づいて優先順位を付け、適切な所有者に割り当て、明確な進捗報告を作成し、コード、CI、オブザーバビリティと緊密に連携できるシステムを探しましょう。
中でも優れたツールは、エージェントのようなワークフローもサポートしています。SLAを監視し、レビュー担当者にリマインドを送り、処理が滞っているアイテムをエスカレーションし、ステークホルダー向けに結果を要約するボットなどです。バグ解決を改善するためのAIツールを以下にご紹介します:
1. ClickUp(コンテキスト対応AI、自動化、エージェント型ワークフローに最適)
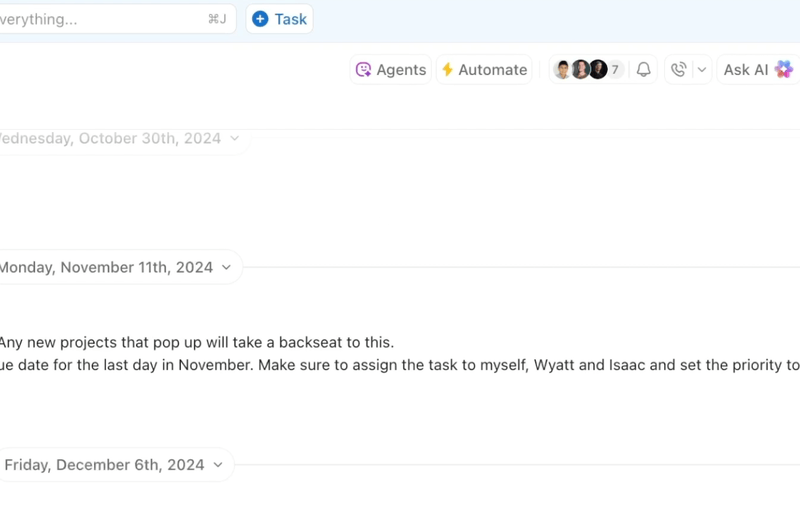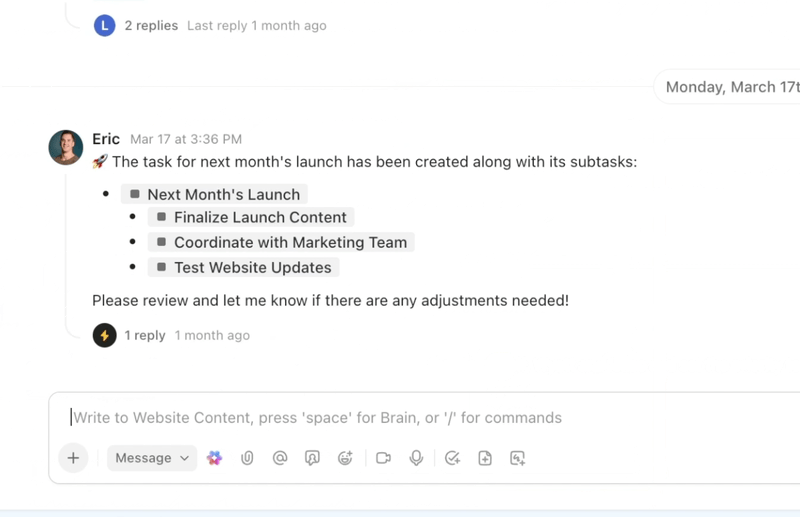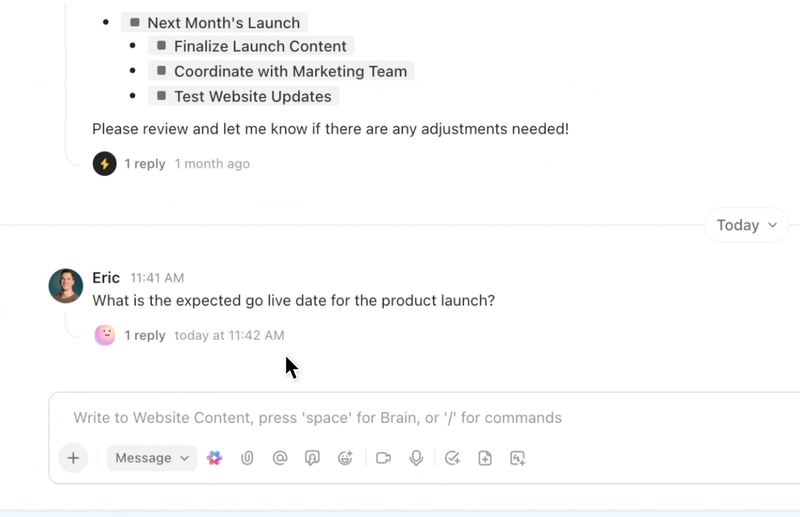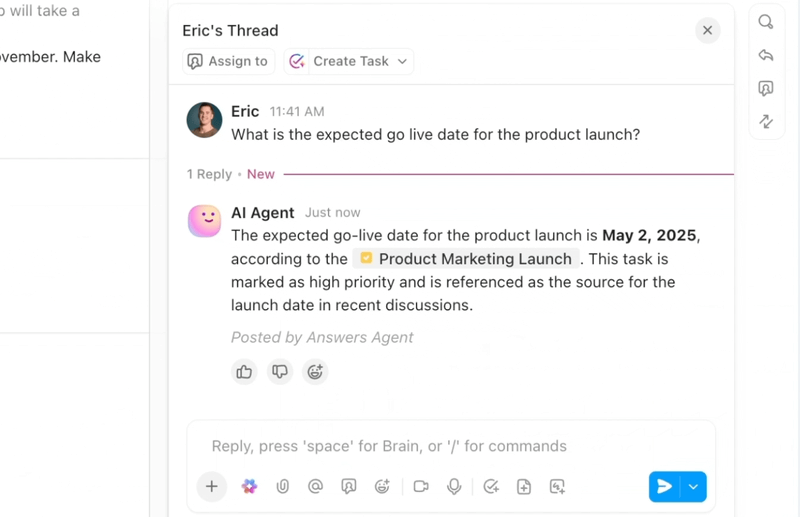
効率的でインテリジェントなバグ解決ワークフローをお求めの場合は、仕事のためのオールインワンアプリ「ClickUp」が、AI、自動化、エージェント型ワークフロー支援を一か所に集約します。
ClickUp Brainは、長いバグスレッドを要約し、添付ファイルから再現ステップや環境の詳細を抽出し、重複の可能性が高いものをフラグ付けし、次のアクションを提案することで、適切なコンテキストを瞬時に提示します。チームは、Slackやチケット、ログをいちいち確認する必要がなく、すぐにアクションに移せる、整理された充実した記録を入手できます。
ClickUpの自動化機能とオートパイロットエージェントにより、常に手動で管理することなく仕事を円滑に進めることができます。バグは適切なチームに自動的に割り当てられ、所有者が指定され、SLAや期日が設定されます。仕事の進捗に合わせてステータスが更新され、関係者はタイムリーに通知を受け取ることができます。
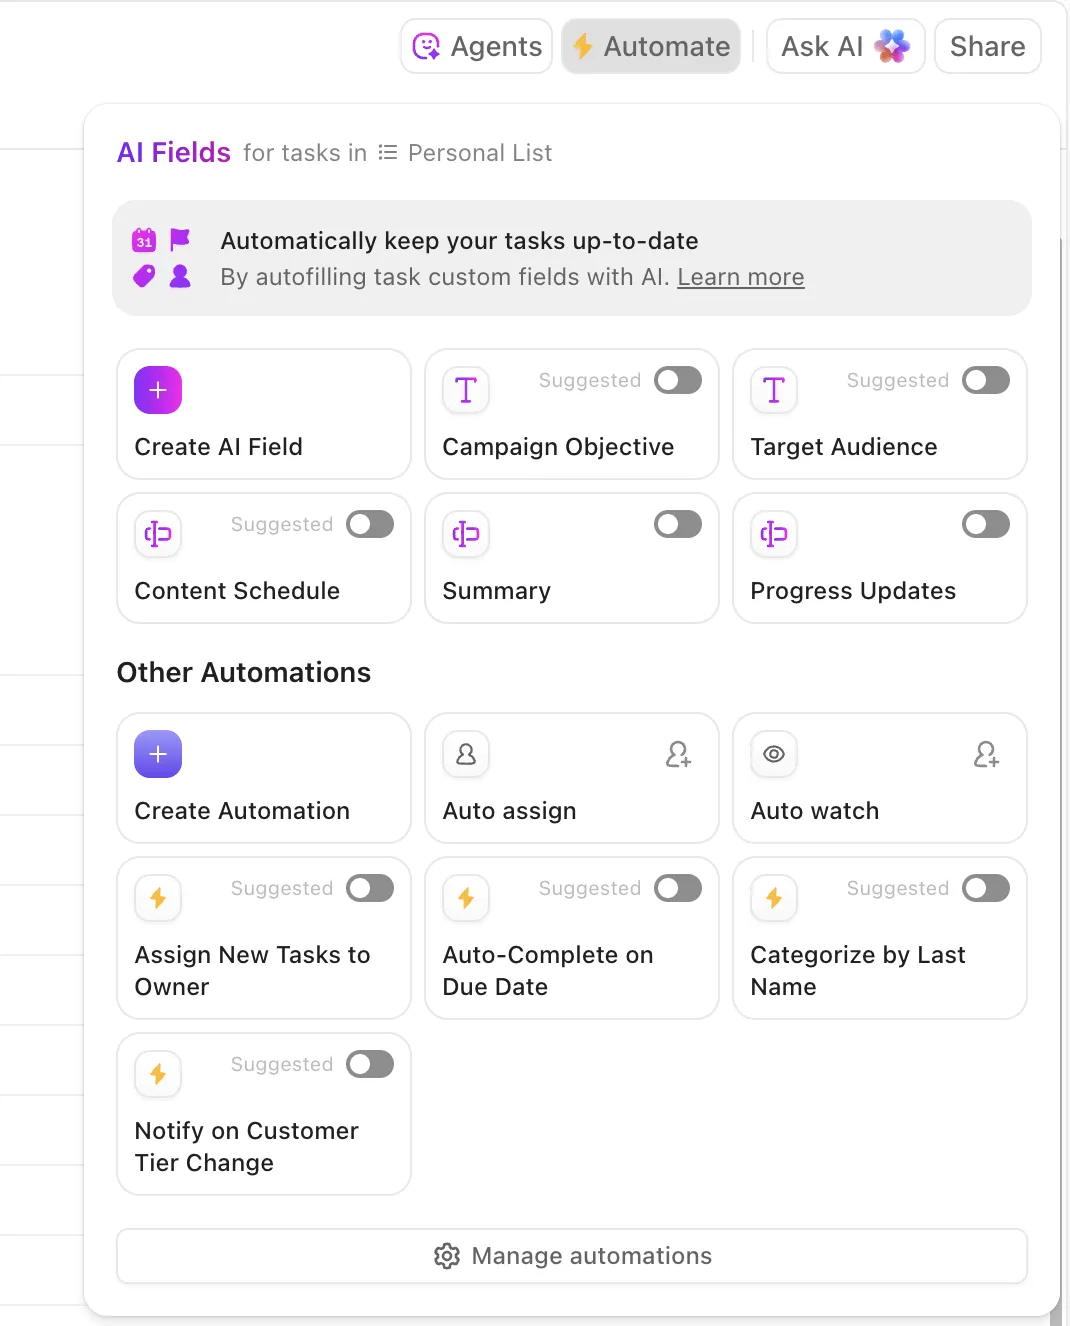
これらのエージェントは、問題のトリアージや分類、類似した報告のグループ化、過去の修正事例を参照して適切な対応策を提案すること、さらには緊急アイテムのエスカレーションまで行うことができるため、処理件数が急増した場合でもMTTAとMTTRを短縮できます。
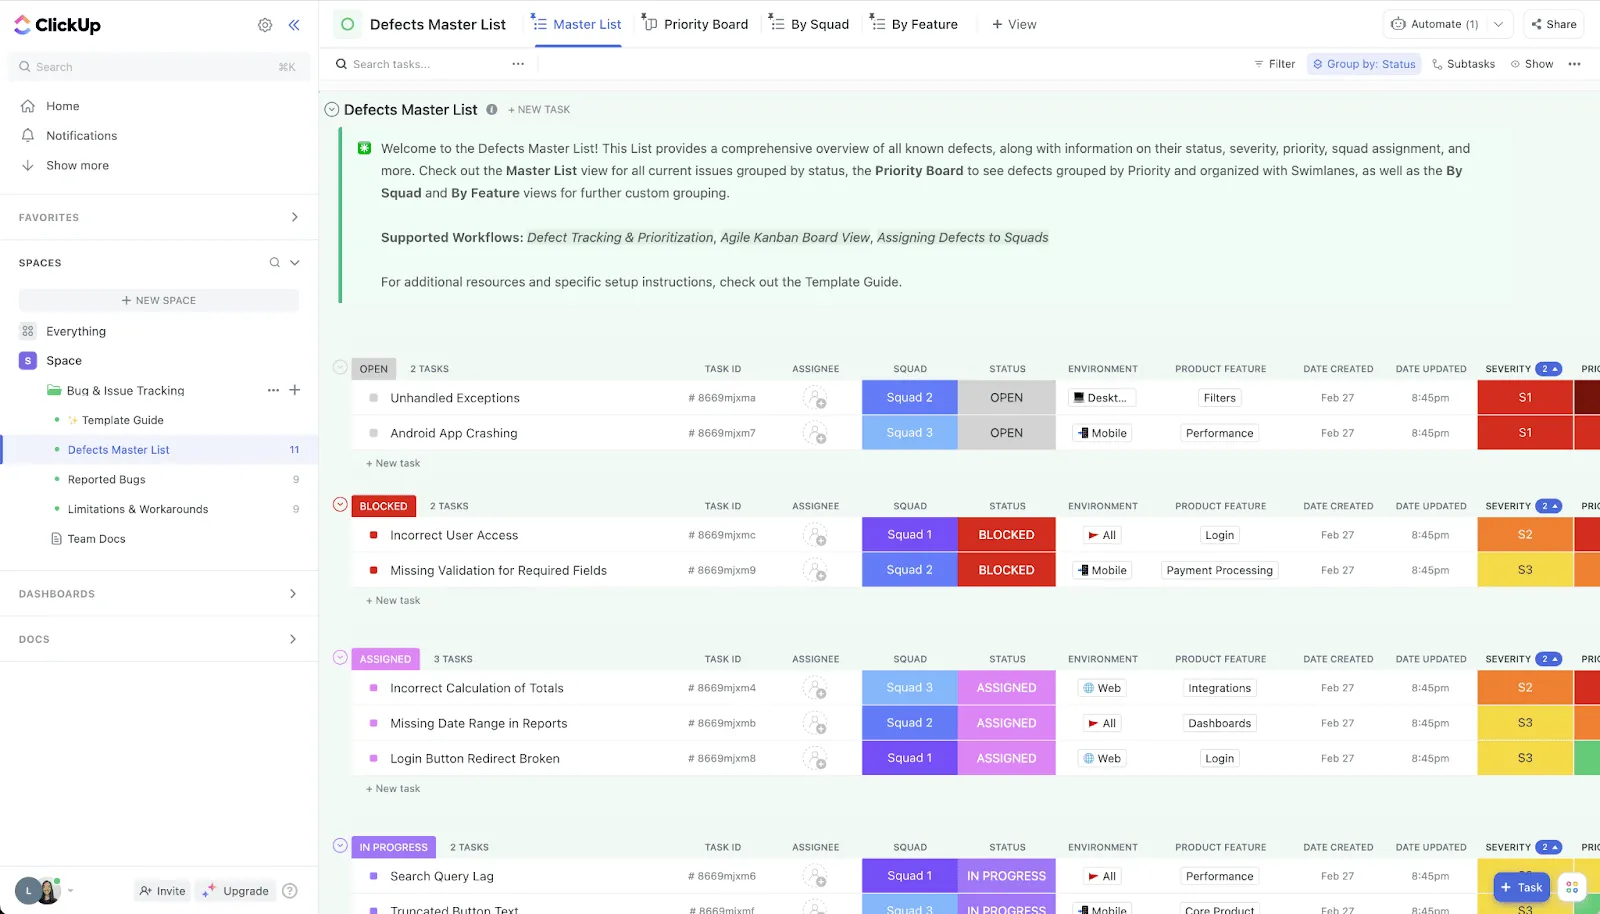
🛠️ すぐに使えるツールキットをお探しですか?「ClickUp バグ・課題追跡テンプレート」は、ClickUp for Software が提供する強力なソリューションで、サポート、エンジニアリング、プロダクト各チームがソフトウェアのバグや問題を容易に把握・管理できるよう設計されています。 「リスト」、「ボード」、「ワークロード」、「フォーム」、「タイムライン」などのカスタマイズ可能なビューを活用することで、チームは各自に最適な方法でバグ追跡プロセスを可視化し、管理することができます。
このテンプレートには20種類のカスタムステータスと7種類のカスタムフィールドが用意されており、ニーズに合わせたワークフローを構築できるため、すべての問題を発見から解決まで確実に追跡できます。組み込みの自動化機能により反復的なタスクが処理されるため、貴重な時間を節約し、手作業の負担を軽減できます。
💟 特典:Brain MAX は 、AI を搭載したデスクトップ用ツールであり 、スマートで実用的な機能により、バグの解決を加速するように設計されています。
バグを発見した際は、Brain MAXの音声入力機能を使って問題を口述するだけで済みます。音声メモは即座に文字起こしされ、新規または既存のバグチケットに添付ファイルとして添付できます。また、エンタープライズ検索機能は、ClickUp、GitHub、Google Drive、Slackなど、接続しているすべてのツールを横断的に検索し、関連するバグ報告、エラーログ、コードスニペット、ドキュメントを抽出します。これにより、アプリを切り替えることなく、必要なコンテキストをすべて把握できます。
修正作業の調整が必要ですか?Brain MAXを使えば、適切な開発者にバグを割り当て、ステータス更新の自動リマインダーを設定し、進捗状況を追跡することが、すべてデスクトップから行えます!
2. Sentry(エラーの捕捉に最適)
Sentryは 、エラー、トレース、ユーザーセッションを一元的に収集することで、MTTD(平均検出時間)と再現時間を短縮します 。AIを活用した問題のグループ化によりノイズを低減し、「Suspect Commit」機能と所有権ルールによってコードの所有者候補を特定するため、問題の割り当てが瞬時に行われます。セッションリプレイ機能により、エンジニアは正確なユーザーの操作経路やコンソール/ネットワークの詳細情報を確認できるため、延々とやり取りを繰り返すことなく問題を再現できます。
Sentry AIの機能は、問題の背景情報を要約し、一部のスタックでは、問題のあるコードを参照した「Autofix」パッチを提案します。これにより、重複チケットの削減、割り当ての迅速化、そして報告から動作するパッチまでのプロセスの短縮といった実用的な効果が得られます。
3. GitHub Copilot(コードレビューを迅速に行うのに最適)
Copilot は 、エディター内での修正サイクルを加速させます 。スタックトレースを解説し、ターゲットを絞ったパッチを提案し、修正を確実にするための単体テストを記述し、再現スクリプトの骨組みを作成します。
Copilot Chatは、不具合のあるコードを分析し、より安全なリファクタリングを提案し、コードレビューを迅速化するコメントやプルリクエストの説明文を生成します。必須のレビューやCIと組み合わせることで、特に再現手順が明確で範囲が限定されたバグにおいて、「診断→実装→テスト」のプロセスを数時間短縮します。
4. Snyk by DeepCode AI(パターンの発見に最適)
DeepCodeのAIを活用した静的解析は、コーディング中やプルリクエスト(PR)内で欠陥やセキュリティ上の問題となるパターンを検出します。問題のあるフローをハイライト表示し、その原因を説明するとともに、コードベースの慣用表現に合わせた安全な修正案を提案します。
マージ前に回帰バグを検出し、開発者に安全なコーディングパターンを提示することで、新規バグの発生率を低減し、レビューでは見つけにくい複雑なロジックエラーの修正を迅速化できます。IDEやプルリクエスト(PR)との連携により、実際の仕事現場に近い環境でこれらのプロセスを実行できます。
5. DatadogのWatchdogとAIOps(ログ分析に最適)
DatadogのWatchdogは、機械学習(ML)を活用して、ログ、メトリクス、トレース、リアルユーザーモニタリング全体から異常を検出します。スパイクをデプロイマーカー、インフラの変更、トポロジーと関連付け、考えられる根本原因を提示します。
顧客に影響を与える不具合については、検出まで数分、アラートのノイズを削減するための自動グループ化、そして調査すべき箇所を具体的に示す手がかりが得られます。白紙の状態から始めるのではなく、「このデプロイがこれらのサービスに影響を与え、このエンドポイントでエラー率が上昇した」という情報から分析を開始できるため、トリアージ時間が短縮されます。
⚡️ テンプレートアーカイブ:ExcelおよびClickUp用の無料問題追跡・ログテンプレート
6. New Relic AI(トレンドの特定と要約に最適)
New Relicの「Errors Inbox」は、サービスやバージョンごとに類似したエラーをグループ化し、AIアシスタントが影響を要約し、考えられる原因を特定し、関連するトレースやトランザクションへのリンクを提供します。
デプロイメントの相関関係とエンティティ変更の分析により、最近のリリースが原因であることが一目でわかります。分散システムの場合、このコンテキスト情報により、チーム間のやり取りに費やす時間を数時間短縮し、確固たる仮説を立てた上で、バグを適切な所有者に割り当てることができます。
7. Rollbar(自動化されたワークフローに最適)
Rollbarは、インテリジェントなフィンガープリント技術を用いて重複をグループ化し、発生傾向を追跡するリアルタイムのエラー監視を専門としています。AIを活用した要約や根本原因のヒントにより、チームは影響範囲(影響を受けたユーザー、影響を受けたバージョン)を把握でき、テレメトリやスタックトレースからは再現の手がかりを迅速に得ることができます。
Rollbarのワークフロールールは、タスクの自動作成、重大度のタグ付け、所有者に割り当てを行うことができ、雑多なエラーストリームを、コンテキストが添付された優先順位付けされたキューに変換します。
8. PagerDuty AIOps およびランブック自動化(ロータッチ診断のベストプラクティス)
PagerDutyは、イベントの相関分析と機械学習(ML)を活用したノイズ低減機能により、アラートストームを実用的なインシデントに集約します。
ダイナミックルーティングにより、問題は即座に適切な当直担当者に割り当てられ、ランブック自動化によって、人間が対応する前に診断や緩和措置(サービスの再起動、デプロイのロールバック、Feature Flagsの切り替えなど)を開始できます。バグ解決時間に関しては、MTTAの短縮、P0に対する迅速な緩和措置、そしてアラート疲労による時間の損失削減につながります。
その共通のテーマは、すべてのステップにおける自動化とAIの活用です。バグを早期に検出し、よりスマートにルーティングし、より早くコードにたどり着き、エンジニアの作業を妨げることなくステータスを共有できます。これらすべてが相まって、バグ解決時間の大幅な短縮につながります。
📖 詳細はこちら:DevOpsにおけるAIの活用方法
バグ解決におけるAI活用の例
つまり、AIはついに実験室の枠を飛び出し、実際の現場でバグ解決時間を短縮しているのです。
その方法を見てみましょう!
| ドメイン/組織 | AIの活用方法 | 効果・メリット |
|---|---|---|
| Ubisoft | 10年分の社内コードで学習させたAIツール「 Commit Assistant」を開発しました。このツールは、コーディングのフェーズでバグを予測・防止します。 | 時間とコストの大幅な削減を目指します。従来、ゲーム開発費の最大70%がバグ修正に費やされてきました。 |
| Razer(Wyvrn Platform) | バグの検出を自動化し、QAレポートを生成するためのAI搭載「 QA Copilot」(UnrealおよびUnityと統合)をリリースしました。 | バグの検出率を最大25%向上させ、QA時間を半減させます。 |
| Google / DeepMind & Project Zero | FFmpegやImageMagickなどのオープンソースソフトウェアにおけるセキュリティ脆弱性を自律的に検出するAIツール「Big Sleep」が発表されました。 | 20件のバグを特定し、すべて人間の専門家によって検証され、パッチ適用が予定されています。 |
| カリフォルニア大学バークレー校の研究者たち | 「CyberGym」というベンチマークを用いて、AIモデルが188のオープンソースプロジェクトを分析した結果、17件の脆弱性(うち15件は未知の「ゼロデイ」バグ)を発見し、概念実証(PoC)用のエクスプロイトを生成しました。 | 脆弱性の検出やエクスプロイト対策の自動化において、AIの進化し続ける能力を実証します。 |
| Spur(イェール大学のスタートアップ) | 平易な言葉で記述されたテストケースの説明を、自動化されたWebサイトテスト手順に変換するAIエージェントを開発しました。これは、実質的に「自動生成されるQAワークフロー」と言えます。 | 人的介入を最小限に抑え、自律的なテストを実現します |
| Androidのバグレポートを自動的に再現する | NLPと強化学習を活用し、バグレポートの文言を解析して、Androidのバグを再現するためのステップを生成しました。 | 精度67%、再現率77%を達成し、バグ報告の74%を再現することに成功し、従来の方法を上回る成果を上げました。 |
バグ解決時間の測定におけるよくある間違い
測定が正確でなければ、改善プランも正確にはなりません。
バグ解決ワークフローにおける「不適切な数値」の多くは、定義の曖昧さ、ワークフローの不統一、および分析の浅さから生じています。
まずは基本から始めましょう――「開始/終了」の定義、待機や再調査の扱い方――そして、顧客が実際に体験しているのと同じ視点でデータを読み解いてください。これには以下が含まれます:
❌ 境界線の曖昧さ: 同じダッシュボード内で「報告済み→解決済み」と「報告済み→閉じた」を混在させたり(あるいは月ごとに切り替えたり)すると、傾向の分析が無意味になってしまいます。いずれか一方の境界線を選び、それを文書化し、チーム全体で徹底してください。両方が必要な場合は、明確なラベルを付けて別々のメトリクスとして公開してください。
❌ 平均値のみに依存するアプローチ:平均値に頼ると、処理に時間がかかる少数の外れ値が存在するキューの実態が見えにくくなります。「典型的な」所要時間には中央値(P50)を、予測可能性やSLAにはP90を使用し、キャパシティプランニングには平均値を活用しましょう。単一の数値だけでなく、常に分布全体を把握するようにしてください。
❌ セグメンテーションの欠如:すべてのバグをひとまとめにすると、P0レベルのインシデントと、表面的なP3レベルのバグが混在してしまいます。重大度、発生源(顧客/QA/モニタリング)、コンポーネント/チーム、および「新規/回帰」ごとにセグメント分けしましょう。P0/P1のP90値はステークホルダーが実際に感じる影響を表し、P2以上の中央値はエンジニアリングチームがプランを立てる際の基準となります。
❌ 「一時停止」時間を無視していないか:顧客からのログ、外部ベンダー、あるいはリリース時期を待っている状態ではありませんか?「ブロック中」や「一時停止中」を重要なステータスとして追跡しなければ、解決時間は議論の種になってしまいます。カレンダー時間とアクティブ時間の両方を報告することで、ボトルネックを可視化し、議論を終わらせましょう。
❌ 時間の正規化における不整合:タイムゾーンが混在していたり、処理の途中で営業時間とカレンダー時間の切り替えが行われたりすると、比較結果が不正確になります。タイムスタンプを1つのタイムゾーン(またはUTC)に統一し、SLAの測定単位をビジネス時間とするかカレンダー時間とするかを一度決定し、一貫して適用してください。
❌ 不完全な登録情報と重複チケット:環境情報やビルド情報の欠落、および重複チケットは、処理時間を水増しし、所有権の判別を困難にします。登録時に必須フィールドを標準化し、ログ、バージョン、デバイスなどの情報を自動的に補完し、処理時間をリセットすることなく重複を解消しましょう。重複チケットは「新規」問題としてではなく、「リンクされている」問題としてクローズしてください。
❌ ステータスモデルの不統一:独自のステータス(「QA準備中(ish)」、「レビュー待ち 2」など)は、ステータスごとの所要時間を不明確にし、状態遷移の信頼性を損ないます。標準的なワークフロー(新規 → トリアージ済み → 進行中 → レビュー中 → 解決済み → 閉じた)を定義し、標準プロセスから外れた状態がないか監査を行ってください。
❌ ステータスごとの所要時間を無視する: 単なる「合計時間」の番号だけでは、仕事がどこで停滞しているかはわかりません。「トリアージ中」、「レビュー中」、「ブロック中」、「QA中」の各ステータスで費やされた時間を把握し、分析しましょう。コードレビューのP90が実装時間を大幅に上回っている場合、解決策は「コーディングを速くすること」ではなく、レビューのキャパシティを解放することです。
🧠 豆知識:DARPAが主催した最新の「AIサイバーチャレンジ」では、サイバーセキュリティの自動化において画期的な飛躍が示されました。このコンテストでは、人間の介入なしに、ソフトウェアの脆弱性を自律的に検出し、悪用し、修正するように設計されたAIシステムが紹介されました。 優勝チーム「Team Atlanta」は、注入されたバグの77%を見事に発見し、その61%を正常に修正することに成功し、AIが欠陥を見つけるだけでなく、積極的に修正する力を持っていることを実証しました。
❌ 再報告の盲点:再報告を新規バグとして扱うと、計測時間がリセットされ、MTTRが過大評価されてしまいます。再報告率と「安定したクローズまでの時間」(すべてのサイクルにおける最初の報告から最終的なクローズまでの時間)を追跡しましょう。再報告の増加は、通常、再現性の低さ、テストの不備、あるいは「完了」の定義が曖昧であることを示しています。
❌ MTTAの無視:チームはMTTRにばかり注目し、MTTA(認識・所有権が明確になるまでの時間)を無視しがちです。MTTAが高いことは、解決に時間がかかるという早期の警告サインです。MTTAを測定し、深刻度ごとにSLAを設定し、ルーティングやエスカレーションを自動化して、MTTAを低く抑えましょう。
❌ ガードレールのないAI/自動化:レビューなしにAIに深刻度の設定や重複チケットのクローズを任せてしまうと、エッジケースが誤分類されたり、知らず知らずのうちにメトリクスが歪められたりする恐れがあります。AIは提案として活用し、P0/P1については人間の確認を必須とし、データの信頼性を維持するためにモデルのパフォーマンスを毎月監査しましょう。
これらの連携を強化すれば、解決時間のチャートはようやく実態を反映するようになります。そこから改善は相乗効果を生みます。受付プロセスの改善によりMTTAが短縮され、状態の明確化によって真のボトルネックが明らかになり、セグメント別のP90値によって、経営陣に確実に実現できる成果を約束できるようになります。
⚡️ テンプレートアーカイブ:ソフトウェアテスト用テストケーステンプレート10選
バグ解決を改善するためのベストプラクティス
まとめとして、覚えておくべき重要なポイントを以下に紹介します!
| 🧩 ベストプラクティス | 💡 その意味 | 🚀 その重要性 |
| 堅牢なバグ追跡システムを活用する | 一元化されたバグ追跡システムを使用して、報告されたすべてのバグを追跡しましょう。 | バグの見落としを防ぎ、チーム間でバグのステータスを可視化します。 |
| 詳細なバグレポートを作成する | 視覚的なコンテキスト、OS情報、再現ステップ、および深刻度を含めてください。 | 開発者が必要な情報を最初からすべて把握できるため、バグをより迅速に修正できるようになります。 |
| バグの分類と優先順位付け | 優先度マトリックスを使用して、バグを緊急度と影響度で分類しましょう。 | チームがまず重要なバグや緊急の問題に注力できるようにします。 |
| 自動化テストを活用する | CI/CDパイプライン内でテストを自動的に実行しましょう。 | 早期発見をサポートし、回帰バグを防止します。 |
| 明確なレポート作成ガイドラインを定義する | バグのレポート作成に関するテンプレートやトレーニングを提供しましょう。 | これにより、正確な情報の把握と円滑なコミュニケーションが実現します。 |
| 主要なメトリクスを追跡する | 解決時間、経過時間、および応答時間を測定します。 | 履歴データを活用して、パフォーマンスの追跡と改善を可能にします。 |
| 先手を打つアプローチを採用する | ユーザーからの苦情を待つのではなく、先手を打ってテストを行いましょう。 | 顧客満足度を高め、サポートの負担を軽減します。 |
| スマートツールと機械学習を活用する | 機械学習を活用してバグを予測し、修正案を提案しましょう。 | 根本原因の特定やバグの修正における効率が向上します。 |
| SLAへの準拠 | 解決に関する合意済みのサービスレベル契約(SLA)のミーティングを確実に遵守しましょう。 | 信頼を築き、クライアントの期待にタイムリーに応えることができます。 |
| 継続的な見直しと改善 | 再オープンされたバグを分析し、フィードバックを収集し、プロセスを改善しましょう。 | 開発プロセスとバグ管理の継続的な改善を促進します。 |
コンテキストAIでバグ解決をシンプルに
バグ解決が最も速いチームは、個人の英雄的な活躍に頼っていません。彼らは、明確な開始・終了の定義、整然とした受付プロセス、ビジネスへの影響度に基づく優先順位付け、明確な所有権、そしてサポート、QA、エンジニアリング、リリース部門を横断した緊密なフィードバックループといったシステムを構築しています。
ClickUpは、バグ解決システムのためのAI搭載の指令センターとなることができます。すべての報告を1つのキューに集約し、構造化されたフィールドでコンテキストを標準化します。そして、ClickUp AIにトリアージ、要約、優先順位付けを任せ、自動化機能によってSLAを遵守させ、期限が迫った場合はエスカレーションを行い、関係者の連携を保ちます。バグを顧客、コード、リリースに紐づけることで、経営陣は影響を把握でき、実務担当者は業務の流れを維持できます。
バグ解決時間を短縮し、ロードマップの予測可能性を高めたいとお考えなら、今すぐClickUpに登録して、四半期単位ではなく、数日単位で成果の向上を実感しましょう。
よくある質問
バグ解決時間の適正な目安とは?
「理想的な」数値というものは一つだけではありません。深刻度、リリースモデル、リスク許容度によって異なります。「一般的な」パフォーマンスには中央値(P50)を、約束やSLAにはP90を使用し、深刻度や発生源ごとに分類して分析しましょう。
バグの解決とバグのクローズにはどのような違いがあるのでしょうか?
「解決(Resolution)」とは、修正が実装され(例:コードのマージ、設定の適用)、チームがその問題が解消されたとみなした状態を指します。「クローズ(Closure)」とは、問題が検証され、正式に完了した状態(例:ターゲット環境でのQAによる検証完了、リリース、または「修正しない」「重複」として理由を明記してマークされた状態)を指します。多くのチームでは、この両方を測定しています。「報告→解決」はエンジニアリングのスピードを反映し、「報告→クローズ」はエンドツーエンドの品質フローを反映します。 ダッシュボードで各フェーズが混在しないよう、定義を統一してください。
バグの解決時間とバグの検出時間の違いは何ですか?
検出時間(MTTD)とは、欠陥が発生またはリリースされた後、監視、QA、またはユーザーを通じてその欠陥を発見するまでに要する時間のことです。解決時間とは、検出・レポート作成から修正の実施(および必要に応じて検証・リリース)に至るまでの時間のことです。これら2つが相まって「顧客への影響期間」を定義します。つまり、迅速な検出、迅速な確認、迅速な解決、そして安全なリリースです。 また、MTTA(認識・割り当てまでの時間)を追跡することで、解決に時間がかかることを示唆することが多いトリアージの遅延を特定することもできます。
AIはバグの解決にどのように役立つのでしょうか?
AIは、通常時間がかかりがちな「受付、トリアージ、診断、修正、検証」という一連のプロセスを効率化します。
- 受付とトリアージ: 長いレポートを自動で要約し、再現ステップや環境情報を抽出し、重複をフラグ付けし、重大度や優先度を提案することで、エンジニアが明確な状況把握から作業を開始できるようにします(例:ClickUp AI、Sentry AI)。
- ルーティングとSLA: 該当するコンポーネントや所有者を予測し、タイマーを設定し、MTTAやレビュー待ちが予定より遅れた場合にエスカレーションを行うことで、「ステータス待機時間」を削減します(ClickUp自動化およびエージェント型ワークフロー)。
- 診断: 類似したエラーをクラスタリングし、スパイクを最近のコミットやリリースと関連付け、スタックトレースやコードのコンテキストに基づいて、考えられる根本原因を特定します(Sentry AIなど)。
- 実装:リポジトリ内のパターンに基づいてコードの変更やテストを提案し、「作成・修正」のループを加速させます(GitHub Copilot、DeepCode社のSnyk Code AI)。
- 検証とコミュニケーション:再現手順からテストケースを作成し、リリースノートやステークホルダー向け進捗報告の草案を作成し、経営陣や顧客向けにステータスを要約します(ClickUp AI)。ClickUpを指令センターとし、Sentry/Copilot/DeepCodeをスタックに組み合わせて活用することで、チームは「ヒーロー的な対応」に頼ることなく、MTTA/P90の時間を短縮できます。