
Projekty szkolenia AI rzadko kończą się niepowodzeniem na poziomie modelu. Problemy pojawiają się, gdy eksperymenty, dokumentacja i aktualizacje dla interesariuszy są rozproszone po zbyt wielu narzędziach.
W tym przewodniku omówiono proces szkolenia modeli za pomocą Databricks DBRX — modelu LLM, który jest nawet dwukrotnie bardziej wydajny obliczeniowo niż inne wiodące modele — przy jednoczesnym uporządkowaniu związanych z tym zadań w ClickUp.
Od ustawień i dostrajania po dokumentację i aktualizacje między zespołami — przekonasz się, jak jeden, zintegrowany obszar roboczy pomaga wyeliminować rozproszenie kontekstu i pozwala zespołowi skupić się na tworzeniu, a nie na szukaniu. 🛠
Czym jest DBRX?
DBRX to potężny, otwarty model językowy (LLM) zaprojektowany specjalnie do szkolenia i wnioskowania modeli AI w przedsiębiorstwach. Ponieważ jest to oprogramowanie open source na licencji Databricks Open Model License, Twój zespół ma pełny dostęp do wag i architektury modelu, co pozwala na jego sprawdzanie, modyfikowanie i wdrażanie na własnych warunkach.
Dostępne są dwie wersje: DBRX Base do głębokiego wstępnego szkolenia oraz DBRX Instruct do gotowych do użycia zadań polegających na wykonywaniu poleceń.
Architektura DBRX i projekt oparty na modelu „mixture-of-experts”
DBRX rozwiązuje zadania przy użyciu architektury typu Mixture-of-Experts (MoE). W przeciwieństwie do tradycyjnych dużych modeli językowych, które wykorzystują wszystkie swoje miliardy parametrów do każdego obliczenia, DBRX aktywuje tylko ułamek wszystkich parametrów (najbardziej odpowiednich ekspertów) dla danego zadania.
Pomyśl o tym jak o zespole wyspecjalizowanych ekspertów – zamiast angażować wszystkich w rozwiązywanie każdego problemu, system w inteligentny sposób kieruje każde zadanie do osób o najbardziej odpowiednich kwalifikacjach i parametrach.
Nie tylko skraca to czas reakcji, ale także zapewnia najwyższą wydajność i wyniki, jednocześnie znacznie obniżając koszty obliczeniowe.
Oto krótki przegląd kluczowych parametrów technicznych:
- Łączna liczba parametrów: 132 mld we wszystkich modelach ekspertów
- Aktywne parametry: 36 mld na jeden przebieg
- Liczba ekspertów: łącznie 16 (routing MoE Top-4), z czego 4 są aktywni dla dowolnego tokenu
- Okno kontekstowe: 32 tys. tokenów
Specyfikacje danych szkoleniowych i tokenów DBRX
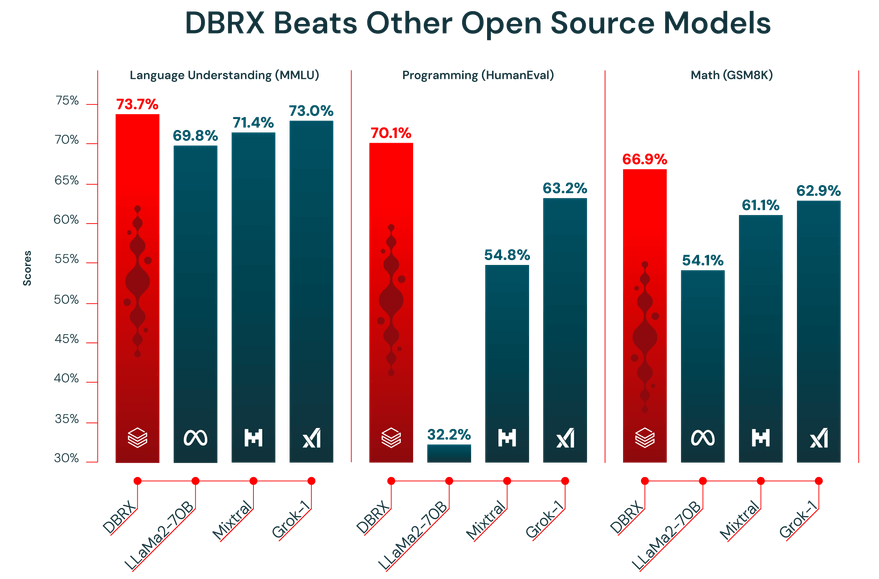
Wydajność modelu LLM zależy od jakości danych, na których został wytrenowany. Model DBRX został wstępnie wytrenowany na ogromnym zbiorze danych zawierającym 12 bilionów tokenów, starannie wyselekcjonowanym przez zespół Databricks przy użyciu zaawansowanych narzędzi do przetwarzania danych. Właśnie dlatego osiągnął tak dobre wyniki w branżowych testach porównawczych.
Ponadto DBRX oferuje okno kontekstowe o rozmiarze 32 000 tokenów. Jest to ilość tekstu, którą model może uwzględnić jednocześnie. Duże okno kontekstowe jest niezwykle pomocne w przypadku złożonych zadań, takich jak streszczanie długich raportów, przeglądanie obszernych dokumentów prawnych lub tworzenie zaawansowanych systemów generowania wzbogaconego o wyszukiwanie (RAG), ponieważ pozwala modelowi zachować kontekst bez skracania lub pomijania informacji.
🎥 Obejrzyj to wideo, aby zobaczyć, jak usprawniona koordynacja projektów może zmienić cykl pracy przy szkoleniu modeli AI i wyeliminować utrudnienia związane z przełączaniem się między niepowiązanymi narzędziami. 👇🏽
Jak uzyskać dostęp do DBRX i skonfigurować go
DBRX oferuje dwie główne ścieżki dostępu, z których obie zapewniają pełny dostęp do wag modeli na korzystnych warunkach komercyjnych. Możesz skorzystać z Hugging Face, aby uzyskać maksymalną elastyczność, lub uzyskać dostęp bezpośrednio przez Databricks, aby cieszyć się bardziej zintegrowanym doświadczeniem.
Uzyskaj dostęp do DBRX za pośrednictwem Hugging Face
Dla zespołów, które cenią sobie elastyczność i są już zaznajomione z ekosystemem Hugging Face, idealnym rozwiązaniem jest dostęp do DBRX za pośrednictwem hubu. Pozwala to na zintegrowanie modelu z istniejącymi cyklami pracy opartymi na transformatorach.
Oto jak zacząć:
- Załóż konto w serwisie Hugging Face lub zaloguj się na swoje konto
- Przejdź do karty modelu DBRX w hubie i zaakceptuj warunki licencji
- Zainstaluj bibliotekę transformers wraz z niezbędnymi zależnościami, takimi jak accelerate
- Użyj klasy `AutoModelForCausalLM` w skrypcie w języku Python, aby załadować model DBRX
- Skonfiguruj swój potok wnioskowania, pamiętając, że DBRX wymaga znacznej ilości pamięci GPU (VRAM) do efektywnego działania
📖 Czytaj więcej: Jak skonfigurować temperaturę modelu LLM
Uzyskaj dostęp do DBRX za pośrednictwem Databricks
Jeśli Twój zespół korzysta już z Databricks do inżynierii danych lub uczenia maszynowego, najłatwiejszym sposobem jest uzyskanie dostępu do DBRX za pośrednictwem tej platformy. Eliminuje to trudności związane z ustawieniami i zapewnia wszystkie narzędzia potrzebne do MLOps dokładnie tam, gdzie już pracujesz.
Aby rozpocząć, wykonaj następujące kroki w swoim obszarze roboczym Databricks:
- Przejdź do sekcji „Model Garden” lub „Mosaic AI”
- W zależności od potrzeb wybierz DBRX Base lub DBRX Instruct
- Skonfiguruj punkt końcowy serwera w celu uzyskania dostępu do API lub skonfiguruj środowisko notebooka do interaktywnego użytkowania
- Rozpocznij testowanie wnioskowania przy użyciu próbkowych podpowiedzi, aby upewnić się, że wszystko działa poprawnie, zanim zwiększysz skalę szkolenia lub wdrożenia modelu AI.
Takie podejście zapewnia płynny dostęp do narzędzi takich jak MLflow do śledzenia eksperymentów oraz Unity Catalog do zarządzania modelami.
📮 ClickUp Insight: Przeciętny pracownik spędza ponad 30 minut dziennie na poszukiwaniu informacji związanych z pracą — to ponad 120 godzin rocznie straconych na przeszukiwanie e-maili, wątków na Slacku i rozproszonych plików.
Inteligentny asystent AI wbudowany w Twój obszar roboczy może to zmienić. Poznaj ClickUp Brain.
Zapewnia natychmiastowe wglądy i odpowiedzi, wyświetlając w ciągu kilku sekund odpowiednie dokumenty, rozmowy i szczegóły zadań — dzięki czemu możesz przestać szukać i zacząć pracować.
Jak dostroić DBRX i trenować niestandardowe modele AI
Gotowy model, bez względu na to, jak zaawansowany by nie był, nigdy nie zrozumie specyficznych niuansów Twojej działalności. Ponieważ DBRX jest oprogramowaniem typu open source, możesz go precyzyjnie dostosować, aby stworzyć niestandardowy model, który „mówi językiem” Twojej firmy lub wykonuje konkretne zadanie, które chcesz mu powierzyć.
Oto trzy popularne sposoby, dzięki którym możesz to zrobić:
1. Dostrój DBRX za pomocą zbiorów danych Hugging Face
Dla zespołów, które dopiero zaczynają lub pracują nad typowymi zadaniami, świetnym źródłem informacji są publiczne zbiory danych z serwisu Hugging Face Hub. Są one wstępnie sformatowane i łatwe do załadowania, co oznacza, że nie musisz spędzać godzin na przygotowywaniu danych.
Proces ten jest dość prosty:
- Znajdź w hubie zbiór danych pasujący do Twojego zadania (np. wykonywanie poleceń, streszczanie).
- Załaduj go, korzystając z biblioteki zbiorów danych
- Upewnij się, że dane są sformatowane w postaci par instrukcja-odpowiedź
- Skonfiguruj skrypt szkoleniowy, wykorzystując hiperparametry, takie jak tempo uczenia się i rozmiar partii
- Uruchom zadanie szkoleniowe, pamiętając o okresowym zapisywaniu punktów kontrolnych
- Oceń dostrojony model na oddzielonym zbiorze walidacyjnym, aby zmierzyć poprawę wyników
2. Dostosuj DBRX za pomocą lokalnych zbiorów danych
Najlepsze wyniki zazwyczaj uzyskuje się dzięki dopracowaniu modelu przy użyciu własnych, zastrzeżonych danych. Pozwala to nauczyć model specyficznej terminologii, stylu i wiedzy branżowej Twojej firmy. Pamiętaj jednak, że opłaca się to tylko wtedy, gdy dane są czyste, dobrze przygotowane i mają wystarczającą objętość.
Wykonaj poniższe kroki, aby przygotować swoje dane wewnętrzne:
- Gromadzenie danych: Zbierz wysokiej jakości przykłady z wewnętrznych stron wiki, dokumentów i baz danych
- Konwersja formatu: Uporządkuj swoje dane w spójnym formacie instrukcja-odpowiedź, często w postaci wierszy JSON
- Filtrowanie jakości: Usuń wszystkie przykłady niskiej jakości, zduplikowane lub nieistotne
- Podział na zestaw walidacyjny: Odłóż niewielką część danych (zazwyczaj 10–15%) w celu oceny wydajności modelu
- Sprawdź ochronę prywatności: Usuń lub zamaskuj wszelkie dane osobowe (PII) lub dane wrażliwe
3. Dostrajaj DBRX za pomocą StreamingDataset
Jeśli Twój zbiór danych okaże się zbyt duży, by zmieścić się w pamięci komputera, nie martw się – możesz skorzystać z biblioteki Streaming Dataset firmy Databricks. Pozwala ona na strumieniowe przesyłanie danych bezpośrednio z pamięci masowej w chmurze podczas uczenia modelu, zamiast ładowania wszystkich danych do pamięci naraz.
Oto jak to zrobić:
- Przygotowanie danych: Oczyść i uporządkuj dane szkoleniowe, a następnie zapisz je w formacie umożliwiającym przesyłanie strumieniowe, takim jak JSONL lub CSV, w chmurze
- Konwersja formatu strumieniowego: Przekonwertuj swój zbiór danych na format przystosowany do strumieniowania, taki jak Mosaic Data Shard (MDS), aby można go było efektywnie odczytywać podczas uczenia.
- Ustawienia modułu ładującego dane szkoleniowe: Skonfiguruj moduł ładujący dane szkoleniowe tak, aby wskazywał na zdalny zbiór danych, i zdefiniuj lokalną pamięć podręczną do tymczasowego przechowywania danych
- Inicjalizacja modelu: Rozpocznij proces dostrajania w DBRX, korzystając z frameworka szkoleniowego z wsparciem dla StreamingDataset, takiego jak LLM Foundry
- Szkolenie oparte na strumieniowaniu: Uruchom zadanie szkoleniowe, podczas gdy dane są przesyłane strumieniowo partiami w trakcie szkolenia, zamiast ładować je w całości do pamięci
- Punkty kontrolne i odzyskiwanie: płynne wznowienie uczenia w przypadku przerwania sesji, bez powielania lub pomijania danych
- Ocena i wdrożenie: Zweryfikuj wydajność dopracowanego modelu i wdroż go, korzystając z preferowanych ustawień serwowania lub wnioskowania
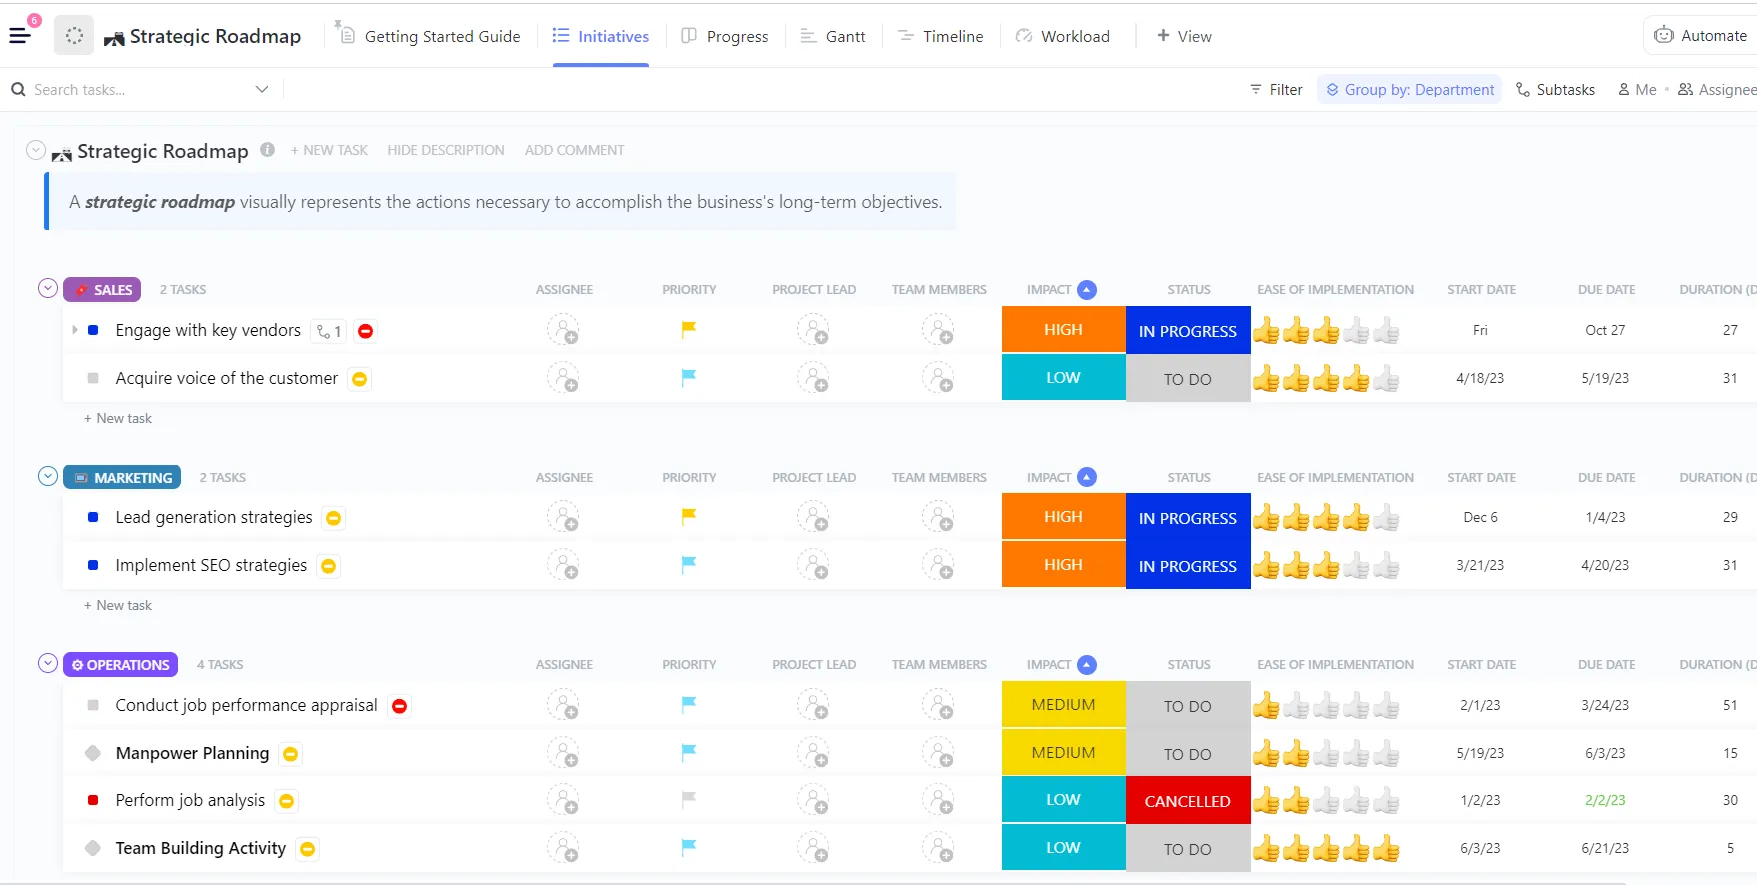
💡Wskazówka dla profesjonalistów: Zamiast tworzyć plan szkolenia DBRX od podstaw, zacznij od szablonu planu projektów dotyczących sztucznej inteligencji i uczenia maszynowego w ClickUp i dostosuj go do potrzeb swojego zespołu. Zapewnia on przejrzystą strukturę planowania zbiorów danych, faz szkolenia, oceny i wdrożenia, dzięki czemu możesz skupić się na organizacji pracy, a nie na tworzeniu struktury cyklu pracy.
Przykłady zastosowań DBRX w szkoleniu modeli AI
Posiadanie potężnego modelu to jedno, ale zupełnie inną sprawą jest dokładna wiedza o tym, w jakich obszarach się on sprawdza.
Kiedy nie masz jasnego obrazu mocnych stron modelu, łatwo jest poświęcić czas i zasoby na próby dostosowania go do zadań, do których po prostu się nie nadaje. Prowadzi to do słabych wyników i frustracji.
Unikalna architektura i dane szkoleniowe DBRX sprawiają, że rozwiązanie to wyjątkowo dobrze nadaje się do kilku kluczowych zastosowań w Enterprise. Znajomość tych atutów pomoże Ci dostosować model do celów biznesowych i zmaksymalizować zwrot z inwestycji.
Generowanie tekstu i tworzenie zawartości
DBRX Instruct jest precyzyjnie dostrojony do wykonywania instrukcji i generowania tekstu wysokiej jakości. Dzięki temu stanowi potężne narzędzie do automatyzacji szerokiego zakresu zadań związanych z zawartością. Jego duża pamięć kontekstowa stanowi znaczącą zaletę, umożliwiając obsługę długich dokumentów bez utraty wątku.
Możesz go wykorzystać do:
- Dokumentacja techniczna: Twórz i udoskonalaj instrukcje obsługi produktów, dokumentację API oraz przewodniki dla użytkowników
- Zawartość marketingowa: szkice wpisów na blogu, biuletynów e-mailowych i aktualizacji w mediach społecznościowych
- Tworzenie raportów: Podsumowuj wyniki analizy złożonych danych i twórz zwięzłe streszczenia dla kadry kierowniczej
- Tłumaczenie i lokalizacja: Dostosuj istniejącą zawartość do nowych rynków i odbiorców
Zadania związane z generowaniem kodu i debugowaniem
Znaczna część danych szkoleniowych DBRX obejmowała kod, co czyni go wydajnym narzędziem LLM dla programistów. Może on pomóc w przyspieszeniu cykli rozwoju poprzez automatyzację powtarzalnych zadań związanych z kodowaniem oraz wspieranie w rozwiązywaniu złożonych problemów.
Oto kilka sposobów, w jakie Twój zespół inżynierów może to wykorzystać:
- Autouzupełnianie kodu: Automatyczne generowanie treści funkcji na podstawie komentarzy lub ciągów dokumentacyjnych
- Wykrywanie błędów: Analizuj fragmenty kodu, aby zidentyfikować potencjalne błędy lub nieścisłości logiczne
- Wyjaśnienie kodu: Przekładaj skomplikowane algorytmy lub starszą wersję kodu na prosty język angielski
- Generowanie testów: Twórz testy jednostkowe na podstawie sygnatury funkcji i oczekiwanego zachowania
RAG i aplikacje wykorzystujące długi kontekst
Generowanie wspomagane wyszukiwaniem (RAG) to potężna technika, która opiera odpowiedzi modelu na prywatnych danych Twojej firmy. Jednak systemy RAG często borykają się z problemami w przypadku modeli o małych oknach kontekstowych, co wymusza agresywne dzielenie danych na fragmenty, co z kolei może prowadzić do utraty ważnego kontekstu. Okno kontekstowe DBRX o rozmiarze 32K sprawia, że jest to doskonała podstawa dla niezawodnych aplikacji RAG.
Dzięki temu możesz tworzyć zaawansowane narzędzia wewnętrzne, takie jak:
- Enterprise search: Stwórz chatbota, który odpowiada na pytania pracowników, korzystając z wewnętrznej bazy wiedzy
- Obsługa klienta: Stwórz agenta, który generuje odpowiedzi oparte na dokumentacji produktu
- Pomoc badawcza: Opracuj narzędzie, które potrafi syntetyzować informacje z setek stron artykułów naukowych
- Sprawdzanie zgodności: Automatycznie weryfikuj treści marketingowe pod kątem zgodności z wewnętrznymi wytycznymi dotyczącymi marki lub dokumentami regulacyjnymi
Jak zintegrować szkolenie z DBRX z cyklem pracy Twojego zespołu
Udany projekt szkolenia modeli AI to coś więcej niż tylko kod i moc obliczeniowa. To wspólny wysiłek, w który zaangażowani są inżynierowie uczenia maszynowego, analitycy danych, menedżerowie produktu oraz interesariusze.
Gdy ta współpraca jest rozproszona między notatnikami Jupyter, kanałami Slacka i oddzielnymi narzędziami do zarządzania projektami, powstaje rozproszenie kontekstu – sytuacja, w której kluczowe informacje o projekcie są rozrzucone po zbyt wielu narzędziach.
ClickUp rozwiązuje ten problem. Zamiast żonglować wieloma narzędziami, otrzymujesz jedną zintegrowaną przestrzeń roboczą AI, w której zarządzanie projektami, dokumentacja i komunikacja współistnieją — dzięki czemu Twoje eksperymenty pozostają spójne od etapu planowania, przez realizację, aż po ocenę.
Nigdy nie tracisz z oczu eksperymentów i postępów
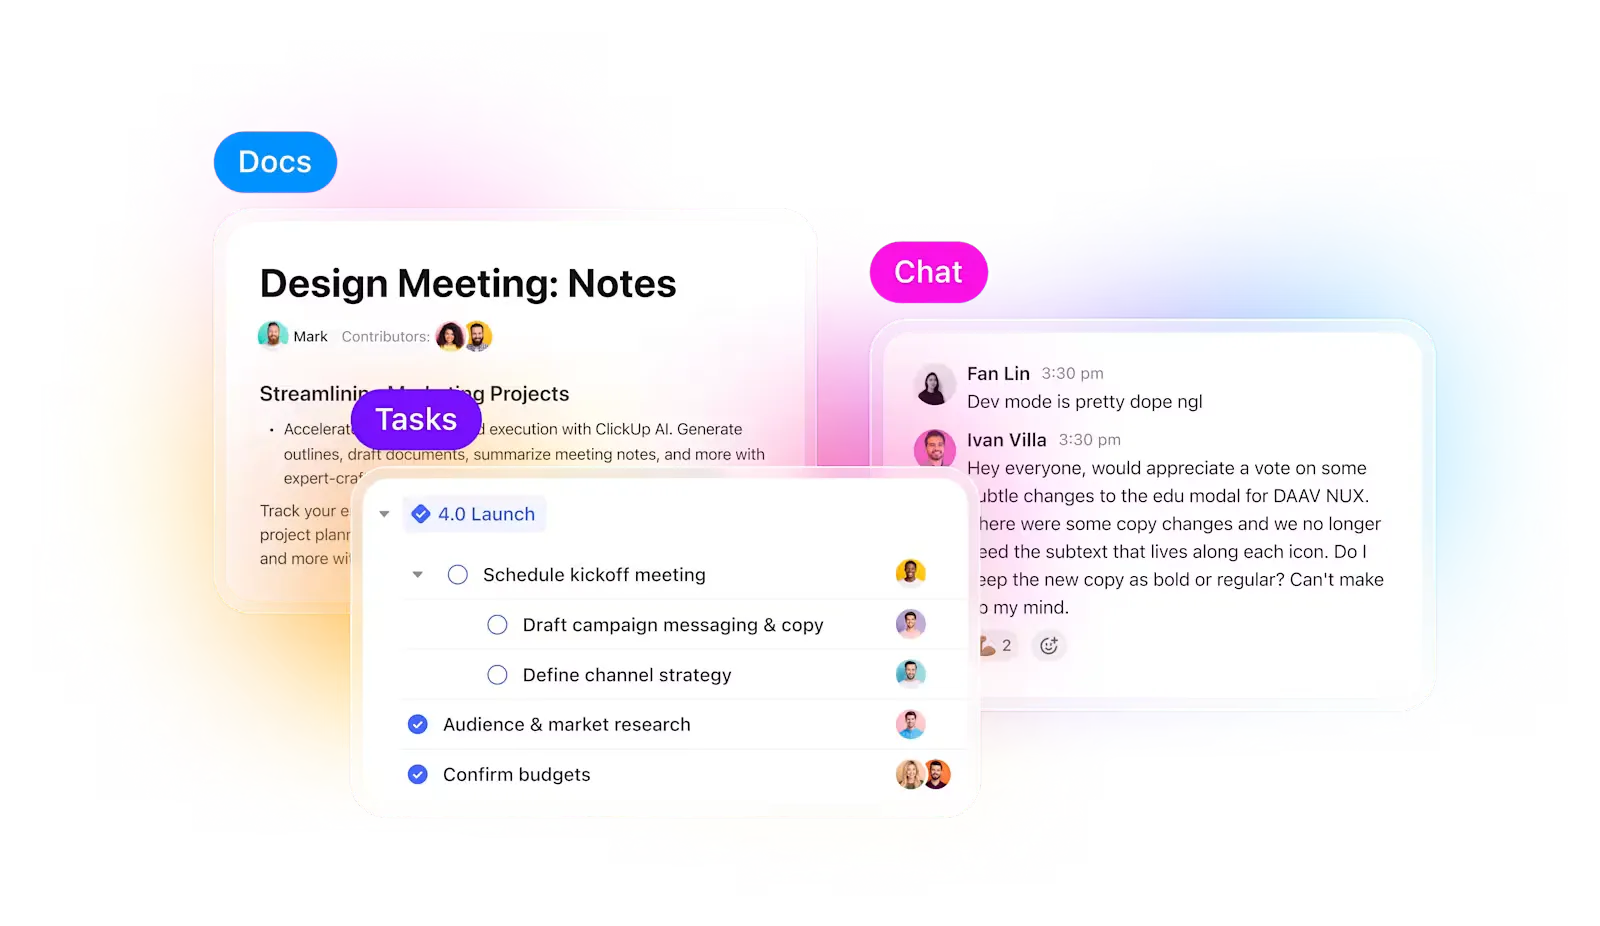
Podczas przeprowadzania wielu eksperymentów najtrudniejsze nie jest trenowanie modelu, ale śledzenie zmian zachodzących w trakcie tego procesu. Która wersja zbioru danych została wykorzystana, jaka szybkość uczenia się dała najlepsze wyniki lub które uruchomienie zostało wdrożone?
ClickUp znacznie ułatwia ten proces. W zadaniach ClickUp możesz osobno śledzić każdy przebieg szkolenia, a w ramach zadań możesz korzystać z pól niestandardowych, aby rejestrować:
- Wersja zbioru danych
- Hiperparametry
- Wariant modelu (DBRX Base vs DBRX Instruct)
- Status szkolenia (W kolejce, W trakcie, W trakcie oceny, Wdrożone)
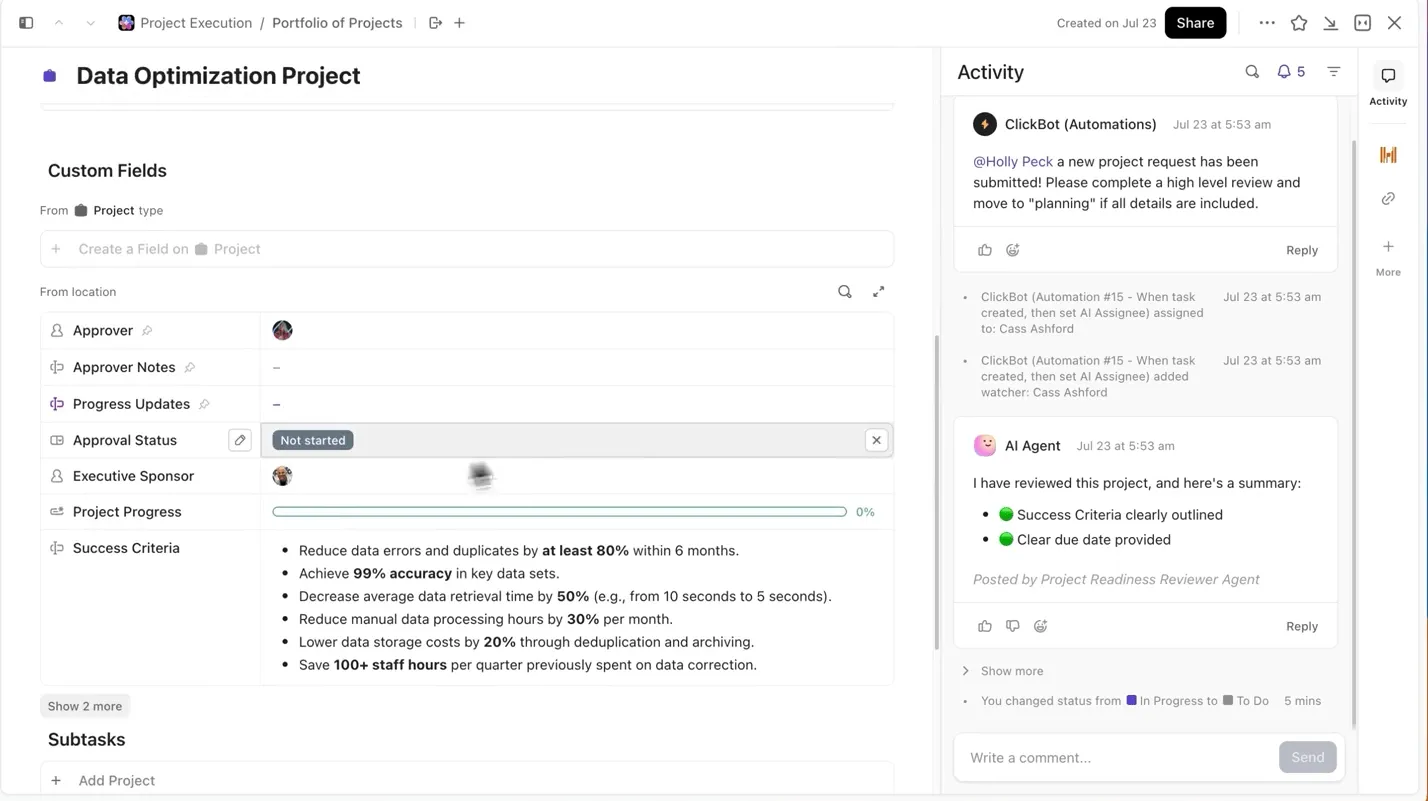
Dzięki temu każdy udokumentowany eksperyment jest łatwy do wyszukania, można go łatwo porównać z innymi i powtórzyć.
Powiązaj dokumentację modeli z pracą
Nie musisz przełączać się między notatnikami Jupyter, plikami README ani wątkami na Slacku, aby zrozumieć kontekst zadania eksperymentu.
Dzięki ClickUp Docs możesz uporządkować architekturę modelu, skrypty przygotowania danych lub wskaźniki oceny oraz zapewnić do nich łatwy dostęp , dokumentując je w dokumencie z funkcją wyszukiwania , który zawiera bezpośrednie połączone linki do zadań eksperymentalnych, z których pochodzą.
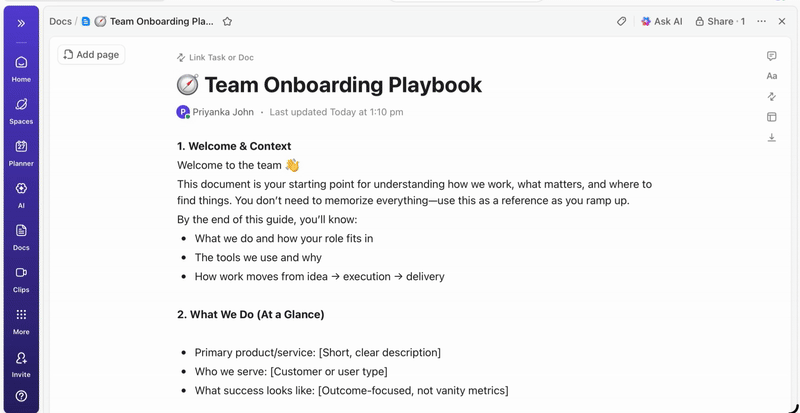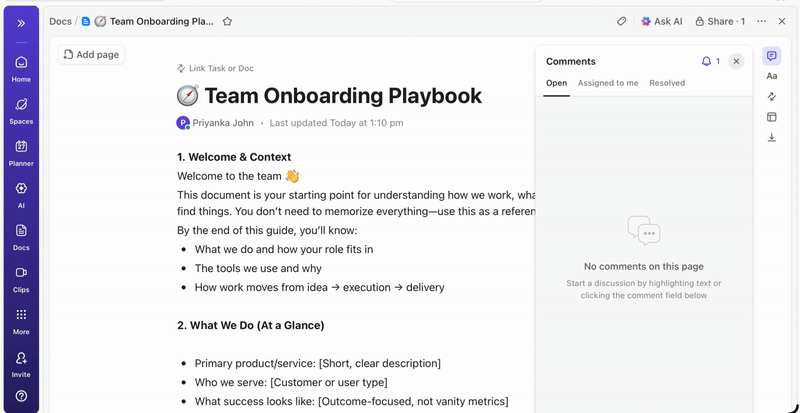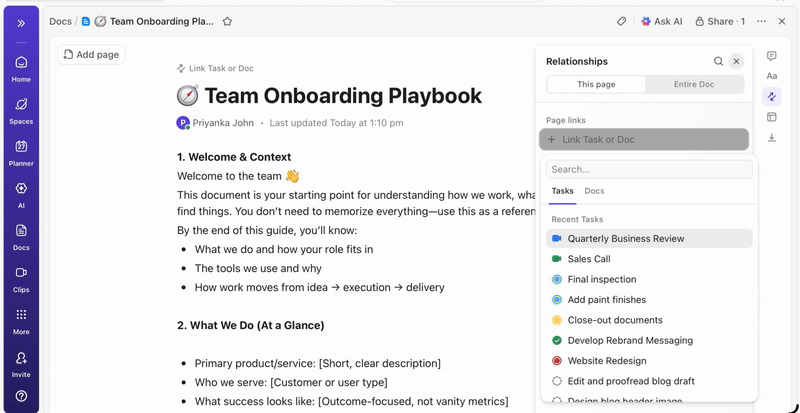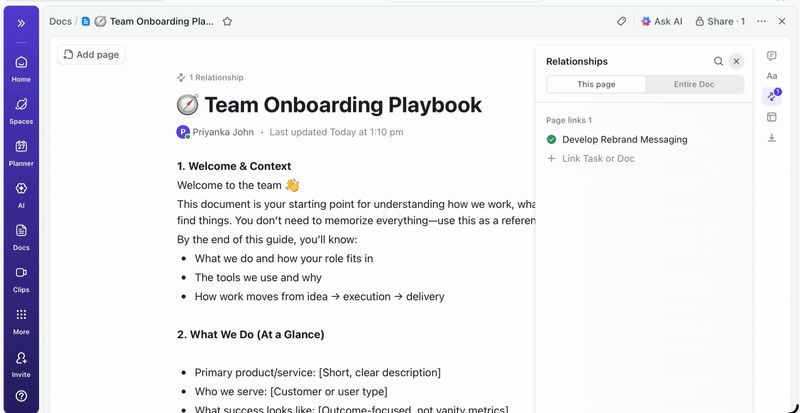
💡Wskazówka dla profesjonalistów: Prowadź na bieżąco opis projektu w ClickUp Docs, zawierający szczegółowe informacje o każdej decyzji – od architektury po wdrożenie – dzięki czemu nowi członkowie zespołu zawsze będą mogli szybko zapoznać się ze szczegółami projektu bez konieczności przeszukiwania starych wątków.
Zapewnij interesariuszom widoczność w danych w czasie rzeczywistym
Panele kontrolne ClickUp pokazują postęp eksperymentów i obciążenie pracą zespołu w czasie rzeczywistym. I
Zamiast ręcznie kompilować aktualizacje lub wysyłać e-maile, pulpity nawigacyjne aktualizują się automatycznie na podstawie danych zawartych w zadaniach. Dzięki temu interesariusze mogą w dowolnym momencie sprawdzić, na jakim etapie są prace, i nie muszą przeszkadzać Ci pytaniami typu „jaki jest status?”.
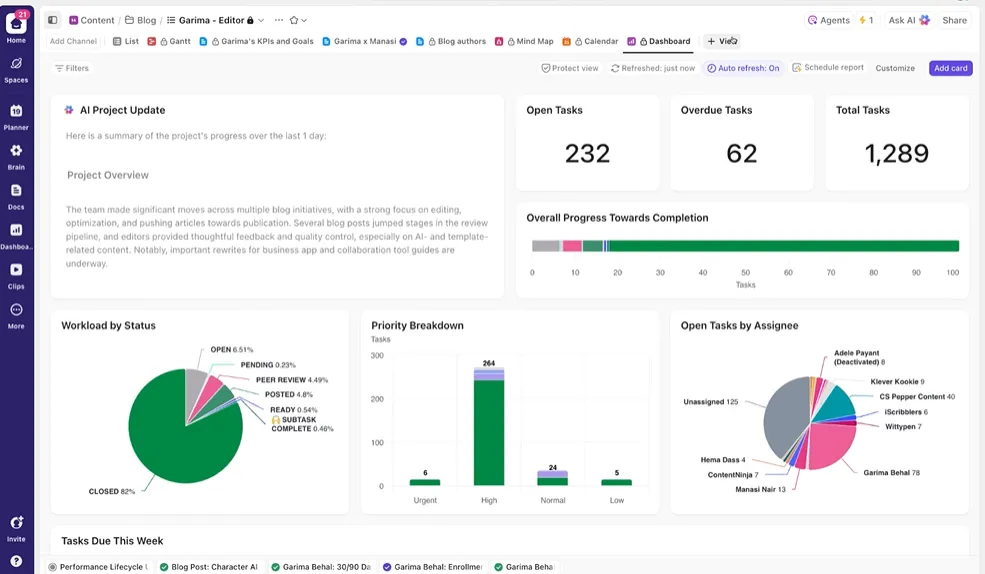
Dzięki temu możesz skupić się na przeprowadzaniu eksperymentów, zamiast ciągle zajmować się raportowaniem ręcznie.
Spraw, by AI stała się Twoim inteligentnym pomocnikiem w projektach
Nie musisz ręcznie przeglądać danych szkoleniowych z ostatnich tygodni, aby uzyskać podsumowanie dotychczasowych eksperymentów. Wystarczy, że w komentarzu do dowolnego zadania wykonasz wzmiankę o @Brain, a ClickUp Brain zapewni Ci potrzebną pomoc, uwzględniając pełny kontekst Twoich poprzednich i bieżących projektów.
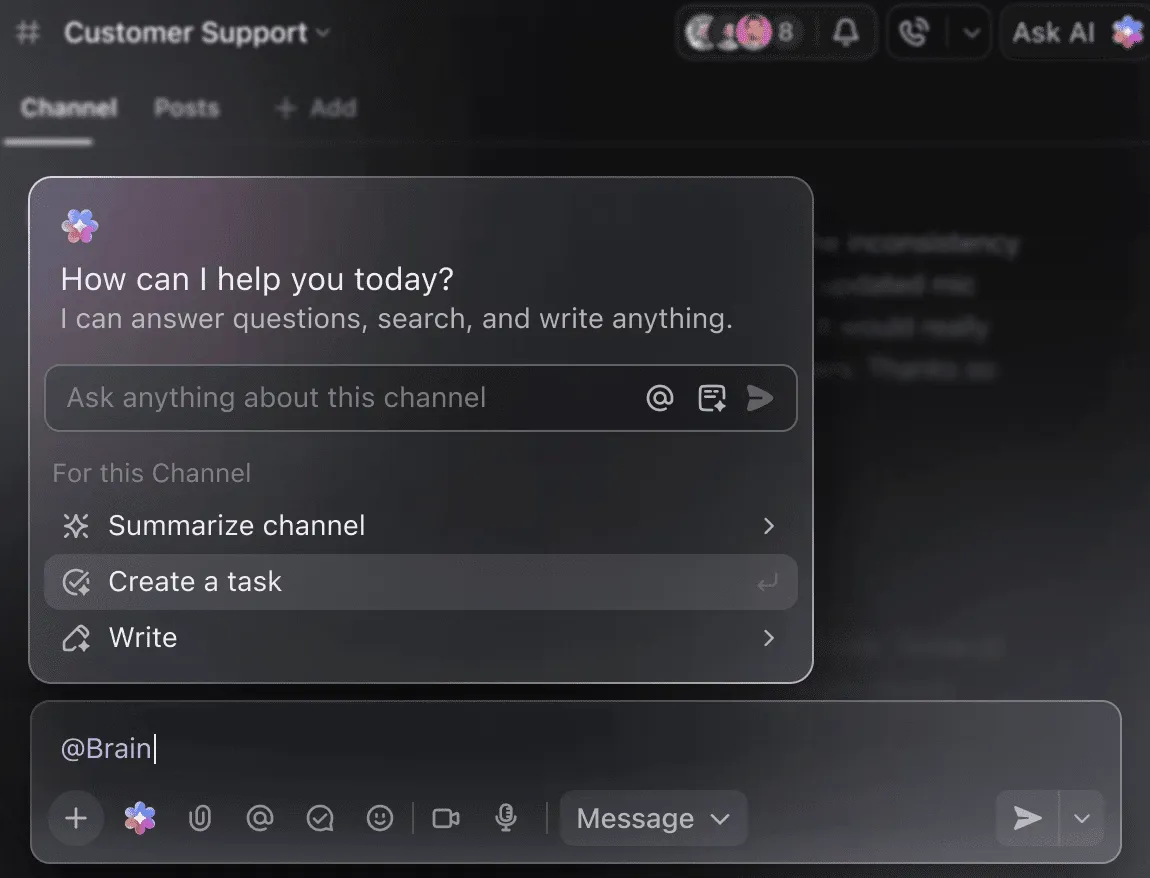
Możesz poprosić Brain o „Podsumowanie eksperymentów z ostatniego tygodnia w 5 punktach” lub „Sporządzenie dokumentu z najnowszymi wynikami hiperparametrów” i natychmiast otrzymać dopracowany wynik.
🧠 Zaleta ClickUp: Superagenci ClickUp idą o krok dalej — potrafią zautomatyzować całe cykle pracy w oparciu o zdefiniowane przez Ciebie wyzwalacze, a nie tylko odpowiadać na Twoje pytania. Dzięki superagentom możesz automatycznie tworzyć nowe zadania szkoleniowe DBRX za każdym razem, gdy zostanie przesłany zbiór danych, powiadamiać swój zespół oraz podłączać odpowiednie dokumenty, gdy sesja szkoleniowa się zakończy lub osiągnie punkt kontrolny, a także generować cotygodniowe podsumowanie postępów i wysyłać je do interesariuszy, nie musząc nic robić.
Typowe błędy, których należy unikać
Rozpoczęcie projektu szkoleniowego z wykorzystaniem DBRX to ekscytujące wyzwanie, ale kilka typowych pułapek może zniweczyć Twój postęp. Unikanie tych błędów pozwoli Ci zaoszczędzić czas, pieniądze i wiele frustracji.
- Niedocenianie wymagań sprzętowych: DBRX jest potężnym narzędziem, ale zajmuje też dużo miejsca. Próba uruchomienia go na nieodpowiednim sprzęcie doprowadzi do błędów braku pamięci i nieudanych zadań szkoleniowych. Należy pamiętać, że DBRX (132B) wymaga co najmniej 264 GB pamięci VRAM do wnioskowania 16-bitowego lub około 70–80 GB w przypadku kwantyzacji 4-bitowej.
- Pomijanie kontroli jakości danych: Jeśli dane wejściowe są złej jakości, wyniki też będą złej jakości. Dostrajanie modelu na podstawie nieuporządkowanego zbioru danych o niskiej jakości sprawi jedynie, że model nauczy się generować nieuporządkowane wyniki o niskiej jakości.
- Ignorowanie ograniczeń długości kontekstu: Chociaż okno kontekstowe DBRX o rozmiarze 32K jest dość pojemne, nie jest nieskończone. Przekazywanie modelowi danych wejściowych przekraczających ten limit spowoduje ciche skrócenie danych i spadek wydajności jako wynik.
- Kiedy należy używać wersji Base zamiast Instruct: DBRX Base to surowy, wstępnie wytrenowany model przeznaczony do dalszego szkolenia na dużą skalę. W przypadku większości zadań polegających na wykonywaniu poleceń należy zacząć od DBRX Instruct, który został już precyzyjnie dostrojony do tego celu.
- Oddzielenie prac szkoleniowych od koordynacji projektu: Gdy śledzenie eksperymentów odbywa się w jednym narzędziu, a plan projektu w innym, powstają silosy informacyjne. Skorzystaj z zintegrowanej platformy, takiej jak ClickUp, aby zsynchronizować prace techniczne z koordynacją projektu.
- Zaniedbanie oceny przed wdrożeniem: Model, który dobrze radzi sobie na danych szkoleniowych, może spektakularnie zawieść w rzeczywistych warunkach. Zawsze weryfikuj swój dopracowany model na oddzielnym zbiorze testowym przed wdrożeniem go do środowiska produkcyjnego.
- Zaniedbywanie złożoności dostrajania: Ponieważ DBRX jest modelem typu „Mixture-of-Experts”, standardowe skrypty do dostrajania mogą wymagać specjalistycznych bibliotek, takich jak Megatron-LM lub PyTorch FSDP, aby obsłużyć rozdzielenie parametrów na wiele procesorów graficznych (GPU).
DBRX a inne platformy do szkolenia modeli AI
Wybór platformy do szkolenia modeli AI wiąże się z fundamentalnym dylematem: kontrola kontra wygoda. Modele własne, dostępne wyłącznie za pośrednictwem API, są łatwe w użyciu, ale ograniczają użytkownika do ekosystemu danego dostawcy.
Modele z otwartymi wagami, takie jak DBRX, zapewniają pełną kontrolę, ale wymagają większej wiedzy technicznej i odpowiedniej infrastruktury. Taki wybór może sprawić, że poczujesz się zagubiony, niepewny, która ścieżka faktycznie wspiera Twoje długoterminowe cele — jest to wyzwanie, przed którym staje wiele zespołów podczas wdrażania AI.
W poniższej tabeli przedstawiono kluczowe różnice, które pomogą Ci podjąć świadomą decyzję.
| Wagi | Otwórz (niestandardowy) | Zastrzeżone | Otwórz (niestandardowy) | Zastrzeżone |
| Dostrajanie | Pełna kontrola | Oparte na API | Pełna kontrola | Oparte na API |
| Własna infrastruktura | Tak | Nie | Tak | Nie |
| Licencja | DB Open Model | Warunki korzystania z OpenAI | Społeczność Llama | Terminy związane z antropiką |
| Kontekst | 32K | 128 tys. – 1 mln | 128K | 200 tys. – 1 mln |
DBRX to właściwy wybór, gdy potrzebujesz pełnej kontroli nad modelem, musisz korzystać z własnego serwera ze względów bezpieczeństwa lub zgodności z przepisami albo zależy Ci na elastyczności, jaką zapewnia liberalna licencja komercyjna. Jeśli nie dysponujesz dedykowaną infrastrukturą GPU — lub bardziej cenisz sobie szybkość wprowadzenia produktu na rynek niż niestandardową personalizację — lepszym rozwiązaniem mogą być alternatywy oparte na API.
Zacznij trenować mądrzej dzięki ClickUp
DBRX zapewnia gotową do wdrożenia w przedsiębiorstwie podstawę do tworzenia niestandardowych aplikacji AI, oferując przejrzystość i kontrolę, których nie zapewniają modele zastrzeżone. Jego wydajna architektura MoE pozwala obniżyć koszty wnioskowania, a otwarta konstrukcja ułatwia precyzyjne dostrajanie. Jednak zaawansowana technologia to tylko połowa sukcesu.
Prawdziwe powodzenie wynika z dostosowania pracy technicznej do wspólnego cyklu pracy zespołu. Trenowanie modeli AI to praca zespołowa, a kluczowe znaczenie ma synchronizacja eksperymentów, dokumentacji i komunikacji z interesariuszami. Gdy zgromadzisz wszystko w jednym, zintegrowanym obszarze roboczym i ograniczysz rozproszenie kontekstu, będziesz w stanie szybciej dostarczać lepsze modele.
Zacznij korzystać z ClickUp za darmo, aby koordynować swoje projekty szkolenia AI w jednym obszarze roboczym ClickUp. ✨
Często zadawane pytania
Jak monitorować postępy szkolenia w DBRX?
Możesz monitorować proces uczenia za pomocą standardowych narzędzi do uczenia maszynowego, takich jak TensorBoard, Weights & Biases czy MLflow. Jeśli przeprowadzasz uczenie w ekosystemie Databricks, MLflow jest natywnie zintegrowane, co zapewnia płynne śledzenie eksperymentów.
Czy mogę zintegrować DBRX z CI/CD i potokami wdrażania?
Tak, DBRX można zintegrować ze standardowymi potokami MLOps. Dzięki konteneryzacji modelu można go wdrożyć przy użyciu platform orkiestracji, takich jak Kubeflow, lub niestandardowych cykli pracy CI/CD.
Jaka jest różnica między DBRX Base a DBRX Instruct?
DBRX Base to podstawowy, wstępnie wytrenowany model przeznaczony dla zespołów, które chcą przeprowadzać dalsze wstępne szkolenie w konkretnej dziedzinie lub precyzyjne dostrajanie głębokiej architektury. DBRX Instruct to precyzyjnie dostrojona wersja zoptymalizowana pod kątem wykonywania instrukcji, co czyni ją lepszym punktem wyjścia dla większości projektów związanych z tworzeniem aplikacji.
Jak DBRX wypada na tle GPT-4 w kontekście korporacyjnych projektów AI?
Główną różnicą jest kontrola. DBRX zapewnia pełny dostęp do wag modelu, umożliwiając niestandardową personalizację i samodzielne hostowanie, podczas gdy GPT-4 jest usługą dostępną wyłącznie za pośrednictwem API.
Czy z DBRX można korzystać za darmo?
Wagi modeli DBRX są dostępne bezpłatnie na licencji Databricks Open Model License. Użytkownik ponosi jednak koszty infrastruktury obliczeniowej niezbędnej do uruchomienia lub dostrojenia modelu.