
AI-projecten voor training mislukken zelden op modelniveau. Ze lopen echter vast wanneer experimenten, documentatie en updates voor belanghebbenden verspreid zijn over te veel verschillende tools.
Deze handleiding leidt je stap voor stap door het trainen van modellen met Databricks DBRX – een LLM die tot twee keer zo reken-efficiënt is als andere toonaangevende modellen – terwijl je het bijbehorende werk overzichtelijk houdt in ClickUp.
Van installatie en afstemming tot documentatie en teamoverschrijdende updates: je zult zien hoe één enkele, geïntegreerde werkruimte helpt om contextversnippering tegen te gaan en ervoor zorgt dat je team zich kan concentreren op het bouwen, in plaats van op het zoeken. 🛠
Wat is DBRX?
DBRX is een krachtig, open-source groot taalmodel (LLM) dat speciaal is ontworpen voor het trainen en uitvoeren van inferenties met AI-modellen binnen ondernemingen. Omdat het open source is onder de Databricks Open Model License, heeft uw team volledige toegang tot de gewichten en architectuur van het model, waardoor u het naar eigen inzicht kunt inspecteren, aanpassen en implementeren.
Het is verkrijgbaar in twee varianten: DBRX Base voor diepgaande pre-training en DBRX Instruct voor kant-en-klare taken waarbij instructies moeten worden opgevolgd.
De architectuur van DBRX en het ‘mixture-of-experts’-ontwerp
DBRX lost taken op met behulp van een Mixture-of-Experts (MoE)-architectuur. In tegenstelling tot traditionele grote taalmodellen die al hun miljarden parameters voor elke afzonderlijke berekening gebruiken, activeert DBRX voor een bepaalde taak slechts een fractie van het totale aantal parameters (de meest relevante experts).
Zie het als een team van gespecialiseerde experts; in plaats van dat iedereen aan elk probleem werkt, wijst het systeem elke Taak op intelligente wijze toe aan de meest geschikte persoon op basis van de bijbehorende parameters.
Dit verkort niet alleen de responstijd, maar levert ook topprestaties en -resultaten op, terwijl de rekenkosten aanzienlijk worden verlaagd.
Hier volgt een kort overzicht van de belangrijkste specificaties:
- Totaal aantal parameters: 132 miljard voor alle experts
- Actieve parameters: 36 miljard per forward pass
- Aantal experts: 16 in totaal (MoE Top-4-routing), waarvan er 4 actief zijn voor elk willekeurig token
- Contextvenster: 32.000 tokens
Specificaties voor trainingsgegevens en tokens van DBRX
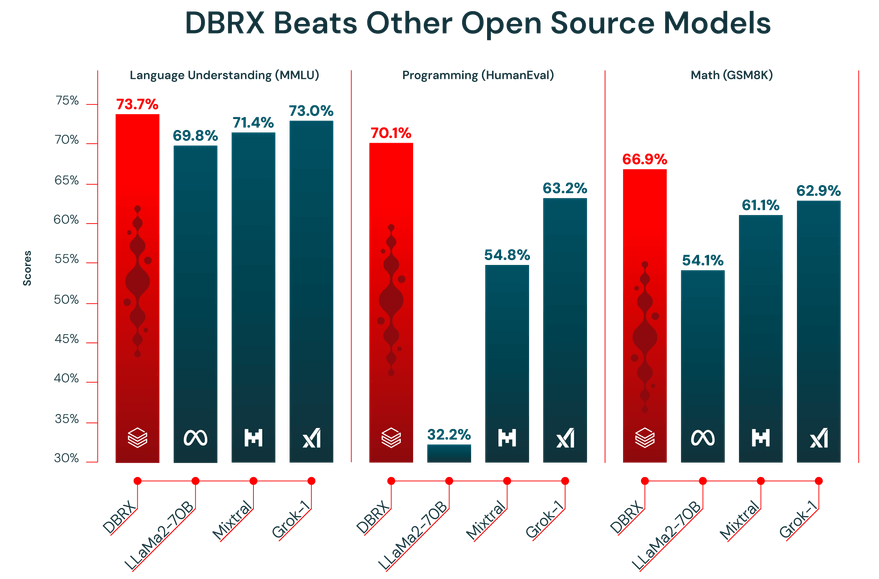
De prestaties van een LLM zijn slechts zo goed als de data waarop het is getraind. DBRX is vooraf getraind op een enorme dataset van 12 biljoen tokens, die zorgvuldig is samengesteld door het Databricks-team met behulp van hun geavanceerde tools voor gegevensverwerking. Dat is precies de reden waarom het zo goed presteerde in benchmarks binnen de sector.
Daarnaast heeft DBRX een contextvenster van 32.000 tokens als functie. Dit is de hoeveelheid tekst die het model in één keer kan verwerken. Een groot contextvenster is uiterst nuttig voor complexe taken zoals het samenvatten van lange rapporten, het doorzoeken van omvangrijke juridische documenten of het bouwen van geavanceerde RAG-systemen (Retrieval-Augmented Generation), omdat het model hierdoor de context kan behouden zonder informatie af te kappen of te vergeten.
🎥 Bekijk deze video om te zien hoe gestroomlijnde projectcoördinatie je AI-trainingswerkstroom kan transformeren en de frictie wegneemt die ontstaat door het schakelen tussen losstaande tools. 👇🏽
Toegang krijgen tot DBRX en de instellingen ervan
DBRX biedt twee primaire toegangsmanieren, die beide volledige toegang bieden tot de modelgewichten onder soepele commerciële voorwaarden. U kunt Hugging Face gebruiken voor maximale flexibiliteit of rechtstreeks toegang krijgen via Databricks voor een meer geïntegreerde ervaring.
Krijg toegang tot DBRX via Hugging Face
Voor teams die flexibiliteit belangrijk vinden en al vertrouwd zijn met het Hugging Face-ecosysteem, is toegang tot DBRX via de hub de ideale manier. Hiermee kun je het model integreren in je bestaande, op Transformers gebaseerde werkstroom.
Zo ga je aan de slag:
- Maak een Hugging Face-account aan of log in op je account
- Ga naar de DBRX-modelkaart in de hub en accepteer de licentievoorwaarden
- Installeer de transformers-bibliotheek samen met de benodigde afhankelijkheden, zoals accelerate
- Gebruik de klasse `AutoModelForCausalLM` in je Python-script om het DBRX-model te laden
- Configureer uw inferentiepijplijn en houd er rekening mee dat DBRX aanzienlijk veel GPU-geheugen (VRAM) nodig heeft om effectief te kunnen werken
📖 Lees meer: Hoe configureer je de LLM-temperatuur?
Krijg toegang tot DBRX via Databricks
Als je team al Databricks gebruikt voor data-engineering of machine learning, is toegang tot DBRX via dat platform de gemakkelijkste manier. Het bespaart je problemen bij de installatie en biedt je alle tools die je nodig hebt voor MLOps, precies daar waar je al aan het werk bent.
Volg deze stappen in je Databricks-werkruimte om aan de slag te gaan:
- Ga naar de Model Garden of de sectie Mosaic AI
- Kies DBRX Base of DBRX Instruct, afhankelijk van uw behoeften
- Configureer een serving-eindpunt voor API-toegang of stel een notebook-omgeving in voor interactief gebruik
- Begin met het testen van inferentie aan de hand van voorbeeldprompts om te controleren of alles correct werkt, voordat u de training of implementatie van uw AI-model opschaalt
Deze aanpak biedt je naadloze toegang tot tools zoals MLflow voor het bijhouden van experimenten en de Unity Catalog voor modelbeheer.
📮 ClickUp Insight: De gemiddelde professional besteedt meer dan 30 minuten per dag aan het zoeken naar werkgerelateerde informatie – dat is meer dan 120 uur per jaar die verloren gaat aan het doorzoeken van e-mails, Slack-threads en verspreide bestanden.
Een intelligente AI-assistent die in je werkruimte is geïntegreerd, kan daar verandering in brengen. Maak kennis met ClickUp Brain.
Het biedt direct inzicht en antwoorden door binnen enkele seconden de juiste documenten, gesprekken en Taakdetails naar voren te halen – zodat u kunt stoppen met zoeken en aan het werk kunt gaan.
Hoe u DBRX kunt afstemmen en aangepaste AI-modellen kunt trainen
Een kant-en-klaar model, hoe krachtig ook, zal nooit de unieke nuances van uw business begrijpen. Omdat DBRX open source is, kunt u het nauwkeurig afstemmen om een aangepast model te maken dat de taal van uw business spreekt of een specifieke taak uitvoert die u het graag wilt laten uitvoeren.
Hier zijn drie veelgebruikte manieren waarop je dit kunt doen:
1. Verfijn DBRX met datasets van Hugging Face
Voor teams die net beginnen of aan veelvoorkomende taken werken, zijn openbare datasets van Hugging Face hub een geweldige bron. Ze zijn vooraf in een geschikt format opgemaakt en eenvoudig te laden, waardoor je geen uren hoeft te besteden aan het voorbereiden van je gegevens.
Het proces is vrij eenvoudig:
- Zoek op de hub een dataset die bij uw taak past (bijv. instructies opvolgen, samenvatten)
- Laad het op via de datasetbibliotheek
- Zorg ervoor dat de gegevens zijn geformatteerd als instructie-responsparen
- Configureer je trainingsscript met hyperparameters zoals leersnelheid en batchgrootte
- Start de trainingstaak en zorg ervoor dat je gedurende een periode regelmatig checkpoints opslaat
- Evalueer het verfijnde model op een apart gehouden validatieset om de verbetering te meten
2. DBRX verfijnen met lokale datasets
Meestal behaalt u de beste resultaten door het model te verfijnen met uw eigen bedrijfsgegevens. Zo kunt u het model de specifieke terminologie, stijl en domeinkennis van uw bedrijf bijbrengen. Houd er wel rekening mee dat dit alleen loont als uw gegevens schoon en goed voorbereid zijn, en voldoende volume hebben.
Volg deze stappen om je interne gegevens voor te bereiden:
- Gegevensverzameling: Verzamel voorbeelden van hoge kwaliteit uit uw interne wiki's, documenten en databases
- Formaatconversie: Structureer je gegevens in een consistent instructie-antwoordformaat, vaak als JSON-regels
- Kwaliteitsfiltering: Verwijder alle voorbeelden van lage kwaliteit, dubbele of irrelevante voorbeelden
- Validatiesplit: Reserveer een klein deel van je gegevens (meestal 10-15%) om de prestaties van het model te evalueren
- Privacycontrole: Verwijder of maskeer alle persoonlijk identificeerbare informatie (PII) of gevoelige gegevens
3. DBRX verfijnen met StreamingDataset
Als je dataset uiteindelijk te groot blijkt te zijn om in het geheugen van je computer te passen, geen zorgen: je kunt de Streaming Dataset-bibliotheek van Databricks gebruiken. Hiermee kun je gegevens rechtstreeks vanuit de cloudopslagruimte streamen terwijl het model wordt getraind, in plaats van alles in één keer in het geheugen te laden.
Zo gaat u te werk bij het doen van de dingen:
- Datavoorbereiding: Maak je trainingsgegevens schoon en structureer ze, en sla ze vervolgens op in een streambaar format zoals JSONL of CSV in cloudopslagruimte
- Conversie naar streamingformat: Converteer uw dataset naar een streamingvriendelijk format, zoals Mosaic Data Shard (MDS), zodat deze tijdens het trainen efficiënt kan worden gelezen
- Installatie van de training loader: Configureer je training loader zodat deze naar de externe dataset verwijst en definieer een lokale cache voor tijdelijke opslagruimte
- Modelinitialisatie: Start het DBRX-fine-tuningproces met behulp van een trainingsframework dat StreamingDataset ondersteunt, zoals LLM Foundry
- Training op basis van streaming: Voer de training uit terwijl de gegevens tijdens de training in batches worden gestreamd, in plaats van volledig in het geheugen te worden geladen
- Checkpoints en herstel: Ga naadloos verder met trainen als een run wordt onderbroken, zonder dat gegevens worden gedupliceerd of overgeslagen
- Evaluatie en implementatie: Controleer de prestaties van het geoptimaliseerde model en implementeer het met behulp van uw favoriete serving- of inferentie-installatie
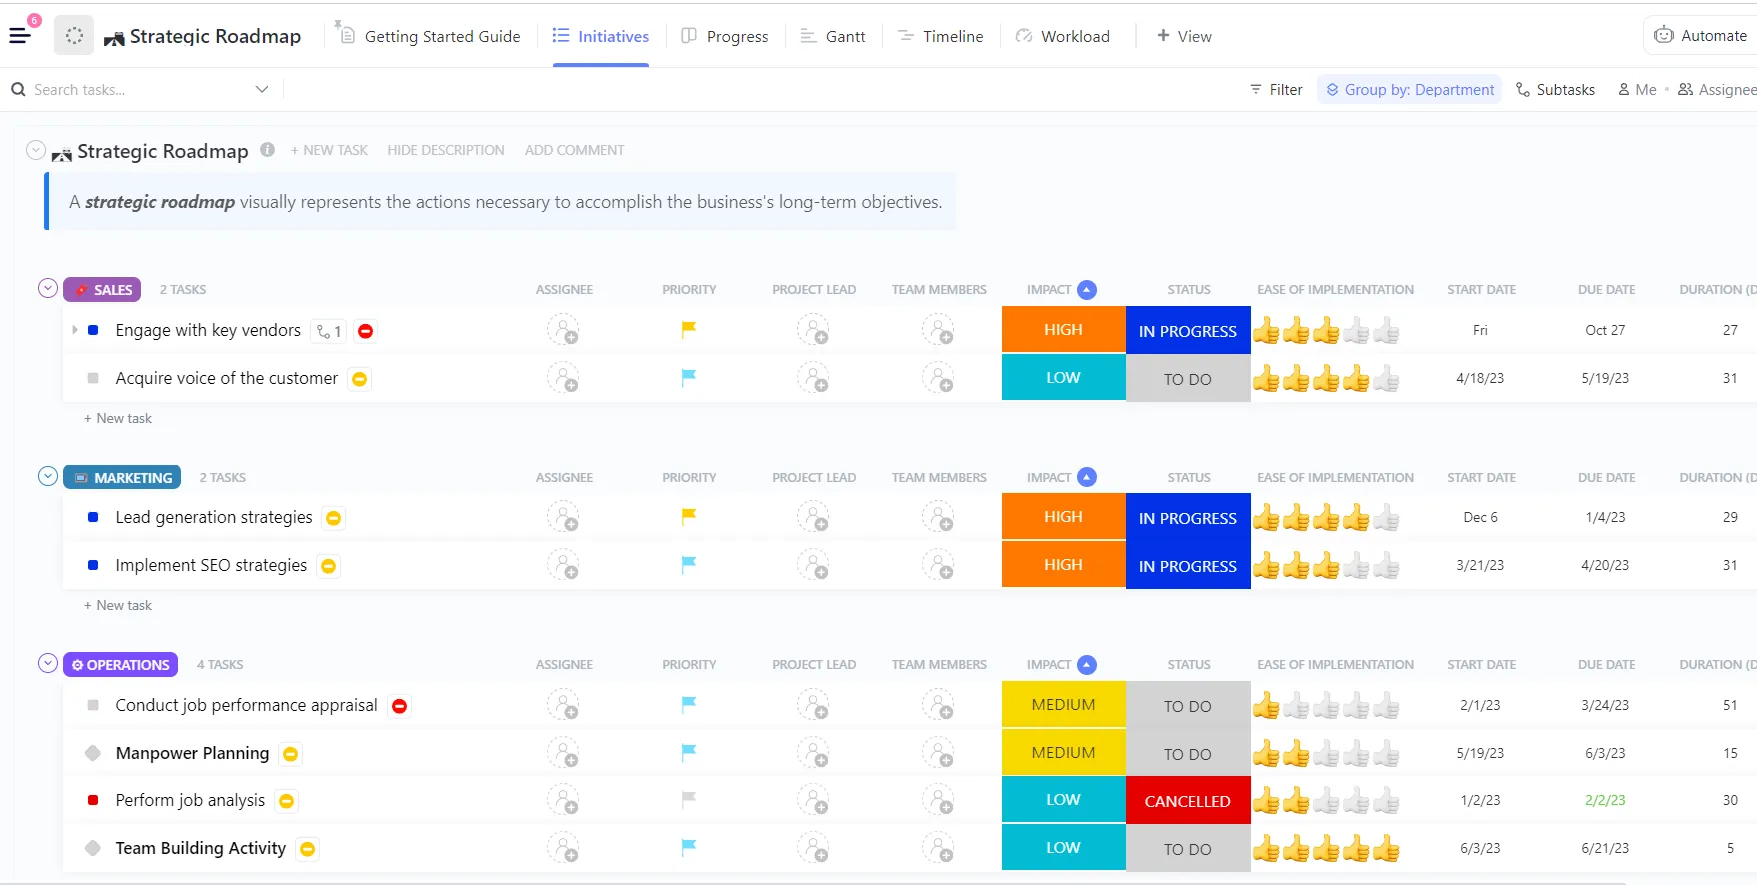
💡Pro-tip: In plaats van een DBRX-trainingsplan helemaal zelf op te stellen, kun je beter beginnen met ClickUp’s AI- en machine learning-projecten-roadmap-sjabloon en deze aanpassen aan de behoeften van je team. Het biedt een duidelijke structuur voor het plannen van datasets, trainingsfasen, evaluatie en implementatie, zodat je je kunt concentreren op het organiseren van je werk in plaats van het opzetten van een werkstroom.
Toepassingen van DBRX voor het trainen van AI-modellen
Het is één ding om een krachtig model te hebben, maar het is iets heel anders om precies te weten waar het uitblinkt.
Als je geen duidelijk beeld hebt van de sterke punten van een model, is het gemakkelijk om tijd en middelen te verspillen aan pogingen om het te laten werken op gebieden waar het simpelweg niet geschikt is. Dit leidt tot ondermaatse resultaten en frustratie.
Dankzij de unieke architectuur en trainingsgegevens van DBRX is het bijzonder geschikt voor verschillende sleutelgebruiksscenario's binnen ondernemingen. Als u deze sterke punten kent, kunt u het model afstemmen op uw bedrijfsdoelstellingen en uw rendement op investering maximaliseren.
Tekstgeneratie en het aanmaken van content
DBRX Instruct is nauwkeurig afgestemd op het opvolgen van instructies en het genereren van hoogwaardige tekst. Dit maakt het een krachtig hulpmiddel voor de automatisering van een breed bereik aan inhoudsgerelateerde taken. Het grote contextvenster is een belangrijk voordeel, waardoor het lange documenten kan verwerken zonder de thread kwijt te raken.
Je kunt het gebruiken voor:
- Technische documentatie: Produceer en verfijn producthandleidingen, API-referenties en gebruikershandleidingen
- Marketingcontent: conceptblogberichten, e-mailnieuwsbrieven en updates voor sociale media
- Rapportage: Vat complexe gegevensbevindingen samen en stel beknopte samenvattingen op voor het management
- Vertaling en lokalisatie: Pas bestaande content aan voor nieuwe markten en doelgroepen
Taak op het gebied van codegeneratie en foutopsporing
Een aanzienlijk deel van de trainingsdata van DBRX bestond uit code, waardoor het een krachtige LLM-ondersteuning voor ontwikkelaars is. Het kan ontwikkelingscyclusen versnellen door repetitieve code-taken te automatiseren en te helpen bij het oplossen van complexe problemen.
Hier zijn een paar manieren waarop je engineeringteam hiervan gebruik kan maken:
- Codeaanvulling: Genereer automatisch functielichamen op basis van opmerkingen of docstrings
- Foutdetectie: analyseer codefragmenten om mogelijke fouten of logische onjuistheden op te sporen
- Uitleg bij de code: Vertaal complexe algoritmen of verouderde code naar begrijpelijk Engels
- Testgeneratie: Maak unit-tests op basis van de handtekening en het verwachte gedrag van een functie
RAG en toepassingen met een lange context
Retrieval-Augmented Generation (RAG) is een krachtige techniek waarmee de antwoorden van een model worden gebaseerd op de privégegevens van uw bedrijf. RAG-systemen hebben echter vaak moeite met modellen die kleine contextvensters hebben, waardoor agressieve gegevensverdeling noodzakelijk is, waardoor belangrijke context verloren kan gaan. Het contextvenster van 32K van DBRX maakt het een uitstekende basis voor robuuste RAG-toepassingen.
Hiermee kunt u krachtige interne tools bouwen, zoals:
- Zoeken binnen de onderneming: Maak een chatbot die vragen van medewerkers beantwoordt aan de hand van uw interne kennisbank
- Klantenservice: Bouw een agent die ondersteuningsreacties genereert op basis van uw productdocumentatie
- Onderzoeksondersteuning: Ontwikkel een tool die informatie uit honderden pagina's aan onderzoeksartikelen kan samenvatten
- Nalevingscontrole: Controleer marketingteksten automatisch aan de hand van interne merkrichtlijnen of regelgevingsdocumenten
Hoe u DBRX-training kunt integreren in de werkstroom van uw team
Een succesvol project voor het trainen van AI-modellen draait om meer dan alleen code en rekenkracht. Het is een gezamenlijke inspanning waarbij ML-engineers, datawetenschappers, productmanagers en belanghebbenden betrokken zijn.
Wanneer deze samenwerking verspreid is over Jupyter-notebooks, Slack-kanalen en afzonderlijke tools voor projectmanagement, ontstaat er contextversnippering: een situatie waarin cruciale projectinformatie verspreid is over te veel tools.
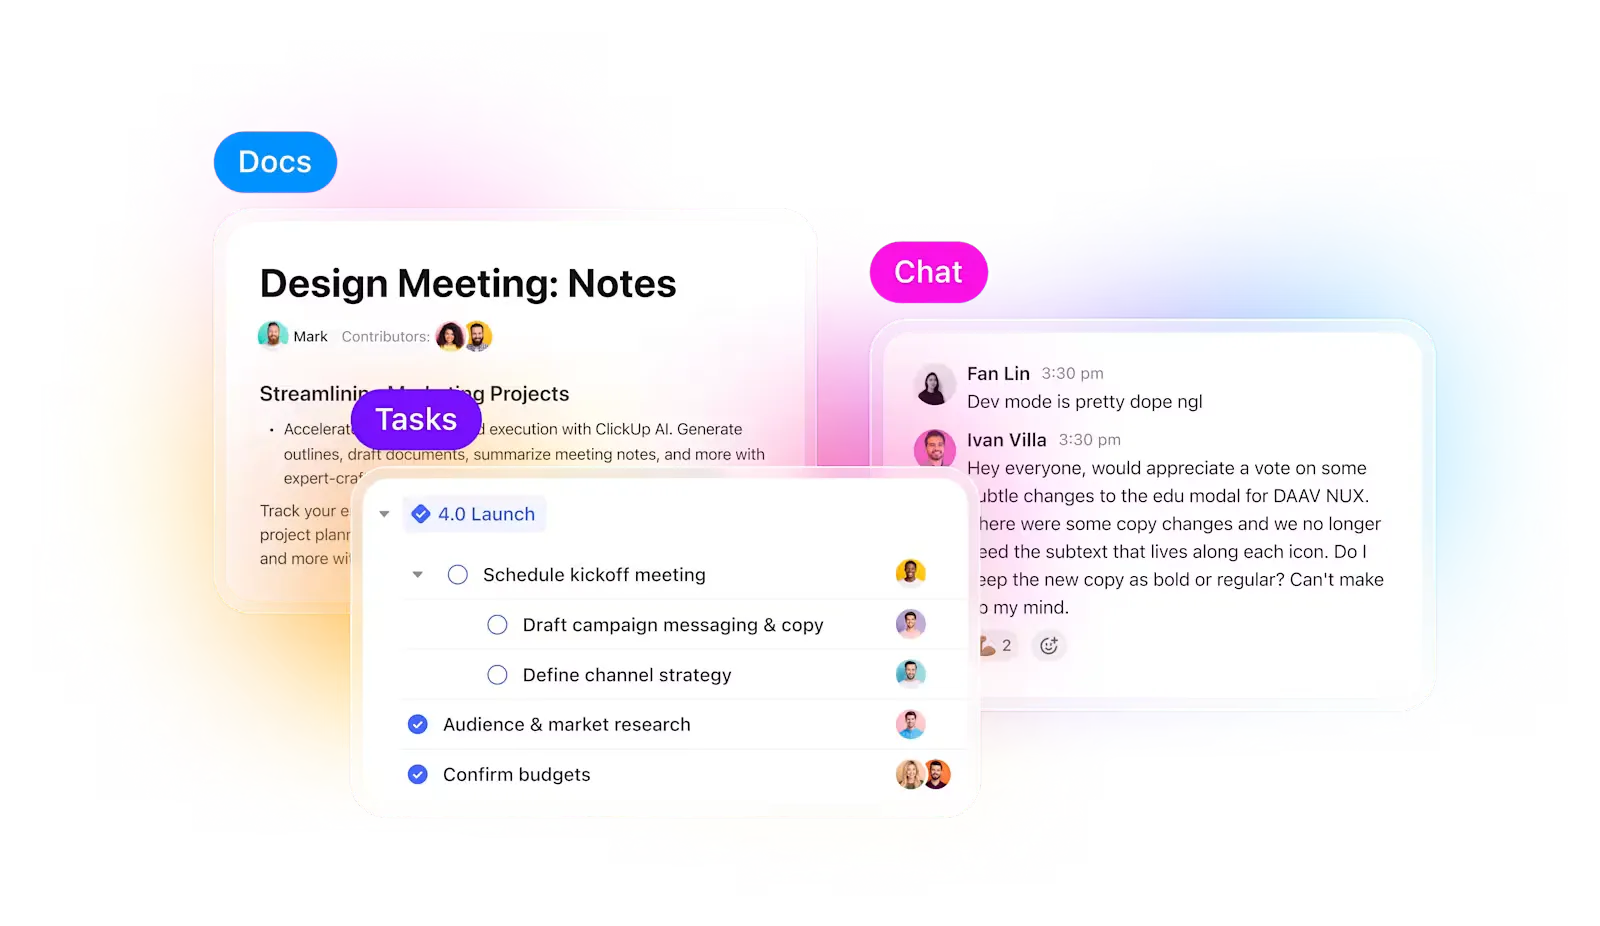
ClickUp biedt de oplossing. In plaats van met meerdere tools te moeten jongleren, beschik je over één geïntegreerde AI-werkruimte waar projectmanagement, documentatie en communicatie samenkomen – zodat je experimenten naadloos op elkaar aansluiten, van planning tot uitvoering en evaluatie.
Blijf nooit het overzicht houden over experimenten en voortgang
Bij het uitvoeren van meerdere experimenten is het moeilijkste deel niet het trainen van het model, maar het bijhouden van wat er tijdens het proces is veranderd. Welke versie van de dataset is gebruikt, welke leersnelheid leverde de beste resultaten op, of welke run is geïmplementeerd?
ClickUp maakt dit proces supergemakkelijk voor je. Je kunt elke trainingsronde afzonderlijk bijhouden in ClickUp-taken, en binnen taken kun je aangepaste velden gebruiken om het volgende vast te leggen:
- Versie van de dataset
- Hyperparameters
- Modelvariant (DBRX Base versus DBRX Instruct)
- Trainingsstatus (In de wachtrij, Wordt uitgevoerd, Wordt geëvalueerd, Geïmplementeerd)
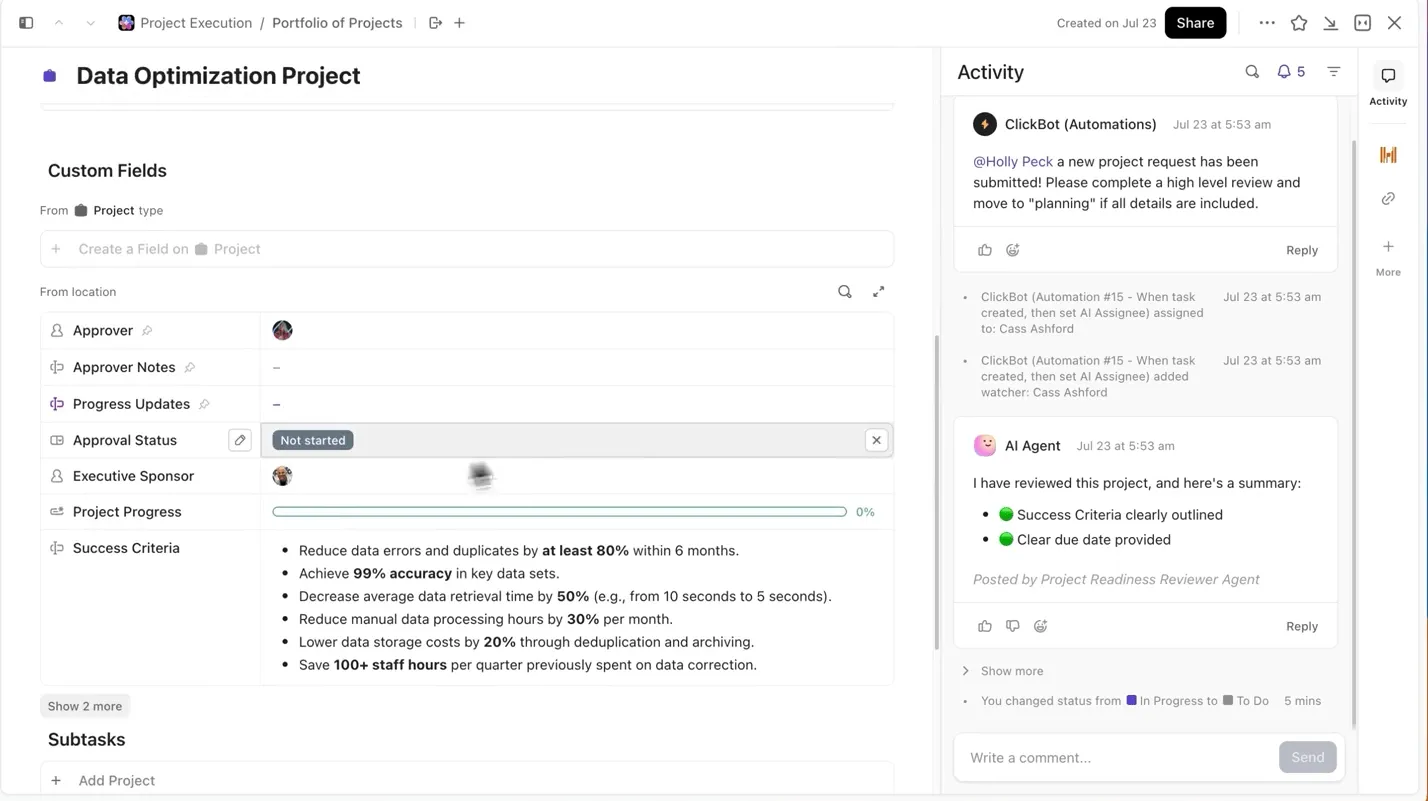
Op die manier is elk gedocumenteerd experiment doorzoekbaar, gemakkelijk te vergelijken met andere en reproduceerbaar.
Houd de modeldocumentatie gekoppeld aan het werk
Je hoeft niet heen en weer te schakelen tussen Jupyter-notebooks, README-bestanden of Slack-threads om de context van de taken van een experiment te begrijpen.
Met ClickUp Docs kun je je modelarchitectuur, scripts voor gegevensvoorbereiding of evaluatiestatistieken overzichtelijk en toegankelijk houden door ze te documenteren in een doorzoekbaar document dat rechtstreeks gekoppeld is aan de experimenttaken waaruit ze afkomstig zijn.
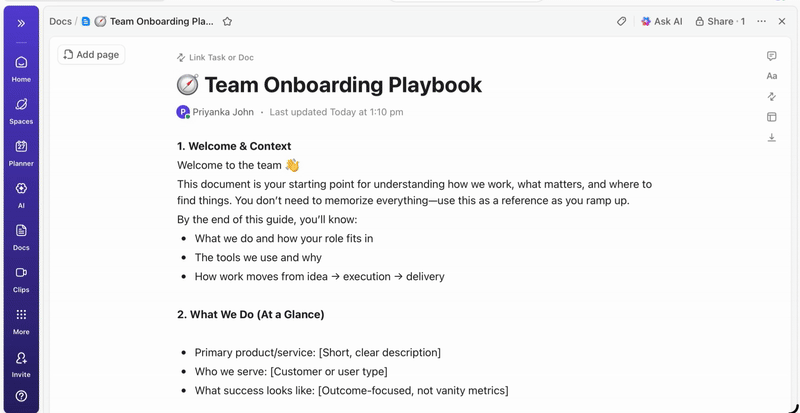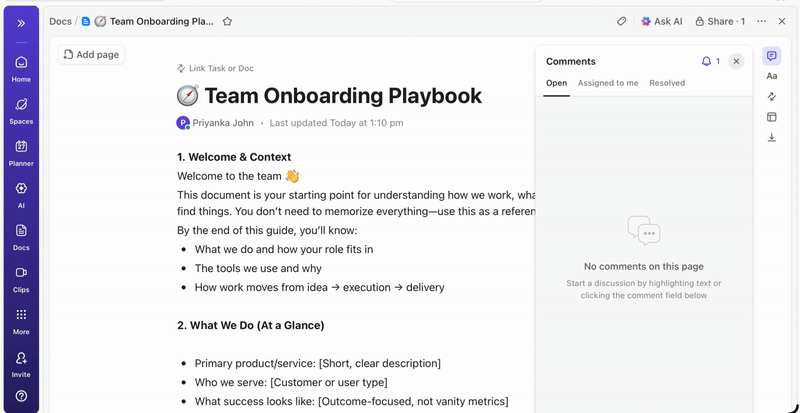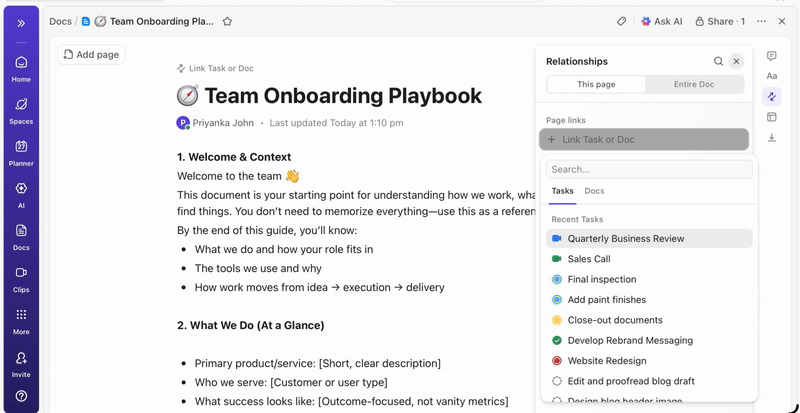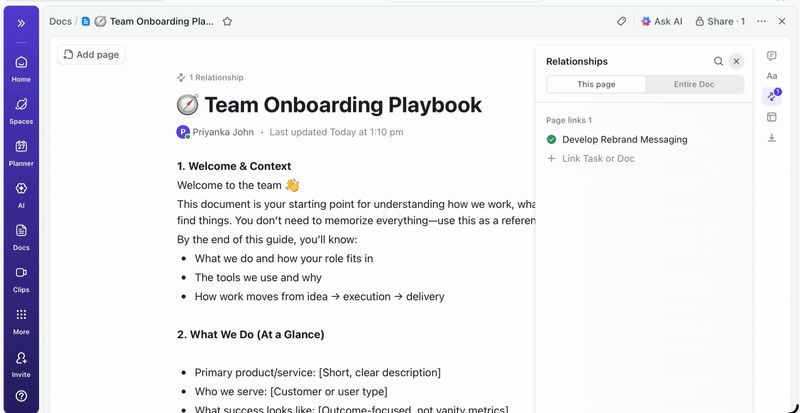
💡Pro-tip: Houd een actueel projectoverzicht bij in ClickUp Docs waarin elke beslissing gedetailleerd wordt beschreven, van architectuur tot implementatie, zodat nieuwe leden van het team altijd snel op de hoogte zijn van de projectdetails zonder dat ze door oude threads hoeven te spitten
Geef belanghebbenden realtime zichtbaarheid
ClickUp-dashboards geven in realtime inzicht in de voortgang van experimenten en de werklast van het team. I
In plaats van handmatig updates samen te stellen of e-mails te versturen, worden dashboards automatisch bijgewerkt op basis van de gegevens in je taken. Zo kunnen belanghebbenden op elk moment een kijkje nemen, zien hoe de status is en hoeven ze je nooit te storen met vragen als “wat is de status?”.
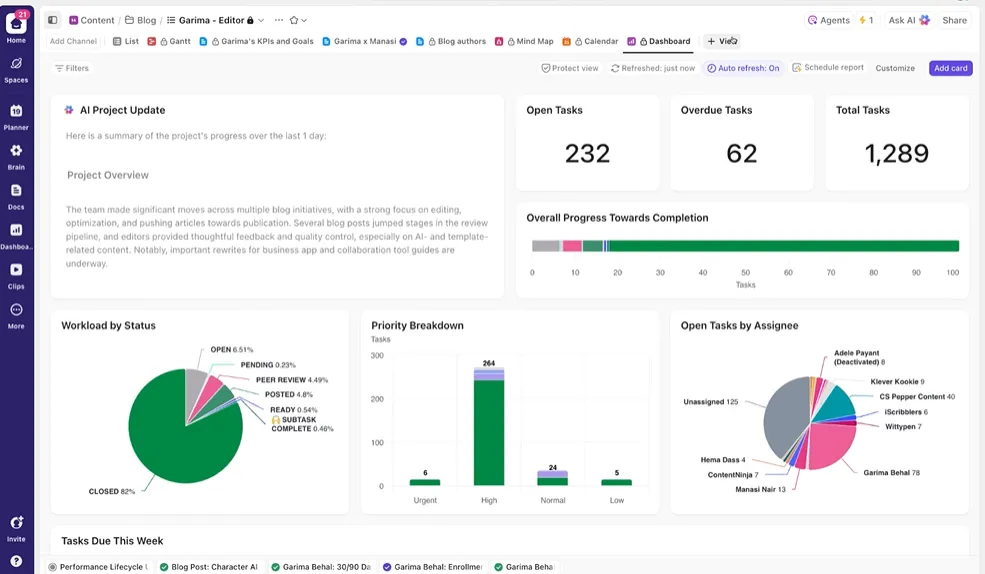
Zo kun je je concentreren op het uitvoeren van experimenten in plaats van dat je voortdurend handmatig rapportage moet doen over deze experimenten.
Maak van AI je slimme projectpartner
Je hoeft niet handmatig weken aan trainingsgegevens door te spitten om een overzicht te krijgen van de experimenten tot nu toe. Maak gewoon een vermelding van @Brain in een opmerking bij een Taak, en ClickUp Brain biedt je de hulp die je nodig hebt, met volledige context over je eerdere en lopende projecten.
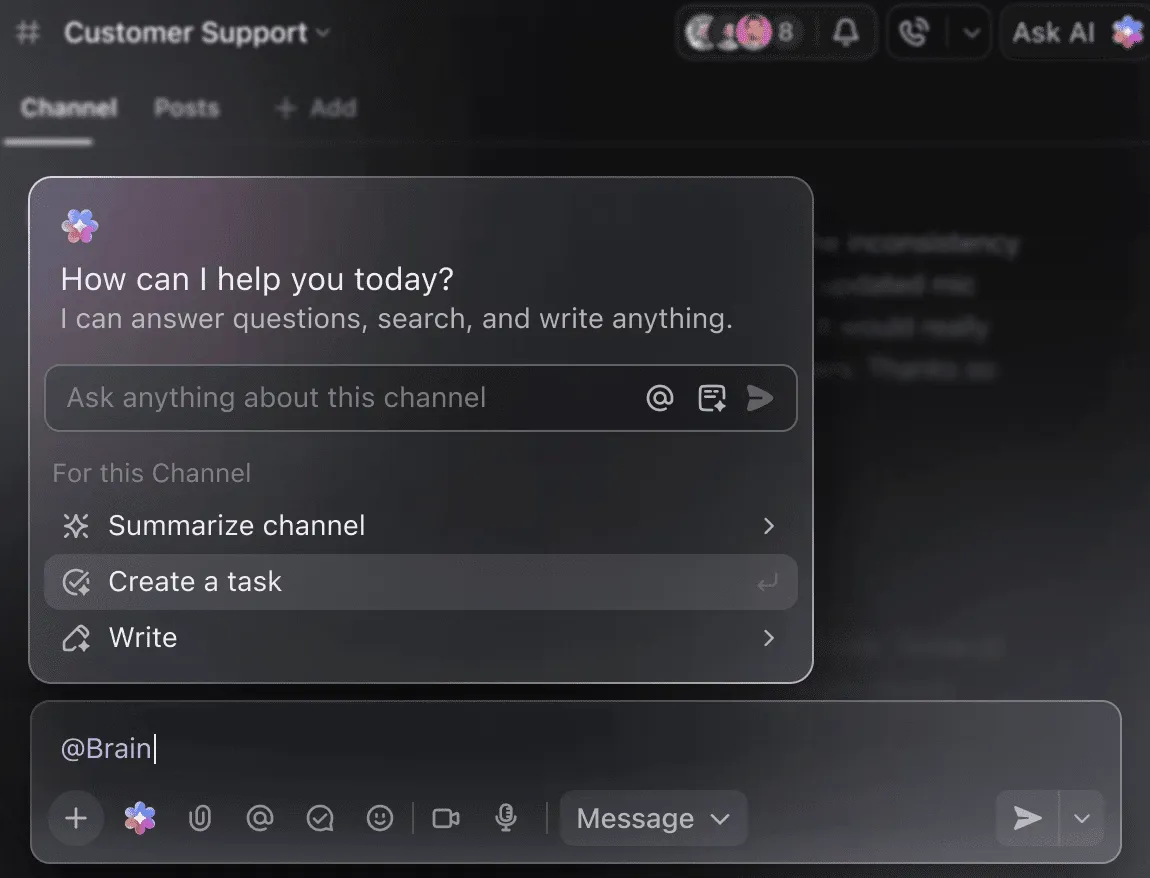
Je kunt Brain vragen om ‘de experimenten van vorige week in vijf punten samen te vatten’ of ‘een document op te stellen met de nieuwste hyperparameterresultaten’, en je krijgt direct een verzorgd resultaat.
🧠 Het voordeel van ClickUp: De Super Agents van ClickUp gaan nog een stap verder: ze kunnen volledige werkstroomautomatisering uitvoeren op basis van door u gedefinieerde triggers, en doen meer dan alleen uw vragen beantwoorden. Met Super Agents kun je automatisch een nieuwe DBRX-trainingstaak aanmaken zodra er een dataset wordt geüpload, je team hiervan op de hoogte stellen, relevante documenten koppelen wanneer de training is voltooid of een checkpoint bereikt, en een wekelijks voortgangsoverzicht genereren en dit naar belanghebbenden sturen zonder dat je er zelf iets voor hoeft te doen.
Veelgemaakte fouten die je moet vermijden
Het starten van een DBRX-trainingsproject is spannend, maar een paar veelvoorkomende valkuilen kunnen je voortgang in de weg staan. Door deze fouten te vermijden, bespaar je tijd, geld en een hoop frustratie.
- Onderschatting van hardwarevereisten: DBRX is krachtig, maar ook omvangrijk. Als je het op onvoldoende hardware probeert uit te voeren, leidt dit tot 'out-of-memory'-fouten en mislukte trainingstaken. Houd er rekening mee dat DBRX (132B) minimaal 264 GB VRAM vereist voor 16-bits inferentie, of ongeveer 70 GB tot 80 GB bij gebruik van 4-bits kwantisering
- Het overslaan van controles op de gegevenskwaliteit: Garbage in, garbage out. Het finetunen op basis van een rommelige dataset van lage kwaliteit zal het model alleen maar leren om rommelige resultaten van lage kwaliteit te produceren.
- Let op de beperkingen voor de contextlengte: Hoewel het contextvenster van 32K van DBRX ruim is, is het niet oneindig. Als u het model invoergegevens geeft die deze limiet overschrijden, heeft dit als resultaat stille inkorting en slechte prestaties
- Wanneer is het gepast om Base te gebruiken in plaats van Instruct: DBRX Base is een onbewerkt, vooraf getraind model dat bedoeld is voor verdere, grootschalige training. Voor de meeste taken waarbij instructies moeten worden opgevolgd, kunt u het beste beginnen met DBRX Instruct, dat al voor dat doel is gefinetuned
- Het scheiden van trainingswerkzaamheden en projectcoördinatie: Wanneer je experimenten in de ene tool bijhoudt en je projectplan in een andere, ontstaan er informatiesilo’s. Gebruik een geïntegreerd platform zoals ClickUp om je technische werkzaamheden en projectcoördinatie synchroniseren
- Het negeren van evaluatie vóór implementatie: Een model dat goed presteert op uw trainingsgegevens, kan in de praktijk spectaculair falen. Valideer uw verfijnde model altijd op een apart gehouden testset voordat u het in productie neemt.
- De complexiteit van fine-tuning over het hoofd zien: Omdat DBRX een Mixture-of-Experts-model is, kunnen standaard fine-tuning-scripts gespecialiseerde bibliotheken zoals Megatron-LM of PyTorch FSDP vereisen om parameterverdeling over meerdere GPU's af te handelen
DBRX versus andere AI-trainingsplatforms
Bij het kiezen van een AI-trainingsplatform moet je een fundamentele afweging maken: controle versus gemak. Eigen, uitsluitend via API toegankelijke modellen zijn gebruiksvriendelijk, maar binden je aan het ecosysteem van een leverancier.
Modellen met open gewichten, zoals DBRX, bieden volledige controle, maar vereisen meer technische expertise en infrastructuur. Deze keuze kan ervoor zorgen dat je vastloopt en niet zeker weet welke weg daadwerkelijk je langetermijndoelen ondersteunt – een uitdaging waar veel teams mee te maken krijgen bij de implementatie van AI.
In deze tabel worden de belangrijkste verschillen op een rijtje gezet, zodat u een weloverwogen beslissing kunt nemen.
| Gewichten | Open (Aangepast) | Eigen ontwikkeling | Open (Aangepast) | Eigen ontwikkeling |
| Fijnafstemming | Volledige controle | Op API gebaseerd | Volledige controle | Op API gebaseerd |
| Zelf hosten | Ja | Nee | Ja | Nee |
| Licentie | DB Open Model | OpenAI-voorwaarden | Llama-community | Anthropic-termen |
| Context | 32K | 128K – 1M | 128K | 200.000 – 1 miljoen |
DBRX is de juiste keuze wanneer u volledige controle over het model nodig hebt, om redenen van veiligheid of naleving zelf moet hosten, of de flexibiliteit van een ruime commerciële licentie wilt. Als u niet over een speciale GPU-infrastructuur beschikt – of als u de waarde van snelle marktintroductie belangrijker vindt dan uitgebreide aangepaste mogelijkheden – zijn API-gebaseerde alternatieven wellicht een betere keuze.
Begin slimmer met trainen met ClickUp
DBRX biedt je een enterprise-ready basis voor het bouwen van aangepaste AI-toepassingen, met de transparantie en controle die je bij propriëtaire modellen niet krijgt. De efficiënte MoE-architectuur houdt de inferentiekosten laag en het open ontwerp maakt het eenvoudig om het model te verfijnen. Maar sterke technologie is slechts de helft van het verhaal.
Echt succes ontstaat door je technische werk af te stemmen op de samenwerkingswerkstroom van je team. Het trainen van AI-modellen is een teaminspanning, en het is cruciaal om experimenten, documentatie en communicatie met belanghebbenden te synchroniseren. Door alles in één geïntegreerde werkruimte onder te brengen en contextversnippering tegen te gaan, kun je sneller betere modellen opleveren.
Ga gratis aan de slag met ClickUp om je AI-trainingsprojecten in één werkruimte te coördineren. ✨
Veelgestelde vragen
Hoe houd ik de voortgang van de training bij in DBRX?
Je kunt het trainingsproces volgen met behulp van standaard ML-tools zoals TensorBoard, Weights & Biases of MLflow. Als je binnen het Databricks-ecosysteem traint, is MLflow native geïntegreerd om experimenten naadloos bij te houden.
Kan ik DBRX integreren met CI/CD- en implementatiepijplijnen?
Ja, DBRX kan worden geïntegreerd in standaard MLOps-pijplijnen. Door het model te containeriseren, kunt u het implementeren met behulp van orkestratieplatforms zoals Kubeflow of aangepaste CI/CD-werkstroom.
Wat is het verschil tussen DBRX Base en DBRX Instruct?
DBRX Base is het fundamentele, vooraf getrainde model dat bedoeld is voor teams die domeinspecifieke voortgezette pre-training of diepgaande architecturale fine-tuning willen uitvoeren. DBRX Instruct is een fine-tuned versie die is geoptimaliseerd voor het opvolgen van instructies, waardoor het een beter uitgangspunt is voor de meeste applicatieontwikkeling.
Hoe verhoudt DBRX zich tot GPT-4 voor AI-projecten binnen ondernemingen?
Het belangrijkste verschil is controle. DBRX biedt je volledige toegang tot de modelgewichten voor uitgebreide aanpassing en zelfhosting, terwijl GPT-4 een dienst is die uitsluitend via een API werkt.
Kun je DBRX gratis gebruiken?
De DBRX-modelgewichten zijn gratis beschikbaar onder de Databricks Open Model License. U bent echter zelf verantwoordelijk voor de kosten van de rekeninfrastructuur die nodig is om het model uit te voeren of te verfijnen.