
IT-Notfälle können ohne Achtung eintreten.
Von Serverausfällen bis hin zu Cyberangriffen – ohne einen soliden Wiederherstellungsplan könnte Ihr Geschäft stundenlange Ausfallzeiten, Datenverluste und erhebliche finanzielle Schäden erleiden, wobei 54 % der schwerwiegenden Ausfälle Kosten von über 100.000 US-Dollar verursachen.
Dieser Blog führt Sie Schritt für Schritt durch die Erstellung eines umfassenden IT-Notfallwiederherstellungsplans, der Ihre Systeme schützt, klare Wiederherstellungsziele definiert und sicherstellt, dass Ihr Team genau weiß, was zu erledigen ist, wenn etwas schiefgeht.
Was ist ein IT-NotfallwiederherstellungsPlan?
Wenn Ihre Server gerade jetzt ausfallen würden, wüsste Ihr Team dann genau, was zu erledigen ist? 🛠️
Ein IT-Notfallwiederherstellungsplan (Disaster Recovery, DR) ist Ihre dokumentierte Strategie zur Wiederherstellung von IT-Systemen und Daten nach einer Störung – von Naturkatastrophen bis hin zu Cyberangriffen. Er ist im Wesentlichen Ihr Leitfaden, um die Technik wieder in Betrieb zu nehmen, wenn etwas schiefgeht.
💡 DR vs. Geschäftskontinuität
Bei der Notfallwiederherstellung (Disaster Recovery, DR) liegt der Schwerpunkt speziell auf der Wiederherstellung Ihrer IT-Infrastruktur und Ihrer Daten. Die Geschäftskontinuität (Business Continuity, BC) ist weiter gefasst und zielt darauf ab, den gesamten Geschäftsbetrieb während und nach einer Krise aufrechtzuerhalten, selbst wenn die IT ausgefallen ist. Betrachten Sie die Notfallwiederherstellung als einen wesentlichen Bestandteil Ihrer gesamten BC-Strategie.
💡 DR vs. Geschäftskontinuität
Bei der Notfallwiederherstellung (Disaster Recovery, DR) liegt der Schwerpunkt speziell auf der Wiederherstellung Ihrer IT-Infrastruktur und Ihrer Daten. Die Geschäftskontinuität (Business Continuity, BC) ist weiter gefasst und zielt darauf ab, den gesamten Geschäftsbetrieb während und nach einer Krise aufrechtzuerhalten, selbst wenn die IT ausgefallen ist. Betrachten Sie die Notfallwiederherstellung als einen wesentlichen Bestandteil Ihrer gesamten BC-Strategie.
Ihr Notfallwiederherstellungsplan ist wichtig, denn Ausfallzeiten kosten mehr als nur Geld. Jede Minute, in der Ihre Systeme offline sind, kann das Vertrauen Ihrer Kunden untergraben, den Betrieb stören und sogar zu Bußgeldern wegen Nichteinhaltung von Vorschriften führen. Ein umfassender Notfallwiederherstellungsplan ist Ihr Wegweiser zur Ausfallsicherheit.
Ein guter Plan umfasst:
- Verfahren zum Backup: Wie und wo Sie Kopien wichtiger Informationen speichern, damit Sie diese wiederherstellen können
- Schritte zur Systemwiederherstellung: Die genaue Reihenfolge, in der Dienste in der richtigen Reihenfolge wieder online geschaltet werden müssen
- Zuständigkeiten im Team: Wer übernimmt welche Aufgaben während eines Incidents, um Verwirrung zu vermeiden?
- Kommunikationsprotokolle: Wie Sie die Beteiligten – von Ihrem Team bis hin zu Ihren Kunden – auf dem Laufenden halten
- Wiederherstellungsziele: Ihre konkreten Ziele dazu, wie schnell Systeme wieder betriebsbereit sein müssen und wie viel Datenverlust akzeptabel ist
Häufige IT-Notfallszenarien und deren Auswirkungen
Katastrophen sind nicht nur Hollywood-Szenarien; sie treffen Geschäfte jeden Tag. Wenn Sie verstehen, wovor Sie sich schützen, können Sie eine wesentlich stärkere Abwehr aufbauen.
Naturkatastrophen und Sachschäden
Ereignisse wie Überschwemmungen, Brände, Erdbeben und großflächige Stromausfälle können ganze Rechenzentren innerhalb von Minuten zerstören. Als beispielsweise eine schwere Überschwemmung ein Rechenzentrum in Nashville traf, verloren einige Unternehmen Daten aus mehreren Wochen und standen vor einer monatelangen Wiederherstellung. Der beste Schutz dagegen ist geografische Redundanz, d. h. die Verteilung Ihrer Infrastruktur auf mehrere physische Speicherorte, damit ein einzelnes Ereignis nicht alles lahmlegen kann.
Cyberangriffe und Datenkompromittierung
Ransomware, Distributed-Denial-of-Service-Angriffe (DDoS) und Datenlecks unterscheiden sich von physischen Katastrophen. Sie sind oft schwerer zu erkennen, können sich unbemerkt über Verbindungen von vernetzten Systemen ausbreiten und zielen häufig auch auf Ihre Backup-Systeme ab, was die Wiederherstellung besonders schwierig macht. Die Häufigkeit und Raffinesse dieser Cyberangriffe nimmt branchenübergreifend weiter zu. Ransomware ist mittlerweile bei 44 % aller bestätigten Sicherheitsvorfälle beteiligt und stellt damit eine der größten Bedrohungen dar.
Hardwareausfälle und Datenverlust
Manchmal fallen selbst die am besten getesteten und bewährtesten Backup-Systeme einfach aus. Serverabstürze, Speicherausfälle und Störungen an Netzwerkgeräten können ohne Vorwarnung auftreten. Selbst wenn Sie über redundante (Backup-)Systeme verfügen, können diese dennoch gleichzeitig ausfallen, wenn sie gemeinsame Komponenten oder Stromquellen nutzen, wodurch ein Single Point of Failure entsteht.
👀 Wussten Sie schon: Im Oktober 2025 kam es bei AWS zu einem schwerwiegenden Ausfall, als ein Fehler im internen DNS-Managementsystem für Amazon DynamoDB dazu führte, dass die Auflösung von Domainnamen in der Rechenzentrumsregion US-EAST-1 fehlschlug. Dieser „kleine“ technische Fehler war der Auslöser für eine Kettenreaktion, die Dutzende von AWS-Diensten betraf und weltweit Hunderte beliebter Apps und Plattformen lahmlegte – von Messaging- und Social-Media-Apps bis hin zu Banken, Gaming-Websites und vielem mehr. Für viele Menschen ließ der Ausfall einen Großteil des Internets vorübergehend „verschwinden“ und machte damit deutlich, wie anfällig unsere digitale Infrastruktur ist, wenn so viel von einer Handvoll Cloud-Anbietern abhängt.
Softwarefehler und Dienstunterbrechungen
Eine beschädigte Datenbank, ein fehlgeschlagenes Software-Update oder ein einfacher Fehler in der Konfiguration können ganze Plattformen lahmlegen. Sie werden vielleicht feststellen, dass sich eine einzige falsch konfigurierte Codezeile wie eine Kettenreaktion durch verbundene Systeme ausbreiten und einen weitreichenden Ausfall mit großem Wirkungsbereich verursachen kann. Ein ordnungsgemäßes Änderungsmanagement und dedizierte Testumgebungen sind Ihre besten Verbündeten, um diese Risiken zu minimieren.
Menschliche Fehler und Fehlkonfigurationen
Versehentliche Löschungen, fehlerhafte Konfigurationen und unbefugte Änderungen gehören nach wie vor zu den häufigsten Ursachen für IT-Ausfälle. Ein einziger falscher Befehl oder eine gelöschte Datei kann stundenlange Ausfallzeiten und eine Beeinträchtigung der Dienstqualität als Auslöser haben. Schulungen und Zugriffskontrollen helfen zwar, können menschliche Fehler jedoch nicht vollständig ausschließen.
📮ClickUp Insight: 92 % der Mitarbeiter verwenden uneinheitliche Methoden zur Nachverfolgung von Elementen, was das Ergebnis versäumter Entscheidungen und Verzögerungen bei der Umsetzung ist.
Ganz gleich, ob Sie Folge-Notizen versenden oder Tabellenkalkulationen verwenden – der Prozess ist oft unübersichtlich und ineffizient. Mit den Funktionen für die Aufgabenverwaltung von ClickUp müssen Sie sich darüber keine Gedanken mehr machen. Erstellen Sie Aufgaben aus Chats, ClickUp-Aufgabenkommentaren, Dokumenten und E-Mails mit nur einem Klick!
Wichtige Schlüsselkomponenten eines IT-Notfallwiederherstellungsplans
Ein solider DR-Plan ist Ihr umfassendes Handbuch für die Wiederherstellung des Geschäfts. Jede dieser Komponenten baut auf den anderen auf, um einen umfassenden Schutz für Ihr Geschäft zu gewährleisten.
Risikobewertung und Priorisierung
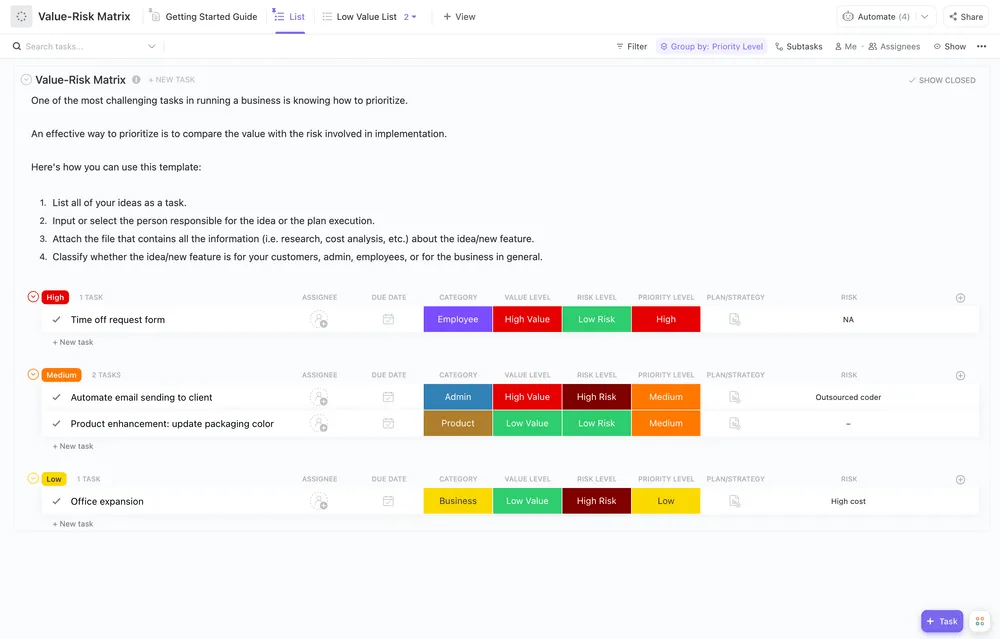
Zunächst müssen Sie wissen, womit Sie es zu tun haben. Eine Risikobewertung ist der Prozess, bei dem Sie Ihre Schwachstellen identifizieren und die Wahrscheinlichkeit sowie die Auswirkungen jeder potenziellen Bedrohung bewerten. Sie können dies in einer Matrix darstellen, um zu erkennen, welche Bedrohungen am schwerwiegendsten sind.
Ihre Bewertung sollte folgende Punkte umfassen:
- Kritische Systeme: Was unbedingt in Betrieb bleiben muss, damit Ihr Geschäft funktionieren kann
- Vertraulichkeit der Daten: Welche Informationen erfordern den höchsten Schutzgrad (z. B. Kundendaten)?
- Abhängigkeiten: Welche anderen Systeme oder Prozesse fallen aus, wenn ein System ausfällt?
📖 Weiterlesen: So implementieren Sie IT-Infrastrukturmanagement
Analyse der geschäftlichen Auswirkungen und Kritikalität
Ermitteln Sie anschließend die tatsächlichen Kosten von Ausfallzeiten. Eine Business Impact Analysis (BIA) hilft Ihnen dabei, die finanziellen und betrieblichen Auswirkungen eines Ausfalls für jedes einzelne System zu ermitteln. Auf diese Weise können Sie Ihre Systeme nach ihrer Kritikalität einstufen und den damit verbundenen Aufwand für die Wiederherstellung entsprechend priorisieren.
| Kritisch | Weniger als eine Stunde | Zahlung, Kundendatenbanken |
| Hoch | Eine bis vier Stunden | E-Mail, interne Kommunikationstools |
| Medium | Vier bis 24 Stunden | Entwicklungsumgebungen, tools für die Berichterstellung |
| Niedrig | 24+ Stunden | Archivsysteme, Testserver außerhalb der Produktion |
RTO- und RPO-Ziele
Diese beiden Abkürzungen bilden das Herzstück Ihrer Wiederherstellungsstrategie.
- Recovery Time Objective (RTO): Dies ist die maximale Zeitspanne, die Sie sich leisten können, während der ein System ausgefallen sein darf. Es beantwortet die Frage: „Wie schnell muss das System wieder online sein?“
- Recovery Point Objective (RPO): Dies ist die maximale Datenmenge, deren Verlust Sie sich leisten können, gemessen in Zeit. Es beantwortet die Frage: „Wie viele Daten können wir verlieren, ohne dass dadurch erheblicher Schaden entsteht?“
Beispielsweise könnte Ihr internes E-Mail-System eine Wiederherstellungszeit (RTO) von vier Stunden haben, während Ihre kundenorientierte E-Commerce-Datenbank eine Wiederherstellungszielzeit (RPO) von nur 15 Minuten aufweist, was bedeutet, dass Sie nicht mehr als 15 Minuten an Daten der Transaktionen verlieren dürfen.
Plan zum Backup und zur Wiederherstellung der Daten
Ihr Backup-Plan ist Ihr ultimatives Sicherheitsnetz. Eine gängige Best Practice ist die 3-2-1-Regel: Bewahren Sie mindestens drei Kopien Ihrer wichtigen Daten auf, speichern Sie diese auf zwei verschiedenen Medientypen und bewahren Sie eine dieser Kopien außerhalb des Unternehmens auf.
Außerdem können Sie zwischen verschiedenen Arten von Backups wählen:
- Vollständige Backups: Eine vollständige Kopie aller Daten, die in der Regel wöchentlich oder monatlich erledigt wird
- Inkrementelle Backups: Es werden nur die Änderungen gesichert, die seit dem letzten Backup jeglicher Art vorgenommen wurden.
- Differenzielle Backups: Sichern alle Änderungen, die seit dem letzten vollständigen Backup vorgenommen wurden
Vor allem müssen Sie Ihren Backup-Wiederherstellungsprozess regelmäßig testen. Ein ungetestetes Backup ist nur eine Hoffnung, kein Plan.
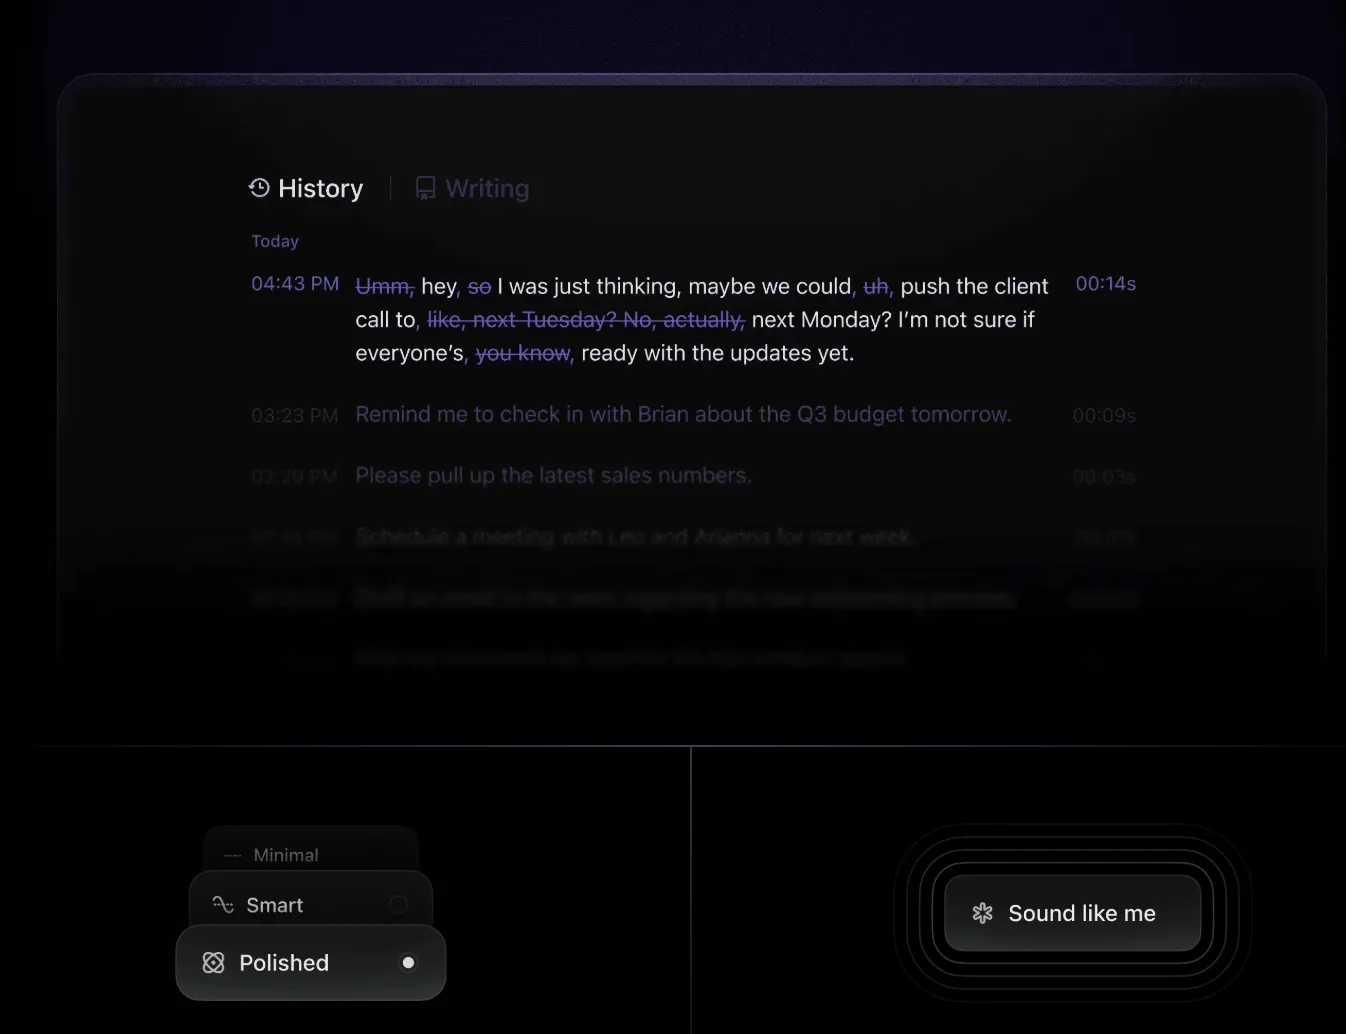
💟 Bonus: Erfassen Sie wichtige Details während stressreicher Incidents mithilfe der Sprach-zu-Text-Funktion von ClickUp Brain MAX, damit Ihnen keine wichtigen Informationen entgehen, selbst wenn das Tippen nicht möglich ist. Sprechen Sie einfach Ihre Beobachtungen ein und überlassen Sie die Dokumentation der KI.
Kommunikationsplan und Informationen für die Beteiligten
Wenn eine Katastrophe eintritt, ist ein klarer Kommunikationsplan von entscheidender Bedeutung. Ihr Plan muss Benachrichtigungsketten festlegen, wie oft Sie Updates bereitstellen und welche Kanäle Sie für jede Art von Incident nutzen.
Verschiedene Gruppen benötigen unterschiedliche Informationen:
- Interne Teams: Benötigen technische Details und konkrete Elemente
- Kunden: Sie möchten den Status des Service erfahren und wissen, wann mit einer Lösung zu rechnen ist
- Anbieter: Müssen möglicherweise unterstützt oder bei Eskalationen hinzugezogen werden
- Aufsichtsbehörden: Je nach Branche können formelle Benachrichtigungen erforderlich sein.
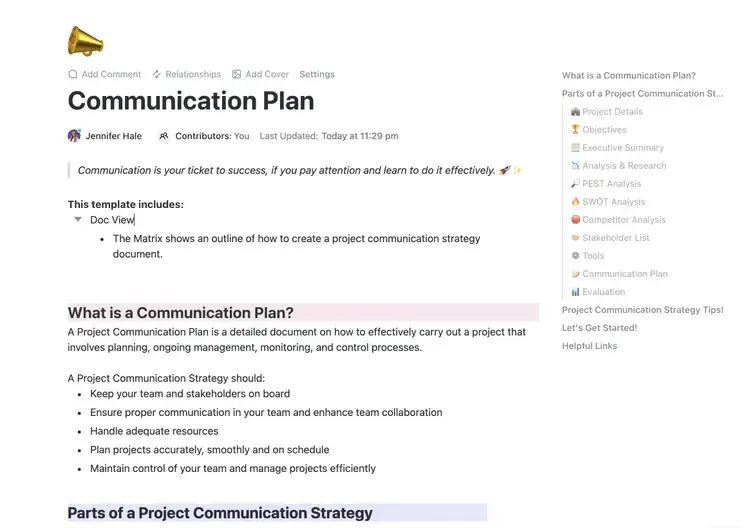
Tools wie diese gebrauchsfertige Vorlage für einen Kommunikationsplan von ClickUp können Ihnen helfen, in einer Krisensituation dank eines festgelegten Protokolls schneller zu handeln.
Test- und Schulungsprogramm
Ein Plan, den man nie testet, ist ein Plan, der scheitern wird. Regelmäßige Tests decken Lücken und Schwachstellen auf, bevor eine echte Katastrophe eintritt.
Planen Sie im Laufe des Jahres verschiedene Arten von Tests ein:
- Tabletop-Übungen: Ihr Team durchspielt ein Katastrophenszenario auf Papier, um die Logik des Plans zu überprüfen.
- Teilweise Failovers: Sie testen die Wiederherstellung bestimmter, nicht kritischer Komponenten oder Dienste.
- Umfassende DR-Tests: Sie schließen ein vollständiges Failover auf Ihre Backup-Systeme ab (der ultimative Test)
Aktualisieren Sie nach jedem Test Ihre Dokumentation und schulen Sie neue Mitglieder des Teams umgehend in den Abläufen.
📖 Weiterlesen: So entwickeln Sie effektive IT-Richtlinien und -Verfahren
Schritte zur Erstellung eines IT-Notfallwiederherstellungsplans
Die Erstellung Ihres DR-Plans muss nicht unbedingt eine überwältigende Aufgabe sein.
So können Sie Schritt für Schritt vorgehen. 🙌
Schritt 1: Erstellen Sie das Bestandsverzeichnis der IT-Ressourcen
Was Sie nicht kennen, können Sie auch nicht schützen. Erstellen Sie zunächst eine Liste, in der jede Hardware, jede Software, jedes Repository und jede Systemabhängigkeit in Ihrer Umgebung aufgeführt ist. Achten Sie darauf, die Kontaktdaten der Anbieter, Lizenzschlüssel und Konfigurationsdetails aufzunehmen, damit Sie im Wiederherstellungsfall schnell darauf zugreifen können.
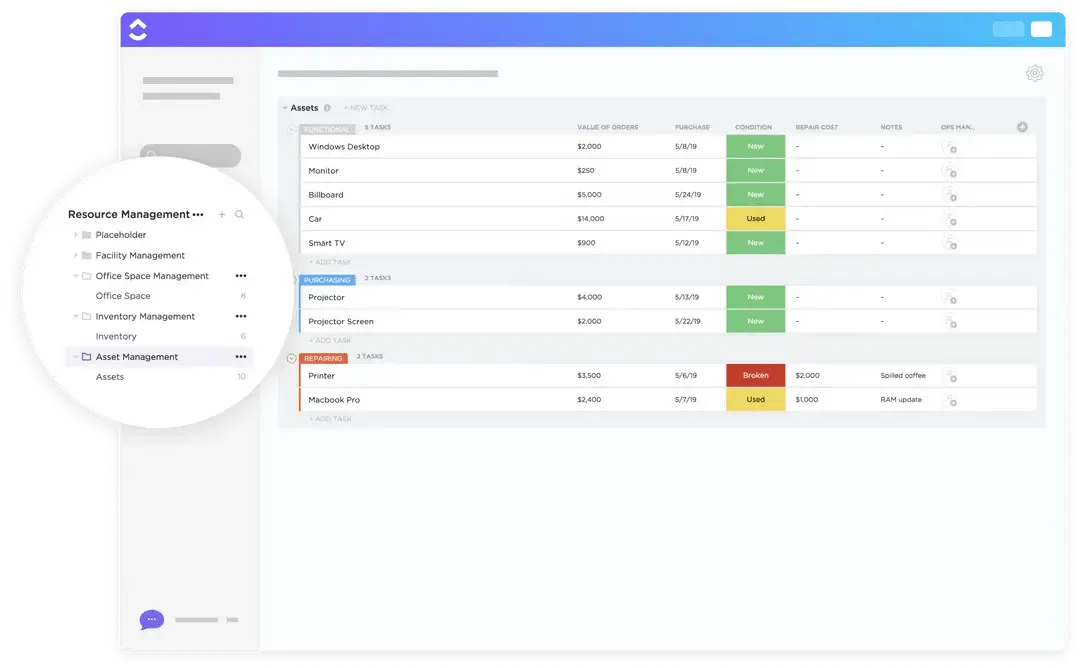
Die ClickUp-ITAM-Vorlage vereint Incident-Management, Problem-Management, Change-Management, einfache Lösungen für das Asset-Management und Wissensmanagement. Unsere ITSM-Vorlage für bekannte Fehler vereinfacht die Nachverfolgung bekannter Fehler in Ihren Systemen. Entdecken Sie alle unsere IT-Vorlagen, sobald sich Ihre Anforderungen ändern.
Passen Sie Ihre Workflows für jede ITAM-Phase benutzerdefiniert an – von der Bereitstellung und Konfiguration bis hin zur Wartung und Außerbetriebnahme.
Schritt 2: Klassifizieren Sie kritische Dienste
Ermitteln Sie nun, welche dieser Ressourcen geschäftskritisch sind und welche lediglich ein „Nice-to-have“ darstellen. Erstellen Sie Karten zu Service-Abhängigkeiten, die zeigen, wie Ihre Systeme miteinander verbunden sind und voneinander abhängen. Achten Sie dabei besonders auf kundenorientierte Dienste, die sich direkt auf den Umsatz oder die Benutzererfahrung auswirken.
🎥 Sehen Sie sich diese praktische Anleitung an, die zeigt, wie Sie mithilfe der leistungsstarken Features von ClickUp einen strukturierten, übergreifenden Plan erstellen – von der Festlegung von Zielen über die Zuweisung von Aufgaben bis hin zur Nachverfolgung des Fortschritts.
Schritt 3: Risiken und Bedrohungen bewerten
Bewerten Sie Risiken und Bedrohungen, indem Sie die Wahrscheinlichkeit und die Auswirkungen jeder Bedrohungsart für Ihre spezifische Situation einschätzen. Berücksichtigen Sie dabei Ihre geografischen Risiken (befinden Sie sich in einem Erdbebengebiet oder in einem Hochwassergebiet?) sowie branchenspezifische Bedrohungen (wie regulatorische Änderungen oder gezielte Cyberangriffe). Dokumentieren Sie alles in einem Risikoregister, damit Sie die Nachverfolgung im Laufe der Zeit durchführen können.

Die ClickUp-Whiteboard-Vorlage zur Risikobewertung verleiht Ihrem Risikobewertungsprozess eine visuelle Dimension. Sie unterstützt Sie bei der Bewertung und Kategorisierung von Risiken und regt Ihr Team dazu an, Erkenntnisse freizugeben und in einem ansprechenden, visuellen Format zusammenzuarbeiten.
Mit dieser Vorlage können Sie:
- Bewerten Sie Risikokategorien und potenzielle Auswirkungen
- Analysieren Sie Daten, um potenzielle Problembereiche zu identifizieren
- Legen Sie vorbeugende Maßnahmen fest, um das Risiko zu minimieren
Mit Features zum Zeichnen, Schreiben und Hinzufügen von Haftnotizen eignet sich diese Whiteboard-Vorlage für das Risikomanagement perfekt zur Bewertung der Risiken Ihres Projekts.
Schritt 4: Legen Sie RTO- und RPO-Einzelziele fest
Arbeiten Sie direkt mit Ihren Stakeholdern aus dem Geschäft zusammen, um festzulegen, welche Ausfallzeiten und welchen Datenverlust diese für jede der zuvor identifizierten Service-Stufen als akzeptabel erachten. Sie müssen die Kosten für eine schnellere Wiederherstellung gegen die geschäftlichen Auswirkungen abwägen – nicht alles erfordert eine sofortige Wiederherstellung ohne Datenverlust. Holen Sie sich die Zustimmung der Geschäftsleitung zu diesen Einzelzielen ein.
Schritt 5: Backup- und Failover-Pfade definieren
Nachdem Sie Ihre Einzelziele festgelegt haben, können Sie nun Ihre technischen Lösungen entwerfen. Erstellen Sie Backup-Strategien, die auf das RPO jedes einzelnen Systems zugeschnitten sind, und planen Sie detaillierte Failover-Verfahren, einschließlich alternativer Verarbeitungsstandorte und Notfallzugriffsmethoden. Fügen Sie Netzwerkdiagramme und Schritt-für-Schritt-Anleitungen hinzu, um eine fehlerfreie Ausführung zu gewährleisten.
Schritt 6: Rollen zuweisen und Eskalationsverfahren festlegen
Legen Sie die Struktur Ihres DR-Teams mit klaren Zuständigkeiten und Entscheidungsbefugnissen fest. Erstellen Sie umfassende Kontaktlisten mit Haupt- und Ersatzpersonal für jede Rolle. Eine RACI-Matrix (Responsible, Accountable, Consulted, Informed) ist ein hervorragendes Tool, um Verwirrung während eines stressreichen Incidents zu vermeiden.
Schritt 7: Dokumentieren und kommunizieren Sie den Plan
Dokumentieren und kommunizieren Sie den Plan mit klaren, schrittweisen Anleitungen, die jeder in Ihrem Team auch unter Druck befolgen kann. Es ist entscheidend, diese Dokumentation an einem leicht zugänglichen Speicherort zu speichern, der von Ihrer primären Infrastruktur getrennt ist. Stellen Sie sicher, dass jedes Mitglied des Teams genau weiß, wo es den Plan im Krisenfall finden kann.

Optimieren Sie Ihre Projektplanung mit der RACI-Planungsvorlage von ClickUp. Diese Dokument-Vorlage ist ein echter Game-Changer und bietet ein übersichtliches Diagramm zur Definition von Teamrollen und Verantwortlichkeiten in Bezug auf Projektaufgaben. Nutzen Sie das RACI-Framework (Responsible, Accountable, Consulted, Informed), um alle auf den gleichen Stand zu bringen und so Verantwortlichkeit sowie die Ausrichtung auf die Unternehmensziele sicherzustellen.
Schritt 8: Testen, überprüfen und verbessern
Planen Sie schließlich vierteljährliche Tests ein, um Ihre Verfahren zu überprüfen und eventuelle Lücken zu identifizieren. Dokumentieren Sie alle aus den einzelnen Tests und tatsächlichen Incidents gewonnenen Erkenntnisse und nutzen Sie diese, um Ihren Plan zu aktualisieren. Richten Sie ein systematisches System zur Nachverfolgung von Verbesserungen ein, um sicherzustellen, dass alle festgestellten Probleme behoben werden.
🌼 Wussten Sie schon: Im Jahr 2017 kam es bei Gitlab zu einem schwerwiegenden Datenbankausfall. Während der Wiederherstellung stellte das Unternehmen fest, dass mehrere seiner Backup-Methoden bereits seit Tagen unbemerkt versagt hatten. Dieser Incident hat der gesamten Tech-Branche eine wichtige Lektion erteilt: Die Überprüfung von Backups ist unverzichtbar. Ein ungetestetes Backup ist eigentlich gar kein Backup.
🌼 Wussten Sie schon: Im Jahr 2017 kam es bei Gitlab zu einem schwerwiegenden Datenbankausfall. Während der Wiederherstellung stellte das Unternehmen fest, dass mehrere seiner Backup-Methoden bereits seit Tagen unbemerkt versagt hatten. Dieser Incident hat der gesamten Tech-Branche eine wichtige Lektion erteilt: Die Überprüfung von Backups ist unverzichtbar. Ein ungetestetes Backup ist eigentlich gar kein Backup.
Strategien und Lösungen für die Notfallwiederherstellung
Nicht jedes Unternehmen benötigt denselben DR-Ansatz. Lassen Sie uns Ihre Optionen auf der Grundlage Ihres Budgets, Ihrer Wiederherstellungsanforderungen und der verfügbaren Ressourcen erkunden.
Ansatz für Backup und -wiederherstellung
Dies ist die einfachste und kostengünstigste Methode. Dabei werden regelmäßig Backups an einem externen Speicherort (z. B. in der Cloud oder in einem sekundären Rechenzentrum) erstellt und bei Bedarf manuell wiederhergestellt. Dieser Ansatz eignet sich am besten für nicht kritische Systeme, die eine längere Wiederherstellungszeit (RTO) tolerieren können, da die Wiederherstellung Stunden oder sogar Tage dauern kann.
Hochverfügbarkeit und Redundanz
Diese Strategie zielt darauf ab, einzelne Ausfallquellen durch den Einsatz mehrerer aktiver Systeme zu beseitigen. Techniken wie Lastenausgleich, Server-Clustering und RAID-Speicher stellen sicher, dass bei Ausfall einer Komponente sofort eine andere die Aufgaben übernimmt. Obwohl die Einstellung und Wartung dieses Ansatzes mit höheren Kosten verbunden ist, lassen sich Ausfallzeiten auf wenige Sekunden oder Minuten minimieren, was ihn ideal für kritische Dienste macht.
Replikations- und Failover-Optionen
Bei der Replikation werden Daten nahezu in Echtzeit an einen sekundären Standort kopiert, wodurch bei einem Notfall nur minimale Datenverluste entstehen.
- Synchrone Replikation: Schreibt Daten gleichzeitig sowohl auf den primären als auch auf den sekundären Standort und garantiert so, dass keinerlei Datenverlust entsteht. Allerdings erfordert sie eine hohe Bandbreite und kann Ihr primäres System verlangsamen.
- Asynchrone Replikation: Daten werden zunächst am Primärstandort geschrieben und anschließend mit einer geringen Verzögerung an den Sekundärstandort kopiert. Diese Methode ist kostengünstiger und hat geringere Auswirkungen auf die Leistung, allerdings gehen Sie dabei ein geringes Risiko eines Datenverlusts ein.
Cloud-basierte Notfallwiederherstellung und DRaaS
Disaster Recovery as a Service (DRaaS) ist für viele Unternehmen zu einer beliebten Wahl geworden. Es bietet eine nutzungsabhängige Abrechnung, sofortige geografische Verteilung und Automatisierung der Wiederherstellungsabläufe, ohne dass eigene physische DR-Standorte aufgebaut und gewartet werden müssen. Cloud-DR eliminiert die enormen Investitionskosten eines Backup-Rechenzentrums und bietet gleichzeitig eine schnellere Skalierbarkeit und mehr Flexibilität als herkömmliche „Hot“, „Warm“ oder „Cold Site“-Ansätze.
Wie ClickUp die Planung der IT-Notfallwiederherstellung optimiert
Die Verwaltung eines DR-Plans über verstreute Tabellenkalkulationen, Dokumente und E-Mail-Ketten hinweg birgt ein eigenes Katastrophenrisiko.
Diese Art der Arbeitsausbreitung, die Fragmentierung der Arbeit über mehrere, voneinander getrennte Tools hinweg, die nicht miteinander kommunizieren, sowie die Kontextausbreitung, bei der Teams Stunden damit verschwenden, nach Informationen zu suchen, die über verschiedene Apps und Plattformen verstreut sind, führen zu Verwirrung, veralteten Informationen und langsamen Reaktionszeiten – und das in einer Situation, in der jede Sekunde zählt.
Mit dem ClickUp Converged AI Workspace – einer einzigen, sicheren Plattform, auf der alle Ihre Arbeitsanwendungen, Daten und Workflows zusammen mit kontextbezogener KI als Intelligenzebene vereint sind – lassen sich Projektmanagement, Dokumentation und Teamkommunikation miteinander verbinden. Machen Sie Schluss mit dem Hin- und Herwechseln zwischen verschiedenen Plattformen und vereinen Sie Ihre DR-Planung, Tests und die Reaktion auf Incidents in einem einheitlichen System.
Zentralisierte DR-Dokumentation mit ClickUp Docs und integrierter KI-Unterstützung
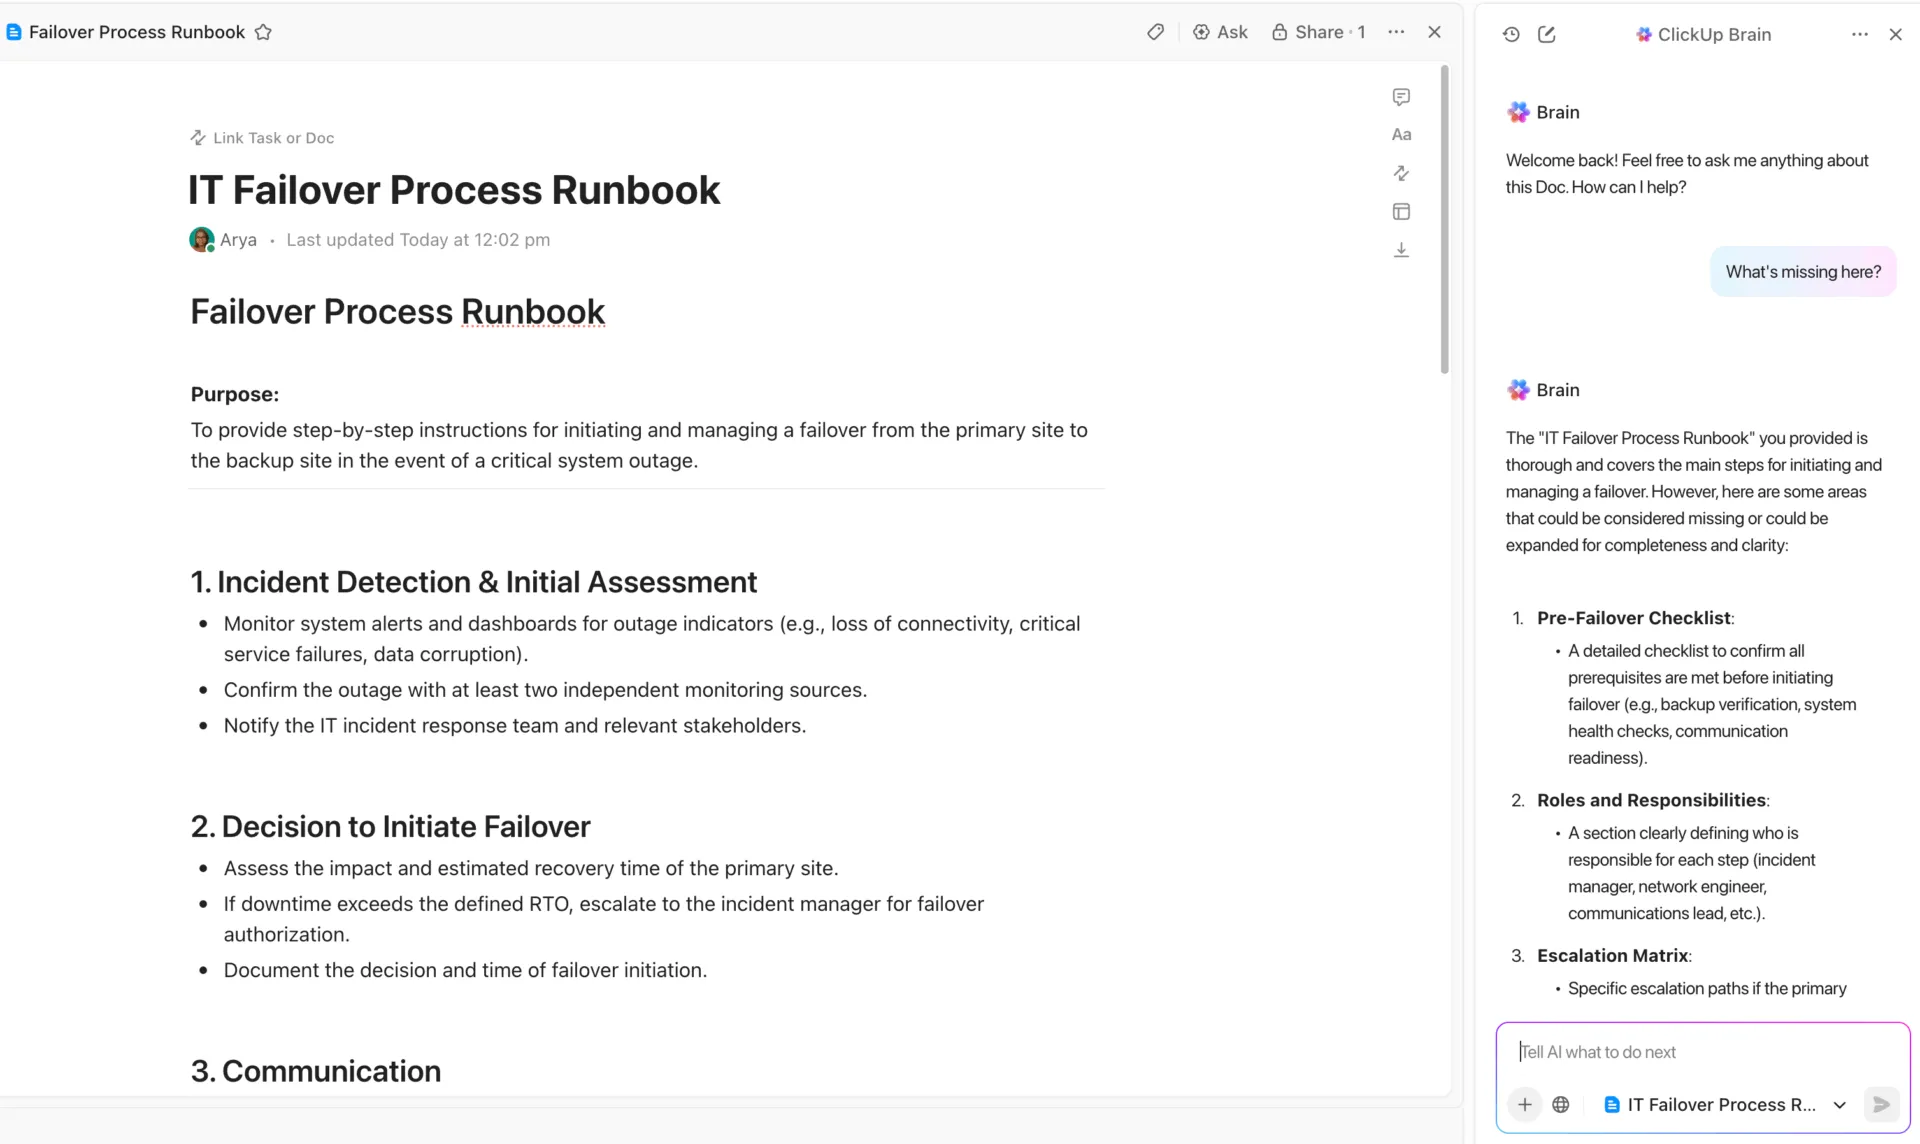
Stellen Sie mit ClickUp Docs sicher, dass Ihr Team stets über eine einzige zuverlässige Informationsquelle verfügt.
Erstellen Sie Ihren gesamten Notfallwiederherstellungsplan in einem kollaborativen Arbeitsbereich, in dem jeder während eines Incidents in Echtzeit mitwirken kann. Verknüpfen Sie Dokumente direkt mit Incident-Aufgaben und Projekten für eine nahtlose Navigation, und betten Sie Diagramme oder Runbooks ein, damit wichtige Informationen genau dort verfügbar sind, wo Sie sie benötigen.
Das Beste daran: Sie können Ihre Dokumente vor versehentlichen Bearbeitungen schützen und mithilfe der detaillierten ClickUp-Berechtigungen steuern, wer sensible Wiederherstellungsverfahren einsehen oder ändern darf. Jede Änderung wird im Verlauf des Dokuments durch die Nachverfolgung protokolliert, sodass Sie über einen lückenlosen Prüfpfad verfügen.
KI-gestützte Erstellung von Plänen mit ClickUp Brain
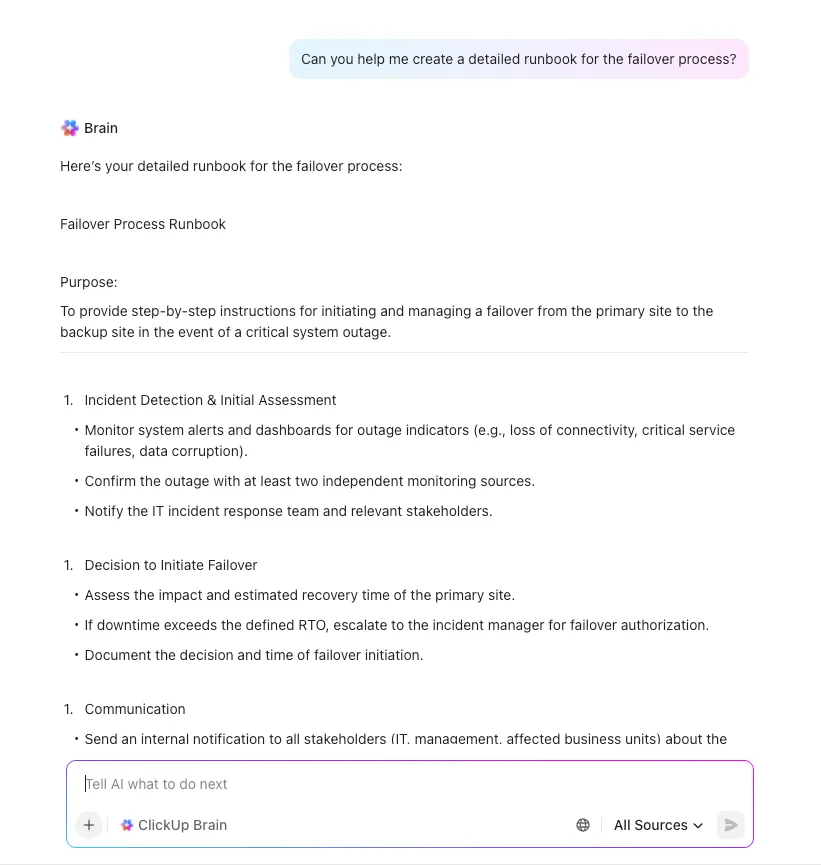
Beschleunigen Sie die Planung der Notfallwiederherstellung und schließen Sie kritische Lücken mit ClickUp Brain – Ihrem kontextbezogenen KI-Assistenten, der Ihren gesamten Arbeitsbereich versteht. Im Gegensatz zu generischen KI-Tools nutzt ClickUp Brain die tatsächlichen Aufgaben, Dokumente und Workflows Ihres Unternehmens, um präzise und umsetzbare Unterstützung für DR-Initiativen zu bieten.
Geben Sie einfach eine Anfrage wie „Erstelle eine Checkliste für die Notfallwiederherstellung unserer E-Commerce-Plattform“ in ClickUp Brain ein und erhalten Sie sofort eine umfassende, maßgeschneiderte Vorlage, die auf Ihre Systeme, Prozesse und Compliance-Anforderungen abgestimmt ist. Diese kann Ihnen bei folgenden Aufgaben helfen:
- Kontextbezogenes Verständnis: ClickUp Brain hat Zugriff auf die Struktur, den Inhalt und die Berechtigungen Ihres Arbeitsbereichs. Es kann auf Aufgaben, Dokumente, Kommentare und sogar verbundene Apps zurückgreifen und liefert so Antworten und Handlungsvorschläge, die genau auf Ihre tatsächliche Arbeit zugeschnitten sind – nicht nur allgemeine Vorschläge.
- Fehlerbehebung & Anleitung: Beheben Sie Probleme sofort, erhalten Sie Schritt-für-Schritt-Anleitungen oder fragen Sie nach Best Practices zu jedem ClickUp-Feature. Brain kann Sie durch komplexe Prozesse führen, wiederholende Aufgaben automatisieren und Ihnen helfen, Hindernisse zu beseitigen.
- Automatisierung und Beschleunigung von Workflows: Nutzen Sie vorgefertigte oder benutzerdefinierte KI-Agenten, um mehrstufige Workflows zu automatisieren, Anfragen zu priorisieren oder wiederkehrende Aufgaben zu verwalten – und sparen Sie so jede Woche mehrere Stunden Zeit.
- Erweiterte Suche: Finden Sie Informationen, die irgendwo in Ihrem Workspace verborgen sind – einschließlich Aufgaben, Dokumenten und integrierten Tools –, selbst wenn diese schon Jahre alt sind oder mit der Standardsuche nur schwer an ihren Speicherort zu finden sind.
- Echtzeit-Zusammenfassungen und -Updates: Erstellen Sie sofort Projekt-Updates, Meeting-Protokolle oder Berichte über den Fortschritt auf der Grundlage von Live-Daten aus dem Workspace.
- Vereinfachung der technischen Dokumentation: Wandeln Sie komplexe technische Dokumente in klare, umsetzbare Anleitungen oder Checklisten um, an die sich Ihr Team auch unter Zeitdruck halten kann.
- Multi-Modell-Intelligenz: Wählen Sie aus führenden KI-Modellen (OpenAI GPT-4.1, GPT-5, Claude, Gemini und mehr), um bei jeder Aufgabe die besten Ergebnisse zu erzielen – ohne separate Abonnements.
- Sicherheit und berechtigungsbasierte Steuerung: Brain greift nur auf Informationen zu, für deren Einsicht Sie bereits eine Berechtigung besitzen, und gewährleistet so strenge Standards im Bereich des Datenschutzes und der Compliance.
- Unterhaltung-basierte Benutzeroberfläche: Verwenden Sie @brain in Kommentaren oder beim Chatten, um kontextbezogene Einblicke zu erhalten, Antwortentwürfe zu erstellen oder als Auslöser für Automatisierungen zu verwenden, ohne Ihren Workflow zu unterbrechen.
- Benutzerdefinierte Eingabeaufforderungen und gespeicherte Workflows: Speichern und verwenden Sie Eingabeaufforderungen für wiederkehrende Aufgaben erneut, um Konsistenz zu gewährleisten und Ihrem gesamten Team Zeit zu sparen.
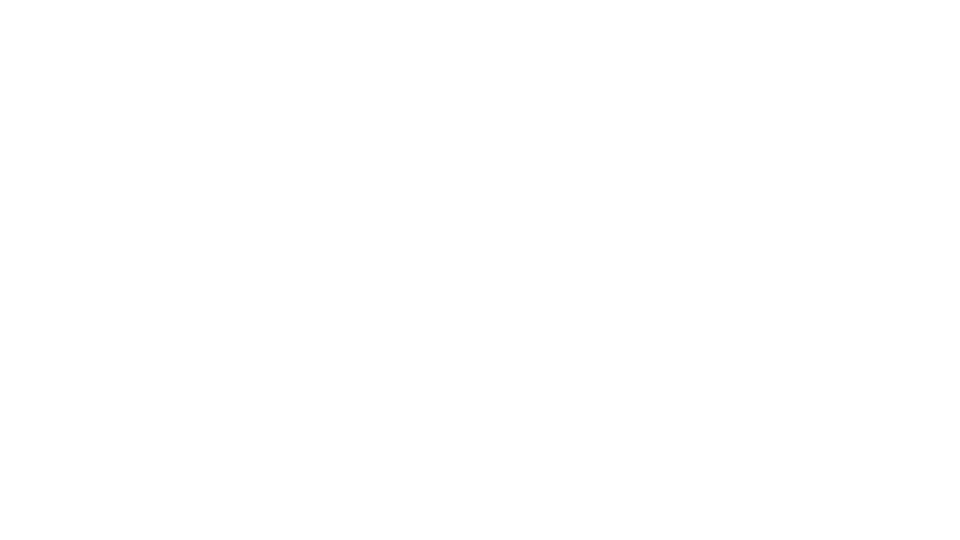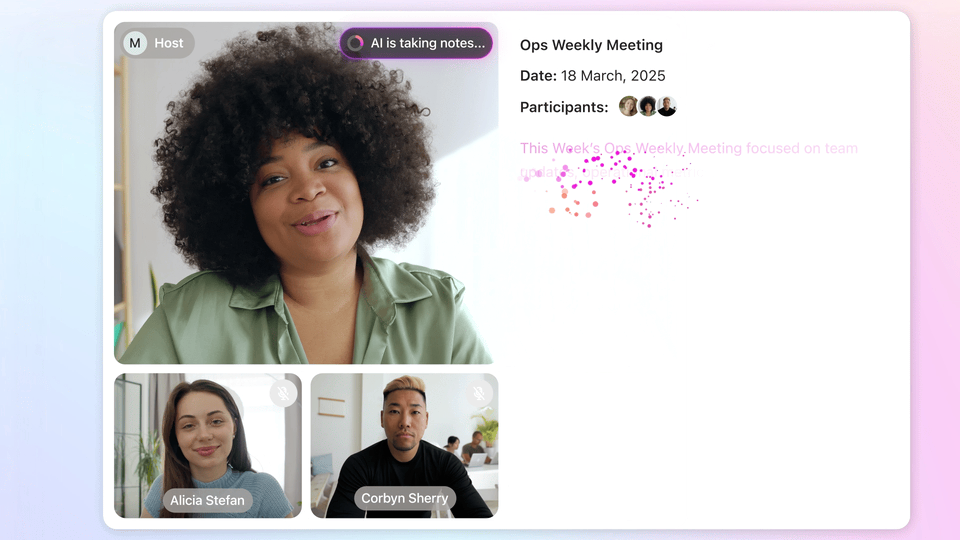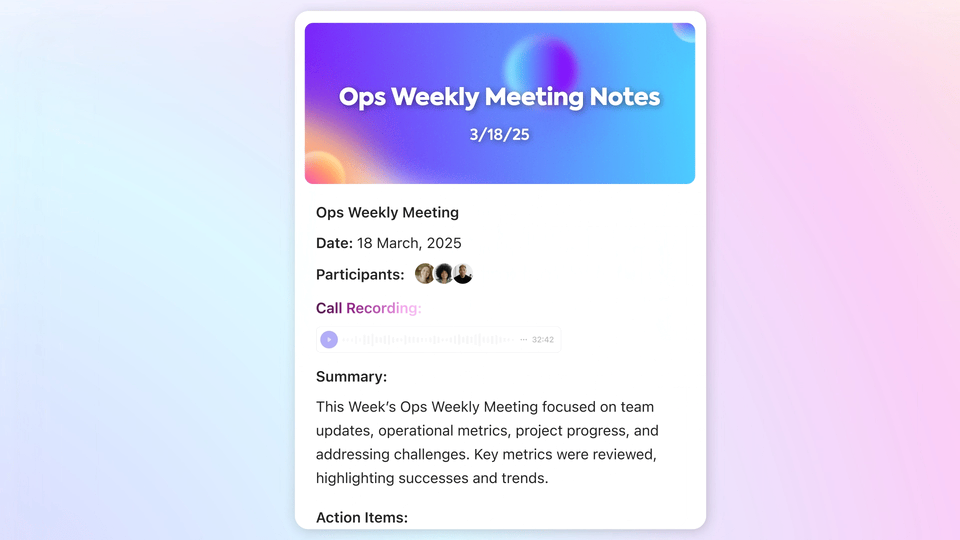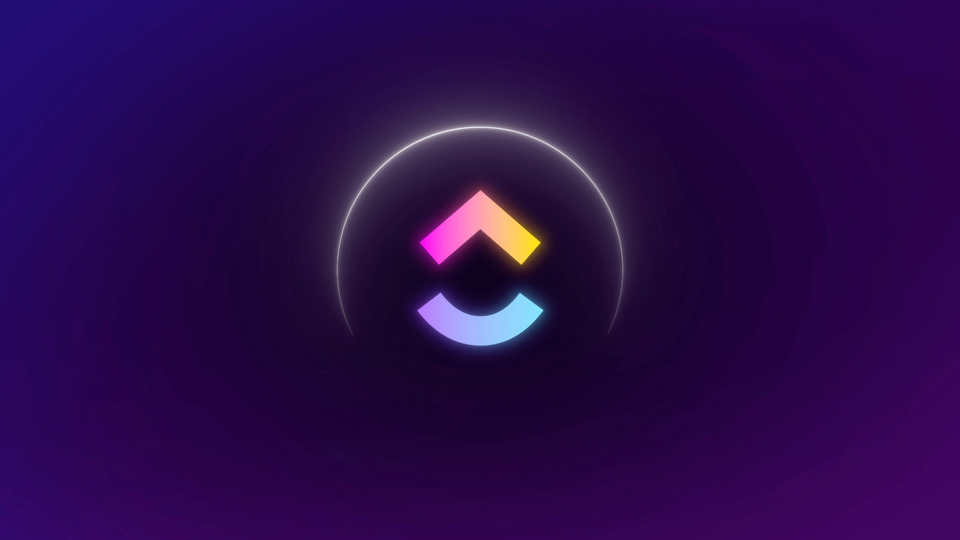
💡Profi-Tipp: Verpassen Sie keine Erkenntnisse aus Ihren Meetings zur Vorfallauswertung, indem Sie jedes Detail mit dem ClickUp AI Notetaker festhalten. Er kann an Ihren virtuellen Meetings teilnehmen, die gesamte Diskussion transkribieren und automatisch eine Liste mit Maßnahmen aus den gewonnenen Erkenntnissen erstellen. So entsteht ein durchsuchbarer Vorfallverlauf, sodass Sie schnell auf vergangene Ereignisse und deren Lösungen zurückgreifen können.
Automatisierte DR-Workflows mit ClickUp-Automatisierungen
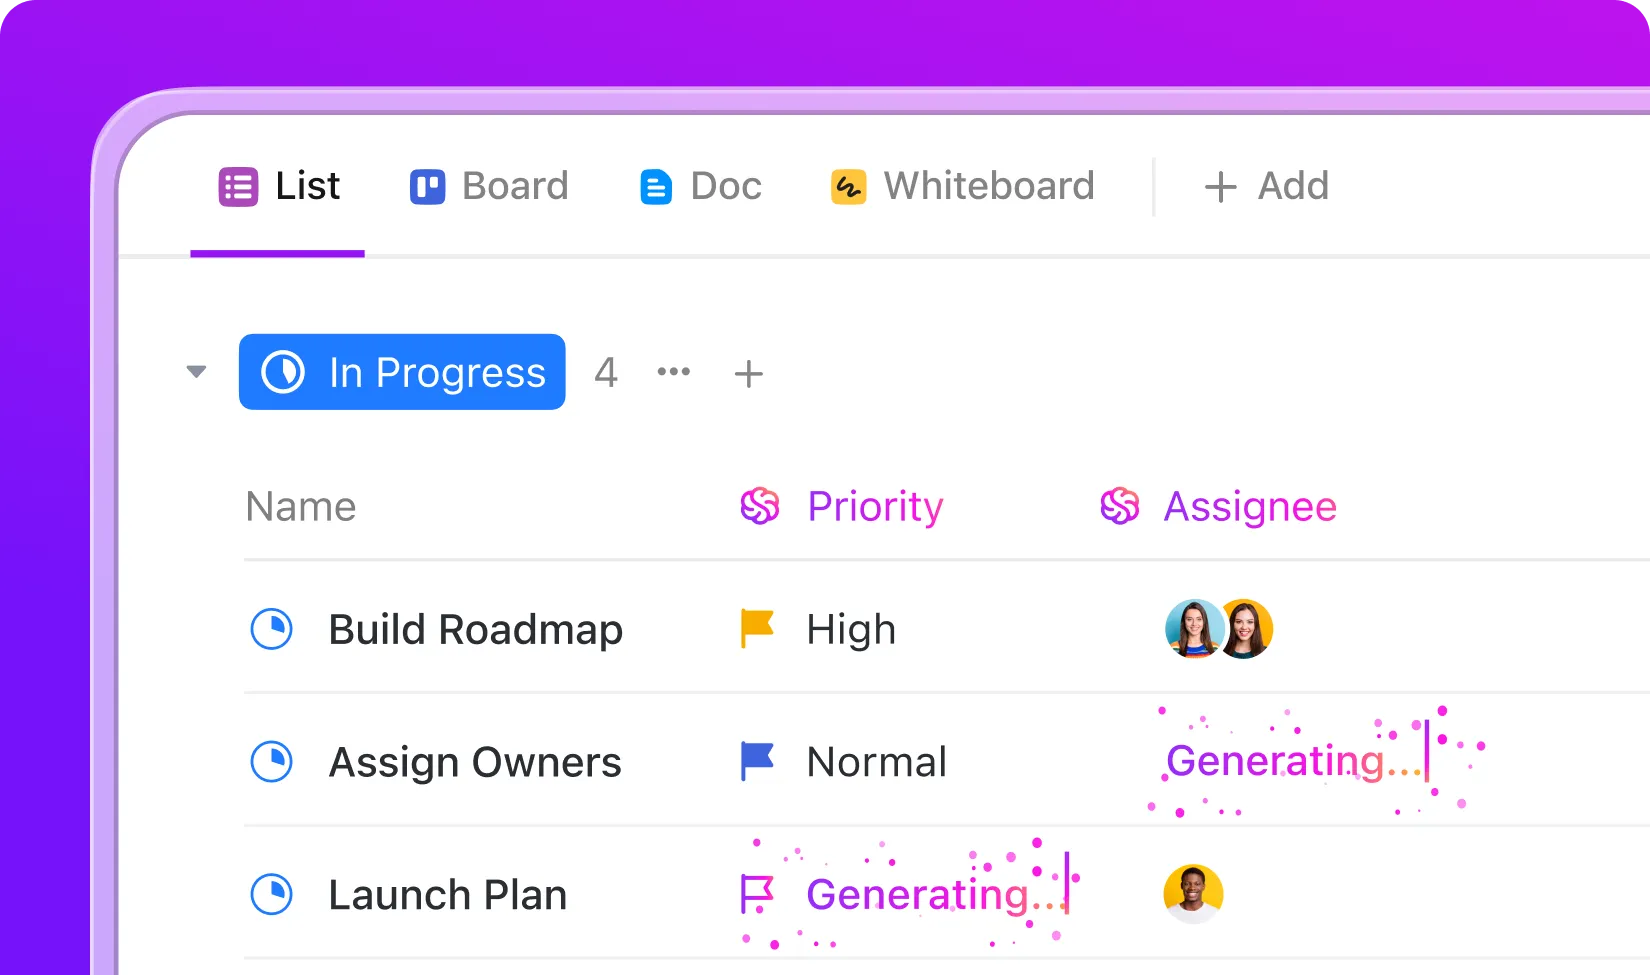
Stellen Sie sich vor, Ihr Team ist mit einem plötzlichen Ausfall konfrontiert – jede Sekunde zählt, und Sie können es sich nicht leisten, auch nur einen einzigen Schritt zu übersehen. Mit den ClickUp AI-Agenten und Automatisierungen müssen Sie nicht mehr hektisch reagieren oder sich auf Ihr Gedächtnis verlassen. Sobald ein Incident gemeldet wird, springt die KI von ClickUp ein, leitet Ihr Team an und übernimmt die Routineaufgaben, sodass Sie sich auf die Lösung des Problems konzentrieren können.
So funktioniert es in einem realen Szenario:
- Wenn jemand eine Aufgabe als „Incident gemeldet“ markiert, erstellt ClickUp Agent automatisch eine Checkliste mit Schritten, weist diese den richtigen Personen zu und startet einen Timer, um die Nachverfolgung der Dauer der Wiederherstellung durchzuführen.
- Wenn der Incident als „kritisch“ eingestuft wird, kann ein Agent sofort eine Warn-E-Mail an Ihr Führungsteam senden und einen speziellen Chatraum – Ihren „Kriegsraum“ – einrichten, damit alle an einem Ort chatten können.
- Die KI kann frühere Berichte über Incidents und relevante Unterlagen abrufen, sodass Ihr Team alles, was es benötigt, sofort zur Hand hat.
Sehen Sie sich den Workflow hier an:
Mit den ClickUp AI-Agenten erhalten Sie einen zuverlässigen digitalen Teamkollegen, der Ihrem Team hilft, ruhig, organisiert und effektiv zu bleiben – selbst unter Druck.
Echtzeit-Nachverfolgung mit ClickUp-Dashboards
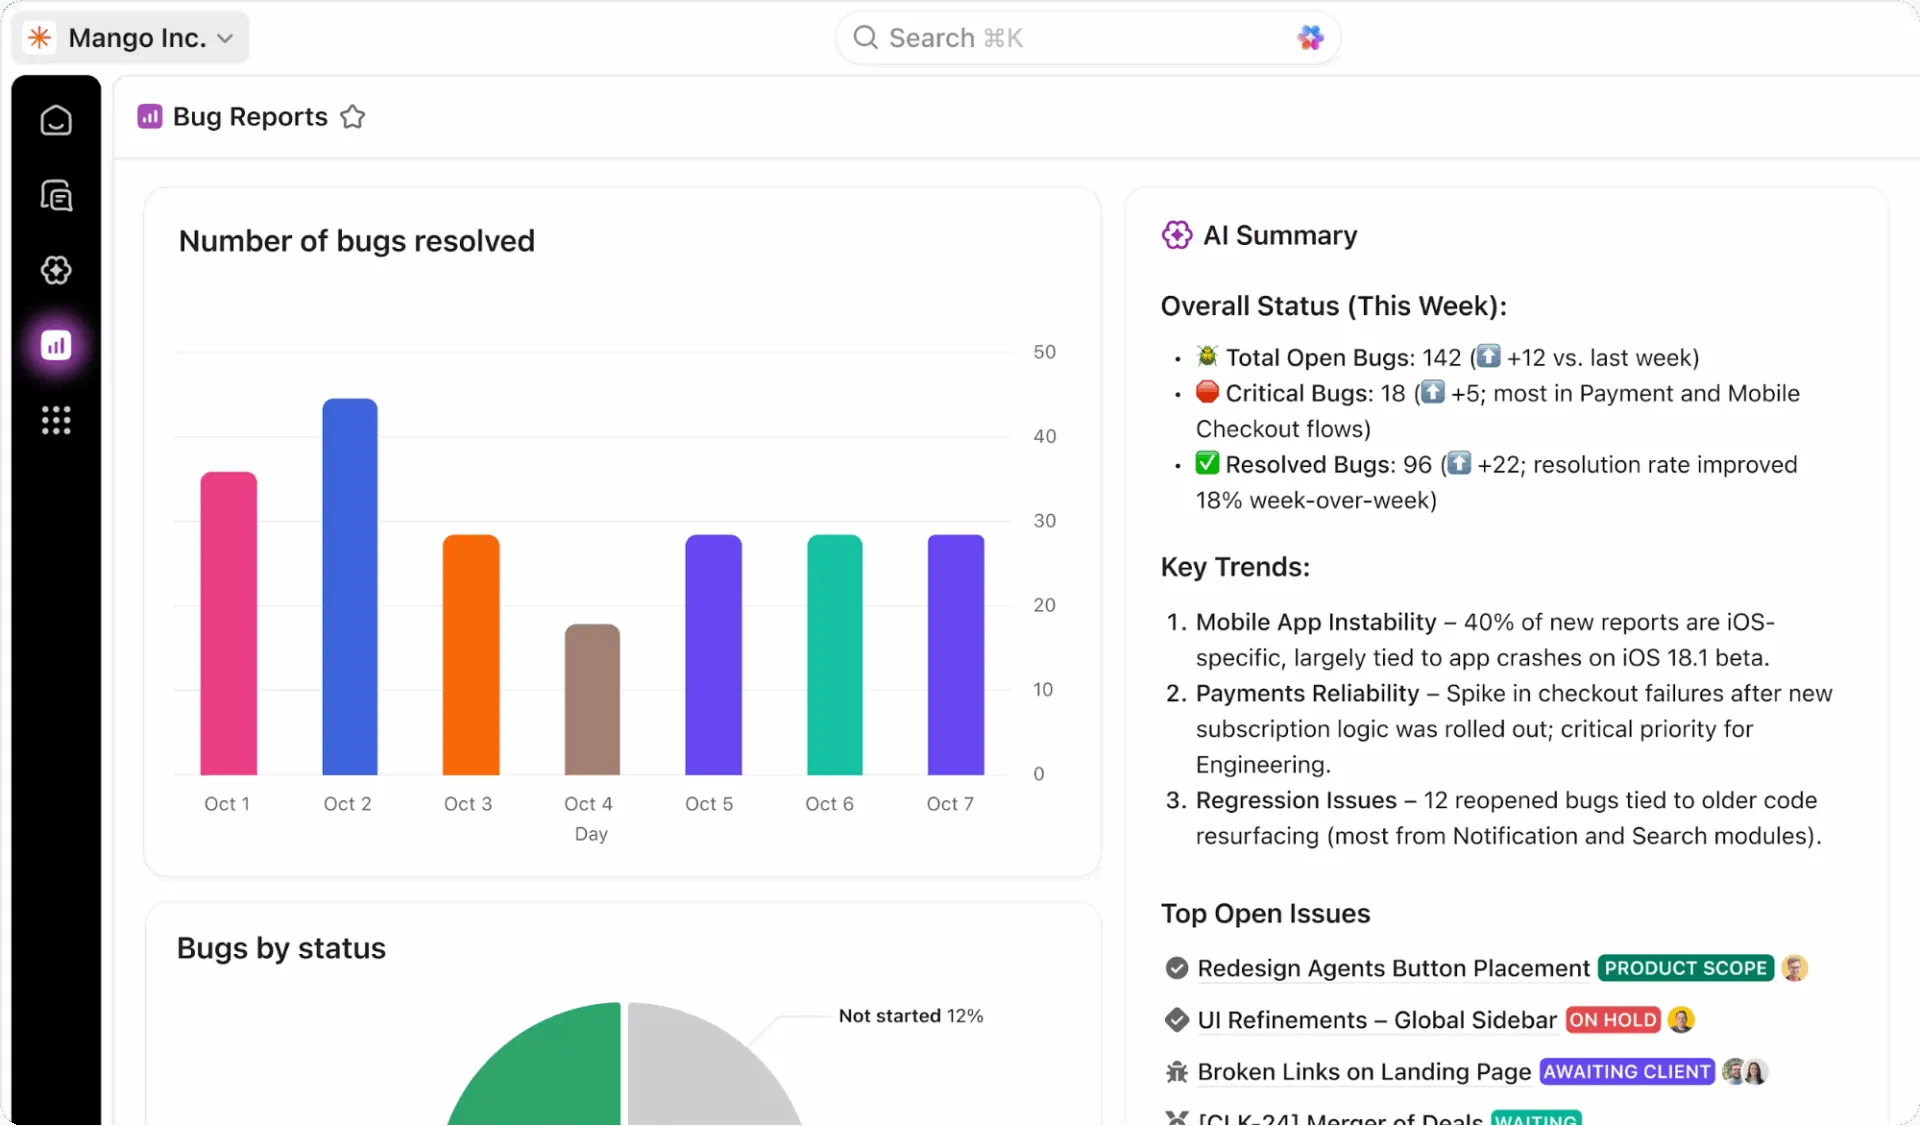
Verschaffen Sie sich eine umfassende Sichtbarkeit über den Zustand Ihres DR-Programms, indem Sie mit ClickUp-Dashboards alles in Echtzeit verfolgen. Sie können Widgets erstellen, um die RTO- und RPO-Leistung während der Tests zu überwachen, die Abschlussquoten der Tests zu verfolgen und Trends bei Incidents im Zeitverlauf anzuzeigen.
Fügen Sie Ihren Aufgaben benutzerdefinierte ClickUp-Felder hinzu, um die Systemkritikalität, den Wiederherstellungsstatus und die Testergebnisse zu verfolgen, und führen Sie anschließend alle diese Daten in einer übersichtlichen Gesamtansicht zusammen. Diese Dashboards liefern Ihnen für die Führungsebene geeignete Berichte, die dank Echtzeitdaten aus den Test- und Vorfallreaktionsaktivitäten Ihres Teams stets auf dem neuesten Stand sind.
📖 Weiterlesen: So erstellen Sie eine Checkliste für die Risikobewertung
Erstellen Sie noch heute Ihren DR-Plan
Jeder Tag, an dem Sie ohne einen DR-Plan arbeiten, ist ein Glücksspiel, das Sie sich nicht leisten können zu verlieren. Katastrophen sind unvermeidlich – sei es durch Naturereignisse, technische Ausfälle oder Fehler –, aber Ihre Vorbereitung entscheidet darüber, ob sie zu geringfügigen Unannehmlichkeiten oder zu schweren Katastrophen werden.
Ein umfassender DR-Plan erfordert, dass Sie Ihre Risiken kennen, klare Verfahren dokumentieren und diese regelmäßig testen. Die richtigen tools machen diesen Prozess überschaubar, indem sie das Chaos durch verstreute Dokumente und manuelle Prozesse beseitigen.
Selbst einfache Notfallpläne sind besser als gar keine, wenn eine Katastrophe eintritt. Durch regelmäßige Tests und Aktualisierungen verwandeln Sie Ihren DR-Plan von einem verstaubten Dokument in ein lebendiges System, das Ihr Geschäft wirklich schützt.
Machen Sie den ersten Schritt und beginnen Sie noch heute mit der Erstellung Ihres DR-Plans mit ClickUp. Starten Sie kostenlos mit ClickUp und vereinen Sie Ihre gesamte Planung für die Notfallwiederherstellung, Dokumentation und Reaktion auf Incidents auf einer einheitlichen Plattform. ✨
Häufig gestellte Fragen
Wie oft sollten Teams eine Vorlage für einen IT-Notfallwiederherstellungsplan aktualisieren?
Sie sollten Ihren DR-Plan mindestens viermal im Jahr überprüfen und ihn unmittelbar nach wesentlichen Änderungen an der Infrastruktur oder nach tatsächlichen Incidents aktualisieren. Die meisten Unternehmen führen jährlich eine umfassende, gründliche Überarbeitung durch, um alle gewonnenen Erkenntnisse einzubeziehen und sich an neue Technologien anzupassen.
Welche Teams sind für die Dokumentation und das Testen der Notfallwiederherstellung zuständig?
IT-Teams, Teams für Sicherheit und Planer für Geschäftskontinuität leiten in der Regel den Aufwand für die Planung und das Testen von Notfallplänen. Sie benötigen jedoch wichtige Inputs von Führungskräften aus dem operativen Bereich und den Geschäftsbereichen, um sicherzustellen, dass der Plan den tatsächlichen geschäftlichen Anforderungen und Prioritäten entspricht.
Wie führen wir die Nachverfolgung von RTO und RPO während Disaster-Recovery-Tests durch?
Verwenden Sie Stoppuhren und eindeutige Zeitstempel, um bei jedem Test die tatsächlichen Wiederherstellungszeiten mit Ihren definierten Einzelzielen zu vergleichen. Es ist entscheidend, etwaige Abweichungen zwischen Ihrem Einzelziel und der tatsächlichen Leistung in Ihren Testberichten zu dokumentieren, um daraus Leiten für zukünftige Verbesserungen abzuleiten.
Welche Tools helfen dabei, einen Notfallwiederherstellungsplan zu dokumentieren und zu automatisieren?
Projektmanagement-Plattformen wie ClickUp eignen sich ideal, um die Dokumentation zu zentralisieren, Workflows zu automatisieren und Metriken für Ihr gesamtes DR-Programm zu verfolgen. Sie können diese dann mit spezialisierten DR-Tools kombinieren, die die technischen Aspekte der Datenreplikation und des System-Failovers abdecken.