
Os projetos de treinamento de IA raramente falham no nível do modelo. Eles enfrentam dificuldades quando os experimentos, a documentação e as atualizações para as partes interessadas ficam espalhados por muitas ferramentas diferentes.
Este guia orienta você passo a passo no treinamento de modelos com o Databricks DBRX — um LLM que é até duas vezes mais eficiente em termos de computação do que outros modelos líderes —, mantendo o trabalho relacionado a ele organizado no ClickUp.
Da configuração e ajuste fino à documentação e atualizações entre equipes, você verá como um único espaço de trabalho integrado ajuda a eliminar a dispersão de contexto e mantém sua equipe focada na criação, e não na busca por informações. 🛠
O que é o DBRX?
O DBRX é um modelo de linguagem de grande porte (LLM) poderoso e de código aberto, projetado especificamente para o treinamento e a inferência de modelos de IA corporativos. Por ser de código aberto sob a Licença de Modelo Aberto da Databricks, sua equipe tem acesso total aos pesos e à arquitetura do modelo, permitindo que você o inspecione, modifique e implante da maneira que desejar.
Ele está disponível em duas versões: o DBRX Base, para pré-treinamento profundo, e o DBRX Instruct, para tarefas prontas para uso que envolvem seguir instruções.
Arquitetura do DBRX e projeto de “mistura de especialistas”
O DBRX resolve tarefas usando uma arquitetura de Mistura de Especialistas (MoE). Ao contrário dos grandes modelos de linguagem tradicionais, que utilizam todos os seus bilhões de parâmetros para cada cálculo, o DBRX ativa apenas uma fração de seus parâmetros totais (os especialistas mais relevantes) para qualquer tarefa específica.
Pense nisso como uma equipe de especialistas; em vez de todos trabalharem em todos os problemas, o sistema direciona de forma inteligente cada tarefa para os parâmetros mais adequados.
Isso não apenas reduz o tempo de resposta, mas também oferece desempenho e resultados de alto nível, ao mesmo tempo em que reduz significativamente os custos computacionais.
Aqui está uma rápida visão geral de suas principais especificações:
- Total de parâmetros: 132 bilhões em todos os especialistas
- Parâmetros ativos: 36 bilhões por passagem de avanço
- Número de especialistas: 16 no total (roteamento MoE Top-4), com 4 ativos para qualquer token específico
- Janela de contexto: 32 mil tokens
Especificações dos dados de treinamento e dos tokens do DBRX
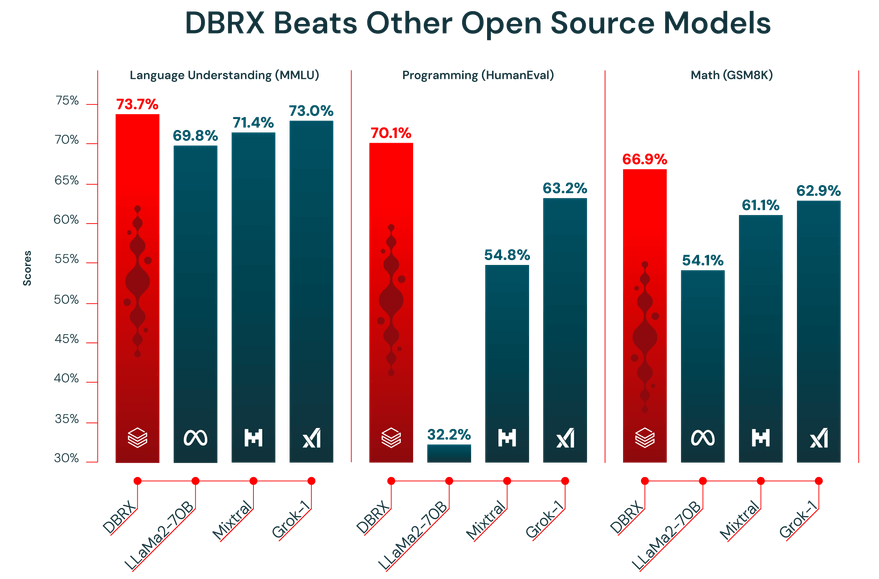
O desempenho de um LLM depende da qualidade dos dados com os quais ele foi treinado. O DBRX foi pré-treinado em um enorme conjunto de dados de 12 trilhões de tokens, cuidadosamente selecionado pela equipe da Databricks usando suas ferramentas avançadas de processamento de dados. É exatamente por isso que ele apresentou um desempenho sólido nos benchmarks do setor.
Além disso, o DBRX possui uma janela de contexto de 32.000 tokens. Essa é a quantidade de texto que o modelo pode considerar de uma só vez. Uma janela de contexto ampla é extremamente útil para tarefas complexas, como resumir relatórios longos, analisar documentos jurídicos extensos ou construir sistemas avançados de geração aumentada por recuperação (RAG), pois permite que o modelo mantenha o contexto sem truncar ou esquecer informações.
🎥 Assista a este vídeo para ver como uma coordenação de projetos mais ágil pode transformar seu fluxo de trabalho de treinamento de IA e eliminar o atrito causado pela alternância entre ferramentas desconectadas. 👇🏽
Como acessar e configurar o DBRX
O DBRX oferece duas formas principais de acesso, ambas proporcionando acesso total aos pesos do modelo sob condições comerciais flexíveis. Você pode usar o Hugging Face para obter o máximo de flexibilidade ou acessá-lo diretamente pelo Databricks para uma experiência mais integrada.
Acesse o DBRX pelo Hugging Face
Para equipes que valorizam a flexibilidade e já estão familiarizadas com o ecossistema do Hugging Face, acessar o DBRX por meio do Hub é a melhor opção. Isso permite que você integre o modelo aos seus fluxos de trabalho existentes baseados em transformers.
Veja como começar:
- Crie ou faça login na sua conta do Hugging Face
- Acesse o cartão do modelo DBRX no Hub e aceite os termos da licença
- Instale a biblioteca transformers juntamente com as dependências necessárias, como o accelerate
- Use a classe `AutoModelForCausalLM` em seu script Python para carregar o modelo do DBRX
- Configure seu pipeline de inferência, lembrando-se de que o DBRX requer uma quantidade significativa de memória da GPU (VRAM) para funcionar de maneira eficaz
📖 Leia mais: Como configurar a temperatura do LLM
Acesse o DBRX pelo Databricks
Se sua equipe já usa o Databricks para engenharia de dados ou aprendizado de máquina, acessar o DBRX por meio da plataforma é a maneira mais fácil. Isso elimina os obstáculos da configuração e oferece todas as ferramentas necessárias para MLOps exatamente onde você já está trabalhando.
Siga estas etapas em seu espaço de trabalho do Databricks para começar:
- Acesse a seção Model Garden ou Mosaic AI
- Escolha entre o DBRX Base ou o DBRX Instruct, dependendo das suas necessidades
- Configure um endpoint de serviço para acesso à API ou configure um ambiente de notebook para uso interativo
- Comece a testar a inferência com prompts de exemplo para garantir que tudo esteja funcionando corretamente antes de ampliar o treinamento ou a implantação do seu modelo de IA
Essa abordagem oferece acesso integrado a ferramentas como o MLflow para acompanhamento de experimentos e o Unity Catalog para governança de modelos.
📮 ClickUp Insight: O profissional médio passa mais de 30 minutos por dia procurando informações relacionadas ao trabalho — isso significa mais de 120 horas por ano perdidas vasculhando e-mails, conversas no Slack e arquivos espalhados.
Um assistente inteligente de IA integrado ao seu espaço de trabalho pode mudar isso. Conheça o ClickUp Brain.
Ele oferece insights e respostas instantâneas, exibindo os documentos, conversas e detalhes de tarefas certos em segundos — para que você possa parar de procurar e começar a trabalhar.
Como ajustar o DBRX e treinar modelos de IA personalizados
Um modelo pronto para uso, por mais poderoso que seja, nunca compreenderá as nuances específicas do seu negócio. Como o DBRX é de código aberto, você pode ajustá-lo para criar um modelo personalizado que fale a linguagem da sua empresa ou execute uma tarefa específica que você gostaria que ele realizasse.
Aqui estão três maneiras comuns de fazer isso:
1. Faça o ajuste fino do DBRX com conjuntos de dados do Hugging Face
Para equipes que estão começando ou trabalhando em tarefas comuns, os conjuntos de dados públicos do Hugging Face Hub são um ótimo recurso. Eles já vêm pré-formatados e são fáceis de carregar, o que significa que você não precisa passar horas preparando seus dados.
O processo é bem simples:
- Encontre um conjunto de dados no Hub que corresponda à sua tarefa (por exemplo, seguir instruções, resumo)
- Carregue-o usando a biblioteca de conjuntos de dados
- Certifique-se de que os dados estejam formatados em pares de instrução-resposta
- Configure seu script de treinamento com hiperparâmetros como taxa de aprendizado e tamanho do lote
- Inicie o processo de treinamento, certificando-se de salvar pontos de verificação periodicamente
- Avalie o modelo ajustado em um conjunto de validação reservado para medir a melhoria
2. Faça o ajuste fino do DBRX com conjuntos de dados locais
Normalmente, você obtém os melhores resultados ao fazer o ajuste fino com seus próprios dados proprietários. Isso permite que você ensine ao modelo a terminologia, o estilo e o conhecimento de domínio específicos da sua empresa. Lembre-se, porém, de que isso só vale a pena se seus dados estiverem limpos, bem preparados e tiverem volume suficiente.
Siga estas etapas para preparar seus dados internos:
- Coleta de dados: Reúna exemplos de alta qualidade a partir de seus wikis internos, documentos e bancos de dados
- Conversão de formato: Estruture seus dados em um formato consistente de instrução-resposta, geralmente como linhas JSON
- Filtragem de qualidade: Remova quaisquer exemplos de baixa qualidade, duplicados ou irrelevantes
- Divisão para validação: Reserve uma pequena parte dos seus dados (normalmente de 10% a 15%) para avaliar o desempenho do modelo
- Revisão de privacidade: Remova ou oculte quaisquer informações de identificação pessoal (PII) ou dados confidenciais
3. Faça o ajuste fino do DBRX com o StreamingDataset
Se o seu conjunto de dados acabar sendo grande demais para caber na memória da sua máquina, não se preocupe: você pode usar a biblioteca Streaming Dataset do Databricks. Ela permite que você transmita dados diretamente do armazenamento em nuvem enquanto o modelo está sendo treinado, em vez de carregar tudo na memória de uma só vez.
Veja como você pode fazer isso:
- Preparação de dados: Limpe e estruture seus dados de treinamento e, em seguida, armazene-os em um formato transmissível, como JSONL ou CSV, em um armazenamento na nuvem
- Conversão de formato para streaming: Converta seu conjunto de dados para um formato compatível com streaming, como o Mosaic Data Shard (MDS), para que ele possa ser lido com eficiência durante o treinamento
- Configuração do carregador de treinamento: Configure seu carregador de treinamento para apontar para o conjunto de dados remoto e defina um cache local para armazenamento temporário de dados
- Inicialização do modelo: Inicie o processo de ajuste fino do DBRX usando uma estrutura de treinamento compatível com o StreamingDataset, como o LLM Foundry
- Treinamento baseado em streaming: execute a tarefa de treinamento enquanto os dados são transmitidos em lotes durante o treinamento, em vez de serem carregados inteiramente na memória
- Pontos de verificação e recuperação: Retome o treinamento sem interrupções caso uma execução seja interrompida, sem duplicar ou pular dados
- Avaliação e implantação: Valide o desempenho do modelo ajustado e implante-o usando sua configuração preferida de serviço ou inferência
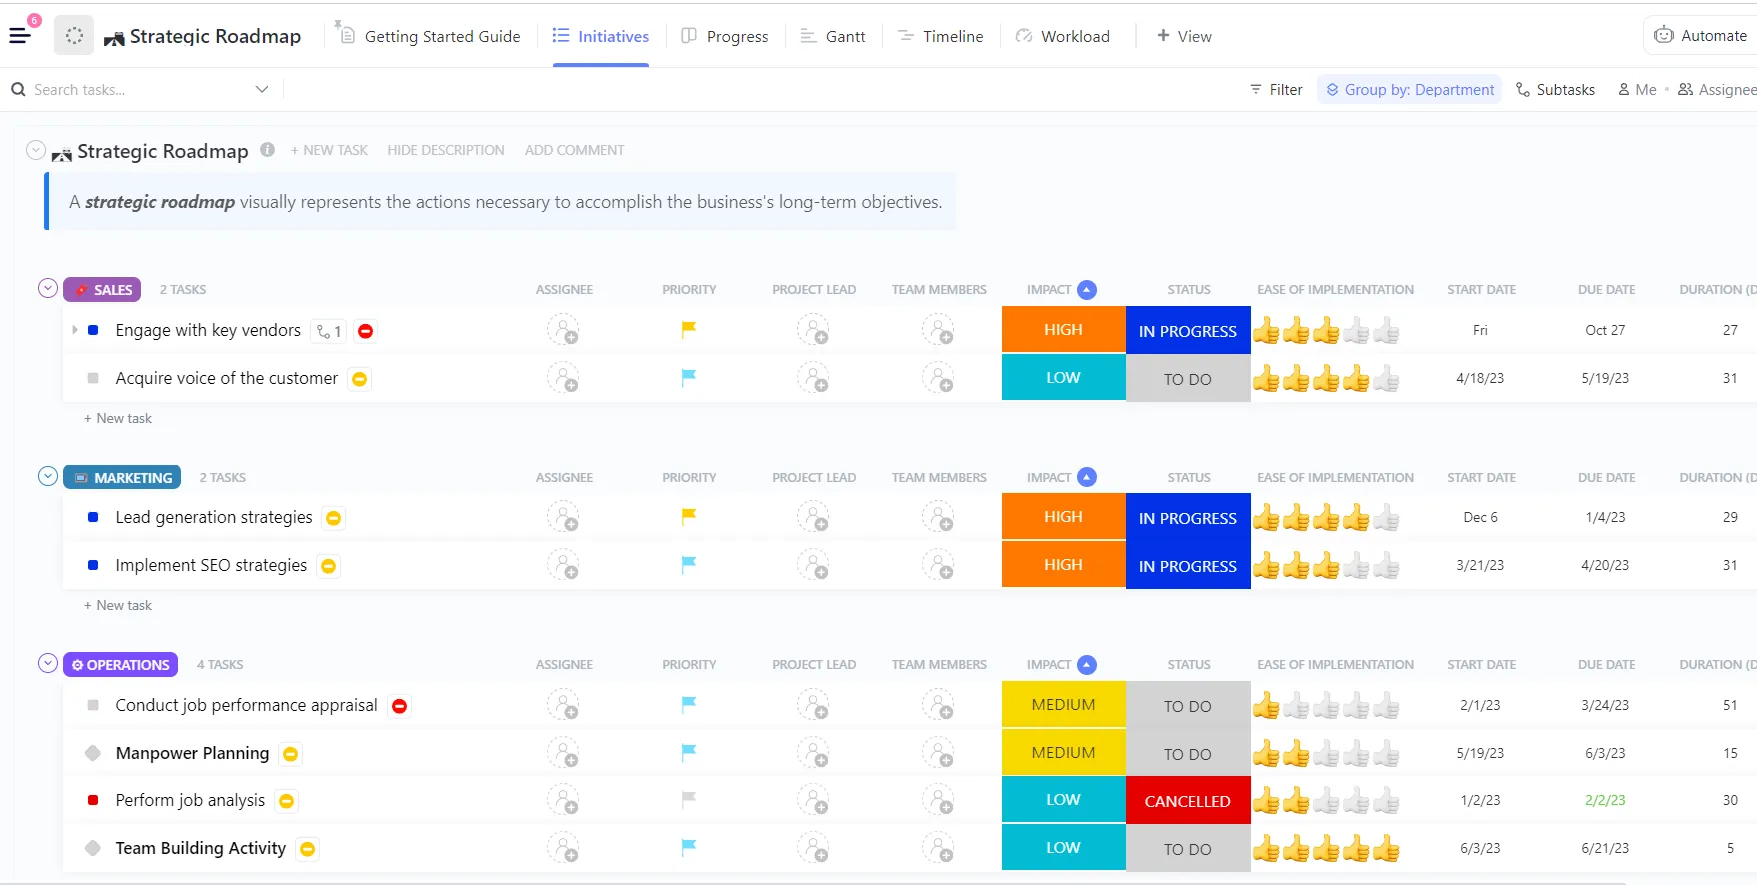
💡Dica profissional: Em vez de criar um plano de treinamento do DBRX do zero, comece com o Modelo de Roteiro para Projetos de IA e Aprendizado de Máquina do ClickUp e adapte-o às necessidades da sua equipe. Ele oferece uma estrutura clara para o planejamento de conjuntos de dados, fases de treinamento, avaliação e implantação, para que você possa se concentrar em organizar seu trabalho em vez de estruturar um fluxo de trabalho.
Casos de uso do DBRX para treinamento de modelos de IA
Uma coisa é ter um modelo poderoso, mas outra é saber exatamente onde ele se destaca.
Quando você não tem uma visão clara dos pontos fortes de um modelo, é fácil desperdiçar tempo e recursos tentando fazê-lo funcionar em situações nas quais ele simplesmente não se encaixa. Isso leva a resultados abaixo do esperado e à frustração.
A arquitetura exclusiva do DBRX e seus dados de treinamento o tornam excepcionalmente adequado para diversos casos de uso corporativos importantes. Conhecer esses pontos fortes ajuda você a alinhar o modelo aos seus objetivos de negócios e maximizar o retorno sobre o investimento.
Geração de texto e criação de conteúdo
O DBRX Instruct foi cuidadosamente otimizado para seguir instruções e gerar textos de alta qualidade. Isso o torna uma ferramenta poderosa para automatizar uma ampla gama de tarefas relacionadas a conteúdo. Sua ampla janela de contexto é uma vantagem significativa, permitindo que ele lide com documentos longos sem perder o fio da meada.
Você pode usá-lo para:
- Documentação técnica: Gere e aprimore manuais de produtos, referências de API e guias do usuário
- Conteúdo de marketing: rascunhos de posts de blog, boletins informativos por e-mail e atualizações nas redes sociais
- Geração de relatórios: resuma descobertas complexas a partir de dados e crie resumos executivos concisos
- Tradução e localização: Adapte o conteúdo existente para novos mercados e públicos
Tarefas de geração de código e depuração
Uma parte significativa dos dados de treinamento do DBRX incluía código, tornando-o um suporte LLM capaz para desenvolvedores. Ele pode ajudar a acelerar os ciclos de desenvolvimento ao automatizar tarefas repetitivas de codificação e auxiliar na resolução de problemas complexos.
Veja algumas maneiras pelas quais sua equipe de engenharia pode aproveitar essa ferramenta:
- Autocompletar código: Gere automaticamente corpos de funções a partir de comentários ou docstrings
- Detecção de bugs: analise trechos de código para identificar possíveis erros ou falhas lógicas
- Explicação do código: Traduzir algoritmos complexos ou código legado para uma linguagem simples
- Geração de testes: Crie testes de unidade com base na assinatura de uma função e no comportamento esperado
RAG e aplicações com contexto extenso
A Geração Aumentada por Recuperação (RAG) é uma técnica poderosa que baseia as respostas de um modelo nos dados privados da sua empresa. No entanto, os sistemas RAG frequentemente enfrentam dificuldades com modelos que possuem janelas de contexto pequenas, o que obriga a um particionamento agressivo dos dados, podendo resultar na perda de contexto importante. A janela de contexto de 32K do DBRX o torna uma excelente base para aplicações RAG robustas.
Isso permite que você crie ferramentas internas poderosas, como:
- Pesquisa corporativa: Crie um chatbot que responda às perguntas dos funcionários usando sua base de conhecimento interna
- Suporte ao cliente: Crie um agente que gere respostas de suporte com base na documentação do seu produto
- Assistência à pesquisa: Desenvolva uma ferramenta capaz de sintetizar informações de centenas de páginas de artigos científicos
- Verificação de conformidade: verifique automaticamente se os textos de marketing estão em conformidade com as diretrizes internas da marca ou com documentos regulatórios
Como integrar o treinamento do DBRX ao fluxo de trabalho da sua equipe
Um projeto bem-sucedido de treinamento de modelos de IA envolve muito mais do que apenas código e recursos computacionais. Trata-se de um esforço colaborativo que envolve engenheiros de aprendizado de máquina, cientistas de dados, gerentes de produto e partes interessadas.
Quando essa colaboração fica espalhada por notebooks do Jupyter, canais do Slack e ferramentas de gerenciamento de projetos separadas, você cria uma dispersão de contexto, uma situação em que informações críticas do projeto ficam espalhadas por um número excessivo de ferramentas.
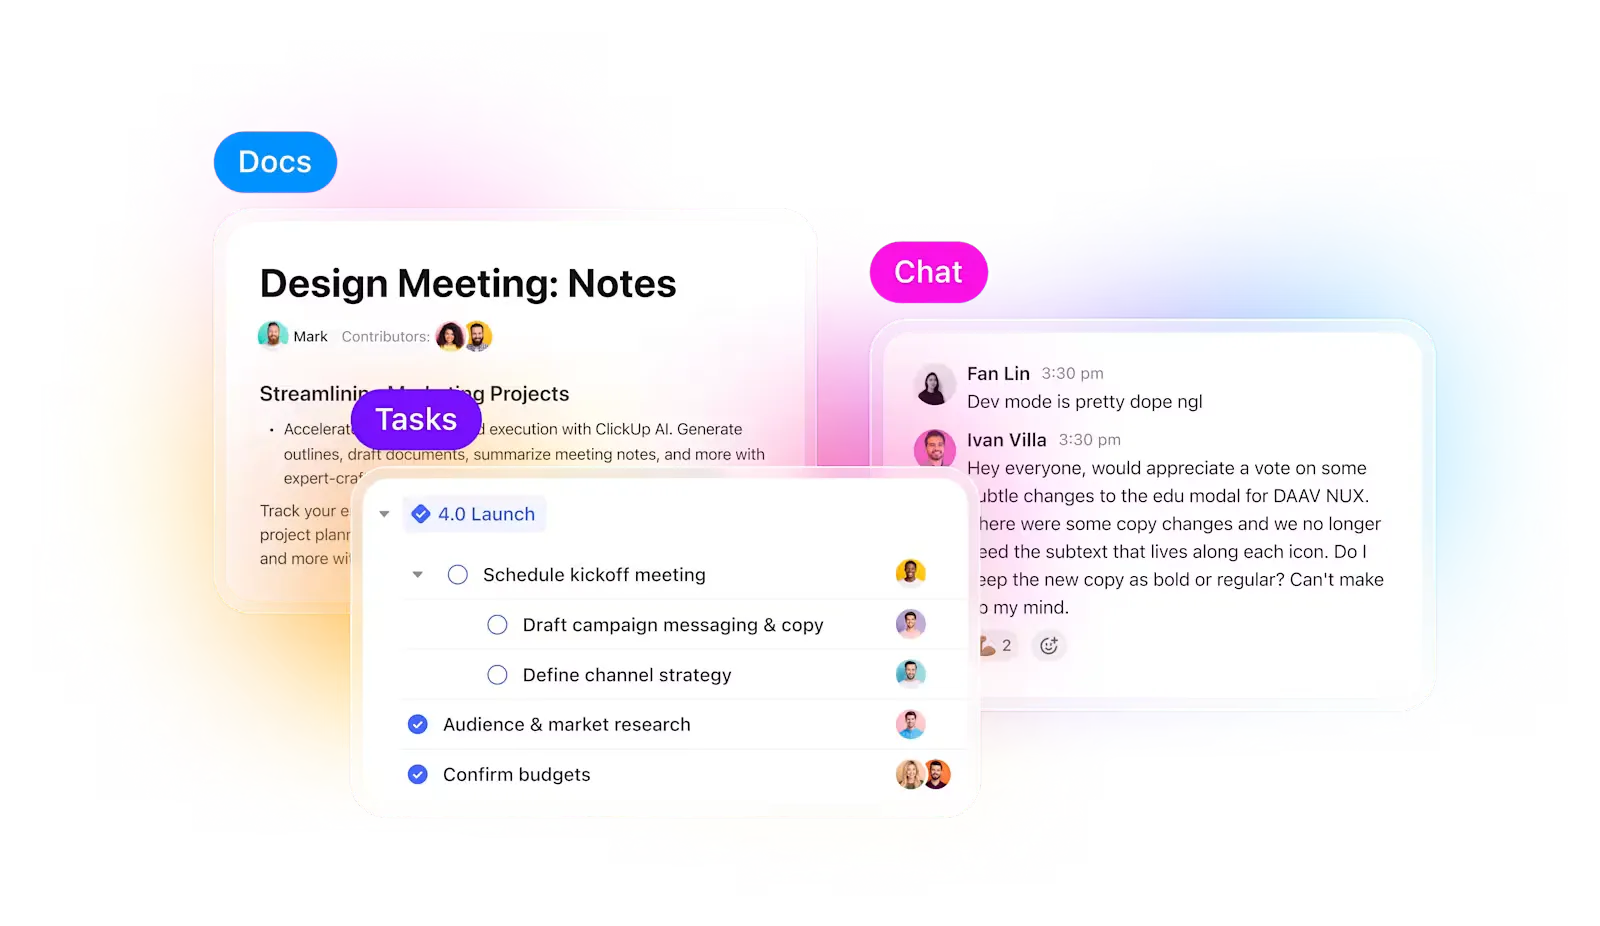
O ClickUp resolve isso. Em vez de ter que lidar com várias ferramentas, você conta com um Espaço de Trabalho Convergente de IA onde o gerenciamento de projetos, a documentação e a comunicação estão reunidos — para que seus experimentos permaneçam conectados desde o planejamento até a execução e a avaliação.
Nunca perca o controle das experiências e do progresso
Ao realizar vários experimentos, a parte mais difícil não é treinar o modelo, e sim acompanhar o que mudou durante o processo. Qual versão do conjunto de dados foi usada, qual taxa de aprendizado teve melhor desempenho ou qual execução foi implementada?
O ClickUp torna esse processo superfácil para você. Você pode acompanhar cada rodada de treinamento separadamente nas Tarefas do ClickUp e, dentro das tarefas, pode usar os Campos Personalizados para registrar:
- Versão do conjunto de dados
- Hiperparâmetros
- Variante do modelo (DBRX Base x DBRX Instruct)
- Status do treinamento (Na fila, Em execução, Em avaliação, Implantado)
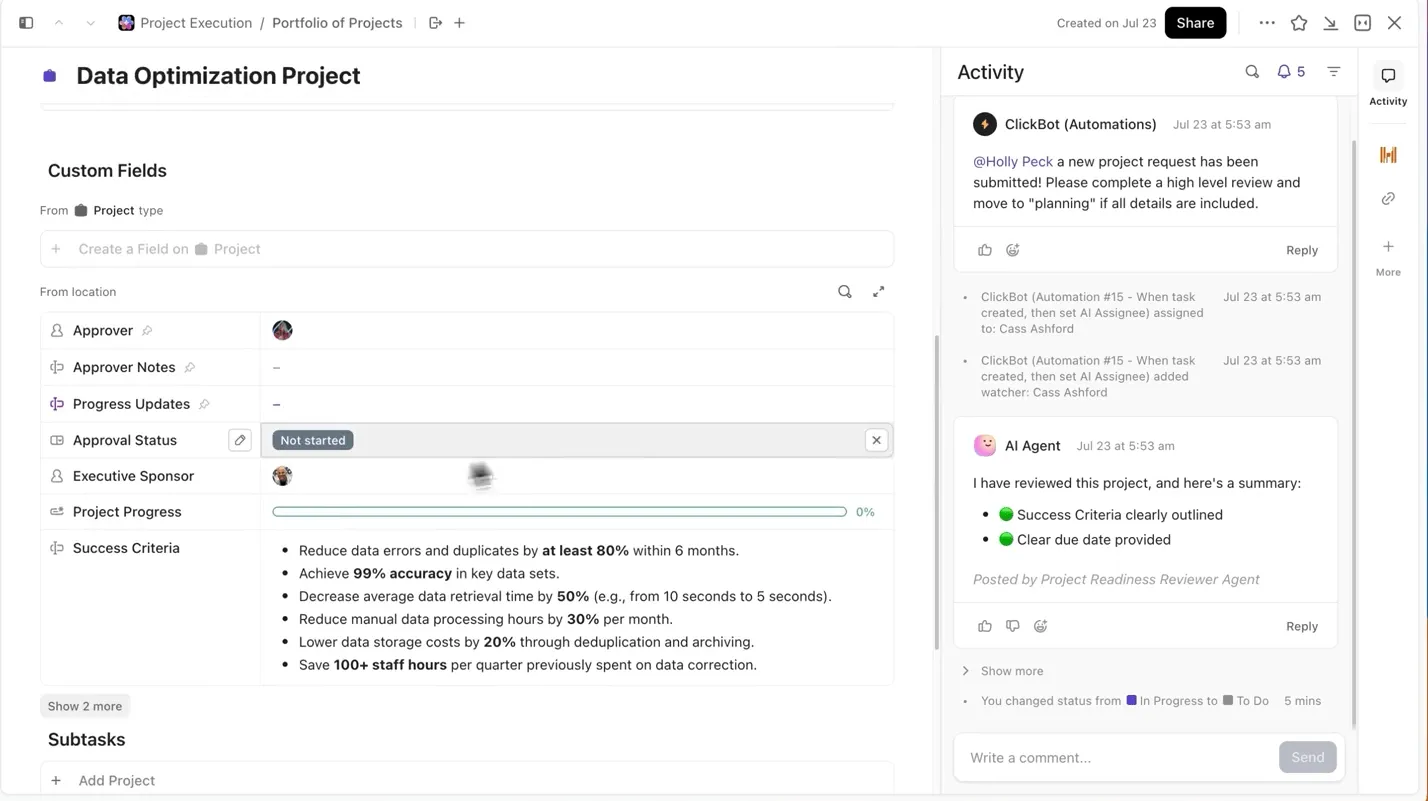
Dessa forma, cada experimento documentado fica acessível para pesquisa, fácil de comparar com outros e reproduzível.
Mantenha a documentação do modelo vinculada ao trabalho
Você não precisa ficar alternando entre notebooks do Jupyter, arquivos README ou threads do Slack para entender o contexto da tarefa de um experimento.
Com o ClickUp Docs, você pode manter sua arquitetura de modelo, scripts de preparação de dados ou métricas de avaliação organizados e acessíveis, documentando-os em um documento pesquisável que se vincula diretamente às tarefas do experimento de onde eles vieram.
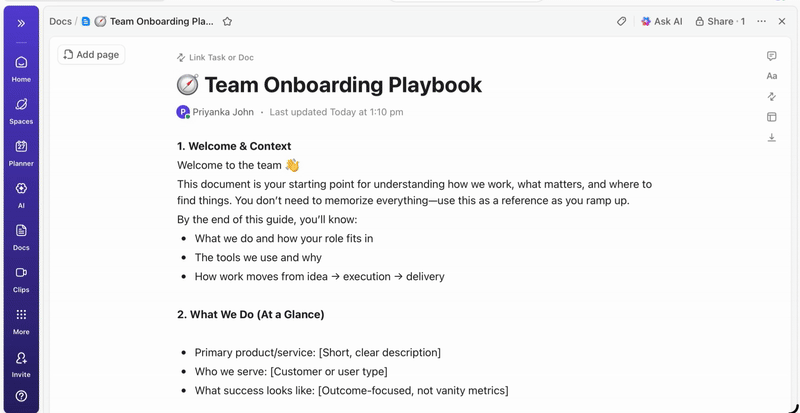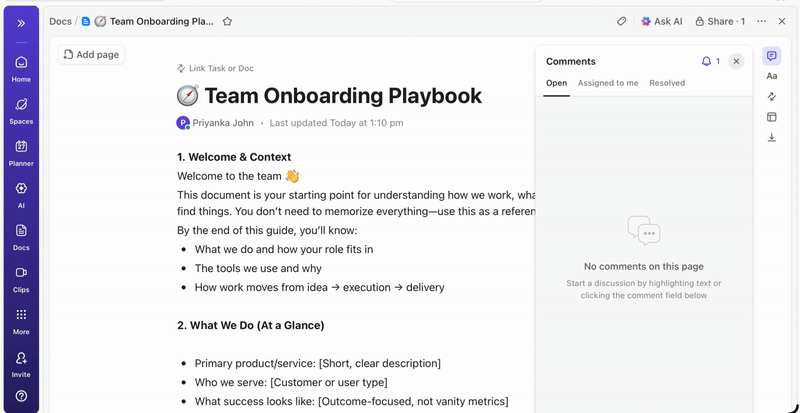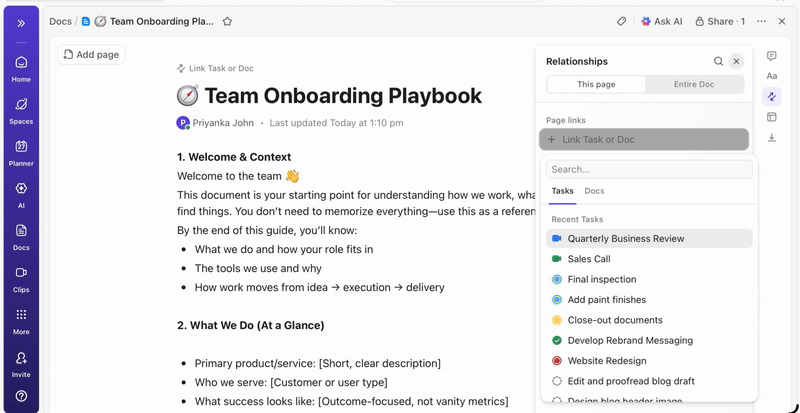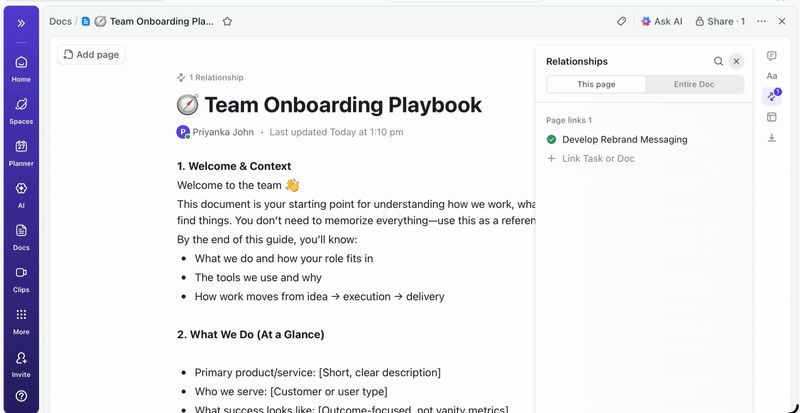
💡Dica profissional: Mantenha um resumo do projeto atualizado no ClickUp Docs que detalhe todas as decisões, desde a arquitetura até a implantação, para que novos membros da equipe possam sempre se atualizar sobre os detalhes do projeto sem precisar vasculhar discussões antigas
Ofereça visibilidade em tempo real às partes interessadas
Os painéis do ClickUp mostram o andamento dos experimentos e a carga de trabalho da equipe em tempo real. I
Em vez de compilar atualizações manualmente ou enviar e-mails, os painéis são atualizados automaticamente com base nos dados das suas tarefas. Assim, as partes interessadas podem acessar a qualquer momento, ver como as coisas estão e nunca precisam interromper você com perguntas do tipo “qual é o status?”.
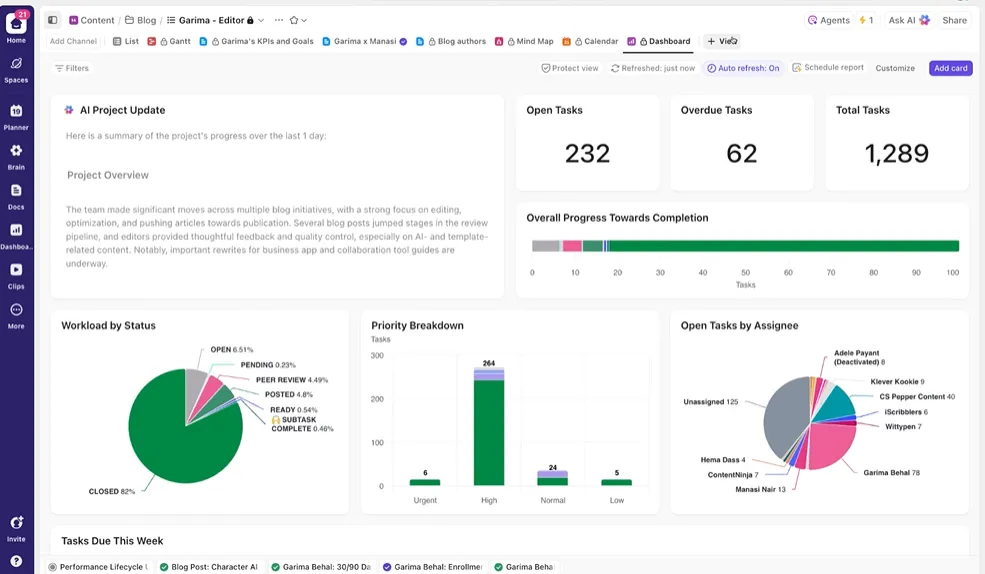
Dessa forma, você se concentra em realizar experimentos, em vez de ter que gerar relatórios manualmente o tempo todo.
Transforme a IA em seu parceiro inteligente de projetos
Você não precisa vasculhar manualmente semanas de dados de treinamento para obter um resumo dos experimentos realizados até o momento. Basta mencionar @Brain em qualquer comentário de tarefa, e o ClickUp Brain lhe dará a ajuda necessária com todo o contexto dos seus projetos passados e em andamento.
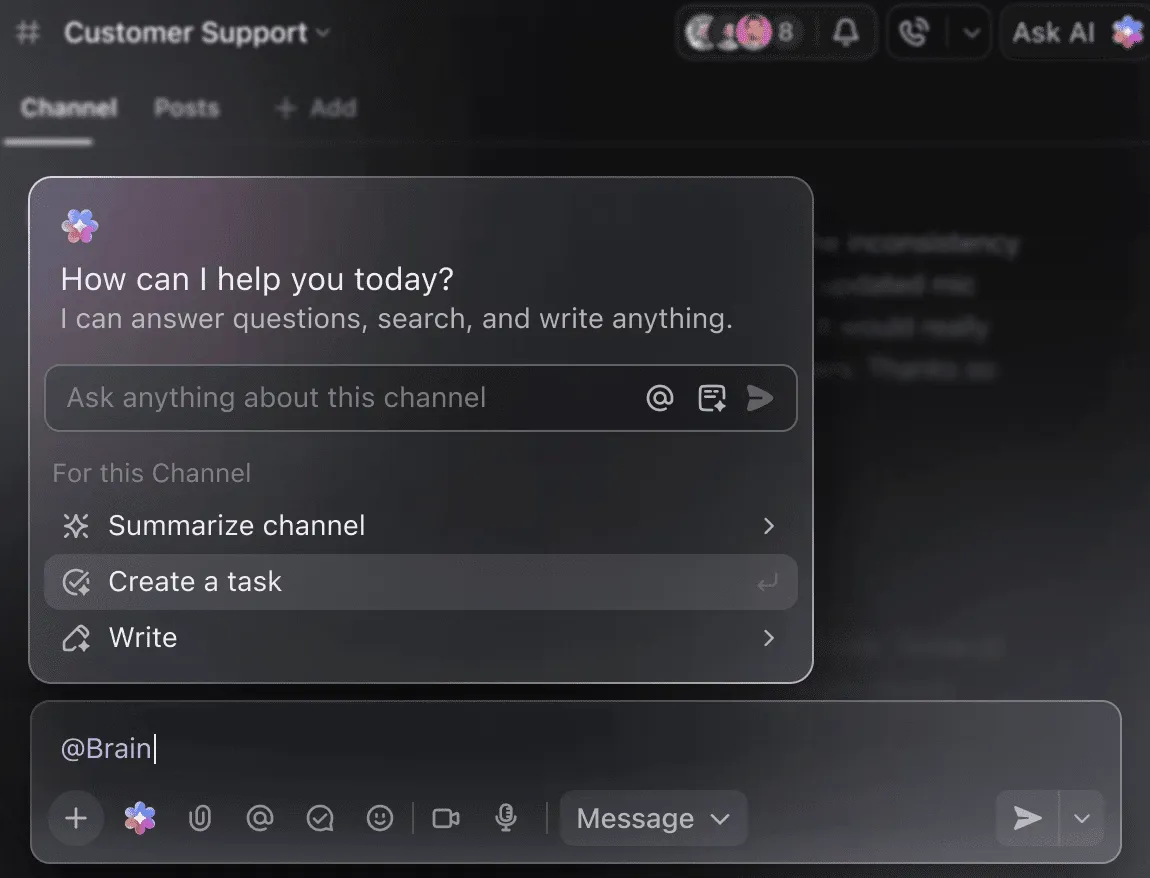
Você pode pedir ao Brain para “Resumir os experimentos da semana passada em 5 pontos-chave” ou “Elaborar um rascunho de documento com os resultados mais recentes dos hiperparâmetros” e obter instantaneamente um resultado bem elaborado.
🧠 A vantagem do ClickUp: Os Super Agentes do ClickUp vão muito além — eles podem automatizar fluxos de trabalho inteiros com base em gatilhos definidos por você, não apenas responder às suas perguntas. Com os superagentes, você pode criar automaticamente uma nova tarefa de treinamento do DBRX sempre que um conjunto de dados for carregado, notificar sua equipe e vincular documentos relevantes quando a execução do treinamento for concluída ou atingir um ponto de verificação, além de gerar um resumo semanal do progresso e enviá-lo às partes interessadas sem que você precise fazer nada.
Erros comuns a evitar
Começar um projeto de treinamento com o DBRX é empolgante, mas algumas armadilhas comuns podem atrapalhar seu progresso. Evitar esses erros vai economizar tempo, dinheiro e muita frustração.
- Subestimar os requisitos de hardware: o DBRX é poderoso, mas também é grande. Tentar executá-lo em hardware inadequado resultará em erros de memória insuficiente e falhas nas tarefas de treinamento. Lembre-se de que o DBRX (132B) requer pelo menos 264 GB de VRAM para inferência de 16 bits, ou aproximadamente 70 GB a 80 GB ao usar quantização de 4 bits
- Ignorar as verificações de qualidade dos dados: se os dados de entrada forem ruins, os resultados também serão ruins. O ajuste fino em um conjunto de dados desorganizado e de baixa qualidade só ensinará o modelo a produzir resultados desorganizados e de baixa qualidade
- Ignorando os limites de comprimento do contexto: Embora a janela de contexto de 32K do DBRX seja generosa, ela não é infinita. Alimentar o modelo com entradas que excedam esse limite resultará em truncamento silencioso e baixo desempenho
- Quando é mais adequado usar o Base em vez do Instruct: O DBRX Base é um modelo bruto e pré-treinado, destinado a um treinamento adicional em grande escala. Para a maioria das tarefas que envolvem seguir instruções, você deve começar com o DBRX Instruct, que já foi ajustado especificamente para essa finalidade
- Isolar o trabalho de treinamento da coordenação do projeto: quando o acompanhamento de seus experimentos fica em uma ferramenta e o plano do projeto em outra, você cria silos de informação. Use uma plataforma integrada como o ClickUp para manter seu trabalho técnico e a coordenação do projeto em sincronia
- Negligenciar a avaliação antes da implantação: um modelo que apresenta bom desempenho nos dados de treinamento pode falhar espetacularmente no mundo real. Sempre valide seu modelo ajustado em um conjunto de teste reservado antes de implantá-lo em produção
- Negligenciando a complexidade do ajuste fino: Como o DBRX é um modelo do tipo “Mixture-of-Experts”, scripts padrão de ajuste fino podem exigir bibliotecas especializadas, como Megatron-LM ou PyTorch FSDP, para lidar com o particionamento de parâmetros entre várias GPUs
DBRX x outras plataformas de treinamento de IA
A escolha de uma plataforma de treinamento de IA envolve uma escolha fundamental: controle versus conveniência. Modelos proprietários, acessíveis apenas por API, são fáceis de usar, mas prendem você ao ecossistema de um fornecedor.
Modelos de pesos abertos, como o DBRX, oferecem controle total, mas exigem mais conhecimento técnico e infraestrutura. Essa escolha pode deixar você sem saber para onde ir, sem ter certeza de qual caminho realmente apoia suas metas de longo prazo — um desafio que muitas equipes enfrentam durante a adoção da IA.
Esta tabela detalha as principais diferenças para ajudá-lo a tomar uma decisão informada.
| Pesos | Abrir (Personalizado) | Proprietário | Abrir (Personalizado) | Exclusivo |
| Ajuste fino | Controle total | Baseado em API | Controle total | Baseado em API |
| Hospedagem própria | Sim | Não | Sim | Não |
| Licença | DB Open Model | Termos da OpenAI | Comunidade Llama | Termos da Anthropic |
| Contexto | 32K | 128 mil – 1 milhão | 128K | 200 mil – 1 milhão |
O DBRX é a escolha certa quando você precisa de controle total sobre o modelo, precisa hospedar por conta própria por motivos de segurança ou conformidade, ou deseja a flexibilidade de uma licença comercial permissiva. Se você não possui infraestrutura de GPU dedicada — ou valoriza a rapidez de lançamento no mercado mais do que a personalização profunda —, alternativas baseadas em API podem ser mais adequadas.
Comece a treinar de forma mais inteligente com o ClickUp
O DBRX oferece uma base pronta para uso corporativo na criação de aplicativos de IA personalizados, com a transparência e o controle que você não encontra em modelos proprietários. Sua eficiente arquitetura MoE mantém os custos de inferência baixos, e seu design aberto facilita o ajuste fino. Mas uma tecnologia robusta é apenas metade da equação.
O verdadeiro sucesso vem do alinhamento do seu trabalho técnico com o fluxo de trabalho colaborativo da sua equipe. O treinamento de modelos de IA é um trabalho em equipe, e manter os experimentos, a documentação e a comunicação com as partes interessadas em sincronia é fundamental. Ao reunir tudo em um único espaço de trabalho convergente e reduzir a dispersão de contexto, você pode entregar modelos melhores e mais rapidamente.
Comece a usar o ClickUp gratuitamente para coordenar seus projetos de treinamento de IA em um único espaço de trabalho. ✨
Perguntas frequentes
Como posso acompanhar o andamento do treinamento no DBRX?
Você pode monitorar o treinamento usando ferramentas padrão de aprendizado de máquina, como TensorBoard, Weights & Biases ou MLflow. Se estiver treinando dentro do ecossistema do Databricks, o MLflow está integrado nativamente para um acompanhamento contínuo dos experimentos.
É possível integrar o DBRX com CI/CD e pipelines de implantação?
Sim, o DBRX pode ser integrado a pipelines padrão de MLOps. Ao colocar o modelo em um contêiner, você pode implantá-lo usando plataformas de orquestração como o Kubeflow ou fluxos de trabalho personalizados de CI/CD.
Qual é a diferença entre o DBRX Base e o DBRX Instruct?
O DBRX Base é o modelo pré-treinado fundamental, destinado a equipes que desejam realizar pré-treinamento contínuo específico para cada domínio ou ajuste fino da arquitetura de redes profundas. O DBRX Instruct é uma versão ajustada, otimizada para seguir instruções, o que o torna um ponto de partida melhor para a maioria dos projetos de desenvolvimento de aplicativos.
Como o DBRX se compara ao GPT-4 em projetos de IA corporativos?
A principal diferença é o controle. O DBRX oferece acesso total aos pesos do modelo para personalização avançada e hospedagem própria, enquanto o GPT-4 é um serviço exclusivamente por API.
É possível usar o DBRX de graça?
Os pesos do modelo DBRX estão disponíveis gratuitamente sob a Licença de Modelo Aberto da Databricks. No entanto, você é responsável pelos custos da infraestrutura de computação necessária para executar ou ajustar o modelo.