
Les incidents informatiques peuvent survenir sans avertissement.
Des pannes de serveurs aux cyberattaques, sans plan de reprise solide, votre entreprise pourrait subir des heures d'indisponibilité, des pertes de données et de graves préjudices financiers, 54 % des pannes graves coûtant plus de 100 000 dollars américains.
Cet article vous guide dans l'élaboration d'un plan complet de reprise après sinistre informatique qui protège vos systèmes, définit des objectifs de reprise clairs et garantit que votre équipe sache exactement quoi faire en cas de problème.
Qu'est-ce qu'un plan de reprise après sinistre informatique ?
Si vos serveurs tombaient en panne à l'instant même, votre équipe saurait-elle exactement quoi faire ? 🛠️
Un plan de reprise après sinistre (DR) informatique est votre stratégie documentée visant à restaurer les systèmes informatiques et les données après toute interruption, qu'il s'agisse de catastrophes naturelles ou de cyberattaques. Il s'agit en substance de votre guide pratique pour remettre vos systèmes en service lorsque des problèmes surviennent.
💡 Reprise après sinistre (DR) vs. Continuité d'activité pour l'entreprise
La reprise après sinistre (DR) vise spécifiquement à restaurer votre infrastructure informatique et vos données. La continuité d’activité (BC) a une portée plus large : elle vise à maintenir l’ensemble de votre entreprise opérationnelle pendant et après une crise, même en cas de panne informatique. Considérez la reprise après sinistre comme un élément clé de votre stratégie globale de continuité d’activité.
💡 Reprise après sinistre (DR) vs. Continuité d'activité pour l'entreprise
La reprise après sinistre (DR) vise spécifiquement à restaurer votre infrastructure informatique et vos données. La continuité d’activité (BC) a une portée plus large : elle vise à maintenir l’ensemble de votre entreprise opérationnelle pendant et après une crise, même en cas de panne informatique. Considérez la reprise après sinistre comme un élément clé de votre stratégie globale de continuité d’activité.
Votre plan de reprise après sinistre est essentiel, car les temps d’arrêt ont un coût qui va bien au-delà de l’aspect financier. Chaque minute pendant laquelle vos systèmes sont hors service peut éroder la confiance de vos clients, perturber vos opérations et même entraîner des amendes pour non-conformité. Un plan de reprise après sinistre complet est votre feuille de route vers la résilience.
Un bon forfait doit inclure :
- Procédures de sauvegarde des données : comment et où stocker des copies des informations critiques afin de pouvoir les restaurer
- Étapes de restauration du système : la séquence exacte à suivre pour remettre les services en ligne dans le bon ordre
- Responsabilités de l'équipe : qui fait quoi en cas d'incident pour éviter toute confusion ?
- Protocoles de communication : comment tenir informées les parties prenantes, de votre équipe à vos clients
- Objectifs de reprise : vos objectifs spécifiques concernant la rapidité avec laquelle les systèmes doivent être remis en service et le niveau de perte de données jugé acceptable
Scénarios courants de sinistres informatiques et leurs conséquences
Les catastrophes ne sont pas seulement des scénarios hollywoodiens ; elles touchent les entreprises au quotidien. Comprendre contre quoi vous vous protégez vous aide à mettre en place une défense bien plus solide.
Catastrophes naturelles et dommages matériels
Des évènements tels que les inondations, les incendies, les tremblements de terre et les coupures de courant majeures peuvent détruire des centres de données entiers en quelques minutes. Lorsqu’une inondation majeure a frappé un centre de données à Nashville, par exemple, certaines entreprises ont perdu des semaines de données et ont dû faire face à des mois de restauration. La meilleure protection contre ce type de situation est la redondance géographique, qui consiste à répartir votre infrastructure sur plusieurs emplacements physiques afin qu’un seul évènement ne puisse pas tout mettre hors service.
Cyberattaques et compromission des données
Les ransomwares, les attaques par déni de service distribué (DDoS) et les fuites de données diffèrent des sinistres physiques. Ils sont souvent plus difficiles à détecter, peuvent se propager silencieusement à travers les systèmes connectés et ciblent fréquemment vos systèmes de sauvegarde, ce qui rend la reprise particulièrement difficile. La fréquence et la sophistication de ces cyberattaques ne cessent d’augmenter dans tous les secteurs d’activité. Les ransomwares sont désormais impliqués dans 44 % de toutes les fuites confirmées, ce qui en fait une menace majeure.
Pannes matérielles et perte de données
Il arrive parfois que même les systèmes de sauvegarde les plus testés et les plus fiables tombent en panne. Les pannes de serveurs, les défaillances de stockage et les dysfonctionnements des équipements réseau peuvent survenir sans avertissement. Même si vous disposez de systèmes redondants (de sauvegarde), ceux-ci peuvent tout de même tomber en panne simultanément s’ils partagent des composants ou des sources d’alimentation communs, créant ainsi un point de défaillance unique.
👀 Le saviez-vous ? En octobre 2025, AWS a subi une panne majeure lorsqu’un bug dans son système interne de gestion DNS pour Amazon DynamoDB a provoqué l’échec de la résolution des noms de domaine dans la région du centre de données US-EAST-1. Ce « petit » défaut technique a déclenché une défaillance en cascade sur des dizaines de services AWS et a mis hors service des centaines d’applications et de plateformes populaires à l’échelle mondiale — des applications de messagerie et de réseaux sociaux aux banques, en passant par les sites de jeux vidéo, etc. Pour de nombreuses personnes, cette panne a temporairement fait « disparaître » une grande partie d’Internet, soulignant à quel point notre infrastructure numérique est fragile lorsque tant de choses dépendent d’une poignée de fournisseurs de cloud.
Erreurs logicielles et interruption de service
Une base de données corrompue, une mise à jour logicielle qui a échoué ou une simple erreur de configuration peuvent mettre hors service des plateformes entières. Vous constaterez peut-être qu’une seule ligne de code mal configurée peut avoir un effet domino sur les systèmes connectés, provoquant une panne généralisée aux répercussions considérables. Une gestion des changements adéquate et des environnements de test dédiés sont vos meilleurs alliés pour minimiser ces risques.
Erreurs humaines et erreurs de configuration
Les suppressions accidentelles, les configurations incorrectes et les modifications non autorisées restent parmi les causes les plus courantes de pannes informatiques. Une seule commande erronée ou un fichier supprimé peut déclencher plusieurs heures d’indisponibilité et une dégradation des services. Si la formation et les contrôles d’accès constituent des mesures utiles, ils ne permettent pas d’éliminer totalement les erreurs humaines.
📮ClickUp Insight : 92 % des employés utilisent des méthodes incohérentes pour le suivi des éléments à mener, ce qui entraîne des décisions manquées et des retards dans l'exécution.
Que vous envoyiez des notes de suivi ou utilisiez des feuilles de calcul, le processus est souvent fragmenté et inefficace. Grâce aux fonctionnalités de gestion des tâches de ClickUp, vous n’aurez plus jamais à vous en soucier. Créez des tâches à partir du chat, des commentaires sur les tâches ClickUp, des documents et des e-mails en un seul clic !
Éléments clés d'un plan de reprise après sinistre informatique
Un plan de reprise après sinistre solide constitue votre guide complet pour reprendre vos activités. Chacun de ces éléments s'appuie sur les autres pour offrir une protection complète à votre entreprise.
Évaluation et hiérarchisation des risques
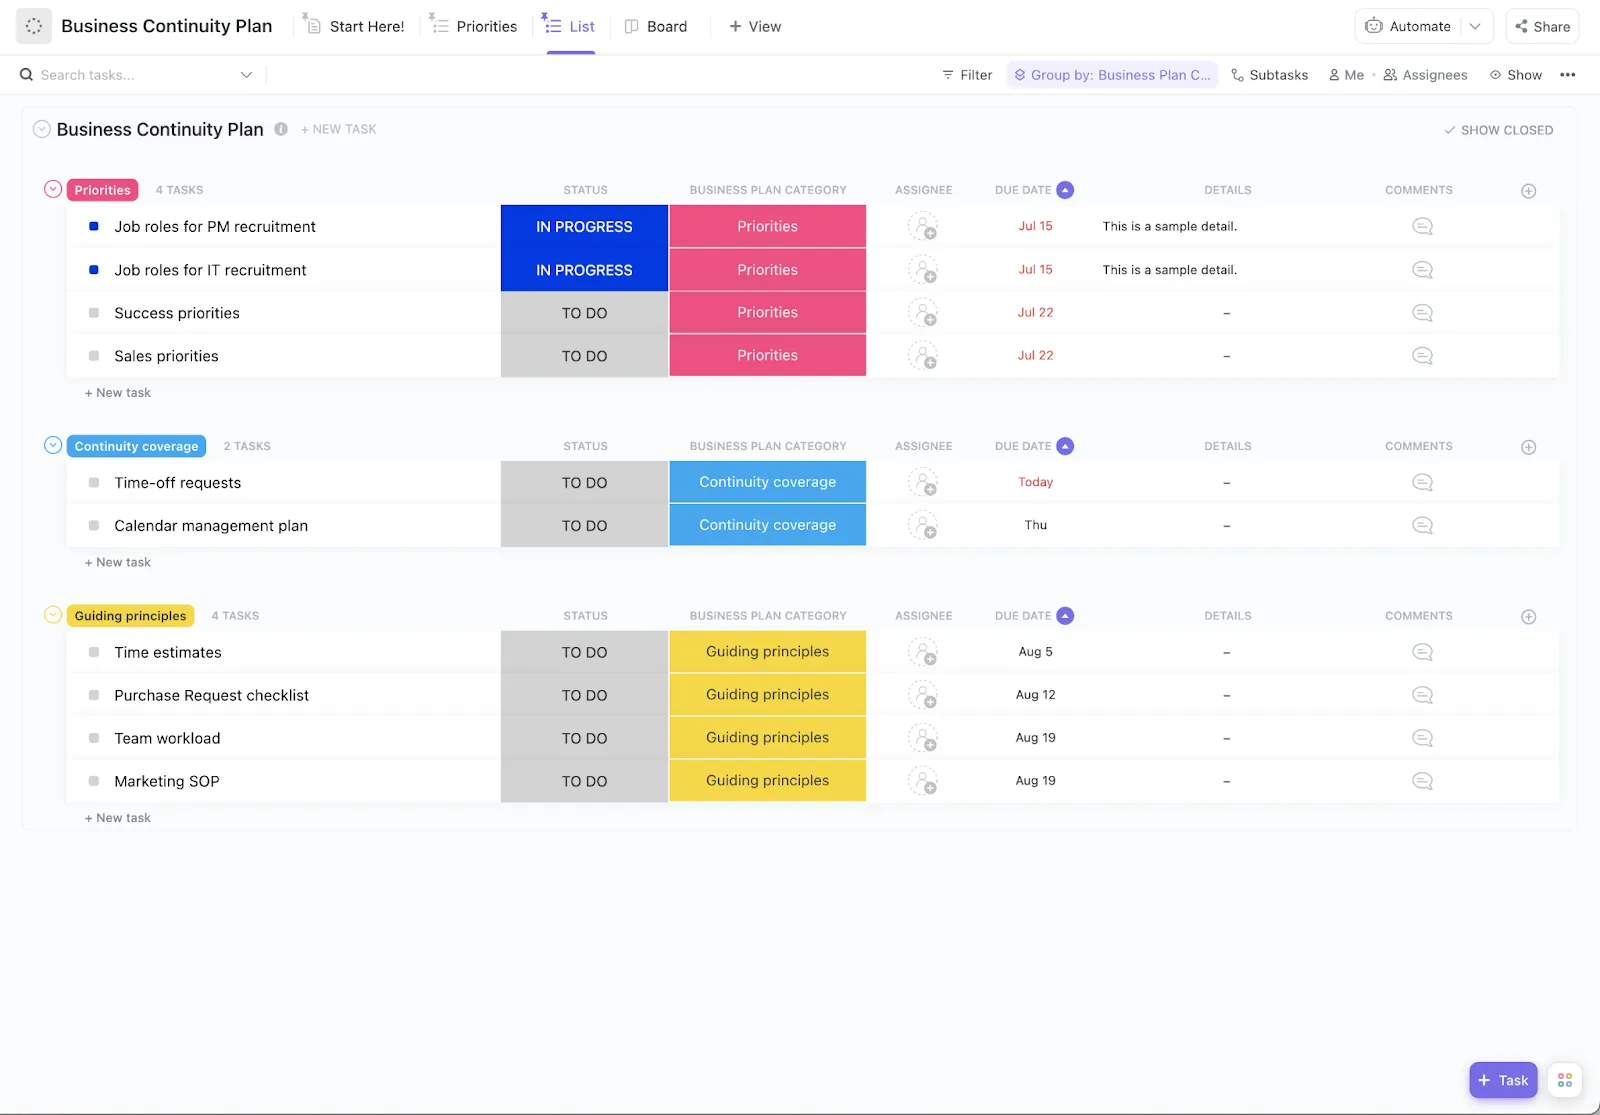
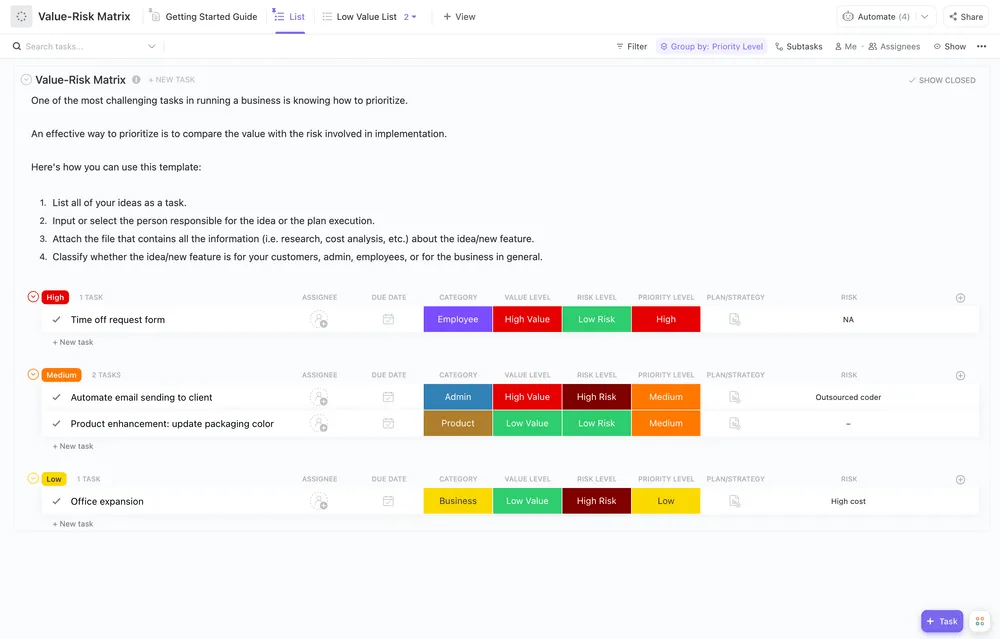
Tout d’abord, vous devez savoir à quoi vous avez affaire. Une évaluation des risques consiste à identifier vos vulnérabilités et à évaluer la probabilité et l’impact de chaque menace potentielle. Vous pouvez organiser ces informations dans une matrice des risques afin d’identifier les menaces les plus graves.
Votre évaluation doit porter sur les points suivants :
- Systèmes critiques: ceux qui doivent absolument rester opérationnels pour que votre entreprise puisse fonctionner
- Sensibilité des données : quelles informations nécessitent le plus haut niveau de protection (comme les données clients) ?
- Dépendances : quels autres systèmes ou processus sont affectés lorsque chaque système tombe en panne ?
📖 En savoir plus : Comment mettre en œuvre la gestion de l'infrastructure informatique
Analyse de l'impact sur l'activité et de la criticité
Ensuite, évaluez le coût réel des temps d’arrêt. Une analyse d’impact sur l’activité (BIA) vous aide à déterminer l’impact financier et opérationnel d’une panne pour chaque système. Cela vous permet de classer vos systèmes par niveau de criticité afin de hiérarchiser vos efforts de reprise.
| Critique | Moins d'une heure | Traitement des paiements, bases de données clients |
| Élevé | Une à quatre heures | E-mail, outils de communication interne |
| Moyen | De 4 à 24 heures | Environnements de développement, outils de rapports |
| Faible | Plus de 24 heures | Systèmes d'archivage, serveurs de test hors production |
Objectifs RTO et RPO
Ces deux acronymes sont au cœur de votre stratégie de reprise d'activité.
- Objectif de temps de reprise (RTO) : il s'agit de la durée maximale pendant laquelle vous pouvez vous permettre qu'un système soit hors service. Il répond à la question suivante : « Dans quel délai devons-nous remettre ce système en ligne ? »
- Objectif de point de reprise (RPO) : il s'agit de la quantité maximale de données que vous pouvez vous permettre de perdre, mesurée en temps. Il répond à la question suivante : « Quelle quantité de données pouvons-nous perdre sans subir de préjudice majeur ? »
Par exemple, votre système d’e-mail interne peut avoir un RTO de quatre heures, mais votre base de données de commerce en ligne destinée à vos clients peut avoir un RPO de seulement 15 minutes, ce qui signifie que vous ne pouvez pas perdre plus de 15 minutes de données liées aux transactions.
Forfait de sauvegarde et de reprise des données
Votre plan de sauvegarde constitue votre filet de sécurité ultime. Une bonne pratique courante est la règle du 3-2-1 : conservez au moins trois copies de vos données importantes, stockez-les sur deux types de supports différents et conservez l'une de ces copies hors site.
Vous aurez également le choix entre différents types de sauvegarde :
- Sauvegardes complètes : une copie intégrale de toutes les données, généralement à faire chaque semaine ou chaque mois
- Sauvegardes incrémentielles : ne sauvegardent que les modifications apportées depuis la dernière sauvegarde, quel que soit son type
- Sauvegardes différentielles : sauvegardent toutes les modifications apportées depuis la dernière sauvegarde complète.
Mais surtout, vous devez tester régulièrement votre processus de restauration des sauvegardes. Une sauvegarde non testée n'est qu'un espoir, pas un plan.
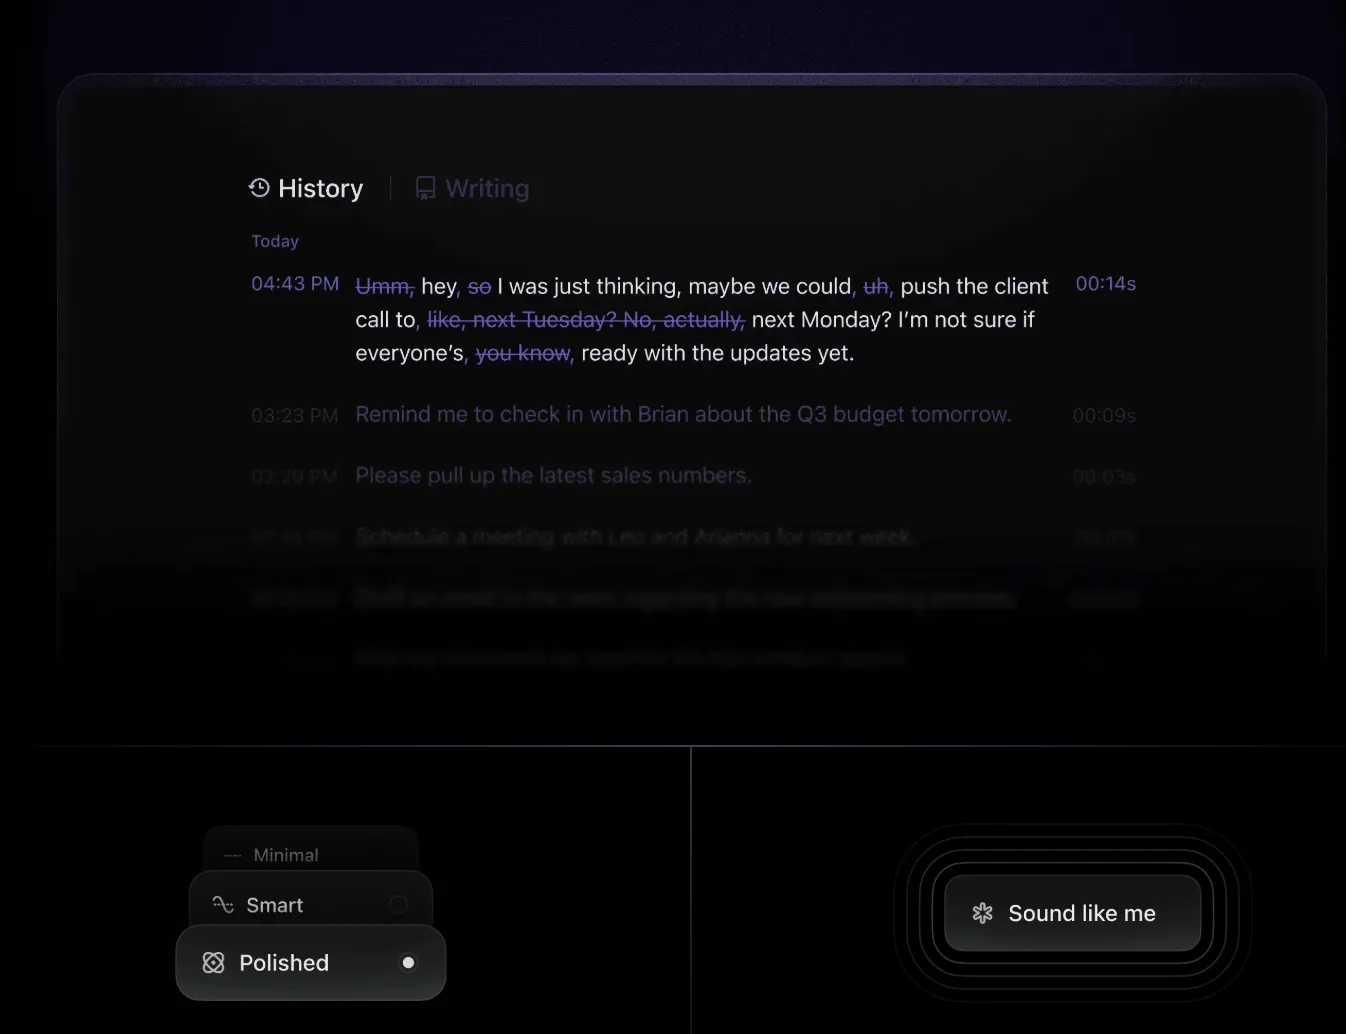
💟 Bonus : Enregistrez les détails essentiels lors d’incidents particulièrement stressants grâce à la fonctionnalité de reconnaissance vocale de ClickUp Brain MAX, afin de ne jamais manquer d’informations importantes, même lorsque la saisie au clavier n’est pas envisageable. Il vous suffit de dicter vos observations et de laisser l’IA se charger de la documentation.
Plan de communication et mises à jour destinées aux parties prenantes
En cas de sinistre, un plan de communication clair est essentiel. Votre plan doit définir les chaînes de notification, la fréquence des mises à jour et les canaux que vous utiliserez pour chaque type d’incident.
Chaque groupe a besoin d’informations spécifiques :
- Équipes internes : vous avez besoin de détails techniques et d’éléments concrets à mettre en œuvre
- Clients : Vous avez besoin de connaître le statut du service et la date prévue de résolution du problème
- Fournisseurs : il peut être nécessaire de faire appel à eux pour obtenir de l'assistance ou en cas d'escalade.
- Organismes de réglementation : peuvent exiger des notifications officielles en fonction de votre secteur d’activité
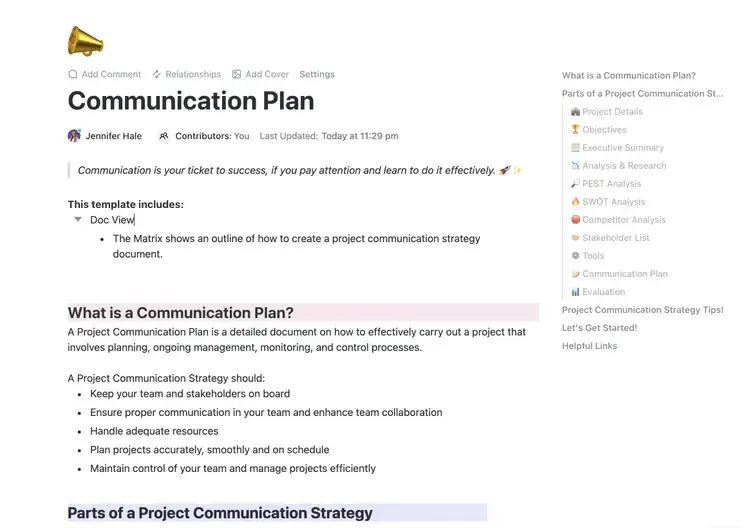
Des outils tels que ce modèle de plan de communication prêt à l'emploi proposé par ClickUp peuvent vous aider à agir plus rapidement grâce à un protocole bien établi en cas de crise.
Programme de tests et de formation
Un plan que l'on ne teste jamais est un plan voué à l'échec. Des tests réguliers permettent de mettre en évidence les lacunes et les faiblesses avant qu'une véritable catastrophe ne survienne.
Prévoyez différents types de tests tout au long de l'année :
- Exercices sur papier : votre équipe simule un scénario de sinistre sur papier afin de vérifier la cohérence du plan.
- Basculement partiel : vous testez la reprise de composants ou de services spécifiques et non critiques.
- Tests complets de reprise après sinistre : vous effectuez un basculement complet vers vos systèmes de sauvegarde (le test ultime)
Après chaque test, mettez à jour votre documentation et formez immédiatement les nouveaux membres de l'équipe aux procédures.
📖 En savoir plus : Comment élaborer des politiques et procédures informatiques efficaces
Étapes pour élaborer un plan de reprise après sinistre informatique
L'élaboration de votre plan de reprise après sinistre n'a pas besoin d'être une tâche insurmontable.
Voici comment vous y prendre, étape par étape. 🙌
Étape 1 : Établir l'inventaire des actifs
Vous ne pouvez pas protéger ce dont vous ignorez l’existence. Commencez par établir une liste des actifs répertoriant chaque élément matériel, logiciel, référentiel de données et dépendance système présent dans votre environnement. Veillez à y inclure les coordonnées des fournisseurs, les clés de licence et les détails de configuration afin de pouvoir y accéder rapidement en cas de reprise.
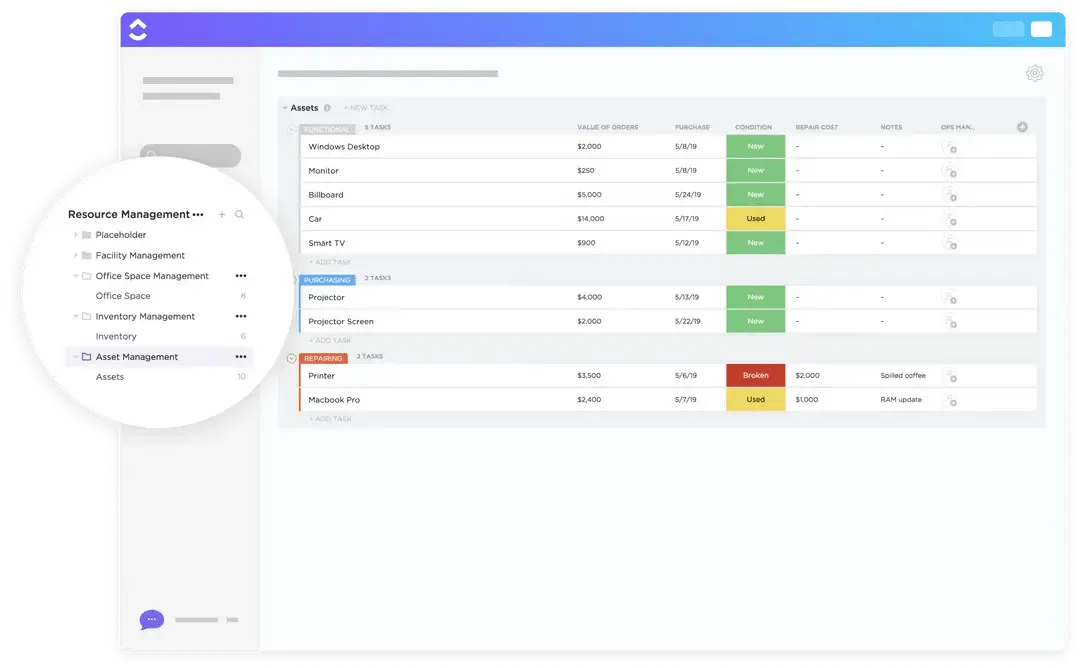
Le modèle ITAM de ClickUp regroupe la gestion des incidents, la gestion des problèmes, la gestion des changements, des solutions simples de gestion des actifs et la gestion des connaissances. Notre modèle ITSM « Erreurs connues » simplifie le suivi des erreurs connues dans vos systèmes. Découvrez tous nos modèles informatiques dès que vos besoins évoluent.
Personnalisez vos flux de travail comme vous le souhaitez pour chaque étape de la gestion des actifs informatiques (ITAM), du déploiement et de la configuration à la maintenance et à la mise hors service.
Étape 2 : Classer les services critiques
Identifiez ensuite quels actifs sont essentiels à la mission de l’entreprise et lesquels sont simplement complémentaires. Créez des cartes de dépendances des services qui montrent comment vos systèmes sont interconnectés et dépendent les uns des autres. Accordez une attention particulière aux services en contact avec la clientèle qui ont un impact direct sur le chiffre d’affaires ou l’expérience utilisateur.
🎥 Regardez ce tutoriel pratique qui vous montre comment élaborer un plan structuré et de haut niveau à l’aide des puissantes fonctionnalités de ClickUp, de la définition des objectifs à l’attribution des tâches en passant par le suivi des progrès.
Étape 3 : Évaluer les risques et les menaces
Évaluez les risques et les menaces en analysant la probabilité et l’impact de chaque type de menace dans votre situation spécifique. Tenez compte des risques géographiques (vous trouvez-vous dans une zone sismique ou une plaine inondable ?) ainsi que des menaces propres à votre secteur d’activité (telles que les changements réglementaires ou les cyberattaques ciblées). Consignez toutes ces informations dans un registre des risques afin de pouvoir en assurer le suivi au fil du temps.

Le modèle de Tableau blanc d'évaluation des risques ClickUp apporte une dimension visuelle à votre processus d'évaluation des risques. Il facilite l'évaluation et la classification des risques, tout en incitant votre équipe à partager ses idées et à collaborer dans un format attrayant et visuel.
Ce modèle vous permet de :
- Évaluez les catégories de risques et leurs impacts potentiels
- Analysez les données pour identifier les sources potentielles de problèmes
- Déterminez les mesures préventives permettant de réduire l'exposition aux risques
Grâce à ses fonctionnalités qui vous permettent de dessiner, d'écrire et d'ajouter des post-it, ce modèle de Tableau blanc dédié à la gestion des risques est idéal pour évaluer les risques liés à votre projet.
Étape 4 : Définir les cibles RTO et RPO
Collaborez directement avec les parties prenantes de votre entreprise pour définir ce qu’elles considèrent comme un temps d’arrêt et une perte de données acceptables pour chaque niveau de service que vous avez identifié précédemment. Vous devrez trouver un équilibre entre le coût d’une reprise plus rapide et l’impact sur l’activité : tout ne nécessite pas une reprise instantanée sans aucune perte de données. Obtenez l’accord de la direction sur ces cibles.
Étape 5 : Définir les chemins de sauvegarde et de basculement
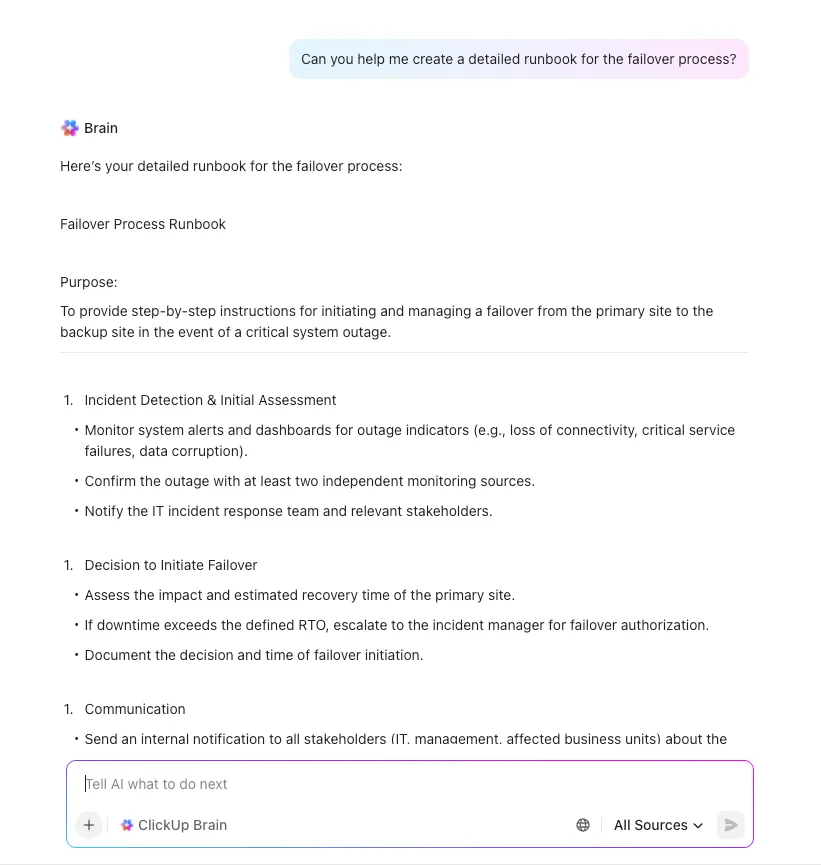
Une fois vos cibles fixées, vous pouvez désormais concevoir vos solutions techniques. Élaborez des stratégies de sauvegarde adaptées au RPO de chaque système et planifiez des procédures de basculement détaillées, y compris des sites de traitement de secours et des méthodes d’accès d’urgence. Intégrez des schémas de réseau et des guides opérationnels étape par étape pour garantir une exécution sans faille.
Étape 6 : Attribuer les rôles et définir les procédures d'escalade
Définissez la structure de votre équipe de reprise après sinistre en établissant clairement les responsabilités et les pouvoirs décisionnels. Créez des listes de contacts exhaustives indiquant le personnel principal et de sauvegarde pour chaque rôle. Une matrice RACI (Responsable, Comptable, Consulté, Informé) est un excellent outil pour éviter toute confusion lors d’un incident générant un stress important.
Étape 7 : Documenter et communiquer le plan
Documentez et communiquez ce plan à l'aide de procédures claires et détaillées, étape par étape, que n'importe quel membre de votre équipe pourra suivre, même en situation de stress. Il est essentiel de conserver cette documentation dans un emplacement facilement accessible, distinct de votre infrastructure principale. Assurez-vous que chaque membre de l'équipe sache exactement où trouver le plan en cas de crise.

Rationalisez la planification de vos projets grâce au modèle de planification RACI de ClickUp. Ce modèle de document change la donne : il propose un diagramme clair permettant de définir les rôles et les responsabilités de l’équipe par rapport aux tâches du projet. Adoptez le cadre RACI (Responsable, Comptable, Consulté et Informé) pour mettre tout le monde sur la même longueur d’onde, en garantissant la responsabilisation et l’alignement sur les objectifs de l’organisation.
Étape 8 : Tester, analyser et améliorer
Enfin, programmez des tests trimestriels pour valider vos procédures et identifier d’éventuelles lacunes. Consignez tous les enseignements tirés de chaque test et de tout incident réel, et utilisez-les pour mettre à jour votre plan. Mettez en place un système de suivi systématique des améliorations afin de vous assurer que tous les problèmes identifiés sont résolus.
🌼 Le saviez-vous ? En 2017, GitLab a subi une panne majeure de sa base de données. Au cours de la reprise, l’entreprise a découvert que plusieurs de ses méthodes de sauvegarde avaient échoué en silence pendant plusieurs jours. Cet incident a enseigné à l’ensemble du secteur technologique une leçon cruciale : la validation des sauvegardes est incontournable. Une sauvegarde non testée n’est pas vraiment une sauvegarde.
🌼 Le saviez-vous ? En 2017, GitLab a subi une panne majeure de sa base de données. Au cours de la reprise, l’entreprise a découvert que plusieurs de ses méthodes de sauvegarde avaient échoué en silence pendant plusieurs jours. Cet incident a enseigné à l’ensemble du secteur technologique une leçon cruciale : la validation des sauvegardes est incontournable. Une sauvegarde non testée n’est pas vraiment une sauvegarde.
Stratégies et solutions de reprise après sinistre
Toutes les entreprises n'ont pas besoin de la même approche en matière de reprise après sinistre. Examinons ensemble les options qui s'offrent à vous en fonction de votre budget, de vos besoins en matière de reprise et des ressources dont vous disposez.
Stratégie de sauvegarde et de restauration
Il s’agit de la méthode la plus simple et la plus économique. Elle consiste à effectuer des sauvegardes régulières vers un emplacement distant (comme le cloud ou un centre de données secondaire), puis à les restaurer manuellement en cas de besoin. Cette approche est particulièrement adaptée aux systèmes non critiques pouvant tolérer un RTO plus long, car la reprise peut prendre plusieurs heures, voire plusieurs jours.
Haute disponibilité et redondance
Cette stratégie vise à éliminer les points de défaillance uniques en utilisant plusieurs systèmes actifs. Des techniques telles que l'équilibrage de charge, la mise en cluster des serveurs et le stockage RAID garantissent que, si un composant tombe en panne, un autre prend instantanément le relais. Bien que plus coûteuse à mettre en place et à entretenir, cette approche permet de réduire les temps d'arrêt à quelques secondes ou minutes seulement, ce qui la rend idéale pour les services critiques.
Options de réplication et de basculement
La réplication consiste à copier les données en temps quasi réel vers un site secondaire, ce qui garantit une perte de données minimale en cas de sinistre.
- Réplication synchrone : elle écrit les données simultanément sur les sites principal et secondaire, garantissant ainsi une perte de données nulle. Elle nécessite toutefois une bande passante élevée et peut ralentir votre système principal.
- Réplication asynchrone : les données sont d'abord écrites sur le site principal, puis copiées sur le site secondaire avec un léger décalage. Cette méthode est moins coûteuse et a moins d'impact sur les performances, mais elle comporte un faible risque de perte de données.
Reprise après sinistre dans le cloud et DRaaS
La reprise après sinistre en tant que service (DRaaS) est devenue un choix très prisé par de nombreuses entreprises. Elle offre une tarification à l'utilisation, une distribution géographique instantanée et une automatisation de la reprise, sans qu'il soit nécessaire de construire et de maintenir vos propres sites physiques de reprise après sinistre. La reprise après sinistre dans le cloud élimine les dépenses d'investissement considérables liées à un centre de données de sauvegarde, tout en offrant une évolutivité plus rapide et une plus grande flexibilité que les approches traditionnelles de sites « chauds », « tièdes » ou « froids ».
Comment ClickUp simplifie la planification de la reprise après sinistre informatique
La gestion d’un plan de reprise après sinistre à partir de feuilles de calcul, de documents et de chaînes d’e-mails dispersés constitue en soi un risque de sinistre.
Cette prolifération du travail, la fragmentation du travail entre de multiples outils déconnectés qui ne communiquent pas entre eux, ainsi que la prolifération des contextes, lorsque les équipes perdent des heures à rechercher des informations dispersées dans différentes applications et plateformes, entraînent de la confusion, des informations obsolètes et des temps de réponse lents alors que chaque seconde compte.
Grâce à ClickUp Converged AI Workspace — une plateforme unique et sécurisée où toutes vos applications professionnelles, vos données et vos flux de travail coexistent avec une IA contextuelle servant de couche d’intelligence — qui combine gestion de projet, documentation et communication d’équipe. Ne jonglez plus entre plusieurs plateformes et regroupez votre planification de reprise après sinistre, vos tests et votre réponse aux incidents au sein d’un système unifié.
Documentation centralisée sur la reprise après sinistre grâce à ClickUp Docs et à l'assistance IA intégrée
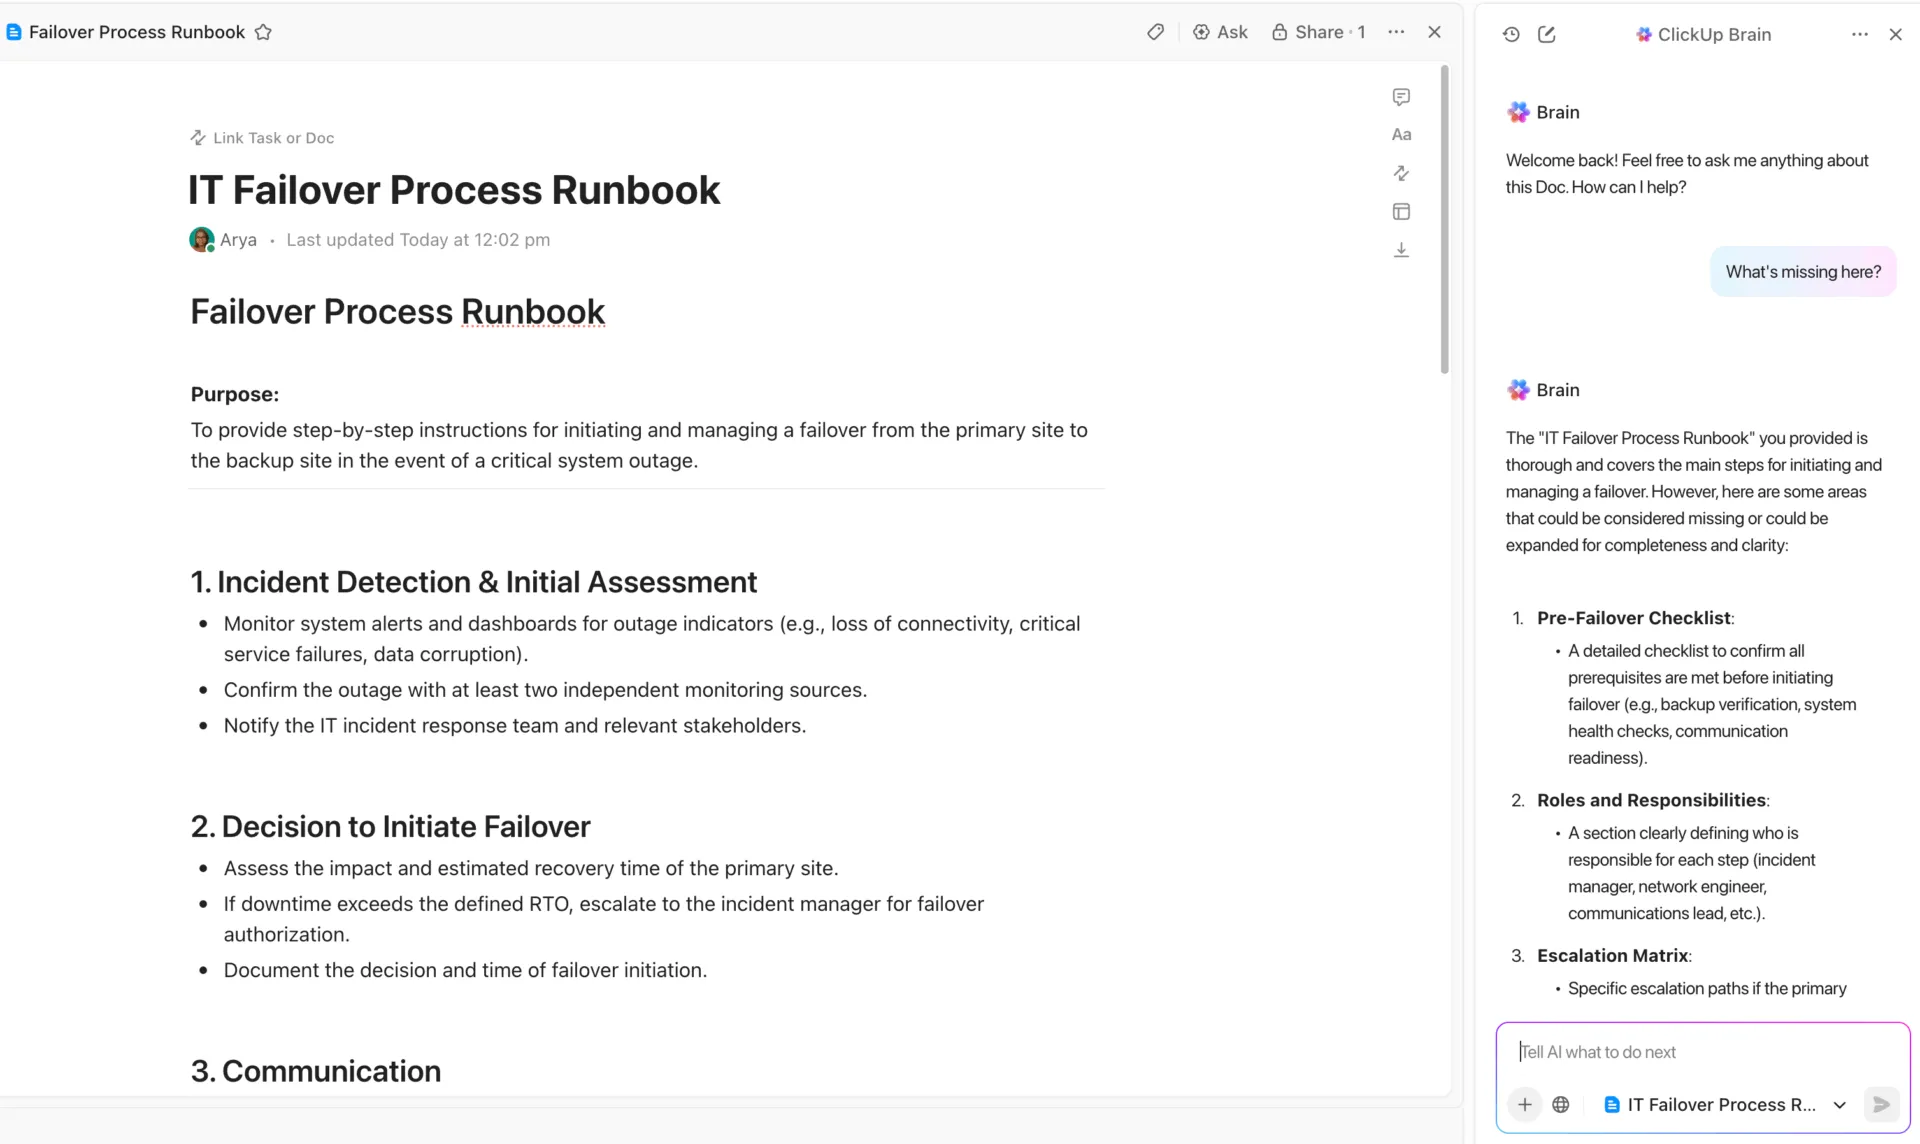
Assurez-vous que votre équipe dispose toujours d’une source unique et fiable d’informations grâce à ClickUp Docs.
Élaborez l'intégralité de votre plan de reprise après sinistre dans un espace collaboratif où chacun peut apporter sa contribution en temps réel en cas d'incident. Associez directement des documents aux tâches et aux projets liés à l'incident pour une navigation fluide, et intégrez des schémas ou des guides opérationnels afin de disposer des informations essentielles là où vous en avez besoin.
Mieux encore, vous pouvez protéger vos documents pour empêcher toute modification accidentelle et utiliser les permissions granulaires de ClickUp pour contrôler qui peut afficher ou modifier les procédures de reprise d'activité sensibles. Chaque modification est suivie dans l'historique du document, ce qui vous offre une piste d'audit complète.
Création de plans optimisée par l’IA avec ClickUp Brain
Accélérez la planification de la reprise après sinistre et comblez les lacunes critiques grâce à ClickUp Brain, votre assistant IA contextuel qui comprend l’ensemble de votre environnement de travail. Contrairement aux outils d’IA génériques, ClickUp Brain s’appuie sur les tâches, les documents et les flux de travail réels de votre organisation pour fournir une assistance précise et concrète dans le cadre de vos initiatives de reprise après sinistre.
Il vous suffit de soumettre une requête à ClickUp Brain, par exemple : « Crée une checklist de reprise après sinistre pour notre plateforme de commerce électronique », pour recevoir instantanément un modèle complet et sur mesure, adapté à vos systèmes, à vos processus et à vos exigences de conformité. Cela peut vous aider à :
- Connaissance du contexte : ClickUp Brain a accès à la structure, au contenu et aux permissions de votre environnement de travail. Il peut se référer aux tâches, aux documents, aux commentaires et même aux applications connectées, afin de vous fournir des réponses et des actions adaptées à votre travail concret — et non pas seulement des suggestions génériques.
- Dépannage et conseils : Résolvez instantanément les problèmes, obtenez des instructions étape par étape ou demandez des bonnes pratiques sur n'importe quelle fonctionnalité de ClickUp. Brain peut vous guider à travers des processus complexes, réaliser l'automatisation des tâches répétitives et vous aider à résoudre les obstacles.
- Automatisation et accélération des flux de travail : utilisez des agents IA prédéfinis ou personnalisés pour automatiser des flux de travail en plusieurs étapes, trier les demandes ou gérer les tâches récurrentes, ce qui vous fera gagner plusieurs heures chaque semaine.
- Recherche approfondie : retrouvez des informations enfouies n'importe où dans votre environnement de travail, qu'il s'agisse de tâches, de documents ou d'outils intégrés, même si elles datent de plusieurs années ou sont difficiles à localiser avec une recherche standard.
- Résumés et mises à jour en temps réel : générez instantanément des mises à jour de projet, des résumés de réunion ou des rapports d'avancement à partir des données en temps réel de l'environnement de travail.
- Simplification de la documentation technique : Transformez des documents techniques complexes en procédures ou checklists claires et concrètes que votre équipe pourra suivre, même sous pression.
- Intelligence multimodèle : Choisissez parmi les principaux modèles d’IA (OpenAI GPT-4.1, GPT-5, Claude, Gemini, etc.) pour obtenir les meilleurs résultats, quelle que soit la tâche à accomplir — aucun abonnement supplémentaire n’est nécessaire.
- Sécurisé et respectueux des autorisations : Brain n'accède qu'aux informations que vous êtes déjà autorisé à consulter, garantissant ainsi le respect de normes strictes en matière de confidentialité et de conformité.
- Interface de discussion : utilisez @brain dans les commentaires ou en discutant pour obtenir des informations contextuelles, rédiger des réponses ou déclencher des automatisations sans quitter votre flux de travail
- Invites personnalisées et flux de travail enregistrés : enregistrez et réutilisez des invites et des instructions pour les besoins récurrents, ce qui garantit la cohérence et permet à votre équipe de gagner du temps.
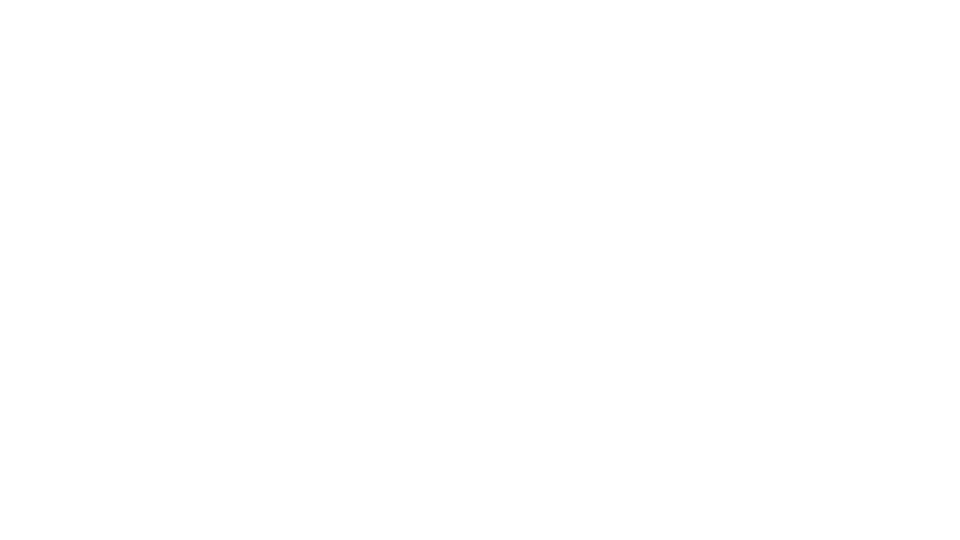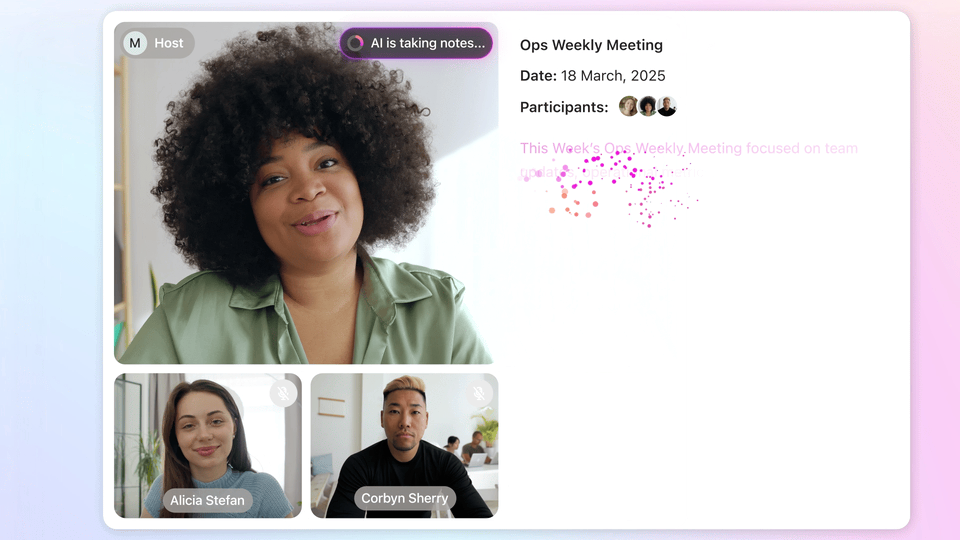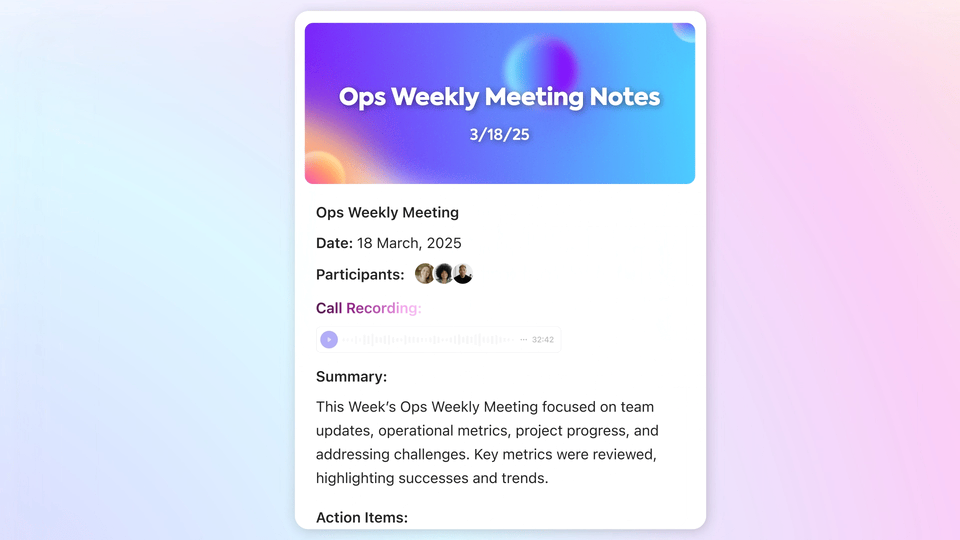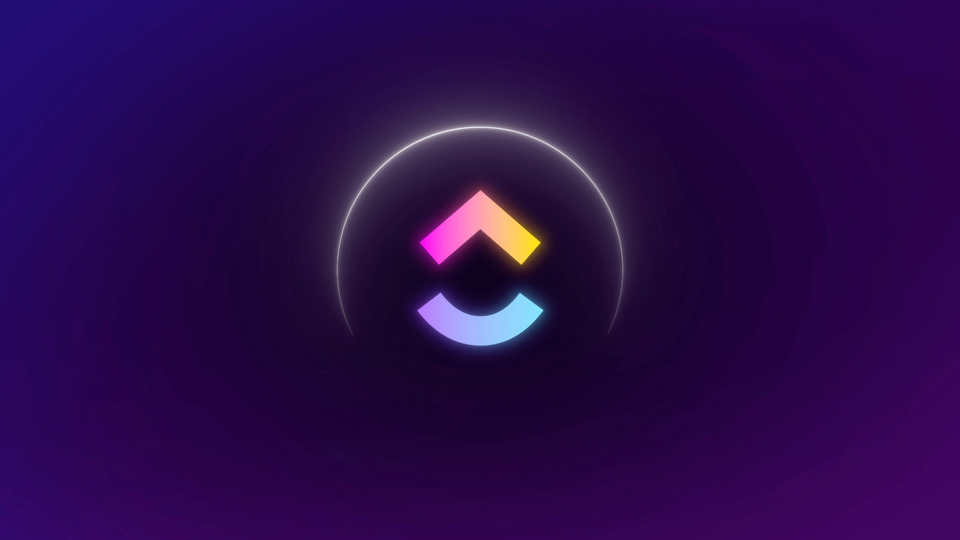
💡Conseil de pro : ne manquez jamais une leçon tirée de vos réunions de bilan d’incident en consignant chaque détail grâce à ClickUp AI Notetaker. Cet outil peut se connecter à vos réunions virtuelles, transcrire l’intégralité de la discussion et générer automatiquement une liste d’éléments à prendre en compte à partir des enseignements tirés. Vous disposez ainsi d’un historique des incidents consultable, ce qui vous permet de retrouver rapidement les évènements passés et leurs résolutions.
Flux de travail de reprise après sinistre automatisé avec ClickUp Automatisations
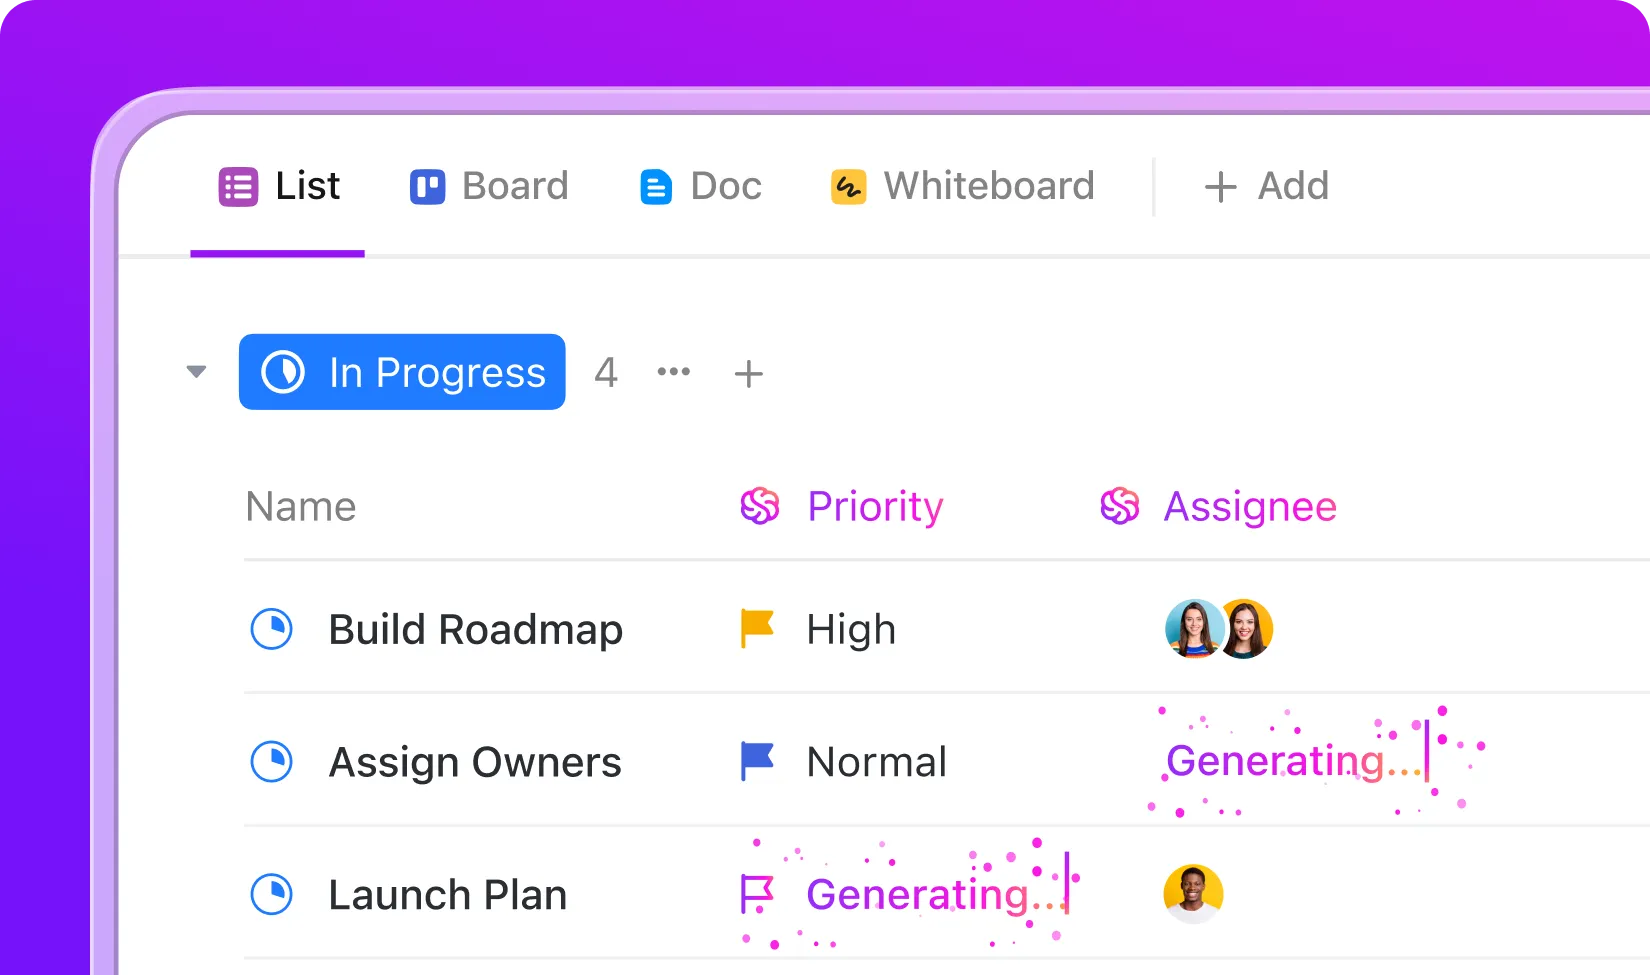
Imaginez que votre équipe soit confrontée à une panne soudaine : chaque seconde compte, et vous ne pouvez pas vous permettre de négliger la moindre étape. Grâce aux agents IA et aux automatisations de ClickUp, vous n’avez plus besoin de vous démener ni de vous fier à votre mémoire. Dès qu’un incident est signalé, l’IA de ClickUp se met en action, guide votre équipe et se charge des tâches fastidieuses afin que vous puissiez vous concentrer sur la résolution du problème.
Voici comment cela fonctionne dans un scénario réel :
- Lorsqu'un utilisateur marque une tâche comme « Incident déclaré », ClickUp Agent crée automatiquement une checklist des étapes d'intervention, les attribue aux personnes concernées et lance un chronomètre pour suivre le temps nécessaire à la reprise des activités.
- Si l’incident est classé « critique », un agent peut immédiatement envoyer un e-mail d’alerte à votre équipe de direction et créer un salon de discussion dédié — votre « cellule de crise » — afin que tout le monde puisse communiquer au même endroit.
- L'IA peut extraire les rapports d'incidents passés et la documentation pertinente, afin que votre équipe dispose de tout ce dont elle a besoin à portée de main.
Découvrez le flux de travail ici :
Avec les agents ClickUp AI, vous disposez d’un coéquipier numérique fiable qui aide votre équipe à rester sereine, organisée et efficace, même en situation de pression.
Suivi en temps réel grâce aux tableaux de bord ClickUp
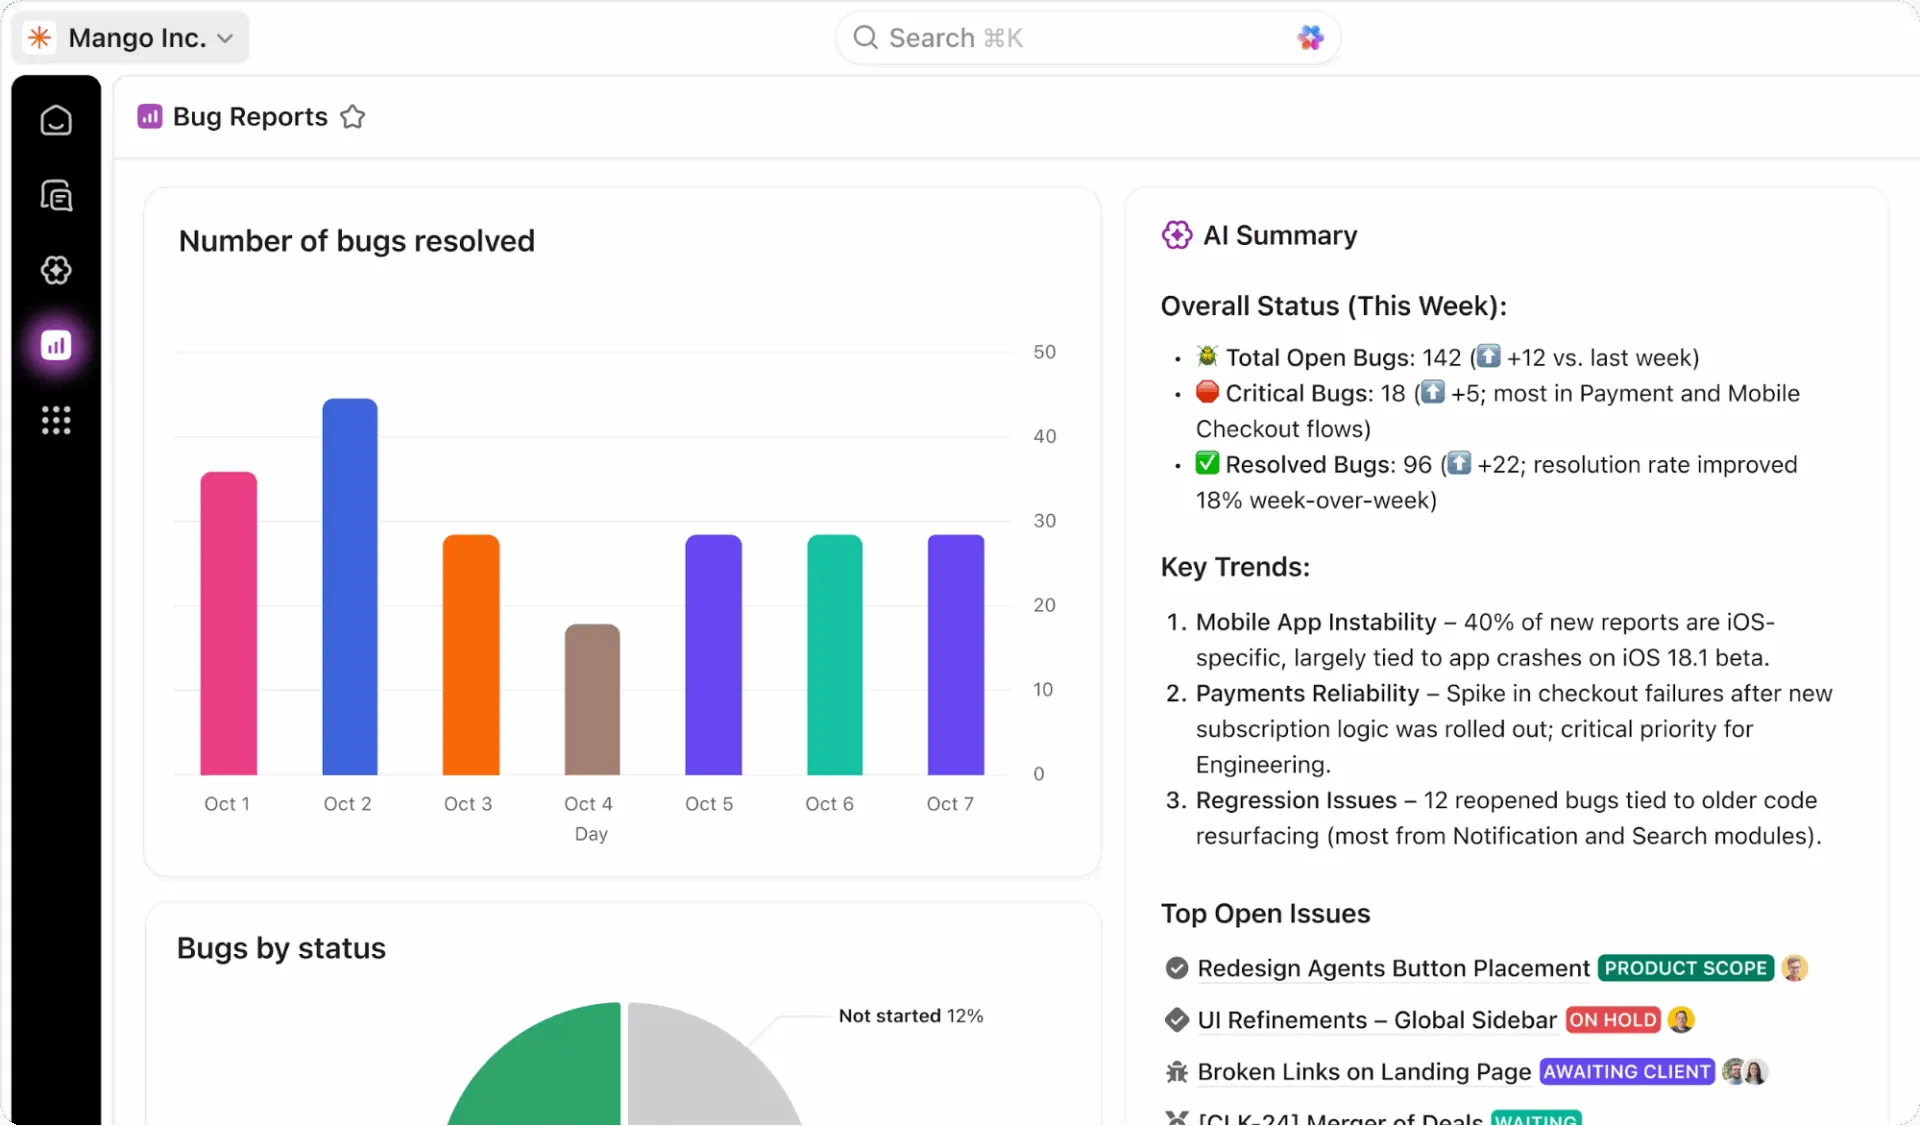
Bénéficiez d’une visibilité complète sur l’état de votre programme de reprise après sinistre en temps réel grâce aux tableaux de bord ClickUp. Vous pouvez créer des widgets pour surveiller vos performances RTO et RPO pendant les tests, suivre les taux d’achèvement des tests et afficher les tendances des incidents au fil du temps.
Ajoutez des champs personnalisés ClickUp à vos tâches pour suivre le niveau de criticité du système, l'état de la reprise et les résultats des tests, puis regroupez toutes ces données dans une vue d'ensemble. Ces tableaux de bord vous fournissent des rapports prêts à être présentés à la direction, toujours à jour grâce aux données en temps réel issues des activités de test et de réponse aux incidents menées par votre équipe.
📖 En savoir plus : Comment créer une checklist pour l'évaluation des risques
Élaborez votre plan de reprise après sinistre dès aujourd’hui
Chaque jour où vous exercez vos activités sans plan de reprise après sinistre est un pari que vous ne pouvez pas vous permettre de perdre. Les sinistres sont inévitables – qu’ils soient d’origine naturelle, dus à des défaillances techniques ou à des erreurs humaines –, mais c’est votre niveau de préparation qui détermine s’ils se traduiront par des désagréments mineurs ou par des catastrophes majeures.
Un plan de reprise après sinistre complet nécessite de bien cerner vos risques, de documenter des procédures claires et de les tester régulièrement. Les outils adaptés facilitent ce processus en éliminant le chaos lié à la dispersion des documents et aux processus manuels.
Même les plans d'urgence les plus élémentaires valent mieux que rien lorsque la catastrophe frappe. Des tests et des mises à jour réguliers transformeront votre plan de reprise après sinistre, qui passera d'un document poussiéreux à un système dynamique qui protège véritablement votre entreprise.
Faites la première étape et commencez dès aujourd’hui à élaborer votre plan de reprise après sinistre avec ClickUp. Lancez-vous gratuitement avec ClickUp et regroupez l’ensemble de votre planification de reprise après sinistre, de votre documentation et de votre gestion des incidents sur une seule et même plateforme unifiée. ✨
Foire aux questions
À quelle fréquence les équipes doivent-elles mettre à jour un modèle de plan de reprise après sinistre informatique?
Vous devez revoir votre plan de reprise après sinistre au moins quatre fois par an et le mettre à jour immédiatement après tout changement significatif de l'infrastructure ou tout incident réel. La plupart des organisations procèdent chaque année à une révision majeure et approfondie afin d'intégrer tous les enseignements tirés et de s'adapter aux nouvelles technologies.
Quelles équipes sont responsables de la documentation et des tests liés à la reprise après sinistre ?
Les équipes informatiques, les équipes de sécurité et les responsables de la continuité des activités dirigent généralement les efforts de planification et de test de la reprise après sinistre. Cependant, ils ont besoin des contributions essentielles des responsables des opérations et des unités opérationnelles pour s'assurer que le plan correspond aux besoins et aux priorités réels de l'entreprise.
Comment suivre les indicateurs RTO et RPO lors des tests de reprise après sinistre ?
Utilisez des chronomètres et des horodatages clairs pour mesurer les temps de reprise réels par rapport aux cibles que vous avez définies lors de chaque test. Il est essentiel de consigner dans vos rapports de test tout écart entre vos cibles et les performances réelles afin d’orienter les améliorations futures.
Quels outils permettent de documenter et d'effectuer l'automatisation d'un plan de reprise après sinistre ?
Les plateformes de gestion de projet telles que ClickUp sont idéales pour centraliser la documentation, réaliser l’automatisation des flux de travail et effectuer le suivi des indicateurs de performance de l’ensemble de votre programme de reprise après sinistre. Vous pouvez ensuite les associer à des outils spécialisés de reprise après sinistre qui gèrent les aspects techniques de la réplication des données et du basculement des systèmes.