
Los proyectos de entrenamiento de IA rara vez fracasan a nivel de modelo. Las dificultades surgen cuando los experimentos, la documentación y las actualizaciones para las partes interesadas se encuentran dispersas en demasiadas herramientas.
Esta guía te explica paso a paso cómo entrenar modelos con Databricks DBRX —un modelo de lenguaje grande (LLM) que es hasta dos veces más eficiente en términos de computación que otros modelos líderes— mientras mantienes organizado todo el trabajo relacionado con ello en ClickUp.
Desde la configuración y el ajuste fino hasta la documentación y las actualizaciones entre equipos, verás cómo un único entorno de trabajo convergente ayuda a eliminar la dispersión de información y mantiene a tu equipo centrado en crear, no en buscar. 🛠
¿Qué es DBRX?
DBRX es un potente modelo de lenguaje a gran escala (LLM) de código abierto diseñado específicamente para el entrenamiento y la inferencia de modelos de IA en el ámbito de las corporaciones. Al tratarse de un modelo de código abierto bajo la Licencia de Modelos Abiertos de Databricks, tu equipo tiene acceso completo a los pesos y la arquitectura del modelo, lo que te permite inspeccionarlo, modificarlo e implementarlo según tus propias condiciones.
Está disponible en dos variantes: DBRX Base, para el preentrenamiento profundo, y DBRX Instruct, para tareas de seguimiento de instrucciones listas para usar.
Arquitectura de DBRX y diseño de «mezcla de expertos»
DBRX resuelve tareas utilizando una arquitectura de «mezcla de expertos» (MoE). A diferencia de los grandes modelos de lenguaje tradicionales, que utilizan todos sus miles de millones de parámetros para cada cálculo, DBRX solo activa una fracción de sus parámetros totales (los expertos más relevantes) para cualquier tarea concreta.
Piensa en ello como un equipo de expertos especializados; en lugar de que todo el mundo trabaje en todos los problemas, el sistema asigna de forma inteligente cada tarea a los profesionales más cualificados según los parámetros correspondientes.
Esto no solo reduce el tiempo de respuesta, sino que también ofrece un rendimiento y unos resultados de primer nivel, al tiempo que reduce significativamente los costes computacionales.
A continuación, te ofrecemos un resumen de sus especificaciones clave:
- Total de parámetros: 132 000 millones en todos los expertos
- Parámetros activos: 36 mil millones por pasada hacia adelante
- Número de expertos: 16 en total (enrutamiento MoE Top-4), con 4 activos para cualquier token dado
- Ventana de contexto: 32 000 tokens
Especificaciones de los datos de entrenamiento y los tokens de DBRX
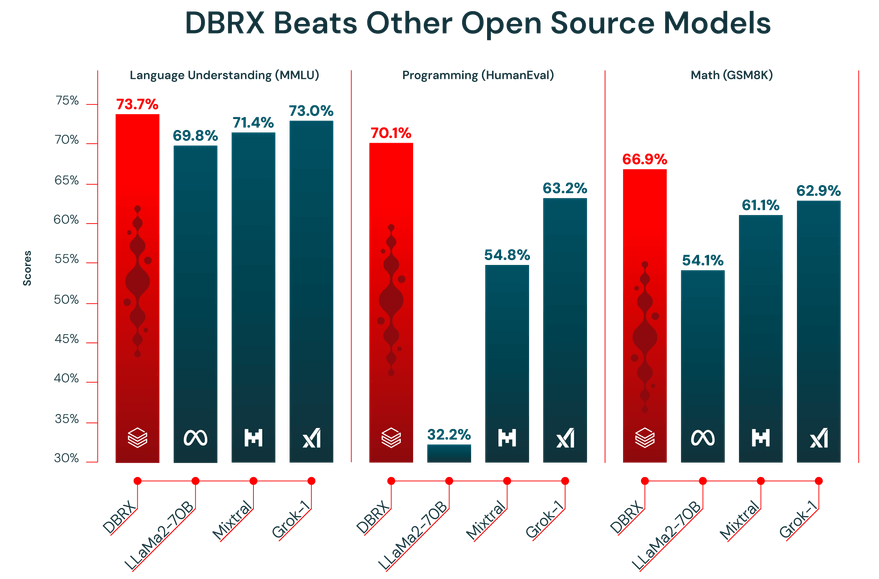
El rendimiento de un modelo de lenguaje grande (LLM) depende de la calidad de los datos con los que se haya entrenado. DBRX se entrenó previamente con un enorme conjunto de datos de 12 billones de tokens, cuidadosamente seleccionado por el equipo de Databricks utilizando sus avanzadas herramientas de procesamiento de datos. Esa es precisamente la razón por la que obtuvo unos resultados excelentes en las pruebas comparativas del sector.
Además, DBRX cuenta con una ventana de contexto de 32 000 tokens. Esta es la cantidad de texto que el modelo puede tener en cuenta de una sola vez. Una ventana de contexto amplia resulta muy útil para tareas complejas como resumir informes largos, analizar documentos jurídicos extensos o crear sistemas avanzados de generación aumentada por recuperación (RAG), ya que permite al modelo mantener el contexto sin truncar ni olvidar información.
🎥 Mira este vídeo para descubrir cómo una coordinación de proyectos optimizada puede transformar tu flujo de trabajo de entrenamiento de IA y eliminar las dificultades que supone cambiar entre herramientas inconexas. 👇🏽
Cómo acceder a DBRX y realizar los ajustes necesarios
DBRX ofrece dos vías de acceso principales, ambas con acceso completo a los pesos de los modelos bajo condiciones comerciales flexibles. Puedes utilizar Hugging Face para disfrutar de la máxima flexibilidad o acceder directamente a través de Databricks para una experiencia más integrada.
Accede a DBRX a través de Hugging Face
Para los equipos que valoran la flexibilidad y ya se sienten cómodos con el ecosistema de Hugging Face, acceder a DBRX a través del hub es la opción ideal. Te permite integrar el modelo en tus flujos de trabajo existentes basados en transformers.
A continuación te explicamos cómo empezar:
- Crea una cuenta en Hugging Face o inicia sesión en la tuya
- Accede a la tarjeta del modelo DBRX en el hub y acepta los términos de la licencia.
- Instala la biblioteca «transformers» junto con las dependencias necesarias, como «accelerate».
- Utiliza la clase `AutoModelForCausalLM` en tu script de Python para cargar el modelo de DBRX.
- Configura tu canalización de inferencia, teniendo en cuenta que DBRX requiere una cantidad considerable de memoria de la GPU (VRAM) para funcionar de forma eficaz.
📖 Más información: Cómo configurar la temperatura de un modelo de lenguaje grande (LLM)
Accede a DBRX a través de Databricks
Si tu equipo ya utiliza Databricks para la ingeniería de datos o el aprendizaje automático, acceder a DBRX a través de la plataforma es la forma más sencilla. Elimina las dificultades de configuración y te ofrece todas las herramientas que necesitas para MLOps justo donde ya estás trabajando.
Sigue estos pasos en tu entorno de trabajo de Databricks para empezar:
- Accede a la sección «Model Garden» o «Mosaic IA».
- Elige entre DBRX Base o DBRX Instruct, según tus necesidades.
- Configura un punto final de servicio para el acceso a la API o configura un entorno de cuaderno para uso interactivo
- Empieza a probar la inferencia con muestras de indicaciones para asegurarte de que todo funciona correctamente antes de ampliar el entrenamiento o la implementación de tu modelo de IA.
Este enfoque te ofrece un acceso fluido a herramientas como MLflow para el seguimiento de experimentos y Unity Catalog para la gestión de modelos.
📮 ClickUp Insight: El profesional medio dedica más de 30 minutos al día a buscar información relacionada con el trabajo; eso supone más de 120 horas al año perdidas rebuscando entre correos electrónicos, hilos de Slack y archivos dispersos.
Un asistente inteligente de IA integrado en tu entorno de trabajo puede cambiar eso. Te presentamos ClickUp Brain.
Ofrece información y respuestas al instante al mostrar los documentos, las conversaciones y los detalles de las tareas adecuados en cuestión de segundos, para que puedas dejar de buscar y ponerte a trabajar.
Cómo ajustar DBRX y entrenar modelos de IA personalizados
Un modelo ya desarrollado, por muy potente que sea, nunca comprenderá los matices únicos de tu empresa. Como DBRX es de código abierto, puedes ajustarlo para crear un modelo personalizado que se adapte al lenguaje de tu empresa o que realice una tarea específica que desees que lleve a cabo.
Aquí tienes tres formas habituales de hacerlo:
1. Ajusta DBRX con los conjuntos de datos de Hugging Face
Para los equipos que acaban de empezar o que trabajan en tareas habituales, los conjuntos de datos públicos de Hugging Face Hub son un recurso fantástico. Están preformateados y son fáciles de cargar, lo que significa que no tendrás que dedicar horas a preparar tus datos.
El proceso es bastante sencillo:
- Busca en el hub un conjunto de datos que se adapte a tu tarea (por ejemplo, seguir instrucciones, resumir).
- Cárgalo utilizando la biblioteca de conjuntos de datos
- Asegúrate de que los datos estén en formato de pares de instrucción-respuesta.
- Configura tu script de entrenamiento con hiperparámetros como la tasa de aprendizaje y el tamaño del lote.
- Inicia el proceso de entrenamiento, asegurándote de guardar los puntos de control durante periodos regulares.
- Evalúa el modelo ajustado en un conjunto de validación independiente para medir la mejora.
2. Ajusta DBRX con conjuntos de datos locales
Normalmente, obtendrás los mejores resultados si realizas un ajuste fino con tus propios datos. Esto te permite enseñar al modelo la terminología, el estilo y los conocimientos específicos del sector de tu empresa. Solo tienes que tener en cuenta que solo merecerá la pena si tus datos están limpios y bien preparados, y cuentan con un volumen suficiente.
Sigue estos pasos para preparar tus datos internos:
- Recopilación de datos: Recopila ejemplos de alta calidad de tus wikis internos, documentos y bases de datos.
- Conversión de formato: Estructura tus datos en un formato coherente de instrucción-respuesta, normalmente en forma de líneas JSON.
- Filtrado por calidad: Elimina cualquier ejemplo de baja calidad, duplicado o irrelevante.
- División para validación: Reserva una pequeña parte de tus datos (normalmente entre el 10 % y el 15 %) para evaluar el rendimiento del modelo.
- Revisión de privacidad: Elimina u oculta cualquier información de carácter personal (PII) o datos sensibles.
3. Ajusta DBRX con StreamingDataset
Si tu conjunto de datos resulta ser demasiado grande para caber en la memoria de tu equipo, no te preocupes: puedes utilizar la biblioteca Streaming Dataset de Databricks. Te permite transmitir datos directamente desde el almacenamiento en la nube mientras se entrena el modelo, en lugar de cargarlos todos en la memoria de una sola vez.
A continuación te explicamos cómo hacerlo:
- Preparación de datos: Limpia y estructura tus datos de entrenamiento y, a continuación, guárdalos en un formato compatible con flujos de datos, como JSONL o CSV, en un almacenamiento en la nube.
- Conversión de formato para streaming: Convierte tu conjunto de datos a un formato compatible con el streaming, como Mosaic Data Shard (MDS), para que se pueda leer de forma eficiente durante el entrenamiento.
- Configuración del cargador de entrenamiento: Configura tu cargador de entrenamiento para que apunte al conjunto de datos remoto y define una caché local para el almacenamiento temporal de datos.
- Inicialización del modelo: Inicia el proceso de ajuste fino de DBRX utilizando un marco de entrenamiento con compatibilidad para StreamingDataset, como LLM Foundry.
- Entrenamiento basado en streaming: ejecuta la tarea de entrenamiento mientras los datos se transmiten por lotes durante el proceso, en lugar de cargarlos íntegramente en la memoria.
- Puntos de control y recuperación: reanuda el entrenamiento sin problemas si se interrumpe una ejecución, sin duplicar ni omitir datos.
- Evaluación e implementación: Valida el rendimiento del modelo ajustado e impleméntalo utilizando tu configuración preferida de servicio o inferencia.
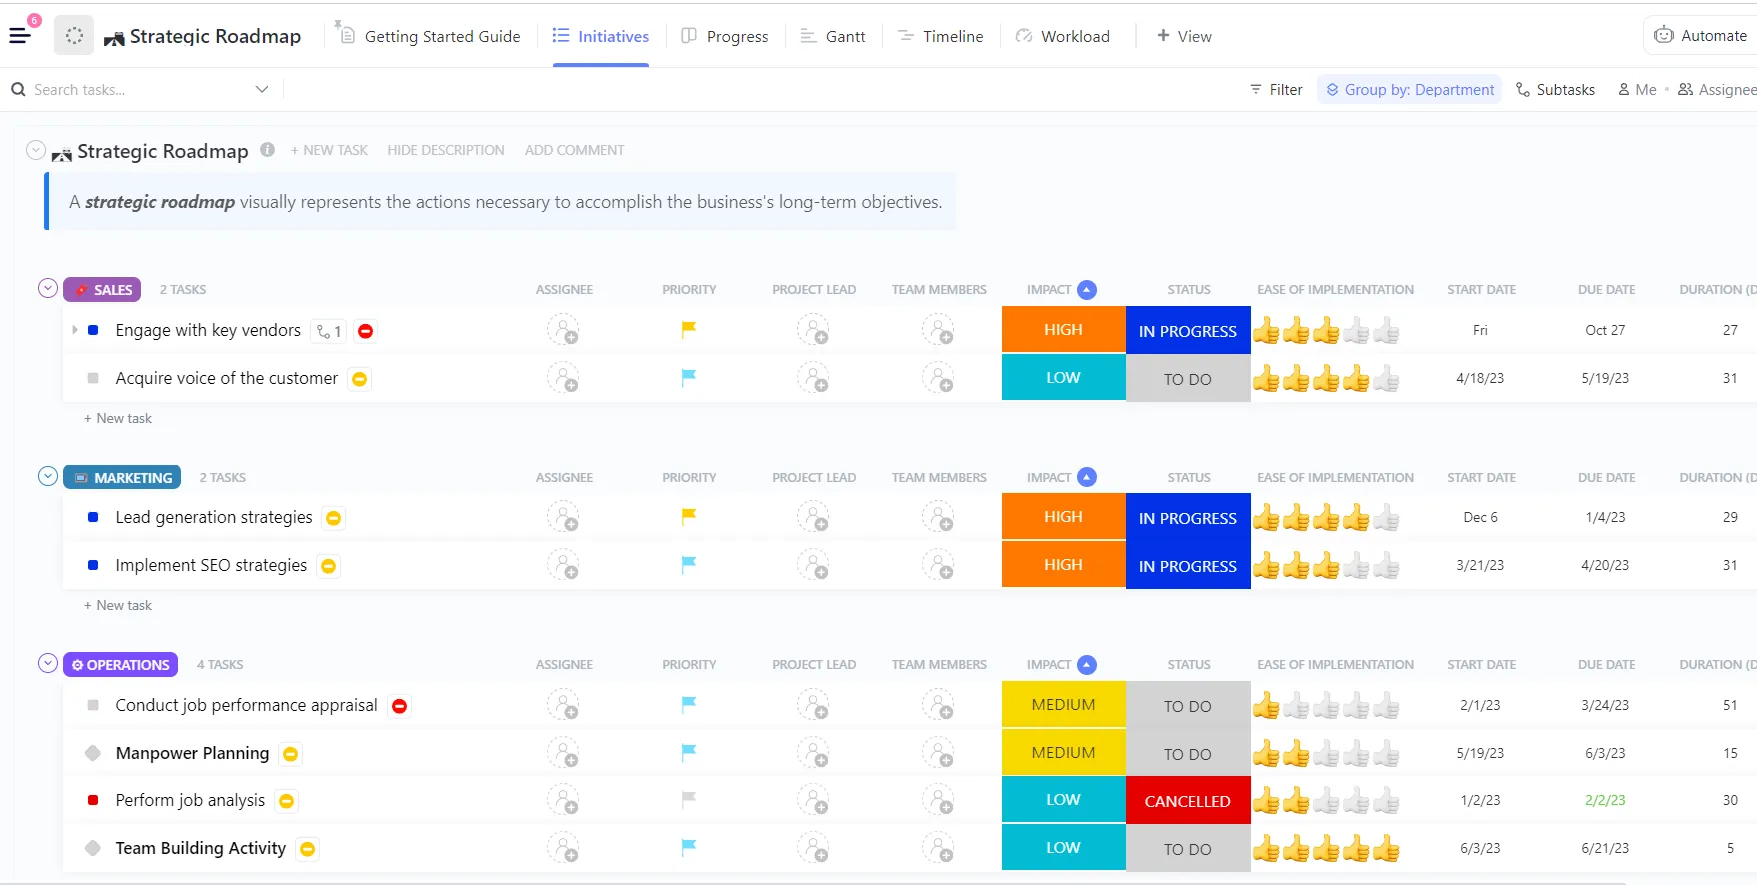
💡Consejo de experto: En lugar de crear un plan de entrenamiento de DBRX desde cero, empieza con la plantilla de hoja de ruta para proyectos de IA y aprendizaje automático de ClickUp y adáptala a las necesidades de tu equipo. Ofrece una estructura clara para planificar los conjuntos de datos, las fases de entrenamiento, la evaluación y la implementación, de modo que puedas centrarte en organizar tu trabajo en lugar de en estructurar un flujo de trabajo.
Casos de uso de DBRX para el entrenamiento de modelos de IA
Una cosa es tener un modelo potente, pero otra muy distinta es saber exactamente en qué aspectos destaca.
Cuando no se tiene una idea clara de los puntos fuertes de un modelo, es fácil dedicar tiempo y recursos a intentar que funcione en situaciones en las que simplemente no encaja. Esto da lugar a resultados mediocres y a frustración.
La arquitectura única de DBRX y sus datos de entrenamiento lo hacen especialmente adecuado para varios casos de uso clave en el ámbito de las corporaciones. Conocer estas ventajas te ayudará a adaptar el modelo a tus objetivos empresariales y a maximizar el retorno de la inversión.
Generación de texto y creación de contenidos
DBRX Instruct está especialmente optimizado para seguir instrucciones y generar texto de alta calidad. Esto lo convierte en una potente herramienta para automatizar una amplia gama de tareas relacionadas con el contenido. Su amplia ventana de contexto es una ventaja significativa, ya que le permite manejar documentos largos sin perder el hilo.
Puedes utilizarlo para:
- Documentación técnica: Crea y perfecciona manuales de productos, referencias de API y guías de usuario.
- Contenido de marketing: Borradores de entradas de blog, boletines informativos por correo electrónico y publicaciones en redes sociales
- Generación de informes: resume los resultados de datos complejos y crea resúmenes ejecutivos concisos
- Traducción y localización: Adapta el contenido existente a nuevos mercados y públicos.
Tareas de generación de código y depuración
Una parte significativa de los datos de entrenamiento de DBRX incluía código, lo que lo convierte en una herramienta de apoyo de LLM muy útil para los desarrolladores. Puede ayudar a acelerar los ciclos de desarrollo al automatizar tareas repetitivas de programación y facilitar la resolución de problemas complejos.
A continuación te mostramos algunas formas en las que tu equipo de ingeniería puede sacarle partido:
- Autocompletado de código: Genera automáticamente el cuerpo de las funciones a partir de comentarios o cadenas de documentación.
- Detección de errores: Analiza fragmentos de código para identificar posibles errores o fallos lógicos.
- Explicación del código: Traduce algoritmos complejos o código heredado/a a un lenguaje sencillo.
- Generación de pruebas: Crea pruebas unitarias basadas en la firma de una función y en el comportamiento esperado.
RAG y aplicaciones de contexto extenso
La generación aumentada por recuperación (RAG) es una potente técnica que basa las respuestas de un modelo en los datos privados de tu empresa. Sin embargo, los sistemas RAG suelen tener dificultades con modelos que tienen ventanas de contexto pequeñas, lo que obliga a una segmentación agresiva de los datos que puede provocar la pérdida de contexto importante. La ventana de contexto de 32K de DBRX lo convierte en una base excelente para aplicaciones RAG robustas.
Esto te permite crear potentes herramientas internas, como:
- Búsqueda empresarial: Crea un chatbot que responda a las preguntas de los empleados utilizando tu base de conocimientos interna.
- Soporte al cliente: Crea un agente que genere respuestas de soporte basadas en la documentación de tu producto.
- Asistencia en investigación: Desarrolla una herramienta capaz de sintetizar la información de cientos de páginas de artículos de investigación.
- Comprobación del cumplimiento normativo: Verifica automáticamente los textos de marketing según las directrices internas de la marca o los documentos normativos.
Cómo integrar el entrenamiento con DBRX en el flujo de trabajo de tu equipo
El éxito de un proyecto de entrenamiento de modelos de IA va más allá del código y la potencia de cálculo. Se trata de un esfuerzo colaborativo en el que participan ingenieros de aprendizaje automático, científicos de datos, gestores de producto y partes interesadas.
Cuando esta colaboración se dispersa entre cuadernos de Jupyter, canales de Slack y herramientas de gestión de proyectos independientes, se produce una dispersión del contexto, una situación en la que la información crítica del proyecto se encuentra dispersa en demasiadas herramientas.
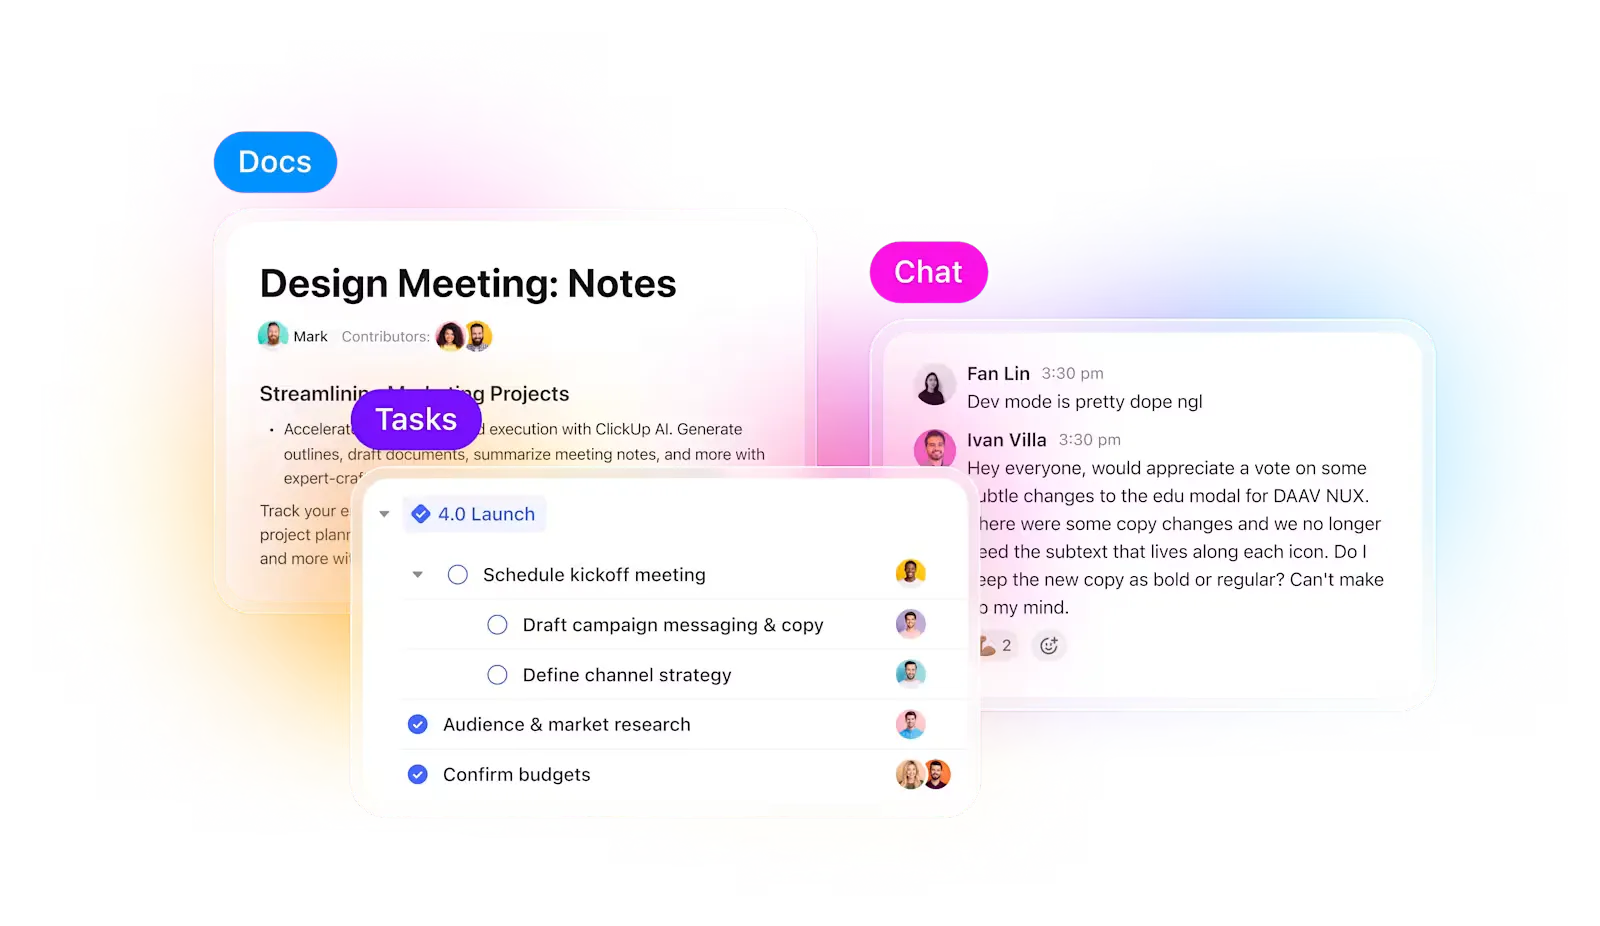
ClickUp resuelve ese problema. En lugar de tener que hacer malabarismos con múltiples herramientas, dispones de un único entorno de trabajo convergente de IA donde conviven la gestión de proyectos, la documentación y la comunicación, de modo que tus experimentos permanecen conectados desde la planificación hasta la ejecución y la evaluación.
No pierdas nunca el seguimiento de los experimentos y su progreso
Cuando se llevan a cabo varios experimentos, lo más difícil no es entrenar el modelo, sino llevar un seguimiento de lo que ha cambiado durante el proceso. ¿Qué versión del conjunto de datos se utilizó, qué tasa de aprendizaje funcionó mejor o qué ejecución se implementó?
ClickUp te facilita enormemente este proceso. Puedes realizar el seguimiento de cada sesión de entrenamiento por separado en las tareas de ClickUp y, dentro de las tareas, puedes utilizar los Campos personalizados para registrar:
- Versión del conjunto de datos
- Hiperparámetros
- Variante del modelo (DBRX Base frente a DBRX Instruct)
- Estado del entrenamiento (En cola, En ejecución, En evaluación, Implementado)
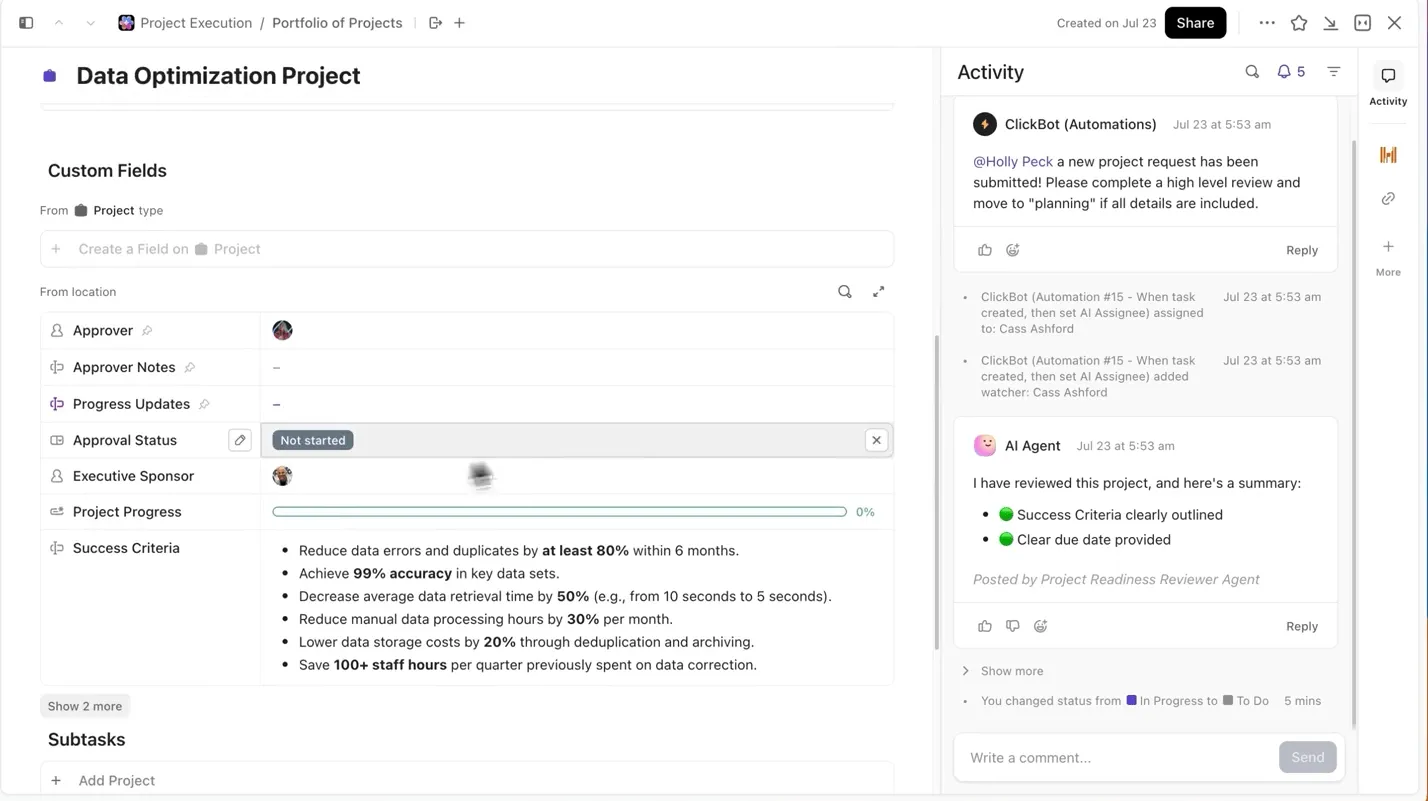
De este modo, todos los experimentos documentados se pueden buscar, comparar fácilmente con otros y reproducir.
Mantén la documentación de los modelos vinculada al trabajo
No tendrás que estar saltando entre cuadernos de Jupyter, archivos README o hilos de Slack para entender el contexto de la tarea de un experimento.
Con ClickUp Docs, puedes mantener organizada y accesible la arquitectura de tu modelo, los scripts de preparación de datos o las métricas de evaluación, documentándolos en un documento con función de búsqueda que enlaza directamente con las tareas del experimento de las que proceden.
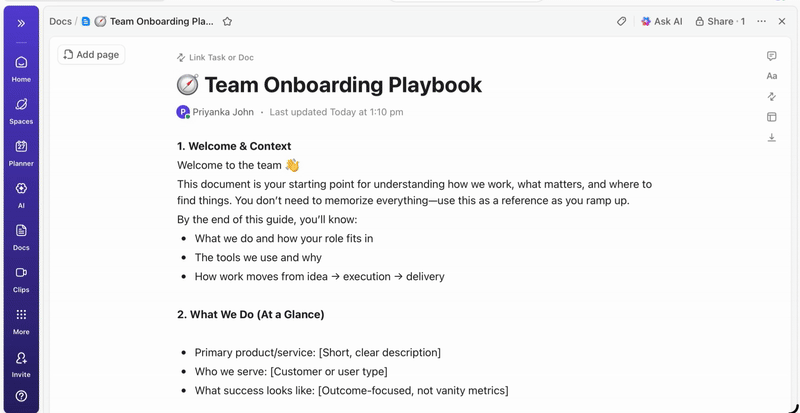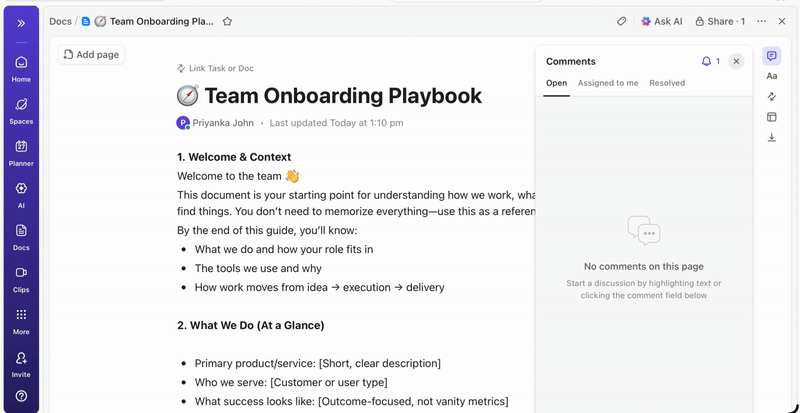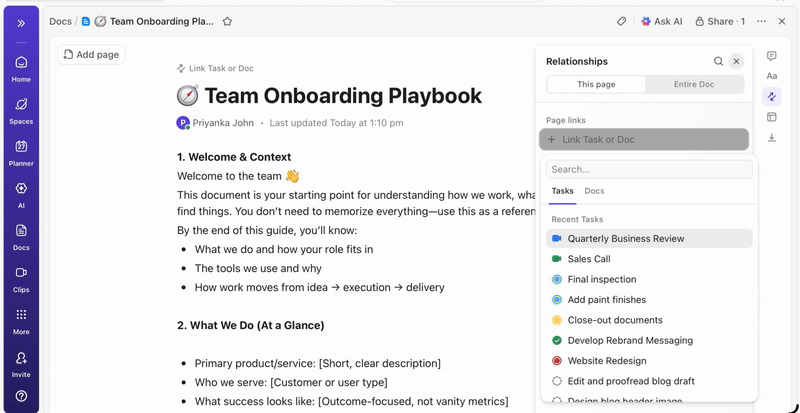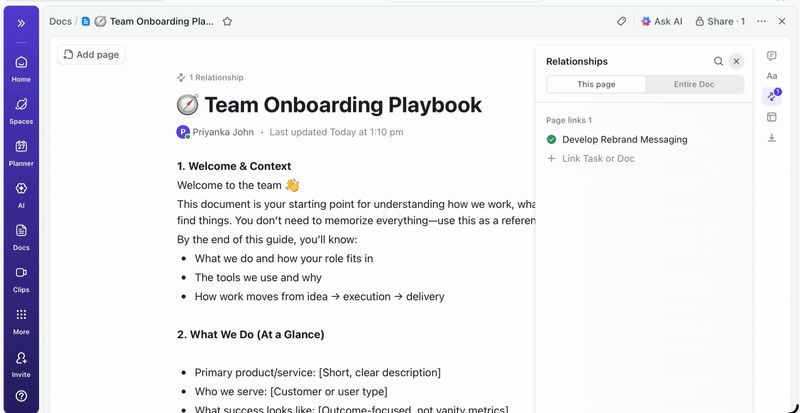
💡Consejo profesional: Mantén un resumen actualizado del proyecto en ClickUp Docs que detalle cada decisión, desde la arquitectura hasta la implementación, para que los nuevos miembros del equipo puedan ponerse al día con los detalles del proyecto sin tener que rebuscar en hilos antiguos.
Ofrece visibilidad en tiempo real a las partes interesadas
Los paneles de ClickUp muestran el progreso de los experimentos y la carga de trabajo del equipo en tiempo real. I
En lugar de recopilar manualmente las actualizaciones o enviar correos electrónicos, los paneles se actualizan automáticamente en función de los datos de tus tareas. Así, las partes interesadas pueden consultar en cualquier momento el estado de las cosas y nunca tendrán que interrumpirte con preguntas del tipo «¿en qué estado estamos?».
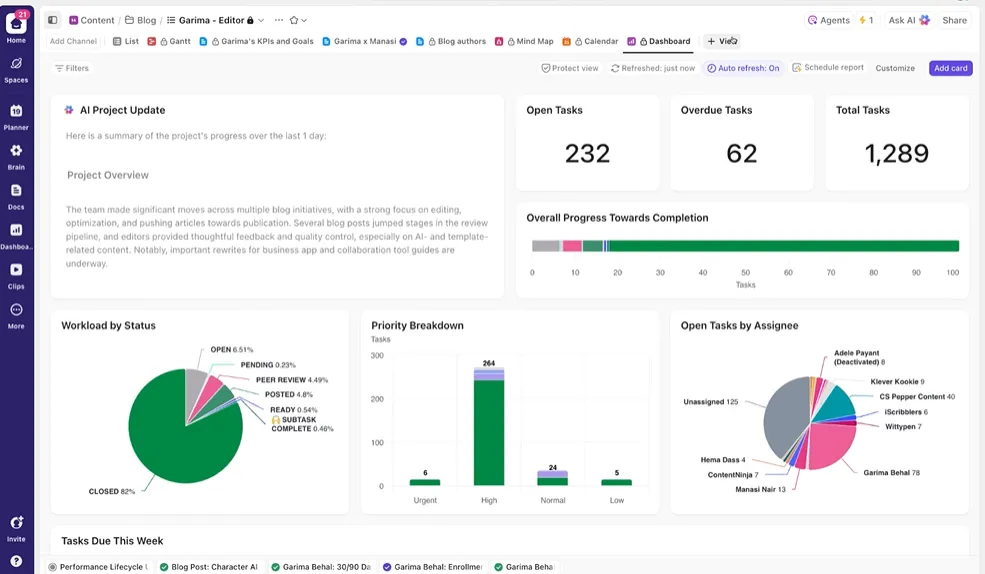
De esta forma, podrás centrarte en llevar a cabo los experimentos en lugar de tener que realizar la elaboración de informes manualmente de forma constante.
Convierte la IA en tu compañero inteligente para los proyectos
No tienes que revisar manualmente semanas de datos de entrenamiento para obtener un resumen de los experimentos realizados hasta ahora. Solo tienes que hacer una mención de @Brain en cualquier comentario de una tarea, y ClickUp Brain te proporcionará la ayuda que necesitas con todo el contexto de tus proyectos pasados y en curso.
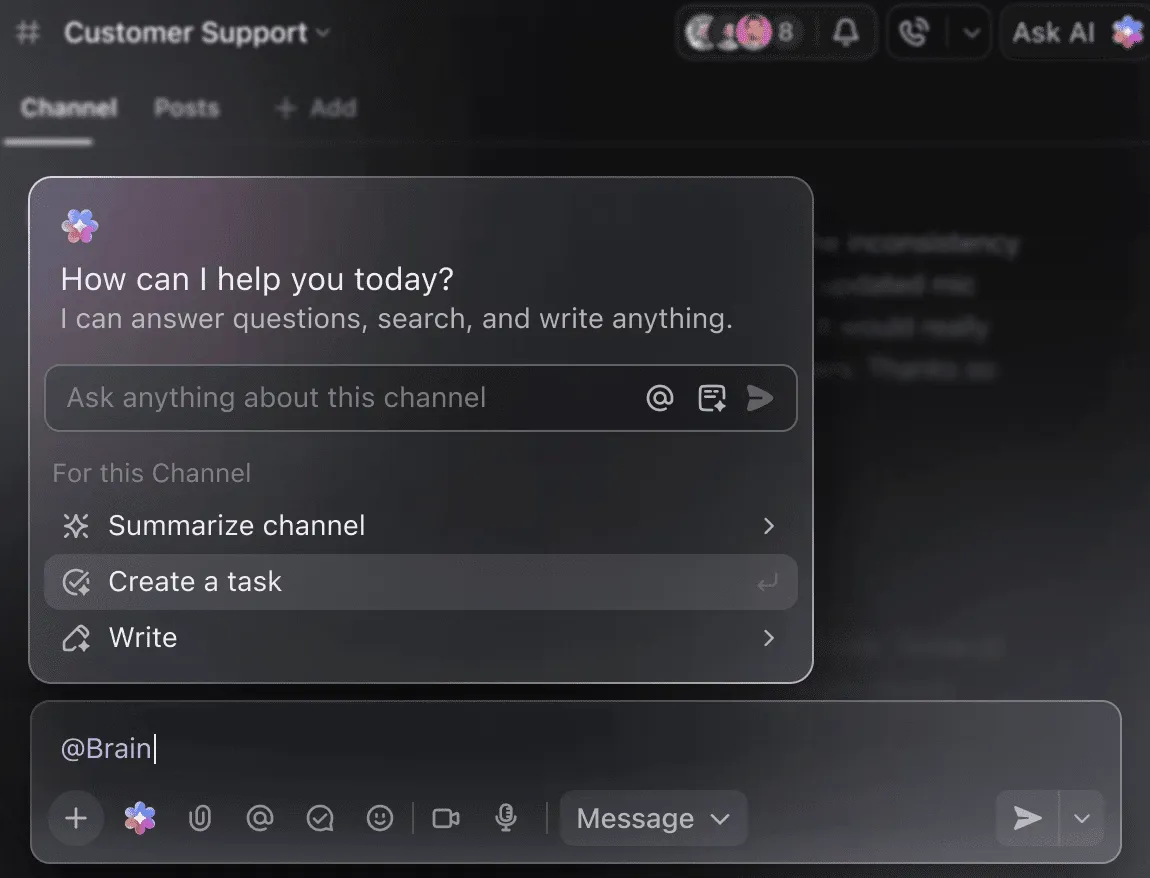
Puedes pedirle a Brain que «resuma los experimentos de la semana pasada en cinco puntos clave» o que «redacte un documento con los últimos resultados de los hiperparámetros», y obtendrás al instante un resultado impecable.
🧠 La ventaja de ClickUp: Los «Superagentes» de ClickUp van mucho más allá: pueden automatizar flujos de trabajo completos basándose en los desencadenantes que tú definas, no solo responder a tus preguntas. Con los superagentes, puedes crear automáticamente una nueva tarea de entrenamiento de DBRX cada vez que se suba un conjunto de datos, notificarlo a tu equipo y vincular los documentos relevantes cuando finalice la sesión de entrenamiento o se alcance un punto de control, además de generar un resumen semanal del progreso y enviarlo a las partes interesadas sin que tengas que hacer nada.
Errores comunes que hay que evitar
Embarcarse en un proyecto de entrenamiento con DBRX es emocionante, pero algunos errores habituales pueden frenar tu progreso. Evitar estos errores te ahorrará tiempo, dinero y mucha frustración.
- Subestimar los requisitos de hardware: DBRX es potente, pero también ocupa mucho espacio. Intentar ejecutarlo en un hardware inadecuado provocará errores de memoria insuficiente y fallos en los trabajos de entrenamiento. Ten en cuenta que DBRX (132B) requiere al menos 264 GB de VRAM para la inferencia de 16 bits, o entre 70 y 80 GB aproximadamente cuando se utiliza la cuantificación de 4 bits.
- Omitir los controles de calidad de los datos: si los datos de entrada son erróneos, los resultados también lo serán. El ajuste fino de un conjunto de datos desordenado y de baja calidad solo enseñará al modelo a generar resultados desordenados y de baja calidad.
- Ignorando los límites de longitud del contexto: Aunque la ventana de contexto de 32K de DBRX es generosa, no es infinita. Si se introducen datos en el modelo que superen este límite, se producirá un truncamiento silencioso y un rendimiento deficiente.
- Cuándo es adecuado utilizar Base en lugar de Instruct: DBRX Base es un modelo sin procesar y preentrenado, destinado a un entrenamiento posterior a gran escala. Para la mayoría de las tareas que implican seguir instrucciones, deberías empezar con DBRX Instruct, que ya ha sido ajustado específicamente para ese fin.
- Aislar el trabajo de entrenamiento de la coordinación del proyecto: cuando el seguimiento de tus experimentos se realiza en una herramienta y el plan del proyecto en otra, se crean silos de información. Utiliza una plataforma integrada como ClickUp para sincronizar tu trabajo técnico y la coordinación del proyecto.
- Descuidar la evaluación antes de la implementación: un modelo que funcione bien con tus datos de entrenamiento puede fracasar estrepitosamente en el mundo real. Valida siempre tu modelo ajustado en un conjunto de prueba independiente antes de implementarlo en producción.
- Pasar por alto la complejidad del ajuste fino: dado que DBRX es un modelo de «mezcla de expertos», los scripts estándar de ajuste fino pueden requerir bibliotecas especializadas como Megatron-LM o PyTorch FSDP para gestionar la distribución de parámetros entre varias GPU.
DBRX frente a otras plataformas de entrenamiento de IA
La elección de una plataforma de entrenamiento de IA implica una disyuntiva fundamental: control frente a comodidad. Los modelos propietarios, que solo funcionan a través de API, son fáciles de usar, pero te atan al ecosistema de un proveedor.
Los modelos de pesos abiertos, como DBRX, ofrecen un control total, pero requieren más conocimientos técnicos e infraestructura. Esta elección puede hacerte sentir estancado, sin saber con certeza qué camino te ayuda realmente a alcanzar tus metas a largo plazo, un reto al que se enfrentan muchos equipos durante la adopción de la IA.
Esta tabla detalla las diferencias clave para ayudarte a tomar una decisión informada.
| Ponderaciones | Abrir (personalizado) | Propietario | Abrir (personalizado) | Propietario |
| Ajuste fino | Control total | Basado en API | Control total | Basado en API |
| Autohospedaje | Sí | No | Sí | No |
| Licencia | DB Open Model | Términos de OpenAI | Comunidad Llama | Términos de Anthropic |
| Contexto | 32K | 128 000 – 1 millón | 128K | 200 000 – 1 millón |
DBRX es la opción adecuada cuando necesitas un control total sobre el modelo, debes alojarlo tú mismo por motivos de seguridad o cumplimiento normativo, o deseas la flexibilidad que ofrece una licencia comercial permisiva. Si no dispones de una infraestructura de GPU dedicada —o si valoras más la rapidez de comercialización que la personalización avanzada—, las alternativas basadas en API pueden ser más adecuadas.
Empieza a entrenar de forma más inteligente con ClickUp
DBRX te ofrece una base preparada para el ámbito de las corporaciones con la que crear aplicaciones de IA personalizadas, con la transparencia y el control que no te ofrecen los modelos propietarios. Su eficiente arquitectura MoE mantiene bajos los costes de inferencia, y su diseño abierto facilita el ajuste fino. Pero una tecnología sólida es solo la mitad de la ecuación.
El verdadero éxito se consigue alineando el trabajo técnico con el flujo de trabajo colaborativo de tu equipo. El entrenamiento de modelos de IA es un trabajo en equipo, y es fundamental sincronizar los experimentos, la documentación y la comunicación con las partes interesadas. Cuando reúnes todo en un único entorno de trabajo convergente y reduces la dispersión de información, puedes lanzar mejores modelos con mayor rapidez.
Empieza gratis con ClickUp para coordinar tus proyectos de entrenamiento de IA en un único entorno de trabajo. ✨
Preguntas frecuentes
¿Cómo puedo supervisar el progreso del entrenamiento en DBRX?
Puedes supervisar el entrenamiento utilizando herramientas estándar de aprendizaje automático como TensorBoard, Weights & Biases o MLflow. Si estás realizando el entrenamiento dentro del ecosistema de Databricks, MLflow está integrado de forma nativa para un seguimiento fluido de los experimentos.
¿Puedo integrar DBRX con CI/CD y los procesos de implementación?
Sí, DBRX se puede integrar en flujos de trabajo estándar de MLOps. Al contenerizar el modelo, puedes implementarlo utilizando plataformas de orquestación como Kubeflow o flujos de trabajo personalizados de CI/CD.
¿Cuál es la diferencia entre DBRX Base y DBRX Instruct?
DBRX Base es el modelo preentrenado básico destinado a equipos que desean llevar a cabo un preentrenamiento continuo específico para un dominio o un ajuste fino de la arquitectura profunda. DBRX Instruct es una versión ajustada y optimizada para seguir instrucciones, lo que la convierte en un mejor punto de partida para la mayoría de los desarrollos de aplicaciones.
¿En qué se diferencia DBRX de GPT-4 para proyectos de IA empresarial?
La principal diferencia es el control. DBRX te ofrece acceso completo a los pesos del modelo para una personalización profunda y el autoalojamiento, mientras que GPT-4 es un servicio que solo funciona a través de una API.
¿Se puede utilizar DBRX de forma gratuita?
Los pesos del modelo DBRX están disponibles gratis bajo la licencia Databricks Open Model License. No obstante, los costes de la infraestructura informática necesaria para ejecutar o ajustar el modelo corren a cargo del usuario.