
Desastres de TI podem ocorrer sem aviso prévio.
De falhas de servidor a ataques cibernéticos — e sem um plano de recuperação sólido, sua empresa pode enfrentar horas de inatividade, perda de dados e graves prejuízos financeiros, sendo que 54% das interrupções graves custam mais de US$ 100.000.
Este blog orienta você na elaboração de um plano abrangente de recuperação de desastres de TI que proteja seus sistemas, defina objetivos claros de recuperação e garanta que sua equipe saiba exatamente o que fazer quando algo der errado.
O que é um plano de recuperação de desastres de TI?
Se seus servidores parassem de funcionar agora mesmo, sua equipe saberia exatamente o que fazer? 🛠️
Um plano de recuperação de desastres de TI (DR) é sua estratégia documentada para restaurar sistemas e dados de TI após qualquer interrupção — desde desastres naturais até ataques cibernéticos. É, essencialmente, seu manual para colocar a tecnologia de volta em operação quando algo der errado.
💡 Recuperação de Desastres (DR) x Continuidade de Negócios
A recuperação de desastres (DR) concentra-se especificamente na restauração de sua infraestrutura de TI e de seus dados. A continuidade de negócios (BC) é mais abrangente, visando manter toda a sua empresa operacional durante e após uma crise, mesmo que a TI esteja fora do ar. Pense na DR como uma parte essencial de sua estratégia geral de BC.
💡 Recuperação de Desastres (DR) x Continuidade de Negócios
A recuperação de desastres (DR) concentra-se especificamente na restauração de sua infraestrutura de TI e de seus dados. A continuidade de negócios (BC) é mais abrangente, visando manter toda a sua empresa operacional durante e após uma crise, mesmo que a TI esteja fora do ar. Pense na DR como uma parte essencial de sua estratégia geral de BC.
Seu plano de recuperação de desastres é importante porque o tempo de inatividade custa mais do que apenas dinheiro. Cada minuto em que seus sistemas ficam fora do ar pode minar a confiança dos clientes, interromper as operações e até mesmo resultar em multas por não conformidade. Um plano abrangente de recuperação de desastres é o seu roteiro para a resiliência.
Um bom plano abrange:
- Procedimentos de backup de dados: como e onde você armazena cópias de informações críticas para poder restaurá-las
- Etapas de restauração do sistema: a sequência exata para restabelecer os serviços na ordem correta
- Responsabilidades da equipe: Quem faz o quê durante um incidente para evitar confusão
- Protocolos de comunicação: Como você manterá as partes interessadas informadas, desde sua equipe até seus clientes
- Objetivos de recuperação: Suas metas específicas quanto à rapidez com que os sistemas devem voltar a funcionar e quanto à quantidade aceitável de perda de dados
Cenários comuns de desastres de TI e seus impactos
Desastres não são apenas cenários de Hollywood; eles acontecem com empresas todos os dias. Entender contra o que você está se protegendo ajuda a construir uma defesa muito mais sólida.
Desastres naturais e danos físicos
Eventos como inundações, incêndios, terremotos e grandes quedas de energia podem destruir data centers inteiros em questão de minutos. Quando uma grande inundação atingiu um data center em Nashville, por exemplo, algumas empresas perderam semanas de dados e enfrentaram meses de recuperação. A melhor proteção contra isso é a redundância geográfica, o que significa distribuir sua infraestrutura por vários locais físicos para que um único evento não possa derrubar tudo.
Ataques cibernéticos e violação de dados
Ransomware, ataques distribuídos de negação de serviço (DDoS) e violações de dados são diferentes de desastres físicos. Eles costumam ser mais difíceis de detectar, podem se espalhar silenciosamente por sistemas conectados e, com frequência, também têm como alvo seus sistemas de backup, tornando a recuperação especialmente desafiadora. A frequência e a sofisticação desses ataques cibernéticos continuam a aumentar em todos os setores, com o ransomware agora aparecendo em 44% de todas as violações confirmadas, o que o torna uma das principais ameaças.
Falhas de hardware e perda de dados
Às vezes, mesmo os sistemas de backup mais testados e confiáveis simplesmente param de funcionar. Falhas no servidor, falhas de armazenamento e mau funcionamento de equipamentos de rede podem ocorrer sem aviso prévio. Mesmo que você tenha sistemas redundantes (de backup), eles ainda podem falhar ao mesmo tempo se compartilharem componentes ou fontes de alimentação comuns, criando um único ponto de falha.
👀 Você sabia? Em outubro de 2025, a AWS sofreu uma grande interrupção quando um bug em seu sistema interno de gerenciamento de DNS para o Amazon DynamoDB causou uma falha na resolução de nomes de domínio na região do data center US-EAST-1. Essa “pequena” falha técnica desencadeou uma cadeia de falhas em dezenas de serviços da AWS e derrubou centenas de aplicativos e plataformas populares em todo o mundo — desde aplicativos de mensagens e redes sociais até bancos, sites de jogos e muito mais. Para muitas pessoas, a interrupção fez com que grande parte da Internet “desaparecesse” temporariamente, destacando o quão frágil é nossa infraestrutura digital quando tanto depende de um punhado de provedores de nuvem.
Erros de software e interrupção de serviços
Um banco de dados corrompido, uma atualização de software com falha ou um simples erro de configuração podem derrubar plataformas inteiras. Você pode perceber que uma única linha de código mal configurada pode causar um efeito em cascata nos sistemas conectados, criando uma interrupção generalizada com um grande raio de impacto. O gerenciamento adequado de mudanças e ambientes de teste dedicados são seus melhores aliados para minimizar esses riscos.
Erros humanos e configurações incorretas
Exclusões acidentais, configurações incorretas e alterações não autorizadas continuam sendo uma das causas mais comuns de interrupções de TI. Um único comando errado ou um arquivo excluído pode causar horas de tempo de inatividade e degradação do serviço. Embora o treinamento e os controles de acesso ajudem, eles não conseguem eliminar totalmente os erros humanos.
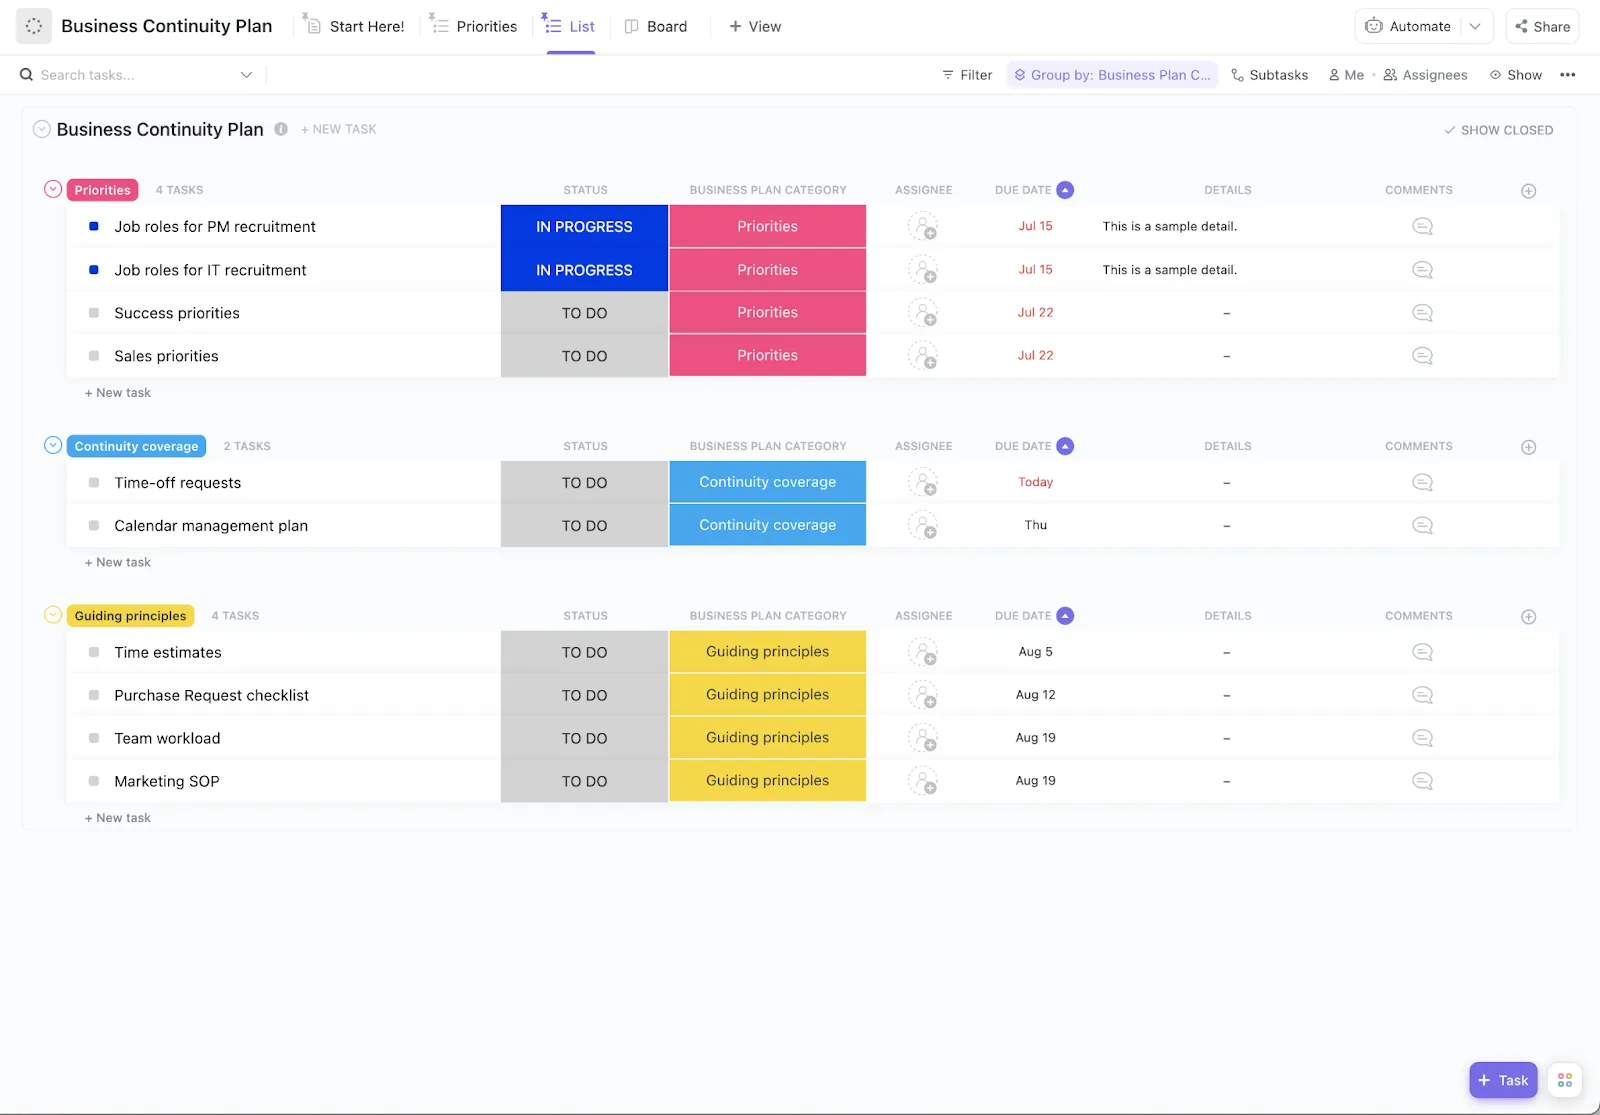
📮ClickUp Insight: 92% dos funcionários utilizam métodos inconsistentes para acompanhar tarefas pendentes, o que resulta em decisões não tomadas e atrasos na execução.
Seja enviando notas de acompanhamento ou usando planilhas, o processo costuma ser disperso e ineficiente. Com os recursos de gerenciamento de tarefas do ClickUp, você nunca mais precisará se preocupar com isso. Crie tarefas a partir do chat, dos comentários de tarefas do ClickUp, de documentos e de e-mails com um único clique!
Componentes-chave de um plano de recuperação de desastres de TI
Um plano de recuperação de desastres (DR) sólido é o seu manual completo para voltar a operar. Cada um desses componentes se complementa aos demais para criar uma proteção abrangente para sua empresa.
Avaliação e priorização de riscos
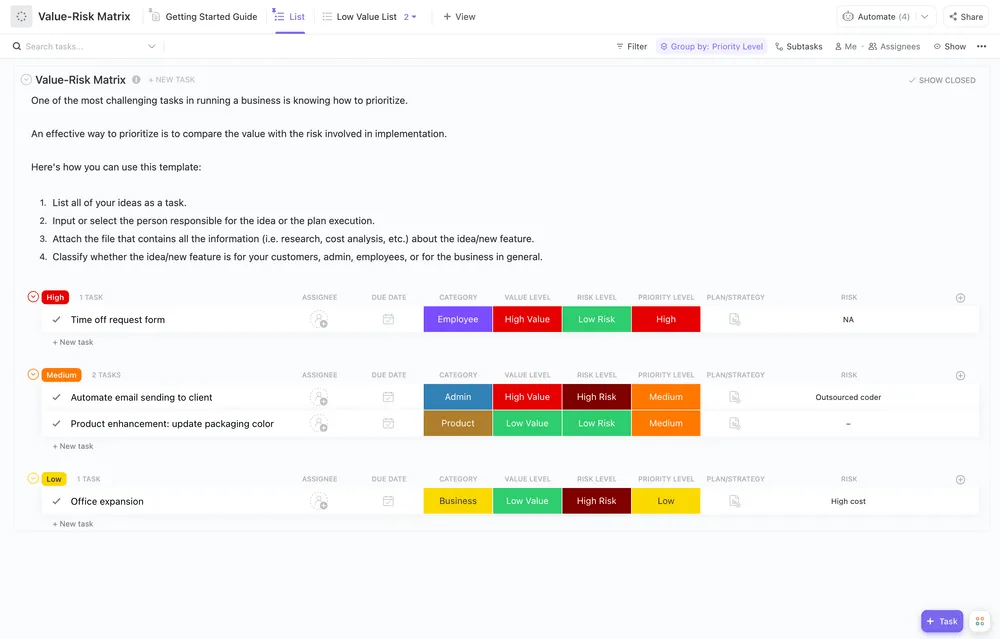
Primeiro, você precisa saber o que está enfrentando. Uma avaliação de riscos é o processo de identificar suas vulnerabilidades e avaliar a probabilidade e o impacto de cada ameaça potencial. Você pode organizar isso em uma matriz de riscos para identificar quais ameaças são mais graves.
Sua avaliação deve abranger:
- Sistemas críticos: o que precisa, sem dúvida, permanecer em funcionamento para que sua empresa continue operando
- Sensibilidade dos dados: Quais informações precisam do mais alto nível de proteção (como dados de clientes)
- Dependências: Quais outros sistemas ou processos são afetados quando cada sistema apresenta falha
Análise de impacto nos negócios e criticidade
Em seguida, calcule o custo real do tempo de inatividade. Uma análise de impacto nos negócios (BIA) ajuda a determinar o impacto financeiro e operacional de uma interrupção para cada sistema. Isso permite que você classifique seus sistemas em níveis de criticidade para priorizar seus esforços de recuperação.
| Crítico | Menos de uma hora | Processamento de pagamentos, bancos de dados de clientes |
| Alto | De uma a quatro horas | E-mail, ferramentas de comunicação interna |
| Médio | De quatro a 24 horas | Ambientes de desenvolvimento, ferramentas de geração de relatórios |
| Baixo | Mais de 24 horas | Sistemas de arquivamento, servidores de teste fora de produção |
Objetivos de RTO e RPO
Essas duas siglas são o cerne da sua estratégia de recuperação.
- Objetivo de Tempo de Recuperação (RTO): É o tempo máximo que você pode permitir que um sistema fique fora do ar. Ele responde à pergunta: “Com que rapidez precisamos que o sistema volte a funcionar?”
- Objetivo de Ponto de Recuperação (RPO): É a quantidade máxima de dados que você pode se dar ao luxo de perder, medida em tempo. Ele responde à pergunta: “Quantos dados podemos perder sem causar danos graves?”
Por exemplo, seu sistema interno de e-mail pode ter um RTO de quatro horas, mas seu banco de dados de comércio eletrônico voltado para o cliente pode ter um RPO de apenas 15 minutos, o que significa que você não pode perder mais do que 15 minutos de dados de transações.
Plano de backup e recuperação de dados
Seu plano de backup é sua rede de segurança definitiva. Uma prática recomendada comum é a regra 3-2-1: mantenha pelo menos três cópias de seus dados importantes, armazene-as em dois tipos diferentes de mídia e mantenha uma dessas cópias fora do local.
Você também poderá escolher entre diferentes tipos de backup:
- Backups completos: uma cópia completa de todos os dados, geralmente realizada semanalmente ou mensalmente
- Backups incrementais: fazem backup apenas das alterações realizadas desde o último backup, seja de qualquer tipo
- Backups diferenciais: Faz o backup de todas as alterações realizadas desde o último backup completo
Acima de tudo, você deve testar regularmente seu processo de restauração de backup. Um backup não testado é apenas uma esperança, não um plano.
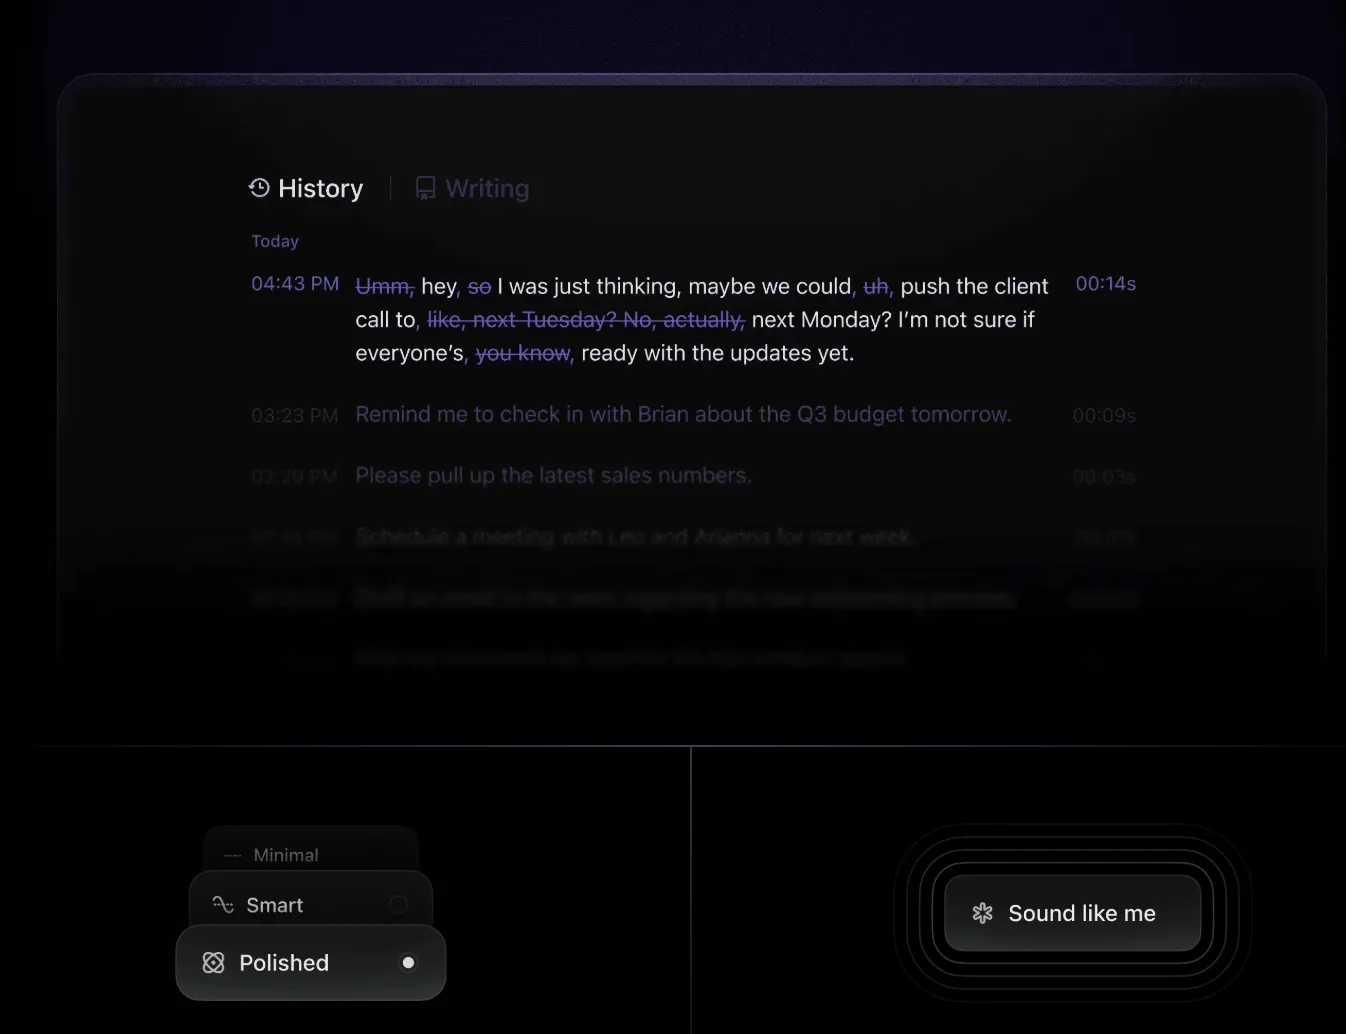
💟 Bônus: Registre detalhes críticos durante incidentes de alta tensão usando o recurso de conversão de voz em texto do ClickUp Brain MAX, para que você nunca perca informações importantes, mesmo quando não for prático digitar. Basta falar suas observações e deixar que a IA cuide da documentação.
Plano de comunicação e atualizações para as partes interessadas
Quando ocorre um desastre, um plano de comunicação claro é fundamental. Seu plano deve definir as cadeias de notificação, a frequência com que você fornecerá atualizações e quais canais serão utilizados para cada tipo de incidente.
Grupos diferentes precisam de informações diferentes:
- Equipes internas: Precisam de detalhes técnicos e ações específicas
- Clientes: Precisam saber o status do serviço e quando esperam que o problema seja resolvido
- Fornecedores: pode ser necessário recorrer a eles para suporte ou escalações
- Órgãos reguladores: podem exigir notificações formais, dependendo do seu setor
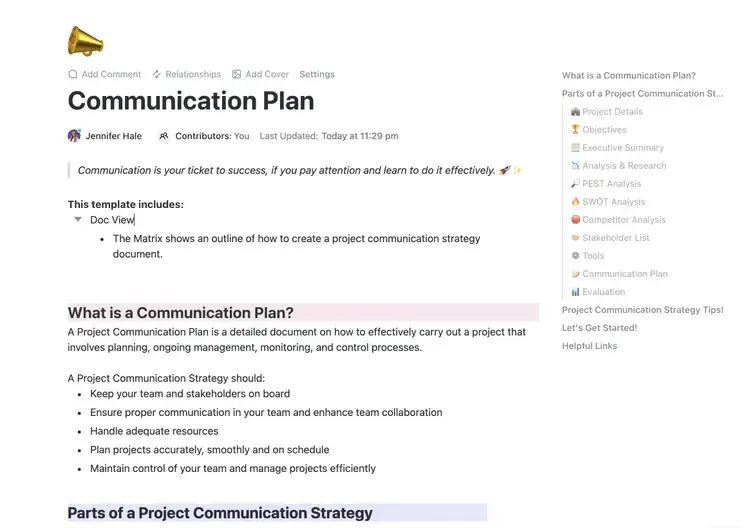
Ferramentas como este modelo de plano de comunicação pronto para uso do ClickUp podem ajudá-lo a agir mais rapidamente com um protocolo estabelecido durante uma crise.
Programa de testes e treinamento
Um plano que nunca é testado é um plano que fracassará. Testes regulares revelam lacunas e pontos fracos antes que um desastre real ocorra.
Programe diferentes tipos de testes ao longo do ano:
- Exercícios simulados: Sua equipe simula um cenário de desastre no papel para verificar a lógica do plano
- Failovers parciais: você testa a recuperação de componentes ou serviços específicos e não críticos
- Testes completos de recuperação de desastres: você executa uma transição completa para seus sistemas de backup (o teste definitivo)
Após cada teste, atualize sua documentação e treine imediatamente os novos membros da equipe sobre os procedimentos.
Etapas para criar um plano de recuperação de desastres de TI
Elaborar seu plano de recuperação de desastres não precisa ser uma tarefa complicada.
Veja como você pode fazer isso, um passo de cada vez. 🙌
Etapa 1: Criar o inventário de ativos
Não é possível proteger o que você não sabe que possui. Comece criando um inventário de ativos que liste todos os itens de hardware, software, repositórios de dados e dependências de sistema em seu ambiente. Certifique-se de incluir contatos de fornecedores, chaves de licença e detalhes de configuração para consulta rápida durante uma recuperação.
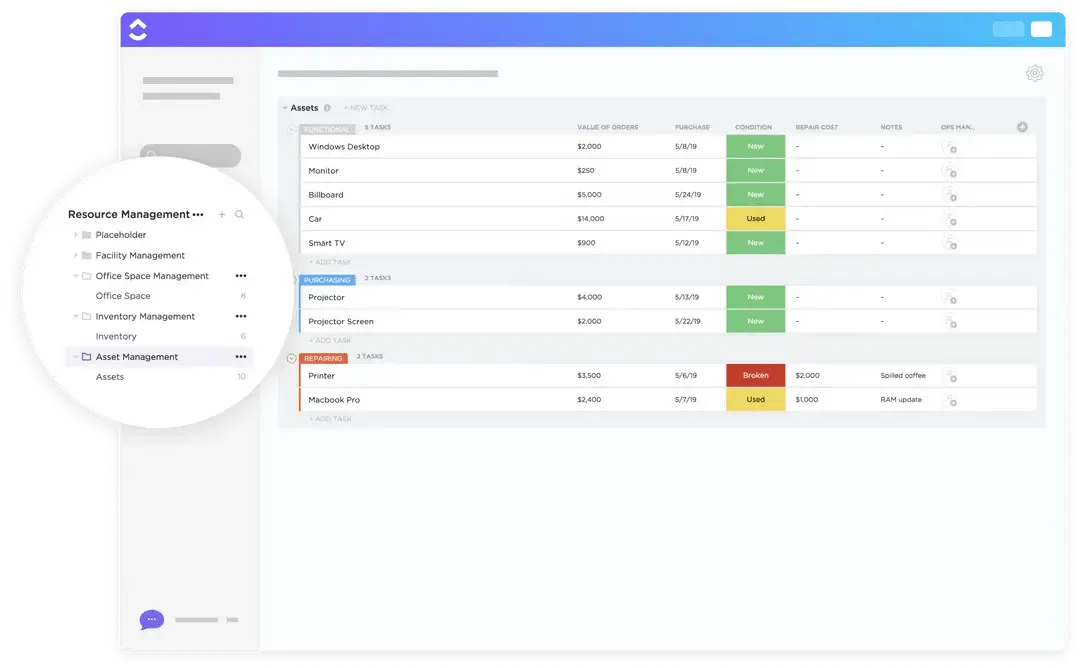
O modelo de ITAM do ClickUp reúne gerenciamento de incidentes, gerenciamento de problemas, gerenciamento de mudanças, soluções simples de gerenciamento de ativos e gerenciamento de conhecimento. Nosso modelo de erros conhecidos do ITSM simplifica o acompanhamento de erros conhecidos em seus sistemas. Explore todos os nossos modelos de TI assim que sua necessidade mudar.
Personalize seus fluxos de trabalho da maneira que desejar para cada etapa do ITAM, desde a implantação e configuração até a manutenção e a baixa.
Etapa 2: Classificar serviços críticos
Agora, identifique quais desses ativos são essenciais para a operação e quais são apenas opcionais. Crie mapas de dependência de serviços que mostrem como seus sistemas se conectam e dependem uns dos outros. Preste atenção especial a quaisquer serviços voltados para o cliente que tenham impacto direto na receita ou na experiência do usuário.
🎥 Assista a este tutorial prático que demonstra como criar um plano estruturado e abrangente usando os poderosos recursos do ClickUp — desde o estabelecimento de metas até a atribuição de tarefas e o acompanhamento do progresso.
Etapa 3: Avaliar riscos e ameaças
Avalie riscos e ameaças analisando a probabilidade e o impacto de cada tipo de ameaça para a sua situação específica. Leve em consideração seus riscos geográficos (você está em uma zona sísmica ou em uma planície aluvial?) e quaisquer ameaças específicas do setor (como mudanças regulatórias ou ataques cibernéticos direcionados). Documente tudo em um registro de riscos para que você possa acompanhá-los ao longo do tempo.

O modelo de quadro branco de avaliação de riscos do ClickUp cria uma dimensão visual para o seu processo de avaliação de riscos. Ele auxilia na avaliação e categorização de riscos, inspirando sua equipe a compartilhar ideias e colaborar em um formato envolvente e visual.
Este modelo permite que você:
- Avalie as categorias de risco e os impactos potenciais
- Analise os dados para identificar possíveis áreas de preocupação
- Determine medidas preventivas para reduzir a exposição a riscos
Com recursos que permitem desenhar, escrever e adicionar notas adesivas, este modelo de quadro branco para gestão de riscos é perfeito para avaliar os riscos do seu projeto.
Etapa 4: Defina as metas de RTO e RPO
Trabalhe diretamente com as partes interessadas da sua empresa para definir o que elas consideram tempo de inatividade e perda de dados aceitáveis para cada nível de serviço identificado anteriormente. Você precisará equilibrar o custo de uma recuperação mais rápida com o impacto nos negócios — nem tudo precisa de uma recuperação instantânea e sem perda de dados. Obtenha a aprovação da diretoria para essas metas.
Etapa 5: Definir caminhos de backup e failover
Com suas metas definidas, agora você pode projetar suas soluções técnicas. Crie estratégias de backup adaptadas ao RPO de cada sistema e planeje procedimentos detalhados de failover, incluindo locais alternativos de processamento e métodos de acesso de emergência. Inclua diagramas de rede e manuais passo a passo para garantir uma execução infalível.
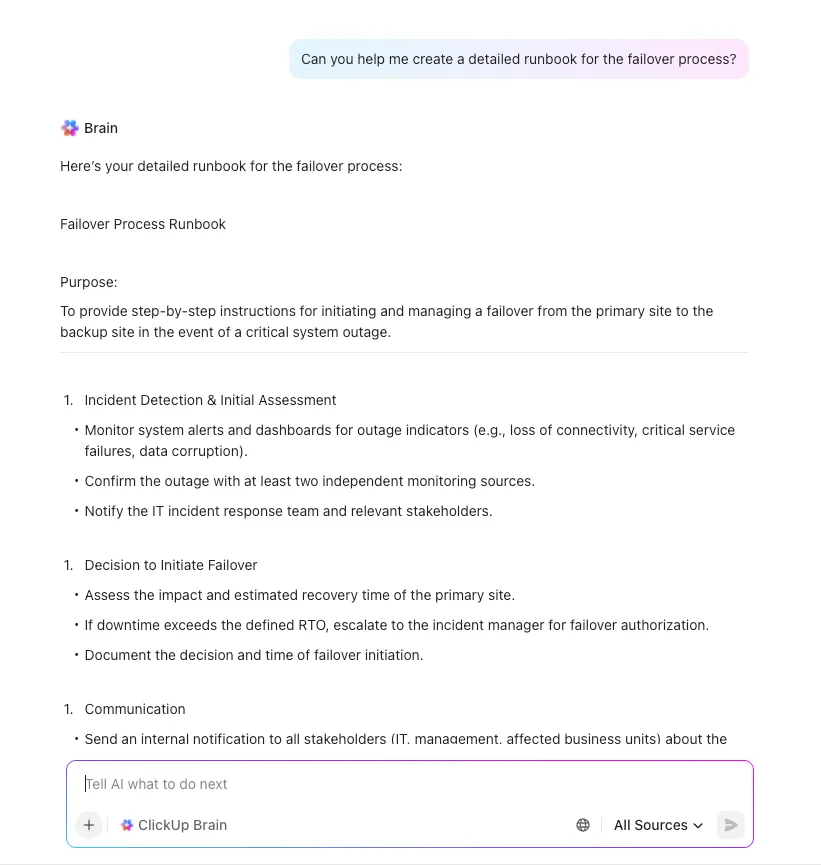
Etapa 6: Atribuir funções e escalonamento
Defina a estrutura da sua equipe de recuperação de desastres com responsabilidades claras e autoridade para a tomada de decisões. Crie listas de contatos abrangentes com pessoal principal e de reserva para cada função. Uma matriz RACI (Responsável, Prestador de Contas, Consultado, Informado) é uma ótima ferramenta para eliminar confusões durante um incidente de alto estresse.
Etapa 7: Documentar e comunicar o plano
Documente e comunique o plano com procedimentos claros e passo a passo que qualquer membro da sua equipe possa seguir, mesmo sob pressão. É fundamental armazenar essa documentação em um local de fácil acesso, separado da sua infraestrutura principal. Certifique-se de que todos os membros da equipe saibam exatamente onde encontrar o plano durante uma crise.

Otimize o planejamento de seus projetos com o modelo de planejamento RACI do ClickUp. Esse modelo do Doc é revolucionário, oferecendo um gráfico claro para definir as funções e responsabilidades da equipe em relação às tarefas do projeto. Adote a estrutura RACI (Responsável, Prestador de Contas, Consultado e Informado) para que todos estejam alinhados, garantindo a prestação de contas e o alinhamento com as metas organizacionais.
Etapa 8: Teste, analise e aprimore
Por fim, programe testes trimestrais para validar seus procedimentos e identificar eventuais lacunas. Documente todas as lições aprendidas em cada teste e em quaisquer incidentes reais, e use-as para atualizar seu plano. Crie um sistema sistemático de acompanhamento de melhorias para garantir que quaisquer problemas encontrados sejam resolvidos.
🌼 Você sabia? Em 2017, o GitLab sofreu uma grande interrupção no banco de dados. Durante a recuperação, eles descobriram que vários de seus métodos de backup vinham falhando silenciosamente há dias. Esse incidente ensinou à indústria de tecnologia inteira uma lição crucial: a validação do backup é imprescindível. Um backup não testado não é, na verdade, um backup.
🌼 Você sabia? Em 2017, o GitLab sofreu uma grande interrupção no banco de dados. Durante a recuperação, eles descobriram que vários de seus métodos de backup vinham falhando silenciosamente há dias. Esse incidente ensinou à indústria de tecnologia inteira uma lição crucial: a validação do backup é imprescindível. Um backup não testado não é, na verdade, um backup.
Estratégias e soluções de recuperação de desastres
Nem toda organização precisa da mesma abordagem de recuperação de desastres. Vamos explorar suas opções com base no seu orçamento, nas suas necessidades de recuperação e nos recursos disponíveis.
Abordagem de backup e restauração
Esse é o método mais simples e econômico. Ele envolve a realização de backups regulares para um local externo (como a nuvem ou um data center secundário) e, em seguida, a restauração manual desses backups quando necessário. Essa abordagem é mais indicada para sistemas não críticos que podem tolerar um RTO mais longo, já que a recuperação pode levar horas ou até dias.
Alta disponibilidade e redundância
Essa estratégia visa eliminar pontos únicos de falha por meio do uso de vários sistemas ativos. Técnicas como balanceamento de carga, clustering de servidores e armazenamento RAID garantem que, caso um componente falhe, outro assuma o controle instantaneamente. Embora seja mais cara de implementar e manter, essa abordagem pode minimizar o tempo de inatividade para apenas segundos ou minutos, tornando-a ideal para serviços críticos.
Opções de replicação e failover
A replicação envolve a cópia de dados quase em tempo real para um local secundário, o que garante perda mínima de dados durante um desastre.
- Replicação síncrona: grava dados simultaneamente nos sites primário e secundário, garantindo zero perda de dados. No entanto, ela exige alta largura de banda e pode tornar o sistema primário mais lento
- Replicação assíncrona: grava os dados primeiro no site primário e, em seguida, os copia para o site secundário com um pequeno atraso. É mais econômica e causa menos impacto no desempenho, mas você aceita um pequeno risco de perda de dados
Recuperação de desastres baseada em nuvem e DRaaS
A Recuperação de Desastres como Serviço (DRaaS) tornou-se uma opção popular para muitas empresas. Ela oferece preços com pagamento conforme o uso, distribuição geográfica instantânea e orquestração automatizada da recuperação, sem a necessidade de construir e manter seus próprios locais físicos de recuperação de desastres. A recuperação de desastres na nuvem elimina a enorme despesa de capital de um data center de backup, ao mesmo tempo em que proporciona escalabilidade mais rápida e maior flexibilidade do que as abordagens tradicionais de locais “quentes”, “mornos” ou “frios”.
Como o ClickUp agiliza o planejamento de recuperação de desastres de TI
Gerenciar um plano de recuperação de desastres (DR) por meio de planilhas, documentos e cadeias de e-mails dispersos cria um risco de desastre por si só.
Esse tipo de dispersão do trabalho — a fragmentação das tarefas entre várias ferramentas desconectadas que não se comunicam entre si — e a dispersão do contexto, quando as equipes perdem horas procurando informações espalhadas por aplicativos e plataformas, levam à confusão, a informações desatualizadas e a tempos de resposta lentos, em momentos em que cada segundo conta.
Com o ClickUp Converged AI Workspace — uma plataforma única e segura onde todos os seus aplicativos de trabalho, dados e fluxos de trabalho coexistem com IA contextual como camada de inteligência — que combina gerenciamento de projetos, documentação e comunicação em equipe. Pare de alternar entre várias plataformas e reúna seu planejamento de recuperação de desastres, testes e resposta a incidentes em um único sistema unificado.
Documentação centralizada de recuperação de desastres com o ClickUp Docs e assistência por IA integrada
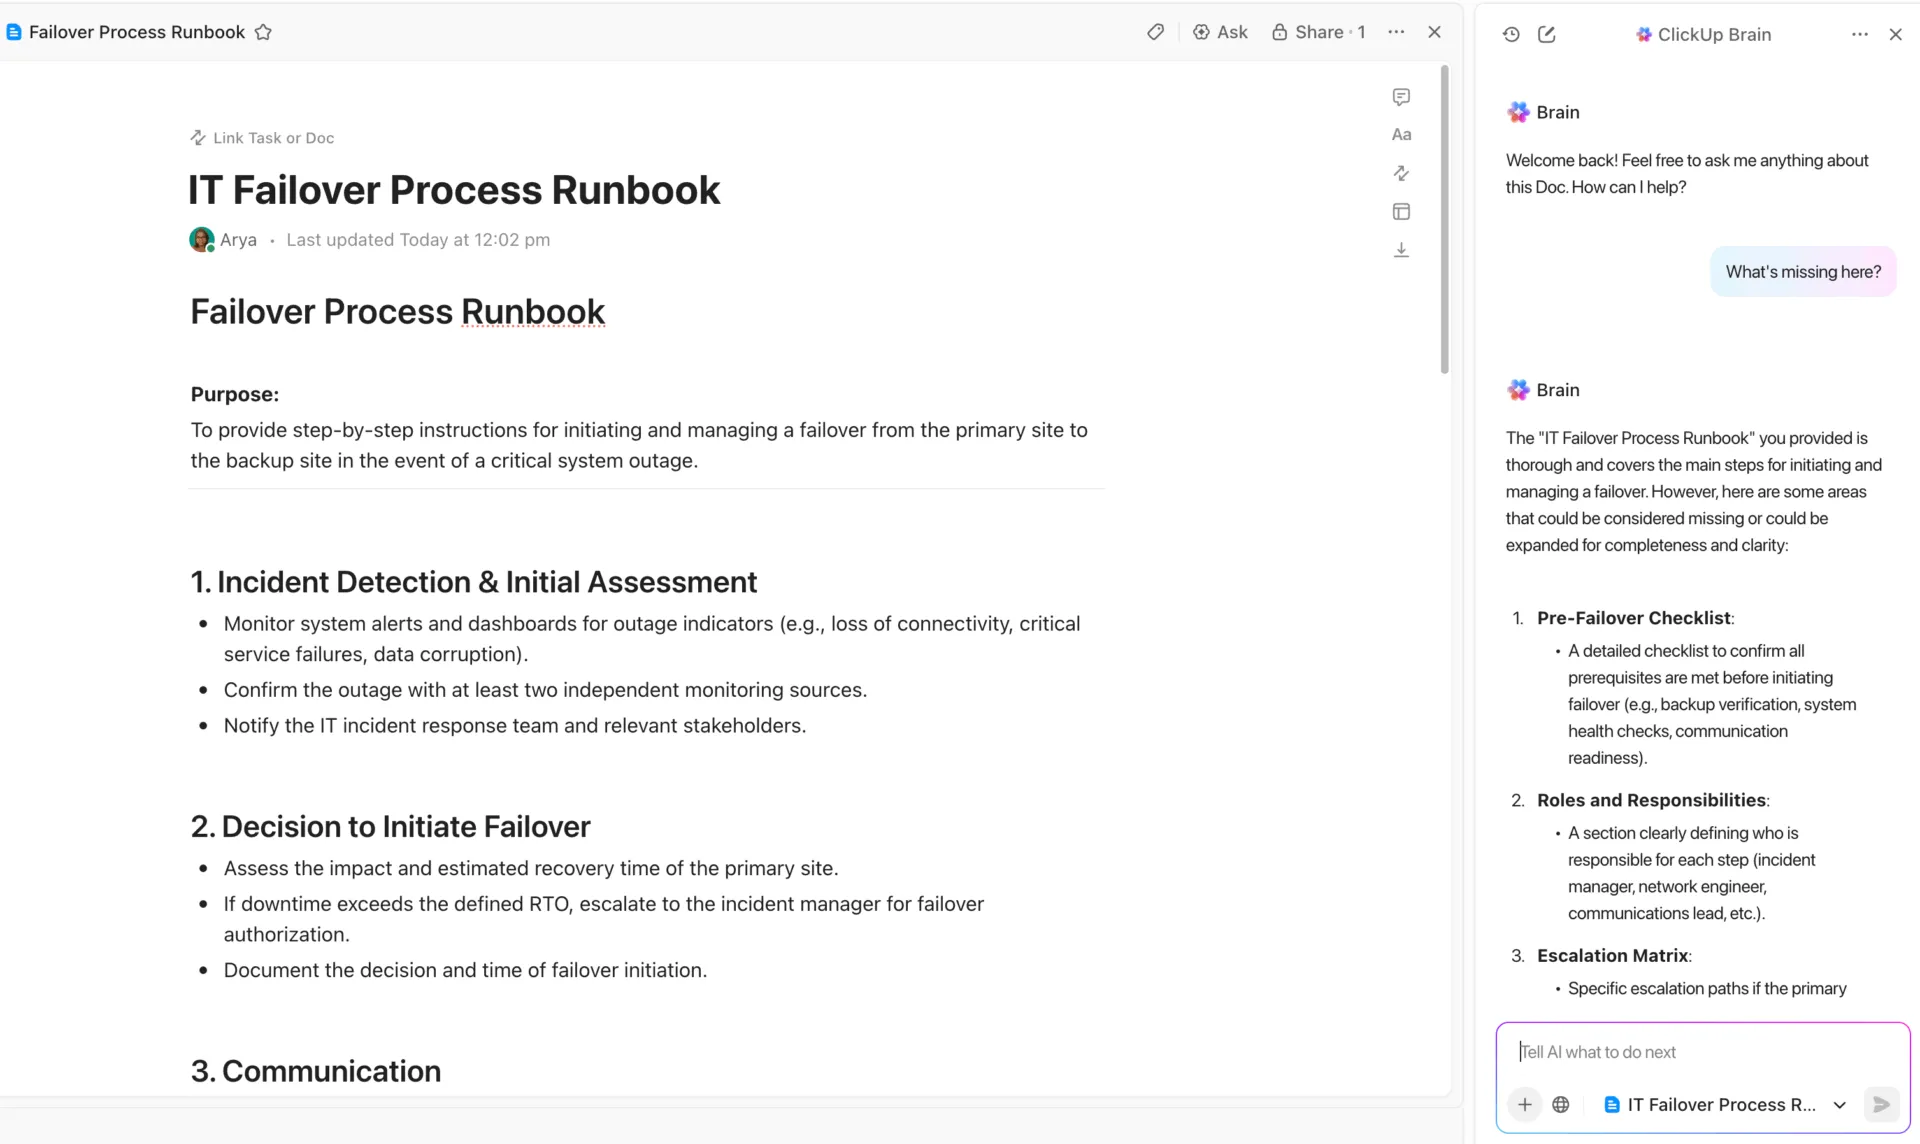
Garanta que sua equipe sempre tenha uma única fonte de informação confiável com o ClickUp Docs.
Elabore todo o seu plano de recuperação de desastres em um espaço colaborativo onde todos possam contribuir em tempo real durante um incidente. Vincule documentos diretamente a tarefas e projetos relacionados a incidentes para facilitar a navegação e incorpore diagramas ou manuais operacionais para manter as informações essenciais exatamente onde você precisa delas.
E o melhor de tudo: você pode proteger seus documentos para evitar edições acidentais e usar as permissões granulares do ClickUp para controlar quem pode visualizar ou alterar procedimentos confidenciais de recuperação. Cada alteração é registrada no histórico do documento, proporcionando a você uma trilha de auditoria completa.
Criação de planos com tecnologia de IA usando o ClickUp Brain
Acelere o planejamento de recuperação de desastres e elimine lacunas críticas com o ClickUp Brain — seu assistente de IA contextual que compreende todo o seu espaço de trabalho. Ao contrário de ferramentas genéricas de IA, o ClickUp Brain utiliza as tarefas, documentos e fluxos de trabalho reais da sua organização para oferecer suporte preciso e prático às iniciativas de recuperação de desastres.
Basta enviar uma solicitação ao ClickUp Brain, como: “Crie uma lista de verificação de recuperação de desastres para nossa plataforma de comércio eletrônico”, e receberá instantaneamente um modelo abrangente e personalizado, alinhado aos seus sistemas, processos e necessidades de conformidade. Ele pode ajudá-lo com:
- Consciência contextual: O ClickUp Brain tem acesso à estrutura, ao conteúdo e às permissões do seu espaço de trabalho. Ele pode consultar tarefas, documentos, comentários e até mesmo aplicativos conectados, fornecendo respostas e ações personalizadas para o seu trabalho específico — e não apenas sugestões genéricas
- Solução de problemas e orientação: Resolva problemas instantaneamente, obtenha instruções passo a passo ou solicite as melhores práticas sobre qualquer recurso do ClickUp. O Brain pode guiá-lo por processos complexos, automatizar tarefas repetitivas e ajudar a resolver obstáculos
- Automação e aceleração do fluxo de trabalho: use agentes de IA pré-configurados ou personalizados para automatizar fluxos de trabalho com várias etapas, classificar solicitações ou gerenciar tarefas recorrentes — economizando horas por semana
- Pesquisa avançada: Encontre informações ocultas em qualquer lugar do seu espaço de trabalho, incluindo tarefas, documentos e ferramentas integradas, mesmo que tenham anos de idade ou sejam difíceis de localizar com a pesquisa padrão
- Resumos e atualizações em tempo real: gere atualizações de projetos, resumos de reuniões ou relatórios de progresso instantaneamente, a partir de dados em tempo real do espaço de trabalho
- Simplificação da documentação técnica: Transforme documentos técnicos complexos em procedimentos ou listas de verificação claras e práticas que sua equipe possa seguir, mesmo sob pressão
- Inteligência multimodelo: Escolha entre os principais modelos de IA (OpenAI GPT-4.1, GPT-5, Claude, Gemini e outros) para obter os melhores resultados em qualquer tarefa — sem a necessidade de assinaturas separadas
- Seguro e com controle de permissões: o Brain só acessa informações para as quais você já tem permissão de visualização, mantendo rigorosos padrões de privacidade e conformidade
- Interface conversacional: Use @brain nos comentários ou no chat para obter insights contextuais, redigir respostas ou acionar automações sem sair do seu fluxo de trabalho
- Solicitações personalizadas e fluxos de trabalho salvos: salve e reutilize solicitações para necessidades recorrentes, garantindo consistência e economizando tempo para toda a sua equipe
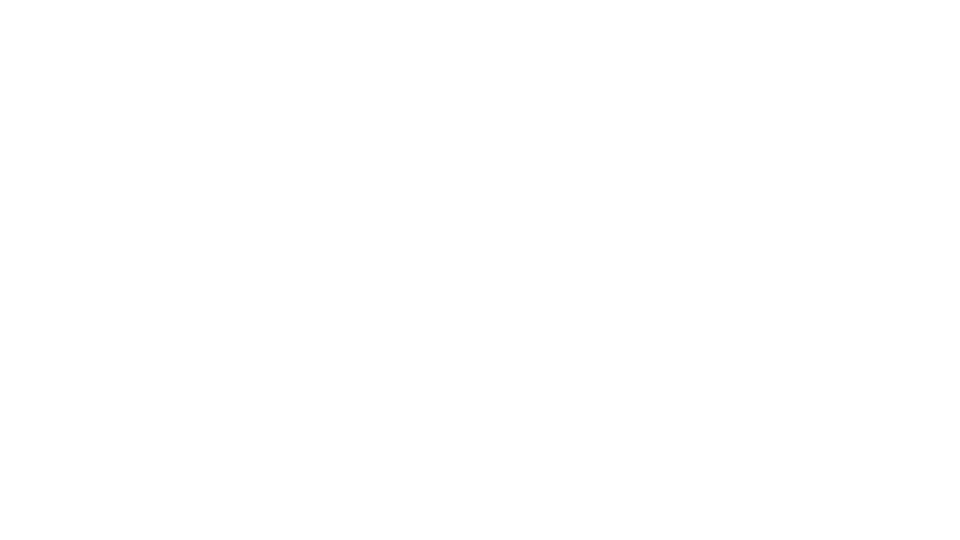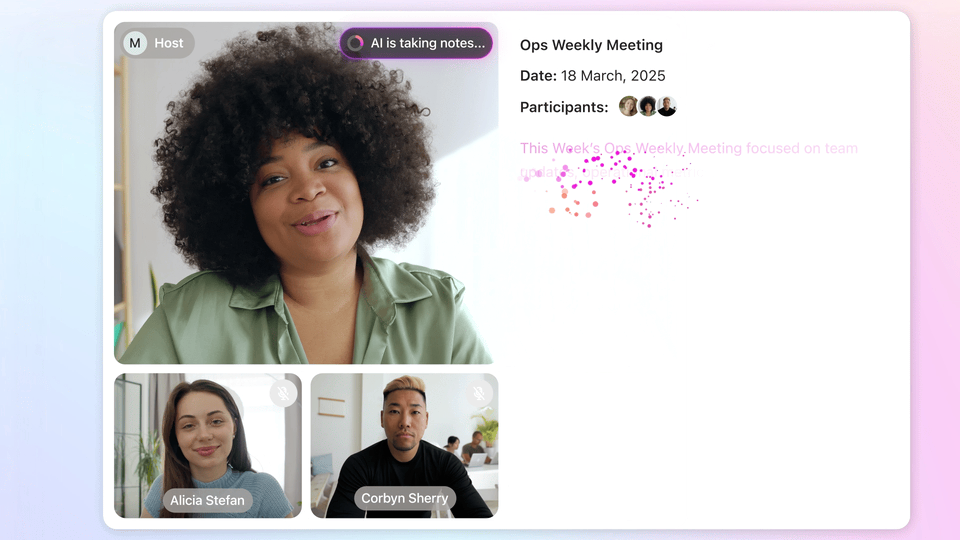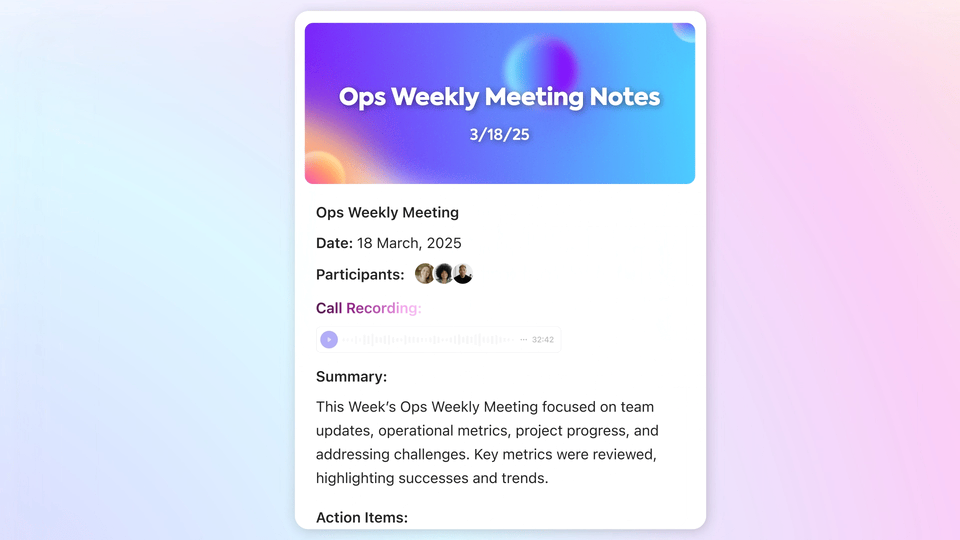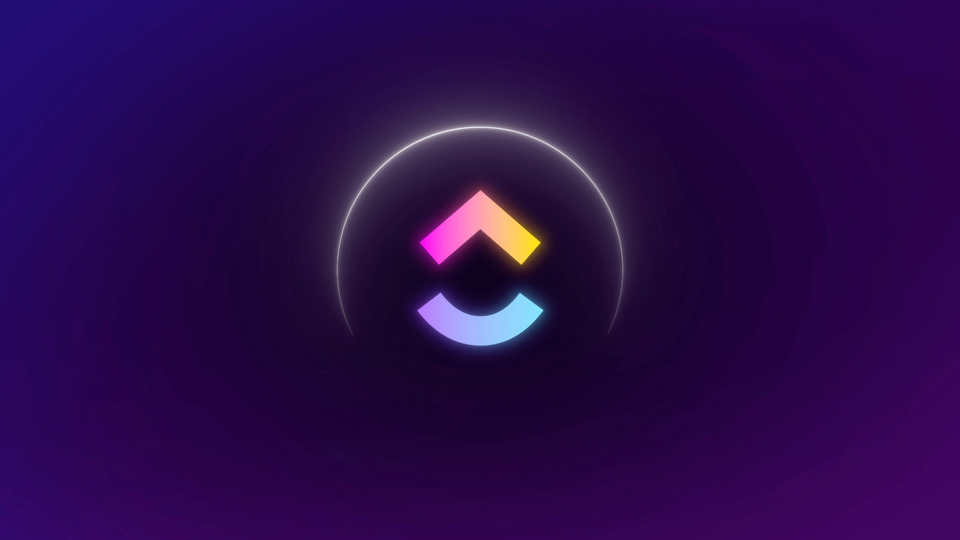
💡Dica profissional: Nunca perca uma lição das suas reuniões de análise de incidentes, registrando todos os detalhes com o ClickUp AI Notetaker. Ele pode participar das suas reuniões virtuais, transcrever toda a discussão e gerar automaticamente uma lista de ações a serem tomadas com base nas lições aprendidas. Isso cria um histórico de incidentes pesquisável, para que você possa consultar rapidamente eventos passados e suas soluções.
Fluxos de trabalho automatizados de recuperação de desastres com o ClickUp Automations
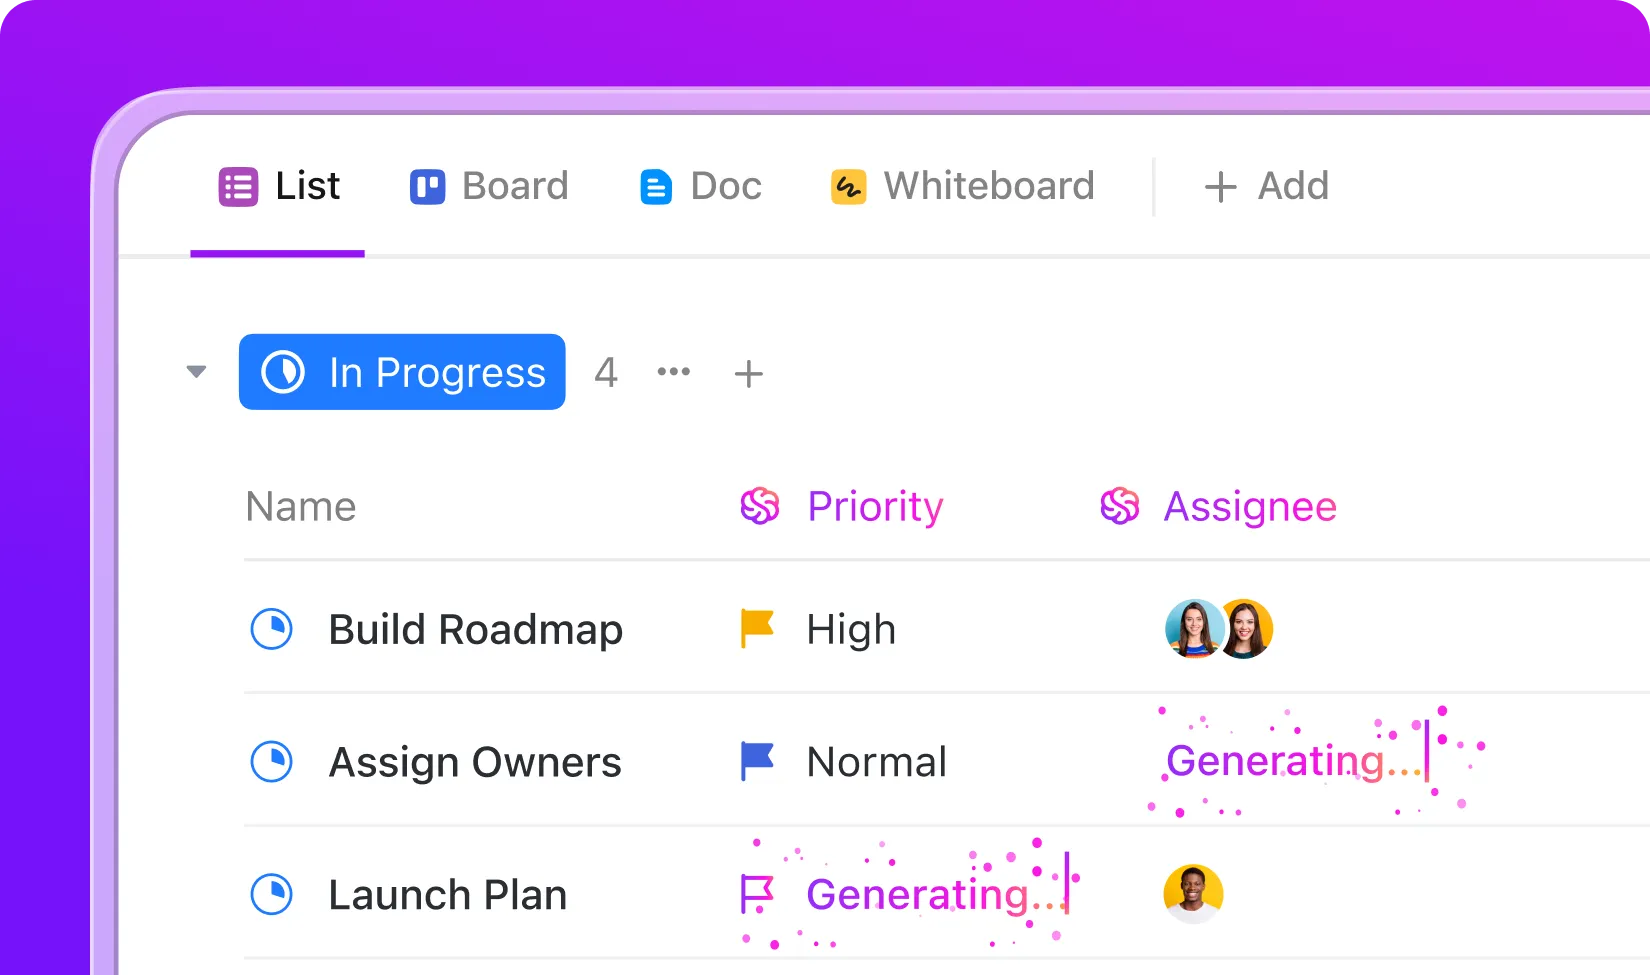
Imagine que sua equipe esteja enfrentando uma interrupção repentina — cada segundo conta, e você não pode se dar ao luxo de pular nenhuma etapa. Com os Agentes de IA e as Automações do ClickUp, você não precisa se desesperar nem confiar na memória. Assim que um incidente é declarado, a IA do ClickUp entra em ação, orientando sua equipe e cuidando das tarefas rotineiras para que você possa se concentrar na resolução do problema.
Veja como isso funciona em um cenário real:
- Quando alguém marca uma tarefa como “Incidente Declarado”, o ClickUp Agent cria automaticamente uma lista de verificação com as etapas de resposta, atribui-as às pessoas certas e inicia um cronômetro para acompanhar quanto tempo leva para a recuperação
- Se o incidente for classificado como “Crítico”, um agente pode enviar instantaneamente um e-mail de alerta para sua equipe de liderança e criar uma sala de bate-papo especial — sua “sala de comando” — para que todos possam se comunicar em um único lugar
- A IA pode acessar relatórios de incidentes anteriores e documentação relevante, para que sua equipe tenha tudo o que precisa ao alcance das mãos
Veja o fluxo de trabalho aqui:
Com os Agentes de IA do ClickUp, você conta com um colega de equipe digital confiável que ajuda sua equipe a manter a calma, a organização e a eficácia — mesmo sob pressão.
Acompanhamento em tempo real com os painéis do ClickUp
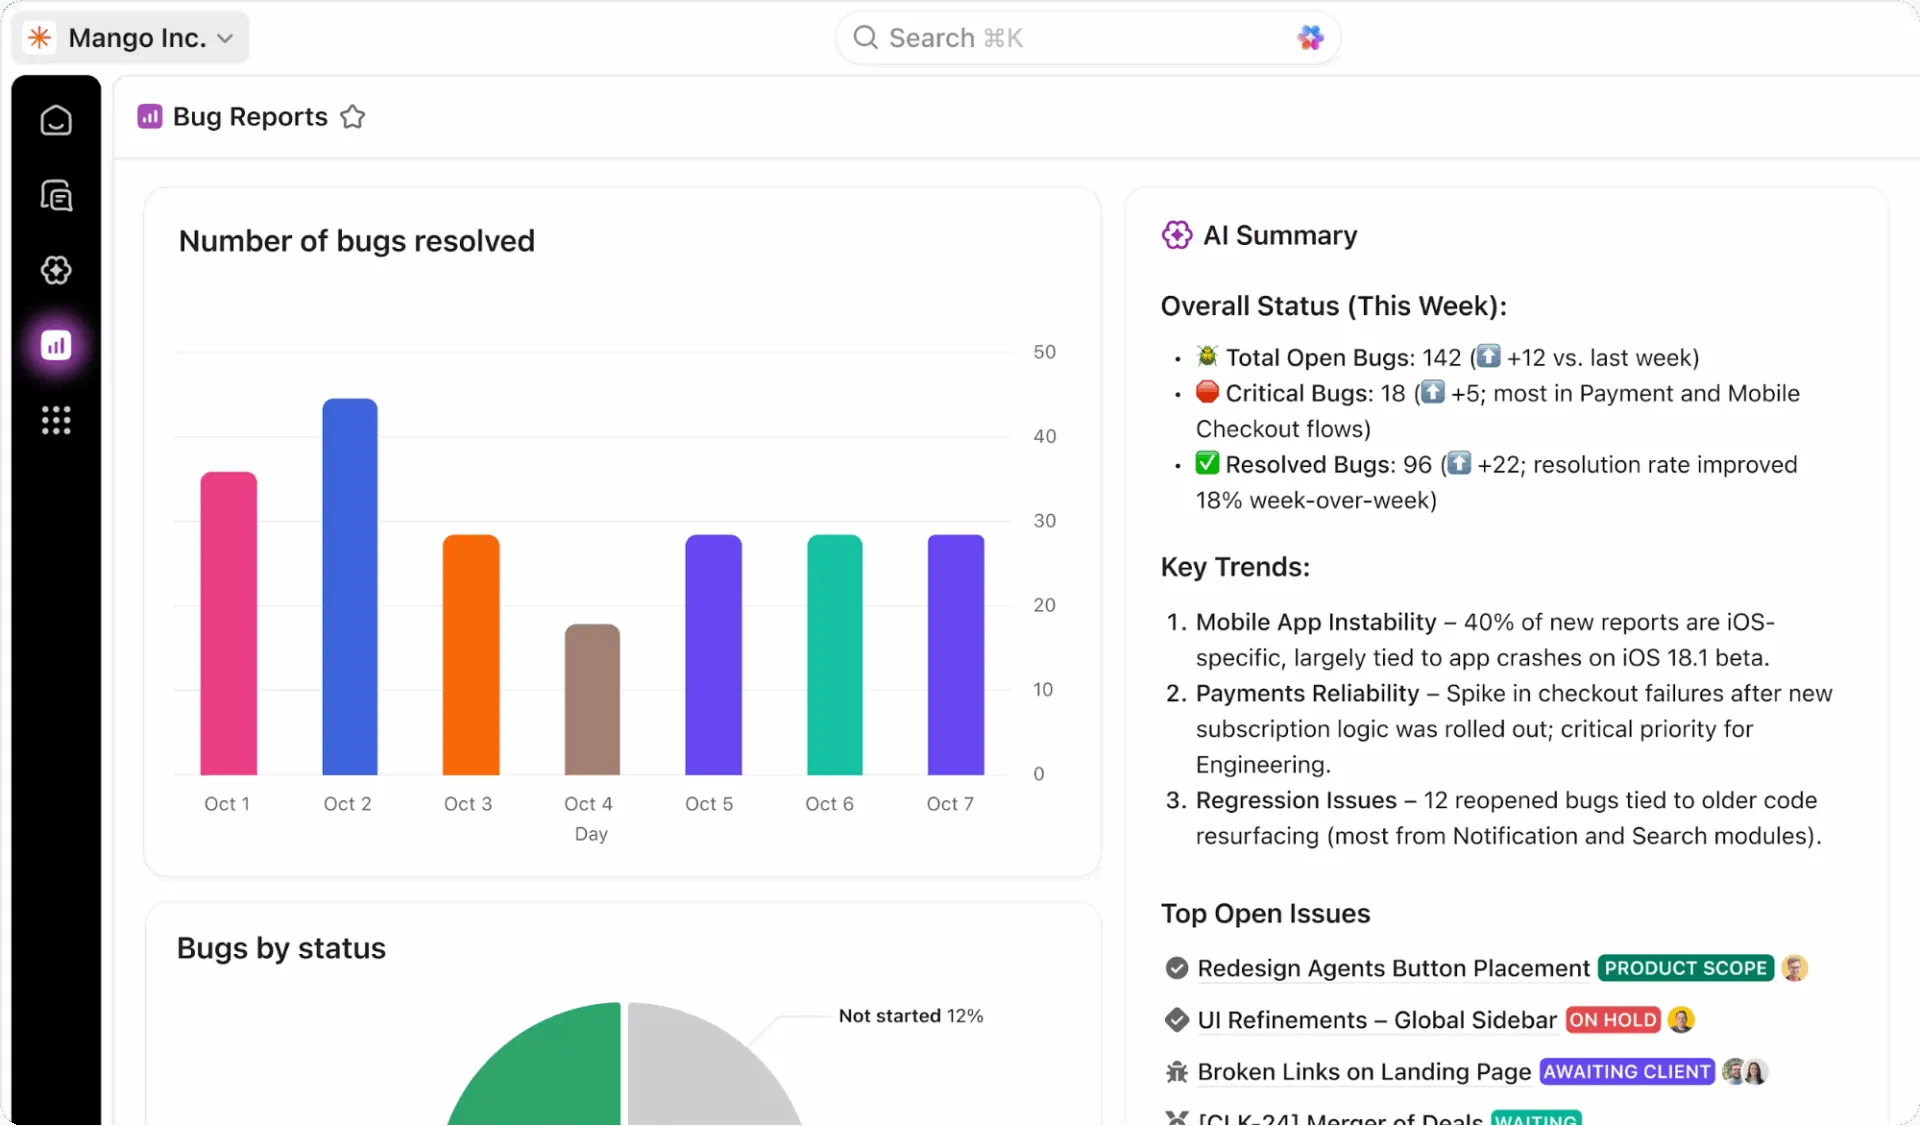
Obtenha visibilidade completa do estado do seu programa de recuperação de desastres, acompanhando tudo em tempo real com os painéis do ClickUp. Você pode criar widgets para monitorar o desempenho do RTO e do RPO durante os testes, acompanhar as taxas de conclusão dos testes e visualizar as tendências de incidentes ao longo do tempo.
Adicione campos personalizados do ClickUp às suas tarefas para acompanhar a criticidade do sistema, o status de recuperação e os resultados dos testes; em seguida, reúna todos esses dados em uma visão geral de alto nível. Esses painéis oferecem relatórios prontos para a diretoria, sempre atualizados com dados em tempo real das atividades de teste e resposta a incidentes da sua equipe.
Elabore seu plano de recuperação de desastres hoje mesmo
Cada dia em que você opera sem um plano de recuperação de desastres é uma aposta que você não pode se dar ao luxo de perder. Desastres são inevitáveis — sejam eles de origem natural, falhas tecnológicas ou erros humanos —, mas é a sua preparação que determina se eles se tornarão pequenos transtornos ou grandes catástrofes.
Um plano abrangente de recuperação de desastres exige a compreensão dos riscos, a documentação de procedimentos claros e a realização de testes regulares. As ferramentas certas tornam esse processo mais gerenciável, eliminando a desorganização causada por documentos dispersos e processos manuais.
Mesmo planos de contingência básicos são melhores do que não ter nada quando ocorre um desastre. Testes e atualizações regulares transformarão seu plano de recuperação de desastres de um documento empoeirado em um sistema dinâmico que realmente protege sua empresa.
Dê o primeiro passo e comece a elaborar seu plano de recuperação de desastres com o ClickUp hoje mesmo. Comece a usar o ClickUp gratuitamente e reúna todo o seu planejamento de recuperação de desastres, documentação e resposta a incidentes em uma única plataforma unificada. ✨
Perguntas frequentes
Com que frequência as equipes devem atualizar um modelo de plano de recuperação de desastres de TI?
Você deve revisar seu plano de recuperação de desastres pelo menos quatro vezes por ano e atualizá-lo imediatamente após quaisquer mudanças significativas na infraestrutura ou incidentes reais. A maioria das organizações realiza uma revisão abrangente e aprofundada anualmente para incorporar todas as lições aprendidas e se adaptar às novas tecnologias.
Quais equipes são responsáveis pela documentação e pelos testes de recuperação de desastres?
Equipes de TI, equipes de segurança e planejadores de continuidade de negócios geralmente lideram os esforços de planejamento e teste de recuperação de desastres. No entanto, eles precisam de contribuições essenciais dos líderes de operações e das unidades de negócios para garantir que o plano esteja alinhado às necessidades e prioridades reais da empresa.
Como monitoramos o RTO e o RPO durante os testes de recuperação de desastres?
Use cronômetros e registros de data e hora claros para medir os tempos reais de recuperação em comparação com as metas definidas durante cada teste. É fundamental documentar quaisquer discrepâncias entre a meta e o desempenho real nos relatórios de teste para orientar melhorias futuras.
Quais ferramentas ajudam a documentar e automatizar um plano de recuperação de desastres?
Plataformas de gerenciamento de projetos, como o ClickUp, são ideais para centralizar a documentação, automatizar fluxos de trabalho e acompanhar métricas de todo o seu programa de recuperação de desastres. Você pode, então, combiná-las com ferramentas especializadas em recuperação de desastres que lidam com os aspectos técnicos da replicação de dados e do failover do sistema.