
La plupart des équipes considèrent la génération de requêtes SQL comme un tour de magie. Il suffit de saisir une question pour obtenir une requête.
Mais voici la réalité : Snowflake Cortex Analyst ne fonctionne aussi bien que le modèle sémantique que vous créez au préalable, et l’installation n’est pas une mince affaire. En apprenant à utiliser Snowflake Cortex pour la génération de requêtes SQL, les équipes chargées des données peuvent désormais transformer le langage naturel en requêtes complexes et exécutables en quelques secondes.
Ce guide vous accompagne tout au long du processus de mise en œuvre, depuis la définition de votre modèle sémantique YAML jusqu'à la formulation de requêtes dans votre entrepôt de données à l'aide du langage naturel, afin que vous compreniez à la fois la puissance de cet outil et ses prérequis avant de vous lancer.
Nous examinons également les limites de Snowflake Cortex et la manière dont ClickUp peut fournir l'assistance pour les flux de travail plus larges liés à la génération de requêtes SQL.
Qu'est-ce que Snowflake Cortex Analyst ?
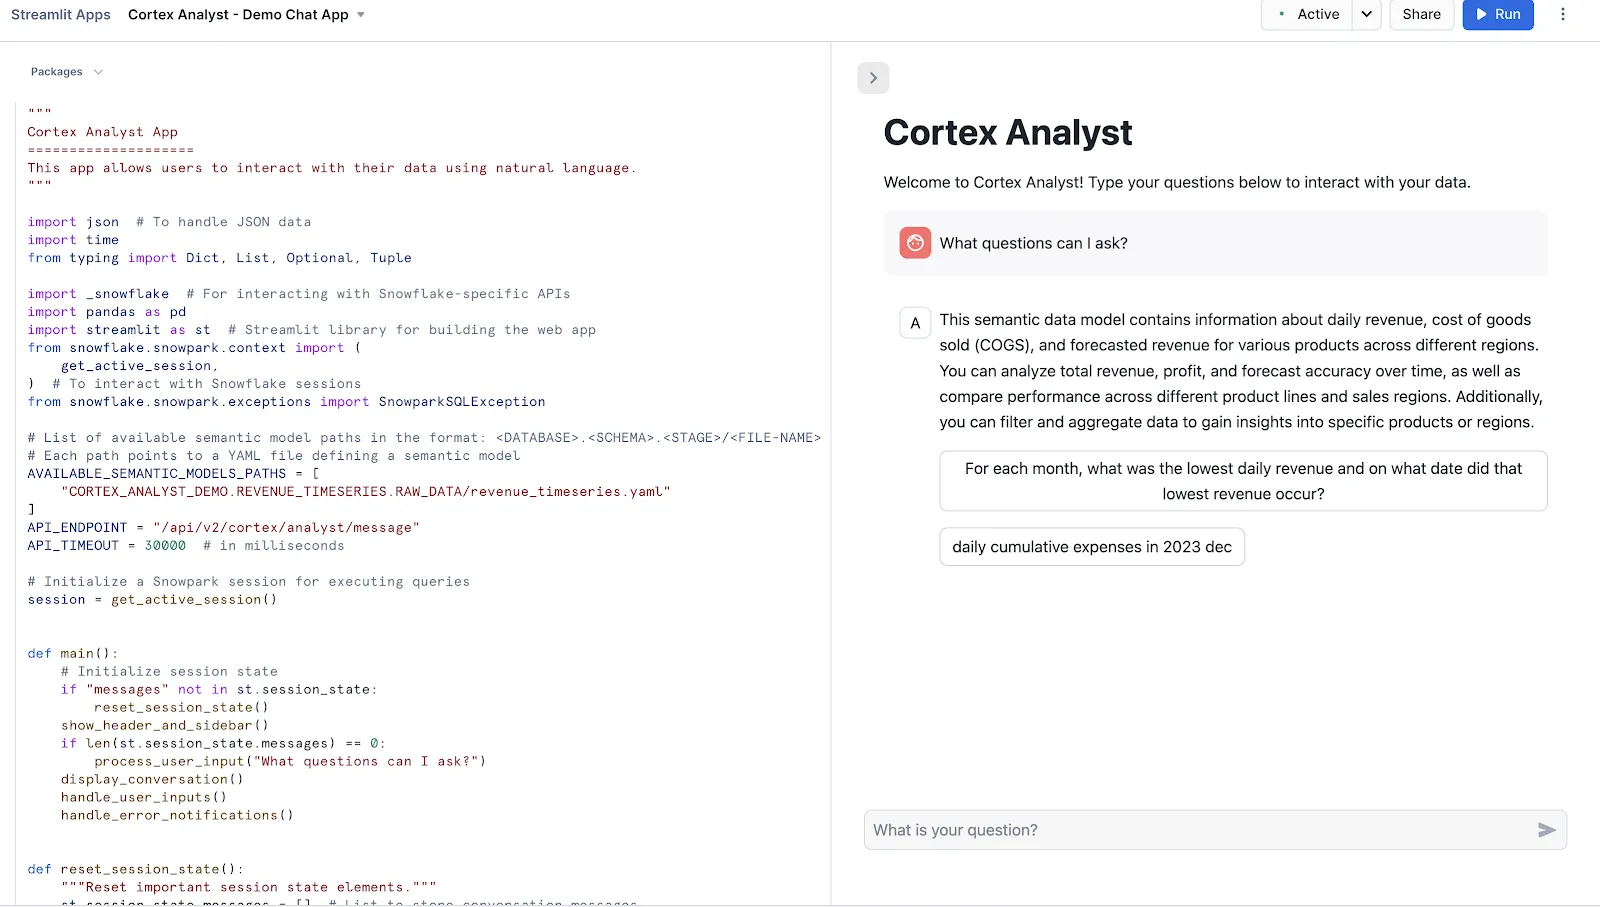
Snowflake Cortex Analyst est un service entièrement géré qui vous permet de créer des applications conversationnelles à partir de vos données analytiques.
Il utilise un agent spécialisé de conversion de texte en SQL pour transformer des questions en langage naturel en requêtes précises et exécutables. Ce service comble le fossé entre les structures de données complexes et les utilisateurs de l'entreprise qui ont besoin de réponses sans avoir à écrire de code.
Parmi les principales fonctionnalités, on trouve :
- Une interface très précise pour interagir avec des données structurées
- Utilisation de modèles sémantiques pour comprendre votre logique d’entreprise et votre terminologie spécifiques
- Dispose d'une API REST pour une intégration facile dans des applications personnalisées ou des outils de BI
- Préserver la confidentialité des données en traitant les requêtes au sein du périmètre de sécurité de Snowflake
📮 ClickUp Insight : 88 % des personnes interrogées dans le cadre de notre sondage utilisent l'IA pour leurs tâches personnelles, mais plus de 50 % hésitent à l'utiliser au travail. Les trois principaux obstacles ? L'absence d'intégration transparente, le manque de connaissances ou les préoccupations en matière de sécurité.
Mais que se passerait-il si l'IA était intégrée à votre environnement de travail et qu'elle était déjà sécurisée ? ClickUp Brain, l'assistant IA intégré à ClickUp, fait de cette vision une réalité. Il comprend les demandes formulées en langage naturel, répondant ainsi aux trois principales préoccupations liées à l'adoption de l'IA, tout en effectuant la connexion entre votre chat, vos tâches, vos documents et vos connaissances au sein de l'environnement de travail.
Trouvez des réponses et des informations en un seul clic !
Prérequis pour la génération de requêtes SQL avec Snowflake Cortex
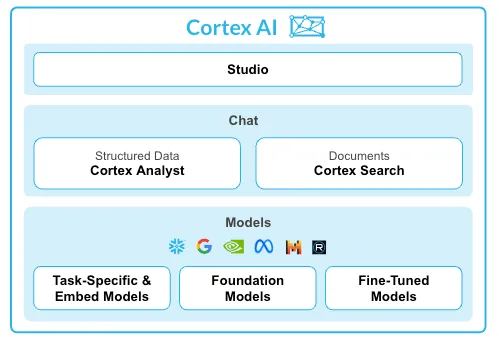
Se lancer dans Snowflake Cortex sans une installation adéquate est source de frustration. Vous risquez d'obtenir des résultats inexacts, de perdre du temps à résoudre des problèmes et de conclure à tort que l'outil ne fonctionne pas, alors que le véritable problème réside en réalité dans des bases insuffisantes.
Pour éviter cela, vous devez d'abord mettre en place trois éléments fondamentaux.
1. Configurez votre base de données et vos tables
L'intelligence de votre IA dépend des données auxquelles elle a accès. Si le schéma de votre base de données est un véritable labyrinthe de noms de colonnes cryptiques tels que « cust_dat_v2_final », vos analystes comme votre IA auront du mal à s'y retrouver.
Cette confusion conduit l'IA à générer des jointures incorrectes ou à extraire des données des mauvaises colonnes, et votre équipe perd des heures à essayer de déchiffrer le schéma avant même de pouvoir écrire une requête.
Commencez par vous assurer que votre logiciel d'entrepôt de données contient les tables que vous souhaitez que Cortex Analyst interroge. Dans la mesure du possible, utilisez des noms de colonnes clairs et descriptifs. Par exemple, une colonne nommée « customer_lifetime_value » est bien plus intuitive, tant pour les humains que pour l'IA, que « clv_01 ».
Pour procéder à l'installation, votre rôle Snowflake devra disposer des permissions suivantes :
- UTILISATION : Sur la base de données et le schéma contenant vos tables
- SELECT : Sur les tables que vous souhaitez que Cortex Analyst présente sous forme de requêtes
- ÉTAPE DE CRÉATION : Sur le schéma, qui est nécessaire pour importer votre fichier de modèle sémantique
📖 À lire également : Comment utiliser Snowflake Cortex pour la Business Intelligence
2. Créez votre fichier de modèle sémantique
Le principal obstacle avec tout outil de conversion de texte en SQL est que l’IA ne maîtrise pas le langage propre à votre entreprise. Elle ne sait pas d’emblée que « ARR » signifie « chiffre d’affaires annuel récurrent » ou que la table « clients » est jointe à la table « commandes » via le champ « customer_id ».
Sans ce contexte, l'IA pourrait générer du code SQL techniquement valide mais logiquement erroné, vous fournissant ainsi des réponses qui semblent correctes mais qui sont dangereusement trompeuses.
Le modèle sémantique est la solution. Il s’agit d’un fichier YAML qui fait office de « couche de traduction » personnalisée, permettant à Cortex Analyst d’apprendre le vocabulaire et la logique spécifiques à votre entreprise. La création et la maintenance de ce fichier relèvent d’un effort collaboratif entre les ingénieurs de données, qui utilisent des outils ETL pour connaître le schéma, et les analystes métier, qui maîtrisent la terminologie.
Votre fichier de modèle sémantique doit contenir les clés suivantes :
| Composant | Objectif |
| Tables | La liste répertorie chaque table avec une description en langage clair de sa fonction |
| Colonnes | Définit le type sémantique de chaque colonne (comme une catégorie ou un indicateur) et peut inclure des échantillons de valeurs |
| Relations | Spécifie comment les tables s'interconnectent via des jointures, éliminant ainsi toute approximation pour l'IA |
| Requêtes vérifiées | Fournit des exemples de paires « question-SQL » qui constituent des guides très utiles pour le LLM. |
3. Configurer Cortex Search Service (facultatif)
Parfois, les réponses dont vous avez besoin sont cachées dans du texte non structuré, comme des descriptions de produits, des tickets d'assistance ou des transcriptions d'appels. Les requêtes SQL standard ne peuvent pas exploiter ces données, ce qui signifie que vous passez souvent à côté du « pourquoi » derrière le « quoi ».
Vous pouvez, si vous le souhaitez, ajouter ici Snowflake Cortex Search Service. Il s'agit d'une couche de « recherche en tant que service » qui vous permet d'effectuer des requêtes sur vos tables structurées et vos données textuelles non structurées à l'aide d'agents IA pour l'analyse des données.
Vous devez configurer Cortex Search si vos analystes ont besoin de poser des questions nécessitant d’extraire du contexte à partir d’un texte avant de générer du code SQL. Par exemple, vous pourriez d’abord rechercher tous les avis sur les produits contenant l’expression « problème de batterie », puis générer une requête SQL pour agréger les données de vente de ces produits uniquement.
Pour la génération de SQL pur à partir de tables structurées, ce service n'est pas nécessaire.
🧠 Anecdote : Au début des années 1970, les chercheurs d'IBM Donald Chamberlin et Raymond Boyce ont créé le « Structured English Query Language ». Ils ont dû changer le nom en SQL car « SEQUEL » était déjà une marque déposée par un constructeur aéronautique britannique.
Guide étape par étape pour générer du code SQL avec Cortex Analyst
Vous avez terminé le travail préparatoire, mais vous vous retrouvez désormais face à un écran vide, sans savoir exactement comment procéder. Comment passer d'une question que vous vous posez à une requête SQL exécutable ? Lorsque la gestion du flux de travail n'est pas claire, les nouveaux outils restent souvent inutilisés et l'investissement consacré à leur installation est gaspillé.
Le processus pratique est d'une simplicité rafraîchissante. Découvrons-le de plus près !
Étape n° 1 : Préparez vos données dans Snowflake
Avant toute chose, vos données structurées doivent être stockées dans Snowflake. Chaque application Cortex Analyst est associée soit à une seule table, soit à une vue composée d’une ou plusieurs tables. Assurez-vous que vos tables ont bien été créées et renseignées.
Si vous effectuez un chargement à partir de fichiers plats :
- Importez vos fichiers de données (par exemple, des fichiers CSV) vers une étape Snowflake
- Utilisez la commande COPY INTO pour charger les données de l'étape dans vos tables.
- Vérifiez que la charge des données a été réussie avant de poursuivre.
📖 À lire également : Comment utiliser Snowflake Cortex pour l'analyse de données de l'entreprise
Étape n° 2 : Créer un modèle sémantique (ou une vue sémantique)
Il s'agit de l'étape d'installation la plus cruciale. La puissance de Cortex Analyst réside dans la combinaison de grands modèles linguistiques (LLM) et de modèles sémantiques, un fichier YAML qui accompagne le schéma de votre base de données et encode le contexte de l'entreprise.
Les vues sémantiques constituent désormais la méthode recommandée par Snowflake pour Cortex Analyst. Elles stockent les indicateurs métier, les relations et les définitions directement au sein de Snowflake. Les anciens fichiers de modèles sémantiques YAML fonctionnent toujours, mais Snowflake oriente les nouvelles implémentations vers les vues sémantiques.
Votre modèle sémantique ou votre vue doit inclure :
- Descriptions des tables et des colonnes : explications en langage clair de la signification de chaque champ
- Indicateurs métier : définitions des champs calculés tels que le chiffre d'affaires, le taux de désabonnement ou le taux de conversion
- Filtres et synonymes : termes alternatifs que les utilisateurs pourraient employer (par exemple, « annulé » mappé sur une valeur de statut spécifique)
- Requêtes vérifiées : le référentiel de requêtes vérifiées de Snowflake stocke des paires « question-SQL » approuvées. Lorsqu’une question d’un utilisateur ressemble à l’une de ces entrées, Cortex Analyst peut s’y référer lors de la génération de requêtes SQL.
🤝 Petit rappel : Snowflake recommande de ne pas utiliser plus de 10 tables et de ne pas effectuer de sélection pour plus de 50 colonnes afin d’obtenir des performances optimales dans le flux de travail Snowsight.
Étape n° 3 : Importez le modèle sémantique dans une étape Snowflake
Si vous utilisez un modèle sémantique basé sur YAML, celui-ci doit être déployé afin que Cortex Analyst puisse y faire référence lors de l'exécution.
- Importez votre fichier .yaml vers une étape interne de Snowflake (par exemple, RAW_DATA)
- Vérifiez que le fichier apparaît dans l'étape via l'interface utilisateur Snowsight ou à l'aide de la commande LIST @stage_name
- Notez le chemin d'accès à l'étape ; vous y ferez référence dans vos appels API ou dans la configuration de votre application.
Si vous utilisez une vue sémantique, cette étape est gérée en natif au sein de Snowflake et ne nécessite aucun téléchargement séparé.
🔍 Le saviez-vous ? En SQL, la valeur NULL ne signifie ni zéro ni vide. Elle représente des données inconnues ou manquantes, ce qui entraîne des comportements contre-intuitifs, comme des comparaisons qui ne renvoient ni vrai ni faux.
Étape n° 4 : Envoyez une question en langage naturel via l'API REST
La génération du code SQL proprement dite commence alors. L'API REST génère une requête SQL pour une question donnée à l'aide d'un modèle sémantique ou d'une vue sémantique fourni(e) dans la requête.
Structurez votre requête API à l'aide des éléments suivants :
- Messages ; un tableau contenant la question de l'utilisateur avec le rôle : « utilisateur »
- Une référence à votre modèle sémantique ou à votre vue sémantique
- Votre modèle préféré (ou laissez le paramètre sur « auto » pour que Cortex effectue la sélection)
Vous pouvez mener des discussions à plusieurs tours, au cours desquelles vous pouvez poser des questions complémentaires qui s'appuient sur les requêtes précédentes.
Étape n° 5 : Analyser la réponse de l'API
Chaque message d'une réponse peut comporter plusieurs blocs de contenu de types différents. Les trois valeurs actuellement prises en charge pour le champ « type » sont : « texte », « suggestions » et « SQL ».
Voici ce que signifie chaque type :
- SQL : Cortex a généré une requête avec succès ; voici celle que vous allez exécuter
- texte: Un texte expliquant ou répondant au code SQL en langage naturel
- suggestions : Le type de contenu « suggestion » n'est inclus dans une réponse que si la question de l'utilisateur était ambiguë et que Cortex Analyst n'a pas pu renvoyer d'instruction SQL pour cette requête. Utilisez-les pour clarifier ou affiner la question
🔍 Le saviez-vous ? L'ordre dans lequel vous écrivez le code SQL n'est pas celui dans lequel il s'exécute. Même si vous écrivez SELECT en premier, les bases de données traitent en réalité les clauses FROM et WHERE avant de sélectionner les colonnes. Cela prête à confusion tant pour les débutants que pour les utilisateurs expérimentés.
Étape n° 6 : Exécutez le code SQL généré dans Snowflake
Une fois que vous disposez du bloc SQL issu de la réponse, exécutez-le sur votre entrepôt virtuel Snowflake. La requête SQL générée est exécutée dans votre entrepôt virtuel Snowflake afin de produire le résultat final. Les données restent dans les limites de la gouvernance de Snowflake.
Éléments clés à connaître au moment de l'exécution :
- Cortex Analyst s'intègre pleinement aux politiques de contrôle d'accès basé sur les rôles (RBAC) de Snowflake, garantissant ainsi que les requêtes SQL générées et exécutées respectent tous les contrôles d'accès établis.
- Si un utilisateur n'a pas accès à une table, la requête échouera lors de son exécution, tout comme ce serait le cas avec un code SQL écrit manuellement.
- Des frais de calcul liés à l'entrepôt de données s'appliquent à cette étape, en plus des frais d'utilisation propres à Cortex Analyst.
Étape n° 7 : Affiner et itérer
Il n'est pas toujours garanti d'obtenir une requête parfaite dès le premier essai. Voici comment améliorer les résultats au fil du temps :
- Ajoutez des requêtes vérifiées à votre modèle sémantique pour les questions qui reviennent régulièrement.
- Enrichissez votre modèle sémantique avec de meilleures descriptions, des synonymes et des filtres lorsque Cortex interprète mal un terme.
- Utilisez les discussions à plusieurs tours pour approfondir la recherche, par exemple avec « Maintenant, filtre les résultats par région » ; les discussions à plusieurs tours permettent de poser des questions complémentaires qui s'appuient sur les requêtes précédentes.
- Surveillez l'utilisation via CORTEX_ANALYST_USAGE_HISTORY et l'historique des requêtes Snowflake afin d'identifier les schémas récurrents dans les requêtes ayant échoué ou étant inexactes.
🧠 Anecdote : Une seule condition JOIN manquante peut entraîner d'énormes problèmes. Oublier une condition JOIN peut générer un produit cartésien, multipliant considérablement le nombre de lignes et provoquant parfois le plantage des systèmes.
Bonnes pratiques pour optimiser la précision de la conversion texte-SQL dans Snowflake
La qualité de votre modèle sémantique détermine directement la précision des requêtes qu'il génère. Voici les bonnes pratiques qui permettent d'améliorer cette précision. 🛠️
- Ajoutez des requêtes vérifiées à votre modèle sémantique : c'est la mesure la plus efficace à faire. Intégrez de nombreux exemples de paires « question-SQL » qui reflètent la manière dont votre équipe pose réellement ses questions.
- Utilisez des noms de colonnes et de tables descriptifs : le modèle fonctionne mieux lorsque les noms de colonnes et de tables sont explicites. Si vous ne pouvez pas modifier le schéma, ajoutez des descriptions claires dans votre fichier YAML pour tout nom de colonne obscur.
- Inclure des échantillons de valeurs : l'ajout d'échantillons de données pour les colonnes catégorielles (telles que le statut ou la région) aide le modèle à comprendre les options de filtrage valides disponibles.
- Testez avec des cas limites : pendant le développement, posez délibérément des questions ambiguës ou complexes afin d’identifier les points où votre modèle sémantique a besoin de plus de contexte ou de précisions.
- Faites évoluer votre modèle sémantique : Considérez votre modèle sémantique comme un document évolutif. Il doit être mis à jour en permanence grâce à un processus itératif basé sur les requêtes qui aboutissent et celles qui échouent.
ClickUp : une alternative plus simple à Snowflake Cortex
Snowflake Cortex est particulièrement adapté lorsque les équipes souhaitent générer du code SQL et exécuter des requêtes sur des données structurées. Les équipes définissent des schémas, mappent les relations et rédigent des requêtes pour extraire des informations. Cette installation est particulièrement adaptée aux environnements riches en données, notamment lorsque les analystes sont responsables de la création des rapports.
De nombreuses équipes n’ont toutefois pas besoin d’une couche SQL complète pour répondre aux questions opérationnelles quotidiennes. Les chefs de produit, les responsables de programme et les équipes opérationnelles souhaitent souvent obtenir des réponses rapides en lien avec leur travail courant.
ClickUp propose une approche plus accessible. Les équipes posent des questions en langage courant, consultent des tableaux de bord en temps réel et exploitent les informations obtenues sans avoir à écrire de code SQL ni à créer de modèles sémantiques.
Générez et affinez vos requêtes SQL plus rapidement
Snowflake Cortex est spécialement conçu pour générer des requêtes SQL à partir d'ensembles de données structurés dans un environnement d'entrepôt de données. Cette fonctionnalité est particulièrement efficace lorsque vos données sont déjà stockées dans Snowflake et que vos schémas sont déjà définis.
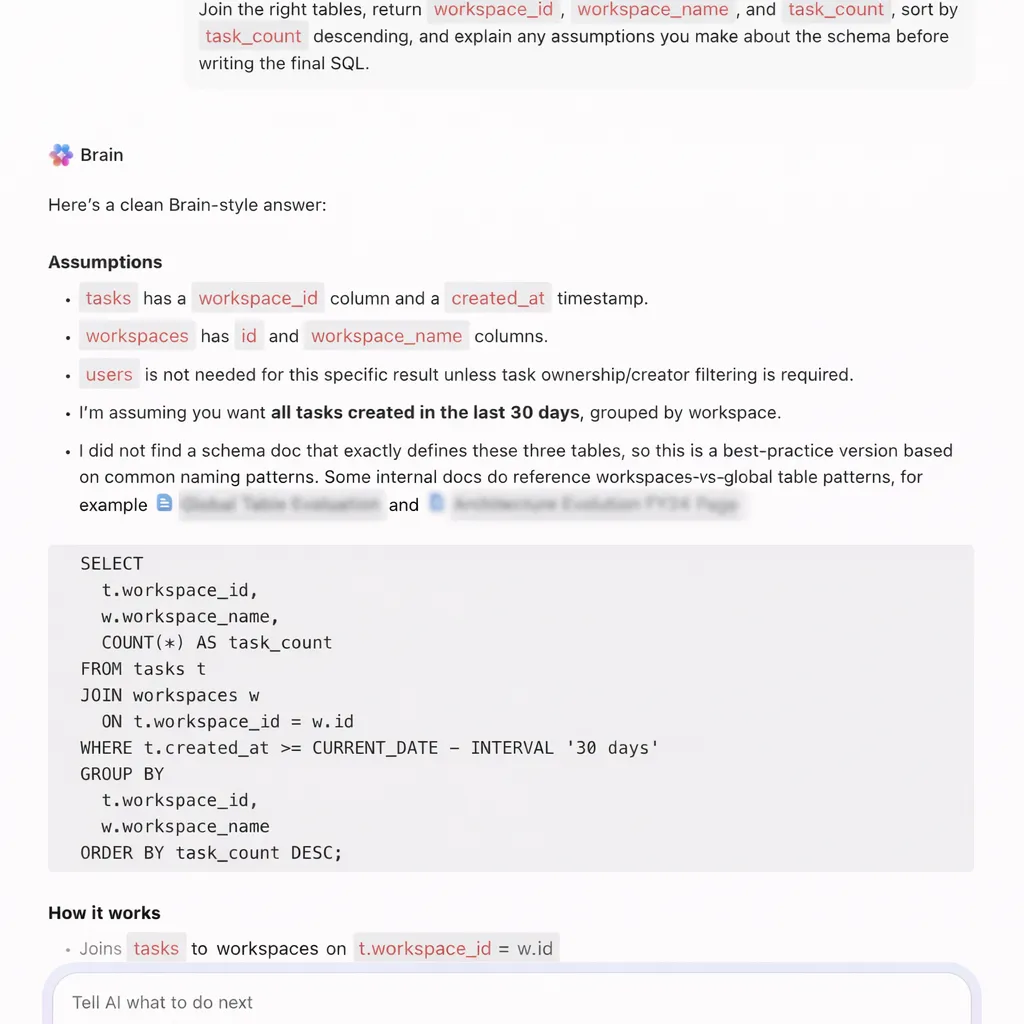
ClickUp Brain prend en charge la génération de requêtes SQL de manière plus flexible et axée sur l'exécution. Les équipes génèrent, affinent et stockent leurs requêtes SQL directement au sein de leur environnement de travail, là où s'effectuent déjà les analyses, les discussions et les prises de décision.
Imaginons qu'un analyste produit travaille sur une analyse de fidélisation dans ClickUp. Au lieu de changer d'outil pour rédiger des requêtes, il demande à ClickUp Brain :
📌 Essayez cette invitation : Écrivez une requête SQL pour calculer le taux de rétention sur sept jours des utilisateurs regroupés par cohorte d'inscription.
ClickUp Brain génère une requête structurée qui inclut un regroupement par cohorte, des filtres de date et une logique de rétention. L'analyste colle la requête dans Snowflake ou un autre entrepôt de données et l'exécute immédiatement.
Cela permet de :
- Créez des jointures entre plusieurs tables, telles que les utilisateurs, les commandes et les évènements
- Convertissez des questions sur les produits formulées en anglais courant en logique SQL prête à être exécutée
- Déboguez les requêtes défaillantes et identifiez les problèmes, tels que des jointures incorrectes ou des conditions manquantes.
- Réécrivez vos requêtes pour améliorer leurs performances ou leur lisibilité
Par exemple, lors d'une analyse d'une expérience de croissance, un responsable marketing demande : « Rédigez une requête SQL pour comparer les taux de conversion entre deux pages de destination au cours des 14 derniers jours ».
ClickUp Brain génère la requête à l'aide d'agrégations conditionnelles et de filtres de date. L'équipe l'exécute dans Snowflake et valide les résultats de l'expérience.
📌 Essayez cette invitation : Corrigez cette requête SQL dans laquelle la jointure duplique des lignes et expliquez le problème.
ClickUp Brain identifie le problème de jointure, corrige la requête et explique comment des lignes en double sont apparues en raison de conditions de jointure incorrectes.
Remplacez les rapports basés sur le langage SQL
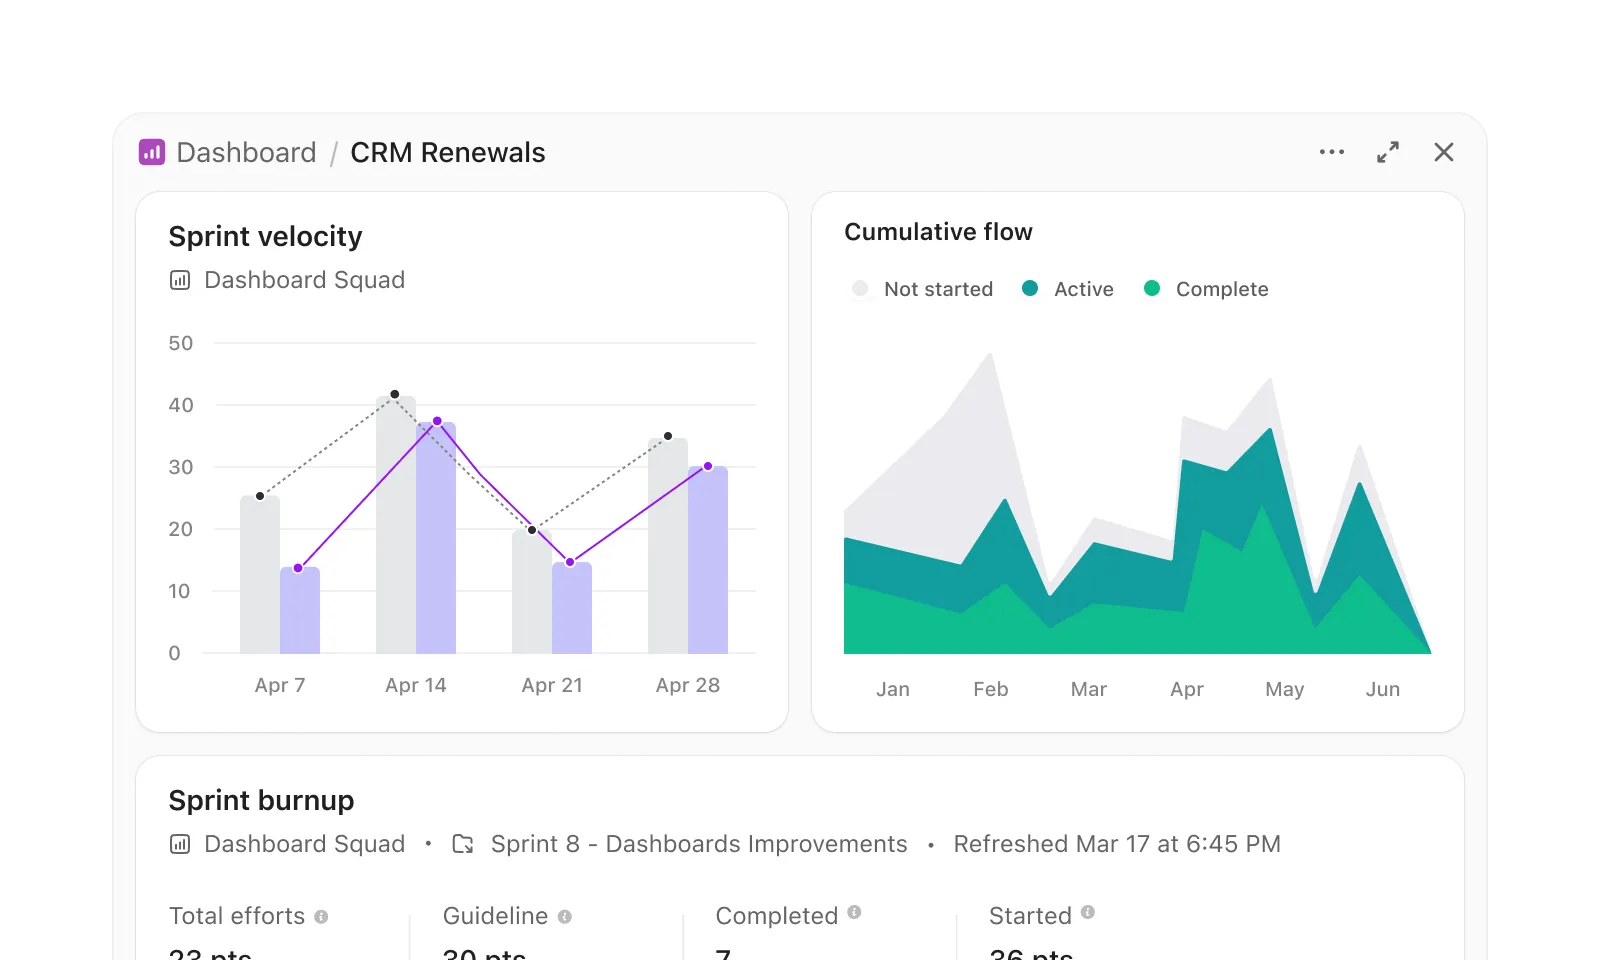
Les flux de travail Snowflake Cortex impliquent souvent de générer du code SQL, d'exécuter des requêtes et de visualiser les résultats dans une couche distincte. Les tableaux de bord ClickUp suppriment ce processus en plusieurs étapes et présentent les informations directement à partir du travail en temps réel.
Une équipe de gestion de programme chargée du suivi de l'état de préparation d'une version peut créer un tableau de bord sans avoir à écrire de requêtes. Par exemple, un tableau de bord dédié à une version peut inclure :
- Une carte de liste de tâches filtrée pour afficher les tâches en retard dans toutes les équipes produit
- Une carte de charge de travail qui présente la distribution des tâches entre les ingénieurs
- Un diagramme à barres comparant les tâches achevées aux tâches en attente par sprint
- Une carte de calcul permettant de suivre le temps moyen d'exécution
Imaginons qu'un chef de projet consulte ce tableau de bord avant une réunion de lancement. Il constate immédiatement que les services backend affichent des taux de latence plus élevés. Il ouvre la carte de la liste des tâches et examine précisément celles qui présentent un risque.
Partage d'un utilisateur réel de ClickUp:
ClickUp nous permet de nous transmettre RAPIDEMENT des projets, de vérifier FACILEMENT leur statut et offre à notre responsable une vue d'ensemble de notre charge de travail à tout moment, sans qu'elle ait à nous interrompre. Nous avons sans aucun doute gagné une journée par semaine grâce à ClickUp, voire plus. Le nombre d'e-mails a CONSIDÉRABLEMENT diminué.
ClickUp nous permet de nous transmettre RAPIDEMENT des projets, de vérifier FACILEMENT leur statut et offre à notre responsable une vue d'ensemble de notre charge de travail à tout moment, sans qu'elle ait à nous interrompre. Nous avons sans aucun doute gagné une journée par semaine grâce à ClickUp, voire plus. Le nombre d'e-mails a CONSIDÉRABLEMENT diminué.
Agissez sur la base d’informations exploitables sans avoir recours à des pipelines
Snowflake Cortex se concentre sur l'extraction d'informations à partir des données. Les équipes doivent toujours interpréter les résultats et déclencher des actions séparément.
Les Super Agents IA de ClickUp comblent ce fossé et transforment les informations en actions concrètes. Ils agissent comme des coéquipiers IA qui surveillent en permanence les données de l'environnement de travail et prennent des mesures en fonction des conditions.
Imaginons qu'un chef de projet supervise plusieurs initiatives produit. Un Super Agent peut :
- Surveillez les tâches sur l'ensemble des projets et détectez lorsque les tâches en retard dépassent un seuil défini
- Identifiez des schémas récurrents, tels que des retards répétés à la même étape du flux de travail
- Créez une tâche qui résume les projets concernés et attribuez-la au responsable du programme.
- Avertissez les propriétaires d'équipe lorsque des tâches critiques restent en suspens après les dates limites
Par exemple, au cours d’un cycle de mise en production, un Super Agent détecte que plus de 10 tâches à haute priorité n’ont pas respecté leurs échéances au sein de deux équipes. Il crée alors une tâche ClickUp intitulée « Risque lié à la mise en production : échéances non respectées », y ajoute toutes les pièces jointes concernées et la confie au chef de projet pour qu’il l’examine immédiatement.
Les équipes peuvent également interagir directement avec le Super Agent : « Analyse tous les projets en cours et mets en évidence les risques liés à la livraison pour ce sprint ».
Le Super Agent passe en revue les échéances, les dépendances et le statut des tâches, puis publie un résumé structuré dans l'environnement de travail.
Voici comment configurer votre propre Super Agent dans ClickUp :
Centralisez vos flux de travail liés aux données avec ClickUp
Les outils de conversion de texte en SQL, tels que Snowflake Cortex, facilitent l'accès aux données. Cependant, obtenir des résultats fiables demande encore de l'effort.
Les équipes ont besoin de schémas clairs, de modèles sémantiques solides et d’itérations continues pour garantir la précision des résultats. Même après avoir généré la bonne requête, le travail ne s’arrête pas là. Il faut encore que quelqu’un interprète les résultats, partage les informations pertinentes et les transforme en décisions.
ClickUp propose une approche différente. Au lieu de séparer l'analyse de l'exécution, ClickUp établit la connexion entre les deux. Les équipes génèrent du code SQL, documentent leurs conclusions, collaborent sur leurs résultats et agissent en conséquence au sein d'un même environnement de travail.
ClickUp Brain aide à rédiger et à affiner les requêtes, tandis que les tableaux de bord et les agents IA aident les équipes à suivre les résultats et à faire avancer le travail sans avoir à passer d'un outil à l'autre.
Snowflake Cortex vous aide à obtenir des réponses. ClickUp vous aide à faire quelque chose avec elles. Inscrivez-vous dès aujourd'hui sur ClickUp!
Foire aux questions
Qu'est-ce que Snowflake Cortex Analyst et en quoi diffère-t-il de Cortex IA ?
Snowflake Cortex Analyst est un service spécialisé au sein de la suite plus large Snowflake Cortex IA. Cortex Analyst se concentre spécifiquement sur la génération de requêtes SQL à partir de texte à l'aide de modèles sémantiques, tandis que Cortex IA inclut un intervalle plus large de fonctions LLM, d'inférence de modèles d'apprentissage automatique et de capacités de recherche.
Snowflake Cortex Analyst fonctionne-t-il avec des sources de données externes telles que les tables Iceberg ?
Oui, Cortex Analyst peut interroger les tables Apache Iceberg gérées via Snowflake. À condition que ces tables soient accessibles au sein de votre environnement Snowflake et correctement définies dans votre modèle sémantique, vous pouvez générer des requêtes les concernant.
Quelle est la précision de la génération de requêtes SQL à partir de texte proposée par Snowflake pour les requêtes complexes ?
La précision des requêtes complexes dépend presque entièrement de la qualité de votre modèle sémantique. Un modèle présentant des relations entre tables bien définies, de nombreuses requêtes vérifiées et des métadonnées descriptives produira des résultats nettement plus précis pour les jointures multi-tables et les agrégations complexes.
Quel est le coût de Snowflake Cortex pour les fonctionnalités de génération de requêtes SQL ?
La tarification de Snowflake Cortex Analyst suit le modèle de facturation à l'utilisation de Snowflake, ce qui signifie que vous êtes facturé en fonction des crédits de calcul utilisés pendant le processus de génération des requêtes. Pour connaître les tarifs les plus récents, veuillez toujours vous reporter à la documentation officielle de Snowflake relative à la tarification.