
نادرًا ما تفشل مشاريع تدريب الذكاء الاصطناعي على مستوى النموذج. لكنها تواجه صعوبات عندما تكون التجارب والوثائق وتحديثات الأطراف المعنية مبعثرة عبر عدد كبير جدًا من الأدوات.
يرشدك هذا الدليل خطوة بخطوة إلى تدريب النماذج باستخدام Databricks DBRX — وهو نموذج لغة كبير (LLM) يتميز بكفاءة حسابية تصل إلى ضعف كفاءة النماذج الرائدة الأخرى — مع الحفاظ على تنظيم الأعمال المرتبطة به في ClickUp.
بدءًا من الإعداد والضبط الدقيق وصولًا إلى التوثيق والتحديثات المشتركة بين الفرق، سترى كيف تساعد مساحة العمل الواحدة والمتكاملة في القضاء على تشتت السياق والحفاظ على تركيز فريقك على البناء، وليس على البحث. 🛠
ما هو DBRX؟
DBRX هو نموذج لغوي ضخم (LLM) قوي ومفتوح المصدر، مصمم خصيصًا لتدريب نماذج الذكاء الاصطناعي والاستدلال في المؤسسات. ونظرًا لأنه مفتوح المصدر بموجب ترخيص Databricks Open Model، يتمتع فريقك بإمكانية الوصول الكامل إلى أوزان النموذج وبنيته، مما يتيح لك فحصه وتعديله ونشره وفقًا لشروطك الخاصة.
يتوفر البرنامج في نسختين: DBRX Base للتدريب التمهيدي العميق وDBRX Instruct للمهام الجاهزة التي تتطلب اتباع التعليمات.
بنية DBRX وتصميم «مزيج الخبراء»
يحل DBRX المهام باستخدام بنية «مزيج الخبراء» (Mixture-of-Experts أو MoE). وعلى عكس نماذج اللغة الكبيرة التقليدية التي تستخدم كل معلماتها التي تبلغ مليارات المعلمات في كل عملية حسابية، فإن DBRX لا يُفعّل سوى جزء بسيط من إجمالي معلماته (الخبراء الأكثر صلة) لأي مهمة معينة.
تخيل الأمر كفريق من الخبراء المتخصصين؛ فبدلاً من أن يعمل الجميع على كل مشكلة، يقوم النظام بتوجيه كل مهمة بذكاء إلى المعلمات المطابقة الأكثر تأهيلاً.
ولا يقتصر الأمر على تقليل وقت الاستجابة فحسب، بل يوفر أيضًا أداءً ونتائج من الدرجة الأولى مع خفض تكاليف الحوسبة بشكل كبير.
فيما يلي نظرة سريعة على مواصفاته الرئيسية:
- إجمالي المعلمات: 132 مليار عبر جميع الخبراء
- المعلمات النشطة: 36 مليار لكل تمريرة أمامية
- عدد الخبراء: 16 في المجموع (توجيه MoE Top-4)، مع 4 خبراء نشطين لأي توكن معين
- نافذة السياق: 32 ألف رمز
بيانات التدريب ومواصفات الرموز في DBRX
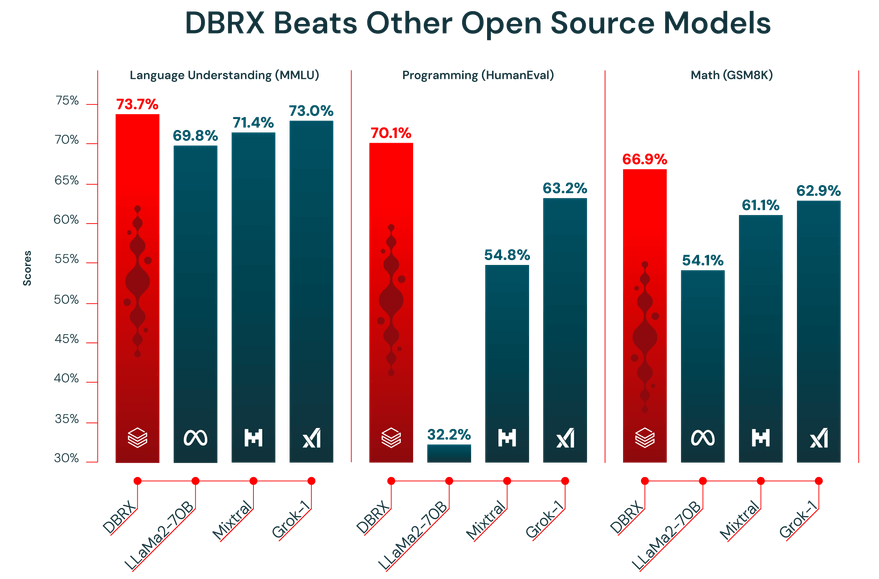
يعتمد أداء نموذج اللغة الكبير (LLM) بشكل كامل على جودة البيانات التي تم تدريبه عليها. تم تدريب DBRX مسبقًا على مجموعة بيانات ضخمة تضم 12 تريليون رمز، تم تجميعها بعناية من قبل فريق Databricks باستخدام أدوات معالجة البيانات المتقدمة الخاصة بهم. وهذا بالضبط هو السبب وراء أدائه القوي في معايير الأداء القياسية للصناعة.
بالإضافة إلى ذلك، يتميز DBRX بنافذة سياق تضم 32,000 رمز. وهذا هو حجم النص الذي يمكن للنموذج معالجته في المرة الواحدة. وتعد نافذة السياق الكبيرة مفيدة للغاية في المهام المعقدة مثل تلخيص التقارير الطويلة، أو البحث في الوثائق القانونية المطولة، أو بناء أنظمة متقدمة للاستخراج المعزز بالتوليد (RAG)، حيث تتيح للنموذج الحفاظ على السياق دون اقتطاع المعلومات أو نسيانها.
🎥 شاهد هذا الفيديو لترى كيف يمكن للتنسيق السلس للمشاريع أن يُحدث تحولًا في سير عمل تدريب الذكاء الاصطناعي لديك ويقضي على الصعوبات الناتجة عن التبديل بين أدوات غير مترابطة. 👇🏽
كيفية الوصول إلى DBRX وإعداده
يوفر DBRX طريقتين رئيسيتين للوصول، وكلاهما يتيح الوصول الكامل إلى أوزان النماذج بموجب شروط تجارية مرنة. يمكنك استخدام Hugging Face للحصول على أقصى قدر من المرونة أو الوصول إليه مباشرةً عبر Databricks لتجربة أكثر تكاملاً.
يمكنك الوصول إلى DBRX عبر Hugging Face
بالنسبة للفرق التي تقدر المرونة وتعتاد بالفعل على نظام Hugging Face، فإن الوصول إلى DBRX عبر Hub هو الخيار الأمثل. فهو يتيح لك دمج النموذج في سير العمل الحالي القائم على محولات Transformers.
إليك كيفية البدء:
- أنشئ حسابًا على Hugging Face أو سجّل الدخول إلى حسابك
- انتقل إلى بطاقة نموذج DBRX في «المحور» وقم بقبول شروط الترخيص
- قم بتثبيت مكتبة transformers مع التبعيات الضرورية مثل accelerate
- استخدم فئة AutoModelForCausalLM في البرنامج النصي الخاص بك بلغة Python لتحميل نموذج DBRX
- قم بتكوين مسار الاستدلال الخاص بك، مع مراعاة أن DBRX يتطلب ذاكرة GPU (VRAM) كبيرة لضمان التشغيل الفعال
📖 اقرأ المزيد: كيفية تكوين درجة حرارة نموذج اللغة الكبير (LLM)
يمكنك الوصول إلى DBRX عبر Databricks
إذا كان فريقك يستخدم Databricks بالفعل في هندسة البيانات أو التعلم الآلي، فإن الوصول إلى DBRX عبر هذه المنصة هو أسهل طريقة. فهذا يزيل صعوبات الإعداد ويوفر لك جميع الأدوات التي تحتاجها لعمليات MLOps في المكان الذي تعمل فيه بالفعل.
اتبع هذه الخطوات داخل مساحة عمل Databricks الخاصة بك للبدء:
- انتقل إلى قسم «Model Garden» أو «Mosaic AI»
- اختر إما DBRX Base أو DBRX Instruct، حسب احتياجاتك
- قم بتكوين نقطة نهاية تقديم للوصول إلى واجهة برمجة التطبيقات (API) أو قم بإعداد بيئة دفتر ملاحظات للاستخدام التفاعلي
- ابدأ في اختبار الاستدلال باستخدام أمثلة على المطالبات للتأكد من أن كل شيء يعمل بشكل صحيح قبل توسيع نطاق تدريب نموذج الذكاء الاصطناعي أو نشره
يمنحك هذا النهج وصولاً سلسًا إلى أدوات مثل MLflow لتتبع التجارب وUnity Catalog لإدارة النماذج.
📮 نظرة ثاقبة من ClickUp: يقضي الموظف العادي أكثر من 30 دقيقة يوميًا في البحث عن المعلومات المتعلقة بالعمل — أي ما يزيد عن 120 ساعة سنويًا تضيع في البحث في رسائل البريد الإلكتروني ومواضيع Slack والملفات المتناثرة.
يمكن لمساعد ذكي يعمل بالذكاء الاصطناعي ومدمج في مساحة العمل الخاصة بك أن يغير ذلك. تعرف على ClickUp Brain.
يقدم لك هذا النظام رؤى وإجابات فورية من خلال عرض المستندات والمحادثات وتفاصيل المهام المناسبة في غضون ثوانٍ — حتى تتمكن من التوقف عن البحث والبدء في العمل.
كيفية ضبط DBRX وتدريب نماذج الذكاء الاصطناعي المخصصة
لن يتمكن أي نموذج جاهز، مهما كانت قوته، من فهم الفروق الدقيقة الفريدة لأعمالك. ونظرًا لأن DBRX مفتوح المصدر، يمكنك ضبطه بدقة لإنشاء نموذج مخصص يتحدث لغة شركتك أو يؤدي مهمة محددة ترغب في أن يتولاها.
فيما يلي ثلاث طرق شائعة للقيام بذلك:
1. ضبط DBRX بدقة باستخدام مجموعات بيانات Hugging Face
بالنسبة للفرق التي بدأت للتو أو التي تعمل على مهام شائعة، تُعد مجموعات البيانات العامة من Hugging Face Hub موردًا رائعًا. فهي مُهيأة مسبقًا وسهلة التحميل، مما يعني أنك لن تضطر إلى قضاء ساعات في إعداد بياناتك.
العملية بسيطة للغاية:
- ابحث في «المنصة» عن مجموعة بيانات تتناسب مع مهمتك (على سبيل المثال، اتباع التعليمات، أو التلخيص)
- قم بتحميله باستخدام مكتبة مجموعات البيانات
- تأكد من تنسيق البيانات في شكل أزواج من التعليمات والاستجابات
- قم بتكوين برنامج التدريب الخاص بك باستخدام المعلمات الفائقة مثل معدل التعلم وحجم الدفعة
- ابدأ مهمة التدريب، مع الحرص على حفظ نقاط التحقق بشكل دوري
- قم بتقييم النموذج المُحسَّن على مجموعة التحقق المُستبعدة لقياس مدى التحسن
2. ضبط DBRX باستخدام مجموعات البيانات المحلية
عادةً ما تحصل على أفضل النتائج من خلال الضبط الدقيق باستخدام بياناتك الخاصة. يتيح لك ذلك تعليم النموذج المصطلحات والأسلوب والمعرفة المتخصصة الخاصة بشركتك. فقط ضع في اعتبارك أن ذلك لن يؤتي ثماره إلا إذا كانت بياناتك نظيفة ومُعدة جيدًا، وذات حجم كافٍ.
اتبع هذه الخطوات لإعداد بياناتك الداخلية:
- جمع البيانات: اجمع أمثلة عالية الجودة من مواقع الويكي الداخلية والوثائق وقواعد البيانات الخاصة بك
- تحويل التنسيق: قم بتنظيم بياناتك في تنسيق متسق من نوع «الأمر-الاستجابة»، وغالبًا ما يكون ذلك على شكل أسطر JSON
- تصفية الجودة: إزالة أي أمثلة منخفضة الجودة أو مكررة أو غير ذات صلة
- تقسيم البيانات للتحقق من الصحة: خصص جزءًا صغيرًا من بياناتك (عادةً ما بين 10 و15٪) لتقييم أداء النموذج
- مراجعة الخصوصية: قم بإزالة أو إخفاء أي معلومات شخصية (PII) أو بيانات حساسة
3. ضبط DBRX بدقة باستخدام StreamingDataset
إذا كانت مجموعة البيانات الخاصة بك كبيرة جدًا بحيث لا تتسع في ذاكرة جهازك، فلا تقلق، يمكنك استخدام مكتبة Streaming Dataset من Databricks. فهي تتيح لك بث البيانات مباشرةً من التخزين السحابي أثناء تدريب النموذج، بدلاً من تحميلها كلها في الذاكرة دفعة واحدة.
إليك كيفية القيام بذلك:
- تحضير البيانات: قم بتنقية بيانات التدريب وتنظيمها، ثم قم بتخزينها بتنسيق قابل للبث مثل JSONL أو CSV في التخزين السحابي
- تحويل تنسيق البث: قم بتحويل مجموعة البيانات الخاصة بك إلى تنسيق مناسب للبث، مثل Mosaic Data Shard (MDS)، بحيث يمكن قراءتها بكفاءة أثناء التدريب
- إعداد أداة تحميل التدريب: قم بتكوين أداة تحميل التدريب الخاصة بك لتشير إلى مجموعة البيانات البعيدة وحدد ذاكرة تخزين مؤقتة محلية لتخزين البيانات المؤقتة
- تهيئة النموذج: ابدأ عملية الضبط الدقيق لـ DBRX باستخدام إطار عمل تدريبي يدعم StreamingDataset، مثل LLM Foundry
- التدريب القائم على البث: قم بتشغيل مهمة التدريب أثناء بث البيانات على دفعات خلال التدريب، بدلاً من تحميلها بالكامل في الذاكرة
- نقاط التحقق والاستعادة: استأنف التدريب بسلاسة في حالة انقطاع عملية التشغيل، دون تكرار البيانات أو تخطيها
- التقييم والنشر: تحقق من أداء النموذج الذي تم ضبطه بدقة وانشره باستخدام إعدادات الخدمة أو الاستدلال التي تفضلها
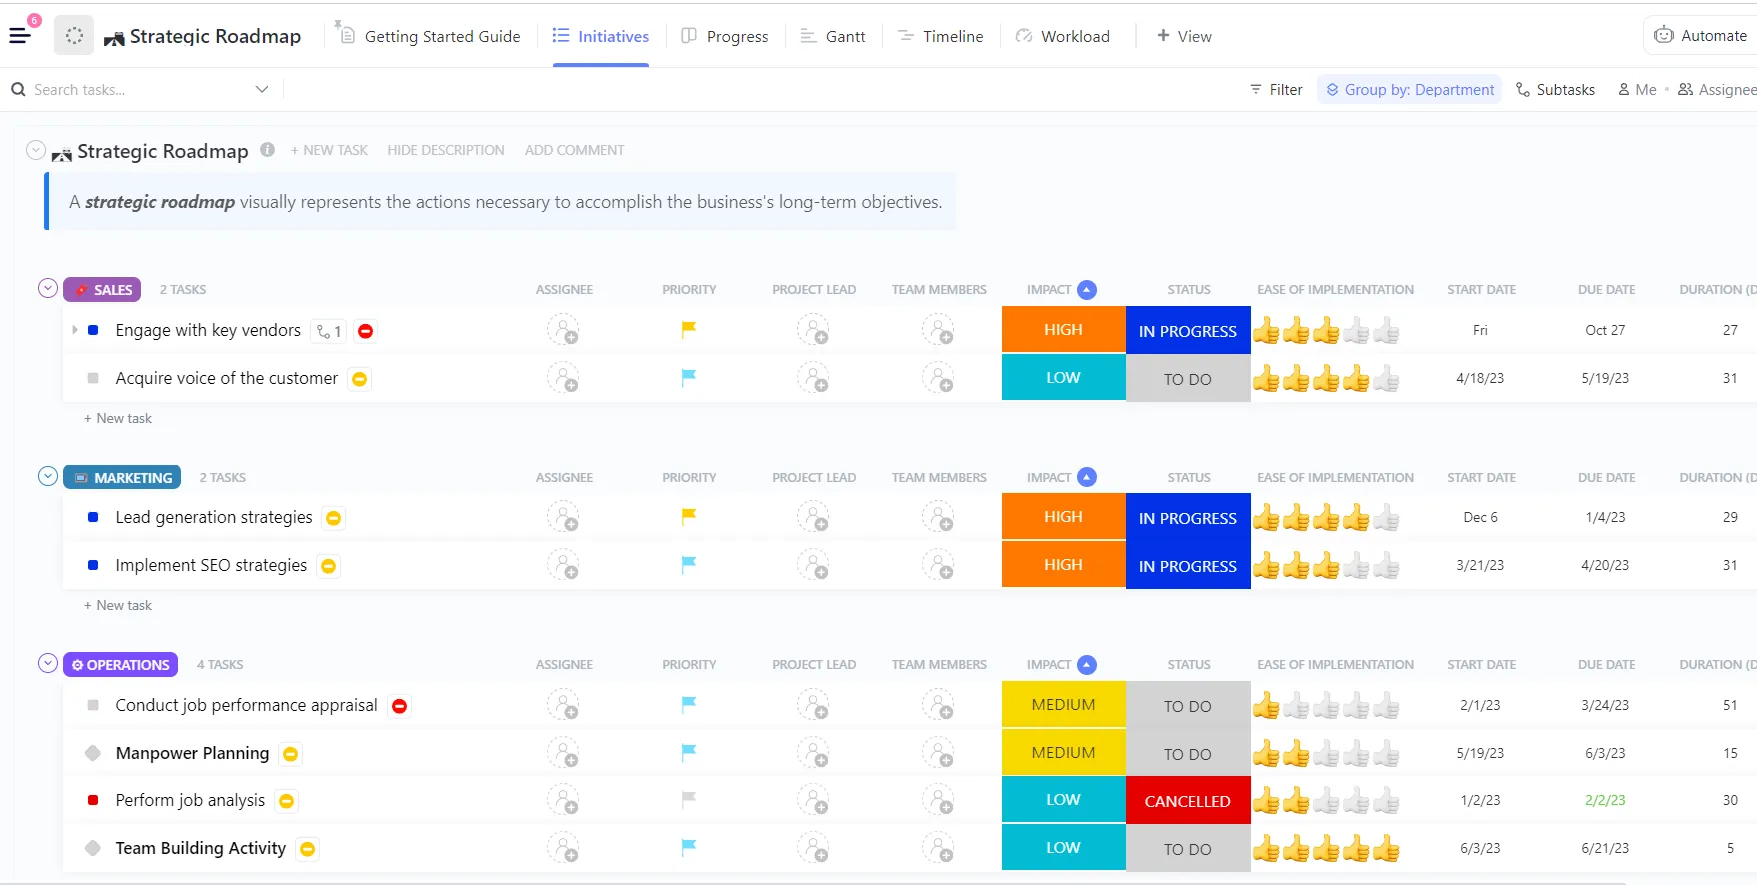
💡نصيحة للمحترفين: بدلاً من إنشاء خطة تدريب DBRX من الصفر، ابدأ باستخدام قالب خارطة طريق مشاريع الذكاء الاصطناعي والتعلم الآلي من ClickUp وقم بتعديله وفقًا لاحتياجات فريقك. يوفر هذا القالب هيكلًا واضحًا لتخطيط مجموعات البيانات ومراحل التدريب والتقييم والنشر، بحيث يمكنك التركيز على تنظيم عملك بدلاً من هيكلة سير العمل.
حالات استخدام DBRX لتدريب نماذج الذكاء الاصطناعي
إن امتلاك نموذج قوي أمر، ومعرفة المجالات التي يبرز فيها بالضبط أمر آخر.
عندما لا تكون لديك صورة واضحة عن نقاط قوة النموذج، فمن السهل أن تضيع الوقت والموارد في محاولة جعله يعمل في مجالات لا يناسبها. وهذا يؤدي إلى نتائج دون المستوى المطلوب وإحباط.
تجعل البنية الفريدة لـ DBRX وبيانات التدريب الخاصة به منه أداة مناسبة بشكل استثنائي للعديد من حالات الاستخدام المؤسسية الرئيسية. إن معرفة نقاط القوة هذه تساعدك على مواءمة النموذج مع أهداف عملك وتحقيق أقصى عائد على الاستثمار.
توليد النصوص وإنشاء المحتوى
تم ضبط DBRX Instruct بدقة لاتباع التعليمات وإنشاء نصوص عالية الجودة. وهذا يجعله أداة قوية لأتمتة مجموعة واسعة من المهام المتعلقة بالمحتوى. وتعد نافذة السياق الكبيرة التي يتمتع بها ميزة كبيرة، حيث تتيح له معالجة المستندات الطويلة دون فقدان تسلسل الفكرة.
يمكنك استخدامه من أجل:
- الوثائق الفنية: إنشاء وتحسين كتيبات المنتجات، ومراجع واجهة برمجة التطبيقات (API)، وأدلة المستخدم
- محتوى تسويقي: مسودات منشورات المدونة، والنشرات الإخبارية عبر البريد الإلكتروني، وتحديثات وسائل التواصل الاجتماعي
- إنشاء التقارير: تلخيص النتائج المعقدة المستخلصة من البيانات وإنشاء ملخصات تنفيذية موجزة
- الترجمة والتوطين: تكييف المحتوى الحالي ليتناسب مع الأسواق والجماهير الجديدة
مهام إنشاء الكود وتصحيح الأخطاء
تضمن جزء كبير من بيانات التدريب في DBRX أكواد برمجية، مما يجعله أداة دعم قوية للمطورين في مجال النماذج اللغوية الكبيرة (LLM). ويمكنه المساعدة في تسريع دورات التطوير من خلال أتمتة مهام البرمجة المتكررة والمساعدة في حل المشكلات المعقدة.
فيما يلي بعض الطرق التي يمكن لفريق الهندسة لديك الاستفادة منها:
- إكمال الكود: إنشاء نصوص الدوال تلقائيًا من التعليقات أو سلاسل الوثائق
- الكشف عن الأخطاء: تحليل مقتطفات الكود لتحديد الأخطاء المحتملة أو الثغرات المنطقية
- شرح الكود: ترجم الخوارزميات المعقدة أو الكود القديم إلى لغة إنجليزية بسيطة
- إنشاء الاختبارات: قم بإنشاء اختبارات الوحدة بناءً على توقيع الدالة والسلوك المتوقع
تطبيقات RAG وتطبيقات السياق الطويل
يُعد «التوليد المعزز بالاسترجاع» (RAG) تقنية قوية تستند استجابات النموذج فيها إلى البيانات الخاصة بشركتك. ومع ذلك، غالبًا ما تواجه أنظمة RAG صعوبات مع النماذج التي تحتوي على نوافذ سياق صغيرة، مما يفرض تقسيم البيانات بشكل مكثف قد يؤدي إلى فقدان سياق مهم. وتُعد نافذة السياق التي تبلغ سعتها 32 ألفًا في DBRX أساسًا ممتازًا لتطبيقات RAG القوية.
يتيح لك ذلك إنشاء أدوات داخلية قوية، مثل:
- البحث المؤسسي: أنشئ روبوتًا محادثةً يجيب على أسئلة الموظفين باستخدام قاعدة المعرفة الداخلية الخاصة بك
- دعم العملاء: أنشئ وكيلًا يولد ردودًا للدعم تستند إلى وثائق منتجك
- المساعدة في مجال الأبحاث: تطوير أداة قادرة على توليف المعلومات من مئات الصفحات من الأوراق البحثية
- التحقق من الامتثال: تحقق تلقائيًا من النصوص التسويقية وفقًا لإرشادات العلامة التجارية الداخلية أو الوثائق التنظيمية
كيفية دمج تدريب DBRX مع سير عمل فريقك
إن نجاح مشروع تدريب نماذج الذكاء الاصطناعي لا يقتصر على الكود والحوسبة فحسب. بل هو جهد تعاوني يشارك فيه مهندسو التعلم الآلي وعلماء البيانات ومديرو المنتجات وأصحاب المصلحة.
وعندما يتوزع هذا التعاون بين دفاتر Jupyter وقنوات Slack وأدوات إدارة المشاريع المنفصلة، فإنك تخلق ما يُعرف بـتشتت السياق، وهي حالة تتوزع فيها المعلومات المهمة للمشروع عبر عدد كبير جدًا من الأدوات.
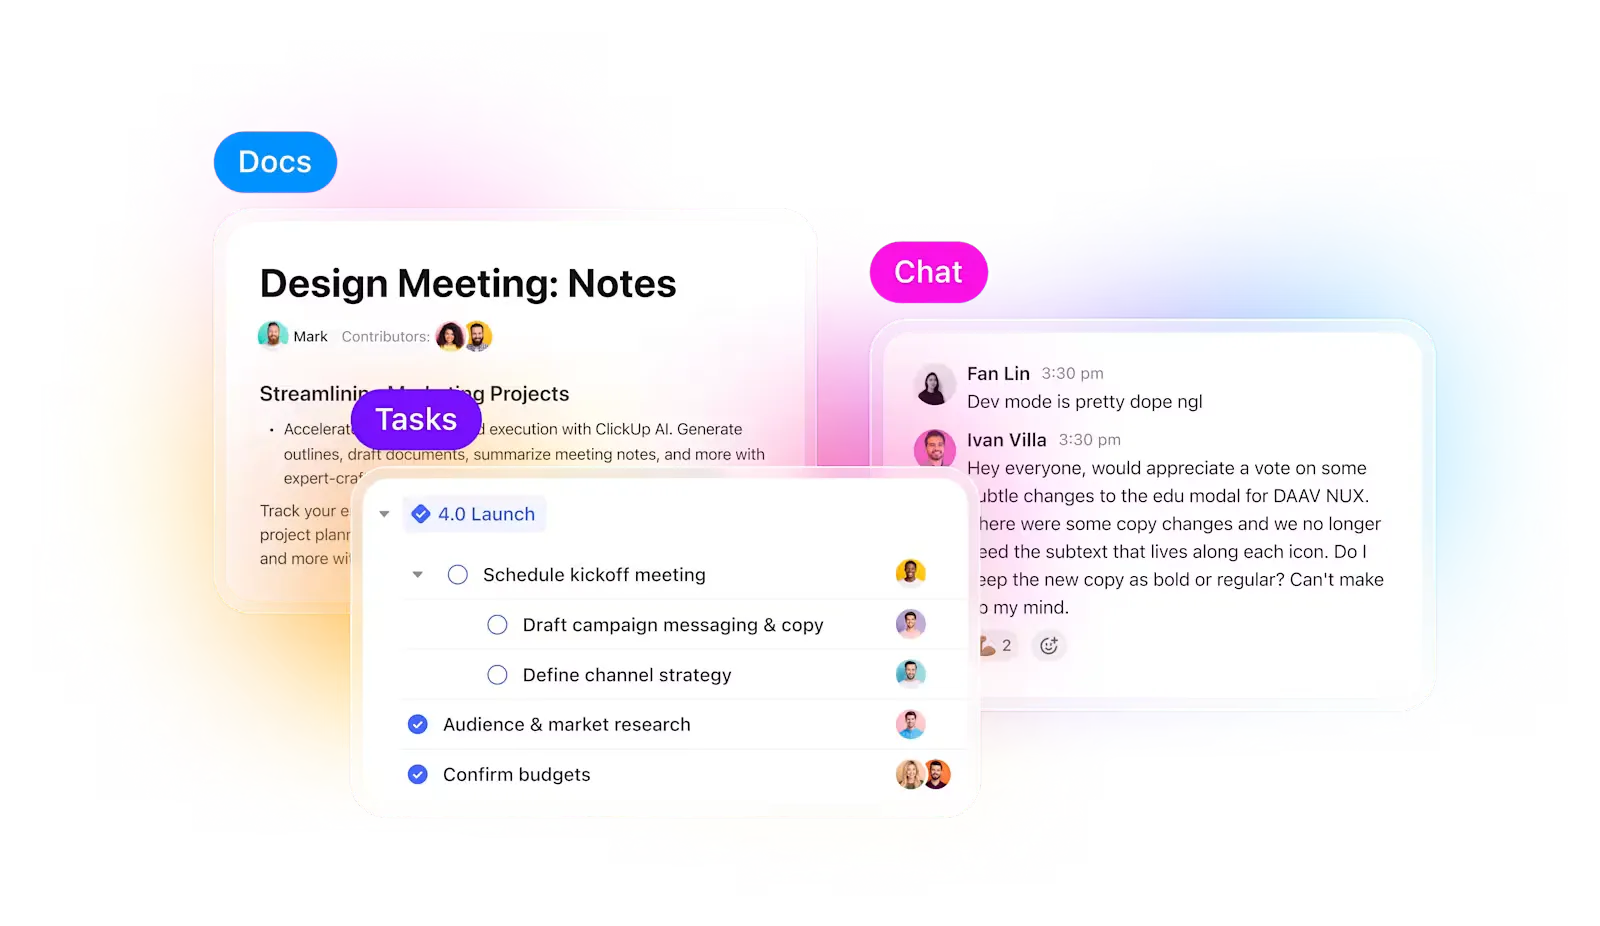
يقدم ClickUp حلاً لهذه المشكلة. بدلاً من التبديل بين أدوات متعددة، تحصل على مساحة عمل واحدة مدمجة للذكاء الاصطناعي تجمع بين إدارة المشاريع والتوثيق والتواصل — بحيث تظل تجاربك مترابطة بدءًا من التخطيط مرورًا بالتنفيذ وصولاً إلى التقييم.
لا تفقد أبدًا تتبع التجارب والتقدم المحرز
عند إجراء تجارب متعددة، لا يكمن الجزء الأصعب في تدريب النموذج، بل في تتبع التغييرات التي طرأت خلال العملية. ما هي نسخة مجموعة البيانات التي تم استخدامها، وما هو معدل التعلم الذي حقق أفضل أداء، أو أي عملية تشغيل تم نشرها؟
يجعل ClickUp هذه العملية سهلة للغاية بالنسبة لك. يمكنك تتبع كل دورة تدريب على حدة في مهام ClickUp، وداخل المهام، يمكنك استخدام الحقول المخصصة لتسجيل:
- إصدار مجموعة البيانات
- المعلمات الفائقة
- متغيرات النموذج (DBRX Base مقابل DBRX Instruct)
- حالة التدريب (في قائمة الانتظار، قيد التشغيل، قيد التقييم، تم نشرها)
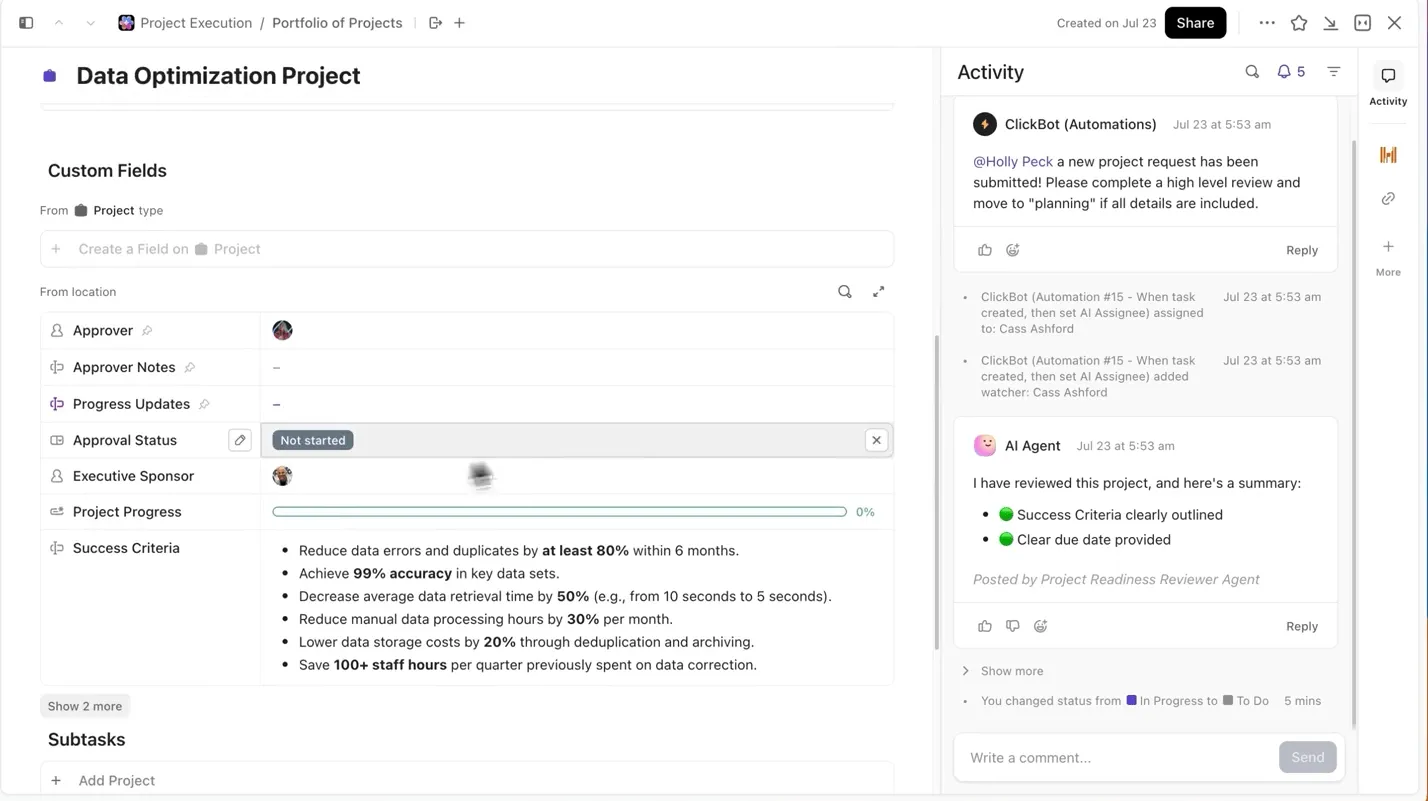
وبهذه الطريقة، تصبح كل تجربة موثقة قابلة للبحث، وسهلة المقارنة مع التجارب الأخرى، وقابلة للتكرار.
حافظ على ارتباط وثائق النموذج بالعمل
لن تضطر إلى التنقل بين دفاتر Jupyter وملفات README أو سلاسل المحادثات في Slack لفهم سياق مهمة التجربة.
باستخدام ClickUp Docs، يمكنك الحفاظ على تنظيم بنية النموذج ونصوص إعداد البيانات ومقاييس التقييم وإمكانية الوصول إليها من خلال توثيقها في مستند قابل للبحث يرتبط مباشرة بمهام التجربة التي نشأت منها.
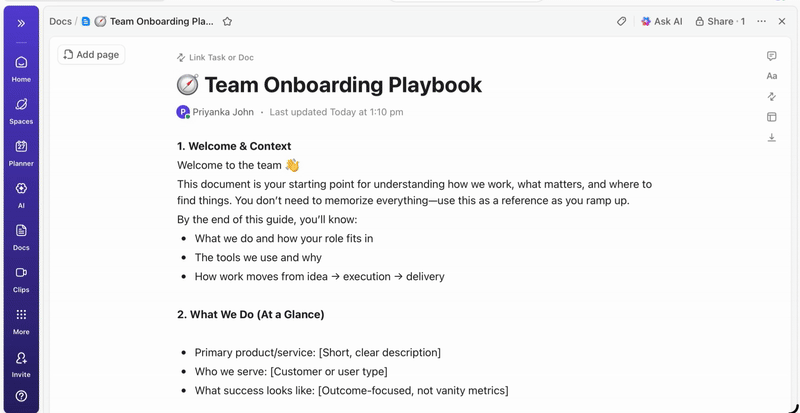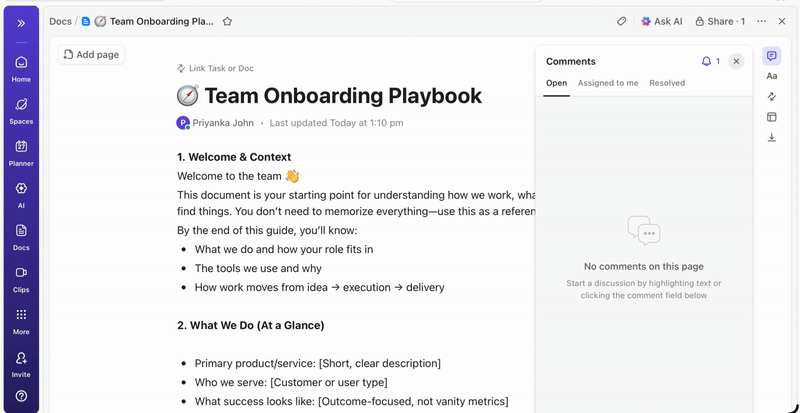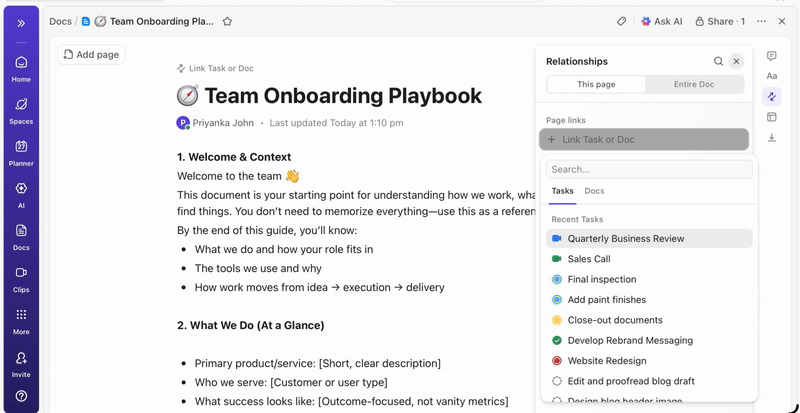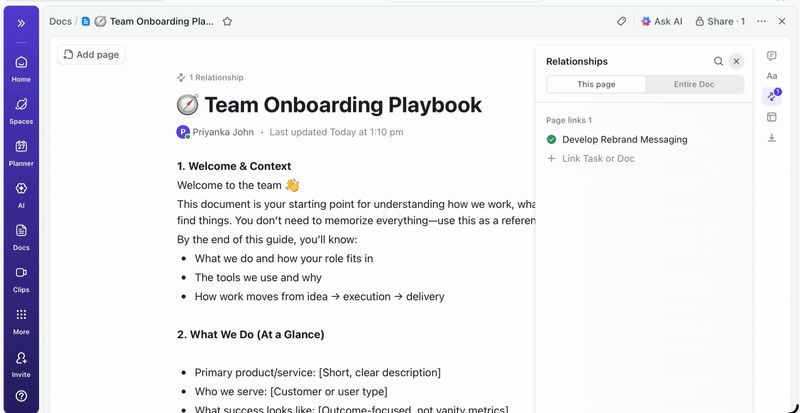
💡نصيحة للمحترفين: احتفظ بملخص مشروع محدث في ClickUp Docs يتضمن تفاصيل كل قرار، بدءًا من البنية وصولًا إلى النشر، حتى يتمكن أعضاء الفريق الجدد دائمًا من الاطلاع على تفاصيل المشروع دون الحاجة إلى البحث في سلاسل المحادثات القديمة
امنح أصحاب المصلحة رؤية في الوقت الفعلي
تعرض لوحات معلومات ClickUp تقدم التجارب وحجم عمل الفريق في الوقت الفعلي. I
بدلاً من تجميع التحديثات يدويًّا أو إرسال رسائل البريد الإلكتروني، يتم تحديث لوحات المعلومات تلقائيًّا استنادًا إلى البيانات الموجودة في مهامك. وبذلك يمكن لأصحاب المصلحة الاطلاع على الوضع في أي وقت، ومعرفة أين وصلت الأمور، ولن يضطروا أبدًا إلى مقاطعتك بأسئلة من نوع «ما هو الوضع؟».
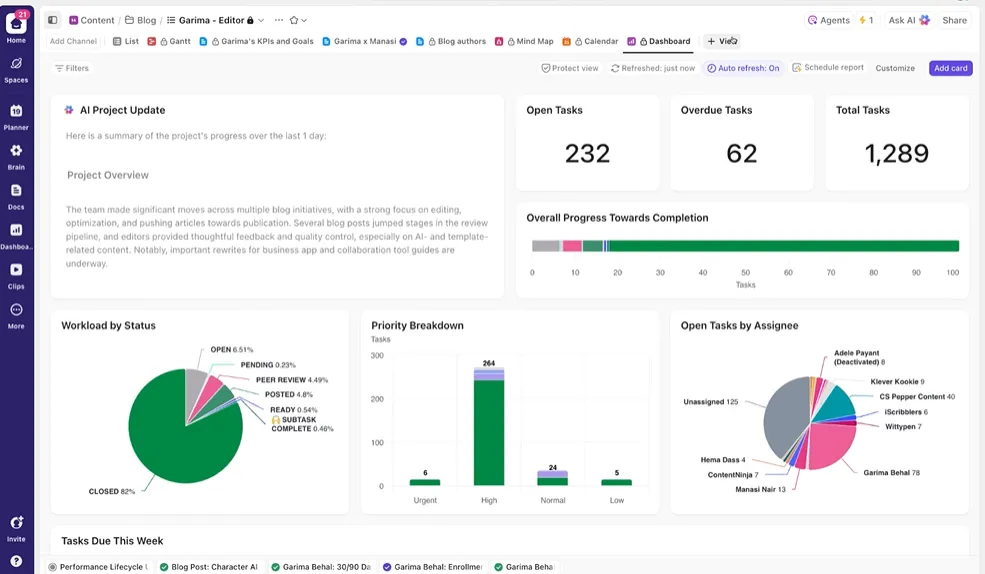
وبهذه الطريقة، يمكنك التركيز على إجراء التجارب بدلاً من الاضطرار إلى إعداد تقارير عنها يدويًّا باستمرار.
اجعل الذكاء الاصطناعي شريكك الذكي في المشاريع
لست مضطرًا إلى البحث يدويًّا في بيانات تدريب تمتد لأسابيع للحصول على ملخص للتجارب التي أُجريت حتى الآن. ما عليك سوى الإشارة إلى @Brain في أي تعليق على المهمة، وسيقدم لك ClickUp Brain المساعدة التي تحتاجها مع السياق الكامل لمشاريعك السابقة والجارية.
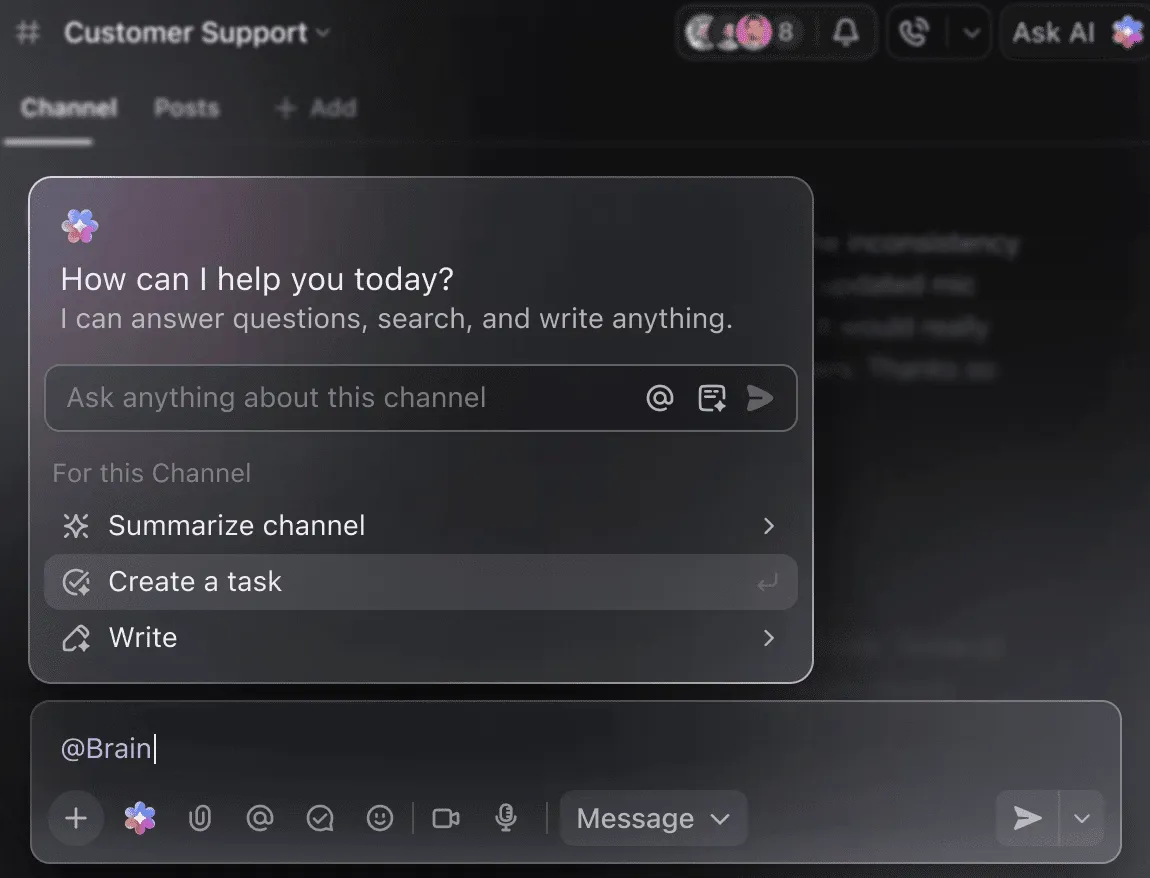
يمكنك أن تطلب من Brain «تلخيص تجارب الأسبوع الماضي في 5 نقاط» أو «صياغة مستند يتضمن أحدث نتائج المعلمات الفائقة»، وستحصل على الفور على ناتج متقن.
🧠 ميزة ClickUp: تأخذ " الوكلاء الفائقون " في ClickUp الأمر إلى أبعد من ذلك بكثير — فهم قادرون على أتمتة سير العمل بالكامل بناءً على المشغلات التي تحددها، وليس مجرد الإجابة على أسئلتك. بفضل الوكلاء الفائقين، يمكنك إنشاء مهمة تدريب DBRX جديدة تلقائيًا كلما تم تحميل مجموعة بيانات، وإخطار فريقك، وربط المستندات ذات الصلة عند انتهاء عملية التدريب أو الوصول إلى نقطة تفتيش، وإنشاء ملخص أسبوعي للتقدم المحرز وإرساله إلى أصحاب المصلحة دون أن تضطر إلى القيام بأي شيء.
الأخطاء الشائعة التي يجب تجنبها
يعد الشروع في مشروع تدريب باستخدام DBRX أمرًا مثيرًا، لكن هناك بعض العقبات الشائعة التي قد تعرقل تقدمك. وتجنب هذه الأخطاء سيوفر عليك الوقت والمال ويقيك من الكثير من الإحباط.
- التقليل من شأن متطلبات الأجهزة: DBRX قوي، لكنه كبير الحجم أيضًا. ستؤدي محاولة تشغيله على أجهزة غير ملائمة إلى حدوث أخطاء نفاد الذاكرة وفشل مهام التدريب. ضع في اعتبارك أن DBRX (132B) يتطلب ما لا يقل عن 264 جيجابايت من ذاكرة VRAM للاستدلال 16 بت، أو ما يقارب 70 إلى 80 جيجابايت عند استخدام التكمية 4 بت
- تجاهل فحوصات جودة البيانات: «إذا دخلت بيانات رديئة، فستخرج نتائج رديئة». إن إجراء الضبط الدقيق على مجموعة بيانات فوضوية ومنخفضة الجودة لن يؤدي إلا إلى تعليم النموذج إنتاج مخرجات فوضوية ومنخفضة الجودة
- تجاهل حدود طول السياق: على الرغم من أن نافذة السياق التي تبلغ 32 ألفًا في DBRX كبيرة، إلا أنها ليست لانهائية. سيؤدي تزويد النموذج بمدخلات تتجاوز هذا الحد إلى اقتطاع صامت وأداء ضعيف
- متى يكون استخدام «Base» مناسبًا بدلاً من «Instruct»: يُعد DBRX Base نموذجًا أوليًا تم تدريبه مسبقًا، وهو مخصص للتدريب الإضافي على نطاق واسع. بالنسبة لمعظم المهام التي تتطلب اتباع التعليمات، يجب أن تبدأ باستخدام DBRX Instruct، الذي تم ضبطه بالفعل لهذا الغرض
- فصل أعمال التدريب عن تنسيق المشاريع: عندما يكون تتبع تجاربك في أداة واحدة وخطة مشروعك في أداة أخرى، فإنك تخلق "صوامع" للمعلومات. استخدم منصة متكاملة مثل ClickUp للحفاظ على التزامن بين أعمالك الفنية وتنسيق مشاريعك
- إهمال التقييم قبل النشر: قد يفشل النموذج الذي يحقق أداءً جيدًا على بيانات التدريب الخاصة بك فشلًا ذريعًا في العالم الواقعي. احرص دائمًا على التحقق من صحة النموذج الذي تم ضبطه بدقة على مجموعة اختبار محجوبة قبل نشره في بيئة الإنتاج
- التغاضي عن تعقيد عملية الضبط الدقيق: نظرًا لأن DBRX هو نموذج من نوع «مزيج الخبراء» (Mixture-of-Experts)، فقد تتطلب نصوص البرمجة القياسية الخاصة بالضبط الدقيق مكتبات متخصصة مثل Megatron-LM أو PyTorch FSDP للتعامل مع توزيع المعلمات عبر وحدات معالجة الرسومات (GPUs) المتعددة
DBRX مقابل منصات تدريب الذكاء الاصطناعي الأخرى
يتطلب اختيار منصة تدريب الذكاء الاصطناعي إجراء مقايضة أساسية: التحكم مقابل الراحة. فالنماذج الاحتكارية التي تعتمد على واجهة برمجة التطبيقات (API) فقط سهلة الاستخدام، لكنها تقيدك بنظام المورد.
توفر نماذج الأوزان المفتوحة مثل DBRX تحكمًا كاملاً، لكنها تتطلب مزيدًا من الخبرة التقنية والبنية التحتية. وقد يجعلك هذا الاختيار تشعر بأنك عالق، غير متأكد من المسار الذي يدعم أهدافك على المدى الطويل فعليًّا — وهو تحدٍ يواجهه العديد من الفرق أثناء اعتماد الذكاء الاصطناعي.
يوضح هذا الجدول الفروق الرئيسية لمساعدتك في اتخاذ قرار مستنير.
| الأوزان | فتح (مخصص) | مسجلة الملكية | فتح (مخصص) | مسجلة الملكية |
| الضبط الدقيق | تحكم كامل | قائم على واجهة برمجة التطبيقات (API) | تحكم كامل | قائم على واجهة برمجة التطبيقات (API) |
| الاستضافة الذاتية | نعم | لا | نعم | لا |
| الترخيص | نموذج DB المفتوح | شروط OpenAI | مجتمع Llama | مصطلحات Anthropic |
| السياق | 32K | 128 ألف – 1 مليون | 128 ألف | 200 ألف – 1 مليون |
يُعد DBRX الخيار الأمثل عندما تحتاج إلى تحكم كامل في النموذج، أو تضطر إلى الاستضافة الذاتية لأسباب تتعلق بالأمان أو الامتثال، أو ترغب في التمتع بالمرونة التي توفرها الترخيص التجاري المرن. إذا لم تكن تمتلك بنية تحتية مخصصة لوحدات معالجة الرسومات (GPU) — أو إذا كنت تفضل سرعة طرح المنتج في السوق على التخصيص المتعمق — فقد تكون البدائل القائمة على واجهة برمجة التطبيقات (API) خيارًا أنسب لك.
ابدأ التدريب بطريقة أكثر ذكاءً مع ClickUp
يوفر لك DBRX أساسًا جاهزًا للاستخدام المؤسسي لبناء تطبيقات الذكاء الاصطناعي المخصصة، مع الشفافية والتحكم اللذين لا تحصل عليهما من النماذج الاحتكارية. تعمل بنية MoE الفعالة الخاصة به على خفض تكاليف الاستدلال، كما أن تصميمه المفتوح يجعل عملية الضبط الدقيق سهلة. لكن التكنولوجيا القوية ليست سوى نصف المعادلة.
يأتي النجاح الحقيقي من مواءمة عملك التقني مع سير العمل التعاوني لفريقك. يعد تدريب نماذج الذكاء الاصطناعي عملاً جماعياً، ومن الضروري الحفاظ على التناسق بين التجارب والوثائق والتواصل مع الأطراف المعنية. عندما تجمع كل شيء في مساحة عمل واحدة متكاملة وتقلل من تشتت السياق، يمكنك تقديم نماذج أفضل وبسرعة أكبر.
ابدأ مجانًا مع ClickUp لتنسيق مشاريع تدريب الذكاء الاصطناعي الخاصة بك في مساحة عمل واحدة. ✨
الأسئلة الشائعة
كيف يمكنني مراقبة تقدم عملية التدريب في DBRX؟
يمكنك مراقبة عملية التدريب باستخدام أدوات التعلم الآلي القياسية مثل TensorBoard أو Weights & Biases أو MLflow. إذا كنت تقوم بالتدريب ضمن نظام Databricks، فإن MLflow مدمج بشكل أصلي لتتبع التجارب بسلاسة.
هل يمكنني دمج DBRX مع CI/CD وخطوط أنابيب النشر؟
نعم، يمكن دمج DBRX في مسارات MLOps القياسية. من خلال تحويل النموذج إلى حاوية، يمكنك نشره باستخدام منصات التنسيق مثل Kubeflow أو سير عمل CI/CD المخصص.
ما الفرق بين DBRX Base و DBRX Instruct؟
يُعد DBRX Base النموذج الأساسي المُدرَّب مسبقًا والمُصمم للفرق التي ترغب في إجراء تدريب مسبق مستمر خاص بمجال معين أو ضبط دقيق للهندسة المعمارية العميقة. أما DBRX Instruct فهو نسخة مُحسَّنة ومُعدَّلة خصيصًا لاتباع التعليمات، مما يجعله نقطة انطلاق أفضل لمعظم عمليات تطوير التطبيقات.
كيف يقارن DBRX بـ GPT-4 في مشاريع الذكاء الاصطناعي للمؤسسات؟
يكمن الاختلاف الرئيسي في التحكم. يمنحك DBRX وصولاً كاملاً إلى أوزان النموذج من أجل التخصيص المتعمق والاستضافة الذاتية، في حين أن GPT-4 هي خدمة تعتمد على واجهة برمجة التطبيقات (API) فقط.
هل يمكنك استخدام DBRX مجانًا؟
تتوفر أوزان نماذج DBRX مجانًا بموجب ترخيص Databricks Open Model License. ومع ذلك، فإنك تتحمل تكاليف البنية التحتية الحاسوبية اللازمة لتشغيل النموذج أو ضبطه.