
IT災害は、警告なく発生する可能性があります。
サーバーのクラッシュからサイバー攻撃に至るまで、確固たる復旧プランがなければ、ビジネスは数時間に及ぶダウンタイム、データの損失、そして深刻な経済的損害に直面する可能性があります。実際、深刻なシステム停止の54%は10万米ドル以上の損失をもたらしています。
このブログ記事では、システムを保護し、明確な復旧目標を定義し、問題が発生した際にチームが何をすべきかを正確に把握できるようにする、包括的なIT災害復旧プランの策定手順を解説します。
IT災害復旧プランとは?
もし今、サーバーがダウンしてしまったら、あなたのチームは何をやることを正確に把握していますか? 🛠️
IT災害復旧(DR)プランとは、自然災害からサイバー攻撃に至るまで、あらゆる障害発生後にITシステムやデータを復旧させるための、文書化された戦略のことです。これは、問題が発生した際にテクノロジーを復旧させるための、いわば「プレイブック」です。
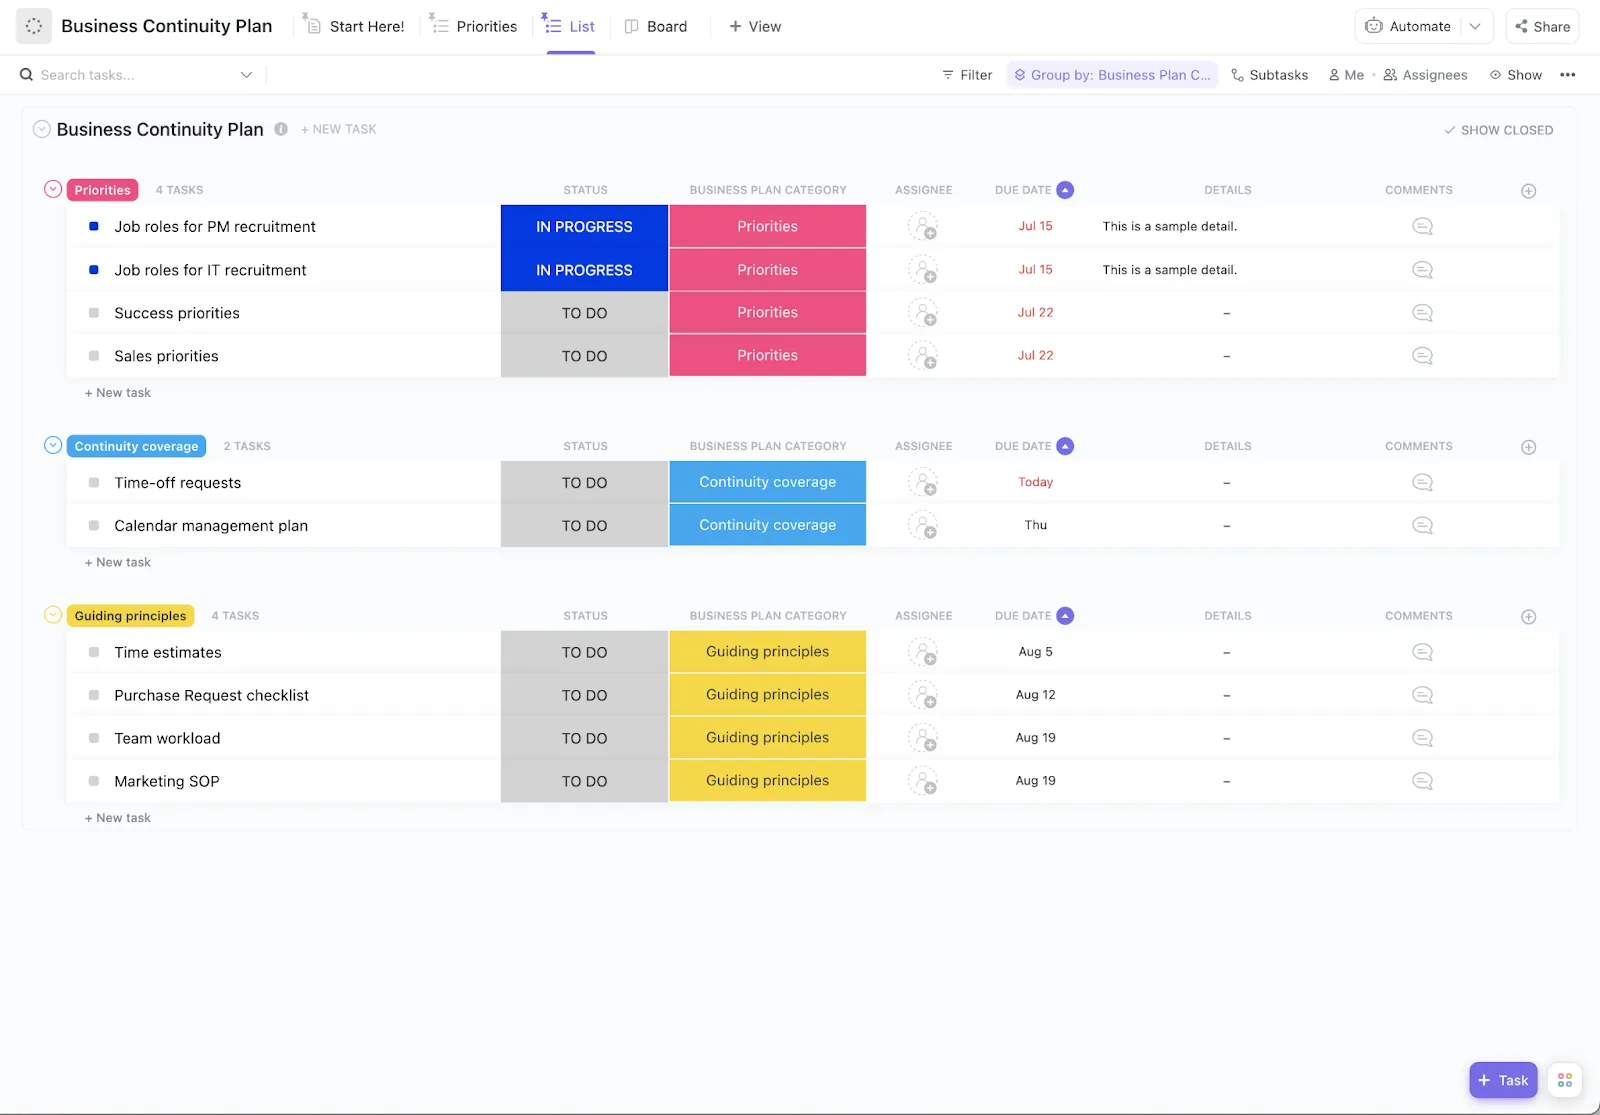
💡 災害復旧(DR)とビジネス継続(BC)の違い
ディザスタリカバリ(DR)は、特にITインフラとデータの復旧に焦点を当てています。一方、事業継続(BC)はより広範な概念であり、たとえITシステムがダウンしていても、危機発生中および発生後もビジネス全体を稼働させ続けることを目指しています。DRは、事業継続戦略全体における重要な要素であると捉えてください。
💡 災害復旧(DR)とビジネス継続(BC)の違い
ディザスタリカバリ(DR)は、特にITインフラとデータの復旧に焦点を当てています。一方、事業継続(BC)はより広範な概念であり、たとえITシステムがダウンしていても、危機発生中および発生後もビジネス全体を稼働させ続けることを目指しています。DRは、事業継続戦略全体における重要な要素であると捉えてください。
ダウンタイムは金銭的な損失にとどまらないため、災害復旧プランは極めて重要です。システムが停止している間、1分ごとに顧客の信頼が損なわれ、業務が中断し、さらにはコンプライアンス違反による罰金につながる可能性さえあります。包括的な災害復旧プランは、レジリエンスを実現するための道しるべとなります。
優れたプランには、以下の要素が含まれます:
- データバックアップの手順: 重要な情報のコピーをどのように、どこに保存し、復元できるようにするか
- システムの復旧ステップ: サービスを正しい順序で復旧させるための具体的なステップ
- チームの役割分担: 混乱を避けるために、インシデント発生時に誰がどのような役割を担うか
- コミュニケーション手順: チームから顧客に至るまで、関係者に情報をどのように共有するか
- 復旧目標: システムをどのくらいの速さで復旧させる必要があるか、またどの程度のデータ損失が許容範囲であるかについて、具体的に定めた目標
よくあるIT災害のシナリオと影響
災害はハリウッド映画だけの話ではありません。ビジネスでは毎日実際に発生しています。何から身を守る必要があるのかを理解することで、より強固な防御体制を構築することができます。
自然災害および物理的損傷
洪水、火災、地震、大規模な停電などのイベントは、データセンター全体を数分で破壊する可能性があります。例えば、ナッシュビルのデータセンターが大規模な洪水に見舞われた際、一部の企業は数週間分のデータを失い、数ヶ月にわたる復旧作業を余儀なくされました。これに対する最善の対策は、地理的冗長性です。つまり、インフラを複数の物理的な場所に分散させることで、単一のイベントによってすべてがダウンするのを防ぐのです。
サイバー攻撃とデータ漏洩
ランサムウェア、分散型サービス拒否(DDoS)攻撃、データ侵害は、物理的な災害とは異なります。これらは検知が困難な場合が多く、接続されたシステムを通じて目立たずに拡散し、バックアップシステムもターゲットとされることが多いため、復旧が特に困難になります。あらゆる業界において、こうしたサイバー攻撃の頻度と巧妙さは増し続けており、現在、確認されたデータ侵害の44%にランサムウェアが関与しており、最大の脅威となっています。
ハードウェアの故障とデータ損失
たとえ、入念にテストされ、信頼性の高いバックアップシステムであっても、時には故障することがあります。サーバーのクラッシュ、ストレージの障害、ネットワーク機器の不具合は、警告なく発生する可能性があります。冗長化(バックアップ)システムを導入していても、共通のコンポーネントや電源を共有している場合、それらが同時に故障し、単一障害点(SPOF)となる可能性があります。
👀 ご存知でしたか: 2025年10月、AWSは、Amazon DynamoDBの内部DNS管理システムにバグが発生し、US-EAST-1データセンターリージョンでドメイン名解決が失敗したことにより、大規模なサービス停止に見舞われました。 この「些細な」技術的欠陥がトリガーとなり、数十のAWSサービスに連鎖的な障害が発生し、メッセージングアプリやソーシャルアプリから銀行、ゲームサイトなど、世界中で数百もの人気アプリやプラットフォームがダウンしました。多くの人々にとって、この障害によりインターネットの大部分が一時的に「消えてしまった」ように感じられ、ごく少数のクラウドプロバイダーに多くのものが依存している状況下で、デジタルインフラがいかに脆弱であるかが浮き彫りになりました。
ソフトウェアのエラーやサービスの中断
データベースの破損、ソフトウェア更新の失敗、あるいは単純な設定エラーが、プラットフォーム全体をダウンさせる可能性があります。設定エラーのある1行のコードが、接続されたシステム全体に連鎖的に影響を及ぼし、広範囲にわたる大規模な障害を引き起こすことがあるでしょう。こうしたリスクを最小限に抑えるためには、適切な変更管理と専用のテスト環境が不可欠です。
人為のエラーや設定ミス
誤った削除、設定ミス、および不正な変更は、依然としてITシステム停止の最も一般的な原因の一つです。たった1つの誤ったコマンドや、1つのファイルの削除が、数時間に及ぶダウンタイムやサービス品質の低下をトリガーにする可能性があります。トレーニングやアクセス制御は有効ですが、人的ミスを完全に排除することはできません。
📮ClickUpインサイト:従業員の92%が、アクション項目の追跡に一貫性のない方法を採用しており、その結果、意思決定の見落としや実行の遅れが生じています。
フォローアップのメモを送る場合でも、スプレッドシートを使用する場合でも、そのプロセスは散漫で非効率になりがちです。ClickUpのタスク管理機能を使えば、そのような心配は一切不要です。チャット、ClickUpタスクコメント、ドキュメント、電子メールから、ワンクリックでタスクを作成できます!
IT災害復旧プランの主要な構成要素
堅実なDRプランは、システムを復旧させるための包括的なプレイブックです。これらの各要素は互いに連携し合い、ビジネスを包括的に保護する体制を構築します。
リスク評価と優先順位付け
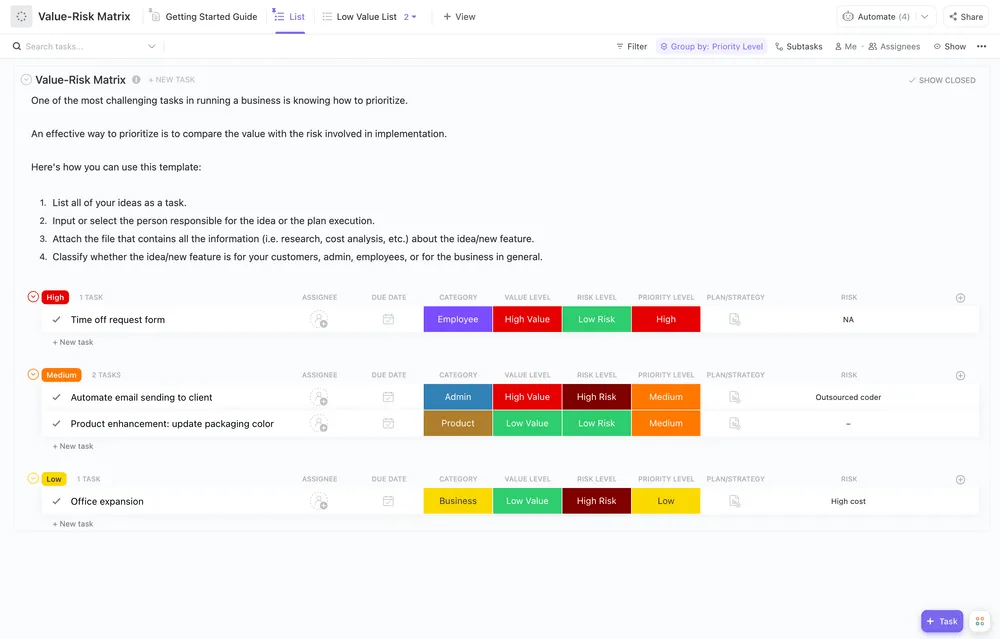
まず、どのような課題に直面しているかを把握する必要があります。リスク評価とは、自社の脆弱性を特定し、各潜在的な脅威の発生確率と影響度を評価するプロセスです。これをリスクマトリックスに整理することで、どの脅威が最も深刻であるかを確認できます。
評価では、以下の項目を網羅する必要があります:
- 重要システム:ビジネスの運営に不可欠で、絶対に稼働し続けなければならないシステムとは
- データの機密性: どのような情報(顧客データなど)が最高レベルの保護を必要とするか
- 依存関係: 各システムが障害を起こした場合、他にどのシステムやプロセスが機能しなくなるか
📖 詳細はこちら:ITインフラ管理の導入方法
ビジネス影響分析と重要度
次に、ダウンタイムによる実際のコストを算出しましょう。ビジネス影響度分析(BIA)を行うことで、各システムにおける障害発生時の財務的および業務上の影響を特定できます。これにより、システムを重要度レベルごとに分類し、復旧作業の優先順位を決定することが可能になります。
| 重要 | 1時間未満 | 支払い処理、顧客データベース |
| 高 | 所要時間:1~4時間 | 電子メール、社内コミュニケーションツール |
| Medium | 4~24時間 | 開発環境、レポート作成ツール |
| 低 | 24時間以上 | アーカイブシステム、非本番環境のテストサーバー |
RTOおよびRPOの目標
これら2つの頭字語は、復旧戦略の中核をなすものです。
- 復旧時間目標(RTO): これは、システムのダウンを許容できる最大時間です。「システムをどのくらいの速さで復旧させる必要があるか」という問いに答えるものです。
- 復旧時点目標(RPO): これは、許容できるデータの最大損失量を時間単位で測定したものです。「重大な損害を招くことなく、どの程度のデータを失ってもよいか」という問いに対する答えとなります。
例えば、社内電子メールシステムのRTOは4時間である一方、顧客向けのeコマースデータベースのRPOはわずか15分である場合があります。これは、15分を超えるトランザクションデータを失うことが許されないことを意味します。
データのバックアップおよび復旧プラン
バックアッププランは、究極の安全策です。一般的なベストプラクティスとして「3-2-1のルール」があります。これは、重要なデータを少なくとも3部作成し、2種類の異なるメディアに保存し、そのうち1部をオフサイトに保管するというものです。
また、以下のさまざまなバックアップ方式の中から選択することになります:
- フルバックアップ: すべてのデータの完全なコピー。通常、毎週または毎月完了されます。
- 増分バックアップ: あらゆる種類のバックアップにおいて、前回のバックアップ以降に行われた変更のみをバックアップします。
- 増分バックアップ: 前回のフルバックアップ以降に行われたすべての変更をバックアップします
何よりも重要なのは、バックアップの復元プロセスを定期的にテストすることです。テストされていないバックアップは、単なる「希望」に過ぎず、プランとは言えません。
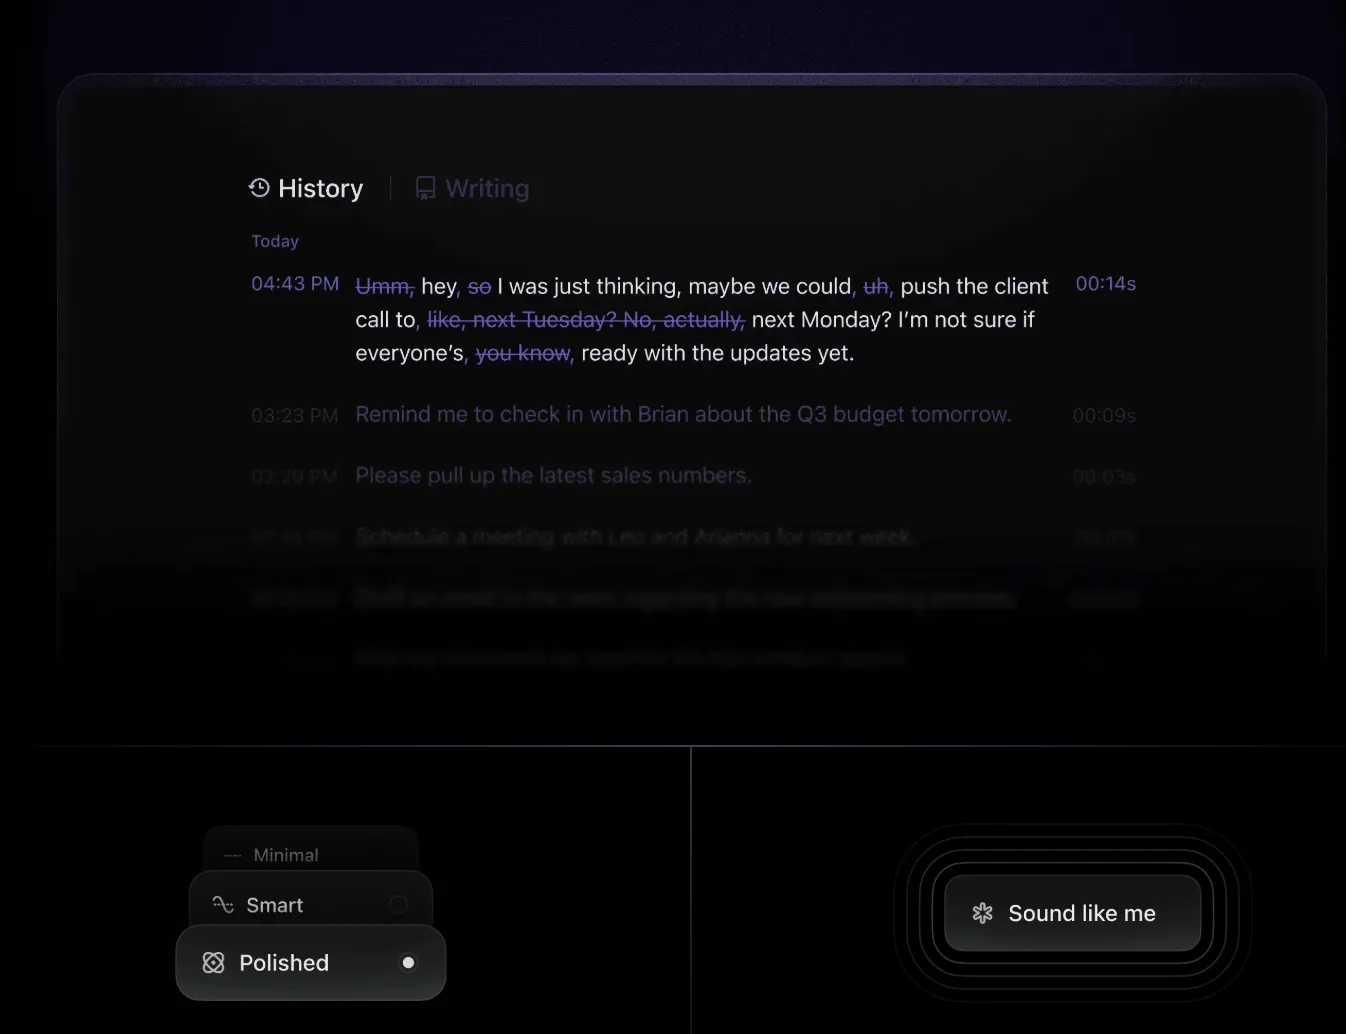
💟 特典:ClickUp Brain MAXの音声入力機能を活用して、ストレスの多いインシデント発生時に重要な詳細を記録しましょう。キーボード入力が困難な状況でも、重要な情報を見逃すことはありません。観察内容を話すだけで、AIが記録を代行します。
コミュニケーションプランと関係者への情報提供
災害が発生した際、明確なコミュニケーションプランがすべてです。プランには、通知の連鎖、最新情報の提供頻度、およびインシデントの種類ごとに使用するチャネルを明確に定義しておく必要があります。
組織ごとに必要な情報は異なります:
- 社内チーム向け: 技術的な詳細や具体的なアクションアイテムが必要な場合
- お客様へ: サービスのステータスや、復旧の見込み時期を把握する必要があります
- ベンダー: サポートやエスカレーションのために、ベンダーへの依頼が必要になる場合があります。
- 規制当局: 業界によっては、正式な通知が必要となる場合があります。
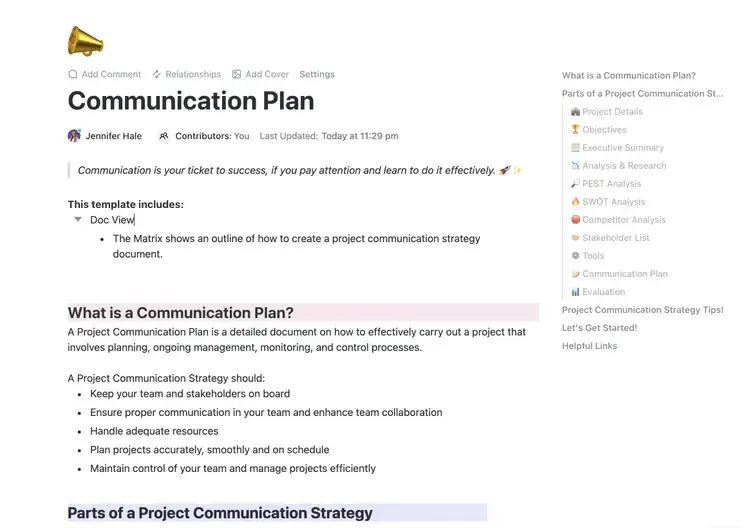
ClickUpのこの「すぐに使えるコミュニケーションプランテンプレート」のようなツールを活用すれば、危機発生時に確立された手順に従って迅速に対応することができます。
テストおよびトレーニングプログラム
テストを行わないプランは、失敗に終わるプランです。定期的なテストを行うことで、実際の災害が発生する前に、プランの不備や弱点を明らかにすることができます。
年間を通じて、さまざまな種類のテストを計画しましょう:
- 机上演習: チームが紙の上で災害シナリオをシミュレーションし、プランの整合性を確認します。
- 部分的なフェイルオーバー: 重要度の低い特定のコンポーネントやサービスの復旧をテストします。
- 完全なDRテスト: バックアップシステムへの完全なフェイルオーバーを完了します(究極のテスト)。
テストのたびに、ドキュメントを更新し、新しいチームメンバーに対して直ちに手順の研修を実施してください。
📖 詳細はこちら:効果的なITポリシーと手順の策定方法
IT災害復旧プランを作成するためのステップ
DRプランの策定は、決して困難な作業である必要はありません。
ここでは、そのステップを一つずつ解説していきます。🙌
ステップ1:資産台帳の作成
「存在を把握していないものは保護できません」。まずは、環境内のすべてのハードウェア、ソフトウェア、データリポジトリ、およびシステムの依存関係を網羅した資産インベントリを作成することから始めましょう。復旧時にすぐに参照できるよう、ベンダーの連絡先、ライセンスキー、および構成の詳細も必ず含めてください。
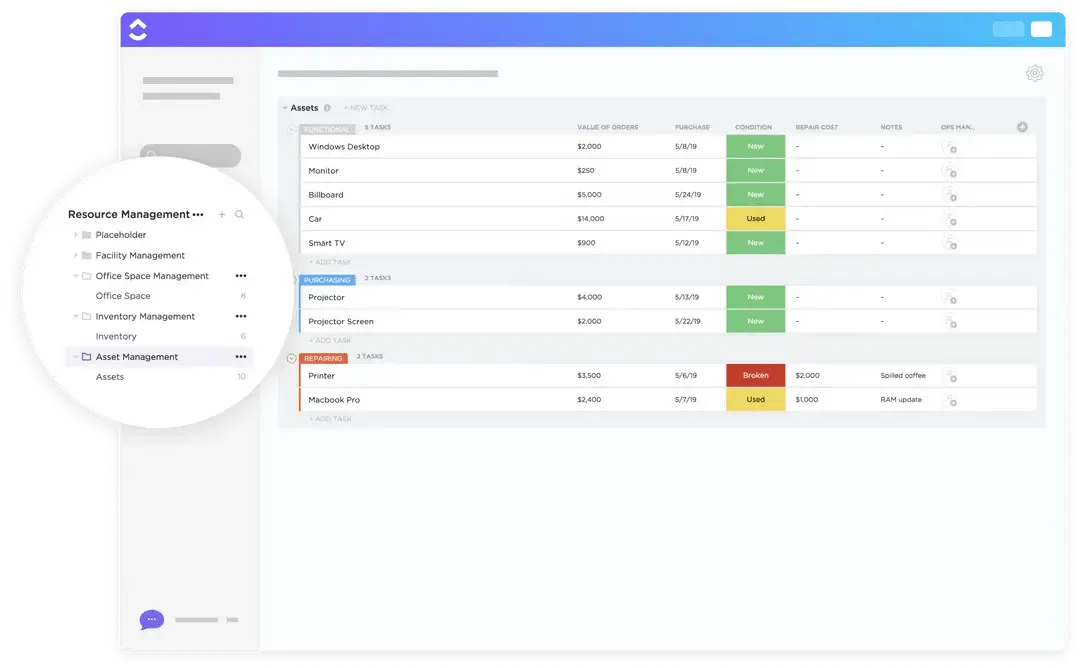
ClickUpのITAMテンプレートは、インシデント管理、問題管理、変更管理、シンプルな資産管理ソリューション、およびナレッジ管理を統合しています。当社のITSM「既知のエラー」テンプレートは、システム内の既知のエラーを追跡するプロセスを簡素化します。目的が変わった際には、当社のすべてのITテンプレートをぜひご活用ください。
導入や設定から保守、廃棄に至るまで、ITAMの各フェーズにおいて、ご希望のスタイルに合わせてワークフローをカスタムできます。
ステップ2:重要なサービスの分類
次に、それらの資産のうち、どの資産が「業務に不可欠」であり、どの資産が「あれば便利なもの」であるかを特定します。システムがどのように相互に接続し、依存し合っているかを示すサービス依存関係マップを作成します。収益やユーザー体験に直接影響を与える顧客向けサービスには、特に注意を払ってください。
🎥 この実践的な解説動画では、目標の設定からタスクの割り当て、進捗の追跡に至るまで、ClickUpの強力な機能を活用して、体系的で高水準なプランを策定する方法をご紹介します。
ステップ3:リスクと脅威の評価
自社の具体的な状況において、各脅威タイプの発生確率と影響を評価し、リスクと脅威を分析します。地理的なリスク(地震多発地域や洪水危険地域にあるか?)や、業界特有の脅威(規制の変更や標的型サイバー攻撃など)も考慮してください。すべてをリスク登録簿に記録し、長期的に追跡できるようにします。

ClickUpのリスク評価ホワイトボードテンプレートは、リスク評価プロセスに視覚的な側面をもたらします。リスクの評価や分類を支援し、チームが洞察を共有し、魅力的で視覚的なフォーマットで協働するよう促します。
このテンプレートを使用すると、以下のことが可能になります:
- リスクの分類と潜在的な影響を評価する
- データを分析し、潜在的な懸念事項を特定する
- リスクへの曝露を低減するための予防策を策定する
描画、書き込み、付箋の追加が可能な機能を備えたこのリスク管理用ホワイトボードテンプレートは、プロジェクトのリスク評価に最適です。
ステップ4:RTOおよびRPOのターゲットを設定する
事業部門のステークホルダーと直接連携し、先に特定した各サービス階層について、彼らが許容できるダウンタイムやデータ損失の範囲を定義します。迅速な復旧にかかるコストとビジネスへの影響のバランスを考慮する必要があります。すべてのケースで、即時のデータ損失ゼロの復旧が求められるわけではありません。これらのターゲットについて、経営陣の承認を得てください。
ステップ5:バックアップおよびフェイルオーバーの経路を定義する
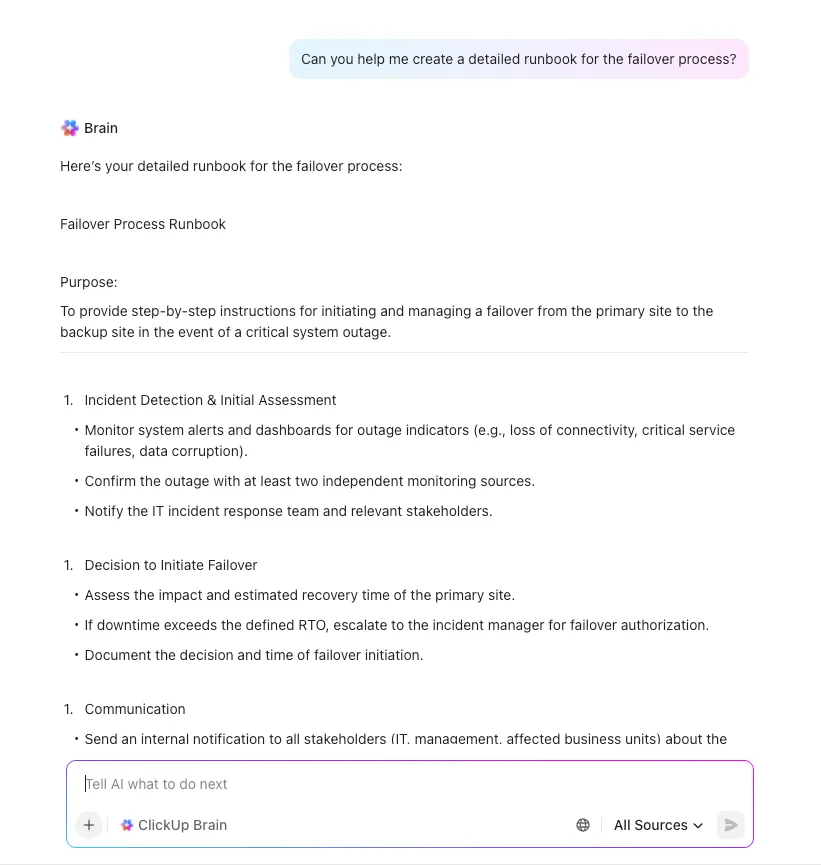
目標を設定したら、次は技術的なソリューションを設計します。各システムのRPOに合わせたバックアップ戦略を策定し、代替処理拠点や緊急時のアクセス方法など、詳細なフェイルオーバー手順をプランします。実行を確実に成功させるために、ネットワーク図や段階的な手順書も盛り込みましょう。
ステップ6:役割の割り当てとエスカレーション
責任範囲と意思決定権限を明確にしたDRチームの体制を定義しましょう。各役割ごとに、主担当者とバックアップ担当者を記載した包括的な連絡先リストを作成してください。RACIマトリックス(Responsible:責任者、Accountable:説明責任者、Consulted:相談対象者、Informed:報告対象者)は、ストレスの高いインシデント発生時に混乱を防ぐための優れたツールです。
ステップ7:プランを文書化し、周知徹底する
チームメンバーなら誰でも、プレッシャーのかかる状況下でも実行できる、明確でステップごとの手順を盛り込んだプランを文書化し、周知徹底してください。この文書は、主要なインフラとは別の、アクセスしやすい場所に保管することが極めて重要です。危機発生時に、すべてのチームメンバーがプランの所在を正確に把握できるようにしてください。

ClickUpのRACI計画テンプレートを活用して、プロジェクト計画を効率化しましょう。このドキュメントテンプレートは、プロジェクトタスクに関連するチームの役割と責任を明確に定義するためのチャートを提供し、業務の在り方を一変させる画期的なツールです。RACI(Responsible、Accountable、Consulted、Informed)フレームワークを取り入れることで、全員の認識を統一し、責任の所在を明確にするとともに、組織目標との整合性を確保できます。
ステップ8:テスト、見直し、改善
最後に、四半期ごとにテストを実施し、手順の有効性を確認するとともに、不備を特定しましょう。各テストや実際のインシデントから得られた教訓をすべて文書化し、それらを活用してプランを更新してください。発見された問題が確実に解決されるよう、体系的な改善追跡システムを構築しましょう。
🌼 ご存知でしたか:2017年、GitLabは大規模なデータベース障害に見舞われました。復旧作業の過程で、同社は複数のバックアップ手法が数日間も気づかれずに失敗し続けていたことを発見しました。このインシデントは、テクノロジー業界全体に重要な教訓をもたらしました。それは、バックアップの検証は絶対に欠かせないということです。テストされていないバックアップは、実質的にバックアップとは言えません。
🌼 ご存知でしたか:2017年、GitLabは大規模なデータベース障害に見舞われました。復旧作業の過程で、同社は複数のバックアップ手法が数日間も気づかれないまま失敗し続けていたことを発見しました。このインシデントは、テクノロジー業界全体に「バックアップの検証は絶対不可欠である」という重要な教訓をもたらしました。テストされていないバックアップは、実質的にバックアップとは言えません。
災害復旧戦略とソリューション
すべての組織に同じDRアプローチが必要というわけではありません。ご予算、復旧のニーズ、利用可能なリソースに基づいて、最適な選択肢を検討しましょう。
バックアップと復元の方法
これは最もシンプルで費用対効果の高い方法です。オフサイトの場所(クラウドやセカンダリデータセンターなど)に定期的なバックアップを行い、必要に応じて手動で復元します。復旧には数時間から数日かかる場合があるため、このアプローチは、より長いRTOを許容できる非重要システムに最適です。
高可用性と冗長性
この戦略は、複数の稼働中のシステムを活用することで、単一障害点を排除することを目的としています。ロードバランシング、サーバークラスタリング、RAIDストレージなどの技術により、あるコンポーネントに障害が発生しても、別のコンポーネントが即座に引き継ぐことが保証されます。導入や維持にはより多くのコストがかかりますが、このアプローチによりダウンタイムを数秒から数分にまで最小限に抑えることができるため、重要なサービスに最適です。
レプリケーションとフェイルオーバーのオプション
レプリケーションとは、データをほぼリアルタイムでセカンダリサイトへコピーするものであり、これにより災害発生時のデータ損失を最小限に抑えることができます。
- 同期レプリケーション: プライマリサイトとセカンダリサイトの両方に同時にデータを書き込むため、データ損失がゼロであることを保証します。ただし、高い帯域幅を必要とし、プライマリシステムの動作が遅くなる可能性があります。
- 非同期レプリケーション: まずプライマリサイトにデータを書き込み、その後、わずかな遅延を置いてセカンダリサイトにコピーします。コストが低く、パフォーマンスへの影響も少ないですが、データ損失のリスクがわずかにあります。
クラウドベースの災害復旧およびDRaaS
ディザスタ・リカバリー・アズ・ア・サービス(DRaaS)は、多くのビジネスにとって一般的な選択肢となっています。DRaaSでは、自社で物理的なDRサイトを構築・維持する必要がなく、従量課金制の料金体系、即時の地理的分散、自動化された復旧オーケストレーションが提供されます。クラウドDRは、バックアップデータセンターにかかる巨額の設備投資を排除すると同時に、従来のホットサイト、ウォームサイト、コールドサイトといったアプローチよりも迅速なスケーリングと高い柔軟性を実現します。
ClickUpがIT災害復旧プランをどのように効率化するか
散在するスプレッドシート、文書、電子メールのやり取りにまたがってDRプランを管理することは、それ自体が災害リスクを生み出します。
このような「仕事の拡散」、つまり相互に連携しない複数のツールに仕事が分散してしまう状況や、チームがアプリやプラットフォームに散在する情報を探すのに何時間も費やしてしまう「コンテキストの拡散」は、混乱や情報の陳腐化を招き、1秒を争う状況において対応の遅れにつながります。
ClickUp Converged AIワークスペースは、プロジェクト管理、ドキュメント管理、チームコミュニケーションを統合し、すべての業務用アプリ、データ、ワークフローを、インテリジェンス層として文脈に応じたAIと共に一元管理できる、単一のセキュアなプラットフォームです。複数のプラットフォームを併用する手間を省き、DRの計画、テスト、インシデント対応を1つの統合システムにまとめましょう。
ClickUp Docsと組み込みのAIアシスタントを活用した、DRドキュメントの一元管理
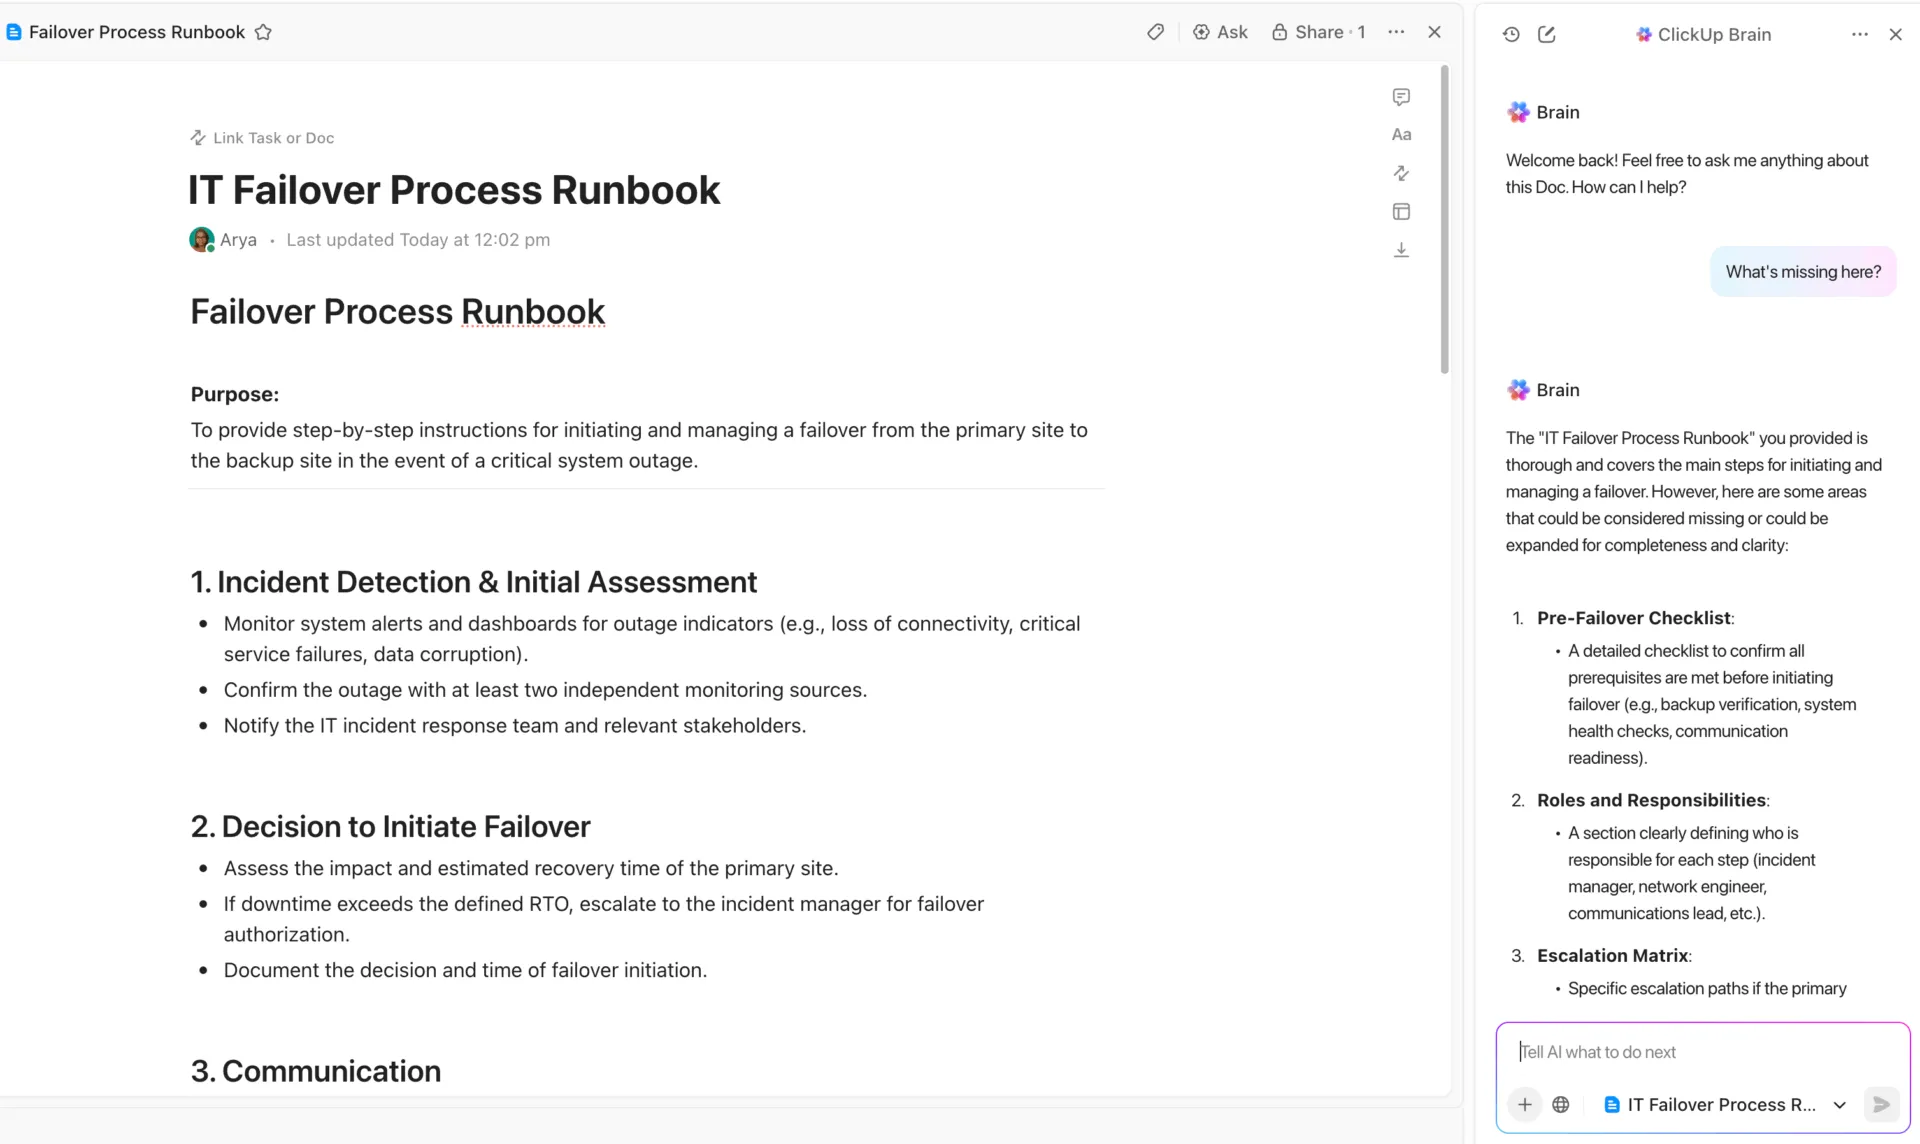
ClickUp Docsを活用して、チームが常に「唯一の真実の源」を共有できるようにしましょう。
インシデント発生時に全員がリアルタイムで貢献できるコラボレーションスペースで、災害復旧プラン全体を構築しましょう。ドキュメントをインシデントのタスクやプロジェクトに直接リンクさせてシームレスなナビゲーションを実現し、図やランブックを埋め込むことで、重要な情報を必要な場所に確実に配置できます。
何より、ドキュメントを保護して誤った編集を防ぐことができるほか、ClickUpのきめ細かな許可設定を活用して、機密性の高い復旧手順を閲覧または変更できるユーザーを制御できます。すべての変更はドキュメントの履歴に追跡されるため、完全な監査証跡を確保できます。
ClickUp Brainを活用したAIによるプラン作成
ワークスペース全体を把握するコンテキスト対応AIアシスタント「ClickUp Brain」を活用して、災害復旧計画の策定を加速させ、重大なギャップを解消しましょう。一般的なAIツールとは異なり、ClickUp Brainは組織の実際のタスク、ドキュメント、ワークフローを活用し、災害復旧(DR)の取り組みに対して、正確で実践的なサポートを提供します。
ClickUp Brainに「当社のeコマースプラットフォーム用の災害復旧チェックリストを作成してください」といったプロンプトを送信するだけで、自社のシステム、プロセス、コンプライアンス要件に合わせた包括的でカスタマイズされたテンプレートを即座に受け取ることができます。これにより、以下のことが可能になります:
- コンテキスト認識: ClickUp Brainは、ワークスペースの構造、コンテンツ、許可にアクセスできます。タスク、ドキュメント、コメント、さらには接続アプリまで参照し、単なる一般的な提案ではなく、実際の仕事に合わせた回答やアクションを提供します。
- トラブルシューティングとガイダンス: ClickUpのあらゆる機能について、問題を即座に解決したり、ステップバイステップの手順を確認したり、ベストプラクティスを尋ねたりできます。Brainは、複雑なプロセスを順を追って案内したり、反復的なタスクを自動化したり、障害の解消を支援したりします。
- 自動化とワークフローの効率化: 既成またはカスタムのAIエージェントを活用して、多段階のワークフローの自動化、リクエストの優先順位付け、定期的な仕事の管理を行い、毎週数時間の時間を節約しましょう。
- 詳細検索: タスク、ドキュメント、連携ツールなど、ワークスペース内のどこに埋もれていても、たとえ数年前のものや標準的な検索では場所がわからない情報であっても、検索できます。
- リアルタイムの要約と最新情報: ワークスペースのライブデータを活用して、プロジェクトの最新情報、ミーティングの要約、進捗レポートを即座に作成できます。
- 技術ドキュメントの簡素化: 複雑な技術ドキュメントを、チームがプレッシャーのかかる状況下でも実行できる、明確で実践的な手順やチェックリストに変換します。
- マルチモデルAI: 主要なAIモデル(OpenAI GPT-4.1、GPT-5、Claude、Geminiなど)から選択し、あらゆるタスクで最適な結果を得ることができます。別途のサブスクリプションは不要です。
- セキュリティと権限管理: Brainは、ユーザーが閲覧許可をすでに持っている情報のみにアクセスするため、厳格なプライバシーおよびコンプライアンス基準を維持します。
- 会話型インターフェース: コメントやチャットで @brain を使用すると、ワークフローを離れることなく、文脈に応じたインサイトの取得、返信の草案作成、自動化のトリガー起動が可能です。
- カスタムプロンプトと保存済みワークフロー: 繰り返し発生するニーズに対応するプロンプトを保存して再利用することで、チーム全体での一貫性を確保し、時間を節約できます。
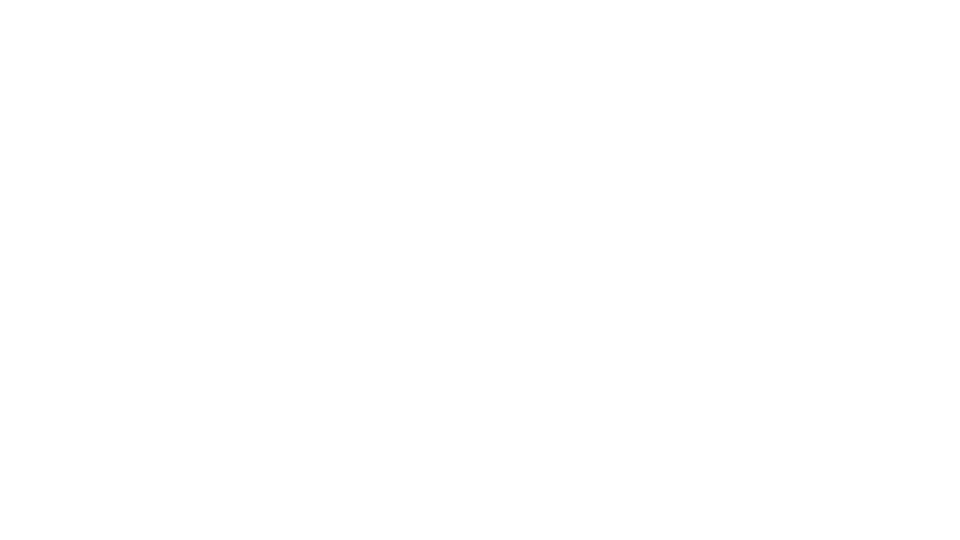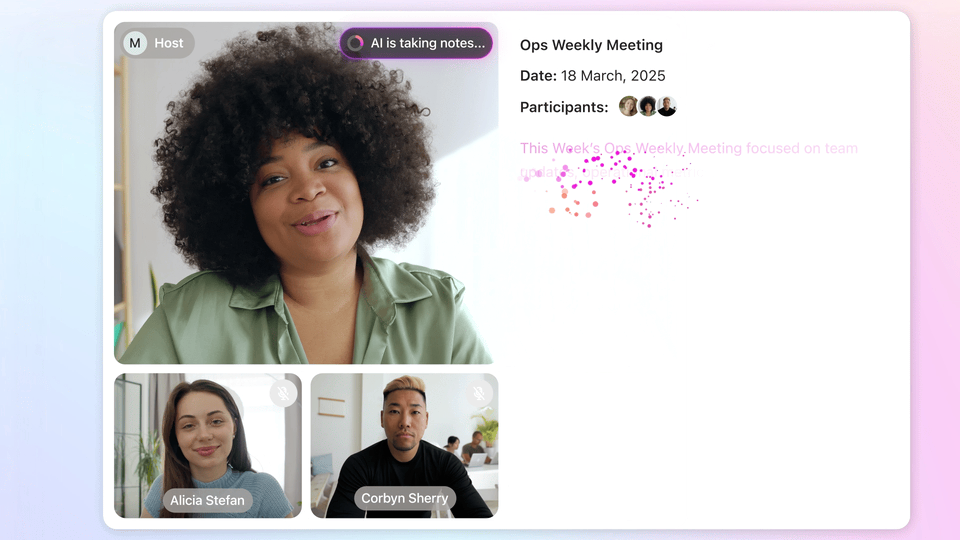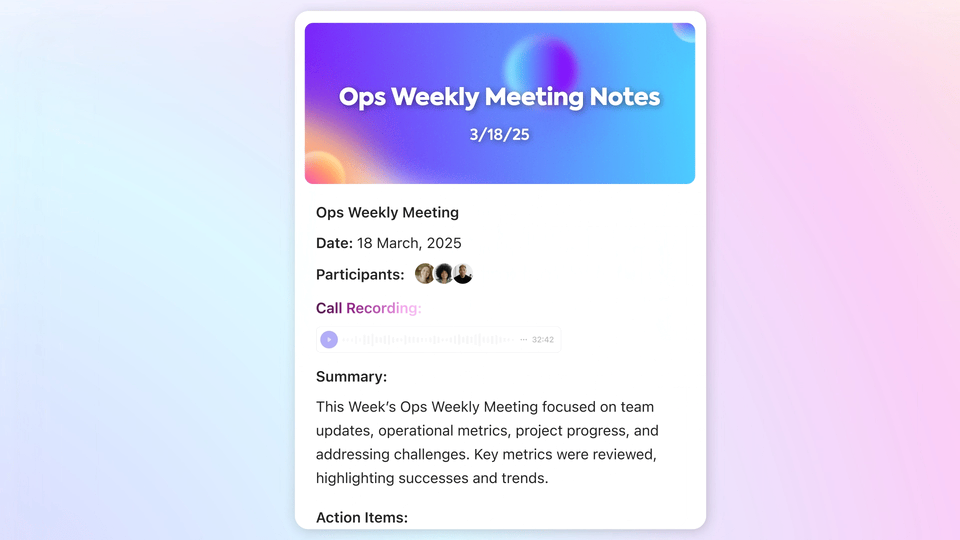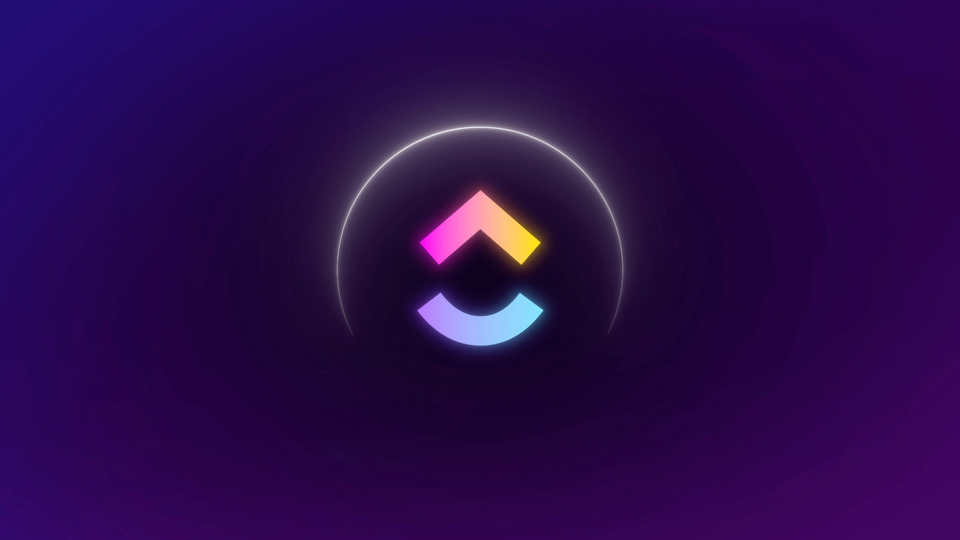
💡プロのヒント:ClickUp AI Notetakerを使って細部まで記録し、インシデントレビューミーティングの教訓を見逃さないようにしましょう。このツールはオンラインミーティングに参加し、議論の全内容を文字起こしし、得られた教訓からアクションアイテムのリストを自動的に生成します。これにより、検索可能なインシデント履歴が作成されるため、過去のイベントとその解決策を素早く参照できます。
ClickUp Automationsを活用した自動化されたDRワークフロー
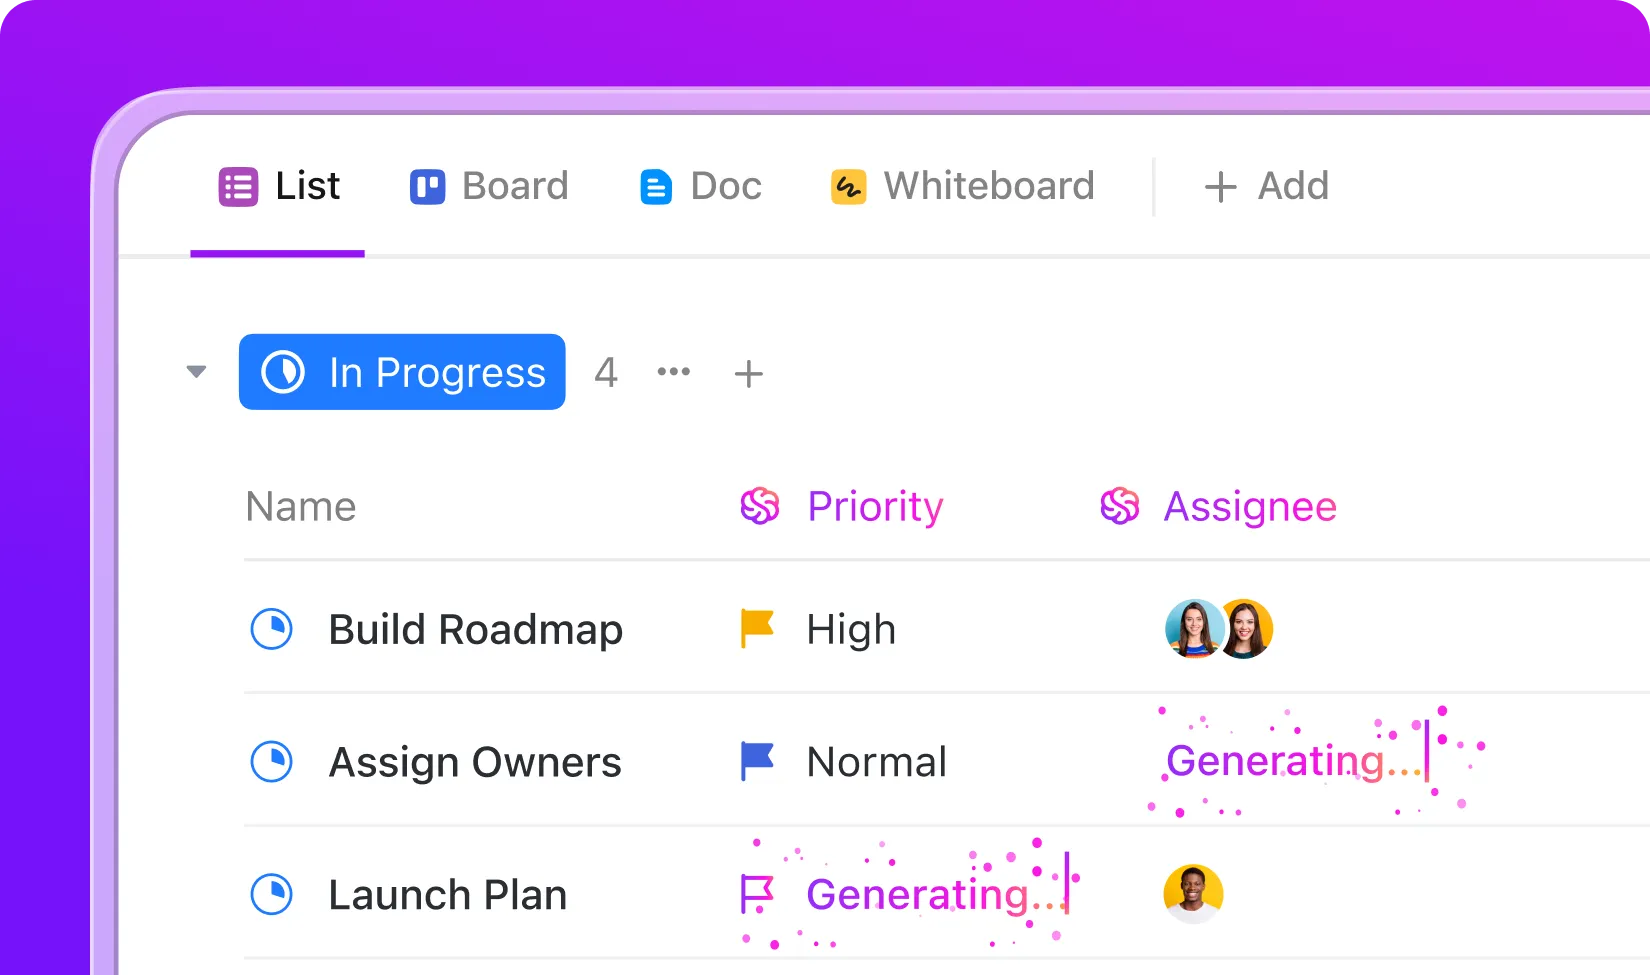
チームが突然のシステム停止に直面したと想像してみてください。1秒を争う状況であり、ステップを1つでも見落とす余裕はありません。ClickUp AIエージェントと自動化機能があれば、慌てたり記憶に頼ったりする必要はありません。インシデントが宣言されるとすぐに、ClickUp AIが即座に動き出し、チームを導きながら煩雑な作業を処理するため、あなたは問題の解決に集中できます。
実際のシナリオでは、次のように機能します:
- 誰かがタスクを「インシデント発生」としてマークすると、ClickUp Agentは自動的に対応ステップのチェックリストを作成し、適切な担当者に割り当て、復旧にかかる時間を追跡するためのタイマーを開始します。
- インシデントが「重大」とマークされた場合、エージェントは即座に経営陣へ電子メールを送信し、特別なチャットルーム(「ウォールーム」)を設定することで、全員が1か所でコミュニケーションをとれるようにします。
- AIが過去のインシデント報告書や関連文書を自動的に抽出するため、チームは必要な情報をすべてすぐに手元に用意できます。
ワークフローはこちらをご覧ください:
ClickUp AIエージェントを活用すれば、プレッシャーのかかる状況でも、チームが冷静さを保ち、整理整頓され、効率的に業務を進められるようサポートする、頼りになるデジタルチームメイトを手に入れることができます。
ClickUpダッシュボードによるリアルタイム追跡
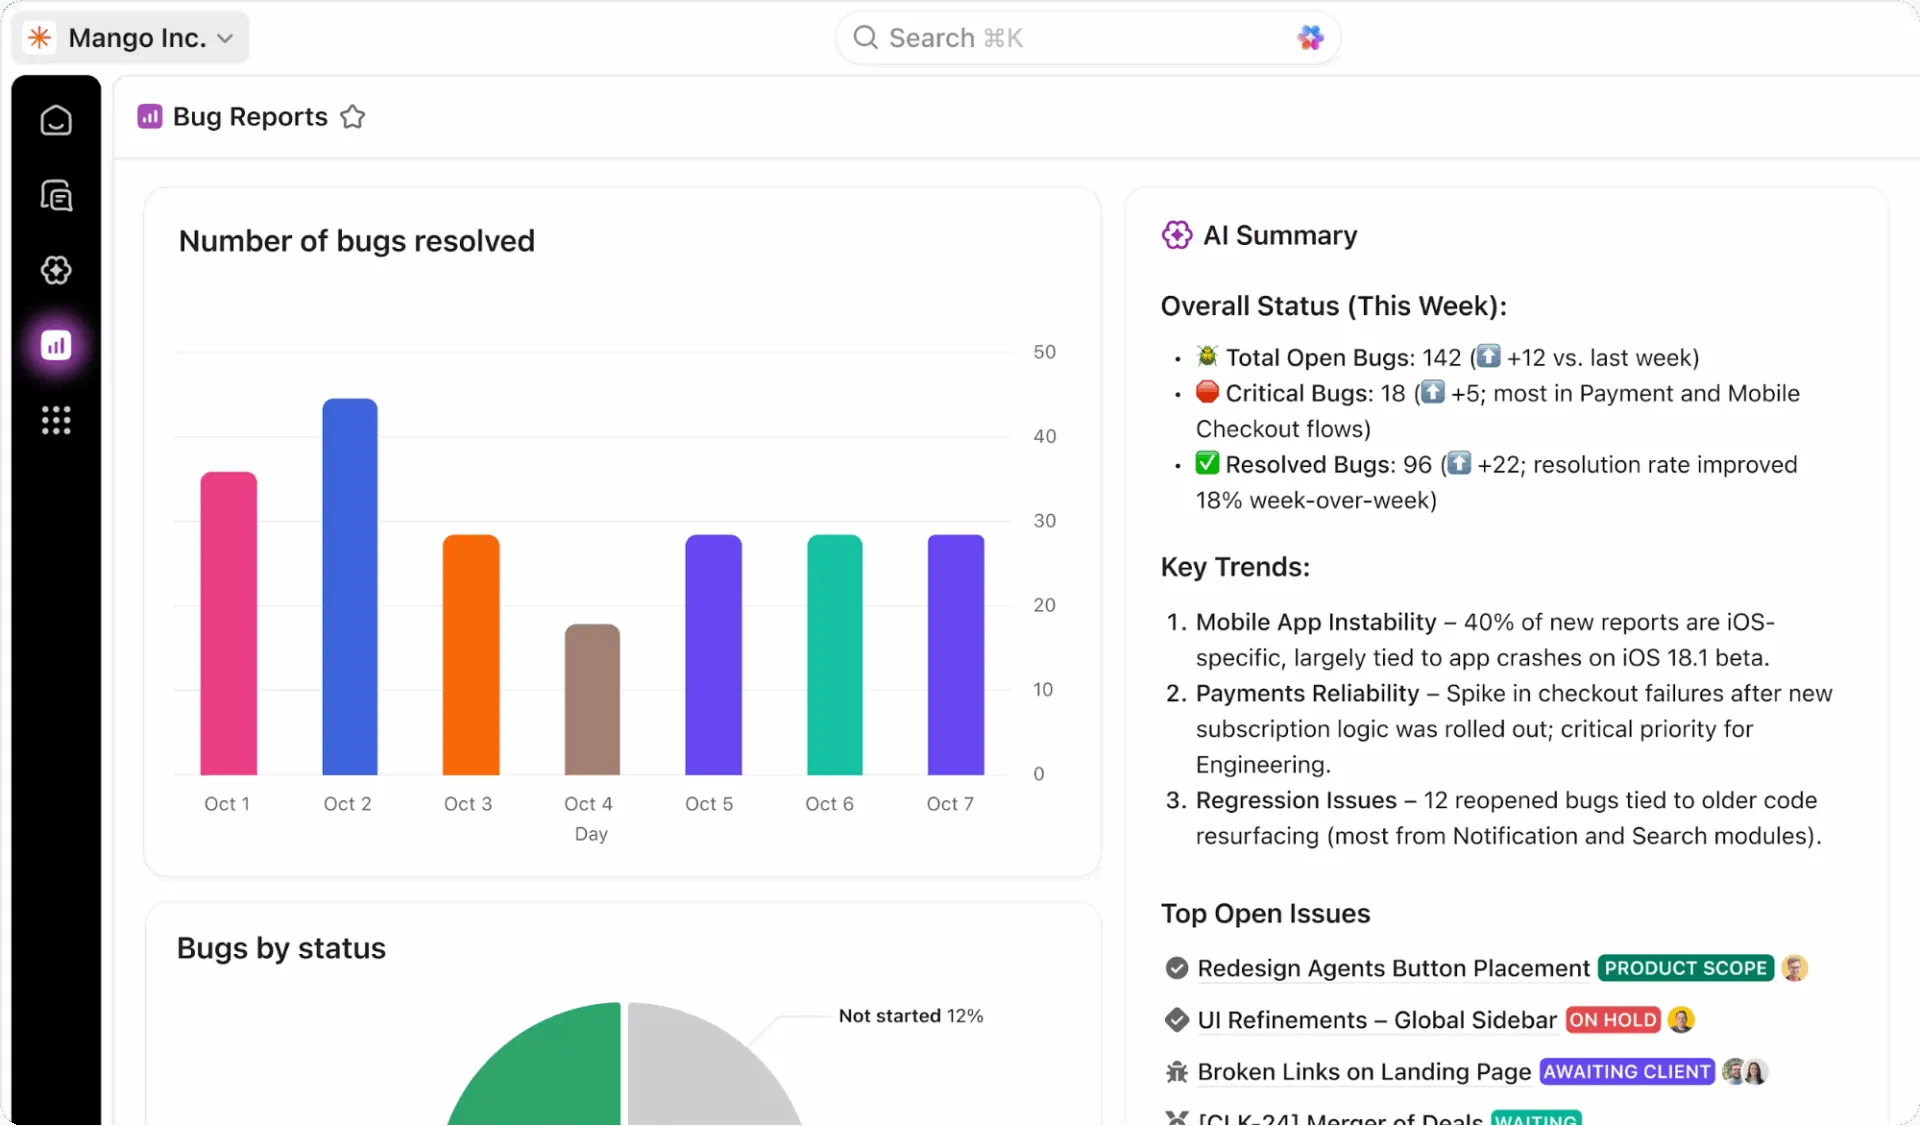
ClickUpダッシュボードを使用してすべてをリアルタイムで追跡することで、DRプログラムの健全性を完全に可視化できます。ウィジェットを作成して、テスト中のRTOおよびRPOのパフォーマンスを監視したり、テストの完了率を追跡したり、経時的なインシデントの傾向を確認したりすることができます。
タスクにClickUpのカスタムフィールドを追加して、システムの重要度、復旧ステータス、テスト結果を追跡し、そのすべてのデータを全体像として把握できるように集約しましょう。これらのダッシュボードは、チームのテストやインシデント対応活動からのリアルタイムデータに基づき、常に最新の状態に更新される、経営陣向けのレポートを提供します。
📖 詳細はこちら:リスク評価チェックリストの作成方法
今すぐDRプランを策定しましょう
DRプランなしに業務を続ける毎日が、負けるわけにはいかない賭けです。自然災害、技術的な障害、エラーなど、災害は避けられません。しかし、それが些細な不便で済むか、それとも大惨事になるかは、事前の準備次第です。
包括的なDRプランを策定するには、リスクを把握し、明確な手順を文書化し、定期的にテストを行う必要があります。適切なツールを活用すれば、散在する文書や手作業によるプロセスの混乱を解消し、このプロセスを円滑に進めることができます。
災害が発生した際、基本的な緊急対応プランであっても、何もないよりははるかにましです。定期的なテストと更新を行うことで、DRプランは単なる埃をかぶった文書から、ビジネスを真に守る「生きている」システムへと生まれ変わります。
今すぐClickUpを使って、DRプランの策定に向けた第一ステップを踏み出しましょう。ClickUpを無料で利用開始し、災害復旧プラン、ドキュメント、インシデント対応のすべてを1つの統合プラットフォームにまとめましょう。✨
よくある質問
チームはIT災害復旧プランのテンプレートをどのくらいの頻度で更新すべきでしょうか?
DRプランは少なくとも年に4回見直しを行い、インフラに大幅な変更があった場合や実際のインシデントが発生した場合は、直ちに更新する必要があります。多くの組織では、得られた教訓をすべて反映し、新しい技術に対応するために、毎年大規模かつ詳細な見直しを行っています。
災害復旧に関する文書化やテストは、どのチームが担当するのでしょうか?
通常、ITチーム、セキュリティチーム、および事業継続計画担当者が、DRのプラン策定とテストを主導します。しかし、プランが実際のビジネスニーズや優先度と整合していることを確実にするためには、運用部門や事業部門のリーダーからの重要な意見が必要です。
災害復旧テスト中に、RTOとRPOをどのように追跡すればよいでしょうか?
各テストでは、ストップウォッチや明確なタイムスタンプを使用して、定義したターゲット値に対する実際の復旧時間を測定してください。今後の改善に向けた指針とするため、テストレポートにはターゲット値と実際のパフォーマンスとの間に生じたギャップを必ず記録することが重要です。
災害復旧プランの文書化と自動化に役立つツールにはどのようなものがありますか?
ClickUpのようなプロジェクト管理プラットフォームは、DRプログラム全体のドキュメントを一元管理し、ワークフローを自動化し、メトリクスを追跡するのに最適です。さらに、データレプリケーションやシステムのフェイルオーバーといった技術的な側面を扱う専用のDRツールと組み合わせて活用することができます。