
Les projets d’entraînement d’IA échouent rarement au niveau du modèle. Ils rencontrent des difficultés lorsque les expériences, la documentation et les mises à jour destinées aux parties prenantes sont dispersées entre trop d’outils.
Ce guide vous explique comment entraîner des modèles avec Databricks DBRX — un LLM jusqu’à deux fois plus efficace en termes de calcul que les autres modèles de référence — tout en organisant le travail associé dans ClickUp.
De l’installation et du réglage fin à la documentation et aux mises à jour inter-équipes, vous découvrirez comment un environnement de travail unique et convergent permet d’éliminer la dispersion des informations et permet à votre équipe de se concentrer sur le développement, et non sur la recherche. 🛠
Qu'est-ce que DBRX ?
DBRX est un puissant modèle linguistique de grande envergure (LLM) open source, spécialement conçu pour l'entraînement et l'inférence des modèles d'IA en entreprise. Comme il s'agit d'un logiciel open source sous licence Databricks Open Model License, votre équipe dispose d'un accès complet aux poids et à l'architecture du modèle, ce qui vous permet de l'inspecter, de le modifier et de le déployer selon vos propres conditions.
Il existe en deux versions : DBRX Base pour le pré-entraînement en profondeur et DBRX Instruct pour les tâches de suivi d'instructions prêtes à l'emploi.
Architecture de DBRX et conception de type « mixture-of-experts »
DBRX résout des tâches à l'aide d'une architecture de type « Mixture-of-Experts » (MoE). Contrairement aux grands modèles linguistiques traditionnels qui utilisent l'ensemble de leurs milliards de paramètres pour chaque calcul, DBRX n'active qu'une fraction de ses paramètres totaux (les experts les plus pertinents) pour une tâche donnée.
Considérez cela comme une équipe d’experts spécialisés : au lieu que chacun s’occupe de tous les problèmes, le système achemine intelligemment chaque tâche vers les experts les plus qualifiés en fonction des paramètres correspondants.
Non seulement cela réduit les temps de réponse, mais cela garantit également des performances et des résultats de premier ordre tout en réduisant considérablement les coûts de calcul.
Voici un aperçu de ses principales caractéristiques techniques :
- Nombre total de paramètres : 132 milliards pour l'ensemble des experts
- Paramètres actifs : 36 milliards par passage en avant
- Nombre d'experts : 16 au total (routage MoE Top-4), dont 4 actifs pour un jeton donné
- Fenêtre de contexte : 32 000 jetons
Spécifications des données d'entraînement et des jetons DBRX
Les performances d’un LLM dépendent entièrement de la qualité des données sur lesquelles il a été entraîné. DBRX a été pré-entraîné sur un immense ensemble de données de 12 000 milliards de jetons, soigneusement sélectionné par l’équipe de Databricks à l’aide de ses outils avancés de traitement des données. C’est précisément pour cette raison qu’il a obtenu d’excellents résultats lors des tests de performance du secteur.
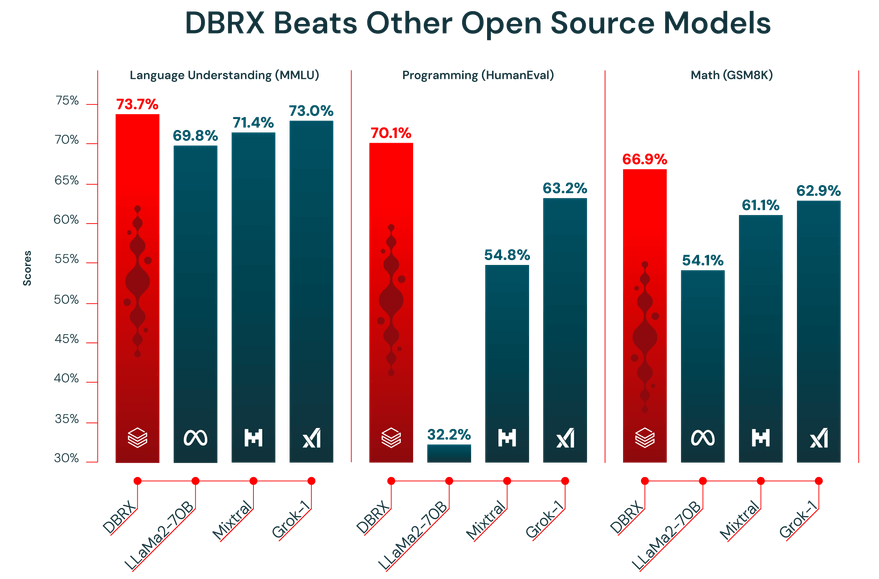
De plus, DBRX dispose d’une fonctionnalité de fenêtre de contexte de 32 000 tokens. Il s’agit de la quantité de texte que le modèle peut prendre en compte en une seule fois. Une grande fenêtre de contexte est extrêmement utile pour des tâches complexes telles que le résumé de longs rapports, l’analyse approfondie de documents juridiques volumineux ou la création de systèmes avancés de génération augmentée par la recherche (RAG), car elle permet au modèle de conserver le contexte sans tronquer ni oublier d’informations.
🎥 Regardez cette vidéo pour découvrir comment une coordination de projet rationalisée peut transformer votre flux de travail d'entraînement de l'IA et éliminer les frictions liées au passage d'un outil à l'autre. 👇🏽
Comment accéder à DBRX et le configurer
DBRX propose deux modes d’accès principaux, qui offrent tous deux un accès complet aux poids des modèles selon des conditions commerciales souples. Vous pouvez utiliser Hugging Face pour une flexibilité maximale ou y accéder directement via Databricks pour une expérience plus intégrée.
Accédez à DBRX via Hugging Face
Pour les équipes qui privilégient la flexibilité et qui maîtrisent déjà l'écosystème Hugging Face, accéder à DBRX via le hub est la solution idéale. Cela vous permet d'intégrer le modèle dans vos flux de travail existants basés sur Transformers.
Voici comment commencer :
- Créez un compte Hugging Face ou connectez-vous à votre compte
- Accédez à la carte du modèle DBRX sur le hub et acceptez les conditions de licence.
- Installez la bibliothèque transformers ainsi que les dépendances nécessaires, telles que accelerate.
- Utilisez la classe `AutoModelForCausalLM` dans votre script Python pour charger le modèle DBRX.
- Configurez votre pipeline d'inférence en gardant à l'esprit que DBRX nécessite une quantité importante de mémoire GPU (VRAM) pour fonctionner efficacement.
📖 En savoir plus : Comment configurer la température d'un LLM
Accédez à DBRX via Databricks
Si votre équipe utilise déjà Databricks pour l’ingénierie des données ou l’apprentissage automatique, accéder à DBRX via cette plateforme est la solution la plus simple. Cela vous évite les difficultés liées à l’installation et vous offre tous les outils nécessaires aux MLOps directement dans votre environnement de travail habituel.
Suivez ces étapes dans votre environnement de travail Databricks pour commencer :
- Accédez à la section « Model Garden » ou « Mosaic IA ».
- Sélectionnez DBRX Base ou DBRX Instruct, en fonction de vos besoins.
- Configurez un point de terminaison de service pour l'accès à l'API ou mettez en place un environnement de notebook pour une utilisation interactive
- Commencez à tester l'inférence à l'aide d'exemples de requêtes pour vous assurer que tout fonctionne correctement avant d'étendre l'entraînement ou le déploiement de votre modèle d'IA.
Cette approche vous offre un accès transparent à des outils tels que MLflow pour le suivi des expériences et Unity Catalog pour la gouvernance des modèles.
📮 ClickUp Insight : Un professionnel passe en moyenne plus de 30 minutes par jour à rechercher des informations liées à son travail, soit plus de 120 heures par an perdues à fouiller dans ses e-mails, ses fils de discussion Slack et ses fichiers éparpillés.
Un assistant IA intelligent intégré à votre environnement de travail peut changer la donne. Découvrez ClickUp Brain.
Il fournit des informations et des réponses instantanées en mettant en avant les documents, les discussions et les détails des tâches pertinents en quelques secondes, ce qui vous permet d'arrêter de chercher et de vous mettre au travail.
Comment affiner les paramètres de DBRX et entraîner des modèles d'IA personnalisés
Un modèle prêt à l’emploi, aussi puissant soit-il, ne comprendra jamais les nuances propres à votre entreprise. DBRX étant open source, vous pouvez l’ajuster pour créer un modèle personnalisé qui parle le langage de votre entreprise ou qui effectue une tâche spécifique que vous souhaitez lui confier.
Voici trois méthodes courantes à faire :
1. Affiner le modèle DBRX avec les ensembles de données Hugging Face
Pour les équipes qui débutent ou qui travaillent sur des tâches courantes, les ensembles de données publics de Hugging Face Hub constituent une excellente ressource. Ils sont mis en forme et faciles à charger, ce qui vous évite de passer des heures à préparer vos données.
Le processus est assez simple :
- Trouvez sur le hub un ensemble de données adapté à votre tâche (par exemple, suivi d'instructions, résumation).
- Chargez-le à l'aide de la bibliothèque de jeux de données
- Assurez-vous que les données sont mises en forme sous forme de paires instruction-réponse.
- Configurez votre script d'entraînement à l'aide d'hyperparamètres tels que le taux d'apprentissage et la taille des lots
- Lancez la tâche d'entraînement en veillant à enregistrer régulièrement des points de contrôle au cours d'une période donnée.
- Évaluez le modèle optimisé sur un ensemble de validation mis de côté afin de mesurer les progrès réalisés.
2. Affiner DBRX avec des ensembles de données locaux
C'est généralement en effectuant un ajustement fin à l'aide de vos propres données que vous obtiendrez les meilleurs résultats. Cela vous permet d'enseigner au modèle la terminologie, le style et les connaissances métier spécifiques à votre entreprise. Gardez simplement à l'esprit que cela n'est rentable que si vos données sont propres, bien préparées et suffisamment volumineuses.
Suivez ces étapes pour préparer vos données internes :
- Collecte de données : rassemblez des exemples de haute qualité à partir de vos wikis, documents et bases de données internes
- Conversion de format : structurez vos données dans un format instruction-réponse cohérent, généralement sous forme de lignes JSON
- Filtrage de qualité : Supprimez tous les exemples de mauvaise qualité, en double ou non pertinents
- Échantillon de validation : Réservez une petite partie de vos données (généralement 10 à 15 %) pour évaluer les performances du modèle.
- Vérification de la confidentialité : supprimez ou masquez toute information permettant d'identifier une personne (PII) ou toute donnée sensible.
3. Affiner le réglage de DBRX avec StreamingDataset
Si votre ensemble de données s'avère trop volumineux pour tenir dans la mémoire de votre machine, pas de souci : vous pouvez utiliser la bibliothèque Streaming Dataset de Databricks. Elle vous permet de diffuser des données en continu directement depuis un stockage cloud pendant l'entraînement du modèle, plutôt que de les charger toutes en mémoire en une seule fois.
Voici comment faire :
- Préparation des données : nettoyez et structurez vos données d'entraînement, puis stockez-les dans un format compatible avec les flux, tel que JSONL ou CSV, dans un espace de stockage cloud.
- Conversion au format de streaming : Convertissez votre jeu de données dans un format adapté au streaming, tel que Mosaic Data Shard (MDS), afin qu’il puisse être lu efficacement pendant l’entraînement
- Installation du chargeur d'entraînement : configurez votre chargeur d'entraînement pour qu'il pointe vers le jeu de données distant et définissez un cache local pour le stockage temporaire des données
- Initialisation du modèle : lancez le processus de réglage fin de DBRX à l'aide d'un framework d'entraînement prenant en charge StreamingDataset, tel que LLM Foundry
- Entraînement basé sur le streaming : exécutez la tâche d'entraînement pendant que les données sont transmises par lots au fur et à mesure, plutôt que d'être chargées intégralement en mémoire
- Points de contrôle et reprise : reprenez l'entraînement en toute fluidité si une exécution est interrompue, sans dupliquer ni ignorer de données
- Évaluation et déploiement : validez les performances du modèle optimisé et déployez-le à l'aide de votre installation de service ou d'inférence préférée
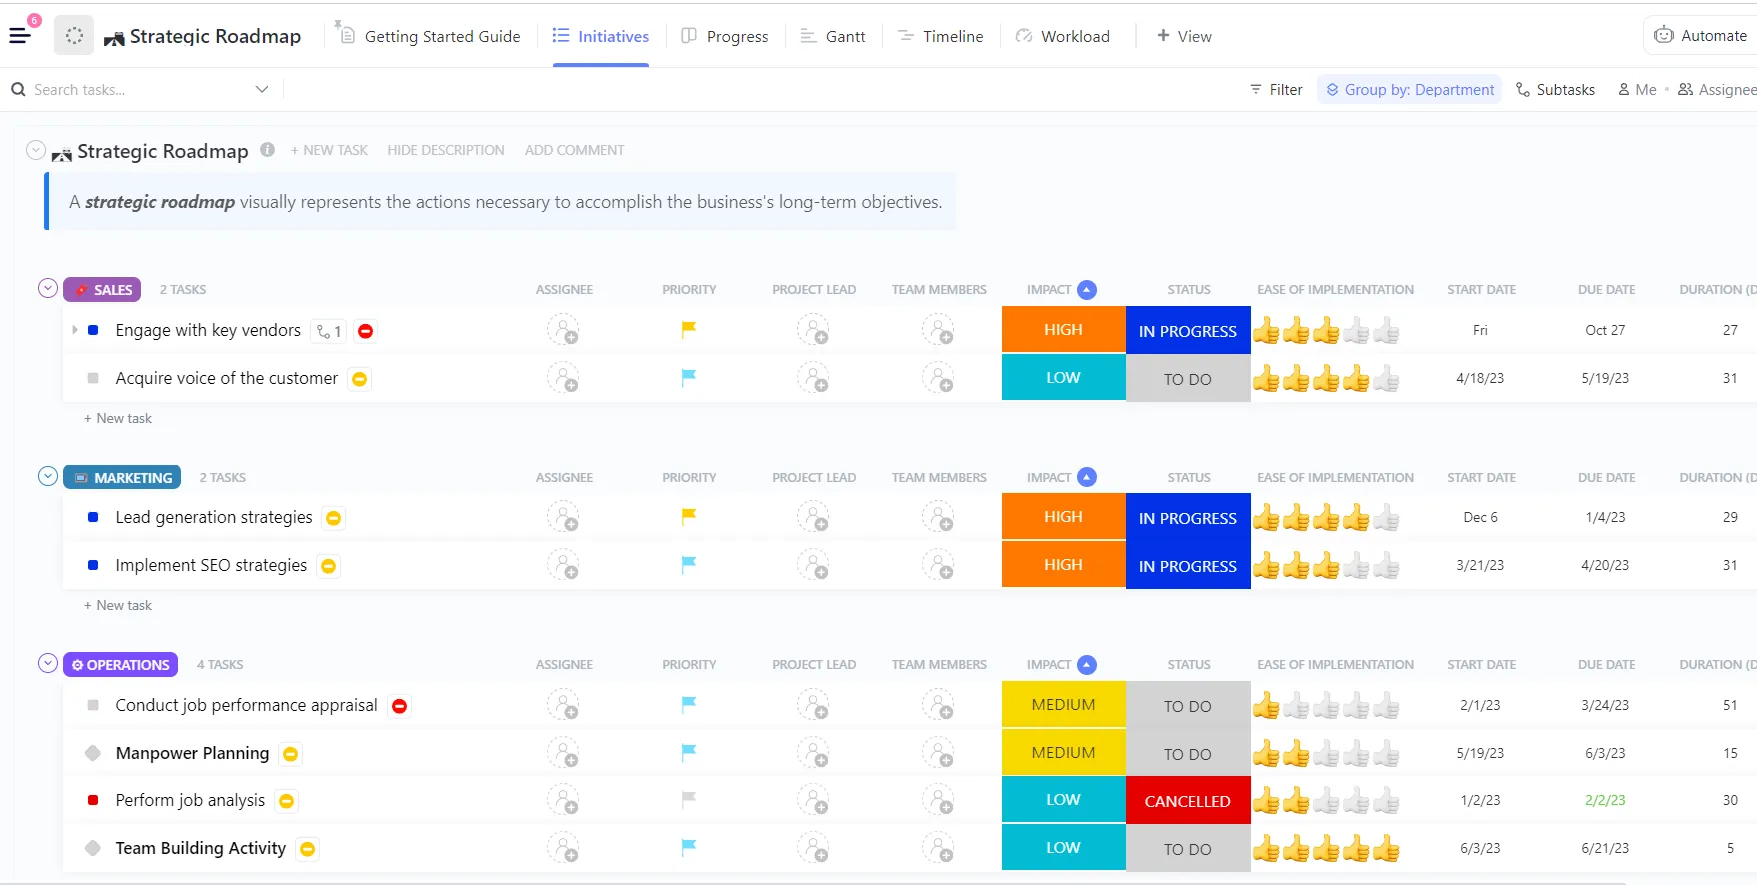
💡Conseil de pro : au lieu de créer un plan d'entraînement DBRX à partir de zéro, commencez par le modèle de feuille de route pour les projets d'IA et d'apprentissage automatique de ClickUp et adaptez-le aux besoins de votre équipe. Il offre une structure claire pour planifier les ensembles de données, les phases d'entraînement, l'évaluation et le déploiement, ce qui vous permet de vous concentrer sur l'organisation de votre travail plutôt que sur la mise en place d'un flux de travail.
Cas d'utilisation de DBRX pour l'entraînement de modèles IA
C'est une chose de disposer d'un modèle puissant, mais c'en est une autre de savoir exactement dans quels domaines il excelle.
Lorsque l’on ne dispose pas d’une vision claire des atouts d’un modèle, on risque facilement de consacrer du temps et des ressources à essayer de le faire travailler dans des contextes où il n’est tout simplement pas adapté. Cela conduit à des résultats médiocres et à de la frustration.
Grâce à son architecture unique et à ses données d'entraînement, DBRX est particulièrement bien adapté à plusieurs cas d'utilisation clés en entreprise. Connaître ces atouts vous aide à aligner le modèle sur vos objectifs commerciaux et à optimiser votre retour sur investissement.
Génération de texte et création de contenu
DBRX Instruct est spécialement conçu pour suivre des instructions et générer du texte de haute qualité. Cela en fait un outil puissant pour automatiser un large éventail de tâches liées au contenu. Sa grande fenêtre contextuelle constitue un avantage significatif, lui permettant de traiter de longs documents sans perdre le fil.
Vous pouvez l'utiliser pour :
- Documentation technique : générez et peaufinez des manuels produit, des références API et des guides d'utilisation pour les utilisateurs
- Contenu marketing : brouillons d'articles de blog, de newsletters par e-mail et de publications sur les réseaux sociaux
- Génération de rapports : résumez les résultats issus de données complexes et créez des résumés exécutifs concis
- Traduction et localisation : Adaptez le contenu existant à de nouveaux marchés et publics
Tâches de génération de code et de débogage
Une part importante des données d’entraînement de DBRX comprenait du code, ce qui en fait un outil LLM performant pour les développeurs. Il peut contribuer à accélérer les cycles de développement en effectuant l’automatisation des tâches de codage répétitives et en facilitant la résolution de problèmes complexes.
Voici quelques exemples d'utilisation pour votre équipe d'ingénieurs :
- Complétion de code : générez automatiquement des corps de fonction à partir de commentaires ou de chaînes de documentation
- Détection des bugs : analysez des extraits de code pour identifier les erreurs potentielles ou les failles logiques
- Explication du code : Traduisez des algorithmes complexes ou du code hérité en langage clair.
- Génération de tests : créez des tests unitaires en fonction de la signature d’une fonction et du comportement attendu
RAG et applications à contexte étendu
La génération augmentée par la recherche (RAG) est une technique puissante qui ancrent les réponses d’un modèle dans les données privées de votre entreprise. Cependant, les systèmes RAG rencontrent souvent des difficultés avec les modèles dotés de fenêtres de contexte restreintes, ce qui oblige à un découpage agressif des données pouvant entraîner la perte de contexte important. La fenêtre de contexte de 32K de DBRX en fait une excellente base pour des applications RAG robustes.
Cela vous permet de créer des outils internes performants, tels que :
- Recherche d'entreprise : Créez un chatbot capable de répondre aux questions des collaborateurs à l'aide de votre base de connaissances interne
- Service client : Créez un agent capable de générer des réponses d'assistance basées sur la documentation de votre produit
- Assistance à la recherche : Développez un outil capable de synthétiser les informations issues de centaines de pages d'articles de recherche
- Contrôle de conformité : vérifiez automatiquement la conformité des textes marketing par rapport aux directives internes de la marque ou aux documents réglementaires.
Comment intégrer l'entraînement DBRX au flux de travail de votre équipe
La réussite d’un projet d’entraînement de modèles d’IA ne se résume pas au code et à la puissance de calcul. Il s’agit d’un effort collaboratif impliquant des ingénieurs en apprentissage automatique, des data scientists, des chefs de produit et les parties prenantes.
Lorsque cette collaboration est dispersée entre des notebooks Jupyter, des canaux Slack et des outils de gestion de projet distincts, vous créez une prolifération du contexte, une situation dans laquelle les informations essentielles au projet sont dispersées entre un trop grand nombre d'outils.
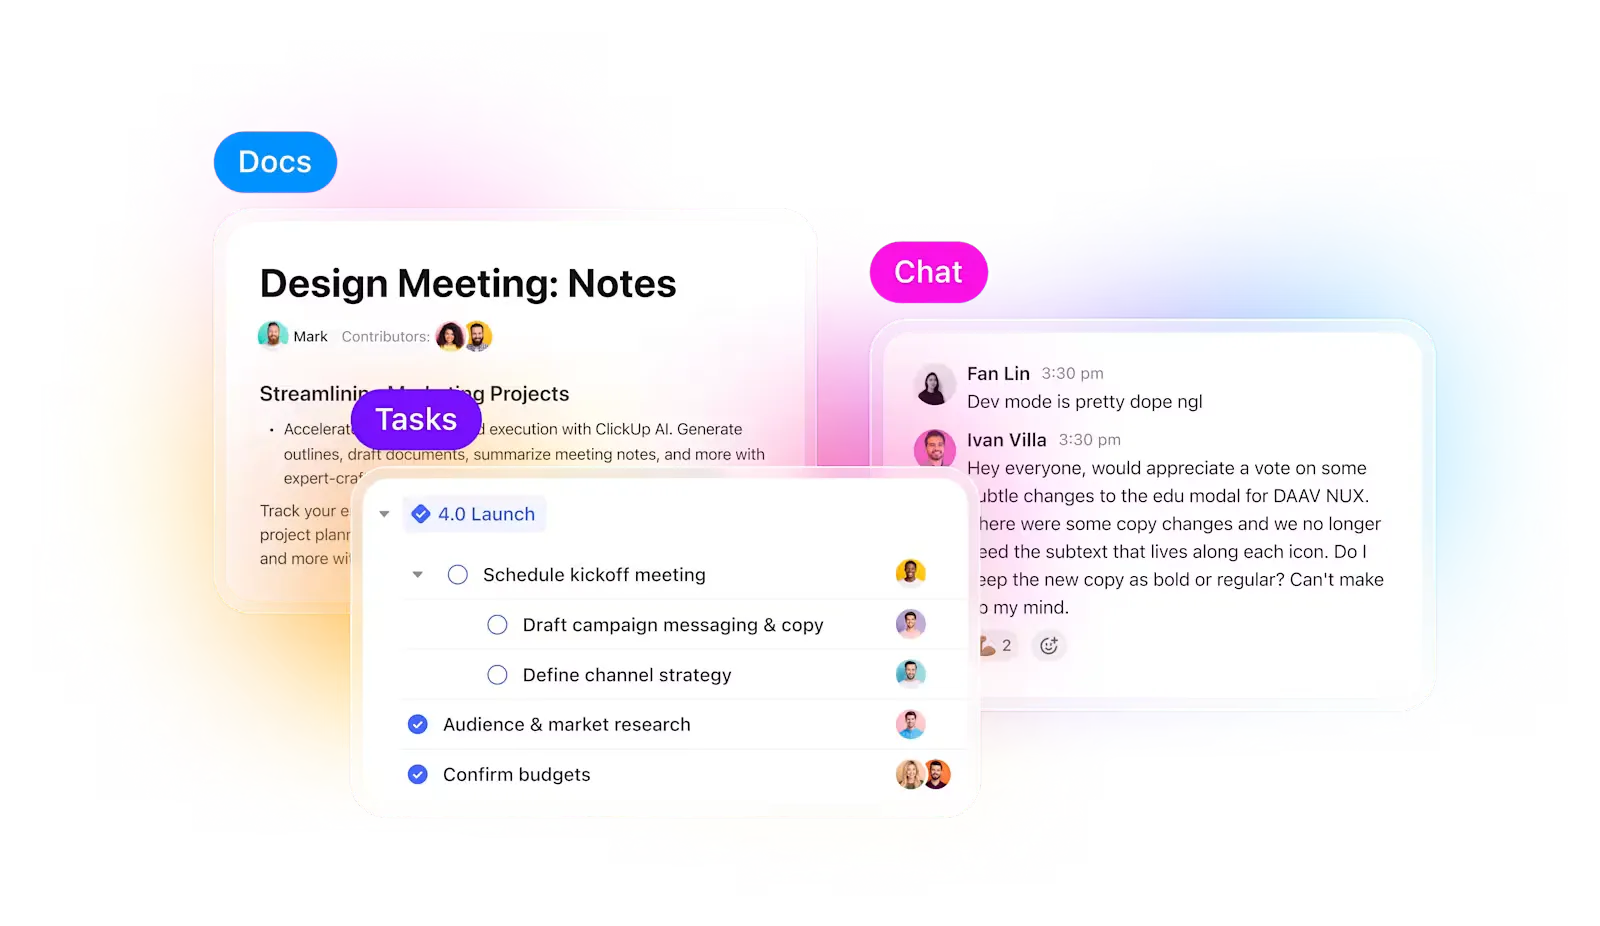
ClickUp apporte la solution. Au lieu de jongler entre plusieurs outils, vous disposez d’un environnement de travail IA convergent où la gestion de projet, la documentation et la communication coexistent, afin que vos expériences restent cohérentes de la planification à l’exécution, en passant par l’évaluation.
Ne perdez jamais le suivi de vos expériences et de votre progression
Lorsqu’on mène plusieurs expériences, le plus difficile n’est pas d’entraîner le modèle, mais le suivi de ce qui a changé au cours du processus. Quelle version du jeu de données a été utilisée, quel taux d’apprentissage a donné les meilleurs résultats, ou quelle exécution a été déployée ?
ClickUp vous facilite grandement ce processus. Vous pouvez suivre chaque session d'entraînement séparément dans les tâches ClickUp, et au sein de ces tâches, vous pouvez utiliser les champs personnalisés pour consigner :
- Version du jeu de données
- Hyperparamètres
- Variante de modèle (DBRX Base vs DBRX Instruct)
- Statut de l'entraînement (En file d'attente, En cours, En évaluation, Déployé)
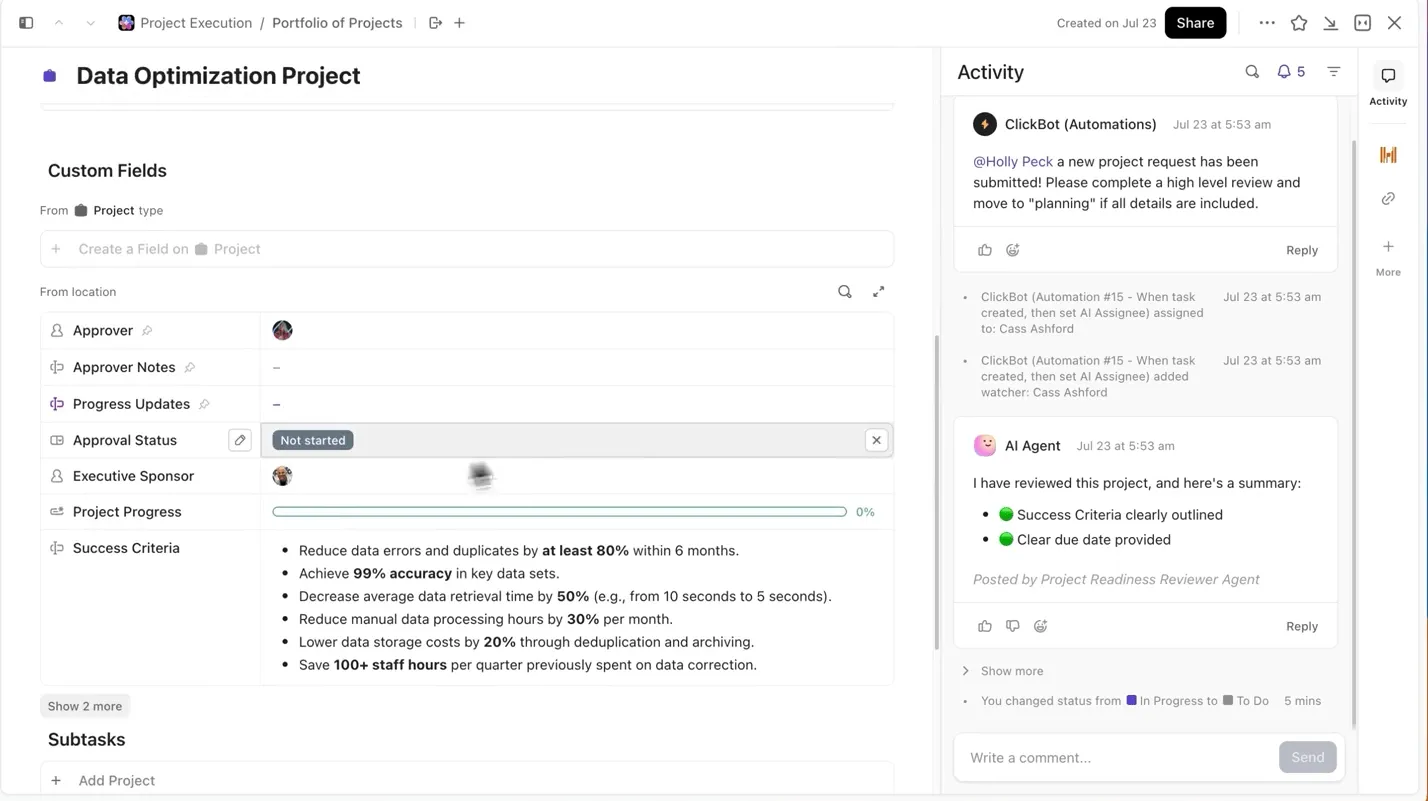
Ainsi, chaque expérience documentée est consultable, facile à comparer aux autres et reproductible.
Assurez-vous que la documentation des modèles reste liée au travail
Vous n’avez plus besoin de passer sans cesse des notebooks Jupyter aux fichiers README ou aux fils de discussion Slack pour comprendre le contexte d’une tâche liée à une expérience.
Avec ClickUp Docs, vous pouvez organiser et rendre accessibles votre architecture de modèle, vos scripts de préparation des données ou vos indicateurs d'évaluation en les documentant dans un document consultable qui est lié aux tâches d'expérimentation dont ils sont issus.
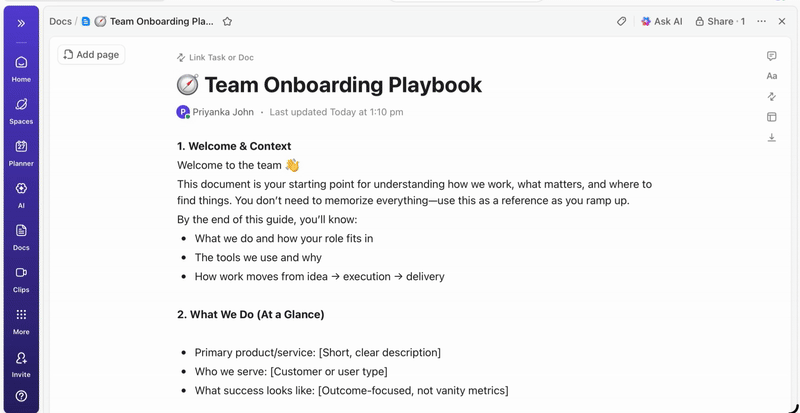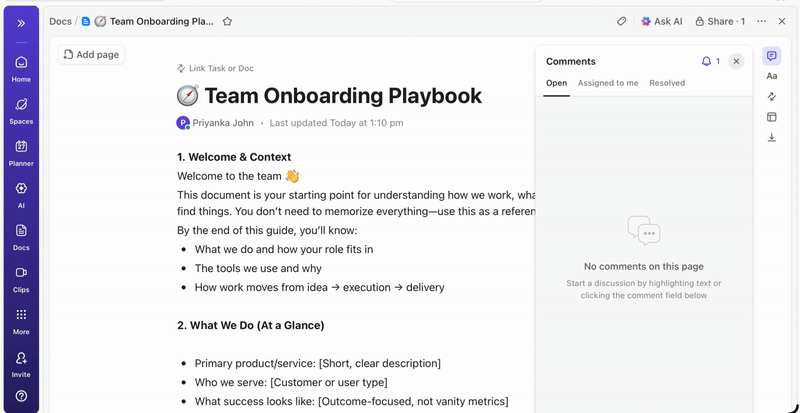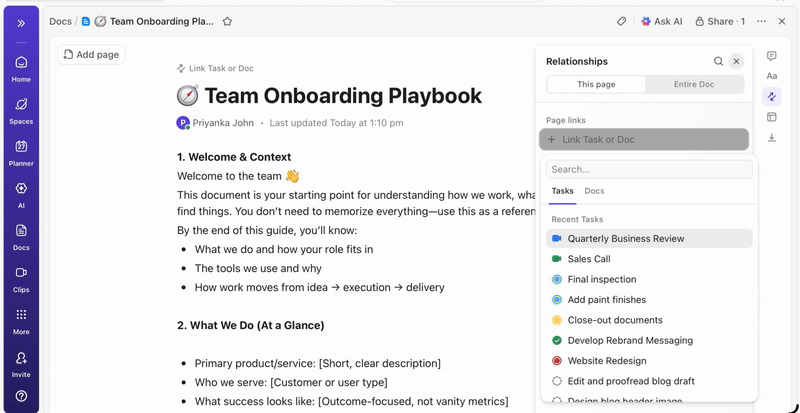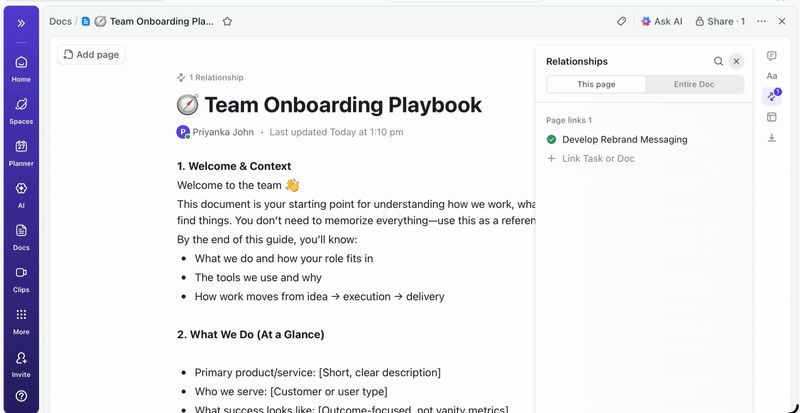
💡Conseil de pro : tenez à jour un cahier des charges évolutif dans ClickUp Docs qui détaille chaque décision, de l'architecture au déploiement, afin que les nouveaux membres de l'équipe puissent toujours se mettre à jour sur les détails du projet sans avoir à fouiller dans d'anciens fils de discussion.
Offrez aux parties prenantes une visibilité en temps réel
Les tableaux de bord ClickUp affichent en temps réel la progression des expériences et la charge de travail des équipes. I
Au lieu de compiler manuellement les mises à jour ou d’envoyer des e-mails, les tableaux de bord se mettent à jour automatiquement en fonction des données de vos tâches. Les parties prenantes peuvent ainsi se connecter à tout moment, voir où en sont les choses et n’ont plus jamais besoin de vous interrompre pour vous demander « quel est le statut du projet ? ».
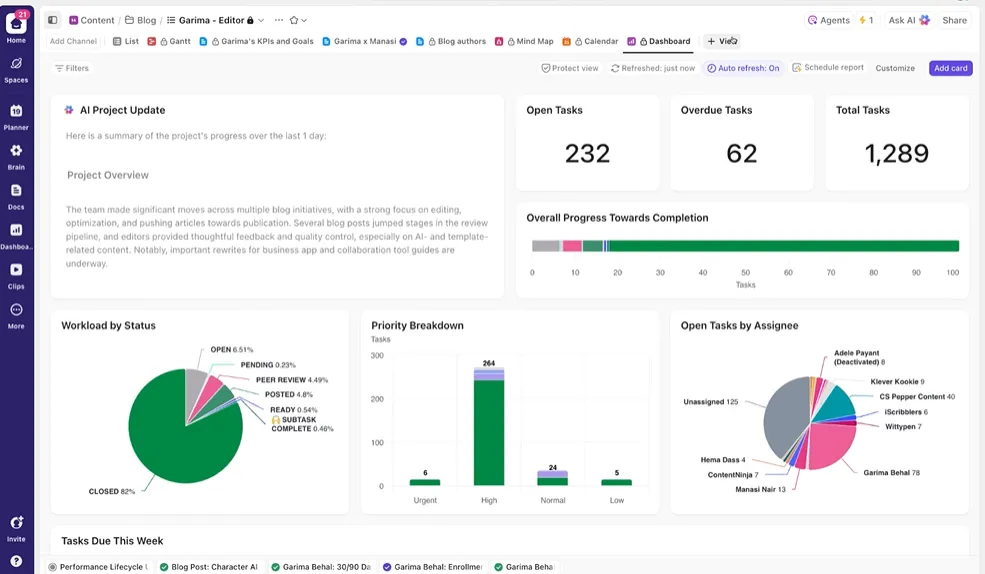
Vous pouvez ainsi vous concentrer sur la réalisation des expériences plutôt que de devoir constamment rédiger des rapports manuellement.
Faites de l'IA votre assistant de projet intelligent
Vous n’avez pas besoin de passer au crible manuellement des semaines de données d’entraînement pour obtenir un résumé des expériences menées jusqu’à présent. Il vous suffit de mentionner @Brain dans n’importe quel commentaire de tâche, et ClickUp Brain vous apportera l’aide dont vous avez besoin en vous fournissant le contexte complet de vos projets passés et en cours.
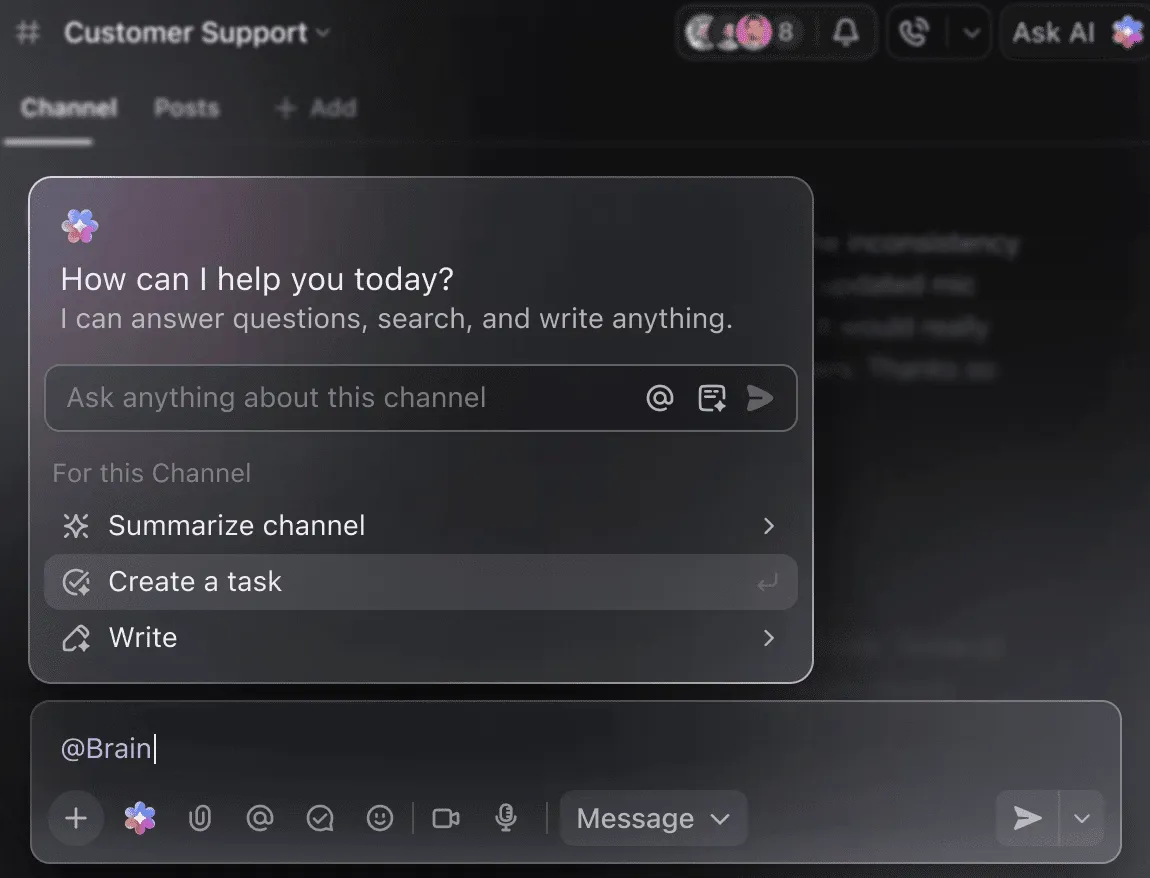
Vous pouvez demander à Brain de « résumer les expériences de la semaine dernière en 5 points » ou de « rédiger un document présentant les derniers résultats des hyperparamètres », et obtenir instantanément un résultat soigné.
🧠 L'avantage ClickUp : les « Super Agents » de ClickUp vont bien plus loin : ils peuvent automatiser des flux de travail entiers en fonction des déclencheurs que vous définissez, et ne se contentent pas de répondre à vos questions. Grâce aux Super Agents, vous pouvez créer automatiquement une nouvelle tâche d’entraînement DBRX dès qu’un ensemble de données est importé, en informer votre équipe, lier les documents pertinents une fois l’entraînement terminé ou lorsqu’il atteint un point de contrôle, et générer un résumé hebdomadaire de la progression pour le transmettre aux parties prenantes sans que vous ayez à intervenir.
Erreurs courantes à éviter
Se lancer dans un projet d'entraînement avec DBRX est passionnant, mais certains écueils courants peuvent compromettre votre progression. Éviter ces erreurs vous permettra de gagner du temps, de l'argent et de vous épargner bien des frustrations.
- Sous-estimer la configuration matérielle requise : DBRX est puissant, mais il est également volumineux. Tenter de l’exécuter sur un matériel inadéquat entraînera des erreurs de mémoire insuffisante et l’échec des tâches d’entraînement. Gardez à l’esprit que DBRX (132B) nécessite au moins 264 Go de VRAM pour une inférence en 16 bits, ou environ 70 à 80 Go en cas d’utilisation d’une quantification en 4 bits.
- Négliger les contrôles de qualité des données : si les données d'entrée sont erronées, les résultats le seront aussi. Le réglage fin sur un ensemble de données désorganisé et de mauvaise qualité ne fera qu'apprendre au modèle à produire des résultats désorganisés et de mauvaise qualité.
- Ignorer les limites de longueur du contexte : bien que la fenêtre de contexte de 32K de DBRX soit généreuse, elle n’est pas infinie. Fournir au modèle des entrées dépassant cette limite entraînera une troncature silencieuse et un résultat de performances inférieur.
- Quand utiliser Base plutôt qu'Instruct : DBRX Base est un modèle brut, pré-entraîné, destiné à un entraînement supplémentaire à grande échelle. Pour la plupart des tâches consistant à suivre des instructions, vous devriez commencer par DBRX Instruct, qui a déjà été optimisé à cette fin.
- Séparation du travail d’entraînement et de la coordination de projet : lorsque le suivi de vos expériences se fait dans un outil et que votre plan de projet en est un autre, vous créez des silos d’informations. Utilisez une plateforme intégrée comme ClickUp pour synchroniser votre travail technique et la coordination de votre projet.
- Négliger l'évaluation avant le déploiement : un modèle qui donne de bons résultats sur vos données d'entraînement peut échouer lamentablement dans la réalité. Validez toujours votre modèle optimisé sur un ensemble de test mis de côté avant de le déployer en production.
- La complexité du réglage fin souvent négligée : DBRX étant un modèle de type « Mixture-of-Experts », les scripts de réglage fin standard peuvent nécessiter des bibliothèques spécialisées telles que Megatron-LM ou PyTorch FSDP pour gérer le partitionnement des paramètres sur plusieurs GPU.
DBRX par rapport aux autres plateformes d'entraînement de l'IA
Le choix d’une plateforme d’entraînement IA implique un compromis fondamental : contrôle contre commodité. Les modèles propriétaires, accessibles uniquement via une API, sont faciles à utiliser mais vous enferment dans l’écosystème d’un fournisseur.
Les modèles à poids ouverts comme DBRX offrent un contrôle total, mais nécessitent davantage d’expertise technique et d’infrastructure. Ce choix peut vous donner l’impression d’être dans une impasse, sans savoir quelle voie correspond réellement à vos objectifs à long terme — un défi auquel de nombreuses équipes sont confrontées lors de l’adoption de l’IA.
Ce tableau présente les principales différences afin de vous aider à prendre une décision éclairée.
| Poids | Ouvrir (personnalisé) | Exclusif | Ouvrir (personnalisé) | Exclusif |
| Réglage fin | Contrôle total | Basé sur une API | Contrôle total | Basé sur une API |
| Auto-hébergement | Oui | Non | Oui | Non |
| Licence | DB Open Model | Conditions générales d'OpenAI | Communauté Llama | Termes Anthropic |
| Contexte | 32K | 128 000 – 1 million | 128K | 200 000 – 1 million |
DBRX est le choix idéal lorsque vous avez besoin d’un contrôle total sur le modèle, que vous devez l’héberger vous-même pour des raisons de sécurité ou de conformité, ou que vous recherchez la flexibilité offerte par une licence commerciale permissive. Si vous ne disposez pas d’une infrastructure GPU dédiée, ou si vous privilégiez la rapidité de mise sur le marché plutôt qu’une personnalisation poussée, les alternatives basées sur des API pourraient mieux vous convenir.
Commencez à entraîner vos modèles plus intelligemment avec ClickUp
DBRX vous offre une base prête à l’emploi pour développer des applications d’IA personnalisées, avec une transparence et un contrôle que vous ne retrouvez pas dans les modèles propriétaires. Son architecture MoE efficace permet de réduire les coûts d’inférence, et sa conception ouverte facilite le réglage fin. Mais une technologie performante ne représente que la moitié de l’équation.
La véritable réussite passe par l’alignement de votre travail technique sur le flux de travail collaboratif de votre équipe. L’entraînement des modèles d’IA est un travail d’équipe, et il est essentiel de synchroniser les expériences, la documentation et la communication avec les parties prenantes. En regroupant tout dans un environnement de travail unique et en réduisant la dispersion des informations, vous pouvez livrer de meilleurs modèles, plus rapidement.
Commencez gratuitement avec ClickUp pour coordonner vos projets d'entraînement d'IA dans un seul environnement de travail. ✨
Foire aux questions
Comment suivre la progression de l'entraînement dans DBRX ?
Vous pouvez surveiller l'entraînement à l'aide d'outils d'apprentissage automatique standard tels que TensorBoard, Weights & Biases ou MLflow. Si vous effectuez l'entraînement au sein de l'écosystème Databricks, MLflow est intégré en natif pour un suivi transparent des expériences.
Puis-je intégrer DBRX aux pipelines CI/CD et de déploiement ?
Oui, DBRX peut être intégré dans des pipelines MLOps standard. En conteneurisant le modèle, vous pouvez le déployer à l'aide de plateformes d'orchestration telles que Kubeflow ou de flux de travail CI/CD personnalisés.
Quelle est la différence entre DBRX Base et DBRX Instruct ?
DBRX Base est le modèle de base pré-entraîné destiné aux équipes qui souhaitent effectuer un pré-entraînement continu spécifique à un domaine ou un réglage fin de l'architecture profonde. DBRX Instruct est une version réglée finement, optimisée pour suivre des instructions, ce qui en fait un meilleur point de départ pour la plupart des développements d'applications.
Comment DBRX se compare-t-il à GPT-4 pour les projets d'IA d'entreprise ?
La principale différence réside dans le contrôle. DBRX vous offre un accès complet aux poids du modèle pour une personnalisation poussée et un auto-hébergement, tandis que GPT-4 est un service accessible uniquement via une API.
Peut-on utiliser DBRX gratuitement ?
Les poids des modèles DBRX sont disponibles gratuitement sous licence Databricks Open Model License. Toutefois, les coûts liés à l'infrastructure de calcul nécessaire à l'exécution ou au réglage fin du modèle sont à votre charge.