
Zřejmě znáte ten nepříjemný pocit: zákazník nahlásí chybu, sprint se zastaví a souvislosti se ztratí v diskusích na Slacku. Pokud se bez centrálního systému potýkáte s přijímáním hlášení o chybách, jejich prioritizací a eskalací mezi týmy, nejste v tom sami.
Právě proto se dnes asi 21 % vývojářů spoléhá na umělou inteligenci, aby zefektivnilo procesy ladění. Inteligentní automatizace sledování chyb se rychle mění z novinky v nezbytnost.
V tomto příspěvku vám ukážeme, jak vám inteligentní sledování chyb podporované umělou inteligencí pomůže rychleji zaznamenávat chyby, upřednostňovat to, na čem záleží, zefektivnit třídění a podpořit lepší spolupráci.
A to nejlepší? Vše je podloženo příklady z praxe a daty, na které se můžete spolehnout.
Co je to umělá inteligence pro sledování a řešení chyb?
Umělá inteligence pro sledování a řešení chyb přináší strojové učení a zpracování přirozeného jazyka do samého jádra práce s chybami – od okamžiku jejich zaznamenání až po jejich opravu a využití jako nástrojů pro učení.
Představte si to jako digitálního asistenta, který dokáže:
- Porozumějte příchozím hlášením chyb (i těm chaotickým) a roztřiďte je do kategorií
- Odhadněte závažnost (P0, P1 atd.) na základě identifikace vzorců, jako je četnost pádů aplikace nebo dopad na uživatele
- Navrhujte pravděpodobné duplikáty nebo související problémy a snižte tak nadbytečné úsilí při třídění
- Odhalte stopy vedoucí k příčině problému seskupením podobných selhání nebo cest v kódu
- Automaticky generujte souhrny a přehledy o postupu pro zainteresované strany
Díky integraci umělé inteligence do jednotného pracovního prostředí – kde se prolínají hlášení chyb, technické poznámky, zpětná vazba od zákazníků i strategie – pracují týmy chytřeji, rychleji a koordinovaněji, aniž by docházelo k zbytečnému rušení nebo nutnosti provádět manuální kroky.
📮ClickUp Insight: 33 % našich respondentů uvádí rozvoj dovedností jako jeden z případů využití umělé inteligence, o který mají největší zájem. Například pracovníci bez technického vzdělání se mohou chtít naučit vytvářet úryvky kódu pro webové stránky pomocí nástroje s umělou inteligencí.
V takových případech platí, že čím více kontextu má umělá inteligence o vaší práci, tím lepší budou její reakce. Jako univerzální aplikace pro práci v tom vyniká umělá inteligence ClickUp. Ví, na jakém projektu pracujete, a může vám doporučit konkrétní kroky nebo dokonce snadno provádět úkoly, jako je vytváření úryvků kódu.
Proč sledování chyb stále zpomaluje vývoj
I dnes se většina týmů stále potýká se sledováním chyb, které prodlužuje dodání. Zde jsou nejčastější příčiny:
- Vysoký počet chyb: Záplava přicházejících hlášení – zejména po vydání nové verze – znamená, že urgentní záležitosti často zapadnou nebo se zpozdí
- Izolovaná komunikace: Popisy, priority a aktualizace se ztrácejí v e-mailových vláknech, na Slacku nebo v samostatných nástrojích, což vede k nesouladu a zmatku
- Prioritizace podle počtu, nikoli podle dopadu: Přednost má nejhlasitější nebo nejnovější chyba, nikoli nutně ta, která nejvíce poškozuje uživatele nebo plán vývoje produktu.
- Ruční zpracování dat: Sledování stavů chyb, aktualizace tabulek, organizování přehledových panelů – to vše zabírá čas, který by se dal věnovat ladění nebo vývoji nových funkcí
- Nedostatek přehledu nebo trendů: Bez agregovaných dat je těžké rozpoznat opakující se problémy nebo odhalit systémové příčiny, dokud se z nich nestanou plnohodnotné krize
- Pomalý přehled pro zainteresované strany: Týmy produktového vývoje, podpory a vedení nedostávají včasné a jasné informace, což vede k nesouladu očekávání a neefektivnímu hašení požárů
Dobrou zprávou je, že umělá inteligence vám s tím může pomoci téměř ve všech případech – pokud ne ve všech!
Jak umělá inteligence a strojové učení mění sledování a řešení chyb
Představte si, že spíte ve své posteli, v pohodlí a bezpečí, s vědomím, že vaši budovu chrání noční hlídač, který je vždy ve službě.
Umělá inteligence vnáší tuto úroveň bdělosti do vašeho pracovního postupu při sledování chyb. Neustále skenuje, analyzuje a filtruje kód, aby odhalila nežádoucí narušitele, a dokonce nabízí řešení – ano, aniž byste ji k tomu museli pobízet.
Toto se mění:
- Rychlejší detekce chyb a chytřejší testování: Nástroje umělé inteligence se mohou učit z minulých chyb, testovacích běhů a vzorců kódu, aby odhalily problémy ještě předtím, než se dostanou do produkčního prostředí. Například společnost Test.ai snížila počet defektů po spuštění o 30 % v systému pro správu velkých dat tím, že generovala a prioritizovala testovací případy na základě historických dat a dokonce je automaticky spouštěla
- Vyšší přesnost, méně manuální práce. Představte si, jaké inovace můžete ve své organizaci odemknout tím, že osvobodíte zkušené vývojáře od zdlouhavého třídění chyb. Ve společnosti Ericsson nyní systém TRR založený na strojovém učení automaticky přiřazuje přibližně 30 % příchozích hlášení o chybách s 75% přesností a tyto automaticky směrované opravy jsou dokončeny přibližně o 21 % rychleji než při ručním přiřazování.
- Chytřejší analýza příčin: V rozsáhlých systémech – jako jsou mikroslužby – je určení původu kritických problémů často obrovskou hádankou. Řešením je lokalizace založená na umělé inteligenci: Společnost Alibaba používá systém s názvem MicroHECL, který zkracuje dobu hledání příčiny z 30 minut na pouhých 5 minut při zachování vysoké přesnosti
- Automatické opravy (s lidským zásahem): Už to není sci-fi – nástroje jako Getafix se učí z oprav kódu napsaných lidmi a okamžitě navrhují potenciální opravy chyb podobné těm lidským, přičemž je seřazují tak, že inženýři musí ověřit pouze ty nejrelevantnější návrhy
Abychom na základě výše uvedených příkladů shrnuli, jak se sledování chyb vyvíjí, přinášíme zde srovnání tradičních metod a metod využívajících umělou inteligenci:
Tradiční sledování chyb vs. sledování chyb s využitím umělé inteligence
| Proces | Tradiční přístup | Přístup založený na umělé inteligenci |
| Detekce a testování | Ruční psaní testů, reaktivní ladění po vydání | Proaktivní detekce s prioritizací založenou na strojovém učení a automaticky generovanými testovacími případy |
| Třídění a klasifikace | Vývojáři nebo týmy technické podpory ručně označují, řadí podle priority a přiřazují jednotlivé problémy | Kategorizace založená na NLP, označování závažnosti a automatické přiřazování (např. TRR) |
| Analýza příčin | Časově náročné ruční kontroly kódu a sledování protokolů, často izolované | Seskupování a detekce anomálií rychle odhalí příčiny problémů, a to i napříč službami |
| Opravy | Inženýři provádějí opravy ručně – často tak, že jednu po druhé kopírují dřívější opravy | Automaticky generované nebo navrhované opravy na základě naučených vzorců (např. Getafix) |
| Doba zpracování | Pomalé, náchylné k chybám a nejednotné | Rychlejší, konzistentnější a stále přesnější – umělá inteligence se učí ze stávajících dat a stává se chytřejší |
Umělá inteligence zdaleka nenahrazuje vaše vývojáře, ale zajišťuje, že z jejich práce získáte ty nejlepší výsledky.
Pomáhá také vývojářům přejít od hašení požárů k tvorbě – k lepšímu využití jejich cenného času a pečlivě zdokonalených dovedností.
📚 Přečtěte si také: Jak využít umělou inteligenci k automatizaci úkolů
Výhody umělé inteligence při sledování chyb a ladění
🧠 Zajímavost: Pouze 2,5 % společností oslovených v průzkumu Techreviewer v roce 2025 ještě nezavedlo umělou inteligenci do vývoje softwaru!
Potřebujete ještě více přesvědčivých argumentů, než necháte umělou inteligenci analyzovat váš kód?
Zde je důvod, proč chytré týmy přešly od experimentování s umělou inteligencí k jejímu zavedení do celého životního cyklu vývoje softwaru (SDLC).
- Vyšší přesnost a širší pokrytí: V procesech kontroly kvality pomáhá umělá inteligence s vysokou přesností odhalovat kritické chyby a zároveň zvyšuje celkové pokrytí. Systémy umělé inteligence od společnosti Agentic mohou provádět kontroly nezávisle a autonomně, i když lidé zrovna nepracují
- Menší závislost na manuálním testování: Umělá inteligence výrazně omezuje manuální testování, díky čemuž se týmy mohou soustředit na strategii, nikoli na tabulky
- Zvýšená produktivita: Díky tomu, že umělá inteligence přebírá detekci chyb a snižuje náročnost různých typů testování softwaru, se výrazně zvyšuje efektivita vývojářů. 82,3 % vývojářů v nedávném průzkumu uvedlo, že dosáhli zvýšení produktivity o ≥20 %, zatímco u 24,1 % tento nárůst přesáhl 50 %.
📌 Proč je to důležité pro vaše vývojové týmy: Když umělá inteligence převezme opakující se úkoly v oblasti testování a třídění chyb, vaše týmy získají zpět čas, přehled a rychlost… aniž by tím utrpěla kvalita.
Zajímá vás, jak můžete dosáhnout stejných výsledků?
Dáme vám k dispozici ty správné nástroje pro vaši práci!
Nejlepší nástroje pro sledování a řešení chyb založené na umělé inteligenci
Chcete-li inteligentně začlenit umělou inteligenci do svých pracovních postupů při sledování a řešení chyb, zvažte tyto nejlépe hodnocené softwarové nástroje pro sledování chyb, které jsou v současné době na trhu k dispozici:
ClickUp
Jako univerzální aplikace pro práci podporuje ClickUp softwarové týmy sjednoceným pracovním prostorem, který propojuje všechny fáze životního cyklu řešení. Místo toho, abyste museli zvládat příjem chyb v Zendesk, jejich třídění ve Slacku a opravy v GitHubu, ClickUp vše sjednotí na jednom místě.
Díky tomu se váš pracovní postup při sledování chyb a řešení problémů stane intuitivnějším a transparentnějším – a to díky ClickUp Brain, nejkomplexnější a kontextově orientované pracovní AI na světě.
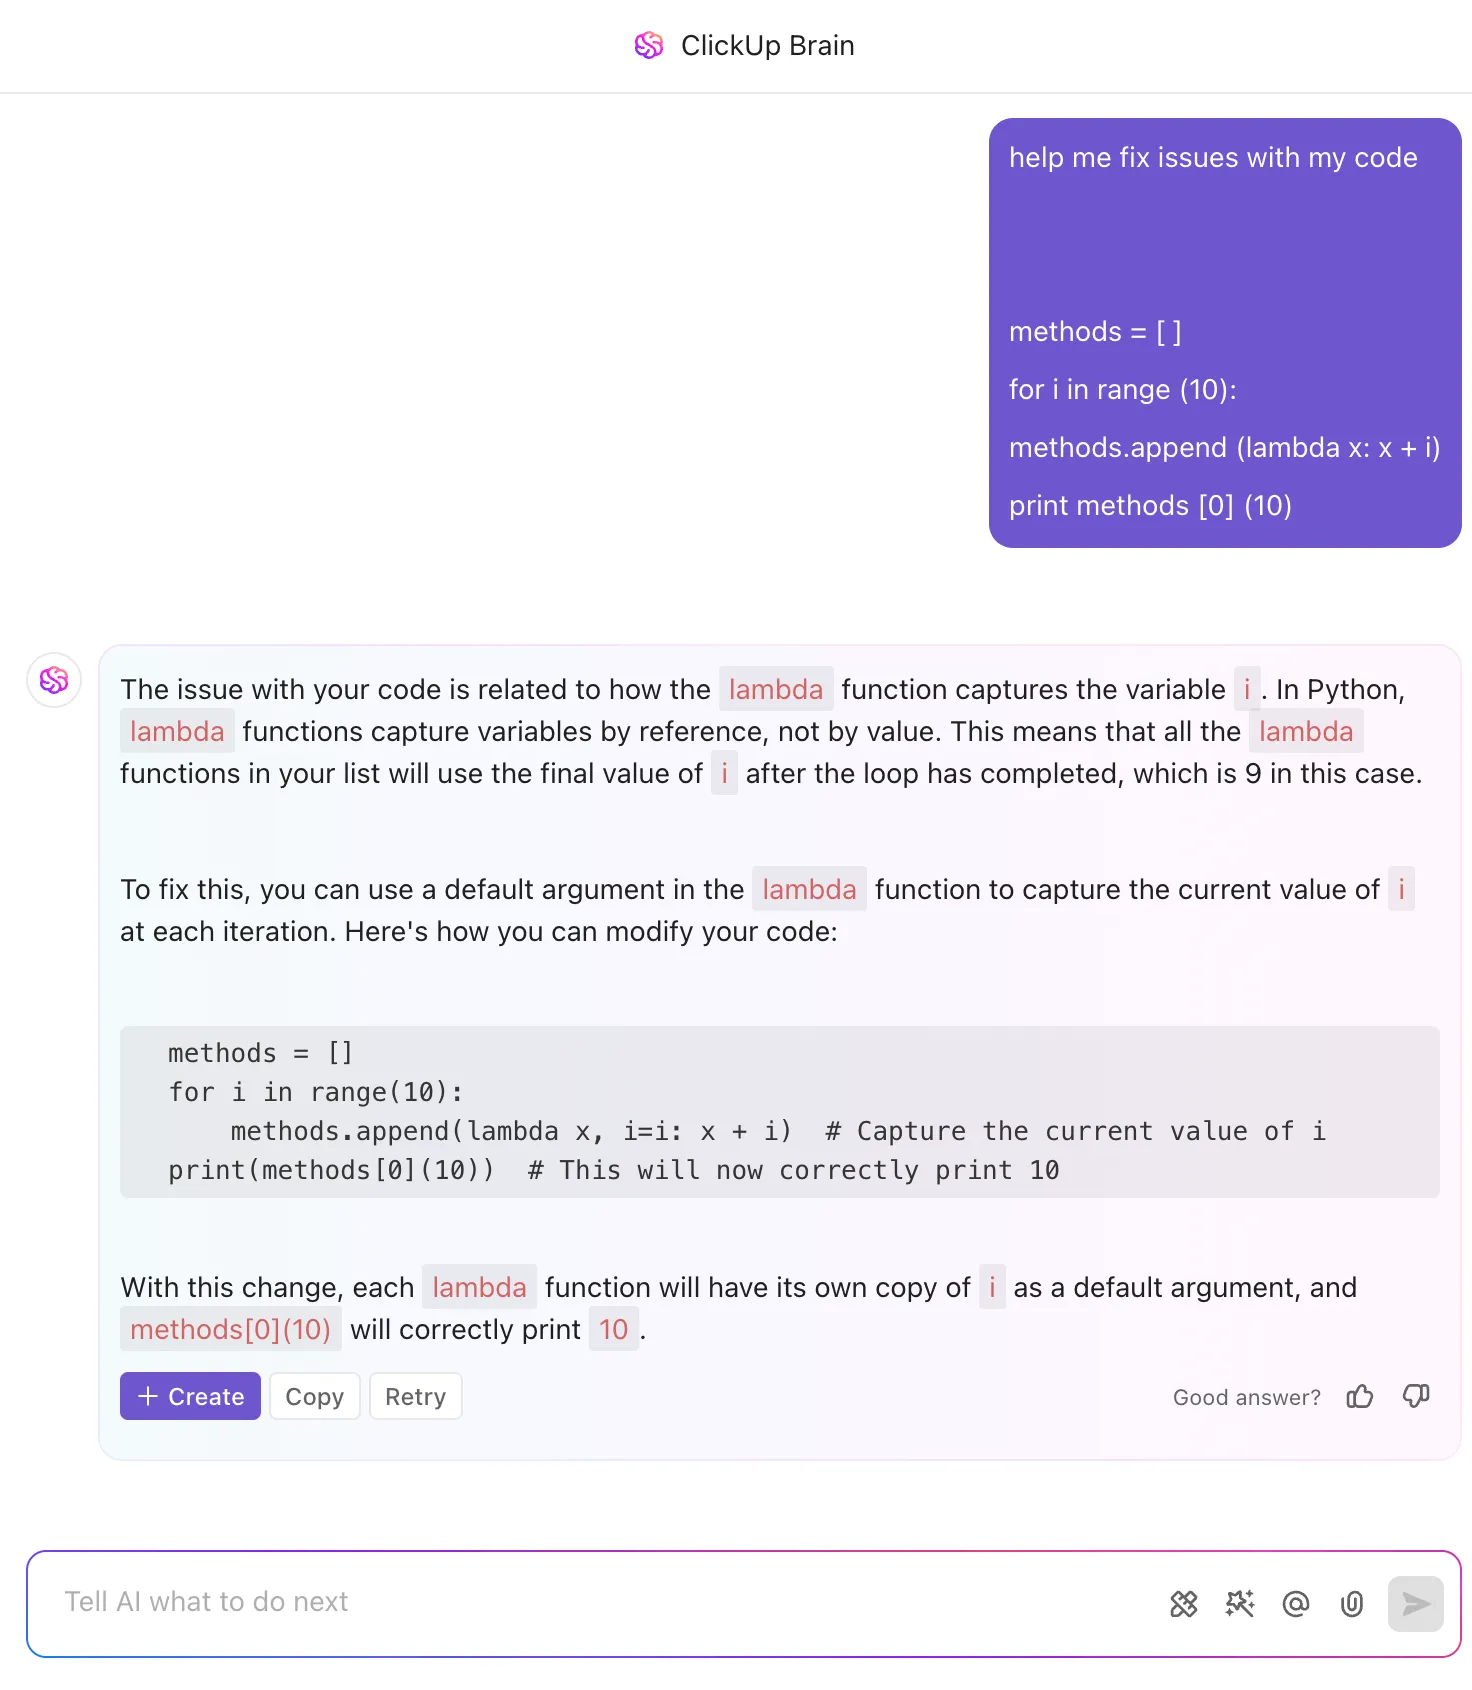
Zde je krátký přehled toho, jak ClickUp zrychluje a zefektivňuje proces sledování a řešení chyb:
- Formuláře ClickUp shromažďují hlášení chyb a automaticky přeměňují každý problém na sledovatelný a řešitelný úkol v ClickUp – takže závažné chyby nezůstávají nevyřešené celé dny, nebo ještě hůře, měsíce
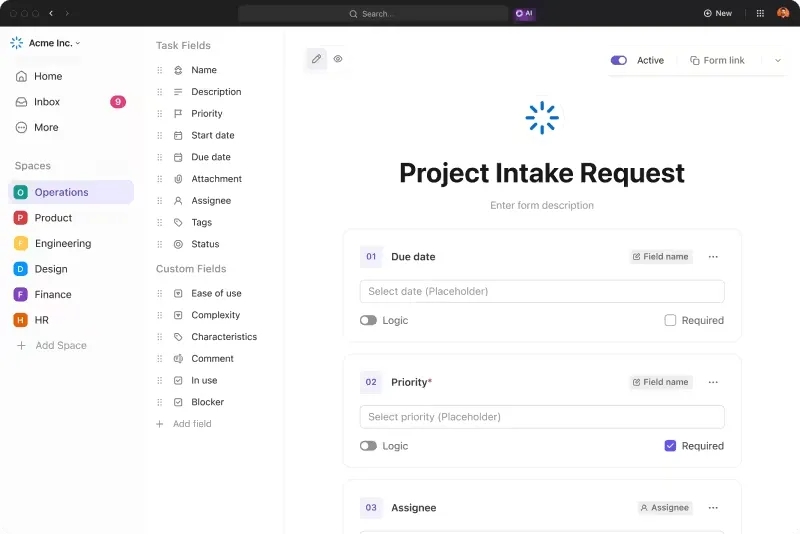
- Díky agentům umělé inteligence Autopilot od ClickUp můžete automaticky shrnout hlášení o chybách, označit duplicity a dokonce automaticky přiřadit závažnost a odpovědnost na základě přednastavených podmínek. Agenti mohou také pomoci doplnit chybějící údaje na základě analýzy kontextu
- Jakmile je chyba zaznamenána v úkolu, spustí se automatizace ClickUp, které ji přiřadí správnému vývojáři a zajistí synchronizaci stavu s pull requesty
- Inženýři mohou spolupracovat na opravách prostřednictvím chatu ClickUp v reálném čase, který umožňuje také videohovory přes SyncUps, zatímco umělá inteligence připravuje dokumentaci a poznámky k vydání pro budoucí použití
- Díky integrovaným dashboardům ClickUp mají vedoucí pracovníci přehled o životním cyklu, pracovní zátěži a retrospektivách v reálném čase
Tyto výkonné funkce společně vytvářejí uzavřený cyklus, v němž se příjem, třídění, provádění, dokumentace a analýza odehrávají plynule na jednom místě. Týmům, jako je ten váš, to ušetří hodiny práce v každém sprintu a zajistí, že nic neunikne pozornosti.
💡 Tip pro pokročilé: Chcete díky AI ušetřit při opravování chyb ještě více času? Diktujte hlášení o chybách okamžitě pomocí funkce „Talk to Text“ v ClickUp Brain MAX, vaší superaplikaci s AI pro stolní počítače. Stačí vyslovit popis problému a kroky vedoucí k selhání se přepíší a hladce přidají do tiketu. Žádné psaní, méně chyb.
Navíc sjednocené podnikové vyhledávání Brain MAX prohledává úkoly a dokumenty v ClickUp, GitHub, Slack, Drive a dalších službách – a okamžitě načítá relevantní protokoly, žádosti o pull (PR) nebo dřívější opravy přímo do zobrazení třídění chyb.
Sentry
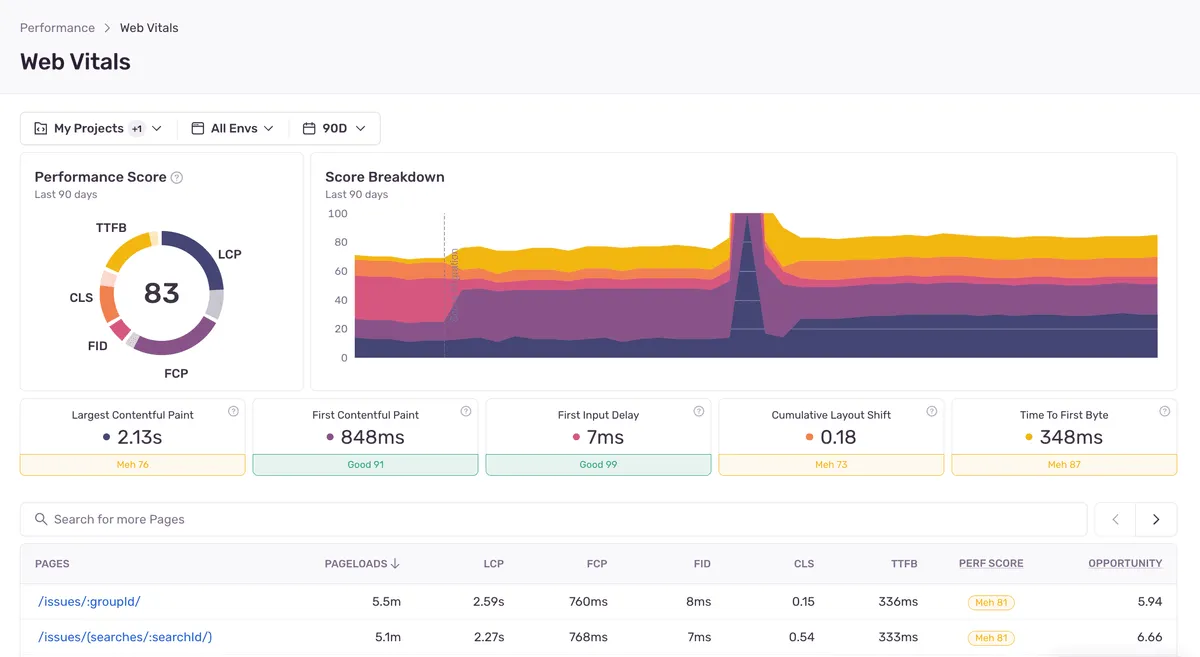
Platforma pro monitorování aplikací Sentry je navržena pro detekci chyb v reálném čase v produkčních prostředích. Její klasifikace problémů založená na umělé inteligenci automaticky seskupuje podobné chyby, čímž omezuje rušivé signály a poskytuje vývojářům jasný přehled o dopadech.
Sentry podporuje jazyky jako Python, JavaScript, Java, Go a další a integruje se přímo do CI/CD pipeline. Díky monitorování výkonu mohou týmy identifikovat pomalé transakce, úniky paměti nebo regrese ještě předtím, než se to projeví u zákazníků.
Sentry vyniká zejména monitorováním na produkční úrovni: namísto ručního prohledávání protokolů získáte přímo v dashboardu automatizovaný přehled chyb, kontext uživatele a analýzu zásobníku volání.
Pro manažery podpory to znamená rychlejší eskalaci kritických chyb P0. Vedoucím produktů poskytuje spolehlivá data, díky nimž mohou upřednostňovat opravy podle dopadu na uživatele nebo tržby.
DeepCode AI (Snyk Code)
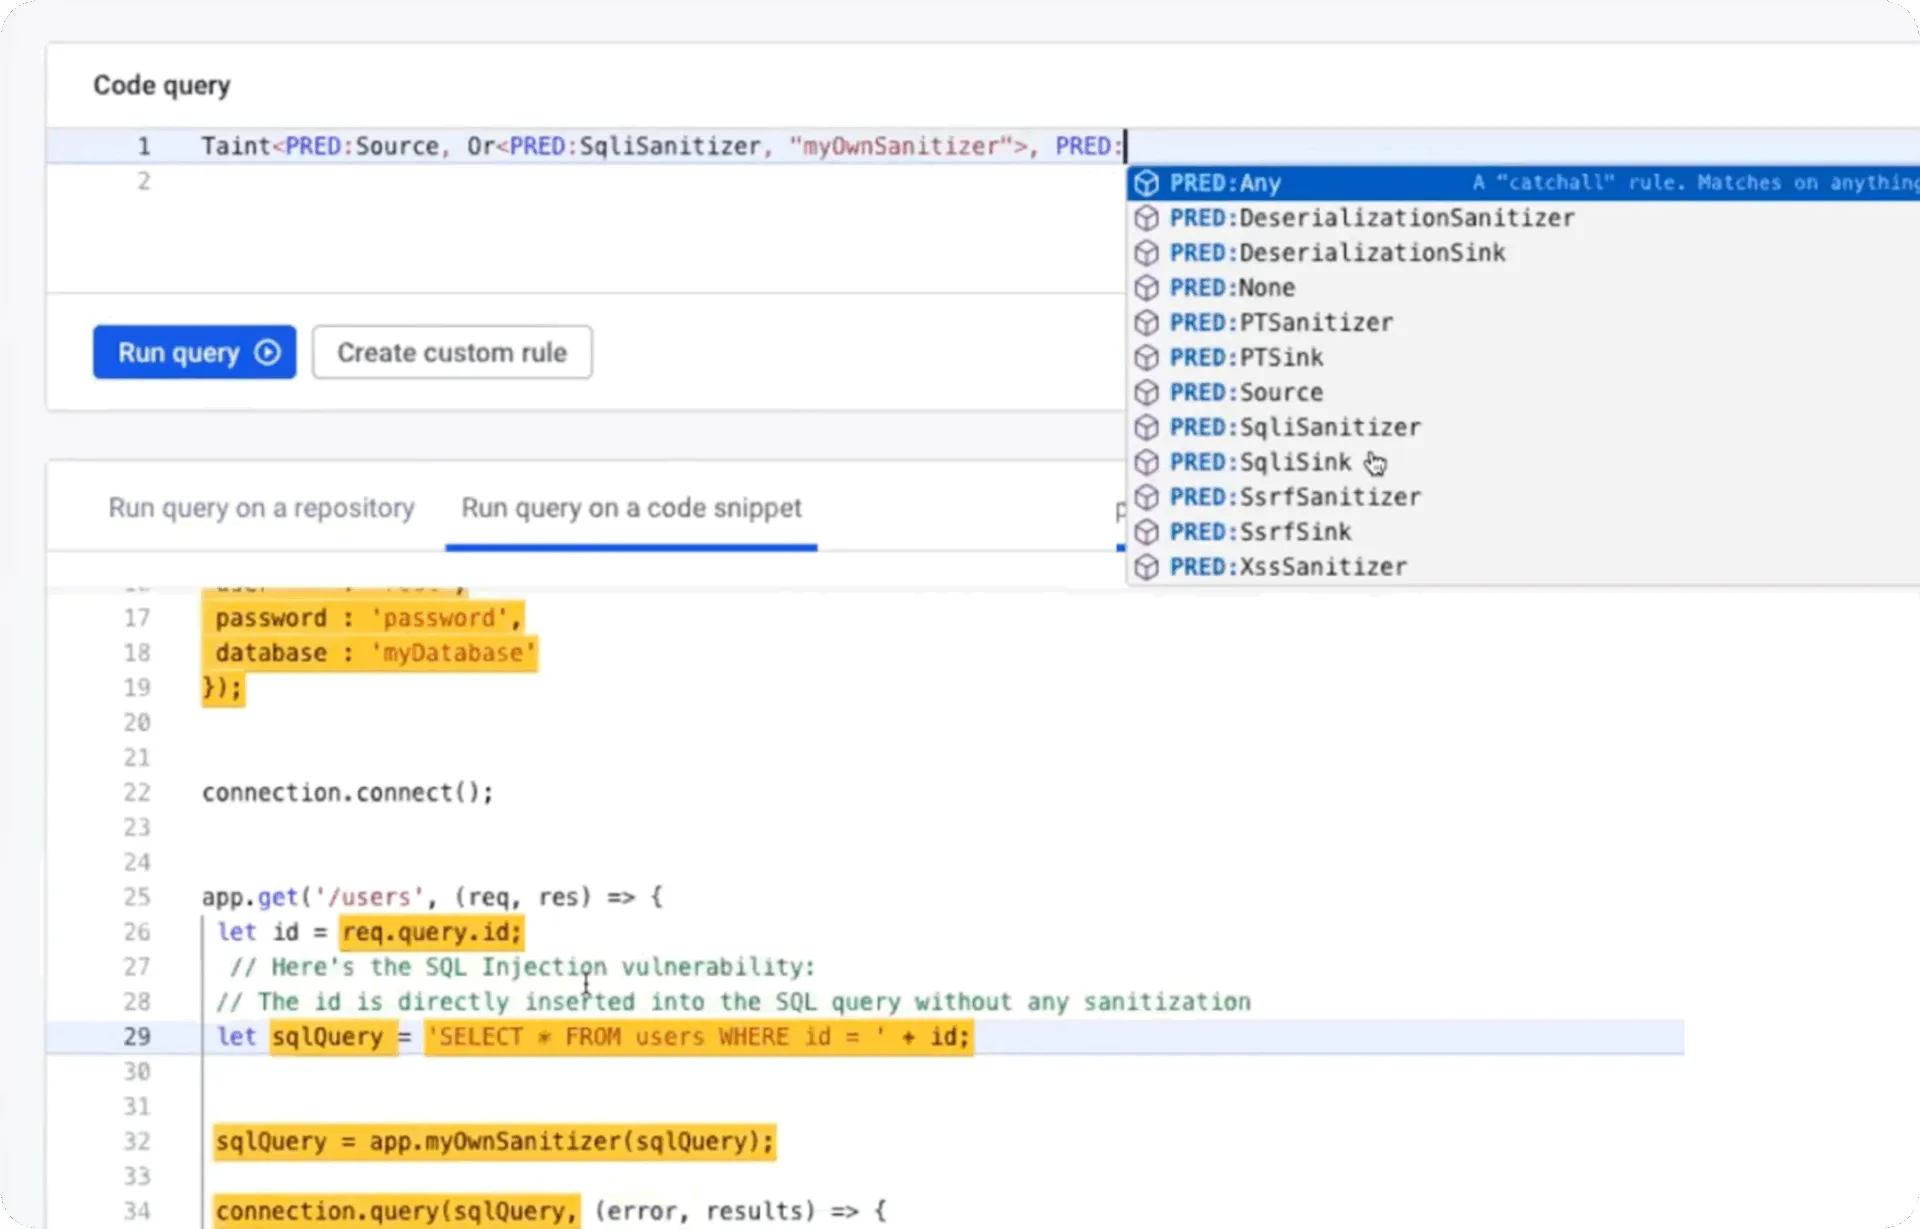
DeepCode, nyní součást Snyk Code, využívá umělou inteligenci pro statické testování bezpečnosti aplikací (SAST) a detekci chyb. Pomocí modulu strojového učení, který byl vycvičen na milionech repozitářů, prohledává váš kód v reálném čase a odhaluje chyby a zranitelnosti již během psaní.
Na rozdíl od tradičních linterů, které označují vše, DeepCode řadí problémy podle závažnosti a zneužitelnosti, což pomáhá vývojářům soustředit se nejprve na problémy s velkým dopadem. Nástroj také navrhuje automatické opravy – často nabízí nápravu běžných chyb nebo zranitelností jediným kliknutím.
Nástroj se integruje do IDE (VS Code, IntelliJ), GitHubu, GitLabu a Bitbucketu, takže zpětná vazba přichází přímo tam, kde vývojáři pracují. DeepCode však nejvíce vyniká u vývojářských týmů, které hledají rovnováhu mezi rychlostí a bezpečností: snižuje náročnost ruční revize kódu a zlepšuje bezpečnostní postavení, přičemž zabraňuje vkrádání chyb. Organizacím, které rychle rostou, zajišťuje, že nové funkce budou uvedeny na trh bez skrytých časovaných bomb.
GitHub Copilot
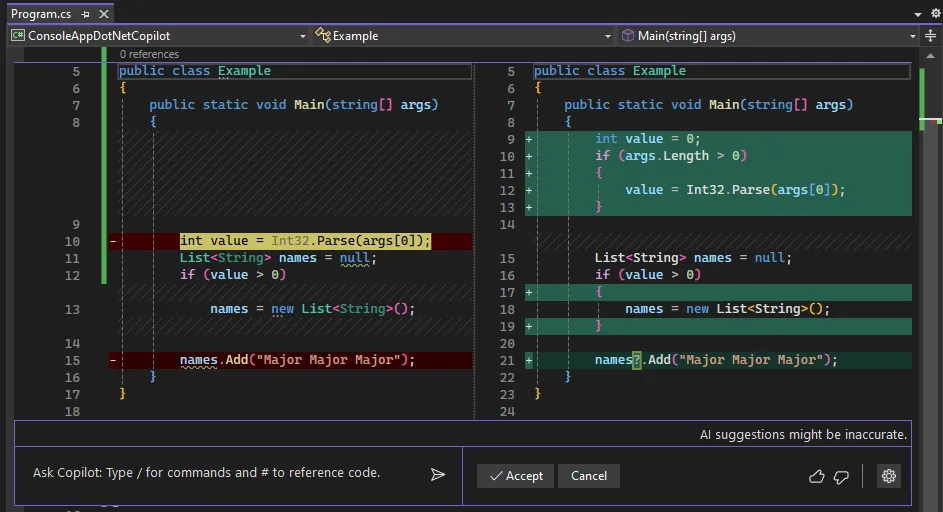
GitHub Copilot, který je synonymem pro asistenty pro programování využívající umělou inteligenci, je nejznámější díky automatickému doplňování kódu, ale je užitečný i při opravách chyb. Funkce Copilot Autofix automaticky navrhuje opravy běžných zranitelností a regresních chyb – v některých kategoriích vyřeší až 90 % výstrah.
Pro vývojáře to znamená, že ladění probíhá na stejném místě jako programování, přičemž kontext je čerpán z okolních souborů, knihoven a závislostí. Copilot se přímo integruje s VS Code, IDE od JetBrains a pull requesty na GitHubu.
Může automaticky navrhovat opravy, které inženýři ověří, místo aby je museli psát od nuly. Výsledkem jsou kratší cykly řešení a méně problémů po vydání.
Bugasura
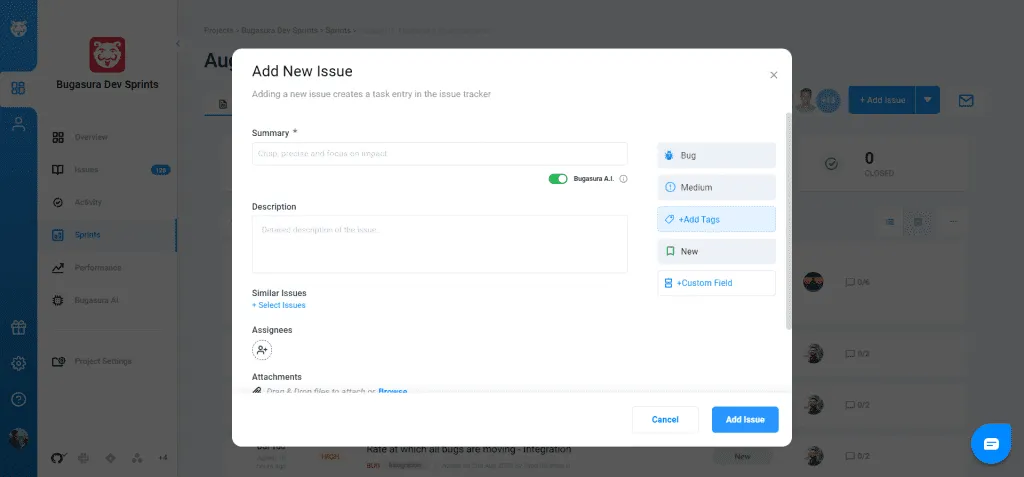
Bugasura je moderní, nenáročný nástroj pro sledování problémů, který klade důraz na rychlost a jednoduchost. Je navržen pro distribuované produktové a QA týmy, které pomocí umělé inteligence zefektivňují vytváření chyb, automaticky přiřazují odpovědné osoby a řadí problémy podle závažnosti.
Týmům se líbí kontextové hlášení chyb: problémy můžete vizuálně zachytit pomocí snímků obrazovky nebo videa, opatřit je poznámkami a odeslat spolu s přiloženými údaji o prostředí. Tím se omezuje typická výměna zpráv mezi oddělením kontroly kvality, podporou a vývojáři.
Bugasura se integruje se Slackem, GitHubem, Jirou a nástroji pro řízení projektů, čímž zajišťuje synchronizaci aktualizací napříč pracovními postupy. Bugasura usnadňuje sběr strukturovaných a reprodukovatelných hlášení chyb bez vynechání jakýchkoli detailů. Zároveň zajišťuje, že váš backlog odráží jak problémy zákazníků, tak technické potřeby.
Testim.io
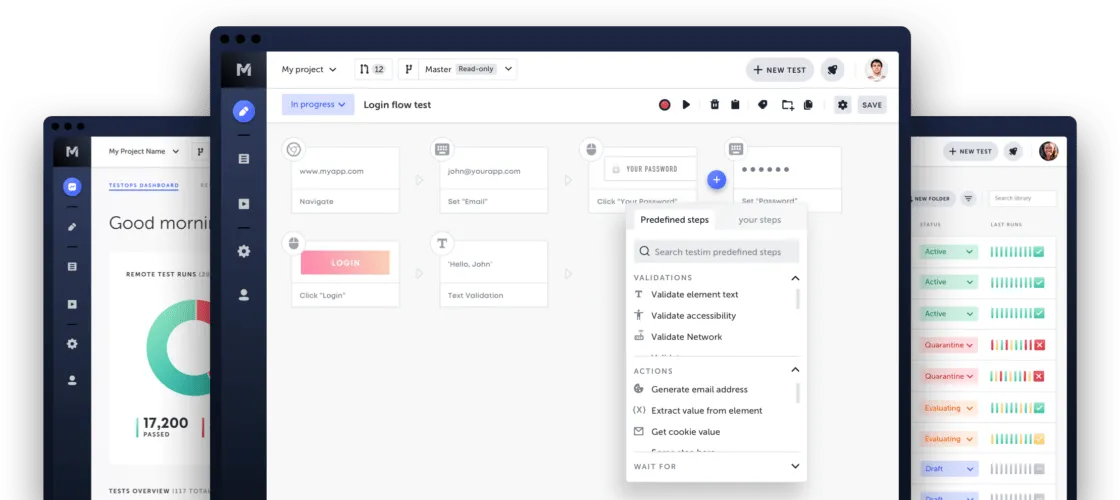
Testim.io se zaměřuje na automatizaci testování založenou na umělé inteligenci s přímým propojením se sledováním chyb. Jeho největší předností jsou testy s automatickou opravou: když se změní prvky uživatelského rozhraní (například poloha nebo ID tlačítka), Testim automaticky aktualizuje lokátory, místo aby došlo k selhání testu. Tím se snižuje počet falešných pozitiv a omezuje se zdlouhavá údržba, která trápí oddělení kontroly kvality.
Umělá inteligence také generuje testovací případy na základě uživatelských toků, provádí je v různých prohlížečích a na různých zařízeních a automaticky zaznamenává chyby včetně snímků obrazovky a kontextu prostředí. Pro odborníky v praxi to znamená, že opakované cykly kontroly kvality trvají hodiny, nikoli dny, a kritické regrese se odhalí ještě před vydáním. Vedoucím pracovníkům to dává jistotu, že mohou produkty vydávat rychleji, aniž by tím ohrozili stabilitu.
A co z toho vyplývá? Testim není jen o testování – uzavírá celý cyklus tím, že přímo propojuje selhání s hlášeními o chybách, čímž vašim vývojářským a QA týmům usnadňuje předávání práce.
Srovnání nejlepších nástrojů pro sledování a řešení chyb využívajících umělou inteligenci
Nejste si jisti, který nástroj pro sledování chyb využívající umělou inteligenci je pro vás ten pravý? Abychom vám tento proces usnadnili, připravili jsme zde seznam rozhodovacích kritérií:
| Nástroj | Nejvhodnější pro | Klíčové funkce | Ceny* |
| ClickUp | Ideální pro střední a velké produktové a podpůrné týmy (ředitelé, manažeři QA, technická podpora). Ideální řešení pro týmy, které hledají jediný pracovní prostor pro příjem → třídění → provedení → retrospektivy. | • Agenti s umělou inteligencí pro shrnutí chyb a automatické přiřazování• Formuláře pro zadávání chyb + automatická detekce duplicit• Dokumenty, poznámky k vydání a stránky wiki vypracované umělou inteligencí prostřednictvím ClickUp Brain• Dashboardy pro sledování životního cyklu chyb a retrospektiv | K dispozici je bezplatný tarif; Enterprise: Ceny na míru |
| Sentry | Ideální řešení pro technické týmy od startupů až po velké podniky, které potřebují monitorování chyb v produkčním prostředí v reálném čase. | • Seskupování a klasifikace chyb s podporou umělé inteligence • Sledování výkonu a detekce pomalých dotazů • Dopad na uživatele a kontext trasování zásobníku • Upozornění integrovaná do CI/CD pipeline | K dispozici je bezplatná verze; placené tarify začínají na 29 $/měsíc; Enterprise: ceny na míru |
| DeepCode AI (Snyk Code) | Ideální řešení pro týmy vývojářů a organizace zaměřené na bezpečnost, které potřebují rychle detekovat chyby a zranitelnosti v kódových základnách. | • Statická analýza založená na umělé inteligenci (SAST)• Návrhy automatických oprav s přímou nápravou• Integrace s IDE a repozitáři (GitHub, GitLab, Bitbucket)• Prioritizace podle závažnosti chyby a možnosti jejího zneužití | K dispozici je bezplatná verze; placené tarify začínají na 25 $/měsíc; Enterprise: ceny na míru |
| GitHub Copilot | Ideální pro týmy softwarových vývojářů (od malých až po podnikové). Ideální pro vývojáře, kteří potřebují opravy chyb a návrhy kódu přímo v kódu pomocí AI. | • Doplňování kódu pomocí AI v IDE • Funkce Autofix vyřeší přibližně 90 % běžných upozornění • Návrhy zohledňující kontext z repozitáře a knihoven • Integrace pull requestů s pracovními postupy GitHubu | Placené tarify začínají na 10 USD za měsíc na uživatele; Enterprise: Ceny na míru |
| Bugasura | Ideální řešení pro menší týmy QA a podpory, které hledají vizuální a nenáročné sledování chyb s automatickým přiřazováním pomocí umělé inteligence. | • Vizuální hlášení chyb pomocí snímků obrazovky a poznámek • Automatické přiřazování a stanovování priorit pomocí umělé inteligence • Integrace s pracovními postupy (Slack, GitHub, Jira) • Jednoduchá správa backlogu pro agilní týmy | Bezplatný tarif (až 5 uživatelů; placené tarify od 5 $ za uživatele a měsíc; Enterprise: ceny na míru |
| Testim.io | Ideální řešení pro týmy zajišťování kvality ve středních a velkých organizacích, zaměřené na automatizované regresní testování a detekci chyb. | • Testovací případy generované umělou inteligencí • Samonapravující se lokátory pro snížení nestability testů • Automatické zaznamenávání chyb s kontextem prostředí • Integrace s CI/CD a Jira/GitHub | K dispozici je bezplatná zkušební verze; ceny na míru |
Aktuální ceny najdete na webových stránkách nástroje*
📚 Přečtěte si také: Nejlepší moderní nástroje pro testování kvality
Krok za krokem: Pracovní postup opravy chyb pomocí umělé inteligence
Chcete pragmatický pracovní postup založený na umělé inteligenci, který můžete snadno začlenit do svého vývojového týmu? Máme pro vás podrobného průvodce a profesionální tipy, jak vám ClickUp usnadní implementaci každého kroku až desetkrát.
Krok 1: Příjem a třídění
Hlášení chyb jsou užitečná pouze v kontextu, ve kterém se objevují. Pokud je váš proces přijímání hlášení chaotický – hlášení roztroušená po Slacku nebo vágní poznámky typu „nefunguje to“ v Jira – začínáte v nevýhodě.
Dobré přijetí znamená dvě věci: strukturu a přehlednost.
- Struktura vzniká tím, že lidem poskytnete jediné místo, kde mohou nahlásit chyby v softwaru, ať už se jedná o formulář, integraci s helpdeskem nebo koncový bod API
- Jasnost znamená, že zpráva obsahuje dostatek podrobností k tomu, aby bylo možné na jejím základě jednat
Umělá inteligence v tomto ohledu pomáhá čím dál více tím, že klade upřesňující otázky, porovnává nové hlášení se známými problémy a navrhuje úroveň závažnosti, takže týmy nemusí trávit hodiny debatami o tom, zda se jedná o P0 nebo P2.
🦄 Jak vám ClickUp pomůže:
Díky formulářům ClickUp můžete hlášení chyb standardizovat hned od začátku. Pomohou vám zaznamenat strukturovaná data o chybách a přesměrovat je přímo do vyhrazeného seznamu ve formě jednotlivých úkolů.
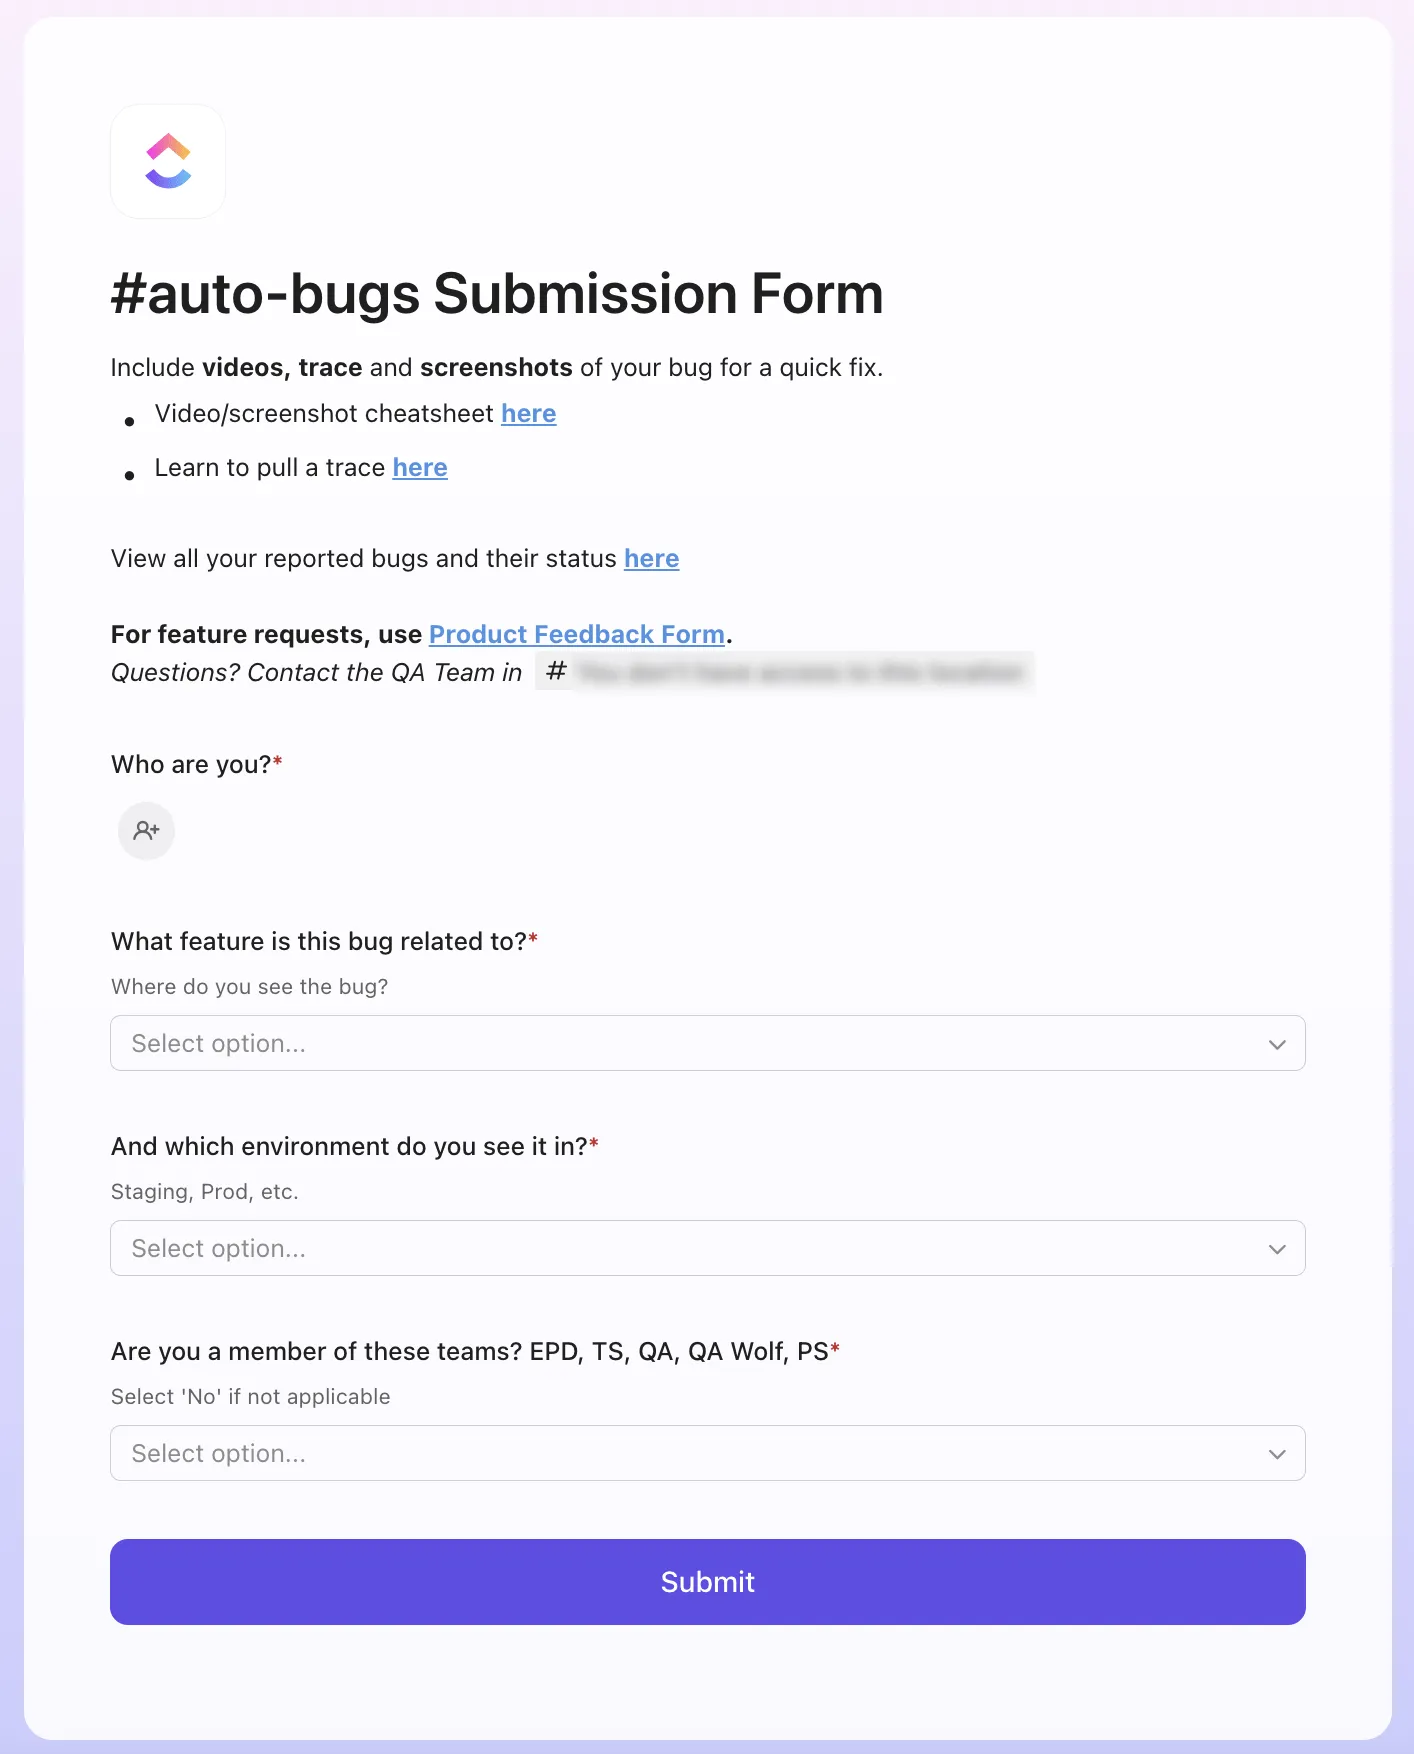
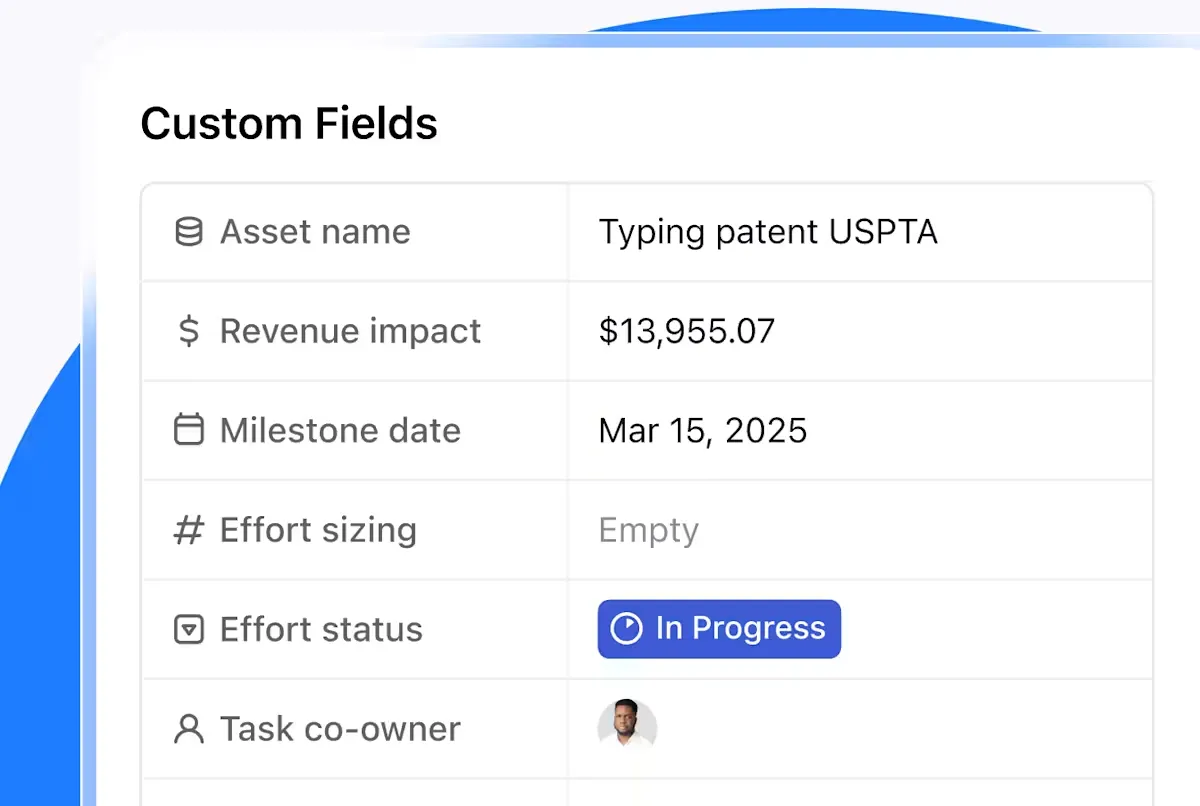
Ke každému úkolu můžete přidat vlastní pole, včetně kategorie chyby, priority, dotčeného prostředí, poznámek a dokonce i osob pověřených jejím vyřešením. Vyplňte je ručně nebo nechte pole AI automaticky je kategorizovat a přiřadit jim prioritu na základě nastavených pokynů.
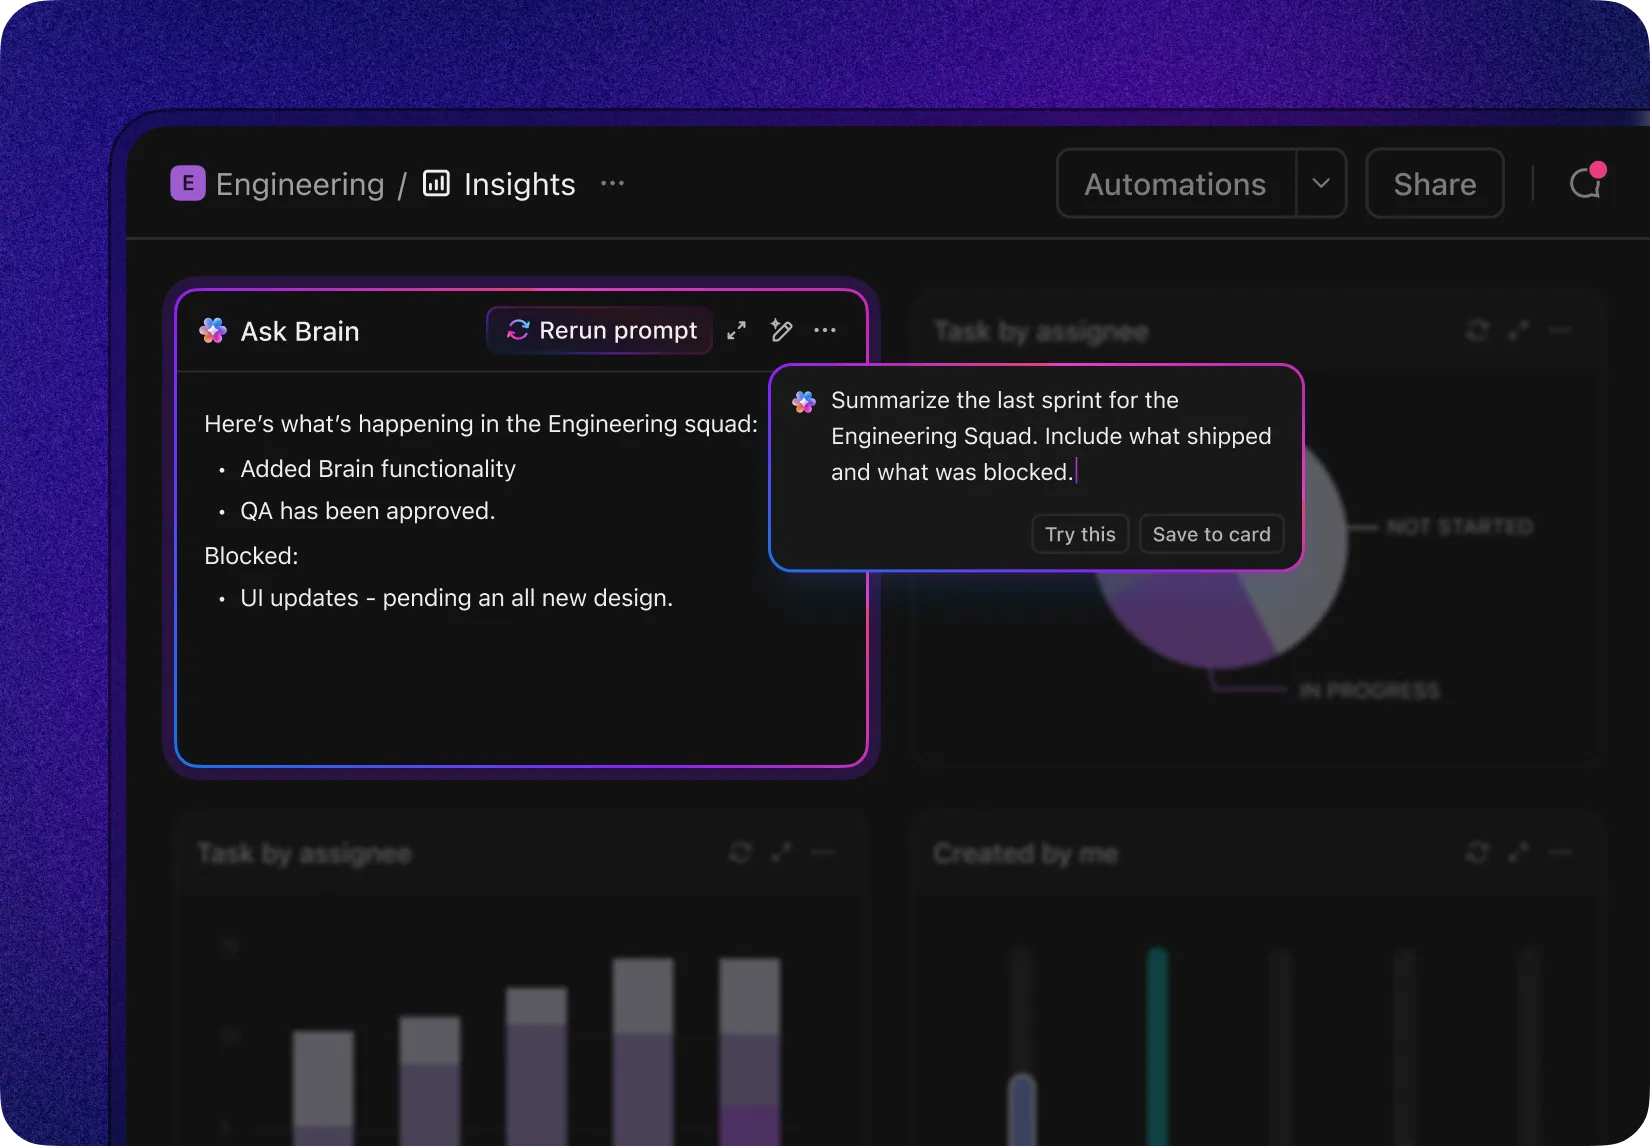
ClickUp Brain automaticky shrnuje dlouhé nebo opakující se zprávy a označuje duplicity, aby inženýři neztráceli čas tím, že se dvakrát zabývají stejným problémem.
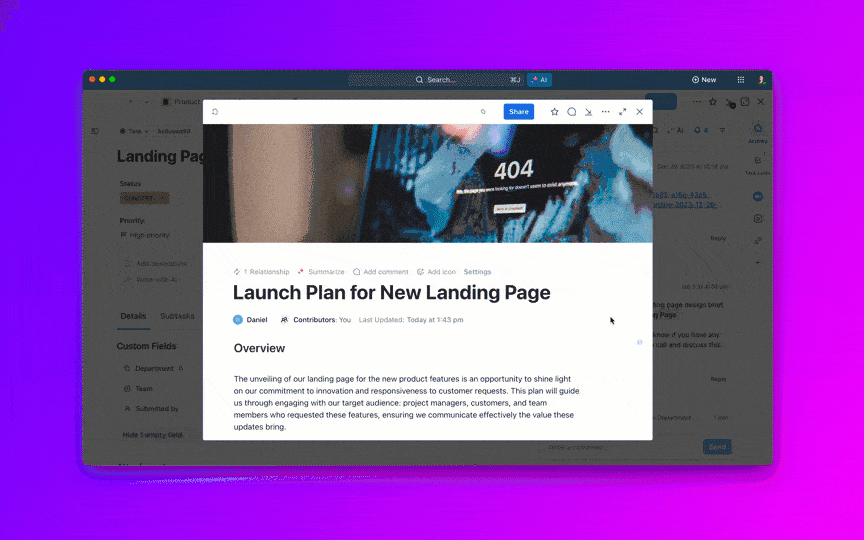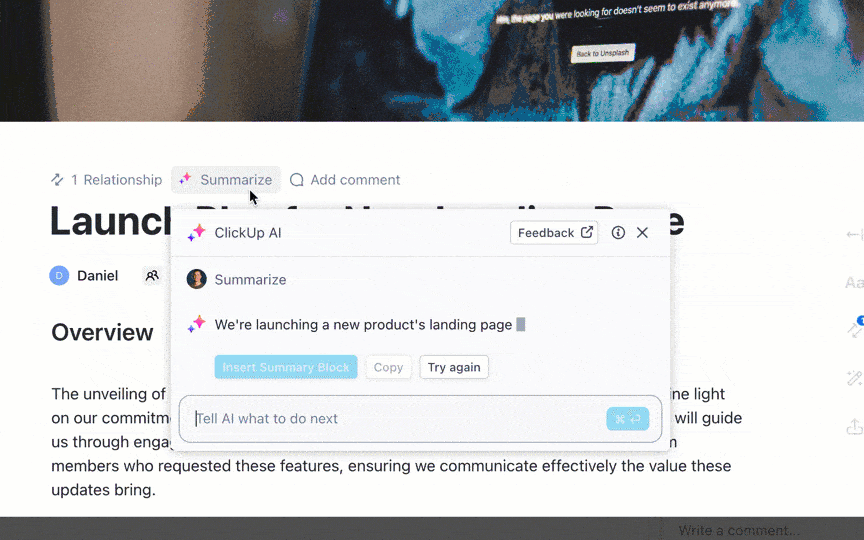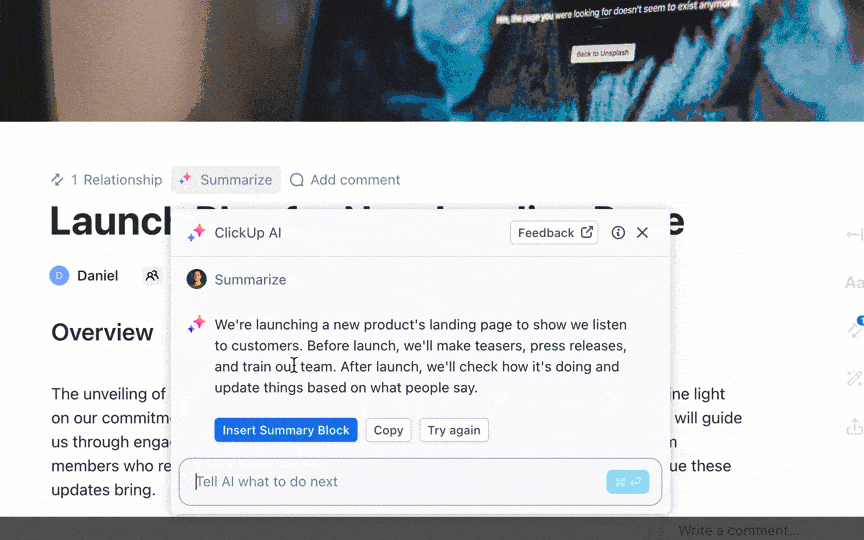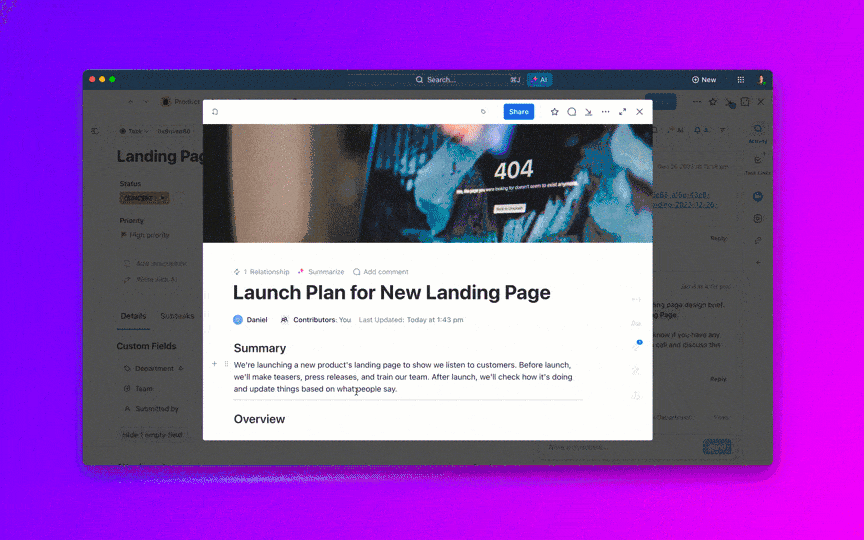
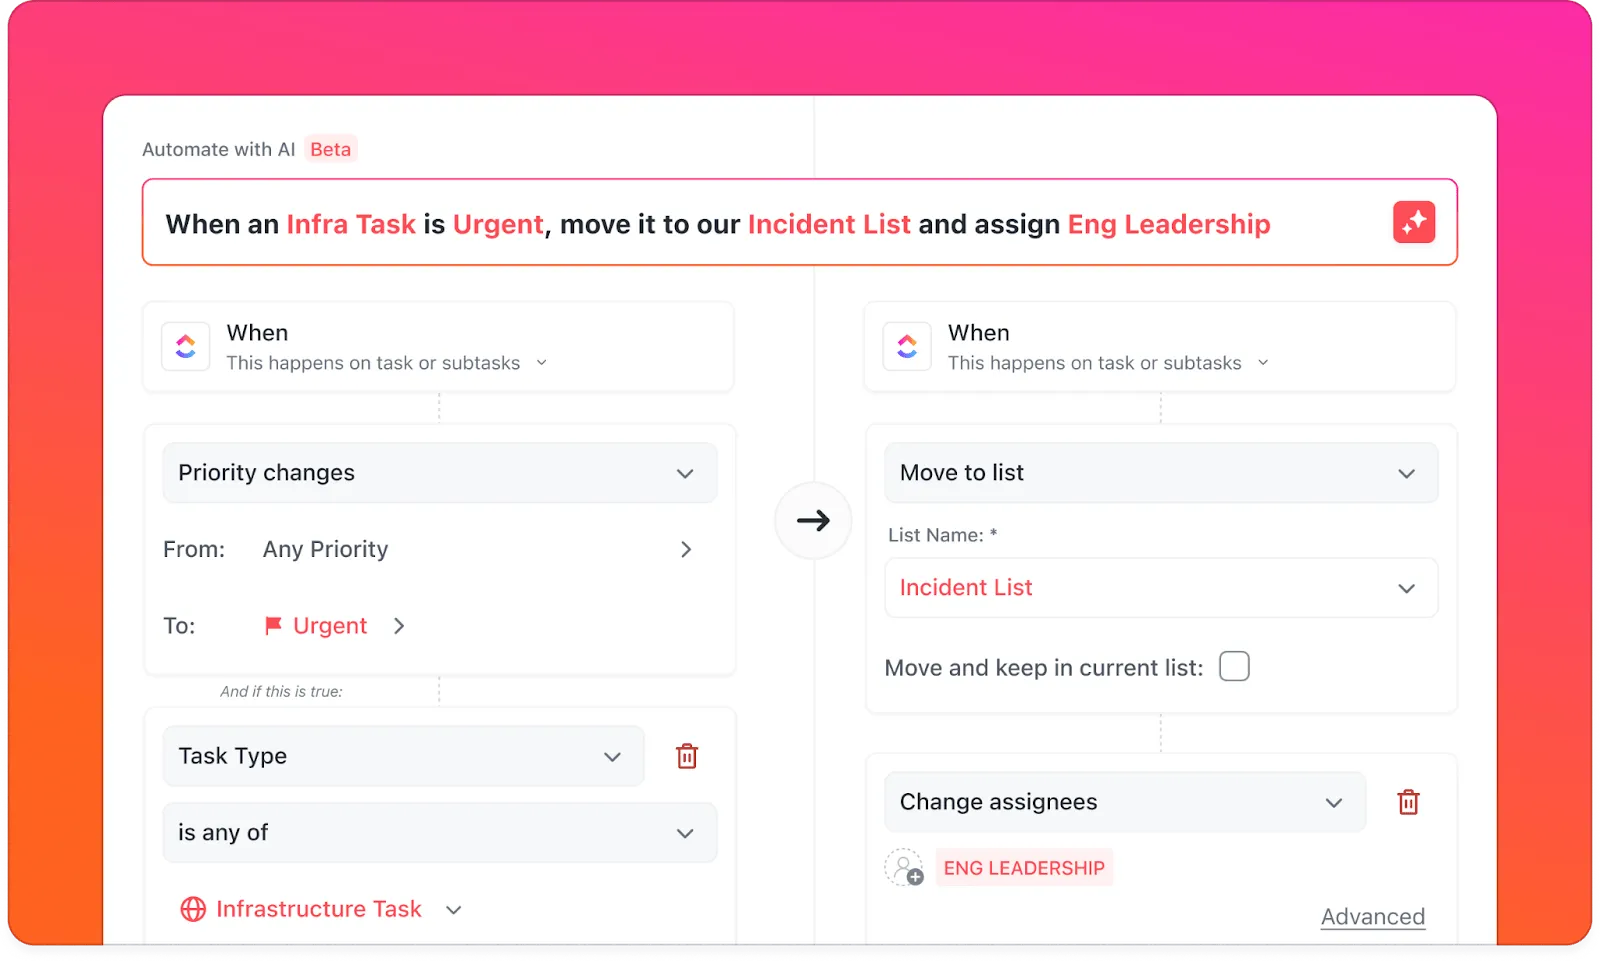
A pokud v hlášení o chybě chybí klíčové údaje, agenti Autopilot v ClickUp mohou provést rychlou kontrolu a požádat o další informace ještě předtím, než se hlášení dostane do vašeho backlogu. A konečně, automatizace ClickUp dokážou přesměrovat chyby P0/P1 do správné fronty pro pohotovostní služby a nastavit časovače SLA, aniž byste museli hnout prstem.
Krok 2: Stanovte priority a přiřaďte úkoly
Právě v tomto bodě většina týmů naráží na problém. Priorita chyb se často určuje podle toho, kdo křičí nejhlasitěji. Může se stát, že vás manažer osloví ve Slacku nebo že dojde k eskalaci ze strany zákazníka, což s sebou nese riziko, že dostanete hodnocení s jednou hvězdičkou.
Chytřejším přístupem je zvážit dopad ve vztahu k vynaloženému úsilí:
- Kolik uživatelů je tímto problémem postiženo
- Jak závažná je porucha?
- Jak daleko máte k vydání a
- Co bude k opravě zapotřebí
Umělá inteligence dokáže tyto proměnné zpracovat ve velkém měřítku a dokonce doporučit odpovědnou osobu na základě vlastnictví kódu nebo předchozích oprav, čímž ušetří hodiny ruční komunikace.
🦄 Jak vám ClickUp pomůže:
V ClickUp můžete nastavit vlastní pole pro zaznamenávání dopadu, závažnosti nebo hodnoty ARR každé chyby a nechat umělou inteligenci, aby za vás vygenerovala skóre priority.
Automatizace okamžitě směruje chyby k příslušnému inženýrovi nebo týmu, zatímco šablony pro sledování problémů zajišťují, že každá chyba je již předem doplněna o kroky k reprodukci a kritéria přijatelnosti. Výsledkem je jasnější rozdělení odpovědnosti již od samého začátku.
💡 Tip pro profesionály: Využijte ClickUp Sprints a zobrazení Workload View v ClickUp, abyste získali přehled o volné kapacitě svého týmu. Pomůže vám to lépe odhadovat a realističtěji přidělovat chyby.

Krok 3: Realizace a spolupráce
Skutečná práce začíná až po přiřazení chyby. Vaši inženýři musí problém reprodukovat, vystopovat jeho původ a opravit ho – obvykle při současném řešení desítek dalších priorit.
Umělá inteligence může tento proces urychlit tím, že navrhne pravděpodobné příčiny (na základě protokolů nebo minulých incidentů) a dokonce připraví první verzi opravy.
Stejně důležitá je i spolupráce. Nejlepší týmy nezahrabávají kontext do e-mailů; poznámky, snímky obrazovky a kroky k reprodukci chyby připojují přímo k samotné chybě. Krátká videa nebo komentované záznamy obrazovky často v revizích předčí dlouhé texty a zajistí, že všichni budou na stejné vlně, aniž by bylo nutné pořádat nekonečné schůzky.
💡 Tip pro profesionály: Nezapomeňte opravu propojit s původní událostí, aby auditní stopy zůstaly zachovány i po vydání.
🦄 Jak vám ClickUp pomůže:
Díky integraci ClickUp s GitHubem a GitLabem je každá větev, každý commit nebo PR přímo propojen s nahlášenými chybami.
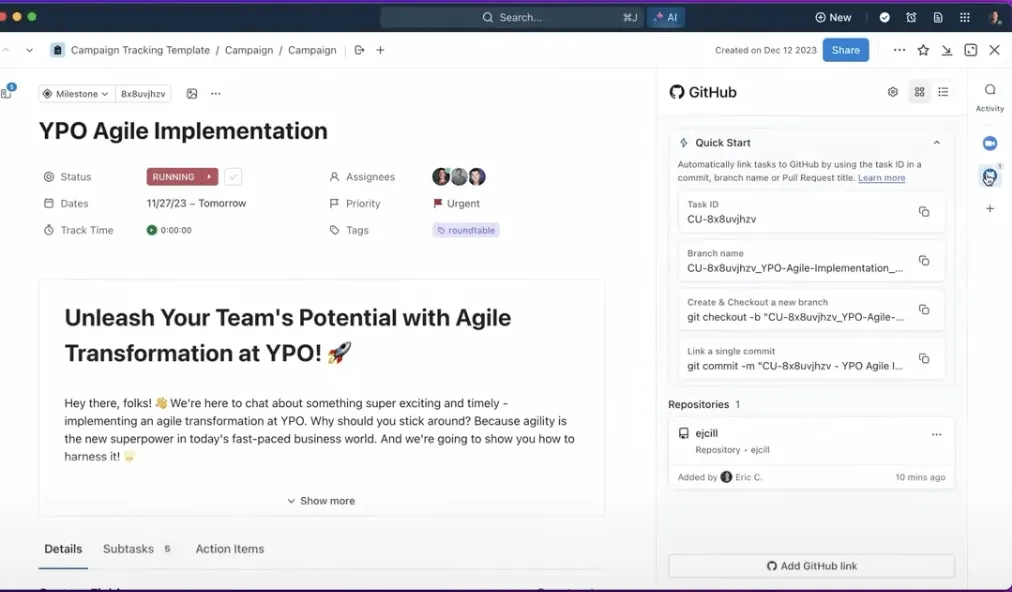
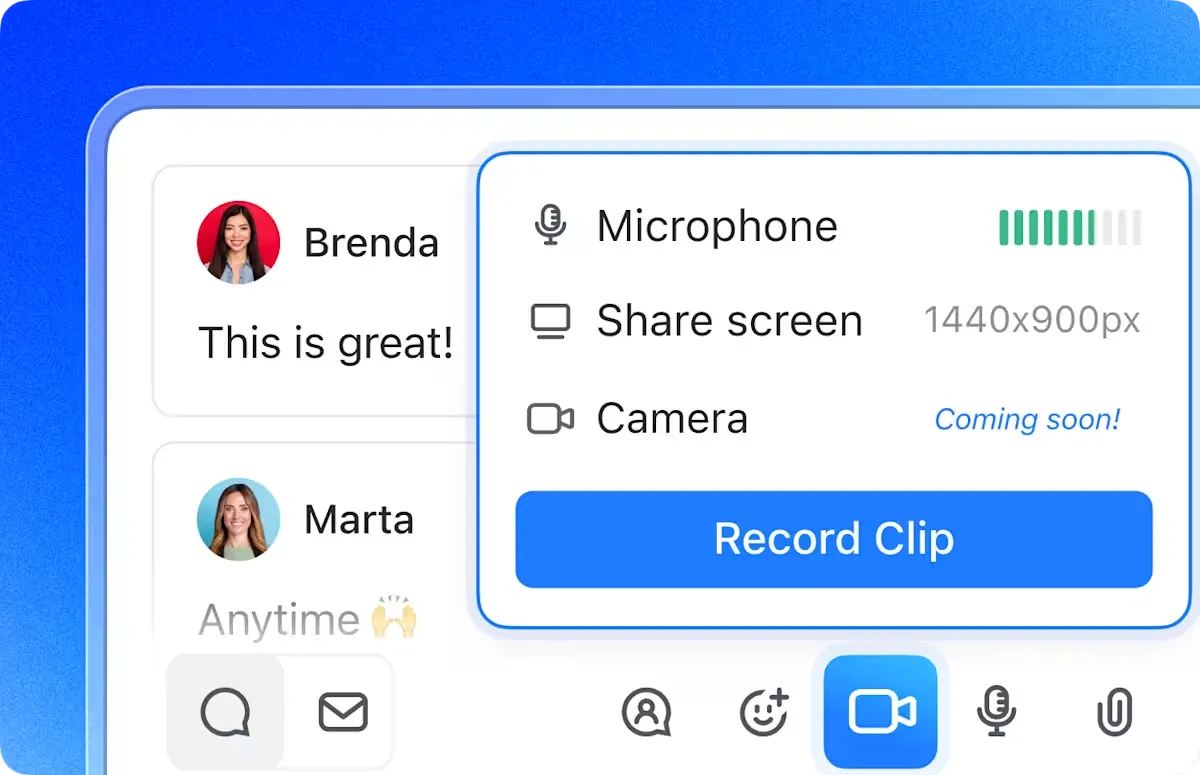
Inženýři mohou nahrávat krátká videa ClickUp Clips, aby předvedli, jak chybu reprodukovat, nebo provedli tým svým opravným balíčkem, a ClickUp Docs jsou k dispozici přímo vedle úkolů pro zaznamenávání technických poznámek nebo plánů vrácení změn.
👀 Věděli jste, že? ClickUp Brain za vás dokonce připraví návrh dokumentace nebo komentářů ke kódu, takže oprava není jen provedena, ale také vysvětlena pro budoucí potřebu.
Krok 4: Komunikujte a dokumentujte
Uzavření chyby není jen o sloučení kódu. Jde o to udržet všechny zúčastněné strany na stejné vlně a zajistit, aby se získané poznatky uchovaly. Tým podpory potřebuje vědět, co má sdělit zákazníkům, vedení chce mít jistotu, že jsou vyřešena hlavní rizika, a vývojáři by se měli poučit, jak podobným problémům v budoucnu předcházet. Psaní poznámek z retrospektiv v izolovaných týmech nebo zapomínání na aktualizaci poznámek k vydání až do poslední chvíle se tak může rychle stát významnou překážkou.
Naštěstí umělá inteligence nyní umožňuje generovat rychlé souhrny, připravovat návrhy aktualizací pro zákazníky a dokonce vytvářet opakovaně použitelné položky wiki přímo z historie chyb. Osvědčeným postupem je převést každou významnou opravu pomocí umělé inteligence na opakovaně použitelný zdroj – příručku, článek v znalostní bázi nebo jednoduchý kontrolní seznam preventivních opatření.
💡 Tip pro profesionály: Nastavte předvídatelný rytmus komunikace o aktualizacích: upozornění v reálném čase fungují nejlépe u kritických chyb (P0/P1); denní přehled shrnuje stav aktivních chyb; a týdenní souhrn může pomoci zlepšit přehled pro vedení a podporu.
🦄 Jak vám ClickUp pomůže:
Spojte ClickUp Brain s ClickUp Docs a proměňte historii úkolů týkajících se chyb během několika minut v návrhy poznámek k vydání nebo přehledné souhrny pro zákazníky. Využijte funkci Vztahy v ClickUp k propojení příslušných dokumentů a úkolů, aby byly znalosti snadno dohledatelné.
Centralizované úložiště Docs Hub uchovává postupy a zajišťuje, že opravy přetrvají i po skončení jednotlivého sprintu.
Týdenní aktualizace lze automaticky generovat pomocí přednastavených AI agentů ClickUp do centralizované Bug Wiki.
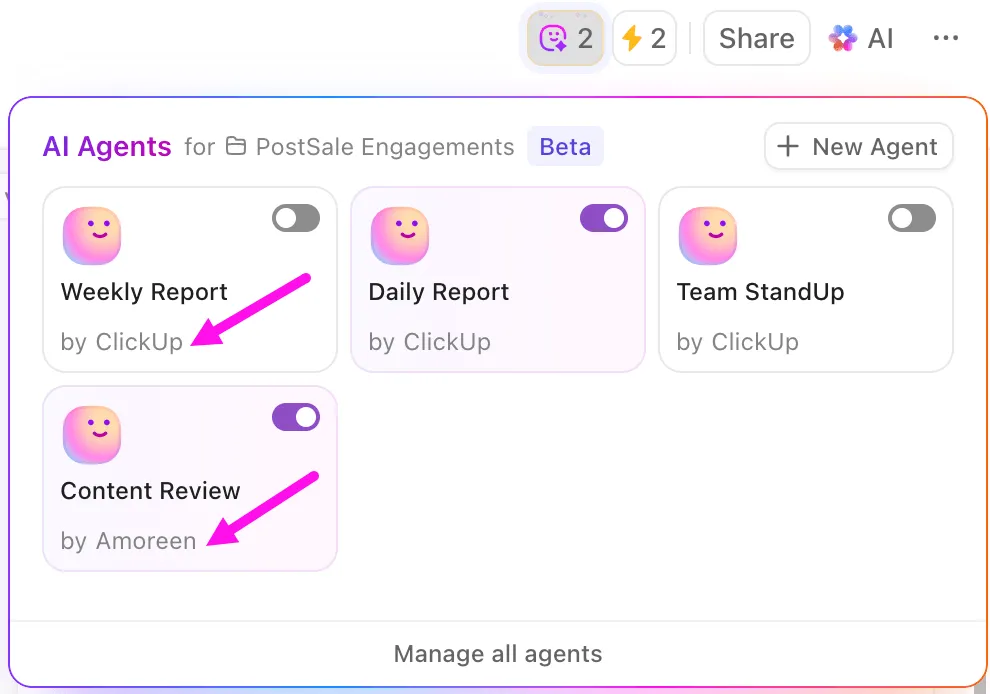
Podívejte se na toto video a dozvíte se více o předem připravených agentech Autopilot!
A protože veškerá komunikace probíhá přímo v ClickUp – ať už jde o komentáře, úkoly nebo dokumenty –, nemusíte přeskakovat mezi různými nástroji, abyste si poskládali celkový obraz.
🧠 Zajímavost: Chcete rozesílat e-mailové aktualizace o opravách, aniž byste museli opustit svůj pracovní prostor ClickUp? Pořiďte si ClickApp pro e-maily a rozesílejte e-maily přímo z úkolů a komentářů v ClickUp.
Krok 5: Vytváření zpráv a analýza
Proces ve skutečnosti nekončí opravou jedné chyby. Důležité je také pochopit širší souvislosti:
- Které typy chyb vás brzdí nejvíce?
- Které týmy nesou největší zátěž?
- Jak dlouho ve skutečnosti trvá odhalení, oprava a vydání konkrétního typu chyby?
Analýza pomocí umělé inteligence vám to usnadní tím, že odhalí vzorce, které by vám mohly uniknout: opakující se regrese v konkrétním modulu, týmy s nedostatečnými zdroji, které soustavně porušují SLA, nebo nárůst znovu otevřených ticketů.
Pořádejte krátké retrospektivy zaměřené na prevenci podobných problémů. Díky těmto poznatkům se chyby přestanou být jen jednorázovými problémy a stanou se příležitostmi k systémovému zlepšení. Proměňte akční položky na sledované úkoly s odpovědnými osobami a termíny splnění.
🦄 Jak vám ClickUp pomůže:
Dashboardy ClickUp vám poskytují živý přehled o metrikách, které skutečně ovlivňují chování: MTTR, míra opětovného otevření a porušení SLA rozčleněné podle přidělené osoby, týmu nebo priority. Můžete nastavit filtry a vytvořit uložené pohledy, abyste se zaměřili na kritická místa.
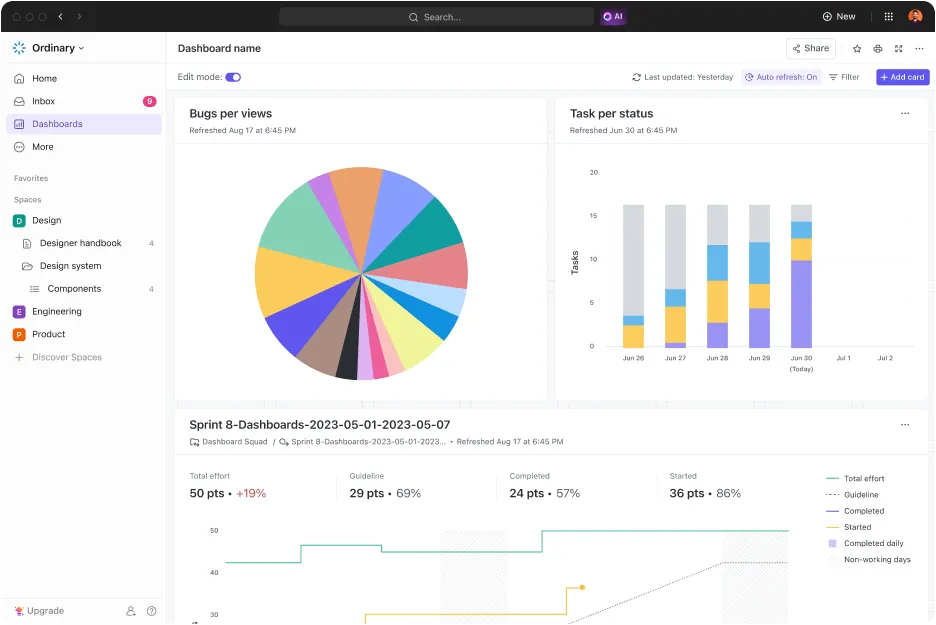
Karty AI v rámci dashboardů mohou odhalit skryté trendy – například skupinu chyb souvisejících s nedávným vydáním nové funkce – aniž byste museli ručně podrobně prohledávat data.
💡 Tip pro profesionály: Využijte šablony pro retrospektivy v ClickUp a proměňte své poznatky v konkrétní následné kroky. Umožní vám stanovit cíle SMART pro preventivní opatření, přiřadit odpovědnost a sledovat pokrok, takže poznatky nezůstanou jen na prezentacích – promění se v měřitelné změny.
Proč tento postup funguje: Dodržováním tohoto pětikrokového procesu zkracujete dobu od nahlášení (lepší přijetí), dobu do rozhodnutí (hodnocení priority) a dobu do opravy (precizní provedení), přičemž zachováváte kontext a každou událost proměňujete v institucionální paměť.
Šablony pro řešení chyb
Chcete zavést výše uvedený pracovní postup, ale odrazuje vás čas a úsilí potřebné k jeho nastavení?
Vyzkoušejte tyto šablony ClickUp připravené k okamžitému použití a získejte náskok:
1. Šablona ClickUp pro sledování chyb a problémů
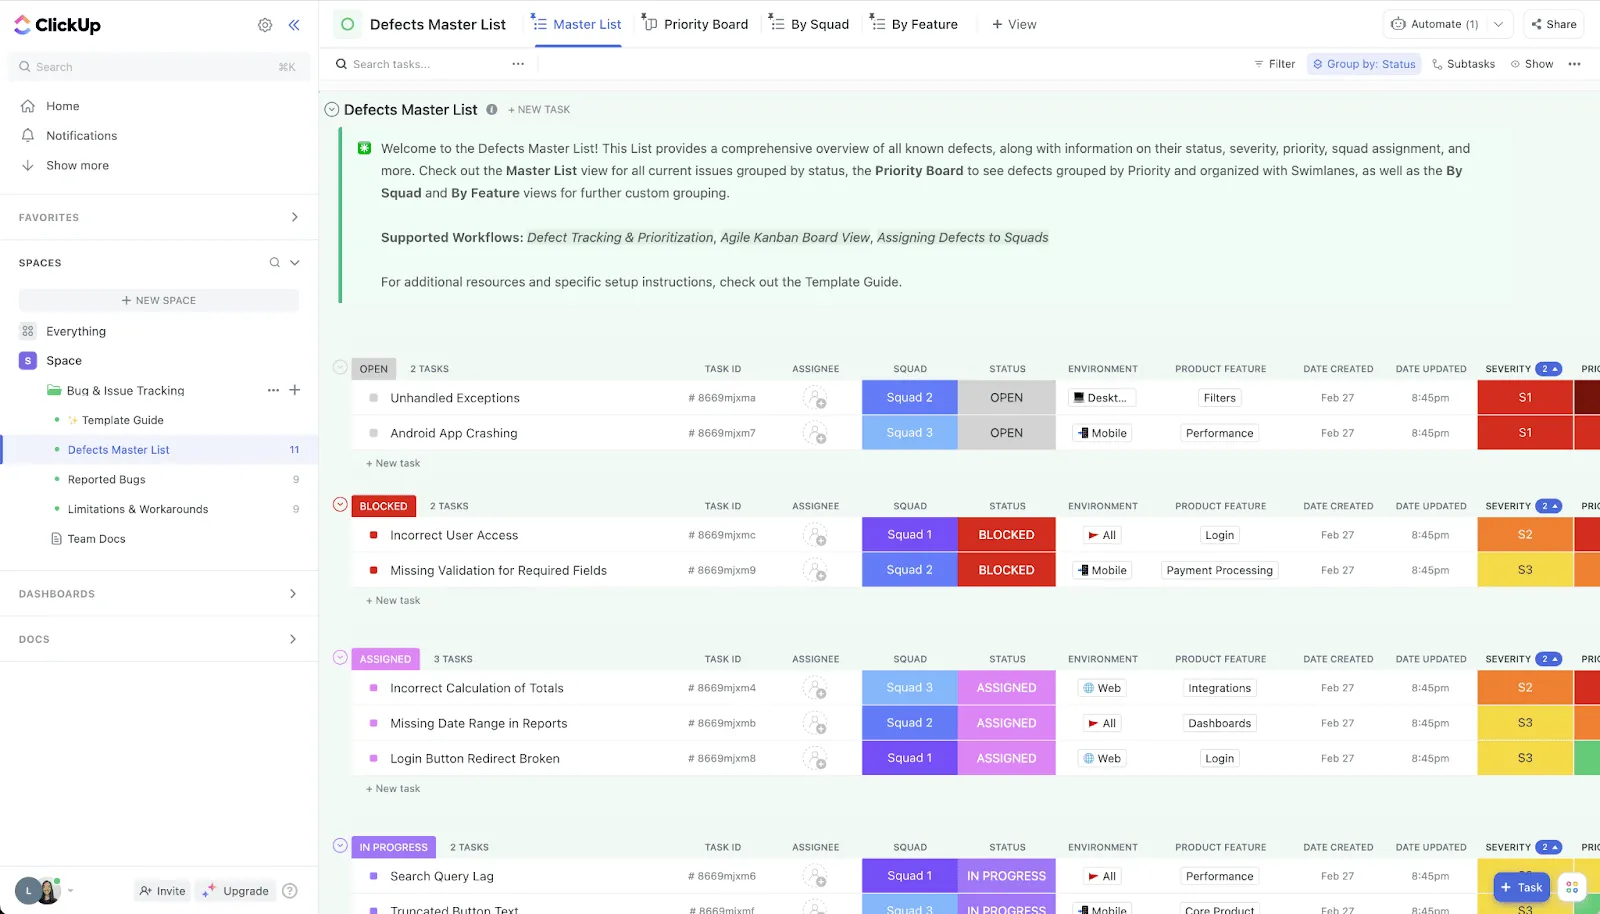
Pokud se potýkáte s hlášeními od týmů podpory, kontroly kvality a produktového vývoje a neradi přepínáte mezi různými nástroji, šablona ClickUp pro sledování chyb a problémů vám zásadně změní život. Sdružuje vše do jednoho pracovního prostoru – vstupní formuláře pro softwarové týmy, sledované úkoly týkající se chyb, přehledy o postupu a řídicí panely – takže váš tým může postupovat od nahlášení až po vyřešení, aniž by musel opustit ClickUp.
- Obsahuje celou řadu přednastavených zobrazení ClickUp – Seznam, Kanban, Pracovní zátěž, Časová osa –, takže můžete sledovat životní cyklus chyby ze všech úhlů pohledu
- Zahrnuje vlastní pole pro prostředí, závažnost a stav – není třeba žádné další nastavování
- Zahrnuje vstupní formuláře, které přeměňují nahlášené chyby na aktivní úkoly, včetně metadat
- Nabízí integrované přehledové panely, díky kterým můžete na první pohled sledovat počet chyb, rychlost řešení a úzká místa
🤝 Ideální pro: Toto řešení je ideální pro full-stack týmy – produktové manažery, vedoucí QA a manažery podpory –, kteří hledají jednotný systém pro sledování chyb, který lze spustit během několika sekund
2. Šablona hlášení chyb v ClickUp
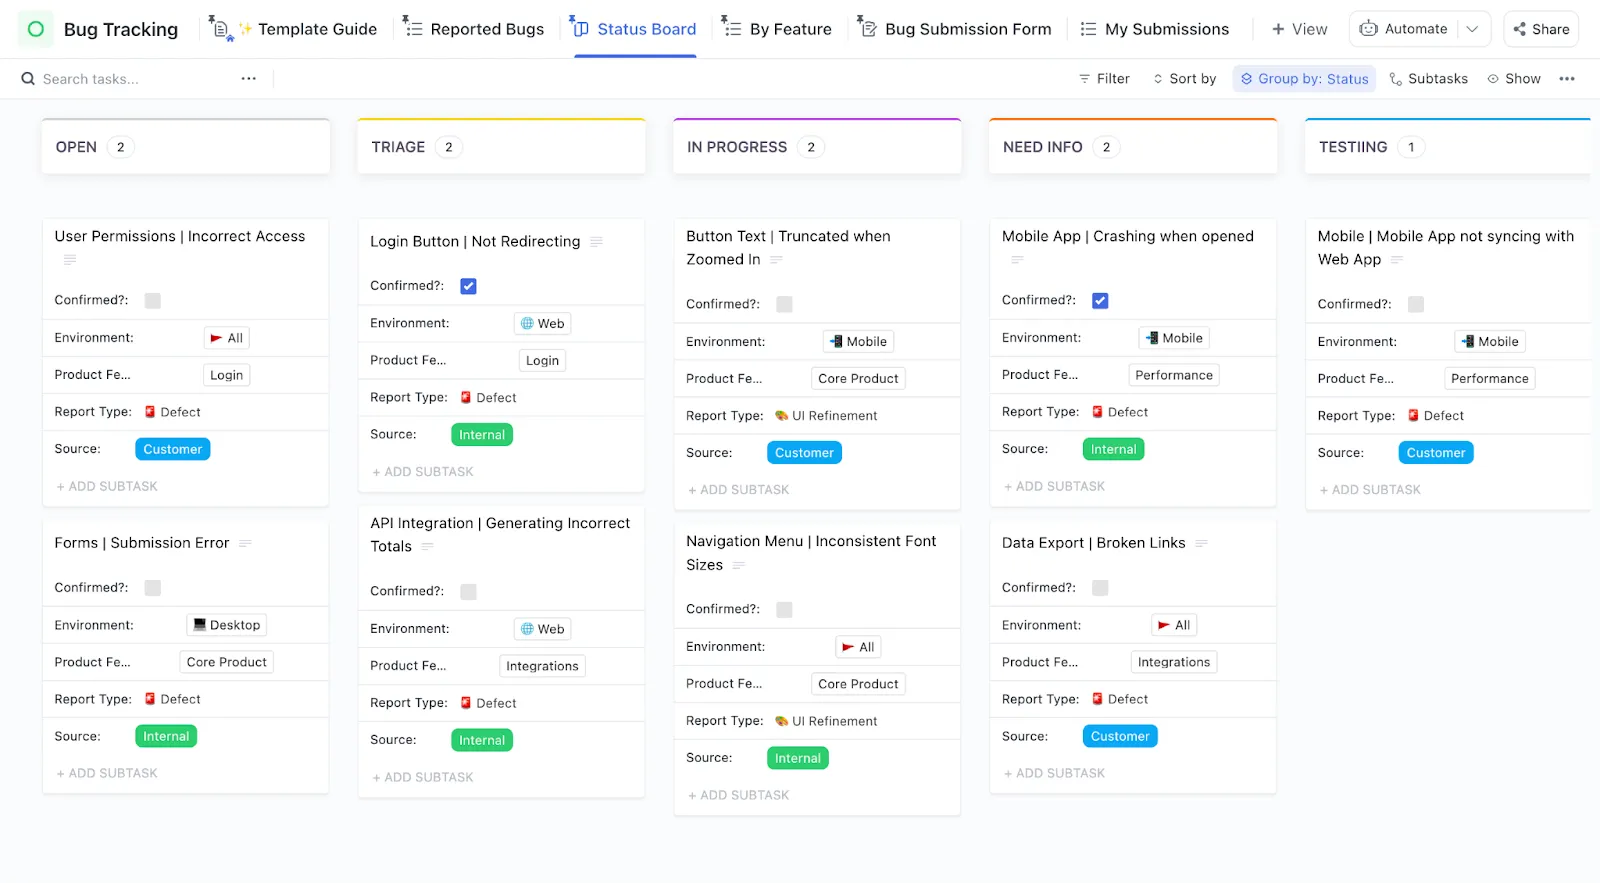
Když záleží především na rychlosti a přehlednosti řešení, šablona hlášení chyb v ClickUp vám nabízí přehledný a strukturovaný způsob zaznamenávání chyb – včetně logického sledu podrobností a integrovaného sledování stavu.
Pomáhá omezit dotazy typu „Co jsi udělal? Kde jsi to viděl?“, takže inženýři tráví čas opravami, nikoli hledáním souvislostí.
- Každý úkol je vybaven přehledným rozvržením formuláře – prostředí, kroky k reprodukci, očekávané vs. skutečné výsledky, dopad
- Vlastní stavy úkolů provázejí chybu od stavu „Nová“ až po „Hotovo“, čímž se snižuje zmatek při předávání úkolů
- Vizualizace, jako jsou štítky s prioritami, vám pomohou provést třídění na první pohled
🤝 Ideální pro: inženýry QA, testery a pracovníky podpory, kteří potřebují hlásit chyby přesně a konzistentně
3. Šablona úkolu pro chyby v ClickUp

Někdy už máte podrobnosti o chybě k dispozici, ale ne ve správném formátu, který potřebujete k jejich zaznamenání. Šablona úkolu „Chyba“ v ClickUp vám nabízí rychlou a jednoduchou strukturu pro sledování jedné chyby od začátku do konce. Je nenáročná, snadno se zavádí a perfektně se hodí k vyplnění mezer v ad hoc pracovních postupech.
- Vhodné i pro začátečníky: připraveno k okamžitému použití
- Obsahuje standardní vlastní pole, díky nimž zůstanou vaše úkoly konzistentní
- Ideální pro zaznamenané chyby, které vyžadují rychlou strukturaci – není nutná žádná dodatečná konfigurace
- Udržuje váš seznam chyb přehledný, nikoli chaotický
🤝 Ideální pro: pracovníky podpory nebo techniky, kteří potřebují rychle zaznamenat nebo evidovat problémy – zejména když je čas omezený a jasnost nemůže počkat
4. Šablona pro sledování problémů v ClickUp
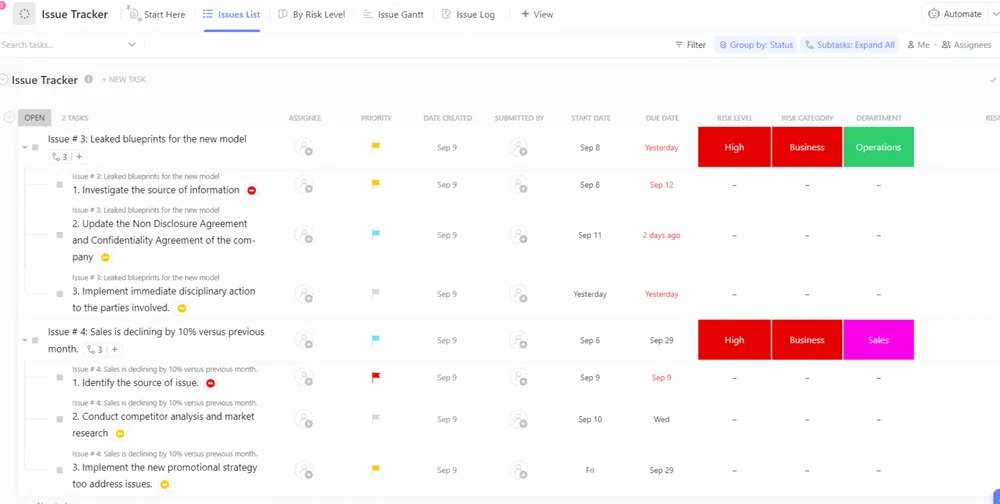
Potřebujete univerzálnější šablonu, která zvládne jak chyby, tak i netechnické problémy? Šablona ClickUp Issue Tracker je ideální pro ukládání a správu všech nahlášených problémů v centrální databázi.
- Umožňuje vám sledovat chyby, požadavky na nové funkce a problémy s dodávkami – vše na jednom místě
- Obsahuje přizpůsobitelné stavy, zobrazení a pole vhodná pro třídění a stanovení priorit
- Usnadňuje spolupráci díky ukládání všech informací do sdílené databáze problémů
- Rychle se přizpůsobí metodikám Scrum, Kanban nebo hybridním pracovním postupům
🤝 Ideální pro: manažery produktového provozu, vedoucí IT a produktové manažery koordinující mezifunkční pracovní postupy – zejména v případech, kdy se problémy netýkají pouze technické stránky
5. Šablona formuláře pro zpětnou vazbu v ClickUp
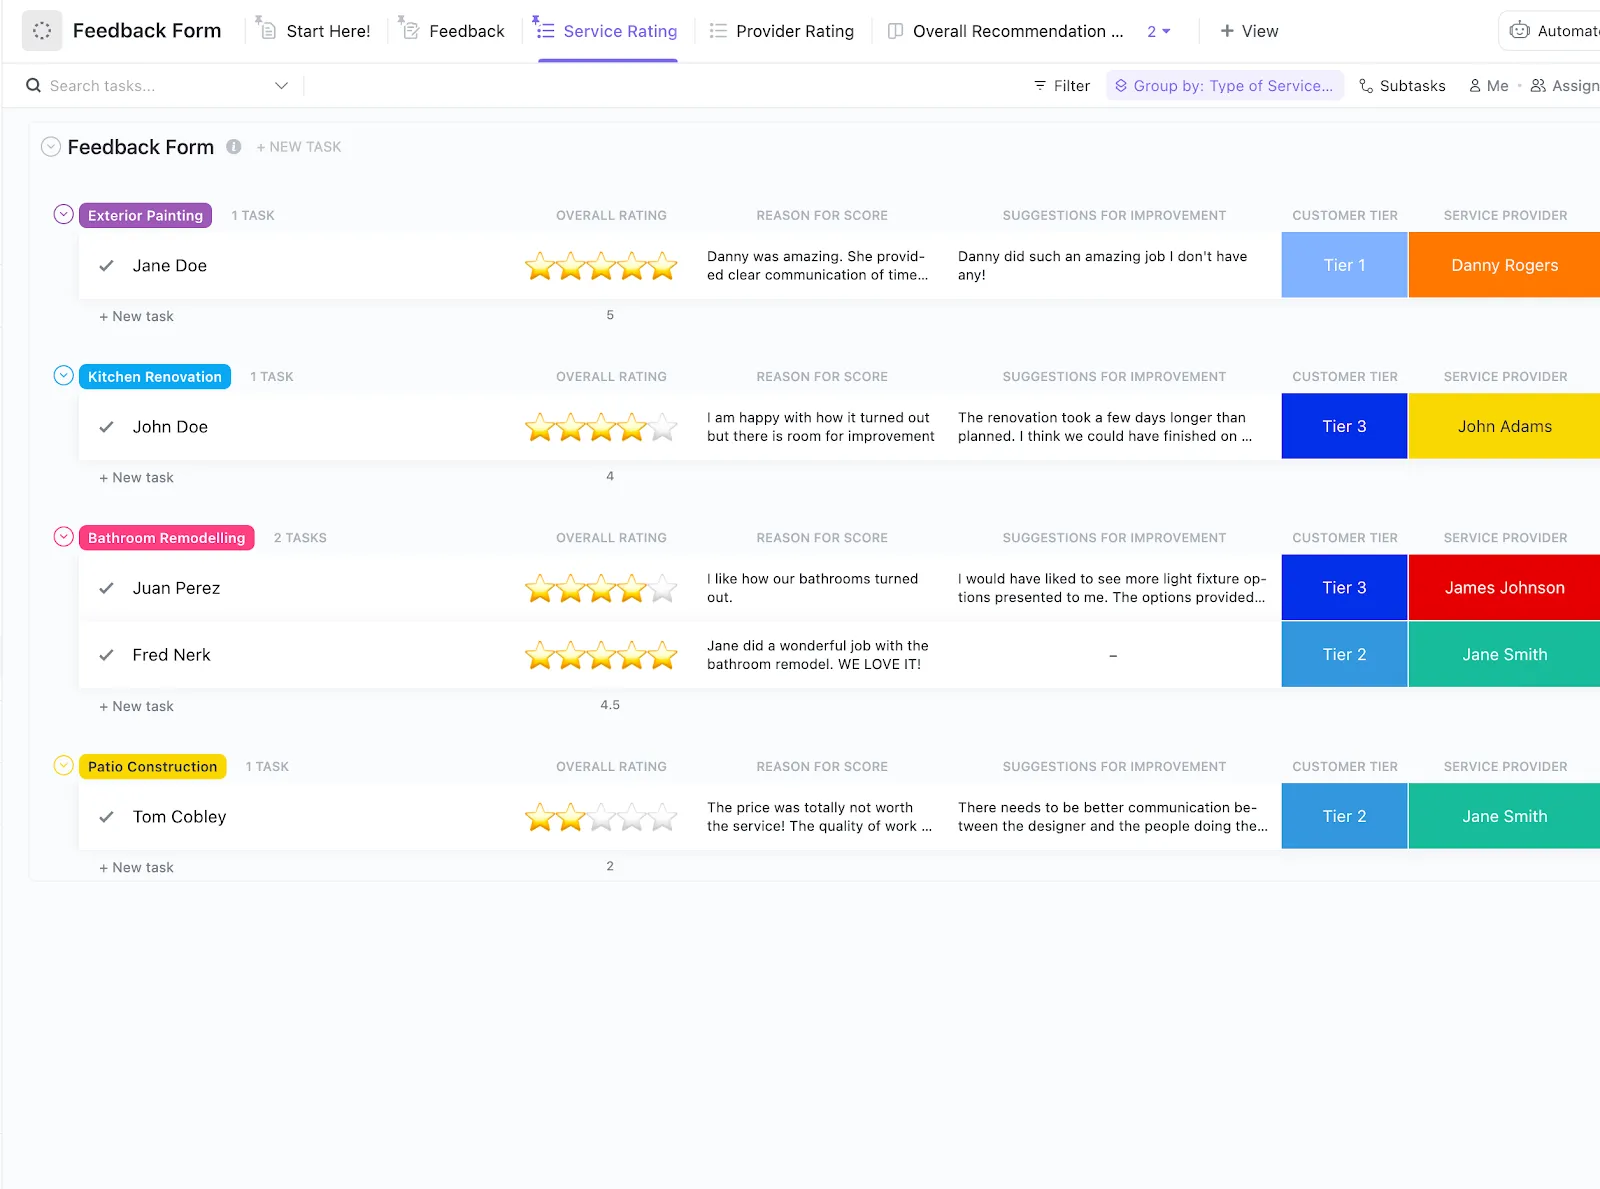
Když sbíráte zpětnou vazbu k chybám – nejen od svého týmu podpory, ale také přímo od zákazníků nebo beta testerů – určitě nechcete, aby se ve vaší složce „Stažené soubory“ hromadily další chaotické dotazníky. Šablona formuláře pro zpětnou vazbu ClickUp nabízí strukturovaný, ale flexibilní formulář, který zajistí, že budete sbírat zpětnou vazbu konzistentně, aniž byste přišli o nuance nebo kontext.
Proč se vám to bude líbit:
- Umožňuje vám vytvářet cílené průzkumy – s využitím hodnotících škál, otevřených polí nebo otázek s výběrem z více možností – abyste přesně zachytili to, na čem vašemu produktu záleží
- Obsahuje výkonné zobrazení (seznam, tabule, tabulka a další), díky kterým můžete na první pohled třídit odpovědi podle úrovně uživatele, sentimentu nebo typu problému
- Obsahuje vlastní pole – jako „Úroveň zákazníka“, „Celkové hodnocení“ nebo „Návrhy na zlepšení“ –, která vám pomohou analyzovat zpětnou vazbu v kontextu přímo v ClickUp
- Zahrnuje automatizaci směrování a sledování zpětné vazby, aby se důležité informace neztratily v záplavě dalších informací
🤝 Ideální pro: Produktové manažery, výzkumníky v oblasti uživatelského zážitku (UX) a vedoucí podpory, kteří potřebují jednoduchý a efektivní způsob, jak shromažďovat zpětnou vazbu od uživatelů a reagovat na ni – zejména při vytváření pracovního postupu pro třídění nebo prioritizaci chyb s využitím umělé inteligence
💡 Tip pro pokročilé: Místo ručního procházení odeslaných formulářů použijte ClickUp Brain k:
- Shrňte zpětnou vazbu do témat (např. „obavy ohledně cen“, „požadavky na nové funkce“, „chyby v uživatelském rozhraní“)
- Proveďte analýzu sentimentu, abyste na první pohled věděli, která zpětná vazba je pozitivní, negativní nebo neutrální
- Zvýrazněte trendy v čase pomocí dotazů v Brainu v přirozeném jazyce, například: „Jaký je nejčastější požadavek z zpětné vazby za 3. čtvrtletí?“
- Automaticky generujte zprávy nebo další kroky, které můžete sdílet se zainteresovanými stranami, a to přímo na základě shromážděných dat
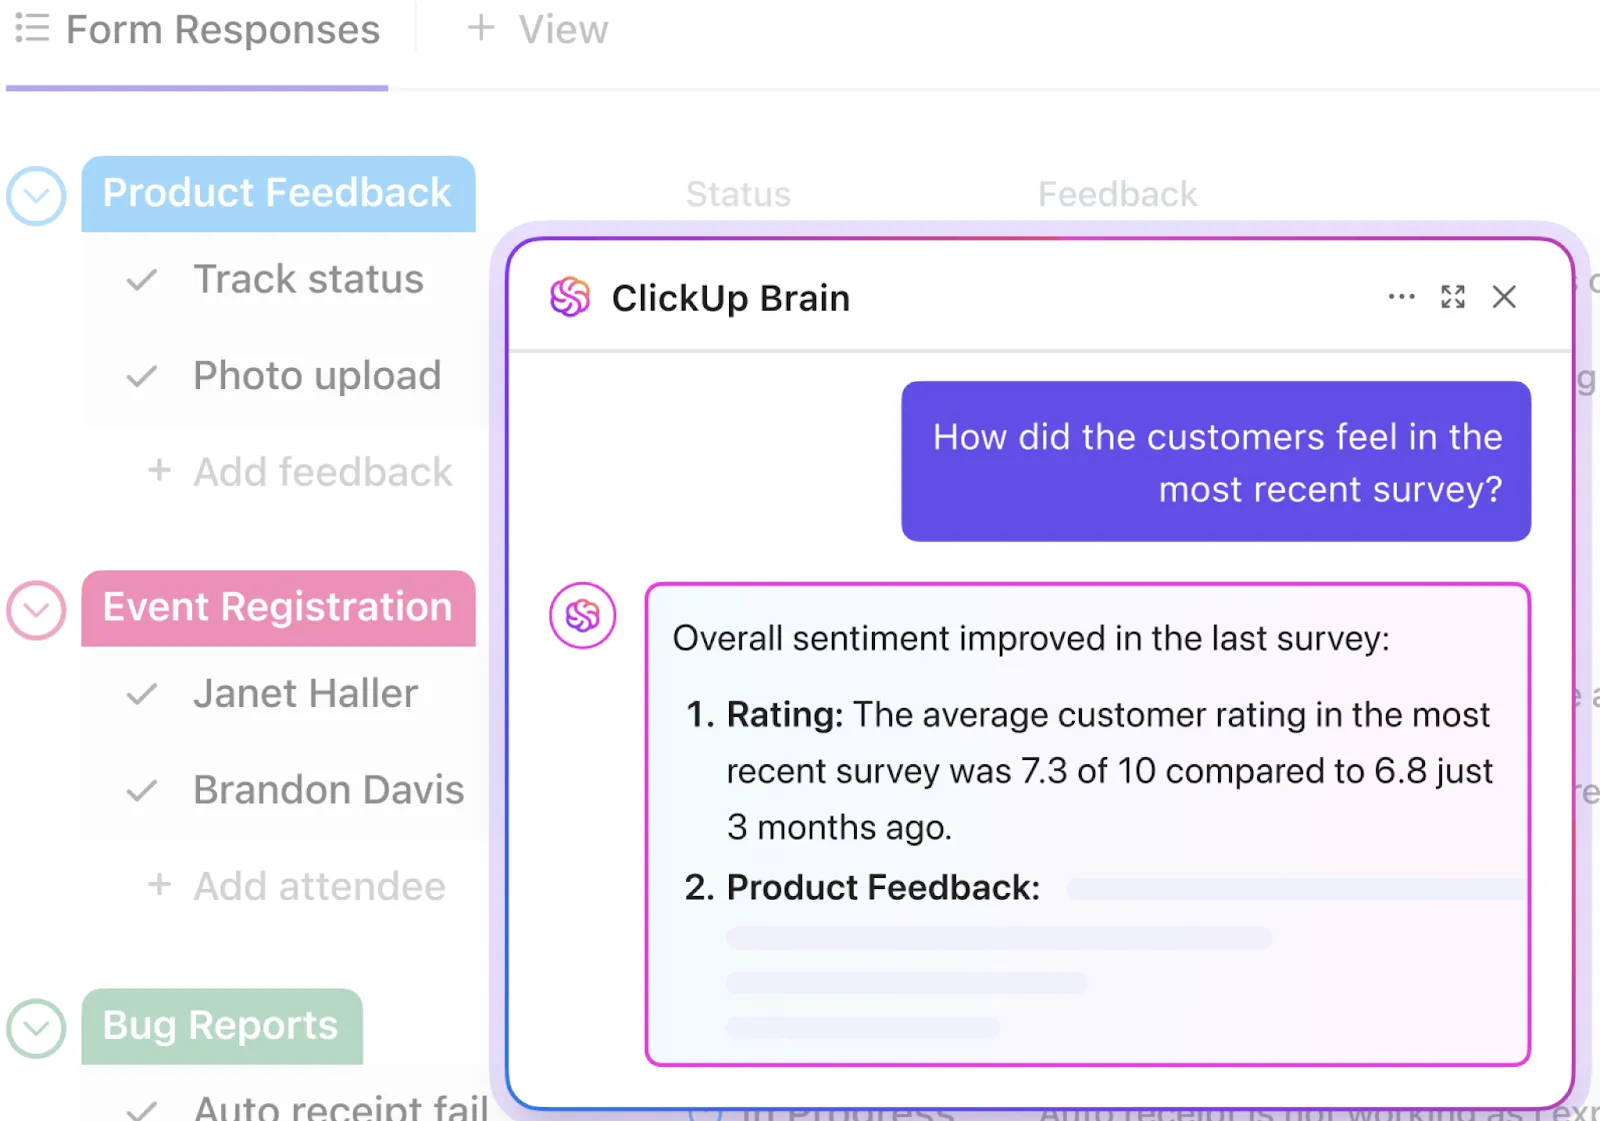
Díky tomu se váš formulář pro zpětnou vazbu promění v živé centrum poznatků. Rozlučte se s exportováním tabulek a přivítejte praktické závěry během několika sekund.
Příklady z praxe a případové studie sledování chyb s využitím umělé inteligence
Pojďme nyní opustit teorii a podívat se, jak firmy ve skutečnosti využívají umělou inteligenci k odhalování chyb. V této části najdete konkrétní příklady a výsledky, na kterých záleží.
1. Detekce anomálií v open-source projektech
Představte si umělou inteligenci, která nejen plní příkazy, ale uvažuje jako bezpečnostní expert. To je koncept, na kterém je založen Big Sleep, nový nástroj pro vyhledávání anomálií vyvinutý společností Google DeepMind a týmem Project Zero. Na rozdíl od tradičních nástrojů tento systém autonomně prohledává open-source kódové základny a hledá zranitelnosti, které by lidskému oku – i stávající automatizaci – mohly uniknout.
Při svém prvním nasazení v reálném prostředí prohledala tato technologie široce používané projekty, jako jsou FFmpeg a ImageMagick, a odhalila 20 dosud neznámých zranitelností.
Společnost Google zdůraznila, že ačkoli detekci zajišťuje umělá inteligence, lidský dohled zůstává nezbytnou součástí celého procesu vyhodnocování. Díky podobným iniciativám se Google dostává do čela nové generace proaktivní kybernetické obrany.
2. Chytřejší přiřazování chyb s využitím umělé inteligence
Ve velkých softwarových projektech je třídění hlášení chyb – jejich přiřazování správnému vývojáři – pracné a náchylné k chybám. Hlášení chyb obsahují volně zadaný text, úryvky kódu, záznamy o stavu zásobníku a další rušivé vstupy. Tradiční modely založené na vlastnostech typu „bag-of-words“ (BOW) často opomíjejí kontext a pořadí, což vede k neoptimální přesnosti.
Tým inženýrů z IBM Research přišel s radikálním řešením: DeepTriage. Navrhli využití hluboké obousměrné rekurentní neuronové sítě založené na pozornosti (DBRNN-A), která se učí bohaté, kontextově citlivé reprezentace přímo z názvů a popisů chyb.
DeepTriage využil pro učení vlastností bez dohledu jak natriedené (opravené), tak netriedené (otevřené) hlášení chyb – na rozdíl od předchozích studií, které tuto přibližně 70 % dat ignorovaly. Po transformaci hlášení chyb na husté vektorové vlastnosti byly na této reprezentaci trénovány různé klasifikátory (softmax, SVM, Naïve Bayes, kosinová vzdálenost) s cílem předpovědět nejpravděpodobnějšího vývojáře.
Model DBRNN-A překonal tradiční modely BOW a statistické modely – dosáhl výrazně vyšší průměrné přesnosti Rank-10 (tj. vývojář se umístil mezi 10 nejlepšími předpověďmi).
3. Včasné odhalení neplatných hlášení chyb
Studie s volným přístupem publikovaná v časopise Empirical Software Engineering se zabývala tím, jak modely strojového učení pomáhají identifikovat neplatná hlášení chyb nebo spam v průmyslových prostředích. Příliš mnoho neplatných hlášení zpomaluje třídění a znesnadňuje stanovení priorit.
Nástroje pro vizuální a verbální vysvětlení – využívající nejmodernější rámce interpretovatelnosti strojového učení – výrazně zvýšily důvěru ve srovnání s neprůhlednými předpověďmi. Použitím takových modelů, které jsou přizpůsobeny k včasnému odhalování neplatných podání, se podařilo výrazně omezit počet nepodstatných záznamů ve frontě chyb.
Díky tomu mohly týmy zabývající se tříděním chyb věnovat více času skutečným, významným chybám a méně času filtrování bezvýznamných hlášení.
📚 Přečtěte si také: Jak využít umělou inteligenci v DevOps
Výzvy a omezení umělé inteligence při sledování a řešení chyb
Umělá inteligence je výkonný urychlovač, ale jako každý nástroj má i své nevýhody. Na co si dát pozor při zavádění umělé inteligence do sledování a řešení chyb:
Kvalita vstupních dat
Umělá inteligence vzkvétá na strukturovaných a podrobných hlášeních chyb – názvech, reprodukovatelných krocích, značkách závažnosti, údajích o prostředí a dalších klíčových informacích. Většina organizací se však stále potýká s nekonzistentními, neúplnými nebo dokonce duplicitními hlášeními, která jsou roztříštěna v konverzacích na Slacku, tabulkách a systémech pro sledování chyb. Pokud tyto údaje zadáte do systému s umělou inteligencí, bude výsledek stejně nespolehlivý: nesprávně klasifikované chyby, nesprávně stanovené priority a promarněný čas vývojářů.
📮ClickUp Insight: 30 % našich respondentů využívá nástroje umělé inteligence k výzkumu a shromažďování informací. Existuje ale umělá inteligence, která vám pomůže najít ten jeden ztracený soubor v práci nebo ten důležitý vlákno ve Slacku, které jste zapomněli uložit?
Ano! Funkce Connected Search od ClickUp, poháněná umělou inteligencí, dokáže okamžitě prohledávat veškerý obsah vašeho pracovního prostoru, včetně integrovaných aplikací třetích stran, a vyhledávat tak poznatky, zdroje a odpovědi. Ušetřete až 5 hodin týdně díky pokročilému vyhledávání v ClickUp!
Zkreslení modelu a past nadměrné závislosti
Umělá inteligence, která byla trénována především na historických chybách, může mít potíže s detekcí nových typů selhání – zejména těch, které jsou způsobeny nově se objevujícími technologickými stacky, neobvyklými integracemi nebo dosud neznámými okrajovými případy. Rizikem je zde falešná jistota: umělá inteligence může novou kritickou chybu zařadit jako duplicitu s nízkou prioritou, což zpozdí opravy a podkopá důvěru.
Odborníci dokonce varují, že přílišná závislost na umělé inteligenci bez dohledu se může obrátit proti vám. Firmy musí umělou inteligenci začlenit do konkrétních oblastí s nízkým rizikem, jako je stanovování priorit problémů – zdůrazňují však, že bez tohoto opatrného přístupu mohou nástroje umělé inteligence ve skutečnosti bránit produktivitě a morálce vývojářů.
Spolehlivost infrastruktury a provozu
Zatímco 94 % backendových inženýrů a vedoucích IT oddělení používá nástroje umělé inteligence, pouze 39 % z nich disponuje robustními interními rámcemi, které je podporují. Tento nesoulad vede k systémům, které selhávají při škálování, podkopávají důvěru nebo vytvářejí další technický dluh.
Nedostatek důvěry
Důvěra je téma, u kterého stojí za to se na chvíli zastavit. Inženýři a manažeři podpory nebudou slepě přijímat úkoly řízené umělou inteligencí, dokud se systém důsledně neosvědčí. Tato „důvěryhodnostní propast“ znamená, že zavádění této technologie je často pomalejší, než slibují dodavatelé.
Připočtěte k tomu skryté náklady na implementaci – čas strávený integrací s nástroji pro správu verzí, CI/CD a monitorování – a je jasné, že umělá inteligence není řešením typu „plug-and-play“.
Problém vysvětlitelnosti
Mnoho systémů umělé inteligence funguje jako černé skříňky, které bez kontextu vydávají označení závažnosti nebo návrhy na opravy. Týmy chtějí vědět, proč byla chyba zařazena mezi priority nebo přidělena konkrétnímu týmu. Bez transparentnosti se vedoucí pracovníci zdráhají zakládat důležitá rozhodnutí o vydávání verzí na výstupech umělé inteligence.
📌 Stručně řečeno: Umělá inteligence dokáže zrychlit to, co již funguje – pokud je však váš proces chaotický, hrozí, že se tím ještě zvýší množství šumu. Včasné rozpoznání těchto omezení je klíčovým rozdílem mezi neúspěšným zavedením a úspěšným pracovním postupem založeným na umělé inteligenci.
Osvědčené postupy pro implementaci umělé inteligence při řešení chyb
Pokud umělá inteligence není zázračným řešením, jak ji tedy správně využívat? Zvažte tyto osvědčené postupy:
Používejte umělou inteligenci jako skalpel, ne jako kladivo
Začněte tím, že identifikujete nejúžší a nejbolestivější úzké místo ve vašem procesu řešení chyb – možná jsou to duplicitní hlášení, která zahlcují třídění, nebo hodiny promarněné ručním přiřazováním problémů. Právě tam nasadíte umělou inteligenci jako první. Rychlé úspěchy vytvoří dynamiku a vybudují důvěru napříč týmy vývojářů, podpory a produktového týmu.
🧠 Zajímavost: 92,4 % softwarových společností zaznamenalo po zavedení umělé inteligence pozitivní dopady na životní cyklus vývoje softwaru (SDLC). To není náhoda. Ve skutečnosti to odráží chytré a cílené nasazení.
Udělejte z údržby dat svou nejvyšší prioritu
Umělá inteligence se učí z toho, co jí poskytnete. Zajistěte, aby hlášení chyb byla konzistentní a obsahovala jasně označená pole pro prostředí, kroky k reprodukci a závažnost.
Standardizace zadávání výrazně zlepšuje schopnost umělé inteligence správně klasifikovat a stanovovat priority. Mnoho úspěšných týmů vytváří jednoduché šablony nebo formuláře pro zadávání, které zaručují, že každá zpráva obsahuje všechny podstatné údaje ještě předtím, než se jí umělá inteligence ujme.
Zapojte do procesu i lidi
Umělá inteligence sice vyniká v rozpoznávání vzorců, ale stále se nemůže rovnat lidskému úsudku. Nechte ji navrhovat závažnost, priority nebo dokonce opravy kódu – ale umožněte inženýrům, aby je ověřili. Postupem času, jak se bude zvyšovat přesnost, bude možné lidský dohled omezovat. Toto postupné předávání úkolů buduje důvěru namísto odporu.
Buďte při měření důkladní
Zavedení umělé inteligence nelze ospravedlnit pouze na základě intuice. Sledujte metriky jako MTTR (průměrná doba do vyřešení), MTTD (průměrná doba do detekce), míru opětovného otevření a počet přehlédnutých chyb před a po zavedení umělé inteligence. Týmy, které tyto zlepšení zveřejňují interně – „doba třídění klesla ze čtyř hodin na 20 minut“ –, zaznamenávají rychlejší přijetí ze strany vedení i inženýrů.
Usilujte o transparentnost a vysvětlitelnost
Chcete-li se vyhnout problému „černé skříňky“, vyberte si systémy, které ukazují, proč byla chyba zařazena mezi priority nebo proč byla přiřazena ke konkrétní příčině.
Myslete dlouhodobě a upřednostňujte systémy
Společnost Deloitte předpovídá, že do roku 2027 bude generativní umělá inteligence – i podle konzervativních odhadů – integrována do všech digitálních produktů, a to i do procesů řešení chyb. To znamená, že umělá inteligence se musí přizpůsobit architektuře, firemní kultuře a strategii – a ne jen slibovat další rychlý úspěch.
Budoucnost umělé inteligence v řešení chyb
Pojďme nahlédnout do budoucnosti a zjistit, kam umělá inteligence směřuje proces řešení chyb.
Agentická umělá inteligence se mění z asistenta na autonomního spoluhráče
Do roku 2028 bude 15 % každodenních pracovních rozhodnutí přijímáno autonomně agenty umělé inteligence.
Přechod k agentní AI – autonomním agentům, kteří mohou jednat, rozhodovat se a přizpůsobovat se – probíhá rychlým tempem. Třídění chyb je v tomto ohledu přirozeným cílem, přičemž AI bude brzy schopna diagnostikovat, prioritizovat a dokonce opravovat určité typy chyb – aniž by inženýři museli hnout prstem.
📮 ClickUp Insight: 15 % zaměstnanců se obává, že automatizace by mohla ohrozit část jejich práce, ale 45 % tvrdí, že by jim to umožnilo soustředit se na práci s vyšší přidanou hodnotou. Názory se mění – automatizace nenahrazuje pracovní role, ale přetváří je tak, aby měly větší dopad.
Například při uvedení produktu na trh mohou AI agenti ClickUp automatizovat přidělování úkolů a připomínky termínů a poskytovat aktualizace stavu v reálném čase, takže týmy nemusí neustále sledovat novinky a mohou se soustředit na strategii. Tak se z projektových manažerů stávají lídři projektů!
💫 Skutečné výsledky: Společnost Lulu Press díky automatizacím ClickUp ušetří 1 hodinu denně na každého zaměstnance, což vede k 12% zvýšení efektivity práce.
Samoregenerace a prediktivní testování se stávají standardem
S rostoucí složitostí aplikací a zkracováním cyklů vydávání se samoléčba a prediktivní testování mění z „vítaného doplňku“ na nezbytnou součást infrastruktury.
Jedna případová studie ukázala, že týmy zajišťující kvalitu uvízly ve frustrujícím cyklu: nestabilní testovací skripty selhávaly při každé drobné aktualizaci uživatelského rozhraní a inženýři každý měsíc strávili více než 40 hodin pouhou údržbou automatizovaných testů. Bylo to nákladné, pomalé a demoralizující.
Poté zavedli rámec pro samoregeneraci založený na umělé inteligenci a strojovém učení. Místo toho, aby se systém zhroutil pokaždé, když se změnil nějaký prvek, přizpůsoboval se v reálném čase – automaticky znovu identifikoval lokátory a aktualizoval se bez neustálého ručního zásahu.
Dopad byl dramatický. Měsíční čas strávený údržbou klesl z přibližně 40 hodin na pouhých 12, což představuje snížení o 70 %. Stejný trend zaznamenaly i náklady, přičemž úspory se odhadují na přibližně 60 %, a adaptivní detekce si při zpracování změn udržela působivou úspěšnost přibližně 85 %.
Generativní umělá inteligence píše testy, provádí opravy a ještě mnohem více
Generativní modely již nyní vytvářejí testovací případy a diagnostikují vzorce selhání. Průkopnická výzkumná studie zdůrazňuje, jak může umělá inteligence dynamicky generovat a přizpůsobovat testy na základě kontextu – čímž zvyšuje efektivitu regresního testování a snižuje riziko lidských chyb.
Vývojáři se mění z „hasičů“ na „architekty“
70 % vývojářů nepovažuje umělou inteligenci za hrozbu.
Díky umělé inteligenci mohou inženýři věnovat méně času opakovanému ladění a více času strategickému řešení problémů a inovacím.
Zavedení umělé inteligence trvale změnilo vývoj softwaru – výrazně snížilo zátěž vývojářů automatizací opakujících se úkolů, zefektivnilo pracovní postupy a umožnilo vývojářům soustředit se na kreativní řešení problémů a inovace.
Zavedení umělé inteligence navždy změnilo vývoj softwaru – výrazně snížilo zátěž vývojářů automatizací opakujících se úkolů, zefektivnilo pracovní postupy a umožnilo vývojářům soustředit se na kreativní řešení problémů a inovace.
Už za pár let se týmy nebudou dohadovat, zda by jim měla umělá inteligence pomáhat. Budou se rozhodovat, který agent by měl zpracovávat protokoly, který provádět třídění a který připravovat návrh opravy.
Umělá inteligence nebude stát jen po boku vašeho týmu, ale před ním – bude odhalovat výmoly, abyste mohli budovat hladší cesty do budoucna.
📚 Přečtěte si také: Nejlepší agenti s umělou inteligencí pro programování
Odstraňujte chyby, ne čas svého týmu. Vyzkoušejte ClickUp!
Skutečná budoucnost umělé inteligence ve sledování a řešení chyb spočívá v předvídavosti, nikoli v hašení požárů. A právě v tom vyniká ClickUp.
ClickUp není jen další nástroj pro sledování chyb; je to univerzální aplikace pro práci, která sjednocuje příjem, třídění, provádění, retrospektivy a reportování do jedné platformy. Díky umělé inteligenci integrované přímo do vašich úkolů, dokumentů, formulářů a dashboardů máte vše, co potřebujete k rychlejšímu řešení chyb, poučení se z nich a udržení soustředění vašeho týmu na to, co je důležité.
Závěr: Umělá inteligence vám pomáhá odstraňovat chyby. ClickUp vám pomáhá zvládat chaos.
Vyzkoušejte ClickUp ještě dnes zdarma!
Často kladené otázky (FAQ)
Jaký je rozdíl mezi sledováním chyb pomocí umělé inteligence a tradičním sledováním chyb?
Sledování chyb pomocí umělé inteligence automatizuje detekci, kategorizaci a stanovení priority problémů pomocí strojového učení, zatímco tradiční sledování chyb se spoléhá na ruční zadávání a lidské třídění. Umělá inteligence omezuje nadbytečné informace, označuje duplicity a urychluje řešení, na rozdíl od ručních pracovních postupů, které mohou být pomalejší a náchylnější k chybám.
Jak přesná je umělá inteligence při detekci chyb?
Podle recenzovaných výzkumů a testování v oboru dosahují moderní modely umělé inteligence pro detekci chyb až 90% přesnosti při klasifikaci a odhalování vad. Přesnost se zvyšuje díky strukturovaným hlášením o chybách a rozsáhlejším trénovacím datovým sadám.
Jak umělá inteligence určuje priority chyb?
Umělá inteligence určuje priority chyb na základě analýzy závažnosti, dopadu na uživatele, četnosti výskytu a obchodního kontextu. Využívá historická data a signály v reálném čase k doporučení úrovní priority, takže problémy s velkým dopadem se objeví dříve než ty méně kritické.
Může umělá inteligence automaticky opravovat chyby?
Ano, v omezených případech. Nástroje umělé inteligence, jako jsou Getafix od Facebooku a GitHub Copilot Autofix, navrhují nebo generují opravy pro opakující se vzorce chyb. Ve většině případů však inženýři stále před nasazením opravy kontrolují a ověřují.
Dokáže umělá inteligence předvídat chyby ještě předtím, než k nim dojde?
Umělá inteligence dokáže na základě historických údajů o chybách, metrik složitosti kódu a testovacích vzorců předvídat oblasti náchylné k chybám. Prediktivní analýzy upozorňují na vysoce rizikové moduly, což týmům umožňuje proaktivně posílit testování nebo provést refaktoring kódu.
Jaké jsou náklady na zavedení sledování chyb pomocí umělé inteligence?
Náklady se liší. Mnoho nástrojů nabízí bezplatné tarify, zatímco řešení umělé inteligence pro podniky mohou mít individuální ceny v závislosti na objemu využití, integracích a potřebách v oblasti pokročilé analytiky.
Jak se nástroje umělé inteligence integrují s Jira nebo GitHubem?
Většina řešení pro sledování chyb využívajících umělou inteligenci se přímo integruje s Jira a GitHub prostřednictvím API, aplikací nebo pluginů. Díky těmto integracím zůstávají úkoly týkající se chyb, commity a pull requesty propojené, což zajišťuje plynulejší třídění a řešení.
Jaké výzvy přináší umělá inteligence při ladění?
Mezi výzvy spojené s využitím umělé inteligence při ladění patří problémy s kvalitou dat, zaujatost modelů, nedostatek transparentnosti a nedostatek důvěry. Umělá inteligence může nesprávně klasifikovat nové chyby, způsobit skryté náklady na implementaci nebo fungovat jako „černá skříňka“ bez možnosti vysvětlení.
Nahradí sledování chyb pomocí umělé inteligence inženýry QA?
Ne, sledování chyb pomocí umělé inteligence nenahrazuje inženýry QA. Umělá inteligence automatizuje opakující se třídění a detekci, ale inženýři QA zůstávají nepostradatelní pro posuzování, explorativní testování a ověřování oprav. Umělá inteligence doplňuje týmy QA a umožňuje jim soustředit se na strategii, okrajové případy a zlepšování kvality softwaru.