
Các dự án huấn luyện AI hiếm khi thất bại ở cấp độ mô hình. Vấn đề nảy sinh khi các thí nghiệm, tài liệu và thông tin cập nhật cho các bên liên quan bị phân tán trên quá nhiều công cụ.
Hướng dẫn này sẽ hướng dẫn bạn từng bước về việc huấn luyện mô hình với Databricks DBRX — một mô hình ngôn ngữ lớn (LLM) có hiệu suất tính toán cao gấp đôi so với các mô hình hàng đầu khác — đồng thời giúp tổ chức công việc liên quan một cách có hệ thống trong ClickUp.
Từ thiết lập và tinh chỉnh đến việc lập tài liệu và cập nhật liên đội, bạn sẽ thấy cách một không gian làm việc duy nhất, tích hợp giúp loại bỏ tình trạng thông tin phân tán và giúp nhóm của bạn tập trung vào việc phát triển, chứ không phải tìm kiếm. 🛠
DBRX là gì?
DBRX là một mô hình ngôn ngữ lớn (LLM) mã nguồn mở mạnh mẽ, được thiết kế chuyên biệt cho việc huấn luyện và suy luận mô hình AI trong doanh nghiệp. Vì DBRX là mã nguồn mở theo Giấy phép Mô hình Mở Databricks, nhóm của bạn có quyền truy cập đầy đủ vào các trọng số và kiến trúc của mô hình, cho phép bạn kiểm tra, sửa đổi và triển khai mô hình theo cách riêng của mình.
Sản phẩm này có hai phiên bản: DBRX Base dành cho quá trình huấn luyện sâu ban đầu và DBRX Instruct dành cho các công việc tuân theo hướng dẫn sẵn có.
Kiến trúc DBRX và thiết kế hỗn hợp chuyên gia
DBRX giải quyết các công việc bằng cách sử dụng kiến trúc Mixture-of-Experts (MoE). Khác với các mô hình ngôn ngữ lớn truyền thống sử dụng toàn bộ hàng tỷ tham số của mình cho mỗi phép tính, DBRX chỉ kích hoạt một phần nhỏ trong tổng số tham số (các chuyên gia phù hợp nhất) cho bất kỳ công việc cụ thể nào.
Hãy hình dung nó như một nhóm chuyên gia chuyên môn; thay vì mọi người đều tham gia giải quyết mọi công việc, hệ thống sẽ tự động phân công từng công việc đến các chuyên gia phù hợp nhất dựa trên các tham số tương ứng.
Điều này không chỉ giúp rút ngắn thời gian phản hồi mà còn mang lại hiệu suất và kết quả hàng đầu, đồng thời giảm đáng kể chi phí tính toán.
Dưới đây là tổng quan nhanh về các thông số kỹ thuật chính của nó:
- Tổng số tham số: 132 tỷ trên tất cả các mô hình chuyên gia
- Tham số hoạt động: 36 tỷ trên mỗi lần truyền qua
- Số lượng chuyên gia: Tổng cộng 16 (phương pháp MoE Top-4), với 4 chuyên gia hoạt động cho mỗi token cụ thể
- Cửa sổ bối cảnh: 32K token
Thông số kỹ thuật về dữ liệu huấn luyện và token của DBRX
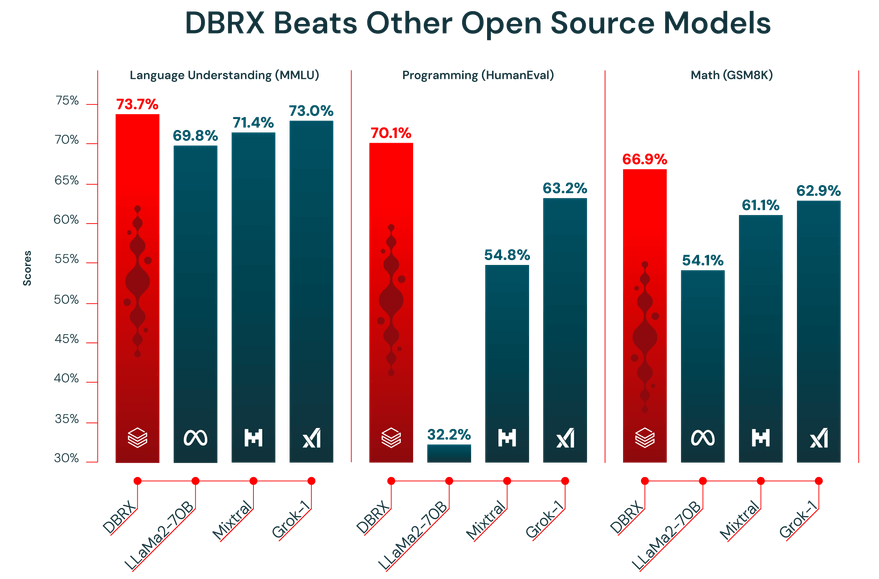
Hiệu suất của một mô hình ngôn ngữ lớn (LLM) phụ thuộc hoàn toàn vào chất lượng dữ liệu được sử dụng để huấn luyện. DBRX đã được huấn luyện trước trên một bộ dữ liệu khổng lồ gồm 12 nghìn tỷ token, được nhóm Databricks tuyển chọn kỹ lưỡng bằng các công cụ xử lý dữ liệu tiên tiến của họ. Chính điều này đã giúp DBRX đạt được hiệu suất vượt trội trong các bài kiểm tra chuẩn của ngành.
Ngoài ra, DBRX còn có tính năng cửa sổ ngữ cảnh 32.000 token. Đây là lượng văn bản mà mô hình có thể xử lý cùng một lúc. Cửa sổ ngữ cảnh lớn rất hữu ích cho các công việc phức tạp như tóm tắt các báo cáo dài, phân tích các tài liệu pháp lý dài dòng hoặc xây dựng các hệ thống tạo nội dung được tăng cường bằng truy xuất (RAG) tiên tiến, vì nó cho phép mô hình duy trì ngữ cảnh mà không bị cắt xén hoặc bỏ sót thông tin.
🎥 Xem video này để thấy việc phối hợp dự án được tối ưu hóa như thế nào có thể thay đổi quy trình huấn luyện AI của bạn và loại bỏ những rắc rối khi phải chuyển đổi giữa các công cụ không liên kết với nhau. 👇🏽
Cách truy cập và cài đặt DBRX
DBRX cung cấp hai phương thức truy cập chính, cả hai đều cho phép truy cập đầy đủ vào các trọng số mô hình theo điều khoản thương mại linh hoạt. Bạn có thể sử dụng Hugging Face để có được sự linh hoạt tối đa hoặc truy cập trực tiếp qua Databricks để có trải nghiệm tích hợp hơn.
Truy cập DBRX thông qua Hugging Face
Đối với các nhóm coi trọng tính linh hoạt và đã quen thuộc với hệ sinh thái Hugging Face, việc truy cập DBRX thông qua Hub là lựa chọn lý tưởng. Điều này cho phép bạn tích hợp mô hình vào các quy trình làm việc dựa trên Transformer hiện có của mình.
Dưới đây là cách bắt đầu:
- Tạo hoặc đăng nhập vào tài khoản Hugging Face của bạn
- Truy cập thẻ mô hình DBRX trên Hub và chấp nhận các điều khoản cấp phép
- Cài đặt thư viện transformers cùng với các phụ thuộc cần thiết như accelerate
- Sử dụng lớp AutoModelForCausalLM trong tập lệnh Python của bạn để tải mô hình DBRX
- Cấu hình đường ống suy luận của bạn, lưu ý rằng DBRX yêu cầu dung lượng bộ nhớ GPU (VRAM) đáng kể để hoạt động hiệu quả
📖 Đọc thêm: Cách cấu hình nhiệt độ LLM
Truy cập DBRX thông qua Databricks
Nếu nhóm của bạn đã sử dụng Databricks cho công việc kỹ thuật dữ liệu hoặc học máy, việc truy cập DBRX thông qua nền tảng này là cách đơn giản nhất. Điều này giúp loại bỏ các rào cản trong quá trình thiết lập và cung cấp cho bạn tất cả các công cụ cần thiết cho MLOps ngay tại nơi bạn đang làm việc.
Hãy làm theo các bước sau trong Không gian Làm việc Databricks của bạn để bắt đầu:
- Truy cập vào phần Model Garden hoặc phần Mosaic AI
- Lựa chọn DBRX Base hoặc DBRX Instruct tùy theo nhu cầu của bạn
- Cấu hình điểm cuối phục vụ để truy cập API hoặc cài đặt môi trường notebook để sử dụng tương tác
- Bắt đầu thử nghiệm suy luận với các lời nhắc mẫu để đảm bảo mọi thứ hoạt động chính xác trước khi mở rộng quy mô đào tạo hoặc triển khai mô hình AI của bạn
Cách tiếp cận này giúp bạn truy cập liền mạch vào các công cụ như MLflow để theo dõi thí nghiệm và Unity Catalog để quản trị mô hình.
📮 ClickUp Insight: Trung bình, mỗi chuyên gia dành hơn 30 phút mỗi ngày để tìm kiếm thông tin liên quan đến công việc — điều này đồng nghĩa với việc mỗi năm họ mất hơn 120 giờ để lục lọi email, các chủ đề trên Slack và các tệp tin nằm rải rác.
Một trợ lý AI thông minh được tích hợp sẵn trong không gian làm việc của bạn có thể thay đổi điều đó. Hãy khám phá ClickUp Brain.
Nó cung cấp thông tin chi tiết và câu trả lời ngay lập tức bằng cách hiển thị các tài liệu, cuộc hội thoại và chi tiết công việc phù hợp chỉ trong vài giây — giúp bạn ngừng tìm kiếm và bắt đầu công việc.
Cách tinh chỉnh DBRX và huấn luyện các mô hình AI tùy chỉnh
Một mô hình có sẵn, dù mạnh mẽ đến đâu, cũng sẽ không bao giờ hiểu được những nét đặc thù riêng biệt của kinh doanh của bạn. Vì DBRX là mã nguồn mở, bạn có thể tinh chỉnh nó để tạo ra một mô hình tùy chỉnh phù hợp với ngôn ngữ của công ty bạn hoặc thực hiện một công việc cụ thể mà bạn muốn nó đảm nhận.
Dưới đây là ba cách phổ biến để thực hiện việc cần làm này:
1. Tinh chỉnh DBRX bằng các bộ dữ liệu của Hugging Face
Đối với các nhóm mới bắt đầu hoặc đang thực hiện các công việc thông thường, các bộ dữ liệu công khai từ Hugging Face Hub là một nguồn tài nguyên tuyệt vời. Chúng đã được định dạng sẵn và dễ tải, nghĩa là bạn không cần phải mất hàng giờ để chuẩn bị dữ liệu.
Quy trình này khá đơn giản:
- Tìm bộ dữ liệu trên Hub phù hợp với công việc của bạn (ví dụ: tuân theo hướng dẫn, tóm tắt)
- Tải dữ liệu bằng thư viện tập dữ liệu
- Đảm bảo dữ liệu được định dạng thành các cặp lệnh-phản hồi
- Cấu hình tập lệnh huấn luyện của bạn với các siêu tham số như tốc độ học và kích thước lô
- Khởi chạy tác vụ huấn luyện, đồng thời đảm bảo lưu các điểm kiểm tra kỳ
- Đánh giá mô hình đã được tinh chỉnh trên tập dữ liệu xác thực được giữ lại để đo lường mức độ cải thiện
2. Tinh chỉnh DBRX bằng các bộ dữ liệu cục bộ
Thông thường, bạn sẽ đạt được kết quả tốt nhất bằng cách tinh chỉnh mô hình dựa trên dữ liệu độc quyền của riêng mình. Điều này cho phép bạn dạy mô hình các thuật ngữ, phong cách và kiến thức chuyên ngành cụ thể của công ty bạn. Tuy nhiên, hãy lưu ý rằng việc này chỉ mang lại hiệu quả nếu dữ liệu của bạn sạch sẽ, được chuẩn bị kỹ lưỡng và có khối lượng đủ lớn.
Thực hiện theo các bước sau để chuẩn bị dữ liệu nội bộ của bạn:
- Thu thập dữ liệu: Thu thập các ví dụ chất lượng cao từ các trang wiki nội bộ, tài liệu và cơ sở dữ liệu của bạn
- Chuyển đổi định dạng: Tổ chức dữ liệu của bạn theo định dạng lệnh-phản hồi nhất quán, thường dưới dạng các dòng JSON
- Lọc chất lượng: Loại bỏ các ví dụ có chất lượng thấp, trùng lặp hoặc không liên quan
- Phân chia dữ liệu để kiểm định: Dành ra một phần nhỏ dữ liệu (thường là 10–15%) để đánh giá hiệu suất của mô hình
- Kiểm tra bảo mật: Xóa hoặc che giấu mọi thông tin nhận dạng cá nhân (PII) hoặc dữ liệu nhạy cảm
3. Tinh chỉnh DBRX với StreamingDataset
Nếu tập dữ liệu của bạn quá lớn để chứa vừa trong bộ nhớ máy, đừng lo lắng, bạn có thể sử dụng thư viện Streaming Dataset của Databricks. Thư viện này cho phép bạn truyền dữ liệu trực tiếp từ kho lưu trữ đám mây trong khi mô hình đang được huấn luyện, thay vì phải tải toàn bộ dữ liệu vào bộ nhớ cùng một lúc.
Dưới đây là việc cần làm:
- Chuẩn bị dữ liệu: Làm sạch và cấu trúc dữ liệu huấn luyện, sau đó lưu trữ dưới định dạng có thể truyền dữ liệu như JSONL hoặc CSV trên dịch vụ lưu trữ đám mây
- Chuyển đổi định dạng dữ liệu luồng: Chuyển đổi tập dữ liệu của bạn sang định dạng phù hợp với dữ liệu luồng, chẳng hạn như Mosaic Data Shard (MDS), để dữ liệu có thể được đọc một cách hiệu quả trong quá trình huấn luyện
- Thiết lập trình tải dữ liệu huấn luyện: Thiết lập trình tải dữ liệu huấn luyện để trỏ đến bộ dữ liệu từ xa và định nghĩa bộ nhớ đệm cục bộ để lưu trữ dữ liệu tạm thời
- Khởi tạo mô hình: Bắt đầu quá trình tinh chỉnh DBRX bằng cách sử dụng một khung huấn luyện hỗ trợ StreamingDataset, chẳng hạn như LLM Foundry
- Huấn luyện dựa trên luồng dữ liệu: Chạy tác vụ huấn luyện trong khi dữ liệu được truyền theo từng đợt trong quá trình huấn luyện, thay vì tải toàn bộ dữ liệu vào bộ nhớ
- Điểm kiểm tra và khôi phục: Tiếp tục huấn luyện một cách liền mạch nếu quá trình huấn luyện bị gián đoạn, mà không cần sao chép hoặc bỏ qua dữ liệu
- Đánh giá và triển khai: Xác thực hiệu suất của mô hình đã được tinh chỉnh và triển khai mô hình đó bằng cách sử dụng thiết lập phục vụ hoặc suy luận mà bạn ưa thích
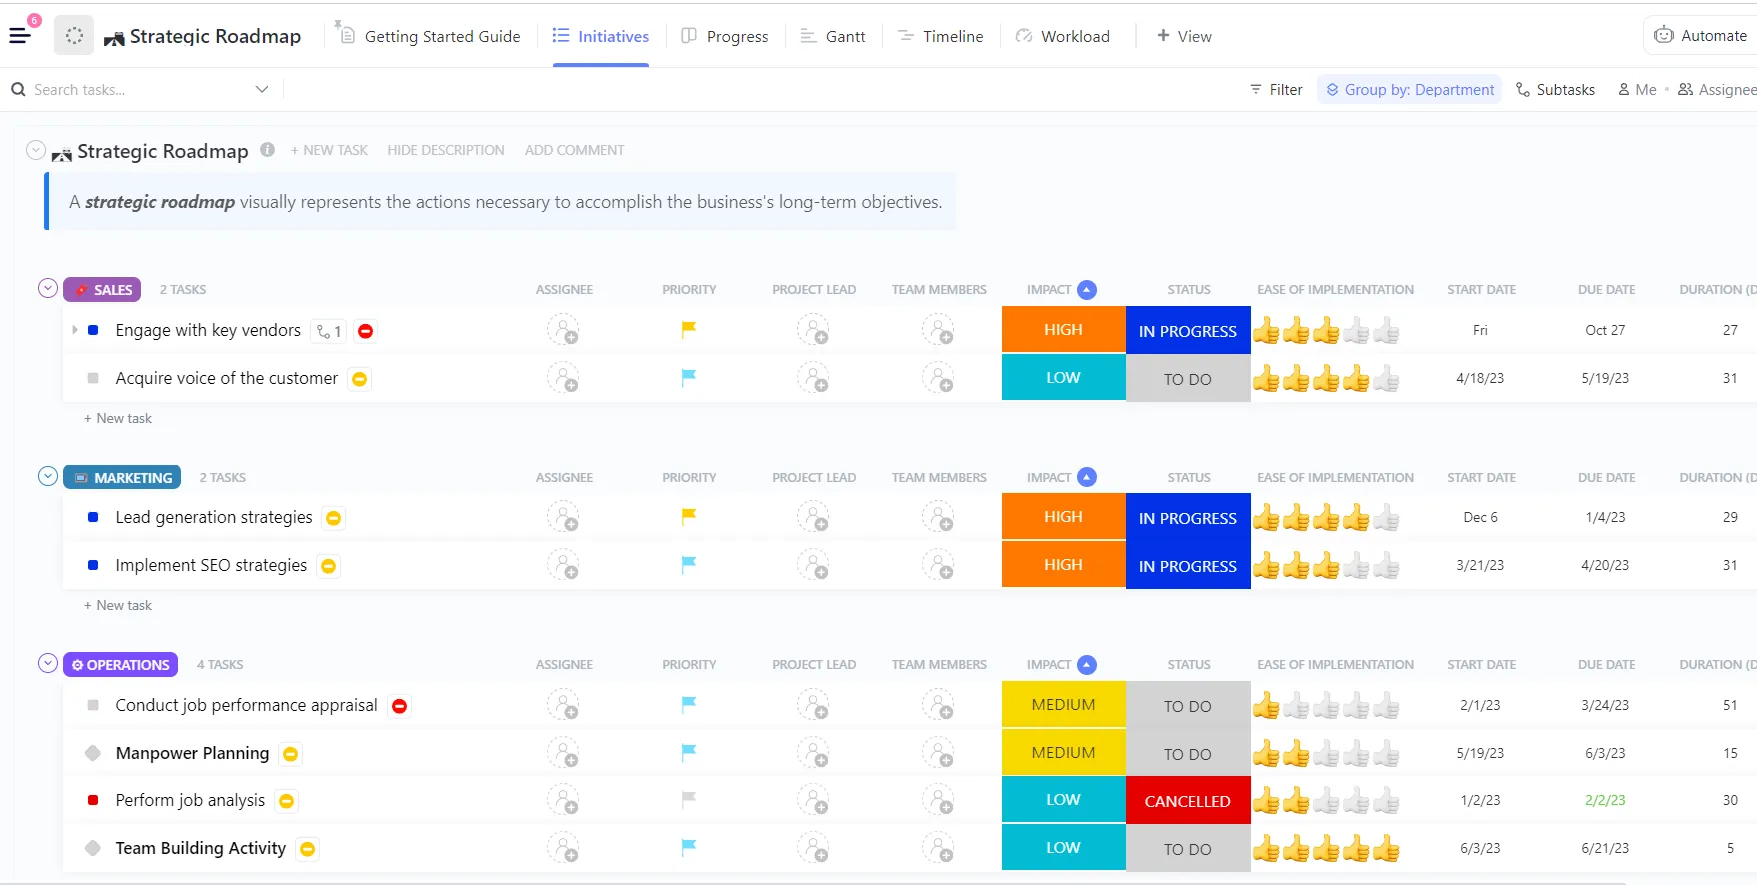
💡Mẹo chuyên nghiệp: Thay vì xây dựng kế hoạch huấn luyện DBRX từ đầu, hãy bắt đầu với Mẫu lộ trình dự án AI và Học máy của ClickUp và điều chỉnh nó cho phù hợp với nhu cầu của nhóm bạn. Mẫu này cung cấp một cấu trúc rõ ràng để lập kế hoạch cho tập dữ liệu, các giai đoạn huấn luyện, đánh giá và triển khai, giúp bạn tập trung vào việc tổ chức công việc thay vì phải xây dựng quy trình làm việc.
Các trường hợp sử dụng DBRX cho việc huấn luyện mô hình AI
Có một mô hình mạnh mẽ là một chuyện, nhưng biết chính xác mô hình đó phát huy hiệu quả ở đâu lại là chuyện khác.
Khi bạn chưa có cái nhìn rõ ràng về những điểm mạnh của mô hình, bạn rất dễ lãng phí thời gian và nguồn lực để cố gắng áp dụng mô hình đó vào những trường hợp mà nó hoàn toàn không phù hợp. Điều này dẫn đến kết quả không như mong đợi và gây ra sự thất vọng.
Kiến trúc độc đáo và dữ liệu huấn luyện của DBRX khiến nền tảng này đặc biệt phù hợp với nhiều trường hợp sử dụng quan trọng trong doanh nghiệp. Hiểu rõ những điểm mạnh này sẽ giúp bạn điều chỉnh mô hình sao cho phù hợp với mục tiêu kinh doanh và tối đa hóa lợi tức đầu tư.
Tạo văn bản và tạo/lập nội dung
DBRX Instruct được tối ưu hóa để tuân thủ các hướng dẫn và tạo ra văn bản chất lượng cao. Điều này khiến nó trở thành một công cụ mạnh mẽ để tự động hóa một phạm vi rộng của các công việc liên quan đến nội dung. Cửa sổ ngữ cảnh rộng lớn của nó là một lợi thế đáng kể, cho phép nó xử lý các tài liệu dài mà không bị mất chủ đề.
Bạn có thể sử dụng nó cho:
- Tài liệu kỹ thuật: Tạo và hoàn thiện các tài liệu hướng dẫn sản phẩm, tài liệu tham khảo API và hướng dẫn người dùng
- Nội dung tiếp thị: Bản nháp bài viết blog, bản tin email và các bài đăng trên mạng xã hội
- Tạo báo cáo: Tóm tắt các kết quả phân tích dữ liệu phức tạp và tạo các bản tóm tắt điều hành súc tích
- Dịch thuật và bản địa hóa: Điều chỉnh nội dung hiện có để phù hợp với các thị trường và đối tượng mới
Các công việc tạo mã và gỡ lỗi
Một phần đáng kể trong dữ liệu huấn luyện của DBRX bao gồm mã nguồn, giúp nó trở thành công cụ hỗ trợ LLM hiệu quả cho các nhà phát triển. Nó có thể giúp đẩy nhanh chu kỳ phát triển bằng cách tự động hóa các công việc lập trình lặp đi lặp lại và hỗ trợ giải quyết các vấn đề phức tạp.
Dưới đây là một số cách mà nhóm kỹ thuật của bạn có thể tận dụng công cụ này:
- Tự động hoàn thành mã: Tự động tạo nội dung hàm từ các bình luận hoặc docstring
- Phát hiện lỗi: Phân tích các đoạn mã để xác định các lỗi tiềm ẩn hoặc lỗ hổng logic
- Giải thích mã nguồn: Chuyển đổi các thuật toán phức tạp hoặc mã nguồn cũ sang tiếng Anh thông dụng
- Tạo bài kiểm thử: Tạo các bài kiểm thử đơn vị dựa trên chữ ký hàm và hành vi dự kiến của hàm
RAG và các ứng dụng bối cảnh dài
Retrieval-Augmented Generation (RAG) là một kỹ thuật mạnh mẽ giúp các phản hồi của mô hình dựa trên dữ liệu riêng tư của công ty bạn. Tuy nhiên, các hệ thống RAG thường gặp khó khăn với các mô hình có cửa sổ ngữ cảnh nhỏ, buộc phải chia nhỏ dữ liệu một cách mạnh tay, dẫn đến việc mất đi ngữ cảnh quan trọng. Cửa sổ ngữ cảnh 32K của DBRX khiến nó trở thành nền tảng tuyệt vời cho các ứng dụng RAG mạnh mẽ.
Điều này cho phép bạn xây dựng các công cụ nội bộ mạnh mẽ, chẳng hạn như:
- Tìm kiếm doanh nghiệp: Tạo một chatbot trả lời các câu hỏi của nhân viên bằng cách sử dụng cơ sở kiến thức nội bộ của bạn
- Hỗ trợ khách hàng: Xây dựng một hệ thống tự động tạo ra các phản hồi hỗ trợ dựa trên tài liệu hướng dẫn sản phẩm của bạn
- Hỗ trợ nghiên cứu: Phát triển một công cụ có thể tổng hợp thông tin từ hàng trăm trang bài báo nghiên cứu
- Kiểm tra tuân thủ: Tự động xác minh nội dung tiếp thị dựa trên các hướng dẫn thương hiệu nội bộ hoặc các tài liệu quy định
Cách tích hợp quá trình huấn luyện DBRX vào quy trình làm việc của nhóm
Một dự án huấn luyện mô hình AI thành công không chỉ đơn thuần là vấn đề về mã nguồn và tài nguyên tính toán. Đó là một nỗ lực hợp tác giữa các kỹ sư học máy, nhà khoa học dữ liệu, quản lý sản phẩm và các bên liên quan.
Khi sự hợp tác này bị phân tán trên các sổ tay Jupyter, các kênh Slack và các công cụ quản lý dự án riêng biệt, bạn sẽ tạo ra sự phân tán bối cảnh, một tình huống mà thông tin quan trọng của dự án bị phân tán trên quá nhiều công cụ.
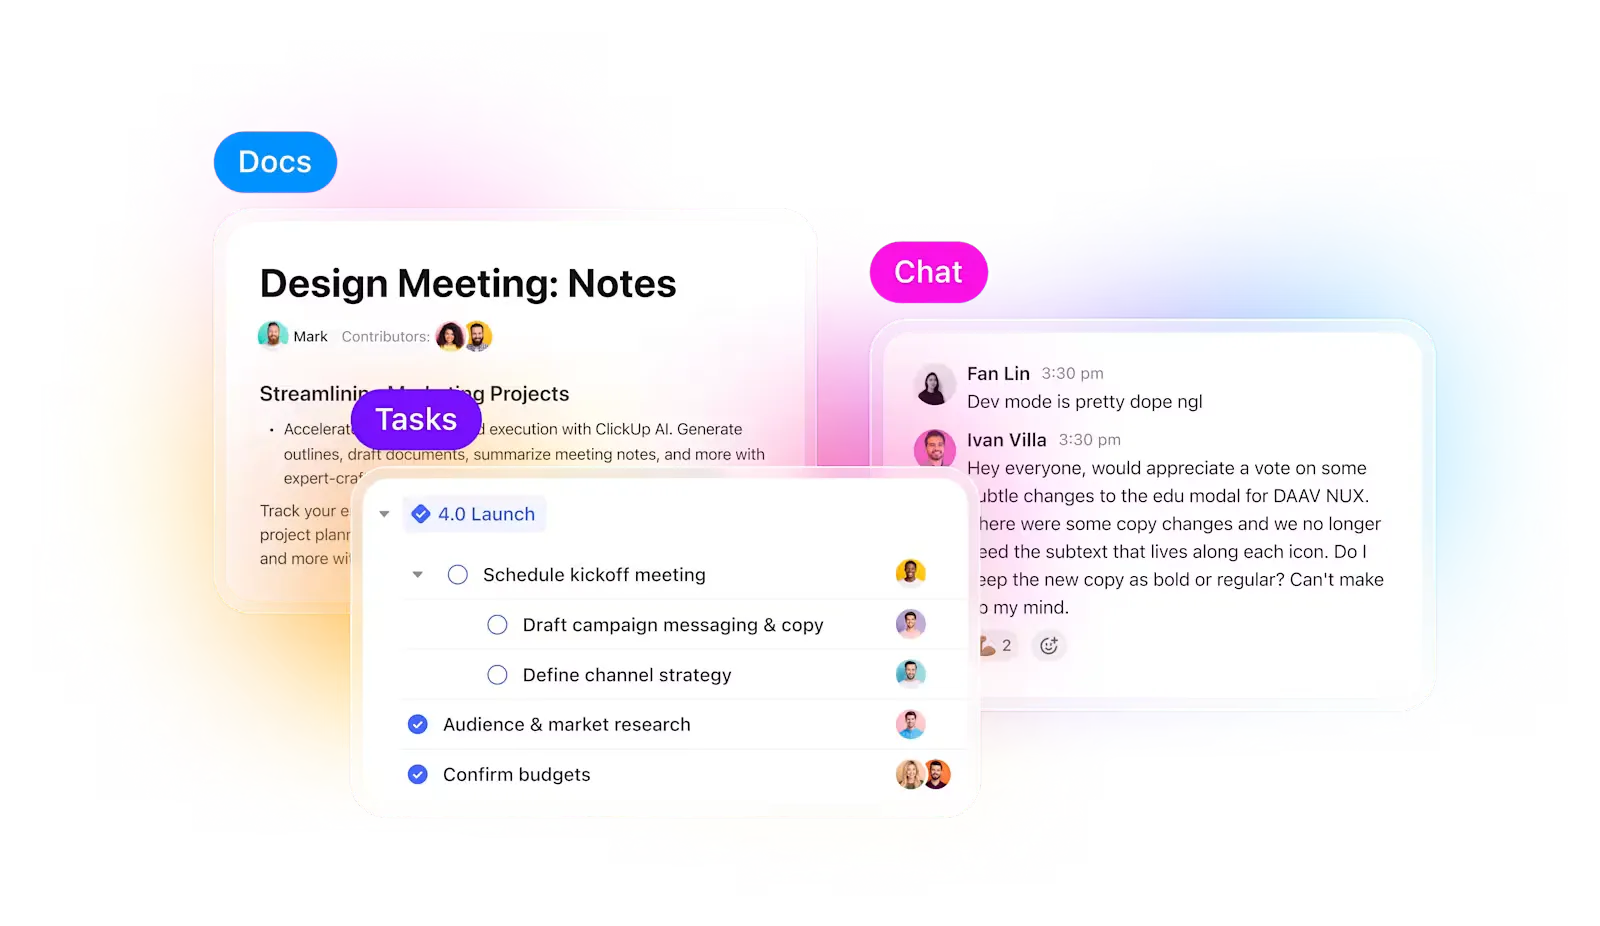
ClickUp giải quyết vấn đề đó. Thay vì phải xoay xở với nhiều công cụ khác nhau, bạn sẽ có một Không gian Làm việc AI tích hợp, nơi quản lý dự án, tài liệu và giao tiếp được kết hợp trong cùng một nền tảng — nhờ đó các thí nghiệm của bạn luôn được kết nối liền mạch từ giai đoạn kế hoạch, thực thi đến đánh giá.
Không bao giờ bỏ lỡ các thí nghiệm và tiến độ
Khi thực hiện nhiều thí nghiệm, phần khó nhất không phải là huấn luyện mô hình, mà là đang theo dõi những thay đổi xảy ra trong quá trình đó. Phiên bản tập dữ liệu nào đã được sử dụng, tốc độ học nào mang lại hiệu quả tốt nhất, hay phiên bản chạy nào đã được triển khai?
ClickUp giúp quá trình này trở nên cực kỳ đơn giản cho bạn. Bạn có thể theo dõi mỗi lần huấn luyện riêng biệt trong nhiệm vụ ClickUp, và trong các nhiệm vụ, bạn có thể sử dụng Trường Tùy chỉnh để ghi lại:
- Phiên bản tập dữ liệu
- Siêu tham số
- Biến thể mô hình (DBRX Base so với DBRX Instruct)
- Trạng thái huấn luyện (Đang xếp hàng, Đang chạy, Đang đánh giá, Đã triển khai)
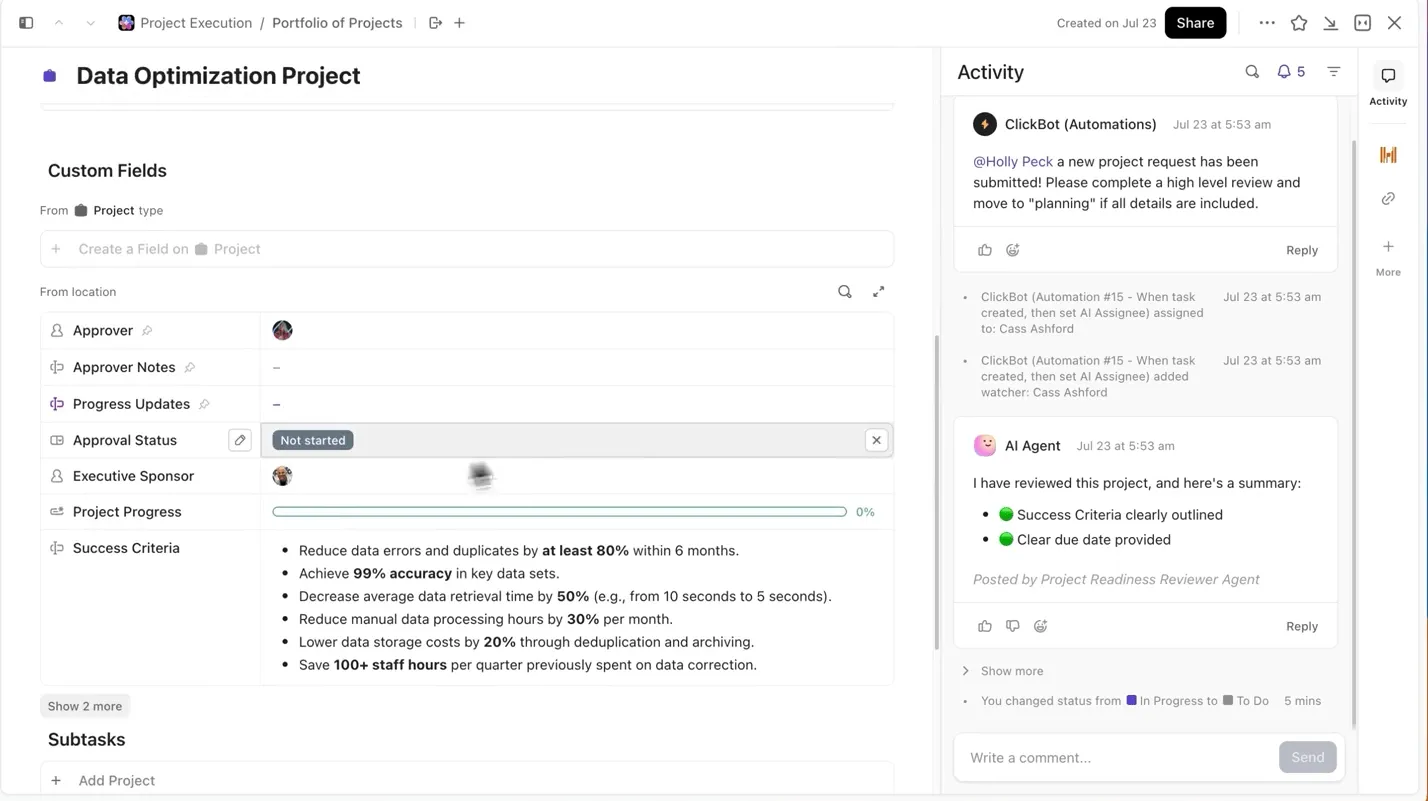
Nhờ đó, mọi thí nghiệm được ghi chép đều có thể tìm kiếm được, dễ so sánh với các thí nghiệm khác và có thể tái tạo lại.
Giữ tài liệu mô hình gắn liền với công việc
Bạn không cần phải chuyển qua lại giữa các notebook Jupyter, tệp README hay các chủ đề trên Slack để nắm bắt bối cảnh của công việc trong một thí nghiệm.
Với ClickUp Docs, bạn có thể sắp xếp và truy cập dễ dàng kiến trúc mô hình, các tập lệnh chuẩn bị dữ liệu hoặc các chỉ số đánh giá bằng cách ghi chép chúng vào một tài liệu có thể tìm kiếm được, liên kết trực tiếp đến các công việc thí nghiệm mà chúng xuất phát.
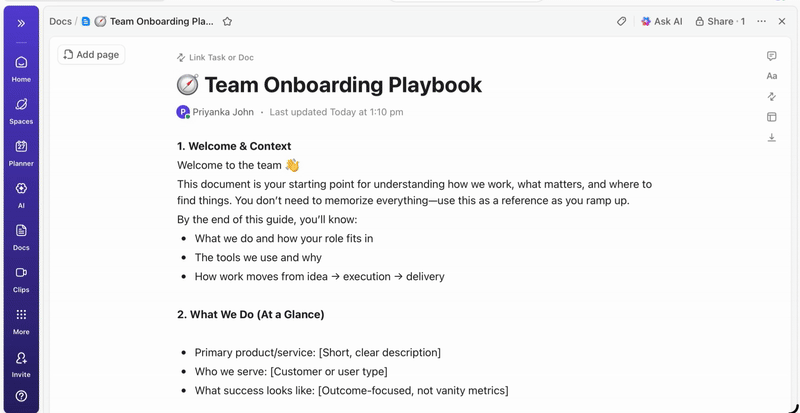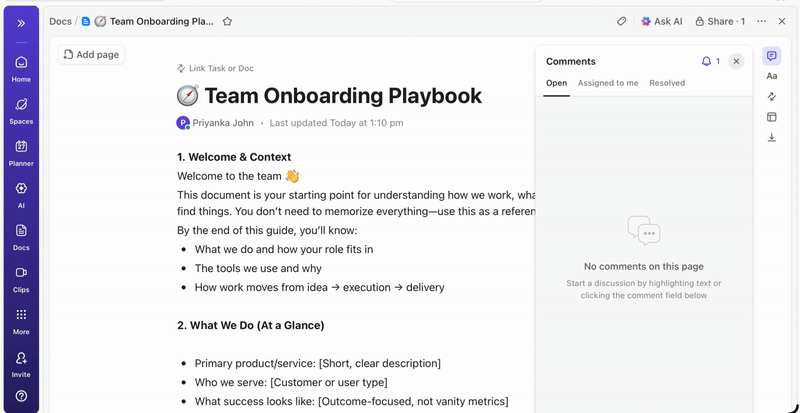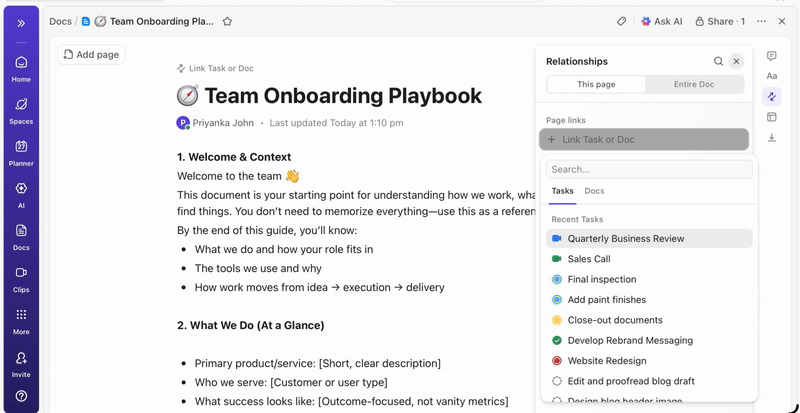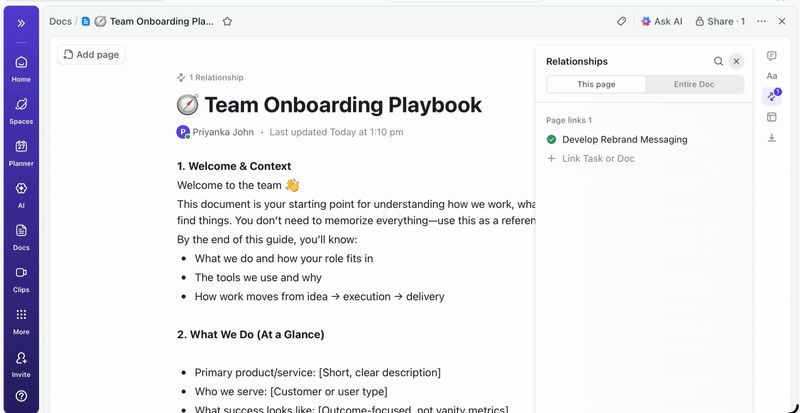
💡Mẹo chuyên nghiệp: Duy trì một bản tóm tắt dự án cập nhật liên tục trong ClickUp Tài liệu, trong đó nêu chi tiết mọi quyết định, từ kiến trúc đến triển khai, để các thành viên mới trong nhóm luôn có thể nắm bắt nhanh chóng các chi tiết dự án mà không cần phải lục lọi các chủ đề cũ
Hiển thị cho các bên liên quan tình hình theo thời gian thực
Các bảng điều khiển ClickUp hiển thị tiến độ thí nghiệm và khối lượng công việc của nhóm theo thời gian thực. I
Thay vì phải tổng hợp các bản cập nhật thủ công hoặc gửi email, các bảng điều khiển sẽ tự động cập nhật dựa trên dữ liệu trong các công việc của bạn. Nhờ đó, các bên liên quan có thể kiểm tra trạng thái bất cứ lúc nào, nắm bắt tình hình hiện tại và không bao giờ phải làm phiền bạn với những câu hỏi kiểu “trạng thái hiện tại thế nào?”.
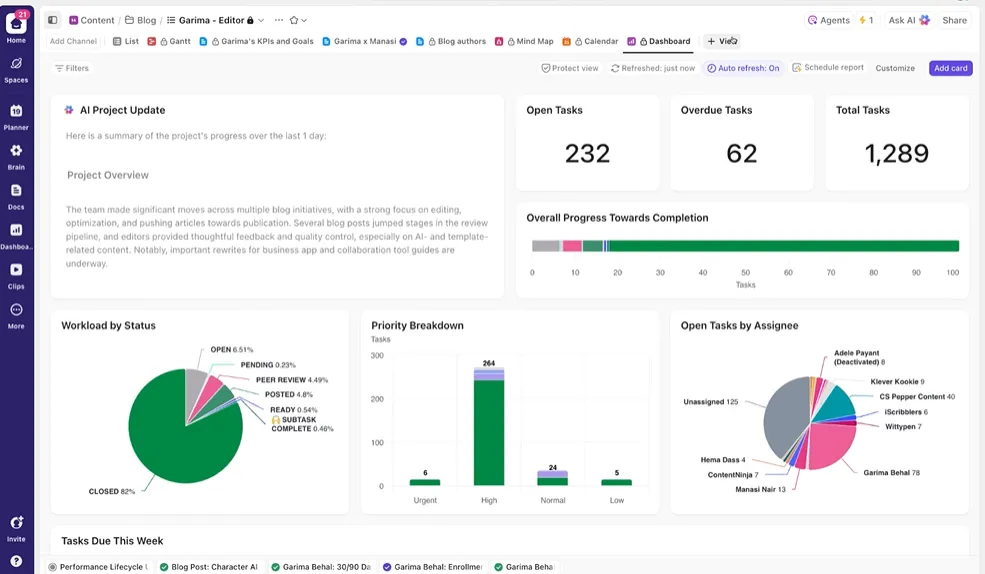
Nhờ đó, bạn có thể tập trung vào việc thực hiện các thí nghiệm thay vì phải liên tục báo cáo thủ công về chúng.
Biến AI thành trợ thủ đắc lực cho dự án của bạn
Bạn không cần phải tự tay lục lọi hàng tuần dữ liệu huấn luyện để có được bản tóm tắt về các thí nghiệm đã thực hiện. Chỉ cần đề cập @Brain trong bất kỳ bình luận nào trên công việc, và ClickUp Brain sẽ cung cấp cho bạn sự hỗ trợ cần thiết với bối cảnh đầy đủ về các dự án đã qua và đang diễn ra.
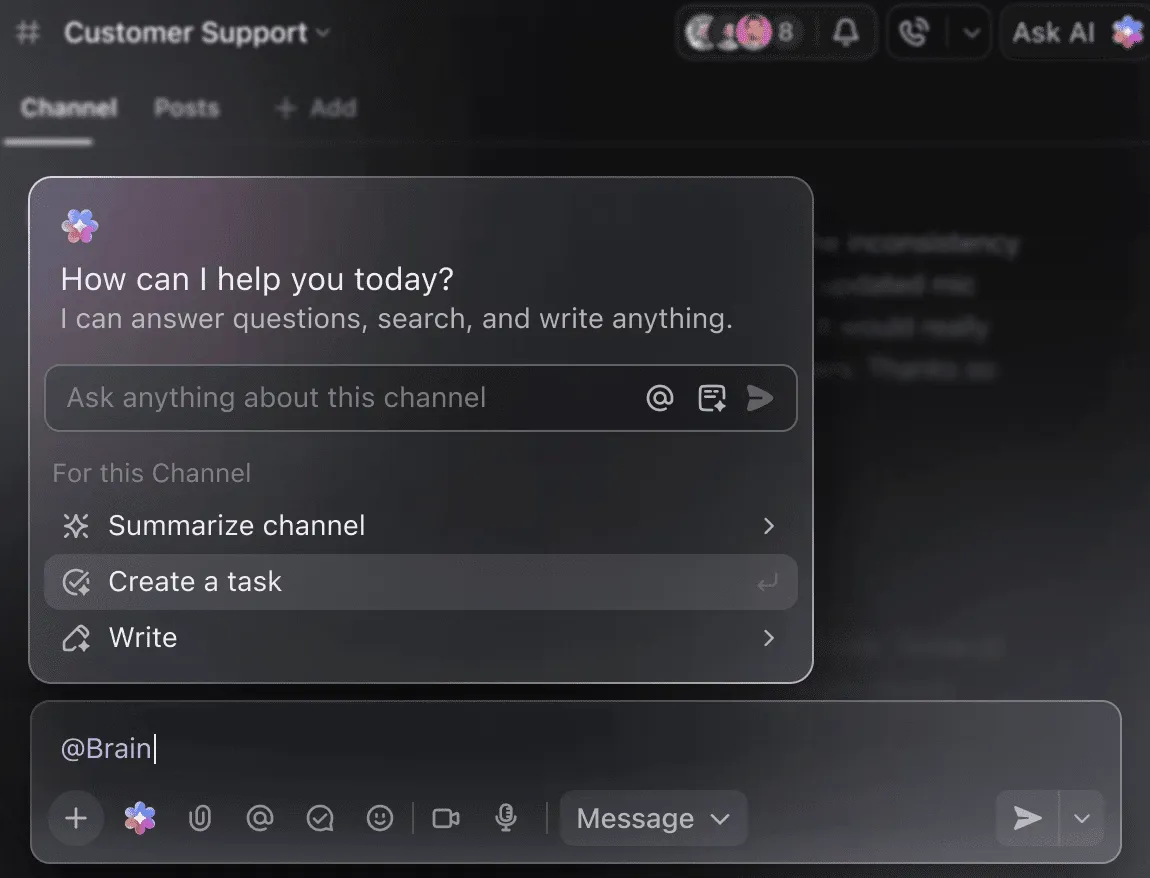
Bạn có thể yêu cầu Brain “Tóm tắt các thí nghiệm của tuần trước thành 5 điểm chính” hoặc “Soạn thảo một tài liệu với kết quả siêu tham số mới nhất”, và ngay lập tức nhận được kết quả hoàn chỉnh.
🧠 Lợi thế của ClickUp: Các Super Agent của ClickUp còn tiến xa hơn thế nữa — chúng có thể tự động hóa toàn bộ quy trình làm việc dựa trên các điều kiện kích hoạt do bạn xác định, chứ không chỉ đơn thuần trả lời các câu hỏi của bạn. Với các siêu trợ lý, bạn có thể tự động tạo một công việc huấn luyện DBRX mới mỗi khi bộ dữ liệu được tải lên, thông báo cho nhóm của bạn, liên kết các tài liệu liên quan khi quá trình huấn luyện hoàn tất hoặc đạt đến điểm kiểm tra, đồng thời tạo báo cáo tiến độ hàng tuần và gửi cho các bên liên quan mà bạn không cần phải làm gì cả.
Những sai lầm thường gặp cần tránh
Bắt tay vào một dự án huấn luyện DBRX là điều rất thú vị, nhưng một số sai lầm thường gặp có thể làm chậm tiến độ của bạn. Tránh những sai lầm này sẽ giúp bạn tiết kiệm thời gian, tiền bạc và giảm bớt rất nhiều sự bực bội.
- Đánh giá thấp yêu cầu phần cứng: DBRX rất mạnh mẽ, nhưng cũng rất “khổng lồ”. Việc cố gắng chạy nó trên phần cứng không đủ mạnh sẽ dẫn đến lỗi hết bộ nhớ và các tác vụ huấn luyện bị thất bại. Hãy lưu ý rằng DBRX (132B) yêu cầu ít nhất 264GB VRAM cho suy luận 16-bit, hoặc khoảng 70GB–80GB khi sử dụng lượng tử hóa 4-bit
- Bỏ qua các bước kiểm tra chất lượng dữ liệu: Dữ liệu đầu vào kém chất lượng sẽ dẫn đến kết quả đầu ra kém chất lượng. Việc tinh chỉnh mô hình trên một tập dữ liệu lộn xộn và chất lượng thấp sẽ chỉ khiến mô hình tạo ra các kết quả lộn xộn và kém chất lượng.
- Bỏ qua giới hạn độ dài bối cảnh: Mặc dù cửa sổ bối cảnh 32K của DBRX khá rộng rãi, nhưng nó không phải là vô hạn. Việc cung cấp cho mô hình các đầu vào vượt quá giới hạn này sẽ dẫn đến việc cắt bớt dữ liệu mà không có cảnh báo và hiệu suất kém là kết quả.
- Khi nào nên sử dụng DBRX Base thay vì DBRX Instruct: DBRX Base là một mô hình thô, đã được huấn luyện sẵn, dành cho việc huấn luyện tiếp theo trên quy mô lớn. Đối với hầu hết các công việc tuân theo hướng dẫn, bạn nên bắt đầu với DBRX Instruct, mô hình này đã được tinh chỉnh sẵn cho mục đích đó.
- Tách biệt công việc huấn luyện khỏi việc điều phối dự án: Khi công việc đang theo dõi thí nghiệm được thực hiện trên một công cụ riêng biệt và kế hoạch dự án lại nằm trên một công cụ khác, bạn sẽ tạo ra các “hộp đen” thông tin. Hãy sử dụng một nền tảng tích hợp như ClickUp để đảm bảo công việc kỹ thuật và việc điều phối dự án luôn đồng bộ với nhau
- Bỏ qua việc đánh giá trước khi triển khai: Một mô hình hoạt động tốt trên dữ liệu huấn luyện có thể thất bại thảm hại trong thực tế. Luôn kiểm chứng mô hình đã được tinh chỉnh của bạn trên tập dữ liệu thử nghiệm được giữ lại trước khi triển khai vào môi trường sản xuất
- Bỏ qua độ phức tạp của quá trình tinh chỉnh: Vì DBRX là mô hình Mixture-of-Experts, các skript tinh chỉnh tiêu chuẩn có thể yêu cầu các thư viện chuyên dụng như Megatron-LM hoặc PyTorch FSDP để xử lý việc phân chia tham số trên nhiều GPU
DBRX so với các nền tảng huấn luyện AI khác
Việc lựa chọn nền tảng huấn luyện AI đòi hỏi phải cân nhắc giữa hai yếu tố cơ bản: quyền kiểm soát và sự tiện lợi. Các mô hình độc quyền, chỉ hỗ trợ API rất dễ sử dụng nhưng lại khiến bạn bị ràng buộc trong hệ sinh thái của nhà cung cấp.
Các mô hình trọng số mở như DBRX mang lại quyền kiểm soát hoàn toàn nhưng đòi hỏi nhiều kiến thức kỹ thuật và hạ tầng hơn. Lựa chọn này có thể khiến bạn cảm thấy bế tắc, không chắc chắn con đường nào thực sự hỗ trợ mục tiêu dài hạn của mình — một thách thức mà nhiều nhóm phải đối mặt trong quá trình áp dụng AI.
Bảng này phân tích các điểm khác biệt chính để giúp bạn đưa ra quyết định sáng suốt.
| Hệ số trọng số | Mở (Tùy chỉnh) | Độc quyền | Mở (Tùy chỉnh) | Độc quyền |
| Tinh chỉnh | Kiểm soát hoàn toàn | Dựa trên API | Kiểm soát hoàn toàn | Dựa trên API |
| Tự lưu trữ | Có | Không | Có | Không |
| Giấy phép | Mô hình mở DB | Điều khoản của OpenAI | Cộng đồng Llama | Các thuật ngữ của Anthropic |
| Bối cảnh | 32K | 128K – 1M | 128K | 200.000 – 1.000.000 |
DBRX là lựa chọn phù hợp khi bạn cần toàn quyền kiểm soát mô hình, phải tự lưu trữ để đảm bảo bảo mật hoặc tuân thủ quy định, hoặc muốn sự linh hoạt từ một giấy phép thương mại có quyền truy cập linh hoạt. Nếu bạn không có hạ tầng GPU chuyên dụng — hoặc bạn coi trọng tốc độ đưa sản phẩm ra thị trường hơn là tùy chỉnh sâu — các giải pháp thay thế dựa trên API có thể phù hợp hơn.
Bắt đầu huấn luyện thông minh hơn với ClickUp
DBRX cung cấp cho bạn một nền tảng sẵn sàng cho doanh nghiệp để xây dựng các ứng dụng AI tùy chỉnh, với tính minh bạch và khả năng kiểm soát mà các mô hình độc quyền không thể mang lại. Kiến trúc MoE hiệu quả của nó giúp giảm chi phí suy luận, và thiết kế mở của nó giúp việc tinh chỉnh trở nên dễ dàng. Tuy nhiên, công nghệ mạnh mẽ chỉ là một nửa của phương trình.
Thành công thực sự đến từ việc kết hợp công việc kỹ thuật với quy trình làm việc hợp tác của nhóm. Huấn luyện mô hình AI là một hoạt động đòi hỏi sự phối hợp của cả nhóm, và việc đồng bộ hóa các thí nghiệm, tài liệu và giao tiếp với các bên liên quan là vô cùng quan trọng. Khi bạn tập trung mọi thứ vào một không gian làm việc thống nhất và giảm thiểu sự phân tán thông tin, bạn có thể triển khai các mô hình tốt hơn, nhanh hơn.
Bắt đầu sử dụng ClickUp miễn phí để điều phối các dự án huấn luyện AI của bạn trong một không gian làm việc duy nhất. ✨
Câu hỏi thường gặp
Làm thế nào để theo dõi tiến độ huấn luyện trong DBRX?
Bạn có thể theo dõi quá trình huấn luyện bằng các công cụ ML tiêu chuẩn như TensorBoard, Weights & Biases hoặc MLflow. Nếu bạn đang huấn luyện trong hệ sinh thái Databricks, MLflow được tích hợp sẵn để theo dõi các thí nghiệm một cách liền mạch.
Tôi có thể tích hợp DBRX với CI/CD và các đường ống triển khai không?
Đúng vậy, DBRX có thể được tích hợp vào các đường ống MLOps tiêu chuẩn. Bằng cách đóng gói mô hình dưới dạng container, bạn có thể triển khai mô hình đó thông qua các nền tảng điều phối như Kubeflow hoặc các quy trình CI/CD tùy chỉnh.
Sự khác biệt giữa DBRX Base và DBRX Instruct là gì?
DBRX Base là mô hình được huấn luyện sẵn cơ bản, dành cho các nhóm muốn thực hiện quá trình huấn luyện tiếp theo theo lĩnh vực cụ thể hoặc tinh chỉnh kiến trúc sâu. DBRX Instruct là phiên bản được tinh chỉnh, tối ưu hóa để tuân theo các hướng dẫn, giúp nó trở thành điểm khởi đầu tốt hơn cho hầu hết các dự án phát triển ứng dụng.
DBRX so sánh như thế nào với GPT-4 trong các dự án AI dành cho doanh nghiệp?
Sự khác biệt chính nằm ở khả năng kiểm soát. DBRX cho phép bạn truy cập đầy đủ vào các tham số mô hình để tùy chỉnh sâu và tự lưu trữ, trong khi GPT-4 là dịch vụ chỉ hỗ trợ qua API.
Bạn có thể sử dụng DBRX miễn phí không?
Các trọng số mô hình DBRX được cung cấp miễn phí theo Giấy phép Mô hình Mở của Databricks. Tuy nhiên, bạn phải chịu trách nhiệm về chi phí cơ sở hạ tầng tính toán cần thiết để chạy hoặc tinh chỉnh mô hình.