Anda merilis pembaruan perangkat lunak terbaru, dan laporan mulai berdatangan.
Tiba-tiba, satu metrik menjadi penentu segala hal, mulai dari CSAT/NPS hingga keterlambatan roadmap: waktu penyelesaian bug.
Para eksekutif memandangnya sebagai metrik penepatan janji—apakah kita dapat merilis produk, belajar, dan melindungi pendapatan sesuai jadwal? Para praktisi merasakan kesulitan di lapangan—tiket yang terduplikasi, kepemilikan yang tidak jelas, eskalasi yang berlebihan, serta konteks yang tersebar di Slack, spreadsheet, dan alat-alat terpisah.
Fragmentasi tersebut memperpanjang siklus, menyembunyikan akar masalah, dan mengubah penetapan prioritas menjadi tebak-tebakan.
Hasilnya? Proses pembelajaran yang melambat, komitmen yang tidak terpenuhi, dan tumpukan pekerjaan yang secara diam-diam membebani setiap sprint.
Panduan ini adalah panduan lengkap Anda untuk mengukur, membandingkan, dan mempersingkat waktu penyelesaian bug, serta menunjukkan secara konkret bagaimana AI mengubah alur kerja dibandingkan dengan proses manual tradisional.
Apa itu Waktu Penyelesaian Bug?
Waktu penyelesaian bug adalah lamanya waktu yang dibutuhkan untuk memperbaiki sebuah bug, yang diukur mulai dari saat bug dilaporkan hingga bug tersebut sepenuhnya terselesaikan.
Dalam praktiknya, penghitungan waktu dimulai saat suatu masalah dilaporkan atau terdeteksi (melalui pengguna, tim QA, atau sistem pemantauan) dan berakhir saat perbaikan telah diterapkan dan digabungkan ke dalam kode, siap untuk verifikasi atau rilis—tergantung pada bagaimana tim Anda mendefinisikan “selesai.”
Contoh: sebuah crash P1 yang dilaporkan pada pukul 10.00 pagi hari Senin, dengan perbaikan yang digabungkan pada pukul 15.00 hari Selasa, memiliki waktu penyelesaian sekitar 29 jam.
Hal ini berbeda dengan waktu deteksi bug. Waktu deteksi mengukur seberapa cepat Anda mengenali suatu cacat setelah terjadi (alarm berbunyi, alat pengujian QA menemukannya, pelanggan melaporkannya).
Waktu penyelesaian mengukur seberapa cepat Anda beralih dari tahap deteksi ke tahap perbaikan—mulai dari triase, reproduksi, diagnosis, implementasi, tinjauan, pengujian, hingga persiapan rilis. Anggaplah deteksi sebagai “kami tahu ada masalah,” dan penyelesaian sebagai “masalahnya sudah diperbaiki dan siap.”
Tim-tim menggunakan batasan yang sedikit berbeda; pilih salah satu dan gunakan secara konsisten agar tren Anda akurat:
- Dilaporkan → Selesai: Berakhir ketika perbaikan kode telah digabungkan dan siap untuk QA. Baik untuk meningkatkan produktivitas tim engineering
- Dilaporkan → Ditutup: Termasuk validasi QA dan rilis. Cocok untuk SLA yang berdampak pada pelanggan
- Terdeteksi → Terselesaikan: Dimulai saat pemantauan/QA mendeteksi masalah, bahkan sebelum tiket dibuat. Berguna bagi tim yang banyak menangani produksi
🧠 Fakta Menarik: Sebuah bug yang unik sekaligus lucu di Final Fantasy XIV mendapat pujian karena sifatnya yang sangat spesifik, hingga para pembaca menjulukinya sebagai “Perbaikan Bug Paling Spesifik dalam Game MMO Tahun 2025.” ” Bug tersebut muncul ketika pemain menetapkan harga item tepat antara 44.442 gil dan 49.087 gil di zona acara tertentu—yang menyebabkan pemutusan koneksi akibat kemungkinan terjadinya glitch overflow bilangan bulat.
Mengapa hal ini penting
Waktu penyelesaian masalah merupakan faktor penentu dalam ritme rilis. Waktu penyelesaian yang lama atau tidak dapat diprediksi memaksa pemotongan cakupan, penerapan hotfix, dan penundaan rilis; hal ini menimbulkan utang perencanaan karena kasus-kasus ekstrem (outlier) lebih sering menggagalkan sprint daripada yang disarankan oleh rata-rata.
Hal ini juga terkait langsung dengan kepuasan pelanggan. Pelanggan akan bersedia mentoleransi masalah jika masalah tersebut segera diakui dan diselesaikan dengan cara yang dapat diprediksi. Perbaikan yang lambat—atau lebih buruk lagi, perbaikan yang tidak konsisten—akan memicu eskalasi, menurunkan skor CSAT/NPS, dan membahayakan perpanjangan langganan.
Singkatnya, jika Anda mengukur waktu penyelesaian bug secara akurat dan sistematis serta menguranginya, peta jalan dan hubungan Anda akan membaik.
📖 Baca Selengkapnya: Cara Menentukan Prioritas Bug untuk Penyelesaian Masalah yang Efisien
Bagaimana Cara Mengukur Waktu Penyelesaian Bug?
Pertama, tentukan kapan waktu mulai dan berakhir.
Sebagian besar tim memilih antara "Dilaporkan → Diselesaikan" (perbaikan telah digabungkan dan siap untuk diverifikasi) atau "Dilaporkan → Ditutup" (tim QA telah memvalidasi dan perubahan tersebut telah dirilis atau ditutup dengan alasan lain).
Pilih satu definisi dan gunakan secara konsisten agar tren Anda bermakna.
Sekarang Anda memerlukan beberapa metrik yang dapat diamati. Mari kita uraikan metrik-metrik tersebut:
Metrik pelacakan bug utama yang perlu diperhatikan:
| 📊 Metrik | 📌 Apa artinya | 💡 Manfaatnya | 🧮 Rumus (Jika Berlaku) |
|---|---|---|---|
| Jumlah Bug 🐞 | Jumlah total bug yang dilaporkan | Memberikan gambaran menyeluruh mengenai kesehatan sistem. Angkanya tinggi? Saatnya untuk menyelidikinya. | Jumlah Bug = Semua bug yang tercatat dalam sistem {Terbuka + Tertutup} |
| Bug yang Belum Diselesaikan 🚧 | Bug yang belum diperbaiki | Menampilkan beban kerja saat ini. Membantu dalam menentukan prioritas. | Bug Terbuka = Total Bug - Bug yang Telah Ditutup |
| Bug yang Telah Ditutup ✅ | Bug yang telah diselesaikan dan diverifikasi | Melacak kemajuan dan pekerjaan yang telah diselesaikan. | Bug yang Ditutup = Jumlah bug dengan status "Ditutup" atau "Terselesaikan" |
| Tingkat Keparahan Bug 🔥 | Tingkat keparahan bug (misalnya, kritis, utama, minor) | Membantu proses triase berdasarkan dampaknya. | Dilacak sebagai bidang kategorikal, tanpa rumus. Gunakan filter/pengelompokan. |
| Prioritas Bug 📅 | Seberapa mendesak bug tersebut perlu diperbaiki | Membantu dalam perencanaan sprint dan rilis. | Juga merupakan bidang kategorikal, biasanya diberi peringkat (misalnya, P0, P1, P2). |
| Waktu Penyelesaian ⏱️ | Waktu dari pelaporan bug hingga perbaikan | Mengukur tingkat responsivitas. | Waktu Penyelesaian = Tanggal Ditutup - Tanggal Dilaporkan |
| Tingkat Pembukaan Kembali 🔄 | Persentase bug yang dibuka kembali setelah ditutup | Mencerminkan kualitas perbaikan atau masalah regresi. | Tingkat Pembukaan Kembali (%) = {Bug yang Dibuka Kembali ÷ Total Bug yang Ditutup} × 100 |
| Kebocoran Bug 🕳️ | Bug yang lolos ke lingkungan produksi | Menunjukkan efektivitas QA/pengujian perangkat lunak. | Tingkat Kebocoran (%) = {Bug Produksi ÷ Total Bug} × 100 |
| Kepadatan Cacat 🧮 | Bug per satuan ukuran kode | Menyoroti area kode yang rentan terhadap risiko. | Kepadatan Bug = Jumlah Bug ÷ KLOC {Kilo Lines of Code} |
| Bug yang Telah Ditugaskan vs. Belum Ditugaskan 👥 | Distribusi bug berdasarkan kepemilikan | Memastikan tidak ada yang terlewatkan. | Gunakan filter: Belum Ditugaskan = Bug di mana kolom "Ditugaskan Kepada" bernilai null |
| Umur Bug yang Masih Terbuka 🧓 | Berapa lama sebuah bug tetap belum terselesaikan | Mendeteksi risiko stagnasi dan penumpukan pekerjaan. | Usia Bug = Tanggal Saat Ini - Tanggal Dilaporkan |
| Bug Duplikat 🧬 | Jumlah laporan duplikat | Menyoroti kesalahan dalam proses penerimaan. | Tingkat Duplikat = Jumlah Duplikat ÷ Jumlah Total Bug × 100 |
| MTTD (Mean Time to Detect) 🔎 | Waktu rata-rata yang dibutuhkan untuk mendeteksi bug atau insiden | Mengukur efisiensi pemantauan dan kesadaran. | MTTD = Σ(Waktu Deteksi - Waktu Munculnya Bug) ÷ Jumlah Bug |
| MTTR (Mean Time to Resolve) 🔧 | Waktu rata-rata untuk memperbaiki bug sepenuhnya setelah terdeteksi | Melacak responsivitas tim teknik dan waktu perbaikan. | MTTR = Σ(Waktu Penyelesaian - Waktu Deteksi) ÷ Jumlah Bug yang Telah Diselesaikan |
| MTTA (Mean Time to Acknowledge) 📬 | Waktu dari saat bug terdeteksi hingga saat seseorang mulai menangani bug tersebut | Menunjukkan reaktivitas tim dan responsivitas terhadap peringatan. | MTTA = Σ(Waktu Pengakuan - Waktu Deteksi) ÷ Jumlah Bug |
| MTBF (Mean Time Between Failures) 🔁 | Waktu antara satu kegagalan yang telah diselesaikan dan kegagalan berikutnya yang terjadi | Menunjukkan stabilitas dari waktu ke waktu. | MTBF = Total Waktu Operasional ÷ Jumlah Kegagalan |
⚡️ Arsip Template: 15 Template dan Formulir Laporan Bug Gratis untuk Pelacakan Bug
Faktor-Faktor yang Mempengaruhi Waktu Penyelesaian Bug
Waktu penyelesaian sering kali disamakan dengan “seberapa cepat para insinyur menulis kode.”
Namun, itu hanyalah salah satu bagian dari proses tersebut.
Waktu penyelesaian bug merupakan gabungan dari kualitas saat penerimaan, efisiensi alur kerja melalui sistem Anda, dan risiko ketergantungan. Ketika salah satu dari faktor tersebut terganggu, waktu siklus menjadi lebih lama, prediktabilitas menurun, dan keluhan semakin meningkat.
Kualitas penerimaan menentukan arahnya
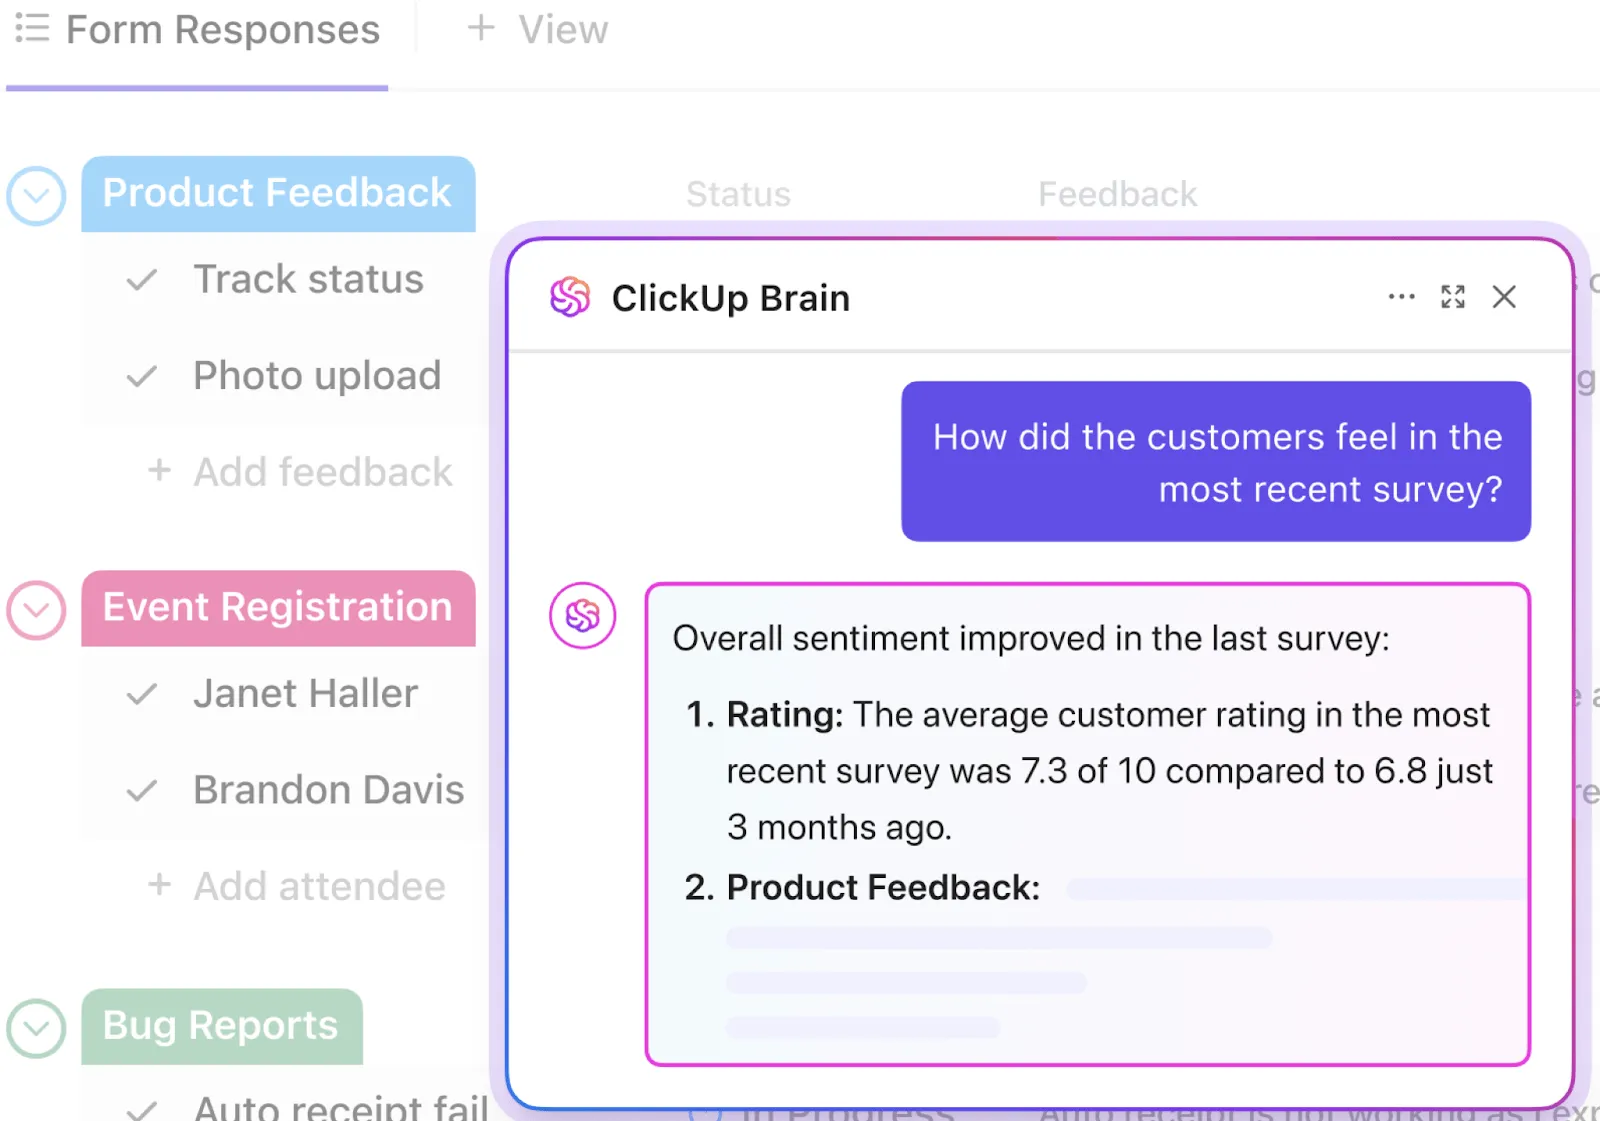
Laporan yang masuk tanpa langkah-langkah reproduksi yang jelas, detail lingkungan, log, atau informasi versi/build memaksa terjadinya komunikasi bolak-balik yang berlebihan. Laporan duplikat dari berbagai saluran (dukungan, QA, pemantauan, Slack) menimbulkan kebisingan dan memecah tanggung jawab.
Semakin cepat Anda mengumpulkan konteks yang tepat—dan menghilangkan duplikat—semakin sedikit proses serah terima dan permintaan klarifikasi yang akan Anda butuhkan di kemudian hari.
Penetapan prioritas dan perutean menentukan siapa yang menangani bug tersebut dan kapan
Label tingkat keparahan yang tidak sesuai dengan dampak terhadap pelanggan/bisnis (atau yang berubah seiring waktu) menyebabkan antrian menjadi kacau: tiket yang paling banyak dikeluhkan mendahului yang lain, sementara bug berdampak tinggi justru tertunda.
Aturan perutean yang jelas berdasarkan komponen/pemilik, serta antrian tunggal yang akurat, mencegah pekerjaan P0/P1 tertimbun di bawah tugas-tugas “terbaru dan berisik.”
Tanggung jawab dan proses serah terima adalah faktor yang diam-diam merugikan
Jika tidak jelas apakah suatu bug termasuk dalam tim seluler, otentikasi backend, atau platform, bug tersebut akan dipindahkan. Setiap pemindahan akan mereset konteks.
Perbedaan zona waktu memperparah masalah ini: bug yang dilaporkan pada akhir hari tanpa penanggung jawab yang ditentukan dapat terbuang 12–24 jam sebelum ada yang mulai mereproduksinya. Definisi yang jelas mengenai “siapa yang bertanggung jawab atas apa”, dengan penanggung jawab piket atau DRI mingguan, dapat menghilangkan keterlambatan tersebut.
Kemampuan untuk mereproduksi masalah bergantung pada kemampuan pemantauan
Log yang tidak lengkap, ID korelasi yang hilang, atau kurangnya jejak crash membuat diagnosis menjadi sekadar tebakan. Bug yang hanya muncul dengan flag, tenant, atau bentuk data tertentu sulit direproduksi di lingkungan pengembangan.
Jika para insinyur tidak dapat mengakses data yang telah disterilkan dan mirip dengan lingkungan produksi secara aman, mereka akhirnya harus melakukan pemantauan, melakukan deployment ulang, dan menunggu—selama berhari-hari alih-alih berjam-jam.
Keselarasan lingkungan dan data memastikan akurasi data Anda
“Berjalan di mesin saya” biasanya berarti “data produksi berbeda.” Semakin jauh lingkungan pengembangan/staging Anda menyimpang dari produksi (konfigurasi, layanan, versi pihak ketiga), semakin lama Anda akan menghabiskan waktu mengejar masalah yang tidak nyata. Snapshot data yang aman, skrip seed, dan pemeriksaan kesesuaian dapat mengurangi kesenjangan tersebut.
Work-in-progress (WIP) dan fokus mendorong throughput aktual
Tim yang kelebihan beban menangani terlalu banyak bug sekaligus, sehingga perhatian mereka terpecah-pecah, dan mereka harus bolak-balik antara tugas dan rapat. Pergantian konteks menambah jam kerja yang tak terlihat.
Batas WIP yang terlihat dan kecenderungan untuk menyelesaikan apa yang sudah dimulai sebelum mengambil pekerjaan baru akan menurunkan median Anda lebih cepat daripada upaya heroik apa pun.
Tinjauan kode, CI, dan kecepatan QA merupakan hambatan klasik
Waktu build yang lambat, pengujian yang tidak stabil, dan SLA tinjauan yang tidak jelas menghambat perbaikan yang seharusnya cepat. Sebuah patch yang hanya membutuhkan 10 menit bisa menghabiskan dua hari menunggu peninjau atau masuk ke dalam pipeline yang memakan waktu berjam-jam.
Demikian pula, antrian QA yang melakukan pengujian secara batch atau bergantung pada uji smoke manual dapat menambah waktu hingga satu hari penuh pada tahap “Dilaporkan → Ditutup,” bahkan ketika proses “Dilaporkan → Diselesaikan” berlangsung cepat.
Ketergantungan memperpanjang antrian
Perubahan lintas tim (skema, migrasi platform, pembaruan SDK), bug dari vendor, atau tinjauan toko aplikasi (seluler) menyebabkan terjadinya waktu tunggu. Tanpa pelacakan eksplisit status “Diblokir/Ditangguhkan”, waktu tunggu tersebut secara tak terlihat menaikkan rata-rata Anda dan menyembunyikan di mana letak hambatan sebenarnya.
Model rilis dan strategi rollback sangat penting
Jika Anda melakukan rilis dalam "release trains" yang besar dengan "gates" manual, bahkan bug yang sudah diselesaikan pun akan tertunda hingga "train" berikutnya diluncurkan. Fitur "feature flags", "canary releases", dan "hotfix lanes" dapat mempersingkat waktu penanggulangan—terutama untuk insiden P0/P1—dengan memungkinkan Anda memisahkan penerapan perbaikan dari siklus rilis penuh.
Arsitektur dan utang teknis menentukan batas atas Anda
Ketergantungan yang erat, kurangnya batas pengujian, dan modul warisan yang tidak transparan membuat perbaikan sederhana menjadi berisiko. Tim mengatasi hal ini dengan pengujian tambahan dan tinjauan yang lebih lama, yang memperpanjang siklus pengembangan. Sebaliknya, kode modular dengan pengujian kontrak yang baik memungkinkan Anda bergerak cepat tanpa merusak sistem yang berdekatan.
Komunikasi dan pengelolaan status memengaruhi tingkat prediktabilitas
Pembaruan yang tidak jelas (“sedang diteliti”) menimbulkan pekerjaan ulang ketika pemangku kepentingan menanyakan perkiraan waktu penyelesaian (ETA), tim dukungan membuka kembali tiket, atau tim produk menaikkan tingkat prioritas masalah. Transisi status yang jelas, catatan mengenai reproduksi dan akar masalah, serta ETA yang dipublikasikan dapat mengurangi tingkat pergantian dan menjaga fokus tim teknik Anda.
📮Wawasan ClickUp: Rata-rata profesional menghabiskan lebih dari 30 menit sehari untuk mencari informasi terkait pekerjaan—itu berarti lebih dari 120 jam per tahun terbuang percuma hanya untuk menelusuri email, utas Slack, dan berkas-berkas yang tersebar.
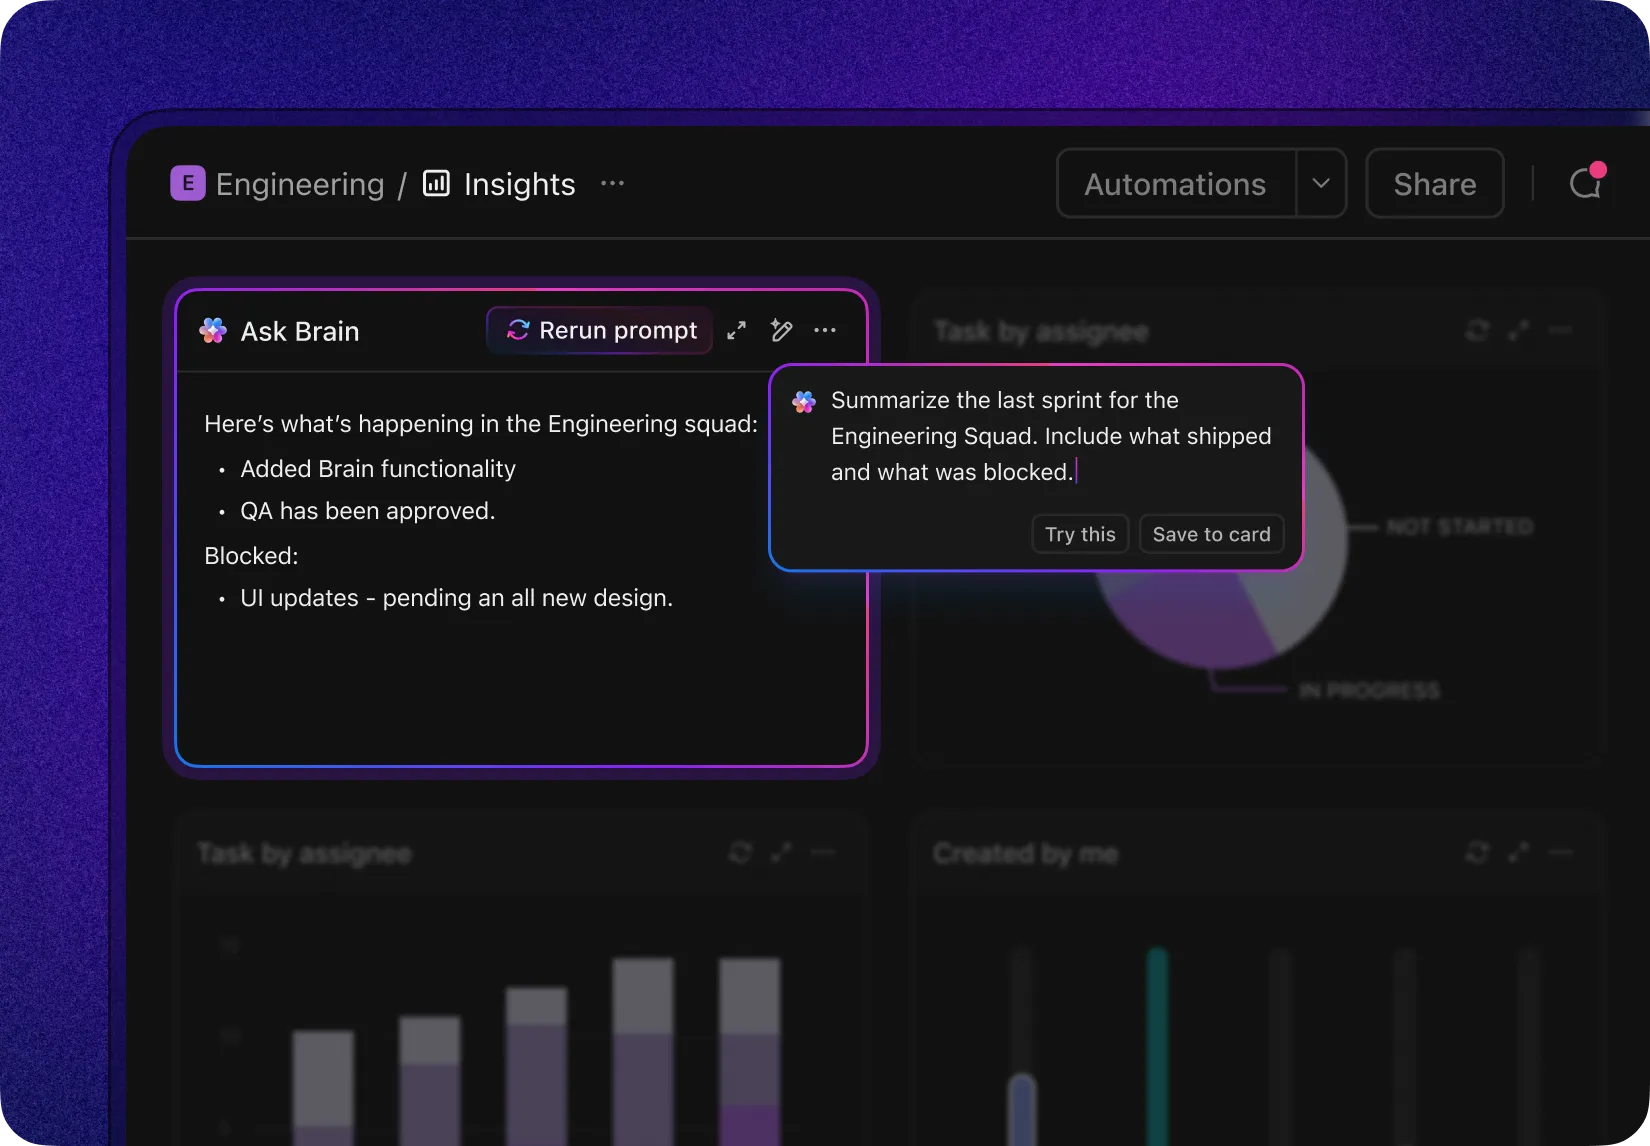
Asisten AI cerdas yang terintegrasi dalam ruang kerja Anda dapat mengubah hal itu. Perkenalkan ClickUp Brain. Ia memberikan wawasan dan jawaban instan dengan menampilkan dokumen, percakapan, dan detail tugas yang tepat dalam hitungan detik—sehingga Anda tidak perlu lagi mencari-cari dan bisa langsung mulai bekerja.
💫 Hasil Nyata: Tim seperti QubicaAMF berhasil menghemat lebih dari 5 jam per minggu dengan menggunakan ClickUp—itu setara dengan lebih dari 250 jam per tahun per orang—dengan menghilangkan proses manajemen pengetahuan yang sudah ketinggalan zaman. Bayangkan apa yang dapat diciptakan tim Anda dengan tambahan satu minggu produktivitas setiap kuartal!
Indikator utama yang menandakan bahwa waktu penyelesaian Anda akan melampaui batas
❗️Meningkatnya “Waktu untuk Menanggapi” dan banyaknya tiket yang tidak memiliki penanggung jawab selama lebih dari 12 jam
❗️Peningkatan durasi “Time in Review/CI” dan ketidakstabilan pengujian yang sering terjadi
❗️Tingkat duplikasi yang tinggi pada tahap penerimaan dan label tingkat keparahan yang tidak konsisten di antara tim
❗️Beberapa bug tertahan di status “Blocked” tanpa dependensi eksternal yang disebutkan
❗️Tingkat pembukaan ulang perlahan-lahan meningkat (perbaikan tidak dapat direproduksi atau definisi "selesai" tidak jelas)
Organisasi yang berbeda merasakan faktor-faktor ini secara berbeda. Para eksekutif mengalaminya sebagai siklus pembelajaran yang terlewatkan dan keterlambatan dalam mencapai target pendapatan; sedangkan para operator merasakannya sebagai gangguan dalam proses triase dan ketidakjelasan tanggung jawab.
Menyesuaikan proses penerimaan, alur, dan ketergantungan adalah cara untuk menurunkan kurva secara keseluruhan—median dan P90.
Ingin mempelajari lebih lanjut tentang cara menulis laporan bug yang lebih baik? Mulailah dari sini. 👇🏼
📖 Baca Selengkapnya: Siklus Hidup Pengujian Perangkat Lunak (STLC): Gambaran Umum dan Fase-fasenya
Tolok Ukur Industri untuk Waktu Penyelesaian Bug
Tolok ukur penyelesaian bug bervariasi tergantung pada toleransi risiko, model rilis, dan seberapa cepat Anda dapat merilis perubahan.
Di sinilah Anda dapat menggunakan median (P50) untuk memahami alur kerja tipikal Anda dan P90 untuk menetapkan janji dan SLA—berdasarkan tingkat keparahan dan sumber (pelanggan, QA, pemantauan).
Mari kita uraikan apa artinya hal tersebut:
| 🔑 Istilah | 📝 Deskripsi | 💡 Mengapa hal ini penting |
|---|---|---|
| P50 (Median) | Nilai tengah—50% perbaikan bug lebih cepat dari ini, dan 50% lebih lambat | 👉 Mencerminkan waktu penyelesaian yang biasa atau paling umum. Berguna untuk memahami kinerja normal |
| P90 (Persentil ke-90) | 90% bug diperbaiki dalam waktu ini. Hanya 10% yang memakan waktu lebih lama | 👉 Menunjukkan batas skenario terburuk (namun tetap realistis). Berguna untuk menetapkan janji kepada pihak eksternal |
| SLA (Perjanjian Tingkat Layanan) | Komitmen yang Anda buat—baik secara internal maupun kepada pelanggan—mengenai seberapa cepat masalah akan ditangani | 👉 Contoh: “Kami menyelesaikan bug P1 dalam waktu 48 jam, 90% dari waktu.” Hal ini membantu membangun kepercayaan dan akuntabilitas |
| Berdasarkan Tingkat Keparahan dan Sumber | Segmentasikan metrik Anda berdasarkan dua dimensi utama: • Tingkat Keparahan (misalnya, P0, P1, P2)• Sumber (misalnya, Pelanggan, QA, Pemantauan) | 👉 Memungkinkan pelacakan dan penetapan prioritas yang lebih akurat, sehingga bug kritis dapat ditangani lebih cepat |
Di bawah ini adalah rentang acuan berdasarkan industri yang sering menjadi sasaran tim yang sudah matang; gunakanlah sebagai titik awal, lalu sesuaikan dengan konteks Anda.
SaaS
Sistem ini selalu aktif dan ramah CI/CD, sehingga hotfix sering dilakukan. Masalah kritis (P0/P1) sering ditargetkan untuk diselesaikan dalam waktu median kurang dari satu hari kerja, dengan P90 dalam 24–48 jam. Masalah non-kritis (P2+) umumnya diselesaikan dalam waktu median 3–7 hari, dengan P90 dalam 10–14 hari. Tim dengan fitur flag yang kuat dan pengujian otomatis cenderung mencapai waktu penyelesaian yang lebih cepat.
Platform e-commerce
Karena alur konversi dan keranjang belanja sangat krusial bagi pendapatan, standar yang diterapkan lebih tinggi. Masalah P0/P1 biasanya diatasi dalam hitungan jam (rollback, penandaan, atau konfigurasi) dan diselesaikan sepenuhnya pada hari yang sama; P90 pada akhir hari atau dalam waktu kurang dari 12 jam merupakan hal yang umum pada musim puncak. Masalah P2+ sering kali diselesaikan dalam 2–5 hari, dengan P90 dalam waktu 10 hari.
Perangkat lunak perusahaan
Proses validasi yang lebih ketat dan jendela perubahan pelanggan memperlambat ritme kerja. Untuk P0/P1, tim menargetkan solusi sementara dalam 4–24 jam dan perbaikan dalam 1–3 hari kerja; P90 dalam 5 hari kerja. Item P2+ sering digabungkan ke dalam rangkaian rilis, dengan median 2–4 minggu tergantung pada jadwal peluncuran pelanggan.
Game dan aplikasi seluler
Backend layanan langsung berperilaku seperti SaaS (pengaktifan fitur dan rollback dalam hitungan menit hingga jam; P90 pada hari yang sama). Pembaruan klien dibatasi oleh proses peninjauan toko: P0/P1 sering kali langsung menggunakan mekanisme di sisi server dan merilis patch klien dalam 1–3 hari; P90 dalam waktu seminggu dengan peninjauan yang dipercepat. Perbaikan P2+ umumnya dijadwalkan ke sprint berikutnya atau rilis konten berikutnya.
Perbankan/Fintech
Tahapan risiko dan kepatuhan mendorong pola “mitigasi cepat, perubahan hati-hati”. Masalah P0/P1 ditangani dengan cepat (penandaan, rollback, pengalihan lalu lintas dalam hitungan menit hingga jam) dan diperbaiki sepenuhnya dalam 1–3 hari; P90 dalam waktu seminggu, dengan mempertimbangkan proses pengendalian perubahan. Masalah P2+ seringkali memakan waktu 2–6 minggu untuk lolos tinjauan keamanan, audit, dan CAB.
Jika angka-angka Anda berada di luar rentang ini, periksa kualitas penerimaan, penyaluran/tanggung jawab, tinjauan kode dan produktivitas QA, serta persetujuan ketergantungan sebelum berasumsi bahwa “kecepatan tim teknik” adalah masalah utamanya.
🌼 Tahukah Anda: Menurut survei Stack Overflow tahun 2024, para pengembang semakin sering menggunakan AI sebagai rekan andalan mereka dalam perjalanan pemrograman. Sebanyak 82% di antaranya menggunakan AI untuk menulis kode—sungguh mitra kreatif! Saat menemui kendala atau mencari solusi, 67,5% mengandalkan AI untuk mencari jawaban, dan lebih dari setengah (56,7%) mengandalkan AI untuk melakukan debug dan mendapatkan bantuan.
Bagi sebagian orang, alat AI juga terbukti berguna untuk mendokumentasikan proyek (40,1%) dan bahkan membuat data atau konten sintetis (34,8%). Penasaran dengan basis kode baru? Hampir sepertiga (30,9%) menggunakan AI untuk segera menguasainya. Menguji kode masih menjadi pekerjaan manual yang melelahkan bagi banyak orang, tetapi 27,2% juga telah memanfaatkan AI di sini. Bidang lain seperti tinjauan kode, perencanaan proyek, dan analitik prediktif menunjukkan tingkat adopsi AI yang lebih rendah, tetapi jelas bahwa AI secara bertahap merasuki setiap tahap pengembangan perangkat lunak.
📖 Baca Selengkapnya: Cara Menggunakan AI untuk Jaminan Kualitas
Cara Mengurangi Waktu Penyelesaian Bug
Kecepatan penyelesaian bug bergantung pada penghilangan hambatan pada setiap tahap serah terima, mulai dari penerimaan hingga rilis.
Manfaat terbesar diperoleh dengan mengoptimalkan 30 menit pertama (penerimaan yang terorganisir, penunjukan pemilik masalah yang tepat, prioritas yang tepat), kemudian mempercepat siklus-siklus berikutnya (reproduksi, tinjauan, verifikasi).
Berikut adalah sembilan strategi yang bekerja secara terintegrasi sebagai satu sistem. AI mempercepat setiap langkah, dan alur kerja terkelola dengan rapi di satu tempat, sehingga para eksekutif mendapatkan kepastian dan para praktisi mendapatkan alur kerja yang lancar.
1. Sentralisasikan penerimaan laporan dan catat konteksnya langsung dari sumbernya
Waktu penyelesaian bug menjadi lebih lama saat Anda harus merekonstruksi konteks dari utas obrolan Slack, tiket dukungan, dan spreadsheet. Salurkan setiap laporan—baik dari tim dukungan, QA, maupun pemantauan—ke dalam satu antrean menggunakan templat terstruktur yang mengumpulkan informasi mengenai komponen, tingkat keparahan, lingkungan, versi/build aplikasi, langkah-langkah untuk mereproduksi masalah, perbandingan antara hasil yang diharapkan dan yang sebenarnya, serta lampiran (log/HAR/tangkapan layar).
AI dapat merangkum laporan panjang secara otomatis, mengekstrak langkah-langkah reproduksi dan detail lingkungan dari lampiran, serta menandai kemungkinan duplikat sehingga proses triase dimulai dengan catatan yang koheren dan diperkaya.
Metrik yang perlu diperhatikan: MTTA (tanggapan dalam hitungan menit, bukan jam), tingkat duplikat, waktu “Perlu Informasi”.
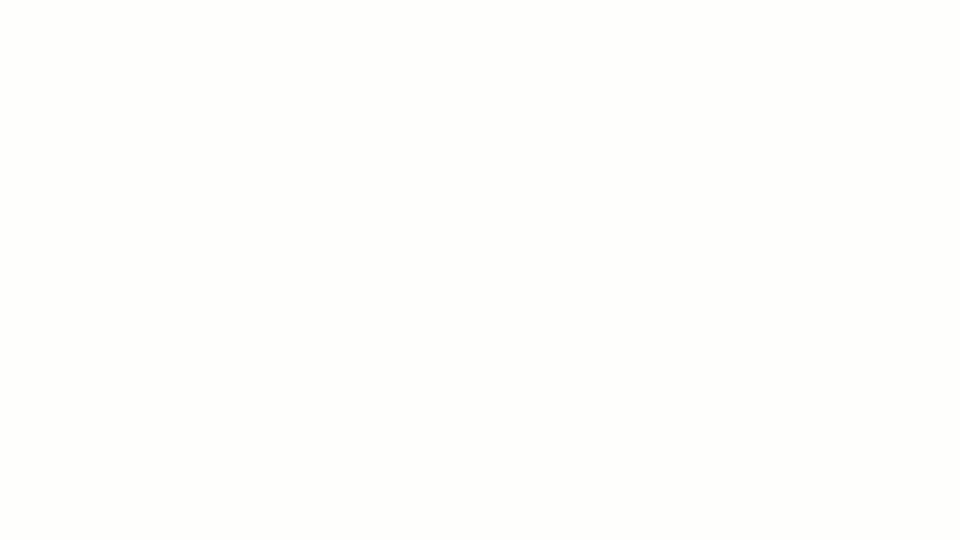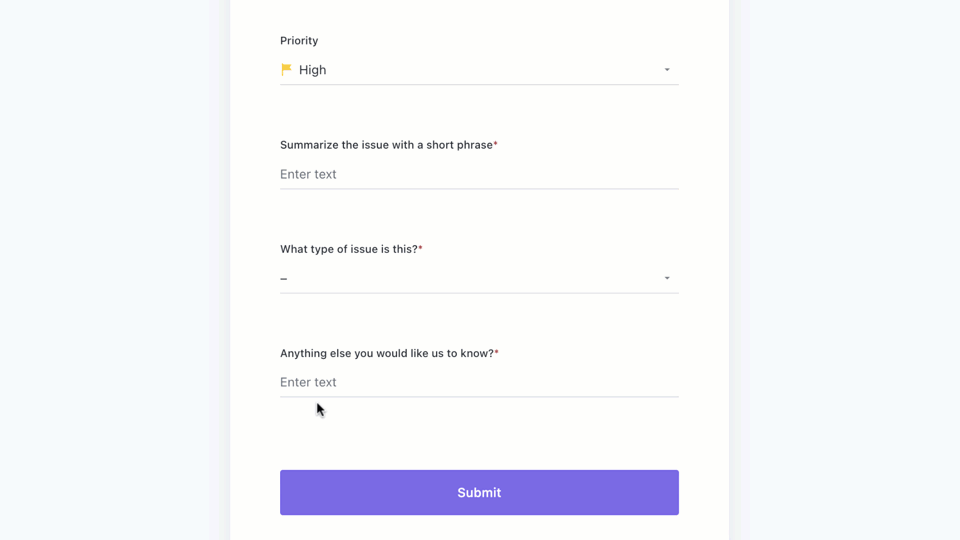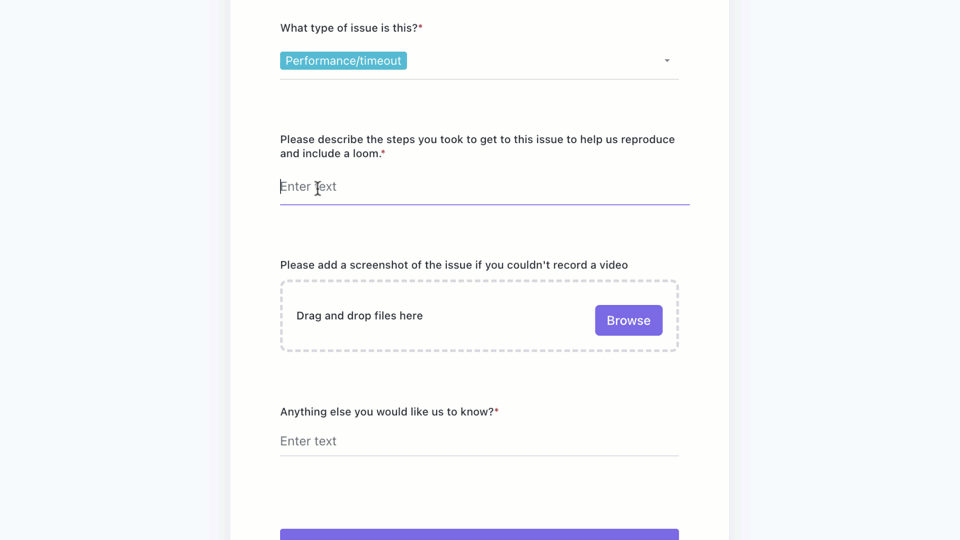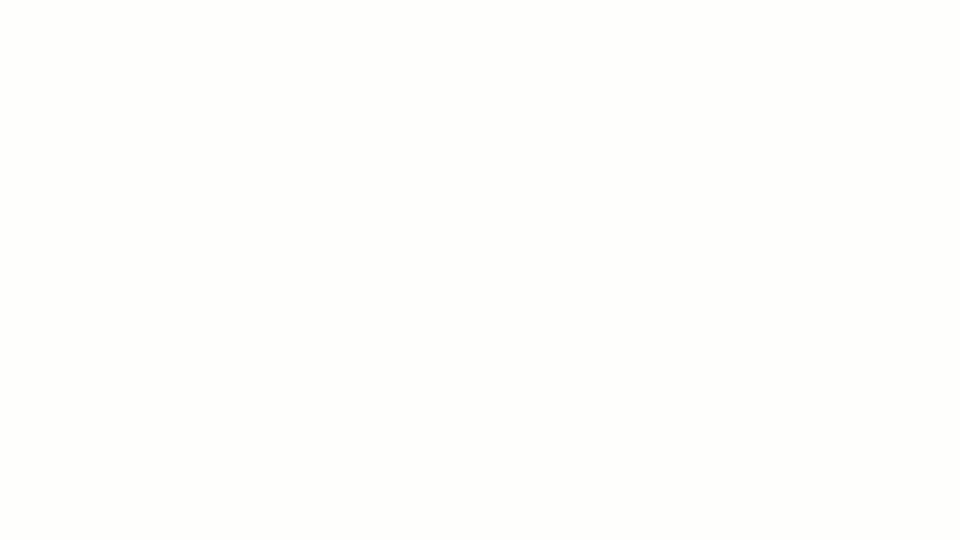
📖 Baca Selengkapnya: Kekuatan Formulir ClickUp: Memperlancar Pekerjaan Tim Perangkat Lunak
2. Triage dan perutean yang dibantu AI untuk memangkas MTTA
Perbaikan tercepat adalah yang langsung sampai ke meja yang tepat.
Gunakan aturan sederhana ditambah AI untuk mengklasifikasikan tingkat keparahan, mengidentifikasi pemilik yang kemungkinan bertanggung jawab berdasarkan komponen/area kode, dan melakukan penugasan otomatis dengan SLA clock. Tetapkan jalur kerja yang jelas untuk P0/P1 versus yang lainnya dan pastikan “siapa yang bertanggung jawab atas ini” tidak ambigu.
Otomatisasi dapat menetapkan prioritas berdasarkan bidang data, mengalihkan masalah ke tim berdasarkan komponen, memulai penghitungan waktu SLA, dan memberi tahu insinyur yang bertugas; AI dapat mengusulkan tingkat keparahan dan penanggung jawab berdasarkan pola sebelumnya. Ketika proses triase dapat diselesaikan dalam 2–5 menit alih-alih perdebatan selama 30 menit, MTTA Anda akan turun dan MTTR Anda pun akan menyusul.
Metrik yang perlu diperhatikan: MTTA, kualitas tanggapan pertama (apakah komentar pertama meminta informasi yang tepat?), jumlah serah terima per bug.
Berikut ini contoh penerapannya:
3. Prioritaskan berdasarkan dampak bisnis dengan tingkatan SLA yang jelas
Prinsip “suara paling keras yang menang” membuat antrean menjadi tidak dapat diprediksi dan mengikis kepercayaan dari para eksekutif yang memantau CSAT/NPS serta perpanjangan langganan.
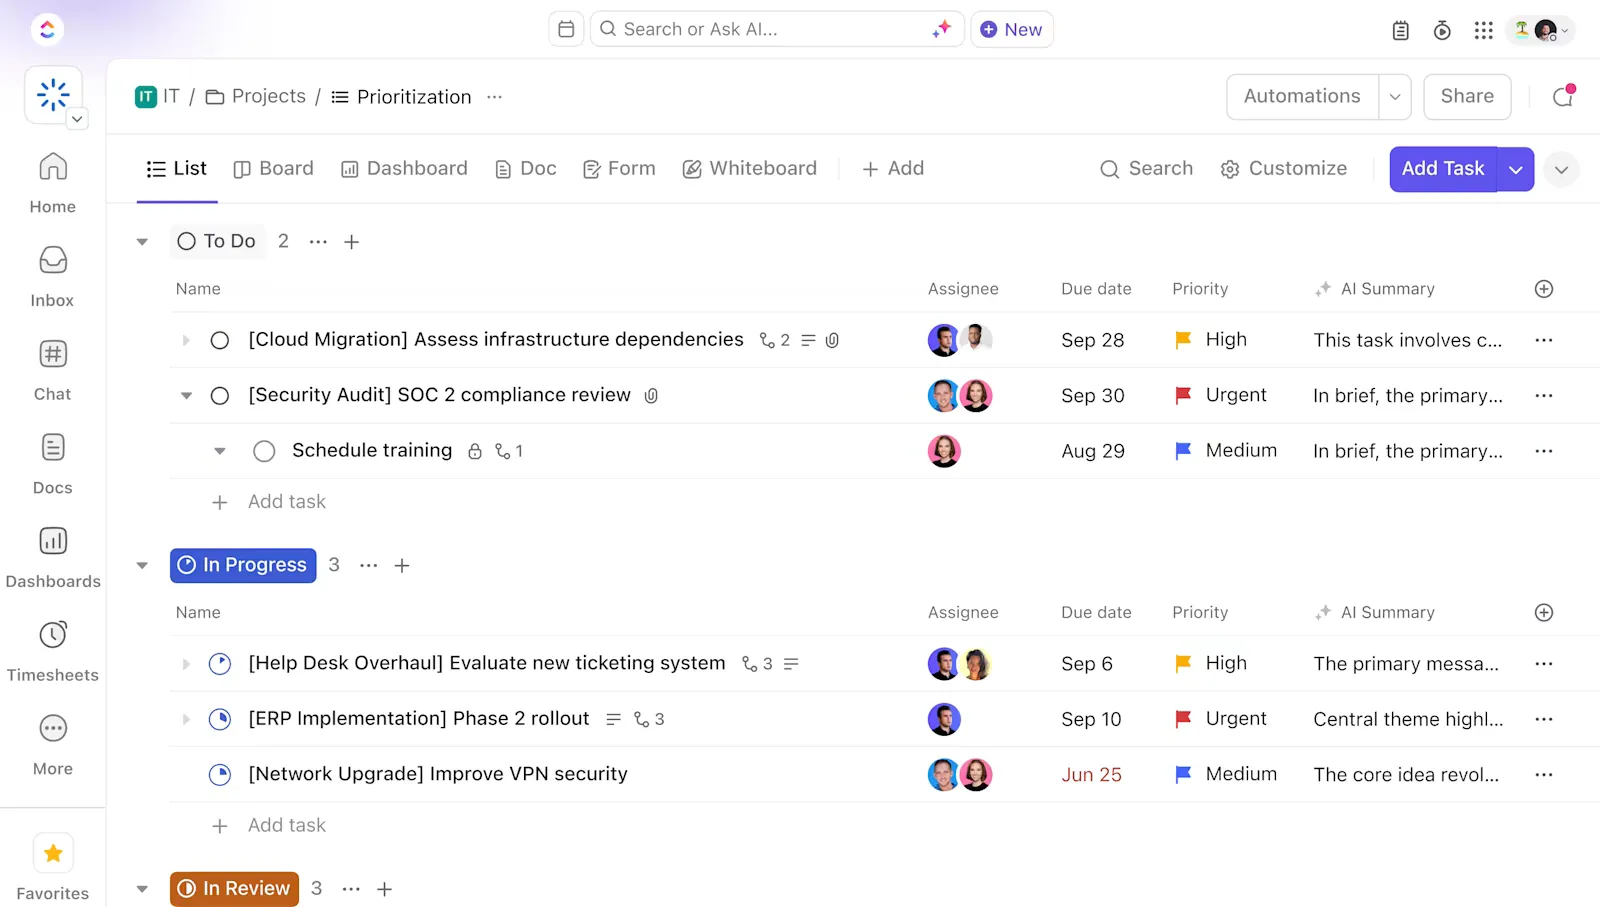
Gantilah itu dengan skor yang menggabungkan tingkat keparahan, frekuensi, ARR yang terpengaruh, tingkat kritis fitur, dan kedekatan dengan periode perpanjangan/peluncuran—dan dukung dengan tingkatan SLA (misalnya, P0: mitigasi dalam 1–2 jam, penyelesaian dalam satu hari; P1: pada hari yang sama; P2: dalam satu sprint).
Jaga agar jalur P0/P1 tetap terlihat dengan batasan WIP agar tidak ada yang tertunda.
Metrik yang perlu diperhatikan: P50/P90 penyelesaian berdasarkan tingkatan, tingkat pelanggaran SLA, korelasi dengan CSAT/NPS.
💡Tips Pro: Fitur Prioritas Tugas, Bidang Kustom, dan Ketergantungan di ClickUp memungkinkan Anda menghitung skor dampak serta menghubungkan bug dengan akun, umpan balik, atau item roadmap; Selain itu, fitur Tujuan di ClickUp membantu Anda mengaitkan kepatuhan terhadap SLA dengan tujuan tingkat perusahaan, yang secara langsung menjawab kekhawatiran eksekutif terkait keselarasan.
4. Jadikan reproduksi dan diagnosis sebagai aktivitas yang dilakukan dalam satu tahap
Setiap permintaan tambahan seperti “bisakah Anda mengirimkan log?” akan memperpanjang waktu penyelesaian.
Standarkan kriteria "baik": kolom yang wajib diisi untuk build/commit, lingkungan, langkah-langkah reproduksi, hasil yang diharapkan vs hasil aktual, serta lampiran untuk log, crash dump, dan berkas HAR. Pasang instrumen telemetri klien/server agar ID crash dan ID permintaan dapat dihubungkan ke jejak (trace).
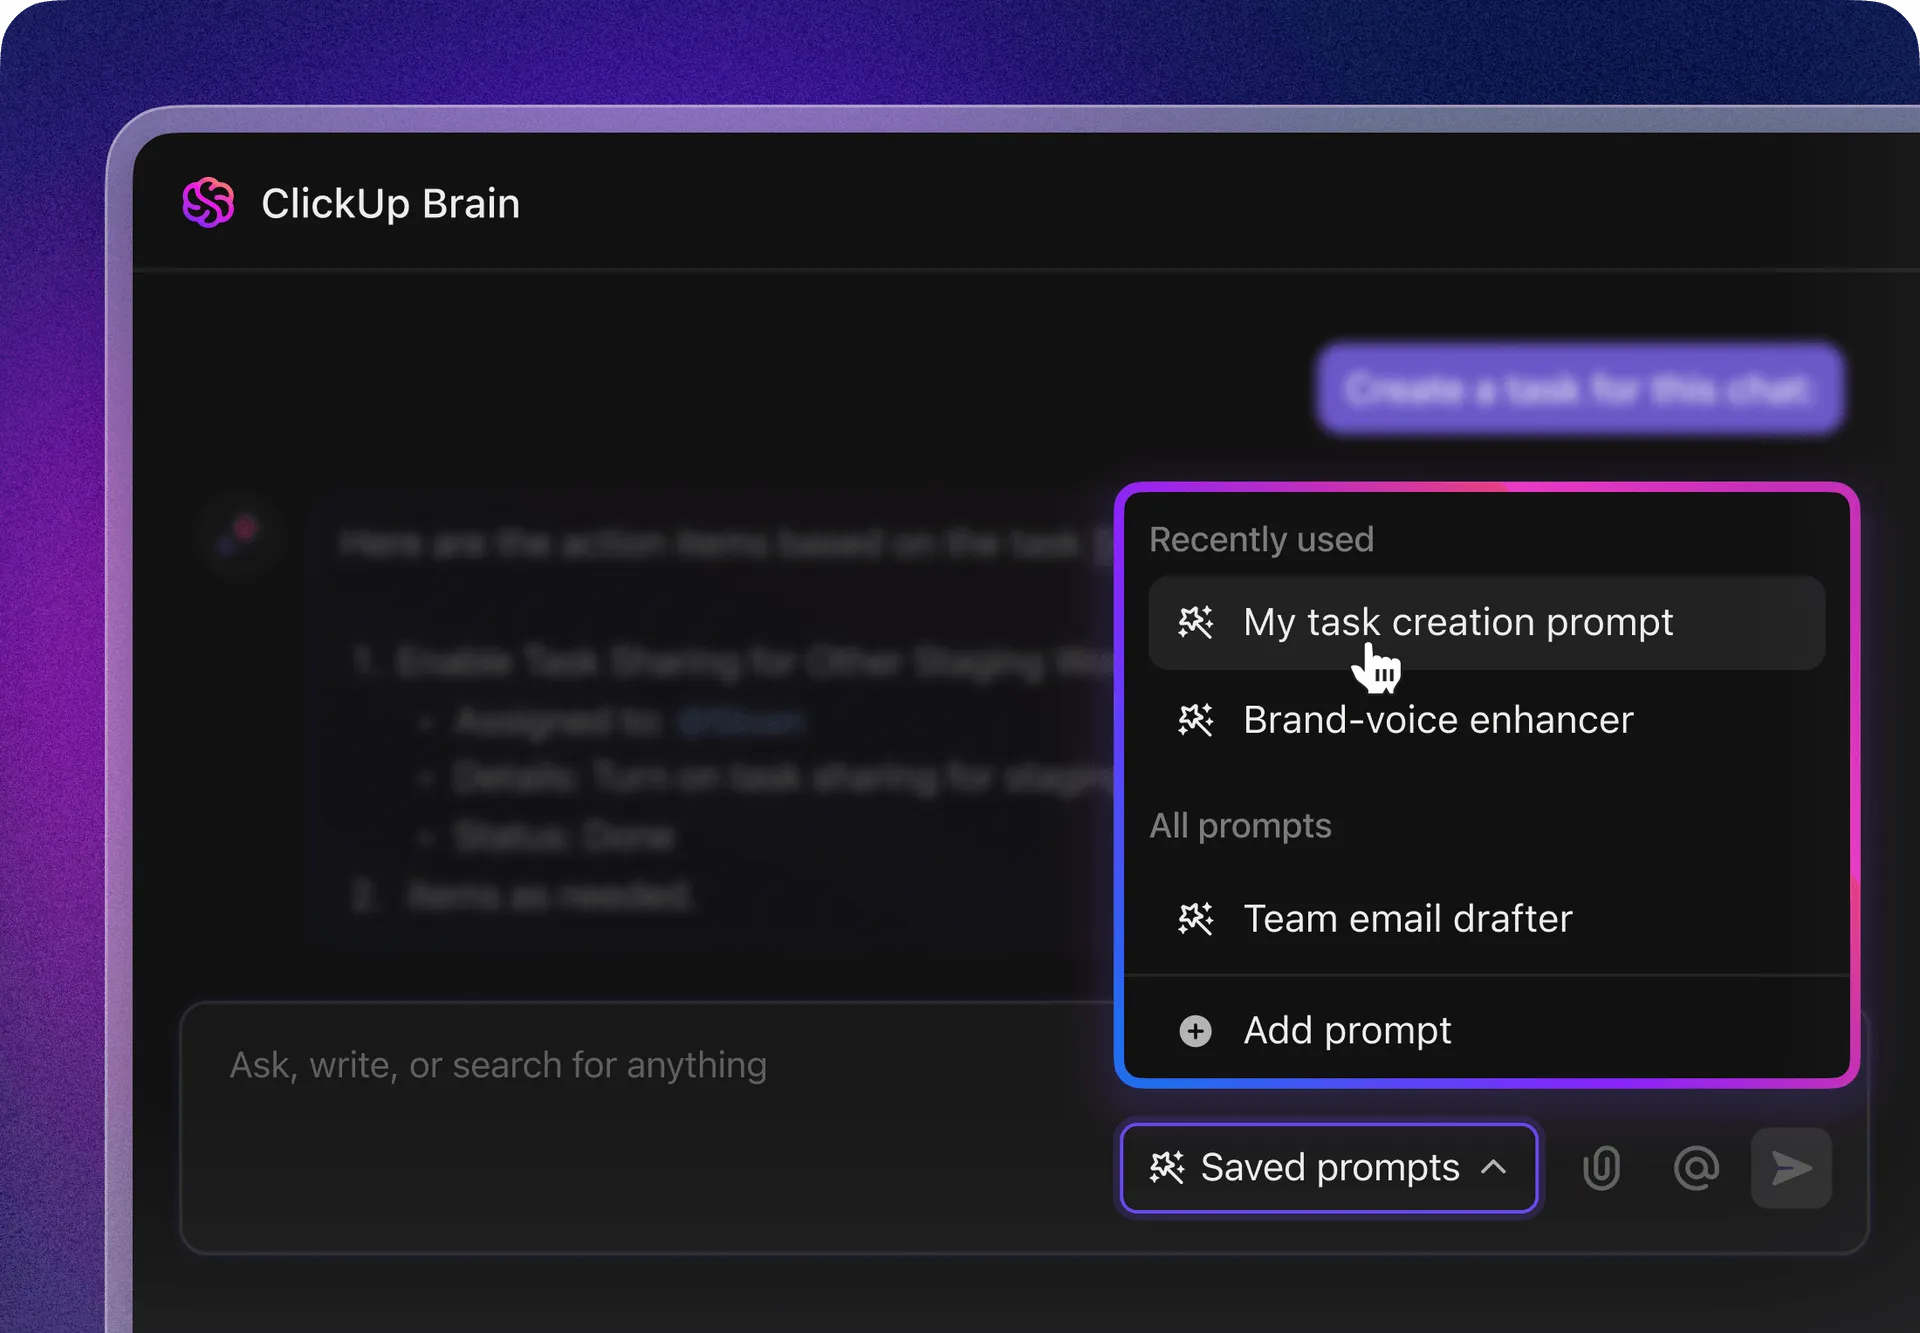
Gunakan Sentry (atau alat serupa) untuk melacak jejak tumpukan (stack trace) dan hubungkan masalah tersebut langsung ke bug. AI dapat membaca log dan jejak untuk mengusulkan domain kesalahan yang kemungkinan besar menjadi penyebabnya serta menghasilkan langkah reproduksi minimal, sehingga mengubah satu jam pemeriksaan manual menjadi beberapa menit kerja yang terfokus.
Simpan panduan penanganan (runbook) untuk kategori bug yang umum agar para insinyur tidak perlu memulai dari awal.
Metrik yang perlu diperhatikan: Waktu yang dihabiskan untuk “Menunggu Informasi,” persentase kasus yang dapat direproduksi pada percobaan pertama, serta tingkat pembukaan ulang yang terkait dengan ketidakmampuan mereproduksi masalah.
📖 Pelajari Lebih Lanjut: Cara Menggunakan AI dalam Pengembangan Perangkat Lunak (Contoh Penggunaan & Alat)
5. Perpendek siklus tinjauan kode dan pengujian
Pull request (PR) besar sering terhenti. Usahakan untuk menerapkan perbaikan yang tepat sasaran, pengembangan berbasis trunk, dan fitur flag agar perbaikan dapat dirilis dengan aman. Tetapkan peninjau secara pra-penugasan berdasarkan kepemilikan kode untuk menghindari waktu idle, dan gunakan daftar periksa (pengujian diperbarui, telemetri ditambahkan, flag dilindungi oleh kill switch) agar kualitas terintegrasi dengan baik.
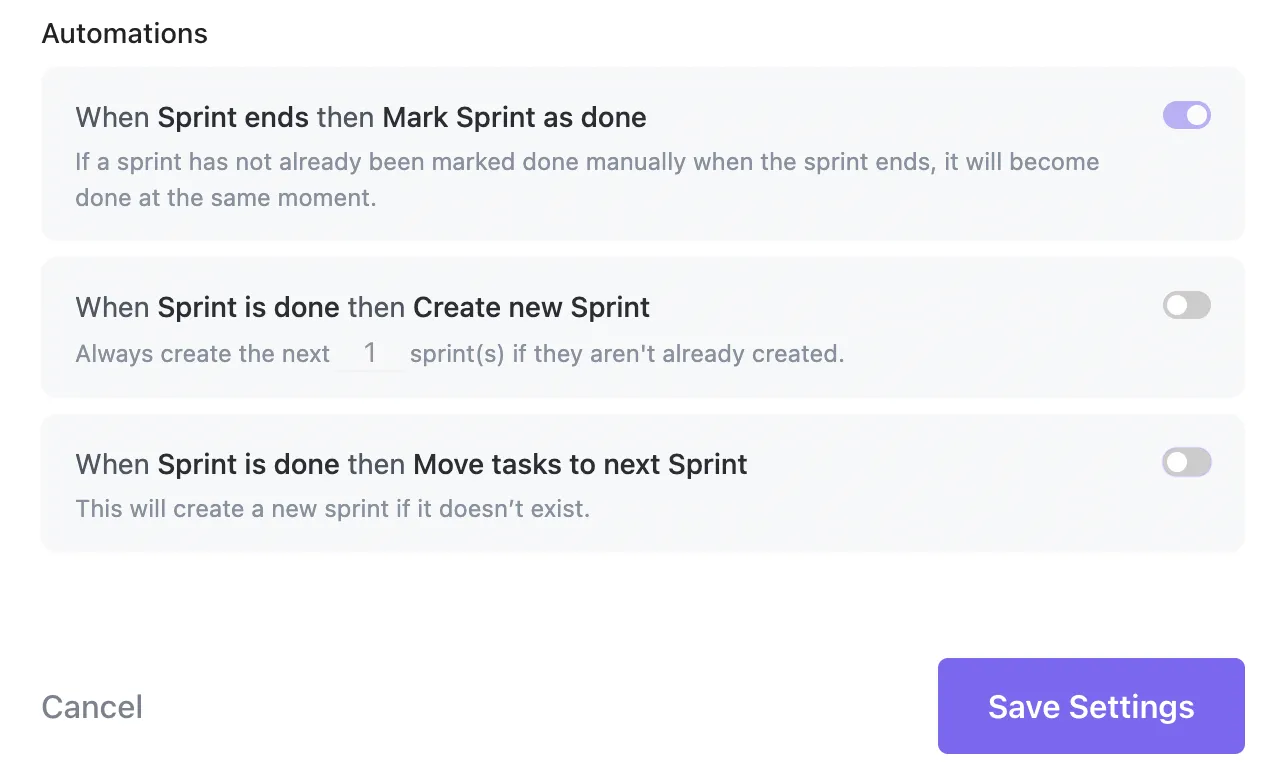
Otomatisasi harus memindahkan bug ke status “Dalam Peninjauan” saat pull request dibuka dan ke status “Terselesaikan” saat penggabungan; AI dapat menyarankan uji unit atau menyoroti perbedaan yang berisiko agar peninjauan lebih terfokus.
Metrik yang perlu diperhatikan: Waktu dalam status “In Review,” tingkat kegagalan perubahan pada PR perbaikan bug, dan latensi tinjauan P90.
Anda dapat menggunakan integrasi GitHub/GitLab di ClickUp untuk menjaga status penyelesaian tetap sinkron; Otomatisasi dapat menerapkan “definisi penyelesaian.”
📖 Baca Selengkapnya: Cara Menggunakan AI untuk Mengotomatiskan Tugas
6. Lakukan verifikasi secara paralel dan wujudkan kesetaraan lingkungan QA
Verifikasi tidak boleh dimulai beberapa hari kemudian atau di lingkungan yang tidak digunakan oleh pelanggan Anda.
Pastikan status “siap untuk QA” tetap ketat: hotfix yang didorong oleh penanda telah divalidasi di lingkungan yang menyerupai produksi dengan data awal yang sesuai dengan kasus yang dilaporkan.
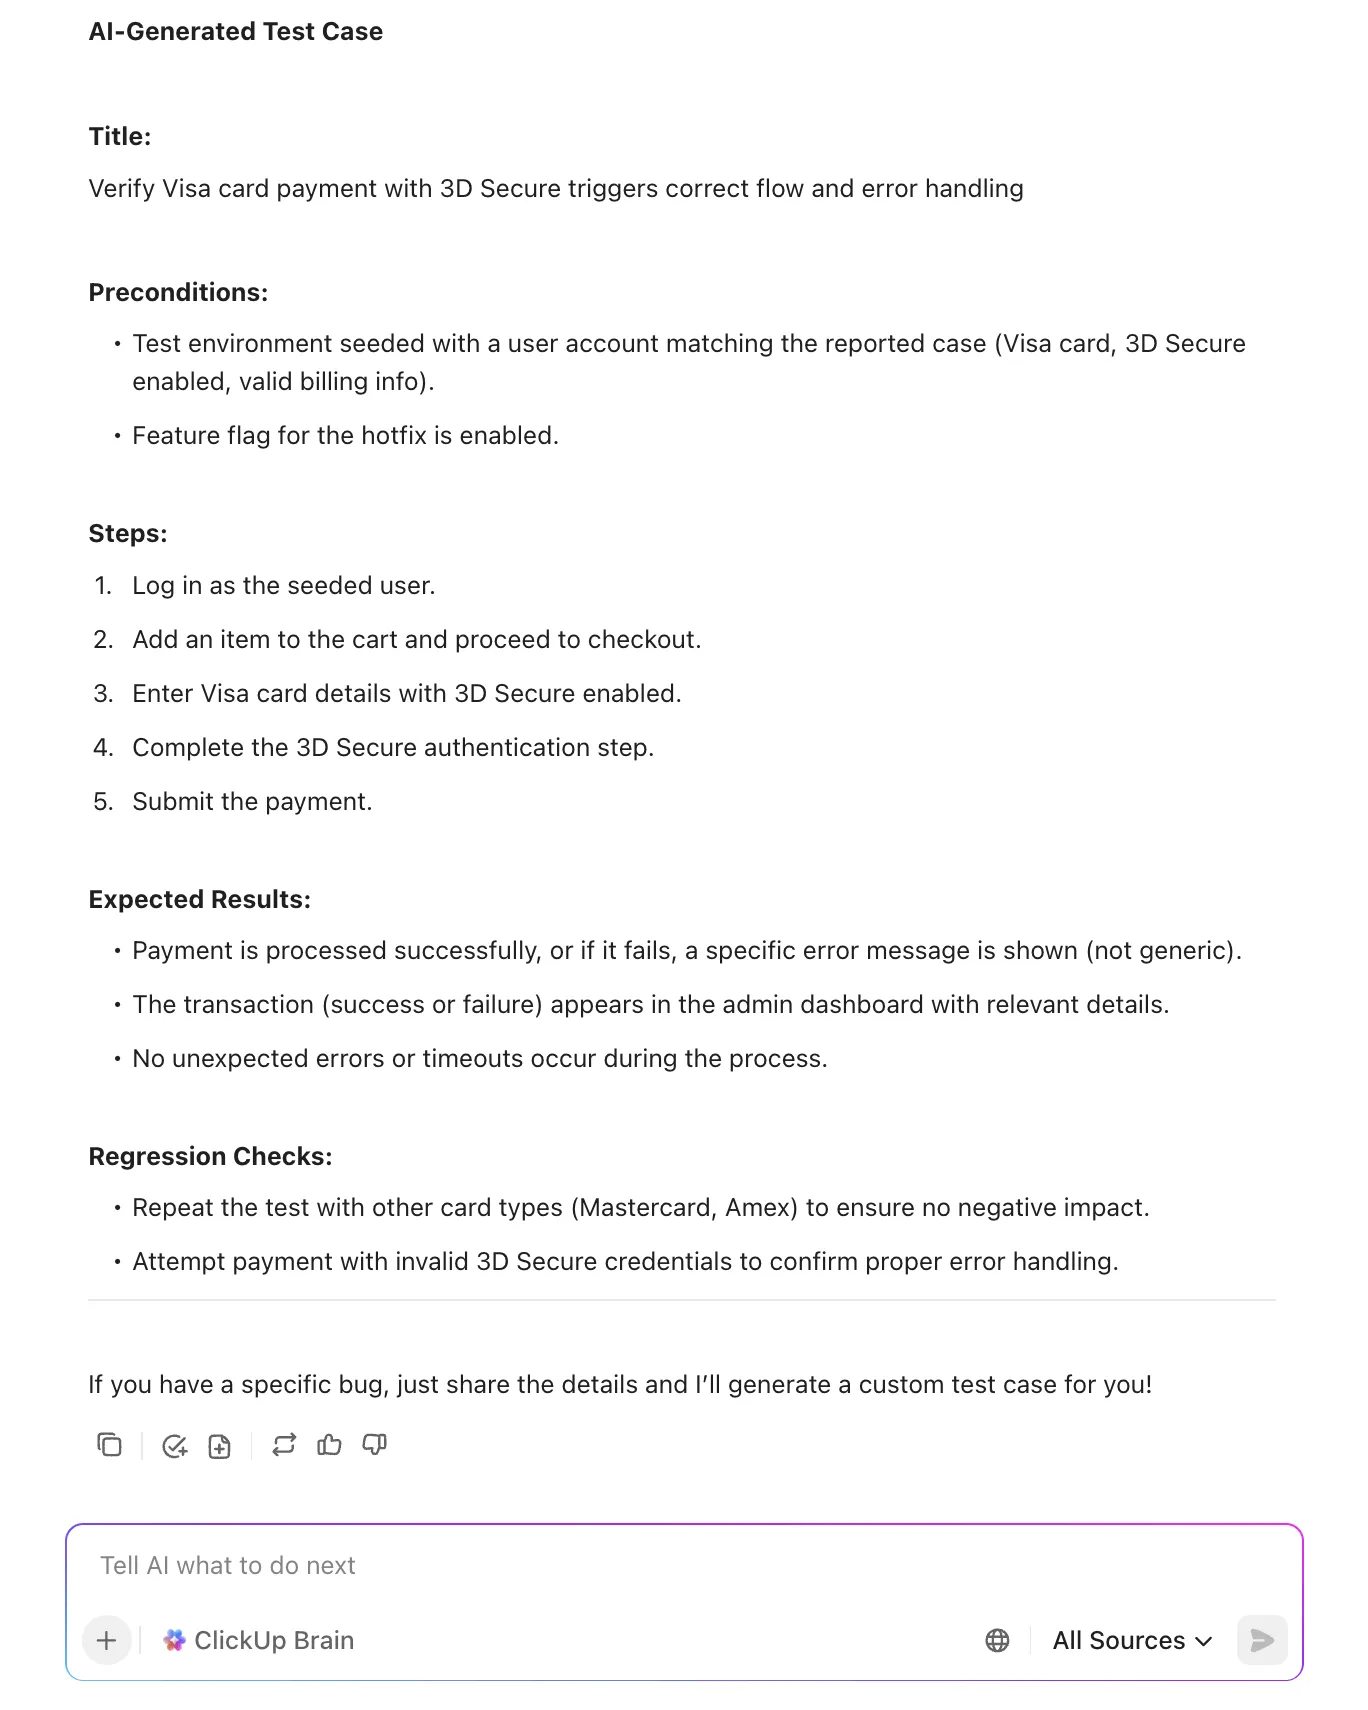
Jika memungkinkan, buat lingkungan sementara dari cabang bug agar tim QA dapat segera memvalidasi; AI kemudian dapat menghasilkan kasus uji berdasarkan deskripsi bug dan regresi sebelumnya.
Metrik yang perlu diperhatikan: Waktu di tahap “QA/Verifikasi,” tingkat pengembalian dari QA ke tim pengembang, serta waktu median untuk menyelesaikan masalah setelah penggabungan kode.
📖 Baca Selengkapnya: Cara Menulis Kasus Uji yang Efektif
7. Sampaikan status secara jelas dan ringkas untuk mengurangi beban koordinasi
Pembaruan yang baik dapat mencegah tiga permintaan status dan satu eskalasi.
Perlakukan pembaruan seperti produk: singkat, spesifik, dan disesuaikan dengan audiens (tim dukungan, eksekutif, pelanggan). Tetapkan frekuensi pelaporan untuk P0/P1 (misalnya, setiap jam hingga masalah teratasi, kemudian setiap empat jam), dan jaga agar ada satu sumber kebenaran yang tunggal.
AI dapat menyusun draf pembaruan yang aman bagi pelanggan dan ringkasan internal berdasarkan riwayat tugas, termasuk status real-time berdasarkan tingkat keparahan dan tim. Bagi para eksekutif seperti Direktur Produk Anda, kelompokkan bug ke dalam inisiatif agar mereka dapat melihat apakah masalah kualitas kritis mengancam janji pengiriman.
Metrik yang perlu diperhatikan: Waktu antara pembaruan status pada P0/P1, skor kepuasan pelanggan (CSAT) pemangku kepentingan terkait komunikasi.
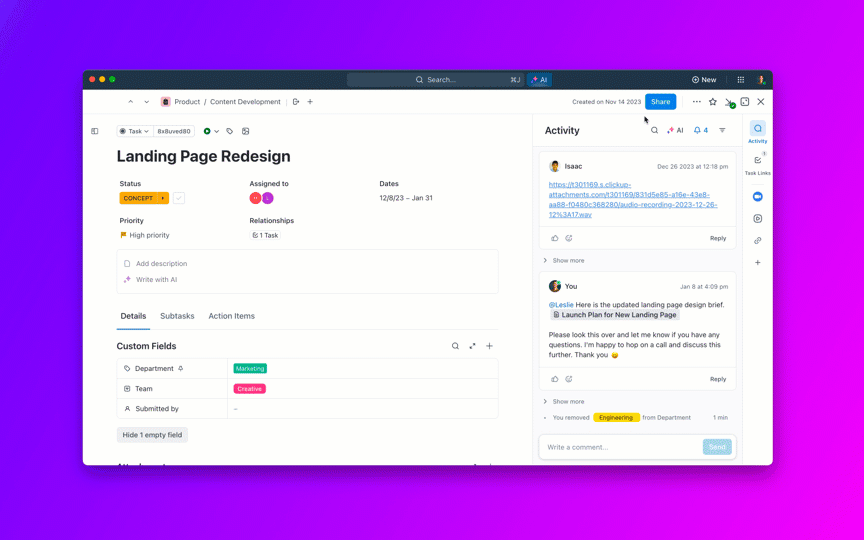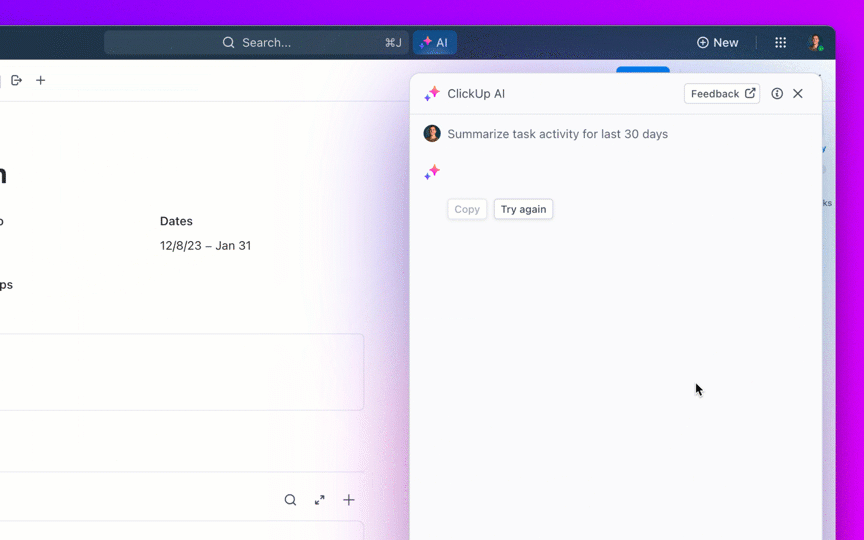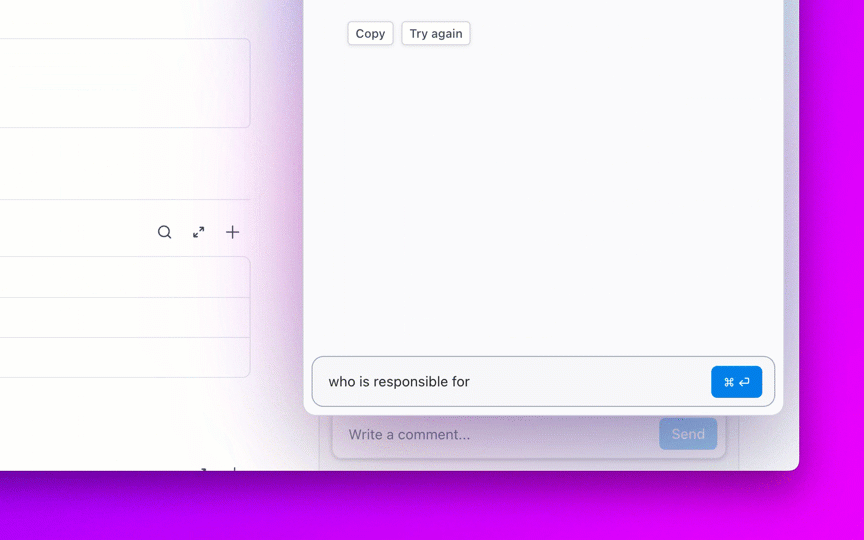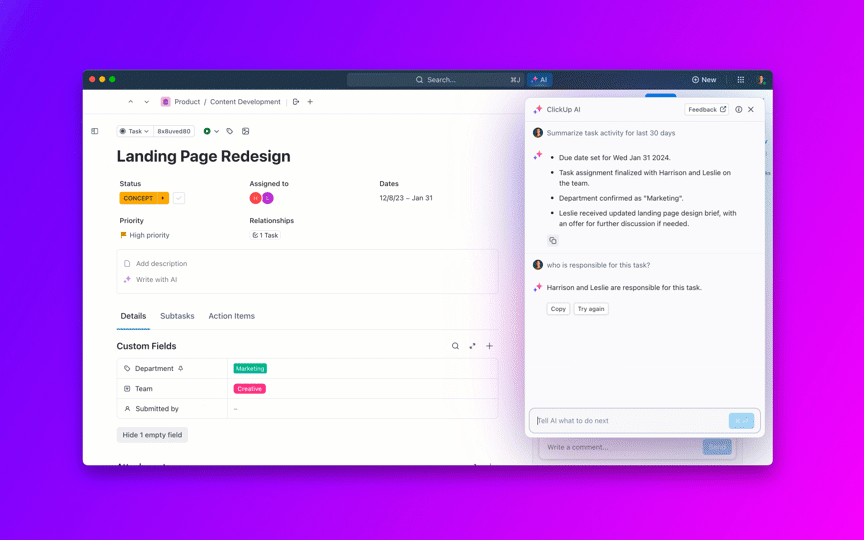
8. Kendalikan penumpukan backlog dan cegah masalah yang “terus terbuka”
Backlog yang terus bertambah dan menumpuk secara diam-diam membebani setiap sprint.
Tetapkan kebijakan penuaan (misalnya, P2 > 30 hari memicu tinjauan, P3 > 90 hari memerlukan justifikasi) dan jadwalkan “triase penuaan” mingguan untuk menggabungkan duplikat, menutup laporan yang sudah tidak berlaku, dan mengubah bug bernilai rendah menjadi item backlog produk.
Gunakan AI untuk mengelompokkan backlog berdasarkan tema (misalnya, “kedaluwarsa token otentikasi,” “ketidakstabilan pengunggahan gambar”) sehingga Anda dapat menjadwalkan minggu perbaikan tematik dan menghapus sekelompok bug sekaligus.
Metrik yang perlu diperhatikan: Jumlah backlog berdasarkan rentang usia, persentase masalah yang ditutup karena duplikat/usang, kecepatan burn-down tematik.
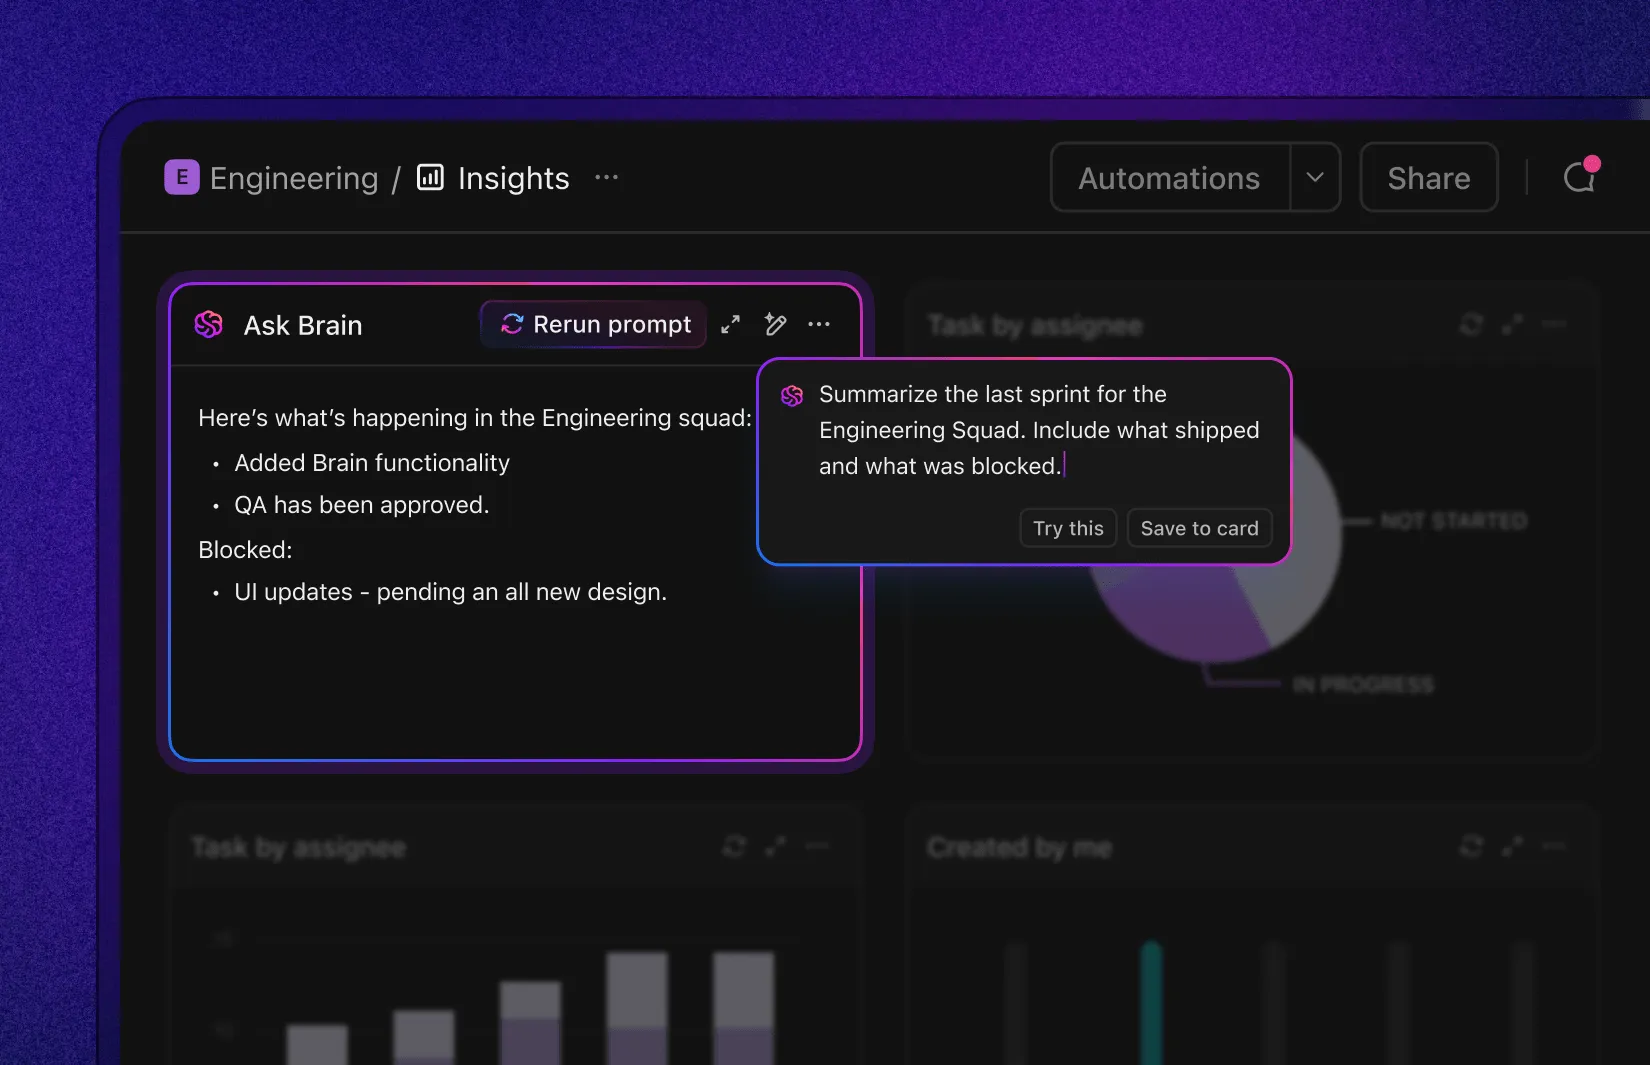
9. Menutup siklus dengan mengidentifikasi akar masalah dan pencegahan
Jika jenis cacat yang sama terus muncul kembali, peningkatan MTTR Anda justru menyembunyikan masalah yang lebih besar.
Lakukan analisis akar masalah yang cepat dan tanpa menyalahkan pihak mana pun pada bug P0/P1 dan P2 yang sering muncul; beri label pada akar masalah (kesenjangan spesifikasi, kesenjangan pengujian, kesenjangan alat, ketidakstabilan integrasi), tautkan ke komponen dan insiden yang terpengaruh, serta lacak tugas tindak lanjut (pengaman, pengujian, aturan lint) hingga selesai.
AI dapat menyusun ringkasan Analisis Penyebab Akar Masalah (RCA) dan mengusulkan tes pencegahan atau aturan lint berdasarkan riwayat perubahan. Dan begitulah cara Anda beralih dari sekadar memadamkan kebakaran menjadi mengurangi jumlah kebakaran.
Metrik yang perlu diperhatikan: Tingkat pembukaan ulang, tingkat regresi, waktu antara kejadian berulang, dan persentase RCA yang telah menyelesaikan tindakan pencegahan.
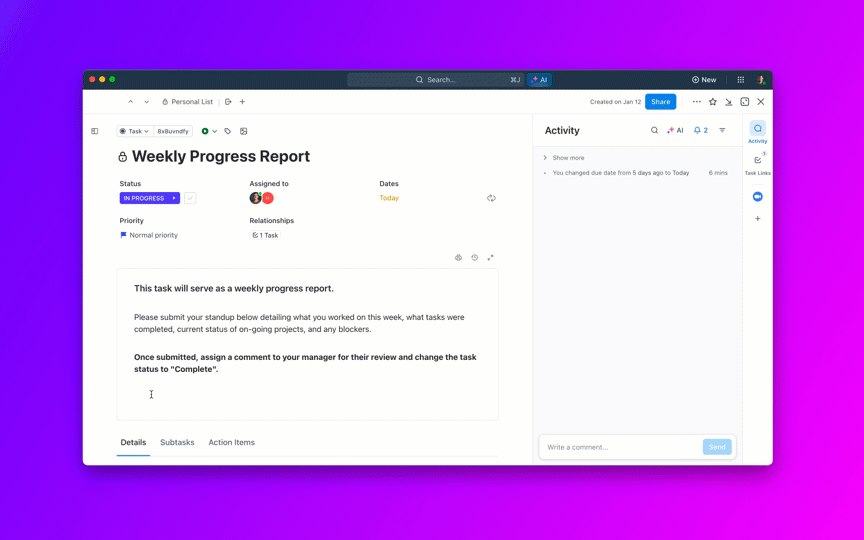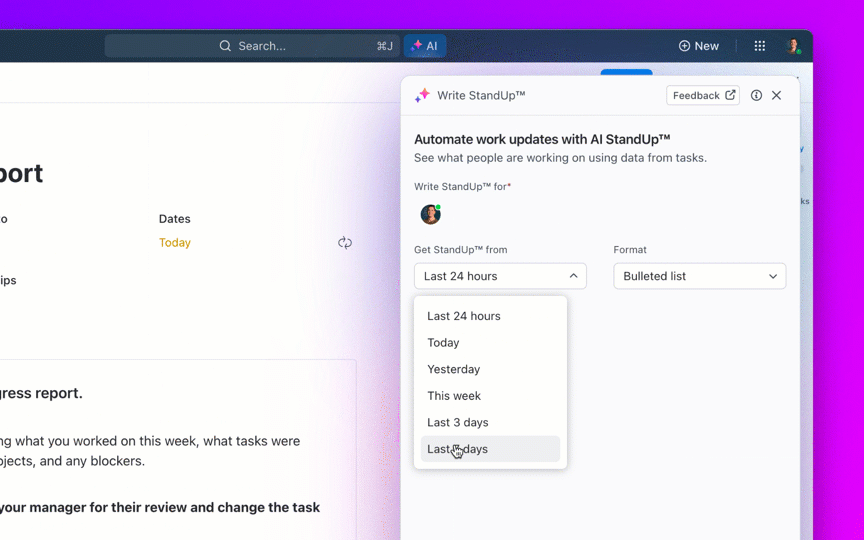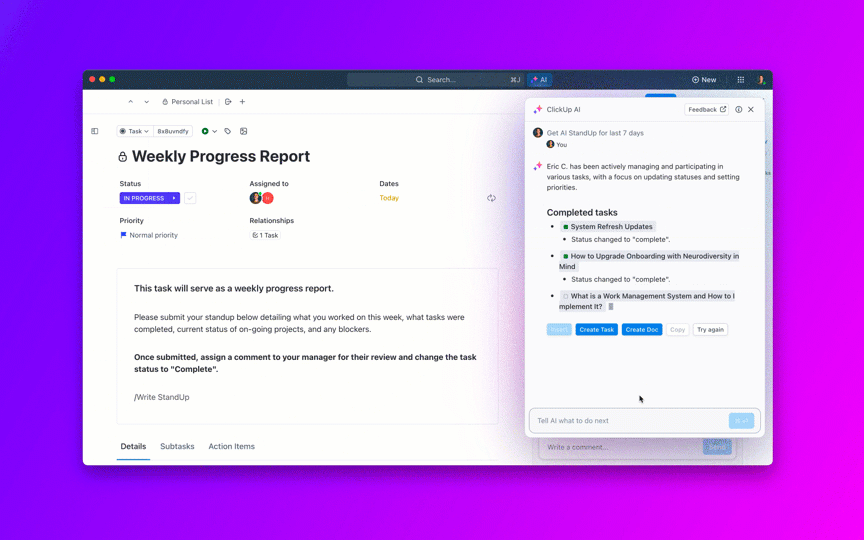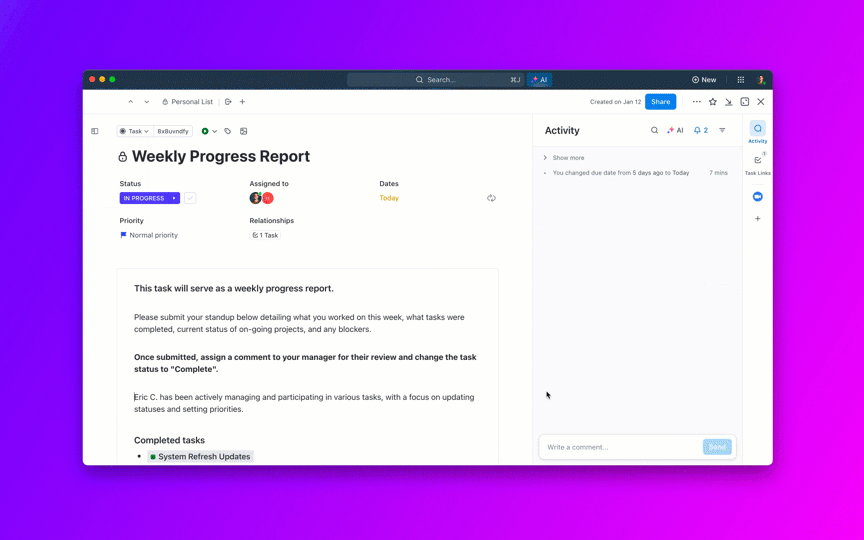
Secara keseluruhan, perubahan-perubahan ini mempercepat proses end-to-end: konfirmasi yang lebih cepat, triase yang lebih terarah, prioritas yang lebih cerdas, lebih sedikit hambatan dalam tahap tinjauan dan QA, serta komunikasi yang lebih jelas. Pimpinan mendapatkan prediktabilitas yang terkait dengan CSAT/NPS dan pendapatan; praktisi mendapatkan antrian yang lebih teratur dengan lebih sedikit peralihan konteks.
📖 Baca Selengkapnya: Cara Melakukan Analisis Penyebab Utama
Alat AI yang Membantu Mengurangi Waktu Penyelesaian Bug
AI dapat memangkas waktu penyelesaian di setiap tahap—penerimaan, triase, perutean, perbaikan, dan verifikasi.
Namun, manfaat sesungguhnya baru terasa ketika alat-alat tersebut memahami konteks dan menjaga agar pekerjaan tetap berjalan tanpa perlu bimbingan terus-menerus.
Carilah sistem yang secara otomatis memperkaya laporan (langkah reproduksi, lingkungan, duplikat), memprioritaskan berdasarkan dampak, meneruskan ke pemilik yang tepat, menyusun pembaruan yang jelas, dan terintegrasi erat dengan kode, CI, dan observabilitas Anda.
Alat-alat terbaik di antaranya juga mendukung alur kerja layaknya agen: bot yang memantau SLA, mengingatkan peninjau, menaikkan tingkat masalah yang terhenti, dan merangkum hasilnya untuk pemangku kepentingan. Berikut adalah daftar alat AI kami untuk penyelesaian bug yang lebih baik:
1. ClickUp (Pilihan terbaik untuk AI kontekstual, otomatisasi, dan alur kerja berbasis agen)
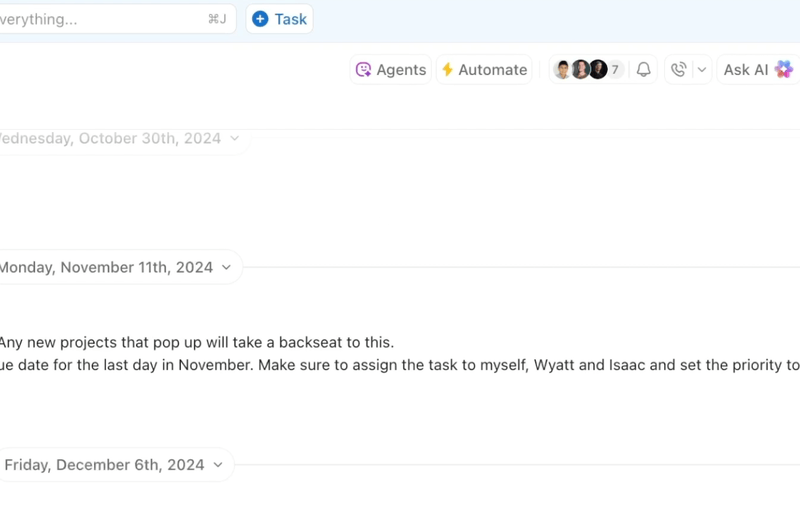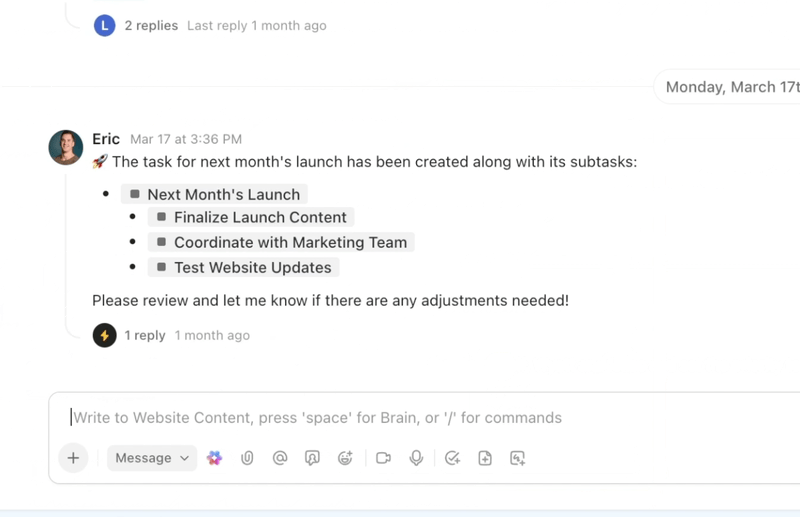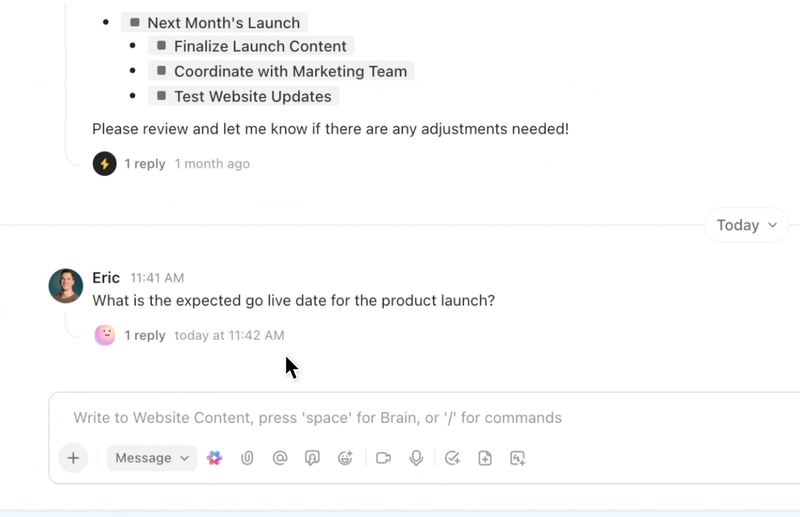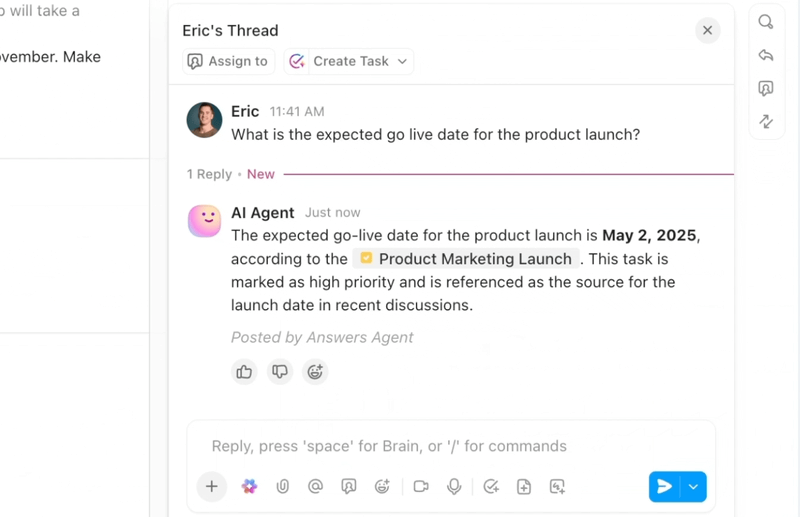
Jika Anda menginginkan alur kerja penyelesaian bug yang efisien dan cerdas, ClickUp, aplikasi serba guna untuk pekerjaan, menggabungkan AI, otomatisasi, dan bantuan alur kerja berbasis agen dalam satu platform.
ClickUp Brain menampilkan konteks yang tepat secara instan—merangkum utas bug yang panjang, mengekstrak langkah-langkah untuk mereproduksi bug serta detail lingkungan dari lampiran, menandai duplikat yang kemungkinan besar terjadi, dan menyarankan tindakan selanjutnya. Alih-alih harus menelusuri Slack, tiket, dan log, tim mendapatkan catatan yang rapi dan kaya informasi yang dapat segera ditindaklanjuti.
Otomatisasi dan Agen Autopilot di ClickUp memastikan pekerjaan terus berjalan tanpa perlu pengawasan terus-menerus. Bug secara otomatis diarahkan ke tim yang tepat, penanggung jawab ditugaskan, SLA dan tenggat waktu ditetapkan, status diperbarui seiring kemajuan pekerjaan, dan pemangku kepentingan menerima pemberitahuan tepat waktu.
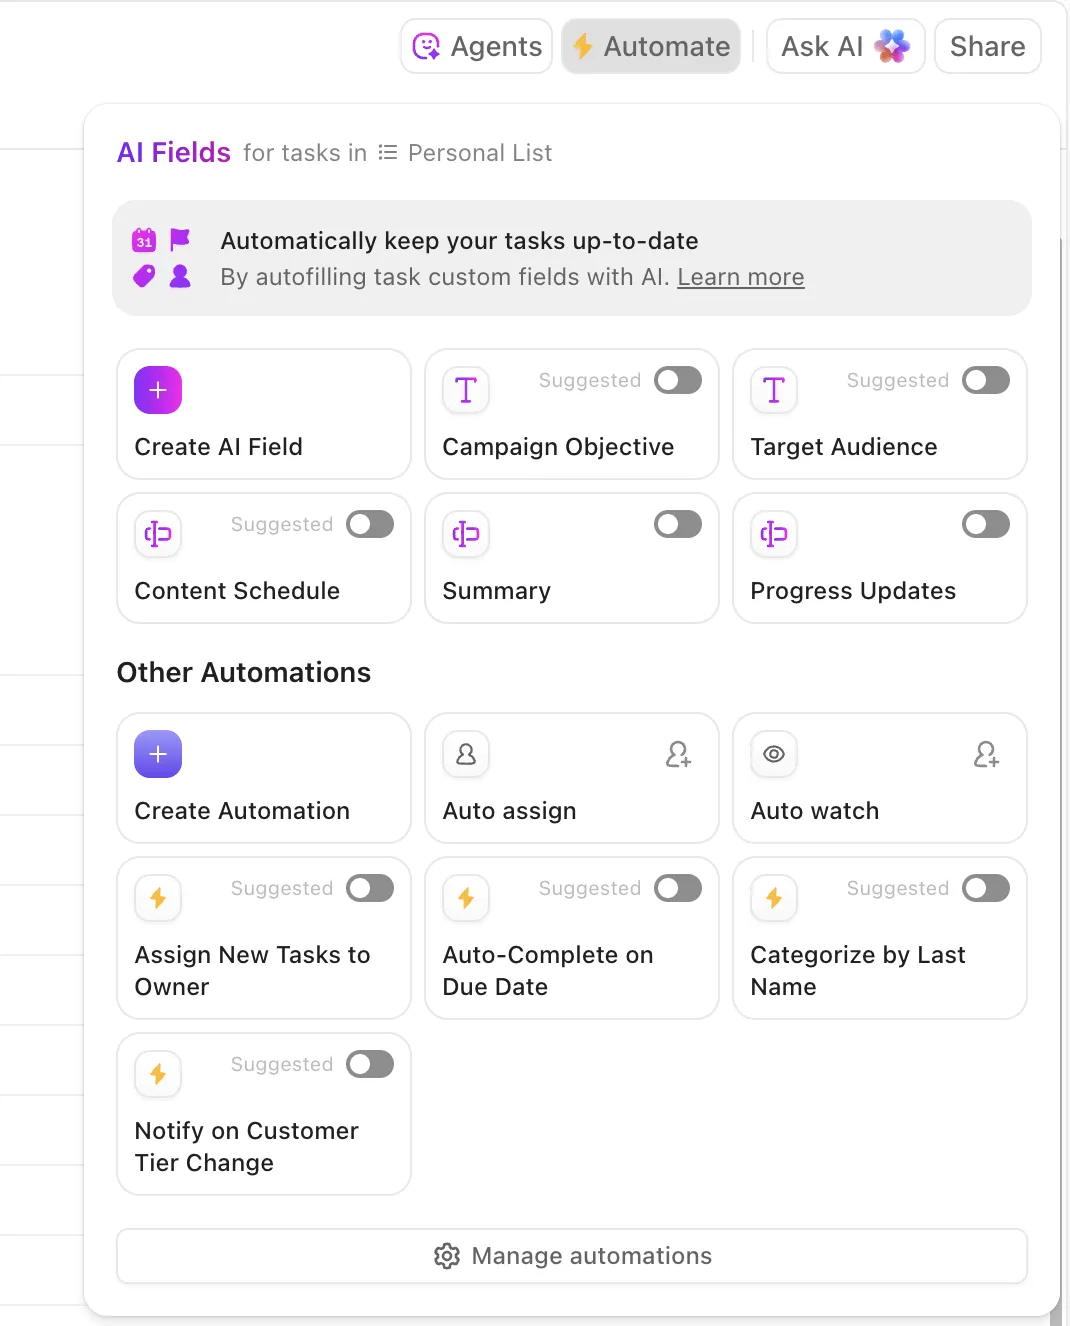
Agen-agen ini bahkan dapat melakukan triase dan mengkategorikan masalah, mengelompokkan laporan yang serupa, merujuk pada solusi historis untuk menyarankan langkah-langkah yang mungkin diambil, serta menaikkan tingkat prioritas item yang mendesak—sehingga MTTA dan MTTR tetap turun meskipun volume melonjak.
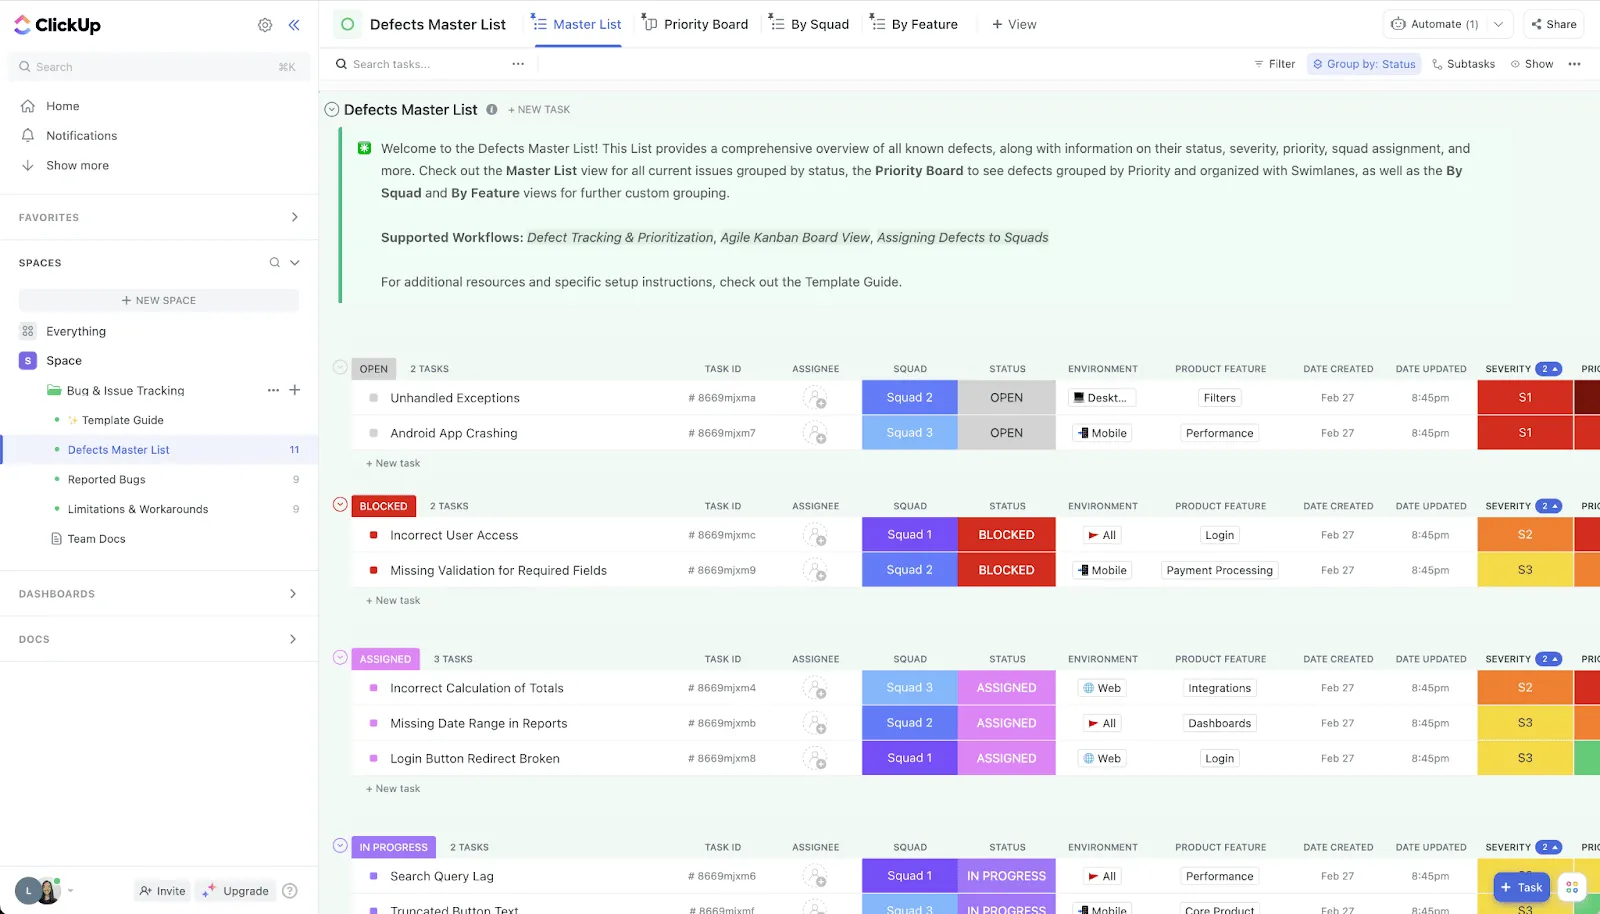
🛠️ Ingin toolkit yang siap pakai? Template Pelacakan Bug & Masalah ClickUp adalah solusi canggih dari ClickUp untuk Perangkat Lunak yang dirancang untuk membantu tim Dukungan, Teknik, dan Produk mengelola bug dan masalah perangkat lunak dengan mudah. Dengan tampilan yang dapat disesuaikan seperti Daftar, Papan, Beban Kerja, Formulir, dan Garis Waktu, tim dapat memvisualisasikan dan mengelola proses pelacakan bug mereka dengan cara yang paling sesuai bagi mereka.
20 Status Kustom dan 7 Bidang Kustom dalam templat ini memungkinkan alur kerja yang disesuaikan, memastikan setiap masalah dilacak mulai dari penemuan hingga penyelesaian. Otomatisasi bawaan menangani tugas-tugas berulang, sehingga menghemat waktu yang berharga dan mengurangi upaya manual.
💟 Bonus: Brain MAX adalah pendamping desktop berbasis AI Anda, yang dirancang untuk mempercepat penyelesaian bug dengan fitur-fitur cerdas dan praktis.
Saat Anda menemukan bug, cukup gunakan fitur "talk-to-text" Brain MAX untuk mendiktekan masalah tersebut—catatan lisan Anda akan langsung ditranskrip dan dapat dilampirkan ke tiket bug baru atau yang sudah ada. Fitur Enterprise Search-nya akan menelusuri semua alat yang terhubung—seperti ClickUp, GitHub, Google Drive, dan Slack—untuk menampilkan laporan bug terkait, log kesalahan, potongan kode, dan dokumentasi, sehingga Anda memiliki semua konteks yang dibutuhkan tanpa perlu berpindah aplikasi.
Perlu mengoordinasikan perbaikan? Brain MAX memungkinkan Anda menugaskan bug kepada pengembang yang tepat, mengatur pengingat otomatis untuk pembaruan status, dan melacak kemajuan—semuanya dari desktop Anda!
2. Sentry (Pilihan terbaik untuk mendeteksi kesalahan)
Sentry mengurangi MTTD dan waktu reproduksi dengan mengumpulkan kesalahan, jejak, dan sesi pengguna di satu tempat. Pengelompokan masalah berbasis AI mengurangi gangguan; fitur “Suspect Commit” dan aturan kepemilikan mengidentifikasi pemilik kode yang kemungkinan besar bertanggung jawab, sehingga pengalihan masalah menjadi instan. Fitur Session Replay memberikan insinyur jalur pengguna yang tepat serta detail konsol dan jaringan untuk mereproduksi masalah tanpa perlu bolak-balik yang tak berujung.
Fitur Sentry AI dapat merangkum konteks masalah dan, pada beberapa stack, mengusulkan patch Autofix yang merujuk pada kode yang bermasalah. Dampaknya secara praktis: lebih sedikit tiket duplikat, penugasan yang lebih cepat, dan jalur yang lebih singkat dari laporan hingga patch yang berfungsi.
3. GitHub Copilot (Pilihan terbaik untuk meninjau kode dengan lebih cepat)
Copilot mempercepat siklus perbaikan di dalam editor. Fitur ini menjelaskan jejak tumpukan (stack traces), menyarankan tambalan yang tepat sasaran, menulis uji unit untuk memastikan perbaikan berhasil, dan membuat kerangka skrip reproduksi.
Copilot Chat dapat menganalisis kode yang bermasalah, mengusulkan refaktorisasi yang lebih aman, serta menghasilkan komentar atau deskripsi PR yang mempercepat proses tinjauan kode. Dikombinasikan dengan tinjauan wajib dan CI, fitur ini memangkas waktu berjam-jam dari tahap “diagnosis → implementasi → pengujian,” terutama untuk bug yang cakupannya jelas dan dapat direproduksi dengan mudah.
4. Snyk oleh DeepCode AI (Terbaik untuk mengidentifikasi pola)
Analisis statis berbasis AI dari DeepCode mendeteksi cacat dan pola yang tidak aman saat Anda menulis kode dan dalam PR. Fitur ini menyoroti alur kode yang bermasalah, menjelaskan penyebabnya, dan mengusulkan perbaikan yang aman yang sesuai dengan idiom basis kode Anda.
Dengan mendeteksi regresi sebelum penggabungan (merge) dan mengarahkan pengembang ke pola yang lebih aman, Anda dapat mengurangi laju kemunculan bug baru serta mempercepat perbaikan kesalahan logika yang rumit dan sulit terdeteksi dalam proses tinjauan. Integrasi dengan IDE dan pull request (PR) memastikan proses ini tetap dekat dengan lokasi kerja.
5. Datadog’s Watchdog dan AIOps (Pilihan terbaik untuk analisis log)
Watchdog dari Datadog menggunakan ML untuk mengidentifikasi anomali di seluruh log, metrik, jejak, dan pemantauan pengguna nyata. Fitur ini mengkorelasikan lonjakan dengan penanda deployment, perubahan infrastruktur, dan topologi untuk menyarankan kemungkinan penyebab utama.
Untuk masalah yang berdampak pada pelanggan, hal ini berarti deteksi dalam hitungan menit, pengelompokan otomatis untuk meminimalkan gangguan notifikasi, dan petunjuk konkret mengenai area yang perlu diperiksa. Waktu triase berkurang karena Anda memulai dengan informasi seperti “deploy ini memengaruhi layanan-layanan ini dan tingkat kesalahan meningkat di endpoint ini”, bukan dari nol.
⚡️ Arsip Template: Template Pelacakan Masalah & Log Gratis di Excel & ClickUp
6. New Relic AI (Pilihan terbaik untuk mengidentifikasi dan merangkum tren)
Fitur Errors Inbox dari New Relic mengelompokkan bug serupa di seluruh layanan dan versi, sementara asisten AI-nya merangkum dampaknya, menyoroti kemungkinan penyebabnya, dan menautkan ke jejak/transaksi yang terlibat.
Korelasi deployment dan analisis perubahan entitas membuat jelas kapan rilis terbaru menjadi penyebabnya. Untuk sistem terdistribusi, konteks tersebut menghemat berjam-jam komunikasi antar tim dan memastikan bug tersebut diteruskan ke pemilik yang tepat dengan hipotesis yang sudah terbentuk dengan baik.
7. Rollbar (Pilihan terbaik untuk alur kerja otomatis)
Rollbar mengkhususkan diri dalam pemantauan kesalahan secara real-time dengan fingerprinting cerdas untuk mengelompokkan duplikat dan melacak tren kemunculan. Ringkasan berbasis AI dan petunjuk akar masalahnya membantu tim memahami cakupan (pengguna yang terpengaruh, versi yang terdampak), sementara data telemetri dan jejak tumpukan (stack traces) memberikan petunjuk cepat untuk mereproduksi masalah.
Aturan alur kerja Rollbar dapat secara otomatis membuat tugas, memberi label tingkat keparahan, dan meneruskannya ke pemilik, sehingga mengubah aliran kesalahan yang berantakan menjadi antrian yang diprioritaskan dengan konteks yang terlampir.
8. PagerDuty AIOps dan otomatisasi runbook (Pilihan terbaik untuk diagnostik dengan intervensi minimal)
PagerDuty menggunakan korelasi peristiwa dan pengurangan gangguan berbasis ML untuk menyederhanakan badai peringatan menjadi insiden yang dapat ditindaklanjuti.
Routing dinamis langsung meneruskan masalah ke petugas jaga yang tepat, sementara otomatisasi runbook dapat memulai proses diagnostik atau tindakan mitigasi (memulai ulang layanan, mengembalikan deployment ke versi sebelumnya, atau mengaktifkan/menonaktifkan fitur) sebelum intervensi manusia diperlukan. Untuk waktu penyelesaian bug, hal ini berarti MTTA yang lebih singkat, mitigasi yang lebih cepat untuk bug P0, dan berkurangnya waktu yang terbuang akibat kelelahan akibat peringatan berulang.
Inti dari proses ini adalah otomatisasi ditambah AI di setiap langkah. Anda dapat mendeteksi masalah lebih awal, mengalihkan masalah dengan lebih cerdas, mencapai kode yang bermasalah lebih cepat, dan mengkomunikasikan status tanpa menghambat kerja para insinyur—semua hal ini berkontribusi pada pengurangan waktu penyelesaian bug yang signifikan.
📖 Baca Selengkapnya: Cara Menggunakan AI dalam DevOps
Contoh Nyata Penggunaan AI untuk Penyelesaian Bug
Jadi, AI kini secara resmi telah keluar dari laboratorium. AI ini berhasil mengurangi waktu penyelesaian bug di lingkungan nyata.
Mari kita lihat caranya!
| Domain / Organisasi | Bagaimana AI Digunakan | Dampak / Manfaat |
|---|---|---|
| Ubisoft | Mengembangkan Commit Assistant, sebuah alat AI yang dilatih menggunakan data kode internal selama satu dekade, yang dapat memprediksi dan mencegah bug pada tahap penulisan kode. | Tujuannya adalah untuk secara drastis mengurangi waktu dan biaya—hingga 70% dari biaya pengembangan game biasanya dihabiskan untuk perbaikan bug. |
| Razer (Platform Wyvrn) | Meluncurkan QA Copilot yang didukung AI (terintegrasi dengan Unreal dan Unity) untuk mengotomatisasi deteksi bug dan menghasilkan laporan QA. | Meningkatkan deteksi bug hingga 25% dan memangkas waktu QA hingga setengahnya. |
| Google / DeepMind & Project Zero | Memperkenalkan Big Sleep, sebuah alat AI yang secara otomatis mendeteksi kerentanan keamanan dalam perangkat lunak sumber terbuka seperti FFmpeg dan ImageMagick. | Telah teridentifikasi 20 bug, semuanya telah diverifikasi oleh ahli manusia dan dijadwalkan untuk diperbaiki. |
| Peneliti UC Berkeley | Dengan menggunakan tolok ukur bernama CyberGym, model AI menganalisis 188 proyek sumber terbuka, mengungkap 17 kerentanan—termasuk 15 bug “zero-day” yang belum diketahui—dan menghasilkan eksploit proof-of-concept. | Menunjukkan kemampuan AI yang terus berkembang dalam mendeteksi kerentanan dan pencegahan eksploitasi secara otomatis. |
| Spur (Startup Yale) | Mengembangkan agen AI yang menerjemahkan deskripsi kasus uji dalam bahasa sehari-hari menjadi rutinitas pengujian situs web otomatis — pada dasarnya merupakan alur kerja QA yang menulis sendiri. | Memungkinkan pengujian otonom dengan intervensi manusia yang minimal |
| Reproduksi Otomatis Laporan Bug Android | Menggunakan NLP dan pembelajaran penguatan untuk menganalisis bahasa dalam laporan bug serta menghasilkan langkah-langkah untuk mereproduksi bug Android. | Mencapai akurasi 67%, recall 77%, dan mereproduksi 74% laporan bug, sehingga mengungguli metode tradisional. |
Kesalahan Umum dalam Mengukur Waktu Penyelesaian Bug
Jika pengukuran Anda tidak akurat, rencana perbaikan Anda pun akan demikian.
Sebagian besar “angka buruk” dalam alur kerja penyelesaian bug berasal dari definisi yang tidak jelas, alur kerja yang tidak konsisten, dan analisis yang dangkal.
Jadi, mulailah dari dasar-dasarnya terlebih dahulu—apa yang dianggap sebagai start/stop, bagaimana Anda menangani masa tunggu dan pembukaan kembali—lalu analisis data sesuai dengan pengalaman pelanggan Anda. Hal itu mencakup:
❌ Batasan yang tidak jelas: Menggabungkan "Dilaporkan→Terselesaikan" dan "Dilaporkan→Ditutup" dalam dasbor yang sama (atau berganti-ganti dari bulan ke bulan) membuat tren menjadi tidak bermakna. Pilih satu batasan, dokumentasikan, dan terapkan secara konsisten di seluruh tim. Jika Anda membutuhkan keduanya, publikasikan sebagai metrik terpisah dengan label yang jelas.
❌ Pendekatan yang hanya mengandalkan rata-rata: Mengandalkan nilai rata-rata menyembunyikan kenyataan bahwa antrian dapat mengandung beberapa kasus penyimpangan yang memakan waktu lama. Gunakan median (P50) untuk waktu “tipikal” Anda, P90 untuk prediktabilitas/SLA, dan gunakan nilai rata-rata untuk perencanaan kapasitas. Selalu perhatikan distribusinya, bukan hanya satu angka saja.
❌ Tanpa segmentasi: Menggabungkan semua bug secara sembarangan akan mencampurkan insiden P0 dengan bug P3 yang bersifat kosmetik. Lakukan segmentasi berdasarkan tingkat keparahan, sumber (pelanggan vs. QA vs. pemantauan), komponen/tim, dan “baru vs. regresi.” P90 P0/P1 Anda adalah apa yang dirasakan oleh pemangku kepentingan; median P2+ Anda adalah dasar perencanaan tim teknik.
❌ Mengabaikan waktu “terhenti”: Menunggu log pelanggan, vendor eksternal, atau jendela rilis? Jika Anda tidak melacak status “Terkendala/Terhenti” sebagai status utama, waktu penyelesaian Anda akan menjadi bahan perdebatan. Laporkan baik waktu kalender maupun waktu aktif agar titik kemacetan terlihat jelas dan perdebatan berhenti.
❌ Kesenjangan normalisasi waktu: Mencampurkan zona waktu atau beralih antara jam kerja dan jam kalender di tengah proses akan merusak perbandingan. Normalisasikan cap waktu ke satu zona (atau UTC) dan tentukan sekali saja apakah SLA diukur dalam jam kerja atau jam kalender; terapkan secara konsisten.
❌ Proses penerimaan yang tidak terstandarisasi dan tiket duplikat: Informasi lingkungan/build yang hilang serta tiket duplikat memperpanjang waktu penyelesaian dan menimbulkan kebingungan mengenai tanggung jawab. Standarisasikan bidang-bidang yang wajib diisi saat penerimaan, lengkapi data secara otomatis (log, versi, perangkat), dan hapus duplikat tanpa mereset waktu—tutup tiket duplikat sebagai tiket yang tertaut, bukan sebagai masalah “baru”.
❌ Model status yang tidak konsisten: Status khusus (“QA Ready-ish,” “Pending Review 2”) menyembunyikan durasi status dan membuat transisi antar status menjadi tidak dapat diandalkan. Tetapkan alur kerja standar (Baru → Telah Disortir → Sedang Berlangsung → Dalam Peninjauan → Telah Diselesaikan → Ditutup) dan lakukan audit terhadap status yang menyimpang dari alur tersebut.
❌ Mengabaikan waktu di setiap status: Angka “waktu total” saja tidak cukup untuk mengetahui di mana pekerjaan terhambat. Catat dan tinjau waktu yang dihabiskan di status Triaged, In Review, Blocked, dan QA. Jika waktu tinjauan kode P90 jauh melebihi waktu implementasi, solusi Anda bukanlah “menulis kode lebih cepat”—melainkan membebaskan kapasitas tinjauan.
🧠 Fakta Menarik: Tantangan AI Cyber terbaru dari DARPA menampilkan lompatan terobosan dalam otomatisasi keamanan siber. Kompetisi ini menampilkan sistem AI yang dirancang untuk secara mandiri mendeteksi, mengeksploitasi, dan memperbaiki kerentanan dalam perangkat lunak—tanpa campur tangan manusia. Tim pemenang, “Team Atlanta,” secara mengesankan berhasil mengungkap 77% dari bug yang disisipkan dan berhasil memperbaiki 61% di antaranya, menunjukkan kemampuan AI yang tidak hanya untuk menemukan kelemahan, tetapi juga secara aktif memperbaikinya.
❌ Kebutaan terhadap kasus yang dibuka kembali: Memperlakukan kasus yang dibuka kembali sebagai bug baru akan mereset waktu dan membuat MTTR terlihat lebih baik. Pantau Tingkat Pembukaan Kembali dan “waktu hingga penutupan stabil” (dari laporan pertama hingga penutupan akhir di seluruh siklus). Meningkatnya kasus yang dibuka kembali biasanya menandakan reproduksi yang lemah, celah dalam pengujian, atau definisi “selesai” yang tidak jelas.
❌ Tanpa MTTA: Tim terlalu fokus pada MTTR dan mengabaikan MTTA (waktu pengakuan/penanggung jawab). MTTA yang tinggi merupakan tanda peringatan dini bahwa penyelesaian akan memakan waktu lama. Ukurlah MTTA, tetapkan SLA berdasarkan tingkat keparahan, dan otomatiskan perutean/eskalasi untuk menekannya.
❌ AI/otomatisasi tanpa batasan: Membiarkan AI menentukan tingkat keparahan atau menutup laporan duplikat tanpa tinjauan dapat menyebabkan kesalahan klasifikasi pada kasus-kasus khusus dan secara diam-diam memengaruhi metrik. Gunakan AI untuk saran, wajibkan konfirmasi manusia pada P0/P1, dan audit kinerja model setiap bulan agar data Anda tetap dapat diandalkan.
Perbaiki celah-celah ini, dan grafik waktu penyelesaian Anda akhirnya akan mencerminkan kenyataan. Dari situ, perbaikan akan terus berlanjut: proses penerimaan yang lebih baik akan mempersingkat MTTA, kondisi yang lebih teratur akan mengungkap titik-titik kemacetan yang sebenarnya, dan P90 yang tersegmentasi akan memberikan janji kepada para pemimpin yang dapat Anda penuhi.
⚡️ Arsip Template: 10 Template Kasus Uji untuk Pengujian Perangkat Lunak
Praktik Terbaik untuk Penyelesaian Bug yang Lebih Baik
Singkatnya, berikut ini adalah poin-poin penting yang perlu diingat!
| 🧩 Praktik terbaik | 💡 Apa artinya | 🚀 Mengapa hal ini penting |
| Gunakan sistem pelacakan bug yang andal | Lacak semua bug yang dilaporkan menggunakan sistem pelacakan bug terpusat. | Memastikan tidak ada bug yang terlewatkan dan memungkinkan visibilitas status bug di seluruh tim. |
| Tulis laporan bug yang terperinci | Sertakan konteks visual, informasi sistem operasi, langkah-langkah untuk mereproduksi masalah, dan tingkat keparahan. | Membantu pengembang memperbaiki bug lebih cepat dengan semua informasi penting yang tersedia sejak awal. |
| Kategorikan & prioritaskan bug | Gunakan matriks prioritas untuk mengurutkan bug berdasarkan tingkat urgensi dan dampaknya. | Memfokuskan tim pada bug kritis dan masalah mendesak terlebih dahulu. |
| Manfaatkan pengujian otomatis | Jalankan pengujian secara otomatis dalam pipeline CI/CD Anda. | Mendukung deteksi dini dan mencegah terjadinya regresi. |
| Tentukan pedoman pelaporan yang jelas | Sediakan templat dan pelatihan tentang cara melaporkan bug. | Hal ini menghasilkan informasi yang akurat dan komunikasi yang lebih lancar. |
| Pantau metrik utama | Ukur waktu penyelesaian, waktu yang telah berlalu, dan waktu respons. | Memungkinkan pelacakan dan peningkatan kinerja menggunakan data historis. |
| Gunakan pendekatan proaktif | Jangan tunggu sampai pengguna mengeluh—lakukan pengujian secara proaktif. | Meningkatkan kepuasan pelanggan dan mengurangi beban dukungan. |
| Manfaatkan alat cerdas & ML | Gunakan pembelajaran mesin untuk memprediksi bug dan menyarankan solusi. | Meningkatkan efisiensi dalam mengidentifikasi akar masalah dan memperbaiki bug. |
| Sesuaikan dengan SLA | Penuhi perjanjian tingkat layanan (SLA) yang telah disepakati untuk penyelesaian masalah. | Membangun kepercayaan dan memenuhi harapan klien tepat waktu. |
| Tinjau dan tingkatkan secara berkelanjutan | Analisis bug yang dibuka kembali, kumpulkan umpan balik, dan sesuaikan proses. | Mendorong peningkatan berkelanjutan pada proses pengembangan dan pengelolaan bug Anda. |
Penyelesaian Bug Menjadi Mudah dengan AI Kontekstual
Tim penyelesaian bug tercepat tidak mengandalkan tindakan heroik. Mereka merancang sistem: definisi awal dan akhir yang jelas, proses penerimaan yang rapi, prioritas berdasarkan dampak bisnis, kepemilikan yang tegas, serta siklus umpan balik yang ketat di seluruh tim dukungan, QA, teknik, dan rilis.
ClickUp dapat menjadi pusat kendali berbasis AI untuk sistem penyelesaian bug Anda. Sentralisasikan setiap laporan ke dalam satu antrian, standarkan konteks dengan bidang terstruktur, dan biarkan AI ClickUp melakukan triase, merangkum, dan memprioritaskan, sementara otomatisasi menegakkan SLA, menaikkan tingkat masalah saat tenggat waktu terlewat, dan menjaga keselarasan para pemangku kepentingan. Hubungkan bug dengan pelanggan, kode, dan rilis sehingga eksekutif dapat melihat dampaknya dan praktisi tetap dalam alur kerja.
Jika Anda siap untuk mengurangi waktu penyelesaian bug dan membuat peta jalan Anda lebih dapat diprediksi, daftarlah ke ClickUp dan mulailah mengukur peningkatan dalam hitungan hari—bukan kuartal.
Pertanyaan yang Sering Diajukan
Berapa lama waktu penyelesaian bug yang ideal?
Tidak ada angka “ideal” yang tunggal—hal ini bergantung pada tingkat keparahan, model rilis, dan toleransi risiko. Gunakan median (P50) untuk kinerja “tipikal” dan P90 untuk komitmen/SLA, serta segmentasikan berdasarkan tingkat keparahan dan sumber.
Apa perbedaan antara penyelesaian bug dan penutupan bug?
Penyelesaian terjadi ketika perbaikan telah diterapkan (misalnya, kode digabungkan, konfigurasi diterapkan) dan tim menganggap bug tersebut telah ditangani. Penutupan terjadi ketika masalah telah diverifikasi dan secara resmi diselesaikan (misalnya, telah divalidasi oleh QA di lingkungan target, dirilis, atau ditandai sebagai "tidak akan diperbaiki"/duplikat dengan alasan yang jelas). Banyak tim mengukur keduanya: Laporan→Terselesaikan mencerminkan kecepatan tim teknik; Laporan→Ditutup mencerminkan alur kualitas dari awal hingga akhir. Gunakan definisi yang konsisten agar dasbor tidak mencampuradukkan tahapan.
Apa perbedaan antara waktu penyelesaian bug dan waktu deteksi bug?
Waktu deteksi (MTTD) adalah lamanya waktu yang dibutuhkan untuk menemukan suatu cacat setelah terjadi atau dirilis—melalui pemantauan, QA, atau pengguna. Waktu penyelesaian adalah lamanya waktu yang dibutuhkan mulai dari deteksi/pelaporan hingga perbaikan diterapkan (dan, jika Anda mau, divalidasi/dirilis). Bersama-sama, keduanya menentukan jendela dampak pelanggan: deteksi cepat, pengakuan cepat, penyelesaian cepat, dan rilis yang aman. Anda juga dapat melacak MTTA (waktu untuk mengakui/menugaskan) guna mengidentifikasi penundaan triase yang sering kali menandakan waktu penyelesaian yang lebih lama.
Bagaimana AI membantu dalam penyelesaian bug?
AI mempercepat proses-proses yang biasanya memakan waktu: penerimaan, triase, diagnosis, perbaikan, dan verifikasi.
- Penerimaan dan triase: Secara otomatis merangkum laporan panjang, mengekstrak langkah-langkah reproduksi/lingkungan, menandai duplikat, dan menyarankan tingkat keparahan/prioritas sehingga insinyur dapat memulai dengan konteks yang jelas (misalnya, ClickUp AI, Sentry AI).
- Perutean dan SLA: Memprediksi komponen/pemilik yang kemungkinan terlibat, mengatur timer, dan melakukan eskalasi ketika MTTA atau waktu tunggu peninjauan melampaui batas—sehingga mengurangi “waktu dalam status” yang tidak produktif (Otomatisasi ClickUp dan alur kerja mirip agen).
- Diagnosis: Mengelompokkan kesalahan serupa, mengkorelasikan lonjakan dengan commit/rilis terbaru, dan mengidentifikasi kemungkinan penyebab utama dengan bantuan jejak tumpukan (stack traces) dan konteks kode (Sentry AI dan sejenisnya).
- Implementasi: Menyarankan perubahan kode dan pengujian berdasarkan pola dari repositori Anda, sehingga mempercepat siklus “tulis/perbaiki” (GitHub Copilot; Snyk Code AI oleh DeepCode).
- Verifikasi dan komunikasi: menyusun kasus uji berdasarkan langkah-langkah reproduksi, menyusun draf catatan rilis dan pembaruan untuk pemangku kepentingan, serta merangkum status untuk eksekutif dan pelanggan (ClickUp AI). Dengan menggunakannya secara bersamaan—ClickUp sebagai pusat komando bersama Sentry/Copilot/DeepCode dalam tumpukan teknologi—tim dapat memangkas waktu MTTA/P90 tanpa harus mengandalkan upaya luar biasa.