
KI-Projekte scheitern selten auf Modellebene. Probleme treten auf, wenn Experimente, Dokumentation und Updates für die Beteiligten auf zu viele Tools verteilt sind.
Dieser Leitfaden führt Sie durch das Training von Modellen mit Databricks DBRX – einem LLM, das bis zu doppelt so recheneffizient ist wie andere führende Modelle – und hilft Ihnen dabei, die damit verbundene Arbeit in ClickUp zu organisieren.
Von der Einrichtung und Feinabstimmung bis hin zur Dokumentation und teamübergreifenden Aktualisierungen – Sie werden sehen, wie ein einziger, zentraler Workspace dazu beiträgt, die Zersplitterung von Informationen zu vermeiden und Ihr Team darauf zu konzentrieren, etwas zu entwickeln, statt nach Informationen zu suchen. 🛠
Was ist DBRX?
DBRX ist ein leistungsstarkes Open-Source-Großsprachenmodell (LLM), das speziell für das Training und die Inferenz von KI-Modellen in Unternehmen entwickelt wurde. Da es unter der Databricks Open Model License als Open Source verfügbar ist, hat Ihr Team vollen Zugriff auf die Gewichte und die Architektur des Modells, sodass Sie es nach Ihren eigenen Vorstellungen überprüfen, anpassen und bereitstellen können.
Es gibt zwei Varianten: DBRX Base für das Deep-Pre-Training und DBRX Instruct für sofort einsatzbereite Aufgaben, bei denen Anweisungen befolgt werden müssen.
DBRX-Architektur und „Mixture-of-Experts“-Design
DBRX löst Aufgaben mithilfe einer „Mixture-of-Experts“-Architektur (MoE). Im Gegensatz zu herkömmlichen großen Sprachmodellen, die bei jeder einzelnen Berechnung alle ihre Milliarden von Parametern nutzen, aktiviert DBRX für eine bestimmte Aufgabe nur einen Bruchteil seiner Gesamtparameter (die relevantesten Experten).
Stellen Sie sich das wie ein Team aus spezialisierten Experten vor: Anstatt dass jeder an jedem Problem arbeitet, leitet das System jede Aufgabe intelligent an die am besten geeigneten Parameter weiter.
Dies verkürzt nicht nur die Reaktionszeit, sondern liefert auch erstklassige Leistung und Ergebnisse bei gleichzeitig deutlich reduzierten Rechenkosten.
Hier ein kurzer Überblick über die wichtigsten Spezifikationen:
- Gesamtzahl der Parameter: 132 Milliarden über alle Experten hinweg
- Aktive Parameter: 36B pro Vorwärtsdurchlauf
- Anzahl der Experten: insgesamt 16 (MoE Top-4-Routing), davon 4 aktiv für jedes beliebige Token
- Kontextfenster: 32.000 Token
DBRX-Trainingsdaten und Token-Spezifikationen
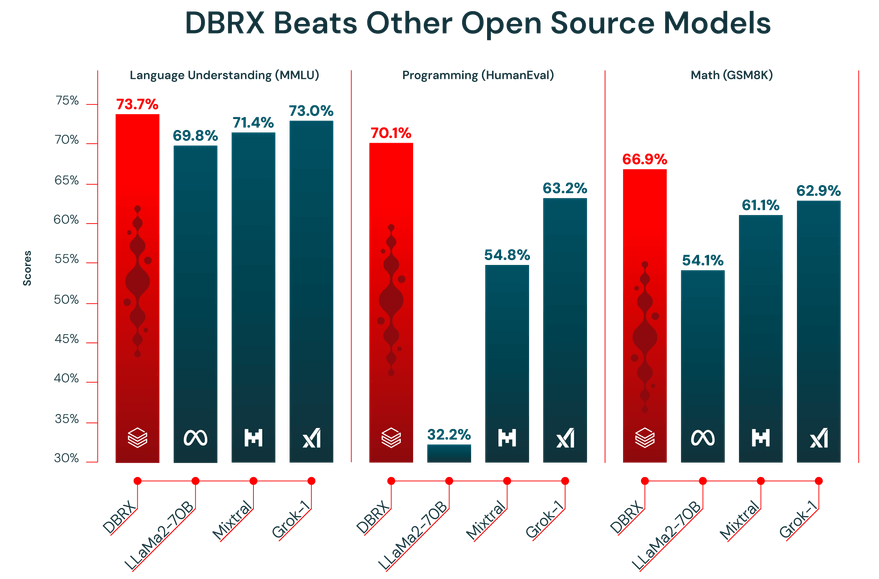
Die Leistung eines LLM hängt entscheidend von der Qualität der Daten ab, mit denen es trainiert wurde. DBRX wurde auf einem riesigen Datensatz mit 12 Billionen Token vortrainiert, der vom Databricks-Team mithilfe seiner fortschrittlichen Datenverarbeitungs-tools sorgfältig zusammengestellt wurde. Genau deshalb hat es bei Branchen-Benchmarks so gut abgeschnitten.
Darüber hinaus verfügt DBRX über ein Kontextfenster von 32.000 Token. Dies ist die Textmenge, die das Modell auf einmal berücksichtigen kann. Ein großes Kontextfenster ist äußerst hilfreich für komplexe Aufgaben wie das Zusammenfassen langer Berichte, das Durchforsten umfangreicher juristischer Dokumente oder den Aufbau fortschrittlicher RAG-Systeme (Retrieval-Augmented Generation), da es dem Modell ermöglicht, den Kontext beizubehalten, ohne Informationen zu kürzen oder zu vergessen.
🎥 Sehen Sie sich dieses Video an, um zu erfahren, wie eine optimierte Projektkoordination Ihren KI-Trainings-Workflow verändern und die Reibungsverluste beim Wechsel zwischen isolierten tools beseitigen kann. 👇🏽
So greifen Sie auf DBRX zu und richten Sie die Einstellungen ein
DBRX bietet zwei Hauptzugangswege, die beide vollen Zugriff auf die Modellgewichte unter großzügigen kommerziellen Bedingungen gewähren. Sie können Hugging Face für maximale Flexibilität nutzen oder direkt über Databricks darauf zugreifen, um eine stärker integrierte Erfahrung zu erhalten.
Greifen Sie über Hugging Face auf DBRX zu
Für Teams, die Wert auf Flexibilität legen und bereits mit dem Hugging-Face-Ökosystem vertraut sind, ist der Zugriff auf DBRX über den Hub der ideale Weg. So können Sie das Modell in Ihre bestehenden, auf Transformer basierenden Workflows integrieren.
So legen Sie los:
- Erstellen Sie ein Hugging Face-Konto oder melden Sie sich an
- Navigieren Sie im Hub zur DBRX-Modellkarte und akzeptieren Sie die Lizenzbedingungen.
- Installieren Sie die „transformers“-Bibliothek zusammen mit den erforderlichen Abhängigkeiten wie „accelerate“.
- Verwenden Sie die Klasse „AutoModelForCausalLM“ in Ihrem Python-Skript, um das DBRX-Modell zu laden.
- Konfigurieren Sie Ihre Inferenz-Pipeline und beachten Sie dabei, dass DBRX für einen effektiven Betrieb erhebliche Mengen an GPU-Speicher (VRAM) benötigt.
📖 Weiterlesen: So konfigurieren Sie die LLM-Temperatur
Greifen Sie über Databricks auf DBRX zu
Wenn Ihr Team bereits Databricks für Data Engineering oder maschinelles Lernen nutzt, ist der Zugriff auf DBRX über diese Plattform der einfachste Weg. So entfallen umständliche Schritte des Setups, und Sie erhalten alle Tools, die Sie für MLOps benötigen, direkt dort, wo Sie ohnehin schon arbeiten.
Befolgen Sie diese Schritte in Ihrer Databricks-Workspace, um loszulegen:
- Wechseln Sie zum „Model Garden“ oder zum Bereich „Mosaic KI“
- Wählen Sie je nach Ihren Anforderungen entweder „DBRX Base“ oder „DBRX Instruct“ aus.
- Konfigurieren Sie einen Serving-Endpunkt für den API-Zugriff oder richten Sie eine Notebook-Umgebung für die interaktive Nutzung ein
- Beginnen Sie mit dem Testen der Inferenz anhand von Beispielanfragen, um sicherzustellen, dass alles korrekt funktioniert, bevor Sie das Training oder die Bereitstellung Ihres KI-Modells ausweiten.
Dieser Ansatz bietet Ihnen nahtlosen Zugriff auf Tools wie MLflow für die Nachverfolgung von Experimenten und den Unity Catalog für die Modellverwaltung.
📮 ClickUp Insight: Im Durchschnitt verbringt ein Berufstätiger täglich mehr als 30 Minuten mit der Suche nach arbeitsbezogenen Informationen – das sind über 120 Stunden pro Jahr, die durch das Durchforsten von E-Mails, Slack-Threads und verstreuten Dateien verloren gehen.
Ein intelligenter KI-Assistent, der in Ihren Workspace integriert ist, kann das ändern. Lernen Sie ClickUp Brain kennen.
Es liefert sofortige Einblicke und Antworten, indem es innerhalb von Sekunden die richtigen Dokumente, Unterhaltungen und Details zu Aufgaben anzeigt – so können Sie aufhören zu suchen und mit der Arbeit beginnen.
So nehmen Sie Feinabstimmungen an DBRX vor und trainieren benutzerdefinierte KI-Modelle
Ein Standardmodell wird, egal wie leistungsfähig es auch sein mag, niemals die einzigartigen Nuancen Ihres Geschäfts verstehen. Da DBRX Open Source ist, können Sie es feinabstimmen, um ein benutzerdefiniertes Modell zu erstellen, das die Sprache Ihres Geschäfts spricht oder eine bestimmte Aufgabe erfüllt, die Sie ihm übertragen möchten.
Hier sind drei gängige Möglichkeiten, wie Sie dies zu erledigen haben:
1. DBRX mit Datensätzen von Hugging Face feinabstimmen
Für Teams, die gerade erst anfangen oder an gängigen Aufgaben arbeiten, sind öffentliche Datensätze aus dem Hugging Face Hub eine hervorragende Ressource. Sie sind bereits vorformatiert und lassen sich leicht laden, sodass Sie keine Stunden mit der Aufbereitung Ihrer Daten verbringen müssen.
Der Ablauf ist ziemlich einfach:
- Suchen Sie im Hub nach einem Datensatz, der zu Ihrer Aufgabe passt (z. B. Befolgen von Anweisungen, Zusammenfassung).
- Laden Sie es über die Datensatzbibliothek
- Stellen Sie sicher, dass die Daten im Format von Befehl-Antwort-Paaren formatiert sind
- Konfigurieren Sie Ihr Trainingsskript mit Hyperparametern wie Lernrate und Batchgröße
- Starten Sie den Trainingsjob und achten Sie darauf, während eines Zeitraums regelmäßig Checkpoints zu speichern.
- Bewerten Sie das feinabgestimmte Modell anhand eines zurückbehaltenen Validierungssatzes, um die Verbesserung zu messen.
2. DBRX mit lokalen Datensätzen feinabstimmen
Die besten Ergebnisse erzielen Sie in der Regel durch eine Feinabstimmung mit Ihren eigenen firmeneigenen Daten. So können Sie dem Modell die spezifische Terminologie, den Stil und das Fachwissen Ihres Unternehmens beibringen. Beachten Sie jedoch, dass sich dies nur lohnt, wenn Ihre Daten sauber und gut aufbereitet sind und ein ausreichendes Volumen aufweisen.
Befolgen Sie diese Schritte, um Ihre internen Daten vorzubereiten:
- Datenerfassung: Sammeln Sie hochwertige Beispiele aus Ihren internen Wikis, Dokumenten und Datenbanken
- Formatkonvertierung: Strukturieren Sie Ihre Daten in ein einheitliches Befehl-Antwort-Format, häufig als JSON-Zeilen.
- Qualitätsfilterung: Entfernen Sie alle Beispiele von geringer Qualität, Duplikate oder irrelevante Beispiele
- Validierungssplit: Legen Sie einen kleinen Teil Ihrer Daten (in der Regel 10–15 %) beiseite, um die Leistung des Modells zu bewerten.
- Datenschutzprüfung: Entfernen oder maskieren Sie alle personenbezogenen Daten (PII) oder sensiblen Daten.
3. DBRX mit StreamingDataset feinabstimmen
Sollte Ihr Datensatz zu groß sein, um in den Arbeitsspeicher Ihres Computers zu passen, ist das kein Problem: Sie können die „Streaming Dataset“-Bibliothek von Databricks nutzen. Damit können Sie Daten während des Modelltrainings direkt aus dem Cloud-Speicher streamen, anstatt sie auf einmal in den Arbeitsspeicher zu laden.
So ist es zu erledigen:
- Datenaufbereitung: Bereinigen und strukturieren Sie Ihre Trainingsdaten und speichern Sie diese anschließend in einem streamfähigen Format wie JSONL oder CSV in einem Cloud-Speicher.
- Konvertierung in ein Streaming-Format: Konvertieren Sie Ihren Datensatz in ein streamingfreundliches Format wie beispielsweise Mosaic Data Shard (MDS), damit er während des Trainings effizient gelesen werden kann.
- Setup des Trainingsloaders: Konfigurieren Sie Ihren Trainingsloader so, dass er auf den Remote-Datensatz verweist, und definieren Sie einen lokalen Cache für den temporären Speicher.
- Modellinitialisierung: Starten Sie den DBRX-Fine-Tuning-Prozess mit einem Trainings-Framework, das StreamingDataset unterstützt, wie beispielsweise LLM Foundry.
- Streaming-basiertes Training: Führen Sie den Trainingsjob aus, während die Daten während des Trainings in Chargen gestreamt werden, anstatt sie vollständig in den Arbeitsspeicher zu laden.
- Checkpoints und Wiederherstellung: Setzen Sie das Training nahtlos fort, wenn ein Durchlauf unterbrochen wird, ohne dass Daten dupliziert oder übersprungen werden.
- Bewertung und Bereitstellung: Überprüfen Sie die Leistung des feinabgestimmten Modells und stellen Sie es mithilfe Ihres bevorzugten Serving- oder Inferenz-Setups bereit.
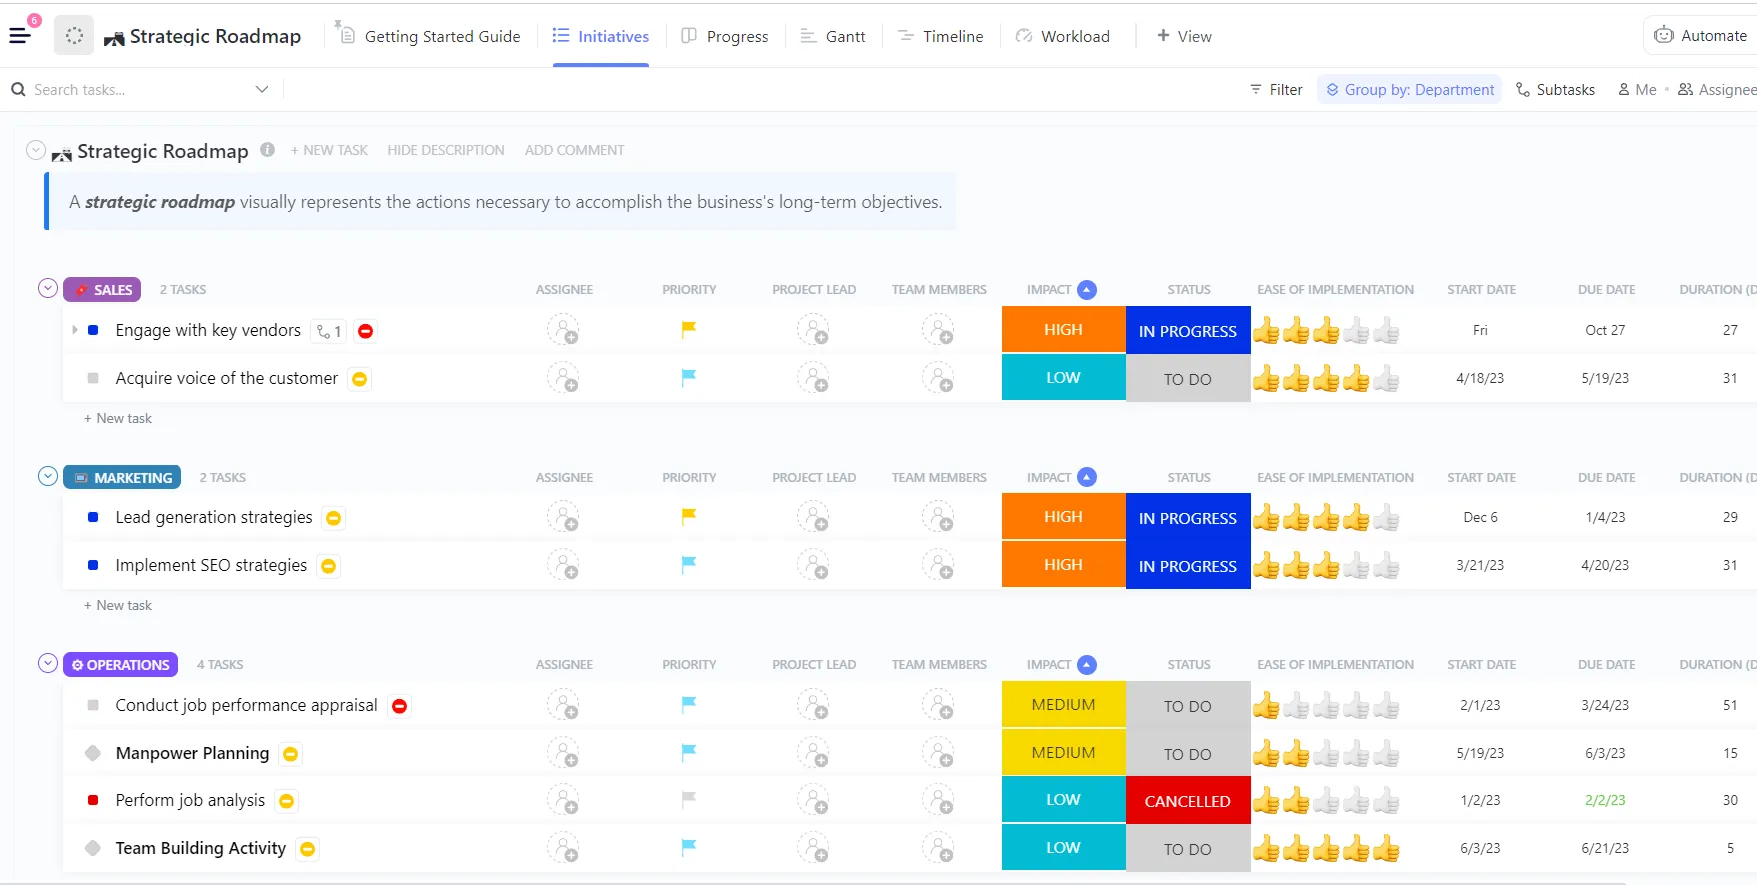
💡Profi-Tipp: Anstatt einen DBRX-Trainingsplan von Grund auf neu zu erstellen, beginnen Sie mit der Vorlage für KI- und Machine-Learning-Projekte von ClickUp und passen Sie diese an die Bedürfnisse Ihres Teams an. Sie bietet eine klare Struktur für die Planung von Datensätzen, Trainingsphasen, Auswertung und Bereitstellung, sodass Sie sich auf die Organisation Ihrer Arbeit konzentrieren können, anstatt einen Workflow zu strukturieren.
DBRX-Anwendungsfälle für das Training von KI-Modellen
Ein leistungsstarkes Modell zu haben ist eine Sache, aber genau zu wissen, wo es seine Stärken ausspielt, ist eine ganz andere.
Wenn man sich kein klares Bild von den Stärken eines Modells machen kann, verschwendet man leicht Zeit und Ressourcen damit, es dort zum Laufen zu bringen, wo es einfach nicht passt. Dies führt zu unterdurchschnittlichen Ergebnissen und Frustration.
Dank seiner einzigartigen Architektur und seiner Trainingsdaten eignet sich DBRX hervorragend für mehrere wichtige Anwendungsfälle in Unternehmen. Wenn Sie diese Stärken kennen, können Sie das Modell besser auf Ihre Geschäftsziele abstimmen und Ihre Kapitalrendite maximieren.
Textgenerierung und Erstellung von Inhalten
DBRX Instruct ist speziell darauf optimiert, Anweisungen zu befolgen und qualitativ hochwertigen Text zu generieren. Damit ist es ein leistungsstarkes Tool für die Automatisierung eines breiten Bereichs an inhaltlichen Aufgaben. Sein großes Kontextfenster ist ein wesentlicher Vorteil, da es so auch lange Dokumente verarbeiten kann, ohne den Faden zu verlieren.
Sie können es für folgende Zwecke nutzen:
- Technische Dokumentation: Erstellen und optimieren Sie Produkthandbücher, API-Referenzen und Benutzerhandbücher
- Marketing-Inhalte: Entwürfe für Blogbeiträge, E-Mail-Newsletter und Social-Media-Beiträge
- Berichterstellung: Fassen Sie komplexe Datenergebnisse zusammen und erstellen Sie prägnante Zusammenfassungen für die Geschäftsleitung
- Übersetzung und Lokalisierung: Passen Sie bestehende Inhalte an neue Märkte und Zielgruppen an
Code-Generierung und Debugging-Aufgaben
Ein erheblicher Teil der Trainingsdaten von DBRX umfasste Code, was es zu einer leistungsfähigen LLM-Unterstützung für Entwickler macht. Es kann dazu beitragen, Entwicklungszyklen zu beschleunigen, indem es wiederholende Programmieraufgaben automatisiert und bei der Lösung komplexer Probleme hilft.
Hier sind einige Möglichkeiten, wie Ihr Entwicklerteam davon profitieren kann:
- Code-Vervollständigung: Generieren Sie automatisch Funktionskörper aus Kommentaren oder Docstrings
- Fehlererkennung: Analysieren Sie Code-Schnipsel, um potenzielle Fehler oder logische Mängel zu identifizieren.
- Erläuterung des Codes: Übersetzen Sie komplexe Algorithmen oder Legacy-Code in leicht verständliches Deutsch.
- Testgenerierung: Erstellen Sie Unit-Tests auf der Grundlage der Signatur einer Funktion und des erwarteten Verhaltens
RAG und Anwendungen mit langem Kontext
Retrieval-Augmented Generation (RAG) ist eine leistungsstarke Technik, die die Antworten eines Modells auf die privaten Daten Ihres Unternehmens basiert. Allerdings haben RAG-Systeme oft Schwierigkeiten mit Modellen, die über kleine Kontextfenster verfügen, was eine aggressive Datenaufteilung erzwingt, bei der wichtiger Kontext verloren gehen kann. Das 32K-Kontextfenster von DBRX macht es zu einer hervorragenden Grundlage für robuste RAG-Anwendungen.
Auf diese Weise können Sie leistungsstarke interne tools entwickeln, wie zum Beispiel:
- Enterprise-Suche: Erstellen Sie einen Chatbot, der Fragen von Mitarbeitern mithilfe Ihrer internen Wissensdatenbank beantwortet.
- Kundensupport: Erstellen Sie einen Agenten, der Support-Antworten auf der Grundlage Ihrer Produktdokumentation generiert
- Forschungsunterstützung: Entwickeln Sie ein tool, das Informationen aus Hunderten von Seiten wissenschaftlicher Arbeiten zusammenfassen kann.
- Compliance-Prüfung: Überprüfen Sie Marketingtexte automatisch anhand interner Markenrichtlinien oder behördlicher Vorgaben.
So integrieren Sie das DBRX-Training in den Workflow Ihres Teams
Bei einem erfolgreichen Projekt zum Trainieren von KI-Modellen geht es um mehr als nur Code und Rechenleistung. Es ist ein gemeinschaftlicher Aufwand, an dem ML-Ingenieure, Datenwissenschaftler, Produktmanager und Stakeholder beteiligt sind.
Wenn diese Zusammenarbeit über Jupyter-Notebooks, Slack-Kanäle und separate Tools für das Projektmanagement verstreut ist, entsteht ein Kontext-Wildwuchs – eine Situation, in der wichtige Projekt-Info über zu viele Tools verstreut ist.
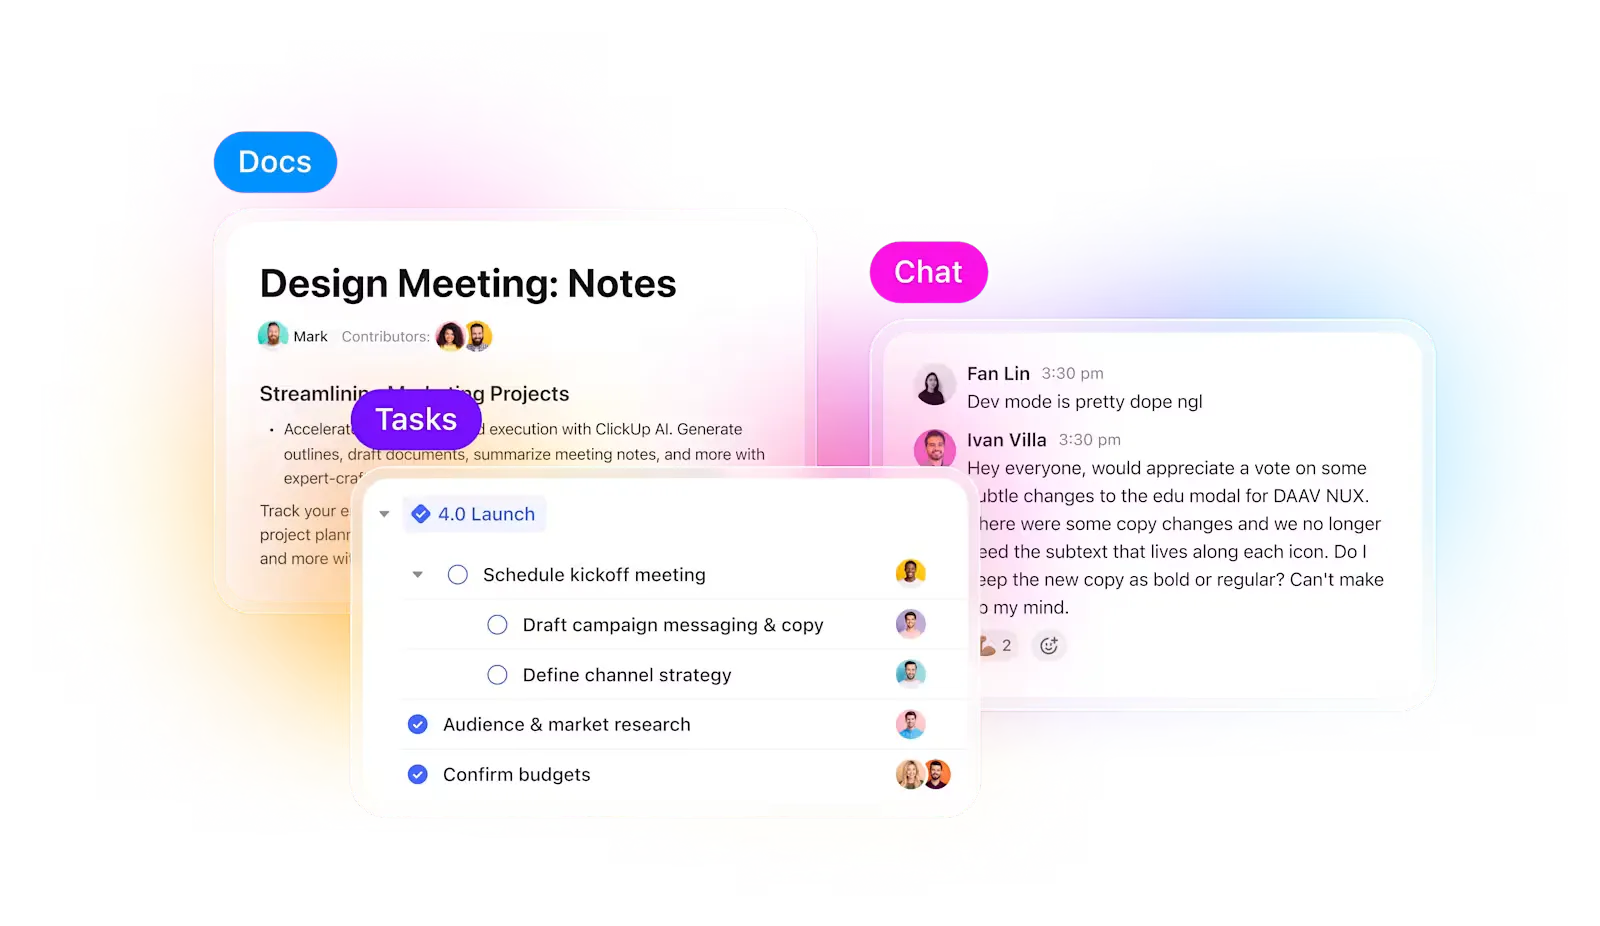
ClickUp löst dieses Problem. Anstatt mehrere Tools gleichzeitig zu nutzen, erhalten Sie einen einzigen konvergenten KI-Arbeitsbereich, in dem Projektmanagement, Dokumentation und Kommunikation unter einem Dach vereint sind – so bleiben Ihre Experimente von der Planung über die Durchführung bis hin zur Auswertung nahtlos miteinander verbunden.
Behalten Sie stets den Überblick über Experimente und Fortschritte
Bei der Durchführung mehrerer Experimente ist nicht das Trainieren des Modells die größte Herausforderung, sondern die Nachverfolgung dessen, was sich während des Prozesses geändert hat. Welche Version des Datensatzes wurde verwendet, welche Lernrate hat am besten funktioniert oder welcher Durchlauf wurde freigegeben?
ClickUp macht diesen Prozess für Sie kinderleicht. Sie können jeden Trainingsdurchlauf separat in ClickUp-Aufgaben nachverfolgen und innerhalb der Aufgaben mithilfe von Benutzerdefinierten Feldern Folgendes protokollieren:
- Datensatz-Version
- Hyperparameter
- Modellvariante (DBRX Base vs. DBRX Instruct)
- Trainingsstatus (In der Warteschlange, Wird ausgeführt, Wird ausgewertet, Bereitgestellt)
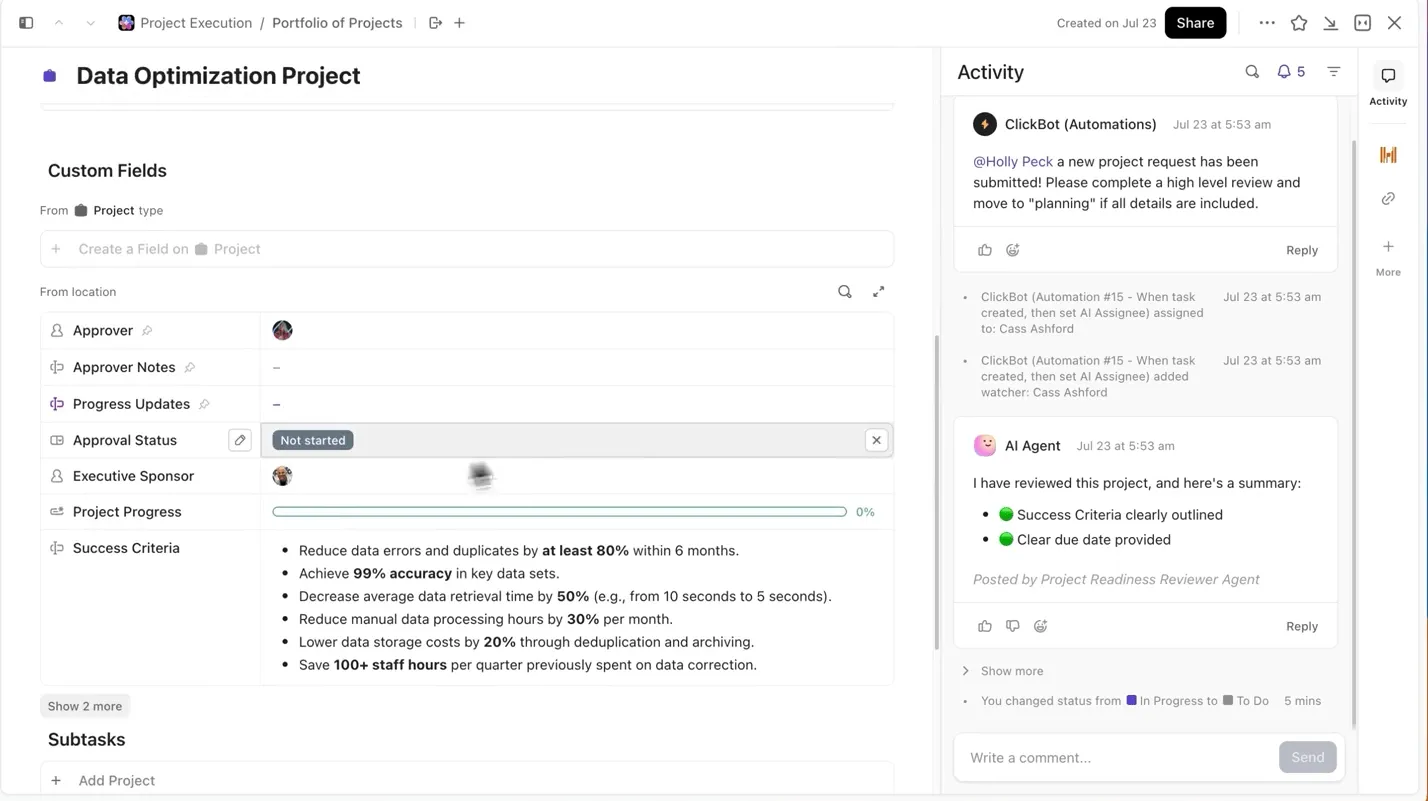
Auf diese Weise ist jedes dokumentierte Experiment durchsuchbar, lässt sich leicht mit anderen vergleichen und ist reproduzierbar.
Halten Sie die Modelldokumentation eng mit der Arbeit verknüpft
Sie müssen nicht zwischen Jupyter-Notebooks, README-Dateien oder Slack-Threads hin- und herspringen, um den Kontext einer Experiment-Aufgabe zu verstehen.
Mit ClickUp Docs können Sie Ihre Modellarchitektur, Skripte zur Datenaufbereitung oder Bewertungskennzahlen übersichtlich und leicht zugänglich organisieren , indem Sie sie in einem durchsuchbaren Dokument dokumentieren, das direkt mit den zugehörigen Experiment-Aufgaben verknüpft ist.
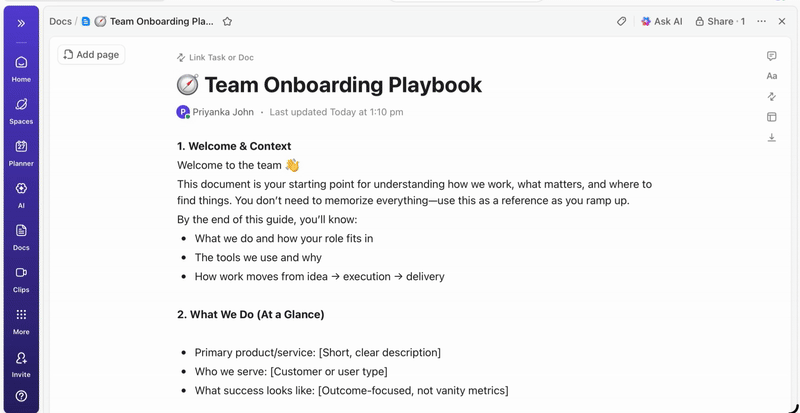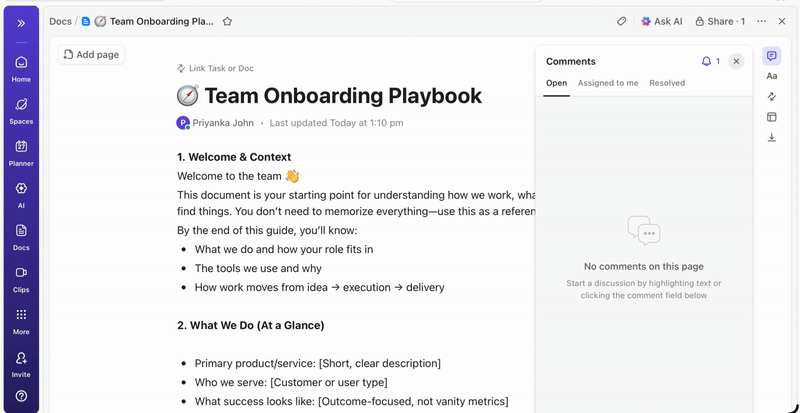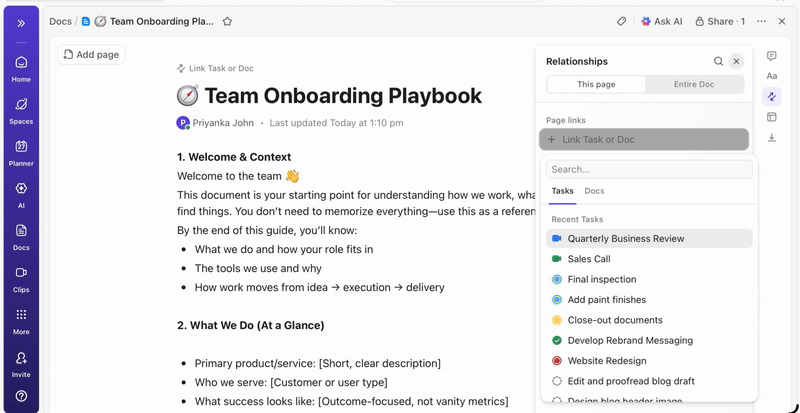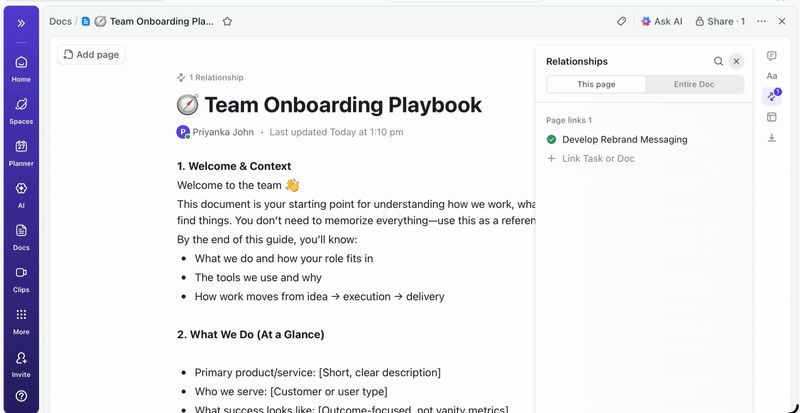
💡Profi-Tipp: Führen Sie in ClickUp Docs ein stets aktuelles Projekt-Briefing, in dem jede Entscheidung – von der Architektur bis zur Bereitstellung – detailliert festgehalten wird, damit neue Mitglieder des Teams sich jederzeit schnell in die Projektdetails einarbeiten können, ohne alte Threads durchforsten zu müssen.
Bieten Sie den Beteiligten Echtzeit-Sichtbarkeit
ClickUp-Dashboards zeigen den Fortschritt der Experimente und die Workload des Teams in Echtzeit an. I
Anstatt Aktualisierungen manuell zusammenzustellen oder E-Mails zu versenden, werden die Dashboards automatisch auf Basis der Daten in Ihren Aufgaben aktualisiert. So können sich die Beteiligten jederzeit einen Überblick verschaffen, den aktuellen Status einsehen und müssen Sie nie wieder mit Fragen wie „Wie ist der Status?“ unterbrechen.
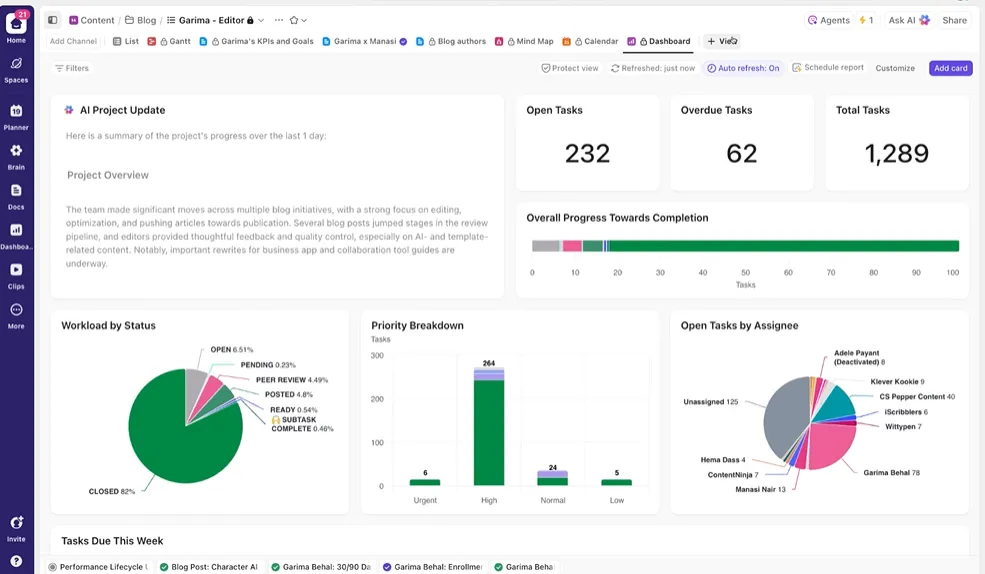
So können Sie sich auf die Durchführung der Experimente konzentrieren, anstatt ständig manuell für die Berichterstellung zuständig zu sein.
Machen Sie KI zu Ihrem intelligenten Projekt-Assistenten
Sie müssen nicht manuell wochenlange Trainingsdaten durchforsten, um sich einen Überblick über die bisherigen Experimente zu verschaffen. Erwähnen Sie einfach @Brain in einem beliebigen Kommentar zu einer Aufgabe, und ClickUp Brain bietet Ihnen die benötigte Unterstützung mit dem vollständigen Kontext zu Ihren vergangenen und laufenden Projekten.
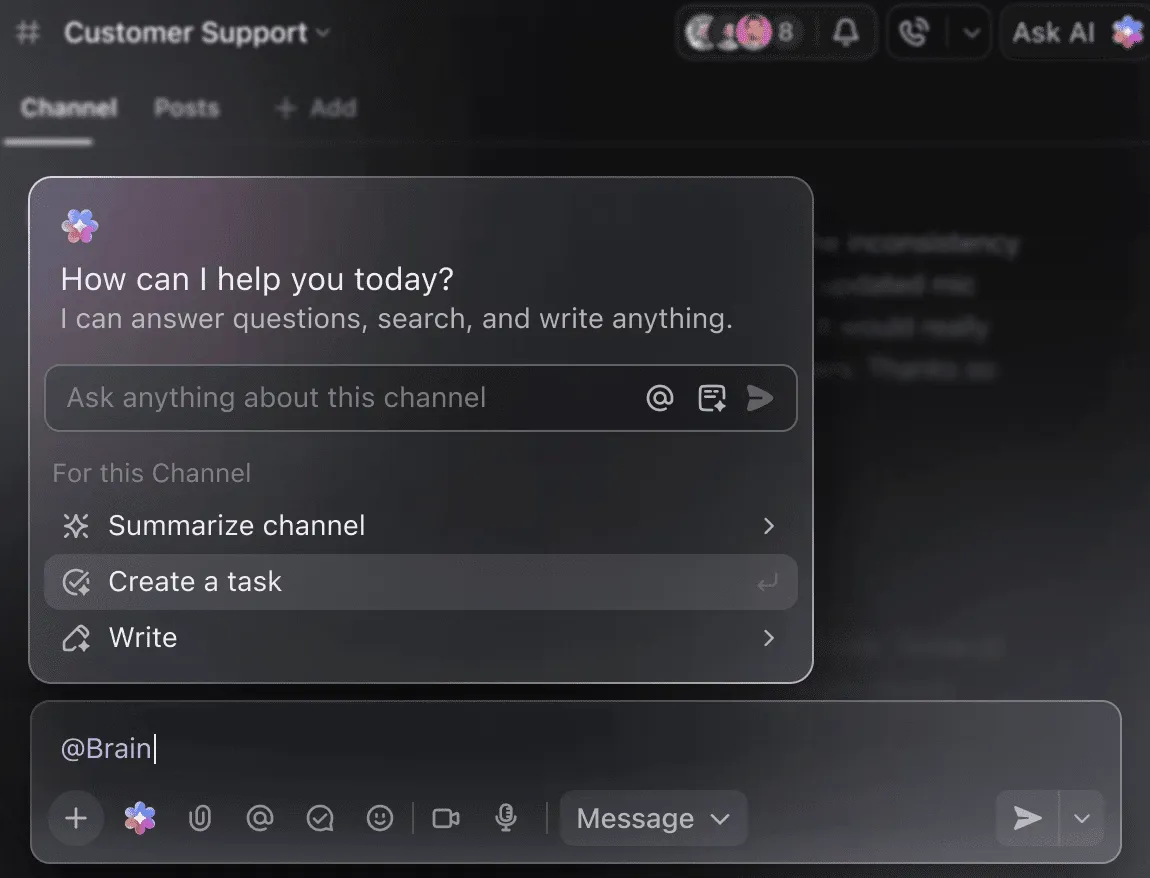
Sie können Brain bitten, „die Experimente der letzten Woche in 5 Stichpunkten zusammenzufassen“ oder „ein Dokument mit den neuesten Hyperparameter-Ergebnissen zu erstellen“, und erhalten sofort ein ausgefeiltes Ergebnis.
🧠 Der ClickUp-Vorteil: Die Super-Agenten von ClickUp gehen noch einen Schritt weiter – sie können ganze Workflows basierend auf von Ihnen definierten Auslösern automatisieren und nicht nur Ihre Fragen beantworten. Mit den Super-Agents können Sie automatisch eine neue DBRX-Trainingsaufgabe erstellen, sobald ein Datensatz hochgeladen wird, Ihr Team benachrichtigen und relevante Dokumente verknüpfen, sobald der Trainingslauf abgeschlossen ist oder einen Meilenstein erreicht, sowie eine wöchentliche Zusammenfassung des Fortschritts erstellen und diese an die Beteiligten senden, ohne dass Sie selbst einen Finger rühren müssen.
Häufige Fehler, die es zu vermeiden gilt
Ein DBRX-Trainingsprojekt zu starten ist spannend, doch einige häufige Fallstricke können Ihren Fortschritt behindern. Wenn Sie diese Fehler vermeiden, sparen Sie Zeit, Geld und viel Frust.
- Unterschätzung der Hardwareanforderungen: DBRX ist leistungsstark, aber auch sehr groß. Der Versuch, es auf unzureichender Hardware auszuführen, führt zu Fehlern im Speicher und fehlgeschlagenen Trainingsaufträgen. Beachten Sie, dass DBRX (132B) für die 16-Bit-Inferenz mindestens 264 GB VRAM benötigt oder etwa 70 GB bis 80 GB bei Verwendung der 4-Bit-Quantisierung.
- Überspringen von Datenqualitätsprüfungen: „Garbage in, garbage out“ – wer schlechte Daten eingibt, erhält schlechte Ergebnisse. Das Feinabstimmen anhand eines unordentlichen, qualitativ minderwertigen Datensatzes führt nur dazu, dass das Modell unordentliche, qualitativ minderwertige Ergebnisse liefert.
- Kontextlängenbeschränkungen ignorieren: Das 32K-Kontextfenster von DBRX ist zwar großzügig bemessen, aber nicht unbegrenzt. Werden dem Modell Eingaben zugeführt, die dieses Limit überschreiten, hat dies als Ergebnis eine stillschweigende Kürzung und eine schlechte Leistung.
- Wann ist die Verwendung von „Base“ anstelle von „Instruct“ sinnvoll: DBRX Base ist ein rohes, vortrainiertes Modell, das für weiteres, groß angelegtes Training vorgesehen ist. Für die meisten Aufgaben, bei denen Anweisungen befolgt werden müssen, sollten Sie mit DBRX Instruct beginnen, das bereits für diesen Zweck feinabgestimmt wurde.
- Trennung von Trainingsarbeit und Projektkoordination: Wenn Ihre Nachverfolgung der Experimente in einem Tool und Ihr Projektplan in einem anderen erfolgt, entstehen Informationssilos. Nutzen Sie eine integrierte Plattform wie ClickUp, um Ihre technische Arbeit und die Projektkoordination aufeinander zu synchronisieren.
- Vernachlässigung der Bewertung vor der Bereitstellung: Ein Modell, das bei Ihren Trainingsdaten gute Ergebnisse liefert, kann in der Praxis spektakulär versagen. Validieren Sie Ihr feinabgestimmtes Modell immer anhand eines separaten Testdatensatzes, bevor Sie es in die Produktion übernehmen.
- Die Komplexität der Feinabstimmung wird oft übersehen: Da es sich bei DBRX um ein „Mixture-of-Experts“-Modell handelt, benötigen Standard-Skripte zur Feinabstimmung möglicherweise spezielle Bibliotheken wie Megatron-LM oder PyTorch FSDP, um die Verteilung der Parameter auf mehrere GPUs zu bewältigen.
DBRX im Vergleich zu anderen KI-Trainingsplattformen
Die Entscheidung für eine /AI-Trainingsplattform ist mit einem grundlegenden Kompromiss verbunden: Kontrolle vs. Komfort. Proprietäre, ausschließlich über APIs zugängliche Modelle sind einfach zu bedienen, binden Sie jedoch an das Ökosystem eines Anbieters.
Modelle mit offenen Gewichten wie DBRX bieten vollständige Kontrolle, erfordern jedoch mehr technisches Fachwissen und Infrastruktur. Diese Entscheidung kann dazu führen, dass Sie sich festgefahren fühlen und unsicher sind, welcher Weg Ihre langfristigen Ziele tatsächlich unterstützt – eine Herausforderung, mit der viele Teams bei der Einführung von KI konfrontiert sind.
Diese Tabelle fasst die wichtigsten Unterschiede zusammen, damit Sie eine fundierte Entscheidung treffen können.
| Gewichte | Öffnen (Benutzerdefiniert) | Eigenentwicklung | Öffnen (Benutzerdefiniert) | Eigenentwicklung |
| Feinabstimmung | Volle Kontrolle | API-basiert | Volle Kontrolle | API-basiert |
| Selbsthosting | Ja | Nein | Ja | Nein |
| Lizenz | DB Open Model | OpenAI-Begriffe | Llama-Community | Begriffe von Anthropic |
| Hintergrund | 32K | 128.000 – 1.000.000 | 128K | 200.000 – 1.000.000 |
DBRX ist die richtige Wahl, wenn Sie die volle Kontrolle über das Modell benötigen, aus Gründen der Sicherheit oder Compliance selbst hosten müssen oder die Flexibilität einer großzügigen kommerziellen Lizenz wünschen. Wenn Sie keine dedizierte GPU-Infrastruktur haben – oder wenn Ihnen der Wert einer schnellen Markteinführung wichtiger ist als benutzerdefinierte Anpassungsmöglichkeiten –, sind API-basierte Alternativen möglicherweise besser geeignet.
Beginnen Sie mit ClickUp, intelligenter zu trainieren
DBRX bietet Ihnen eine Enterprise-gerechte Grundlage für die Entwicklung benutzerdefinierter KI-Anwendungen – mit einer Transparenz und Kontrolle, die proprietäre Modelle nicht bieten. Die effiziente MoE-Architektur hält die Inferenzkosten niedrig, und das offene Design erleichtert die Feinabstimmung. Doch starke Technologie ist nur die halbe Miete.
Wahrer Erfolg entsteht, wenn Sie Ihre technische Arbeit auf den kollaborativen Workflow Ihres Teams abstimmen. Das Trainieren von KI-Modellen ist Teamarbeit, und es ist entscheidend, Experimente, Dokumentation und die Kommunikation mit den Beteiligten aufeinander abzustimmen. Wenn Sie alles in einem einzigen, konsolidierten Workspace zusammenführen und die Zersplitterung von Kontextinformationen reduzieren, können Sie bessere Modelle schneller bereitstellen.
Starten Sie kostenlos mit ClickUp, um Ihre KI-Trainingsprojekte in einem Workspace zu koordinieren. ✨
Häufig gestellte Fragen
Wie kann ich den Trainingsfortschritt in DBRX überwachen?
Sie können das Training mit Standard-ML-Tools wie TensorBoard, Weights & Biases oder MLflow überwachen. Wenn Sie innerhalb des Databricks-Ökosystems trainieren, ist MLflow nativ integriert, um eine nahtlose Nachverfolgung der Experimente zu ermöglichen.
Kann ich DBRX in CI/CD- und Deployment-Pipelines integrieren?
Ja, DBRX lässt sich in Standard-MLOps-Pipelines integrieren. Durch die Containerisierung des Modells können Sie es mithilfe von Orchestrierungsplattformen wie Kubeflow oder benutzerdefinierten CI/CD-Workflows bereitstellen.
Was ist der Unterschied zwischen DBRX Base und DBRX Instruct?
DBRX Base ist das grundlegende, vortrainierte Modell für Teams, die ein domänenspezifisches, fortlaufendes Vortraining oder eine tiefgreifende Feinabstimmung der Architektur durchführen möchten. DBRX Instruct ist eine feinabgestimmte Version, die für das Befolgen von Anweisungen optimiert ist und somit für die meisten Anwendungsentwicklungen einen besseren Ausgangspunkt darstellt.
Wie schneidet DBRX im Vergleich zu GPT-4 bei KI-Projekten in Unternehmen ab?
Der Hauptunterschied liegt in der Kontrolle. DBRX bietet Ihnen vollen Zugriff auf die Modellgewichte für benutzerdefinierte Anpassungen und Selbsthosting, während GPT-4 ein reiner API-Dienst ist.
Kann man DBRX kostenlos nutzen?
Die DBRX-Modellgewichte sind unter der Databricks Open Model License kostenlos verfügbar. Sie tragen jedoch die Kosten für die Recheninfrastruktur, die zum Ausführen oder Feinabstimmen des Modells erforderlich ist.