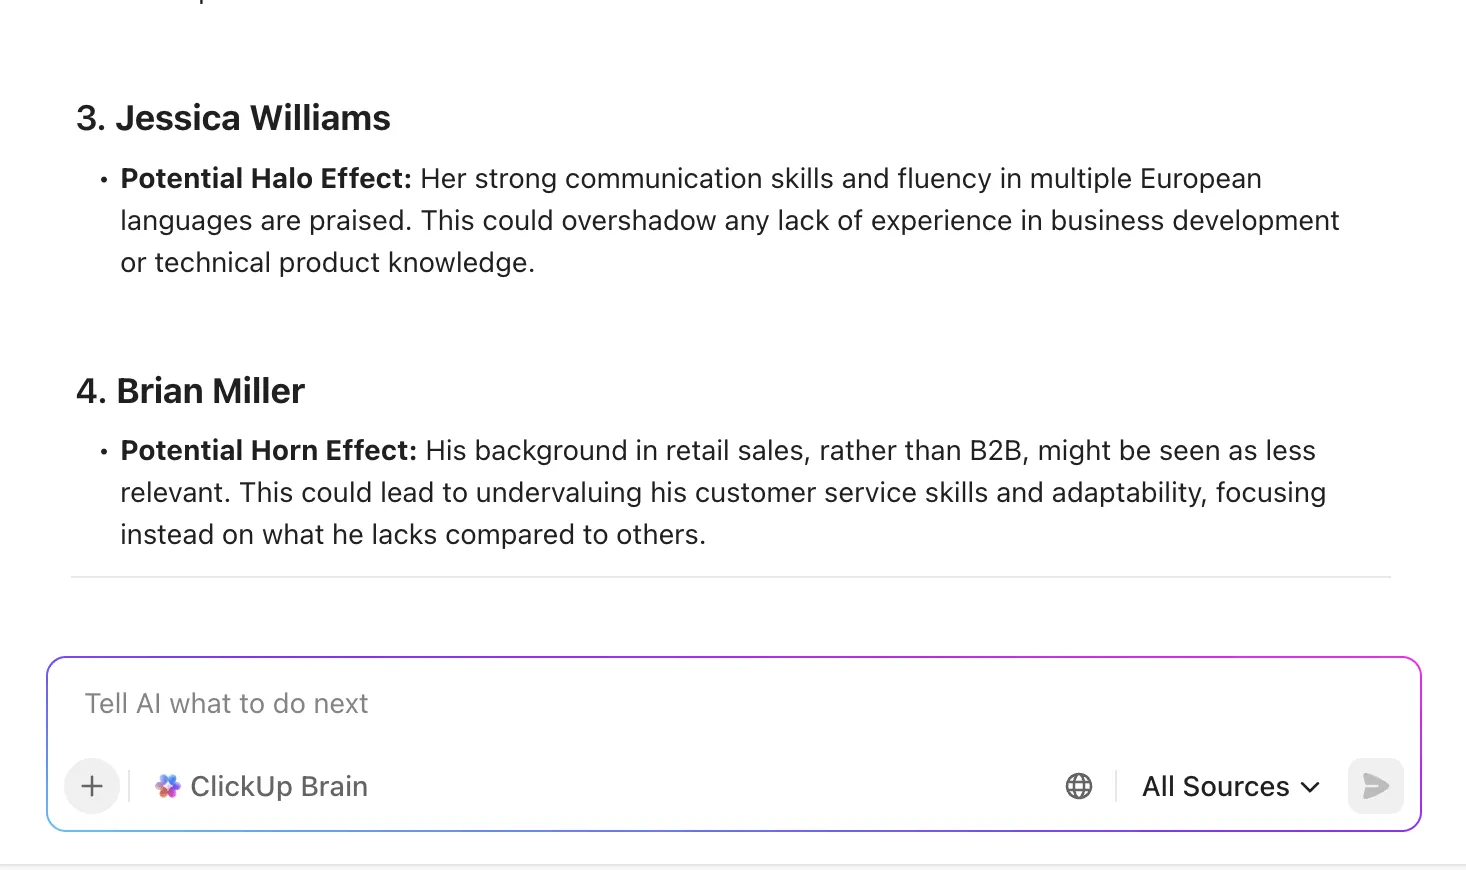

Partiskhet inom AI kan verka som ett tekniskt problem. Men dess effekter visar sig i den verkliga världen och kan ofta vara förödande.
När ett AI-system lutar åt fel håll, även om det bara är lite, kan det leda till orättvisa resultat.
Och med tiden kan dessa små problem leda till frustrerade kunder, anseendeproblem eller till och med frågor om regelefterlevnad som du inte hade förutsett.
De flesta team har inte för avsikt att bygga partisk AI. Det händer eftersom data är oordnade, den verkliga världen är ojämn och de verktyg vi använder inte alltid fungerar som vi förväntar oss. Den goda nyheten är att du inte behöver vara datavetare för att förstå vad som händer.
I det här blogginlägget går vi igenom vad AI-bias egentligen är, varför det uppstår och hur det kan ta sig uttryck i vardagliga affärsverktyg.
Vad är partiskhet inom AI?
Partiskhet inom AI uppstår när ett system för artificiell intelligens ger systematiska, orättvisa resultat som konsekvent gynnar eller missgynnar vissa grupper av människor. Det handlar inte bara om slumpmässiga fel, utan om förutsägbara mönster som blir en del av hur AI:n fattar beslut. Orsaken? AI lär sig av data som speglar befintlig mänsklig partiskhet, andra omedvetna fördomar och samhälleliga ojämlikheter.
Tänk på det så här: om du tränar en rekryteringsalgoritm på tio års företagsdata där 90 % av cheferna var män, kan AI:n felaktigt lära sig att det är en viktig kvalifikation för en chefsroll att vara man. AI:n har inte onda avsikter; den identifierar och upprepar helt enkelt de mönster den har fått se.
Här är vad som gör partiskhet inom AI så knepigt:
- Det är systematiskt, inte slumpmässigt: Orättvisan är inte ett engångsfel utan ett återkommande mönster i AI:ns resultat
- Det är ofta osynligt: Partiska resultat kan döljas bakom den komplexa matematiken i en till synes neutral algoritm, vilket gör dem svåra att upptäcka
- Det handlar om data och design: Partiskhet smyger sig in i systemet genom de val vi människor gör när vi bygger och tränar AI
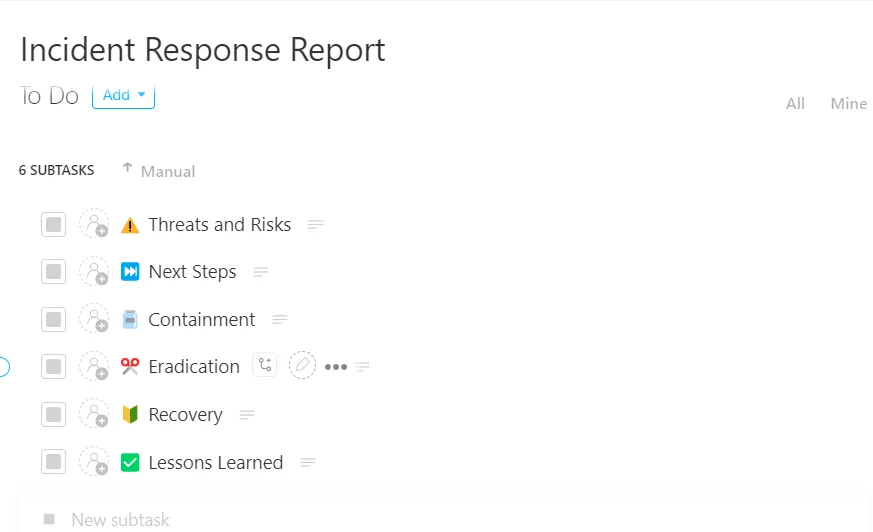
⭐ Utvald mall
ClickUps mall för incidenthanteringsrapporter erbjuder en färdig struktur för att dokumentera, spåra och lösa incidenter från början till slut. Registrera alla relevanta incidentuppgifter, håll reda på tydligt kategoriserade statusar och dokumentera viktiga attribut som allvarlighetsgrad, berörda grupper och åtgärder. Mallen stöder anpassade fält för uppgifter som Godkänt av, Incidentanteckningar och Stödjande dokument, vilket bidrar till att tydliggöra ansvar och bevis under hela granskningsprocessen.
Varför det är viktigt att minska partiskhet i AI
När dina AI-system är orättvisa riskerar du att skada verkliga människors liv.
Detta utsätter i sin tur din organisation för allvarliga affärsmässiga utmaningar och kan till och med förstöra det förtroende som du har arbetat hårt för att bygga upp hos dina kunder.
En partisk AI som nekar någon ett lån, avvisar en jobbansökan eller ger en felaktig rekommendation medför allvarliga konsekvenser i verkligheten.
Nya branschstandarder och ramverk uppmuntrar nu organisationer att aktivt identifiera och åtgärda partiskhet i sina AI-system. Riskerna drabbar din organisation från alla håll:
- Regulatorisk risk: Att inte uppfylla nya AI-standarder kan leda till betydande affärsmässiga utmaningar
- Skada på företagets anseende: När allmänheten får reda på att din AI är partisk är det oerhört svårt att återvinna deras förtroende
- Operativ ineffektivitet: Partiska modeller ger opålitliga resultat eller AI-hallucinationer som leder till dåliga beslut och kräver kostsamma korrigeringar
- Etiskt ansvar: Din organisation bör säkerställa att den teknik ni använder behandlar alla användare rättvist
När du lyckas med att minska partiskheten bygger du AI-system som människor faktiskt kan lita på. Rättvis AI öppnar dörrar till nya marknader, förbättrar kvaliteten på dina beslut och visar alla att du är engagerad i att driva en etisk verksamhet.
📮 ClickUp Insight: 22 % av våra respondenter är fortfarande skeptiska när det gäller att använda AI på jobbet. Av dessa 22 % oroar sig hälften för sin dataintegritet, medan den andra hälften helt enkelt inte är säkra på att de kan lita på vad AI säger.
ClickUp tar itu med båda dessa problem genom robusta säkerhetsåtgärder och genom att skapa detaljerade länkar till uppgifter och källor för varje svar.
Det innebär att även de mest försiktiga teamen kan börja dra nytta av produktivitetsökningen utan att behöva oroa sig för om deras information är skyddad eller om de får tillförlitliga resultat.
Typer och källor till partiskhet inom AI
Partiskhet kan smyga sig in i dina AI-system från flera håll.
Från det ögonblick du börjar samla in data till långt efter att systemet har tagits i drift förblir denna faktor relativt stabil. Men om du vet var du ska leta kan du rikta in dina insatser och sluta spela ett ändlöst spel av ”whack-a-mole” med orättvisa resultat.
Urvalsbias
Urvalsbias uppstår när de data du använder för att träna din AI inte på ett korrekt sätt återspeglar den verkliga världen där AI:n kommer att användas.
Om du till exempel bygger ett röstigenkänningssystem som huvudsakligen tränats på data från talare av amerikansk engelska kommer det naturligtvis att ha svårt att förstå personer med skotsk eller indisk accent, på samma sätt som stora språkmodeller (LLM) i 85,1 % av fallen gynnar namn som förknippas med vita vid granskning av CV:n. Denna underrepresentation skapar enorma blinda fläckar, vilket gör att din modell inte är rustad att betjäna hela grupper av människor.
Algoritmisk partiskhet
Algoritmisk partiskhet uppstår när modellens utformning eller matematiska process förstärker orättvisa mönster, även om data verkar neutrala.
En persons postnummer bör inte avgöra om hen beviljas ett lån, men om postnumren i dina träningsdata är starkt korrelerade med etnicitet kan algoritmen lära sig att använda platsen som en indikator för diskriminering.
Problemet förvärras ytterligare av återkopplingsloopar – när en partisk förutsägelse (till exempel att avslå ett lån) matas tillbaka in i systemet som nya data, förstärks partiskheten bara med tiden.
Mänskliga beslutsfördomar
Varje val som en person gör när hen bygger ett AI-system kan leda till partiskhet.
Detta innefattar att besluta vilka data som ska samlas in, hur de ska märkas och hur man definierar ”framgång” för modellen. Ett team kan till exempel omedvetet gynna data som stöder det de redan tror (bekräftelsebias) eller lägga för stor vikt vid den första informationen de ser (förankringsbias).
Även de team som har de bästa avsikterna kan oavsiktligt bygga in sina egna antaganden och världsbild i ett AI-system.
Exempel på partiskhet inom AI i verkligheten
Verkliga företag har drabbats av allvarliga konsekvenser när deras AI-system visat sig vara partiska, vilket kostat dem miljoner i skadestånd och förlorat kundernas förtroende. Här är några dokumenterade exempel:
1. Partiska rekryteringsverktyg
Ett av de mest omtalade fallen handlade om ett stort teknikföretag som skrotade ett internt AI-rekryteringssystem efter att det hade lärt sig att gynna manliga kandidater framför kvinnliga. Systemet hade tränats på ett decennium av CV:n där de flesta som fick anställning var män. Därför började det straffa CV:n som innehöll ord som ”kvinnors” och till och med nedvärderade utexaminerade från kvinnliga högskolor.
Detta visar hur bias i historiska data – när tidigare mönster speglar befintlig ojämlikhet – kan smyga sig in i automatiseringen om den inte granskas noggrant. Men i takt med att automatiserad rekrytering med AI blir allt vanligare blir problemet ännu större.
🌼 Visste du att: Aktuella siffror visar att 37 % av organisationerna nu ”aktivt integrerar” eller ”experimenterar” med Gen AI-verktyg i rekryteringsarbetet, en ökning från 27 % för ett år sedan.
2. Ansiktsigenkänning som missar hälften av befolkningen
Forskning ledd av Joy Buolamwini och dokumenterad i studien Gender Shades visade att kommersiella ansiktsigenkänningssystem hade felprocent på upp till 34,7 % för mörkhyade kvinnor, jämfört med mindre än 1 % för ljushyade män.
Detta är återigen ett tecken på obalanserade träningsdatauppsättningar. Partiskhet i biometriska verktyg har ännu mer långtgående effekter.
Polisen och myndigheter har också stött på problem med partisk ansiktsigenkänning. Undersökningar från The Washington Post visade att vissa av dessa system var betydligt mer benägna att felidentifiera personer från marginaliserade grupper. I flera verkliga fall ledde detta till felaktiga gripanden, allmän upprördhet och stor oro över hur dessa verktyg påverkar människors rättigheter.
3. Hälsoalgoritmer som prioriterar vården för lågt
AI-system inom hälso- och sjukvården som är utformade för att förutsäga vilka patienter som behöver extra vård har också visat sig vara partiska.
I ett väl dokumenterat fall drabbades en allmänt använd prediktionsalgoritm inom hälso- och sjukvården av ett allvarligt fel. Den var avsedd att hjälpa till att avgöra vilka patienter som skulle få extra vård, men slutade istället med att systematiskt ge svarta patienter lägre prioritet, även när de var lika sjuka eller sjukare än vita patienter.
Det berodde på att modellen använde sjukvårdsutgifter som ett mått på medicinskt behov. Eftersom svarta patienter historiskt sett haft lägre sjukvårdsutgifter på grund av ojämlik tillgång till vård, behandlade algoritmen dem som mindre behövande. Följaktligen ledde detta till att vårdresurser styrdes bort från dem som faktiskt behövde dem mest. Forskare fann att en enkel justering av detta mått skulle kunna öka tillgången till rättvisa vårdprogram avsevärt.
Oro kring just dessa frågor har fått medborgarrättsorganisationer att kräva ”equity-first”-standarder inom AI för hälso- och sjukvården. I december 2025 publicerade NAACP en detaljerad plan där man uppmanade sjukhus, teknikföretag och beslutsfattare att införa partiskhetstester, transparenta designmetoder, inkluderande ramverk och styrningsverktyg för AI för att förhindra att de rasrelaterade ojämlikheterna inom hälso- och sjukvården fördjupas.
4. Kreditalgoritmer med ojämlika resultat
AI och automatiserat beslutsfattande påverkar inte bara vad du ser på sociala medier, utan även vem som får tillgång till pengar och på vilka villkor.
Ett av de mest omtalade exemplen från verkligheten kom från Apple Card , ett digitalt kreditkort utfärdat av Goldman Sachs.
År 2019 berättade kunder på sociala medier att kortets algoritm för kreditgränser gav vissa män betydligt högre gränser än deras fruar eller kvinnliga partners. Detta hände även när paren uppgav liknande ekonomiska profiler. En mjukvaruingenjör sa att han fick en kreditgräns som var 20 gånger högre än sin frus, och till och med Apples medgrundare Steve Wozniak bekräftade en liknande upplevelse som rörde hans maka.
Dessa mönster väckte stor upprördhet bland allmänheten och ledde till en utredning av New York State Department of Financial Services om huruvida algoritmen diskriminerade kvinnor, vilket tydligt visade hur automatiserade finansiella verktyg kan ge ojämlika resultat.
5. Automatiska undertexter och röstigenkänning som utesluter vissa röster
Taligenkänning och automatiska textningssystem lyssnar ofta inte lika mycket på alla. Flera studier har visat att dessa verktyg tenderar att fungera bättre för vissa talare än för andra, beroende på faktorer som accent, dialekt, etnicitet och om engelska är talarens modersmål.
Detta beror på att kommersiella system vanligtvis tränas på datamängder som domineras av vissa talmönster – ofta västerländsk, standardiserad engelska – vilket gör att andra röster blir underrepresenterade.
Forskare vid Stanford testade till exempel fem ledande tal-till-text-system (från Amazon, Google, Microsoft, IBM och Apple) och fann att de gjorde nästan dubbelt så många fel vid transkribering av tal från svarta talare jämfört med vita talare. Problemet uppstod även när försökspersonerna sa samma ord under samma förhållanden.
När undertexter är felaktiga för vissa talare kan det leda till en dålig användarupplevelse och bristande tillgänglighet för personer som är beroende av undertexter. Ännu värre är att det kan bidra till partiska resultat i system som använder taligenkänning inom rekrytering, utbildning eller hälso- och sjukvård.
Var och ett av dessa exempel illustrerar ett specifikt sätt på vilket partiskhet kan inbyggas i automatiserade system, genom skev träningsdata, dåligt valda approximationer eller icke-representativa tester. I samtliga fall är konsekvenserna inte bara av teknisk natur – de påverkar möjligheter, undergräver förtroendet och medför reella affärsmässiga och etiska risker.
📖 Läs mer: Risker kontra problem – vad är skillnaden?
Sammanfattning: Hur partiskhet inom AI yttrar sig och vem den drabbar
| Var fördomar uppstod | Vem påverkades | Effekter i verkligheten |
|---|---|---|
| Rekryteringsalgoritmer (skrotat AI-rekryteringsverktyg) | Kvinnor | CV:n nedgraderades på grund av könsrelaterade nyckelord, vilket minskade tillgången till intervjuer och jobbmöjligheter. |
| Ansiktsigenkänningssystem (Gender Shades + fall av felaktiga gripanden) | Mörkhyade kvinnor; marginaliserade etniska grupper | Betydligt högre andel felidentifieringar ledde till felaktiga gripanden, skada på anseendet och oro kring medborgerliga rättigheter. |
| Algoritmer för riskprognoser inom hälso- och sjukvården (studie från University of Chicago) | Svarta patienter | Patienterna prioriterades bort när det gällde extra vård eftersom hälso- och sjukvårdsutgifterna användes som ett bristfälligt mått på medicinskt behov, vilket förvärrade ojämlikheterna inom hälso- och sjukvården. |
| Algoritmer för kreditgränser (utredningen om Apple Card) | Kvinnor | Män beviljades betydligt högre kreditgränser än kvinnliga partners med samma kvalifikationer, vilket påverkade deras tillgång till finansiering och lånekapacitet. |
| Taligenkänning och automatiska undertexter (Stanford ASR-studie) | Talare med icke-standardiserade accenter; svarta talare | Nästan dubbelt så höga felfrekvenser skapade tillgänglighetshinder, missförstånd och partiska resultat i verktyg som används vid rekrytering, utbildning och daglig digital åtkomst. |
Strategier för att minska partiskhet som fungerar
Det finns ingen enskild mirakelkur för att eliminera partiskhet i AI.
För att effektivt minska partiskhet krävs ett flerlagrigt skydd som tillämpas under hela AI:s livscykel. Genom att kombinera dessa beprövade strategier kan du avsevärt minska risken för orättvisa resultat.
Samla in mångsidiga träningsdata
Representativa data är den absoluta grunden för rättvis AI.
Din modell kan inte lära sig att betjäna grupper av människor som den aldrig har stött på under träningen. Börja med att granska dina befintliga datamängder för att identifiera eventuella demografiska luckor. Gör sedan en medveten insats för att samla in nya data från dessa underrepresenterade grupper.
När det är svårt att hitta data från verkligheten kan du använda tekniker som dataaugmentering (att skapa modifierade kopior av befintliga data) eller generering av syntetiska data för att fylla luckorna.
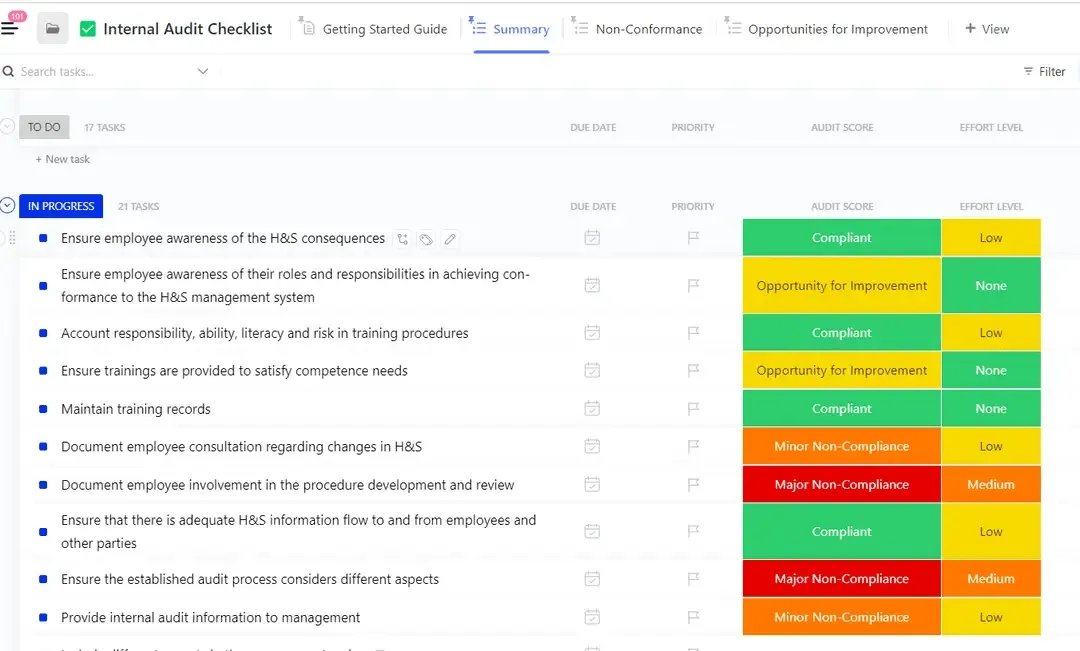
🚧 Verktygslåda: Använd ClickUps mall för internrevisionschecklista för att planera din revisionsprocess.
Testa modeller för partiskhet
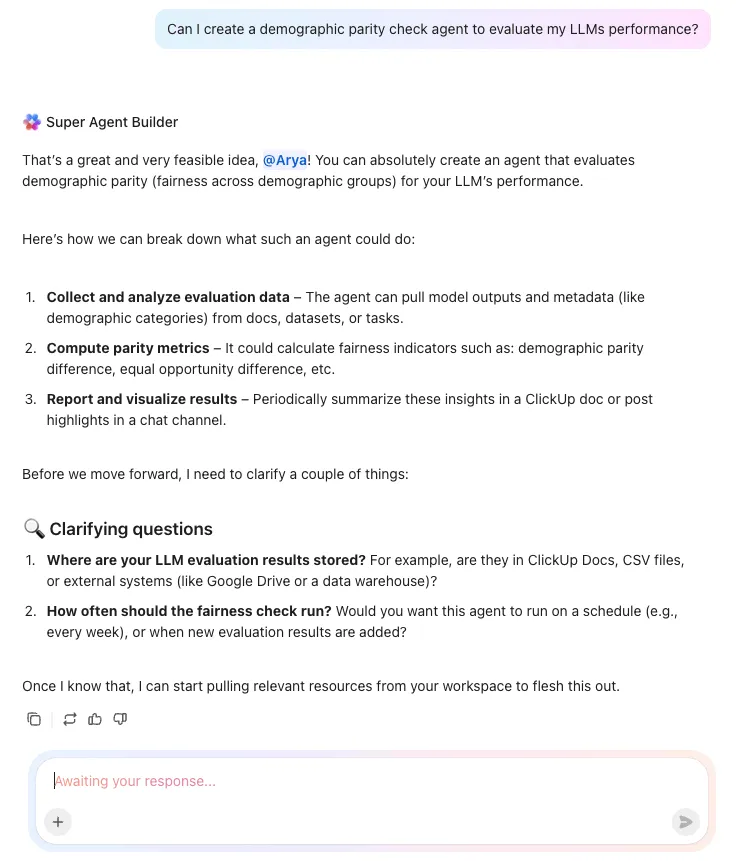
Du måste systematiskt testa för partiskhet för att upptäcka den innan den orsakar verklig skada. Använd rättvisemått för att mäta hur din modell presterar i olika grupper.
Demografisk jämlikhet kontrollerar till exempel om modellen ger ett positivt resultat (t.ex. ett godkänt lån) i samma utsträckning för alla grupper, medan utjämnade odds kontrollerar om felfrekvenserna är lika stora.
Dela upp modellens prestanda efter alla möjliga demografiska faktorer – etnicitet, kön, ålder, geografi – för att upptäcka var noggrannheten sjunker eller orättvisor smyger sig in.
Se till att människan alltid är delaktig
Automatiserade system kan missa subtila, kontextspecifika orättvisor som en människa skulle upptäcka direkt. En strategi där människan är delaktig i processen är avgörande vid beslut med stora konsekvenser, där AI kan ge en rekommendation men en människa fattar det slutgiltiga beslutet.
Detta är särskilt viktigt inom områden som rekrytering, kreditgivning och medicinsk diagnostik. För att detta ska fungera måste dina mänskliga granskare vara utbildade i att upptäcka partiskhet och ha befogenhet att åsidosätta AI:ns förslag.
Tillämpa tekniker för algoritmisk rättvisa
Du kan också använda tekniska metoder för att direkt ingripa och minska partiskheten. Dessa tekniker kan delas in i tre huvudkategorier:
- Förbearbetning: Detta innebär att man justerar träningsdata innan modellen tar del av dem, ofta genom att omviktning eller omsampling av data för att skapa en mer balanserad representation av olika grupper
- In-processing: Här lägger du till krav på rättvisa direkt i modellens träningsprocess och lär den att optimera både noggrannhet och rättvisa samtidigt
- Efterbearbetning: Detta innebär att man justerar modellens slutliga förutsägelser efter att de har gjorts för att säkerställa att resultaten är rättvisa mellan olika grupper
Dessa tekniker innebär ofta en avvägning, där en liten minskning av den totala noggrannheten kan vara nödvändig för att uppnå en betydande förbättring av rättvisan.
💟 Bonus: BrainGPT är din AI-drivna hjälpreda på skrivbordet som tar testningen av AI-bias till nästa nivå genom att ge dig tillgång till flera ledande modeller – inklusive GPT-5, Claude, Gemini och fler – allt på ett och samma ställe.
Det innebär att du enkelt kan köra samma frågor eller scenarier på olika modeller, jämföra deras resonemangsförmåga och upptäcka var svaren skiljer sig åt eller visar på partiskhet. Denna AI-superapp låter dig också använda röst-till-text-funktioner för att skapa testfall, dokumentera dina iakttagelser och organisera resultaten för en jämförande analys.
Dess avancerade resonemang och kontextmedvetna verktyg hjälper dig att felsöka problem, lyfta fram mönster och förstå hur varje modell hanterar känsliga ämnen. Genom att centralisera ditt arbetsflöde och möjliggöra transparent testning av flera modeller ger Brain MAX dig möjlighet att granska, jämföra och hantera AI-bias med självförtroende och precision.
Öka transparensen och förklarbarheten
Om du inte vet hur din modell fattar beslut kan du inte rätta till den när den gör fel. Tekniker för förklarbar AI (XAI) hjälper dig att kika in i den ”svarta lådan” och se vilka dataegenskaper som ligger till grund för förutsägelserna.
Du kan också skapa modellkort, som fungerar som näringsdeklarationer för din AI, där du dokumenterar dess avsedda användning, prestandadata och kända begränsningar.
📮ClickUp Insight: 13 % av de som svarade på vår enkät vill använda AI för att fatta svåra beslut och lösa komplexa problem. Men endast 28 % uppger att de använder AI regelbundet i arbetet. En möjlig orsak: säkerhetsfarhågor!
Användare kanske inte vill dela känslig beslutsdata med en extern AI.
ClickUp löser detta genom att integrera AI-driven problemlösning direkt i din säkra arbetsyta. Från SOC 2 till ISO-standarder uppfyller ClickUp de högsta datasäkerhetsstandarderna och hjälper dig att använda generativ AI-teknik på ett säkert sätt i hela din arbetsyta.
Riktlinjer för AI-styrning och ansvarsskyldighet
Ett starkt styrningsprogram för AI skapar tydligt ansvar och enhetliga standarder som alla i teamet kan följa.
Din organisation behöver tydliga styrningsstrukturer för att säkerställa att någon alltid är ansvarig för att utveckla och implementera AI på ett etiskt sätt.
Här är de viktigaste delarna i ett effektivt styrningsprogram för AI:
| Styrningsaspekt | Vad det innebär | Åtgärder för din organisation |
|---|---|---|
| Tydligt ansvar | Särskilda personer eller team ansvarar för AI-etik, tillsyn och efterlevnad | • Utse en ansvarig för AI-etik eller bilda en tvärfunktionell kommitté• Fastställ ansvarsområden för data, modellkvalitet, regelefterlevnad och risk• Involvera representanter från juridik, teknik, produktutveckling och mångfaldsarbete i övervakningen |
| Dokumenterade riktlinjer | Skriftliga riktlinjer som definierar hur data samlas in, används och övervakas under hela AI-livscykeln | • Skapa interna riktlinjer för datainsamling, märkning, integritet och lagring • Dokumentera standarder för modellutveckling, validering och driftsättning • Kräv att teamen följer checklistor innan de levererar något AI-system |
| Revisionsspår | En transparent dokumentation av beslut, modellversioner, datamängder och ändringar | • Implementera versionshantering för datamängder och modeller • Logga viktiga beslut, modellparametrar och granskningsresultat • Lagra revisionsspår i ett centralt, tillgängligt arkiv |
| Regelbundna granskningar | Löpande utvärderingar av AI-system för att kontrollera förekomsten av partiskhet, avvikelser och brister i efterlevnaden | • Planera in kvartalsvisa eller halvårsvisa bedömningar av partiskhet genom en gedigen utvärdering av stora språkmodeller (LLM) • Omskola eller omkalibrera modeller när prestandan sjunker eller beteendet förändras • Granska modeller efter större datauppdateringar eller produktförändringar |
| Plan för hantering av incidenter | Ett tydligt protokoll för att identifiera, rapportera och korrigera partiskhet eller skada orsakad av AI | • Skapa ett internt arbetsflöde för eskalering av partiskhetsärenden • Definiera hur problem ska utredas och vem som godkänner åtgärder • Beskriv kommunikationssteg för användare, kunder eller tillsynsmyndigheter vid behov |
💡Proffstips: Ramverk som NIST:s ramverk för riskhantering inom AI och EU:s AI-lag, med böter på upp till 7 % av den årliga omsättningen, kan utgöra utmärkta mallar för att bygga upp ditt eget styrningsprogram.
Så här implementerar du åtgärder för att minska partiskhet med ClickUp
ClickUps samlade AI-arbetsyta samlar alla delar av ditt AI-styrningsprogram i en enda välorganiserad arbetsyta.
Dina team kan hantera uppgifter, lagra policyer, granska revisionsresultat, diskutera risker och spåra incidenter utan att behöva växla mellan olika verktyg eller tappa sammanhanget. Varje modellpost, beslutslogg och åtgärdsplan förblir länkad, så att du alltid vet vem som gjorde vad och varför.
Och eftersom ClickUps AI förstår arbetet i din arbetsmiljö kan den ta fram tidigare utvärderingar, sammanfatta långa rapporter och hjälpa ditt team att hålla sig uppdaterat i takt med att standarderna utvecklas. Resultatet blir ett styrningssystem som är enklare att följa, enklare att granska och betydligt mer tillförlitligt i takt med att din AI-användning växer.
Låt oss bryta ner det i ett arbetsflöde!
Steg 1: Skapa din arbetsyta för AI-styrning
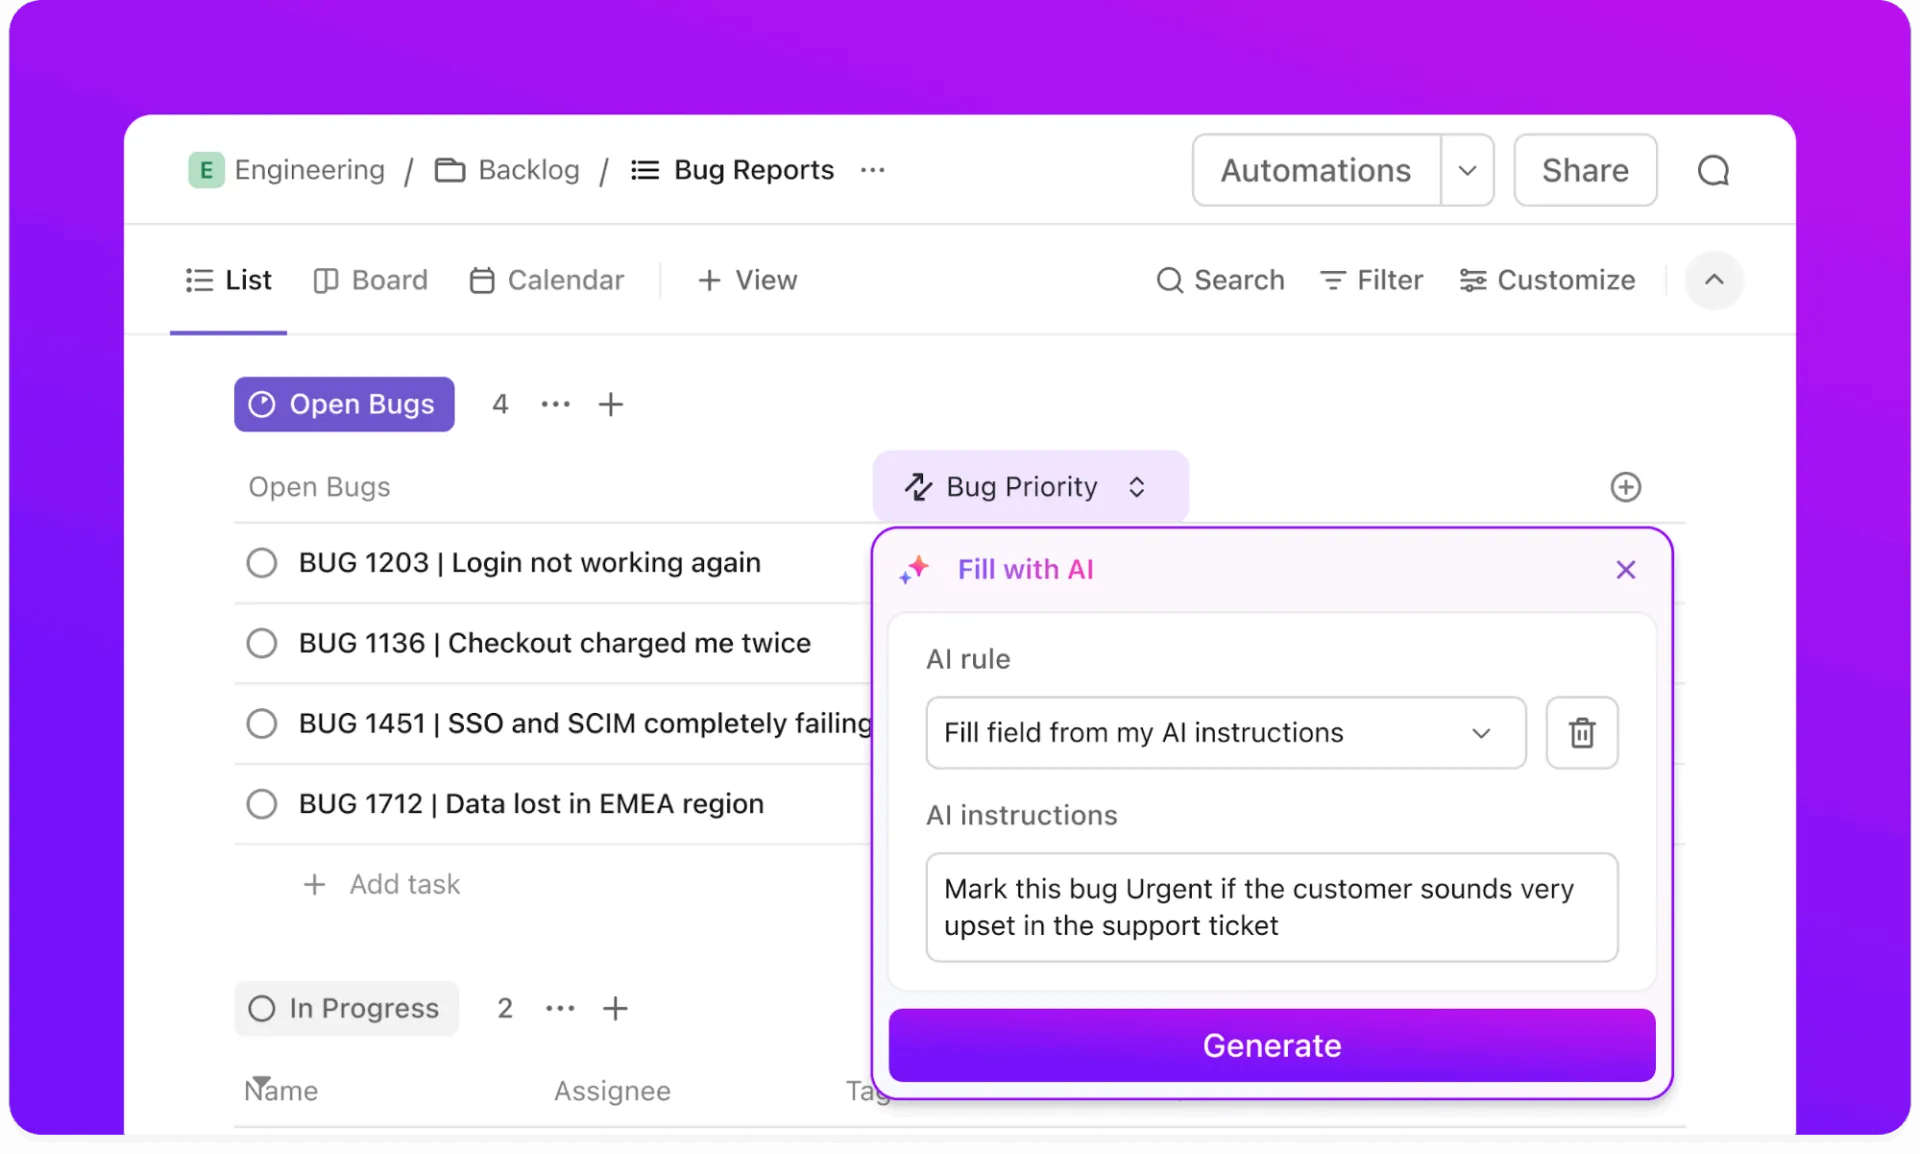
Börja med att skapa ett särskilt utrymme i ClickUp för allt arbete som rör styrning. Lägg till listor för din modellinventering, partiskhetsbedömningar, incidentrapporter, policydokument och schemalagda granskningar så att alla delar av programmet finns samlade i en kontrollerad miljö.
Konfigurera anpassade fält eller AI-fält för att spåra rättvisemätvärden, partiskhetspoäng, modellversioner, granskningsstatus och risknivåer. Använd rollbaserade behörigheter för att säkerställa att endast auktoriserade granskare, ingenjörer och ansvariga för regelefterlevnad har åtkomst till känsligt AI-arbete. Detta skapar den strukturella grunden som konkurrenternas punktverktyg och generiska projektplattformar inte kan erbjuda.
Steg 2: Skapa ett styrningsramverk
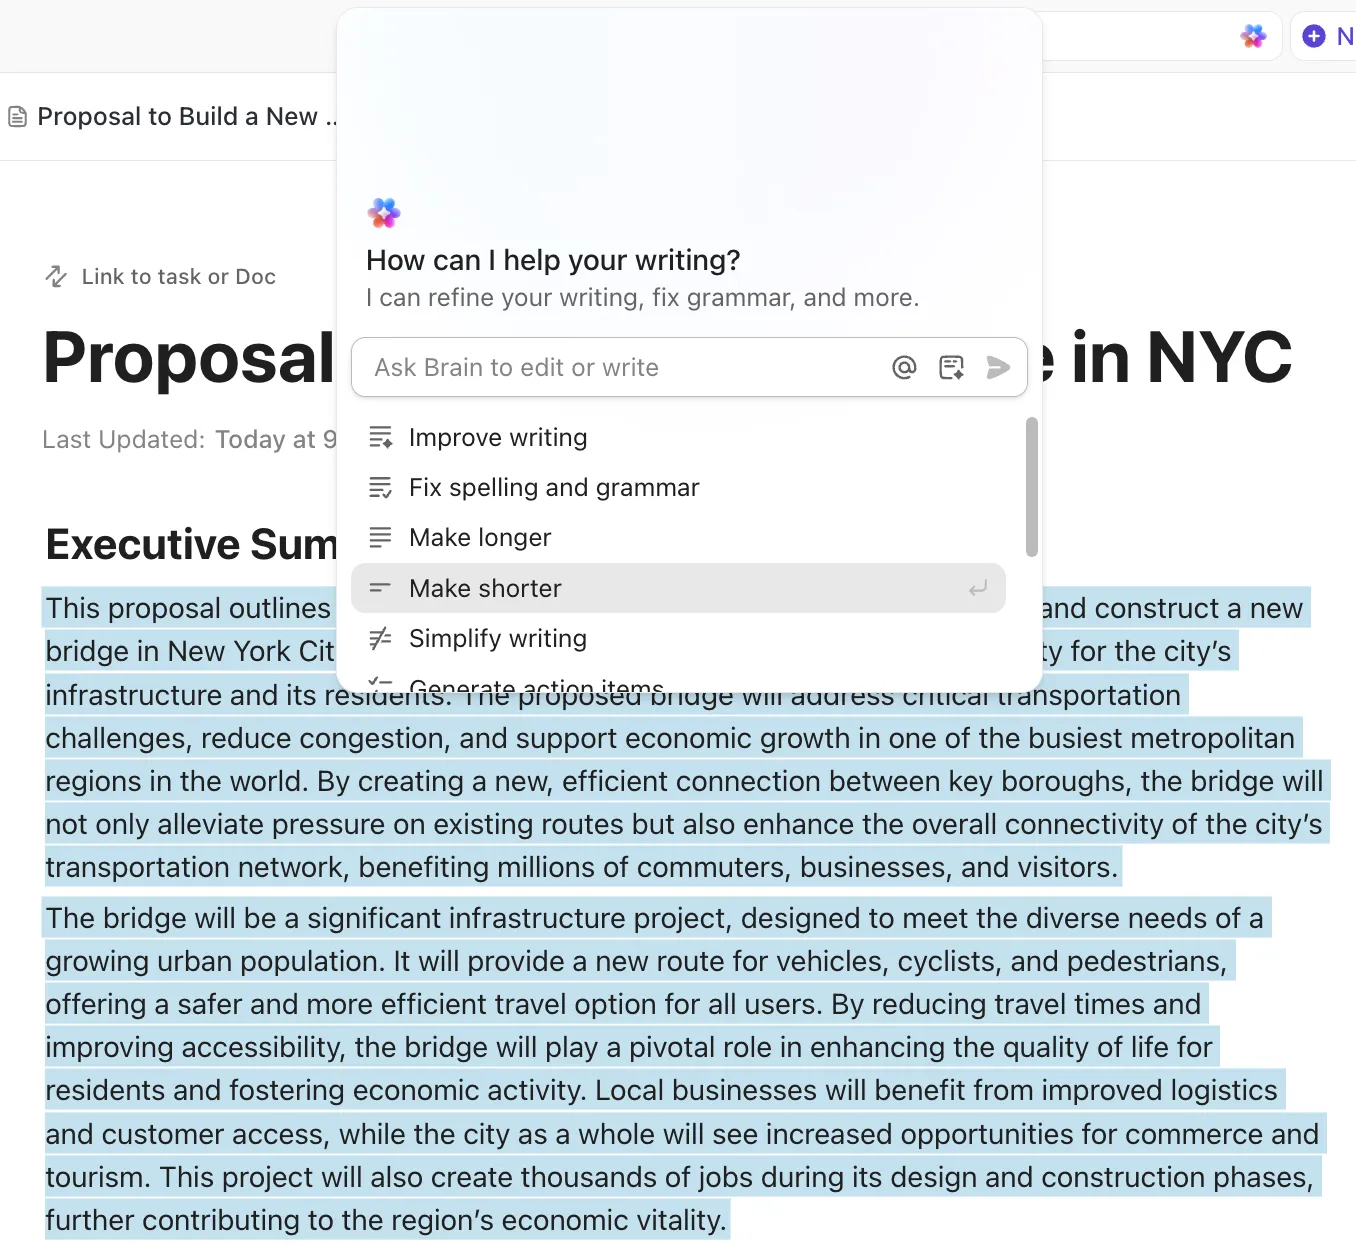
Skapa sedan ett ClickUp Doc som ska fungera som din levande styrningshandbok. Här beskriver du dina rutiner för utvärdering av partiskhet, tröskelvärden för rättvisa, riktlinjer för modelldokumentation, steg för mänsklig inblandning och eskaleringsprotokoll.
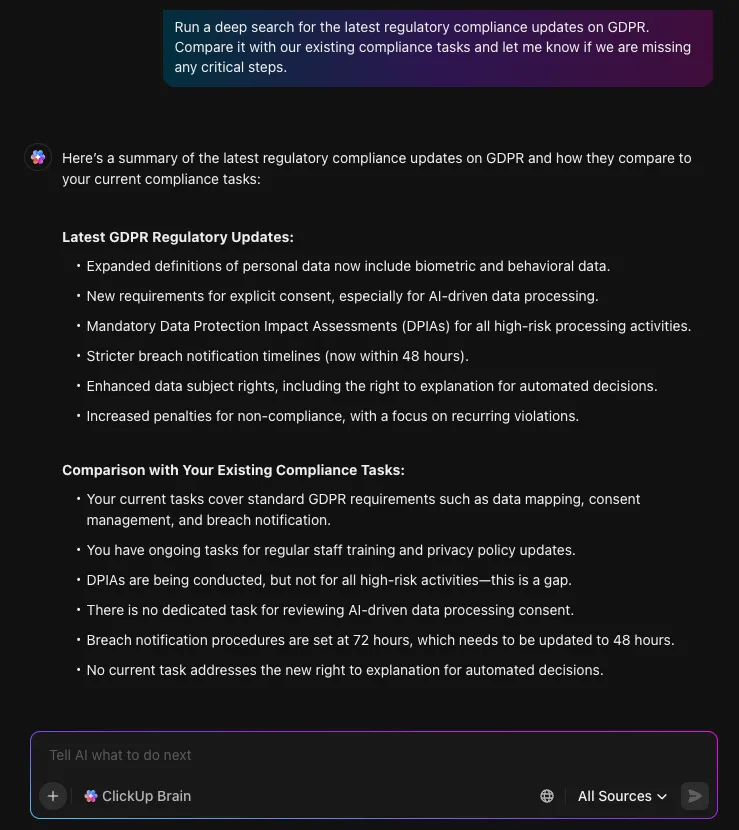
Eftersom dokumenten förblir kopplade till uppgifter och modellposter kan dina team samarbeta utan att förlora versionshistoriken eller sprida ut filer över olika verktyg. Dessutom kan ClickUp Brain hjälpa till att sammanfatta externa regler, utarbeta utkast till nya policyer eller lyfta fram tidigare revisionsresultat, vilket gör policyarbetet mer konsekvent och spårbart.
Eftersom systemet kan söka på webben, växla mellan flera AI-modeller och sammanställa information till tydliga riktlinjer kan ditt team hålla sig à jour med nya standarder och branschförändringar utan att behöva lämna arbetsytan. Allt du behöver – policyuppdateringar, insikter om regelverk och tidigare beslut – samlas på ett och samma ställe, vilket gör ditt styrningssystem mer stabilt och betydligt enklare att underhålla.
Steg 3: Registrera varje modell
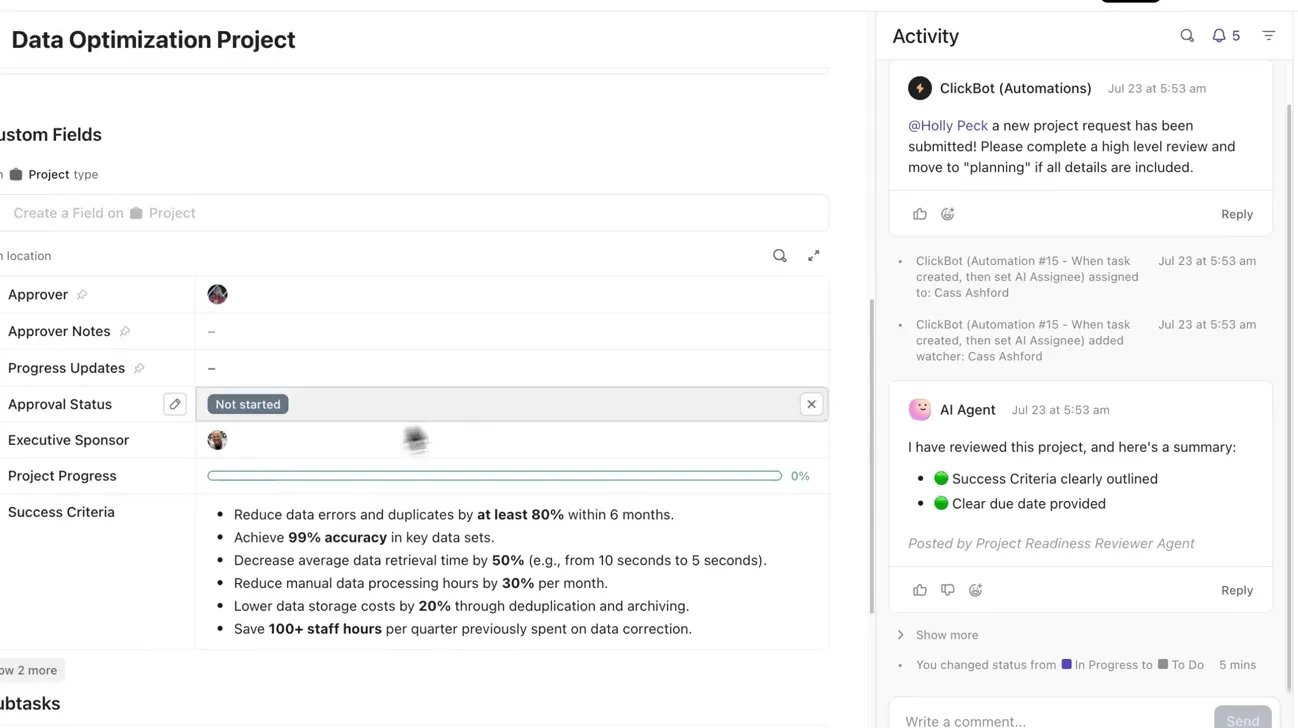
Varje modell bör ha sin egen uppgift i listan ”Modellinventering” så att ägarskap och ansvar alltid är tydliga.
Spåra enkelt varje fall av partiskhet som en åtgärdspost genom att använda ClickUp-uppgifter och ClickUp-anpassade fält för att strukturera dina arbetsflöden för partiskhetsbedömning och fånga upp alla viktiga detaljer.
På så sätt kan du spåra typ av partiskhet, allvarlighetsgrad, åtgärdsstatus, ansvarig teammedlem och nästa granskningsdatum, vilket säkerställer att varje problem har ett tydligt ansvar och en tidsfrist.
Bifoga datamängder, utvärderingssammanfattningar och spårbarhetsanteckningar så att allt finns samlat på ett ställe. Automatiserade system kan sedan meddela granskare när en modell flyttas till testmiljö eller produktion.
Steg 4: Genomför schemalagda och händelsebaserade partiskhetsgranskningar
Biasgranskningar bör genomföras både enligt ett återkommande schema och som svar på specifika utlösande faktorer.
Skapa enkla regler via ClickUp Automations som automatiskt utlöser granskningsuppgifter när en modell når en ny milstolpe i driftsättningen eller när det är dags för en schemalagd granskning. Du kommer aldrig mer att missa en kvartalsvis partiskhetsbedömning, eftersom Automations kan tilldela rätt granskare, ställa in korrekta deadlines och till och med skicka påminnelser när förfallodagen närmar sig.

För händelsebaserade granskningar gör ClickUp Forms det enkelt att samla in rapporter om partiskhetsincidenter eller feedback från människor, medan granskare använder anpassade fält för att logga brister i rättvisan, testresultat och rekommendationer. Varje inlämnat formulär vidarebefordras till ditt team som en uppgift, vilket skapar en repeterbar granskningsprocess.
Steg 5: Utred och åtgärda fall av partiskhet
När ett problem med partiskhet identifieras ska du skapa en incidentuppgift som beskriver allvarlighetsgraden, berörda grupper, modellversion och nödvändiga åtgärder. AI-agenter kan eskalera högriskfynd till ansvariga för regelefterlevnad och tilldela lämpliga granskare och ingenjörer.
Varje åtgärd, testresultat och valideringssteg kopplas till incidentrapporten. ClickUp Brain kan skapa sammanfattningar för ledningen eller hjälpa till att förbereda åtgärdsnoteringar för din styrningsdokumentation, vilket gör att allt förblir transparent och spårbart.
Steg 6: Övervaka tillståndet för ditt AI-styrningsprogram
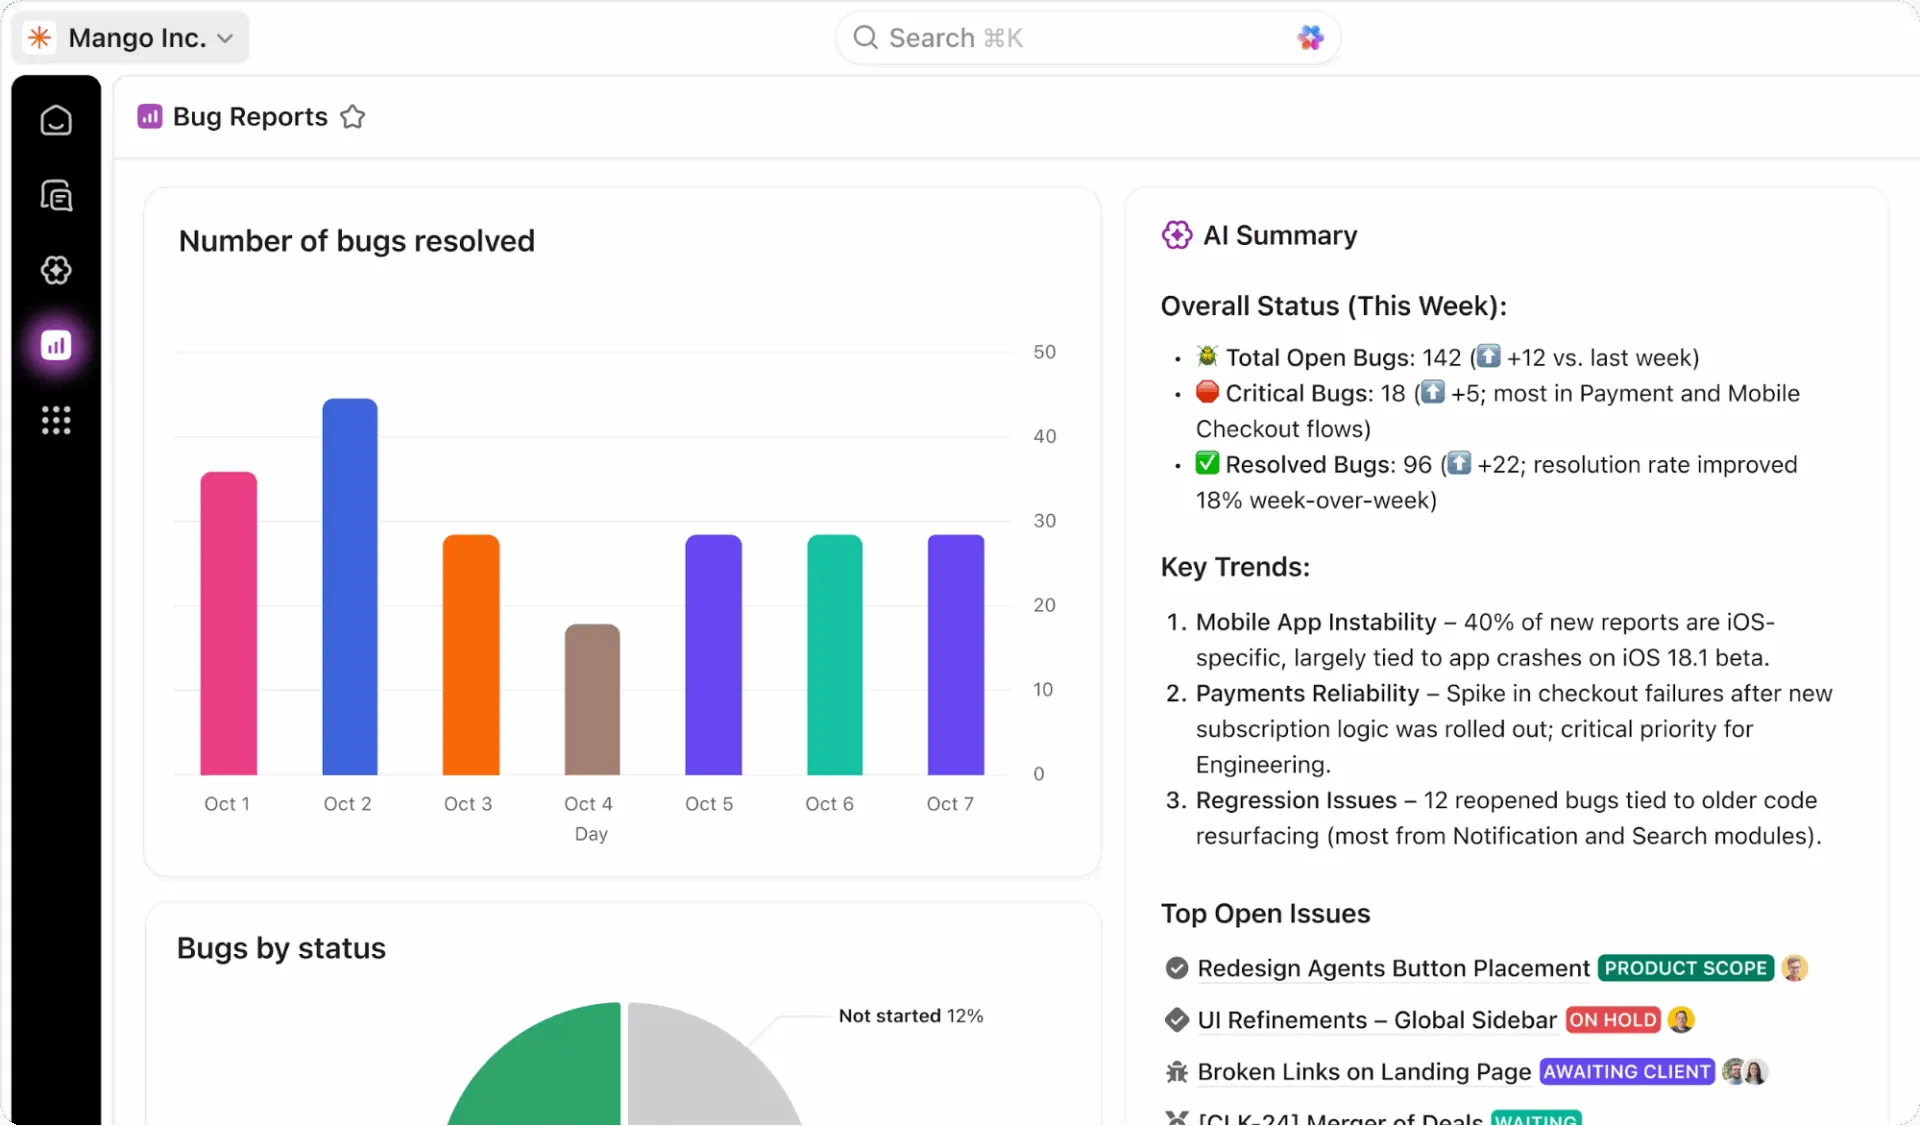
Skapa slutligen dashboards som ger ledningen en realtidsöversikt över ditt program för att minska partiskhet.
Inkludera paneler som visar öppna incidenter, tid till lösning, andel slutförda revisioner, rättvisemätvärden och efterlevnadsstatus för alla aktiva modeller. De kodfria instrumentpanelerna i ClickUp kan automatiskt hämta data och uppdatera uppgifter allteftersom arbetet fortskrider, med AI-sammanfattningar inbyggda i din instrumentpanelsvy.
Kontroller av partiskhet efter driftsättning
Ditt arbete är inte klart när AI-modellen tas i drift.
Det är faktiskt nu som det verkliga testet börjar. Modeller kan ”glida iväg” och utveckla nya fördomar över tid när de verkliga data de utgår ifrån börjar förändras. Kontinuerlig övervakning är det enda sättet att upptäcka dessa framväxande fördomar innan de orsakar omfattande skada.
Här är vad din löpande övervakning bör omfatta:
| Övning | Vad det säkerställer |
|---|---|
| Prestationsuppföljning per grupp | Mäter kontinuerligt modellens noggrannhet och rättvisa över olika demografiska segment så att skillnader upptäcks tidigt |
| Detektering av datadrift | Övervakar förändringar i indata som kan leda till ny partiskhet eller försämra modellens prestanda över tid |
| Användarfeedback | Tillhandahåller tydliga kanaler för användare att rapportera partiska eller felaktiga resultat, vilket förbättrar den praktiska övervakningen |
| Planerade granskningar | Säkerställer kvartalsvisa eller halvårsvisa djupgående analyser av modellbeteende, rättvisemätvärden och efterlevnadskrav |
| Incidenthantering | Definierar en strukturerad process för att utreda, korrigera och dokumentera alla rapporterade fall av partiskhet |
💟 Bonus: Generativa AI-system kräver särskilt stor vaksamhet eftersom deras resultat är betydligt mindre förutsägbara än traditionella maskininlärningsmodeller. En utmärkt teknik för detta är red-teaming, där ett särskilt team aktivt försöker framkalla partiska eller skadliga svar från modellen för att identifiera dess svaga punkter.
Airbnbs Project Lighthouse är till exempel en utmärkt branschstudie av ett företag som genomför systematisk övervakning av partiskhet efter implementering.
Det är ett forskningsinitiativ som undersöker hur uppfattad etnisk tillhörighet kan påverka bokningsresultaten, vilket hjälper företaget att identifiera och minska diskriminering på plattformen. Initiativet använder metoder som skyddar integriteten, samarbetar med medborgarrättsorganisationer och omsätter resultaten i produkt- och policyförändringar, vilket gör det möjligt för fler gäster att använda plattformen utan att stöta på osynliga hinder.
Minska partiskhet i AI med ClickUp
Att bygga rättvis och ansvarstagande AI är ett åtagande för hela organisationen.
När dina riktlinjer, medarbetare, processer och verktyg fungerar i harmoni skapar du ett styrningssystem som kan anpassa sig till nya risker, reagera snabbt på incidenter och vinna förtroende hos de människor som litar på dina produkter.
Med strukturerade granskningar, tydlig dokumentation och ett repeterbart arbetsflöde för hantering av partiskhet kan teamen arbeta samstämmigt och ta ansvar, istället för att reagera i krisläge.
Genom att centralisera allt i ClickUp – från modellregister till granskningsresultat och incidentrapporter – skapar du en gemensam operativ plattform där besluten är transparenta, ansvarsfördelningen tydlig och förbättringsåtgärderna aldrig går förlorade i virrvarret.
En stark styrning bromsar inte innovationen – den stabiliserar den. Är du redo att integrera åtgärder mot partiskhet i dina AI-arbetsflöden? Kom igång gratis med ClickUp och börja bygga upp ditt AI-styrningsprogram redan idag.
Vanliga frågor
Vad är det första steget mot att minska partiskhet i AI?
Ett bra första steg är att genomföra en partiskhetsgranskning av dina befintliga AI-system. Denna utgångsbedömning visar var det för närvarande förekommer orättvisor och hjälper dig att prioritera dina åtgärder för att minska dem.
Hur mäter team partiskhet och rättvisa inom AI?
Team använder specifika mått på rättvisa, såsom demografisk jämlikhet, utjämnade odds och disparat påverkan, för att kvantifiera partiskhet. Vilket mått som är rätt beror på ditt specifika användningsfall och vilken typ av rättvisa som är viktigast i det sammanhanget.
När bör teamen införa granskning med mänsklig inblandning?
Du bör alltid lägga till ett steg med mänsklig granskning vid beslut med stora konsekvenser som väsentligt påverkar en persons liv eller möjligheter, till exempel vid rekrytering, kreditgivning eller hälso- och sjukvård. Det är också klokt att använda detta under den tidiga fasen av införandet av en ny modell, när dess beteende fortfarande är oförutsägbart.
Hur skiljer sig upptäckten av partiskhet åt inom generativ AI?
Eftersom generativ AI kan producera ett nästan oändligt antal oförutsägbara svar räcker det inte att bara kontrollera noggrannheten. Du måste använda aktiva testmetoder som red-teaming och storskalig urvalsanalys av utdata för att ta reda på om modellen producerar partiskt innehåll under olika förhållanden.