
IT-katastrofer kan inträffa utan förvarning.
Allt från serverkrascher till cyberattacker – utan en gedigen återställningsplan kan ditt företag drabbas av timmar av driftstopp, förlorade data och allvarliga ekonomiska skador, där 54 % av de allvarliga avbrotten kostar över 100 000 US-dollar.
Den här bloggen guidar dig genom hur du skapar en omfattande IT-katastrofåterställningsplan som skyddar dina system, definierar tydliga återställningsmål och säkerställer att ditt team vet exakt vad de ska göra när något går fel.
Vad är en IT-katastrofåterställningsplan?
Om dina servrar skulle krascha just nu, skulle ditt team veta exakt vad de ska göra? 🛠️
En IT-katastrofåterställningsplan (DR-plan) är din dokumenterade strategi för att återställa IT-system och data efter en störning – allt från naturkatastrofer till cyberattacker. Det är i grunden din handbok för att få tekniken igång igen när något går fel.
💡 DR kontra affärskontinuitet
Katastrofåterställning (DR) fokuserar specifikt på att återställa din IT-infrastruktur och dina data. Affärskontinuitet (BC) är ett bredare begrepp som syftar till att hålla hela verksamheten igång under och efter en kris, även om IT-systemen är nere. Betrakta DR som en viktig del av din övergripande BC-strategi.
💡 DR kontra affärskontinuitet
Katastrofåterställning (DR) fokuserar specifikt på att återställa din IT-infrastruktur och dina data. Affärskontinuitet (BC) är ett bredare begrepp som syftar till att hålla hela verksamheten igång under och efter en kris, även om IT-systemen är nere. Betrakta DR som en viktig del av din övergripande BC-strategi.
Din katastrofåterställningsplan är viktig eftersom driftstopp kostar mer än bara pengar. Varje minut som dina system är ur drift kan det undergräva kundernas förtroende, störa verksamheten och till och med leda till böter för bristande efterlevnad. En omfattande katastrofåterställningsplan är din vägkarta till motståndskraft.
En bra plan omfattar:
- Rutin för säkerhetskopiering av data: Hur och var du lagrar kopior av viktig information så att du kan återställa den
- Steg för systemåterställning: Den exakta sekvensen för att återuppta tjänsterna i rätt ordning
- Teamets ansvarsområden: Vem gör vad under en incident för att undvika förvirring
- Kommunikationsprotokoll: Hur du håller intressenterna uppdaterade, från ditt team till dina kunder
- Återställningsmål: Dina specifika mål för hur snabbt systemen måste återupptas och hur stor dataförlust som är acceptabel
Vanliga IT-katastrofscenarier och deras konsekvenser
Katastrofer är inte bara något som händer i Hollywood – de drabbar företag varje dag. Att förstå vad du skyddar dig mot hjälper dig att bygga upp ett mycket starkare försvar.
Naturkatastrofer och fysiska skador
Händelser som översvämningar, bränder, jordbävningar och omfattande strömavbrott kan förstöra hela datacenter på några minuter. När en stor översvämning drabbade ett datacenter i Nashville förlorade till exempel vissa företag flera veckors data och stod inför månader av återställningsarbete. Det bästa skyddet mot detta är geografisk redundans, vilket innebär att man sprider sin infrastruktur över flera fysiska platser så att en enskild händelse inte kan slå ut allt.
Cyberattacker och dataintrång
Ransomware, distribuerade överbelastningsattacker (DDoS) och dataintrång skiljer sig från fysiska katastrofer. De är ofta svårare att upptäcka, kan sprida sig obemärkt genom anslutna system och riktar sig ofta även mot dina säkerhetskopieringssystem, vilket gör återställningen särskilt utmanande. Frekvensen och sofistikationsgraden hos dessa cyberattacker fortsätter att öka inom alla branscher, och ransomware förekommer nu i 44 % av alla bekräftade intrång, vilket gör dem till ett av de största hoten.
Hårdvarufel och dataförlust
Ibland kan även de mest beprövade och pålitliga säkerhetskopieringssystemen helt enkelt sluta fungera. Serverkrascher, lagringsfel och fel på nätverksutrustning kan inträffa utan förvarning. Även om du har redundanta (reserv)system kan de fortfarande sluta fungera samtidigt om de delar gemensamma komponenter eller strömkällor, vilket skapar en enda felpunkt.
👀 Visste du att: I oktober 2025 drabbades AWS av ett omfattande avbrott när en bugg i det interna DNS-hanteringssystemet för Amazon DynamoDB orsakade att domännamnsupplösningen sluta fungera i datacenterregionen US-EAST-1. Denna ”lilla” tekniska defekt utlöste en kedjereaktion av fel i dussintals AWS-tjänster och slog ut hundratals populära appar och plattformar världen över – från meddelande- och sociala appar till banker, spelsajter och mycket mer. För många människor fick avbrottet stora delar av internet att tillfälligt ”försvinna”, vilket tydligt visade hur sårbar vår digitala infrastruktur är när så mycket är beroende av en handfull molnleverantörer.
Programvarufel och driftstörningar
En skadad databas, en misslyckad programuppdatering eller ett enkelt konfigurationsfel kan sätta hela plattformar ur spel. Du kanske märker att en enda felkonfigurerad kodrad kan sprida sig genom anslutna system och orsaka ett omfattande avbrott med stor påverkan. Korrekt förändringshantering och dedikerade testmiljöer är dina bästa verktyg för att minimera dessa risker.
Mänskliga fel och felkonfigurationer
Oavsiktliga raderingar, felaktiga konfigurationer och obehöriga ändringar är fortfarande några av de vanligaste orsakerna till IT-avbrott. Ett enda felaktigt kommando eller en raderad fil kan leda till flera timmars driftstopp och försämrad tjänstekvalitet. Utbildning och åtkomstkontroller hjälper visserligen, men de kan inte helt eliminera mänskliga misstag.
📮ClickUp Insight: 92 % av de anställda använder inkonsekventa metoder för att följa upp åtgärder, vilket leder till uteblivna beslut och försenad genomförande.
Oavsett om du skickar uppföljningsmeddelanden eller använder kalkylark är processen ofta splittrad och ineffektiv. Med ClickUps funktioner för uppgiftshantering behöver du aldrig oroa dig för detta. Skapa uppgifter direkt från chatt, ClickUp-kommentarer, dokument och e-postmeddelanden med ett enda klick!
Viktiga komponenter i en IT-katastrofåterställningsplan
En gedigen katastrofåterställningsplan är din kompletta handbok för att komma tillbaka online. Var och en av dessa komponenter bygger på de andra för att skapa ett heltäckande skydd för ditt företag.
Riskbedömning och prioritering
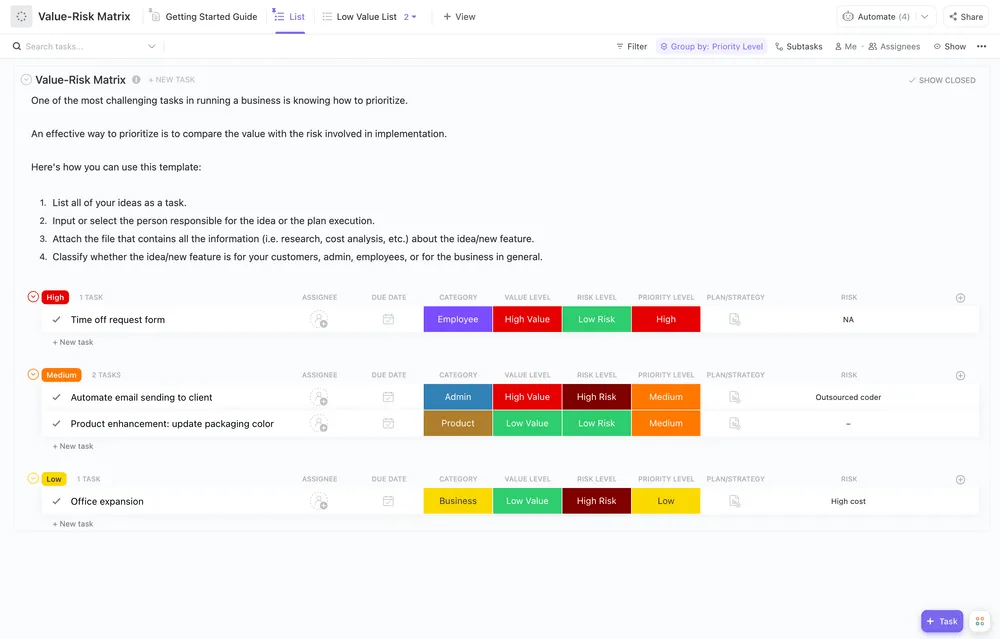
Först måste du veta vad du har att göra med. En riskbedömning är en process där du identifierar dina sårbarheter och utvärderar sannolikheten för och konsekvenserna av varje potentiellt hot. Du kan organisera detta i en riskmatris för att se vilka hot som är allvarligast.
Din utvärdering bör omfatta:
- Kritiska system: Vad som absolut måste fortsätta att fungera för att din verksamhet ska kunna bedrivas
- Datakänslighet: Vilken information kräver högsta skyddsnivå (t.ex. kunddata)?
- Beroenden: Vilka andra system eller processer slutar fungera när ett system går ner?
Analys av affärseffekter och kritikalitet
Räkna sedan ut de faktiska kostnaderna för driftstopp. En affärspåverkananalys (BIA) hjälper dig att fastställa de ekonomiska och operativa konsekvenserna av ett driftstopp för varje system. På så sätt kan du klassificera dina system efter kritikalitetsnivå för att prioritera dina återställningsinsatser.
| Kritiskt | Mindre än en timme | Betalningshantering, kunddatabaser |
| Hög | En till fyra timmar | E-post, interna kommunikationsverktyg |
| Medium | Fyra till 24 timmar | Utvecklingsmiljöer, rapporteringsverktyg |
| Låg | 24+ timmar | Arkivsystem, testservrar utanför produktionsmiljön |
RTO- och RPO-mål
Dessa två förkortningar utgör kärnan i din återställningsstrategi.
- Återställningstidsmål (RTO): Detta är den maximala tid som du kan tillåta att ett system är ur drift. Det besvarar frågan: ”Hur snabbt behöver vi få systemet i drift igen?”
- Återställningspunktsmål (RPO): Detta är den maximala mängd data du har råd att förlora, mätt i tid. Det besvarar frågan: ”Hur mycket data kan vi förlora utan att det orsakar allvarliga skador?”
Till exempel kan ditt interna e-postsystem ha en RTO på fyra timmar, men din kundinriktade e-handelsdatabas kan ha en RPO på bara 15 minuter, vilket innebär att du inte får förlora mer än 15 minuters transaktionsdata.
Plan för säkerhetskopiering och återställning av data
Din säkerhetskopieringsplan är ditt ultimata skyddsnät. En vanlig rekommenderad metod är 3-2-1-regeln: ha minst tre kopior av dina viktiga data, lagra dem på två olika typer av media och förvara en av dessa kopior utanför anläggningen.
Du kommer också att välja mellan olika typer av säkerhetskopiering:
- Fullständiga säkerhetskopior: En fullständig kopia av all data, som vanligtvis görs varje vecka eller varje månad
- Inkrementella säkerhetskopior: Säkerhetskopierar endast ändringar som gjorts sedan den senaste säkerhetskopian, oavsett typ.
- Differentiella säkerhetskopior: Säkerhetskopierar alla ändringar som gjorts sedan den senaste fullständiga säkerhetskopieringen
Det viktigaste är att du regelbundet testar din process för återställning av säkerhetskopior. En otestad säkerhetskopia är bara en förhoppning, inte en plan.
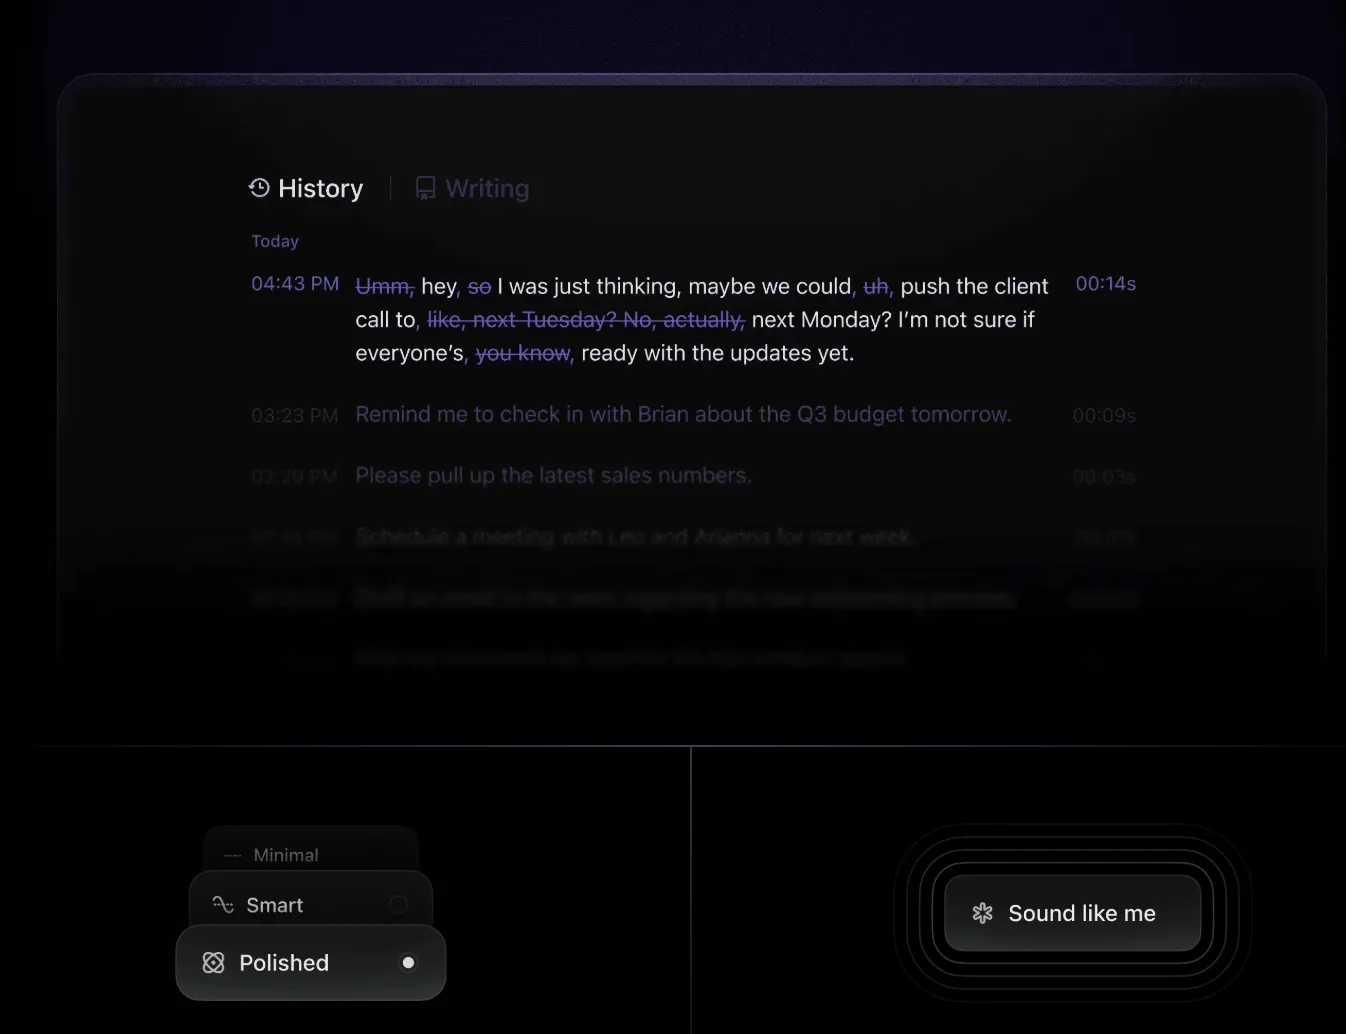
💟 Bonus: Fånga upp viktiga detaljer under stressiga incidenter med hjälp av ClickUp Brain MAX:s tal-till-text-funktion, så att du aldrig missar viktig information även när det inte är praktiskt att skriva. Säg bara vad du observerar, så sköter AI:n dokumentationen.
Kommunikationsplan och uppdateringar till intressenter
När en katastrof inträffar är en tydlig kommunikationsplan avgörande. Din plan måste definiera meddelandekedjor, hur ofta du ska ge uppdateringar och vilka kanaler du ska använda för varje typ av incident.
Olika grupper behöver olika information:
- Interna team: Behöver tekniska detaljer och specifika åtgärder
- Kunder: Behöver veta servicestatusen och när ni förväntar er att problemet ska vara löst
- Leverantörer: Kan behöva anlitas för support eller eskaleringar
- Tillsynsmyndigheter: Kan kräva formella anmälningar beroende på vilken bransch du verkar inom
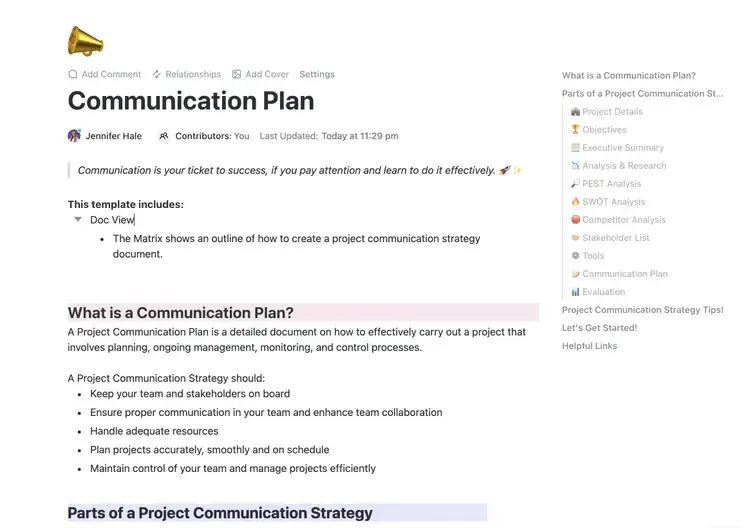
Verktyg som denna färdiga mall för kommunikationsplan från ClickUp kan hjälpa dig att agera snabbare med ett fastställt protokoll under en kris.
Test- och utbildningsprogram
En plan som aldrig testas är en plan som kommer att misslyckas. Regelbundna tester avslöjar brister och svagheter innan en verklig katastrof inträffar.
Planera in olika typer av tester under året:
- Simuleringsövningar: Ditt team går igenom ett katastrofscenario på papper för att kontrollera planens logik
- Partiella failovers: Du testar återställningen av specifika, icke-kritiska komponenter eller tjänster
- Fullständiga DR-tester: Du genomför en fullständig övergång till dina reservsystem (det ultimata testet)
Efter varje test ska du uppdatera dokumentationen och omedelbart utbilda nya teammedlemmar i rutinerna.
Steg för att skapa en IT-katastrofåterställningsplan
Att utarbeta en katastrofåterställningsplan behöver inte vara överväldigande.
Så här kan du ta itu med det steg för steg. 🙌
Steg 1: Skapa en inventering av tillgångarna
Du kan inte skydda det du inte vet att du har. Börja med att skapa en tillgångsförteckning som listar all hårdvara, mjukvara, datalager och systemberoenden i din miljö. Se till att inkludera leverantörskontakter, licensnycklar och konfigurationsuppgifter för snabb åtkomst vid en återställning.
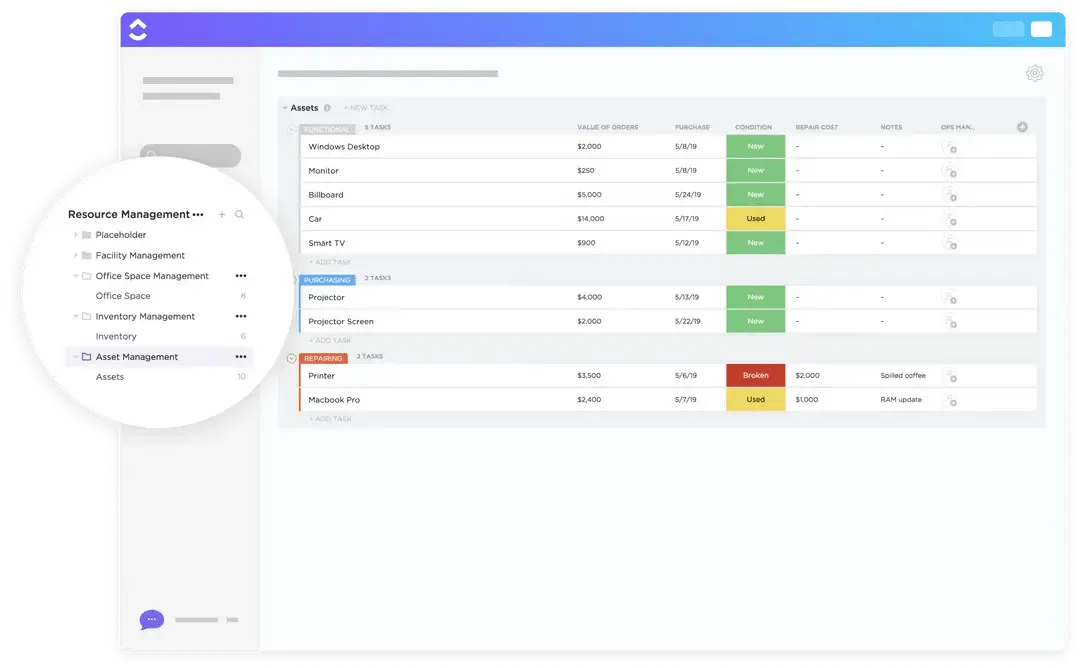
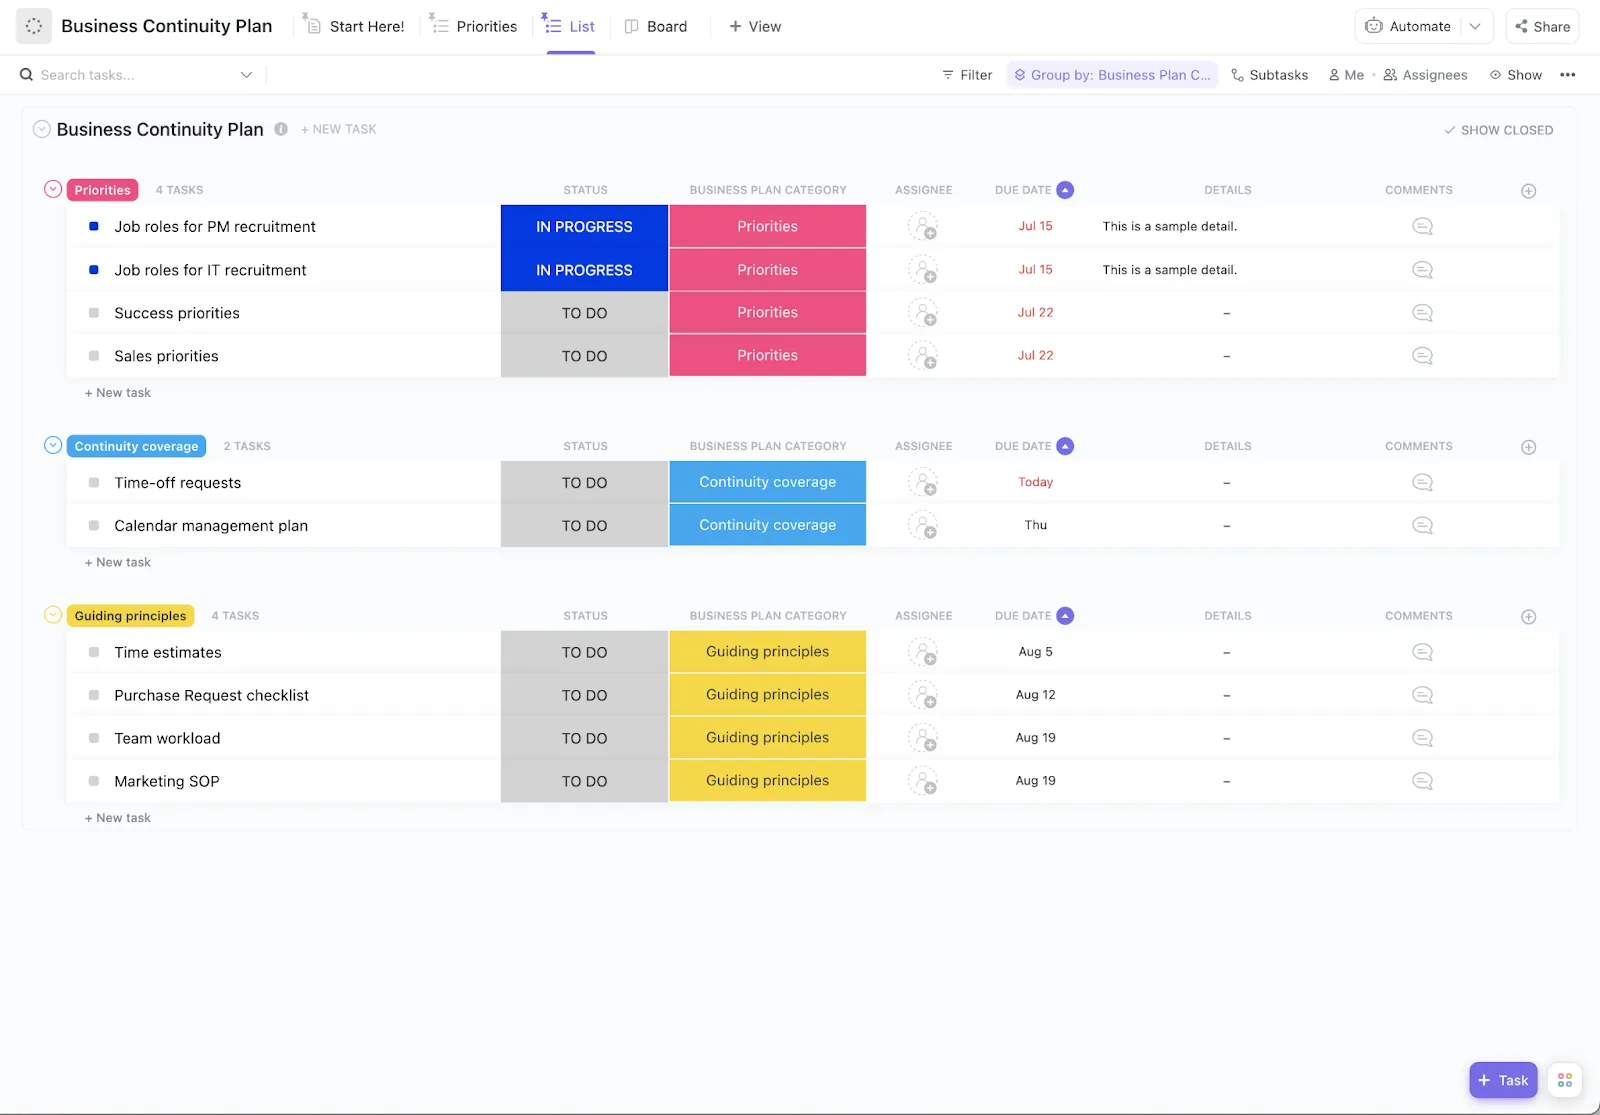
ClickUp-mallen för IT-tillgångshantering (ITAM) kombinerar incidenthantering, problemhantering, förändringshantering, enkla lösningar för tillgångshantering och kunskapshantering. Vår ITSM-mall för kända fel förenklar hur du spårar kända fel i dina system. Utforska alla våra IT-mallar så snart dina behov förändras.
Anpassa dina arbetsflöden precis som du vill för varje ITAM-fas, från driftsättning och konfiguration till underhåll och avveckling.
Steg 2: Klassificera kritiska tjänster
Identifiera nu vilka av dessa tillgångar som är affärskritiska och vilka som bara är bra att ha. Skapa kartor över tjänsteberoenden som visar hur dina system är kopplade till varandra och är beroende av varandra. Lägg särskild vikt vid kundinriktade tjänster som direkt påverkar intäkterna eller användarupplevelsen.
🎥 Titta på den här praktiska genomgången som visar hur du skapar en strukturerad, övergripande plan med hjälp av ClickUps kraftfulla funktioner – från att sätta upp mål till att tilldela uppgifter och följa upp framstegen.
Steg 3: Utvärdera risker och hot
Bedöm risker och hot genom att utvärdera sannolikheten och konsekvenserna av varje hottyp för just din situation. Ta hänsyn till geografiska risker (befinner du dig i ett jordbävningsområde eller ett översvämningsområde?) och eventuella branschspecifika hot (som förändringar i regelverket eller riktade cyberattacker). Dokumentera allt i ett riskregister så att du kan följa utvecklingen över tid.

ClickUps whiteboardmall för riskbedömning ger en visuell dimension åt din riskbedömningsprocess. Den underlättar riskbedömningen och kategoriseringen samt inspirerar ditt team att dela insikter och samarbeta i ett engagerande och visuellt format.
Med den här mallen kan du:
- Utvärdera riskkategorier och potentiella konsekvenser
- Analysera data för att identifiera potentiella problemområden
- Fastställ förebyggande åtgärder för att minska riskexponeringen
Med funktioner som gör att du kan rita, skriva och lägga till klisterlappar är den här whiteboardmallen för riskhantering perfekt för att utvärdera riskerna i ditt projekt.
Steg 4: Fastställ RTO- och RPO-mål
Samarbeta direkt med dina affärsintressenter för att definiera vad de anser vara acceptabla driftstopp och dataförluster för varje tjänstenivå som du identifierat tidigare. Du måste väga kostnaden för snabbare återställning mot den affärsmässiga påverkan – inte allt kräver omedelbar återställning utan dataförlust. Se till att få ledningens godkännande av dessa mål.
Steg 5: Definiera vägar för säkerhetskopiering och failover
När du har fastställt dina mål kan du nu utforma dina tekniska lösningar. Skapa säkerhetskopieringsstrategier som är anpassade efter varje systems RPO och planera detaljerade procedurer för failover, inklusive alternativa bearbetningsplatser och metoder för åtkomst i nödsituationer. Inkludera nätverksdiagram och steg-för-steg-handböcker för att göra genomförandet felsäkert.
Steg 6: Tilldela roller och eskalering
Definiera strukturen för ditt DR-team med tydliga ansvarsområden och beslutsbefogenheter. Skapa omfattande kontaktlistor med primär- och reservpersonal för varje roll. En RACI-matris (Responsible, Accountable, Consulted, Informed) är ett utmärkt verktyg för att undvika förvirring under en stressig incident.
Steg 7: Dokumentera och kommunicera planen
Dokumentera och kommunicera planen med tydliga, stegvisa anvisningar som alla i ditt team kan följa, även under press. Det är avgörande att denna dokumentation förvaras på en lättillgänglig plats som är skild från din primära infrastruktur. Se till att varje teammedlem vet exakt var planen finns under en kris.

Effektivisera din projektplanering med ClickUps RACI-planeringsmall. Denna dokumentmall är en riktig game-changer som erbjuder ett tydligt diagram för att definiera teamets roller och ansvarsområden i relation till projektuppgifterna. Använd RACI-ramverket (Responsible, Accountable, Consulted och Informed) för att se till att alla är på samma sida, vilket säkerställer ansvarstagande och samstämmighet med organisationens mål.
Steg 8: Testa, granska och förbättra
Slutligen, planera in kvartalsvisa tester för att validera dina rutiner och identifiera eventuella brister. Dokumentera alla lärdomar från varje test och eventuella verkliga incidenter, och använd dem för att uppdatera din plan. Skapa ett system för att systematiskt följa upp förbättringar för att säkerställa att alla problem som upptäcks åtgärdas.
🌼 Visste du att: År 2017 drabbades GitLab av ett omfattande databasavbrott. Under återställningen upptäckte de att flera av deras säkerhetskopieringsmetoder hade misslyckats utan att någon märkt det i flera dagar. Denna händelse lärde hela teknikbranschen en viktig läxa: validering av säkerhetskopior är absolut nödvändigt. En otestad säkerhetskopia är egentligen ingen säkerhetskopia alls.
🌼 Visste du att: År 2017 drabbades GitLab av ett omfattande databasavbrott. Under återställningen upptäckte de att flera av deras säkerhetskopieringsmetoder hade misslyckats utan att någon märkt det i flera dagar. Denna händelse lärde hela teknikbranschen en viktig läxa: validering av säkerhetskopior är absolut nödvändigt. En otestad säkerhetskopia är egentligen ingen säkerhetskopia alls.
Strategier och lösningar för katastrofåterställning
Alla organisationer behöver inte samma strategi för katastrofåterställning. Låt oss utforska dina alternativ utifrån din budget, dina återställningsbehov och tillgängliga resurser.
Strategi för säkerhetskopiering och återställning
Detta är den enklaste och mest kostnadseffektiva metoden. Den innebär att man regelbundet säkerhetskopierar till en extern plats (till exempel molnet eller ett sekundärt datacenter) och sedan manuellt återställer dem vid behov. Denna metod passar bäst för icke-kritiska system som tål en längre RTO, eftersom återställningen kan ta timmar eller till och med dagar.
Hög tillgänglighet och redundans
Denna strategi syftar till att eliminera enskilda felpunkter genom att använda flera aktiva system. Tekniker som lastbalansering, serverkluster och RAID-lagring säkerställer att om en komponent faller ur drift tar en annan omedelbart över. Även om denna metod är dyrare att installera och underhålla kan den minimera driftstopp till endast några sekunder eller minuter, vilket gör den idealisk för kritiska tjänster.
Alternativ för replikering och failover
Replikering innebär att data kopieras i nära realtid till en sekundär plats, vilket säkerställer minimal dataförlust vid en katastrof.
- Synkron replikering: Skriver data till både den primära och den sekundära platsen samtidigt, vilket garanterar att inga data går förlorade. Det kräver dock hög bandbredd och kan göra att ditt primära system blir långsammare.
- Asynkron replikering: Skriver först data till den primära platsen och kopierar den sedan till den sekundära platsen med en liten fördröjning. Det är billigare och påverkar prestandan mindre, men du accepterar en liten risk för dataförlust.
Molnbaserad katastrofåterställning och DRaaS
Disaster Recovery as a Service (DRaaS) har blivit ett populärt val för många företag. Det erbjuder prissättning enligt faktisk användning, omedelbar geografisk distribution och automatiserad återhämtningskoordinering utan att du behöver bygga och underhålla egna fysiska DR-anläggningar. Molnbaserad DR eliminerar de enorma kapitalkostnaderna för ett reservdatacenter samtidigt som det ger snabbare skalbarhet och större flexibilitet än traditionella metoder med hot-, warm- eller cold-site-anläggningar.
Hur ClickUp effektiviserar planeringen av IT-katastrofåterställning
Att hantera en katastrofåterställningsplan med hjälp av spridda kalkylblad, dokument och e-postkedjor skapar en egen katastrofrisk.
Denna typ av arbetsspridning – fragmenteringen av arbetet över flera, isolerade verktyg som inte kommunicerar med varandra – samt kontextspridning, där team slösar bort timmar på att söka efter information utspridd över olika appar och plattformar, leder till förvirring, föråldrad information och långa svarstider när varje sekund räknas.
Med ClickUp Converged AI Workspace – en enda, säker plattform där alla dina arbetsappar, data och arbetsflöden samsas med kontextuell AI som intelligenslager – som kombinerar projektledning, dokumentation och teamkommunikation. Sluta jonglera med flera plattformar och samla din DR-planering, testning och incidenthantering i ett enda enhetligt system.
Centraliserad dokumentation av katastrofåterställning med ClickUp Docs och inbyggd AI-assistans
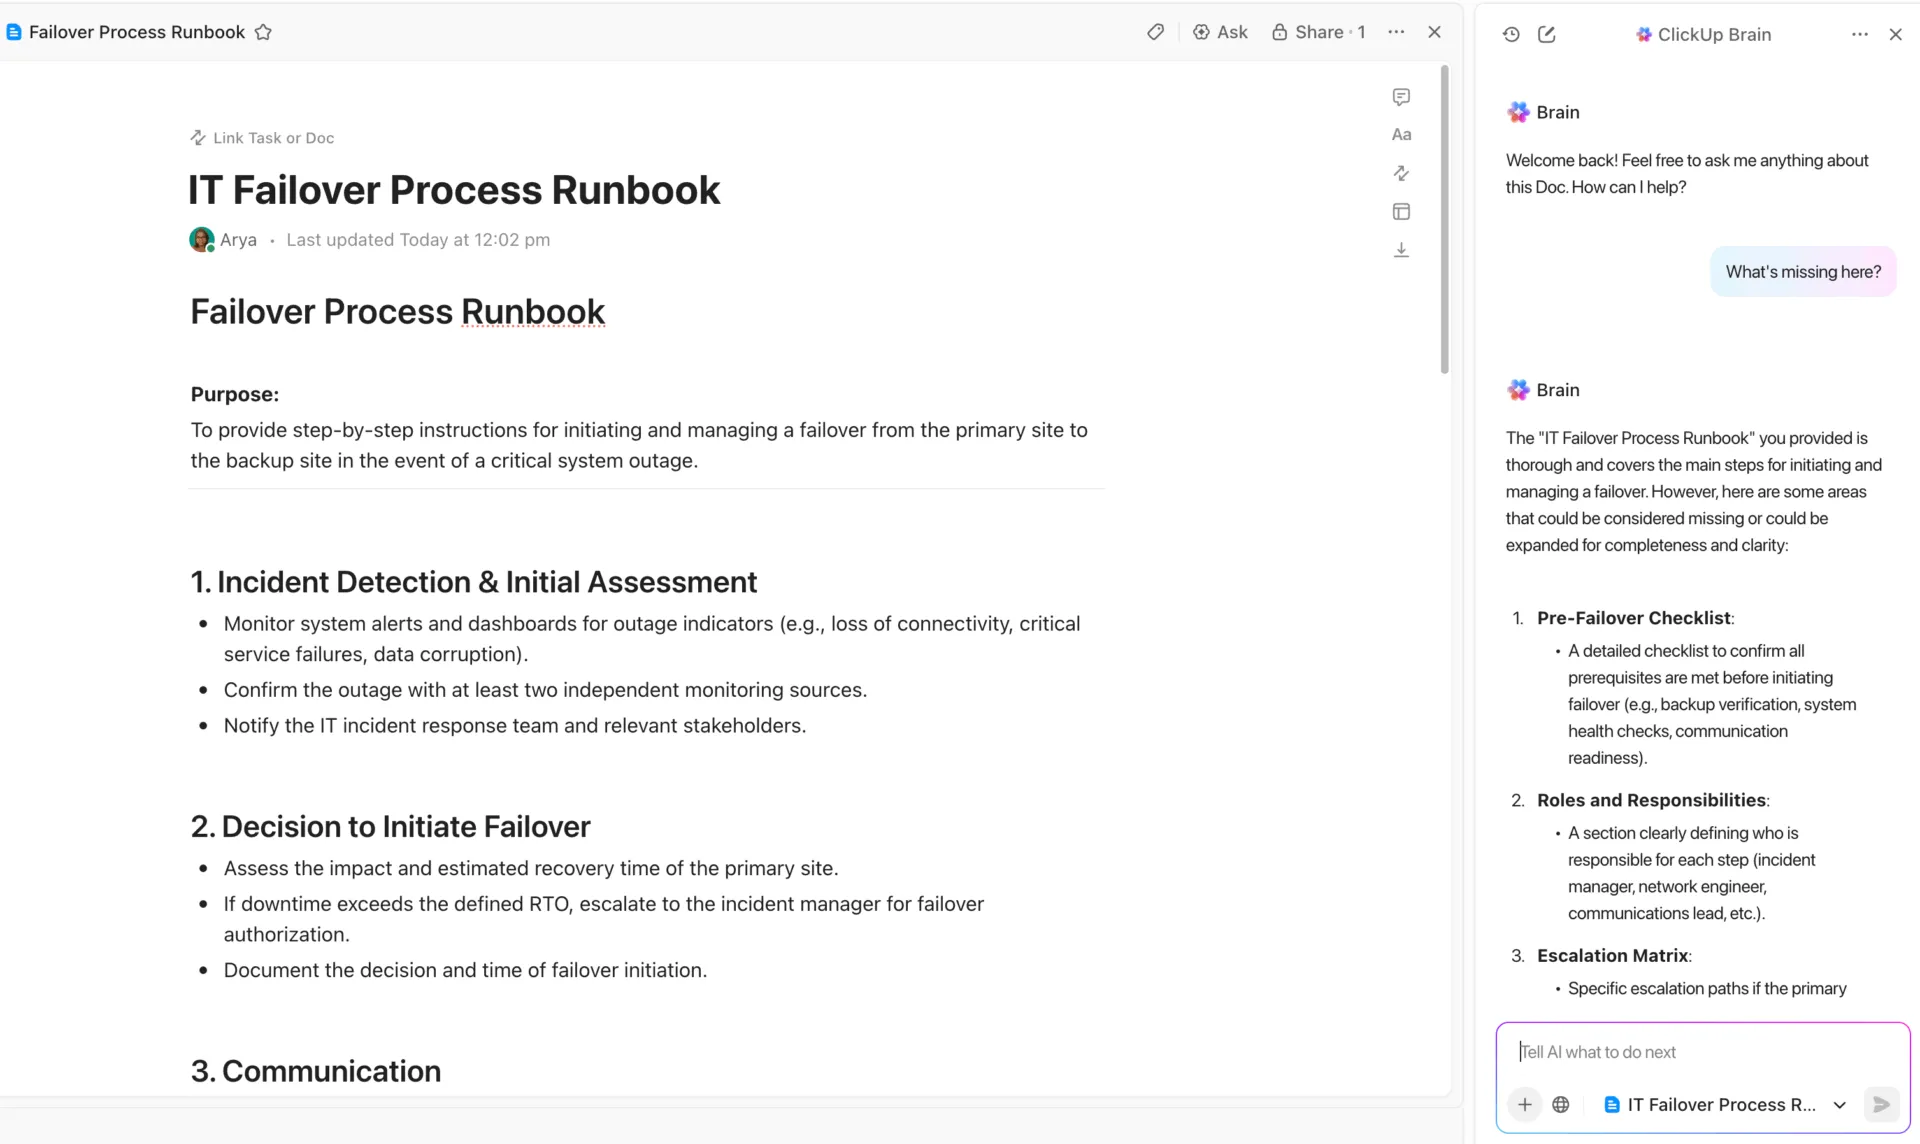
Se till att ditt team alltid har en enda källa till sanningen med ClickUp Docs.
Skapa hela din katastrofåterställningsplan i ett samarbetsutrymme där alla kan bidra i realtid under en incident. Länka dokument direkt till incidentuppgifter och projekt för smidig navigering, och bädda in diagram eller handböcker så att viktig information finns precis där du behöver den.
Det bästa av allt är att du kan skydda dina dokument för att förhindra oavsiktliga ändringar och använda detaljerade behörigheter i ClickUp för att styra vem som kan visa eller ändra känsliga återställningsprocedurer. Varje ändring spåras i dokumentets historik, vilket ger dig en fullständig revisionsspår.
AI-driven planering med ClickUp Brain
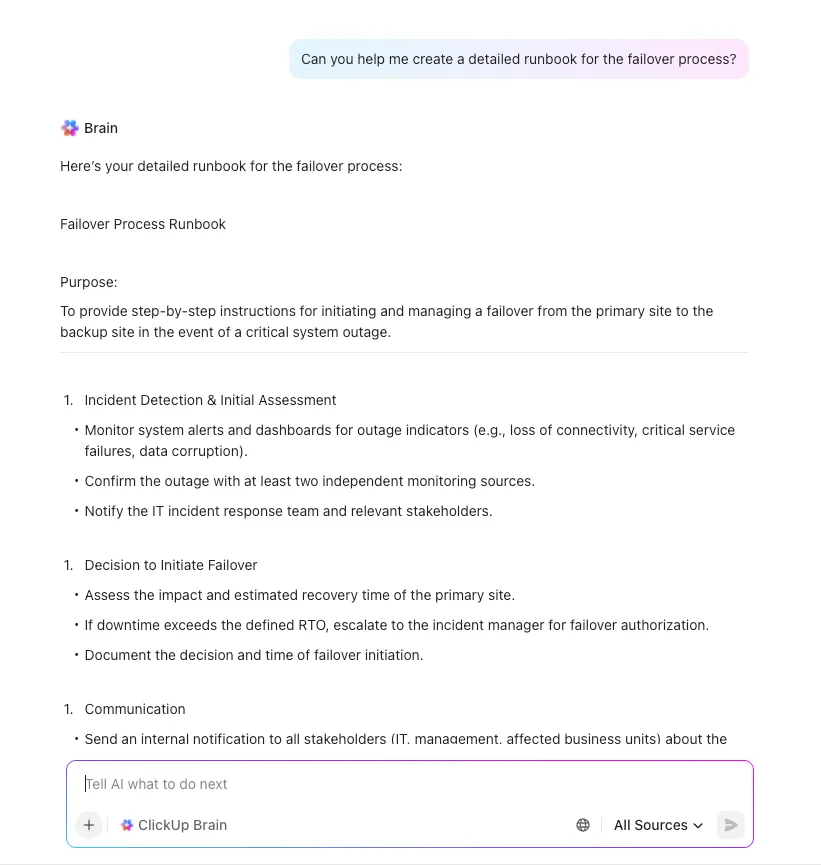
Påskynda planeringen av katastrofåterställning och eliminera kritiska luckor med ClickUp Brain – din kontextuella AI-assistent som förstår hela ditt arbetsutrymme. Till skillnad från generiska AI-verktyg utnyttjar ClickUp Brain din organisations faktiska uppgifter, dokument och arbetsflöden för att ge exakt och praktiskt stöd för katastrofåterställningsinitiativ.
Be bara ClickUp Brain om något i stil med ”Skapa en checklista för katastrofåterställning för vår e-handelsplattform” så får du omedelbart en omfattande, skräddarsydd mall som är anpassad efter dina system, processer och efterlevnadskrav. Den kan hjälpa dig med:
- Kontextuell medvetenhet: ClickUp Brain har tillgång till strukturen, innehållet och behörigheterna i ditt arbetsutrymme. Det kan hänvisa till uppgifter, dokument, kommentarer och till och med anslutna appar, vilket ger svar och åtgärder som är skräddarsydda för ditt faktiska arbete – inte bara generiska förslag
- Felsökning och vägledning: Felsök problem direkt, få steg-för-steg-instruktioner eller be om bästa praxis för vilken ClickUp-funktion som helst. Brain kan guida dig genom komplexa processer, automatisera repetitiva uppgifter och hjälpa till att lösa hinder
- Automatisering och snabbare arbetsflöden: Använd färdiga eller anpassade AI-agenter för att automatisera flerstegsarbetsflöden, prioritera förfrågningar eller hantera återkommande uppgifter – vilket sparar timmar varje vecka
- Djup sökning: Hitta information som ligger gömd var som helst i din arbetsmiljö, inklusive uppgifter, dokument och integrerade verktyg, även om den är flera år gammal eller svår att hitta med vanlig sökning
- Sammanfattningar och uppdateringar i realtid: Skapa projektuppdateringar, mötesreferat eller lägesrapporter direkt utifrån data från arbetsytan i realtid
- Förenkling av teknisk dokumentation: Omvandla komplexa tekniska dokument till tydliga, praktiska procedurer eller checklistor som ditt team kan följa, även under press
- Intelligens baserad på flera modeller: Välj bland ledande AI-modeller (OpenAI GPT-4.1, GPT-5, Claude, Gemini och fler) för bästa resultat i alla uppgifter – inga separata prenumerationer krävs
- Säker och behörighetsbaserad: Brain har endast åtkomst till information som du redan har behörighet att se, vilket säkerställer strikta standarder för integritet och efterlevnad
- Konversationsgränssnitt: Använd @brain i kommentarer eller chatt för att få kontextuella insikter, skapa svarutkast eller utlösa automatiseringar utan att behöva lämna ditt arbetsflöde
- Anpassade uppmaningar och sparade arbetsflöden: Spara och återanvänd uppmaningar för återkommande behov, vilket säkerställer enhetlighet och sparar tid för hela teamet
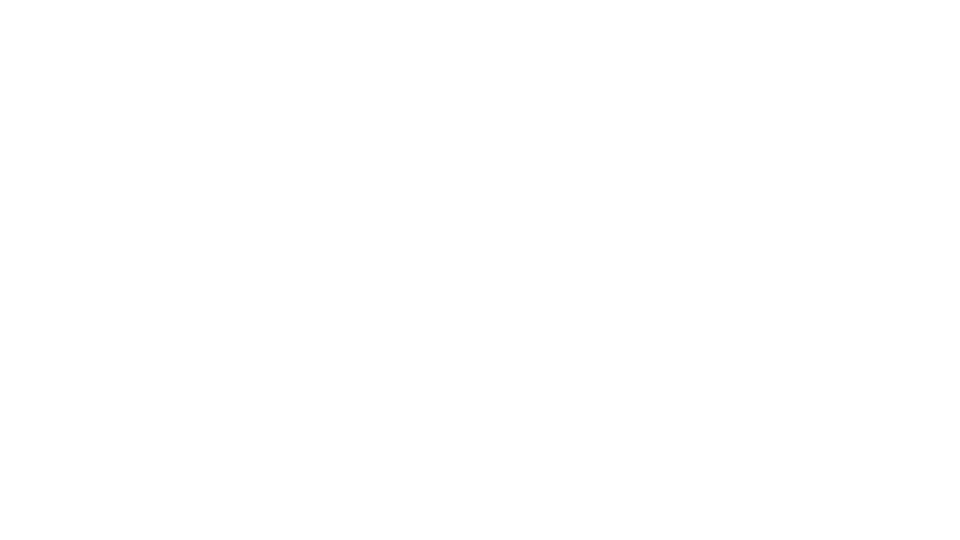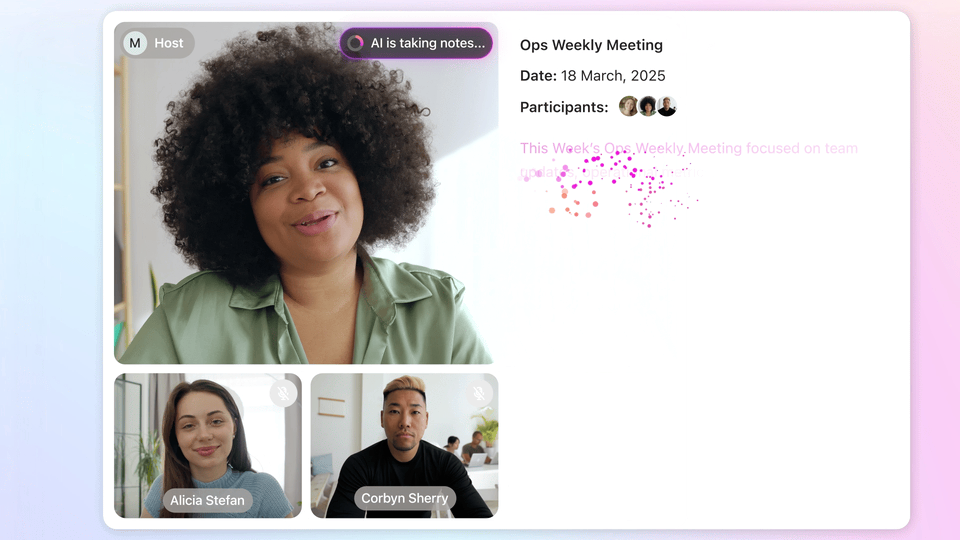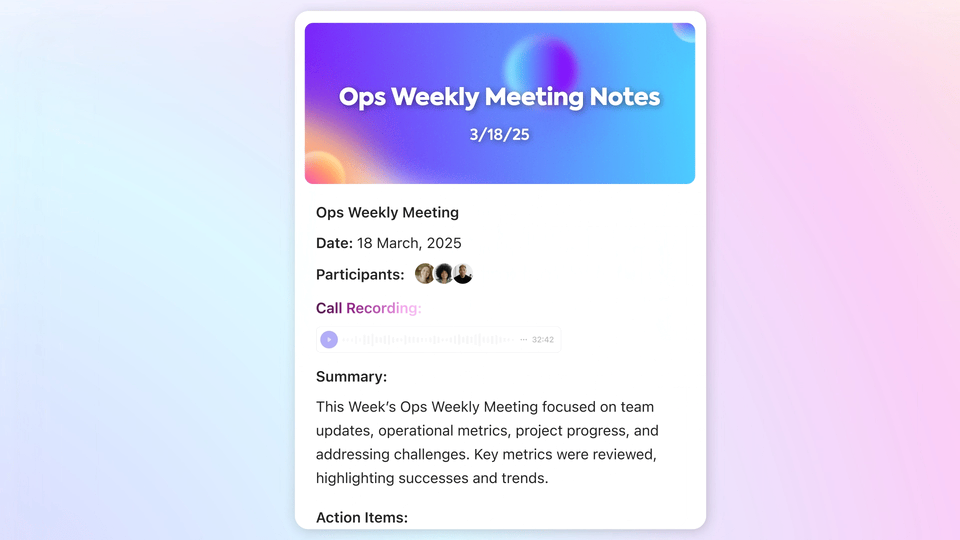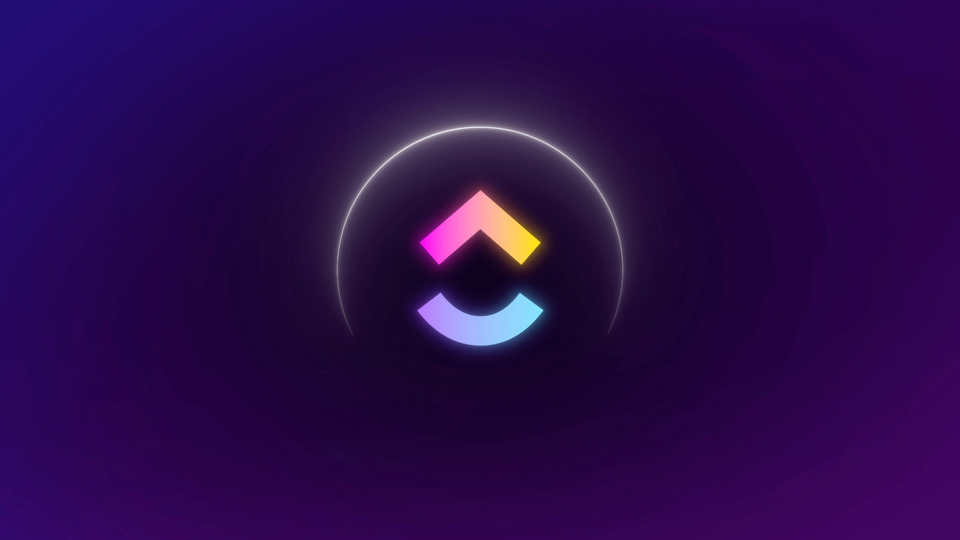
💡Proffstips: Missa aldrig något från era möten för incidentgenomgång genom att dokumentera varje detalj med ClickUp AI Notetaker. Verktyget kan delta i era virtuella möten, transkribera hela diskussionen och automatiskt generera en lista över åtgärder utifrån de lärdomar som dragits. Detta skapar en sökbar historik över incidenter, så att ni snabbt kan gå tillbaka och se tidigare händelser och hur de löstes.
Automatiserade DR-arbetsflöden med ClickUp Automations
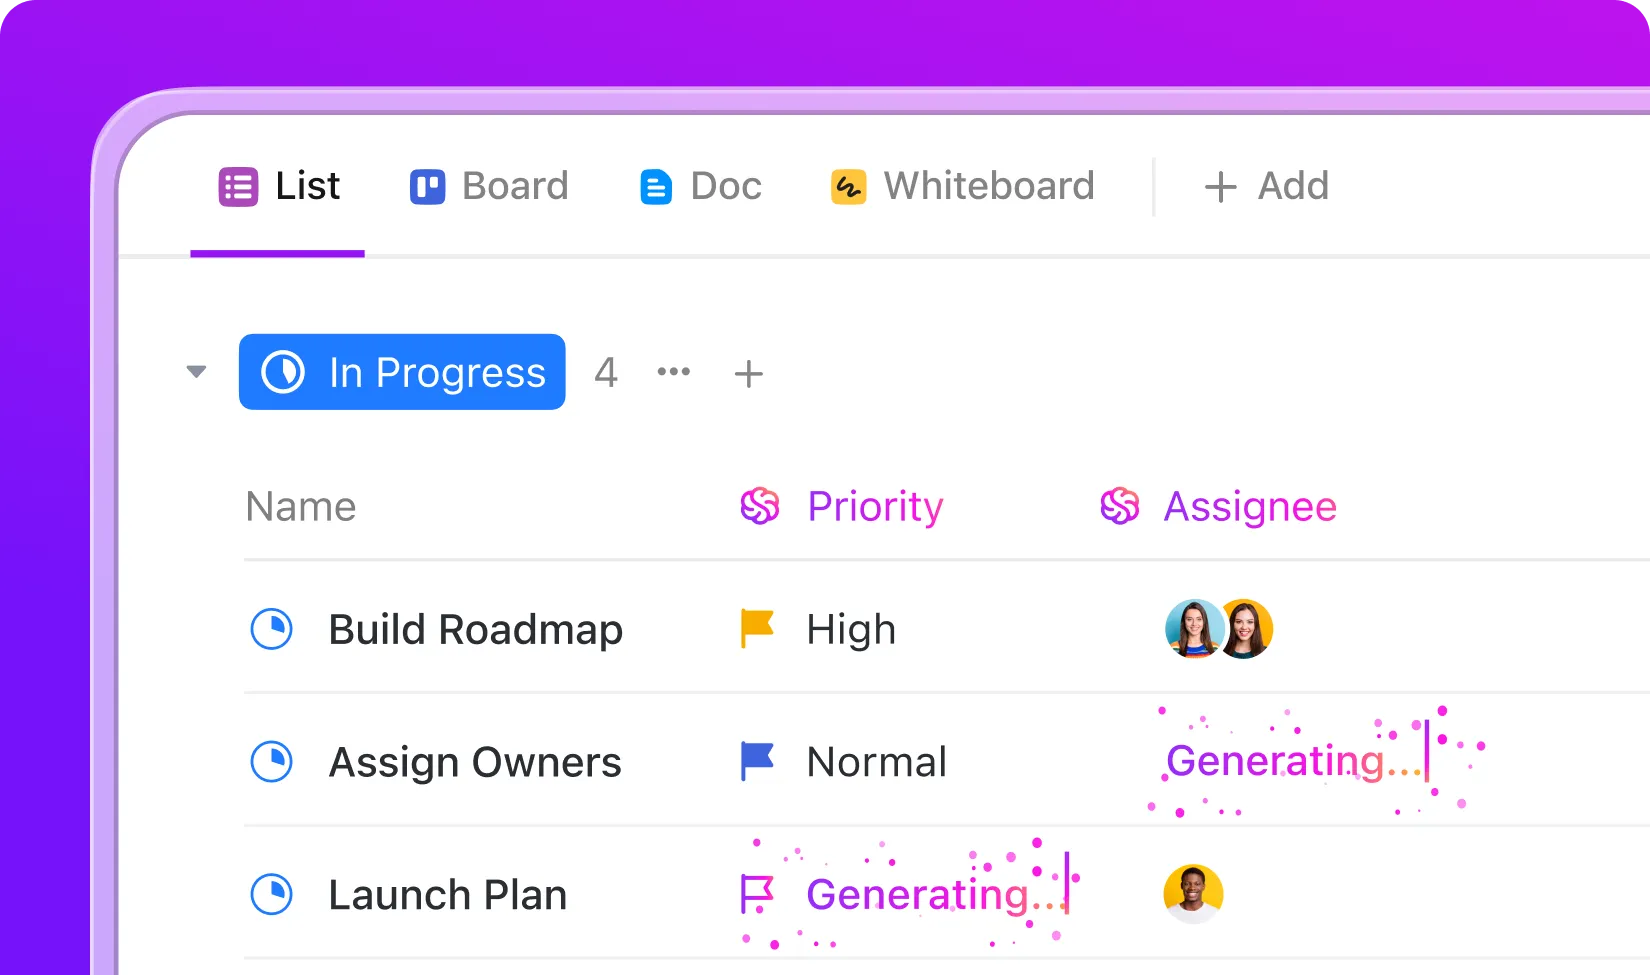
Tänk dig att ditt team drabbas av ett plötsligt avbrott – varje sekund räknas och du har inte råd att missa ett enda steg. Med ClickUp AI Agents och Automations behöver du inte stressa eller förlita dig på minnet. Så snart en incident rapporteras sätter ClickUps AI igång, guidar ditt team och sköter de rutinmässiga uppgifterna så att du kan fokusera på att lösa problemet.
Så här fungerar det i ett verkligt scenario:
- När någon markerar en uppgift som ”Incident deklarerad” skapar ClickUp Agent automatiskt en checklista med åtgärder, tilldelar dem till rätt personer och startar en timer för att mäta hur lång tid återställningen tar.
- Om incidenten markeras som ”Kritisk” kan en agent omedelbart skicka ett varningsmejl till ledningsgruppen och skapa ett särskilt chattrum – ert ”krigsrum” – så att alla kan kommunicera på ett och samma ställe
- AI-systemet kan hämta tidigare incidentrapporter och relevant dokumentation, så att ditt team har allt de behöver inom räckhåll.
Se arbetsflödet här:
Med ClickUp AI Agents får du en pålitlig digital kollega som hjälper ditt team att hålla sig lugnt, organiserat och effektivt – även när trycket är högt.
Spårning i realtid med ClickUp-instrumentpaneler
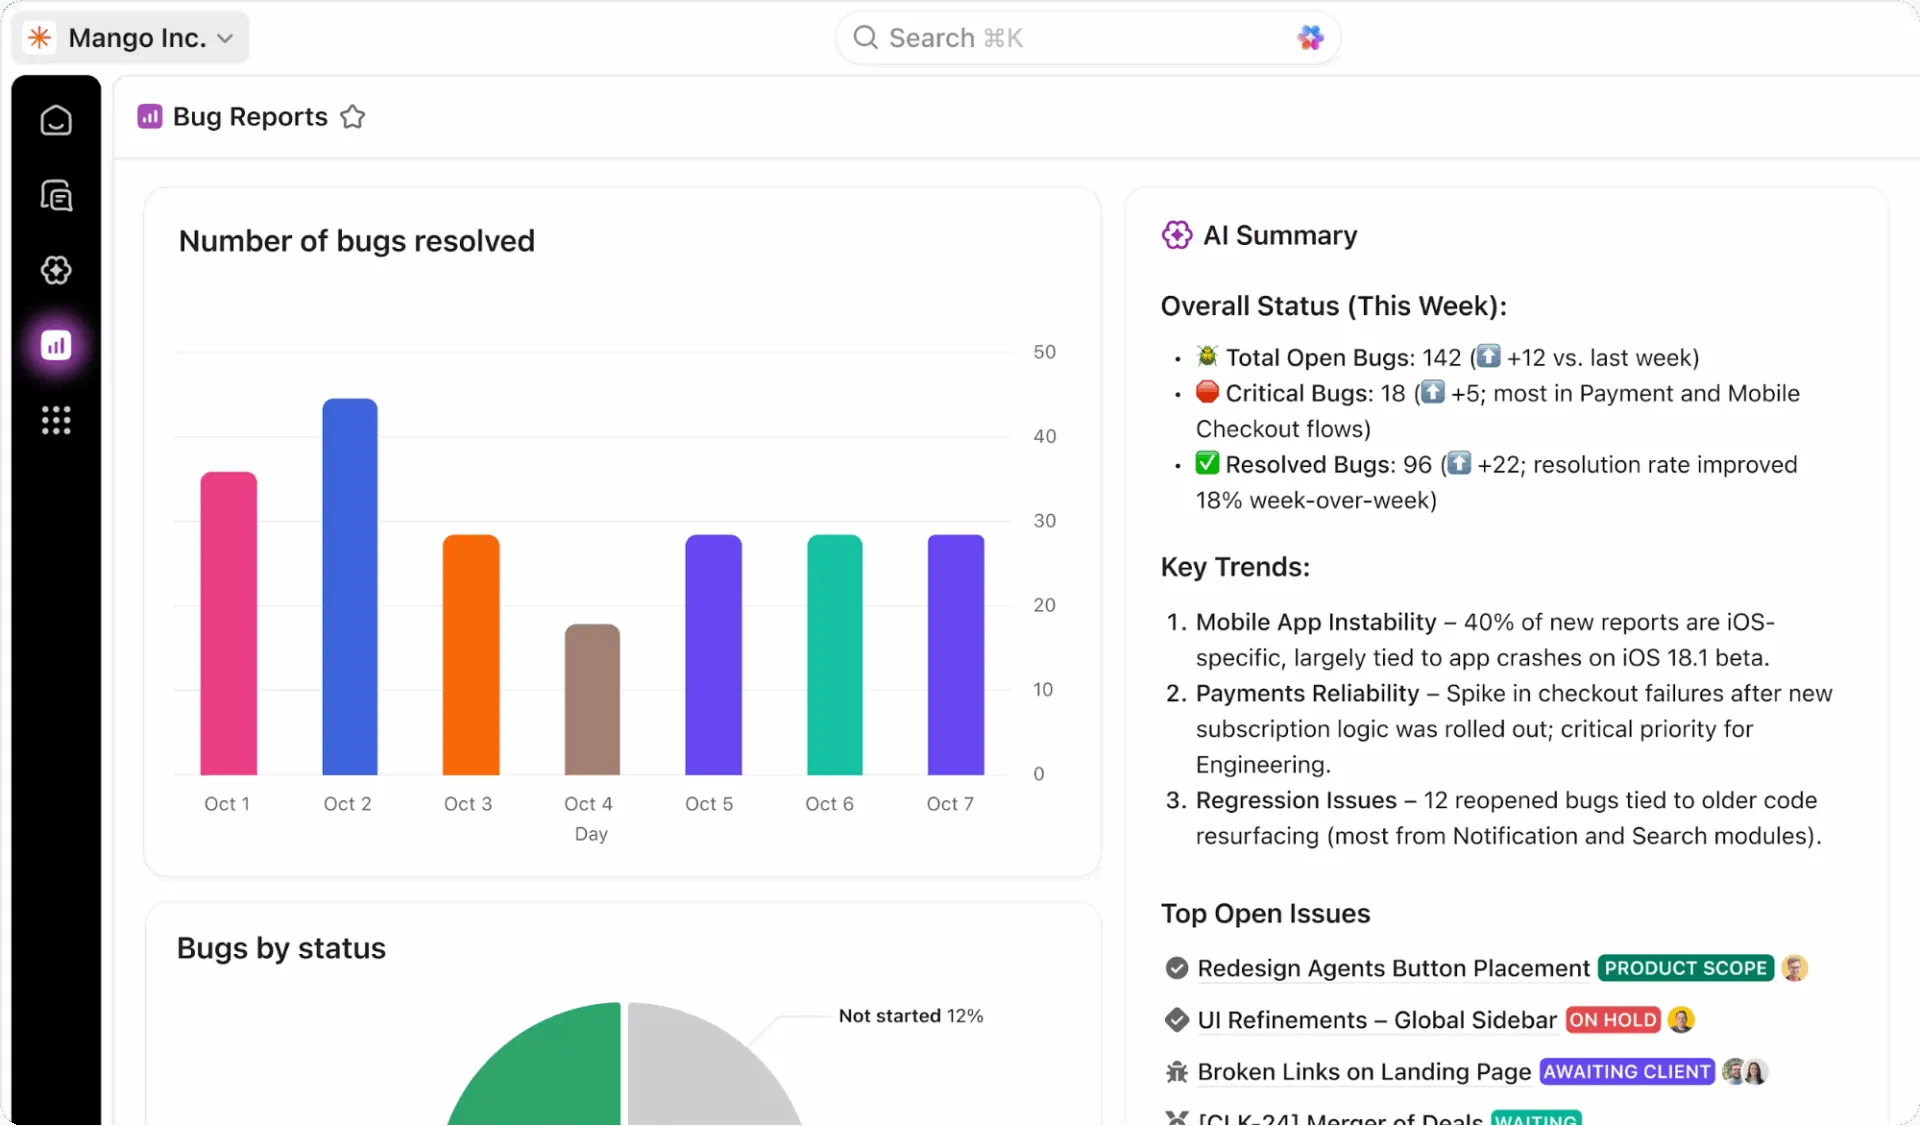
Få fullständig insyn i ditt DR-programs status genom att spåra allt i realtid med ClickUp-dashboards. Du kan skapa widgets för att övervaka dina RTO- och RPO-resultat under tester, spåra hur många tester som slutförts och se trender för incidenter över tid.
Lägg till anpassade fält i ClickUp till dina uppgifter för att spåra systemkritikalitet, återställningsstatus och testresultat, och samla sedan all denna data i en översiktsvy. Dessa instrumentpaneler ger dig rapporter som är redo att presenteras för ledningen och som alltid är uppdaterade med realtidsdata från ditt teams test- och incidenthanteringsaktiviteter.
Skapa din katastrofåterställningsplan redan idag
Varje dag som du bedriver verksamhet utan en katastrofåterställningsplan är ett risktagande som du inte har råd att förlora. Katastrofer är oundvikliga – oavsett om de beror på naturkatastrofer, tekniska fel eller mänskliga misstag – men det är din förberedelse som avgör om de blir mindre besvär eller stora katastrofer.
En heltäckande katastrofåterställningsplan kräver att du förstår dina risker, dokumenterar tydliga rutiner och testar dem regelbundet. Med rätt verktyg blir processen hanterbar, eftersom du slipper kaoset med utspridda dokument och manuella processer.
Även enkla beredskapsplaner är bättre än ingenting alls när en katastrof inträffar. Regelbundna tester och uppdateringar förvandlar din katastrofåterställningsplan från ett dammigt dokument till ett levande system som verkligen skyddar din verksamhet.
Ta det första steget och börja bygga upp din katastrofåterställningsplan med ClickUp redan idag. Kom igång gratis med ClickUp och samla all din planering för katastrofåterställning, dokumentation och incidenthantering på en enda plattform. ✨
Vanliga frågor
Hur ofta bör teamen uppdatera mallen för en IT-katastrofåterställningsplan?
Du bör se över din katastrofåterställningsplan minst fyra gånger om året och uppdatera den omedelbart efter varje större infrastrukturförändring eller verklig incident. De flesta organisationer genomför en omfattande och grundlig översyn en gång om året för att införliva alla lärdomar och anpassa sig till ny teknik.
Vilka team ansvarar för dokumentationen och testningen av katastrofåterställningen?
IT-team, säkerhetsteam och de som planerar för verksamhetskontinuitet leder vanligtvis arbetet med att planera och testa katastrofåterställningen. De behöver dock viktig input från drifts- och affärsenhetschefer för att säkerställa att planen stämmer överens med de faktiska affärsbehoven och prioriteringarna.
Hur mäter vi RTO och RPO under test av katastrofåterställningen?
Använd stoppur och tydliga tidsstämplar för att mäta de faktiska återställningstiderna mot dina definierade mål under varje test. Det är avgörande att dokumentera eventuella avvikelser mellan målet och den faktiska prestandan i dina testrapporter för att vägleda framtida förbättringar.
Vilka verktyg kan hjälpa till att dokumentera och automatisera en katastrofåterställningsplan?
Projektledningsplattformar som ClickUp är perfekta för att centralisera dokumentation, automatisera arbetsflöden och följa upp nyckeltal för hela ditt katastrofåterställningsprogram. Du kan sedan kombinera dem med specialiserade verktyg för katastrofåterställning som hanterar de tekniska aspekterna av datareplikering och systemfailover.