
Wordt u overspoeld door data? Zelfs de meest ervaren dataprofessionals hebben moeite om de vloedgolf aan data die door een ‘digital-first’-wereld wordt gegenereerd bij te houden – om nog maar te zwijgen van het streven naar efficiëntere processen. Van webanalyses tot klantgegevens en prestatiestatistieken: het is uw taak om deze data zo nauwkeurig en actueel mogelijk te houden. ✨
Een degelijk databaseontwerp is essentieel voor het opzetten en onderhouden van een database voor uw bedrijf, maar zelfs dan moet u weten hoe u kruisvervuiling en gegevensredundantie kunt voorkomen. Afhankelijkheden definiëren de relatie tussen gegevensattributen, wat helpt bij alles, van gegevensnauwkeurigheid tot geavanceerde inzichten.
Het lastige? Er zijn zo veel soorten afhankelijkheden om uit te kiezen. Maar functionele afhankelijkheden zijn onmisbaar als je staat te popelen om een database aan te leggen.
In deze handleiding leggen we uit wat een functionele afhankelijkheid is, geven we enkele voorbeelden van alle functionele afhankelijkheden en bieden we handige tips om het maximale uit uw relationele database te halen.

Wat is een functionele afhankelijkheid?
Een functionele afhankelijkheid is een type afhankelijkheid waarbij een relatie bestaat tussen twee variabelen. Aan de linkerkant staat het bepalende attribuut, ook wel de primaire sleutel genoemd, en aan de rechterkant het afhankelijke attribuut, ook wel het niet-sleutelattribuut genoemd. De functie of het resultaat verandert afhankelijk van de relatie tussen de twee variabelen.
We weten dat dit een beetje ingewikkeld klinkt, dus hier volgt een uitleg over hoe functionele afhankelijkheden werken:
- Stel dat u klantdatabasesoftware gebruikt om de verjaardagen van uw klanten bij te houden. U wilt klanten op hun verjaardag een aangepaste e-mail sturen om klantloyaliteit te bevorderen
- Je moet een functionele afhankelijkheid gebruiken om elke gebruiker op zijn of haar verjaardag een e-mail te sturen – want zeg nou zelf, zou een willekeurige 'Happy Birthday'-mail naar 300 mensen er niet een beetje vreemd uitzien?
- In dit geval is de functie voor het versturen van een e-mail afhankelijk van de variabele met de verjaardag van de klant
- Als u dit soort relatie in uw database wilt hebben, moet u een functionele afhankelijkheid instellen tussen de verjaardag van de klant en de functie die op zijn of haar verjaardag de e-mail verstuurt.
Functionele afhankelijkheden zijn van fundamenteel belang voor databasenormalisatie. Door middel van normalisatie organiseert u een database – net zoals u een kamer opruimt – om gegevens zo te ordenen dat herhaling wordt voorkomen.
De regels van functionele afhankelijkheden in databasebeheersystemen
Functionele afhankelijkheden volgen verschillende inferentieregels, ook wel de axioma's van Armstrong genoemd.
Er zijn drie belangrijke regels voor functionele afhankelijkheid:
- Reflexiviteit: De reflexiviteitsregel stelt dat als attribuut A gerelateerd is aan attribuut X, attribuut X ook gerelateerd is aan attribuut A. Als A bijvoorbeeld iemands voornaam is en X iemands achternaam, dan zijn deze twee attributen altijd aan elkaar gerelateerd
- Augmentatie: De augmentatieregel stelt dat als je gegevens aan een variabele toevoegt – ook wel augmentatie genoemd – je die augmentatie moet toevoegen aan de set van attributen. Dus als je het veld ‘voornaam’ aanvult met een bijnaam, is dat veld nu ook gerelateerd aan het veld ‘achternaam’.
- Transitiviteit: De transitiviteitsregel stelt dat als attribuut A gerelateerd is aan attribuut C, attribuut B bijgevolg ook gelijk is aan attribuut C. Maak je hier niet te druk om – transitieve afhankelijkheid betekent dat het ene soms het andere kan bepalen, wat op zijn beurt weer een derde ding bepaalt. Als je bijvoorbeeld in je CRM-platform barcodes voor klanten genereert op basis van hun voor- en achternaam, dan bepaalt de naam de plaats van de klant in een alfabetische lijst
Functionele afhankelijkheden zetten je datamodellen om in daadwerkelijke relatieschema's met behulp van SQL, waardoor de integriteit van je gegevens behouden blijft. In de praktijk kun je functionele afhankelijkheden gebruiken in je databasebeheersysteem, of DBMS, om je te bevrijden van gegevensredundanties en 'oeps'-momenten die databases kapotmaken. 👀
Volledige functionele afhankelijkheid versus gedeeltelijke functionele afhankelijkheid
Voordat we de verschillende soorten functionele afhankelijkheden bekijken, is het belangrijk om onderscheid te maken tussen gedeeltelijke en volledige functionele afhankelijkheden.
Stel dat u de gegevens van uw organigram in een database invoert. Bij een volledige functionele afhankelijkheid is een attribuut afhankelijk van een andere set attributen, maar niet van een subset daarvan. Laten we dus zeggen dat we een combinatie hebben van ‘Naam medewerker’ en ‘Medewerker-ID’ die bepalend is voor een ‘Locatie’.
Als je de ‘Naam van de medewerker’ en het ‘Medewerkersnummer’ kent, kun je de ‘Locatie’ bepalen. Maar je kunt niet op basis van die twee variabelen alleen de ‘Locatie’ bepalen. In dit geval is de ‘Locatie’ volledig afhankelijk van de combinatie van de ‘Naam van de medewerker’ en het ‘Medewerkersnummer’.
Er is sprake van een gedeeltelijke functionele afhankelijkheid wanneer een attribuut alleen afhankelijk is van een deel van de primaire sleutel in plaats van van de samengestelde primaire sleutel. Als u bijvoorbeeld het gegevensveld ‘Aantal werkjaren’ kunt afleiden uit ‘Medewerkers-ID’, is er sprake van een gedeeltelijke afhankelijkheid omdat ‘Aantal werkjaren’ niet afhankelijk is van ‘Locatie’.
Het klinkt misschien als een klein verschil, maar dit heeft grote gevolgen voor de normalisatie van gegevens. Gedeeltelijke functionele afhankelijkheden kunnen leiden tot redundantie in je database, wat betekent dat je deze moet aanpakken in de tweede normale vorm (2NF) van het normalisatieproces. Dit is niet het einde van de wereld, maar het is zeker iets dat je op termijn zult moeten oplossen. 🛠️
Eerste, tweede en derde normale vorm in SQL
Wanneer u gegevens normaliseert, is het doel om alle afwijkingen bij het invoegen, bijwerken of verwijderen in uw database te elimineren die voor grote problemen kunnen zorgen. Er zijn drie stappen bij normalisatie met functionele afhankelijkheden.
Eerste normale vorm
Beschouw de eerste normale vorm als de basis voor het bouwen van een systeem waarin u functionele afhankelijkheden kunt gebruiken. Het legt de basis voor het identificeren van afhankelijkheden in de tweede en derde normale vorm. Technisch gezien bevat 1NF attributen die uitsluitend atomaire waarden bevatten, waardoor er geen herhalende groepen zijn.
Tweede normale vorm
Nadat u de gegevens aan 1NF hebt onderworpen, beschikt u over een tabel waarin alle niet-sleutelattributen volledig functioneel afhankelijk zijn van de primaire sleutel. In 2NF verwijdert u gedeeltelijke afhankelijkheden door tabellen op te splitsen, om er nogmaals zeker van te zijn dat elk niet-sleutelattribuut volledig afhankelijk is van de primaire sleutel.
Derde normale vorm
Nadat een gegevenstabel in 2NF is gebracht, gaat deze over naar 3NF zodra alle attributen uitsluitend functioneel afhankelijk zijn van de primaire sleutel en van niets anders. In 3NF verwijdert u in deze fase alle transitieve afhankelijkheden door de tabel verder op te splitsen.
1NF legt de fase voor van functionele afhankelijkheden, terwijl 2NF en 3NF de manier waarop u die gegevens organiseert verfijnen door de functionele afhankelijkheden te herstructureren. Dit zorgt ervoor dat u elk stukje data op de meest logische plaats opslaat, waardoor redundantie wordt verminderd en de gegevensintegriteit wordt verbeterd.

Soorten functionele afhankelijkheden met voorbeelden
Als u klaar bent om aan de slag te gaan met functionele afhankelijkheden, kunt u kiezen uit vier opties.
Triviaal
Een triviale afhankelijkheid is een basistype van functionele afhankelijkheid waarbij een attribuut of een verzameling attributen zichzelf bepaalt. Elke afhankelijke is hier een deelverzameling van de determinant. Met andere woorden: als C een deelverzameling is van A, is de functionele relatie triviaal.
Het klinkt misschien een beetje voor de hand liggend, maar een voorbeeld hiervan is het identificeren van de titel van een boek wanneer je zowel de titel als de auteur kent. Het is vrij eenvoudig om de relatie tussen deze twee attributen te zien, en daarom zijn triviale functionele afhankelijkheden het gemakkelijkst te begrijpen.
Niet-triviaal
Hier wordt het pas echt interessant. Bij een niet-triviale functionele afhankelijkheid kan het ene attribuut een ander, afzonderlijk attribuut bepalen. In dit geval is A een verzameling attributen en B eveneens, maar B is geen deelverzameling van A. Als B geen deelverzameling van A is, hebben ze een niet-triviale relatie.
Er is sprake van een niet-triviale relatie als u een database met boeken aanmaakt, aan elk boek een unieke code toekent en de titel van het boek kunt opzoeken als u de aan het boek toegekende code kent.
Meervoudige waarden
Bij een meerwaardige afhankelijkheid is één attribuut verbonden met meerdere andere attributen. Attributen in uw set van afhankelijke attributen zijn niet van elkaar afhankelijk. Dus als attributen A en C geen functionele afhankelijkheid hebben, is de relatie tussen B, A en C meerwaardig.
Om de analogie met boeken voort te zetten: dit is te vergelijken met een auteur die veel boeken heeft geschreven. Als je zijn of haar naam kent, kun je een lijst met alle boeken maken die hij of zij heeft geschreven. Bij een meerwaardige functionele afhankelijkheid zijn er meerdere boeken gekoppeld aan de naam van één auteur.
Transitief
Er is sprake van een transitieve functionele afhankelijkheid wanneer het ene attribuut het andere bepaalt, en dat vervolgens weer een ander. Het lijkt een beetje op een kettingreactie. Als dit je bekend in de oren klinkt, komt dat omdat dit type functionele afhankelijkheid de regel van transitiviteit volgt.
In dit geval geldt: als A gelijk is aan B en B gelijk is aan C, dan moet A gelijk zijn aan C. Stel dat u een boekdatabase aan het opzetten bent, en dat uw unieke boekcodes de uitgevers en hun genres bepalen. Als u de boekcode kent, kunt u achterhalen wie de uitgever is en tot welk genre het boek behoort.
Functionele afhankelijkheden gebruiken voor databasebeheer
Kunt u niet wachten om aan de slag te gaan met functionele afhankelijkheden? U bent gratis vrij om functionele afhankelijkheden te gebruiken zoals u dat wilt, maar als u slimmer en met minder gedoe wilt werken, kies dan voor ClickUp.
Hier volgt een kort overzicht van hoe je een database in ClickUp kunt opzetten en functionele afhankelijkheden kunt integreren:
Allereerst moet je een database aanmaken in ClickUp. Je kunt gegevensbladen uit Excel importeren of helemaal zelf aanmaken.
Met de tabelweergave van ClickUp kunt u gegevens in bulk bewerken en andere aangepaste weergaven gebruiken om gegevens over vrijwel alles bij te houden. ClickUp visualiseert ook gegevens, zodat u in een mum van tijd inzicht krijgt in uw database.
Het goede nieuws is dat je hier niet helemaal vanaf nul hoeft te beginnen. Met de databasesjablonen van ClickUp is het aanmaken van een database een fluitje van een cent.
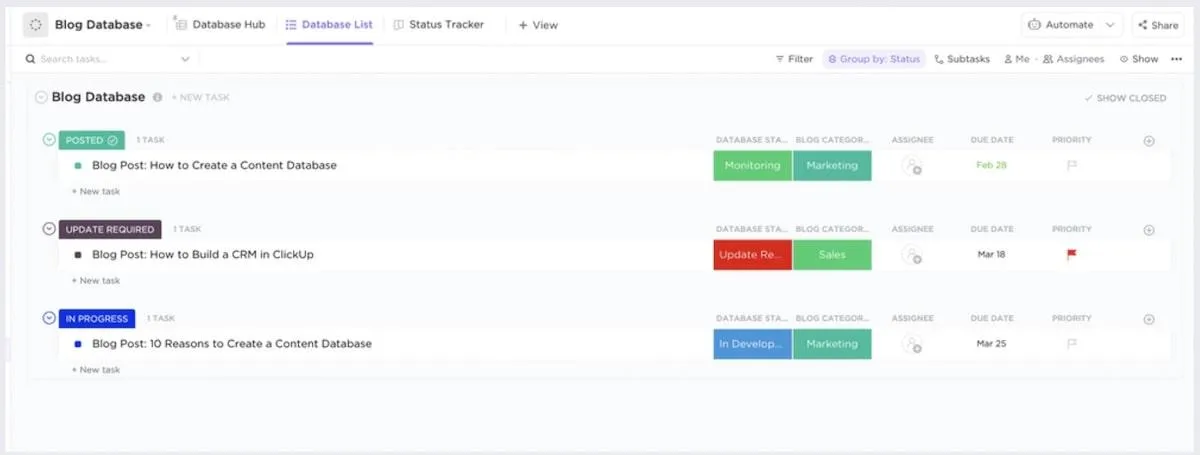
De ClickUp-blogdatabasesjabloon is superhandig voor contentplanning, en de ClickUp-medewerkerslijstsjabloon is perfect om snel een database met informatie over collega's aan te maken. Dit is ook een database waarvoor geen code nodig is, dus als je een database wilt bouwen zonder SQL te leren, dan zit je bij ons goed.
Functionele afhankelijkheden integreren in ClickUp
Normaal gesproken zou je je helemaal moeten verdiepen in SQL om functionele afhankelijkheden in een database aan te maken. Gelukkig maakt de drag-and-drop-interface van ClickUp het eenvoudig om relaties tussen taken en documenten aan te maken. Bovendien maken de AI-tools in ClickUp databasebeheer een fluitje van een cent – zelfs als je zelf geen database-expert bent.
Zo kunt u een afhankelijkheid aanmaken in uw ClickUp-database.
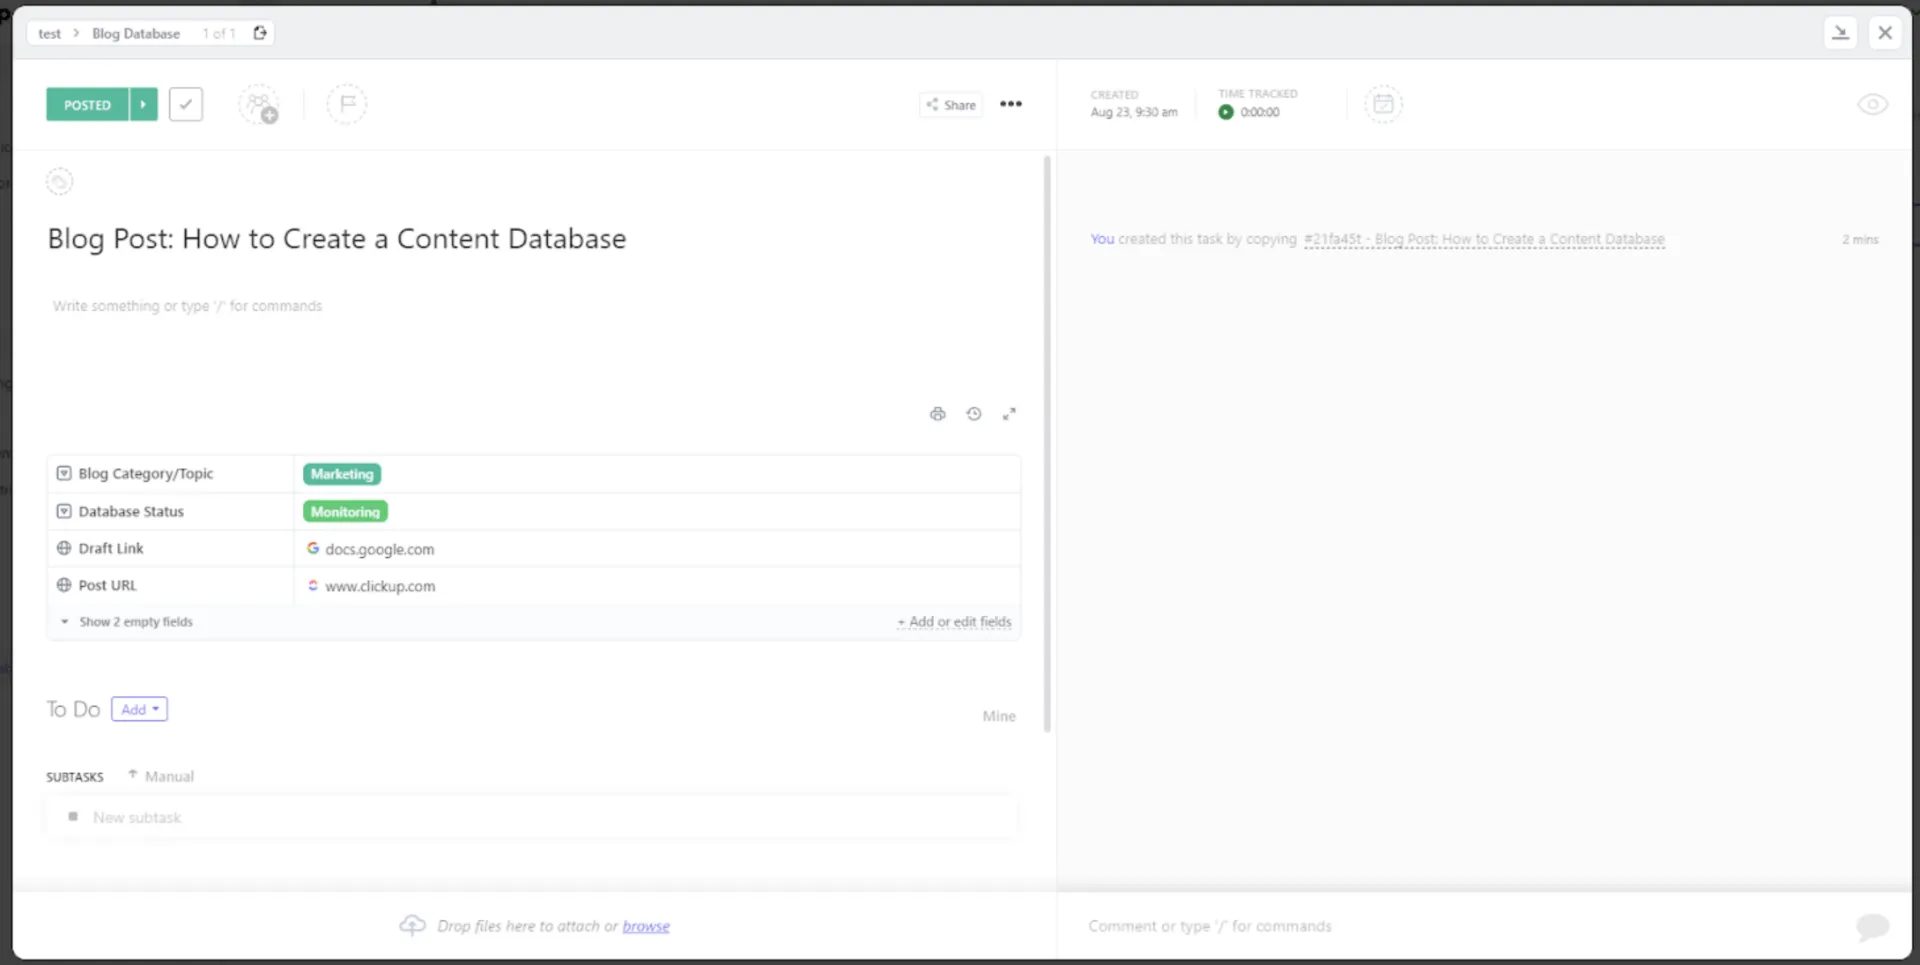
Klik eerst op de taak waarmee u wilt werken.
Ga naar Relaties > Afhankelijkheid. Kies uit In afwachting van, Blokkerend en Taken om de relatie aan te passen.
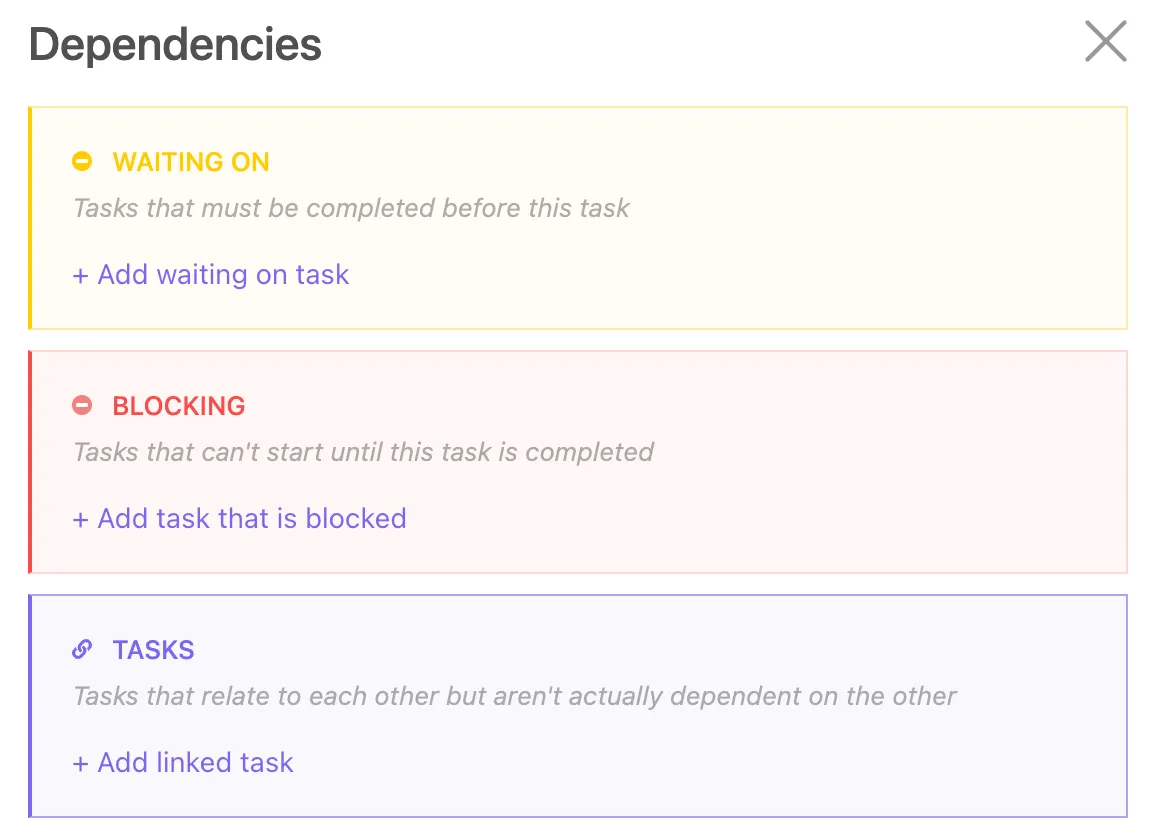
In dit geval kiezen we Waiting On en zoeken we naar een andere Taak die verband houdt met de huidige Taak.
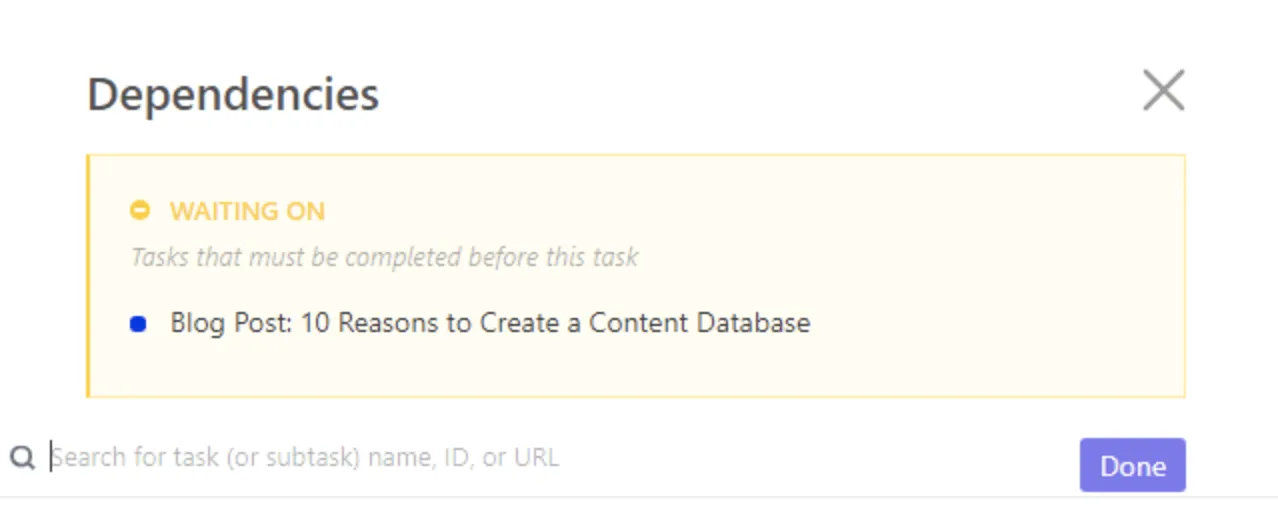
Klik op 'Klaar' en je bent, nou ja, klaar! 🙌
Vereenvoudig afhankelijkheden met ClickUp
Wie zegt dat databasebeheer ingewikkeld moet zijn? Zolang u de ins en outs van functionele afhankelijkheden begrijpt, kunt u een snelle, nauwkeurige database ontwerpen die uw organisatie vooruit helpt.
Je hoeft dit ook niet alleen te doen. ClickUp is een degelijk databasebeheersysteem dat gegevens combineert met sjablonen, projecten, taken, doelen en alles daartussenin.
Bespaar meer tijd en concentreer je op taken met een hoge waarde door over te stappen op het echte alles-in-één-platform van ClickUp.
Probeer het zelf: maak een gratis ClickUp-account aan om een betere database op te zetten!