
AIトレーニングプロジェクトがモデルレベルで失敗することはほとんどありません。問題となるのは、実験、ドキュメント、ステークホルダーへの報告などが、あまりにも多くのツールに分散してしまっている場合です。
このガイドでは、他の主要モデルに比べて最大2倍の計算効率を誇るLLM「Databricks DBRX」を用いたモデルのトレーニング手順を解説するとともに、ClickUpで関連仕事を整理・管理する方法についても説明します。
セットアップや微調整から、ドキュメント作成、チーム間の情報共有に至るまで、単一の統合ワークスペースが、情報の散在を解消し、チームが「検索」ではなく「構築」に集中できるようにする仕組みをご紹介します。🛠
DBRXとは?
DBRXは、企業向けのAIモデルのトレーニングおよび推論に特化して設計された、強力なオープンソースの大規模言語モデル(LLM)です。Databricks Open Model Licenseに基づくオープンソースであるため、チームはモデルの重みやアーキテクチャに完全にアクセスでき、独自の条件に合わせてモデルを検証、修正、デプロイすることが可能です。
DBRXには、ディーププレトレーニング用の「DBRX Base」と、すぐに使える指示従順タスク用の「DBRX Instruct」の2つのバリエーションがあります。
DBRXのアーキテクチャと「専門家混合モデル(Mixture of Experts)」の設計
DBRXは、Mixture-of-Experts(MoE)アーキテクチャを用いてタスクを解決します。あらゆる計算に数十億ものパラメーターをすべて使用する従来の大規模言語モデルとは異なり、DBRXは特定のタスクに対して、総パラメーター数のごく一部(最も関連性の高いエキスパート)のみを活性化させます。
これを、専門知識を持つエキスパートのチームと捉えてください。全員があらゆる問題に取り組むのではなく、システムが各タスクを、そのパラメーターに最も適した人材にインテリジェントに割り当てます。
これにより、応答時間が短縮されるだけでなく、最高レベルのパフォーマンスと出力が得られる一方で、計算コストも大幅に削減されます。
主な仕様を簡単にご紹介します:
- パラメーター総数: すべてのエキスパートを合わせて1,320億
- アクティブパラメーター数: 1回のフォワードパスあたり360億
- エキスパート数: 計16名(MoE Top-4ルーティング)、任意のトークンに対して4名がアクティブ
- コンテキストウィンドウ: 32Kトークン
DBRXのトレーニングデータとトークンの仕様
LLMの性能は、学習に使用したデータの質に左右されます。DBRXは、Databricksチームが高度なデータ処理ツールを用いて慎重に選定した、12兆トークンという膨大なデータセットで事前学習されています。まさにそれが、業界のベンチマークで優れた性能を発揮した理由です。
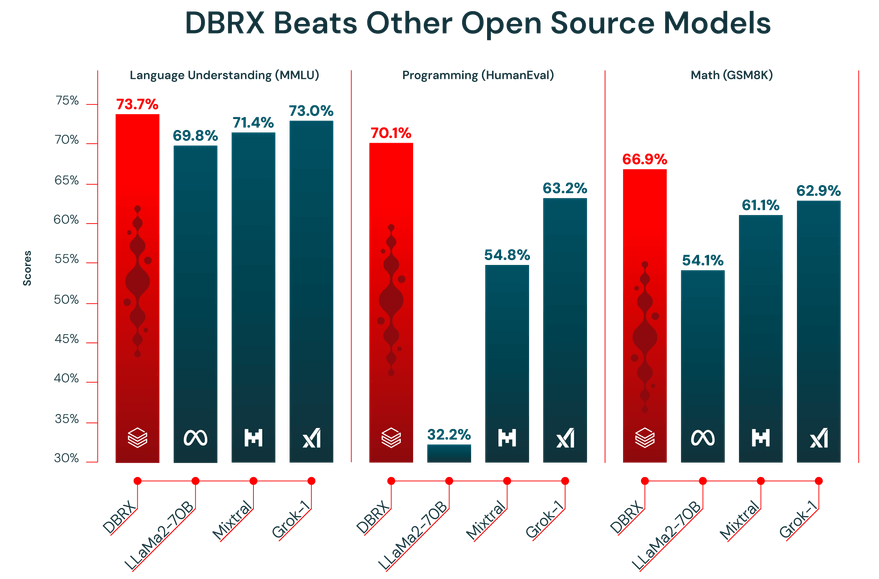
さらに、DBRXには32,000トークンのコンテキストウィンドウの機能があります。これは、モデルが一度に処理できるテキストの量です。コンテキストウィンドウが大きいと、長いレポートの要約、膨大な法的文書の精査、あるいは高度な検索拡張生成(RAG)システムの構築といった複雑なタスクにおいて非常に役立ちます。これにより、モデルは情報を切り捨てたり忘れたりすることなく、文脈を維持することができるからです。
🎥 このビデオをご覧いただき、プロジェクトの連携が円滑化されることで、AIトレーニングのワークフローがどのように変革され、連携していないツール間を切り替える際の煩わしさが解消されるかをご確認ください。👇🏽
DBRXへのアクセス方法と設定方法
DBRXには主に2つのアクセス方法があり、いずれも寛容な商用利用許可のもとでモデル重みへのフルアクセスを提供します。最大限の柔軟性を求める場合はHugging Faceを利用し、より統合された体験を求める場合はDatabricksから直接アクセスすることができます。
Hugging FaceからDBRXにアクセスする
柔軟性を価値としており、すでにHugging Faceのエコシステムに慣れているチームにとっては、hub経由でDBRXにアクセスするのが理想的な方法です。これにより、既存のTransformerベースのワークフローにモデルを統合することができます。
まずは以下の手順から始めましょう:
- Hugging Faceアカウントを作成するか、ログインしてください
- hub上のDBRXモデルカードに移動し、ライセンス規約に同意してください
- transformersライブラリと、accelerateなどの必要な依存関係をインストールしてください。
- Pythonスクリプト内でAutoModelForCausalLMクラスを使用して、DBRXモデルを読み込みます
- DBRXを効果的に動作させるには、かなりのGPUメモリ(VRAM)が必要であることを念頭に置きながら、推論パイプラインを設定してください。
📖 詳細はこちら:LLMの温度設定方法
Databricks経由でDBRXにアクセスする
チームですでにデータエンジニアリングや機械学習にDatabricksを利用している場合、同プラットフォームを通じてDBRXにアクセスするのが最も簡単な方法です。これにより、セットアップの手間が省け、普段仕事をしている環境のまま、MLOpsに必要なすべてのツールを利用できるようになります。
Databricksワークスペース内で以下のステップに従って、始めましょう:
- 「Model Garden」または「Mosaic AI」セクションへ移動してください
- ニーズに応じて、DBRX Base または DBRX Instruct のいずれかを選択してください
- APIアクセス用のサービングエンドポイントを構成したり、対話型利用のためのノートブック環境を設定したりできます。
- AIモデルのトレーニングやデプロイを本格化する前に、サンプルプロンプトを使って推論テストを行い、すべてが正しく動作していることを確認しましょう。
このアプローチにより、実験の追跡に役立つMLflowや、モデルガバナンスに役立つUnity Catalogといったツールにシームレスにアクセスできるようになります。
📮 ClickUpインサイト: ビジネスパーソンは1日平均30分以上を仕事関連の情報の検索に費やしています。これは、電子メールやSlackのスレッド、散在するファイルをくまなく探すことに、年間120時間以上を浪費していることに相当します。
ワークスペースに組み込まれたインテリジェントなAIアシスタントなら、その状況を一変させることができます。そこで登場するのが「ClickUp Brain」です。
適切なドキュメント、会話、タスクの詳細を数秒で表示することで、即座に洞察や答えを提供します。これにより、検索に時間を費やすことなく、すぐに仕事に取り掛かることができます。
DBRXの微調整とカスタムAIモデルのトレーニング方法
既製のモデルは、どれほど高性能であっても、貴社のビジネス特有のニュアンスを理解することは決してできません。DBRXはオープンソースであるため、微調整を行うことで、貴社の言語を理解したり、特定のタスクを処理したりするカスタムモデルを作成することができます。
これをやることについての一般的な方法を3つご紹介します:
1. Hugging Faceのデータセットを使ったDBRXの微調整
始めたばかりのチームや、一般的なタスクに取り組んでいるチームにとって、Hugging Face Hubの公開データセットは素晴らしいリソースです。これらはあらかじめフォーマットされており、読み込みも簡単なので、データ準備に何時間も費やす必要がありません。
そのプロセスは非常にシンプルです:
- Hubで、タスク(例:指示の遂行、要約するなど)に合ったデータセットを見つけましょう。
- データセットライブラリを使用して読み込みます
- データが「指示-応答」のペアフォーマットになっていることを確認してください
- 学習率やバッチサイズなどのハイパーパラメータを使用して、トレーニングスクリプトを設定します
- トレーニングジョブを起動し、期間ごとにチェックポイントを保存するようにしてください
- ファインチューニングされたモデルを、保留しておいた検証データセットで評価し、性能の向上度を測定します
2. ローカルデータセットを用いたDBRXの微調整
通常、自社独自のデータを用いて微調整を行うことで、最良の結果が得られます。これにより、自社特有の用語、文体、ドメイン知識をモデルに学習させることができます。ただし、データがクリーンで適切に準備されており、十分な量がある場合にのみ、その効果が発揮されることを念頭に置いておいてください。
以下のステップに従って、社内データを準備してください:
- データ収集: 社内のwiki、ドキュメント、データベースから高品質な例を収集します
- フォーマットの変換: データを、一貫性のある指示-応答フォーマット(多くの場合、JSONフォーマットの行単位)に構造化してください。
- 品質フィルタリング: 質の低い例、重複した例、または関連性のない例をすべて削除する
- 検証用データ分割: モデルの性能を評価するために、データのごく一部(通常は10~15%)を割り当てます。
- プライバシーに関する確認: 個人を特定できる情報(PII)や機密データは削除またはマスキングしてください。
3. StreamingDataset を使った DBRX の微調整
データセットが大きすぎてマシンのメモリに収まらない場合でも、心配はいりません。DatabricksのStreaming Datasetライブラリを利用すれば、データを一度にすべてメモリに読み込むのではなく、モデルのトレーニング中にクラウドストレージから直接データをストリーミングできます。
そのことをやる方法は以下の通りです:
- データ準備: トレーニングデータをクリーニングして構造化した後、JSONLやCSVなどのストリーム可能なフォーマットでクラウドストレージに保存します。
- ストリーミングフォーマットへの変換: トレーニング中に効率的に読み込めるよう、データセットをMosaic Data Shard(MDS)などのストリーミングに適したフォーマットに変換します。
- トレーニングローダーのセットアップ: トレーニングローダーがリモートデータセットを指すようにセットアップし、一時的なデータストレージ用のローカルキャッシュを定義します。
- モデルの初期化: LLM Foundryなど、StreamingDatasetをサポートするトレーニングフレームワークを使用して、DBRXのファインチューニングプロセスを開始します。
- ストリーミングベースのトレーニング: トレーニング中にデータをメモリに完全に読み込むのではなく、バッチ単位でストリーミングしながらトレーニングジョブを実行します。
- チェックポイントとリカバリ: トレーニングの実行が中断された場合でも、データの重複やスキップを発生させることなく、シームレスにトレーニングを再開できます。
- 評価とデプロイ: 微調整されたモデルのパフォーマンスを検証し、お好みのサービングまたは推論セットアップを使用してデプロイします。
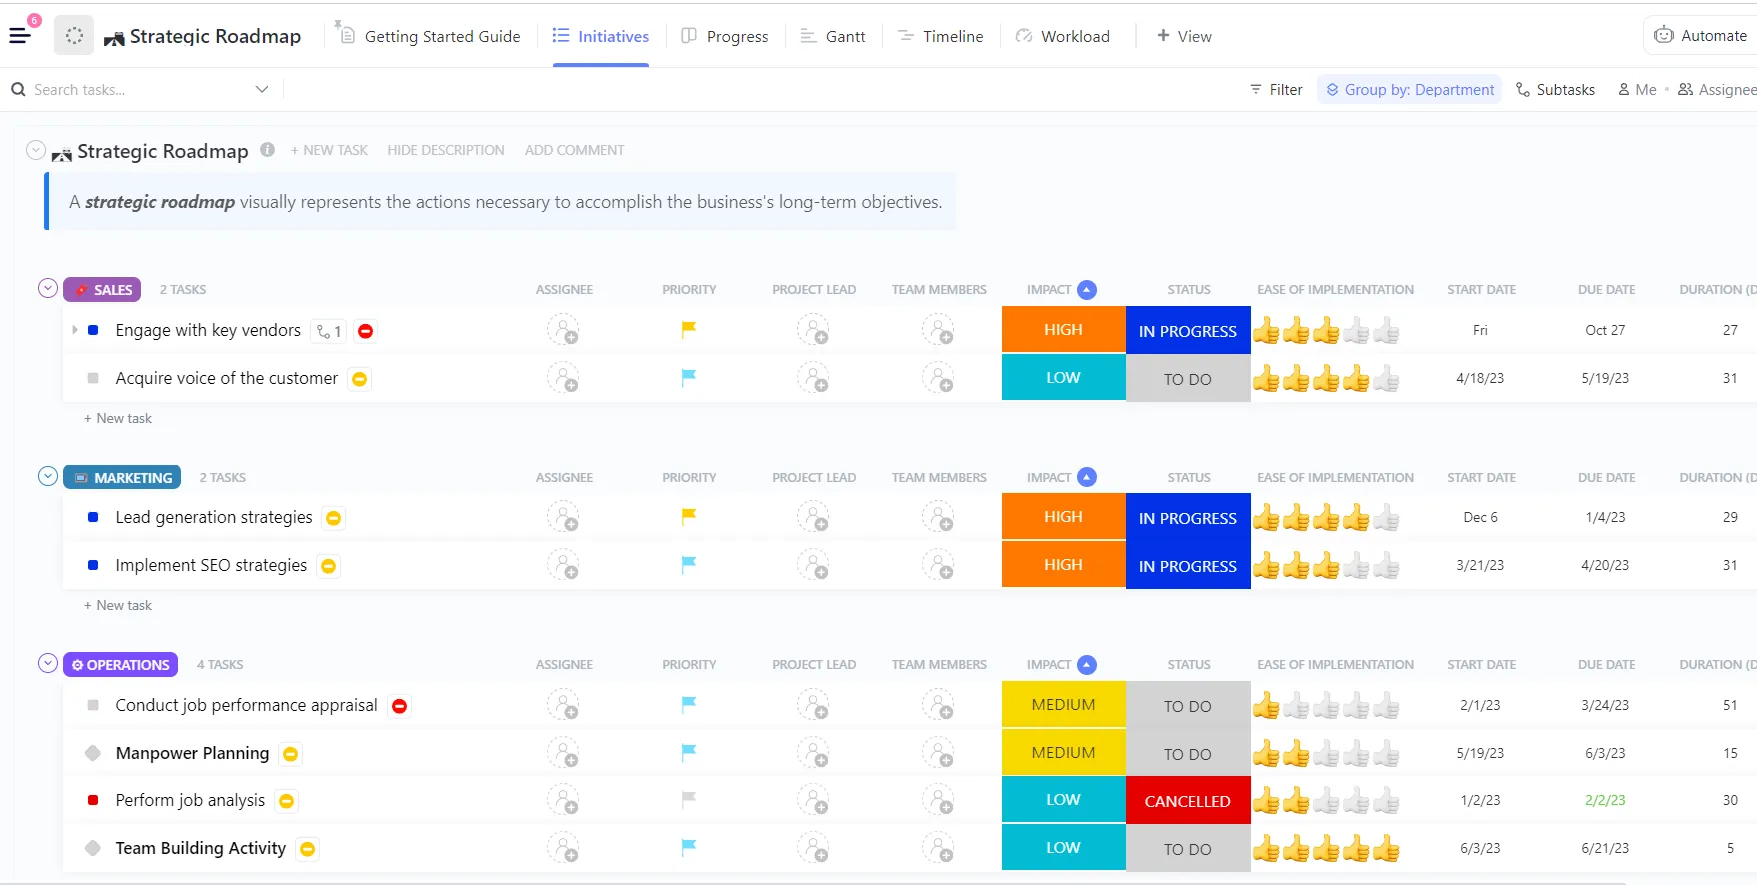
💡プロのヒント: DBRXのトレーニングプランをゼロから作成する代わりに、ClickUpの「AIおよび機械学習プロジェクトのロードマップテンプレート」を基に、チームのニーズに合わせて調整してみましょう。このテンプレートには、データセット、トレーニングフェーズ、評価、デプロイメントを計画するための明確な構造が用意されているため、ワークフローの構築に時間を割くことなく、作業の整理に集中できます。
AIモデル学習におけるDBRXの活用事例
強力なモデルを持つことと、そのモデルがどこで真価を発揮するかを正確に把握することは、まったく別の話です。
モデルの強みが明確でない場合、そもそも適していない場面でモデルを機能させようと、時間やリソースを無駄に費やしてしまいがちです。その結果、期待外れの結果となり、フラストレーションが溜まることになります。
DBRXの独自のアーキテクチャとトレーニングデータにより、いくつかの主要な企業ユースケースに極めて適しています。これらの強みを理解することで、モデルをビジネス目標に整合させ、投資対効果を最大化することができます。
テキスト生成とコンテンツ作成
DBRX Instructは、指示に従い、高品質なテキストを生成するように微調整されています。これにより、コンテンツに関連する幅広いタスクを自動化する強力なツールとなっています。その広いコンテキストウィンドウは大きな利点であり、スレッドを見失うことなく長い文書を処理することが可能です。
次のような用途にご利用いただけます:
- 技術ドキュメント: 製品マニュアル、APIリファレンス、ユーザーガイドの作成と改善
- マーケティングコンテンツ: ブログ記事の草案、電子メールマガジン、ソーシャルメディアの更新情報
- レポート作成: 複雑なデータ分析結果を要約し、簡潔なエグゼクティブ要約を作成します
- 翻訳とローカライズ: 既存のコンテンツを新しい市場や対象読者向けに適応させる
コード生成とデバッグのタスク
DBRXのトレーニングデータの大部分はコードで構成されており、開発者にとって強力なLLMサポートとなっています。反復的なコーディングタスクを自動化し、複雑な問題解決を支援することで、開発サイクルの加速に貢献します。
エンジニアリングチームがこれを活用できる方法をいくつかご紹介します:
- コード補完: コメントやdocstringから関数本体を自動的に生成
- バグ検出: コードスニペットを分析して、潜在的なエラーや論理的な欠陥を特定します
- コードの説明: 複雑なアルゴリズムやレガシーコードを平易な英語に翻訳する
- テスト生成: 機能の署名と期待される動作に基づいて、ユニットテストを作成します
RAGおよびロングコンテキストアプリケーション
リトリーバル・オーグメンテッド・ジェネレーション(RAG)は、企業のプライベートデータに基づいてモデルの応答を生成する強力な技術です。しかし、RAGシステムでは、コンテキストウィンドウが小さいモデルの場合、重要な文脈が失われる恐れのある過度なデータ分割を余儀なくされることがよくあります。DBRXの32Kコンテキストウィンドウは、堅牢なRAGアプリケーションを構築するための優れた基盤となります。
これにより、次のような強力な社内ツールを構築できます:
- 企業検索: 社内ナレッジベースを活用して、従業員の質問に答えるチャットボットを作成しましょう
- カスタマーサポート: 製品ドキュメントに基づいたサポート回答を生成するエージェントを構築しましょう
- 研究支援: 数百ページに及ぶ研究論文から情報を統合できるツールを開発する
- コンプライアンスチェック: マーケティングコピーを、社内のブランドガイドラインや規制文書に照らして自動的に検証します。
DBRXのトレーニングをチームのワークフローに組み込む方法
AIモデルのトレーニングプロジェクトを成功させるには、コードや計算リソースだけでは不十分です。MLエンジニア、データサイエンティスト、プロダクトマネージャー、そしてステークホルダーが協力して取り組む必要があります。
こうした共同作業がJupyterノートブック、Slackチャンネル、個別のプロジェクト管理ツールなどに分散していると、「コンテキストの散在」という状況が生じます。これは、重要なプロジェクト情報があまりにも多くのツールに散らばってしまう状態を指します。
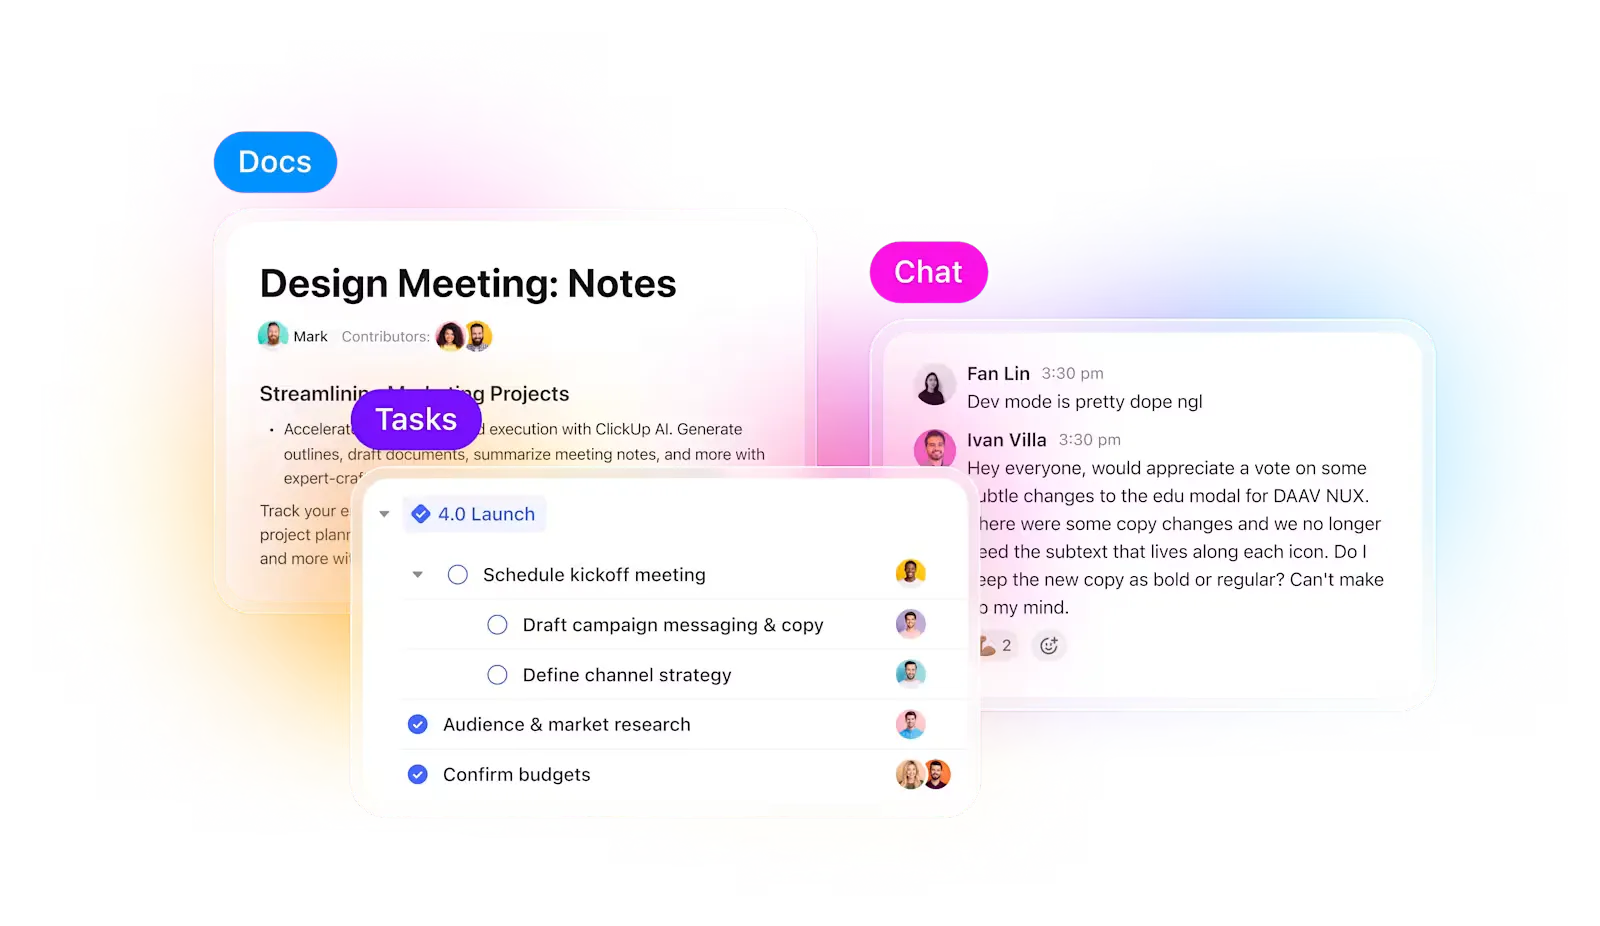
ClickUpならその課題を解決します。複数のツールを使い分ける代わりに、プロジェクト管理、ドキュメント作成、コミュニケーションが一体となった「統合AIワークスペース」を利用できるため、実験の計画から実行、評価に至るまで一貫した接続が保たれます。
実験や進捗を見失うことはありません
複数の実験を実行する際、最も難しいのはモデルのトレーニングそのものではなく、その過程で何が変更されたかを追跡し続けることです。どのデータセットのバージョンが使用されたか、どの学習率が最も良い結果をもたらしたか、あるいはどの実行結果が本番環境にデプロイされたか、といった点です。
ClickUpを使えば、このプロセスが驚くほど簡単になります。ClickUpタスクで各トレーニング実行を個別に追跡でき、タスク内ではカスタムフィールドを使用して以下の情報を記録できます:
- データセットのバージョン
- ハイパーパラメータ
- モデルのバリエーション(DBRX Base 対 DBRX Instruct)
- トレーニングステータス(キュー入り、実行中、評価中、デプロイ済み)
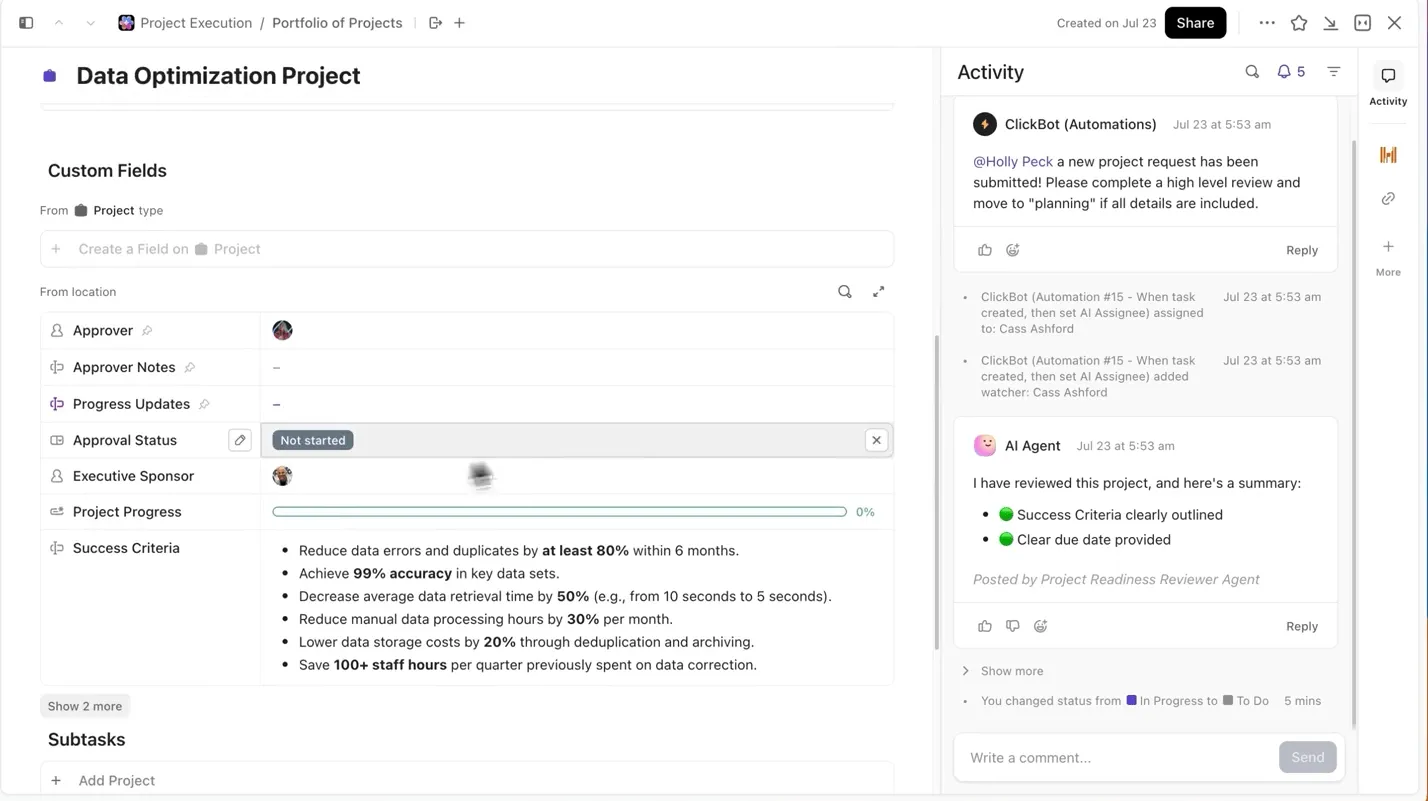
そうすることで、記録されたすべての実験を検索可能にし、他の実験との比較も容易になり、再現性も確保できます。
モデルのドキュメントを仕事と密接に連携させる
実験タスクの背景を理解するために、JupyterノートブックやREADMEファイル、Slackのスレッドの間を行き来する必要はありません。
ClickUp Docsを使えば、モデルアーキテクチャ、データ前処理スクリプト、評価メトリクスなどを、元のエクスペリメントタスクに直接リンクされた検索可能なドキュメントとして記録することで、整理整頓し、いつでもアクセスできるようにすることができます。
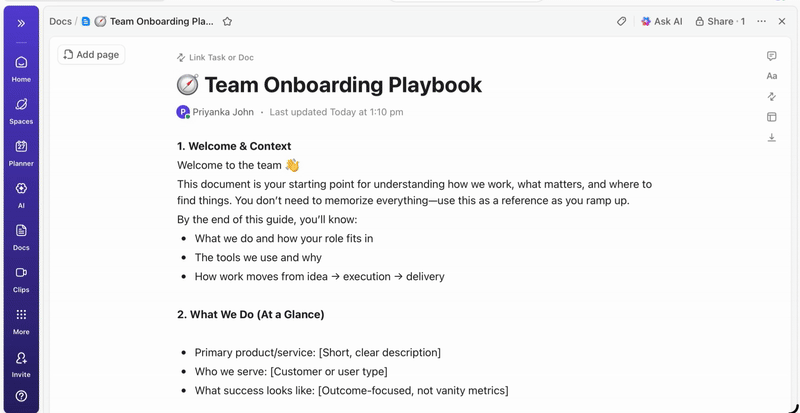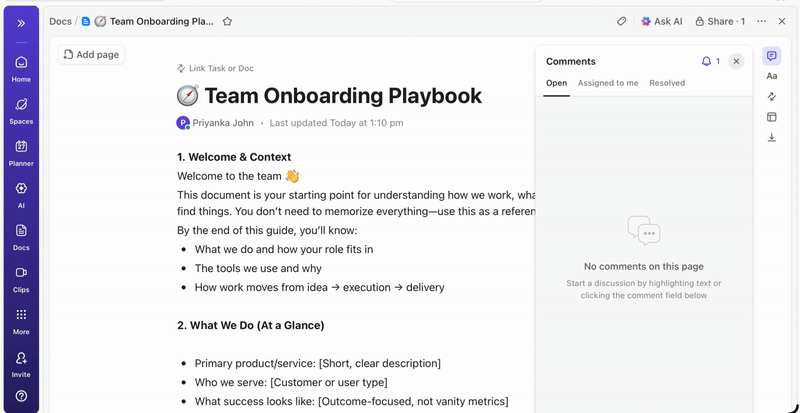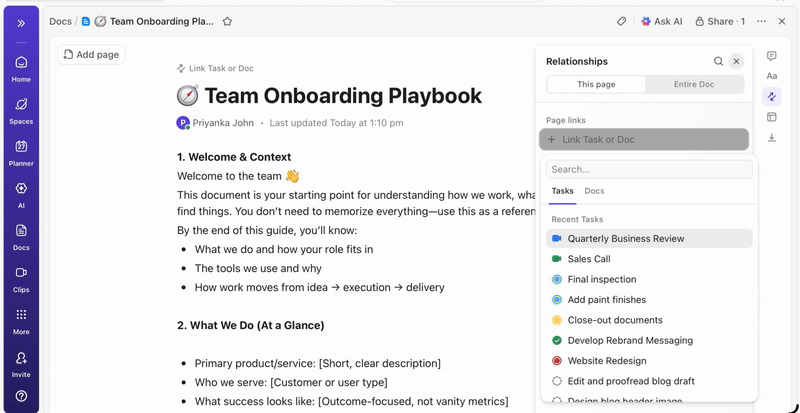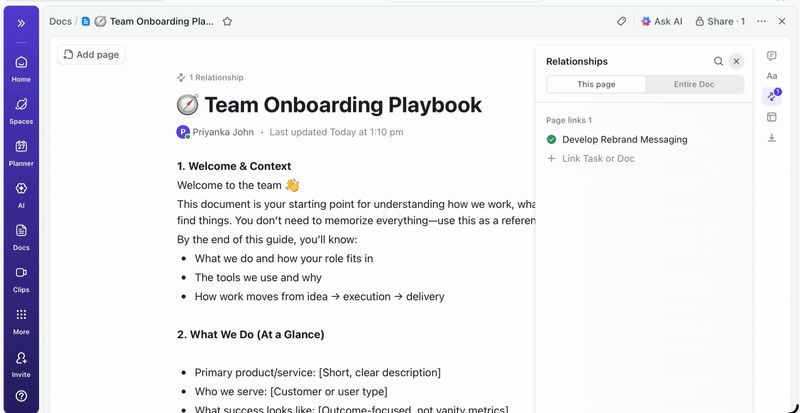
💡プロのヒント: ClickUp Docsに、アーキテクチャからデプロイに至るまでのあらゆる決定事項を詳細に記した「常に更新されるプロジェクト概要」を作成しておきましょう。そうすれば、新しいチームメンバーも過去のスレッドをいちいち探すことなく、いつでもプロジェクトの詳細をすぐに把握できるようになります。
ステークホルダーにリアルタイムの可視性を提供
ClickUpのダッシュボードでは、実験の進捗状況やチームの作業負荷をリアルタイムで確認できます。I
更新内容を手作業でまとめたり、電子メールを送信したりする代わりに、タスク内のデータに基づいてダッシュボードが自動的に更新されます。そのため、関係者はいつでも状況を確認でき、ステータスを把握できるため、「ステータスはどうなっていますか?」といった質問であなたの作業を中断させる必要がなくなります。
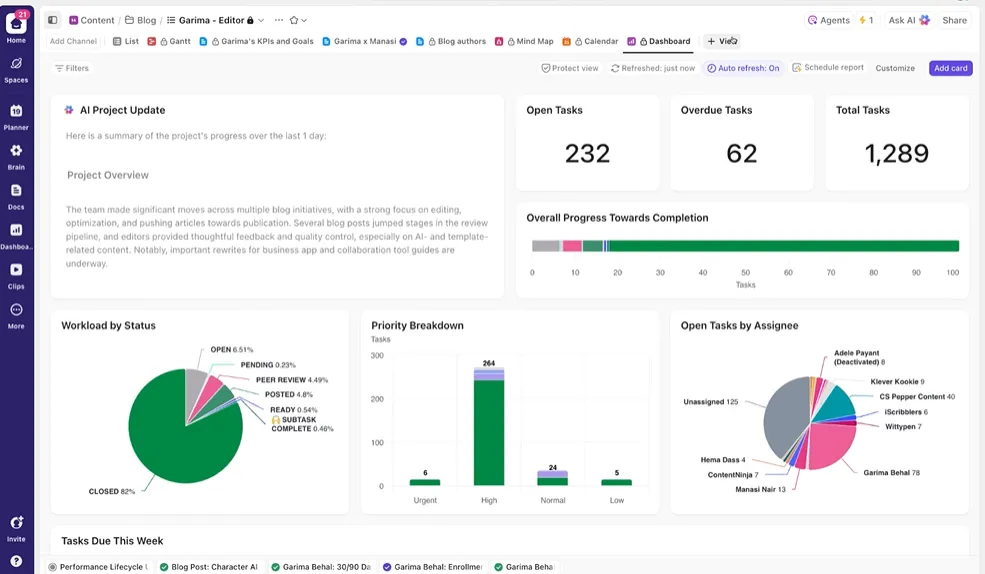
これにより、実験のレポート作成を常に手動で行う必要がなくなり、実験の実行そのものに集中できるようになります。
AIをスマートなプロジェクトの相棒に変えましょう
これまでの実験の要約を把握するために、数週間にわたるトレーニングデータを手作業で丹念に調べる必要はありません。タスクのコメントで @Brain をメンションするだけで、ClickUp Brain が、過去および進行中のプロジェクトの完全なコンテキストに基づいて、必要な支援を提供します。
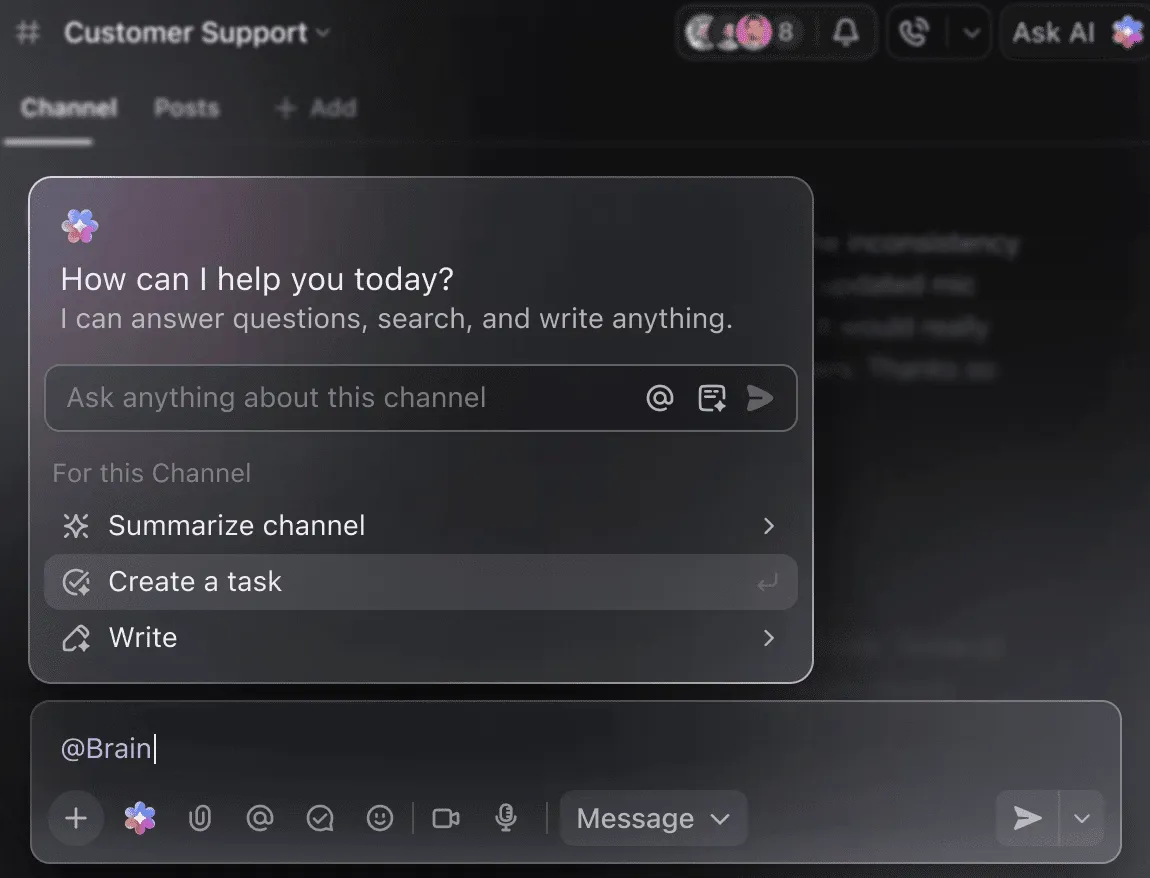
Brainに「先週の実験を5つの箇条書きで要約して」や「最新のハイパーパラメータの結果をまとめたドキュメントの草案を作成して」と依頼すれば、即座に洗練された出力が得られます。
🧠 ClickUpの利点:ClickUpの「スーパーエージェント」は、単なる質問への回答にとどまらず、ユーザーが定義したトリガーに基づいてワークフロー全体を自動化することで、その機能をさらに拡張します。 スーパーエージェントを使えば、データセットがアップロードされるたびに新しいDBRXトレーニングタスクを自動的に作成し、チームに通知し、トレーニングの実行が完了したりチェックポイントに達したりした際に関連するドキュメントをリンクさせ、さらに週ごとの進捗要約を生成してステークホルダーに送信することも、一切手を加えることなく実現できます。
避けるべきよくある間違い
DBRXを使ったトレーニングプロジェクトに着手するのはワクワクすることですが、いくつかのよくある落とし穴が進捗を妨げる可能性があります。これらのミスを回避することで、時間と費用を節約し、多くのフラストレーションを軽減できます。
- ハードウェア要件の過小評価: DBRXは高性能ですが、容量も大きいです。不十分なハードウェアで実行しようとすると、メモリ不足エラーが発生し、トレーニングジョブが失敗します。DBRX(132B)では、16ビット推論の場合、少なくとも264GBのVRAMが必要であり、4ビット量子化を使用する場合は約70GB~80GBが必要となる点に留意してください。
- データ品質チェックを省略すること:「ゴミを入れれば、ゴミが出る」。乱雑で質の低いデータセットで微調整を行っても、モデルが生成するのは乱雑で質の低い出力結果ばかりになってしまいます。
- コンテキストの長さリミットを無視しない: DBRXの32Kのコンテキストウィンドウは十分な容量ですが、無限ではありません。このリミットを超える入力をモデルに与えると、結果として黙って切り捨てられ、パフォーマンスが低下します。
- 「Instruct」が適している場合の「Base」の使用について: DBRX Baseは、さらなる大規模なトレーニングを目的とした、未加工の事前学習済みモデルです。指示に従うタスクのほとんどについては、その目的のためにすでに微調整済みのDBRX Instructから始めることをお勧めします。
- トレーニング仕事とプロジェクト調整の分断: 実験の追跡をあるツールで行い、プロジェクトプランを別のツールで行う場合、情報の分断が生じます。ClickUpのような統合プラットフォームを活用して、技術的な仕事とプロジェクト調整を常に同期させましょう。
- デプロイ前の評価を怠る: トレーニングデータでは良好なパフォーマンスを発揮するモデルでも、実環境では予想外の大失敗を招く可能性があります。微調整したモデルを本番環境にデプロイする前に、必ず保留しておいたテストセットで検証を行ってください。
- 微調整の複雑さを見落としがち: DBRXはMixture-of-Expertsモデルであるため、標準的な微調整スクリプトでは、複数のGPUにわたるパラメーターのシャーディングを処理するために、Megatron-LMやPyTorch FSDPなどの専用ライブラリが必要になる場合があります。
DBRXと他のAIトレーニングプラットフォームの比較
AIトレーニングプラットフォームの選定には、「制御性」と「利便性」という根本的なトレードオフが伴います。独自仕様のAPI専用モデルは使い勝手が良い反面、ベンダーのエコシステムに縛られてしまいます。
DBRXのようなオープンウェイトモデルは完全な制御が可能ですが、より高度な技術的専門知識とインフラストラクチャを必要とします。この選択により、長期的な目標を実際に支える道がどれなのか分からず、行き詰まってしまう可能性があります。これは、AI導入において多くのチームが直面する課題です。
このテーブルでは、適切な判断を下せるよう、主な違いを詳しく解説しています。
| 重み | 開く(カスタム) | 独自開発 | 開く(カスタム) | 独自開発 |
| 微調整 | 完全な制御 | APIベース | 完全な制御 | APIベース |
| セルフホスティング | はい | いいえ | はい | いいえ |
| ライセンス | DB Open Model | OpenAIの利用規約 | Llamaコミュニティ | Anthropicの用語 |
| 背景 | 32K | 128K – 1M | 128K | 20万~100万 |
DBRXは、モデルを完全に制御する必要がある場合、セキュリティやコンプライアンスの理由でセルフホスティングが必須の場合、あるいは柔軟性の高い商用ライセンスを求めている場合に最適な選択肢です。専用のGPUインフラストラクチャをお持ちでない場合、あるいは高度なカスタム化よりも市場投入のスピードを重視する場合は、APIベースの代替ソリューションの方が適しているかもしれません。
ClickUpで、よりスマートなトレーニングを始めましょう
DBRXは、独自開発のモデルでは得られない透明性と制御性を備え、カスタムAIアプリケーションを構築するための企業対応の基盤を提供します。その効率的なMoEアーキテクチャにより推論コストを低く抑え、オープンな設計により微調整も容易に行えます。しかし、優れた技術だけでは十分とは言えません。
真の成功は、技術的な作業とチームの共同ワークフローを連携させることから生まれます。AIモデルのトレーニングはチームワークが不可欠であり、実験、ドキュメント、ステークホルダーとのコミュニケーションを常に同期させておくことが極めて重要です。すべてを単一の統合ワークスペースに集約し、情報のばらつきを削減することで、より優れたモデルをより迅速にリリースできるようになります。
ClickUpを無料で始めて、AIトレーニングプロジェクトを1つのワークスペースで一元管理しましょう。✨
よくある質問
DBRXでトレーニングの進捗状況を監視するにはどうすればよいですか?
TensorBoard、Weights & Biases、MLflowなどの標準的なMLツールを使用して、トレーニング状況を監視できます。Databricksエコシステム内でトレーニングを行う場合、MLflowがネイティブに統合されているため、実験の追跡をシームレスに行うことができます。
DBRXをCI/CDやデプロイパイプラインと連携させることはできますか?
はい、DBRXは標準的なMLOpsパイプラインに統合可能です。モデルをコンテナ化することで、Kubeflowなどのオーケストレーションプラットフォームや、カスタムCI/CDワークフローを使用してデプロイすることができます。
DBRX BaseとDBRX Instructの違いは何ですか?
DBRX Baseは、ドメイン固有の継続的な事前学習や、ディープアーキテクチャの微調整を行いたいチーム向けの、基盤となる事前学習済みモデルです。DBRX Instructは、指示に従うように最適化された微調整済みバージョンであり、ほとんどのアプリケーション開発において、より適した出発点となります。
企業AIプロジェクトにおいて、DBRXとGPT-4を比較するとどうでしょうか?
主な違いは制御性です。DBRXでは、モデルの重みへの完全なアクセス権が与えられ、高度なカスタムやセルフホスティングが可能ですが、GPT-4はAPIのみのサービスです。
DBRXは無料で利用できますか?
DBRXモデルの重みデータは、Databricks Open Model Licenseに基づき無料で利用可能です。ただし、モデルの実行や微調整に必要なコンピューティングインフラの費用は、お客様のご負担となります。