
Sind Sie von Daten überflutet? Selbst die erfahrensten Datenexperten haben Mühe, mit der Datenflut Schritt zu halten, die eine digital geprägte Welt mit sich bringt – ganz zu schweigen davon, die Prozesse effizienter zu gestalten. Von Webanalysen über Kundendaten bis hin zu Metriken: Sie sind dafür verantwortlich, diese Daten so genau und aktuell wie möglich zu halten. ✨
Ein solides Datenbankdesign ist für die Erstellung und Pflege einer Datenbank für Ihr Unternehmen unerlässlich, doch selbst dann müssen Sie wissen, wie Sie Ihre Arbeit vor Datenvermischungen und Datenredundanzen schützen können. Abhängigkeiten definieren die Beziehungen zwischen Datenattributen, was von der Datengenauigkeit bis hin zu tiefgreifenden Erkenntnissen Alles betrifft.
Der Haken daran? Es gibt so viele Arten von Abhängigkeiten zur Auswahl. Aber funktionale Abhängigkeiten sind ein Muss, wenn du es kaum erwarten kannst, eine Datenbank zu erstellen.
In diesem Leitfaden erklären wir Ihnen, was eine funktionale Abhängigkeit ist, nennen Ihnen einige Beispiele für alle Arten von funktionalen Abhängigkeiten und geben Ihnen hilfreiche Tipps zur optimalen Nutzung Ihrer relationalen Datenbank.

Was ist eine funktionale Abhängigkeit?
Eine funktionale Abhängigkeit ist eine Art von Abhängigkeit, bei der eine Beziehung zwischen zwei Variablen besteht. Auf der linken Seite steht das bestimmende Attribut, auch als Primärschlüssel bezeichnet, und auf der rechten Seite das abhängige Attribut, auch als Nicht-Schlüssel-Attribut bezeichnet. Die Funktion oder das Ergebnis ändert sich je nach der Beziehung zwischen den beiden Variablen.
Wir wissen, dass das etwas kompliziert klingt, daher hier eine Erklärung, wie funktionale Abhängigkeiten funktionieren:
- Nehmen wir an, Sie nutzen eine Kundendatenbank-Software zur Nachverfolgung der Geburtstage Ihrer Kunden. Sie möchten Ihren Kunden an ihrem Geburtstag eine benutzerdefinierte E-Mail senden, um die Kundenbindung zu stärken.
- Sie müssen eine funktionale Abhängigkeit verwenden, um jedem Benutzer an seinem Geburtstag eine E-Mail zu senden – schließlich würde ein irrelevanter Massenversand mit „Herzlichen Glückwunsch zum Geburtstag“ an 300 Personen doch etwas seltsam wirken, oder?
- In diesem Fall besteht die Abhängigkeit der Funktion zum Versenden einer E-Mail von der Variablen „Geburtstag des Kunden“.
- Wenn Sie diese Art von Beziehung in Ihrer Datenbank wünschen, müssten Sie eine funktionale Abhängigkeit zwischen dem Geburtstag des Kunden und der Funktion einrichten, die am Geburtstag eine E-Mail versendet.
Funktionale Abhängigkeiten sind für die Datenbanknormalisierung von grundlegender Bedeutung. Durch die Normalisierung organisieren Sie eine Datenbank – ähnlich wie beim Aufräumen eines Zimmers –, um Daten so anzuordnen, dass Wiederholungen vermieden werden.
Die Regeln funktionaler Abhängigkeiten in Datenbankmanagementsystemen
Funktionale Abhängigkeiten folgen mehreren Inferenzregeln – auch bekannt als Armstrongs Axiome.
Es gibt drei wichtige Regeln für funktionale Abhängigkeiten:
- Reflexivität: Die Reflexivitätsregel besagt, dass, wenn Attribut A mit Attribut X in Beziehung steht, auch Attribut X mit Attribut A in Beziehung steht. Als Beispiel: A ist der Vorname einer Person und X ist der Nachname einer Person. Diese beiden Attribute stehen immer in Beziehung zueinander.
- Ergänzung: Die Ergänzungsregel besagt, dass, wenn Sie einer Variablen Daten hinzufügen – was auch als Ergänzung bezeichnet wird –, Sie diese Ergänzung zur Menge der Attribute hinzufügen müssen. Wenn Sie also das Feld „Vorname“ um einen Spitznamen ergänzen, steht dieses Feld nun auch in Beziehung zum Feld „Nachname“.
- Transitivität: Die Transitivitätsregel besagt: Wenn Attribut A mit Attribut C in Beziehung steht, dann gilt durch Assoziation auch, dass Attribut B gleich Attribut C ist. Lassen Sie sich davon nicht den Kopf zerbrechen – eine transitive Abhängigkeit bedeutet, dass manchmal eine Sache eine andere bestimmt, die wiederum eine dritte Sache bestimmt. Wenn Sie beispielsweise in Ihrer CRM-Plattform Barcodes für Kunden auf der Grundlage ihrer Vor- und Nachnamen generieren, dann bestimmt der Name die Position des Kunden in einer alphabetischen Liste.
Funktionale Abhängigkeiten wandeln Ihre Datenmodelle mithilfe von SQL in ein tatsächliches Relationenschema um, wodurch die Datenintegrität gewahrt bleibt. In der Praxis können Sie funktionale Abhängigkeiten in Ihrem Datenbankmanagementsystem (DBMS) nutzen, um Datenredundanzen und „Hoppla“-Momente zu vermeiden, die zu Datenbankausfällen führen können. 👀
Vollständige funktionale Abhängigkeit im Vergleich zur partiellen funktionalen Abhängigkeit
Bevor wir uns die verschiedenen Arten funktionaler Abhängigkeiten ansehen, ist es wichtig, zwischen partiellen und vollständigen funktionalen Abhängigkeiten zu unterscheiden.
Nehmen wir an, Sie speichern Ihre Organigrammdaten in einer Datenbank. Bei einer vollständigen funktionalen Abhängigkeit hängt ein Attribut von einer anderen Attributmenge ab, jedoch nicht von einer Teilmenge dieser Attributmenge. Nehmen wir also an, wir haben eine Kombination aus „Mitarbeitername“ und „Mitarbeiter-ID“, die einen „Standort“ bestimmt.
Wenn Sie den „Mitarbeiternamen“ und die „Mitarbeiter-ID“ kennen, können Sie den „Speicherort“ ermitteln. Allerdings können Sie den „Speicherort“ nicht allein anhand dieser beiden Variablen bestimmen. In diesem Fall besteht eine vollständige Abhängigkeit zwischen dem „Speicherort“ und der Kombination aus „Mitarbeitername“ und „Mitarbeiter-ID“.
Eine partielle funktionale Abhängigkeit liegt vor, wenn ein Attribut nur von einem Teil des Primärschlüssels abhängt und nicht vom gesamten zusammengesetzten Primärschlüssel. Wenn Sie beispielsweise das Feld „Arbeitsjahre“ anhand der „Mitarbeiter-ID“ ermitteln können, liegt eine partielle Abhängigkeit vor, da „Arbeitsjahre“ nicht von „Standort“ abhängt.
Es mag wie ein kleiner Unterschied klingen, hat aber große Auswirkungen auf die Datennormalisierung. Partielle funktionale Abhängigkeiten können zu Redundanzen in Ihrer Datenbank führen, was bedeutet, dass Sie diese im Rahmen der zweiten Normalform (2NF) des Normalisierungsprozesses beheben müssen. Das ist zwar kein Weltuntergang, aber definitiv etwas, das Sie später beheben müssen. 🛠️
Erste, zweite und dritte Normalform in SQL
Wenn Sie Daten normalisieren, besteht das Ziel darin, alle Anomalien beim Einfügen, Aktualisieren oder Löschen in Ihrer Datenbank zu beseitigen, die zu schwerwiegenden Problemen führen können. Die Normalisierung mithilfe funktionaler Abhängigkeiten erfolgt in drei Schritten.
Erste Normalform
Betrachten Sie die erste Normalform als Grundlage für den Aufbau eines Systems, in dem Sie funktionale Abhängigkeiten nutzen können. Sie bildet die Basis für die Identifizierung von Abhängigkeiten in der zweiten und dritten Normalform. Technisch gesehen enthält die 1NF Attribute, die ausschließlich atomare Werte enthalten, wodurch sichergestellt wird, dass keine sich wiederholenden Gruppen vorhanden sind.
Zweite Normalform
Nachdem Sie die Daten in die 1. Normalform (1NF) gebracht haben, verfügen Sie über eine Tabelle, in der alle Nicht-Schlüsselattribute vollständig funktional vom Primärschlüssel abhängig sind. In der 2. Normalform (2NF) beseitigen Sie partielle Abhängigkeiten, indem Sie Tabellen aufteilen, um sicherzustellen, dass jedes Nicht-Schlüsselattribut vollständig vom Primärschlüssel abhängt.
Dritte Normalform
Nachdem eine Datentabelle in 2NF ist, wird sie auf 3NF gebracht, sobald alle Attribute ausschließlich funktional vom Primärschlüssel abhängig sind und von nichts anderem. In 3NF beseitigen Sie in dieser Phase alle transitiven Abhängigkeiten durch weitere Tabellenaufteilungen.
Die 1. Normalform (1NF) bildet die Phase für funktionale Abhängigkeiten, während die 2. Normalform (2NF) und die 3. Normalform (3NF) die Organisation dieser Daten durch eine Umstrukturierung der funktionalen Abhängigkeiten verfeinern. Dadurch wird sichergestellt, dass jedes Datenelement an der logischsten Stelle gespeichert wird, wodurch Redundanzen reduziert und gleichzeitig die Datenintegrität verbessert werden.

Arten von funktionalen Abhängigkeiten mit Beispielen
Wenn Sie bereit sind, funktionale Abhängigkeiten zu nutzen, stehen Ihnen vier Optionen zur Auswahl.
Trivial
Eine triviale Abhängigkeit ist eine grundlegende Art der funktionalen Abhängigkeit, bei der ein Attribut oder eine Menge von Attributen sich selbst bestimmt. Jedes einzelne abhängige Element ist hier eine Teilmenge des bestimmenden Elements. Mit anderen Worten: Wenn C eine Teilmenge von A ist, handelt es sich um eine triviale funktionale Beziehung.
Es mag vielleicht etwas offensichtlich klingen, aber ein Beispiel wäre die Identifizierung des Titels eines Buches, wenn man sowohl den Titel als auch den Verfasser kennt. Die Beziehung zwischen diesen beiden Attributen ist ziemlich leicht zu erkennen, weshalb triviale funktionale Abhängigkeiten am einfachsten zu verstehen sind.
Nicht trivial
Hier wird es erst richtig interessant. Bei einer nicht-trivialen funktionalen Abhängigkeit kann ein Attribut ein anderes, eigenständiges Attribut bestimmen. In diesem Fall ist A eine Menge von Attributen, ebenso wie B, aber B ist keine Teilmenge von A. Wenn B keine Teilmenge von A ist, besteht zwischen ihnen eine nicht-triviale Beziehung.
Sie haben es mit einer nicht-trivialen Beziehung zu tun, wenn Sie eine Datenbank mit Büchern anlegen, jedem Buch einen eindeutigen Code zuweisen und den Titel des Buches nachschlagen können, sobald Sie den dem Buch zugewiesenen Code kennen.
Mehrwertig
Bei einer mehrwertigen Abhängigkeit ist ein Attribut mit mehreren anderen Attributen verbunden. Die Attribute in Ihrer Gruppe von abhängigen Attributen sind nicht voneinander abhängig. Wenn also die Attribute A und C keine funktionale Abhängigkeit aufweisen, ist die Beziehung zwischen B, A und C mehrwertig.
Um bei der Analogie mit Büchern zu bleiben: Das ist so, als hätte ein Verfasser viele Bücher geschrieben. Wenn Sie seinen Namen kennen, können Sie eine Liste aller Bücher auflisten, die er geschrieben hat. Bei einer mehrwertigen funktionalen Abhängigkeit sind mit dem Namen eines Verfassers mehrere Bücher verknüpft.
Transitiv
Eine transitive funktionale Abhängigkeit liegt vor, wenn ein Attribut ein anderes bestimmt, das wiederum ein weiteres bestimmt. Das ist so etwas wie eine Kettenreaktion. Wenn Ihnen das bekannt vorkommt, dann deshalb, weil diese Art der funktionalen Abhängigkeit der Transitivitätsregel folgt.
In diesem Fall gilt: Wenn A gleich B und B gleich C ist, dann muss A gleich C sein. Nehmen wir an, Sie erstellen eine Buchdatenbank, und Ihre eindeutigen Buchcodes bestimmen die Verlage und deren Genres. Wenn Sie den Buchcode kennen, können Sie herausfinden, um welchen Verlag es sich handelt und welchem Genre das Buch angehört.
So nutzen Sie funktionale Abhängigkeiten für die Datenbankverwaltung
Möchten Sie funktionale Abhängigkeiten nutzen? Es steht Ihnen frei, funktionale Abhängigkeiten nach Belieben einzusetzen – wenn Sie jedoch intelligenter und mit weniger Aufwand arbeiten möchten, entscheiden Sie sich für ClickUp.
Hier finden Sie einen kurzen Überblick darüber, wie Sie in ClickUp eine Datenbank erstellen und funktionale Abhängigkeiten einbinden können:
Zunächst müssen Sie eine Datenbank in ClickUp einrichten. Sie können Datenblätter aus Excel importieren oder eigene von Grund auf neu erstellen.
Die Tabelle von ClickUp ermöglicht Massenbearbeitungen und andere benutzerdefinierte Ansichten für die Nachverfolgung von Daten nahezu zu jedem Thema. ClickUp visualisiert zudem Daten, sodass Sie Ihre Datenbank in Rekordzeit auswerten können.
Die gute Nachricht ist, dass Sie hier nicht bei Null anfangen müssen. Mit den Datenbankvorlagen von ClickUp wird die Erstellung von Datenbanken zum Kinderspiel.
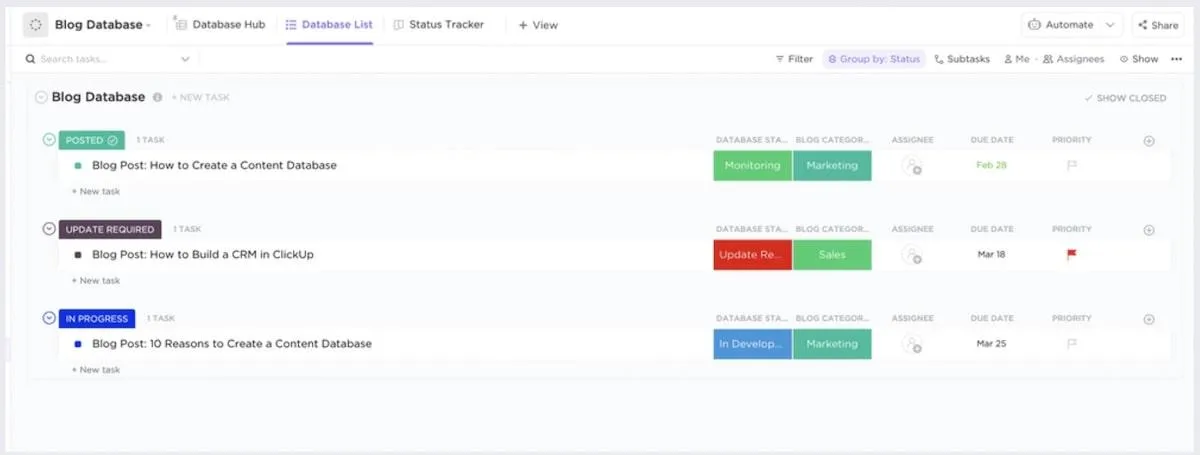
Die ClickUp-Blog-Datenbankvorlage ist äußerst hilfreich für die Planung des Inhalts, und die ClickUp-Mitarbeiterverzeichnis-Vorlage eignet sich perfekt, um schnell eine Datenbank mit den Kontaktdaten Ihrer Kollegen zu erstellen. Auch hierbei handelt es sich um eine No-Code-Datenbank. Wenn Sie also eine Datenbank erstellen möchten, ohne SQL lernen zu müssen, sind Sie bei uns genau richtig.
Einbindung funktionaler Abhängigkeiten in ClickUp
Normalerweise müsste man sich mit SQL abmühen, um funktionale Abhängigkeiten in einer Datenbank zu erstellen. Glücklicherweise macht die Drag-and-Drop-Oberfläche von ClickUp das Erstellen von Beziehungen zwischen Aufgaben und Dokumenten ganz einfach. Und es schadet auch nicht, dass die KI-Tools in ClickUp die Datenbankverwaltung zum Kinderspiel machen – selbst wenn man selbst kein Datenbankprofi ist.
So können Sie eine Abhängigkeit in Ihrer ClickUp-Datenbank erstellen.
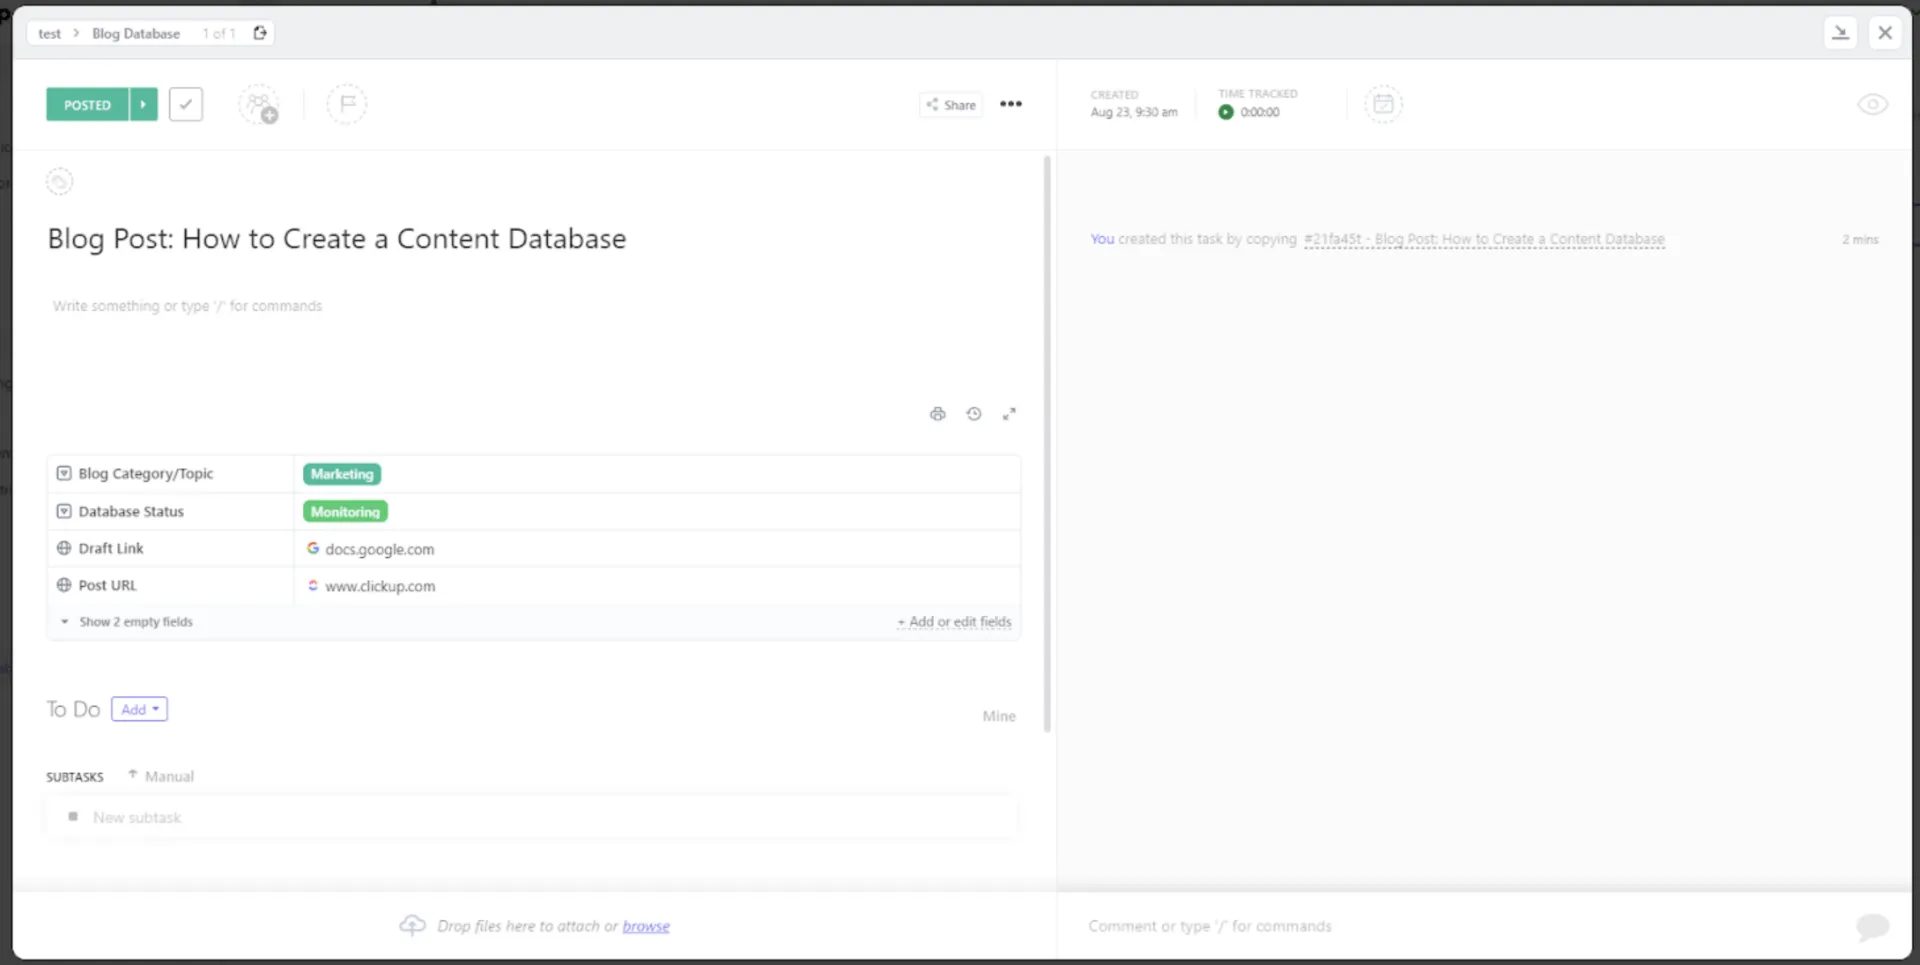
Klicken Sie zunächst auf die Aufgabe, mit der Sie arbeiten möchten.
Gehen Sie zu „Beziehungen“ > „Abhängigkeit“. Wählen Sie zwischen Warten auf, Blockieren und Aufgaben, um die Beziehung benutzerdefiniert anzupassen.
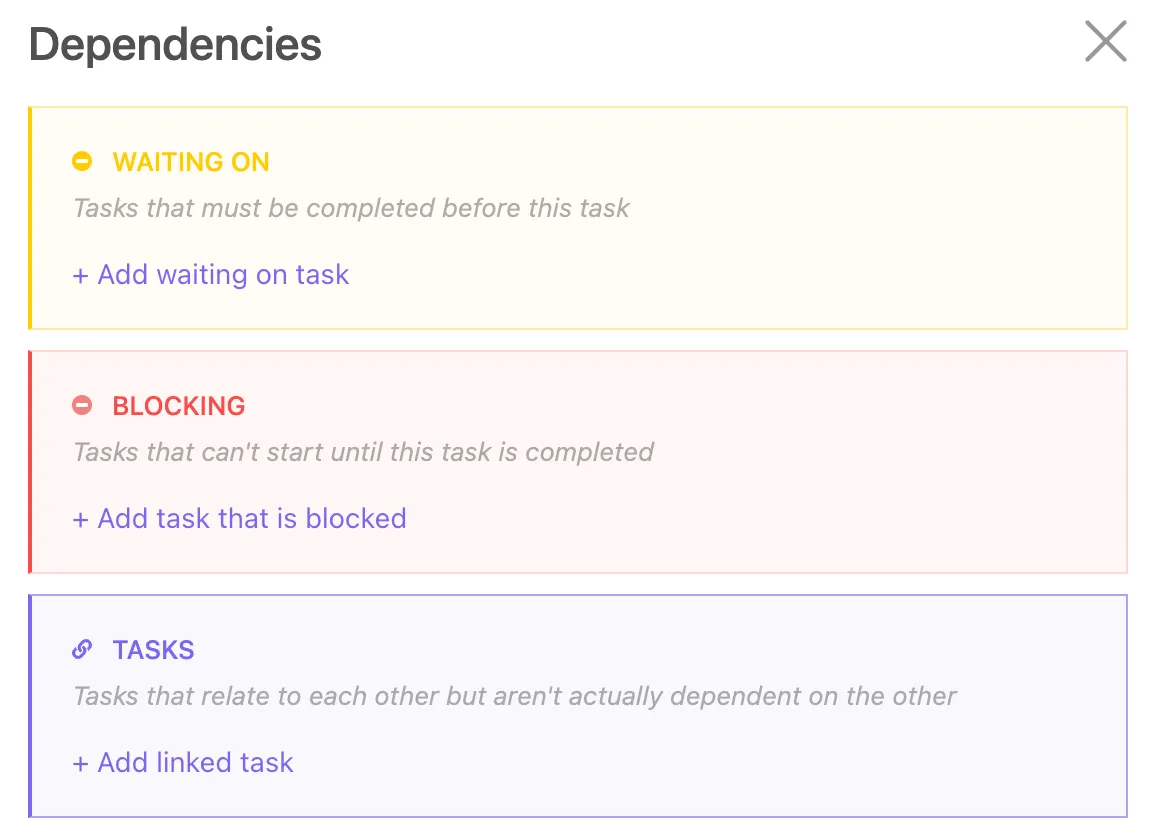
In diesem Fall wählen wir Waiting On und suchen nach einer anderen Aufgabe, die mit der aktuellen Aufgabe in Beziehung steht.
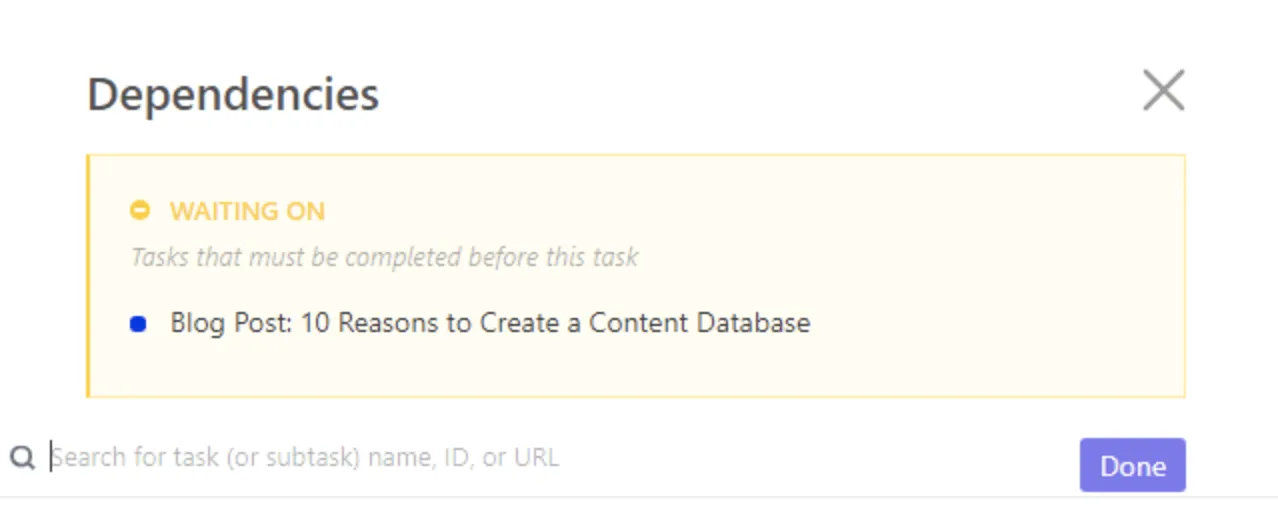
Klicken Sie auf „Erledigt“, und schon ist es erledigt! 🙌
Vereinfachen Sie Abhängigkeiten mit ClickUp
Wer sagt, dass Datenbankverwaltung kompliziert sein muss? Solange Sie die Abhängigkeiten zwischen den Funktionen genau verstehen, können Sie eine schnelle und präzise Datenbank entwerfen, die Ihr Unternehmen voranbringt.
Das müssen Sie auch nicht alleine bewältigen. ClickUp ist ein zuverlässiges Datenbankmanagementsystem, das Daten mit Vorlagen, Projekten, Aufgaben, Zielen und allem, was dazwischen liegt, kombiniert.
Sparen Sie Zeit und konzentrieren Sie sich auf wertschöpfende Aufgaben, indem Sie auf die echte All-in-One-Plattform von ClickUp umsteigen.
Probieren Sie es selbst aus: Erstellen Sie ein kostenloses ClickUp-Konto, um eine bessere Datenbank aufzubauen!