
データに埋もれていませんか?最も経験豊富なデータ専門家であっても、デジタルファーストの世界が生み出すデータの津波に追いつくのに苦労しています。プロセスの効率化を図ることは言うまでもありません。ウェブ分析から顧客データ、メトリクスに至るまで、これらのデータを可能な限り正確かつ最新の状態に保つ責任はあなたにあります。 ✨
ビジネス向けのデータベースを構築・維持するには、堅牢なデータベース設計が不可欠ですが、それだけでなく、データの相互汚染や冗長性を排除する方法も理解しておく必要があります。依存関係はデータ属性間の関係を定義するものであり、データの正確性から高度な分析に至るまで、すべての面で役立ちます。
最大の難点は? 選択できる依存関係の種類が実にたくさんあることです。しかし、データベースの作成を待ちきれないという方には、機能依存関係は必須の要素です。
このガイドでは、機能依存関係とは何かを解説し、あらゆる機能依存関係の例をいくつか紹介するとともに、リレーショナルデータベースを最大限に活用するための役立つヒントを提供します。

機能依存関係とは何ですか?
関数依存関係とは、2つの変数間に関係がある依存関係の一種です。左側には決定属性(主キーとも呼ばれます)があり、右側には従属属性(非キー属性とも呼ばれます)があります。2つの変数間の関係によって、機能や結果が変わってきます。
少し複雑に聞こえるかもしれませんが、機能依存関係の仕組みは以下の通りです:
- 例えば、顧客データベースソフトウェアを使って買い物客の誕生日を追跡しているとします。顧客との良好な関係を築くために、誕生日にパーソナライズされた電子メールを送信したいと考えています。
- 各ユーザーの誕生日に電子メールを送信するには、機能依存関係を使用する必要があります。何しろ、300人全員に無関係な「お誕生日おめでとう」という一斉送信をしたら、少し不自然に見えてしまうのではないでしょうか?
- この場合、電子メールを送信する機能は、顧客の誕生日の変数に依存関係があります。
- データベースにこの種の関係を設定したい場合は、顧客の誕生日と、誕生日に電子メールを送信する機能との間に機能依存関係を設定する必要があります。
機能依存関係は、データベースの正規化において基本的な概念です。正規化を通じて、まるで部屋を片付けるようにデータベースを整理し、データの重複を避けるように配置します。
データベース管理システムにおける機能依存関係のルール
機能依存関係は、アームストロングの公理とも呼ばれるいくつかの推論規則に従います。
関数依存関係には、主に3つのルールがあります:
- 反射性: 反射性則によれば、属性Aが属性Xと関連している場合、属性Xも属性Aと関連していることになります。例えば、Aが人の名で、Xが人の姓である場合、これら2つの属性は常に互いに関連することになります。
- 拡張(Augmentation): 拡張ルールによれば、変数にデータを追加すること(拡張とも呼ばれる)を行った場合、その拡張を属性のセットに追加しなければなりません。したがって、名(first name)フィールドにニックネームを追加した場合、そのフィールドは姓(last name)フィールドとも関連付けられることになります。
- 推移性:推移性の法則によれば、属性Aが属性Cと関連している場合、その関連性によって属性Bも属性Cと等しくなります。あまり深く考えすぎないでください。推移的な依存関係とは、ある要素が別の要素を決定し、その要素がさらに別の要素を決定するということがあり得ることを意味します。例えば、CRMプラットフォームで顧客の氏名に基づいてバーコードを生成する場合、その氏名によってアルファベット順のリストにおける顧客の位置が決まります。
関数依存関係は、SQL を使用してデータモデルを実際のリレーショナルスキーマに変換し、データの整合性を維持します。実際には、データベース管理システム(DBMS)で関数依存関係を活用することで、データの冗長性を排除し、データベースを破損させるような「うっかりミス」を防ぐことができます。👀
完全機能依存関係と部分機能依存関係
機能依存関係の種類について検討する前に、部分的な機能依存関係と完全な機能依存関係を区別することが重要です。
例えば、組織図のデータをデータベースに格納するとします。完全な機能依存関係では、ある属性は別の属性の集合に依存しますが、その属性のサブセットには依存しません。そこで、「従業員名」と「従業員ID」の組み合わせによって「場所」が決定されると仮定しましょう。
「従業員名」と「従業員ID」が分かれば、「場所」を特定できます。ただし、これら2つの変数だけを見て「場所」を特定することはできません。この場合、「場所」は「従業員名」と「従業員ID」の組み合わせに完全に依存関係があります。
部分的な依存関係とは、属性が複合主キー全体ではなく、主キーの一部にのみ依存している場合に発生します。たとえば、「従業員ID」からデータフィールド「勤続年数」を特定できる場合、「勤続年数」は「場所」に依存していないため、部分的な依存関係が存在することになります。
些細な違いのように聞こえるかもしれませんが、これはデータの正規化に大きな影響を及ぼします。部分機能依存関係はデータベース内の冗長性につながる可能性があり、正規化プロセスの第2正規形(2NF)で対処する必要があります。大したことではありませんが、いずれは修正しなければならない問題です。🛠️
SQLにおける第1、第2、第3正規形
データを正規化する際の目標は、データベースに混乱を招きかねない挿入、更新、削除の異常を排除することです。機能依存関係を用いた正規化には、3つのステップがあります。
第1正規形
第1正規形は、関数依存関係を活用できるシステムを構築するための基礎と考えてください。これは、第2正規形および第3正規形における依存関係を特定するための土台となります。技術的に言えば、1NFでは属性には原子値のみが含まれ、繰り返しグループが存在しないことが保証されています。
第2正規形
データを1NFに変換すると、鍵以外のすべての属性が主鍵に完全に機能的に依存するテーブルが得られます。2NFでは、テーブルを分割して部分的な依存関係を排除し、鍵以外のすべての属性が主鍵に完全に依存していることを再確認します。
第3正規形
データテーブルが2NFになった後、すべての属性が主キーのみに機能的に依存し、それ以外には依存しなくなると、3NFへと移行します。3NFでは、このフェーズでさらにテーブルを分割することで、すべての推移的依存関係を排除します。
1NFは関数依存関係のフェーズを築き、2NFおよび3NFは関数依存関係を再構築することで、データの整理方法をさらに洗練させます。これにより、あらゆるデータが最も論理的な場所に格納され、冗長性が削減されると同時に、データ整合性も向上します。

機能依存関係の種類と例
機能依存関係の利用を開始する準備ができているなら、4つの選択肢から選ぶことができます。
些細なこと
自明な依存関係とは、属性または属性の集合がそれ自体を決定する、機能的依存関係の基本的なタイプです。ここでは、すべての従属集合が決定集合の部分集合となります。つまり、CがAの部分集合である場合、その機能的関係は自明であると言えます。
少し当たり前のように聞こえるかもしれませんが、例を挙げると、タイトルと著者の両方が分かっている場合に、その本のタイトルを特定することです。これら2つの属性の関係は一目瞭然であり、そのため、単純な依存関係は最も理解しやすいのです。
決して単純ではない
ここからがさらに興味深いところです。非自明な依存関係では、ある属性が別の異なる属性を決定づけることがあります。この場合、AもBも属性の集合ですが、BはAの部分集合ではありません。BがAの部分集合でない場合、両者の間には非自明な関係が存在します。
書籍のデータベースを作成し、各書籍に一意のコードを割り当て、そのコードが分かれば書籍のタイトルを検索できる場合、そこには非自明な関係が存在します。
多値
多値依存関係では、1つの属性が他の複数の属性と接続します。依存対象の属性群内の属性は、互いに依存し合っていません。したがって、属性AとCの間に機能的依存関係がない場合、B、A、Cの関係は多値依存関係となります。
本の例えを続けると、これは多くの本を執筆した著者のようなものです。その著者の名前が分かれば、その著者が書いたすべての本をリストすることができます。多値機能依存関係では、1人の著者の名前に複数の本がリンクされています。
推移的
推移的関数依存関係とは、ある属性が別の属性を決定し、さらに別の属性を決定するという関係のことです。これは一種の連鎖反応のようなものです。この説明が聞き覚えがあると思われるなら、それはこの種の依存関係が「推移性の法則」に従っているからです。
この場合、AがBに等しく、BがCに等しければ、AはCに等しくなければなりません。例えば、書籍データベースを構築しているとします。そのデータベースでは、一意の書籍コードによって出版社とジャンルが決まっています。書籍コードが分かれば、出版社とそのジャンルを特定することができます。
データベース管理における機能依存関係の活用方法
関数依存関係の利用を始めたいとお考えですか?関数依存関係はご自身の判断で自由に活用できますが、手間をかけずに効率的に仕事を進めたい場合は、ClickUpをご利用ください。
ここでは、ClickUpでデータベースを構築し、機能的依存関係を組み込む方法について簡単に概要を説明します:
まずは、ClickUpでデータベースを設定する必要があります。Excelからデータシートをインポートすることも、一から独自に作成することも可能です。
ClickUpのテーブルビューでは、一括編集やその他のカスタムビューを利用して、あらゆるデータの追跡が可能です。また、ClickUpはデータを可視化することで、データベースの構築を驚くほど短時間で完了させることができます。
幸いなことに、一から始める必要はありません。ClickUpのデータベーステンプレートを使えば、データベースの作成は驚くほど簡単です。
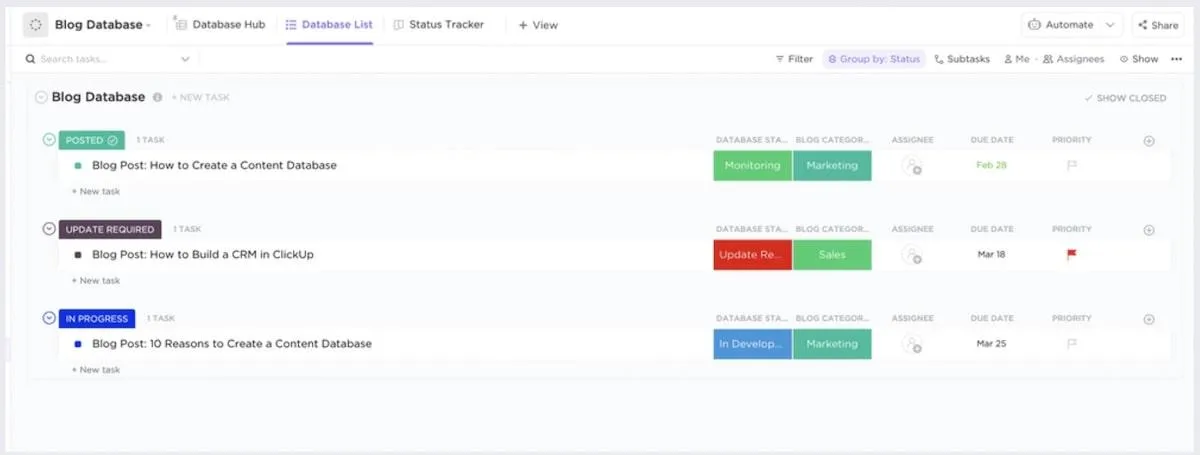
「ClickUpブログ用データベーステンプレート」はコンテンツ計画に非常に役立ち、「 ClickUp社員名簿テンプレート」は同僚の連絡先情報をまとめたデータベースを素早く作成するのに最適です。これらも「ノーコード」のデータベースですので、SQLを学ばずにデータベースを構築したい方にも最適です。
ClickUpでの機能依存関係の導入
通常、データベースに機能依存関係を作成するには、SQLを駆使して作業する必要があります。幸いなことに、ClickUpのドラッグ&ドロップインターフェースを使えば、タスクとドキュメント間の「リレーションシップ」を簡単に作成できます。さらに、ClickUpのAIツールを使えば、たとえデータベースの専門家でなくても、データベース管理が驚くほど簡単になります。
ClickUpデータベースで依存関係を作成する方法は以下の通りです。
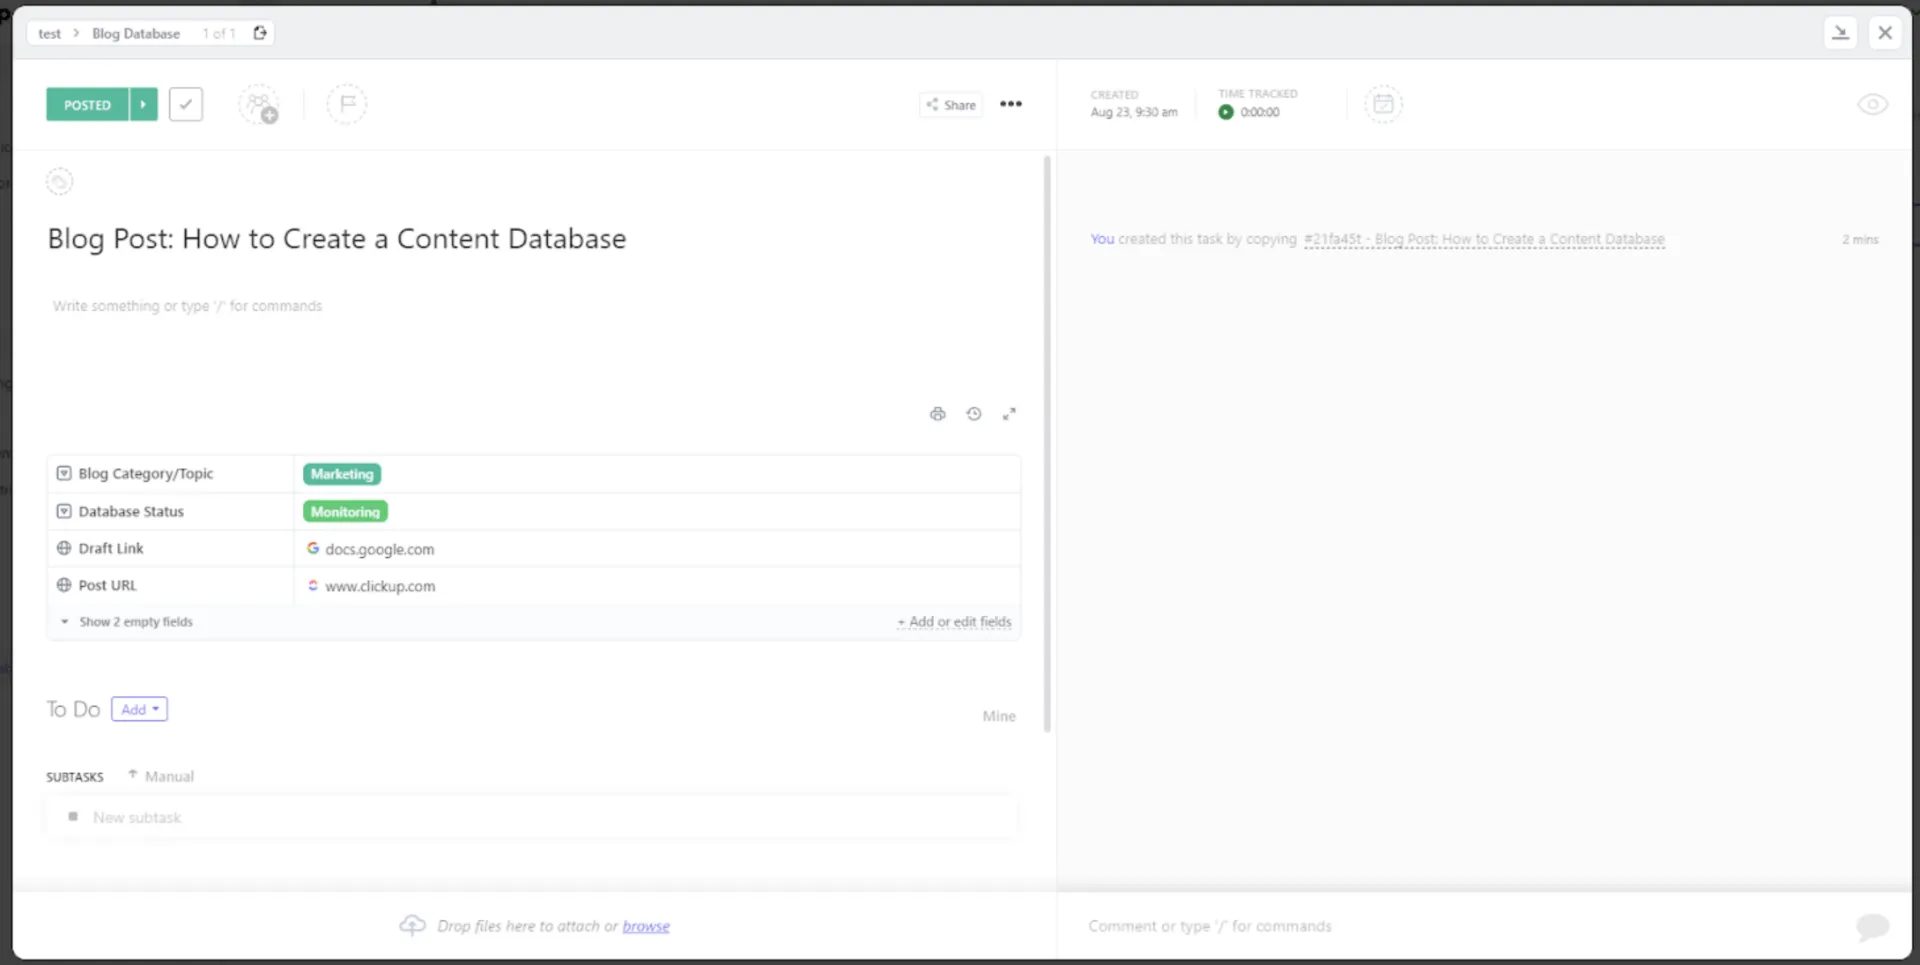
まず、仕事したいタスクをクリックしてください。
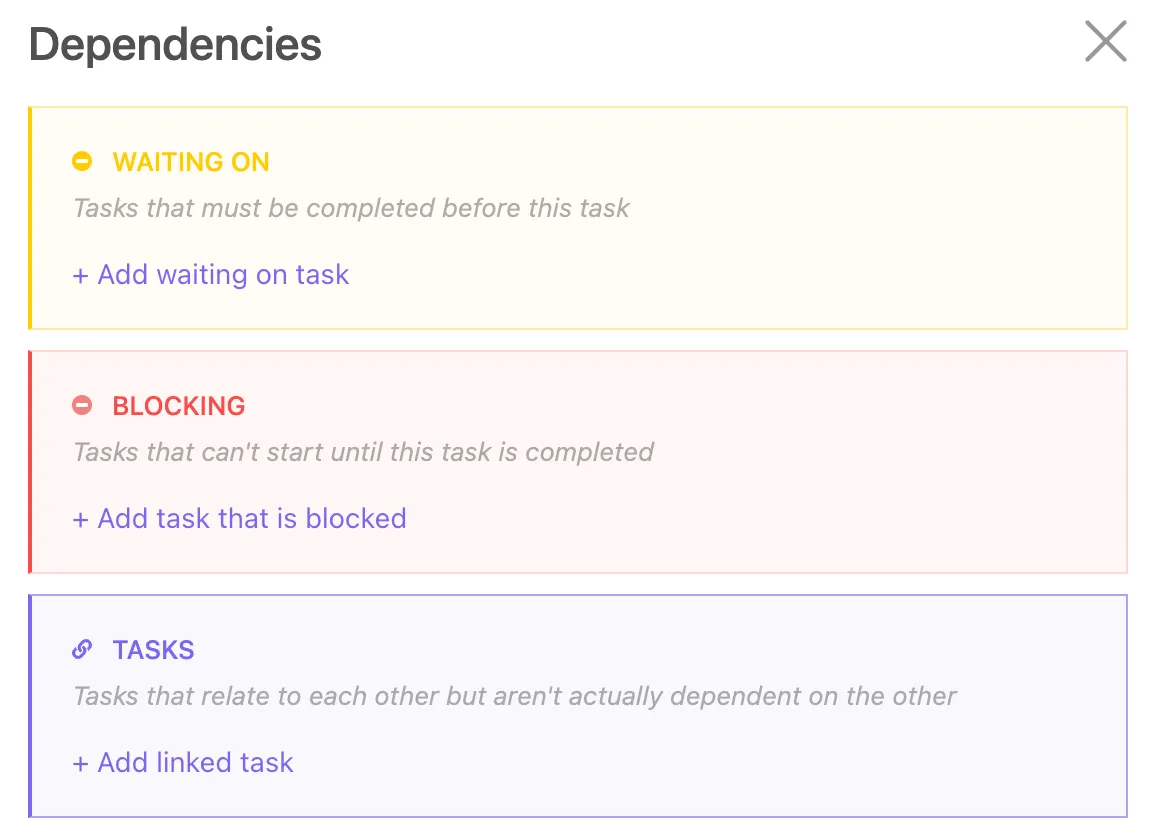
[リレーションシップ] > [依存関係] に移動します。待機中、ブロック中、タスクから選択して、依存関係をカスタムしてください。
この場合、Waiting On を選択し、現在のタスクに関連する別のタスクを検索します。
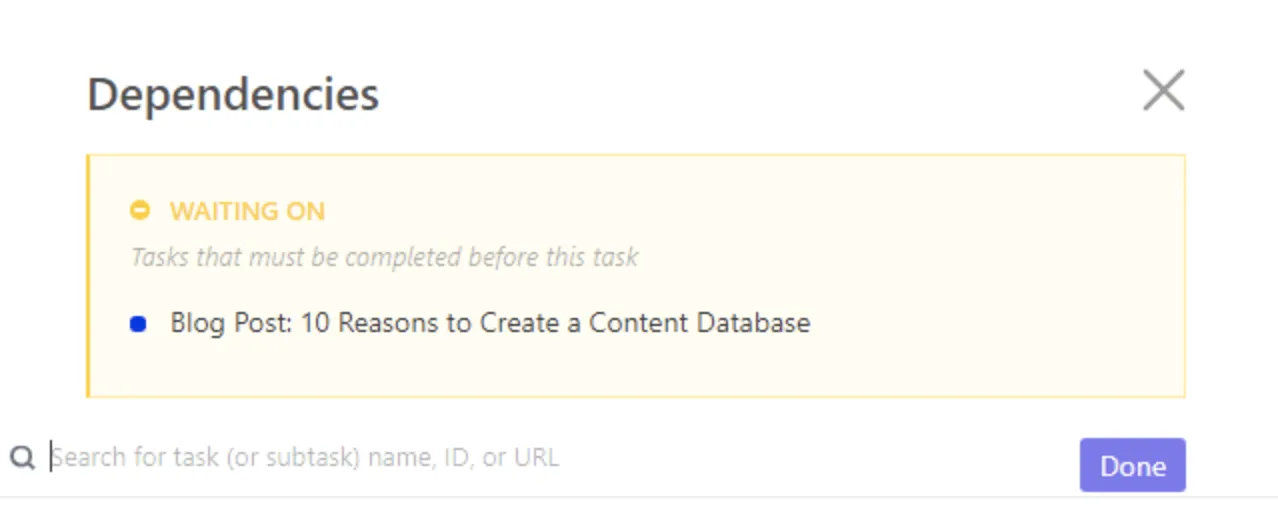
「完了」をクリックすれば、これで完了です! 🙌
ClickUpで依存関係をシンプルに
「データベース管理は複雑でなければならない」なんて誰が言ったのでしょうか?機能依存関係の仕組みをしっかりと理解していれば、組織の発展を支える、高速で正確なデータベースを設計することができるでしょう。
また、これを一人でやる必要もありません。ClickUpは、データとテンプレート、プロジェクト、タスク、目標、そしてその間のすべてを統合した、堅牢なデータベース管理システムです。
ClickUpの真にオールインワンなプラットフォームに切り替えることで、時間をさらに節約し、価値の高いタスクに集中しましょう。
ぜひ試してみてください:無料のClickUpアカウントを作成して、より優れたデータベースを構築しましょう!