
IT havárie mohou nastat bez varování.
Od selhání serverů až po kyberútoky – bez spolehlivého plánu obnovy může vaše firma čelit hodinovým výpadkům, ztrátě dat a vážným finančním škodám, přičemž 54 % závažných výpadků stojí více než 100 000 USD.
Tento blog vás provede tvorbou komplexního plánu obnovy po havárii v oblasti IT, který chrání vaše systémy, definuje jasné cíle obnovy a zajišťuje, že váš tým přesně ví, co má dělat, když dojde k problému.
Co je to plán obnovy po havárii v oblasti IT?
Kdyby právě teď došlo k výpadku vašich serverů, věděl by váš tým přesně, co má dělat? 🛠️
Plán obnovy po havárii (DR) je vaše zdokumentovaná strategie pro obnovení IT systémů a dat po jakémkoli narušení – od přírodních katastrof až po kyberútoky. Jedná se v podstatě o váš postup pro zprovoznění technologií v případě, že dojde k problémům.
💡 Obnova po havárii vs. kontinuita podnikání
Obnova po havárii (DR) se zaměřuje konkrétně na obnovu vaší IT infrastruktury a dat. Kontinuita podnikání (BC) má širší záběr a jejím cílem je udržet celý váš podnik v provozu během krize i po ní, a to i v případě výpadku IT. Považujte DR za klíčovou součást vaší celkové strategie BC.
💡 Obnova po havárii vs. kontinuita podnikání
Obnova po havárii (DR) se zaměřuje konkrétně na obnovu vaší IT infrastruktury a dat. Kontinuita podnikání (BC) má širší záběr a jejím cílem je udržet celý váš podnik v provozu během krize i po ní, a to i v případě výpadku IT. Považujte DR za klíčovou součást vaší celkové strategie BC.
Váš plán obnovy po havárii je důležitý, protože prostoje stojí víc než jen peníze. Každá minuta, kdy jsou vaše systémy mimo provoz, může podkopat důvěru zákazníků, narušit provoz a dokonce vést k pokutám za nedodržení předpisů. Komplexní plán obnovy po havárii je vaším návodem k zajištění odolnosti.
Dobrý plán zahrnuje:
- Postupy zálohování dat: Jak a kde ukládáte kopie důležitých informací, abyste je mohli obnovit
- Kroky k obnovení systému: Přesný postup pro obnovení služeb ve správném pořadí
- Odpovědnosti týmu: Kdo co dělá během incidentu, aby se předešlo zmatkům
- Komunikační protokoly: Jak budete informovat zainteresované strany, od svého týmu až po zákazníky
- Cíle obnovy: Vaše konkrétní cíle týkající se toho, jak rychle musí být systémy obnoveny a jaká míra ztráty dat je přijatelná
Běžné scénáře IT havárií a jejich dopady
Katastrofy nejsou jen hollywoodské scénáře; v podnikatelském světě k nim dochází každý den. Pochopení toho, před čím se chráníte, vám pomůže vybudovat mnohem silnější obranu.
Přírodní katastrofy a fyzické poškození
Události jako povodně, požáry, zemětřesení a rozsáhlé výpadky elektrického proudu mohou během několika minut zničit celá datová centra. Když například datové centrum v Nashvillu zasáhla velká povodeň, některé společnosti přišly o data za několik týdnů a čekala je měsíce trvající obnova. Nejlepší ochranou proti tomu je geografická redundance, což znamená rozložení infrastruktury do více fyzických lokalit, aby jedna událost nemohla vyřadit vše z provozu.
Kybernetické útoky a ohrožení dat
Ransomware, útoky typu Distributed Denial-of-Service (DDoS) a úniky dat se liší od fyzických katastrof. Často je obtížnější je odhalit, mohou se tiše šířit napříč propojenými systémy a často se zaměřují i na vaše zálohovací systémy, což zotavení značně ztěžuje. Četnost a sofistikovanost těchto kyberútoků ve všech odvětvích neustále roste, přičemž ransomware se nyní podílí na 44 % všech potvrzených úniků dat, což z něj činí jednu z největších hrozeb.
📖 Přečtěte si více: 10 způsobů, jak snížit kybernetická bezpečnostní rizika v projektovém řízení
Poruchy hardwaru a ztráta dat
Někdy selžou i ty nejlépe otestované a nejspolehlivější zálohovací systémy. K výpadkům serverů, poruchám úložišť a selháním síťových zařízení může dojít bez varování. I když máte redundantní (záložní) systémy, mohou selhat současně, pokud sdílejí společné komponenty nebo zdroje napájení, čímž vzniká jediný bod selhání.
👀 Věděli jste, že: V říjnu 2025 došlo u AWS k závažnému výpadku, když chyba v interním systému správy DNS pro Amazon DynamoDB způsobila selhání překladu doménových jmen v datovém centru regionu US-EAST-1. Tato „malá“ technická závada vyvolala řetězovou poruchu napříč desítkami služeb AWS a způsobila výpadek stovek populárních aplikací a platforem po celém světě – od aplikací pro zasílání zpráv a sociálních sítí až po banky, herní weby a další. Pro mnoho lidí tento výpadek dočasně způsobil, že velká část internetu „zmizela“, což poukázalo na to, jak křehká je naše digitální infrastruktura, když tolik závisí na hrstce poskytovatelů cloudových služeb.
Chyby softwaru a přerušení služeb
Poškozená databáze, neúspěšná aktualizace softwaru nebo pouhá chyba v konfiguraci mohou způsobit výpadek celých platforem. Možná jste si všimli, že jediný nesprávně nakonfigurovaný řádek kódu může mít kaskádový efekt na propojené systémy a způsobit rozsáhlý výpadek s velkým dopadem. Správné řízení změn a vyhrazená testovací prostředí jsou vašimi nejlepšími spojenci při minimalizaci těchto rizik.
Lidské chyby a nesprávné konfigurace
Náhodné smazání, nesprávné konfigurace a neoprávněné změny patří i nadále k nejčastějším příčinám výpadků IT. Jediný nesprávný příkaz nebo smazaný soubor může způsobit několikahodinový výpadek a zhoršení kvality služeb. Školení a kontroly přístupu sice pomáhají, ale lidské chyby nedokážou zcela vyloučit.
📮ClickUp Insight: 92 % zaměstnanců používá nejednotné metody ke sledování úkolů, což vede k opomenutým rozhodnutím a zpožděnému provedení.
Ať už posíláte následné poznámky nebo používáte tabulky, tento proces je často roztříštěný a neefektivní. Díky funkcím správy úkolů v ClickUp se o to už nikdy nebudete muset starat. Vytvářejte úkoly z chatu, komentářů k úkolům v ClickUp, dokumentů a e-mailů jediným kliknutím!
Klíčové součásti plánu obnovy po havárii v oblasti IT
Dobře promyšlený plán obnovy po havárii je vaším kompletním návodem, jak obnovit provoz. Každá z těchto složek navazuje na ostatní a společně vytvářejí komplexní ochranu pro vaši firmu.
Posouzení rizik a stanovení priorit
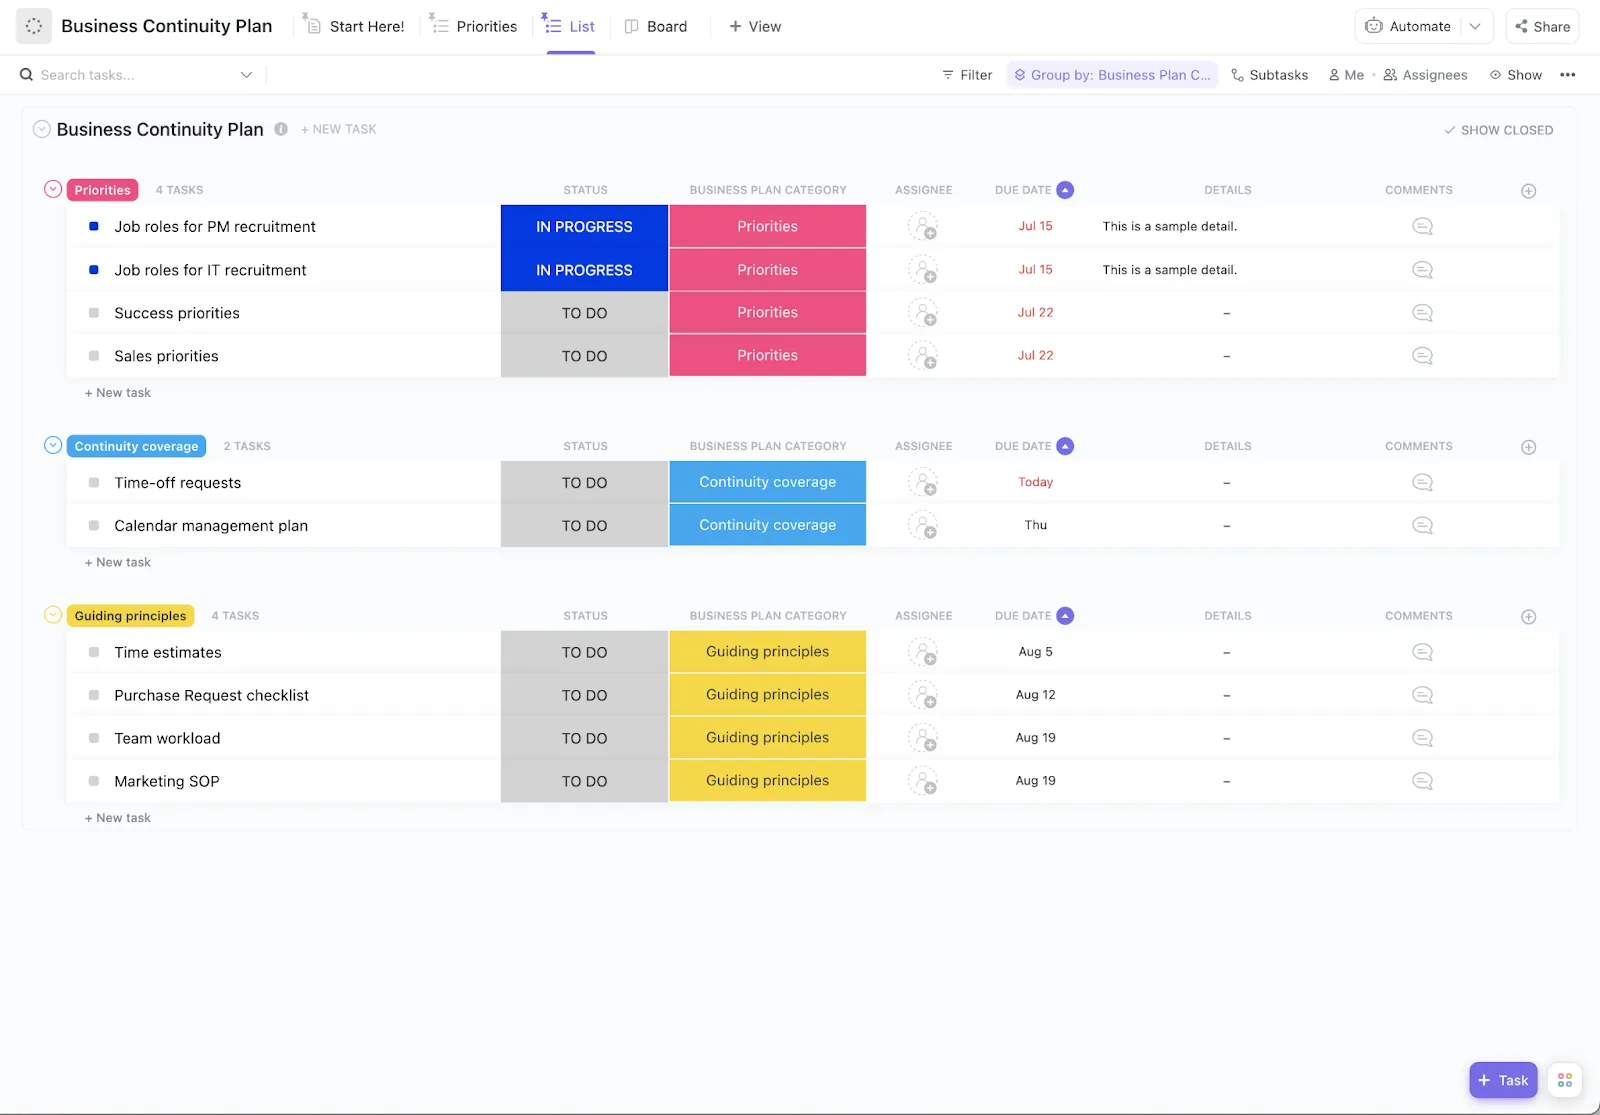
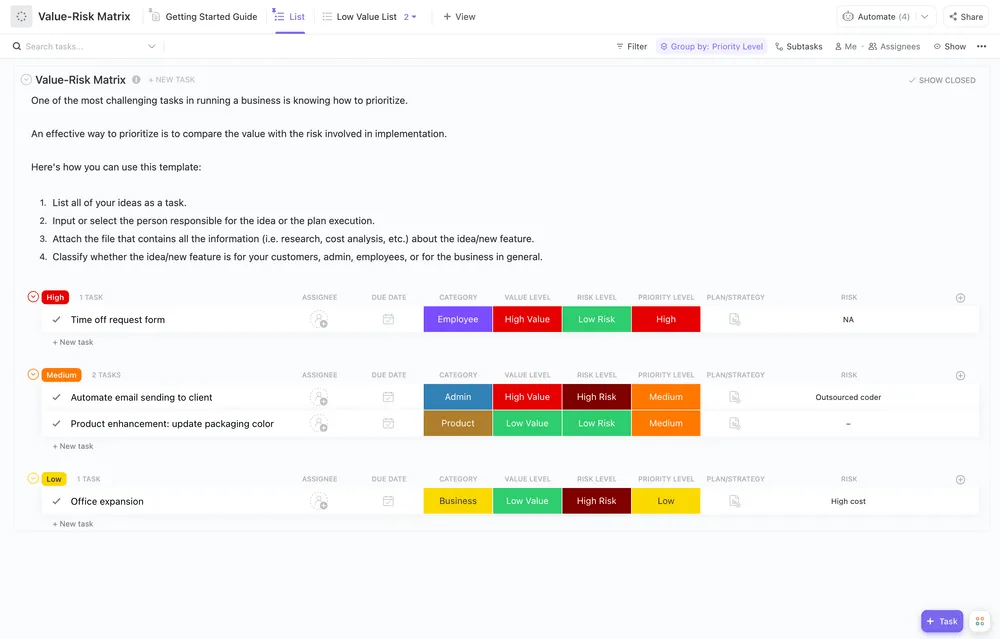
Nejprve musíte vědět, čemu čelíte. Posouzení rizik je proces identifikace vašich slabých míst a vyhodnocení pravděpodobnosti a dopadu každé potenciální hrozby. Výsledky můžete uspořádat do matice rizik, abyste zjistili, které hrozby jsou nejzávažnější.
Vaše hodnocení by mělo zahrnovat:
- Kritické systémy: Co musí bezpodmínečně zůstat v provozu, aby vaše firma mohla fungovat
- Citlivost dat: Které informace vyžadují nejvyšší úroveň ochrany (například údaje o zákaznících)
- Závislosti: Jaké další systémy nebo procesy přestanou fungovat, když dojde k selhání jednotlivých systémů
📖 Přečtěte si více: Jak zavést správu IT infrastruktury
Analýza dopadu na podnik a kritičnost
Dále si vypočítejte skutečné náklady spojené s prostoji. Analýza dopadu na podnikání (BIA) vám pomůže určit finanční a provozní dopad výpadku u každého systému. To vám umožní rozdělit systémy do úrovní kritičnosti a stanovit priority při obnově.
| Kritické | Méně než jedna hodina | Zpracování plateb, databáze zákazníků |
| Vysoká | Jedna až čtyři hodiny | E-mail, nástroje pro interní komunikaci |
| Střední | 4 až 24 hodin | Vývojová prostředí, nástroje pro tvorbu reportů |
| Nízká | 24+ hodin | Archivační systémy, testovací servery mimo produkční prostředí |
Cíle RTO a RPO
Tyto dvě zkratky tvoří jádro vaší strategie obnovy.
- Cílová doba obnovy (RTO): Jedná se o maximální dobu, po kterou si můžete dovolit, aby byl systém mimo provoz. Odpovídá na otázku: „Jak rychle potřebujeme, aby byl systém opět v provozu?“
- Cíl bodu obnovy (RPO): Jedná se o maximální množství dat, jehož ztrátu si můžete dovolit, měřené v čase. Odpovídá na otázku: „Kolik dat můžeme ztratit, aniž by to způsobilo vážné škody?“
Například váš interní e-mailový systém může mít RTO čtyři hodiny, ale vaše databáze e-shopu určená pro zákazníky může mít RPO pouhých 15 minut, což znamená, že nesmíte ztratit více než 15 minut transakčních dat.
Plán zálohování a obnovy dat
Váš zálohovací plán je vaší nejdůležitější pojistkou. Osvědčeným postupem je pravidlo 3-2-1: uchovávejte alespoň tři kopie důležitých dat, ukládejte je na dva různé typy médií a jednu z těchto kopií uchovávejte mimo pracoviště.
Budete si také moci vybrat mezi různými typy zálohování:
- Úplné zálohy: Kompletní kopie všech dat, obvykle prováděná jednou týdně nebo jednou měsíčně
- Inkrementální zálohy: Zálohují se pouze změny provedené od poslední zálohy jakéhokoli typu
- Diferenciální zálohy: Zálohují všechny změny provedené od poslední úplné zálohy
A co je nejdůležitější, musíte pravidelně testovat proces obnovy záloh. Netestovaná záloha je jen naděje, nikoli plán.
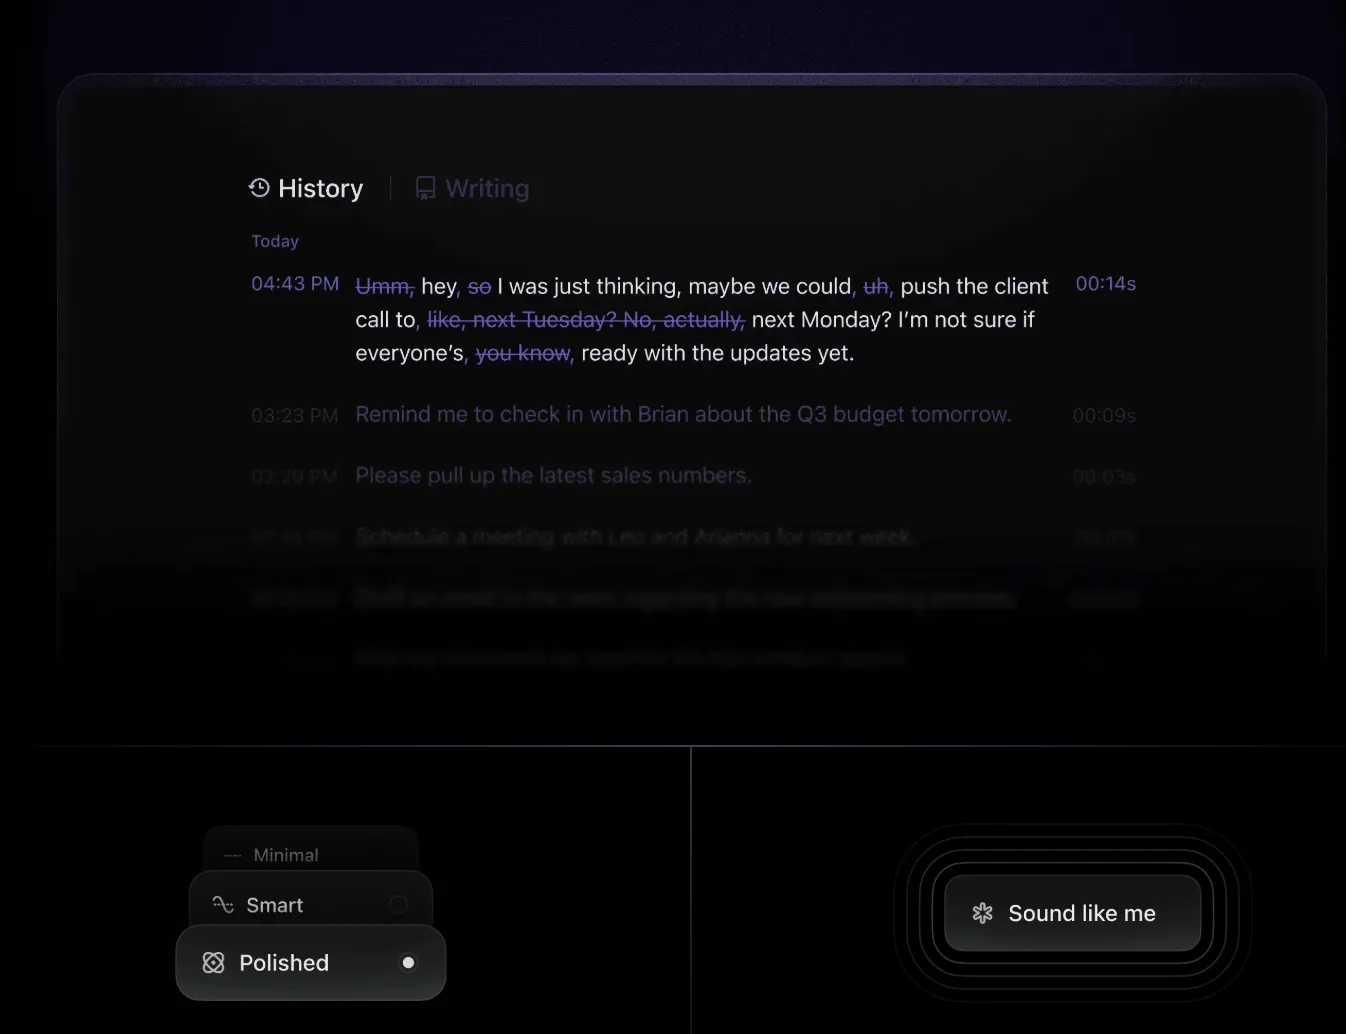
💟 Bonus: Zaznamenávejte klíčové podrobnosti během mimořádně náročných incidentů pomocí funkce převodu řeči na text v ClickUp Brain MAX, abyste nikdy nezmeškali důležité informace, i když není možné psát na klávesnici. Stačí vyslovit své postřehy a nechat umělou inteligenci postarat se o dokumentaci.
Komunikační plán a informování zainteresovaných stran
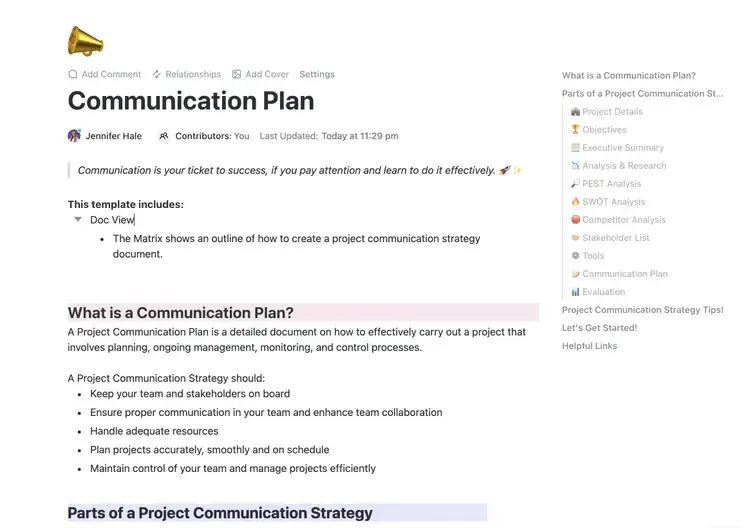
Když dojde k havárii, je jasný komunikační plán naprosto zásadní. Váš plán musí definovat řetězce oznamování, frekvenci poskytování aktualizací a kanály, které budete používat pro každý typ incidentu.
Různé skupiny potřebují různé informace:
- Interní týmy: Potřebujete technické podrobnosti a konkrétní kroky k provedení
- Zákazníci: Potřebujete znát stav služby a vědět, kdy se očekává vyřešení problému
- Dodavatelé: Může být nutné je zapojit pro poskytnutí podpory nebo při eskalacích
- Regulační orgány: V závislosti na vašem odvětví mohou vyžadovat formální oznámení.
Nástroje, jako je tato šablona komunikačního plánu od ClickUp připravená k okamžitému použití, vám mohou pomoci jednat rychleji díky zavedenému protokolu během krizové situace.
Program testování a školení
Plán, který nikdy netestujete, je plán, který selže. Pravidelné testování odhalí mezery a slabá místa ještě předtím, než dojde ke skutečné havárii.
Naplánujte si v průběhu roku různé typy testů:
- Simulační cvičení: Váš tým si na papíře projde scénář havárie, aby ověřil logiku plánu
- Částečné převzetí služeb: Testujete obnovu konkrétních, nekritických komponent nebo služeb
- Kompletní testy obnovy po havárii: Provedete kompletní převzetí služeb záložními systémy (konečný test)
Po každém testu aktualizujte dokumentaci a nové členy týmu okamžitě proškolte v těchto postupech.
📖 Přečtěte si více: Jak vypracovat účinné IT zásady a postupy
Kroky k vytvoření plánu obnovy po havárii v oblasti IT
Vytvoření plánu obnovy po havárii nemusí být nijak složité.
Zde je návod, jak na to krok za krokem. 🙌
Krok 1: Vytvořte inventář aktiv
Nemůžete chránit to, o čem nevíte, že to máte. Začněte vytvořením inventáře aktiv, který obsahuje seznam veškerého hardwaru, softwaru, úložišť dat a systémových závislostí ve vašem prostředí. Nezapomeňte uvést kontakty na dodavatele, licenční klíče a podrobnosti o konfiguraci, abyste k nim měli během obnovy rychlý přístup.
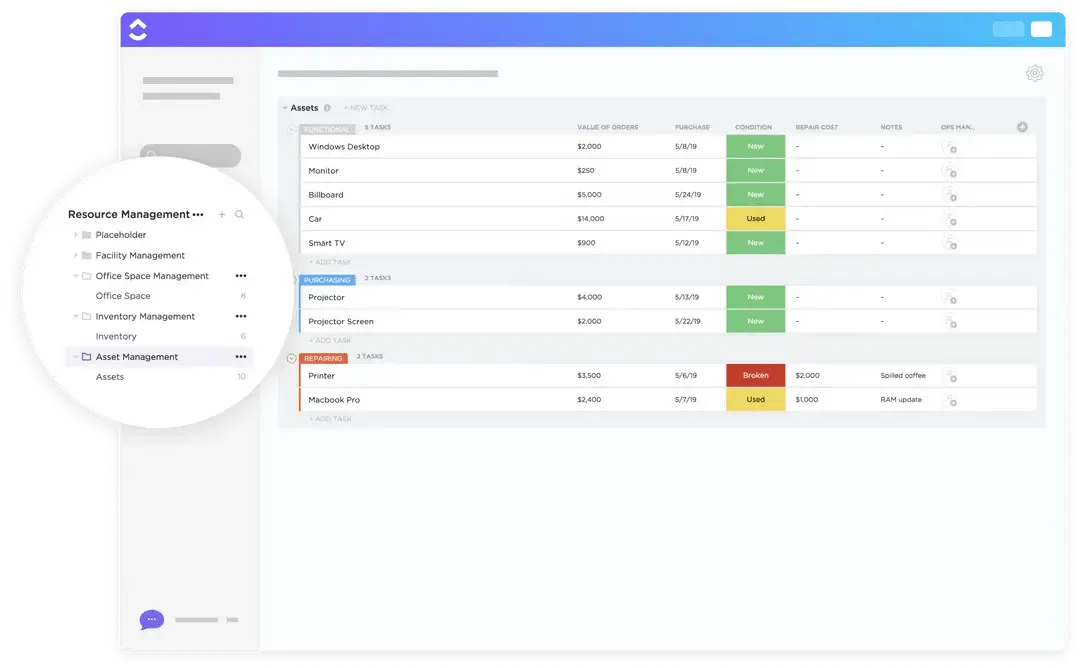
Šablona ClickUp pro správu IT aktiv (ITAM) spojuje správu incidentů, správu problémů, správu změn, jednoduchá řešení pro správu aktiv a správu znalostí. Naše šablona ITSM pro známé chyby zjednodušuje sledování známých chyb ve vašich systémech. Prozkoumejte všechny naše IT šablony, jakmile se změní váš účel.
Přizpůsobte si pracovní postupy podle svých představ pro každou fázi správy IT aktiv (ITAM), od nasazení a konfigurace až po údržbu a vyřazení z provozu.
Krok 2: Klasifikace kritických služeb
Nyní určete, která z těchto aktiv jsou kriticky důležitá pro chod firmy a která jsou pouze doplňková. Vytvořte mapy závislostí služeb, které ukazují, jak jsou vaše systémy propojeny a jak na sobě vzájemně závisí. Zvláštní pozornost věnujte službám určeným zákazníkům, které mají přímý dopad na tržby nebo uživatelský zážitek.
🎥 Podívejte se na tento praktický návod, který ukazuje, jak pomocí výkonných funkcí ClickUp vytvořit strukturovaný plán na vysoké úrovni – od stanovení cílů přes přidělování úkolů až po sledování pokroku.
Krok 3: Posouzení rizik a hrozeb
Posuďte rizika a hrozby tím, že vyhodnotíte pravděpodobnost a dopad každého typu hrozby na vaši konkrétní situaci. Zohledněte geografická rizika (nacházíte se v seizmicky aktivní oblasti nebo v záplavovém území?) a jakékoli hrozby specifické pro vaše odvětví (například změny v předpisech nebo cílené kyberútoky). Vše zdokumentujte v registru rizik, abyste mohli sledovat jejich vývoj v čase.

Šablona tabule pro hodnocení rizik v ClickUp vnáší do vašeho procesu hodnocení rizik vizuální rozměr. Pomáhá při hodnocení a kategorizaci rizik a inspiruje váš tým ke sdílení poznatků a spolupráci v poutavém a vizuálně přitažlivém formátu.
Tato šablona vám umožní:
- Vyhodnoťte kategorie rizik a potenciální dopady
- Analyzujte data a identifikujte potenciální problémové oblasti
- Stanovte preventivní opatření ke snížení vystavení rizikům
Díky funkcím, které vám umožňují kreslit, psát a přidávat poznámkové lístky, je tato šablona tabule pro řízení rizik ideální pro vyhodnocení rizik vašeho projektu.
Krok 4: Stanovte cíle RTO a RPO
Spolupracujte přímo s klíčovými zainteresovanými stranami ve vaší firmě a společně s nimi definujte, co považují za přijatelnou dobu výpadku a ztrátu dat pro každou úroveň služeb, kterou jste dříve identifikovali. Budete muset najít rovnováhu mezi náklady na rychlejší obnovu a dopadem na podnikání – ne vše vyžaduje okamžitou obnovu bez ztráty dat. Získejte souhlas vedení s těmito cíli.
Krok 5: Definujte cesty pro zálohování a převzetí služeb při selhání
Jakmile si stanovíte cíle, můžete přistoupit k návrhu technických řešení. Vytvořte strategie zálohování přizpůsobené hodnotám RPO jednotlivých systémů a naplánujte podrobné postupy pro převzetí služeb v případě selhání, včetně náhradních zpracovatelských lokalit a metod nouzového přístupu. Přiložte síťové diagramy a podrobné návody, aby byla realizace bezchybná.
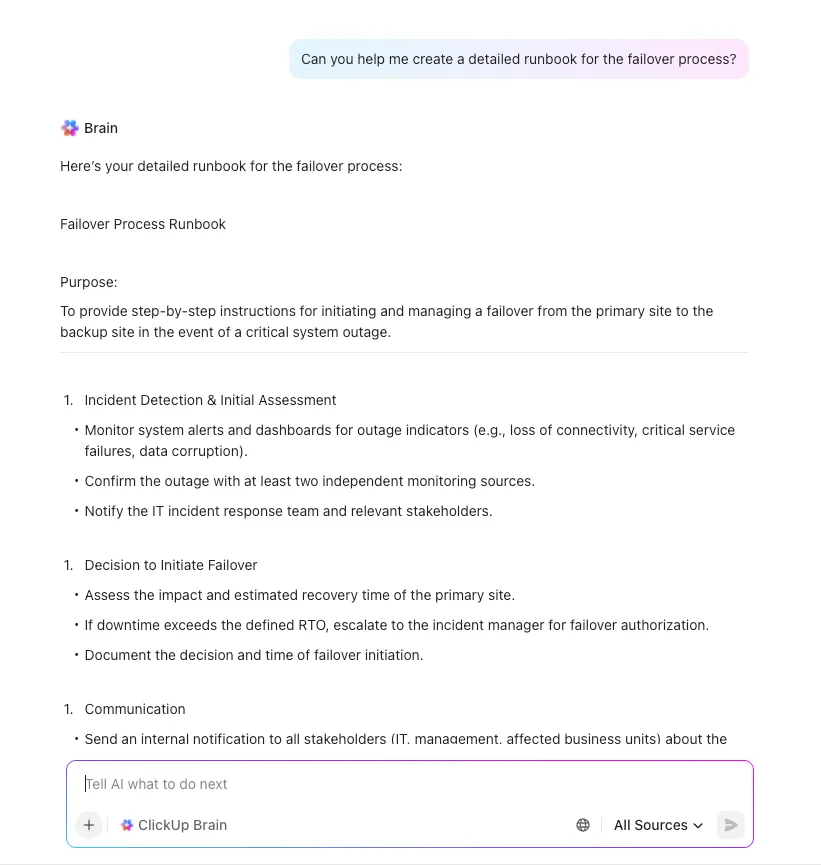
Krok 6: Přiřaďte role a postupy eskalace
Definujte strukturu svého týmu pro obnovu po havárii s jasně stanovenými odpovědnostmi a rozhodovacími pravomocemi. Vytvořte komplexní seznamy kontaktů s primárními a záložními pracovníky pro každou roli. Matice RACI (Responsible, Accountable, Consulted, Informed – odpovědný, zodpovědný, konzultovaný, informovaný) je skvělým nástrojem k eliminaci nejasností během incidentu s vysokou mírou stresu.
Krok 7: Zaznamenejte a sdělte plán
Zaznamenejte plán a sdělte jej pomocí jasných, podrobných postupů, které dokáže dodržet každý člen vašeho týmu, a to i pod tlakem. Je zásadní uložit tuto dokumentaci na snadno přístupném místě, které je oddělené od vaší primární infrastruktury. Zajistěte, aby každý člen týmu přesně věděl, kde plán v případě krize najít.

Zefektivněte plánování projektů pomocí šablony RACI od ClickUp. Tato šablona dokumentu je revoluční a nabízí přehledný graf pro definování rolí a odpovědností týmu v souvislosti s úkoly projektu. Využijte rámec RACI (Responsible, Accountable, Consulted, Informed – odpovědný, zodpovědný, konzultovaný a informovaný), abyste zajistili, že všichni budou na stejné vlně, a zajistili tak odpovědnost a soulad s cíli organizace.
Krok 8: Testujte, vyhodnocujte a vylepšujte
Nakonec naplánujte čtvrtletní testy, abyste ověřili své postupy a odhalili případné mezery. Zaznamenejte si všechny poznatky získané z každého testu i ze skutečných incidentů a využijte je k aktualizaci svého plánu. Vytvořte systematický systém sledování zlepšování, abyste zajistili, že všechny zjištěné problémy budou vyřešeny.
🌼 Věděli jste, že: V roce 2017 došlo ve společnosti GitLab k závažnému výpadku databáze. Během obnovy zjistili, že několik jejich metod zálohování již několik dní tiše selhávalo. Tato událost dala celému technologickému odvětví důležitou lekci: ověřování záloh je nezbytné. Neotestovaná záloha vlastně není žádnou zálohou.
🌼 Věděli jste, že: V roce 2017 došlo ve společnosti GitLab k závažnému výpadku databáze. Během obnovy zjistili, že několik jejich metod zálohování již několik dní tiše selhávalo. Tato událost dala celému technologickému odvětví důležitou lekci: ověřování záloh je nezbytné. Neotestovaná záloha vlastně není žádnou zálohou.
Strategie a řešení pro obnovu po havárii
Ne každá organizace potřebuje stejný přístup k obnově po havárii. Prozkoumáme vaše možnosti na základě vašeho rozpočtu, potřeb v oblasti obnovy a dostupných zdrojů.
Přístup k zálohování a obnově
Jedná se o nejjednodušší a nejhospodárnější metodu. Spočívá v pravidelném zálohování dat na externí úložiště (například do cloudu nebo do sekundárního datového centra) a jejich následném ručním obnovení v případě potřeby. Tento přístup je nejvhodnější pro nekritické systémy, které mohou tolerovat delší dobu obnovy (RTO), protože obnovení může trvat hodiny nebo dokonce dny.
Vysoká dostupnost a redundance
Cílem této strategie je eliminovat jednotlivé body selhání pomocí více aktivních systémů. Techniky jako vyvažování zátěže, serverové clustery a úložiště RAID zajišťují, že v případě selhání jedné komponenty ji okamžitě převezme jiná. Ačkoli je tento přístup nákladnější na zavedení a údržbu, dokáže zkrátit prostoje na pouhé sekundy či minuty, což z něj činí ideální řešení pro kritické služby.
Možnosti replikace a převzetí služeb při selhání
Replikace spočívá v kopírování dat téměř v reálném čase na sekundární lokalitu, což zajišťuje minimální ztrátu dat v případě havárie.
- Synchronní replikace: Zapisuje data současně na primární i sekundární lokalitu, čímž zaručuje nulovou ztrátu dat. Vyžaduje však vysokou šířku pásma a může zpomalit váš primární systém.
- Asynchronní replikace: Data se nejprve zapíší na primární lokalitu a poté se s mírným zpožděním zkopírují na sekundární lokalitu. Je to levnější řešení s menším dopadem na výkon, ale musíte akceptovat malé riziko ztráty dat.
Obnova po havárii v cloudu a služba DRaaS
Služba zotavení po havárii (DRaaS) se stala oblíbenou volbou pro mnoho podniků. Nabízí platby podle skutečného využití, okamžité geografické rozložení a automatizovanou koordinaci zotavení, aniž byste museli budovat a udržovat vlastní fyzická zotavovací centra. Cloudové zotavení po havárii eliminuje obrovské kapitálové výdaje spojené se záložním datovým centrem a zároveň poskytuje rychlejší škálovatelnost a větší flexibilitu než tradiční přístupy typu „hot“, „warm“ nebo „cold“.
Jak ClickUp zefektivňuje plánování obnovy po havárii v IT
Správa plánu obnovy po havárii rozptýleného v různých tabulkách, dokumentech a e-mailových řetězcích představuje samo o sobě riziko katastrofy.
Tento druh rozptýlení práce, fragmentace práce napříč mnoha nesouvislými nástroji, které mezi sebou nekomunikují, a rozptýlení kontextu, kdy týmy ztrácejí hodiny hledáním informací roztroušených po různých aplikacích a platformách, vede ke zmatkům, zastaralým informacím a pomalým reakcím v situacích, kdy záleží na každé vteřině.
S ClickUp Converged AI Workspace – jednotnou a bezpečnou platformou, kde jsou všechny vaše pracovní aplikace, data a pracovní postupy propojeny s kontextovou umělou inteligencí jako vrstvou inteligence – která kombinuje řízení projektů, dokumentaci a týmovou komunikaci. Přestaňte se potýkat s více platformami a sjednoťte plánování obnovy po havárii, testování a reakci na incidenty do jednoho uceleného systému.
Centralizovaná dokumentace k obnově po havárii pomocí ClickUp Docs a integrované AI asistence
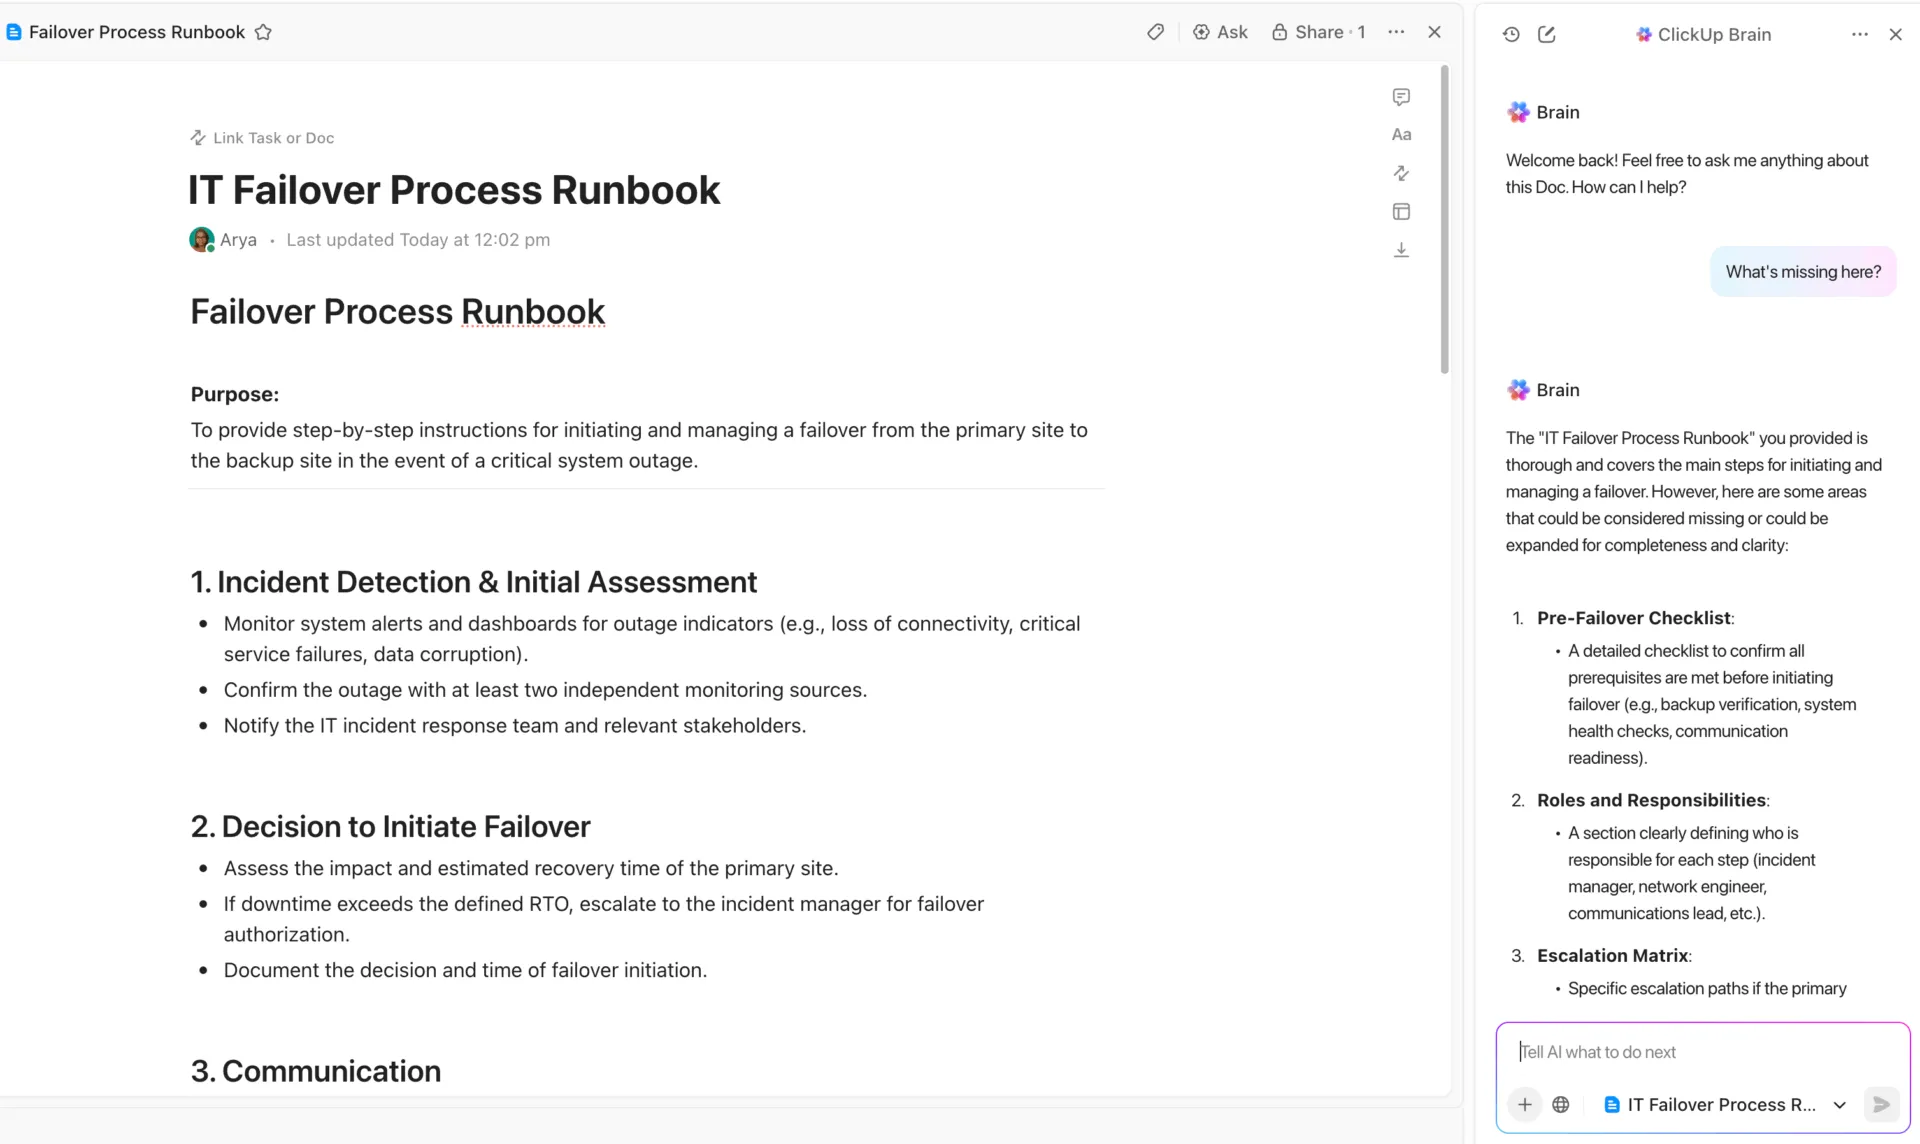
Zajistěte, aby váš tým měl vždy k dispozici jediný spolehlivý zdroj informací díky ClickUp Docs.
Vytvořte si kompletní plán obnovy po havárii v prostředí pro spolupráci, kde může každý v reálném čase přispívat během incidentu. Propojte dokumenty přímo s úkoly a projekty souvisejícími s incidentem, abyste mohli plynule navigovat, a vkládejte diagramy nebo provozní příručky, abyste měli důležité informace přesně tam, kde je potřebujete.
A co je nejlepší, můžete své dokumenty chránit před neúmyslnými úpravami a pomocí podrobných oprávnění v ClickUp řídit, kdo může citlivé postupy obnovy prohlížet nebo měnit. Každá změna se zaznamenává v historii dokumentu, což vám poskytuje kompletní auditní stopu.
Vytváření plánů s využitím umělé inteligence pomocí ClickUp Brain
Urychlete plánování obnovy po havárii a odstraňte kritické mezery pomocí ClickUp Brain – vašeho kontextového asistenta s umělou inteligencí, který rozumí celému vašemu pracovnímu prostoru. Na rozdíl od obecných nástrojů s umělou inteligencí využívá ClickUp Brain skutečné úkoly, dokumenty a pracovní postupy vaší organizace, aby poskytoval přesnou a praktickou podporu pro iniciativy v oblasti obnovy po havárii.
Stačí zadat do ClickUp Brain požadavek typu „Vytvoř kontrolní seznam pro obnovu po havárii pro naši e-commerce platformu“ a okamžitě získáte komplexní šablonu na míru, která odpovídá vašim systémům, procesům a požadavkům na dodržování předpisů. Pomůže vám s:
- Kontextové povědomí: ClickUp Brain má přístup ke struktuře, obsahu a oprávněním vašeho pracovního prostoru. Může odkazovat na úkoly, dokumenty, komentáře a dokonce i propojené aplikace, čímž poskytuje odpovědi a akce přizpůsobené vaší konkrétní práci – nejde jen o obecné návrhy.
- Řešení problémů a návody: Okamžitě řešte problémy, získejte podrobné pokyny nebo se zeptejte na osvědčené postupy týkající se jakékoli funkce ClickUp. Brain vás provede složitými procesy, automatizuje opakující se úkoly a pomůže vyřešit překážky.
- Automatizace a zrychlení pracovních postupů: Využijte předem připravené nebo vlastní agenty s umělou inteligencí k automatizaci vícestupňových pracovních postupů, třídění požadavků nebo správě opakujících se úkolů – a ušetřete tak každý týden několik hodin času.
- Hloubkové vyhledávání: Najděte informace ukryté kdekoli ve vašem pracovním prostředí, včetně úkolů, dokumentů a integrovaných nástrojů, i když jsou staré několik let nebo je obtížné je najít pomocí standardního vyhledávání.
- Souhrny a aktualizace v reálném čase: Okamžitě generujte aktualizace projektů, souhrny schůzek nebo zprávy o postupu prací na základě dat z pracovního prostoru v reálném čase
- Zjednodušení technické dokumentace: Převádějte složité technické dokumenty na srozumitelné a praktické postupy nebo kontrolní seznamy, které může váš tým dodržovat i v náročných situacích
- Více modelová inteligence: Vyberte si z předních modelů umělé inteligence (OpenAI GPT-4.1, GPT-5, Claude, Gemini a další) a dosáhněte nejlepších výsledků při jakémkoli úkolu – bez nutnosti samostatných předplatných
- Bezpečné a s ohledem na oprávnění: Brain přistupuje pouze k informacím, ke kterým již máte oprávnění, čímž dodržuje přísné standardy ochrany soukromí a souladu s předpisy
- Konverzační rozhraní: Použijte @brain v komentářích nebo chatu, abyste získali kontextové informace, vytvořili návrhy odpovědí nebo spustili automatizované procesy, aniž byste museli opustit svůj pracovní postup
- Vlastní výzvy a uložené pracovní postupy: Ukládejte a opakovaně používejte výzvy pro opakující se potřeby, čímž zajistíte konzistentnost a ušetříte čas celému týmu
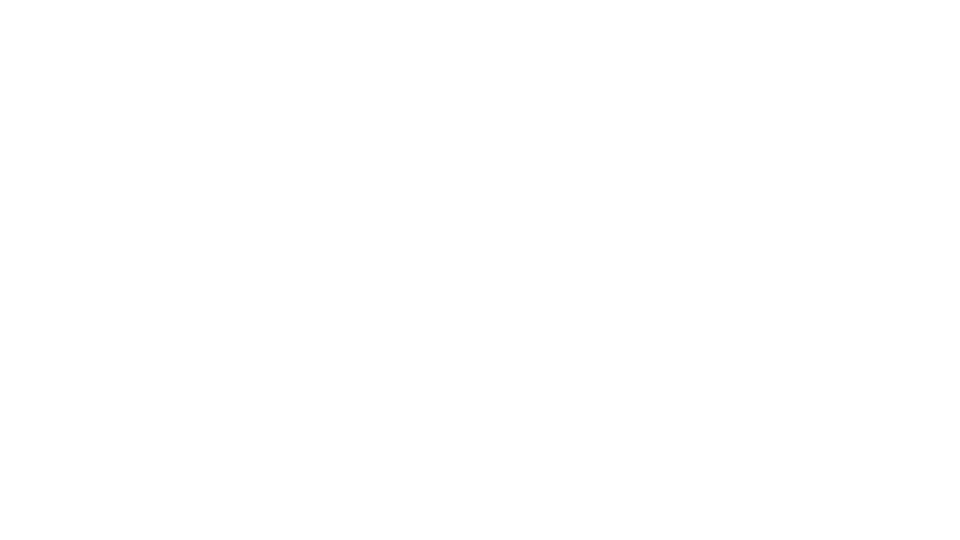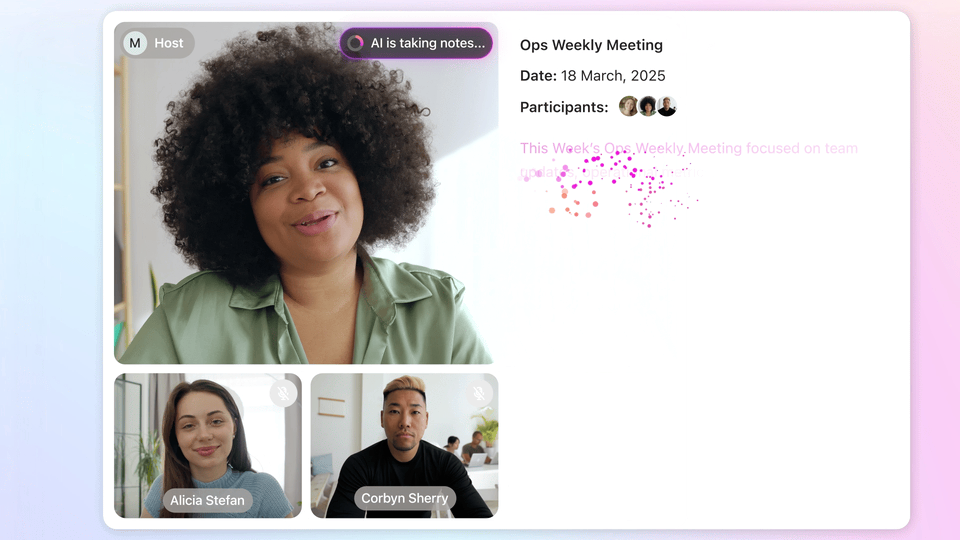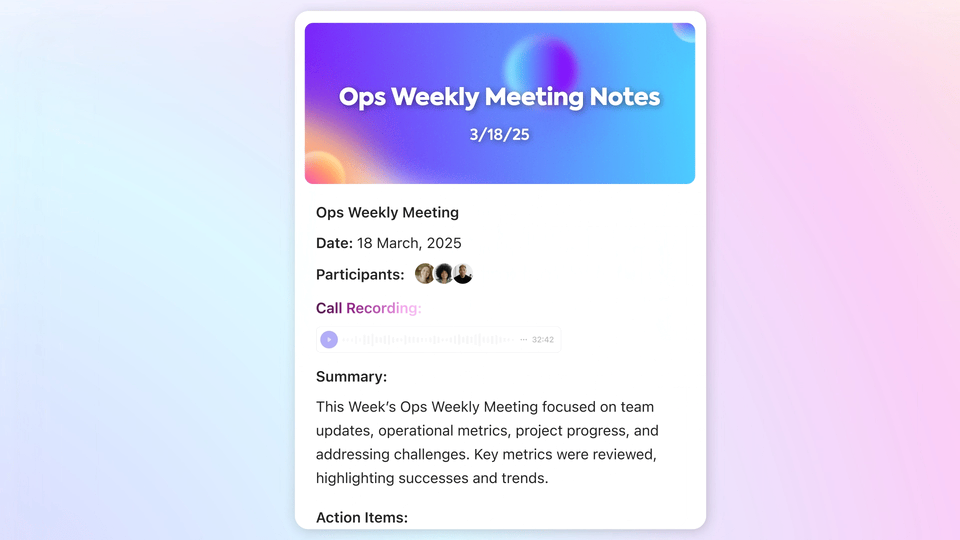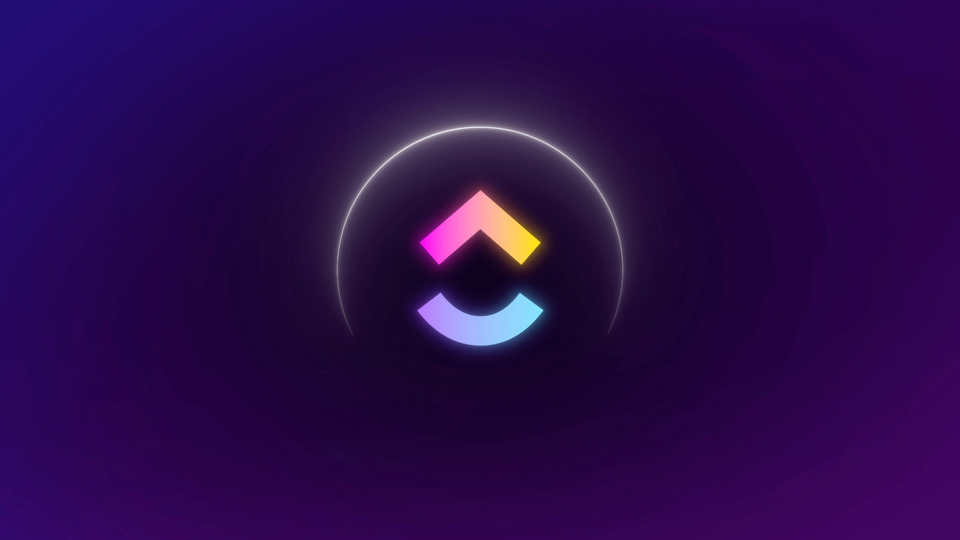
💡Tip od profesionálů: Nenechte si ujít žádné ponaučení z vašich schůzek věnovaných vyhodnocení incidentů – zaznamenejte každý detail pomocí nástroje ClickUp AI Notetaker. Ten se může připojit k vašim virtuálním schůzkám, přepsat celou diskusi a automaticky vygenerovat seznam akčních položek na základě získaných poznatků. Vytvoří se tak prohledávatelná historie incidentů, díky níž můžete rychle vyhledat minulé události a jejich řešení.
Automatizované pracovní postupy pro obnovu po havárii pomocí ClickUp Automations
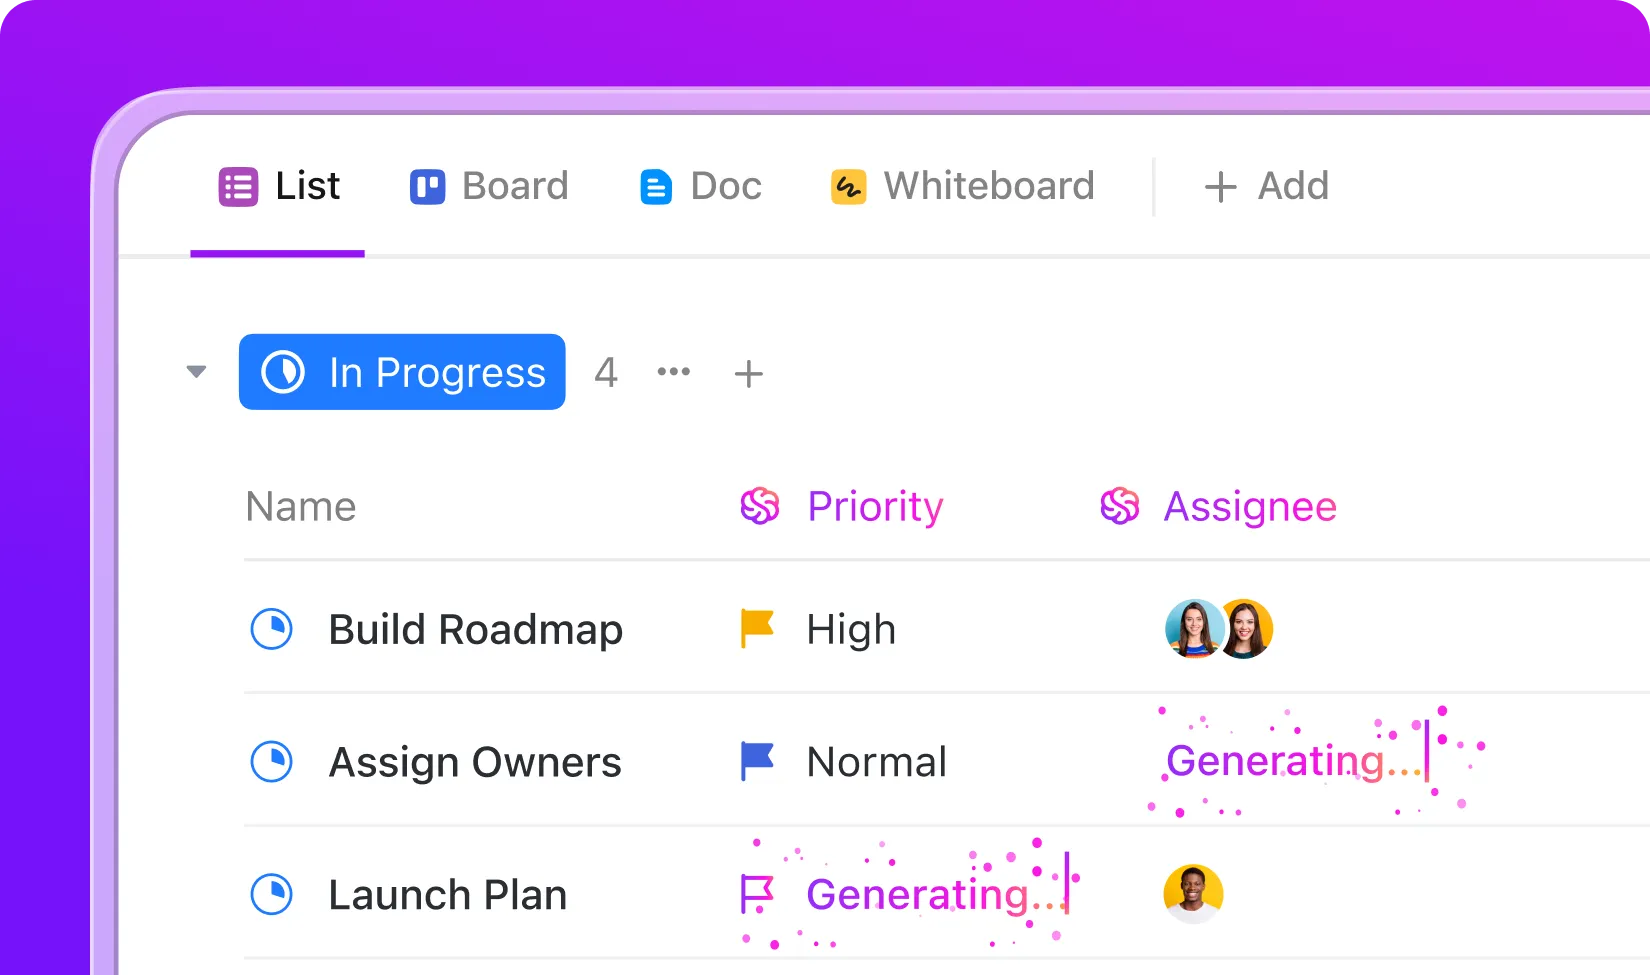
Představte si, že váš tým čelí náhlému výpadku – každá vteřina se počítá a nemůžete si dovolit vynechat ani jediný krok. Díky AI agentům a automatizacím v ClickUp se nemusíte honit ani spoléhat na paměť. Jakmile je incident nahlášen, AI v ClickUp se okamžitě uvede do akce, provede váš tým a postará se o rutinní úkoly, abyste se mohli soustředit na řešení problému.
Takto to funguje v reálném scénáři:
- Jakmile někdo označí úkol jako „Hlášení incidentu“, ClickUp Agent automaticky vytvoří kontrolní seznam kroků pro reakci, přiřadí je příslušným osobám a spustí časomíru, aby sledoval, jak dlouho trvá obnovení.
- Pokud je incident označen jako „kritický“, může agent okamžitě odeslat e-mailové upozornění vašemu vedoucímu týmu a zřídit speciální chatovací místnost – vaši „velitelnu“ –, aby všichni mohli komunikovat na jednom místě.
- Umělá inteligence dokáže vyhledat zprávy o minulých incidentech a relevantní dokumentaci, takže váš tým má vše, co potřebuje, na dosah ruky.
Prohlédněte si pracovní postup zde:
S AI agenty ClickUp získáte spolehlivého digitálního parťáka, který vašemu týmu pomůže zachovat klid, přehled a efektivitu – i v náročných situacích.
Sledování v reálném čase pomocí dashboardů ClickUp
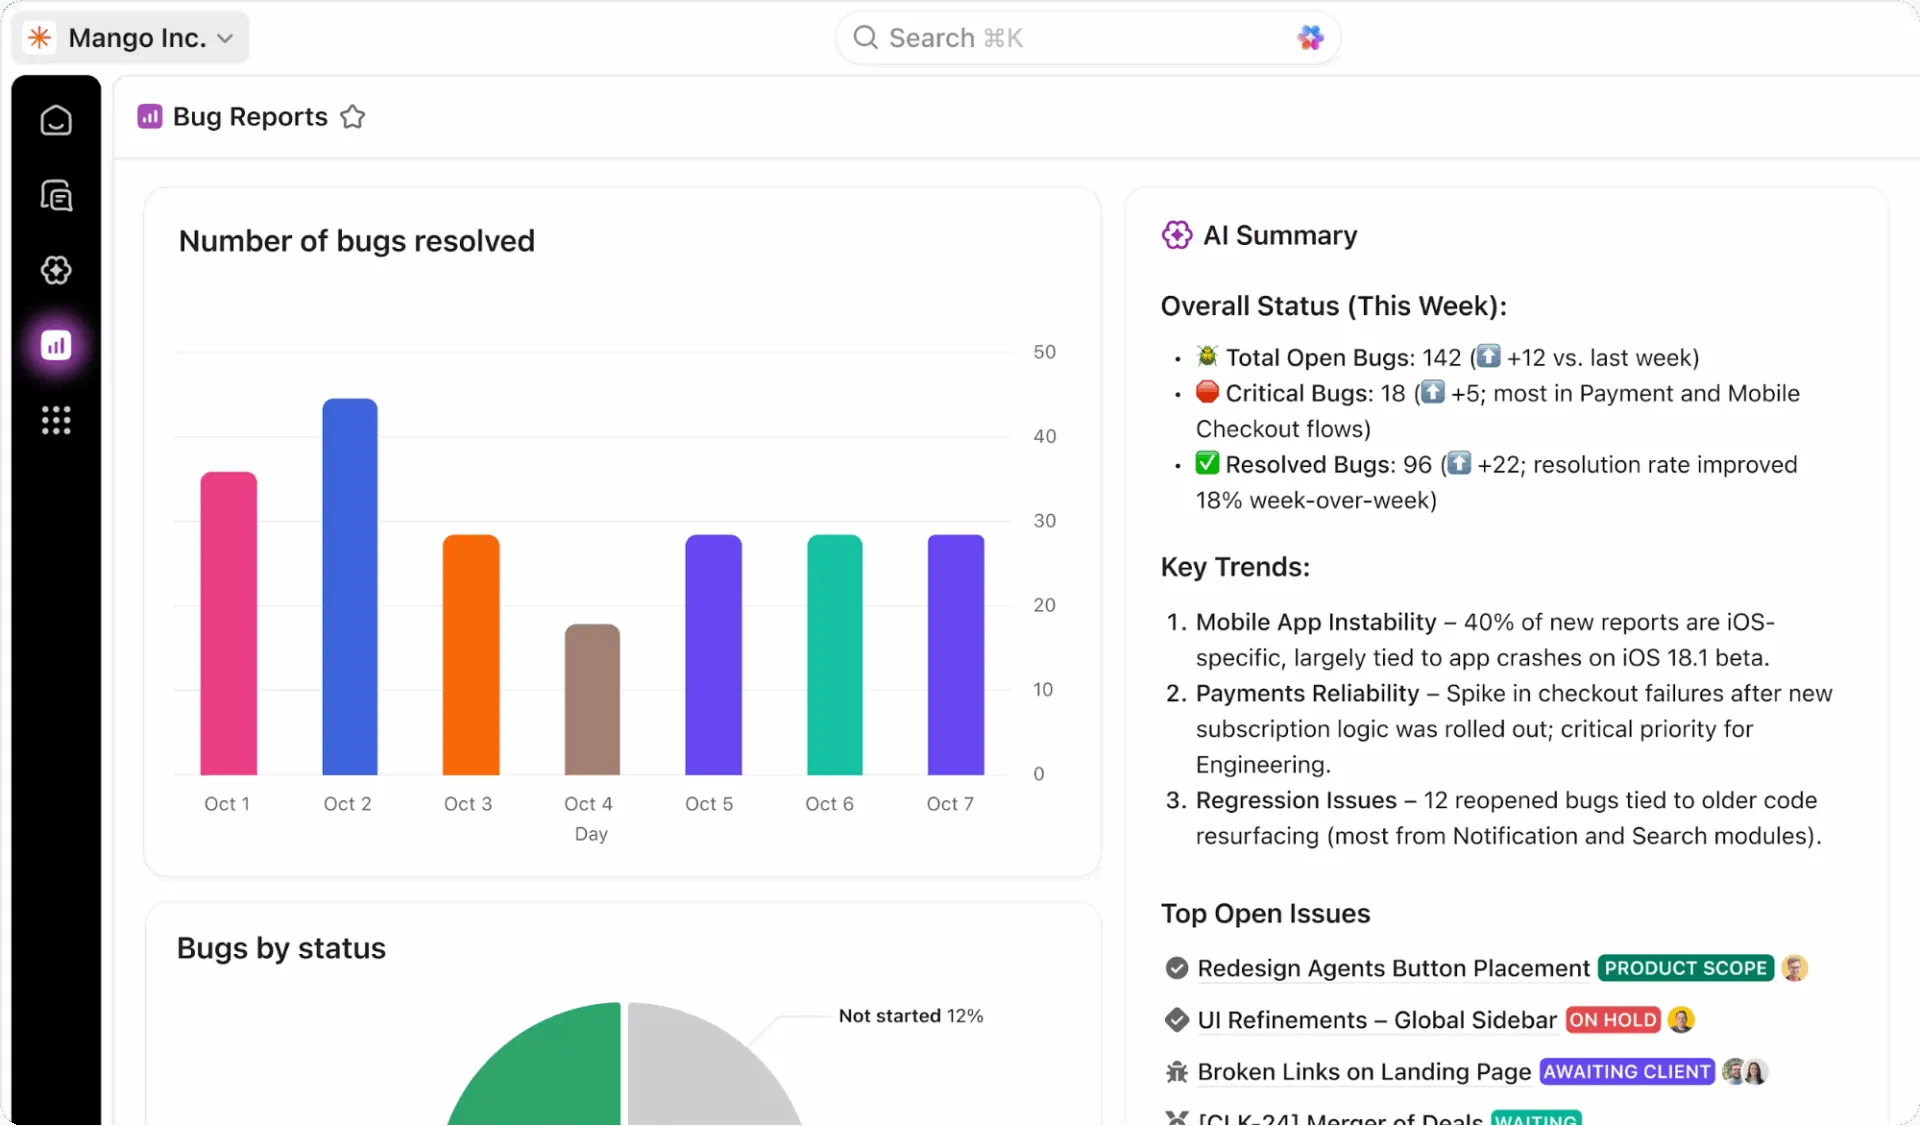
Získejte kompletní přehled o stavu vašeho programu obnovy po havárii díky sledování všech údajů v reálném čase pomocí dashboardů ClickUp. Můžete vytvářet widgety pro sledování výkonu RTO a RPO během testů, sledovat míru dokončení testů a prohlížet si trendy incidentů v čase.
Přidejte do svých úkolů vlastní pole ClickUp, abyste mohli sledovat kritičnost systému, stav obnovy a výsledky testů, a poté všechna tato data shrnujte do jednoho přehledného zobrazení. Tyto řídicí panely vám poskytují přehledné zprávy pro vedení, které jsou vždy aktuální díky údajům v reálném čase z testování a reakcí na incidenty vašeho týmu.
📖 Přečtěte si více: Jak vytvořit kontrolní seznam pro posouzení rizik
Vytvořte si svůj plán obnovy po havárii ještě dnes
Každý den, kdy fungujete bez plánu obnovy po havárii, je sázkou, kterou si nemůžete dovolit prohrát. Havárie jsou nevyhnutelné – ať už jde o přírodní katastrofy, technologické selhání nebo lidskou chybu –, ale právě vaše příprava rozhoduje o tom, zda se stanou pouhými drobnými nepříjemnostmi, nebo velkými katastrofami.
Komplexní plán obnovy po havárii vyžaduje pochopení vašich rizik, zdokumentování jasných postupů a jejich pravidelné testování. Správné nástroje tento proces usnadňují tím, že eliminují chaos způsobený roztříštěnými dokumenty a manuálními procesy.
I základní pohotovostní plány jsou lepší než nic, když dojde k havárii. Pravidelné testování a aktualizace promění váš plán obnovy po havárii z zaprášeného dokumentu na živý systém, který skutečně chrání vaši firmu.
Udělejte první krok a začněte ještě dnes vytvářet svůj plán obnovy po havárii s ClickUp. Začněte s ClickUp zdarma a sjednoťte veškeré plánování obnovy po havárii, dokumentaci a reakci na incidenty na jedné jednotné platformě. ✨
Často kladené otázky
Jak často by týmy měly aktualizovat šablonu plánu obnovy po havárii v IT?
Plán obnovy po havárii byste měli přezkoumat alespoň čtyřikrát ročně a aktualizovat jej ihned po jakýchkoli významných změnách infrastruktury nebo skutečných incidentech. Většina organizací provádí každoročně rozsáhlou a důkladnou revizi, aby do plánu zapracovala všechny získané poznatky a přizpůsobila se novým technologiím.
Které týmy mají na starosti dokumentaci a testování obnovy po havárii?
Plánování a testování obnovy po havárii obvykle vedou IT týmy, bezpečnostní týmy a plánovači kontinuity podnikání. Potřebují však zásadní podněty od vedoucích provozních a obchodních útvarů, aby zajistili, že plán bude v souladu se skutečnými obchodními potřebami a prioritami.
Jak sledujeme RTO a RPO během testů obnovy po havárii?
Při každém testu používejte stopky a jasné časové značky k měření skutečných dob obnovy ve srovnání s definovanými cíli. Je zásadní zaznamenat ve zprávách o testech veškeré rozdíly mezi cílovým a skutečným výkonem, aby bylo možné na jejich základě provádět budoucí zlepšení.
Jaké nástroje pomáhají dokumentovat a automatizovat plán obnovy po havárii?
Platformy pro řízení projektů, jako je ClickUp, jsou ideální pro centralizaci dokumentace, automatizaci pracovních postupů a sledování metrik pro celý váš program obnovy po havárii. Můžete je pak kombinovat se specializovanými nástroji pro obnovu po havárii, které se starají o technické aspekty replikace dat a převzetí služeb při selhání systému.