
En kundtjänstbot som lär sig av varje interaktion. En säljassistent som anpassar sin strategi utifrån insikter i realtid. Det här är inte bara koncept – det är verklighet, tack vare AI-inlärningsagenter.
I ClickUp tar denna idé formen av Super Agents , AI-teammates som använder inlärningsloopar för att ta ansvar för resultaten i flerstegsarbetsflöden istället för att nöja sig med ett enda svar.
Men vad är det som gör dessa agenter unika, och hur fungerar en inlärningsagent för att uppnå denna anpassningsförmåga?
Till skillnad från traditionella AI-system som fungerar med fast programmering utvecklas inlärningsagenter.
De anpassar, förbättrar och förfinar sina handlingar över tid, vilket gör dem oumbärliga inom branscher som självkörande fordon och hälso- och sjukvård, där flexibilitet och precision är avgörande.
Tänk på dem som AI som blir smartare med erfarenhet, precis som människor.
I den här bloggen ska vi utforska de viktigaste komponenterna, processerna, typerna och tillämpningarna av inlärningsagenter inom AI. 🤖
⏰ Sammanfattning på 60 sekunder
Här följer en kort introduktion till inlärningsagenter inom AI:
Vad de gör: Anpassar sig genom interaktioner, t.ex. kundtjänstbotar som förfinar sina svar.
Viktiga användningsområden: Robotteknik, personaliserade tjänster och smarta system som hushållsapparater.
Kärnkomponenter:
- Lärandeelement: Samlar in kunskap för att förbättra prestationen
- Prestationselement: Utför uppgifter baserat på inlärd kunskap
- Kritiker: Utvärderar åtgärder och ger feedback
- Problemgenerator: Identifierar möjligheter till vidare lärande
Inlärningsmetoder:
- Övervakad inlärning: Känner igen mönster med hjälp av märkta data
- Oövervakad inlärning: Identifierar strukturer i omärkta data
- Förstärkningsinlärning: Lär sig genom försök och misstag
Praktisk betydelse: Förbättrar anpassningsförmågan, effektiviteten och beslutsfattandet inom olika branscher.
⚙️ Bonus: Känner du dig överväldigad av AI-jargongen? Ta en titt på vår omfattande ordlista över AI-termer för att enkelt förstå grundläggande begrepp och avancerad terminologi.
Vad är inlärningsagenter inom AI?
Lärande agenter inom AI är system som förbättras över tid genom att lära sig av sin omgivning. De anpassar sig, fattar smartare beslut och optimerar sina åtgärder utifrån feedback och data.
Till skillnad från traditionella AI-system, som förblir oföränderliga, utvecklas inlärningsagenter kontinuerligt. Detta gör dem oumbärliga inom robotik och för personliga rekommendationer, där förhållandena är oförutsägbara och ständigt förändras.
🔍 Visste du att? Lärande agenter fungerar i en återkopplingsslinga – de uppfattar omgivningen, lär sig av återkopplingen och förfinar sina handlingar. Detta är inspirerat av hur människor lär sig av erfarenhet.
Viktiga komponenter i inlärningsagenter
Lärande agenter består vanligtvis av flera sammankopplade komponenter som samverkar för att säkerställa anpassningsförmåga och förbättring över tid.
Här är några viktiga komponenter i denna inlärningsprocess. 📋
Lärandeelement
Agentens huvudsakliga uppgift är att tillägna sig kunskap och förbättra prestandan genom att analysera data, interaktioner och feedback.
Med hjälp av AI-tekniker som övervakad inlärning, förstärkningsinlärning och oövervakad inlärning anpassar och uppdaterar agenten sitt beteende för att förbättra sin funktionalitet.
📌 Exempel: En virtuell assistent som Siri lär sig användarens preferenser över tid, till exempel ofta använda kommandon eller specifika accenter, för att kunna ge mer träffsäkra och personanpassade svar.
Prestationselement
Denna komponent utför uppgifter genom att interagera med omgivningen och fatta beslut baserat på tillgänglig information. Den är i huvudsak agentens ”handlingsarm”.
📌 Exempel: I självkörande fordon bearbetar prestandakomponenten trafikdata och omgivningsförhållanden för att fatta beslut i realtid, till exempel att stanna vid ett rött trafikljus eller undvika hinder.
Kritiker
Kritikern utvärderar de åtgärder som vidtagits av prestationselementet och ger feedback. Denna feedback hjälper inlärningselementet att identifiera vad som fungerade bra och vad som behöver förbättras.
📌 Exempel: I ett rekommendationssystem analyserar kritiken användarnas interaktioner (som klick eller hopp över) för att avgöra vilka förslag som var framgångsrika och hjälper inlärningselementet att förfina framtida rekommendationer.
Problemgenerator
Denna komponent uppmuntrar till utforskning genom att föreslå nya scenarier eller åtgärder som agenten kan testa.
Det tvingar agenten att gå utanför sin komfortzon, vilket säkerställer kontinuerlig förbättring. Agenten förhindrar också suboptimala resultat genom att bredda agentens erfarenhetsbas.
📌 Exempel: Inom e-handels-AI kan problemgeneratorn föreslå personaliserade marknadsföringsstrategier eller simulera kundernas beteendemönster. Detta hjälper AI:n att förfina sin strategi för att kunna ge rekommendationer som är skräddarsydda efter olika användares preferenser.
Inlärningsprocessen hos inlärningsagenter
Lärande agenter förlitar sig främst på tre huvudkategorier för att anpassa sig och förbättras. Dessa beskrivs nedan. 👇
1. Övervakad inlärning
Agenten lär sig från märkta datamängder, där varje indata motsvarar en specifik utdata.
Denna metod kräver en stor mängd korrekt märkta data för träning och används i stor utsträckning inom tillämpningar som bildigenkänning, språköversättning och bedrägeriupptäckt.
📌 Exempel: Ett e-postfiltreringssystem lär sig att klassificera e-postmeddelanden som skräppost eller inte utifrån historiska data. Inlärningselementet identifierar mönster mellan indata (e-postinnehåll) och utdata (klassificeringsetiketter) för att göra korrekta förutsägelser.
2. Oövervakad inlärning
Dolda mönster eller samband i data framträder när agenten analyserar information utan uttryckliga etiketter. Denna metod fungerar väl för att upptäcka avvikelser, skapa rekommendationssystem och optimera datakomprimering.
Det hjälper också till att identifiera insikter som kanske inte är omedelbart synliga med märkta data.
📌 Exempel: Kundsegmentering inom marknadsföring kan gruppera användare utifrån deras beteende för att utforma riktade kampanjer. Fokus ligger på att förstå strukturen och bilda kluster eller associationer.
3. Förstärkningsinlärning
Till skillnad från ovanstående innebär förstärkningsinlärning (RL) att agenter vidtar åtgärder i en miljö för att maximera den ackumulerade belöningen över tid.
Agenten lär sig genom försök och misstag och får återkoppling i form av belöningar eller straff.
🔔 Kom ihåg: Valet av inlärningsmetod beror på problemet, datatillgängligheten och miljöns komplexitet. Förstärkningsinlärning är avgörande för uppgifter utan direkt övervakning, eftersom den använder återkopplingsslingor för att anpassa åtgärderna.
Tekniker för förstärkningsinlärning
- Policyiteration: Optimerar belöningsförväntningarna genom att direkt lära sig en policy som kopplar tillstånd till handlingar
- Värdeiteration: Fastställer optimala åtgärder genom att beräkna värdet av varje tillstånd-åtgärdspar
- Monte Carlo-metoder: Simulerar flera framtida scenarier för att förutsäga belöningar för handlingar, särskilt användbara i dynamiska och probabilistiska miljöer
Exempel på verkliga tillämpningar av RL
- Autonom körning: RL-algoritmer tränar fordon att navigera säkert, optimera rutter och anpassa sig till trafikförhållandena genom att kontinuerligt lära sig från simulerade miljöer
- AlphaGo och spel-AI: Förstärkningsinlärning gjorde det möjligt för Googles AlphaGo att besegra mänskliga mästare genom att lära sig optimala strategier för komplexa spel som Go
- Dynamisk prissättning: E-handelsplattformar använder RL för att anpassa prissättningsstrategier utifrån efterfrågemönster och konkurrenternas agerande för att maximera intäkterna
🧠 Kul fakta: Inlärningsagenter har besegrat mänskliga mästare i spel som schack och Starcraft, vilket visar på deras anpassningsförmåga och intelligens.
Q-learning och neurala nätverk
Q-learning är en mycket vanlig RL-algoritm där agenterna lär sig värdet av varje tillstånd-åtgärdspar genom utforskning och återkoppling. Agenten bygger upp en Q-tabell, en matris som tilldelar förväntade belöningar till tillstånd-åtgärdspar.
Den väljer den åtgärd som har det högsta Q-värdet och förfinar sin tabell iterativt för att förbättra noggrannheten.
📌 Exempel: En AI-driven drönare som lär sig att leverera paket på ett effektivt sätt använder Q-inlärning för att utvärdera rutter. Den gör detta genom att tilldela belöningar för leveranser i tid och straffpoäng för förseningar eller kollisioner. Med tiden förfinar den sin Q-tabell för att välja de mest effektiva och säkra leveransvägarna.
Q-tabeller blir dock opraktiska i komplexa miljöer med högdimensionella tillståndsrum.
Här kommer neurala nätverk in i bilden, som approximerar Q-värden istället för att lagra dem explicit. Denna förändring gör det möjligt för förstärkningsinlärning att hantera mer komplexa problem.
Deep Q-nätverk (DQN) tar detta ett steg längre genom att utnyttja djupinlärning för att bearbeta råa, ostrukturerade data såsom bilder eller sensorinmatningar. Dessa nätverk kan direkt koppla sensorinformation till handlingar, vilket eliminerar behovet av omfattande feature engineering.
📌 Exempel: I självkörande bilar bearbetar DQN:er sensordata i realtid för att lära sig körstrategier, såsom filbyten eller undvikande av hinder, utan förprogrammerade regler.
Dessa avancerade metoder gör det möjligt för agenterna att skala upp sina inlärningsförmågor till uppgifter som kräver hög beräkningskapacitet och anpassningsförmåga.
⚙️ Bonus: Lär dig hur du skapar och förfinar en AI-kunskapsbas som effektiviserar informationshanteringen, förbättrar beslutsfattandet och ökar teamets produktivitet.
Inlärningsprocessen för agenter lägger vikt vid att utforma strategier för intelligent beslutsfattande i realtid. Här är viktiga aspekter som underlättar beslutsfattandet:
- Utforskning kontra utnyttjande: Agenter balanserar mellan att utforska nya handlingar för att hitta bättre strategier och att utnyttja kända handlingar för att maximera belöningarna
- Beslutsfattande med flera agenter: I samarbets- eller tävlingssammanhang interagerar agenterna och anpassar sina strategier utifrån gemensamma mål eller motståndarnas taktik.
- Strategiska avvägningar: Agenterna lär sig också att prioritera mål utifrån sammanhanget, till exempel att balansera hastighet och noggrannhet i ett leveranssystem
🎤 Podcasttips: Ta en titt på vår sammanställda lista över populära AI-podcasts för att fördjupa din förståelse för hur inlärningsagenter fungerar.
Typer av AI-agenter
Lärande agenter inom artificiell intelligens finns i olika former, var och en anpassad till specifika uppgifter och utmaningar.
Låt oss utforska hur de fungerar, deras unika egenskaper och exempel från verkligheten. 👀
Enkla reflexagenter
Sådana agenter reagerar direkt på stimuli utifrån fördefinierade regler. De använder en villkor-åtgärd-mekanism (om-då) för att välja åtgärder utifrån den aktuella miljön utan att ta hänsyn till historiken eller framtiden.
Egenskaper
- Fungerar enligt ett logikbaserat villkor-åtgärd-system
- Anpassar sig inte till förändringar och lär sig inte av tidigare handlingar
- Fungerar bäst i transparenta och förutsägbara miljöer
Exempel
En termostat fungerar som en enkel reflexagent genom att sätta på värmen när temperaturen sjunker under ett inställt tröskelvärde och stänga av den när den stiger. Den fattar beslut uteslutande baserat på aktuella temperaturmätningar.
🧠 Kul fakta: I vissa experiment tilldelas inlärningsagenterna simulerade behov, såsom hunger eller törst, vilket uppmuntrar dem att utveckla målinriktade beteenden och lära sig hur de effektivt kan tillgodose dessa ”behov”.
Modellbaserade reflexagenter
Dessa agenter har en intern modell av världen som gör att de kan beakta effekterna av sina handlingar. De drar också slutsatser om omgivningens tillstånd utöver det de omedelbart kan uppfatta.
Egenskaper
- Använder en lagrad modell av miljön för beslutsfattande
- Uppskattar det aktuella tillståndet för att hantera delvis observerbara miljöer
- Erbjuder större flexibilitet och anpassningsförmåga jämfört med enkla reflexagenter
Exempel
En självkörande Tesla-bil använder en modellbaserad agent för att navigera på vägarna. Den upptäcker synliga hinder och förutsäger rörelserna hos fordon i närheten, inklusive de som befinner sig i döda vinklar, med hjälp av avancerade sensorer och realtidsdata. Detta gör att bilen kan fatta precisa och välgrundade körbeslut, vilket förbättrar säkerheten och effektiviteten.
🔍 Visste du att? Konceptet med inlärningsagenter efterliknar ofta beteenden som observerats hos djur, till exempel inlärning genom försök och misstag eller belöningsbaserad inlärning.
Funktioner hos programvaruagenter och virtuella assistenter
Dessa agenter verkar i digitala miljöer och utför specifika uppgifter självständigt.
Virtuella assistenter som Siri eller Alexa bearbetar användarinmatningar med hjälp av naturlig språkbehandling (NLP) och utför åtgärder som att svara på frågor eller styra smarta enheter.
Egenskaper
- Förenklar dagliga uppgifter som schemaläggning, inställning av påminnelser eller styrning av enheter
- Förbättras kontinuerligt med hjälp av inlärningsalgoritmer och data från användarinteraktioner
- Fungerar asynkront och svarar i realtid eller när den aktiveras
Exempel
Alexa kan spela musik, ställa in påminnelser och styra smarta hem-enheter genom att tolka röstkommandon, ansluta till molnbaserade system och utföra lämpliga åtgärder.
🔍 Visste du att? Nyttjebaserade agenter, som fokuserar på att maximera resultaten genom att utvärdera olika åtgärder, arbetar ofta tillsammans med inlärningsbaserade agenter inom AI. Inlärningsagenter förfinar sina strategier över tid utifrån erfarenhet, och de kan använda nyttjebaserat beslutsfattande för att fatta smartare val.
Multiagent-system och tillämpningar inom spelteori
Dessa system består av flera interagerande agenter som samarbetar, konkurrerar eller arbetar självständigt för att uppnå individuella eller gemensamma mål.
Dessutom styrs deras beteende ofta av principer från spelteorin i konkurrenssituationer.
Egenskaper
- Kräver samordning eller förhandling mellan agenterna
- Fungerar väl i dynamiska och distribuerade miljöer
- Simulerar eller hanterar komplexa system såsom försörjningskedjor eller stadstrafik
Exempel
I Amazons automatiserade lagersystem arbetar robotar (agenter) tillsammans för att plocka, sortera och transportera varor. Dessa robotar kommunicerar med varandra för att undvika kollisioner och säkerställa en smidig drift. Principer från spelteorin hjälper till att hantera konkurrerande prioriteringar, såsom att balansera hastighet och resurser, för att säkerställa att systemet fungerar effektivt.
Tillämpningar av inlärningsagenter
Lärande agenter har förändrat många branscher genom att förbättra effektiviteten och beslutsfattandet.
Här är några viktiga tillämpningar. 📚
Robotik och automatisering
Lärande agenter utgör kärnan i modern robotik och gör det möjligt för robotar att agera autonomt och anpassningsbart i dynamiska miljöer.
Till skillnad från traditionella system som kräver detaljerad programmering för varje uppgift gör inlärningsagenter det möjligt för robotar att förbättra sig själva genom interaktion och återkoppling.
Så här fungerar det
Robotar utrustade med inlärningsagenter använder tekniker som förstärkningsinlärning för att interagera med sin omgivning och utvärdera resultaten av sina handlingar. De förfinar sitt beteende över tid, med fokus på att maximera belöningar och undvika straff.
Neurala nätverk tar detta ett steg längre och gör det möjligt för robotar att bearbeta komplexa data, såsom visuella intryck eller rumsliga layouter, vilket underlättar sofistikerat beslutsfattande.
Exempel
- Autonoma fordon: Inom jordbruket driver inlärningsagenter autonoma traktorer som navigerar på åkrarna, anpassar sig till varierande markförhållanden och optimerar sådd- eller skördeprocesserna. De använder realtidsdata för att förbättra effektiviteten och minska svinnet.
- Industrirobotar: Inom tillverkningsindustrin finjusterar robotarmar utrustade med inlärningsagenter sina rörelser för att förbättra precision, effektivitet och säkerhet, till exempel i monteringslinjer för bilar.
Simulering och agentbaserade modeller
Lärande agenter driver simuleringar som erbjuder ett kostnadseffektivt och riskfritt sätt att studera komplexa system.
Dessa system efterliknar dynamiken i den verkliga världen, förutsäger resultat och optimerar strategier genom att modellera agenter med distinkta beteenden och anpassningsförmåga.
Så här fungerar det
Lärande agenter i simuleringar observerar sin omgivning, testar olika åtgärder och anpassar sina strategier för att maximera effektiviteten. De lär sig och förbättras kontinuerligt över tid, vilket gör att de kan optimera resultaten.
Simuleringar är mycket effektiva inom supply chain management, stadsplanering och robotutveckling.
Exempel
- Trafikstyrning: Simulerade agenter modellerar trafikflödet i städer. Detta gör det möjligt för forskare att testa åtgärder som nya vägar eller trängselavgifter innan de genomförs.
- Epidemiologi: I pandemisimuleringar efterliknar inlärningsagenter mänskligt beteende för att bedöma sjukdomars spridning. Det hjälper också till att utvärdera effektiviteten hos smittskyddsåtgärder såsom social distansering.
💡 Proffstips: Optimera förbehandlingen av data inom AI-maskininlärning för att förbättra inlärningsagenternas noggrannhet och effektivitet. Högkvalitativa indata säkerställer ett mer tillförlitligt beslutsfattande.
Intelligenta system
Lärande agenter driver intelligenta system genom att möjliggöra databehandling i realtid och anpassning till användarnas beteende och preferenser.
Från smarta hushållsapparater till autonoma städrobotar – dessa system förändrar hur användarna interagerar med tekniken och gör vardagssysslorna mer effektiva och anpassade efter individen.
Så här fungerar det
Enheter som Roomba använder inbyggda sensorer och inlärningsagenter för att kartlägga hemmets utformning, undvika hinder och optimera städrutterna. De samlar ständigt in och analyserar data – till exempel områden som kräver frekvent städning eller möblernas placering – vilket förbättrar deras prestanda för varje användningstillfälle.
Exempel
- Smarta hem-enheter: Termostater som Nest lär sig användarnas scheman och temperaturpreferenser. De justerar automatiskt inställningarna för att spara energi samtidigt som de upprätthåller komforten
- Robotdammsugare: Roomba samlar in många datapunkter per sekund. Detta lär den att ta sig runt möbler och identifiera områden med hög trafik för effektiv städning.
Dessa intelligenta system belyser de praktiska tillämpningarna av inlärningsagenter i vardagen, till exempel att effektivisera arbetsflöden och automatisera repetitiva uppgifter för ökad effektivitet.
🔍 Visste du att? Roomba samlar in över 230 400 datapunkter per sekund för att kartlägga ditt hem.
Internetforum och virtuella assistenter
Lärande agenter spelar en avgörande roll för att förbättra interaktioner online och digital assistans. De gör det möjligt för forum och virtuella assistenter att erbjuda personanpassade upplevelser.
Så här fungerar det
Lärande agenter modererar diskussioner i forum och identifierar och tar bort spam eller skadligt innehåll. Intressant nog rekommenderar de också relevanta ämnen till användarna utifrån deras surfhistorik.
Virtuella AI-assistenter som Alexa och Google Assistant använder inlärningsagenter för att bearbeta naturligt språk, vilket förbättrar deras kontextuella förståelse över tid.
Exempel
- Internetforum: Reddits modereringsbotar använder inlärningsagenter för att genomsöka inlägg efter regelöverträdelser eller kränkande språk. Sådan AI-baserad moderering bidrar till att online-gemenskaperna förblir säkra och engagerande.
- Virtuella assistenter: Alexa lär sig användarens preferenser, till exempel favoritlistan eller ofta använda kommandon för smarta hem, för att kunna ge personlig och proaktiv hjälp
⚙️ Bonus: Lär dig hur du kan använda AI på din arbetsplats för att öka produktiviteten och effektivisera arbetsuppgifter med hjälp av intelligenta agenter.
Utmaningar vid utveckling av inlärningsagenter
Utvecklingen av inlärningsagenter innebär tekniska, etiska och praktiska utmaningar, bland annat algoritmdesign, beräkningskrav och implementering i verkligheten.
Låt oss titta på några av de viktigaste utmaningarna som AI-utvecklingen står inför i takt med att den utvecklas. 🚧
Balans mellan utforskning och utnyttjande
Lärande agenter står inför dilemmat att hitta en balans mellan utforskning och utnyttjande.
Även om algoritmer som epsilon-greedy kan vara till hjälp är det i hög grad kontextberoende att uppnå rätt balans. Dessutom kan överdriven utforskning leda till ineffektivitet, medan ett alltför stort fokus på utnyttjande kan resultera i suboptimala lösningar.
Hantera höga beräkningskostnader
Att träna avancerade inlärningsagenter kräver ofta omfattande beräkningsresurser. Detta gäller särskilt i miljöer med komplex dynamik eller stora tillstånds- och handlingsutrymmen.
Tänk på att algoritmer som förstärkningsinlärning med neurala nätverk, till exempel Deep Q-Learning, kräver betydande processorkraft och minne. Du kommer att behöva hjälp med att göra realtidsinlärning praktiskt genomförbar för tillämpningar med begränsade resurser.
Att övervinna skalbarhetsproblem och överföringsinlärning
Det är fortfarande en utmaning att skala upp inlärningsagenter så att de fungerar effektivt i stora, flerdimensionella miljöer. Transferinlärning, där agenter tillämpar kunskap från ett område till ett annat, befinner sig fortfarande i sin linda.
Detta har begränsat deras förmåga att generalisera mellan olika uppgifter eller miljöer.
📌 Exempel: En AI-agent som tränats för schack skulle ha svårt med Go på grund av de väsentligt olika reglerna och målen, vilket belyser utmaningen med att överföra kunskap mellan olika områden.
Datakvalitet och tillgänglighet
Lärande agenters prestanda beror i hög grad på kvaliteten och mångfalden hos träningsdata.
Otillräckliga eller partiska data kan leda till ofullständigt eller felaktigt lärande och resultera i suboptimala eller oetiska beslut. Dessutom kan insamling av data från verkligheten för träning vara kostsamt och tidskrävande.
⚙️ Bonus: Utforska AI-kurser för att fördjupa din förståelse för andra agenter.
Verktyg och resurser för inlärningsagenter
Utvecklare och forskare använder olika verktyg för att bygga och träna inlärningsagenter. Ramverk som TensorFlow, PyTorch och OpenAI Gym erbjuder en grundläggande infrastruktur för att implementera algoritmer för maskininlärning.
Dessa verktyg hjälper också till att skapa simulerade miljöer. Vissa AI-appar förenklar och förbättrar dessutom denna process.
För traditionella metoder inom maskininlärning är verktyg som Scikit-learn fortfarande pålitliga och effektiva.
För att hantera forsknings- och utvecklingsprojekt inom AI erbjuder ClickUp mer än bara uppgiftshantering – det fungerar som en central knutpunkt för att organisera uppgifter, följa upp framsteg och möjliggöra smidigt samarbete mellan team.
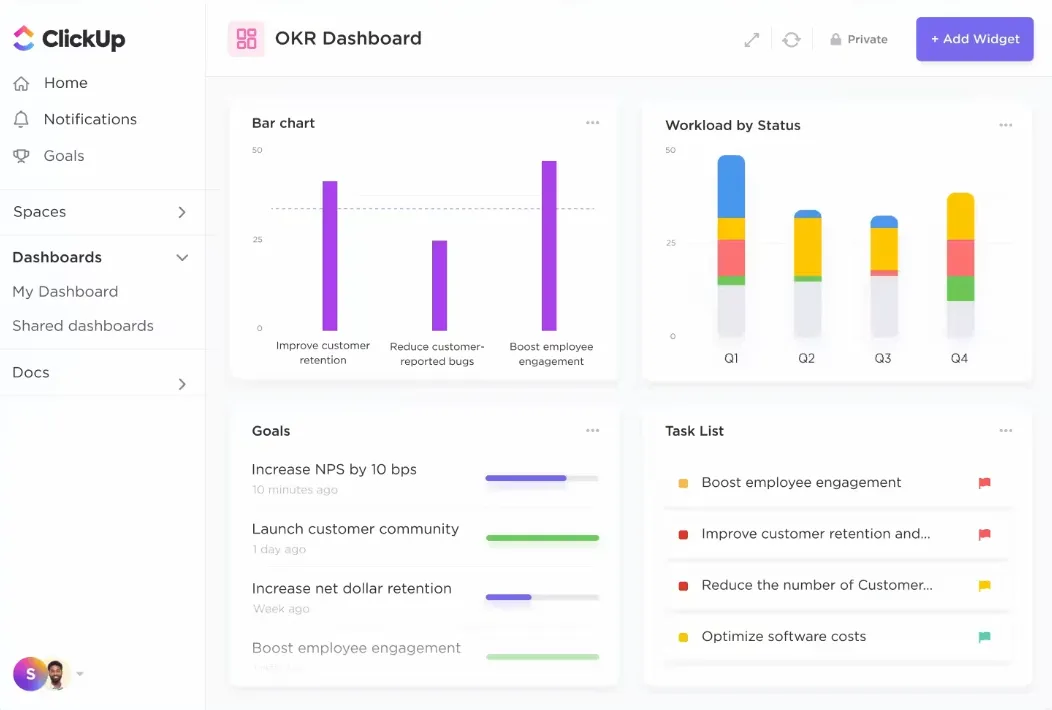
ClickUp för AI-projektledning minskar den manuella arbetsinsatsen som krävs för att utvärdera uppgifternas status och fördela arbetsuppgifter.
Istället för att manuellt följa upp varje uppgift eller ta reda på vem som är tillgänglig sköter AI det tunga arbetet. Den kan automatiskt uppdatera framstegen, identifiera flaskhalsar och föreslå den bästa personen för varje uppgift utifrån arbetsbelastning och kompetens.
På så sätt lägger du mindre tid på tråkiga administrativa uppgifter och mer tid på det som verkligen betyder något – att driva dina projekt framåt.
Här är några AI-drivna funktioner som sticker ut. 🤩
ClickUp Brain
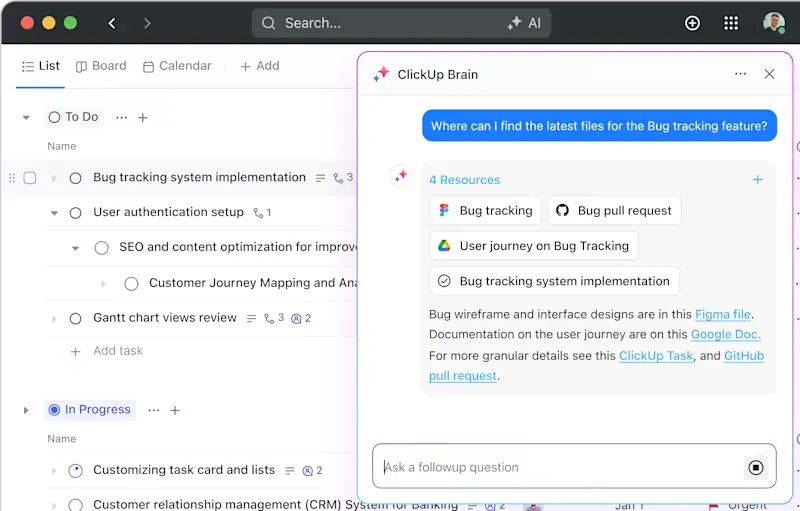
ClickUp Brain, en AI-driven assistent som är inbyggd i plattformen, förenklar även de mest komplexa projekten. Den delar upp omfattande studier i hanterbara uppgifter och deluppgifter, vilket hjälper dig att hålla ordning och följa planen.
Behöver du snabb tillgång till experimentresultat eller dokumentation? Skriv bara in en sökfråga så hämtar ClickUp Brain allt du behöver på några sekunder. Du kan till och med ställa uppföljningsfrågor baserade på befintliga data, vilket gör att det känns som att du har en personlig assistent.
Dessutom kopplar den automatiskt samman uppgifter med relevanta resurser, vilket sparar dig tid och arbete.
Låt oss säga att du genomför en studie om hur agenter för förstärkningsinlärning förbättras över tid.
Du har flera steg – litteraturgenomgång, datainsamling, experiment och analys. Med ClickUp Brain kan du be om att ”dela upp den här studien i uppgifter”, och då skapas automatiskt deluppgifter för varje fas.
Du kan sedan be den att hämta relevanta artiklar om Q-learning eller datauppsättningar om agenters prestanda, vilket den gör omedelbart. När du arbetar dig igenom uppgifterna kan ClickUp Brain länka specifika forskningsartiklar eller experimentresultat direkt till uppgifterna, så att allt hålls välorganiserat.
Oavsett om du arbetar med forskningsramverk eller vardagliga projekt ser ClickUp Brain till att du arbetar smartare, inte hårdare.
ClickUp-automatiseringar
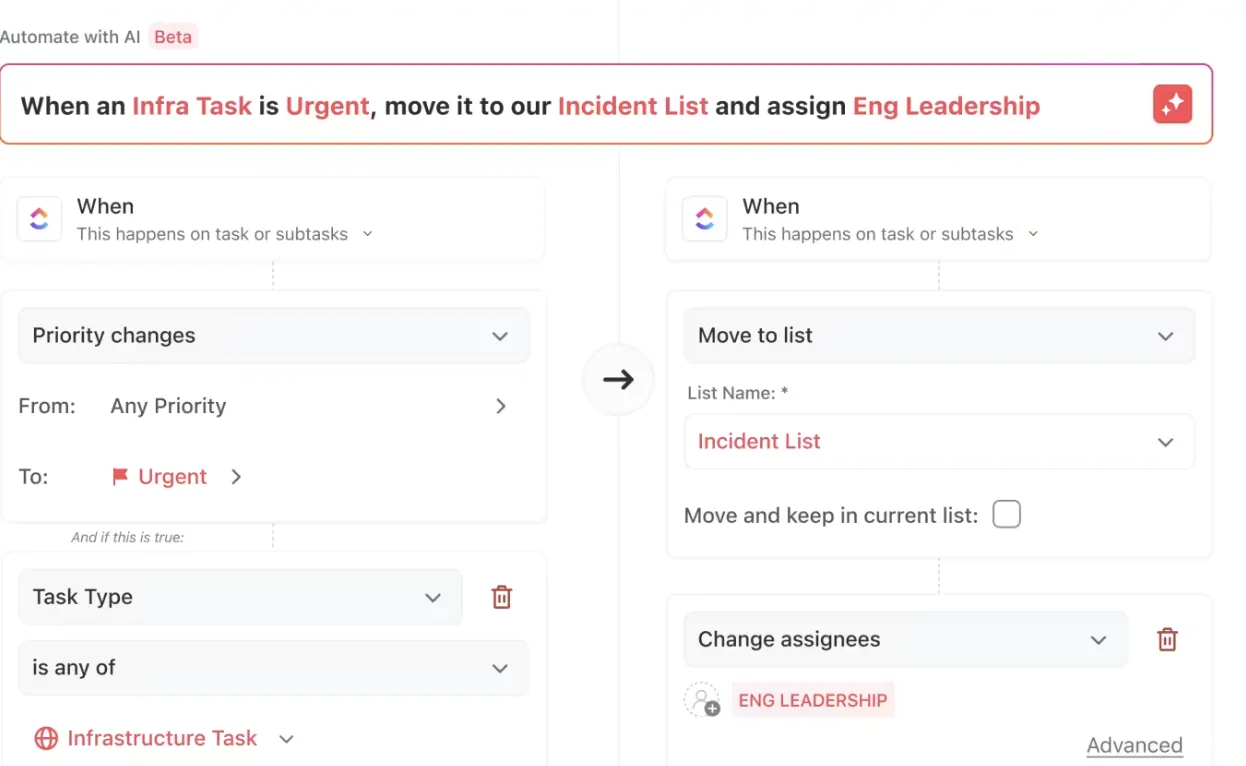
ClickUp Automations är ett enkelt men kraftfullt sätt att effektivisera ditt arbetsflöde.
Den möjliggör omedelbar tilldelning av uppgifter så snart förutsättningarna är uppfyllda, meddelar berörda parter om milstolpar i arbetet och flaggar för förseningar – allt utan manuellt ingripande.
Du kan även använda kommandon i naturligt språk, vilket gör hanteringen av arbetsflöden ännu enklare. Du behöver inte fördjupa dig i komplexa inställningar eller teknisk jargong – berätta bara för ClickUp vad du behöver, så skapar det automatiseringen åt dig.
Oavsett om det handlar om att ”flytta uppgifter till nästa steg när de markeras som slutförda” eller ”tilldela en uppgift till Sarah när prioriteten är hög”, så förstår ClickUp din begäran och ställer in den automatiskt.
Utveckla inlärningsagenter som en mästare med ClickUp
För att bygga AI-inlärningsagenter behöver du en expertkombination av strukturerade arbetsflöden och anpassningsbara verktyg. Det ökade kravet på teknisk expertis gör det hela ännu mer utmanande, särskilt med tanke på att sådana uppgifter är av statistisk och datastödd karaktär.
Överväg att använda ClickUp för att effektivisera dessa projekt. Utöver ren organisation stöder detta verktyg ditt teams innovation genom att eliminera onödiga ineffektiviteter.
ClickUp Brain hjälper dig att bryta ner komplexa uppgifter, hämta relevanta resurser direkt och erbjuder AI-drivna insikter för att hålla dina projekt organiserade och på rätt spår. Samtidigt hanterar ClickUp Automations repetitiva uppgifter, som att uppdatera statusar eller tilldela nya uppgifter, så att ditt team kan fokusera på helheten.
Tillsammans eliminerar dessa funktioner ineffektivitet och gör det möjligt för ditt team att arbeta smartare, vilket underlättar innovation och framsteg.
Registrera dig gratis på ClickUp idag. ✅