
AI 훈련 프로젝트가 모델 수준에서 실패하는 경우는 드뭅니다. 실험, 문서화, 이해관계자 업데이트가 너무 많은 도구에 흩어져 있을 때 문제가 발생합니다.
이 가이드에서는 다른 주요 모델보다 연산 효율이 최대 2배 높은 LLM인 Databricks DBRX를 사용하여 모델을 훈련하는 과정을 단계별로 안내하며, 이와 관련된 일을 ClickUp에서 체계적으로 관리하는 방법도 함께 설명합니다.
설정과 미세 조정부터 문서화 및 팀 간 업데이트에 이르기까지, 단일 통합 작업 공간이 어떻게 맥락의 산만함을 해소하고 팀이 검색이 아닌 개발에 집중할 수 있도록 돕는지 확인해 보세요. 🛠
DBRX란 무엇인가요?
DBRX는 기업용 AI 모델 훈련 및 추론을 위해 특별히 설계된 강력한 오픈소스 대규모 언어 모델(LLM)입니다. Databricks Open Model License에 따라 오픈소스로 제공되므로, 팀은 모델의 가중치와 아키텍처에 대한 완전한 접근 권한을 갖게 되어, 원하는 방식으로 모델을 검토, 수정 및 배포할 수 있습니다.
DBRX는 심층 사전 훈련용인 ‘DBRX Base’와 즉시 사용 가능한 지시 수행 작업용인 ‘DBRX Instruct’의 두 가지 버전으로 제공됩니다.
DBRX 아키텍처 및 전문가 혼합(Mixture-of-Experts) 설계
DBRX는 Mixture-of-Experts(MoE) 아키텍처를 사용하여 작업을 해결합니다. 모든 계산에 수십억 개의 매개변수를 모두 사용하는 기존의 대규모 언어 모델과 달리, DBRX는 주어진 작업에 대해 전체 매개변수 중 일부(가장 관련성이 높은 전문가들)만 활성화합니다.
이를 전문 분야별 전문가로 구성된 팀이라고 생각해보세요. 모든 구성원이 모든 문제를 해결하는 대신, 시스템이 각 작업을 가장 적합한 매개변수를 갖춘 전문가에게 지능적으로 배정합니다.
이를 통해 응답 시간을 단축할 뿐만 아니라, 최고 수준의 성능과 결과를 제공하면서 동시에 컴퓨팅 비용을 대폭 절감할 수 있습니다.
다음은 주요 사양을 간략히 살펴본 것입니다:
- 총 매개변수 수: 모든 전문가 모델 합산 1,320억 개
- 활성 매개변수: 전방 전파당 36B
- 전문가 수: 총 16명 (MoE Top-4 라우팅), 특정 토큰에 대해 4명이 활성 상태
- 컨텍스트 창: 32K 토큰
DBRX 훈련 데이터 및 토큰 사양
LLM의 성능은 훈련에 사용된 데이터의 품질에 따라 결정됩니다. DBRX는 Databricks 팀이 첨단 데이터 처리 tools를 활용해 신중하게 선별한 12조 토큰 규모의 방대한 데이터셋으로 사전 훈련되었습니다. 바로 이 때문에 업계 벤치마크에서 뛰어난 성능을 보인 것입니다.
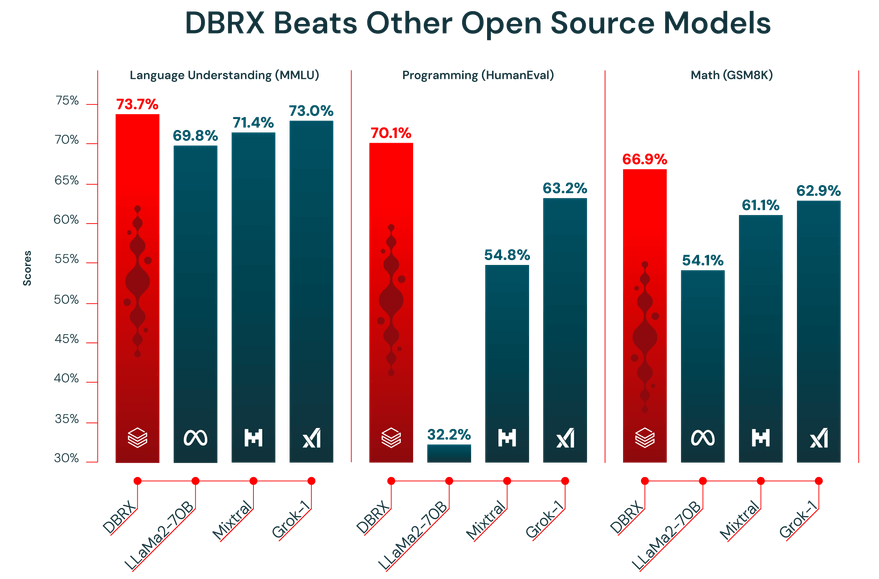
또한, DBRX는 32,000 토큰 규모의 컨텍스트 윈도우 기능을 제공합니다. 이는 모델이 한 번에 처리할 수 있는 텍스트의 양을 의미합니다. 컨텍스트 윈도우가 크면 모델이 정보를 잘라내거나 잊어버리지 않고 맥락을 유지할 수 있으므로, 긴 보고서 요약, 방대한 법률 문서 분석, 또는 고급 RAG(검색 강화 생성) 시스템 구축과 같은 복잡한 작업에 매우 유용합니다.
🎥 이 비디오를 통해 효율적인 프로젝트 협업을 통해 AI 훈련 워크플로우가 어떻게 변화하고, 서로 연동되지 않은 도구 간 전환으로 인한 불편함이 어떻게 해소되는지 확인해 보세요. 👇🏽
DBRX에 접속하고 설정을 하는 방법
DBRX는 두 가지 주요 접근 경로를 제공하며, 두 경로 모두 관대한 상업적 권한 하에서 모델 가중치에 대한 완전한 접근 권한을 부여합니다. 최대한의 유연성을 원한다면 Hugging Face를 사용하거나, 보다 통합된 환경을 원한다면 Databricks를 통해 직접 액세스할 수 있습니다.
Hugging Face를 통해 DBRX에 접속하세요
유연성을 중요시하며 이미 Hugging Face 생태계에 익숙한 팀이라면, hub(허브)를 통해 DBRX에 접근하는 것이 가장 이상적인 방법입니다. 이를 통해 기존 트랜스포머 기반 워크플로우에 모델을 통합할 수 있습니다.
시작하는 방법은 다음과 같습니다:
- Hugging Face 계정을 생성하거나 로그인하세요
- hub에서 DBRX 모델 카드로 이동하여 라이선스 약관에 동의하세요.
- transformers 라이브러리와 accelerate와 같은 필수 의존성을 함께 설치하세요.
- Python 스크립트에서 AutoModelForCausalLM 클래스를 사용하여 DBRX 모델을 불러오세요.
- DBRX가 원활하게 작동하려면 상당한 양의 GPU 메모리(VRAM)가 필요하다는 점을 염두에 두고 추론 파이프라인을 구성하세요.
📖 더 읽어보기: LLM 온도 설정 방법
Databricks를 통해 DBRX에 접속하세요
팀에서 이미 데이터 엔지니어링이나 머신러닝을 위해 Databricks를 사용하고 있다면, 해당 플랫폼을 통해 DBRX에 접속하는 것이 가장 쉬운 방법입니다. 이렇게 하면 설정 과정에서 발생하는 번거로움을 줄일 수 있을 뿐만 아니라, 이미 작업 중인 환경에서 MLOps에 필요한 모든 tools를 바로 활용할 수 있습니다.
Databricks 작업 공간에서 다음 단계를 따라 시작해 보세요:
- 'Model Garden' 또는 'Mosaic AI' 섹션으로 이동하세요.
- 필요에 따라 DBRX Base 또는 DBRX Instruct 중 하나를 선택하세요.
- API 액세스를 위한 서빙 엔드포인트를 구성하거나, 대화형 사용을 위한 노트북 환경을 설정하세요.
- AI 모델 훈련이나 배포를 확대하기 전에, 샘플 프롬프트를 사용하여 추론 테스트를 시작해 모든 것이 올바르게 작동하는지 확인하세요.
이 접근 방식을 통해 실험 추적을 위한 MLflow나 모델 거버넌스를 위한 Unity Catalog와 같은 tools를 원활하게 활용할 수 있습니다.
📮 ClickUp 인사이트: 일반 직장인은 하루 평균 30분 이상을 업무 관련 정보를 찾는 데 소비합니다. 이는 이메일, Slack 스레드, 여기저기 흩어진 파일을 뒤지는 데 연간 120시간 이상을 낭비하는 셈입니다.
작업 공간에 내장된 지능형 AI 어시스턴트가 이러한 상황을 바꿀 수 있습니다. 바로 ClickUp Brain입니다.
몇 초 만에 관련 문서, 대화 내용, 작업 세부 정보를 표시하여 즉각적인 통찰력과 해답을 제공하므로, 더 이상 검색에 시간을 낭비하지 않고 바로 일을 시작할 수 있습니다.
DBRX를 미세 조정하고 맞춤형 AI 모델을 훈련하는 방법
기성 모델은 아무리 강력하더라도 귀사의 비즈니스에 고유한 미묘한 차이를 결코 이해하지 못합니다. DBRX는 오픈 소스이므로, 이를 미세 조정하여 귀사의 언어를 이해하거나 귀사가 원하는 특정 작업을 수행할 수 있는 맞춤형 모델을 만들 수 있습니다.
이를 수행할 수 있는 세 가지 일반적인 방법은 다음과 같습니다:
1. Hugging Face 데이터셋을 활용한 DBRX 미세 조정
막 시작했거나 일반적인 작업을 수행하는 팀에게는 Hugging Face hub의 공개 데이터셋이 훌륭한 자료가 됩니다. 이 데이터셋들은 미리 형식이 지정되어 있어 쉽게 불러올 수 있으므로, 데이터 준비에 몇 시간을 소비할 필요가 없습니다.
이 과정은 꽤 간단합니다:
- hub에서 자신의 작업에 맞는 데이터셋(예: 지시 사항 따르기, 요약)을 찾아보세요.
- 데이터셋 라이브러리를 사용하여 불러오기
- 데이터가 명령-응답 쌍 형식으로 형식화되었는지 확인하십시오.
- 학습률 및 배치 크기 같은 하이퍼파라미터를 사용하여 훈련 스크립트를 구성하세요.
- 훈련 작업을 실행하고, 기간마다 체크포인트를 저장하도록 하세요.
- 미리 분리해 둔 검증 데이터 세트를 사용하여 미세 조정된 모델을 평가하고, 성능 개선 정도를 측정해 보세요.
2. 로컬 데이터셋을 사용하여 DBRX 미세 조정하기
일반적으로 자체 보유한 데이터로 미세 조정을 수행하면 최상의 결과를 얻을 수 있습니다. 이를 통해 모델에 회사의 특정 용어, 스타일 및 도메인 지식을 가르칠 수 있습니다. 단, 데이터가 깨끗하고 잘 정리되어 있으며 충분한 양을 갖추고 있을 때만 효과가 있다는 점을 명심하세요.
다음 단계를 따라 내부 데이터를 준비하세요:
- 데이터 수집: 내부 wiki, 문서 및 데이터베이스에서 고품질의 예시를 수집하세요.
- 형식 변환: 데이터를 일관된 명령-응답 형식으로 구조화하세요. 대개 JSON 라인 형태로 작성됩니다.
- 품질 필터링: 품질이 낮거나 중복되거나 관련성이 없는 예시를 모두 제거하세요.
- 검증 데이터 분할: 모델의 성능을 평가하기 위해 데이터의 일부(일반적으로 10~15%)를 따로 분리해 두세요.
- 프라이버시 검토: 개인 식별 정보(PII) 또는 민감한 데이터는 삭제하거나 가림 처리하십시오.
3. StreamingDataset을 활용한 DBRX 미세 조정
데이터셋이 너무 커서 컴퓨터 메모리에 모두 들어가지 않는다고 해도 걱정하지 마세요. Databricks의 스트리밍 데이터셋(Streaming Dataset) 라이브러리를 사용할 수 있습니다. 이 라이브러리를 사용하면 모델 훈련 중에 데이터를 한 번에 메모리에 모두 불러오는 대신, 클라우드 스토리지에서 직접 데이터를 스트리밍할 수 있습니다.
다음은 그 방법입니다:
- 데이터 준비: 훈련 데이터를 정리하고 구조화한 다음, JSONL이나 CSV와 같은 스트리밍 가능한 형식으로 클라우드 스토리지에 저장하세요.
- 스트리밍 형식 변환: 데이터셋을 Mosaic Data Shard(MDS)와 같은 스트리밍에 적합한 형식으로 변환하여, 훈련 중에 효율적으로 읽을 수 있도록 하세요.
- 훈련 로더 설정: 훈련 로더가 원격 데이터 세트를 가리키도록 구성하고, 임시 데이터 저장소를 위한 로컬 캐시를 정의하세요.
- 모델 초기화: LLM Foundry와 같이 StreamingDataset을 지원하는 훈련 프레임워크를 사용하여 DBRX 미세 조정 프로세스를 시작하세요.
- 스트리밍 기반 훈련: 훈련 중에 데이터를 메모리에 완전히 불러오는 대신, 데이터가 배치 단위로 스트리밍되는 동안 훈련 작업을 실행합니다.
- 체크포인트 및 복구: 실행이 중단되더라도 데이터를 중복하거나 건너뛰지 않고 원활하게 훈련을 재개할 수 있습니다.
- 평가 및 배포: 미세 조정된 모델의 성능을 검증하고, 선호하는 서빙 또는 추론 설정을 사용하여 배포하세요.
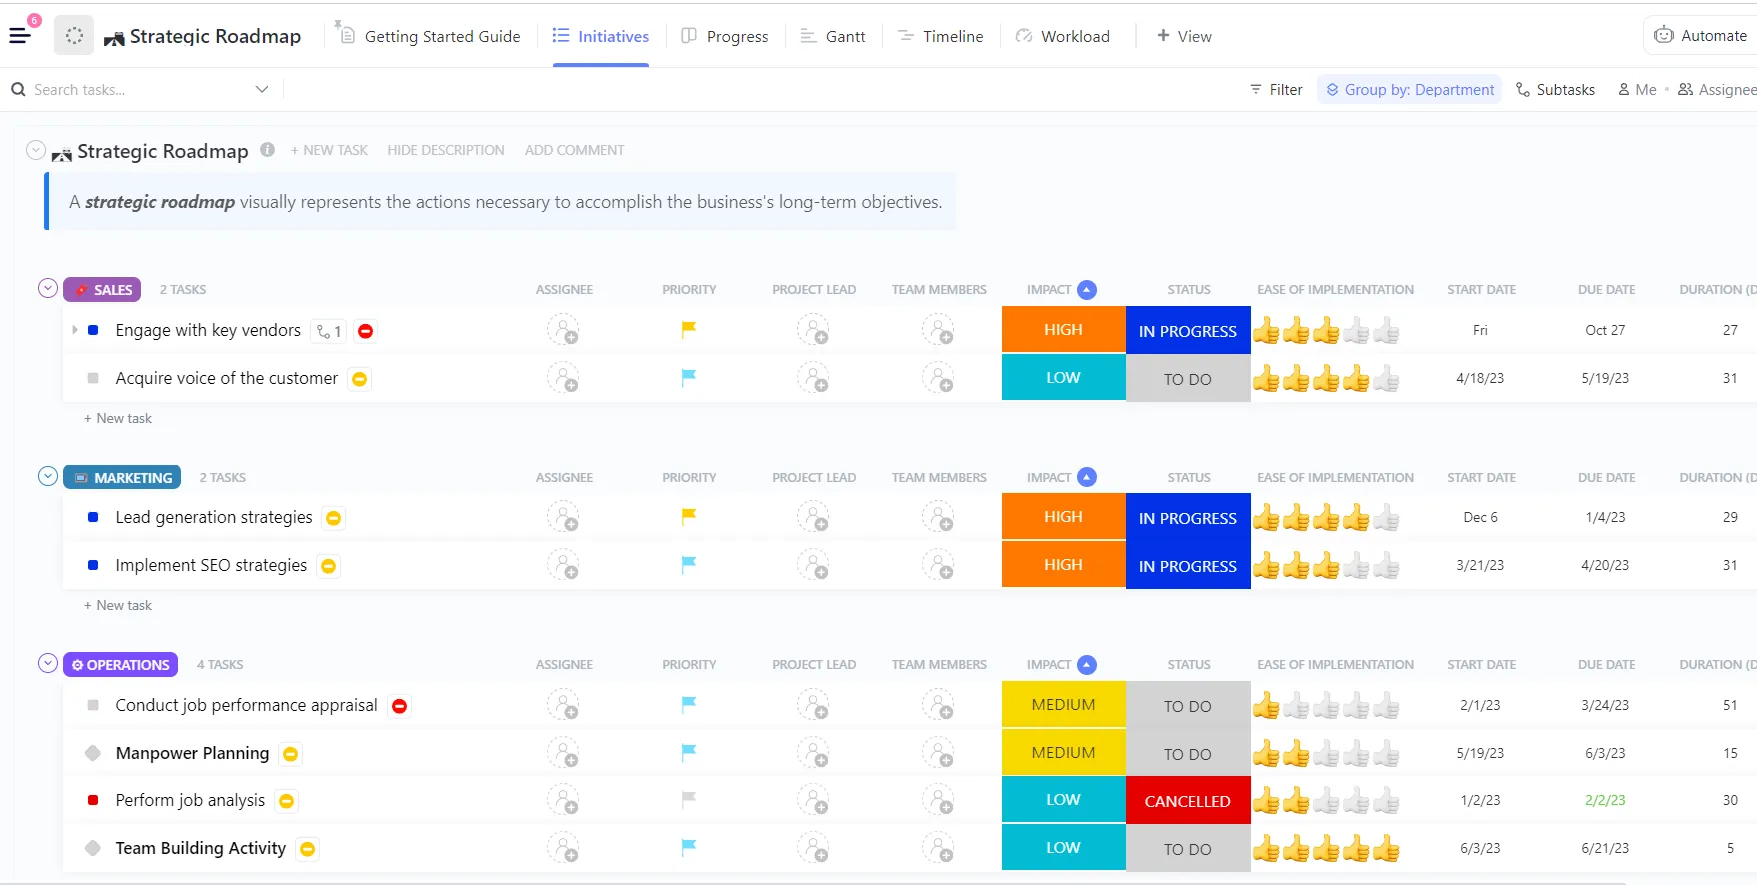
💡전문가 팁: DBRX 훈련 계획을 처음부터 직접 수립하는 대신, ClickUp의 AI 및 머신러닝 프로젝트 로드맵 템플릿 을 활용하여 팀의 필요에 맞게 조정해 보세요. 이 템플릿은 데이터셋, 훈련 단계, 평가 및 배포를 계획할 수 있는 명확한 구조를 제공하므로, 워크플로우를 구성하는 데 시간을 낭비하지 않고 업무 정리에만 집중할 수 있습니다.
AI 모델 훈련을 위한 DBRX 활용 사례
강력한 모델을 보유하는 것과 그 모델이 정확히 어떤 부분에서 빛을 발하는지 파악하는 것은 별개의 문제입니다.
모델의 강점을 명확히 파악하지 못하면, 모델이 적합하지 않은 곳에 적용하려고 시간과 자원을 낭비하기 쉽습니다. 이는 기대에 미치지 못하는 결과와 좌절감으로 이어집니다.
DBRX의 독창적인 아키텍처와 훈련 데이터 덕분에 여러 주요 기업용 사용 사례에 특히 적합합니다. 이러한 강점을 파악하면 모델을 비즈니스 목표에 부합하도록 조정하고 투자 수익률을 극대화할 수 있습니다.
텍스트 생성 및 콘텐츠 생성
DBRX Instruct는 지시를 따르고 고품질의 텍스트를 생성하도록 정교하게 조정되었습니다. 덕분에 다양한 콘텐츠 관련 작업을 자동화하는 데 유용한 강력한 tool입니다. 넓은 컨텍스트 창은 주요 장점으로, 긴 문서를 처리할 때도 맥락을 놓치지 않고 처리할 수 있게 해줍니다.
다음과 같은 용도로 활용할 수 있습니다:
- 기술 문서: 제품 설명서, API 참조 문서 및 사용자 가이드를 생성하고 개선하세요.
- 마케팅 콘텐츠: 블로그 게시물 초안, 이메일 뉴스레터, 소셜 미디어 게시물
- 보고서 생성: 복잡한 데이터 분석 결과를 요약하고 간결한 경영진 요약 보고서를 작성하세요.
- 번역 및 현지화: 기존 콘텐츠를 새로운 시장과 대상 고객에 맞게 조정하세요.
코드 생성 및 디버깅 작업
DBRX의 훈련 데이터 중 상당 부분은 코드로 구성되어 있어, 개발자들에게 유용한 LLM 지원 도구로 자리매김했습니다. 이 도구는 반복적인 코딩 작업을 자동화하고 복잡한 문제 해결을 지원함으로써 개발 주기를 단축하는 데 도움을 줄 수 있습니다.
엔지니어링 팀이 이를 활용할 수 있는 몇 가지 방법은 다음과 같습니다:
- 코드 자동 완성: 주석이나 docstring을 기반으로 기능 본문을 자동으로 생성합니다.
- 버그 탐지: 코드 스니펫을 분석하여 잠재적인 오류나 논리적 결함을 식별합니다.
- 코드 설명: 복잡한 알고리즘이나 레거시 코드를 쉬운 영어로 번역하세요.
- 테스트 생성: 기능의 서명과 예상 동작을 기반으로 단위 테스트를 생성하세요.
RAG 및 장문 컨텍스트 애플리케이션
검색 강화 생성(RAG) 은 모델의 응답을 기업의 사내 데이터에 기반하게 하는 강력한 기술입니다. 그러나 RAG 시스템은 컨텍스트 윈도우가 작은 모델의 경우 종종 어려움을 겪으며, 이로 인해 중요한 컨텍스트가 손실될 수 있는 과도한 데이터 분할을 강요받기도 합니다. DBRX의 32K 컨텍스트 윈도우는 견고한 RAG 애플리케이션을 위한 훌륭한 기반이 됩니다.
이를 통해 다음과 같은 강력한 내부 tools를 구축할 수 있습니다:
- 기업용 검색: 내부 지식 기반을 활용해 직원의 질문에 답변하는 챗봇을 만들어 보세요.
- 고객 지원: 제품 문서를 기반으로 지원 답변을 생성하는 챗봇을 구축하세요.
- 연구 지원: 수백 페이지에 달하는 연구 논문의 정보를 종합할 수 있는 tool을 개발하세요.
- 규정 준수 확인: 마케팅 문구를 내부 브랜드 가이드라인이나 규제 문서에 따라 자동으로 검증합니다.
DBRX 훈련을 팀 워크플로우에 통합하는 방법
성공적인 AI 모델 훈련 프로젝트는 단순히 코드와 컴퓨팅 자원만으로 이루어지는 것이 아닙니다. 이는 머신러닝 엔지니어, 데이터 과학자, 제품 관리자, 이해관계자들이 함께 협력하는 과정입니다.
이러한 협업이 Jupyter 노트북, Slack 채널, 별도의 프로젝트 관리 도구 등에 흩어져 있을 경우, 중요한 프로젝트 정보가 너무 많은 도구에 분산되는 ‘컨텍스트 산재(context sprawl)’ 현상이 발생합니다.
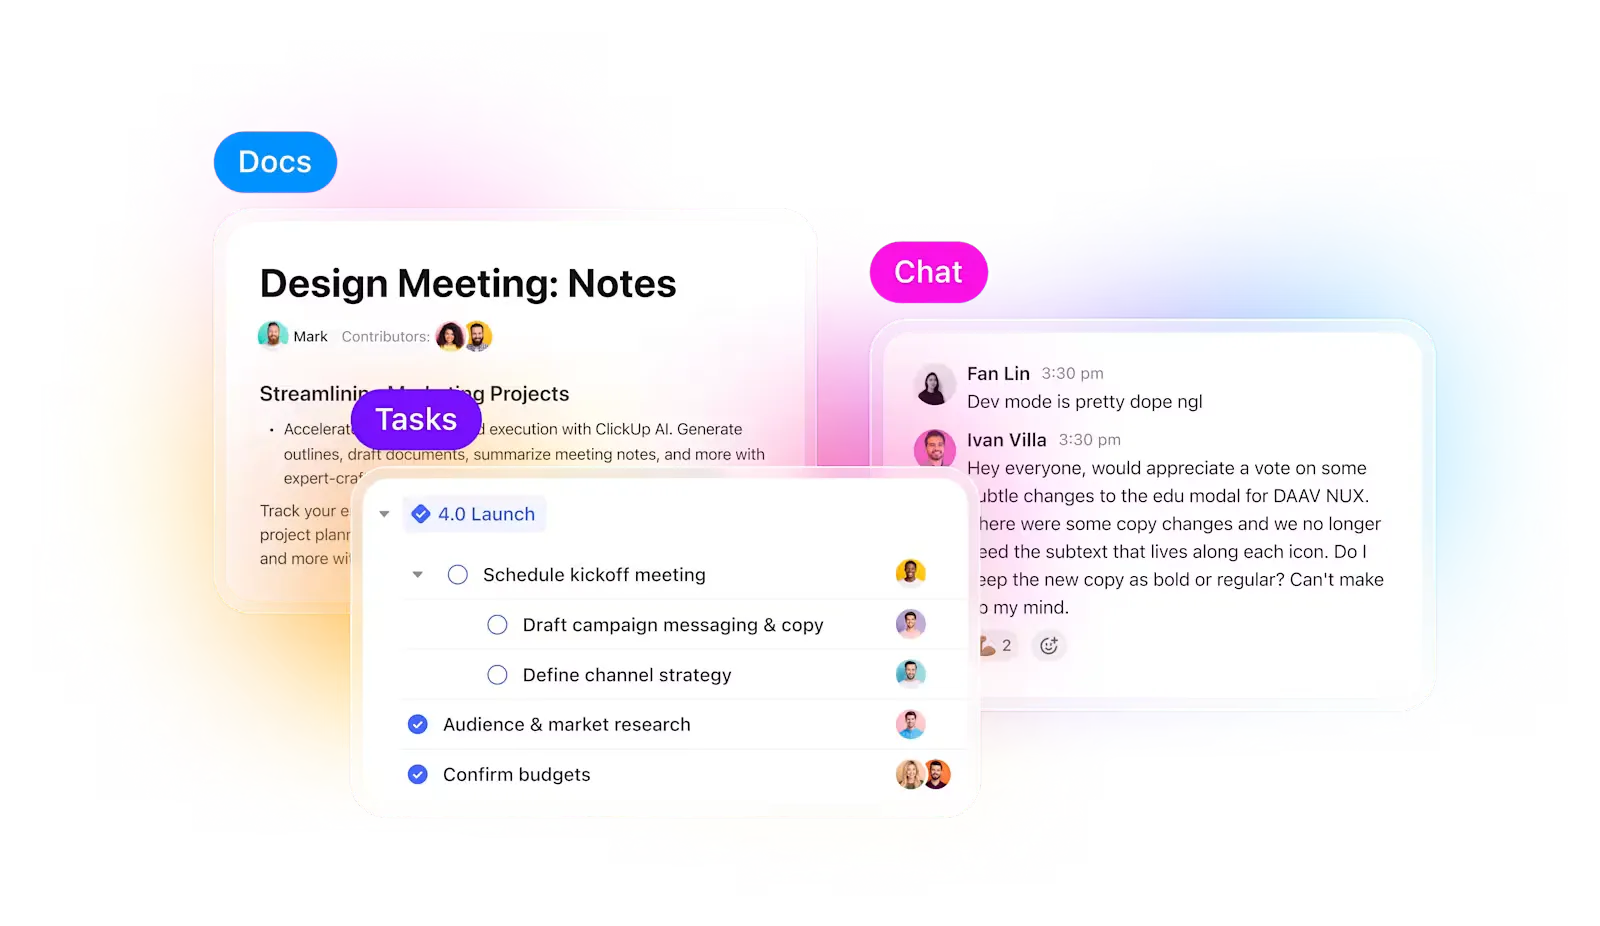
ClickUp이 이 문제를 해결해 드립니다. 여러 도구를 번갈아 사용해야 하는 번거로움 대신, 프로젝트 관리, 문서화, 커뮤니케이션이 하나로 통합된 ‘통합 AI 작업 공간’을 통해 실험의 기획부터 실행, 평가에 이르기까지 모든 과정이 유기적으로 연결됩니다.
실험과 진행 상황을 추적하세요
여러 실험을 진행할 때 가장 어려운 부분은 모델 훈련 자체가 아니라, 그 과정에서 무엇이 변경되었는지 추적하는 것입니다. 어떤 데이터셋 버전이 사용되었는지, 어떤 학습률이 가장 좋은 성과를 냈는지, 아니면 어떤 실행 결과가 배포되었는지 등을 파악해야 합니다.
ClickUp을 사용하면 이 과정을 매우 간편하게 진행할 수 있습니다. ClickUp 작업에서각 훈련 실행을 개별적으로 추적할 수 있으며, 작업 내에서 사용자 지정 필드를 사용하여 다음 내용을 기록할 수 있습니다:
- 데이터셋 버전
- 하이퍼파라미터
- 모델 변형 (DBRX Base 대 DBRX Instruct)
- 훈련 상태 (대기 중, 실행 중, 평가 중, 배포됨)
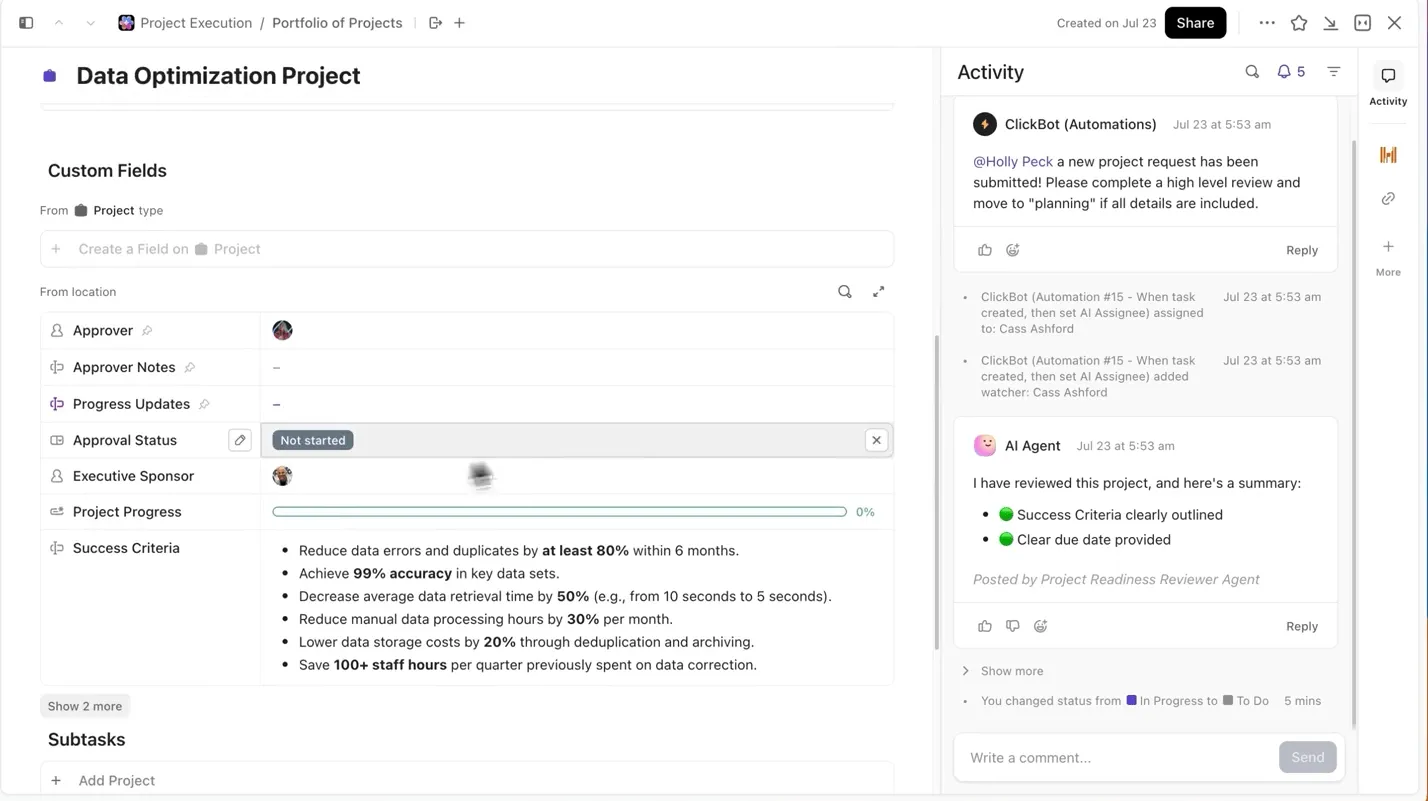
이렇게 하면 문서화된 모든 실험을 검색할 수 있고, 다른 실험과 쉽게 비교할 수 있으며, 재현도 가능합니다.
모델 문서를 일과 연계하여 관리하세요
이제 실험 작업의 맥락을 파악하기 위해 Jupyter 노트북, README 파일, Slack 스레드 사이를 오갈 필요가 없습니다.
ClickUp Docs를 사용하면 모델 아키텍처, 데이터 전처리 스크립트 또는 평가 메트릭을 해당 실험 작업과 직접 연결된 검색 가능한 문서에 기록함으로써 체계적으로 정리하고 쉽게 접근할 수 있습니다.
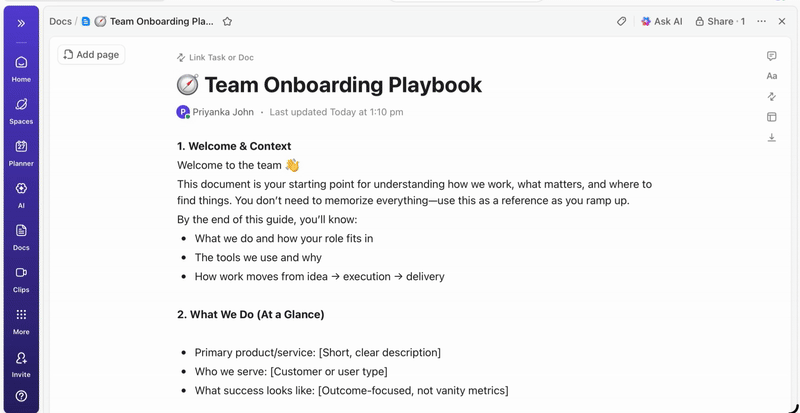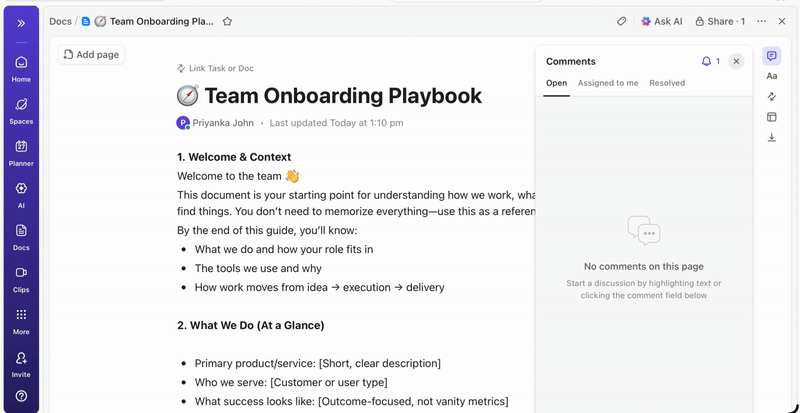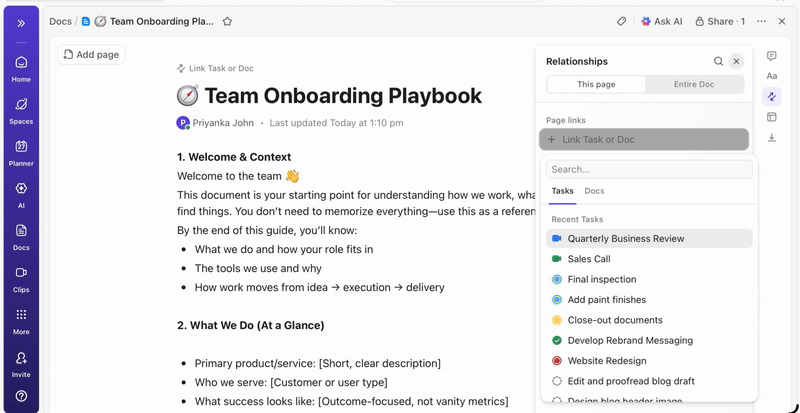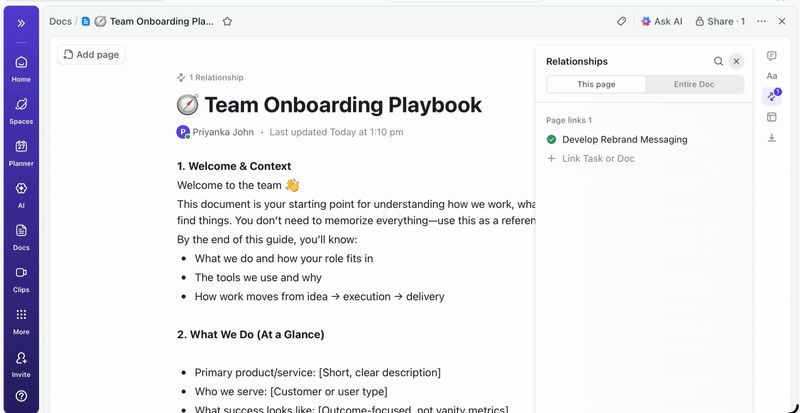
💡전문가 팁: 아키텍처부터 배포에 이르기까지 모든 의사결정을 상세히 기록한 프로젝트 개요 문서를 ClickUp Docs에 지속적으로 업데이트해 두세요. 그러면 새로 합류한 팀 회원들도 과거 스레드를 일일이 뒤지지 않고도 언제든지 프로젝트 세부 내용을 빠르게 파악할 수 있습니다.
이해관계자들에게 실시간 가시성을 제공하세요
ClickUp 대시보드는 실험 진행 상황과 팀의 업무량을 실시간으로 보여줍니다. I
수동으로 업데이트 내용을 정리하거나 이메일을 보내는 대신, 대시보드는 작업에 포함된 데이터를 기반으로 자동으로 업데이트됩니다. 따라서 이해관계자들은 언제든지 진행 상황을 확인할 수 있으며, “현재 상태는 어떻게 되나요?”라는 질문으로 여러분의 업무를 방해할 필요가 없습니다.
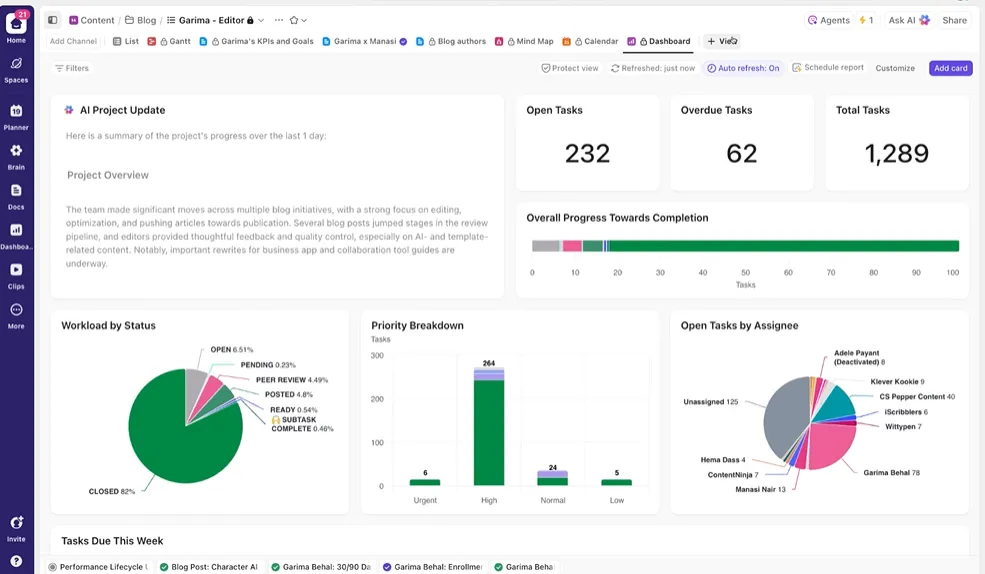
이렇게 하면 실험 결과를 수시로 수동으로 보고해야 하는 번거로움 없이, 실험 실행 자체에 집중할 수 있습니다.
AI를 스마트한 프로젝트 조력자로 만들어 보세요
지금까지 진행된 실험 결과를 요약하기 위해 수주 분량의 훈련 데이터를 일일이 수동으로 샅샅이 뒤질 필요가 없습니다. 어떤 작업의 댓글에든 @Brain을 멘션하기만 하면, ClickUp Brain이 과거 및 진행 중인 프로젝트의 전체 맥락을 바탕으로 필요한 도움을 제공해 드립니다.
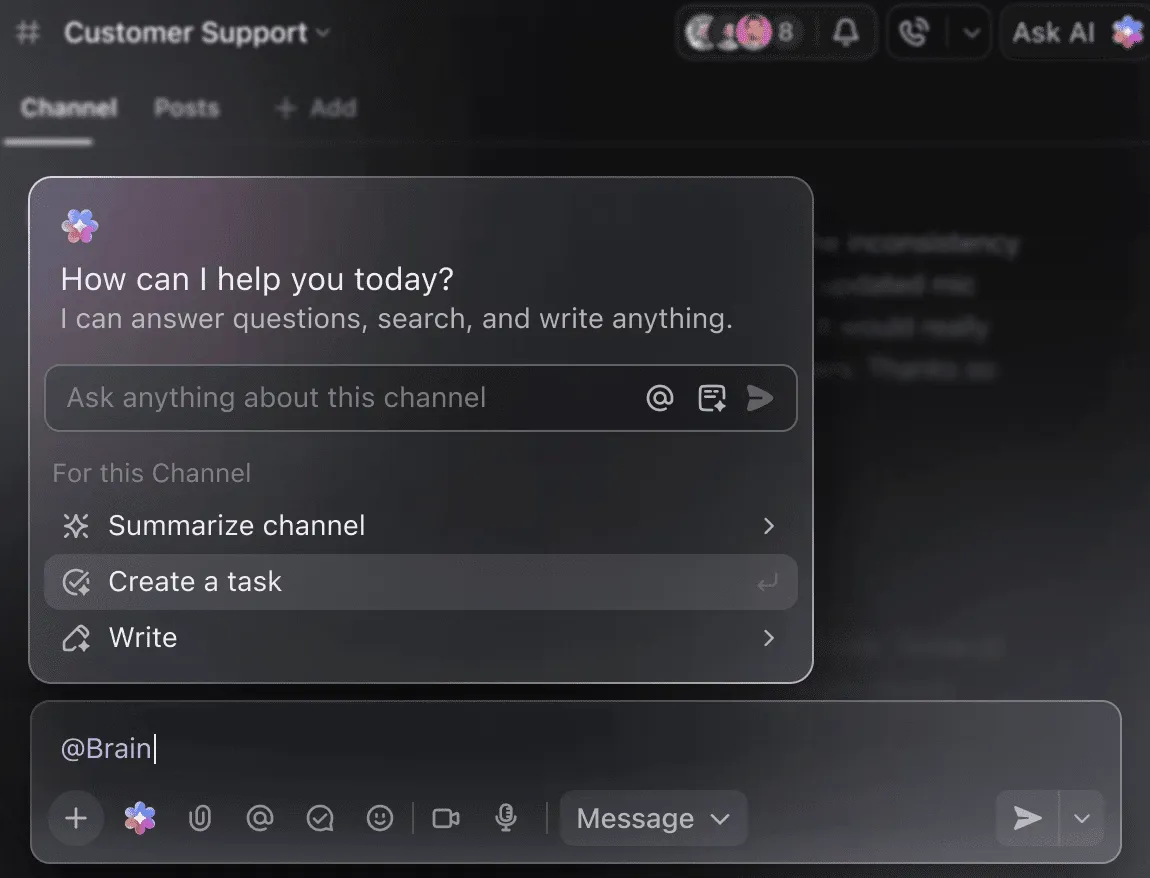
Brain에게 ‘지난주 실험 결과를 5가지 요점으로 요약해 줘’ 또는 ‘최신 하이퍼파라미터 결과를 담은 문서 초안을 작성해 줘’라고 요청하면, 즉시 완성도 높은 결과물을 얻을 수 있습니다.
🧠 ClickUp의 장점: ClickUp의 슈퍼 에이전트는 단순히 질문에 답하는 것을 넘어, 사용자가 정의한 트리거를 기반으로 전체 워크플로우를 자동화할 수 있습니다. 슈퍼 에이전트를 활용하면 데이터셋이 업로드될 때마다 새로운 DBRX 훈련 작업을 자동으로 생성하고, 팀원들에게 알림을 보낼 수 있으며, 훈련이 완료되거나 체크포인트에 도달하면 관련 문서를 연결하고, 주간 진행 상황 요약 보고서를 생성하여 사용자가 직접 손을 대지 않아도 이해관계자들에게 전달할 수 있습니다.
피해야 할 흔한 실수
DBRX 훈련 프로젝트를 시작하는 것은 흥미진진하지만, 몇 가지 흔한 함정이 진행 과정을 방해할 수 있습니다. 이러한 실수를 피하면 시간과 비용을 절약할 수 있을 뿐만 아니라 많은 좌절감도 덜 수 있습니다.
- 하드웨어 요구 사항 과소평가: DBRX는 강력하지만 용량이 큽니다. 부적절한 하드웨어에서 실행하려고 하면 메모리 부족 오류가 발생하고 훈련 작업이 실패할 수 있습니다. DBRX(132B)는 16비트 추론을 위해 최소 264GB의 VRAM이 필요하며, 4비트 양자화를 사용할 경우 약 70GB~80GB가 필요하다는 점을 유의하십시오.
- 데이터 품질 점검 생략: 입력 데이터가 엉망이면 출력 결과도 엉망입니다. 정리되지 않고 품질이 낮은 데이터셋으로 미세 조정을 진행하면, 모델은 엉망이고 품질이 낮은 결과물만 생성하도록 학습하게 됩니다.
- 컨텍스트 길이 한도 무시: DBRX의 32K 컨텍스트 윈도우는 넉넉한 편이지만 무한한 것은 아닙니다. 이 한도를 초과하는 입력 데이터를 모델에 공급하면 아무런 경고 없이 데이터가 잘리고 성능이 저하되는 결과가 발생합니다.
- 지시 수행 작업에 DBRX Base를 사용하는 것이 적절한 경우: DBRX Base는 추가적인 대규모 훈련을 위해 설계된, 사전 훈련된 원시 모델입니다. 대부분의 지시 수행 작업의 경우, 해당 목적에 맞게 이미 미세 조정된 DBRX Instruct로 시작해야 합니다.
- 훈련 작업과 프로젝트 조정을 분리하는 문제: 실험 추적은 한 도구에서, 프로젝트 계획은 다른 도구에서 관리하면 정보의 단절이 발생합니다. ClickUp과 같은 통합 플랫폼을 사용하여 기술적 작업과 프로젝트 조정을 동기화하세요.
- 배포 전 평가를 소홀히 하는 경우: 훈련 데이터에서는 우수한 성능을 보인 모델이라도 실제 환경에서는 완전히 실패할 수 있습니다. 미세 조정된 모델을 프로덕션 환경에 배포하기 전에 항상 별도로 분리해 둔 테스트 세트를 통해 검증하십시오.
- 파인 튜닝의 복잡성을 간과하기 쉬운 점: DBRX는 Mixture-of-Experts 모델이기 때문에, 표준 파인 튜닝 스크립트를 사용할 경우 여러 GPU에 걸친 매개변수 샤딩을 처리하기 위해 Megatron-LM이나 PyTorch FSDP와 같은 특수 라이브러리가 필요할 수 있습니다.
DBRX 대 다른 AI 훈련 플랫폼
AI 훈련 플랫폼을 선택할 때는 ‘제어’와 ‘편의성’이라는 근본적인 상충 관계를 고려해야 합니다. 독점적이고 API로만 제공되는 모델은 사용하기 쉽지만, 특정 공급업체의 생태계에 얽매이게 됩니다.
DBRX와 같은 오픈 웨이트 모델은 완벽한 제어 기능을 제공하지만, 더 많은 기술적 전문 지식과 인프라가 필요합니다. 이러한 선택으로 인해 장기적인 목표를 실제로 지원하는 길이 무엇인지 확신하지 못해 막막함을 느낄 수 있는데, 이는 많은 팀이 AI 도입 과정에서 직면하는 과제입니다.
이 테이블은 여러분이 정보에 기반한 결정을 내릴 수 있도록 주요 차이점을 상세히 정리해 놓았습니다.
| 가중치 | 열기 (맞춤형) | 독점 | 열기 (맞춤형) | 독점 |
| 파인 튜닝 | 완벽한 제어 | API 기반 | 완벽한 제어 | API 기반 |
| 자체 호스팅 | 네 | 아니요 | 네 | 아니요 |
| 라이선스 | DB Open Model | OpenAI 이용 약관 | Llama 커뮤니티 | Anthropic 용어 |
| 배경 | 32K | 128K – 1M | 128K | 20만 – 100만 |
DBRX는 모델을 완전히 제어해야 하거나, 보안 또는 규정 준수를 위해 자체 호스팅이 필수적이거나, 유연한 상용 라이선스의 이점을 원할 때 적합한 선택입니다. 전용 GPU 인프라가 없거나, 심층적인 맞춤형 설정보다 시장 출시 속도를 더 중요하게 생각한다면 API 기반의 대안이 더 적합할 수 있습니다.
ClickUp으로 더 스마트하게 훈련을 시작하세요
DBRX는 독점 모델에서는 얻을 수 없는 투명성과 제어 기능을 바탕으로, 맞춤형 AI 애플리케이션을 구축할 수 있는 기업급 기반을 제공합니다. 효율적인 MoE 아키텍처는 추론 비용을 절감해 주며, 개방형 설계 덕분에 미세 조정이 용이합니다. 하지만 강력한 기술만으로는 충분하지 않습니다.
진정한 성공은 기술적 작업과 팀의 협업 워크플로우를 조화롭게 연계할 때 이루어집니다. AI 모델 훈련은 팀워크가 필요한 작업이며, 실험, 문서화, 이해관계자 간의 소통을 동기화하여 유지하는 것이 매우 중요합니다. 모든 요소를 하나의 통합된 작업 공간으로 모아 맥락의 분산을 줄이면, 더 나은 모델을 더 빠르게 출시할 수 있습니다.
ClickUp을 무료로 시작해 단일 작업 공간에서 AI 훈련 프로젝트를 효율적으로 관리해 보세요. ✨
자주 묻는 질문
DBRX에서 훈련 진행 상황을 모니터링하려면 어떻게 해야 하나요?
TensorBoard, Weights & Biases, MLflow와 같은 표준 ML tools를 사용하여 훈련 과정을 모니터링할 수 있습니다. Databricks 생태계 내에서 훈련을 진행하는 경우, MLflow가 기본적으로 통합되어 있어 실험을 원활하게 추적할 수 있습니다.
DBRX를 CI/CD 및 배포 파이프라인과 연동할 수 있나요?
네, DBRX는 표준 MLOps 파이프라인에 통합될 수 있습니다. 모델을 컨테이너화하면 Kubeflow와 같은 오케스트레이션 플랫폼이나 맞춤형 CI/CD 워크플로우를 사용하여 배포할 수 있습니다.
DBRX Base와 DBRX Instruct의 차이점은 무엇인가요?
DBRX Base는 도메인별 지속적인 사전 학습이나 심층 아키텍처 미세 조정을 수행하고자 하는 팀을 위한 기초 사전 학습 모델입니다. DBRX Instruct는 지시 사항 따르기에 최적화된 미세 조정 버전으로, 대부분의 애플리케이션 개발에 더 적합한 출발점이 됩니다.
기업용 AI 프로젝트에서 DBRX는 GPT-4와 비교했을 때 어떤 점이 다를까요?
가장 큰 차이점은 제어권입니다. DBRX는 심층적인 맞춤형 설정과 자체 호스팅을 위해 모델 가중치에 대한 완전한 접근 권한을 제공하는 반면, GPT-4는 API 전용 서비스입니다.
DBRX를 무료로 사용할 수 있나요?
DBRX 모델 가중치는 Databricks Open Model License에 따라 무료로 제공됩니다. 단, 모델을 실행하거나 미세 조정하는 데 필요한 컴퓨팅 인프라 비용은 사용자가 부담해야 합니다.